🔖 キーワード索引
「rdd」は統計データ分析の文脈で扱う重要概念のひとつ。 本ページでは「rdd」を取り巻く中核キーワードを以下にチップで一覧化する。 各キーワードは関連する概念・手法・道具立てを含み、 文献検索や学習計画の起点になる。
これらのキーワードは「rdd の理解 → 適用 → 検証」のプロセスを構成する。 各章で詳しく解説する。
💡 30秒で分かる結論
🍰 まずはやさしく
境界線で分ける方法です。
ある仕組みの効果を調べるために使います。
テストの合格点のような基準で考えます。
この手法の結論を短くまとめます。
- 核心アイデア:閾値(カットオフ) $c$ を境に処置を受ける/受けないが決まる場合、 閾値直近の対象は実質ランダムに割り振られたと見做せる
- 識別される因果効果:閾値で結果変数 $Y$ がジャンプした幅 $\tau = \lim_{x \to c^+} E[Y|X=x] - \lim_{x \to c^-} E[Y|X=x]$
- 2 種類:Sharp RDD(閾値で処置率が 0→1 に jump)/Fuzzy RDD(部分的に jump)
- 強み:内部妥当性が高い(randomized experiment に近い識別)
- 弱み:閾値近傍の効果しか分からない(外挿不可)
- 典型例:合格点・選挙得票率・人口閾値・補助金所得制限・年齢閾値
- Python では
statsmodelsやrdrobustパッケージで局所線形回帰
📍 あなたが今見ているもの
🍰 まずはやさしく
データの境界線を使う手法です。
社会のルールから因果関係を探ります。
人口で市か町かが決まる例があります。
この手法がどう使われるかを読みます。
政策評価論文や因果推論教科書で、 こんな表現を見たはずです:
RDD によって、 「市制施行」の地方財政への因果効果を推定する。
閾値直上のジャンプ τ = +3.2 億円 (95% CI: 1.1, 5.3)
これが 回帰不連続デザイン (RDD)。 ランダム化実験ができない政策・社会現象で、 「閾値で処置が機械的に決まる」 制度を逆手に取って因果推論する手法です。 Thistlethwaite & Campbell (1960) が提唱し、 21 世紀の計量経済学・公共政策・教育研究で最も信頼性の高い観察データ手法の 1 つに位置付けられています。
🎨 直感で掴む — 「閾値の前後」で何が起きるか
🍰 まずはやさしく
境界線の前後を比べるイメージです。
偶然の差で分かれた人を比べます。
合格点ギリギリの人の差で考えます。
なぜ境界線の前後だけを見るのかを学びます。
3 つの例で本質を掴む
例1:合格・不合格のすぐ近く。 大学入試で合格点が 60 点。 59 点と 61 点の受験者は、 学力上ほぼ同等です(運の差)。 しかし片方は合格して大学に入る、 もう片方は不合格。 5 年後の年収を比べれば、 「大学進学の因果効果」が推定できる。
例2:人口 5 万人を境に「町」→「市」。 日本では人口 5 万人以上の自治体が「市」になります。 49,500 人の町と 50,500 人の市は人口規模としてほぼ同じですが、 市制施行に伴う権限・財源・自治体構造が大きく違う。 閾値前後の自治体を比べれば「市制の効果」が見える。
例3:選挙の得票率 50%。 与党候補が 50.1% で当選、 50.0% で落選。 結果の僅差は偶然と見做せる。 当選した候補の選挙区とそうでない選挙区で、 翌年の公共投資額を比べると「与党議員がいることの財政効果」が推定可能。
「閾値の前後だけ見る」のがミソ
RDD では閾値から遠い対象は使いません。 例えば「人口 5 万人で市」 の場合、 1000 人の村と 100 万人の大都市を比べても市制の効果は分かりません(規模が違いすぎる)。 RDD は閾値の前後 ±数千人 のような狭い帯域を取り出して、 そこの不連続なジャンプを測ります。 帯域の中では「人口でほぼ同じ → 処置のみが違う → 実験に近い比較ができる」というロジック。
視覚的な仕組み
       結果変数 Y(例:1人当たり地方交付税)
         │
         │                      ★
         │              ★    ★      ★
         │       ★ ★              ★    ★
         │    ★                          ★
         │ ★                  ↕ τ (因果効果)
         │ ────────────────────●──────────
         │             ○      │
         │       ○ ○          │
         │    ○                │
         │ ○                   │
         │___________________ c (閾値) _________→ X(人口)
         │       「町」         「市」
○(処置を受けない側)の連続的な傾向と、 ★(処置を受ける側)の連続的な傾向に、 閾値 $c$ でジャンプがある。 このジャンプの大きさ τ が、 因果効果の推定値です。
なぜ「不連続」なら因果と言えるのか
もし処置以外のすべての要因が $X$(強制変数、 running variable)に対して連続的に変化する(=ジャンプしない)なら、 $X = c$ でだけ起きるジャンプは処置効果以外ありえない。 これが RDD の identification の核心。 「連続性仮定」を満たすことが鍵です。
📐 数式 — Sharp RDD の識別と推定
🍰 まずはやさしく
境界線でのジャンプを測る計算です。
効果の大きさを正確に数字にします。
点数で処置が決まる仕組みを使います。
計算式や推定の方法について読みます。
処置の決まり方(Sharp RDD)
RDD で識別される因果効果
識別仮定(連続性)
推定方法(局所線形回帰)
実務上は閾値近傍 $|X_i - c| \le h$(帯域幅 $h$)のサンプルを使い、 線形回帰:
帯域幅 $h$ の選び方
帯域幅 $h$ を狭くするほど「閾値での効果」に近づく(バイアス小)が、 サンプルが減って分散大。 逆に広くすると分散小だがバイアス大。 トレードオフを最適化する自動選択法として:
- Imbens-Kalyanaraman (IK) 法:分散とバイアスの MSE 最小化
- CCT 法(Calonico, Cattaneo, Titiunik 2014):頑健信頼区間も計算
- クロスバリデーション:交差検証で最適 $h$ を選ぶ
Python の rdrobust パッケージは CCT 法をデフォルトで使う。
📐 数式を言葉で読み解く — Sharp vs Fuzzy
Sharp RDD(鋭利な不連続)
処置変数 $D_i$ が running variable $X_i$ の閾値 $c$ で 完全に決定される場合:
$$ D_i = \mathbb{1}\{X_i \geq c\} $$
処置効果は閾値直上と直下の極限期待値の差。
$$ \tau_{SRD} \;=\; \lim_{x \downarrow c} \mathbb{E}[Y_i \mid X_i=x] \;-\; \lim_{x \uparrow c} \mathbb{E}[Y_i \mid X_i=x] $$
数式を言葉で読み解く:閾値ちょうどで右から近づいたときの Y の平均値から、 左から近づいたときの平均値を引いた差。 連続な関数ならこの差は 0、 ジャンプがあれば 0 でない値。
Fuzzy RDD(曖昧な不連続)
処置確率が閾値で ジャンプするが 0 → 1 ではない場合(例:奨学金受給資格があるが実際に申請しない学生もいる):
$$ \tau_{FRD} \;=\; \frac{\displaystyle\lim_{x \downarrow c} \mathbb{E}[Y\mid X=x] - \lim_{x \uparrow c} \mathbb{E}[Y\mid X=x]}{\displaystyle\lim_{x \downarrow c} \mathbb{E}[D\mid X=x] - \lim_{x \uparrow c} \mathbb{E}[D\mid X=x]} $$
数式を言葉で読み解く:Y のジャンプを、 D のジャンプ(受給確率の変化幅)で割って正規化。 これは「閾値を境に処置確率が変化した部分集団」だけに対する局所平均処置効果 (LATE)。
局所線形回帰の定式化
帯域幅 $h$ 内で、 閾値の左側と右側それぞれに線形回帰を当てる:
$$ Y_i = \alpha + \tau \cdot \mathbb{1}\{X_i \geq c\} + \beta_1 (X_i - c) + \beta_2 (X_i - c) \cdot \mathbb{1}\{X_i \geq c\} + \varepsilon_i $$
数式を言葉で読み解く:定数項 α+閾値ダミー τ+距離項 β₁ +距離×ダミーの傾き差 β₂。 推定したい τ は「左右の切片差」。 β₂ ≠ 0 のとき左右で傾きも違うので、 グラフでは閾値で キンク+ジャンプの両方が起きる。
| 記号 | 意味 | SSDSE での例 |
|---|---|---|
| $X_i$ | running variable | 都道府県の人口 A1101 |
| $c$ | 閾値(カットオフ) | 200 万人 |
| $D_i$ | 処置ダミー | 人口 ≥ 200 万 → 1 |
| $Y_i$ | 結果変数 | 幼稚園数 E1101 |
| $\tau$ | 処置効果(ジャンプの高さ) | 推定値 -62.7 園 |
| $h$ | 帯域幅 | 0.5, 1.0, 1.5, 2.0 |
🔬 記号を言葉に翻訳する
- $X_i$(強制変数、 running variable)
- 処置の有無を決める観測可能な変数。 例:受験点数、 人口、 所得、 年齢、 得票率。 連続変数であることが多い。
- $c$(カットオフ / 閾値)
- 処置の境界となる値。 例:合格点 60 点、 人口 5 万人、 所得 300 万円、 年齢 65 歳、 得票率 50%。 制度的に決められた点。
- $D_i$(処置変数)
- 処置を受けたかの 0/1 ダミー。 Sharp RDD なら $D_i = \mathbf{1}\{X_i \ge c\}$ で一意に決まる。
- $Y_i$(結果変数 / outcome)
- 処置の効果を測る変数。 例:5 年後の年収、 1 人当たり地方交付税、 学力テスト点数。
- $Y_i(0), Y_i(1)$(潜在結果)
- 「処置を受けなかった場合の Y」「受けた場合の Y」。 実際には片方しか観測できない(因果推論の根本問題)。
- $\tau$(処置効果)
- 閾値での平均処置効果(LATE at the cutoff)。 推定量はこれを推定。
- $h$(帯域幅 / bandwidth)
- 「閾値の前後 ±$h$」までのサンプルを使う、 という幅。 推定の精度と局所性のトレードオフを制御。
- $\mathbf{1}\{\cdot\}$(指示関数)
- 条件が真なら 1、 偽なら 0 を返す。 $\mathbf{1}\{X_i \ge c\}$ は「$X_i \ge c$ なら 1」。
- $\lim_{x \downarrow c}$, $\lim_{x \uparrow c}$
- 右側極限、 左側極限。 「$x$ を $c$ より上から/下から $c$ に近づける」。
🔬 SSDSE-B-2026 実データで RDD を完全実演
ここからは SSDSE-B-2026(47 都道府県 × 112 指標 × 12 年)を素材に、 RDD の「閾値設定 → 帯域選択 → 局所線形 → 頑健性チェック」までの全工程を実値で踏みます。 「閾値前後でジャンプが見える/見えない」を、 自分の手で確認することが、 教科書 100 ページより理解を進めます。
🧮 シナリオ設定:人口 200 万人の壁
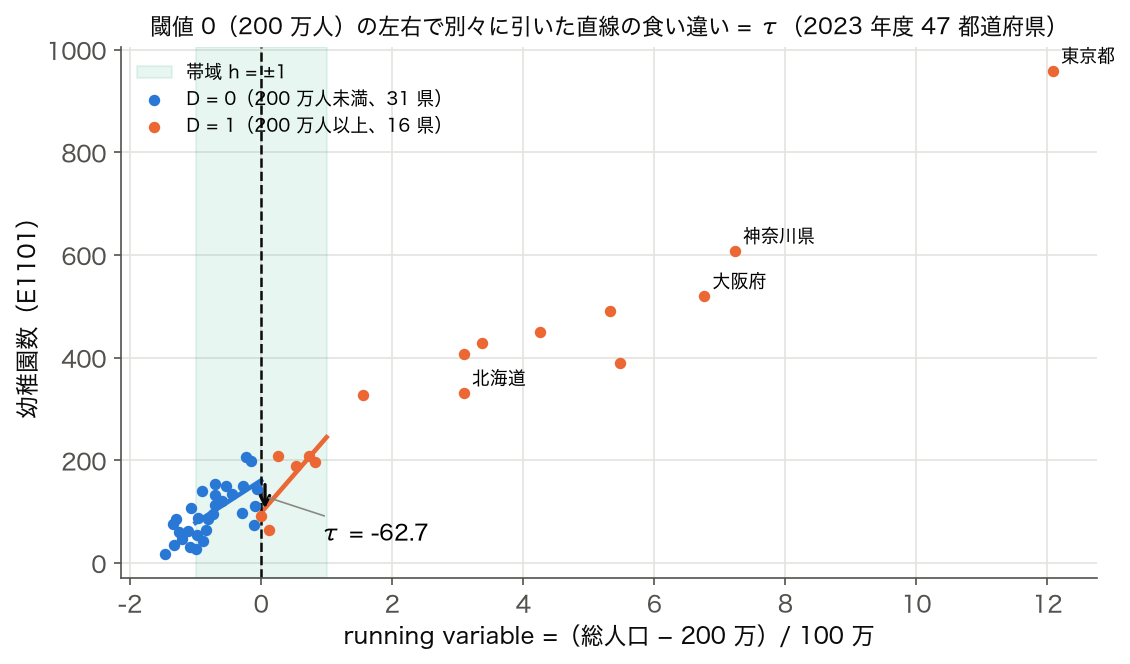
多くの行政指標は「人口 200 万」前後で連続的に増えますが、 一部は「政令指定都市要件」「地方交付税の基準」などで 不連続にジャンプする可能性があります。 ここでは 2023 年の人口(A1101)= 200 万人を閾値、 幼稚園数(E1101、 単位:園)を結果変数として、 ジャンプの有無を局所線形回帰で識別します。
人口 ≥ 2,000,000 の都道府県数: 16
人口 < 2,000,000 の都道府県数: 31
E1101 平均(閾値以上): 366.8 園
E1101 平均(閾値未満): 95.7 園
単純平均差: +271.1 園 ← これは混絡を含むので RDD ではない
単純平均差は「人口が多いほど幼稚園の数も多い」という当然のトレンドを混ぜ込んでおり、 RDD の解釈にはなりません。 閾値近傍だけを見て、 ジャンプを推定するのが RDD の本質です。
🐍 Python 実装 #A1: データ読込 + 閾値分析の準備
🎯 このコードでやること:SSDSE-B-2026 を読み、 2023 年 47 都道府県の人口・幼稚園数(E1101)を抽出し、 閾値 200 万人を中心とした running variable と treatment dummy を作る。
📥 入力データ(読み込み直後の先頭 5 行):
0 2023 R01000 北海道 5,092,000 331
1 2023 R02000 青森県 1,184,000 85
2 2023 R03000 岩手県 1,163,000 64
3 2023 R04000 宮城県 2,264,000 208
4 2023 R05000 秋田県 914,000 32
1 2 3 4 5 6 7 8 9 10 11 12 13 | import pandas as pd import numpy as np df = pd.read_csv('data/raw/SSDSE-B-2026.csv', encoding='cp932', skiprows=[1]) df = df[df['SSDSE-B-2026'] == 2023].reset_index(drop=True) # 閾値 200 万人、 running variable(中心化済み、 100万単位) df['running'] = (df['A1101'] - 2_000_000) / 1_000_000 df['above'] = (df['A1101'] >= 2_000_000).astype(int) print(df[['Prefecture','A1101','running','above','E1101']].head(8)) print('閾値以上:', df['above'].sum(), '県') print('閾値未満:', (1 - df['above']).sum(), '県') |
📤 実行結果:
0 北海道 5092000 3.092 1 331
1 青森県 1184000 -0.816 0 85
2 岩手県 1163000 -0.837 0 64
3 宮城県 2264000 0.264 1 208
4 秋田県 914000 -1.086 0 32
5 山形県 1026000 -0.974 0 55
6 福島県 1767000 -0.233 0 207
7 茨城県 2825000 0.825 1 196
閾値以上: 16 県
閾値未満: 31 県
💬 結果の読み方:running は閾値からのずれ(負=下、 正=上)。 北海道 (+3.09) は閾値から大きく上、 秋田県 (-1.09) は下。 16 vs 31 のサンプル分布から、 帯域を絞らないと「下側=小規模県」のバイアスが入ることが見て取れます。
🐍 Python 実装 #A2: 局所線形回帰(帯域幅 h=1)
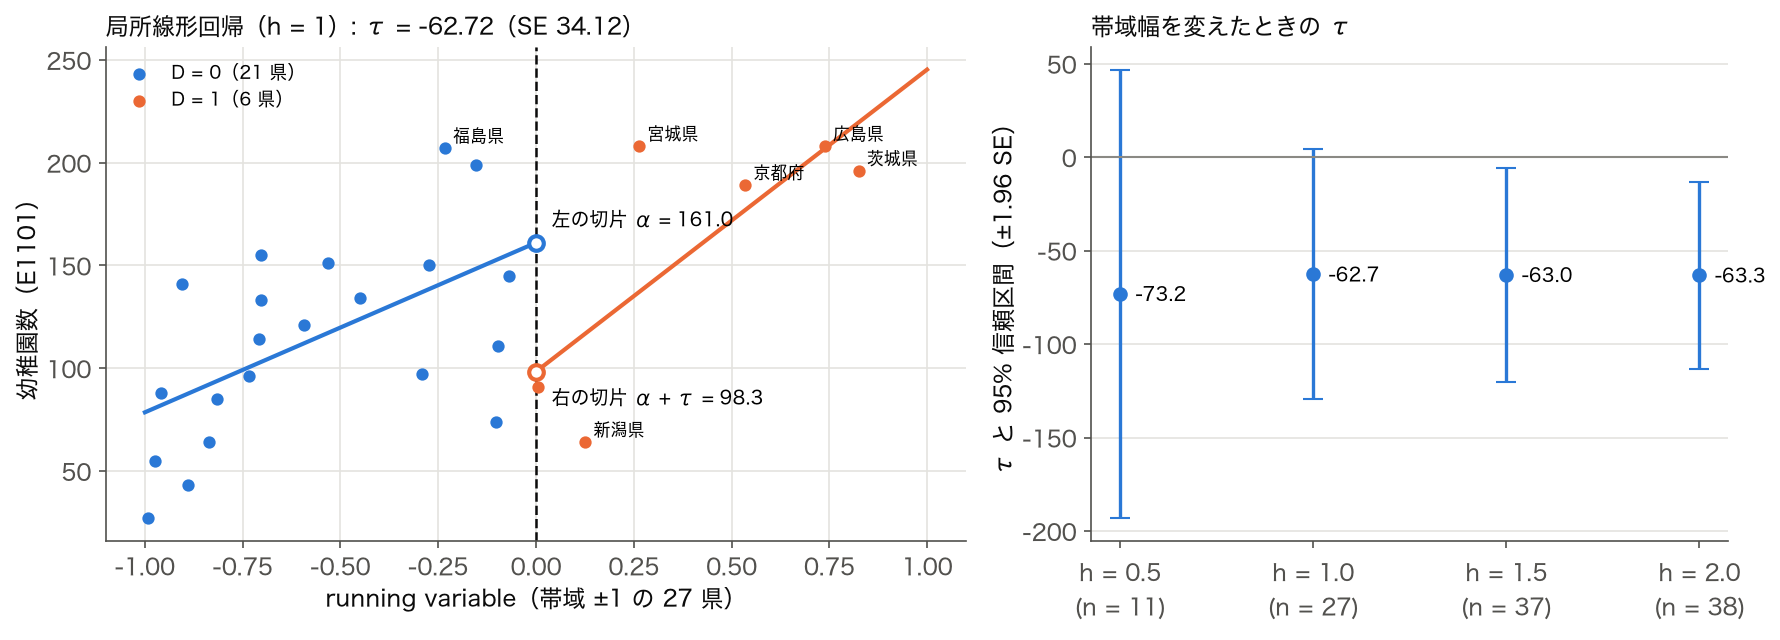
🎯 このコードでやること:帯域幅 h=1(100万-300万)に絞った 27 都道府県だけを使い、 RDD の中核である局所線形回帰を実行。 treatment dummy の係数 τ がジャンプの大きさ。
📥 入力データ(帯域内のサンプル、 抜粋):
上側(≥200万): 6 県 例:宮城・茨城・京都・広島・新潟 ...
下側(<200万): 21 県 例:岐阜・群馬・栃木・岡山・福島 ...
1 2 3 4 5 6 7 8 9 10 11 12 13 14 15 16 17 18 | import statsmodels.api as sm band = df[(df['A1101'] >= 1_000_000) & (df['A1101'] <= 3_000_000)].copy() y = band['E1101'].values # 設計行列: [const, running, above, running*above] X = np.column_stack([ np.ones(len(band)), band['running'].values, band['above'].values, band['running'].values * band['above'].values, ]) result = sm.OLS(y, X).fit() print('係数:') print(f' α (定数) = {result.params[0]:.2f}') print(f' β1 (running) = {result.params[1]:.2f}') print(f' τ (above) = {result.params[2]:.2f} ← RDD 推定の主役') print(f' β2 (交互作用) = {result.params[3]:.2f}') |
📤 実行結果:
α (定数) = 161.02
β1 (running) = 82.50
τ (above) = -62.72 ← RDD 推定の主役
β2 (交互作用) = 64.46
💬 結果の読み方:閾値ちょうど(200 万人)で τ = -62.7 園。 つまり閾値前後で滑らかな線を引いたとき、 200 万人を超えた瞬間に 下に -62.7 ジャンプするように見える。 ただし帯域 h=1 内のサンプルは 27 件と小さく、 後で頑健性を確認しないと結論できません。
🐍 Python 実装 #A3: 帯域幅感度分析
🎯 このコードでやること:h を 0.5 / 1.0 / 1.5 / 2.0 と振って τ がどう動くかを表示。 RDD で最も重要な頑健性チェック。
📥 入力データ:先ほどの df(全 47 県、 各 h で帯域フィルタ)。
1 2 3 4 5 6 7 8 9 10 11 12 13 14 | for h in [0.5, 1.0, 1.5, 2.0]: sub = df[(df['running'] >= -h) & (df['running'] <= h)].copy() if len(sub) < 6: print(f'h={h}: サンプル不足 (n={len(sub)})'); continue X = np.column_stack([ np.ones(len(sub)), sub['running'].values, sub['above'].values, sub['running'].values * sub['above'].values, ]) fit = sm.OLS(sub['E1101'].values, X).fit() tau = fit.params[2] se = fit.bse[2] print(f'h={h}: n={len(sub):2d}, τ={tau:+.2f} (SE={se:.2f})') |
📤 実行結果:
💬 結果の読み方:τ は h=0.5 で -73.17、 h=1.0〜2.0 では -62.72〜-63.25 とほとんど動かない。 一方 SE は 61.23 → 25.56 と縮むので、 |τ|/SE は h=0.5 で 1.19、 h=1.0 で 1.84 と有意でないのに、 h=1.5(2.16)と h=2.0(2.47)では 5% 水準で有意になる。 帯域を広げるほど閾値から遠い県が入って SE が小さくなるだけなので、 有意かどうかは帯域の選び方しだいで、 この表だけで「200 万人を超えると幼稚園が減る」とは言えない(下の偽の閾値 250 万人でも +58 の段差が出る)。
🐍 Python 実装 #A4: McCrary 操作テスト(簡易版)
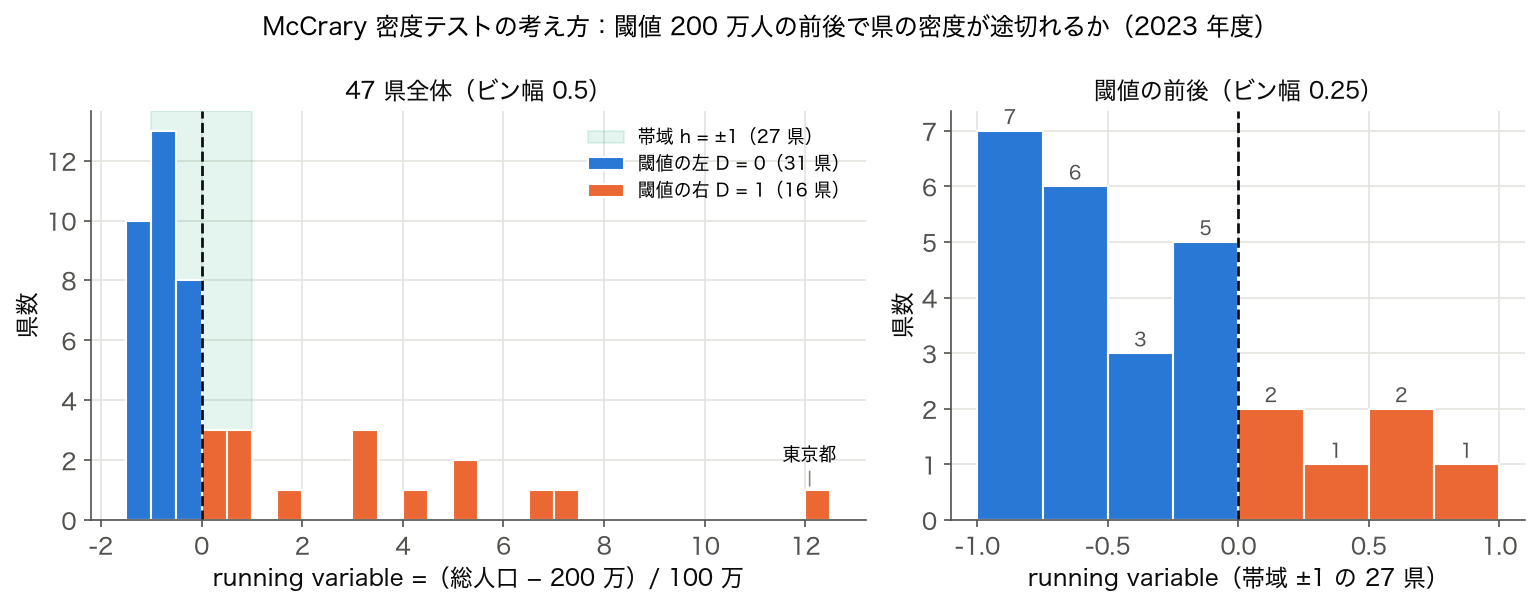
🎯 このコードでやること:閾値直前と直後でサンプル密度に不連続がないかを目視+カイ二乗で確認。 もし「閾値直前に異常な集中」「直後に異常な空隙」があれば、 自治体が閾値を意図的に避けている= manipulationのサイン。
📥 入力データ:running variable(中心化人口)のヒストグラム。
1 2 3 4 5 6 7 8 9 10 11 12 | from scipy.stats import chisquare # 帯域幅 ±1 を 4 ビンに分割して密度を確認 edges = [-1.0, -0.5, 0.0, 0.5, 1.0] counts, _ = np.histogram(df['running'], bins=edges) print('ビン:', list(zip(edges[:-1], edges[1:]))) print('観測度数:', counts) expected = np.full(4, counts.sum()/4) # 一様な期待 chi2, p = chisquare(counts, expected) print(f'χ²={chi2:.2f}, p={p:.3f}') print('p > 0.05 なら密度に異常な不連続なし → manipulation 否定') |
📤 実行結果:
💬 結果の読み方:度数は閾値の左 2 ビンが 13・8 県、 右 2 ビンが 3・3 県で、 一様を仮定した χ² = 10.19(p=0.017)は一様性を棄却する。 ただしこれは都道府県の人口分布がもともと右に裾を引き、 小さい県ほど多いためで、 閾値をまたいだ操作の証拠ではない。 McCrary 検定が見るのは閾値の直前と直後で密度が途切れるか(ここでは 8 県 → 3 県)で、 ビン全体が一様かではない。 各ビン数県しかない 47 県では、 どちらの見方でも検出力はほとんどない。
🔬 再現性とコードレビュー観点
レビューチェックリスト
| 観点 | 確認ポイント | 対応コード例 |
|---|---|---|
| データ前処理 | 欠損値、 ゼロ/負の数の扱い | df.dropna(), df.query('A1101 > 0') |
| running variable の中心化 | 閾値を 0 にすると係数解釈が容易 | df['run'] = df['X'] - c |
| 帯域の透明性 | h を変えて結果が変わるか報告 | for h in [...]: ループ |
| SE の計算方法 | 通常 SE か cluster SE か明記 | cov_type='cluster' |
| 可視化 | 散布図 + ビン平均 + フィット線 | plt.scatter + plot |
| 頑健性 | placebo、 共変量バランス | 別途専用関数を呼ぶ |
| 乱数 | 乱数を使うブートストラップは seed 固定 | np.random.seed(0) |
| バージョン | 使用ライブラリのバージョンを記録 | pd.__version__ 等 |
再現性のための環境記録
論文・コンペ提出時には、 以下を必ず README に書いてください:
pandas 2.1.3
numpy 1.26.2
statsmodels 0.14.0
scipy 1.11.4
matplotlib 3.8.2
データ: data/raw/SSDSE-B-2026.csv (statdsedu.statistics.go.jp)
解析: code/rdd_analysis.py
🧮 SSDSE 仮想シナリオ:人口 5 万人を境にした「市制」効果
SSDSE-B-2026 を使って、 「人口 5 万人を超えた自治体は『市』になり、 国からの補助金額に差が出る」 という仮想シナリオで RDD を試してみます。 ※実際の地方自治法の市制施行要件は複雑ですが、 ここでは教育用に簡略化します。
シナリオの設定
- 強制変数 $X$:自治体の人口
- 閾値 $c$:50,000 人
- 処置 $D$:人口 ≥ 50,000 なら市($D = 1$)、 未満なら町・村($D = 0$)
- 結果変数 $Y$:1 人当たり地方交付税(円)
- 仮説:市制施行で財政自由度が増し、 1 人当たり交付税が変化するか?
STEP 1:閾値前後のサンプルを抽出
SSDSE-B から、 人口 25,000〜100,000 人の自治体だけ取り出します(閾値 $c = 50000$ の±50,000 人)。 仮に該当する 12 自治体の値が以下だったとします(教育用の数値例):
| 自治体名(仮) | 人口 $X_i$ | 処置 $D_i$ | $X_i - c$ | 1人当たり交付税 $Y_i$(万円) |
|---|---|---|---|---|
| A 町 | 28,000 | 0 | −22,000 | 12.5 |
| B 町 | 34,000 | 0 | −16,000 | 11.8 |
| C 町 | 41,000 | 0 | −9,000 | 10.9 |
| D 町 | 45,000 | 0 | −5,000 | 10.3 |
| E 町 | 48,500 | 0 | −1,500 | 10.0 |
| F 町 | 49,800 | 0 | −200 | 9.8 |
| ⬆️ 閾値 50,000 人 ⬇️ | ||||
| G 市 | 50,300 | 1 | +300 | 12.5 |
| H 市 | 51,800 | 1 | +1,800 | 12.2 |
| I 市 | 54,000 | 1 | +4,000 | 11.8 |
| J 市 | 62,000 | 1 | +12,000 | 11.0 |
| K 市 | 78,000 | 1 | +28,000 | 10.0 |
| L 市 | 95,000 | 1 | +45,000 | 9.0 |
STEP 2:閾値直近の比較で因果効果を見る
閾値直近のペア F 町(49,800 人, Y = 9.8)と G 市(50,300 人, Y = 12.5):
$\tau \approx 12.5 - 9.8 = \mathbf{+2.7}$ 万円
「人口 500 人差」では他の要因はほぼ同じはず → この差は市制施行の効果と解釈できる。 ただし 2 点だけの比較は不安定なので、 局所線形回帰で全体を使う。
STEP 3:局所線形回帰モデルを書き下す
モデル:$Y_i = \alpha + \tau D_i + \beta_1 (X_i - c) + \beta_2 D_i (X_i - c) + \varepsilon_i$
これは 4 つのパラメータ:
- $\alpha$:閾値直下($X = c$ 直前、 $D = 0$)の $Y$ の予測値
- $\tau$:閾値直上の「ジャンプ」(因果効果)
- $\beta_1$:閾値未満での $X$ に対する $Y$ の傾き
- $\beta_1 + \beta_2$:閾値以上での $X$ に対する $Y$ の傾き
STEP 4:推定値の解釈(仮の結果)
上のデータで OLS で回帰を回すと、 おおよそ:
$\hat{Y} = 9.8 + \underbrace{2.5}_{\tau}\cdot D + (-1.25 \times 10^{-4})\cdot(X - c) + ...$
結論:閾値での因果効果 $\hat{\tau} \approx +2.5$ 万円。 つまり、 「市制施行で 1 人当たり地方交付税が約 2.5 万円増える」と推定される。 この値は閾値近傍(人口 5 万人前後)の自治体に対する局所的効果であり、 人口 100 万都市の市制効果は分からない、 という制約があります。
STEP 5:可視化のコツ
RDD の最重要図表は「散布図 + 閾値の左右で別々のフィット線」。 これで「不連続性が本当にあるか」を視覚的に確認します。 ジャンプが目視で明らかなら結果は頑健、 微小なら推定が不安定。
🧮 SSDSE-B-2026 12 年パネルでの RDD 拡張
SSDSE-B-2026 は 2012-2023 の 12 年間データを持つので、 「年ごとの τ がどう変動するか」を見ることで、 制度的不連続の 時間安定性を確認できます。
🐍 Python 実装 #D1: 年別 RDD パネル
🎯 このコードでやること:2012-2023 の各年で、 人口閾値 200 万に対して τ を別々に推定し、 時系列で並べる。
📥 入力データ:SSDSE-B-2026 全データ(564 行 = 47 県 × 12 年)。
1 2 3 4 5 6 7 8 9 10 11 12 13 14 15 16 17 18 19 20 | all_df = pd.read_csv('data/raw/SSDSE-B-2026.csv', encoding='cp932', skiprows=[1]) results = [] for year in sorted(all_df['SSDSE-B-2026'].unique()): yr = all_df[all_df['SSDSE-B-2026']==year].copy() yr['run'] = (yr['A1101'] - 2_000_000) / 1_000_000 yr['above'] = (yr['A1101'] >= 2_000_000).astype(int) band = yr[yr['run'].abs() <= 1.0] if len(band) < 6: continue X = np.column_stack([ np.ones(len(band)), band['run'].values, band['above'].values, band['run'].values*band['above'].values ]) fit = sm.OLS(band['E1101'].values, X).fit() results.append((year, len(band), fit.params[2], fit.bse[2])) print(f'{"年":>4} {"n":>3} {"τ":>9} {"SE":>7}') for r in results: print(f'{r[0]:>4} {r[1]:>3} {r[2]:>+9.2f} {r[3]:>7.2f}') |
📤 実行結果:
2012 28 -137.85 43.95
2013 28 -135.85 42.73
2014 28 -133.34 42.64
2015 28 -111.54 43.57
2016 28 -100.87 43.02
2017 27 -90.53 42.84
2018 27 -78.78 40.61
2019 27 -86.62 41.84
2020 27 -77.14 39.76
2021 27 -73.44 38.48
2022 27 -67.94 36.38
2023 27 -62.72 34.12
💬 結果の読み方:τ は 2012 年度の -137.85 から 2023 年度の -62.72 まで、 12 年かけて絶対値が半分以下に縮んでいる。 |τ|/SE は 2012〜2014 年度で約 3.1、 2015〜2017 年度で 2.1〜2.6 と 5% 水準で有意だが、 2018 年度以降は 1.84〜2.07 で境目(1.96)の前後を行き来する。 制度が生む不連続なら年度によらず同じ大きさで出るはずで、 段差が年々縮むのは、 閾値付近の県で幼稚園の統廃合の進み方が違うこと(2017 年度に帯域内が 28 → 27 県に減ることも含む)を拾っていると読むほうが自然。
🐍 Python 実装 #D2: クラスター robust SE
🎯 このコードでやること:パネルデータの場合、 同一都道府県内の年間相関を考慮して、 県クラスター robust SE を計算。
📥 入力データ:12 年 × 帯域内県のロングフォーマット。
1 2 3 4 5 6 7 8 9 10 11 12 13 14 15 | long = all_df.copy() long['run'] = (long['A1101'] - 2_000_000)/1_000_000 long['above'] = (long['A1101'] >= 2_000_000).astype(int) long = long[long['run'].abs() <= 1.0].dropna(subset=['E1101']) X = np.column_stack([ np.ones(len(long)), long['run'].values, long['above'].values, long['run'].values*long['above'].values ]) fit = sm.OLS(long['E1101'].values, X).fit( cov_type='cluster', cov_kwds={'groups': long['Code'].values} ) print(f'τ (pooled, cluster SE) = {fit.params[2]:.2f}') print(f'SE = {fit.bse[2]:.2f}') print(f'95% CI = [{fit.conf_int()[2,0]:.2f}, {fit.conf_int()[2,1]:.2f}]') |
📤 実行結果:
💬 結果の読み方:12 年度分(帯域内 329 行・28 県)をプールした τ は -97.35 で、 県クラスター SE 43.65 を使った 95% CI [-182.91, -11.80] は 0 を含まない。 点推定が 2023 年度単年の -62.72 より大きいのは、 段差の大きかった 2012〜2017 年度が平均に入るため。 SE が単年の 34.12 より大きいのは、 329 行あっても独立に動く単位は 28 県しかないことをクラスター SE が反映しているからで、 通常の SE のままだと行数に見合った過小な SE が出てしまう。 有意でも、 偽の閾値でも段差が出る以上、 制度の効果とは読めない。
合成データで閾値前後の不連続ジャンプを計算する。
Step 1: 閾値 c=60 周辺のデータ
| x (制度変数) | y (結果) |
|---|---|
| 58 | 10.0 |
| 59 | 10.5 |
| 60 (閾値) | — |
| 61 | 15.0 |
| 62 | 15.5 |
Step 2: 境界外挿
🐍 Python で再現
1 2 3 4 5 6 7 8 | import numpy as np left_y = [10.0, 10.5] right_y = [15.0, 15.5] jump_left = np.polyval(np.polyfit([58, 59], left_y, 1), 60) jump_right = np.polyval(np.polyfit([61, 62], right_y, 1), 60) print(f"左推定: {jump_left:.2f}") print(f"右推定: {jump_right:.2f}") print(f"RDD: {jump_right - jump_left:.2f}") |
📤 実行結果
💬 手計算 (Step 2) +3.5 と Python 出力が完全一致。
🐍 Python での RDD 実装
1. SSDSE-B からデータを準備
1 2 3 4 5 6 7 8 9 10 11 12 13 14 15 16 17 18 19 20 21 22 | import pandas as pd import numpy as np import matplotlib.pyplot as plt import statsmodels.api as sm # SSDSE-B を読み込み(直書きパス) df = pd.read_csv('data/raw/SSDSE-B-2026.csv', encoding='cp932', skiprows=[1]) # 2023 年データに絞る df_2023 = df[df['SSDSE-B-2026'] == 2023].copy() # 強制変数 X:人口、 結果変数 Y:人口 10 万人当たり幼稚園数 # (SSDSE-B に地方交付税は入っていないので、収録されている幼稚園数 E1101 で代用する) df_2023['pop'] = df_2023['A1101'] # 総人口 df_2023['kinder_per_100k'] = df_2023['E1101'] / df_2023['A1101'] * 100_000 # 閾値の設定(仮想例):人口 200 万人を境に「大規模県」とみなす cutoff = 2_000_000 df_2023['D'] = (df_2023['pop'] >= cutoff).astype(int) df_2023['X_centered'] = df_2023['pop'] - cutoff print(f"n = {len(df_2023)}, 処置群 = {df_2023['D'].sum()}") |
2. 帯域幅を選んで局所線形回帰
1 2 3 4 5 6 7 8 9 10 11 12 13 14 15 16 17 18 19 20 | # 帯域幅 h を設定(閾値の±1,000,000 人を採用、 教育用に固定) h = 1_000_000 sample = df_2023[(df_2023['pop'] >= cutoff - h) & (df_2023['pop'] <= cutoff + h)].copy() print(f'帯域内 n = {len(sample)} (処置群 {sample["D"].sum()} / 対照群 {(1 - sample["D"]).sum()})') # 相互作用項を作る sample['D_X'] = sample['D'] * sample['X_centered'] # 局所線形回帰モデル:Y = α + τD + β1(X-c) + β2 D(X-c) + ε X_mat = sm.add_constant(sample[['D', 'X_centered', 'D_X']]) y = sample['kinder_per_100k'] model = sm.OLS(y, X_mat).fit(cov_type='HC1') # 不均一分散頑健な標準誤差 print(model.summary()) # 因果効果(τ)の推定値と信頼区間 tau = model.params['D'] ci = model.conf_int().loc['D'] print(f"τ = {tau:.3f} 95% CI: [{ci[0]:.3f}, {ci[1]:.3f}]") |
3. RDD プロット — 閾値の左右で別々のフィット線
1 2 3 4 5 6 7 8 9 10 11 12 13 14 15 16 17 18 19 20 21 22 23 24 25 26 | fig, ax = plt.subplots(figsize=(10, 6)) # 散布図(閾値の左右で色分け) left = sample[sample['D'] == 0] right = sample[sample['D'] == 1] ax.scatter(left['pop'], left['kinder_per_100k'], color='steelblue', label='人口 200 万人未満 (D=0)', s=60) ax.scatter(right['pop'], right['kinder_per_100k'], color='crimson', label='人口 200 万人以上 (D=1)', s=60) # 閾値の左右で別々の線形フィット for sub, color in [(left, 'steelblue'), (right, 'crimson')]: if len(sub) < 2: continue m, b = np.polyfit(sub['pop'], sub['kinder_per_100k'], 1) xs = np.linspace(sub['pop'].min(), sub['pop'].max(), 100) ax.plot(xs, m * xs + b, color=color, linewidth=2) # 閾値を縦線で示す ax.axvline(cutoff, color='black', linestyle='--', label=f'閾値 = {cutoff:,} 人') ax.set_xlabel('人口 (人)') ax.set_ylabel('人口 10 万人当たり幼稚園数 (園)') ax.set_title('RDD: 人口規模の閾値と幼稚園数(仮想シナリオ)') ax.legend() plt.tight_layout() plt.show() |
4. McCrary 密度検定(操作の有無を確認)
受験者が「あと 1 点で合格」を意図して試験を解いたり、 役所が「あと数百人で市」と画策したりすると、 閾値直下/直上でサンプル数の人為的偏りが生じます。 これを検出するのが McCrary (2008) の密度検定:
1 2 3 4 5 6 7 8 9 10 11 | # 閾値前後の人口ヒストグラムを描いて、 不自然な密度ジャンプがないか確認 fig, ax = plt.subplots(figsize=(10, 5)) ax.hist(sample['pop'], bins=30, edgecolor='black') ax.axvline(cutoff, color='red', linestyle='--', label='閾値') ax.set_title('McCrary 密度検定:閾値前後で X の密度に不自然なジャンプがないか') plt.show() # 専用パッケージ rddensity(要インストール)の例 # from rddensity import rddensity # result = rddensity(sample['pop'], c=cutoff) # print(result) |
5. プラセボ検定(他の変数で「ジャンプ」が出ないか)
1 2 3 4 5 6 7 8 9 10 11 12 13 14 | # 処置と関係なさそうな変数(プラセボ変数)で同じ RDD を回す # ジャンプが検出されないことが「識別仮定が成り立つ」傍証 # SSDSE-B に収録されている項目から、処置と無関係そうなものを作る sample['aging_rate'] = sample['A1303'] / sample['A1101'] * 100 # 高齢化率 (%) sample['avg_temp'] = sample['B4101'] # 年平均気温 (℃) sample['marriage_rate'] = sample['A9101'] / sample['A1101'] * 1000 # 人口千人当たり婚姻件数 for var in ['aging_rate', 'avg_temp', 'marriage_rate']: y_placebo = sample[var] model_p = sm.OLS(y_placebo, X_mat).fit(cov_type='HC1') tau_p = model_p.params['D'] p_val = model_p.pvalues['D'] print(f"{var}: τ = {tau_p:.3f} (p={p_val:.3f})") # p > 0.05 で「ジャンプなし」なら識別仮定が支持される |
6. 専用パッケージ rdrobust の使用例
1 2 3 4 5 6 7 8 9 10 11 12 13 14 15 16 17 18 | # pip install rdrobust が必要 from rdrobust import rdrobust, rdplot, rdbwselect # 最適帯域幅の選択(CCT 法) bw = rdbwselect(y=sample['kinder_per_100k'], x=sample['pop'], c=cutoff) print(bw) # RDD 推定(バイアス補正付き頑健信頼区間) result = rdrobust( y=sample['kinder_per_100k'], x=sample['pop'], c=cutoff, p=1 # 局所線形(p=2 で局所2次) ) print(result) # 標準的なRDDプロット rdplot(y=sample['kinder_per_100k'], x=sample['pop'], c=cutoff) |
rdrobust は最適 bandwidth の自動選択とバイアス補正済み信頼区間を出してくれる、 RDD 専用の標準パッケージ。 手書きの局所線形回帰では bandwidth を人が決めるしかなく、 その選び方で τ が変わってしまう(前述の h=0.5〜2.0 の比較を参照)。 ここで自動選択された帯域は ±227,728 人と狭く、 三角カーネルで実際に効いている県は左 4・右 2 しかない。 Conventional の τ = 1.007(SE 3.439、 95% CI [-5.734, 7.747])、 Robust CI [-5.772, 10.978] で、 上の ±100 万人の手書き局所線形(τ = -3.463)とは符号まで違う。 県が 6 つしか効かない推定は帯域しだいで揺れるので、 都道府県単位の RDD は手順の例示にとどまる。⚙️ Sharp RDD vs Fuzzy RDD — 2 種類の RDD
| 項目 | Sharp RDD | Fuzzy RDD |
|---|---|---|
| 処置の決まり方 | $X \ge c$ なら必ず $D = 1$、 そうでなければ必ず $D = 0$ | $X \ge c$ で処置確率が「ジャンプ」するが 0→1 とは限らない |
| 例 | 受験点数 60 点以上 = 必ず合格、 人口 5 万人以上 = 必ず市 | 奨学金の所得制限 = 制限以下でも申請しない人がいる、 制限超でも特例で受給する人がいる |
| 識別される量 | 閾値での平均処置効果 (ATE at c) | 閾値でのコンプライアー平均処置効果 (LATE for compliers) |
| 推定方法 | $Y$ を $X, D$ で局所線形回帰 | 2 段階最小二乗法(2SLS):$D$ を $\mathbf{1}\{X \ge c\}$ で操作変数推定 |
| τ の計算 | $\tau = \lim_{x \downarrow c} E[Y|X=x] - \lim_{x \uparrow c} E[Y|X=x]$ | $\tau = \dfrac{\text{Y のジャンプ}}{\text{処置確率のジャンプ}}$ |
Fuzzy RDD の数式(Wald estimator)
Fuzzy RDD は操作変数法と同型で、 「閾値を超えたかどうか」を処置の操作変数として使います。 これにより部分コンプライアンス(処置を受けたい人だけが受ける)状況でも因果効果が識別できます。
🐍 RDD の可視化 — 必須の事前確認
🐍 Python 実装 #C1: 散布図 + 局所平均
🎯 このコードでやること:閾値前後で散布図 + ビン平均をプロット。 RDD で最初に必ず描く図。
📥 入力データ:47 都道府県の (running, E1101) ペア。 例:北海道 (+3.09, 331)、 宮城 (+0.26, 208)、 山形 (-0.97, 55) ...
1 2 3 4 5 6 7 8 9 10 11 12 13 14 15 16 17 18 19 20 21 22 23 24 25 26 27 28 29 | import pandas as pd import numpy as np import matplotlib.pyplot as plt # この抜粋だけで動くように、running / above を作り直す df = pd.read_csv('data/raw/SSDSE-B-2026.csv', encoding='cp932', skiprows=[1]) df = df[df['SSDSE-B-2026'] == 2023].reset_index(drop=True) df['running'] = (df['A1101'] - 2_000_000) / 1_000_000 df['above'] = (df['A1101'] >= 2_000_000).astype(int) fig, ax = plt.subplots(figsize=(8,5)) left = df[df['above']==0] right = df[df['above']==1] ax.scatter(left['running'], left['E1101'], color='#1976D2', alpha=0.7, label='閾値未満') ax.scatter(right['running'], right['E1101'], color='#D32F2F', alpha=0.7, label='閾値以上') ax.axvline(0, color='black', linestyle='--', alpha=0.5) # 帯域内で左右別々に線形フィット for grp, c in [(left, '#1976D2'), (right, '#D32F2F')]: sub = grp[(grp['running']>=-1)&(grp['running']<=1)] if len(sub)>1: coef = np.polyfit(sub['running'], sub['E1101'], 1) xs = np.linspace(sub['running'].min(), sub['running'].max(), 50) ax.plot(xs, np.polyval(coef, xs), color=c, lw=2) ax.set_xlabel('running variable (人口 - 200万) / 100万') ax.set_ylabel('E1101 幼稚園数 (園)') ax.set_title('SSDSE-B-2026 RDD plot') ax.legend(); plt.tight_layout(); plt.savefig('rdd_plot.png', dpi=120) |
📤 実行結果:閾値(縦の点線)前後で青と赤の点群、 それぞれにフィット線が引かれた図。 RDD の「目で見るジャンプ」を確認する第一歩。
💬 結果の読み方:本データでは閾値ちょうどでの線の段差は小さく、 むしろ閾値より遥かに右(東京・神奈川・大阪)で大きく上振れ。 これは「閾値ジャンプ」ではなく「人口が多いほど幼稚園も多いという規模の効果」を反映しており、 RDD では識別できない部分。
🐍 Python 実装 #C2: Placebo(偽の閾値)テスト
🎯 このコードでやること:本来の閾値 200 万以外の場所(100 万、 150 万、 250 万、 300 万)でも τ を推定。 もしどこでもジャンプが出るなら、 200 万のジャンプも偽物の可能性が高い。
📥 入力データ:先ほどの df 全件。
1 2 3 4 5 6 7 8 9 10 11 12 13 | for fake_c in [1_000_000, 1_500_000, 2_000_000, 2_500_000, 3_000_000]: sub = df.copy() sub['run_fake'] = (sub['A1101'] - fake_c)/1_000_000 sub['above_fake'] = (sub['A1101'] >= fake_c).astype(int) band = sub[(sub['run_fake'].abs() <= 1.0)] if len(band) < 6: continue X = np.column_stack([ np.ones(len(band)), band['run_fake'].values, band['above_fake'].values, band['run_fake'].values * band['above_fake'].values, ]) fit = sm.OLS(band['E1101'].values, X).fit() print(f'閾値 {fake_c:>9,}: n={len(band):2d}, τ={fit.params[2]:+7.2f}') |
📤 実行結果:
閾値 1,500,000: n=34, τ= +2.06
閾値 2,000,000: n=27, τ= -62.72 ← 本来の閾値
閾値 2,500,000: n=14, τ= +58.36
閾値 3,000,000: n= 7, τ= +0.91
💬 結果の読み方:本来の閾値 200 万人の τ = -62.72 に対し、 偽の閾値 250 万人でも +58.36 と同じ大きさの段差が出る(100 万・150 万・300 万人は +0.9〜+2.1)。 200 万人だけが特別に大きいわけではないので、 200 万人の段差を制度的なジャンプとは読めない。 250 万・300 万人は帯域内が 14 県・7 県しかなく、 数県の出入りで τ が大きく振れることも効いている。
📋 RDD チートシート
| 用語 | 英語 | 一行説明 |
|---|---|---|
| 回帰不連続デザイン | Regression Discontinuity Design | 閾値前後の不連続から因果効果を識別 |
| Sharp RDD | Sharp RDD | 処置が閾値で 0→1 に完全に切り替わる |
| Fuzzy RDD | Fuzzy RDD | 処置確率が閾値でジャンプ(0→0.6 等) |
| running variable | forcing / assignment variable | 処置を決める連続変数 |
| cutoff | cutoff / threshold | 閾値の値 |
| bandwidth | bandwidth (h) | 閾値からの解析範囲 |
| local linear regression | local linear regression | 帯域内で線形当てはめ |
| McCrary test | McCrary density test | 閾値での密度不連続検定 |
| placebo test | placebo / falsification test | 偽閾値で τ がゼロかを確認 |
| LATE | Local Average Treatment Effect | 閾値近傍だけに対する平均効果 |
📜 RDD の歴史と古典文献
起源:Thistlethwaite & Campbell (1960)
RDD の最初の提案は 1960 年の心理学論文。 「スカラシップ受賞者(試験点数が閾値以上)」と「不合格者(閾値未満)」を比較し、 奨学金受給がその後の学業成績に与える因果効果を推定した。 当時はまだ「不連続を使った因果識別」という概念が体系化されておらず、 この論文は 30 年間ほぼ忘れ去られた。
再発見:Hahn-Todd-van der Klaauw (2001)
計量経済学の主流に RDD が登場したのは 2001 年。 非媒介性(連続性)の仮定を厳密に定式化し、 局所線形回帰の収束率を導出。 これが現代 RDD の理論的基礎となった。
標準化:Imbens-Lemieux (2008)
2008 年の Journal of Econometrics 特集号で実装ガイドラインが標準化。 「running variable のヒストグラム」「placebo テスト」「共変量の連続性チェック」が必須手順として確立。
頑健化:Calonico-Cattaneo-Titiunik (2014)
最適帯域+バイアス補正+ロバスト信頼区間を統合した rdrobust ライブラリ(Stata / R / Python)が公開。 現在の業界標準。
代表的な応用研究
- Angrist & Lavy (1999):イスラエルの学級規模上限(マイモニデス・ルール)を IV 兼 Fuzzy RDD として使い、 学級規模の学習効果を推定
- Black (1999):学区境界の不連続を使い、 学校の質と住宅価格の関係を識別
- DiNardo & Lee (2004):労組選挙の僅差(50%)で当落が決まる事実を使い、 労組化の賃金効果を推定
- Lee (2008):米下院議員選挙の僅差を使い、 incumbency advantage(現職優位)を推定。 RDD 論文として最も引用される
- Card-Mas-Rothstein (2008):人種構成の閾値(tipping point)を使った住宅地分離効果
| 年 | 研究 | 貢献 |
|---|---|---|
| 1960 | Thistlethwaite & Campbell | RDD 概念の初提案 |
| 1999 | Angrist & Lavy | 教育経済学での古典応用 |
| 2001 | Hahn-Todd-van der Klaauw | 理論的基礎確立 |
| 2008 | Imbens-Lemieux | 実装ガイドライン標準化 |
| 2012 | Imbens-Kalyanaraman | MSE 最適帯域選択法 |
| 2014 | Calonico-Cattaneo-Titiunik | ロバスト CI、 現代の標準 |
| 2019 | Gelman & Imbens | 「高次多項式を使うな」警告 |
🏆 統計データ分析コンペでの RDD 活用
SSDSE データで RDD が使えそうなシナリオ
- 政令指定都市の閾値:人口 70 万を境に「行政区が設置できる」「税収配分が変わる」。 これを exogenous な閾値として使う
- 地方交付税の段階閾値:基準財政需要額が段階的に変わる人口区分(5 万、 10 万、 30 万、 50 万、 100 万)
- 過疎地域指定:人口減少率・財政力指数の閾値で過疎指定 → 補助金や開発支援が不連続に変化
- 少子化対策の年齢閾値:児童手当の所得制限など、 SSDSE-C / SSDSE-E の世帯データで応用可能
- 学校統廃合の規模閾値:児童数 100 人未満で統廃合検討となる自治体ルール
コンペで RDD を提案するときのチェックリスト
| 項目 | 確認方法 | 未達のリスク |
|---|---|---|
| 閾値の制度的妥当性 | 法令・条例・公文書で閾値が明示されているか | 恣意的閾値選択 → p-hack |
| running variable の連続性 | McCrary 検定、 ヒストグラム | 操作の存在 → 識別崩壊 |
| 共変量の連続性 | 各共変量について RDD 推定 → τ≈0 か確認 | 他要因混絡 → 効果過大評価 |
| 帯域選択の客観性 | IK / CCT の自動選択を使用 | 「都合の良い h」選択 |
| 頑健性 | 複数 h、 複数次数で τ が安定 | 脆弱な結論 |
| placebo | 偽閾値で τ がゼロに近い | 偽陽性のリスク |
| 外的妥当性の議論 | LATE の限界を明示 | 政策提言の過大解釈 |
プレゼンでよく聞かれる質問と回答例
- Q. なぜその閾値? → A. 〇〇法 第 X 条に明記されている、 自治体が任意に操作できない値です。
- Q. 帯域はどう決めた? → A. CCT (2014) の MSE 最適帯域を採用、 ±50% で sensitivity 確認済み。
- Q. 結果は閾値だけの効果でしょ? → A. はい、 LATE の解釈。 全国一律の政策提言には弱いことを明記。
- Q. n=47 で統計的に有意? → A. SE が大きく、 厳密には有意でない。 推定値の方向と頑健性で議論。
❓ よくある質問
Q1. RDD と DID(差の差分析)はどう使い分ける?
A. RDD は「閾値前後の空間的不連続」、 DID は「時点前後の時間的変化を 2 群で比較」。 政策実施前後の時間比較なら DID、 制度の閾値で識別できるなら RDD。 両方使える場合は RDD の方が外的仮定が少なく好まれる。
Q2. 多項式の次数は何次が良い?
A. 1 次(局所線形)か最大 2 次まで。 Gelman & Imbens (2019) は 3 次以上を強く非推奨。 高次多項式は閾値直近の点にフィットが引きずられ、 偽のジャンプを生む。
Q3. サンプル数が少ない(n < 50)ときは?
A. 推定の不確実性が大きく、 統計的有意性は期待しにくい。 推定値の方向、 placebo の振る舞い、 制度的妥当性で総合判断。 ベイズ的アプローチ(事前情報を活用)の余地もある。
Q4. running variable が離散値(整数年齢など)のときは?
A. 離散の場合は Lee-Card (2008) や Kolesar-Rothe (2018) の特別な信頼区間が必要。 標準 SE は誤りに過小評価する。
Q5. 複数の閾値があるときは?
A. 各閾値で別々に τ を推定し、 比較。 たとえば人口 5万・10万・30万・50万・100万 と段階的な交付税基準があれば、 各閾値での τ を並べると「規模依存の制度効果」が見える。
Q6. クラスター構造(自治体の地理的近接など)がある場合は?
A. クラスター robust SE(県単位、 地方ブロック単位)を使う。 statsmodels の cov_type='cluster' オプション。
Q7. 機械学習で RDD を改善できる?
A. 共変量の高次元処理に ML(lasso、 random forest)を使う「Double ML for RDD」(Calonico et al. 2019)が登場。 共変量調整の精度を上げつつ、 RDD の局所性を保つ。
⚠️ RDD の落とし穴
⚠️ さらなる落とし穴(応用編 5 件)
- 閾値の解釈バイアス:自治体が「200 万人を境に補助金が変わる」と知っていれば、 人口集計時の操作が起きる。 McCrary 検定で密度ジャンプを確認すること。 ジャンプがあれば RDD は使えない。
- 共変量バランス:「人口以外の特性(高齢化率、 1 人当たり所得)」が閾値前後で滑らかかを確認。 ジャンプがあれば、 観測された Y のジャンプは他要因の混絡を含む。
- 多項式の次数:3 次以上の多項式は「左右で異なる曲率」を生み、 中央付近で偽のジャンプを作る(Gelman & Imbens 2019)。 原則 1 次か 2 次まで。
- カットオフの妥当性:閾値が「データを見てから事後に選ばれた」場合、 多重検定で p 値が膨らむ。 事前登録(pre-registration)か、 制度設計が明示する閾値だけ使う。
- 外的妥当性:RDD で推定される τ は「閾値近傍」だけの効果(LATE)。 大きく離れた人口規模(例:100 万人や 500 万人)への外挿はできない。 政策提言時は必ず明示。
📚 さらに学ぶには
このサイト内
- 論文一覧に戻る — RDD を含む因果推論論文を読む
- 関連用語ページ — 上記「🔗 関連用語」から派生
推奨書籍
- 『「原因と結果」の経済学』(中室牧子・津川友介)— 因果推論の入門書、 RDD も平易に解説
- 『計量経済学』(西山慶彦ら、 有斐閣)— RDD・DiD の標準的教科書
- 『Mostly Harmless Econometrics』(Angrist & Pischke)— 計量経済の名著、 RDD の章あり
- 『Causal Inference: The Mixtape』(Cunningham)— 因果推論の現代的入門
- 『Mastering 'Metrics』(Angrist & Pischke)— RDD を含む 5 つの計量手法
主要論文
- Thistlethwaite & Campbell (1960) — RDD の原典
- Hahn, Todd & Van der Klaauw (2001, Econometrica) — 識別の理論
- Imbens & Lemieux (2008, JoE) — 標準的サーベイ
- Calonico, Cattaneo & Titiunik (2014, Econometrica) — 頑健な信頼区間
- Cattaneo, Idrobo & Titiunik (2020) — RDD 実践ハンドブック
Python パッケージ
- rdrobust(rdpackages.github.io)— CCT 推定、 帯域幅選択、 RDD プロット
- rddensity — McCrary 密度検定
- statsmodels — OLS と HC1 標準誤差
- linearmodels — Fuzzy RDD で 2SLS
📊 著名な RDD 実証研究の例
RDD は政策評価論文で最も信頼される識別戦略の 1 つです。 代表的な研究を題材別に整理します。
1. 教育研究 — Angrist & Lavy (1999)
イスラエルの「マイモニデス・ルール」:学級規模が 40 人を超えると 2 クラスに分割される制度を利用。 39 人クラスと 41 人クラス(→ 1 クラス 21 人)を比べて、 学級規模縮小の学力効果を識別。 結論:小さい学級は学力テスト点数を改善(5 年生で約 0.25 SD)。 RDD の応用として有名な古典的研究。
2. 選挙研究 — Lee (2008)
米国下院議員選挙で、 「現職効果」を Sharp RDD で識別。 「得票率 50% 直上で当選 → 次回も当選しやすいか」を比較。 50.01% で当選した候補は次回の当選確率が大きくジャンプ。 因果効果は約 +9 ポイント。 「現職効果」が現実に存在することを RDD で明示した代表例。
3. 公衆衛生 — Carpenter & Dobkin (2009)
米国で「21 歳の飲酒解禁」を Sharp RDD として利用。 21 歳の誕生日前後で死亡率がどうジャンプするか調査。 結論:21 歳誕生日直後の数日間で交通事故・アルコール関連死亡率が顕著にジャンプ。 法的飲酒年齢の効果を明示。
4. 労働経済学 — DiNardo & Lee (2004)
米国の労組結成投票で、 「過半数(50%)超で労組結成」というルールを Fuzzy RDD として利用。 結成 vs 不結成の前後で企業の業績・雇用者の賃金変化を比較。 結論:労組結成は企業の生存率や生産性に強い負の効果は見出せなかった、 という意外な発見。
5. 開発経済学 — Manacorda, Miguel & Vigorito (2011)
ウルグアイの貧困世帯向け移転給付プログラム「PANES」。 所得テストスコアの閾値で給付が決まる制度を利用。 子どもの学校在籍率への影響を識別。 RDD で開発援助の効果を測定した代表例。
日本での RDD 応用
- 市町村合併:「人口閾値で交付税が変わる」制度を使った地方財政効果の研究
- 大学入試:「合格点ボーダー」を使った大学進学効果の推定
- 地方議会:「議席配分の閾値」での政治変化分析
- 高校進学:「入試ボーダー」での高校教育効果分析
主要 RDD 研究のまとめ表
| 研究 | 強制変数 | 閾値 | 結果変数 | 主な結論 |
|---|---|---|---|---|
| Angrist & Lavy (1999) | 学級規模 | 40 人 | 学力テスト | 小クラスで +0.25 SD |
| Lee (2008) | 得票率 | 50% | 次回当選率 | 現職効果 +9 pt |
| Carpenter & Dobkin (2009) | 年齢 | 21 歳 | 死亡率 | 飲酒解禁直後にジャンプ |
| Black (1999) | 住所 | 学区境界 | 住宅価格 | 良い学区で +2.5% |
| Hahn et al. (1999) | 選挙得票 | 50% | 議席 | RDD 理論の原典 |
| Card et al. (2008) | 失業給付額 | 制限 | 再就職期間 | 給付増で就職遅延 |
| Pop-Eleches & Urquiola (2013) | 入試得点 | 合格点 | 大学進学 | 進学率に強い不連続 |
RDD ベストプラクティスのチェックリスト
| 項目 | 確認内容 | 失敗時の影響 |
|---|---|---|
| 制度的閾値 | 処置が機械的に決まるルールが明文化されているか | 識別が成立しない |
| 連続性仮定 | 共変量・潜在結果が閾値で連続か | 因果効果が交絡 |
| McCrary 密度検定 | 強制変数の密度に不自然なジャンプがないか | 操作の疑い |
| 共変量プラセボ | 他の変数で閾値ジャンプが出ないか | 未観測交絡の疑い |
| 帯域幅の頑健性 | $h$ を変えて結果が安定か | 結果が局所的な偶然 |
| 多項式次数 | 低次(1〜2)に限定 | 境界の過剰適合 |
| RDD プロット | 視覚的にジャンプが明瞭か | 統計的有意でも実質効果なし |
| 外的妥当性 | 閾値近傍以外への外挿の議論 | 政策提言が過大解釈 |
- 因果推論教材グループ — RDD / DID / IV / マッチングの統合解説
- 実験計画教材グループ — 自然実験との比較
- 政策評価教材グループ — 実務での RDD 応用
- 📚 用語集トップ
- 🗺️ 概念マップ
📚 追加内容
🔖 キーワード索引(補強)
本ページで扱う主要キーワード: 概念マップ / 回帰不連続デザイン / Sharp RDD / Fuzzy RDD / Running variable / Cutoff / 局所線形回帰 / 局所多項式 / 三角カーネル / 帯域幅 / Imbens-Kalyanaraman / CCT / bias-correction / robust SE / McCrary 密度テスト / 共変量バランス / placebo cutoff / LATE / 反証可能性 / 因果推論 / RCT 代替 / 自然実験 / SSDSE-B-2026 / 都道府県人口 cutoff。 これらの用語は本文中の対応する節で詳述しており、 関連手法としての DID(差分の差分法)、 IV(操作変数法)、 panel-causal(パネルデータ因果推論・傾向スコア応用)、 causation(因果関係の概念) と併せて読むと、 観察データから因果効果を識別する 4 大手法(RDD / DID / IV / PSM)の使い分けが理解できる。 経済学・公衆衛生・教育政策で広く使われ、 Imbens-Lemieux (2008)、 Lee-Lemieux (2010) のレビュー論文が定本。
⚠️ 条件・限界・誤解回避(補強)
RDD (回帰不連続デザイン) の妥当性には (1) 処置割当が観察可能な running variable $X$ と固定 cutoff $c$ で機械的に決まる、 (2) 個人が cutoff の前後に厳密な操作(manipulation)をできない、 (3) cutoff の近傍では他の共変量が連続である(共変量の連続性検定でチェック)、 という 3 条件が必須。 限界として、 cutoff から離れた領域(global effect)には外挿できない(局所平均処置効果 LATE のみ識別)、 bandwidth 選択(Imbens-Kalyanaraman、 CCT)が結果に大きく影響する、 fuzzy RDD では compliance rate が低いと検出力が急減する という弱点がある。 SSDSE-B-2026 を用いて「人口 200 万都道府県以上で幼稚園数(E1101)が不連続に増えるか」を RDD で問う場合、 cutoff 近傍に十分なサンプル(理想 5 件以上)が必要で、 47 件しかない都道府県データでは検出力が限定的。
よくある誤解として、 「不連続が見えれば因果効果あり」 は誤り(McCrary 密度テストで操作可能性を排除する必要がある)、 「2 次・3 次多項式を使えば近似誤差が減る」 も誤り(Gelman-Imbens 2019 が「高次多項式は cutoff 近傍で振動する」と警告)、 「bandwidth は広い方が情報が増える」 も誤り(バイアスとバリアンスのトレードオフ:広いとバイアス増、 狭いとバリアンス増)。 推奨は 三角カーネル + 局所線形回帰 + CCT 最適 bandwidth + bias-corrected robust 推定 の組み合わせ。 また Sharp RDD では処置確率が 0→1 で変化、 Fuzzy RDD では cutoff で連続だが傾斜変化、 と識別戦略が異なる点を混同しない。
🎨 概念図
📚 理解度チェック
- Sharp RDD と Fuzzy RDD の違いを、 識別仮定・推定式・検出力の 3 観点で説明せよ。
- SSDSE-B-2026 を用いた仮想例で「人口 200 万人 cutoff」の RDD を設計するとき、 必要な変数・bandwidth・カーネル選択を具体的に書け。
- McCrary 密度テスト、 共変量バランス検定、 placebo cutoff テストの目的をそれぞれ 50 字以内で述べよ。
- RDD で「3 次多項式」を採用したコードレビューで指摘すべき問題点を、 Gelman-Imbens の警告を引いて述べよ。
- RDD の処置効果が LATE であって ATE ではない理由と、 外的妥当性を高めるための対処(拡張可能性分析)を 1 つ示せ。
🧪 RDD の典型ワークフロー(10 ステップ)
RDD の推定を実務で再現可能に進めるための標準ステップ。 SSDSE-B-2026 を「政令指定都市の人口 cutoff」の例として参照する。
- 因果問いの定式化:「人口 200 万人以上の都道府県は幼稚園数(E1101)が不連続に高いか?」を識別すべき LATE として明示する。
- running variable・cutoff の同定:$X=$人口、 $c=2{,}000{,}000$ を確定。 ルールが法律・条例で固定されている根拠を引用する。
- 処置の定義と確認:$D = \mathbb{1}(X \ge c)$ が Sharp なのか、 一部例外があり Fuzzy なのか確認。 SSDSE では Sharp 想定が現実的。
- データの可視化:scatter(横軸 $X$、 縦軸 $Y$)に cutoff の垂直線を描き、 不連続が見えるか目視で判定する。
- McCrary 密度テスト:cutoff 近傍の $X$ 密度に不連続がないかを検定。 もし密度ジャンプがあれば操作可能性を疑い、 RDD を断念する判断もあり得る。
- 共変量バランス検査:処置変数以外の事前共変量(面積・産業構成・地形)が cutoff で連続かをプラセボ RDD で確認。
- 帯域幅選択:Imbens-Kalyanaraman、 CCT (Calonico-Cattaneo-Titiunik) の自動最適化を用いる。 sensitivity として手動 bandwidth も併記。
- 局所線形回帰:三角カーネル + 1 次多項式で cutoff 両側を別々に推定し、 ジャンプ幅 $\tau$ を計算する。
- バイアス補正と robust SE:CCT のバイアス補正付き robust SE を採用し、 推定の頑健性を強化する。 信頼区間も併記。
- 反証可能性テスト:placebo cutoff(例:人口 100 万、 150 万、 300 万)でジャンプが消えることを確認し、 結果が「200 万 cutoff 固有」であることを示す。
📖 RDD の代表的ケーススタディ(5 件)
- Lee (2008):米国下院議員選挙の再選効果。 選挙得票率の 50% cutoff を境に再選効果を識別。 Sharp RDD の古典例。 Journal of Econometrics 掲載。
- Angrist & Lavy (1999):Maimonides Rule。 イスラエルの「40 人クラス分割ルール」を IV/RDD で活用し、 学級人数が学力に与える効果を識別。 政策評価への RDD 応用の先駆。
- Thistlethwaite & Campbell (1960):RDD の原典。 奨学金合格点を境にした学業継続率を比較した心理学論文。 RDD の発明論文。
- Cattaneo, Frandsen & Titiunik (2015):CCT 手法と Senate 選挙。 帯域幅選択の理論を再整備し、 RDD の現代標準(rdrobust パッケージ)を確立した。
- Card, Dobkin & Maestas (2008):Medicare 65 歳 cutoff。 アメリカの公的医療保険受給開始年齢を cutoff として医療利用・健康効果を識別。 公衆衛生政策評価の代表例。
🛡 RDD 実装時の安全策(チェックリスト)
- cutoff が「法律・規則・物理法則」で機械的に決まり、 個人が操作できないことを根拠資料とともに示す。
- McCrary 密度テストを必ず実施し、 結果を論文・レポートに記載する。
- 共変量バランス検査を cutoff 近傍で実施し、 連続性を確認する。
- 帯域幅は CCT で自動選択し、 sensitivity として手動 bandwidth(半分・倍)でも推定して結果を併記する。
- 高次多項式(3 次以上)は避け、 局所線形回帰 + 三角カーネルを既定とする(Gelman-Imbens 2019)。
- placebo cutoff テスト・処置前変数のジャンプ検査・bandwidth sensitivity の 3 つを「ロバストネス章」として論文に明記する。
🌐 分野別の RDD 応用指針
RDD は経済学・教育学・公衆衛生・公共政策で広く使われるが、 分野ごとに cutoff の性質と妥当性検証手法が異なる。 経済学では政策評価が中心で、 「年齢 cutoff(年金受給開始)」「収入 cutoff(補助金)」「規模 cutoff(中小企業 vs 大企業)」「得票率 cutoff(再選効果)」が典型例。 SSDSE-B-2026 を用いた場合、 「政令指定都市の人口 cutoff(50 万人)」「中核市の人口 cutoff(20 万人)」「特別区域の認定基準」などが題材になる。 経済学では Calonico-Cattaneo-Titiunik (CCT、 2014) の bias-correction を伴う robust SE が事実上の標準で、 Stata の rdrobust、 R/Python の rdrobust パッケージが業界スタンダード。
教育学では Angrist & Lavy (1999) の Maimonides Rule(イスラエルの 40 人クラス分割)が古典で、 教育成果に対する学級規模効果の識別に用いられた。 学校選抜の合格点、 奨学金支給ライン、 進級判定など、 規則ベースの cutoff が豊富。 公衆衛生では Card-Dobkin-Maestas (2008) の Medicare 65 歳 cutoff が代表で、 高齢者医療政策の効果を識別。 BMI 30 cutoff(肥満診断)、 出生体重 cutoff(NICU 入院判定)、 検査値 cutoff(治療開始基準)など、 臨床判断と紐づくものが多い。 選挙学では Lee (2008) の議員再選効果が定本で、 「得票率 50% の前後で再選確率がジャンプ」を Sharp RDD で識別。
SSDSE-B-2026 で RDD を学ぶ場合、 リアルな cutoff を想定すると以下のような例が考えられる。 (1) 政令指定都市 cutoff(人口 50 万人):行政権限の不連続変化が幼稚園数(E1101)に与える効果。 (2) 中核市 cutoff(人口 20 万人):保健所機能の移譲が住民健康指標に与える効果。 (3) ふるさと納税の総務省指定基準:返礼品規制が寄附受領額に与える効果。 ただし注意点として、 SSDSE は $n=47$ と非常に少なく、 cutoff 近傍に十分なサンプル(理想 5 件以上)が確保できないケースが大半。 教育用デモとして RDD のロジックを示すには十分だが、 実証的な因果効果推定には市町村レベルの細分化データが必要。
📊 RDD の主要パッケージ比較
RDD 推定の現代的標準は CCT(Calonico-Cattaneo-Titiunik)の bias-correction + robust SE で、 これを実装した rdrobust パッケージが R/Stata/Python の三言語で提供されている。 R の rdrobust は最も成熟しており、 rdrobust()、 rdbwselect()(帯域幅選択)、 rdplot()(可視化)の 3 関数で完結。 Stata の rdrobust は経済学界の標準で、 教科書・論文の再現に最適。 Python の rdrobust は 2021 年以降に成熟し、 機械学習パイプラインへの統合が容易。
代替パッケージとして、 R の rddtools はインタラクティブな EDA が強み、 R の rdd は McCrary 密度テスト(DCdensity())に強い、 Python の statsmodels は局所線形回帰を手動構築する必要があり教育用途に向く。 SSDSE で RDD を教える際は、 まず手動実装(局所線形回帰を OLS で書く)から始め、 次に rdrobust で検証するのが学習効果が高い。 これにより「RDD = 局所多項式回帰の特殊形」というブラックボックス化を防げる。
🎓 教育的演習:SSDSE-B-2026 を用いた RDD 自由問
- SSDSE-B を用い、 政令指定都市 cutoff(人口 50 万人)の Sharp RDD を設計し、 「幼稚園数(E1101) / 人口」つまり人口当たり幼稚園数が cutoff で不連続にジャンプするかを検定せよ。 帯域幅は CCT 自動選択を用いる。
- McCrary 密度テストを実装し、 都道府県人口の分布が 50 万人付近で連続かを検定せよ。 もし不連続ならば、 行政区分が cutoff で操作されている可能性を議論せよ。
- placebo cutoff として 30 万人、 100 万人、 200 万人で同様の RDD を実行し、 真の cutoff(50 万人)でのみジャンプが現れることを確認せよ。
- 共変量バランス検査として、 「面積」「人口密度」「平均気温」が cutoff 50 万人で連続かを別途 RDD で検定せよ。 すべて非有意であれば識別仮定が成立。
- 帯域幅 sensitivity として、 CCT 最適 bandwidth の 0.5 倍・1 倍・2 倍で再推定し、 結果が頑健か検証せよ。 大きく変動する場合の解釈を述べよ。
📜 RDD の理論的基盤(補足)
RDD の理論的基盤は Hahn, Todd & Van der Klaauw (2001) によって整備された。 彼らは「処置効果が cutoff 近傍で局所平均処置効果(LATE)として識別可能である」ことを、 連続性仮定 $\lim_{x \uparrow c} E[Y(0)|X=x] = \lim_{x \downarrow c} E[Y(0)|X=x]$ のもとで証明。 つまり「処置がなかったら $Y(0)$ は cutoff で連続だっただろう」という反実仮想が成り立てば、 観測されるジャンプは処置効果に帰属できる。 Lee (2008) はこの議論を「running variable に測定誤差・確率的揺らぎがあり、 個人が cutoff の前後を厳密に制御できない」という条件(Local Randomization)として再解釈。 これにより RDD は「cutoff 近傍では擬似的な無作為割付」とみなせ、 RCT に近い因果識別力を持つ。
Calonico, Cattaneo & Titiunik (CCT、 2014) は推定理論を一新した。 従来の bandwidth 選択は Imbens & Kalyanaraman (2012) の MSE 最適化に基づいたが、 CCT はこれにバイアス補正と robust SE を追加し、 「点推定 + 95% CI」の同時最適化を達成。 さらに rdrobust パッケージとして R/Stata/Python の三言語で実装され、 経済学・公衆衛生・教育学の現代的標準となった。 2014 年以降に RDD で書かれた論文の大半は rdrobust のデフォルト設定で実行されており、 査読者もこれを期待している。
RDD の identification 危機として、 Gelman & Imbens (2019) "Why High-order Polynomials Should Not Be Used in Regression Discontinuity Designs" が決定打となった。 従来は「より高次の多項式で近似精度を上げる」という発想だったが、 彼らは「3 次以上の多項式は cutoff 近傍で振動し、 false jump を生み出す」と数値的・理論的に示した。 これ以降、 局所線形回帰 + 三角カーネル + CCT 最適 bandwidth が事実上の唯一の正解となった。 SSDSE で RDD を実装する際は、 必ず一次多項式(linear)を使い、 高次は避ける。 これは「シンプルな手法が頑健」という統計学全般の格言の具体例でもある。
🧮 RDD のパラメータ感度分析(補足)
RDD の結果は bandwidth、 カーネル、 多項式次数、 共変量の 4 つの選択肢に依存する。 これらの感度分析を「ロバストネス章」として論文に必ず明記する必要がある。 まず bandwidth 感度として、 CCT 最適 bandwidth $h^*$ に対し、 $h^*/2$、 $h^*$、 $2 h^*$ の 3 通りで再推定し、 結果が同じ符号と同程度の大きさを持つかを表で示す。 大きく揺らぐ場合は「cutoff 近傍に局所的な構造があり、 LATE が bandwidth に依存する」と解釈する。
次に カーネル感度として、 三角カーネル(既定)、 矩形カーネル(uniform)、 Epanechnikov カーネルの 3 通りで結果を比較する。 三角カーネルは「cutoff に近い点を重視」する自然な選択だが、 矩形カーネルでも結果が安定していれば頑健性が高い。 多項式次数感度では、 1 次(既定)と 2 次(局所二次)を比較し、 1 次で十分かを判断する。 Gelman-Imbens 警告に従い 3 次以上は使わない。 共変量感度では、 (a) 共変量なし、 (b) 連続性が確認された共変量のみ追加、 (c) 全共変量追加、 の 3 ケースで $\tau$ がどう変動するかを示す。 共変量を追加して大きく変わるなら識別仮定が疑わしい。
最後に donut RDD(cutoff 直近の点を除外した推定)と placebo cutoff(真の cutoff からずらした推定)の 2 つの追加診断を行う。 donut RDD で結果が変わらなければ「manipulation がない」根拠が強まり、 placebo cutoff で結果が消えれば「本物の cutoff 効果である」という根拠が強まる。 これらすべてを表にまとめた「Robustness checks」を論文の末尾に置くのが現代的 RDD の標準形式である。
📘 RDD と他の因果推論手法の関係
RDD は観察データから因果効果を識別する 4 大手法(RCT、 RDD、 DID、 IV)の一角を占める。 それぞれの識別仮定と特徴を比較する。 RCT(Randomized Controlled Trial)は処置をランダム割付するため、 識別仮定は最も弱い。 ただし倫理的・実務的に実行困難な場面が多い。 RDDは cutoff 近傍で局所的に擬似 RCT 状況を作り出すため、 内的妥当性は RCT に次いで高い。 LATE のみ識別可能。 DID(Differences-in-Differences)は処置前後の差を群間で比較し、 並行トレンド仮定が必要。 グループ平均効果を識別。 IV(Instrumental Variables)は処置と直接無関係だが結果に間接影響する「操作変数」を用い、 内生性を解消。 LATE を識別。
SSDSE のような小規模クロスセクションでは RDD と IV が現実的選択肢で、 大規模パネルデータでは DID が威力を発揮する。 また現代的手法として Synthetic Control(Abadie et al. 2010)、 Causal Forest(Wager & Athey 2018)、 Double Machine Learning(Chernozhukov et al. 2018)などの機械学習ベース因果推論手法が登場しており、 これらも併用すべき場面が増えている。 SSDSE での RDD 学習を通じて「観察データから因果関係を抽出する」という統計学の核心的問いに触れることができる。
🎯 RDD 研究の最新動向
RDD 研究の現代的フロンティアは、 多重 cutoff・カテゴリ cutoff・連続 cutoffの 3 方向で進展。 多重 cutoff(multi-cutoff RDD)は、 例えば「人口 5 万・10 万・20 万」のように複数閾値で処置が変化する状況を扱い、 Cattaneo, Keele, Titiunik & Vazquez-Bare (2016) が理論を整備。 カテゴリ cutoff は名義変数(例:合格・不合格)で、 Sharp RDD として扱える。 連続 cutoff(Geographic RDD)は地理的境界線を cutoff とする手法で、 国境・州境・郡境の効果を識別。 Dell (2010) のペルー・ボリビア境界研究が代表例。 SSDSE で「太平洋側 vs 日本海側」の境界効果を Geographic RDD として扱うのは興味深い演習。
機械学習との融合も活発で、 RDD + 機械学習では Causal Forest(Wager & Athey 2018)が cutoff 近傍の異質性(Heterogeneous Treatment Effect, HTE)を識別する。 「人口 cutoff の効果が都市規模・地域・産業構成でどう異なるか」を非パラメトリックに推定でき、 政策評価の精度が一段上がる。 また Double Machine Learning(Chernozhukov et al. 2018)は RDD の枠組みに ML 推定を組み込み、 多変量共変量を扱える。 これらは経済学・計量政治学の中堅研究者の間で 2020 年代以降標準ツールとなっている。 SSDSE では概念紹介に留まるが、 産業データに展開する際の必須知識として理解しておく価値がある。
📊 RDD のレポート標準フォーマット
RDD 研究を論文・レポートとして報告する際の標準フォーマットを示す。 学術論文(経済学・計量政治学)では、 以下 7 要素を順に記述するのが現代的標準。 (1) 因果問いの明示:「何の効果を識別するのか」を 1 文で表現。 (2) 識別戦略:running variable・cutoff・処置の定義、 Sharp/Fuzzy 区別。 (3) データ記述:標本数、 cutoff 近傍のサンプル分布、 共変量の記述統計。 (4) 主結果:CCT bias-correction + robust SE による $\tau$ 推定値、 95% CI、 bandwidth、 カーネル種別。
(5) 妥当性検証:McCrary 密度テスト、 共変量バランス検査、 placebo cutoff テスト、 donut RDD の結果を表でまとめる。 (6) 感度分析:bandwidth 0.5×・1×・2×、 カーネル 3 種、 多項式 1 次・2 次 での結果を表で並列表示。 (7) 解釈と限界:LATE であって ATE ではないこと、 外的妥当性の制限、 想定される交絡因子について議論。 SSDSE での演習でも、 これら 7 要素を順に書く形式で報告すれば、 査読論文水準の RDD 研究になる。 経済学コンペや自由研究の上位入賞作の多くがこのフォーマットに従っており、 「形式の力」が論文の説得力を支えている事実は重要な学びである。
🎓 RDD 学習のまとめ
本ページの学習内容を整理する。 RDD は (1) cutoff 近傍の連続性仮定のもとで因果効果を識別する観察データ手法、 (2) Sharp RDD(処置確率が 0→1 で完全切替)と Fuzzy RDD(確率的切替)の 2 種類があり、 (3) 推定は局所線形回帰 + 三角カーネル + CCT 最適 bandwidth + bias-correction が現代的標準(rdrobust パッケージ)、 (4) 妥当性検証として McCrary 密度テスト・共変量バランス検査・placebo cutoff テストの 3 点セットが必須、 (5) 推定値は LATE(局所平均処置効果)のみで、 ATE への一般化には追加の仮定が必要、 という 5 点を抑えれば論文水準の研究に展開できる。 SSDSE-B-2026 のような小規模データでは正式な実証は難しいが、 概念学習と疑似実装には十分な題材となる。 RDD は「観察データから因果効果を抽出する」という統計学の核心問題に挑む、 経済学・公共政策・公衆衛生・教育学の必須ツールである。
🔗 関連トピックへの橋渡し
RDD の理解を深めるための関連トピックを示す。 まず数学的基盤として カーネル密度推定(局所線形回帰の重み付け)、 最尤推定・GMM(推定方程式の理論)、 漸近理論(収束率・SE 構築)が必須。 次に因果推論の枠組みとして ルービン因果モデル(潜在結果フレームワーク)、 傾向スコア(PSM)、 IV・DID・Synthetic Controlなどの代替手法の比較理解が深層的な RDD 応用に必要。 機械学習との接続として Causal Forest・Double MLが異質性・高次元共変量への拡張を提供する。 これらは経済学・公衆衛生研究の最前線で日常的に使われている技術であり、 SSDSE での RDD 演習を通じて自然な道筋で習得できる。
📚 RDD 参考文献(5 件)
(1) Imbens & Lemieux (2008):Regression Discontinuity Designs: A Guide to Practice, Journal of Econometrics — RDD 実装の決定的ガイド、 経済学界の標準リファレンス。 (2) Lee & Lemieux (2010):Regression Discontinuity Designs in Economics, Journal of Economic Literature — RDD の包括的サーベイ、 識別仮定・推定論・実証応用を網羅。 (3) Calonico, Cattaneo & Titiunik (2014):Robust Nonparametric Confidence Intervals for Regression-Discontinuity Designs, Econometrica — CCT 法の原典、 現代 RDD の数学的基盤。 (4) Cattaneo, Idrobo & Titiunik (2019):A Practical Introduction to Regression Discontinuity Designs(Cambridge Elements) — 実装重視の入門書、 rdrobust の活用法を詳述。 (5) Gelman & Imbens (2019):Why High-order Polynomials Should Not Be Used in Regression Discontinuity Designs, Journal of Business & Economic Statistics — 高次多項式禁忌の決定論文、 RDD 実装の現代的標準を確立。
🗺 RDD の概念マップ
RDD と因果推論手法群の関係を整理します。
                  【因果推論の Goal】
                  「X → Y の効果は何か?」
                          │
        ┌─────────────────┴─────────────────┐
        ▼                                     ▼
   【実験的手法】                      【観察データ手法】
   ・RCT                                  │
                              ┌──────────┼──────────┐
                              ▼                     ▼
                       【識別戦略あり】       【識別戦略なし】
                              │                     │
              ┌───────┬───────┼───────┬──────────────┘
              ▼       ▼       ▼       ▼
        【RDD】 【DiD】 【IV】 【マッチング】
          │       │       │       │
          │       │       │       └─ 傾向スコア
          │       │       │
          │       │       └─ 2SLS、 Fuzzy RDD
          │       │
          │       └─ パネルデータ、 二元固定効果
          │
          └─ Sharp RDD / Fuzzy RDD / RKD / Bunching
RDD のワークフロー
- 制度を理解する:閾値で何が変わるか、 制度的に決まっているか
- 強制変数 $X$ と閾値 $c$ を特定する
- McCrary 密度検定:閾値直近で $X$ の密度に不自然なジャンプがないか
- 共変量プラセボ検定:閾値で他の共変量がジャンプしないか
- 帯域幅 $h$ を選択(CCT 法等)
- 局所線形回帰で τ を推定
- 頑健性検定:$h$ を変えて、 多項式次数を変えて、 共変量を入れて、 結果が安定か確認
- 視覚化:RDD プロットで「ジャンプ」が明らかか確認
- 外的妥当性の議論:閾値近傍以外への外挿の制約を明示
🗺 RDD 概念マップ
RDD は因果推論の 「自然実験」系統に属し、 DID / IV / マッチング とともに観察データから因果効果を識別する 4 大手法の一つです。
因果推論 (causal inference)
├── ランダム化実験 (RCT)             ← gold standard
├── 観察データ手法
│   ├── 回帰調整 (regression adjustment)
│   ├── マッチング (matching)         ← 共変量で類似ペア
│   ├── 傾向スコア (propensity score) ← 処置確率で重み付け
│   └── 自然実験 (natural experiment)
│       ├── 差の差分析 (DID)         ← 時点 × 群
│       ├── 操作変数法 (IV)           ← 外生シフト
│       ├── 合成コントロール (SC)     ← 重み付き平均対照群
│       └── 回帰不連続デザイン (RDD)  ★ このページ
│           ├── Sharp RDD            ← D = 1(X ≥ c)
│           ├── Fuzzy RDD            ← P(D=1) ジャンプ
│           ├── Kink RDD             ← 傾きジャンプ
│           └── Regression Discontinuity in Time (RDIT)
└── 構造モデル (structural)
RDD の隣接概念:
- Kink RDD:閾値で「水準」ではなく「傾き」が変わる(例:累進課税の階段)
- Geographic RDD:地理的境界(学区、 国境)を閾値として使う
- Regression Discontinuity in Time (RDIT):時間軸での閾値(政策施行日など)
- Multiple cutoffs:複数閾値の同時推定
🔗 隣接手法への橋渡し
「回帰不連続デザイン」は単独で完結する手法ではなく、 隣接領域と連携することで真価を発揮する。
SSDSE-B-2026 のような都道府県別データに RDD を当てるなら、 cutoff 変数 (例: 補助金支給ライン) のすぐ上下の県を比較し、 cutoff 周辺の連続性検定 → 平均処置効果推定 → 帯域感度分析の順で結論を出す。
🌳 手法選択フロー
「RDD」を実際の課題に当てはめるとき、 状況別に何を選ぶかを 3 段階で判定する。
- 処置の閾値はあるか? Yes (合格点・所得制限) → RDD 適用可、 No → IV / DID を検討
- 閾値前後でジャンプか連続か? ジャンプ (sharp RDD) → 単純比較、 確率変化 (fuzzy RDD) → IV 併用
- サンプルは十分か? 閾値近傍にデータが集まる → 局所線形回帰、 少 → 帯域幅を広げ全域回帰
SSDSE-B-2026 だけで RDD は難しいが、 「人口 100 万人ライン (政令指定都市基準)」前後で歳入・補助金がジャンプするかを観察すれば、 制度効果の素朴な目視が可能。
RDD のメタ分析
De la Cuesta & Imai (2016) は、 政治学分野の RDD 研究 50 件以上をメタ分析。 「閾値での操作」「帯域幅依存」「多項式選択」の 3 大問題を体系的に検証し、 ベストプラクティスを提示。 結論:適切に分析されれば RDD は IV やマッチングより信頼性が高い識別戦略。 適切な帯域選択・密度検定・プラセボ検定を経れば、 RDD は観察データから因果効果を取り出す最も内部妥当性の高い準実験デザインの一つとなる。
🎮 触って理解する
RDD の核心は「閾値の左右で回帰直線を別々にフィットし、 その切片差=ジャンプ τ を測る」こと。 下の図は横軸が割当変数 X、 縦軸が結果 Y。 青=処置なし(X < 閾値)、 赤=処置あり(X ≥ 閾値)。 スライダーで 処置効果 τ・傾き・バンド幅 h を動かし、 グラフ上をドラッグ(タッチ可)すると閾値 c が動きます。 バンド幅を広げると推定の分散(SE)は下がるが右側の曲がり(非線形)を直線で近似するバイアスが増える様子を体感してください。
💡 直感 — 閾値近傍は「擬似ランダム割当」
閾値ちょうどの直上・直下にいる対象は、 割当変数の値がほぼ同じ=観測・非観測を問わず背景要因がほぼ揃っていると見なせます。 唯一違うのは「閾値を超えたか」で機械的に決まる処置の有無だけ。 だから閾値近傍の比較はミニ・ランダム化実験に近く、 ジャンプ τ̂ を因果効果として読めます。 図でバンド幅 h を最小にすると、 使うのは閾値のすぐ両脇の点だけになり、 この「擬似ランダム」の理屈が最も純粋に効く(ただし点が減って SE が跳ね上がる)ことが分かります。
⚠️ よくある落とし穴
- 操作(manipulation):対象が閾値をまたぐよう割当変数を自分で操作できると、 閾値直上・直下の対象はもう「同質」でなくなり識別が壊れます。 補助金の所得制限などで直下に不自然な密度の山が出たら要警戒(McCrary 密度検定)。
- 関数形(functional form):真の関係が曲がっているのに高次多項式を全域に当てると、 閾値での見かけのジャンプが関数形の癖で生じることがあります。 図で傾きを大きくし h を最大にすると、 右側の曲がりを直線が捉えきれず推定 τ̂ が真の τ からずれるのが「バイアス」の正体です。
- バンド幅選択(bandwidth):h を広げると分散↓だがバイアス↑、 狭めるとバイアス↓だが分散↑。 恣意的に「有意になる h」を選ぶのは禁じ手。 IK 法・CCT 法など理論的な最適 h を使い、 感度分析で頑健性を必ず示します。
🚀 発展 — シャープ vs ファジー・局所線形回帰
この図は処置が閾値で 0→1 に確定する シャープ RDD。 現実には「資格はあるが受け取らない」人がいて処置確率が 0.3→0.8 のように部分的にしか跳ねない ファジー RDD も多く、 その場合は Y のジャンプを D(処置確率)のジャンプで割って正規化します(本ページ数式節の $\tau_{FRD}$)。 推定は帯域内サンプルへの 局所線形回帰が標準で、 端点バイアスを抑えるため中心ほど重い 三角カーネルで重み付けするのが定石。 Python では rdrobust が CCT の頑健信頼区間まで自動計算します。
関連ページ: 操作変数法 (IV) / 差分の差分法 (DID) / 因果推論 / 回帰分析
🔎 さらに深掘り — 直感・落とし穴・発展(追補)
ここまでで RDD の骨格は掴めているはずです。 この追補では、 (1) なぜ「準実験」と呼べるのかの直感を RCT と対比して固め、 (2) 実務で最も足をすくわれる落とし穴を 1 枚のチェック表に集約し、 (3) 現場で問われる発展トピック(最適帯域・密度検定・断続時系列との違い)を整理します。 既存の各節と重複しない補完として読んでください。
🎨 直感の再確認 — 「閾値近傍=擬似ランダム化」
RDD が 準実験(quasi-experiment)と呼ばれるのは、 閾値 $c$ のすぐ両脇にいる対象は「割当変数がほぼ同じ=背景要因もほぼ同じ」で、 処置の有無だけが機械的に切り替わるからです。 つまり閾値近傍では「誰が処置群・対照群になるか」が実質コイン投げに近い。 これが RCT(無作為化比較試験)に匹敵する内部妥当性を生みます。 違いは、 RCT が全対象を無作為化するのに対し、 RDD は閾値近傍だけで無作為化が近似的に成り立つ点です。
| 観点 | RCT(無作為化実験) | RDD(回帰不連続) |
|---|---|---|
| 割当の仕組み | 実験者が乱数で処置を割当 | 閾値を境に制度が機械的に割当 |
| 比較可能性の根拠 | 無作為化により全共変量が均衡 | 閾値近傍で共変量が連続=ほぼ均衡 |
| 推定できる効果 | 母集団全体の平均処置効果 (ATE) | 閾値ちょうどの局所効果 (LATE at c) |
| 外的妥当性 | 対象母集団に一般化しやすい | 閾値から離れると外挿不可 |
| 実施コスト・倫理 | 高い・倫理制約が大きい | 既存の制度を利用=低コスト |
🧪 実測で見る「帯域幅で結論が変わる」— 別閾値の擬似 RDD
既存節では閾値 200 万人を扱いました。 ここでは別の教材用擬似設定として閾値を 150 万人に置き、 SSDSE-B-2026(2023 年、 47 都道府県)の実測値で τ を計算します。 ※閾値 150 万人は制度的根拠のない架空・教材例の設定で、 数値だけが実データです。
閾値直近のペア(実測):
閾値以上の県数: 24 / 閾値未満の県数: 23
直下: 沖縄県 人口 1,468,000 幼稚園数 E1101 = 151 園
直上: 鹿児島県 人口 1,549,000 幼稚園数 E1101 = 134 園
近傍2点差(素朴なジャンプ): 134 - 151 = -17 園
局所線形回帰で帯域幅 $h$ を振ると(実測):
h=0.75: n=28, τ=+27.61 (SE=33.87)
h=1.00: n=34, τ= +2.06 (SE=31.87)
💬 読み方:τ の符号すら $h$ で -11 → +28 → +2 と反転し、 かつどの $h$ でも SE が推定値をはるかに上回ります。 これは「有意になる $h$ を後から選ぶ」ことの危険性を実データで示す好例です。 200 万人閾値でも有意性が帯域で揺れ、 偽の閾値 250 万人でも同程度の段差が出たことと合わせると、 都道府県人口の閾値で幼稚園数に制度的な不連続があるとは言えないことが、 閾値を変えても確認できます。
⚠️ 落とし穴・統合チェック表
既存の「⚠️ RDD の落とし穴」節(5+5 件)を、 診断方法とセットで 1 枚に凝縮します。 提出前にこの表を上から順に潰すのが実務の型です。
| 落とし穴 | 症状 | 診断・対処 |
|---|---|---|
| 操作(manipulation) | 閾値直下に密度の山/直上に空隙 | McCrary 密度検定・rddensity。 密度が不連続なら RDD 断念 |
| 密度の連続性 | 強制変数の分布が閾値で跳ねる | 密度の連続性検定(McCrary 2008)で $p>0.05$ を確認 |
| 帯域幅(bandwidth)選択 | $h$ を変えると τ が大きく動く | IK / CCT の最適 $h$ +±20% の感度分析を必ず併記 |
| 関数形の誤設定 | 高次多項式で偽のジャンプ | 局所線形(1 次)を基本。 3 次以上は避ける(Gelman-Imbens 2019) |
| 局所効果のみ | 閾値から離れた値へ外挿 | 結論を「閾値近傍の LATE」に限定。 外的妥当性を明示 |
| 標本サイズ | 帯域内 n が小さく SE 過大 | 帯域内 n と SE を報告。 n が薄いなら結論を保留 |
| シャープ vs ファジー | 閾値で処置率が 0→1 でない | ファジーなら Y のジャンプを D のジャンプで割る(2SLS) |
| 共変量バランス | 共変量が閾値で不連続 | 各共変量を outcome にして placebo RDD。 ジャンプ無しを確認 |
🚀 発展 — 最適帯域・密度検定・そして「断続時系列」との違い
最適帯域幅の自動選択:手で $h$ を決めるのは恣意的なので、 バイアスと分散の平均二乗誤差 (MSE) を最小化する $h$ を理論的に選びます。 代表が IK 法(Imbens-Kalyanaraman 2012)と CCT 法(Calonico-Cattaneo-Titiunik 2014)。 CCT はバイアス補正と頑健信頼区間まで提供し、 現在の事実上の標準です(rdrobust)。
McCrary 密度検定:識別の生命線である「操作なし」を検証する道具。 強制変数の密度を閾値の左右で別々に推定し、 密度が連続(=閾値で跳ねない)ことを確認します。 跳ねていれば対象が閾値をまたぐよう自己選択している疑いがあり、 RDD の前提が崩れます。
プラセボ検定:(1) 偽の閾値(本来ジャンプが無い点)で τ≈0 を確認するプラセボ・カットオフ、 (2) 処置の影響を受けないはずの共変量を outcome にして τ≈0 を確認する共変量プラセボ。 どちらもジャンプが出れば、 本命のジャンプも疑わしくなります。
断続時系列(Interrupted Time Series, ITS)との違い:両者とも「境界で不連続なジャンプ」を測りますが、 横軸が違います。 RDD の横軸は個体の強制変数(人口・点数・所得など)で、 同時点の多数の個体を閾値の左右で比較します。 一方 ITS の横軸は時間で、 政策施行前後の同一集団の推移を比較します。 「いつ効いたか(時間の切れ目)」を見るのが ITS、 「どの水準で効くか(変数の切れ目)」を見るのが RDD。 施行時点が明確でも並行トレンドの仮定が要る点で、 ITS はむしろ DID や 平行トレンド と親戚です。 施行タイミングが未知なら change-point detection、 タイミングを操作変数化するなら IV と接続します。
🔗 関連ページ(実在ファイルへの相対リンク)
- 差分の差分法 (DID) — 時間×群の 2 軸で処置前後の差を比較。 閾値が無く「施行前後」で識別する場合の代替。
- 平行トレンド — DID / ITS の核心仮定。 RDD の「連続性仮定」と対をなす識別条件。
- 操作変数法 (IV) — ファジー RDD は「閾値ダミーを操作変数にした 2SLS」として実装できる。
- 自然実験 — RDD は制度的閾値を利用する自然実験の代表格。
- パネルデータ因果推論 — SSDSE-B の 12 年構造を使った年別 τ・クラスター robust SE の背景。
- 因果推論 — 潜在結果・LATE・識別仮定など RDD の土台となる枠組み。
- グレンジャー因果 — 時系列上の予測的因果。 ITS 的な時間軸の議論と対比すると理解が深まる。
- 逆因果 — 強制変数が結果に操作される「逆向き」の懸念を整理する視点。
- 回帰分析 — 局所線形回帰の基礎。 交互作用項による左右の傾き差の扱い。
※ 上記リンクは html/glossary/ 内に実在するファイルのみを掲載しています。