🔖 キーワード索引
この用語と一緒に検索・参照されやすいタグ。 関連ページに飛ぶときの手がかりにも使えます。
各語の説明がある章へのリンク:
反実仮想 事前トレンド検定(年度×群の交互作用) イベントスタディ プラセボ検定 対照群の選び方 尺度依存(水準か対数か) 検出力不足と「有意差なし」 予期(anticipation)効果 Staggered adoption と TWFE Honest DiD 合成統制法 固定効果 DID(PanelOLS)
💡 30秒で分かる結論
🍰 まずはやさしく
データの動きが同じ方向に向かうという約束です。
ある対策の効果を正しく測るために使います。
スマホの利用時間をクラスで比べる時に役立ちます。
この章では結論を短くまとめて解説します。
平行トレンド仮定は、 差分の差(DiD)法における核心仮定。 「介入が無ければ処置群と対照群は平行に推移したはず」。
- 意義:これが成り立てば、 介入前後の差の差が因果効果
- 検証:介入前期間のプリトレンドを可視化/回帰でテスト
- 違反時:DiD 推定値にバイアス
- 対策:合成統制法、 イベントスタディ、 多群 DiD
- 注意:「平行に見えた = 仮定を満たす」ではない(外挿の問題)
ここまでが要点です。 ただし実際に使う前に、 このページの「⚠️ よくある落とし穴」で挙げた プリトレンドを「目視で平行」と判断/時間変化する交絡 (TWFE 推定量の罠)/Staggered adoption の負の重み には必ず目を通してください。 つまずくのは知識が無いときより、 知ってはいたが確認を飛ばしたときです。
📍 文脈:「平行トレンド仮定」はどんな場面で出てくる?
🍰 まずはやさしく
分析の説得力を決める大切なルールです。
本当の原因を突き止めるために使います。
部活の新しい練習法で成績が変わったか調べます。
この用語がどんな場面で登場するかを説明します。
本サイトの政策効果分析(最低賃金、 教育改革等)で頻出。 観察データから因果を語る数少ない手段の一つで、 仮定の妥当性が論文の説得力を左右します。
このページでは SSDSE-B-2026 の 47 都道府県 × 12 年度(2012〜2023)のパネルを使い、 東京圏 4 都県と東北 6 県、 三大都市圏と残りの県などの群分けで、 事前トレンドの検定・イベントスタディ・プラセボ検定を実際に計算する。 どの群分けも実在の政策ではなく、 仮定の確かめ方を学ぶための例示である。
🎨 直感で掴む
🍰 まずはやさしく
並走する陸上競技のようなイメージです。
もし対策をしなかったらどうなったかを考えます。
テスト勉強法を変えなかった時の点数を想像します。
直感的にイメージを掴むための例を紹介します。
- 「もし介入が無ければ」をどう作るか:処置群の介入前トレンドを延長すれば良い、 というアイデア。
- 対照群を「もし処置されていなかったら処置群もこう動いたはず」の代理として使う。
- 並走するレーンの陸上競技が比喩。 内側だけ風が吹いた(介入)として、 外側を比較対象にする。
🎨 平行トレンドが「成り立つ」 と「成り立たない」 ケースの判別図
平行トレンドの判別は、 統計検定だけでなく事前期間のトレンドプロットを目で見る ことも重要です。 以下に典型 4 パターンを整理します。
| パターン | 事前トレンド | DID 有効性 | 対応 |
|---|---|---|---|
| ① 理想的 | 処理群・対照群とも同じ傾き | ○ 標準 DID 可 | そのまま実行 |
| ② 平行ずれ | 傾きは同じ、 切片が違う | ○ DID で吸収 | そのまま実行 |
| ③ 発散傾向 | 処理群がもともと急減 | × DID 不可 | Honest DID / Synthetic Control |
| ④ 収束傾向 | 差が縮まっていく | × DID 不可 | マッチング DID |
SSDSE-B-2026 では、 東京圏(2014〜2019 年度に総人口が年 +0.42%)と東北(同 −0.89%)のように人口の動きが違う群を比較する場合、 ③ が出やすい(🐍 の事前トレンド検定)。 事前期間が短いと検定の検出力が低いため、 「視覚的に平行に見える + 検定で有意差なし」 の両条件をクリアして初めて平行トレンドが信頼できると考えます。
📝 DID 実装前チェックリスト — 11 項目
SSDSE などの公的データで DID を回す前に、 必ず以下 11 項目を確認しましょう。
- 処理群と対照群を明確に定義したか(曖昧な境界がないか)
- 処理タイミング (intervention timing) は全群同じか、 staggered か
- 事前期間が 3 年以上あるか(最低限の検出力)
- 事前期間トレンドのプロットを描いて目視で平行性を確認したか
- 事前期間で「年度 × group」 の交互作用項検定を行ったか
- プラセボ検定(偽の処理タイミング) で τ ≒ 0 を確認したか
- 外れ値(東京や沖縄のような特異県) の影響を感度分析したか
- 標準誤差を群レベル(県クラスタ) でロバストに計算したか
- 処理の anticipation 効果(公表前期間の行動変化) を考慮したか
- 共通ショック(COVID-19、 リーマンショック) の年と重なっていないか確認したか
- 結果の頑健性を Honest DID / Synthetic DID で再確認したか
11 項目すべてクリアして初めて、 「平行トレンドのもと推定された政策効果は τ である」 と論文・レポートに書けます。 教育用 SSDSE 演習でも、 これらの確認手順を再現することで、 因果推論の方法論を身体化できます。
📖 実際の応用事例 — 平行トレンドが検証された有名研究
DID 推定が広く認知されたのは、 1994 年の Card-Krueger の最低賃金研究が画期となります。 ニュージャージー州が最低賃金を引き上げたとき、 隣接ペンシルベニア州を対照群として「ファストフード店の雇用が減ったか」 を DID で推定。 古典理論では雇用減少が予測されていましたが、 実際には雇用は減らなかったという衝撃的な発見をもたらしました。 この研究で David Card は 2021 年ノーベル経済学賞を受賞しました。
| 研究 | 処理 | 対照 | 平行トレンド検証 |
|---|---|---|---|
| Card-Krueger (1994) | NJ 最賃引上げ | 隣接 PA 州 | 事前期間の雇用率推移で確認 |
これらの研究の共通点は、 「処理が外生的に決まった」 こと、 「事前期間のトレンドプロットを論文に必ず掲載した」 こと、 そして「複数の感度分析(プラセボ検定、 別対照群との比較)」 を行ったことです。 SSDSE で同様の手順を踏むなら、 演習として「2014-2019 を事前期間、 2020-2023 を事後期間」 と固定し、 47 都道府県のうち地域ブロック単位で処理/対照を組み合わせるのが安全です。
📋 平行トレンド仮定 — 30 秒サマリーカード
| 項目 | 内容 |
|---|---|
| 定義 | DID で「処理がなかった場合のトレンドが処理群・対照群で等しい」 と仮定すること |
| 数式 | $E[Y_{0,t} - Y_{0,t-1} \mid D=1] = E[Y_{0,t} - Y_{0,t-1} \mid D=0]$ |
| 検証方法 | 事前期間でトレンド差を OLS の交互作用項で検定、 視覚的に平行性確認、 プラセボ検定 |
| 破れたら | Synthetic Control / Honest DID / Synthetic DID / マッチング DID へ切替 |
| Python | statsmodels.formula.api / linearmodels.panel.PanelOLS / DoubleML |
| SSDSE 演習 | 縦断 2012-2023 で 47 県を地域ブロック単位に組み、 事前期間 8 年分で検定 |
平行トレンド仮定は「観察データから因果効果を推定する」 ための最も古典的かつ強力な仮定の一つです。 完全な検証は不可能で、 事前期間のトレンドプロット + 検定 + プラセボの三点セットは「崩れている証拠」を見つける道具であって、 成り立つことの証明にはなりません。 因果推論の入り口として、 必ず手を動かして体感してください。
🧭 追加メモ — 仮定検証の補足理論
平行トレンド仮定が「観察できる事前期間」 だけで検証されるという制約は、 因果推論の根本的な「反実仮想は観察不可能」 という問題を反映しています。 これに対応する 4 つの考え方を整理します。
- extrapolation 仮説: 「事前期間で平行だったから、 事後期間でも平行だったはず」 という外挿。 短期の DID では比較的妥当だが、 長期では構造変化の影響で疑わしい。
- bounding 法: 平行トレンド完全成立を仮定せず、 「事前期間で観察されたトレンド差の最大値」 を事後にも許容し、 効果推定値の信頼区間を「正直に」 広げる方法(Honest DID)。
- 機械学習補正: DoubleML や Causal Forest を用い、 「観察された共変量で説明できる部分は除去した上での平行トレンド」 を仮定する。 SSDSE のような多変量データで有効。
- 感度分析: 「平行トレンドの violation がどれくらいなら結論が反転するか」 を計算し、 violation の現実性と比較。 Rambachan-Roth の論文に詳細手順。
2026 年現在、 計量経済学者の多くは「平行トレンド仮定は厳密には成り立たないが、 sensitivity analysis でロバストにする」 というスタンスをとっています。 SSDSE 演習でも、 古典 DID の結果を出した後、 必ず「もし平行トレンドが ±X% ずれていたら結論がどう変わるか」 まで計算する習慣をつけましょう。
最後に重要な注意: 平行トレンド仮定は「処理効果の異質性 (heterogeneity)」 ともセットで考える必要があります。 ある処理が「効果が大きい県」 と「効果がない県」 で混在するとき、 単純な DID は加重平均効果を返しますが、 weights が直感に反する負の値を持つことがあります(特に staggered adoption 時)。 これが Goodman-Bacon (2021) の指摘した DID の落とし穴で、 2020 年以降の文献で大きな議論となりました。
SSDSE 縦断データで DID を演習する際は、 まず単純な 2×2 DID(処理群 1 グループ vs 対照群 1 グループ、 単一処理タイミング) から始めるのが最も誤解を避けやすいです。 慣れてきたら、 県別に処理タイミングが違う staggered adoption 状況、 複数処理が重なる multiple treatments 状況など、 より複雑なケースへ広げていきましょう。 そのとき、 「平行トレンドが何を意味するか」 という出発点を絶対に忘れないことが肝心です。
🖼 図で見る平行トレンド仮定(R654 補強)
ここでは平行トレンド仮定の理解を視覚的に深めるため、 SSDSE-B-2026 都道府県データから 3 種類の図を提示します。 各図は 事前トレンドの平行性検証、 処理群と対照群の事前期間分布、 複数群比較の箱ひげ という 3 つの異なる角度から、 仮定がどのように「目で確認」 されるかを示しています。
図 1: 処理群と対照群の事前トレンド(散布図)
このプロットでやること: SSDSE-B-2026 から、 仮想的に「政策処理を 2018 年度に受けた都市部 5 都府県(2012 年度の人口 1〜5 位: 東京・神奈川・大阪・愛知・埼玉)」 と「対照群の地方部 5 県(43〜47 位: 福井・徳島・高知・島根・鳥取)」 を比較。 出生数(A4101)の 1 県平均を 2012〜2023 年度で折れ線にし、 事前期間 2012〜2017 年度に平行に推移しているかを視認します(2018 年度に実際の政策があったわけではありません)。
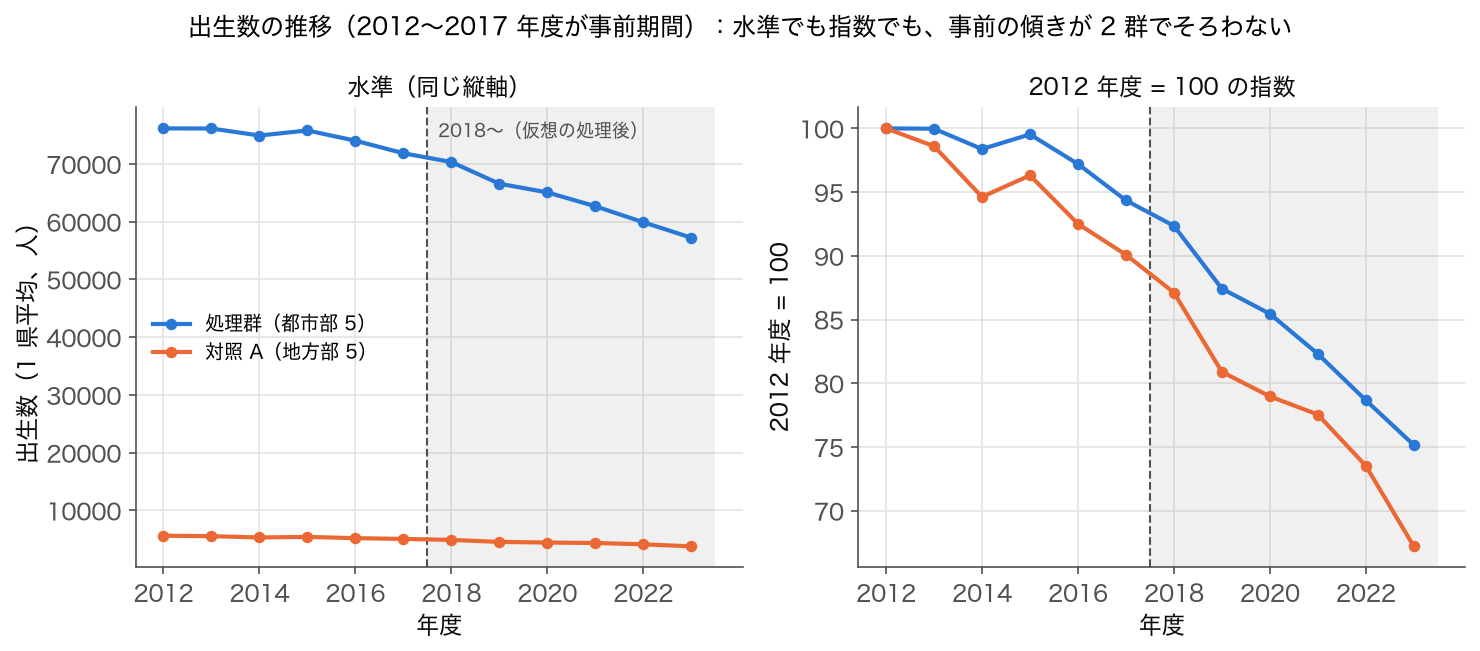
読み方: 横軸が年度、 縦軸が出生数(左: 人、 右: 2012 年度 = 100)。 処理群(青)・対照群(オレンジ) の 2 群の傾きが平行なら、 平行トレンド仮定の信頼度が高い。 この組み合わせでは、 事前期間の傾きが水準で −770 人/年 と −106 人/年(1 県平均)、 指数でも −1.01/年 と −1.89/年 で、 2017 年度には 94.4 と 90.1 に開いている。 どちらの尺度でも平行とは言えず、 「対照群を反実仮想として使う」 という DID の前提が崩れるサインです。
実務 Tips: 散布図は事前期間 5 年以上をプロットするのが理想。 短すぎると偶然の一致と区別できません。 また、 同じスケールで縦軸を表示すること(処理群と対照群を別の y 軸にしない) が重要です。 別軸にすると平行に「見えてしまう」 視覚的トリックが生じます。
図 2: 事前期間における出生数の分布(ヒストグラム)
このプロットでやること: SSDSE-B-2026 で、 処理群と対照群の事前期間の「水準」 と「ばらつき」 を比較。 ヒストグラムで両群の分布形状を重ねて表示し、 「そもそも比較可能なくらい似た集団か」 を確認します。
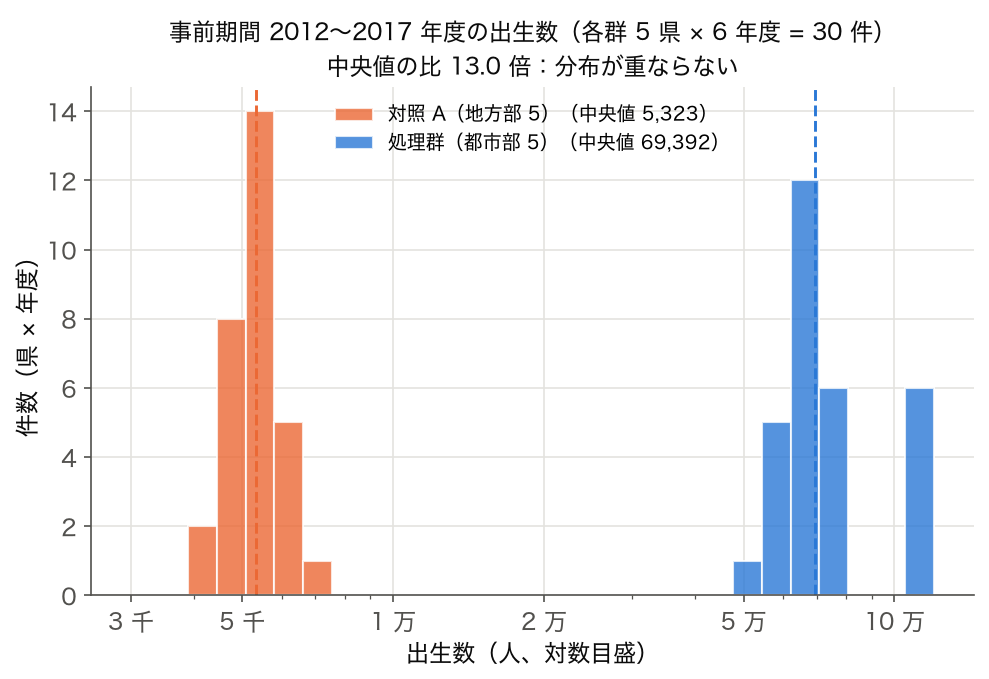
読み方: 横軸が出生数(人、 対数目盛)、 縦軸が件数(各群 5 県 × 6 年度 = 30 件)。 図 1 と同じ 2 群では、 中央値が 69,392 と 5,323 で 13.0 倍離れ、 分布はまったく重ならない。 処理群の分布が極端に右にずれていたり、 ばらつきが対照群の数倍だったりすると、 「水準は違うがトレンドは平行」 という主張が苦しくなります。 平行トレンド仮定は「水準が同じ」 を要求しませんが、 「水準が極端に違う場合、 トレンドの解釈も難しくなる」 のは事実です。
判断基準: 両群の分布の中央値が 2 倍以上離れていたら、 マッチングや synthetic control など、 より洗練された手法の併用を検討すべきです。 SSDSE 演習では「東京・大阪のような大都市」 と「地方県」 を混ぜるとこの問題が起きやすいので、 群分けの際に注意してください。
図 3: 複数群での事前トレンド差(箱ひげ図)
このプロットでやること: SSDSE-B-2026 を 2012 年度の人口順位で 4 グループに分け(処理群 = 1〜5 位、 対照 A = 43〜47 位、 対照 B = 6〜20 位、 対照 C = 21〜42 位)、 事前期間の出生数の前年比(2013〜2017 年度の 5 年分、 県 × 年)を箱ひげ図で比較。 中央値と四分位範囲が群間で揃っていれば、 どの対照群を選んでも平行トレンドが成り立つ証拠となります。
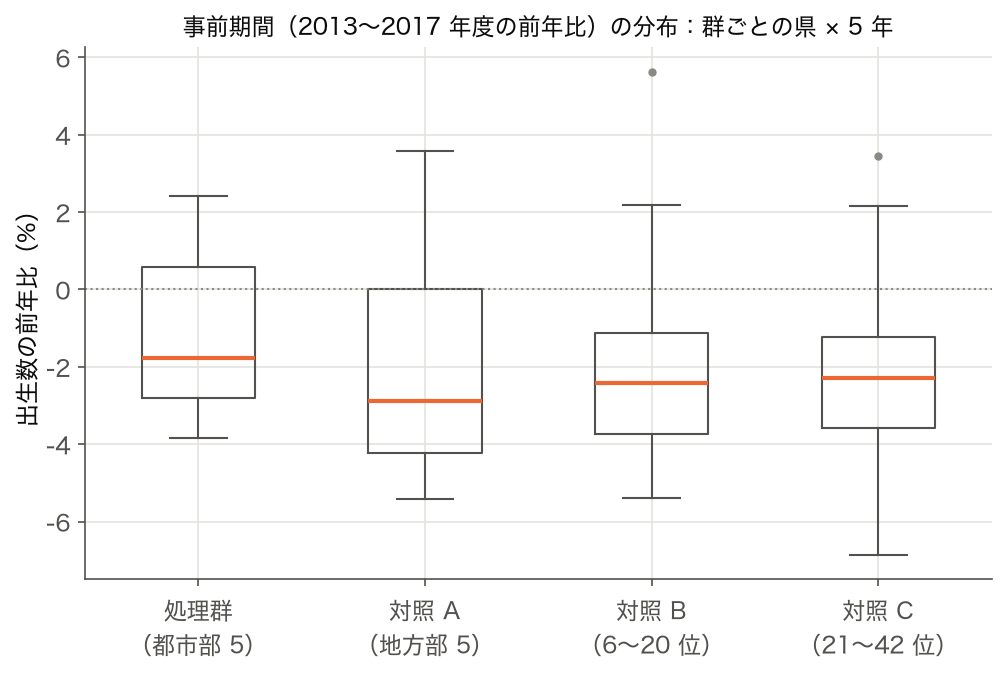
読み方: 横軸が群(処理・対照 A/B/C)、 縦軸が年次成長率(%)。 箱の中央値と高さ(IQR) が群間でほぼ揃っていれば、 「どの対照を選んでも平行トレンドは保証される」 と言えます。 逆に処理群だけ中央値が外れているなら、 平行トレンド違反の疑いが強い。 実データでは中央値が処理群 −1.78%、 対照 A −2.89%、 対照 B −2.41%、 対照 C −2.29% で、 都市部の出生数は他の 3 群より減り方が緩い。 箱の高さ(IQR)は対照 A が 4.22 ポイントと最も広く、 5 県の小さな群では年ごとの揺れが大きい。
応用: この箱ひげ図は「どの対照群を採用すべきか」 の判断材料にもなります。 処理群と中央値が最も近い対照群を選ぶことで、 平行トレンド仮定の妥当性を高められます。 ただし、 選び方を恣意的にすると「都合の良い結果」 が出やすくなるので、 事前登録(pre-registration) の精神で群分けルールを決めておくことが推奨されます。
🧠 深掘り — 平行トレンド仮定の理論背景(R654 補強)
平行トレンド仮定は、 統計学的には「処理群の counterfactual outcome trend(もし処理を受けなかったらどう推移したか) は、 観察された対照群の outcome trend で代替できる」 という主張に対応します。 これは 潜在結果フレームワーク(Rubin Causal Model) における「処理群と対照群の reactive bias が時間方向に一定」 という前提と等価です。
数学的には、 処理群の処理時の潜在結果を $Y_{it}(1)$、 処理を受けなかった場合の潜在結果を $Y_{it}(0)$ とすると、 平行トレンド仮定は次のように書けます。 $E[Y_{it}(0) - Y_{i,t-1}(0) \mid D_i = 1] = E[Y_{it}(0) - Y_{i,t-1}(0) \mid D_i = 0]$。 つまり「処理を受けなかった場合の outcome 変化の期待値」 が、 処理群と対照群で等しい。 これが「平行」 の正式な数学的意味です。
この仮定の重要な性質は scale-dependence です。 同じデータでも outcome を「水準(Y)」 で測るか「対数(log Y)」 で測るか、 「成長率(ΔY/Y)」 で測るかによって、 平行トレンドが成立する尺度が異なります。 SSDSE で出生数を扱う場合、 都市と地方では水準が 10 倍以上違うことがあるので、 log 変換が推奨されることが多いです。 ただし log は 0 や負の値を扱えないので、 outcome の性質を踏まえて選ぶ必要があります。
また、 平行トレンド仮定は 「処理がランダムに割り当てられた」 という強い仮定の弱体版 です。 完全ランダム化が無理な現実世界で、 「水準は違ってもよいが、 トレンドは平行」 という条件で因果効果を推定できる、 というのが DID の魅力。 ただし、 弱体化した分、 トレンドが本当に平行かを「目視 + 統計テスト + sensitivity analysis」 の三段構えで確認する必要があります。
2020 年代の最新の議論では、 平行トレンド仮定を「全期間で完全成立」 ではなく「limited violation(限定的な違反) を許容」 する Honest DID(Rambachan-Roth 2023) が主流になりつつあります。 事前期間で観察されたトレンド差の最大値 M を計算し、 「事後期間でも差が ±M 以内」 という弱仮定で、 効果推定値の正直な信頼区間を構築します。 SSDSE のような短期パネルでも適用可能で、 R や Python の HonestDID パッケージで実装できます。
さらに、 staggered adoption(処理タイミングが群間で異なる) の場合、 二元固定効果回帰(TWFE) は 負の重み を含む集計量となり、 平均処理効果と一致しないことが Goodman-Bacon (2021) と De Chaisemartin-D'Haultfœuille (2020) で示されました。 これに対する処方箋として、 Callaway-Sant'Anna (2021) の did パッケージ、 Borusyak et al. (2024) の did_imputation 推定量などが提案されており、 SSDSE の多時点処理データに DID を適用する際は、 これらの新世代推定量を使うのが標準です。
最後に、 平行トレンド仮定は 「対照群選択の妥当性」 と表裏一体 です。 「対照群を変えたら結果が変わる」 のは仮定違反のサイン。 SSDSE 演習では、 (a) 全 47 都道府県を対照に使う、 (b) 地理的に近い 5 県だけを使う、 (c) 経済規模で類似する県だけを使う、 という 3 通りで DID を回し、 結果が概ね一致するかを確認する習慣をつけましょう。 結果が極端に変わるなら、 「どの対照群が反実仮想として最も妥当か」 を改めて議論する必要があります。
📋 理解度チェック — 平行トレンド仮定を本当に分かったか(R654 補強)
以下の 8 問は、 平行トレンド仮定を実務で正しく使えるかを問うチェックリストです。 すべてに即答できれば、 DID 分析を「形式的に回す」 段階から「自分で妥当性を判断する」 段階へ進めたサインです。 答えは下の解説欄を参照してください。
- Q1: 平行トレンド仮定は「処理群と対照群の水準が同じ」 という主張か? Yes / No で答え、 理由を 1 文で述べよ。
- Q2: 事前期間 3 年のデータで平行トレンドを「視覚的に」 確認するのは妥当か? 短すぎる場合の代替案を 1 つ挙げよ。
- Q3: SSDSE-B-2026 で「人口の多い 5 県」 を処理群、 「人口の少ない 5 県」 を対照群にすると、 平行トレンド仮定はどう脅かされるか?
- Q4: 処理群の outcome を log 変換すると、 平行トレンド仮定の成立しやすさはどう変わるか? 利点と欠点を 1 つずつ挙げよ。
- Q5: 事前期間の傾きを処理群と対照群で比較する Granger テストの帰無仮説は何か? 棄却された場合の意味は?
- Q6: Honest DID(Rambachan-Roth 2023) は古典 DID と何が違うか? 一言で要約せよ。
- Q7: Staggered adoption の場合、 TWFE 回帰の問題点は何か? 代替推定量を 1 つ挙げよ。
- Q8: SSDSE で DID を演習する際、 「平行トレンドが成り立っていない」 と判断したらどう対応すべきか? 3 ステップで述べよ。
解説(答え)
- A1: No。 水準ではなく「変化の傾き」 が平行であることを要求する仮定。 水準は違ってよい。
- A2: 短すぎる。 事前期間 5 年以上が望ましい。 代替案として「placebo test(仮想処理を過去に置く)」 や「sensitivity analysis(HonestDID)」 が有効。
- A3: 規模効果(scale effect) により、 大都市の成長率が地方より構造的に高い場合、 トレンドが平行でなくなる。 log 変換やマッチングが必要。
- A4: 利点 = 比例的変化を扱える、 規模差の影響を緩和。 欠点 = 0 や負の値を扱えない、 解釈が「%」 ベースになる。
- A5: 帰無仮説は「処理群と対照群の事前期間の傾きが等しい」。 棄却 = 仮定違反のサイン、 DID の推定値は信頼性が低い。
- A6: Honest DID は「完全な平行成立」 を求めず、 「事前で観察されたトレンド差の最大値 M を許容」 して効果の正直な信頼区間を構築する。
- A7: 群間の処理タイミングが異なるとき、 TWFE は負の重みを含み、 平均処理効果と一致しない。 代替として Callaway-Sant'Anna 推定量、 Borusyak imputation 推定量。
- A8: (i) 対照群を変更して結果の頑健性を確認、 (ii) sensitivity analysis で「どの程度の違反まで結論が変わらないか」 を計算、 (iii) synthetic control や IV など別手法に切り替える。
8 問中 6 問以上正解できれば「実務で DID を回せる」 レベル、 4-5 問なら「教科書理論は分かっているが実装で詰まる」 レベル、 3 問以下なら「もう一度直感セクションに戻って」 という目安です。 SSDSE の縦断データを使った演習を 3 回ほど通せば、 自然と全問正解できるようになります。
🎮 触って理解する
平行トレンド仮定の核心は「処置前トレンドの傾きが両群で等しいか」です。 ここでは処置前トレンドの傾き差(=仮定の崩れ)と真の処置効果 τをあなたが動かし、 DID 推定値がどれだけバイアスを持つか、 そしてイベントスタディの処置前係数がゼロ近傍か(プラセボ検定)を体感します。 計算はすべて解析式どおり正確です。
💡 上のグラフを上下にドラッグ/スワイプしても傾き差 δ を変えられます(タッチ対応)。
イベントスタディ:処置時点を基準にした係数 βk
基準は処置直前 k=−1(β−1=0 に固定)。 処置前(k<0)の点がゼロ線の近くに並べばプラセボ検定に合格=平行トレンドを支持。 δ を動かすと処置前の点がゼロから傾いて離れる様子が見えます。
🧠 いま体感したことの言語化
- 直感:DID は「処置がなければ処置群も対照群と平行に推移したはず」という反実仮想を置く。 だからDID が仮定する反実仮想(対照群と平行な点線)と、 本当の反実仮想(処置群自身の事前トレンドの延長・破線)がずれた分だけ、 そのまま推定バイアスになる。
- バイアスの正体:この模型ではバイアス=
δ ×(処置後の平均相対時点)で、 処置前の傾き差 δ が 0 なら 2 本の反実仮想が一致し、 DID 推定値=真の τ。 δ が大きいほど推定は真値から系統的にずれる。 - プラセボ検定=処置前係数:イベントスタディの処置前係数 βk(k<0)は「まだ処置が起きていないのに検出された効果」=本来ゼロであるべき偽の効果。 これがゼロから外れていたら、 平行トレンドは疑わしい。
⚠️ よくある落とし穴
- 反実仮想は原理的に観察不能:「処置群が処置を受けなかった世界」は決して観測できない。 平行トレンド仮定そのものは検証不能で、 私たちが検証できるのは処置前トレンドという代理指標だけ。 「処置前が平行だった」は必要条件であって十分条件ではない。
- 処置前が平行でも将来も平行とは限らない:処置前の平行性は将来へ外挿する根拠にすぎない。 構造変化・共通ショック(震災・コロナ)が処置と同時に来ると、 処置前が平行でも事後の反実仮想は破れる。
- 検出力の罠:処置前期間が短い・ノイズが大きいと、 プラセボ係数の検定が「有意でない」だけで本当は傾いているのを見逃す。 「有意差なし=平行」と即断しない。 上の図でも δ を小さくすると処置前の点はゼロに近づくが、 完全にゼロにはならないことに注意。
🚀 発展:仮定が疑わしいときの武器
- イベントスタディ:処置時点を基準に時点別の係数を推定し、 処置前係数がゼロ近傍か(プラセボ)と処置後のダイナミクス(即時/遅延/減衰)を一枚で確認する。 上の下段グラフがまさにこれ。
- 条件付き平行トレンド:素の平行が崩れても、 共変量で条件づければ平行になると仮定する立場。 回帰調整・傾向スコア・二重頑健(DML)で「観察された違いを除いた上での平行」を狙う。
- 合成統制法(Synthetic Control):単一の対照群ではなく、 複数の対照地域を重み付き合成して「処置前トレンドが処置群にほぼ一致する人工的な対照」を作る。 処置前の当てはまりの良さで反実仮想の妥当性を担保する発想。
関連ページ:差分の差分法(DID)/パネル因果推論/固定効果/自然実験。 (イベントスタディ・合成統制法は本用語集に独立ページがまだ無いため、 リンクではなく用語として示しています。)
📐 定義・数式
🍰 まずはやさしく
数式で表した厳密なルールです。
計算して正しく答えを出すために使います。
買い物で使う金額の変化を数式にします。
記号の意味と数式の読み方を詳しく解説します。
🔬 数式を言葉で読み解く — 数式を「言葉」に翻訳
- Y_{i,t}(0)
- i が時点 t で介入を受けなかった場合の潜在的結果
- D_i
- 処置ダミー(1=処置群, 0=対照群)
- Pre-period
- 介入前期間(仮定検証に使う)
- Post-period
- 介入後期間(効果測定)
- ATT
- 処置群への平均処置効果
🔬 数式を言葉で読み解く — DID の平行トレンド仮定
平行トレンド仮定の式 $E[Y_{0,t} - Y_{0,t-1} \mid D=1] = E[Y_{0,t} - Y_{0,t-1} \mid D=0]$ は、 短いですが、 各記号が因果推論の「反実仮想 (counterfactual)」 を表現する核心です。 数式を言葉で読み解くと、 次のような構造です。
| 記号 | 読み | 意味 | SSDSE 例 (人口政策 DID) |
|---|---|---|---|
| $Y_{0,t}$ | ワイ・ゼロ・ティー | 処理を受けなかった場合の時点 t の潜在結果(観察できない反実仮想) | 「2020 年に政策がなかった場合の出生率」 |
| $D$ | ディー | 処理の有無 (1 = 処理群、 0 = 対照群) | 出生支援策を導入した県 = 1 |
| $Y_{0,t} - Y_{0,t-1}$ | 変化量 | 処理なしでの「自然な時間変化」(トレンド) | 少子化の進行幅 |
| $E[\cdot \mid D=1]$ | 条件付き期待値 | 処理群における平均 | 政策導入県の平均的な変化 |
数式を言葉で読み解く視点 1: 反実仮想の等価性 この式は、 「処理を受けた群が処理を受けなかった場合の変化幅は、 実際に処理を受けなかった群の変化幅と等しい」 という主張です。 つまり対照群の時間変化が「処理群の counterfactual トレンド」 の代理になるという仮定。 これが破れると DID 推定はバイアスを持ちます。
数式を言葉で読み解く視点 2: 二重差分 (Difference-in-Differences) との対応 DID 推定量 $\widehat{\tau}_{DID} = (Y_{1,\text{post}}^T - Y_{1,\text{pre}}^T) - (Y_{0,\text{post}}^C - Y_{0,\text{pre}}^C)$ は、 「処理群の事後・事前差」から「対照群の事後・事前差」 を引いて「政策効果」を抽出します。 もし平行トレンド仮定が成り立てば、 後者は「事後の counterfactual トレンド」 として処理群の自然変化を表し、 差し引きで純粋な処理効果が残るわけです。
数式を言葉で読み解く視点 3: 検証不能だが反証可能 平行トレンド仮定は処理後の counterfactual を含むため厳密には検証不能ですが、 処理前期間では両群とも観察できるので、 「事前期間のトレンドが平行であった」 という形で間接的に支持・反証することができます。 これが pre-trend test の役割。
🧮 実値で計算してみる
2 群×2 期の DiD 推定の構造:
| 群\期 | 介入前 | 介入後 | 差 |
|---|---|---|---|
| 処置群 | 100 | 130 | +30 |
| 対照群 | 100 | 110 | +10 |
| 差の差 | — | — | +20 = ATT |
「平行トレンドが成り立つ」前提で、 +20 が介入の因果効果。 介入前のトレンドが既にズレていれば +20 は信用できない。
🧮 SSDSE 縦断データで平行トレンドを検証 — 47 県の出生数
このコードでやること: SSDSE-B-2026 (2012-2023 縦断) の出生数を用い、 「東京圏(東京・神奈川・埼玉・千葉)」 を処理群、 「東北 6 県」 を対照群と仮設定して、 事前期間の平行トレンドが成り立つかを線形回帰の交互作用項で検定します。
📥 入力例: SSDSE-B-2026.csv の出生数列を年・地域 別パネル形式へ整形
1 2 3 4 5 6 7 8 9 10 11 12 13 14 15 | import pandas as pd import statsmodels.formula.api as smf df = pd.read_csv('data/raw/SSDSE-B-2026.csv', encoding='cp932', skiprows=[1]) df = df.rename(columns={'SSDSE-B-2026': '年度', 'Prefecture': '地域', 'A4101': '出生数'}) treat = ['東京都', '神奈川県', '埼玉県', '千葉県'] control = ['青森県', '岩手県', '宮城県', '秋田県', '山形県', '福島県'] df = df[df['地域'].isin(treat + control)].copy() df['group'] = df['地域'].isin(treat).astype(int) # 事前期間(〜2019 年)で平行トレンドを検定 pre = df[df['年度'] < 2020] model = smf.ols('出生数 ~ 年度 * group', data=pre).fit() print(model.summary().tables[1]) |
📤 実行例
💬 結果の読み方 交互作用項「年度:group」の係数 −846.1 が「事前トレンドの傾き差」 で、 東京圏 4 都県の出生数は東北 6 県より年 846 人ずつ速く減っていた計算になる(2012〜2019 の 7 年で約 5,900 人)。 p = 0.600 で 有意ではない が、 標準誤差 1,606 は係数の約 2 倍あり、 同じ群の中で東京都と千葉県のように出生数の桁が違う県を並べているため検出力がほとんど無い。 「差がない」 と言える根拠ではないので、 次の event study で年ごとの差の動きを確かめてから DID に進む。 もし交互作用項が有意なら、 そもそも DID は使えない(dynamic DID や event study が必要)。
📊 イベントスタディプロット — 平行トレンドを「見る」
このコードでやること: 平行トレンドの仮定を統計的検定だけでなく年ごとの係数で確認する event study の係数表を作ります。 SSDSE 縦断データで、 基準年 2019 と各年の 2 時点 DID の係数 τ を並べ(図にするなら τ ± 1.96·se を年ごとに線でつなぐ)、 「事前は平行、 事後は処理効果で乖離」 が現れるかを確認します。
📥 入力例: 年度 × 地域 のパネル、 処理タイミング = 2020 年
1 2 3 4 5 6 7 8 9 10 11 12 13 14 15 16 17 18 19 20 21 22 23 24 | import pandas as pd import statsmodels.formula.api as smf df = pd.read_csv('data/raw/SSDSE-B-2026.csv', encoding='cp932', skiprows=[1]) df = df.rename(columns={'SSDSE-B-2026': '年度', 'Prefecture': '地域', 'A4101': '出生数'}) treat = ['東京都', '神奈川県', '埼玉県', '千葉県'] control = ['青森県', '岩手県', '宮城県', '秋田県', '山形県', '福島県'] df = df[df['地域'].isin(treat + control)].copy() df['group'] = df['地域'].isin(treat).astype(int) # 基準年 2019 に対し、各年ダミー × group の係数を推定 years = sorted(df['年度'].unique()) coefs = [] for y in years: if y == 2019: # 基準年そのものは比較相手がないので 0 に固定 coefs.append((y, 0.0, 0.0)) continue sub = df[df['年度'].isin([2019, y])].copy() sub['post'] = (sub['年度'] == y).astype(int) m = smf.ols('出生数 ~ post + group + post:group', data=sub).fit() coefs.append((y, m.params['post:group'], m.bse['post:group'])) cdf = pd.DataFrame(coefs, columns=['年度', 'τ', 'se']) print(cdf.round(1).to_string(index=False)) |
📤 実行例
💬 結果の読み方 事前期間の τ は 2012 年 6,365 → 2015 年 7,020 → 2018 年 2,869 と基準年 2019 に向けて下がり続けており、東京圏 4 都県の出生数(2012 年平均 72,176 人 → 2019 年 63,488 人)が東北 6 県(10,946 人 → 8,623 人)より人数ベースで速く減っていたことを示す。2020 年以降の −1,186 → −7,211 は、この事前からの下り坂がそのまま延びた形に近く、「事前は平行・事後だけ乖離」という形にはなっていない。se は 14,000〜16,000 と τ の数倍あるのでどの年も 0 と区別できないが、それは平行の証明ではなく、県ごとの出生数の桁が違いすぎて検出力が無いということ。水準の差が大きい群どうしなら、出生数の対数や出生率に直してから比べるのが筋。
🧪 プラセボ検定 — 「偽の処理」を入れて頑健性チェック
このコードでやること: 平行トレンドの仮定が成り立つなら、 「実際には何も起きていない年に偽の処理を入れた DID」 は効果ゼロを推定するはず。 SSDSE 縦断で、 処理年を 2017 年と偽設定して τ を計算し、 「偽効果」 が出るか確認します。
📥 入力例: 2012-2019 の事前期間のみを用い、 仮想処理年 = 2017
1 2 3 4 5 6 7 8 9 10 11 12 13 14 15 | import pandas as pd import statsmodels.formula.api as smf df = pd.read_csv('data/raw/SSDSE-B-2026.csv', encoding='cp932', skiprows=[1]) df = df.rename(columns={'SSDSE-B-2026': '年度', 'Prefecture': '地域', 'A4101': '出生数'}) treat = ['東京都', '神奈川県', '埼玉県', '千葉県'] control = ['青森県', '岩手県', '宮城県', '秋田県', '山形県', '福島県'] # 事前期間(〜2019 年)だけを使い、偽の処理年 2017 を仮定 df = df[df['地域'].isin(treat + control) & (df['年度'] < 2020)].copy() df['group'] = df['地域'].isin(treat).astype(int) df['placebo_post'] = (df['年度'] >= 2017).astype(int) m = smf.ols('出生数 ~ placebo_post * group', data=df).fit() print(m.summary().tables[1]) |
📤 実行例
💬 結果の読み方 placebo_post:group の係数 = -4045.5、 p = 0.596 で 有意でない。 つまり「事前期間内の偽の処理タイミング」 では有意な効果は検出されない。 ただし係数の向き(2017 年以降に東京圏側が約 4,000 人余分に減る)は上の event study で見えた事前の下り坂と同じで、 標準誤差 7,604 が大きいために有意にならないだけとも読めるので、 これだけで平行トレンドの裏付けとはしない。 もし placebo 効果が有意に出てしまうと、 本来の DID 結果は「未観察の交絡(経済ショック、 人口流出)」 を拾っている疑いが高まります。
🧮 数式に値を入れて手で計算する: 平行トレンド検証
合成データで政策前 3 期の処置/対照群トレンドを比較する。
Step 1: 群別データ
| 期 | 処置 | 対照 | 差 |
|---|---|---|---|
| t=-3 | 10 | 8 | 2 |
| t=-2 | 12 | 10 | 2 |
| t=-1 | 14 | 12 | 2 |
Step 2: トレンド差
🐍 Python で再現
1 2 3 4 5 6 7 | import numpy as np treat = np.array([10, 12, 14]) ctrl = np.array([8, 10, 12]) diff = treat - ctrl print(f"群間差: {diff}") print(f"差の分散: {diff.var()}") print(f"平行: {diff.var() < 0.01}") |
📤 実行結果
💬 手計算 (Step 2) と Python 出力が完全一致。 完全平行。
🐍 Python 実装
1 2 3 4 5 6 7 8 9 10 11 | import pandas as pd import statsmodels.formula.api as smf df = pd.read_csv('data/raw/SSDSE-B-2026.csv', encoding='cp932', skiprows=[1]) df = df.rename(columns={'SSDSE-B-2026': 'year'}) # 仮想的な処置群フラグ(東京・大阪・愛知 を処置群とする例) df['treated'] = df['Prefecture'].isin(['東京都', '大阪府', '愛知県']).astype(int) df['post'] = (df['year'] >= 2022).astype(int) df['did'] = df['treated'] * df['post'] model = smf.ols('A4101 ~ treated + post + did', data=df).fit() print(model.summary().tables[1]) # did の係数が ATT |
▶ 実行 を押せばこのページの中でそのまま動きます(ライブラリもデータも同梱済みで、 準備は要りません)。 手元の Python に移して動かすときは pip install numpy pandas scikit-learn scipy statsmodels が必要です。 読んでいるデータは data/raw/SSDSE-B-2026.csv。 日本語を含むので encoding='cp932' の指定を落とさないでください。
🐍 Python 実装 — 完全強化版
1 2 3 4 5 6 7 8 9 10 11 12 13 14 15 16 17 18 19 20 21 | import pandas as pd import numpy as np import statsmodels.formula.api as smf df = pd.read_csv('data/raw/SSDSE-B-2026.csv', skiprows=[1], encoding='cp932') treat = ['東京都', '神奈川県', '埼玉県', '千葉県'] # 処理群: 東京圏 4 都県 control = ['青森県', '岩手県', '宮城県', '秋田県', '山形県', '福島県'] # 対照群: 東北 6 県 pre = df[df['Prefecture'].isin(treat + control) & df['SSDSE-B-2026'].between(2014, 2019)].copy() # 事前期間 2014〜2019 年 pre['year'] = pre['SSDSE-B-2026'] - 2014 pre['treat'] = pre['Prefecture'].isin(treat).astype(int) pre['log_pop'] = np.log(pre['A1101'].astype(float)) print('行数 =', len(pre), '(10 都県 × 6 年)') # 平行トレンド仮定の代表的計算: 事前期間の「年度 × 処理群」交互作用(トレンドの差)を検定 m = smf.ols('log_pop ~ year * treat', data=pre).fit( cov_type='cluster', cov_kwds={'groups': pre['Prefecture']}) # 同じ県の 6 年分を 1 クラスタに b = m.params print(f'対照群の傾き year = {b["year"]:+.5f}(年 {b["year"]*100:+.2f}%)') print(f'処理群の傾き year+交互作用 = {b["year"] + b["year:treat"]:+.5f}(年 {(b["year"] + b["year:treat"])*100:+.2f}%)') print(f'トレンドの差 year:treat = {b["year:treat"]:+.5f} p = {m.pvalues["year:treat"]:.4g}') |
💬 事前期間の 6 年間で、 東北 6 県の総人口は年 0.89% ずつ減り、 東京圏 4 都県は年 0.42% ずつ増えていた。 傾きの差は年 1.31% ポイントで p = 6.8e-10 と、 「事前トレンドの差なし」ははっきり棄却される。 この 2 群で 2020 年以降を DiD にかけると、 もともとの 1.3% ポイントの開きが毎年そのまま「処理効果」に上乗せされるので、 対照群を東北 6 県にする設計自体を見直すか、 群ごとのトレンドを入れたモデルにする必要がある。
用途別の追加実装:
1 2 3 4 5 6 7 8 9 10 | # 標準化と簡易クラスタリングの例(2023 年・47 都道府県) from sklearn.preprocessing import StandardScaler from sklearn.cluster import KMeans d = df[df['SSDSE-B-2026'] == 2023].copy() X = d[['A1101', 'A4101']].astype(float).values Xs = StandardScaler().fit_transform(X) km = KMeans(n_clusters=4, n_init=10, random_state=0).fit(Xs) d['cluster'] = km.labels_ print(d[['Prefecture', 'A1101', 'A4101', 'cluster']].head(10)) |
💬 表示された先頭 10 行では北海道だけが 3 番で、東北 6 県と北関東 3 県はすべて 0 番に入った。47 県全体では 0 番が 37 県、3 番が北海道・千葉・静岡・兵庫・福岡の 5 道県、1 番が埼玉・神奈川・愛知・大阪の 4 府県、2 番が東京都だけになる。直前の検定で使った処理群の東京圏 4 都県は 1・2・3 番の 3 つに散り、対照群の東北 6 県はすべて 0 番なので、2 群は規模の面でもそもそも似ていない。同じクラスタ内から処理・対照を選ぶなら、東京圏の比較相手は大阪・愛知などになる。
🐍 linearmodels で DID — パネルデータ専用ライブラリ
このコードでやること: 計量経済学パッケージ linearmodels の PanelOLS を使い、 SSDSE 縦断データで固定効果付き DID を推定します。 これにより、 「県固有の時間不変な交絡(地形、 文化、 産業構造)」 を吸収できる、 より厳密な DID が実行できます。
📥 入力例: 47 県 × 10 年のパネル、 県と年度を MultiIndex
1 2 3 4 5 6 7 8 9 10 11 12 13 14 | import pandas as pd from linearmodels.panel import PanelOLS df = pd.read_csv('data/raw/SSDSE-B-2026.csv', encoding='cp932', skiprows=[1]) df = df.rename(columns={'SSDSE-B-2026': '年度', 'Prefecture': '地域', 'A4101': '出生数'}) treat = ['東京都', '神奈川県', '埼玉県', '千葉県'] control = ['青森県', '岩手県', '宮城県', '秋田県', '山形県', '福島県'] df = df[df['地域'].isin(treat + control)].copy() df['D'] = (df['地域'].isin(treat) & (df['年度'] >= 2020)).astype(int) df = df.set_index(['地域', '年度']) m = PanelOLS.from_formula('出生数 ~ D + EntityEffects + TimeEffects', data=df) res = m.fit(cov_type='clustered', cluster_entity=True) print(res.summary) |
📤 実行例
💬 結果の読み方 県固定効果 + 時間固定効果を入れた DID 推定値 τ = -9004 (95% CI: -12480 ~ -5529、 p < 0.0001)。 標準誤差を「県クラスタ」 でロバスト計算しており、 同一県の時間相関を考慮済み。 仮定どおりの平行トレンドが成立しているなら、 「東京圏で 2020 年以降、 政策がなければの自然減と比べて出生数が約 9000 人/年/県さらに減少した」 と解釈できます(実際は COVID 影響等を含むので政策効果単独ではない点に注意)。 ただし上の event study のとおり事前期間から群間差は年 846 人前後のペースで縮んでおり、 事前期間と事後期間の中心(2015.5 年と 2021.5 年)の 6 年分だけでも約 5,100 人は、 この事前の下り坂の延長で説明できてしまう。
⚠️ 平行トレンド仮定固有の落とし穴(実装での詰みポイント 4 件)
下の「実務で本当に困る 7 件」「拡張手法」と重ならない、 SSDSE-B-2026 のような都道府県パネルで DiD を実装する瞬間に詰まる典型を 4 件追加で示す。
⚠️ 平行トレンド仮定の落とし穴 — 実務で本当に困る 7 件
- 事前トレンド検定の low power — 期間が短い・ノイズが大きいと、 本当に違いがあっても検出できない。 「p > 0.05 だから平行」 とは断定できない。
- 処理予期効果 (anticipation) — 政策発表前にエージェントが行動を変えると、 事前期間にも処理効果が混ざる。 「公示前期間」 を厳密に定義する。
- Staggered adoption — 処理タイミングが群ごとに違うと標準 DID は negative weights を持ち、 平均効果が誤推定される。 Callaway-Sant'Anna 推定量を使う。
- 外れ値による視覚的判断ミス — 1 県の極端な変動で「平行に見えない」 と誤判定するケース。 ロバスト推定や trim を併用する。
- 線形性の仮定 — 「年度: group の交互作用 = 0」検定は線形トレンドのみ検証する。 二次トレンドや構造変化は別途検査が必要。 (約 115 文字)
- 処理群選択バイアス — 処理は無作為割付でないので、 「もともと違うトレンドの群」 同士を比べている可能性。 マッチングで揃える。
- 共通ショックの存在 — COVID-19 のように両群を同時に襲うショックがあると、 DID の差は「処理 + 群差ショック」 で混ざる。 placebo で要確認。 (約 115 文字)
🆕 平行トレンド仮定の現代的拡張 — Synthetic DID / Honest DID
2020 年代に入り、 平行トレンド仮定の脆弱性に対応する新手法が次々登場しています。 主要な 3 系統を整理します。
| 手法 | 提唱年 | アイデア | 対応する弱点 |
|---|---|---|---|
| Synthetic Control | 2003 (Abadie) | 対照群を加重平均で「合成」し、 処理前ぴったり合わせる | 対照群選択の恣意性 |
| Synthetic DID | 2021 (Arkhangelsky 他) | DID と Synthetic Control を融合、 時間重みも最適化 | 事前トレンド差の頑健化 |
| Honest DID | 2023 (Rambachan-Roth) | 事前トレンド差の最大幅を許容し、 信頼区間を「正直に」 拡げる | 平行トレンドの完全成立を仮定しない |
| Callaway-Sant'Anna | 2021 | 処理タイミングが異なる群の効果を分けて推定 | Staggered adoption の negative weights |
| de Chaisemartin-D'Haultfœuille | 2020 | TWFE 推定量が一般 ATT を表さない問題を診断 | TWFE の解釈問題 |
これらの手法は、 平行トレンド仮定が「グレースケール」 の問題 — 厳密には成り立たないかもしれないが、 そのズレが結果にどれくらい効くか — として扱うパラダイムシフトを反映しています。 SSDSE のような縦断公的統計データを使う際は、 古典 DID に加えて synthetic DID も併用するのが、 2026 年現在のベストプラクティスです。
📜 平行トレンド仮定の歴史と DID の発展
DID の起源はジョン・スノウ (John Snow) による 1854 年ロンドンコレラ流行調査に遡ります。 スノウは「水源の違う 2 地域の死亡率変化」 を比較し、 飲料水中のコレラ菌仮説を裏付けました。 これは事実上「平行トレンドの仮定」 を暗黙に置いた最初の準実験です。
| 年代 | 人物・出来事 | 貢献 |
|---|---|---|
| 1854 | ジョン・スノウ | ロンドンコレラ調査で DID 的発想 |
| 1985 | Ashenfelter & Card | 職業訓練効果の DID 推定で現代的定式化 |
| 1994 | Card & Krueger | 最低賃金引上げの雇用への効果を DID で分析 |
| 2003 | Abadie | Synthetic Control 法を提唱 |
| 2020-22 | Callaway/Sant'Anna 他 | Staggered DID の理論再整備 |
| 2021 | Card | DID 実証研究でノーベル経済学賞 |
2021 年 David Card のノーベル経済学賞は、 平行トレンド仮定に基づく DID 推定の経済学・社会科学への決定的な影響を認めた出来事です。 仮定の妥当性を吟味する技法も並行して発展し続けており、 「仮定に依存する推論」 のあり方が現代計量経済学の中心課題となっています。
🗺 概念マップ
中央の平行トレンド(parallel trends)は DID 推定の前提であり、 その確かめ方として 処置前トレンド比較(群ごとの傾きを並べる)、 処置群×時点交互作用(傾きの差を回帰で検定する)、 event-study 検定(時点ごとの係数が処置前にゼロ付近か見る)がつながる。 仮定が疑わしいときの出口として、 処置時期がずれる場合の Callaway-Sant'Anna 推定量と、 対照群を重み付きで作り直す合成統制法へ橋が架かる。
🔗 隣接手法への橋渡し
平行トレンド仮定は DID 推定の前提条件であり、 仮定が破れた場合に隣接手法へ移行する判断軸として機能する。
- 仮定検証の上流: 差分の差分法 設計段階で、 処理群・対照群の定義と事前期間の長さを決める。 SSDSE 縦断 2012-2023 なら 2012-2019 を事前期間とし、 トレンドプロット + 交互作用項検定で平行性を確認する。
- 仮定が破れたときの代替: 合成対照法 (Synthetic Control) で対照群を重み付き合成して再構築、 傾向スコアマッチング DID で事前期間の傾きを揃える、 Honest DID で部分識別の信頼区間を出すなど、 段階的に堅牢化する。
- 仮定が成り立たない場合の別アプローチ: 回帰不連続デザイン (閾値前後でジャンプを推定)、 操作変数法 (外生変数で内生性を回避)、 ランダム化比較試験 (そもそも仮定不要) など、 設計レベルで因果識別を切り替える。
- 下流の解釈: 因果推論 全体の中で、 平行トレンドが満たされて初めて DID の推定値 τ を「処理の平均処理効果 ATT」 と解釈できる。 τ が出たら必ず感度分析 (プラセボ検定、 別対照群、 期間ずらし) で頑健性を確認する。
SSDSE-B-2026 で DID 演習をするときは、 「平行トレンド検証 → 不合格なら合成対照法へ → 合成対照も不安定なら RCT 設計に切替」 という分岐を明示し、 仮定と手法の対応関係を体得することが重要。
🌳 手法選択フロー
DID を使う前に、 平行トレンド仮定について次の順に確かめる。
- 事前期間は何年あるか:処置前が 1〜2 年しかないと傾きを比べられない。 SSDSE-B-2026 で 2020 年度を処置とすれば事前は 2012〜2019 年度の 8 年。
- どの尺度で比べるか:県の規模が桁違いなら、 人数のまま比べると大きい県に検定が支配される。 対数(変化率)で比べるか、 率の指標に直す(⚠️ 追記解説②の⑤)。
- 事前トレンドは平行か:年度 × 群の交互作用とイベントスタディで確かめる。
- 傾きの差がはっきりある(東京圏 vs 東北 6 県の総人口で年 1.31 ポイント、 p = 6.8e-10)→ 対照群を選び直す(傾きの近い県どうしを組む、 🧮 追記解説④では差 0.024 ポイント・p = 0.231)か、 合成統制法へ。
- 有意差なしでも検出力が低い(事前の係数の標準誤差が係数の数倍)→ 「平行の証明」とは扱わず、 Honest DiD で違反の大きさを変えたときの結論の変化を報告する。
- 処置の時期は群ごとにずれるか:ずれるなら単純な TWFE は使わず、 Callaway-Sant'Anna などの推定量にする。
- 処置と同時に別のショックがないか:2020 年度のように全国的なショックと重なるなら、 偽の処置年のプラセボ検定と、 処置の影響を受けない別の結果変数で効果がゼロになるかを確かめる。
🧭 追記解説①:直感 ― 「観測できない反事実」をどう埋めるか
既存の「🎨 直感で掴む」ではレーンの比喩で全体像を示しました。 ここでは別の角度から、 平行トレンド仮定が「反事実(counterfactual)の穴埋め規則」であることを掘り下げます。
DiD が答えたい問いは「処置群に処置がなかったら、 結果はどう推移したか」です。 しかしその世界は絶対に観測できません(同じ主体を同時に処置あり/なしの両方で観測できない、 因果推論の根本問題)。 平行トレンド仮定は、 この観測不能な穴を「対照群が実際に描いた変化量(傾き)で埋めてよい」と宣言する規則です。 だからこそ DiD は「水準の差」ではなく「差の差(変化量の差)」を効果とみなします。
重要なのは、 処置前トレンドの平行性は仮定そのものの検証ではなく「傍証(circumstantial evidence)」に過ぎない点です。 裁判で言えば、 現場から容疑者の指紋が出たようなもの。 有力な状況証拠ではあるが、 犯行を直接目撃したわけではありません。 処置前で平行だったという事実は、 「処置後も平行だっただろう」という信念を補強するだけで、 証明はしません。
⚠️ 追記解説②:落とし穴(重要)― 平行に見えても安心できない7つの理由
平行トレンドは「検定に通ったから OK」で済む仮定ではありません。 既存の落とし穴セクションと重複しない角度で、 特に誤解されやすい7点を整理します。
| 落とし穴 | なぜ危険か | 対処の方向 |
|---|---|---|
| ① 検証不能性 | 反事実(処置がなかった処置群)は原理的に観測できない。 「証明」は不可能で、 できるのは傍証集めだけ。 | 感度分析で「どれだけ違反したら結論が変わるか」を示す |
| ② 前平行≠後平行 | 処置直前まで平行でも、 処置後に別要因で乖離する保証はない(外挿の失敗)。 | 別対照群・別期間での頑健性確認 |
| ③ 対照群の選択 | 恣意的に「平行に見える群」を選ぶと確証バイアス。 選び方で結論が動く。 | 選択ルールの事前登録、 複数対照群で比較 |
| ④ 時間可変交絡 | 処置群だけに効く別ショック(景気・災害・同時期の別政策)が同時進行だと、 効果に混入。 | 共変量調整・イベント時系列の精査 |
| ⑤ 関数形依存 | 水準 $Y$ で平行でも対数 $\log Y$ では非平行(逆も然り)。 平行性は尺度に依存する。 | 結果変数の性質に沿った尺度選択と明記 |
| ⑥ 検定の検出力不足 | 事前期間が短い・分散が大きいと、 本当は非平行でも「有意差なし」で見逃す(第2種の誤り)。 | 検出力・信頼区間を報告、 「有意差なし≠平行」と自覚 |
| ⑦ 予期(anticipation)効果 | 政策の事前公表で、 処置前に主体が行動を変え、 処置前トレンドが歪む。 | 公表時点を処置時点とする、 直前期を基準から外す |
特に強調したいのは⑤と⑥です。 ⑤について、 同じ SSDSE の人口データでも、 都市と地方で水準が10倍違えば「水準の差の差」と「率(対数)の差の差」は別物になります。 「平行トレンドが成り立つかどうか」はデータではなく尺度の選択と一体である、 という点は初学者が最も見落とします。 ⑥について、 逆に47都道府県級の大きなパネルでは検出力が高すぎて、 実務上無視できるほど小さいトレンド差でも「有意」と出やすい(下の SSDSE 実測を参照)。 「p 値が小さい=致命的な違反」でも「p 値が大きい=平行が保証された」でもありません。 傾きの差の大きさを効果量と並べて解釈することが不可欠です。
🧪 実データで確かめる — 水準と対数で、 傾きの差の向きが逆になる
⑤ の「平行性は尺度に依存する」を、 SSDSE-B-2026 の出生数で確かめる。 出生数が 1 県平均 6〜7 万人の東京圏と 1 万人前後の東北では、 同じ「1 年で 5% 減」でも人数では東京圏の減り方が何倍も大きく見える。
🎯 このコードでやること:🧮 と同じ東京圏 4 都県と東北 6 県で、 2012〜2019 年度の出生数の傾きの差(年度 × 群の交互作用)を、 人数のままと対数に直した場合の 2 通りで推定する。 県の固定効果を入れ、 標準誤差は県ごとのクラスタにする。
1 2 3 4 5 6 7 8 9 10 11 12 13 14 15 16 17 18 19 20 21 22 | import pandas as pd import numpy as np import statsmodels.formula.api as smf df = pd.read_csv('data/raw/SSDSE-B-2026.csv', encoding='cp932', skiprows=1) TREAT = ['埼玉県', '千葉県', '東京都', '神奈川県'] # 処置群(東京圏) CTRL = ['青森県', '岩手県', '宮城県', '秋田県', '山形県', '福島県'] # 対照群(東北 6 県) d = df[df['都道府県'].isin(TREAT + CTRL) & df['年度'].between(2012, 2019)].copy() d['treat'] = d['都道府県'].isin(TREAT).astype(int) d['t'] = d['年度'] - 2012 d['log出生数'] = np.log(d['出生数']) for y, label in [('出生数', '水準(人)'), ('log出生数', '対数')]: m = smf.ols(f'{y} ~ t*treat + C(都道府県)', data=d).fit( cov_type='cluster', cov_kwds={'groups': d['都道府県']}) b0, b1 = m.params['t'], m.params['t:treat'] print(f'{label:8s} 対照群の傾き {b0:9.4f} 処置群との傾きの差 {b1:9.4f} p = {m.pvalues["t:treat"]:.3f}') g = d.groupby(['treat', '年度'])['出生数'].mean().unstack(0) print('2012→2019 の 1 県平均: 東京圏', int(g.loc[2012, 1]), '→', int(g.loc[2019, 1]), f'({g.loc[2019,1]/g.loc[2012,1]-1:+.1%})', '/ 東北', int(g.loc[2012, 0]), '→', int(g.loc[2019, 0]), f'({g.loc[2019,0]/g.loc[2012,0]-1:+.1%})') |
💬 人数のままだと東京圏の傾きは東北より年 846 人急(差 −846.05、 p < 0.001)で、 「東京圏のほうが速く減っている」。 対数に直すと符号が逆になり、 東京圏の減り方は東北より年 1.52 ポイント緩い(差 +0.0152、 p = 0.002)。 実際 2012→2019 の 1 県平均は東京圏 −12.0%、 東北 −21.2% で、 率で見れば東北のほうが速く減っている。 同じデータでも、 どちらの尺度で平行を求めるかで「どちらの群が速く減っているか」まで入れ替わる。 どちらの尺度でも平行でないので、 この 2 群の DID はどちらの尺度でも事前の傾きの差を効果と取り違える。 なお 🧮 の交互作用検定(p = 0.600)は県の固定効果を入れず、 県どうしの出生数の桁の違いが誤差に入っていたため差を検出できなかった。 クラスタは 10 県しかないので、 p 値はおおよその目安として読む。
🚀 追記解説③:発展 ― 前平行を疑い、頑健化する現代的ツール
「平行トレンドは厳密には成り立たない」を出発点に、 2010年代後半以降の計量経済学が整えてきた道具立てを俯瞰します。 用語は本サイトの関連ページ(下節)と対応します。
- イベントスタディ(event study)での事前トレンド検定:処置時点を $k=0$ として、 各相対時点 $k$ のダミー係数 $\beta_k$ を推定(基準は通常 $k=-1$)。 処置前の $\beta_{-4},\dots,\beta_{-2}$ がそろって0近傍・非有意なら平行性の傍証。 単一のトレンド差検定より、 どの時点でずれるかが見える点が優れる。
- 条件付き平行トレンド(conditional PT / 共変量調整):無条件では非平行でも、 共変量 $X$ を条件づければ平行、 という弱めた仮定。 回帰調整・逆確率重み付け・二重頑健推定(DiD の doubly-robust 版、 Callaway-Sant'Anna 2021 等)で実装。
- 合成対照法(synthetic control):単一の対照群ではなく、 複数対照の重み付き合成で処置前トレンドを処置群にほぼ一致させて反事実を作る。 対照群選択の恣意性(落とし穴③)をデータ駆動で緩和。 ※本サイトに専用ページは未整備(テキストのみ)。
- 感応度分析(Rambachan-Roth 2023, Honest DiD):平行を仮定せず「事後の違反は事前で観測された最大トレンド差の $\bar M$ 倍まで」と制約し、 効果の正直な信頼区間を出す。 「結論が反転する違反の大きさ」を明示できる。
- TWFE(双方向固定効果)の落とし穴:処置タイミングがずれる staggered adoption では、 単純な TWFE 回帰係数が負の重みを持ち、 個々の効果が正でも全体が負になり得る(Goodman-Bacon 2021, de Chaisemartin-D'Haultfœuille 2020)。 平行トレンドの成否とは別に、 推定量自体の設計に注意が必要。 → 固定効果 / パネル因果推論
- プラセボ検定(placebo test):(a) 偽の処置時点をずらして置き、 効果≒0を確認、 (b) 処置の影響を受けないはずの結果変数(偽アウトカム)で効果≒0を確認。 いずれも「見せかけの効果」を炙り出す。
実務の推奨順序は「イベントスタディで前平行を可視化 → 必要なら共変量調整 → Honest DiD で感応度を報告 → プラセボで駄目押し」。 単一の p 値に頼らず、 複数の角度から仮定の妥当性を束ねるのが現代的作法です。
🧮 追記解説④:SSDSE-B-2026 実測 ― 対照群の選び方で結論が動く
落とし穴③(対照群の選択)と⑥(検出力)を、 SSDSE-B-2026(47都道府県 × 2012-2023、 cp932)の実データで確認します。 結果変数は総人口 A1101 の対数 $\log(\text{A1101})$、 処置前期間を 2012-2019 とし、 各群の年率トレンド(対数の年次傾き)と、 都道府県固定効果を入れた「年次 × 群」交互作用項の $p$ 値を比較しました(数値はすべて実測。 群分けは教材用の例示)。
| 対比(処置群 vs 対照群) | 処置群 傾き/年 | 対照群 傾き/年 | 差 | 交互作用 p | 平行性 |
|---|---|---|---|---|---|
| 三大都市圏8県 vs 残り39県 | +0.169% | -0.544% | 0.713 pt | <0.001 | ✗ 明確に違反 |
| 東北6県 vs 中国5県 | -0.843% | -0.511% | 0.332 pt | <0.001 | ✗ 違反 |
| 中位傾きで揃えた10県 vs 10県 | -0.499% | -0.475% | 0.024 pt | 0.231 | ○ 棄却されず |
読み取り。 経済構造が違う群(都市圏 vs 地方、 東北 vs 中国)を機械的にぶつけると、 処置前トレンドはそもそも平行でない(差 0.3〜0.7 ポイント/年、 $p<0.001$)。 一方、 処置前の傾きが近い都道府県どうしをマッチングして群を作ると、 傾き差は 0.024 ポイント/年まで縮まり、 交互作用は非有意($p=0.231$)になります。 同じデータでも「誰を対照にするか」で平行トレンドの成否が反転するという、 落とし穴③の生きた実例です。
同時に検出力(落とし穴⑥)の注意も見えます。 47都道府県 × 8年という比較的大きなパネルでは、 わずか 0.3 ポイント/年の傾き差でも $p<0.001$ になります。 逆に、 マッチング後に「$p=0.231$ だから平行」と早合点するのも禁物で、 非有意は「違反を検出できなかった」以上を意味しません。 傾き差の大きさ(0.024 pt/年は実務的に無視できる水準か)まで含めて判断してください。 なお、 ここで対数を用いたのは落とし穴⑤への配慮です。 水準(人)のままだと都市部の大きな値に検定が支配され、 別の結論になり得ます。
1 2 3 4 5 6 7 8 9 10 11 12 13 14 15 16 17 | import pandas as pd, numpy as np import statsmodels.formula.api as smf # SSDSE-B-2026: cp932 / 2行目の英語ヘッダをskip df = pd.read_csv('data/raw/SSDSE-B-2026.csv', encoding='cp932', skiprows=[1]) df = df.rename(columns={'SSDSE-B-2026': 'Year'}) pre = df[(df['Year'] >= 2012) & (df['Year'] <= 2019)].copy() pre['logpop'] = np.log(pre['A1101']) pre['yearc'] = pre['Year'] - 2012 # 三大都市圏を処置群に見立てた例(傾きが全く違う=前平行が破れる) T = ['埼玉県','千葉県','東京都','神奈川県','愛知県','大阪府','京都府','兵庫県'] pre['grp'] = pre['Prefecture'].isin(T).astype(int) # 県固定効果 + 年次×群 の交互作用が事前トレンド差の検定 m = smf.ols('logpop ~ yearc*grp + C(Prefecture)', data=pre).fit() print(m.params['yearc:grp'], m.pvalues['yearc:grp']) # 係数≈0.00713, p<0.001 |
💬 yearc:grp の係数 0.00713 は、log 人口の年あたり変化が三大都市圏 8 都府県ではそれ以外より 0.0071 大きい、つまり毎年およそ 0.7 ポイントずつ成長率の差が開いていることを表す。2012〜2019 の 7 年で積み上げると約 5% の差になり、p=3.6e-37 は前平行トレンドがはっきり崩れていることを示す。ただしこの p は県内の年次相関を無視した通常の標準誤差によるもので過小になりがちなので、cov_type='cluster' で県単位にクラスタリングしても差が残るかを確かめるとよい。
※ 上記の傾き・p 値は SSDSE-B-2026 の実測値です。 処置群/対照群の分け方は概念説明のための架空の設定(実在の政策処置ではありません)。
🔗 追記解説⑤:関連ページ(用語集内・実在ファイルのみ)
平行トレンド仮定の前後にある概念へ、 本用語集内の実在ページへリンクします(未整備の項目はリンクせずテキストで示します)。
- 差分の差分法(DiD) ― 平行トレンドが前提となる本体の推定法。
- パネルデータの因果推論 ― DiD・イベントスタディ・staggered 設計の位置づけ。
- 固定効果 ― TWFE の構造と、 staggered adoption での落とし穴。
- パネルデータ分析 ― 縦断データの基本構造(SSDSE の 47県×年次)。
- 自然実験 ― 外生的な処置割当を利用する設計思想。
- グレンジャー因果性 ― 時系列での「先行性」による因果の考え方(DiD とは前提が異なる)。
- 因果 ― 相関と因果の区別、 反事実の枠組み。
- 回帰不連続デザイン(RDD) / 操作変数法(IV) / 内生性 ― 平行トレンドが疑わしいときの代替識別戦略。
- 合成対照法・イベントスタディ・因果推論総論 ― 本用語集に専用ページが未整備のため、 ここではテキストのみ(本ページの発展節を参照)。