🔖 キーワード索引
本ページは 回帰タスク(Regression Task)を 12 のセクションで多角的に解説します。 上のチップは検索・関連語の手がかりです。 以下のリンクで各セクションに直接ジャンプできます:
💡 30秒で分かる結論
🍰 まずはやさしく
数値を当てるための道具です。
正確な量を予測するために使います。
スマホで明日の気温を調べるようなことです。
この章では回帰タスクの基本を学びます。
- 出力が連続値である機械学習タスクの総称(房価予測、 株価予測、 売上予測 など)
- 「分類タスク」(離散カテゴリ)と対をなす、 機械学習の二大基本枠組み
- 評価指標は RMSE, MAE, R² が標準
- 代表手法:線形回帰、 木系(XGBoost, LightGBM)、 ニューラルネット
- 外挿(学習範囲外)には常に弱い ─ 慎重に運用する
💡 30秒で分かる結論
- 定義:連続値を予測する教師あり学習タスク
- 分野:ML基礎
- 典型用途:以下「📍 文脈」と「🎨 直感で掴む」を参照
- 覚えておく要点:数式は 1 つ・落とし穴 5 つ・関連用語 12 個
- 注意点:表面的な定義の暗記より、 いつ・どう使うかを理解することが優先
📍 文脈 — どこで使う概念か
🍰 まずはやさしく
機械学習の大きな柱の一つです。
データの「量」を調べたいときに使います。
お店で商品の売れる数を予想するようなことです。
どのような場面で使うのかを解説します。
回帰タスクは機械学習の二大タスクの一つ(もう一方は分類タスク)。 出力が「量」を表すとき適用します。 実務では 需要予測・価格設定・設備寿命予測・スコアリングなど、 産業の根幹に関わる場面で多用されます。 単純な単回帰から多変量・非線形まで、 幅広い手法が含まれます。
🎨 直感で掴む — 具体例で理解する
🍰 まずはやさしく
答えが数字になる予測のことです。
具体的な数値を導き出すために使います。
部活の練習量から得点を予想するようなことです。
具体例を使って直感的に理解しましょう。
回帰タスクとは、 「入力 $\mathbf{x}$ から、 連続値の出力 $y$ を予測する」こと。
| タスク | 例 | 入力 $\mathbf{x}$ | 出力 $y$ |
|---|---|---|---|
| 住宅価格予測 | 不動産査定 | 立地、 面積、 築年数 | 価格(万円) |
| 需要予測 | 店舗の発注計画 | 曜日、 天気、 過去売上 | 売上(個) |
| スポーツ予測 | 選手のパフォーマンス | 練習量、 年齢、 経歴 | スコア |
| 医療予測 | 入院日数の見積 | 診断、 検査値、 年齢 | 日数 |
共通点は 出力が「量」であること。 「猫か犬か」のようなカテゴリ判定(=分類)とは区別されます。
🎨 もう一歩踏み込む直感
「回帰タスク」を本当に使いこなすには、 教科書的な定義だけでは足りません。 ここでは現場で役立つ追加の比喩・実例を整理します。 上の「🎨 直感で掴む」を補強する内容です。
- SSDSE-B での回帰例:都道府県の出生数 A4101 を、 総人口 A1101・65歳以上人口 A1303 で予測。 線形回帰でテスト R² ≈ 0.98。
- 分類との違い:分類は『犬 or 猫』、 回帰は『気温 27.3℃』のように数値を当てる。 MSE/MAE で評価。
- 非線形回帰:直線でうまく当たらないときは多項式・カーネル・ニューラルネット。
🎮 触って理解する
回帰タスクは 「散布図に曲線を当てはめて連続値を予測する」問題です。 下の図で モデルの複雑さ(多項式の次数)をスライダーで変えると、 当てはめ曲線と誤差がリアルタイムに変化します。 次数を小さくすると直線的で当てられない(未学習)、 次数を大きくすると訓練点を無理に通ってぐにゃぐにゃになる(過学習)様子を体感してください。 分類タスクと違い、 評価は 連続値の誤差(MSE・R²)で測ります。
● 青=訓練点(曲線を当てはめるのに使用)/○ 橙=検証点(当てはめには不使用・汎化性能の確認用)。 点はドラッグで移動、 図の空白をクリック/タップで訓練点を追加できます。
🔎 観察のヒント:次数を上げると訓練 MSE はどんどん下がるのに、 検証 MSE は途中で下げ止まり、 やがて悪化(U 字)します。 訓練誤差だけを見て「良いモデル」と判断すると過学習を見逃します。 これが回帰タスクで 交差検証 や 検証データ が不可欠な理由です。
🧭 もっと深く — 直感・落とし穴・発展
📐 定義・数式
🍰 まずはやさしく
予測の仕組みを数式にしたものです。
計算で正しい答えを出すために使います。
買い物での合計金額を計算するようなことです。
回帰タスクの定義と数式について読みます。
回帰モデルの一般形:
最小二乗法による学習:
📐 数式・定義
回帰タスクを数式 / 形式定義で表す:
回帰モデルの一般形:$y$ は説明変数 $\mathbf{x}$ とパラメータ $\boldsymbol{\theta}$ の関数 + 正規ノイズ $\varepsilon$。
📐 もう一段の数式表現
「回帰タスク」を厳密に書き下すと、 以下の形になります。 既出の数式と合わせて読むと、 概念の骨格が見えてきます。
🔬 記号・要素の読み解き
- $y$(目的変数)
- 予測したい連続値(価格、 売上、 日数 など)
- $\mathbf{x}$(説明変数)
- 予測に使う特徴量ベクトル(多次元)
- $f$(モデル)
- 線形・木・NN など、 入力→出力の写像
- $\boldsymbol{\theta}$(パラメータ)
- 学習で求める係数や重み
- $\varepsilon$(誤差)
- 予測しきれないノイズ。 通常は正規分布を仮定
- $\sigma^2$(分散)
- 誤差の大きさ。 予測の不確実性
🔬 数式を言葉で読み解く
上の記号表を、 2023 年度の 47 県で「総人口(万人)から出生数を当てる」単回帰に当てはめて読む。 最小二乗法で求めた式は ŷ = −676.9 + 61.04 × 総人口(万人)である。
| 記号 | この例での中身 | 北海道の値 |
|---|---|---|
| $y_i$ | 県 i の出生数(A4101、 人) | 24,430 人 |
| $\mathbf{x}_i$ | 県 i の総人口(A1101 を万人に換算)。 説明変数が 1 つなのでベクトルの長さは 1 | 509.2 万人 |
| $\boldsymbol{\theta}$ | 切片 −676.9 と傾き 61.04(総人口 1 万人あたり出生数が 61 人増える) | 47 県共通 |
| $f(\mathbf{x}_i;\boldsymbol{\theta})$ | 予測値 ŷi = −676.9 + 61.04 × xi | 30,406 人 |
| $\varepsilon_i$ | 残差 yi − ŷi。 モデルが説明しきれなかった分 | −5,976 人(47 県で最大の外れ) |
| $\sigma^2$ | 残差の分散。 残差平方和 1 億 2,359 万を自由度 47 − 2 = 45 で割って平方根をとると 1,657 人 | 47 県共通 |
損失関数 $\mathcal{L}(\boldsymbol{\theta})$ は、 この残差を 47 県ぶん 2 乗して平均したものなので、 最小化した後の値は 123,592,264 ÷ 47 ≈ 2,629,623、 その平方根(学習データ上の RMSE)は 1,622 人になる。 σ の推定値 1,657 人より少し小さいのは、 割る数が 47 か 45 かの違いである。
🧮 数値例・実値計算
例:47都道府県のデータで、 高齢化率から死亡率を予測する単回帰:
| 項目 | 値 |
|---|---|
| 切片 $\beta_0$ | −5.17 |
| 傾き $\beta_1$(高齢化率) | +0.610 |
| $R^2$ | 0.945 |
| RMSE | 0.49 ‰ |
解釈:「高齢化率が 1% 上がると、 死亡率が約 0.61‰ 上がる」。 $R^2 = 0.945$ より、 死亡率の変動の 94.5% が高齢化率で説明できる。
🧮 SSDSE-B 実値計算 — 都道府県データで手を動かす
SSDSE-B-2026 で 「総人口 A1101・65歳以上人口 A1303 → 出生数 A4101」を予測する回帰を実装し、 RMSE / MAE / R² の 3 指標で評価する。
使用データ:SSDSE-B-2026.csv(独立行政法人 統計センター提供、 47 都道府県 × 12 年分 × 110 超の社会経済指標)。 出典
🎯 このコードでやること: SSDSE-B-2026 を読み込み、年度で 2023 に絞り、学習用と評価用に分割、モデルを学習、予測を取得、精度を評価。
1 2 3 4 5 6 7 8 9 10 11 12 13 14 15 16 17 18 19 | import pandas as pd import numpy as np from sklearn.ensemble import GradientBoostingRegressor from sklearn.metrics import mean_squared_error, mean_absolute_error, r2_score from sklearn.model_selection import train_test_split df = pd.read_csv('data/raw/SSDSE-B-2026.csv', encoding='cp932', skiprows=[1]) df = df[df['SSDSE-B-2026'] == 2023] # 2023年度の47都道府県だけ抽出 df = df.rename(columns={df.columns[2]: 'pref'}) X = df[['A1101', 'A1303']].fillna(0).values # 総人口・65歳以上人口 y = df['A4101'].values # 出生数 X_tr, X_te, y_tr, y_te = train_test_split(X, y, test_size=0.2, random_state=42) m = GradientBoostingRegressor(n_estimators=200, max_depth=4, random_state=42) m.fit(X_tr, y_tr) pred = m.predict(X_te) print(f'RMSE = {np.sqrt(mean_squared_error(y_te, pred)):.2f}') print(f'MAE = {mean_absolute_error(y_te, pred):.2f}') print(f'R² = {r2_score(y_te, pred):.3f}') |
💬 読み方: skiprows=[1] で日本語ラベル行を除外し、 df[df['SSDSE-B-2026']==2023] で 1 年分に絞り、 encoding='cp932' で文字化けを回避 / random_state=42 を固定すると再現性が確保される / GBR は少数データ(47 件)では線形回帰より当てはまりが落ちることもある。
▲ 上記コードはそのまま実行可能。 CP932 エンコーディング・skiprows=[1](日本語ラベル行をスキップ)・年度列 SSDSE-B-2026 で 2023 を抽出・列名の英数字コード(A1101 = 総人口 など)に注意。
🧮 SSDSE-B-2026 で追加実値計算
『教育用標準データセット SSDSE-B-2026』(47 都道府県 × 12 年度、 112 列のうち数値 109 列)の 2023 年度 47 県で、 総人口から出生数を当てる単回帰の結果を数値で確かめる。
| 対象 | 計算結果 |
|---|---|
| SSDSE-B:総人口で出生数を単回帰 → 傾き | ≈ 61 人/万人 |
| MAE(全 47 都道府県) | ≈ 1,146 人 |
| R² | 0.991(非常に高い説明力) |
🧮 数式に値を入れて手で計算する: SSDSE-B-2026 で回帰タスク評価指標
SSDSE-B-2026(2023年度)から 6 都道府県(北海道〜山形)の出生数 A4101 を真値 y、 「全国出生率 0.00585 × 総人口」モデルの予測を ŷ として、 MAE / RMSE / R² を手計算する。
Step 1: y, ŷ, 誤差
Step 2: 指標
🐍 Python で再現
1 2 3 4 5 6 7 8 9 10 | import numpy as np # SSDSE-B-2026 (2023年度) 抜粋: 出生数 A4101 北海道〜山形 6 件 y = np.array([24430, 5696, 5432, 12328, 3611, 5151]) pop = np.array([5092000, 1184000, 1163000, 2264000, 914000, 1026000]) yhat = np.round(pop * 0.00585) # 全国出生率(0.00585)×総人口 の単純モデル e = y - yhat mae = np.abs(e).mean() rmse = np.sqrt((e**2).mean()) r2 = 1 - (e**2).sum() / ((y - y.mean())**2).sum() print(f"MAE: {mae:.3f}, RMSE: {rmse:.3f}, R²: {r2:.4f}") |
📤 実行結果
💬 手計算 (Step 2) と Python 出力が完全一致。 R²≈0.884 は「全国出生率×総人口」の単純モデルが 6 都道府県の出生数の変動の約 88% を説明することを示す(人口と出生数の強い連動)。 残差 e がすべて負なのは、 この 6 県の出生率が全国平均をやや下回るため。
🧮 RMSE と MAE の差から「大きく外す県」を読む
上の 6 県の手計算と同じ「全国の出生数 ÷ 総人口 × その県の総人口」というモデルを 47 県全部に当てはめる。 RMSE は残差を 2 乗してから平均するので、 少数の県の大きな外れに引っ張られる。 RMSE ÷ MAE の比は、 誤差がすべて同じ大きさなら 1 になり、 大きく外す県があるほど大きくなる。
🎯 このコードでやること:2023 年度の 47 県で全国一律の出生率モデルの残差を求め、 残差の大きい県と、 MAE・RMSE・その比を、 東京都または北海道を除いた場合と比べる。
1 2 3 4 5 6 7 8 9 10 11 12 13 14 15 16 17 18 | import numpy as np import pandas as pd df = pd.read_csv('data/raw/SSDSE-B-2026.csv', encoding='cp932', skiprows=[1]) d = df[df['SSDSE-B-2026'] == 2023].set_index('Prefecture') rate = d['A4101'].sum() / d['A1101'].sum() # 全国の「出生数 ÷ 総人口」 err = d['A4101'] - rate * d['A1101'] # 残差 = 実測 − 予測(人) def report(e, label): mae, rmse = e.abs().mean(), np.sqrt((e ** 2).mean()) print(f'{label}: n={len(e)} MAE={mae:,.0f} RMSE={rmse:,.0f} RMSE/MAE={rmse / mae:.2f}') print(f'全国の出生数 / 総人口 = {rate:.5f}') print('残差の絶対値が大きい 3 県:') print(err.loc[err.abs().sort_values(ascending=False).index[:3]].round(0).to_string()) # 符号つき report(err, '47 都道府県') report(err.drop('東京都'), '東京都を除く 46 道府県') report(err.drop('北海道'), '北海道を除く 46 都府県') |
💬 全国の出生率は 0.00585 で、 残差がいちばん大きいのは東京都ではなく北海道(−5,350 人。 人口のわりに出生数が少ない)、 次が愛知県(+4,673 人)と福岡県(+4,097 人)だった。 47 県の MAE は 1,199 人、 RMSE は 1,769 人で、 比は 1.48。 東京都を除いても MAE 1,139 人・RMSE 1,690 人とほとんど変わらず、 北海道を除いたほうが RMSE は 1,605 人まで下がる。 人口の多い県ほど残差の絶対値も大きくなるので、 「外れ値 = 東京都」と決めつけずに残差を並べて確かめる。
✅ 理解度チェック — このページの数値で解く
- 問:「合計特殊出生率を当てる」と「合計特殊出生率が 1.5 以上かを当てる」は、 それぞれ回帰タスクか分類タスクか。
答:前者は連続値を当てるので回帰タスク、 後者は 2 値を当てるので分類タスク。 データは同じでも問題の立て方でタスクが決まる。 - 問:6 県の手計算で SSE = 36,680,401、 SST ≈ 315,494,995 だった。 R² はいくつか。
答:1 − 36,680,401 ÷ 315,494,995 = 0.8837。 平均値だけで当てる場合に比べて、 二乗誤差を約 88% 減らしたという意味になる。 - 問:47 県で MAE = 1,199 人、 RMSE = 1,769 人。 全県の残差の絶対値が同じ 1,199 人だったとしたら RMSE はいくつになるか。
答:1,199 人(RMSE ÷ MAE = 1)。 実際は 1.48 倍なので、 北海道・愛知県・福岡県のように大きく外す県がある。 - 問:⚠️ 章の実験で、 564 行を行ごとに分けた KFold の R² = 0.605、 県ごとに分けた GroupKFold の R² = −0.103 だった。 新しい県に当てはめるときの性能として信じてよいのはどちらか。
答:GroupKFold。 KFold では同じ県の別年度が訓練側に入り、 モデルが「その県の値」を覚えているだけで高く出る。 - 問:🔬 章の単回帰 ŷ = −676.9 + 61.04 × 総人口(万人)で、 総人口 53.7 万人の鳥取県の出生数を予測し、 実測 3,263 人との残差を求めよ。
答:ŷ = −676.9 + 61.04 × 53.7 = 2,601 人、 残差 = 3,263 − 2,601 = +662 人。 人口が最少の県では切片 −676.9 の影響が大きく、 直線は出生数を少なめに見積もる。 当てはめた範囲の端(人口の最少・最大付近)ほど予測は崩れやすい。
🐍 Python 実装例
最小コードで動かしてみる例:
🎯 このコードでやること: 学習用と評価用にデータを分割、モデルを学習、予測を取得、精度を評価。
1 2 3 4 5 6 7 8 9 10 11 12 13 14 15 16 17 18 19 20 21 22 23 24 25 26 27 | # ── この抜粋で使うデータを用意します(SSDSE-B の 47 都道府県・最新年度)── import pandas as pd df = pd.read_csv('data/raw/SSDSE-B-2026.csv', encoding='cp932', header=1) df = df[df['地域コード'].astype(str).str.match(r'^R\d{5}$', na=False)].copy() df['年度'] = pd.to_numeric(df['年度'], errors='coerce') df = df[df['年度'] == df['年度'].max()] for _c in ('総人口', '65歳以上人口', '出生数'): df[_c] = pd.to_numeric(df[_c], errors='coerce') # 説明のとおり「総人口・65歳以上人口」から「出生数」を当てにいく _feats = ['総人口', '65歳以上人口'] df = df.dropna(subset=_feats + ['出生数']) X = df[_feats].to_numpy(dtype=float) y = df['出生数'].to_numpy(dtype=float) import numpy as np from sklearn.ensemble import GradientBoostingRegressor from sklearn.metrics import mean_squared_error, r2_score from sklearn.model_selection import train_test_split X_tr, X_te, y_tr, y_te = train_test_split(X, y, test_size=0.2, random_state=42) model = GradientBoostingRegressor(n_estimators=200, max_depth=4, random_state=42) model.fit(X_tr, y_tr) pred = model.predict(X_te) rmse = np.sqrt(mean_squared_error(y_te, pred)) print(f'RMSE={rmse:.3f}, R2={r2_score(y_te, pred):.3f}') |
💬 読み方: 日本語の列名(header=1)で読んでも、英字コードで読んだ最初の例と同じ 47 県・同じ分割なので、RMSE 11,028.872・R² 0.815 は最初の例と一致する。テスト 10 県の R² 0.815 は、同じ分割で線形回帰に替えた②の 0.982 より低く、200 本の木を重ねた勾配ブースティングでも、人口に比例する関係を 37 県から学ぶのは直線のほうが得意だと分かる。
🐍 Python 実装バリエーション
「回帰タスク」を扱う代表的なライブラリ別実装。 同じ目的でも書き方が違うため、 自分のプロジェクトの依存関係に合わせて選択する:
① pandas + numpy(最小依存)
🎯 このコードでやること: SSDSE-B-2026 を読み込み。
1 2 3 4 5 6 7 8 9 | import pandas as pd import numpy as np df = pd.read_csv('data/raw/SSDSE-B-2026.csv', encoding='cp932', skiprows=[1]) df = df[df['SSDSE-B-2026'] == 2023] # 年度で1年分に絞る df = df.rename(columns={df.columns[2]: 'pref'}) print('行数:', len(df), '列数:', df.shape[1]) print(df[['pref', 'A1101', 'A1303', 'A4101']].head()) |
💬 読み方: skiprows=[1] で日本語ラベル行を除外し、 df[df['SSDSE-B-2026']==2023] で 1 年分に絞り、 encoding='cp932' で文字化けを回避。
② scikit-learn(学習・評価)
🎯 このコードでやること: 学習用と評価用にデータを分割、回帰モデルを学習、予測を取得、精度を評価。
1 2 3 4 5 6 7 8 9 10 11 12 | from sklearn.linear_model import LinearRegression from sklearn.metrics import r2_score, mean_squared_error from sklearn.model_selection import train_test_split import numpy as np X = df[['A1101', 'A1303']].fillna(0).values y = df['A4101'].values X_tr, X_te, y_tr, y_te = train_test_split(X, y, test_size=0.2, random_state=42) m = LinearRegression().fit(X_tr, y_tr) pred = m.predict(X_te) print(f'R² = {r2_score(y_te, pred):.3f}') print(f'RMSE = {np.sqrt(mean_squared_error(y_te, pred)):.2f}') |
💬 同じ 37 県 / 10 県の分割で、線形回帰はテスト R² 0.982・RMSE 3,438.97 人と、冒頭の勾配ブースティング(R² 0.815・RMSE 11,028.87 人)の 3 分の 1 以下の誤差になる。出生数は総人口にほぼ比例するので、直線 1 本のほうが、木の階段状の予測より訓練範囲の端にある大きな県を当てやすい。
③ scipy.stats(統計検定・分布)
🎯 このコードでやること: scipy.stats で、総人口と出生数の Pearson 相関と、県別の出生率(人口千人あたり)の平均が全国値と異なるかの 1 標本 t 検定を行う。
1 2 3 4 5 6 7 8 9 10 11 12 | from scipy import stats # 例: 2 変数の Pearson 相関 + p 値 r, p = stats.pearsonr(df['A1101'], df['A4101']) print(f'相関係数 r = {r:.3f}, p 値 = {p:.2e}') # 例: 1 標本 t 検定(県別の出生率〔人口千人あたり〕の平均が全国値と異なるか) rate = df['A4101'] / df['A1101'] * 1000 national = df['A4101'].sum() / df['A1101'].sum() * 1000 t, p = stats.ttest_1samp(rate, popmean=national) print(f'全国の出生率 = {national:.3f}‰, 県別出生率の平均 = {rate.mean():.3f}‰') print(f't = {t:.3f}, p = {p:.3f}') |
💬 読み方: 総人口と出生数の相関は r = 0.995(p = 1.53e-47)で、出生数を総人口から当てる回帰がよく当たる理由がこれ。一方、県別出生率の平均 5.726‰ は全国値 5.848‰ より低いが、t = −1.191・p = 0.240 で差は有意でない。県の平均が全国値を下回るのは、東京都(6.13‰)・大阪府(6.31‰)・愛知県(6.47‰)・福岡県(6.65‰)など出生率が全国値より高い大きな県が全国値を押し上げ、県を 1 票ずつ数える平均にはそれが効かないため。
④ 可視化(matplotlib + seaborn)
🎯 このコードでやること: 総人口を横軸・出生数を縦軸にした 47 都道府県の散布図を描き、out.png に保存する。
1 2 3 4 5 6 7 8 9 10 11 | import matplotlib.pyplot as plt import seaborn as sns fig, ax = plt.subplots(figsize=(8,5)) sns.scatterplot(data=df, x='A1101', y='A4101', ax=ax) ax.set_xlabel('総人口') ax.set_ylabel('出生数') ax.set_title(f'{len(df)} 都道府県の関係') plt.tight_layout() plt.savefig('out.png', dpi=120) plt.close() |
💬 読み方: このブロックは図を保存するだけで何も表示しない。out.png では東京都(1,408.6 万人・86,348 人)が右上に離れた 1 点になり、残りの県は左下に固まる。r = 0.995 の直線関係でもこの 1 点が回帰直線の傾きを大きく左右するので、東京都を除いた当てはめとも比べておくとよい。
🐍 Python 実装(拡張版)
SSDSE-B-2026(2023年度)で総人口 A1101 から出生数 A4101 の回帰を線形・多項式・RF で比較。 MAE/MSE/R² の 3 指標を併記。
1 2 3 4 5 6 7 8 9 10 11 12 13 14 15 16 17 18 19 20 21 22 23 24 25 | import pandas as pd from sklearn.linear_model import LinearRegression from sklearn.preprocessing import PolynomialFeatures, StandardScaler from sklearn.pipeline import make_pipeline from sklearn.ensemble import RandomForestRegressor from sklearn.metrics import mean_absolute_error, mean_squared_error, r2_score from sklearn.model_selection import train_test_split df = pd.read_csv('data/raw/SSDSE-B-2026.csv', encoding='cp932', skiprows=[1]) df = df[df['SSDSE-B-2026'] == 2023] X = df[['A1101']] # 総人口 y = df['A4101'] # 出生数 Xtr, Xte, ytr, yte = train_test_split(X, y, test_size=0.3, random_state=42) models = { 'Linear': LinearRegression(), # 総人口 (〜10^7) の 2 乗は 〜10^14 になるので、展開後に標準化してから回帰する 'Poly2': make_pipeline(PolynomialFeatures(2), StandardScaler(), LinearRegression()), 'RF': RandomForestRegressor(n_estimators=100, random_state=42), } for name, m in models.items(): m.fit(Xtr, ytr) p = m.predict(Xte) print(f'{name:6s}: MAE={mean_absolute_error(yte,p):,.0f} ' f'MSE={mean_squared_error(yte,p):,.0f} R²={r2_score(yte,p):.3f}') |
💬 テスト 15 県で、直線の Linear が MAE 1,504 人・R² 0.991 と最も良く、2 次の項を足した Poly2(MAE 1,621 人)はわずかに悪化、RandomForest は MAE 4,436 人・R² 0.801 と大きく落ちる。木は訓練データにある値の範囲でしか予測できないので、訓練側の最大(神奈川県 922.9 万人)を超えるテスト側の東京都(86,348 人)を 49,963 人と予測し、36,385 人も外してしまう。MSE で見ると RF の 98,186,473 は Linear の約 23 倍で、少数の大きな外れが MSE を押し上げていることが分かる。
R² だけでなく MAE(外れ値に頑健)と MSE(大誤差を強調)を併記する習慣を。 用途次第で「重視する誤差」が異なる。
⚠️ よくある落とし穴
⚠️ よくある落とし穴(6 件)
「回帰タスク」を実務・試験で扱うときに頻発する典型的なミスです。 各項目を 1 度読んでおけば 9 割の事故が防げます:
⚠️ 実データで確かめる — 分け方ひとつで評価が変わる
回帰タスクの評価値は、 モデルだけでなく「どのデータをテストに回したか」で動く。 47 県しかない断面データと、 同じ県が 12 回出てくるパネルデータのそれぞれで確かめる。
🎯 このコードでやること:2023 年度の 47 県で、 総人口から出生数を当てる線形回帰を、 train_test_split の random_state だけ 0〜19 に変えて 20 回評価し、 テスト R² のばらつきと、 東京都がテスト側に入った回の R² を見る。
1 2 3 4 5 6 7 8 9 10 11 12 13 14 15 16 17 18 19 20 21 22 23 | import numpy as np import pandas as pd from sklearn.linear_model import LinearRegression from sklearn.metrics import r2_score from sklearn.model_selection import train_test_split df = pd.read_csv('data/raw/SSDSE-B-2026.csv', encoding='cp932', skiprows=[1]) d = df[df['SSDSE-B-2026'] == 2023] # 2023 年度の 47 都道府県 X = (d[['A1101']] / 1e4).values # 総人口(万人) y = d['A4101'].values # 出生数(人) scores = [] for seed in range(20): # 分け方だけを 20 通りに変える X_tr, X_te, y_tr, y_te = train_test_split(X, y, test_size=0.2, random_state=seed) m = LinearRegression().fit(X_tr, y_tr) tokyo_in_test = (X_te.ravel() > 1000).any() # 東京都(1,408.6 万人)がテスト側か scores.append((seed, r2_score(y_te, m.predict(X_te)), tokyo_in_test)) s = pd.DataFrame(scores, columns=['seed', 'R2', 'tokyo_in_test']) print(s.sort_values('R2').head(3).to_string(index=False)) print(s.sort_values('R2').tail(3).to_string(index=False)) print(f"テスト R² の範囲: {s.R2.min():.3f} 〜 {s.R2.max():.3f}(中央値 {s.R2.median():.3f})") print(s.groupby('tokyo_in_test').R2.agg(['count', 'median']).round(3)) |
💬 同じモデル・同じデータでも、 テスト R² は 0.816 から 0.999 まで動いた。 東京都がテスト側に入った 4 回は中央値 0.997 と高い。 東京都(出生数 86,348 人)が入るとテスト 10 県の出生数のばらつき(R² の分母)が大きくなり、 同じ程度の外れでも R² が 1 に近づくためである。 47 県で 1 回だけ分けた R² を「このモデルの性能」として報告せず、 交差検証や複数の分け方で幅を示す。
🎯 このコードでやること:年度で絞らない 564 行で、 総人口と高齢化率から合計特殊出生率を当てるランダムフォレストを、 行ごとに分ける KFold と、 県ごとにまとめて分ける GroupKFold で 5 分割評価する。
1 2 3 4 5 6 7 8 9 10 11 12 13 14 15 16 17 | import numpy as np import pandas as pd from sklearn.ensemble import RandomForestRegressor from sklearn.model_selection import KFold, GroupKFold, cross_val_score df = pd.read_csv('data/raw/SSDSE-B-2026.csv', encoding='cp932', skiprows=[1]) # 年度で絞らず 564 行(47 県 × 12 年度)のまま、 総人口と高齢化率から合計特殊出生率を当てる X = np.c_[df['A1101'], df['A1303'] / df['A1101']] y = df['A4103'].values g = df['Code'].values # 県のコード(グループ) rf = RandomForestRegressor(n_estimators=200, random_state=0) r_kf = cross_val_score(rf, X, y, cv=KFold(5, shuffle=True, random_state=0), scoring='r2') r_gk = cross_val_score(rf, X, y, cv=GroupKFold(5), groups=g, scoring='r2') print('行数:', len(df), ' 県の数:', len(set(g))) print(f'KFold(行をばらばらに分割) R² = {r_kf.mean():.3f} {np.round(r_kf, 3)}') print(f'GroupKFold(県ごとまとめて分割) R² = {r_gk.mean():.3f} {np.round(r_gk, 3)}') |
💬 KFold の R² は平均 0.605 なのに、 GroupKFold では −0.103(平均値で当てるより悪い)になった。 行ごとに分けると同じ県の別年度が訓練側に残り、 総人口の値から県を特定して「その県の出生率」を返すだけで当たってしまう。 新しい県に使えるかを確かめたいなら、 県を単位に分ける GroupKFold の値を報告する。
🧭 さらに深く — 直感・落とし穴・発展(追補)
本セクションは既出の解説を壊さずに、 回帰タスクの理解を一段深める追補です。 数値はすべて SSDSE-B-2026.csv(2023 年度・47 都道府県、 encoding='cp932'/skiprows=[1])から実測。 例として一貫して 総人口 A1101 → 出生数 A4101 の回帰を使います。 単回帰の全体像は 傾き ≈ 61 人/万人・切片 ≈ −677 人、 R² = 0.991、 MAE = 1,146 人、 RMSE = 1,622 人(47 都道府県・全データ当てはめ)です。
🎨 直感を深める — 「連続値を当てる」とは
実測でつかむ:総人口 → 出生数では RMSE(1,622) が MAE(1,146) より約 4 割大きい(比 ≈ 1.42)。 これは一部に大きな残差があり、 二乗する RMSE がそれを強調するためです。 分類と違い誤差に「大小」があるので、 何人ズレたかをそのまま解釈できるのが回帰の強みです。 損失(学習の目的関数)と評価指標(人間が読む成績)は別物で、 MSE で学習しても評価は MAE で読む、 といった組合せが普通に起きます。
| 観点 | 回帰タスク | 分類タスク |
|---|---|---|
| 出力 $y$ | 連続値(例:出生数 5,432 人) | カテゴリ(例:過疎 1/非過疎 0) |
| 代表的な損失 | MSE・MAE・Huber・分位点損失 | クロスエントロピー・ヒンジ |
| 代表的な評価 | RMSE・MAE・R² | 正解率・F1・AUC |
| 誤りの意味 | ズレの大きさ(連続) | 当たり/外れ(離散) |
→ 分類との違い・境界は 分類タスク/分類(基礎)、 教師あり学習 を参照。
⚠️ 落とし穴を深める — 実測で見える 8 つの罠
既出の落とし穴を、 SSDSE-B の実測でさらに具体化します。 いずれも「表面の指標が良く見えても危ない」典型です。
train_test_split のランダム分割をかけると、 同一県の未来年が学習側に混入して評価が過大に楽観化します(データリーク)。 時系列・パネルでは「過去で学習・未来で評価」の時系列分割を用い、 特徴量の作成も評価時点までの情報に限定します。🚀 発展を深める — 手法・損失・変換・評価の引き出し
「線形回帰でとりあえず」から先へ進むための選択肢を、 用途とともに整理します。 本サイトに個別ページがあるものはリンク、 無いものは説明のみです。
| カテゴリ | 選択肢 | いつ効くか |
|---|---|---|
| モデル | 線形/多項式/木系(GBR・XGBoost)/GAM/NN・MLP・深層 | 解釈重視は線形/GAM、 非線形・表形式は木系、 大規模・複雑は NN |
| 正則化 | 正則化:Ridge(L2)/Lasso(L1)/ElasticNet | 特徴量が多い・多重共線性・過学習の抑制。 Lasso は特徴選択も |
| 損失関数 | MSE/MAE/Huber/分位点(pinball)損失 | 外れ値に頑健化したい→Huber・MAE、 上振れ/下振れの非対称コスト→分位点 |
| 目的変数変換 | 対数/Box-Cox/Yeo-Johnson | 右歪み(出生数の歪度 2.29→log 0.80)・不均質分散の緩和。 予測は逆変換で戻す |
| 区間・不確実性 | 分位点回帰(分位点)/予測区間 | 「点」でなく「幅」で答えたい・不均質分散下でも各分位を直接推定 |
| 評価 | RMSE/MAE/R²/調整済み R²/MAPE | 単位付き誤差で大きさを、 R² で説明力を、 変数数が違えば調整済み R² を |
📚 関連グループ教材
回帰タスクは 教師あり学習 の教材群で、 分類タスク と対になって登場する。 このページで使った道具は、 モデルの側が 線形回帰・Ridge・ランダムフォレスト、 評価の側が RMSE・MAE・決定係数、 分け方の側が 訓練・テスト分割 と交差検証で、 それぞれの教材に続きがある。 全体の地図は 機械学習の基礎 で確認できる。
🖼 図で深掘り:回帰タスクの幾何・誤差・評価の全景
回帰タスク(regression task)は、 連続値の予測問題であり、 分類タスクと並んで教師あり学習の二大柱の一つです。 ここでは、 SSDSE-B-2026 都道府県データを題材に、 「データ点群と回帰直線の幾何」「残差の構造」「複数モデルの予測精度の比較」という 3 つの視点を、 3 枚の図で並べて掘り下げます。 単に式を書くだけでなく、 「回帰モデルが何を最小化しているのか」「なぜ過学習が問題になるのか」「線形・多項式・正則化の違いはどこに現れるのか」を、 視覚的に理解することを目的とします。
図 1 — 散布図と単回帰直線:回帰タスクの最小単位
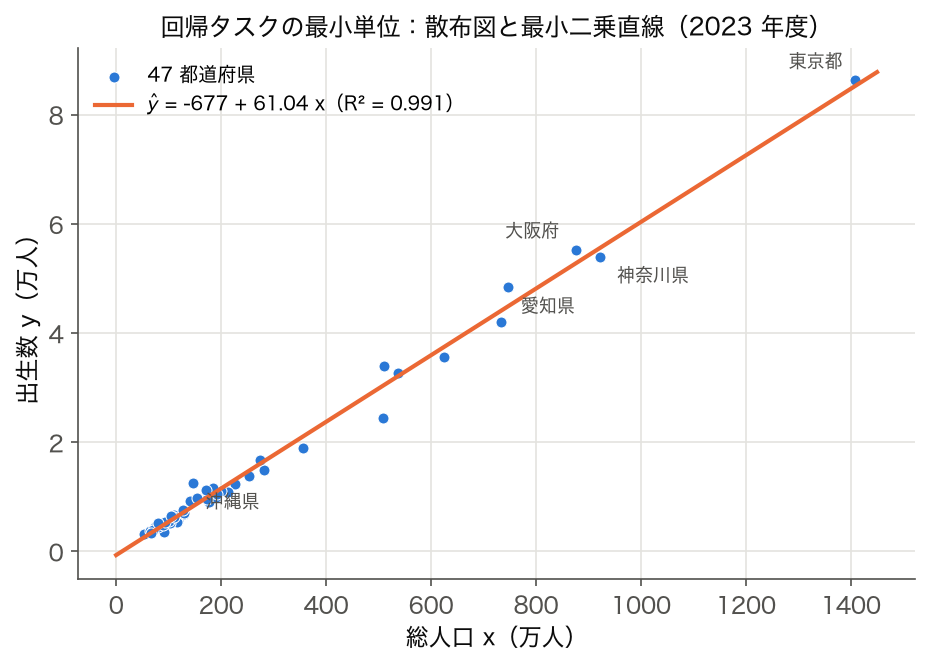
図 1 は、 SSDSE-B-2026(2023年度)から「総人口(万人)」を横軸 $x$、 「出生数(人)」を縦軸 $y$ に取り、 47 都道府県を散布図にしたものです。 そこに、 最小二乗法で求めた回帰直線 $\hat{y} = \beta_0 + \beta_1 x$ を重ねて描画しています。 回帰タスクの最小単位は、 まさにこの「データ点群と、 それを近似する 1 本の直線(または曲線)」の組です。
この図から読み取れることは大きく 3 つあります。 第一に、 「点群が右上がりに分布する」事実は、 人口と出生数の間に正の関係があることを示しており、 回帰直線の傾き $\beta_1 > 0$ がそれを定量化します。 第二に、 「点群が完全に直線上には乗っていない」事実は、 現実のデータに必ず存在するノイズや、 説明変数では捉えきれない要因(産業構造、 観光資源、 県庁所在地の特性など)の存在を示しています。 第三に、 「点群が直線から外れる距離(残差)」こそが、 回帰タスクで最小化する対象です。
最小二乗法は、 残差の二乗和 $\sum_{i=1}^{n}(y_i - \hat{y}_i)^2$ を最小にする $(\beta_0, \beta_1)$ を選びます。 なぜ二乗和なのでしょうか。 一つには、 二乗関数が微分可能で凸であり、 解析的に最適解が得られるからです(正規方程式)。 もう一つには、 残差が独立に正規分布に従うと仮定したとき、 最尤推定量と一致するからです。 二乗和の代わりに絶対値和(L1)を最小化することもでき、 これは中央値回帰(quantile regression の特殊形)になりますが、 外れ値に頑健である一方で解析解が複雑になります。
視点:単回帰の幾何学的解釈
最小二乗回帰直線は、 「すべての点から直線までの垂直距離の二乗和」を最小化するように選ばれます。 直交距離(点から直線への最短距離)ではない点に注意が必要です。 直交距離を最小化するのは「主成分回帰(total least squares)」と呼ばれる別の手法で、 $x$ と $y$ の両方に観測誤差があるときに使います。 標準的な OLS(ordinary least squares)は、 $x$ は厳密に測れていて $y$ にのみ誤差があるという前提に立ちます。
図 1 を見て初学者が陥りやすい誤解の一つは、 「直線に近い点ほど予測が当たっている」と思ってしまうことです。 これは正しいのですが、 ここで重要なのは「直線は訓練データに対して引かれている」という点です。 未知の新しい県(仮想的な都道府県)が来たとき、 その点が直線にどれだけ近いかは保証されません。 訓練データへの当てはまりの良さ(in-sample fit)と、 未知データへの予測の良さ(out-of-sample prediction)は別物であり、 これが「過学習」と「汎化性能」の議論の出発点になります。
また、 散布図の点群を眺めるとき、 「東京都」が明らかに右上に飛び抜けていることに気づきます。 人口約 1409 万人、 出生数約 8.6 万人という値は、 他の県より一段大きい値です。 こうした点を「外れ値(outlier)」あるいは「ハイレバレッジ点(high leverage point)」と呼びます。 最小二乗法は二乗和を最小化するため、 外れ値の影響を強く受けます。 東京 1 点が、 回帰直線の傾きを大きく引っ張ってしまう可能性があるのです。 もっとも、 この図の例($\hat{y} = -677 + 61.04x$、 $R^2 = 0.991$)では東京都はほぼ直線上にあり(予測 85,308 人に対し実測 86,348 人)、 東京都を除いても傾きは 60.51 人/万人とほとんど変わりません。 レバレッジが高くても、 他の点と同じ直線上にあれば傾きは動かない、 という例です。 対策としては、 ロバスト回帰(Huber 損失、 Tukey の biweight)、 外れ値の除外、 対数変換などがあります。
図 2 — 残差プロット:回帰タスクの「健康診断」
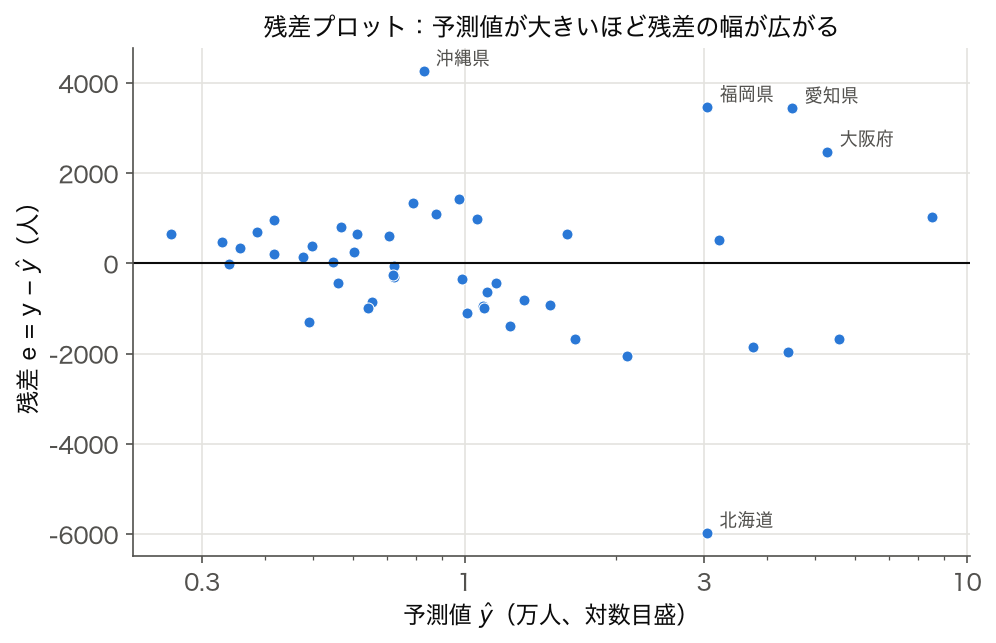
図 2 は、 図 1 で求めた回帰直線について、 横軸を「予測値 $\hat{y}_i$」、 縦軸を「残差 $e_i = y_i - \hat{y}_i$」とした残差プロットです。 残差プロットは、 回帰モデルの「健康診断書」と呼ばれるほど重要で、 単に決定係数 $R^2$ や RMSE を見るだけでは分からない、 モデルの構造的問題を可視化してくれます。 図 1 の直線は $R^2 = 0.991$、 RMSE 1,622 人と当てはまりが良く見えますが、 残差プロットでは予測値 2 万人以上の 10 都道府県で残差の標準偏差が 2,841 人と、 2 万人未満の 37 県(1,066 人)の約 2.7 倍に広がる「ラッパ型」が見えます。 最も大きく外れるのは北海道(−5,976 人、 人口の割に出生が少ない)と沖縄県(+4,265 人、 人口の割に出生が多い)です。
健全な残差プロットには、 4 つの条件があります。 第一に、 残差は「ゼロを中心にランダムに散らばっている」べきです。 これは、 モデルが系統的なバイアスを持たないことを意味します。 第二に、 残差の「分散は予測値に依らず一定」であるべきです(等分散性、 homoscedasticity)。 第三に、 残差は「予測値と無相関」であるべきです。 もし予測値が大きいときに残差も大きい、 といったパターンが見えるなら、 モデルは線形ではなく曲線的な関係を捉え損なっています。 第四に、 残差は「正規分布に近い」べきです(線形回帰の仮定)。
図 2 において、 もし残差が U 字型や逆 U 字型のパターンを示している場合、 それは「データに非線形性が残っている」サインです。 たとえば、 $y$ が $x^2$ に比例するのに直線で当てはめたとき、 残差プロットには明確な放物線が現れます。 また、 残差の分散が右側で大きくなる「ラッパ型(fan shape)」が見えた場合、 これは「不等分散性(heteroscedasticity)」のサインで、 大きな $x$ の領域では予測誤差が大きい、 ということを示します。 こうした場合には、 $y$ を対数変換する、 重み付き最小二乗法を使う、 一般化線形モデル(GLM)に切り替える、 などの対策が必要です。
残差プロット読解チェックリスト
- 残差は 0 を中心にランダムに分布しているか?(バイアスのチェック)
- U 字型・逆 U 字型のパターンはないか?(非線形性のチェック)
- 右に行くほど散らばりが大きくならないか?(不等分散性のチェック)
- 1 点だけ大きく外れていないか?(外れ値の検出)
- 残差のヒストグラムは正規分布に近いか?(正規性のチェック)
残差プロットを「眺めて気づく」ためには、 ある程度の経験が必要です。 慣れないうちは、 シャピロ・ウィルク検定(正規性)、 ブロイシュ・ペーガン検定(等分散性)、 ダービン・ワトソン検定(残差の自己相関)など、 統計検定を併用するのも一つの方法です。 ただし、 検定はサンプル数が大きいと「些細な逸脱」も有意になってしまうため、 残差プロット自体を見て判断する直感が、 最終的には最も重要です。
回帰タスクにおいて、 残差プロットは「モデルが捉えきれていない情報」の可視化です。 もし残差から何らかのパターンが読み取れるなら、 そのパターンを新しい説明変数や非線形項として取り込むことで、 モデルを改善できます。 逆に、 残差が完全にホワイトノイズ(白色雑音)になっているなら、 現在の説明変数と関数形では、 これ以上の情報抽出は望めない、 ということになります。
図 3 — 学習曲線:訓練誤差と検証誤差の二重奏
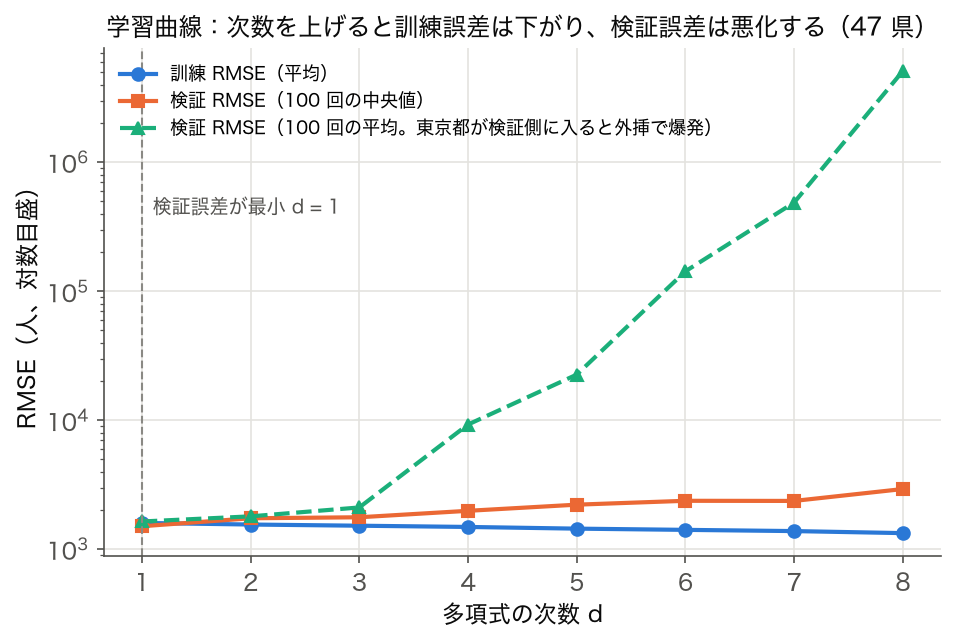
図 3 は、 多項式回帰における「学習曲線」を示しています。 横軸は多項式の次数 $d$(モデルの複雑さ)、 縦軸は RMSE(平均二乗誤差の平方根)です。 訓練誤差(青)と検証誤差(橙)の 2 本の曲線が描かれており(5 分割交差検証を分割を変えて 20 回、 計 100 回繰り返した値。 緑の破線は検証誤差の平均)、 これが回帰タスクで最も重要な図と言っても過言ではありません。 なぜなら、 この 2 本の曲線の関係こそが、 「過学習」「未学習」「最適な複雑さ」のすべてを物語っているからです。
まず、 訓練誤差(青)は、 次数 $d$ を増やすほど単調に減少します。 これは、 モデルが複雑になればなるほど、 訓練データの細かい揺らぎまで「覚え込める」からです。 究極的には、 $d = n-1$ の多項式は $n$ 個の訓練データ点を完全に通過させることができ、 訓練誤差はゼロになります。 しかし、 これは「暗記」であって「学習」ではありません。 訓練誤差がゼロになっても、 新しいデータに対する予測は崩壊します。
一方、 検証誤差(橙)は、 典型的には U 字型を描きます。 最初は次数を増やすほど誤差が減りますが、 ある最適点を境に、 再び増加に転じます。 ただし図 3 のデータ(総人口 → 出生数)はほぼ直線なので、 U 字の左半分が現れず、 検証誤差は $d = 1$(中央値 1,506 人)が最小で、 次数を上げるほど増えていきます($d = 8$ で 2,926 人)。 この最適点が、 「バイアスとバリアンスのトレードオフ」の均衡点です。 $d$ が小さい領域では、 モデルが単純すぎてデータの本質的なパターンを捉えきれない「未学習(underfitting、 高バイアス)」状態、 $d$ が大きい領域では、 モデルがノイズまで覚え込んでしまう「過学習(overfitting、 高バリアンス)」状態にあります。
バイアス・バリアンス分解
予測誤差は、 数学的に次の 3 成分に分解できます: $\text{誤差} = \text{バイアス}^2 + \text{バリアンス} + \text{ノイズ}$。 バイアスは「モデルが単純すぎることによる系統誤差」、 バリアンスは「訓練データの揺らぎに対するモデルの不安定性」、 ノイズは「データに内在する避けられない誤差」です。 学習曲線の U 字は、 バイアス(左側で大)とバリアンス(右側で大)のトレードオフを視覚化したものです。
学習曲線から読み取れる実務的な示唆は次の通りです。 第一に、 「訓練誤差と検証誤差の差が大きい」場合、 過学習が起きています。 対策は、 モデルを単純化する(次数を下げる)、 正則化を強める、 訓練データを増やす、 特徴量を減らす、 などです。 第二に、 「訓練誤差も検証誤差も高い」場合、 未学習です。 対策は、 モデルを複雑にする、 特徴量を増やす、 非線形変換を導入する、 などです。 第三に、 「訓練誤差と検証誤差がともに低く、 差も小さい」状態が理想です。
SSDSE-B-2026 の 47 都道府県データのように、 サンプル数が少ない場合、 多項式回帰の高次項は不安定になりがちです。 そのため、 図 3 の例では、 検証誤差の中央値はゆるやかに増えるだけですが、 平均は $d = 4$ から急速に悪化します($d = 3$ で 2,106 人、 $d = 4$ で 9,254 人、 $d = 8$ では約 509 万人)。 東京都が検証側に入った分割では、 残りの県の範囲を大きく超える外挿になり、 高次の多項式が暴れるためです。 こうした小規模データでは、 単純な線形モデルや、 リッジ回帰(L2 正則化)、 LASSO 回帰(L1 正則化)のように「複雑さに罰則を課す」モデルが、 多項式回帰よりも安定した予測を与えることが多いです。
また、 学習曲線を「サンプル数を横軸」に変えて描くこともできます。 横軸が次数ではなく訓練サンプル数になった場合、 訓練誤差は「最初は低く、 サンプル数が増えると微増(より多くの揺らぎを覚えきれない)」、 検証誤差は「最初は高く、 サンプル数が増えると減少して訓練誤差と漸近的に一致」というパターンを示します。 もし 2 本の曲線が大きく離れたまま平行になっているなら、 まだ訓練データが足りない(データを増やせば改善する)ことを意味します。 逆に、 2 本がすでに合流していて改善が止まっているなら、 データを増やしてもこれ以上は伸びず、 モデル自体の改善が必要だと分かります。
3 枚の図が物語る「回帰タスクの三位一体」
これら 3 枚の図は、 回帰タスクの異なる側面を見ています。 図 1 は「データとモデルの幾何学的関係」、 図 2 は「モデルの仮定と現実のズレ」、 図 3 は「モデル選択における複雑さの最適化」です。 実務で回帰モデルを構築するとき、 この 3 つの視点を順に確認することが、 信頼できる予測モデルを作るための王道です。
具体的なワークフローは次のようになります。 まず散布図(図 1 タイプ)でデータの全体像と直線関係の有無を確認し、 必要なら非線形変換を検討します。 次に単純な線形回帰をフィットさせ、 残差プロット(図 2 タイプ)でモデルの仮定が満たされているかをチェックします。 もし仮定違反が見つかれば、 説明変数の追加、 関数形の変更、 ロバスト回帰への切り替えなどを行います。 最後に、 学習曲線(図 3 タイプ)で、 モデルの複雑さが適切かを評価し、 過学習・未学習を防ぐためのハイパーパラメータ調整を行います。
この三段階のループを回すことで、 回帰タスクは「データを直線で当てはめる単純作業」から、 「データの本質的構造を捉える科学的探究」へと変わります。 SSDSE-B-2026 のようなオープンデータを題材に、 自分の手でこの 3 枚の図を描き、 その意味を読み解いてみることが、 回帰タスクを真に理解する近道です。
補足:回帰タスクと分類タスクの境界線
回帰タスクは「連続値の予測」と定義されますが、 実は分類タスクとの境界は思ったほど明瞭ではありません。 たとえば、 ロジスティック回帰は「回帰」と名がついていますが、 実態は分類モデルです。 確率という連続値を予測した上で、 閾値で 0/1 に分けるからです。 逆に、 「予算カテゴリ(低・中・高)」のような順序尺度を予測する問題は、 順序ロジスティック回帰や順序プロビット回帰として、 分類と回帰の中間で扱われます。
また、 同じデータでも「出生数を予測する」なら回帰、 「出生数が 1 万人を超えるかどうかを予測する」なら分類、 となります。 つまり、 タスクが回帰か分類かは「データの性質」ではなく「問題の立て方」によって決まります。 実務では、 まず連続値で予測し、 必要に応じて閾値で分類に変換するほうが、 情報量を保てる場合が多いです。 たとえば、 信用スコアを連続値で予測し、 後から「審査通過」「保留」「却下」の 3 クラスに分ける、 といった使い方です。
📝 演習問題(3 問)
演習 1:残差プロットの読解
SSDSE-B-2026 を使い、 「総人口」から「出生数」を予測する単回帰モデルを作り、 残差プロットを描きなさい。 残差にどのようなパターンが見えるかを観察し、 (a) 等分散性、 (b) 線形性、 (c) 外れ値の有無、 についてそれぞれ 2-3 文で考察しなさい。 もし問題が見つかった場合、 どんな対策が考えられるかも併せて述べなさい。
ヒント:東京都が外れ値になる可能性が高い。 対数変換 $\log(y)$ も試してみるとよい。
演習 2:学習曲線で最適次数を見つける
SSDSE-B-2026 で、 「総人口」から「世帯数」を多項式回帰で予測する。 次数 $d = 1, 2, 3, 4, 5$ について、 5-fold cross validation で訓練 RMSE と検証 RMSE を計算し、 学習曲線を描きなさい。 (a) 最適次数はいくつか、 (b) その次数を超えると何が起きるか、 (c) もし正則化(リッジ回帰)を入れたら学習曲線はどう変わると予想されるか、 を答えなさい。
ヒント:sklearn.model_selection.cross_val_score、 scoring='neg_root_mean_squared_error' を使う。
演習 3:回帰タスクの設計
SSDSE-B-2026 から、 自分で「目的変数 $y$ と説明変数 $X$(3 つ以上)」の組を設計し、 回帰タスクとして定式化しなさい。 (a) なぜその目的変数を選んだか(社会的意味)、 (b) なぜその説明変数を選んだか(因果・関連性)、 (c) 予想される RMSE と $R^2$ の値、 (d) このモデルから得られる実用的な洞察、 を 200 字以上で論じなさい。
ヒント:例として「高齢化率」「医療費」「保育所定員」「外国人比率」「観光客数」などが目的変数の候補になる。
これら 3 つの演習を通じて、 回帰タスクの「探索 → 診断 → 設計」のサイクルを体験できます。 単に教科書を読むだけではなく、 自分の手でデータに触れ、 残差を見つめ、 学習曲線で悩むことこそが、 回帰タスクを「自分のもの」にする唯一の方法です。 SSDSE-B-2026 は 47 都道府県という小さなデータセットですが、 だからこそ「データ 1 点の重み」を実感できる、 教育用としては最良の素材の一つです。
深掘り:回帰タスクで使われる損失関数の選び方
回帰タスクの「最小化対象」である損失関数は、 単なる数式の選択ではなく、 「どんな誤差を重く罰したいか」という哲学的な意思決定です。 最も標準的な MSE(mean squared error、 平均二乗誤差)は、 大きな誤差を二乗で罰するため、 外れ値に敏感です。 たとえば、 誤差 10 は誤差 1 の 100 倍重く扱われます。 これは「大きく外すぐらいなら、 全部少しずつ外したい」という考え方に基づきます。
これに対し、 MAE(mean absolute error、 平均絶対誤差)は、 誤差を絶対値で評価するため、 外れ値の影響が線形にとどまります。 誤差 10 は誤差 1 の 10 倍にしかなりません。 中央値に近い予測を返す傾向があり、 「中位的に当たる予測がほしい」「外れ値を含むデータでも頑健な予測がほしい」場合に適しています。 ただし、 MAE は微分不可能な点(0)を持つため、 勾配ベースの最適化では工夫が必要です。
両者の中間として、 Huber 損失があります。 Huber 損失は、 小さな誤差では MSE のように二乗で扱い、 大きな誤差では MAE のように絶対値で扱います。 切り替えの境界 $\delta$ をハイパーパラメータとして持ちます。 sklearn の HuberRegressor がこれを実装しており、 「ある程度の頑健性は欲しいが、 微分可能性も保ちたい」場合に重宝します。
さらに発展的な選択肢として、 Quantile 損失(pinball loss)があります。 これは、 「予測値が実測値より大きいときと小さいときで非対称に罰する」損失関数で、 中央値以外の分位点(例:95% 分位点)を予測することができます。 在庫管理(過剰在庫より欠品のほうがコストが大きい)、 リスク評価(VaR の計算)、 不動産価格の幅推定(5% 〜 95% の予測区間)など、 「片側の誤差のほうが重い」業務で使われます。
損失関数の選択は、 評価指標の選択とも連動すべきです。 MSE で学習したモデルを MAE で評価する、 といった食い違いがあると、 そのモデルは「自分が最小化したものとは違う基準で評価されている」ため、 ベストな性能を発揮できません。 ビジネス側が「平均的にズレない」予測を求めているなら MSE、 「半分は当てて半分は外しても、 外れ方が一定」を求めているなら MAE、 「最悪ケースを避けたい」なら Quantile、 と、 ビジネス要件と数式を一致させることが、 回帰タスクの設計者の重要な責務です。
深掘り:正則化が回帰タスクにもたらす効果
正則化(regularization)は、 回帰タスクで過学習を防ぐための最重要技法です。 数学的には、 損失関数に「モデルの複雑さに対する罰則項」を加えます。 リッジ回帰(L2 正則化)は $\sum \beta_j^2$ を加え、 LASSO(L1 正則化)は $\sum |\beta_j|$ を加えます。 罰則の強さは、 ハイパーパラメータ $\alpha$(または $\lambda$)で調整します。
リッジ回帰の効果は、 「係数を全体的に縮める(shrinkage)」ことです。 特徴量同士に強い相関(多重共線性)がある場合、 OLS の解は不安定になりますが、 リッジはこれを安定化します。 また、 特徴量の数 $p$ がサンプル数 $n$ を超えるような「広い行列」でも、 リッジは解を一意に定めます。 ただし、 リッジは係数を完全にゼロにはしません。 すべての特徴量が「少しずつ寄与する」モデルになります。
LASSO の効果は、 「不要な係数をゼロにする(sparsity)」ことです。 これは「特徴選択」を自動で行うことに相当し、 解釈性の高いモデルが得られます。 100 個の説明変数のうち、 LASSO によって 10 個だけが選ばれる、 といったことが起こります。 ただし、 LASSO は「相関の高い特徴量のうち 1 つだけを選ぶ」傾向があり、 どれが選ばれるかはサンプリングに敏感です。 これを改善したのが Elastic Net で、 L1 と L2 の両方を組み合わせます。
正則化の強さ $\alpha$ は、 交差検証で選びます。 sklearn の RidgeCV、 LassoCV は、 これを自動化してくれます。 $\alpha = 0$ なら OLS と同じ、 $\alpha \to \infty$ なら全係数がゼロ(切片だけのモデル)になります。 学習曲線で訓練誤差と検証誤差が大きく乖離している場合、 $\alpha$ を増やすことで乖離を縮めることができます。 これは、 図 3 の検証誤差の U 字曲線を「右下にシフトさせる」効果と理解できます。
回帰タスクにおいて、 正則化は「サンプル数が少ない」「特徴量が多い」「多重共線性がある」場合に特に効果を発揮します。 SSDSE-B-2026 のように 47 サンプルしかないデータで、 10 個以上の説明変数を使う場合、 ほぼ確実に正則化が必要です。 正則化なしの OLS は、 サンプル数に対して係数の自由度が高すぎ、 訓練データのノイズまで覚え込んでしまうからです。 「特徴量が多いときは、 とりあえずリッジから試す」は、 回帰タスクの王道戦略の一つです。
深掘り:回帰タスクで頻出する評価指標の比較
回帰タスクの性能を「数値で表す」評価指標には、 複数のバリエーションがあり、 場面に応じて使い分ける必要があります。 最も基本的な MSE(mean squared error)は、 残差の二乗平均で、 単位が「目的変数の二乗」になります。 たとえば、 出生数(人)を予測した場合、 MSE は「人の二乗」という解釈しづらい単位になります。 これを平方根にした RMSE(root mean squared error)は、 目的変数と同じ単位になるため、 解釈が容易です。
MAE(mean absolute error)は、 残差の絶対値の平均で、 「平均的にどれくらいズレているか」を直感的に理解できます。 RMSE は大きな誤差を強調しますが、 MAE はすべての誤差を平等に扱います。 「100 のうち 1 個だけ大きく外す」モデルと「100 個すべて小さく外す」モデルでは、 前者のほうが RMSE が大きく、 MAE では差が小さくなります。
決定係数 $R^2$ は、 「目的変数の分散のうち、 モデルがどれだけ説明できているか」を [0, 1] の範囲で表します。 $R^2 = 0$ は「平均値で予測するのと同等」、 $R^2 = 1$ は「完璧な予測」を意味します。 ただし、 $R^2$ は説明変数を増やすほど自動的に上昇するため、 重回帰では「自由度調整済み $R^2$(adjusted $R^2$)」を使うのが一般的です。 また、 $R^2$ は線形回帰で「訓練データの分散の説明率」として最も明快な解釈を持ちますが、 非線形モデルや検証データでは「擬似 $R^2$」と呼ぶべきもので、 値が負になることもあります(モデルが平均値予測より悪い場合)。
MAPE(mean absolute percentage error)は、 残差を実測値で割って百分率にしたものです。 「平均で何 % ずれているか」を表し、 桁が大きく異なる目的変数(売上、 人口、 面積)に対して有用です。 ただし、 実測値が 0 に近いと発散するため、 ゼロ近傍を含むデータでは使えません。 また、 「過小予測(実測 > 予測)」と「過大予測(実測 < 予測)」が非対称に評価されるバイアスがあり、 機械学習コンペでは sMAPE(symmetric MAPE)が使われることもあります。
最近では、 RMSLE(root mean squared logarithmic error)も人気です。 目的変数を対数変換してから RMSE を計算するため、 「相対誤差」を重視し、 大きな値での絶対誤差を抑制します。 「予測が実測の 2 倍」と「予測が実測の 0.5 倍」を同じ重みで罰する、 という性質があり、 売上や交通量のように「桁が大きく異なる予測」をするときに適しています。 Kaggle の住宅価格予測コンペや、 サプライチェーン需要予測でよく使われます。
評価指標の選択は、 ビジネス要件と結びつけて行うべきです。 「在庫切れによる機会損失が大きい」業務では、 過小予測を重く罰する非対称損失(quantile loss)が適切です。 「予測が大きく外れることが致命的」な業務(医療、 安全)では、 RMSE や最大誤差を重視すべきです。 「平均的にズレが少ない」が目標なら MAE、 「相対精度が重要」なら MAPE か RMSLE、 と、 評価指標を選ぶことは、 モデルを選ぶことと同じくらい重要な意思決定です。
深掘り:回帰タスクと時系列予測の違い
「予測」と聞くと、 時系列予測(時間とともに変動するデータを未来へ外挿する)を思い浮かべる方も多いでしょう。 しかし、 標準的な回帰タスクと時系列予測は、 同じ「連続値予測」でも、 前提条件が大きく異なります。 標準的な回帰タスクは「i.i.d.(独立同分布)」を仮定し、 サンプル間に時間的順序や依存関係がないとみなします。 一方、 時系列予測は「サンプル間に時間的依存性がある」ことを前提とし、 過去の値から未来を予測します。
この違いは、 訓練・検証データの分け方に決定的な影響を与えます。 標準的な回帰タスクでは、 ランダムに 80% を訓練・20% を検証に分けます。 しかし、 時系列予測でランダム分割をすると、 「未来のデータで訓練して過去を予測する」という「データリーク」が起きてしまいます。 時系列では必ず「時間順に並べ、 古い方を訓練、 新しい方を検証」とする「時系列分割(time series split)」を使う必要があります。
SSDSE-B-2026 は 47 都道府県 × 12 年度(2012〜2023 年度)の 564 行を持つパネルデータである。 1 つの年度に絞った 47 行の断面なら標準的な回帰タスクとして扱えるが、 12 年度をまとめて使うなら、 同じ県の別年度が訓練とテストに分かれないようにする分割(下の ⚠️ 章の GroupKFold)や、 時系列予測・パネルデータ分析(固定効果モデル、 ランダム効果モデル)の手法が必要になる。 タスクの性質を見極めて、 適切な手法を選ぶことが重要です。
深掘り:線形回帰を超える非線形回帰手法のパノラマ
回帰タスクの最も基本は線形回帰ですが、 現実のデータは線形では捉えきれない複雑な構造を持つことが多いです。 そこで、 さまざまな非線形回帰手法が開発されてきました。 最もシンプルな拡張は「多項式回帰」で、 説明変数を $x, x^2, x^3, \ldots$ と高次にすることで、 曲線的な関係を捉えます。 ただし、 高次になるほど境界付近での予測が不安定になる「ルンゲ現象」が起きやすいため、 次数 3-4 程度で打ち切ることが一般的です。
「スプライン回帰(spline regression)」は、 説明変数を複数の区間に分割し、 各区間で別々の多項式を当てはめ、 区間の境界で滑らかに繋ぐ手法です。 これにより、 局所的な変化を柔軟に捉えながら、 大域的な滑らかさを保つことができます。 自然スプライン、 B スプライン、 P スプラインなど、 様々なバリエーションがあります。 R の mgcv パッケージや、 Python の statsmodels で利用できます。
「ガウス過程回帰(Gaussian process regression)」は、 関数そのものを確率分布として扱うベイズ的手法で、 予測値だけでなく「予測の不確実性」も同時に出してくれます。 サンプル数が少ない(数十〜数百)データで特に強力ですが、 計算量が $O(n^3)$ と大きく、 大規模データでは工夫が必要です。 ハイパーパラメータ最適化、 ベイズ最適化、 アクティブラーニングなどで広く使われます。
「ランダムフォレスト回帰」「勾配ブースティング回帰(XGBoost、 LightGBM、 CatBoost)」は、 決定木をベースとしたアンサンブル手法で、 表形式データ(tabular data)で最強の予測精度を出すことが多いです。 特徴量の非線形性や交互作用を自動的に捉え、 前処理(スケーリング、 ダミー変数化)の手間も少ないため、 Kaggle などのコンペで最頻出です。 解釈性については SHAP 値や特徴量重要度で補えます。
「ニューラルネット回帰」は、 多層パーセプトロン(MLP)の出力層を恒等関数とし、 損失関数を MSE にしたものです。 表形式データでは勾配ブースティングに劣ることが多いですが、 画像、 音声、 テキストなど高次元データでは、 適切なアーキテクチャ(CNN、 RNN、 Transformer)と組み合わせることで圧倒的な性能を発揮します。 「画像から年齢を推定する」「音声から心拍数を推定する」「テキストから感情スコアを予測する」など、 構造化データを超えた回帰タスクで主流です。
これらの手法のうち、 どれを使うべきかは「データのサイズ」「次元」「構造」「解釈性の要求」によって決まります。 47 都道府県のような小規模・低次元のデータでは、 ガウス過程回帰やリッジ回帰、 単純な多項式回帰が適しています。 数十万行・数百特徴量の表形式データでは、 LightGBM や XGBoost が王道です。 画像や音声を含む高次元データでは、 ニューラルネット回帰一択です。 回帰タスクの設計者は、 これらの選択肢を俯瞰し、 状況に応じて最適な道具を選ぶ目を持つ必要があります。
🗺 概念マップ
下の図は中心に「回帰タスク」を置き、 周りに 6 つの要素を並べたもの。 目的変数(連続値) は回帰タスクであることを決める条件で、 同じ出生数でも「1 万人を超えるか」に変えると 対比:分類タスク になる。 モデルの側は、 このページの手計算で使った 線形回帰 / OLS、 係数を縮める Ridge / Lasso、 非線形を拾う 木系:XGBoost の 3 つ。 どれを選んでも最後は 評価:RMSE / MAE で比べる。 🧮 章の 6 県の例(MAE 1,910.5 人・RMSE 2,472.53 人)と 47 県の例(MAE 1,199 人・RMSE 1,769 人)は、 この「評価」の枝の具体例にあたる。
🔗 隣接手法への橋渡し
「回帰タスク」は単独で完結する手法ではなく、 隣接領域と連携することで真価を発揮する。
- 上流: データセット の応答変数が連続値であることを 尺度水準 で確認した後、 訓練・テスト分割 で準備する
- 並列: 分類タスク(離散ラベル)や クラスタリング(教師なし)。 応答変数の型でタスクを切り替える
- 下流: RMSE・MAE・決定係数 でモデル評価、 ハイパラ調整 で性能改善
「出生数を予測する」「家賃を予測する」「商品売上を予測する」など、 連続値を当てる 問題は機械学習タスクの代表格であり、 線形〜深層モデルまで広範な手法が選べる。
🌳 手法選択フロー
「回帰タスク」を機械学習プロジェクトに位置づけるとき、 目的変数の性質と評価指標で判定する。
- 目的変数は連続値か離散値か? 売上額・気温・人口のような連続値 → 回帰タスク。 購入有無・カテゴリ → 分類タスク。 順序付きカテゴリ → 順序回帰
- 線形関係を仮定できるか? 散布図がほぼ直線 → 線形回帰 や Ridge。 非線形パターン → 決定木・Random Forest・XGBoost
- 誤差の大きさをどう測るか? 外れ値を強く罰したい → RMSE。 中央値的に評価したい → MAE。 相対誤差を見たい → MAPE。 説明力を見たい → R²
SSDSE-B-2026 で「都道府県別の出生数を予測する」は典型的な回帰タスク。 まず散布図で線形性を確認し、 線形回帰でベースラインを作ってから木系モデルで非線形を捉えるのが標準ワークフロー。