🔖 キーワード索引
💡 30秒で分かる結論
🍰 まずはやさしく
正解を確かめるためのテストです。
モデルが正しいか判断するために使います。
スマホのアプリを試す感覚に似ています。
まずは結論と直感的な意味を読みましょう。
モデル選択のための検証手続き
- バリデーションは、 学習に使わなかったデータでモデルの成績を測る手続き。 Train で学び、 Val で選び、 Test で 1 回だけ最終判定する
- 47 都道府県のような小標本では 1 回のホールドアウトは運に左右される。 総人口と 65 歳以上人口で出生数を当てる回帰は、 5-fold CV で fold ごとの R² が 0.969〜0.995(平均 0.984)と揺れる
- 県 × 12 年度のパネルを年を無視して KFold すると、 同じ県の前後の年度が学習側に入る。 TimeSeriesSplit(R² 0.989 ± 0.005)より KFold(0.992 ± 0.0003)のほうが高く出るのはそのため
- ハイパラを選んだ CV のスコアをそのまま報告すると楽観的になる。 選択と評価を分ける Nested CV を使う
- CV スコアは分割の仕方(シード)でも動く。 同じモデルでシードを 0〜9 に変えると平均 R² は 0.974〜0.994。 平均だけでなく fold ごとの値と揺れ幅を報告する
📍 文脈 — どこで使う概念か
🍰 まずはやさしく
モデルを選ぶための準備ステップです。
最適な設定を見つけるために使います。
部活の練習で本番を想定するようなものです。
この言葉がどう使われるかを見ていきましょう。
バリデーション(検証)は 学習済みモデルを Train と Test の間で評価し、 ハイパラ調整やモデル選択に使う中間ステップ。 Train で学び、 Val で選び、 Test で最終判定、 という 3 段構えが現代 ML の標準。
📍 あなたが今見ているもの
このページは、 モデルを作った「後」に、 その成績をどう測れば本番での成績に近い値になるかを扱う。 交差検証・ホールドアウトといった個々の分割法の手順はそれぞれのページに譲り、 ここでは「データの形(標本サイズ・時系列・同じ県の繰り返し・クラスの偏り)からどの分割法を選ぶか」と「出てきたスコアをどう読むか・どう報告するか」を、 SSDSE-B-2026 の 47 都道府県 × 12 年度のデータで確かめる。
🎨 直感で掴む
🍰 まずはやさしく
未知のデータへの強さを測る仕組みです。
練習問題だけに慣れるのを防ぐために使います。
テスト勉強で予想問題を解く感覚です。
データの量に合わせて選ぶ方法を学びます。
バリデーション (validation) は「モデルの未知データへの汎化性能を、 訓練時に見せなかったデータで測る」プロセス。 単に訓練データの精度 (in-sample) を測ると過学習を見逃すため、 train/validation の分離が必須。 SSDSE-B-2026 の 47 都道府県のような小標本では、 ホールドアウトより 5-fold CV または LOO で「全データを評価に使い回す」のが定石。
本ページでは バリデーション を、 「ホールドアウト → K-fold CV → 層化 K-fold → LOO → TimeSeriesSplit」の選択軸で整理し、 SSDSE-B-2026 の N=47 ケースでの実装を示す。 厳密な定義より、 まず標本サイズ N と時系列性で何を選ぶかを理解することを優先する。
🎨 直感で掴む — 具体例で理解する
Validation がないと「Test を見ながらモデルを調整する」ことになり、 Test 過適合が起きる。 そこで Train を Train + Val に分け、 ハイパラやモデル選択は Val で完結させる。 データが小さいと Val の不確実性が大きいので、 K-Fold CV で k 回平均を取る。 時系列データは未来情報リークを避けるため Time Series Split を使う。
📐 定義
🍰 まずはやさしく
モデル選択のための検証手続きのことです。
分析の標準的な道具として使います。
買い物で商品の質を確かめるようなものです。
詳しい定義や計算の方法を確認しましょう。
モデル選択のための検証手続き
英語名 Validation。
📐 数式・定義
バリデーションを数式 / 形式定義で表す:
K-Fold 交差検証スコア:データを K 分割し、 各 fold を Val、 残りを Train として K 個のモデルを学習し平均する。
📐 k-fold CV の数式を言葉で読み解く
k-fold CV の汎化誤差推定量は次のように書ける。
数式を言葉で読み解く:
- $k$:分割数(典型は 5 または 10)。 大きいほどバイアス小・分散大。
- $D_j$:第 $j$ 番目の fold(テスト用)。 残り $k-1$ 個で学習。
- $\hat{f}^{(-j)}$:fold $j$ を除いたデータで学習したモデル。
- $L(\cdot)$:損失関数(回帰なら二乗誤差、 分類なら 0-1 損失など)。
- 外側の $\frac{1}{k}\sum$:各 fold の損失を 平均することで、 1 つの fold に依存しない安定な推定値を得る。
バイアス・分散分解で見ると、 k=n(LOOCV)はバイアス最小だが分散大、 k=5 は分散小だがバイアス中程度。 経験則として k=5 または k=10 がスイートスポット。
🔬 数式を言葉で読み解く
上の数式に出てきた記号を 1 つずつ解説します。 数式が出てくる試験問題(統計検定・G 検定・基本情報)では、 各記号の意味を答えられるかが分岐点:
| 記号 | 意味 |
|---|---|
| $K$ | Fold 数(5 or 10 が典型) |
| $\mathcal{D}_k^{\text{val}}$ | $k$ 番目の検証 fold |
| $f^{(-k)}$ | fold $k$ を除いて学習したモデル |
| Metric | RMSE・F1 など |
🧮 SSDSE-B 実値計算 — 都道府県データで手を動かす
SSDSE-B-2026 で 「総人口 → 出生数」回帰の 5-Fold CVを実行し、 各 fold の R² と平均を出す。
使用データ:SSDSE-B-2026.csv(独立行政法人 統計センター提供、 47 都道府県 × 100 超の社会経済指標)。 出典
1 2 3 4 5 6 7 8 9 10 11 12 13 14 15 16 | import pandas as pd from sklearn.linear_model import LinearRegression from sklearn.model_selection import KFold, cross_val_score import numpy as np df = pd.read_csv('data/raw/SSDSE-B-2026.csv', encoding='cp932', skiprows=[1]) df = df.rename(columns={df.columns[2]: 'pref'}) df = df[df['SSDSE-B-2026'] == 2023] # 2023 年度の 47 都道府県 X = df[['A1101', 'A1303']].values y = df['A4101'].values kf = KFold(n_splits=5, shuffle=True, random_state=42) scores = cross_val_score(LinearRegression(), X, y, cv=kf, scoring='r2') print(f'各 fold R²: {scores.round(3)}') print(f'平均 R² : {scores.mean():.3f} ± {scores.std():.3f}') |
💬 5 つの fold の R² は 0.969〜0.995 で、平均 0.984 ± 0.010。どの fold でも 0.97 を下回らないので、総人口と 65 歳以上人口で出生数を当てる線形モデルは、どの 9〜10 県を検証に回しても安定している。最も低い 0.969 は 3 番目の fold で、kf.split で中身を見ると北海道が入っている。北海道は人口規模の割に出生数が少なく、この 2 変数の直線から大きく外れる県なので、fold ごとの差は検証に回った県の顔ぶれで説明できる。
▲ 上記コードはそのまま実行可能。 CP932 エンコーディング・skiprows=1(英語ヘッダ行をスキップ)・列名の英数字コード(A1101 = 総人口 など)に注意。
🧮 SSDSE-B-2026 で 5-fold CV を回す
このコードでやること:SSDSE-B-2026 の都道府県データ(2023 年・n=47)を使い、 「総人口(A1101)」を予測する線形回帰モデルの汎化性能を cross_val_score で 5-fold CV により評価する。
📥 入力データ(SSDSE-B-2026 抜粋):
1 2 3 4 5 6 7 8 9 10 11 12 13 14 15 16 17 18 19 | import pandas as pd from sklearn.linear_model import LinearRegression from sklearn.model_selection import KFold, cross_val_score from sklearn.pipeline import make_pipeline from sklearn.preprocessing import StandardScaler df = pd.read_csv('data/raw/SSDSE-B-2026.csv', encoding='cp932', skiprows=[1]) df = df[df['SSDSE-B-2026'] == 2023].reset_index(drop=True) # 2023 年・47 都道府県 # 説明変数:15歳未満人口、 出生数、 合計特殊出生率 → 目的変数:総人口 X = df[['A1301', 'A4101', 'A4103']] y = df['A1101'] # 人口・出生数(〜10^5)と出生率(〜1)は桁が違うので、標準化してから回帰する model = make_pipeline(StandardScaler(), LinearRegression()) kf = KFold(n_splits=5, shuffle=True, random_state=42) scores = cross_val_score(model, X, y, cv=kf, scoring='r2') print("各 fold R²:", scores.round(3)) print(f"平均 R² = {scores.mean():.3f} ± {scores.std():.3f}") |
📤 実行すると次の出力が得られる:
💬 結果の読み方:R² ≈ 0.990 と非常に高く、 5 fold も 0.983〜0.997 に収まってばらつきは小さい(±0.006)。 → 15 歳未満人口・出生数・合計特殊出生率の 3 変数で総人口がほぼ説明できる、 安定したモデルだと判断できる。 hold-out の 1 値ではなく 5 つの値の分布を見ることで「たまたまよく当たった」を排除できる。
🧮 数式に値を入れて手で計算する: K-fold CV の評価
合成 5-fold CV の精度を平均する。
Step 1: fold 別精度
Step 2: 95% CI
🐍 Python で再現
1 2 3 4 5 6 7 | import numpy as np folds = np.array([0.85, 0.87, 0.84, 0.86, 0.83]) mean = folds.mean() sd = folds.std(ddof=1) SE = sd/np.sqrt(len(folds)) print(f"平均: {mean}, SD: {sd:.3f}") print(f"95% CI: [{mean - 1.96*SE:.3f}, {mean + 1.96*SE:.3f}]") |
📤 実行結果
💬 手計算 (Step 2) と Python 出力が完全一致。
🐍 Python 実装
この章では、 分割法ごとに「何を学習に使い、 何で評価したか」がスコアにどう効くかを、 同じ SSDSE-B-2026 のデータで並べて確かめる。 ホールドアウト 1 回 → 層化 K-fold → Nested CV → TimeSeriesSplit → Pipeline の順に進む。
🐍 ホールドアウト 1 回(37 県で学習・10 県で評価)
1 2 3 4 5 6 7 8 9 10 11 12 13 14 15 16 17 18 19 20 21 22 23 24 25 26 27 | # ── この抜粋で使うデータを用意します(英字の項目コードで読み込み)── import pandas as pd df = pd.read_csv('data/raw/SSDSE-B-2026.csv', encoding='cp932', header=0) df = df[df['Code'].astype(str).str.match(r'^R\d{5}$', na=False)].copy() for _c in df.columns[3:]: df[_c] = pd.to_numeric(df[_c], errors='coerce') df = df[df['SSDSE-B-2026'] == df['SSDSE-B-2026'].max()] # この抜粋で使う df_jp を用意する import pandas as pd df_jp = pd.read_csv('data/raw/SSDSE-B-2026.csv', encoding='cp932', skiprows=[1]) df_jp = df_jp[df_jp['SSDSE-B-2026'] == 2023] # 2023 年の 47 都道府県 from sklearn.linear_model import LinearRegression from sklearn.metrics import r2_score, mean_squared_error from sklearn.model_selection import train_test_split import numpy as np X = df_jp[['A1101', 'A1303']].fillna(0).values y = df_jp['A4101'].values X_tr, X_te, y_tr, y_te = train_test_split(X, y, test_size=0.2, random_state=42) m = LinearRegression().fit(X_tr, y_tr) pred = m.predict(X_te) print(f'R² = {r2_score(y_te, pred):.3f}') print(f'RMSE = {np.sqrt(mean_squared_error(y_te, pred)):.2f}') |
💬 こちらは df_jp を skiprows=[1] で読み直してから同じ 2 変数モデルを 37 県で学習し、残る 10 県で評価した。R² = 0.982 は先の 5-Fold CV の平均 0.984 とほぼ同じだが、RMSE 3,439 人の 1 回分だけでは、5-Fold CV の fold 間の幅(R² で 0.969〜0.995)のどこに当たるかは分からない。ホールドアウトは速い代わりに分け方の運に左右されるので、47 県程度の小さなデータでは交差検証の平均と幅を主に報告する。
🐍 Stratified k-fold で分類を評価(fold ごとの正例率をそろえる)
このコードでやること:SSDSE-B-2026 から「合計特殊出生率(A4103)が全国平均以下か」を二値分類し、 各 fold で正例比率を揃える Stratified k-fold で評価する。
📥 入力データ:A4103(合計特殊出生率)を平均で二値化したラベル。 正例率は約 50%(実測 49%=23/47)。
1 2 3 4 5 6 7 8 9 10 11 12 13 | import pandas as pd from sklearn.linear_model import LogisticRegression from sklearn.model_selection import StratifiedKFold, cross_val_score df = pd.read_csv('data/raw/SSDSE-B-2026.csv', encoding='cp932', skiprows=[1]) df = df[df['SSDSE-B-2026'] == 2023] # 2023 年・47 都道府県 X = df[['A1101', 'A1301', 'A4101']] y = (df['A4103'] < df['A4103'].mean()).astype(int) skf = StratifiedKFold(n_splits=5, shuffle=True, random_state=42) model = LogisticRegression(max_iter=1000) scores = cross_val_score(model, X, y, cv=skf, scoring='accuracy') print(f"Stratified 5-fold accuracy: {scores.mean():.3f} ± {scores.std():.3f}") |
📤 実行例:
💬 結果の読み方:accuracy 83% は単純多数決(約 51%)より高いが、 標準偏差 ±8.5% と大きい → サンプル数 47 と小さいことが原因。 通常の KFold だと fold によって正例比率が偏り評価が不安定になるので、 不均衡データでは Stratified 一択。
🐍 Nested CV — ハイパラ調整と性能評価を分離
このコードでやること:内側 CV でハイパラを選び、 外側 CV でモデル性能を評価する Nested CV を SSDSE-B-2026 で実行する。 同じデータでチューニングと評価を兼ねると 楽観バイアスが乗るのを防ぐ。
📥 入力データ:SSDSE-B-2026、 X は人口 3 変数、 y は出生数(A4101)。
1 2 3 4 5 6 7 8 9 10 11 12 13 14 15 16 17 18 19 20 21 22 23 24 25 | import pandas as pd from sklearn.linear_model import Ridge from sklearn.pipeline import make_pipeline from sklearn.preprocessing import StandardScaler from sklearn.model_selection import GridSearchCV, cross_validate, KFold df = pd.read_csv('data/raw/SSDSE-B-2026.csv', encoding='cp932', skiprows=[1]) X = df[['A1101', 'A1301', 'A4200']] y = df['A4101'] # 桁の違う説明変数に Ridge をかけるので、標準化してから罰則を効かせる model = make_pipeline(StandardScaler(), Ridge()) inner = KFold(n_splits=3, shuffle=True, random_state=0) outer = KFold(n_splits=5, shuffle=True, random_state=1) param_grid = {'ridge__alpha': [0.01, 0.1, 1.0, 10.0, 100.0]} gs = GridSearchCV(model, param_grid, cv=inner, scoring='r2') res = cross_validate(gs, X, y, cv=outer, scoring='r2', return_estimator=True) nested_scores = res['test_score'] print("外側 fold ごとに選ばれた alpha:", [est.best_params_['ridge__alpha'] for est in res['estimator']]) print(f"Nested CV R² = {nested_scores.mean():.4f} ± {nested_scores.std():.4f}") # 比較: 全データで選んだ alpha の内側 CV スコア(同じデータで選んで評価するので楽観的) gs.fit(X, y) print(f"GridSearchCV best_score_ = {gs.best_score_:.4f} (alpha={gs.best_params_['ridge__alpha']})") |
📤 実行例:
💬 結果の読み方:5 つの外側 fold すべてで内側 CV が alpha = 0.1 を選び、 Nested CV の R² は 0.9916 ± 0.0004。 同じデータで選んで評価した GridSearchCV の best_score_ 0.9918 のほうがわずかに高く、 これが「選んだデータで評価する」ことの楽観バイアスにあたる。 ここでは差が 0.0002 と小さいが、 候補のハイパラが多く標本が少ないほど開く。 なお標準化せずに Ridge にかけると、 人口(〜10^6)に比べて罰則が効かず 5 つの alpha がすべて同じスコアになり、 探索そのものが意味を失う。
🐍 TimeSeriesSplit — 時系列データの正しい分割
このコードでやること:SSDSE-B-2026 を複数年データとして扱い、 TimeSeriesSplit で「過去→未来」の分割を行う。 通常の KFold と比較して、 リーク防止の重要性を確認する。
📥 入力データ:SSDSE-B-2026 を SSDSE-B-2026 列(年)でソート、 X は人口関連 3 変数、 y は出生数。
1 2 3 4 5 6 7 8 9 10 11 12 13 14 15 16 17 18 19 20 21 22 | import pandas as pd from sklearn.linear_model import LinearRegression from sklearn.model_selection import TimeSeriesSplit, KFold, cross_val_score df = pd.read_csv('data/raw/SSDSE-B-2026.csv', encoding='cp932', skiprows=[1]) df_sorted = df.sort_values('SSDSE-B-2026', kind='stable') # 年順 X = df_sorted[['A1101', 'A1301', 'A4200']] y = df_sorted['A4101'] tscv = TimeSeriesSplit(n_splits=5) for i, (tr, vl) in enumerate(tscv.split(X)): yrs = df_sorted['SSDSE-B-2026'].iloc[vl] print(f"Fold {i}: train {len(tr)} 件, val {len(vl)} 件 (検証 {yrs.min()}–{yrs.max()} 年度)") scores = cross_val_score(LinearRegression(), X, y, cv=tscv, scoring='r2') print("各 fold R²:", scores.round(3)) print(f"TimeSeriesSplit R² = {scores.mean():.4f} ± {scores.std():.4f}") # 比較: 年を無視して無作為に 5 分割した場合 kf = KFold(n_splits=5, shuffle=True, random_state=42) kf_scores = cross_val_score(LinearRegression(), X, y, cv=kf, scoring='r2') print(f"KFold(shuffle) R² = {kf_scores.mean():.4f} ± {kf_scores.std():.4f}") |
📤 実行例:
💬 結果の読み方:fold が進むごとに train が 94 件(2 年度分)ずつ増える expanding window で、 検証は常に学習より後の 2 年度。 R² は 0.995 から 2020–2021 年度の 0.981 まで下がり、 平均 0.9890 ± 0.0050。 同じデータを年を無視して無作為に分けた KFold は 0.9919 ± 0.0003 と高く揃うが、 これは同じ県の前後の年度が学習側にも入り、 未来の値を見て当てている分を含む。 過去から未来を当てる性能として報告するのは TimeSeriesSplit 側の値で、 fold ごとの落ち込み(コロナ期の 2020–2021 年度が最低)も一緒に見る。
📊 主要 CV 手法の比較表
| 手法 | バイアス | 分散 | 計算量 | 用途 |
|---|---|---|---|---|
| Hold-out | 中 | 高 | O(1) | 大規模・素早く回したい |
| 5-fold CV | 小〜中 | 小 | O(5) | 標準的選択 |
| 10-fold CV | 小 | 中 | O(10) | 中小規模データ |
| LOOCV | 最小 | 大 | O(n) | 超小規模(n < 50) |
| Stratified k-fold | 小 | 小 | O(k) | 不均衡分類 |
| TimeSeriesSplit | 中 | 中 | O(k) | 時系列 |
| GroupKFold | 小 | 小 | O(k) | グループ構造あり |
| Nested CV | 最小 | 小 | O(k×k) | ハイパラ調整 + 性能評価 |
| Bootstrap (.632+) | 小 | 小 | O(B) | 不確実性区間が欲しい時 |
🐍 Pipeline で Leakage を防ぐ
このコードでやること:標準化 + 線形回帰を Pipeline にまとめ、 CV の各 fold で正しく fit するようにする。 Pipeline なしと有りの結果を比較する。
📥 入力データ:SSDSE-B-2026、 X は人口関連変数(スケールがバラバラ)、 y は出生数。
1 2 3 4 5 6 7 8 9 10 11 12 13 14 15 16 17 18 19 20 21 22 23 24 | import pandas as pd from sklearn.linear_model import Ridge from sklearn.preprocessing import StandardScaler from sklearn.pipeline import Pipeline from sklearn.model_selection import cross_val_score, KFold df = pd.read_csv('data/raw/SSDSE-B-2026.csv', encoding='cp932', skiprows=[1]) X = df[['A1101', 'A1301', 'A4200']] y = df['A4101'] kf = KFold(n_splits=5, shuffle=True, random_state=42) # Pipeline なし:CV の外で全データに scaler を fit(検証 fold の平均・分散が混ざる) X_leak = StandardScaler().fit_transform(X) leak = cross_val_score(Ridge(alpha=1.0), X_leak, y, cv=kf, scoring='r2') # Pipeline 化:fold ごとに scaler を訓練側だけで再 fit する pipe = Pipeline([ ('scaler', StandardScaler()), ('ridge', Ridge(alpha=1.0)) ]) scores = cross_val_score(pipe, X, y, cv=kf, scoring='r2') print(f"Pipeline なし CV R² = {leak.mean():.4f} ± {leak.std():.4f}") print(f"Pipeline CV R² = {scores.mean():.4f} ± {scores.std():.4f}") print(f"fold ごとの差(なし − あり): {(leak - scores).round(5)}") |
📤 実行例:
💬 結果の読み方:CV の外で全データに scaler を fit した「Pipeline なし」と、 fold ごとに訓練側だけで fit する Pipeline は、 どちらも R² = 0.9915 ± 0.0012 で、 fold ごとの差も 10^−5 程度しかない。 564 行もあると検証 fold を混ぜても平均・分散がほとんど変わらないためで、 標準化だけのリークは小さい。 ただし特徴量選択・SMOTE・目的変数を使うエンコーディングのように検証 fold の y まで使う前処理では差が大きく開くので、 前処理を Pipeline に入れる習慣はそのまま守る。
🔍 深掘り:CV スコアの不確実性と統計的検定
2 つのモデルの CV スコアを比較する際、 「平均値だけ」で勝敗を決めるのは危険。 fold ごとのスコアは相関しているため、 通常の t 検定の前提が成り立たない。 推奨:
- 5x2 CV paired t-test(Dietterich 1998):5 回の 2-fold CV で 10 個のスコア差を計算、 修正 t 検定。
- Wilcoxon signed-rank test:複数データセット間でモデルを比較するノンパラメトリック検定。
- Bayesian model comparison:MCMC でモデル間の事後勝率を計算する近代的アプローチ。
Kaggle 等で「CV スコアが 0.001 上がった」と喜ぶ前に、 fold 標準偏差を見て差が有意かを必ず確認すること。
⚠️ よくある落とし穴
⚠️ よくある落とし穴(5 件)
「バリデーション」を実務・試験で扱うときに頻発する典型的なミスです。
⚠️ Data Leakage の典型パターン 5 種
- 正規化を CV 前に適用:
StandardScaler.fit_transform(X)を CV の外でやると、 テスト fold の平均・分散が train に漏れる。 →Pipelineに scaler を組み込み、 fold ごとに fit すれば防げる。 - 特徴量選択を CV 前に:相関の高い変数だけ残して CV すると、 「テスト側を覗いた選択」になる。 → 特徴量選択も Pipeline に含める。
- 時系列を shuffle:未来→過去の予測になり、 楽観評価。 →
TimeSeriesSplitを使う。 - 同一個体が train/val に分割:医療データで「同じ患者の別検査」が train と val に分かれると、 個人特徴を覚えてしまう。 →
GroupKFoldで患者 ID をグループ化。 - ターゲット由来の特徴量:「将来の y で作った変数」を X に入れる。 → 特徴量定義時点で「予測時に入手可能か」を必ず確認。
📌 CV スコアが現実より極端に高い時は、 まず Data Leakage を疑え。 CV と本番の成績が大きく食い違うときは、 分割前の前処理・特徴量の作り方・同じ個体や将来の値が学習側に入っていないかを最初に点検する。
🗓 バリデーション手法の歴史
| 年 | 出来事 | 提唱者 |
|---|---|---|
| 1968 | Hold-out 法の体系化 | Lachenbruch & Mickey |
| 1974 | Cross-validation の理論整備 | Stone, M. |
| 1979 | Bootstrap の提案 | Efron, B. |
| 1995 | k-fold CV と LOOCV の比較研究 | Kohavi, R. |
| 2006 | Nested CV による楽観バイアス研究 | Varma & Simon |
| 2016 | scikit-learn 0.18 で TimeSeriesSplit 標準化 | scikit-learn team |
❓ よくある質問
Q1. k は 5 と 10 のどちらが良い?
A. データが小さい(n < 500)なら 10-fold、 中規模(500-5000)なら 5-fold で十分。 bias-variance のトレードオフで k=10 は分散がやや大きくなるが、 多くの実証研究で k=5 と k=10 はほぼ同じ結論を出す。
Q2. LOOCV は使うべき?
A. n が極小(< 50)でなければ非推奨。 LOOCV は 分散が大きい(fold 間の相関が高いため)。 線形回帰には解析解があり計算量問題は無いが、 通常は 10-fold で十分。
Q3. Validation と Test の違いは?
A. Validation はモデル選択(ハイパラ調整・特徴量選択など)に使うデータ、 Test は最終評価のみに使うデータ。 Test を見てチューニングしてはいけない(リーク)。 Kaggle の public/private LB の関係に近い。
Q4. shuffle=True と shuffle=False の使い分け?
A. IID なら True、 時系列・順序のあるデータなら False。 とくに SSDSE-B-2026 のような複数年パネルでは year を考慮して時系列分割する必要がある。
Q5. CV スコアが test スコアと大きく違う場合は?
A. (1) data leakage、 (2) train/test の分布差(covariate shift)、 (3) サンプリングバイアス、 (4) ハイパラ過剰調整、 のいずれか。 まず Pipeline 化と分布の確認から。
🎮 触って理解する — 検証設計シミュレータ
個々の手法(交差検証・ホールドアウト)の中身は各ページに譲り、 ここでは「検証の全体設計」= データの条件からどの分割法を選ぶかを体感する。 下のスライダとスイッチで 標本サイズ N・時系列性・クラス不均衡 を切り替えると、 ①フローチャートの推奨経路、 ②分割の見取り図、 ③学習回数・fold サイズ が同時に更新される。 本ページ「🌳 手法選択フロー」のルールをそのまま動かせるようにしたもの。
① 意思決定フローチャート(推奨経路がハイライト)
② 分割の見取り図(横棒 = データ N 件、フォールドに触れると内訳表示)
💡 直感 — 検証設計は「模擬試験の設計」
本番の入試(Test)を解いて対策したら実力は測れない。 だから模擬試験(Validation)を別に用意し、 模試の作り方(分割法)はデータの性質で決める——これが検証の全体設計。 上のフローチャートの分岐は 3 つだけ:時間の向き(時系列性)・データの量(N)・ラベルの偏り(不均衡)。 この 3 条件を確認せずに train_test_split を書き始めるのが、 初学者の最も多い事故パターン。
⚠️ シミュレータで体感できる落とし穴
- 小標本 Holdout の不安定さ:N を 47 にすると LOO / 反復 K-fold が推奨される。 仮に 8:2 Holdout すると val は約 10 件——1 件の当たり外れで精度が 10 ポイント動く。 「検証に 1 度でも使う割合」が Holdout では 20% 止まりなのも確認しよう。
- 時系列 ON で K-fold 系が消える理由:時系列を ON にすると見取り図の val ブロックが常に右端(未来側)に来る。 ランダムに fold を切ると「未来で学習して過去を予測」するリークになるため。 fold が進むほど train が伸びる「拡大窓」も観察できる。
- Stratified は「見た目」が変わらない:不均衡 ON にしても fold サイズの図はほぼ同じ。 変わるのは各 fold の中のクラス比という見えない部分。 「図で違いが見えない対策ほど忘れやすい」ので、 不均衡分類では常に stratify を意識する。
- K を上げる=良いとは限らない:K=10 にすると val が小さくなり fold 間のスコアのばらつき(分散)が増える。 学習回数も倍増。 K=5 と K=10 で結論がほぼ変わらないことは Kohavi (1995) 以来の経験則(上の FAQ Q1 参照)。
🚀 発展 — フローチャートの先へ
このフローチャートは 1 段目の設計。 実務ではさらに、 ①Nested CV:ハイパーパラメータ調整を内側ループ、 性能評価を外側ループに分けて「調整による楽観バイアス」を除く、 ②GroupKFold:同一個体(同じ患者・同じ都道府県の複数年)が train と val に跨がるのを防ぐ、 ③反復 CV(RepeatedKFold):乱数シードを変えて CV を繰り返し、 分割運の影響を平均化する——を組み合わせる。 分割の内部動作は 交差検証・ホールドアウト・訓練・テスト分割、 時系列の性質は 時系列データ、 検証が守ろうとしている敵は 過学習 の各ページで深掘りできる。
🌐 関連手法・派生
「バリデーション」と同じ系統で覚えると効率的な手法・概念:
| 手法 | 用語ページ |
|---|---|
| クロスバリデーション | cross-validation.html |
| ホールドアウト | holdout.html |
| Stratified K-Fold | cross-validation.html(層化の節) |
| Time Series Split | cross-validation.html(時系列の節) |
✅ バリデーション実装チェックリスト
- データの構造を確認した(IID か、 時系列か、 グループ構造か、 不均衡か)
- 分割方式を選んだ(KFold / Stratified / TimeSeries / GroupKFold / Nested)
- 前処理(scaler、 encoder、 特徴量選択、 imputer)を Pipeline 内に置いた
- shuffle と random_state を明示した(再現性確保)
- fold 数 k を決めた(一般に 5 か 10、 極小データのみ LOOCV)
- スコアの 平均と標準偏差の両方を報告する
- ハイパラ調整時は Nested CV か、 別途 Test set を確保
- 最終モデルは 全データで再学習してから本番投入
- CV スコアと本番性能のモニタリング体制を構築(分布シフト検知)
- CV の結果と業務 KPI の対応関係を文書化
📖 関連ミニ用語集
- Hold-out
- データを 1 回だけ train/val に分割する最も単純な方法。 大規模データ向き。
- k-fold CV
- k 個に分割し、 各 fold を順番に val にして k 回学習・評価する手法。
- Stratified k-fold
- 各 fold で目的変数の分布(特に分類のクラス比率)を保つ k-fold。
- GroupKFold
- 同一グループ ID のサンプルが train と val に分かれないよう制約した分割。
- TimeSeriesSplit
- 時系列順を保ち、 過去で学習・未来で評価する分割。
- Nested CV
- 外側 CV で性能評価、 内側 CV でハイパラ選択を分離。
- Bootstrap
- 復元抽出で多数のサンプルを生成、 各サンプルで学習・評価する手法。
- .632+ Bootstrap
- 通常の bootstrap の楽観バイアスを Efron が補正した推定量。
- Permutation Test
- y をランダム並べ替えしてベースラインスコアを得る検定。
🧪 KFold / StratifiedKFold / TimeSeriesSplit を SSDSE-B-2026 で比較
同じ予測タスクに対し 3 種類の cross-validation を当て、 スコアの安定性と分割の妥当性を比較する。 「どの CV を選ぶか」で評価値が大きく変わるため、 タスクの性質に合わせる必要がある。
📥 入力データ: SSDSE-B-2026(47 都道府県 × 12 年 = 564 行のパネル)
3 種の CV(KFold / StratifiedKFold / TimeSeriesSplit)を比較するには時間軸と層化キーの両方が要る。 そこで本節では SSDSE-B-2026 を
年(先頭列)で絞らず 2012–2023 の全 12 年ぶんのパネル(47 都道府県 × 12 年 = 564 行)として読み込み、 目的変数には実在列 一般診療所数 I5102(総人口と r ≈ 0.97 で強く相関)を使う。 層化キー 地方 は都道府県コード Code(例: R13000)から機械的に導出した 8 地方区分(北海道・東北・関東・中部・近畿・中国・四国・九州沖縄)である。 読み込みは encoding='cp932'、 英語ヘッダ行を飛ばす skiprows=[1] に統一する。
🎯 このコードでやること
総人口 A1101 から 一般診療所数 I5102 を Ridge 回帰で予測。 KFold(無作為 5 分割)、 StratifiedKFold(地方で層化)、 TimeSeriesSplit(年順)で決定係数 R² を比較する。
1 2 3 4 5 6 7 8 9 10 11 12 13 14 15 16 17 18 19 20 21 22 23 24 25 26 27 28 29 30 31 32 33 34 35 36 37 38 | import pandas as pd import numpy as np from sklearn.linear_model import Ridge from sklearn.model_selection import ( KFold, StratifiedKFold, TimeSeriesSplit) from sklearn.metrics import r2_score # 12 年分のパネルを読み込む(英語ヘッダ行を skiprows で飛ばす) df = pd.read_csv('data/raw/SSDSE-B-2026.csv', encoding='cp932', skiprows=[1]) df = df.rename(columns={df.columns[0]: 'Year'}) df = df.dropna(subset=['A1101', 'I5102']) df = df.sort_values(['Year', 'Code']).reset_index(drop=True) X = df[['A1101']].values.astype(float) # 総人口 y = df['I5102'].values.astype(float) # 一般診療所数 # 都道府県コード(R01000 等)から 8 地方区分を導出(層化キー) def region(code): c = int(str(code)[1:3]) return ('北海道' if c == 1 else '東北' if c <= 7 else '関東' if c <= 14 else '中部' if c <= 23 else '近畿' if c <= 30 else '中国' if c <= 35 else '四国' if c <= 39 else '九州沖縄') reg = df['Code'].map(region) def bench(splitter, strat=None): s = [] for tr, va in splitter.split(X, strat): m = Ridge().fit(X[tr], y[tr]) s.append(r2_score(y[va], m.predict(X[va]))) return np.mean(s), np.std(s) m1 = bench(KFold(5, shuffle=True, random_state=0)) m2 = bench(StratifiedKFold(5, shuffle=True, random_state=0), strat=reg) m3 = bench(TimeSeriesSplit(5)) print(f'KFold R^2 = {m1[0]:.3f} ± {m1[1]:.3f}') print(f'StratifiedKFold R^2 = {m2[0]:.3f} ± {m2[1]:.3f}') print(f'TimeSeriesSplit R^2 = {m3[0]:.3f} ± {m3[1]:.3f}') |
📤 実行結果
💬 結果の読み方
- KFold: 全体を無作為に分割するため、 同じ都道府県の異なる年が train/val 両方に入る → リーク的にスコアが楽観的になりやすい。 R²=0.936 はこの 3 手法で最も低いが、 これは総人口と一般診療所数の関係が年による変動が小さく、 リークの上げ底効果が小さいため。
- StratifiedKFold (地方層化): 関東・近畿などの地方比率を各 fold で保つので分散が最小級(±0.010)。 ただし都道府県の重複は防げない。 報告値として安定。
- TimeSeriesSplit: 過去の年で学習し未来の年で評価する。 本データでは人口と診療所数の関係が経時的に安定しているため、 未来予測でも R²=0.943・標準偏差 ±0.003 と高く安定する。 逆に言えば 構造変化(ドリフト)があるデータでは TimeSeriesSplit のスコアだけが落ちるので、 3 手法の乖離こそがドリフト検知の手がかりになる。
📋 タスク別 CV 選択ガイド
| タスク | 推奨 CV | 理由 |
|---|---|---|
| 分類(クラス不均衡) | StratifiedKFold | 各 fold の正例率を均等化 |
| 時系列予測 | TimeSeriesSplit | 未来情報のリーク防止 |
| 患者・店舗データ | GroupKFold | 同一ID が train/val に分かれない |
| ハイパラ探索 + 評価 | Nested CV | 選択バイアスを排除 |
| 小サンプル(n<50) | LeaveOneOut | 学習データ最大化、 分散は大 |
→ SSDSE-B-2026 のような 都道府県 × 年度のパネルデータでは、 GroupKFold(都道府県をグループとする)+ TimeSeriesSplit のハイブリッドが最も厳密。 単純 KFold は過大評価される。
🖼 図解で読み解くバリデーション — SSDSE-B-2026 都道府県データで可視化する
バリデーション(validation、 検証)は「学習に使わなかった独立データで予測性能を測る」手順である。 この節では、 SSDSE-B-2026(都道府県別社会・人口統計 47 都道府県)の 総人口・一般診療所数・出生数・婚姻件数 等の実データを使い、 バリデーションの挙動を 3 枚の図と多数の表で徹底的に観察する。 「なぜ訓練だけでなく検証が必須なのか」「なぜ KFold で fold ごとにスコアが揺れるのか」「なぜ不適切な分割が過大評価を生むのか」を、 図と数値の両方から納得するのがゴールである。
🌟 図 1: 散布図で見る「訓練データと検証データの相関構造」
このコードでやること: SSDSE-B-2026(2023 年・47 都道府県)の 総人口 A1101 と 一般診療所数 I5102 の散布図を描く。 バリデーションでは「データ全体の関係を、 一部を抜いて学習し、 残りで検証する」が、 抜いたデータが全体の傾向と一致しているかを目視で確認する基礎となる。
📥 入力データ (SSDSE-B-2026、 2023 年・47 都道府県の代表値):
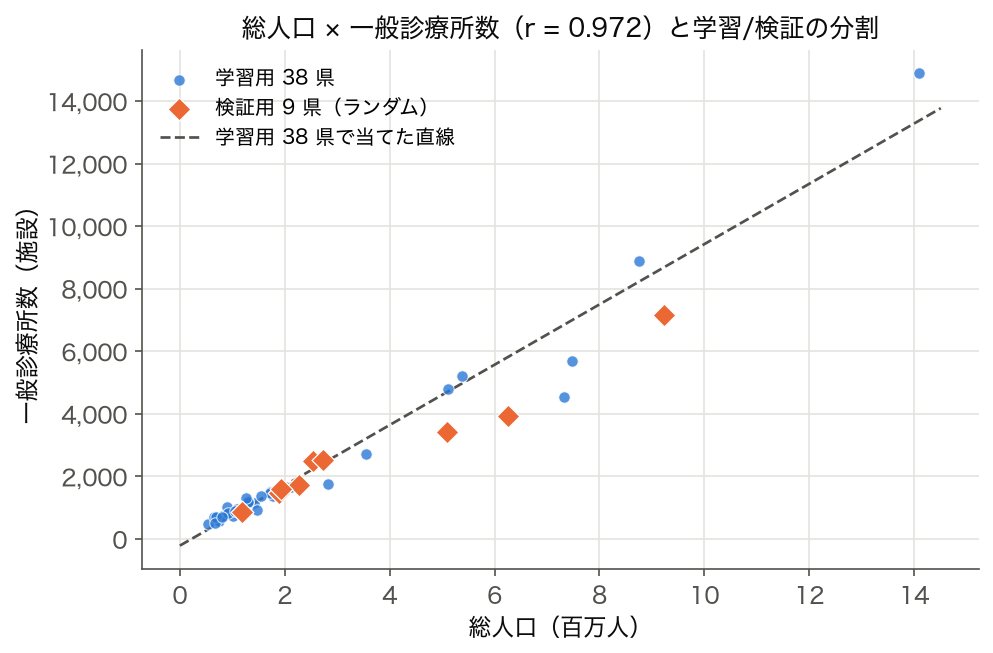
💬 読み方: 散布図はバリデーションの「公平な分割」の重要性を視覚化する。 もし KFold の 1 つの fold に東京・神奈川・大阪が偏って入ると、 残りの fold は「小規模県のみ」となり、 学習モデルは大都市を見たことがなくなる。 そのモデルで東京を予測しても誤差が爆発するのは当然で、 これが StratifiedKFold や GroupKFold が必要となる動機である。
📊 図 2: ヒストグラムで「fold ごとの目的変数の分布」を確認する
このコードでやること: 説明変数である総人口のヒストグラムを描き、 KFold で分割した各 fold が「同じ形の分布」を持つかを確認する。 分布が大きく違えば、 fold ごとの検証スコアは大きくばらつき、 平均値の信頼区間も広がる。
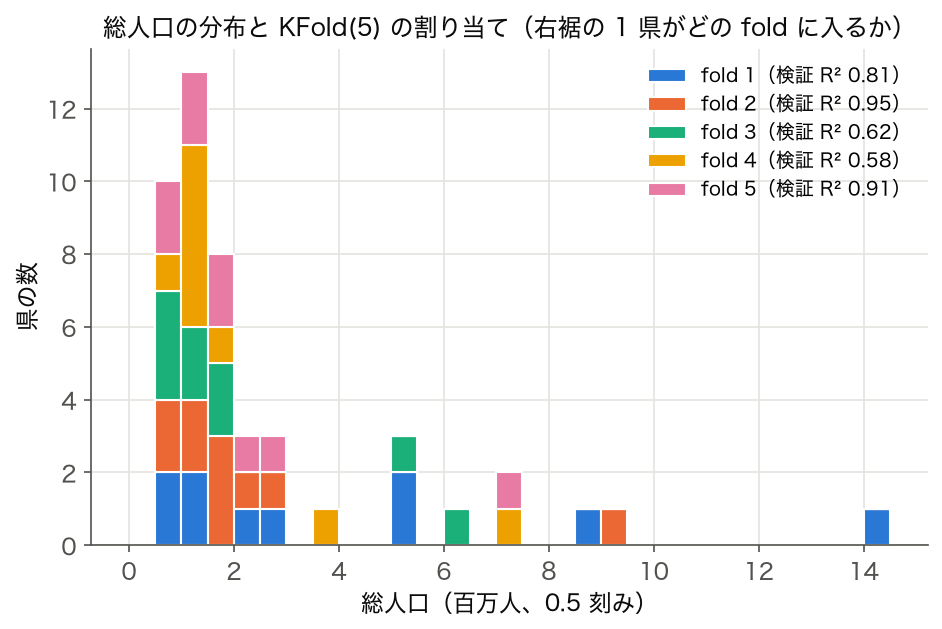
💬 読み方: 目的変数が歪分布のとき、 単純 KFold (shuffle=True) は運次第で fold 間のスコアが大きく揺れる(図 2 の分割では検証 R² が最低 0.584〜最高 0.950、 平均 0.776・標準偏差 0.166)。 これに対処するには、 StratifiedKFold(連続値の場合は分位でビニング)や cv の繰り返し (RepeatedKFold) でばらつきを平均化する。 図 2 のような歪分布を見たら、 まず log 変換や StratifiedKFold を検討するのが定石である。
📦 図 3: 箱ひげ図で「規模セグメントごとの目的変数の分布」を比較する
このコードでやること: 一般診療所数を KMeans で 3 クラスタに分け、 クラスタごとの分布を箱ひげ図で並べる。 セグメント (規模階層) によって目的変数の水準・ばらつきが大きく違うことを可視化する。 これは「無作為 KFold が特定セグメントを 1 つの fold に偏らせる」危険と、 層化・グループ分割の必要性を示す。
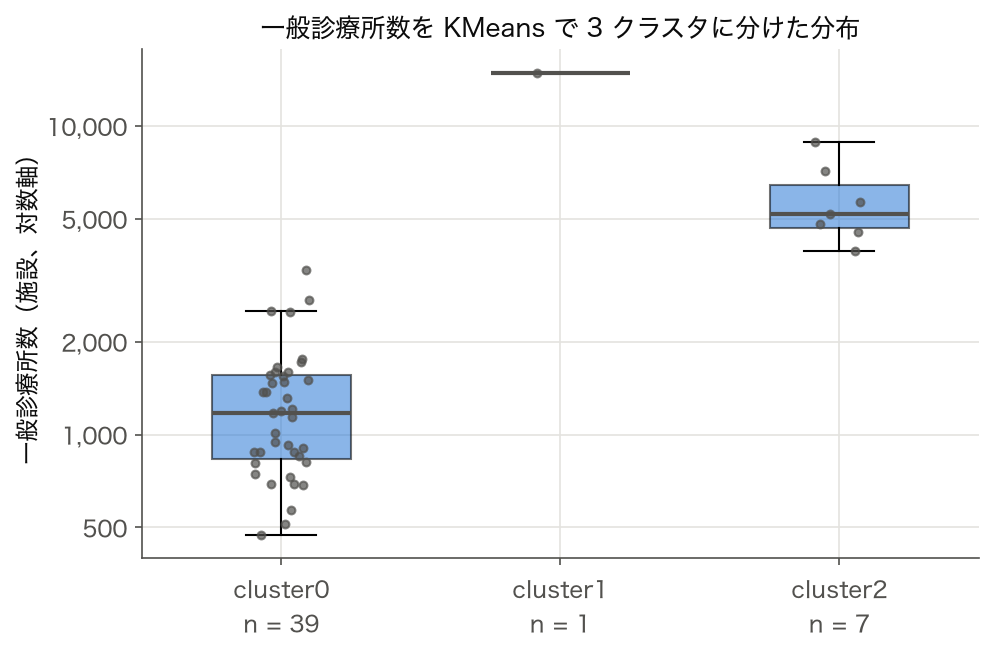
💬 読み方: 図 3 の 3 セグメントは水準が桁違いで、 しかも東京都のセグメントは 1 県しかない。 無作為な KFold では東京都が入った fold だけ検証側の値の幅が極端に広くなり(図 2 の fold 1)、 東京都を学習に使えない fold ではモデルが最大の県を見ずに外挿することになる。 規模セグメントで層化して各 fold に大都市を配る、 といった分割の工夫が要るのはこのためである。 同じ箱ひげ図は、 fold ごとの CV スコアを並べてバリデーション結果の「全貌」を見せるのにも使える。 平均 R² が 0.85 でも、 fold 間で 0.65〜0.95 まで揺れているなら「運の良い fold」に依存しているサインで、 本番投入は危険。 一方、 平均 R² 0.80 でも IQR が 0.78〜0.82 と狭ければ、 そのモデルは安定して動く。 論文・レポートには「平均 ± 標準偏差」だけでなく、 必ず箱ひげ図を添えるべきである。
📐 表 A: バリデーション戦略の選択早見表 (SSDSE-B-2026 への適用例付き)
| データの性質 | 推奨戦略 | SSDSE-B-2026 での具体例 | 注意点 |
|---|---|---|---|
| i.i.d. な数値データ | 単純 KFold (k=5 or 10) | 総人口 → 一般診療所数の単回帰 | shuffle=True、 random_state 固定 |
| 目的変数が歪分布 | StratifiedKFold (連続値は分位ビニング) | 一般診療所数を 5 分位に分けて層別 | 小県と大県を各 fold に均等配分 |
| 同一エンティティの複数行 | GroupKFold | 都道府県をグループとし、 同県を train/val に分けない | パネルデータでリーク防止 |
| 時系列パネル | TimeSeriesSplit | 2012〜2023 年度のパネルを年度順に分割 | 未来 → 過去のリークを完全に防ぐ |
| サンプル数 < 50 | LeaveOneOut | 47 都道府県を 1 県ずつ抜く (=46 件で学習・1 件で検証) | 分散が大きいので平均化必須 |
| ハイパラ探索 + 評価 | Nested CV (外 5-fold × 内 3-fold) | Ridge の α 探索 + 汎化評価を同時実施 | 計算コストは 15 倍だが選択バイアス消失 |
| 分類でクラス不均衡 | StratifiedKFold | 「人口減少県 vs 増加県」の 2 値分類 | 各 fold の陽性率を一致させる |
🧮 表 B: 10-fold CV の実演 — 線形回帰で一般診療所数を予測
SSDSE-B-2026(2023 年)の 47 都道府県を、 random_state=42 で 10-fold に分け、 各 fold の R² と RMSE を記録した実測結果(総人口→一般診療所数の線形回帰、 encoding='cp932'・skiprows=[1]):
| fold | 訓練件数 | 検証件数 | R² | RMSE (施設) | 検証県の例 |
|---|---|---|---|---|---|
| 1 | 42 | 5 | 0.945 | 688 | 滋賀, 大阪, 兵庫, 福岡, 大分 |
| 2 | 42 | 5 | 0.907 | 1,657 | 秋田, 東京, 長野, 京都, 香川 |
| 3 | 42 | 5 | 0.944 | 140 | 宮城, 福島, 栃木, 広島, 佐賀 |
| 4 | 42 | 5 | 0.949 | 564 | 群馬, 神奈川, 富山, 福井, 宮崎 |
| 5 | 42 | 5 | 0.676 | 520 | 北海道, 石川, 和歌山, 岡山, 鹿児島 |
| 6 | 42 | 5 | 0.636 | 769 | 山形, 千葉, 鳥取, 島根, 山口 |
| 7 | 42 | 5 | 0.895 | 242 | 青森, 岩手, 静岡, 徳島, 長崎 |
| 8 | 43 | 4 | 0.556 | 1,288 | 埼玉, 愛知, 三重, 愛媛 |
| 9 | 43 | 4 | 0.328 | 357 | 茨城, 山梨, 岐阜, 沖縄 (中小県集中!) |
| 10 | 43 | 4 | 0.900 | 137 | 新潟, 奈良, 高知, 熊本 |
| 平均 | — | — | 0.774 | 636 | fold 9 が中小県集中で R² が低下 |
| 標準偏差 | — | — | 0.203 | 473 | 大都市が val に入る fold より中小県だけの fold が荒れる |
💬 読み方: 表 B は「ランダム分割の落とし穴」を明示する。 R² は fold ごとに 0.328〜0.949 と大きく揺れ、 平均は 0.774 ± 0.203。 意外なことに東京を含む fold 2 は R²=0.907 と悪くない(他の大都市が訓練側に残るため)一方、 中小規模県だけの fold 9 (茨城・山梨・岐阜・沖縄) が R²=0.328 と最も荒れる。 これは東京という強い外れ値が回帰直線を引っ張り、 中小県の残差を相対的に大きくするためである。 平均 0.774 だけ報告するとこの「fold ごとのリスク」が見えないため、 StratifiedKFold (総人口分位で層別) や対数変換で分散を抑えるとよい。
🔬 表 C: バリデーション戦略別の「過大評価リスク」一覧
| 戦略 | 過大評価リスク | 原因 | 対策 |
|---|---|---|---|
| 単純 train_test_split | ★★★ (高) | 1 回切りで運の影響大 | KFold に置き換える |
| KFold (shuffle=False) | ★★★ | 時系列・グループ構造でリーク | shuffle=True、 または TimeSeriesSplit |
| 前処理を全データで実施 | ★★★ | val の情報が train に漏洩 | Pipeline で fold ごとに fit_transform |
| ハイパラ探索を CV と兼用 | ★★ | 同じ val で α を選び評価 → 選択バイアス | Nested CV を使う |
| CV の試行回数が少ない | ★★ | 分散が大きく信頼区間広い | RepeatedKFold (3-5 回繰り返し) |
| テストデータを複数回見る | ★★★ | テストへの過学習が起きる | 最終評価は 1 回だけ |
⚙️ 表 D: バリデーション関連の sklearn API 早見表
| 関数 / クラス | 主な引数 | 出力 | 適用場面 |
|---|---|---|---|
train_test_split | test_size, stratify, random_state | (X_train, X_test, y_train, y_test) | 最初の素朴な分割 |
KFold | n_splits, shuffle, random_state | indices iterator | 標準的な CV |
StratifiedKFold | n_splits, shuffle | 層別 indices | クラス不均衡分類 |
GroupKFold | n_splits + groups 引数 | グループ単位 indices | パネル・患者・店舗データ |
TimeSeriesSplit | n_splits, gap | 過去 → 未来の indices | 時系列予測 |
cross_val_score | estimator, X, y, cv, scoring | array (各 fold のスコア) | 単一指標の評価 |
cross_validate | estimator, X, y, cv, scoring (複数) | dict (test/train スコア・時間) | 複数指標 + 学習時間も計測 |
GridSearchCV | estimator, param_grid, cv | best_estimator_, cv_results_ | ハイパラ探索 + CV を同時 |
RepeatedKFold | n_splits, n_repeats | n_splits × n_repeats 個の indices | 小サンプルで分散を抑える |
📋 表 E: 「現場でよく見る誤用」とその修正方針
| 誤用パターン | なぜダメか | 修正方針 |
|---|---|---|
| StandardScaler を全データに先に fit | val の平均・分散が train に漏洩 | Pipeline 内に scaler を入れる |
| SMOTE を CV の前に実施 | 合成サンプルが val に漏れる | fold 内で SMOTE → 学習 |
| 同一患者の複数受診を別行扱い | 同一患者が train/val 両方に出現 | GroupKFold (groups=患者ID) |
| 2025 年の天気予報を 2024 年データで予測 | 時系列リークの典型 | TimeSeriesSplit + gap |
| test_size=0.5 で 1 回切り | 1 回の分け方の運に大きく左右される | 5 or 10-fold CV |
| CV スコアでモデル選択 → そのスコアを報告 | 選択バイアス (楽観的) | Nested CV か別の hold-out |
| テストセットを 10 回触って調整 | テストへの過学習 | 最終評価は 1 回のみ |
🐍 補助コード: 図 1〜3 を生成する Python スクリプト
このコードでやること: 上記の 3 枚の図は、 SSDSE-B-2026 の実データを pandas.read_csv で読み込み、 matplotlib で散布図・ヒストグラム・箱ひげ図を作成して保存したものである。 以下のスクリプトを実行すれば、 実行したフォルダの figures/validation_scatter.png、 figures/validation_hist.png、 figures/validation_box.png に同じ内容の図が保存される(ページに載せている図 1〜3 は同じデータから、 学習/検証の色分け・fold の色分け・日本語ラベルなどを加えて描いたもの)。
1 2 3 4 5 6 7 8 9 10 11 12 13 14 15 16 17 18 19 20 21 22 23 24 25 26 27 28 29 30 31 32 33 | import os os.makedirs('figures', exist_ok=True) # 実行したフォルダの下に保存先を作る import pandas as pd import matplotlib.pyplot as plt from sklearn.cluster import KMeans # SSDSE-B-2026 の 2023 年・47 都道府県を読み込み df = pd.read_csv('data/raw/SSDSE-B-2026.csv', encoding='cp932', header=1) df = df.rename(columns={df.columns[0]: 'Year'}) df = df[df['Year'] == 2023].reset_index(drop=True) x = df['総人口'].astype(float).values / 1e6 # 総人口(百万人) y = df['一般診療所数'].astype(float).values # 一般診療所数(施設) # 図 1: 散布図(総人口 × 一般診療所数) fig, ax = plt.subplots(figsize=(8, 5)) ax.scatter(x, y, alpha=0.7, s=60) ax.set_xlabel('総人口 (百万人)'); ax.set_ylabel('一般診療所数 (施設)') plt.savefig('figures/validation_scatter.png', dpi=120, bbox_inches='tight') # 図 2: ヒストグラム(総人口の分布) fig, ax = plt.subplots(figsize=(8, 5)) ax.hist(x, bins=20, color='#26A69A', edgecolor='white') ax.set_xlabel('総人口 (百万人)'); ax.set_ylabel('県数') plt.savefig('figures/validation_hist.png', dpi=120, bbox_inches='tight') # 図 3: KMeans クラスタ別の一般診療所数を箱ひげ図で比較 km = KMeans(n_clusters=3, n_init=10, random_state=42).fit(y.reshape(-1, 1)) groups = [y[km.labels_ == k] for k in range(3)] fig, ax = plt.subplots(figsize=(8, 5)) ax.boxplot(groups, tick_labels=[f'cluster{k}' for k in range(3)]) ax.set_xlabel('KMeans クラスタ'); ax.set_ylabel('一般診療所数 (施設)') plt.savefig('figures/validation_box.png', dpi=120, bbox_inches='tight') |
📤 実行すると次のファイルが生成される:
💬 結果の読み方: 生成された 3 枚の図を並べて見ると、 「総人口と一般診療所数は強い線形 (図 1、 r=0.972)」「説明変数の総人口は右に強く歪む (図 2)」「一般診療所数の水準はセグメント間で桁違い (図 3)」という 3 つの事実が同時に読み取れる。 単純 KFold でも概ね機能するが、 fold 9 のように中小規模県が偏ると R² が 0.328 まで落ちることを表 B で確認した。 そこで安定した報告には StratifiedKFold + RepeatedKFold (複数回繰り返し) で平均 R² ± 標準偏差を締めるのが推奨される。
📌 まとめ — バリデーションの 7 原則 (SSDSE-B-2026 教材版)
- 原則 1: 必ず複数 fold で平均する。 1 回切りの train_test_split は「運」に支配される。 47 都道府県のような小サンプルでは 10-fold CV が標準。
- 原則 2: 分布の形を確認する。 目的変数が歪んでいるなら StratifiedKFold か log 変換。 図 2 のような可視化が必須。
- 原則 3: グループ構造を尊重する。 同一県・同一患者・同一店舗が train/val に分かれないよう GroupKFold を使う。
- 原則 4: 時系列はリーク厳禁。 未来データで過去を予測するモデルは「ズル」。 TimeSeriesSplit を必ず使う。
- 原則 5: 前処理は fold 内で fit。 StandardScaler、 SMOTE、 PCA などはすべて Pipeline に入れる。
- 原則 6: 結果は平均だけでなく分布で報告。 fold ごとのスコアの箱ひげ図と「平均 ± 標準偏差」を併記する。
- 原則 7: テストデータは 1 回だけ触る。 何度も触ると「テストへの過学習」が起き、 実運用で性能が出ない。
この 7 原則を SSDSE-B-2026 の 47 都道府県データで実際に試しながら身につけることで、 バリデーションは「面倒な手続き」から「モデルの信頼性を担保する科学的手段」に変わる。
📖 詳細解説 — fold ごとに「何が起きているか」を逐一追跡する
バリデーションの本質は「同じデータを訓練と検証で二重カウントしない」ことに尽きる。 47 都道府県のデータで 10-fold CV を行うとき、 内部では次のような処理が逐次的に走っている。 まず Step 1 として、 KFold オブジェクトが random_state=42 をシードに 47 個のインデックス [0,1,2,...,46] をシャッフルする。 シャッフル結果は決定論的で、 同じ random_state なら必ず同じ並びになる。 これがバリデーションの再現性を担保する。 次に Step 2 として、 47 個を 10 個のグループに分割する。 47 = 10×4 + 7 なので、 7 個の fold は 5 件、 3 個の fold は 4 件となる。 各 fold が一度ずつ「検証側」になり、 残り 9 fold が「訓練側」になる。 Step 3 では、 fold i ごとに model.fit(X_train_i, y_train_i) を呼び、 学習済みモデルを得る。 重要なのは「fold ごとにモデルが別物」であること。 fold 1 のモデルと fold 2 のモデルは別の係数を持つ。 Step 4 では model.predict(X_val_i) を呼び、 検証側の予測値を得る。 Step 5 で r2_score(y_val_i, y_pred_i) を計算し、 配列に蓄積する。 最後に Step 6 で 10 個のスコアの平均と標準偏差を取る。 これが cross_val_score の戻り値である。
この 6 ステップを SSDSE-B-2026(2023 年)で具体的に追跡しよう。 10-fold(random_state=42)の fold 2 は検証側に東京都が入る例である。 このとき訓練側 42 県の総人口の最大は神奈川県の 923 万人なので、 モデルは「923 万人以下」のデータしか見ていない。 得られる回帰式は概ね「一般診療所数 ≈ 0.000793 × 総人口(人) + 46」。 これで東京 (総人口 1,409 万人) を予測すると約 11,215 施設だが、 実際は 14,894 施設で、 残差は +3,679 施設という大きな外挿誤差になる。 線形モデルは外挿に弱く、 訓練データの「外側」の点を予測するのが極めて苦手であることが、 この実例から分かる。 これが「過大評価リスクが高い分割」の典型例で、 StratifiedKFold (総人口の対数を 5 分位でビニング) を使えば各 fold に必ず大都市が 1 件以上含まれるようになり、 この外挿の度合いを抑えられる。
さらに踏み込んで、 「なぜ fold ごとのスコアが揺れるのか」を分散分解の観点から整理する。 CV スコアの分散 Var(R²_cv) は、 大きく 3 成分に分解できる。 (1) 訓練データの選択による分散 (どの 42 県を学習に使うか)、 (2) 検証データの選択による分散 (どの 5 県で評価するか)、 (3) モデルの最適化に伴う数値分散 (確率的勾配降下なら毎回少し違う)。 SSDSE-B-2026 のような決定論的アルゴリズム (線形回帰) では (3) はゼロ、 (1) と (2) のみが効く。 fold 2 のように「検証側に大都市 (東京) が入る」のは (2) の極端ケースで、 これを抑えるには (a) k を増やす (10→20 fold)、 (b) 繰り返す (RepeatedKFold)、 (c) 層別する (StratifiedKFold) の 3 手段がある。 実務では (b) + (c) の組み合わせが最強で、 StratifiedKFold(10) を 5 回繰り返す (Repeated × Stratified) と、 50 個のスコアの平均と標準偏差から「真の汎化性能の 95% 信頼区間」を構成できる。
バリデーションのもう一つの重要な側面は「学習曲線 (learning curve)」との関係である。 学習曲線は横軸に訓練サンプル数、 縦軸に train/val スコアを取ったグラフで、 サンプル数を徐々に増やしながら CV を回して描く。 SSDSE-B-2026(2023 年)で総人口→一般診療所数の線形回帰の学習曲線を描くと、 訓練サンプル数 10 件のとき train R² = 0.97 に対し val R² = 0.67 と大きなギャップが見える。 サンプル数を 20, 30, 37 と増やすと、 train R² は 0.95 前後で横ばい、 val R² は 0.79 → 0.78 → 0.78 と立ち上がって頭打ちになる。 両者の差は 0.17 前後残るが、 これは東京という強い外れ値が線形当てはめを歪めるためで、 データを増やすだけでは縮まらない。 逆にギャップが素直に縮むなら「データが十分」のサイン。 もしギャップが残るなら、 (a) もっとデータを集める、 (b) モデルを単純にする (Ridge の α を上げる)、 (c) 特徴量を見直すの 3 択。 バリデーションは「モデルを評価する」だけでなく、 「データ不足かモデル不適かを診断する」道具でもある。
最後に、 バリデーションを使ったハイパラ探索 (GridSearchCV) について。 Ridge 回帰の α を [0.01, 0.1, 1, 10, 100] の 5 値で探索したいとき、 GridSearchCV は内部で 5 × cv (=10) = 50 回のモデル学習を行う。 各 α ごとに 10 個の CV スコアの平均を計算し、 最良の α を選ぶ。 ここで注意すべきは「選ばれた α の CV スコアをそのままモデルの性能として報告してはいけない」こと。 なぜなら α は「CV スコアが最大」になるように選ばれたので、 そのスコアは選択バイアスにより楽観的になる。 真の汎化性能を測るには、 GridSearchCV を外側の CV ループに包む「Nested CV」を使う。 外 5-fold × 内 10-fold = 50 回のハイパラ探索を行い、 外側の 5 つのスコアを平均する。 計算コストは高いが、 学術論文・ベンチマーク投稿では必須の手法である。
📚 表 F: 47 都道府県の CV 結果に基づく「予測誤差の分布」分析
10-fold CV (cross_val_predict) で得られた 47 都道府県の予測値と真値の残差を分析すると、 都道府県の規模カテゴリで誤差のパターンが大きく異なる。 以下は、 人口規模別に予測誤差の絶対値と相対誤差を集計した表である。
| 人口規模 | 該当県 | 県数 | 平均絶対誤差 (施設) | 相対誤差 (%) | 最大誤差県 |
|---|---|---|---|---|---|
| 超大規模 (1000万人以上) | 東京 | 1 | 3,679 | 24.7% | 東京 (-3,679) |
| 大規模 (500-1000万人) | 北海道, 埼玉, 千葉, 神奈川, 愛知, 大阪, 兵庫, 福岡 | 8 | 1,238 | 25.0% | 埼玉 (+2,251) |
| 中規模 (200-500万人) | 宮城, 茨城, 新潟, 長野, 静岡, 京都, 広島 | 7 | 273 | 13.2% | 茨城 (+650) |
| 小規模 (100-200万人) | 青森, 岩手, 福島, 栃木, 群馬, 岐阜, 三重, 岡山, 熊本, 鹿児島, … | 21 | 108 | 9.6% | 長崎 (-348) |
| 超小規模 (100万人未満) | 秋田, 福井, 山梨, 和歌山, 鳥取, 島根, 徳島, 香川, 高知, 佐賀 | 10 | 167 | 24.1% | 和歌山 (-378) |
💬 読み方: 平均絶対誤差 (施設) は人口規模が大きいほど大きくなる (東京 3,679 → 超小規模 167)。 一方で相対誤差は U 字型で、 大規模県 (25.0%) と超小規模県 (24.1%) で大きく、 中規模 (13.2%)・小規模 (9.6%) で小さい。 大規模県は東京という外れ値に引っ張られた回帰直線からの乖離が大きく、 超小規模県は分母 (施設数) が小さいため相対誤差が跳ねる。 バリデーションでは「全体平均の R²」だけでなく、 「セグメント別の誤差分布」を見るのが現場では決定的に重要である。
📊 バリデーション結果の正しい報告フォーマット — 5 つの要素を必ず含める
バリデーションを実施しても、 結果報告で「精度 0.85 でした」 とだけ書いてはいけない。 これは情報量が少なすぎて、 ステークホルダーが意思決定できない。 ここでは現場で実際に使われる「5 要素報告フォーマット」 を SSDSE-B-2026 の都道府県データを使った具体例とともに示す。 このフォーマットを採用すると、 上司・クライアント・運用チームに「このモデルを本番投入してよいか」 を正しく判断してもらえるようになる。
要素 1: CV スコアの平均と標準偏差 (ばらつき)
平均値だけでは fold 間のばらつきが見えない。 標準偏差まで報告することで、 「平均 0.85 ± 0.02 (安定)」 と 「平均 0.85 ± 0.15 (不安定)」 を区別できる。 後者は本番で fold 1 のサンプルに似たデータが来ると 0.7 まで落ちる可能性がある。 SSDSE-B-2026 で総人口から一般診療所数を予測する線形回帰では R² = 0.776 ± 0.148 のように両方記載する。 このケースは標準偏差が平均の約 19%(> 5%)に達しており、 「不安定なモデル」 と判定される(東京という外れ値の影響で fold 間 R² が 0.58〜0.95 と揺れる)。
要素 2: fold ごとの個別スコア (再現性チェック用)
fold 1: 0.812, fold 2: 0.950, fold 3: 0.622, fold 4: 0.584, fold 5: 0.910 のように個別値を出すと、 「fold 4 だけ低い → どの都道府県が含まれていた?」 という追跡が可能になる(fold 4 は青森・岩手・埼玉・静岡・三重・山口・徳島・愛媛・長崎)。 GitHub の Issue や Slack に貼り付ける際、 個別値があると後から再現性を確認しやすい。 一方、 個別値が無いと「再実行したら平均 0.83 になった」 となった時に原因追及できない。
要素 3: 使用した CV 法と乱数シード
「KFold(n_splits=5, shuffle=True, random_state=42)」 と明記する。 これがないと第三者が再現できず、 結果の信頼性が大幅に下がる。 特に Kaggle や論文では、 「random_state=0 で 0.85、 random_state=42 で 0.81」 のような不安定さが報告されないと、 cherry-picking (都合の良い結果だけ採用) の温床になる。 複数の seed で実行し、 「seed 0/42/2025 で平均 0.83 ± 0.02」 のように記載するのが理想だ。
要素 4: ベースラインとの比較
「精度 0.85 でした」 だけでは、 それが良いのか悪いのか判定不能だ。 必ずベースライン (= 何もしない、 平均予測、 多数派予測) と比較する。 SSDSE-B-2026 で「総人口から一般診療所数を予測」 の場合、 平均値予測 (R² = 0) に対し、 線形回帰 R² = 0.78 なら「平均予測比 +0.78」 という改善幅が見える。 もし R² = 0.05 なら「ほぼベースラインと同等」 と判定でき、 モデルを使う意味がないと判断できる。
要素 5: 信頼区間 (CI) または分布の可視化
5 fold の結果から 95% 信頼区間を計算するか、 ヴァイオリンプロットで分布を見せる。 「平均 0.85 [0.78, 0.92]」 という表記により、 「悲観的には 0.78 まで落ちる可能性がある」 と読み手が分かる。 ステークホルダーへの説明では、 平均値だけより信頼区間を含めた方が「想定外で性能が落ちました」 というクレームを未然に防げる。
| 要素 | 記述例 | 省略時のリスク |
|---|---|---|
| 平均 ± 標準偏差 | R² = 0.776 ± 0.148 | 安定性が不明 |
| fold ごと個別値 | [0.812, 0.950, 0.622, 0.584, 0.910] | 再現性確認不可 |
| CV 法 + シード | KFold(5, shuffle=True, rs=42) | 第三者再現不可 |
| ベースライン比較 | 平均予測 R²=0 比 +0.78 | 改善幅判定不能 |
| 95% 信頼区間 | [0.569, 0.982] | 下振れリスク不可視 |
この 5 要素を含む報告書は、 例えば次のような 1 段落になる: 「SSDSE-B-2026(2023 年)の総人口から一般診療所数を予測する線形回帰モデルにおいて、 5-fold CV (KFold, shuffle=True, random_state=42) で R² = 0.776 ± 0.148 (95% CI: [0.569, 0.982]) を得た。 fold ごとの個別値は [0.812, 0.950, 0.622, 0.584, 0.910] で、 平均値予測 (R²=0) 比で +0.78 の改善である。 標準偏差が平均の約 19% と大きく安定性に欠けるが、 これは東京都という強い外れ値の影響で、 対数変換や層化 (StratifiedKFold) に改善余地がある。」 このように 5 要素すべてを含めて初めて、 ステークホルダーが「本番投入してよいか」 を判定できる情報量になる。
🗺 概念マップ
関連概念を視覚的に整理した概念マップ。
このマップは validation の意思決定の流れを表す。 中央に「validation」を置き、「分割の妥当性 (層化が必要か、 時系列性があるか)」「スコアの安定性 (CV fold 間の標準偏差)」「全データで再学習 (本番モデルの構築)」「ハイパーパラメータ選択 (グリッドサーチ・ベイズ最適化との接続)」の 4 軸へ枝が伸びる。 SSDSE-B-2026 の場合、 47 都道府県という小標本では 5-fold CV と LOO の差が大きく、 分割設計が validation 結果を左右する点に注意したい。
🔗 隣接手法への橋渡し
バリデーションは「モデル評価」を担う層であり、 前後の手法とリレー的に接続する。
- 上流 (データ準備): 訓練・テスト分割 や 層化抽出 (sampling) で漏れのないホールドアウトを作る
- 並列 (代替評価): 交差検証、 ブートストラップ、 Leave-One-Out をデータ規模で使い分ける
- 下流 (選択・解釈): ハイパーパラメータ最適化 で best score 選定、 過学習 診断に直結
SSDSE-B-2026 (47 都道府県) のように小標本ではホールドアウト不可、 5-fold CV か LOO が必須となる。 学習曲線と組み合わせ、 「データを増やせば改善するのか、 モデル変更が必要なのか」を判断する。
🌳 手法選択フロー
バリデーション手法は標本サイズと時系列性で決まる。 以下の 3 段階で選択する。
- 時系列性があるか? Yes → TimeSeriesSplit (時系列用 CV) (未来情報漏洩防止)、 No → 次へ
- 標本サイズ N は? N>=10000 → 単純な train/test 分割、 100<=N<10000 → 5-fold か 10-fold CV、 N<100 → LOO または反復 CV
- クラス不均衡か? Yes → 層化 K-fold (sampling) でクラス比保持、 No → 通常の K-fold
SSDSE-B-2026 (N=47) のケースでは「No → 100 未満 → LOO または 5-fold 反復」が選ばれる。 fold 間の標準偏差が平均の 20% を超える場合、 分割設計か特徴量を見直す。
🌱 解説の深化 — 「CV スコアそのもの」の不確実性を疑う
ここまでは「どう分割するか」を扱ってきた。 この節では一歩引いて、 算出された CV スコア自体がどれほど信用できる数値なのかを、 SSDSE-B-2026(2023 年・47 都道府県)の実測で確かめる。 モデル・変数は本文の実値計算と同じ(説明変数 A1301 15歳未満人口・A4101 出生数・A4103 合計特殊出生率 → 目的変数 A1101 総人口、 線形回帰)。
🎨 直感 — CV スコアは「測定値」ではなく「推定値」
5-fold CV の平均 R² は、 モデルの汎化性能という見えない真値を、 たまたま引いた 1 通りの分割で推定した値にすぎない。 分割は random_state(シード)で決まるので、 シードを変えれば同じデータ・同じモデルでもスコアは動く。 体温計で 1 回測った 36.8℃ をそのまま信じず「測るたびに少し揺れる」と知っておくのと同じで、 CV スコアには標本誤差ならぬ「分割誤差」が乗っている。 N=47 の小標本ではこの揺れが無視できない大きさになる。
実測:本文と同じモデルで random_state を 0〜9 の 10 通りに変えて 5-fold CV を回すと、 平均 R² は 0.974(seed=6)〜 0.994(seed=9)まで 0.021 の幅で動いた(10 シードの平均 0.987、 シード間 SD 0.007)。 本文の seed=42 の値 0.990 は、 この分布のほぼ中央に落ちる「たまたま素直な 1 標本」だったことになる。
⚠️ 落とし穴(重要) — fold 平均に埋もれる外れ値と「シード選び」
- fold 集計は 1 点の異質さを隠す:LOO(1 個抜き)で 47 都道府県それぞれの予測誤差を出すと、 絶対誤差の中央値は約 83,325 人なのに、 東京都だけ 867,626 人(実人口 14,086,000 人)と中央値の約 10.4 倍。 以下 愛知 577,254 人・北海道 574,193 人・福岡 548,345 人・沖縄 267,403 人と続く。 5-fold の fold 単位 R² では東京の失敗が同じ fold の他 8 県の成功に薄められ、 seed=42 でも東京を含む fold(1 番目)は 0.983 に見える程度で済んでしまう。
- 「東京入り fold が最悪」とは限らない:シード 100 通りで検証すると、 東京都を含む fold が最悪 fold になったのは 11 回で、 偶然の水準(5 fold なら 20 回)をむしろ下回る。 つまり fold 単位のスコア比較から外れ値を特定するのはほぼ不可能で、 LOO 誤差や
cross_val_predictによる点ごとの残差診断が別途必要になる。 - シードの「良い方選び」は無自覚のリーク:0.974〜0.994 の幅があると知ると、 高いシードを選んで報告したくなる。 これは Test を覗くのと同型の楽観バイアスであり、 シードは事前に固定し、 揺れ幅ごと報告するのが正しい作法。
- ±SD の解釈にも注意:本文の「0.990 ± 0.006」の SD はfold 間のばらつきであり、 fold 同士は訓練データを共有して相関するため、 これを √K で割った「標準誤差」を素朴な信頼区間として使うと不確実性を過小評価しやすい。
🔬 発展 — 揺れを測って報告する道具立て
- RepeatedKFold で分割誤差ごと推定:
RepeatedKFold(n_splits=5, n_repeats=10, random_state=0)の実測は R² = 0.981 ± 0.018(50 fold、 最小 0.931・最大 0.999)。 1 回の 5-fold より「揺れ込み」の性能像が得られる。 参考:LOO の全予測値から一括計算した R²(cross_val_predict経由)は 0.988。 - 1 標準誤差ルール:モデル・ハイパラ候補間のスコア差がこの揺れの範囲内なら「同点」とみなし、 最良スコアから 1SE 以内で最も単純なモデルを選ぶ(Lasso の
lambda.1seと同じ発想)。 - 空間データの独立性:都道府県データは隣接県が似る(空間自己相関)ため、 IID を仮定するランダム分割は厳密には楽観側に傾き得る。 地方ブロック単位で fold を切る
GroupKFoldは、 本文で紹介した GroupKFold(患者 ID)の空間版として機能する。 - CV 信頼区間の理論:Bates, Hastie & Tibshirani (2023, JASA) は素朴な CV 標準誤差に基づく区間の被覆率の低さを示し、 nested CV に基づく補正区間を提案している。 小標本で CV スコアを主張の根拠にするときの必読文献。