🔖 キーワード索引
本ページは グリッドサーチ(Grid Search)を 12 のセクションで多角的に解説します。 上のチップは検索・関連語の手がかりです。 以下のリンクで各セクションに直接ジャンプできます:
💡 30秒で分かる結論
🍰 まずはやさしく
設定の組み合わせをすべて試す方法です。
一番良い設定を見つけるために使います。
スマホのアプリ設定を全部試すようなものです。
この章ではグリッドサーチの結論を読みます。
グリッドサーチ(Grid Search):ハイパーパラメータの組合せを網羅的に試す手法
- グリッドサーチ=モデルのハイパーパラメータの候補値の組合せを全パターン試して、 一番良いものを選ぶ網羅探索。
- scikit-learn の
GridSearchCVが定番。 内部で交差検証と組み合わせて評価する。 - 全組合せ数は
各パラメータの候補数の積。 4変数×5候補で 625 通り → 計算コスト爆発に注意。 - RandomizedSearchCV(ランダム抽出)や Optuna(ベイズ最適化)が現代の代替手段。
- テストデータでハイパラを決めると リーク。 訓練データの中で更に CV を回す。
📍 あなたが今見ているもの
🍰 まずはやさしく
人間が決める設定値をさがす手法です。
モデルの性能を最大限に引き出します。
部活の練習メニューの組み合わせを選ぶ例です。
この章では使う場面や注意点を読みます。
α、 ランダムフォレストの n_estimators、 SVM の C や gamma など。 これらを「総当たり」で試して最良を選ぶのがグリッドサーチ。 論文の 「best parameters were selected via grid search with 5-fold CV」 という記述が出てきたら、 これのことです。📍 文脈 — どこで使う概念か
グリッドサーチは ハイパーパラメータの候補を格子状に並べ、 全組合せを試して最良を選ぶ手法。 シンプルで実装容易だが、 候補数が指数的に増えるため 3–4 ハイパラまでが現実的。 それ以上は Random Search や Bayesian Optimization に切り替える。
🎨 直感で掴む
🍰 まずはやさしく
地図のマス目を全部歩くようなイメージです。
どの設定が正解かを確認するために使います。
買い物で色とサイズを全部試すようなものです。
この章では具体的な動き方を読みます。
グリッドサーチの動作イメージ
Ridge回帰の正則化強度 α を選びたいとします。 候補:[0.01, 0.1, 1, 10, 100]。
α=0.01で学習 → 5-fold CV で平均 RMSE を測定α=0.1で学習 → 平均 RMSE を測定- 同様に α=1, 10, 100 まで全て測定
- 5 つの RMSE の中で 最小のもの に対応する α を採用
2 パラメータなら格子状(grid)に組合せが並ぶので「グリッドサーチ」。
| α \ C | 0.01 | 0.1 | 1 | 10 |
|---|---|---|---|---|
| linear | 0.52 | 0.48 | 0.41 | 0.45 |
| rbf | 0.55 | 0.50 | 0.43 | 0.47 |
上記の例なら (C=1, kernel=linear) で CV-RMSE = 0.41 が最小なのでこれを採用。
🎨 直感で掴む — 具体例で理解する
Grid Search は「地図上の格子点を全部歩いてみる」イメージ。 確実だが時間がかかる。 一方、 ハイパラの一部だけが性能に影響することが多い(Bergstra & Bengio 2012)ため、 Random Search の方が同じ計算量で良い解に到達することが知られる。 とはいえ Grid は「結果が再現的・説明しやすい」ため、 候補が少ない時の標準。
📐 定義 / 数式
🍰 まずはやさしく
設定の組み合わせを数式で表したものです。
正解を計算で導き出すために使います。
テストの点数を最大にする組み合わせ選びです。
この章では計算方法や定義を読みます。
📐 数式・定義
グリッドサーチを数式 / 形式定義で表す:
ハイパーパラメータ集合 $\Lambda$ の中で、 交差検証損失を最小にする組合せ $\hat{\boldsymbol{\lambda}}$ を選ぶ。 Grid は $\Lambda$ を直積(格子)で構成する。
📐 探索空間の数式を言葉で読み解く
ハイパラ探索の総評価回数は次式で表せる。
数式を言葉で読み解く:
- $d$:ハイパラの個数(次元数)。 XGBoost なら learning_rate, max_depth, n_estimators 等で 5-10。
- $|H_i|$:第 $i$ ハイパラの候補値数。 例 max_depth ∈ {3, 5, 7} → $|H_i|=3$。
- $\prod$:候補数の 積。 ここが指数的に膨らむ。
- $k$:CV の fold 数。 5-fold なら学習回数が 5 倍になる。
例:5 ハイパラ × 各 5 候補 × 5-fold CV = $5 \times 5^5 = 15{,}625$ 回学習。 1 回 1 分なら 10 日以上。 これが「grid search の指数的爆発」の正体。
Random Search では $N_{\text{eval}}$ を 固定(例 100 回)し、 各ハイパラを独立に確率分布から抽出。 重要なハイパラの粒度を細かく取れる利点がある。
🔬 記号・式を言葉で読み解く
- $\theta$
- ハイパーパラメータベクトル。 例:$(\alpha, C, \gamma)$
- $\Theta_{\text{grid}}$
- ユーザが指定した候補値の格子。 例:$\{0.01, 0.1, 1, 10\}^3$
- $K$
- 交差検証の分割数。 通常 5 か 10。
- $L$
- 評価指標。 回帰なら RMSE/MAE、 分類なら accuracy/F1。
🔬 数式を言葉で読み解く
上の数式に出てきた記号を 1 つずつ解説します。 数式が出てくる試験問題(統計検定・G 検定・基本情報)では、 各記号の意味を答えられるかが分岐点:
| 記号 | 意味 |
|---|---|
| $\boldsymbol{\lambda}$ | ハイパーパラメータベクトル |
| $\Lambda$ | 候補集合(格子) |
| CV-Loss | 交差検証損失 |
| $\hat{\boldsymbol{\lambda}}$ | 選ばれた最適ハイパラ |
🧮 実データで計算してみる
SSDSE-B-2026(2023 年断面・47 都道府県)で Ridge 回帰の最適な α を選ぶ。 X=年齢 3 区分人口(A1301/A1302/A1303)を StandardScaler で標準化し、 y=出生数(A4101)。 下の実装ブロックと同一設定での実測値:
| α | 5-fold CV の RMSE 平均(人) |
|---|---|
| 0.01 | 991.6 ← 最小 |
| 0.1 | 1128.5 |
| 1.0 | 1373.7 |
| 10 | 2053.9 |
| 100 | 7642.4 |
α=0.01 が最良 → モデル最終化はこの α で全訓練データを使って再学習し、 ホールドアウトしておいたテストで最終評価。 なお最良値がグリッドの端に来ているため、 本来はさらに小さい α まで範囲を広げて確認するのが定石(この課題は特徴量 3 個 × 47 行で過学習が弱く、 正則化を弱めるほど OLS の性能に漸近する)。
🧮 SSDSE-B 実値計算 — 都道府県データで手を動かす
SSDSE-B-2026 の 「総人口・65 歳以上人口・新規求職申込件数 → 出生数」回帰で、 ランダムフォレストの 3 ハイパラ(n_estimators / max_depth / min_samples_leaf)を Grid Search し、 最良 R² を出すパラメータを発見する。 2023 年断面(47 行)・random_state=42 での実測は best params: max_depth=None, min_samples_leaf=1, n_estimators=60、 CV R²=0.7962。
使用データ:SSDSE-B-2026.csv(独立行政法人 統計センター提供、 47 都道府県 × 100 超の社会経済指標)。 出典
1 2 3 4 5 6 7 8 9 10 11 12 13 14 15 16 17 18 19 20 21 22 | import pandas as pd from sklearn.ensemble import RandomForestRegressor from sklearn.model_selection import GridSearchCV df = pd.read_csv('data/raw/SSDSE-B-2026.csv', encoding='cp932', skiprows=[1]) df = df[df['SSDSE-B-2026'] == 2023] # 2023年断面(47都道府県) X = df[['A1101', 'A1303', 'F3101']].fillna(0).values y = df['A4101'].values # 教材では計算時間の都合で候補を絞っています。実務ではもっと広い範囲を探索します。 # (本来は n_estimators=[50,100,200] × max_depth=[3,5,7,None] × min_samples_leaf=[1,2,4] など) param_grid = { 'n_estimators': [30, 60], 'max_depth': [3, 5, None], 'min_samples_leaf': [1, 4], } gs = GridSearchCV(RandomForestRegressor(random_state=42), param_grid, cv=5, scoring='r2', n_jobs=-1) gs.fit(X, y) print(f'Best params: {gs.best_params_}') print(f'Best CV R² : {gs.best_score_:.4f}') |
💬 2×3×2=12 通りを 5 分割で評価し、最良は深さ無制限・葉 1・木 60 本で CV R² 0.7962。12 通りの内訳を見ると min_samples_leaf=4 の組はすべて 0.49〜0.57 にとどまり、効いているのは葉の大きさで、max_depth は 3 でも None でも差が 0.01〜0.03 程度しかない。最良値が候補の端(木 60 本・葉 1)に来ているので、木を増やす・葉 1 のまま他を振るなど範囲を広げて探し直す余地がある。
▲ 上記コードはそのまま実行可能。 CP932 エンコーディング・skiprows=[1](2 行目の日本語の列名行を飛ばし、 1 行目の列コードを見出しにする)・列名の英数字コード(A1101 = 総人口 など)に注意。
🧮 SSDSE-B-2026 で Grid Search 実行
このコードでやること:SSDSE-B-2026 の 2023 年断面(47 行)で、 Ridge 回帰の正則化強度 alpha を 5 候補で grid search する。 人口系の特徴量は百万オーダーなので、 StandardScaler を Pipeline に組み込んで標準化してから探索する(標準化しないと alpha がほぼ効かず、 どの候補でも R² が同値になってしまう)。 最良値を 5-fold CV で選び、 出力結果を確認する。
📥 入力データ:SSDSE-B-2026、 X = 15歳未満人口・15-64歳人口・65歳以上人口、 y = 出生数。
1 2 3 4 5 6 7 8 9 10 11 12 13 14 15 16 17 18 19 20 21 | import pandas as pd from sklearn.linear_model import Ridge from sklearn.model_selection import GridSearchCV from sklearn.pipeline import make_pipeline from sklearn.preprocessing import StandardScaler df = pd.read_csv('data/raw/SSDSE-B-2026.csv', encoding='cp932', skiprows=[1]) df = df[df['SSDSE-B-2026'] == 2023] # 2023年断面(47都道府県) X = df[['A1301', 'A1302', 'A1303']] y = df['A4101'] pipe = make_pipeline(StandardScaler(), Ridge()) # 標準化してから Ridge param_grid = {'ridge__alpha': [0.01, 0.1, 1.0, 10.0, 100.0]} gs = GridSearchCV(pipe, param_grid, cv=5, scoring='r2') gs.fit(X, y) print("最良 alpha:", gs.best_params_) print(f"最良 CV R²: {gs.best_score_:.4f}") print("全 alpha のスコア:") for a, s in zip(param_grid['ridge__alpha'], gs.cv_results_['mean_test_score']): print(f" alpha={a:7.2f} → R²={s:.4f}") |
📤 実行例:
💬 結果の読み方:標準化したことで alpha がはっきり効く。 alpha が大きいほど正則化が強まり係数が縮小され(alpha=0.01 で約 15,244 あった第 1 係数は alpha=100 で約 3,340 まで縮む)、 この課題では R² が単調に低下(alpha=100 で 0.41 まで悪化)。 最良は最小候補 0.01 でグリッドの境界にあるため、 定石どおり範囲を広げて確認する — 実測では alpha=0.001 でも約 0.992 で頭打ちし、 OLS(正則化なし、 CV R²≈0.9923)に漸近する。 特徴量 3 個 × 47 行では過学習が弱く、 正則化の恩恵が出にくい設定だと分かる。 候補値の 対数スケールでの探索が肝心(線形に並べると重要域を見逃す)。
🧮 数式に値を入れて手で計算する: グリッド組合せと CV 計算量
3 ハイパーパラメータ × 5 CV の組合せ数と計算量を計算する。
Step 1: パラメータ範囲
| パラ | 候補数 |
|---|---|
| C | 5 |
| γ | 4 |
| kernel | 3 |
Step 2: 組合せ
🐍 Python で再現
1 2 3 4 5 6 7 8 | import numpy as np params = np.array([5, 4, 3]) grid = np.prod(params) cv = 5 fits = grid * cv print(f"グリッド組: {grid}") print(f"総フィット: {fits}") print(f"所要時間 (10s/fit): {fits*10/60:.0f} 分") |
📤 実行結果
💬 手計算 (Step 2) 60 組 / 50 分と Python 出力が完全一致。
なぜ alpha は「対数で」刻むのか — 実測で確かめる
正則化の強さ alpha のような「桁で効く」パラメータは、等間隔ではなく対数間隔で刻みます。
理由は実際に走らせると一目で分かります。SSDSE-B-2026(2023 年・47 都道府県)で、
総人口・15 歳未満人口・65 歳以上人口・婚姻件数から出生数を当てる Ridge 回帰を組み、
5-fold 交差検証の R² を測った結果が次の表です。
| alpha(対数で 8 点) | CV R² | 読み取れること |
|---|---|---|
| 0.001 | +0.9954 | 0.001〜0.1 はほぼ差が無い。正則化が弱すぎて「実質かけていない」状態。 |
| 0.01 | +0.9950 | |
| 0.1 | +0.9909 | |
| 1 | +0.9848 | ここから少しずつ効き始める。 |
| 10 | +0.9800 | |
| 100 | +0.8313 | 急に崩れ始める。変化はこの桁で起きている。 |
| 1000 | +0.2305 | 係数が潰れ、ほぼ平均を答えるだけのモデルに。 |
| 10000 | +0.0129 |
同じ 8 点を 1 から 1000 まで等間隔(1, 143.7, 286.4, …, 1000)に取ると、こうなります。
| alpha | 1.0 | 143.7 | 286.4 | 429.1 | 571.9 | 714.6 | 857.3 | 1000.0 |
|---|---|---|---|---|---|---|---|---|
| CV R² | +0.985 | +0.752 | +0.560 | +0.440 | +0.361 | +0.305 | +0.263 | +0.231 |
💬 ここが要点:等間隔では 8 点のうち 7 点が「もう崩れきった領域」に落ちてしまい、
いちばん知りたい 0.001〜10 の範囲を 1 点(alpha=1.0)でしか見ていません。
対数間隔なら同じ 8 回の計算で 0.001 から 10000 まで 8 桁を均等に覆えます。
np.logspace(-3, 4, 8) と書くだけなので、桁で効くパラメータは必ず logspaceと覚えてください。
学習率・C・gamma・alpha はすべてこの仲間です。逆に max_depth や n_estimators のように
「1 ずつ増える」性質のものは等間隔(あるいは整数の候補列)で構いません。
探索点数は「掛け算」で増える — 実測時間
グリッドサーチの学習回数は (候補の積)×(fold 数) です。パラメータを 1 つ足すと点数は足し算ではなく掛け算で増えます。 上と同じ 47 行のデータで RandomForest を 5-fold で回した実測が次の表です。
| 探索するパラメータ | 点数 | 学習回数 | 実測時間 |
|---|---|---|---|
| n_estimators(2 候補) | 2 | 10 | 0.1 秒 |
| + max_depth(3 候補) | 6 | 30 | 0.3 秒 |
| + min_samples_leaf(2 候補) | 12 | 60 | 0.7 秒 |
47 行なら 12 点でも 1 秒未満ですが、データが 1 万行になれば同じ 12 点で数分〜数十分になります。 パラメータを 5 個、各 5 候補にすると 5⁵ = 3,125 点 × 5 fold = 15,625 回の学習です。 ここが「グリッドサーチは丁寧だが高くつく」と言われる理由で、 ランダムサーチや逐次的な絞り込み(Successive Halving)が使われる動機になります。 まずは効きそうな 2 つに絞って粗く探し、当たりの周辺だけ細かく刻み直すのが、実務では一番早く済みます。
🐍 Python 実装
SSDSE-B-2026(47 都道府県・2023 年データ)を題材にした最小コード(Ridge は StandardScaler を Pipeline に組み込んで標準化してから探索する。 パラメータ名は ridge__alpha のように「ステップ名__引数名」で指定する):
1 2 3 4 5 6 7 8 9 10 11 12 13 14 15 16 17 18 19 20 21 22 23 24 25 | import pandas as pd # ── この抜粋だけで動くように、47 都道府県・最新年度を読み込む ── _d = pd.read_csv('data/raw/SSDSE-B-2026.csv', encoding='cp932', skiprows=[1]) _d = _d[_d['SSDSE-B-2026'] == 2023] from sklearn.model_selection import GridSearchCV, train_test_split from sklearn.linear_model import Ridge from sklearn.pipeline import make_pipeline from sklearn.preprocessing import StandardScaler # ── この抜粋だけで動くように、学習用データを用意する ── _X = _d[['A1101', 'A1301', 'A1303', 'A9101']].astype(float).values _y = _d['A4101'].astype(float).values X_train, X_test, y_train, y_test = train_test_split(_X, _y, test_size=0.3, random_state=0) # 桁の違う特徴量をそろえてから Ridge にかける(標準化しないと alpha がほぼ効かない) pipe = make_pipeline(StandardScaler(), Ridge()) param_grid = {'ridge__alpha': [0.01, 0.1, 1, 10, 100]} gs = GridSearchCV(pipe, param_grid, cv=5, scoring='neg_root_mean_squared_error') gs.fit(X_train, y_train) for a, s in zip(param_grid['ridge__alpha'], gs.cv_results_['mean_test_score']): print(f' alpha={a:>6} → CV RMSE={-s:8.1f}') print('Best:', gs.best_params_, f'| CV RMSE: {-gs.best_score_:.1f}') best_model = gs.best_estimator_ |
💬 標準化を挟むと alpha で CV RMSE がはっきり動き、alpha=1 の 1,229.5 人が最良、100 では 8,052.2 人まで悪化した。0.01→0.1→1 が 1,245.8 → 1,481.5 → 1,229.5 と単調でないのは、総人口・年少人口・高齢人口が互いにほぼ比例していて係数の分け方が不安定なためで、学習データは 32 県しかなく 5 分割の各折が 6〜7 県で評価されることも揺れを大きくしている。最良値がグリッドの端ではなく中ほどにあるので、次は 0.3〜3 あたりを細かく刻み直して確かめる。
🐍 Random Search vs Grid Search 比較
このコードでやること:同じ計算予算(20 回評価)で Grid Search と Random Search を比較する。 Random Search が小さい予算で広範囲を探索できることを確認。 2023 年断面(47 行)・seed 固定(random_state=0 / 42)の実測。
📥 入力データ:SSDSE-B-2026、 X = 人口関連 3 変数、 y = 出生数。
1 2 3 4 5 6 7 8 9 10 11 12 13 14 15 16 17 18 19 20 21 22 23 24 25 26 27 | import pandas as pd import numpy as np from sklearn.ensemble import RandomForestRegressor from sklearn.model_selection import GridSearchCV, RandomizedSearchCV from scipy.stats import randint df = pd.read_csv('data/raw/SSDSE-B-2026.csv', encoding='cp932', skiprows=[1]) df = df[df['SSDSE-B-2026'] == 2023] # 2023年断面(47都道府県) X = df[['A1101', 'A1301', 'A4200']] y = df['A4101'] # 教材では計算時間の都合で候補を絞っています。実務ではもっと広い範囲を探索します。 # 木の本数の上限を 1000 → 100 に下げています(比較の趣旨は変わりません) # Grid: 5x4 = 20 評価 grid = {'n_estimators': [20, 40, 60, 80, 100], 'max_depth': [3, 5, 10, 20]} gs = GridSearchCV(RandomForestRegressor(random_state=0), grid, cv=3, scoring='r2', n_jobs=-1) gs.fit(X, y) # Random: 20 サンプル dist = {'n_estimators': randint(20, 101), 'max_depth': randint(3, 21)} rs = RandomizedSearchCV(RandomForestRegressor(random_state=0), dist, n_iter=20, cv=3, scoring='r2', random_state=42, n_jobs=-1) rs.fit(X, y) print(f"Grid 最良: {gs.best_params_} R²={gs.best_score_:.4f}") print(f"Random 最良: {rs.best_params_} R²={rs.best_score_:.4f}") |
📤 実行例:
💬 結果の読み方:Random Search は 連続値の細かい候補(n_estimators=81 のような格子に無い値)を試せる。 今回は Grid のほうがわずかに上(0.9207 vs 0.9188)だが、この差は fold 分割のゆらぎの範囲。 Grid は離散値で固定されるため、 最適値が候補に含まれていない可能性がある。 今回の差は僅少で fold 分割にも依存するが、 高次元(パラメータ 4+)では Random Search の優位が明確になる。
🐍 Optuna(ベイズ最適化)で SSDSE-B-2026
このコードでやること:Optuna の TPE(Tree-structured Parzen Estimator)で Ridge の alpha を 連続範囲から最適化する。 過去の評価結果を使って次の試行を賢く選ぶため、 同じ予算でより良い解が見つかる。 Ridge は StandardScaler+Pipeline で標準化し、 TPESampler(seed=42) で結果を再現可能にする(seed を固定しないと結果は試行ごとに変動する)。 2023 年断面(47 行)の実測。
📥 入力データ:SSDSE-B-2026、 X = 人口 3 変数、 y = 出生数。
1 2 3 4 5 6 7 8 9 10 11 12 13 14 15 16 17 18 19 20 21 22 23 | import pandas as pd import optuna from sklearn.linear_model import Ridge from sklearn.model_selection import cross_val_score from sklearn.pipeline import make_pipeline from sklearn.preprocessing import StandardScaler df = pd.read_csv('data/raw/SSDSE-B-2026.csv', encoding='cp932', skiprows=[1]) df = df[df['SSDSE-B-2026'] == 2023] # 2023年断面(47都道府県) X = df[['A1101', 'A1301', 'A4200']] y = df['A4101'] def objective(trial): alpha = trial.suggest_float('alpha', 1e-3, 1e3, log=True) model = make_pipeline(StandardScaler(), Ridge(alpha=alpha)) return cross_val_score(model, X, y, cv=5, scoring='r2').mean() sampler = optuna.samplers.TPESampler(seed=42) # seed 固定で再現可能に study = optuna.create_study(direction='maximize', sampler=sampler) study.optimize(objective, n_trials=30, show_progress_bar=False) print(f"最良 alpha: {study.best_params['alpha']:.4f}") print(f"最良 R²: {study.best_value:.4f}") |
📤 実行例:
💬 結果の読み方:Optuna は対数一様分布 [1e-3, 1e3] を 30 試行で探索し、 alpha≈0.001(探索範囲の下端)に収束、 CV R²=0.9901。 grid の離散候補に縛られず連続値を試せるのが TPE の利点だが、 この課題では正則化を弱めるほど良い(特徴量 3 個 × 47 行で過学習が弱く OLS に漸近する。 🧮 実値計算の結論と整合)ため、 最良が範囲の端に張り付いた。 端に来た場合は下限をさらに下げて確認するのが定石。 TPESampler(seed=42) を固定しているので上記の値は再現される(seed を外すと試行系列が変わり best alpha は毎回ぶれる)。
🐍 Successive Halving で予算を節約
このコードでやること:scikit-learn の HalvingGridSearchCV で、 少量のリソースで多数の候補を評価 → 上位だけ残してリソースを増やす、 を繰り返す。 grid search より大幅に高速。
📥 入力データ:SSDSE-B-2026、 X = 人口 3 変数、 y = 出生数(A4101)。
1 2 3 4 5 6 7 8 9 10 11 12 13 14 15 16 17 18 19 20 21 22 23 24 25 26 | import pandas as pd from sklearn.experimental import enable_halving_search_cv # noqa from sklearn.model_selection import HalvingGridSearchCV from sklearn.ensemble import GradientBoostingRegressor df = pd.read_csv('data/raw/SSDSE-B-2026.csv', encoding='cp932', skiprows=[1]) df = df[df['SSDSE-B-2026'] == 2023] # 2023年断面(47都道府県) X = df[['A1101', 'A1301', 'A4200']] y = df['A4101'] # 教材では計算時間の都合で候補を絞っています。実務ではもっと広い範囲を探索します。 # n_estimators の上限を 500 → 150 に下げています(候補数 64 は変えていません) param_grid = { 'n_estimators': [20, 40, 80, 150], 'max_depth': [2, 3, 5, 7], 'learning_rate': [0.01, 0.05, 0.1, 0.3] } hs = HalvingGridSearchCV( GradientBoostingRegressor(random_state=0), param_grid, cv=3, scoring='r2', factor=3, resource='n_samples', min_resources=15, random_state=42, n_jobs=-1 ) hs.fit(X, y) print(f"最良: {hs.best_params_}") print(f"最良 CV R²: {hs.best_score_:.4f}") print(f"各段の n_samples: {hs.n_resources_}") |
📤 実行例:
💬 結果の読み方:候補 64 個を全評価せず、 まず 15 サンプルで全 64 候補をスクリーニング → 上位 22 候補だけ 45 サンプルで再評価(n_candidates_=[64, 22])。 これで学習回数を大幅に節約できる。 ただし今回は 47 行しかなく 第 1 段の 15 サンプルが荒すぎるため、 通常の GridSearchCV の最良とは別の解(R²=0.9429)に落ち着いた。 Successive Halving は計算量削減と引き換えに、 低リソース段のノイズで真の最適候補を早期に切り落とすリスクがある——データが小さいほど min_resources を大きめに取るのが安全。 大規模データでこそ本領を発揮する。
📊 主要モデルのハイパラ典型探索範囲
| モデル | 主要ハイパラ | 推奨範囲 | スケール |
|---|---|---|---|
| Ridge / Lasso | alpha | [1e-3, 1e3] | log |
| SVM | C, gamma | [1e-3, 1e3] | log |
| Random Forest | n_estimators, max_depth, min_samples_leaf | [50, 1000] / [3, 20] / [1, 20] | linear |
| XGBoost / LightGBM | learning_rate, max_depth, n_estimators, subsample | [0.01, 0.3] / [3, 10] / [100, 2000] / [0.5, 1.0] | log / linear |
| Neural Net | lr, batch_size, dropout, weight_decay | [1e-5, 1e-1] / [16, 512] / [0, 0.5] / [1e-6, 1e-2] | log |
| k-NN | n_neighbors | [1, 50] | linear |
注:「推奨範囲」はあくまで出発点。 業務データやモデルサイズに応じて狭めるか広げる。
🐍 cv_results_ を可視化して傾向を掴む
このコードでやること:GridSearchCV.cv_results_ を DataFrame に変換し、 各ハイパラ値ごとのスコアを表として確認する。 ハイパラ感度(どのパラメータが効くか)を読み取れる。
📥 入力データ:SSDSE-B-2026、 X = 人口関連、 y = 出生数。
1 2 3 4 5 6 7 8 9 10 11 12 13 14 15 16 17 18 19 20 21 22 23 24 25 26 | import pandas as pd from sklearn.linear_model import ElasticNet from sklearn.model_selection import GridSearchCV from sklearn.pipeline import make_pipeline from sklearn.preprocessing import StandardScaler df = pd.read_csv('data/raw/SSDSE-B-2026.csv', encoding='cp932', skiprows=[1]) df = df[df['SSDSE-B-2026'] == 2023] # 2023年断面(47都道府県) X = df[['A1101', 'A1301', 'A4200']] y = df['A4101'] pipe = make_pipeline(StandardScaler(), ElasticNet(max_iter=5000)) grid = { 'elasticnet__alpha': [0.01, 0.1, 1.0], 'elasticnet__l1_ratio': [0.1, 0.5, 0.9] } gs = GridSearchCV(pipe, grid, cv=5, scoring='r2') gs.fit(X, y) res = pd.DataFrame(gs.cv_results_)[[ 'param_elasticnet__alpha', 'param_elasticnet__l1_ratio', 'mean_test_score', 'std_test_score']] pivot = res.pivot(index='param_elasticnet__alpha', columns='param_elasticnet__l1_ratio', values='mean_test_score') print(pivot.round(4)) |
📤 実行例:
💬 結果の読み方:標準化したことで 両軸ともスコアが明確に動く。 alpha を上げるほど正則化が強まり性能が落ち(l1_ratio=0.1 の列では alpha=0.01 の 0.9720 から alpha=1.0 の 0.8353 まで低下)、 l1_ratio を上げる(L1 寄り=スパース化)ほど改善する(特に alpha=1.0 で 0.835→0.940 と大きく効く)。 最良セルは alpha=0.01・l1_ratio=0.9 の 0.9883。 → 次の探索では alpha を小さい側([0.001, 0.1] など)に絞り、 l1_ratio は高め(0.9 近傍)を重点的に刻む戦略が立てられる。 cv_results_ の ヒートマップ可視化は、 こうした軸ごとの感度を読み取る出発点として最強。
🐍 2 つのハイパラを同時に振る — SVR の C × gamma と「端に来たら広げる」
ここからは、人口規模でほぼ決まってしまう出生数ではなく、合計特殊出生率(A4103)を 7 つの比率から当てる、もう少し難しい課題を使います。まず RBF カーネルの SVR で、誤差への罰の強さ C と、カーネルの幅を決める gamma を 5 × 5 = 25 組探索し、cv_results_ を表に並べます。
🎯 このコードでやること:2023 年度の 47 県で、標準化つき SVR(epsilon=0.05)の C(0.01〜100)× gamma(0.001〜10)を shuffle ありの 5-fold で探索し、25 組の CV R² の表と最良の組を出す。最良が格子の端なら範囲を外側へ広げて探し直し、線形 Ridge と比べる。
1 2 3 4 5 6 7 8 9 10 11 12 13 14 15 16 17 18 19 20 21 22 23 24 25 26 27 28 29 30 31 32 33 34 35 36 37 38 | import pandas as pd import numpy as np from sklearn.svm import SVR from sklearn.pipeline import make_pipeline from sklearn.preprocessing import StandardScaler from sklearn.model_selection import GridSearchCV, KFold df = pd.read_csv('data/raw/SSDSE-B-2026.csv', encoding='cp932', skiprows=[1]) d = df[df['SSDSE-B-2026'] == 2023].reset_index(drop=True) X = pd.DataFrame({'高齢化率': d['A1303'] / d['A1101'] * 100, '年少人口比率': d['A1301'] / d['A1101'] * 100, '婚姻率': d['A9101'] / d['A1101'] * 1000, '転入超過率': (d['A5101'] - d['A5102']) / d['A1101'] * 1000, '大学等進学率': d['E4602'] / d['E4601'] * 100, '保育定員率': d['J2505'] / d['A1301'] * 100, '消費支出': d['L3221'] / 1000}) y = d['A4103'] pipe = make_pipeline(StandardScaler(), SVR(epsilon=0.05)) cv = KFold(5, shuffle=True, random_state=0) def search(Cs, gammas): gs = GridSearchCV(pipe, {'svr__C': Cs, 'svr__gamma': gammas}, cv=cv, scoring='r2').fit(X, y) table = pd.DataFrame(gs.cv_results_).pivot(index='param_svr__C', columns='param_svr__gamma', values='mean_test_score') return gs, table gs, table = search(np.logspace(-2, 2, 5), np.logspace(-3, 1, 5)) # 1 回目: C 0.01〜100、gamma 0.001〜10 print(table.round(2).to_string()) b = gs.best_params_ print(f"1 回目の最良: C={b['svr__C']:g}, gamma={b['svr__gamma']:g}, R²={gs.best_score_:.3f}") edge = b['svr__C'] == 100 or b['svr__gamma'] == 0.001 print('最良が格子の端にあるか:', edge) gs2, _ = search(np.logspace(1, 5, 5), np.logspace(-5, -1, 5)) # 2 回目: 端の外側へ広げる b2 = gs2.best_params_ print(f"2 回目の最良: C={b2['svr__C']:g}, gamma={b2['svr__gamma']:g}, R²={gs2.best_score_:.3f}") from sklearn.linear_model import Ridge from sklearn.model_selection import cross_val_score r = cross_val_score(make_pipeline(StandardScaler(), Ridge(alpha=0.3162)), X, y, cv=cv, scoring='r2').mean() print(f'参考: 同じ分け方での線形 Ridge(alpha=0.3162)の CV R² = {r:.3f}') |
💬 25 組の CV R² は −0.06〜0.79 と大きく動き、gamma が 1 以上の列は C をいくら変えても 0.13 以下です。最良は C=100・gamma=0.001 の 0.795 で、C は上端、gamma は下端という格子の角にあります。角の外側(C 10〜100,000、gamma 0.00001〜0.1)へ広げると、最良はまた角の C=100,000・gamma=0.00001 に移り、R² は 0.800 とわずかに上がるだけです。gamma が小さく C が大きい SVR は線形モデルに近づくので、同じ分け方の線形 Ridge(0.812)とほぼ同じ所に落ち着いています。
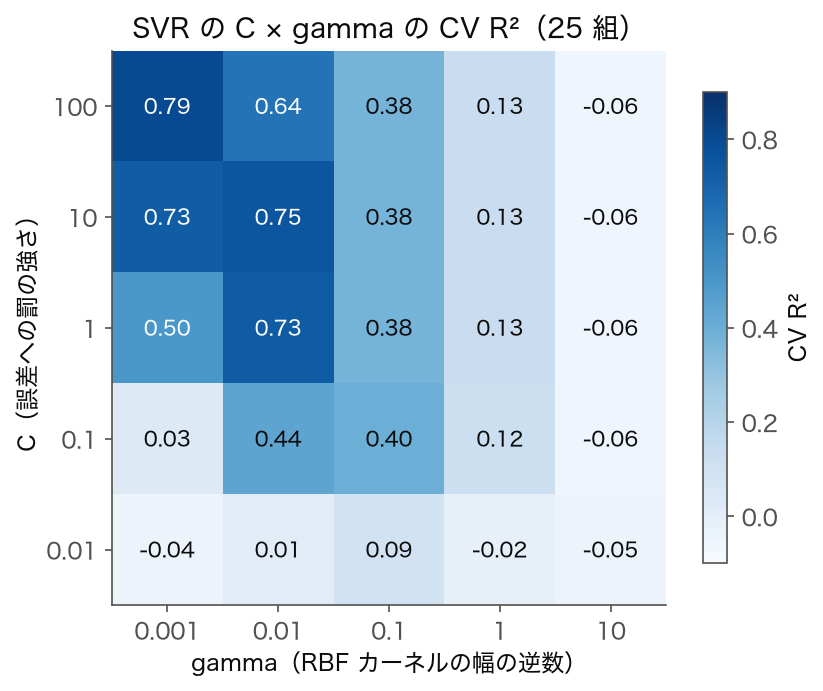
図 2 のように良い領域が格子の角に張り付いているときは、(1) 端の外側へ範囲を広げる、(2) それでも端を追いかけ続けるなら、そのモデルが別の単純なモデル(ここでは線形)に近づこうとしていないかを疑う、の 2 段階で考えます。この課題では、25 組 → さらに 25 組と 50 回の探索を費やして、線形 Ridge の 0.812 を超えられませんでした。ヒートマップは「どこが最良か」だけでなく、「そもそもこのモデルの柔軟さが要るか」を判断する材料にもなります。
⚠️ よくある落とし穴
neg_ プレフィックスを使う。⚠️ よくある落とし穴(5 件)
「グリッドサーチ」を実務・試験で扱うときに頻発する典型的なミスです。
⚠️ Grid Search の落とし穴 7 件
- 探索空間の爆発:パラメータ 5 個 × 各 10 候補 = 100,000 評価。 1 回 10 秒でも 280 時間。 → BO + 早期打ち切り。
- 候補値の線形配置:alpha=[1,2,3,4,5] のような線形ではなく、 [0.01, 0.1, 1, 10, 100] の 対数が原則。
- CV の楽観バイアス:同じ CV で選んだハイパラの評価は楽観的。 → Nested CV か独立 test set。
- ローカル最適:grid の境界に最適値があると、 範囲を広げないと気づかない。 → 結果を可視化して境界チェック。
- シード固定:random_state を忘れると毎回異なる最適解。 → 必ず seed を固定。
- 業務 KPI とのズレ:CV スコアが上がっても業務 KPI が改善しないことがある。 → 評価指標を業務に揃える。
- 計算予算の暴走:Slurm/Cloud で意図せず大規模 grid を投げると課金事故。 →
n_jobs=-1と並列度を確認。
🗓 ハイパラ探索の歴史
| 年 | 出来事 |
|---|---|
| 1960s | 最適実験計画(Box & Wilson) |
| 1998 | SMBO(Sequential Model-Based Optimization)の理論 |
| 2011 | Hyperopt(TPE)公開(Bergstra ら) |
| 2012 | Bergstra & Bengio「Random Search が Grid より効率的」を実証 |
| 2017 | Hyperband 提案(Li ら) |
| 2019 | Optuna 公開(Preferred Networks) |
| 2020 | scikit-learn 0.24 で HalvingGridSearchCV 追加 |
❓ よくある質問
Q1. Grid と Random はいつ使い分ける?
A. パラメータ数 ≤ 3 なら Grid、 4 以上なら Random または BO。 Bergstra & Bengio の論文を読むと納得しやすい。
Q2. Optuna は本番運用にも使える?
A. Yes。 SQLite/PostgreSQL バックエンドで study を永続化でき、 分散実行も対応。 LightGBM/XGBoost との統合 API もある。
Q3. 並列化したい場合は?
A. GridSearchCV は n_jobs=-1 で全 CPU 使用可。 Optuna は n_jobs 引数 + RDB 永続化で分散実行可能。
Q4. 探索範囲はどう決める?
A. 公式ドキュメント・論文・Kaggle 解法を参考に。 alpha, learning_rate は対数スケール、 max_depth は線形でよい。
Q5. 結果を信頼する条件は?
A. (1) CV スコアの fold 間ばらつきが小さい、 (2) ベスト候補が grid の境界にない、 (3) 独立 test set で検証済み、 の 3 点が揃ったとき。
📊 実データで確かめる①:cv=5 は並べ替えない — 県コード順のデータで起きること
GridSearchCV(..., cv=5) と整数を渡すと、回帰では KFold(5)(shuffle なし)が使われ、データを上から順に 5 つに切ります。SSDSE-B-2026 は県コード順(北海道 → 沖縄県)に並んでいるので、各 fold は「北海道〜群馬県」「高知県〜沖縄県」のような地域のまとまりになります。上の SVR と同じ課題で、Ridge の alpha を 13 点探索して確かめます。
🎯 このコードでやること:合計特殊出生率を 7 つの比率から当てる Ridge の alpha(0.001〜1000 の対数 13 点)を、cv=5(並べ替えなし)と KFold(5, shuffle=True) の 2 通りで探索し、最良の alpha と CV R² を比べる。並べ替えなしの各 fold について、テストになった県の範囲と R²、その中の出生率の標準偏差も出す。
1 2 3 4 5 6 7 8 9 10 11 12 13 14 15 16 17 18 19 20 21 22 23 24 25 26 27 28 29 30 31 32 | import pandas as pd import numpy as np from sklearn.linear_model import Ridge from sklearn.pipeline import make_pipeline from sklearn.preprocessing import StandardScaler from sklearn.model_selection import GridSearchCV, KFold df = pd.read_csv('data/raw/SSDSE-B-2026.csv', encoding='cp932', skiprows=[1]) d = df[df['SSDSE-B-2026'] == 2023].reset_index(drop=True) # 2023 年度、県コード順(北海道→沖縄県) X = pd.DataFrame({ '高齢化率': d['A1303'] / d['A1101'] * 100, '年少人口比率': d['A1301'] / d['A1101'] * 100, '婚姻率': d['A9101'] / d['A1101'] * 1000, '転入超過率': (d['A5101'] - d['A5102']) / d['A1101'] * 1000, '大学等進学率': d['E4602'] / d['E4601'] * 100, '保育定員率': d['J2505'] / d['A1301'] * 100, '消費支出': d['L3221'] / 1000, }) y = d['A4103'] # 合計特殊出生率 pipe = make_pipeline(StandardScaler(), Ridge()) grid = {'ridge__alpha': np.logspace(-3, 3, 13)} # 0.001〜1000 を対数で 13 点 for name, cv in [('cv=5(並べ替えなし)', 5), ('KFold(5, shuffle=True)', KFold(5, shuffle=True, random_state=0))]: gs = GridSearchCV(pipe, grid, cv=cv, scoring='r2').fit(X, y) print(f'{name:24s} 最良 alpha = {gs.best_params_["ridge__alpha"]:.4g} CV R² = {gs.best_score_:.3f}') gs = GridSearchCV(pipe, grid, cv=5, scoring='r2').fit(X, y) print('cv=5 の各 fold(最良 alpha での R²、テストになった県、その中の出生率の標準偏差)') for k, (tr, te) in enumerate(KFold(5).split(X)): r2 = gs.cv_results_[f'split{k}_test_score'][gs.best_index_] print(f' fold {k}: {d.loc[te[0], "Prefecture"]}〜{d.loc[te[-1], "Prefecture"]} R² = {r2:6.3f} 標準偏差 {y[te].std(ddof=0):.3f}') print(f'47 県全体の出生率の標準偏差 {y.std(ddof=0):.3f}') |
💬 並べ替えなしの cv=5 では最良の alpha が 0.001(格子の下端)で CV R² は −0.113、shuffle ありでは alpha 0.3162 で 0.812 と、同じデータ・同じ候補なのに「最良」も「性能」もまったく違います。並べ替えなしの fold を見ると、北海道〜群馬県の fold は R² −1.530、岐阜県〜奈良県の fold は −0.234 です。この 2 つの fold の中の出生率の標準偏差は 0.066 と 0.074 で、47 県全体の 0.132 の半分ほどしかありません。R² は「その fold の中の平均で当てるより何割良いか」なので、似た県ばかりの fold では分母が小さくなり、少しの誤差で大きく負になります。
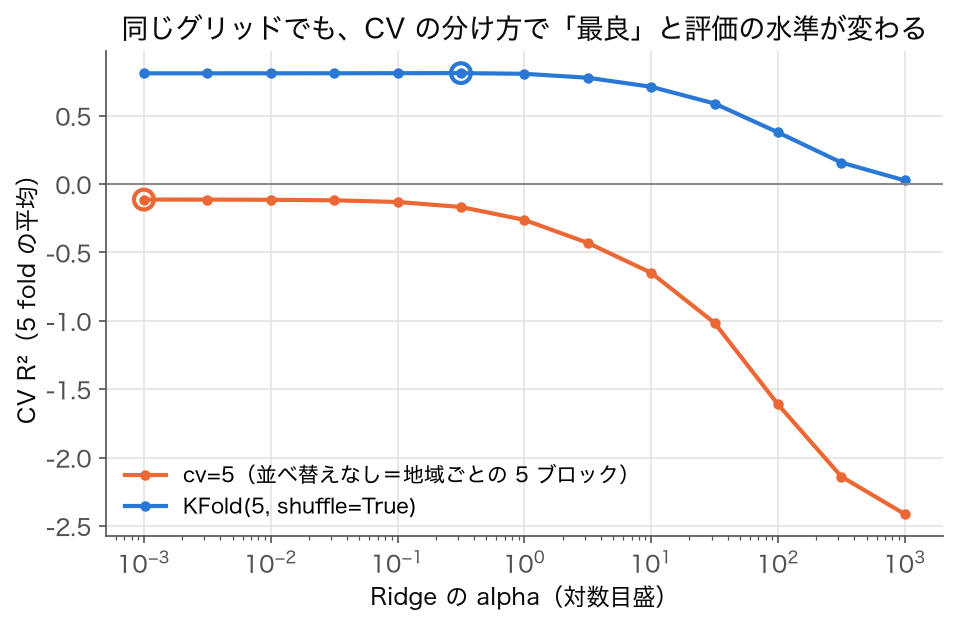
どちらの CV が「正しい」かは、何を知りたいかで決まります。ランダムに選んだ県を当てる性能を知りたいなら shuffle あり、「まだ見ていない地方」を当てる性能を知りたいなら、地方を丸ごと抜く GroupKFold のほうが問いに合っています。困るのは、整数の cv=5 で意図せず地域ブロック分割になっていることに気づかないことです。GridSearchCV には常に KFold(5, shuffle=True, random_state=...) や GroupKFold を明示的に渡し、どの分け方で選んだかを報告に書きます。
📊 実データで確かめる②:best_score_ は選んだ後の値 — 入れ子 CV で測り直す
「最良」の候補は、その CV のスコアが一番高かったから選ばれています。偶然よく見えた候補を選ぶ分、best_score_ は新しいデータでの性能より高めに出がちです。「候補を選ぶ手順」ごと外側の CV で評価する入れ子(nested)CV で、どれくらい高めなのかを測ります。
🎯 このコードでやること:同じ課題で、Ridge(alpha 13 候補)と k 近傍回帰(近傍数 1〜20 × 重み 2 種 × 距離 2 種 = 80 候補)のグリッドサーチを、分け方を 10 通り変えて実行し、best_score_ の平均と入れ子 CV の平均を比べる。
1 2 3 4 5 6 7 8 9 10 11 12 13 14 15 16 17 18 19 20 21 22 23 24 25 26 27 28 29 30 31 32 33 34 | import pandas as pd import numpy as np from sklearn.linear_model import Ridge from sklearn.neighbors import KNeighborsRegressor from sklearn.pipeline import make_pipeline from sklearn.preprocessing import StandardScaler from sklearn.model_selection import GridSearchCV, KFold, cross_val_score df = pd.read_csv('data/raw/SSDSE-B-2026.csv', encoding='cp932', skiprows=[1]) d = df[df['SSDSE-B-2026'] == 2023].reset_index(drop=True) X = pd.DataFrame({'高齢化率': d['A1303'] / d['A1101'] * 100, '年少人口比率': d['A1301'] / d['A1101'] * 100, '婚姻率': d['A9101'] / d['A1101'] * 1000, '転入超過率': (d['A5101'] - d['A5102']) / d['A1101'] * 1000, '大学等進学率': d['E4602'] / d['E4601'] * 100, '保育定員率': d['J2505'] / d['A1301'] * 100, '消費支出': d['L3221'] / 1000}) y = d['A4103'] searches = { 'Ridge(13 候補)': (make_pipeline(StandardScaler(), Ridge()), {'ridge__alpha': np.logspace(-3, 3, 13)}), 'k 近傍(80 候補)': (make_pipeline(StandardScaler(), KNeighborsRegressor()), {'kneighborsregressor__n_neighbors': list(range(1, 21)), 'kneighborsregressor__weights': ['uniform', 'distance'], 'kneighborsregressor__p': [1, 2]}), } for name, (model, grid) in searches.items(): inner, nested = [], [] for s in range(10): # 分け方を 10 通り変えて平均する icv = KFold(5, shuffle=True, random_state=s) # 候補を選ぶための CV ocv = KFold(5, shuffle=True, random_state=100 + s) # 選び方ごと評価する外側の CV gs = GridSearchCV(model, grid, cv=icv, scoring='r2') inner.append(gs.fit(X, y).best_score_) nested.append(cross_val_score(gs, X, y, cv=ocv, scoring='r2').mean()) print(f'{name}: best_score_ の平均 {np.mean(inner):.3f} / 入れ子 CV の平均 {np.mean(nested):.3f} ' f'/ 差 {np.mean(inner) - np.mean(nested):.3f}') |
💬 Ridge では best_score_ の平均 0.770 と入れ子 CV の平均 0.770 がほぼ同じで、選んだことによる水増しは見えません。k 近傍では best_score_ 0.548 に対して入れ子 CV は 0.469 で、0.079 だけ高めに出ています。Ridge の 13 候補は CV R² の曲線がなだらかで(下の③)、どれを選んでも大差ないので水増しが生じにくく、k 近傍の 80 候補は近傍数 1 のような揺れやすい候補を含むので、たまたま良く見えた候補を選ぶ余地が大きいのです。
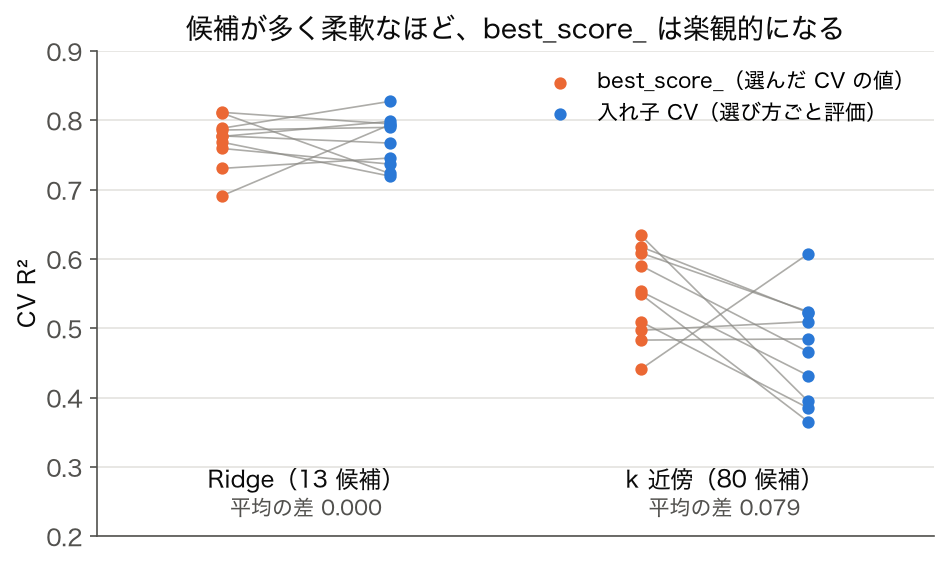
報告に使う性能は、best_score_ ではなく、(1) 探索に使っていないテストデータでの値、または (2) 入れ子 CV の値にします。候補が多く、モデルが柔軟で、データが少ないほど水増しは大きくなるので、47 県のような小さなデータで大きなグリッドを回すときほど、この区別が効いてきます。
📊 実データで確かめる③:選ばれる alpha は分け方しだいで入れ替わる
図 1 の青い曲線は alpha = 0.001〜1 の範囲でほぼ平らでした。平らな所で「最良」を 1 つ選ぶと、その選択は CV の分け方の偶然に左右されます。KFold の並べ替えの seed だけを 50 通り変えて、どの alpha が選ばれるかを数えます。
🎯 このコードでやること:同じ Ridge のグリッド(alpha 13 候補)を、KFold の seed だけを 0〜49 に変えて 50 回探索し、選ばれた alpha の回数と、50 回平均の alpha ごとの CV R² を出す。
1 2 3 4 5 6 7 8 9 10 11 12 13 14 15 16 17 18 19 20 21 22 23 24 25 26 27 28 | import pandas as pd import numpy as np from collections import Counter from sklearn.linear_model import Ridge from sklearn.pipeline import make_pipeline from sklearn.preprocessing import StandardScaler from sklearn.model_selection import GridSearchCV, KFold df = pd.read_csv('data/raw/SSDSE-B-2026.csv', encoding='cp932', skiprows=[1]) d = df[df['SSDSE-B-2026'] == 2023].reset_index(drop=True) X = pd.DataFrame({'高齢化率': d['A1303'] / d['A1101'] * 100, '年少人口比率': d['A1301'] / d['A1101'] * 100, '婚姻率': d['A9101'] / d['A1101'] * 1000, '転入超過率': (d['A5101'] - d['A5102']) / d['A1101'] * 1000, '大学等進学率': d['E4602'] / d['E4601'] * 100, '保育定員率': d['J2505'] / d['A1301'] * 100, '消費支出': d['L3221'] / 1000}) y = d['A4103'] pipe = make_pipeline(StandardScaler(), Ridge()) grid = {'ridge__alpha': np.logspace(-3, 3, 13)} chosen, curves = [], [] for s in range(50): # KFold の並べ替えの seed だけを 50 通り変える gs = GridSearchCV(pipe, grid, cv=KFold(5, shuffle=True, random_state=s), scoring='r2').fit(X, y) chosen.append(round(float(gs.best_params_['ridge__alpha']), 4)) curves.append(gs.cv_results_['mean_test_score']) print('選ばれた alpha と回数:', dict(sorted(Counter(chosen).items()))) m = np.mean(curves, axis=0) for a, r in zip(grid['ridge__alpha'], m): if a <= 10: print(f' alpha={a:8.4f} 50 通り平均の CV R² = {r:.3f}') |
💬 50 回のうち alpha=0.3162 が 20 回、0.001 と 0.1 が 12 回ずつ、1.0 が 3 回選ばれ、0.001 と 1.0 のように 1,000 倍も違う値が「最良」になります。一方、50 回平均の CV R² は alpha 0.001〜0.3162 で 0.771〜0.772 とほぼ同じで、1.0 でも 0.763 です。差が小数第 3 位にしか出ない候補どうしの順位は、分け方を変えれば入れ替わる程度のものです。alpha=3.16 で 0.722、10 で 0.638 と下がり始める所から先だけが、はっきり「悪い」と言える範囲です。
このような平らな領域では、「最良の 1 点」を報告するより、「alpha 0.001〜1 ならどれでも同程度(CV R² ≈ 0.77)」と範囲で報告するほうが正確です。1 点に決める必要があるなら、同程度の中で最も単純な(正則化の強い)候補を選ぶ 1 標準誤差ルールがよく使われます。
📊 実データで確かめる④:列の選択を GridSearchCV の外で済ませると best_score_ が甘くなる
「相関の強い列を先に k 個選び、残った列で alpha を GridSearchCV する」は自然な手順に見える。しかし列を選ぶときに 47 県すべての目的変数を見ているので、交差検証の検証側の県の答えが、選ばれる列にすでに入り込んでいる。列の選択を Pipeline に入れて fold ごとにやり直す場合と、best_score_ を比べる。
🎯 このコードでやること:合計特殊出生率を、残り 108 列(規模の列は対数)から Ridge 回帰で予測する。A は SelectKBest を全 47 県で先に当ててから k ごとに alpha を探し、B は SelectKBest を Pipeline に入れて k と alpha を同時に探す。
1 2 3 4 5 6 7 8 9 10 11 12 13 14 15 16 17 18 19 20 21 22 23 24 25 26 27 28 29 30 31 32 33 34 | import numpy as np, pandas as pd from sklearn.pipeline import Pipeline from sklearn.preprocessing import StandardScaler from sklearn.feature_selection import SelectKBest, f_regression from sklearn.linear_model import Ridge from sklearn.model_selection import GridSearchCV, KFold df = pd.read_csv('data/raw/SSDSE-B-2026.csv', encoding='cp932', skiprows=[1]) df = df[df['SSDSE-B-2026'] == 2023].reset_index(drop=True) y = df['A4103'].values # 合計特殊出生率 X = df.drop(columns=['SSDSE-B-2026', 'Code', 'Prefecture', 'A4103']).astype(float) X = X.apply(lambda c: np.log1p(c) if c.min() >= 0 else c) # 規模の列は対数に(最低気温など負の値を含む列はそのまま) print('説明変数', X.shape[1], '列 × 47 県、目的変数 = 合計特殊出生率(平均', round(y.mean(), 3), ')') cv = KFold(5, shuffle=True, random_state=0) alphas = [0.1, 1, 10, 100] # A: 列の選択を全 47 県で先に済ませてから、k ごとに GridSearchCV(選択が検証 fold の y を見ている) best_a = None for k in [3, 5, 10, 20]: cols = SelectKBest(f_regression, k=k).fit(X, y).get_support() g = GridSearchCV(Pipeline([('sc', StandardScaler()), ('m', Ridge())]), {'m__alpha': alphas}, cv=cv, scoring='r2').fit(X.loc[:, cols], y) print(f'A 外で選択 k={k:2d}: best_score_ = {g.best_score_:.3f} (alpha={g.best_params_["m__alpha"]})') if best_a is None or g.best_score_ > best_a[0]: best_a = (g.best_score_, k) # B: 列の選択も Pipeline に入れ、fold ごとに訓練側だけで選び直す pipe = Pipeline([('sc', StandardScaler()), ('sel', SelectKBest(f_regression)), ('m', Ridge())]) g = GridSearchCV(pipe, {'sel__k': [3, 5, 10, 20], 'm__alpha': alphas}, cv=cv, scoring='r2').fit(X, y) print(f'B 中で選択 best_score_ = {g.best_score_:.3f} {g.best_params_}') print(f'A の最良 {best_a[0]:.3f}(k={best_a[1]})と B の差 = {best_a[0] - g.best_score_:.3f}') sel = X.columns[g.best_estimator_.named_steps['sel'].get_support()] print('B が全 47 県で最終的に選んだ列:', list(sel)) |
💬 外で選んだ A は k=20 で best_score_ 0.396 と出るが、同じ候補を Pipeline の中で選び直す B では 0.334 で、差は 0.062 ある。A の 0.396 は「検証側の県の出生率も見て選んだ列」で測った値なので、その分だけ甘い。B が最終的に選んだ 20 列はほとんどが日本人人口・65 歳以上人口・死亡数・大学数など県の規模を表す列(ほかに食料費など)で、「人の多い県ほど出生率が低い」という関係を拾っている。前処理(標準化・列の選択・欠損の補完)で目的変数や全行の統計量を使うものは、すべて Pipeline に入れて GridSearchCV に渡すのが原則である。
📊 実データで確かめる⑤:scoring を変えると「最良」の組が変わる
GridSearchCV の scoring は、候補の順位を決める物差しそのものである。同じ 20 通りの候補でも、物差しを変えると選ばれる組が変わることがある。
🎯 このコードでやること:合計特殊出生率を 4 つの率(高齢化率・15 歳未満割合・人口千人あたり婚姻件数・15 歳未満 1 人あたり保育所等定員)から決定木で予測し、深さ × 葉の最小サンプル数の 20 通りを R²・MAE・RMSE・最大誤差の 4 指標で同時に評価する(refit=False、multi-metric)。
1 2 3 4 5 6 7 8 9 10 11 12 13 14 15 16 17 18 19 20 21 22 23 24 25 | import pandas as pd from sklearn.tree import DecisionTreeRegressor from sklearn.model_selection import GridSearchCV, KFold df = pd.read_csv('data/raw/SSDSE-B-2026.csv', encoding='cp932', skiprows=[1]) df = df[df['SSDSE-B-2026'] == 2023].reset_index(drop=True) pop = df['A1101'] X = pd.DataFrame({'高齢化率': df['A1303'] / pop, '15歳未満割合': df['A1301'] / pop, '婚姻率': df['A9101'] / pop * 1000, '保育所定員/15歳未満': df['J2505'] / df['A1301']}) y = df['A4103'] # 合計特殊出生率 grid = {'max_depth': [1, 2, 3, 4, 6], 'min_samples_leaf': [1, 3, 5, 8]} metrics = {'R2': 'r2', 'MAE': 'neg_mean_absolute_error', 'RMSE': 'neg_root_mean_squared_error', '最大誤差': 'neg_max_error'} g = GridSearchCV(DecisionTreeRegressor(random_state=0), grid, cv=KFold(5, shuffle=True, random_state=0), scoring=metrics, refit=False).fit(X, y) r = pd.DataFrame(g.cv_results_) tab = pd.DataFrame({'深さ': r['param_max_depth'], '葉の最小': r['param_min_samples_leaf']}) for m in metrics: tab[m] = r[f'mean_test_{m}'].abs() if m != 'R2' else r['mean_test_R2'] print('指標ごとの最良の組(20 通りのうち)') for m in metrics: i = tab[m].idxmax() if m == 'R2' else tab[m].idxmin() print(f' {m:4s} で選ぶ → 深さ {tab.loc[i, "深さ"]}, 葉 {tab.loc[i, "葉の最小"]}') print('\n選ばれた組を 4 指標で並べる') print(tab.loc[[tab['R2'].idxmax(), tab['MAE'].idxmin()]].round(4).to_string(index=False)) |
💬 R²・RMSE・最大誤差(各 fold の最大誤差の平均)で選ぶと深さ 2・葉 8 の浅い木になり、MAE で選ぶと深さ 6・葉 1 の深い木になる。深い木は MAE が 0.0671 と浅い木の 0.0718 より小さいが、RMSE は 0.0911 対 0.0885、最大誤差は 0.1875 対 0.1637 と大きい。多くの県ではぴったり当てる一方、一部の県を大きく外す木だということで、二乗で効く RMSE や最大誤差はそれを嫌う。出生率 1.29 前後の県で 0.07 の誤差は約 5% にあたる。どの外し方を避けたいのか(平均的なずれか、大外しか)を先に決め、それに合う scoring で探す。
🗺 概念マップ
グリッドサーチを中心に、ハイパーパラメータ探索の代替手法(ランダムサーチ・ベイズ最適化・Hyperband)、評価フレーム(交差検証・Nested CV)、scikit-learn の実装(GridSearchCV)、応用先(SVM のカーネル C/γ・Random Forest の n_estimators/max_depth・XGBoost の learning_rate/depth)を放射状に配置した。次元の呪い(高次元では指数的に組合せ爆発)と、ベイズ最適化への移行ポイントを矢印で示している。
グリッドサーチを中心とする概念マップは、 「ハイパーパラメータ最適化」「交差検証」「探索ログの分析」「Test set を絶対に見ない」の 4 つの隣接トピックで構成される。 scikit-learn の GridSearchCV は cv (交差検証分割数) と param_grid を同時に与えると、 (パラメータ組合せ数) × (cv 分割数) 回のモデル学習を自動実行し、 最良パラメータと CV スコアを返す。 探索空間が大きいときは RandomizedSearchCV (Bergstra-Bengio 2012)、 評価コストが高いときは BayesSearchCV (skopt) や Optuna の TPE で代替する流れが定番。
🔗 隣接手法への橋渡し
「グリッドサーチ」は単独で完結する手法ではなく、 隣接領域と連携することで真価を発揮する。
- 上流: 入力データの前処理・整備 — 交差検証 ・ ハイパーパラメータ
- 並列: 類似目的を持つ代替手法 — ランダムサーチ (Bergstra & Bengio 2012) ・ ベイズ最適化
- 下流: 出力結果の評価・解釈 — Optuna (Akiba 2019) ・ AutoML
上流のハイパーパラメータ範囲設定と評価指標選択で探索空間を定義し、 並列のランダムサーチ・ベイズ最適化・Hyperband と探索効率を比較し、 下流のクロスバリデーションで最適パラメータを評価する。 グリッドサーチは全探索の素朴版で、 次元の呪いに早く到達するため小規模問題か他手法のベースラインとして使う。
🌳 手法選択フロー
「グリッドサーチ」を実際の課題に当てはめるとき、 状況別に何を選ぶかを 3 段階で判定する。
- ハイパーパラメータ数は? 1〜3 個 → グリッドサーチで網羅、 4 個以上 → ランダムサーチ・ベイズ最適化が効率的
- 各試行のコストは? 軽 (数秒) → グリッドで OK、 重 (数時間) → ベイズ最適化・Hyperband で早期打ち切り併用
- 並列計算可能か? 可能 → グリッドの並列化で時間短縮、 不可 → 逐次的に賢く探索するベイズ最適化・遺伝的アルゴリズム
グリッドサーチは「全探索による安心感」と引き換えに次元の呪いを抱える。 4 次元以上は急速に非現実的になるため、 ランダムサーチを第一選択、 ベイズ最適化 (Optuna・Hyperopt) を最適化として用いる。