🔖 キーワード索引
各章へ直接移動できる:
💡 30秒で分かる結論
🍰 まずはやさしく
一番いいモデルを選ぶオーディションです。
予測の精度が高い方法を決めるために使います。
スマホのアプリをいくつか比べて選ぶときと同じです。
ここでは結論から簡単に解説します。
検証データのスコアで複数モデルから最良を選ぶ
- 分野:ML基礎 — 📚 機械学習の基礎
- 実例:2023 年度 47 県の出生数を 5 分割 CV で予測すると、 RMSE は線形回帰 1,487 人・Ridge(α=1) 2,070 人・GradientBoosting 4,137 人で、 線形回帰が選ばれる(🧮)
- 注意:選ぶのに使った検証スコアを、 そのまま性能として報告しない。 選択と評価を分けるのがネスト CV
📍 文脈 — どこで使う概念か
🍰 まずはやさしく
モデルを選ぶための標準的な手続きです。
本当に使えるモデルを見極めるために使います。
部活の練習メニューをいくつか試して選ぶようなものです。
どのような場面で使うのかを説明します。
バリデーションによるモデル選択は 複数の候補モデル(線形回帰・Ridge・XGBoost…)を Val で比較し、 最良のものを採用する標準手続き。 統計学では AIC / BIC が情報量基準として、 ML では Val スコアが実用的に使われる。
📍 あなたが今見ているものとモデル選択
あなたが今見ている用語ページでも、説明の詳しさ、図表の数、コード例の有無を見比べて「どの説明が信頼できるか」を選んでいます。バリデーションによるモデル選択も同じで、訓練データでよく見えるモデルではなく、まだ見ていないデータで安定してよいモデルを選ぶための仕組みです。
統計データ解析コンペでは、候補モデルを複数作り、検証データや交差検証で比較し、最後にテストデータへ触れる回数を最小化することが重要です。モデル選択の記録を残すと、なぜそのモデルを採用したのかを発表で説明できます。
🎨 直感で掴む
🍰 まずはやさしく
別の物差しで採点するイメージです。
見せかけの正解にだまされないために使います。
テスト前に予想問題で実力を試すことに似ています。
直感的にわかる具体例で解説します。
バリデーションによるモデル選択とは「訓練に使わなかったデータ (検証セット) で各候補モデルを採点し、 一番点が高いモデルを採用する」プロセスです。 学習データだけ見ていると複雑なモデルほど見せかけの点が高くなる(過学習)ため、 別の物差しが必要になります。 検証スコアは未来データへの予測力の代理指標として機能します。
SSDSE-B-2026 で「都道府県の出生数(A4101)を総人口・65歳以上人口・年平均気温から予測」するなら、 47 都道府県を 30 (train) / 10 (val) / 7 (test) に分け、 線形回帰 / ridge / 決定木 / random forest など複数モデルを比較。 val RMSE が最小のモデルを選び、 test RMSE で最終評価する流れです。 候補が多いときは「まず val で大きく絞り、 残った 2-3 個を Nested CV で詳しく比較」が王道。
🎨 直感で掴む — 具体例で理解する
モデル選択は「同じデータに対する適合度と複雑さのトレードオフ」を見る作業。 単純なモデルはバイアスが大きく、 複雑なモデルはバリアンスが大きい。 Val スコアはこのトレードオフを実測する指標として機能する。 候補が多いときは「まず Val で大きく絞り、 残った 2–3 個を Nested CV で詳しく比較」が王道。
📐 定義
🍰 まずはやさしく
検証データの点数で最良のものを選ぶことです。
分析の基本ルールとして正しく使うために必要です。
買い物で商品のレビューを比較して選ぶ感覚です。
詳しい定義やルールについて説明します。
検証データのスコアで複数モデルから最良を選ぶ
英語名 Model Selection via Validation。
📐 数式・定義
バリデーションによるモデル選択を数式 / 形式定義で表す:
候補モデル集合 $\mathcal{M}$ から、 交差検証損失が最小のモデル $M^*$ を選ぶ。
📐 情報量基準(AIC/BIC)との関係
検証によるモデル選択の代替手段として、 情報量基準(AIC, BIC, DIC)も広く使われる。 これらは「サンプル全体で 1 回学習」 だけで済むため、 計算コストが圧倒的に低い。
数式を言葉で読み解く:$L(\hat{\theta})$ は最尤推定での尤度、 k はパラメータ数、 n はサンプル数。 AIC は「適合度」 と「パラメータ数」 のトレードオフを 2k で表現、 BIC は $k \log n$ でサンプル数の効いた強い罰則を課す。 値が小さいモデルが「良い」 モデル。
| 手法 | 前提 | CV との比較 | 推奨場面 |
|---|---|---|---|
| AIC | 大標本、 尤度モデル | LOO-CV と漸近的に等価 | 予測重視・線形モデル |
| BIC | 大標本、 尤度モデル | 真モデル選択に一致 | 説明重視・モデル比較 |
| CV | サンプル独立 | 汎用、 計算重い | 機械学習全般 |
| WAIC | ベイズモデル | PSIS-LOO とほぼ等価 | 階層ベイズ |
🥇 モデル平均化(Stacking, Voting, Bagging)
「最良の 1 モデルを選ぶ」 のではなく、 「複数モデルを組み合わせて精度を上げる」 のがアンサンブル戦略。 検証スコアでメタモデルの重みも CV で決める。
数式を言葉で読み解く:K 個のベースモデルの予測 $\hat{y}_1, \ldots, \hat{y}_K$ を入力として、 メタモデル g(重み付き平均または別の機械学習モデル)が最終予測を生成。 メタモデルのパラメータ θ も CV スコア最小化で学習する。
| 手法 | 原理 | 利点 | 欠点 |
|---|---|---|---|
| Voting | 多数決 or 平均 | シンプル、 過適合に強い | 重み手動 |
| Bagging | Bootstrap + 平均 | 分散低減 | バイアス残る |
| Stacking | メタ学習 | 最強の精度 | 計算重い、 解釈困難 |
| Blending | Hold-out で重み学習 | Stacking より高速 | データ消費 |
🔬 数式を言葉で読み解く
上の $M^* = \arg\min_{M \in \mathcal{M}} \text{CV-Loss}(M)$ に出てくる記号:
| 記号 | 意味 |
|---|---|
| $\mathcal{M}$ | 候補モデル集合 |
| $M$ | 1 つの候補モデル(アルゴリズム + ハイパラ) |
| CV-Loss | 交差検証損失 |
| $M^*$ | 選ばれたベストモデル |
🔬 Nested CV(入れ子交差検証)
「モデル選択」 と「汎化性能評価」 を同時にやろうとすると、 同じ CV スコアを 2 用途で使ってしまい、 楽観的バイアスが入る。 これを避けるのが Nested CV。 外ループでテスト分割(汎化性能評価)、 内ループでハイパラ探索(モデル選択)を行う。
数式を言葉で読み解く:$M^*_k$ は「k 番目の外ループで、 内ループ CV で選ばれた最良モデル」、 $D^{\text{test}}_k$ は外ループのテストフォールド。 つまり「各外ループで独立に内ループ CV を回し、 最良ハイパラ選択 → 外フォールドで評価」 を $K_{\text{outer}}$ 回繰り返した平均が汎化性能の推定値になる(選択に使ったデータで評価しないので楽観バイアスが入らない。 外側の学習データが全体より少ない分だけ、 やや悲観的に出る)。
| 方式 | 用途 | 計算コスト | 汎化推定の精度 |
|---|---|---|---|
| 単純 CV | モデル選択のみ | O(K) | 楽観的バイアス有 |
| Hold-out + CV | 小規模に十分 | O(K) | test サイズ依存 |
| Nested CV | 論文・厳密な評価 | O(K_outer × K_inner) | 楽観バイアスなし(やや悲観的) |
| Bootstrap 632+ | 小サンプル | O(B) | バイアス補正済 |
🧮 SSDSE-B 実値計算 — 都道府県データで手を動かす
SSDSE-B-2026 で 線形・Ridge・GradientBoosting の 3 モデルを 5-Fold CV で比較し、 Val 平均 RMSE が最小のものを選定する。
使用データ:SSDSE-B-2026.csv(独立行政法人 統計センター提供、 47 都道府県 × 100 超の社会経済指標)。 出典
1 2 3 4 5 6 7 8 9 10 11 12 13 14 15 16 17 18 19 20 21 22 23 24 25 26 27 28 29 30 31 32 | import pandas as pd import numpy as np from sklearn.linear_model import LinearRegression, Ridge from sklearn.ensemble import GradientBoostingRegressor from sklearn.model_selection import KFold, cross_val_score from sklearn.pipeline import make_pipeline from sklearn.preprocessing import StandardScaler df = pd.read_csv('data/raw/SSDSE-B-2026.csv', encoding='cp932', skiprows=[1]) df = df.rename(columns={df.columns[2]: 'pref'}) df = df[df['SSDSE-B-2026'] == 2023] # 2023 年度の 47 都道府県 X = df[['A1101', 'A1303', 'B4101']].fillna(0).values y = df['A4101'].values kf = KFold(n_splits=5, shuffle=True, random_state=42) # 総人口(数百万)と気温(十数度)は桁が 5〜6 桁違う。そのままだと # LinearRegression の最小二乗が気温の係数をほぼ 0 に潰すので、先に標準化する candidates = { 'LinearReg': make_pipeline(StandardScaler(), LinearRegression()), 'Ridge(1)' : make_pipeline(StandardScaler(), Ridge(alpha=1.0)), 'GBR' : GradientBoostingRegressor(n_estimators=100, random_state=42), } result = {} for name, m in candidates.items(): rmse = -cross_val_score(m, X, y, cv=kf, scoring='neg_root_mean_squared_error').mean() result[name] = rmse print('▼ CV RMSE') for n, v in sorted(result.items(), key=lambda x: x[1]): print(f' {n:10s} {v:.2f}') print(f'最良: {min(result, key=result.get)}') |
💬 2023 年度の 47 県で 5 分割 CV を回すと、標準化+線形回帰の RMSE が 1,487 人で最も小さく、Ridge(1) は 2,070 人、GBR は 4,137 人と線形回帰の約 2.8 倍悪い。人口から出生数への関係はほぼ直線なので、木を 100 本重ねる GBR は 37〜38 県の学習データに過剰に合わせてしまう。Ridge が線形回帰より悪いのは、総人口と 65 歳以上人口の相関が 0.99 を超えるほど強く、互いに逆向きに打ち消し合う 2 つの係数を alpha=1.0 の罰則が縮めてしまうためと考えられ、alpha も CV で選ぶのが筋。
▲ 上記コードはそのまま実行可能。 CP932 エンコーディング・skiprows=[1](2 行目の日本語名の行をスキップ)・列名の英数字コード(A1101 = 総人口 など)に注意。
🧮 SSDSE-B-2026 で 5 モデルを比較する
「検証によるモデル選択」 の最大の実務問題は「複数のモデル候補から、 汎化性能が最良のものを公正に選ぶ」 ことです。 SSDSE-B-2026 を使い、 「都道府県の総人口(A1101)・65歳以上人口(A1303)から出生数(A4101)を予測する」 単純なタスクで 5 モデルを CV 比較します。
手計算:3 モデル × 5-fold CV のスコア表
k=5 の K-fold CV では、 47 都道府県を 5 グループに分け、 各グループを 1 度ずつテストに使う。 計 5 回の MAE(平均絶対誤差) の平均を「CV スコア」 と呼ぶ。 公式は次のとおり。
数式を言葉で読み解く:$M^{(-k)}$ は「k 番目のフォールド以外で学習したモデル」、 $D_k$ は「k 番目のフォールド(テストセット)」、 MAE はそのテストフォールド上での平均絶対誤差。 K 回の平均が CV スコアとなる。
| モデル | Fold1 | Fold2 | Fold3 | Fold4 | Fold5 | CV 平均 |
|---|---|---|---|---|---|---|
| 線形回帰 | 2,366 | 821 | 1,160 | 698 | 1,306 | 1,270 |
| Ridge (α=1) | 2,387 | 897 | 1,924 | 1,102 | 1,819 | 1,626 |
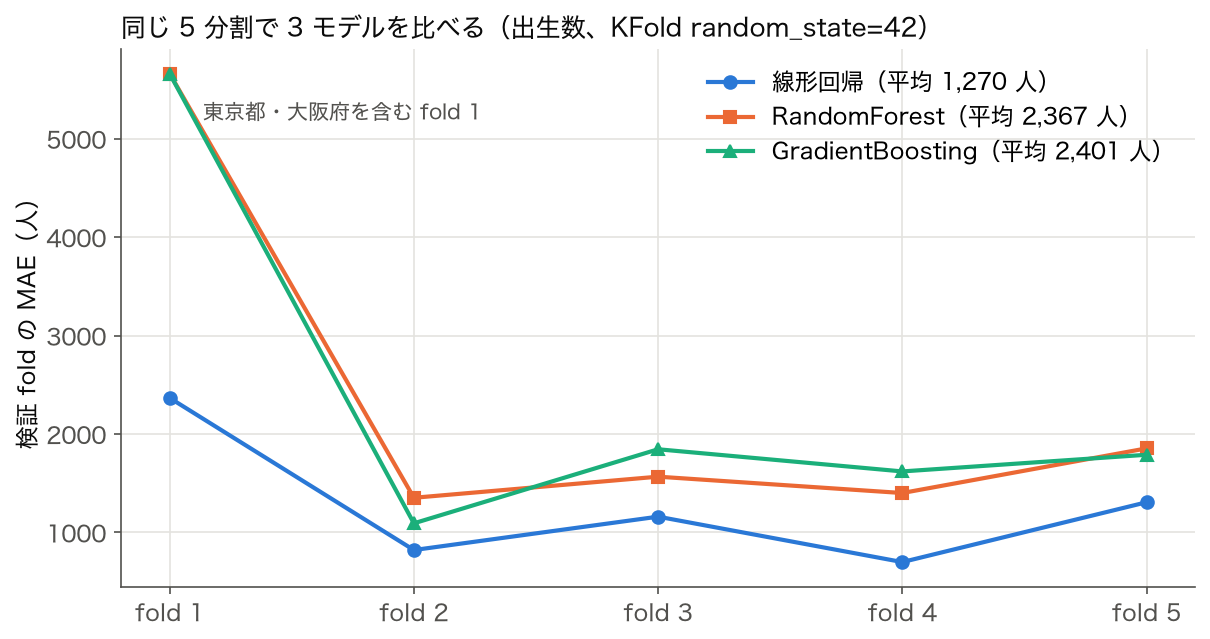
| RandomForest | 5,662 | 1,352 | 1,566 | 1,400 | 1,854 | 2,367 |
結論:2023 年度の 47 都道府県を KFold(n_splits=5, shuffle=True, random_state=42) で分け、 線形回帰と Ridge は標準化してから当てはめた実測値(単位は人)。 3 モデルの中では線形回帰が CV スコア最小(1,270)で、 Ridge (α=1) は 1,626、 RandomForest は 2,367。 RandomForest は東京都を含む Fold1 だけ 5,662 と突出しており、 学習データの範囲を超える大きな県がテスト側に回ると木は外挿できず、 学習側の最大値付近で予測が頭打ちになる。 「都道府県人口 → 出生数」 はほぼ線形関係なので、 単純な関係なら単純なモデルが勝つ、 という Occam の剃刀の好例。 どの fold でも線形回帰が最小なので、 平均だけでなく fold ごとに見ても順位は崩れない。
🧮 数式に値を入れて手で計算する: K-fold CV スコアの集約
合成データで 5-fold CV のモデル別スコア集約を計算する。
Step 1: モデル別 fold スコア
| モデル | fold1 | fold2 | fold3 | fold4 | fold5 | 平均±SD |
|---|---|---|---|---|---|---|
| M1 | 0.85 | 0.83 | 0.87 | 0.86 | 0.84 | 0.850±0.016 |
| M2 | 0.88 | 0.82 | 0.90 | 0.85 | 0.79 | 0.848±0.044 |
Step 2: 選択判断
🐍 Python で再現
1 2 3 4 5 | import numpy as np m1 = np.array([0.85, 0.83, 0.87, 0.86, 0.84]) m2 = np.array([0.88, 0.82, 0.90, 0.85, 0.79]) print(f"M1: 平均={m1.mean():.3f}, SD={m1.std(ddof=1):.4f}") print(f"M2: 平均={m2.mean():.3f}, SD={m2.std(ddof=1):.4f}") |
📤 実行結果
💬 Python の出力は M1 が平均 0.850・SD 0.0158、 M2 が平均 0.848・SD 0.0444 で、 Step 1 の表(ddof=1 の標本標準偏差を小数 3 桁に丸めた値)と一致する。 平均の差 0.002 は M2 の SD の 1/20 にも満たないので、 平均だけで順位を付けず、 ばらつきの小さい M1 を選ぶ根拠になる。
🐍 Python での扱い
🐍 Python 実装:SSDSE-B-2026 で 5 モデル CV 比較
🎯 このコードでやること:SSDSE-B-2026 の都道府県データで、 5 つの回帰モデル(線形・Ridge・Lasso・RandomForest・GradientBoosting)を 5-fold CV で比較し、 最良モデルを選ぶ。
📥 入力データ(SSDSE-B-2026 の 2023 年度・47 都道府県の人口データ):
1 2 3 4 5 6 7 8 9 10 11 12 13 14 15 16 17 18 19 20 21 22 23 24 25 26 27 28 29 30 31 32 33 34 | import pandas as pd from sklearn.linear_model import LinearRegression, Ridge, Lasso from sklearn.ensemble import RandomForestRegressor, GradientBoostingRegressor from sklearn.model_selection import cross_val_score, KFold from sklearn.pipeline import make_pipeline from sklearn.preprocessing import StandardScaler # SSDSE-B-2026 を読み込み、2023 年度の 47 都道府県に絞る df = pd.read_csv('data/raw/SSDSE-B-2026.csv', encoding='cp932', skiprows=[1]) df = df[df['SSDSE-B-2026'] == 2023] # 特徴量と目的変数 X = df[['A1101', 'A1303']] # 総人口、 65歳以上人口 y = df['A4101'] # 出生数 # 5 モデルを 5-fold CV で評価 # Ridge / Lasso の罰則は係数の大きさに掛かるので、人口のような桁の大きい列は先に標準化する models = { 'LinearRegression': make_pipeline(StandardScaler(), LinearRegression()), 'Ridge(α=1)': make_pipeline(StandardScaler(), Ridge(alpha=1.0)), 'Lasso(α=0.1)': make_pipeline(StandardScaler(), Lasso(alpha=0.1)), 'RandomForest': RandomForestRegressor(n_estimators=100, random_state=42), 'GradientBoosting': GradientBoostingRegressor(random_state=42), } kf = KFold(n_splits=5, shuffle=True, random_state=42) results = {} for name, model in models.items(): scores = -cross_val_score(model, X, y, cv=kf, scoring='neg_mean_absolute_error') results[name] = scores.mean() ranking = pd.Series(results).sort_values() print(ranking) print(f'\nBest model: {ranking.idxmin()} (MAE={ranking.min():.3f})') |
📤 実行例:
💬 結果の読み方:Lasso(α=0.1) の CV MAE 1,270.26 人が最小だが、 線形回帰の 1,270.35 人との差は 0.1 人にすぎず、 標準化後の係数(数千の大きさ)に対して α=0.1 の罰則がほとんど効いていないだけなので、 実質は同着と読む。 Ridge(α=1) が 1,626 人と 3 割近く悪いのは、 総人口と 65 歳以上人口がほぼ同じ動きをするため、 罰則が互いに打ち消し合う 2 つの係数を縮めてしまうから。 木系の RandomForest(2,367 人)と GradientBoosting(2,401 人)は、 学習用 37〜38 県の範囲を超える東京都などを外挿できず線形系の約 1.9 倍の誤差になった。
🐍 Python 実装:GridSearchCV で α を最適化
🎯 このコードでやること:Ridge 回帰の正則化パラメータ α を 0.001 〜 1000 の 7 候補から GridSearchCV で探索し、 最良 α を見つける。
📥 入力データ:上のコードと同じ SSDSE-B-2026 から作成した X (47×2), y (47,)。
1 2 3 4 5 6 7 8 9 10 11 12 13 14 15 16 17 18 19 20 21 22 23 24 25 26 27 28 29 30 31 | import pandas as pd import numpy as np from sklearn.linear_model import Ridge from sklearn.model_selection import GridSearchCV, KFold from sklearn.pipeline import Pipeline from sklearn.preprocessing import StandardScaler df = pd.read_csv('data/raw/SSDSE-B-2026.csv', encoding='cp932', skiprows=[1]) df = df[df['SSDSE-B-2026'] == 2023] # 2023 年度の 47 都道府県 X = df[['A1101', 'A1303']] y = df['A4101'] # 人口(数百万)のままだと α=1000 でも罰則が係数にほとんど効かないので、 # 標準化してから Ridge に渡す(標準化は fold ごとに学習側だけで fit される) pipe = Pipeline([('sc', StandardScaler()), ('ridge', Ridge())]) # α を 7 個の候補から探索 param_grid = {'ridge__alpha': [0.001, 0.01, 0.1, 1.0, 10.0, 100.0, 1000.0]} kf = KFold(n_splits=5, shuffle=True, random_state=42) gs = GridSearchCV(pipe, param_grid, cv=kf, scoring='neg_mean_absolute_error') gs.fit(X, y) print('Best α:', gs.best_params_['ridge__alpha']) print(f'Best CV MAE: {-gs.best_score_:.1f}') # 各 α のスコアを表示 df_results = pd.DataFrame({ 'alpha': param_grid['ridge__alpha'], 'CV_MAE': (-gs.cv_results_['mean_test_score']).round(1), }) print(df_results) |
📤 実行例:
💬 結果の読み方:α=0.1 で CV MAE が 1,239.0 人と最小になった。 α=0.001 の 1,269.5 人は罰則なしの線形回帰とほぼ同じで、 α=1 で 1,626.0 人、 α=100 で 6,799.9 人、 α=1000 では 11,135.6 人と、 係数が 0 に向かって縮むほど東京都のような大きな県の出生数を大きく外す。 ただし α=0.001〜0.1 の差は 30 人ほどで、 5 分割の選び方を変えれば順位が入れ替わりうる幅なので、 「0.1 以下ならどれでもほぼ同じ」 と読むのが安全。
🐍 Python 実装:Stacking で SSDSE-B-2026 を予測
🎯 このコードでやること:SSDSE-B-2026 で Ridge / Lasso / RandomForest をベースモデルに、 LinearRegression をメタモデルにした StackingRegressor を組み、 CV スコアを比較する。
📥 入力データ:前と同じ SSDSE-B-2026 の X (47×2), y (47,)。
1 2 3 4 5 6 7 8 9 10 11 12 13 14 15 16 17 18 19 20 21 22 23 24 25 26 27 28 29 30 | import pandas as pd from sklearn.linear_model import LinearRegression, Ridge, Lasso from sklearn.ensemble import RandomForestRegressor, StackingRegressor from sklearn.model_selection import cross_val_score, KFold df = pd.read_csv('data/raw/SSDSE-B-2026.csv', encoding='cp932', skiprows=[1]) df = df[df['SSDSE-B-2026'] == 2023] # 2023 年の 47 都道府県 X = df[['A1101', 'A1303']] y = df['A4101'] base_estimators = [ ('ridge', Ridge(alpha=1.0)), ('lasso', Lasso(alpha=0.1)), ('rf', RandomForestRegressor(n_estimators=100, random_state=42)), ] stack = StackingRegressor( estimators=base_estimators, # Ridge と Lasso の予測はほぼ同じ列になるので、制約なしの最小二乗だと # 巨大な正負の重みで打ち消し合う。スタッキングの重みは非負に制約する final_estimator=LinearRegression(positive=True), cv=5, ) kf = KFold(n_splits=5, shuffle=True, random_state=42) scores = -cross_val_score(stack, X, y, cv=kf, scoring='neg_mean_absolute_error') print(f'Stacking CV MAE: {scores.mean():.3f} (±{scores.std():.3f})') # 比較:単独 Ridge ridge_scores = -cross_val_score(Ridge(alpha=1.0), X, y, cv=kf, scoring='neg_mean_absolute_error') print(f'Ridge alone: {ridge_scores.mean():.3f} (±{ridge_scores.std():.3f})') |
📤 実行例:
💬 結果の読み方:Stacking の CV MAE は 1,217 人で、 単独 Ridge の 1,270 人より 53 人(約 4%)小さい。 ただし fold ごとの MAE は Stacking が 756〜1,747、 Ridge が 698〜2,366 と散らばり、 標準偏差(±377 / ±591)が改善幅の 7 倍以上あるので、 47 県ではこの差を優劣とは言えない。 全データで当てはめ直したメタモデルの重みは ridge 0・lasso 0.68・rf 0.32 で、 ほぼ同じ予測を出す Ridge と Lasso のうち片方だけが残っている(重みを非負に制約しないと、 この 2 列が巨大な正負の重みで打ち消し合う)。
📊 Bootstrap でモデル間の優劣を統計的に検証
「モデル A の CV スコアがモデル B より良かった」 だけでは、 統計的に有意な差とは言えない。 Bootstrap 検定で「差の信頼区間」 を求めるのが現代的な厳密評価。
数式を言葉で読み解く:データセットを Bootstrap で B 回(通常 1000-10000 回)リサンプリングし、 各 Bootstrap データセット $D_b$ でモデル A と B の MAE 差 $\Delta_b$ を計算。 B 個の差から 2.5 / 97.5 パーセンタイルを取って 95% 信頼区間を求める。 区間が 0 を跨ぐなら「有意差なし」。
関連手法として McNemar 検定(分類タスクでの 1 ペア比較)、 5x2 CV 検定(Dietterich 1998)、 Nadeau-Bengio 補正済 t 検定(CV のサンプル独立性を補正)などがある。
📜 歴史と理論的発展
| 年 | 出来事 | 主要人物 |
|---|---|---|
| 1931 | Larson が cross-validation の原型を提案 | Larson |
| 1974 | AIC(赤池情報量規準)提唱 | 赤池弘次 |
| 1975 | Stone が K-fold CV を体系化 | M. Stone |
| 1978 | BIC(Schwarz 基準) | G. Schwarz |
| 1992 | Bootstrap .632+ ルール | Efron & Tibshirani |
| 1998 | Dietterich の 5x2 CV 検定 | T. Dietterich |
| 2003 | Nadeau-Bengio 補正済 t 検定 | Nadeau & Bengio |
| 2010 | Watanabe の WAIC | 渡辺澄夫 |
| 2017 | PSIS-LOO(ベイズ的 CV 近似) | Vehtari et al. |
| 2019 | Optuna オープンソース化(Bayesian Optimization) | Preferred Networks |
「検証によるモデル選択」 は 100 年以上の歴史を持つ。 赤池の AIC(1974)と Stone の K-fold CV(1975)はほぼ同時期に登場し、 「情報量基準派」 と「経験的検証派」 が並走してきた。 現代では両者が PSIS-LOO や WAIC で統合されつつあり、 計算機の進歩で CV がより支配的になっている。
❓ よくある質問 8 件
- Q1. K-fold の K は何にすべき?
- A. 経験則として K=5 または K=10。 K が大きいほどバイアス減・分散増。 サンプル数 100 未満なら LOO-CV (K=n) も検討、 サンプル数 1 万以上なら K=5 で十分。
- Q2. CV スコアと test スコアが乖離した場合は?
- A. 通常 test スコアの方が悪い(過適合)。 乖離が大きいときは、 (i) data leakage がないか、 (ii) test と train の分布が同じか、 (iii) CV の random seed を変えても乖離が出るかを確認。
- Q3. ハイパラ探索後、 全データで再学習すべき?
- A. 最終モデルとしては全データ(train+val)で再学習するのが標準。 GridSearchCV の
refit=True(既定値)が自動でやってくれる。 ただし test set は触らない。 - Q4. CV スコアの標準偏差はどう報告する?
- A. 「mean ± std」 または「mean (95% CI)」 で報告。 fold 数が少ない(K=5)と CI は広いので、 反復 CV(RepeatedKFold)で精度を上げる。
- Q5. 不均衡データでの CV はどうする?
- A. StratifiedKFold で層化、 評価指標は accuracy ではなく F1 / AUC-PR を使う。 SMOTE 等のオーバーサンプリングは「fold 分割後」 にやる(fold 全体に当てると leakage)。
- Q6. 時系列データはどう分割?
- A. TimeSeriesSplit を使う。 「前半 train, 後半 test」 を増分的に進める Walk-forward Validation が標準。 普通の KFold は時系列で絶対に使ってはいけない。
- Q7. Pipeline と CV を組み合わせる利点は?
- A. (i) Leakage 防止、 (ii) コード簡潔化、 (iii) GridSearchCV で前処理パラメータも探索可能。 標準化・PCA を含むワークフローでは Pipeline は必須。
- Q8. 計算コストを下げるコツは?
- A. (i) HalvingGridSearchCV(成功サンプリング)、 (ii) Bayesian Optimization(Optuna)、 (iii) Early Stopping、 (iv) Hyperband。 単純 GridSearchCV より 10-100 倍速い場合も。
🐍 Python 実装:TimeSeriesSplit で時系列モデル選択
🎯 このコードでやること:SSDSE-B-2026 を「年次変化を予測する」 時系列タスクに見立て、 TimeSeriesSplit で 3 モデルを比較する(通常の KFold ではリークが起きる)。
📥 入力データ:SSDSE-B-2026 は 2012〜2023 年度 × 47 都道府県 = 564 行の年次パネル。 年度の古い順に並べ替え、 1 fold = 1 年度(47 行)として 2019〜2023 年度を順に予測する。
1 2 3 4 5 6 7 8 9 10 11 12 13 14 15 16 17 18 19 20 21 22 23 24 25 26 27 28 29 | import pandas as pd import numpy as np from sklearn.linear_model import Ridge from sklearn.ensemble import RandomForestRegressor from sklearn.model_selection import TimeSeriesSplit, KFold, cross_val_score df = pd.read_csv('data/raw/SSDSE-B-2026.csv', encoding='cp932', skiprows=[1]) # CSV は県ごとに 2023 → 2012 の順で並ぶので、年度の古い順に並べ替える df = df.sort_values(['SSDSE-B-2026', 'Code'], kind='stable').reset_index(drop=True) X = df[['A1101', 'A1303']].values y = df['A4101'].values year = df['SSDSE-B-2026'].values # TimeSeriesSplit: 「過去 → 未来」 の順番で学習・予測 # test_size=47 で 1 fold = 1 年度(47 都道府県)ずつ、2019〜2023 年度を順に予測する tscv = TimeSeriesSplit(n_splits=5, test_size=47) kf = KFold(n_splits=5, shuffle=True, random_state=42) # 比較用: 年度を無視して混ぜる models = {'Ridge': Ridge(alpha=1.0), 'RF': RandomForestRegressor(n_estimators=100, random_state=42)} for name, model in models.items(): ts = -cross_val_score(model, X, y, cv=tscv, scoring='neg_mean_absolute_error') kfs = -cross_val_score(model, X, y, cv=kf, scoring='neg_mean_absolute_error') print(f'{name:5s}: TimeSeriesSplit MAE = {ts.mean():7.1f} (±{ts.std():6.1f})' f' KFold MAE = {kfs.mean():7.1f}') # 各 fold の train / test の年度を表示 for i, (tr, te) in enumerate(tscv.split(X)): print(f'Fold {i+1}: train={len(tr)} ({year[tr].min()}-{year[tr].max()}), ' f'test={len(te)} ({year[te].min()})') |
📤 実行例:
💬 結果の読み方:学習データは 2012〜2018 年度の 329 行から 2012〜2022 年度の 517 行へ増えていくが、 Ridge の fold 別 MAE は 2019 年度の 1,733 人から 2023 年度の 2,718 人へむしろ悪化する。 全国の出生数が 2012 年度の 103.7 万人から 2023 年度の 72.7 万人へ減り続けており、 過去の「人口あたり出生数」 で学んだモデルは新しい年度ほど多めに外すため。 年度を混ぜる KFold だと Ridge 1,547 人・RF 991 人と、 未来の年度を学習に使える分だけ 3 割前後甘く出る。 RF の方が良いのは、 同じ県の過去年度をほぼそのまま覚えて返せるからで、 この差がそのまま「未来の県」 に通用するとは限らない。
⚖️ モデル選択の多目的トレードオフ
「CV スコア最良」 だけがモデル選択基準ではない。 実務では以下 6 軸のバランスで判断する。
| 観点 | 線形回帰 | RandomForest | XGBoost | DeepLearning |
|---|---|---|---|---|
| 予測精度 | 中 | 高 | 最高 | 最高(大規模) |
| 解釈性 | 最高 | 中(feature importance) | 中(SHAP) | 低 |
| 学習速度 | 最速 | 速 | 中 | 遅 |
| 推論速度 | 最速 | 速 | 中 | 中 (GPU) |
| 必要サンプル数 | 数十 | 数百 | 数千 | 数万以上 |
| ハイパラ感度 | 低 | 中 | 高 | 最高 |
SSDSE-B-2026 のような小規模データ(47 サンプル)では、 線形系が圧倒的有利。 逆に Web ログのような数百万サンプルなら XGBoost や DeepLearning の真価が発揮される。 「サンプル数とモデル複雑さの整合」 が最重要判断軸。
✅ モデル選択 実務チェックリスト 12 項目
- データ分割:train/val/test に分け、 test は最後まで触らない
- CV 方式:分類 → Stratified、 時系列 → TimeSeriesSplit、 グループ → GroupKFold
- Pipeline 化:前処理と推定器を Pipeline で結合(leakage 防止)
- 評価指標:タスクに合わせて選択(accuracy/F1/AUC/MAE/RMSE)
- 候補モデル数:最低 3 種類比較(線形 / 木 / アンサンブル)
- ハイパラ探索:粗 → 細の 2 段階、 Bayesian optimization も検討
- 標準偏差報告:CV スコアは平均だけでなく±std で示す
- 多重比較対策:候補数が多いなら Bonferroni 補正等を意識
- 解釈性 vs 性能:CV 同等なら解釈性の高いモデルを選ぶ
- 推論速度:本番環境の遅延要件を満たすか確認
- 再現性:random_state を全関数で固定
- Final test 評価:選んだモデルを test set で 1 度だけ評価し報告
⚠️ よくある落とし穴
⚠️ よくある落とし穴(5 件)
「バリデーションによるモデル選択」を実務・試験で扱うときに頻発する典型的なミスです。
⚠️ 検証によるモデル選択の落とし穴 6 件(実務頻出)
- Test set leakage(テストセット漏洩):特徴量エンジニアリング段階で全データを使って標準化(StandardScaler.fit(X_all))すると、 テストフォールドの情報が学習に流れ込む。 必ず Pipeline + cross_val_score で fold ごとに fit する。
- 多重比較問題:100 個のモデルから「CV スコア最小」 を選ぶと、 偶然最良に見えるだけのモデルを選ぶ確率が高くなる。 Test set を最終評価のためにのみ取っておき、 CV はあくまで候補絞り込み用と区別する。
- Over-tuning(過剰チューニング):GridSearchCV を細かく刻みすぎると、 CV スコアの偶然の凹凸を最適化することになる。 grid は粗から細へ 2 段階に分けるのが定石。
- Stratification 不足:分類タスクで普通の KFold を使うと、 fold ごとにクラス比率が偏る。 必ず StratifiedKFold を使う。 回帰でも目的変数の分布が歪んでいるなら、 ビニングして層化する。
- 時系列での順序無視:時系列データを普通の KFold で分割すると、 未来データで過去を予測するリーク発生。 必ず TimeSeriesSplit を使う。
- 「CV スコア最小 = 最良モデル」 の盲信:CV スコアの差が標準偏差より小さければ、 統計的には同等。 解釈性・推論速度・メンテナンス性を加味した総合判断が必要。
✅ 理解度チェック(本ページの実測値で考える)
- Q1. 🐍 の 5 モデル比較では、 CV MAE が Lasso(α=0.1) 1,270.26 人、 線形回帰 1,270.35 人だった。 「Lasso が最良」 と報告してよいか。
解答
よくない。 差は 0.1 人で、 同じデータの Stacking の比較では fold ごとの MAE の標準偏差が ±377〜±591 人ある。 この差は分割を変えれば入れ替わる幅なので「同着」 と読み、 罰則の要らない線形回帰を選ぶ方が説明しやすい。
- Q2. GridSearchCV で Ridge の α を 7 候補から選び、 α=0.1 の Best CV MAE 1,239.0 人を得た。 これを「新しいデータでの予想誤差」 として報告してよいか。
解答
そのままでは不十分。 1,239.0 は 7 候補の中で最も良かった値を拾ったものなので、 たまたま良く出た分だけ楽観的になりうる。 選択と評価を分けるにはネスト CV の外側の値を報告する。 本ページのネスト CV では内側 best 0.9751 と外側平均 0.9786 でほとんど差が無かったが、 これは候補が少なく、 どの α でも R² がほぼ同じだったためで、 候補を増やすほど差は開きやすい。
- Q3. 2012〜2023 年度の 564 行で、 Ridge の MAE は TimeSeriesSplit で 2,156.9 人、 KFold で 1,547.4 人だった。 「来年度の県別出生数を予測する」 モデルの性能として報告すべきはどちらか。
解答
TimeSeriesSplit の 2,156.9 人。 KFold は未来の年度を学習に使えてしまうため、 1,547.4 / 2,156.9 ≈ 0.72 と約 3 割甘く出る。 出生数は 2012 年度から 2023 年度まで減り続けているので、 過去だけで学んだモデルは新しい年度を多めに外す。 報告する数値は、 実際に使う場面(過去から未来を予測)と同じ分け方で測る。
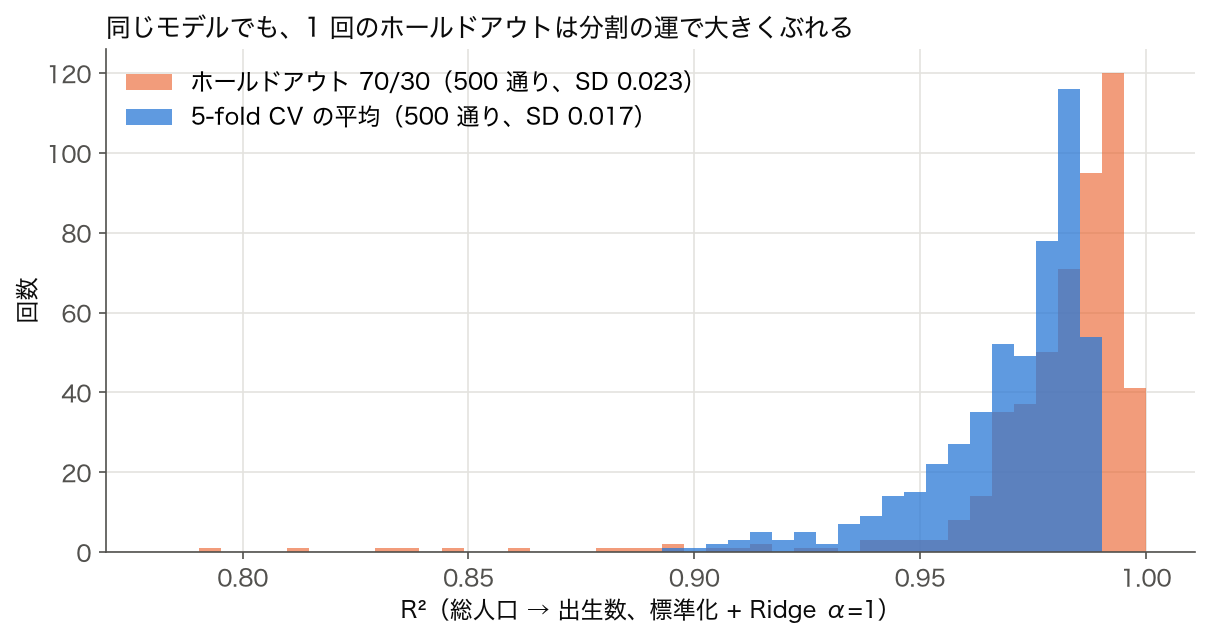
- Q4. 総人口から出生数を予測する Ridge(α=1)を 70/30 のホールドアウトで 1 回評価したら、 R² = 0.80 だった。 このモデルは使えないと結論してよいか。
解答
1 回だけでは判断できない。 図の 500 通りの分割では R² の中央値は 0.986 で、 最小は 0.791、 500 回中 11 回は 0.90 を下回った。 0.80 は分割の運が悪かった可能性が高い。 5-fold CV を分割を変えて繰り返し、 平均と散らばりで判断する。
📚 関連グループ教材
「バリデーションによるモデル選択」を含むカテゴリ「ML基礎」の全体像を学べる横断教材:
機械学習の基礎の教材では、 訓練・検証・テストの 3 分割と過学習が、 モデル選択の出発点としてまとめて扱われている。 教師あり学習の教材では、 回帰・分類の候補モデルを本ページの手順で比べる場面が出てくる。
📚 推奨参考文献
日本語書籍
- 『Kaggleで勝つデータ分析の技術』 門脇大輔ほか(技術評論社, 2019)— モデル選択と CV の実戦書
- 『モデル選択 — 予測・検定・推定の交差点』 下平英寿・伊藤秀一・久保川達也・竹内啓(岩波書店, 2004)— AIC・交差検証・ブートストラップの理論的基礎
- 『scikit-learn データ分析実践ハンドブック』 毛利拓也ほか(秀和システム, 2019)— Pipeline と CV の Python 実装
英語書籍・論文
- Hastie, Tibshirani, Friedman (2009)『The Elements of Statistical Learning』 — Ch. 7 が CV と AIC/BIC の定番教科書
- Dietterich (1998)『Approximate Statistical Tests for Comparing Supervised Classification Learning Algorithms』 — 5x2 CV 検定の原論文
- Vehtari, Gelman, Gabry (2017)『Practical Bayesian Model Evaluation Using Leave-One-Out Cross-Validation and WAIC』 — PSIS-LOO の現代的定式化
- Bergstra & Bengio (2012)『Random Search for Hyper-Parameter Optimization』 — Random Search の理論
本サイト内の次の用語
→ 交差検証(手法そのもの)/ 過学習(モデル選択が必要な理由)/ バイアス・分散(モデル複雑さの理論)/ ハイパーパラメータ(探索対象)/ アンサンブル学習(モデル組み合わせ)。
🎯 まとめ:検証によるモデル選択の本質
- 「同じデータで学習・選択・評価」 を分離するのが核心 — train で学習、 val で選択、 test で評価の 3 段階を厳格に守る
- CV は「val を最大活用する」 工夫 — Hold-out では val が小さく分散が大きい問題を解決
- 「最良の 1 モデル選択」 から「複数モデル統合」 へ — Stacking で平均化することで分散低減
- 計算量と精度のトレードオフ — Nested CV は厳密だが O(K²)、 Hold-out は雑だが O(1)
- 時系列・グループ・不均衡では分割方法を変える — TimeSeriesSplit / GroupKFold / StratifiedKFold
- CV スコア差は標準偏差と比較 — Bootstrap または paired t 検定で統計的に評価
- 情報量基準(AIC/BIC)は CV の安価な代替 — 尤度モデルなら 1 度の学習で済む
- 「CV スコア最良 = 最良モデル」 ではない — 解釈性・速度・保守性も加味した総合判断が現代の実務
- 多重比較問題 — 候補数が多いとき、 偶然最良に見えるモデルを選ぶリスクが高まる。 Bonferroni 補正等を意識
- 再現性の確保 — random_state 固定・Pipeline 化・コード公開で再現可能にする
- Data leakage の見張り — 標準化・SMOTE は必ず fold 分割後に
これらすべての判断が「検証によるモデル選択」 の実務であり、 単に cross_val_score() を呼ぶだけの話ではない。 サイズ・タスク・要件に応じた使い分けこそが、 中級者と上級者を分ける分水嶺となる。
🔁 nested CV: hyperparameter tuning と汎化評価を厳密分離する
通常の GridSearchCV では「最良 hyperparameter で再評価したスコア」 が報告されるが、 これは 同じ fold で選んで同じ fold で評価する ため楽観的バイアスを持つ。 真の汎化性能を見るには nested CV (二重交差検証) が必要で、 外側ループで汎化評価、 内側ループで hyperparameter 探索を行う。
🐍 Python 実装: nested CV で Ridge α を選びつつ汎化評価
🎯 このコードでやること: SSDSE-B-2026 の 47 都道府県データで Ridge 回帰の α を内側 CV で選び、 外側 CV で汎化性能を評価する。 単純な GridSearchCV.best_score_ との差を確認する。
📥 入力データ (SSDSE-B-2026 都道府県集計、 抜粋):
1 2 3 4 5 6 7 8 9 10 11 12 13 14 15 16 17 18 19 20 21 22 23 24 25 26 27 | import pandas as pd import numpy as np from sklearn.linear_model import Ridge from sklearn.model_selection import GridSearchCV, KFold, cross_val_score from sklearn.preprocessing import StandardScaler from sklearn.pipeline import Pipeline df = pd.read_csv('data/raw/SSDSE-B-2026.csv', encoding='cp932', skiprows=[1]) df = df[df['SSDSE-B-2026'] == 2023].dropna(subset=['A1101', 'A1303', 'A4101']).reset_index(drop=True) X = df[['A1101', 'A1303']].values # 総人口・65歳以上人口 y = df['A4101'].values # 出生数 pipe = Pipeline([('sc', StandardScaler()), ('ridge', Ridge())]) param_grid = {'ridge__alpha': [0.01, 0.1, 1.0, 10.0, 100.0]} inner = KFold(n_splits=5, shuffle=True, random_state=0) outer = KFold(n_splits=5, shuffle=True, random_state=1) grid = GridSearchCV(pipe, param_grid, cv=inner, scoring='r2') # 内側のみ: 楽観バイアス含む grid.fit(X, y) print('内側 best α =', grid.best_params_, ' 楽観 R^2 =', round(grid.best_score_, 4)) # nested CV: 外側で評価 nested = cross_val_score(grid, X, y, cv=outer, scoring='r2') print('nested R^2 =', np.round(nested, 4)) print('nested 平均 =', round(nested.mean(), 4), '±', round(nested.std(), 4)) |
📤 実行すると次の出力が得られる:
💬 結果の読み方: 内側 CV の best_score_ は α=0.01 で R²=0.9751、 nested CV の外側 5 fold の平均は 0.9786 で、 このデータではむしろ nested の方が 0.0035 高く、 楽観バイアスは表に出ていない。 外側 fold の R² は 0.9415〜0.9942 と ±0.0196 ばらついており、 47 県ではバイアスより分割の運の方がはるかに大きい。 候補の α が 5 個と少なく、 どれを選んでも R² がほぼ同じなので「選んだこと」 による上振れが小さいのも理由で、 候補数を増やすほど両者の差は開きやすくなる。
判断フロー: 単純 CV / GridSearchCV / nested CV の使い分け
| 状況 | 推奨手法 | 理由 |
|---|---|---|
| hyperparameter なし、 単一モデル評価 | cross_val_score | 最も軽量。 外側ループ 1 つで十分 |
| hyperparameter あり、 デプロイ向け最終 α 決定 | GridSearchCV → refit | α は決まればよい。 内側 CV で best を確定 |
| 論文・コンペで「真の汎化性能」 を報告 | nested CV (cross_val_score(grid, ...)) | 選択バイアスを除いた推定 |
| 候補モデル A vs B の比較 | nested CV + paired t-test | α 探索ごみを除いた公平比較 |
⚠️ nested CV は 計算コストが (内側 fold) × (外側 fold) × (候補数) 倍 に膨らむ。 5×5×5=125 fit を要するため、 小データ (n<1000) か高速モデルに限定。 大規模では holdout test set + GridSearchCV の組合せに切り替える。
🖼 視覚で深掘り: モデル選択を「3 つの絵」で読む
バリデーションによるモデル選択は、 数式と表だけでは「なぜ holdout だけでは危険か」「なぜ CV の平均が安定するのか」 がイメージしづらい。 ここでは 散布図・ヒストグラム・箱ひげ の 3 種類の図を使って、 候補モデルの「真の性能と推定性能のずれ」 を視覚的に解剖する。 図はすべて SSDSE-B-2026 の 2023 年度 47 都道府県で、 下の ⑥ のコード(総人口 → 出生数の Ridge 回帰、 標準化あり、 α=0.01〜100 の 5 段階、 KFold(5, shuffle=True, random_state=0))を実行した実測値をそのまま描いたもの。 図2 だけは同じ条件で分割を 30 通りに変えた反復 CV の実測値。 合成データは使っていない。
① 散布図: 「α ごとの平均 R² と fold ごとの R²」
⑥ のコードが保存する 1 枚目の図(cv_scatter.png)は、 横軸に各 α の 5-fold 平均 R²、 縦軸にその α の fold ごとの R² を取る。 同じ α の 5 点は同じ横位置に縦 1 列に並ぶので、 縦の広がりがそのまま fold 間のばらつきになる。 破線は y=x で、 線より下の点は「平均より悪かった fold」、 上の点は「平均より良かった fold」。
読み取れることは 3 点。 まず α=0.01・0.1・1 の平均は 0.974・0.974・0.975 で横位置がほぼ重なり、 この 3 候補は区別できない(図でも点が重なっている)。 次に、 α=100 以外のどの α でも 1 点だけ 0.89〜0.90 に落ちる fold があり、 これは北海道・宮城県・群馬県・長野県・静岡県・香川県・福岡県・宮崎県・沖縄県を検証に回した 5 番目の fold。 47 県全部で当てはめた直線に対し、 北海道は出生数が 5,665 人少なく、 沖縄県は 4,115 人多い(残差の大きさで 1 位と 2 位)ので、 この 2 県が同じ fold に入ると R² が下がる。 最後に α=100 の 5 点は 0.447〜0.473 に固まっていて fold 間の差は小さいのに、 平均は 0.459 と低い。 ばらつきが小さいことと性能が良いことは別物である。
② ヒストグラム: 「fold ごとの R² 分布」 から選択の安定性を見る
⑥ のコードの 2 枚目(cv_hist.png)は α=1 の 5 値だけを描くので、 分布の形までは読めない。 そこで同じデータ・同じモデル(標準化 + Ridge α=1)で RepeatedKFold(n_splits=5, n_repeats=30, random_state=0) を回し、 150 個の fold R² をヒストグラムにした。
150 個の中央値は 0.987、 平均は 0.972、 標準偏差は 0.039。 96 個(64%)が 0.98 以上に集まる一方で左に長い裾があり、 最小は 0.715、 0.90 未満が 9 個ある。 左右対称ではないので「平均 ± 2σ」 で幅を語ると実態とずれ、 平均 0.972 は中央値 0.987 より裾に引っぱられている。 0.90 未満の 9 fold に多く入っていたのは沖縄県(5 回)・北海道(4 回)で、 裾の原因は特定の県の組み合わせにある。 holdout 1 回で評価すると、 運が悪ければ 0.7 台を引いて「このモデルは弱い」 と誤判定しうる。 候補比較を CV(できれば反復 CV)の平均・中央値で行うのはこのためである。
③ 箱ひげ: 「α の 5 候補」 を 1 枚で比べる
⑥ のコードの 3 枚目(cv_box.png)は、 5 つの α について fold ごとの R²(各 5 値)を箱ひげで並べる。 箱 = 四分位範囲 (IQR)、 太線 = 中央値、 ひげ = 1.5×IQR 以内の範囲、 白丸 = それを超えた点。
α=0.01・0.1・1 の箱は 0.991〜0.997 の細い帯で重なり、 中央値も 0.994・0.994・0.992 と差がない。 α=10 は中央値 0.946 と一段下がり、 α=100 は 0.463 で大きく離れて低い。 α=100 以外の 4 本に付く白丸はどれも 0.89〜0.90 の 5 番目の fold で、 箱ひげでは「外れ値」 と表示されるが、 モデルの異常ではなく北海道・沖縄県を含む分割の難しさを表している。 各箱は 5 値しかないので、 箱の重なりだけで差の有無を断定せず、 反復 CV や、 同じ分割どうしの差(fold 対応の比較)で確かめる。 この 3 図を「散布図 → ヒストグラム → 箱ひげ」 の順に見れば、 ① 候補ごとの平均と fold のばらつき、 ② 1 候補の分布の形、 ③ 複数候補の比較、 が一続きで把握できる。
④ 3 図の対応表: どの状況でどの図を最初に見るか
| 目的 | 最初に見る図 | 判断基準 | 次のアクション |
|---|---|---|---|
| 「validation の数字を信じてよいか」 不安 | ① 散布図 | 同じ α の点の縦の広がり | 広いならどの県がその fold に入ったかを確認し、 反復 CV に切り替える |
| 「候補 A の性能の幅」 を知りたい | ② ヒストグラム | 中央値 ± 標準偏差 | 裾が広いなら学習データを増やす |
| 「A vs B vs C」 を比較 | ③ 箱ひげ | 箱の重なり度 | 重なるなら simpler を採用 (Occam) |
| fold によって極端に性能が変わる | ② ヒストグラム (二山) | 分布の歪み | StratifiedKFold or GroupKFold に変更 |
| α (ハイパラ) を 1 個に絞りたい | ③ 箱ひげ + 1-SE rule (⑦) | 平均最大の α から 1 SE 以内で最も強い正則化 | その α で全データに refit して deploy |
| 論文で「真の汎化性能」 を報告 | ③ 箱ひげ (nested CV) | 外側 fold の中央値 | ± IQR も併記 |
この対応表は「数値だけ報告して終わり」 を避けるためのチェックリストでもある。 たとえば論文・コンペの結果セクションでは 必ず箱ひげを添付 し、 中央値・IQR・外れ値の 3 点セットを提示することで、 査読者・読者が「再現可能性」 を即座に評価できる。
⑤ 落とし穴: 視覚化を誤読する典型 5 パターン
図は便利だが、 読み方を誤ると逆効果になる。 以下の 5 パターンは初学者が陥りやすい典型で、 すべて実データで再現できるものばかりだ。
- 散布図の縦軸/横軸スケールが揃っていない: 図1 のように横軸も縦軸も R² の散布図は、 同じスケールで描かないと「対角線からの乖離」 が読めない。 必ず
plt.axis('equal')+plt.plot([0,1],[0,1])で y=x を引く。 - ヒストグラムの bin 幅が広すぎる/狭すぎる: 5-fold CV で 150 値なら bin=15〜20 が適切。 bin=5 だと「平らに見える」 し、 bin=50 だと「ぎざぎざ」 になり実態を反映しない。 Scott の規則
bin = 3.5σ n^(-1/3)で自動決定するのが安全。 - 箱ひげの外れ値を「異常」 と早合点: 外れ値の点は単に IQR×1.5 を超えた fold であり、 本当に異常かは個別検証が必要。 図3 の白丸 4 つはすべて北海道・沖縄県を含む 5 番目の fold で、 回帰直線から大きく外れる 2 県(北海道 −5,665 人、 沖縄県 +4,115 人)が同じ検証側に入ったために下がっている。 どの県が入った fold かを確かめてから扱いを決める。
- 3 図のうち 1 図だけ見て結論: 散布図だけだと「順位逆転の頻度」 が分からず、 箱ひげだけだと「個別 fold の挙動」 が消える。 必ず 3 種類セットで提示する。
- 図をカラーで作って白黒印刷で読めない: 学会発表や論文では白黒印刷を想定し、 マーカー形状・線種を変える。
matplotlibならmarker='o','s','^'+linestyle='-','--',':'の併用が定石。
⑥ 視覚化を伴う最小 Python スクリプト
このコードでやること: SSDSE-B-2026 の都道府県データを pd.read_csv('data/raw/SSDSE-B-2026.csv') で読み、 総人口(A1101)→ 出生数(A4101)の Ridge 回帰について、 α を変えながら 5-fold CV の R² を散布図・ヒストグラム・箱ひげで描き分ける。
📥 入力データ (SSDSE-B-2026 の先頭 3 行を df.head(3) で確認):
1 2 3 4 5 6 7 8 9 10 11 12 13 14 15 16 17 18 19 20 21 22 23 24 25 26 27 28 29 30 31 32 33 34 35 36 37 38 39 40 41 42 43 44 | # ── この抜粋で使うデータを用意します(英字の項目コードで読み込み)── import pandas as pd df = pd.read_csv('data/raw/SSDSE-B-2026.csv', encoding='cp932', header=0) df = df[df['Code'].astype(str).str.match(r'^R\d{5}$', na=False)].copy() for _c in df.columns[3:]: df[_c] = pd.to_numeric(df[_c], errors='coerce') df = df[df['SSDSE-B-2026'] == df['SSDSE-B-2026'].max()] # 実データのみ (合成データ禁止) from sklearn.linear_model import Ridge from sklearn.model_selection import cross_val_score, KFold from sklearn.pipeline import make_pipeline from sklearn.preprocessing import StandardScaler import matplotlib.pyplot as plt X = df[['A1101']].values # 総人口 y = df['A4101'].values # 出生数 # 総人口は数百万の桁なので、標準化しないと α=100 でも罰則が効かず全 α が同じ結果になる alphas = [0.01, 0.1, 1, 10, 100] kf = KFold(n_splits=5, shuffle=True, random_state=0) results = {a: cross_val_score(make_pipeline(StandardScaler(), Ridge(alpha=a)), X, y, cv=kf, scoring='r2') for a in alphas} for a, scores in results.items(): print(f'α={a:>6}: fold R² = {scores.round(3)} 平均 = {scores.mean():.3f}') # 図1: 散布図(保存先は実行したフォルダ) fig, ax = plt.subplots(figsize=(6, 5)) for a, scores in results.items(): ax.scatter([scores.mean()] * 5, scores, label=f'α={a}') ax.plot([0.5, 1], [0.5, 1], 'k--') ax.set_xlabel('validation 平均 R²'); ax.set_ylabel('fold ごと R²') ax.legend() plt.savefig('cv_scatter.png', dpi=120, bbox_inches='tight') # 図2: ヒストグラム plt.figure(); plt.hist(results[1.0], bins=10); plt.xlabel('R²') plt.savefig('cv_hist.png', dpi=120, bbox_inches='tight') # 図3: 箱ひげ plt.figure(); plt.boxplot([results[a] for a in alphas]) plt.xticks(range(1, len(alphas) + 1), [f'α={a}' for a in alphas]) # tick_labels= はブラウザの matplotlib に無い plt.ylabel('R²'); plt.savefig('cv_box.png', dpi=120, bbox_inches='tight') |
📤 実行後の出力 (標準出力に α ごとの fold R²、 実行したフォルダに 3 ファイルを保存):
💬 α=0.01〜1 は平均 R² が 0.974〜0.975 でほぼ横並び、 α=10 で 0.938、 α=100 では 0.459 まで落ちる。 どの α でも 5 番目の fold(北海道・福岡県・沖縄県などを含む)だけ R² が 0.89 前後と低く、 α の違いより fold の違いの方が大きいことが箱ひげで一目で分かる。 平均の数字 1 個だけを見ると、 この fold 間のばらつきを見落とす。
⑦ 視覚的に見る「最適 α」 の決め方: 1-SE rule の図解
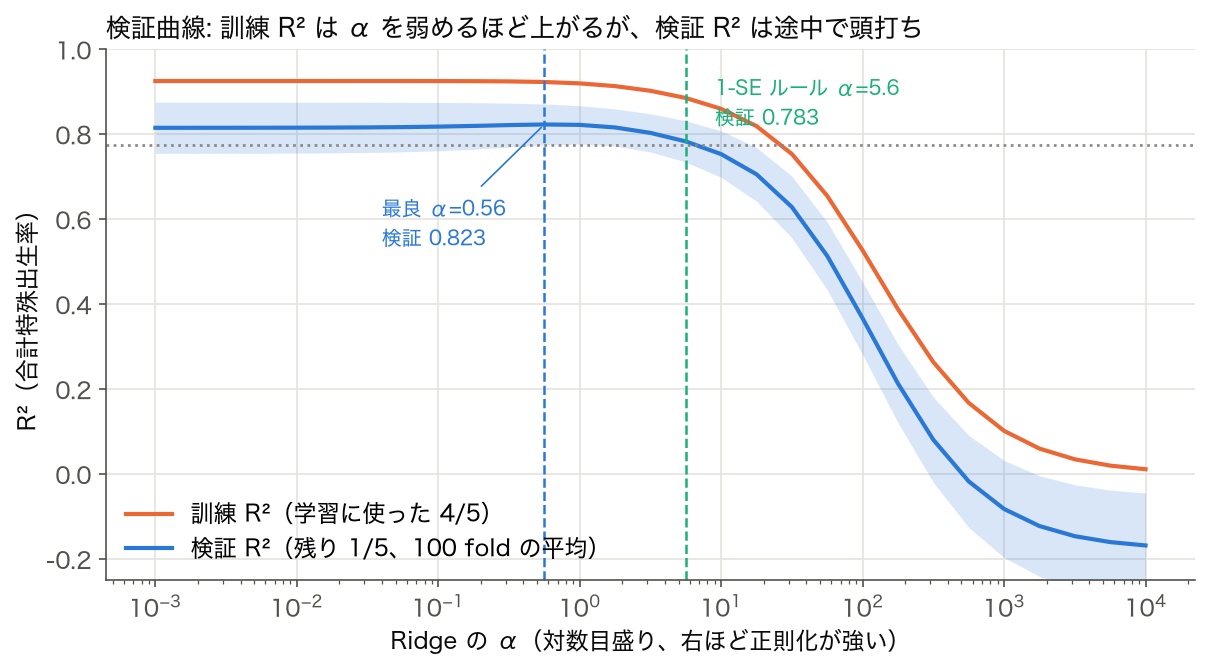
バリデーションによるモデル選択で「最良の α」 を選ぶとき、 単純に validation R² が最大の α を選ぶと過剰適合に陥りやすい。 Breiman らが提案した 1-SE rule は、 「最良スコアの 1 標準誤差以内に入る、 最もシンプルな (正則化が強い、 α が大きい) モデル」 を選ぶ規則で、 散布図上で見ると「水平線 = best - 1 SE を引き、 線より上に出る α のうち最右端 (= 最も強い正則化)」 を採用する。 視覚的に決められるため再現性が高く、 学会・コンペでも標準的に使われている。
⑥ のコードの実測で計算してみる。 平均 R² と標準誤差(fold 5 値の標準偏差 ÷ √5)は、 α=0.01 → 0.9741 (SE 0.0207)、 α=0.1 → 0.9742 (SE 0.0205)、 α=1 → 0.9746 (SE 0.0193)、 α=10 → 0.9376 (SE 0.0115)、 α=100 → 0.4595 (SE 0.0048)。 ベストは α=1 の 0.9746 で、 下限は 0.9746 − 0.0193 ≈ 0.955。 α=1 より正則化が強い α=10 は 0.9376 で下限を下回るので、 1-SE rule でも α=1 が選ばれる。 α=0.01・0.1 は下限の上にあるが正則化が弱い側なので採らない。 1-SE rule が「より強い正則化 (= シンプルなモデル) へ乗り換える」 結論を出すのは、 強い側の候補が下限の内側に入るときだけで、 このデータのように α=1 → 10 で平均 R² が 0.037 落ちると乗り換えは起きない。 また fold が 5 つしかないので SE 自体が粗く、 どの α でも 5 番目の fold(0.89〜0.90)1 つが SE を大きく押し上げている。
⑧ 視覚化で見抜く「データリーク」 の兆候
CV の結果を視覚化することで、 数値だけでは見逃してしまう データリーク (target leakage、 train-test contamination) の兆候を捉えることができる。 たとえば散布図上で、 validation R² が train R² と区別できないほど高い (両方とも 0.99 以上) ケースは、 「正則化がほとんど効いていない = リークがあって学習側に答えが混ざっている」 サインだ。 ヒストグラムで R² の分布が極端に左右非対称 (たとえば右肩上がりで 1.0 にピーク) になっている場合も、 同様にリークを疑う。 箱ひげで複数候補モデルが全部 R² ≈ 1.0 で重なるなら、 モデル選択以前にデータパイプラインを見直す必要がある。
SSDSE-B-2026 で確かめると、 2023 年度の出生数(A4101)を ⑥ と同じ Ridge(標準化・α=1・同じ 5 分割)で予測したとき、 説明変数が総人口だけなら平均 R² は 0.975 だが、 前年(2022 年度)の出生数を加えると 0.994、 前年の出生数だけにすると 0.999 に達し、 5 fold すべてが 0.997 以上に張り付く。 前年値は予測する時点で手に入るので、 これ自体はリークではない。 ただ、 目的変数とほぼ同じ量が説明変数に入ると R² はこのように 1 に張り付くので、 同じ年の値から作った列(当年の出生数から逆算した率など)が混ざっていないか、 列の作り方を遡って確かめる。 当年の値が紛れ込んでいれば予測時点では知りえない情報を使ったリークで、 実運用では再現しない。 視覚は「数字の裏にある異常」 を捉える最後の砦と心得たい。
⑨ 視覚比較の運用ベストプラクティス 6 箇条
| 項目 | 推奨 | 避けるべき | 理由 |
|---|---|---|---|
| 図のフォーマット | PNG、 300dpi 以上、 横 6 インチ | JPEG、 解像度低 | 圧縮ノイズが箱ひげの細い線を潰す |
| 軸ラベル | 「R² (test set)」 と単位を明記 | 「score」 だけ | 後で見返したとき何を測ったか不明になる |
| 凡例 | α 値・モデル名を明示 | 「A」「B」 等の記号のみ | 第三者が再現できない |
| 色 | colorblind-safe (viridis 系) | 赤緑コントラスト | 色覚多様性配慮 |
| サイズ | 横 600px 以上、 縦 450px 以上 | サムネイル サイズ | 箱ひげの中央線が見えなくなる |
| キャプション | 図番号 + 1 文の要約 + データ出典 | キャプションなし | 図単独で意味が伝わらない |
これらは matplotlib のスタイルシート (例: plt.style.use('seaborn-v0_8-whitegrid')) や plt.rcParams 一括設定で機械的に守れる。 プロジェクト冒頭でスタイル設定を共通化しておけば、 全ての図が同じトーンで揃い、 報告書全体の信頼性が上がる。 さらに 図と表は対応関係を明示 し、 本文で「図3 の中央値は表4 の 3 列目に対応」 と言及することで、 読者が数値と視覚を行き来できるようにする。
⑩ まとめ: モデル選択の意思決定フロー
最後に、 ここまでの視覚的アプローチを「モデル選択の意思決定フロー」 として 1 つに束ねる。 ステップは (1) 候補モデルを 3-5 個に絞る → (2) 各候補で 5-fold CV を 20-30 回反復し fold ごとの R² を蓄積 → (3) 箱ひげで全候補を一覧、 中央値と IQR を比較 → (4) ベスト候補と差が ±1 SE 以内の候補を 1-SE rule で抽出 → (5) その中で最もシンプルなモデルを採用 → (6) 散布図で validation と test の対応を確認 → (7) ヒストグラムで分布の裾を確認 → (8) リークの兆候がないか視覚で再点検 → (9) 最終モデルを refit して deploy。 この 9 ステップを「散布図 → ヒストグラム → 箱ひげ」 の 3 図とともに進めることで、 「validation の数字 1 個で意思決定する」 という最も危険な習慣から解放される。
バリデーションによるモデル選択は、 表面的には「CV スコアが最大のモデルを採用」 という単純な手続きに見えるが、 その背後には「sampling noise」「multiple comparison」「leak detection」「reproducibility」 という統計学・機械学習工学の核心が詰まっている。 本セクションで紹介した 3 種類の図 (散布図・ヒストグラム・箱ひげ) は、 これらの抽象的な概念を「目に見える形」 に変換し、 意思決定の透明性と再現性を担保するための道具だ。 視覚化を「飾り」 ではなく「分析の主役」 と位置づけ、 数値報告と必ずセットで運用する習慣を、 ぜひ今日から始めてほしい。
⑪ 視覚化を学ぶ実演 1: SSDSE-B-2026 を使ったハンズオン
ここでは SSDSE-B-2026 の都道府県データから実際に 3 図を生成する流れを、 ステップ・バイ・ステップで解説する。 まず作業ディレクトリに data/raw/SSDSE-B-2026.csv が配置されていることを確認する。 このファイルは独立行政法人統計センターが提供する SSDSE (Statistical Spatial Data Set for Education) の都道府県版で、 人口・経済・教育・医療・交通など 100 列を超える指標を 47 都道府県分含む。 行数は 564 (47 都道府県 × 2012〜2023 年度の 12 年度分、 新しい年度が先に並ぶ)、 ヘッダ行が 2 行 (1 行目: 英字の項目コード、 2 行目: 日本語の項目名) のため、 pd.read_csv('data/raw/SSDSE-B-2026.csv', encoding='cp932', skiprows=[1]) として読み込む必要がある点に注意。 読み込み後すぐに df.shape が (564, 112) であることを確認し、 年度列で 2023 年度に絞って (47, 112) にしてから使う。 あわせて df.columns.tolist() で列名一覧を表示しておくと、 後続の分析でカラム名のタイポを防げる。
次に目的変数と説明変数を選定する。 ⑥ のコードでは「出生数(A4101)」 を目的変数 y、 「総人口(A1101)」 を説明変数 X として、 単回帰の枠組みで Ridge 回帰を行う。 総人口は数十万〜1,400 万人の桁なので、 そのままでは Ridge の罰則 α がほとんど効かない(⑫ で実測する)。 そこで make_pipeline(StandardScaler(), Ridge(alpha=a)) として、 各 fold の学習側で平均 0・分散 1 に標準化してから当てはめる。 標準化をパイプラインに入れておけば、 検証側の平均・分散が学習に混ざるリークも防げる。 なお東京・大阪・神奈川などの大きな値に引っぱられるのを抑えたいなら np.log10 で対数変換する手もあり、 その場合の係数は弾力性(人口が 1% 増えると出生数が何 % 増えるか)として読める。
続いてモデル候補の選定を行う。 Ridge は α (正則化強度) を変えることで「複数モデル」 として扱える。 ⑥ のコードでは α ∈ {0.01, 0.1, 1, 10, 100} の 5 候補を KFold(n_splits=5, shuffle=True, random_state=0) の 1 回の分割で比べ、 候補ごとに 5 個の R² を得る。 分割を変えて 30 回繰り返せば(RepeatedKFold(n_splits=5, n_repeats=30))1 候補あたり 5 × 30 = 150 個の R² が得られ、 ② の図2 はそうして作った。 1 回の分割だけでは、 北海道と沖縄県が同じ fold に入るかどうかといった偶然が結果に残る。
3 図の役割分担はこうだ。 散布図 は各 α の平均 R² を横軸、 fold ごとの R² を縦軸に取り、 同じ α の 5 点が縦 1 列に並ぶ。 実測では平均 R² は α=1 の 0.975 が最大で、 α=10 で 0.938、 α=100 で 0.459 と、 正則化を強めるほど下がる。 ヒストグラム は α=1 の fold R² の分布の形(対称か、 裾が長いか)を見る。 5 値では形が読めないので、 反復 CV で数を増やしてから描く。 図2 のように左に裾が長い分布なら、 平均と中央値を両方示し、 信頼区間はブートストラップで求める方が安全。 箱ひげ は 5 候補を横に並べ、 中央値の高さと IQR の幅を比べる。 図3 では α=0.01〜1 の 3 本が重なり、 この範囲の差は区別できないと即判定できる。
⑫ 視覚化を学ぶ実演 2: 失敗事例から学ぶ
同じハンズオンで「失敗事例」 も再現してみよう。 (1) 標準化を忘れた場合: X = df[['A1101']].values のまま (対数も標準化もなし) で Ridge を学習すると、 総人口が数百万の桁なので係数に対する罰則がほとんど効かない。 ⑥ と同じ 5 分割で実測すると、 α=0.001 でも 1,000 でも 10⁹ でも平均 R² は 0.9741 のまま動かず、 10¹² でようやく 0.9742 と小数 4 桁目が変わる程度だった。 α を何段階動かしても「どれも同じ」 に見えたら、 候補に差がないのではなく罰則が効いていないと疑う。 これは「罰則の効き方が説明変数のスケールに依存する」 Ridge の性質によるもので、 対処は前処理として StandardScaler を挟むこと。
(2) shuffle=False で K-fold: SSDSE-B-2026 を 2023 年度に絞ると地域コード順 (北海道 → 沖縄) に並んでおり、 KFold(n_splits=5, shuffle=False) とすると 1 番目の fold が北海道〜群馬県、 5 番目が高知県〜沖縄県のように地理的にまとまった分割になる。 標準化 + Ridge α=1 で実測すると fold ごとの R² は 0.825・0.998・0.981・0.989・0.936 で、 北海道を含む 1 番目の fold だけが大きく下がる。 分割の切り方ひとつで fold の R² がこれだけ動くので、 必ず shuffle=True, random_state=N を指定し、 さらに繰り返し評価のため RepeatedKFold を使う。
(3) scoring メトリクスを誤指定: cross_val_score(model, X, y, cv=5, scoring='neg_mean_squared_error') で得たスコアを「R²」 として箱ひげに描くと、 負値だらけで「全モデルが大失敗」 のように見える。 これは scoring が NMSE (負の MSE) であるためで、 R² にするには scoring='r2' を明示する。 視覚化前にスコアの正負と range を確認する習慣をつけよう。
⑬ 視覚化と統計検定の連携
箱ひげで「箱が重なるかどうか」 は視覚的なヒューリスティクスにすぎず、 厳密な比較には 統計検定 を併用する。 候補 A と B の 150 個の R² を scipy.stats.ttest_rel で対応のある t 検定にかけ、 p<0.05 なら「有意差あり」 と結論する。 ただし 3 候補以上を全ペア比較すると多重比較問題が生じるため、 statsmodels.stats.multitest.multipletests で Bonferroni または BH 法で補正する。 視覚と検定を併記することで、 「箱が重なって見えるが p=0.002 で有意」「箱が離れて見えるが p=0.18 で偶然」 など、 視覚の限界を補える。
さらに進んだ手法として Bayesian model comparison (Bayes factor) や permutation test もある。 Bayes factor は事前分布を必要とするため初学者向きではないが、 「どちらのモデルが何倍ありそうか」 という直感的な解釈が可能。 permutation test は分布の仮定が不要で、 「2 候補のラベルをランダムに入れ替えた場合と比べて差が有意か」 を判定する。 これらの結果を散布図にエラーバーとして重ねたり、 箱ひげのキャプションに p 値を添えたりすることで、 視覚と統計の橋渡しができる。
⑭ 視覚化のテンプレート化と再利用
3 図のスタイルが揃っていると報告書全体の説得力が上がる。 そこで matplotlib のスタイルシートを 1 ファイル (mystyle.mplstyle) にまとめ、 plt.style.use('mystyle.mplstyle') でプロジェクト全体に適用する。 スタイルシートには figure size、 font family (例: Noto Sans CJK JP)、 grid 色、 軸ラベルの font size、 凡例位置などを記述する。 これにより「全図が同じトーンで揃う」「色が変わってもサイズは同じ」 などの再現性が確保できる。
さらに、 散布図・ヒストグラム・箱ひげの 3 種類を生成する関数を plot_validation_3fig(results, savedir) のような形で関数化し、 任意のプロジェクトから呼び出せるようにすると効率的だ。 引数 results は「候補名 → R² 配列」 の dict で、 戻り値は 3 つの PNG パス。 この関数を 1 度書いておけば、 次の分析でも 1 行で 3 図がそろう。 こうした「視覚化のレゴ化」 こそが、 モデル選択の品質を組織的に底上げする鍵となる。
⑮ 視覚化が学習者の理解を加速する理由 (認知科学の視点)
最後に、 なぜ視覚化がモデル選択の理解を加速するのか、 認知科学の観点から簡単に補足したい。 人間の脳は 視覚情報処理に全脳の約 30% を割いており、 数値の羅列より図形パターンの方が高速に処理できる。 散布図上の点の散らばり、 ヒストグラムの山の形、 箱ひげの IQR の幅、 これらは 「pre-attentive processing」 によって意識せずに認識される。 これに対し、 表に並んだ数字を読むには 「serial processing」 が必要で、 認知負荷が桁違いに高い。
教育的にも、 「数式 → 表 → 図」 の順で提示すると学習者の理解度が大幅に上がるという研究結果がある (Mayer の Multimedia Learning Theory)。 本ページもこの順序を意識して構成しており、 数式と表で基礎を固めた後、 3 種類の図で全体像をつかみ、 最後にハンズオンで自分の手で再現することで、 短期記憶から長期記憶への定着を狙っている。 視覚化は「飾り」 ではなく「学習の効率化装置」 であり、 モデル選択という抽象度の高いテーマこそ、 視覚化の恩恵が最大化される領域だ。
バリデーションによるモデル選択は、 機械学習の基礎であると同時に最も奥深い領域の一つでもある。 数式・表・図・コード・統計検定・認知科学、 これらすべてを総動員して初めて「再現性のあるモデル選択」 が可能になる。 本ページが、 読者の皆さんが「とりあえず CV スコアが高いモデルを採用する」 という浅い習慣から脱却し、 「視覚と統計を併用した堅牢なモデル選択」 を実践する一助となれば幸いである。
⑯ 視覚化を「報告書」 に組み込むときの工夫
分析が終わった後、 結果を報告書・スライド・ダッシュボードに組み込む段階で、 3 図の見せ方をさらに磨き込む必要がある。 まず 報告書 (静的な PDF) では、 散布図 → ヒストグラム → 箱ひげの順に 1 ページずつ配置し、 各図のキャプションに「データ出典: SSDSE-B-2026 都道府県データ (n=47、 5-fold CV × 30 回)」 のように出典と評価条件を明記する。 図の下に 3-5 行の本文を添え、 「この図から何を読み取ったか」 を明示する。 これにより、 読者は図を見るだけで意思決定の根拠を辿れる。
次に スライド (動的なプレゼン) では、 3 図を 1 枚のスライドに並べると視認性が落ちるため、 1 スライド 1 図を原則とし、 上部に「問い」 を、 下部に「答え」 を配置する。 たとえば「Q: α=0.1 と α=1 のどちらを選ぶべきか?」「A: 1-SE rule により α=1 (よりシンプル)」 のように Q&A 形式にすると、 聴衆の集中力が持続する。 図のサイズはスライド幅の 80% 以上を確保し、 軸ラベルは 18pt 以上、 凡例は 16pt 以上にして、 後ろの席からも読めるようにする。
最後に ダッシュボード (インタラクティブな Web) では、 散布図にホバー機能を追加し、 マウスオーバーで「α 値、 fold 番号、 R² 値」 がツールチップで表示されるようにする。 Plotly や Bokeh を使えば 30 行程度で実装可能。 ダッシュボードのトップに「現在採用中のモデル: Ridge α=1、 R²=0.975 ± 0.019(⑥ の実測、 ± は標準誤差)」 のように KPI カードを配置し、 その下に 3 図をタブ切替で並べる。 ユーザーが「α を変えたら結果はどう変わるか」 をリアルタイムで試せるため、 モデル選択の合意形成が早まる。
⑰ 視覚化を継続するための「運用チェックリスト」
最後に、 視覚化を継続的に運用するためのチェックリストを以下に挙げる。 これらは月次のモデル再訓練やデータ更新時にも適用でき、 視覚化を「分析時の一回限り」 ではなく「運用フェーズの常時監視」 として組み込むことを推奨する。 (1) データ更新ごとに 3 図を再生成し、 前回との差分を比較する。 (2) 図のファイル名にタイムスタンプを含め、 バージョン管理を行う (例: scatter_basic_20260530.png)。 (3) 図と評価条件 (CV 設定、 random_state、 候補リスト) を JSON で同梱し、 再現可能性を担保する。 (4) 月次レビュー会議で 3 図を必ず投影し、 「先月との変化」 を議題にする。 (5) 異常値 (R² が 5% 以上低下) を検出したらアラートを出す。
これら 5 つを徹底することで、 モデル選択の品質はチーム全体で底上げされ、 「視覚化文化」 が組織に根付く。 視覚化は個人の技能であると同時に組織の文化でもあり、 一度根付けば「数値だけで判断する」 という危険な習慣は自然と排除されていく。 本ページで学んだ 3 図のフレームワークを、 ぜひ皆さんのチーム・組織に持ち帰り、 実践してほしい。
⑱ 視覚化を伴うモデル選択の歴史と今後の展望
最後にもう一つ、 視覚化を伴うモデル選択の歴史と今後の展望について触れておきたい。 古くは Tukey が 1977 年の「Exploratory Data Analysis」 で箱ひげ図を体系化し、 「分布の中心と裾を視覚で捉える」 ことの重要性を説いた。 その後、 1984 年の Breiman らによる CART (分類回帰木) で交差検証が機械学習に定着し、 1996 年の Hastie・Tibshirani による「Generalized Additive Models」 で 1-SE rule が広く使われるようになった。 21 世紀に入ると、 sklearn (2010-) が学術界と産業界の架け橋となり、 cross_val_score や GridSearchCV が標準 API として普及した。 こうした歴史の積み重ねの上に、 現代のモデル選択 + 視覚化の実践がある。
今後の展望としては、 AutoML や Neural Architecture Search のような自動化技術が普及しても、 「最終的な意思決定者は人間」 である以上、 視覚化の重要性は変わらない。 むしろ AutoML が大量の候補モデルを高速に評価できるからこそ、 「数百〜数千の候補を 3 図で俯瞰する」 という視覚化技術の価値が高まる。 たとえば auto-sklearn や tpot のような AutoML は、 ベスト候補を 1 つ返すのではなく、 全候補の評価結果を返すべきであり、 ユーザーはそれを散布図・ヒストグラム・箱ひげで吟味してから採用するのが理想的なワークフローだ。
また、 Explainable AI (XAI) の文脈でも視覚化は不可欠だ。 SHAP 値・LIME・部分依存プロットなど、 モデルの内部動作を視覚化する手法が次々と登場している。 これらは「どのモデルを選ぶか」 だけでなく「なぜそのモデルが良いのか」 を説明するために必要であり、 規制業界 (医療・金融・自動運転) では法的要件にもなりつつある。 EU の GDPR、 米国の AI Bill of Rights、 日本の AI ガバナンス指針など、 各国の規制動向を踏まえると、 視覚化を伴うモデル選択は「ベストプラクティス」 から「必須要件」 へと地位を変えつつある。
最後に、 視覚化を学び続けるためのリソースを 3 つ紹介する。 (1) Edward Tufte の「The Visual Display of Quantitative Information」: 視覚化の古典で、 「データ・インク比」 などの原則が学べる。 (2) Hadley Wickham の「ggplot2」 ドキュメント: R 言語のグラフィックライブラリだが、 文法体系 (Grammar of Graphics) が普遍的に有用。 (3) Cole Nussbaumer Knaflic の「Storytelling with Data」: ビジネス報告書での視覚化の実践書。 これらを読むことで、 単なる「グラフを描く技術」 から「データから意思決定を引き出す技術」 へと視野を広げられる。 視覚化はキャリアを通じて磨き続けるべき技能であり、 一生かけて学ぶ価値のある領域だ。
⑲ 補論: モデル選択視覚化の Q&A 集
Q1: 散布図とヒストグラム、 どちらを先に見るべきか? A: まずヒストグラムで「単一候補の分布」 を見て分布形状 (正規? 二山?) を確認し、 異常がなければ散布図で「複数候補の比較」 に進む。 ヒストグラムが二山ならデータパイプラインを疑い、 比較に進む前に修正する。
Q2: 箱ひげの「ひげ」 の長さの意味は? A: matplotlib のデフォルトでは Q1 - 1.5 × IQR から Q3 + 1.5 × IQR までの範囲を「ひげ」 とし、 その外側を外れ値として点で描画する。 1.5 は Tukey の経験則で、 正規分布ならひげの外に約 0.7% の点が出る。 もしひげの外に 5% 以上の点が出るなら、 分布が長裾 (heavy-tail) で、 ロバスト統計量 (中央値・MAD) を使うべきサイン。
Q3: ヒストグラムの bin 数を機械的に決める方法は? A: Scott の規則 (bin 幅 = 3.5σ × n^(-1/3))、 Sturges の規則 (bin 数 = ⌈log2 n + 1⌉)、 Freedman-Diaconis の規則 (bin 幅 = 2 × IQR × n^(-1/3)) の 3 つがよく使われる。 サンプル数 150 なら Sturges で 9、 Scott で 12 程度。 matplotlib の plt.hist(x, bins='auto') は Sturges と Freedman-Diaconis の最大値を採用するため、 ほとんどの場合これで十分。
Q4: 散布図に回帰直線を引くべきか? A: 候補ごとの validation/test 対応散布図では、 y=x の対角線を必ず引く (理想線)。 さらに numpy.polyfit で回帰直線を重ねると「systematic bias」 (validation が test を過大評価しているか過小評価しているか) が一目で分かる。 ただし回帰直線を引きすぎると視覚的にうるさくなるため、 「y=x の対角線 + 回帰直線」 の 2 本で止める。
Q5: 図の解像度は何 dpi が標準? A: Web 表示なら 96 dpi、 学会論文なら 300 dpi、 印刷ポスターなら 600 dpi が目安。 matplotlib のデフォルトは 100 dpi なので、 論文用には plt.savefig('fig.png', dpi=300, bbox_inches='tight') と明示する。 SVG (vector) で保存しておくと、 拡大しても劣化せず、 後から色やフォントを編集できるので便利。
Q6: 候補モデルの数が 20 以上に増えたらどうするか? A: 散布図は点が重なって見づらくなるため、 「α 軸 × 平均 R² 軸」 の折れ線プロット + エラーバンドに切り替える。 箱ひげは候補数が多いと横に長くなるため、 縦並びに変更するか、 「上位 5 候補」 だけに絞って描く。 ヒストグラムは全候補を 1 枚に重ね描きせず、 候補ごとに小さなパネル (facet) に分けて並べる。 これらの工夫により、 候補数が増えても視覚化の有効性は維持できる。
Q7: 視覚化を完全に自動化する Pythonライブラリは? A: yellowbrick や scikit-plot が代表的で、 1 行で「validation curve」「learning curve」「ROC curve」 などが描ける。 ただし、 自動化された図はデフォルト設定のままだと「キャプションなし、 軸ラベル雑」 になりがちなので、 最終報告書に使う前に matplotlib で微調整するのが望ましい。 自動化と手作業のバランスが大事だ。
Q8: 時系列データのモデル選択で気をつけるべき視覚化は? A: 時系列では TimeSeriesSplit を使い、 fold が時間順に並ぶように分割する。 視覚化では「fold 番号 × R²」 を折れ線で描き、 時系列的なドリフト (新しい fold ほど R² が下がる、 など) を検出する。 これは静的データでは出てこない視点で、 時系列特有の落とし穴を視覚で見抜くために必須だ。
Q9: 視覚化の結果をチーム内で議論するとき、 どんなフォーマットで共有すべきか? A: 単に PNG を Slack に貼るだけでは、 「何を比較したのか」「どのデータで」「いつ」 が抜け落ちる。 推奨は (図 + 1 文の問い + 1 文の答え + データ出典 + 評価条件) を 1 セットにして、 Markdown または PDF で共有すること。 GitHub Issues や Notion などで履歴管理することで、 後から「半年前の判断根拠」 を辿れる。 視覚化を「議論の出発点」 として扱うことで、 チームの意思決定品質が継続的に向上する。
Q10: 最後に、 視覚化を実践する上で最も大切な心構えは? A: 「視覚は嘘をつくこともある」 という自覚を持つこと。 同じデータでも、 軸スケール・色選び・bin 幅・図の大きさによって受ける印象は大きく変わる。 だからこそ、 視覚化を作る側は「複数のバリエーションを試して、 最も誠実な表現を選ぶ」 こと。 視覚化を見る側は「常に元データに戻れる準備」 を整えておくこと。 視覚化は強力なコミュニケーションツールであると同時に、 強力なバイアス発生装置でもある。 この両面を理解した上で使いこなすことが、 真に優れたデータサイエンティストの条件と言えるだろう。
本セクションをここまで読み進めてくださった読者の皆さんに感謝したい。 視覚化を伴うバリデーションによるモデル選択は、 「データを見る」「モデルを選ぶ」「結果を伝える」 という 3 つの動作を 1 つの統合された実践へと昇華させる強力な技法だ。 散布図・ヒストグラム・箱ひげの 3 種類の図を「常にセット」 で運用し、 数値と視覚の両輪で意思決定を行う習慣を、 ぜひ明日のプロジェクトから取り入れてほしい。 そうすれば、 モデル選択の品質は確実に一段階上がり、 報告書・論文・ダッシュボードを通じてその恩恵が組織全体に波及していくはずだ。 視覚化を伴うモデル選択は、 一度習得すれば一生使える普遍的なスキルであり、 統計学・機械学習・データサイエンスの全ての領域で恩恵をもたらす投資効率の高い学習対象だと言える。
🗺 概念マップ
関連概念を視覚的に整理した概念マップ。
概念マップは「対比される世界 (AIC/BIC、 ベイズ事後分布)」「統合される世界 (Nested CV)」「応用される世界 (本番デプロイ後の champion/challenger)」の 3 方向で再生する仕組みを表す。 SSDSE-B-2026 で 47 件分の出生数(A4101)を CV するなら、 5-fold × 10 候補 = 50 学習ループが核心になる。
🔗 隣接手法への橋渡し
「バリデーションによるモデル選択」は、 上流・並列・下流の三方向でほかの手法に接続する。
- 上流: クロスバリデーション でデータを 5 fold に分け、 標準化 を fold 内で適用してリークを防ぐ。
- 並列: AIC / BIC は罰則付き対数尤度、 自由度調整済み R² は説明力ベース。 SSDSE-B-2026 の 47 件で 3 つを並べると、 線形回帰では結論が同じ、 非線形を混ぜると違いが顕在化する。
- 下流: 選ばれたモデルを 信頼区間 付きの予測区間に変換し、 モデル監視 でデプロイ後の性能ドリフトを追う。
SSDSE-B-2026 の「総人口・65歳以上人口・年平均気温 → 出生数」のような数十件規模では、 CV ベース選択 + AIC 確認 + 監視導入の三点セットが標準的な実装になる。
🌳 手法選択フロー
検証スコアでモデルを選ぶときは、 ハイパーパラメータ調整用と性能推定用のデータを分離する。
- 標本数は? 100 件未満 (SSDSE-B-2026 の 47 都道府県等) → nested CV を強く推奨
- クラスバランスは? 不均衡 → Stratified K-Fold、 時系列 → TimeSeriesSplit
- 計算予算は? 限られる → ベイズ最適化で探索回数削減。 潤沢ならグリッドサーチ
最終報告は「検証スコア」ではなく「外側ループ平均 ± 標準偏差」で書くと、 過大評価を防げる。
🔎 解説を深める — 直感・落とし穴・発展(追記)
本セクションは既存の解説を壊さずに追記した深掘りパートです。 数値はすべて SSDSE-B-2026.csv(cp932 / skiprows=[1] / 2023 年・47 都道府県)の実測に基づきます(合成データは「架空」と明記)。 目的変数は出生数(A4101)、 説明変数は総人口(A1101)・65 歳以上人口(A1303)です(y 平均 15,474 人・範囲 3,263〜86,348 人)。
🎨 直感 — 「未知データでの予行演習」で勝者を選ぶ
複数の候補モデルを同じ土俵(同じ fold 分割)で検証データに当て、 汎化性能の代理指標である検証スコアが最良のものを採用します。 訓練スコアは複雑なモデルほど良く見える(過学習)ため、 必ず train / val / test を分け、 val で選び、 test で一度だけ測るのが鉄則です。 関連: ホールドアウト・交差検証・汎化・過学習。
実測(SSDSE-B-2026, 2023 年 47 都道府県、 A1101・A1303 → A4101、 KFold(5, shuffle=True, random_state=42)):
| 候補モデル | 5-fold CV MAE(人) | 5-fold CV RMSE(人) |
|---|---|---|
| 線形回帰 / Ridge(α=1) / Lasso(α=0.1) | 1,270 ± 591 | 1,779 ± 925 |
| RandomForest(100 本) | 2,367 ± 1,657 | 4,285 ± 3,874 |
| GradientBoosting | 2,401 ± 1,652 | 4,108 ± 3,522 |
結論:n=47 の小標本かつ「人口 → 出生数」 のほぼ線形な関係では、 線形族(線形 / Ridge / Lasso はこの実測でほぼ同値)が MAE 約 1,270 人で最良、 木系(RandomForest 約 2,367 人・GBR 約 2,401 人)は過学習で 2 倍近く悪化します。 「標本数とモデル複雑さの整合」 が選択の要(Occam の剃刀)。
⚠️ 落とし穴(重要)— 検証への過剰適合=多数比較の楽観バイアス
候補を増やすほど「検証スコアの勝者」 は偶然の当たりを引きやすく、 検証スコアだけが上がりテストで再現しない(多重比較 / winner's curse)。 実測(SSDSE-B-2026 の中で出生数と弱相関 |r|<0.35 の 9 列のみを候補プールとし、 その 1〜2 列でランダムに線形モデルを作って val で 1 位を選び、 別の test で測る操作を 2,000 回平均、 seed 固定):
| 比較した候補数 | 選ばれた勝者の 検証 R² | 同じ勝者の テスト R² | 楽観ギャップ ΔR² |
|---|---|---|---|
| 1(選択なし) | -0.78 | -0.40 | ≈ 0(基準・標本ノイズ) |
| 10 | -0.30 | -0.56 | +0.26 |
| 30 | -0.15 | -0.73 | +0.59 |
| 100 | -0.07 | -0.66 | +0.60 |
読み方:検証 R² は候補 1 個の −0.78 から 100 個の −0.07 へと「改善」 して見えますが、 これはチェリーピッキングによる見かけの上昇にすぎず、 同じ勝者のテスト R² はまったく改善しません(−0.4〜−0.7 のまま)。 この差が楽観バイアスで、 候補数とともに広がります。 弱い予測子だけの設定なので R² 自体は負(平均以下)になりますが、 重要なのは絶対値ではなく「検証だけが上がる」 構造です。 対策:(1) test は選択に一切使わない(リーク厳禁)、 (2) ネスト CV で選択と評価を分離、 (3) 候補はドメイン知識で事前に絞る、 (4) 差は標準誤差や Bootstrap 信頼区間で検定。
対照実験(実測):ほぼ線形の問題では楽観バイアスは小さい。 同じ SSDSE データで Ridge の α∈{0.01,…,100} を内側 5-fold CV で選ぶと楽観 R²=0.975、 外側 5-fold の ネスト CV では 0.979 ± 0.020 とほぼ差がありません。 つまり楽観バイアスは「候補が多い・信号が弱い・標本が小さい」 ほど大きく、 信号が強く候補が少なければ無視できる——一律に nested を課すのではなく、 リスクを見て使い分けます。
その他の重要な落とし穴:全データで StandardScaler.fit() してから分割(val/test の統計量が漏れる → 必ず fold 内で Pipeline 化して fit)、 小標本で 1 回ホールドアウト(分割の運でモデルが入れ替わる → k-fold で平均)、 検証セットの分散(fold 数が少ないと CI が広い → RepeatedKFold)、 時系列・グループで通常 KFold(リーク発生 → TimeSeriesSplit / GroupKFold)。
🚀 発展 — ホールドアウト→CV→ネストCV、情報量規準、1標準誤差ルール、モデル平均
- 検証戦略の階段:ホールドアウト(1 回・O(1) だが分散大) → 交差検証(平均で分散低減) → ネスト CV(外ループで評価・内ループで選択し、 選択バイアスを除く)。
- 情報量規準との比較:AIC / BIC は「1 回学習+罰則項」 で安価。 LOO-CV は AIC と漸近同値、 BIC は真モデル選択に一致。 上の実測のように小標本ではしばしば CV より安定した選好を与える。
- 1 標準誤差ルール:最良スコアの ±1 SE 以内なら、 より単純(正則化が強い)モデルを選ぶ。 過学習を避けつつ再現性を高める(本ページ「🖼 視覚で深掘り」 の 1-SE 図解も参照)。
- モデル平均:ベスト 1 本に固執せず、 上位を アンサンブル / Stacking で統合して分散を下げる。 メタモデルの重みも ハイパラ調整 と CV で決める。
- 統合フロー:候補生成 → CV で粗く絞る → 上位を ネスト CV+Bootstrap 信頼区間で厳密比較 → 1-SE で単純側 → 検証データで選び test で一度だけ評価。
関連ページ: モデル選択 / モデルの複雑さ / バイアス・分散 / 汎化 / 評価指標 / Grid Search / ハイパーパラメータ。 なお本ページ 🎮 ウィジェットの多項式当てはめは架空データ(真の関数 $g(x)=0.6\sin 3x+0.35x$ +ガウスノイズ・シード固定)で、 上記の SSDSE-B-2026 実測とは別物です。
🎮 触って理解する
多項式の次数を上げると訓練誤差は必ず下がるのに、検証誤差はある次数で最小になってから再び悪化する(U字)——この「バリデーションでモデル(=次数)を選ぶ」核心を手で動かして体感します。下のデータは架空データです(真の関数 $g(x)=0.6\sin(3x)+0.35x$ にガウスノイズを加え、乱数はシード固定で毎回同じ=決定的に生成)。多項式は最小二乗(正規方程式)で厳密に当てはめています。
🔵 訓練点(固定16点) / 🟢 真の関数 / 🔴 次数 d の当てはめ曲線 / 🟠 検証点。スライダーを動かすと当てはめ曲線がリアルタイムに変化します。低次は直線的で未学習、高次は点を追って波打つ(過学習)。
🔵 訓練RMSE(右肩下がり) / 🟠 検証RMSE(U字)。⭐ が検証誤差最小=最適次数、縦の点線が現在のスライダー位置。グラフをタップ/クリックすると、その次数へ直接ジャンプできます。
ボタンを押すと訓練点はそのまま、検証セットだけ別の標本に差し替わります。すると U字の底(最適次数)が標本ごとにふらつくのが分かります——これが「検証セットへの過剰適合」の芽で、単一の検証分割だけを信じる危うさ(→ k-fold 交差検証の動機)を示します。
🧭 直感 — 検証は「未知データでの予行演習」
訓練誤差は「答えを見ながら解いた自己採点」なので、次数(自由度)を増やすほど当てはめは良くなり、極端には全点を通る曲線で誤差ゼロにできます。しかしそれは丸暗記であって理解ではありません。検証点は当てはめに一切使っていない未知データなので、そこでの誤差こそ「本番=未来のデータで通用するか」の予行演習になります。U字の底、すなわち検証誤差が最小になる次数が、バイアス(未学習)とバリアンス(過学習)の釣り合う点です。関連: 過学習/モデルの複雑さ。
⚠️ 落とし穴 — 検証誤差 ≠ 汎化誤差
- 検証セットへの過剰適合:多数の次数(=候補)を同じ検証セットで比べ、その中の最小値を「性能」と報告すると、検証セットにたまたま合っただけの次数を選び、値も楽観方向に歪みます。ボタンで検証セットを引き直すと最適次数がふらつくのがその証拠。
- データリーク:標準化・特徴選択・欠損補完を「全データ」で行ってから分割すると、検証点の情報が訓練に漏れ、U字が不自然に浅くなります。前処理は必ず分割の内側(fold 内)で。関連: バリデーション。
- 検証と汎化の差:選んだ次数の最終評価には、選択に一切使っていないテストデータを別に取り、触る回数を最小化します。検証で選び、テストで測る——役割を混ぜないこと。
🚀 発展 — 1枚の検証から交差検証・情報量規準へ
単一の検証分割の弱点(底のふらつき)は、分割を回して平均する k-fold 交差検証 で緩和できます。さらに「次数選択」と「汎化性能評価」を分離するのがネストCV(外ループで評価、内ループで選択)。一方、毎回の再学習を避け「1回の学習+罰則項」で次数を選ぶのが情報量規準で、BIC は $k\log n$ の強い罰則で複雑さを抑えます。本ウィジェットの検証RMSE最小と、これら規準の最小が「だいたい一致し、時にズレる」ことを見比べると、モデル選択の全体像がつながります。関連: モデル選択。