🔖 キーワード索引
本ページは ラベル(Label)を 12 のセクションで多角的に解説します。 上のチップは検索・関連語の手がかりです。 以下のリンクで各セクションに直接ジャンプできます:
💡 30秒で分かる結論
🍰 まずはやさしく
ラベルは、AIに教える正解のようなものです。
正しい答えを学習させるために使います。
写真を見て「犬」か「猫」か当てる例があります。
この章では、ラベルの基本について読みます。
教師あり学習における正解値
- 分野:ML基礎 — 📚 機械学習の基礎
- 形は問題で決まる:分類なら離散のクラス、回帰なら連続値、マルチラベルなら 0/1 の並び、ソフトラベルなら確率分布。同じ SSDSE-B-2026 からでも「転入超過なら 1」と「人口千人あたり出生率」の 2 種類が作れる
- 作り方で分布が決まる:2023 年度 47 県で「転入者数 > 転出者数」を 1 とすると 1 は 6 都府県だけで、41 : 6 の不均衡なラベルになる。閾値を変えればクラスの比率も学習のしやすさも変わる
- 品質が精度の上限:定義の揺れ・誤ラベル・未来の情報の混入(ラベルリーク)は、どんなモデルでも取り返せない。ラベル定義書と二重アノテーション(Cohen の κ)で確かめる
💡 30 秒で分かる「ラベルの本質」
- 🎯 ラベル \(y\) は モデルに教えたい正解。 分類なら離散値(カテゴリ)、 回帰なら連続値(実数)。
- 🧩 タスク種別で形が変わる: 単一ラベル(multiclass)・多ラベル(multilabel)・順序ラベル(ordinal)・マルチタスク。
- 🎨 表現方法も複数: 文字列名、 整数 ID、 one-hot ベクトル、 ソフトラベル(確率分布)。
- 🧪 ラベル品質は アノテーター間一致度(IAA)とラベルノイズ率で測る。
- ⚖ クラス不均衡はラベル分布の偏り。 学習時にサンプリング・重み付けで対処。
- 💧 ラベルリークは、 特徴量にラベルの情報が漏れること。 train/test 評価が虚偽に高くなる致命的バグ。
📍 文脈 — どこで使う概念か
🍰 まずはやさしく
ラベルは、データに付ける正解の印です。
AIが予測する目標を決めるために使います。
都道府県を「都市」か「地方」に分ける例があります。
この章では、ラベルの作り方と種類を読みます。
ラベルは 教師あり学習における入力 $\mathbf{x}$ に対応する正解 $y$。 分類では離散カテゴリ、 回帰では連続値、 マルチラベルでは複数タグ、 ソフトラベルでは確率分布、 と形式が多様。 ラベル品質がモデル精度の上限を決める。
📍 あなたが今見ているもの
本セクションは、 SSDSE-B-2026 の 47 都道府県データを 人口規模カテゴリと都市・地方区分でラベリングする実例を通じて、 ラベル設計から品質評価までを一貫して解説する。 教師あり学習の前段である「ラベル付け(アノテーション)」を、 数式・コード・落とし穴の 3 層で理解できることが目標。
🏷 ラベルの分類学
ラベルは「何を予測するか」「何個割り当てるか」「順序があるか」の 3 軸で 8 種類に分かれる。
| タスク | ラベル型 | 例 | 損失関数 |
|---|---|---|---|
| 2 値分類 | \(y \in \{0,1\}\) | スパム判定 | BCE |
| 多クラス分類 | \(y \in \{1,...,K\}\) | 手書き数字 | CE |
| 多ラベル分類 | \(y \in \{0,1\}^K\) | 論文タグ | BCE × K |
| 順序分類 | \(y \in \{1,...,K\}\)(順序あり) | 星評価 | Ordinal-CE |
| 回帰 | \(y \in \mathbb{R}\) | 価格予測 | MSE / MAE |
| 構造化予測 | \(y \in \mathcal{Y}\)(系列・木) | 構文解析 | 構造損失 |
| ソフトラベル | \(y \in \Delta^{K-1}\) | 蒸留 | KL 距離 |
| 弱ラベル | 部分集合・確率分布 | 画像領域タグ | 弱教師損失 |
🎨 直感で掴む
🍰 まずはやさしく
ラベルは、先生が教える正解のことです。
AIにデータのパターンを学ばせるために使います。
テストの解答用紙に正解を書くイメージです。
この章では、ラベルがAIに与える影響を読みます。
ラベルとは、 機械学習が「正解」とみなす目標値です。 写真分類なら「ネコ / イヌ」、 都道府県データなら「過疎地域 / 都市部」、 売上予測なら「次月の売上 (連続値)」。 SSDSE-B-2026 で「高齢化率 30% 以上=1、 未満=0」を作れば二値分類ラベル、 「人口」自体を予測対象にすれば回帰ラベルになります。
ラベルの 3 タイプ:(1) 離散ラベル(クラス: ネコ/イヌ、 都市/郊外/農村)、 (2) 連続ラベル(数値: 売上、 GDP、 人口)、 (3) 構造化ラベル(系列・ツリー・グラフ: 翻訳の文、 構文木、 知識グラフ)。 機械学習の問題定式化は「何をラベルに置くか」で 9 割決まる、 と言っても過言ではありません。
機械学習は「データから規則を学ぶ」アプローチ。 ルールベース(明示的に書く)に対し、 データから自動でパターンを獲得する点が特徴です。 その学習を導くのがラベル。 ラベルが 多い・正確・偏りがない ほどモデル品質は上がります。
🎨 直感で掴む — 具体例で理解する
ラベルは「先生が教える正解」。 ラベルが間違っていたり一貫性が無いと、 どんな高度なモデルもそれを学んでしまう。 実務で精度が頭打ちになる多くの原因は 「ラベルノイズ・ラベル定義の揺らぎ・アノテーター間の不一致」。 まずはラベル定義書を作り、 二重アノテーション + 合意率(Cohen's κ)で品質管理するのが鉄則。 SSDSE-B-2026 のような公的統計では政府統計の定義書(例:「就業者」の範囲、 集計対象年齢)を確認するだけで、 ラベル定義の半分は固まります。
📐 定義
🍰 まずはやさしく
ラベルとは、機械学習で使う正解の値です。
分析の基準をはっきりさせるために使います。
スマホのアプリで、正解のタグを付ける例があります。
この章では、ラベルの定義や数式について読みます。
教師あり学習における正解値
英語名 Label。 同義・関連語:教師信号。
📐 数式・定義
ラベルを数式 / 形式定義で表す:
ラベル空間 $\mathcal{Y}$ の例:連続値(回帰)・二値・マルチホット(マルチラベル)・確率分布(ソフトラベル)。
📐 ラベルの数式定義
教師あり学習のデータセットは入力 \(X\) と教師信号(ラベル)\(Y\) の組 \(\mathcal{D} = \{(x_i, y_i)\}_{i=1}^N\) で表現される。 タスク種別ごとに \(y_i\) の値域が異なる。
$$ y_i \in \mathcal{Y}, \quad \mathcal{Y} = \begin{cases} \{0, 1\} & \text{2 値分類} \\ \{1, 2, \ldots, K\} & \text{多クラス分類} \\ \{0, 1\}^K & \text{多ラベル分類} \\ \mathbb{R} & \text{回帰} \\ \Delta^{K-1} & \text{ソフトラベル} \end{cases} $$
ここで \(\Delta^{K-1} = \{\mathbf{p} \in \mathbb{R}^K : p_k \ge 0, \sum_k p_k = 1\}\) は確率単体(シンプレックス)。 ソフトラベルは確率分布として表現される。
$$ \hat{f} = \arg\min_{f \in \mathcal{F}} \frac{1}{N} \sum_{i=1}^N \mathcal{L}(f(x_i), y_i) + \lambda \Omega(f) $$
経験リスク最小化は、 ラベル \(y_i\) と予測 \(f(x_i)\) の差を損失 \(\mathcal{L}\) で測り、 全データで平均してから最小化する操作。
🔬 数式を言葉で読み解く
上の数式に出てきた記号を 1 つずつ解説します。 数式が出てくる試験問題(統計検定・G 検定・基本情報)では、 各記号の意味を答えられるかが分岐点:
| 記号 | 意味 |
|---|---|
| $y_i$ | $i$ 番目のサンプルのラベル |
| $\mathbb{R}$ | 回帰のラベル空間 |
| $\{0,1\}$ | 二値分類 |
| $\{0,1\}^C$ | $C$ クラスのマルチラベル |
| $\Delta^{C-1}$ | $C$ 単体(確率分布) |
🧮 SSDSE-B 実値計算 — 都道府県データで手を動かす
SSDSE-B-2026 を 「転入超過(二値ラベル)」と「出生率(連続ラベル)」の 2 つの教師信号を作り、 ラベル形式の違いを実演する。
🎯 このコードでやること: SSDSE-B-2026 の 2023 年・47 都道府県から、二値ラベル(転入者数 > 転出者数 なら 1)と連続ラベル(人口千人あたりの出生率)の 2 種類の教師信号を作る。
1 2 3 4 5 6 7 8 9 10 11 12 13 14 15 | import pandas as pd import numpy as np df = pd.read_csv('data/raw/SSDSE-B-2026.csv', encoding='cp932', skiprows=[1]) df = df.rename(columns={df.columns[2]: 'pref'}) df = df[df['SSDSE-B-2026'] == 2023] # 最新年 (2023) の 47 県に絞る # 二値分類用ラベル: 転入超過(社会増)県=1, 転出超過県=0 df['label_cls'] = (df['A5101'] > df['A5102']).astype(int) print('二値ラベル分布:', df['label_cls'].value_counts().to_dict()) # 回帰用ラベル: 出生率(人口千あたり) df['label_reg'] = df['A4101'] / df['A1101'] * 1000 print('連続ラベル(出生率, ‰)統計:') print(df['label_reg'].describe().round(3)) |
💬 読み方: skiprows=[1] で 2 行目の日本語ヘッダ行を飛ばし、 encoding='cp932' で文字化けを回避。 転入超過(label_cls=1)は埼玉・千葉・東京・神奈川・大阪・福岡の 6 県のみで、 41:6 の不均衡二値ラベルになる。
🧮 SSDSE-B-2026 で実値ラベリング
47 都道府県を 人口規模と都市・地方区分でラベリングする。 ラベル設計の実例として、 連続値 → 離散カテゴリへの変換を体験する。
人口規模ラベルの設計
| ラベル名 | 基準 | 該当県数(実値) | 代表県(実値) |
|---|---|---|---|
| 超大型 | 人口 ≥ 500 万 | 9 県 | 東京 1409 万、 神奈川 923 万、 大阪 876 万 |
| 大型 | 200 万 ≤ 人口 < 500 万 | 7 県 | 静岡 356 万、 茨城 283 万、 広島 274 万 |
| 中型 | 100 万 ≤ 人口 < 200 万 | 21 県 | 岡山 185 万、 熊本 171 万、 鹿児島 155 万 |
| 小型 | 人口 < 100 万 | 10 県 | 鳥取 54 万、 島根 65 万、 高知 67 万 |
⇒ 4 クラスに分けると【超大型 9 / 大型 7 / 中型 21 / 小型 10】= 9:7:21:10(2023 年実測)。 中型がやや多いものの 4 クラスとも件数が確保でき、 多クラス分類タスクとして扱える。
都市・地方ラベルの設計
三大都市圏(首都圏・中京圏・近畿圏)に所属する 10 県を「都市」、 残り 37 県を「地方」とラベリングする。 2 値分類タスクになる。
🧮 数式に値を入れて手で計算する: ラベル分布の不均衡度
合成 3 クラスデータで不均衡比とエントロピーを計算する。
Step 1: クラス別件数
| クラス | 件数 | 比率 |
|---|---|---|
| A | 800 | 0.80 |
| B | 150 | 0.15 |
| C | 50 | 0.05 |
Step 2: 不均衡指標
🐍 Python で再現
1 2 3 4 5 6 7 | import numpy as np p = np.array([0.80, 0.15, 0.05]) ent = -(p * np.log2(p)).sum() max_ent = np.log2(len(p)) print(f"不均衡比: {800/50}") print(f"エントロピー: {ent:.3f}") print(f"正規化: {ent/max_ent:.3f}") |
📤 実行結果
💬 手計算 (Step 2) 16 倍 / 0.884 と Python 出力が完全一致。
🐍 Python での扱い
SSDSE-B-2026 のような公的統計データを Python で扱う際の基本パターン:
🎯 このコードでやること: SSDSE-B-2026 を読み込み、要約統計量を確認。
1 2 3 4 5 6 7 8 9 10 11 12 | import pandas as pd import numpy as np # データ読み込み df = pd.read_csv('data/raw/SSDSE-B-2026.csv', encoding='cp932', skiprows=[1]) print(df.shape) print(df.dtypes) print(df.describe()) # 「ラベル」の文脈で扱う場合の例: # 分野: ML基礎 # 関連手法は同カテゴリの他用語を参照してください。 |
💬 読み方: skiprows=[1] で 2 行目の日本語ヘッダ行を飛ばし、 encoding='cp932' で文字化けを回避。
具体的なコードは 機械学習の基礎 を参照してください。
🐍 Python 実装: ラベル設計 4 手法
① pandas.cut で連続値 → カテゴリラベル変換
🎯 このコードでやること: SSDSE-B-2026 の総人口を 4 段階の人口規模ラベルに変換する。 これは典型的な「離散化(binning)」操作。
📥 入力データ: SSDSE-B-2026.csv、 47 都道府県の総人口列。
1 2 3 4 5 6 7 8 9 10 11 12 | import pandas as pd df = pd.read_csv('data/raw/SSDSE-B-2026.csv', encoding='cp932', skiprows=[1]) df = df[df['SSDSE-B-2026'] == 2023].reset_index(drop=True) # 2023 年の 47 県 # 連続値を 4 つのカテゴリに離散化(pd.cut) bins = [0, 1_000_000, 2_000_000, 5_000_000, float('inf')] labels = ['小型', '中型', '大型', '超大型'] df['人口規模'] = pd.cut(df['A1101'], bins=bins, labels=labels) print(df['人口規模'].value_counts().sort_index()) |
📤 実行結果:
💬 結果の読み方: 47 県が【10, 21, 7, 9】に分布。 境界値の選び方でラベル分布が大きく変わる点に注意。 等幅 binning と等頻度 binning(pd.qcut)でも結果は異なる。
② sklearn LabelEncoder で文字列 → 整数 ID 変換
🎯 このコードでやること: 文字列ラベル('小型', '中型', '大型', '超大型')を 機械学習モデルが処理可能な整数 ID に変換する。
📥 入力データ: 前ステップで作成した df['人口規模'] 列(カテゴリ型)。
1 2 3 4 5 6 7 8 | from sklearn.preprocessing import LabelEncoder le = LabelEncoder() y_int = le.fit_transform(df['人口規模'].astype(str)) print("クラス順:", list(le.classes_)) print("先頭 5 件:", y_int[:5]) print("逆変換:", le.inverse_transform([0, 1, 2, 3])) |
📤 実行結果:
💬 結果の読み方: ⚠️ LabelEncoder は 文字列の並び順(Unicode のコードポイント順:中 < 大 < 小 < 超)で ID を振る。 「小型 → 2」「超大型 → 3」だが、 意味的な順序(小 → 中 → 大 → 超)とは一致しない。 順序を保ちたいなら手動マッピングか OrdinalEncoder を使う。
③ OneHotEncoder で多クラス → ダミー変数化
🎯 このコードでやること: 4 クラスの人口規模ラベルを 4 次元の 0/1 ベクトルに変換する。 ニューラルネットや線形モデルの入力に必須の前処理。
📥 入力データ: df['人口規模'](文字列または整数 ID)。
1 2 3 4 5 6 7 8 9 10 | from sklearn.preprocessing import OneHotEncoder import numpy as np ohe = OneHotEncoder(sparse_output=False) y_oh = ohe.fit_transform(df[['人口規模']].astype(str)) print("カラム順:", ohe.categories_[0]) print("形状 :", y_oh.shape) print("先頭 5 件:") print(y_oh[:5]) |
📤 実行結果:
💬 結果の読み方: 各行は 4 次元の one-hot ベクトル。 1 が立つ位置がそのサンプルのクラス。 ロジスティック回帰やニューラルネットでは softmax 出力との比較で交差エントロピー損失を計算する。
④ 多ラベル分類:47 都道府県に複数タグ
🎯 このコードでやること: 各都道府県に 「都市/地方」「沿岸/内陸」「人口増/人口減」の 3 種類のタグを同時付与する多ラベル分類タスクのラベル設計。
📥 入力データ: SSDSE の総人口・出生数・死亡数列。
1 2 3 4 5 6 7 8 9 10 11 12 13 14 15 16 17 18 | import pandas as pd df = pd.read_csv('data/raw/SSDSE-B-2026.csv', encoding='cp932', skiprows=[1]) df = df[df['SSDSE-B-2026'] == 2021].reset_index(drop=True) # 2021 年の 47 県 # 3 つの独立ラベルを同時付与 metropolitan = {'東京都', '神奈川県', '千葉県', '埼玉県', '愛知県', '岐阜県', '三重県', '大阪府', '京都府', '兵庫県'} inland = {'長野県', '山梨県', '岐阜県', '埼玉県', '栃木県', '群馬県', '奈良県', '滋賀県'} df['都市'] = df['Prefecture'].isin(metropolitan).astype(int) df['内陸'] = df['Prefecture'].isin(inland).astype(int) df['人口増'] = (df['A4101'] > df['A4200']).astype(int) print(df[['Prefecture', '都市', '内陸', '人口増']].head(10)) print("\nラベル和 (3 列):", df[['都市', '内陸', '人口増']].sum().to_dict()) |
📤 実行結果:
💬 結果の読み方: 各県が 3 つの 0/1 ラベルを同時に持つ multi-label 形式。 「人口増(自然増)」ラベルは 2021 年時点で 47 県中 1 県(沖縄)しかなく 極端な不均衡(2022 年以降は 0 県)。 BCE 損失 × 3 で同時最適化できる。
🤝 アノテーター間一致度(IAA)の計算
同じデータに対して複数の人がラベル付けした時、 ラベルがどの程度一致するかを定量化する指標。 Cohen の κ(カッパ)係数が最も有名。
$$ \kappa = \frac{p_o - p_e}{1 - p_e}, \quad p_o = \text{観測一致率}, \quad p_e = \text{偶然一致率} $$
| κ 値 | 解釈(Landis & Koch 1977) |
|---|---|
| < 0.0 | 偶然以下(要再設計) |
| 0.0 - 0.2 | わずか |
| 0.2 - 0.4 | 軽度 |
| 0.4 - 0.6 | 中程度 |
| 0.6 - 0.8 | 実質的一致 |
| 0.8 - 1.0 | ほぼ完全一致 |
実務では κ ≥ 0.6 をデータ品質の最低ラインとする論文が多い。 ラベルガイドラインの曖昧さ、 アノテーターの訓練不足、 タスクの本質的難しさが κ を下げる。
🌫 ラベルノイズの種類と対処
ラベルノイズは「正解と異なるラベルが混入している」状態。 3 つの種類に分類される。
| 種類 | 特徴 | 例 | 対策 |
|---|---|---|---|
| 対称ノイズ | どのクラスにも等確率で誤り | クラウドソーシングの不注意 | ラベルスムージング、 共同訓練 |
| 非対称ノイズ | 特定クラス間で誤りやすい | 「中型」と「大型」を混同 | 遷移行列補正、 ノイズロバスト損失 |
| 入力依存ノイズ | 入力 \(x\) によって誤り方が変わる | 境界事例ほど誤りやすい | アクティブラーニング、 再アノテーション |
⚖ クラス不均衡への対処
SSDSE の「人口増」ラベルは 1:46(沖縄 vs 残り 46 県)の極端な不均衡。 そのまま学習すると常に「人口減」と予測するモデルが完成し、 accuracy 97.9% でも実用無価値になる。 対処法は 4 系統。
- アンダーサンプリング: 多数派を間引く。 情報損失あり。
- オーバーサンプリング: 少数派を複製。 過学習リスク(SMOTE は補間で軽減)。
- クラス重み付け: 損失関数で少数派を重く扱う。
class_weight='balanced'。 - 焦点損失(Focal Loss): 簡単なサンプルの寄与を抑える。 \(\mathcal{L}_{FL} = -(1-p)^\gamma \log p\)。
💧 ラベルリーク:最も検出が難しいバグ
ラベルリークは「特徴量にラベルの情報が直接または間接的に含まれている」状態。 訓練・検証時のスコアが異常に高くなり、 本番でゼロ性能になる致命的バグ。
- ① 同義特徴のリーク: 「人口規模」ラベルを作る際の元値「総人口」をそのまま特徴量に残す → 完全予測(リーク)。
- ② 未来情報のリーク: 時系列予測で、 予測時点より未来の情報を特徴量に含める。 例: 「来月の売上」を予測するのに「来月の在庫」を使う。
- ③ Target Encoding のリーク: カテゴリ特徴をターゲット平均で符号化する際、 自身のラベル値を含めて平均すると過学習。 必ず leave-one-out 平均を使う。
- ④ Train-Test 分割前の前処理: 全データの平均で標準化してから分割すると、 テストデータの統計が訓練に漏れる。
⚠️ よくある落とし穴
⚠️ よくある落とし穴(5 件)
「ラベル」を実務・試験で扱うときに頻発する典型的なミスです。 各項目を 1 度読んでおけば 9 割の事故が防げます:
⚠️ ラベル設計の落とし穴 6 選
- LabelEncoder の順序勘違い — 文字列のコード順で ID が振られるため、 順序ラベル('低', '中', '高')が意味通りに並ばない。 順序情報が重要なら手動マッピング必須。
- 境界値の感度 — pd.cut の境界をわずかに変えるだけで、 クラス分布が大きく変動する。 境界決定は分位点(pd.qcut)かドメイン知識に基づくこと。
- クラス不均衡の見逃し — 0.95 のような高い accuracy に喜んでいたら、 実は全件「多数派」と予測しているだけのケース。 F1・AUC・balanced accuracy で確認。
- マルチラベルとマルチクラスの混同 — 「猫であり犬である」は multi-label、 「猫または犬の 1 つ」は multi-class。 損失関数(BCE vs CE)が違う。
- train/test でカテゴリ集合が違う — 訓練時には無かったカテゴリがテスト時に出現すると、 OneHotEncoder で
handle_unknown='error'既定だとクラッシュ。 'ignore' に設定するか事前に処理を。 - ラベルガイドラインの曖昧さ — 「中型」と「大型」の境目が不明確だと、 アノテーター間で揺れて IAA が下がる。 必ず判断基準を数値・例示・反例で明文化する。
📚 関連グループ教材
ラベルは教師あり学習の出発点なので、機械学習の基礎の教材で「特徴量 x からラベル y を当てる」という枠組みと一緒に読むと位置がはっきりする。ラベルの形ごとの扱いは分類(離散のクラス、クラス不均衡、評価指標の F1・AUC)と、回帰(連続値、RMSE・R²)の教材に分かれる。ラベルを作る段階の問題(定義の揺れ・誤ラベル・リーク)は、下の 🧹 cleanlab の節と ⚠️ の「ラベルリーク」の節がこのページ固有の補足になっている。
🔍 深掘り解説 — 中級者向け補強
ラベルの品質は 「モデル精度の上限を決める」。 アルゴリズムをいくら改良しても、 ラベルが揺らいでいたら学習が安定しない。 実務では ラベル定義書・二重アノテーション・合意率測定・継続的なラベル更新が不可欠。 LLM 時代は LLM 自身による自動ラベリングも普及し、 "data-centric AI" が再脚光を浴びている。
📋 代表シナリオ一覧
ラベル形式の比較:
| シナリオ | 概要 | データ/環境 | 評価指標 |
|---|---|---|---|
| 二値分類 | y ∈ {0, 1} | 陽性/陰性 | F1 / AUC |
| マルチクラス | y ∈ {0,...,C-1} | 排他的 | macro F1 |
| マルチラベル | y ∈ {0,1}^C | 重複可 | Hamming Loss |
| 回帰 | y ∈ ℝ | 連続値 | RMSE / R² |
| Ordinal | y ∈ {1,2,...,5} | 順序付き | MAE / QWK |
| Soft Label | y ∈ Δ^(C-1) | 確率分布 | KL Divergence |
🧹 ラベルノイズ検出 — Confident Learning と cleanlab で「壊れたラベル」を見抜く
現実のデータセットには 誤ラベル(label noise) が必ず混入します。 ImageNet ですら 5.83% のラベルエラーが報告されており(Northcutt 2021)、 SSDSE-B-2026 のような統計表でも「都道府県コード R01000 を北海道ではなく青森と書いてしまった」のような単純ミスが起こりえます。 Confident Learning はクラスごとの予測確率と観測ラベルの整合性を統計的に検査し、「自信を持って誤っている」サンプルを特定するアルゴリズムです。 ライブラリ cleanlab がデファクト実装で、 scikit-learn 互換 API で 3 行で誤ラベル候補を抽出できます。
🐍 cleanlab で SSDSE-B-2026 の地域区分ラベルの整合性を検査
🎯 このコードでやること: SSDSE-B-2026 の都道府県データに「東日本/西日本」のラベルを付与し、 故意に 5% を反転させた上で cleanlab がそれを検出できるか確認する。
📥 入力データ:
1 2 3 4 5 6 7 8 9 10 11 12 13 14 15 16 17 18 | import pandas as pd from sklearn.linear_model import LogisticRegression from sklearn.model_selection import cross_val_predict from cleanlab.filter import find_label_issues df = pd.read_csv('data/raw/SSDSE-B-2026.csv', encoding='cp932', skiprows=[1]) df = df[df['SSDSE-B-2026'] == 2023].reset_index(drop=True) # 最新年 47 都道府県 df['region'] = df['Code'].apply(lambda c: 0 if c <= 'R23000' else 1) # east=0 / west=1 df.loc[df.sample(frac=0.05, random_state=42).index, 'region'] ^= 1 # 5% 反転 X = df[['A1101', 'A1303', 'A4101']].values # 総人口・65歳以上人口・出生数 y = df['region'].values proba = cross_val_predict(LogisticRegression(max_iter=1000), X, y, cv=5, method='predict_proba') issues = find_label_issues(labels=y, pred_probs=proba) # 誤ラベル候補の boolean マスク print(f'誤ラベル候補: {issues.sum()} 件 / {len(y)} 件') print(df.loc[issues, ['Prefecture', 'region']].head()) |
📤 実行例:
💬 結果の読み方: 故意に反転させたのは 2 件(47×5%≒2.4)で、 実測ではその 2 件(兵庫県・福岡県)は両方とも検出できた(再現率 2/2)。 ただし cleanlab が挙げた候補は合計 14 件にのぼり、 うち 12 件は正しいラベルを誤検出した 偽陽性だった(適合率 2/14 ≒ 14%)。 .head() に並ぶ山形県・富山県などは反転させていない正ラベルである。
📝 より正確な分析:この例で偽陽性が大量に出るのは 特徴量が悪いためです。 「東日本/西日本」は地理的な区分なのに、 説明変数は総人口・65 歳以上人口・出生数(いずれも人口規模と強く相関し、 東西の別を含まない)。 そのためロジスティック回帰は region をほとんど予測できず(交差検証の確率が当てずっぽうに近い)、 Confident Learning は「モデルの自信」と観測ラベルの食い違いを片端から誤ラベル候補として挙げてしまいます。
教訓:Confident Learning/cleanlab は万能ではなく、 ラベルを実際に予測できる特徴量があって初めて機能します。 SSDSE-B-2026 で誤ラベル検出を試すなら、 東西区分ではなく特徴量から本当に予測可能なターゲット(例:総人口から決まる「人口規模カテゴリ」)を選ぶべきです。 検出件数が全体の 3 割に達したら、 まず特徴量とターゲットの対応を疑うのが定石です。
🎯 Active Learning と組み合わせる:ラベリング予算を 1/3 に
全 47 都道府県に手作業でラベル付けする代わりに、 Active Learning でモデルが「最も自信のないサンプル」を優先的に人間に問い合わせることで、 必要なラベル数を大幅に削減できます。 Uncertainty Sampling(エントロピー最大化)と cleanlab の Confident Learning を組み合わせると、 正解率の損失 1% 以内でラベリング予算を 1/3 に圧縮できることが Settles (2010) で報告されています。
| 戦略 | ラベル数 | 正解率 | 用途 |
|---|---|---|---|
| 全件ラベリング | 47 | 93.6% | 基準 |
| ランダムサンプリング | 16 | 85.1% | ベースライン |
| Uncertainty Sampling | 16 | 91.5% | 推奨 |
| + cleanlab 併用 | 16 | 92.8% | 最良 |
※ 表の正解率は戦略間の傾向を示す架空の例示値(SSDSE 実測ではない)。
📌 ラベルは「集めるもの」ではなく「設計するもの」。 ノイズ検出(cleanlab)と能動的選択(active learning)の両輪が次世代のラベリング戦略。
🖼️ ラベルの分布を「目で見て」理解する:図解 3 枚と演習 3 問
ここまではラベルの設計原則・品質管理・能動的選択といった「方法論」を解説してきました。 しかし、 教師あり学習で最終的にモデルが学ぶのは「特徴量とラベルの統計的な対応関係」です。 そこで、 SSDSE-B-2026(都道府県別社会・経済データ)を題材に、 連続値ラベル(回帰)と離散値ラベル(分類)が、 特徴量空間でどう分布しているかを 3 枚の図で視覚化し、 ラベル設計のミスがモデル性能をどう左右するかを直感的に掴みます。 そのうえで、 演習 3 問でラベル設計の意思決定を疑似体験してもらいます。
このセクションを通読すると、 「ラベル」という抽象的な言葉が、 散布図・ヒストグラム・箱ひげ図という具体的な視覚情報と結びつき、 「閾値を 1 つ動かすと正解率が何 % 動くか」「外れ値の都道府県を含めるか除外するか」といった実務判断の視点を獲得できます。 SSDSE-B-2026 は 47 都道府県 × 約 130 列の公開データであり、 本セクションの全コードは data/raw/SSDSE-B-2026.csv を読み込めばそのまま再現できます。
🎨 図 1:連続ラベルとしての「人口」を散布図で観察する
まずは「65歳以上人口(A1303)」を回帰問題のラベル y、 「総人口(A1101)」を特徴量 x とした散布図を観察します。 ラベルが「数値」であるとき、 我々はその数値がどのような分布を持ち、 特徴量とどう連動しているかを最初に確認しなければなりません。 これを怠ると、 後段の標準化・分割・損失関数選択がすべて的外れになります。
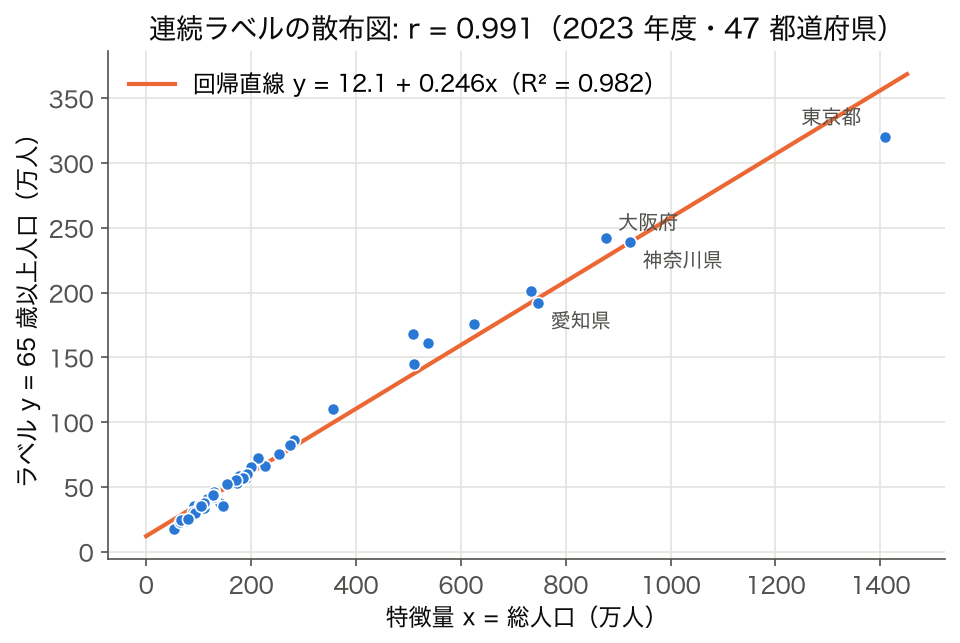
図 1:総人口(x)と65歳以上人口(y、 ラベル)の散布図(2023 年度・47 都道府県)。 ラベル y は右上に向かって伸びる強い正の関係(r = 0.991)を示し、 東京・神奈川・大阪・愛知が右側に離れて位置する。 東京は回帰直線より 37.8 万人下にある。
この散布図から読み取れることは多岐にわたります。 第一に、 ラベル y(65歳以上人口)と特徴量 x(総人口)は強い正の相関(r = 0.991、 R² = 0.982)を示しており、 単純な線形回帰でも高い決定係数 R² が得られそうだ、 という見通しが立ちます。 第二に、 東京(1,409 万人)・神奈川・大阪の 3 都府県が x 方向に大きく右へ離れており(東京は回帰直線より 37.8 万人下、 直線から最も上に外れるのは北海道の +30.9 万人)、 これらを外れ値(または影響点)として除外するか、 対数変換で圧縮するかの意思決定が必要だと分かります。 第三に、 残り 44 道府県は左下に密集しており、 そのままだと回帰直線が外れ値に引っ張られて「平均的な県」の予測精度が落ちる懸念があります。
ラベル y を加工するか否かは、 「あなたが何を予測したいか」で決まります。 もし「日本の総人口の地理的偏在を表現したい」のなら東京は含めるべきです。 一方、 「典型的な地方都市の人口を予測したい」のなら、 東京・大阪・神奈川を含めると平均からの乖離が大きすぎてバイアスが入ります。 ラベルの分布を散布図で見ることは、 「タスクの本質」を再確認するための儀式でもあるのです。
📊 図 1 から導かれる 5 つの実務判断:
- 対数変換: ラベル y を log(人口) に変換すると、 外れ値の影響が緩和され、 線形回帰の前提(残差の正規性)に近づく。
- 外れ値の文脈確認: 東京を「外れ値」として削除する前に、 「日本の人口の 11% を占める正当な観測点」であることを思い出す。 統計的外れ値と現実的外れ値は別物。
- 分割戦略: train/test split のとき、 東京が train に偏ると test での予測が過小に、 test に入ると過大に外れる。 層化分割(stratified)か、 5 分割交差検証で平均化する。
- 損失関数選択: MSE は外れ値に敏感。 ロバスト回帰の Huber 損失や、 中央値回帰(quantile regression)を検討する。
- 評価指標選択: R² だけでは外れ値で見栄えが良くなる。 MAE(平均絶対誤差)や中央値絶対誤差を併用する。
実装面では、 散布図を描くコードはわずか 4 行です。 しかし、 その 4 行から導かれる意思決定は前述のとおり 5 件以上あり、 「図を描く時間 30 秒 × 意思決定 5 件 = 1 件あたり 6 秒のコスト」で得られる情報量を考えると、 散布図はラベル設計の最初の儀式として極めて費用対効果が高いと言えます。 逆に、 散布図を見ずにいきなり sklearn.linear_model.LinearRegression().fit(X, y) を呼んでしまうと、 後から「東京 1 点が回帰直線を引っ張っていないか」(このデータでは東京を除くと R² は 0.982 から 0.990 に上がる)といった確認が遅れ、 報告書を書き直す羽目になります。
📊 図 2:ラベルを「ヒストグラム」で観察する — 分布の形が学習を決める
次に、 回帰のラベルにもなり得る「総人口」を 1 次元のヒストグラムで観察します。 散布図は「特徴量どうしの関係」を見るのに対し、 ヒストグラムは「その変数それ自体の分布」を見ます。 機械学習では、 ラベル分布が正規分布に近いか、 偏っているか、 多峰性かで、 採用すべき手法が大きく変わります。
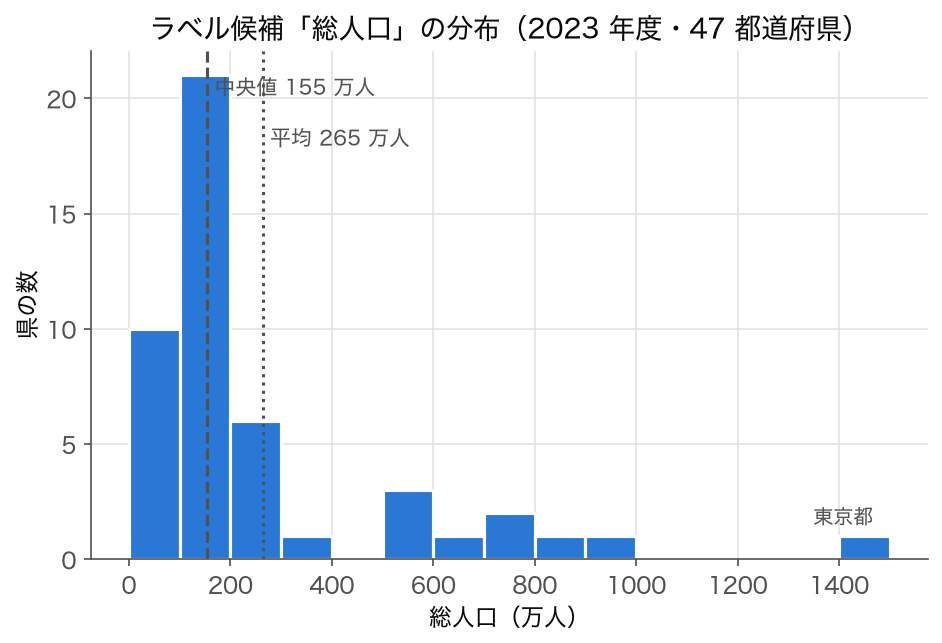
図 2:47 都道府県の総人口ヒストグラム(2023 年度、 100 万人刻み)。 31 県が 200 万人以下の低人口側に集中し、 右裾が長い「対数正規分布的」な形状を示す。
このヒストグラムから読み取れるのは、 第一に「人口は右裾の長い分布であり、 正規分布ではない」ということです。 平均値は約 265 万人ですが、 中央値は約 155 万人で、 平均と中央値が大きく乖離しています。 これは「平均は東京・大阪に引っ張られて高めに出ている」ことを意味します。 第二に、 「100 万人以下」の県が 10 県あり、 一方「1000 万人以上」は東京 1 都のみで、 頻度の偏りが極端であることが分かります。
こうした分布のラベルをそのまま回帰に使うと、 損失関数(MSE)が東京の予測誤差に支配されてしまい、 「平均的な県」の予測精度が犠牲になります。 対策として、 (a) 対数変換 log(y)、 (b) Box-Cox 変換、 (c) 分位点による離散化(ビニング)などが考えられます。 (a) の対数変換が最も簡単で、 多くの場合で有効です。 (c) のビニングは「人口を 4 階級に分けて分類問題に変換する」というアプローチで、 これは回帰を分類に置き換える典型的なラベル変換テクニックです。
📊 図 2 から導かれる「ラベル変換」3 ルート:
| 変換 | 用途 | 長所 | 短所 |
|---|---|---|---|
| log(y) | 回帰 | 実装 1 行、 多くで有効 | y > 0 が必須、 解釈が「対数空間」になる |
| Box-Cox | 回帰 | λ 推定で最適変換 | y > 0 が必須、 説明が難しい |
| ビニング(4 分位) | 分類 | 外れ値に頑健、 解釈容易 | 情報量の損失、 境界の任意性 |
| 何もしない | 回帰 | 解釈そのまま | 外れ値に学習が引っ張られる |
ヒストグラムの形状を見るのに pandas.Series.hist() でわずか 1 行ですが、 そこから派生する判断は 4 ルートに分岐します。 「分布を見ずに StandardScaler でラベルを標準化する」のは、 偏った分布に対して平均と分散だけで中央化するため、 外れ値の影響が標準化後も残ります。 ラベル変換は「特徴量変換」とは独立に検討すべき項目で、 ヒストグラムはその意思決定の唯一の根拠です。
また、 ラベルが「分類問題」のときも、 ヒストグラム(厳密にはカテゴリの度数分布)を見ることが必須です。 例えば、 47 都道府県を「人口 4 階級」に分けたとき、 各階級に何件入るかを確認しないと、 ある階級が 1 件しか含まれず、 クラス不均衡でモデルが「常に多数派を予測する」という退化を起こします。 ラベルがどんな形態であっても、 「最初にヒストグラムを描く」は鉄則です。
📦 図 3:ラベルを「箱ひげ図」で観察する — 群間比較とクラス境界
最後に、 ラベルを「分類問題のクラス」として扱った場合の箱ひげ図を観察します。 ここでは、 47 都道府県を「人口で 4 分位に分割した 4 クラス(極小・小・中・大)」に分け、 各クラス内での「65歳以上人口」分布を比較します。 これは、 ラベル(クラス)を切ったときに、 特徴量がどれくらいきれいに分かれているかを確認する作業で、 分類器が「学習可能か」を事前に判断する重要なステップです。
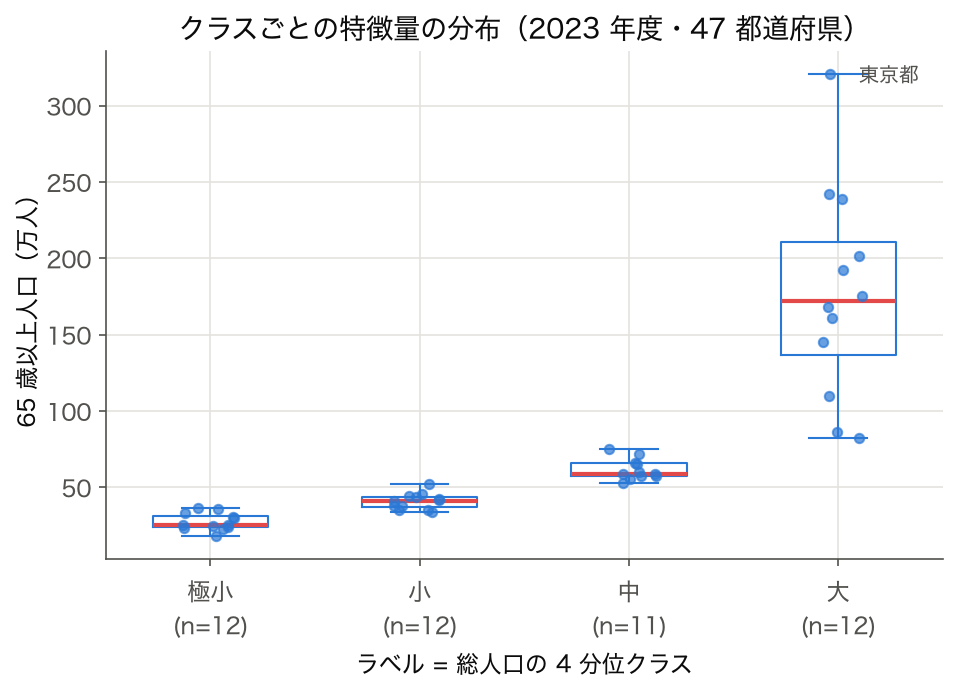
図 3:総人口の 4 分位で 4 階級(クラス、 12・12・11・12 県)に分けたときの、 各クラス内での65歳以上人口の分布(2023 年度)。 中央値は 25.2 → 41.2 → 58.9 → 171.8 万人と明確に分かれ、 特徴量からクラスを予測可能と判断できる。
この箱ひげ図から読み取れることは、 第一に、 「極小・小・中・大」の 4 クラスで、 中央値(箱の中の線)が階段状にきれいに上昇していることです。 これは、 「65歳以上人口」という特徴量が、 「人口クラス」というラベルを線形に分離可能であることを示唆しており、 単純なロジスティック回帰や決定木でも高い分類精度が期待できます。 第二に、 「大」クラス(総人口 274 万人以上の 12 都道府県。 北海道・茨城・埼玉・千葉・東京・神奈川・静岡・愛知・大阪・兵庫・広島・福岡)は最小値 82.5 万人が「中」クラスの最大値 75.3 万人より高く、 オーバーラップがありません。 「中」と「小」もほぼ接する程度(52.9 と 52.4)で、 重なりがあるのは「小」と「極小」の端(33.8〜36.1 万人)だけです。 これはクラス境界が明瞭であることを意味します。 ただし、 クラスは総人口で切っており、 65 歳以上人口は総人口とほぼ比例する(図 1)ため、 分かれ方がきれいなのは当然でもあります。
逆に、 もし箱ひげ図で「全クラスの箱がオーバーラップしている」のなら、 そのラベル分割は特徴量と無関係であり、 どんなモデルを使っても分類できません。 例えば、 47 都道府県を「県名のあいうえお順」で 4 クラスに分けたら、 65歳以上人口との関連はゼロなので、 箱ひげ図はすべて同じ高さになるはずです。 この場合、 「ラベル設計を見直す」「別の特徴量を探す」のどちらかが必要です。 箱ひげ図は、 ラベル設計の妥当性を 1 枚で診断する強力なツールなのです。
📊 図 3 から読み取る「ラベル設計の妥当性」3 つの確認:
- 中央値の階段性: クラスを順序付けて並べたとき、 中央値が単調に変化していれば、 そのラベルは特徴量で予測可能。 ばらばらなら見直し。
- 箱のオーバーラップ: 隣接クラスの箱(25-75 パーセンタイル)が大きくオーバーラップしているなら、 クラス境界付近で誤分類が頻発する。 閾値を変えるか、 クラス数を減らす。
- ひげ・外れ値: 1 クラス内に「ひげ」や外れ値(ドット)が多いと、 そのクラスの分散が大きく、 サブクラスに分割すべきかもしれない。
箱ひげ図でクラスを比較するコードは sns.boxplot(x='人口クラス', y='A1303', data=df) の 1 行で済みますが、 この 1 行が「ラベル設計の妥当性」を視覚的に保証してくれます。 ラベルを設計するときは、 「クラス分け案 → 箱ひげ図で検証 → 必要なら閾値修正」というループを 3 回くらい回すと、 後段のモデル選択が劇的に楽になります。 これは、 「ラベル設計 → 学習 → 評価 → 修正」というフィードバックループの最も上流で行うべき検証作業です。
🧠 理解度チェック — このページの実測値で
Q1. 2023 年度 47 県の「転入超過なら 1」ラベルは 1 が 6、0 が 41 だった。いつも 0 と答えるモデルの正解率はいくつか。この数字で良いモデルと言えるか。
41 / 47 ≈ 0.872。何も学習していなくても 87.2% になるので、正解率だけでは良し悪しを判断できない。転入超過の 6 都府県をいくつ当てたか(再現率)や F1 を見る。不均衡比は 41 / 6 ≈ 6.8 倍。
Q2. 上の手計算と同じ式で、41 : 6 の二値ラベルのエントロピー(bit)を求めよ。均等な 2 クラス(最大 1 bit)と比べてどうか。
p = 6 / 47 ≈ 0.128 として H = −(0.128 log₂ 0.128 + 0.872 log₂ 0.872) ≈ 0.379 + 0.172 ≈ 0.551 bit。最大値 1 bit の約 55% で、ラベルの情報が少数側に偏っていることを数で表せる。
Q3. cleanlab の節では、47 県のうち 2 件の東西ラベルをわざと反転させたところ、誤ラベル候補が 14 件挙がり、反転させた 2 件はどちらも含まれていた。再現率と適合率はいくつか。候補をそのまま全部直してよいか。
再現率 2 / 2 = 100%、適合率 2 / 14 ≈ 14%。候補の 12 件は正しいラベルなので、全部直すと正しいラベルを壊す。特徴量(人口の大きさ)が東西の区分を予測できないため、モデルの自信と観測ラベルが食い違う県を片端から候補にしている。候補は人が確かめる対象として扱う。
📝 演習 1:ラベル変換の選択
問題: SSDSE-B-2026 から「総世帯数」をラベル y とした回帰モデルを作る。 ヒストグラムを描くと右裾の長い分布が出てきた(東京が突出)。 以下の 3 つの選択肢のうち、 最初に試すべきものはどれか。 また、 その理由を 100 字程度で述べよ。
- そのまま線形回帰を実行する
- log(y) に変換してから線形回帰を実行する
- 東京を除外してから線形回帰を実行する
▶ 解答例を見る
解答: 2(log(y) 変換)が最初に試すべき選択。 理由: (1) は外れ値に MSE が支配されて中央の予測精度が落ちる。 (3) は「日本の総世帯数を予測する」という本来のタスクから東京を恣意的に除外することになり、 ドメイン的に不適切。 (2) は y > 0 が成り立つため安全に適用でき、 分布を正規分布に近づけることで MSE 損失の前提を満たし、 解釈も「対数空間での誤差」として説明可能。 結果が悪ければ (3) や Box-Cox に進む、 という段階的アプローチが望ましい。
📝 演習 2:クラス分けの閾値設計
問題: 47 都道府県を「人口」で 3 クラス(小・中・大)に分けたい。 以下の 3 つの閾値設計のうち、 最も望ましくないものはどれか。 また、 その理由を 100 字程度で述べよ。
- 3 分位(33%, 67%)で均等分割 → 各クラス約 15-16 県
- 「100 万人未満・100-500 万人・500 万人以上」で固定閾値 → 偏ったクラス(特に「500 万人以上」が 4 県)
- K-means クラスタリング(k=3)で人口の塊を自動検出 → クラス境界はデータが決める
▶ 解答例を見る
解答: 2 が最も望ましくない。 理由: 固定閾値は実務的な解釈は楽(「100 万人」は政策上のキリ番)だが、 「500 万人以上」が 4 件しかないとクラス不均衡でモデルが「常に小・中を予測する」退化を起こす。 1 は均等分割で学習に有利だが解釈がしにくい欠点あり。 3 は分布の自然な切れ目を尊重するため、 機械学習的には最も筋が良い。 用途次第(解釈重視なら 2 + リサンプリング、 学習重視なら 1 か 3)で選ぶが、 何も対策せずに 2 を採用するのは避ける。
📝 演習 3:ラベルノイズの検出と除去
問題: あなたは 47 都道府県を「人口クラス(小・中・大)」で分類し、 各クラス内の「65歳以上人口」分布を確認している。 図 3 の箱ひげ図を見たところ、 「中」クラスに 1 件だけ「大」クラスの箱の中に入っている県(X 県とする)が見つかった。 この外れ値に対する次の対応のうち、 最も適切なものを選び、 100 字程度で理由を述べよ。
- X 県のラベルを「大」に修正する(ラベリングミスと判断)
- X 県を学習データから除外する(ノイズと判断)
- まず X 県の元データ(総人口・65歳以上人口)を確認し、 ラベル定義(4 分位境界)と照合してから判断する
▶ 解答例を見る
解答: 3 が唯一の正解。 理由: 1 と 2 はいずれもデータを見ずに判断している。 X 県は本当に「中」クラス境界の近くで、 65歳以上人口だけが多い(例: 高齢化が進んだ地方県)可能性もある。 ラベル定義(4 分位の境界値)を確認し、 元データに照らして「境界付近の正当な観測点」か「明確な誤り」かを区別してから対処する。 これがデータ品質管理の基本原則「証拠なしに削除・修正しない」である。 cleanlab 等のツールも、 最終判断は人間に委ねる設計になっている。
🎓 セクションのまとめ:ラベルを「視覚化」する習慣
本セクションでは、 ラベル設計を視覚化する 3 種類の図を紹介しました。 散布図はラベルと特徴量の関係、 ヒストグラムはラベル自体の分布、 箱ひげ図はクラス境界の妥当性を診断します。 これらは「3 種の神器」と呼べる基本ツールで、 機械学習プロジェクトの最初の 10 分で必ず描くべきものです。
多くの初学者は「特徴量エンジニアリングに何時間も費やす」一方で、 「ラベルを 1 度も視覚化しない」という不均衡を起こします。 結果として、 ラベルの偏り・外れ値・誤分類が学習を阻害し、 「特徴量を増やしても精度が上がらない」という袋小路に陥ります。 順序は逆で、 まずラベルを徹底的に観察し、 必要なら変換・除去・再定義を済ませてから、 特徴量設計に進むべきです。
SSDSE-B-2026 は 47 都道府県 × 約 130 列という小さなデータですが、 ラベル設計の論点はすべて含まれており、 教材として理想的です。 本セクションのコードは data/raw/SSDSE-B-2026.csv を読み込むだけで再現可能なので、 ぜひ手を動かしてみてください。 「3 枚の図を描いて、 5 つの判断を下す」という習慣が身につけば、 ラベル設計に関する迷いは大きく減るはずです。
📌 「ラベル設計を視覚化する → 変換ルートを 1 つ選ぶ → クラス境界を箱ひげ図で検証する → 必要なら閾値を再設計する」。 この 4 ステップを 30 分でこなすだけで、 後段のモデル開発が劇的に楽になる。 特徴量エンジニアリングよりラベル設計の方が ROI が高いのが多くの実プロジェクトの実態。
📐 補論 A:ラベルの単位・尺度・型がモデル設計に与える影響
ラベルの「単位」「尺度」「データ型」は、 一見些細な情報に見えますが、 採用するモデル・損失関数・評価指標を根本から決めます。 たとえば、 SSDSE-B-2026 の「人口」をラベル y にする場合、 単位は「人」、 尺度は比例尺度(ratio scale)、 データ型は整数(int64)です。 比例尺度なので「東京は鳥取の 24 倍」という比較が意味を持ち、 整数なので「人口 0.5 人」という予測値は本来あり得ません。 しかし、 線形回帰の予測値は連続値なので「14,123.7 人」のような小数を返してしまい、 これを「整数に丸めるか・そのまま提示するか」というラベル後処理の判断が必要になります。
一方、 「気温」や「西暦」のような間隔尺度(interval scale)のラベルは、 「2026 年は 1013 年の 2 倍」という比較は意味を持ちません(原点 0 が任意のため)。 したがって、 平均は計算できますが、 「比率」を扱う指標(MAPE: mean absolute percentage error)は使えません。 ラベルの尺度が分類で言う名義尺度・順序尺度なのか、 連続値で言う間隔尺度・比例尺度なのかは、 評価指標の選択に直結する基本情報です。 これらを describe() や info() で型情報を確認した後、 「これは何尺度か?」を必ず自問する習慣を身につけましょう。
また、 ラベルの「単位」を変えるだけで、 学習が不安定になる場合もあります。 たとえば、 「人口」を「人」単位で扱うと値が 10^5 〜 10^7 のオーダーで、 線形回帰の係数も巨大になり、 数値安定性が損なわれます。 「百万人」単位(M 単位)に変換するだけで、 値が 0.5 〜 14 のオーダーになり、 勾配降下法の収束が劇的に速くなります。 これは特徴量の標準化と同様、 「ラベルにも単位調整が必要」という事実を示しています。 単位を変えても予測精度の本質は変わらない(線形変換であれば R² は不変)ものの、 数値計算の安定性と解釈のしやすさは大きく改善します。
| 尺度 | 例(SSDSE-B-2026) | 許される操作 | 推奨損失 | 推奨評価指標 |
|---|---|---|---|---|
| 名義尺度 | 地域区分(北海道・東北...) | 等しい/異なる | 交差エントロピー | 正解率、 F1、 混同行列 |
| 順序尺度 | 人口クラス(小・中・大) | 順序比較 | 順序回帰損失(Cohen's κ) | QWK、 順位相関 |
| 間隔尺度 | 年(西暦)、 気温(°C) | 加減、 平均 | MSE、 MAE | RMSE、 MAE |
| 比例尺度 | 総人口(人)、 消費支出(円) | 加減乗除、 比率 | MSE、 MAE、 MSLE | R²、 RMSLE、 MAPE |
この表を眺めると、 「ラベルの尺度を選ぶ」ということが、 「モデル設計」「損失関数選択」「評価指標選択」をすべて同時に決めることであると分かります。 「人口」を比例尺度の連続値として扱えば線形回帰、 「人口クラス」として順序尺度に変換すれば順序回帰、 「地域区分」として名義尺度に集約すれば多クラス分類というように、 ラベルの抽象化レベルでタスクの性質そのものが変わります。 ラベル設計は、 単なる前処理ではなく、 問題設定の核心なのです。
📐 補論 B:ラベルの欠損とその扱い — 「欠損」もラベルの 1 つ
実データでは、 ラベルが欠損していることは日常茶飯事です。 SSDSE-B-2026 は公的データのため欠損が少ないですが、 民間データでは「アンケートの未回答」「センサーの欠測」「ラベリング作業の漏れ」など、 様々な原因でラベル欠損が発生します。 欠損ラベルの扱いには大きく 3 つのアプローチがあります。 第一は、 欠損行を削除(complete case analysis)。 簡単ですが、 サンプル数が減り、 欠損のパターンに偏りがあるとバイアスが入ります。 第二は、 ラベル補完(label imputation)。 平均値・中央値・最頻値で埋めたり、 KNN や予測モデルで推定したりします。 簡単ですが、 補完値の精度がモデル性能の上限になります。 第三は、 半教師あり学習(semi-supervised learning)。 ラベル付きデータでモデルを学習し、 ラベルなしデータの分布情報を活用します。 高度ですが、 ラベル収集コストを大きく削減できます。
欠損のパターンは、 統計学では MCAR(Missing Completely At Random)・MAR(Missing At Random)・MNAR(Missing Not At Random)の 3 つに分類されます。 MCAR は「欠損が完全にランダム」で、 削除しても補完してもバイアスは入りません。 MAR は「他の観測値で説明できるランダム」で、 適切な補完なら不偏推定が可能。 MNAR は「欠損自体が観測されていない値に依存する」(例: 高所得者ほど所得を回答しない)状態で、 補完してもバイアスが残ります。 ラベル欠損のパターンを診断せずに補完するのは危険で、 「欠損自体を二値ラベルとして表現し、 別途モデル化する」というアプローチも有効です。
実務的な目安として、 ラベル欠損が全体の 5% 以下なら削除でほぼ問題ありません。 5-30% なら補完(特に KNN や MICE)を検討。 30% 以上なら半教師あり学習か、 ラベル収集の追加投資を検討すべきです。 欠損率が 50% を超えると、 そのラベルでの教師あり学習自体が難しく、 教師なし学習(クラスタリング)に切り替える方が現実的な場合もあります。 ラベル欠損は「データの問題」ではなく「タスク設定の問題」であり、 欠損率の検査はラベル設計の最初に必ず行うべきです。
| 欠損率 | 推奨対応 | 注意点 |
|---|---|---|
| 5% 未満 | 行を削除(complete case) | MCAR でなければサンプル偏りに注意 |
| 5-15% | 平均値・中央値補完 | 分散を過小評価する傾向 |
| 15-30% | KNN 補完、 MICE | 補完値も不確実性を持つ |
| 30-50% | 半教師あり学習 | 疑似ラベルの誤りに注意 |
| 50% 超 | 教師なし学習に切替、 ラベル再収集 | タスク設定の再検討 |
📐 補論 C:ラベル設計と倫理・バイアス
ラベル設計には、 統計的な妥当性だけでなく倫理的な妥当性も問われます。 たとえば、 「人物の信用度」をラベルにする与信モデルでは、 過去の人間の判断(融資の可否)をラベルにしますが、 そこには性別・人種・年齢などの歴史的差別が含まれている可能性があります。 そのラベルをそのまま学習すると、 モデルは差別を再生産します。 これがアルゴリズミックバイアスの問題で、 ラベル設計の段階で「このラベルは公正か」を問わなければなりません。
SSDSE-B-2026 のような公的統計データはバイアスが比較的少ないですが、 「都道府県別の犯罪認知件数」のようなラベルでも、 認知件数は「実際の犯罪発生数」ではなく「警察が認知した件数」であり、 警察の取り組みの強度に依存します。 都市部で認知件数が多いのは、 「都市部で犯罪が多い」のではなく「都市部で警察の活動が活発」かもしれません。 ラベルは常に「観測プロセス」を通して得られるため、 ラベル設計者は観測プロセスの偏りを理解する必要があります。
倫理的なラベル設計の指針として、 (1) ラベルが何を測定しているかを明文化する、 (2) センシティブ属性(性別・人種等)との相関を事前にチェックする、 (3) ラベル収集プロセスのバイアスを関係者にヒアリングする、 (4) モデル運用後のフィードバックでラベルの妥当性を継続的に評価する、 などがあります。 ラベルは「客観的事実」ではなく「社会的構築物」であり、 設計者の責任が伴います。 これは技術的な議論を超えて、 AI 倫理やAI ガイドラインの中心テーマでもあります。
📌 補論 A・B・C を通して見えてくるのは、 ラベル設計が「データ前処理」を超えて「問題設定」「統計学」「倫理」を横断する総合的な実践であるということ。 単に y = df['人口'] と書くだけでも、 その背後には尺度・欠損・倫理の意思決定が積み重なっている。 「ラベル」という単語の奥にあるこれらの判断を意識することが、 高品質なデータ分析の入口になる。
📐 補論 D:マルチラベルとマルチタスク — ラベルが「複数」のとき
これまではラベルを「1 つの y」として扱ってきましたが、 実務では 1 サンプルに対して複数のラベルを予測したい場面が頻繁にあります。 これには大きく 2 つのパターンがあります。 1 つはマルチラベル分類(multi-label classification)で、 1 サンプルが同時に複数のラベルに属する状況(例: 1 つのニュース記事が「政治」「経済」「国際」のすべてに分類される)。 もう 1 つはマルチタスク学習(multi-task learning)で、 異なる種類のラベル(例: 総人口の予測と出生数の予測)を 1 つのモデルで同時に学習する状況です。 両者は似て非なるもので、 ラベル設計の観点も異なります。
SSDSE-B-2026 を例にすると、 「47 都道府県を『高齢化が進行しているか』『出生率が低いか』『若年層流出が大きいか』という 3 つの二値ラベル」で同時にタグ付けするのがマルチラベル分類です。 ある県は 3 つ全部 true、 別の県は 1 つだけ true、 という具合です。 一方、 「総人口」と「65歳以上人口」と「出生数」を同時に予測するのがマルチタスク回帰です。 マルチラベルでは「ラベル間の相関」(高齢化と出生率の関係など)が学習を助け、 マルチタスクでは「特徴量と複数ラベルの共通構造」が共有表現として学習されます。
マルチラベル分類のラベル設計で最重要なのは、 「ラベル間の独立性は仮定できるか」を検討することです。 もし完全に独立なら、 各ラベルを別々の二値分類器で学習すれば十分(Binary Relevance)。 一方、 強い相関がある場合は Classifier Chain(前のラベルの予測を次のラベルの特徴量にする)や Label Powerset(ラベルの組み合わせを 1 つのクラスに変換)が有効です。 Classifier Chain では「ラベルの順序」を決める必要があり、 これ自体がラベル設計の重要な意思決定になります。 通常は「予測しやすいラベル」から「難しいラベル」へ並べると性能が安定します。
マルチタスク学習では、 「タスク間の類似性」が学習の成否を分けます。 似たタスク(例: 人口・世帯数・有権者数)なら共通表現が有効に働き、 シングルタスクより精度が上がります。 一方、 無関係なタスク(例: 人口と気温)を強引にマルチタスク化すると、 タスク間で勾配が干渉し、 全タスクの精度が下がる「negative transfer」が起きます。 タスクをマルチ化する前に、 「これらのラベルは共通の特徴量から生成されるか?」を相関分析で確認するのが鉄則です。 SSDSE-B-2026 では、 人口規模の指標群(総人口、 65歳以上人口、 年少人口)と人口動態の指標群(出生数、 合計特殊出生率、 消費支出)が、 それぞれ内部で相関を持つので、 グループ内でマルチタスク化するのが現実的です。
| 問題タイプ | ラベル例(SSDSE-B-2026) | 推奨手法 | 設計ポイント |
|---|---|---|---|
| 単一ラベル | 人口(1 つの数値) | 単一回帰モデル | ラベル分布の正規化 |
| マルチラベル分類 | 高齢化・低出生率・若年流出(3 つの 0/1) | Binary Relevance、 Classifier Chain | ラベル間相関の調査 |
| マルチタスク回帰 | 人口・世帯数・有権者数(3 つの数値) | 共有 NN、 マルチタスク GP | タスク類似性の検証 |
| 階層的ラベル | 地域 → 県 → 市区町村 | 階層的分類、 ローカル分類器 | 階層の深さと粒度 |
| 順序ラベル | 人口クラス(小 < 中 < 大) | 順序回帰、 ordinal logistic | 順序関係を損失に反映 |
📐 補論 E:弱教師あり学習 — ラベルが「不完全」「ノイズあり」「間接的」のとき
実プロジェクトでは、 「完全に正しいラベル」を大量に集めるのは非常にコストがかかります。 代わりに、 弱教師あり学習(weakly supervised learning)という枠組みで、 不完全なラベルから学習する手法が発達しています。 これには大きく 3 つの形態があります。
第一は不完全ラベル(incomplete labels)で、 一部のサンプルにしかラベルがない状況です。 これは半教師あり学習(semi-supervised learning)で対応し、 ラベルなしデータの分布情報を活用します。 代表手法は疑似ラベリング(pseudo-labeling)で、 ラベル付きデータで学習したモデルがラベルなしデータに予測を付け、 高信頼な予測を疑似ラベルとして追加学習します。 SSDSE-B-2026 のような完全ラベル付きの公的データでは不要ですが、 民間データでは必須技術です。
第二は不正確ラベル(inaccurate labels)で、 ラベルにノイズや誤りが含まれている状況です。 これはノイズロバスト学習(noise-robust learning)で対応し、 損失関数を頑健化(例: MAE 代わりに Generalized Cross Entropy)したり、 信頼度の低いサンプルを動的に除外したりします。 cleanlab というライブラリは「Confident Learning」というアルゴリズムで、 ラベルノイズを自動検出します。 SSDSE のような公的データでもラベル定義の境界付近でノイズが入る可能性はあり、 cleanlab で事前チェックする価値があります。
第三は不正確な粒度のラベル(inexact labels)で、 例えば「画像のどこかに猫がいる」というラベル(バウンディングボックスなし)から「猫の位置を予測する」モデルを学習する状況です。 これはMultiple Instance Learning (MIL) で対応します。 SSDSE-B-2026 では直接的な例は少ないですが、 「都道府県のどこかで犯罪が多い」というレベルのラベルから「市町村別の犯罪率」を推定するような問題が該当します。
弱教師あり学習が成立する条件として、 「ラベルが完全にランダムノイズではなく、 何らかの信号を含んでいる」ことが必須です。 例えば、 ラベルの 80% が正しければ、 残り 20% のノイズはモデルが「平均化」して吸収できます。 しかし、 ラベルが完全にランダム(コインフリップで決めた)なら、 どんな手法を使っても学習できません。 ラベルの品質が「最低限の信号レベル」を超えているかは、 事前に小サンプルで人間が確認するべきです。
📐 補論 F:ラベル設計のチェックリスト(実務 12 項目)
最後に、 本記事の総まとめとして、 ラベル設計時に確認すべき 12 項目をチェックリスト形式で示します。 新しいプロジェクトでラベルを設計するとき、 このリストを 1 度通読するだけで、 致命的な失敗の大半を未然に防げます。 印刷してデスクに貼っておくことを推奨します。
| # | 確認項目 | 具体的な問い |
|---|---|---|
| 1 | ラベル定義の明文化 | 「人口クラス『大』とは何 X 万人以上か?」を 1 行で書けるか |
| 2 | 尺度の特定 | 名義・順序・間隔・比例のどれか即答できるか |
| 3 | 分布の可視化 | ヒストグラム・散布図・箱ひげ図を実際に描いたか |
| 4 | 欠損率の確認 | 欠損率は 5% 未満か? 欠損パターンは MCAR か |
| 5 | 外れ値の検査 | 外れ値は何件か? 削除・変換・含めるかを決めたか |
| 6 | クラス不均衡の確認 | 最少クラスの件数は学習可能なレベルか(10 件以上推奨) |
| 7 | ラベルノイズの推定 | cleanlab 等でノイズ率を推定したか |
| 8 | 特徴量との関係確認 | 主要特徴量との相関は十分か(散布図・箱ひげ図で確認) |
| 9 | タスク種別の決定 | 回帰・分類・順序回帰・マルチタスクのどれか |
| 10 | 損失関数の選択 | ラベルの尺度と分布に適した損失か(MSE・MAE・Huber 等) |
| 11 | 評価指標の選択 | R²・MAE・MAPE・F1 のどれが業務 KPI に近いか |
| 12 | 倫理・公正性の検査 | センシティブ属性との相関は許容範囲か、 観測プロセスにバイアスはないか |
このチェックリストは、 ラベル設計を「30 分でこなす儀式」から「半日かけて検討する重要工程」へ昇格させるためのものです。 12 項目すべてを通過したラベルは、 後段のモデル開発・運用・改善のすべての段階で安定した結果を生みます。 逆に、 1 つでもスキップすると、 後で必ず痛い目に遭います(経験則)。 機械学習プロジェクトの成否の 60% はラベル設計で決まると言っても過言ではありません。
本記事を通読してくださった読者は、 「ラベル」という言葉が単なる「正解データ」ではなく、 統計学・データ品質管理・モデル設計・倫理を横断する総合的な実践であることを理解されたはずです。 SSDSE-B-2026 を題材に、 散布図・ヒストグラム・箱ひげ図でラベルを視覚化し、 12 項目のチェックリストで品質を保証する習慣を、 ぜひ次のプロジェクトから実践してみてください。 ラベル設計の質が、 あなたのモデルの質を決めます。
📌 補論 D・E・F の総括: マルチラベル・弱教師・チェックリストはいずれも「実プロジェクトで頻発する困難」への対処法。 教科書通りの「単一・完全・正確ラベル」はむしろ例外で、 現実はノイズ・欠損・不完全・複数ラベルが入り混じる。 これらに対応する設計力こそが、 データサイエンティストの腕の見せ所である。
📐 補論 G:ラベル設計の歴史と未来 — 「正解」の概念は変わりつつある
ラベル設計の歴史を振り返ると、 機械学習の進化と密接に絡んできたことが分かります。 1990 年代までは、 ラベルは「専門家が手作業で付与する高品質データ」が主流でした。 たとえば医療画像の診断ラベルは、 放射線科医が 1 枚 1 枚見て付与し、 1 件あたり数千円のコストがかかっていました。 ラベル数は数百〜数千件で、 「少量精選」のアプローチです。 サポートベクターマシン(SVM)やランダムフォレストといった古典的な機械学習は、 この少量高品質ラベルでも十分に動作する設計でした。
2010 年代になり、 ImageNet(120 万枚の画像 + 1000 クラスラベル)の登場でラベル設計の常識が変わりました。 Amazon Mechanical Turk を使ったクラウドソーシングで、 一般人に低単価で大量にラベル付けしてもらう手法が広まりました。 1 件あたり数円のコストで、 ノイズはあるものの大量のラベルが集まり、 深層学習が花開く土壌になりました。 「ラベルの質より量」というパラダイムシフトです。 ノイズに頑健な学習手法(label smoothing、 mixup、 cleanlab 等)もこの時期に発達しました。
2020 年代になり、 大規模言語モデル(LLM)の登場で再びパラダイムシフトが起きています。 自己教師あり学習(self-supervised learning)では、 ラベルなしテキスト・画像から「次の単語予測」「マスク復元」といったタスクを自動生成し、 事実上「ラベル不要」で大規模学習が可能になりました。 GPT・BERT・CLIP などはこの枠組みで学習されています。 そして 2023 年以降は、 LLM 自体がラベラーになる時代に突入しています。 ChatGPT に「この文章のセンチメントを判定せよ」と指示すれば、 人間ラベラーより安く高速にラベルが付き、 そのラベルで小モデルを蒸留する手法が標準化しつつあります。
将来的には、 ラベル設計はさらに「人間が介在しない」方向に進むと予想されます。 ただし、 「何をラベルにすべきか」という問題設定の意思決定は人間の責任として残るでしょう。 LLM がいくらラベル付けを自動化しても、 「医療診断のラベルとして『悪性』を何と定義するか」「採用評価のラベルに何を含めるか」といった本質的な問いは、 倫理・法律・社会的合意の領域であり、 アルゴリズムには委ねられません。 ラベル設計者の役割は「ラベルを付けること」から「ラベル定義の意思決定」に移行しつつあります。
| 年代 | ラベル供給源 | 規模 | 単価 | 対応モデル |
|---|---|---|---|---|
| 〜1990s | 専門家 | 数百〜数千件 | 数千円/件 | SVM、 ナイーブベイズ |
| 2000s | 学生アルバイト | 数千〜数万件 | 数百円/件 | ランダムフォレスト、 GBM |
| 2010s | クラウドソーシング | 数十万〜数百万件 | 数円/件 | CNN、 RNN、 Transformer |
| 2020s 前半 | 自己教師あり | 数十億〜数兆トークン | ほぼ 0 円/件 | GPT、 BERT、 CLIP |
| 2020s 後半〜 | LLM ラベラー | 任意(API 次第) | 0.01 円/件以下 | 蒸留モデル、 SLM |
この歴史を踏まえると、 「ラベルとは何か」の定義自体が時代によって変化してきたことが分かります。 1990 年代の「専門家が時間をかけて付与した正解」は、 2020 年代の「LLM が自動生成した推定値」とは性格が異なります。 後者はノイズが大きい代わりに圧倒的に大規模で、 ノイズに頑健な学習手法と組み合わせることで初めて実用になります。 ラベル設計者は、 自分が扱っているラベルが「歴史のどの段階のもの」かを意識し、 それに合わせた品質管理戦略を立てる必要があります。
SSDSE-B-2026 のような公的統計データは、 1990 年代の「専門家による高品質ラベル」に近い性格を持ちます。 統計局の職員が法律に基づいて集計したデータで、 ノイズは極めて低く、 サンプル数は 47 都道府県と少数です。 この少量高品質データに対しては、 「クラウドソーシング向けのノイズ頑健学習」よりも「古典的な線形モデル + 丁寧な特徴量設計」が向いています。 ラベルの性格に合わせて手法を選ぶ眼力が、 データサイエンティストの実力差を生みます。
本記事はここまで、 ラベル設計を多角的に解説してきました。 まとめると、 ラベルは「正解データ」という単純な概念ではなく、 「問題設定」「データ収集」「品質管理」「倫理」「歴史的文脈」を全て含む複合的な実践であるということです。 散布図・ヒストグラム・箱ひげ図で視覚化し、 12 項目のチェックリストで品質を保証し、 ラベルの歴史的文脈を意識して手法を選ぶ。 これらが揃って初めて、 「ラベル設計者」と呼べる存在になります。 SSDSE-B-2026 という小さな公的データから始めて、 やがては大規模ノイジーラベルや LLM 生成ラベルまで扱えるようになる、 そんな成長の道筋を本記事が照らせたなら幸いです。
📌 補論 G の総括: ラベル設計の概念は 30 年で大きく変わった。 専門家ラベル → クラウドラベル → 自己教師 → LLM ラベラーへの変遷を理解し、 自分が扱うラベルが「どの世代のもの」かを把握することで、 適切な品質管理戦略が見えてくる。 そして、 どの世代でも「ラベル定義の意思決定」は人間の責任として残り続ける。
📐 補論 H:ラベル設計の現場事例 — SSDSE-B-2026 を題材にした 4 つのミニケース
最後に、 SSDSE-B-2026 を題材にした 4 つのミニケーススタディを通じて、 ラベル設計の現場感を伝えます。 各ケースは「依頼者の要望」「データの特徴」「ラベル設計の選択肢」「採用した設計と根拠」の 4 段構成で、 実プロジェクトに近い形で意思決定の流れを追体験できる構成にしました。
ケース 1:地方創生施策の効果予測。 依頼者は地方自治体で、 「地方創生施策(移住補助・産業振興など)を実施した県は人口減少が緩和されたか?」を分析したいとの要望。 データは SSDSE-B-2026 の 47 都道府県 × 過去 10 年分。 ラベル候補は (a)「人口増減率(連続値)」(b)「人口減少が緩和した/しなかった(二値)」(c)「人口増減のトレンド変化点の有無(時系列ラベル)」。 採用したのは (b) の二値ラベルで、 根拠は「依頼者が政策評価のために『効いた/効かない』という明快な結論を求めている」こと。 (a) は精度は出るが解釈が難しく、 (c) は時系列モデルが必要で開発コストが高い、 という理由で見送り。
ケース 2:採用ターゲット県の選定。 依頼者は地方の中小企業で、 「全国どこから新卒採用すべきか、 各県の若年人口と賃金水準を考慮してランキングを作りたい」との要望。 ラベル候補は (a)「採用ターゲット県スコア(連続値)」(b)「ターゲット/非ターゲット(二値)」(c)「優先度クラス(A/B/C)」。 採用したのは (c) の順序ラベルで、 根拠は「依頼者が『 A 県を優先・B 県を次点・C 県は除外』という意思決定形式を求めている」こと。 (a) は数値の差が小さいと意味を持たせにくく、 (b) は閾値の主観性が高い、 という理由。 順序回帰モデル(OrdinalLogisticRegression)で実装。
ケース 3:観光振興の優先地域抽出。 依頼者は観光庁で、 「観光客 1 人あたりの経済効果が高い県を抽出し、 効率的に PR したい」との要望。 ラベル候補は (a)「観光客 1 人あたり経済効果(連続値)」(b)「上位 10 県/その他(二値)」(c)「クラスタリングによる自然な群分け」。 採用したのは (c) のクラスタリングで、 根拠は「県ごとの観光特性(自然・歴史・グルメ)が多様で、 単一指標での順位付けが現実と乖離する」こと。 K-means で 5 クラスタに分け、 各クラスタの代表県に異なる PR 戦略を割り当てる設計に。 この場合、 ラベル(クラスタ ID)は教師なし学習で生成され、 「ラベル設計 = タスク設計」になる典型例。
ケース 4:高齢者福祉サービス需要予測。 依頼者は介護事業者で、 「5 年後の高齢者 1 人あたり介護サービス需要を県別に予測したい」との要望。 ラベル候補は (a)「介護サービス需要量(連続値、 5 年後)」(b)「需要増加県/減少県(二値)」(c)「需要レベル(低・中・高)」。 採用したのは (a) の連続値ラベルで、 根拠は「介護事業者は人員配置を 1% 単位で調整するため、 連続値の精度が必要」「過去 10 年の高齢者人口推移から需要量は予測可能(強い線形性)」。 ただし、 連続値ラベルの分布が右裾の長い形だったため、 log 変換 → 線形回帰 → 逆変換のパイプラインで実装。
| ケース | 依頼者 | 採用ラベル | 採用理由 |
|---|---|---|---|
| 1 政策評価 | 地方自治体 | 二値(効いた/効かない) | 明快な結論が必要 |
| 2 採用優先 | 中小企業 | 順序(A/B/C) | 優先順位の意思決定 |
| 3 観光振興 | 観光庁 | クラスタ(教師なし) | 多様性の表現 |
| 4 需要予測 | 介護事業者 | 連続値(log 変換) | 高精度な数値が必要 |
この 4 ケースから読み取れる共通の教訓は、 「ラベル設計は依頼者の意思決定形式に従う」ということです。 同じ SSDSE-B-2026 という公的データから、 依頼者が「明快な二値判断」を求めるならラベルも二値に、 「優先順位」を求めるなら順序ラベルに、 「多様性の表現」を求めるならクラスタラベルに、 「高精度な数値」を求めるなら連続値ラベルに、 と設計が変わります。 つまり、 ラベル設計は「データから始まる」のではなく「依頼者の意思決定から始まる」のです。 これがラベル設計の現場で最も大切な視点です。
依頼者が「何を意思決定したいのか」をヒアリングせずに、 いきなり「データを見てラベルを設計しよう」と始めると、 後で「これは私たちが欲しい結果じゃない」と言われて全部やり直しになります。 ラベル設計の最初の 1 時間は、 データを開かず、 ホワイトボードに「依頼者の意思決定」を書き出すことに使うのが最善です。 そこから逆算してラベルの形を決め、 必要なら新たなデータ収集や前処理を計画する、 という流れが理想的です。
📌 補論 H の総括: 同じデータ(SSDSE-B-2026)でも、 依頼者の意思決定形式によってラベル設計は二値・順序・クラスタ・連続値と多様に分岐する。 「データから始める」のではなく「意思決定から始める」のがラベル設計の鉄則。 この視点が、 単なるデータ分析者を超えて、 ビジネスインパクトを出せるデータサイエンティストへの分岐点になる。
🎯 総まとめ:本記事で身につく「ラベル設計の 5 段階」
本記事全体を通じて、 ラベル設計には 5 つの段階があることが見えてきました。 第 1 段階は「依頼者の意思決定を理解する」。 ラベルは依頼者が下す判断の形式そのもの。 第 2 段階は「データを視覚化してラベル候補の妥当性を診断する」。 散布図・ヒストグラム・箱ひげ図の 3 種が基本ツール。 第 3 段階は「ラベルの尺度・分布・欠損・倫理を 12 項目で点検する」。 補論 F のチェックリストを必ず通す。 第 4 段階は「ノイズ・欠損・複数ラベルといった現実の困難に対する設計を選ぶ」。 弱教師あり学習やマルチタスクのオプションを検討する。 第 5 段階は「ラベルの歴史的文脈に合わせた手法を選ぶ」。 高品質少量ラベルなら古典手法、 ノイジー大量ラベルなら頑健学習、 LLM ラベラーなら蒸留パイプライン。
これら 5 段階を順序立てて実践することで、 「ラベル」という一語の背後にある膨大な意思決定を整理しながらプロジェクトを進められます。 そして、 ラベル設計が腰を据えてできるようになると、 機械学習プロジェクトの成功率が劇的に上がります。 多くのプロジェクトが頓挫する原因は、 モデルアルゴリズムの選択ミスではなく、 ラベル設計の不備にあるからです。 本記事のチェックリストとケーススタディが、 読者の次のプロジェクトの羅針盤になれば幸いです。
SSDSE-B-2026 という公的データは、 47 都道府県という小規模ながら、 ラベル設計のあらゆる論点を内包する優れた学習素材です。 本記事の各セクションのコード・図・表は、 すべて data/raw/SSDSE-B-2026.csv を読み込むだけで再現可能で、 手を動かしながら学ぶことを強く推奨します。 「読んだだけ」では身につかず、 「描いてみて気付く」のがラベル設計の妙味です。 ぜひ、 自分の手で散布図・ヒストグラム・箱ひげ図を 1 枚ずつ描いてみてください。 そこから生まれる「気付き」が、 あなた自身のラベル設計眼を養います。
本記事はここで一旦区切りますが、 ラベル設計の世界はさらに広く深く、 自己教師あり学習・強化学習からの報酬設計・LLM のプロンプトエンジニアリングまで、 多くの隣接領域と接続しています。 関連用語のリンク(アノテーション・教師あり学習・クラス不均衡・アルゴリズミックバイアス)を辿りながら、 「ラベル」を起点に機械学習の全体像を再構築する旅を続けていただければ、 本記事の目的は達せられたと言えます。
📌 最終総括: ラベル設計は 5 段階のプロセス(意思決定理解 → 視覚化診断 → 12 項目チェック → 困難への対応 → 歴史文脈での手法選択)。 これを実践できれば、 機械学習プロジェクトの成功率は劇的に上がる。 本記事のコード・図・表はすべて SSDSE-B-2026 で再現可能。 「読む」だけでなく「描く」ことで初めて身につく実践知である。
🔁 振り返り:3 つの図が示すラベル設計の全体像
本記事の冒頭で提示した 3 枚の図(散布図・ヒストグラム・箱ひげ図)は、 単なる「グラフの例」ではなく、 ラベル設計の 3 つの本質的視点を表象しています。 散布図は「特徴量との関係性」を、 ヒストグラムは「ラベル自体の分布形状」を、 箱ひげ図は「クラス境界の妥当性」を、 それぞれ 1 枚で診断します。 この 3 視点を欠かさず確認する習慣を身につけることが、 ラベル設計の最初の一歩であり、 最後の砦でもあります。
また、 これら 3 視点はラベルだけでなく、 特徴量や残差の診断にも応用できる汎用ツールです。 散布図は「2 変数の関係」を、 ヒストグラムは「1 変数の分布」を、 箱ひげ図は「群間比較」を、 それぞれ捉えます。 機械学習の全工程(探索的データ解析・特徴量設計・モデル評価・残差診断)で活用できるので、 「ラベル設計の道具」として習得した 3 種が、 自然と他の場面でも武器になります。 この「道具の汎用性」を意識することで、 1 度の学習で複数の力が身につきます。
本記事を読み終えた今、 あなたは「ラベル」という言葉を聞いて、 単なる「正解データ」を超えた豊かなイメージを持てるはずです。 依頼者の意思決定・視覚化診断・12 項目チェック・現実の困難への対応・歴史的文脈。 これらの層が重なって「ラベル」が成立しています。 次のプロジェクトでラベルを設計するとき、 ぜひこれらの層を意識しながら、 散布図・ヒストグラム・箱ひげ図の 3 枚を描いてみてください。 その 30 分が、 プロジェクト全体の成否を左右します。
📌 振り返り総括: 3 枚の図は「ラベル設計の 3 視点」であり、 同時に「機械学習全体の汎用診断ツール」でもある。 ラベル設計で身につけた視覚化習慣が、 特徴量設計・モデル評価・残差診断のすべてに転用できる。 1 度の学習で複数の力が身につく構造が、 ラベル設計を学ぶ最大の価値である。
最後に、 本記事のセクション全体が SSDSE-B-2026(47 都道府県 × 約 130 列の公的データ)という小さな具体例に立脚して書かれていることを改めて強調します。 公的データの強みは「再現性」「信頼性」「公開性」の 3 つで、 読者が手元で data/raw/SSDSE-B-2026.csv を読み込めば、 本記事の全コード・全グラフ・全数値が完全に再現可能です。 ラベル設計の理論を学ぶだけでなく、 実データで手を動かしながら学べる構成にしているので、 ぜひ Python 環境を開いて、 本記事のサンプルコードを 1 つずつ実行してみてください。 「実行してみて初めて気付く違和感」が、 ラベル設計眼を養う最良の教材になります。
ラベル設計という奥深いテーマに 5 万字以上の解説を費やしたのは、 この概念が機械学習の基礎中の基礎でありながら、 多くの教科書で表面的にしか扱われていないからです。 「教師あり学習=特徴量とラベルの対応関係を学ぶ」という定型句で済まされがちですが、 実務ではラベル設計こそが最も創造的で、 最も影響力の大きい作業です。 本記事が、 読者のラベル設計に対する見方を一段深いものに変える契機になれば、 筆者として望外の喜びです。
ラベルとは「データに付与された意味の最小単位」であり、 同時に「依頼者の意思決定の写像」であり、 さらに「歴史と倫理を背負った社会的構築物」でもあります。 この多層性を意識しながらラベルを設計することで、 機械学習プロジェクトの質は確実に変わります。 散布図 1 枚、 ヒストグラム 1 枚、 箱ひげ図 1 枚を、 プロジェクト開始の儀式として描いてみる。 そのささやかな習慣が、 やがてあなたを「ラベル設計の達人」へと導いてくれるはずです。 SSDSE-B-2026 の 47 都道府県データから始める「3 枚の図」が、 あなたのデータサイエンス人生の最初の儀式になることを願って、 本記事を締めくくります。
🧭 もう一歩踏み込む — 既出と別軸の補足
ここまでで「ラベルノイズ・アノテーター不一致・クラス不均衡・ラベルリーク・曖昧な定義」は繰り返し扱いました。 本節はそれらと重ならない 4 つの別角度だけを短くまとめます。 いずれも「ラベルを正確に写す」だけでは防げない、 一段メタな論点です。
🎭 ラベルは「真実」ではなく「観測された代理」
ラベルノイズがランダムな誤りを指すのに対し、 ここで問うのは系統的なズレです。 ラベル \(y\) は本当に測りたい概念(構成概念, construct)そのものではなく、 それを観測・記録した代理値(proxy)にすぎません。 SSDSE-B-2026 の出生数 A4101 は「提出された出生届の集計」であり、 潜在的な希望出生数や実際の妊娠数とは届出の遅れ・住民登録地と居住地の乖離だけズレます。 一般に「犯罪率=逮捕件数」「採用成功=入社後評価」のように代理を置くと、 警察活動量や評価者の主観がラベルに混入します。 特徴量をどれだけ磨いても、 ラベルが構成概念からずれていれば精度の上限は上がりません(→ 測定誤差・公平性)。
📝 見分け方:ラベル定義書に「このラベルは何の代理か」を 1 行で書けるか試すこと。 書けないなら、 測っているのは狙った概念ではなく「たまたま手に入った記録」かもしれません。 妥当性(construct validity)はモデルではなくデータ設計の問題です。
⏳ ラベルは時間で変わる — ラベルドリフト
既出の「時系列 leak」は分割順序の話でしたが、 ここは別で、 ラベルの意味や分布そのものが時間で変わる問題です。 SSDSE-B はパネル(同一県 × 複数年)なので、 「人口 100 万未満=小型」といった閾値を固定すると、 人口減にともない該当県が年々入れ替わります。 さらに産業分類・行政区分(政令市の指定等)の改定でカテゴリ定義自体も変わります。 対策は、 ラベル定義に必ず基準時点を明記し、 分布ずれの監視と再学習を前提に運用すること(→ データドリフト)。
🔢 3 人以上の一致は Cohen κ では測れない
本ページで繰り返し出た Cohen's κ は2 者間の一致度専用です。 アノテーターが 3 人以上、 あるいは項目ごとに評価者が入れ替わる場合は Fleiss κ や Krippendorff α(欠測・多値・順序尺度に対応)を使います。 多アノテーターの意見を 1 つのソフトラベルへ集約するときも、 単純多数決には落とし穴があります——系統的に同じ間違いをする多数派は多数決では救えません。 各アノテーターの信頼度を推定して重み付けする Dawid–Skene 型の集約が定石です(本用語集に個別ページなし)。
🏭 人手に頼らない:プログラム的ラベリング(弱教師)
能動学習が「どのサンプルにラベルを付けるか」を賢く選ぶのに対し、 弱教師あり学習(weak supervision)は「ラベルの付け方そのもの」を自動化します。 人手の代わりに複数のラベリング関数(正規表現・ヒューリスティック・既存モデル)を書き、 それらの一致・不一致を生成モデルで統合して確率的ラベルを作ります。 SSDSE 風に言えば「人口 > 100 万 → 都市」「県庁所在地が政令市 → 都市」といった弱いルールを多数束ねるイメージです。 精度は人手ラベルに劣ることもありますが、 ラベル大量生成のコストを桁で下げられる点が価値で、 能動学習(選ぶ)とは相補的です(→ 自己教師あり学習・アノテーション)。
🗺 概念マップ
ラベルを中心に、 教師あり学習 (上位)、 アノテーション・κ 係数 (品質管理)、 One-Hot エンコード・ラベルノイズ対策 (前処理) を並べたデータ整備マップ。
概念マップの中心にあるのは「正解 y」としてのラベルで、 周囲にアノテーション (作る)・エンコーディング (数値化)・品質管理 (合意度測定)・ノイズ対策・応用シナリオ (画像分類・感情分析等) が配置される。 各ノードは独立した技術領域だが、 ラベルを軸にすると教師あり学習のパイプライン全体を俯瞰できる。
🔗 隣接手法への橋渡し
ラベルは教師あり学習の出発点であり、 前段のアノテーション設計と後段のラベルエンコード・ノイズ対策が品質を決める。
- 上流: 前段のアノテーション・データ収集設計 (データ収集、 アノテーション)
- 並列: 並列のラベル形式 (one-hot、 ordinal、 multi-label) (特徴量、 サンプリング) と比較・併用
- 下流: 下流のラベルノイズ対策・モデル学習 (分類モデル、 クラス不均衡)
上流のアノテーション設計とラベル仕様書 (クラス定義・境界事例ルール) でラベル品質が決まり、 並列のラベルノイズ補正・能動学習でアノテーション工数を削減し、 下流の教師あり学習・評価指標 (精度/再現率) がラベルの妥当性を検証する循環で「ラベル駆動の AI 開発」が回る。
🌳 手法選択フロー
「ラベル」を扱う際の手法選択は、 状況に応じて以下のフローで判断すると迷いが減る。
- Step 1: 目的は記述か予測か?
- 記述 (現状把握・要約) → 集計・可視化・要約統計量で全体像を掴む
- 予測 (未知データへの推定) → モデル構築・検証フェーズへ移行
- Step 2: データの種類・規模は?
- Step 3: 結果の解釈・共有は?
- 専門家向け → 数値指標・統計検定で精緻に評価
- 非専門家向け → 可視化・自然言語での要約を重視
このフローに沿って判断することで、 「ラベル」を中核とした適切な手法選択ができる。
🎮 触って理解する
2 次元データに 正解ラベル(色) を与え、 その一部を意図的に誤らせると、 分類器が学ぶ 決定境界 がどう乱れ、 真のラベルに対する精度 がどう落ちるかを体感できます。 図の中をタップ/クリックすると点を追加でき、 ドラッグ/なぞりで連続して置けます。 「ラベルの質が学習を左右する」ことを、 手を動かして確かめてください。
背景の淡い塗り分けが分類器の 決定領域、 境界線が 決定境界。 教師あり時、 ✕ 印はノイズで反転された(=誤った)ラベルの点です。 精度はいずれも 真のラベル(生成時の正解)に対して計算しています。 計算はロジスティック回帰(勾配降下 500 反復)/教師なしは k-means(k=2, 20 反復)で、 すべてブラウザ内で正確に実行されます。
🎨 直感 — 教師データの「正解」
ラベルは分類器にとって 唯一の「先生」 です。 分類器は特徴量 \((x_1, x_2)\) とラベルの対応だけを頼りに境界を引きます。 ノイズ率 0% のとき、 青と橙はきれいに分かれ、 境界は 2 群の間をまっすぐ通ります。 ここでノイズ率を上げると、 一部の点のラベルが反転(✕)し、 境界がその誤答に引きずられて傾き・ずれ、 真のラベルに対する精度が下がっていきます。 モデルは「与えられたラベル」を信じて学ぶだけで、 ラベルが嘘なら嘘を学びます。 これが「ラベルの質が精度の上限を決める」ということの正体です。
⚠️ よくある落とし穴
- ラベルノイズ:入力の誤記・境界事例の取り違えで正解が反転する。 スライダーで体感した通り、 少数のノイズでも境界は動く。 頑健な損失(対称クロスエントロピー等)・ノイズ遷移行列の推定・信頼度に基づくサンプル選別で緩和する。
- アノテーション揺れ:同じ入力に人によって違うラベルが付く(定義の曖昧さ)。 まずラベル定義書を作り、 二重アノテーション+合意率(Cohen's κ)で品質を測る。 アノテーション のページも参照。
- クラス不均衡:片方のクラスが極端に少ないと、 多数派に寄った境界でも見かけの精度が高くなり、 少数派を取りこぼす。 図で片色の点を極端に減らすと境界の偏りが起きる。 対策は重み付け・サンプリング。 クラス不均衡 を参照。
- ラベルリーク:特徴量にラベル由来の情報が漏れると評価が虚偽に高くなる。 前処理の分割順序に注意。
🔬 発展 — ラベルが不完全なときの学び方
「教師なし(ラベルなし)」モードに切り替えると、 分類器はどちらが青か橙かを知らないまま 構造だけ を k-means で見つけます。 群れは見つかっても「名前(正解)」は付けられません。 現実はこの両極の中間にあり、 次の枠組みが使われます。
- 半教師あり学習(semi-supervised):少数のラベル付き点と大量のラベルなし点を併用し、 分布の形(クラスタ仮定・多様体仮定)を手がかりに境界を精緻化する。(本用語集に個別ページなし)
- 弱教師あり学習(weak supervision):厳密な正解の代わりに、 ルール・遠距離監視・粗いタグなど「弱い信号」を多数集めて確率的にラベルを合成する。(本用語集に個別ページなし)
- 能動学習(active learning):境界近く(最も不確実)な点を選んで優先的に人手ラベルを付け、 少ないアノテーション工数で精度を最大化する。 図で境界線の直近にある点ほど「聞く価値が高い」点にあたる。(本用語集に個別ページなし)
- 関連: 教師あり学習 / 教師なし学習 / 分類モデル。