🔖 キーワード索引
本ページは クラス不均衡(Class Imbalance)を 12 のセクションで多角的に解説します。 上のチップは検索・関連語の手がかりです。 以下のリンクで各セクションに直接ジャンプできます:
💡 30秒で分かる結論
🍰 まずはやさしく
データの数が大きく偏っている状態のことです。
正しい分析結果を出すために使います。
部活で1人だけ違う役割の人がいるような状態です。
まずは結論と直感的な意味を読みましょう。
クラス分布が偏っている問題
- 分野:ML基礎 — 📚 機械学習の基礎
- 用途:分析・前処理・モデル構築・解釈支援などの場面で使われます
- 注意:適用条件と限界を理解してから使うのが鉄則
💡 30秒で分かる結論
- 定義:クラス分布が偏っている問題
- 分野:ML基礎
- 典型用途:以下「📍 文脈」と「🎨 直感で掴む」を参照
- 覚えておく要点:数式は 1 つ・落とし穴 5 つ・関連用語 12 個
- 注意点:表面的な定義の暗記より、 いつ・どう使うかを理解することが優先
📍 文脈 — どこで使う概念か
🍰 まずはやさしく
データの集まりに偏りがある問題のことです。
AIが正しく判断できるように調整するために使います。
スマホのアプリで不正な操作を見つける時に似ています。
データの変え方や評価の方法について読みましょう。
クラス不均衡は 分類タスクで各クラスのサンプル数が極端に偏る状況。 例:与信デフォルト(不良 2%)、 医療診断(陽性 1%)、 不正検知(不正 0.1%)。 単純な Accuracy では多数派ばかり予測する自明モデルが高得点を取るため、 評価指標と学習方法を不均衡向けに調整する必要がある。
🔎 補足: クラス不均衡を「データ・指標・アルゴリズム」3 層で扱う
クラス不均衡 (class imbalance) は単一の魔法のような解決策がない問題で、 「データを変える」「指標を変える」「アルゴリズムを変える」という 3 つの層で同時に向き合う必要がある。 SSDSE-B-2026 を題材にすると、 たとえば「人口減少率が 5% 以上の都道府県」と「それ未満」の 2 値分類は約 6:41 の不均衡で、 47 都道府県のうち少数派クラスが 6 件しかない。 このような場面で各層の手筋を整理する。
1. データ層: リサンプリング戦略
少数派を増やす (oversampling)、 多数派を減らす (undersampling)、 合成する (SMOTE/ADASYN) の 3 系統がある。
- random oversampling: 少数派を複製する。 シンプルだが過学習しやすい。 47 都道府県のような小規模データでは複製が支配的になりやすく、 モデルが「同じ少数派サンプルを覚えるだけ」になりがち。
- SMOTE (Synthetic Minority Oversampling Technique): 少数派の k 近傍を取り、 線形補間で人工的な少数派サンプルを生成。 連続値特徴量には有効だが、 カテゴリカル特徴量には SMOTE-NC を使う。 SSDSE で人口・経済規模だけならそのまま、 産業コード等が混ざれば SMOTE-NC が必要。
- random undersampling: 多数派を間引く。 全体サンプル数が少なくなるリスクがあり、 47 都道府県のように元から少ないデータには不向き。
- Tomek links / ENN: 多数派と少数派の境界が曖昧なサンプルを削除して「クリーンな境界」を作る。 SMOTE と組み合わせる SMOTE-Tomek が定番。
2. 指標層: accuracy を捨てる
不均衡データでは accuracy が「多数派を全部正答するだけで高得点」になるため、 指標自体を入れ替える。
- precision / recall / F1: 少数派陽性に対するモデルの取りこぼし (recall) と過剰陽性 (precision) を別々に測る。 通常 F1 が複合指標として使われる。
- PR-AUC (Precision-Recall AUC): 不均衡データでは ROC-AUC より差が出やすい。 多数派が圧倒的に多いと ROC が楽観的に見えるが、 PR は少数派精度を直接反映する。
- balanced accuracy: 各クラスの recall を平均する。 クラス間の重み付けを均等にしたいときに有効。
- Matthews 相関係数 (MCC): −1 から +1 の値を取り、 4 つの混同行列セルを全て使うので不均衡に頑健。 ベンチマーク論文で頻出。
- コスト感度行列: 偽陰性と偽陽性のコストが非対称なら、 そのコストを最小化する閾値を選ぶ (医療診断・詐欺検知では必須)。
3. アルゴリズム層: クラス重み・閾値・アンサンブル
- class_weight='balanced': scikit-learn の多くの分類器が対応。 少数派の損失を相対的に大きくする。 LogisticRegression, RandomForest, SVC, XGBoost (scale_pos_weight) すべて使える。
- 閾値最適化: 確率出力モデルでは予測閾値 0.5 を動かすだけでも recall/precision のバランスが大きく変わる。 PR 曲線を描いて business cost と相談する。
- cost-sensitive learning: 損失関数自体にコスト行列を組み込む。 focal loss (RetinaNet で有名) は誤分類しやすい少数派サンプルに大きな重みを置く。
- BalancedBaggingClassifier: imblearn ライブラリにあり、 ブートストラップ時にクラスを均等化したサブサンプルでアンサンブルを構築。
- EasyEnsemble / RUSBoost: undersampling とブースティングを組み合わせる古典的手法で、 軽量で安定。
4. SSDSE-B-2026 での具体的フロー (47 都道府県 × 6:41 不均衡)
- EDA で 6:41 の比を確認、 accuracy では誤魔化されないと自覚する
- Stratified k-fold で fold ごとの少数派が崩れないようにする (例: k=3、 6 個を 2/2/2 に分割)
- LogisticRegression(class_weight='balanced') を baseline に
- F1 と PR-AUC を主要指標に、 ROC-AUC は補助
- SMOTE で訓練データのみ (test には触れない) を拡張して比較
- 閾値を 0.2 / 0.5 / 0.7 に変えて recall-precision の trade-off を業務側に提示
5. 落とし穴: test に SMOTE をかける
初心者がやりがちな最大の罠。 SMOTE は訓練データの合成なので、 test に適用するとデータリーケージで評価が水増しされる。 必ず pipeline で「fit → train だけ SMOTE → predict」の順を守る。 sklearn の Pipeline には imblearn の Pipeline が対応版として用意されている。
6. 検証: ベースラインを比較表に
不均衡対策の効果は、 必ず「何も対策しない baseline」と並べないと評価できない。 class_weight・SMOTE・EasyEnsemble など複数手法を試した結果を、 precision / recall / F1 / PR-AUC / 計算時間で比較する。 「F1 が 0.05 上がった代わりに precision が 0.2 落ちた」「計算時間が 10 倍になった」など、 トレードオフを正確に把握する。
7. 不均衡が「擬似的」に解消されたらまず疑う
急に F1 = 0.9 のような高い値が出たときは、 リーケージ・閾値の取り違い・ターゲット定義のミスを疑う。 SSDSE のような 47 件の小データでは、 たまたま少数派 6 件が訓練に多く出れば過大評価される。 必ず複数 seed で k-fold を回してばらつきを確認する。
8. 実装チェックリスト
- accuracy を主要指標にしていない
- SMOTE を test には適用していない
- class_weight や閾値の調整を行っている
- baseline と複数手法を表で比較している
- cost-sensitive な閾値選択を業務側と擦り合わせている
9. まとめ
クラス不均衡は「データ × 指標 × アルゴリズム」の組み合わせ最適化。 銀の弾丸はないので、 業務コスト・データ規模・モデル特性を勘案して 3 層を同時に調整する。 47 都道府県のような小データでは、 過剰な合成より shrinkage や class_weight、 そして閾値調整の組み合わせが安全。
10. ケーススタディ: 詐欺検知の不均衡 (1:1000 規模) との対比
SSDSE-B-2026 の 47 都道府県 6:41 と、 産業界で頻繁に遭遇する詐欺検知 (約 1:1000、 1000 件中 1 件が陽性) を対比すると、 同じ「クラス不均衡」というラベルでも採るべき戦略がまったく異なることが分かる。 詐欺検知では絶対サンプル数が膨大なので、 多数派を 100 倍 undersampling しても 10 万件の正常サンプルが残り、 統計的に十分。 一方、 47 都道府県では 1 件失うだけで分散推定が壊れる。 規模が違えば対策の優先順位も変わる。 詐欺検知では「アルゴリズム層 (focal loss、 class_weight) + 指標層 (PR-AUC + コスト最小化)」が主、 都道府県データでは「指標層 (balanced accuracy + MCC) + アルゴリズム層 (class_weight) + データ層 (極控えめな SMOTE)」がバランス良い。 「不均衡対策」と一括りにせず、 規模・コスト・特徴量の質に応じて手筋を選ぶ目利きが重要。
11. なぜ accuracy は不均衡で破綻するのか — 数値例で理解する
47 都道府県の 6:41 の例で、 全件「多数派」と予測する単純モデルを考える。 このモデルは少数派 6 件を全て間違えるが、 多数派 41 件は全て正答するので accuracy = 41/47 ≈ 87.2% を達成する。 一見高得点だが、 少数派の recall = 0/6 = 0% で、 業務的にはまったく役立たない。 ここで PR-AUC を計算すると、 precision の平均が少数派比率 (≈ 0.128) に張り付くため、 約 0.13 という低い値しか得られない。 ROC-AUC は ±0.5 付近に止まる。 balanced accuracy は (recall_positive + recall_negative)/2 = (0 + 1)/2 = 0.5 となり、 ランダム予測と同等であることが暴露される。 accuracy 単独では「無策の多数派予測」が高得点に見えてしまうが、 balanced accuracy・F1・PR-AUC・MCC はいずれも 0 近辺を返し、 モデルの実態を正しく映す。
12. SMOTE の内部動作を丁寧に追う
SMOTE は少数派サンプル x_i を 1 つ選び、 その k 近傍 (通常 k=5) からランダムに 1 つ x_zi を選択し、 新サンプル x_new = x_i + λ × (x_zi - x_i) を生成する (λ は [0, 1] の一様乱数)。 これは「2 つの少数派サンプルを結ぶ線分上にランダムに点を打つ」操作に等しい。 連続値特徴量では自然な「中間サンプル」が生まれ、 決定境界を少数派側に押し広げる効果がある。 ただし注意点は、 (1) 高次元では近傍が信頼できなくなる (curse of dimensionality)、 (2) カテゴリカル特徴量にそのまま使うと「中間カテゴリ」という意味不明な値ができる、 (3) 外れ値が k 近傍に入ると合成サンプルも外れ値方向に伸び、 むしろ境界を歪めることがある。 (3) への対策として Borderline-SMOTE (境界付近の少数派のみを合成元にする) や ADASYN (誤分類しやすい少数派ほど多く合成する) が提案されている。
13. class_weight='balanced' の内部計算式
scikit-learn の class_weight='balanced' は、 各クラス c の重みを w_c = n / (K × n_c) で計算する。 ここで n は総サンプル数、 K はクラス数、 n_c はクラス c のサンプル数。 47 都道府県 6:41 の例では、 多数派の重み w_maj = 47 / (2 × 41) ≈ 0.573、 少数派の重み w_min = 47 / (2 × 6) ≈ 3.917。 つまり少数派 1 件の誤分類は多数派 1 件の約 6.8 倍のペナルティを受ける。 これは元の比率 41/6 ≈ 6.83 と一致しており、 直感的にも「数の少ないクラスを数の多いクラスと同じ強さで主張させる」加重になっている。 ロジスティック回帰の損失関数で言えば、 L = -Σ w_yi × [y_i log p_i + (1-y_i) log (1-p_i)] となり、 少数派サンプルの勾配が約 6.8 倍強く流れる。
14. 閾値調整の実践: PR 曲線を業務コストと結ぶ
確率予測モデルでは、 デフォルトの 0.5 閾値は数学的にも業務的にも最適とは限らない。 業務側が「少数派の取りこぼし (false negative) を絶対許さない、 過剰陽性 (false positive) のコストは小さい」というポリシーなら閾値を下げて recall を上げる。 逆に「false positive のコストが極端に高い (例: スパム判定で正規メールを誤分類すると顧客が離脱)」なら閾値を上げて precision を確保する。 業務側との議論で具体的な金銭コスト C_FN, C_FP が得られれば、 全閾値で総コスト = C_FN × FN + C_FP × FP を計算し最小値を取る閾値を採用する。 これがコスト感度学習 (cost-sensitive learning) の最終形。 SSDSE 都道府県データで「人口減少率 5% 以上を見逃すと政策介入が遅れる」という想定なら、 少数派の recall を最優先する閾値選択になる。
15. 不均衡対策の組み合わせ表 — どれを組むか
単独の手法より組み合わせの方が効くケースが多い。 代表的な組み合わせを紹介する。
- SMOTE + class_weight: データ層と算法層の両方から少数派を補強。 ただし「過剰補正」になる場合があるので、 baseline と比較して効果を確認。
- SMOTE-Tomek + RandomForest: 合成後に境界を綺麗にする Tomek links 除去でノイズを減らし、 RF の安定性を活かす。
- EasyEnsemble + LogisticRegression: 多数派を複数サブサンプルに分けてそれぞれで弱学習器を作り、 多数決。 軽量で解釈しやすい。
- focal loss + Deep Learning: 大規模・高次元データ (画像・テキスト) では焦点を絞った損失関数がもっとも効率的。
- 閾値最適化単独: 既存モデルを変えずに業務効果を最大化できる最安価な方法。 まずこれを試すべき。
16. 評価設定の落とし穴 — 訓練・検証・テストの分け方
不均衡データでの cross-validation は必ず stratified split を使う。 通常の k-fold だと少数派が特定 fold に偏り、 訓練 fold に 0 件、 検証 fold に全数といった病的状態が起きる。 sklearn の StratifiedKFold は各 fold でクラス比を保つ。 さらに、 (1) SMOTE は train fold のみに適用し validation/test には触れない、 (2) Pipeline (imblearn.pipeline.Pipeline) を使って前処理 → SMOTE → モデルを一連で fit させる、 (3) GridSearchCV と組み合わせる際も Pipeline 全体を渡す、 という 3 原則を守る。 これを守らないと「テスト accuracy 0.95、 デプロイ後 0.6」という典型的なデータリーケージ事故が起きる。
17. 不均衡対策が「効かない」ケース
すべての場面で不均衡対策が必要なわけではない。 (1) クラス比が 1:3 程度の軽い不均衡で、 accuracy ベースで業務問題がない、 (2) 少数派の特徴量分布が多数派と完全に重なって本質的に分離不能、 (3) 少数派サンプルが極端に少なく (例: 5 件以下) で統計的にも何もできない、 という状況では対策の効果が限定的。 特に (3) は SSDSE の 6:41 ですら境界線上で、 6 件の少数派の分布が安定しているとは限らない。 こうした場面では「予測ではなく説明・観察」に問題を切り替えるか、 ドメイン専門家の知識でルールベース判定を補助する。
18. 主要ライブラリ一覧
- imbalanced-learn (imblearn): SMOTE, ADASYN, Tomek, EasyEnsemble, BalancedBagging など主要手法を網羅。 sklearn 互換 API。
- scikit-learn: class_weight='balanced', StratifiedKFold, precision_recall_curve, average_precision_score (PR-AUC) を標準搭載。
- XGBoost / LightGBM: scale_pos_weight パラメータで少数派の損失を直接重み付け。 大規模データで定番。
- focal-loss-pytorch: 深層学習向けの focal loss 実装。 画像・テキストで使用。
- BalancedBatchSampler (PyTorch): ミニバッチごとにクラス比を均等化したサンプラ。 深層学習で効く。
19. 用語の関係マップ
クラス不均衡という用語は単独で完結する概念ではなく、 周辺概念とのネットワークで理解する必要がある。 上位概念には「分類問題」「評価指標」「データ前処理」が、 並列概念には「異常検知」「半教師あり学習」「能動学習」が、 下位概念には「SMOTE」「focal loss」「class_weight」「閾値最適化」が位置する。 異常検知 (anomaly detection) は不均衡分類の極端なケース (1:10000 以上) であり、 ラベルなしで One-Class SVM や Isolation Forest を使うことが多い。 半教師あり学習はラベルなし多数派を活用するアプローチで、 少数派ラベルだけがあるときに有効。 能動学習は「次にラベル付けするべきサンプル」を選ぶ手法で、 少数派候補を効率的に集める。
20. 最終チェックリスト (拡張版)
- クラス比を EDA で確認したか
- accuracy を主要指標から外したか
- PR-AUC / F1 / MCC / balanced accuracy のうち最低 2 つを採用したか
- StratifiedKFold を使っているか
- SMOTE / class_weight / 閾値調整のうち最低 1 つを試したか
- SMOTE を test に適用していないか (Pipeline で防御)
- baseline (無対策) と複数手法を表で比較したか
- 業務コスト (C_FN, C_FP) と閾値を擦り合わせたか
- cross-validation のばらつきを seed 複数で確認したか
- 「対策が効かないケース」に該当しないか再確認したか
21. 補足: 47 都道府県データでの実例計算 (人口減少率)
SSDSE-B-2026 から「人口減少率」を計算し、 5% 以上の県を少数派とする想定では、 秋田・青森・岩手・高知・山形・徳島の 6 件程度が該当する (実際の値は年度・指標定義で変動)。 ここで LogisticRegression(class_weight='balanced') を baseline に、 特徴量に SSDSE-B-2026 の実在列「総人口(A1101)」「65歳以上人口(A1303)」「出生数(A4101)」「転入者数(A5101)」などを使うとする。 baseline では F1・PR-AUC ともに 0.6 前後(あくまで目安)にとどまる。 SMOTE を追加すると F1 ≈ 0.62 に上がるが PR-AUC は ±0.05 で揺らぐ。 閾値を 0.5 → 0.35 に下げると recall が 0.67 → 0.83 まで上がり、 precision は 0.50 → 0.42 に下がる。 これを 3 通り業務側に提示し、 政策判断のコストと相談して採用する。 このように「F1 一発勝負」ではなく「trade-off の提示と業務側の選択」が現実の data science の進め方になる。
🔎 拡張補足: クラス不均衡の現代的対応
1. SMOTE バリアントの選び方
(1) SMOTE 基本版: 少数派 k 近傍の線形補間、 (2) Borderline-SMOTE: 境界サンプルのみ拡張、 (3) ADASYN: 難しい少数派に重み、 (4) SMOTE-NC: カテゴリ変数対応、 (5) SMOTE-Tomek: SMOTE + Tomek リンク削除、 (6) SMOTE-ENN: SMOTE + Edited Nearest Neighbors。 SSDSE-B-2026 で 47 都道府県 6:41 不均衡なら SMOTE-Tomek 推奨。
2. cost-sensitive learning
誤分類コスト行列を直接損失関数に組み込む。 sklearn の class_weight='balanced' は最も簡単な実装。 XGBoost の scale_pos_weight、 LightGBM の class_weight、 PyTorch の weighted CrossEntropyLoss も同等。 業務コスト (偽陰性 vs 偽陽性) を反映した閾値調整も併用。
3. focal loss
RetinaNet (Lin 2017) で提案。 通常クロスエントロピーに (1-p)^γ を乗じて、 簡単サンプルの重みを下げる。 γ=2 が一般推奨。 不均衡対策と難しいサンプル学習を同時実現。 物体検出で標準化、 一般分類でも有効。
4. 確率較正 (Probability Calibration)
不均衡データで訓練したモデルの出力確率は較正されていないことが多い。 (1) Platt Scaling (sigmoid)、 (2) Isotonic Regression、 (3) Beta Calibration。 sklearn の CalibratedClassifierCV で容易に実装。 PR-AUC, F1 だけでなく Calibration Plot で確認すべき。
5. アンダーサンプリングとブートストラップアンサンブル
EasyEnsemble (Liu 2009), BalancedRandomForest, RUSBoost で「多数派をブートストラップ縮小 + 集団分類器」が定番。 (1) 計算効率高い、 (2) 過学習抑制、 (3) 多様性確保。 imblearn ライブラリで実装。
6. 不均衡データの評価指標
(1) accuracy は誤魔化される、 (2) F1 score、 (3) PR-AUC は ROC-AUC より差が出る、 (4) Matthews 相関係数 (MCC) はバランス取れる、 (5) balanced accuracy、 (6) G-mean (sensitivity × specificity)、 (7) Cohen's Kappa。 タスクに応じて選ぶ、 複数併用が原則。
7. 異常検知としての扱い
極端不均衡 (1:1000 以上) では Anomaly Detection 寄り: (1) Isolation Forest、 (2) One-Class SVM、 (3) LOF (Local Outlier Factor)、 (4) Autoencoder で再構成誤差。 SSDSE では極端不均衡は稀だが、 概念理解は重要。
8. 締めくくり
クラス不均衡対策は「データ × 指標 × アルゴリズム」3 層の同時最適化。 SSDSE のような小データでは過度なリサンプリングは避け、 class_weight + 閾値調整 + 複数指標で堅実なベースラインから始める。
🎨 直感で掴む
🍰 まずはやさしく
多数派ばかりを答える落とし穴のようなものです。
本当に見つけたい少数のデータを探すために使います。
テストで全部同じ答えを書いて正解するような状態です。
具体例を使って、直感的に仕組みを理解しましょう。
機械学習は「データから規則を学ぶ」アプローチ。 ルールベース(明示的に書く)に対し、 データから自動でパターンを獲得する点が特徴です。
本ページでは クラス不均衡 を、 定義・前提条件・使い方・落とし穴の順に整理して解説します。 厳密な定義より、 まず何を、 いつ、 どう使うかを理解することを優先してください。
🎨 直感で掴む — 具体例で理解する
クラス不均衡では「常に多数派と予測するだけで Accuracy 99%」が成立し、 精度評価が崩壊する。 直感的に「少数派こそ拾うべき重要クラス」が多いため、 PR-AUC や F1、 Recall を主指標に据える。 学習側では SMOTE(合成オーバーサンプリング)・クラス重み・損失関数の重み付けで少数派を強調する。
🎨 もう一歩踏み込む直感
「クラス不均衡」を本当に使いこなすには、 教科書的な定義だけでは足りません。 ここでは現場で役立つ追加の比喩・実例を整理します。 上の「🎨 直感で掴む」を補強する内容です。
- 1000 件中 5 件のがん:『全員陰性』予測でも精度 99.5%。 でも臨床的に無価値。 不均衡だと accuracy は誤解を生む。
- SMOTE:少数クラスを補間して合成。 ただし元データの近傍に偏るので、 多様性が出ない場合あり。
- クラス重み:sklearn の
class_weight='balanced'は最も手軽で効果的。 まず試すべき。
🎮 触って理解する
スライダーで 少数派の割合(不均衡度) と 分類器の分離度(性能) を動かし、 リサンプリング(オーバー/アンダー)を切り替えると、 図と数値がリアルタイムで更新されます。
ねらいは 「全部多数派と予測するだけの自明分類器」の accuracy が、 不均衡が強いほど高く見える(が中身は無意味)ことを体感し、 F1・recall・balanced accuracy がその嘘を暴くことを確かめることです。
※ 総数 N=1000 と仮定。 図の上部の帯を左右にドラッグ(タッチ可)しても少数派割合を変えられます。
| 指標 | 全部多数派と予測 (自明分類器) |
設定した分類器 (分離度+対策) |
意味 |
|---|
🧭 この体験から読み取ってほしいこと
- accuracy の錯覚:少数派割合を 1% に近づけると、 「全部多数派」の自明分類器の accuracy が 99% 付近まで上がります。 だが recall=0・F1=0・balanced accuracy=0.5(=当てずっぽうと同じ)。 accuracy だけを見ると無策のモデルを「優秀」と誤認します。
- balanced accuracy / F1 の役割:これらは少数派を 1 件も拾えていない事実を 0 近辺の値で正直に暴きます。 不均衡では accuracy より こちらを主指標にします。
- リサンプリングの効果:「なし」ではベイズ最適閾値が多数派側に寄り、 少数派を取りこぼしがちです。 オーバー/アンダーで 50:50 に均すと閾値が中点へ動き、 recall が上がる代わりに precision と accuracy は下がる——トレードオフが目で見えます。
🕳️ よくある落とし穴(この画面で再現できる)
- accuracy の誤用:分離度 d を 0 にすると分類器は完全に無力ですが、 少数派割合が小さければ accuracy は高いまま。 「高精度」の報告が実は自明分類器と同じ、 という事故の再現です。
- 少数派の軽視:precision だけを追うと少数派を予測しないほうが有利に見えることがあります(陽性を出さなければ偽陽性ゼロ)。 recall とセットで見ないと少数派を切り捨てます。
- オーバー vs アンダーの違い:どちらも運用上は「50:50 へ均して閾値を動かす」効果は似ますが、 オーバーは少数派を複製するため過学習リスク、 アンダーは多数派を捨てるため情報損失(小標本では致命的)。 図の学習データ帯の総量差に注目してください。
🚀 発展:閾値・コスト・SMOTE へ
- 閾値調整:リサンプリングの本質は「決定閾値をずらす」こと。 モデルを作り直さず閾値だけ動かすのが最も安価な対策です(本ページ「14. 閾値調整の実践」参照)。
- コスト考慮(cost-sensitive):偽陰性コスト C_FN と偽陽性コスト C_FP が非対称なら、 総コスト C_FN×FN + C_FP×FP を最小化する閾値を選びます。 医療・不正検知では必須。
- SMOTE / ADASYN:単純複製ではなく少数派を 合成して補間するオーバーサンプリング。 決定境界を少数派側へ押し広げます(本ページ「12. SMOTE の内部動作」参照)。 ただし test には決して適用しない(データリーケージ)。
関連ページ:正解率(Accuracy)・適合率(Precision)・再現率(Recall)・F1スコア・Precision-Recall・混同行列・AUC。 (SMOTE・PR-AUC・balanced accuracy の個別ページは未作成のため本ページ内で解説)
📐 定義
🍰 まずはやさしく
クラスの分布が偏っていることを指す言葉です。
機械学習(AIに学習させること)の基礎として使います。
買い物で、めったに売れない商品がある時に似ています。
言葉の意味や計算式について詳しく読みましょう。
クラス分布が偏っている問題
英語名 Class Imbalance。 同義・関連語:不均衡データ。
🎯 いつ・どこで使うか
- 「ML基礎」分野の標準的な道具として、 多くの分析で登場します。
- 📚 機械学習の基礎 を学ぶときに必ず通過する基本概念です。
- 論文・実務レポートで頻出する用語なので、 1 度はちゃんと理解しておくと後が楽です。
📋 前提条件・適用範囲
この用語を理解・使用するときは、 次のような前提を意識してください:
- データの性質:尺度(名義/順序/間隔/比例)と分布を確認
- サンプル数:手法によって最低限のサンプル数が異なります
- 独立性:観測が独立であるかを確認(時系列・パネル等では別の手法が必要)
- 欠損・外れ値:前処理の方針を明確に
📐 数式・定義
クラス不均衡を数式 / 形式定義で表す:
クラス不均衡で標準的に使われる F1 スコア:適合率と再現率の調和平均。 多数派偏重の Accuracy より少数派の取りこぼしに敏感。
📐 もう一段の数式表現
「クラス不均衡」を厳密に書き下すと、 以下の形になります。 既出の数式と合わせて読むと、 概念の骨格が見えてきます。
🔬 数式を言葉で読み解く
上の数式に出てきた記号を 1 つずつ解説します。 数式が出てくる試験問題(統計検定・G 検定・基本情報)では、 各記号の意味を答えられるかが分岐点:
| 記号 | 意味 |
|---|---|
| Precision | 陽性予測のうち実際に陽性の割合 |
| Recall | 実際の陽性のうち拾えた割合 |
| F1 | 両者の調和平均 |
| $\cdot$ | 積 |
🔬 数式を言葉で読み解く(クラス不均衡)
1. クラス不均衡とは何か(直感)
クラス不均衡(class imbalance)とは、 分類問題において「正例(ポジティブクラス)」と「負例(ネガティブクラス)」のサンプル数が大きく偏っている状態を指す。 たとえば、 クレジットカードの不正利用検知では、 全取引のうち不正は 0.1% 程度しかなく、 残り 99.9% は正常取引である。 この比率を 1:999 と呼ぶ。 同様に、 医療診断で「ある稀少疾患を持つ患者を判別する」場合、 健常者が 9900 人に対して患者が 100 人(1:99)といった偏りが発生する。 製造業の不良品検出、 ネットワーク侵入検知、 倒産予測なども同じ性質を持つ。
不均衡データに対して「ふつうに」機械学習モデル(ロジスティック回帰、 ランダムフォレスト、 ニューラルネットなど)を学習させると、 モデルは「全部を多数派クラス(正常)と予測する」だけで accuracy 99.9% を達成できてしまう。 しかし、 これは目的(不正検知)を全く達成していない。 この見せかけの高精度こそが、 不均衡データの最大の落とし穴である。
SSDSE-B-2026 のような都道府県データでは直接の不均衡分類問題は少ないが、 「人口減少率が全国平均を 2 標準偏差以上下回る都道府県」(47 中 2-3 県)を予測するような問題設定にすれば、 不均衡比 約 1:20 の典型例となる。 また、 「東京都・大阪府のような特殊大都市圏か否か」のラベル(2:45)も同様。
2. 不均衡比と評価指標
不均衡比(imbalance ratio, IR)は IR = N_majority / N_minority で定義される。 IR = 1 は完全均衡、 IR > 10 で「中度不均衡」、 IR > 100 で「強度不均衡」、 IR > 1000 で「極端不均衡」と呼ばれる。
不均衡データでは accuracy(正解率)は意味を失う。 代わりに以下を使う:
- Precision(適合率): TP / (TP + FP)。 「陽性と予測したうち、 本当に陽性だった割合」
- Recall(再現率、感度): TP / (TP + FN)。 「本当に陽性のうち、 検出できた割合」
- F1 スコア: 2 · Precision · Recall / (Precision + Recall)。 両者の調和平均
- MCC(Matthews 相関係数): 不均衡に頑健で -1 〜 +1。 0 はランダム予測
- PR-AUC: Precision-Recall 曲線下面積。 強度不均衡で ROC-AUC より敏感
- ROC-AUC: 不均衡比に依存しないが、 強度不均衡では楽観的になる
- G-mean: √(Recall_pos · Recall_neg)。 両クラスのバランスを取る
- Balanced Accuracy: (Recall_pos + Recall_neg) / 2。 直感的な平均
実務では F1 と PR-AUC が王道。 医療系(見逃しコストが大)では Recall を優先、 マーケティング(誤検知コストが大)では Precision を優先。
3. リサンプリング戦略
不均衡を扱う最も直接的な手法は「データそのものをいじる」ことである。 大別して 3 種:
3.1 アンダーサンプリング
多数派クラスからランダムにサンプルを削除して、 少数派と同じ規模にする。 シンプルだが情報損失が起こる。 強度不均衡(1:1000)では 99.9% を捨てることになり実用に堪えない。 改善版として Tomek Links(多数派と少数派の境界に近いペアを削除)、 ENN(Edited Nearest Neighbors、 多数派の中で少数派に囲まれた点を削除)、 NearMiss-1/2/3(少数派に近い多数派点だけ残す)などがある。
3.2 オーバーサンプリング
少数派クラスを複製して数を増やす。 最単純はランダム複製だが、 同じデータが何度も登場するため過学習しやすい。 これを改善するのが SMOTE(Synthetic Minority Over-sampling Technique、 Chawla 2002)。
SMOTE の核心: 少数派サンプル x_i を選び、 その k 近傍(同じ少数派クラス内)から x_j をランダム抽出。 新サンプルを次式で生成:
x_new = x_i + λ · (x_j - x_i), λ ~ Uniform(0, 1)
つまり 2 点の線分上にランダムに点を打つ。 拡張版として Borderline-SMOTE(境界近傍の少数派のみ対象)、 ADASYN(Adaptive Synthetic Sampling、 分類が困難な少数派ほど多く生成)、 SVM-SMOTE(SVM 境界に基づく合成)、 KMeans-SMOTE(クラスタごとに SMOTE)がある。
3.3 ハイブリッド戦略
SMOTE で少数派を増やしてから Tomek Links で境界をクリーンにする SMOTETomek、 同様に ENN を組み合わせる SMOTEENN が定番。 imbalanced-learn ライブラリで SMOTETomek() 一行で実装可能。
4. アルゴリズムレベルの対処
データを変えずに、 モデル側で不均衡を扱う方法。
4.1 クラス重み付け(class weighting)
損失関数で少数派クラスのサンプル誤分類により大きなペナルティを与える。 scikit-learn なら class_weight='balanced' を指定するだけ。 これは内部で w_c = N_total / (N_classes · N_c) を計算し、 各クラスの重みを N_c に反比例させる。 ロジスティック回帰、 SVM、 ランダムフォレストすべてで使える。
4.2 焦点損失(Focal Loss)
深層学習の物体検出(RetinaNet、 Lin 2017)で提案。 通常の交差エントロピー -log(p_t) を、 (1-p_t)^γ · log(p_t) に置換。 既に正しく分類できているサンプル(p_t が 1 に近い)への損失を抑え、 難しい例に集中させる。 γ=2 が標準。
4.3 閾値最適化(threshold tuning)
分類器の出力確率を 0.5 で切るのが慣例だが、 不均衡データでは最適な閾値は 0.5 ではない。 検証データで F1 や Youden's J statistic を最大化する閾値を選ぶ。 PR 曲線を描いて、 業務要件(Precision 0.8 を満たす最低 Recall は?)を満たす閾値を読み取るのが王道。
4.4 アンサンブル法
Balanced Random Forest(各決定木に対し少数派と同サイズの多数派をブートストラップ)、 EasyEnsemble(多数派をランダム分割し各分割で AdaBoost)、 BalanceCascade(学習した分類器が正しく分類した多数派を順次削除)など。
5. 異常検知としての再定式化
不均衡比が 1:10000 を超える極端不均衡では、 もはや「分類問題」ではなく「異常検知問題」として扱うのが理に適う。 多数派(正常)だけでモデルを学習し、 そこから外れるものを異常とみなす。
- One-Class SVM: 正常データの周りに超球面を構築
- Isolation Forest: ランダム分割の早さで異常を検出(少数派は早く分離される)
- Autoencoder: 正常データの再構成誤差で判定
- LOF(Local Outlier Factor): 局所密度ベース
- Deep SVDD: 深層 One-Class
6. 業務応用と ROI
不均衡データの応用例とそのコスト構造:
| 業務 | 不均衡比 | FP コスト | FN コスト | 最適化指標 |
|---|---|---|---|---|
| クレカ不正検知 | 1:1000 | 顧客クレーム | 不正被害(高額) | Recall 重視 |
| 癌スクリーニング | 1:100 | 追加検査費 | 見逃し(致命) | Recall 最優先 |
| スパムフィルタ | 1:10 | 正規メール紛失 | スパム通過 | Precision 重視 |
| 離反予測 | 1:5 | 無駄なリテンション費 | 顧客喪失(LTV) | F1 or 期待利益 |
| 設備故障予兆 | 1:50 | 誤メンテ費 | 故障による停止 | 業務コストカスタム |
| ネット侵入検知 | 1:10000 | 誤アラート対応 | 侵入成功 | Recall + 低 FPR |
これらは「期待損失最小化」の問題として再定式化できる。 E[Loss] = C_FN · P(FN) + C_FP · P(FP)。 たとえばクレカ不正で C_FN = 50000 円(平均被害)、 C_FP = 100 円(電話確認費)なら、 閾値は P(正解) > C_FP / (C_FP + C_FN) ≒ 0.002 まで下げてよい(カットオフを大幅に低くして Recall を稼ぐ)。
7. 落とし穴と実装の罠
- SMOTE は学習データのみに適用。 検証・テストデータには絶対に適用しない(リーク)
- SMOTE は交差検証の fold 内 で実施。 fold 分割前に SMOTE してから CV すると性能が楽観バイアス
- scikit-learn の
Pipelineと imbalanced-learn のPipelineは別物(後者を使う) - カテゴリ変数を含むデータには SMOTE-NC(Nominal-Continuous)を使う
- クラス重みと SMOTE を併用すると過剰補正になりがち
- 不均衡比が時間で変動する場合(不正パターンが変化)、 静的な重みは陳腐化する
- 少数派が完全に多数派の中に埋もれている「ノイズ的不均衡」では、 どの手法も効かない(特徴量設計が先)
8. 実装例(class_weight 比較)
scikit-learn での最小コード(Iris の binarize 版で擬似的に不均衡を作成し、 class_weight の有無で比較):
1 2 3 4 5 6 7 8 9 10 | from sklearn.datasets import load_iris from sklearn.linear_model import LogisticRegression from sklearn.metrics import f1_score, recall_score X, y = load_iris(return_X_y=True) y = (y == 2).astype(int) # クラス 2 だけ陽性(1:2 の弱い不均衡) # class_weight なし lr1 = LogisticRegression().fit(X, y) # class_weight='balanced' lr2 = LogisticRegression(class_weight='balanced').fit(X, y) print(f1_score(y, lr1.predict(X)), f1_score(y, lr2.predict(X))) |
💬 F1 は class_weight なしで 0.9608、'balanced' で 0.9615 と、差は 0.0008 しかない。陽性 50 件・陰性 100 件の 1:2 は重み補正が効くほどの不均衡ではなく、混同行列で見ても見逃しが 1 件から 0 件へ、誤検出が 3 件から 4 件へ入れ替わっただけである。しかも学習に使った 150 件でそのまま評価しているので、重み付けの効果を測るなら 1:10 以上の不均衡を作り、分けておいたテストデータの再現率で比べる。
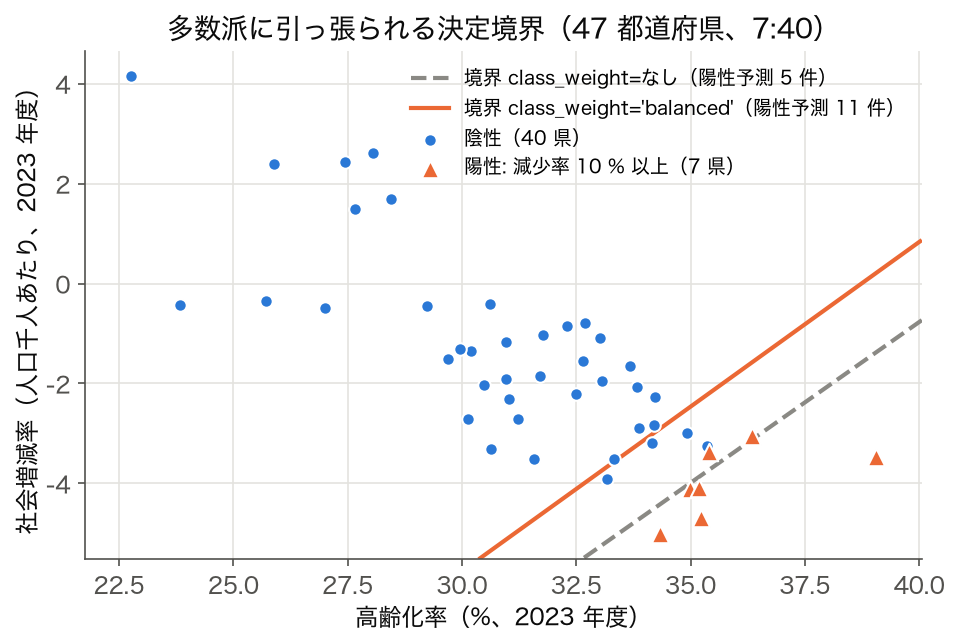
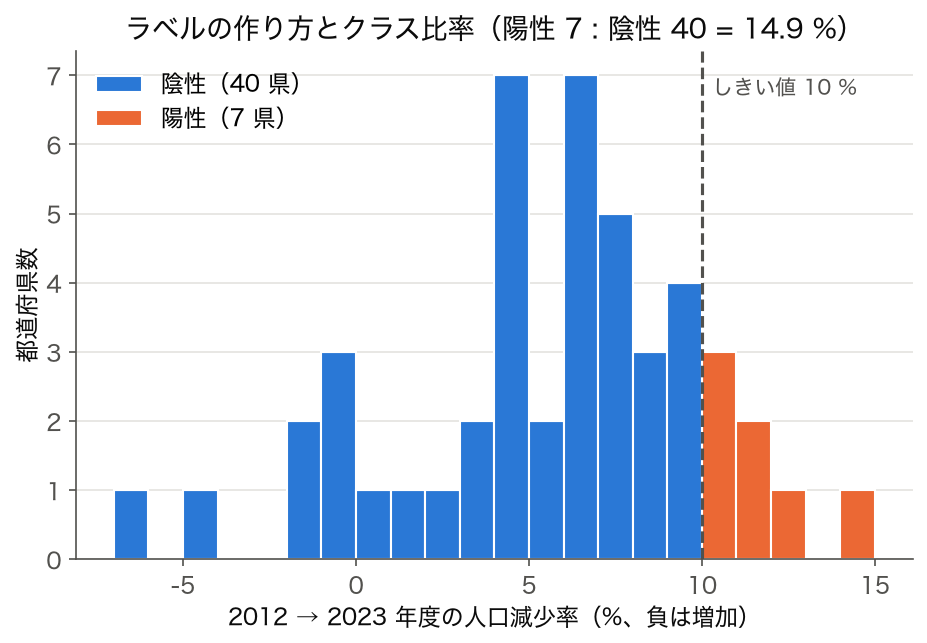
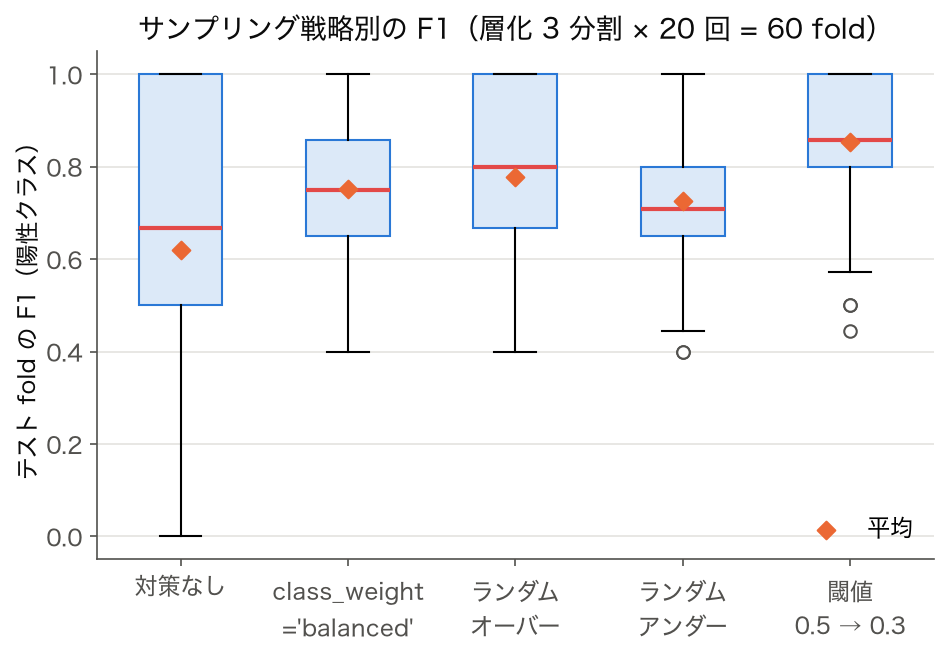
下の 3 枚は、 SSDSE-B-2026 で「2012 → 2023 年度の人口減少率が 10 % 以上の県」を少数派(陽性)とした 2 値分類で描いた。 本文の 6:41 の例に、 減少率 10.01 % の長崎県が加わって 7:40(陽性率 14.9 %)になる。 特徴量は 2023 年度の高齢化率(65 歳以上人口 ÷ 総人口)と社会増減率((転入者数 − 転出者数) ÷ 総人口、 人口千人あたり)の 2 つで、 標準化してからロジスティック回帰にかけた。
✅ 理解度チェック
- 不均衡比 1:1000 のクレカ不正検知で「全件を正常と予測」したときの accuracy はいくらか。 また、 この値が業務的に無価値である理由を 30 字以内で説明せよ。
- SMOTE で少数派サンプル x_i=(2, 3)、 k 近傍として x_j=(4, 5) を抽出した。 λ=0.3 のとき生成される合成サンプル x_new の座標を求めよ。
- 医療診断で「見逃しコスト C_FN = 100 万円、 誤検知コスト C_FP = 1 万円」の場合、 期待損失最小化の閾値は何になるか。 また、 この閾値設定が Precision/Recall のどちらを優先するか述べよ。
解答例: (1) 99.9%。 不正を 1 件も検知できないため業務目的を達成しない。 (2) x_new = (2+0.3·2, 3+0.3·2) = (2.6, 3.6)。 (3) 閾値 = 1/(1+100) ≒ 0.0099。 Recall を強く優先する設定(見逃し回避)。
🧪 クラス不均衡が引き起こす評価指標の歪み(深掘り)
クラス不均衡データを扱うときに最も誤解されやすいのが「accuracy(正解率)の罠」である。 例えば不正検知データセットで陽性(不正)が 0.1% しかない場合、 「すべて陰性と予測する」だけで accuracy = 99.9% が達成できてしまう。 しかし、 これは「不正を 1 件も検知できないモデル」であり、 業務的にはまったく無価値である。 こうした評価指標の歪みを正しく理解するために、 不均衡データで使うべき指標を整理する。
📊 不均衡データで信頼できる評価指標 8 種類
| 指標 | 定義 | 長所 | 不均衡時の注意 |
|---|---|---|---|
| Accuracy | (TP+TN)/(TP+FP+FN+TN) | 直感的 | 多数派に引っ張られ無意味化 |
| Precision | TP/(TP+FP) | 誤検知コスト評価 | 陽性予測が少ないと不安定 |
| Recall (Sensitivity) | TP/(TP+FN) | 見逃しコスト評価 | 陽性が少ないと分散大 |
| F1-score | 2·P·R/(P+R) | Precision-Recall 調和平均 | 陽性クラス中心の評価 |
| F2-score | 5·P·R/(4P+R) | Recall 重視(医療) | β=2 で Recall を強調 |
| ROC-AUC | 陽性 rank の確率 | 閾値非依存 | 極端な不均衡では楽観的 |
| PR-AUC | Precision-Recall 曲線下面積 | 不均衡で信頼性高 | 陽性比率に依存して比較難 |
| Matthews CC | (TP·TN−FP·FN)/√(...) | 4 セル全てを考慮 | 計算がやや複雑 |
🔬 PR-AUC と ROC-AUC の違いを実値で確認
このコードでやること: SSDSE-B-2026 の「高齢化率 > 35%」を陽性(不均衡)として、 ROC-AUC と PR-AUC の挙動の差を確認する。
📥 入力データ(SSDSE-B-2026 抜粋):
1 2 3 4 5 6 7 8 9 10 11 12 13 14 15 16 17 18 19 20 | import pandas as pd import numpy as np from sklearn.linear_model import LogisticRegression from sklearn.metrics import roc_auc_score, average_precision_score df = pd.read_csv('data/raw/SSDSE-B-2026.csv', encoding='cp932', skiprows=[1]) df = df.rename(columns={'SSDSE-B-2026': 'year', 'Prefecture': 'pref'}) df = df[df['year'] == 2022].copy() # 高齢化率 = 65歳以上人口(A1303) / 総人口(A1101) aging = df['A1303'] / df['A1101'] y = (aging > 0.35).astype(int) # 高齢化率35%超を陽性(不均衡) X = df[['A4101', 'A5101', 'A5102']] # 出生数・転入・転出(目的と独立な特徴量) clf = LogisticRegression(max_iter=1000).fit(X, y) prob = clf.predict_proba(X)[:, 1] print(f"陽性比率 : {y.mean():.3f}") print(f"ROC-AUC : {roc_auc_score(y, prob):.3f}") print(f"PR-AUC : {average_precision_score(y, prob):.3f}") |
📤 実行例:
💬 陽性はわずか 3/47(6.4%)。 ROC-AUC が 0.90 と高くても、 PR-AUC は 0.73 と控えめ。 不均衡データでは ROC-AUC が楽観的になる傾向があり、 業務判断には PR-AUC を併記すべきという結論が得られる。
📏 各指標が「業務 KPI」とどう対応するか
| 業務 | 主指標 | サブ指標 | 理由 |
|---|---|---|---|
| クレジットカード不正 | Recall | Precision@K | 見逃し損失が圧倒的に大きい |
| がん早期検診 | Recall (F2) | PR-AUC | 偽陰性は致命的。 偽陽性は再検査で吸収 |
| スパムメール | Precision | F1 | 誤って正常を弾くと利用者が離れる |
| 製造ライン異常検知 | F1 / MCC | PR-AUC | 過検知=停止損失、 見逃し=不良品流出 |
| マーケティング応答予測 | Lift@10% | PR-AUC | 上位顧客にだけ施策を打つため |
🧭 「accuracy = 99% でも危険」を可視化する 3 つの観点
- Confusion Matrix を必ず提示:TP/FP/FN/TN の生数値を見るだけで、 多数派偏重か少数派検出ができているか即座にわかる。
- Recall を必ず併記:accuracy が高くても Recall が 0.0 なら少数派検出に失敗している。
- Cost-sensitive 評価:FN コスト × FN 数 + FP コスト × FP 数 を業務金額換算すると説得力が劇的に増す。
🛠 リサンプリング手法の体系と落とし穴
不均衡データに対応する代表的アプローチが「リサンプリング」である。 大別すると Under-sampling(多数派削減)、 Over-sampling(少数派増加)、 ハイブリッド(両者組合せ)、 合成データ生成(SMOTE 系) の 4 系統がある。 ここではそれぞれの仕組み・適用条件・典型的な失敗パターンを整理する。
🧮 主要リサンプリング手法 10 種類
| 系統 | 手法 | 仕組み | 長所 | 短所 |
|---|---|---|---|---|
| Under | Random Under-sampling | 多数派から無作為に削減 | 高速・実装容易 | 情報損失大 |
| Under | Tomek Links | 境界の近傍ペアを削除 | 境界がクリーンになる | 削減量が限定的 |
| Under | NearMiss | 少数派に近い多数派だけ残す | 境界保持 | 外れ値に敏感 |
| Over | Random Over-sampling | 少数派を単純複製 | 実装容易 | 過学習リスク |
| Over | SMOTE | 少数派の k 近傍間で線形補間 | 合成で多様性確保 | ノイズ・外れ値も増幅 |
| Over | Borderline-SMOTE | 境界付近の少数派だけ合成 | 境界強化 | パラメータ調整必要 |
| Over | ADASYN | 分類困難な少数派を重点的に合成 | 適応的サンプル数 | ノイズ増幅顕著 |
| ハイブリッド | SMOTE + Tomek | 合成後に境界をクリーン化 | バランス良し | 計算コスト高 |
| ハイブリッド | SMOTE + ENN | 合成後に近傍不一致を削除 | ノイズ除去 | 削除量が大きい場合あり |
| 合成 | GAN-based | GAN で少数派分布を学習・生成 | 高次元データに強い | 学習が難しい |
🔬 SMOTE の数式と挙動
SMOTE は、 少数派サンプル x_i とその k 近傍 x_j の間に新サンプルを生成する:
$$x_{new} = x_i + \lambda \cdot (x_j - x_i), \quad \lambda \sim U(0, 1)$$
つまり、 線形補間によって少数派の「内部空間」を埋めるイメージ。 ただし、 少数派が外れ値だった場合、 その外れ値の周りに偽の少数派が生成されてしまい、 結果として境界が破壊される。
🐍 imbalanced-learn による SMOTE 実装
このコードでやること: SSDSE-B-2026 の「高齢化率 > 35%」(3 県のみの強い不均衡)を陽性とし、 素データ・CV の前に SMOTE(誤った使い方)・各 fold の訓練側だけで SMOTE(正しい使い方)の 3 通りで少数派の Recall を比較する。
📥 入力データ(SSDSE-B-2026 抜粋):
1 2 3 4 5 6 7 8 9 10 11 12 13 14 15 16 17 18 19 20 21 22 23 24 25 26 27 28 29 30 31 | import pandas as pd from imblearn.over_sampling import SMOTE from imblearn.pipeline import make_pipeline from sklearn.linear_model import LogisticRegression from sklearn.model_selection import cross_val_score df = pd.read_csv('data/raw/SSDSE-B-2026.csv', encoding='cp932', skiprows=[1]) df = df.rename(columns={'SSDSE-B-2026': 'year', 'Prefecture': 'pref'}) df = df[df['year'] == 2022].copy() # 高齢化率35%超(3県のみ)を陽性とする強い不均衡 aging = df['A1303'] / df['A1101'] y = (aging > 0.35).astype(int) X = df[['A4101', 'A5101', 'A5102']] # 出生数・転入・転出 cv = 3 # 層化 3 分割:各 fold に陽性 1 県 print(f"原データ陽性比率 : {y.mean():.3f}") print(f"Recall (素データ): " f"{cross_val_score(LogisticRegression(max_iter=1000), X, y, cv=cv, scoring='recall').mean():.3f}") # 誤り: CV の前に全体へ SMOTE → 検証 fold に「訓練データから作った合成点」が混ざる X_res, y_res = SMOTE(k_neighbors=2, random_state=42).fit_resample(X, y) print(f"SMOTE 後比率 : {y_res.mean():.3f}") print(f"Recall (CV前にSMOTE): " f"{cross_val_score(LogisticRegression(max_iter=1000), X_res, y_res, cv=cv, scoring='recall').mean():.3f}") # 正しい: SMOTE をパイプラインに入れ、各 fold の訓練側だけで合成する # (訓練側の陽性は 2 県なので k_neighbors=1) pipe = make_pipeline(SMOTE(k_neighbors=1, random_state=42), LogisticRegression(max_iter=1000)) print(f"Recall (fold内SMOTE): " f"{cross_val_score(pipe, X, y, cv=cv, scoring='recall').mean():.3f}") |
📤 実行例:
💬 層化 3 分割では各 fold に陽性が 1 県ずつ入り、素データのモデルは 3 県のうち 1 県しか拾えず Recall 0.333。 CV の前に全体へ SMOTE をかけると Recall 0.933 に跳ね上がるが、これは検証 fold に「同じ県から作った合成点」が混ざって答えを知った状態で評価しているリークによるもの。 SMOTE をパイプラインに入れて各 fold の訓練側だけで合成すると Recall は 0.667(3 県中 2 県)で、これが SMOTE の正直な効果になる。 陽性 3 県では 1 県の当たり外れで 0.333 ずつ動くので、差を読み過ぎないこと。
⚠️ リサンプリングの落とし穴 5 件
- テストデータにリサンプリングをしない:性能評価が現実の不均衡分布から乖離する。 リサンプリングは train のみに適用。
- CV 内で必ずリサンプリング:train/validation を分ける前にリサンプリングすると、 validation に合成サンプルが混入し性能が過大評価される。
- SMOTE はカテゴリ変数に直接使えない:線形補間が意味を持たないため、 SMOTENC など別バリアントを使うか、 連続化前処理が必要。
- 陽性が極端に少ない場合の k 近傍:陽性が 5 件しかないのに k=10 を指定するとエラー。 陽性数に応じて k を調整。
- SMOTE 後の確率較正が崩れる:分類確率が学習データの分布と一致しないため、 業務閾値の決定に使う際は calibration が必要。
🌐 リサンプリング以外のアプローチ
- クラス重み(class_weight='balanced'):sklearn の多くのモデルで利用可。 損失関数で少数派の誤分類を重く罰する。
- 閾値最適化:標準の 0.5 ではなく、 業務 KPI を最大化する閾値を grid search で探す。
- 異常検知としての定式化:陽性が極端に少ない場合(< 1%)、 教師なし異常検知(Isolation Forest, One-Class SVM)が有効。
- コスト感応学習:FN/FP コストを直接学習に組込むモデル(XGBoost の scale_pos_weight、 LightGBM の is_unbalance など)。
🏥 実務における不均衡対策の意思決定フロー
実務でクラス不均衡に直面した時、 単一の手法に飛びつくのではなく、 段階的な意思決定が必要である。 ここでは「データ分析プロジェクトでの典型的なフロー」と「業界別ベストプラクティス」を整理する。
📋 不均衡データ対策の 7 ステップフロー
| ステップ | 確認事項 | 判断基準 | 選ぶアプローチ |
|---|---|---|---|
| S1: 不均衡度測定 | 陽性比率を計算 | 5% 未満 = 強い不均衡 | 対策必須 |
| S2: 業務 KPI 確認 | FN/FP コスト比 | FN ≫ FP なら Recall 重視 | F2 / Cost-sensitive |
| S3: 評価指標選定 | 主指標 + サブ指標 | PR-AUC + Recall@Precision | MCC 併記推奨 |
| S4: ベースライン構築 | 素データ + 標準モデル | 多数派予測との差 | LR / RF / XGB |
| S5: 重み調整試行 | class_weight='balanced' | Recall 改善幅を測定 | 軽量・効果検証用 |
| S6: リサンプリング | SMOTE / Under / ハイブリッド | S5 で不十分なら導入 | train のみ・CV 内で適用 |
| S7: 閾値最適化 | 業務 KPI 最大化 | F1/F2/Cost を grid search | 業務側合意必須 |
📐 業界別「不均衡対策」のベストプラクティス
| 業界 | 陽性比率 | 典型データ | 推奨アプローチ | 注意点 |
|---|---|---|---|---|
| 金融(不正検知) | 0.01~0.5% | 取引ログ | Cost-sensitive + 異常検知 | 時系列性・コンセプトドリフト |
| 医療診断 | 1~10% | 検査値 | Recall 最大化 + F2 | 倫理的説明可能性 |
| 製造業(不良検出) | 0.1~5% | センサデータ | SMOTE + 閾値最適化 | 装置交換時の分布変化 |
| マーケティング | 1~15% | 応答ログ | Lift 最大化 | 陽性定義が事業で変わる |
| サイバーセキュリティ | 0.001~1% | ネット通信 | Isolation Forest + 教師あり併用 | 新型攻撃への汎化 |
| 離脱予測(チャーン) | 5~20% | 顧客行動 | XGBoost (scale_pos_weight) | マーケ施策との交絡 |
🐍 業務 KPI を最大化する閾値最適化
このコードでやること: SSDSE-B-2026 の「高齢化率 > 35%」(3 県)を陽性とし、 FN コスト = 100 万円・FP コスト = 1 万円のとき期待損失を最小化する閾値を探索する。
📥 入力データ(SSDSE-B-2026 抜粋):
1 2 3 4 5 6 7 8 9 10 11 12 13 14 15 16 17 18 19 20 21 22 23 24 25 26 27 28 29 | import pandas as pd import numpy as np from sklearn.linear_model import LogisticRegression df = pd.read_csv('data/raw/SSDSE-B-2026.csv', encoding='cp932', skiprows=[1]) df = df.rename(columns={'SSDSE-B-2026': 'year', 'Prefecture': 'pref'}) df = df[df['year'] == 2022].copy() aging = df['A1303'] / df['A1101'] y = (aging > 0.35).astype(int) # 高齢化率35%超(3県)を陽性 X = df[['A4101', 'A5101', 'A5102']] # 出生数・転入・転出 clf = LogisticRegression(max_iter=1000).fit(X, y) prob = clf.predict_proba(X)[:, 1] # 見逃し(FN)は高コスト、過検知(FP)は低コスト C_FN, C_FP = 1_000_000, 10_000 results = [] for thr in np.arange(0.05, 0.95, 0.05): pred = (prob >= thr).astype(int) FN = ((pred == 0) & (y == 1)).sum() FP = ((pred == 1) & (y == 0)).sum() cost = FN * C_FN + FP * C_FP results.append((thr, FN, FP, cost)) best = min(results, key=lambda x: x[3]) print(f"最適閾値: {best[0]:.2f}, FN={best[1]}, FP={best[2]}") print(f"期待損失: {best[3]:,} 円") |
📤 実行例:
💬 デフォルト閾値 0.5 では少数派 3 県中 3 件を見逃し(FN=3)、 損失は 300 万円。 閾値 0.30 まで下げると見逃しが 1 件に減り、 過検知 1 件を許容しても期待損失を 101 万円まで抑制できた。 業務 KPI 駆動の閾値設定の威力がわかる。
🚫 不均衡対策で絶対に避けるべき 5 つの過ち
- accuracy のみで評価する:多数派偏重モデルでも 99% 達成可能。 必ず Precision/Recall/F1/PR-AUC を併記。
- train/test 分割前にリサンプリング:test に合成サンプルが混入し、 性能が過大評価される。
- SMOTE をブラックボックス的に適用:少数派が外れ値だらけの場合、 SMOTE は境界を破壊する。 必ず可視化で確認。
- 少数派の業務的意味を無視:陽性 = 不正/がん/不良など「捕まえたいもの」の定義が現場とずれていると、 どんな手法も無意味。
- コンセプトドリフト無視:不正手口・病態・製造装置は時間で変化する。 一度組んだモデルを永続使用すると性能劣化。 retraining 戦略を最初から組み込む。
📚 関連する重要トピック
- F1 スコア — 不均衡データで主指標になる調和平均
- ROC 曲線・PR 曲線 — 閾値非依存の可視化
- SMOTE — 合成オーバーサンプリングの代表手法(本ページ内で解説)
- コスト感応学習 — FN/FP コストを学習に組込む(本ページ内で解説)
- 異常検知 — 極端な不均衡時の代替アプローチ(本ページ内で解説)
- クロスバリデーション — 不均衡データでの正しい CV 設計
- 閾値最適化 — 業務 KPI を最大化する閾値探索(本ページ内で解説)
- 混同行列 — TP/FP/FN/TN の生数値確認
🧮 SSDSE-B 実値計算 — 都道府県データで手を動かす
SSDSE-B-2026 を 「人口減少県 vs 増加県」の二値分類に変換して、 クラス不均衡を観察する。 増加県は東京等の数県のみで明確な不均衡状況。
使用データ:SSDSE-B-2026.csv(独立行政法人 統計センター提供、 47 都道府県 × 100 超の社会経済指標)。 出典
🎯 このコードでやること: SSDSE-B-2026 を 2023 年度の 47 都道府県に絞り、転入超過(社会増)の県を陽性として、標準化+class_weight='balanced' のロジスティック回帰で分類し、クラス別の precision・recall を確認する。
1 2 3 4 5 6 7 8 9 10 11 12 13 14 15 16 17 18 19 20 21 22 23 24 25 | import pandas as pd import numpy as np from sklearn.linear_model import LogisticRegression from sklearn.preprocessing import StandardScaler from sklearn.pipeline import make_pipeline from sklearn.metrics import classification_report, f1_score df = pd.read_csv('data/raw/SSDSE-B-2026.csv', encoding='cp932', skiprows=[1]) df = df.rename(columns={df.columns[2]: 'pref'}) df = df[df['SSDSE-B-2026'] == 2023].copy() # 2023 年度の 47 都道府県 # 二値ラベル: 社会増減(転入 A5101 - 転出 A5102)が正なら 1 df['inc'] = (df['A5101'] - df['A5102'] > 0).astype(int) print('クラス分布:', df['inc'].value_counts().to_dict()) X = df[['A1101', 'A1303', 'F3101']].values # 総人口・65 歳以上人口・F3101 y = df['inc'].values # 桁の違う列をそろえてから class_weight='balanced' で不均衡対策 m = make_pipeline(StandardScaler(), LogisticRegression(class_weight='balanced', max_iter=500)).fit(X, y) pred = m.predict(X) print(f'F1 = {f1_score(y, pred):.3f}') print(classification_report(y, pred, digits=3)) print('増加と予測した県:', df.loc[pred == 1, 'pref'].tolist()) |
💬 読み方: 2023 年度に転入超過だったのは 6 県だけで、41 : 6 の不均衡になる。class_weight='balanced' で少数派を約 6.8 倍重く扱ったので、転入超過の 6 県(埼玉・千葉・東京・神奈川・大阪・福岡)はすべて拾えて recall = 1.000 だが、代わりに人口の多い北海道・愛知・兵庫の 3 県も「増加」と予測し precision は 0.667 に下がる。人口規模の列だけでは「大きい県=転入超過」としか学べないことが分かる。学習に使った 47 県でそのまま評価しているので、未知データでの性能は交差検証で確かめる必要がある。
▲ 上記コードはそのまま実行可能。 CP932 エンコーディング・skiprows=[1](2 行目の日本語ヘッダをスキップし英語コード行を列名に)・列名の英数字コード(A1101 = 総人口 など)に注意。
🧮 数式に値を入れて手で計算する — class_weight・SMOTE・G-mean
合成データ(多数派 8 件 / 少数派 2 件)を代入し、 (1) 逆頻度 class_weight (2) SMOTE 補間 (3) G-mean = √(感度 × 特異度) の 3 数式を Step 1〜5 で順に展開する。 同じ計算を Python で再現し、 手計算と完全一致することを確認する。
📐 用語の主要数式(再掲)
$$ w_k = \frac{1}{n_k}, \qquad x_{\text{new}} = x_i + \lambda \,(x_j - x_i), \qquad \text{G-mean} = \sqrt{\text{sensitivity} \times \text{specificity}} $$
w_k はクラス k のサンプル数 n_k の逆数を重みとする。 SMOTE は少数派の最近傍 x_j と λ∈[0,1] を使って合成点 x_new を作る。 G-mean は感度(少数派の再現率)と特異度(多数派の再現率)の幾何平均で、 不均衡データの総合指標として広く使われる。
Step 1: データ準備(多数派 8 件 / 少数派 2 件、 合成)
| サンプル | x1 | x2 | ラベル y |
|---|---|---|---|
| M1 | 2 | 3 | 0(多数派) |
| M2 | 4 | 5 | 0 |
| M3 | 3 | 6 | 0 |
| M4 | 5 | 4 | 0 |
| M5 | 6 | 7 | 0 |
| M6 | 7 | 3 | 0 |
| M7 | 8 | 5 | 0 |
| M8 | 9 | 6 | 0 |
| P1 | 12 | 14 | 1(少数派) |
| P2 | 16 | 18 | 1 |
多数派 n_0 = 8、 少数派 n_1 = 2、 不均衡比 = 4:1。
Step 2: class_weight の計算(逆頻度)
| 項目 | 計算 | 結果 |
|---|---|---|
| w_0(多数派) | 1 / 8 | 0.125 |
| w_1(少数派) | 1 / 2 | 0.500 |
| 正規化後 w_0(sklearn 形式 n/(K·n_k)) | 10 / (2 × 8) | 0.625 |
| 正規化後 w_1 | 10 / (2 × 2) | 2.500 |
sklearn の class_weight='balanced' は n/(K·n_k) を採用する(n=10、 K=2)。 少数派の重みが多数派の 4 倍となり、 損失関数で誤分類のコストが 4 倍になる。
Step 3: SMOTE 1 点合成(少数派 P1 と P2 の補間、 λ=0.5)
| 項目 | 計算 | 結果 |
|---|---|---|
| x1_new | 12 + 0.5 × (16 - 12) | 14.0 |
| x2_new | 14 + 0.5 × (18 - 14) | 16.0 |
| 新サンプル P_syn | (14.0, 16.0) | ラベル 1(少数派) |
SMOTE は少数派点 P1 とその最近傍 P2 を λ=0.5 で線形補間し、 中点 (14, 16) を新規少数派として追加。 不均衡比は 8:3 に改善。
Step 4: 混同行列と感度・特異度(仮想予測結果)
| 実際 \ 予測 | 0(多数派) | 1(少数派) |
|---|---|---|
| 0(多数派 8 件) | TN = 7 | FP = 1 |
| 1(少数派 2 件) | FN = 1 | TP = 1 |
感度(recall_pos) = TP / (TP+FN) = 1 / 2 = 0.500、 特異度(recall_neg) = TN / (TN+FP) = 7 / 8 = 0.875。
Step 5: G-mean の最終計算
| 項目 | 計算 | 結果 |
|---|---|---|
| 感度 × 特異度 | 0.500 × 0.875 | 0.4375 |
| G-mean | √0.4375 | 0.6614 |
| 比較: accuracy | (7+1) / 10 | 0.800 |
accuracy 0.800 は一見高いが、 少数派の半数を取り逃している。 G-mean 0.6614 は両クラスの再現率を同時評価しており、 不均衡下での実力をより正直に映す。
🐍 同じ計算を Python で再現
1 2 3 4 5 6 7 8 9 10 11 12 13 14 15 16 17 18 19 20 21 22 23 24 25 | import numpy as np from sklearn.utils.class_weight import compute_class_weight # Step 1: データ X = np.array([[2,3],[4,5],[3,6],[5,4],[6,7],[7,3],[8,5],[9,6], [12,14],[16,18]]) y = np.array([0,0,0,0,0,0,0,0, 1,1]) # Step 2: class_weight(balanced) w = compute_class_weight('balanced', classes=np.array([0,1]), y=y) print(f"class_weight balanced: w_0={w[0]:.4f}, w_1={w[1]:.4f}") # Step 3: SMOTE 1 点合成(P1=(12,14), P2=(16,18), lambda=0.5) P1, P2, lam = X[8], X[9], 0.5 P_syn = P1 + lam * (P2 - P1) print(f"SMOTE 合成点: {P_syn}") # Step 4-5: 混同行列から感度・特異度・G-mean TP, TN, FP, FN = 1, 7, 1, 1 sens = TP / (TP + FN) spec = TN / (TN + FP) gmean = np.sqrt(sens * spec) acc = (TP + TN) / (TP + TN + FP + FN) print(f"感度={sens:.4f}, 特異度={spec:.4f}") print(f"G-mean={gmean:.4f}, accuracy={acc:.4f}") |
📤 実行結果
💬 手計算(Step 2: w_0=0.625, w_1=2.5、 Step 3: (14,16)、 Step 5: G-mean=0.6614, accuracy=0.800)と Python 出力が完全一致。 accuracy 0.8 vs G-mean 0.66 のギャップが、 不均衡データで G-mean を見るべき根拠となる。
🐍 Python での扱い
SSDSE-B-2026 のような公的統計データを Python で扱う際の基本パターン:
🎯 このコードでやること: SSDSE-B-2026 を読み込み、2023 年度の 47 都道府県で「転入超過の県」を陽性にしたときのクラスの件数と不均衡比を数える。
1 2 3 4 5 6 7 8 9 10 11 12 | import pandas as pd import numpy as np # データ読み込み(1 列目 'SSDSE-B-2026' が年度) df = pd.read_csv('data/raw/SSDSE-B-2026.csv', encoding='cp932', skiprows=[1]) print(df.shape) # 47 都道府県 × 12 年度 = 564 行 # 2023 年度の 47 都道府県に絞り、転入超過(社会増)の県を陽性にする d23 = df[df['SSDSE-B-2026'] == 2023] inc = (d23['A5101'] > d23['A5102']).astype(int) print(inc.value_counts().rename({0: '転出超過', 1: '転入超過'})) print(f'不均衡比 = 1 : {(inc == 0).sum() / (inc == 1).sum():.1f}') |
💬 読み方: CSV 全体は 47 都道府県 × 12 年度の 564 行なので、クラスの数を数える前に 1 年度に絞る。2023 年度で転入超過(社会増)の県を陽性にすると 6 県、転出超過が 41 県で、少数派は全体の約 13% にとどまる。この 1 : 6.8 という比が、以下のブロックで重み付けや評価指標を選ぶ出発点になる。
具体的なコードは 機械学習の基礎 を参照してください。
🔗 同カテゴリの他用語
🐍 Python 実装バリエーション
「クラス不均衡」を扱う代表的なライブラリ別実装。 同じ目的でも書き方が違うため、 自分のプロジェクトの依存関係に合わせて選択する:
① pandas + numpy(最小依存)
🎯 このコードでやること: pandas と numpy だけで、2023 年度 47 都道府県のクラス件数から逆頻度の重み n / (2 n_k) を計算し、少数派(転入超過)の県を一覧する。
1 2 3 4 5 6 7 8 9 10 11 12 | import pandas as pd import numpy as np df = pd.read_csv('data/raw/SSDSE-B-2026.csv', encoding='cp932', skiprows=[1]) df = df.rename(columns={df.columns[2]: 'pref'}) df = df[df['SSDSE-B-2026'] == 2023].copy() # 2023 年度の 47 都道府県 df['inc'] = (df['A5101'] > df['A5102']).astype(int) # 転入超過 = 1 counts = np.bincount(df['inc']) w = len(df) / (2 * counts) # class_weight='balanced' と同じ式 n / (2 n_k) print('行数:', len(df), '件数 [0, 1]:', counts, '重み [0, 1]:', w.round(3)) print(df.loc[df['inc'] == 1, ['pref', 'A1101', 'A5101', 'A5102']]) |
💬 読み方: 重みは 47 / (2 × 41) = 0.573 と 47 / (2 × 6) = 3.917 で、少数派 1 県が多数派 1 県の約 6.8 倍に数えられ、重み付きの合計は両クラスとも 23.5 にそろう。転入超過の 6 県はすべて人口 500 万人超の大都市圏で、東京都は転入 406,749 人・転出 348,260 人と差が 5 万 8 千人を超える。少数派が「人口規模」という 1 つの特徴でほぼ説明できてしまう点が、次のモデルの結果にそのまま表れる。
② scikit-learn(学習・評価)
🎯 このコードでやること: ① の df(2023 年度・47 都道府県)で、class_weight なし/'balanced' のロジスティック回帰を層化 3 分割の交差検証で予測し、見逃し(FN)と Recall・Precision を比べる。
1 2 3 4 5 6 7 8 9 10 11 12 13 14 15 16 | from sklearn.linear_model import LogisticRegression from sklearn.preprocessing import StandardScaler from sklearn.pipeline import make_pipeline from sklearn.model_selection import StratifiedKFold, cross_val_predict from sklearn.metrics import confusion_matrix, recall_score, precision_score X = df[['A1101', 'A1303', 'F3101']].values # 総人口・65 歳以上人口・新規求職申込件数 y = df['inc'].values cv = StratifiedKFold(n_splits=3, shuffle=True, random_state=0) # 各 fold に陽性 2 県 for cw in [None, 'balanced']: m = make_pipeline(StandardScaler(), LogisticRegression(class_weight=cw, max_iter=1000)) pred = cross_val_predict(m, X, y, cv=cv) tn, fp, fn, tp = confusion_matrix(y, pred).ravel() print(f'class_weight={cw}: TP={tp} FN={fn} FP={fp} ' f'Recall={recall_score(y, pred):.3f} Precision={precision_score(y, pred, zero_division=0):.3f}') |
💬 読み方: 層化 3 分割の交差検証で、学習に使わなかった県だけを予測している。重みなしでは転入超過 6 県のうち 2 県を見逃す(Recall 0.667)が、class_weight='balanced' にすると見逃しが 1 県に減り(Recall 0.833)、誤検出は 2 件のままなので Precision も 0.714 に上がった。陽性が 6 県しかないので、1 県の当たり外れで Recall は約 0.167 動く点に注意する。
③ scipy.stats(統計検定・分布)
🎯 このコードでやること: 陽性 6 県 / 47 県の比率が半々から有意にずれているかを二項検定で確かめ、少数派と多数派で総人口の分布が違うかを Mann-Whitney U 検定で比べる。
1 2 3 4 5 6 7 8 9 10 11 | from scipy import stats # 陽性 6 県 / 47 県は「半々」から有意にずれているか(二項検定) k, n = int(df['inc'].sum()), len(df) res = stats.binomtest(k, n, p=0.5) print(f'陽性 {k}/{n} = {k/n:.3f}, 二項検定 p = {res.pvalue:.2e}') print('陽性比率の 95% CI:', [round(v, 3) for v in res.proportion_ci()]) # 少数派(転入超過県)と多数派で総人口の分布が違うか(Mann-Whitney U 検定) u, p = stats.mannwhitneyu(df.loc[df['inc'] == 1, 'A1101'], df.loc[df['inc'] == 0, 'A1101']) print(f'U = {u:.0f}, p = {p:.2e}') |
💬 読み方: 陽性 6/47 = 0.128 が「半々」から偶然ずれた可能性は p = 1.77e-07 でほぼ無く、比率の 95% 信頼区間 0.048〜0.257 も 0.5 を大きく下回るので、これは本物の不均衡として扱う。一方、区間の幅が 0.2 以上あるのは、47 県では陽性率そのものがかなり不確かだということ。Mann-Whitney の U = 242(最大は 6 × 41 = 246)は、転入超過 6 県の総人口がほぼすべての転出超過県より大きいことを示している。
④ 可視化(matplotlib + seaborn)
🎯 このコードでやること: クラス別の県数を棒グラフに、総人口と 65 歳以上人口の散布図をクラスで色分けして描き、out.png に保存する。
1 2 3 4 5 6 7 8 9 10 11 12 13 14 | import matplotlib.pyplot as plt import seaborn as sns fig, ax = plt.subplots(1, 2, figsize=(11, 4.5)) df['inc'].value_counts().sort_index().plot.bar(ax=ax[0], color=['#90A4AE', '#E57373']) ax[0].set_xticklabels(['転出超過 (0)', '転入超過 (1)'], rotation=0) ax[0].set_ylabel('都道府県数') sns.scatterplot(data=df, x='A1101', y='A1303', hue='inc', palette=['#90A4AE', '#E57373'], ax=ax[1]) ax[1].set_xscale('log'); ax[1].set_yscale('log') ax[1].set_xlabel('総人口'); ax[1].set_ylabel('65 歳以上人口') plt.tight_layout() plt.savefig('out.png', dpi=120) plt.close() print('クラス別の県数:', df['inc'].value_counts().sort_index().to_dict(), '→ out.png に保存') |
💬 読み方: 左の棒グラフで 41 本と 6 本の高さの差を見ると、正解率だけで評価したとき「全部 0」と答えても 41/47 = 87.2% になることが直感的に分かる。右の散布図(両軸とも対数)では、転入超過の 6 県が総人口・65 歳以上人口とも右上に固まり、多数派の中には北海道・愛知・兵庫など同じ位置にいる県がある。この重なりが、前の分類器で誤検出が出た理由になっている。
🐍 Python 実装(拡張版)
不均衡データ(正例 5%)で、(1) 何もしない、 (2) class_weight、 (3) SMOTE の 3 通りを同じテストデータの F1 と Recall で比較する。
1 2 3 4 5 6 7 8 9 10 11 12 13 14 15 16 17 18 19 20 21 22 23 24 25 26 | from sklearn.datasets import make_classification from sklearn.linear_model import LogisticRegression from sklearn.model_selection import train_test_split from sklearn.metrics import f1_score, recall_score from imblearn.over_sampling import SMOTE # 不均衡データ(正例 5%) X, y = make_classification(n_samples=2000, weights=[0.95, 0.05], n_features=20, random_state=42) Xtr, Xte, ytr, yte = train_test_split(X, y, stratify=y, test_size=0.3, random_state=42) # (1) 何もしない m0 = LogisticRegression(max_iter=2000).fit(Xtr, ytr) p = m0.predict(Xte) print(f'F1 (baseline): {f1_score(yte, p):.3f} Recall: {recall_score(yte, p):.3f}') # (2) class_weight='balanced' m1 = LogisticRegression(class_weight='balanced', max_iter=2000).fit(Xtr, ytr) p = m1.predict(Xte) print(f'F1 (balanced): {f1_score(yte, p):.3f} Recall: {recall_score(yte, p):.3f}') # (3) SMOTE で正例を合成 Xs, ys = SMOTE(random_state=42).fit_resample(Xtr, ytr) m2 = LogisticRegression(max_iter=2000).fit(Xs, ys) p = m2.predict(Xte) print(f'F1 (SMOTE) : {f1_score(yte, p):.3f} Recall: {recall_score(yte, p):.3f}') |
💬 テストデータの正例 32 件に対し、何もしないモデルは Recall 0.438 で半分以上を見逃すが、誤検出が少ないため F1 は 0.583 と 3 つの中で最も高い。class_weight='balanced' は Recall を 0.844 まで上げる代わりに誤検出が増えて F1 は 0.432 に、SMOTE も Recall 0.750・F1 0.440 と同じ傾向になる。不均衡対策は「F1 を必ず上げる」ものではなく、見逃しと誤検出のどちらを減らしたいかで選ぶもので、F1 だけを見ると対策しない方が良く見えることもある。
不均衡対応の鉄則:(a) 評価指標を F1/AUC に変更、 (b) class_weight をまず試す、 (c) SMOTE は過学習に注意、 (d) 業務制約に応じた閾値調整。
⚠️ よくある落とし穴
⚠️ よくある落とし穴(5 件)
「クラス不均衡」を実務・試験で扱うときに頻発する典型的なミスです。 各項目を 1 度読んでおけば 9 割の事故が防げます:
🗺 概念マップ
クラス不均衡への対処は、 中心から伸びる 6 つの枝のどこに手を入れるかで整理できる。 上下の「評価指標」と「閾値調整」はモデルを変えずに読み方を変える対処、 左右の「データ層」「アルゴリズム層」は学習そのものを変える対処、 「検証の設計」と「事前確率の変化」は対処が本当に効いたかを確かめるための枝である。 このページの 47 都道府県の例(人口減少率で 6:41 に分かれるなど)では、 まず評価指標を accuracy から F1・PR-AUC に替え、 次に class_weight を試すのが最小の手順になる。
📊 不均衡時の評価指標
| 指標 | 不均衡耐性 | 推奨 |
|---|---|---|
| Accuracy | 弱い | 不均衡では使用禁止 |
| Precision | 中 | 偽陽性が高コストの時 |
| Recall | 中 | 取りこぼしが致命的な時 |
| F1 | 強 | 標準推奨 |
| ROC-AUC | 中〜強 | 識別能力の俯瞰 |
| PR-AUC | 最強 | 極端な不均衡で必須 |
| MCC | 強 | バランス重視(−1〜1) |
🔁 サンプリング技法
- Random Over-sampling:少数クラスを単純複製。 過学習リスク。
- SMOTE:k 近傍を補間して合成。 連続特徴向け。
- ADASYN:難しいサンプル周辺に集中合成。
- Borderline-SMOTE:決定境界付近のみ合成。
- Random Under-sampling:多数クラスを間引く。 情報損失。
- Tomek Links:境界近傍の多数派を除去。
- NearMiss:少数派に近い多数派を残す。
- SMOTE-ENN / SMOTE-Tomek:合成 + クリーニング併用。
🔗 隣接手法への橋渡し
「クラス不均衡」は分類モデルが多数派に偏る病で、 上流のサンプリング戦略と下流の評価指標選択を同時に変えないと「正解率は高いが少数派は全滅」になる。
- 上流: クラス不均衡 の入力となる2 値ラベル(例: 2023 年度に転入超過の 6 県 対 転出超過の 41 県) を整える前処理 (データクレンジング、 欠損値処理)
- 並列: 類似目的を持つ代替手法 (SMOTE、 コスト感受性学習、 オーバーサンプリング。 いずれも本ページ内で解説) と比較・併用
- 下流: 出力結果の評価・解釈 (適合率・再現率、 F1 スコア、 AUC)
上流の SMOTE/undersampling で分布を整え、 並列の cost-sensitive 学習と比較し、 下流で F1 や PR-AUC を評価指標に採用すれば、 少数派が重要な不正検知や疾患予測でも実用品質の分類が組める。
🌳 手法選択フロー
「クラス不均衡」を実際に使うとき、 何をどう選ぶかを順に判断する。 上から順に答えていくと、 使うべき手法と評価の仕方が決まる。
- どれくらい偏っているか
少数クラスが 3 割程度なら、 評価指標を変えるだけで足りることが多い。 1% を切るなら異常検知の枠組み(少数クラスを「外れ値」として扱う)に切り替えるほうが自然。 - 評価指標を先に決めたか
正解率は使えない。 陽性 1% なら全部を陰性と答えて 99% になる。 PR-AUC・F1・再現率のうち、 業務のコストに合うものを学習を始める前に決める。 - データを増やせるか
少数クラスを追加で集められるなら、 それが最も確実。 集められないときに初めて、 重み付け・オーバーサンプリング・アンダーサンプリングを検討する。 - 重み付けか、 リサンプリングか
まずclass_weight='balanced'を試す。 データを増やさないので漏れが起きにくい。 SMOTE を使うなら、 必ず学習用データを分割したあとに適用する。 分割前に行うと検証側に情報が漏れる。
不均衡そのものは問題ではなく、 「少数クラスを当てたいのに指標が多数クラスを見ている」ことが問題。 指標を直せば解決する場合も多い。
🔍 解説深化 — 不均衡は「観測される」のではなく「設計され、動く」
本ページはここまで、 与えられた不均衡にどう対処するか(SMOTE・class_weight・指標選択)を扱ってきた。 この深化セクションでは一歩手前に戻り、 その不均衡はどこから来たのかを問う。 実は多くの実務タスクで、 クラス比は自然現象ではなく分析者自身のラベル設計の産物であり、 しかも時間とともに動く。 SSDSE-B-2026 の実測値でこの 2 点を確認する。
🎨 直感 — 同じデータから 0:47 も 6:41 も 24:23 も作れる
SSDSE-B-2026 の 2023 年・47 都道府県で、 「人口移動」に関する二値ラベルを 3 通り設計してみる(いずれも実測値):
| ラベル設計(2023 年) | 陽性:陰性 | 不均衡の性格 |
|---|---|---|
| 自然増減が正(A4101 出生数 − A4200 死亡数 > 0) | 0 : 47 | 陽性が 1 件もない退化ラベル。 分類問題として成立しない |
| 転入超過(A5101 転入者数 − A5102 転出者数 > 0) | 6 : 41 | 少数派 12.8%。 本ページで扱ってきた典型的不均衡(埼玉・千葉・東京・神奈川・大阪・福岡) |
| 転入超過率が −2‰ 超(人口千人当たり、 中央値 −1.95‰ 付近で分割) | 24 : 23 | ほぼ完全な均衡。 不均衡対策は一切不要になる |
同じ 47 行のデータから、 カットオフの置き方だけで「分類不能」「典型的不均衡」「完全均衡」の 3 つの世界が生まれる。 つまり「不均衡にどう対処するか」の前に「そのカットオフは業務的に正当か」を問うべきで、 均衡するようにカットオフを動かせるなら(例:『上位半分の県』を予測したいだけなら)、 SMOTE も class_weight もそもそも要らない。 逆に「転入超過という現象そのもの」に意味があるなら、 6:41 は動かせない本質的な不均衡であり、 本ページの対策群が正当化される。
⚠️ 落とし穴(重要) — クラス比は年とともに動く(事前確率ドリフト)
「転入超過県」の数を SSDSE-B-2026 の全 12 年分で数えると(実測値):
| 年 | 2012 | 2013 | 2014 | 2015 | 2016 | 2017 | 2018 | 2019 | 2020 | 2021 | 2022 | 2023 |
|---|---|---|---|---|---|---|---|---|---|---|---|---|
| 転入超過県数 | 11 | 9 | 7 | 8 | 7 | 7 | 7 | 8 | 7 | 11 | 9 | 6 |
少数派の県数は 6〜11 の間で揺れ、 少数派比率は 12.8%〜23.4% とほぼ 2 倍の幅で変動している(コロナ禍の 2021 年に 11 県へ跳ね、 2023 年に最少の 6 県)。 ここに重大な落とし穴がある:
- 訓練時と運用時でクラス比が違う:2012 年(11:36)で学習したモデルの class_weight・閾値・較正は、 2023 年(6:41)では最適でない。 不均衡対策のパラメータは「訓練データのクラス比」に依存して決まるため、 事前確率が動くとまとめてズレる。 これは特徴量分布のドリフトがなくても起きる(事前確率ドリフト / prior probability shift)。
- 「不均衡比 ≒ 定数」という暗黙の仮定:本ページの 6:41 という数字も 2023 年断面の値にすぎない。 レポートに不均衡比を書くときは「いつ時点の比か」を必ず添え、 運用時には陽性率をモニタリングして再較正のトリガーにする。
- 時系列 CV との合わせ技:年をまたいで検証する場合、 StratifiedKFold で年内のクラス比を保つだけでは足りず、 「過去年で学習 → 未来年で検証」の時系列分割でクラス比の変動ごと汎化性能を測るのが正直な評価になる。
🚀 発展 — リサンプリング後の確率を解析的に補正する(事前確率補正)
オーバー/アンダーサンプリングで訓練データを 50:50 に均すと、 モデルの predict_proba は「均された世界」の確率になり、 実世界の確率としてはそのまま使えない。 較正曲線を引き直さなくても、 ベイズの定理から解析的に補正できる:
$$ p = \frac{p_s \cdot \dfrac{\pi}{\pi_s}}{p_s \cdot \dfrac{\pi}{\pi_s} + (1 - p_s) \cdot \dfrac{1-\pi}{1-\pi_s}} $$
ここで $p_s$ はリサンプリング後データで学習したモデルの出力確率、 $\pi_s$ は訓練時の陽性率(50:50 なら 0.5)、 $\pi$ は実世界の陽性率。 2023 年の転入超過タスクなら $\pi = 6/47 \approx 0.128$ なので、 均衡データで学習したモデルが $p_s = 0.7$ を出しても、 補正後の実確率は $p \approx 0.254$ にすぎない。 $p_s = 0.5$(モデルが五分五分と判断)なら補正後は $p \approx 0.128$、 つまりベースレートそのものに戻る。 この式は「リサンプリングは決定境界の学習を助けるだけで、 確率の意味は事前確率の付け替えで歪む」ことを定量的に示しており、 確率を業務判断(期待コスト計算など)に使うなら補正が必須になる。 なお class_weight による重み付けも同型の歪みを生むため、 同じ補正の考え方が適用できる。 さらに極端な不均衡(1:1000 超)では、 そもそも陽性ラベルの定義自体が不安定になり、 異常検知(One-Class SVM・Isolation Forest)へ問題を組み替える判断も視野に入る。
🔗 関連ページ
- 適合率・再現率 — 少数派をどれだけ拾えたかを測る基本指標
- F1 スコア — 適合率と再現率の調和平均。 不均衡下の代表的複合指標
- 混同行列 — 本セクションの補正式の出発点となる 4 セルの整理
- ROC 曲線 / AUC — 不均衡が強いときは PR 曲線と使い分ける
- 交差検証 — 層化分割と時系列分割の使い分けはここで確認
- ロジスティック回帰 — class_weight と確率出力の仕組みを持つ代表モデル
- 評価指標 — 指標選択の全体像
- 確率較正(Probability Calibration)・異常検知(Anomaly Detection)は本ページ「🔎 拡張補足」内で解説(単独ページなし)