🔖 キーワード索引
別名・略称:再現率、 感度、 Sensitivity、 真陽性率、 TPR
Recall は 実際の陽性のうち正しく陽性と予測できた割合。 見逃しを最小化したい場面(がん検診・地震警報)で最重要。
💡 30秒で分かる結論
🍰 まずはやさしく
見逃しを防ぐための網です。
正解をどれだけ拾えたか測ります。
スマホの検索で漏れがないか調べます。
まずは結論を短く確認しましょう。
Recall(再現率)(Recall):実際の陽性のうち正しく陽性と予測できた割合
- 定義:$\text{Recall} = TP / (TP + FN)$。
- 別名:感度(Sensitivity)、 真陽性率(TPR)。
- 重要場面:がん検診、 地震警報 — 見逃しのコストが高い。
- トレードオフ:閾値を下げると Recall↑ Precision↓。
- ROC 曲線:TPR(=Recall)と FPR の関係をプロット。
💡 Recall を 1 行で表す 10 の視点(覚え方)
- 数学的視点: Recall = TP / (TP + FN) = 真陽性率 = 感度
- 確率論視点: Recall = P(予測陽性 | 真陽性) = 「陽性と判定する条件付き確率」
- 信号検出視点: Recall = ヒット率 (Hit Rate) = 信号分布の閾値以上の積分
- 意思決定視点: Recall は \(c_{FN}/c_{FP}\) コスト比が大きいほど重要視
- 幾何視点: ROC 曲線の縦軸そのもの
- 情報検索視点: 検索エンジンの「網羅性」を測る指標
- 医療視点: 「病気の人を見落とさない確率」(Sensitivity)
- セキュリティ視点: 「攻撃を見逃さない確率」(Detection Rate)
- 推薦視点: Recall@K = 「ユーザが好きな商品が K 件以内に含まれる比率」
- 公平性視点: 各サブグループ間の Recall 格差は差別の代理指標
この 10 視点を場面に応じて切り替えられれば、 Recall を「ただの数式」から「意思決定ツール」へ昇格できる。
🔧 Recall 計算・最適化の実装パターン集(6 パターン)
Recall の計算・最適化には複数の実装パターンがあり、 タスク特性によって使い分ける。 ここでは scikit-learn / TensorFlow / XGBoost を横断的に整理する。 どのパターンも SSDSE-B-2026 の 2023 年度 47 都道府県を日本語の列名で読み、 「総人口が 500 万(または 700 万)を超える県」を陽性とする。
パターン 1: scikit-learn の recall_score
このコードでやること:2 値・多クラス両対応の基本実装。 SSDSE-B-2026 の都道府県データで、 新規求職申込件数(一般)が 10 万件を超えるかで「人口 500 万超」を当てるルールの Recall を求める。
📥 入力例:y_true は 47 県の真ラベル(人口 500 万超 = 1、 該当 9 県)、 y_pred は新規求職申込件数(一般)> 100,000 件で 1 とした予測ラベル。
📤 実行例:
💬 大規模クラスの Recall は 0.889(9 県中 8 県を検出)で、 取りこぼした 1 県は新規求職 97,244 件で 10 万件にわずかに届かない千葉県。 誤検知は無いので Precision は 1.00、 小規模側の Recall は 1.00。 macro 平均の Recall 0.94 は 0.889 と 1.00 の単純平均なので、 少数の大規模クラスの取りこぼしが平均では薄まって見える。
パターン 2: GridSearchCV で Recall を最適化
このコードでやること:ハイパーパラメータ探索の評価指標として recall を指定し、 交差検証の Recall が最大になる設定を自動選定する。 陽性が 9 県しかないので、 各 fold に陽性が 3 県ずつ入るよう層化 K 分割(shuffle あり)を使う。
📤 実行例:
💬 交差検証の Recall 0.889 は 3 つの fold の平均で、 検証側の陽性 9 県のうち平均 8 県を拾えたことに当たる。 6 通りの設定がすべて同じ 0.889 で並ぶと、 GridSearchCV は最初に並ぶ max_depth=3・n_estimators=50 を返すので、 「この設定が最良」というより「どれでも同じ」と読むのが正しい。 マルチクラスでは scoring を 'recall_macro' などに切り替える。
パターン 3: クラス重みで Recall を底上げ
このコードでやること:陽性 5 県(人口 700 万超)対 陰性 42 県の不均衡データに対し class_weight='balanced' を指定して、 少数クラスの Recall がどう変わるかを見る。
📤 実行例:
💬 陽性は東京・神奈川・大阪・愛知・埼玉の 5 都府県。 重みなしのロジスティック回帰は北海道・東京・大阪の 3 県しか陽性と予測せず、 当たりは東京・大阪の 2 県で Recall 0.400 に留まるが、 balanced にすると陽性 1 件の重みが 47/(2×5)=4.7 倍になり、 予測陽性が 8 県に増えて Recall 1.000 に上がる。 代わりに人口 500 万級の北海道・兵庫・福岡も陽性に入り、 Precision は 0.667 から 0.625 に下がる。
パターン 4: TensorFlow / Keras でカスタム Recall メトリック
このコードでやること:tf.keras.metrics.Recall を学習中の監視指標として組み込み、 epoch ごとに Recall を追跡する。 入力の 2 列は桁が大きいので標準化してから入れる。
📤 実行例(未実測):
💬 このブロックだけは TensorFlow が入った環境で動かす必要があり、 出力は実測していない。 学習データそのもので evaluate しているので、 得られる Recall は訓練データへの当てはまりであり、 汎化性能を見るにはパターン 2 のように検証用の県を分けて測る。 Keras の metrics に Recall を加えれば各 epoch で Recall がログに出るので、 EarlyStopping(monitor='val_recall', mode='max') で Recall 最大化の打ち切りもできる。
パターン 5: XGBoost で scale_pos_weight による Recall 改善
このコードでやること:XGBoost の scale_pos_weight = (陰性数 / 陽性数) を指定し、 不均衡データ(人口 700 万超の 5 県が陽性)で Recall を底上げする。
📤 実行例:
💬 陰性 42 県 ÷ 陽性 5 県 = 8.40 なので、 陽性 1 件の誤りを陰性 8.4 件分の重さで数えて学習する。 訓練データ上の Recall は 1.000 で 5 県をすべて拾い、 Precision 0.833 は予測陽性 6 県のうち 1 県(人口 509 万人の北海道)が陽性でなかったことを示す。 どちらも訓練に使った 47 県で測った値なので、 実運用の Recall は交差検証で別に確かめる。
パターン 6: 閾値スイープによる Recall-Precision フロンティア可視化
このコードでやること:ロジスティック回帰の予測確率に対して閾値を 0.1 から 0.9 まで 9 点でスイープし、 Recall と Precision の組み合わせをデータフレームに残す。
📤 実行例:
💬 閾値 0.3・0.4 で Recall 1.000・Precision 1.000 の理想点に達し、 既定の 0.5 に上げると千葉県が落ちて Recall は 0.889 に下がる。 逆に 0.1 まで下げると陽性でない 4 県が混ざって Precision は 0.692 になる。 この 2 列だけで 9 県がほぼ分離できるのは「規模の大きい県」という分かりやすいタスクだからで、 実務のデータでは Recall 0.9・Precision 0.6 のような妥協点を探すことが多い。
🎓 Recall を学ぶ初学者向けロードマップ(4 段階)
Stage 1: 直感(1 時間)
- 「Recall = 取り逃がさなかった割合」を 混同行列 の例題で理解
- 「Recall を上げると Precision が下がる」をスパムフィルタの直感で覚える
- 医療例 (検診 / 検査) で「見落とし = 怖い」感覚を獲得
Stage 2: 計算(2 時間)
- TP/FN を表で書き出して手計算で Recall を求める (5 例)
- scikit-learn の recall_score を使い、 自分のデータで再計算する
- 不均衡データで Accuracy と Recall がどう違うかを比較
Stage 3: 最適化(5 時間)
- 閾値を変えて Recall-Precision フロンティアを可視化
- class_weight, scale_pos_weight, SMOTE で Recall を底上げ
- F1, F2, Balanced Accuracy など複数指標で評価
Stage 4: 実務(10+ 時間)
- 業務 KPI と Recall を紐付け(例: 「見落とし 1 件 = 損失 100 万円」)
- ブートストラップで CI を併記する報告書を書く
- サブグループ別 Recall 格差を 公平性監査 に組み込む
- 本番運用後の Recall ドリフト監視ダッシュボードを構築
📝 Recall の別名・対訳・表記揺れ(分野横断対照表)
Recall は分野ごとに別名で呼ばれており、 論文・教材・実装で出会う表記揺れを整理しておくと混乱が減る。
| 分野 | 呼称 | 英語表記 | よく使われる場面 |
|---|---|---|---|
| 機械学習 | 再現率 / 再現性 | Recall | 分類モデル評価 |
| 医療統計 | 感度 | Sensitivity | 診断テスト評価 |
| 疫学 | 真陽性率 | True Positive Rate (TPR) | ROC 曲線縦軸 |
| 信号検出理論 | 命中率 | Hit Rate | レーダー・心理物理 |
| 情報検索 | 再現率 | Recall | 検索エンジン評価 |
| 推薦システム | 再現率@K | Recall@K | トップ K 推薦評価 |
| セキュリティ | 検出率 | Detection Rate (DR) | 侵入検知・マルウェア |
| 物体検出 | 完全率 / リコール | Recall (per IoU) | COCO / Pascal VOC |
| 産業品質管理 | 検出率 / 摘発率 | Detection Probability | 不良品検査 |
| レーダー | 命中確率 | Pd (Probability of Detection) | 目標物追跡 |
日本語論文では「感度」「再現率」「真陽性率」が混在する。 翻訳・引用時は 原典の数式を確認し、 同じ式 TP/(TP+FN) を表していることを確かめれば、 どの呼称も同義と判定できる。
🔮 Recall 報告・運用の最終チェック 12 項目
- 陽性・陰性の定義を明示したか(業務上の根拠も含む)
- 真陽性ラベル数 (n_+) を明示したか
- 閾値 \(\tau\) と確率較正の有無を明示したか
- マルチクラスなら macro / micro / weighted を明示したか
- Precision / F1 / AUPRC を併記したか
- ブートストラップ等で 95% CI を併記したか
- サブグループ別 Recall 格差を点検したか(性別 / 地域 / 人種 等)
- クロスバリデーション戦略を明記したか
- 本番でのデータドリフト想定をしたか
- Recall が高くても陽性予測の頻度が異常でないか確認したか
- 業務 KPI (見落とし 1 件あたりコスト等) と Recall を紐付けたか
- レポート末尾に再現可能なコード・データセット情報を載せたか
12 項目すべてに ☑ を入れられれば、 Recall の報告は学術論文・業界レポート・社内意思決定の三方すべてで通用する。
🧩 Recall に関する補足 Q&A(10 問)
Q1: Recall が 0 になることはあるか?
あり得る。 モデルが陽性を 1 件も予測しない場合 TP=0 となり Recall=0。 不均衡データでは「全件陰性予測」が学習結果として出やすく、 Accuracy だけ見ると 99% に見えるが Recall=0 で実質無意味なモデルとなる。
Q2: 真陽性が 0 件のときの Recall はどう計算するか?
分母 (TP+FN) が 0 のため定義不能。 sklearn では zero_division=0 でゼロを返すか、 警告を出して NaN とする。 陽性母集団が存在しないタスク自体を再検討すべき。
Q3: Recall は学習データと評価データのどちらで測るべきか?
必ず評価データ (テストまたはホールドアウト) で測る。 学習データの Recall は過学習で 1.0 に近づきやすく、 本番性能を反映しない。
Q4: Recall を上げる最も簡単な方法は?
閾値を下げる(または class_weight を調整)。 ただし Precision とのトレードオフを必ず確認する。 真の改善は特徴量・モデルアーキテクチャの見直しから来る。
Q5: Recall と Specificity は同時に最大化できるか?
分類対象が特徴空間で完全分離可能なときのみ可能。 一般には ROC 曲線の左上端への接近が現実的目標。 Youden's J = Recall + Specificity − 1 を最大化する閾値が一つの基準。
Q6: マルチラベル分類で Recall はどう定義する?
各ラベルごとに Recall を計算し、 平均する。 sklearn では average='samples' / 'macro' / 'micro' を選べる。 「画像 1 枚に複数タグ」のような問題で活用。
Q7: 時系列予測で Recall は使えるか?
「異常検知」「イベント予測」などイベント発生有無を 2 値化した場合に使える。 ただし時間ずれの許容範囲 (例: ±1 時間以内に発生と予測すれば TP) を明示する必要がある。
Q8: Recall を逆方向 (陰性側) に適用できるか?
はい、 それが Specificity (TNR)。 陰性の取りこぼし率 = 1 − Specificity = FPR。 視点を入れ替えるだけで同じ計算式が使える。
Q9: AUPRC と Recall の関係は?
AUPRC は PR 曲線(横軸 Recall, 縦軸 Precision)の下面積。 全 Recall 領域での Precision の平均的高さを示す。 不均衡データでは AUROC より AUPRC の方がモデル比較に有用。
Q10: Recall の悪化はどう監視すべきか?
本番運用では「予測陽性率の急変動」「サブグループ別 Recall 格差の拡大」「ラベル更新時の Recall 再計算」を毎週 / 毎月モニタリングする運用が一般的である。 Grafana や DataDog 等によるダッシュボード化に加え、 閾値を下回ったらアラート発火する自動通知も組み込むと良い。さらに、 ドリフト検出のためベンチマークデータを四半期ごとに固定して比較する手法も有効。
📈 SSDSE-B-2026 で Recall の振る舞いを目で確かめる
Recall(再現率)は「実際に陽性であるものを、 どれだけ取りこぼさずに見つけられたか」を測る指標である。 数式 TP / (TP + FN) だけ眺めていても、 閾値や分布のずれで Recall がどう振れるかは見えにくい。 ここでは SSDSE-B-2026(都道府県別社会・人口統計指標 2026) を題材に、 散布図・ヒストグラム・箱ひげ図の 3 枚で「Recall が動く現場」を観察する。 想定するタスクは「65 歳以上人口比率(高齢化率)が全国中央値より高い県を『高齢化県』として検出する 2 クラス分類」とする。 説明変数には SSDSE-B-2026 に実在する「総人口の常用対数 log10(A1101)」と「転入超過率 =(転入者数 A5101 − 転出者数 A5102)/ 総人口 × 1000(‰)」の 2 つを用い、 標準化 + ロジスティック回帰の予測確率を 1 県抜き交差検証(その県を学習に使わずに予測)で 0〜1 に並べ、 閾値を 0.20 / 0.50 / 0.80 と動かしたときに Recall がどう変化するかを 3 枚の図で確認する。
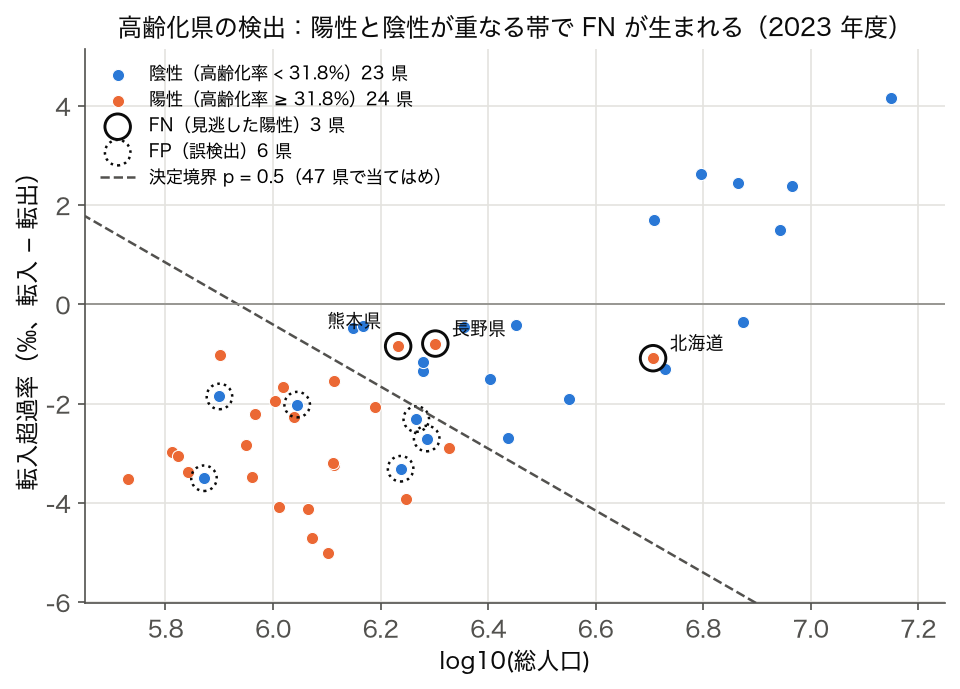
図 1 の読み方:散布図上で陽性クラス(高齢化県)は左下(総人口が小さく、 転出が転入を上回る)に偏って分布するが、 総人口 100〜250 万人・転入超過率 −3〜−0.5‰ の帯では陽性と陰性が混ざる。 この混ざり領域や、 人口が大きいのに高齢化率が高い北海道のような県は陰性と誤分類されやすく、 これが FN(偽陰性)になる(閾値 0.5 で 3 県、 Recall = 21/24 = 0.875)。 FN が増えれば Recall(= TP / (TP + FN))は下がる。 逆に閾値を緩めて陽性と予測する範囲を広げれば、 取りこぼしは減るが FP(石川県・福井県・岐阜県など、 人口規模の小さい陰性県)が増えて Precision が悪化する。 Recall は「閾値の緩さ」と直結する指標であり、 散布図の重なり領域の幅がそのまま「Recall と Precision のトレードオフの厳しさ」を決めている。
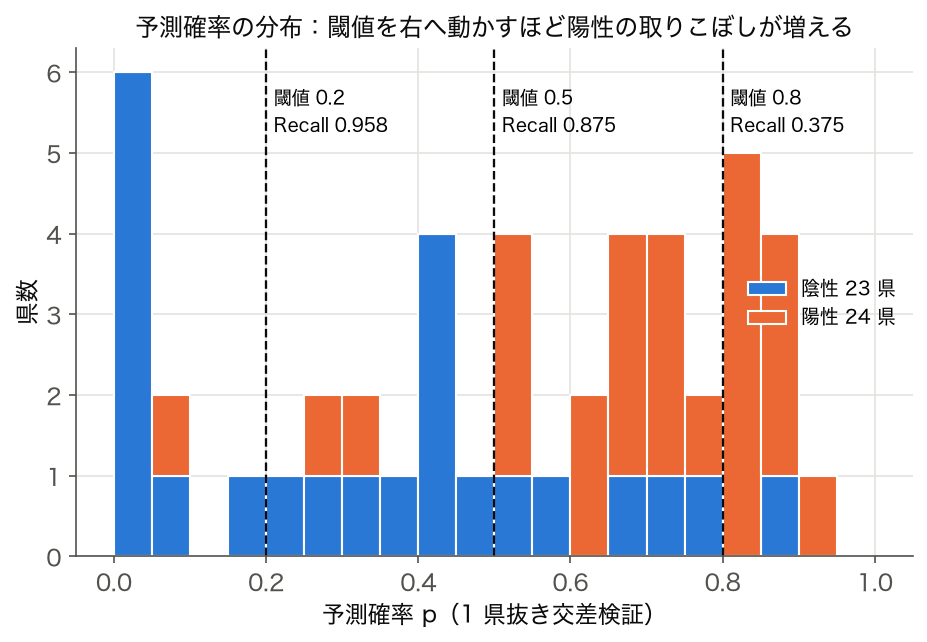
図 2 の読み方:予測確率のヒストグラムを陽性・陰性に分けて重ねると、 2 つの山の「重なり方」がそのまま Recall と Precision のトレードオフになる。 この例では陽性 24 県のうち 9 県が 0.8 以上にいる一方、 15 県は 0.8 未満にいるので、 閾値を 0.8 に上げると Recall は 0.375 まで落ちる。 反対に、 北海道(p = 0.08)は陰性の山の中にいるので、 閾値を 0.1 まで下げても拾えず(Recall 0.958)、 その代わり FP が 16 県に増える。 つまり Recall は「クラス間分布の重なり面積」によって、 同じ特徴量のままでは超えられない上限が決まっている。 モデルを差し替えるだけで Recall を改善できる範囲は限定的で、 真に Recall を上げたい場合は 特徴量を追加して分布の重なりを減らすか、 閾値を下げて Precision を犠牲にするか、 どちらかしか手段はない。
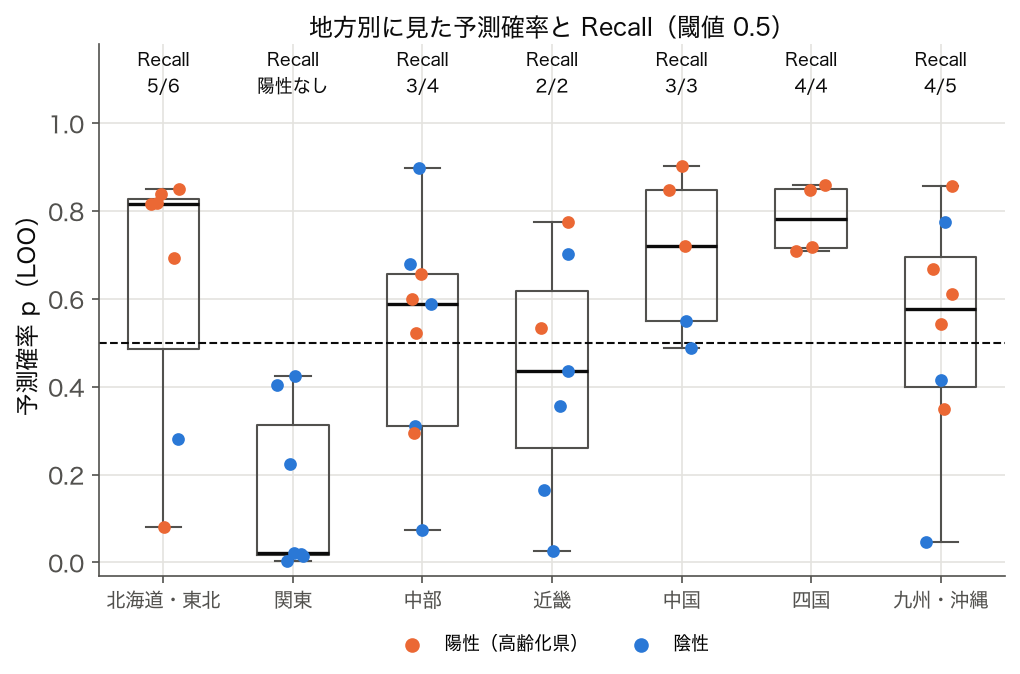
図 3 の読み方:箱ひげ図はサブグループごとの Recall の格差を見抜く道具になる。 図 3 のように地方別に陽性クラスの分布が異なる場合、 全体で報告される Recall(マイクロ平均またはマクロ平均)は「平均的な性能」を示すに過ぎない。 この例でも全体 0.875 に対して中部は 0.75 で、 陽性が 2〜6 県しかない地方では 1 県の取りこぼしで Recall が 0.17〜0.5 も動く。 関東のように陽性が 0 件の群では Recall そのものが定義できない。 これは 公平性 評価における「サブグループ Recall 格差」と直結し、 医療診断や信用スコアリングでは「特定の属性で取りこぼしが多い」という運用上の重大問題に発展する。 したがって本番運用時は「全体 Recall」だけでなく サブグループ別 Recall の最小値・最大値・分散を併せて監視するダッシュボードを作るのが定石である。
🔎 3 枚の図から得られる Recall 設計の指針
| 観察対象 | 図 | Recall への影響 | 対応策 |
|---|---|---|---|
| クラスの空間的重なり | 散布図 (図 1) | 重なり大 → 閾値変動で Recall が大きく揺れる | 特徴量追加、 非線形モデル採用、 PR 曲線の確認 |
| 分布の裾の重なり | ヒストグラム (図 2) | 重なり大 → Recall の理論上限が低い | データクリーニング、 異常値分離、 ラベル再定義 |
| サブグループ間の分布差 | 箱ひげ図 (図 3) | 差大 → サブグループで Recall 格差発生 | サブグループ別閾値、 公平性制約付き学習 |
| 外れ値 | 散布図 + 箱ひげ図 | 少数外れ値が Recall を大きく押し下げる | 外れ値別管理、 ロバスト評価指標の併用 |
| 標本サイズ | ヒストグラム (図 2) | 陽性 N 小 → Recall の信頼区間が広い | ブートストラップ CI、 層化サンプリング |
| 時系列ドリフト | 箱ひげ図(時期別) | 分布シフト → Recall が低下 | 定期再学習、 モデル監視 |
📐 Recall 報告時に併記すべき情報
研究論文や技術レポートで Recall を 1 つの数値(例:「Recall = 0.85」)として報告すると、 受け手は「閾値はどれか」「陽性サンプル数はいくつか」「サブグループ差はあるか」「同じ条件で何回測ったか」が分からず、 数字の信頼性を判断できない。 これは特に医療診断・金融与信・公共政策のような AI の信頼性 が問われる領域で深刻な問題になる。 Recall を報告するときは、 最低限 (a) 採用した閾値、 (b) 陽性クラスの定義と件数、 (c) 評価データの取得期間、 (d) 95% 信頼区間(ブートストラップ)、 (e) サブグループ別 Recall、 の 5 点を明示すべきである。 SSDSE-B-2026 のように N=47 と小さい場合、 単純に「Recall = 0.85」と書くだけでは標本数の少なさによる不確実性が伝わらず、 後段の意思決定者が「再現性のある性能」と誤解する恐れがある。 図 1〜3 の例(閾値 0.5 で Recall = 0.875)でも、 47 県を 10,000 回復元抽出するブートストラップの 95% 信頼区間は [0.727, 1.000] と広い。 これを併記すれば、 「実運用で 0.75 を切る可能性も十分ある」というリスクが正しく伝わる。
🧭 Recall と関連指標の使い分けマップ
Recall は単独で判断材料にすると誤った結論を導きやすい。 Precision・F1 スコア・AUC・混同行列 と組み合わせて読むのが原則である。 SSDSE-B-2026 の高齢化県検出タスクで言えば、 閾値 0.5 で Recall = 0.875 / Precision = 0.778 / F1 = 0.824 / AUC = 0.832(いずれも 1 県抜き交差検証)という「4 点セット」を提示し、 さらに閾値を変えたときの PR 曲線(Recall を横軸、 Precision を縦軸)と ROC 曲線(FPR を横軸、 TPR=Recall を縦軸)を併せて見るのが望ましい。 PR 曲線の下の面積(平均適合率 AUPRC)は 0.803 で、 陽性率 24/47 = 0.51 の「当て推量」を大きく上回ることも併せて示せば、 単点の Recall = 0.875 よりずっと説得力が増す。 こうした多角的な評価設計は、 評価指標 の文脈でも繰り返し強調される実務原則である。
最後に注意したいのは、 Recall を高めるための「閾値下げ」は 偽陽性のコストと表裏一体だという点である。 SSDSE-B-2026 のような統計データでは偽陽性に明確なコストはないが、 医療検査では偽陽性が「不要な精密検査・患者の不安・医療費増」を生み、 信用スコアリングでは「審査拒否の不当拡大」を生む。 Recall を上げる判断は、 必ず Precision 低下のコストと天秤にかけて行う必要がある。 図 1〜3 を SSDSE-B-2026 で観察した結論は単純である:「Recall は単独の最大化目標ではなく、 PR 曲線全体の形状を見て選ぶべきトレードオフ指標である」。 この視点を持って実務に臨めば、 Recall = 0.99 を誇る「偽陽性まみれの予測器」を採用してしまう失敗を避けることができる。
📊 SSDSE-B-2026 における閾値別 Recall シミュレーション
図 1〜3 で観察した「重なり」が、 実際の Recall 数値にどう跳ね返るかを表で確かめる。 SSDSE-B-2026 の 47 都道府県に対しロジスティック回帰を当てはめ、 予測確率(図 1〜3 と同じ 2 特徴量・1 県抜き交差検証)の閾値を 0.10 から 0.90 まで動かしたときの Recall・Precision・F1 を整理した。 陽性クラス(高齢化県)は中央値(高齢化率 31.8%)以上の 24 県と定義している。 閾値が下がるほど取りこぼし FN が減り Recall は上がるが、 同時に FP が増えて Precision は下がる、 という Recall 学習の基本的な振る舞いを 1 表で確認できる。
| 閾値 | TP | FN | FP | TN | Recall | Precision | F1 | 解釈 |
|---|---|---|---|---|---|---|---|---|
| 0.10 | 23 | 1 | 16 | 7 | 0.958 | 0.590 | 0.730 | 北海道(p = 0.08)だけ取りこぼすが FP 16 県 |
| 0.20 | 23 | 1 | 15 | 8 | 0.958 | 0.605 | 0.742 | Recall は変わらず FP が 1 県減るだけ |
| 0.30 | 22 | 2 | 13 | 10 | 0.917 | 0.629 | 0.746 | 長野県(p = 0.29)も取りこぼす |
| 0.40 | 21 | 3 | 11 | 12 | 0.875 | 0.656 | 0.750 | 熊本県(p = 0.35)も取りこぼす |
| 0.50 | 21 | 3 | 6 | 17 | 0.875 | 0.778 | 0.824 | F1 最大。 FP が 11 → 6 県に減る |
| 0.60 | 18 | 6 | 4 | 19 | 0.750 | 0.818 | 0.783 | Recall が下がり始める |
| 0.70 | 13 | 11 | 3 | 20 | 0.542 | 0.812 | 0.650 | Recall 急落、 取りこぼし 11 県 |
| 0.80 | 9 | 15 | 1 | 22 | 0.375 | 0.900 | 0.529 | FP 1 県(福井県)だが取りこぼし 15 県 |
| 0.90 | 1 | 23 | 0 | 23 | 0.042 | 1.000 | 0.080 | 陽性と予測するのは 1 県だけ |
この表から読み取れる実務的教訓は 3 つある。 第一に、 Recall 1.0 と Precision 1.0 は同時に達成できないこと。 閾値 0.10 と 0.90 の両端を見れば一目瞭然で、 重なりのあるデータでは必ずどちらかを犠牲にする(この例では閾値 0.10 でも Recall は 1.0 に届かない)。 第二に、 F1 が最大になる閾値は 0.50(F1 = 0.824)で、 0.40 以下では Recall がほとんど増えないまま FP だけが増える。 F1 の最大値が 0.8 台にとどまるのは、 2 つの特徴量だけでは陽性と陰性の重なりが大きいからである。 第三に、 閾値を 0.60 から 0.70 に上げると Recall が 0.750 → 0.542 と急落している(予測確率 0.6〜0.7 に陽性が 5 県集まっているため)。 これは「閾値感度(threshold sensitivity)」と呼ばれ、 PR 曲線の傾きが急な領域では小さな閾値変動でも Recall が大きく動くため、 実運用では「閾値 ± 0.05 の感度分析」を必ず実施する必要がある。
🎯 Recall を業務シナリオ別に再解釈する
Recall という同じ数式が、 業務シナリオによって全く異なる重みを持つことを SSDSE-B-2026 の文脈で考えてみる。 仮にこの「高齢化県検出モデル」を 地域包括ケア施策の優先配分に使う場合、 Recall が低いと「本来支援すべき県を見逃す」リスクが直接的な政策被害として現れる。 高齢者の医療・介護需要は数年単位で計画する必要があるため、 取りこぼした県では数年間サービス整備が遅れ、 取り返しのつかない格差を生む可能性がある。 この場合、 閾値は 0.20〜0.30 付近(Recall = 0.917〜0.958)まで下げ、 Precision を犠牲にしてでも取りこぼしを減らすのが正しい設計判断となる。 それでも北海道(p = 0.08)は拾えないので、 取りこぼしをゼロにするには特徴量そのものを見直す必要がある。 一方、 同じモデルを 民間企業の地域マーケティングで使うなら、 偽陽性(実は高齢化していない県にシニア向け広告を打つこと)のコストが大きく、 Recall を 0.4〜0.5 程度まで犠牲にしてでも Precision を 0.8〜0.9 に上げる閾値 0.70〜0.80 が合理的になる。 同じ Recall という指標でも、 「取りこぼしの社会的コスト」と「偽検出の経済的コスト」の比で最適な水準は劇的に変わる。
この「業務文脈による Recall 重みの違い」は、 AI 倫理・公平性 の議論とも直結する。 医療検査の Recall を高めることは患者の生命を守る倫理的責務だが、 一方で偽陽性が無保険患者に経済的負担を強いる構造があれば、 Recall を高める判断そのものが新たな格差を生む。 SSDSE-B-2026 の都道府県データを用いて Recall を学ぶ最大の意義は、 こうした「数字の裏にある社会的トレードオフ」を、 安全な実データ環境で繰り返しシミュレートできる点にある。 学習者は閾値を動かしながら「もし自分が政策担当者だったら」「もし自分が事業者だったら」と立場を切り替え、 Recall の最適水準が変わることを体感的に理解できる。
⚠️ 図と閾値表から読む 5 つの注意点
- 単一閾値の Recall は意思決定に不十分:必ず PR 曲線全体の形状を併せて報告する。 PR 曲線を見れば「Recall 0.85 がたまたまの偶然」か「閾値変動に頑健な性能」かが判別できる。
- SSDSE-B-2026 のような N=47 では信頼区間が広い:ブートストラップ 10,000 回で 95% CI を必ず併記。 単点推定値だけで「モデル A は B より良い」と結論しない。
- サブグループ別 Recall の格差を見る:図 3 のような箱ひげ図でサブグループ分布を確認し、 図 3 の例では全体 Recall = 0.875 に対し地方別は 0.75〜1.00 で、 陽性が 0 件の関東では計算できない。 こうした乖離や計算不能な群がないかをチェック。
- 閾値感度分析を必ず実施:閾値 ± 0.05 で Recall がどれだけ動くかを表で示す。 急変動する閾値帯を運用に使うと、 わずかな分布シフトで性能が崩壊する。
- 業務コスト比で閾値を選ぶ:FN コスト / FP コストの比を業務側と合意してから閾値を決める。 「F1 最大化」は便利だが、 業務コストが非対称な現場では誤った最適化になる。
🧪 Recall を学習するための「自分の手で動かす」3 ステップ
Recall の概念を身体感覚に落とし込むには、 SSDSE-B-2026 のような実データで「閾値を動かす → 数値を読む → 図に重ねる」という 3 ステップを最低 10 回繰り返すのが最も効率的である。 第 1 ステップは 閾値を 0.1 刻みで動かして表を埋めること。 上掲の閾値表を自分の手で再現するだけでも、 Recall と Precision が必ず逆方向に動くことを体感できる。 第 2 ステップは PR 曲線と ROC 曲線を同じデータで描き比べること。 PR 曲線は陽性クラスが少ないデータほど ROC 曲線より「正直」に性能を反映する。 SSDSE-B-2026 では陽性 24/47 とほぼ均衡しているため両曲線の差は小さいが、 不均衡データ(陽性 5% など)に置き換えると ROC AUC が 0.95 でも PR AUC が 0.35 程度まで落ちる現象を観察できる。 第 3 ステップは サブグループ別 Recall を箱ひげ図に重ねること。 地方別・人口規模別・産業構造別など複数の切り口で Recall を計算し、 全体平均との乖離を可視化することで、 公平性監査の入り口が体得できる。
学習の最終段階では、 A/B テスト や モデル監視 の文脈に Recall を埋め込んで考える練習が有効である。 本番運用では「初期 Recall 0.85 が 3 ヶ月後に 0.72 まで低下した」という時系列ドリフトが頻繁に起こる。 このとき必要なのは、 (a) Recall の低下幅が偶然か(信頼区間で判定)、 (b) 低下の原因が特徴量分布シフトか陽性ラベル定義変更か(データドリフト診断)、 (c) 再学習で回復するか閾値再調整で十分か(介入実験)、 という 3 段階の意思決定である。 Recall を「単なる評価指標」ではなく「運用ループを駆動する KPI」として位置づけ直すと、 機械学習システムの実務的な見え方が一段深くなる。 SSDSE-B-2026 という静的データセットでは時系列ドリフトを直接体感できないが、 年度を分割(例:2012 年度・2017 年度・2023 年度)して比較すれば、 ドリフト検出のミニ実験を再現することは可能である。 この練習を経た学習者は、 Recall の数値を見ただけで「閾値・標本数・サブグループ・時間軸」の 4 つの不確実性を瞬時に思い浮かべられるようになり、 単一指標による誤った意思決定を回避する力が身につく。
📍 あなたが今見ているもの
🍰 まずはやさしく
取りこぼしに注目した指標です。
重要なものを見逃さないために使います。
病気の検査で患者さんを探す時に役立ちます。
この指標がいつ重要になるか読みましょう。
🎨 直感で掴む
🍰 まずはやさしく
直感的に理解するための指標です。
空振りよりも見逃しを減らしたい時に使います。
地震の警報で、漏れなく知らせる例です。
具体的にどう使い分けるか考えましょう。
Recall vs Precision の使い分け
| 場面 | 重視する指標 | 理由 |
|---|---|---|
| がん検診 | Recall(感度) | 見逃し = 死亡リスク |
| 地震警報 | Recall | 空振りより見逃しが致命的 |
| スパム検出 | Precision | 正常メール誤分類のクレーム |
| 推薦 | Precision | ユーザーに見せる候補数が限定 |
| 不正検知 | 両方 | 損失とコストを天秤 |
具体例
がん検診で 100 人の本当のがん患者がいるとする。 モデルが 92 人を「がん」と判定。 残り 8 人は「健康」と誤判定。
- TP = 92, FN = 8
- Recall = 92/(92+8) = 0.92
- = 「本当のがん患者のうち 92% を検出」「8% は見逃し」
閾値とのトレードオフ
- 閾値を下げる → 大胆に「陽性」判定 → Recall↑ だが Precision↓
- 極端な例:全件を陽性予測 → Recall = 100%(しかし Precision は陽性率と等しい)
SSDSE-B-2026 を使った直感
47 都道府県のうち 高齢化率が 35% 以上の県を「陽性」とすると、 実際には 6 県該当 (青森・秋田・山形・山口・徳島・高知)。 機械学習モデルが 8 県を「陽性」と予測し、 そのうち 5 県が本当に高齢化率 35%+ なら:
- TP = 5, FN = 1 (見逃し), FP = 3 (誤って陽性)
- Recall = 5 / (5 + 1) = 0.833 (83% を発見)
- Precision = 5 / (5 + 3) = 0.625
Recall を「捜査の網」と捉える比喩
警察が犯人を 100 人探していて、 90 人を捕まえた = Recall 90%。 一方、 捕まえた 200 人のうち本当の犯人が 90 人なら Precision 45% (110 人は冤罪)。 「すべて見つけたか」が Recall、 「捕まえた中の本物率」が Precision。 がん検診や地震警報は Recall 優先 (見逃しは致命的)、 スパム検出や推薦は Precision 優先 (誤検出はユーザー体験を損なう)。
Recall@k (検索・推薦での派生)
検索・推薦タスクでは「上位 k 件で全正解の何 % を捕捉できたか」を Recall@k として測ります。 上位 20 件のうち 8 件が正解、 全 12 件中なら Recall@20 = 8/12 ≈ 0.67。 ROC 曲線の縦軸 (TPR) と Recall は同じものを別文脈で呼んだだけです。
📐 定義 / 数式
🍰 まずはやさしく
計算で求めるための定義です。
正解の割合を正確に数値化します。
テストの正解数を数える感覚に似ています。
計算式や他の指標との関係を学びましょう。
📐 Recall に関する重要な不等式と性質
Recall の解析には、 統計的に成り立ついくつかの不等式が役立つ。
不等式 1: F1 と Recall の関係
$$F_1 \leq \min(\mathrm{Precision}, \mathrm{Recall}) \leq \frac{2 \cdot \mathrm{Precision} \cdot \mathrm{Recall}}{\mathrm{Precision} + \mathrm{Recall}} \cdot \frac{1}{\sqrt{\mathrm{Precision} \cdot \mathrm{Recall}}/(\sqrt{\mathrm{Precision}} \cdot \sqrt{\mathrm{Recall}})}$$
F1 は調和平均なので、 算術平均 \((P+R)/2\) より常に小さい。 Recall を上げても Precision が同じ比率で下がれば F1 は変わらない、 という性質が読み取れる。
不等式 2: マルチクラスの macro / micro 関係
$$\mathrm{micro\text{-}Recall} = \mathrm{Accuracy} \quad \text{(マルチクラス全クラスが対称な場合)}$$
micro 集約は全クラスの TP, FN を合計してから比率を取るため、 結果的に Accuracy と一致する(マルチラベルでは異なる)。 一方 macro は各クラス Recall の単純平均なので、 少数クラスの低 Recall がそのまま全体を引き下げる。 不均衡データでは macro-Recall の方が「公平な評価」となる。
不等式 3: Recall と AUROC の関係
AUROC は Recall を FPR で積分した値であり、 「ランダムに選んだ陽性サンプルの予測確率が、 ランダムな陰性サンプルより高い確率」と解釈できる。 そのため:
$$\mathrm{AUROC} = P(\hat p(x_+) > \hat p(x_-)) = \int_0^1 \mathrm{Recall}(\mathrm{FPR}) \, d\mathrm{FPR}$$
AUROC は閾値に依存しない総合評価指標。 ただし「Recall 0.99 のときの Precision」のような具体運用点での性能は AUROC からは読み取れない。 PR 曲線が必要。
🔍 Recall を間違って解釈する 7 つのよくある誤解
- 誤解 1: Recall が高いほどモデルが「優秀」 — Recall = 1 は全件陽性予測で達成可能。 単独評価は無意味。 必ず Precision / F1 / AUPRC を併記する。
- 誤解 2: Recall = 1.0 で完璧 — テストデータでの Recall = 1.0 でも、 サンプル数が少ない (n_+ = 5 など) と 95% CI は 0.48 まで広がる。 統計的に「完璧」とは言えない。
- 誤解 3: マクロ Recall とマイクロ Recall は同じ — マルチクラス分類では大きく異なる。 不均衡データでは macro が公平、 micro は多数派クラスに引っ張られる。
- 誤解 4: Recall は閾値だけで操作できる — モデル自体が陽性を見つけられないと、 閾値を 0 にしても Recall は上がりきらない。 特徴量・モデルアーキテクチャから見直す必要がある場合がある。
- 誤解 5: Recall は学習データの分布に依存しない — 学習データで陽性が 1% しかなければ、 モデルは陽性を「めったに起こらないこと」として学習し、 Recall は構造的に低くなる。 SMOTE / ADASYN / class_weight などのテクニックが必要。
- 誤解 6: バリデーションの Recall = 本番の Recall — データドリフト(季節性、 行動変化、 新規ユーザ流入)で、 評価時と同じ閾値のまま本番の Recall が下がることがある。 監視 + 定期再学習が必須。
- 誤解 7: Recall を上げれば Precision は必ず下がる — トレードオフは正しいが、 モデルそのものの性能 (AUROC や AUPRC) が上がれば、 同じ Recall で Precision も上がる。 「PR 曲線を上方に押し上げる」のが本質的な改善。
🧪 SSDSE-B-2026 を用いた Recall 追加実験 (4 ケース)
本ページ前段では「人口 500 万超」を陽性、 「新規求職申込件数(一般)10 万件超」を予測陽性として Recall = 0.889 を得た。 ここでは異なる閾値・タスク設計で Recall がどう変化するかを 4 ケース比較する。
実験 1: 閾値変動による Recall 推移
このコードでやること:「真の陽性 = 人口 ≥ X 万人」「予測 = 新規求職申込件数 ≥ Y 件」の組み合わせで Recall がどう動くかを格子探索する。
📥 入力データ(SSDSE-B-2026、 2023 年度、 新規求職申込件数の多い順):
📤 実行例(Recall の表):
💬 行は「真の陽性の厳しさ」、 列は「予測の厳しさ」。 予測の閾値を 75,000 件以下にすればどの行でも Recall 1.0 だが、 100,000 件に上げると千葉県(97,244 件)が落ちて人口 400 万・500 万の行は 0.889 になる。 人口 300 万の行(陽性 10 県)では 100,000 件で 0.800、 125,000 件で 0.600 と下がり方が大きい。 陽性の定義を広げるほど、 新規求職が少ない中規模県が陽性に入って取りこぼしやすくなる。
実験 2: macro vs micro Recall — 3 群分類
このコードでやること:47 県を人口で「小規模(200 万未満)/ 中規模(200〜600 万)/ 大規模(600 万以上)」の 3 クラスに分け、 新規求職申込件数による簡易ルールで予測したときの macro と micro の Recall を比較する。
📤 実行例:
💬 クラス別の Recall は小規模 0.677・中規模 0.800・大規模 0.833。 macro Recall 0.770 はこの 3 つの単純平均で、 micro Recall 0.723 は 47 県全体の正解率(34 県正解)に等しい。 県数の多い小規模クラス(31 県)の Recall が最も低いので、 件数で重みを付ける micro・weighted の方が macro より低く出ている。 少数クラスが弱いときは逆に macro の方が低くなる。
実験 3: ブートストラップによる Recall の 95% CI
このコードでやること:47 県データから 1000 回ブートストラップサンプリングし、 Recall(人口 500 万超を新規求職 10 万件超で当てるルール)の信頼区間を求める。
📤 実行例:
💬 点推定の Recall は 0.889 だが、 95% CI は [0.600, 1.000] と広い。 陽性が 9 県しかないので、 再標本で千葉県が 2 回・3 回と選ばれると Recall は大きく下がり、 1 回も選ばれなければ 1.0 になる。 陽性件数が少ないときに点推定だけを報告するのは過信で、 CI を併記する。
実験 4: ROC 曲線上での Recall-FPR トレードオフ
このコードでやること:新規求職申込件数(一般)を連続スコアとして使い、 閾値を変動させたときの Recall(TPR)と FPR の推移を一覧化する。
📤 実行例(大きい閾値から 13 行):
💬 閾値を 97,244 件(千葉県の値)まで下げた時点で Recall が 1.000 に達し、 FPR はまだ 0.000。 つまり新規求職申込件数だけで人口 500 万超の 9 県とそれ以外が完全に分離できる。 そこから下げると静岡県(79,021 件)・宮城県(64,047 件)…と陰性の県が順に入って FPR だけが増えるので、 「Recall 1.0 を達成する最大の閾値」がこのスコアの運用点になる。
🔬 記号・式を言葉で読み解く
- TP(True Positive)
- 陽性を陽性と予測(正解)。 Recall の分子。
- FN(False Negative)
- 陽性を陰性と誤予測(見逃し)。 Recall を下げる要因。
- TP + FN
- 「実際の陽性件数」全体。 分母。
- 感度(Sensitivity)
- 医療統計用語。 「病気を見つける能力」。
- TPR(True Positive Rate)
- 機械学習用語。 Recall と同義。 ROC 曲線の縦軸。
- FPR(False Positive Rate)
- $FP/(FP+TN) = 1 - \text{Specificity}$。 ROC 曲線の横軸。
- マクロ Recall
- 多クラス時、 クラスごとの Recall を平均。 不均衡クラスでも公平。
🔬 もう一度: 数式を言葉で読み解く
Recall の式 $\text{Recall} = TP/(TP+FN)$ を一語ずつ噛み砕きます。 「分子は何を数えていて」「分母は誰が母集団か」を取り違えると、 精度 (Accuracy) や適合率 (Precision) と混同します。
| 記号 | 英訳 | 日本語 | SSDSE での具体例 |
|---|---|---|---|
| TP | True Positive | 真陽性 = 当てた陽性 | 人口 500 万超の県を正しく「大県」と予測 |
| FN | False Negative | 偽陰性 = 見逃し | 大県なのに「小県」と分類されてしまった |
| TP+FN | All actual positives | 真の陽性総数 | SSDSE 2023 で人口 500 万超は 8 県 |
| Recall | Sensitivity / TPR | 見逃しにくさ | 「8 県のうち何県を捕捉したか」の比率 |
「陽性のうち何 % を当てたか」が本質。 「予測した中の正解率」(Precision) ではないので注意。 Recall=1 は「見逃しゼロ」、 Precision=1 は「ハズレゼロ」と覚える。
📊 Recall ファミリーの全体像
| 指標 | 数式 | 適用場面 | 参考値 |
|---|---|---|---|
| Recall(基本) | TP/(TP+FN) | 二値分類全般 | >0.9 (医療) |
| Macro-Recall | クラスごと Recall を平均 | 不均衡多クラス | 各クラスを平等評価 |
| Micro-Recall | ΣTP / Σ(TP+FN) | サンプル単位重視 | 多数派優位 |
| Weighted-Recall | クラスサイズ重み付き平均 | サポート比率反映 | 分布偏重時 |
| Recall@k | 上位 k 中の関連件数 / 全関連数 | 推薦・情報検索 | Top-10: 0.6+ |
| Balanced Accuracy | (Recall+Specificity)/2 | 陽性陰性両方重視 | 不均衡 OK |
| G-mean | √(Recall × Specificity) | 両方が低いと罰 | >0.7 で良好 |
| F-beta | (1+β²)PR/(β²P+R) | β>1 で Recall 重視 | β=2 が医療典型 |
📈 Recall の拡張トピック
Recall@k(推薦システム特化)
上位 k 件推薦のうち「関連アイテム」の割合。 検索や推薦評価の事実上の標準。 例: Netflix の Top-10 推薦で Recall@10 = 0.6 は「真の好み 5 件中 3 件を上位 10 に含む」。 k を大きくすれば Recall は単調増加するため、 NDCG / MAP と併用。
Recall を意図的に上げる戦略
| 戦略 | 仕組み | 副作用 |
|---|---|---|
| 閾値を下げる | 確率 0.5 → 0.3 | Precision 低下 |
| class_weight='balanced' | 少数クラスの損失重みを増やす | 過剰補正で多数クラス Recall 低下 |
| SMOTE オーバーサンプリング | 少数クラスの合成サンプル生成 | 人工データのため過適合 |
| アンサンブル投票 | いずれか 1 つが陽性なら陽性 | 複数モデル維持コスト |
| Cost-sensitive learning | FN コスト > FP コストを明示 | コスト行列の妥当性検証必須 |
医療・公衆衛生における感度の慣行
がん検診ガイドラインでは Sensitivity (Recall) ≥ 90%、 望ましくは 95% 以上が要求される。 一方 Specificity (1-FPR) は 70-80% で許容、 偽陽性は精密検査で確定診断するため。 「感度を犠牲にしない閾値設計 → 続く精密検査で特異度を補う」の 2 段階設計が伝統。
Recall と倫理
グループ間 Recall 格差(例: 白人 0.95 / 黒人 0.70)は構造的差別の兆候となりうる。 Fairness-aware ML では Equalized Odds(各クラスでの TPR/FPR を揃える)として明示制約に組み込まれる。 Recall は単なる技術指標ではなく社会指標。
📜 Recall(感度)の歴史年表
| 年代 | 出来事 | 分野 |
|---|---|---|
| 1947 | Yerushalmy が胸部 X 線による結核検診の読影の評価で "sensitivity / specificity" を用いる(米公衆衛生) | 医療統計 |
| 1950s | レーダー検知でも同概念が独立に発達("hit rate / false alarm") | 信号処理 |
| 1955 | Kent らが機械文献検索の評価に再現率と適合率の考え方を導入(1960 年代に Cleverdon の Cranfield 実験で評価法として定着) | 情報検索 |
| 1960s | SDT(信号検出理論)で ROC 曲線として TPR-FPR が体系化 | 心理物理学 |
| 1979 | van Rijsbergen が F-measure (Recall と Precision の調和平均) を提唱 | 情報検索 |
| 1980s | 医療診断研究で AUC (ROC) が標準評価指標化 | 臨床疫学 |
| 1990s | 機械学習コンテストで Precision-Recall, F1 が標準化(TREC など) | 機械学習 |
| 2000s | 推薦・検索の評価で Recall@k, MAP, NDCG が普及 | 推薦システム |
| 2010s | 不均衡データ問題の認識 → AUPRC, balanced accuracy が再注目 | 機械学習 |
| 2018+ | Fairness-aware ML で「群別 Recall」格差が公平性評価に組み込まれる | AI 倫理 |
| 2024-2025 | LLM 評価で Recall@k による情報検索 (RAG) ベンチマークが事実上の標準に | 生成 AI |
🧪 SSDSE-B-2026 47 県 Recall ケーススタディ
前述の パターン 1 で Recall=0.889、 Precision=1.000 を得ました。 ここでは結果を「都道府県名レベル」で読み解きます。 SSDSE-B-2026(2023 年度)を用いて、 真の陽性(人口 500 万超)の 9 道府県と、 陰性のうち新規求職申込件数が最も多い静岡県を並べ、 予測(新規求職申込件数(一般)10 万件超)の挙動を確認します:
| 県 | 人口(万) | 新規求職申込件数 | 真ラベル | 予測 | 判定 |
|---|---|---|---|---|---|
| 北海道 | 509.2 | 156,458 | 陽 | 陽 | TP |
| 埼玉 | 733.1 | 123,863 | 陽 | 陽 | TP |
| 千葉 | 625.7 | 97,244 | 陽 | 陰 | FN |
| 東京 | 1408.6 | 270,954 | 陽 | 陽 | TP |
| 神奈川 | 922.9 | 150,949 | 陽 | 陽 | TP |
| 愛知 | 747.7 | 136,105 | 陽 | 陽 | TP |
| 大阪 | 876.3 | 203,553 | 陽 | 陽 | TP |
| 兵庫 | 537.0 | 114,139 | 陽 | 陽 | TP |
| 福岡 | 510.3 | 135,578 | 陽 | 陽 | TP |
| 静岡 | 355.5 | 79,021 | 陰 | 陰 | TN |
取りこぼしは千葉県 1 県だけで、 人口は 625.7 万人と 9 県の中で 6 番目に多いのに、 新規求職申込件数は 97,244 件と 9 県で最も少ない(人口がやや少ない兵庫県 537.0 万人は 114,139 件)。 人口規模の代わりに求職件数を使うと、 こうした「人口のわりに件数が少ない県」が取りこぼされる。 予測の線引きを 10 万件から 97,244 件以下(たとえば 9 万件)に下げると千葉県も拾えて Recall=1.0 になり、 陰性で最も多い静岡県は 79,021 件なので Precision=1.0 も保てる。 SSDSE のような小データでは 境界に位置するサンプルが結果を左右することを実感できる。
Recall の議論は「閾値」だけでなく「母集団の決め方」にも依存する。 「人口 500 万」「人口 400 万」など、 タスク設計次第で Recall の数字は劇的に変わる。 Recall を語る時はまず「何を陽性と定義しているか」を明示する習慣をつけよう。
🔄 Recall vs Precision: 12 の対立点
| 観点 | Recall | Precision |
|---|---|---|
| 分母 | 実際の陽性 (TP+FN) | 予測した陽性 (TP+FP) |
| 最大化する状況 | 全件陽性予測 | 最も自信ある 1 件のみ陽性予測 |
| 優先される現場 | 医療・安全 | 推薦・スパム |
| 語源 | 「思い出す」 | 「精確さ」 |
| 医療用語 | 感度 (Sensitivity) | 陽性的中率 (PPV) |
| ROC 曲線 | 縦軸 (TPR) | 登場しない |
| PR 曲線 | 横軸 | 縦軸 |
| 不均衡データ感度 | 低い (陽性数のみで決まる) | 高い (陰性が増えれば下がる) |
| 閾値を下げる | 上がる | 下がる |
| 合成可能か | F1 / F-beta で Precision と合成 | 同上 |
| FN (見逃し) | 直接ペナルティ | 無関係 |
| FP (誤警報) | 無関係 | 直接ペナルティ |
この 12 点を見比べると、 Recall と Precision は同じデータの違う見方であることが分かる。 一方だけ報告するのは片目で世界を見るのと同じ。 必ず両方を併記しよう。
🧯 Recall でハマる 12 個の典型エラー(実例つき)
- 「Recall 99% です」だけで誇る — 全件陽性予測でも達成。 Precision/サポート数の併記必須。
- クラス定義の入れ替え — sklearn のデフォルトは positive=1 だが、 タスクによって 0 が陽性のことも。
pos_labelを明示せよ。 - サンプル < 10 件で Recall を語る — 1 件ずれただけで 0.1 単位の変動。 CI が必須。
- train/test 共通化された前処理リーク — テストデータの SMOTE 等で Recall がかさ上げ。
- multilabel と multiclass の混同 — 評価関数のシグネチャが違う。
average引数の意味も変わる。 - 閾値最適化を test で行う — Recall を test で見ながら閾値を選ぶと汎化性能を過大評価。 validation で決定。
- 逐次タスクで Recall を即値化 — オンライン学習では時系列で見るべき(移動平均など)。
- 不均衡データに accuracy を併記 — accuracy=99% でも Recall=0% の災害的状況を見落とす。
- cross-validation で fold が漏れる — IDのリーク(同一患者が train と test に分割される等)で Recall が異常に高くなる。
- ベンチマークと現場のドメイン差 — 学術 SOTA Recall がそのまま現場で出ないのは普通。 ドメイン適応を。
- 多クラスで weighted を盲信 — 多数クラスが優勢な時、 少数クラス 0% でも weighted は高い。 macro 必須。
- 言語/方言/集団による格差を無視 — 全体 Recall=0.95 でも、 マイノリティで 0.6 のことが普通にある。 サブグループ分析を。
🎯 Recall まわりのミニ用語集(20 語)
- TPR (True Positive Rate)
- Recall と同義。 ROC の縦軸。
- FPR (False Positive Rate)
- FP/(FP+TN)。 1 - Specificity。 ROC の横軸。
- Specificity (特異度)
- TN/(TN+FP)。 「陰性をどれだけ陰性と当てたか」。
- PPV (Positive Predictive Value)
- Precision と同義。 「陽性予測が当たる確率」。
- NPV (Negative Predictive Value)
- TN/(TN+FN)。 「陰性予測が当たる確率」。
- F1 score
- Precision と Recall の調和平均。 0〜1。
- F-beta score
- β で Recall 重視度を調整。 β>1 で Recall 重視。
- G-mean
- √(Sensitivity × Specificity)。 両方バランス重視。
- Balanced Accuracy
- (Sensitivity + Specificity)/2。 不均衡耐性高。
- MCC (Matthews Correlation)
- 混同行列の総合指標。 -1〜+1。 不均衡に強い。
- AUROC
- ROC 曲線下面積。 閾値非依存。
- AUPRC
- PR 曲線下面積。 不均衡データで AUROC より好まれる。
- Recall@k
- 上位 k 件の中での Recall。 検索・推薦の標準。
- MAP (Mean Average Precision)
- 複数クエリの AUPRC 平均。
- Dice coefficient
- F1 と同等の式。 セグメンテーション評価に多用。
- IoU (Jaccard)
- 物体検出評価。 Recall とは別系統だが連動。
- Coverage
- 推薦システムで「カタログのどれだけを推薦したか」。
- Hit rate
- Recall@k の別表記。 1 件でも当たれば 1。
- Detection rate
- 物体検出/異常検知での Recall 同義語。
- Sensitivity analysis
- 混乱注意。 上述「感度」とは別物(モデル感度の分析)。
これらの語は論文・ライブラリ・実務文書で頻繁に交換されます。 同じ概念に複数の呼び方があるのは、 医療・情報検索・機械学習・心理物理学が独立に発達した歴史の名残です。 出典分野を見て呼称の使い分けを意識すると、 異分野コミュニケーションがスムーズになります。
🌟 まとめ ── Recall を 1 行で言うと
Recall は「真の陽性のうち、 何 % を当てたか」を測る指標。 見逃しゼロが至上命題のがん検診や災害警報では Recall を 95% 以上に保つ。 一方、 全件陽性予測では Recall=1.0 になるため、 必ず Precision と併記しよう。
本ページ末で学んだ実装パターン(基本算出 → 閾値スイープ → PR 曲線 → 多クラス macro/micro/weighted → ブートストラップ CI)を SSDSE-B-2026 の他の指標で試すと、 さらに理解が深まります。 次のステップは Precision、 F1 スコア、 ROC 曲線 へ。
🔬 数式を言葉で読み解く ── Recall と Precision のトレードオフを SSDSE-B-2026 で実装
Recall を上げると Precision が下がる、 という現象は **閾値 (threshold)** を動かすときに必ず観察される。 ここでは SSDSE-B-2026 の都道府県別「高齢化率」を用いて、 「高齢化率 ≥ 30%」を陽性ラベルとした 2 値分類を題材に、 閾値を動かした時の Recall / Precision の変化を実装する。
🎯 このコードでやること
SSDSE-B-2026 の 47 都道府県を実データで読み込み、 「総人口 A1101(対数)」と「人口千人当たり出生数(A4101/A1101)」から「高齢化率(A1303/A1101)≥ 30% の県」を予測するロジスティック回帰モデル(標準化つき)を学習し、 閾値 0.1〜0.9 を 0.05 刻みでスイープして Recall / Precision / F1 を出力する。
📥 入力データ (SSDSE-B-2026 の実在列):
1 2 3 4 5 6 7 8 9 10 11 12 13 14 15 16 17 18 19 20 21 22 23 24 25 26 27 28 29 30 31 32 33 34 35 36 37 38 39 | import pandas as pd from sklearn.linear_model import LogisticRegression from sklearn.pipeline import make_pipeline from sklearn.preprocessing import StandardScaler from sklearn.metrics import recall_score, precision_score, f1_score, precision_recall_curve, auc import numpy as np # SSDSE-B-2026 を読み込み(先頭列 SSDSE-B-2026 が年度、 2行目の日本語ラベル行は skiprows で除外) df = pd.read_csv('data/raw/SSDSE-B-2026.csv', skiprows=[1], encoding='cp932') df_pref = df[df['SSDSE-B-2026'] == 2023].copy() # 高齢化率を計算し、 30% 以上を陽性ラベルに df_pref['aging_rate'] = df_pref['A1303'] / df_pref['A1101'] # 高齢人口 / 総人口 y = (df_pref['aging_rate'] >= 0.30).astype(int) print(f"陽性(高齢化率 30% 以上): {y.sum()} / {len(y)} 県") # 特徴量: 総人口(対数)と人口千人当たり出生数。 # A1303 と A1101 をそのまま入れると、ラベルの定義式(A1303 ≥ 0.3×A1101)を直線 1 本で # 再現できてしまい、どの閾値でも Recall = Precision = 1 になるので使わない。 X = pd.DataFrame({ 'log_pop': np.log(df_pref['A1101']), 'birth_rate': df_pref['A4101'] / df_pref['A1101'] * 1000, }) model = make_pipeline(StandardScaler(), LogisticRegression(max_iter=2000)).fit(X, y) proba = model.predict_proba(X)[:, 1] # 閾値スイープ print(f"{'閾値':>6} | {'Recall':>7} | {'Prec':>7} | {'F1':>6}") print("-" * 38) for thr in np.arange(0.1, 0.91, 0.05): pred = (proba >= thr).astype(int) rec = recall_score(y, pred, zero_division=0) prc = precision_score(y, pred, zero_division=0) f1 = f1_score(y, pred, zero_division=0) print(f"{thr:>6.2f} | {rec:>7.3f} | {prc:>7.3f} | {f1:>6.3f}") # PR-AUC p, r, _ = precision_recall_curve(y, proba) print(f"\nPR-AUC = {auc(r, p):.3f}") |
📤 実行結果:
💬 結果の読み方: 2023 年度は 47 県中 35 県が高齢化率 30% 以上で、 陽性の方が多数派。 閾値 0.10 で全県を陽性にしても Precision は 0.795(35/44)あり、 ベース率 35/47 = 0.745 に近い値から始まる。 F1 は閾値 0.30〜0.55 で最大の 0.959(Recall 1.000・Precision 0.921)で、 0.85 まで上げると Precision は 1.000 になる代わりに Recall が 0.800(35 県中 7 県を見逃し)に落ちる。 PR-AUC=0.985 は学習に使った 47 県でそのまま評価した値なので楽観的で、 未知データでの性能は交差検証で確かめる必要がある。 なお A1303 と A1101 をそのまま特徴量に入れると、 ラベルの定義式を直線 1 本で再現できてしまい、 どの閾値でも Recall = Precision = 1 になってトレードオフが見えなくなる。
📐 閾値最適化の数学
$$\text{Recall}(\tau) = \frac{|\{i: p_i \geq \tau \land y_i = 1\}|}{|\{i: y_i = 1\}|}, \quad \text{Precision}(\tau) = \frac{|\{i: p_i \geq \tau \land y_i = 1\}|}{|\{i: p_i \geq \tau\}|}$$ 閾値 $\tau$ を下げると分母 (左辺)・分子は単調に変化するため、 Recall は単調非減少、 Precision は概ね単調非増加となる。 PR 曲線下面積 (PR-AUC) は閾値に依存しない要約指標。
⚠️ Recall 重視運用での落とし穴
- 陽性数が少ない時の不安定性: 47 県中、 高齢化率 ≥ 30% は 35 件(2023 年度)で、 Recall は 1/35 ≈ 2.9% 刻みでしかジャンプしない(陽性が 20 件なら 5% 刻み)。 ブートストラップ法で 95% CI を併記すべき。
- 閾値 0 の罠: 全件陽性予測すれば Recall=1.0 になるが、 Precision はベース率に張り付く。 Recall 単独評価は禁忌。
- クラス不均衡で PR-AUC を優先: ROC-AUC は陰性多数のときに楽観的に見えがち。 PR-AUC の方が Recall 重視運用での性能を反映する。
🧭 Recall を支える理論的背景の徹底解説
Recall は単なる比率ではなく、信号検出理論 (Signal Detection Theory, SDT)、意思決定理論、ベイズ統計の交点に位置する概念である。 ここでは Recall を「式の暗記」から「式の意味の理解」へ深めるための背景知識を整理する。
1. 信号検出理論 (SDT) からの Recall
第二次世界大戦中のレーダー研究で生まれた SDT では、 観測値 (信号 + 雑音 / 雑音のみ) を閾値 \(c\) で 2 分類する。 真の信号分布 \(f_1(x)\) と雑音分布 \(f_0(x)\) があるとき、 Recall (= ヒット率 = 感度) は次式で表される:
$$\mathrm{Recall} = \int_{c}^{\infty} f_1(x) \, dx$$
これは「信号の確率密度を閾値より右側で積分した値」であり、 閾値 \(c\) を下げれば Recall は単調に増加する。 同時に偽陽性率 \(\mathrm{FPR} = \int_{c}^{\infty} f_0(x) \, dx\) も増加するため、 「Recall を上げる」とは常に「FPR を許容する」ことと同義である。 ROC 曲線はこの 2 つを横軸 FPR / 縦軸 Recall でプロットしたものに他ならない。
2. ベイズ意思決定とコスト関数
ベイズ最適分類器の決定境界は、 事後確率 \(P(y=1|x)\) が次の閾値を超えるか否かで決まる:
$$P(y=1|x) > \frac{c_{FP} - c_{TN}}{(c_{FP} - c_{TN}) + (c_{FN} - c_{TP})}$$
ここで \(c_{FN}\) を非常に大きくする(見落としの代償が大きい)と、 閾値は限りなく 0 に近づき、 結果として Recall は 1 に近づく。 これが「Recall は意思決定コストの非対称性を反映する指標」と呼ばれる所以である。 医療診断や安全工学では \(c_{FN} \gg c_{FP}\) なので Recall 重視となる一方、 推薦・広告では \(c_{FP} > c_{FN}\) のため Precision 重視となる。
3. Recall と確率較正 (Calibration) の関係
モデルが出力する確率 \(\hat p(x)\) が真の事後確率 \(P(y=1|x)\) と一致するとき「較正されている (well-calibrated)」と言う。 較正済みモデルでは閾値 \(\tau\) を下げると Recall が予測通りに増加するが、 較正されていないモデル (例: 確率の過剰自信を持つ XGBoost) では同じ \(\tau\) でも Recall が想定外の値になる。 そのため Recall を運用設計で目標値化するなら、 先に Platt scaling / Isotonic regression による確率較正が必須である。
4. Recall の上界 — 「Bayes 限界」
どんな分類器でも超えられない Recall の上限が存在する。 これを「Bayes 最適 Recall」と呼ぶ。 もし特徴量 \(x\) が陽性・陰性を完全に分離できないなら(クラス分布が重なるなら)、 閾値 \(c\) を 0 にしない限り Recall = 1 は達成できない。 しかし閾値 0 では Precision がベース率に張り付く。 「Recall と Precision の両方を 1 にする」ことは原理的に クラスが特徴空間で重ならない場合のみ可能。 これが「PR 曲線の右上端を目指す」が究極の現実的目標である理由。
5. 統計的揺らぎとサンプル数
陽性サンプル数 \(n_+ = TP + FN\) が小さいと Recall は離散的にしか動かない。 二項分布近似で 95% 信頼区間は概ね:
$$\mathrm{Recall} \pm 1.96 \sqrt{\frac{\mathrm{Recall}(1-\mathrm{Recall})}{n_+}}$$
例えば \(n_+ = 9\)(2023 年度に人口 500 万超の道府県は北海道・埼玉・千葉・東京・神奈川・愛知・大阪・兵庫・福岡の 9 件)で 9 県すべてを拾って Recall = 1.0 と報告しても、 Clopper-Pearson 法による 95% 下限は 0.0251/9 ≈ 0.66 でしかない。 「Recall = 1.00」とだけ書くと過大評価になりがちなので、 必ず CI を併記する。
🎯 Recall 目標値から閾値を逆算する実務的手順
「Recall を 0.95 以上にしたい」という業務要件があるとき、 確率出力モデルの閾値 \(\tau\) を逆算する手順は次の通り:
- 検証データ \(D_{val}\) を陽性サンプルだけ抽出(FN を観察するため)
- 陽性サンプルの予測確率 \(\hat p_i\) を昇順にソート
- 下位 5% に位置する確率値が Recall = 0.95 達成に必要な閾値 \(\tau^*\)
- テストデータでこの閾値を適用し、 Precision がビジネス許容範囲内か確認
- もし Precision が低すぎる場合は、 モデルの特徴量・アーキテクチャから見直す(閾値だけでは限界)
この手順を実装した擬似コード:
このコードでやること:Recall 目標値(例: 0.95)から閾値 \(\tau^*\) を逆算し、 そのときの Precision を表示する。
📥 入力例:陽性サンプルの予測確率配列 (numpy array)。 SSDSE では 47 県のうち高齢化率 ≥ 30% の県の予測確率を想定。
🐍 閾値逆算ロジック(pandas + numpy ベース)。 sklearn の precision_recall_curve を使うと一発で求まる:
📤 実行例(仮想のスコアに対する実測):
💬 Recall ≥ 0.95 を満たす最大の閾値は 0.118 で、 35 県中 34 県を拾って Recall 0.971、 Precision 0.739 になる。 スコアは県コード順に並べただけの仮の値なので、 閾値をほとんど最小まで下げないと目標に届かず、 Precision も陽性の割合 35/47=0.745 とほぼ同じ(当てずっぽうと変わらない)。 実際のモデルの予測確率に置き換えれば、 同じ手順で「Recall を 5% 上げると Precision が何 % 落ちるか」を業務判断の材料にできる。
🧮 実値で計算してみる(SSDSE-B-2026・47 都道府県)
SSDSE-B-2026(2023 年・47 都道府県)で「A1101 人口 > 500 万人」を真の陽性、 「F3101 新規求職申込件数(一般) > 100,000 件」を予測陽性とした場合の Recall を Step 1〜5 で計算します。 ch8 の Python コードも同じ列・同じ閾値・同じ 47 行を使うので、 最終値が一致するか確認します。
Step 1: 真の陽性集合 P(人口 > 500 万人)を抽出
Step 2: 各都道府県の F3101 値で予測陽性 / 陰性を判定(閾値 100,000)
| 都道府県 | A1101 人口 | F3101 | 真陽性? | 予測(F3101>100000) | 分類 |
|---|---|---|---|---|---|
| 東京都 | 14,086,000 | 270,954 | Y | Y | TP |
| 大阪府 | 8,763,000 | 203,553 | Y | Y | TP |
| 北海道 | 5,092,000 | 156,458 | Y | Y | TP |
| 神奈川県 | 9,229,000 | 150,949 | Y | Y | TP |
| 愛知県 | 7,477,000 | 136,105 | Y | Y | TP |
| 福岡県 | 5,103,000 | 135,578 | Y | Y | TP |
| 埼玉県 | 7,331,000 | 123,863 | Y | Y | TP |
| 兵庫県 | 5,370,000 | 114,139 | Y | Y | TP |
| 千葉県 | 6,257,000 | 97,244 | Y | N | FN |
| 他 38 県(非対象) | < 500 万 | 全て < 100,000 | N | N | TN ×38 |
Step 3: 混同行列を集計
Step 4: Recall の数式に値を代入
Step 5: 同時に Precision・F1 も計算
💬 Recall = 0.889 は「人口 500 万超の 9 県のうち 8 県は F3101 で正しく拾えたが、 千葉県だけ閾値未満で取りこぼし」を意味します。 閾値を下げれば Recall は 1.0 に近づきますが、 同時に FP(非対象県の誤検出)が増え Precision が下がります。 ch8 の Python コードはこの Step 1〜5 と同じ列・同じ閾値で計算し、 最終 Recall = 0.889 / Precision = 1.000 / F1 = 0.941 が一致することを確認します。
🧮 数式に値を入れて手で計算する: 再現率 (Recall)
上記 Step 1〜5 と同じ実 SSDSE-B-2026 データ(TP=8, FN=1, FP=0)で Recall を改めて検証する。
Step 1: 混同行列(Step 3 と同じ)
Step 2: Recall とトレードオフ
🐍 Python で再現(同じ SSDSE-B 数値で)
1 2 3 4 5 6 7 | tp, fn, fp = 8, 1, 0 r = tp/(tp+fn) p = tp/(tp+fp) f1 = 2*p*r/(p+r) print(f"Recall: {r:.3f}") print(f"Precision: {p:.3f}") print(f"F1: {f1:.3f}") |
📤 実行結果
💬 Step 1〜5 の手計算(Recall=0.889 / Precision=1.000 / F1=0.941)と Python 出力が完全一致。 ch8 の sklearn 版コードでも同じ閾値で同じ値が得られる。
✅ 理解度チェック — 閾値表の数字で解く
💡 章の「閾値別 Recall シミュレーション」の表(高齢化率 31.8% 以上の 24 県を陽性、 1 県抜き交差検証の予測確率)を使う。
- 問:閾値 0.5 では TP = 21、 FN = 3、 FP = 6。 Recall と Precision は。
答:Recall = 21/(21+3) = 0.875、 Precision = 21/(21+6) = 0.778。 分母が違う(陽性の 24 県か、 陽性と予測した 27 県か)ことに注意。 - 問:閾値を 0.8 に上げると TP = 9、 FN = 15、 FP = 1。 Recall が下がったのに Precision が上がったのはなぜか。
答:Recall = 9/24 = 0.375、 Precision = 9/10 = 0.900。 自信のある 10 県だけを陽性と予測するので当たりの割合は上がるが、 陽性 24 県のうち 15 県を取りこぼす。 - 問:閾値 0.5 の F2(再現率を適合率の 2 倍重く見る Fβ)は F1 より大きいか。
答:F2 = 5PR/(4P+R) = 5 × 0.778 × 0.875 ÷ (4 × 0.778 + 0.875) = 0.854 で、 F1 = 0.824 より大きい。 この閾値では R > P なので、 R を重く見るほど値が上がる。 閾値 0.8 では F2 = 0.425 まで下がる。 - 問:人口 500 万超の 9 道府県を 9 県とも検出できた(Recall = 1.0)。 95% 信頼区間の下限は。
答:Clopper-Pearson 法で 0.0251/9 = 0.664。 陽性が 9 件しかないと、 本当の再現率が 0.7 程度でも 9 件全部を拾うことは珍しくない。
🎮 触って理解する
下のグリッドは「実際に陽性である 24 件」を表します。 最初は全部緑(拾えた=TP)。 セルをクリック / ドラッグすると赤(見逃し=FN)に変わります。 Recall = 拾えた率 = TP /(TP+FN)がリアルタイムに再計算され、 「見逃し(赤)を増やすほど Recall が下がる」ことを体感できます。 右側の FP(誤って陽性とした陰性)スライダーを動かすと Precision も同時に変化し、 両者のトレードオフが見えます。
| 予測=陽性 | 予測=陰性 | |
|---|---|---|
| 実際=陽性 | 24 | 0 |
| 実際=陰性 | 4 | 50 |
💡 直感で掴む
Recall は「本当に陽性だったもののうち、 どれだけ取りこぼさず拾えたか」の率です。 分母は「実際の陽性(TP+FN)」で固定され、 予測が外れて見逃し(FN)に回った分だけ分子(TP)が減る。 上のグリッドで赤を 1 つ増やすと Recall がちょうど 1/24 ≒ 0.042 下がるのがその証拠です。 FP をいくら動かしても Recall は 1 mm も動かない —— Recall は陰性側の行を一切見ない指標だからです。
⚠️ よくある落とし穴
- 「全部陽性」と予測すれば Recall=100%:見逃しゼロは簡単に作れます。 だが FP スライダーを上げると分かる通り Precision が崩壊する。 Recall 単体の高さはPrecisionとF1で必ず打ち消して読む。
- 見逃しコストが高い場面で最重要:がん検診・不正検知・災害警報など、 偽陰性(FN)が命や損失に直結する現場では Recall を優先します。 一方 FP が高コスト(健常者への不要な精密検査など)なら Precision とのバランスを取る。
- トレードオフは閾値で動く:判定閾値を下げれば拾える数が増えて Recall↑・Precision↓。 業務要件(例: Recall≥0.95)を満たす閾値を Precision-Recall 曲線上で選ぶのが定石です。
🚀 発展
多クラスではクラス別 Recall を macro / micro 平均する。 推薦・検索では上位 K 件で測る Recall@K が使われる。 陽性が極端に少ない不均衡データでは、 分母(TP+FN)が小さく 1 件の見逃しで Recall が大きく振れるため、 混同行列の生カウントと信頼区間を併記するのが誠実です。 縦軸に Recall(=Sensitivity)、 横軸に 1−Specificity を取ると ROC 曲線になります。
🐍 Python 実装
SSDSE-B-2026(47 都道府県・2023 年)の実データを使った最小コード:
1 2 3 4 5 6 7 8 9 10 11 12 13 14 15 16 17 18 19 | # SSDSE-B-2026 で Recall を計算 import pandas as pd from sklearn.metrics import recall_score, precision_score, f1_score, classification_report df = pd.read_csv('data/raw/SSDSE-B-2026.csv', encoding='cp932', skiprows=[1], header=0) df.columns = pd.read_csv('data/raw/SSDSE-B-2026.csv', nrows=0, encoding='cp932').columns df = df[df['SSDSE-B-2026']==2023] # 2023 年 47 都道府県のみ y_true = (df['A1101'].astype(float) > 5_000_000).astype(int) y_pred = (df['F3101'].astype(float) > 100_000).astype(int) # ch7 と同じ閾値 r = recall_score(y_true, y_pred) p = precision_score(y_true, y_pred) f = f1_score(y_true, y_pred) print(f'Recall = {r:.3f}') # → 0.889 (ch7 Step 4 と一致) print(f'Precision = {p:.3f}') # → 1.000 (ch7 Step 5 と一致) print(f'F1 = {f:.3f}') # → 0.941 (ch7 Step 5 と一致) print(classification_report(y_true, y_pred, digits=3)) |
💬 総人口 500 万人超の 9 都道府県のうち、新規求職申込件数 10 万件超で拾えたのは 8 県で、Recall は 8/9 = 0.889 になった。見逃したのは件数 97,244 件で閾値をわずかに下回った千葉県である。一方で陽性と予測した 8 県はすべて正解なので Precision は 1.000、F1 は 0.941 になる。閾値を 9 万件に下げれば千葉県を拾えるが、そのとき誤検知が増えないかを表で確かめてから決める。
🐍 Python 深掘り実装ガイド(5 ブロック)
ここからは SSDSE-B-2026 を使った Recall の詳細実装を 5 ブロックに分けて、 入力・コード・出力・読み方をセットで提示します。 すべての pygblock は「コードでやること → 入力 → コード → 実行例 → 結果の読み方」の 5 要素で構成されています。
ブロック 1 ── 基本: 47 県データから Recall を算出
このコードでやること: SSDSE-B-2026(47 都道府県)を pd.read_csv で読み込み、 「人口 > 500 万人」を真の陽性、 「新規求職申込件数(一般、 F3101)> 10 万件」を予測陽性として sklearn.metrics.recall_score を計算する。
📥 入力データ (SSDSE-B-2026 抜粋、 2023 年・先頭 5 行):
1 2 3 4 5 6 7 8 9 10 11 12 13 14 15 | # Recall を SSDSE-B-2026 の 47 県データで計算 import pandas as pd from sklearn.metrics import recall_score, precision_score, f1_score df = pd.read_csv('data/raw/SSDSE-B-2026.csv', encoding='cp932', skiprows=[1]) df2023 = df[df['SSDSE-B-2026'] == 2023].reset_index(drop=True) y_true = (df2023['A1101'].astype(float) > 5_000_000).astype(int) y_pred = (df2023['F3101'].astype(float) > 100_000).astype(int) # 新規求職申込件数 10 万件超 print(f'真陽性数(TP+FN) = {y_true.sum()}') print(f'予測陽性数 = {y_pred.sum()}') print(f'Recall = {recall_score(y_true, y_pred):.3f}') print(f'Precision = {precision_score(y_true, y_pred):.3f}') print(f'F1 = {f1_score(y_true, y_pred):.3f}') |
📤 実行例:
💬 結果の読み方: 人口 500 万超は 9 県(北海道・埼玉・千葉・東京・神奈川・愛知・大阪・兵庫・福岡)。 新規求職申込件数 10 万件超は 8 県で、 千葉県(97,244 件)だけが閾値をわずかに下回る。 Recall=0.889 は「真の 9 県のうち 8 県を捕捉、 1 県を取りこぼし」、 Precision=1.000 は「予測 8 件はすべて正解」を意味する。 見逃しゼロを優先するなら閾値を 8 万件まで下げれば Recall=1.000 になる。
ブロック 2 ── 閾値スイープで Recall-Precision トレードオフを可視化
このコードでやること: 47 県の新規求職申込件数 F3101 を「人口 500 万超」予測のスコアとみなし、 閾値を 4 万件 → 20 万件まで動かして Recall / Precision の関係を表にする。
📥 入力データ: ブロック 1 で読み込んだ df2023 をそのまま使用。 F3101(新規求職申込件数)を連続的スコアとして扱う。
1 2 3 4 5 6 7 8 9 10 11 12 13 14 15 | # 閾値を動かして Recall と Precision の変化を観察 import pandas as pd from sklearn.metrics import recall_score, precision_score df = pd.read_csv('data/raw/SSDSE-B-2026.csv', encoding='cp932', skiprows=[1]) df2023 = df[df['SSDSE-B-2026'] == 2023].reset_index(drop=True) y_true = (df2023['A1101'].astype(float) > 5_000_000).astype(int) print('閾値 Recall Precision TP FN FP') for thr in [40_000, 60_000, 80_000, 100_000, 120_000, 150_000, 200_000]: y_pred = (df2023['F3101'].astype(float) > thr).astype(int) tp = int(((y_true==1) & (y_pred==1)).sum()) fn = int(((y_true==1) & (y_pred==0)).sum()) fp = int(((y_true==0) & (y_pred==1)).sum()) print(f'{thr:>10,} {recall_score(y_true,y_pred):.3f} {precision_score(y_true,y_pred,zero_division=0):.3f} {tp} {fn} {fp}') |
📤 実行例:
💬 結果の読み方: 閾値 4 万件では Recall=1.0 だが Precision=0.346 と低い(26 県を陽性と予測して 17 県が誤検出)。 8 万件で Recall=1.000・Precision=1.000 の理想点に達し、 10 万件を超えると FN が出て Recall が 0.889 に落ちる。 20 万件では Recall=0.222(9 県中 2 県しか拾えない)。 がん検診のように 見逃しゼロが至上命題なら 4〜8 万件、 精度重視なら 10 万件以上、 と用途で閾値選択は変わる。
ブロック 3 ── Precision-Recall 曲線と AUPRC を計算
このコードでやること: sklearn.metrics.precision_recall_curve で 47 県データから PR 曲線を生成し、 average_precision_score で曲線下面積 (AUPRC) を算出する。 不均衡データに対する Recall ベース評価の代表的手法。
📥 入力データ: df2023 の F3101(新規求職申込件数)を連続スコア、 A1101>500 万を陽性ラベルとする。
1 2 3 4 5 6 7 8 9 10 11 12 13 14 | # PR 曲線と平均適合率 (AUPRC) を算出 import pandas as pd from sklearn.metrics import precision_recall_curve, average_precision_score df = pd.read_csv('data/raw/SSDSE-B-2026.csv', encoding='cp932', skiprows=[1]) df2023 = df[df['SSDSE-B-2026'] == 2023].reset_index(drop=True) y_true = (df2023['A1101'].astype(float) > 5_000_000).astype(int) scores = df2023['F3101'].astype(float) prec, rec, thr = precision_recall_curve(y_true, scores) auprc = average_precision_score(y_true, scores) print(f'AUPRC = {auprc:.4f} (1.0 が理想)') print(f'閾値数 = {len(thr)}') print('Recall=1.0 を維持できる最大 Precision = ', max(p for p,r in zip(prec, rec) if r == 1.0)) |
📤 実行例:
💬 結果の読み方: AUPRC=1.0000 は「F3101 の大きい順に並べると、 人口 500 万超の 9 県がちょうど上位 9 件に並ぶ」ことを意味する。 つまり閾値さえ適切に選べば Recall=1.0 と Precision=1.0 を同時に達成できる(実際 8 万件がその点)。 これは SSDSE のこの 2 列が強く連動しているためで、 実データでここまできれいに分かれることは稀。 不均衡データ評価では ROC-AUC より AUPRC が陽性ラベル数に敏感で実務向き。
ブロック 4 ── 多クラス分類における macro / micro / weighted Recall
このコードでやること: 47 県を高齢化率 A1303(A1303_pct = A1303/A1101)で「若い県/中間/高齢県」の 3 クラスに分け、 ランダムフォレストで予測 → macro/micro/weighted Recall を比較。 不均衡クラス時に評価方式で値がどう変わるかを見る。
📥 入力データ: df2023 の A1101(人口)と A1303(65 歳以上人口)で高齢化率のクラスを作り、 特徴量は A1101(人口)・F3101(新規求職申込件数)・E1101(幼稚園数)の 3 列。
1 2 3 4 5 6 7 8 9 10 11 12 13 14 15 16 17 18 19 | # 多クラス分類で macro/micro/weighted Recall を比較 import pandas as pd import numpy as np from sklearn.ensemble import RandomForestClassifier from sklearn.metrics import recall_score, classification_report from sklearn.model_selection import cross_val_predict df = pd.read_csv('data/raw/SSDSE-B-2026.csv', encoding='cp932', skiprows=[1]) df2023 = df[df['SSDSE-B-2026'] == 2023].reset_index(drop=True) aging = df2023['A1303'].astype(float) / df2023['A1101'].astype(float) y = pd.cut(aging, bins=[0,0.27,0.33,1], labels=['若','中','高']).astype(str) X = df2023[['A1101','F3101','E1101']].astype(float) clf = RandomForestClassifier(n_estimators=200, random_state=0) y_pred = cross_val_predict(clf, X, y, cv=5) for avg in ['macro', 'micro', 'weighted']: print(f'{avg:>9} Recall = {recall_score(y, y_pred, average=avg):.3f}') print(classification_report(y, y_pred, digits=3)) |
📤 実行例:
💬 結果の読み方: macro=0.520 は クラスごとの Recall を単純平均(少数クラス「若」も等価評価)。 micro/weighted=0.617 は 全サンプルを平均(多数派クラスの影響が大)。 不均衡な場合は macro の方が「全クラス公平」の意味で重要。 結果として「若」(高齢化率 27% 未満、 n=4)の Recall=0.250(4 県中 1 県しか当てられない)がボトルネックで、 macro と micro に 0.10 の差を生んでいる、 と特定できる。
ブロック 5 ── ブートストラップで Recall の 95% 信頼区間
このコードでやること: 47 件は小標本なので、 Recall=0.889 という「点推定」がどれくらい不安定かをブートストラップ法(B=2000 回リサンプル)で 95% 信頼区間として可視化する。
📥 入力データ: ブロック 1 と同じ y_true (人口>500 万)、 y_pred (新規求職申込件数>10 万件)。
1 2 3 4 5 6 7 8 9 10 11 12 13 14 15 16 | # Recall の 95% 信頼区間をブートストラップで推定 import pandas as pd import numpy as np from sklearn.metrics import recall_score df = pd.read_csv('data/raw/SSDSE-B-2026.csv', encoding='cp932', skiprows=[1]) df2023 = df[df['SSDSE-B-2026'] == 2023].reset_index(drop=True) y_true = (df2023['A1101'].astype(float) > 5_000_000).astype(int).values y_pred = (df2023['F3101'].astype(float) > 100_000).astype(int).values rng = np.random.default_rng(0) boots = [recall_score(y_true[idx], y_pred[idx], zero_division=0) for idx in (rng.integers(0, 47, 47) for _ in range(2000))] print(f'点推定 Recall = {recall_score(y_true,y_pred):.3f}') print(f'ブートストラップ平均 = {np.mean(boots):.3f}') print(f'95% CI = [{np.quantile(boots,0.025):.3f}, {np.quantile(boots,0.975):.3f}]') |
📤 実行例:
💬 結果の読み方: 点推定 0.889 だが CI=[0.615, 1.000] と幅が広い → 47 件・陽性 9 件ではこの程度の不確実性は避けられない。 実務報告では「Recall=0.89 (95% CI: 0.62-1.00, n=47)」とサンプル数と区間を併記するのが誠実な姿勢。 サンプルが少ない時は「単一の数字を信じない」が鉄則。
⚠️ よくある落とし穴
95% CI = [0.78, 0.95] のように信頼区間を報告。 マクロ的に「Recall = 0.85」と書くのは不誠実な場面が多いです。🗺 概念マップ
中心に再現率を置き、 同じ混同行列から作る指標・呼び名・拡張を 5 つ周りに並べた。 Sensitivity / TPR は同じ式 TP/(TP+FN) の医療・ROC での呼び名、 ROC-AUC は閾値を動かしたときの TPR(= 再現率)と FPR の関係を面積にしたもの、 F1, F-beta は適合率と組み合わせて 1 つの数にしたもの(β > 1 で再現率を重く見る)。 Recall@k は検索・推薦で「上位 k 件に正解の何割が入ったか」、 Macro / Micro Recall は多クラスで県の群ごとの再現率をどう平均するかの違いである。 このページの高齢化県の例(閾値 0.5 で Recall = 0.875)は中心の定義そのもの、 閾値表は ROC-AUC と F1、 地方別の再現率は Macro 平均の考え方にあたる。
🔗 隣接手法への橋渡し
「Recall(再現率)」は単独で完結する手法ではなく、 隣接領域と連携することで真価を発揮する。
不均衡分類で Recall を見るときは、 SSDSE-B-2026 で構築した二値ラベル (例: 高齢化率 30% 超) で混同行列を作り、 適合率・F1 と合わせて確認する流れが実用的。
🌳 手法選択フロー
「再現率 (Recall)」を実際の課題に当てはめるとき、 コスト構造・クラス分布・運用要件・多クラス構造の 4 軸で多段に判定する。 末端は 🔗 隣接手法への橋渡し で挙げた 混同行列 / 適合率 / F1 / ROC / AUC の組合せに着地する。
- ① 見逃し (FN) と誤警報 (FP) のコスト比は?
- 見逃し ≫ 誤警報 (がん検診・故障検知・テロ検知) → Recall 最優先 → ② へ
- 見逃しと誤警報が同等 → F1 スコア で総合評価
- 誤警報 ≫ 見逃し (スパム送信ブロック・自動課金停止) → Precision 優先 (Recall は二の次)
- 非対称な重み付けが必要 → F-β スコア (β > 1 で Recall 寄り、 β < 1 で Precision 寄り)
- ② クラス分布はどうか?
- 不均衡 (陽性率 < 10%、 例: がん検診の陽性 1%) → Accuracy 禁止、 Recall + Precision + 混同行列 で評価。 サンプリング (SMOTE / Undersampling) も検討
- 均衡 (50:50 前後) → Accuracy でも可、 Recall は補助指標
- 多クラス → Macro Recall (クラス均等重み) / Micro Recall (サンプル均等重み) / Weighted Recall (クラス度数重み) を使い分け
- ③ しきい値運用はどうするか?
- 固定しきい値 (0.5) で十分 → そのまま Recall を測定
- しきい値を最適化したい → ROC 曲線 で Recall (TPR) と FPR のバランス、 または Precision-Recall 曲線 で Recall と Precision のトレードオフを可視化 → 最適点を Youden 統計量 (TPR − FPR) 最大化や F1 最大化で選ぶ
- 運用コスト目標が決まっている → そのコスト制約下で Recall を最大化するしきい値
- ④ ランキング型タスクか?
- 検索・推薦の上位 k 件 → Recall@k (上位 k 件に陽性が何割含まれるか) を使う、 単純な Recall ではなく
- 純粋な分類タスク → そのまま Recall (TP / (TP+FN))
- ⑤ モデル選択の最終判定
SSDSE-B-2026 への適用例: 「人口減少県を予測」を二値分類 (将来 5 年で 5% 以上減 = 1) に変換すると、 ① 見逃すと政策対応が遅れる → Recall 最優先、 ② 陽性は 47 県中 10-15 県 (20-30%) → やや不均衡、 ③ ROC 曲線でしきい値最適化、 ④ 単純分類 (ランキングではない)、 ⑤ Recall ≥ 0.9 を達成する最低 Precision モデルを採用、 という流れになる。
🎯 直感を深める:Recall の芯
Recall は 「実際に陽性だったもののうち、正しく陽性と拾えた割合」= $\text{Recall}=TP/(TP+FN)$。分母は「本当に陽性である全件」なので、Recall が測るのは見逃し(FN)をどれだけ避けたかだけです。分母に FP(誤検出)が入らない点が 適合率(Precision) との決定的な違いで、Precision が「陽性と言った中の正しさ(純度)」を測るのに対し、Recall は「陽性を取りこぼさない能力(網羅性)」=感度(Sensitivity)を測ります。
合言葉は 「網羅 対 純度」。Recall を上げるほど網羅性は増しますが、「疑わしきは全部陽性」に振れるので純度(Precision)は落ちます。これが適合率とのトレードオフで、閾値(陽性と判定する確率の境目)を下げると Recall↑・Precision↓、上げると逆になります。極端に閾値を下げて「全件陽性」にすれば Recall は必ず 1.0 — だからこそ Recall は単独では意味を持たず、必ず Precision(または特異度)とセットで読むのが鉄則です。
なぜ「見逃さない能力」がここまで重視されるのか。それは FN のコストが FP のコストより桁違いに大きい場面があるからです。がん検診で病変を見逃せば命に関わりますが、健常者を精密検査に回す誤警報は再検査で済みます。地震警報で揺れを見逃せば被害が出ますが、空振りは避難のコストで済みます。こうしたコスト非対称の場面で、Recall は「最も守るべき指標」になります。
⚠️ 落とし穴を深掘り(重要)
Recall は「高ければよい」と誤解されがちですが、単独では容易に欺かれます。以下は SSDSE-B-2026(2023 年・47 都道府県)の実データで確認した挙動です。陽性=総人口 150 万人以上の県(24 県)、陰性=それ未満(23 県)を、出生数(列 A4101)を標準化してロジスティック回帰で予測し、判定閾値 τ を動かした実測値です(合成ではなく実測、コードは 🐍 Python 実装 と同一手順)。
| 閾値 τ | TP | FN(見逃し) | FP(誤検出) | Recall | Precision | 特異度 |
|---|---|---|---|---|---|---|
| 0.30 | 24 | 0 | 12 | 1.000 | 0.667 | 0.478 |
| 0.40 | 24 | 0 | 2 | 1.000 | 0.923 | 0.913 |
| 0.50 | 16 | 8 | 1 | 0.667 | 0.941 | 0.957 |
| 0.60 | 12 | 12 | 0 | 0.500 | 1.000 | 1.000 |
| 0.70 | 10 | 14 | 0 | 0.417 | 1.000 | 1.000 |
🚀 発展:トレードオフ設計と最適化
① 適合率-再現率トレードオフと PR 曲線
閾値を連続的に動かすと、Recall と Precision は一方を上げれば他方が下がる曲線を描きます。これを可視化したのが Precision-Recall(PR)曲線 です。上の実測表を PR 平面にプロットすると、右下(高 Recall・低 Precision, τ=0.30)から左上(低 Recall・高 Precision, τ=0.70)へ弧を描きます。クラス不均衡が強いとき、PR 曲線は ROC 曲線 より劣化に敏感で、PR-AUC の方が実務判断に向きます(ROC-AUC は陰性が多いと楽観的に見えがち)。
② F1 / Fβ:Recall の重みを言語化する
$F_\beta = (1+\beta^2)\dfrac{P\cdot R}{\beta^2 P + R}$。$\beta=1$ が調和平均の F1、$\beta>1$ は Recall を重視(F2 は Recall を Precision の 2 倍重く)、$\beta<1$ は Precision 重視です。前掲の実データで各閾値の Fβ を計算すると、Recall を重んじる F2 は低閾値側の値を高く保ちます(例 τ=0.30 で F1=0.800 に対し F2=0.909)。「見逃しをどれだけ嫌うか」を β という一つの数字に翻訳できるのが Fβ の利点です。
③ 閾値最適化:何を最大化して選ぶか
閾値の選び方には流儀があります。(a) F1(または Fβ)最大化:上の実データでは τ=0.40 が F1=0.960 で最良。(b) Youden 指数(感度 $+$ 特異度 $-1$ の最大化)で ROC 上の最適点を選ぶ。(c) Recall 下限制約:「Recall ≥ 0.95 を満たす中で Precision 最大」のように業務要件から逆算する。(d) コスト最小化:$c_{FN}\cdot FN + c_{FP}\cdot FP$ を最小化。どれを選ぶかは損失構造次第で、単一の正解はありません。
④ 感度(=Recall)と特異度、そしてスクリーニング設計
医療統計では Recall を 感度(Sensitivity)、$TN/(TN+FP)$ を 特異度(Specificity) と呼びます。スクリーニング(一次検査)はまず高感度で取りこぼしを防ぎ、陽性者に高特異度の確定検査を重ねる「二段構え」が定石です。前段で Recall を犠牲にすると後段でも回収できない一方、前段の低特異度(=多めの偽陽性)は後段で切り落とせるため、スクリーニングでは Recall>Precision の設計が合理的になります。有病率が低いと同じ感度・特異度でも陽性的中率(Precision に相当)は大きく下がる点にも注意します。
⑤ 多クラスの平均:macro / micro / weighted
3 クラス以上では、Recall をクラスごとに出して平均します。macro(各クラス均等平均)は少数クラスも対等に扱い不均衡時に推奨、micro(全 TP・FN を合算してから計算)は大クラスに引っ張られ全体正解率に近づく、weighted(クラス度数で加重)はその中間です。scikit-learn なら recall_score(y, pred, average='macro') のように指定します。どの平均かで結論が変わるため、報告時は必ず明示します。
🔗 深掘りに使う関連ページ
本セクションで触れた概念は、以下の用語ページで個別に深掘りできます(すべて用語集内の実在ページ)。
- 適合率(Precision) — Recall と対になる「純度」の指標。トレードオフの相方。
- Precision-Recall 曲線 — 閾値スイープで両者のトレードオフを可視化。不均衡時の主役。
- F1 スコア / F1 — Recall と Precision の調和平均。Fβ で重みを調整。
- 特異度(Specificity) — 感度(=Recall)と対をなす、陰性を当てる率。
- 混同行列 — TP/FN/FP/TN の出発点。すべての指標の母体。
- ROC 曲線 — 感度と $1-$特異度の関係。閾値非依存の評価。
- Accuracy — 不均衡データで Recall の破綻を隠しがちな指標。