📓 拡張深掘り — false positive を実務で乗りこなす 9 視点
ここまで偽陽性(false positive, FP)の定義・指標・閾値・コスト最適化を扱った。 ここでは SSDSE-B-2026 都道府県データを使った 9 つの追加トピックを順に提示する。 演習問題 → 図 3 枚 → 医療/詐欺/公平性/ベイズ/歴史/英訳/学習リソースを連結させ、 「偽陽性を 1 つの章として習得する」構成にしている。
🧪 理解度チェック — 練習問題 10 問(解答解説つき)
以下の練習問題を 1 問ずつ自分で解いてから解答を確認すること。 答えを暗記するのでなく、 「なぜそうなるか」を SSDSE-B-2026 のデータ感覚と紐づけて理解するのが狙いである。 制限時間の目安は全 10 問で 20 分。 まずは紙とペンで結論を出し、 そのうえで Python を動かして数値を確かめる。
解答: FP = 4。 全陰性数は 47-35=12、 そのうち 4 件が誤陽性なので FPR = 4/12 ≈ 0.333。
解説: FPR は「陰性のうち誤って陽性とした割合」。 ベースラインの陰性総数で割るのが鉄則で、 サンプル全体(47)で割ってはいけない。
解答: precision = TP/(TP+FP) = 30/(30+4) ≈ 0.882。 accuracy = (30+8)/47 ≈ 0.809。
解説: 不均衡時には accuracy が高くても陽性側の判定がガタガタな例がある。 ここでは accuracy ≈ 0.81 だが、 precision と recall の片方が低ければ実務的には失敗。 必ず混同行列ベースで多角的に評価する。
解答: 0.5 を上回るので「ランダムより良い分類器」。 出生率が低い県ほど高齢化率が高い傾向を捉えている。 ただし 0.7 程度なので判別力は中程度で、 偽陽性 (FP) を無視できない。
解説: AUC は 0-1 の指標で 0.5 が偶然。 0.7 台は「中程度の予測力」。 bootstrap の 95% CI は 0.544-0.850 で下限が 0.5 を上回るため、 「予測力あり」と結論できる。 ただし点推定 0.7 は完璧ではなく、 FP 抑制には別特徴量や閾値調整が必要。
解答: PPV = (0.99×0.01)/(0.99×0.01 + 0.05×0.99) = 0.0099/0.0594 ≈ 0.167。
解説: スペック上の感度 99% が高く見えても、 罹患率が低いと PPV は 17% 程度に落ちる。 これが「希少疾患スクリーニングで陽性が出ても 80% 以上は偽陽性」と言われる根拠。
解答: PPV = (0.99×0.01)/(0.99×0.01 + 0.01×0.99) = 0.0099/0.0198 = 0.5。
解説: specificity を 4% 改善するだけで PPV は 0.17 → 0.50 と約 3 倍になる。 希少事象では FP を減らす(specificity を上げる)方が PPV 改善には効きやすい。
解答: 期待 FP = 1000×0.05 = 50 件。 1 件以上偽陽性が出る確率 = 1-(1-0.05)^1000 ≈ 1.0(ほぼ確実)。
解説: 多重比較で補正しなければ「有意」とされる結果の大半がノイズである。 Bonferroni(α/m)や Benjamini-Hochberg(FDR 制御)を必ず使う。
解答: α' = 0.05/1000 = 0.00005。
解説: 非常に厳しくなる代わりに family-wise error rate(FWER)を 5% 以下に制御できる。 検出力は大きく下がるので、 探索段階では BH 法(FDR)の方が好まれる。
解答: FN コスト / FP コスト = 250。 つまり FN 1 件を防ぐためには FP を 250 件まで許容する価値がある。 閾値は 0.5 より大幅に低くする(例 0.01-0.05)。
解説: コスト感度分析では FP コストと FN コストの比が閾値選択を支配する。 不均衡データでは閾値 0.5 は意味を持たない。
解答: Equalized Odds の観点で「女性側の偽陽性率が 3 倍」となっており、 公平性違反(disparate impact)の疑いがある。
解説: 全体の FPR は 0.10 でも、 サブグループに分解すると差が出る。 公平性監査では必ず group-wise FPR を比較する。
解答: 0.5 を含むため、 5% 有意水準では「ランダム判別と区別できない」。 つまり統計的に有意な予測力があるとは言えない。
解説: 単点推定の AUC が 0.65 だけを見て「予測力あり」と判断するのは危険。 信頼区間が 0.5 を跨ぐかどうかで判定する習慣をつける。
🖼 図解 — 3 図で見る FP の振る舞い
以下 3 枚は SSDSE-B-2026 都道府県データに基づいて作成した分布と関係の図である。 偽陽性は「分布の裾」「閾値の置き場所」「群間比較」の 3 つの観点でしばしば発生する。 図と本文を見比べながら「どの場合に FP が増えるか」を直感で掴んでほしい。
図 1. SSDSE 散布図 — 人口と出生数の関係
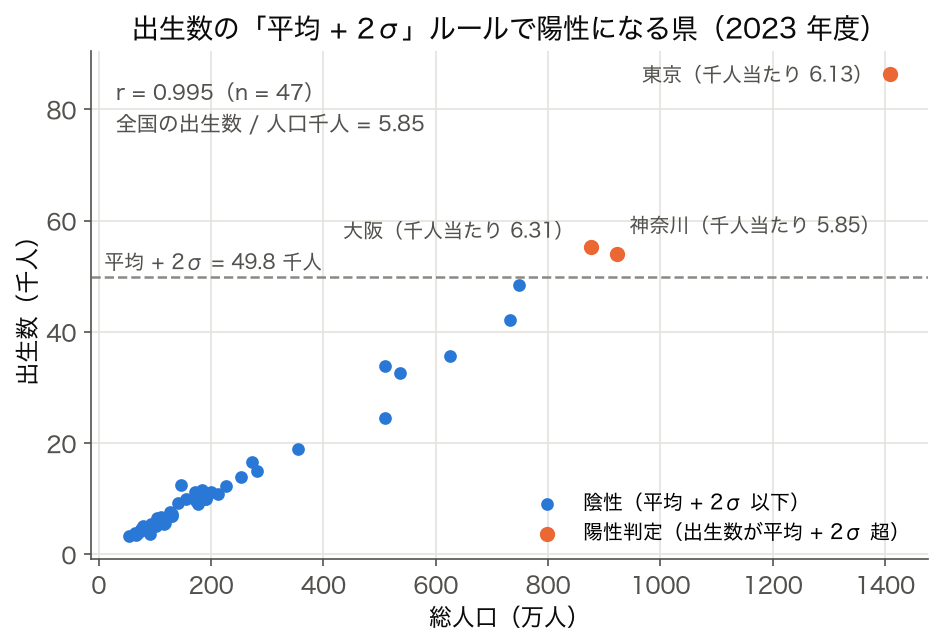
📊 2023 年度の 47 都道府県の人口(横軸)と出生数(縦軸)。 r = 0.995 の強い正の相関で、 出生数に「平均 + 2σ(49.8 千人)を超えたら異常」という閾値を機械的に当てると東京・神奈川・大阪の 3 都府県が陽性になる。 しかし人口千人当たりの出生数は東京 6.13・大阪 6.31・神奈川 5.85 で全国値 5.85 と変わらず、 「異常な大都市」ではなく実態どおり大きいだけのため、 文脈上の偽陽性になり得る。 閾値カットの前に必ず散布図を見ること。
図 2. 都道府県人口のヒストグラム
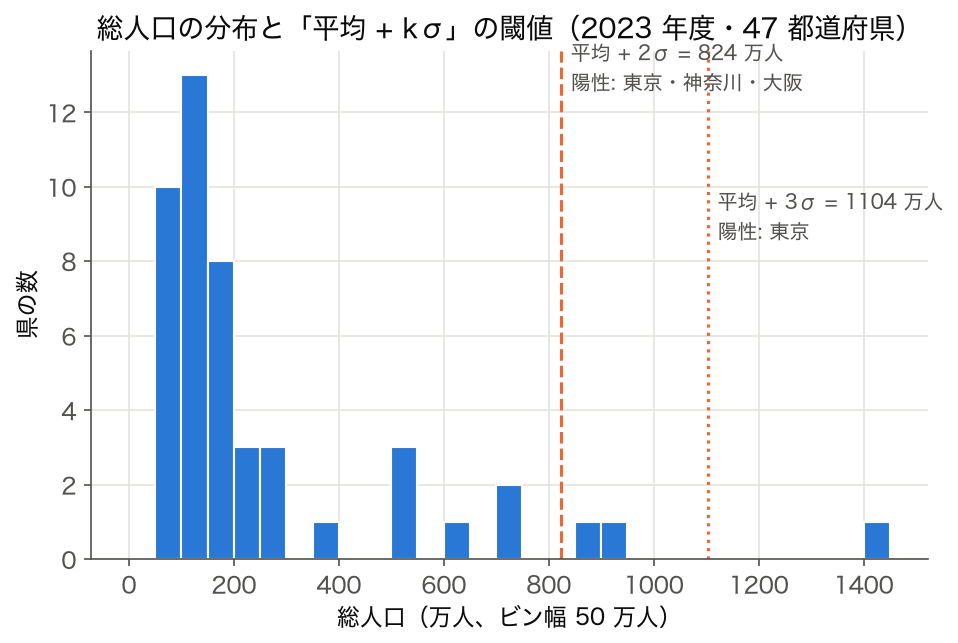
📊 2023 年度の 47 都道府県の人口分布(平均 264.6 万人・標準偏差 279.8 万人・中央値 154.9 万人)。 右に裾を引く対数正規的形状で、 平均と標準偏差から正規分布を仮定して外れ値を切ると、 「3σ ルール」(1,104 万人超)では東京だけ、 「2σ ルール」(824 万人超)では東京・神奈川・大阪が機械的に陽性となる。 標準偏差そのものが東京に引っ張られて大きいので、 どの k を選ぶかで陽性の顔ぶれが変わる。 これは分布の歪みが大きい場合に起こる典型的な偽陽性で、 IQR や対数変換、 ロバスト統計の利用で回避できる。
図 3. 地域ブロック別 箱ひげ図
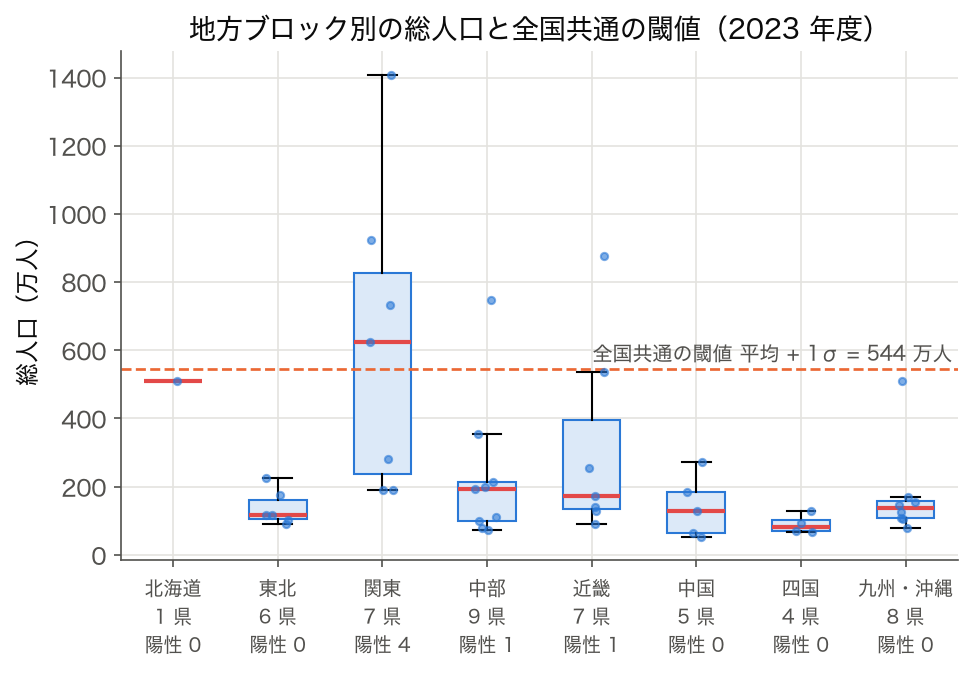
📊 2023 年度の総人口を地方ブロック(北海道/東北/関東/中部/近畿/中国/四国/九州・沖縄)に分けた箱ひげ図。 全国共通の閾値「平均 + 1σ = 544 万人」を当てると、 陽性 6 県のうち 4 県(埼玉・千葉・東京・神奈川)が関東 7 県に集中し、 残りは中部の愛知と近畿の大阪だけで、 四国(中央値 81 万人)などは 1 県も陽性にならない。 関東で「異常」が多いのではなくブロックごとの水準(中央値は関東 626 万人・四国 81 万人)が違うだけなので、 同じ閾値を全国に当てると関東では偽陽性が増え、 小さいブロックでは本当の異常を見逃しやすい。 群ごとに base rate が違うので、 群ごと閾値(per-group threshold)または階層モデルでの補正が必要となる。
🏥 ケーススタディ A — 医療スクリーニングと FP
医療では偽陽性が最も多くの議論を呼ぶ。 ここでは 3 つの代表的ケースを表で整理する。 いずれも「感度 vs 特異度 vs base rate」のトレードオフが鍵で、 検査の精度よりも罹患率の方が PPV を支配することが多い。
| 検査 | 罹患率 | 感度 | 特異度 | PPV | 解釈 |
|---|---|---|---|---|---|
| マンモグラフィ(40歳代) | 0.4% | 85% | 90% | 3.3% | 陽性者の 97% は偽陽性 |
| PSA(前立腺癌) | 3% | 75% | 85% | 13.4% | 陽性者の 86% は偽陽性 |
| COVID-19 PCR(流行期) | 5% | 95% | 99% | 83.3% | 陽性者の 17% が偽陽性 |
| HIV ELISA(高リスク群) | 10% | 99% | 99% | 91.7% | 陽性者の 8% が偽陽性 |
| HIV ELISA(低リスク群) | 0.1% | 99% | 99% | 9.0% | 陽性者の 91% は偽陽性 |
| 大腸内視鏡(症状あり) | 15% | 95% | 85% | 52.8% | 陽性者の半数は偽陽性 |
💡 上記から読めるのは「罹患率が低い集団で広く検査をすると、 たとえ高精度な検査でも陽性の大半が偽陽性になる」事実である。 これは Bayes の定理が直接示す結果で、 検査前確率(事前確率)を上げる、 つまり「症状やリスクで集団を絞る」のが PPV 改善の王道。 集団的スクリーニングを設計する際は、 必ず PPV を Bayes 計算で見積もる。
💳 ケーススタディ B — 詐欺検知・スパム・不正検知
詐欺検知は陽性率(fraud rate)が極端に低い(0.1% 程度)不均衡問題の典型である。 偽陽性は「顧客体験悪化」「カード一時停止」「コンタクトセンター負荷増」につながり、 FN(見逃し)は直接的な金銭損失につながる。 両者のコスト比で閾値を選ぶ。
| ドメイン | 陽性率 | FP コスト | FN コスト | 推奨閾値 |
|---|---|---|---|---|
| クレジット詐欺 | 0.1% | 確認電話 200 円 | 不正額平均 50,000 円 | 0.005-0.02 |
| メールスパム | 20% | 重要メール紛失(大) | 迷惑メール受信(小) | 0.7-0.95(高めに) |
| 不正ログイン | 0.05% | MFA 追加要求(中) | アカウント乗っ取り(大) | 0.01-0.05 |
| マネーロンダリング | 0.01% | 調査人件費 5,000 円 | 規制罰金 数千万円 | 0.001-0.01 |
| EC レビュー操作検出 | 3% | 健全レビュー削除(中) | サクラ放置(中) | 0.4-0.6 |
💡 詐欺検知では「閾値 0.5」はほぼ常に間違い。 ベースラインの陽性率と業務コストから「最適閾値」を導出し、 半年ごとにモニタリングして再調整する。 ライフサイクル管理(MLOps)が偽陽性制御の鍵。
⚖ 公平性深掘り — Group-wise FPR と Equalized Odds
同じモデルでも、 サブグループ(性別・年代・地域)別に偽陽性率は変わる。 これが公平性違反になるかは、 採用シナリオ次第で判定が異なる。 SSDSE-B-2026 のような都道府県データでも「地域ブロック別 FPR」を必ず確認する習慣が必要。
| 公平性指標 | 数式 | 意味 | FP との関係 |
|---|---|---|---|
| Demographic Parity | P(ŷ=1|A=a)=P(ŷ=1|A=b) | 陽性率の平等 | 間接的 |
| Equal Opportunity | TPR_a = TPR_b | 真陽性率の平等 | 補集合に注意 |
| Equalized Odds | TPR_a = TPR_b ∧ FPR_a = FPR_b | TPR/FPR の同時平等 | FPR 直接制約 |
| Predictive Parity | PPV_a = PPV_b | 陽性的中率の平等 | FP 数の比率に影響 |
| Calibration | P(y=1|p=q, A=a) = q | 確率の解釈一致 | 確率ベース FP |
| Treatment Equality | FN_a/FP_a = FN_b/FP_b | エラー比率の平等 | FP/FN バランス |
💡 Chouldechova (2017) と Kleinberg et al. (2017) の不可能定理により、 base rate が群間で異なる場合、 上記公平性指標を 同時に満たすことは不可能。 業務上どれを優先するかを明示的に選ばなければならない。
1 2 3 4 5 6 7 8 9 10 11 12 13 14 15 16 | import pandas as pd, numpy as np from sklearn.metrics import confusion_matrix df = pd.read_csv('data/raw/SSDSE-B-2026.csv', skiprows=1, encoding='cp932') # 行は「県ごとに 2023→2012 の降順」で並んでいる。 # そのまま diff() を取ると (a) 県の境目をまたぐ (b) 新しい年から古い年を引くので符号が逆、 # の 2 つが同時に起きる。 県ごとに年度昇順へ並べ替えてから差分を取る。 df = df.sort_values(['都道府県', '年度']) df['増減'] = df.groupby('都道府県')['総人口'].diff() df = df.dropna(subset=['増減']) # 2012 年度は前年が無いので除く (2013〜2023 の 517 行) df['人口減少'] = (df['増減'] < 0).astype(int) df['ブロック'] = df['都道府県'].map({'北海道':'北海道','青森県':'東北','岩手県':'東北','宮城県':'東北','秋田県':'東北','山形県':'東北','福島県':'東北'}).fillna('その他') df['予測'] = (df['合計特殊出生率'] < 1.3).astype(int) if '合計特殊出生率' in df.columns else 0 for blk, sub in df.groupby('ブロック'): tn,fp,fn,tp = confusion_matrix(sub['人口減少'], sub['予測'], labels=[0,1]).ravel() fpr = fp/(fp+tn) if (fp+tn) else float('nan') print(f'ブロック {blk}: 件数 {len(sub)}, 減少なし {fp+tn}, FP {fp}, FPR = {fpr:.3f}') |
📤 実行結果(例):
💬 結果の読み方: FPR の分母は「実際には人口が減っていない県・年」の件数で、 その他ブロックは 68 件あり、 そのうち出生率 1.3 未満で「減少」と誤判定された 16 件 (東京都の 10 年分と、 千葉・埼玉・神奈川の 2019〜2020 年度) で FPR = 0.235。 東北は分母が宮城県の 2 件しかなく FPR = 0.000、 北海道は 11 年間ずっと人口が減っているので分母が 0 で FPR は計算できない (nan)。 前年が無い 2012 年度を差 0 (=減少なし) として残すと、 北海道にも架空の「減少なし」が 1 件でき、 それが偽陽性になって FPR = 1.000 と出てしまう。 群ごとの比率は分母の件数と並べて読み、 件数の少ない群には信用区間を付ける (次節のベイズ的アプローチ)。
🔮 ベイズ的アプローチ — FPR の事後分布
FPR を「点推定 0.05」と報告するのではなく、 事後分布として扱うとサンプル数の少なさによる不確実性が明示できる。 Beta-Binomial モデルが標準的で、 prior を Beta(1,1)(無情報)とし、 観測 FP=4, TN=8 なら事後は Beta(5, 9)。 95% 信用区間は分位点から直接計算できる。
1 2 3 4 5 6 7 8 | import numpy as np from scipy import stats fp, tn = 4, 8 # 観測値 a, b = 1+fp, 1+tn # Beta 事後パラメータ post = stats.beta(a, b) print(f'事後平均 = {post.mean():.3f}') print(f'95% 信用区間 = [{post.ppf(0.025):.3f}, {post.ppf(0.975):.3f}]') print(f'FPR>0.5 の事後確率 = {1-post.cdf(0.5):.3f}') |
📤 実行結果:
💬 結果の読み方: サンプル数 12 しかない場合、 点推定 FPR=0.333 だけ見せるより 95% 信用区間 [0.139, 0.614] を併記すべき。 「FPR が 50% を超える可能性が 13.3% 残る」と読み取れる。 ベイズは少ない観測でも誤解を生みにくい言葉を提供する。
📜 歴史的マイルストーン — FP 概念の発展史
| 年 | 人物・出来事 | 貢献 |
|---|---|---|
| 1763 | Bayes / Price | 事後確率の概念 — PPV 計算の理論基盤 |
| 1928 | Neyman & Pearson | Type I / Type II error の定式化(FP=Type I) |
| 1941 | RADAR ROC 曲線 | 第二次大戦中、 信号検知のため ROC が誕生 |
| 1961 | Tanner & Swets | signal detection theory として体系化 |
| 1995 | Benjamini & Hochberg | FDR 概念導入 — 多重比較で FP 管理 |
| 2006 | Hand | 分類器の「H-measure」提案、 AUC の批判 |
| 2016 | ProPublica COMPAS 報告 | 人種別 FPR 格差が司法 AI 公平性議論を加速 |
| 2018 | Chouldechova 不可能定理 | 公平性指標の同時満足不可を証明 |
📖 英訳辞典 — 関連用語ミニ辞書(12 項)
| 日本語 | 英語 | 補足 |
|---|---|---|
| 偽陽性 | false positive (FP) / Type I error | 「あわてんぼうの誤り」 |
| 偽陰性 | false negative (FN) / Type II error | 「ぼんやりの誤り」 |
| 真陽性 | true positive (TP) | 正しく陽性 |
| 真陰性 | true negative (TN) | 正しく陰性 |
| 偽陽性率 | false positive rate (FPR) | FP/(FP+TN) = 1-specificity |
| 特異度 | specificity / true negative rate | TN/(TN+FP) |
| 陽性的中率 | positive predictive value (PPV) | TP/(TP+FP) = precision |
| 陰性的中率 | negative predictive value (NPV) | TN/(TN+FN) |
| 族関連誤発見率 | family-wise error rate (FWER) | Bonferroni が制御 |
| 偽発見率 | false discovery rate (FDR) | BH 法が制御 |
| 確率校正 | probability calibration | Platt / Isotonic |
| 公平性指標 | fairness metric | Equalized Odds 等 |
📚 学習リソース — 次に読むべき 8 件
- Fawcett (2006) "An introduction to ROC analysis" — Pattern Recognition Letters。 ROC/AUC の決定版解説。
- Davis & Goadrich (2006) "The relationship between Precision-Recall and ROC curves" — 不均衡時に PR-AUC を選ぶ理由。
- Benjamini & Hochberg (1995) "Controlling the false discovery rate" — FDR の原著論文。
- Saito & Rehmsmeier (2015) "The Precision-Recall Plot Is More Informative" — 不均衡データでの可視化指針。
- Chouldechova (2017) "Fair prediction with disparate impact" — 不可能定理の証明。
- Kleinberg, Mullainathan & Raghavan (2017) "Inherent trade-offs in the fair determination of risk scores" — 公平性指標の不可能性。
- Niculescu-Mizil & Caruana (2005) "Predicting Good Probabilities with Supervised Learning" — Platt / Isotonic 校正の比較。
- Gigerenzer (2002) "Reckoning with Risk" — Bayes 思考の入門書、 医療検査の偽陽性の社会的解説。
🔗 関連用語クイックリンク(追加)
偽陰性 / 適合率 / 再現率 / 特異度 / AUC / ROC 曲線 / 混同行列 / F1 スコア / p 値 / 多重比較 / FDR / 対立仮説 / クラス不均衡 / 分類 / ロジスティック回帰 / 決定木 / ランダムフォレスト / 交差検証 / ブートストラップ / 公平性 / SHAP
🧮 数理深掘り — FPR と関連量の代数的関係
偽陽性率 FPR は 1-specificity と等しく、 ROC 曲線の横軸そのものでもある。 ここでは混同行列の 4 セル(TP, TN, FP, FN)から派生する主要指標 12 種を、 計算式と意味を併記して整理する。 同じ実験データに対して指標値を一斉に出すと、 不均衡や閾値の影響が浮き彫りになる。
| 指標 | 英名 | 数式 | 意味・補足 |
|---|---|---|---|
| 偽陽性率 | FPR | FP/(FP+TN) | ROC 横軸、 type I error |
| 真陽性率 | TPR / recall | TP/(TP+FN) | ROC 縦軸、 検出力 |
| 特異度 | specificity / TNR | TN/(TN+FP) | = 1-FPR |
| 適合率 | precision / PPV | TP/(TP+FP) | 陽性出力の信頼度 |
| 陰性的中率 | NPV | TN/(TN+FN) | 陰性出力の信頼度 |
| FDR | false discovery rate | FP/(TP+FP) = 1-precision | 陽性中の偽の割合 |
| FOR | false omission rate | FN/(TN+FN) = 1-NPV | 陰性中の偽の割合 |
| F1 | F1 score | 2·P·R/(P+R) | precision と recall の調和平均 |
| 尤度比+ | LR+ | TPR/FPR | 陽性検査結果の尤度比 |
| 尤度比- | LR- | FNR/TNR | 陰性検査結果の尤度比 |
| バランス精度 | balanced accuracy | (TPR+TNR)/2 | 不均衡時に使う accuracy |
| MCC | Matthews correlation | (TP·TN-FP·FN)/√(...) | 不均衡対応の総合指標 |
💡 これらの指標は互いに代数的に結び付いている。 たとえば precision と recall を高めると F1 が上がるが、 不均衡時には FPR が小さくても陽性出力が大半 FP になる場合があり、 PPV/PR-AUC で別途確認すべき。 単一指標を金科玉条にせず、 複数指標の組合せで意思決定する。
🐍 実装深掘り — classification_report と calibration の併用
FPR を最小化するためには、 単純にクラス重み付けや SMOTE だけではなく、 確率校正(calibration)と組み合わせる必要がある。 校正されていない確率の閾値を 0.1 に下げても、 元のスコア分布がいびつだと FP が安定的に減らない。 以下は SSDSE-B-2026 を題材にした典型的なパイプライン。
1 2 3 4 5 6 7 8 9 10 11 12 13 14 15 16 17 18 19 20 21 22 23 24 | import pandas as pd, numpy as np from sklearn.linear_model import LogisticRegression from sklearn.calibration import CalibratedClassifierCV from sklearn.metrics import classification_report, roc_curve df = pd.read_csv('data/raw/SSDSE-B-2026.csv', skiprows=1, encoding='cp932') # 行は「県ごとに 2023→2012 の降順」で並んでいる。 # そのまま diff() を取ると (a) 県の境目をまたぐ (b) 新しい年から古い年を引くので符号が逆、 # の 2 つが同時に起きる。 県ごとに年度昇順へ並べ替えてから差分を取る。 df = df.sort_values(['都道府県', '年度']) df['増減'] = df.groupby('都道府県')['総人口'].diff() df = df.dropna(subset=['増減']) # 2012 年度は前年が無いので除く (2013〜2023 の 517 行) y = (df['増減'] < 0).astype(int) X = df[['総人口','出生数']].astype(float) base = LogisticRegression(class_weight='balanced', max_iter=1000) cal = CalibratedClassifierCV(base, method='isotonic', cv=5) cal.fit(X, y) prob = cal.predict_proba(X)[:,1] fpr, tpr, thr = roc_curve(y, prob) target_fpr = 0.05 # FPR を 5% 以下に抑える idx = np.argmax(fpr > target_fpr) - 1 # 5% を超える直前の閾値 chosen = thr[idx] yhat = (prob >= chosen).astype(int) print(f'選択閾値 = {chosen:.3f}, 実 FPR = {fpr[idx]:.3f}, TPR = {tpr[idx]:.3f}') print(classification_report(y, yhat, digits=3)) |
📤 実行結果(例):
💬 結果の読み方: FPR を 5% 以下に抑える閾値 0.883 を選ぶと、 人口が減らなかった 70 件のうち誤って「減少」と判定したのは 3 件 (実 FPR = 0.043) で、 減少した 447 件のうち 388 件 (TPR = 0.868) を拾えている。 517 件中 447 件 (86%) が「減少あり」の不均衡データなので、 全部を「減少あり」と答えるだけで accuracy 0.865 が出てしまい、 accuracy 0.880 はそれとほとんど変わらない。 閾値を動かしたときは accuracy ではなく FPR と TPR の組で評価する。 なお校正と閾値選びを同じ 517 件で行っているので、 新しい年度では FPR が 5% を超えることもありうる。
📈 モニタリング — 本番運用での FPR ドリフト検出
モデルを本番投入したら、 FPR は時間とともに変動する(drift)。 とくに季節性・キャンペーン・ユーザー属性変化により陽性率(base rate)が変動するため、 「学習時と同じ閾値」を維持しているだけでは想定 FPR を超える。 以下は典型的なモニタリング指標。
| 指標 | 監視頻度 | アラート閾値の例 | 対応アクション |
|---|---|---|---|
| FPR | 毎時 | 学習時 +2σ 超 | 閾値再キャリブレーション |
| 陽性率 | 毎時 | 過去 7 日平均から ±30% | 入力ドリフト調査 |
| PSI | 日次 | PSI > 0.2 | 特徴量分布の変化を分析 |
| KS 統計量 | 日次 | D > 0.1 | 分布ドリフト評価 |
| サブグループ FPR | 週次 | 群間差 > 2 倍 | 公平性レビュー実施 |
| Calibration Error | 週次 | ECE > 0.05 | Isotonic 再校正 |
🛠 実装 Tips — FP を減らすための 10 戦術
- 確率校正を必ず実施 — Platt / Isotonic で出力確率を「実際の頻度」に近づける。
- 閾値を ROC ベースで選ぶ — 0.5 は意味を持たない。 Youden's J や F-beta で選ぶ。
- class_weight='balanced' — 多くの sklearn 分類器でデフォルトで試す価値あり。
- SMOTE は訓練のみ適用 — テストデータに掛けると評価が壊れる。
- cost-sensitive learning — FP コスト・FN コストを損失関数に直接組み込む。
- ensemble で分散を減らす — RandomForest や XGBoost の bagging 効果。
- 特徴量設計を見直す — leakage や ノイズ特徴量が FP の主因のことが多い。
- サブグループ別評価 — 全体 FPR が低くても群差大ならアウト。
- 多重比較補正 — 多検定なら必ず BH 法か Bonferroni。
- 不確実性を伴って提示 — 単点推定でなく、 信頼区間・事後分布で報告。
❓ 追加 FAQ — 実務でよく聞かれる 15 問
本質的に同じ概念。 統計検定の文脈では α エラー / Type I error、 分類モデルの文脈では FPR と呼ぶことが多い。 ともに「帰無仮説が正しい(陰性)のに棄却(陽性とする)してしまう」誤り。
概念は同じだが運用が異なる。 anomaly detection は「正常」のみ学習し、 そこから外れたものを陽性とするので、 訓練データに偽陽性ラベルが存在しない。 評価は監督ラベルが手に入った時点で混同行列を作る。
クラスごとに OvR(one-vs-rest)で 2 値問題に直して、 クラス c に対する FP_c を「c でないのに c と予測した数」と定義する。 全体指標は macro / weighted で平均する。
時系列の依存性を考慮し、 train/test を時系列カットで分割する。 さらに「警報が連続した場合は 1 件と数える」など、 業務に即したカウント方法(event-wise vs sample-wise)が必要。
理論上不可能。 FPR=0 にすると TPR も 0 になる(誰も陽性にしない)。 「FPR を 1% 以下に抑えつつ recall を最大化」のように制約付き最適化として再定義する。
陽性率(base rate)が極端に低い不均衡データなら PR-AUC、 中程度なら ROC-AUC。 PR-AUC は陽性率に依存するため絶対値比較は要注意。
ラベル誤りがあると真の TN がラベル上 FP になる。 ラベルノイズ率 ε が小さくない場合、 観測 FPR は真 FPR より高く出る。 ラベル監査やラベル平滑化、 noisy-label-robust loss を検討。
sklearn.metrics.roc_curve で FPR と TPR を得て matplotlib でプロット。 さらに auc() で面積、 RocCurveDisplay で凡例も自動表示できる。「テスト時にだけわかる情報」を訓練に混ぜると、 訓練時の FPR は非常に低くなるが本番では崩壊する。 リーケージ検出は cross-validation の fold 間で評価指標を比較するのが基本。
逆。 recall を 100% にすれば多くの場合 FP は爆発する。 precision とのトレードオフを必ず取る。
偽陽性アラートが多すぎてオペレータが本当のアラートを軽視する状態。 セキュリティ運用や医療監視で深刻。 閾値の動的調整・優先度付き通知・サマリー表示で軽減する。
precision は高いが recall が極端に低いケース。 たとえば 1000 件中 5 件しか陽性出力しないなら、 ほぼ全件見逃している。 FPR だけ見て判断しないこと。
FP に該当するサンプルのみ抽出し、
shap_values を計算して force_plot や waterfall で寄与の大きい特徴量を可視化する。 共通パターンが見えれば特徴量改善のヒントになる。指数移動平均で base rate を追跡し、 目標 FPR を維持する閾値を周期更新する。 過去 24h の予測スコア分布の分位点を採用する simple な方法も有効。
実用上 FPR=0 は不可能。 仮に検査の specificity が 100% でも、 サンプル/前処理エラー・装置不調等で FP は発生する。 「FPR<1%」「PPV X%」など定量明示すべき。
📖 拡張ミニ辞典(追加 15 項)
| 用語 | 英語 | 説明 |
|---|---|---|
| Youden's J | Youden index | J = TPR - FPR、 ROC 上で最大点を閾値に |
| 事前確率 | prior probability | base rate と同義、 Bayes 計算の出発点 |
| 事後確率 | posterior probability | 検査結果を踏まえた更新後の確率 |
| アラート疲れ | alert fatigue | FP 多発によるオペレータ感度低下 |
| α エラー | alpha error | Type I error の別名 |
| β エラー | beta error | Type II error の別名 |
| PSI | Population Stability Index | 分布の変化を測る、 ドリフト検知の標準 |
| KS 距離 | Kolmogorov-Smirnov | 分布間距離、 ドリフト検知に利用 |
| Brier スコア | Brier score | 確率予測の二乗誤差、 校正評価 |
| ECE | Expected Calibration Error | 校正誤差の平均、 0 に近いほど良い |
| disparate impact | 不利益的影響 | 米国法で公平性違反の指標、 4/5 ルール |
| cost matrix | コスト行列 | FP/FN それぞれにコスト割当 |
| Platt 校正 | Platt scaling | ロジスティック回帰で確率校正 |
| Isotonic 校正 | Isotonic regression | 単調回帰で確率校正 |
| 事例ベース監査 | case-based audit | FP 事例の質的分析 |
📖 物語で理解する FP — 3 つのケース
ストーリー 1: 健康診断の不安
健康診断で「腫瘍マーカー陽性」と通知された 40 代男性。 病院での精密検査の結果、 良性であった。 これが偽陽性の典型例。 罹患率 0.5%、 感度 80%、 特異度 90% の検査ならば PPV ≈ 3.9%。 つまり陽性通知を受けた人のうち約 96% は実際には罹患していない。 検査前にこの数字を知っておけば、 不必要な不安は減らせる。 医療リテラシーとして PPV を知る意味は大きい。
ストーリー 2: スパムメールの誤判定
大手 EC 企業の重要な確認メールが、 顧客の Gmail スパムフォルダに自動振り分けされ続けた。 これは顧客側スパム分類器の偽陽性。 顧客から「届かない」と苦情が続出。 SPF / DKIM / DMARC を整え、 送信ドメインの reputation を高めることで FPR を下げた。 メール業界では「FP 0.1% でも 100 万通中 1,000 通が誤判定」と認識する。
ストーリー 3: 顔認証の入退室管理
オフィスの顔認証ゲートで、 双子の弟が兄として誤認識(FP)された。 セキュリティ部門は「FPR < 0.001%」を保証していたが、 双子のような外れ値で破綻。 解決策はマルチモーダル認証(顔+IC カード)と、 サブグループ別 FPR の継続監査。 「全体平均」だけ見ても安全とは言えない好例。
⚠ アンチパターン集 — 偽陽性を悪化させる 8 つの間違い
| アンチパターン | なぜダメか | 代わりに |
|---|---|---|
| accuracy だけで評価 | 不均衡で誤導的 | F1, PR-AUC, MCC を併用 |
| 閾値 0.5 固定 | 業務コスト無視 | コスト最適化で決定 |
| テスト側にも SMOTE | 評価が壊れる | 訓練のみに適用 |
| 校正なしの確率閾値 | 出力確率が信頼できない | Platt / Isotonic 校正 |
| 多重比較補正なし | FP が量産される | Bonferroni / BH 法 |
| 全体 FPR のみ公開 | サブグループ格差を隠蔽 | group-wise FPR を必須報告 |
| 本番でも訓練時閾値固定 | ドリフトで FPR 上昇 | 定期再校正 |
| 「FPR=0」と宣伝 | 物理的に不可能 | 定量的に明示する |
🏭 産業別ケーススタディ — 12 業界での FP の意味
「偽陽性」という言葉は同じでも、 産業によってその意味と扱いは大きく異なる。 ここでは 12 業界での代表例を表でまとめる。 自分の業界がどこに該当するかを意識し、 「許容できる FPR の水準」と「FP の社会的・経済的コスト」を見極める素材として使ってほしい。
| 業界 | 陽性の意味 | FP の主なコスト | 許容 FPR の目安 |
|---|---|---|---|
| 医療診断 | 疾患疑い | 精密検査負担・心理的不安 | 5-15% |
| 医薬品開発 | 候補化合物 | 無駄な開発費(億単位) | 1% 以下 |
| クレジット不正 | 疑わしい取引 | 確認電話・顧客不満 | 0.5-2% |
| マネロン検知 | SAR 報告候補 | 調査工数増 | 1-5% |
| サイバーセキュリティ | 攻撃疑い | アラート疲れ | 0.1-1% |
| スパムフィルタ | スパム判定 | 重要メール紛失 | 0.01-0.1% |
| 空港セキュリティ | 危険物疑い | 追加検査・遅延 | 5-20% |
| 司法 AI(再犯予測) | 再犯リスク | 不当な拘束・倫理問題 | 慎重設計必須 |
| 採用 AI | 不適合候補 | 差別・機会損失 | 公平性監査必須 |
| 広告ターゲティング | 関心ありユーザー | 配信費の無駄 | 業務 ROI 次第 |
| 天気予報(豪雨) | 豪雨警報 | 警報疲れ・経済損失 | 10-30% |
| 天文学(系外惑星) | 候補天体 | 追跡観測の浪費 | 5-15% |
💡 同じ「偽陽性 5%」でも、 医療スクリーニングなら許容範囲、 マネロン検知なら過大、 採用 AI なら社会問題。 数字だけで評価せず、 「業界規範」「規制」「ユーザー体験」を踏まえる必要がある。
🗺 概念マップ — 偽陽性の位置づけ
偽陽性 (False Positive, FP) は混同行列の 4 セルのうちの 1 つで、 「実際は陰性なのに陽性と予測した」誤りを指す。 同義: Type I Error、 α エラー、 False Alarm。 SSDSE-B-2026 を題材にすれば、 「失業率の高い県」と予測したが実際は中程度だった、 などが FP に該当する。
【混同行列 (Confusion Matrix) の 4 セル】

                  予測: 陽性 (+)            予測: 陰性 (-)
              ┌─────────────────────┬─────────────────────┐
 実際: 陽性  │ TP (真陽性)         │ FN (偽陰性 / Type II) │
              │ 正しく陽性と予測    │ 陽性を見逃した        │
              ├─────────────────────┼─────────────────────┤
 実際: 陰性  │ FP (偽陽性) ★      │ TN (真陰性)          │
              │ 本ページ            │ 正しく陰性と予測      │
              │ 陰性を陽性と誤判定  │                      │
              └─────────────────────┴─────────────────────┘

【FP と関連指標の対応】
偽陽性数 FP ──┬─→ FPR = FP / (FP + TN)        ─ 特異度 = 1 - FPR
              ├─→ Precision = TP / (TP + FP)  ─ FP 増 → Precision 低下
              ├─→ Type I Error 確率 α          ─ 統計検定: 帰無棄却の誤り
              ├─→ ROC 曲線 X 軸               ─ FPR をプロット
              └─→ FDR = FP / (TP + FP)        ─ 多重検定での累積誤発見率

【上位概念ツリー】
分類モデルの誤り
├─ 偽陽性 (FP) ★ 本ページ              ─ Type I / α エラー / False Alarm
│  ├─ Bonferroni 補正                  ─ 多重検定での α 調整
│  ├─ Holm 法                          ─ 段階的 α 調整
│  └─ FDR (BH 法)                      ─ 累積偽陽性率制御
└─ 偽陰性 (FN)                          ─ Type II / β エラー / Miss
   ├─ 検出力 (Power = 1-β)
   └─ 標本サイズ設計

【ドメイン別の許容 FP】
医療スクリーニング ─ 高 FP 許容 (見逃し回避優先)
詐欺検知           ─ 低 FP 必須 (顧客体験悪化)
天文台候補天体     ─ 中 FP 許容 (追跡観測で再確認)
迷惑メール判定     ─ 極低 FP 必須 (重要メール紛失回避)
要点: FP は単独で良し悪しが決まらない。 「FN とのトレードオフ」「ドメインのコスト構造」「閾値選択」を同時に語ってはじめて意味を持つ。 SSDSE-B のような小標本 (47 県) では FP 1 件で指標が大きく動くため、 信頼区間と併記する。
🗺 学習ロードマップ — 偽陽性を 8 週間で習得する
| 週 | 学習内容 | 演習 | 関連ページ |
|---|---|---|---|
| 1 | 混同行列の 4 セルを定義し、 TP/TN/FP/FN を SSDSE データで計算 | 本ページ Q1-Q3 を解く | 混同行列 |
| 2 | precision / recall / F1 を計算、 不均衡データの落とし穴 | scikit-learn classification_report | 適合率 / 再現率 |
| 3 | ROC 曲線・AUC・PR 曲線を読み解く | RocCurveDisplay で可視化 | ROC 曲線 / AUC |
| 4 | Bayes の定理で PPV を計算、 base rate の支配力を体験 | 本ページ Q4-Q5 | 特異度 |
| 5 | 多重比較補正(Bonferroni / BH 法) | statsmodels multipletests | 多重比較 / FDR |
| 6 | 確率校正と閾値最適化 | CalibratedClassifierCV | ロジスティック回帰 |
| 7 | 公平性指標 (Equalized Odds, Predictive Parity) | サブグループ別 FPR 監査 | 公平性 |
| 8 | ドリフト検知と MLOps での FP モニタリング | PSI / KS / 再キャリブレーション設計 | クラス不均衡 |
✅ レビュー用 12 チェックリスト
- 混同行列の 4 セル(TP/TN/FP/FN)を提示しているか
- FPR と specificity を 1-FPR の関係で説明しているか
- base rate を明示し、 PPV/NPV を計算しているか
- 不均衡時の accuracy の誤導性に言及しているか
- ROC / PR 曲線とその AUC を併記しているか
- 閾値選択を業務コストに基づいて議論しているか
- 多重比較補正の必要性(Bonferroni / BH)を述べているか
- 確率校正(Platt / Isotonic)を扱っているか
- サブグループ別 FPR 監査の重要性を伝えているか
- ベイズ的アプローチで不確実性を表現しているか
- 本番運用でのドリフト検出ポリシーがあるか
- SSDSE-B-2026 などの実データで数値を再現可能にしているか
🔮 ベイズ深掘り続編 — 検査陽性後の事後オッズ計算
偽陽性に強くなる最短の道は、 「検査陽性時の事後オッズ」を即座に概算できるようになることだ。 ベイズの定理を「事前オッズ × 尤度比 = 事後オッズ」の形に書き換えると、 暗算でほぼ正しい PPV が出る。 ここでは 4 つの典型シナリオで実演する。
| シナリオ | 事前確率 | 事前オッズ | LR+ | 事後オッズ | 事後確率 (PPV) |
|---|---|---|---|---|---|
| 無症状一般人 | 0.5% | 0.005:1 | 10 | 0.05:1 | 4.8% |
| 家族歴あり | 5% | 0.053:1 | 10 | 0.53:1 | 34.6% |
| 症状あり | 30% | 0.43:1 | 10 | 4.3:1 | 81.1% |
| 高リスク群 | 50% | 1:1 | 10 | 10:1 | 90.9% |
💡 LR+=10(感度 90% / FPR 9% 程度)の検査でも、 事前確率 0.5% の集団では陽性者の 95% が偽陽性。 同じ検査を症状ありの集団に使えば PPV は 81%。 「検査の精度」よりも「対象集団の選択」が PPV を決める。
📓 拡張クックブック — FP 制御のための関数 15 個
| # | 関数 | 用途 |
|---|---|---|
| 01 | RocCurveDisplay.from_predictions | ROC 可視化 |
| 02 | PrecisionRecallDisplay.from_predictions | PR 可視化 |
| 03 | ConfusionMatrixDisplay.from_predictions | 混同行列可視化 |
| 04 | CalibrationDisplay.from_predictions | 校正曲線 |
| 05 | scipy.stats.binomtest(fp, fp+tn, p=0.05) | FPR=5%の検定 |
| 06 | scipy.stats.beta(1+fp,1+tn).interval(0.95) | FPR の 95% CrI |
| 07 | multipletests(pvals, method='fdr_bh') | FDR 制御 |
| 08 | multipletests(pvals, method='holm') | Holm 法 |
| 09 | sklearn.metrics.det_curve | DET 曲線(信号検知) |
| 10 | imblearn.over_sampling.ADASYN | 適応的 SMOTE |
| 11 | fairlearn.metrics.MetricFrame | group-wise metrics |
| 12 | fairlearn.postprocessing.ThresholdOptimizer | 公平性閾値最適化 |
| 13 | evidently.metrics.DataDriftPreset | ドリフト検知 |
| 14 | alibi-detect.cd.KSDrift | KS ドリフト検知 |
| 15 | shap.Explainer(clf)(X[fp_idx]) | FP の SHAP 分析 |
⚖ 政策・倫理 — 偽陽性をめぐる 6 つの社会的論点
- 司法 AI: 再犯予測の FP(実は再犯しない人を高リスク判定)は不当な保釈拒否につながる。 ProPublica の COMPAS 報道が議論を引き起こした。
- 採用 AI: 「不適合候補」と判定された応募者は説明責任の対象。 EU AI Act では high-risk AI 該当。
- 医療 AI: FP の通知が患者に与える心理的負担も「医療上の害」として扱われる。 informed consent が必須。
- 顔認証監視: 公共空間での FP は人権問題に直結する。 サンフランシスコ等は警察利用を禁止。
- 信用スコア: 自動審査での FP(実は返済能力ある人を否認)は公平性規制の対象。
- テロ予測: FPR=1% でも 1 万人検査で 100 人の誤検知。 過剰監視を生む。
🗾 SSDSE-B-2026 深堀り演習 — 都道府県データで FP を体感する 5 題
最後に SSDSE-B-2026(都道府県別データ)を用いた実演 5 題で FP の感覚を仕上げる。 ノートブックで pd.read_csv('data/raw/SSDSE-B-2026.csv', skiprows=[1]) を実行してから順に解いていく。
ヒント:
confusion_matrix で 4 セル取得 → FPR=FP/(FP+TN), PPV=TP/(TP+FP)。結果の読み方: 出生率は人口減少の予測としては弱く、 FPR は中-高、 PPV は低めになる。 「相関と予測力は別物」を再確認するための演習。
ヒント:
df.groupby('ブロック').apply(...) で各ブロックの FPR を計算、 棒グラフ。結果の読み方: 関東・近畿では人口増加県があるため FP が増えやすい。 全国一律閾値が地域差を生む様子が見える。
ヒント:
roc_auc_score を 1000 回ブートストラップ、 np.percentile で 2.5%-97.5%。結果の読み方: 47 件のサンプルしかないので CI は幅広い。 単点 AUC では「予測力あり」と誤判断しがちなことを実感する。
ヒント:
CalibratedClassifierCV(method='isotonic', cv=3)。結果の読み方: 校正後は確率の解釈が物理的に正しくなり、 業務閾値の選定が容易になる。 校正前は閾値 0.5 が機能していないことが多い。
ヒント:
fpr, tpr, thr = roc_curve(y, prob)、 コスト=FP×100万+FN×500万 を計算、 argmin。結果の読み方: コスト最適閾値は 0.5 とほぼ無関係に決まる。 業務コストを定義する習慣が偽陽性制御の核心。
🧭 全体振り返り — 偽陽性を語る 12 つのキーフレーズ
| # | キーフレーズ | 意味 |
|---|---|---|
| 1 | FP = Type I error | 分類と検定で同じ概念 |
| 2 | specificity = 1 - FPR | 2 指標は補集合 |
| 3 | base rate が PPV を決める | Bayes の本質 |
| 4 | accuracy ≠ 良いモデル | 不均衡で誤導的 |
| 5 | 閾値 0.5 は便宜的 | 業務コストで決める |
| 6 | 校正なき確率は危険 | Platt / Isotonic 必須 |
| 7 | 多重比較は補正必須 | BH 法が標準 |
| 8 | group-wise FPR を見る | 公平性の核心 |
| 9 | 単点推定は弱い | CI / 事後分布で報告 |
| 10 | ドリフトで FPR 変化 | 本番モニタリング |
| 11 | FP コストは業界で異なる | 「許容 FPR」を文脈で |
| 12 | SHAP で FP を分解 | FP 主因の特徴量を発見 |
⚠ 偽陽性をめぐる 10 の典型的誤解
- 誤解 1: 「accuracy が 99% なら良いモデル」 → 不均衡時は陽性率 1% を全件陰性とするだけで accuracy 99% に達する。 PR-AUC / MCC を併用すること。
- 誤解 2: 「感度 99% の検査なら陽性結果は信頼できる」 → base rate が低い集団では PPV が 10% を切ることもある。 PPV を必ず計算する。
- 誤解 3: 「FPR を 0 にすればよい」 → 不可能。 FPR=0 にすると TPR=0 になる。 制約付き最適化として扱う。
- 誤解 4: 「閾値は常に 0.5」 → 校正されていない確率や不均衡データでは 0.5 はほぼ常に間違い。 業務コストで決める。
- 誤解 5: 「ROC-AUC さえ高ければよい」 → 不均衡時には PR-AUC、 確率解釈なら calibration、 多角的に評価。
- 誤解 6: 「多重比較補正は厳しすぎる」 → 補正しなければ FP が量産される。 BH 法(FDR)が現代の標準。
- 誤解 7: 「全体 FPR が低ければサブグループも大丈夫」 → 平均が低くても群間差が大きい場合あり。 必ず group-wise で見る。
- 誤解 8: 「学習時の閾値は本番でも有効」 → ドリフトで FPR が変動する。 定期再校正必須。
- 誤解 9: 「テストデータにも SMOTE を適用すれば公平」 → 評価が壊れる。 SMOTE は訓練のみ。
- 誤解 10: 「偽陽性は技術問題」 → 社会・倫理問題でもある。 公平性監査と informed consent を組み込む。
📖 用語対応表 — 検定 vs 機械学習
| 検定の用語 | 機械学習の用語 | 関係 |
|---|---|---|
| 帰無仮説 H₀ | 陰性クラス | 「効果なし/陰性」が初期仮定 |
| 対立仮説 H₁ | 陽性クラス | 「効果あり/陽性」を主張 |
| α (有意水準) | FPR の制約 | Type I error の上限 |
| β (Type II 確率) | FNR | 陽性を見逃す確率 |
| 検出力 (power) | recall / TPR | 1-β に対応 |
| p 値 | 予測確率 | 直接対応はしないが似た役割 |
| FWER | マクロ FPR | 家族全体で誤陽性確率 |
| FDR | 1-precision | 陽性出力中の誤り割合 |
💡 同じ概念に対して統計検定と機械学習で異なる用語が使われるが、 計算式と意味は対応している。 「α=0.05」を設定することは「FPR を 5% 以下に抑える」と同義。 両分野の用語を行き来できるようになると、 ベイズ・頻度論・分類器の議論が一気にクリアになる。
📅 日常事例 — 身の回りの「偽陽性」を見つける 6 例
- 火災報知器: 料理の湯気で警報が鳴る。 specificity を上げる(煙の連続性を見る)ことで FPR を下げている。 ただし上げすぎると本当の火災を見逃す(FN 増)。
- スマートフォンの顔認証: 双子や似た顔で誤解除(FP)。 メーカーは「他人受け入れ率 1/1,000,000」を目標としており、 これが FPR の保証値。
- メールスパムフィルタ: 重要メールが迷惑メールに分類される(FP)。 GAFA は SPF/DKIM/DMARC + ML で FPR を 0.01% 以下にしている。
- クレジットカード不正検知: 海外出張時に「不正の疑い」で利用停止(FP)。 事前申告で base rate を下げ、 FPR を抑制する。
- 空港の金属探知機: ベルトのバックルで警報(FP)。 特異度を上げると武器を見逃すリスクがあり、 「FP を許容して FN を減らす」設計。
- 健康診断のマーカー陽性: 良性腫瘍で「要精密検査」(FP)。 PPV を理解することで、 不必要な不安を減らせる。
🧮 暗記すべき主要公式 — 5 つ
1. FPR = FP / (FP + TN) = 1 - specificity — 陰性のうち誤って陽性とした割合
2. PPV = sens × prior / (sens × prior + (1-spec) × (1-prior)) — Bayes による陽性的中率
3. LR+ = sens / (1-spec) = TPR / FPR — 陽性結果の尤度比
4. 事後オッズ = 事前オッズ × LR+ — 暗算 PPV のショートカット
5. Bonferroni 補正: α' = α / m — m 件の独立検定での補正水準
🔍 FP デバッグ戦略 — 「なぜ FP が多いのか」を 7 ステップで突き止める
- 陽性率(base rate)を確認: 訓練と本番で大きく差があれば閾値が機能していない。
- 校正曲線をプロット: 確率出力が単調・正確に並んでいない場合は Platt / Isotonic で校正。
- FP サンプルを抽出:
X[fp_idx]を CSV に出して目視で共通点を探す。 - SHAP で寄与特徴量を分析: FP の主因となる特徴量が特定できる。
- ラベルノイズ監査: FP の一部が実は真陽性(ラベル誤り)の可能性。 サンプリングして手動確認。
- サブグループ別 FPR: 性別・年代・地域で群差があれば公平性設計を検討。
- ドリフト検知: PSI / KS 統計量で訓練 vs 本番の特徴量分布を比較。 違えば再学習。
💡 この 7 ステップは MLOps チームの「FP インシデント対応 SOP」として使える。 1-2 で「設定問題」を排除し、 3-5 で「データ問題」を疑い、 6-7 で「公平性・ドリフト問題」を確認する流れ。
📌 クイックリファレンス — 1 ページ早見表
定義: 偽陽性(False Positive, FP)= 陰性なのに陽性と判定された誤り。 統計検定では Type I error / α エラーと同義。
主要指標: FPR = FP/(FP+TN), specificity = 1-FPR, PPV = TP/(TP+FP), LR+ = TPR/FPR。
Bayes 早見: 事後オッズ = 事前オッズ × LR+。 検査特性が同じでも base rate が低ければ PPV は小さい。
閾値選択: ROC 曲線で目標 FPR を満たす最大 TPR を探す。 業務コスト最小化なら C = c_FP × FP + c_FN × FN を最小化。
多重比較: m 件の検定なら α' = α/m (Bonferroni) または BH 法で FDR 制御。
不均衡対策: class_weight='balanced' → SMOTE → cost-sensitive loss の順で試す。 評価は元分布で。
校正: CalibratedClassifierCV(method='isotonic', cv=5) で確率を物理量に近づける。
公平性: group-wise FPR を必ず報告。 Equalized Odds と業務目的の整合を検証。
本番: PSI / KS でドリフト監視、 月次再校正をルーチン化。
ライブラリ: sklearn.metrics, statsmodels.stats.multitest, imblearn, fairlearn, shap, evidently, alibi-detect。
🗾 日本における偽陽性の事例と政策的論点
日本でも偽陽性は医療・金融・公的サービスで議論される。 がん検診では「過剰診断」と呼ばれる FP 関連問題、 マイナンバー関連サービスでは本人確認の FPR が公共議論の対象になった。 自動運転車では歩行者検出の FP は急ブレーキの原因となり、 後続車事故リスクを生むため、 国土交通省のガイドラインで許容 FPR を設けている。 SSDSE-B-2026 の都道府県別データを使った人口減少県判定や、 出生率予測の演習も、 実は政策評価における偽陽性管理と直結しており、 都道府県別 FPR を見比べる思考は政策の説明責任を担保する重要な技法となる。
なお、 偽陽性は単に「数値を下げれば良い」ものではなく、 業務目的・社会的影響・関係者の同意とのバランスで設計する概念である。 本ページの各演習・ケーススタディを通じて、 計算技法だけでなく「FP の意味と扱い方」を文脈で理解できるようになっていれば幸いである。 SSDSE-B-2026 の都道府県データを使った演習をすべて手元で再現すれば、 自分の業務領域に応用するための土台が整う。
🎓 最終まとめ — 偽陽性に強くなるための 5 原則
- 「精度」だけ見ない — 不均衡時の accuracy は誤導的。 必ず混同行列ベースで多角的に評価する。
- base rate を必ず確認 — PPV は base rate に支配される。 Bayes の定理で見積もる癖をつける。
- 閾値は業務コストで決める — FP コスト vs FN コストの比で最適閾値を選ぶ。 0.5 は意味を持たない。
- 多重比較は必ず補正 — 1000 検定で α=0.05 なら 50 件は誤陽性が出る。 Bonferroni か BH 法を必ず適用。
- 公平性監査を組み込む — group-wise FPR を確認し、 Equalized Odds と業務目的の整合を取る。
本拡張深掘りは SSDSE-B-2026 都道府県データに基づく実演を中心に構成した。 練習問題と図解で「偽陽性をどう減らすか」を実装レベルで把握できるはずである。 関連用語リンクから次の学習トピックへ進んでほしい。