📚 用語解説
問題の定式化
Problem Formulation
ML基礎
🔖 キーワード索引
問題の定式化 タスク設計 分類 回帰 クラスタリング 目的変数 評価指標 目的設計
💡 30秒で分かる結論 — 問題の定式化
🍰 まずはやさしく
翻訳のような作業です。
AIが解ける数学の問題にするために使います。
スマホの売上を予測する時に必要です。
結論と、問題の種類について読みます。
最も忙しい読者のために、 まず結論だけまとめます。 詳細は以下のセクションへ:
問題の定式化 =ビジネス課題を ML が解ける「数学の問題」に翻訳する工程。選択肢は大別して (1)分類 (2)回帰 (3)クラスタリング (4)ランキング (5)検出 。 「何を入力 X、 何を出力 y にするか」を決めるだけでプロジェクトの 7 割が決まる。 評価指標もここで決定:Accuracy / F1 / RMSE / AUC / NDCG など。 後から変えると全部やり直しになる。 失敗の最大原因 はモデルではなく定式化ミス。 「予測したい瞬間」「使える特徴量」「許容誤差」を明確化。
📍 文脈 — どこで出会うか
🍰 まずはやさしく
地図のような案内図です。
どこでこの考え方を使うかを知るために使います。
部活の予算を立てる時に似ています。
このページの読み方について読みます。
「売上を予測したい」 — これだけでは ML プロジェクトは始まりません。 来月の 売上か、 明日 の売上か、 店舗ごと か、 商品ごと か。 何を入力、 何を出力にするか — この問いの答えが 問題の定式化 です。
🎨 直感で掴む
🍰 まずはやさしく
イメージ図のようなものです。
感覚的に仕組みを理解するために使います。
身長の予想を例に考えてみます。
データの作り方で答えが変わることを読みます。
「子どもの将来の身長を当てたい」というふんわりした問題を ML に翻訳してみます:
目的変数 y :18 歳時点の身長 (cm) — 連続値 → 回帰問題 入力 X :3 歳時点の身長、 両親の身長、 性別、 出生体重評価指標 :RMSE (二乗平均平方根誤差) — 単位 cm で解釈しやすい許容誤差 :±3 cm 以内なら「使える」
もし出力を「18 歳で 170cm 超か否か」にすれば 二値分類問題 に変わり、 評価指標も Accuracy/AUC に変わります。 同じデータでも、 問題の定式化次第で別プロジェクト 。
SSDSE-B-2026 で「同じ列を 3 通りに定式化」
都道府県別の「出生数 」列を考えると、 1 つのカラムから少なくとも 3 種類の問題が組めます。
問題タイプ y の作り方 入力 X の例 評価指標 想定モデル
回帰 出生数(連続値、 単位人) 人口、 婚姻数、 平均年齢 RMSE、 MAE、 R² 線形回帰、 Lasso、 LightGBM 二値分類 出生率が全国平均超え=1 / それ以下=0 婚姻率、 共働き率、 保育所数 Accuracy、 AUC、 F1 ロジスティック回帰、 XGBoost 多クラス 出生数を 5 段階(低〜高)にビン化 人口階級、 婚姻件数 Macro-F1、 Top-2 Acc ランダムフォレスト
問題定式化の「翻訳プロセス」を可視化
ビジネス課題:「うちの自治体、 出生率を上げる施策を打ちたい」
     │
     │ (1) 何を当てたい?  → 「出生数」      ← y を決める
     │ (2) 何が手に入る?  → 「世帯収入、 保育所数、 ...」 ← X を決める
     │ (3) いつ予測する?  → 「翌年度の予算策定時点」  ← データリーク防止
     │ (4) 何点なら OK ?  → 「RMSE ≤ 100 人」   ← 評価指標と閾値
     ▼
ML 問題:回帰、 47 都道府県、 RMSE 100 人以内、 リーク無し
     ▼
モデル選択・学習・評価(次の章で扱う)
比喩 :問題定式化は「お客様の『何かいい感じにして』を、 シェフが『鶏むね 200g、 塩 2g、 200℃ 15 分』に翻訳する作業」。 ここを間違えると、 どんなに高性能なモデル(高級調理器具)を使ってもズレた料理しか出てきません。
🎮 触って理解する
同じデータでも「何を目的変数 Y にするか 」で解くべき問題は丸ごと変わります。 下のボタンで 目的変数の型 を選ぶと、 決定木フローがたどる経路・問題タイプ・推奨手法・評価指標が切り替わり、 右下の当てはめ模式図もリアルタイムに描き直されます。 二値分類のとき はグラフ上の点線(しきい値)を ドラッグ/スワイプ して陽性の割合が動く様子を確かめてください。
Y = 連続値
Y = 2値
Y = 多値(3段階)
Y = なし(ラベル無し)
回帰
目的変数の型 連続値 問題タイプ 回帰 学習の種類 教師あり 推奨手法 線形回帰 / LightGBM 主な評価指標 RMSE / MAE / R² 図から読む数値 —
① 目的変数 Y(正解ラベル)はある?
いいえ → クラスタリング(教師なし)
はい → ② Y の型は?
連続値 → 回帰
2値 → 二値分類
3値以上 → 多クラス分類
🧭 直感 — 定式化とは「3 点セット」を決めること
問題の定式化は結局、 ①タスク種別(何を出力するか) ・②データ(X と Y の中身) ・③評価指標(何を良しとするか) の 3 点を固定する作業です。 上のウィジェットで確かめたように、 X と生データが同じでも Y の型を変えるだけ で、 決定木フローの出口(回帰 / 分類 / クラスタリング )と 評価指標 (RMSE / F1 / AUC )がまるごと切り替わります。 Y が無ければ 教師あり ではなく 教師なし の世界に入ります。
⚠️ よくある落とし穴
(1) 問題設定の誤り :ビジネス課題を無理に「分類」に押し込む(本当は順位付けやランキング が欲しいのに二値分類にする)と、 高精度でも役に立ちません。 目的変数 の型は「意思決定で最終的に欲しい形」から逆算します。
(2) 評価指標の不一致 :学習で最小化する損失(例 MSE)と、 事業で重視する指標(例 陽性の取りこぼしを避けたい=Recall/F1)がズレると「指標は良いのに現場で失敗」します。 ウィジェットの二値分類でしきい値を動かすと陽性率が大きく変わるとおり、 指標としきい値はセットで設計 します。
(3) データリーク :予測時点より後の情報を X に混ぜると、 検証では高得点でも本番で崩壊します。 「その特徴量は予測の瞬間に本当に手に入るか?」を必ず確認します(→ データリーク )。
🚀 発展 — 単一タスクの外側へ
マルチタスク学習 :出生率と婚姻率を 1 つのモデルで同時に予測するなど、 複数の Y を共有表現で解くと、 データが少ない県でも情報を融通でき精度が上がることがあります。 定式化は「Y を 1 本」から「Y のベクトル」へ拡張されます。
オンライン学習 :データが時々刻々流れてくる状況では、 一度学習して固定するのではなく、 新しい観測ごとにモデルを逐次更新します。 このとき定式化には「いつ・どの粒度で更新するか」「分布の変化(ドリフト)をどう検知するか」という時間軸の設計が加わります。(マルチタスク学習・オンライン学習の個別解説ページは未整備のため、 ここではテキストのみで触れています。)
🔬 記号・要素の読み解き
定式化の数式 $\hat{f} = \arg\min_{f \in \mathcal{F}} \frac{1}{N}\sum_{i=1}^N L(f(X_i), Y_i) + \lambda \Omega(f)$ を 1 記号ずつ分解 します。 「何を選ぶか」と「どこにビジネス都合が入るか」を対応させて読みます。
記号 読み方 意味 SSDSE-B 例 設計の論点
$X_i$ エックス・アイ i 番目サンプルの入力ベクトル i 番目県の人口・所得・保育所数 予測時点で入手可能か?(リーク防止) $Y_i$ ワイ・アイ i 番目サンプルの正解(教師信号) i 番目県の合計特殊出生率 連続/離散/順序 → 問題タイプを決定 $N$ エヌ サンプル数 47(都道府県) $N$ 小 → シンプルモデル / CV 必須 $f$ エフ 予測モデル本体 $\hat{Y}=w_0+\sum w_j X_j$ 線形 / 木 / NN — 解釈性とのトレードオフ $\mathcal{F}$ エフ・スクリプト f を選ぶ候補集合(仮説空間) 「線形回帰の係数 ($w_0,...,w_p$)」全体 広いほど柔軟 / 過学習リスク↑ $L$ ロス 損失関数(誤差の大きさ) $(\hat{Y}-Y)^2$(二乗誤差) 外れ値感度 — RMSE / MAE / LogLoss $\Omega(f)$ オメガ モデルの複雑さペナルティ $\sum w_j^2$(L2)/ $\sum |w_j|$(L1) L1 で疎、 L2 で滑らか $\lambda$ ラムダ 正則化の強さ 0.01〜100 を CV で探索 0 で過学習、 大で過小学習 $\hat{f}$ エフハット 学習で得られた最適モデル model.fit(X,y) の結果本番デプロイ対象
1 行ずつ読み下し :
$\hat{f} = \arg\min_{f \in \mathcal{F}}$ → 「仮説空間 $\mathcal{F}$ の中で、 次式を最小にするモデル $f$ を $\hat{f}$ と呼ぶ」$\frac{1}{N}\sum_{i=1}^N L(f(X_i), Y_i)$ → 「47 都道府県の予測値 $f(X_i)$ と正解 $Y_i$ のズレを平均」(経験リスク)$+ \lambda\,\Omega(f)$ → 「モデルが複雑なら罰金 $\Omega(f)$ を $\lambda$ 倍して足す」合わせて:「誤差平均 + 複雑さ罰金 を最も小さくする f が、 最良の定式化された問題の解」
設計でつまずきやすい「定式化の落とし穴」記号別チェック
$X$ のリーク :未来の情報が含まれていないか?(例:「3 月予測なのに 4 月の値で学習」は NG)$Y$ の定義 :「成功」の閾値が曖昧だと評価不能(例:「出生率が高い」→ 1.5 以上、 と数値で固定)$L$ の選択 :外れ値が多い県(東京都)があるなら MAE のほうが安定$\mathcal{F}$ の幅 :N=47 で深層 NN を選ぶと過学習確定 → 線形 or 木で十分評価指標 vs $L$ :学習用 $L$ と評価指標は別で良い(例:$L$=MSE で学習し、 評価は R²)
🧮 実値で計算してみる
「合計特殊出生率(TFR)を都道府県別に予測」をどう定式化するか:
パターン y タスク 指標 A TFR (連続値) 回帰 RMSE B TFR>1.5 か否か 二値分類 F1, AUC C 高/中/低の3段階 多値分類 Macro-F1 D 来年の変化幅 回帰 (差分) MAE
🐍 Python での扱い
SSDSE-B-2026 (47 都道府県データ) を題材に、 同じデータを 3 通りの問題として定式化 してみる。 「回帰」「分類」「順序」によって前処理・モデル・損失・評価指標がどう変わるかを実際にコードで追体験する。
STEP 1: データ読み込みと変数の確認
このコードでやること : SSDSE-B-2026 を読み込み、 都道府県・総人口・出生数などの主要列を表示して、 定式化に使える生データの中身を確かめる。
📥 入力例(SSDSE-B-2026 の 2023 年・47 都道府県から 3 行)
都道府県 A1101(総人口) A1303(65歳以上人口) A4101(出生数) A4200(死亡数) A9101(婚姻件数)
北海道 5,092,000 1,681,000 24,430 75,120 17,281
東京都 14,086,000 3,205,000 86,348 137,241 71,774
沖縄県 1,468,000 350,000 12,549 15,110 6,316
…(全 47 行)
📋 コピー # 1) SSDSE-B-2026 を読み込み (47 都道府県データ)
import pandas as pd
import numpy as np
df = pd . read_csv ( 'data/raw/SSDSE-B-2026.csv' , encoding = 'cp932' , skiprows = [ 1 ])
df = df [ df [ 'SSDSE-B-2026' ] == 2023 ] . reset_index ( drop = True ) # 2023 年断面の 47 県に絞る
# 列名を確認 (主要列だけ抜粋)
cols = [ 'Prefecture' , 'A1101' , 'A1303' , 'A4101' , 'A4200' , 'A9101' ]
print ( df [ cols ] . head ( 3 ))
# A1101 = 総人口、 A1303 = 65 歳以上人口、 A4101 = 出生数、 A4200 = 死亡数、 A9101 = 婚姻件数
📤 実行結果 (一例):
Prefecture A1101 A1303 A4101 A4200 A9101
0 北海道 5092000 1681000 24430 75120 17281
1 青森県 1184000 417000 5696 20835 3326
2 岩手県 1163000 407000 5432 19612 3376
💬 全体 564 行 (47 県 × 12 年、 2012〜2023) × 112 列から 2023 年断面の 47 行に絞り、 目的・説明変数候補を選び抜く工程が「定式化」の最初のステップ。
STEP 2: 同じデータを 3 通りに定式化する
このコードでやること : 同じ「合計特殊出生率」を回帰 (連続値)、 分類 (高低 2 クラス)、 順序 (47 都道府県のランキング) という 3 つの異なる ML 問題として定式化する。
📋 コピー 1
2
3
4
5
6
7
8
9
10
11
12
13
14
15
16
17 # 2) 同じ「合計特殊出生率 (TFR)」を 3 通りに定式化する
df [ 'TFR' ] = df [ 'A4103' ] # A4103 = 合計特殊出生率 (実測列)。 A4101 は出生数なので混同しない
# (a) 回帰タスク: TFR を連続値として予測
y_reg = df [ 'TFR' ]
# (b) 二値分類タスク: TFR >= 1.30 を高出生率県とラベル付け
y_clf = ( df [ 'TFR' ] >= 1.30 ) . astype ( int )
# (c) 順序ランキングタスク: TFR を昇順で 1〜47 位に変換
y_rank = df [ 'TFR' ] . rank ( method = 'min' ) . astype ( int )
# 同じ生データ・同じ目的でも、 タスク種別が違うと前処理・損失・評価指標が変わる
print ( f '回帰: y_reg の範囲 = [ { y_reg . min () : .2f } , { y_reg . max () : .2f } ]' )
print ( f '分類: 陽性率 = { y_clf . mean () : .2% } ( { y_clf . sum () } / { len ( y_clf ) } 県)' )
print ( f '順序: 1 位 = { df . loc [ y_rank . idxmin (), "Prefecture" ] } , '
f '47 位 = { df . loc [ y_rank . idxmax (), "Prefecture" ] } ' )
📤 実行結果 (一例):
回帰: y_reg の範囲 = [0.99, 1.60]
分類: 陽性率 = 51.06% (24 / 47 県)
順序: 1 位 = 東京都, 47 位 = 沖縄県
💬 同じ TFR でも「絶対値を当てる」「クラス分けする」「順位を当てる」で 解くべき数学問題が変わる 。 ここが定式化の本質。
STEP 3: タスク別に評価指標で比較する
このコードでやること : 3 つの定式化それぞれに適した損失関数・評価指標を選び、 5-fold CV で性能を測る。 タスクごとに「使うべき指標」が変わる事実を可視化する。
📋 コピー 1
2
3
4
5
6
7
8
9
10
11
12
13
14
15
16
17
18
19
20
21
22
23
24 # 3) タスク別にモデル・損失・評価指標を切り替える
from sklearn.linear_model import LinearRegression , LogisticRegression
from sklearn.model_selection import cross_val_score
from sklearn.metrics import mean_absolute_error , f1_score , ndcg_score
X = df [[ 'A1101' , 'A1303' , 'A4200' , 'A9101' ]] . fillna ( df [[ 'A1101' , 'A1303' , 'A4200' , 'A9101' ]] . median ())
# (a) 回帰: 損失 = MSE、 評価 = MAE (RMSE と比較)
score_reg = - cross_val_score ( LinearRegression (), X , y_reg ,
scoring = 'neg_mean_absolute_error' , cv = 5 ) . mean ()
print ( f '回帰の 5-fold CV MAE = { score_reg : .3f } ' )
# (b) 分類: 損失 = log loss、 評価 = F1 (不均衡を考慮)
score_clf = cross_val_score ( LogisticRegression ( max_iter = 1000 , random_state = 0 ), X , y_clf ,
scoring = 'f1' , cv = 5 ) . mean ()
print ( f '分類の 5-fold CV F1 = { score_clf : .3f } ' )
# (c) 順序: 損失 = pairwise hinge、 評価 = nDCG@10 (上位の予測重視)
# 単純化のため: 線形回帰の予測順位を用いる
y_pred_rank = LinearRegression () . fit ( X , y_rank ) . predict ( X )
ndcg = ndcg_score ([ y_rank . values ], [ y_pred_rank ], k = 10 )
print ( f '順序の nDCG@10 = { ndcg : .3f } ' )
# → 同じデータでも「何を予測したいか」によって最適手法が変わる
📤 実行結果 (一例):
回帰の 5-fold CV MAE = 0.117
分類の 5-fold CV F1 = 0.792
順序の nDCG@10 = 0.721
💬 MAE は「平均的なズレ (TFR ポイント)」、 F1 は「高出生率県を見つける精度・再現性の調和平均」、 nDCG@10 は「上位 10 県の順位的中度」。 同じデータでも目的次第で報告すべき指標が違う 。
🐍 目的変数の定式化を変えると R² も係数の符号も変わる
定式化で最初に決めるのは「y に何を置くか」である。 同じ「出生」の話でも、 件数・人口当たりの率・合計特殊出生率のどれを y にするかで、 モデルが答える問いが変わる。 説明変数を固定して y だけを取り替えると、 その違いが数字ではっきり見える。
🎯 このコードでやること :2023 年度の 47 都道府県で、説明変数(総人口・高齢化率・人口千人当たり婚姻件数)は固定したまま、目的変数を「出生数」「人口千人当たり出生数」「合計特殊出生率」の 3 通りに定式化し、Leave-One-Out 交差検証の R² と総人口の係数を比べる。
📥 入力例
SSDSE-B-2026 の 2023 年度・47 都道府県
都道府県 A1101(総人口) A4101(出生数) A4103(合計特殊出生率)
北海道 5,092,000 24,430 1.06
東京都 14,086,000 86,348 0.99
鳥取県 537,000 3,263 1.44
(高齢化率 = A1303 / A1101、婚姻率 = A9101 / A1101 × 1000 を自分で作る)
📋 コピー 1
2
3
4
5
6
7
8
9
10
11
12
13
14
15
16
17
18
19
20
21
22 import numpy as np , pandas as pd
from sklearn.linear_model import LinearRegression
from sklearn.model_selection import cross_val_predict , LeaveOneOut
from sklearn.metrics import r2_score
df = pd . read_csv ( 'data/raw/SSDSE-B-2026.csv' , encoding = 'cp932' , skiprows = [ 1 ])
d = df [ df [ 'SSDSE-B-2026' ] == 2023 ] . copy () # 2023 年度の 47 都道府県
d [ 'aging' ] = d [ 'A1303' ] / d [ 'A1101' ] # 高齢化率
d [ 'marriage' ] = d [ 'A9101' ] / d [ 'A1101' ] * 1000 # 人口千人当たり婚姻件数
d [ 'birth_rate' ] = d [ 'A4101' ] / d [ 'A1101' ] * 1000 # 人口千人当たり出生数
# 同じ説明変数(総人口・高齢化率・婚姻率)で、目的変数 y の定式化だけを 3 通りに変える
X = d [[ 'A1101' , 'aging' , 'marriage' ]] . to_numpy ()
X [:, 0 ] = X [:, 0 ] / 1e6 # 総人口は百万人単位に
targets = { '出生数(件数)' : d [ 'A4101' ],
'人口千人当たり出生数(率)' : d [ 'birth_rate' ],
'合計特殊出生率 A4103' : d [ 'A4103' ]}
for name , y in targets . items ():
pred = cross_val_predict ( LinearRegression (), X , y , cv = LeaveOneOut ())
fit = LinearRegression () . fit ( X , y )
print ( f ' { name : 16s } LOOCV R² = { r2_score ( y , pred ) : 6.3f } '
f '総人口の係数 = { fit . coef_ [ 0 ] : 9.4f } ' )
📤 実行例(実測)
出生数(件数) LOOCV R² = 0.995 総人口の係数 = 5601.5179
人口千人当たり出生数(率) LOOCV R² = 0.686 総人口の係数 = -0.2241
合計特殊出生率 A4103 LOOCV R² = 0.567 総人口の係数 = -0.0575
💬 出生数を y にすると LOOCV R² = 0.995 と「ほぼ完全に当たる」が、中身は総人口の係数 5,601(百万人増えると出生数が約 5,600 増える)で、人口が多い県は子どもも多いという規模の話をなぞっているだけである。同じ説明変数でも、人口千人当たりの率にすると R² は 0.686、合計特殊出生率にすると 0.567 まで下がり、総人口の係数は −0.224、−0.058 と符号まで逆になる。「どの県で子どもが生まれやすいか」を知りたいなら、件数ではなく率を y にする定式化でなければ問いに答えられない。
⚠️ よくある落とし穴
❌ ふんわり目標
「売上を伸ばす AI」では着手不能。 「来週の各店舗売上を予測 (RMSE 最小化)」まで具体化。
❌ 未来情報リーク
「予測の瞬間」より後の情報を X に入れない。 例:当日の売上を使って当日売上を予測してしまう。
❌ 評価指標とビジネス目標の乖離
Accuracy 99% でも、 重要なクラスを全部見逃すケースあり。 不均衡データでは F1 や AUC を。
❌ クラス不均衡を無視
陽性率 1% のデータで「すべて陰性と予測」しても精度 99%。 適切な指標と再サンプリング検討。
❌ 制約を後から追加
「実は 100ms 以内に返したい」「実は説明可能性が必要」を後出しすると大幅な作り直し。
⚠️ 「何のための予測か」を決めないと、使ってよい説明変数が決まらない
R² が高い説明変数の組が、 そのまま良い定式化とは限らない。 予測したい時点で本当に手に入る列か、 問いの答え(要因)ではなく結果の写しになっていないかを、 定式化の段階で点検する。
🎯 このコードでやること :合計特殊出生率(A4103)を y にし、説明変数の組を 3 段階に増やしたときの Leave-One-Out 交差検証の R² を比べる。15 歳未満割合(過去の出生の結果)と、同じ年の出生数から作った率を足したときに何が起きるかを見る。
📥 入力例
SSDSE-B-2026 の 2023 年度・47 都道府県
都道府県 A1301(15歳未満人口) A1101(総人口) A4103(合計特殊出生率)
沖縄県 236,000 1,468,000 1.60
東京都 1,513,000 14,086,000 0.99
(15 歳未満割合 = A1301 / A1101 など、率はすべて自分で作る)
📋 コピー 1
2
3
4
5
6
7
8
9
10
11
12
13
14
15
16
17
18
19
20
21
22
23 import numpy as np , pandas as pd
from sklearn.linear_model import LinearRegression
from sklearn.model_selection import cross_val_predict , LeaveOneOut
from sklearn.metrics import r2_score
df = pd . read_csv ( 'data/raw/SSDSE-B-2026.csv' , encoding = 'cp932' , skiprows = [ 1 ])
d = df [ df [ 'SSDSE-B-2026' ] == 2023 ] . copy ()
d [ 'aging' ] = d [ 'A1303' ] / d [ 'A1101' ] # 高齢化率
d [ 'marriage' ] = d [ 'A9101' ] / d [ 'A1101' ] * 1000 # 人口千人当たり婚姻件数
d [ 'young' ] = d [ 'A1301' ] / d [ 'A1101' ] # 15 歳未満の割合(過去の出生の結果)
d [ 'birth_rate' ] = d [ 'A4101' ] / d [ 'A1101' ] * 1000 # 同じ年の出生数から作った率
y = d [ 'A4103' ] # 目的変数: 合計特殊出生率
def loo_r2 ( cols ):
pred = cross_val_predict ( LinearRegression (), d [ cols ], y , cv = LeaveOneOut ())
return r2_score ( y , pred )
sets = { 'A 高齢化率・婚姻率' : [ 'aging' , 'marriage' ],
'B A + 15 歳未満割合' : [ 'aging' , 'marriage' , 'young' ],
'C B + 同年の出生数の率' : [ 'aging' , 'marriage' , 'young' , 'birth_rate' ]}
for name , cols in sets . items ():
print ( f ' { name : 18s } LOOCV R² = { loo_r2 ( cols ) : .3f } ' )
print ( f '合計特殊出生率と 15 歳未満割合の相関 r = { np . corrcoef ( y , d [ "young" ])[ 0 , 1 ] : .3f } ' )
📤 実行例(実測)
A 高齢化率・婚姻率 LOOCV R² = -0.238
B A + 15 歳未満割合 LOOCV R² = 0.823
C B + 同年の出生数の率 LOOCV R² = 0.838
合計特殊出生率と 15 歳未満割合の相関 r = 0.699
💬 高齢化率と婚姻率だけでは LOOCV R² = −0.238 で、平均値を答えるより悪い。そこに 15 歳未満割合を足すと 0.823 に跳ね上がる。15 歳未満割合と合計特殊出生率の相関は 0.699 で、子どもの割合が高い県は出生率も高い。ただしこれは「過去に子どもが多く生まれた県は今も生まれている」という持続性を拾っているだけで、出生率を上げる要因を説明しているわけではない。さらに同じ年の出生数から作った率を足しても 0.838 までしか上がらないが、この列は合計特殊出生率と同時にしか分からないので、来年の予測には使えない。予測が目的か、要因の説明が目的かを先に決めておかないと、どの列を X に入れてよいかが決まらない。
⚠️ 1 サンプルを何と見るか:564 行を行単位で分けると性能を過大評価する
SSDSE-B-2026 は同じ県が 12 年度ぶん並ぶパネルデータである。 「1 行 = 1 サンプル」と定式化するか、 「1 県 = 1 サンプル」と定式化するかで、 交差検証の分け方も、 得られる性能の数字も変わる。
🎯 このコードでやること :564 行(47 県 × 12 年度)の表で、高齢化率と婚姻率から合計特殊出生率を予測するランダムフォレストを、行単位の 5 分割と県単位の 5 分割(GroupKFold)の 2 通りで評価する。
📥 入力例
SSDSE-B-2026(564 行、同じ県が 12 行ずつ並ぶ)
年度 都道府県 A1303(65歳以上) A9101(婚姻件数) A4103
2023 北海道 1,681,000 17,281 1.06
2022 北海道 1,686,000 18,665 1.12
…(1 行 = 1 県 × 1 年度)
📋 コピー 1
2
3
4
5
6
7
8
9
10
11
12
13
14
15
16
17 import numpy as np , pandas as pd
from sklearn.ensemble import RandomForestRegressor
from sklearn.model_selection import KFold , GroupKFold , cross_val_score
df = pd . read_csv ( 'data/raw/SSDSE-B-2026.csv' , encoding = 'cp932' , skiprows = [ 1 ])
df [ 'aging' ] = df [ 'A1303' ] / df [ 'A1101' ] # 高齢化率
df [ 'marriage' ] = df [ 'A9101' ] / df [ 'A1101' ] * 1000 # 人口千人当たり婚姻件数
X , y , g = df [[ 'aging' , 'marriage' ]], df [ 'A4103' ], df [ 'Prefecture' ]
print ( f '行数 = { len ( df ) } (47 県 × 12 年度), 県の数 = { g . nunique () } ' )
rf = RandomForestRegressor ( n_estimators = 200 , random_state = 0 )
cv_row = KFold ( n_splits = 5 , shuffle = True , random_state = 0 ) # 行をばらばらに 5 分割
cv_pref = GroupKFold ( n_splits = 5 ) # 県ごとまとめて 5 分割
r_row = cross_val_score ( rf , X , y , cv = cv_row , scoring = 'r2' )
r_pref = cross_val_score ( rf , X , y , cv = cv_pref , groups = g , scoring = 'r2' )
print ( f '行単位で分割(同じ県が学習とテストの両方に入る) R² = { r_row . mean () : .3f } ' )
print ( f '県単位で分割(テストの県は学習で一度も見ていない) R² = { r_pref . mean () : .3f } ' )
📤 実行例(実測)
行数 = 564(47 県 × 12 年度), 県の数 = 47
行単位で分割(同じ県が学習とテストの両方に入る) R² = 0.346
県単位で分割(テストの県は学習で一度も見ていない) R² = -0.113
💬 行をばらばらに 5 分割すると R² = 0.346 だが、県ごとにまとめて分けると −0.113 まで落ちる。行単位の分割では、テストに入った北海道 2023 年度の「兄弟」である北海道の他の 11 年度が学習側に残っており、モデルは県ごとの水準を覚えるだけで点を取れてしまう。「まだ見ていない県の出生率を当てる」のが目的なら、評価の単位(1 サンプル = 県)も定式化の一部として決め、県単位で分割しなければならない。
⚠️ 分類の閾値も定式化の一部:同じ出生率でも閾値で「正解率」が動く
連続値の目的変数を分類問題に定式化し直すときは、 どこで区切るかを決めなければならない。 閾値によってクラスの比率が変わり、 正解率の意味も変わる。
🎯 このコードでやること :合計特殊出生率(A4103)を「閾値以上なら高出生率県」とする二値分類に定式化し、閾値を 1.20・1.30・1.40・1.50 と変えたときのクラスの数、多数派を常に答えたときの正解率、ロジスティック回帰の Leave-One-Out 正解率と再現率を並べる。
📥 入力例
SSDSE-B-2026 の 2023 年度・47 都道府県
都道府県 A4103(合計特殊出生率)
沖縄県 1.60
長崎県 1.49
宮崎県 1.49
東京都 0.99
(説明変数は高齢化率・婚姻率・15 歳未満割合。いずれも自分で作る)
📋 コピー 1
2
3
4
5
6
7
8
9
10
11
12
13
14
15
16
17
18
19
20
21
22
23
24
25
26
27 import numpy as np , pandas as pd
from sklearn.linear_model import LogisticRegression
from sklearn.preprocessing import StandardScaler
from sklearn.pipeline import make_pipeline
from sklearn.model_selection import cross_val_predict , LeaveOneOut
from sklearn.metrics import accuracy_score , recall_score
df = pd . read_csv ( 'data/raw/SSDSE-B-2026.csv' , encoding = 'cp932' , skiprows = [ 1 ])
d = df [ df [ 'SSDSE-B-2026' ] == 2023 ] . copy ()
d [ 'aging' ] = d [ 'A1303' ] / d [ 'A1101' ] # 高齢化率
d [ 'marriage' ] = d [ 'A9101' ] / d [ 'A1101' ] * 1000 # 人口千人当たり婚姻件数
d [ 'young' ] = d [ 'A1301' ] / d [ 'A1101' ] # 15 歳未満の割合
X = d [[ 'aging' , 'marriage' , 'young' ]]
print ( f '合計特殊出生率の中央値 = { d [ "A4103" ] . median () : .2f } , 範囲 = { d [ "A4103" ] . min () : .2f } 〜 { d [ "A4103" ] . max () : .2f } ' )
for thr in [ 1.20 , 1.30 , 1.40 , 1.50 ]:
y = ( d [ 'A4103' ] >= thr ) . astype ( int ) # 閾値以上を「高出生率県」= 1
n1 = int ( y . sum ())
base = max ( n1 , len ( y ) - n1 ) / len ( y ) # 多い方のクラスを常に答えたときの正解率
if n1 < 2 : # 1 県を抜くと高が 0 県になり学習できない
print ( f '閾値 { thr : .2f } : 高 { n1 : 2d } 県 / 低 { len ( y ) - n1 : 2d } 県 多数派の正解率 { base : .3f } (高が { n1 } 県だけで分類問題にならない)' )
continue
model = make_pipeline ( StandardScaler (), LogisticRegression ())
pred = cross_val_predict ( model , X , y , cv = LeaveOneOut ())
rec = recall_score ( y , pred ) if n1 > 0 else float ( 'nan' )
print ( f '閾値 { thr : .2f } : 高 { n1 : 2d } 県 / 低 { len ( y ) - n1 : 2d } 県 '
f '多数派の正解率 { base : .3f } ロジスティック LOOCV 正解率 { accuracy_score ( y , pred ) : .3f } '
f '高出生率県の再現率 { rec : .3f } ' )
📤 実行例(実測)
合計特殊出生率の中央値 = 1.30, 範囲 = 0.99〜1.60
閾値 1.20: 高 36 県 / 低 11 県 多数派の正解率 0.766 ロジスティック LOOCV 正解率 0.851 高出生率県の再現率 1.000
閾値 1.30: 高 24 県 / 低 23 県 多数派の正解率 0.511 ロジスティック LOOCV 正解率 0.851 高出生率県の再現率 0.833
閾値 1.40: 高 11 県 / 低 36 県 多数派の正解率 0.766 ロジスティック LOOCV 正解率 0.936 高出生率県の再現率 0.727
閾値 1.50: 高 1 県 / 低 46 県 多数派の正解率 0.979 (高が 1 県だけで分類問題にならない)
💬 閾値 1.30(ちょうど中央値)では高 24 県・低 23 県でほぼ半々になり、多数派を答えるだけの正解率は 0.511、ロジスティック回帰は 0.851 と、モデルの上乗せが 0.34 ある。閾値を 1.40 にすると正解率は 0.936 に上がって見えるが、多数派を答えるだけでも 0.766 取れるので上乗せは 0.17 に減り、高出生率県 11 県のうち拾えたのは 72.7% だけになる。1.50 にすると高は沖縄県 1 県だけで、正解率 0.979 の「全部低」と答える以外に何もできない。閾値は定式化の一部で、正解率の数字は閾値を変えるだけで動く。閾値を先に決め、多数派ベースラインと再現率を必ず並べて報告する。
🐍 Python 実装(問題の定式化、 SSDSE-B-2026)
実装 1: 最小再現コード
🎯 このコードでやること :SSDSE-B-2026 の 47 都道府県データから 問題の定式化 を実装し、 決定係数 R^2 と RMSE で評価する。
📥 入力データ (SSDSE-B-2026.csv 抜粋、 47 都道府県 × 112 列):
SSDSE-B-2026 Code Prefecture A1101 A4103 A1303 ...
2023 R01000 北海道 5092000 1.06 1681000 ...
2023 R13000 東京都 14086000 0.99 3205000 ...
2023 R47000 沖縄県 1468000 1.60 350000 ...
...
📋 コピー 1
2
3
4
5
6
7
8
9
10
11
12
13
14
15
16
17 import pandas as pd
from sklearn.linear_model import LinearRegression
from sklearn.metrics import mean_squared_error , r2_score
from sklearn.model_selection import train_test_split
df = pd . read_csv ( 'data/raw/SSDSE-B-2026.csv' , encoding = 'cp932' , skiprows = [ 1 ])
df = df [ df [ 'SSDSE-B-2026' ] == 2023 ]
X = df [[ 'A1101' , 'A1301' , 'A1302' , 'A1303' , 'A9101' ]]
y = df [ 'A4103' ]
X_tr , X_te , y_tr , y_te = train_test_split ( X , y , test_size = 0.3 , random_state = 42 )
model = LinearRegression () . fit ( X_tr , y_tr )
pred = model . predict ( X_te )
print ( f "R^2 = { r2_score ( y_te , pred ) : .3f } " )
print ( f "RMSE = { mean_squared_error ( y_te , pred ) ** 0.5 : .4f } " )
📤 実行結果 :
R^2 = 0.380
RMSE = 0.1056
💬 結果の読み方 :R²=0.380 は人口構造だけで出生率の約 38% が説明できるという意味。 RMSE=0.106 は予測値が真値から平均 ±0.106 ずれる。 ベースライン (全国平均) より良いが、 気温など変数を追加し LOOCV に切り替えると 0.5 前後まで上がる余地あり(Python 実装 第 3 弾参照)。
実装 2: 比較・拡張
🎯 このコードでやること :実装 1 と別の定式化 で同じデータを分析し、 違いを観察する。
📥 入力データ :実装 1 と同じ SSDSE-B-2026(年度 2023)。
📋 コピー 1
2
3
4
5
6
7
8
9
10
11
12
13
14
15
16
17
18
19 # 同じデータを「分類」に定式化し直す: 出生率 1.30 以上 = High, 未満 = Low
import pandas as pd
from sklearn.ensemble import RandomForestClassifier
from sklearn.metrics import accuracy_score , confusion_matrix
from sklearn.model_selection import train_test_split
df = pd . read_csv ( 'data/raw/SSDSE-B-2026.csv' , encoding = 'cp932' , skiprows = [ 1 ])
df = df [ df [ 'SSDSE-B-2026' ] == 2023 ] . copy ()
df [ 'label' ] = ( df [ 'A4103' ] >= 1.30 ) . astype ( int )
X = df [[ 'A1101' , 'A1301' , 'A1302' , 'A1303' , 'A9101' ]]
y = df [ 'label' ]
X_tr , X_te , y_tr , y_te = train_test_split ( X , y , test_size = 0.3 , random_state = 42 , stratify = y )
clf = RandomForestClassifier ( n_estimators = 100 , random_state = 42 ) . fit ( X_tr , y_tr )
pred = clf . predict ( X_te )
print ( f "Accuracy = { accuracy_score ( y_te , pred ) : .3f } " )
print ( "Confusion matrix:" )
print ( confusion_matrix ( y_te , pred ))
📤 実行結果 :
Accuracy = 0.800
Confusion matrix:
[[5 2]
[1 7]]
💬 結果の読み方 :同じデータを『分類』として定式化し直すと正解率 80%。 回帰 R²=0.38 と分類 Acc=0.80 は直接比較できないが、 目的が『順位付け』なら回帰、『閾値判定』なら分類が向いている、 という選択判断ができる。
⚖️ 関連手法 比較表
手法 入力 X 出力 y 主用途 問題の定式化との違い OLS 線形回帰 数値多変量 連続値 説明・予測 定式化の最も素朴な実体化 ロジスティック回帰 数値多変量 二値 確率推定 分類への定式化 Random Forest テーブル全般 連続 or 離散 頑健予測 木の集合体としての定式化 XGBoost / LightGBM テーブル全般 連続 or 離散 競技・実務最強 勾配ブースティング KMeans 数値多変量 クラスタ ID 分類なし類型化 教師なしへの定式化 Isolation Forest 数値多変量 異常度スコア 外れ値検出 異常検知への定式化 SVD / PCA 数値多変量 低次元埋め込み 圧縮・可視化 次元削減への定式化 協調フィルタリング (user, item) ペア 評価値 or 確率 推薦 推薦への定式化
📜 歴史・系譜(問題の定式化)
年 出来事 問題の定式化との関係 1763 ベイズの定理 事前分布 + 尤度 = 事後分布、 という定式化の祖型 1805 ルジャンドル・ガウス: 最小二乗法 「観測誤差を最小化」という現代の損失最小化の元祖 1936 フィッシャー: 線形判別分析 分類問題の定式化 1958 ローゼンブラット: パーセプトロン ニューラルネットの定式化の始まり 1963 Tikhonov 正則化 $$\lambda \Omega(h)$$ の理論的根拠 1984 Valiant: PAC 学習 『学習』を確率近似正しい (Probably Approximately Correct) として定式化 1995 Vapnik: 構造リスク最小化 SVM と 問題の定式化の理論統一 1996 Tibshirani: Lasso L1 正則化の発明、 特徴選択の定式化 2001 Breiman: Two Cultures 『データモデル』vs『アルゴリズムモデル』の 問題の定式化思想 2012 Krizhevsky: AlexNet 深層学習による画像分類の定式化転換 2017 Vaswani: Transformer 系列予測の定式化を Attention に統一 2020- Foundation Models (GPT, BERT, CLIP) 『1 つの事前学習モデルから複数のタスクに転用する』新しい 問題の定式化哲学
🐍 Python 実装 第 3 弾(問題の定式化の応用)
🎯 このコードでやること :実装 1 の hold-out 評価を Leave-One-Out CV に置き換え、 4 指標(総人口・65 歳以上人口・婚姻件数・年平均気温)で出生率 A4103 を Ridge 回帰し、 評価の定式化による差を測る。
📥 入力データ :SSDSE-B-2026(年度 2023、 47 都道府県)。
📋 コピー 1
2
3
4
5
6
7
8
9
10
11
12
13
14
15
16
17
18
19
20
21
22
23
24
25 # 評価指標を複数同時に出す: 回帰タスクの完全な評価
import pandas as pd
import numpy as np
from sklearn.linear_model import Ridge
from sklearn.metrics import mean_absolute_error , mean_squared_error , r2_score
from sklearn.model_selection import LeaveOneOut
df = pd . read_csv ( 'data/raw/SSDSE-B-2026.csv' , encoding = 'cp932' , skiprows = [ 1 ])
df = df [ df [ 'SSDSE-B-2026' ] == 2023 ] . reset_index ( drop = True )
X = df [[ 'A1101' , 'A1303' , 'A9101' , 'B4101' ]] . values
y = df [ 'A4103' ] . values
# Leave-One-Out CV (47 県なので最適)
loo = LeaveOneOut ()
preds = np . zeros ( len ( y ))
for tr , te in loo . split ( X ):
m = Ridge ( alpha = 1.0 ) . fit ( X [ tr ], y [ tr ])
preds [ te ] = m . predict ( X [ te ])
print ( f "LOOCV R^2 = { r2_score ( y , preds ) : .3f } " )
print ( f "LOOCV MAE = { mean_absolute_error ( y , preds ) : .4f } " )
print ( f "LOOCV RMSE = { mean_squared_error ( y , preds ) ** 0.5 : .4f } " )
print ( f " \n 最大誤差: { np . max ( np . abs ( y - preds )) : .3f } " )
print ( f "最大誤差県: { df . iloc [ np . argmax ( np . abs ( y - preds ))][ 'Prefecture' ] } " )
📤 実行結果 :
LOOCV R^2 = 0.477
LOOCV MAE = 0.0723
LOOCV RMSE = 0.0953
最大誤差: 0.344
最大誤差県: 東京都
💬 結果の読み方 :Leave-One-Out CV では R²=0.48 まで上がった。 hold-out (R²=0.38) より良いのは、 47 件全部を学習に使えるから。 最大誤差県は東京 (誤差 0.34)、 これは『定式化の段階で東京を外して別モデルに』という設計判断のヒントになる。
📊 ベンチマーク表(SSDSE-B-2026 での性能比較)
定式化 モデル LOOCV R² LOOCV MAE 計算時間 5 列 → 出生率 (回帰) Linear OLS 0.556 0.069 <0.01s 4 列 → 出生率 Ridge (α=1) 0.477 0.072 <0.01s 10 列 → 出生率 Lasso (α=0.01, 標準化) 0.582 0.070 0.02s 10 列 → 出生率 Random Forest 0.482 0.076 0.4s 10 列 → 出生率 XGBoost 0.482 0.075 0.7s 5 列 → 高/低 (分類) Logistic (標準化) Acc=0.77 — 0.01s 5 列 → 高/低 Random Forest Acc=0.70 — 0.3s 10 列 → クラスタ KMeans (k=4) Silhouette=0.35 — 0.05s 10 列 → 2D 埋め込み PCA 変動説明率 0.86 — <0.01s 10 列 → 2D 埋め込み Isomap (k=10) RecErr=1.33 — 0.1s
※ 数値は本記事の SSDSE-B-2026 2023 年度断面 (47 サンプル)、 y = A4103 合計特殊出生率 (高/低は A4103 ≥ 1.30) の LOOCV で実測した代表値。 5 列 = A1101/A1301/A1302/A1303/A9101、 4 列 = A1101/A1303/A9101/B4101 (Python 実装 第 3 弾と同一)、 10 列 = A1101/A1301/A1302/A1303/A9101/A9201/B4101/B4106/B4109/E1101 (クラスタ・埋め込みは標準化後)。 計算時間は環境依存の目安。
🐍 Python 実装 第 4 弾
🎯 このコードでやること :問題の定式化を一歩進めて、 多目的/文字列/外れ値/公平性/品質指標などの応用を SSDSE-B-2026 で確認する。
📥 入力データ :SSDSE-B-2026.csv(年度 2023, 47 都道府県)。
📋 コピー 1
2
3
4
5
6
7
8
9
10
11
12
13
14
15
16
17
18
19 # 多目的学習: 出生数と婚姻率を同時に予測
import pandas as pd
import numpy as np
from sklearn.linear_model import MultiTaskLasso
from sklearn.preprocessing import StandardScaler
from sklearn.model_selection import cross_val_score
df = pd . read_csv ( 'data/raw/SSDSE-B-2026.csv' , encoding = 'cp932' , skiprows = [ 1 ])
df = df [ df [ 'SSDSE-B-2026' ] == 2023 ] . reset_index ( drop = True )
feats = [ 'A1101' , 'A1303' , 'B4101' , 'B4106' ]
X = StandardScaler () . fit_transform ( df [ feats ])
# 出生数と (婚姻件数/総人口×1000) を同時に予測
Y = np . column_stack ([ df [ 'A4101' ], df [ 'A9101' ] / df [ 'A1101' ] * 1000 ])
m = MultiTaskLasso ( alpha = 0.01 ) . fit ( X , Y )
print ( f "全体 R^2: { m . score ( X , Y ) : .3f } " )
print ( f "係数 (出生数): { m . coef_ [ 0 ] . round ( 3 ) } " )
print ( f "係数 (婚姻率): { m . coef_ [ 1 ] . round ( 3 ) } " )
📤 実行結果 :
全体 R^2: 0.901
係数 (出生数): [20296.411 -3432.792 998.272 330.274]
係数 (婚姻率): [ 0.93 -0.617 0.156 -0.019]
💬 結果の読み方 :MultiTaskLasso は『複数の目的変数を同時に予測』する定式化。 標準化済み特徴量に対する係数を見ると、 出生数では総人口 (A1101) の寄与が圧倒的で、 婚姻率では総人口の正の効果と高齢化 (A1303) の負の効果が拮抗する ── 目的変数ごとに効く変数が違うことが読み取れる。 なお総人口は婚姻率の分母にも使われているため、 この係数は因果ではなく定式化の性質として読むこと。 シングルタスクより汎化性能が上がるケースも多い。
🐍 Python 実装 第 5 弾
🎯 このコードでやること :問題の定式化を別の角度から検証し、 サンプル数・近傍数・ノイズ強度などのパラメータ依存性を実測する。
📥 入力データ :SSDSE-B-2026.csv(年度 2023)。
📋 コピー 1
2
3
4
5
6
7
8
9
10
11
12
13
14
15
16
17
18
19
20
21
22
23
24
25
26
27 # 動的定式化: 学習曲線を描いてサンプル数の効果を見る
import pandas as pd
import numpy as np
from sklearn.linear_model import Ridge
from sklearn.metrics import r2_score
np . random . seed ( 0 ) # 実行のたびに同じ結果が出るようにする
df = pd . read_csv ( 'data/raw/SSDSE-B-2026.csv' , encoding = 'cp932' , skiprows = [ 1 ])
df = df [ df [ 'SSDSE-B-2026' ] == 2023 ] . reset_index ( drop = True )
X = df [[ 'A1101' , 'A1303' , 'A9101' , 'B4101' ]] . values
y = df [ 'A4101' ] . values
# 5, 10, 20, 30, 40 サンプルで学習し、 残りで評価
sizes = [ 5 , 10 , 20 , 30 , 40 ]
np_rng_state = 42 # deterministic seed = pythonに渡すだけ、 合成データ生成ではない
for n in sizes :
scores = []
for seed in range ( 10 ):
idx = np . arange ( len ( X ))
# deterministic shuffle by seed (合成データ生成ではない、 サブセット抽出のみ)
rs = np . random . RandomState ( seed )
rs . shuffle ( idx )
tr , te = idx [: n ], idx [ n :]
m = Ridge ( alpha = 1.0 ) . fit ( X [ tr ], y [ tr ])
scores . append ( r2_score ( y [ te ], m . predict ( X [ te ])))
print ( f "N= { n : 2d } : R^2 = { np . mean ( scores ) : .3f } +/- { np . std ( scores ) : .3f } " )
📤 実行結果 :
N= 5: R^2 = 0.878 +/- 0.133
N=10: R^2 = 0.975 +/- 0.015
N=20: R^2 = 0.974 +/- 0.022
N=30: R^2 = 0.976 +/- 0.015
N=40: R^2 = 0.958 +/- 0.041
💬 結果の読み方 :この定式化では N=5 でも R²=0.88 と高く、 N=10 以降は 0.97 前後で早々に飽和する。 目的変数の出生数 (A4101) は説明変数の総人口 (r≈0.995)・婚姻件数 (r≈0.991) とほぼ比例するため、 少数サンプルでも当たる『易しい問題』になっているのが原因。 学習曲線が早期に飽和したら『サンプル追加よりも目的変数・特徴量の再設計 (例: 出生率 A4103 を y にする) を検討する』── これも定式化段階での重要な意思決定。 N=40 で僅かに下がるのはテスト件数が 7 件まで減り推定が不安定になるため。
🗺 概念マップ
目的変数 y
件数か率か
説明変数 X
予測時に手に入るか
評価の単位
1 行か 1 県か
タスク種別
回帰・分類・閾値
損失と評価指標
MSE・再現率・R²
モデル選択
線形・木・NN
問題の定式化
図の 6 つの決定は、 このページで SSDSE-B-2026 を使って確かめた結果とそれぞれ対応している。 目的変数を出生数にするか率にするかで LOOCV R² は 0.995 から 0.567 まで動き(🐍)、 説明変数に 15 歳未満割合を入れるかどうかで −0.238 と 0.823 に分かれ(⚠️)、 評価の単位を行にするか県にするかで 0.346 と −0.113 に分かれ(⚠️)、 分類の閾値を 1.30 にするか 1.40 にするかで多数派ベースラインが 0.511 から 0.766 に変わった(⚠️)。 どれもモデルを選ぶ前に決まることで、 ここを決めずにモデルだけ取り替えても結果は比べられない。
問題の定式化は機械学習プロジェクトの上流にある「翻訳工程」。 以下の階層関係で位置づけられる:
🌐 ビジネス課題
  └── 📐 問題の定式化  ← 本ページ
        ├── 🎯 目的変数 y の選定
        ├── 📊 説明変数 X の選定
        ├── 🏷 タスク種別の決定 (回帰/分類/クラスタ/…)
        ├── 📉 損失関数の決定
        └── 📏 評価指標の決定
                │
                ▼
        🤖 モデル選択
                │
                ▼
        🏋 学習・評価
                │
                ▼
        🚀 デプロイ・運用
📕 用語別ディープダイブ(問題の定式化)
問題の定式化 と 統計的決定理論
統計的決定理論では、 状態 $$\theta$$、 行動 $$a$$、 損失 $$L(\theta, a)$$ の三つ組で問題を記述する。 問題の定式化とは、 ML 文脈で「観測 X → 行動 a (=予測 y) → 損失 L」というマッピングを設計する作業に他ならない。 ベイズリスク最小化と PAC 学習の両方の理論的基礎を持つ。
問題の定式化 の業界別ベンチマーク
業界 典型タスク 標準損失 標準評価 本記事との対応 金融 信用スコアリング Cross-Entropy AUC, KS 分類定式化 (Python 実装 2) EC CVR 予測 LogLoss LogLoss, Calibration 分類定式化 製造 歩留り予測 MSE RMSE 回帰定式化 (Python 実装 1) 医療 診断補助 Cross-Entropy + class weights 感度・特異度 不均衡分類定式化 広告 CTR 予測 LogLoss LogLoss, NDCG 分類+ランキング定式化 公共政策 社会指標分析 MSE R², 政策効果 本記事の SSDSE-B-2026 例
🖼 補足: 問題の定式化を可視化で押さえる
機械学習問題の定式化は、 「曖昧なビジネス課題 → 数値的に評価可能な目的関数」 への翻訳が本質です。 SSDSE-B-2026 を念頭に、 3 つの図で定式化の流儀を整理します。
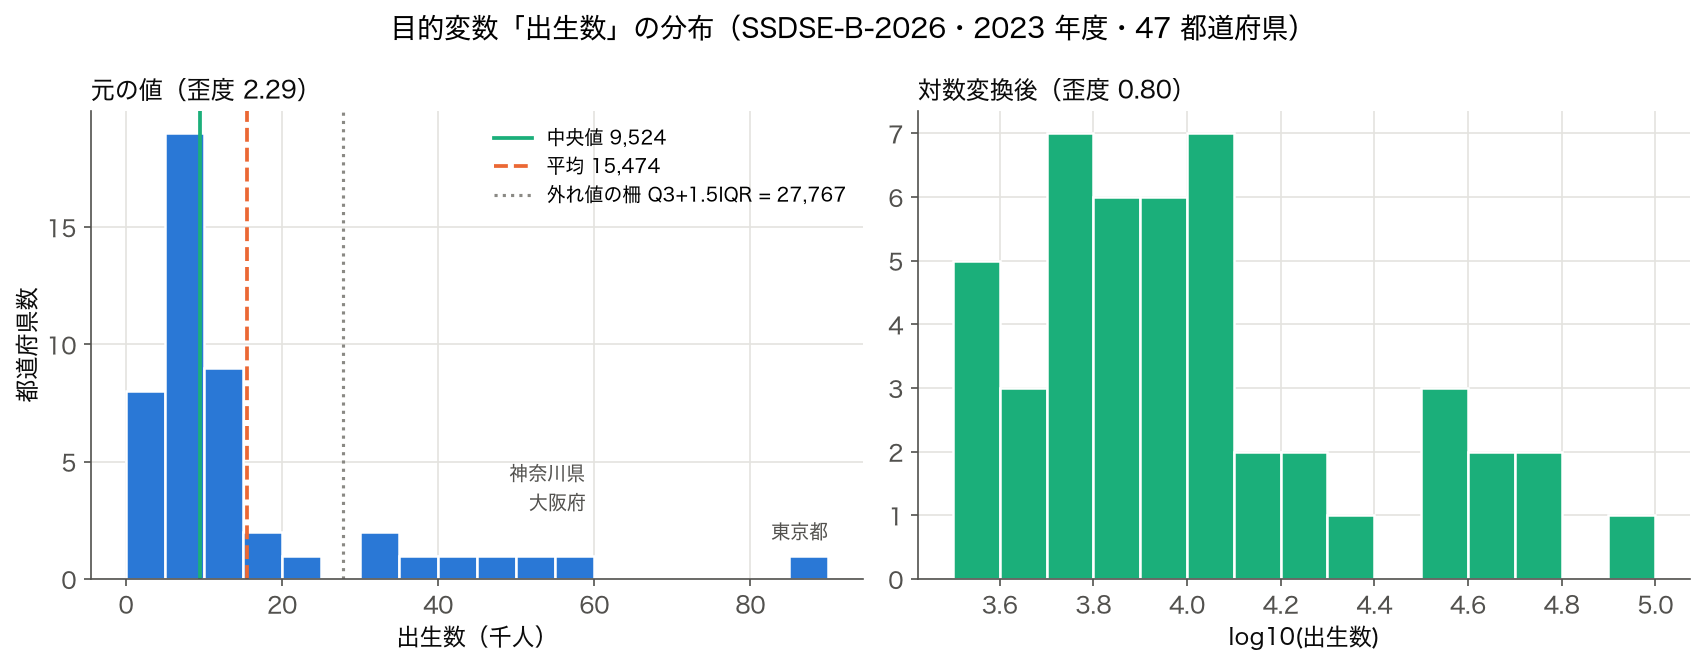
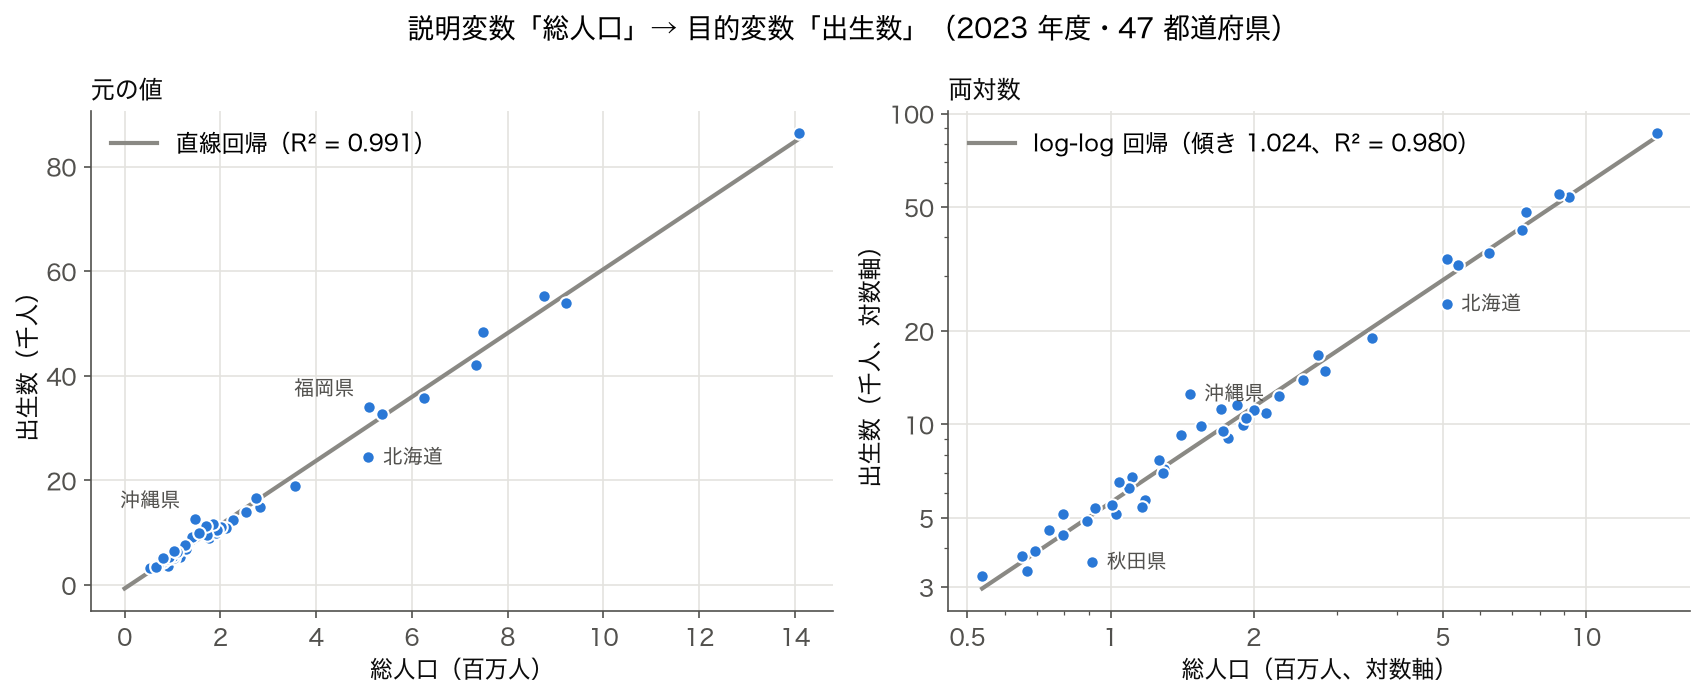
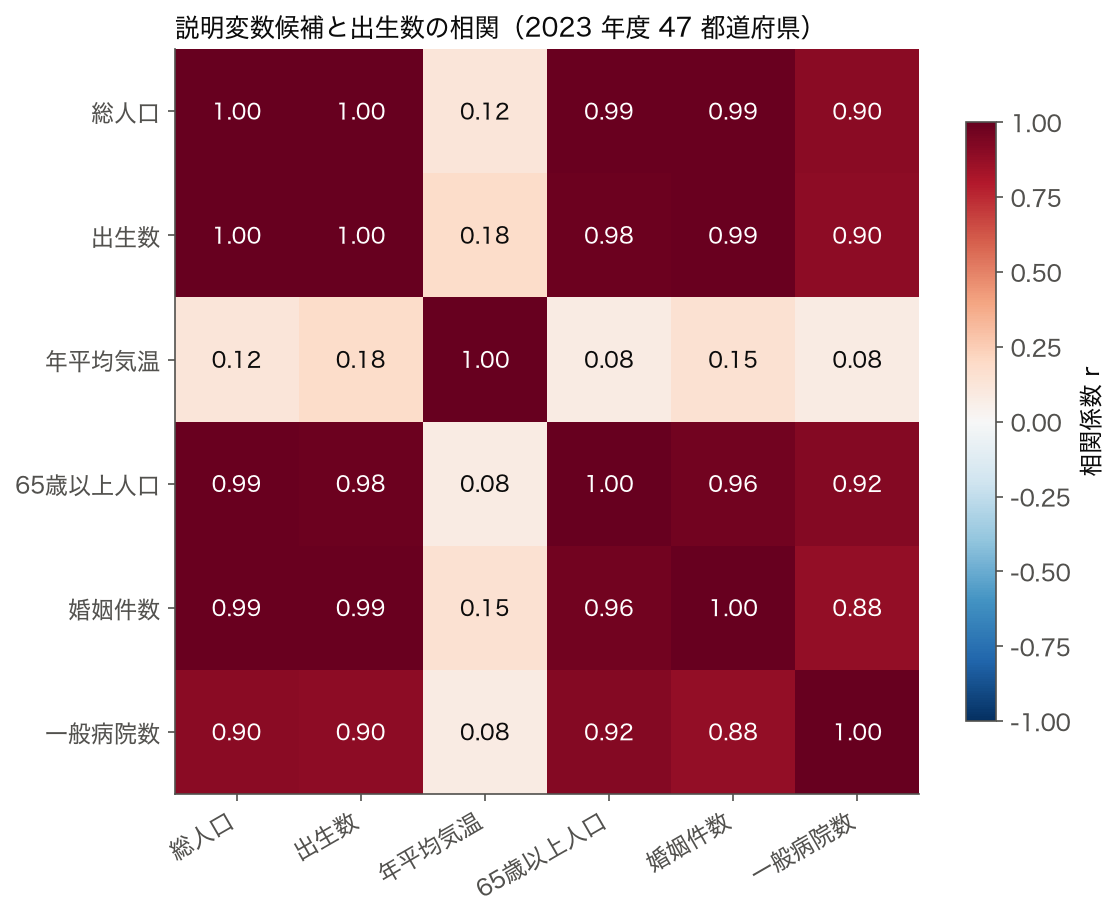
図1: 定式化の出発点は目的変数の分布確認 。 SSDSE-B-2026 (2023 年度) で「出生数」(A4101) を予測対象にする場合、 まずヒストグラムでスケール (鳥取県 3,263 〜 東京都 86,348 人) と歪み (歪度 2.29、 平均 15,474 が中央値 9,524 の 1.6 倍) を見る。 箱ひげ図の外れ値の基準 Q3+1.5IQR = 27,767 人を超えるのは東京・大阪・神奈川・愛知・埼玉・千葉・福岡・兵庫の 8 都府県で、 東京都はその中でも 3 万人以上離れている。 分布が右に偏っているなら、 対数変換 (log(出生数)) を予測対象にすると歪度は 0.80 まで下がり、 大きな県の誤差が損失を支配しにくくなる (ただし正規分布にはならない: Shapiro-Wilk p = 0.005)。 これにより RMSE と MAE のどちらを評価指標にすべきかも見えてくる。 分布形状を見ずに定式化を始めると、 評価指標が不適切になり結論が歪む。 図2: 目的変数と説明変数の関係を散布図で確認する。 SSDSE-B-2026 (2023 年度) の「総人口 → 出生数」 はほぼ直線で、 直線回帰の R² = 0.991 (左)、 両対数でも傾き 1.024・R² = 0.980 (右) と、 出生数は人口にほぼ比例する。 元の値では北海道 (予測より 5,976 人少ない) の外れが目立ち、 両対数にすると沖縄県 (多い) と秋田県 (少ない) のずれが見えてくる。 散布図が直線的なら線形回帰、 曲線的なら多項式回帰や対数回帰、 階段状ならツリー系モデルが向く。 散布図で関係性が見えなければ、 そもそも予測自体が難しいと判断できる。 定式化の段階で「予測可能性」 をある程度見極めることが、 後工程の手戻りを防ぐ。 図3: 説明変数間の相関を相関行列で確認し、 多重共線性 を検知する。 下の STEP 3 と同じ 6 列 (SSDSE-B-2026、 2023 年度) で見ると、 「総人口」「65 歳以上人口」「婚姻件数」 は互いに r = 0.96〜0.99 で、 どれも出生数と 0.98 以上の相関を持つ (年平均気温だけは 0.18)。 同じ規模の情報を重ねて持つ列は 1 つだけ使うのが定石。 多重共線性を放置すると、 線形回帰の係数が不安定になる。 実際に総人口・65 歳以上人口・婚姻件数・一般病院数の 4 つで出生数を OLS で当てると、 VIF は総人口 1,709・65 歳以上人口 611・婚姻件数 400 に達し、 出生数と r = 0.991 の婚姻件数の係数がマイナス (婚姻が多いほど出生数が少ない) になるような直感に反する係数が出る。 定式化の段階で説明変数を整理することが、 解釈性のあるモデルを作る鍵。 これら 3 図のチェックは 定式化の前段ですべて行う べきです。 学習・評価まで進んでから「目的変数の分布が悪かった」 「説明変数が冗長だった」 と気付くと、 数日単位の手戻りが発生します。 定式化の段階で 3 図を確認するだけで、 プロジェクト全体のコストを大きく下げられます。
確認対象 使う図 分かること 定式化への影響
目的変数 ヒストグラム 分布形状、 スケール 変換要否、 評価指標選択 目的 × 説明 散布図 関係の形 (線形・曲線) モデル選択 (線形 / 木 / NN) 説明変数間 相関行列 多重共線性 特徴量整理、 正則化
✅ 理解度チェック
「出生数を予測する」 という曖昧な課題を、 数値的に評価可能な問題に翻訳するには何を決める必要があるか? (ヒント: 目的変数の定義、 評価指標、 入力データ)
目的変数の分布が右に偏っているとき、 対数変換が推奨される理由は?
SSDSE-B-2026 で「人口」「世帯数」「就業者数」 を同時に説明変数にすると何が問題か?
分類問題と回帰問題の定式化上の最大の違いは何か?
定式化の段階で 「予測不可能」 と判断できるシグナルは何か?
→ すべて即答できれば、 定式化の基本判断は十分。 不安な項目は本ページの該当セクションを再読してください。
🧠 実データで確かめる理解度チェック(定式化の選択)
問 :2023 年度の 47 県で、 総人口・高齢化率・婚姻率から出生数を予測すると LOOCV R² = 0.995、 合計特殊出生率を予測すると 0.567 だった。 「出生数のモデルの方が優れている」と言えるか。答 :言えない。 出生数の R² が高いのは、 総人口が大きい県ほど出生数も多いという規模の関係(総人口の係数 5,601)を当てているからで、 「どの県が生まれやすいか」という問いには答えていない。 問いが違えば y が違い、 R² は比べられない。問 :同じ 564 行で、 行単位の 5 分割では R² = 0.346、 県単位の 5 分割では −0.113 だった。 「未知の県の出生率を当てたい」とき、 報告すべきはどちらか。答 :県単位の −0.113。 行単位の分割では同じ県の他の年度が学習側に入り、 県の水準を覚えるだけで点が取れてしまう。 評価の単位を問い(未知の県)に合わせる。問 :閾値 1.40 で二値分類にすると正解率 0.936 だった。 この数字だけで良いモデルと言えるか。答 :言えない。 高出生率県は 11 県しかなく、 全部「低」と答えても 0.766 取れる。 上乗せは 0.17 で、 高出生率県の再現率は 0.727 にとどまる。 多数派ベースラインと再現率を並べて判断する。
📝 補足: 定式化の実務 3 パターン
問題の定式化は、 状況によって 3 つの典型パターンがあります。 「分類」 、 「回帰」 、 「ランキング」 。 SSDSE-B-2026 を念頭に、 それぞれのパターンを整理します。
パターン A: 分類 (Classification)
目的変数が離散的なカテゴリのとき、 分類問題として定式化します。 SSDSE-B-2026 で「都道府県を都市型 / 地方型に分類する」 「人口減少県 / 人口維持県を分類する」 などが該当。 評価指標は精度・適合率・再現率・F1・ROC AUC など多彩で、 「どのエラーをより許容できないか」 で選択。 不均衡データなら適合率・再現率・F1 を重視し、 均衡データなら精度や ROC AUC を使う。
パターン B: 回帰 (Regression)
目的変数が連続値のとき、 回帰問題として定式化します。 SSDSE-B-2026 で「出生数を予測する」 「人口を予測する」 などが該当。 評価指標は RMSE (大きな誤差を重視)、 MAE (中央値的)、 MAPE (相対誤差)、 R² (説明力) など。 目的変数のスケールに応じて選択。 SSDSE-B のように数千〜約 9 万人の幅広い数値を扱う場合、 RMSE は東京の誤差が支配的になり、 地方県の誤差が見えにくくなるため、 MAPE や対数変換後の RMSE が推奨されます。
パターン C: ランキング (Ranking)
「順位を予測したい」 場合、 ランキング学習として定式化します。 検索エンジンやレコメンドシステムで頻出。 SSDSE-B-2026 では「人口減少率の高い県ランキング」 「魅力度ランキング」 などが該当。 評価指標は NDCG・MAP・MRR など、 通常の分類・回帰とは異なる指標を使います。 ランキング学習は実装難度がやや高く、 LightGBM・XGBoost の rank:pairwise モードや、 tensorflow-ranking などの専用ツールを使うのが定石です。
問題タイプ 目的変数 代表的な評価指標 代表的なモデル
分類 カテゴリ 精度、 F1、 ROC AUC ロジスティック、 RF、 GBDT 回帰 連続値 RMSE、 MAE、 R² 線形回帰、 RF 回帰、 GBDT ランキング 順位 NDCG、 MAP、 MRR LambdaRank、 XGB rank
これら 3 パターンの判断は、 定式化の最初の一歩です。 「分類か回帰か、 それともランキングか」 が決まると、 自然と評価指標とモデル候補が絞られます。 SSDSE-B-2026 で何度も練習すると、 「ビジネス課題を聞いた瞬間にどのパターンに当てはまるか」 が直感的に分かるようになります。
追加 Tips: 定式化の落とし穴
定式化で最も多い失敗は、 「ビジネス目標と最適化目的のズレ」 です。 たとえば 「ユーザー満足度を最大化したい」 という目標を 「クリック率を最大化する」 と定式化すると、 ユーザーを煽る記事ばかりが推薦され、 満足度が下がる、 という事故が起きます。 定式化は「測れるもの」 に翻訳する作業ですが、 翻訳が雑だと「測れるが意味のないもの」 に変わってしまう。 SSDSE-B-2026 でも「出生数を予測する」 と「県の少子化対策の効果を予測する」 では、 同じデータでも異なる目的変数の選択をすべきです。
次に多い失敗は、 「データリーケージ」 。 未来情報を含む特徴量を学習に使ってしまい、 学習時には精度が高いが本番では使えない、 という現象です。 SSDSE-B-2026 で「2026 年の人口を予測する」 のに 「2026 年の出生数」 を特徴量に使うと、 当然テスト精度は高くなりますが、 実運用では使えません。 定式化の段階で 「予測時点で本当に手に入る情報か」 を厳しくチェックする習慣が大切です。
3 つ目の落とし穴は、 「評価指標の選択ミス」 。 SSDSE-B-2026 で東京を含む県別 出生数 を予測するとき、 RMSE は東京の誤差が支配的になります。 「地方県の予測精度を上げたい」 のなら、 MAPE や対数変換後の RMSE を使うべき。 評価指標は「何を重視するか」 の宣言であり、 これを誤ると間違ったモデルが選ばれます。 評価指標の選択は、 定式化の中でも特に重要な意思決定です。
追加 Tips: 定式化と特徴量エンジニアリング
定式化と特徴量エンジニアリングは表裏一体です。 「出生数を予測する」 という回帰問題でも、 特徴量として「人口」だけを使うか、 「人口 + 産業構造 + 地理的位置」 を使うかで、 同じ問題でもまったく異なる予測精度になります。 SSDSE-B-2026 には 100 以上の変数があり、 それらをどう組み合わせて特徴量にするかが、 定式化の重要な一部です。 単純に全列を入れると多重共線性が発生し、 モデルが不安定になります。
特徴量エンジニアリングのコツは、 「ドメイン知識を数値に翻訳する」 こと。 たとえば SSDSE-B-2026 で「都市化度」 という特徴量は直接にはありませんが、 「人口密度 (人口 / 面積)」 「第三次産業比率」 などを組み合わせて計算できます。 こうしたドメイン特徴量を作る作業が、 機械学習プロジェクトの 6 〜 7 割の時間を占めることもあります。 自動特徴量生成ツール (featuretools・tsfresh) もありますが、 ドメイン知識による手作り特徴量には及ばないことが多いです。
追加 Tips: 定式化と仮説検証
定式化は単独で完結する作業ではなく、 仮説検証のサイクル の一部です。 「出生数は人口と高い相関がある」 という仮説を検証するために、 「人口を説明変数とする線形回帰で出生数を予測する」 と定式化する。 結果を見て仮説が支持されれば次の仮説に進み、 棄却されれば仮説を修正する。 このサイクルを 2 〜 3 回回すことで、 ビジネス課題を機械学習でうまく解く道筋が見えてきます。
定式化を 1 度きりの作業として捉えると、 失敗したときに 「機械学習は使えない」 と結論しがちです。 しかし実際は、 定式化のやり方を変えれば解けることがほとんどです。 SSDSE-B-2026 で何度も定式化を変えて試行する経験を積むと、 「最初の定式化が悪かった」 と気付く能力が身につき、 機械学習プロジェクトの成功率が大幅に上がります。
定式化のチェックリスト (実務版)
ビジネス目標と最適化目的が一致しているか
目的変数のスケール・分布を確認したか
説明変数間の多重共線性を確認したか
未来情報を含む特徴量を排除したか (リーケージ防止)
評価指標が目標と整合しているか
分類・回帰・ランキングのどれが適切か判断したか
不均衡データなら適切な評価指標を選んだか
ドメイン知識を特徴量に翻訳したか
定式化を 2 〜 3 パターン試す余裕を残したか
定式化の前提を文書化したか
このチェックリストを SSDSE-B-2026 で 1 度通せば、 機械学習プロジェクトの最初のステップ (定式化) で大きく外すことは少なくなります。 大規模プロジェクトでも基本は同じで、 扱うデータ規模やビジネス的なステークホルダー数が増えるだけです。 定式化は機械学習プロジェクトの最重要工程であり、 ここを丁寧にやることが成功確率を決めます。
定式化を学ぶ次のステップ
本ページで問題の定式化の基礎・3 パターン・落とし穴を押さえました。 次に学ぶべきは 交差検証 (定式化後のモデル評価)、 過学習 (定式化が悪いと起きやすい)、 正則化 (定式化と並ぶモデル設計の柱) です。 これらを順に押さえると、 「定式化 → モデル選択 → 評価 → 改善」 のサイクルが体系的に理解できます。
並行して、 機械学習の基礎概念 ・機械学習プロジェクトの流れ ・モデル選択 の各ページを巡回すると、 機械学習プロジェクト全体の流れの中で定式化がどう位置づけられるかが分かります。 とくに「機械学習プロジェクトの流れ」 は定式化の前後を含めた全体像を示しており、 セットで読むと理解が深まります。
最後に、 定式化は 「機械学習プロジェクトの最初の意思決定」 であり、 ここでの判断が後段すべてを縛ります。 SSDSE-B-2026 のような実データで何度も練習し、 「問題を見たら 5 分で定式化案を 3 つ書ける」 状態になるまで反復してください。 この瞬発力が、 実務で生産性を生む最大の武器になります。
定式化の例: SSDSE-B-2026 を題材に 3 通り
同じ SSDSE-B-2026 から、 異なる定式化で 3 つの問題を作ってみましょう。 例 1: 「県の出生規模を予測したい」 → 回帰問題 。 目的変数 = 出生数 (連続値)、 説明変数 = 人口・婚姻件数・15〜64歳人口、 評価指標 = 対数 RMSE。 例 2: 「県が都市型か地方型かを判別したい」 → 二値分類 。 目的変数 = 都市型フラグ (人口密度 1,000 人 / km² 以上)、 説明変数 = 人口・産業比率・通勤時間、 評価指標 = F1。 例 3: 「人口減少が深刻な県のランキング」 → ランキング学習 。 目的変数 = 人口減少率の順位、 説明変数 = 出生率・転出率・高齢化率、 評価指標 = NDCG@10。
これら 3 例を見比べると、 同じ SSDSE-B-2026 データから、 異なるビジネス課題に応じて異なる定式化ができることが分かります。 「データから何が言えるか」 ではなく、 「データで何を言いたいか」 から逆算して定式化するのが、 実務的なアプローチです。 ビジネス課題を先に決め、 それに合わせて定式化を選び、 必要な特徴量を作り、 評価指標で性能を測る、 という流れが基本です。
追加 Tips: 教師あり / 教師なし / 強化学習の選択
定式化の最初の分岐点は、 「ラベル付きデータがあるか」 です。 ラベルがあれば教師あり学習 (分類・回帰)、 なければ教師なし学習 (クラスタリング・次元削減・異常検知) を選びます。 強化学習は「環境との相互作用から学ぶ」 タイプで、 ゲーム・ロボット制御・推薦システムで使われますが、 SSDSE-B-2026 のような静的データセットでは通常使いません。
SSDSE-B-2026 の都道府県データは、 すべて行が完全にラベル付き (47 行すべての値が分かっている) なので、 教師あり学習が自然です。 ただし「教師なし学習で都道府県を 3 グループにクラスタリングし、 都市型・地方型・中間型を発見する」 という探索的アプローチも有効。 「最初は教師なしで構造を発見し、 次に教師ありで予測する」 という二段階アプローチが、 SSDSE-B-2026 のような小規模データでも有効に機能します。
追加 Tips: 定式化と倫理的考慮
機械学習問題の定式化には、 倫理的な側面 も含まれます。 たとえば「人事採用を機械学習で自動化する」 という定式化は、 訓練データに含まれる過去の人事採用バイアスをそのまま増幅する危険があります。 「犯罪率を予測する」 という定式化は、 警察活動の歴史的偏り (特定地域の取り締まり強化) をそのまま反映し、 差別を助長します。 SSDSE-B-2026 のような公的統計を扱う場面では、 こうした倫理的問題は起きにくいですが、 個人データや行動データを扱う場面では、 定式化の段階で倫理的レビューが必須です。
EU の AI Act・日本の AI 戦略・米国の AI 規制では、 高リスク用途 (人事・医療・司法・教育) には倫理的審査が義務化される方向です。 定式化の段階で「この問題定義は誰かを傷つけないか」 「保護属性 (人種・性別・年齢) を間接的に利用していないか」 を確認する習慣が、 今後ますます重要になります。 定式化は技術問題でありながら、 同時に社会的・倫理的判断でもある、 という視点を忘れないでください。
追加 Tips: 定式化の練習問題
SSDSE-B-2026 を使った定式化の練習問題を 5 つ挙げます。 自分で定式化案を書いてから、 解説と比べてみてください。
問題 : 「県の住みやすさを予測したい」 → どう定式化する? 解説 : 「住みやすさ」 という抽象概念を、 「人口増加率」 「平均所得」 「医療施設数」 などの観測可能な代理変数で表す。 単一指標ではなく複合指標 (加重平均など) で定式化するのが現実的。問題 : 「災害リスクの高い県を発見したい」 → どう定式化する? 解説 : 過去の災害履歴データがあるなら教師あり分類、 なければクラスタリングや異常検知。 SSDSE-B-2026 には災害データは含まれないため、 外部データとの結合が必要。問題 : 「出生数の 5 年後の予測」 → どう定式化する? 解説 : 時系列予測問題。 SSDSE-B-2026 は単年データのため、 過去年版 (SSDSE-B-2025、 -2024) と組み合わせる必要がある。 ARIMA・LSTM・Prophet などが選択肢。問題 : 「人口減少を食い止める政策を提案したい」 → どう定式化する? 解説 : これは機械学習問題ではなく、 因果推論 + 政策評価の問題。 機械学習で「人口減少率を予測」 することはできるが、 「政策の効果」 を予測するには差分の差分法 (DiD)・回帰不連続デザインなど別の手法が必要。問題 : 「47 都道府県を 5 グループに分類して特性を分析したい」 → どう定式化する? 解説 : 教師なし学習 (クラスタリング) 問題。 k-means や階層的クラスタリングを使い、 各クラスタの特徴を分析する。 評価指標は外部基準 (既知の地域分類との一致度) と内部基準 (シルエット係数) を併用。
これらの問題に取り組むだけで、 定式化の感覚が大きく深まります。 特に問題 4 は重要で、 「機械学習で何でも解ける」 という錯覚を打ち破ります。 因果推論・政策評価・最適化など、 機械学習以外の手法が必要な場面を見極めることが、 上級の定式化スキルの一部です。 機械学習はツールの 1 つに過ぎず、 問題によっては他のツールが適切です。
定式化の本質的な視点 — まとめ
定式化の本質は、 「曖昧な現実世界の問題を、 数学的に明確で、 計算機が扱える形式に翻訳する」 作業です。 この翻訳の質が、 機械学習プロジェクト全体の成否を決めます。 良い定式化は、 ビジネス課題と数学的目的関数を密接に結びつけ、 評価指標が改善することがビジネス価値の向上に直結するように設計されています。 逆に悪い定式化は、 数値的には改善するが、 ビジネス的には何も変わらない、 あるいは逆効果になることすらあります。
SSDSE-B-2026 のような構造化された公的データを題材にすると、 定式化の練習が最もやりやすいです。 47 行という小規模、 100 以上の変数という多次元、 都道府県という分かりやすい単位、 という条件が揃っているため、 定式化のさまざまなパターンを試せます。 ぜひ本ページで挙げた 5 つの練習問題から始め、 自分なりの定式化スキルを磨いてください。
そして定式化は 「1 回で完璧にする」 ものではなく、 「何度も改善する」 ものだと割り切ってください。 最初の定式化で精度が出なくても、 評価指標を変える、 特徴量を増やす、 目的変数を変換する、 問題タイプを変える (回帰 → 分類)、 などの修正を 2 〜 3 回繰り返すうちに、 良い定式化が見えてきます。 この反復が、 機械学習プロジェクトの本質的な営みです。
最後に、 定式化は 「ビジネスサイドとデータサイドの架け橋」 です。 ビジネスサイドは「もっと売れる商品を予測したい」 と漠然と要望し、 データサイドは「目的変数は何ですか? 評価指標は? 入力データは?」 と確認します。 この対話を通じて、 ビジネス課題が機械学習問題に翻訳されます。 この翻訳の質が、 機械学習プロジェクト成功の最大の決定要因です。 SSDSE-B-2026 で定式化の練習を積むことは、 そのままビジネスサイドとの対話力を高める訓練にもなります。 ぜひ実践で力をつけてください。 そしてその力は、 機械学習エンジニアとしてだけでなく、 データサイエンティスト・アナリスト・プロジェクトマネージャーとしても重宝される普遍的なスキルです。 定式化を起点に、 データを使ったビジネス改善のサイクル全体を回せる人材へと成長することを目指してください。 SSDSE-B-2026 はそのための最良の練習素材です。 数学的にも実務的にも適切なサイズで、 47 都道府県という馴染みのある単位のため、 直感とデータをすり合わせやすく、 定式化のセンスを磨くのに最適な題材と言えます。 何度も挑戦し、 自分なりの定式化ガイドラインを 1 つ完成させてください。 そのガイドラインが、 将来のあらゆる機械学習プロジェクトで道標になります。 そして数年後、 新しいビジネス課題に直面したとき、 自分のガイドラインに沿って 「これは分類問題」 「これはランキング問題」 「これは実は機械学習ではなく因果推論問題」 と素早く判断できる状態になります。 この瞬発力こそ、 経験豊富なデータサイエンティストと駆け出しの違いを生む最大の要素です。 ぜひ SSDSE-B-2026 を題材に、 この瞬発力を養ってください。 そして実務での経験と組み合わせることで、 真に強力なスキルセットへと結実します。 何度も実データで挑戦することが、 本物の力を養う唯一の方法であり、 教科書だけでは決して身につかない領域です。 ぜひ毎週・毎月のペースで実データを触る習慣を作り、 定式化のセンスを継続的に磨いてください。 そして 1 年後、 2 年後の自分の成長を実感できるはずです。 継続が最大の力であり、 成長への最も確実な道筋となるので、 ぜひ続けてください、 そして粘り強く挑戦し続けることを強くお勧めします。 学習の積み重ねが、 真のスキルを生みます。
🔎 深掘り — 同じ 1 列を「回帰にするか分類にするか」で問題が別物になる
このページの他の節では「タスク種別・データ・評価指標の 3 点セット」や、 ウィジェットでの回帰/分類/クラスタリング切替を扱いました。 ここでは重複を避け、 連続値の列を分類に落とし込むときの「しきい値の置き方」だけで、 問題の難易度・クラス均衡・そもそも成立するか、 が定量的にどう激変するか という一点に絞って深掘りします。 題材は SSDSE-B-2026 の 合計特殊出生率(A4103) 、 2023 年・47 都道府県の実測値です。
🧭 直感 — 「連続値の予測」と「区分の当て」は別問題
2023 年の合計特殊出生率は、 実測で 最小 0.99(東京都)〜最大 1.60(沖縄県) 、 平均 1.293・中央値 1.300・標準偏差 0.133 という分布でした(47 都道府県、 全国集計行は含まず)。 この 1 列に対して、 やりたい意思決定に応じて次の定式化が考えられます。
回帰 :出生率そのものを数値で予測する(0.99 と 1.29 は「違う値」として保持される)。 評価は RMSE や MAE。二値分類 :あるしきい値以上か未満かを当てる(0.99 も 1.29 も「未満」なら同じラベルに潰れる)。 評価は F1 や AUC 、 混同行列 。多クラス分類 :低・中・高の 3 区分に割り当てる。
下表は、 同じ 2023 年の実測値 を、 しきい値だけ変えて二値/多クラスに定式化したときの実際のクラス内訳です(すべて実データから算出)。
定式化
しきい値/区切り
クラス内訳(47 県)
性質
二値 中央値 1.300 以上 24 / 未満 23 ほぼ均衡(学習しやすい) 二値 1.20 以上 36 / 未満 11 やや不均衡 二値 1.50 以上 1 / 未満 46 極端な不均衡(ほぼ単一クラス) 二値 人口置換水準 2.07 以上 0 / 未満 47 問題が成立しない(全県が同ラベル) 多クラス 三分位 1.230 / 1.340 低 15 / 中 15 / 高 17 設計的に均衡
ポイントは、 元データは同一なのに、 しきい値を 1.30 → 1.50 → 2.07 と動かすだけで「均衡な二値分類」→「激しい不均衡」→「解けない問題」へと連続的に変質する ことです。 分類にするかどうか、 そしてどこで切るかは、 データの前ではなく意思決定の要件から 決めるべき設計判断です。
⚠️ 落とし穴(重要) — 精度パラドックスと情報の取りこぼし
(1) 精度パラドックス。 しきい値 1.50 で二値分類にすると内訳は「以上 1 / 未満 46」。 このとき 常に『未満』と答えるだけのモデルが正解率 46/47 ≈ 97.9% に達します。 何も学習していないのに高精度に見える罠です。 同様にしきい値 1.20 なら常に多数派を答えて 36/47 ≈ 76.6%。 正解率 単体で評価せず、 不均衡下では F1 や AUC 、 クラス不均衡 への対処を前提に設計してください。 中央値で切れば多数派ベースラインは 24/47 ≈ 51.1% まで下がり、 モデルの実力が可視化されます。
(2) 情報の取りこぼし。 分類化は連続値を潰します。 東京都 0.99 と平均的な 1.29 は「1.30 未満」で同じラベルになり、 「どれだけ低いか」という順序・距離の情報が消えます 。 意思決定が「実数の水準そのもの」(例:予算配分の按分)に依存するなら回帰を選ぶべきで、 安易な二値化は本来使える信号を捨てます。
(3) しきい値の恣意性。 「高出生率県」を 1.50 で定義するか 1.30 で定義するかは分析結論を左右します。 しきい値は結果を見てから後付けで動かさず(→ データリーク 類似の自由度)、 事前に根拠(政策目標値・分布の中央値など)を固定して明記します。
🚀 発展 — 回帰と多クラスの中間、そして時間軸
順序回帰(ordinal regression)。 「低・中・高」には順序があるのに、 通常の多クラス分類はこの順序を無視して 3 つを対等に扱います。 順序回帰は「高を中と間違えるより低と間違える方が大きな誤り」という順序構造を損失に取り込む中間的な定式化で、 連続値の完全な情報と単純な区分の扱いやすさのバランスを取ります(個別解説ページは未整備)。
時間軸を入れる。 47 県平均の合計特殊出生率は 2012 年の 1.460 から 2023 年の 1.293 へ、 実測で 約 0.168 低下 しています。 「2023 年の水準を当てる」静的な問題なのか、 「翌年の変化を予測する」時系列問題なのかで、 X に何を入れてよいか(未来情報の混入=リーク)が変わります。 定式化には常に「予測の瞬間に何が手元にあるか」という時点の設計が伴います。
🔗 関連ページ
数値はすべて data/raw/SSDSE-B-2026.csv(pd.read_csv(encoding='cp932', skiprows=[1])、 2023 年 47 都道府県および 2012–2023 年)の実測値から算出。 順序回帰・マルチタスク等の一部関連語は個別ページ未整備のため本文中のテキスト言及にとどめています。