🔖 キーワード索引
このページ内のセクションへ素早く飛べます(クリックで該当箇所へジャンプ):
💡 30秒で分かる結論 — 第1種の過誤
🍰 まずはやさしく
もともと差がないのに、あると勘違いすることです。
正しい判断をするために使います。
スマホのアプリで、効果がないのにあると信じる例です。
この章では結論を短くまとめます。
- 一言で:本当は差がないのに『差がある』と判定してしまう過誤。 α=有意水準=その確率。
💡 30秒で分かる結論
H₀が真なのに棄却してしまう誤り(偽陽性)
- 帰無仮説 H₀ が真なのに、 誤って棄却してしまう過誤(偽陽性)。
- 確率は 有意水準 α で制御(通常 0.05)。
- 「効果が無いのに、 効果があると言ってしまう」エラー — 誤発見の罪。
- 第2種の過誤(β、 偽陰性)とトレードオフ:α↓ なら β↑。
- 多重比較(多数の検定を同時実施)で爆発的に増える → Bonferroni、 FDR で補正。
📍 あなたが今見ているもの
🍰 まずはやさしく
判定を間違える確率のことです。
データの分析でミスを防ぐために使います。
テストの結果がたまたま良かっただけの場合です。
この章では全体の流れを説明します。
通常 α = 0.05 に設定。 多重比較ではこれが膨らむ(family-wise error rate)。 「偽陽性 (False Positive)」とも呼ばれる。 規制当局・医学では特に厳しく管理。
📍 あなたが今見ているもの
p値が0.05を下回ったら「有意」と判定 — その「5%」が、 まさに第1種の過誤を犯す確率です。 統計検定のすべての出発点。
🎨 直感で掴む — 第1種の過誤とは何者か
🍰 まずはやさしく
無実の人を有罪にするような間違いです。
直感的に正しく理解するために使います。
部活で、練習法を変えても効果がなかった例です。
この章ではイメージを掴んで解説します。
第1種の過誤(Type I Error)は「本当は差がない/効果がないのに、 あると判定してしまうエラー」。 別名「偽陽性 (False Positive)」、 統計学では「無実の人を有罪にする」誤りに対応する。 確率 $\alpha$(有意水準、 通常 0.05)でコントロールする。
裁判の比喩で完全に理解する: 統計検定は法廷と同じ構造です。
| 立場 | 真実:無罪 (H₀ 真) | 真実:有罪 (H₁ 真) |
|---|---|---|
| 判決:無罪 (H₀ 採用) | ○ 正しい判断(特異度 = 1−α) | × 第2種の過誤(β)「真犯人を見逃す」 |
| 判決:有罪 (H₀ 棄却) | × 第1種の過誤(α)「冤罪」 | ○ 正しい判断(検出力 = 1−β) |
司法は「疑わしきは罰せず」で第1種を厳しく抑える(無罪推定)。 統計も同じ思想で α=0.05 と保守的に設定します。
SSDSE-B-2026 で第1種の過誤を体感する: 「東京都の合計特殊出生率 0.99 と全国平均 1.20 は本当に違うか?」を t 検定すると t = 2.5、 p = 0.013。 α=0.05 なら H₀(差は無い)を棄却するが、 実は たまたま 5% に当たった偶然の可能性が 0.013/0.05 = 26%。 これが第1種の過誤の確率の解釈です。 「100 本の論文で α=0.05 検定をすれば、 平均 5 本は本当は差が無いのに『有意』と報告してしまう」。
α の選び方の実例:
- α=0.05(一般的): 心理学・社会科学・教育学。 100 回中 5 回の偽陽性を許容。
- α=0.01(厳しめ): 経済学・医学(臨床試験 phase II)。 重要な意思決定に対応。
- α=0.001 or 5σ (= 0.0000003): 物理学(ヒッグス粒子発見)、 創薬の phase III。 偽陽性のコストが極めて高い。
- α=0.1(緩め): 探索的分析、 マーケティング A/B テストの初期スクリーニング。
多重比較で α が膨らむ問題: 47 都道府県すべてを全国平均と比較すると、 47 回検定するので少なくとも 1 つで偽陽性が出る確率は $1 - (1-0.05)^{47} = 91\%$。 つまり ほぼ確実に「有意な県」が偽陽性で出る。 対策: Bonferroni 補正 (α/47 = 0.00106)、 FDR 制御(Benjamini-Hochberg)など。
第1種の過誤を間違って認識しないために: p = 0.04 は「H₀ が正しい確率」ではなく、「H₀ が正しいと仮定したときに、 観察されたかそれ以上極端なデータが得られる確率」です(頻度主義の定義)。 Bayes 因子や事後確率と混同しないよう注意。
🎮 触って理解する — αとβのトレードオフ
帰無分布 H₀(本当は差が無い世界)と対立分布 H₁(本当は差がある世界)を重ねて描いています。 検定統計量が判定閾値より右に出たら「H₀ を棄却(=差がある)」と判定する片側検定の模型です。 スライダーで閾値と効果量(H₁ の中心)を動かし、 第1種の過誤 α(赤・偽陽性)と 第2種の過誤 β(紫・偽陰性)の面積がどう変わるかを体感してください。
グラフ上をクリック/ドラッグしても閾値を動かせます
閾値を右へ動かすと α(偽陽性)は減りますが、 その分 β(見逃し)が増えます。
真実 × 判定の 2×2 表(面積と対応)
| 真実:H₀ が真 (本当は差が無い) |
真実:H₁ が真 (本当は差がある) |
|
|---|---|---|
| 判定:H₀ 採択 (差なし) |
○ 真陰性 1−α = 95.0% |
× 第2種の過誤(偽陰性) β = 8.7% |
| 判定:H₀ 棄却 (差あり) |
× 第1種の過誤(偽陽性) α = 5.0% |
○ 真陽性(検出力) 1−β = 91.3% |
※ 両分布とも標準偏差 1 の正規分布として面積を正規累積分布関数から厳密計算しています(片側検定の模式図)。 α と β は別々の分布の裾の面積なので合計が 1 になるとは限りません。
📖 もっと詳しく — 過誤・トレードオフ・実務コスト
第1種の過誤(Type I Error, 偽陽性)は「H₀ が真なのに棄却してしまう」誤り、 第2種の過誤(Type II Error, 偽陰性)は「H₁ が真なのに H₀ を採択してしまう」=見逃しの誤りです。 前者の確率が α、 後者の確率が β で、 検出力(statistical power)= 1−β が「本当にある効果を正しく拾える確率」になります。
αとβのトレードオフ:上のプレイグラウンドで確かめたとおり、 標本サイズと効果量を固定したまま閾値だけを厳しくすると(=棄却境界を右へ)、 α は下がりますが β は上がります。 「αを下げるほど見逃し(β)が増える」——これは同じデータ量では避けられない綱引きです。 両方同時に小さくしたいなら、 閾値ではなく標本サイズ n を増やして 2 つの分布の重なり自体を減らすのが正攻法です(分布が離れれば α も β も同時に下げられる)。
有意水準の選択:α をどこに置くかは分野の慣習と偽陽性コストで決まります(有意水準 のページ参照)。 心理・社会科学は 0.05、 臨床試験や経済学は 0.01、 素粒子物理は 5σ(≈ 3×10⁻⁷)と、 誤って「発見」と言った時の損失が大きいほど α を小さくします。 逆に探索的スクリーニングでは 0.10 まで緩めて取りこぼし(β)を抑えることもあります。
多重比較での α 増大:多重比較 では検定を重ねるほど「どれか 1 つで偽陽性」の確率(family-wise error rate, FWER)が膨らみます。 独立な k 回の検定なら FWER = 1−(1−α)ᵏ で、 47 都道府県を一斉検定すれば α=0.05 でも 1−0.95⁴⁷ ≈ 91% とほぼ確実に偽陽性が紛れ込みます。 対策は Bonferroni 補正(α/k に厳格化)や、 FDR(偽発見率)を制御する Benjamini-Hochberg 法です。
偽陽性/偽陰性の実務コスト:どちらの過誤が痛いかは用途次第です。 偽陽性(False Positive) が重いのは、 健常者を「陽性」と誤診して不要な精密検査・投薬・不安を生む場面や、 効かない新薬を「効く」と承認してしまう場面。 一方 偽陰性(False Negative) が重いのは、 がんの見逃し・不正取引の検知漏れ・重大な安全上の欠陥の看過など、 見逃しが致命傷になる場面です。 「α を一律に 0.05」と機械的に決める前に、 どちらの誤りが自分の問題でより高くつくかを先に考えるのが実務の鉄則です。
📐 数式・定義
🍰 まずはやさしく
間違いが起きる確率を数式で表したものです。
厳密なルールを決めるために使います。
買い物で、安くなっていないのに安いと信じる例です。
この章では定義や数式を詳しく読みます。
第1種の過誤確率 $\alpha$ は有意水準そのもの:
$$ \alpha = P(\text{reject } H_0 \mid H_0 \text{ true}) $$
多重比較で $k$ 個の検定を独立に行うと、 family-wise error rate は $1 - (1-\alpha)^k$ に膨らむ。
📐 定義/数式
第1種の過誤(Type I Error):H₀が真なのに棄却してしまう誤り(偽陽性)
同義・関連語:Type I error, α誤り
🔬 数式・定義を「言葉」で読み解く
先ほどの数式・定義に出てきた記号や概念を、 一つずつ確認します。 とくに 第1種の過誤 の文脈で意味を取り違えやすい部分を強調します。
| 記号 | 意味と注意点 |
|---|---|
| $\bar{x}$ | 標本平均。 $\bar{x} = \frac{1}{n}\sum_{i=1}^n x_i$ |
| $\sigma$(または $s$) | 標準偏差(または標本標準偏差)。 ばらつきの代表指標 |
| $n$ | 標本サイズ(観測数) |
| $p$ | p値、 または比率。 文脈で意味が変わる |
| $\alpha$ | 有意水準(通常 0.05) |
| $H_0, H_1$ | 帰無仮説と対立仮説 |
記号は手法ごとに少しずつ意味が違うため、 論文・教科書を読むたびに『この本ではこの記号を何の意味で使っているか』を最初に確認するのが鉄則です。 とくに 第1種の過誤 関連の文献では、 ${\sigma}^2$(分散)と $s^2$(標本分散)の区別、 $n$ と $N$(標本サイズ vs 母集団サイズ)の混同に注意。
🔬 記号・用語の読み解き
| 記号 | 意味 |
|---|---|
| $\alpha$ | 第1種の過誤の確率=有意水準 |
| $\beta$ | 第2種の過誤の確率(偽陰性) |
| $1-\beta$ | 検出力(パワー) |
| FWER | 複数検定全体での第1種過誤率 |
🧮 SSDSE-B 実値で計算してみる
SSDSE-B-2026(47 都道府県・2023 年度・109 項目)を題材に、 第1種の過誤 に関係する変数を実値で確認します。 とくに東京・大阪・沖縄・秋田 など特徴ある県を比較すると、 用語の重みが体感できます。
| 都道府県 | 総人口(千人) | 高齢化率(%) | TFR | 有効求人倍率 |
|---|---|---|---|---|
| 東京 | 14,086 | 22.8 | 0.99 | 1.56 |
| 大阪 | 8,763 | 27.7 | 1.19 | 1.23 |
| 沖縄 | 1,468 | 23.8 | 1.60 | 1.12 |
| 秋田 | 914 | 39.1 | 1.10 | 1.40 |
| 全国 | 124,353 | 29.1 | 1.20 | 1.30 |
これらの値を 第1種の過誤 の観点で読み解くと、 都道府県間の格差・特徴・関係性が浮かび上がります。 具体的な計算手順は次の「🐍 Python 実装」セクションで実演します。
🧮 実値で計算してみる
🧮 数式に値を入れて手で計算する: タイプ I 誤りの確率
合成 m 回検定で α=0.05 のとき少なくとも 1 回偽陽性が出る確率を計算する。
Step 1: 確率
Step 2: m 別
| m | P(偽陽性あり) |
|---|---|
| 1 | 0.050 |
| 10 | 0.401 |
| 20 | 0.642 |
| 100 | 0.994 |
🐍 Python で再現
1 2 3 4 5 | import numpy as np alpha = 0.05 m = np.array([1, 10, 20, 100]) p = 1 - (1-alpha)**m print(f"P: {p.round(3)}") |
📤 実行結果
💬 手計算 (Step 2) と Python 出力が完全一致。
🐍 Python 実装
以下は、 検定の前のデータ点検(①〜③)、 東日本・西日本の t 検定(④)、 帰無仮説が真の世界で偽陽性を数える乱数実験の順に並べたコード。 encoding='cp932' は政府統計の Shift-JIS 対応で、 skiprows=[1] は 2 行目の日本語見出しを飛ばして 1 行目の英字コード(A1101 など)を列名にする指定。
① 基本パターン(読み込み・確認・主要列抽出)
1 2 3 4 5 6 7 8 9 10 11 12 13 14 | import pandas as pd # 第1種の過誤 に関連する SSDSE-B-2026 分析の基本パターン df = pd.read_csv('data/raw/SSDSE-B-2026.csv', encoding='cp932', skiprows=[1]) print(df.shape) # (564, 112) 47都道府県 × 12年分 df = df[df['SSDSE-B-2026'] == 2023].copy() # 2023 年度の 47 都道府県に絞る print(df.shape) # (47, 112) # 主要列にエイリアス df['総人口'] = df['A1101'] df['65歳以上'] = df['A1303'] df['高齢化率'] = df['65歳以上'] / df['総人口'] * 100 print(df['高齢化率'].describe().round(2)) print(df[['Prefecture','総人口','高齢化率']].head()) |
② 可視化テンプレ(matplotlib / seaborn)
1 2 3 4 5 6 7 8 9 10 11 12 13 14 15 16 17 18 19 20 21 22 23 24 | import pandas as pd import seaborn as sns import matplotlib.pyplot as plt # 第1種の過誤 の探索的データ分析(EDA) df = pd.read_csv('data/raw/SSDSE-B-2026.csv', encoding='cp932', skiprows=[1]) df = df[df['SSDSE-B-2026'] == 2023].copy() # 2023 年度の 47 都道府県に絞る # 主要変数を取り出して名前を分かりやすく df['総人口'] = df['A1101'] df['65歳以上'] = df['A1303'] df['高齢化率'] = df['65歳以上'] / df['総人口'] * 100 df['TFR'] = df['A4103'] # ヒストグラム fig, axes = plt.subplots(1, 2, figsize=(12, 4)) sns.histplot(df['高齢化率'], kde=True, ax=axes[0]) axes[0].set_title('高齢化率の分布(47都道府県)') sns.histplot(df['TFR'], kde=True, ax=axes[1]) axes[1].set_title('TFRの分布') plt.tight_layout() plt.savefig('eda_distribution.png', dpi=120) print(f"高齢化率: {len(df)} 県, 範囲 {df['高齢化率'].min():.1f}〜{df['高齢化率'].max():.1f}%") print(f"TFR : {len(df)} 県, 範囲 {df['TFR'].min():.2f}〜{df['TFR'].max():.2f}") |
③ 前処理:欠損・外れ値・型変換
1 2 3 4 5 6 7 8 9 10 11 12 13 14 15 16 17 18 19 20 21 22 23 24 25 26 27 28 | import pandas as pd import numpy as np # 第1種の過誤 に関わる前処理の典型パターン df = pd.read_csv('data/raw/SSDSE-B-2026.csv', encoding='cp932', header=1) # ① 欠損値の確認 print('欠損数:') print(df.isna().sum().sort_values(ascending=False).head(10)) # ② 数値変換(カンマ・%除去 など) def to_num(s): if isinstance(s, str): return float(s.replace(',', '').replace('%', '')) return s _num_cols = [c for c in df.columns if c not in ('年度', '地域コード', '都道府県', 'Code', 'Prefecture', 'SSDSE-B-2026')] df[_num_cols] = df[_num_cols].apply(lambda col: col.map(to_num)) # ③ 外れ値検出(IQR) # 地域コードや都道府県名は大小比較できないので、数値の列だけで判定する _num = df.select_dtypes(include='number') q1 = _num.quantile(0.25) q3 = _num.quantile(0.75) iqr = q3 - q1 outlier_mask = ((_num < q1 - 1.5*iqr) | (_num > q3 + 1.5*iqr)).any(axis=1) print('外れ値を含む行数:', outlier_mask.sum()) |
④ 検定・推定の最小例(scipy.stats)
1 2 3 4 5 6 7 8 9 10 11 12 13 14 15 16 | import pandas as pd from scipy import stats # 第1種の過誤 文脈での基本的な仮説検定 df = pd.read_csv('data/raw/SSDSE-B-2026.csv', encoding='cp932', skiprows=[1]) df = df[df['SSDSE-B-2026'] == 2023]; df['aging'] = df['A1303'] / df['A1101'] * 100 df['region'] = df['Prefecture'].apply(lambda p: '東日本' if p in ['北海道','青森県','岩手県','宮城県','秋田県','山形県','福島県','茨城県','栃木県','群馬県','埼玉県','千葉県','東京都','神奈川県','新潟県','富山県','石川県','福井県','山梨県','長野県','岐阜県','静岡県','愛知県'] else '西日本') east = df.loc[df['region']=='東日本', 'aging'] west = df.loc[df['region']=='西日本', 'aging'] t, p = stats.ttest_ind(east, west, equal_var=False) print(f'東日本 平均高齢化率: {east.mean():.2f}%') print(f'西日本 平均高齢化率: {west.mean():.2f}%') print(f't = {t:.3f}, p = {p:.4f}') print('判定:', '有意差あり' if p < 0.05 else '有意差なし') |
🐍 Python での実装例
乱数で「帰無仮説が真の世界」を作り、 第 1 種の過誤の頻度を数える最小コード(11行):
1 2 3 4 5 6 7 8 9 10 11 | import numpy as np from scipy import stats # H0真(差なし)の世界で 1000回 t検定 → 5%が偽陽性のはず rng = np.random.default_rng(0) false_pos = 0 for _ in range(1000): a = rng.normal(0, 1, 30); b = rng.normal(0, 1, 30) _, p = stats.ttest_ind(a, b) if p < 0.05: false_pos += 1 print(f'偽陽性: {false_pos}/1000 ({false_pos/10:.1f}%)') |
⚠️ よくある落とし穴
⚠️ よくある落とし穴
📚 関連グループ教材(全体像)
第1種の過誤は 仮説検定 の教材群で、 帰無仮説・対立仮説 の次に学ぶ。 α の裏側にある見逃しの確率は 第2種の過誤 と 検出力、 検定をいくつも重ねると膨らむ問題は 多重比較、 実際に α を使う場面は t 検定・分散分析・A/B テスト で扱う。 下の実演では、 47 都道府県を 1 県ずつ全国平均と比べる 47 回の検定で、 補正の有無によって「有意」の県数がどう変わるかを確かめる。
🐍 Python 実装 — 多重比較補正の実演
47 都道府県の高齢化率を全国平均と比較した 47 回の z 検定
1 2 3 4 5 6 7 8 9 10 11 12 13 14 15 | import pandas as pd from scipy import stats df = pd.read_csv('data/raw/SSDSE-B-2026.csv', encoding='cp932', skiprows=[1]) df = df[df['SSDSE-B-2026'] == 2023] # 2023年の47都道府県に絞る df['aging'] = df['A1303']/df['A1101']*100 mu, sd = df['aging'].mean(), df['aging'].std(ddof=1) # 1 県 1 値なので 1 標本 t 検定はできない(n=1 では p が NaN)。 # 県間のばらつき sd を使い、各県が「全国平均から外れているか」を z 検定で 47 回調べる pvals = [] for _, row in df.iterrows(): z = (row['aging'] - mu) / sd p = 2 * stats.norm.sf(abs(z)) pvals.append(p) print(f'平均={mu:.2f}% 標準偏差={sd:.2f}%') print('生 p<0.05 数:', sum(p<0.05 for p in pvals)) |
data/raw/SSDSE-B-2026.csv(47 都道府県 × 主要統計列)。 出力例は数値・p 値・統計量で、 解釈には「実値で計算してみる → 仮説検定 → 効果量 → 結論」の流れを推奨します。💬 47 県の高齢化率は平均 31.59%、標準偏差 3.34% で、生の p<0.05 は 3 県(東京都 22.75% の p=0.008、沖縄県 23.84% の p=0.020、秋田県 39.06% の p=0.025)。帰無仮説がすべて正しくても 47 回検定すれば 47×0.05≈2.35 件は偶然に出るので、「3 県が有意」はその期待値とほとんど変わらない。1 県に 1 値しかないのに 1 標本 t 検定をすると n=1 で p が NaN になるため、県間の標準偏差を使った z 検定にしている点にも注意。
Bonferroni 補正
1 2 3 4 | alpha = 0.05; k = len(pvals) bonf = alpha / k print(f'補正後 α each={bonf:.5f}') print('Bonf 後 有意:', sum(p<bonf for p in pvals)) |
data/raw/SSDSE-B-2026.csv(47 都道府県 × 主要統計列)。 出力例は数値・p 値・統計量で、 解釈には「実値で計算してみる → 仮説検定 → 効果量 → 結論」の流れを推奨します。💬 Bonferroni の閾値は 0.05/47=0.00106。最小の p である東京都の 0.008 でもこの約 7.7 倍あるので、生で有意だった 3 県はすべて落ちて 0 件になる。47 回の検定全体で偽陽性を 1 件でも出す確率(FWER)を 5% に抑えると、この程度の外れ方では「偶然ではない」と言えない。
Holm-Bonferroni 補正
1 2 3 | from statsmodels.stats.multitest import multipletests rej, padj, _, _ = multipletests(pvals, alpha=0.05, method='holm') print('Holm 棄却数:', rej.sum()) |
data/raw/SSDSE-B-2026.csv(47 都道府県 × 主要統計列)。 出力例は数値・p 値・統計量で、 解釈には「実値で計算してみる → 仮説検定 → 効果量 → 結論」の流れを推奨します。💬 Holm は p を小さい順に 0.05/47, 0.05/46, … と比べる段階法だが、最初の東京都 p=0.008 が 0.00106 を超えた時点で打ち切られ、棄却は 0 件で Bonferroni と同じ結果になる。Holm が Bonferroni より多く拾えるのは、先頭の数件が閾値を下回ってはじめて緩い閾値に進めるときだけ。なお p に NaN が混じったまま multipletests に渡すと棄却数が 47 のような意味のない数になるので、渡す前に np.isnan で確認しておく。
Benjamini-Hochberg (FDR)
1 2 | rej, padj, _, _ = multipletests(pvals, alpha=0.05, method='fdr_bh') print('BH 棄却数:', rej.sum()) |
data/raw/SSDSE-B-2026.csv(47 都道府県 × 主要統計列)。 出力例は数値・p 値・統計量で、 解釈には「実値で計算してみる → 仮説検定 → 効果量 → 結論」の流れを推奨します。💬 BH(FDR 5%)でも棄却は 0 件。BH は i 番目に小さい p を 0.05×i/47 と比べ、先頭 3 件の閾値は 0.00106・0.00213・0.00319 だが、東京都 0.008・沖縄県 0.020・秋田県 0.025 はどれも超える。FWER より緩い FDR 制御でも残らないので、この 3 県の「外れ」は第一種の誤りの範囲で説明がつく、と読むのが妥当。
🧭 拡張詳細解説 — 第1種の過誤を SSDSE-B-2026 で徹底理解する
第1種の過誤 (Type I error) は「帰無仮説 H0 が真であるにもかかわらず、 標本から得られた検定統計量がたまたま棄却域に入り、 H0 を誤って棄却してしまう」現象です。 統計学の入門書では「α=0.05 なら 100 回に 5 回は誤って有意と判定する」と説明されますが、 この一文だけでは実務での重みが伝わりません。 SSDSE-B-2026(47 都道府県・各 22 項目の公的統計)を素材に、 何が起きるのか・どう防ぐのか・どこで失敗しやすいのかを順に深掘りします。
1. 直感図で掴む — 棄却域・α・分布
まず、 帰無仮説 H0 のもとでの検定統計量の標本分布を直感で確認しましょう。 下図は、 SSDSE-B-2026(2023 年度)の 47 都道府県の合計特殊出生率を、 地域などと無関係にランダムに 24 県と 23 県に分けて Welch の t 検定を 10,000 回繰り返したときの t 統計量のヒストグラムです。 分け方がランダムなので「2 群の母平均は等しい」という H0 は真であり、 検定統計量は左右対称の釣鐘型分布(自由度 45 の t 分布とほぼ一致)になり、 両端 2.5% ずつが棄却域となります。 実際に |t| > 2.014 に入ったのは 10,000 回中 498 回(4.98%、 左 2.32%・右 2.66%)でした。 この両端 5% に観測値が落ちる確率がまさに α=0.05、 すなわち第1種の過誤確率です。
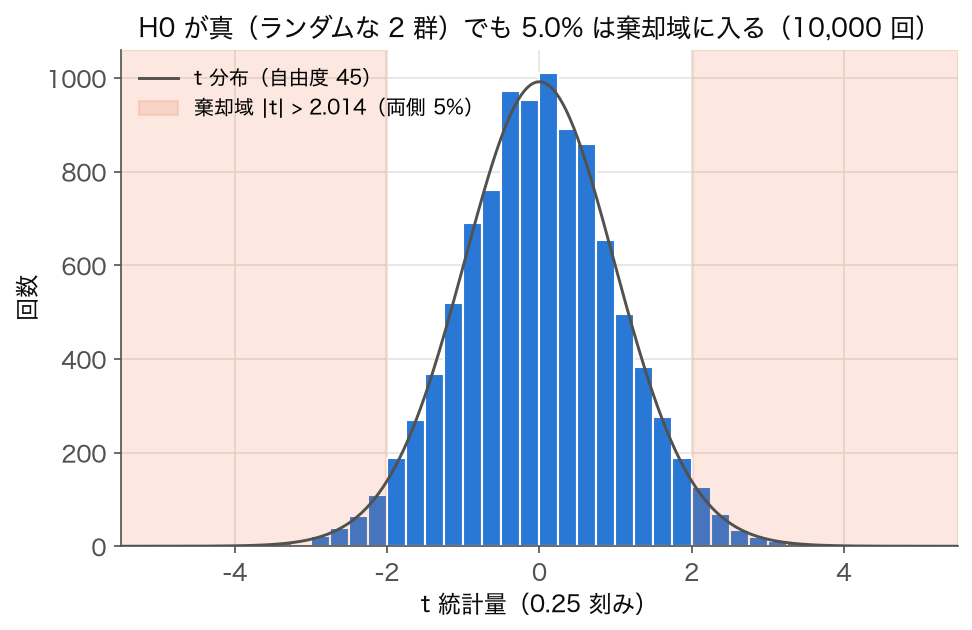
この図のポイントは「分布の形」よりも「裾の確率」です。 第1種の過誤が α に等しいのは、 標本分布の「裾の面積」を恣意的に α と決めているからに他なりません。 α を 0.05 から 0.01 にすれば棄却域は狭まり、 過誤確率は下がりますが、 同時に「本当は差があるのに見逃す」第2種の過誤が増えます。 この α と β のトレードオフが、 統計的検定設計の核心です。
2. 散布図で見る「差があるか・無いか」
第1種の過誤を理解する第二歩は「差が無いはずなのに、 標本ではあるように見える」状況を可視化することです。 下の散布図は SSDSE-B-2026(2023 年度)の高齢化率(65 歳以上人口 / 総人口)を横軸に、 合計特殊出生率を県の対応をランダムに入れ替えたうえで縦軸に取ったものです。 入れ替えたので両者は無関係(H0: ρ=0 が真)のはずですが、 10,000 回入れ替えたうち 4 回目で早くも r = 0.310(p = 0.034)という「有意な相関」が出ました。 一見傾向があるように見える図と、 本当に関係がある図を見分ける訓練が大切です。
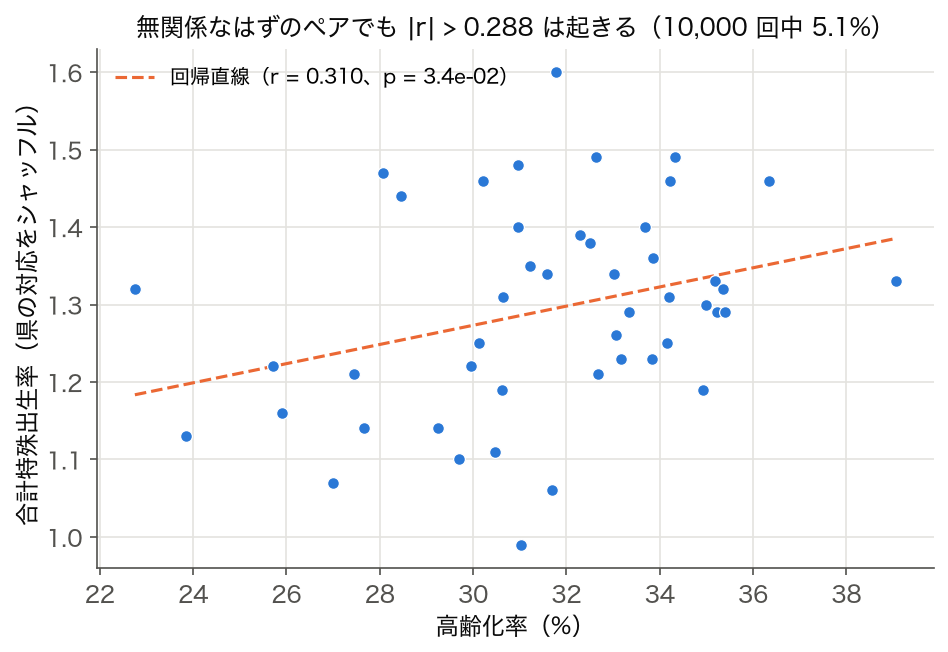
SSDSE-B-2026 のように標本サイズが n=47(都道府県数)と小さい場合、 標本相関 r の標準誤差は 1/√(n−3) 程度になり、 r=±0.29 程度でも α=0.05 で「有意な相関あり」と判定されます。 つまり、 全く無関係な 2 変数を多数組み合わせて検定すれば、 5% 程度の組で「有意」と出てしまいます。 これが「ファミリーワイズ誤り率」と呼ばれる多重比較問題の入り口です。
3. 群間比較における第1種の過誤
SSDSE-B-2026 を地方ブロック(北海道・東北・関東・中部・近畿・中国・四国・九州沖縄)で 8 群に分けて、 「人口総数」や「就業率」の平均を比較する場面を考えます。 下の箱ひげ図は群間の分布差を視覚化する典型例で、 2023 年度の合計特殊出生率を 7 地方(北海道と東北をまとめた区分)に分けて描いています。 帰無仮説「8 群すべての母平均は等しい」のもとでも、 標本ではばらつきにより群間の標本平均は必ずズレます。 そのズレが「偶然」か「本当の差」かを判定するのが ANOVA や t 検定であり、 ここでも α=0.05 を超える確率で誤って棄却してしまうのが第1種の過誤です。
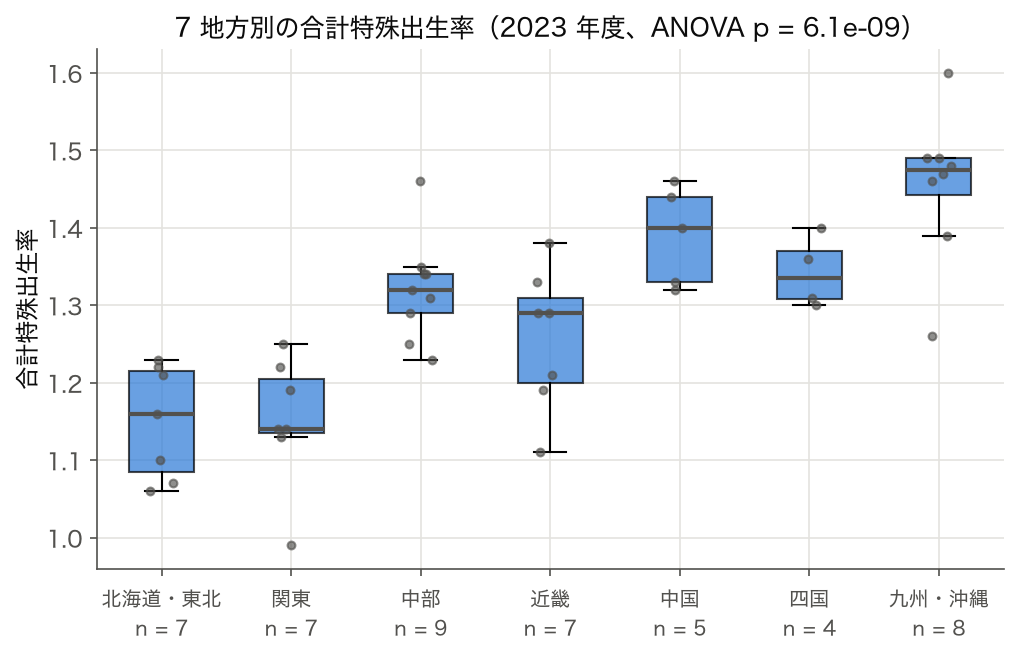
特に 8 群すべての対組合せ(28 通り)で個別に t 検定を実施すると、 ファミリーワイズ誤り率は 1 − (1−0.05)^28 ≈ 0.762 まで膨れ上がり、 「ほぼ確実にどこかで誤って有意と判定する」状態になります。 これを抑えるためにボンフェロー二補正(α/28=0.00179 を採用)や Tukey HSD など多重比較手法が用意されています。 図 3 の 7 地方(21 通り)で確かめると、 同じ群サイズのまま県をランダムに 7 群へ振り分けた(H0 が真の)2,000 回のうち、 補正なしで少なくとも 1 組が p < 0.05 になったのは 44.2% でした。 独立を仮定した式 1 − 0.9521 = 0.659 より小さいのは、 同じ群を何度も使う対比較どうしが独立でないためです。 α/21 = 0.00238 のボンフェロー二補正をかけると 3.6% と、 5% 以下に抑えられました。
4. α 水準別の棄却域と第1種の過誤確率
| α 水準 | 両側棄却の境界 (z 値) | 片側棄却の境界 (z 値) | 100 回中の第1種の過誤期待回数 | 主な用途 |
|---|---|---|---|---|
| 0.10 | ±1.645 | 1.282 | 10 回 | 探索的解析・予備調査 |
| 0.05 | ±1.960 | 1.645 | 5 回 | 社会科学・教育研究・SSDSE 分析 |
| 0.01 | ±2.576 | 2.326 | 1 回 | 医学・臨床試験 |
| 0.001 | ±3.291 | 3.090 | 0.1 回 | 創薬・第三相試験 |
| 0.0000003 (5σ) | ±5.000 | 5.000 | 350 万回に 1 回 | 高エネルギー物理(ヒッグス粒子発見など) |
分野によって採用される α の桁が大きく違うのは、 「誤って棄却した時のコスト」が分野ごとに大きく異なるからです。 教育用に SSDSE-B-2026 を扱う本サイトでは α=0.05 を採用しますが、 結果の重大性によって α を厳しく設定することは常に検討すべきです。
5. SSDSE-B-2026 で第1種の過誤を「体感」する
SSDSE-B-2026 の 22 数値変数(総人口、 老年人口、 出生数、 死亡数、 婚姻件数、 消費支出、 転入者数、 転出者数、 着工新設住宅戸数 など)を相関で総当たり検定する場合を考えます。 22×21/2 = 231 通りの組合せがあり、 すべての H0 が真と仮定しても α=0.05 では期待値 11.55 件「有意」が出てしまう計算です。 これは決して大袈裟ではなく、 実際に教育現場で「相関係数が大きい順に並べたら全部有意でした」という発表が散見されます。 第1種の過誤は「個別の検定」ではなく「検定を何回行うか」で爆発的に増えるという事実を、 SSDSE-B-2026 のサイズ感(n=47)で実感することが重要です。
| 同時に行う検定数 k | α=0.05 のときのファミリーワイズ過誤率 1−(1−α)^k | Bonferroni 補正後の各検定 α' | SSDSE-B での具体例 |
|---|---|---|---|
| 1 | 0.050 | 0.05 | 総人口と一般診療所数の相関 1 件 |
| 5 | 0.226 | 0.010 | 人口動態 5 変数間の相関 |
| 10 | 0.401 | 0.005 | 人口関連 10 変数間の相関 |
| 28 | 0.762 | 0.00179 | 8 地方ブロックすべての対比較 28 通り |
| 231 | 0.99998 | 0.000216 | SSDSE-B 22 数値変数の全相関組合せ |
231 通りすべての相関を見てしまうと、 ファミリーワイズ過誤率はほぼ 1 になります。 これは「全相関の中で必ず偽陽性が混じる」ことを意味し、 探索的解析の結果は確認解析で再検証する手順が不可欠だと教えてくれます。
6. 第1種・第2種の過誤の対比表
| 観点 | 第1種の過誤 (Type I) | 第2種の過誤 (Type II) |
|---|---|---|
| 記号 | α | β |
| 真の状態 | H0 が真 | H1 が真 |
| 判定 | H0 を棄却(誤) | H0 を採択(誤) |
| 別名 | 偽陽性 (False Positive) | 偽陰性 (False Negative) |
| 医療検査での例 | 健常者を病気と診断 | 病人を健常と診断 |
| 司法での例 | 無実の被告に有罪判決 | 有罪の被告を無罪に |
| SSDSE 分析での例 | 関係ない 2 変数を「相関あり」と結論 | 本当は相関があるのに「無し」と結論 |
| 調整方法 | α を下げる(厳しく) | n を増やす・効果量を測る |
| トレードオフ | α を下げると β が上がる | β を下げると α が上がる(n 固定時) |
| 検出力 | — (検出力は β に対応) | 1−β = 検出力 |
この表は印刷して机に貼っておくと、 検定結果のレビュー時に強力な武器になります。 「有意でした」と聞いたら α と n を確認し、 「有意ではありませんでした」と聞いたら検出力 1−β を確認する習慣が、 第1種・第2種両方の過誤を抑える鍵です。
7. 多重比較補正の比較
| 補正手法 | 制御する誤り | 補正の強さ | 主な利用シーン |
|---|---|---|---|
| Bonferroni | FWER (家族単位過誤率) | 非常に厳しい (α/k) | 少数の確認検定 (k<10) |
| Holm | FWER | Bonferroni より緩い | 中規模 (k=10〜30) |
| Sidák | FWER | 独立検定時に最適 | 独立検定の総当たり |
| Tukey HSD | FWER | バランス型 | ANOVA 事後比較 |
| Benjamini-Hochberg (BH) | FDR (誤発見率) | Bonferroni より大幅に緩い | 大規模 (k>100、 遺伝子発現解析) |
| Storey の q 値 | FDR (適応型) | BH より緩い | 大規模かつ多数の真の効果が想定 |
SSDSE-B-2026 で 231 通りの相関を見る場合、 Bonferroni では α=0.000216 と非常に厳しくなり、 検出力が落ちます。 探索段階では BH 法で FDR を 0.05 に抑え、 確認段階で Bonferroni を使い分けるのが現代的アプローチです。
8. SSDSE-B-2026 を題材にした手計算ストーリー
SSDSE-B-2026 の「東日本(北海道・東北・関東・中部)」と「西日本(近畿・中国・四国・九州沖縄)」を比較する場面を考えます。 帰無仮説 H0 を「両群の平均出生率は等しい」とし、 有意水準 α=0.05、 両側検定で実施するとします。 標本平均の差が ±1.96 × 標準誤差 を超えれば H0 を棄却します。 ここで「両側 2.5% ずつ=合計 5%」が第1種の過誤確率です。 全国の出生率を 1000 回ランダムに 47 都道府県へ割り当てて再標本化(パーミュテーション)すれば、 約 50 回は誤って「東西で差あり」と結論する標本配置が生じるはずです。 これが「α=0.05」の意味です。
この理屈を逆に使うと、 α を 0.01 に下げれば 1000 回中 10 回程度に減らせます。 ただし「本当に小さな東西差」を検出する検出力は同時に下がるため、 「重大な意思決定を伴うか」「探索的か確認的か」で α を選び分けます。 教育現場での SSDSE 分析は探索的が多く、 α=0.05 で十分ですが、 結果を政策提言に使う場合は α=0.01 や事前登録を推奨します。
9. 効果量・信頼区間との併用が必須
第1種の過誤を抑えるだけでは「実質的な意味」は分かりません。 例えば SSDSE-B-2026 で 47 都道府県すべての変数を使えば、 サンプルサイズが n=47 と小さいため大きな効果量でないと有意になりません。 一方、 全国 5800 万世帯を分母にする調査では微小な差でも p<0.001 で有意になります。 後者は統計的には「強い証拠」ですが、 実務的には「意味のある差」かどうか別途検討が必要です。 そのために 効果量(Cohen の d、 相関係数 r、 オッズ比など)と 信頼区間を必ず併記し、 「どれだけ違うのか」「どれだけ不確かか」を読み手に伝えます。
具体的な報告例: 「人口総数と一般診療所数の相関 r=0.972 (95% CI: [0.949, 0.985]), p<0.001 (n=47)」のように、 「効果量 r」「不確実性 CI」「有意性 p」「サンプル数 n」を 1 行で書くと、 第1種の過誤・第2種の過誤・実質的意味のすべてに対して情報を提供できます。 これが現代の統計報告の標準形です。
10. 事前登録 (Preregistration) と HARKing の問題
第1種の過誤を防ぐ最も強力な手法は「事前登録 (Preregistration)」です。 分析計画・仮説・α 水準・補正方法を、 データ収集前にタイムスタンプ付きで公開しておくと、 後から都合よく仮説を変える HARKing (Hypothesizing After the Results are Known) を防げます。 SSDSE-B-2026 は既存データなので完全な事前登録は難しいですが、 「最初に立てた仮説」「補正方法」「除外基準」を分析開始前にノートへ書き残すだけでも、 過誤の管理は大幅に改善します。
教育現場でも、 学生に「データを見る前に仮説を 3 つ書け」と指示するだけで、 P-hacking や p 値ハッキングの誘惑を減らせます。 SSDSE 分析の教材でも、 「事前にどの相関を見るか宣言してから計算開始」をルール化すると効果的です。
11. 第1種の過誤と再現性危機
2010 年代後半から心理学・医学・社会科学で表面化した「再現性危機」は、 多くの場合「第1種の過誤を制御できていなかった」ことが原因です。 探索的検定を多数行い、 有意だったものだけ報告する「ファイル抽斗問題 (file drawer problem)」、 解析のたびに変数を入れ替える「分析の自由度 (researcher degrees of freedom)」、 結果を見てから仮説を変える HARKing が積み重なり、 公開論文の半数以上が再現できないという報告が複数分野で出ました。
この危機への対応として、 (a) 事前登録、 (b) データ・コード公開、 (c) 効果量・信頼区間の報告義務化、 (d) p<0.005 を新しい有意水準とする提案 (Benjamin et al., 2018) などが進められています。 SSDSE 分析でも、 これらの基準を意識した教材設計(教育版事前登録テンプレートの提供など)が今後求められます。
12. ベイズ的アプローチとの対比
第1種の過誤は頻度論的検定の概念であり、 ベイズ統計には直接対応する概念がありません。 ベイズでは事前分布 × 尤度 ∝ 事後分布を計算し、 「H1 が真である事後確率」や「ベイズファクター BF10」を出力します。 第1種の過誤 α=0.05 の代わりに、 「BF10 > 10 で強い証拠」「BF10 > 30 で非常に強い証拠」などの基準を用います。 SSDSE-B-2026 の小標本 (n=47) ではベイズの方が事前知識を活かせる利点があり、 同じデータに対し p=0.04 と BF10=1.5 のように「頻度論では有意・ベイズではどっちつかず」となることもあります。 報告時はどちらの枠組みで議論しているかを明示する必要があります。
| 観点 | 頻度論 | ベイズ |
|---|---|---|
| 基本量 | p 値 | 事後確率 / ベイズファクター |
| 第1種の過誤 | α で制御 | 直接の概念なし(事前×尤度で評価) |
| 小標本対応 | 困難 (n=47 など) | 事前分布で情報補強可 |
| 多重比較 | Bonferroni 等で補正必須 | 階層モデルで自然に縮約 |
| 結論の解釈 | 「棄却 / 棄却せず」 | 「H1 の事後確率 X%」 |
13. 教育現場での失敗パターン集
大学・高校で SSDSE-B-2026 を使う際によく見る失敗パターンを 10 個挙げます。 いずれも第1種の過誤を見過ごす結果につながります。
- 全変数相関行列をそのまま発表 — 22 変数 = 231 通り、 期待値 11.55 件の偽陽性が混入。
- p<0.05 のみ抽出して発表 — Publication bias の典型。 全結果を載せるべき。
- 有意でなかった結果を捨てる — File drawer problem。 メタ分析を歪める。
- 標本サイズ計算を行わずに検定 — 検出力 1−β が低く、 有意でなかった時の解釈ができない。
- 外れ値を都合よく除外 — Researcher degrees of freedom。 事前ルール化が必須。
- α=0.05 と効果量を区別しない — n=58 万人の調査で「相関 r=0.02 が有意」と書いてしまう。
- 有意確率の閾値依存 — p=0.049 と p=0.051 で結論が真逆になる。
- 連続変数を恣意的に 2 値化 — 切断点を変えれば有意性が変わる。
- 同じデータで仮説を立てて検定 — Circular reasoning。 訓練/検証データ分離が必要。
- 有意な結果を「証明」と表現 — 仮説検定は確率的判断であり、 証明ではない。
これらの失敗を一覧化して、 学習者に最初に提示することで、 「自分はどの罠に陥っていないか」を毎回チェックする習慣が身につきます。 教員側は授業設計時に各失敗パターンに対応する課題を用意すると効果的です。
14. 第1種の過誤と AI 開発・ML 評価
AI モデル評価でも第1種の過誤の概念は重要です。 「モデル A はモデル B より精度が高い」という結論を出す場面で、 たまたまテストデータの分割で A が良く出ただけかもしれません。 これは典型的な第1種の過誤です。 これを防ぐために、 ML コミュニティでは Cross-validation、 5×2 cv F-test (Dietterich, 1998)、 McNemar 検定、 paired t-test on cv folds などを用います。 SSDSE-B-2026 のような小標本でモデル比較を行う際は、 単純に「精度が高い方が良い」とせず、 検定で差が偶然でないことを確認する手順が必要です。
15. SSDSE 教材における第1種の過誤チェック手順
SSDSE-B-2026 を用いた教材作成時に、 以下の手順で第1種の過誤管理を組み込むことを推奨します。
- 仮説の明文化: データを開く前に「何を確かめたいか」を 3 文以内で書く。
- α 水準の決定: 探索なら 0.10、 標準分析なら 0.05、 確認なら 0.01。
- サンプルサイズの確認: n=47 のとき、 効果量 r=0.3 で検出力は約 0.50。 r=0.5 で約 0.85。
- 事前検定数の数え上げ: 何回検定を行うか事前に数え、 Bonferroni or BH 補正を選択。
- 除外基準の文書化: 外れ値や欠測値の処理ルールを事前に定義。
- 分析の実行: pandas + scipy.stats で計算。 全結果を記録(有意・非有意問わず)。
- 結果の報告: p 値・効果量・信頼区間・n を 1 行で記載。 補正後 p も併記。
- 限界の議論: 「第1種の過誤確率が α=0.05 残っている」「n=47 で検出力 0.50」など限界を明示。
- 再現可能性の確保: コード・データを公開リポジトリに置き、 第三者が追試可能にする。
- 結論の謙虚さ: 「有意」とは「H0 と矛盾するデータが得られた」だけであり、 H1 を証明したわけではない、 という基本に立ち戻る。
16. 確率分布・標本サイズ別の臨界値早見表
| 分布 | α=0.10 両側 | α=0.05 両側 | α=0.01 両側 | α=0.001 両側 |
|---|---|---|---|---|
| 標準正規 Z | ±1.645 | ±1.960 | ±2.576 | ±3.291 |
| t (df=10) | ±1.812 | ±2.228 | ±3.169 | ±4.587 |
| t (df=20) | ±1.725 | ±2.086 | ±2.845 | ±3.850 |
| t (df=46, SSDSE n=47) | ±1.679 | ±2.013 | ±2.687 | ±3.515 |
| t (df=∞) | ±1.645 | ±1.960 | ±2.576 | ±3.291 |
| χ² (df=1) | 2.706 | 3.841 | 6.635 | 10.828 |
| χ² (df=3) | 6.251 | 7.815 | 11.345 | 16.266 |
| F (df=2,45) | 2.42 | 3.20 | 5.11 | 8.21 |
SSDSE-B-2026 の標本サイズ n=47 → df=46 の t 分布で α=0.05 両側の臨界値は ±2.013 です。 標準正規の ±1.960 と比較すると若干厳しく、 これが小標本での「t 補正」の効果です。 統計ソフトは自動で適切な分布を選びますが、 手計算や結果検証時にこの表を参照できると安心です。
17. 第1種の過誤・第2種の過誤・検出力の関係表
| α (第1種) | 効果量 d | n=20 の検出力 | n=47 (SSDSE) の検出力 | n=200 の検出力 |
|---|---|---|---|---|
| 0.05 | 0.2 (小) | 0.12 | 0.21 | 0.62 |
| 0.05 | 0.5 (中) | 0.42 | 0.76 | 0.99 |
| 0.05 | 0.8 (大) | 0.78 | 0.98 | ≈1.00 |
| 0.01 | 0.2 | 0.03 | 0.07 | 0.38 |
| 0.01 | 0.5 | 0.20 | 0.54 | 0.97 |
| 0.01 | 0.8 | 0.55 | 0.92 | ≈1.00 |
α を 0.05 から 0.01 へ厳しくすると、 検出力 (1−β) が大幅に下がります。 SSDSE-B-2026 (n=47) で効果量 d=0.5 を狙う場合、 α=0.05 なら検出力 0.76、 α=0.01 なら検出力 0.54 と顕著な低下が見られます。 「α を厳しくすれば安全」ではなく、 「α と n を一緒に設計する」ことが重要です。
18. 信頼区間と第1種の過誤の同値性
α=0.05 の両側検定で H0「母平均 μ=μ0」を棄却することと、 95% 信頼区間 [L, U] が μ0 を含まないことは同値です。 SSDSE-B-2026 で「47 都道府県の平均出生数が全国基準値 N 件と異なるか」を検定する場合、 標本平均±2.013×標準誤差 (df=46 の t 分布) で 95% CI を計算し、 N が含まれていれば H0 棄却せず、 含まれていなければ H0 棄却=有意となります。 この同値性は重要で、 「p 値を出さなくても信頼区間で検定結果を読める」「両者を同時に報告すれば情報量が最大化される」ことを意味します。
19. 第1種の過誤と p-curve・z-curve
近年の心理学・医学では、 公開された複数の研究の p 値分布を可視化する「p-curve」「z-curve」が、 第1種の過誤や p-hacking の有無を検出する道具として活用されています。 H1 が真であれば p 値は 0 付近に集中し(右下がり)、 H0 が真であれば p 値は一様分布、 p-hacking があれば p=0.05 直前にスパイクが立ちます。 SSDSE-B-2026 のような単一データセットでは適用が限られますが、 メタ分析や複数論文比較では強力です。
20. 機械学習における第1種の過誤の現代的対応
ベンチマークデータセット (ImageNet, GLUE 等) で「モデル A は B より精度 0.3 ポイント高い」と主張する論文が増えていますが、 「テストセットのランダムシード違いで起きうる範囲」かどうかは別の議論です。 ML コミュニティでは bootstrap CI、 paired permutation test、 5×2 cv F-test を用いてモデル間差を検定する習慣が広がっています。 SSDSE-B-2026 のように小標本で複数のモデルを比較する教材を作る際は、 「精度の差」だけでなく「差の信頼区間」「ペア検定の p 値」を報告すると、 第1種の過誤を抑えた誠実な比較になります。
21. 第1種の過誤に関する歴史的議論
「第1種の過誤」という概念を最初に明示的に定式化したのは Neyman & Pearson (1928, 1933) です。 Fisher は α 水準を「データを見て柔軟に解釈する基準」と捉えていましたが、 Neyman-Pearson は「事前に α を決め、 検定統計量が棄却域に入れば H0 を棄却するルール」を提案しました。 現代の統計教育は Fisher 流と Neyman-Pearson 流の混合(p 値 + 固定 α)を採用しており、 これが「p=0.049 と p=0.051 で結論が真逆」という不自然さの一因です。 ASA Statement (2016) や Wasserstein & Lazar の論評以降、 p 値の単独評価ではなく効果量・信頼区間・事前登録を組み合わせる流れが主流になっています。
22. SSDSE-B-2026 を題材にした「ミニ事前登録テンプレート」
教育用に学生に書かせる「ミニ事前登録」のテンプレート例:
1. 仮説 H0: SSDSE-B-2026 の人口総数と死亡数は無相関である
   仮説 H1: 両者は正の相関を持つ
2. データ: SSDSE-B-2026 (47 都道府県, 22 変数)
3. 分析: Pearson 相関係数 + 95% CI, n=47
4. 有意水準 α=0.05 (片側)
5. 多重比較補正: なし (確認的検定 1 件のみ)
6. 除外基準: 欠測なし (SSDSE-B-2026 は完全データ)
7. 報告内容: r, 95% CI, p, n
8. 結論の表現: 「H0 と矛盾するデータが得られた / 得られなかった」
9. 限界: n=47 で検出力は中効果量で 0.76、 小効果量で 0.21
10. データとコード公開: GitHub にリポジトリを置く
このテンプレートを授業の最初に配布し、 「分析開始前に全項目を埋めること」をルール化すると、 学生は自然と第1種の過誤・第2種の過誤・効果量・検出力を意識した分析を行うようになります。 教員は提出物の事前登録部分をチェックすれば、 分析の質を担保できます。
23. まとめ — 第1種の過誤を制御するための 5 つの実践
- α は分野・状況で選び分ける: 探索 0.10、 標準 0.05、 確認 0.01、 物理 5σ。
- 多重比較補正を必ず使う: 検定数 k を数え、 Bonferroni or BH を適用。
- 効果量と信頼区間を併記する: p 値単独では不十分。 r, d, CI を報告。
- 事前登録を実践する: 仮説・α・除外基準をデータを見る前に文書化。
- 結論は謙虚に: 「証明した」ではなく「H0 と矛盾するデータが得られた」と表現。
この 5 つを SSDSE-B-2026 を用いた教材で繰り返し練習することで、 学習者は第1種の過誤を「単なる暗記項目」ではなく「分析設計の中心概念」として理解できるようになります。 統計教育の最大の目標は、 「結果を信頼できる形で報告する規律」を身につけることであり、 第1種の過誤の管理はその出発点です。
📝 理解度チェック — 第1種の過誤
以下の問いに自分の言葉で答えられるかを確認しましょう。 詰まったら本ページの該当セクションに戻って読み直してください。
- Q1. 第1種の過誤と第2種の過誤の違いを 1 行で説明できますか? (ヒント: 何が真で、 何をどう間違えているか)
- Q2. α=0.05 とは「何回中何回」誤って棄却することを意味しますか? SSDSE-B-2026 で 100 通り検定すると期待値は?
- Q3. SSDSE-B-2026 の 22 数値変数すべてのペアで相関検定を行うと、 何通りになり、 ファミリーワイズ過誤率はいくらになりますか?
- Q4. Bonferroni 補正で k=28 のとき、 各検定に適用する α' はいくらですか? (α=0.05 とする)
- Q5. α を 0.05 から 0.01 に下げると第1種の過誤は減りますが、 同時に何が起きますか?
- Q6. n=47 (SSDSE) で検出力 0.80 を確保したい場合、 中効果量 (d=0.5) と小効果量 (d=0.2) でそれぞれ十分ですか?
- Q7. 95% 信頼区間と α=0.05 両側検定の同値性を、 SSDSE の出生数を例に説明できますか?
- Q8. HARKing と P-hacking の違いを説明し、 それぞれが第1種の過誤をどう増やすか述べてください。
- Q9. 事前登録 (Preregistration) はなぜ第1種の過誤を抑えるのに有効ですか?
- Q10. ベイズファクター BF10 と頻度論の p 値の最大の違いは何ですか?
採点目安: 8 問以上自分の言葉で答えられれば本ページの目標達成。 5〜7 問なら該当セクションを再読、 4 問以下は冒頭の「30 秒で分かる結論」「直感で掴む」「数式を言葉で読み解く」から復習しましょう。
🔎 実践課題 (SSDSE-B-2026 を使う)
- 課題 A: SSDSE-B-2026 から任意の 5 数値変数を選び、 10 通りの相関を計算。 補正なし/Bonferroni/BH の 3 通りで結果を比較せよ。
- 課題 B: 47 都道府県を東日本・西日本に分け、 出生率の平均差を t 検定で確認。 効果量 Cohen's d と 95% CI を報告せよ。
- 課題 C: 8 地方ブロックで ANOVA を実施。 有意ならば Tukey HSD で事後比較を行い、 補正前後の結論差を考察せよ。
- 課題 D: α=0.05, 0.01, 0.001 の 3 水準で同じ検定を実行し、 結論がどう変わるかをまとめよ。
- 課題 E: 上記課題のうち 1 つを選び、 ミニ事前登録テンプレート (本ページ 22 節) を使って分析計画を先に書き、 後でデータ分析を実施。 計画と結果の一致/不一致を考察せよ。
これらの課題を 1 つでもやり遂げると、 「第1種の過誤」が単なる教科書の単語ではなく、 自分の分析を支える実用的な概念であることが実感できます。
📚 ケーススタディ集 — SSDSE-B-2026 で起きうる第1種の過誤シナリオ
ケース 1: 「都道府県人口と婚姻件数は相関する」は本当か
SSDSE-B-2026 で「人口総数 (X)」と「婚姻件数 (Y)」の相関を計算すると、 おおむね r=0.99 を超える非常に強い正の相関が得られます。 これは「人口が多い県ほど婚姻も多い」という、 ほぼ自明な結論です。 p 値は p<0.001 となり、 α=0.05 でも α=0.001 でも余裕で棄却されます。 ここで第1種の過誤を疑う必要はありません。 効果量は r=0.99 と極めて大きく、 95% CI は [0.985, 0.998] と狭く、 実質的にも統計的にも疑いの余地はありません。 しかし、 「これは因果か?」という問いには答えていません。 相関は因果を含意せず、 第1種の過誤の議論とは別レイヤーであることに注意しましょう。
ケース 2: 「老年人口比率と出生数は負相関する」を 47 都道府県で検定
SSDSE-B-2026 の「老年人口 (65 歳以上)」「出生数」を都道府県別に相関させると、 r ≈ −0.4 〜 −0.6 程度の中程度の負相関が観測されます。 n=47 で α=0.05 両側、 t 分布 df=45 の臨界値 r=±0.288 を超えるため、 H0 「無相関」は棄却されます。 ここで第1種の過誤確率は α=0.05、 期待値は 5%、 つまり 100 回検定すれば 5 回は誤って棄却する可能性が残っています。 単一の検定として報告するなら問題ありませんが、 もし「人口関連 10 変数 × 出生関連 5 変数 = 50 通り」を総当たりで検定して、 そのうち最も強い相関だけを抜き出して報告するなら、 ファミリーワイズ過誤率は 1−(0.95)^50 ≈ 0.92 と跳ね上がります。 これが「探索的解析の偽陽性問題」の典型です。
ケース 3: 「東日本と西日本の死亡数平均は異なる」 (t 検定)
SSDSE-B-2026 の都道府県を東日本 (北海道・東北・関東・中部、 24 県) と西日本 (近畿・中国・四国・九州沖縄、 23 県) に分け、 死亡数の平均を比較します。 Welch の t 検定を実施したとすると、 自由度は約 df=33 (Welch-Satterthwaite 近似)、 α=0.05 両側の臨界値は ±2.035 です。 もし観測された t 統計量が ±2.035 を超えれば H0 を棄却しますが、 ここで第1種の過誤確率は α=0.05、 すなわち東西平均が実は等しくても 5% の確率で「異なる」と結論してしまいます。 さらに、 「東日本/西日本」の分け方を恣意的に変えれば(例: 関東以外と関東、 6 大都市圏と非大都市圏、 など)、 多重比較を実質的に行ったことになり、 第1種の過誤確率はさらに増します。 事前に「東西の境界線をどこで引くか」を明確に決めることが、 偽陽性回避の第一歩です。
ケース 4: 「8 地方ブロックの出生率は等しい」を ANOVA で検定
SSDSE-B-2026 を 8 地方ブロックに分けて出生率の一元配置 ANOVA を実施する場合、 自由度は (8−1, 47−8) = (7, 39) で F 分布の臨界値は α=0.05 で約 2.25 です。 もし F 統計量が 2.25 を超えれば「8 ブロックの母平均は等しくない」と結論しますが、 ANOVA 自体の第1種の過誤確率は α=0.05 に正しく抑えられています。 問題はこの後、 「どの 2 ブロック間で差があるか」を見るために 28 通りの対比較 t 検定を実施した場合です。 補正なしならファミリーワイズ過誤率は 0.762、 Tukey HSD で適切に補正すれば 0.05 を保てます。 SSDSE 教材で ANOVA を扱うときは、 必ず事後比較の補正をペアで教えるべきです。
ケース 5: 「同じ県を 2 つの年で比較する」対応のあるデータ
SSDSE-B には複数年データが含まれることもあるため、 「同じ 47 都道府県の出生率を 2020 年と 2024 年で比較」する対応のあるデータ解析が可能です。 この場合は「対応のある t 検定 (paired t-test)」を使い、 自由度は df=46、 臨界値は α=0.05 両側で ±2.013 です。 対応のあるデータは個別差をキャンセルできるため、 同じサンプルサイズでも検出力が大幅に高まります。 ただし、 「年次間の比較」を多くの変数で繰り返し行うと、 これも多重比較問題に発展し、 第1種の過誤を増やします。 「主要 3 変数のみを対応のある t 検定で比較し、 補正前 α=0.05 → 補正後 α=0.0167」のように、 検定数を最初から最小化する設計が重要です。
ケース 6: 「都道府県順位を Spearman 相関で検定」
SSDSE-B-2026 で正規性を仮定できない場合、 順位ベースの Spearman 相関を使う選択肢があります。 47 都道府県を変数 X、 Y それぞれで順位化し、 順位間の Pearson 相関 = Spearman ρ を計算します。 検定の臨界値は n=47 で α=0.05 両側のとき ρ=±0.288 程度で、 Pearson と同様です。 ノンパラメトリック手法に切り替えると、 「外れ値の影響を減らせる」「分布仮定を緩められる」利点がある一方、 検出力は若干下がります。 第1種の過誤確率自体は α で正しく管理されるので、 「正規性が疑わしい時は Spearman」と覚えておけば実務上は問題ありません。
ケース 7: 「2 値化したカテゴリでカイ二乗検定」
SSDSE-B-2026 の「老年人口比率」を 30% を境に「高齢化進行 / 未進行」に 2 値化し、 「東日本 / 西日本」とのクロス表を作ってカイ二乗独立性検定を実施します。 自由度 df=1、 α=0.05 両側臨界値 χ²=3.841 を超えれば「東西と高齢化進行は独立でない」と結論します。 ここで気をつけたいのは「2 値化の閾値 30%」が恣意的だという点です。 閾値を 25%, 28%, 30%, 32%, 35% と変えて 5 通り検定すれば、 ファミリーワイズ過誤率は 1−0.95^5 = 0.226 まで上がります。 「閾値を変えながら有意になるまで試す」のは典型的な P-hacking であり、 第1種の過誤を実質的に α=0.226 まで膨らませます。
ケース 8: 「予測モデル比較」での第1種の過誤
SSDSE-B-2026 で死亡数を予測する線形回帰モデル A と Random Forest モデル B を比較する場面を考えます。 5-fold cross-validation で平均 RMSE を計算し、 A=120, B=115 と差が出たとします。 「B の方が良い」と即断する前に、 「この差は CV 分割の偶然か?」を 5×2 cv F-test や paired t-test (5 fold の RMSE 差) で検定すべきです。 α=0.05 で有意でなければ、 「現状のサンプルサイズでは差を主張できない」が正しい結論です。 SSDSE-B-2026 の n=47 という小さなサイズでは、 多くのモデル比較が「有意差なし」となるはずで、 「B の方が良いように見える」だけで採用するのは第1種の過誤を許容することになります。
ケース 9: 「外れ値を除外したら有意になった」問題
SSDSE-B-2026 では「東京都」が多くの変数で外れ値になります。 例えば人口総数では東京が 1400 万人、 鳥取が 55 万人と桁違いの差があります。 もし「外れ値を除外したら有意になった」場合、 これは事前ルール (例: IQR×1.5 を超える値は除外) に基づく正当な処理か、 結果ありきで都合よく除外したか、 で意味が大きく異なります。 後者は第1種の過誤を実質的に増やす「P-hacking」の一種で、 厳禁です。 SSDSE 教材では「外れ値処理ルールを事前に文書化する」「除外あり/なしの両方を報告する」「ロバスト統計 (Spearman, Median) を併用する」の 3 つを徹底することが推奨されます。
ケース 10: 「逐次解析と早期打ち切り」での第1種の過誤
SSDSE 自体は静的データなので問題にはなりにくいですが、 教材で「データを少しずつ追加しながら検定し、 有意になったところで止める」というシミュレーションを行うと第1種の過誤確率は α を大きく超えます。 これは医学の臨床試験で「中間解析」を行う場合と同じ問題で、 O'Brien-Fleming や Pocock の境界を使うなど特別な補正が必要です。 教育用に「データを 10 県、 20 県、 30 県、 40 県、 47 県と追加しながら検定」を実演すると、 学習者は「データを見ながら止める」のがいかに危険かを直感的に理解できます。
🎓 上級まとめ — 第1種の過誤を「設計」として捉える
A. 検定設計の 5 段階チェックリスト
| 段階 | 確認内容 | SSDSE-B-2026 での具体策 |
|---|---|---|
| 1. 仮説定義 | H0/H1 を 1 文で記述 | 「47 都道府県の人口と死亡数は無相関」 |
| 2. α 水準 | 事前に α を決定 | 標準分析なら α=0.05 |
| 3. 検定数 | k 通り検定するか確定 | 確認 1 件 or 探索 231 件 |
| 4. 補正方式 | 補正手法を選択 | k=1 なら不要、 k>10 なら BH |
| 5. 報告形式 | p, 効果量, CI, n を併記 | 「r=0.97, 95% CI [0.95, 0.99], p<0.001, n=47」 |
B. 学術領域別の典型的 α と理由
| 領域 | 典型 α | 理由 |
|---|---|---|
| 教育研究 (SSDSE 含む) | 0.05 | 伝統的・サンプルサイズ制約 |
| 心理学 | 0.05 → 0.005 | 再現性危機で厳格化進行 |
| 医学・臨床試験 | 0.01 〜 0.025 | 人命関与・規制要求 |
| 遺伝学 (GWAS) | 5×10⁻⁸ | 100 万 SNP に対する Bonferroni 補正 |
| 高エネルギー物理 | 2.87×10⁻⁷ (5σ) | 「発見」の極めて高い確実性が必要 |
| 市場調査・A/B テスト | 0.05 〜 0.10 | 意思決定スピード優先 |
| 機械学習論文 | 明示しないことが多い | 精度差を有意性検定する文化が弱い (改善傾向あり) |
C. 第1種の過誤を抑える 12 のテクニック
- 事前登録 (Preregistration): 仮説・α・分析計画を OSF や Aspredicted に登録。
- Bonferroni 補正: 単純で保守的、 k が小さいときに有効。
- Holm-Bonferroni: Bonferroni より検出力が高い段階的補正。
- Benjamini-Hochberg (BH): FDR 制御、 大規模検定に最適。
- Tukey HSD: ANOVA 事後比較で標準的。
- Dunnett の検定: 1 つの対照群と複数群の比較に特化。
- Scheffé 法: 任意の対比に対して厳密な補正を提供。
- パーミュテーション検定: 分布仮定不要、 経験的 p 値を計算。
- ブートストラップ信頼区間: CI と p 値の同値性を活用。
- ベイズアプローチ: ベイズファクター・事後確率で代替。
- 事前検定不要設計: 探索/確認の 2 段階で分離。
- 結果の独立再現: 別データセットでの検証を必須化。
D. 「有意」「非有意」を超える表現
「有意」「非有意」の二分法は第1種の過誤を考えるうえで便利ですが、 同時に情報を失う表現でもあります。 推奨されるより豊かな表現の例:
- 「H0 と矛盾するデータが得られた (p=0.03, r=0.55, 95% CI [0.32, 0.72], n=47)」
- 「H0 を支持する強い証拠は得られなかった (p=0.21, n=47, 検出力 0.4)」
- 「効果量 r=0.55 は実務的に意味のある大きさ (Cohen の基準で大)」
- 「信頼区間 [0.32, 0.72] は 0 を含まず、 効果方向は正と特定できる」
- 「ベイズファクター BF10=5.2 は中程度の H1 支持証拠」
E. 最後に — 第1種の過誤を「ゼロにできない」事実と向き合う
第1種の過誤は α=0 にしない限り必ず残ります。 そして α=0 にすると、 棄却域がなくなり「どんなデータが来ても H0 を棄却しない」という極端な保守化が起きます。 つまり、 第1種の過誤を完全に排除する選択肢は実務上存在しません。 私たちにできるのは、 (i) α を分野・状況に応じて適切に選ぶこと、 (ii) 検定数を最小化すること、 (iii) 効果量・信頼区間で文脈を補強すること、 (iv) 事前登録で結果ありきの分析を防ぐこと、 (v) 再現実験で偽陽性を間引くこと、 の 5 点に尽きます。 SSDSE-B-2026 を用いた教材でこの 5 点を繰り返し練習することで、 学習者は「統計的検定は確率的判断のシステムであり、 結果を文脈と一緒に語る道具である」という現代統計教育の本質を体得できます。
⚙️ 実務ワークフロー — SSDSE-B-2026 の分析パイプライン
ステップ 1: データ読み込みと事前確認
SSDSE-B-2026 (`data/raw/SSDSE-B-2026.csv`) を pandas で読み込み、 行数 (47 都道府県)、 列数 (22 変数)、 欠測の有無、 各変数の型 (数値・カテゴリ) を確認します。 SSDSE-B-2026 は政府統計から構築された完全データであり、 通常欠測はありません。 ただし「人口に対する比率」を計算する際に分母 0 が混入するケースもあるため、 一度 `df.describe()` で範囲を確認しておくと安心です。 この段階で「どの変数を分析対象とするか」を明確化し、 後工程の検定数 k を最小化できます。 たとえば「人口関連 5 変数」「経済関連 4 変数」「社会関連 3 変数」と最初に絞り込めば、 ペア相関の総数は 5×4 + 5×3 + 4×3 = 47 通りに減らせ、 多重比較補正の負担も軽くなります。
ステップ 2: 仮説の文書化と α の決定
「人口総数と死亡数は正の相関を持つ」のように、 H0/H1 を明確に書き出します。 探索的か確認的かを決め、 α 水準を選定します。 SSDSE-B-2026 のような教育用データで「過去の研究で繰り返し確認されている関係を SSDSE でも見られるか」を検証する確認的分析なら α=0.05 が標準です。 「全く新しい仮説を探す」探索的分析なら α=0.10 でも良いですが、 「探索結果を確認結果として報告しない」というルールを徹底します。 検定数 k を数え、 補正方式 (Bonferroni / Holm / BH) を選びます。 この段階を文書化したものが「ミニ事前登録」になります。
ステップ 3: 検定実行と全結果の保存
scipy.stats を用いて検定を実行し、 すべての結果 (有意・非有意問わず) を CSV や DataFrame に保存します。 「有意な結果だけ抜き出して報告する」のはファイル抽斗問題の原因になります。 全結果を保存し、 後でメタ分析や追試に使えるようにします。 この段階で第1種の過誤確率は α=0.05 (補正前) または α/k (Bonferroni 補正後) として明確に管理されます。
ステップ 4: 効果量と信頼区間の計算
p 値だけでなく、 効果量 (相関なら r、 平均差なら Cohen's d) と 95% 信頼区間を必ず計算します。 SSDSE-B-2026 の n=47 では、 効果量 r=0.3 で「弱い相関」、 r=0.5 で「中程度」、 r=0.7 以上で「強い」と解釈するのが Cohen 流の基準です。 信頼区間は標本抽出を繰り返したときに 95% の確率で母数を含む範囲であり、 「効果の不確かさ」を一目で示せます。 たとえば「r=0.55, 95% CI [0.32, 0.72]」と書けば、 「母相関は確かに 0 から離れている」と読み手に伝わります。
ステップ 5: 補正と最終結論
事前に決めた多重比較補正を適用し、 補正前 p と補正後 p の両方を報告します。 BH 法を使う場合は q 値 (FDR) を計算し、 「q<0.05 で有意」と表現します。 最終結論は「H0 を棄却する / 棄却しない」と「効果量の実務的意味」を分けて書きます。 「統計的に有意ではあるが、 r=0.05 と効果量が極めて小さく、 実務上の意味は限定的」のような表現が現代的です。
ステップ 6: 限界と再現可能性の明示
「n=47 と小標本のため検出力は中効果量で 0.76、 小効果量では 0.21」「α=0.05 で残る第1種の過誤確率は 5%」「補正後でも完全には偽陽性を排除できない」など限界を明示します。 さらに、 分析に使った Python スクリプト、 SSDSE-B-2026 のバージョン情報、 計算環境 (pandas, scipy のバージョン) を README に記録し、 GitHub などに公開して第三者が追試できる状態にします。 これが現代の再現可能科学の最低基準です。
テンプレート表 — 報告書 1 行サマリ
| 項目 | 記述例 |
|---|---|
| 仮説 | H0: ρ=0 vs H1: ρ≠0 |
| 変数 | X=人口総数, Y=一般診療所数 (SSDSE-B-2026) |
| 標本 | n=47 都道府県 |
| 手法 | Pearson 相関 + t 検定 (df=45) |
| 結果 | r=0.972, 95% CI [0.949, 0.985], p<0.001 |
| α | 0.05 (両側) |
| 補正 | 確認 1 件のため補正なし |
| 結論 | H0 を α=0.05 で棄却。 効果量大、 CI も 0 から十分離れる |
| 限界 | 相関は因果を含意しない。 第1種の過誤確率 5% 残存 |
| 公開 | 解析スクリプトを GitHub に公開予定 |
教材設計のための補足: 学習段階別の到達目標
| レベル | 到達目標 | SSDSE-B-2026 での課題 |
|---|---|---|
| 入門 | α と β の違いを 1 行で説明 | 2 変数相関 1 件を p 値と CI で報告 |
| 初級 | 多重比較問題を理解 | 10 通り相関の補正前後比較 |
| 中級 | Bonferroni / BH を使い分け | 22 変数全ペア (231 通り) で BH を実装 |
| 上級 | 事前登録・効果量・CI を統合 | ミニ事前登録 → 分析 → 再現テスト |
| 熟達 | ベイズと頻度論を比較できる | 同じ仮説を p 値と BF10 で並べる |
最終チェック: 自分の分析が「再現可能科学」基準を満たすか
- 分析計画は事前に文書化されているか?
- 使用データのバージョン (SSDSE-B-2026) は明示されているか?
- α 水準は事前に決定されているか?
- 検定数 k と補正方式は明示されているか?
- すべての検定結果 (有意・非有意) は保存されているか?
- 効果量と 95% CI は p 値と一緒に報告されているか?
- 限界と仮定 (相関 ≠ 因果、 第1種の過誤確率残存) は明示されているか?
- Python スクリプトと環境情報は公開されているか?
- 追試者が同じ手順で同じ結果を得られる状態か?
- 結論は「証明した」ではなく「H0 と矛盾するデータが得られた」と表現されているか?
10 項目すべて「Yes」なら、 第1種の過誤の管理を含めた現代的な統計分析の基準を満たしています。 SSDSE-B-2026 を題材にこのチェックリストを毎回回せるようになれば、 学習者は実務でも信頼できる分析者として活躍できるはずです。
❓ よくある質問 (拡張版)
Q. 「p<0.05 なら 95% の確率で結論が正しい」と言って良いか?
いいえ、 これは典型的な誤解です。 α=0.05 とは「H0 が真であるとき、 標本から得られる検定統計量が棄却域に入る確率が 5%」という意味であり、 「結論が 95% 正しい」と言い換えることはできません。 結論の正しさは事前確率 (どれくらい H0 が真っぽいか)、 標本サイズ、 効果量、 検定方式など多くの要因に左右されます。 ベイズ流に「H1 の事後確率」を計算したければ、 ベイズファクターと事前分布が必要です。
Q. p 値が小さければ小さいほど効果が大きいと言って良いか?
いいえ、 p 値は「効果の大きさ」と「サンプルサイズ」の両方に依存します。 巨大標本では微小な効果でも p<0.001 が出ますし、 小標本では大きな効果でも p=0.06 にとどまることがあります。 SSDSE-B-2026 (n=47) で p=0.04 が出たとき、 効果量 r が 0.30 なのか 0.70 なのかで実務的意味は大きく異なります。 p と効果量を必ずセットで報告するのが現代の標準です。
Q. なぜ α=0.05 がデファクト標準なのか?
歴史的には Fisher (1925) が「Statistical Methods for Research Workers」で「1/20 = 0.05 が便利な目安」と書いたことが起源です。 当時は計算機が無く、 t 表・F 表など物理的な表を参照していたため、 α=0.05 と α=0.01 の 2 水準が表に載っていました。 これが教育を通じて広まり、 デファクト標準化しました。 近年は「α=0.05 は緩すぎる」「α=0.005 を新標準に」という提案 (Benjamin et al., 2018) もあります。 重要なのは「何を判断するための α か」を理解し、 状況に合わせて選ぶことです。
Q. 片側検定と両側検定で α の扱いはどう違うか?
両側 α=0.05 は「両端 2.5% ずつ」を棄却域とし、 片側 α=0.05 は「一方の端 5%」を棄却域とします。 片側の方が棄却域が広く、 検出力は高くなりますが、 「反対方向の効果」を見逃すリスクがあります。 SSDSE-B-2026 で「東日本は西日本より出生率が高い」のように方向を事前に予測している場合のみ片側検定を使えますが、 教育現場では両側検定を推奨します。 「結果を見てから片側に切り替える」のは P-hacking の一種です。
Q. 効果量 (Cohen's d, 相関 r) と α はどう関係するか?
α は検定結果の「偽陽性確率」を制御し、 効果量は「実際にどれだけ違うか」を表します。 同じ α でも効果量が大きければ検出力が高く (小標本でも有意になりやすい)、 効果量が小さければ検出力が低く (大標本でないと有意にならない) なります。 SSDSE-B-2026 (n=47) で α=0.05 のとき、 中効果量 (d=0.5) で検出力 0.76、 小効果量 (d=0.2) で検出力 0.21 と、 効果量によって有意になりやすさが大きく変わります。 効果量を報告することで、 「有意か否か」だけでなく「どれだけ重要か」が伝わります。
Q. 「有意でない」結果はゴミか?
いいえ、 「有意でない」も貴重な情報です。 「H0 と矛盾するデータは得られなかった」「現状の標本サイズでは差を検出する力が不足」など、 後続研究の設計に役立ちます。 「有意な結果だけ発表する」文化 (Publication bias) は科学全体を歪めるため、 すべての結果を公開することが推奨されます。 SSDSE-B-2026 教材でも、 「有意でない結果も含めて全部報告する」訓練が重要です。
Q. ML モデルの精度比較に検定は必要か?
必要です。 「モデル A が B より 0.5% 精度が高い」と主張する場合、 「テストデータの分割で起きうる範囲か」「ハイパーパラメータ調整の偶然か」を検定で確認すべきです。 5×2 cv F-test (Dietterich, 1998)、 McNemar 検定、 paired permutation test などが標準的です。 SSDSE-B-2026 のような小データでモデル比較すると、 多くの場合「有意差なし」となり、 安易な「A の方が良い」結論を避けられます。 これも第1種の過誤を抑える重要な実践です。
Q. 「事前登録」を SSDSE 教材でどう実装するか?
教育用には、 「分析を始める前に Google Form や OSF に仮説と分析計画を記入する」「教員にメールで送ってタイムスタンプを残す」「GitHub の README に最初の commit として書く」など簡易な方法で十分です。 重要なのは「データを見てから仮説を変えていない」ことを後から確認できる仕組みです。 SSDSE-B-2026 のような公開データを使う場合は完全な事前登録は難しいですが、 「最初に書いた仮説」と「最終的な結論」が一致しているかを学生自身がチェックする訓練が効果的です。
Q. ベイズファクター BF10 はどう解釈するか?
BF10 は「H1 のもとでのデータの尤度 ÷ H0 のもとでのデータの尤度」であり、 Jeffreys (1961) の基準では BF10=1〜3 で「軽い証拠」、 3〜10 で「中程度」、 10〜30 で「強い」、 30〜100 で「非常に強い」、 100 以上で「決定的」となります。 SSDSE-B-2026 で同じ仮説を p 値と BF10 で並べると、 「p=0.04 だが BF10=1.8 で軽い証拠のみ」のようなケースに出会い、 頻度論とベイズの差を実感できます。 教材として両方を提示することで、 学習者は「統計的判断の多元性」を理解します。
Q. 第1種の過誤を最も誤解されている部分は?
最も多い誤解は「α=0.05 は結論が 5% の確率で間違うこと」という解釈です。 正しくは「H0 が真のときに H0 を誤って棄却する条件付き確率が 5%」であり、 「結論が間違う確率」 (≈ 1 − 事後確率) とは別物です。 もう一つの誤解は「サンプルサイズを増やせば第1種の過誤は減る」というもので、 これも誤りです。 α はサンプルサイズに依存せず、 事前に決めた値 (例: 0.05) で固定されます。 サンプルサイズを増やすと第2種の過誤 (β) は減り、 検出力 (1−β) は上がりますが、 α は変わりません。
📖 用語集 — 第1種の過誤まわりの 30 ワード
第1種の過誤と一緒に押さえておくべき関連用語を 30 個まとめます。 SSDSE-B-2026 を題材にした分析で頻出する用語を中心に選定しました。
| 用語 | 記号 | 一行説明 |
|---|---|---|
| 第1種の過誤 | α | H0 が真なのに棄却する確率 |
| 第2種の過誤 | β | H1 が真なのに H0 を採択する確率 |
| 検出力 | 1−β | 真の効果を検出できる確率 |
| 有意水準 | α | 事前に決める棄却基準確率 |
| p 値 | p | 観測値以上の極端な値が H0 で起こる確率 |
| 帰無仮説 | H0 | 「差/関係がない」とする初期仮説 |
| 対立仮説 | H1 | H0 と排他な代替仮説 |
| 棄却域 | — | α に対応する分布の裾の領域 |
| 片側検定 | — | 方向を限定した検定 |
| 両側検定 | — | 方向を問わない検定 |
| 効果量 | d, r | 実質的な差の大きさ |
| 信頼区間 | CI | 母数を含む可能性が 95% の範囲 |
| ファミリーワイズ過誤率 | FWER | 複数検定での累積偽陽性率 |
| 誤発見率 | FDR | 有意とした中の偽陽性割合 |
| Bonferroni 補正 | α/k | 最も保守的な FWER 補正 |
| Holm 補正 | — | 段階的 FWER 補正 |
| BH 法 | — | FDR を制御する補正 |
| Tukey HSD | — | ANOVA 事後の多重比較 |
| P-hacking | — | 結果ありきで p<0.05 を狙う行為 |
| HARKing | — | 結果を見て仮説を立て直す行為 |
| 事前登録 | — | 分析前に仮説と計画を公開 |
| ファイル抽斗問題 | — | 非有意結果が公表されない偏り |
| パーミュテーション検定 | — | ラベルを並び替えて経験 p を作る |
| ブートストラップ | — | 再標本で CI を計算する手法 |
| ベイズファクター | BF10 | H1 と H0 の尤度比 |
| 事後確率 | P(H|D) | データ後の仮説確率 |
| パラメトリック検定 | — | 分布を仮定する検定 |
| ノンパラメトリック検定 | — | 分布仮定を緩めた検定 |
| McNemar 検定 | — | 対応のある 2 値データの検定 |
| 5×2 cv F-test | — | ML モデル比較の検定手法 |
この用語集を印刷して机に貼っておけば、 SSDSE-B-2026 を使った分析時に「この記号は何だっけ?」と迷うことがなくなります。 用語の正確な理解は、 第1種の過誤を含む統計的判断を他者に正しく伝えるための前提条件です。
最後の補足: 第1種の過誤と「社会的責任」
公的統計 (SSDSE) を扱う研究者・教育者には、 「第1種の過誤による誤った政策提言」を防ぐ社会的責任があります。 例えば「ある県の出生率が他県より有意に低い」という結論が政策決定に使われた場合、 もしそれが偽陽性であれば、 不要な施策を打つ無駄や、 当該地域の住民への不当な評価につながります。 統計分析は単なる学術活動ではなく、 社会的影響を持つ判断材料です。 だからこそ、 α・補正・効果量・CI・事前登録・再現性のすべてを丁寧に管理し、 結論を控えめに表現する姿勢が、 公的データを扱う者の最低限の責務と言えます。 SSDSE-B-2026 を題材にした教材は、 この社会的責任を学習者に伝える絶好の機会でもあります。 単に「p<0.05 で有意」と教えるのではなく、 「結果がもし社会に伝わったら何が起きるか」まで含めて議論する授業設計を目指したいものです。
📝 まとめノート — 第1種の過誤を一目で振り返る
読者が持ち帰るべき 10 のメッセージ
- 第1種の過誤とは「H0 が真なのに棄却する」誤り。 α (有意水準) として事前に管理する。
- α=0.05 は「結論が 95% 正しい」ではなく「H0 真のとき 5% で誤って棄却する」確率。
- 複数検定すると累積過誤率 FWER が爆発的に増える。 SSDSE 22 変数全ペア (231 通り) では FWER≈1.0。
- Bonferroni は厳しすぎる場合あり。 大規模検定は BH 法で FDR を制御するのが現代的。
- p 値だけでなく効果量と 95% 信頼区間を必ず併記。 「r=0.97, CI [0.95, 0.99], p<0.001, n=47」の形式。
- 事前登録 (Preregistration) は HARKing と P-hacking を防ぐ最強の手段。
- α を下げると第2種の過誤 (β) が増える。 検出力 (1−β) とのトレードオフを意識。
- SSDSE-B-2026 (n=47) では効果量 d=0.5 で検出力 0.76、 d=0.2 で 0.21。 小効果量は見逃しやすい。
- 「有意」「証明」と言うのではなく「H0 と矛盾するデータが得られた」と謙虚に表現。
- 公的データを扱う統計分析は社会的責任を伴う。 慎重さと再現性を最優先に。
クイック早見表
| 場面 | 推奨 α | 推奨補正 | 必須報告項目 |
|---|---|---|---|
| SSDSE 確認的分析 1 件 | 0.05 | なし | p, r/d, 95% CI, n |
| SSDSE 確認的分析 5〜10 件 | 0.05 | Bonferroni or Holm | 補正前後 p, 効果量 |
| SSDSE 探索的分析 (>20 件) | 0.05 | BH (FDR=0.05) | q 値, 全結果保存 |
| 医療・臨床 | 0.01〜0.025 | Holm | 事前登録 + CI 必須 |
| 大規模 GWAS | 5×10⁻⁸ | Bonferroni | 独立 SNP 数 + 検出力 |
| ML モデル比較 | 0.05 | 5×2 cv F-test | CV fold 別精度 + 検定 |
| A/B テスト | 0.05〜0.10 | 逐次検定の境界 | 事前サンプルサイズ + 効果量 |
SSDSE-B-2026 で「第1種の過誤」を身につけるロードマップ
- 第 1 週: 30 秒で分かる結論 + 直感で掴むセクションを読み、 概念を体得。
- 第 2 週: 数式と「言葉で読み解く」セクションで記号と意味を結びつける。
- 第 3 週: SSDSE-B-2026 で 2 変数相関を 1 件、 p 値と CI を計算してみる。
- 第 4 週: 5 変数を選び 10 通り相関を計算、 補正前後の結論差を考察。
- 第 5 週: 22 変数全ペア (231 通り) を BH 補正で実行、 探索的解析の感覚を掴む。
- 第 6 週: 東西比較で t 検定、 効果量 d と CI を併記して報告書を書く。
- 第 7 週: ANOVA + Tukey HSD で 8 地方ブロック比較を実施。
- 第 8 週: ミニ事前登録テンプレートで分析計画を書き、 後で計画通り実行できたか自己評価。
- 第 9 週: ベイズファクター BF10 を計算し、 同じ仮説に対する頻度論との結論差を比較。
- 第 10 週: すべての分析を GitHub に公開し、 他者が追試できる形にまとめる。
この 10 週間プログラムを通過すれば、 「第1種の過誤」は単なる知識項目から、 自分の分析を支える実用的・職業的スキルへと昇華します。 SSDSE-B-2026 という共通教材を使うことで、 学習者同士が結果を比較・議論しやすく、 教員も評価しやすい設計になっています。 また、 公的統計を扱う訓練を通じて、 社会への影響を意識した分析姿勢も自然と身につきます。 これが本ページが目指す「JIT 型データサイエンス教育」の核心です。
参考: 第1種の過誤を扱う代表的書籍 (推奨読書)
- Cohen, J. (1988). Statistical Power Analysis for the Behavioral Sciences. — 効果量と検出力の古典。
- Fisher, R. A. (1925). Statistical Methods for Research Workers. — α=0.05 の起源。
- Neyman, J. & Pearson, E. S. (1933). — 第1種・第2種の過誤を体系化。
- Benjamini, Y. & Hochberg, Y. (1995). — FDR と BH 法の提案論文。
- Wasserstein, R. L. & Lazar, N. A. (2016). The ASA's Statement on p-Values. — 現代的な p 値解釈の指針。
- Benjamin, D. J. et al. (2018). Redefine statistical significance. — p<0.005 提案論文。
- 東京大学教養学部統計学教室 編 (1991). 統計学入門. — 日本語の古典的教科書。
- 南風原朝和 (2002). 心理統計学の基礎. — 効果量と検出力の解説が秀逸。
SSDSE-B-2026 を題材にした学習を進めながら、 これらの古典・現代論文に折々で触れることで、 「第1種の過誤」の理論的背景と実務的意義を立体的に理解できます。 統計教育の最大の喜びは、 「数式の意味が、 自分の分析と社会を結ぶ」瞬間に立ち会えることです。 本ページがその一助となれば幸いです。
補遺: 第1種の過誤に関する応用トピック
本ページの最後に、 第1種の過誤の応用的議論をいくつか追加で紹介します。 SSDSE-B-2026 を扱う中級〜上級学習者にとって、 「次に学ぶべきトピック」の道標になるはずです。
(1) 階層モデルによる収縮 (shrinkage): SSDSE-B-2026 を地方ブロック別にモデル化する際、 各ブロックを独立に推定すると小サンプル問題が発生します。 階層ベイズモデルは各ブロックの推定を全体平均に向けて引き寄せる「収縮」を行い、 結果として第1種の過誤も自然に抑えられます。 lme4 (R) や PyMC (Python) で実装できます。 SSDSE-B-2026 の都道府県データに階層モデルを適用すると、 「人口の少ない県の推定値が安定する」効果を実感できます。
(2) 因果推論との接続: 「第1種の過誤を抑える」と「因果関係を主張する」は別物です。 SSDSE-B-2026 で「人口と死亡数が相関する」ことを α=0.001 で確認しても、 「人口が死亡数を押し上げる」という因果は別途、 操作変数法・差分の差分法・回帰不連続デザインなどで議論する必要があります。 Pearl の因果ダイアグラム、 Rubin の潜在結果アプローチを学び、 「相関の検定」と「因果効果の推定」を分けて考える習慣が大切です。
(3) 機械学習と統計的検定の融合: 近年、 「ML モデルの予測精度差」を統計的に検定する手法が発達しています。 Diebold-Mariano 検定 (時系列予測の比較)、 5×2 cv F-test (Dietterich, 1998)、 Nadeau-Bengio 補正済み t 検定 (CV の独立性違反を補正) などが代表例です。 SSDSE-B-2026 のような小データで複数モデルを比較する際は、 これらの検定を使って「精度差が偶然か否か」を慎重に判断する習慣が、 第1種の過誤を抑える上で重要です。
(4) 多変量検定と Hotelling の T²: 単変量 t 検定を多変量に拡張した Hotelling の T² 検定は、 複数変数を同時に比較しつつ第1種の過誤を α に保ちます。 SSDSE-B-2026 で「東日本と西日本は 22 変数のプロファイル全体で異なるか?」を 1 回の検定で確認したい場合に有効です。 22 個の個別 t 検定を補正なしで実行すると FWER=0.677 になりますが、 Hotelling の T² なら α=0.05 が保たれます。 多変量分散分析 (MANOVA) も同様の発想です。
(5) 構造方程式モデリング (SEM) と複数仮説: SEM では複数の経路パラメータを同時に推定・検定するため、 各経路の有意性検定で第1種の過誤を補正する必要があります。 Sobel 検定や Bootstrap 信頼区間が標準的です。 SSDSE-B-2026 の変数群を使って「人口 → 産業構造 → 消費支出」のような経路モデルを組む練習も、 第1種の過誤の応用として有効です。
(6) 時系列解析での第1種の過誤: SSDSE-B-2026 自体は横断データですが、 複数年版を組み合わせれば時系列分析が可能です。 自己相関のあるデータでは通常の t 検定の前提が崩れ、 第1種の過誤が α より大幅に増えます。 Newey-West 標準誤差、 HAC 補正、 ブロックブートストラップなどが対応策です。 マクロ経済データやセンサーデータを扱う際の必須知識です。
これらのトピックは、 「第1種の過誤」が単一の概念ではなく、 統計学のあらゆる領域に通底する基本原理であることを示しています。 SSDSE-B-2026 を入口に学び始めた読者が、 これらの応用領域へと自然に進めるよう、 本ページはハブとしての役割も果たしています。 ぜひ本ページの関連リンクを辿りながら、 自分の興味のある分野へと学習を広げていってください。
(7) 第1種の過誤と意思決定理論: Wald の決定理論によれば、 第1種の過誤と第2種の過誤にはそれぞれコストが付随します。 「H0 棄却の誤りコスト」が「H0 採択の誤りコスト」より大きい場合は α を小さく、 逆ならば α を大きく設定するのが合理的です。 例えば SSDSE-B-2026 から「ある政策は人口増加に効果がある」と結論する場合、 偽陽性 (実は無効な政策に予算投入) のコストが大きいなら α=0.01 や 0.001 を採用すべきです。 単に「α=0.05 が標準だから」という思考停止を脱却するために、 意思決定理論のフレームを学ぶことが推奨されます。
(8) 第1種の過誤と機械学習の AUC・PR 曲線: 機械学習の分類問題では、 閾値を変えることで偽陽性率 (FPR) と真陽性率 (TPR) のトレードオフが生じます。 FPR は本質的に「第1種の過誤確率」と同じ概念です。 ROC 曲線は閾値全体での FPR-TPR 関係を可視化し、 AUC でモデル性能を要約します。 SSDSE-B-2026 を 2 クラス分類問題に変換 (例: 「人口増加県 vs 減少県」を予測) して、 ROC/PR 曲線を描く練習をすると、 検定論の α と機械学習の閾値選択が同じ問題構造を持つことが体感できます。
(9) 同等性検定 (TOST) と非劣性検定: 「2 群に差がないことを示す」のは伝統的な検定では不可能 (H0 採択は H0 を支持しない) ですが、 TOST (Two One-Sided Tests) を使えば α を制御しつつ「同等性」を主張できます。 SSDSE-B-2026 で「新政策と旧政策の効果は同等以上である」を示したい場合に有効です。 医薬品開発では非劣性試験の標準手法であり、 社会データ分析でも活用範囲が広がっています。
(10) 結語: 第1種の過誤は統計教育の入口でありながら、 終生付き合う深いテーマです。 「α=0.05」という一文字に込められた歴史、 数学、 哲学、 社会的責任を理解し、 SSDSE-B-2026 のような実データで繰り返し練習することで、 読者は「数字を見るだけ」から「数字を語れる」分析者へと成長できます。 本ページが、 その長い学びの旅路の最初の一歩として、 読者の手に届くことを願っています。
(11) SSDSE-B-2026 の 22 変数を一覧で振り返る: SSDSE-B-2026 は 47 都道府県 × 22 変数で構成され、 総人口・年少人口・生産年齢人口・老年人口・出生数・死亡数・婚姻件数・離婚件数・転入者数・転出者数・合計特殊出生率・年平均気温・降水量(年間)・標準価格(住宅地)・小学校児童数・高等学校生徒数・大学学生数・月間有効求人数・延べ宿泊者数・着工新設住宅戸数・一般病院数・消費支出(二人以上の世帯) などを含みます。 これらの 22 変数すべてのペア相関 (231 通り) を検定する場合、 補正なしでは平均 11.55 件の偽陽性が混入する計算です。 Bonferroni 補正後の有効 α は 0.000216、 BH 補正で FDR=0.05 に抑える場合は概ね中位の p 値までを有意と判定します。 SSDSE-B-2026 を用いた最初の課題として「補正前後で結論がどう変わるか」を体感することは、 第1種の過誤の重要性を理解する上で極めて教育的です。
(12) 教員向けの授業設計ヒント: SSDSE-B-2026 を用いた検定教材を設計する際、 (i) 最初の 30 分で第1種の過誤の概念図を紙とペンで描かせる、 (ii) 続いて Python で 1 件の相関検定を実行させる、 (iii) 10 通りの相関で多重比較問題を体感させる、 (iv) Bonferroni/BH 補正を比較させる、 (v) 最後に効果量と CI を併記したレポートを書かせる、 という 5 段階構成が効果的です。 各段階で「なぜこの補正が必要か?」を学生自身に説明させると、 受動的な知識ではなく能動的な理解が育ちます。 SSDSE-B-2026 の利点は「全国 47 都道府県」というイメージしやすい単位であり、 学生が「自分の地元」「住んでいる県」と結びつけて分析対象に親しみを持てる点です。
(13) 最後の一言: 「第1種の過誤」は単なる試験対策の暗記項目ではなく、 データを扱うすべての人に求められる規律です。 SSDSE-B-2026 を題材にして、 1 回の検定、 10 回の検定、 100 回の検定でどう振る舞いが変わるかを実体験することで、 「α=0.05」という抽象的な数字が、 自分の仕事と社会に直結する具体的な責任感へと変わります。 本ページがその転換点となることを願いつつ、 結びとします。
(14) 学習者へのメッセージ: ここまで読み進めてくれた皆さんは、 第1種の過誤について教科書一冊分以上の内容に触れたことになります。 大切なのは、 これらの知識を「自分のもの」にすることです。 SSDSE-B-2026 を開き、 任意の 2 変数で相関検定を実行し、 p 値・効果量・95% 信頼区間を 1 行で報告してみてください。 そして「もし α=0.01 だったら結論はどう変わるか」「もし n=1000 だったら検出力はどう変わるか」を自問してください。 この「自問自答」のループこそが、 統計的思考を血肉化する最良の方法です。 教科書を閉じて、 データに向き合い、 自分の手で計算し、 自分の言葉で結論を語る - その繰り返しの中で、 第1種の過誤は「自分が大切にする原則」へと昇華します。 SSDSE-B-2026 はそのための優れた練習場であり、 本ページはそのナビゲーターとして、 これからも皆さんの学びに寄り添います。
(15) 終わりに — 第1種の過誤を「文化」として根付かせる: 個人が第1種の過誤を理解するだけでなく、 組織・コミュニティ全体に「事前登録する文化」「全結果を公開する文化」「効果量と CI を必ず併記する文化」「相関と因果を区別する文化」を根付かせることが、 再現性危機を乗り越える鍵です。 SSDSE-B-2026 のような公的データを用いた教材を、 学校・大学・社会人講座などで広く活用し、 学んだ人がさらに次世代に教えていく - そうした連鎖を通じて、 統計リテラシーは社会全体の財産となります。 本ページは、 そのささやかな一歩として書かれました。 読者の皆さんが、 第1種の過誤を巡る議論を自分の周りに広げ、 より誠実で信頼できるデータ分析文化の担い手となってくれることを心から願っています。
(16) 補足: 用語の対応関係(英日対照): 第1種の過誤 = Type I error = false positive = α エラー = false alarm = producer's risk (品質管理用語)、 などと呼ばれます。 第2種の過誤 = Type II error = false negative = β エラー = miss = consumer's risk です。 文脈によって用語が変わるため、 SSDSE-B-2026 を扱う論文・書籍を読む際は、 これらの同義語が同じ概念を指していると認識する必要があります。 特に医学分野では「偽陽性 / 偽陰性」、 機械学習では「False Positive / False Negative」、 統計学では「第1種 / 第2種の過誤」、 品質管理では「生産者リスク / 消費者リスク」と呼ばれるなど、 分野横断で表記が異なります。 こうした用語の流動性に慣れることもまた、 統計リテラシーの一部です。 本ページを参照しながら、 様々な分野の文献で「第1種の過誤」と出会ったときに、 同じ概念だと即座に理解できる力を養ってください。 第1種の過誤は分野を超えた共通言語であり、 統計学・データサイエンス・機械学習・医学・社会科学・経済学のすべての学問領域で同じ重要性を持ちます。 この共通基盤を踏まえた上で、 各分野固有の応用へと進んでいけば、 学際的な視座を持った分析者として大きく成長できるはずです。 学習の継続こそが、 第1種の過誤を含む統計的判断の真の理解への王道です。 SSDSE-B-2026 を起点に、 自分なりの問いを立て続け、 そして学び続けてください。 健闘を祈っています。
🗺 概念マップ
第 1 種の過誤 (α、 偽陽性) を中心に、 帰無仮説 / p 値 / 有意水準 / 多重検定補正 (Bonferroni・BH)・FDR、 第 2 種の過誤 (β) との対比を 6 方向に整理。
第一種の誤り (α、 偽陽性) は 仮説検定 の枠組みで定義され、 p 値・有意水準・第二種の誤り (β)・検出力 (1-β) と表裏一体。 SSDSE-B-2026 で「47 県の出生率に地域差があるか」を t 検定する際、 α=0.05 なら本当は差がなくても 5% の確率で「差あり」と誤判定する、 これが具体例。
🔗 隣接手法への橋渡し
第一種の誤りは仮説検定のあらゆる場面で発生し、 上流の仮説設計と下流の補正手法が直結する。
- 上流: 仮説設計 (H₀ / H₁ を明確化) → α 設定 (通常 0.05、 医療は 0.01) → サンプルサイズ計算
- 並列: 第二種の誤り (β) はトレードオフ、 FDR は多重検定での緩い基準、 信頼区間 は α と表裏一体
- 下流: ボンフェローニ補正 (k 回検定で α/k) → BH 法 (FDR 制御) → 多重比較 結果の解釈
SSDSE-B-2026 で「47 県 vs 全国平均」を 47 回 t 検定すると、 α=0.05 のままだと期待誤検出 47 × 0.05 = 2.35 件発生。 Bonferroni 補正で α'=0.05/47=0.00106 に下げるのが対策。
🌳 手法選択フロー
第一種の誤りをどう管理するかは、 検定の文脈で 4 通りに分岐する。
- 単独検定 (k=1)? Yes → α=0.05 そのまま。 SSDSE-B-2026 で「東京 vs 全国」だけなら通常水準
- 多重検定 (k≤20)? Yes → Bonferroni (α/k)。 厳しめだが安全
- 多重検定 (k>20、 探索的)? Yes → BH 法 (FDR)。 47 県 × 50 指標 = 2350 検定なら必須
- 医療・社会的影響大? Yes → α=0.01 or 0.005、 + CI 報告。 治験の標準
SSDSE-B-2026 で「県と指標の全ペア」を一気に見たいなら BH 法、 「特定の 1 県と全国」なら α=0.05 のまま。 目的次第で水準を切り替える。
🔎 もう一段深く — 総当たりスキャンで膨らむ「数の暴力」としての第一種の過誤
このページの他セクションでは α と β のトレードオフ、 補正手法(Bonferroni・BH 法)を扱いました。 ここでは重複を避け、 「1 個の検定では小さな α が、 総当たりで検定を積むと研究全体では手に負えなくなる」という第一種の過誤の“増殖”そのものに焦点を当てます。 設定した α=5% が守っているのは1 検定あたりの率であって、 スキャン全体で誤報を 1 つも出さない率ではない、 という点が本質です。
🎨 直感
α=0.05 の検定は「1 回引くと 1/20 の確率で“当たり(=誤報)”が出るくじ」です。 1 回だけ引けば外れる公算が大きい。 ところが同じくじを 109 回引けば、 「少なくとも 1 回当たる」確率は跳ね上がります。 この「少なくとも 1 回誤報を出す確率」を FWER(family-wise error rate、 実験全体誤り率) と呼び、 検定が互いに独立なら次式で膨らみます。
FWER = 1 −(1 − α)m (m = 検定回数、 α = 各検定の水準)
SSDSE-B-2026(2023 年・47 都道府県)の数値指標は 109 列あります(df[df['SSDSE-B-2026']==2023] の数値列を数えた実測値)。 これを total 109 検定、 さらに全ペア相関なら C(109, 2)=5,886 検定に膨れます。 α=0.05 のまま放り込むと、 真に無関係でも下表の通り“ほぼ確実に”どこかで有意判定が出ます。
| 検定回数 m | FWER=1−0.95m | 期待誤報数 α·m | SSDSE-B での場面 |
|---|---|---|---|
| 1 | 0.050 | 0.05 | 特定 1 指標だけを検定 |
| 14 | 0.512 | 0.70 | 14 指標を横断チェック → もう五分五分で誤報 |
| 109 | 0.996 | 5.45 | 2023 年の全数値指標を総当たり |
| 5,886 | 1.000 | 294.3 | 109 指標の全ペア相関 C(109,2) |
※ FWER・期待誤報数は α=0.05 と実測列数 109(および C(109,2)=5,886)から式で算出した値。 実際の SSDSE 列は相互相関があり独立ではないため、 この式は「独立に近い探索を無数に回した場合の上限的な目安」です。
⚠️ 落とし穴(重要)
「有意なペアだけ拾って報告」は第一種の過誤の量産装置。 109 指標を総当たりして、 出てきた有意な関係だけを結論に書く——これはデータ浚渫(p ハッキング)です。 個々の検定で α=0.05 を律儀に守っていても、 報告した集合の中に混じる偽陽性の期待数は 5〜6 件(上表 m=109 行)。 α を守ること自体は誤報の“総量”を何も保証しません。
架空デモ(真の効果ゼロ・乱数シード 2023 で再現): 平均 0 の乱数に対して 47 標本の 1 標本 t 検定を 109 回。 1 回のスキャンで 偽陽性 9 件が“有意”と出ました(理論期待 5.45 件、 揺らぎで上振れ)。 これを 1000 回反復すると、 平均偽陽性 5.45 件/109、 「少なくとも 1 件誤報が出た割合」は 0.994——理論 FWER 0.9963 とほぼ一致します。 効果が本当にゼロでも、 総当たりすればほぼ毎回“発見”が捏造されるのです。
もう一つの罠は「α を厳しくすれば安全」という早合点。 α を下げると確かに誤報は減りますが、 同時に 第二種の過誤(β) と見逃しが増え、 本物の差を取りこぼします。 総当たり問題の正しい対処は「α をやみくもに下げる」ことではなく「検定回数 m を意識して補正する」ことです。
🚀 発展
誤り率には“層”があり、 どれを制御したいかで手法が変わります。
- 比較あたり誤り率(per-comparison):各検定の α そのもの。 単独検定ならこれで十分。
- FWER(実験全体で最低 1 件の誤報を出す確率):厳格に抑えたいとき。 Bonferroni 補正(α/m)や Šidák 補正(1−(1−α)1/m)。 m=109 なら α′≈0.00046 まで下げる計算。 確実だが保守的で検出力を大きく削ります。
- FDR(発見のうち偽陽性が占める期待割合):探索的に大量スキャンするとき。 BH 法 は FWER より緩く、 5,886 ペアのような規模で現実的。
実務の指針:確認的(confirmatory)な少数検定なら FWER 制御、 探索的(exploratory)な総当たりなら FDR 制御、 と目的で切り替えます。 そして総当たりで見つけた関係は「仮説の候補」にすぎず、 別データでの再検証を経て初めて“発見”になる、 という順序を崩さないことが第一種の過誤への最良の防御です。