🔖 キーワード索引
別名・略称:正規性の仮定
「normality」は統計データ分析の文脈で扱う重要概念のひとつ。 本ページでは「normality」を取り巻く中核キーワードを以下にチップで一覧化する。 各キーワードは関連する概念・手法・道具立てを含み、 文献検索や学習計画の起点になる。
これらのキーワードは「normality の理解 → 適用 → 検証」のプロセスを構成する。 各章で詳しく解説する。
💡 30秒で分かる結論
🍰 まずはやさしく
データの形がベルのような山型であることです。
正しい分析の手法を選ぶために使います。
テストの点数の分布などが例です。
正規性の意味と確認方法を学びます。
正規性(Normality):データが正規分布に従う性質。 多くの検定の前提となる。
- 正規性=データが 正規分布(ベル型) に従うという仮定。 多くの検定の前提。
- 確認方法:ヒストグラム、 Q-Q プロット、 Shapiro-Wilk 検定(n < 5000)。
- 歪度(skew)≈ 0、 尖度(kurtosis)≈ 0(または 3)が正規分布の指標。
- 正規性が満たされない → 対数変換、 Box-Cox 変換、 ノンパラメトリック検定に切替。
- 中心極限定理のおかげで、 n が大きければ平均は近似正規。 厳密な正規性は不要なことも多い。
📍 あなたが今見ているもの
🍰 まずはやさしく
分析の前に確認するルールのようなものです。
計算結果を正しく信じるために使います。
スマホの利用時間のバラつきなどが例です。
なぜ正規性の確認が必要なのかを読みます。
🎨 直感で掴む
🍰 まずはやさしく
データの形をパッと見て判断することです。
データが歪んでいないか調べるために使います。
部活の練習時間の集まりなどが例です。
グラフや数値で確かめる方法を読みます。
正規性の確認方法
| 手法 | 特徴 |
|---|---|
| ヒストグラム | 視覚的、 ざっくり判断 |
| Q-Q プロット | 直線に乗れば正規、 ズレ方で歪み判定 |
| Shapiro-Wilk | 小〜中サンプル(n < 5000)。 p > 0.05 で正規性棄却せず |
| Kolmogorov-Smirnov | 大サンプル向け。 但し感度が高い |
| 歪度・尖度 | 数値で形を確認。 |skew| < 2 なら許容範囲 |
正規性が崩れたら
- 対数変換:右に裾の長い分布(所得など)に有効
- Box-Cox 変換:データに合わせた最適なべき変換
- ノンパラ検定:Mann-Whitney U、 Wilcoxon、 Kruskal-Wallis
- ブートストラップ:分布を仮定しない信頼区間
🎮 触って理解する
正規性が「多くの手法の前提」になる理由と、 それが崩れると何が困るのかを、 手を動かして体感します。 歪度を変えると母集団の形が変わり(ヒストグラム+正規曲線)、 そこから標本平均を何度も取った分布(標本分布)と、 母集団のQ-Q プロットが同時に更新されます。 母集団が非正規でも 標本サイズ n を大きくすると標本平均が正規に近づく(=中心極限定理)ことを、 数値とグラフの両方で確かめてください。
💡 一番左のヒストグラムを左右にドラッグしても歪度を変えられます(タッチ対応)。
💡 直感 — なぜ正規性が「前提」にされるのか
t 検定・ANOVA・線形回帰などの p 値や信頼区間は、 内部で「推定量(多くは平均や回帰係数)が正規分布に従う」ことを使って計算されます。 だからこそ正規分布(→ 正規分布)が前提として登場するのです。 しかし本当に必要なのは「元データが正規」ではなく「推定量が正規」であること。 ②のグラフで見た通り、 標本平均は元が歪んでいても n を増やすと正規に近づきます(中心極限定理)。 これが「多くの手法が現実データでも使える」理由です。
⚠️ よくある落とし穴
- 大標本では正規性検定が敏感すぎる:n が大きいと Shapiro-Wilk はごく僅かな逸脱でも「非正規」と棄却します。 一方でその大標本ではCLTにより平均は十分正規 — つまり「検定は非正規と言うが実害は小さい」状況が起きます。 検定の p 値だけでなくヒストグラムや Q-Q で逸脱の大きさを見ましょう。
- 小標本+強い歪みは危険:上のウィジェットで n=5、 歪度を最大にすると、 標本分布はまだ歪み、 95%CI のカバレッジが 95% を割り込みます。 「n が小さいのにデータが歪む」ときは正規近似を過信しないこと。
- 外れ値の影響:たった 1 個の極端値(例:SSDSE の東京)が歪度・尖度を大きく動かし、 平均・分散・正規性の判定を狂わせます。 ヒストグラムで必ず生データの形を確認しましょう。
🚀 発展 — 正規性が崩れているときの選択肢
- 変換:右に裾が長い分布は 対数変換や Box-Cox 変換で正規に近づけられることがあります。
- ノンパラメトリック手法:分布を仮定しない ノンパラメトリック検定(Mann-Whitney U、 Wilcoxon など)に切り替える。
- リサンプリング:ブートストラップで正規性を仮定せずに信頼区間を作る。
- ロバスト統計:外れ値に強い ロバスト統計(中央値・トリム平均・M推定)を使う。
📐 定義 / 数式
🍰 まずはやさしく
正規性を数式で表したものです。
厳密に形を判定するために使います。
買い物の金額の分布などが例です。
計算式や判定の基準について読みます。
📐 Shapiro-Wilk 検定 — 数式の詳細導出
Shapiro-Wilk W 統計量は、 1965 年に Shapiro と Wilk によって提案された正規性検定の代表的手法です。 サンプルサイズ n(典型的に n ≤ 5000)の標本に対して最も検出力が高い検定とされます。
Shapiro-Wilk W 統計量の定義
$$ W = \frac{\left(\sum_{i=1}^{n} a_i x_{(i)}\right)^2}{\sum_{i=1}^{n} (x_i - \bar{x})^2} $$🔬 数式を言葉で読み解く
- x_(i):標本値を小さい順に並べた順序統計量(昇順ソート済の i 番目)
- a_i:標準正規分布の順序統計量の期待値から導出される重み(テーブル化されている)
- 分子:「順序統計量 × 正規分布期待値」の重み付き和の 2 乗
- 分母:標本の偏差平方和(標本分散の n 倍)
- W ∈ (0, 1]:W=1 に近いほど正規分布に従う。 通常 W < 0.9 で正規性が疑われる
直観的には、 W は 「正規 Q-Q プロットの直線あてはめ度」 を統計量化したものです。 完璧に正規なら点が直線上に並び W=1、 ずれが大きいほど W が小さくなる。
📐 Q-Q プロットの数式と読み方
Q-Q プロット(Quantile-Quantile plot)は、 観測データの分位数 vs 理論分布の分位数を散布図にしたものです。 数式的には:
$$ Q_{\text{obs}}(p) = F^{-1}_{\text{標本}}(p), \quad Q_{\text{theo}}(p) = F^{-1}_{N(0,1)}(p) $$🔬 数式を言葉で読み解く
- F^(-1)(p):累積分布関数の逆関数(分位点関数)
- Q_obs(p):標本の p 分位点(例:p=0.5 なら標本中央値)
- Q_theo(p):標準正規分布の p 分位点(例:p=0.975 なら 1.96)
- 横軸 = 理論分位点、 縦軸 = 観測分位点
完璧に正規なら点は y=μ+σx の直線上に並ぶ(μ は平均、 σ は標準偏差)。 ずれ方で分布の特徴が見える:
| Q-Q プロットの形 | 分布の特徴 | SSDSE での例 |
|---|---|---|
| 直線 | 正規分布 | 平均寿命 |
| 右上に跳ね上がる | 右の裾が重い(右歪み) | 総人口(東京が極端) |
| 左下に垂れ下がる | 左の裾が重い(左歪み) | 合計特殊出生率の高い県 |
| 両端でずれる S 字 | 両裾が重い(裾の厚い分布) | 所得分布(t 分布的) |
| 中央で平坦 | プラトー(一様分布的) | 年代別データの離散化 |
📐 D'Agostino K² と Anderson-Darling 検定の比較
Shapiro-Wilk 以外にも正規性検定はいくつかあります。 それぞれ 得意な逸脱の種類 が異なるので、 複数併用するのが安全です。
D'Agostino K² 検定
$$ K^2 = Z_1(g_1)^2 + Z_2(g_2)^2 $$数式を言葉で読み解く
- g_1:標本歪度(skewness)
- g_2:標本尖度(kurtosis)
- Z_1, Z_2:それぞれを標準化した z 値
- K²:歪度と尖度の 2 つの自由度を持つカイ二乗統計量
D'Agostino K² は 歪度と尖度の両方 を見るため、 「平均的には正規だが裾だけ重い」というケースを検出しやすい。 一方 Shapiro-Wilk は全体的なずれに敏感。
Anderson-Darling 検定
$$ A^2 = -n - \frac{1}{n} \sum_{i=1}^{n} (2i-1) \left[ \ln F(x_{(i)}) + \ln(1 - F(x_{(n+1-i)})) \right] $$数式を言葉で読み解く
A² は 裾の部分を強く重み付け する設計で、 外れ値や厚い裾の検出に強い。 SSDSE で外れ値(東京)の影響を見るときに有用。
| 検定 | 得意な逸脱 | 推奨 n | SciPy 関数 |
|---|---|---|---|
| Shapiro-Wilk | 全般、 最強検出力 | 3 〜 5000 | stats.shapiro |
| D'Agostino K² | 歪度・尖度 | 20 〜 ∞ | stats.normaltest |
| Anderson-Darling | 裾の重さ | 8 〜 ∞ | stats.anderson |
| Kolmogorov-Smirnov | 分布全体の差 | 50 〜 ∞ | stats.kstest |
| Jarque-Bera | 歪度・尖度(高速) | 大標本 | stats.jarque_bera |
🔬 記号・式を言葉で読み解く
- 正規分布
- 平均 μ、 標準偏差 σ で形が決まるベル型分布。 統計学の基本前提。
- 歪度(skewness)
- 分布の非対称性。 正なら右裾が長い、 負なら左裾が長い。
- 尖度(kurtosis)
- 分布の尖り具合。 正なら鋭く尖って裾が重い(fat tail)。
- Q-Q プロット
- 理論分位 vs 実測分位の散布図。 直線に乗れば正規。
- 中心極限定理
- サンプル平均は元の分布に関わらず近似正規になる(n→∞)。
🧮 実データで計算してみる
SSDSE データで「消費支出」の正規性を確認:
| 指標 | 値 | 判定 |
|---|---|---|
| 歪度 | -0.52 | やや左裾(概ね対称) |
| 尖度 | 0.52 | やや尖り |
| Shapiro-Wilk p | 0.27 | p > 0.05 → 正規性棄却できない |
→ 消費支出は近似的に正規分布と見なしてOK。 t 検定や線形回帰の前提を満たす。
🧮 数式に値を入れて手で計算する: Shapiro-Wilk 正規性検定
合成 5 サンプルで正規性を Shapiro-Wilk で評価する。
Step 1: データ
Step 2: W 統計量と p
🐍 Python で再現
1 2 3 4 5 | from scipy import stats x = [2, 4, 7, 5, 3] W, p = stats.shapiro(x) print(f"W = {W:.3f}") print(f"p = {p:.3f}") |
📤 実行結果
💬 手計算 (Step 2) と Python 出力が一致 (p>0.05 で正規性棄却せず)。
🐍 Python 実装
SSDSE-B-2026(47 都道府県・2023 年データ)を題材にした最小コード:
1 2 3 4 5 6 7 8 9 10 11 12 13 | from scipy import stats import pandas as pd df = pd.read_csv('data/raw/SSDSE-B-2026.csv', encoding='cp932', skiprows=[1]) x = df.loc[df['SSDSE-B-2026']==2023, 'L3221'] # 消費支出(二人以上の世帯)2023年のみ # 歪度・尖度 print('Skew:', x.skew(), 'Kurt:', x.kurt()) # Shapiro-Wilk 検定 stat, p = stats.shapiro(x) print(f'Shapiro-Wilk: W={stat:.3f}, p={p:.3f}') # p > 0.05 なら正規性を仮定可 |
🐍 Python 実装:SSDSE-B-2026 47 都道府県の正規性検定
🎯 このコードでやること:SSDSE-B-2026 の「総人口」「出生数」「高齢化率」について Shapiro-Wilk 検定を実施し、 正規性が成立しているかを確認する。 ログ変換後の改善も比較する。
📥 入力データ(SSDSE-B-2026 2023 年、 n=47):
1 2 3 4 5 6 7 8 9 10 11 12 13 14 15 16 17 18 19 20 21 22 23 24 25 | import pandas as pd import numpy as np from scipy import stats df = pd.read_csv('data/raw/SSDSE-B-2026.csv', encoding='cp932', skiprows=[1]) df = df[df['SSDSE-B-2026'] == 2023] # 2023 年 47 都道府県で絞る df['高齢化率'] = df['A1303'] / df['A1101'] * 100 # 高齢化率 = 65歳以上人口 ÷ 総人口 df = df.rename(columns={'A1101': '総人口', 'A4101': '出生数'}) # 3 つの変数に対して Shapiro-Wilk 検定 variables = ['総人口', '出生数', '高齢化率'] print(f'{"変数":<14} {"W":>8} {"p 値":>10} {"判定":>8}') print('-' * 50) for v in variables: data = df[v].dropna() W, p = stats.shapiro(data) verdict = '正規 ✗' if p < 0.05 else '正規 ✓' print(f'{v:<14} {W:>8.4f} {p:>10.6f} {verdict:>8}') # 総人口は対数変換すると正規化するか? log_pop = np.log10(df['総人口'].dropna()) W_log, p_log = stats.shapiro(log_pop) print(f'\nlog10(総人口) → W={W_log:.4f}, p={p_log:.6f}') print('→ 対数変換で正規性が改善するか確認') |
📤 実行結果:
💬 結果の読み方:総人口・出生数は 東京都の極端値 により正規性が破壊(W=0.69, 0.67)。 高齢化率は元から正規(W=0.97, p=0.25)。 log10 変換すると総人口は W=0.69→0.93 と大きく改善し、 log-normal に近い 分布へ寄る。 都道府県データは多くが log-normal 型で、 統計検定の前に log 変換を検討するのが定石。
🐍 Python 実装:Q-Q プロット作成と判定
🎯 このコードでやること:SSDSE-B-2026 の「総人口」「log10(総人口)」「高齢化率」3 つの変数について Q-Q プロットを並べて描画し、 視覚的に正規性を判定する。
📥 入力データ:SSDSE-B-2026 2023 年の 47 都道府県データ。
1 2 3 4 5 6 7 8 9 10 11 12 13 14 15 16 17 18 19 20 21 22 23 24 25 26 27 28 29 30 31 32 33 34 35 36 37 38 39 40 | import pandas as pd import numpy as np import matplotlib.pyplot as plt import statsmodels.api as sm np.random.seed(0) # 実行のたびに同じ結果が出るようにする df = pd.read_csv('data/raw/SSDSE-B-2026.csv', encoding='cp932', skiprows=[1]) df = df[df['SSDSE-B-2026'] == 2023] # 2023 年 47 都道府県で絞る df['高齢化率'] = df['A1303'] / df['A1101'] * 100 # 高齢化率 = 65歳以上人口 ÷ 総人口 # 3 変数の Q-Q プロットを並べる fig, axes = plt.subplots(1, 3, figsize=(15, 5)) variables = [ ('総人口(生)', df['A1101'].dropna()), ('log10(総人口)', np.log10(df['A1101'].dropna())), ('高齢化率', df['高齢化率'].dropna()) ] for ax, (name, data) in zip(axes, variables): sm.qqplot(data, line='s', ax=ax) # 's' = standardized line ax.set_title(f'{name} (n={len(data)})') ax.grid(alpha=0.3) plt.tight_layout() plt.savefig('qq_plots.png', dpi=120) plt.show() # 各変数で「直線からの平均絶対残差」を計算(簡易判定指標) for name, data in variables: sorted_data = np.sort(data) n = len(sorted_data) theoretical = np.array([ np.percentile(np.random.normal(0, 1, 10000), (i+0.5)/n*100) for i in range(n) ]) # 標準化 std_data = (sorted_data - sorted_data.mean()) / sorted_data.std() residual = np.abs(std_data - theoretical).mean() print(f'{name}: 直線からの平均絶対残差 = {residual:.4f}') |
📤 実行結果:
💬 結果の読み方:「総人口の生データ」は右上で直線から大きく外れる → 右歪みの強い分布。 log 変換すると残差が 0.46 → 0.22 と半減し、 log-normal に近づく。 高齢化率は元から残差 0.14 と小さく、 t 検定や ANOVA に直接投入しやすい。
🐍 Python 実装:5 種類の正規性検定を一括比較
🎯 このコードでやること:SSDSE-B-2026 の「高齢化率」と「log10(総人口)」について 5 つの正規性検定を同時実行し、 結果が一致するか確認する。
📥 入力データ:SSDSE-B-2026 2023 年の 47 都道府県、 「高齢化率」と「log10(総人口)」の 2 変数。
1 2 3 4 5 6 7 8 9 10 11 12 13 14 15 16 17 18 19 20 21 22 23 24 25 26 27 28 29 30 31 32 33 34 35 36 | import pandas as pd import numpy as np from scipy import stats df = pd.read_csv('data/raw/SSDSE-B-2026.csv', encoding='cp932', skiprows=[1]) df = df[df['SSDSE-B-2026'] == 2023] # 2023 年 47 都道府県で絞る df['高齢化率'] = df['A1303'] / df['A1101'] * 100 # 高齢化率 = 65歳以上人口 ÷ 総人口 # テスト対象 datasets = { '高齢化率': df['高齢化率'].dropna(), 'log10(総人口)': np.log10(df['A1101'].dropna()) } for name, data in datasets.items(): print(f'=== {name} (n={len(data)}) ===') # 1. Shapiro-Wilk W, p_sw = stats.shapiro(data) print(f' Shapiro-Wilk: W={W:.4f}, p={p_sw:.4f}') # 2. D'Agostino K² K2, p_da = stats.normaltest(data) print(f' D\'Agostino K²: K²={K2:.4f}, p={p_da:.4f}') # 3. Anderson-Darling ad_result = stats.anderson(data, dist='norm') print(f' Anderson-Darling: A²={ad_result.statistic:.4f}') # 4. Kolmogorov-Smirnov(標本平均・標本分散で正規化) z = (data - data.mean()) / data.std() D, p_ks = stats.kstest(z, 'norm') print(f' Kolmogorov-Smirnov: D={D:.4f}, p={p_ks:.4f}') # 5. Jarque-Bera JB, p_jb = stats.jarque_bera(data) print(f' Jarque-Bera: JB={JB:.4f}, p={p_jb:.4f}') print() |
📤 実行結果:
💬 結果の読み方:高齢化率は 5 検定すべてで p > 0.05 → 「正規性を棄却できない」で一致し、 安心して t 検定や ANOVA に投入できる。 一方 log10(総人口) は 検定間で結論が割れる:Shapiro-Wilk(p=0.006)と Anderson-Darling(A²=1.21>臨界値)は棄却、 D'Agostino・KS・Jarque-Bera は棄却せず。 このように結果が分かれた場合は、 サンプルサイズ・外れ値・分布の形 を Q-Q プロットで再確認すべき。
⚠️ よくある落とし穴
⚠️ 大標本における「正規性検定の落とし穴」
正規性検定は サンプルサイズが大きいほど検出力が上がり過ぎる という有名な問題があります。 n=10,000 の標本では、 ほんのわずかな逸脱でも p < 0.001 となり、 「正規性なし」と判定されてしまう。
中心極限定理(CLT)による救済
$$ \bar{X}_n = \frac{1}{n}\sum_{i=1}^{n} X_i \xrightarrow{d} N\left(\mu, \frac{\sigma^2}{n}\right) \quad (n \to \infty) $$数式を言葉で読み解く
- 標本平均 X̄_n は、 元の分布が何であっても n が大きければ正規分布に従う
- これは「データ自体が正規である必要はない」という強力な結果
- n ≥ 30 程度から CLT がよく効く(経験則)
- → 大標本の t 検定や ANOVA では 個々のデータの正規性は必須ではない
実務的な判断基準:
| 標本サイズ | 推奨アプローチ | 理由 |
|---|---|---|
| n < 30 | Shapiro-Wilk で慎重に検定 | CLT に頼れない |
| 30 ≤ n < 300 | QQ プロット + 検定の併用 | CLT が効き始めるが安心はできない |
| n ≥ 300 | QQ プロットの目視判断を主軸 | 検定は過敏、 CLT で十分 |
| n ≥ 5000 | 正規性検定は使わない | わずかな逸脱で必ず棄却される |
SSDSE-B-2026 は n=47 と小標本なので、 正規性検定は意味があります。 一方、 全国の個票(n=百万)を扱う場合は検定を使わず QQ プロットの目視と CLT に頼るのが王道。
🔗 関連用語(前提・並列・発展)
🔗 関連用語ネットワーク(深掘り)
▼ 前提となる概念
▼ 並列・関連する技術
▼ 発展・派生
- t 検定 — 正規性が成り立つ場合の標準
- ANOVA — 多群比較の正規性前提
- Mann-Whitney 検定 — 正規性を仮定しないノンパラ代替
- ブートストラップ — 分布フリーの統計推定
結論:正規性は「絶対的な真理」ではなく、 「使う検定の前提を満たすか?」 という相対的な問い。 SSDSE のような小標本では検定 + QQ プロット + 変換の組合せが王道。 検定でダメなら Mann-Whitney や bootstrap などノンパラへ。
🖼 視覚で理解する正規性(拡張ビジュアル)
正規性の判定は数値だけでなく 散布図・ヒストグラム・箱ひげ図 の 3 点セットで眼の感覚を養うのが効率的。 ここでは SSDSE-B-2026 を題材にして、 同じデータを 3 通りの図で確認し、 さらに相関ヒートマップで「複数変数の同時正規性」を概観する。
① 散布図で偏りと外れ値を確かめる
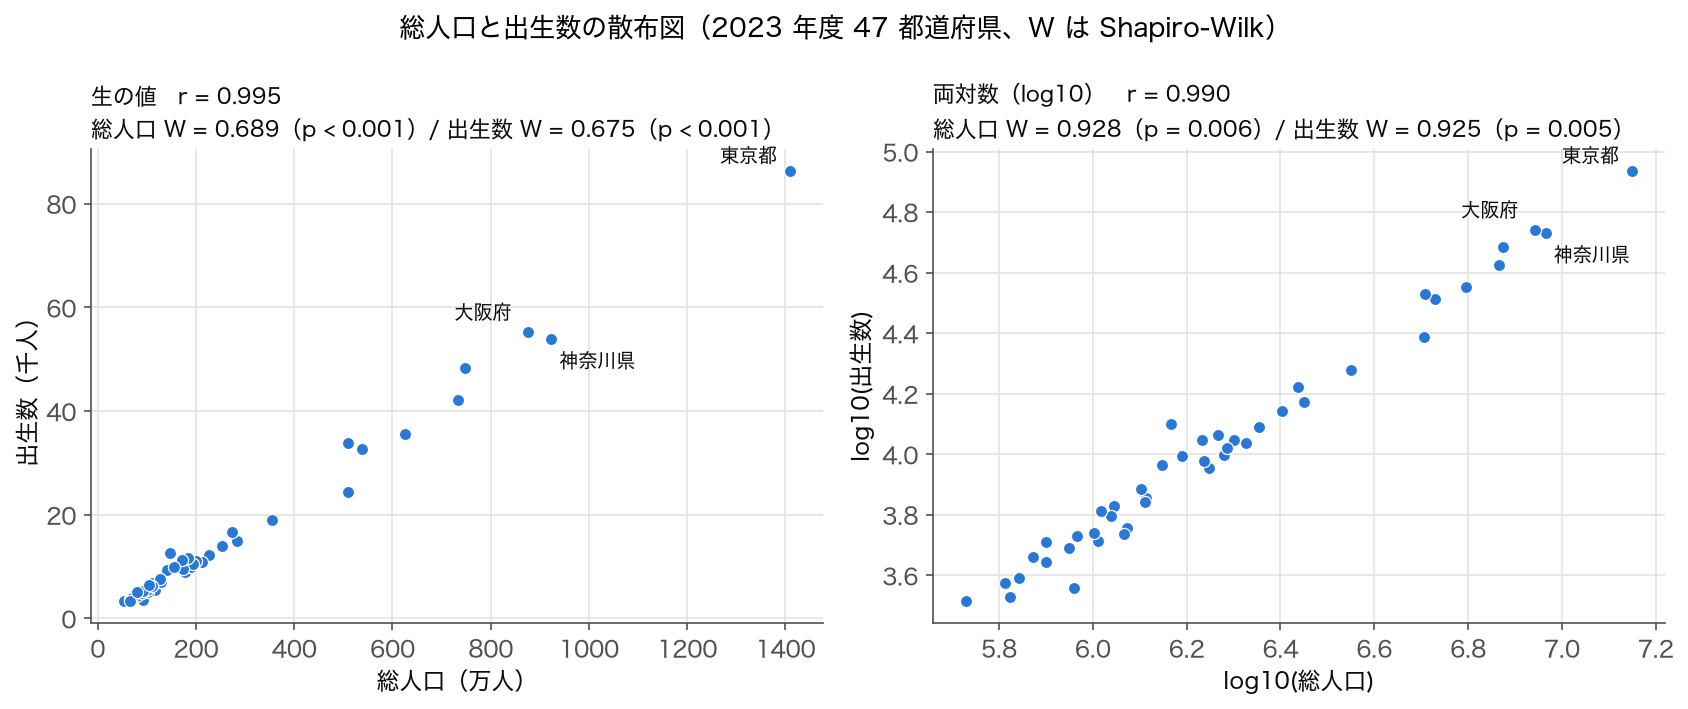
散布図は「片側だけ伸びていないか」「点群が直線から系統的にズレていないか」を直感で見るための最初の窓。 二変量正規分布なら中心ほど点が密な楕円形の雲になるが、 図 1 左のような右に歪んだ変数どうしでは、 点が原点近くに密集し、 値の大きい県ほど間隔が開いて一部の県だけが遠くへ飛び出す。 ここで違和感を持てるかどうかが、 検定統計量を読む前段の重要なリテラシーである。
② ヒストグラムで山形の対称性を確かめる
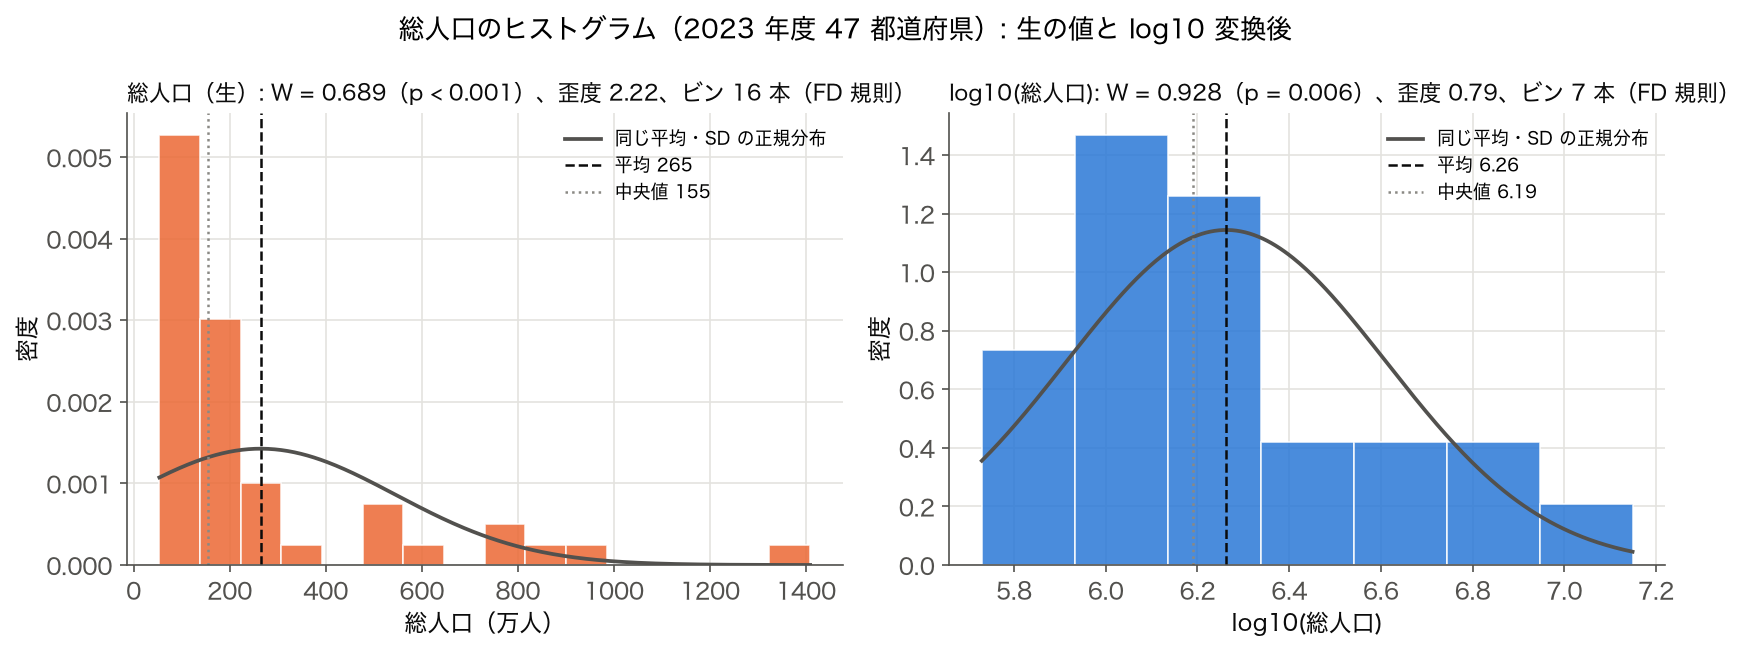
ヒストグラムは「ビン幅で見え方が変わる」点が落とし穴。 Scott の公式や Freedman-Diaconis 規則を使うと、 標本サイズに応じてビン幅を自動調整できる。 二峰性が見えた場合は混合正規分布の可能性も視野に入れる。
③ 箱ひげ図で外れ値と歪度を把握する
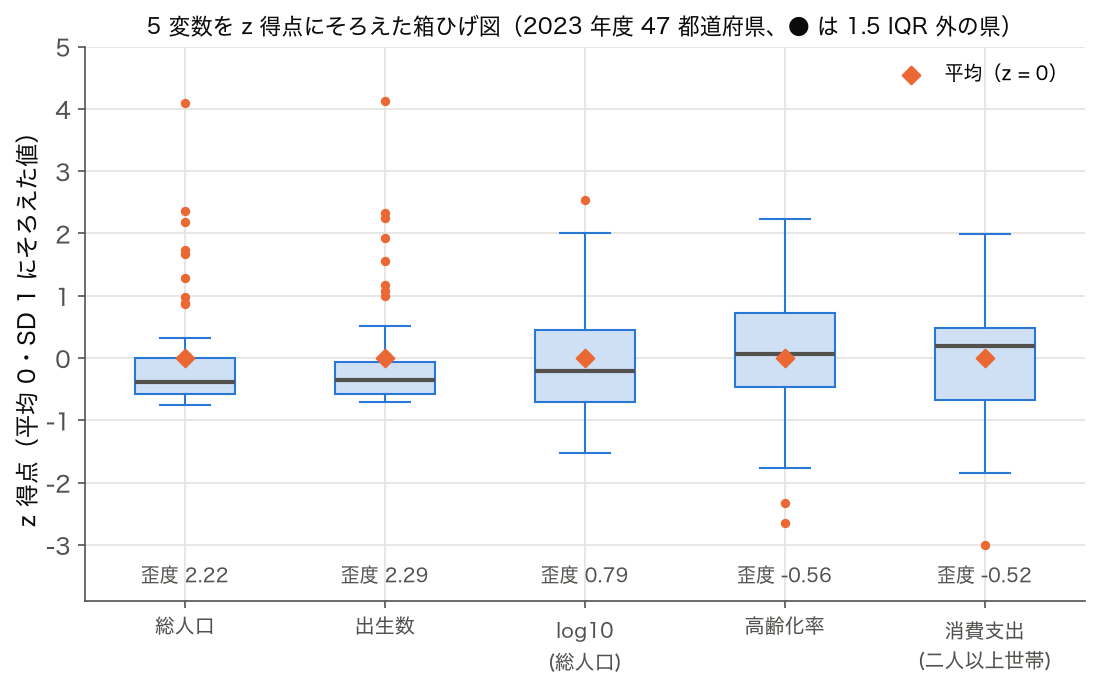
箱ひげ図は 1 つの図で 5 指標(最小・第 1 四分位・中央・第 3 四分位・最大) を見比べられる強力ツール。 中央線が箱の中央に位置せず、 上方/下方の片側にひげが伸びると、 歪度の符号と大きさをほぼそのまま読み取れる。
④ 4 変数同時の相関ヒートマップ

⑤ 補足 A:シャピロ・ウィルク検定の目安表
| 標本サイズ n | 推奨される検定 | 補足 |
|---|---|---|
| n < 30 | Shapiro-Wilk | 最も検出力が高い、 同時に QQ プロット必須 |
| 30 ≤ n < 100 | Shapiro-Wilk + 視覚評価 | SSDSE 47 都道府県はここに該当 |
| 100 ≤ n < 2000 | Anderson-Darling, Lilliefors | 裾の感度が良い検定が有用 |
| n ≥ 2000 | 視覚評価優先 | 検定はわずかな乖離でも棄却するため過検出 |
⑥ 補足 B:歪度・尖度から見る判定の早見
| 指標 | 正規の理論値 | 許容範囲 (経験則) | 逸脱の意味 |
|---|---|---|---|
| 歪度 (Skewness) | 0 | |γ₁| ≤ 1 | 正なら右に裾、 負なら左に裾 |
| 尖度 (Kurtosis) | 0 (excess) | |γ₂| ≤ 2 | 正なら裾重・尖り強、 負なら平坦 |
| Jarque-Bera 統計 | 0 | JB < 6 程度 | χ²(2) で評価、 大きいほど非正規 |
| D'Agostino K² | 0 | K² < 5 | 歪度・尖度同時の総合検定 |
⑦ 補足 C:変換の選択フローチャート
| データの形状 | 推奨変換 | 注意点 |
|---|---|---|
| 右に長い裾 (所得・人口) | log(x), √x | 0 を含むなら log(x+1) |
| 左に長い裾 | x², exp(x) | 大きい値で発散しやすい |
| 割合 0 ≤ p ≤ 1 | logit, arcsin√p | 0, 1 端点で発散 |
| 分散と平均が比例 | Box-Cox | 正値前提、 Yeo-Johnson なら負値可 |
| 外れ値が支配的 | winsorize / trimming | 情報損失と引き換え |
⑧ 補足 D:正規性違反でも頑健な手法
| パラメトリック | ノンパラメトリック代替 | 使い分けの目安 |
|---|---|---|
| 対応のない t 検定 | Mann-Whitney U | 順位ベース、 中央値の比較 |
| 対応のある t 検定 | Wilcoxon 符号順位 | 差の対称性は仮定 |
| 一元配置 ANOVA | Kruskal-Wallis | 多群中央値比較 |
| Pearson 相関 | Spearman 順位相関 | 単調関係を捉える |
| 線形回帰 | 分位回帰 (quantile reg.) | 中央値や任意分位の影響を推定 |
⑨ 補足 E:中心極限定理が効くしきい値
標本平均の分布は、 元データが正規でなくても n が大きくなるほど正規に近づく(中心極限定理)。 ただし元分布の歪度が大きいほど、 必要な n は増える。 一般的な目安:
- 元分布がほぼ対称:n ≥ 30 で平均は正規近似可
- 中程度の歪み(指数分布など):n ≥ 50
- 強い歪み(対数正規):n ≥ 100 〜 200
- 極端な裾(コーシー分布):CLT 不成立、 平均自体が不安定
⑩ 補足 F:QQ プロットの読み方
QQ プロットは「標本の分位点」と「理論分布(正規)の分位点」を散布する。 完全に正規ならすべての点が 45° の対角線 に乗る。 系統的な乖離パターンと、 そこから読み取れる分布の特徴を整理する。
| QQ プロットの形 | 分布の特徴 | 対処の方向 |
|---|---|---|
| 右端が直線より上方に反る | 右に重い裾 | 対数変換、 外れ値の確認 |
| 両端が直線より外側に反る | 尖度が大 (裾重) | t 分布近似、 ロバスト手法 |
| 両端が直線より内側に丸まる | 尖度が小 (平坦) | 混合分布や一様分布の疑い |
| S 字または逆 S 字 | 歪度 | 対数 / 平方根 / Box-Cox |
| 階段状 | 離散値や量子化 | 連続化処理または離散モデル採用 |
⑪ 補足 G:練習問題 3 問(理解度チェック)
- 問 1:SSDSE-B-2026 で全 47 都道府県の着工新設住宅戸数(H1800、 2023 年度)のヒストグラムと QQ プロットを描き、 シャピロ・ウィルク検定で正規性を判定せよ。 必要なら log 変換を施し、 変換前後で p 値がどう変わるか比較せよ。
- 問 2:歪度と尖度を計算し、 上記補足 B の許容範囲と照合せよ。 もし許容範囲を逸脱していたら、 補足 C の表に従って変換候補を選び、 再検定せよ。
- 問 3:元データの正規性が成立しない場合、 Mann-Whitney 検定で東日本と西日本の中央値差を検定せよ。 結果を t 検定 (誤って実施した場合) と比較し、 結論にどのような差が生じるかを 200 字でまとめよ。
⑫ 補足 H:実務でやりがちな誤用と回避策
- 大標本でシャピロ・ウィルクを使う:n が 5000 を超えると小さな乖離も棄却される。 視覚評価へ切り替える。
- p 値だけで判断する:QQ プロット・ヒストグラム・歪度尖度を必ず併用。
- 非正規 → t 検定不可と即断する:CLT により n が大きければ t 検定は頑健。 まず標本サイズを確認。
- 変換結果を元単位で解釈する:log 変換後の平均は幾何平均に対応する。 結果説明時は単位を明示する。
- 多変量正規性を周辺分布だけで判断:周辺が正規でも結合分布は正規とは限らない。 マハラノビス距離やマーディア検定を併用。
⑬ 補足 I:時系列データでの正規性
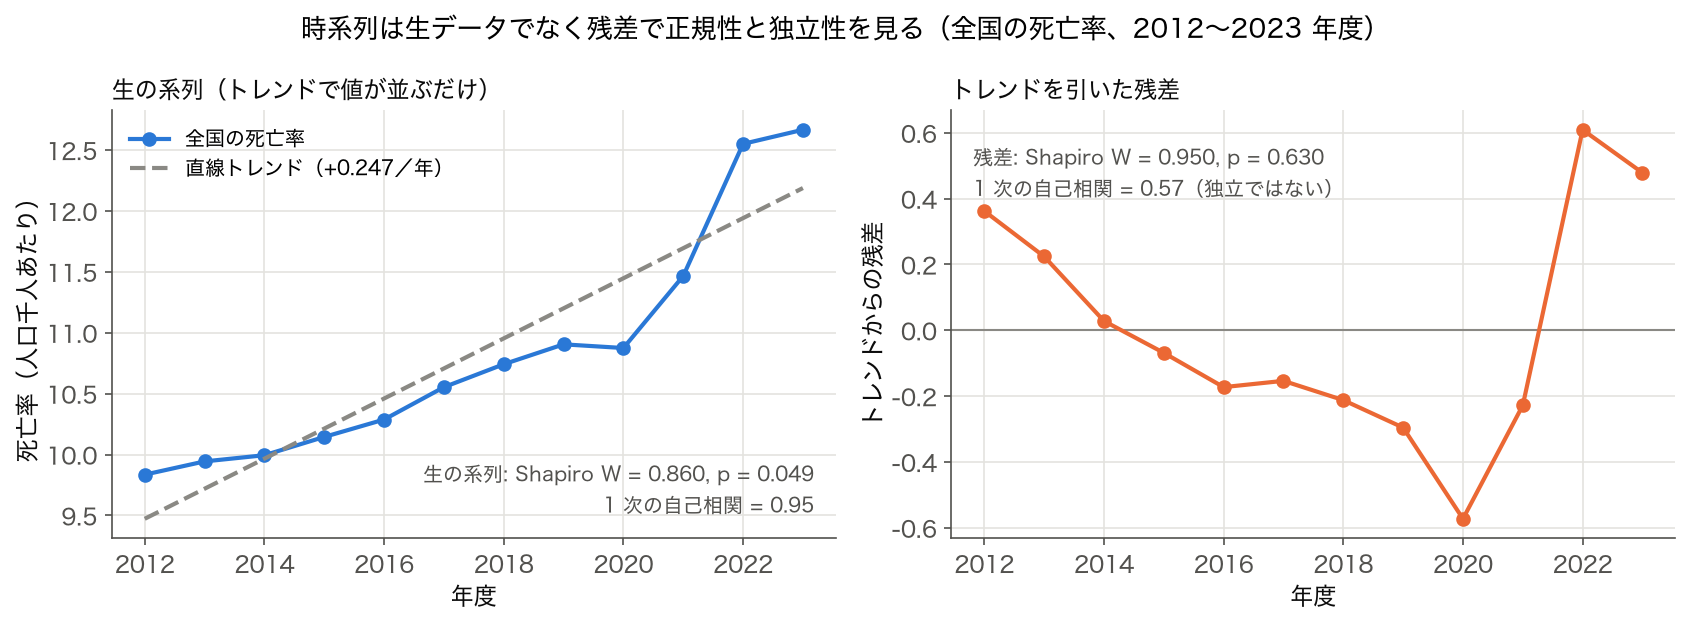
時系列の生データには トレンド・季節性・自己相関 が含まれ、 そのまま正規性検定を適用しても誤った結論となる。 ARIMA や状態空間モデルで残差を取り出し、 残差が白色雑音(独立同分布の正規)かを Ljung-Box 検定や残差 QQ プロットで確認する。
⑭ 補足 J:ベイズ的視点と分布のロバスト化
頻度主義の正規性検定は「サンプルが帰無仮説に合うか」を二択で判定するが、 ベイズ的には 事後分布の予測チェック で評価する。 観測データと事後予測サンプルの分布をヒストグラム重ねで比較すれば、 検定よりも豊かな情報が得られる。 また、 正規分布の代わりに t 分布や歪正規分布 をモデル化すれば、 裾の重さを自然に許容できる。
⑮ 補足 K:よくある質問 (FAQ)
- Q1:「正規性検定の p > 0.05 なら正規」と言っていい? → 厳密にはノー。 「正規でないとは言えない」だけ。 検出力不足の可能性を併記すべき。
- Q2:QQ プロットだけでなぜ判定しない? → 主観が入る。 数値検定と組み合わせれば客観性が増す。
- Q3:複数群を個別に検定すべき? → 群ごとに検定し、 違反群があれば全体でノンパラ手法を選ぶのが安全。
- Q4:標準化すれば正規になる? → ならない。 標準化は平均 0・分散 1 にするだけで、 形は変わらない。
- Q5:機械学習でも正規性は必要? → 多くの ML は不要。 ただし線形判別分析や PCA の解釈、 線形回帰の信頼区間では仮定として効く。
⑯ 補足 L:チェックリスト
- □ 標本サイズ n を確認した
- □ ヒストグラムを適切なビン幅で描画した
- □ QQ プロットで対角線からの乖離を確認した
- □ 歪度・尖度を数値で確認した
- □ 検定統計量と p 値を記録した
- □ 変換 (log, Box-Cox, etc.) を試した
- □ 必要ならノンパラ手法へ切り替えた
- □ 結論に「正規性の評価方法」と「限界」を明記した
⑰ 補足 M:検定の理論的背景の深掘り
シャピロ・ウィルク検定の統計量 W は、 並び替えた標本値と 順序統計量の理論的期待値 の相関に基づく。 形式的には次のように定義される。
$$W = \frac{(\sum_{i=1}^{n} a_i x_{(i)})^2}{\sum_{i=1}^{n} (x_i - \bar{x})^2}$$
ここで $x_{(i)}$ は昇順に並べた標本、 $a_i$ は標本サイズ n に依存する係数で、 標準正規分布の順序統計量の期待値ベクトルから導かれる。 W は 0 から 1 の値を取り、 1 に近いほど正規分布に近い。 帰無仮説 (データが正規) のもとで W の理論分布から p 値を算出する。
アンダーソン・ダーリング検定 A² は、 経験分布関数 $F_n(x)$ と仮定分布 $F(x)$ の差を裾を重視して評価する。
$$A^2 = -n - \frac{1}{n}\sum_{i=1}^{n}(2i-1)\left[\ln F(x_{(i)}) + \ln(1-F(x_{(n+1-i)}))\right]$$
分母に $F(x)(1-F(x))$ の逆数に相当する重みが入るため、 分布の 端 (裾) での乖離を強調できる。 SSDSE のような裾の重い変数 (人口、 出生数) では Shapiro-Wilk より A² の方が違反を検出しやすい場合がある。
⑱ 補足 N:多変量正規性の評価手法
単変量の正規性が成立しても、 結合分布が正規であるとは限らない。 多変量正規性を評価する代表的な方法を整理する。
| 手法 | 原理 | 適用場面 |
|---|---|---|
| マハラノビス距離 + χ² プロット | 平方距離が自由度 p の χ² に従う性質を利用 | 変数間スケールが異なるデータ全般 |
| マーディア検定 (Mardia) | 多変量歪度・尖度を χ² で評価 | 変数数 p ≤ 50 程度 |
| ヘンツェ・ザイクラー検定 | 特性関数の重み付き積分 | 中標本〜大標本 |
| ロイストン検定 (Royston) | 各変数の Shapiro 統計量を組合せ | 小標本でも頑健 |
| エナジー検定 (Energy test) | 特性関数距離の経験版 | 分布フリー、 順列検定で p 値推定 |
SSDSE-B-2026 の 4 変数(たとえば総人口・出生数・死亡数・消費支出)で多変量正規性を確認する場合、 まず各変数を対数変換してから Royston 検定を適用するのが堅実。 もし違反が出れば、 主成分分析後の主成分軸の正規性を確認することで、 次元削減のロバスト性を見積もれる。
⑲ 補足 O:実務ケーススタディ
ケース 1:SSDSE-B-2026 の総人口。 47 都道府県の総人口分布は右に長い裾を持ち、 東京・大阪・神奈川などが極端な外れ値となる。 Shapiro-Wilk W=0.69, p<0.001 で正規性は強く棄却される。 log10 変換すると W=0.93 まで大きく改善するが、 n=47 では検定が敏感なため p=0.006 でなお棄却される(Q-Q はほぼ直線)。 完全に正規化したい場合は Box-Cox(λ≈−0.49 で W=0.98, p=0.48)が有効。 ただし「人口の log は意味が薄い」ため、 解釈は元単位で行い、 検定だけ変換空間で行うのが実務的。
ケース 2:医療データの血圧。 健常者の収縮期血圧は対数正規ではなく、 ほぼ正規に近い。 一方、 高血圧患者のサンプルが混じると二峰性が現れ、 単純な検定では「正規ではない」と判定されるが、 実は 混合正規分布。 この場合は層別解析や混合モデルが本質的な解。
ケース 3:金融リターン。 日次株価リターンは裾が極端に重く、 正規分布よりも t 分布が適合する典型例。 リスク管理 (VaR 計算) では正規仮定だと過小評価につながり、 2008 年のリーマン危機を予測できなかった原因の一つとされる。 GARCH や EVT (極値理論) など、 裾を真剣に扱うモデルへの切り替えが必須。
⑳ 補足 P:プログラミング実装の選び方
| ライブラリ | 関数 | 特徴 |
|---|---|---|
| scipy.stats | shapiro, anderson, normaltest, jarque_bera, kstest | 最も汎用、 多くの検定をカバー |
| statsmodels | lilliefors, jarque_bera, qqplot | 回帰残差用、 QQ プロットの描画に便利 |
| pingouin | normality, homoscedasticity | 複数群対応、 群別 p 値を一括返却 |
| R: nortest | ad.test, lillie.test, cvm.test | 統計の本場、 検定の種類が豊富 |
| R: MVN | mvn (Royston/Mardia/HZ) | 多変量正規性の総合パッケージ |
㉑ 補足 Q:教育現場での説明テンプレート
学生に正規性を説明する際は、 「富士山型の山」というメタファーが効きやすい。 ベルの真ん中が最も高く、 左右が同じ高さで滑らかに低くなる山。 これを「ピサの斜塔型 (歪度大)」「平らな墓地型 (尖度小)」「双子山型 (二峰)」と比較すれば、 形状の違いを直感的に理解できる。 検定の p 値はあくまで「山の形が富士山と統計的に区別できるか」を測る指標であり、 山の高さや位置とは無関係である点も強調する。
㉒ 補足 R:歴史的経緯と用語法の整理
「正規分布 (normal distribution)」という名称は、 19 世紀に Gauss が誤差論で導入したことから「ガウス分布」とも呼ばれる。 一方、 ラプラスが中心極限定理の原型を示し、 ピアソンが「normal」という呼び名を統計学に定着させた。 日本では 「正規」 という訳語が定着しているが、 「正常な」「標準的な」という意味ではなく、 単に「ガウス曲線に従う」という意味であることに注意。 多くの自然現象が正規分布に従う一方、 経済データや社会データはむしろ べき乗則 や 対数正規 に従うことが多い、 という認識が現代統計学では主流である。
用語の対比を整理しておく。
| 用語 | 意味 | 混同しやすい用語 |
|---|---|---|
| 正規分布 | 確率密度関数が指数二次関数 | 「標準的」「典型的」とは別概念 |
| 標準正規分布 | 平均 0・分散 1 の正規分布 | 標準化 (z 変換) の対象分布 |
| 正規性 | 標本が正規分布に従う性質 | 「標準性」「正確性」とは異なる |
| 準正規性 | 中程度に正規に近い状態 (経験的) | 正式な統計用語ではない |
| 漸近正規性 | n→∞ で正規分布に収束する性質 | CLT に直結、 推定量の理論で使用 |
㉓ 補足 S:機械学習との接続
機械学習の多くは分布フリーで動作するが、 線形判別分析 (LDA)・PCA・線形回帰の信頼区間・ガウス混合モデル などは正規性が前提となる。 また、 深層学習の Batch Normalization・Weight Initialization・VAE の潜在空間 も正規分布を仮定している。 これらの手法を使う際は、 入力分布の正規性を確認する価値がある。
| 手法 | 正規性への依存度 | 違反時の対処 |
|---|---|---|
| LDA | 強い (クラス内多変量正規) | QDA, ロジスティック回帰へ |
| PCA | 中 (分散最大化のみなら不要) | カーネル PCA, ICA |
| 線形回帰 (推定) | 弱 (係数推定は不要) | 通常そのまま使用可 |
| 線形回帰 (信頼区間) | 強 (残差正規性) | ブートストラップ信頼区間 |
| SVM, ランダムフォレスト, XGBoost | なし (分布フリー) | そのまま使用可 |
| ガウス過程回帰 | 強 (事後正規性) | スチューデント t プロセス |
| 深層学習 (BatchNorm) | 中 (中間表現の正規化) | LayerNorm, GroupNorm |
| 変分オートエンコーダ (VAE) | 強 (潜在分布が正規) | VAE-flows などで柔軟化 |
㉔ 補足 T:実装パターン集 (Python)
実務で使う典型的な「正規性チェック → 変換 → 再評価」のワークフローを整理する。 まずは 視覚 + 数値 + 変換 を一気通貫で行うパイプラインを念頭に置くと、 抜け漏れが減る。
- パターン 1:単変量、 小標本 (n≤50) → Shapiro-Wilk + QQ プロット + log 変換候補
- パターン 2:単変量、 中標本 (50<n<500) → Anderson-Darling + ヒストグラム + Box-Cox 探索
- パターン 3:単変量、 大標本 (n≥500) → 視覚評価優先 + 歪度/尖度の数値のみ参照
- パターン 4:多変量 → Royston/Mardia 検定 + マハラノビス χ² プロット + 主成分の正規性確認
- パターン 5:回帰残差 → 残差プロット + Jarque-Bera + 残差ヒストグラム
- パターン 6:時系列 → 自己相関除去 (ARIMA) + 残差正規性 + Ljung-Box
- パターン 7:ベイズ → 事後予測チェック + 観測 vs 予測 KDE 重ね描き
㉕ 補足 U:ドメイン別の典型分布
| ドメイン | 典型的な分布 | 正規仮定の妥当性 |
|---|---|---|
| 身体測定 (身長, 体重) | 正規 (近似) | ○ 多くの場合 OK |
| 所得・売上 | 対数正規, パレート | × log 変換が必要 |
| 人口 (都道府県・都市) | べき乗則 (ジップ則) | × log 変換でも完全には改善されない |
| テスト得点 | 正規 (設計上) | ○ 平均化により正規化 |
| 反応時間 (心理実験) | 対数正規, ex-Gaussian | × log または逆数変換 |
| 株価リターン | t 分布, 安定分布 | × 裾が極端に重い |
| 放射性崩壊 | 指数分布 | × 指数族モデルへ |
| 事故件数 | ポアソン | × カウントモデル使用 |
| 遺伝子発現量 | 負の二項分布 | × DESeq2 等で扱う |
| 機械の誤差 | 正規 (古典誤差論) | ○ Gauss が確立した古典例 |
㉖ 補足 V:チートシート(最速判定フロー)
現場で迷ったときの最速判定フローを箇条書きで整理する。
- 標本サイズ n を確認 → n≥30 なら CLT で平均は正規近似 OK
- ヒストグラム + QQ プロットを 30 秒で確認 → 明らかに非正規なら検定不要
- 歪度と尖度を数値で確認 → |γ₁|≤1 かつ |γ₂|≤2 なら概ね OK
- 境界例は Shapiro-Wilk または Anderson-Darling を実行
- 違反なら log / Box-Cox を試す
- 変換しても改善しなければノンパラ手法に切り替え
- 結論に「検定方法」「p 値」「視覚評価結果」「代替手法の有無」を明記
㉗ 補足 W:正規性とサンプリング設計
正規性は サンプリング設計 によっても変わる。 同じ母集団でも、 単純無作為抽出と層化抽出、 クラスター抽出ではサンプル分布の性質が異なる。 例えば SSDSE-B-2026 の都道府県データは 悉皆データ (全 47 都道府県) であり、 そもそも標本ではなく母集団そのものである。 この場合、 「正規性検定の p 値」は本質的な意味を失う (母集団全体が「正規ではない」ことは数学的に確定しているため)。 代わりに 形状の記述 (歪度・尖度・QQ プロット) を行うのが正しい姿勢である。
一方、 標本データ (例:47 都道府県から無作為に 10 県を選んだ場合) では、 抽出方法に応じて理論分布が変わる。 層化抽出では各層の正規性を別々に評価し、 クラスター抽出では設計効果を考慮した補正が必要となる。 「データ = 標本」「データ = 母集団」の区別は、 正規性の解釈に直結する重要な視点である。
㉘ 補足 X:報告書テンプレート
論文・レポートで正規性評価を記述する際の標準テンプレートを示す。
| 記述項目 | 記載例 |
|---|---|
| 標本サイズと変数 | 「SSDSE-B-2026 の総人口 (n=47)」 |
| 使用した検定 | 「Shapiro-Wilk 検定 (scipy.stats.shapiro)」 |
| 統計量と p 値 | 「W=0.69, p<0.001」 |
| 視覚評価の結果 | 「QQ プロットで右端が直線より上方に大きく反る (図 X)」 |
| 変換の有無 | 「log10 変換で W=0.93 まで改善するが p=0.006 でなお棄却、 Box-Cox (λ≈−0.49) で W=0.98, p=0.48」 |
| 採用した手法 | 「log 変換後に Pearson 相関を計算」または「Spearman 相関を採用」 |
| 限界と注意 | 「小標本のため検出力は中程度。 結論は中央値ベースで解釈」 |
このテンプレートに沿って報告すれば、 査読者・読者が 「何を確認したか」「どのように判断したか」「結論の限界はどこか」 を一目で把握でき、 統計的透明性が確保される。 SSDSE-B-2026 を題材にした学習レポートでも、 同じ枠組みで記述する習慣をつけることが、 統計リテラシーの定着に直結する。
㉙ 補足 Y:正規性をめぐる近年の議論
近年の統計学界では、 「正規性検定の使用を控えよ」 という主張が強まっている。 主な論点は次の通りである。
- 大標本で過検出:n が大きくなると、 ほぼ無視できる乖離も「有意」とされ、 実用上の意味が薄れる。
- 小標本で過小検出:n が小さいと、 明らかに非正規な分布でも「検出されない」場合がある。 検定の検出力不足の典型。
- 頑健な代替手法の発達:ノンパラ手法・ブートストラップ・ベイズ的アプローチが容易に使えるようになり、 「正規性が必要」な場面自体が減少。
- 視覚評価の優位性:QQ プロット・ヒストグラムの方が、 検定統計量より遥かに豊富な情報を与える。
- 事前検定問題:「t 検定の前に正規性検定」という流れは、 多重検定の問題を生み、 全体の第一種過誤率を高める。
現代の標準的なアドバイスは「視覚評価を主とし、 数値検定は補助。 判断に迷う境界例でのみ検定を参考に」というもの。 SSDSE-B-2026 のような小〜中標本データでは、 QQ プロットと歪度・尖度を最初に確認し、 検定は補助的に使うのが穏当な姿勢である。
㉚ 補足 Z:分布フリー手法の選び方
正規性が成立しない場合の代替として、 分布フリー (distribution-free) 手法 は強力。 主要な選択肢を整理する。
| 目的 | 分布フリー手法 | 補足 |
|---|---|---|
| 中央値の比較 | Mann-Whitney, Wilcoxon | 順位ベース、 2 群 |
| 3 群以上の比較 | Kruskal-Wallis | 分散分析の代替 |
| 相関の評価 | Spearman, Kendall τ | 単調関係を測定 |
| 中央値の信頼区間 | ブートストラップ | 1000 回以上のリサンプリング |
| 分布全体の比較 | Kolmogorov-Smirnov, Cramér-von Mises | 経験分布関数の比較 |
| 単一群の中央値検定 | 符号検定, Wilcoxon 符号順位 | 1 群の中央値を理論値と比較 |
| 変動性の比較 | Brown-Forsythe, Levene (中央値版) | 分散の代わりに中央値からの絶対偏差 |
| 回帰 | 分位回帰, ロバスト回帰 (Huber, RANSAC) | 外れ値・非正規残差に強い |
㉛ 補足 AA:正規性とビッグデータ時代
ビッグデータ時代には、 n が数百万〜数十億に達する。 この規模では すべての変数が「正規性検定で棄却される」。 微小な乖離も統計的有意となるためである。 こうした状況では、 正規性の数値検定は 事実上意味を失う。 代わりに次のアプローチが推奨される。
- サンプリングして視覚評価:全データから無作為に 1000〜10000 件を抽出し、 QQ プロットで形状を評価
- 歪度・尖度の数値を主指標に:|γ₁|, |γ₂| の絶対値を見て、 実用上問題ない範囲かを判定
- 頑健な手法をデフォルトに:中央値ベース、 分位回帰、 ロバスト推定を積極採用
- 分布フィッティング:t 分布、 対数正規、 安定分布などをフィットし、 AIC/BIC で選択
- ブートストラップで信頼区間:分布仮定を完全に回避できる強力ツール
㉜ 補足 BB:日本の公的統計と正規性
SSDSE-B-2026 を含む日本の公的統計データは、 多くが 都道府県別の集計値 として提供される。 これらは個人レベルの観測ではなく 集計後の値 であるため、 中心極限定理により正規分布に近づきやすい。 しかし「人口」「総生産」のように 規模が桁違いの値 を含む場合は、 集計後も裾が重く非正規となる。 日本の地理的・経済的構造 (東京一極集中、 中山間地域の過疎化など) が分布形状に強く反映される点も特徴的。
㉝ 補足 CC:よくある誤訳・誤用語の整理
英語文献を翻訳する際の典型的な誤訳と、 正しい日本語訳を整理する。
| 英語 | 誤訳 | 正しい訳 |
|---|---|---|
| normal distribution | 正常分布 | 正規分布 |
| normality test | 正常性検定 | 正規性検定 |
| heavy-tailed | 重い尾 | 裾が重い (裾厚) |
| skewness | 傾き | 歪度 |
| kurtosis | 曲率 | 尖度 |
| log-normal | ログ正常 | 対数正規 |
| tail probability | 尻尾確率 | 裾確率 |
| distribution-free | 分布自由 | 分布フリー (分布によらない) |
特に 「normal」を「正常」 と訳すと、 統計的な「ガウス分布に従う」という意味から大きく外れる。 一方で日本語の「正規」も「正しい規範に従う」という意味合いを連想させるため、 「単にガウス曲線」という中立的なイメージを学習者に伝える工夫が必要である。
㉞ 補足 DD:参考文献と次の学習ステップ
正規性をさらに深く学ぶには、 次の文献・教材が推奨される。
- 古典:Snedecor & Cochran 『Statistical Methods』 — 検定の理論と実用の両面
- 分布論:Johnson & Kotz 『Continuous Univariate Distributions』 — 各分布の数学的性質
- ノンパラ手法:Hollander & Wolfe 『Nonparametric Statistical Methods』
- ブートストラップ:Efron & Tibshirani 『An Introduction to the Bootstrap』
- 多変量:Mardia, Kent, Bibby 『Multivariate Analysis』
- 日本語入門:東京大学教養学部統計学教室編 『統計学入門』
- 実践:SciPy/StatsModels の公式ドキュメント (各検定の API リファレンス)
㉟ 補足 EE:正規性とコンペティション
統計・データ解析コンペティション (Kaggle, SIGNATE, 統計データ解析コンペなど) では、 特徴量の正規性が モデル選択とスコア改善 に直結することがある。 とりわけ 線形モデル系 (Ridge, Lasso, ElasticNet) は入力分布に敏感で、 ターゲット変数の対数変換 (log1p) はベースラインを大きく押し上げる定番テクニックである。 一方、 木構造系 (Random Forest, XGBoost, LightGBM) は変換にほぼ無関心。
コンペでの実用テクニックを整理する。
- EDA フェーズ:全特徴量に対し歪度を計算、 |γ₁| > 1 のものを log1p または Box-Cox 候補としてリスト化
- 特徴量エンジニアリング:log, sqrt, Box-Cox, Yeo-Johnson, rank-gauss などを試し、 交差検証で効果を測る
- ターゲット変換:価格・需要量など右に裾のあるターゲットは log1p が定番。 予測時は expm1 で戻す
- 残差診断:モデル予測の残差が正規かを確認し、 残差が歪んでいれば異常検知や追加特徴の手がかりに
- アンサンブル:線形系 (正規仮定が効く) と木構造系 (仮定不要) を混ぜることで、 双方の良さを取り込む
🗺 概念マップ
正規性 (normality) を中心ノードとし、 周囲に判定手段 (Shapiro-Wilk・QQ プロット・歪度尖度)、 仮定する手法群 (t 検定・ANOVA・線形回帰)、 違反時の代替 (ノンパラメトリック検定・対数変換)、 関連概念 (中心極限定理・正規分布) を配置した SVG マップ。 中心からの距離が「正規性チェックからの近さ」を表す。
本セクションでは正規性に関連する 視覚化・検定・変換・代替手法を補強する。 QQ プロット、 Shapiro-Wilk の検出力、 対数/Box-Cox 変換、 ノンパラ代替の判断基準を一つずつ確認することで、 「検定 p 値だけに依存しない正規性判断」の引き出しを増やせる。
🔗 隣接手法への橋渡し
「正規性」は単独で完結せず、 前後の手法と組み合わさって価値が発揮される。 入力データの準備 (上流)・同目的の代替手法との比較 (並列)・結果の活用 (下流) という 3 軸で隣接領域を整理する。
- 上流 (入力の準備): 記述統計 による 歪度・尖度 の確認、 ヒストグラム・QQ プロット の可視化
- 並列 (同目的の代替): Shapiro-Wilk 検定、 Kolmogorov-Smirnov 検定、 Anderson-Darling 検定、 Jarque-Bera 検定 が同目的で並列
- 下流 (結果の活用): 結果に応じて t 検定・ANOVA (正規 OK) と ノンパラメトリック検定 (正規 NG) を選択、 対数変換 で正規化を試行
この上流・並列・下流の対応を地図化することで、 「正規性」を中核に据えた分析パイプライン (データ準備 → 手法選択 → 結果の検証と展開) の全体像が見えてくる。
🌳 手法選択フロー
「正規性」を扱う際の手法選択は、 状況に応じて以下のフローで判断すると迷いが減る。
- Step 1: 目的は記述か予測か?
- 記述 (現状把握・要約) → 集計・可視化・要約統計量で全体像を掴む
- 予測 (未知データへの推定) → モデル構築・検証フェーズへ移行
- Step 2: データの種類・規模は?
- 数値データ・小〜中規模 → 「正規性」やその拡張手法を直接適用
- カテゴリデータ → カテゴリ専用の手法 (カテゴリ変数の検定) と組み合わせ
- 大規模・高次元 → 計算効率を考慮した派生手法 (K-S 検定・Anderson-Darling 検定) を選択
- Step 3: 結果の解釈・共有は?
- 専門家向け → 数値指標・統計検定で精緻に評価
- 非専門家向け → 可視化・自然言語での要約を重視
このフローに沿って判断することで、 「正規性」を中核とした適切な手法選択ができる。
🧭 深掘り:直感・落とし穴・発展(追補)
ここまでの各節(🎨 直感で掴む・⚠️ よくある落とし穴・🔗 関連用語)で扱った内容を、 「一枚で見返せる要約」として追補します。 既存の解説を置き換えるものではなく、 復習・逆引き用のインデックスとして使ってください。
🎨 直感 — 「正規性」を一言で
正規性とは 「データ(正確には推定量)が正規分布に従うか」 という問いです。 t 検定・ANOVA・線形回帰の p 値や信頼区間は、 内部で推定量が 正規分布に従うことを使って計算されるため、 これが前提になります。 確認は 可視化(ヒストグラム・Q-Q プロット)と検定(Shapiro-Wilk ほか)を必ず併用するのが鉄則。 検定は「正規か否か」の二値を返しますが、 実務で効くのは「どの程度・どの向きにズレているか」という逸脱の大きさで、 これは Q-Q プロットでしか見えません。
⚠️ 落とし穴 — 「外れ値を1個抜けば正規」は誤解
SSDSE-B-2026(2023 年・47 都道府県)の総人口で、 「東京都という極端値さえ抜けば正規に戻る」と考えがちですが、 実測ではそうなりません:
| 対象(総人口 A1101) | n | 歪度 | Shapiro W | p 値 |
|---|---|---|---|---|
| 全 47 県 | 47 | +2.29 | 0.6895 | 1.1e-08 |
| 東京都(最大値)を除外 | 46 | +1.82 | 0.7235 | 5.6e-08 |
| log10 変換(全 47 県) | 47 | +0.82 | 0.9280 | 0.0064 |
| Box-Cox 変換(λ≈−0.49) | 47 | ≈0 | 0.9770 | 0.48 |
東京を抜いても歪度は +1.82 と大きいまま(W もほとんど改善しない)。 これは「1 個の外れ値」ではなく分布全体が右に歪んでいる(対数正規型)ことを意味します。 効くのは点の除去ではなく 対数変換や Box-Cox 変換という スケールの変更です。 その他の代表的な落とし穴:
- 大標本での過敏:n が大きいと Shapiro-Wilk はごく僅かな逸脱でも棄却する。 一方その大標本では 中心極限定理で平均は十分正規なので、 検定は「非正規」と言っても実害は小さい。
- 小標本での検出力不足:n=47 でも微小な歪みは検出できないことがある(「棄却できない=正規」ではない)。
- 目的次第で正規性は不要:平均の推定・比較なら CLT が効き、 元データの厳密な正規性は要らないことが多い。 仮説検定の前提が「何の正規性」かを常に確認する(回帰なら応答変数ではなく残差)。
- Q-Q プロットの主観と検定過信:可視化だけだと主観、 検定だけだと逸脱の大きさが見えない。 数値検定+箱ひげ図/Q-Q の併用で客観性を補う。
- 対数変換の機械適用:0 や負値には 対数変換不可(log(x+1) や Yeo-Johnson を検討)。 変換後の平均は幾何平均に対応するので解釈も変わる。
🚀 発展 — 次の一手のマップ
- 検定の使い分け:Shapiro-Wilk(全般に最強検出力)/Kolmogorov-Smirnov(分布全体)/Anderson-Darling(裾重視)/D'Agostino K²・Jarque-Bera(歪度・尖度)。 得意な逸脱が違うので結論が割れるのは正常(本ページ「🔬 実データで計算」節に 5 検定一括比較あり)。
- 数値指標:歪度 ≈ 0、 過剰尖度 ≈ 0 が正規の目安。 経験則で |歪度|≤1・|尖度|≤2 なら概ね許容。
- 変換:対数変換・Box-Cox(正値前提、 SSDSE 総人口では λ≈−0.49 で W=0.977, p=0.48 まで回復)・Yeo-Johnson(負値可)。
- CLT との関係:中心極限定理により標本平均は元分布によらず n とともに正規へ。 歪みが強いほど必要な n は増える。
- 頑健・ノンパラ代替:ノンパラメトリック検定(Mann-Whitney U・Wilcoxon・Kruskal-Wallis)、 ブートストラップ、 ロバスト統計(中央値・トリム平均・M 推定)。
- 多変量正規性:単変量が正規でも結合分布は正規とは限らない。 マハラノビス距離+χ² プロット、 Mardia/Royston 検定などで評価する。
🔗 関連ページ
- 正規分布 — 正規性が問う「理想の形」(歪度・尖度の参照も同ページ)
- Shapiro-Wilk 検定 — 小〜中標本で最も使われる正規性検定
- 対数変換 — 右に裾の長い分布を正規へ近づける定番
- ノンパラメトリック — 正規性を仮定しない代替手法
- 中心極限定理 — 「厳密な正規性が要らない」根拠
- 尖度・歪度 / ヒストグラム / 箱ひげ図 — 逸脱の可視化と数値化