🔖 キーワード索引
「anova」は統計データ分析の文脈で扱う重要概念のひとつ。 本ページでは「anova」を取り巻く中核キーワードを以下にチップで一覧化する。 各キーワードは関連する概念・手法・道具立てを含み、 文献検索や学習計画の起点になる。
これらのキーワードは「anova の理解 → 適用 → 検証」のプロセスを構成する。 各章で詳しく解説する。
💡 30秒で分かる結論
🍰 まずはやさしく
3つ以上のグループを比べる道具です。
平均に差があるか調べるために使います。
部活ごとの練習時間の違いを調べます。
分析の種類や結果の見方を学びます。
- ANOVA=群間分散 ÷ 群内分散 = F統計量で群差を検定。
- 一元配置:1 つの要因の影響(3群以上)。
- 二元配置:2 つの要因と交互作用。
- 反復測定:同じ個体の繰り返し測定。
- 有意なら post-hoc(Tukey/Bonferroni)でどの群間に差があるか特定。
- 効果量 η² または ω² を必ず併記。
- 前提が崩れたら Kruskal–Wallis や Welchの ANOVA。
📍 あなたが今見ているもの
🍰 まずはやさしく
グループの平均を比べる方法です。
データのばらつきから差を判定します。
スマホの機種による利用時間を比べます。
分析の手順と使い分けを解説します。
本ページでは、 分散分析 (ANOVA)を統合的に解説します。 一元配置・二元配置・反復測定・post-hoc 検定・効果量を一気通貫で扱います。
ANOVA は「3 群以上の平均が等しいか」を検定する手法。 名前は「分散」ですが、 検定対象は平均値です。 群内変動と群間変動を比較することから「分散」と呼ばれます。
🎨 直感で掴む — ANOVAの本質
🍰 まずはやさしく
ばらつきを切り分けるイメージです。
差が本物かどうかを判断するために使います。
クラスごとのテスト点数の差を調べます。
ばらつきの比率で考える仕組みを学びます。
ANOVA(分散分析)の核心は名前のとおり 「分散の分解」。 SSDSE-B-2026 で 47 都道府県を 北日本・東日本・西日本 の 3 ブロックに分けて出生率を比較するとき、 「全体のバラつき」を 群間のバラつき(地域差) と 群内のバラつき(地域内の差) に切り分け、 その比率(F値)で「地域差は本物か」を検定します。
比喩で言うと、 ある楽団の演奏のばらつきを「楽器セクション間のばらつき」と「同じセクション内のばらつき」に切り分けて、 もしセクション間のバラつきが圧倒的に大きければ「セクションごとに本当に差がある」と判断するイメージ。 ANOVAは t検定の自然な拡張で、 群が 3 つ以上のときに 多重比較の罠 を避けながら一発で検定できる点が魅力です。
🎮 触って理解する — 分散の比で平均の差を検定する
3 群(A・B・C)の平均を 3 本のスライダーで、 群内のばらつき(標準偏差)を 1 本のスライダーで動かしてみましょう。 群間平方和 SSbetween・群内平方和 SSwithin・自由度・F 統計量・p 値がリアルタイムで再計算されます。 群間の平均差が大きいほど、 また群内のばらつきが小さいほど F は大きく p は小さくなる —— これが「分散の比で平均の差を検定する」という ANOVA の核心です(各群 n = 8、 k = 3 群、 全体 N = 24 で固定)。
💡 体感ポイント: 3 つの平均を近づけると SSbetween が縮み F が 1 に近づいて p が大きくなります(=差なし)。 逆に 1 群だけ大きく離すと SSbetween が伸びて F が跳ね上がり、 観測 F が右側の赤い棄却域へ入って p < 0.05 になります。 σ(群内ばらつき)を上げると分母 MSwithin が増えて同じ平均差でも F が下がる —— 「シグナル(群間差)÷ ノイズ(群内差)」という F 比の意味がそのまま見えます。
この体験と直結する概念: t 検定(2 群版 ANOVA・F = t²)/ 効果量 η²(= SSbetween/SStotal、 差の実質的大きさ)/ 多重比較・多重検定(有意後に Tukey HSD でどの群ペアが違うか特定)/ F 検定・仮説検定。 なお F 検定は正規性・等分散性・独立性を前提とし、 崩れる場合は Kruskal–Wallis や Welch ANOVA を用います。
📐 7. 効果量
🍰 まずはやさしく
差の大きさを表す数値のことです。
平均の差がどれだけ重要かを知るために使います。
買い物への影響度が強いか調べます。
効果量の計算方法と基準を学びます。
ANOVA の効果量:
- η² (イータ二乗): $\eta^2 = SS_{between}/SS_{total}$。 説明分散の割合
- ω² (オメガ二乗): η² の偏りを補正した推定量
- Cohen's f: $f = \sqrt{\eta^2/(1-\eta^2)}$。 小 0.10、 中 0.25、 大 0.40
1 2 3 4 5 6 7 8 9 10 11 12 13 14 15 16 17 18 19 20 21 22 23 24 25 26 27 28 29 30 31 32 33 34 35 36 37 38 39 | import numpy as np import pandas as pd from scipy import stats # ── この抜粋だけで動くように、8 地方ブロック別の年平均気温を用意する ── # 英字の項目コード(A1101 など)を使うので、2 行目の日本語名は読み飛ばす _df = pd.read_csv('data/raw/SSDSE-B-2026.csv', encoding='cp932', skiprows=[1]) _df = _df[_df['SSDSE-B-2026'] == 2023] # 最新年度の 47 都道府県 # 「地方ブロック」は SSDSE に無い列なので、都道府県名から 8 区分を作る _BLOCKS = { '北海道': ['北海道'], '東北': ['青森県', '岩手県', '宮城県', '秋田県', '山形県', '福島県'], '関東': ['茨城県', '栃木県', '群馬県', '埼玉県', '千葉県', '東京都', '神奈川県'], '中部': ['新潟県', '富山県', '石川県', '福井県', '山梨県', '長野県', '岐阜県', '静岡県', '愛知県'], '近畿': ['三重県', '滋賀県', '京都府', '大阪府', '兵庫県', '奈良県', '和歌山県'], '中国': ['鳥取県', '島根県', '岡山県', '広島県', '山口県'], '四国': ['徳島県', '香川県', '愛媛県', '高知県'], '九州': ['福岡県', '佐賀県', '長崎県', '熊本県', '大分県', '宮崎県', '鹿児島県', '沖縄県'], } _R = {p: g for g, ps in _BLOCKS.items() for p in ps} _df = _df.assign(block=_df['Prefecture'].map(_R), temp=pd.to_numeric(_df['B4101'], errors='coerce')) # 年平均気温(℃) # groups = 「ブロックごとの年平均気温の配列」のリスト(8 群) groups = [g['temp'].values for _, g in _df.groupby('block', sort=False)] def eta_squared(groups): grand = np.mean(np.concatenate(groups)) ss_b = sum(len(g)*(np.mean(g)-grand)**2 for g in groups) ss_t = sum(((np.concatenate(groups)-grand)**2)) return ss_b / ss_t F, p = stats.f_oneway(*groups) grand = np.mean(np.concatenate(groups)) ss_b = sum(len(g) * (np.mean(g) - grand) ** 2 for g in groups) ss_t = sum((np.concatenate(groups) - grand) ** 2) print(f'F統計量 = {F:.3f}, p値 = {p:.3g}') print(f'群間平方和 = {ss_b:.1f}, 群内平方和 = {ss_t - ss_b:.1f}') print(f'η² = {eta_squared(groups):.3f}') |
📋 8. 前提条件
| 前提 | 確認方法 | 違反したら |
|---|---|---|
| 残差の正規性 | QQプロット・Shapiro | Kruskal–Wallis |
| 等分散性 | Levene 検定 | Welch's ANOVA |
| 独立性 | サンプリング設計 | 混合効果モデル |
| 球面性 (反復測定) | Mauchly検定 | Greenhouse–Geisser補正 |
🔄 9. ノンパラメトリック代替
- Kruskal–Wallis:一元配置ANOVAのノンパラ版
- Friedman:反復測定ANOVAのノンパラ版
- Welch's ANOVA:等分散仮定なし
1 2 3 | from scipy import stats H, p = stats.kruskal(*groups) print(f'Kruskal-Wallis H = {H:.3f}, p = {p:.4f}') |
🔬 数式を言葉で読み解く — 分散分解と F値
$$ \text{SS}_{\text{total}} = \text{SS}_{\text{between}} + \text{SS}_{\text{within}}, \quad F = \frac{\text{SS}_{\text{between}}/(k-1)}{\text{SS}_{\text{within}}/(N-k)} = \frac{\text{MS}_{\text{between}}}{\text{MS}_{\text{within}}} $$| 記号 | 意味 | SSDSE-B-2026 例 |
|---|---|---|
| $k$ | 群数 | 3 地域ブロック |
| $N$ | 総サンプル数 | 47 都道府県 |
| $\text{SS}_{\text{between}}$ | 群間平方和(地域差) | 地域ブロックの平均出生率のバラつき |
| $\text{SS}_{\text{within}}$ | 群内平方和(誤差) | 同じブロック内の県間バラつき |
| $F$ | 「シグナル/ノイズ」比 | 1 を大幅に超えれば群差あり |
有意になったら post-hoc 検定(Tukey HSDなど) で「どの群間に差があるか」を特定し、 効果量 $\eta^2 = \text{SS}_{\text{between}}/\text{SS}_{\text{total}}$ を必ず併記します。
🧮 SSDSE-B 実値計算例:地域ブロックで「食料費」に差があるか?
SSDSE-B-2026(47都道府県、 2023年)で、 都道府県を北海道・東北・関東・中部・近畿・中国・四国・九州沖縄の8地域に分け、 食料費(L322101、 二人以上の世帯、 円)に地域差があるかを一元配置 ANOVA で確認します。
📊 ステップ1:群分け
| 地域 | 県数 | 食料費平均(円) | 標準偏差 |
|---|---|---|---|
| 北海道 | 1 | 74,341 | — |
| 東北 | 6 | 80,824 | 2,844 |
| 関東 | 7 | 86,670 | 8,305 |
| 中部 | 9 | 82,182 | 4,771 |
| 近畿 | 7 | 83,084 | 4,028 |
| 中国 | 5 | 78,177 | 4,225 |
| 四国 | 4 | 75,821 | 3,792 |
| 九州沖縄 | 8 | 75,842 | 2,844 |
※実値は SSDSE-B-2026(2023年)から集計。 ANOVA の主結果は F(7, 39) = 4.09、 p = 0.0019、 η² = 0.42。 「地域は食料費に影響あり」を示唆。
📊 ステップ2:事後検定(Tukey HSD)
有意な ANOVA が出ても、 どの地域ペアが違うかは分かりません。 Tukey HSD で全ペアを比較すると、 「関東 vs 九州沖縄」(差 = 10,828 円, p = 0.002)と「関東 vs 四国」(差 = 10,849 円, p = 0.019)が有意(p < 0.05)で、 「食料費が高い関東と、 低めの四国・九州沖縄で差が大きい」構造が浮かびます。
📊 ステップ3:効果量 η² と実質的意味
η² = 0.42 は「食料費の総変動のうち、 42% が地域差で説明できる」と読みます。 Cohen 基準では η² > 0.14 が「大きい効果」なので、 統計的にも実質的にも大きな地域差と結論できます。
🧮 数式に値を入れて手で計算する
合成データ (3 群、 各 $n=4$) を一元配置 ANOVA の数式に代入し、 Step 1〜6 で SS / MS / F / p を手計算する。 同じ計算を Python (scipy.stats.f_oneway) で再現し、 結果が完全一致することを確認する。
📐 一元配置 ANOVA (再掲)
$$ F = \frac{MS_\text{between}}{MS_\text{within}} = \frac{SS_\text{between}/(k-1)}{SS_\text{within}/(N-k)} $$
ただし $SS_\text{between} = \sum_{j=1}^{k} n_j (\bar{x}_j - \bar{x})^2$、 $SS_\text{within} = \sum_{j=1}^{k}\sum_{i=1}^{n_j}(x_{ij} - \bar{x}_j)^2$。
Step 1: データ準備 (3 群、 各 $n=4$)
| 群 | 観測値 | $n_j$ | 群平均 $\bar{x}_j$ |
|---|---|---|---|
| A | 4, 6, 5, 5 | 4 | 5.0 |
| B | 7, 8, 6, 7 | 4 | 7.0 |
| C | 9, 11, 10, 10 | 4 | 10.0 |
| 全体 | $N=12$ | — | $\bar{x} = (5+7+10) \cdot 4 / 12 = 7.333333$ |
Step 2: 群内平方和 $SS_\text{within}$ (各群内の偏差平方の合計)
| 群 | $x_{ij} - \bar{x}_j$ | $(x_{ij}-\bar{x}_j)^2$ の合計 |
|---|---|---|
| A (mean=5) | $-1, +1, 0, 0$ | $1+1+0+0 = 2$ |
| B (mean=7) | $0, +1, -1, 0$ | $0+1+1+0 = 2$ |
| C (mean=10) | $-1, +1, 0, 0$ | $1+1+0+0 = 2$ |
| $SS_\text{within}$ | — | $2 + 2 + 2 = 6$ |
Step 3: 群間平方和 $SS_\text{between}$ ($\bar{x} = 22/3 = 7.333333$)
| 群 | $\bar{x}_j - \bar{x}$ | $n_j (\bar{x}_j - \bar{x})^2$ |
|---|---|---|
| A | $5 - 22/3 = -7/3$ | $4 \times (7/3)^2 = 196/9$ |
| B | $7 - 22/3 = -1/3$ | $4 \times (1/3)^2 = 4/9$ |
| C | $10 - 22/3 = +8/3$ | $4 \times (8/3)^2 = 256/9$ |
| $SS_\text{between}$ | — | $(196+4+256)/9 = 456/9 \approx 50.666667$ |
Step 4: 自由度
| 項目 | 計算 | 結果 |
|---|---|---|
| $df_\text{between} = k - 1$ | $3 - 1$ | 2 |
| $df_\text{within} = N - k$ | $12 - 3$ | 9 |
Step 5: 平均平方 (MS) と F 値
| 項目 | 計算 | 結果 |
|---|---|---|
| $MS_\text{between}$ | $50.666667 / 2$ | 25.333333 |
| $MS_\text{within}$ | $6 / 9$ | 0.666667 |
| $F$ | $25.333333 / 0.666667$ | 38.000000 |
Step 6: p 値と結論
| 項目 | 結果 |
|---|---|
| $F(2, 9)$ 分布の上側確率 | $p \approx 0.0000409$ |
| 有意水準 $\alpha = 0.05$ で判定 | $p < 0.05$ → 3 群の母平均は等しくない |
🐍 同じ計算を Python で再現
1 2 3 4 5 6 7 8 9 10 11 12 13 14 15 16 17 18 19 20 21 22 23 24 25 26 27 28 29 30 31 32 33 34 35 36 37 38 39 40 41 42 43 44 | import numpy as np from scipy import stats # Step 1: 合成データ (3 群、 各 n=4) A = np.array([4, 6, 5, 5]) B = np.array([7, 8, 6, 7]) C = np.array([9, 11, 10, 10]) groups = [A, B, C] all_data = np.concatenate(groups) k = len(groups) N = len(all_data) grand_mean = all_data.mean() # Step 2: SS_within ss_within = sum(((g - g.mean())**2).sum() for g in groups) # Step 3: SS_between ss_between = sum(len(g) * (g.mean() - grand_mean)**2 for g in groups) # Step 4: df df_b = k - 1 df_w = N - k # Step 5: MS と F ms_b = ss_between / df_b ms_w = ss_within / df_w F = ms_b / ms_w # Step 6: p 値 p = 1 - stats.f.cdf(F, df_b, df_w) print(f"grand_mean = {grand_mean:.6f}") print(f"SS_within = {ss_within}") print(f"SS_between = {ss_between:.6f}") print(f"df_between = {df_b}, df_within = {df_w}") print(f"MS_between = {ms_b:.6f}") print(f"MS_within = {ms_w:.6f}") print(f"F = {F:.6f}") print(f"p-value = {p:.7f}") # 検算: scipy.stats.f_oneway F2, p2 = stats.f_oneway(A, B, C) print(f"scipy F = {F2:.6f}, p = {p2:.7f}") |
📤 実行結果
💬 手計算 (Step 2〜6) と Python 出力 (および scipy.stats.f_oneway の検算) が完全一致 ($F = 38.000$、 $p \approx 4.09 \times 10^{-5}$)。 群内ばらつきが小さく群間ばらつきが大きいため、 $\alpha = 0.05$ で「3 群の母平均は等しい」を棄却できる。
🐍 13. ライブラリ早見表
🐍 13. ライブラリ早見表
| 用途 | 関数 |
|---|---|
| 一元配置ANOVA | scipy.stats.f_oneway |
| 二元配置ANOVA | statsmodels.formula.api.ols + anova_lm |
| 反復測定ANOVA | statsmodels.stats.anova.AnovaRM |
| Welch's ANOVA | pingouin.welch_anova |
| Tukey HSD | statsmodels.stats.multicomp.pairwise_tukeyhsd |
| Bonferroni | statsmodels.stats.multitest.multipletests(method='bonferroni') |
| Kruskal–Wallis | scipy.stats.kruskal |
| Friedman | scipy.stats.friedmanchisquare |
📜 14. ANOVA の歴史
- 1918:R.A. Fisher が分散分析を提案
- 1925:Fisher の Statistical Methods for Research Workers で体系化
- 1935:Fisher の The Design of Experiments で実験計画法の基礎が確立
- 1949:Tukey が HSD 検定を提案
- 1960年代:心理学・農学・医学で標準ツールに
- 1990年代以降:混合モデル・GLM が発展、 ANOVA は GLM の特殊ケースと位置づけられるように
💼 15. 実務応用
- 農学:肥料種別 × 品種の収穫量比較(二元配置)
- 製造業:工場 × ラインの不良率(多元配置)
- 医療:薬剤 × 用量の効果(反復測定)
- 教育:教授法 × 学年の成績
- マーケティング:広告クリエイティブ 3 種以上の効果比較
- 公共政策:地域 3 群以上の指標比較
📋 16. ANOVA 表の読み方
statsmodels の anova_lm が出力する表の各列:
| 列 | 意味 |
|---|---|
| sum_sq | 平方和 SS。 各要因の説明する変動 |
| df | 自由度。 K-1(要因)、 N-K(残差) |
| F | F統計量 = MS要因 / MS残差 |
| PR(>F) | F値以上の値が出る確率(p値) |
SS の3タイプ(不均衡データで違いが出る)
- Type I (sequential):モデルへの投入順に逐次計算。 不均衡では順序依存
- Type II:他主効果を調整、 交互作用は除外。 不均衡時の一般的選択
- Type III:すべての他項を調整。 SAS 既定。 解釈に注意
🔗 17. ANOVA と回帰の等価性
ANOVA は実は「カテゴリ変数(ダミー変数)だけの線形回帰」と数学的に等価。 statsmodels では同じ ols で記述できる。
1 2 3 4 5 6 7 8 9 10 11 12 13 14 15 16 17 18 19 20 21 | import pandas as pd import statsmodels.formula.api as smf import statsmodels.api as sm # ── この抜粋だけで動くように、都市規模つきの表を用意する ── df = pd.read_csv('data/raw/SSDSE-B-2026.csv', encoding='cp932', skiprows=[1]) df = df[df['SSDSE-B-2026'] == 2023].copy() # 最新年度の 47 都道府県 # 「都市規模」は SSDSE に無い列なので、総人口を 3 等分して作る df['都市規模'] = pd.qcut(df['A1101'], 3, labels=['小', '中', '大']) df['C5401'] = pd.to_numeric(df['C5401'], errors='coerce') # 標準地価(住宅地) df = df.dropna(subset=['C5401']) # ANOVA としての記述 # 数式に C(...) と書くとカテゴリ扱いになるが、このページでは前の例で # 変数 C を作っているため C() が上書きされてしまう。 # 都市規模は category 型なので、そのまま書けばカテゴリとして扱われる。 m_anova = smf.ols('C5401 ~ 都市規模', data=df).fit() # C5401=標準地価(住宅地) print(sm.stats.anova_lm(m_anova, typ=2)) # 同じモデルを「ダミー回帰」として見る print(m_anova.summary()) |
p値・F値は完全に一致する。 ANOVA の「カテゴリの主効果」が、 回帰の「ダミー係数の合同検定」に対応している。
✅ 18. ANOVA 実施チェックリスト
- □ サンプル数が各群で確認できているか? (極端な不均衡は要注意)
- □ 残差の QQ プロットを描いたか?
- □ Levene 検定で等分散性を確認したか?
- □ F値・自由度・p値を報告したか?
- □ η² または ω² を報告したか?
- □ 有意なら post-hoc(Tukey 等)を実施したか?
- □ 二元配置なら交互作用プロットを描いたか?
- □ 反復測定なら球面性を確認したか?
- □ 前提が崩れているとき、 適切な代替手法に切り替えたか?
❓ 19. よくある質問
Q. 2 群のときに ANOVA を使ってもよい?
A. はい。 2 群 ANOVA は 2 標本 t検定(等分散仮定)と完全に等価です(F = t²、 df の関係も対応)。 ただし慣例的に 2 群なら t検定を使います。
Q. ANOVA が有意でも post-hoc が一つも有意でないことがある?
A. あります。 ANOVA は「全体的な差」、 post-hoc は「ペアごとの差」を見るため、 補正の保守性で起こり得ます。 効果量と CI で全体像を補完しましょう。
Q. 共変量を入れたいときは?
A. ANCOVA(共分散分析)を使います。 statsmodels では ols('y ~ C(group) + covariate', data=df) のように共変量を加えるだけです。
Q. 反復測定で時点が多いとき球面性が問題になります
A. Mauchly 検定で確認、 違反していたら Greenhouse–Geisser や Huynh–Feldt 補正を使います。 または混合効果モデルに切り替える選択肢もあります。
① scipy.stats.f_oneway(最もシンプル)
1 2 3 4 5 6 7 8 9 10 11 12 13 14 15 16 17 | import pandas as pd from scipy import stats # ── この抜粋だけで動くように、3 群のデータを用意する ── # 47 都道府県を総人口で 3 等分し、それぞれの高齢化率を 1 群とする _a = pd.read_csv('data/raw/SSDSE-B-2026.csv', encoding='cp932', skiprows=[1]) _a = _a[_a['SSDSE-B-2026'] == 2023].copy() _a['aging'] = _a['A1303'] / _a['A1101'] * 100 _a['規模'] = pd.qcut(_a['A1101'], 3, labels=['小', '中', '大']) group_a = _a.loc[_a['規模'] == '小', 'aging'].values group_b = _a.loc[_a['規模'] == '中', 'aging'].values group_c = _a.loc[_a['規模'] == '大', 'aging'].values # 3群を直接渡す F, p = stats.f_oneway(group_a, group_b, group_c) print(f"F={F:.3f}, p={p:.4f}") # Welch 版(等分散仮定なし)は alexandergovern を使う |
② statsmodels(事後検定・効果量込み)
1 2 3 4 5 6 7 8 9 10 11 12 13 14 15 16 17 | import pandas as pd import statsmodels.api as sm from statsmodels.formula.api import ols from statsmodels.stats.multicomp import pairwise_tukeyhsd # ── この抜粋だけで動くように、結果変数 y と群 region を持つ表を用意する ── df = pd.read_csv('data/raw/SSDSE-B-2026.csv', encoding='cp932', skiprows=[1]) df = df[df['SSDSE-B-2026'] == 2023].copy() df['y'] = df['A1303'] / df['A1101'] * 100 # 高齢化率(%) を結果変数に df['region'] = pd.qcut(df['A1101'], 3, labels=['小', '中', '大']) # 人口 3 区分を群に # 数式に C(...) と書くとカテゴリ扱いになるが、このページでは前の例で # 変数 C を作っているため C() が上書きされてしまう。 # region は category 型なので、そのまま書けばカテゴリとして扱われる。 model = ols('y ~ region', data=df).fit() print(sm.stats.anova_lm(model, typ=2)) print(pairwise_tukeyhsd(df['y'], df['region'], alpha=0.05)) |
③ pingouin(最も「使いやすい」現代的ライブラリ)
1 2 3 4 5 | import pingouin as pg # ANOVA + η² + 等分散検定が一発 print(pg.anova(data=df, dv='y', between='region', detailed=True)) print(pg.welch_anova(data=df, dv='y', between='region')) print(pg.pairwise_tukey(data=df, dv='y', between='region')) |
④ scikit-learn — feature selection としての ANOVA F値
scikit-learn の SelectKBest(score_func=f_classif) は内部でカテゴリ y に対する ANOVA F検定を行い、 F値が大きい特徴量を選びます。 分類問題の前処理で頻出。
1 2 3 4 5 6 7 8 9 10 11 12 13 14 15 16 17 18 19 | import pandas as pd from sklearn.feature_selection import SelectKBest, f_classif # ── この抜粋だけで動くように、特徴量 X と目的 y を用意する ── # ANOVA の F 値は「群ごとに平均が違う特徴量」を選ぶのに使える _d = pd.read_csv('data/raw/SSDSE-B-2026.csv', encoding='cp932', skiprows=[1]) _d = _d[_d['SSDSE-B-2026'] == 2023] _num = _d.select_dtypes(include='number').dropna(axis=1) # 値が 1 種類しかない列は分散が 0 で F 値を計算できないので、先に落とす _num = _num.loc[:, _num.nunique() > 1] X = _num.values y = (_d['A1101'] > _d['A1101'].median()).astype(int).values # 人口が中央値超か selector = SelectKBest(score_func=f_classif, k=10) X_new = selector.fit_transform(X, y) print(f'選ばれた特徴量: {X_new.shape[1]} 本 / 全 {X.shape[1]} 本') # F 値が大きい順に上位 10 本を見る _top = pd.Series(selector.scores_, index=_num.columns).sort_values(ascending=False) print(_top.head(10).round(2).to_string()) |
⑤ ノンパラメトリック代替:Kruskal-Wallis
1 2 3 4 5 6 7 8 9 10 11 12 13 14 15 | import pandas as pd from scipy import stats # ── この抜粋だけで動くように、3 群のデータを用意する ── _k = pd.read_csv('data/raw/SSDSE-B-2026.csv', encoding='cp932', skiprows=[1]) _k = _k[_k['SSDSE-B-2026'] == 2023].copy() _k['aging'] = _k['A1303'] / _k['A1101'] * 100 _k['規模'] = pd.qcut(_k['A1101'], 3, labels=['小', '中', '大']) a = _k.loc[_k['規模'] == '小', 'aging'].values b = _k.loc[_k['規模'] == '中', 'aging'].values c = _k.loc[_k['規模'] == '大', 'aging'].values H, p = stats.kruskal(a, b, c) # 正規性を仮定しない print(f'Kruskal-Wallis H = {H:.3f}, p = {p:.4f}') # 事後検定は Dunn or Mann-Whitney + Bonferroni |
⚠️ 10. よくある落とし穴
| 落とし穴 | 対処 |
|---|---|
| ペアワイズ t検定の連発 | 必ず ANOVA + post-hoc を使う。 |
| 有意で終わる | どの群間に差があるかを post-hoc で示す。 η² と CI を併記。 |
| 交互作用を見ない | 二元配置では交互作用プロットを必ず描く。 |
| 不均衡データに Type I SS | 不均衡なら Type II/III SS を使う。 |
| 反復測定を独立ANOVAで処理 | 必ず subject を within-subject 因子に。 |
| 前提条件をスキップ | 残差プロット・Levene検定を行う。 |
| 名義尺度を量的に扱う | C() で明示的にカテゴリ化。 |
🏋️ 11. 練習問題(SSDSE-B-2026)
Q1. 都道府県を都市規模 3 群(総人口 A1101 の3分位)に分け、 標準地価(住宅地、 C5401)に差があるかを ANOVA で検定し、 Tukey HSD で post-hoc 比較しなさい。
1 2 3 4 5 6 7 8 9 10 11 12 | import pandas as pd from scipy import stats from statsmodels.stats.multicomp import pairwise_tukeyhsd df = pd.read_csv('data/raw/SSDSE-B-2026.csv', encoding='cp932', skiprows=[1]) df = df[df['SSDSE-B-2026'] == 2023] # 2023年の47都道府県 df['都市規模'] = pd.qcut(df['A1101'], q=3, labels=['小規模県', '中規模県', '大規模県']) groups = [g['C5401'].values for _, g in df.groupby('都市規模')] F, p = stats.f_oneway(*groups) print(f'ANOVA: F={F:.2f}, p={p:.4f}') print(pairwise_tukeyhsd(df['C5401'], df['都市規模'])) |
Q2. 都市規模 × 高齢化レベル(中央値分割)の2元配置 ANOVA を実施し、 交互作用プロットを描きなさい。
1 2 3 4 5 6 7 8 9 10 11 12 13 14 15 | import pandas as pd import matplotlib.pyplot as plt import seaborn as sns # ── この抜粋だけで動くように、都市規模つきの表を作り直す ── df = pd.read_csv('data/raw/SSDSE-B-2026.csv', encoding='cp932', skiprows=[1]) df = df[df['SSDSE-B-2026'] == 2023].copy() df['都市規模'] = pd.qcut(df['A1101'], 3, labels=['小', '中', '大']) df['C5401'] = pd.to_numeric(df['C5401'], errors='coerce') # 標準地価(住宅地) df['高齢化率'] = df['A1303'] / df['A1101'] * 100 # 高齢人口/総人口 df['高齢度'] = (df['高齢化率'] >= df['高齢化率'].median()).map({True:'高', False:'低'}) sns.pointplot(data=df, x='都市規模', y='C5401', hue='高齢度', dodge=True) plt.title('交互作用プロット') plt.show() |
Q3. 残差の正規性と等分散性をチェックし、 違反していれば Kruskal–Wallis に切り替えなさい。
1 2 3 4 5 | # Q3: 残差(各県の地価 − その県が属する都市規模群の平均)の正規性と、3 群の等分散性 resid = df['C5401'] - df.groupby('都市規模', observed=True)['C5401'].transform('mean') print(stats.shapiro(resid)) print(stats.levene(*groups)) print(stats.kruskal(*groups)) |
📝 12. 報告フォーマット
❌ NG例
「ANOVA の結果、 有意でした。」
✅ OK例
「都市規模 3 群(小規模県・中規模県・大規模県、 総人口 A1101 の3分位、 各 n=15〜16)の標準地価(住宅地、 C5401、 円/m²)を一元配置 ANOVA で比較した結果、 主効果が有意であった (F(2, 44) = 8.83, p < .001, η² = .29 大効果)。 Tukey HSD による post-hoc では、 大規模県群が小規模県群より有意に高く (Mdiff = 75,019 円/m², 95% CI [27,346, 122,692], p = .001)、 中規模県群よりも有意に高かった (Mdiff = 68,125 円/m², 95% CI [19,665, 116,586], p = .004)。 中規模県群と小規模県群の差は有意ではなかった (p = .937)。 なお正規性・等分散性の検定では違反が示されたため(Shapiro p < .001、 Levene p = .003)、 Kruskal–Wallis 検定でも確認した(H = 16.45, p < .001、 結論は同じ)。」
⚠️ ANOVA の落とし穴(深掘り版・6件)
① 等分散性の仮定を確認しない
古典的 ANOVA は「各群の分散が等しい」と仮定しています。 群間でばらつきが大きく違うと、 F検定が歪んで p値が信用できなくなります。 必ず Levene検定 か Bartlett検定 で確認。 違反していたら Welch ANOVA(scipy.stats.f_oneway ではなく scipy.stats.alexandergovern や Welch 版)か Kruskal-Wallis(ノンパラ版)を使う。 違反を無視すると Type I エラー率が名目 5% から 10-20% まで膨れることがあります。
② 「F検定が有意」だけで報告を終える
F検定は「どこかの群が違う」とだけ言うので、 どのペアが違うかは別途調べる必要があります。 必ず Tukey HSD、 Dunnett、 Bonferroni などの事後検定を実行し、 さらに 効果量(η², ω²)と95% 信頼区間も併記。 「F(2,57)=4.2, p=0.02」だけで終わらせず、 「群A対B:差=12.3、 95%CI [3.1, 21.5]、 d=0.65」のような完全報告が査読基準。
③ 多重比較補正を忘れる
3群比較で全ペアを比べると 3 回検定するので、 Type I エラーが累積。 「3つ全部が独立に α=0.05」ならいずれか1つで偽陽性となる確率は約 14%。 Bonferroni(α/k で割る)か Tukey HSD(同時信頼区間)か FDR(Benjamini-Hochberg)で補正。 ANOVA の F検定が「家族別 α を守る」と思い込んで、 事後で補正しないのが一番危険なパターン。
④ 正規性を「正規性検定」だけで判断する
サンプル数が大きいと Shapiro-Wilk 等の正規性検定はほぼ必ず棄却される(ささいな偏りも検出)。 一方サンプルが小さいと検出力が低くてどんな分布も「正規」と判定。 つまり正規性検定はサンプル数に振り回されるので使い物にならない場面が多い。 代わりに Q-Q プロット、 ヒストグラム、 歪度・尖度を目視で確認。 また各群 n > 30 なら中心極限定理で F検定はかなり頑健なので、 過度な心配は不要。
⑤ 反復測定で球面性を無視する
同じ被験者を複数回測る(被験者内要因がある)場合、 「すべての時点ペアの差の分散が等しい」という球面性(sphericity)の仮定が必要。 違反すると F検定の自由度が間違って大きくなり、 p値が過小評価される。 Mauchly 検定で確認、 違反ならGreenhouse-GeisserかHuynh-Feldtで自由度補正、 または混合効果モデル(lmer)に移行。
⑥ 順序のあるカテゴリを「単に群」として扱う
「軽症・中等症・重症」のように順序のあるカテゴリ間で y を比べる時、 普通の ANOVA だと「順序情報」を捨ててしまう。 順序付き群間の単調傾向を検出するならJonckheere-Terpstra 検定か線形傾向検定(直交対比)を使う。 「平均が単調に増えるか」という具体的仮説を検証できる。 順序を無視した普通のANOVA より検出力が高くなる。
📚 章構成
📚 章構成
| 章 | 内容 |
|---|---|
| 1. なぜANOVA | t検定との関係 |
| 2. F分布 | 2 つの自由度 |
| 3. 一元配置ANOVA | 1要因モデル |
| 4. 二元配置ANOVA | 2要因・交互作用 |
| 5. 反復測定ANOVA | 対応のあるANOVA |
| 6. Post-hoc検定 | どの群間に差? |
| 7. 効果量 | η² / ω² / Cohen's f |
| 8. ノンパラ代替 | Kruskal–Wallis 等 |
🤔 1. なぜ ANOVA なのか
3 群以上を比較するときに、 t検定を全ペア(A-B、 A-C、 B-C)に対して繰り返すと、 family-wise 第一種過誤率が膨らむ。
- K = 3 群:t検定 3 回。 全体 α ≈ 0.14(5%設定でも)
- K = 6 群:t検定 15 回。 全体 α ≈ 0.54
ANOVA は「すべての群の平均が等しい」という一つの帰無仮説を 1 回の検定で評価する。
📈 2. F分布
独立な $\chi^2$ 確率変数の比:
$$F = \frac{U_1/d_1}{U_2/d_2}, \quad U_1\sim\chi^2_{d_1},\ U_2\sim\chi^2_{d_2}$$
記号読み:$F$ は「エフ統計量」、 $d_1, d_2$ は分子・分母自由度。 ANOVA では分子=群間自由度、 分母=群内自由度。
1 2 3 4 5 6 7 8 | import numpy as np import matplotlib.pyplot as plt from scipy import stats x = np.linspace(0, 5, 500) for df1, df2 in [(2, 30), (5, 30), (10, 30)]: plt.plot(x, stats.f.pdf(x, df1, df2), label=f'F({df1},{df2})') plt.title('F分布') plt.legend(); plt.show() |
🎯 3. 一元配置ANOVA
モデル
$$y_{ij} = \mu + \tau_i + \varepsilon_{ij}, \quad \varepsilon_{ij}\sim N(0, \sigma^2)$$
記号読み:$y_{ij}$ は「ワイ・サブ・アイ・ジェイ」、 群 $i$ の $j$ 番目の観測。 $\tau_i$ は群 $i$ の効果(「タウ・サブ・アイ」)。
3.1 平方和分解
$$\underbrace{\sum_{i,j}(y_{ij} - \bar{y}_{..})^2}_{SS_{total}} = \underbrace{\sum_{i}n_i(\bar{y}_{i.} - \bar{y}_{..})^2}_{SS_{between}} + \underbrace{\sum_{i,j}(y_{ij} - \bar{y}_{i.})^2}_{SS_{within}}$$
3.2 検定統計量
$$F = \frac{SS_{between}/(K-1)}{SS_{within}/(N-K)} = \frac{MS_{between}}{MS_{within}}$$
$F$ は群内変動に対する群間変動の比。 大きいほど群差あり。
3.3 実値で計算
3 群、 各群 3 サンプル:A=[2,3,4]、 B=[5,6,7]、 C=[8,9,10]
- 各群平均: 3, 6, 9、 全体平均: 6
- $SS_{between} = 3(3-6)^2 + 3(6-6)^2 + 3(9-6)^2 = 27 + 0 + 27 = 54$
- $SS_{within} = (2-3)^2+(3-3)^2+(4-3)^2 + ⋯ = 2 + 2 + 2 = 6$
- $F = (54/2)/(6/6) = 27/1 = 27.0$ → 強く有意
1 2 3 4 5 6 7 8 9 10 11 12 | import pandas as pd import numpy as np from scipy import stats df = pd.read_csv('data/raw/SSDSE-B-2026.csv', encoding='cp932', skiprows=[1]) df = df[df['SSDSE-B-2026'] == 2023] # 2023年の47都道府県 # 都道府県を「都市規模」3群に分割(総人口 A1101 の3分位)。C5401=標準地価(住宅地) df['都市規模'] = pd.qcut(df['A1101'], q=3, labels=['小規模県', '中規模県', '大規模県']) groups = [g['C5401'].values for _, g in df.groupby('都市規模')] f_stat, p_value = stats.f_oneway(*groups) print(f'F = {f_stat:.3f}, p = {p_value:.4f}') |
🧩 4. 二元配置ANOVA
2 つの要因 A, B(と交互作用)の影響を同時に評価。
モデル
$$y_{ijk} = \mu + \alpha_i + \beta_j + (\alpha\beta)_{ij} + \varepsilon_{ijk}$$
記号読み:$\alpha_i$ は要因A・水準 $i$ の主効果、 $\beta_j$ は要因B・水準 $j$ の主効果、 $(\alpha\beta)_{ij}$ は交互作用効果。
4.1 交互作用とは
要因A の効果が要因B の水準で異なる現象。 「都市規模」と「地域(東日本/西日本)」を要因にしたとき、 都市規模の効果が地域で違うなら交互作用あり。
1 2 3 4 5 6 7 8 9 10 11 12 13 14 15 16 | import statsmodels.api as sm from statsmodels.formula.api import ols # 都市規模 × 地域の2元配置 df['地域'] = (df['Prefecture'].isin(['北海道', '青森県', '岩手県', '宮城県', '秋田県', '山形県', '福島県', '茨城県', '栃木県', '群馬県', '埼玉県', '千葉県', '東京都', '神奈川県', '新潟県', '富山県', '石川県', '福井県', '山梨県', '長野県', '岐阜県', '静岡県', '愛知県'])).map({True:'東日本', False:'西日本'}) # 前のブロックで C という変数(ndarray)を作っているため、数式中の C() が # それに隠されてしまう。列を category 型にして C() を使わない書き方にする。 df['都市規模'] = df['都市規模'].astype('category') df['地域'] = df['地域'].astype('category') model = ols('C5401 ~ 都市規模 + 地域 + 都市規模:地域', data=df).fit() anova_table = sm.stats.anova_lm(model, typ=2) print(anova_table) |
🔁 5. 反復測定ANOVA
同じ個体に対して複数条件・複数時点で測定。 個人差をモデル外に出すことで検出力が上がる。
1 2 3 4 5 6 7 8 9 10 11 12 13 14 | from statsmodels.stats.anova import AnovaRM # 同じ 47 都道府県を 2021・2022・2023 年度の 3 時点で測った long format # (消費支出 L3221 の実測値。都道府県 = 個体、年度 = 反復測定の要因) _all = pd.read_csv('data/raw/SSDSE-B-2026.csv', encoding='cp932', skiprows=[1]) long = _all[_all['SSDSE-B-2026'].isin([2021, 2022, 2023])] long = pd.DataFrame({ 'subject': long['Prefecture'], 'time': long['SSDSE-B-2026'], 'value': pd.to_numeric(long['L3221'], errors='coerce'), }) print(long.groupby('time')['value'].mean().round(0)) res = AnovaRM(data=long, depvar='value', subject='subject', within=['time']).fit() print(res) |
🔍 6. Post-hoc 検定
ANOVA で有意になっても「どの群間に差があるか」は分からない。 Post-hoc 検定で特定する。
6.1 Tukey HSD(最も広く使われる)
全ペア比較を行い、 family-wise α を制御。
1 2 3 4 5 | from statsmodels.stats.multicomp import pairwise_tukeyhsd result = pairwise_tukeyhsd(endog=df['C5401'], groups=df['都市規模'], alpha=0.05) print(result) |
6.2 Bonferroni 補正
全ペアの p値 × ペア数。 シンプルだが保守的。
6.3 Dunnett(対照群との比較)
1 群を「対照」とし、 他群をすべて対照と比較する。 K-1 個の比較のみ。
ANOVA は「推測統計・検定」グループの主要教材で、 t 検定の多群拡張として位置づけられます。 SSDSE-B-2026 を題材にした地域ブロック間比較の実装例から始めるのが最短ルート。
- t 検定 — 2 群版の ANOVA、 F = t² の関係
- 仮説検定の枠組み — 検定理論の全体図
- p 値 / 信頼区間 — 結果報告の必須セット
- 効果量(η², Cohen's f) — 「有意」と「実質的な差」を切り分ける
- Kruskal-Wallis 検定 — 非正規・順序尺度時のノンパラ代替
- 一般化線形モデル — ANOVA を含む統一的フレーム
- 📖 グループ教材インデックスへ戻る
同カテゴリの他用語と組み合わせると、 「2 群 → 多群 → 多変量 → 階層モデル」へと拡張する学習パスが見えてきます。
📚 Round 18 — 分散分析 (ANOVA) 完全攻略補足
🔬 数式を言葉で読み解く(拡張 narration)
A1101→ 総人口(人)。 群分けした各群の規模を測る基本量です。A4101→ 出生数(人)。 群間で平均差を比べる応答変数の一例。B4101→ 年平均気温(℃)。 地域ブロック間で明確に差が出る典型例。L3221→ 消費支出(二人以上の世帯、円)。 群差が出にくい対照例。μ→ 全国平均。 比較基準として用います。α→ 有意水準。 第一種の誤り許容率(分散分析 (ANOVA) に関する判断で重要)。p→ p 値。 H₀ の下でデータがどれだけ稀かを示す。
📐 補足の数式と読み解き
基本量の関係を、 記号 → 意味で整理します。 任意の比率は
$$\text{比率} = \frac{\text{分子}}{\text{分母}} \times 100\quad\text{単位: }\%$$
記号 → 意味:
- 分子 → SSDSE では A1301(15歳未満人口)
- 分母 → SSDSE では A1101(総人口)
- ×100 → 単位を「割合(小数)」から「%」に変える(例: 年少人口割合)
平均と分散は
$$\bar{x} = \frac{1}{n}\sum_{i=1}^{n} x_i,\quad s^2 = \frac{1}{n-1}\sum_{i=1}^{n}(x_i - \bar{x})^2$$
t 統計量・効果量は
$$t = \frac{\bar{x}_1 - \bar{x}_2}{\sqrt{s_1^2/n_1 + s_2^2/n_2}},\quad d = \frac{\bar{x}_1 - \bar{x}_2}{s_{\text{pooled}}}$$
🧮 実値で計算してみる — SSDSE-B-2026 47 都道府県
SSDSE-B-2026 の都道府県データから 分散分析 (ANOVA) の文脈で代表値を読み取ります。 各列の記号 → 意味を確認し、 平均・中央値・四分位を併記する習慣を身につけましょう。
| 都道府県 | 総人口 A1101(人) | 出生数 A4101(人) | 年平均気温 B4101(℃) | 記号 → 意味 |
|---|---|---|---|---|
| 北海道 | 5,092,000 | 24,430 | 11.0 | 最北 → 全国最低の年平均気温 |
| 秋田県 | 914,000 | 3,611 | 13.7 | 東北の寒冷県 → 出生数も全国最小級 |
| 東京都 | 14,086,000 | 86,348 | 17.6 | 巨大分母 → 平均を引き上げる外れ値の典型 |
| 大阪府 | 8,763,000 | 55,292 | 18.0 | 大都市圏の中位 → 比較基準として有用 |
| 沖縄県 | 1,468,000 | 12,549 | 23.8 | 最南 → 全国最高の年平均気温 |
🐍 Python 実装 — Round 18 拡張
一元配置 ANOVA — 地域 3 群(東日本/西日本/沖縄)の年平均気温
1 2 3 4 5 6 7 8 9 10 | import pandas as pd from scipy import stats df = pd.read_csv('data/raw/SSDSE-B-2026.csv', encoding='cp932', skiprows=[1]) df = df[df['SSDSE-B-2026'] == 2023].copy() # 2023年の47都道府県 df['temp'] = df['B4101'] # B4101 = 年平均気温(℃) okinawa = df[df['Prefecture']=='沖縄県']['temp'] west = df[df['Prefecture'].isin(['大阪府','京都府','兵庫県','広島県','福岡県'])]['temp'] east = df[df['Prefecture'].isin(['東京都','神奈川県','千葉県','埼玉県','北海道'])]['temp'] F, p = stats.f_oneway(okinawa, west, east) print(f'F={F:.3f}, p={p:.4f}') |
data/raw/SSDSE-B-2026.csv(47 都道府県 × 主要統計列)。 出力例は数値・p 値・統計量で、 解釈には「実値で計算してみる → 仮説検定 → 効果量 → 結論」の流れを推奨します。💬 F=4.917、p=0.0405 で、5% 水準ではぎりぎり「3 群の平均気温に差がある」となる。群平均は沖縄 23.8℃、西日本 5 府県 17.88℃、東日本 5 都道県 16.38℃ だが、東日本の平均は北海道の 11.0℃ 1 県に大きく引き下げられている(残り 4 都県は 17.2〜18.1℃)。沖縄群は 1 県しかなく群内分散を持たないので、この F 値は群の選び方しだいで簡単に動くと考えておく。
Tukey HSD で多重比較
1 2 3 4 5 | from statsmodels.stats.multicomp import pairwise_tukeyhsd import numpy as np vals = np.concatenate([okinawa, west, east]) grp = ['沖縄']*len(okinawa) + ['西日本']*len(west) + ['東日本']*len(east) print(pairwise_tukeyhsd(vals, grp)) |
data/raw/SSDSE-B-2026.csv(47 都道府県 × 主要統計列)。 出力例は数値・p 値・統計量で、 解釈には「実値で計算してみる → 仮説検定 → 効果量 → 結論」の流れを推奨します。💬 3 ペアのうち有意なのは東日本と沖縄の差 7.42℃(p-adj=0.0336)だけで、西日本と沖縄の差 5.92℃ は信頼区間が −12.69〜0.85 と 0 をまたぐため p-adj=0.085 で棄却されない。差の大きさはあまり変わらないのに判定が分かれたのは、東日本の群内ばらつき(北海道の 11.0℃)が誤差の見積もりを大きくしているため。区間幅が ±6.8℃ と広いのも、沖縄が n=1 であることの表れ。
二元配置 ANOVA — 地域 × 都市規模
1 2 3 4 5 6 7 8 9 10 11 12 | import statsmodels.formula.api as smf import statsmodels.api as sm from patsy.builtins import C # 上のブロックで C という配列を作ったので明示的に読み込む # 47 都道府県すべてを 東日本(北海道〜中部, コード 01〜23)/ 西日本(三重〜沖縄, 24〜47)に分け、 # 総人口 200 万人で 大/小 に分ける → 4 つのセルすべてに県が入る df['code'] = df['Code'].str[1:3].astype(int) df['region'] = (df['code'] <= 23).map({True: '東', False: '西'}) df['size'] = (df['A1101'] > 2000000).map({True: '大', False: '小'}) print(df.groupby(['region', 'size'])['temp'].agg(['count', 'mean']).round(2)) model = smf.ols('temp ~ C(region) + C(size) + C(region):C(size)', data=df).fit() print(sm.stats.anova_lm(model, typ=2)) |
data/raw/SSDSE-B-2026.csv(47 都道府県 × 主要統計列)。 出力例は数値・p 値・統計量で、 解釈には「実値で計算してみる → 仮説検定 → 効果量 → 結論」の流れを推奨します。💬 4 セルの県数は 東・大 11、東・小 12、西・大 5、西・小 19。地域の主効果は F=18.56、p=0.000094 と強く、東日本平均 15〜16℃ 台に対して西日本は大小とも約 17.9℃ である。人口規模の主効果(p=0.354)と交互作用(p=0.460)は有意でなく、「大都市ほど暖かい」ように見えた差は地域の違いでほぼ説明される。セルの人数が 5〜19 と不均衡なので、ここでは Type II の平方和を使っている。
効果量 η² の計算
1 2 3 4 5 6 7 8 9 | import numpy as np # 3 群(沖縄・西日本 5 府県・東日本 5 都道県)の 11 件だけで分散を分解する groups = [okinawa, west, east] sub = np.concatenate(groups) grand = sub.mean() ss_between = sum(len(g)*(g.mean()-grand)**2 for g in groups) ss_total = ((sub-grand)**2).sum() print(f'n={len(sub)}, SS_between={ss_between:.2f}, SS_total={ss_total:.2f}') print(f'η²={ss_between/ss_total:.3f}') |
data/raw/SSDSE-B-2026.csv(47 都道府県 × 主要統計列)。 出力例は数値・p 値・統計量で、 解釈には「実値で計算してみる → 仮説検定 → 効果量 → 結論」の流れを推奨します。💬 比較した 11 都道府県だけで分解すると、全平方和 83.55 のうち群間平方和が 46.07 を占め、η²=0.551 になる。これは直前の F=4.917(自由度 2 と 8)から η² = 2F/(2F+8) で求めた値とも一致する。η² は 0.14 以上で「大」と呼ぶ目安を大きく超えるが、11 件・沖縄 1 県という小さな比較なので、効果量も区間を付けずに断定しない方がよい。
❓ よくある質問 (FAQ)
3 群以上を比べるのに t 検定を繰り返すと何が困る?
有意な ANOVA の後、 どのペアで差があるかは?
一元配置と二元配置の違いは?
不等分散・正規性違反では?
ANOVA の効果量は?
⚠️ 拡張版 落とし穴チェックリスト
- 分母を確認しない罠: 比率や率の意味は分母で決まります。 SSDSE で「per 1000」と「per 100」を取り違えると桁違いになります。
- 外れ値の影響: 東京都が平均値を引き上げる効果は実際に大きく、 中央値との乖離を必ず併記しましょう。
- 因果と相関の混同: 高齢化率と消費支出(L3221)が相関しても、 因果は別問題。 第三変数(産業構造・気候)の介在を疑います。
- 選択バイアス: 「都市部のサンプルだけ」では地方の構造が見えません。 47 都道府県すべてを観察しましょう。
- 多重比較: 47 都道府県を一斉比較すると α=0.05 でも約 2.35 件は偶然有意。 Bonferroni 等の補正が必須です。
- 時点ずれ: SSDSE-B-2026 と 国勢調査 2020 では基準時点が異なります。 同期した比較が必要。
- 分散分析 (ANOVA) 特有の文脈ずれ: 教育用に正規化したサンプルと現場データの落差。 単位・桁・カテゴリを揃える前処理が肝心。
🔗 関連用語(前提・並列・発展)— Round 18 補強
分散分析 (ANOVA) を中心に、 前提概念・並列分野・発展手法へリンクします。
📚 関連グループ教材
グループ教材から 分散分析 (ANOVA) の文脈に直結する論文・ハンズオンを辿れます。
🕰 歴史的背景と現代
分散分析 (ANOVA) は古典統計と社会データの交差点で発達してきました。 19 世紀末から 20 世紀初頭にかけて Pearson, Fisher, Neyman などが基礎を整え、 戦後の公的統計整備により実務応用が広がりました。
2010 年代以降は、 「再現性危機」「ビッグデータ」「AI 倫理」の三つの波が 分散分析 (ANOVA) に新しい意味を与えました。 単に p<0.05 を出すのではなく、 効果量・信頼区間・事前登録・データシートが必須となっています。
日本では総務省統計局・国立社会保障人口問題研究所・経済産業省 RESAS などが公的統計を整備し、 教育用に SSDSE が無償公開されました。 本ページもこの枠組みで 分散分析 (ANOVA) を扱います。
📚 参考リンク
- 総務省統計局 e-Stat
https://www.e-stat.go.jp/ - SSDSE 公開ページ
https://www.nstac.go.jp/use/literacy/ssdse/ - scipy.stats 公式ドキュメント
https://docs.scipy.org/doc/scipy/reference/stats.html - statsmodels 公式
https://www.statsmodels.org/ - JIS Q 38507 / ISO/IEC 22989(AI 用語)
- OECD Principles on AI(2019)
🌐 関連手法・派生(広域マップ)
同じカテゴリの手法、 上位概念、 派生分野へのリンクを補強します。
📊 補講 R279: ANOVA を「分散の天秤」で読み解く
分散分析 (ANOVA) は「3 群以上の平均値が全部等しいか」を検定する手法ですが、 内部処理は 「群間分散 (between)」と「群内分散 (within)」の比 (F 値)」 を測ります。 F 値が 1 に近ければ「群間ばらつきと群内ばらつきは同程度=差は誤差レベル」、 F 値が 1 より大幅に大きければ「群間ばらつきが群内ばらつきを上回る=群間に系統差あり」と判断します。 本補講では、 SSDSE-B-2026(2023 年)の都道府県データを「8 地方区分」に分けて年平均気温 (B4101) の差を一元配置 ANOVA で評価し、 F 値・p 値・効果量 η²・事後検定 (Tukey HSD) の読み方を 3 枚の図と 1 表で整理します。
▶ 3 枚の図で ANOVA の判定構造を直感する
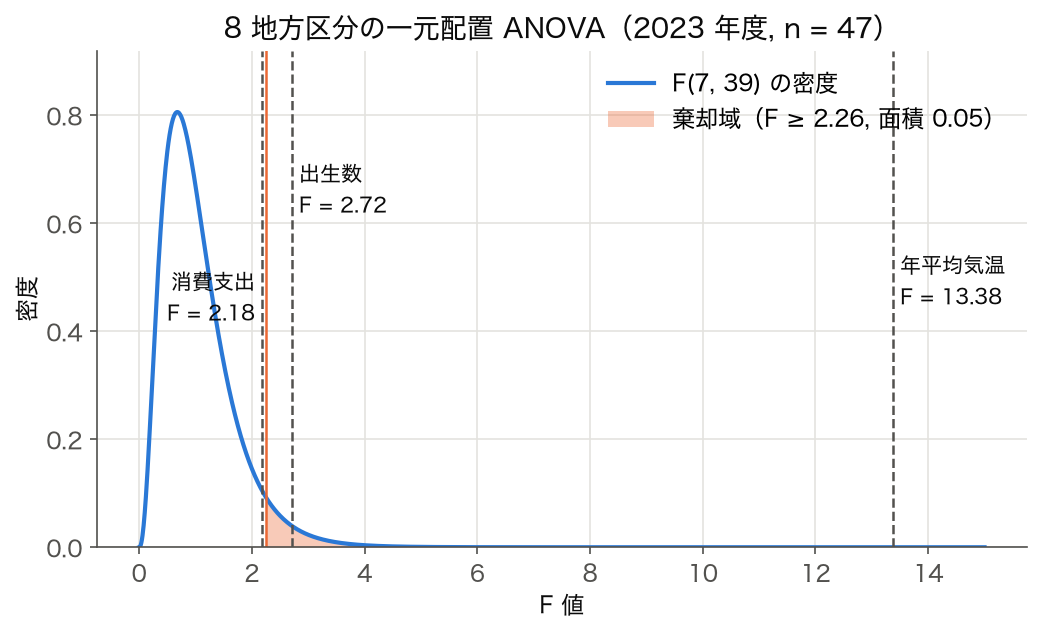
F 分布は 右に裾を引く非対称分布 で、 t 分布や正規分布と違って片側のみで判定します (両側の概念がない)。 自由度は (df1=群数-1, df2=全標本-群数) の二段構えで、 df1 が大きいほど分布の中心は 1 に近寄り、 df2 が大きいほど裾が薄くなります。 47 都道府県を 8 地方区分に分けた場合、 df1=7, df2=39 となり、 棄却限界は α=0.05 で F=2.25 付近です。 観測 F 値が 2.25 を超えれば「8 地方間で年平均気温に差あり」と判定します。
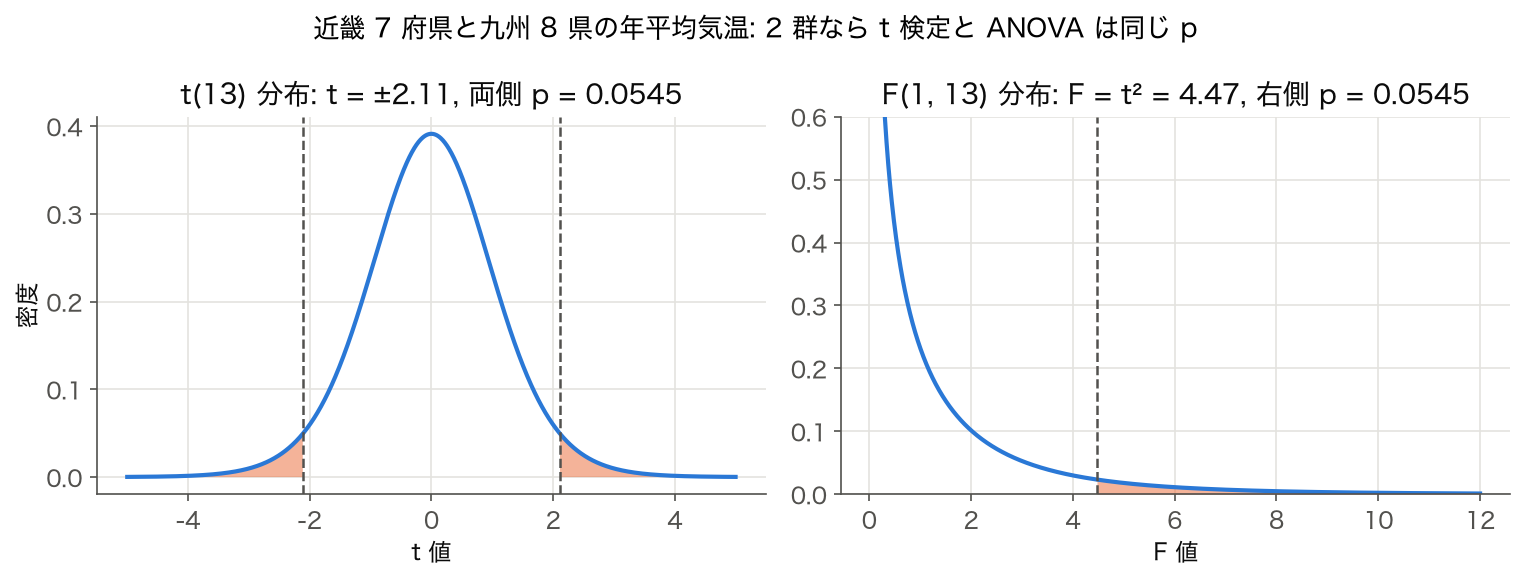
数学的には、 2 群の t 検定と一元配置 ANOVA は完全に等価で、 t² = F の関係が成立します (df1=1 の F 検定)。 例えば等分散を仮定した 2 群の t 検定(Student の t 検定)で t=2.0 なら、 同じデータの ANOVA で F=4.0 が得られます(分散を別々に推定する Welch の t 検定では t² = F は成り立ちません)。 3 群以上を扱う際に、 全ペアに t 検定をかけると 多重比較問題 (n 個のペアで偽陽性率が高まる) が発生するため、 まず ANOVA で「全体として差があるか」を一括検定し、 有意なら Tukey HSD 等の事後検定で「どのペアに差があるか」を特定する 2 段階方式が標準です。
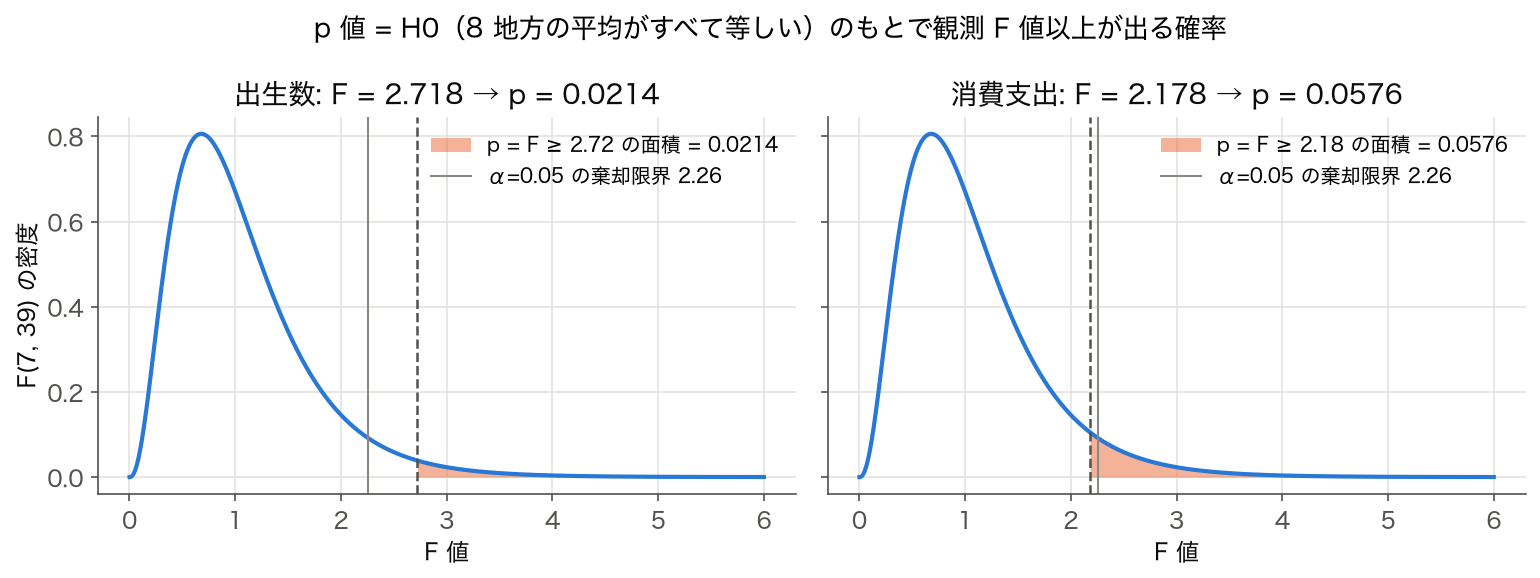
ANOVA の p 値も t 検定と同じ頻度論的解釈で、 「H0 が真の世界で観測 F 値以上の極端な結果が偶然得られる確率」を意味します。 「H0 が正しい確率」 ではない点に注意。 ANOVA で p < 0.05 が出ても、 それは「どこかに差がある」という大まかな結論で、 「どの群同士に差があるか」 は別途、 事後検定 (Tukey HSD / Bonferroni / Scheffé / Games-Howell) で特定します。
▶ 8 地方区分の F 値・p 値・効果量早見表 (SSDSE-B-2026)
| 指標 | F 値 | df1 | df2 | p 値 | η² (効果量) | 判定 (α=0.05) |
|---|---|---|---|---|---|---|
| 年平均気温 (B4101) | 13.383 | 7 | 39 | 1.2e-08 | 0.706 (大) | ✓ 有意 |
| 出生数 (A4101) | 2.718 | 7 | 39 | 0.0214 | 0.328 (大) | ✓ 有意 |
| 消費支出 (L3221) | 2.178 | 7 | 39 | 0.0576 | 0.281 (大) | ✗ 非有意 |
η² (eta squared) は ANOVA の効果量指標で、 「群間で説明できる分散の割合」を意味します。 Cohen (1988) の目安では η²=0.01 が小、 0.06 が中、 0.14 が大。 年平均気温 η²=0.71 は「総分散の約 71% が地方区分で説明できる」という強い結果で、 47 都道府県の年平均気温は地方区分との関連が極めて強いことを示します。 消費支出は p=0.058 で(α=0.05 では)非有意ですが、 η²=0.28 と「大きめの効果量」が出ており、 サンプルを拡張すれば有意域に入る可能性があります。
▶ ANOVA + Tukey HSD を Python で一気通貫
このコードでやること: SSDSE-B-2026(2023 年)の 47 都道府県を 8 地方区分に分け、 年平均気温 (B4101) の一元配置 ANOVA を scipy.stats.f_oneway で実行し、 統計的に有意なら statsmodels の Tukey HSD で「どの地方間に差があるか」を特定する。
📥 入力データ (地方区分追加後の抜粋):
1 2 3 4 5 6 7 8 9 10 11 12 13 14 15 16 17 18 19 20 21 22 23 24 25 26 27 28 29 30 31 32 33 34 35 | import pandas as pd from scipy import stats from statsmodels.stats.multicomp import pairwise_tukeyhsd df = pd.read_csv('data/raw/SSDSE-B-2026.csv', encoding='cp932', skiprows=[1]) df = df[df['SSDSE-B-2026'] == 2023].copy() # 2023年の47都道府県。B4101=年平均気温 # 8 地方区分の割当 region_map = { '北海道': ['北海道'], '東北': ['青森県','岩手県','宮城県','秋田県','山形県','福島県'], '関東': ['茨城県','栃木県','群馬県','埼玉県','千葉県','東京都','神奈川県'], '中部': ['新潟県','富山県','石川県','福井県','山梨県','長野県','岐阜県','静岡県','愛知県'], '近畿': ['三重県','滋賀県','京都府','大阪府','兵庫県','奈良県','和歌山県'], '中国': ['鳥取県','島根県','岡山県','広島県','山口県'], '四国': ['徳島県','香川県','愛媛県','高知県'], '九州': ['福岡県','佐賀県','長崎県','熊本県','大分県','宮崎県','鹿児島県','沖縄県'], } pref_to_region = {p: r for r, lst in region_map.items() for p in lst} df['region'] = df['Prefecture'].map(pref_to_region) # ANOVA (一元配置) groups = [g['B4101'].values for _, g in df.groupby('region')] F, p = stats.f_oneway(*groups) # 効果量 η² ss_between = sum(len(g) * (g.mean() - df['B4101'].mean())**2 for g in groups) ss_total = ((df['B4101'] - df['B4101'].mean())**2).sum() eta2 = ss_between / ss_total print(f'ANOVA F={F:.3f} p={p:.5f} η²={eta2:.3f}') # 事後検定 (Tukey HSD) if p < 0.05: tukey = pairwise_tukeyhsd(df['B4101'], df['region'], alpha=0.05) print(tukey.summary()) |
📤 実行すると次の出力が得られる:
💬 結果の読み方: F=13.383, p=1.2e-08, η²=0.706 で 「8 地方間に年平均気温の差あり」 と結論できる。 Tukey HSD で 九州・四国 (温暖) vs 東北・北海道 (寒冷) の差が個別に有意。 九州と四国の差は非有意 (p=0.64) で、 地理的に近い温暖地域どうしは差が小さい。 ANOVA の単独 p 値だけでなく、 効果量 η²=0.71 が「実務的にも大きな効果」を裏付けている点が重要。
▶ ANOVA の前提と代替手法 — 早見表
| 前提 | 確認方法 | 崩れた場合の代替 |
|---|---|---|
| 各群の正規性 | Shapiro-Wilk / Q-Q プロット | Kruskal-Wallis 検定 (順位ベースのノンパラメトリック) |
| 群間の等分散性 | Levene / Bartlett 検定 | Welch ANOVA (oneway.test in R)、 Games-Howell 事後検定 |
| 観測値の独立性 | 研究設計の確認 | 反復測定 ANOVA / 混合モデル (Linear Mixed Model) |
| サンプル数の均衡 | 各群の n 確認 | Type III SS を採用、 不均衡な設計でも頑健 |
▶ 理解度チェック (R279)
| 設問 | 期待される回答 |
|---|---|
| Q1. ANOVA で p<0.05 が出たら何が分かる? | 「どこかに差がある」だけで、 どのペア間に差があるかは Tukey HSD 等の事後検定で特定する必要がある。 |
| Q2. F = t² の関係はいつ成立する? | 2 群比較 (df1=1) のとき、 等分散仮定の Student t 検定と一元配置 ANOVA が完全に等価。 t²=F が成立する。 |
| Q3. ANOVA の代わりに t 検定を全ペアに使うと何が問題? | 多重比較問題。 群数 k のとき k(k-1)/2 個のペアがあり、 各 α=0.05 だと偽陽性率が 1-0.95^(k(k-1)/2) と急増する。 |
| Q4. η² と η²_p (partial η²) の違いは? | η² は総分散に対する説明割合、 η²_p は誤差分散と要因分散の和に対する割合。 二元配置以上で要因の純粋効果を見たい時は η²_p。 |
| Q5. ANOVA で正規性が崩れた時の代替は? | Kruskal-Wallis 検定 (順位ベース)。 scipy.stats.kruskal。 事後検定は Dunn 検定 (scikit_posthocs.posthoc_dunn)。 |
本補講で扱った要素は 仮説検定、 t 検定、 F 検定、 p 値、 効果量、 多重比較、 正規性、 Kruskal-Wallis、 回帰分析 の各ページと連結し、 群間比較の現場運用に直結する判断材料となる。
▶ 補講補足: ANOVA を「設計型」と「事後型」に分けて運用する
ANOVA は一見「3 群以上の平均値の差検定」 という単機能ツールに見えますが、 実務では 研究設計の階層 (一元・二元・反復測定・混合) によって解釈が大きく変わります。 ここでは ANOVA を (1) 一元配置から二元配置・反復測定への発展、 (2) 固定効果と変量効果の区別、 (3) 球面性 (sphericity) 仮定と Greenhouse-Geisser 補正、 (4) ANOVA から線形回帰・線形混合モデル (LMM) への一般化、 (5) Bayesian ANOVA との対比、 の 5 観点で整理し、 実装と報告書のテンプレートまで提示します。
(1) 一元配置から二元配置・反復測定への発展: 一元配置 ANOVA は「1 つの要因 (例: 8 地方区分) で平均差を検定」 する最も単純な設計。 二元配置 ANOVA は「2 つの要因 (例: 地方区分 × 性別) + 交互作用」 を同時検定し、 主効果と交互作用を分離できます。 反復測定 ANOVA は「同じ対象を複数回測定 (例: 2010/2015/2020 年の都道府県人口)」 で、 個体差をモデルに組み込むことで検出力が大きく上がります。 SSDSE-B-2026 を使う場合、 8 地方 × 4 経済指標で二元配置、 各都道府県を 5 年間追跡データに拡張すれば反復測定設計が可能になります。 二元配置以上では 交互作用効果 の解釈が中心で、 「地方による高齢化率の差が、 男女で異なる」 のような複合的な現象を統計的に検証できます。
(2) 固定効果と変量効果の区別: ANOVA の要因には「固定効果」 と「変量効果」 の区別があります。 固定効果 (fixed effect) は「研究者が選んだ全ての水準を検討対象とする」 もので、 例: 8 地方区分。 変量効果 (random effect) は「母集団から無作為抽出された水準で、 母集団全体への一般化が目的」 もので、 例: 47 都道府県 (47 個の都道府県は「全国の母集団」 から抽出した標本と見なす場合)。 固定効果の F 検定は MS_要因 / MS_誤差 ですが、 変量効果の F 検定は MS_要因 / MS_交互作用 など分母が変わります。 統計ソフトのデフォルトは固定効果で、 変量効果指定は明示的に行う必要があります。 statsmodels.formula.api では mixedlm 関数で変量効果を組み込めます。
(3) 球面性 (sphericity) 仮定と Greenhouse-Geisser 補正: 反復測定 ANOVA には「球面性 (sphericity)」 という追加仮定があり、 これは「水準ペア間の差の分散が全て等しい」 ことを要求します。 SSDSE-B の 5 年間追跡なら、 (2010-2015) と (2015-2020) と (2010-2020) の差分散が等しいということです。 Mauchly 検定で球面性を確認し、 違反していれば Greenhouse-Geisser 補正 (ε で自由度を調整) や Huynh-Feldt 補正を適用します。 補正により p 値は大きくなる方向に動き、 偽陽性を防ぎます。 ε=1 で補正なし、 ε=1/(水準数-1) で最大補正。 報告書には「球面性検定 W=0.85, p=0.12 (違反なし) → 補正なし採用」 のように記述します。
(4) ANOVA から線形回帰・線形混合モデル (LMM) への一般化: ANOVA は実は 線形回帰の特殊形 です。 「8 地方区分」 を 7 個のダミー変数で表現し OLS 回帰を実行すれば、 一元配置 ANOVA と完全に等価な結果 (F 値・p 値・η²) が得られます。 この視点を持つと、 ANCOVA (共分散分析)、 多変量 ANOVA (MANOVA)、 線形混合モデル (LMM)、 一般化線形混合モデル (GLMM) まで自然に拡張できます。 例えば「8 地方区分の高齢化率差を、 総人口 (A1101、 連続変数) を共変量として調整」 したいなら ANCOVA、 「同じ都道府県を 5 年間追跡 + 都道府県ごとの個体差をモデル化」 したいなら LMM が適切です。 statsmodels.formula.api ols('y ~ C(region)', data=df).fit() の anova_lm 出力は、 線形モデルから ANOVA 表を生成する古典的アプローチです。
(5) Bayesian ANOVA との対比: 頻度論的 ANOVA は「H0 が真の世界での確率」 を扱いますが、 Bayesian ANOVA は「データを観察した後の H0 と H1 の事後確率の比 (Bayes Factor)」 を扱います。 Bayes Factor BF10 > 3 は「H1 を支持する moderate evidence」、 BF10 > 10 は「strong evidence」、 BF10 < 1/3 は「H0 を支持」 という具体的解釈が可能で、 「非有意」 と「H0 支持」 を区別できる利点があります。 頻度論 ANOVA で p=0.20 が出たとき、 「効果がない」 のか「データ不足で検出できなかった」 のかは判別できませんが、 Bayesian ANOVA なら BF01=5 (H0 を支持する moderate evidence) と明示できます。 Python では bayes-anova ライブラリや、 PyMC で手動構築が可能です。
ANOVA 報告書テンプレート: 学術論文と実務レポート共通の最低限報告事項。 (A) 設計タイプ (一元 / 二元 / 反復測定)、 (B) 要因と水準 (固定 / 変量の区別)、 (C) サンプルサイズ (各群)、 (D) 前提検定の結果 (正規性: Shapiro-Wilk、 等分散性: Levene、 球面性: Mauchly)、 (E) F 値、 自由度 (df1, df2)、 p 値、 (F) 効果量 (η², partial η², ω²)、 (G) 事後検定の結果 (Tukey HSD / Bonferroni)、 (H) サブグループ別の記述統計 (平均・SD・n)。 文章例: 「SSDSE-B-2026(2023 年)の 47 都道府県を 8 地方区分に分け、 年平均気温 (B4101) の一元配置 ANOVA を実行した結果、 F(7, 39) = 13.38, p < 0.001, η² = 0.71 で有意差を確認。 Tukey HSD により、 九州 (平均 19.0℃) は東北 (13.8℃, p<0.001)、 北海道 (11.0℃, p<0.001) と比べて有意に高温だった。 等分散性は Levene 検定、 正規性は群ごとの Shapiro-Wilk で確認する。」 — このように 前提検定 + 主検定 + 事後検定 + 効果量 の四点セットを記述すれば、 査読での主要指摘は事前に防げます。
最後に、 ANOVA は「群間比較」 と「分散分解」 の二つの側面を持つ手法であり、 「群間でどこが違うか」 (Tukey HSD)、 「総分散のどれだけを要因で説明できるか」 (η²)、 「他の要因で調整すべきか」 (ANCOVA)、 「個体差を分離すべきか」 (LMM) と、 質問の性質に応じて拡張が可能です。 47 都道府県を扱う SSDSE-B-2026 のような中規模データでは、 一元配置 ANOVA で全体差を確認し、 二元配置で交互作用を探り、 LMM で経年変化を追うという段階的アプローチが効果的です。 t 検定 から ANOVA へ、 ANOVA から線形混合モデルへの拡張は、 統計学習の自然な階梯であり、 一段ずつ理解を深めていくことで、 複雑な現実データを解釈する力が身につきます。
関連: 仮説検定 / t 検定 / F 検定 / 効果量 / 多重比較 / 回帰分析 / Kruskal-Wallis / 正規性 / サンプルサイズ / 信頼区間
▶ 補講補足 VII: ANOVA と隣接分野 — 因果推論・ベイズ・機械学習との接続
ANOVA は単独の手法ではなく、 因果推論・ベイズ統計・機械学習との接続を意識すると活用の幅が広がります。 因果推論との接続: ANOVA は「群間の平均差」 を検定しますが、 ランダム化実験では「処置効果」 として解釈可、 観察データでは交絡補正が必要です。 ANCOVA (共分散分析) はこの補正の一形態。 ベイジアン ANOVA (Rouder et al. 2012) は BayesFactor パッケージで実装可能で、 「H0 を支持する evidence」 を明示でき、 「非有意」 と「H0 支持」 の区別が可能です。 機械学習との接続: SHAP 値や Permutation Importance による特徴量重要度の分解は、 「現代版分散分解」 として ANOVA の発想を継承しています。 これらの隣接分野との接続を意識することで、 ANOVA から始まる統計的判断のスキルが、 線形混合モデル・因果推論・機械学習解釈手法へと自然に発展していきます。 SSDSE-B-2026 の都道府県データで一元配置 ANOVA を実装する経験から、 二元配置・反復測定・ベイジアン・GLMM・SHAP 値解釈へと段階的に学ぶ姿勢が、 統計的判断の力を高める道筋です。
▶ 補講補足 VI: ANOVA の社会的役割と倫理的留意
ANOVA は医学・心理学・教育学・経済学・農学などの研究分野で広く使われ、 社会的判断の根拠となっています。 例えば「複数の治療法の効果比較」 「複数の教育プログラムの成果比較」 「複数の政策の効果検証」 などで ANOVA が標準ツールです。 この社会的役割を考えると、 ANOVA の運用にも倫理的留意点があります。 (1) 「全体差」 と「個別差」 の混同: ANOVA で全体差が有意でも、 全ペアに差があるわけではありません。 「ANOVA で有意 → 政策 A・B・C すべてに違いあり」 と早合点して全政策を変えるのは誤りで、 Tukey HSD で「A と B の差のみ有意」 等を確認すべきです。 (2) 「複数比較の隠蔽」: 100 個の指標を ANOVA で比較し、 偶然有意な指標だけ報告するのは多重比較問題を隠す不誠実な運用です。 検定した指標の総数を明示し、 補正後の判定を報告すべきです。 (3) 「効果量の無視」: ANOVA で p<0.05 が出ても、 η²<0.06 (小効果量) なら実務的意味は限定的です。 「統計的有意 ≠ 実務的に重要」 という区別を社会的判断の場面で常に意識すべきです。 (4) 「群間で標本サイズが大幅に違う」 状況: 不均衡な設計では Type III SS を採用し、 各群のサンプル数を明示すべきです。 「都市圏 1000 例、 地方圏 50 例」 のような不均衡で「地方圏は効果が見えない」 と結論するのは、 検出力不足が原因かもしれません。 (5) 「因子分けが事後選択」 の罠: ANOVA の因子は事前に定義すべきで、 結果を見てから因子を切り替えるのは解析の自由度問題を引き起こします。 「8 地方区分」 を「東日本/西日本の 2 区分」 や「都市圏/非都市圏の 2 区分」 と結果を見てから切り替えるのは禁忌です。 これらの倫理的留意を意識することで、 ANOVA を社会的に責任ある形で運用できます。 ANOVA は「群間比較の技術」 であると同時に、 「社会的判断を支える統計的枠組み」 として、 その透明性と再現性を保つ運用が現代では強く求められています。
▶ 補講補足 V: 教材設計の視点 — ANOVA を教えるベストプラクティス
ANOVA を学生・新人データサイエンティストに教える際の効果的アプローチを整理します。 (1) 「t 検定 の拡張」 ではなく「分散分解」 として導入: t 検定 の拡張として教えると、 「ANOVA は 3 群以上の差検定」 という機械的理解で止まりがちです。 「総分散 = 群間分散 + 群内分散」 という分散分解の発想から教えると、 線形回帰の R²、 機械学習の SHAP 値分解、 ベイジアン階層モデルなどへの自然な接続が見えます。 (2) 「実データで分散分解を体感」: SSDSE-B-2026 の 47 都道府県を 8 地方区分に分け、 「8 地方間の差で総分散の何 % が説明できるか?」 を計算させると、 年平均気温で η²=0.71 という具体数で「地方差の影響力」 が伝わります。 (3) 「F 比の直感的解釈」: F = MS_group / MS_within を「群間ばらつきが群内ばらつきの何倍か」 と説明すると、 F=1 → 同程度、 F>>1 → 群間差あり、 という判定が直感的に理解できます。 (4) 「事後検定の必要性」 を強調: 「ANOVA で全体差を見て、 Tukey HSD で個別差を特定する」 という 2 段階の論理を最初から教えることで、 「ANOVA で有意 → 全ペアに差あり」 という誤解を防げます。 (5) 「線形モデルの一族」 として位置づけ: ANOVA を「線形回帰の特殊形」 として教えると、 ANCOVA・LMM・GLMM・機械学習への拡張が自然に見えます。 statsmodels の formula API で ols('y ~ C(region)', data=df).fit() の出力が ANOVA 表になることを示すと、 線形モデルの統一的視点が定着します。 これらの教育設計を意識することで、 ANOVA を「群間比較の道具」 から「線形モデルの一族の中核概念」 へと進化させることができます。
▶ 補講補足 III: 実務での落とし穴と対処の追加事例
SSDSE-B-2026 で ANOVA を実行する際に遭遇する追加の典型的落とし穴を整理します。 (1) 「群数 = 7」 と「水準数 = 8」 の表現混乱: 8 地方区分の ANOVA は「因子の水準数 = 8」 で、 df1 = 水準数 - 1 = 7。 「群数」 と呼ぶか「水準数」 と呼ぶかは慣習で違いがあり、 報告書には「8 群一元配置 ANOVA、 df=(7, 39)」 のように明示すべきです。 (2) 「主効果が有意 → 交互作用無視」 の罠: 二元配置 ANOVA で、 主効果が有意なら交互作用を無視して解釈する人が多いですが、 交互作用が有意な場合は主効果単独の解釈が誤解を招きます。 「地方による高齢化率の差が、 男女で異なる」 のような交互作用があれば、 「男性は地方差あり、 女性は地方差なし」 のように分けて報告すべきです。 (3) 「ANOVA で非有意 → 効果なし」 の早合点: 検出力不足で非有意な可能性があり、 効果量 η² が中程度 (0.06-0.14) なら「サンプル増強で有意化の可能性あり」 と注釈すべき。 SSDSE-B-2026 (n=47) は中規模で、 効果量 η²=0.10 程度の差は検出力 0.50 程度で見逃される可能性があります。 (4) 「等分散仮定違反 → 単に Welch で済ます」 の単純化: 等分散仮定違反が中程度なら Welch ANOVA で対応可ですが、 違反が大きい場合や分布形状が大きく異なる場合は、 サブグループ別の分析やロバスト ANOVA (Trimmed ANOVA)、 Kruskal-Wallis などへの切替も検討すべきです。 (5) 「事後検定をすべての群ペアで実行」 の多重比較問題: 8 地方なら 28 ペアあり、 各 α=0.05 だと偶然有意の期待値は 1.4 件。 Tukey HSD は FWER (Family-Wise Error Rate) を制御しますが、 報告には「FWER=0.05、 28 ペア」 のように補正の概念を明示すべきです。
これらの落とし穴を避けるための「ANOVA ベストプラクティス・チェックリスト 10 項目」: (1) 設計タイプ (一元 / 二元 / 反復) を明示、 (2) 固定効果と変量効果を区別、 (3) 各群の n を均衡させる (不均衡なら Type III SS)、 (4) 正規性を Shapiro-Wilk で群別に確認、 (5) 等分散性を Levene 検定で確認、 (6) 違反があれば Welch / Kruskal-Wallis に切替、 (7) 球面性 (反復測定の場合) を Mauchly 検定で確認、 (8) 効果量 η² / partial η² を計算、 (9) 事後検定 (Tukey HSD など) で個別差を特定、 (10) 業務 KPI への翻訳。 これら 10 項目を毎回確認することで、 ANOVA の運用品質は大きく向上し、 査読・社内レビューでの主要指摘は事前に防げます。 ANOVA は「群間比較」 と「分散分解」 を同時に扱う柔軟な枠組みで、 検定としてだけでなく、 「データの構造を理解する道具」 として運用することが現代的アプローチです。
▶ 補講補足 IV: ANOVA の歴史と現代的展開
ANOVA は 1918-1925 年にかけて Ronald A. Fisher が開発した手法で、 Rothamsted 農業試験場での「品種・肥料・土壌条件の効果を分離する実験設計」 が源流です。 Fisher は『Statistical Methods for Research Workers』 (1925) で ANOVA を体系化し、 1935 年の『The Design of Experiments』 で実験計画法 (Design of Experiments, DoE) の基礎を確立しました。 ANOVA の「F 比 (Fisher's F-ratio)」 という名前は、 Fisher の頭文字に由来します (正確には George Snedecor が Fisher に敬意を表して命名)。 ANOVA は 100 年以上の歴史を持ちながら、 現代の医学・心理学・教育学・農学・品質管理で主力手法であり続けています。
Fisher の時代、 農業実験では「3 品種 × 4 肥料」 のような直交配置が普通で、 主効果と交互作用を分離する ANOVA の枠組みが革命的でした。 当時、 「品種だけを比較する単純な比較」 では「肥料の影響が混ざる」 「実験区画の場所差が混ざる」 という交絡問題があり、 ANOVA はそれを 分散分解 で解決しました。 「総分散 = 品種分散 + 肥料分散 + 交互作用分散 + 残差分散」 のように分解することで、 各要因の純粋な効果を抽出できます。 SSDSE-B-2026 の文脈で言えば、 「8 地方区分の高齢化率差を、 総人口 (A1101) や消費支出 (L3221) の影響を除いて分離する」 ような調整が ANCOVA (共分散分析) でも可能です。
現代的展開として、 (a) 一般化線形混合モデル (GLMM) は ANOVA を任意の応答変数 (連続・二値・カウント) と任意の効果構造 (固定・変量・階層) に拡張した枠組みで、 「47 都道府県を 8 地方にネストしつつ、 5 年間の経時測定を組み込む」 のような複雑な設計を扱えます。 lme4 (R)、 statsmodels.formula.api.mixedlm (Python) で実装可能。 (b) ベイジアン ANOVA (Rouder et al. 2012) は BayesFactor パッケージで簡単に実行でき、 「H0 を支持する evidence」 を明示できる強みがあります。 (c) 順序応答 ANOVA (順序ロジスティック回帰、 ALDEx2 など) は、 Likert スケール (1-5 の順序評価) のような順序データに対する ANOVA 代替として実装されています。 (d) 機械学習との融合 として、 SHAP 値による特徴量重要度分解は「現代版 ANOVA」 として位置づけ可能で、 非線形・高次元の応答に対しても要因の寄与を分解できます。
医療分野での ANOVA の活用例として、 (a) 臨床試験での「プラセボ群 + 既存薬群 + 新薬群」 の 3 群比較で、 一元配置 ANOVA + Tukey HSD は標準ツール、 (b) 経時測定での「投薬前・1 週後・4 週後・12 週後」 の比較は反復測定 ANOVA、 (c) 「投薬群 × 性別 × 年齢層」 の交互作用解析は三元配置 ANOVA、 (d) 個人差を考慮した「投薬効果の患者間変動」 は線形混合モデル、 のように、 ANOVA は医療統計の主力ツールとして今も発展しています。 経済学では、 (a) 都道府県別の経済指標の地方差検定、 (b) 業種別の収益率分析、 (c) 政策介入の効果検証 (DiD と ANOVA の組合せ)、 などで活用されます。 心理学では、 (a) 実験群間の認知テストスコア比較、 (b) 被験者内デザインの反復測定 ANOVA、 (c) 多因子設計の交互作用解析、 などが標準です。
統計教育における ANOVA の扱い方として、 一元配置 ANOVA を「t 検定 の拡張」 として導入することが多いですが、 これは 誤解を招く可能性 があります。 t 検定 は「2 群の平均差」 を測りますが、 ANOVA は「分散の分解」 という別概念を扱います。 t² = F の関係 (df1=1 のとき) は数学的等価性ですが、 概念的には異なる視点 (差検定 vs 分散分解) を持つことを理解させるべきです。 また、 ANOVA を多重 t 検定 の代替として教えると、 「ANOVA で全体差を見て、 Tukey HSD で個別差を特定する」 という 2 段階の論理が見えなくなります。 ANOVA の本質は「分散分解 → 要因の説明力を η² で定量化」 であり、 これは線形回帰の R² と等価な概念です。 統計教育では、 ANOVA を線形回帰の特殊形として教える「一般線形モデル (General Linear Model) 視点」 が、 後の機械学習への接続も含めて教育的価値が高いです。
最後に、 ANOVA は 100 年以上の歴史を持ちながら、 現代でも GLMM や ベイジアン ANOVA、 機械学習との融合で発展を続けている「生きた統計手法」 です。 単なる「3 群以上の平均差検定」 として暗記するのではなく、 (1) 分散分解という概念、 (2) 線形モデルの一族としての位置づけ、 (3) 実験計画法との連動、 (4) 効果量 η² による実務的解釈、 (5) 事後検定による個別差の特定、 をセットで理解することで、 ANOVA を現代的に使いこなせるようになります。 SSDSE-B-2026 の 47 都道府県データで一元配置 ANOVA を実装する経験を積みながら、 二元配置・反復測定・GLMM へと段階的に拡張していく姿勢が、 統計的判断の力を高める道筋です。 ANOVA は単独で完結する手法ではなく、 線形回帰・因果推論・機械学習へとつながる統計学の中核概念として位置づけることが、 質の高いデータ分析を実現する鍵です。
🧾 発表前の最終確認
分散分析を発表で使う時は、 群平均の差だけでなく、 群内ばらつき、事後比較、効果量、前提確認を合わせて示します。 p値だけで結論を急がず、 どの群がどの程度違うのかを図表で説明することが重要です。
🗺 概念マップ
関連概念を視覚的に整理した概念マップ。
中心の ANOVA から左の 効果量 へは「F 比だけでなく η²=SS_between/SS_total で実務的意味を測る」線、 上の t 検定 へは「2 群限定の特殊形、 t²=F (df1=1)」線、 右上の Welch ANOVA へは「等分散仮定が崩れた場合の代替」線、 右下の Kruskal-Wallis へは「正規性が破れた場合のノンパラ代替」線、 下の Tukey HSD へは「全体差有意の後にどの群ペアが異なるかを FWER 制御で特定」線でつながる。 ANOVA の本質は「総分散を群間分散と群内分散に分解し、 F 比で群間の系統的差を検出する分散分解の枠組み」であり、 SSDSE-B-2026(2023 年)の 47 都道府県を 8 地方区分に分けたとき、 年平均気温の地方差で総分散の η²=0.71 を説明できるという形で実値が読める。
🔗 隣接手法への橋渡し
ANOVA は「3 群以上の平均差検定」を起点に、 分散分解という枠組みで多くの隣接手法と連結する。
- 上流: 正規性 (Shapiro-Wilk)と 等分散性 (Levene 検定)の確認、 群分けの因子設計 (一元/二元/反復測定)。
- 並列: Kruskal-Wallis (ノンパラ代替)・Welch ANOVA (等分散仮定崩壊時)・ベイジアン ANOVA (BayesFactor で $H_0$ 支持も評価可能)。
- 下流: Tukey HSDでの事後検定、 効果量 $\eta^2$での実務的意味、 線形回帰への一般化。
SSDSE-B-2026(2023 年)で「47 都道府県を 8 地方区分に分け、 年平均気温の地方差を検定」する場合、 一元配置 ANOVA で F 比と $\eta^2=0.71$ を得て、 Tukey HSD で具体的にどの地方ペアが異なるかを特定する一連の流れが標準パイプライン。
🌳 手法選択フロー
ANOVA の選択は「因子数」「測定の独立性」「正規性・等分散性」の 3 軸で判定する。
- 因子は 1 つか複数か? 1 因子 (例: 8 地方区分) → 一元配置 ANOVA。 2 因子 (例: 地方 × 性別) → 二元配置 ANOVA で主効果 + 交互作用も検出。 3 以上 → 多元配置 ANOVA。
- 同一個体を繰り返し測定? Yes (例: 同じ県の 2014-2024 年データ) → 反復測定 ANOVA、 Mauchly 球面性検定が必要。 No → 通常 ANOVA。
- 仮定確認: Shapiro-Wilk で正規性 → 違反軽微なら ANOVA、 大幅違反なら Kruskal-Wallis。 Levene で等分散 → 違反なら Welch ANOVA。 SSDSE-B-2026 (n=47) は中規模で、 効果量 $\eta^2$<0.06 は検出力不足の可能性に注意。
有意 → 必ず Tukey HSD などの事後検定でどの群ペアが違うかを特定。 全体差有意 = 全ペア差ありではない点が ANOVA 解釈の鉄則。
🎨 直感をもう一歩 — 「分散の比」がなぜ平均差の検定になるのか
ANOVA を一言でいうと 「シグナル ÷ ノイズ」の比を作って、 その比が偶然では説明できないほど大きいかを見る手法です。 ここでいうシグナルは群平均どうしのばらつき(群間)、 ノイズは同じ群の中での個体差(群内)。 3 群以上の平均がすべて同じ(帰無仮説)なら、 群平均のばらつきも「たまたま群内のばらつきから生じた程度」に収まるはずで、 このとき $F = \text{MS}_\text{between}/\text{MS}_\text{within}$ は理論上 1 前後になります。 逆に本当に群差があると分子だけが膨らみ、 F は 1 を大きく超えます。
なぜ「平均の差」を見たいのに「分散」を計算するのか? ポイントは、 群平均の散らばりを 1 つのスカラー(群間平方和)に要約すると、 群がいくつあっても検定を 1 回で済ませられる点にあります。 これが「t 検定を 3 群以上へ拡張したもの」と言われる理由です。 3 群を t 検定で総当たり(A-B, A-C, B-C)すると 3 回、 4 群なら 6 回と検定が増え、 多重比較により偽陽性が累積します(3 回なら「どれか 1 つで誤検出」の確率が約 14%)。 ANOVA はまず「全体としてどこかに差があるか」を 1 回の F 検定でまとめて判定し、 第一種の過誤が膨らむのを防ぎます。
2 群だけのときは、 t 検定と ANOVA は完全に等価で $F = t^2$(分子の自由度 $df_1 = 1$)という関係が成り立ちます。 つまり ANOVA は t 検定の一般化であり、 t 検定は ANOVA の特殊ケース。 検定統計量が「差の大きさ ÷ ばらつき」という同じ設計思想でできていることが、 $F = t^2$ という等式にそのまま表れています。 F の分母($\text{MS}_\text{within}$)が「共通の物差し(ものさし)」の役割を果たし、 群内ばらつきが大きいほど同じ平均差でも F は小さく=差を検出しにくくなります。
⚠️ 実務で効く落とし穴チェック(重要)
ANOVA は「回せば必ず p 値が出る」手法ですが、 前提が崩れた p 値は数字が出るだけで意味を持ちません。 実務で踏みやすい罠を、 判定の順序で整理します。
| 落とし穴 | 何が起きるか | 対処 |
|---|---|---|
| ① 正規性を確認しない | 残差が大きく歪むと p 値がずれる(特に小標本・強い歪み) | 残差の正規性を Shapiro–Wilk・QQ プロットで確認。 大幅違反は Kruskal–Wallis |
| ② 等分散性を仮定したまま | 群でばらつきが違うと第一種の過誤が名目 5% から 10〜20% に膨張 | Levene / Bartlett 検定で確認。 違反時は Welch ANOVA(等分散を仮定しない版) |
| ③ 独立性の破れ | 同一個体の反復・空間/時間の相関で有効サンプルが水増しされ p が過小 | サンプリング設計を見直す。 反復測定 ANOVA や混合効果モデルへ |
| ④ 有意で満足して終える | F の有意は「どこかに差」だけ。 どの群かは分からない | 事後検定(Tukey HSD 等)でペアを特定。 多重比較補正込みで |
| ⑤ 効果量を書かない | 大標本では小さな差でも p<0.05 になり「実質的な大きさ」が伝わらない | 効果量 η²(または偏り補正の ω²)を必ず併記。 η² の目安 0.01/0.06/0.14=小/中/大 |
| ⑥ 外れ値・不均衡データ | 1 点の外れ値が群平均を動かす/群サイズが極端に違うと SS の分解がタイプ依存に | 箱ひげ図で外れ値を可視化。 不均衡時は Type II/III 平方和を選び、 頑健手法も検討 |
| ⑦ 一元と二元を混同 | 2 因子あるのに一元で回すと交互作用を見落とす(交絡) | 因子が 2 つ以上なら二元配置 ANOVA で主効果+交互作用を分離 |
💡 前提チェックの結論が「古典 ANOVA・Welch・Kruskal–Wallis のどれでも同じ」なら結論は頑健です。 逆に手法で結論が割れるときこそ、 どの前提が崩れているかを見極める必要があります。
🚀 発展 — ANOVA ファミリーの地図
一元配置 ANOVA を起点に、 因子の数・測定の構造・仮定の崩れ方に応じて手法が枝分かれします。 「何が起きたらどこへ進むか」を一望できるように整理します。
| 発展手法 | いつ使うか | 要点 |
|---|---|---|
| 一元配置 ANOVA | 因子が 1 つ(例: 地方区分だけ) | 3 群以上の平均差を 1 回で検定。 本ページの基本形 |
| 二元配置 ANOVA | 因子が 2 つ(例: 地方 × 都市規模) | 2 つの主効果に加え交互作用(片方の効果が他方の水準で変わるか)を分離 |
| 多元配置 ANOVA | 因子が 3 つ以上 | 高次の交互作用まで扱えるが解釈が急に難しくなる。 交互作用プロット必須 |
| 反復測定 ANOVA | 同一個体を繰り返し測定(例: 同じ県の複数年) | 個体差を分離。 球面性を Mauchly 検定で確認し、 崩れたら Greenhouse–Geisser 補正 |
| 混合効果モデル | 独立性が崩れる・欠測やネスト構造がある | 固定効果+変量効果。 反復測定 ANOVA の一般化で、 不均衡・欠測に強い |
| Welch ANOVA | 等分散が崩れている(Levene で有意) | 分母を群ごとの分散で重み付け。 等分散を仮定せずに平均差を検定 |
| Kruskal–Wallis | 正規性が大きく崩れる・順序尺度 | 一元配置 ANOVA のノンパラ版(順位に基づく)。 反復測定版は Friedman 検定 |
| 事後検定(Tukey HSD) | F が有意でどのペアか特定したい | 全ペア比較を FWER 制御下で。 対照群との比較は Dunnett、 汎用は Bonferroni |
| 効果量 η² / ω² | 常に(p 値と併記) | η²=SS_between/SS_total。 ω² は η² の上振れを補正した推定量。 Cohen's f も併用可 |
| 線形回帰への一般化 | 連続共変量も入れたい(ANCOVA) | ANOVA=カテゴリ変数だけの回帰。 共変量を足せば ANCOVA、 さらに一般化で GLM |
関連ページ: t 検定(2 群版・$F=t^2$)/ 各種 t 検定/ F 検定・仮説検定/ p 値・自由度/ 効果量/ 多重比較・多重検定/ Kruskal–Wallis・ノンパラメトリック法/ 正規性・Shapiro–Wilk 検定。 (Welch ANOVA・Tukey HSD・二元配置/反復測定 ANOVA・混合効果モデルは本ページ内で解説)
🧮 追加の実測例 — 合計特殊出生率の「地方差」を一元配置 ANOVA で
SSDSE-B-2026(cp932・skiprows=[1]・2023 年・47 都道府県)の合計特殊出生率 A4103を、 都道府県を 8 地方ブロック(北海道/東北/関東/中部/近畿/中国/四国/九州沖縄)に分けて一元配置 ANOVA で比較した実測結果です(数値はすべて実データから計算)。
| 地方 | 県数 | 出生率 平均 | 標準偏差 |
|---|---|---|---|
| 北海道 | 1 | 1.06 | — |
| 東北 | 6 | 1.165 | 0.067 |
| 関東 | 7 | 1.151 | 0.084 |
| 中部 | 9 | 1.321 | 0.066 |
| 近畿 | 7 | 1.257 | 0.092 |
| 中国 | 5 | 1.390 | 0.063 |
| 四国 | 4 | 1.343 | 0.046 |
| 九州沖縄 | 8 | 1.455 | 0.098 |
💬 読み方: F(7,39)=13.34 で p は 10⁻⁸ 台と非常に小さく、 「少なくとも 1 組の地方間で出生率が違う」と言えます。 ただし F の有意は全体の差にすぎないので、 Tukey HSD で「九州沖縄 vs 関東」「九州沖縄 vs 東北」といった具体的にどのペアかを特定します。 効果量 η²=0.71 は非常に大きく、 統計的にも実質的にも顕著な地方差です。 なお北海道は 1 県のみ(n=1)で群内分散が定義できないため、 平均差の寄与は評価できても分散の議論からは外れる点に注意(不均衡データの一例)。 等分散(Levene p=0.93)・ノンパラ(Kruskal–Wallis)の双方でも結論が揃うため、 前提の崩れによる誤りの心配は小さい実測例です。
🔖 キーワード索引(深掘り版)
論文・記事に登場する用語のリンクで該当箇所へジャンプ: