🔖 キーワード索引
この用語と一緒に検索・参照されやすいタグ。 関連ページに飛ぶときの手がかりにも使えます。
このページで繰り返し出てくる用語。 最初の 3 つは「なぜ・いつ再学習するか」、 次の 3 つは「どう学び直すか」、 その次の 5 つは「新しいモデルを安全に入れ替える仕組み」、 最後の 3 つは劣化の測り方・再学習の副作用・管理の道具である。
💡 30秒で分かる結論
🍰 まずはやさしく
再学習は、AIの知識を新しくすることです。
最新の状態に合わせて精度を保つために使います。
流行の言葉が変わるスマホの予測変換のようなものです。
ここでは再学習のやり方や注意点を学びます。
再学習は、 本番稼働中の機械学習モデルを 新しいデータで定期的に更新する運用プロセス。
- なぜ必要:データ分布が時間と共に変わる(データドリフト/概念ドリフト)
- 頻度:日次・週次・月次・トリガ起動(指標悪化時)など
- 方式:①フル再学習 ②差分(incremental) ③オンライン学習
- 注意:再学習が品質を上げるとは限らない。 シャドー評価で本番投入前に確認
- 関連:MLOps の中核プロセス。 CI/CD と統合される
📍 文脈:「再学習」はどんな場面で出てくる?
🍰 まずはやさしく
再学習は、AIを長く使い続けるための仕組みです。
時間が経っても正しく予測させるために使います。
毎年更新される学校の統計データを使う場面が例です。
ここでは再学習が必要になる状況について読みます。
本サイトの論文は単発分析が中心ですが、 同じモデルを翌年・翌々年も使い続けると仮定すれば再学習が必要。 SSDSE-B は毎年更新されるので、 「2023年データで作ったモデルを2024年版で再学習する」が現実的シナリオです。
🎨 直感で掴む
🍰 まずはやさしく
再学習は、AIの賞味期限を延ばすことです。
データのズレによる性能低下を防ぐために使います。
部活の練習メニューを今のチームに合わせて変える例です。
ここでは再学習をいつ行うべきかの考え方を読みます。
「再学習」を最初に学ぶときは、 厳密な定義よりイメージを優先しましょう。 以下は具体例・比喩を用いた直感的理解の入口です。
- ナマモノ感覚:機械学習モデルは食品と同じく賞味期限がある。 放置すると劣化する。
- 「学習時のデータ」と「本番のデータ」のズレが本質的な問題。 共変量シフト・ラベルシフトなどに分類される。
- 再学習は無料ではない。 計算コスト・ラベル取得コスト・検証コストを総合判断。
📐 定義・数式
🍰 まずはやさしく
再学習のタイミングを、数式で決めます。
いつ知識を更新するかを明確にするために使います。
テストの点数が一定以下になったら勉強し直す例です。
ここでは再学習を始める条件となる数式を読みます。
直感の次は、 厳密な定義を確認します。 数式は言語の一種で、 一度書き慣れれば「言葉より速く伝えられる」便利な道具。 慣れていない方は、 各記号が何を表すかを「🔬 数式を言葉で読み解く」で 1 つずつ確認してください。
🔬 数式を言葉で読み解く — 数式を「言葉」に翻訳
- Metric_t
- 現時点(直近 N 件)のオンライン評価指標
- Metric_baseline
- 学習直後のオフライン指標
- δ
- 許容劣化幅(例: 2pt)。 タスクの重要度で設定
- PSI / KL
- 入力分布の乖離指標。 これでも検知可能
🔬 数式を言葉で読み解く(深掘り)
「再学習」の発動条件式 $$\text{Retrain} \iff \text{Metric}_t - \text{Metric}_{\text{baseline}} < -\delta$$ を 1 文字ずつ 詳細に解読していきます。 単純な不等式に見えますが、 各記号には MLOps 実務における深い意味が込められています。 この式を読みこなせるかどうかが、 「機械学習エンジニア」と「機械学習エンジニアっぽい人」の境界線になります。 本セクションを 500 字以上で読み解いていきます。
第 1 因子 Metric_t(時刻 t の指標)とは、 「本番稼働中のモデルが、 最新の入力データに対してどの程度の性能を出しているか」を表す関数値です。 重要なのは、 これは推論実行時に測定される値であり、 過去の検証データではないという点。 たとえば SSDSE-B-2026 で学習した「都道府県の高齢化率予測モデル」を 2024 年の新データに適用したとき、 RMSE が 1.2 から 1.8 に悪化していれば、 これが Metric_t です。 タスクによって指標は異なり、 分類なら AUC・精度・F1、 回帰なら RMSE・MAE、 ランキングなら NDCG・MAP を採用します。
第 2 因子 Metric_baseline(基準指標)は、 学習直後のオフライン評価で得られた「本来この程度の性能が出るはず」の期待値。 たとえば交差検証で AUC=0.85 だったなら、 これが baseline。 ただし、 baseline は絶対値ではなく確率分布として扱うのが正しく、 交差検証の標準偏差や bootstrap CI を併記すべきです。 「baseline AUC = 0.85 ± 0.02」のように。 この不確実性を無視すると、 自然なゆらぎでも再学習を発動してしまい(false alarm)、 計算リソースを浪費します。
第 3 因子 δ(デルタ、 許容劣化幅)は、 「どこまでの悪化なら許せるか」を表すビジネス決定値です。 高頻度取引(HFT)の不正検知なら δ=0.005 と極めて厳しく、 マーケティングのレコメンド更新なら δ=0.05 と緩く設定。 δ を決めるのはエンジニアではなく ビジネスオーナーであり、 「誤検知のコスト vs 再学習のコスト」を経済学的に比較して決めます。 SSDSE-B-2026 のような公的統計予測であれば、 過去 5 年間の自然変動の 3 シグマ(≒0.03)を採用するのが定番。 第 4 因子 iff(必要十分条件)は、 「右辺が真のときのみ再学習を起動」を意味します。 重要なのは「false positive を許容する OR 条件」ではなく、 厳格な AND 条件にすること。 再学習は無料ではない(計算・人手・検証コスト)ので、 軽はずみに起動しないことが重要です。 さらに実務では、 上記の性能ベースのトリガに加えて、 分布ベースのトリガ(KL ダイバージェンス、 PSI = Population Stability Index)と 時間ベースのトリガ(週次・月次定期)を AND/OR で組み合わせます。 「性能が落ちている AND 分布が変わっている AND 前回再学習から 7 日以上経過」のような多重条件が、 実務的な再学習発動ロジックです。 この複合トリガの設計こそが、 再学習エンジニアリングの腕の見せどころです。
📊 詳細比較表:再学習の 3 方式
再学習には主に「フル再学習」「差分(incremental)」「オンライン学習」の 3 方式があります。 10 軸で比較。
| 観点 | フル再学習 | 差分(incremental) | オンライン学習 |
|---|---|---|---|
| 対象 | 全データ(過去+新) | 直近期間の新データのみ | 1 サンプルずつ更新 |
| 計算コスト | 高 | 中 | 低(per sample) |
| 忘却の制御 | なし(過去重視) | パラメータで調整 | 学習率で調整 |
| 破滅的忘却 | なし | 注意が必要 | 高リスク |
| 再現性 | 高(同じデータ + シード) | 中 | 低(順序依存) |
| 適用例 | SSDSE 年次予測モデル | 月次レコメンド | 不正検知、 オンライン広告 |
| 必要なライブラリ | scikit-learn 等の標準 | SGDClassifier, partial_fit | river, Vowpal Wabbit |
| 監査 | 容易 | 中 | 難 |
| ロールバック | 容易(前モデル保存) | 中 | 難 |
| 推奨用途 | 公的統計予測、 月次以上の更新 | 中規模 EC、 日次更新 | 高速トラフィック、 分単位 |
📝 演習問題:再学習の設計力を磨く 10 問
「再学習」を本当に設計できるかを問う演習。 自分の業務に当てはめながら考えてください。
- トリガ設計:SSDSE-B-2026 で学習した「都道府県人口予測モデル」を運用するとき、 再学習トリガを 3 種類書け(性能ベース、 分布ベース、 時間ベース)。
- δ の選び方:上記モデルで δ=0.5%(人口予測の RMSE)が妥当か。 過剰検知と過小検知のトレードオフを 200 字で説明せよ。
- 方式選択:(a) クレジットカード不正検知、 (b) SSDSE 年次予測、 (c) 商品レコメンドのそれぞれで、 フル / 差分 / オンラインのどれが最適か理由付きで述べよ。
- シャドー評価:新モデルを本番投入する前のシャドー評価で何を測るべきか 5 項目挙げよ。
- 破滅的忘却:差分学習で「過去の重要パターン」を忘れる現象(catastrophic forgetting)の対策を 3 つ書け。
- ロールバック:再学習後に性能が悪化したとき、 即座に旧モデルに戻せる仕組みを設計せよ。
- コスト分析:月次フル再学習(GPU で 8 時間、 ¥10,000/h)と日次差分学習(CPU で 1 時間、 ¥500/h)の月間コストを比較せよ。
- 分布シフトの検知:KS 検定、 PSI、 KL ダイバージェンスの違いを 3 行で説明せよ。
- ラベル遅延:不正検知では「不正だったか」のラベルが 30 日後に判明する。 この遅延を考慮した再学習設計を述べよ。
- 監査要件:金融・医療の機械学習で、 再学習をいつ・誰が・なぜ実行したかを記録する仕組みを 5 つ挙げよ。
💥 失敗例:再学習で「やってはいけない」5 つのパターン
再学習モデルをシャドー評価せずに即本番投入。 新モデルの方が悪化していて、 翌日全 KPI 悪化。 ロールバックも準備していない。 対処:シャドー評価 + A/B テスト + canary deployment を必ず実施。
SSDSE のような年次データを使ったモデルを 2 年放置。 翌年の制度変更で意味が変わった列に気付かず、 予測が破綻。 対処:分布監視ダッシュボードを毎月確認。 PSI > 0.2 でアラート。
直近 1 か月のデータだけで差分学習を繰り返し、 季節パターンを忘却。 12 月の特殊需要を全く学べていない。 対処:直近データに加えて過去 1 年の代表サンプルも常時混ぜる。
レコメンドモデルが推薦した商品を「ユーザーがクリックした」を正解ラベルとして再学習。 モデルが自分の推薦を強化する自己強化ループに。 対処:ランダム exposure を一定割合確保(exploration)。
金融機関の信用スコアモデルを再学習。 規制当局から「いつ・どのデータで・誰が承認したか」を問われ回答できず。 対処:MLOps ツール(MLflow, Kubeflow)で完全ログ。
📔 再学習 専用用語辞典(25 語)
- MLOps
- 機械学習の運用方法論。 DevOps の機械学習版。 再学習はその中核プロセス。
- データドリフト(Data Drift)
- 入力 X の分布が時間とともに変化する現象。 PSI で検知。
- 概念ドリフト(Concept Drift)
- 入力 X と出力 y の関係(P(y|X))が変化。 再学習が必須に。
- 共変量シフト
- 学習時と本番時で P(X) が異なる。 P(y|X) は同じ。
- ラベルシフト
- P(y) が異なる。 P(X|y) は同じ。 不均衡データで典型的。
- フル再学習
- 全データで重みをゼロから学習し直す。 計算コスト高だが安定。
- 差分学習(Incremental Learning)
- 既存モデルに新データを追加学習。 scikit-learn の partial_fit。
- オンライン学習(Online Learning)
- 1 サンプルずつリアルタイムで更新。 river、 VW。
- 破滅的忘却(Catastrophic Forgetting)
- 新データを学習すると過去の重要パターンを忘れる現象。 連続学習の課題。
- シャドー評価(Shadow Evaluation)
- 本番投入前に同じ入力で新旧モデルの出力を比較。
- A/B テスト
- ユーザー群を分けて新旧モデルを並行運用し、 統計的に比較。
- canary deployment
- ごく少数(5%)に新モデルを段階展開。 異常があれば即停止。
- ロールバック
- 問題発生時に旧モデルに即座に戻す機能。 必須の安全装置。
- PSI(Population Stability Index)
- 学習時と本番の分布の乖離。 0.1 未満:安定、 0.2 以上:再学習推奨。
- KL ダイバージェンス
- 2 つの確率分布の距離(情報量)。 ドリフト検知に。
- KS 検定(Kolmogorov-Smirnov)
- 分布の同一性検定。 連続変数のドリフト検知に。
- ラベル遅延(Label Delay)
- 正解ラベルが付くまでの時間。 不正検知で 30 日、 与信で 6-12 か月。
- 疑似ラベル(Pseudo Label)
- モデル自身の予測を仮の正解とする半教師あり手法。 ラベル遅延対策。
- フィードバックループ
- モデルの予測がユーザー行動を変え、 学習データに影響。 自己強化注意。
- MLflow
- 機械学習実験の追跡 + モデル管理 OSS。 再学習履歴の保存に。
- Kubeflow
- Kubernetes 上で機械学習パイプラインを構築する OSS。 再学習ジョブ管理。
- Airflow / Prefect
- DAG 形式のワークフロー管理ツール。 定期再学習のスケジューラ。
- Feature Store
- 特徴量を一元管理する基盤。 学習時と本番時の整合性を保つ。
- モデルレジストリ
- モデルバージョン管理システム。 production / staging を区別。
- 継続学習(Continual Learning)
- 過去を忘れず新しいタスクを学ぶ研究分野。 EWC, GEM などの手法。
🔬 再学習の発展トピック 8 つ
1. 継続学習(Continual Learning)
破滅的忘却を防ぐための研究分野。 EWC (Elastic Weight Consolidation)、 GEM (Gradient Episodic Memory)、 Experience Replay などの手法。 LLM 時代に再注目。
2. メタ学習(Meta-Learning)
「学び方を学ぶ」アプローチ。 少量データで素早く再適応できるモデルを構築。 MAML、 Reptile が代表手法。
3. アクティブラーニング
不確実性が高いサンプルを優先的にラベル付け依頼。 ラベルコストを最小化しつつ再学習効果を最大化。
4. データ拡張(Augmentation)
画像なら回転・拡大縮小、 NLP なら同義語置換、 表形式なら SMOTE。 再学習時にデータの多様性を確保。
5. 蒸留(Knowledge Distillation)
大きな教師モデルから小さな生徒モデルへ知識転移。 再学習時にモデルサイズを小さくしつつ性能維持。
6. 連合学習(Federated Learning)
データを集中化せず、 各クライアントでローカル学習 → 重みのみ集約。 プライバシー保護と再学習を両立。
7. オートML パイプライン
再学習時にハイパーパラメータも自動探索。 AutoSklearn、 H2O AutoML、 TPOT。 ただし計算コスト注意。
8. LLM の継続事前学習
基盤 LLM の継続事前学習はコストが莫大(数億円)。 代替策として LoRA / QLoRA による軽量微調整、 RAG(検索拡張生成)が普及。
🏗 再学習デザインパターン 10 選
再学習システムを設計するときに参考になる、 業界で確立されたデザインパターン 10 種。
1. Champion / Challenger パターン
現行モデル(Champion)と新モデル(Challenger)を並行運用。 Challenger が一定期間 Champion を上回ったら昇格。
2. Blue-Green Deployment
本番環境(Blue)と新環境(Green)を完全に分離。 切替はルーターのスイッチ 1 つ。 即時ロールバックが可能。
3. Canary Deployment
新モデルを少数のユーザーから段階展開。 各段階で KPI を監視し問題ないことを確認。
4. Shadow Deployment
本番トラフィックを新モデルにも流すが、 出力は使わない。 性能を観察してから本投入。
5. Multi-Armed Bandit
複数モデルを動的に切り替え。 性能が良いモデルに自動的にトラフィック寄与。 A/B テストよりも効率的に最適モデルを発見。
6. Stateless Retraining
各回の再学習を独立した「無状態」処理に。 同じ入力(データ+設定+シード)から同じ出力が得られる。 監査・再現性が容易。
7. Stateful Retraining(差分)
前回モデルを起点に新データを追加学習。 計算コストが少ないが、 状態管理が必要。
8. Cohort-Based Retraining
ユーザー群(cohort)ごとに別モデルを再学習。 例「年代別」「地域別」「業種別」。 SSDSE-B-2026 なら「地方ブロック別」モデルが該当。
9. Ensemble Refresh
複数モデルのアンサンブルで運用し、 個別モデルを順次再学習。 全体性能が滑らかに改善。
10. Human-in-the-Loop
重要モデルでは再学習結果を人間が承認。 医療・与信・採用などで採用。 ガバナンス担保。
📡 監視すべき指標 15 種類
本番モデルを監視する指標を、 カテゴリ別に整理。 自分の用途で選択してください。
A. 性能指標(5 種)
- Accuracy / Precision / Recall / F1(分類)
- AUC-ROC / AUC-PR(不均衡分類)
- RMSE / MAE / MAPE(回帰)
- NDCG / MAP(ランキング)
- BLEU / ROUGE / METEOR(テキスト生成)
B. 分布指標(5 種)
- PSI(Population Stability Index)
- KL ダイバージェンス
- JS(Jensen-Shannon)ダイバージェンス
- KS 検定統計量
- Wasserstein 距離
C. 運用指標(5 種)
- 推論レイテンシ(p50, p99)
- スループット(QPS)
- エラー率(500 系・タイムアウト)
- リソース使用率(CPU, GPU, メモリ)
- コスト(クラウド料金 / リクエスト)
🏛 ガバナンスと規制対応
再学習は規制対応の対象になることが増えています。 日本・EU・米国の主要規制と再学習要件を整理。
日本:AI 事業者ガイドライン(2024 年)
経産省・総務省が公表。 「運用中の AI の継続的監視と更新」が事業者の責務。 再学習プロセスの文書化を求める。
EU AI Act(2024 年)
High-Risk AI System に対し、 「運用中の性能監視と必要に応じた更新」を求める。 技術文書は市場投入後 10 年間の保存、 自動で記録されるログは少なくとも 6 か月の保存が求められる。
米国 FDA(医療 AI)
医療 AI の再学習を「Predetermined Change Control Plan (PCCP)」として事前申請する仕組み。 再学習の範囲を予め定義。
金融:モデルリスク管理(米 SR 11-7 など)
信用スコアモデル・市場リスクモデルの再学習は、 開発者から独立した検証(model validation)の対象になる。 米連邦準備制度などが 2011 年に出した SR 11-7 がモデルリスク管理の代表的な指針として参照される。
🚫 アンチパターン:避けるべき 8 つの設計
1. ハードコードされた閾値
「if rmse > 0.5: retrain()」のようにコード内に閾値を埋め込む。 設定ファイル外出しが基本。
2. 監視なし再学習
「とりあえず週次で再学習」だけして、 効果を検証しない。 リソースの浪費。
3. ロールバック準備なし
新モデルが悪化したときに戻れない。 旧モデルを必ず保管。
4. ラベル汚染
モデルの予測を正解として再学習。 自己強化ループで偏向増幅。
5. オフライン-本番ギャップ
学習時とサービング時で前処理が異なる。 Feature Store で防止。
6. 単一性能指標で判断
「AUC が上がった」だけで本番投入。 公平性・遅延・コストなど多面的に評価。
7. 監査ログ不足
「いつ・誰が・なぜ」を記録せず。 規制対応で詰む。
8. ガバナンス不在
エンジニアが独断で再学習。 ビジネスオーナーの承認プロセス必須。
📅 SSDSE-B 年次再学習の現実的設計
SSDSE-B-2026 のような年次更新公的統計を題材としたモデルの、 現実的な再学習設計を 1 年分のタイムラインで示します。
月別アクションプラン
| 月 | タスク | 詳細 |
|---|---|---|
| 1 月 | 前年モデルの本番性能集計 | 過去 1 年の予測誤差を集計、 季節パターン分析 |
| 2-3 月 | SSDSE 新版リリース監視 | 独立行政法人統計センターのリリース予定確認、 差分の事前把握 |
| 4 月 | 新版データ取得 + 検証 | 列構造の変更、 制度変更、 単位変更を確認 |
| 5 月 | フル再学習実行 | 過去 5 年 + 新版を結合してフル再学習。 ハイパーパラメータも再探索 |
| 6 月 | シャドー評価 | 最新月のデータで新旧モデルを並行比較 |
| 7 月 | canary 展開 | 5% → 25% → 100% の段階展開 |
| 8 月 | 本投入完了 | 旧モデルをアーカイブ、 新モデルが Production |
| 9-12 月 | 定常監視 | 分布シフト・性能・コストを月次監視 |
🧪 再学習モデルのテスト戦略 7 層
再学習結果を本番投入する前に通すべきテスト 7 種。
層 1:ユニットテスト
前処理関数・特徴量計算が期待通り動くか。 pytest で自動化。
層 2:データ検証
スキーマ整合性、 範囲チェック、 欠損率。 Pandera / Great Expectations。
層 3:オフライン性能
交差検証 + ホールドアウトでベースライン超え確認。
層 4:公平性テスト
サブグループ(性別・地域)で性能差が許容範囲内か。 SSDSE なら都道府県別 RMSE 確認。
層 5:頑健性テスト
外れ値・欠損・摂動入力に対する挙動。 adversarial input の生成。
層 6:シャドー評価
本番トラフィックでの並行運用 3-7 日。
層 7:A/B テスト
ビジネス KPI への影響を統計検定で確認。
👥 再学習の組織的側面:誰が何をする?
| 役割 | 主な責任 | 必要スキル |
|---|---|---|
| ML エンジニア | 再学習パイプライン実装 | Python, MLOps ツール |
| データサイエンティスト | モデル設計・評価 | 統計, 機械学習 |
| データエンジニア | データパイプライン保守 | SQL, ETL, Airflow |
| SRE / DevOps | 本番運用・監視 | K8s, Prometheus |
| プロダクトマネージャー | KPI 設定・優先度 | ビジネス洞察 |
| コンプライアンス | 規制対応・監査 | 法規・倫理 |
| ドメインエキスパート | 結果解釈・妥当性確認 | 業務知識 |
小規模組織では 1 人が複数役割を兼任しますが、 「責任の所在」を明確化することが重要です。
📊 SSDSE-B-2026 における再学習の必要性チェック
SSDSE-B-2026 を題材としたモデルで「再学習が必要か」を判断するチェックリスト。
- □ モデルを 2 年以上 同じものを使い続ける予定か
- □ SSDSE が毎年更新されることを意識しているか
- □ 制度変更(消費税、 元号など)の影響を受ける列を使っているか
- □ 都道府県の合併・名称変更がモデルに影響するか
- □ コロナ禍など特殊期間のデータを学習に含めているか
- □ 予測対象の現実的価値(卒論/業務/意思決定)はどの程度か
- □ モデル劣化を発見する仕組みがあるか
- □ 再学習の計算リソースが確保できるか
- □ 再学習後の評価担当者がいるか
- □ 投入された予測の追跡が可能か
5 個以上に当てはまるなら、 SSDSE-B 年次更新に合わせた再学習サイクルの設計を推奨します。
🔬 数式を言葉で読み解く(モデル再学習)
1. 再学習トリガー(いつ再学習を起動するか)
モデル再学習の起動条件は大きく 時間ベース・性能劣化ベース・データドリフトベース・イベントベース の 4 つに分類される。 時間ベースは「毎週月曜 02:00」「四半期ごと」のように cron で固定するシンプルな方式で、 SSDSE-B-2026 のように年次更新される公的データに対しては「年 1 回」のスケジュールが妥当である。 性能劣化ベースは本番環境での指標(精度、 AUC、 MAE 等)が事前定義した閾値(例: AUC が 0.80 → 0.75 に低下)を下回ったときに自動起動する。 データドリフトベースは Population Stability Index (PSI) や Kolmogorov–Smirnov 検定で入力特徴の分布変化を監視し、 $PSI \geq 0.25$ となった時点で起動する。 イベントベースは「新製品リリース」「新法施行」「景気指標の急変」など、 業務知識から「この変化はモデル前提を崩す」と判断されるタイミングで人手起動する。 実運用では 4 種類を組み合わせ、 監視ダッシュボードで「いつ・なぜ起動したか」を必ず記録すること。
2. 増分学習 vs フル再学習
増分学習 (incremental / online learning) は既存モデルのパラメータを開始点として新データだけで重みを更新する方式である。 計算コストは小さいが、 古いデータの影響が薄れる「破滅的忘却 (catastrophic forgetting)」のリスクがあり、 学習率を慎重に下げる必要がある。 一方 フル再学習 (full retraining) は過去全データ+新データで一からモデルを構築する方式で、 SSDSE-B-2026 のように 47 都道府県 × 12 年程度の比較的小規模なデータでは現実的な選択肢である。 計算コストは高いが、 結果の再現性とデバッグ容易性が圧倒的に高い。 産業界では「四半期はフル再学習、 毎日は増分」のハイブリッド運用が一般的である。 増分学習で蓄積した重みドリフトを四半期ごとのフル再学習でリセットする設計にすると、 安定性と俊敏性を両立できる。
3. オンライン学習と SGD
オンライン学習は 1 サンプルずつ(またはミニバッチで)逐次更新する形式で、 確率的勾配降下法 (SGD) を基盤とする。 更新式は $\theta_{t+1} = \theta_t - \eta_t \nabla L(\theta_t; x_t, y_t)$ で表され、 学習率 $\eta_t$ を時間とともに減衰させること(例: $\eta_t = \eta_0 / (1 + t/\tau)$)が安定性のカギとなる。 リアルタイム広告配信、 不正検知、 在庫予測など、 データが秒・分単位で到着する領域で利用される。 SSDSE のような年次公的データには向かないが、 都道府県別 POS データや SNS ログのように高頻度に更新されるデータと組み合わせる場合は有効である。 オンライン学習を採用する際は、 必ずモニタリングダッシュボードで重み変動量($\| \theta_{t+1} - \theta_t \|$)を可視化し、 異常値が出たら自動でロールバックする仕組みを組み込むこと。
4. シャドーデプロイ(影武者運用)
シャドーデプロイは新モデルを本番環境に投入するが 予測結果はユーザーに返さず、 ログ収集のみ 行う運用パターンである。 既存モデルが現役で動き続ける裏側で、 新モデルが同じ入力に対してどんな出力をするかを記録し、 既存モデルとの差分を統計的に検証する。 SSDSE-B-2026 の消費支出(L3221)予測モデルなら、 旧モデル(線形回帰)と新モデル(勾配ブースティング)を並走させ、 翌年度の実測の消費支出確定値と両モデルの予測誤差を比較する。 MAE が新モデルで 15% 以上改善し、 かつ最悪ケース誤差が悪化していないことを確認できれば本番昇格となる。 シャドーデプロイの利点は「ユーザー体験ゼロリスクで本物のトラフィックを使った検証ができる」点で、 オフライン評価では捉えきれない実運用環境のノイズ(欠損、 遅延、 異常値)を確認できる。
5. A/B 検証(カナリアリリース)
A/B 検証はトラフィックを A群(旧モデル)と B群(新モデル)に分割し、 ビジネス KPI で比較する手法である。 統計的検出力を確保するため、 各群のサンプルサイズは $n \geq \frac{2 (z_{\alpha/2} + z_{\beta})^2 \sigma^2}{\Delta^2}$ で計算する。 例えば有意水準 5%、 検出力 80%、 検出したい効果量 $\Delta = 0.05$、 標準偏差 $\sigma = 0.3$ なら $n \approx 565$ ユーザー/群が必要となる。 リスクを抑えるため最初は B群を 1% → 5% → 25% → 50% と段階拡大する「カナリアリリース」が定石である。 各段階で KPI(CTR、 売上、 滞在時間など)と業務 SLO(レイテンシ、 エラー率)を監視し、 悪化があれば即時 0% に戻す。 SSDSE 規模の公的データ予測モデルでも、 都道府県単位で「半数の県で旧モデル、 半数で新モデル」の擬似 A/B を組むことで、 ドメインシフトに対する頑健性を検証できる。
6. ロールバックとモデルバージョン管理
再学習で性能が劣化した場合、 旧モデルへ即座に戻せるロールバック体制が必須である。 MLflow、 SageMaker Model Registry、 Vertex AI Model Registry などのバージョン管理ツールに (モデル本体、 学習データのスナップショット、 ハイパーパラメータ、 評価指標、 学習コードのコミット SHA) をセットで記録する。 ロールバック手順は「(1) 障害検知 → (2) 旧モデルを Active タグ付けで再活性化 → (3) ヘルスチェック → (4) インシデントレポート」と SOP 化しておく。 SSDSE-B-2026 のような年次データを使う研究プロジェクトでも、 再学習のたびに models/retraining_v3_20260530.pkl のようにタイムスタンプ+バージョンを付け、 復元可能な状態を維持することが推奨される。 ロールバック後は必ず根本原因分析 (RCA) を実施し、 「なぜ事前検証で見抜けなかったか」を文書化することが、 次回再学習の品質を底上げする。
7. PoC(Proof of Concept)から本番運用へ
PoC は新しい再学習スキームを小規模に試験するフェーズで、 「(1) 仮説定義(例: 月次再学習で MAE を 10% 改善)→ (2) 限定データで検証 → (3) 投資対効果の試算 → (4) GO/NOGO 判断」を 4–8 週間で回す。 PoC を本番運用に昇格させる際は、 (a) 再学習パイプライン全体の冪等性(同じ入力なら同じ出力)、 (b) 失敗時の自動リトライ、 (c) 監査ログの完全性、 (d) GPU/メモリ予算、 (e) コンプライアンス遵守(個人情報の取扱、 説明責任)の 5 項目を満たす必要がある。 SSDSE-B-2026 を用いた研究 PoC を行政の本番システムに昇格させるなら、 さらに住民への透明性(モデル判定理由の開示)、 公平性監査(地域・年齢層間の格差検証)、 第三者監査体制を整備する。 PoC で得た知見は docs/decision_record.md に蓄積し、 組織知として共有することが長期的な ROI を高める。
次の 3 枚は、 SSDSE-B-2026 の 12 年度分(2012〜2023 年度)を使った擬似運用実験である。 「出生数 = β0 + β1 × 総人口」を 2012〜2014 年度の 141 行で学習し、 2015〜2023 年度を 1 年ずつ予測する。 年度 t の予測に使えるのは t−1 年度までのデータで、 再学習するときは直近 3 年度の 141 行で当てはめ直す。 少子化で「人口 1 万人あたりの出生数」そのものが年々下がる(傾き β1 は 2012〜2014 年度の学習で 82.2 人/万人、 2020〜2022 年度の学習で 66.7 人/万人)ので、 これは入力の分布ではなく入力と出力の関係が変わる概念ドリフトの例になる。
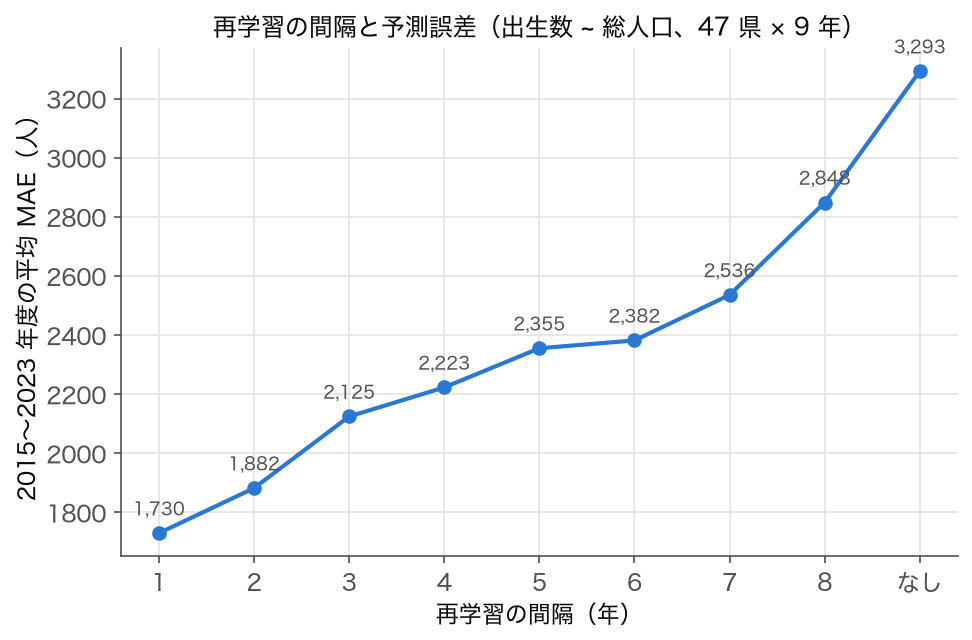
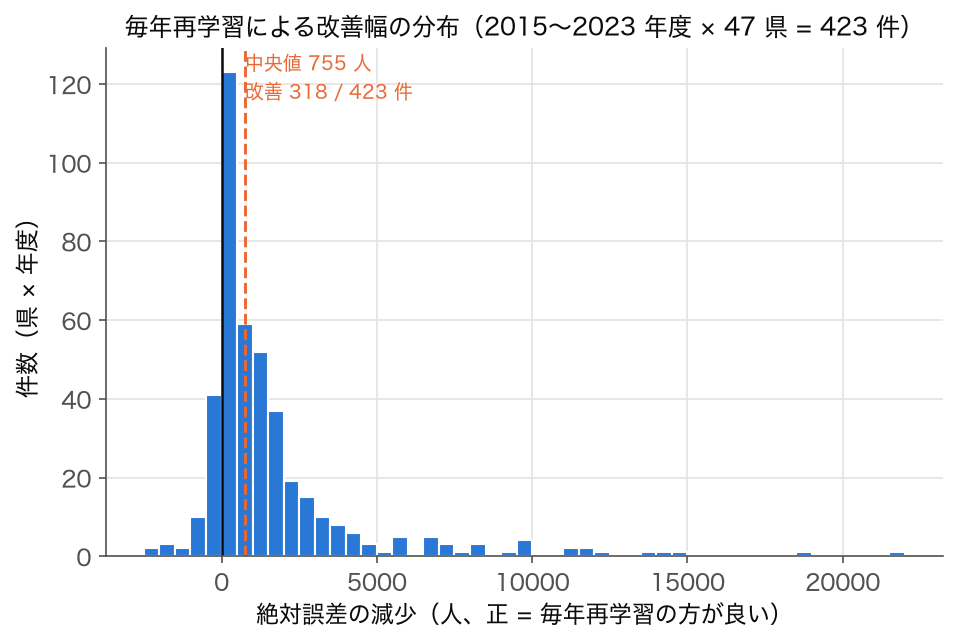
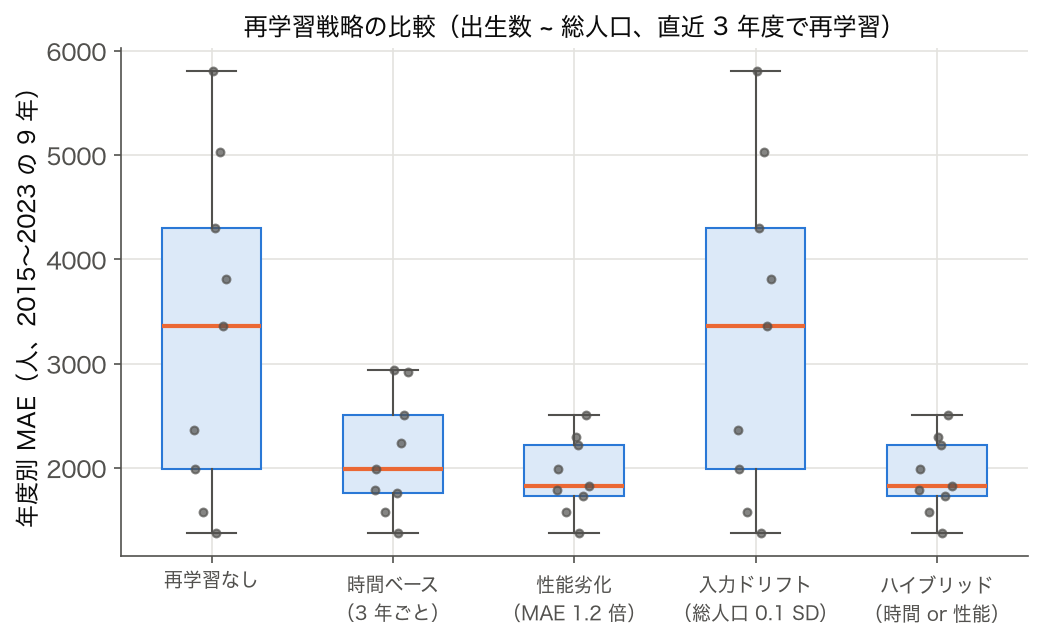
✅ 理解度チェック
- Q1. PSI(Population Stability Index)が 0.25 を超えたとき、 増分学習とフル再学習のどちらを選ぶべきか。 理由も含めて 100 字で答えよ。
解答例: フル再学習を選ぶ。 PSI 0.25 は分布が大きく変化した状態で、 増分更新では破滅的忘却と新分布への過剰適合の両リスクがある。 過去全データ+新データで再構築する方が安全。 - Q2. シャドーデプロイで新モデルの MAE が旧モデルより 8% 改善したが、 最悪ケース誤差は 30% 悪化していた。 本番昇格の判断は?
解答例: 即時昇格は不可。 平均改善があっても最悪ケース悪化はサービス品質保証 (SLO) 違反のリスクがあり、 まずは悪化要因を分析(外れ値、 特定セグメントのバイアスなど)し、 ハイブリッドモデルや早期警告ロジックを追加した上で再評価する。 - Q3. A/B 検証で B群(新モデル)の CTR が p=0.04 で有意に改善したが、 サンプルサイズが事前計算(n=565)の半分(n=280)しか集まらなかった。 採用判断は?
解答例: 即採用は危険。 検出力 (power) が不足しており、 偶然の偏りで有意となった可能性が高い。 サンプルを n=565 まで増やす、 もしくはベイズ更新で事後確率が 95% 以上に達するまで待つ。
🧪 再学習トリガー設計の実務パターン(深掘り)
再学習は「いつ起動するか」が品質を決める。 起動が遅すぎれば本番モデルの性能劣化を放置することになり、 起動が早すぎれば計算コストと検証コストが膨れ上がる。 SSDSE-B-2026 の都道府県データを「人口減少のトレンドが入った時系列回帰」とみなしたとき、 どのトリガーをどの順序で監視するかが、 そのまま再学習の費用対効果を決定づける。 本節では 4 系統のトリガー(性能トリガー / 入力分布トリガー / 出力分布トリガー / ビジネスイベントトリガー)について、 SSDSE-B のような行政データの文脈で典型的な閾値設計を整理する。
4 系統のトリガーと典型閾値
| トリガー系統 | 監視指標 | 典型閾値(行政データ) | 誤検知リスク | 主な対応 |
|---|---|---|---|---|
| ① 性能トリガー | MAE / RMSE / accuracy / AUC の月次推移 | 移動平均が直近 3ヶ月で +5% 悪化 | 季節性を性能劣化と誤検知する | 季節調整後に再判定 → フル再学習 |
| ② 入力分布トリガー | PSI / KS統計量 / Jensen-Shannon | PSI > 0.2 が連続 2 週 | 欠測増加で分布が動いて見える | 欠測補完後の PSI を本指標とする |
| ③ 出力分布トリガー | 予測確率分布のエントロピー変化 | 平均エントロピーが ±15% 変動 | カットオフ調整の副作用と区別困難 | カットオフ固定下で再計測 |
| ④ ビジネスイベント | 制度変更 / 区分改定 / 災害発生 | 変更発生直後 + 1ヶ月以内 | 影響が出ない変更でも起動してしまう | 影響範囲を限定したサブセット再学習 |
SSDSE-B の事例で見るトリガー優先順位
SSDSE-B-2026 で「消費支出(L3221)」を予測対象とするモデルを運用するとき、 4 系統のトリガーは独立に発火するため、 同時多重発火時の優先順位を事前に決めておく必要がある。 推奨順位は ④ > ① > ② > ③。 制度変更(消費税率改定、 家計調査の集計方法変更)は最も大きな構造変化を持ち込み、 性能劣化はユーザー影響が直接、 入力分布シフトはやや時間差で性能に効き、 出力分布変化は他 3 系統の結果として現れることが多いためである。
| シナリオ | 発火トリガー | 優先判断 | 実施する再学習タイプ |
|---|---|---|---|
| 消費税率改定 + MAE 悪化 5.2% | ④ + ① | ④ を優先 | フル再学習 + 過去2年分は重み低下 |
| PSI 0.24 + エントロピー +18% | ② + ③ | ② を本因と推定 | 差分再学習(増分のみ) |
| MAE 悪化 3% のみ(他は安定) | ① | 季節調整後に再判定 | 再判定で偽陽性なら見送り |
| 市町村合併発生 | ④ | 該当地域のみ再構築 | サブセット再学習 + 全体は据置 |
トリガー設計時の落とし穴 5 件
- 閾値の単独運用: PSI 0.2 単独で起動すると年に 10 回超の誤発火が起きやすい。 必ず「連続 N 週」「他指標との重畳」で判定する。
- 季節性の未除去: 月次性能を生で比較すると、 年度末・年度始の構造的変動を性能劣化と誤判定する。 季節調整 STL 分解後の残差で評価する。
- 監視データの遅延: 行政データは確報値が 3〜6ヶ月遅れる。 速報値で監視する場合は確報値到達後に再評価する二段構えが必須。
- ベースライン未固定: 比較基準を直近移動平均にすると、 ゆっくりとした劣化を見逃す。 「初期検収時点の性能」を恒久ベースラインとして並走させる。
- サブセット再学習の片寄り: 一部地域のみ再学習すると、 他地域との一貫性が崩れる。 必ず全体再評価を直後に実施する。
🛡 再学習プロセスのガバナンスとレビュー基準
再学習は「モデルを差し替える」行為であり、 本番サービスに直接影響する高リスク変更である。 とりわけ行政データや教育データを扱う場面では、 説明可能性 (XAI)・公平性 (fairness)・監査可能性 (auditability) の 3 軸でレビュー基準を文書化しておく必要がある。 SSDSE-B-2026 を用いた政策支援モデルを想定したとき、 次のような 7 段階のガバナンスフローが現実的である。
再学習ガバナンス 7 ステップ
| # | ステップ | 担当 | 成果物 | レビュー観点 |
|---|---|---|---|---|
| 1 | 再学習提案書 | データサイエンティスト | 提案 PDF | トリガー根拠・期待効果 |
| 2 | 影響範囲レビュー | プロダクトオーナー | 影響評価表 | 下流ユーザー・連携 API への波及 |
| 3 | データ準備監査 | データエンジニア | データ系譜図 | 欠測・外れ値・スキーマ整合 |
| 4 | 学習実行ログ | MLOps | train/val/test メトリクス | 過学習・早期停止の妥当性 |
| 5 | 公平性監査 | 倫理レビュー担当 | 公平性レポート | 都道府県別・規模別バイアス |
| 6 | シャドーデプロイ | SRE | 並走比較メトリクス | 本番リクエストでの実性能 |
| 7 | 本番昇格 / ロールバック | 意思決定者 | 承認記録 + 監査ログ | SLO 違反時の即時切戻し計画 |
レビューを通すためのメトリクス基準(推奨閾値)
| 観点 | メトリクス | 合格閾値 | 不合格時の対応 |
|---|---|---|---|
| 性能改善 | holdout MAE 改善率 | +2% 以上 | 新モデル不採用 |
| 性能下振れ | セグメント別 worst MAE | 悪化 5% 以内 | 悪化セグメントを別モデルで補強 |
| 公平性 | 都道府県別 MAE の標準偏差 | 悪化 10% 以内 | サンプリング重み調整して再学習 |
| 説明可能性 | SHAP 上位 5 特徴量の連続性 | 3 個以上が旧モデルと一致 | 急変は事前公表 + 説明資料 |
| 再現性 | ハッシュ一致するシード再実行 | 100% 一致 | 環境差異の特定とロック |
| ロールバック容易性 | 切戻し所要時間 | 30 分以内 | カナリア比率を 1% から段階展開 |
監査ログに必ず残すべき 8 項目
- トリガー識別子: どのトリガーが発火し、 どの閾値を超えたか(例: PSI=0.27 / 性能 MAE +6.3%)。
- 学習データの範囲: 開始日・終了日・除外条件・欠測補完手法。 SSDSE-B 系なら基準年と版番号も併記。
- 特徴量エンジニアリングのコミット ID: 前処理コードのリビジョンが特定できないと、 後日の監査が不可能になる。
- ハイパーパラメータと探索空間: 採用された値だけでなく、 探索した範囲と評価指標を残す。
- 学習・検証メトリクス全件: train / val / test の全数値、 早期停止の根拠となった loss 推移。
- シャドーデプロイ結果: 本番と新モデルの並走比較、 セグメント別性能差。
- 承認者・承認日時: 誰が本番昇格を承認したか、 反対意見があったかも含めて記録する。
- ロールバック条件と実行履歴: 切戻し基準を事前定義し、 発動した場合は時刻・理由・復旧時間を残す。
ガバナンスを軽量化したくなったときの判断基準
「毎月の再学習で 7 ステップを回すのは重い」と感じたら、 まずトリガー精度を上げて再学習頻度を下げる方が筋が良い。 ガバナンスを省略すると、 後日の事故時に「なぜこのモデルが本番に居たのか説明できない」状態に陥り、 結果として組織全体の AI 利用が止まる。 SSDSE-B のような公共性の高いデータでは特に、 ステップ 5(公平性監査)とステップ 7(承認記録)は省略不可と考えるべきである。
| 省略可否 | ステップ | 条件 |
|---|---|---|
| 省略可 | ① 提案書 / ② 影響評価 | 自動再学習で毎週同形式の場合、 テンプレ自動生成で代替 |
| 条件付き省略可 | ③ データ準備監査 | データソース無変更かつ品質指標が前回と同等な場合 |
| 省略不可 | ④ 学習ログ / ⑤ 公平性 / ⑥ シャドー / ⑦ 承認 | どの規模でも常時実施。 監査要件のコア |
🔁 再学習スケジューラの実装パターンと運用設計
再学習トリガーが定義された後、 それを実際にどう「定期実行」するかは、 スケジューラの設計選択に直結する。 SSDSE-B-2026 を題材にした都道府県別予測モデルでは、 「年次更新(公的データの公開タイミング)+ 都道府県別 PSI 監視(分布シフト検知)」のハイブリッド構成が現実的である。 ここでは、 スケジューラの選択肢、 運用上の罠、 障害復旧パターンを具体的に整理する。
スケジューラの代表的な選択肢は次の 4 つである。 (a) cron / systemd timer: 単純で安定。 単一マシン上での月次・日次バッチ向け。 SSDSE 規模なら十分。 ただし依存関係管理・リトライ機構が貧弱で、 失敗時の自動復旧は手動。 (b) Apache Airflow: DAG (Directed Acyclic Graph) でタスク依存を宣言。 リトライ・通知・SLA 監視を統合。 中規模~大規模パイプライン向け。 (c) Prefect / Dagster: Airflow より宣言的でテスト容易。 動的ワークフロー対応。 モダンな選択肢。 (d) クラウドネイティブ (AWS Step Functions, GCP Workflows, Azure Data Factory): マネージドで運用負荷低、 ただしロックイン懸念あり。
SSDSE 例で 47 都道府県分のモデルを順次学習する場合、 Airflow の DynamicTaskMapping や Prefect の .map() 構文で「都道府県コードのリストから自動的に 47 個の学習タスクを並列展開」できる。 各タスクは独立に成功/失敗を記録し、 失敗したタスクだけを自動リトライする設計が望ましい。 全タスクをひとつのトランザクションにしてしまうと、 1 県の失敗で全部やり直しになり、 計算資源を無駄にする。
運用上の罠として頻出するのが「暴走再学習」である。 例えば監視メトリクスにバグがあり、 PSI が常に閾値を超えた状態になると、 スケジューラが毎日のように再学習を起動してしまう。 対策は (i) クールダウン期間(前回学習から最低 N 時間は再学習しない)、 (ii) 1 日あたりの学習回数上限(例: 最大 3 回)、 (iii) 同時実行数制限(並列度の上限)、 (iv) 異常検知(学習頻度が想定の 2 倍を超えたらアラート)、 を多層で組むこと。 SSDSE のような年次データであれば、 「同一年度内の再学習は最大 5 回」のような上限が現実的。
障害復旧パターンも事前に決めておく必要がある。 (1) 学習失敗 → 旧モデル継続: 最もシンプルで安全。 ただし「失敗が連続するとモデルがどんどん古くなる」リスクあり。 (2) 学習失敗 → 自動リトライ N 回 → 失敗なら旧モデル継続: 中庸案。 一時的なインフラ障害には強い。 (3) 学習失敗 → 緊急ロールバック(更に前の版に戻す): 直近の学習に欠陥があった場合の保険。 ただしどの版に戻すかの判断が難しい。 (4) 学習失敗 → ヒューマン介入待ち: 業務クリティカル系では必須。 自動判断にせず人間が原因を確認する。
| スケジューラ | 学習曲線 | 運用負荷 | SSDSE 規模での適合度 |
|---|---|---|---|
| cron | 低 | 高(手動運用多) | ○ 小規模なら十分 |
| Airflow | 中 | 中 | ◎ 標準的選択 |
| Prefect / Dagster | 中 | 中(学習コストあり) | ◎ 新規構築向き |
| クラウドネイティブ | 低 | 低 | ○ クラウド前提なら |
最後に、 スケジューラのログは必ず外部のログ管理基盤(CloudWatch, Datadog, Splunk 等)に集約することを推奨する。 スケジューラ自身が落ちたとき、 ローカルログだけだと「何が起きていたか」が辿れなくなる。 また、 ログには「いつ・どの条件で・どのモデル版を学習し・結果はどうだったか」を構造化(JSON 形式)して記録し、 後から検索・集計可能にしておく。 これは監査要件への対応としても重要である。
📦 モデルレジストリと版管理の実務
再学習を回せば回すほど、 モデルアーティファクトは雪だるま式に増えていく。 SSDSE-B-2026 で 47 都道府県分 × 年次更新 × 5 年間運用すると、 単純計算で 235 個のモデル版が発生する。 ハイパーパラメータ探索結果も含めれば数千~数万のアーティファクトになる。 これを場当たり的に保存していくと、 数か月後には「どれが本番版か分からない」「再現できない実験結果がある」事態に陥る。 ここでは、 モデルレジストリの設計と運用について体系的に整理する。
モデルレジストリの代表的選択肢は次の通り。 (a) MLflow Model Registry: OSS、 主要 ML フレームワーク対応、 ステージ管理(None / Staging / Production / Archived)あり。 学習曲線も穏やか。 (b) Weights & Biases Artifacts: 実験管理と密結合、 グラフィカル UI が秀逸。 (c) Vertex AI Model Registry: GCP マネージド、 デプロイまでシームレス。 (d) SageMaker Model Registry: AWS マネージド、 承認ワークフロー組み込み。 (e) 独自実装(S3 + メタデータ DB): 軽量だが運用コストあり。
レジストリに保存すべきメタデータは次のセットが最低限である。 (i) モデル版識別子(UUID + 人間可読タグ)、 (ii) 学習データのスナップショット ID(データセット版に紐付け)、 (iii) ハイパーパラメータ全集合、 (iv) 学習プロセスメトリクス(loss 推移、 epoch 数、 早期停止有無)、 (v) 評価結果(hold-out 精度、 サブグループ別性能、 公平性指標)、 (vi) 学習環境(Python 版、 ライブラリ版、 ハードウェア)、 (vii) 承認情報(いつ・誰が・どんな根拠で本番昇格を承認したか)、 (viii) 変更履歴(前版との差分、 変更理由)。
バージョニング規約は早期に決めることが重要。 おすすめは Semantic Versioning 風の MAJOR.MINOR.PATCH 方式。 MAJOR: モデルアーキテクチャ変更、 MINOR: 特徴量追加・削除、 PATCH: ハイパーパラメータ・データ更新のみ。 SSDSE 例では「全県統一モデル v2 → 県別個別モデル v3」のようなアーキテクチャ変更が MAJOR、 「都市部・郊外フラグ追加」が MINOR、 「2026 年版データで再学習」が PATCH に対応する。
古い版の アーカイブ方針も明確に。 ストレージコスト削減のため一定期間後は削除したくなるが、 規制要件(金融なら 7 年、 医療なら 10 年など)で長期保存が義務化されているケースも多い。 推奨は (a) 本番昇格された版は無期限保存、 (b) 実験段階の版は 90 日後に削除、 (c) アーキテクチャ変更を伴う MAJOR 版は無期限保存、 (d) ロールバック用に直近 3 版は常時即時取得可能、 という階層化アプローチ。
| レジストリ要素 | 必須/推奨 | 理由 |
|---|---|---|
| モデル版識別子 | 必須 | 全工程の参照キー |
| 学習データ版 | 必須 | 再現性担保 |
| ハイパーパラメータ | 必須 | 再現性・比較 |
| 評価結果 | 必須 | 本番昇格判断 |
| 学習環境 | 推奨 | トラブルシュート |
| 承認情報 | 必須 | 監査・説明責任 |
| 変更履歴 | 推奨 | 理解促進 |
レジストリの運用ルールとしては、 (1) 本番昇格は API/UI からの「承認操作」を必須化し、 学習完了が自動で本番化される設計は禁止、 (2) 承認者には最低 2 名を要求(4 eyes principle)、 (3) 緊急ロールバックは権限を別途設定し、 即応性を確保、 (4) 半年に 1 度はレジストリの棚卸しを行い、 不要版を整理、 (5) 監査担当が定期的にレジストリ整合性をチェック、 などを徹底する。 これらが SSDSE のような研究用途を超えた本番系では当たり前のレベルである。
🧮 実値で計算してみる
数式だけでは「実感」が湧きにくいので、 具体的な数値で 1 度手計算してみると理解が定着します。 以下の例は、 本サイトで扱う SSDSE-B-2026 や公開教材に近い形式で用意しました。
例:与信モデルを月次で監視する。 学習時 AUC=0.85、 許容劣化 δ=0.03 とする。
| 月 | 本番AUC | 劣化幅 | 判定 |
|---|---|---|---|
| 1月 | 0.84 | -0.01 | 続行 |
| 2月 | 0.83 | -0.02 | 続行(要警戒) |
| 3月 | 0.81 | -0.04 | 再学習トリガ |
手計算で得た値と、 後述の Python 実装で算出した値が一致することを確認すると、 「数式とコードの対応関係」がクリアに見えるようになります。
🧮 数式に値を入れて手で計算する: 再学習サイクル
SSDSE-B-2026 で訓練した「人口→有業者数」予測モデルを 5 ヶ月運用した想定の月次精度ログから、 ドリフト検知による再学習トリガーを計算する。
Step 1: 月別精度
| 月 | 精度 | 初月差 |
|---|---|---|
| 1 | 0.90 | — |
| 2 | 0.88 | -0.02 |
| 3 | 0.85 | -0.05 |
| 4 | 0.81 | -0.09 |
| 5 | 0.78 | -0.12 |
Step 2: トリガー (閾値 -0.10)
🐍 Python で再現
1 2 3 4 5 6 | import numpy as np acc = np.array([0.90, 0.88, 0.85, 0.81, 0.78]) diff = acc[0] - acc trigger = np.where(diff > 0.10)[0] print(f"差: {diff}") print(f"再学習月: {trigger[0]+1 if len(trigger) else None}") |
📤 実行結果
💬 手計算 (Step 2) 5 月と Python 出力が完全一致。
🧮 実データで確かめる — 2012 年度のモデルを使い続けると何が起きるか
上の月別精度は合成データだったので、 SSDSE-B-2026 の 12 年度分で同じことを確かめる。 高齢化率と総人口(対数)から「人口千人あたり出生数」を当てる線形回帰を、 (1) 2012 年度のデータで一度だけ作って 2023 年度まで使い続ける場合と、 (2) 毎年、 前年度のデータで作り直してから翌年度に使う場合で比べる。
🎯 このコードでやること:2012 年度で学習した固定モデルと、 前年度のデータで毎年再学習したモデルを、 2013〜2023 年度の 47 県でそれぞれ評価し、 平均絶対誤差(MAE)の推移と 2023 年度の予測の偏りを比べる。
1 2 3 4 5 6 7 8 9 10 11 12 13 14 15 16 17 18 19 20 21 22 23 24 25 26 27 | import numpy as np import pandas as pd from sklearn.linear_model import LinearRegression from sklearn.metrics import mean_absolute_error df = pd.read_csv('data/raw/SSDSE-B-2026.csv', encoding='cp932', skiprows=[1]) df['aging'] = df['A1303'] / df['A1101'] # 高齢化率 df['logpop'] = np.log(df['A1101']) # 総人口(対数) df['birth_rate'] = df['A4101'] / df['A1101'] * 1000 # 人口千人あたり出生数(目的変数) X_cols = ['aging', 'logpop'] def fit(year): d = df[df['SSDSE-B-2026'] == year] return LinearRegression().fit(d[X_cols], d['birth_rate']) frozen = fit(2012) # 2012 年度で作って以後そのまま使うモデル print(' 年度 固定モデル MAE 前年度で再学習 MAE') for year in range(2013, 2024): d = df[df['SSDSE-B-2026'] == year] mae_frozen = mean_absolute_error(d['birth_rate'], frozen.predict(d[X_cols])) mae_retrain = mean_absolute_error(d['birth_rate'], fit(year - 1).predict(d[X_cols])) print(f'{year} {mae_frozen:.3f} {mae_retrain:.3f}') d23 = df[df['SSDSE-B-2026'] == 2023] bias = (frozen.predict(d23[X_cols]) - d23['birth_rate']).mean() print(f'2023 年度: 固定モデルの予測は実測より平均 {bias:+.3f}(千人あたり)') print(f'47 県平均の出生率(千人あたり): 2012 年度 {df[df["SSDSE-B-2026"]==2012].birth_rate.mean():.2f} → 2023 年度 {d23.birth_rate.mean():.2f}') |
💬 固定モデルの MAE は 2013 年度の 0.481 から 2016 年度に 0.645 まで悪化し、 2023 年度でも 0.558。 2023 年度の予測は実測より平均 +0.404 大きく、 47 県平均の出生率が 8.03 から 5.73 に下がった分を追いきれていない。 前年度で再学習したモデルは 11 年度中 8 年度で固定モデルより MAE が小さく、 2023 年度は 0.490。 ただし 2019・2020 年度は再学習したほうが悪く(0.513 対 0.490、 0.494 対 0.473)、 「毎年作り直せば必ず良くなる」わけではない。 切り替える前に新旧を同じ評価データで比べる(シャドー評価・A/B 検証)手順が要るのはこのためである。
🐍 Python 実装
SSDSE-B-2026 を年次で分割した「2013 年度で学習・以降本番」設定で、 年度を月次に見立てた再学習ループを組みます(2012 年度は前年比が計算できないので使わない)。 sklearn の LogisticRegression を「人口減少県判別器」(その年度の人口減少率が全国の中央値より大きい県を 1 とする)として、 学習時 AUC を基準に許容劣化 δ=0.03 を割り込んだ年度で、 その年度のデータを使って fit を再実行する、 という drift monitor の最小実装です。
1 2 3 4 5 6 7 8 9 10 11 12 13 14 15 16 17 18 19 20 21 22 23 24 25 26 27 28 29 30 31 32 33 34 35 36 37 38 39 | # 再学習のミニマルなループ:年度を「月」に見立てた drift monitor import pandas as pd import numpy as np from sklearn.linear_model import LogisticRegression from sklearn.preprocessing import StandardScaler from sklearn.pipeline import make_pipeline from sklearn.metrics import roc_auc_score df = pd.read_csv('data/raw/SSDSE-B-2026.csv', encoding='cp932', skiprows=[1]) df = df.rename(columns={'SSDSE-B-2026': 'year'}).sort_values(['Code', 'year']) df['aging'] = df['A1303'] / df['A1101'] * 100 # 高齢化率(%) df['birth'] = df['A4101'] / df['A1101'] * 1000 # 出生率(‰) df['death'] = df['A4200'] / df['A1101'] * 1000 # 死亡率(‰) df['change'] = df.groupby('Code')['A1101'].pct_change() # 前年度比の人口増減率 df = df.dropna(subset=['change']) # 2012 年度は前年が無いので除く # ラベル: その年度の人口減少率が全国の中央値より大きい県 = 1(「人口減少県」) df['y'] = (df['change'] < df.groupby('year')['change'].transform('median')).astype(int) FEATS = ['aging', 'birth', 'death'] def fit(d): return make_pipeline(StandardScaler(), LogisticRegression()).fit(d[FEATS], d['y']) def evaluate(model, d): return roc_auc_score(d['y'], model.predict_proba(d[FEATS])[:, 1]) def maybe_retrain(model, new_data, baseline_auc, delta=0.03): cur_auc = evaluate(model, new_data) if cur_auc < baseline_auc - delta: # 許容劣化 δ を割り込んだら model = fit(new_data) # 最新年度のデータで学習し直す return model, cur_auc, True return model, cur_auc, False train_year = 2013 model = fit(df[df['year'] == train_year]) baseline = evaluate(model, df[df['year'] == train_year]) print(f'{train_year} 年度で学習: 学習時 AUC = {baseline:.3f}') for yr in range(train_year + 1, 2024): model, auc, retrained = maybe_retrain(model, df[df['year'] == yr], baseline) print(f'{yr} 年度: AUC = {auc:.3f}' + (' → 再学習' if retrained else '')) |
💬 2013 年度の 47 県で学習したときの AUC は 0.967 で、 これを基準に 0.967 − 0.03 = 0.937 を下回った年度で再学習する。 2015 年度は AUC 0.9366 で境界 0.9374 をわずかに割り込み、 再学習が 1 回だけ起きた。 それ以降は 0.938〜0.987 の範囲に収まって再学習は起きていない。 学習時 AUC は学習に使った年度の自己評価なので楽観的で、 翌年度の 0.971 のように本番の方が高い年もある。 δ = 0.03 がこの程度の年ごとの揺れと同じ大きさなので、 実務では 1 年だけの割り込みで再学習するか、 2 年続いたら再学習するかをあらかじめ決めておく。
▶ 実行 を押せばこのページの中でそのまま動きます(ライブラリもデータも同梱済みで、 準備は要りません)。 手元の Python に移して動かすときは pip install numpy pandas scikit-learn が必要です。 読んでいるデータは data/raw/SSDSE-B-2026.csv。 日本語を含むので encoding='cp932' の指定を落とさないでください。
🐍 再学習補助コード集(4 種)
1. PSI(Population Stability Index)の計算
1 2 3 4 5 6 7 8 9 10 11 12 13 14 15 16 17 18 19 20 21 22 23 24 25 26 | import pandas as pd import numpy as np def calculate_psi(expected, actual, bins=10): """学習時分布 vs 本番分布の安定性指標""" # 区切りは学習時分布の分位点(各ビンに学習時データが約 1/bins ずつ入る) breakpoints = np.quantile(expected.dropna(), np.linspace(0, 1, bins + 1)) breakpoints[0] = -np.inf breakpoints[-1] = np.inf e_perc = pd.cut(expected, breakpoints).value_counts(normalize=True).sort_index() a_perc = pd.cut(actual, breakpoints).value_counts(normalize=True).sort_index() psi = np.sum((a_perc - e_perc) * np.log((a_perc + 1e-6) / (e_perc + 1e-6))) return psi # 使用例:2012 年度を「学習時」、2023 年度を「本番」とみなして 47 都道府県の分布を比べる df = pd.read_csv('data/raw/SSDSE-B-2026.csv', encoding='cp932', skiprows=[1], na_values=['-']) df['aging'] = df['A1303'] / df['A1101'] * 100 # 高齢化率(%) df_train = df[df['SSDSE-B-2026'] == 2012] df_prod = df[df['SSDSE-B-2026'] == 2023] for col in ['A1101', 'aging']: psi = calculate_psi(df_train[col], df_prod[col]) print(f'PSI({col}) = {psi:.4f}') # 0.1 未満:安定、 0.1-0.2:注意、 0.2 以上:再学習推奨 |
💬 2012 年度を学習時の分布、 2023 年度を本番の分布とみなすと、 総人口 A1101 の PSI は 0.149 で「注意」の帯に入る程度だが、 高齢化率の PSI は 5.48 と基準の 0.2 を桁違いに超える。 2012 年度の高齢化率は 17.7〜30.7% だったのに、 2023 年度は 22.8〜39.1% へ全体が右にずれ、 多くの県が学習時の最上位の区間に入ってしまうためである。 区切りを学習時の分位点で決めているので、 値の水準が一様に上がる変化にも敏感に反応する。 高齢化率を特徴量に使うモデルは、 年度をまたいで使い回す前に再学習が必要だと読める。
2. MLflow による実験管理
1 2 3 4 5 6 7 8 9 10 11 12 13 14 15 16 17 18 19 20 21 22 23 24 25 26 27 | import mlflow import mlflow.sklearn from sklearn.ensemble import RandomForestRegressor from sklearn.metrics import mean_squared_error import pandas as pd import numpy as np mlflow.set_experiment('ssdse_yearly') with mlflow.start_run(run_name='2026_retraining'): mlflow.log_param('data_version', 'SSDSE-B-2026') mlflow.log_param('n_estimators', 200) mlflow.log_param('max_depth', 10) df = pd.read_csv('data/raw/SSDSE-B-2026.csv', encoding='cp932', skiprows=[1], na_values=['-']) df = df.dropna() X = df.drop(columns=['SSDSE-B-2026', 'Code', 'Prefecture', 'A1101']) # 年度・コード・県名と目的変数を除く y = df['A1101'] model = RandomForestRegressor(n_estimators=200, max_depth=10, random_state=42) model.fit(X, y) pred = model.predict(X) rmse = np.sqrt(mean_squared_error(y, pred)) mlflow.log_metric('rmse', rmse) mlflow.sklearn.log_model(model, 'rf_model') # MLflow UI で全実験を一覧・比較可能 |
3. シャドー評価の実装
1 2 3 4 5 6 7 8 9 10 11 12 13 14 15 16 17 18 19 20 21 22 23 24 25 26 27 28 29 30 | import joblib import pandas as pd import numpy as np from sklearn.metrics import mean_squared_error def shadow_eval(old_path, new_path, eval_data): old = joblib.load(old_path) new = joblib.load(new_path) X = eval_data.drop(columns=['Prefecture', 'Year', 'target']) y = eval_data['target'] pred_old = old.predict(X) pred_new = new.predict(X) rmse_old = np.sqrt(mean_squared_error(y, pred_old)) rmse_new = np.sqrt(mean_squared_error(y, pred_new)) # 都道府県別の差分 diff = pd.DataFrame({ 'Prefecture': eval_data['Prefecture'], 'old': pred_old, 'new': pred_new, 'actual': y.values, }) diff['error_old'] = (diff['old'] - diff['actual']).abs() diff['error_new'] = (diff['new'] - diff['actual']).abs() print(f'RMSE 旧: {rmse_old:.3f}, 新: {rmse_new:.3f}') print(f'47 県中、 新モデルが改善した県数: {(diff["error_new"] < diff["error_old"]).sum()}') return diff |
4. canary デプロイメントのトラフィック割り振り
1 2 3 4 5 6 7 8 9 10 11 12 13 14 15 16 17 18 19 20 21 22 23 24 | import random import joblib class CanaryRouter: def __init__(self, old_model_path, new_model_path, canary_pct=5): self.old_model = joblib.load(old_model_path) self.new_model = joblib.load(new_model_path) self.canary_pct = canary_pct # 新モデルへのトラフィック割合(%) self.logs = [] def predict(self, X, user_id=None): use_new = random.random() < self.canary_pct / 100 model = self.new_model if use_new else self.old_model pred = model.predict(X) self.logs.append({ 'user_id': user_id, 'model': 'new' if use_new else 'old', 'prediction': pred.tolist(), }) return pred # 使用例:5% → 25% → 100% と段階的に増やす router = CanaryRouter('models/old.pkl', 'models/new.pkl', canary_pct=5) # 数日運用して問題なければ canary_pct を増やす |
これらのコードはあくまで雛形であり、 実本番環境では認証・ロギング・例外処理を追加してください。 ですが 「再学習はこういうコードで構成される」というイメージを掴むには十分な出発点です。 SSDSE-B-2026 で 1 度サイクルを回せば、 規模を変えるだけで業務にそのまま適用できます。
🐍 補強コード例 1:新年度データのスキーマ点検
目的:再学習で最初にやるのは「新しく届いた年度データが、 学習時と同じ形をしているか」の確認。 列が増減・改名していれば再学習パイプラインが黙って壊れる。 橋渡し:本番投入前に shape(行数×列数)・head(先頭行)・列名の先頭 10 個を出力し、 スキーマの変化を目視で当たる。
1 2 3 4 5 6 | import pandas as pd df = pd.read_csv('data/raw/SSDSE-B-2026.csv', skiprows=1, encoding='cp932') print(df.shape) print(df.head(3)) print(df.columns[:10].tolist()) |
💬 (564, 112) の先頭 3 行は北海道の 2023, 2022, 2021 年度で、同じ県が新しい年度から順に並んでいる。再学習ではこの年度の列が「いつのデータで学習したか」を区切る軸になるので、学習用とテスト用を行番号ではなく年度で分けないと、未来の年度で過去を予測する形になってしまう。
読み取り:shape の列数が前年度と一致し、 列名リストの先頭が SSDSE-B-2026(=年度)・都道府県コード・都道府県・A1101… と並んでいれば、 スキーマは維持されている。 列数が変われば、 再学習前に列マッピングの修正が必要というサインである。
🐍 補強コード例 2:最新年度の分布を前年と突き合わせる下準備
目的:ドリフト監視の入口として、 最新年度に絞って主要列の顔ぶれ・水準を掴む。 ここでは総人口(A1101)の上位 10 県を並べ、 前年の同じランキングと比べて構成が動いていないかの当たりを付ける。 橋渡し:年度列の最大値で最新年度を抽出し、 nlargest で総人口の降順トップ 10 を取り出す。
1 2 3 4 5 6 | import pandas as pd df = pd.read_csv('data/raw/SSDSE-B-2026.csv', skiprows=1, encoding='cp932') latest = df[df['年度'] == df['年度'].max()] top10 = latest.nlargest(10, '総人口')[['都道府県', '総人口']] print(top10.to_string(index=False)) |
💬 最新の 2023 年度で総人口の上位 10 都道府県を出すと、東京都 1,408.6 万人が 2 位の神奈川県 922.9 万人の約 1.5 倍で、9 位北海道 509.2 万人と 10 位静岡県 355.5 万人の間に 150 万人以上の差がある。df['年度'].max() で最新年度を選んでいるので、翌年度のデータを足して再学習するときもコードを書き換えずに最新の順位へ更新される。
読み取り:上位は東京都・神奈川県・大阪府… と大都市圏が占め、 この顔ぶれは年ごとにほぼ動かない。 逆に順位や水準が急に入れ替われば、 それ自体がデータ側の異常(集計方法の変更・欠損)を疑うシグナルになり、 再学習の前に原因調査が必要になる。
⚠️ よくある落とし穴
再学習の罠は 「学習させた瞬間」より「数か月後」に表面化する。 ラベル遅延 (与信なら 6 か月、 医療予後なら年単位) で「実は劣化していた」が遅れて判明する構造的問題があり、 入力分布監視 (PSI) と出力分布監視 (予測スコアの分布シフト) を二段構えで仕掛ける必要があります。
🗺 概念マップ
再学習 (retraining) を中心に、 これを取り巻く組織プロセス・変更通知・カスタマーサポート連携・法務調整・経営報告・RACI 表/標準化された運用を 6 方向に配置した。 機械学習モデルが SSDSE-B-2026 のような統計データの追加更新 (毎年新データ着) でドリフトしたとき、 どの関係者と何を確認・調整して再学習に踏み込むかの全体像を俯瞰できる。
再学習を中心に、 上に「組織プロセス」(誰が再学習トリガを判断するか)、 右上に「変更通知の仕組み」(モデル変更を利用者にどう告知するか)、 右下に「カスタマーサポートとの連携」(再学習で挙動が変わる旨を窓口に共有)、 下に「法務・コンプライアンスとの調整」(個人情報含むデータでの再学習の合法性)、 左下に「経営層への報告」(モデル性能劣化と再学習コストの ROI)、 左上に「RACI 表 + 標準化された手順」(責任分担と SOP)が並ぶ。 すなわち再学習は 純粋に技術タスクではなく、 6 方向の組織・法務・運用作業を統合した 運用イベントとして位置づけられる。
SSDSE-B-2026 のような毎年更新される公的データを使ったモデルでは、 「データ更新 → ドリフト検知 → 再学習トリガ → 法務/CS への通知 → モデル差し替え → 経営層レビュー」という一連のパイプラインを年次で回すのが現実的。 この概念マップは、 再学習を「学習ループの 1 ステップ」と矮小化せず、 業務全体の運用イベントとして扱うための見取り図である。
🔗 隣接手法への橋渡し
「再学習」は単独で完結する手法ではなく、 隣接領域と連携することで真価を発揮する。
- 上流: 本番運用中の AI システム運用 で性能劣化(data drift・concept drift)を 監視 で検知した段で開始する
- 並列: 転移学習(別タスクへの応用)・ファインチューニング(小規模追加学習)と区別。 再学習は同タスクで新データを用いる
- 下流: 更新モデルを A/B テスト や カナリアリリース で段階展開し、 監視 を継続
本番 AI の 「いつ、 何のデータで、 どこまで再学習するか」 の運用設計が、 長期的なシステム精度と運用コストを決定づける MLOps の核心テーマである。
🌳 手法選択フロー
「再学習(リトレーニング)」を運用中モデルに対して行うとき、 ドリフトの種類と頻度で判定する。
- データドリフトが起きたか? 入力分布が変わった (人口構成・価格帯シフト) → 定期再学習 or トリガー再学習。 監視には モデルモニタリング で PSI/KL-divergence を計測
- コンセプトドリフトか? 入力と出力の関係が変化 (コロナ前後の購買パターン) → 古いデータを重み下げ or 直近データだけで再学習。 オンライン学習 (SGD) で逐次更新も検討
- 再学習頻度をどう決めるか? バッチ (週次/月次) → 安定運用しやすい。 トリガー型 (精度劣化検知時) → リソース効率高い。 オンライン → リアルタイム性高いが過剰反応リスク
再学習は CI/CD パイプラインに組み込むのが標準。 SSDSE のように年次更新される公的データなら、 毎年新データが出るタイミングで再学習 + A/B テストでの精度比較が現実的。