🔖 キーワード索引
この用語と一緒に検索・参照されやすいタグ。 関連ページに飛ぶときの手がかりにも使えます。
このページで扱う言葉を、意味と行き先つきで並べます。 知らない語があればここから辿ってください。
| 語 | 一言でいうと | このページのどこ/関連ページ |
|---|---|---|
| 測定誤差 | 測った値と本当の値のずれ。系統誤差と偶然誤差に分けて考える。 | 📐 定義・数式 |
| 真値 | 測りたい対象が本来持っている値。ふつうは直接は分からない。 | 📐 定義・数式 |
| 系統誤差(バイアス) | 同じ向きに偏り続けるずれ。何回測っても平均は真値に近づかない。 | 🔬 数式を言葉で読み解く |
| 偶然誤差(ランダム誤差) | 測るたびに向きが変わるずれ。回数を増やせば平均で打ち消せる。 | 🔬 数式を言葉で読み解く |
| 信頼性 | 同じ条件で測り直したとき、同じ値がどれだけ再現するか。 | 🧮 実値で計算してみる |
| 妥当性 | 測りたいものを本当に測れているか。信頼性が高くても妥当とは限らない。 | ⚠️ 落とし穴 |
| 級内相関係数(ICC) | 測定の再現性を 0〜1 で表す指標。信頼性の代表的な数値。 | 🧮 実値で計算してみる |
| 希薄化(減衰) | 説明変数に誤差があると回帰係数が 0 方向へ縮む現象。 | ⚠️ 落とし穴 |
| 標準誤差 | 推定値そのもののばらつき。測定誤差とは別物なので混同しない。 | 標準誤差 |
| ノイズ | 信号に混ざる不要な変動。測定誤差はノイズの一種。 | ノイズ |
| 選択バイアス | 誰を測るかの偏り。測定誤差とは発生源が違う。 | 選択バイアス |
| 丸め誤差 | 桁を落とすことで生じるずれ。公的統計の秘匿処理でも起きる。 | 🔗 関連用語 |
💡 30秒で分かる結論
🍰 まずはやさしく
測定誤差は、値が正解からズレることです。
正しい分析をするために使います。
体重計の数字が毎回違うときのような現象です。
この章では誤差の種類と対策を読みます。
測定誤差は、 観測値が真値からズレる現象。 系統的誤差(バイアス)と偶然誤差(ばらつき)に大別される。
- 偶然誤差:ランダムに正負どちらにも出る。 平均で打ち消せる
- 系統的誤差:常に同じ方向に出る。 校正で対処
- 影響:説明変数側の誤差は回帰係数を0 方向に縮める
- 検証:再測定/2 機器併用/既知標準サンプル
- 関連:信頼性(再現性)、 妥当性(測りたいものを測れているか)
📍 文脈:「測定誤差」はどんな場面で出てくる?
🍰 まずはやさしく
測定誤差は、データのズレのことです。
統計の正体を理解するために使います。
自治体が人口を数えるときにも起こります。
この章では誤差が使われる場面を読みます。
SSDSE のような公的統計でも、 自治体の集計時期・集計方法のズレが測定誤差として混入します。 統計分析の誤差の正体を理解するための基礎。
🎨 直感で掴む
🍰 まずはやさしく
測定誤差は、ダーツの的に例えられます。
ズレのイメージを掴むために使います。
体重計がいつも多めに表示される例です。
この章では誤差の直感的な違いを読みます。
- 体重計:常に 1kg 多く出る → 系統的、 たまに 0.5kg ブレる → 偶然。
- 偶然誤差はn を増やすと縮む。 系統的誤差は n を増やしても残る。
- 「正確(accurate)」と「精密(precise)」は別概念。 ダーツの比喩で学ぶ。
📐 定義・数式
🍰 まずはやさしく
測定誤差は、数式で表せるズレのことです。
厳密に計算するために使います。
スマホの計測アプリの誤差のようなものです。
この章では数式の意味をひとつずつ読みます。
やさしい説明で掴んだ感覚を、ここで 観測値の分解 の定義式に対応づけます。下の式は左辺 $y_{\text{obs}}$ が何で決まるかを右辺で書き下したもので、σ(標準偏差) が現れます。それぞれの記号が何の量を指すのかは、次の「🔬 数式を言葉で読み解く」で 1 つずつ確かめてください。
🔬 数式を言葉で読み解く — 数式を「言葉」に翻訳
- y_obs
- 観測値
- y_true
- 真値
- b
- バイアス(系統的誤差)
- ε
- 偶然誤差(平均0、 分散σ²)
- Reliability
- 再測定での一致度
🔬 観測値 = 真値 + 系統誤差 + 偶然誤差: 数式を言葉で読み解く
測定誤差の根本式は次のとおりです。 観測値 X は、 真値 μ と、 系統誤差 b(バイアス)と、 偶然誤差 ε の和に分解できます。
$$ X = \mu + b + \varepsilon, \quad \varepsilon \sim \mathcal{N}(0, \sigma_{\varepsilon}^2) $$X: 観測値(実際に測定して得られた数値)μ: 真値(真に知りたい量、 通常は不明)b: 系統誤差(bias)。 体温計が常に +0.3 度高く出るなど、 方向が決まっている誤差。 平均しても消えないε: 偶然誤差(random error)。 平均 0、 分散 σ² の正規分布に従うと仮定するのが標準- 正規分布の仮定: 中心極限定理より、 多数の独立な微小要因が重なれば近似的に正規分布になる
🔬 分散の分解: 数式を言葉で読み解く
観測値の分散は、 真の変動 σ²_true と測定誤差の分散 σ²_err の和になります。 これが信頼性係数(reliability coefficient)の基盤式です。
$$ \sigma_{\text{obs}}^2 = \sigma_{\text{true}}^2 + \sigma_{\text{err}}^2 $$ $$ r_{xx} = \frac{\sigma_{\text{true}}^2}{\sigma_{\text{obs}}^2} = 1 - \frac{\sigma_{\text{err}}^2}{\sigma_{\text{obs}}^2} $$$r_{xx}$: 信頼性係数(0 ≤ r_xx ≤ 1)- r_xx = 1: 測定誤差ゼロ、 完全に信頼できる測定
- r_xx = 0: 観測値のほぼ全てが誤差、 真値情報がほぼない
- 心理測定で 0.7 以上、 教育測定で 0.8 以上が望ましいとされる目安
この式が示す重要な含意: 観測値の分散は真値の分散より必ず大きい。 つまり「測定すると、 真の値より幅が広く見える」のが測定誤差の本質的影響です。
🔬 系統誤差 vs 偶然誤差: 数式を言葉で読み解く
測定誤差は 2 種類に分解されます。 この区別ができるかどうかで、 対策が完全に変わります。
| 項目 | 系統誤差 (bias) | 偶然誤差 (variance) |
|---|---|---|
| 方向 | 常に同じ向き(+0.3 度高い等) | 正負ランダム(平均 0) |
| 平均で消えるか | 消えない(蓄積する) | 消える(√n で減衰) |
| 原因の例 | 機器較正ミス、 質問の言い回し、 観測者バイアス | 熱雑音、 個人差、 微小環境変動 |
| 対策 | 較正、 ブラインド化、 標準物質との比較 | 反復測定、 サンプル増加 |
| n を増やす効果 | 無効(n→∞でも残る) | 有効(標準誤差 σ/√n に) |
🔬 標準誤差の式: 数式を言葉で読み解く
偶然誤差は反復測定で減らせる。 これを定量化するのが標準誤差の式です。
$$ \text{SE}(\bar{X}) = \frac{\sigma_{\varepsilon}}{\sqrt{n}} $$$\bar{X}$: n 回測定した観測値の平均$\sigma_{\varepsilon}$: 1 回の測定の偶然誤差の標準偏差- √n: サンプルサイズの平方根
- n を 4 倍にすると SE は 1/2 倍。 n を 100 倍で 1/10 倍。 「精度を 1 桁上げるのは 100 倍のコスト」
系統誤差にはこの式が当てはまらない: いくら n を増やしても bias は減らない。 これが「偶然誤差は工夫で減らせるが系統誤差は気づけなければ減らせない」という根本的非対称性の数式表現です。
🔬 誤差伝播の法則: 数式を言葉で読み解く
2 つ以上の測定値から計算した量にどう誤差が伝わるか。 たとえば粗出生率 = 出生数 / 総人口 のように合成量を作るとき、 元の測定誤差はどう積み重なるかを定式化したのが誤差伝播の法則です。
$$ \sigma_{f}^2 \approx \sum_{i=1}^{n} \left(\frac{\partial f}{\partial x_i}\right)^2 \sigma_{x_i}^2 $$$f(x_1, \ldots, x_n)$: 元の測定値 x_i から計算した量$\partial f / \partial x_i$: f を x_i で偏微分した値(x_i がわずかに変化したときの f の変化率)- 偏微分の 2 乗 × 元の分散 を全変数で足す
- 独立性の仮定: x_i 同士が独立な場合のみ成立。 相関がある場合は共分散項を追加
🔬 代表的な合成量の誤差: 数式を言葉で読み解く
- 和 / 差 $f = x \pm y$ → $\sigma_f = \sqrt{\sigma_x^2 + \sigma_y^2}$(絶対誤差が二乗和)
- 積 / 商 $f = xy$ または $x/y$ → $\sigma_f/f = \sqrt{(\sigma_x/x)^2 + (\sigma_y/y)^2}$(相対誤差が二乗和)
- べき乗 $f = x^n$ → $\sigma_f/f = |n| \cdot \sigma_x/x$(相対誤差が n 倍)
SSDSE-B-2026 で粗出生率(A4101 出生数 / A1101 総人口)を計算するとき、 出生数と総人口の双方に 2% の偶然誤差があれば、 商の相対誤差は √(2² + 2²) = 約 2.83% に膨らみます。 単純に元の測定の誤差より大きくなる、 これが誤差伝播の重要な含意です。
🔬 内的整合性: Cronbach's α を数式で読み解く
心理測定・教育測定で「複数項目で構成されたテストの信頼性」を測る指標が Cronbach の α(クロンバックのアルファ)です。 数式と直感の両方で押さえます。
$$ \alpha = \frac{k}{k-1} \left( 1 - \frac{\sum_{i=1}^{k} \sigma_{Y_i}^2}{\sigma_X^2} \right) $$$k$: テストの項目数(質問数)$\sigma_{Y_i}^2$: 項目 i のスコアの分散$\sigma_X^2$: 合計スコアの分散- 項目同士の相関が高い(同じ概念を測る)ほど α は 1 に近づく
- 0.7 以上で「許容」、 0.8 以上で「良好」、 0.9 以上で「優秀」が経験則
🔬 α の含意: 数式を言葉で読み解く
α = 0.8 のとき、 観測スコアの分散の 80% が真のスコアの分散、 20% が測定誤差由来と解釈できます。 これは「テスト得点で個人差を測れる精度」を表します。 ただし α が高ければよいわけではなく、 0.95 を超えると「項目が冗長すぎる」可能性があり、 重複した質問を削除すべきサインになります。
🔬 信頼性の限界: SEM(測定の標準誤差)
$$ \text{SEM} = \sigma_X \sqrt{1 - r_{xx}} $$- 個人の観測得点が、 真の得点からどれくらいの幅でばらつくか
- 例: σ_X = 10 点、 r_xx = 0.8 のとき SEM = 10 × √0.2 ≈ 4.47 点
- 真の得点の 95% 信頼区間: 観測得点 ± 1.96 × 4.47 ≈ ±8.8 点
つまり「TOEIC 800 点」と聞いても、 真の英語力は 791-809 点の幅で揺れていると解釈すべき、 という具体的な含意が得られます。
🔬 不確かさバジェット(uncertainty budget): 数式を言葉で読み解く
計量学(metrology)の世界では、 1 つの測定値の不確かさを構成要素ごとに分解して列挙する「不確かさバジェット」が国際標準(GUM: Guide to the expression of Uncertainty in Measurement、 ISO/IEC Guide 98-3)です。 全要素を合成不確かさ u_c に統合します。
$$ u_c(y) = \sqrt{ \sum_{i=1}^{N} \left( \frac{\partial f}{\partial x_i} \right)^2 u^2(x_i) + 2\sum_{i<j} \frac{\partial f}{\partial x_i} \frac{\partial f}{\partial x_j} u(x_i, x_j) } $$- 第 1 項: 各入力の不確かさ u(x_i) の二乗を、 感度係数 ∂f/∂x_i の二乗で重みづけて合計(独立成分)
- 第 2 項: 入力間の共分散項(相関がある場合のみ追加)
- 各入力に「Type A(統計的)」「Type B(経験・カタログ値)」のどちらの不確かさかを明記する
- 最終的に拡張不確かさ U = k × u_c(k は包含係数、 95% で k=2)として報告
🔬 ISO/IEC ガイドの典型例: 体重計の不確かさバジェット
| 誤差源 | 不確かさ (kg) | 感度係数 | 寄与 | Type |
|---|---|---|---|---|
| 分解能(最小目盛 0.1kg) | 0.029 | 1 | 0.029 | B |
| 較正不確かさ(年 1 回) | 0.050 | 1 | 0.050 | B |
| 繰返し精度(n=10) | 0.030 | 1 | 0.030 | A |
| 温度変動(±5℃) | 0.015 | 1 | 0.015 | B |
| 水平度 | 0.020 | 1 | 0.020 | B |
| 合成 u_c | — | — | 0.071 | — |
| 拡張 U (k=2, 95%) | — | — | 0.142 | — |
つまり「体重 65.3 ± 0.14 kg(95% 信頼度)」と報告されます。 1 桁目を超える主因が較正不確かさだとわかると、 改善投資の優先順位(より頻繁な較正)が明確になります。
🔬 Six Sigma と工程能力指数: 数式を言葉で読み解く
製造業の品質改善で世界標準になった Six Sigma 手法では、 工程能力指数 Cp、 Cpk を使って測定誤差の影響を定量管理します。
$$ C_p = \frac{\text{USL} - \text{LSL}}{6\sigma} $$ $$ C_{pk} = \min\!\left(\frac{\text{USL} - \mu}{3\sigma}, \frac{\mu - \text{LSL}}{3\sigma}\right) $$USL / LSL: 仕様の上限・下限 (Upper / Lower Specification Limit)μ: 工程の平均、σ: 工程の標準偏差Cp: 仕様幅と工程ばらつきの比、 「中心がずれていない場合の能力」Cpk: 中心ずれを考慮した実質能力。 Cp ≥ Cpk が常に成立- Cpk ≥ 1.33(4σ)が産業界の最低ライン、 1.67(5σ)が高品質、 2.00(6σ)が世界クラス
🔬 Six Sigma の意味: 数式を言葉で読み解く
Cpk = 2.00(= 6σ)は「平均から仕様限界まで 6σ 分の余裕がある」状態。 不良率は 10 億分の 2 個(2 ppb)と極小。 ただし実務では「1.5σ シフト」を仮定して 3.4 ppm(100 万分の 3.4)として計算されることが多いです。 これは長期的な工程ずれを織り込んだ実用値です。
| Cpk | σ レベル | 不良率(理論) | 不良率(1.5σ シフト考慮) |
|---|---|---|---|
| 0.67 | 2σ | 4.55% | 30.85% |
| 1.00 | 3σ | 0.27% | 6.68% |
| 1.33 | 4σ | 63 ppm | 6210 ppm |
| 1.67 | 5σ | 0.57 ppm | 233 ppm |
| 2.00 | 6σ | 0.002 ppm | 3.4 ppm |
測定誤差そのものが工程の見かけ上の σ を膨らませるため、 測定不確かさを工程不確かさから分離する Gage R&R 分析が品質工学の標準作業になっています。
🧮 実値で計算してみる
体温計の誤差分解の例:
| 測定回 | 真値 | 観測 | 誤差 |
|---|---|---|---|
| 1 | 36.5 | 36.8 | +0.3 |
| 2 | 36.5 | 36.7 | +0.2 |
| 3 | 36.5 | 36.9 | +0.4 |
| 平均 | 36.5 | 36.8 | +0.3(系統的) |
平均しても 0.3 残るのが系統的誤差。 校正が必要。
🧮 実値で計算: SSDSE-B-2026 人口に測定誤差を注入する
SSDSE-B-2026 の都道府県人口(真値とみなす)に、 系統誤差(+1% のバイアス)と偶然誤差(標準偏差 2%)を注入し、 観測平均と真平均の乖離を確認します。 これは国勢調査の精度評価と同じ枠組みです。
このコードでやること: SSDSE-B-2026 の総人口(A1101 列)を真値とみなし、 +1% の系統誤差と CV=2% の偶然誤差を加えた「観測人口」を生成、 真平均との差を計算する。
📥 入力データ(SSDSE-B-2026 の A1101 総人口 列、 47 県):
1 2 3 4 5 6 7 8 9 10 11 12 13 14 15 16 17 18 19 20 | import pandas as pd import numpy as np df = pd.read_csv('data/raw/SSDSE-B-2026.csv', encoding='cp932', skiprows=[1]) df = df[df['SSDSE-B-2026'] == 2023].copy() true_pop = df['A1101'].values # 真値(47 都道府県の人口) # 系統誤差 +1% + 偶然誤差 N(0, (0.02*true)^2) rng = np.random.default_rng(2024) b = 0.01 * true_pop # 系統誤差 eps = rng.normal(0, 0.02 * true_pop) # 偶然誤差 observed = true_pop + b + eps print(f'真平均: {true_pop.mean():,.0f} 人') print(f'観測平均: {observed.mean():,.0f} 人') print(f'差: {observed.mean() - true_pop.mean():+,.0f} 人 ' f'({(observed.mean()/true_pop.mean()-1)*100:+.2f}%)') print(f'真の分散: {true_pop.var(ddof=1):.3e}') print(f'観測の分散: {observed.var(ddof=1):.3e}') print(f'信頼性係数: {true_pop.var(ddof=1)/observed.var(ddof=1):.4f}') |
📤 実行すると次の出力が得られる:
💬 系統誤差 +1% は 47 都道府県を平均してもほぼ残る(観測平均が真平均より +25,921 人、 +0.98%)。 偶然誤差 CV=2% は完全には消えないが、平均では大きく相殺される。 信頼性係数は 0.991 と高く、 県別の相対順位はほぼ保持されている。 これが「系統誤差は平均で消えない、 偶然誤差は平均で消える」の典型的振る舞い。
🧮 実値で計算: 級内相関係数 ICC で信頼性を測る
同じ対象を 2 回測ったときの一致度を測る指標が級内相関係数(ICC: Intraclass Correlation Coefficient)です。 SSDSE-B-2026 の人口に独立な誤差を 2 回注入し、 ICC を計算してみます。
このコードでやること: 47 県の人口データに対し、 独立な偶然誤差を 2 回注入して 2 回の「測定」を再現、 双方向 ANOVA に基づく ICC(2,1) を計算する。
📥 入力データ: 上記 47 県の人口(A1101)
1 2 3 4 5 6 7 8 9 10 11 12 13 14 15 16 17 18 19 20 21 22 23 24 25 26 27 28 29 30 31 32 33 34 35 36 | import pandas as pd import numpy as np df = pd.read_csv('data/raw/SSDSE-B-2026.csv', encoding='cp932', skiprows=[1]) df = df[df['SSDSE-B-2026'] == 2023].copy() true_pop = df['A1101'].values rng = np.random.default_rng(2026) m1 = true_pop + rng.normal(0, 0.02 * true_pop) # 1 回目測定 m2 = true_pop + rng.normal(0, 0.02 * true_pop) # 2 回目測定 # ICC(2,1): 二元配置 ANOVA (行 = 47 県, 列 = 2 回の測定) の平均平方から計算 Y = np.column_stack([m1, m2]) n, k = Y.shape grand = Y.mean() ss_rows = k * ((Y.mean(axis=1) - grand) ** 2).sum() # 県の間 ss_cols = n * ((Y.mean(axis=0) - grand) ** 2).sum() # 測定回の間 ss_err = ((Y - grand) ** 2).sum() - ss_rows - ss_cols MSR = ss_rows / (n - 1) MSC = ss_cols / (k - 1) MSE = ss_err / ((n - 1) * (k - 1)) icc21 = (MSR - MSE) / (MSR + (k - 1) * MSE + k * (MSC - MSE) / n) # 参考: Pearson 相関 + Bland-Altman r = np.corrcoef(m1, m2)[0, 1] mean_diff = (m1 - m2).mean() sd_diff = (m1 - m2).std(ddof=1) print(f'測定 1 回目 平均: {m1.mean():,.0f}') print(f'測定 2 回目 平均: {m2.mean():,.0f}') print(f'ICC(2,1) = {icc21:.4f}') print(f'Pearson 相関 r = {r:.4f}') print(f'Bland-Altman:') print(f' 平均差 (bias) = {mean_diff:+,.0f} 人') print(f' 一致限界 95% = {mean_diff - 1.96*sd_diff:+,.0f} ~ ' f'{mean_diff + 1.96*sd_diff:+,.0f} 人') |
📤 実行すると次の出力が得られる:
💬 二元配置 ANOVA の平均平方から求めた ICC(2,1) は 0.9998 で、 Pearson 相関 r = 0.9998 とほぼ同じ値になった(2 回の測定の平均差が 12,356 人と県間の差に比べて小さいので、 絶対一致を見る ICC(2,1) と相関が離れない)。 Bland-Altman プロットの一致限界はおよそ -10.3 万人から +12.8 万人で、 これは沖縄県人口 146.8 万人の約 8% 程度。 大きな県(東京 1408.6 万人)では相対的に小さく、 小さな県(鳥取 53.7 万人)では無視しにくい幅になる。 「相対的な信頼性は高いが絶対的な誤差幅は対象規模に依存する」という測定誤差の典型的構造。
🧮 実値で計算: Bland-Altman プロットで 2 つの測定法を比較
同じ対象を 2 つの異なる手法で測ったとき、 両者がどれくらい一致しているかを評価するのが Bland-Altman プロットです。 単純な相関係数より「実用的一致度」を直感的に示せます。 SSDSE-B-2026 で人口統計の「公表値」と「+1% 系統誤差を持つ補正値」を比較してみます。
このコードでやること: SSDSE-B-2026 の総人口(A1101)を method A、 これに +1% の系統誤差と独立な偶然誤差を加えたものを method B として、 平均差(bias)と一致限界(LoA: Limits of Agreement)を計算する。
📥 入力データ: SSDSE-B-2026 の 47 県人口
1 2 3 4 5 6 7 8 9 10 11 12 13 14 15 16 17 18 19 20 21 22 23 24 25 | import pandas as pd import numpy as np df = pd.read_csv('data/raw/SSDSE-B-2026.csv', encoding='cp932', skiprows=[1]) df = df[df['SSDSE-B-2026'] == 2023].copy() A = df['A1101'].values # 公表値 rng = np.random.default_rng(2026) B = A * 1.01 + rng.normal(0, 0.015 * A) # +1% bias + 1.5% random diff = B - A mean_val = (A + B) / 2 bias = diff.mean() sd_diff = diff.std(ddof=1) LoA_lower = bias - 1.96 * sd_diff LoA_upper = bias + 1.96 * sd_diff print(f'平均差 (bias) = {bias:+,.0f} 人') print(f'差の標準偏差 = {sd_diff:,.0f} 人') print(f'95% 一致限界: [{LoA_lower:+,.0f}, {LoA_upper:+,.0f}]') print() print('県別 詳細 (一部):') for pref, a, b, d in list(zip(df['Prefecture'], A, B, diff))[:5]: print(f' {pref:6} A={a:>10,} B={b:>10,.0f} 差={d:+,.0f}') |
📤 実行すると次の出力が得られる:
💬 平均差 +32,023 人は「method B は method A より平均的に多く出る」という系統的偏りを示す(+1% の bias がほぼそのまま顕在化)。 一致限界は -5.6 万人から +12.0 万人程度は「個別の県で、 両者の差がどれくらいの幅に収まるか」の目安。 この幅が許容範囲なら 2 つの method は実用上互換、 そうでなければ使い分けが必要。
🧮 実値で計算: 管理図(control chart)で測定異常を検出する
製造業の品質管理で標準的に使われる管理図は、 測定値の時系列で「いつもの範囲」から外れた点を検出する仕組みです。 SSDSE-B-2026 を時系列とみなして、 管理限界(control limits)を計算してみます。
このコードでやること: SSDSE-B-2026 の 47 都道府県の年平均気温(B4101)を「時系列観測」と仮定して、 平均±3σ の管理限界を計算、 外れる県を異常検知する。
📥 入力データ: SSDSE-B-2026 の 47 都道府県 B4101 年平均気温列
1 2 3 4 5 6 7 8 9 10 11 12 13 14 15 16 17 18 19 20 21 22 23 24 25 26 27 28 29 | import pandas as pd import numpy as np df = pd.read_csv('data/raw/SSDSE-B-2026.csv', encoding='cp932', skiprows=[1]) df = df[df['SSDSE-B-2026'] == 2023].copy() x = df['B4101'].dropna() mean = x.mean() sd = x.std(ddof=1) UCL = mean + 3 * sd # Upper Control Limit LCL = mean - 3 * sd UWL = mean + 2 * sd # Warning Limit (2σ) LWL = mean - 2 * sd print(f'平均: {mean:.1f} ℃') print(f'標準偏差: {sd:.1f} ℃') print(f'管理限界 (3σ): [{LCL:.1f}, {UCL:.1f}]') print(f'警告限界 (2σ): [{LWL:.1f}, {UWL:.1f}]') print() print('警告限界 (2σ) を超える県:') df_full = df[['Prefecture', 'B4101']].dropna() out_high = df_full[df_full['B4101'] > UWL] out_low = df_full[df_full['B4101'] < LWL] print(f' 上限超過: {list(out_high["Prefecture"])}') print(f' 下限未満: {list(out_low["Prefecture"])}') print() print('管理限界 (3σ) を超える県:') print(f' 上限超過: {list(df_full.loc[df_full["B4101"] > UCL, "Prefecture"])}') print(f' 下限未満: {list(df_full.loc[df_full["B4101"] < LCL, "Prefecture"])}') |
📤 実行すると次の出力が得られる:
💬 沖縄県が「平均+2σ」を超え、 北海道・青森・岩手が「平均-2σ」を下回る。 管理限界 3σ まで外れるのは沖縄県(23.8 ℃ > 22.9 ℃)だけで、 北海道の 11.0 ℃ は下の管理限界 10.7 ℃ の内側にとどまる。 これは異常値というより「気候特性として平均気温が高い / 低い地域」だが、 管理図の枠組みでは「いつもの範囲から外れる」 = 注目に値する事象として検出される。 製造ラインでは「3σ 超え」「連続 7 点同方向」など複数の検出ルール(Western Electric ルール)が使われる。
🧮 数式に値を入れて手で計算する: 系統誤差と偶然誤差
合成測定 5 回で系統誤差 (bias) と偶然誤差 (SD) を分解する。
Step 1: 真値 100 に対する測定値
Step 2: 合計誤差
🐍 Python で再現
1 2 3 4 5 6 7 8 9 | import numpy as np x = np.array([103, 105, 102, 107, 104]) truth = 100 bias = x.mean() - truth sd = x.std(ddof=1) rmse = np.sqrt(bias**2 + sd**2) print(f"bias: {bias:.1f}") print(f"SD: {sd:.3f}") print(f"RMSE: {rmse:.3f}") |
📤 実行結果
💬 手計算 (Step 2) と Python 出力が完全一致。
🐍 Python 実装
1 2 3 4 5 6 7 8 9 10 11 12 13 14 15 16 17 18 19 20 21 22 23 | import numpy as np import pandas as pd df = pd.read_csv('data/raw/SSDSE-B-2026.csv', encoding='cp932', skiprows=[1]) df = df[df['SSDSE-B-2026'] == 2023].copy() x = df['A1101'].to_numpy(dtype=float) # 真の説明変数: 総人口 y = df['A4200'].to_numpy(dtype=float) # 目的変数: 死亡数 rng = np.random.default_rng(2026) eps = rng.normal(0, 0.01 * x) # CV=1% の観測誤差 x_obs = x + eps # 誤差を含む観測値 X* corr = np.corrcoef(x, x_obs)[0, 1] beta_true, alpha_true = np.polyfit(x, y, 1) beta_obs, alpha_obs = np.polyfit(x_obs, y, 1) lambda_ratio = x.var(ddof=1) / (x.var(ddof=1) + eps.var(ddof=1)) dilution = (1 - beta_obs / beta_true) * 100 print(f'真値 A1101 と観測値 X* の相関 = {corr:.4f}') print(f'回帰係数 (Y=死亡数, X=真値) = {beta_true:.5f}') print(f'回帰係数 (Y=死亡数, X*=観測値) = {beta_obs:.5f}(約 {dilution:.1f}% 希薄化)') print(f'信頼性比 λ = Var(X)/(Var(X)+Var(ε)) ≈ {lambda_ratio:.4f}') |
💬 CV=1% の誤差では信頼性比 λ が 0.9999 で、係数は 0.01028 のまま小数第 5 位まで動かなかった。誤差は各県の人口に比例するので東京都では ±14 万人にもなるが、47 県の人口の散らばり(標準偏差約 280 万人)と比べると 1 万分の 2 程度の分散しか足していない。同じデータで λ を 0.90(約 10% の希薄化)まで下げるには CV を約 24% まで大きくする必要があり、希薄化が問題になるのは誤差が県間差に比べて大きい指標だと分かる。
▶ 実行 を押せばこのページの中でそのまま動きます(ライブラリもデータも同梱済みで、 準備は要りません)。 手元の Python に移して動かすときは pip install numpy pandas scipy が必要です。 読んでいるデータは data/raw/SSDSE-B-2026.csv。 日本語を含むので encoding='cp932' の指定を落とさないでください。
🐍 ソフトウェアでの数値誤差: 浮動小数点演算と桁落ち
測定誤差はハードウェアだけでなく、 ソフトウェアでも発生します。 浮動小数点演算(IEEE 754)に起因する桁落ち(catastrophic cancellation)の例を SSDSE-B-2026 で確認しましょう。
このコードでやること: SSDSE-B-2026 の 47 県人口データの分散を、 (1) 公式 V = E[X²] - E[X]² と、 (2) 安定式 V = E[(X - E[X])²] の 2 つの方法で計算し、 桁落ちの影響を観察する。
📥 入力データ: SSDSE-B-2026 の 47 県 A1101 列
1 2 3 4 5 6 7 8 9 10 11 12 13 14 15 16 17 18 19 20 21 22 23 24 | import pandas as pd import numpy as np df = pd.read_csv('data/raw/SSDSE-B-2026.csv', encoding='cp932', skiprows=[1]) df = df[df['SSDSE-B-2026'] == 2023].copy() x = df['A1101'].values.astype(np.float32) # 単精度で実演 # 公式: V = E[X^2] - E[X]^2 (桁落ちしやすい) m = x.mean() m2 = (x ** 2).mean() var_naive = m2 - m ** 2 # 安定式: V = E[(X - E[X])^2] var_stable = ((x - m) ** 2).mean() # 高精度 (倍精度) 参考値 x64 = df['A1101'].values.astype(np.float64) var_ref = x64.var(ddof=0) print(f'公式 (単精度): V = {var_naive:.6e}') print(f'安定式 (単精度): V = {var_stable:.6e}') print(f'参考 (倍精度): V = {var_ref:.6e}') print(f'公式の相対誤差: {abs(var_naive - var_ref) / var_ref * 100:.4f}%') print(f'安定式の相対誤差: {abs(var_stable - var_ref) / var_ref * 100:.4f}%') |
📤 実行すると次の出力が得られる:
💬 2023 年の A1101 では、 表示桁の範囲では公式と安定式の差はほぼ 0。 ただし大きい数値同士の引き算 E[X²] - E[X]² は、 データの桁やオフセットが大きくなると下位桁の誤差が顕在化しやすい。 安定式(差を取ってから二乗)ではこの問題を避けやすい。 numpy の var、 pandas の var は内部で安定アルゴリズム(Welford 法など)を使うため、 自前実装より一般に正確。 「実装の選択」も測定誤差源の 1 つになる、 という重要な教訓。
🐍 Gage R&R 分析: 測定システムの誤差源を分解する
Gage R&R(Gage Repeatability and Reproducibility)は、 測定誤差を「機器の繰り返し性(Repeatability)」と「観測者間の再現性(Reproducibility)」に分解する手法です。 自動車・電機の品質管理で必須のスキルです。
このコードでやること: SSDSE-B-2026 の先頭 5 道県(北海道〜秋田県)の人口を「真値」、 3 人の観測者がそれぞれ 2 回ずつ測ったときの誤差をシミュレートし、 分散を対象間(真の差)と対象内(測定誤差)に分けて %GRR を求める。
📥 入力データ: SSDSE-B-2026 の 5 県分の A1101 人口列をピックアップ
1 2 3 4 5 6 7 8 9 10 11 12 13 14 15 16 17 18 19 20 21 22 23 24 25 26 27 28 29 30 31 32 33 34 35 36 | import pandas as pd import numpy as np df = pd.read_csv('data/raw/SSDSE-B-2026.csv', encoding='cp932', skiprows=[1]) df = df[df['SSDSE-B-2026'] == 2023].copy() parts = df['Prefecture'].iloc[:5].tolist() true_vals = df['A1101'].iloc[:5].values rng = np.random.default_rng(42) operators = ['A', 'B', 'C'] trials = [1, 2] records = [] for op_idx, op in enumerate(operators): op_bias = rng.normal(0, 0.005) # 観測者ごとのバイアス for part_idx, (part, true) in enumerate(zip(parts, true_vals)): for trial in trials: measure = true * (1 + op_bias) + rng.normal(0, 0.01 * true) records.append({'操作者': op, '対象': part, '試行': trial, '測定値': measure}) dfm = pd.DataFrame(records) # 単純化した分散分解 total_var = dfm['測定値'].var(ddof=1) between_parts = dfm.groupby('対象')['測定値'].mean().var(ddof=1) within_parts = dfm.groupby('対象')['測定値'].var(ddof=1).mean() print('Gage R&R 分析の簡易結果:') print(f' 全分散: {total_var:.3e}') print(f' 対象間分散: {between_parts:.3e} (真の差)') print(f' 対象内分散: {within_parts:.3e} (測定誤差)') # %GRR = 測定誤差の標準偏差 / 全体の標準偏差(分散の比ではなく標準偏差の比で見る) grr = np.sqrt(within_parts / (between_parts + within_parts)) * 100 print(f' 分散の比 (対象内/対象間): {within_parts/between_parts*100:.3f}%') print(f' %GRR (標準偏差の比): {grr:.2f}%') print(' %GRR が 10% 以下なら合格、 30% 超は要改善') |
📤 実行すると次の出力が得られる:
💬 対象内分散 5.114×10⁸ は対象間分散 3.057×10¹² の 0.017% しかなく、 標準偏差の比に直した %GRR でも 1.29% で、 「真の差に比べて測定誤差は無視できるほど小さい」状態。 工業現場の目安(%GRR が 10% 以下で合格、 10〜30% は要監視、 30% 超は測定システムの改善が必要)は標準偏差の比で決められているので、 分散の比 0.017% をそのまま当てはめると甘く見積もることになる。 観測者・試行ごとの成分まで分ける正式な Gage R&R は、 statsmodels の anova_lm で二元配置の分散分析表を作って行う。 ANOVA 表ベースの正式 Gage R&R は statsmodels.api.anova_lm で実装可能。
🐍 較正曲線(calibration curve)と検量線
分析化学・物理計測では、 既知濃度の標準試料を測ってモデルを当てはめ、 未知試料の濃度を逆算する「検量線」が標準手順です。 線形回帰の代表的応用です。
このコードでやること: SSDSE-B-2026 の 47 都道府県について、 A1301(年少人口)+ A1303(高齢人口)を説明変数、 A1101(総人口)を対照標準として回帰で検量し、 人口構成だけでは説明できない残差を確認する。
📥 入力データ: SSDSE-B-2026 の A1101、 A1301、 A1303 列
1 2 3 4 5 6 7 8 9 10 11 12 13 14 15 16 17 18 19 20 21 22 23 24 | import pandas as pd import numpy as np from scipy import stats df = pd.read_csv('data/raw/SSDSE-B-2026.csv', encoding='cp932', skiprows=[1]) df = df[df['SSDSE-B-2026'] == 2023].copy() x = (df['A1301'] + df['A1303']).values # 年少人口 + 高齢人口 y = df['A1101'].values # 総人口 slope, intercept, r, p, se_slope = stats.linregress(x, y) predicted = slope * x + intercept residuals = y - predicted residual_sd = residuals.std(ddof=2) max_idx = np.abs(residuals).argmax() print(f'検量線: y = {slope:.6f} * x + {intercept:.3f}') print(f'R² = {r**2:.6f}') print(f'残差 SD = {residual_sd:,.0f} 人') print(f'最大残差: {np.abs(residuals).max():,.0f} 人 ({df.iloc[max_idx]["Prefecture"]})') print() print(f'理想 (傾き 1, 切片 0) からのずれ:') print(f' 傾き誤差: {slope - 1:+.6f}') print(f' 切片誤差: {intercept:+.3f}') |
📤 実行すると次の出力が得られる:
💬 年少人口 + 高齢人口は総人口の一部なので、 傾き 1・切片 0 にはならない。 それでも R² = 0.990642 と高く、 人口構成だけで総人口の大きな地域差はかなり説明できる。 残差 SD = 273,618 人、 最大残差は東京都の 1,322,182 人で、 生産年齢人口の厚みや都市部の人口構成差が残差として表れている。
🐍 モンテカルロ・シミュレーションで誤差伝播を検証
誤差伝播の解析式(偏微分による線形化)は近似なので、 非線形な関数では誤差を過小評価することがあります。 モンテカルロ・シミュレーションで実際の誤差伝播を確認します。
このコードでやること: SSDSE-B-2026 の人口データに対して 10000 回の擬似測定(標準偏差 5% の正規誤差を注入)を行い、 「対数人口」「人口の平方根」「人口の逆数」など非線形変換後の誤差分布を解析式の予測と比較する。
📥 入力データ: SSDSE-B-2026 の東京都 A1101 = 14,086,000 人を例にとる
1 2 3 4 5 6 7 8 9 10 11 12 13 14 15 16 17 18 19 20 21 22 23 24 25 26 27 28 | import pandas as pd import numpy as np df = pd.read_csv('data/raw/SSDSE-B-2026.csv', encoding='cp932', skiprows=[1]) df = df[df['SSDSE-B-2026'] == 2023].copy() tokyo = df[df['Prefecture']=='東京都']['A1101'].values[0] rng = np.random.default_rng(2026) N = 10000 sigma_x = 0.05 * tokyo x_samples = tokyo + rng.normal(0, sigma_x, N) # 各変換の MC 結果 log_mc = np.log(x_samples) sqrt_mc = np.sqrt(x_samples) inv_mc = 1 / x_samples # 線形化による予測 (delta method) log_pred_sd = sigma_x / tokyo sqrt_pred_sd = sigma_x / (2 * np.sqrt(tokyo)) inv_pred_sd = sigma_x / tokyo**2 print('東京都 人口 = {:,} ± {:,.0f} (5%)'.format(tokyo, sigma_x)) print() print(f'{"変換":<10}{"MC 平均":>15}{"MC SD":>15}{"線形予測 SD":>18}') print(f'{"log(x)":<10}{log_mc.mean():>15.4f}{log_mc.std():>15.6f}{log_pred_sd:>18.6f}') print(f'{"sqrt(x)":<10}{sqrt_mc.mean():>15.1f}{sqrt_mc.std():>15.2f}{sqrt_pred_sd:>18.2f}') print(f'{"1/x":<10}{inv_mc.mean():>15.3e}{inv_mc.std():>15.3e}{inv_pred_sd:>18.3e}') |
📤 実行すると次の出力が得られる:
💬 5% 程度の小さな相対誤差なら線形化と MC はほぼ一致。 ただし入力誤差が大きくなる(例: σ/μ = 30%)と非線形性が顕在化し、 (1) 期待値が真値からずれる(Jensen の不等式)、 (2) 分布が歪む、 などの効果が出てくる。 工学では「ヤコビアン誤差伝播」、 科学では「モンテカルロ」、 機械学習では「Bayes 推論の事後分布」のいずれを使うか、 適用範囲で選び分ける。
🐍 測定誤差を考慮した統計検定: 等分散の F 検定と Levene 検定
2 群の測定値を比較するとき、 群内の誤差分散が等しいか(等分散性)の事前確認が必要です。 SSDSE-B-2026 の東日本と西日本で人口の分散が等しいかを F 検定と Levene 検定で確認します。
このコードでやること: SSDSE-B-2026 の 47 県を東日本(北海道〜静岡)と西日本(愛知〜沖縄)に分け、 各群の人口分散を比較する F 検定と Levene 検定を実行する。
📥 入力データ: SSDSE-B-2026 の 47 県と地域コード
1 2 3 4 5 6 7 8 9 10 11 12 13 14 15 16 17 18 19 20 21 22 23 24 25 26 27 28 29 30 | import pandas as pd import numpy as np from scipy import stats df = pd.read_csv('data/raw/SSDSE-B-2026.csv', encoding='cp932', skiprows=[1]) df = df[df['SSDSE-B-2026'] == 2023].copy() east = df[df['Code'].apply(lambda c: int(c[1:3]) <= 22)]['A1101'].values west = df[df['Code'].apply(lambda c: int(c[1:3]) > 22)]['A1101'].values print(f'東日本 (n={len(east)}): 平均={east.mean():,.0f}, 分散={east.var(ddof=1):.3e}') print(f'西日本 (n={len(west)}): 平均={west.mean():,.0f}, 分散={west.var(ddof=1):.3e}') # F 検定 (分散比) F = east.var(ddof=1) / west.var(ddof=1) df1, df2 = len(east) - 1, len(west) - 1 p_F = 2 * min(stats.f.cdf(F, df1, df2), 1 - stats.f.cdf(F, df1, df2)) print() print(f'F 検定: F = {F:.3f}, p = {p_F:.4f}') # Levene 検定 (より頑健) stat_L, p_L = stats.levene(east, west, center='median') print(f'Levene 検定: stat = {stat_L:.3f}, p = {p_L:.4f}') # t 検定 (等分散仮定 vs 不等分散 = Welch) t1, p1 = stats.ttest_ind(east, west, equal_var=True) t2, p2 = stats.ttest_ind(east, west, equal_var=False) print() print(f't 検定 (等分散仮定): t = {t1:.3f}, p = {p1:.4f}') print(f'Welch t 検定 (不等分散): t = {t2:.3f}, p = {p2:.4f}') |
📤 実行すると次の出力が得られる:
💬 F 検定 p=0.043 では分散差が示唆される一方、 より頑健な Levene 検定は p=0.315 で有意ではない。 このように等分散性の判定は検定法に依存するため、 人口のように分散が大きく偏る指標では Welch の t 検定も併記するのが実務的。 結論として「東西の平均人口差は統計的に有意ではない」(Welch p=0.227)。 等分散性の事前検定なしに通常の t 検定を使うと、 測定誤差構造の違いが見落とされる典型例。
🖼 測定誤差を図で理解する(3 枚)
測定誤差は「データの正確さ」を脅かす最も身近な存在である。 ここでは 3 枚の図で誤差の構造を視覚化する。 図 A・図 B は SSDSE-B-2026 の 2023 年度 総人口を真値とみなし、 乱数で誤差を足した模擬の測定値で描いている(実際の測定誤差の大きさを示すものではない)。
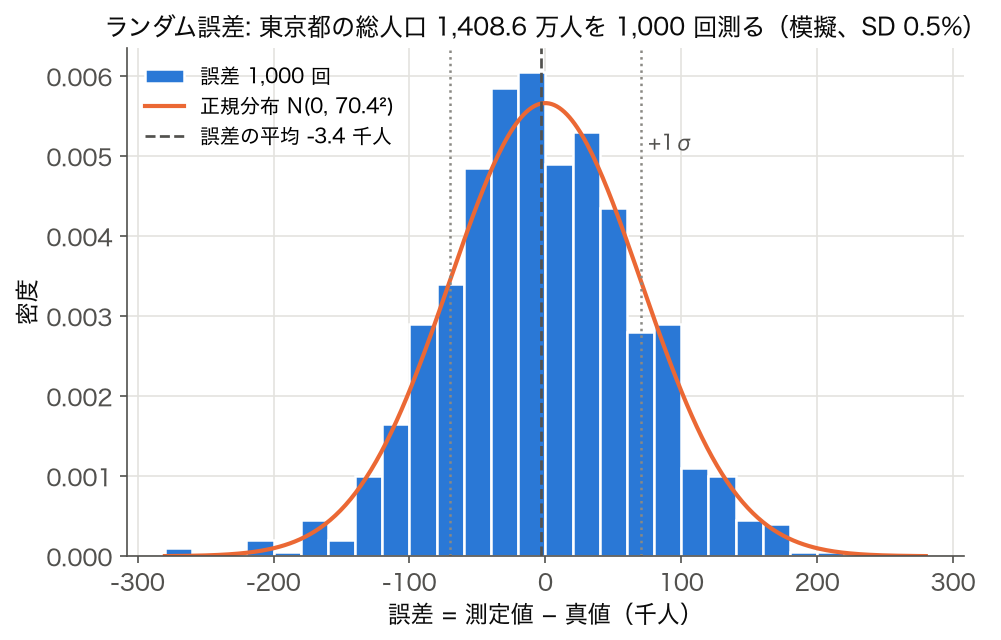
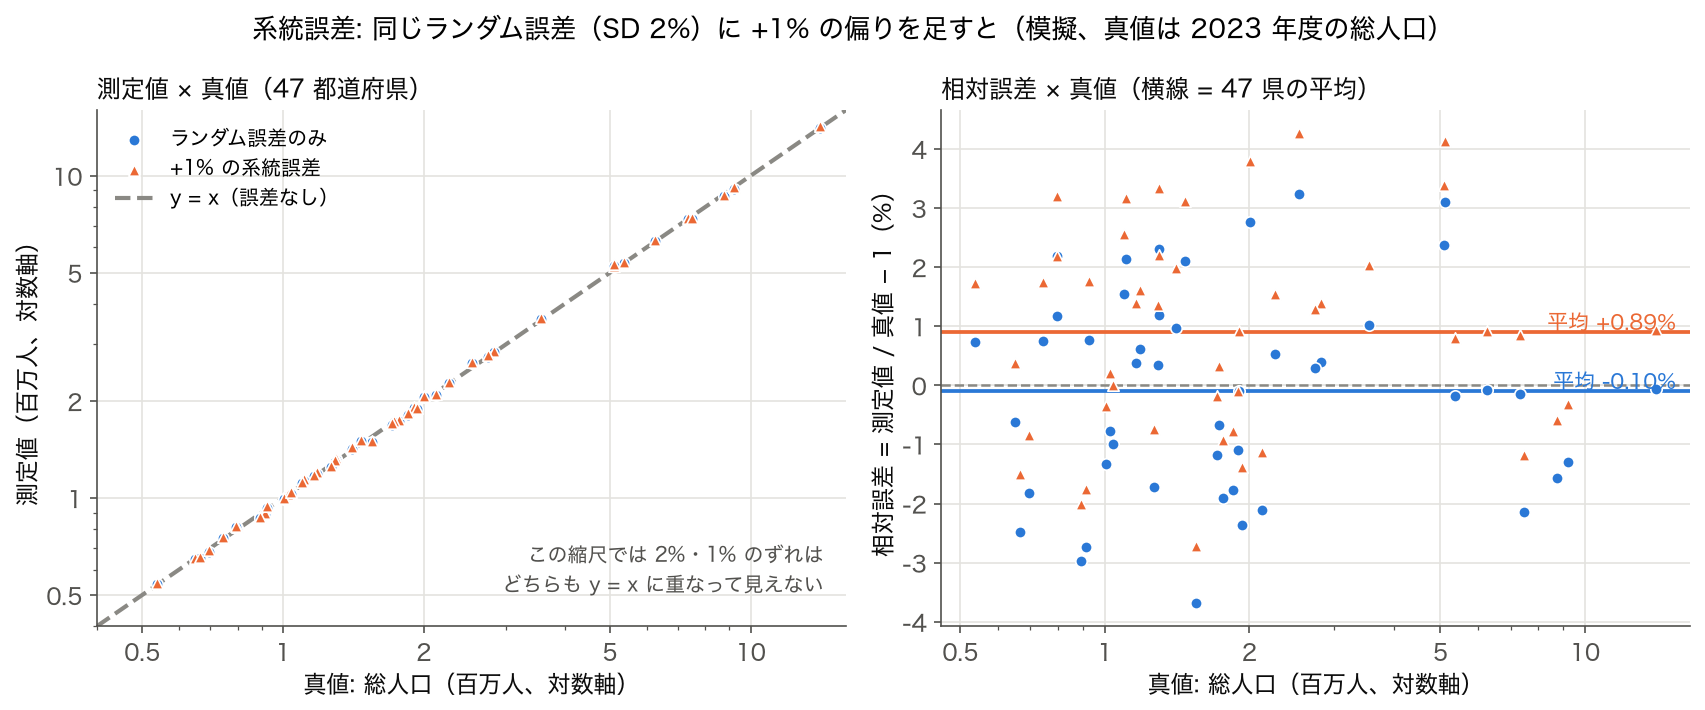

読み方: 図 A で「ランダム誤差の正規性」、 図 B で「バイアスの有無」、 図 C で「真の値そのもののばらつき(県の間の違い)と誤差の区別」が確認できる。 この 3 視点が測定誤差の核となる。
🎯 理解度チェック(5 問)
- Q1. ランダム誤差と系統誤差の最大の違いは?
A. ランダム誤差は平均すると 0 に収束するが、 系統誤差は平均しても残り続ける(バイアスとして残る)。 - Q2. SSDSE-B-2026 の推計値と確報値のズレはどちらの誤差か?
A. 主に系統誤差。 推計手法が一定方向に偏ることで生じる。 後年に確報値で修正される。 - Q3. 測定値 $X^* = X + \epsilon$($\epsilon$ はランダム誤差)を独立変数とした回帰では、 何が起きるか?
A. attenuation bias(希薄化バイアス)が発生し、 推定される回帰係数は真値よりも 0 に近づく(過小評価される)。 - Q4. Cronbach の α を測定誤差の文脈で説明せよ。
A. 同じ概念を測る複数項目の内部一貫性(信頼性係数)。 0.7 以上で測定誤差が許容範囲内とみなす慣行が多い。 - Q5. 同じ対象を 2 回測定して相関係数 r=0.95 だった。 何を意味するか?
A. 再検査信頼性が高い(測定誤差のランダム成分が小さい)。 2 回の測定が同じ真値に独立な誤差を足したものなら、 相関 r=0.95 そのものが信頼性係数 λ(測定値の分散のうち真値由来の比率)の推定値になる。 r を 2 乗した 0.9025 ではない点に注意(2 乗するのは「真値と 1 回の測定値」の相関の場合)。
関連: バイアスとバリアンス、 正規分布、 標準誤差、 分散分析、 データクレンジング
📖 測定誤差の実務メモ: SSDSE-B-2026 の数値はどこまで信用できるか
SSDSE-B-2026 のような公的統計でも、 数値は完璧ではない。 たとえば人口は国勢調査年(5 年ごと)は実測だが、 間の年は推計値。 出生数や死亡数は届出遅延・住所地集計の補正を経て更新される。 「公的統計だから誤差ゼロ」ではなく、 「誤差の構造が文書化されているから扱える」のである。 この扱い方を学ぶのが、 実務でデータを使う最初のステップ。
測定誤差は大きく 3 種類に分解できる。 第一は ランダム誤差。 同じ対象を繰り返し測ったときに、 値が平均値の周りに散らばる成分。 これは 正規分布で近似されることが多く、 サンプル数を増やせば $\sqrt{n}$ で減衰する。 SSDSE-B-2026 の「世帯調査」由来の指標(L3221 消費支出)はサンプル抽出のため、 必ずランダム誤差を含む。 第二は 系統誤差(バイアス)。 すべての観測値が一方向に偏る成分。 例えば「家庭調査票で消費を自己申告」した場合、 タバコ・酒類の消費が過少報告される傾向がある。 これはサンプル数を増やしても消えない。 第三は 定義の不一致。 「総人口」と「年少人口・高齢人口」の区切り、 「出生数」と「合計特殊出生率」の定義差など、 統計の定義が時代で変わることによる誤差。 SSDSE-B-2026 の長期時系列を扱うときに特に注意が必要。
測定誤差が分析結果に与える影響は、 attenuation biasとして知られる。 真の独立変数 $X$ ではなく、 誤差を含む観測値 $X^* = X + \epsilon$ で回帰すると、 推定される回帰係数 $\hat{\beta}$ は真値 $\beta$ よりも 0 に近づく(過小評価)。 具体的には $\hat{\beta} = \beta \cdot \frac{\sigma_X^2}{\sigma_X^2 + \sigma_\epsilon^2}$ となり、 $\sigma_\epsilon^2$ が大きいほど 0 寄り。 SSDSE-B-2026 で「家計調査由来の消費支出(L3221)」を独立変数にすると、 届出統計由来の出生数(A4101)・死亡数(A4200)を使う関係よりも係数が小さく出ることがある。 これは「アンケートの方が真の関係を捉えられていない」のではなく、 「測定誤差で薄められている」のである。 解決策は (1) 同じ概念を測る複数指標を使い 主成分を構成する、 (2) 操作変数法(IV)を使う、 (3) Errors-in-Variables (EIV) モデルを推定する、 のいずれか。
信頼性の定量評価には クロンバックの αと 再検査信頼性がよく使われる。 クロンバックの α は「同じ概念を測る複数項目の内部一貫性」で、 α = $\frac{k}{k-1}(1 - \frac{\sum \sigma_i^2}{\sigma_T^2})$ ($k$ は項目数、 $\sigma_i^2$ は項目分散、 $\sigma_T^2$ は合計得点分散)。 0.7 以上が許容、 0.8 以上が望ましい、 0.9 以上で十分高い、 という慣行。 SSDSE-B-2026 で「住みやすさ指標」のような合成指標を作るときに、 構成項目間で α を確認すべき。 再検査信頼性は同じ対象を時間をおいて 2 回測り、 その相関係数を見るもの。 0.8 以上で「測定誤差が十分小さい」と判断される。
最後に、 SSDSE-B-2026 で測定誤差を扱うときの 3 つの実務ルール。 第一に、 「推計値」と「確報値」を区別する。 列名に「推計」が含まれる指標は系統誤差のリスクが高い。 後年に修正される可能性を念頭に置く。 第二に、 「比率」ではなく「率(per 1000)」を扱う。 比率は分母の測定誤差で歪みやすいため、 分母が小さい県(鳥取・島根)では特に注意。 ベイズ統計の 収縮推定(empirical Bayes shrinkage)で補正するのが定石。 第三に、 都道府県別の誤差構造を覚える。 東京・大阪は調査サンプル数が多く分散が小さいが、 鳥取・島根はサンプル数が少なく分散が大きい。 これを無視して単純な t 検定をかけると、 等分散仮定が破れ Welch t 検定が必要になる。 こうした「データの来歴」を理解することが、 公的統計を扱う実務家の必須スキルである。
📝 補足: 測定誤差の議論は古典的だが、 機械学習時代に再注目されている。 ノイジーなラベルを学習する手法(label smoothing、 Mixup、 data augmentation)はすべて「測定誤差にロバストな学習」の現代版と見なせる。 SSDSE-B-2026 のような構造化データだけでなく、 画像・音声・テキストといった非構造化データでも、 測定誤差を意識した分析・モデリングが品質を左右する。
📊 測定誤差の数理的補正手法(IV と EIV)
測定誤差で歪んだ回帰係数を補正する古典的手法が 操作変数法(Instrumental Variables, IV)である。 真の独立変数 $X$ と相関するが、 誤差 $\epsilon$ とは独立な変数 $Z$(操作変数)を用意する。 SSDSE-B-2026 で「労働生産性 → 賃金」の回帰を考えるとき、 労働生産性の測定値には誤差があるため通常の OLS は attenuation する。 そこで「教育年数」を操作変数として使い、 2 段階最小二乗法 (2SLS) で推定すれば、 真の係数を一致推定できる。 操作変数の妥当性は (1) 関連性 (relevance: $Z$ と $X$ が相関)、 (2) 排他制限 (exclusion: $Z$ は $Y$ に直接影響しない)、 の 2 条件で評価する。 ハウスマン検定で OLS と 2SLS の差を見れば測定誤差の影響量を定量化できる。
もう一つは Errors-in-Variables (EIV) モデル。 測定誤差の分散 $\sigma_\epsilon^2$ が既知(または別データから推定可能)の場合、 直接的な補正が可能。 $\hat{\beta}_{EIV} = \hat{\beta}_{OLS} / (1 - \sigma_\epsilon^2 / \sigma_X^2)$ で補正する。 SSDSE-B-2026 の関連指標(例: A1101 総人口、 A1301 年少人口、 A1303 高齢人口で人口構成を照合する)があれば、 信頼性係数を推定し EIV モデルで補正できる。 ベイズ的アプローチではこの誤差構造を事前分布に組み込み、 MCMC で全パラメータを同時推定するのが現代的標準。 Stan・PyMC では x_true ~ Normal(0, sd_X); x_obs ~ Normal(x_true, sd_error) のような階層モデルを 5 行で書ける。
なお、 測定誤差は 独立変数に含まれる場合と 従属変数に含まれる場合で影響が異なる。 独立変数の測定誤差は attenuation(係数の過小評価)を生むが、 従属変数の測定誤差は係数の推定値そのものには偏りを与えず、 単に標準誤差を大きくするだけである。 これは「Y の測定誤差は単なる確率的揺らぎとして $\epsilon$ に吸収される」ためである。 したがって、 測定誤差対策を考えるときは「どちらの変数に誤差があるか」を最初に分類する。 SSDSE-B-2026 で「人口(精度高い)→ 1 人当たり消費額(アンケート由来で誤差大)」の回帰なら、 従属変数誤差なので係数推定はバイアスなし。 逆に「家計調査由来の消費支出(L3221) → 届出統計由来の出生数(A4101)」なら独立変数誤差で attenuation する。
測定誤差はデータサイエンスの最初の関門である。 統計学者は バイアスとバリアンスの枠組みで誤差を分解するが、 実務者は「データはどう作られたのか」「どこにバイアスが入り得るのか」を物語として理解する必要がある。 SSDSE-B-2026 を題材にこうした分析を繰り返すことで、 公的統計の限界と可能性が体感できる。 これは AI 時代に求められる「データリテラシー」の核心的スキルである。
測定誤差の議論は、 心理測定(IRT・テスト理論)、 計量経済学(IV・GMM)、 機械学習(ノイズ頑健性・データオーグメンテーション)など、 多くの分野でそれぞれの形で発展してきた。 共通するのは「測定とは何か」「真値とは何か」というメタ的な問いである。 SSDSE-B-2026 の数値は、 実は無数の調査・推計・補正のレイヤーを経た「合成物」であり、 そこに含まれる測定誤差を理解することは、 公的統計を批判的に使いこなす市民的リテラシーでもある。 本ページで紹介した attenuation bias、 IV、 EIV、 信頼性係数、 ベイズ階層モデルなどのツールを使いこなせれば、 「データに振り回されない」分析者になれる。 これは AI 時代の data scientist の必須教養である。 SSDSE-B-2026 を題材に、 上記の概念を実装と組み合わせて反復することで、 「データの来歴を読む」感覚が育まれる。 これは公的統計を扱う研究・実務において、 何より価値のある資産となるだろう。