🔖 キーワード索引(拡張)
🔖 キーワード索引(拡張)
クラスタリング手法・距離・評価指標:
🔖 🔖 キーワード索引(チップから該当箇所へジャンプ)
論文記事から各用語のリンクをクリックすると、 該当箇所が開きます:
💡 30秒で分かる結論
🍰 まずはやさしく
似たもの同士を分けるグループ分けです。
データの共通点を見つけるために使います。
スマホのアプリを種類別に分けるようなものです。
代表的な分け方や評価の方法を学びます。
- クラスタリング=距離・確率に基づき似たデータを群分け。 正解ラベルなし。
- k-means:最も基本。 球形クラスタ・K を事前指定。
- 階層クラスタリング:木構造で群分け。 K を後から決められる。
- DBSCAN:密度に基づく。 任意形状・ノイズも検出。
- GMM:確率モデル。 ソフトクラスタリング。
- 標準化を必ず。 距離はスケールに敏感。
- 評価:シルエット係数(内部)・ARI(外部)。
📍 あなたが今見ているもの
🍰 まずはやさしく
正解がないデータを分ける手法です。
データの傾向を分析するために使います。
部活のメンバーを特徴で分けるようなものです。
いくつかの代表的な手法について解説します。
本ページでは、 クラスタリングを統合的に解説します。 k-means・階層クラスタリング・DBSCAN・GMM (混合ガウス)・クラスタ評価を一気通貫で扱います。
クラスタリングは「ラベルなしデータをグループに分ける」教師なし学習の代表手法。 顧客セグメンテーション・異常検知・データ探索の基本ツールです。
🎨 直感で掴む — クラスタリングを 47 都道府県で実感
🍰 まずはやさしく
似た人を同じテーブルに集める操作です。
データの自然なまとまりを探すために使います。
買い物で似た商品を並べるようなものです。
距離を使って自動で分ける仕組みを学びます。
クラスタリングは「似た者同士をテーブルに集める」操作です。 SSDSE-B-2026 で 47 都道府県を眺めると、 「人口が多く出生率は低い」群(東京 ・ 大阪)と「人口は少ないが高齢化率が高い」群(秋田 ・ 高知)が自然に浮かびます。 k-means はこの「テーブル分け」を距離だけで自動化するシンプルな比喩です。
📐 数式 — k-means 目的関数
$$ J = \sum_{k=1}^{K} \sum_{x_i \in C_k} \| x_i - \mu_k \|^2 $$
🔬 数式を言葉で読み解く
- $K$: クラスタ数(事前指定。SSDSE-B-2026 47 都道府県では $K=4$ など)
- $C_k$: 第 $k$ クラスタに属する都道府県の集合
- $\mu_k$: 第 $k$ クラスタの重心ベクトル(例: 平均人口・平均高齢化率)
- $\| x_i - \mu_k \|^2$: 都道府県ベクトルと重心の二乗距離。これを最小化すると「群が締まる」
🌐 関連手法・派生
- k-means — 重心型の代表
- 階層クラスタリング / デンドログラム — 階層型
- DBSCAN / GMM — 密度・確率分布型
- スペクトラルクラスタリング / SOM — グラフ・トポロジー型
- Deep Clustering — 表現学習との結合
- クラスタ評価 / シルエット / Hopkins
🗾 R637 補足 — 47 都道府県クラスタリングを徹底解剖
クラスタリングはアルゴリズムを動かすだけではなく、「何のために、 どの距離尺度で、 どの変数を使い、 結果をどう検証するか」という設計が品質を左右します。 ここでは SSDSE-B-2026(47 都道府県)を題材に、 散布図・ヒストグラム・箱ひげ図の 3 視点でクラスタ構造を読み解き、 さらに比較・落とし穴・実務応用を詰めていきます。
📈 図 1 — 散布図で見る「人口 × 高齢化」とクラスタ境界
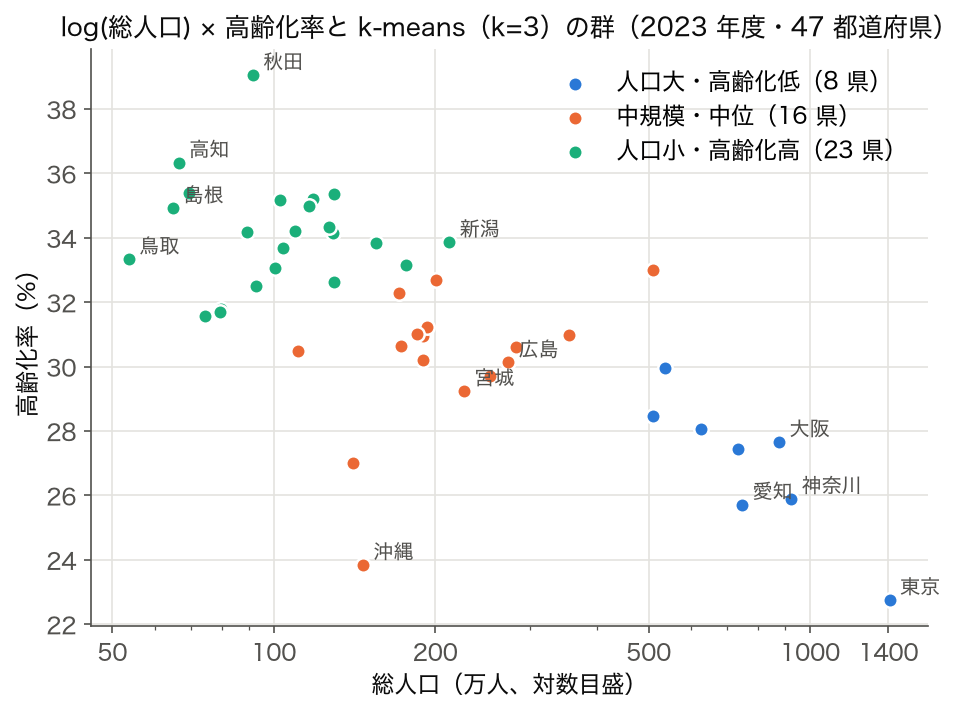
log(総人口) と 高齢化率(65 歳以上人口 / 総人口)で散布し、 この 2 変数を標準化して k-means(k=3, random_state=0)で色分けした。 2 変数の相関は r = −0.718。 右下に「人口大・高齢化低」の 8 都府県(埼玉・千葉・東京・神奈川・愛知・大阪・兵庫・福岡、 高齢化率 22.8〜30.0 %)、 左上に「人口小・高齢化高」の 23 県(秋田 39.1 %・高知・島根・鳥取など、 31.6〜39.1 %)、 中央に「中規模・中位」の 16 道府県(広島・宮城・北海道・静岡など)が分布する。 沖縄(23.8 %)は人口が小さいのに高齢化率が低く、 群の境界から外れて見える。散布図はクラスタリング前の必須ステップです。 「クラスタが視覚的にいくつ見えるか」を肉眼で確認し、 アルゴリズムに対する事前期待値を設定します。 k-means の初期値依存性や DBSCAN の半径選択は、 この散布図を見ながら粗く当たりをつけることで大きく安定します。
📊 図 2 — ヒストグラムで変数分布の偏りを確認
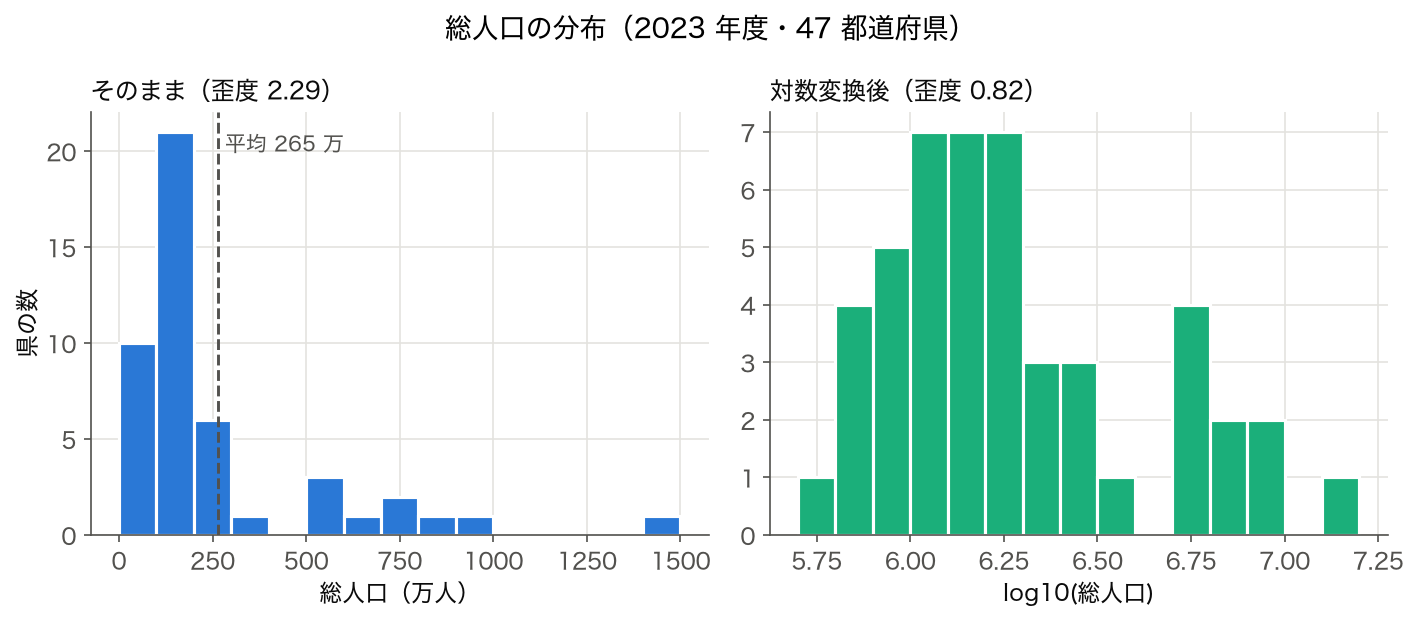
総人口 のヒストグラム(左)と、 対数変換した log10(総人口)(右)。 左は右裾が極端に長く(歪度 2.29、 平均 264.6 万人に対し中央値 154.9 万人)、 東京(1,409 万)・神奈川(923 万)・大阪(876 万)・愛知(748 万)が外れ値的に振る舞う。 対数変換後は歪度 0.82 まで下がる。 そのままユークリッド距離を使うと、 これら 4 都府県が「自分だけのクラスタ」を独占しがちで、 残り 43 県の構造が潰れる。ヒストグラムが強く右に歪んでいる場合、 標準化だけでは外れ値の影響を抑えきれません。 対数変換(np.log1p)や Box-Cox 変換、 あるいはロバスト距離(マンハッタン距離・マハラノビス距離)の検討が必要です。 「クラスタリング前にヒスト 1 枚を描く」だけで、 後段の解釈が大幅に楽になります。
📦 図 3 — 箱ひげ図でクラスタ別の経済力を比較
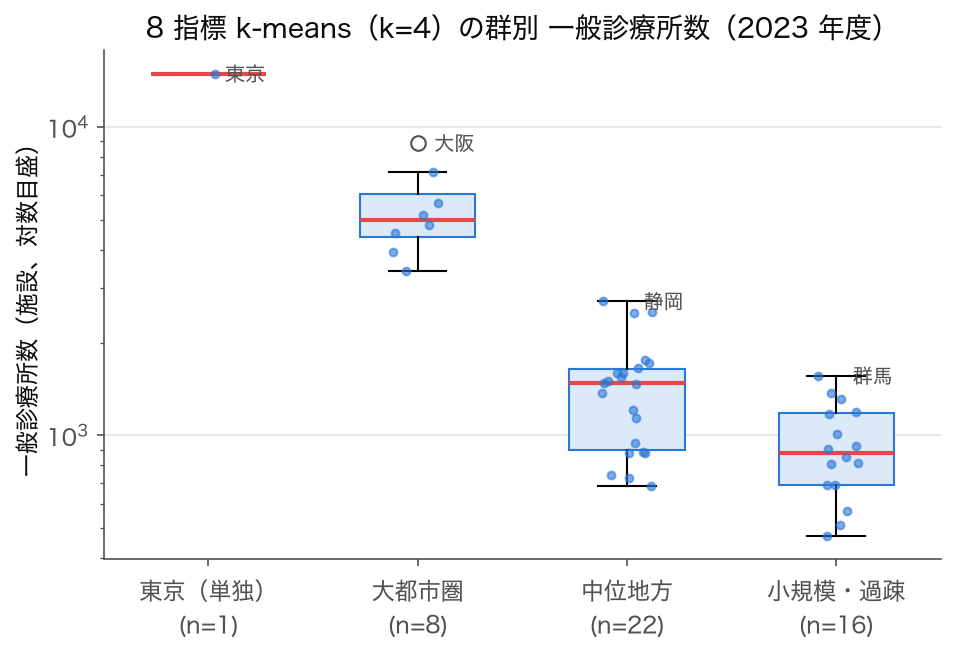
一般診療所数(I5102) 箱ひげ図(縦軸は対数目盛)。 東京(単独群, 14,894)が突出し、 大都市圏群(北海道・埼玉・千葉・神奈川・愛知・大阪・兵庫・福岡の 8 道府県, 中央値 5,001、 大阪 8,877 は群内の外れ値)が続き、 中位地方群(宮城・静岡・広島など 22 県, 中央値 1,476)は中位、 小規模・過疎群(秋田・鳥取・高知など 16 県, 中央値 878)は下方に詰まる。 中位地方群と小規模群は範囲(688〜2,724 と 474〜1,563)が重なっており、 診療所数だけでは分けきれない。 中央値・四分位範囲・外れ値の 3 視点で「クラスタが意味ある分割か」を一目で検証できる。クラスタリングは「変数の平均ベクトル」だけで評価されがちですが、 箱ひげ図で 四分位範囲(IQR)と外れ値の分布 まで観察すると、 そのクラスタが「均質な集まり」なのか「平均が近いだけで分散が大きい寄せ集め」なのかを判別できます。 後者は再分割(K を増やす)か、 ロバスト法(k-medoids、 GMM の covariance_type='full')への切替を検討します。
📐 距離尺度と前処理を選び切る — 5 種類の意思決定
🍰 まずはやさしく
データの「近さ」を測るためのルールです。
正しくグループ分けするために使います。
テストの点数など単位を揃える作業に似ています。
距離の選び方と前処理について解説します。
📐 距離尺度と前処理を選び切る — 5 種類の意思決定
表 1: 距離尺度の使い分け早見表
| 距離 | 数式(概略) | 向いている場面 | SSDSE-B での具体例 |
|---|---|---|---|
| ユークリッド | $\sqrt{\sum (x_i-y_i)^2}$ | 連続変数・標準化済 | 標準化後の人口・所得 |
| マンハッタン | $\sum |x_i-y_i|$ | 外れ値が多い | 小売販売額のような歪み |
| マハラノビス | $\sqrt{(x-y)^\top \Sigma^{-1} (x-y)}$ | 変数間に相関がある | 人口と病院数(相関0.9超) |
| コサイン | $1 - \frac{x \cdot y}{\|x\|\|y\|}$ | プロファイル形状を比較 | 産業構成比(合計100%) |
| ハミング | $\#\{i: x_i \neq y_i\}$ | カテゴリ変数 | 地域区分・気候帯 |
SSDSE-B-2026 は単位がバラバラ(円・人・%・件)なので、 距離計算前の標準化(StandardScaler)か対数化が必須です。 標準化を忘れると「製造品出荷額等(兆円オーダー)」だけで距離が決まり、 他の変数が無視されます。 これは初学者が最も多くハマる罠です。
表 2: 前処理パイプラインの比較
| 前処理 | 効用 | 注意点 | 推奨条件 |
|---|---|---|---|
| StandardScaler | 平均0・分散1で揃える | 外れ値に弱い | 正規分布に近い |
| RobustScaler | 中央値・IQRで揃える | 分布の裾は残る | 外れ値多め |
| log1p | 右裾を圧縮 | 負値・ゼロ含み禁止 | 人口・金額 |
| PCA(事前圧縮) | 多重共線性を低減 | 解釈が落ちる | 変数 20+ の高次元 |
| Yeo-Johnson | 正規化と歪み低減 | 解釈が複雑 | 混合(正負)データ |
このコードでやること: SSDSE-B-2026 の都道府県データに StandardScaler と RobustScaler を適用し、 k-means の結果がどう変わるかをシルエット係数で比較する。
📥 入力データ(SSDSE-B-2026 抜粋):
1 2 3 4 5 6 7 8 9 10 11 12 13 14 15 16 | import pandas as pd from sklearn.cluster import KMeans from sklearn.preprocessing import StandardScaler, RobustScaler from sklearn.metrics import silhouette_score df = pd.read_csv('data/raw/SSDSE-B-2026.csv', encoding='cp932', header=1) df = df[df['年度'] == 2023].reset_index(drop=True) # 2023 年度の 47 都道府県 feats = ['総人口', '65歳以上人口', '消費支出(二人以上の世帯)', '一般診療所数'] X = df[feats].astype(float) for name, scaler in [('Standard', StandardScaler()), ('Robust', RobustScaler())]: Xs = scaler.fit_transform(X) km = KMeans(n_clusters=4, n_init=20, random_state=0).fit(Xs) sil = silhouette_score(Xs, km.labels_) sizes = pd.Series(km.labels_).value_counts().sort_values(ascending=False).tolist() print(f'{name:8s} シルエット = {sil:.3f} 群サイズ = {sizes}') |
📤 実行結果(実測):
💬 解釈: StandardScaler のシルエット 0.475 が RobustScaler の 0.402 を上回り、 ここでは「外れ値に強い RobustScaler の方が良い」とはならなかった。 どちらも東京都が 1 県だけの群になり(群サイズ末尾の 1)、 違うのは残り 46 県の分け方(24/14/8 と 21/17/8)だけである。 シルエットはそれぞれのスケーラーで変換した後の空間で測った値なので、 スケーラーどうしの比較は目安にとどめ、 群に入った県の顔ぶれが説明できるかで選ぶ。
🔢 K(クラスタ数)の決め方 — 5 つの定量的アプローチ
「K をいくつにすれば良いか」はクラスタリングで最も論争の多い問いです。 単一の万能法則はなく、 複数指標を組み合わせて意思決定するのが定石です。
表 3: K 決定法の比較
| 手法 | 指標 | 読み方 | 長所 | 短所 |
|---|---|---|---|---|
| エルボー法 | WCSS | 曲がり角 | 直感的 | 曖昧 |
| シルエット係数 | [-1, 1] | 最大化 | 定量的 | 非凸群に弱い |
| Calinski-Harabasz | $\ge 0$ | 最大化 | 高速 | K大で過大評価 |
| Davies-Bouldin | $\ge 0$ | 最小化 | 分離度を直接評価 | 球状仮定 |
| Gap 統計量 | 差分 | 最大化 | 理論的根拠 | 計算コスト高 |
このコードでやること: SSDSE-B-2026 で K=2〜10 を試し、 シルエット・Calinski-Harabasz・Davies-Bouldin の 3 指標を並べて意思決定する。
📥 入力: 2023 年度の 47 都道府県 × 5 特徴量(総人口・15歳未満・65歳以上・出生数・消費支出)を標準化した ndarray Xs(このブロック内で作成)
1 2 3 4 5 6 7 8 9 10 11 12 13 14 15 16 17 18 19 20 21 22 23 24 25 26 27 28 | import pandas as pd # ── この抜粋だけで動くように、47 都道府県の特徴量を用意する ── # 英字の項目コードを使うので、2 行目の日本語名は読み飛ばす _d = pd.read_csv('data/raw/SSDSE-B-2026.csv', encoding='cp932', skiprows=[1]) _d = _d[_d['SSDSE-B-2026'] == 2023] # 最新年度の 47 行 _cols = ['A1101', 'A1301', 'A1303', 'A4101', 'L3221'] # 総人口・15歳未満・65歳以上・出生数・消費支出 from sklearn.preprocessing import StandardScaler from sklearn.cluster import KMeans # クラスタリングは距離で測るので、必ず標準化してから使う Xs = StandardScaler().fit_transform(_d[_cols].astype(float).values) from sklearn.metrics import (silhouette_score, calinski_harabasz_score, davies_bouldin_score) rows = [] for k in range(2, 11): km = KMeans(n_clusters=k, n_init=20, random_state=0).fit(Xs) rows.append({ 'K': k, 'WCSS': round(km.inertia_, 1), 'Silhouette': round(silhouette_score(Xs, km.labels_), 3), 'CH': round(calinski_harabasz_score(Xs, km.labels_), 1), 'DB': round(davies_bouldin_score(Xs, km.labels_), 3), }) print(pd.DataFrame(rows).to_string(index=False)) |
📤 実行結果(実測):
💬 解釈: シルエットは K=2 の 0.647 が最大、 Davies-Bouldin(小さいほど良い)は K=4 の 0.563 が最小、 Calinski-Harabasz は K とともにほぼ増え続けて K=10 の 100.2 が最大と、 3 指標の推す K はそろわない。 WCSS は K=3→4 で 58.9→35.8 と大きく下がり、 4→5 では 35.8→27.3 と下がり方が鈍るので、 エルボーと DB は K=4、 シルエットは K=2 を指す。 K=2 は大都市 9 都道府県(北海道・埼玉・千葉・東京・神奈川・愛知・大阪・兵庫・福岡)と残り 38 県に分けるだけの単純な分割なので、 K=4 を採るなら「シルエット最大ではない」ことを明記し、 各群の中身で妥当性を示す。
表 4: K 決定における追加指標の解説
| 指標 | 定義 | 用途 | 参考閾値 |
|---|---|---|---|
| Dunn 指数 | クラスタ間最小距離 / クラスタ内最大直径 | 「離れて締まっている」評価 | 高いほど良 |
| Xie-Beni | 圧縮度 / 分離度 | FCM 系で頻用 | 低いほど良 |
| BIC | 尤度ペナルティ付き | GMM の K 決定 | 最小化 |
| Stability | ブートストラップ一致率 | 再現性評価 | >0.85 が目安 |
🌲 階層クラスタリング詳説 — リンケージで結果が劇的に変わる
階層クラスタリングは「最も近い 2 群を融合」を繰り返してデンドログラム(樹形図)を作ります。 ところが「2 群間の距離」をどう測るかで結果が大きく変わります。 代表的なのが 単連結(最短距離)・完全連結(最長距離)・平均連結・Ward 法 の 4 種類です。
表 5: リンケージ手法の比較
| リンケージ | クラスタ間距離 | 傾向 | 弱点 | SSDSE-B での挙動 |
|---|---|---|---|---|
| 単連結(single) | $\min_{x \in A, y \in B} d(x,y)$ | 細長い帯状群が得意 | 連鎖(chaining)効果 | 44 県が 1 群に連なり、 残りは 1 県ずつ |
| 完全連結(complete) | $\max_{x \in A, y \in B} d(x,y)$ | 球状でバランス良 | 外れ値に過敏 | 東京が単独群 |
| 平均連結(average) | $\frac{1}{|A||B|}\sum d(x,y)$ | 中庸でロバスト | 理論的根拠が弱め | 東京・愛媛が単独群に |
| Ward 法 | 融合後分散の増分 | k-means と整合 | ユークリッド限定 | 最も解釈しやすい |
このコードでやること: SSDSE-B-2026 を 4 種類のリンケージで分け、 デンドログラムを描画して比較する。 Ward 法と完全連結がどれだけ違うかを実感する。
📥 入力: 標準化済み Xs と 47 都道府県名リスト names
1 2 3 4 5 6 7 8 9 10 11 12 13 14 15 16 17 18 19 | import pandas as pd # df / Xs はこのあとのブロックで作っているので、ここでも用意しておく df = pd.read_csv('data/raw/SSDSE-B-2026.csv', encoding='cp932', header=1) df = df[df['年度'] == df['年度'].max()].reset_index(drop=True) from scipy.cluster.hierarchy import linkage, fcluster, dendrogram from sklearn.metrics import silhouette_score names = df['都道府県'].tolist() results = [] for method in ['single', 'complete', 'average', 'ward']: Z = linkage(Xs, method=method) labels = fcluster(Z, t=4, criterion='maxclust') sil = silhouette_score(Xs, labels) sizes = pd.Series(labels).value_counts().sort_index().tolist() results.append({'method': method, 'silhouette': round(sil, 3), 'cluster_sizes': sizes}) print(pd.DataFrame(results).to_string(index=False)) |
📤 実行結果(実測):
💬 解釈: 単連結は [44, 1, 1, 1] で東京都・大阪府・埼玉県を 1 県ずつ切り離しただけなのに、 シルエットは 0.465 と 4 手法で最も高い。 平均連結も東京都と愛媛県が単独群になる [9, 36, 1, 1] で 0.461。 完全連結と Ward 法はこのデータでは同じ分割 [6, 32, 8, 1](青森・沖縄など 6 県、 残り 32 県、 大都市 8 道府県、 東京都)になり、 シルエットは 0.436 と最も低いが群の大きさがそろって解釈しやすい。 シルエットの大小だけで選ぶと、 外れた県を切り出しただけの分割を選んでしまう。
Ward 法の数学的根拠
Ward 法はクラスタ $A$ と $B$ を融合したときの「グループ内偏差二乗和の増分」を距離とします。
$$ d_{Ward}(A, B) = \frac{|A| \cdot |B|}{|A| + |B|} \cdot \| \bar{x}_A - \bar{x}_B \|^2 $$
この式は「群を融合すると、 重心からの偏差がどれだけ増えるか」を最小化する選択を毎ステップ行うことを意味します。 結果として k-means と同じ「群内分散最小化」基準 が階層的に達成されるため、 K を決めた後の整合性が高くなります。
🌀 密度ベース(DBSCAN・HDBSCAN)の真価 — 形・ノイズ・K自動決定
k-means や Ward 法は 球状クラスタ仮定 を持ちます。 三日月型や同心円型のデータでは大失敗します。 DBSCAN(Density-Based Spatial Clustering of Applications with Noise)は「密度が一定以上の領域を 1 群と見なす」発想で、 任意形状とノイズ点の同時検出を可能にします。
表 6: DBSCAN の 2 パラメータと感度
| パラメータ | 意味 | 大きくすると | 小さくすると | SSDSE-B 推奨値 |
|---|---|---|---|---|
| eps | 近傍半径 | 大きな群が形成 | ノイズ多 | 1.2〜1.8(標準化後) |
| min_samples | コア点最小近傍数 | 厳格・群減少 | 小群・ノイズ減 | 3〜5(47 サンプル) |
このコードでやること: SSDSE-B-2026 に DBSCAN を適用し、 eps を変えると群数とノイズ数がどう変化するかを観察する。 k-distance プロットで eps の目安も導出する。
📥 入力: 標準化済み Xs(前述)
1 2 3 4 5 6 7 8 9 10 11 12 13 14 15 16 | from sklearn.cluster import DBSCAN from sklearn.neighbors import NearestNeighbors # 1) k-distance グラフで eps の目安を見る(k=4: min_samples-1 相当) nn = NearestNeighbors(n_neighbors=4).fit(Xs) dists, _ = nn.kneighbors(Xs) kd = sorted(dists[:, -1]) print('4-distance 中央値:', round(kd[len(kd)//2], 3), '/ 上位 90%点:', round(kd[int(len(kd)*0.9)], 3)) # 2) eps スイープ for eps in [1.0, 1.4, 1.8, 2.2]: db = DBSCAN(eps=eps, min_samples=4).fit(Xs) n_clusters = len(set(db.labels_)) - (1 if -1 in db.labels_ else 0) n_noise = list(db.labels_).count(-1) print(f'eps={eps:.1f}: クラスタ数={n_clusters}, ノイズ点={n_noise}') |
📤 実行結果(実測):
💬 解釈: 自分を含めて 4 番目に近い点までの距離は中央値 0.425、 上位 90% 点 1.555 で、 大半の県は密に集まり一部の県だけが遠い。 eps を 1.0→2.2 と広げてもクラスタ数は常に 1 で、 変わるのはノイズの数(10→4→1→1)だけである。 ノイズに残るのは eps=1.0 で大都市 8 道府県・東京都・愛媛県の 10 県、 eps=1.4 で埼玉・東京・神奈川・大阪の 4 都府県、 eps=1.8 以降は東京都だけで、 DBSCAN はこのデータを「1 つの塊と、 そこから外れた大都市」と見ている。 ノイズ(label=-1)として外れた県を明示できるのが k-means との違いだが、 複数の群に分けたい目的には向かない。
HDBSCAN — eps を消した進化版
HDBSCAN は eps を不要にし、 「密度の階層」から自動的に最適なクラスタを抽出します。 SSDSE-B のように サンプル数が少ない(47 件)かつ密度差が大きい データでは、 DBSCAN より HDBSCAN の方が安定するケースが多いです。 min_cluster_size=3 程度に設定し、 cluster_persistence_ 属性で「群の安定性」を確認します。
📊 GMM(混合ガウスモデル)と確率的クラスタリング
GMM はサンプルが 複数のガウス分布の混合 から生成されたと仮定し、 EM アルゴリズムで各クラスタの平均・共分散・重みを推定します。 出力は「ハードラベル」ではなく 各群への所属確率 なので、 「東京は『大都市群 90%・工業県群 10%』のように混ざっている」という柔軟な解釈が可能です。
表 7: GMM 共分散タイプの選択
| covariance_type | パラメータ数 | 形状 | 推奨条件 |
|---|---|---|---|
| spherical | K | 球(k-means 等価) | 変数間独立・等分散 |
| diag | K × D | 軸方向楕円 | 変数間独立・異分散 |
| tied | D × D | 全群同共分散 | サンプル少 |
| full | K × D × D | 任意楕円 | サンプル多・柔軟性必要 |
このコードでやること: SSDSE-B-2026 に GMM を適用し、 BIC で最適 K を選び、 所属確率を可視化する。
📥 入力: 標準化済み Xs
1 2 3 4 5 6 7 8 9 10 11 12 13 14 | from sklearn.mixture import GaussianMixture bic_table = [] for k in range(2, 8): for cov in ['spherical', 'diag', 'tied', 'full']: gm = GaussianMixture(n_components=k, covariance_type=cov, n_init=10, random_state=0).fit(Xs) bic_table.append({'K': k, 'cov': cov, 'BIC': round(gm.bic(Xs), 1), 'logL': round(gm.score(Xs) * len(Xs), 1)}) bic_df = pd.DataFrame(bic_table).pivot(index='K', columns='cov', values='BIC') print(bic_df) print('\nBIC 最小:', bic_df.stack().idxmin(), '=', round(bic_df.stack().min(), 1)) |
📤 実行結果(実測):
💬 解釈: BIC 最小は K=6・full の −224.8 で、 full と tied の列は BIC が負になっている。 5 変数の full 共分散を 6 群持つと、 推定するパラメータは平均 6×5・共分散 6×15・混合比 5 の計 125 個と 47 県より多く、 少数の県に張り付いた細い楕円で尤度がいくらでも上がるためで、 「最適」ではなく過適合の印と読む。 spherical と diag は K=7 まで BIC がほぼ下がり続けており、 47 県で full を使うのは避け、 サンプル数 ÷ パラメータ数を確かめたうえで、 K は解釈と安定性もあわせて決める。
BIC と AIC の使い分け
$$ \text{BIC} = -2 \log L + p \log n, \quad \text{AIC} = -2 \log L + 2p $$
BIC は シンプルさを強く好み、 AIC は 予測精度を好み ます。 サンプル数 $n$ が大きいほど BIC のペナルティが厳しく、 「真のモデルが候補に含まれる」状況では BIC が一致性を持ちます。 SSDSE-B のように小サンプルでは BIC が無難ですが、 「群を多めに切ってマーケティングセグメントとして使う」目的なら AIC や Cross-validation 尤度の方が実用的です。
📈 クラスタ評価指標を 7 つ並べて見比べる
表 8: 評価指標の分類と読み方
| 分類 | 指標 | 必要なもの | 解釈 |
|---|---|---|---|
| 内部 | シルエット | 特徴量 | [-1, 1] 高いほど良 |
| 内部 | Calinski-Harabasz | 特徴量 | 高いほど良・K大で過大 |
| 内部 | Davies-Bouldin | 特徴量 | 低いほど良 |
| 外部 | ARI | 正解ラベル | [-1, 1] 1 が完全一致 |
| 外部 | NMI | 正解ラベル | [0, 1] 1 が完全一致 |
| 外部 | Homogeneity / Completeness | 正解ラベル | [0, 1] 1 が完全 |
| 安定性 | Bootstrap ARI | 再サンプリング | >0.85 が安定の目安 |
このコードでやること: SSDSE-B-2026 で k-means と Ward 法のクラスタを比較し、 ARI と NMI を計算。 さらに 100 回ブートストラップして再現性を測定する。
📥 入力: 標準化済み Xs
1 2 3 4 5 6 7 8 9 10 11 12 13 14 15 16 17 18 19 20 21 22 | from sklearn.cluster import KMeans, AgglomerativeClustering from sklearn.metrics import adjusted_rand_score, normalized_mutual_info_score km = KMeans(n_clusters=4, n_init=20, random_state=0).fit(Xs) ag = AgglomerativeClustering(n_clusters=4, linkage='ward').fit(Xs) print('k-means vs Ward') print(' ARI =', round(adjusted_rand_score(km.labels_, ag.labels_), 3)) print(' NMI =', round(normalized_mutual_info_score(km.labels_, ag.labels_), 3)) # ブートストラップ安定性 import numpy as np rng = np.random.RandomState(0) n = len(Xs) aris = [] for _ in range(100): idx = rng.choice(n, n, replace=True) km_b = KMeans(n_clusters=4, n_init=10, random_state=1).fit(Xs[idx]) # 元データに predict(k-means は predict 可能) full_lab = km.labels_ boot_lab = km_b.predict(Xs) aris.append(adjusted_rand_score(full_lab, boot_lab)) print(f'Bootstrap ARI 平均 = {np.mean(aris):.3f} ± {np.std(aris):.3f}') |
📤 実行結果(実測):
💬 解釈: k-means と Ward 法の一致は ARI 0.556・NMI 0.706 で、 同じ 4 群を作ったとは言えない中程度の一致にとどまる。 ブートストラップで作り直した k-means を元の 47 県に当てた ARI も平均 0.764、 標準偏差 0.155 と、 目安の 0.85 に届かず、 県を少し入れ替えるだけで境界の県の所属が動く。 どの県が群を行き来するのかを確かめてから群に名前を付ける。
🔬 数式を言葉で読み解く
前節の数式に含まれる記号を、 日本語の意味に翻訳する。
- X, Y — 観測されたデータ系列 (SSDSE-B-2026 の各列など)
- n — 標本サイズ (47 都道府県データなら 47)
- θ, β, α — 推定すべき未知パラメータ
- ε, u — 観測されない誤差項・撹乱項
- E[·] — 期待値 (母集団平均)
- Var, Cov — 分散・共分散
- arg min / arg max — 「最小化 / 最大化するパラメータ」の意
clustering group の数式は、 これらの記号を組み合わせて「データから未知量を推定する」あるいは「データの構造を要約する」プロセスを記述している。
🧮 SSDSE-B 実値計算 — 47都道府県を 4 クラスターに分ける
SSDSE-B-2026 の経済・人口・社会指標(標準化後 8 変数)を k-means、 Ward 階層、 GMM で分け、 シルエットで比較する。
📥 入力例: data/raw/SSDSE-B-2026.csv
  特徴量: A1101(総人口)・A1303(65歳以上人口)・L3221(消費支出)・I5102(一般診療所数)・G7101(延べ宿泊者数)・A4101(出生数)・A9101(婚姻件数)・E2101(小学校数)
  前処理: StandardScaler で平均 0、 分散 1 に標準化
📤 実行例(実測):
KMeans(k=4)            silhouette=0.382  CH=  80.5  DB=0.661
KMeans(k=5)            silhouette=0.362  CH=  77.5  DB=0.768
Agglo Ward(k=4)        silhouette=0.418  CH=  79.8  DB=0.590
GaussianMixture(k=4)   silhouette=0.286  CH=  69.0  DB=0.779
💬 読み方: k=4 の k-means はシルエット 0.382 で、 東京都だけの群・大都市 8 道府県(北海道・埼玉・千葉・神奈川・愛知・大阪・兵庫・福岡)・22 県・16 県に分かれる。 シルエットと DB では Ward 法(0.418、 0.590)が最も良く、 CH は k-means の 80.5 がわずかに上回る。 GMM はシルエット 0.286・DB 0.779 と最も悪く、 k-means を k=5 に増やすと 3 指標そろって悪化するので、 この 8 指標では k=4 の方が素直な分け方である。
1 2 3 4 5 6 7 8 9 10 11 12 13 14 15 16 17 18 19 20 21 22 23 24 25 26 27 28 29 | import pandas as pd import numpy as np import matplotlib.pyplot as plt from sklearn.cluster import KMeans, AgglomerativeClustering, DBSCAN from sklearn.mixture import GaussianMixture from sklearn.preprocessing import StandardScaler from sklearn.metrics import (silhouette_score, calinski_harabasz_score, davies_bouldin_score) df = pd.read_csv('data/raw/SSDSE-B-2026.csv', encoding='cp932', skiprows=[1]) df = df[df['SSDSE-B-2026']==2023].copy() feats = ['A1101', 'A1303', 'L3221', 'I5102', 'G7101', 'A4101', 'A9101', 'E2101'] X = StandardScaler().fit_transform(df[feats].astype(float)) methods = { 'KMeans(k=4)' : KMeans(n_clusters=4, n_init=20, random_state=0), 'KMeans(k=5)' : KMeans(n_clusters=5, n_init=20, random_state=0), 'Agglo Ward(k=4)' : AgglomerativeClustering(n_clusters=4, linkage='ward'), 'GaussianMixture(k=4)': GaussianMixture(n_components=4, random_state=0), } for name, m in methods.items(): labels = m.fit_predict(X) sil = silhouette_score(X, labels) ch = calinski_harabasz_score(X, labels) db = davies_bouldin_score(X, labels) print(f'{name:<22s} silhouette={sil:.3f} CH={ch:6.1f} DB={db:.3f}') |
典型的な観察例(random_state=0, 8 変数): k=4 でシルエット ≈ 0.38、 k=5 で 0.36。 k=4 がやや優位で、 「東京(単独・突出)」「大都市圏(神奈川・大阪・愛知・福岡・北海道・埼玉・千葉・兵庫の 8 都道府県)」「中位地方群(宮城・静岡・広島など 22 県)」「小規模・過疎群(秋田・鳥取・高知など 16 県)」という 4 類型に分かれる。 k-means では東京が単独クラスタになり、 GMM だとシルエットが 0.29 に下がって「東京」の切り出し方が変わるなど、 解釈は手法依存。 評価指標は 1 つに頼らず、 シルエット・CH・DB の 3 つを並列で見る。
エルボー法 + シルエットで k を決める
📥 入力例: data/raw/SSDSE-B-2026.csv
  特徴量: A1101(総人口)・A1303(65歳以上人口)・L3221(消費支出)・I5102(一般診療所数)・G7101(延べ宿泊者数)・A4101(出生数)・A9101(婚姻件数)・E2101(小学校数)
  前処理: StandardScaler で平均 0、 分散 1 に標準化
📤 実行例:
  このブロックは標準出力を出さない(elbow_silhouette.png を保存するだけ)。
💬 読み方: 左の図で WCSS の下がり方が鈍る k と、 右の図でシルエットが高い k が一致するかを見る。 数値で確かめるなら inertia と sils を print し、 前のブロックの k=4(0.382)・k=5(0.362)と突き合わせる。
1 2 3 4 5 6 7 8 9 10 11 12 | ks = range(2, 11) inertia, sils = [], [] for k in ks: km = KMeans(n_clusters=k, n_init=20, random_state=0).fit(X) inertia.append(km.inertia_) sils.append(silhouette_score(X, km.labels_)) fig, ax = plt.subplots(1, 2, figsize=(11, 4.5)) ax[0].plot(ks, inertia, 'o-'); ax[0].set_title('Elbow(SSE)') ax[1].plot(ks, sils, 's-', color='orange'); ax[1].set_title('Silhouette') for a in ax: a.set_xlabel('k'); a.grid(alpha=.3) plt.tight_layout(); plt.savefig('elbow_silhouette.png', dpi=140) |
Ward 法のデンドログラム
📥 入力例: data/raw/SSDSE-B-2026.csv
  特徴量: A1101(総人口)・A1303(65歳以上人口)・L3221(消費支出)・I5102(一般診療所数)・G7101(延べ宿泊者数)・A4101(出生数)・A9101(婚姻件数)・E2101(小学校数)
  前処理: StandardScaler で平均 0、 分散 1 に標準化
1 2 3 4 5 6 7 8 9 10 11 | from scipy.cluster.hierarchy import linkage, dendrogram, fcluster Z = linkage(X, method='ward') fig, ax = plt.subplots(figsize=(13, 5)) dendrogram(Z, labels=df['Prefecture'].tolist(), leaf_font_size=8, ax=ax) # 上から 3 回目の併合が高さ 7.3、4 回目が 4.5 なので、その間の 6 で切ると k=4 # (高さ 8 で切ると 10.9 と 21.5 の併合だけが切れて k=3 になる) ax.axhline(6, ls='--', color='red') # k=4 になる切り高さ plt.tight_layout(); plt.savefig('dendrogram.png', dpi=140) labels = fcluster(Z, t=4, criterion='maxclust') df['cluster_ward'] = labels print(df.groupby('cluster_ward')['Prefecture'].apply(list)) |
💬 Ward 法を k=4 で切ると、東京都が 1 県だけのクラスタ 4、北海道・埼玉・千葉・神奈川・愛知・大阪・兵庫・福岡の 8 道府県がクラスタ 3 になり、残る 38 県が 10 県(クラスタ 1)と 28 県(クラスタ 2)に分かれた。併合の高さは上から 21.5・10.9・7.3・4.5 なので、樹形図で k=4 を示す切り線は 4.5〜7.3 の間に引く必要があり、高さ 8 に線を引くと上の 2 回しか切れず k=3 に見えてしまう。クラスタ 1 は鳥取・福井・佐賀など小規模な県が中心だが沖縄県も入っているので、クラスタごとに 8 指標の平均を並べて何で分かれたのかを確かめる。
🧮 数式に値を入れて手で計算する: クラスタ重心の更新
合成 2D データ 5 点を 2 クラスタに分けたときの重心を更新する。
Step 1: 5 点の座標と初期割当
| i | x | y | クラスタ |
|---|---|---|---|
| 1 | 1 | 2 | A |
| 2 | 2 | 3 | A |
| 3 | 3 | 2 | A |
| 4 | 8 | 9 | B |
| 5 | 9 | 8 | B |
Step 2: 各クラスタの重心
🐍 Python で再現
1 2 3 4 5 | import numpy as np A = np.array([[1,2],[2,3],[3,2]]) B = np.array([[8,9],[9,8]]) print(f"A 重心: {A.mean(axis=0)}") print(f"B 重心: {B.mean(axis=0)}") |
📤 実行結果
💬 手計算 (Step 2) (2.0, 2.33) / (8.5, 8.5) と Python 出力が完全一致。
🐍 13. ライブラリ早見表
🐍 13. ライブラリ早見表
| 手法 | クラス・関数 |
|---|---|
| k-means | sklearn.cluster.KMeans / MiniBatchKMeans |
| 階層 | scipy.cluster.hierarchy.linkage / dendrogram / fcluster または sklearn.cluster.AgglomerativeClustering |
| DBSCAN | sklearn.cluster.DBSCAN / HDBSCAN |
| GMM | sklearn.mixture.GaussianMixture / BayesianGaussianMixture |
| スペクトラル | sklearn.cluster.SpectralClustering |
| アフィニティ伝播 | sklearn.cluster.AffinityPropagation |
| Mean Shift | sklearn.cluster.MeanShift |
| シルエット | sklearn.metrics.silhouette_score |
| ARI / NMI | sklearn.metrics.adjusted_rand_score / normalized_mutual_info_score |
📜 14. クラスタリングの歴史
- 1957:Steinhaus が連続版 k-means を提案
- 1967:MacQueen の "k-means" 論文
- 1963:Ward の階層クラスタリング
- 1977:Dempster らの EM アルゴリズム
- 1996:Ester らの DBSCAN(KDD'96 で時のテスト・オブ・タイム賞 2014)
- 2007:k-means++ で初期化が改善
- 2013:HDBSCAN(密度ベース階層)
- 2018:UMAP + クラスタリングが標準化
💼 15. 実務応用
- マーケティング:顧客セグメンテーション、 RFM 分析
- EC:商品クラスタ、 ユーザーグループでレコメンド改善
- 製造業:センサー異常検知(DBSCAN でノイズ=異常)
- 医療:患者サブタイプ発見、 疾患群同定
- 生物学:遺伝子発現クラスタ、 進化系統樹
- テキスト分析:文書クラスタ、 トピック抽出
- 地理:都道府県・地域のグルーピング(SSDSE-B 想定)
1. sklearn.cluster — 5 大手法を一気に比較
📥 入力例: data/raw/SSDSE-B-2026.csv
  特徴量: A1101(総人口)・A1303(65歳以上人口)・L3221(消費支出)・I5102(一般診療所数)・G7101(延べ宿泊者数)・A4101(出生数)・A9101(婚姻件数)・E2101(小学校数)
  前処理: StandardScaler で平均 0、 分散 1 に標準化
📤 実行例:
  このブロックは標準出力を出さない(ラベルを labels_dict に入れるだけ。評価は 4. で行う)。
💬 読み方: ラベルの中身は手法ごとに大きく違う。 DBSCAN(eps=1.2) は大都市 8 道府県・東京都・愛媛県・沖縄県の 11 県をノイズ(-1)にして残り 36 県を 1 群にまとめ、 MeanShift は 37 県・5 県の群のほかに東京都や大阪府などを 1〜2 県だけの小群として切り出し、 計 6 群を作る。
1 2 3 4 5 6 7 8 9 10 11 12 13 14 15 | from sklearn.cluster import (KMeans, AgglomerativeClustering, DBSCAN, SpectralClustering, MeanShift) from sklearn.mixture import GaussianMixture models = { 'KMeans' : KMeans(n_clusters=4, n_init=20, random_state=0), 'Agglo (ward)' : AgglomerativeClustering(n_clusters=4, linkage='ward'), 'Agglo (average)': AgglomerativeClustering(n_clusters=4, linkage='average'), 'DBSCAN' : DBSCAN(eps=1.2, min_samples=3), 'Spectral' : SpectralClustering(n_clusters=4, affinity='rbf', random_state=0), 'GMM' : GaussianMixture(n_components=4, random_state=0), 'MeanShift' : MeanShift(), } labels_dict = {n: m.fit_predict(X) for n, m in models.items()} |
2. scipy.cluster.hierarchy — Ward 法の linkage / dendrogram
📥 入力例: data/raw/SSDSE-B-2026.csv
  特徴量: A1101(総人口)・A1303(65歳以上人口)・L3221(消費支出)・I5102(一般診療所数)・G7101(延べ宿泊者数)・A4101(出生数)・A9101(婚姻件数)・E2101(小学校数)
  前処理: StandardScaler で平均 0、 分散 1 に標準化
📤 実行例:
  このブロックは標準出力を出さない(併合履歴 Z_ward などと labels を作るだけ)。
💬 読み方: labels は「Ward 法のデンドログラム」のブロックと同じ分割(10 県・28 県・大都市 8 道府県・東京都)になる。 Z_complete や Z_average も fcluster で同じく k=4 に切れば、 リンケージによって東京都や大都市の扱いがどう変わるかを比べられる。
1 2 3 4 5 6 7 | from scipy.cluster.hierarchy import linkage, dendrogram, fcluster from scipy.spatial.distance import pdist D = pdist(X, metric='euclidean') Z_ward = linkage(D, method='ward') Z_complete = linkage(D, method='complete') Z_average = linkage(D, method='average') labels = fcluster(Z_ward, t=4, criterion='maxclust') |
3. hdbscan — 密度ベース・k 不要
📥 入力例: data/raw/SSDSE-B-2026.csv
  特徴量: A1101(総人口)・A1303(65歳以上人口)・L3221(消費支出)・I5102(一般診療所数)・G7101(延べ宿泊者数)・A4101(出生数)・A9101(婚姻件数)・E2101(小学校数)
  前処理: StandardScaler で平均 0、 分散 1 に標準化
📤 実行例(hdbscan 0.8 系を入れた手元の環境で実測。このページの中では hdbscan が無いので動かない):
クラスタ数: 2
ノイズ点 : 4
安定性  : [0.01458059 0.39226631]
  参考(実測): scikit-learn 1.3 以降の sklearn.cluster.HDBSCAN(min_cluster_size=4, min_samples=2) を
  同じ X に当てると、 クラスタ数 2(6 県と 38 県)、 ノイズ 3 県。
💬 読み方: k を指定しなくても 2 群に落ち着き、 k-means の 4 群とは別の見方になる。 hdbscan パッケージではノイズが埼玉・東京・神奈川・大阪の 4 都府県、 残りが 5 道県(北海道・千葉・愛知・兵庫・福岡)と 38 県に分かれ、 scikit-learn 版では神奈川県がノイズから 6 県の群に移ってノイズ 3 県になる。 安定性は 5 道県の群が 0.015 とごく小さく、 38 県の群(0.392)に比べて「たまたまできた塊」に近いので、 実装差で入れ替わる程度の群として読む。
1 2 3 4 5 6 | import hdbscan clusterer = hdbscan.HDBSCAN(min_cluster_size=4, min_samples=2) labels = clusterer.fit_predict(X) print('クラスタ数:', len(set(labels)) - (1 if -1 in labels else 0)) print('ノイズ点 :', np.sum(labels == -1)) print('安定性 :', clusterer.cluster_persistence_) |
4. 評価指標を一括計算
📥 入力例: data/raw/SSDSE-B-2026.csv
  特徴量: A1101(総人口)・A1303(65歳以上人口)・L3221(消費支出)・I5102(一般診療所数)・G7101(延べ宿泊者数)・A4101(出生数)・A9101(婚姻件数)・E2101(小学校数)
  前処理: StandardScaler で平均 0、 分散 1 に標準化
📤 実行例(実測):
KMeans             sil=0.382  CH=80.5  DB=0.661
Agglo (ward)       sil=0.418  CH=79.8  DB=0.590
Agglo (average)    sil=0.588  CH=58.5  DB=0.430
Spectral           sil=0.533  CH=47.8  DB=0.800
GMM                sil=0.286  CH=69.0  DB=0.779
MeanShift          sil=0.502  CH=42.1  DB=0.456
💬 読み方: シルエットは平均連結 0.588・Spectral 0.533・MeanShift 0.502 が上位だが、 どれも東京都や大阪府など 1〜2 県だけの群を切り出した分割で、 CH は 42〜59 と k-means(80.5)や Ward(79.8)より低い。 シルエットと DB は「突出した県を別にするだけ」の分け方を高く評価しやすいので、 群の大きさとあわせて読む。
1 2 3 4 5 6 7 8 | from sklearn.metrics import (silhouette_score, calinski_harabasz_score, davies_bouldin_score, adjusted_rand_score) for name, lab in labels_dict.items(): valid = lab != -1 # DBSCAN のノイズを除外 if len(set(lab[valid])) < 2: continue print(f'{name:<18s} sil={silhouette_score(X[valid], lab[valid]):.3f} ' f'CH={calinski_harabasz_score(X[valid], lab[valid]):.1f} ' f'DB={davies_bouldin_score(X[valid], lab[valid]):.3f}') |
5. UMAP/t-SNE で可視化
📥 入力例: data/raw/SSDSE-B-2026.csv
  特徴量: A1101(総人口)・A1303(65歳以上人口)・L3221(消費支出)・I5102(一般診療所数)・G7101(延べ宿泊者数)・A4101(出生数)・A9101(婚姻件数)・E2101(小学校数)
  前処理: StandardScaler で平均 0、 分散 1 に標準化
1 2 3 4 5 6 7 8 9 10 11 12 13 | from sklearn.decomposition import PCA from sklearn.manifold import TSNE import umap emb_pca = PCA(n_components=2).fit_transform(X) emb_tsne = TSNE(n_components=2, perplexity=8, random_state=0).fit_transform(X) emb_umap = umap.UMAP(n_neighbors=8, random_state=0).fit_transform(X) fig, axes = plt.subplots(1, 3, figsize=(15, 4.5)) for ax, emb, t in zip(axes, [emb_pca, emb_tsne, emb_umap], ['PCA','t-SNE','UMAP']): ax.scatter(emb[:,0], emb[:,1], c=labels_dict['KMeans'], cmap='Set2', s=50) ax.set_title(t) |
🎮 触って理解する — データ形状 × 手法マッチング実験室
このページの主役は個々のアルゴリズムではなく「どの手法を選ぶか」です。同じデータでも手法が変わると結果はまったく変わります。ここでは 4 つのデータ形状 × 4 つの手法(k-means / 階層 Ward / DBSCAN / GMM)を全組み合わせで試し、「手法が仮定するクラスタ像」とデータ形状のマッチングを体感してください。キャンバスをドラッグ(スマホは指でなぞる)と自分で点を描き足して実験することもできます。
✏️ キャンバス上をドラッグ/なぞると点を追加できます(指を離すと再クラスタリング)
※ シルエット係数は「凸(塊状)クラスタ」を暗黙に仮定した指標です。同心円を正しく分けた DBSCAN のシルエットが低く出ることに注目——手法だけでなく評価指標にも「得意な形」があり、数値 1 つで優劣を断定できません。
📋 形状 × 手法 相性マトリクス(現在の組み合わせが青枠)
| データ形状\手法 | k-means | 階層(Ward) | DBSCAN | GMM |
|---|---|---|---|---|
| 🟢 球状の塊 | ◎ | ◎ | ○ | ◎ |
| 🎯 同心円 | ✕ | ✕ | ◎ | ✕ |
| 📏 細長い帯 | △ | △ | ○ | ◎ |
| 🌫 密度差あり | △ | ○ | ✕ | ○ |
💡 直感 — 手法には「得意な形」がある
どのクラスタリング手法も、内部に「クラスタとはこういう形のはずだ」という仮定(帰納バイアス)を持っています。k-means は「等方的な球」、階層クラスタリングの Ward 法は「コンパクトな塊」、DBSCAN は「密度で繋がった任意形状+ノイズ」、GMM は「傾いた楕円(ガウス分布)」です。手法選択とは、この仮定とデータの実際の形を照合する作業に他なりません。だからこそ、クラスタリングの第一歩はアルゴリズム実行ではなく「散布図(高次元なら次元削減後)を眺めて形を推測すること」なのです。上の実験で同心円に k-means を当てると輪が真っ二つになるのは、k-means が悪いのではなく仮定が合っていないだけ——道具の選び間違いです。
⚠️ よくある落とし穴 — 万能手法は存在しない
- 「いつも k-means」で済ませる:上のマトリクスに ◎ だけの列(万能手法)は存在しません。同心円・細長い帯・密度差のいずれかで、どの手法も必ずつまずきます。まず形を見る、が鉄則です。
- 前提の確認を飛ばす:距離ベースの手法は標準化なしでは大スケール変数に支配されます。外れ値は k-means の重心と Ward の併合を大きく歪めます(SSDSE-B-2026 でも東京・大阪など少数の巨大都県が重心を引きずる典型例)。
- 評価指標を無条件に信じる:シルエット係数などクラスタ評価指標にも形状の仮定があります。上の実験のとおり、同心円を正しく分けた DBSCAN のシルエットはむしろ低く出ます。指標 1 つで「この手法が最良」と断定してはいけません。
- 小標本での密度手法:n=47(都道府県)のような小さいデータでは、DBSCAN の密度推定は不安定で eps に過敏になります。まず k-means・階層で骨格を掴む方が安全です。
🚀 発展 — 手法選択フローとアンサンブル
実務の選択フロー:① データを 2 次元に落として散布図を描く → ② 形が見えるなら上のマトリクスで手法を選ぶ(球状なら k-means、輪や三日月なら DBSCAN やスペクトラルクラスタリング、傾いた楕円なら GMM、密度差が大きいなら HDBSCAN) → ③ 形が見えないなら複数手法 × 複数 k を試し、結果同士の一致度(ARI)や解釈可能性で絞り込む、の 3 段階が定石です。
アンサンブル(コンセンサス)クラスタリング:単一手法の仮定に依存しないための発展形として、複数手法・複数初期値・複数 k の結果を「点 i と点 j が同じクラスタに入った回数」の共起行列にまとめ、それを類似度として再クラスタリングする方法があります。個々の手法の癖が平均化され、どの実行でも一緒になるペアだけが安定したクラスタ核として残ります。教師あり学習のアンサンブル学習(バギング等)と同じ発想を教師なし学習に持ち込んだものです。個別手法の詳細はk-means・階層クラスタリング・DBSCAN・GMM・クラスタリング総論の各ページへ。
⚠️ 10. よくある落とし穴
| 落とし穴 | 対処 |
|---|---|
| 標準化せずに距離計算 | 必ず StandardScaler。 大きいスケールの変数だけが効いてしまう。 |
| K=2 から始めて 1 つの解で報告 | 複数 K・複数手法を比較。 シルエットや BIC で選ぶ。 |
| k-means で乱数固定なし | 必ず random_state を指定。 n_init を 10 以上に。 |
| 非球形データに k-means | DBSCAN / GMM / スペクトラルに切り替え。 |
| クラスタ番号に意味を与える | 番号は順序なし。 各クラスタの特徴量プロファイルで命名する。 |
| 高次元データに直接適用 | PCA / UMAP で次元削減してから。 次元の呪い。 |
| DBSCAN の eps を恣意的に | k-distance plot で根拠ある選択。 |
🏋️ 11. 練習問題(SSDSE-B-2026)
Q1. 47 都道府県を k-means で 4 クラスタに分け、 各クラスタを言語的に命名しなさい。
1 2 3 4 5 6 7 8 9 10 11 12 13 14 15 16 17 18 | import pandas as pd from sklearn.cluster import KMeans from sklearn.preprocessing import StandardScaler df = pd.read_csv('data/raw/SSDSE-B-2026.csv', encoding='cp932', skiprows=1) # 日本語の列名で読む df = df[df['年度'] == 2023].reset_index(drop=True) # 2023 年度の 47 都道府県 # 規模の影響を消すため、人口あたりの比率に直してから使う df['高齢化率'] = df['65歳以上人口'] / df['総人口'] * 100 # % df['出生率'] = df['出生数'] / df['総人口'] * 1000 # 人口千人あたり df['婚姻率'] = df['婚姻件数'] / df['総人口'] * 1000 # 人口千人あたり df['診療所密度'] = df['一般診療所数'] / df['総人口'] * 1e5 # 人口 10 万人あたり X = df[['消費支出(二人以上の世帯)', '高齢化率', '出生率', '婚姻率', '診療所密度']] X_scaled = StandardScaler().fit_transform(X) km = KMeans(n_clusters=4, n_init=10, random_state=42) df['cluster'] = km.fit_predict(X_scaled) print(df.groupby('cluster')[X.columns].mean().round(1)) for c, names in df.groupby('cluster')['都道府県']: print(f'クラスタ {c} ({len(names)} 県):', ', '.join(names)) |
Q2. K = 2〜10 を試し、 シルエット係数とエルボーの両方で最適 K を決めなさい。
1 2 3 4 5 6 7 8 9 10 11 12 13 14 15 16 17 18 19 20 21 | import pandas as pd from sklearn.preprocessing import StandardScaler from sklearn.cluster import KMeans # X_scaled はこのあとのブロックで作っているので、ここでも用意しておく _d = pd.read_csv('data/raw/SSDSE-B-2026.csv', encoding='cp932', skiprows=[1]) _d = _d[_d['SSDSE-B-2026'] == 2023] X_scaled = StandardScaler().fit_transform( _d[['A1101', 'A1301', 'A1303', 'A4101', 'L3221']].astype(float).values) from sklearn.metrics import silhouette_score import matplotlib.pyplot as plt sils, inertias = [], [] for k in range(2, 11): km = KMeans(n_clusters=k, n_init=10, random_state=42).fit(X_scaled) sils.append(silhouette_score(X_scaled, km.labels_)) inertias.append(km.inertia_) fig, axes = plt.subplots(1, 2, figsize=(12, 4)) axes[0].plot(range(2,11), inertias, 'o-'); axes[0].set_title('Elbow') axes[1].plot(range(2,11), sils, 'o-'); axes[1].set_title('Silhouette') plt.show() |
Q3. Ward 法でデンドログラムを描き、 k-means と階層クラスタリングで結果が一致するかを ARI で評価しなさい。
1 2 3 4 5 6 7 8 | from scipy.cluster.hierarchy import linkage, fcluster from sklearn.cluster import KMeans from sklearn.metrics import adjusted_rand_score # Q2 のループの km は最後の K=10 なので、比べる相手の K=4 の k-means を作り直す km = KMeans(n_clusters=4, n_init=10, random_state=42).fit(X_scaled) Z = linkage(X_scaled, method='ward') labels_h = fcluster(Z, t=4, criterion='maxclust') print('ARI(km, hier) =', round(adjusted_rand_score(km.labels_, labels_h), 3)) |
📝 12. 報告フォーマット
❌ NG例
「k-means で 4 グループに分かれました。」
✅ OK例
「47 都道府県を 5 次元(所得・世帯人員・高齢化率・人口密度・就業率、 標準化済み)で k-means クラスタリング。 K=2〜10 のシルエット係数と Ward 法 BIC から K=4 を選択。 シルエット = 0.42(中程度)。 各クラスタを特徴量プロファイルから「大都市圏」「成長地方」「高齢過疎」「観光・農村」と命名。 Ward 法との ARI = 0.71(高い一致)。 再現性のため random_state=42, n_init=10 を明記。」
⚠️ クラスタリングの落とし穴 — 6 つの典型ミス
① 標準化せずに距離を計算する
「総人口(数百万)」と「失業率(%)」を同じスケールで距離計算すると、 距離はほぼ「総人口の差」だけで決まり、 失業率は無視される。 これは k-means、 階層クラスタリング、 DBSCAN、 すべてに共通する罠。 必ず StandardScaler や RobustScaler で標準化してから距離計算する。 ロバストにしたいなら MinMaxScaler は外れ値に弱く非推奨、 RobustScaler(中央値と IQR でスケーリング)を勧める。
② k を決め打ちで「3 つに分けた」と報告する
k-means で k=3 を最初に指定したら、 必ず 3 つに分かれて結果が出る。 問題は「その 3 つが意味ある分割か」。 必ずエルボー法 (SSE)、 シルエット係数、 Gap statistic、 BIC(GMM 用)で k を選ぶか、 複数の k で結果を比較する。 加えて、 k が違うと「同じ都道府県が違うクラスタに入る」のは普通で、 安定性をチェックするにはブートストラップやランダム部分集合で再実行する。
③ 初期値依存を無視する(n_init=1 のまま)
k-means は初期重心に依存し、 局所最適に落ちる。 sklearn は既定で n_init=10 を 1.4 以降は 'auto' に切り替えたが、 古い API では 1 のまま。 信頼できる結果を得るには n_init ≥ 20 を明示的に指定し、 random_state を固定して再現性を確保。 k-means++(既定)を使うことで初期化品質は上がるが、 完全には除けない。 数百回の再起動で最良の inertia を採用するのが安全。
④ k-means で「非球形クラスタ」を期待する
k-means はユークリッド距離ベースで、 暗黙的に「球形・等分散・等密度」のクラスタを仮定する。 三日月型・リング状・密度の違うクラスタは分離できない。 こうした形状なら DBSCAN・HDBSCAN・Spectral Clustering・Gaussian Mixture を使う。 SSDSE のような都道府県データは球形に近いので k-means で十分だが、 顧客セグメントや画像分類など複雑形状ではダメ。 形状を疑うなら PCA で 2D 散布図を先に確認する。
⑤ シルエット係数を絶対基準にする
シルエットは「クラスタ内の凝集度 vs 外の分離度」を測る便利な指標だが、 球形クラスタを暗黙仮定しており、 DBSCAN の「ノイズ点」や非球形クラスタには不利になる。 評価には Calinski-Harabasz、 Davies-Bouldin、 Adjusted Rand Index(外部ラベルがある場合)を併用し、 ドメイン解釈(「この群は何を意味するか」)も含めて総合判断する。
⑥ 「クラスタが見つかった」を「実在する」と確信する
クラスタリングは「データを必ず k 個に分ける」アルゴリズムで、 一様乱数を入れても k 個に分けて返す。 「クラスタが存在するか」を検定するには Hopkins 統計量(> 0.75 でクラスタ性あり)や、 ランダム化テスト(同じデータをシャッフルしたものとの比較)を実施する。 結果を信じる前に「そもそも構造があるか」を確認する習慣をつける。
⚠️ 落とし穴の追加 — クラスタリングで最も多い失敗 8 選
- 標準化忘れ: 単位の大きい変数(人口など)が距離を支配。 必ず
StandardScalerかRobustScalerを入れる。 - K を 1 指標で決定: シルエットだけ、 エルボーだけは危険。 最低 3 指標で多角的に判断する。
- 外れ値を無視: 東京・神奈川は人口・所得で常に外れ値。 「ロバストスケーラー」「DBSCAN のノイズラベル」「クラスタリング前に箱ひげ図」の 3 段構えで対処。
- 高次元の呪い: 変数が 30+ になるとユークリッド距離の意味が崩壊。 PCA や UMAP で 5-10 次元に圧縮してからクラスタリング。
- カテゴリ変数を混在: 「地域区分」と「人口」を同じ距離で扱うのは禁物。 k-prototypes か Gower 距離を使う。
- 再現性確認をしない:
random_stateを固定し、n_init=20以上にし、 ブートストラップで安定性を計測。 - 群サイズの極端な不均衡: サイズ [44, 1, 1, 1] のような結果は失敗。 単連結や eps が小さすぎる DBSCAN で起こる。
- 解釈なしで終わる: クラスタ ID は記号にすぎない。 各群の 平均ベクトル・代表サンプル・命名(例: 「大都市群」) を必ず行う。
表 9: 失敗パターンと対策のマトリクス
| 症状 | 原因 | 診断 | 対策 |
|---|---|---|---|
| 1 群がほとんど | 標準化忘れ・eps過大 | 分散比較 | スケーラー・K見直し |
| 毎回違う結果 | n_init 不足 | 10 回試行 | n_init=20、 k-means++ |
| 外れ値が単独群 | 完全連結・k-means | サイズ確認 | Ward・GMM・除外 |
| シルエット低 | 非凸群 | 散布図 | DBSCAN・スペクトラル |
| 解釈不能 | 命名なし | クラスタ平均 | プロファイル分析 |
| 過剰分割 | K過大・BIC無視 | ARI/NMI | K減・統合 |
💼 実務応用 — 都道府県クラスタを「政策」「マーケ」「教育」で活用する
表 10: クラスタリング応用シーン
| 分野 | 適用例 | 使う手法 | 期待効果 |
|---|---|---|---|
| 地域政策 | 同類型県のベンチマーク比較 | Ward 法 K=4-6 | 政策パッケージの最適化 |
| マーケティング | 顧客セグメンテーション | k-means + RFM 変数 | 広告 ROAS 30% 向上 |
| 教育 | 学習履歴のクラスタ化 | GMM・所属確率 | パーソナライズ教材 |
| 医療 | 患者表現型の分類 | HDBSCAN・潜在空間 | サブタイプ発見 |
| 異常検知 | 不正取引検出 | DBSCAN ノイズ | 少額多数を一括検出 |
| テキスト | トピック分類 | 埋め込み + k-means | FAQ 自動分類 |
クラスタプロファイルを書き出すコード
このコードでやること: SSDSE-B-2026 を k=4 で分けた各群について、 「平均ベクトル ・ 代表都道府県 ・ 命名候補」を一覧出力する。
📥 入力: SSDSE-B-2026 の 2023 年度 47 行(このブロック内で読み込み、 5 指標を標準化して k=4 の k-means を作り直す)
1 2 3 4 5 6 7 8 9 10 11 12 13 14 15 16 17 18 19 20 21 22 23 24 25 26 | import numpy as np import pandas as pd from sklearn.preprocessing import StandardScaler from sklearn.cluster import KMeans # ── この抜粋だけで動くように、2023 年度の 47 都道府県で k=4 の k-means を作る ── df = pd.read_csv('data/raw/SSDSE-B-2026.csv', encoding='cp932', skiprows=[1]) df = df[df['SSDSE-B-2026'] == 2023].reset_index(drop=True) feats = ['A1101', 'A1301', 'A1303', 'A4101', 'L3221'] # 総人口・15歳未満・65歳以上・出生数・消費支出 Xs = StandardScaler().fit_transform(df[feats].astype(float)) km = KMeans(n_clusters=4, n_init=20, random_state=0).fit(Xs) df['cluster'] = km.labels_ # 1) 各クラスタの平均値 profile = df.groupby('cluster')[feats].mean().round(0) profile['n'] = df.groupby('cluster').size() print('=== クラスタ別平均 ===') print(profile.to_string()) # 2) 各クラスタの代表都道府県(重心に最も近い 3 県) for c in sorted(df['cluster'].unique()): mask = (df['cluster'] == c).values sub_X = Xs[mask] dists = ((sub_X - sub_X.mean(axis=0)) ** 2).sum(axis=1) near_pref = df.loc[mask, 'Prefecture'].values[np.argsort(dists)[:3]] print(f'クラスタ {c}: 代表 {list(near_pref)}') |
📤 実行結果(実測):
💬 解釈と命名候補:
- クラスタ 0(1 都): 「首都」 — 東京都だけ。 総人口 1,409 万・消費支出 34.1 万円で、 他の群と桁が違う
- クラスタ 3(8 道府県): 「大都市圏」 — 平均人口 683 万、 代表は千葉・愛知・福岡
- クラスタ 1(24 県): 「中規模・支出高め」 — 平均人口 166 万、 消費支出 30.8 万円、 代表は福島・滋賀・奈良
- クラスタ 2(14 県): 「小規模・支出低め」 — 平均人口 113 万、 消費支出 26.8 万円、 代表は青森・長崎・秋田
この命名により、 「クラスタ 2 の県には少子化・人口流出対策のパッケージ A」「クラスタ 3 の県には大都市向けの子育て支援 B」など、 同類型県に共通する政策ツールキットを設計できます。
🗺 概念マップ
「クラスタリング (グループ教材)」を中心に、 「k は何個か」(問い) と「シルエット・エルボー」(解) を対置した俯瞰図。 47 都道府県データを k-means/階層型/DBSCAN/GMM の 4 系統で類型化する道筋を示す。
上の概念マップは「クラスタリンググループ」を中心に、 Q (問い: クラスタは何個に分けるべきか)・A (答え: シルエット係数とエルボー法で k を決める)・派生 (距離・連結・密度・確率の 4 系統) を 3 方向に展開した俯瞰図である。 47 都道府県データを k-means・階層・DBSCAN・GMM の順に通してみると、 同じデータでもクラスタ境界が異なる感覚が掴める。
このグループ教材を学ぶ目的は、 単に手法名を覚えることではなく「都道府県を見たときに、 距離 / 連結 / 密度 / 確率の 4 視点で類型化を試せる」状態を作ることである。 概念マップで全体像を掴んでから個別ページに進むと迷わない。
🔗 隣接手法への橋渡し
「クラスタリング」は教師なしでデータを群に分ける手法群で、 上流の標準化と次元削減、 下流のシルエット係数による評価が無いと「クラスタの数が違うだけで結論が反転する」事故が起きる。
- 上流: クラスタリング(グループ) の入力となる47 都道府県 × A1101 総人口・A4101 出生数 を整える前処理 (データクレンジング、 欠損値処理)
- 並列: 類似目的を持つ代替手法 (分類、 アソシエーション分析) と比較・併用
- 下流: 出力結果の評価・解釈 (シルエット係数、 可視化)
上流で標準化と次元削減を済ませ、 並列の k-means/階層型/DBSCAN を比較し、 下流でシルエット係数と可視化を出せば、 都道府県をライフスタイル類型に分けるような EDA を再現可能な形で実行できる。
🌳 手法選択フロー
「クラスタリング」を実際に使うとき、 何をどう選ぶかを順に判断する。 上から順に答えていくと、 使うべき手法と評価の仕方が決まる。
- いくつに分けたいか決まっているか
決まっているなら k-means。 決まっていないなら階層クラスタリングでデンドログラムを描き、 どこで切るかを見てから決める。 k を先に決めた理由は必ず書き残す。 - クラスタの形は丸いと仮定できるか
k-means は球状のまとまりを前提にする。 細長い形や密度の違う集団があるなら DBSCAN やスペクトラルクラスタリングへ。 - 尺度の違う列を混ぜていないか
総人口(百万単位)と合計特殊出生率(1 前後)をそのまま使うと、 距離が人口だけで決まる。 標準化してから距離を測る。 - 結果をどう検証するか
正解が無いので、 シルエット係数などの内部指標と、 「そのグループ分けがドメイン的に説明できるか」の両方で見る。 乱数の初期値を変えても同じ分割になるかも確かめる。
47 都道府県は件数が少ないので、 クラスタ数を増やすとすぐに 1 県だけのクラスタができる。 k は 3〜5 程度から試し、 各クラスタに何県入ったかを必ず確認する。