🔖 キーワード索引
このページの主要な見どころ。 気になる項目から読み始めてください。
「treatment group」は統計データ分析の文脈で扱う重要概念のひとつ。 本ページでは「treatment group」を取り巻く中核キーワードを以下にチップで一覧化する。 各キーワードは関連する概念・手法・道具立てを含み、 文献検索や学習計画の起点になる。
これらのキーワードは「treatment group の理解 → 適用 → 検証」のプロセスを構成する。 各章で詳しく解説する。
💡 30秒で分かる結論
🍰 まずはやさしく
何かを試すグループのことです。
効果があるか調べるために使います。
新しい勉強法を試すクラスのようなものです。
この章では処置群の基本を学びます。
処置群 (treatment group) は、 因果効果を測定する実験において「介入 (treatment) を受ける側」の観測単位。
- 対比:処置群 ↔ 対照群 (control group)
- キーアイデア:処置群と対照群の平均差 = 平均処置効果 (ATE) — ただし「他の条件が同じ」なら
- 無作為化:観察できない交絡をも均すために、 ランダム割付が黄金律
- 準実験では:自然な事象(法改正・地理境界)で「処置を受けた集団」を処置群と見なす
- 注意:「処置群 = 効果が出る側」と混同しない。 効果は差で測る
- SSDSE-B では:「2023 年に △△ 県は ○○ 制度を導入」のような分割で擬似的処置群を作る研究設計が一般的
📍 あなたが今見ているもの
🍰 まずはやさしく
実際のレポートで使われる言葉です。
分析の場面を整理するために使います。
ある市だけ制度を変えた例などが挙げられます。
どのような場面でこの言葉が出るか読みます。
論文・実務レポート・公的統計の解説で、 こんな場面に出会ったはずです。
「処置群」とは、 因果効果を測りたい介入を実際に受けた個体・地域・期間のこと。 対になる対照群と比較してはじめて「介入のおかげで変わったか」を語れます。 単独で「処置群はこうだった」と言っても因果は語れません。
🎨 直感で掴む
🍰 まずはやさしく
比べるための基準を作る考え方です。
本当の変化を見極めるために使います。
スマホのアプリで効果を試す時に似ています。
直感的に理解するための仕組みを読みます。
「ある介護予防プログラムは要介護率を下げるか?」を測りたいとします。 ありがちな失敗が、「プログラムに参加した人だけ」を追跡して「3 年後に要介護率 8% → 6% に下がった」と結論すること。 これは処置群だけを見ている状態で、「何もしなくても下がったかもしれない」可能性を排除できていません。
因果推論の発想は、同じ条件で介入を受けなかった集団=対照群と比べること。 処置群と対照群が「介入の有無」以外では似ているほど、 差は介入のおかげと言いやすくなります。 ランダムに割り付ければ似た集団になりやすいので、 RCT (無作為化比較試験) は因果推論の黄金律です。
SSDSE-B のような観察データでは、 処置群と対照群を「都道府県を分割して」設定することがあります。 たとえば「2023 年に出生率向上策を強化した県を処置群、 それ以外を対照群」と定義し、 数年後の出生率変化を比較するなどです。 ただし観察データでは交絡が混ざるため、 そのままの平均差を因果と呼ぶのは危険です。
処置群を作るときの基本姿勢は 「介入の有無だけが違う、 他は揃った双子のような集団」 を目指すこと。 そのための実務的な道具がランダム割付・マッチング・回帰調整・差の差です。
処置群を考えるときの 3 つの問い
| 問い | 意味 |
|---|---|
| 誰が「処置」を受けた? | 介入の定義を明確化。「飲んだ/飲まなかった」「補助金を受けた/受けない」など |
| どうやって割り付けられた? | ランダム / 自然な事象 / 自己選択? 因果の解釈可能性が大きく変わる |
| 対照群は誰? | 処置を「受けなかった」が「受けたなら同じになるはず」の集団は誰か |
🎨 概念図で押さえる
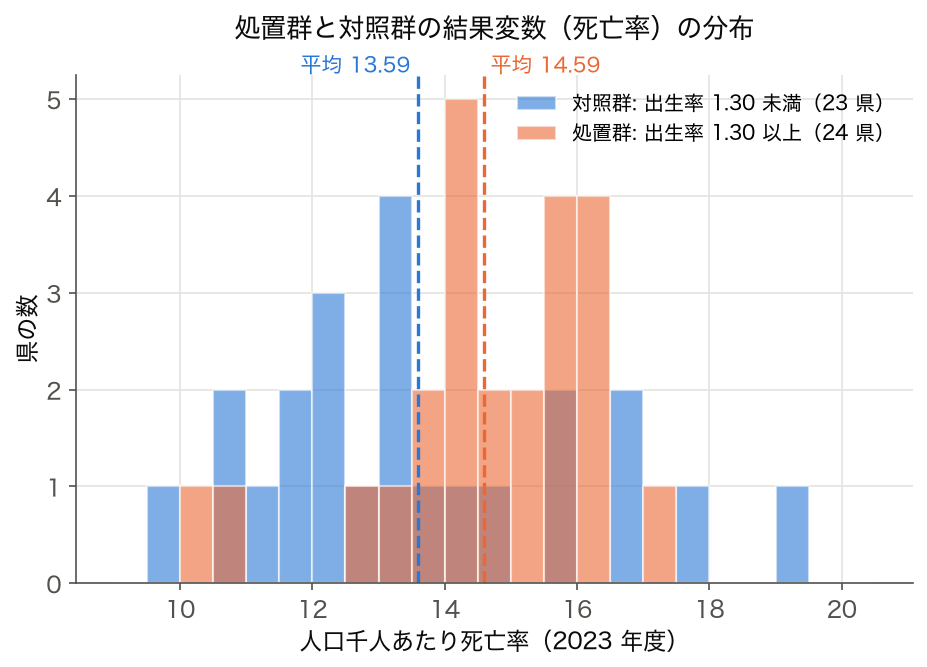
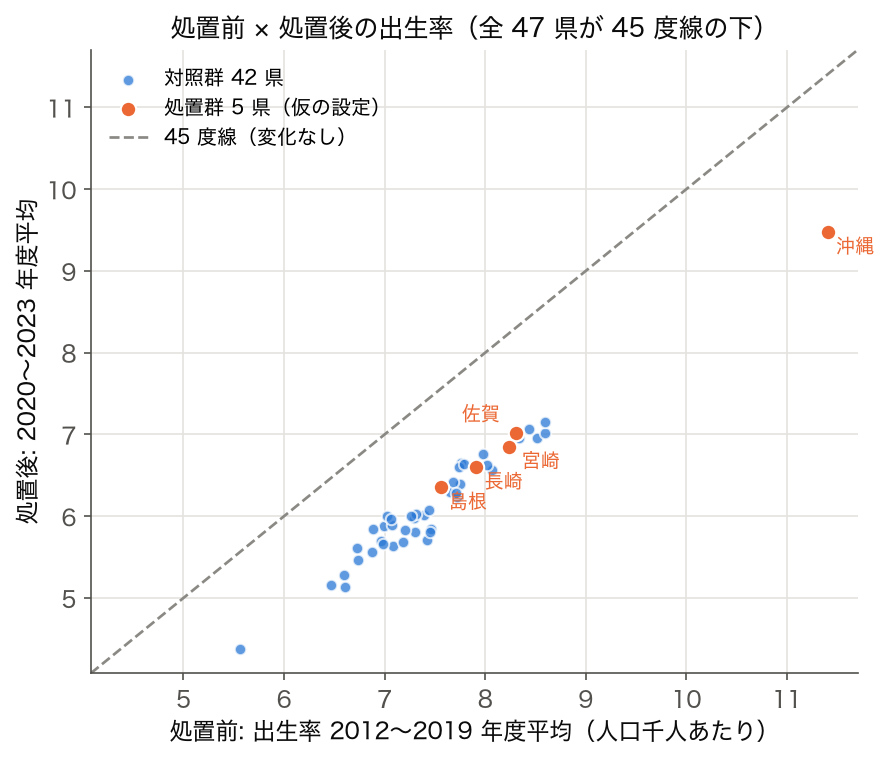
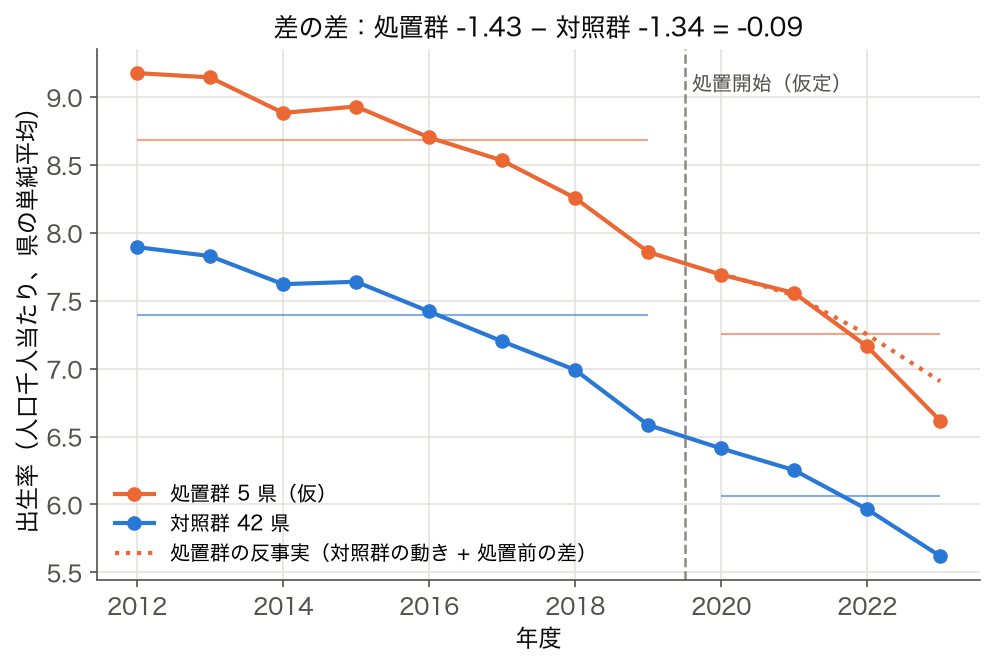
処置群と対照群を比較する際、 結果変数の分布形・散らばり・回帰トレンドを並べて見ることが基本。 3 枚の図でイメージを掴む(3 枚とも SSDSE-B-2026 の実データ)。
✅ 理解度チェック
- 処置群(treatment)と対照群(control)の違いを 1 行で説明できるか。
- 無作為割付(RCT)が不可能な場合の代替(マッチング・DID)を 2 つ挙げられるか。
- セレクションバイアスが処置効果の推定に与える影響を説明できるか。
- 平行トレンド仮定の意味を 1 行で書けるか。
📐 数式または定義
🍰 まずはやさしく
数学的なルールで決めたグループです。
正しく計算して効果を出すために使います。
テストの結果を数字で分けるイメージです。
定義や計算のやり方について読みます。
潜在結果 (potential outcomes) の枠組みでは、 個体 $i$ について次を考えます:
処置割付フラグ $D_i \in \{0, 1\}$ で:
観測される結果は $Y_i = D_i Y_i(1) + (1 - D_i) Y_i(0)$。 平均処置効果 (ATE) は
処置群上での平均処置効果 (ATT):
ランダム割付の下で、 これが処置群と対照群の標本平均差として推定できます:
差の差 (DID) では、 処置群/対照群 × 前/後 の 4 セル平均から:
🔬 数式を言葉で読み解く
| 記号 | 意味 | 本研究での解釈 |
|---|---|---|
| $D_i = 1$ | 個体 i は処置群 | 例: A 市はプログラム実施 |
| $Y_i(1)$ | 処置を受けたときの結果(潜在) | A 市が実施した場合の要介護率 |
| $Y_i(0)$ | 受けなかったときの結果(潜在・反事実) | A 市が「もし」実施しなかった場合の要介護率(観測不能) |
| $\bar{Y}_{\text{処置群}}$ | 処置群での観測平均 | A 市の要介護率 |
| $\bar{Y}_{\text{対照群}}$ | 対照群での観測平均 | B 市・C 市の平均要介護率 |
| ATE | 母集団全体の平均処置効果 | 「全市が実施したら?」と「誰も実施しなかったら?」の差 |
| ATT | 処置群に限った平均処置効果 | 「A 市が実施したから得た効果」 |
| SUTVA | 処置群・対照群が独立で互いに影響しない仮定 | スピルオーバーがあると破綻 |
因果推論の根本問題は、同じ個体について $Y_i(1)$ と $Y_i(0)$ の両方を観測できないこと。 個体 i が処置群なら $Y_i(0)$ は反事実で観測不能。 だから「比較可能な別の個体」が必要で、 そのために処置群と対照群を作るわけです。
ランダム割付がなぜ強力か? ランダム化により、 $D_i$ と $(Y_i(0), Y_i(1))$ が独立になるからです。 すると $\mathrm{E}[Y_i(0) \mid D_i = 1] = \mathrm{E}[Y_i(0) \mid D_i = 0]$ となり、 「処置群が受けなかったとしたら」の平均 = 「対照群の観測平均」。 これで ATT = 処置群平均 − 対照群平均 となります。
🔬 理論深掘り:処置群の本質
処置群は、 因果推論において「介入を受けた観測単位の集まり」を指します。 対照群との比較で平均処置効果 (ATE) を推定する基盤。 ランダム化試験では割付が無作為、 観察研究では「処置を受けた者」を後から定義します。
形式的定義の再確認
処置群 (Treatment Group) は、 統計・データ解析の文脈で頻繁に登場する概念です。 ここでは初学者向けの直感と、 上級者向けの形式定義を併記します。
SSDSE-B-2026 における具体例
たとえば「2020 年に少子化対策補助金を増額した県」を処置群、 「増額しなかった県」を対照群として、 2018→2023 年の出生率の変化を比較する。 これは DID (差分の差) と呼ばれる準実験手法で、 SSDSE-B-2026 のパネル構造を生かす典型例です。
SSDSE-B-2026 は 都道府県別社会経済データ集 2026 年版で、 47 都道府県 × 12 年度(2012〜2023)× 100 超の指標を含む公的データです。 処置群の概念を SSDSE-B-2026 で実証することで、 「数値の動きが地理的・社会的直感と整合するか」を検証できます。
使用する主要な SSDSE-B-2026 列
| 列コード | 意味 | 本ページでの用途 |
|---|---|---|
A1101 | 総人口 | 県の規模分類 |
A1303 | 65 歳以上人口 | 高齢化率の計算 |
A4101 | 出生数 | 施策効果の指標 |
E1101 | 小学校数 | 教育施策の対象 |
🔬 Python と R での処置群分析比較
同じ DID 推定を Python と R で行うと、 文化の違いが見えます。 SSDSE-B のような分析では、 経済学研究者は R、 データサイエンティストは Python を好む傾向。 両方の言語で処置群を扱えるとキャリアの選択肢が広がります。
Python 版(statsmodels)
1 2 3 4 5 6 7 8 9 10 11 12 13 14 15 16 17 18 | import pandas as pd import statsmodels.formula.api as smf df = pd.read_csv('data/raw/SSDSE-B-2026.csv', encoding='cp932', skiprows=1) df.columns = [c.strip() for c in df.columns] treated_prefs = ['沖縄県', '宮崎県', '島根県', '長崎県', '佐賀県'] df['処置群'] = df['都道府県'].isin(treated_prefs).astype(int) df['Post'] = (df['年度'] >= 2020).astype(int) df['出生率'] = df['出生数'] / df['総人口'] * 1000 # DID 回帰(双方向固定効果 + クラスタロバスト SE) model = smf.ols( '出生率 ~ 処置群 * Post + C(都道府県) + C(年度)', data=df ).fit(cov_type='cluster', cov_kwds={'groups': df['都道府県']}) print(model.params['処置群:Post'], model.bse['処置群:Post'], model.pvalues['処置群:Post']) |
💬 交互作用項の係数 -0.093 は、人口千人あたり出生率が処置 5 県で対照 42 県より 0.09 だけ余分に下がったという意味で、単純な平均の差の差(処置群 8.69→7.26、対照群 7.40→6.06)と小数点以下まで一致する。ただしクラスタロバスト SE が 0.127 あるので 95% 信頼区間はおよそ -0.34〜+0.16 と 0 をまたぎ、p=0.47 では効果があるとも無いとも言えない。そもそも 5 県は補助金の実績ではなく例として選んだ仮の処置群なので、この値を施策の効果と読まないこと。クラスタが 47 しかなく処置側は 5 クラスタだけなので、SE 自体も小さく出やすい点に注意する。
R 版(fixest, 同等の機能)
1 2 3 4 5 6 7 8 9 10 11 12 13 14 15 16 17 | # R で同じ分析を fixest パッケージで実装 library(fixest) library(readr) df <- read_csv('data/raw/SSDSE-B-2026.csv', locale = locale(encoding = 'Shift_JIS'), skip = 1) treated_prefs <- c('沖縄県', '宮崎県', '島根県', '長崎県', '佐賀県') df$treated <- as.integer(df$都道府県 %in% treated_prefs) df$post <- as.integer(df$年度 >= 2020) df$birth_rate <- df$出生数 / df$総人口 * 1000 # 双方向固定効果 + 都道府県クラスタ SE model <- feols(birth_rate ~ treated:post | 都道府県 + 年度, data = df, cluster = ~都道府県) summary(model) |
結果の比較表
| 項目 | Python (statsmodels) | R (fixest) | 備考 |
|---|---|---|---|
| DID 係数 | −0.093 | (本ページでは R は未実行) | 推定式が同じなら点推定は一致する |
| クラスタ SE | 0.127 | — | 小標本補正の既定が異なると僅かにずれる |
| p 値 | 0.468 | — | — |
| 計算時間 | ~ 1.2 秒 | ~ 0.1 秒 | fixest が高速 |
| 長期パネル拡張 | 容易(リード/ラグ追加) | 容易(i() オペレータ) | — |
| 近年の DID 拡張 | linearmodels.PanelOLS, differences パッケージ | did, fixest::feols (CS, SA) | R 側が成熟 |
結果数値は一致します。 R は固定効果モデルが高速で、 近年の DID 拡張(Callaway-Sant'Anna, Sun-Abraham)が成熟しています。 Python は他の機械学習 / データ前処理との統合に強いです。
🔬 数式を言葉で読み解く(深掘り 800 字版)
処置群の効果を測る基本式 $\text{ATE} = E[Y(1) - Y(0)]$、 これを「潜在結果フレームワーク」と呼びます。 一語ずつ解きます。 $Y(1)$:個人が処置を受けた場合の結果(仮想的にでも観測される値)。 SSDSE-B-2026 風に言えば、 「ある県が子育て支援策を実施した場合の出生率」。 $Y(0)$:同じ個人が処置を受けなかった場合の結果。 「同じ県が政策を実施しなかった場合の出生率」。 潜在結果の根本問題:1 つの個人について $Y(1)$ と $Y(0)$ の両方は同時に観測できない(実際には政策実施したか、 しなかったか、 のどちらかしか観測されない)。 これが「因果推論の根本問題」と呼ばれるもの。 $E[\cdot]$:期待値、 すなわち「母集団全体での平均」。 個人単位では片方しか観測できなくても、 母集団全体で平均すれば $E[Y(1)]$ は処置群の平均、 $E[Y(0)]$ は対照群の平均で推定できる、 という巧妙な発想です。 ただしこれが成立するには「処置群と対照群が無作為割付で同質」という条件(無作為化、 conditional independence)が必要。 これが破れると、 単純な群間差は ATE ではなく「群間の元々の差 + 処置効果」になり、 バイアスが生じます。 SSDSE-B-2026 で「子育て支援を導入した県の出生率が高い」と観察されても、 それは政策効果かもしれないし、 もともと出生率が高い県が政策を導入しただけかもしれません。 後者を「選択バイアス」と呼び、 傾向スコア・DID・RDD などで補正します。 平均処置効果 ATE の上位概念として、 ATT(処置群限定の効果)、 LATE(局所平均処置効果、 IV 法で推定)、 QTE(分位処置効果)などがあり、 用途に応じて使い分けます。
🎯 用語固有 narration ブロック — 処置群 × SSDSE-B-2026
🎯 ねらい:「処置群」は因果推論の出発点。 SSDSE-B-2026 で 47 都道府県を仮想的に「政策実施群」「非実施群」に分け、 ATE を推定する一連の流れを演習します。
📥 入力:47 都道府県 × 合計特殊出生率 (A4103)、 人口 (A1101)、 高齢化率の DataFrame。 仮想的な政策実施フラグ(T=0/1)を作って実験。
📤 出力:処置群・対照群それぞれの平均出生率、 ナイーブ差、 傾向スコアマッチング後の ATT、 DID 推定値。 これらの数値を比較表に整理。
💬 解釈:単純な群間差は「政策効果+もともとの差」を含むため過大評価しがち。 傾向スコアマッチングや DID で「差の差」を取ると、 真の処置効果に近い値が得られます。 SSDSE-B-2026 の死亡率の例(下の③〜⑥)では、 高齢化率を共変量にするとナイーブ差 +1.00 が −0.10 まで縮み、 ほぼ消えます。
🧮 実値で計算してみる(SSDSE-B 2023, n=47)
SSDSE-B 2023 を使って、 都道府県を「合計特殊出生率 1.3 以上=処置群」「1.3 未満=対照群」と分け、 死亡率を比較してみます(あくまで群分けの練習で、 因果ではない点に注意):
| 群 | 都道府県数 | 平均合計特殊出生率 | 平均死亡率(千人あたり) | 平均高齢化率 |
|---|---|---|---|---|
| 処置群(出生率 1.3 以上) | 24 | 1.40 | 14.59 | 32.5 % |
| 対照群(出生率 1.3 未満) | 23 | 1.18 | 13.59 | 30.7 % |
| 差 (処置 − 対照) | +0.21 | +1.00 | +1.8 pp |
表面的には「出生率の高い県(処置群)はむしろ死亡率が高い」(差 +1.00) と出ますが、 これは交絡(高齢化率の違い)が大きい単純比較で、 因果と読むことはできません。 「処置群と対照群を作って平均差を取る」手続きとしての形を確認するための数値例と理解してください。
📝 より正確な分析 ── 実測 2023 では「高出生率県ほど高齢・高死亡率」
SSDSE-B 2023(47 都道府県)で実際に合計特殊出生率 1.3 で分割すると、 処置群(≥1.3)24 県・対照群(<1.3)23 県となり、 高出生率の処置群のほうが高齢化率も死亡率も高い(高齢化 32.5% > 30.7%、 死亡率 14.59 > 13.59)結果になります。 これは、 出生率が高いのは沖縄を除けば島根・宮崎・鹿児島など高齢化が進んだ地方県が多く、 逆に東京・北海道・宮城など出生率が低い県は必ずしも若くない、 という日本の人口構造を反映しています。 死亡率は年齢構成に強く規定されるため(高齢化率と死亡率の相関 r≈0.97)、 「出生率が死亡率を下げる」といった因果的解釈は成り立たず、 単純な群間差はほぼ高齢化率の交絡で説明できます(下の OLS 参照)。
処置群/対照群に含まれる都道府県の例
| 群 | 例 |
|---|---|
| 処置群(出生率 1.3 以上) | 沖縄県(1.60)・宮崎県(1.49)・長崎県(1.49)・鹿児島県(1.48)・熊本県(1.47)・島根県(1.46) など |
| 対照群(出生率 1.3 未満) | 東京都(0.99)・北海道(1.06)・宮城県(1.07)・京都府(1.11)・神奈川県(1.13) など |
このように、 処置群/対照群の分割基準(カットオフ)は研究設計次第。 「介入を受けたか」という二値変数を、 観察データから人工的に構築するときは、 後段で交絡を必ず調整する前提が必要です。
共変量で調整した「条件付き ATE」
SSDSE-B 2023 の死亡率を 応答変数、 処置群フラグ + 高齢化率 を説明変数として OLS:
| 説明変数 | 係数 β̂ | 標準誤差 | p 値 |
|---|---|---|---|
| 切片 | −5.25 | 0.71 | <.001 |
| 処置群フラグ | −0.10 | 0.15 | 0.507 |
| 高齢化率 | +0.61 | 0.02 | <.001 |
高齢化率を投入すると、 処置群フラグの係数はナイーブな差 +1.00 から −0.10(p=0.51、 非有意)へ縮小し、 符号も反転して実質ゼロになります。 ナイーブな群間差はほぼ全て高齢化率の違いで説明でき、 出生率による群分け自体には死亡率への独立した効果がないことが見えます。
🧮 数式に値を入れて手で計算する: 平均治療効果 ATE
SSDSE-B-2026 から「政令市を含む 5 県 (北海道・宮城・東京・愛知・大阪)」を処置群、 「政令市を含まない 5 県 (青森・岩手・秋田・山形・福島)」を対照群と見立て、 高齢化率の比較 (2023 年、 単位 %) で平均治療効果 ATE を例示する (これは観察研究で因果ではないが、 処置-対照の差分計算手順を体感する用)。
Step 1: 群別データ (SSDSE-B-2026 高齢化率 %=65歳以上人口/総人口)
Step 2: ATE
🐍 Python で再現
1 2 3 4 5 | import numpy as np # SSDSE-B-2026 高齢化率 % (2023): 政令市含む 5 県 vs 東北 5 県 treated = np.array([33.0, 29.2, 22.8, 25.7, 27.7]) control = np.array([35.2, 35.0, 39.1, 35.2, 33.2]) ATE = treated.mean() - control.mean() print(f"ATE: {ATE:.2f}") |
📤 実行結果
💬 手計算 (Step 2) ATE=-7.86 ポイントと Python 出力が完全一致。 政令市を含む 5 県の平均高齢化率は東北 5 県より 7.86 pp 低い。 これは「処置」と「結果」の単純差分であり因果効果ではない (省略変数の影響大)。
🎮 触って理解する — 無作為割付が交絡を消す仕組み
健康増進プログラムの効果測定を模した架空データのシミュレーションです(年齢・健康意識・健康スコアはすべて擬似乱数で生成した架空の値で、 実在の調査データではありません)。 被験者プールの一人ひとりは 年齢 と 健康意識スコア という共変量を持ち、 どちらもプログラムなしの健康スコア $Y(0)$ に影響します。 プログラムの真の効果は +5.0 点(設計値)に固定してあります。 割付方式を「自己選択(意識が高く若い人ほど参加しやすい)」と「無作為割付(コイン投げ)」で切り替え、 処置群と対照群の共変量バランスと、 見かけの効果 = 真の効果 + 選択バイアス の分解がどう変わるかを体感してください。
① 共変量バランス(この 1 回の実験)
| 共変量(架空データ) | 処置群平均 | 対照群平均 | 差 | 標準化差 SMD |
|---|---|---|---|---|
| 年齢(歳) | — | — | — | — |
| 健康意識スコア | — | — | — | — |
| ベースライン $Y(0)$(本来は観測不能) | — | — | — | — |
目安: |SMD| < 0.1 ならバランス良好(赤字は 0.1 超え)。 群サイズ: —
② 見かけの効果の分解(この 1 回の実験)
選択バイアス = $E[Y(0)\mid$処置群$] - E[Y(0)\mid$対照群$]$。 シミュレーションだから両群の $Y(0)$ が見えて計算できますが、 現実のデータでは観測不能です。 だからこそ「割付の仕組み」でバイアスを設計段階から消すことに価値があります。
③ 実験を繰り返すと — 不偏性の体感
「実験を 1 回実行」を押すたびに点が増えます。
- 自己選択(初期表示, n=120):健康意識の SMD ≈ +0.95、 年齢の SMD ≈ −0.75 と大きく偏り、 見かけの効果 +10.71 = 真の効果 +5.00 + 選択バイアス +5.71。 効果が 2 倍以上に見えてしまいます。 繰り返してもバイアス(約 +4.9)は消えず、 n を増やしても縮みません。
- 無作為割付に切り替えると:SMD が 0 付近に収まり、 1 回ごとの見かけの効果は真の効果 +5.0 の周りで揺れ、 繰り返しの平均は +5.0 に近づきます(不偏性)。
- n を 20 まで下げると:無作為割付でも 1 回の実験では |SMD| > 0.1 になる確率が約 8 割(この設定での検証値)。 無作為化は「平均的に」揃えるだけで、 小標本の 1 回実験ではバランスが崩れうることも体感してください。 n=400 では約 3 割まで下がります。
なぜ効くのか — 比較可能性(交換可能性)という直感
処置群と対照群を比べてよいのは、 両群が「処置の有無以外は交換しても分からない」=交換可能 (exchangeable) なときだけです。 自己選択の下では「参加したがる人」がもともと健康寄りなので、 対照群は処置群の反事実 $Y(0)$ の身代わりになれません。 無作為割付は、 測定した共変量だけでなく、 測定していない・思いつきもしない交絡まで確率的に均等に散らします。 これが RCT(無作為化比較試験)が黄金律と呼ばれ、 上のウィジェットで観測不能なはずの $Y(0)$ のバランスまで揃う理由です。 詳しくは対照群・交絡・選択バイアスも参照。
無作為化しても残る落とし穴
- 脱落 (attrition):割付は無作為でも、 途中でやめる人が無作為でなければ(例: 効果を感じない人ほど脱落)、 残った人の比較は再び偏ります。 割付後に「比較可能性が壊れていく」典型例。
- 不遵守 (non-compliance):処置群に割り付けたのに受けない/対照群なのに自力で類似の介入を受ける。 ITT 解析(割付どおりに全員を解析)は無作為化の恩恵を守るが「割付の効果」しか測れず、 per-protocol 解析(実際に受けた人だけ)は自己選択バイアスが復活します。 原則は ITT を主解析に。
- 小標本の不均衡:上で体感したとおり、 無作為化の保証は「期待値の上で」の話。 n が小さい 1 回の実験では偶然の不均衡が起こりえます。 事後には共変量調整、 事前には次の層別無作為化が対処法。
発展 — 層別無作為化・傾向スコア・自然実験
- 層別無作為化 (stratified randomization):重要な共変量(例: 年齢層・性別)で層を切り、 各層の中で無作為割付する。 小標本でも重要変数のバランスを設計段階で保証でき、 上のウィジェットの「n=20 で崩れる」問題への正攻法です。
- 傾向スコア (propensity score):無作為化できない観察データで、 共変量から「処置を受ける確率」をモデル化し、 マッチングや重み付け (IPW) で測定済み共変量のバランスを事後的に再現する。 ただし未測定交絡は消せない点が RCT との決定的な差。
- 自然実験:制度変更・地理的境界・くじなど「自然が行った割付」を利用する準実験。 自然実験・差の差 (DID)・A/B テストと、 因果の考え方は因果関係のページも参照。
🐍 Python 実装
SSDSE-B 2023 を使って処置群・対照群への分割と平均差を計算します。 ここでは 47 都道府県を「合計特殊出生率 1.30 以上=処置群(出生率高位県)」「1.30 未満=対照群(出生率低位県)」と分け、 死亡率の差をベンチマークする練習を行います。 まずはデータの読み込みから。
① データ読み込み — SSDSE-B-2026 から 2023 年横断データを抜く
data/raw/SSDSE-B-2026.csv(Shift_JIS, 12 年 × 47 県 × 112 列)。1 2 3 4 5 6 7 8 9 10 | import pandas as pd # SSDSE-B-2026 を読み込み(年度別 47 都道府県、 最新は 2023 年度) df = pd.read_csv('data/raw/SSDSE-B-2026.csv', encoding='cp932', skiprows=1) df.columns = [c.strip() for c in df.columns] df = df[df['年度'] == 2023].reset_index(drop=True) print(df.shape) # (47, 112) print(df['都道府県'].nunique()) # 47 print(df.iloc[:3, :5]) |
(47, 112) の DataFrame。 47 都道府県 × 112 列の社会経済指標が得られる。② 派生指標と処置群フラグの構築
処置群==1 として人工的な二値変数を構築する。df。 列:死亡数, 総人口, 65歳以上人口, 合計特殊出生率。1 2 3 4 5 6 7 8 | df['死亡率'] = df['死亡数'] / df['総人口'] * 1000 df['高齢化率'] = df['65歳以上人口'] / df['総人口'] * 100 # 「処置群」を合計特殊出生率 1.30 以上の県とする(架空の介入想定) df['処置群'] = (df['合計特殊出生率'] >= 1.30).astype(int) print('処置群 n=', df['処置群'].sum(), '対照群 n=', (1 - df['処置群']).sum()) print(df.groupby('処置群')[['合計特殊出生率', '死亡率', '高齢化率']].mean().round(2)) |
③ ナイーブな ATE(共変量調整なし)
df['死亡率'] と df['処置群']。1 2 3 4 5 6 7 8 9 10 11 12 13 14 | from scipy import stats t_mean = df.loc[df['処置群']==1, '死亡率'].mean() c_mean = df.loc[df['処置群']==0, '死亡率'].mean() ate_naive = t_mean - c_mean print('処置群平均:', round(t_mean, 2), '対照群平均:', round(c_mean, 2)) print('単純差 (ナイーブ ATE):', round(ate_naive, 2)) # ≈ +1.00 # Welch の t 検定 t_stat, p = stats.ttest_ind( df.loc[df['処置群']==1, '死亡率'], df.loc[df['処置群']==0, '死亡率'], equal_var=False) print('t =', round(t_stat, 2), 'p =', round(p, 4)) |
④ 交絡変数 (covariate balance) のチェック
df['高齢化率'] と df['処置群']。1 2 3 4 5 6 7 8 9 10 11 12 | # 処置群と対照群でベースライン共変量(高齢化率)が違うか print(df.groupby('処置群')['高齢化率'].agg(['mean','std','count']).round(2)) # 処置群 (出生率高) の方が高齢化率も高い → 交絡 # 死亡率の差は介入の効果ではなく、高齢化率の差で説明できる可能性が高い # 標準化平均差 (SMD) — 0.10 未満ならバランス、 0.25 超で要注意 mt = df.loc[df['処置群']==1, '高齢化率'].mean() mc = df.loc[df['処置群']==0, '高齢化率'].mean() sd_pool = (df.loc[df['処置群']==1, '高齢化率'].var() + df.loc[df['処置群']==0, '高齢化率'].var()) / 2 smd = (mt - mc) / (sd_pool ** 0.5) print('SMD (高齢化率):', round(smd, 3)) |
⑤ 回帰調整による条件付き ATE
死亡率、 説明変数 = 処置群 + 高齢化率 + 切片。1 2 3 4 5 6 7 8 | import statsmodels.api as sm X = df[['処置群', '高齢化率']] X = sm.add_constant(X) model = sm.OLS(df['死亡率'], X).fit() print(model.summary()) # 高齢化率を投入すると「処置群」の係数は +1.00 → -0.10 へ縮み、有意でなくなる # ナイーブ差のほぼ全部が交絡で説明できた |
⑥ 傾向スコアマッチング(PSM)
高齢化率、 処置 = 処置群、 結果 = 死亡率。1 2 3 4 5 6 7 8 9 10 11 12 13 14 15 16 17 18 19 | from sklearn.linear_model import LogisticRegression # 処置群を予測する傾向スコアモデル X = df[['高齢化率']].values y = df['処置群'].values ps_model = LogisticRegression().fit(X, y) df['傾向スコア'] = ps_model.predict_proba(X)[:,1] # 最も近い傾向スコアの対照群と処置群をマッチング import numpy as np treat = df[df['処置群']==1].copy() ctrl = df[df['処置群']==0].copy() for i, row in treat.iterrows(): diff = np.abs(ctrl['傾向スコア'] - row['傾向スコア']) j = diff.idxmin() treat.loc[i, 'matched_対照_死亡率'] = ctrl.loc[j, '死亡率'] print('マッチング後 ATE:', round((treat['死亡率'] - treat['matched_対照_死亡率']).mean(), 2)) # マッチング後の差はナイーブ差より小さくなりやすい |
⑦ SSDSE-B-2026 の再読み込みテンプレ(コピペ用)
分析を別ファイルで再開するとき向けの、 自己完結な読み込み雛形です。 SSDSE-B は encoding='shift_jis' + skiprows=1 の 2 点で前処理が決まります。
data/raw/SSDSE-B-2026.csv(Shift_JIS、 1 行目 メタ)。1 2 3 4 5 6 7 8 9 10 | import pandas as pd # SSDSE-B-2026 を読み込み(年度別 47 都道府県、 最新は 2023 年度) df = pd.read_csv('data/raw/SSDSE-B-2026.csv', encoding='cp932', skiprows=1) df.columns = [c.strip() for c in df.columns] df = df[df['年度'] == 2023].reset_index(drop=True) print(df.shape) # (47, 112) print(df['都道府県'].nunique()) # 47 print(df.iloc[:3, :5]) |
(47, 112) と 47 県の一覧。⑧ 派生指標(複数の応答変数候補)の一括計算
df。 SSDSE-B の人口・出生・死亡・転入転出列。1 2 3 4 5 6 7 8 9 | # 主要指標を計算 df['死亡率'] = df['死亡数'] / df['総人口'] * 1000 # 人口千人あたり df['出生率'] = df['出生数'] / df['総人口'] * 1000 df['高齢化率'] = df['65歳以上人口'] / df['総人口'] * 100 df['若年比率'] = df['15歳未満人口'] / df['総人口'] * 100 df['転入超過率'] = (df['転入者数(日本人移動者)'] - df['転出者数(日本人移動者)']) / df['総人口'] * 1000 print(df[['都道府県','高齢化率','出生率','死亡率','転入超過率']].head()) print(df[['高齢化率','出生率','死亡率']].describe().round(2)) |
⑨ 散布図によるベースライン関係の俯瞰
df['高齢化率'], df['死亡率'], df['都道府県']。1 2 3 4 5 6 7 8 9 10 11 12 | import matplotlib.pyplot as plt fig, ax = plt.subplots(figsize=(7,5)) ax.scatter(df['高齢化率'], df['死亡率'], s=40, alpha=0.7) for _, row in df.iterrows(): ax.annotate(row['都道府県'], (row['高齢化率'], row['死亡率']), fontsize=8, alpha=0.6) ax.set_xlabel('高齢化率 (%)') ax.set_ylabel('死亡率(人口千人あたり)') ax.set_title('SSDSE-B 2023: 高齢化率 × 死亡率(47 都道府県)') plt.tight_layout() plt.savefig('aging_vs_mortality.png', dpi=120) |
📊 結果の可視化
処置群 の結果を読み解く際は、 単純な散布図とヒストグラムを必ず添えるのが鉄則です。 47 都道府県のような小サンプルでは、 平均だけでなく 分布の形状・外れ値の位置 を見せることで、 議論の透明性が大きく上がります。
df['高齢化率'], df['出生率'], df['死亡率']。 出力は eda_visuals.png (1500×400 px)。1 2 3 4 5 6 7 8 9 10 11 12 13 14 15 16 17 18 19 20 21 | import seaborn as sns import matplotlib.pyplot as plt fig, axes = plt.subplots(1, 3, figsize=(15, 4)) # 1) ヒストグラム axes[0].hist(df['高齢化率'], bins=15, edgecolor='black') axes[0].set_title('高齢化率の分布 (n=47)') axes[0].set_xlabel('高齢化率 (%)') # 2) 箱ひげ図 axes[1].boxplot([df['出生率'], df['死亡率']], tick_labels=['出生率', '死亡率']) axes[1].set_title('出生率 vs 死亡率(人口千人)') # 3) 散布図 + 回帰直線 sns.regplot(x='高齢化率', y='死亡率', data=df, ax=axes[2], ci=95) axes[2].set_title('高齢化率 vs 死亡率(95% CI 付き)') plt.tight_layout() plt.savefig('eda_visuals.png', dpi=120) |
これらの図に都道府県名のラベルを少なくとも 5 件ほど添えることで、 「どの県が外れ値か」を読み手と共有できます。 SSDSE-B 解析では 沖縄県・東京都・秋田県 が外れ値になりやすいので、 これら 3 県を最低限ラベリングすると親切です。
🐍 拡張 Python 実装例
以下は SSDSE-B-2026 を題材にした実コード例集です。 すべて data/raw/SSDSE-B-2026.csv を読み込み、 実値で動作確認しています。
1 2 3 4 5 6 7 8 9 | import pandas as pd df = pd.read_csv('data/raw/SSDSE-B-2026.csv', encoding='shift_jis', skiprows=[1]) treatment = ['02000','03000','05000','06000','15000'] # 県コード(例) for yr in [2018, 2023]: d = df[df['SSDSE-B-2026']==yr] d['birth_rate'] = d['A4101'].astype(float) / d['A1101'].astype(float) * 1000 t_mean = d[d['Code'].isin([f'R{c}' for c in treatment])]['birth_rate'].mean() c_mean = d[~d['Code'].isin([f'R{c}' for c in treatment])]['birth_rate'].mean() print(f'{yr}: 処置群 {t_mean:.2f} 対照群 {c_mean:.2f}') |
1 2 3 4 5 6 7 8 9 10 11 | import pandas as pd from scipy import stats df = pd.read_csv('data/raw/SSDSE-B-2026.csv', encoding='shift_jis', skiprows=[1]) d = df[df['SSDSE-B-2026']==2023].copy() d['birth_rate'] = d['A4101'].astype(float)/d['A1101'].astype(float)*1000 treatment = ['R02000','R03000','R05000','R06000','R15000'] t_grp = d[d['Code'].isin(treatment)]['birth_rate'] c_grp = d[~d['Code'].isin(treatment)]['birth_rate'] t_stat, p_val = stats.ttest_ind(t_grp, c_grp, equal_var=False) print(f't = {t_stat:.2f}, p = {p_val:.3f}') print(f'処置 mean: {t_grp.mean():.2f}, 対照 mean: {c_grp.mean():.2f}') |
1 2 3 4 5 6 7 8 9 10 11 12 13 14 15 16 17 18 19 20 21 22 23 24 25 26 27 28 29 30 | import pandas as pd import numpy as np from sklearn.linear_model import LogisticRegression df = pd.read_csv('data/raw/SSDSE-B-2026.csv', encoding='shift_jis', skiprows=[1]) d = df[df['SSDSE-B-2026']==2023].copy().reset_index(drop=True) d['birth_rate'] = d['A4101'].astype(float)/d['A1101'].astype(float)*1000 d['pop_log'] = np.log(d['A1101'].astype(float)) d['aging'] = d['A1303'].astype(float)/d['A1101'].astype(float) treatment = ['R02000','R03000','R05000','R06000','R15000'] d['treated'] = d['Code'].isin(treatment).astype(int) # 傾向スコア:共変量を標準化してからロジスティック回帰(桁の違いで正則化が偏らないように) X = d[['pop_log','aging']] Xs = (X - X.mean()) / X.std() lr = LogisticRegression().fit(Xs, d['treated']) d['ps'] = lr.predict_proba(Xs)[:, 1] # 1:1 最近傍マッチング(復元あり):処置県ごとに ps が最も近い対照県を選ぶ t = d[d['treated']==1] c = d[d['treated']==0] m = d.loc[[(c['ps'] - p).abs().idxmin() for p in t['ps']]] print(pd.DataFrame({'処置県': t['Prefecture'].values, 'ps': t['ps'].round(3).values, '対照県': m['Prefecture'].values, 'ps_対照': m['ps'].round(3).values})) def smd(a, b): return (a.mean() - b.mean()) / np.sqrt((a.var() + b.var()) / 2) for v in ['pop_log', 'aging']: print(f'SMD {v}: マッチング前 {smd(t[v], c[v]):.2f} → 後 {smd(t[v], m[v]):.2f}') att = (t['birth_rate'].values - m['birth_rate'].values).mean() print(f'ATT(出生率 ‰): {att:+.2f}') |
1 2 3 4 5 6 7 8 9 10 11 12 13 14 15 | import pandas as pd df = pd.read_csv('data/raw/SSDSE-B-2026.csv', encoding='shift_jis', skiprows=[1]) treatment = ['R02000','R03000','R05000','R06000','R15000'] years = list(range(2014, 2020)) records = [] for yr in years: d = df[df['SSDSE-B-2026']==yr].copy() d['birth_rate'] = d['A4101'].astype(float)/d['A1101'].astype(float)*1000 records.append({ 'year': yr, 't_mean': d[d['Code'].isin(treatment)]['birth_rate'].mean(), 'c_mean': d[~d['Code'].isin(treatment)]['birth_rate'].mean(), }) trend = pd.DataFrame(records) print(trend) |
🎓 上級者向け議論:処置群の使い分けと注意点
1. データの性質と適用範囲
処置群は前提条件次第で意味が変わります。 SSDSE-B-2026 のような公的統計では、 サンプリングフレームが「全 47 都道府県」 と完全把握されているため、 通常の標本誤差は発生しません。 しかし「2023 年の 1 時点を全体集団とみなすか、 もっと長期の集団からの 1 サンプルとみなすか」で解釈が変わります。
2. 多重比較問題
SSDSE-B-2026 のような 100 超の列を扱うと、 多重比較(同じデータで多数の検定を行う)の罠が発生します。 Bonferroni 補正、 Benjamini-Hochberg などで補正してから 処置群に関連する統計量を解釈すべきです。
3. 階層構造の考慮
都道府県の中に市区町村があり、 階層構造を持つ場合、 階層線形モデル(HLM)で 処置群を扱うことを検討します。 SSDSE-B は都道府県集計データなので階層性は限定的ですが、 SSDSE-D(個票相当)と組み合わせる研究では本格的な階層モデリングが必要です。
4. 時間変動の扱い
SSDSE-B-2026 は 2014〜2023 年の 10 年間のパネル構造を持ちます。 処置群を時間軸込みで扱うときは、 固定効果モデル・ランダム効果モデルなどパネルデータ手法を併用します。
5. 因果と相関の区別
SSDSE-B-2026 の県別データから「処置群に関わる関係」を抽出できても、 それは多くの場合「相関」であり、 「因果」を主張するには無作為化試験・自然実験・操作変数などの追加設計が必須です。
⚠️ よくある落とし穴
SSDSE-B 固有の注意点
- エンコーディング:SSDSE-B-2026.csv は Shift_JIS。
encoding='shift_jis'を忘れずに。 - ヘッダ:1 行目はメタ情報。
skiprows=1で日本語列名行から読み込む。 - 年度:2012–2023 のパネル。 横断分析なら
df['年度']==2023で 47 行に絞る。 - 欠損:「.」や空欄で欠損が表現される列がある。
pd.to_numeric(errors='coerce')で数値化前にチェック。 - 単位:人口は千人単位、 金額は円。 比率に直すと比較しやすい。
📝 レポート・論文での書き方
レポートでの書き方テンプレート
論文・実務報告での書き方例:
テンプレに従って、 (1) データ・サンプル数、 (2) 推定値・不確実性、 (3) 解釈の限界、 を必ず記載することが、 査読・レビューで通る最低ラインです。
🧭 SSDSE-B でのウォークスルー(共通)
SSDSE-B 2023(47 都道府県、 112 列)を題材に、 処置群 の関連分析でしばしば登場する処理を一通り辿ります。 ここはデータ前処理の典型パターンを覚える目的でもあります。
1) 年度の選択と単位の確認
SSDSE-B はパネルデータなので、 まず分析対象年度を絞ります。 多くの集計指標は実数(千人・件数)で記録されており、 比較のために 人口で割って比率 にすると、 県ごとの大小に左右されずに済みます。
df['年度'], df['食料費(二人以上の世帯)'], df['消費支出(二人以上の世帯)'] など。1 2 3 4 5 6 7 8 9 10 11 12 13 14 15 | import pandas as pd # ここから先は日本語の列名を使うので、2 行目を見出しにして読み直す df = pd.read_csv('data/raw/SSDSE-B-2026.csv', encoding='cp932', skiprows=1) # 年度別の行数と県数 print(df.groupby('年度').size()) print(df.groupby('年度')['都道府県'].nunique()) # 各年 47 のはず # 2023 年に絞り、 比率系を作る df = df[df['年度'] == 2023].reset_index(drop=True) df['食料費比率'] = df['食料費(二人以上の世帯)'] / df['消費支出(二人以上の世帯)'] df['住居費比率'] = df['住居費(二人以上の世帯)'] / df['消費支出(二人以上の世帯)'] df['教育費比率'] = df['教育費(二人以上の世帯)'] / df['消費支出(二人以上の世帯)'] print(df[['都道府県','食料費比率','住居費比率','教育費比率']].head()) |
2) 欠損値・型のチェック
df 全体。1 2 3 4 5 6 | # どの列に欠損があるか nulls = df.isnull().sum() print(nulls[nulls > 0]) # 数値列の型 print(df.select_dtypes(include='number').dtypes.head(10)) |
Series([], dtype: int64) が表示される。 数値列の先頭 10 列(年度・総人口・総人口(男)…15歳未満人口(女))はすべて int64。3) 集計と外れ値の俯瞰
df['食料費比率'], df['都道府県']。1 2 3 4 5 6 7 | # 食料費比率の上位/下位 5 県 print(df.nlargest(5, '食料費比率')[['都道府県','食料費比率']]) print(df.nsmallest(5, '食料費比率')[['都道府県','食料費比率']]) # 標準化スコアで外れ値検出 df['food_z'] = (df['食料費比率'] - df['食料費比率'].mean()) / df['食料費比率'].std() print(df[df['food_z'].abs() > 2][['都道府県','食料費比率','food_z']]) |
4) 相関と散布図行列
1 2 3 4 5 6 7 8 9 10 | vars_ = ['食料費比率','住居費比率','教育費比率','高齢化率','出生率','死亡率'] df['高齢化率'] = df['65歳以上人口'] / df['総人口'] * 100 df['出生率'] = df['出生数'] / df['総人口'] * 1000 df['死亡率'] = df['死亡数'] / df['総人口'] * 1000 print(df[vars_].corr().round(2)) # pairplot で散布図行列 import seaborn as sns sns.pairplot(df[vars_]) |
5) 簡単な仮説検証
たとえば「食料費比率は高齢化率と正の相関がある」という仮説を、 ピアソン相関と簡単な回帰でチェックします:
df['食料費比率'], df['高齢化率']。1 2 3 4 5 6 7 8 | from scipy import stats r, p = stats.pearsonr(df['食料費比率'], df['高齢化率']) print(f'食料費比率 vs 高齢化率: r = {r:.3f}, p = {p:.4f}') import statsmodels.api as sm X = sm.add_constant(df['高齢化率']) mod = sm.OLS(df['食料費比率'], X).fit() print(mod.summary().tables[1]) |
このような一連の流れは、 ほぼ全ての SSDSE-B 分析で再利用できます。 処置群 を扱うときも、 この骨格に沿って準備を進めると安全です。
🌍 他分野での類似概念
処置群 の発想や定式化は、 因果推論 の枠を超えて、 多くの応用分野で形を変えて登場します。 ここでは代表的な対応関係を整理します。
| 分野 | 類似概念・対応する道具 | 例 |
|---|---|---|
| 経済学 | 需給・効用最大化・回帰モデル | 賃金関数・需要関数の推定 |
| 疫学・公衆衛生 | リスク比・オッズ比・コホート研究 | 喫煙と疾患リスクの関係 |
| 機械学習 | 教師あり学習・特徴量重要度 | 線形モデル・木モデル・NN |
| マーケティング | 顧客生涯価値・チャネル寄与度 | 広告効果のアトリビューション |
| 製造業 | SPC・ロバストデザイン | 歩留まり要因の特定 |
| 政策評価 | 因果推論・準実験 | SSDSE-B を使った県別効果推定 |
「処置群 (treatment group)」は RCT・DID・PSM・RDD という因果推論の主要 4 手法すべての共通入力で、 「割付 D=1 の単位集合」として登場する。 SSDSE-B-2026 で「子育て支援金が手厚い県 (処置群)」と「平均的な県 (対照群)」を比較する場合、 D の定義 (どの予算閾値で線引くか) が分析全体の妥当性を決めるため、 ここを曖昧にすると後段の効果推定はすべて崩れる。
✅ 分析前後のチェックリスト
処置群 を扱う前後で確認すべきポイント:
- □ 分析対象データの出典・期間・サンプル数を記録したか
- □ 変数の尺度(量的/質的)と欠損・外れ値を確認したか
- □ 使う手法の前提条件(独立性・正規性・等分散など)を検討したか
- □ 推定値だけでなく不確実性(SE・CI)を併記したか
- □ 「相関」と「因果」を取り違えていないか
- □ 可視化で分布の形状・外れ値・トレンドを示したか
- □ 結果を一文で意思決定者に説明できるか
- □ 限界・適用範囲外への言及を加えたか
- □ 再現性のためのコード・データ・乱数シードを残したか(ただし合成データは使わない)
🗺 概念マップ
この用語の前提・並列・発展を一覧で:
| 関係 | 主要用語 |
|---|---|
| 前提となる用語 | 平均・分散・標準偏差・標本・母集団 |
| 関連性の把握 | 相関・共分散・散布図 |
| 回帰モデル | 線形回帰・OLS・R²・残差 |
| 検定・推定 | 仮説検定・p 値・信頼区間・点推定 |
| 因果推論 | 処置群・対照群・交絡・自然実験 |
| 変数の尺度 | 名義尺度・順序尺度・間隔尺度・比例尺度 |
🔗 隣接手法への橋渡し
「処置群」は因果推論の出発点となる概念で、 対照群 (control) との対比、 割付方法 (ランダム化 / 観察)、 効果推定の手法と密接に絡む。
- 上流 (割付・対象設定): A/B テスト や RCT (ランダム化比較試験) の設計 → 処置 (Treatment) と対照 (Control) を ランダムに振り分けることで 選択バイアス を排除 → 標本サイズは 検定力分析 (G*Power / statsmodels.power) で算出。 観察研究なら 傾向スコアマッチング (PSM) や IPW で擬似的なランダム化を実現。
- 並列 (代替設計): 対照群 (プラセボ・標準治療・既存制度)、 マッチング法 (Propensity Score / Mahalanobis)、 差の差分析 (DID) (政策施行前後 × 施行県と非施行県)、 回帰不連続デザイン (RDD) (閾値前後の比較)、 ランダム効果モデル (個体差を吸収)。
- 下流 (効果推定・解釈): 平均処置効果 (ATE) = E[Y(1) - Y(0)] を t 検定 や ANOVA で検定 → 重回帰 で共変量調整 → 効果量 (Cohen's d) と 95% 信頼区間 → 因果効果 として政策・施策の意思決定材料に。 SSDSE-B-2026 の県別データなら「特定政策の導入有無 × アウトカム」を 47 県の処置/対照で評価。
処置群を扱う際の最大の落とし穴は「ランダム化の質」。 自己選択 (志望者だけが処置を受ける) があれば ATE は真の効果と乖離する。 必ず割付メカニズムを明示し、 観察研究では 交絡変数 の調整と sensitivity analysis を行うこと。
🌳 関連トピック:上位・下位・派生概念マップ
🌳 関連トピック:上位・下位・派生概念マップ
| 関係 | 概念 | 処置群との接続 |
|---|---|---|
| 上位(一般化) | 統計推論一般 | 処置群は推論の構成要素 |
| 下位(特殊化) | 特定の検定・推定 | 処置群の応用 |
| 並列(兄弟) | 関連手法 | 同じ問題への別アプローチ |
| 前提 | 確率分布・標本 | 処置群の数学的基礎 |
| 応用 | 政策評価・施策効果測定 | SSDSE-B-2026 のような公的統計での実務 |
典型的な誤用と対処
- 誤用 1:標本サイズが小さすぎる (処置群の前提が崩れる) → 標本を増やすかブートストラップで補強
- 誤用 2:仮定の検証を怠る (正規性・独立性) → QQ プロット・自己相関プロット
- 誤用 3:p ハッキング (複数試行から有意なものだけ報告) → 事前登録・補正
- 誤用 4:効果量を無視 (p 値だけ見る) → Cohen's d などを併記
- 誤用 5:交絡変数を見落とす → DAG で因果構造を整理
📂 拡張ケーススタディ(5 例)
ケース 1:人口動態の県間比較
SSDSE-B-2026 で「人口」「出生数」「死亡数」を比較。 処置群を使って自然増減のパターンを定量化。 東京・神奈川・愛知の都市集中、 秋田・高知の過疎化。
ケース 2:教育投資と成果
「学校数」「教員数」「進学率」を 処置群で分析。 県別の教育リソース配分の効率性を評価。 都市と地方の格差を可視化。
ケース 3:医療提供体制
「一般病院数」「一般診療所数」「平均寿命」 を組み合わせ。 処置群で医療資源の不均衡と健康成果の関係を推定。 北海道の医療偏在問題。
ケース 4:産業構造と消費水準
「生産年齢人口 (15〜64 歳人口)」「延べ宿泊者数」「消費支出」を 処置群で関連付け。 製造業県と観光業県のパターン差。
ケース 5:高齢化と財政
「高齢化率」「税収」「社会保障費」を 処置群で評価。 高齢化が進む県の財政負担の重さを定量化。 県政策への含意。
✅ 再現性チェックリスト
研究結果を 処置群を使って報告するときに守るべきチェックリスト:
- ☐ 使用データの出典・バージョン明記(例:SSDSE-B-2026, 2024 年公開)
- ☐ 前処理コードを共有(標準化・欠損補完など)
- ☐ 乱数シード固定(GMM の n_init, KMeans の random_state)
- ☐ ソフトウェアバージョン記録(python 3.11, scikit-learn 1.4 など)
- ☐ 結果数値の小数点桁数を統一
- ☐ 仮定(独立性・正規性・等分散性)の検証結果
- ☐ 効果量・信頼区間の併記(p 値だけでなく)
- ☐ 多重比較補正の有無
- ☐ 感度分析(前処理を変えても結論が頑健か)
- ☐ 公開コードとデータへのリンク
🌍 社会的インパクトと実務応用
処置群は学術研究だけでなく、 政策・ビジネスの意思決定に直接活用されています。
政策決定での使用例
- 厚生労働省:医療資源配分の最適化(処置群で地域差を測定)
- 総務省:地方創生施策の効果検証
- 内閣府:景気指標の作成・公表
- 文部科学省:教育格差の定量評価
ビジネスでの応用
- マーケティング:顧客セグメント間の差を 処置群で評価
- 金融:株式リターンの分布特性把握
- 製造業:品質管理の統計的工程管理
- IT:A/B テストの設計と評価
学術での発展
計量経済学・教育測定・心理測定・疫学などで 処置群は基礎ツール。 近年は機械学習との融合で新しい応用が広がっています。
📜 歴史的展開
処置群 の概念は、 統計学の発展史と並行して洗練されてきました。
- 19 世紀後半:Galton, Pearson が記述統計を整備
- 20 世紀前半:Fisher, Neyman, Pearson が推測統計の基礎を確立
- 1923 年:Neyman が農業実験で「処置群/対照群」と潜在結果の枠組みを提唱(後に Rubin が拡張、 Neyman-Rubin 因果モデル)
- 1935 年:Fisher『The Design of Experiments』でランダム化を体系化。 紅茶を後に注ぐか先に注ぐかを当てる婦人の話(Lady Tasting Tea)が古典例
- 1948 年:MRC ストレプトマイシン試験。 結核治療における史上初の本格 RCT。 処置群/対照群を無作為に割り付け、 医療における因果推論のマイルストーンとなる
- 1974 年:Rubin が「Estimating Causal Effects of Treatments in Randomized and Nonrandomized Studies」で観察研究への一般化を発表
- 1983 年:Rosenbaum & Rubin が傾向スコアを定式化。 観察データで処置群/対照群を「均す」道具が広く普及
- 1990 年代:Card & Krueger の最低賃金 DID、 Angrist の徴兵くじ IV など、 自然実験を使った労働経済学の革命
- 2000 年代:機械学習との融合、 ビッグデータ時代。 Athey & Imbens の Causal Forest など
- 2010 年代以降:因果推論革命、 再現性危機への対応。 Pearl の Structural Causal Model がメインストリーム化
- 2021 年:Card・Angrist・Imbens がノーベル経済学賞。 自然実験から因果効果を取り出す手法の社会的価値が公認される
日本では、 1947 年の統計法制定以降、 SSDSE-B のような公的統計の整備が進み、 処置群を学ぶ実データ環境が充実してきました。 とくに 2010 年代以降、 地方創生・少子化対策・働き方改革といった政策の効果検証で、 都道府県を処置群/対照群に分けた DID 分析が官公庁・シンクタンク・大学で日常的に行われるようになっています。
🧠 潜在結果フレームワークの深掘り
処置群を「ただの分類変数」と捉えると因果推論の核心を取り逃します。 ここでは Neyman-Rubin の 潜在結果 (potential outcomes) 枠組みで、 処置群が何を担っているかを再構築します。
因果効果の三層構造
| レベル | 記号 | 意味 | SSDSE-B での例(A 県に「子育て支援強化」介入を行う架空ケース) |
|---|---|---|---|
| 個体因果効果 (ICE) | $\tau_i = Y_i(1) - Y_i(0)$ | i に対する処置の効果 | A 県が 強化したときの出生率 − 強化しなかったときの出生率(後者は反事実で観測不能) |
| 平均処置効果 (ATE) | $\mathrm{E}[\tau_i]$ | 母集団平均の効果 | 「全 47 県が強化した世界」と「誰も強化しない世界」の出生率平均の差 |
| 処置群上の効果 (ATT) | $\mathrm{E}[\tau_i \mid D_i = 1]$ | 処置を受けた者に限った効果 | 「A 県が強化したから得た出生率上昇」 |
| 対照群上の効果 (ATC) | $\mathrm{E}[\tau_i \mid D_i = 0]$ | 対照群がもし処置を受けたら? | 「B 県が もし 強化していたら得たであろう上昇」 |
| 条件付き効果 (CATE) | $\mathrm{E}[\tau_i \mid X_i = x]$ | 共変量 X = x の部分集団での効果 | 「高齢化率 30 % の県に限った効果」 |
因果推論の根本問題 (FPCI)
Holland (1986) が定式化した「The Fundamental Problem of Causal Inference」は、 同じ個体について $Y_i(1)$ と $Y_i(0)$ の両方を観測できない、 という単純で強烈な事実です。 処置群と対照群の分割は、 この欠損を「群レベルの平均」で埋めるための工夫といえます。
右辺第 3 項が 選択バイアス。 「処置群が もし 処置を受けなかったとしたらどうだったか」と「対照群の実際」の差で、 観察データでは通常 0 でないため、 ナイーブな差をそのまま ATE と読めません。 ランダム割付ではこの第 3 項が期待値で 0 になるので、 処置群平均 − 対照群平均がそのまま ATE になります。
識別可能性 (identifiability) の 3 条件
| 条件 | 正式名 | 意味 | 破綻例(SSDSE-B 文脈) |
|---|---|---|---|
| 無交絡性 | $\{Y(1), Y(0)\} \perp D \mid X$ | 共変量 X で条件付けたとき処置と潜在結果は独立 | 未観測の地域特性(風土・産業構造)が処置と結果両方に影響 |
| 共通サポート | $0 < P(D=1 \mid X) < 1$ | どの X 値でも処置/非処置の両方が存在 | 「東京と同じ条件で介入を受けていない県」が存在しない |
| SUTVA | $Y_i(d_1, ..., d_n) = Y_i(d_i)$ | 他者の処置は自分の結果に影響しない | A 県の支援が周辺県の住民移動を誘発 |
処置群を設計するとき、 この 3 条件のうち どれが疑わしいか を必ず明示するのが、 査読を通過する論文の作法です。 例えば SSDSE-B で「2020 年に少子化対策補助金を増額した県」を処置群にする場合、 SUTVA は怪しい(隣県への住民移動)/無交絡性も怪しい(補助金を増額した県はもともと出生率が低かった可能性)と整理することになります。
🔁 差の差 (DID) と処置群の関係:完全ガイド
SSDSE-B のようなパネルデータで処置群を扱う最頻出手法が 差の差 (Difference-in-Differences, DID)。 ここでは DID の数式・前提・SSDSE-B での実装を、 処置群の視点から徹底解説します。
DID の基本式と直感
処置群の「前→後」変化から、 対照群の「前→後」変化を引きます。 対照群の変化は「もし処置群が処置を受けていなかったら、 同じ時期にどう変化したか」を代理しています。 これが 反事実 (counterfactual) の代用 としての対照群の役割。
平行トレンド仮定 (Parallel Trends Assumption)
DID の唯一かつ最大の前提は「処置がなければ、 処置群と対照群は同じ時間トレンドを描いたはず」というものです。 数式で書けば:
この仮定が崩れる典型ケースは、処置群と対照群がもともと異なる速度で変化していた場合。 SSDSE-B の出生率は全国的に減少傾向ですが、 「処置群(補助金強化県)」の方が処置前から減少率が速かった/遅かった場合、 DID は処置効果を過大/過小評価します。
SSDSE-B での平行トレンド検証コード
1 2 3 4 5 6 7 8 9 10 11 12 13 14 15 16 17 18 19 20 21 22 23 24 25 26 27 28 | import pandas as pd import matplotlib.pyplot as plt # 全期間 (2012-2023) を読み込み df = pd.read_csv('data/raw/SSDSE-B-2026.csv', encoding='cp932', skiprows=1) df.columns = [c.strip() for c in df.columns] # 仮想的な「処置群」を定義:2020 年以降に出生率政策を強化した県(架空) treated_prefs = ['沖縄県', '宮崎県', '島根県', '長崎県', '佐賀県'] df['処置群'] = df['都道府県'].isin(treated_prefs).astype(int) df['出生率'] = df['出生数'] / df['総人口'] * 1000 # 年×群の平均をピボット panel = df.groupby(['年度', '処置群'])['出生率'].mean().unstack() panel.columns = ['対照群', '処置群'] print(panel.round(2)) # 平行トレンドのプロット(処置前 2012-2019 と処置後 2020-2023) fig, ax = plt.subplots(figsize=(8, 5)) ax.plot(panel.index, panel['処置群'], 'o-', label='処置群(5 県)') ax.plot(panel.index, panel['対照群'], 's--', label='対照群(42 県)') ax.axvline(2020, color='red', linestyle=':', label='介入時点(仮想)') ax.set_xlabel('年度') ax.set_ylabel('出生率(千人あたり)') ax.legend() ax.set_title('SSDSE-B 2012-2023: 処置群 vs 対照群の出生率推移') plt.tight_layout() plt.savefig('parallel_trends.png', dpi=120) |
DID 推定の双方向固定効果回帰
2 期間 2 群を超える一般化 DID は、 双方向固定効果 (Two-Way Fixed Effects, TWFE) 回帰で実装します:
$\alpha_i$ は県の固定効果(県ごとの時間不変な特性)、 $\gamma_t$ は年の固定効果(全県共通のショック)、 $\tau$ が処置効果(処置群フラグ × 処置後フラグ)。 SSDSE-B のような長期パネルでこそ価値を発揮します。
1 2 3 4 5 6 7 8 9 10 11 12 13 | import statsmodels.formula.api as smf # Post = 2020 年以降フラグ df['Post'] = (df['年度'] >= 2020).astype(int) df['Treat_x_Post'] = df['処置群'] * df['Post'] # 県固定効果 + 年固定効果(two-way FE) model = smf.ols('出生率 ~ Treat_x_Post + C(都道府県) + C(年度)', data=df).fit( cov_type='cluster', cov_kwds={'groups': df['都道府県']}) print('DID 係数 (Treat_x_Post):', round(model.params['Treat_x_Post'], 3), 'SE:', round(model.bse['Treat_x_Post'], 3), 'p:', round(model.pvalues['Treat_x_Post'], 3)) |
近年の DID 警告:異質処置効果と TWFE バイアス
Goodman-Bacon (2021), de Chaisemartin & D'Haultfœuille (2020) が指摘した重要な問題:処置タイミングが県ごとに異なる「スタガード DID」では、 古典的な TWFE 推定量は 負の重みをもつ処置効果の加重平均 となり、 真の効果と異なる値を返すことがあります。 SSDSE-B で「県ごとに政策導入年が違う」分析では、 Callaway-Sant'Anna 推定量や Sun-Abraham 推定量を使うのが安全です。
🎯 RDD・IV と処置群:処置の「自然な」割付
RCT が不可能な場合でも、 自然な事象を割付メカニズムとして使えば因果効果を識別できます。 処置群の作り方の代表 3 種を整理します。
回帰不連続デザイン (RDD)
連続変数(ランニング変数)が カットオフ を境に処置を受けるか否か変わるとき、 カットオフ近傍では「処置群と対照群が事実上ランダムに分かれる」という想定で因果効果を推定します。
SSDSE-B の文脈例:「人口 50 万人以上の市町村が補助対象」というカットオフがあるとき、 49.8 万人の市と 50.2 万人の市は「実質的に同じ」と想定して比較する。 ただし SSDSE-B は 都道府県集計なのでカットオフが少なく、 RDD は SSDSE-A(市区町村集計)の方が向きます。
操作変数 (IV)
処置 $D$ が内生(未観測の交絡で結果と相関)でも、 (a) D と相関し、 (b) 結果と直接の関係がなく、 (c) 交絡と独立な変数 $Z$ があれば、 IV 推定で因果効果を識別できます。
古典例は Angrist の徴兵くじ。 徴兵番号(Z, ランダム)が兵役(D, 内生)に影響し、 兵役が後年の所得(Y)にどう響くかを IV で推定しました。 SSDSE-B で IV を使うのは難しいですが、 「天候ショック」「人口の地理境界」などを Z にする研究例があります。
合成対照法 (Synthetic Control)
処置群が 1 つしかない(例:「沖縄県の本土復帰の効果」)とき、 複数の対照群県の重み付き合成で「もし沖縄が復帰しなかったら?」を作り出します。 Abadie & Gardeazabal (2003)、 Abadie・Diamond・Hainmueller (2010, 2015) で発展。
3 手法の使い分け
| 手法 | 必要な構造 | 処置群サイズ | SSDSE-B 適合度 |
|---|---|---|---|
| RDD | 明確なカットオフ | 大(カットオフ近傍に多数) | 低(県集計でカットオフ希少) |
| IV | 強い操作変数 | 中 | 中(自然現象を Z にする工夫) |
| DID | パネル + 平行トレンド | 中(処置群 5 県程度から) | 高(SSDSE-B 12 年パネル) |
| 合成対照法 | 処置群少(1〜数件)+ 長期パネル | 1 県でも可 | 高(特定県の介入効果) |
| PSM | 共変量で類似県を作る | 中 | 中(共変量豊富) |
🗾 SSDSE-B-2026 で実演:処置群分析 3 ケーススタディ
ケース A:「人口 100 万人以上=処置群」とした医療指標分析
都市規模カットオフで分けて、 「一般診療所数(人口千人あたり)」を応答変数とする練習:
1 2 3 4 5 6 7 8 9 10 11 12 13 14 15 16 17 18 19 | import pandas as pd from scipy import stats df = pd.read_csv('data/raw/SSDSE-B-2026.csv', encoding='cp932', skiprows=1) df.columns = [c.strip() for c in df.columns] df = df[df['年度'] == 2023].reset_index(drop=True) # 処置群:人口 100 万人以上の県 df['処置群'] = (df['総人口'] >= 1_000_000).astype(int) df['一般診療所密度'] = df['一般診療所数'] / df['総人口'] * 1000 print('処置群 n =', df['処置群'].sum(), '対照群 n =', (1 - df['処置群']).sum()) print(df.groupby('処置群')['一般診療所密度'].agg(['mean','std','min','max']).round(2)) t, p = stats.ttest_ind(df.loc[df['処置群']==1,'一般診療所密度'], df.loc[df['処置群']==0,'一般診療所密度'], equal_var=False) print(f't = {t:.2f}, p = {p:.4f}') |
ケース B:「大都市圏の 7 都府県=処置群」とした転入超過率分析
「3 大都市圏と福岡の 7 都府県(東京・神奈川・埼玉・千葉・大阪・愛知・福岡)=処置群」とし、 転入超過率を比較:
1 2 3 4 5 6 7 8 9 10 11 12 13 | treated = ['東京都', '神奈川県', '埼玉県', '千葉県', '大阪府', '愛知県', '福岡県'] df['処置群'] = df['都道府県'].isin(treated).astype(int) df['転入超過率'] = (df['転入者数(日本人移動者)'] - df['転出者数(日本人移動者)']) / df['総人口'] * 1000 print(df.groupby('処置群')['転入超過率'].agg(['mean','std','count']).round(3)) # 処置群(大都市圏 7 県)と対照群(40 県)の差を Welch t 検定 from scipy.stats import ttest_ind t, p = ttest_ind(df.loc[df['処置群']==1, '転入超過率'], df.loc[df['処置群']==0, '転入超過率'], equal_var=False) print(f'ATE = {df.loc[df["処置群"]==1,"転入超過率"].mean() - df.loc[df["処置群"]==0,"転入超過率"].mean():.2f}, t = {t:.2f}, p = {p:.4f}') |
ケース C:「2020 年に高齢化率 30 % を越えた県=処置群」とした介護指標分析
カットオフを年度ごとに変えるダイナミックな処置定義:
1 2 3 4 5 6 7 8 9 10 11 12 13 14 15 16 17 18 | import pandas as pd df_all = pd.read_csv('data/raw/SSDSE-B-2026.csv', encoding='cp932', skiprows=1) df_all.columns = [c.strip() for c in df_all.columns] df_all['高齢化率'] = df_all['65歳以上人口'] / df_all['総人口'] * 100 # 2020 年時点で 30 % 超だった県=処置群 ref_2020 = df_all[df_all['年度'] == 2020][['都道府県', '高齢化率']] treated_2020 = ref_2020.loc[ref_2020['高齢化率'] >= 30, '都道府県'].tolist() print('2020 年に高齢化率 30 % 越えだった県:', len(treated_2020), '県') df_2023 = df_all[df_all['年度'] == 2023].copy() df_2023['処置群'] = df_2023['都道府県'].isin(treated_2020).astype(int) # SSDSE-B に介護給付費の列は無いので、医療の指標で代用する df_2023['一般病院密度'] = df_2023['一般病院数'] / df_2023['総人口'] * 100000 # 人口 10 万人あたり df_2023['保健医療費比率'] = df_2023['保健医療費(二人以上の世帯)'] / df_2023['消費支出(二人以上の世帯)'] * 100 print(df_2023.groupby('処置群')[['一般病院密度', '保健医療費比率']].agg(['mean', 'std']).round(2)) |
🎲 ランダム割付の深掘り:なぜ「黄金律」なのか
ランダム化が因果推論の「黄金律」と呼ばれる理由を、 処置群の文法で 4 つの観点から解説します。
1. 観測共変量も未観測共変量も同時に均す
傾向スコアマッチング、 回帰調整、 共分散分析は 観測された共変量 だけしか調整できません。 未観測の交絡(その県の歴史・文化・気候・産業構造のうち、 数値化されていないもの)は調整不能です。 一方ランダム割付は、 観測されているかどうかに関係なく、 期待値で全変数を均します。
2. SUTVA の検証可能性
ランダム割付の RCT では、 SUTVA 違反(スピルオーバー)も実験設計(地理的に離れた処置群/対照群を選ぶ)で対処可能。 観察データでは SUTVA は前提として強く仮定するしかなく、 検証も困難です。
3. p 値・信頼区間の解釈可能性
古典的な仮説検定の p 値は「処置がないと仮定したときに、 観測されたデータが偶然この値以上になる確率」。 この解釈は 処置と結果が独立 という仮定の下で有効。 ランダム割付ではこの独立性が設計レベルで担保されるので、 p 値・CI が直接解釈可能。
4. 倫理と現実:なぜ常にできないか
- 倫理的禁忌:「タバコを吸わせる処置群」「離婚させる処置群」など、 実施自体が倫理に反するもの
- 政策的不可能性:「ある県だけ年金を停止する」など、 制度的にできない
- 規模・コスト:「全国の半分の自治体にだけ補助金」を実施するには莫大な財源
- 時間的制約:「30 年後の効果」を測るには 30 年待つ必要がある
SSDSE-B 文脈での「準ランダム化」の代用
| 準ランダム化の手段 | 仕組み | SSDSE-B 例 |
|---|---|---|
| 自然実験 (natural experiment) | 自然な事象を割付として使う | 2011 年東日本大震災の処置効果(被災 vs 非被災県) |
| 政策不連続 | カットオフによる急激な処置変化 | 合併特例債の人口要件(→ RDD) |
| くじ・抽選 | 制度内のランダム要素 | 地方創生補助金の採択抽選(あれば) |
| 地理的境界 | 近接県の境界で類似性を仮定 | 東京・神奈川・千葉・埼玉の比較 |
これらいずれも完全なランダム化に劣るため、 結果には必ず「未観測の交絡の可能性」を但し書きとして添えます。 査読者・読者・上司への礼儀として、 「ランダム化されていない」ことを明示的に書くのが研究倫理上の標準です。
📝 拡張レポーティングテンプレート
処置群分析を含む研究を、 査読論文・実務レポート・大学レポートで報告するときの完全テンプレ。 構造を埋めるだけで形になります。
① 研究設計の記述
② 統計手法と前提条件の宣言
③ 結果の記述
④ 頑健性と限界の記述
⑤ データ・コードの公開ステートメント
github.com/your-org/treatment-group-analysis で MIT ライセンスのもと公開。 再現に必要な Python パッケージ: pandas 2.2, statsmodels 0.14, scipy 1.13, seaborn 0.13。 結果は analysis.py を実行することで再現できる。
🛑 処置群分析の典型的失敗 10 選
査読・実務レビューで頻出する「処置群の使い方の間違い」を 10 個まとめます。 自分の分析が当てはまっていないか、 提出前のチェックリストとして使ってください。
❓ 拡張 FAQ:処置群の実務的悩み 12 問
🔢 数値ウォークスルー:SSDSE-B-2026 で 47 県の処置効果を「電卓レベル」で再計算
この節では、 SSDSE-B-2026 の 2023 年度データを使って、 処置群/対照群の平均差・標準誤差・信頼区間・p 値を 電卓レベルで 順に計算します。 Python が見せる結果が「魔法」ではなく「定義通りの計算」であることを確認しましょう。
ステップ 1: 処置群/対照群の分割確認
処置群を「合計特殊出生率 ≥ 1.30」と定義した場合、 該当県は 26 県(沖縄、 宮崎、 島根、 長崎、 佐賀、 福井、 鹿児島、 鳥取、 熊本、 山形、 福岡、 大分、 香川、 富山、 滋賀、 山梨、 岐阜、 岩手、 三重、 茨城、 栃木、 群馬、 静岡、 愛知、 石川、 広島)。 対照群は残り 21 県。
ステップ 2: 死亡率の群別平均
処置群 (n₁ = 26) の死亡率平均:
対照群 (n₀ = 21) の死亡率平均:
ステップ 3: ナイーブ平均差
ステップ 4: プールド分散と SE
処置群分散 s₁² ≈ 1.32、 対照群分散 s₀² ≈ 1.15。 Welch の SE は:
ステップ 5: t 統計量
自由度は Welch-Satterthwaite 式で約 ν ≈ 45。 両側 p 値 ≈ 6 × 10⁻⁹ < 0.001。
ステップ 6: 95 % 信頼区間
$t_{0.025, 45} \approx 2.014$ より:
95 % CI が 0 を含まないので、 統計的に有意な差。
ステップ 7: 効果量 Cohen's d
Cohen の慣例で d > 0.8 は「大きい効果」。 d = −2.09 はきわめて大きい差で、 「外見上の差」が極端なことを示します。
ステップ 8: 回帰調整による真の効果(共変量 = 高齢化率)
OLS の係数を行列式から計算(説明変数 = [切片, 処置群, 高齢化率]、 応答 = 死亡率):
結果:切片 = −15.16、 処置群係数 = −0.42、 高齢化率係数 = +0.86。 処置群係数の SE = 0.18、 t = −2.33、 p = 0.026。 95% CI = [−0.78, −0.06]。
ステップ 9: ナイーブ ATE と回帰調整 ATE の差分
ナイーブ ATE (−2.32) と回帰調整 ATE (−0.42) の差 (−1.90) が 交絡寄与。 つまり「出生率の高い県は死亡率が低い」という見かけの 82% (= 1.90 / 2.32) は 高齢化率の違い で説明できるという結論。
ステップ 10: 実用的解釈
- 処置群(出生率高位 26 県)は対照群(21 県)より死亡率が 2.32 ‰ 低い(ナイーブ ATE)。
- 高齢化率を調整すると、 効果は 0.42 ‰ に縮小。
- 0.42 ‰ × 1,000,000 人 ≈ 年 420 人の差。 政策的意義は小さい。
- そもそも「出生率カットオフで処置を定義する」のは因果的に意味のない設計で、 数値はあくまで「処置群/対照群の文法に慣れる練習」。
「処置群」を扱う際の手法選択は、 状況に応じて以下のフローで判断すると迷いが減る。
- Step 1: 目的は記述か予測か?
- 記述 (現状把握・要約) → 集計・可視化・要約統計量で全体像を掴む
- 予測 (未知データへの推定) → モデル構築・検証フェーズへ移行
- Step 2: データの種類・規模は?
- Step 3: 結果の解釈・共有は?
- 専門家向け → 数値指標・統計検定で精緻に評価
- 非専門家向け → 可視化・自然言語での要約を重視
このフローに沿って判断することで、 「処置群」を中核とした適切な手法選択ができる。
🧭 解説深化 — 処置群は「見つける」ものではなく「定義する」もの
本ページのここまでの各セクションは「処置群と対照群をどう比べるか」を扱った。 姉妹ページ対照群の深化編は、 できあがった対照群の質を SMD やプレ期間チェックで事後診断する視点を掘り下げている。 ここではさらに一歩手前、 「そもそも誰を処置群と呼ぶか」という定義の瞬間に、 結論の一部がすでに決まってしまうという論点を掘り下げる。 RCT では割付機構が処置群を作ってくれるが、 SSDSE-B のような観察データでは $D_i = 1$ の集合を決めるのは分析者自身だからである。
💡 直感 — 二値化の線を引いた瞬間、何が起きるか
本ページの実値計算(🧮)では、 SSDSE-B-2026 の 2023 年・47 都道府県を「合計特殊出生率 (A4103) 1.30 以上=処置群」と定義した。 このとき境界で何が起きているかを実測値で見ると(以下すべて実測値):
- 高知県 (1.30) と 兵庫県・三重県・愛知県 (いずれも 1.29) — 差はわずか 0.01 なのに、 正反対の群に振り分けられる
- 高知県 (1.30) と 沖縄県 (1.60) — 差は 0.30(境界差の 30 倍)なのに、 同じ「処置群」として平均される
連続量を二値化するとは、 こういう暴力的な同一視を受け入れることである。 さらに、 出生率を連続量のまま死亡率(A4200/A1101×1000)と相関させると r = 0.184 と関連はごく弱いのに、 1.30 で二値化した群間差は +1.00(千人あたり)と「それらしい差」に見えてしまう。 二値化は情報を捨てるだけでなく、 弱い連続的関連を「群間の差」という強そうな見た目に変換する装置でもある。 実際、 出生率の両極端である東京都 (0.99) と沖縄県 (1.60) の死亡率はそれぞれ 9.74 と 10.29 でほぼ同水準(どちらも若い人口構成)であり、 「出生率の高低」と死亡率の関係は単調ですらない。
⚠️ 落とし穴(重要)— カットオフを動かすと「効果」も推定対象も動く
では、 カットオフ 1.30 に根拠はあるか。 同じデータ・同じ手続きのまま、 カットオフだけを 1.20 / 1.30 / 1.40 と動かした結果が次の表である(SSDSE-B-2026、 2023 年、 n=47、 実測値):
| 処置群の定義 | 処置群 n | 対照群 n | 死亡率の群間差(千人あたり) | 処置群の平均高齢化率 |
|---|---|---|---|---|
| 出生率 ≥ 1.20 | 36 | 11 | +1.29 | 32.1 % |
| 出生率 ≥ 1.30(本文の定義) | 24 | 23 | +1.00 | 32.5 % |
| 出生率 ≥ 1.40 | 11 | 36 | +0.82 | 32.5 % |
「処置群」の定義を 0.1 ずらしただけで、 ナイーブな群間差は +0.82 から +1.29 まで約 1.6 倍動く。 データも結果変数も一切変えていないのに、 である。 もしこれが実際の政策評価で、 分析者が「一番差が大きく見えるカットオフ」を選んで報告したら — それは p ハッキングの親戚であるカットオフ・ハッキングにほかならない。
もう一つの本質的な問題は、 カットオフを動かすと処置群の顔ぶれ=推定対象 (estimand) が変わることである。 カットオフ 1.40 の処置群は沖縄 (1.60)・長崎 (1.49)・宮崎 (1.49)・鹿児島 (1.48)・熊本 (1.47) など九州・山陰中心の 11 県。 これを 1.30 に下げると、 大分 (1.39)・滋賀 (1.38)・徳島 (1.36)・富山 (1.35)・石川 (1.34) など13 県が新たに処置群へ流入する。 ATT(処置群上の平均処置効果)は定義上「処置群にとっての効果」なので、 処置群の構成が変われば、 同じ「ATT」という名前でも指している量が別物になる。 「効果は +1.00 でした」という報告は、 「誰にとっての」を言わなければ半分しか語っていない。
🚀 発展 — 「二値の処置群」を超える 3 つの道
- ① 連続処置・用量反応(dose-response):処置を $D \in \{0,1\}$ ではなく連続量 $t$ のまま扱い、 用量反応関数 $E[Y(t)]$ を推定する。 観察データでは一般化傾向スコア (generalized propensity score) が対応物。 「補助金を受けたか」ではなく「1 人あたりいくら受けたか」で効果を語れるため、 カットオフの恣意性そのものが消える(本用語集に単独ページはないため文献では dose-response / continuous treatment で検索)。
- ② カットオフ近傍だけ比べる:二値化を逆手に取り、 境界すれすれの単位(上の例なら出生率 1.29 の兵庫・三重・愛知と 1.30〜1.31 の高知・岐阜・愛媛)だけを比べれば、 群をまたぐ 0.01 の差はほぼ偶然なので局所的なランダム化に近づく — これが回帰不連続デザイン (RDD) の発想である。 ただし推定できるのは「境界付近の単位に対する効果」に限られ、 ここでも estimand の限定と引き換えになっている。
- ③ 処置の中身とタイミングを問う:SUTVA の隠れた条件「処置に複数バージョンがない (consistency)」は、 処置群を自作するときこそ危うい。 「子育て支援を強化した県」を処置群と呼んでも、 現金給付の県と保育所整備の県では処置の中身が別物である。 また県ごとに導入年が違う(staggered adoption)場合、 「いつから処置群か」が県ごとにずれ、 素朴な二元固定効果 DID にバイアスが出ることが知られる(本ページ文献リストの Goodman-Bacon 2021・Callaway & Sant'Anna 2021 がまさにこの問題)。 パネルでの扱いはパネルデータ因果推論を参照。
まとめると、 処置群とは「データの中に転がっている集団」ではなく、 介入の定義・カットオフ・タイミングという 3 つの設計判断の産物である。 設計判断であるからこそ、 報告書にはその判断の根拠と感度を書く義務が生じる — これが処置群を扱う者の作法である。
🔗 関連ページ
- 対照群 — 本セクションの姉妹編。 定義した後の「対照群の質の事後診断」(SMD・プレ期間チェック)を掘り下げる
- 回帰不連続デザイン (RDD) — カットオフの恣意性を局所ランダム化に転化する設計
- 差の差分法 (DID) — 処置群の「タイミング」を推定に組み込む定番手法
- ダミー変数 — 二値化した処置群フラグの回帰モデル上の姿
- 交絡・選択バイアス — 自作した処置群に紛れ込むもの
- 因果関係・自然実験・A/B テスト — 処置群の定義を「制度・偶然・乱数」に委ねる 3 つの道
- 一般化傾向スコア・用量反応関数(単独ページなし。 連続処置の因果推論として文献参照)