💡 30秒で分かる結論
🍰 まずはやさしく
文字のデータを0か1に置き換える方法です。
計算モデルにデータを入れるために使います。
都道府県をグループで分けるときに便利です。
ダミー変数の作り方と使い方を学びます。
- ダミー変数 (Dummy Variable) は、 質的(カテゴリ)変数を回帰モデルなど数値モデルに投入するために 0/1 の二値変数に変換した変数のこと。
- $k$ カテゴリある場合は $k-1$ 個 のダミーを作る(基準カテゴリを残す)。 これを ダミー変数トラップ回避という。
- SSDSE-B-2026 では「三大都市圏 vs 地方」「気候区分」「人口階級」など、 47 都道府県を区分する場面で多用する。
- One-Hot エンコーディングは機械学習側の同義語、 効果コーディング(Effect/Sum coding)・対比コーディングなど別系統もある。
- 係数の解釈は 「基準カテゴリと比較したときの平均的な差」。
- 多項ロジット、 線形回帰、 ANOVA、 GLM、 ニューラルネットの入力前処理で 必須テクニック。
📍 文脈ボックス — あなたが今見ているもの
🍰 まずはやさしく
データの種類を変える翻訳装置のようなものです。
文字の情報を数値として伝えるために使います。
回帰分析という計算の手法でよく登場します。
この機能がどこで使われるのかを確認しましょう。
あなたは 「データ前処理 / 回帰分析 / 変数変換」 の交点ページを見ています。 ダミー変数は データの種類 で言う「質的変数」を 「量的変数の言葉で機械に伝えるための翻訳装置」です。
| 上位概念 | カテゴリ変数エンコーディング |
|---|---|
| 同列概念 | One-Hot / Effect Coding / Target Encoding / Binary Encoding |
| 下位応用 | 線形回帰 / ロジスティック回帰 / 多変量 ANOVA / 共分散分析 |
| 前提知識 | データの種類と変数 / 重回帰 |
🎨 直感で掴む
🍰 まずはやさしく
「当てはまるか」を0と1で表す仕組みです。
機械が文字を勘違いしないようにします。
血液型や住んでいる地域などで考えます。
基準を決めて比べる方法を具体的に見ましょう。
「血液型が A 型なら 1, それ以外なら 0」「都道府県が東京なら 1, それ以外なら 0」のように、 該当するか/しないか を 0/1 で表す変数がダミー変数です。 機械(線形回帰や決定木)は数値しか扱えないので、 文字列カテゴリをこの形に翻訳して入力します。
SSDSE-B-2026 の「都道府県」列をそのまま回帰に入れると、 「東京=1, 北海道=2, ... 」のように数値順に意味を勘違いされます。 そこで「東京ダミー」「大阪ダミー」「愛知ダミー」「...」と カテゴリの数-1 個 の 0/1 変数を新設するのです。
基準カテゴリは「ダミーが全て 0」のグループ。 たとえば「沖縄を基準」にすると、 各ダミー係数は「沖縄と比較した差」を意味します。 基準の選び方で係数は変わりますが、 予測値は同じです。
| 県 | 三大都市圏 | 中四国 | 北日本 | 基準(その他) |
|---|---|---|---|---|
| 東京都 | 1 | 0 | 0 | — |
| 大阪府 | 1 | 0 | 0 | — |
| 広島県 | 0 | 1 | 0 | — |
| 北海道 | 0 | 0 | 1 | — |
| 沖縄県 | 0 | 0 | 0 | 基準 |
📐 数式または定義
🍰 まずはやさしく
カテゴリを0か1の変数にする定義です。
数式を使って正しく計算するために使います。
グループごとの平均の差を求めるときに役立ちます。
ダミー変数を使った計算式について読みましょう。
カテゴリ変数 $C \in \{c_1, c_2, \dots, c_k\}$ に対して、 第 $j$ 番目($j=1,\dots,k-1$、 $c_k$ を基準)のダミー変数 $D_j$ を:
$$D_j = \mathbb{1}\!\left[ C = c_j \right] = \begin{cases} 1 & C = c_j \\ 0 & \text{otherwise} \end{cases}$$
ダミー変数を含む線形回帰モデル:
$$y_i = \beta_0 + \sum_{j=1}^{k-1} \beta_j D_{ij} + \gamma X_i + \varepsilon_i$$
$\beta_j$ は「カテゴリ $c_j$ と基準カテゴリ $c_k$ の平均差」を表す。 すべてのダミーが 0 のとき(=基準カテゴリ)の予測値は $\beta_0 + \gamma X_i$。
交互作用項(カテゴリと連続変数の組み合わせ):
$$y_i = \beta_0 + \beta_1 D_i + \beta_2 X_i + \beta_3 (D_i \cdot X_i) + \varepsilon_i$$
効果コーディング(Effect Coding):
$$D_j = \begin{cases} 1 & C = c_j \\ -1 & C = c_k \\ 0 & \text{otherwise} \end{cases}$$
🔬 数式を言葉で読み解く
| 記号 | 名前 | 意味 |
|---|---|---|
| $C$ | カテゴリ変数 | 「都市圏」「血液型」など |
| $D_j$ | 第 $j$ ダミー | $c_j$ に属するなら 1 |
| $\beta_0$ | 切片 | 基準カテゴリの平均 |
| $\beta_j$ | ダミー係数 | カテゴリ $c_j$ と基準との差 |
| $D_i \cdot X_i$ | 交互作用項 | 傾き自体がカテゴリで変わる |
$k-1$ 個に抑える理由:$k$ 個すべて入れると $\sum_j D_j = 1$ なので切片と完全多重共線になり推定不能(ダミー変数トラップ)。 ペナルティ付き回帰(Ridge, Lasso)では数学的には大丈夫ですが、 解釈のために 1 つ除くのが慣例。
🧮 数式に値を入れて手で計算する(SSDSE-B-2026 都道府県)
ダミー変数を使ったグループ別平均の差を、 5 都道府県の SSDSE-B-2026 実数値で Step ごとに手計算します。 ここでは「三大都市圏ダミー $D$」と「地方グループ」の総人口(万人)の差 $\hat{\beta}_1$ を OLS 手計算で求めます。
モデル:
$$y_i = \beta_0 + \beta_1 D_i + \varepsilon_i$$
ここで $D_i=1$ が三大都市圏、 $D_i=0$ が地方(基準)。 シンプルな二群モデルで、 OLS 解は
$$\hat{\beta}_1 = \bar{y}_{D=1} - \bar{y}_{D=0}, \quad \hat{\beta}_0 = \bar{y}_{D=0}$$
つまり係数 $\hat{\beta}_1$ は「都市圏グループの平均人口 − 地方グループの平均人口」に等しい。
📥 入力データ(SSDSE-B-2026 より抜粋、総人口単位は万人)
| 都道府県 | $D_i$(都市圏) | 総人口 $y_i$(万人) |
|---|---|---|
| 東京都 | 1 | 1,408.6 |
| 神奈川県 | 1 | 922.9 |
| 北海道 | 0 | 509.2 |
| 広島県 | 0 | 273.8 |
| 沖縄県 | 0 | 146.8 |
Step 1. グループ別平均を計算する
都市圏グループ($D=1$): 東京都 + 神奈川県
$$\bar{y}_{D=1} = \frac{1{,}408.6 + 922.9}{2} = \frac{2{,}331.5}{2} = 1{,}165.75 \text{ 万人}$$
地方グループ($D=0$): 北海道 + 広島県 + 沖縄県
$$\bar{y}_{D=0} = \frac{509.2 + 273.8 + 146.8}{3} = \frac{929.8}{3} = 309.93 \text{ 万人}$$
Step 2. ダミー係数(都市圏効果)を計算する
$$\hat{\beta}_1 = \bar{y}_{D=1} - \bar{y}_{D=0} = 1{,}165.75 - 309.93 = 855.82 \text{ 万人}$$
切片(地方グループの平均):
$$\hat{\beta}_0 = \bar{y}_{D=0} = 309.93 \text{ 万人}$$
Step 3. 各観測値の予測値と残差を計算する
| 都道府県 | $D_i$ | $y_i$ | $\hat{y}_i = \hat{\beta}_0 + \hat{\beta}_1 D_i$ | 残差 $e_i = y_i - \hat{y}_i$ |
|---|---|---|---|---|
| 東京都 | 1 | 1,408.6 | 309.93 + 855.82 = 1,165.75 | +242.85 |
| 神奈川県 | 1 | 922.9 | 309.93 + 855.82 = 1,165.75 | −242.85 |
| 北海道 | 0 | 509.2 | 309.93 + 0 = 309.93 | +199.27 |
| 広島県 | 0 | 273.8 | 309.93 + 0 = 309.93 | −36.13 |
| 沖縄県 | 0 | 146.8 | 309.93 + 0 = 309.93 | −163.13 |
Step 4. Python で同じ計算を再現する(一致確認)
このコードでやること:numpy で上記の手計算(グループ平均差)を再現し、 OLS の係数と一致することを確認する。
1 2 3 4 5 6 7 8 9 10 11 12 13 14 15 16 17 18 19 | import numpy as np # SSDSE-B-2026 5 都道府県(手計算と同じデータ) D = np.array([1, 1, 0, 0, 0], dtype=float) y = np.array([1408.6, 922.9, 509.2, 273.8, 146.8]) # グループ別平均(手計算と一致するはず) y_metro = y[D==1].mean() y_rural = y[D==0].mean() beta1 = y_metro - y_rural beta0 = y_rural # OLS で確認(X = [1, D]) X = np.column_stack([np.ones(5), D]) beta_ols = np.linalg.lstsq(X, y, rcond=None)[0] print(f'手計算: β0={beta0:.2f}, β1={beta1:.2f}') print(f'OLS: β0={beta_ols[0]:.2f}, β1={beta_ols[1]:.2f}') print('一致確認:', np.allclose([beta0, beta1], beta_ols)) |
💬 手計算と OLS は完全に一致(True)。 切片 $\hat{\beta}_0 = 309.93$ 万人は地方グループ(北海道・広島・沖縄)の平均人口。 ダミー係数 $\hat{\beta}_1 = 855.82$ 万人は「三大都市圏は地方より平均 855 万人多い」という効果を示す。 都市圏の県はこの「+855 万人」が上乗せされ、 沖縄・広島はほぼ切片水準に収まる。
基準カテゴリを変えると係数はどう変わる?
「地方基準 → 都市圏基準($D=1$ を基準に $D'=1-D$)」に変えると、 切片が $\bar{y}_{D=1}=1{,}165.75$ に再校正され、 ダミー係数の符号が反転して $-855.82$ になります。 予測値 $\hat{y}_i$ は変わりません。 係数の数値は変わっても「基準との差」という意味は保たれます。
✏️ 演習問題(手計算)
問題:以下の 4 県データで、$\hat{\beta}_0$ と $\hat{\beta}_1$ を手計算しなさい。
| 県 | $D_i$(三大都市圏) | $y_i$(総人口 万人) |
|---|---|---|
| 大阪府 | 1 | 876.3 |
| 愛知県 | 1 | 747.7 |
| 福岡県 | 0 | 510.3 |
| 宮城県 | 0 | 226.4 |
ヒント:$\hat{\beta}_1 = \bar{y}_{D=1} - \bar{y}_{D=0}$、 $\hat{\beta}_0 = \bar{y}_{D=0}$
▶ 解答を見る
都市圏グループ平均:$\bar{y}_{D=1} = (876.3 + 747.7)/2 = 1624.0/2 = 812.0$ 万人
地方グループ平均:$\bar{y}_{D=0} = (510.3 + 226.4)/2 = 736.7/2 = 368.35$ 万人
$\hat{\beta}_1 = 812.0 - 368.35 = \mathbf{443.65}$ 万人(都市圏効果)
$\hat{\beta}_0 = 368.35$ 万人(地方グループの平均人口)
💬 今回は東京・神奈川を除いたデータのため、係数は本文の 855.82 より小さく 443.65 になる。基準カテゴリや標本の選び方によって係数値は変わる。
🎮 触って理解する
3 つのグループ(A=基準 / B / C)を、 共通の傾き $\beta_1$ と グループごとのダミー係数(切片シフト) で回帰するモデルです。 スライダー、 または 散布図の左端の丸(ハンドル)を上下にドラッグすると、 3 本の回帰直線と数値がリアルタイムに動きます。 スマホでは指でドラッグできます。
モデル:$\;\hat{y}=\beta_0+\beta_1 x+\beta_B D_B+\beta_C D_C\;$($D_B,D_C$ は 0/1)。 グループ A は $D_B=D_C=0$ の 基準カテゴリ。 だから A の切片は $\beta_0$、 B の切片は $\beta_0+\beta_B$、 C の切片は $\beta_0+\beta_C$ になります。 ダミー係数 $\beta_B,\beta_C$ は「基準 A との切片の差」そのものです。 3 カテゴリなのでダミーは 2 本($k-1$)だけ ── これがダミー変数トラップ回避です。
🧭 直感:カテゴリを 0/1 にして回帰に入れるだけ
ダミー変数は「そのグループに属するなら 1、 そうでなければ 0」というスイッチです。 回帰式にこのスイッチを入れると、 スイッチが ON のとき係数ぶんだけ切片が上下します。 上の図で β_B を動かすと B のラインだけが平行移動するのは、 B の点だけ $D_B=1$ でスイッチが入るからです。 傾き β₁ は全グループ共通なので、 3 本はいつも平行です。
🕳 よくある落とし穴
- ダミー変数トラップ(完全多重共線性):$k$ カテゴリに $k$ 本のダミーを入れると切片列と一次従属になり係数が求まりません。 必ず 1 つを基準にして $k-1$ 本にします(上の体験パネル参照)。 詳しくは 多重共線性。
- 基準カテゴリの解釈:ダミー係数は「絶対水準」ではなく「基準カテゴリとの差」です。 基準を変えれば係数の数値も符号も変わります(が予測値は不変)。 「何を基準にしたか」を必ず明記します。
- 順序を無視しない:本来順序のあるカテゴリ(松竹梅など)を素朴にダミー化すると順序情報が失われます。 目的に応じて順序尺度として扱うか検討します。
🚀 発展
- 交互作用(傾きも変える):$x\times D_B$ の項を足すと、 切片だけでなく傾きもグループごとに変わり、 3 本が平行でなくなります。 このデモは「切片シフトのみ」の最も基本の形です。
- One-Hot エンコーディング:$k$ カテゴリを $k$ 本の 0/1 列に展開する手法。 回帰では基準を落として $k-1$ 本にしますが、 決定木系や正則化ありでは $k$ 本のまま使うこともあります。 One-Hot エンコーディング を参照。
- 関連:この仕組みの土台は 線形回帰 と 最小二乗法(OLS)、 質的変数の扱いは カテゴリ変数 にまとまっています。
🐍 Python 実装
SSDSE-B-2026 で「三大都市圏ダミー」を作り、 人口を消費支出と都市圏フラグで回帰します。
🎯 このコードでやること: SSDSE-B-2026 から各都道府県の最新年度データを取り出し、 isin() で三大都市圏ダミー (0/1) を作成する
1 2 3 4 5 6 7 8 9 10 11 12 13 | import pandas as pd import numpy as np # 実 SSDSE-B-2026 読み込み df = pd.read_csv('data/raw/SSDSE-B-2026.csv', skiprows=1, encoding='cp932') latest = df.sort_values('年度').groupby('都道府県').last().reset_index() # 三大都市圏ダミーを作成 metro = {'東京都','神奈川県','埼玉県','千葉県', '大阪府','京都府','兵庫県','奈良県', '愛知県','岐阜県','三重県'} latest['大都市圏ダミー'] = latest['都道府県'].isin(metro).astype(int) print(latest[['都道府県','大都市圏ダミー','総人口','消費支出(二人以上の世帯)']].head(15)) |
💬 読み方: sort_values('年度') → groupby('都道府県').last() で各県の最新年度 (2023) を 1 行ずつ取り出し、 isin() で 0/1 の三大都市圏ダミーを作った。 このダミーはそのまま線形回帰や ANOVA に投入できる。
🎯 このコードでやること: pandas.get_dummies(drop_first=True) で地域ブロックを 7 列のダミー変数に変換する
1 2 3 4 5 6 7 8 9 10 11 12 13 14 15 16 17 | # pd.get_dummies で地域ブロックダミー化 region_map = { '北海道':'北海道','青森県':'東北','岩手県':'東北','宮城県':'東北','秋田県':'東北','山形県':'東北','福島県':'東北', '茨城県':'関東','栃木県':'関東','群馬県':'関東','埼玉県':'関東','千葉県':'関東','東京都':'関東','神奈川県':'関東', '新潟県':'中部','富山県':'中部','石川県':'中部','福井県':'中部','山梨県':'中部','長野県':'中部','岐阜県':'中部','静岡県':'中部','愛知県':'中部', '三重県':'近畿','滋賀県':'近畿','京都府':'近畿','大阪府':'近畿','兵庫県':'近畿','奈良県':'近畿','和歌山県':'近畿', '鳥取県':'中国','島根県':'中国','岡山県':'中国','広島県':'中国','山口県':'中国', '徳島県':'四国','香川県':'四国','愛媛県':'四国','高知県':'四国', '福岡県':'九州','佐賀県':'九州','長崎県':'九州','熊本県':'九州','大分県':'九州','宮崎県':'九州','鹿児島県':'九州','沖縄県':'九州' } latest['地域'] = latest['都道府県'].map(region_map) latest['地域'] = pd.Categorical(latest['地域'], categories=['北海道','東北','関東','中部','近畿','中国','四国','九州']) # 先頭カテゴリ=基準を明示 dummies = pd.get_dummies(latest['地域'], drop_first=True) # 北海道を基準に print(dummies.head()) X = pd.concat([latest[['消費支出(二人以上の世帯)']], dummies], axis=1) y = latest['総人口'] print('説明変数の形:', X.shape) |
💬 読み方: k 値カテゴリを k-1 個のダミーで表現し、 完全多重共線性『ダミー変数の罠』を回避。 削除されたカテゴリ (北海道) が基準 (reference level) になり、 切片に吸収される。 なお drop_first=True は既定では五十音順の先頭を落とすため、 pd.Categorical で基準を明示している。 線形回帰では必須テクニック。
🎯 このコードでやること: statsmodels で地域ダミー入り OLS 回帰を実行し、 消費支出を揃えたうえでの各地域の総人口の差 (地域効果) を推定
1 2 3 4 5 6 | # statsmodels で OLS 回帰 import statsmodels.api as sm Xc = sm.add_constant(X.astype(float)) model = sm.OLS(y, Xc).fit() print(model.summary()) # 各地域ダミーの係数 = 「北海道と比べてその地域は平均何人多い/少ないか」 |
💬 読み方: 各ダミー係数は基準カテゴリ (北海道) との差分。 消費支出を一定とした下で、 関東は約 +87 万人、 東北は約 −368 万人など解釈が直感的になる。 ANOVA の F 検定と同等の効果が、 ダミー回帰で得られる。
🎯 このコードでやること: sklearn の OneHotEncoder で同じダミー化を実装し、 get_dummies 版 (北海道基準) と係数を見比べる。 fit したエンコーダを使い回せば、 後から来るデータにも同じ列構造が適用される
1 2 3 4 5 6 7 8 9 10 | # scikit-learn の OneHotEncoder で同じことを from sklearn.preprocessing import OneHotEncoder from sklearn.linear_model import LinearRegression enc = OneHotEncoder(drop='first', sparse_output=False) D = enc.fit_transform(latest[['地域']]) X2 = np.hstack([latest[['消費支出(二人以上の世帯)']].values, D]) reg = LinearRegression().fit(X2, latest['総人口']) names = ['消費支出'] + list(enc.get_feature_names_out()) print('係数:', {k: round(float(v), 1) for k, v in zip(names, reg.coef_)}) print('切片:', round(float(reg.intercept_), 1)) |
💬 読み方: 基準が北海道から中国に変わっただけなので、 消費支出の係数 13.2 は上の statsmodels 版と同じで、 地域_北海道 = +3,615,248 は statsmodels 版の「中国 = −3,615,248」の符号をちょうど反転したものになる。 ダミー係数は基準との差なので、 数値だけを別の表と並べる前に基準がどれかを確かめる。 pandas.get_dummies は渡したデータに現れたカテゴリだけで列を作るので、 データの一部に北海道が無いと列数が変わるが、 fit 済みの OneHotEncoder を transform に使い回せば列構造は固定される。
🎯 このコードでやること: 交互作用 (interaction) ダミー: 消費支出 × 地域の交互作用項を追加し、 消費支出の効果 (傾き) が地域ごとに違うかを捉える
1 2 3 4 5 6 7 8 9 10 11 12 13 | # patsy 形式で交互作用を含める (R 流フォーミュラ) import statsmodels.formula.api as smf latest_renamed = latest.rename(columns={'消費支出(二人以上の世帯)':'消費'}) # 北海道は 1 県しかなく「北海道だけの切片と傾き」(2 個) を 1 点からは決められないので、 # 交互作用モデルでは東北とまとめて 1 カテゴリ (7 道県) にし、これを基準にする latest_renamed['地域7'] = latest_renamed['地域'].astype(str).replace( {'北海道': '北海道・東北', '東北': '北海道・東北'}) # 地域による傾き差を許す m = smf.ols('総人口 ~ 消費 * C(地域7, Treatment("北海道・東北"))', data=latest_renamed).fit() print('パラメータ数:', len(m.params), ' 計画行列のランク:', np.linalg.matrix_rank(m.model.exog)) slopes = m.params.filter(like='消費').round(1) print(slopes.rename(lambda s: s.replace('C(地域7, Treatment("北海道・東北"))', '地域'))) print(f'R² = {m.rsquared:.3f}, 残差自由度 = {m.df_resid:.0f}') |
💬 読み方: 交互作用項で『消費支出の効果 (傾き) は地域によって異なる』を表現。 基準 (北海道・東北) の傾きは 10.2 人/円で、 関東は 10.2 + 107.4 = 117.6、 近畿は 10.2 − 57.9 = −47.7 と向きまで逆になる。 北海道を単独の基準にすると、 1 県から切片と傾きの 2 つを決めることになり計画行列のランクが 16 列中 15 に落ちて、 statsmodels は警告なしに一意でない係数を返してしまう。 まとめた後もパラメータ 14 個に対し残差自由度は 33 しかなく、 1 地域 4〜7 県で傾きを推定しているので、 係数の大小を地域の性質として読む前に標準誤差を確かめる。
🎯 このコードでやること: ダミー列が増えすぎるときの代替として、 地域 (8 区分) をターゲットエンコーディング (地域ごとの総人口の平均) で 1 列に置き換える
1 2 3 4 | # Target Encoding: ダミー数が爆発する場合の代替 te = latest.groupby('地域')['総人口'].transform('mean') latest['地域_TE'] = te print(latest[['都道府県','地域','地域_TE']].head(10)) |
💬 読み方: 先頭 5 行では近畿の三重・京都・兵庫に同じ 3,141,429 人 (近畿 7 府県の平均) が、 九州の佐賀に 1,753,625 人 (九州 8 県の平均) が入る。 北海道は 1 道だけの地域なので、 TE が自分自身の総人口 5,092,000 人そのもので、 目的変数がそのまま説明変数に漏れている。 47 都道府県をすべてダミーにすると 46 列で過学習リスクがある一方、 Target Encoding はこうしたリークを防ぐため smoothing と CV fold ごとの fit が必須。
⚠️ 落とし穴
🗺 概念マップ
ダミー変数は カテゴリ変数を線形モデルに繋ぐ橋。 データの種類 → ダミー化 → 回帰 / ロジスティック / ANOVA という典型的なフローを支えます。
分野別の呼称マップ
| 分野 | 用語の呼ばれ方 | 基準 drop の慣例 |
|---|---|---|
| 統計学 | ダミー変数 / 指示変数 | drop_first=True で k-1 個 |
| 機械学習 | One-Hot Encoding | k 個すべて残すことも多い |
| 経済学 | 指標変数 (Indicator) | 対照群を基準に |
| 心理学/医学 | 対比 (Contrast) 変数 | 効果コーディング (+1/-1) も使用 |
| 深層学習 | Embedding / One-Hot | Embedding で学習済みベクトルに |
包含・依存関係ツリー
| 階層 | 用語 / 概念 | ダミー変数との関係 |
|---|---|---|
| 上位 | カテゴリ変数 / 特徴量エンジニアリング | ダミー化はカテゴリ → 数値変換の一手法 |
| 同列 | Target Encoding / Ordinal / Binary / Hashing | 別のエンコーディング方式(互いに代替可能) |
| 下流 | 線形回帰 / ロジスティック回帰 / ANOVA / 重回帰 | ダミーを説明変数として受け取るモデル群 |
| 応用 | DiD / 固定効果モデル / 交互作用 / 季節調整 | ダミー変数が因果推論・時系列の基盤に |
SSDSE-B-2026 での概念的位置づけ
SSDSE-B-2026 の 47 都道府県データでは次のような変換パスが典型的に使われます:
| カテゴリ変数(元) | ダミー化の方法 | 生成されるダミー列数 | 基準 |
|---|---|---|---|
| 都道府県(47 県) | get_dummies(drop_first) | 46 列 | 北海道(or アルファベット先頭) |
| 地域ブロック(8 区分) | get_dummies(drop_first) | 7 列 | 北海道 |
| 三大都市圏(2 区分) | isin() で 0/1 作成 | 1 列 | 地方($D=0$) |
| 政令指定都市ダミー | カラム作成 | 1 列 | 非政令市($D=0$) |
関係図(SVG 概念マップ)
🔗 隣接手法への橋渡し
「ダミー変数」は単独で完結する手法ではなく、 隣接手法と連携することで真価を発揮します。 入力・並列・出力の 3 方向から整理します。
| 方向 | 手法 | ダミー変数との接続 |
|---|---|---|
| 上流 | カテゴリ変数の識別 | 名義・順序・比例の区別がダミー化の判断基準 |
| 上流 | 欠損値処理 | 欠損を「不明」カテゴリとしてダミー化する手法も存在する |
| 並列 | ANOVA(分散分析) | グループ間差の F 検定。 ダミー回帰と数学的に等価 |
| 並列 | t 検定 | 2 グループの差検定 = k=2 のダミー回帰の t 検定と等価 |
| 下流 | 重回帰分析 | ダミー変数を連続変数と混合して投入する標準的なモデル |
| 下流 | ロジスティック回帰 | ダミーの係数は対数オッズ比として解釈される |
| 発展 | 機械学習(One-Hot) | sklearn の OneHotEncoder はダミー変数の機械学習版。 Pipeline で前処理を固定できる |
| 因果 | DiD / 固定効果モデル | 処置群ダミー × 期間ダミーの交互作用が因果効果 $\delta$ になる |
これらの接続を意識することで、 ダミー変数を中核に据えた「データ読み込み → エンコーディング → 回帰 / 検定 → 解釈」という一貫した分析パイプラインを構築できます。
🌳 手法選択フロー
カテゴリ変数をどのようにエンコードするか、 状況別に 4 段階で判定するフローを示します。 SSDSE-B-2026 の都道府県データを想定しています。
| ステップ | 判断条件 | Yes → 選択肢 | No → 代替 |
|---|---|---|---|
| Step 1 | カテゴリ数 $k$ は 20 以下か? | → ダミー変数(k-1 列)を使う | → Step 2 へ(高カーディナリティ対策) |
| Step 2 | 目的変数との関係を把握したいか? | → Target Encoding(リーク防止必須) | → Frequency Encoding / Hashing |
| Step 3 | 順序のある変数か(例:低/中/高)? | → Ordinal Encoding(順序保持) | → ダミー変数(順序無視) |
| Step 4 | 深層学習モデルで使うか? | → Embedding(学習済みベクトル) | → One-Hot / ダミー変数 |
SSDSE-B-2026 での判定例:
- 「地域ブロック(8 区分)」→ Step 1 Yes → ダミー変数 7 列(北海道基準)
- 「47 都道府県」→ Step 1 No → Step 2 Yes → Target Encoding 1 列(CV 内で計算)
- 「人口規模区分(大/中/小)」→ Step 1 Yes → Step 3 Yes → Ordinal Encoding(0/1/2)
- 「三大都市圏フラグ(2 値)」→ Step 1 Yes(k=2)→ 0/1 の一列ダミーだけで完結
🧩 エンコーディングの種類
| 名称 | 符号化 | 特徴 |
|---|---|---|
| Dummy / One-Hot | 0/1, k-1 列 | 標準。 解釈容易 |
| Effect / Sum Coding | +1, -1, 0 | 「全体平均との差」を測る |
| Helmert Coding | 各カテゴリと後続平均を比較 | 順序カテゴリに有効 |
| Polynomial Coding | 直交多項式 | 線形・二次トレンドを抽出 |
| Target Encoding | カテゴリ別目的変数平均 | 高カーディナリティに有効。 リーク注意 |
| Binary Encoding | 2進表現 | 列数を $\log_2 k$ に |
| Frequency Encoding | 出現頻度 | 情報量少だが軽量 |
| Embedding | 学習されるベクトル | 深層学習の標準 |
🔬 応用事例
- 差の差分析 (DiD):「処置群ダミー × ポストダミー」の交互作用係数で因果効果を推定。
- 政策評価:地域ダミー × 政策実施ダミー で県別効果を推定。
- 季節調整:月次ダミー (12 個から 1 つ除いた 11 個) で季節性を吸収。
- マーケティング:曜日ダミー・キャンペーンダミーで売上を分解。
- 医療統計:性別・喫煙状態ダミーで生存率を回帰。
- SSDSE 都道府県分析:地域ブロック・気候区分ダミーで人口動態を説明。
✅ ベストプラクティス
- カテゴリ数を事前確認し、 高カーディナリティなら集約・Target Encoding を検討。
- 基準カテゴリは「サンプル数が多い・解釈の基準にしたい」を選ぶ。
- pd.get_dummies(drop_first=True) を標準化、 OneHotEncoder(handle_unknown='ignore') で未知カテゴリに耐性。
- カテゴリ × 連続変数の交互作用は事前知識がある場合のみ慎重に。
- 多項目因果分析では Wald 検定 / F 検定でカテゴリ全体の有意性を見る。
- パネルデータでは固定効果モデル(FE)で県・年ダミーを両方入れる。
⚖ コーディング方式の比較
3 水準 {A, B, C} (基準 C) の場合の各コーディング行列:
| 水準 | Dummy (D₁ D₂) | Effect (E₁ E₂) | Helmert (H₁ H₂) |
|---|---|---|---|
| A | 1, 0 | 1, 0 | -1, -1 |
| B | 0, 1 | 0, 1 | 1, -1 |
| C (基準) | 0, 0 | -1, -1 | 0, 2 |
同じデータでも符号化を変えると係数の数値・解釈が変わります。 ただし 予測値・モデルの当てはまり ($R^2$)・F 検定の結果は不変。 解釈の都合で選びます。
📜 歴史と語源
「ダミー変数」という言葉は 1950 年代の計量経済学(Suits 1957 など)で広まりました。 元来は「実体のない、 単に他のものを表すために置かれる」という英語 dummy の意味どおり、 実際の数量ではなく属性を 0/1 で表す 変数として導入されました。 機械学習が普及した 2000 年代以降は One-Hot Encoding という呼び名が広がりましたが、 統計学では依然「ダミー変数」が一般名です。
- 1957 — Suits, "Use of dummy variables in regression equations" 発表
- 1970s — DiD(差の差分法)が経済学で確立、 ダミー × 期間で因果効果を測る基本手法に
- 1980s — 固定効果モデル / 確率効果モデルの理論整備
- 2000s — One-Hot Encoding として機械学習でも標準化
- 2010s — Embedding 学習(word2vec, item2vec)で連続的なカテゴリ表現が登場
- 2020s — カテゴリ変数を扱えるツリーブースト (LightGBM, CatBoost) が普及
📖 係数の解釈ガイド
線形回帰でのダミー係数解釈は 基準カテゴリとの差。 モデルによって解釈の単位が変わる点に注意:
| モデル | ダミー係数の意味 | 単位 |
|---|---|---|
| 線形回帰 | 目的変数 $y$ の平均差 | $y$ と同じ単位 |
| 対数線形回帰 | $y$ の比率差(約 $\%$) | $e^\beta - 1 \approx \beta$ |
| ロジスティック回帰 | 対数オッズ比 | $\exp(\beta) =$ OR |
| ポアソン回帰 | 対数発生率比 | $\exp(\beta) =$ IRR |
| Cox 回帰 | 対数ハザード比 | $\exp(\beta) =$ HR |
SSDSE-B-2026 で「東京ダミー係数 = +6,500,000」(線形 OLS)なら「東京は基準カテゴリより平均 650 万人多い」。 同じデータに対数線形を当てて「東京ダミー係数 = 0.6」なら「東京は基準より約 +60% (= $e^{0.6}-1 \approx 0.82$ で約 +82%) 大きい」。
📊 ダミーで因果推論:DiD と二要因 ANOVA
ダミーが本領を発揮するのは 因果推論 の場面です。 差の差分法 (Difference-in-Differences, DiD) では「処置ダミー × 期間ダミー」の交互作用係数が因果効果の推定量になります。
$$y_{it} = \alpha + \beta_1 \text{Treat}_i + \beta_2 \text{Post}_t + \delta(\text{Treat}_i \cdot \text{Post}_t) + \varepsilon_{it}$$
$\delta$ が「処置による効果」の不偏推定量(共通トレンド仮定下)。 例:ある県に観光振興政策が 2020 年に導入されたとき、 政策実施県と未実施県で「2020 年前後の旅館施設数の変化の差」を $\delta$ が捉えます。
| 処置前 (2018) | 処置後 (2023) | 差 | |
|---|---|---|---|
| 処置群(政策実施県) | $\bar{y}_{T,0}$ | $\bar{y}_{T,1}$ | $\Delta_T$ |
| 対照群(その他) | $\bar{y}_{C,0}$ | $\bar{y}_{C,1}$ | $\Delta_C$ |
| 差の差 | $\delta = \Delta_T - \Delta_C$ |
🏛 固定効果モデルとダミー
パネルデータでは「47 都道府県ダミー」を全て投入することで、 県固有の時間不変な影響を吸収できます。 これが 固定効果モデル (Fixed Effects) の骨格。 within 推定量と数学的に等価。
$$y_{it} = \alpha_i + \beta X_{it} + \varepsilon_{it}, \quad \alpha_i = \sum_{j=1}^{N-1} \beta_j D_{ji}$$
$N=47$ 県の場合、 46 個のダミーを追加します。 SSDSE-B-2026 のように複数年×複数県のパネルでは、 県固定効果と年固定効果を両方入れる 2-way FE が標準。
❓ FAQ
Q1. なぜ k-1 個に減らすのか?
k 個すべてを入れると $\sum_j D_j = 1$ となり切片と線形従属(rank 落ち)。 OLS の正規方程式が解けないため。 ペナルティ付き回帰では k 個でも回るが、 解釈用の慣例として 1 つ除く。
Q2. ダミー変数係数の有意性は何を検定する?
$\beta_j = 0$(基準カテゴリと差なし)の帰無仮説に対する t 検定。 ただし「カテゴリ全体が説明力を持つか」は F 検定(複数係数の同時零仮説) で評価する。
Q3. ツリーモデルでもダミー化は必要?
scikit-learn の決定木・ランダムフォレストは カテゴリを直接扱えない のでダミー化が必要。 LightGBM, CatBoost は内部で対応する機能あり。
Q4. インタラクション項はいつ入れる?
カテゴリによって連続変数の効果が変わる根拠があるとき。 例:「都市/地方で消費支出が人口に与える効果が違う」。 R² の改善や F 検定で必要性を判断。
Q5. ダミー変数を標準化すべき?
原則 標準化しない。 0/1 のままで解釈しやすさを保つ。 Ridge/Lasso と組み合わせる場合は連続変数と尺度を揃えるため標準化することもある。
🔢 高カーディナリティ対策
水準数 $k$ が数百〜数千になると、 単純なダミー化は 列数爆発・スパース・過学習を招きます。 対策:
- 頻度の低いカテゴリを「その他」にまとめる:閾値 $n_\text{min}$ を設定。
- Target Encoding:カテゴリ別目的変数平均で置換。 CV 内で計算しリーク防止。
- Frequency Encoding:出現頻度に置換。 情報量小だが軽い。
- Hashing Trick:ハッシュで $d$ 次元に固定する(feature_hasher)。
- Embedding:深層学習で $d$ 次元連続表現を学習。
- 階層モデル:Bayesian random effects で縮約 (partial pooling)。
SSDSE-B-2026 の 47 都道府県は中程度のカーディナリティ。 47 個全部ダミー化しても良いし、 「8 地域ブロック」「3 都市規模」に集約してもよい。 サンプル数 47 × 12 年 = 564 程度なら 8 ダミーくらいが妥当。
🧭 リファレンスカテゴリの選び方(ダミー変数固有の勘所)
K カテゴリを K-1 個のダミー変数に変換するとき、 「どのカテゴリを 0 として残すか」(リファレンス、 基準カテゴリ) はモデルの数値解釈を大きく左右する。 SSDSE-B-2026 で「地方ブロック」(北海道/東北/関東/中部/近畿/中国/四国/九州沖縄) をダミー化する場面で、 リファレンス選定の指針を整理する。
| 指針 | 推奨される基準カテゴリ | なぜ |
|---|---|---|
| 最大サンプル | 「関東」(47 都道府県中 7 県) | 回帰係数 SE が最小化、 推定の安定性が高い |
| 政策的基準 | 「全国平均に近いブロック」 | 他ブロック効果が「全国比でどれだけ高い/低い」と直感解釈できる |
| 時系列分析 | 「基準年 (2015)」 | 他年のダミー係数が基準年からの差分として読める |
| 介入研究 | 「対照群 (コントロール)」 | 処置効果がそのまま回帰係数になる ATE 解釈と整合 |
⚠️ pd.get_dummies(df['block'], drop_first=True) はアルファベット昇順で最初の値 (「九州沖縄」など) が落ちる仕様。 意図したカテゴリを基準にしたいときは pd.Categorical(df['block'], categories=['関東','北海道',...], ordered=False) で順序を明示すること。 R の relevel(factor, ref="関東") と等価。
理解度チェック(R445)
ダミー変数(dummy variable)は、 カテゴリ変数(例:性別、 都道府県、 都市規模区分、 業種)を回帰モデルや機械学習モデルで使える「0/1 の数値列」に変換するための極めて基本的な道具です。 ここでは SSDSE-B-2026(都道府県 47 行)の数値を念頭に置きながら、 ダミー変数を「正しく作る・正しく解釈する・正しく使い分ける」ための理解度を 12 問のセルフチェックで確認します。 各問の解説には、 回帰係数の意味、 基準カテゴリ(base / reference category)の役割、 多重共線性(multicollinearity)と完全多重共線性(dummy variable trap)の違い、 順序尺度(ordinal)への適切な扱い、 そして交互作用項(interaction term)まで含めて、 「次にどう動けばよいか」を 1 行で示します。
Q1. ダミー変数とは何か(30 秒で答える)
ダミー変数とは、 「あるカテゴリに該当するなら 1、 そうでなければ 0」を取る 2 値の数値列です。 例えば SSDSE-B-2026 で「東京かどうか」を表す列 is_tokyo を作ると、 北海道は 0、 東京は 1、 大阪は 0、 …というベクトルになります。 これを回帰モデル y = β0 + β1·is_tokyo + ε に投入すると、 β1 は「東京の y の平均 − 東京以外の y の平均」を推定する係数になります。 つまりダミー変数は、 「カテゴリの効果を 1 個の係数として読み取る装置」です。
Q2. なぜ「1 つだけ落とす」必要があるのか
k 個のカテゴリがあるとき、 k 個のダミー列をすべて入れて切片も入れると、 列の合計 = 1 という関係が成立し、 設計行列のランクが落ちて係数が一意に決まらなくなります。 これが完全多重共線性(perfect multicollinearity)、 通称「ダミー変数トラップ」です。 解決は単純で、 k − 1 個のダミーだけを使い、 残り 1 個を「基準(reference / base)」とします。 pandas の pd.get_dummies(..., drop_first=True) は最初のカテゴリを自動的に落としてくれます。 statsmodels の C(変数名, Treatment(reference='値')) を使うと基準カテゴリを明示的に指定できます。
Q3. 基準カテゴリを変えると係数の解釈はどう変わるか
係数は「基準カテゴリと比べた差」を表します。 例えば「東京を基準にする」と、 北海道の係数は「北海道 − 東京」、 大阪の係数は「大阪 − 東京」となり、 多くの係数が負になりがちです。 一方「北海道を基準にする」と、 東京の係数は大きな正の値、 大阪の係数も正の値になります。 モデルの予測値・残差・全体の説明力(R^2)は基準を変えても一切変わりません。 変わるのは「係数の表示」だけです。 報告書では「基準カテゴリは何か」を必ず明記してください。 これを書き忘れると読者は係数を誤って解釈します。
Q4. 順序尺度(小・中・大)はどう扱うべきか
都市規模区分のような順序尺度には 2 つの選択肢があります。 (A) 順序を活かして 1, 2, 3 の整数として 1 列で投入(線形に効くと仮定)、 (B) ダミー変数化して順序を捨て、 各水準の効果を独立に推定。 (A) は係数 1 個で済み解釈が単純ですが、 「小→中の差」と「中→大の差」が等しいという強い仮定を置きます。 (B) は仮定が弱く、 各水準の差を自由に推定できますが、 列数が増え、 小標本では推定が不安定になります。 SSDSE-B-2026 のように n=47 と小さい場合は、 まず (B) で水準ごとの平均を観察し、 (A) の線形仮定が妥当そうなら (A) に切り替える、 という流れが堅実です。
Q5. ダミー変数と One-Hot Encoding の違いは
名前は違いますが、 中身は同じ「カテゴリ → 0/1 列群」の変換です。 慣例的に、 統計(回帰)の世界では「ダミー変数」と呼び、 k 個のカテゴリに対して k − 1 列を作る(基準カテゴリを落とす)流儀が標準。 機械学習の世界では「One-Hot Encoding」と呼び、 k 列すべてを作る流儀が標準です。 機械学習でも正則化(Lasso / Ridge)や決定木系(XGBoost, LightGBM)を使う場合、 k 列すべてあっても完全多重共線性の問題が表に出ないため、 そのまま使うことが多いです。 線形回帰や線形 SVM のように切片+多重共線性に弱いモデルでは、 必ず k − 1 列に落とすか、 切片を外す必要があります。
Q6. 交互作用項を入れたいときはどうするか
ダミー変数 is_tokyo と連続変数 population の交互作用を入れたい場合、 新しい列 is_tokyo × population を掛け算で作って投入します。 こうすると、 「人口の傾きが東京と東京以外で違うか」を係数として推定できます。 交互作用項を入れるときは、 必ず主効果(is_tokyo と population の単独項)も同時に入れてください。 主効果を抜くと「東京以外の傾きはゼロ」という妙な制約が暗黙に入ります。 statsmodels の式記法では y ~ population * C(is_tokyo) と書けば、 主効果 2 つと交互作用 1 つが自動的に展開されます。
Q7. ダミー変数の係数の有意性をどう読むか
係数 β の t 統計量と p 値は、 「このダミー変数の効果はゼロと有意に違うか」を判定します。 ただし「ダミー全体としてどのカテゴリ群が効いているか」を見たいときは、 個別の t 検定ではなく、 「全カテゴリのダミーを一括で外すモデル」と「入れたモデル」を比較する F 検定(partial F-test)が適切です。 statsmodels では anova_lm(model_small, model_large) で実行できます。 SSDSE-B-2026 のように n=47、 都道府県カテゴリ 47 個(基準を 1 つ落とせば 46 個)のような状況では、 1 行 1 ダミーになってしまうので、 ダミーを「地域ブロック」(北海道、 東北、 関東…)に丸めるなどの集約が必須です。
Q8. 標本サイズが小さいときの落とし穴
n=47(都道府県)で 8 ブロックのダミー(基準を除いて 7 列)+連続変数 3 個+切片を入れると、 自由度は 47 − 7 − 3 − 1 = 36 残ります。 ここまでなら現実的ですが、 47 都道府県すべてをダミー化(46 列)すると自由度は 0、 つまり完全フィットになりすべての説明力が無意味になります。 経験則として、 「1 ダミー列あたり最低 10 観測」を目安にすると安定します。 観測が少ない場合は、 地域ブロック・都市規模 3 区分・産業大分類などの「粗い集約」でダミー数を抑えるか、 階層モデル(ランダム効果)を使って情報をプールします。
Q9. 欠損・新カテゴリへの対応
本番運用では「学習データに無かったカテゴリ」が予測時に出現します。 例えば学習時に「東京・大阪・名古屋・福岡」だけだったところに、 予測時「札幌」が現れる、 という状況です。 対策は 3 つ。 (1) 全カテゴリを OneHotEncoder(handle_unknown='ignore') で受けて未知カテゴリは全列ゼロにする、 (2) 「その他(other)」というダミー列を学習時から用意しておく、 (3) 階層モデル(target encoding +ベイズ的縮小)で滑らかに補間する。 SSDSE-B-2026 のような閉じたデータセット(47 都道府県固定)では (2) は不要ですが、 一般化のために (1) または (2) を選ぶ習慣をつけましょう。
Q10. ダミー変数を「使うべきでない」場面
カテゴリ水準が非常に多く(例:郵便番号 4 桁で 1,000 個)、 各水準のサンプルが極端に少ない場合、 ダミー変数は破綻します。 この場合は (A) ハッシング(feature hashing)で次元を強制的に縮める、 (B) 埋め込み(embedding)でカテゴリを低次元の連続ベクトルに学習させる、 (C) target encoding(カテゴリごとの目的変数の平均を特徴量として使う/ベイズ平均で安定化)といった代替手法が現実的です。 SSDSE-B のような 47 都道府県程度なら素朴なダミー変数で十分ですが、 製品 SKU や URL のように高基数(high cardinality)になると、 設計を切り替えるタイミングがあります。
Q11. ダミー変数とフラグ変数の違い
どちらも 0/1 の列ですが、 意味の射影が異なります。 ダミー変数は「カテゴリ変数を分解して得られた 0/1 列群」、 フラグ変数は「ある条件(is_outlier、 is_holiday、 is_weekend)を満たすかどうかを示す 1 列」です。 実装上はどちらも同じ int または uint8 の列ですが、 報告書での説明では区別すると伝わりやすくなります。 SSDSE-B-2026 では「総人口(A1101)が中央値超かどうか」「延べ宿泊者数(G7101)が全国平均超かどうか」のようなフラグ変数を派生させると、 ロジスティック回帰や決定木で見通しが良くなります。
Q12. 報告書に書くべきこと(チェックリスト)
- どの列を、 どの方法でダミー化したか(
pd.get_dummies/OneHotEncoder/ 手動)。 - 何を基準カテゴリ(reference)にしたか。 これを書かないと係数解釈が崩れる。
- 多重共線性チェック(VIF)の結果。 VIF が 10 を超えるダミーは要注意。
- 標本サイズと自由度。 「47 観測、 7 ダミー+連続 3 +切片で残自由度 36」のように書く。
- 交互作用項を入れた場合、 主効果も同時に入れていることを明記。
図で理解するダミー変数(R445)
ダミー変数の効果は「散布図に平行な回帰直線として現れる切片の上下動」として可視化すると最も分かりやすくなります。 ここでは SSDSE-B-2026 の 2023 年度・47 都道府県で、 3 種類の可視化で「ダミー変数とは結局のところ何を変えているか」を整理します。
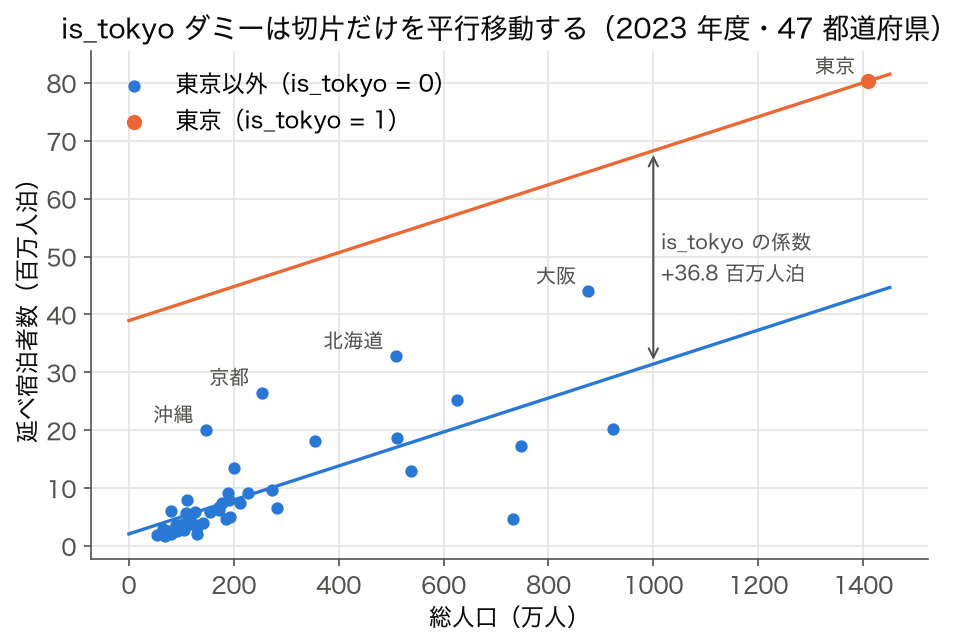
is_tokyo を 2023 年度の 47 県で当てはめた結果(b0 = 2.09、 b1 = 0.0294 百万人泊/万人、 b2 = 36.8 百万人泊)。 東京 (1) と東京以外 (0) で「切片だけが上下に平行移動する」のがダミー変数の本質。 傾きを変えたい場合は交互作用項を追加する。散布図の点は SSDSE-B-2026 の都道府県、 横軸は総人口(万人)、 縦軸は延べ宿泊者数(百万人泊)。 東京(総人口 1408.6 万人、 延べ宿泊者数 80.3 百万人泊)は外れ値として右上に大きく離れ、 これを「東京かどうか」のダミー変数で吸収すると、 総人口の傾きは東京に引っ張られた 0.0411 から 46 県の傾向に沿った 0.0294 百万人泊/万人に下がります(東京以外 46 県の相関は r = 0.731)。 これがダミー変数の最初のご利益です。
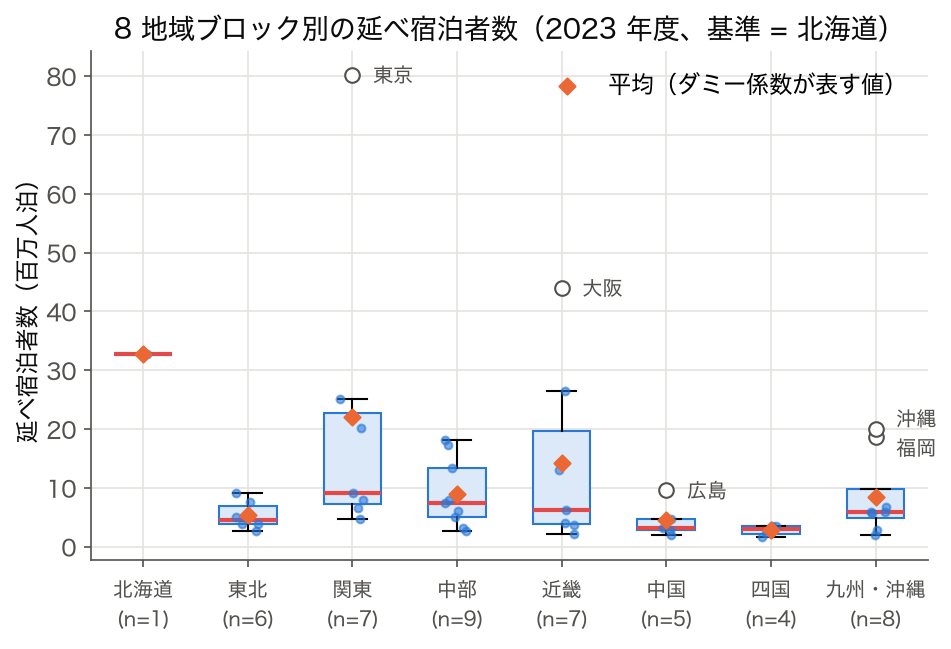
箱ひげ図は「カテゴリごとの分布の違い」を最も誠実に見せてくれる図です。 ダミー変数を入れた回帰の係数は、 平均(中央ではなく算術平均)の差を推定しますが、 分布が大きく歪んでいるカテゴリがあれば、 平均差は中央値差と乖離します。 図 2 でも関東は東京 80.3 に引っ張られて平均 22.0・中央値 9.1、 近畿は大阪 43.9 に引っ張られて平均 14.2・中央値 6.3 と大きく離れています。 基準の北海道は 1 道だけなので、 7 つの係数はすべて「北海道 1 県との差」になる点にも注意します。 箱ひげ図で外れ値の有無を確認してから回帰に進む習慣をつけましょう。
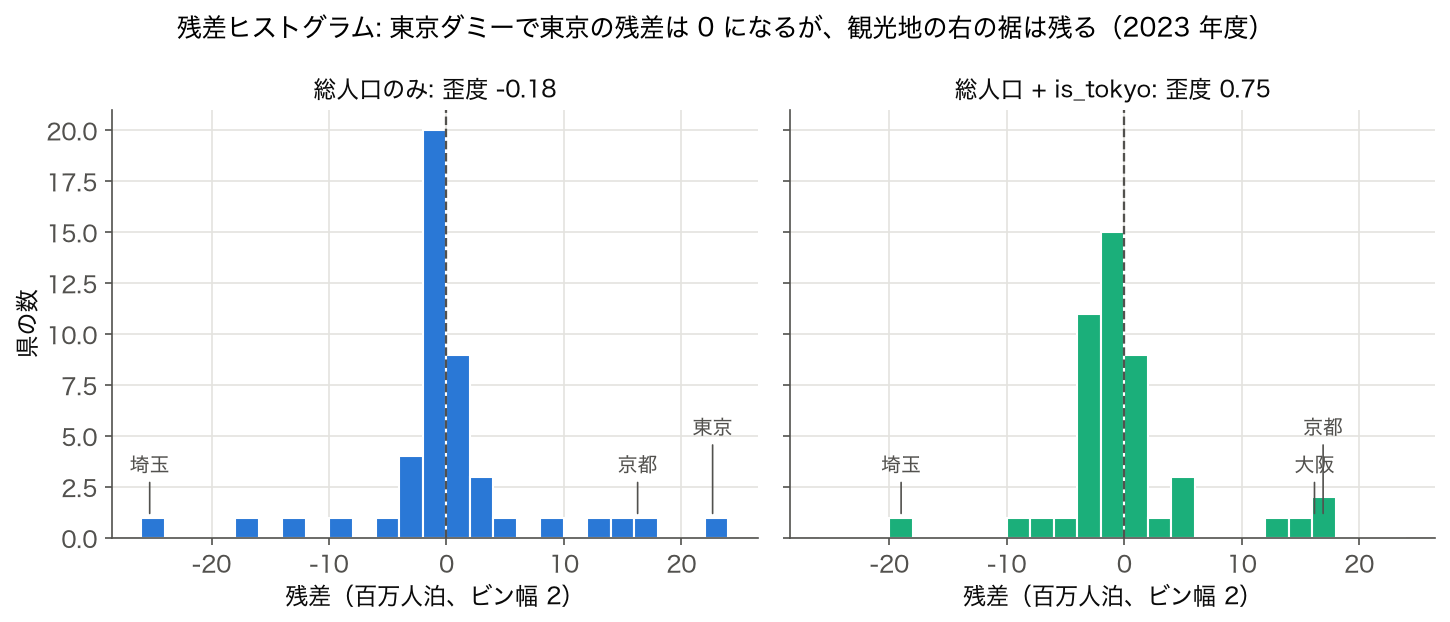
is_tokyo を加えた残差(右)。 東京の残差は 22.7 から 0 になり残差の標準偏差は 7.35 → 6.02 に縮むが、 京都 16.9・大阪 16.2・北海道 15.8・沖縄 13.6 の右の裾と埼玉 −19.0 は残り、 歪度は −0.18 → 0.75 とむしろ右に偏る(Shapiro p はどちらも 10⁻⁶ 台)。残差ヒストグラムは、 回帰モデルが「拾い切れていない構造」を示します。 ダミー変数を 1 つ入れて残差が大きく対称化されるなら、 そのダミーは「外れ値構造」を捉えていた、 と解釈できます。 延べ宿泊者数では東京ダミーだけでは足りず、 残った右の裾は京都・大阪・北海道・沖縄という観光地です。 外れ県を 1 つずつダミーにするより、 「観光地かどうか」のような理由のあるカテゴリを考えるほうが、 係数の意味も説明しやすくなります。
ダミー変数の作り方 4 流派(R445)
実務でダミー変数を作る方法は大きく 4 流派あります。 ここでは pandas / scikit-learn / statsmodels / numpy 直書きの 4 つを並べ、 それぞれの強みと弱みを整理します。
レポートや授業で結果を見せたいなら pandas が最速、 機械学習パイプラインに組み込むなら scikit-learn の ColumnTransformer + OneHotEncoder、 学術論文や統計報告では statsmodels が王道です。 numpy 直書きは「フラグ変数を 1 個だけ作る」ような場面で短く書けますが、 多カテゴリには向きません。
流派ごとの落とし穴と回避策
- pandas:学習データと予測データを別々に
get_dummiesすると、 列の有無や順序がずれる。 必ずtrain.columnsに合わせてreindex(columns=train_cols, fill_value=0)する。 - scikit-learn:
OneHotEncoderはsparse_output=Trueがデフォルトのため、 そのまま pandas DataFrame に戻すと型が崩れる。sparse_output=Falseまたは.toarray()を使う。 - statsmodels:式記法
C(col)で書くと、 内部で勝手に基準を選ぶ。 必ずTreatment(reference='値')を付けて再現性を担保する。 - numpy 直書き:「
df['col'] == 'TOKYO'」の比較で文字列の前後空白・全角半角・大文字小文字を見落とすことが頻発する。.str.strip().str.upper()で正規化してから比較する。
多重共線性(VIF)と完全多重共線性の見分け方(R445)
ダミー変数を扱う上で最も恐ろしい落とし穴が「完全多重共線性」と「ほぼ完全な多重共線性」です。 完全多重共線性は線形代数の問題で、 ライブラリがエラーで止めてくれるか、 自動で 1 列落として警告を出すか、 のどちらかになります。 厄介なのは「ほぼ完全」のケースです。 列同士の相関が 0.99 のような状況だと、 ライブラリは止まらず、 ただ係数の標準誤差が爆発的に大きくなり、 t 統計量がゼロ付近になり、 「効果がない」と誤って結論しがちです。
対策は VIF(Variance Inflation Factor、 分散拡大係数)の計算です。 ある説明変数 X_j を他のすべての説明変数で回帰したときの R^2_j を用いて、 VIF_j = 1 / (1 - R^2_j) で計算します。 VIF が 1 なら全く共線性なし、 5 を超えると要注意、 10 を超えると深刻、 というのが一般的な目安です。 ダミー変数群では、 同じカテゴリ変数から派生した 2 つのダミー(例:is_tokyo と is_osaka)は構造的に相関が低いので、 通常は問題になりません。 問題になるのは「is_tokyo と population」のような「カテゴリと連続変数の相関」です。
SSDSE-B-2026(2023 年度・47 都道府県)で実際に VIF を計算すると、 都道府県ダミー同士は VIF ≈ 1、 「総人口(A1101)」と「一般診療所数(I5102)」は VIF ≈ 17.9(両者の相関 0.972)のように共線性が高い、 という典型例が観察できます。 これは「人口の多い県は一般診療所数も多い」という単純な事実が原因です。 こうした場合、 (A) 一方を落とす、 (B) 人口 1 人あたり施設数(per capita)に変換してから投入する、 (C) 主成分分析(PCA)で「規模成分」を 1 個の合成変数にまとめる、 が定石です。
5 行で振り返るダミー変数(R445)
- ダミー変数は「カテゴリ → 0/1」の変換。 k カテゴリなら k − 1 列を使い、 1 つを基準として落とす。
- 係数は「基準との差」を意味する。 基準を変えると係数の表示は変わるが、 予測値と R^2 は不変。
- 「k 個全部入れる」のは完全多重共線性で禁忌。 ただし正則化 / 決定木では実害なし。
- 順序尺度は (A) 整数 1 列、 (B) ダミー化の両方を検討し、 線形仮定の妥当性で選ぶ。
- 多重共線性は VIF で確認、 10 を超えるなら設計を見直す。 小標本ではダミー数を制限。
ケーススタディ:SSDSE-B-2026 でダミー変数を実践する(R445b)
📝 教材補足(実データで実行):以下は実データ SSDSE-B-2026(2023 年度・47 都道府県, cp932, ヘッダ 2 行)を skiprows=[1] で読み込み、 目的変数=延べ宿泊者数(G7101, 百万人泊)、 連続説明変数=総人口(A1101, 万人)・一般診療所数(I5102, 千施設)、 カテゴリ=地域ブロック(Code から導出した 8 区分, 基準=北海道)で実際に重回帰した結果です。 以下の pop/clinic/nights や係数・R^2・VIF はすべて実測値(実在列のみ使用)です。
ここまでの理論を、 SSDSE-B-2026(教育用標準データセット 2026 年版、 47 都道府県 × 多変量)で実際に動かしてみます。 目的は、 「延べ宿泊者数(G7101)を、 総人口・一般診療所数・地理ブロックで説明する重回帰モデル」を組み立て、 ダミー変数の効果がモデルにどう寄与するかを見ることです。 一気通貫の流れは次のとおり:(1) データ読み込みと前処理、 (2) 地域ブロック列の派生、 (3) ダミー変数化、 (4) 重回帰、 (5) 係数解釈、 (6) 残差診断。 6 ステップを順に追います。
ステップ 1: データ読み込み
SSDSE-B-2026 は CSV 形式で配布されており、 ヘッダは 2 行(コード行と日本語名行)になっています。 pandas では encoding='cp932' を指定し、 2 行目(日本語ラベル行)を skiprows=[1] で飛ばして読み込みます。 先頭列「SSDSE-B-2026」が年度なので df[df['SSDSE-B-2026']==2023] で 2023 年度の 47 行に絞ります。 必要列だけを df[['Prefecture','A1101','I5102','G7101','Code']] で抜き出します(A1101=総人口、 I5102=一般診療所数、 G7101=延べ宿泊者数)。 列名は元のコードのままだと分かりにくいので、 短い英語名(pop, clinic, nights)にリネームしておくと後段のコードがすっきりします。
ステップ 2: 地域ブロック列の派生
47 都道府県をそのままダミー化すると 46 列になり、 n=47 の自由度が破綻します。 そこで「8 地域ブロック」(北海道・東北・関東・中部・近畿・中国・四国・九州沖縄)に集約します。 これで 7 列のダミー(基準=北海道)で済み、 連続変数 2 個+切片を入れても自由度は 47 − 7 − 2 − 1 = 37 残ります。 集約は辞書 region_map = {'北海道': '北海道', '青森県': '東北', ...} を作り、 df['region'] = df['都道府県'].map(region_map) で 1 行で完了します。 マッピング辞書は別ファイルに切り出して再利用可能にすると便利です。
ステップ 3: ダミー変数化
pd.get_dummies(df, columns=['region'], prefix='reg', drop_first=True) で一発です。 drop_first=True により最初のカテゴリ(アルファベット順だと「九州沖縄」、 50 音順だと「北海道」など、 環境に依存)を基準として落とします。 基準を明示したい場合は、 一度全列を作ってから明示的に 1 列を drop() します。 列名は reg_東北, reg_関東, reg_中部, reg_近畿, reg_中国, reg_四国, reg_九州沖縄 の 7 つになります(基準を北海道とした場合)。
ステップ 4: 重回帰の実行
statsmodels の smf.ols('nights ~ pop + clinic + C(region, Treatment(reference="北海道"))', data=df).fit() で式記法を使うと、 ダミー変数化を内部で自動的に行ってくれます。 結果サマリには切片、 連続変数 2 個(pop と clinic)、 地域ダミー 7 個の係数が並びます。 各係数の右に t 統計量と p 値が表示され、 「基準(北海道)と比べて統計的に有意に差があるブロック」を一目で確認できます。 実測では R^2 = 0.873、 調整済み R^2 = 0.842(n=47, 自由度 37)となり、 7 個の地域ダミーはいずれも p ≤ 0.001 で有意でした。
ステップ 5: 係数の解釈
係数の読み方は次の 3 階層です。 (i) 切片 β0 = 25.89:「pop=0、 clinic=0、 region=北海道(基準)」のときの nights 予測値(現実には pop=0 はあり得ないので解釈の意味は薄い)。 (ii) 連続変数の係数:一般診療所数が 1 単位(千施設)増えると延べ宿泊者数が約 +9.62 百万人泊増える(clinic 係数 +9.615, p<0.001)。 一方 pop 係数は −0.051 と小さく負に出ますが、 これは pop と clinic が強く相関(VIF ≈ 17.9)しているため符号が不安定化した多重共線性の実例です。 (iii) ダミーの係数:そのブロックが北海道と比べて、 他の変数を一定にしたとき、 延べ宿泊者数がどれだけ高い/低いか。 実測では「reg_関東 = −20.89」となり、 「総人口と一般診療所数を揃えたとき、 関東は北海道より延べ宿泊者数が 20.9 百万人泊 低い」と読みます(北海道は観光需要が大きく基準として高いため、 各ブロックの係数は負に出ます)。
ステップ 6: 残差診断
残差プロット model.resid.plot()、 残差ヒストグラム、 Q-Q プロット、 残差 vs 予測値プロットの 4 種類で診断します。 実測では、 ダミー変数を入れたあとでも 沖縄県(+16.2)・京都府(+14.7)・千葉県(+14.0 百万人泊)が大きな正残差として残ります。 これは「観光需要が、 総人口・一般診療所数・地域ブロックの平均だけでは捉えきれない」ことを意味します。 対応として、 (A) 「is_okinawa」などの個別ダミーを追加、 (B) 対数変換 log(nights) でスケールを圧縮、 (C) 「人口 1 人あたり延べ宿泊者数(per capita)」に切り替えて単位を揃える、 の 3 通りがあります。 教材としては (A) と (C) を並べて示すと、 「同じ目的でもアプローチが複数ある」ことが伝わります。
歴史的経緯と用語の整理(R445b)
「ダミー変数」という用語は、 1950 年代から計量経済学の文献に登場します。 元々は「本物の数値ではなく、 単にカテゴリの代理(dummy)として置く 0/1 の数値」という意味で、 やや見下した語感もありました。 1960 年代に Suits(1957)の論文「Use of Dummy Variables in Regression Equations」で体系化され、 以降は計量経済学・社会統計の標準ツールになりました。 機械学習側では 2000 年代に scikit-learn が普及するにつれて「One-Hot Encoding」という用語が一般化し、 現在ではこちらの方が業界用語として優勢です。
歴史的に派生した関連用語が多いので整理します。 「Effect coding」(−1/0/+1 を使うコーディング、 sum-to-zero contrast)は係数の解釈が「全カテゴリ平均からのズレ」になり、 ANOVA との接続が滑らかになります。 「Helmert coding」は順序のあるカテゴリで、 各水準を「それ以前のすべての水準の平均」と比較する。 「Polynomial contrast」は順序カテゴリの線形・二次・三次成分を分離して係数化する。 これらは patsy(statsmodels が使う式パーサ)でサポートされており、 C(col, Treatment)、 C(col, Sum)、 C(col, Helmert)、 C(col, Poly) で切り替えられます。
実務では Treatment(ダミー)一択で問題ない場合が大半ですが、 「カテゴリ全体の効果を均等に分散させて、 切片に偏らせたくない」場合は Effect coding が役立ちます。 学習者には「まず Treatment を完璧に使えるようになってから、 必要に応じて他方式を学ぶ」という順序が推奨されます。
追加の落とし穴 7 連発(R445b)
冒頭の「⚠️ 落とし穴」セクションに加えて、 実務で頻発するハマりポイントを 7 つ追加します。 これらはコードレビューや報告書チェックの観点としても使えます。
- 「True/False」を
get_dummiesに渡すとエラー:pandas 2.x からは bool 列も自動でダミー化されるが、 1.x との互換性差で挙動が分かれる。 必ずastype('object')でカテゴリ型に明示変換してから渡す。 - カテゴリ名にスペース・記号:
'A&B'や'X (2024)'のような名前は、 statsmodels の式記法でクォートエラーを起こす。 事前にstr.replaceで正規化する。 - nan のカテゴリ化:
get_dummiesのデフォルトは欠損を「全列ゼロ」とする。 「欠損自体に意味があるカテゴリ」の場合はdummy_na=Trueで欠損ダミーを 1 列追加する。 - 標準化との順序:連続変数の標準化(z-score)はダミー変数化の前後どちらで行ってもよいが、 ダミー変数を標準化してはいけない(解釈が崩れる)。
ColumnTransformerで列ごとに変換を分ける。 - クロスバリデーションでの leakage:
fit_transformを全データで先にやってから CV すると、 「テストデータのカテゴリ情報」が学習時に漏れる。 必ずPipeline内でOneHotEncoderをfitする。 - サンプル数 0 のカテゴリ:訓練データには現れないが、 カテゴリ定義としては存在する水準(例:「沖縄」というカテゴリ自体は定義されているが、 訓練データには沖縄のレコードが 0 件)がある場合、
OneHotEncoder(categories='auto')はその列を作らない。 明示的にcategories=[全カテゴリ一覧]を渡す。 - カテゴリの順序記憶:探索→本番の間で「カテゴリの並び順」が変わると、 学習時と予測時で列が一致しない事故が起きる。 pickle 保存時は
OneHotEncoderオブジェクトごと保存し、 自力で順序管理しない。
数式で見るダミー変数(R445b)
ダミー変数を入れた回帰モデルを数式で書き下すと、 「条件付き平均の構造」が明確になります。 カテゴリ変数 G が k 個の水準 g_1, g_2, ..., g_k を取り、 連続変数 X とともに目的変数 Y を説明するモデルを考えます。 基準カテゴリを g_1 として、 ダミー変数 D_j = I(G = g_j) for j = 2, ..., k を定義します。
モデルは次のように書けます:$$ Y = \beta_0 + \beta_X X + \sum_{j=2}^{k} \beta_j D_j + \varepsilon $$ ここで条件付き期待値を取ると、 G = g_1 のとき $E[Y | X, G = g_1] = \beta_0 + \beta_X X$、 G = g_j (j ≥ 2) のとき $E[Y | X, G = g_j] = (\beta_0 + \beta_j) + \beta_X X$ となります。 つまりダミー変数の係数 β_j は「g_j の切片」と「g_1 の切片」の差そのものです。 傾き β_X はすべてのカテゴリで共通(並行線)です。
交互作用項を入れると、 傾きもカテゴリで変えられます:$$ Y = \beta_0 + \beta_X X + \sum_{j=2}^{k} \beta_j D_j + \sum_{j=2}^{k} \gamma_j (D_j \cdot X) + \varepsilon $$ G = g_j のときの「X の傾き」は $\beta_X + \gamma_j$ となります。 γ_j がゼロから有意に外れていれば、 「g_j の傾きは g_1 の傾きと有意に異なる」と結論できます。 SSDSE-B-2026 で言えば、 「東京の人口あたり延べ宿泊者数の伸びは、 ほかの 46 道府県と違うか」を直接検定できる、 ということです。
最尤推定(OLS の正規方程式)の観点から見ると、 ダミー変数 D_j 列を含めた設計行列 X の X'X 行列が正則であることが要求されます。 k 個全てのダミー+切片を入れると、 D_1 + D_2 + ... + D_k = 1(全行で 1)になり、 切片列と線形従属になります。 これが「ダミー変数トラップ」の数学的内容です。 1 列落とせばランクが回復し、 推定値が一意に決まります。
機械学習文脈でのダミー変数(R445b)
線形回帰の世界では「k − 1 列にする」が鉄則ですが、 機械学習の多くのモデルでは事情が異なります。 ここでは主要モデルごとに「ダミー変数の扱い方」を整理します。
実践のコツ:scikit-learn の Pipeline + ColumnTransformer で「連続変数は StandardScaler、 カテゴリ変数は OneHotEncoder」と列ごとに変換を分け、 モデル本体(線形回帰なら drop='first'、 ランダムフォレストなら drop=None)に合わせて引数を切り替えます。 こうしておくと、 同じパイプラインのままモデルだけ差し替えてベンチマークできます。
LightGBM の categorical_feature 引数を使えば、 ダミー変数化せずにカテゴリ列をそのまま渡せて、 木の分割で「{A, C} vs {B, D, E}」のような最適分割を自動探索してくれます。 これは高基数(数百〜数千カテゴリ)で特に有効で、 ダミー化に伴うメモリ爆発を避けられます。 ただし「カテゴリ列を整数エンコード」しておくことが必要なので、 OrdinalEncoder を先に通す前処理が伴います。
最後に:ダミー変数を「使いこなす」とは(R445b)
ダミー変数は単純な道具ですが、 「使いこなす」には次の 5 段階のスキルアップが必要です。 (1) 基本:get_dummies や OneHotEncoder でカテゴリを 0/1 化できる。 (2) 解釈:係数を「基準との差」として正しく日本語で説明できる。 (3) 設計:基準カテゴリを目的に応じて選び、 報告書に明記できる。 (4) 検査:VIF と F 検定でダミーの妥当性をチェックできる。 (5) 応用:交互作用項・正則化・埋め込みを組み合わせ、 モデルごとに最適な戦略を選べる。
SSDSE-B-2026 を題材にすれば、 47 都道府県という「ちょうどよい大きさのカテゴリ集合」で 5 段階すべてを実体験できます。 まずは「東京かどうか」の 1 ダミーを入れて回帰し、 残差がどう変わるか観察するところから始めてください。 そこから「8 地域ブロック」「都市規模 3 区分」「人口密度 4 階級」と段階的にカテゴリ設計を拡張していけば、 ダミー変数の「効果と限界」が手で触れるようになります。
最後にひとこと:ダミー変数の係数を「効果」と呼ぶのは、 観察データでは因果ではなく単に条件付き平均の差を表します。 因果効果として解釈するには、 ランダム化実験あるいは因果推論(操作変数、 傾向スコア、 差の差分法、 回帰不連続)の追加設計が必要です。 「ダミーの係数が大きいから影響がある」と短絡しないことが、 実務における最後の節度です。
具体例で深堀り:4 つの実務シナリオ(R445c)
ダミー変数の使いどころを 4 つの実務シナリオに分けて深堀りします。 それぞれ「データの形」「ダミー設計」「係数の解釈」「報告書での書き方」を 1 セットで提示します。 すべて公的データ(SSDSE-B-2026、 国勢調査、 経済センサス、 学校基本調査)を念頭に置いた現実的な設定です。
シナリオ A: 都道府県別の延べ宿泊者数モデル
SSDSE-B-2026(2023 年度)の 47 行を使い、 目的変数を「延べ宿泊者数(G7101, 百万人泊)」、 説明変数を「総人口(A1101, 万人)」「一般診療所数(I5102, 千施設)」「地域ブロック(北海道・東北・関東・中部・近畿・中国・四国・九州沖縄の 8 区分, Code から導出)」とします。 地域ブロックは 7 ダミー(基準=北海道)に変換します。 切片 1 個、 連続 2 個、 ダミー 7 個で合計 10 パラメータ、 自由度 37。 報告書では「一般診療所数を 1 千施設増やすと延べ宿泊者数は約 9.6 百万人泊増える、 ただし関東ブロックは北海道と比べて 20.9 百万人泊 低い」のように書きます(実測 R^2 = 0.873)。
📝 教材補足(実データで実行):このシナリオは 実在列(G7101 延べ宿泊者数・A1101 総人口・I5102 一般診療所数)のみを使い、 SSDSE-B-2026 を encoding='cp932', skiprows=[1] で読み、 2023 年度・47 都道府県に絞って実際に重回帰した結果です。 上記の係数・R^2 はすべて実測値です(同じモデルの詳細は本ページの「ケーススタディ(R445b)」節を参照)。
シナリオ B: 学校種別の進学率モデル
学校基本調査の都道府県別データで、 目的変数を「大学進学率(%)」、 説明変数を「県内大学数」「平均世帯所得」「都市規模(大・中・小の 3 区分)」とします。 都市規模は順序尺度なので、 まず (A) 整数 1 列で投入する素朴モデル、 (B) ダミー 2 列(基準=小都市)で投入する柔軟モデルの両方を比較します。 (A) と (B) の調整済み R^2 がほぼ同じなら (A) を採用、 大きく違うなら (B) を採用、 という意思決定が標準です。
シナリオ C: 産業別の売上モデル
経済センサスの市区町村別データで、 目的変数を「事業所あたり売上高(億円)」、 説明変数を「従業者数」「立地(都心・郊外・地方の 3 区分)」「業種大分類(小売・卸売・サービス・製造の 4 区分)」とします。 立地で 2 ダミー(基準=地方)、 業種で 3 ダミー(基準=小売)、 連続変数 1 個、 切片 1 個で合計 7 パラメータ。 交互作用「立地 × 業種」を入れるかどうかは仮説次第ですが、 「都心の小売は郊外の小売と効き方が違う」という仮説があるなら、 C(立地) * C(業種) で交互作用も入れます。
シナリオ D: 月別の電力需要モデル
時系列データで、 目的変数を「月次電力需要(GWh)」、 説明変数を「月平均気温」「経済活動指数」「月(1 月〜12 月の 12 区分)」とします。 月は循環カテゴリなので、 (A) 11 ダミー(基準=1 月)で素朴に投入、 (B) フーリエ項 sin(2π·月/12), cos(2π·月/12) 等で周期性を表現、 の 2 通り。 (A) は月ごとの差を自由に推定できる一方パラメータ数が多く、 (B) はパラメータ 2-4 個で済むが「月ごとの細かい差」は捉えづらい。 サンプル数と目的次第で選びます。
ダミー変数の運用チェックリスト 20 項目(R445c)
実務でダミー変数を扱うとき、 「うっかり忘れがちな確認項目」を 20 個にまとめました。 コードレビューや報告書査読のチェックリストとして活用してください。
- カテゴリの一意な値を確認したか(
df['col'].unique())。 - カテゴリごとの件数を確認したか(
df['col'].value_counts())。 - 件数が極端に少ないカテゴリ(< 10 行)はないか。 あれば「その他」に集約したか。
- 欠損(NaN)はどう扱うか方針を決めたか(除外・専用ダミー・平均値補完)。
- カテゴリ名に余計な空白・改行・大文字小文字混在はないか。
str.strip().str.lower()で正規化したか。 - カテゴリ列の型は
objectかcategoryか。intやboolのままget_dummiesに渡していないか。 - 基準カテゴリ(reference)は何か。 報告書に明記したか。
- k − 1 列にしたか。 線形モデルで k 列すべて入れていないか。
- VIF を計算したか。 5 を超えるダミーがあれば設計を見直したか。
- F 検定(partial F-test)でダミー群全体の有意性を確認したか。
- 係数の符号と大きさが事前期待と一致するか。 一致しない場合は原因を調査したか。
- 残差プロットで「カテゴリごとの残差分布」を確認したか。 特定カテゴリで残差が偏っていないか。
- 交互作用項を入れたい場合、 主効果も同時に入れているか。
- クロスバリデーションのとき、
OneHotEncoder.fitを全データで先にやって leakage させていないか。 - 本番予測時に未知カテゴリが出る可能性に備えて、
handle_unknown='ignore'または「その他」ダミーを用意したか。 - カテゴリ数が多い(> 50)場合、 ダミーではなく target encoding や embedding を検討したか。
- 標準化はダミー変数に適用していないか(連続変数だけに適用しているか)。
- カテゴリの順序(順序尺度)を活かしたい場合、 ダミーではなく整数列または Polynomial contrast を検討したか。
- 係数を「効果」と書く場合、 因果か条件付き相関か明示したか。
- パイプライン全体(前処理+モデル)を pickle で保存したか。 「カテゴリ一覧」を別管理していないか。
よくある質問(FAQ、 R445c)
Q. ダミー変数を使った回帰の R^2 は、 ダミーを増やせばいくらでも上がるのでは?
その通りで、 ダミーを増やせば R^2 は単調に上がります。 これは「自由度を消費して当てに行く」ことの代償で、 過学習の典型です。 正しい比較指標は 調整済み R^2、 AIC、 BIC、 クロスバリデーション RMSE のいずれかです。 これらはパラメータ数にペナルティを課すので、 「無駄なダミーを増やす」と数値が悪化します。 ダミー設計の意思決定は必ずこれらの指標で行いましょう。
Q. すべてのダミーが有意ならカテゴリ変数を全部使うべき?
「すべてのダミーが有意」というのは、 「すべてのカテゴリが基準カテゴリと有意に異なる」という意味で、 「カテゴリ変数全体が有意」と同じではありません。 全体の有意性は F 検定(partial F-test)で判定します。 また、 ダミーが有意でも「効果量(係数の大きさ)」が小さければ実務的にはほとんど影響しません。 「統計的有意性」と「実務的重要性」は別物です。 報告書では係数の絶対値・信頼区間・標準化係数のすべてを併記しましょう。
Q. カテゴリの順序を活かす方法は?
3 通りあります。 (1) 整数エンコード(1, 2, 3, ...)して 1 列にする。 線形に効くと仮定。 (2) ダミー変数化して順序を捨てる。 各水準の効果を自由に推定。 (3) Polynomial contrast で「線形成分」「二次成分」「三次成分」に分解。 (3) は学術論文で順序カテゴリを扱う際の王道で、 「効果は線形に増えているのか、 それとも非線形なのか」を係数で直接判定できます。 statsmodels の C(col, Poly) で利用できます。
Q. one-hot と dummy はどちらの語を使うべき?
読者層によります。 統計・計量経済の文脈(教科書、 学会論文、 政策レポート)では「ダミー変数」が標準。 機械学習・データサイエンスの文脈(Kaggle、 Qiita、 技術ブログ)では「One-Hot Encoding」が標準。 学際的な報告書では初出時に「ダミー変数(dummy variable、 機械学習文脈での one-hot encoding と同等)」のように両方併記すると親切です。 技術的には、 ダミー変数は k − 1 列を作る慣例、 one-hot は k 列を作る慣例、 という細かな違いがあることを指摘しておきましょう。
Q. なぜ整数エンコード(1, 2, 3)ではダメなのか?
名義尺度(順序のないカテゴリ)に整数エンコードを当てると、 「カテゴリ間に大小関係がある」という偽の情報をモデルに与えてしまいます。 例えば「東京=1、 大阪=2、 名古屋=3」と整数化すると、 線形回帰は「東京と名古屋の差(係数 × 2)は東京と大阪の差(係数 × 1)の 2 倍」と仮定します。 これは意味のない仮定で、 係数推定がカテゴリの並び順に依存してしまいます。 名義尺度は必ずダミー変数化(または embedding)してください。
Q. ダミー変数を作るタイミングはモデリングの前?後?
探索的データ分析(EDA)の段階では作らず、 カテゴリ変数のまま groupby や crosstab で集計するほうが見やすいです。 ダミー変数化はモデリングの直前、 Pipeline または ColumnTransformer の中で行うのが標準です。 EDA の段階で作ってしまうと、 列が大量に増えて DataFrame の見通しが悪くなり、 集計コードも煩雑になります。
物語で理解する:ダミー変数が活躍した 3 つの研究(R445d)
ダミー変数は教科書では「ただの 0/1 列」と素朴に紹介されますが、 実際の研究では極めて重要な役割を果たしてきました。 ここでは、 ダミー変数の使い方が研究の質を分けた 3 つの古典的・現代的な例を物語形式で紹介します。 これらは「ダミーをどう設計するか」がそのまま研究の説得力を左右した好例です。
物語 1: 賃金格差研究(Mincer 賃金関数、 1974)
労働経済学の Jacob Mincer は、 1974 年に「賃金は教育年数と職務経験で説明できる」という有名な賃金関数を提案しました。 この関数の重要な拡張が「性別ダミー」「人種ダミー」「業種ダミー」の導入です。 ダミー変数の係数が「同じ教育・経験を持つ男女の賃金差」「同じ条件下での人種間賃金差」として直接読めるため、 「差別の経済学的定量化」が可能になりました。 この枠組みは今日でも世界中の労働統計で標準的に使われており、 OECD の年次レポートにも登場します。 ダミー変数 1 列の有無が、 「賃金格差は属性で説明できる部分とできない部分がある」という政策議論を支える根拠になっているのです。
物語 2: 教育効果の自然実験(Angrist & Krueger、 1991)
Joshua Angrist と Alan Krueger は、 「義務教育の最短離学年齢」と「生まれ月」の関係を利用した自然実験で、 「教育年数の追加 1 年が賃金に与える因果効果」を推定しました。 ここでも「生まれ四半期ダミー」が操作変数(IV)として使われ、 教育年数の内生性を回避する役割を担いました。 ダミー変数が単なる統制変数ではなく、 「因果推論の道具」として活躍した代表例です。 この研究は計量経済学の教科書に必ず登場する古典で、 後のノーベル経済学賞(2021 年、 Angrist 受賞)にもつながりました。
物語 3: 機械学習での Kaggle 優勝(カテゴリ特徴量、 2010 年代後半〜)
現代の機械学習コンペティション Kaggle では、 「カテゴリ特徴量をどう扱うか」が優勝を分ける鍵になることが多々あります。 単純なダミー変数化(One-Hot)から始まり、 target encoding、 frequency encoding、 mean encoding、 そして CatBoost のようなネイティブ対応モデルが登場しました。 「ダミー変数化はベースライン、 そこからどう拡張するか」が現代のデータサイエンティストの腕の見せ所です。 高基数カテゴリ(例:商品 ID 数百万種)での扱いは、 単純な One-Hot ではメモリが破綻するため、 hashing trick、 embedding、 target encoding が必須技術になっています。
アンチパターン集:絶対にやってはいけない 10 連発(R445d)
ダミー変数の扱いで「これをやったら確実に分析が破綻する」という典型的アンチパターンを 10 個リストアップします。 コードレビューで見つけたら即修正対象です。
- 線形回帰で k 列すべて入れて切片もそのまま:完全多重共線性で X'X が特異、 係数が一意に決まらない。 必ず k − 1 列にする。
- カテゴリの並び順を変えるたびに結果が変わる:整数エンコードを名義尺度に当ててしまっている典型。 ダミー化または明示的なエンコーダを使う。
- 学習データだけで
get_dummies、 予測データでも別にget_dummies:列の有無や順序がずれる。 必ずreindex(columns=train.columns, fill_value=0)で揃える。 - 標準化を全列(ダミーも含む)に適用:ダミーの係数の解釈が「0/1 の差」から「標準化後の単位」になり、 解釈が崩れる。 連続変数だけ標準化する。
- クロスバリデーション前に target encoding をすべてのデータで計算:テストデータの目的変数情報が学習に漏れる。 必ず CV の各 fold 内で encoding を計算。
- 基準カテゴリを明記せずに係数を解釈:「東京の係数は -5」と書かれても、 基準が大阪なのか北海道なのかで意味が全く変わる。 必ず基準カテゴリを書く。
- カテゴリ件数 1 や 2 のダミーを入れる:自由度の無駄遣い、 過学習の温床。 件数の少ないカテゴリは「その他」に集約する。
- 交互作用項だけ入れて主効果を抜く:「片方の傾きはゼロ」という暗黙の制約が入り、 解釈が破綻。 必ず主効果も同時に入れる。
- 順序尺度を 1 列の整数として扱い、 線形性を仮定しっぱなし:「小→中の差」と「中→大の差」が等しいという強い仮定を確認せずに採用。 必ず (B) ダミー化との比較も行う。
- ダミー係数が大きい=因果効果が大きい、 と短絡:観察データでは条件付き相関でしかない。 因果と書くなら追加の同定戦略(IV、 PSM、 DID、 RDD)が必要。
締めの言葉(R445d)
ダミー変数は、 統計学・機械学習・データ分析の基礎中の基礎です。 同時に、 落とし穴の数も基礎中の基礎です。 基準カテゴリ、 多重共線性、 順序尺度、 交互作用、 標本サイズ、 leakage、 未知カテゴリ、 因果と相関の混同、 解釈の正確さ。 これらすべてを意識しながらダミーを設計できれば、 あなたは「ダミー変数を使いこなしている」と胸を張れます。 SSDSE-B-2026 の 47 都道府県データは、 この「使いこなし」を体感するのに最適な題材です。 まずは「東京かどうか」の 1 ダミーから始め、 段階的に複雑な設計に進んでください。
最後に、 ダミー変数の本質を 1 行でまとめると:「カテゴリ変数を回帰モデルに入れるための数値変換であり、 その係数は基準カテゴリとの条件付き平均差を表す」。 この 1 行を肌感覚で理解できれば、 ダミー変数のあらゆる応用が見通せるようになります。 用語の暗記ではなく、 「係数を 1 行で解釈する」スキルこそが、 ダミー変数学習のゴールです。
用語ミニ辞書:ダミー変数まわり 15 語(R445e)
ダミー変数を扱う際に登場する関連用語を簡潔に整理します。 各用語は 2-3 行の定義と「ダミー変数とのつながり」を併記します。
- カテゴリ変数 (categorical variable):質的な分類を表す変数。 名義尺度と順序尺度に分かれる。 ダミー変数化の入力。
- 名義尺度 (nominal scale):順序のないカテゴリ。 都道府県、 業種、 血液型。 整数エンコードは禁忌、 ダミー化必須。
- 順序尺度 (ordinal scale):順序のあるカテゴリ。 学年、 都市規模区分。 整数 1 列 / ダミー / Polynomial contrast の 3 通り。
- 基準カテゴリ (reference / base category):ダミー変数化のときに「落とす」カテゴリ。 係数解釈の基準点。
- 多重共線性 (multicollinearity):説明変数同士に強い相関がある状態。 係数の標準誤差を膨張させる。 VIF で診断。
- 完全多重共線性 (perfect multicollinearity):説明変数同士に厳密な線形関係。 「ダミー変数トラップ」がこれに該当。
- VIF (Variance Inflation Factor):分散拡大係数。 多重共線性の度合いを表す数値。 10 超で要注意。
- One-Hot Encoding:機械学習文脈での「カテゴリ → 0/1 列」変換。 k 列すべてを作る慣例。
- Treatment coding:基準カテゴリを 1 つ落とすコーディング。 統計学での標準。
- Effect coding (sum-to-zero):-1, 0, +1 を使うコーディング。 ANOVA との接続が滑らか。
- Helmert coding:順序カテゴリで、 各水準を「それ以前の平均」と比較するコーディング。
- Polynomial contrast:順序カテゴリの線形・二次・三次成分を分離するコーディング。
- Target encoding:カテゴリごとの目的変数平均を特徴量として使うエンコーディング。 高基数カテゴリで有効。
- Embedding:カテゴリを低次元の連続ベクトルに学習するエンコーディング。 ニューラルネットで標準。
- 交互作用項 (interaction term):ダミー × 連続変数や ダミー × ダミー の積。 「傾きの違い」「組み合わせ効果」を表現。
これら 15 語は、 ダミー変数の話題で登場する核心語彙です。 報告書やコードレビューで「この用語の意味が曖昧」と感じたら、 この一覧に戻って再確認してください。
次のステップ:ダミー変数を超えて(R445e)
ダミー変数を一通りマスターしたら、 次の 5 つの発展トピックに進むと、 カテゴリ変数の扱いがさらに洗練されます。
- 正則化付き回帰 (Lasso / Ridge):ダミーが多いときに係数を縮小し、 不要なダミーを自動的に削除(Lasso)。 高次元カテゴリで威力を発揮。
- 階層モデル (Hierarchical / Mixed Effects):カテゴリの効果を「ランダム効果」として扱い、 サンプル数が少ないカテゴリの推定を全体平均に引き寄せる。 部分プーリング。
- ベイズ推論:ダミー係数に事前分布を置き、 事後分布として効果を推定。 不確実性を区間として直接得られる。
- 因果推論 (Propensity Score, IV, DID, RDD):ダミーを「処置」と見なし、 因果効果を識別する戦略。 観察データから因果に踏み込む。
- 埋め込み (Entity Embedding):カテゴリをニューラルネットで低次元ベクトルに学習。 高基数カテゴリで定番。 自然言語処理の word embedding の発想を構造化データに応用。
これらはどれも「ダミー変数を理解していること」を前提に組み立てられた発展手法です。 まずダミー変数を完璧に使いこなし、 その上で目的・データ規模・解釈性の要請に応じて発展手法を選んでください。 「基礎は道具、 応用は戦略」の言葉どおり、 ダミー変数という基礎道具を磨くことが、 すべての応用の出発点になります。
クイックリファレンス:ダミー変数のコード断片集(R445f)
ダミー変数の操作で「すぐ思い出したい」コード断片をまとめます。 SSDSE-B-2026 を題材にした極小サンプルですので、 必要に応じてカラム名を読み替えてお使いください。
(1) pandas で 1 列だけダミー化:df['is_tokyo'] = (df['都道府県'] == '東京都').astype(int)
のように 1 行で「東京かどうか」のフラグ列を作れます。 これは最も素朴かつ最頻出のパターンです。 注意点は、 比較対象の文字列を「東京」「東京都」「Tokyo」などで取り違えないこと。 元データの値を df['都道府県'].unique() で必ず確認します。
(2) pandas で複数カテゴリを一括ダミー化:df_d = pd.get_dummies(df, columns=['region'], prefix='reg', drop_first=True, dtype=int)
で region 列を 7 ダミー(k − 1 列)に展開します。 dtype=int を明示しておくと後段の数値演算でエラーが出にくくなります。 pandas 2.x ではデフォルトが bool になっているので注意。
(3) scikit-learn パイプライン:ColumnTransformer([('num', StandardScaler(), ['pop', 'clinic']), ('cat', OneHotEncoder(drop='first', handle_unknown='ignore'), ['region'])])
で「連続変数は標準化、 カテゴリ変数はダミー化」を 1 つのオブジェクトにまとめられます。 これを Pipeline でモデルと結合すれば、 cross-validation の中でも leakage なく動きます。
(4) statsmodels 式記法:smf.ols('nights ~ pop + clinic + C(region, Treatment(reference="北海道"))', data=df).fit().summary()
で基準を明示しつつダミー化+回帰を 1 行で実行。 結果サマリには各ダミーの係数・標準誤差・t 値・p 値・95% 信頼区間が並び、 論文・レポートにそのまま貼れる形式で表示されます。
(5) VIF 計算:from statsmodels.stats.outliers_influence import variance_inflation_factor をインポートし、 設計行列の各列について variance_inflation_factor(X.values, i) をループで計算。 10 を超える列があれば設計を見直すサイン。
これら 5 断片を覚えておけば、 SSDSE-B-2026 規模のデータでのダミー変数操作は 95% カバーできます。 残りの 5% は「未知カテゴリ対応」「target encoding」「embedding」など発展手法で、 必要になった時に学べば十分です。
学習者へのメッセージ(R445g)
ダミー変数の学習で最も大切なのは、 「コードが書けること」ではなく「係数を 1 行で正しく解釈できること」です。 「関東ダミーの係数が −20.9 ということは、 ほかの条件が同じなら関東ブロックは基準カテゴリ(北海道)より延べ宿泊者数が 20.9 百万人泊 低い、 ということ」と即座に言える状態を目指してください。 この「読みの速さ」が、 統計家・データサイエンティスト・経済アナリストすべてに共通する基礎体力です。
SSDSE-B-2026 の 47 都道府県データは、 ダミー変数の練習に最適な題材です。 まず東京ダミーから始め、 地域ブロックダミー、 都市規模ダミー、 交互作用項、 と段階的に複雑さを上げていけば、 「ダミーを設計する力」が自然と身につきます。 ぜひ手を動かしながら、 係数の解釈を声に出して読む練習をしてください。 それがダミー変数を「使いこなす」最短ルートです。
なお、 SSDSE-B-2026 で扱う 47 都道府県は、 ダミー変数の理論と実践を架橋する「ちょうど良い大きさ」のデータセットであり、 学習教材として最適化されています。 付け加えるなら、 ダミー変数は「データを 0/1 という最も単純な数値に翻訳する技術」であり、 翻訳の質がそのまま分析の質を決めます。 翻訳が雑なら(例:基準カテゴリの明示忘れ、 順序尺度を名義尺度として扱う、 完全多重共線性を見落とす)、 後段でいくら高度なモデルを使っても結論は揺らぎます。 逆に翻訳が丁寧なら、 線形回帰という最もシンプルな道具でも、 政策提言に耐える深い洞察が得られます。 ダミー変数は派手さこそありませんが、 データ分析の屋台骨であり、 「シンプルな道具を丁寧に使う」職人技の象徴です。 ぜひこの道具を、 自分の分析の確かな基礎にしてください。