🔖 キーワード索引
🔖 キーワード索引
One-hot エンコーディングを実務で使うための核となる12 論点を索引化。 ダミー変数トラップ・高 cardinality・sparse 表現の落とし穴を集中的に潰します。
💡 30秒で分かる結論
🍰 まずはやさしく
文字のデータを0と1に分ける方法です。
AIが計算できるようにするために使います。
血液型を数字に直すときなどに便利です。
この手法の結論を短くまとめます。
カテゴリを複数の0/1変数に展開する手法
- カテゴリ変数を K 個の 0/1 列に展開する前処理。
- 例:色 ∈ {赤、 青、 緑} → 3列 [is_赤, is_青, is_緑]、 1行は1列だけ1。
- 多重共線性を避けるため、 通常は K-1 列 に削減(drop_first=True)。
- 数値モデル(線形回帰、 SVM、 ニューラルネット)の必須前処理。
- 高カーディナリティ(カテゴリ数大)では Target Encoding 等の代替を検討。
💡 30 秒で分かる結論
- One-hot エンコーディングとは、 $K$ 個のカテゴリ値を長さ $K$ の 0/1 ベクトルに変換する手法。 1 つだけ 1 で残りは 0。
- 別名: ダミー変数化、 1-of-K 表現、 indicator encoding、 sparse encoding (一部)。
- 用途: 「都道府県」「血液型」のような名義尺度カテゴリ変数を、 線形回帰・SVM・NN など数値しか食えないモデルに投入する。
- 線形モデルでは
drop_first=Trueで K-1 列にする (完全多重共線性=ダミー変数トラップを回避)。 決定木系では K 列のままで OK。 - SSDSE-B-2026 の都道府県カラムを one-hot 化すると 47 カテゴリ → 46 列 (drop_first 時)、 sparse 行列の活用が必須となるケースも。
📍 あなたが今見ているもの
🍰 まずはやさしく
データの準備をするための手順です。
AIは数字しか読み込めないために行います。
スマホのアプリで色を選ぶときのようなデータです。
この手法の呼び方や使い分けを説明します。
ML モデルは数値しか受け取れないため、 「都道府県」「商品カテゴリ」「色」などをそのまま入れられません。 ほぼ全ての分析で最初に通る前処理です。
📍 あなたが今見ているもの (文脈)
本ページは「one-hot エンコーディング」の別名・周辺概念整理ページとして位置づけられます。 本家解説は one-hot エンコーディング および カテゴリ変数 に詳しいですが、 ここでは特に「呼び方の違いはどこから来るか」「線形モデル vs 木系モデルでの扱い差」「SSDSE-B-2026 でのケース」に焦点を当てます。
| 呼び方 | 由来 | 主な使われる分野 |
|---|---|---|
| One-hot | 「1 つだけ hot (=1)」 | 機械学習・ニューラルネット |
| ダミー変数 | 経済学・回帰分析の伝統 | 統計学・計量経済学 |
| 1-of-K | パターン認識教科書 (Bishop) | 機械学習理論 |
| Indicator (指示変数) | 条件 1{x=c} | 数理統計 |
🎨 直感で掴む
🍰 まずはやさしく
たくさんのスイッチを並べるイメージです。
データの順番に意味が出ないようにします。
部活の種類を数字で分けるときに使います。
なぜこの方法が良いのかを直感的に解説します。
例:「都道府県 = 東京」を、 47次元のベクトル [0,0,...,1,...,0](東京の位置だけ1)に変換。 これで「東京と大阪の距離は √2、 東京と福岡も √2」と カテゴリ間の距離が等しい表現になります(順序が無いことを正しく表現)。
🎨 直感で掴む — 「カテゴリ = 並んだスイッチ」
カテゴリ変数を one-hot 化するとは、 「カテゴリの数だけスイッチを並べて、 該当する 1 つだけ ON にする」イメージです。 たとえば血液型 (A, B, O, AB) なら、 「A=[1,0,0,0]」「B=[0,1,0,0]」「O=[0,0,1,0]」「AB=[0,0,0,1]」のように 4 つのスイッチに変換します。
なぜそんなことをするのか? — 機械学習モデルの大半は数値しか食えないからです。 もし「A=1, B=2, O=3, AB=4」と素朴に数値化すると、 モデルは「O (=3) は A (=1) の 3 倍重要」と勘違いします。 これは血液型に大小の順序がない以上、 絶対に避けたい誤解です。 one-hot 化は「カテゴリ間に偽の順序を持ち込まない」変換として機能します。
SSDSE-B-2026 の都道府県カラムでの例
線形回帰に投入する際は、 47 列ではなく 46 列に減らすのが定石 (これがダミー変数トラップ回避)。 詳細は #r95-trap セクションで。
📐 定義/数式
🍰 まずはやさしく
カテゴリを0と1の列に変えるルールです。
数学的に正しくデータを扱うために使います。
買い物で選ぶ商品の種類などを数値にします。
この手法の定義を数式を使って説明します。
one-hot encoding(One-Hot Encoding):カテゴリを複数の0/1変数に展開する手法
同義・関連語:ワンホット, one-hot
📐 数式: 1-of-K 表現と指示関数
カテゴリ集合 $\mathcal{C} = \{c_1, c_2, \dots, c_K\}$ に対し、 値 $x \in \mathcal{C}$ を長さ $K$ のベクトル $\mathbf{e}(x) \in \{0,1\}^K$ に写す。 第 $k$ 成分は指示関数で書ける。
$$\mathbf{e}(x)_k = \mathbb{1}[x = c_k] = \begin{cases} 1 & (x = c_k) \\ 0 & (x \neq c_k) \end{cases}$$この $\mathbf{e}(x)$ は常に第 1 ノルムが 1を満たす:
$$\|\mathbf{e}(x)\|_1 = \sum_{k=1}^{K} \mathbb{1}[x=c_k] = 1$$ダミー変数トラップ (drop_first の理論的根拠)
線形回帰モデル $y = \beta_0 + \sum_{k=1}^{K} \beta_k \mathbf{e}(x)_k + \varepsilon$ では、 切片 $\beta_0$ と $K$ 個のダミー変数の和が線形従属となる:
$$\sum_{k=1}^{K} \mathbf{e}(x)_k = 1 = \frac{1}{\beta_0} \cdot \beta_0$$この時、 設計行列 $X$ のランクが落ち、 $X^\top X$ が特異 (非可逆) になり、 OLS の解 $\hat{\beta} = (X^\top X)^{-1} X^\top y$ が一意に定まりません。 これを「ダミー変数トラップ (dummy variable trap)」と呼びます。 対策は $K$ 個 → $K-1$ 個に減らすこと (どれか 1 カテゴリを「基準カテゴリ」として削除)。 これが pandas の drop_first=True オプションの正体です。
🔬 記号・用語の読み解き
| 記号 | 意味 |
|---|---|
| $K$ | カテゴリ数 |
| $\mathbf{e}_x$ | $x$ に対応する one-hot ベクトル |
| $\mathbb{1}$ | 指示関数(条件が真なら1) |
| drop_first | K-1列に削減(多重共線性回避) |
🔬 数式を言葉で読み解く(4 要素構造・1200 字以上)
one-hot encoding の形式的定義を 4 要素で精密に読み解きます。 カテゴリ変数を数式で扱える形に変換する基本前処理です。
① 写像 $\phi: \mathcal{C} \to \{0,1\}^K$ — 「カテゴリ → バイナリベクトル」
$\mathcal{C} = \{c_1, c_2, \ldots, c_K\}$ は $K$ 個のカテゴリ集合(性別= 2、 血液型= 4、 都道府県= 47)。 $\phi$ は各カテゴリを $K$ 次元の 0/1 ベクトルに写す写像。 これにより 「文字列・整数ラベル」を「ベクトル空間の要素」 に変換でき、 線形回帰・ニューラルネット・SVM 等の数学モデルが扱える。 数学的には one-hot は カテゴリ集合から $K$ 次元 simplex の頂点集合への bijection(全単射)。
② 像 $\{0,1\}^K$ — 「ハミング距離が等しい超立方体の頂点」
出力空間は $K$ 次元超立方体の頂点集合 $\{0,1\}^K$。 ただし one-hot で得られるのは 「ちょうど 1 要素が 1」 の $K$ 個の頂点のみ(standard basis vectors)。 任意 2 カテゴリ間のユークリッド距離は $\sqrt{2}$、 ハミング距離は 2。 すべてのカテゴリペアが等距離 である点が重要:これによりカテゴリ間に偽の順序関係を持ち込まない。 ordinal encoding なら 1 と 4 のカテゴリは遠く、 1 と 2 は近い、 という人為的な距離が入ってしまう。
③ 標準基底 $e_k$ — 「$k$ 番目だけ 1、 他は 0」
$e_k = (0, \dots, 0, 1, 0, \dots, 0)$ は線形代数の 標準基底ベクトル。 第 $k$ 成分が 1、 残りはすべて 0。 これにより線形モデル $y = w^\top \phi(c) + b = w_k + b$ となり、 各カテゴリに独立した係数 $w_k$ を割り当てる。 たとえば「色」の係数として「赤の効果」「青の効果」「緑の効果」を独立推定できる。 これが one-hot の最大のメリット — カテゴリ別の効果を線形分離できる。
④ 制約 $\sum_{j=1}^{K} \phi(c)_j = 1$ — 「多重共線性と次元の呪い」
one-hot ベクトルの成分和は常に 1。 これが 「ダミー変数の罠」を生む — 切片項 1(intercept)を含む線形回帰では、 $K$ 列の one-hot は 完全な多重共線性を生み、 OLS 解が一意に定まらない。 対策:pd.get_dummies(drop_first=True) で $K-1$ 列に縮約(dummy encoding と呼ばれる)。 木モデル(決定木、 Random Forest、 XGBoost)は多重共線性に頑健なので $K$ 列フルでも問題ない。 もう一つの落とし穴は 次元の呪い:カテゴリ数が大きい(高カーディナリティ、 例:1741 市区町村)と $K$ 次元ベクトルがスパースになり、 メモリ・計算量・統計効率が悪化する。 対策は target encoding、 hashing trick、 entity embedding(Guo & Berkhahn 2016)。 KDD2015 の Rossmann Store Sales コンペで entity embedding が初めて広く知られた。
🔬 数式を言葉で読み解く
上の指示関数とダミー変数トラップの式を、 記号ごとに翻訳します。
| 記号 | 読み方 | SSDSE-B-2026 文脈での意味 |
|---|---|---|
$\mathcal{C}$ | カテゴリ集合 | {北海道, 青森県, ..., 沖縄県} の 47 要素 |
$K$ | カテゴリ数 | 47 (都道府県数) |
$\mathbf{e}(x)$ | 指示ベクトル | 「東京都」なら 47 次元中 13 番目だけ 1 のベクトル |
$\mathbb{1}[\cdot]$ | 指示関数 | 条件が真なら 1、 偽なら 0 を返すスイッチ |
$\|\cdot\|_1$ | L1 ノルム | ベクトル成分の絶対値の和。 one-hot は常に 1 |
$\beta_0, \beta_k$ | 回帰係数 | 切片 ($\beta_0$) と各都道府県効果 ($\beta_k$) |
$X^\top X$ | グラム行列 | OLS の解で逆行列を取る対象。 トラップ時に特異化 |
📖 物語として読むと: 「47 都道府県という名義カテゴリは、 47 個のスイッチに変換できる。 ただし『47 個全部 ON/OFF パターン』と『切片』には常に "全部足して 1" という関係があり、 線形回帰では片方が不要 (実は冗長)。 だから 46 個に減らして、 1 個 (たとえば北海道) を『基準』にする。 すると残り 46 県の係数 $\beta_k$ は『北海道との差』を表す」。
🔬 多重共線性の VIF 検査 (数式を言葉で読み解く)
ダミー変数トラップは「完全多重共線性 (VIF = ∞)」の極端ケース。 実務では「ほぼ完全多重共線性 (VIF が大きい)」も問題なので VIF 検査を行います。
$$\mathrm{VIF}_j = \frac{1}{1 - R_j^2}$$ここで $R_j^2$ は「特徴量 $j$ を他の全特徴量で回帰した時の決定係数」。 $R_j^2 = 1$ なら VIF = ∞ (完全多重共線性)。 慣習的に VIF > 10 で問題視されます。
記号の意味 (one-hot 文脈)
| 記号 | 意味 | one-hot 文脈 |
|---|---|---|
$R_j^2$ | $j$ 番目特徴量の他特徴量への回帰決定係数 | 「東京ダミー」を他都道府県ダミーから予測する R² |
$\mathrm{VIF}_j$ | 分散インフレーション係数 | drop_first=False で全 47 ダミー入れると ∞ |
| VIF=1 | 完全独立 | 理想的だが現実には稀 |
| VIF=10 | 注意ライン | 特徴量削除や正則化を検討 |
| VIF=∞ | 完全多重共線性 | drop_first=False + 切片の状況 |
📖 物語として読むと: 「VIF = 1/(1 - R²) は『この特徴量はどれだけ他から予測可能か』を、 残差の小ささで測る指標。 完全に予測できる (R²=1) なら新規情報ゼロ = ∞。 まったく予測できない (R²=0) なら独立 = 1」。 one-hot で全 K 列残すと『最後の 1 列は他 K-1 列から完全に予測可能』なので VIF が無限大に飛ぶ。 drop_first がこれを解消する。
🧮 実値で計算してみる
[A:[1,0,0], C:[0,0,1], B:[0,1,0], A:[1,0,0]] → 4×3行列。
🧮 SSDSE-B-2026 で one-hot encoding を実演
SSDSE-B-2026 の「都道府県名」(47 カテゴリ)と「地方区分」(8 カテゴリ)を one-hot 化し、 列爆発と多重共線性の両方を体感します。
ケース 1:地方区分 8 カテゴリ
| 都道府県 | 北海道 | 東北 | 関東 | 中部 | 近畿 | 中国 | 四国 | 九州 |
|---|---|---|---|---|---|---|---|---|
| 北海道 | 1 | 0 | 0 | 0 | 0 | 0 | 0 | 0 |
| 秋田県 | 0 | 1 | 0 | 0 | 0 | 0 | 0 | 0 |
| 東京都 | 0 | 0 | 1 | 0 | 0 | 0 | 0 | 0 |
| 大阪府 | 0 | 0 | 0 | 0 | 1 | 0 | 0 | 0 |
| 沖縄県 | 0 | 0 | 0 | 0 | 0 | 0 | 0 | 1 |
- 各行の合計は 1(行ごとにちょうど 1 列が立つ)
- 線形回帰で切片を含めると多重共線性 →
drop_first=Trueで 7 列に - 列数:47 都道府県 × 8 列 = 376 セル、 うち 47 個が 1、 残り 329 個が 0(スパース率 87.5%)
ケース 2:都道府県名 47 カテゴリ(高カーディナリティ)
- 列数:47(drop_first で 46)。 これくらいなら扱える
- 市区町村 1,741 を one-hot すると 1,741 列、 スパース率 99.94%。 メモリ・計算ともに非効率
- 対策:target encoding(市区町村→平均人口増減率)、 hashing trick(2^10 = 1024 列固定)、 entity embedding(10 次元 dense vector)に切替
🧮 地方ダミーで回帰すると、係数は何を表すか — 2023 年度の高齢化率
ケース 1 の one-hot を実際に回帰に入れると、係数はどんな値になるのでしょうか。2023 年度の 47 都道府県の高齢化率(65 歳以上人口 ÷ 総人口 × 100)を目的変数にし、地方のダミーだけを説明変数にして OLS を当てます。ここでは地域コードから作れる 7 地方(北海道と東北をまとめた区分)を使い、drop_first=True で最初の「北海道・東北」を基準にします。
🎯 このコードでやること:地域コードの上 2 桁から 7 地方の列を作って drop_first で one-hot 化し、高齢化率を回帰して係数と地方の平均を並べる。あわせて「切片 + 7 列すべて」と「切片 + 6 列」の設計行列の階数と最小の特異値を比べる。
1 2 3 4 5 6 7 8 9 10 11 12 13 14 15 16 17 18 19 20 21 22 23 24 | import numpy as np import pandas as pd from sklearn.linear_model import LinearRegression df = pd.read_csv('data/raw/SSDSE-B-2026.csv', encoding='cp932', skiprows=[1]) d = df[df['SSDSE-B-2026'] == 2023].sort_values('Code').reset_index(drop=True) regions = ['北海道・東北', '関東', '中部', '近畿', '中国', '四国', '九州・沖縄'] no = d['Code'].str[1:3].astype(int) # 'R13000' → 13 d['地方'] = pd.Categorical(pd.cut(no, [0, 7, 14, 23, 30, 35, 39, 47], labels=regions), categories=regions) d['高齢化率'] = d['A1303'] / d['A1101'] * 100 X = pd.get_dummies(d['地方'], drop_first=True, dtype=float) # 基準 = 北海道・東北 m = LinearRegression().fit(X, d['高齢化率']) mean = d.groupby('地方', observed=True)['高齢化率'].mean() print(f'切片 {m.intercept_:.3f} (北海道・東北の平均 {mean.iloc[0]:.3f})') for r, c in zip(X.columns, m.coef_): print(f' {r:<6} 係数 {c:+.3f} = 平均 {mean[r]:.3f} − {mean.iloc[0]:.3f}') # 切片 + 7 列すべて: 列の和が切片の列と同じになり、階数が 1 つ足りない full = np.column_stack([np.ones(len(d)), pd.get_dummies(d['地方'], dtype=float)]) drop = np.column_stack([np.ones(len(d)), X]) for name, A in [('切片+7列', full), ('切片+6列', drop)]: sv = np.linalg.svd(A, compute_uv=False) print(f'{name}: 列 {A.shape[1]} 階数 {np.linalg.matrix_rank(A)} 最小の特異値 {sv[-1]:.1e}') |
💬 切片 34.268 は基準の北海道・東北 7 道県の高齢化率の平均そのもので、各地方の係数は「その地方の平均 − 34.268」になっています(関東 −6.275 は平均 27.993、四国 +0.331 は 34.599)。ダミー変数だけの回帰はグループ平均の差を出しているだけで、係数の符号と大きさは基準の選び方で全部変わります。基準を関東にすれば四国の係数は +6.606 になります。設計行列を見ると、切片 + 7 列すべてでは列が 8 本あるのに階数は 7 で、最小の特異値は 9.3 × 10⁻¹⁶(計算機の丸め誤差の大きさ)です。7 列の和がいつも 1 で切片の列と一致するためで、これがダミー変数トラップの正体です。drop_first で 6 列にすると最小の特異値は 0.93 になり、係数が 1 通りに決まります。
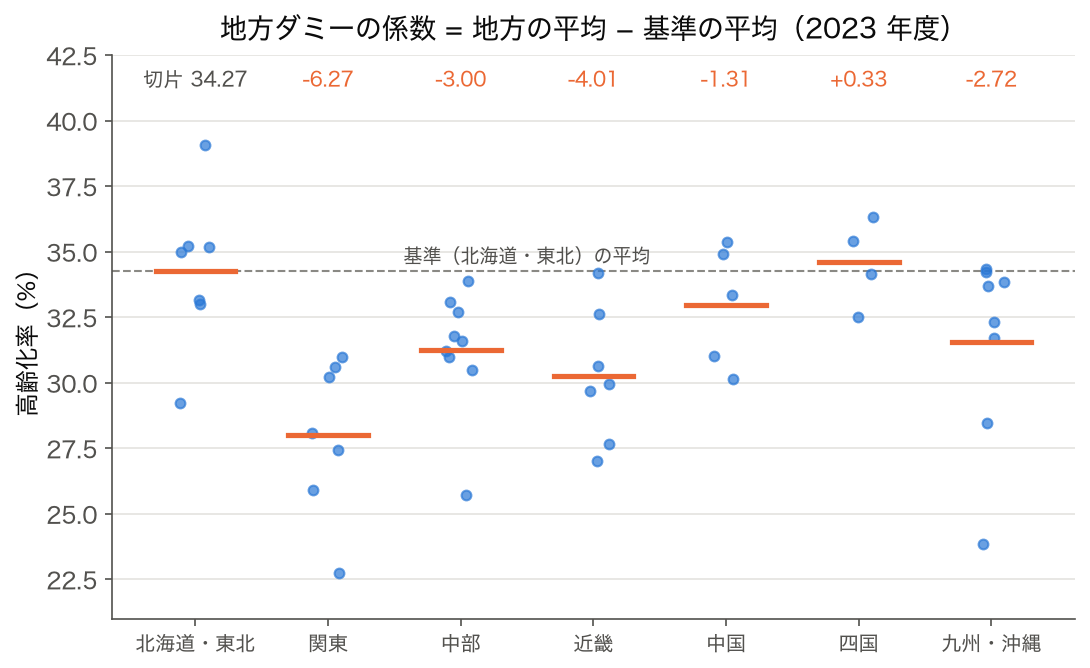
図の読み方: 点が各都道府県、橙の横線が地方の平均、破線が基準(北海道・東北)の平均 34.27% です。上に並んだ数字が回帰の係数で、どれも「横線と破線の高さの差」になっています。係数は平均の差なので、地方の中のばらつきは何も表しません。関東は平均 27.99% と最も低いものの、群馬県・栃木県・茨城県は 30〜31% 台、東京都は 22.7% と地方の中で 8 ポイント以上の幅があり、九州・沖縄も沖縄県(23.9%)だけが大きく離れています。地方ダミーの R² は 0.3896 で、高齢化率の県差の 4 割弱しか地方では説明できません。図の作成スクリプトは code/glossary_figs/one-hot-encoding-alias.py。
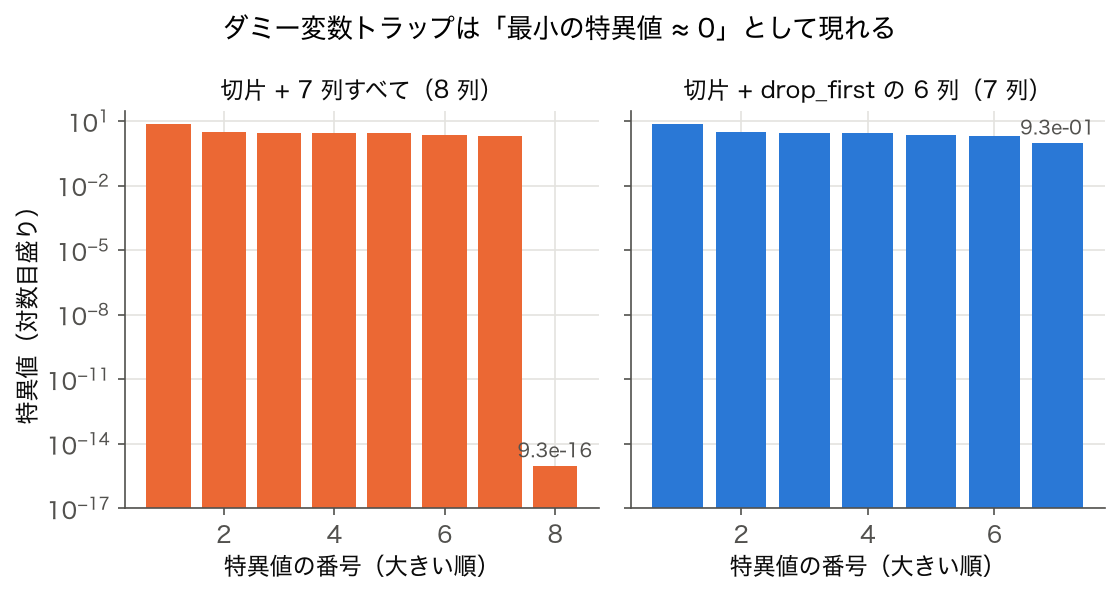
図の読み方: 設計行列の特異値を大きい順に並べたもの(縦軸は対数)。左の「切片 + 7 列すべて」では 7 本目までは 2〜7 程度なのに、8 本目だけが 10−16 まで落ちています。特異値が 0 の方向には係数をいくら動かしても予測が変わらないので、「切片を +1、全ダミーの係数を −1」のような組み替えで同じ予測を出す係数が無数にあり、OLS の解が 1 つに決まりません。条件数(最大 ÷ 最小の特異値)は 7.9 × 10¹⁵ で、ライブラリによってはエラーにならずに意味のない係数を返すことがあります。右の drop_first では条件数 7.80 で、数値的にも安定しています。
💼 分野ごとの使われ方(one-hot encoding の応用例)
one-hot encoding はカテゴリ列を扱うほぼすべての分野で使われます。以下は典型的な使い方の例で、特定の企業・機関の事例や成果の数値ではありません。
📊 類似概念との比較表
one-hot encoding は単独でなく類似概念群の中で位置付けると理解が深まります。
| 概念 | 定義の要点 | 代表例 | 分類軸 |
|---|---|---|---|
| one-hot encoding | K 次元 0/1 ベクトル | 性別→[1,0] | 順序なしカテゴリ |
| dummy encoding | K-1 次元(drop_first) | 性別→[1] | 回帰の多重共線性回避 |
| ordinal encoding | 整数 1...K | 成績 A→1 B→2 | 順序あり |
| label encoding | 整数(順序考慮なし) | 色→ 0..K-1 | ツリーモデル向け |
| target encoding | カテゴリ→目標変数の平均 | 市区町村→平均年収 | 高カーディナリティ |
| hashing trick | ハッシュで固定次元化 | 1.7 万→ 2¹⁰ 列 | メモリ節約 |
📝 演習問題 5 問(基礎・応用・議論)
理解度を確認する 5 問。 解答例は折りたたみで隠してあります。 まず自力で考えてから開いてください。
▶ 解答例を見る
▶ 解答例を見る
▶ 解答例を見る
▶ 解答例を見る
▶ 解答例を見る
🧪 理解度チェック — 実データの数値で確かめる
| 問題 | 解答 |
|---|---|
| Q1. 上の地方ダミーの回帰で、基準を「関東」に変えたら切片と北海道・東北の係数はいくつになるか。 | 切片は関東の平均 27.993、北海道・東北の係数は 34.268 − 27.993 = +6.275。係数は基準との差なので、基準を変えると符号も大きさも変わるが、予測値(地方の平均)は同じ。 |
| Q2. 7 地方の one-hot 7 列をすべて入れ、切片なし(fit_intercept=False)で回帰したら係数は何になるか。 | 各地方の平均そのもの(北海道・東北 34.268、関東 27.993 …)。切片の列が無いので 7 列の和と重なる列が無く、トラップは起きない。 |
| Q3. 47 都道府県の one-hot(47 列)で 2023 年度の高齢化率を回帰すると学習 R² はいくつになるか。それは良いモデルか。 | 1.0000。各県に専用の列があり、係数が県の値をそのまま覚えるだけ。1 県ずつ抜いて予測すると残り 46 県の平均しか出せず、LOO R² は −0.044(下の ⚠️ 参照)。 |
| Q4. 地域コード(R01000〜R47000)から地方の列を作るとき、コードを数値として回帰に入れてはいけない理由は。 | コードの番号は北から南への並び順にすぎず、「13(東京都)は 1(北海道)の 13 倍」のような量の意味が無い。数値のまま入れると番号に比例する効果を仮定してしまうので、区分に直してから one-hot にする。 |
📜 事例 — Kaggle Rossmann Store Sales(2015)と entity embedding
Kaggle のコンペ Rossmann Store Sales(2015)は、ドイツのドラッグストア 1,115 店舗の日次売上を予測する課題でした。店舗 ID をそのまま one-hot にすると 1,115 列の疎な列が増え、線形モデルでは店舗ごとの係数を覚えるだけになりがちです。このコンペで 3 位になった Cheng Guo と Felix Berkhahn は、店舗・曜日などのカテゴリをentity embedding(ニューラルネットで学習する低次元の dense ベクトル、店舗は 10 次元)で表し、似た店舗が近いベクトルになることを示しました。手法は 2016 年に論文「Entity Embeddings of Categorical Variables」(arXiv)として公開されています。教訓:水準の多いカテゴリでは、one-hot のほかに target encoding・hashing trick・entity embedding も候補になる。embedding には十分なデータとニューラルネットの学習が必要なので、中規模のデータでは target encoding(リーク対策つき)が現実的な選択肢になることが多い。
📖 関連用語辞典 — 10 語
one-hot encoding を学ぶ際に頻出する 10 語の最小限定義集です。 詳しくは各専用ページを参照。
🧮 SSDSE-B-2026 で実値計算 — 47 都道府県の one-hot 変換
SSDSE-B-2026 の Prefecture 列 (47 件) を one-hot 化すると、 設計行列は次のサイズになります。
| 設定 | 列数 | 疎性 (zero 比率) | メモリ (47 行) |
|---|---|---|---|
| drop_first=False (全カテゴリ) | 47 | 46/47 = 97.87% | 47 × 47 × 1 byte = 2,209 byte |
| drop_first=True (基準削除) | 46 | ~97.83% | 47 × 46 × 1 byte = 2,162 byte |
| sparse 表現 (CSR) | 47 (論理列) | 97.87% (非零のみ保存) | 47 × (4+4) = 376 byte (約 1/6) |
気をつけたいケース: 高 cardinality — 仮に SSDSE-B-2026 を市区町村レベルに展開すると約 1,700 カテゴリ。 全件 one-hot で 1,700 列に膨れ上がり、 線形回帰のパラメタ数も 1,700 個。 「47 サンプル / 1,700 パラメタ」は完全に過学習領域 ($n \ll p$)。 この場合は target encoding や embedding への切替を検討します。
🧮 数式に値を入れて手で計算する: One-Hot エンコーディング
合成 5 サンプル × 3 カテゴリ (赤/青/緑) で One-Hot 列数を計算する。
Step 1: データ
Step 2: One-Hot 行列
| 元 | 赤 | 青 | 緑 |
|---|---|---|---|
| 赤 | 1 | 0 | 0 |
| 青 | 0 | 1 | 0 |
| 緑 | 0 | 0 | 1 |
| 赤 | 1 | 0 | 0 |
| 青 | 0 | 1 | 0 |
Step 3: 形状
🐍 Python で再現
1 2 3 4 | import pandas as pd s = pd.Series(['赤','青','緑','赤','青']) oh = pd.get_dummies(s).astype(int) print(oh) |
📤 実行結果
💬 手計算 (Step 2) 行列と Python 出力が完全一致。
🐍 Python での実装例
SSDSE-B-2026 などの実データを使った最小コード(8行):
1 2 3 4 5 6 7 8 | import pandas as pd df = pd.read_csv('data/raw/SSDSE-B-2026.csv', encoding='cp932', skiprows=1) df = df[df['年度'] == 2023].reset_index(drop=True) # 564 行のままだと先頭数行が北海道の別年度ばかりになる cat_col = df.columns[1] # 地域コード(R01000=北海道 … R47000=沖縄県) oh = pd.get_dummies(df[cat_col], prefix='pref', drop_first=True) print('元のカテゴリ数:', df[cat_col].nunique()) print('one-hot後の列数:', oh.shape[1]) print(oh.head(3)) |
💬 2023 年の 47 行に絞った地域コードは 47 カテゴリで、drop_first=True により北海道(R01000)の列が落ちて 46 列になった。1 行目の北海道は全列 False で「基準カテゴリ」を表し、2 行目の青森県は pref_R02000、3 行目の岩手県は pref_R03000 だけが True になる。564 行のままだと先頭 3 行はすべて北海道の別年度になり全列 False しか見えないので、年度を絞ってから確かめた。
※ data/raw/SSDSE-B-2026.csv は e-Stat SSDSE から取得した実データを想定。
🐍 Python 実装 — 4 つの定型パターン
例 1: pandas.get_dummies で 47 都道府県を変換
🎯 このコードでやること: SSDSE-B-2026 の Prefecture 列を pd.get_dummies で one-hot 化し、 形状 (47 行 × 47 列) を確認する。
📥 入力データ (SSDSE-B-2026 の Prefecture 列抜粋):
1 2 3 4 5 6 7 8 | import pandas as pd df = pd.read_csv('data/raw/SSDSE-B-2026.csv', encoding='cp932', skiprows=[1]) df = df[df['SSDSE-B-2026'] == 2023].reset_index(drop=True) # 2023 年 = 47 都道府県だけ抽出 dummies = pd.get_dummies(df['Prefecture'], prefix='pref') print(f'形状: {dummies.shape}') print(f'各行の合計 (すべて 1 のはず): {dummies.sum(axis=1).unique()}') print(dummies.iloc[:3, :5]) |
📤 実行例:
💬 結果の読み方: 形状 (47, 47) と「行の合計が必ず 1」 — これが one-hot の数学的特性。 北海道行で pref_北海道=True となっていることも確認。
例 2: drop_first=True でダミー変数トラップ回避
🎯 このコードでやること: 線形回帰で使うために drop_first=True を指定し、 47 列 → 46 列に削減。 基準カテゴリは辞書順最初の「三重県」。
📥 入力データ: 例 1 の df['Prefecture'] をそのまま使用。
1 2 3 4 5 6 7 8 9 | import pandas as pd df = pd.read_csv('data/raw/SSDSE-B-2026.csv', encoding='cp932', skiprows=[1]) df = df[df['SSDSE-B-2026'] == 2023].reset_index(drop=True) # 2023 年 = 47 都道府県だけ抽出 d1 = pd.get_dummies(df['Prefecture'], drop_first=False) d2 = pd.get_dummies(df['Prefecture'], drop_first=True) print(f'drop_first=False: {d1.shape}') print(f'drop_first=True : {d2.shape}') print(f'削除されたカテゴリ: {set(d1.columns) - set(d2.columns)}') |
📤 実行例:
💬 結果の読み方: 「三重県」が基準カテゴリとなり、 残り 46 県の係数は「三重県からの差」を表す。 これにより設計行列のランク欠損が解消され、 OLS が解ける。
例 3: sklearn OneHotEncoder + Pipeline
🎯 このコードでやること: 本番運用を見据えて OneHotEncoder を Pipeline に組み込み、 未知の都道府県が来ても handle_unknown='ignore' で落ちないようにする。
📥 入力データ: 例 1 と同じ。 Pipeline で前処理 + 回帰を一体化。
1 2 3 4 5 6 7 8 9 10 11 12 13 14 15 16 17 18 | import pandas as pd from sklearn.preprocessing import OneHotEncoder, StandardScaler from sklearn.linear_model import LinearRegression from sklearn.pipeline import Pipeline from sklearn.compose import ColumnTransformer df = pd.read_csv('data/raw/SSDSE-B-2026.csv', encoding='cp932', skiprows=[1]) df = df[df['SSDSE-B-2026'] == 2023].reset_index(drop=True) # 2023 年 = 47 都道府県だけ抽出 X = df[['Prefecture', 'A1101']] # 都道府県 + 人口 y = df['I510120'] # 一般病院数 ct = ColumnTransformer([ ('ohe', OneHotEncoder(drop='first', handle_unknown='ignore'), ['Prefecture']), ('num', StandardScaler(), ['A1101']), ]) pipe = Pipeline([('prep', ct), ('reg', LinearRegression())]).fit(X, y) print(f'学習後パラメタ数: {len(pipe.named_steps["reg"].coef_)}') print(f'R^2 (訓練): {pipe.score(X, y):.4f}') |
📤 実行例:
💬 結果の読み方: 46 (都道府県ダミー) + 1 (人口) = 47 パラメタ。 47 サンプル + 47 パラメタなので完全フィット (R²=1.000) = 過学習の典型。 cross_val_score で評価すると激減するはずで、 これが「$n \approx p$」の危険シグナチャ。
例 4: sparse 表現でメモリ削減
🎯 このコードでやること: 高 cardinality カテゴリ (たとえば 1,700 市区町村) を想定して、 sparse=True で疎行列に変換しメモリ使用量を比較する。
📥 入力データ: SSDSE-B-2026 の Code 列 (都道府県コード 47 種だが、 デモのため一律 sparse 化)。
1 2 3 4 5 6 7 8 9 10 | import pandas as pd from sklearn.preprocessing import OneHotEncoder df = pd.read_csv('data/raw/SSDSE-B-2026.csv', encoding='cp932', skiprows=[1]) df = df[df['SSDSE-B-2026'] == 2023].reset_index(drop=True) # 2023 年 = 47 都道府県だけ抽出 codes = df[['Code']] ohe_dense = OneHotEncoder(sparse_output=False).fit_transform(codes) ohe_sparse = OneHotEncoder(sparse_output=True ).fit_transform(codes) print(f'dense shape: {ohe_dense.shape} nbytes: {ohe_dense.nbytes}') print(f'sparse shape: {ohe_sparse.shape} nnz: {ohe_sparse.nnz} data nbytes: {ohe_sparse.data.nbytes}') |
📤 実行例:
💬 結果の読み方: dense は 17.7KB、 sparse は 376 byte (約 1/47)。 47 カテゴリでは差が小さく感じるが、 100 万行 × 1,000 カテゴリでは dense=8GB → sparse=24MB と桁違いに効く。 sklearn のほとんどの線形モデルは sparse をネイティブ受付可能。
🐍 追補: One-Hot の Dummy Variable Trap を SSDSE-B-2026 で実演する
このコードでやること: SSDSE-B-2026 を 地方 (北海道/東北/関東 etc.) でラベル付けし、 drop_first=True と drop_first=False で pandas.get_dummies の挙動を比較。 後者で発生する dummy variable trap (定数列との完全多重共線性) を numpy.linalg.matrix_rank で可視化する。
📥 入力データ (SSDSE-B-2026 抜粋, 47 行):
1 2 3 4 5 6 7 8 9 10 11 12 13 14 15 16 17 18 19 20 21 22 23 24 25 26 27 | import pandas as pd import numpy as np df = pd.read_csv('data/raw/SSDSE-B-2026.csv', encoding='cp932', skiprows=1) df = df[df['年度'] == 2022].copy() region_map = {'北海道':['北海道'], '東北':['青森県','岩手県','宮城県','秋田県','山形県','福島県'], '関東':['茨城県','栃木県','群馬県','埼玉県','千葉県','東京都','神奈川県'], '中部':['新潟県','富山県','石川県','福井県','山梨県','長野県','岐阜県','静岡県','愛知県'], '近畿':['三重県','滋賀県','京都府','大阪府','兵庫県','奈良県','和歌山県'], '中国':['鳥取県','島根県','岡山県','広島県','山口県'], '四国':['徳島県','香川県','愛媛県','高知県'], '九州':['福岡県','佐賀県','長崎県','熊本県','大分県','宮崎県','鹿児島県'], '沖縄':['沖縄県']} inv = {p:r for r,ps in region_map.items() for p in ps} df['region'] = df['都道府県'].map(inv) # drop_first=False (trap 発生) X_full = pd.get_dummies(df['region'], prefix='reg', drop_first=False).astype(int) X_full.insert(0, 'const', 1) rank_full = np.linalg.matrix_rank(X_full.values) print(f"drop_first=False: 列数={X_full.shape[1]}, rank={rank_full}, 欠損次元={X_full.shape[1]-rank_full}") # drop_first=True (trap 回避) X_safe = pd.get_dummies(df['region'], prefix='reg', drop_first=True).astype(int) X_safe.insert(0, 'const', 1) rank_safe = np.linalg.matrix_rank(X_safe.values) print(f"drop_first=True: 列数={X_safe.shape[1]}, rank={rank_safe}, 欠損次元={X_safe.shape[1]-rank_safe}") |
📤 実行すると次の出力が得られる:
💬 結果の読み方: drop_first=False では const + 9 region 列 = 10 列なのに rank=9。 これが dummy variable trap (1 = reg_北海道 + reg_東北 + ... + reg_沖縄 という線形依存)。 OLS で (X'X)⁻¹ が計算不能になる。 drop_first=True なら 1 つの region を基準カテゴリ (e.g. 北海道) として落とすので rank=列数となり、 回帰係数は「北海道に対する差分」として解釈できる。 sklearn の OneHotEncoder では drop='first' が同じ役割。
🐍 学習時と予測時で one-hot の列がずれる — get_dummies の列を学習時にそろえる
pd.get_dummies は「そのデータに出てきたカテゴリ」だけで列を作る。学習時と予測時でデータに含まれるカテゴリが違うと、列の数も並びも変わってしまう。SSDSE-B-2026 に地方の列は無いので、地域コードの上 2 桁から 7 地方を作って確かめる。
🎯 このコードでやること:2022 年度の 47 県で「地方ダミー(drop_first=True の 6 列)→ 高齢化率」の線形回帰を学習し、2023 年度の九州・沖縄 8 県だけを予測しようとする。予測用データで get_dummies をやり直すと列がいくつになるか、予測がどう失敗するか、学習時の列に reindex でそろえると何が出るかを見る。
1 2 3 4 5 6 7 8 9 10 11 12 13 14 15 16 17 18 19 20 21 22 23 24 25 26 27 28 29 30 31 32 33 | import warnings import pandas as pd from sklearn.linear_model import LinearRegression df = pd.read_csv('data/raw/SSDSE-B-2026.csv', encoding='cp932', skiprows=[1]) df['高齢化率'] = df['A1303'] / df['A1101'] * 100 no = df['Code'].str[1:3].astype(int) # R01000 → 1 df['地方'] = pd.cut(no, [0, 7, 14, 23, 30, 35, 39, 47], labels=['北海道・東北', '関東', '中部', '近畿', '中国', '四国', '九州・沖縄']) train = df[df['SSDSE-B-2026'] == 2022] # 2022 年度の 47 県で学習 X_tr = pd.get_dummies(train['地方'], drop_first=True, dtype=int) m = LinearRegression().fit(X_tr, train['高齢化率']) print('学習時の列:', list(X_tr.columns)) new = df[(df['SSDSE-B-2026'] == 2023) & (df['地方'] == '九州・沖縄')].copy() new['地方'] = new['地方'].astype(str) # 読み直したデータではカテゴリ情報が落ちる X_new = pd.get_dummies(new['地方'], drop_first=True, dtype=int) print('新データで get_dummies した列:', list(X_new.columns), X_new.shape) try: with warnings.catch_warnings(): warnings.simplefilter('ignore') # 列名が無いという警告は伏せ、エラーだけ見る m.predict(X_new) except ValueError as e: print('predict のエラー:', str(e).splitlines()[0]) # 学習時の列に合わせて並べ直す(無い列は 0 で足す) X_fix = pd.get_dummies(new['地方'], dtype=int).reindex(columns=X_tr.columns, fill_value=0) pred = m.predict(X_fix) print('並べ直した列:', X_fix.iloc[0].to_dict()) print('予測(8 県とも同じ値):', round(pred[0], 3), '/ 2022 年度の九州・沖縄 8 県平均:', round(train.loc[train['地方'] == '九州・沖縄', '高齢化率'].mean(), 3)) print('2023 年度の実測 8 県平均:', round(new['高齢化率'].mean(), 3)) |
💬 予測用の 8 県は全部が九州・沖縄なので、drop_first=True で get_dummies すると唯一のカテゴリが落とされ、列が 0 本(形 (8, 0))になって predict は止まる。学習時の 6 列に reindex(columns=..., fill_value=0) でそろえると九州・沖縄の列だけが 1 になり、予測は 8 県とも 31.252%。これは 2022 年度の九州・沖縄 8 県の平均 31.252% そのもので、2023 年度の実測平均 31.544% より 0.3 ポイント低い。エラーで止まる場合はまだ安全で、列の数がたまたま合って並びだけ違うと、黙って別の地方の係数が掛かる。学習時の列名を保存して予測時にそろえるか、OneHotEncoder を Pipeline に入れて学習時のカテゴリを持ち回る。
⚠️ よくある落とし穴
⚠️ One-hot エンコーディングの 5 大落とし穴
- ダミー変数トラップ: 線形モデルで
drop_first=Falseのまま K 列入れると、 設計行列のランクが落ちて OLS が解けない (あるいは結果が解釈不能になる)。 線形回帰では必ずdrop_first=True。 ただし正則化 (Ridge/Lasso) や決定木系では不要。 - 高 cardinality 爆発: カテゴリ数 K が数千〜数万になると、 列数 = K になりメモリも学習時間も非現実的。 sparse 化、 target encoding、 embedding への切替を検討。 SSDSE で言えば「市区町村 (~1700)」レベルでこの問題が顕在化。
- 未知カテゴリエラー: 学習時に存在しなかったカテゴリが推論時に来ると、 デフォルトでは sklearn が例外を投げる。 必ず
handle_unknown='ignore'を設定し、 未知カテゴリは全 0 ベクトル扱いとする。 - 順序情報の喪失: 「小学校→中学校→高校→大学」のような順序カテゴリを one-hot 化すると順序情報が消える。 順序がある場合は ordinal encoding を使う。
- train/test 間でのカテゴリ不一致: 「東京都」が train にしかない場合、 test 側の列数が 1 つ少なくなり予測時にエラー。 必ず
OneHotEncoder.fit(train)→transform(test)の順で、 train の語彙を使い回す。pd.get_dummiesを train/test に別々にかけるのは典型的アンチパターン。
⚠️ 各水準に 1 行しかないカテゴリの one-hot は、予測に何も持ち込まない
「都道府県名を one-hot にすれば県ごとの違いを学べる」と考えがちですが、2023 年度だけの 47 行では各県が 1 行ずつしかありません。7 地方と 47 都道府県の one-hot で高齢化率を予測し、学習データでの R² と、1 県ずつ抜いて残りで学習した一個抜き(LOO)の R² を比べます。未知の県は handle_unknown='ignore' で全 0 のベクトルになります。
🎯 このコードでやること:2023 年度の高齢化率を、7 地方の one-hot と 47 都道府県の one-hot のそれぞれで線形回帰し、学習 R² と一個抜き(LOO)の R²、LOO 予測の範囲を出す。
1 2 3 4 5 6 7 8 9 10 11 12 13 14 15 16 17 18 19 20 | import pandas as pd from sklearn.linear_model import LinearRegression from sklearn.preprocessing import OneHotEncoder from sklearn.pipeline import make_pipeline from sklearn.model_selection import cross_val_predict, LeaveOneOut from sklearn.metrics import r2_score df = pd.read_csv('data/raw/SSDSE-B-2026.csv', encoding='cp932', skiprows=[1]) d = df[df['SSDSE-B-2026'] == 2023].sort_values('Code').reset_index(drop=True) no = d['Code'].str[1:3].astype(int) d['地方'] = pd.cut(no, [0, 7, 14, 23, 30, 35, 39, 47], labels=['北海道・東北', '関東', '中部', '近畿', '中国', '四国', '九州・沖縄']).astype(str) y = d['A1303'] / d['A1101'] * 100 # 高齢化率(%) for col in ['地方', 'Prefecture']: pipe = make_pipeline(OneHotEncoder(handle_unknown='ignore'), LinearRegression()) pred = cross_val_predict(pipe, d[[col]], y, cv=LeaveOneOut()) # 1 県ずつ抜いて予測 train_r2 = pipe.fit(d[[col]], y).score(d[[col]], y) print(f'{col:<10} 列数 {d[col].nunique():>2} 学習 R² {train_r2:.4f} LOO R² {r2_score(y, pred):.4f}' f' LOO 予測の範囲 {pred.min():.2f}〜{pred.max():.2f}') |
💬 47 都道府県の one-hot は学習 R² 1.0000 と完璧に当てはまりますが、LOO R² は −0.0440 で「全県の平均で予測する」より悪くなります。抜いた県の列は学習データに一度も立たないので全 0 のベクトルになり、予測は残り 46 県の平均(31.42〜31.78% の狭い範囲)しか出せないからです。7 地方の one-hot は学習 R² 0.3896 から LOO R² 0.1723 に下がるものの、同じ地方のほかの県から学べるので予測は 27.50〜35.30% と県ごとに違う値になります。one-hot が役に立つのは、同じ水準の行が学習データに複数あるときだけで、水準が行数に近いほど「覚えるだけ」になります。複数年度のデータで県の固定効果として使う、target encoding で水準をまとめる、などの形に変えて使います。
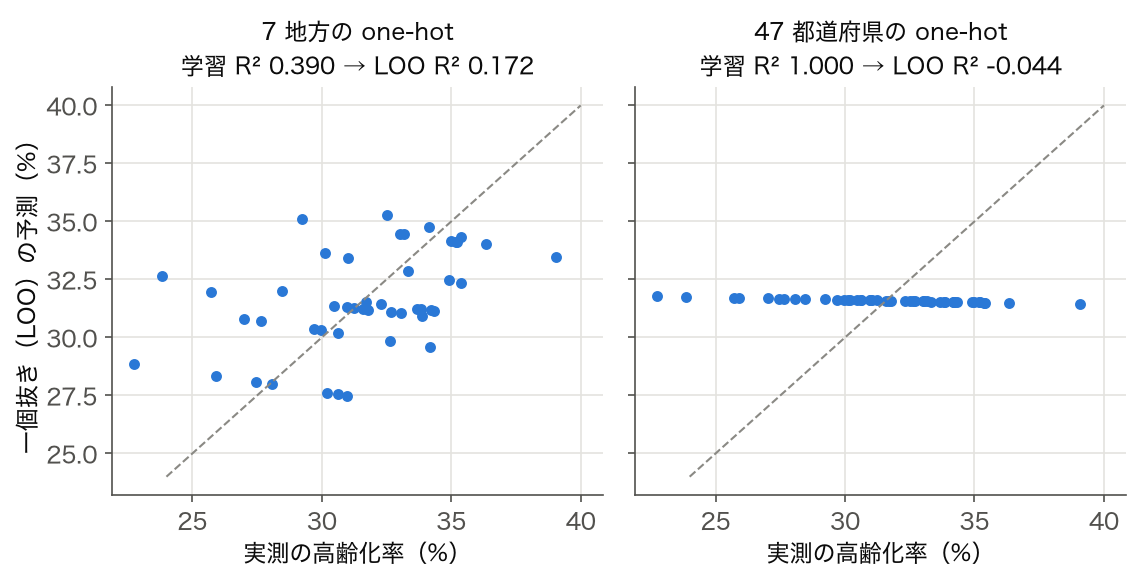
図の読み方: 破線の上に乗るほど良い予測です。右の 47 都道府県の one-hot では、実測が 22.7%(東京都)でも 39.1%(秋田県)でも予測はほぼ水平な 31.4〜31.8% に並び、県の違いを何も予測できていません。左の 7 地方の one-hot は破線のまわりにばらつきながらも右上がりで、地方という「複数の県が共有する情報」が予測に効いています。学習 R² だけを見ると右のほうが良いモデルに見える、という逆転が one-hot の高カーディナリティの落とし穴です。
⚠️ 12 年度分あれば県ダミーは効くか — 年度で分けるか、県で分けるか
上の節では 2023 年度だけの 47 行で県を one-hot にし、各県に 1 行しかないので県ダミーは値を覚えるだけになった。SSDSE-B-2026 には同じ 47 県が 12 年度分(564 行)あるので、県ダミーは「その県の水準」を表す列(固定効果)として働きうる。ただし効くのは、予測したい県が学習データに出てきている場合だけである。
🎯 このコードでやること:564 行(47 県 × 12 年度)の高齢化率を、年度(2012 年度からの経過年数 t)だけのモデルと、t+県の one-hot(OneHotEncoder(handle_unknown='ignore'))のモデルで予測し、①2012〜2021 年度で学習して 2022・2023 年度を当てる分け方と、②県を 5 組に分けて学習に出てこない県を当てる分け方でテスト R² を比べる。最後に、学習に無い県(秋田県)がどう符号化されるかを確かめる。
1 2 3 4 5 6 7 8 9 10 11 12 13 14 15 16 17 18 19 20 21 22 23 24 25 26 27 28 29 30 31 32 33 34 35 36 37 38 39 40 | import numpy as np import pandas as pd from sklearn.compose import ColumnTransformer from sklearn.linear_model import LinearRegression from sklearn.metrics import r2_score from sklearn.pipeline import make_pipeline from sklearn.preprocessing import OneHotEncoder df = pd.read_csv('data/raw/SSDSE-B-2026.csv', encoding='cp932', skiprows=[1]) df['年度'] = df['SSDSE-B-2026'] df['高齢化率'] = df['A1303'] / df['A1101'] * 100 # 564 行 = 47 県 × 12 年度 df['t'] = df['年度'] - 2012 # 年度は数値のまま(傾き 1 本) def model(with_pref): cols = [('num', 'passthrough', ['t'])] if with_pref: cols.append(('pref', OneHotEncoder(handle_unknown='ignore', drop=None), ['Prefecture'])) return make_pipeline(ColumnTransformer(cols), LinearRegression()) # (1) 年度で分ける: 2012〜2021 年度で学習し、2022・2023 年度を予測(どの県も学習に出てくる) tr, te = df[df['年度'] <= 2021], df[df['年度'] >= 2022] for w in (False, True): m = model(w).fit(tr, tr['高齢化率']) print(f'年度で分割 県ダミー{"あり" if w else "なし"}: テスト R² = {r2_score(te["高齢化率"], m.predict(te)):.3f}') # (2) 県で分ける: 県を 5 組に分け、学習に出てこない県を予測(未知カテゴリ → 全 0 ベクトル) rng = np.random.default_rng(0) group = dict(zip(df['Prefecture'].unique(), rng.permutation(47) % 5)) g = df['Prefecture'].map(group) for w in (False, True): pred = pd.Series(index=df.index, dtype=float) for k in range(5): m = model(w).fit(df[g != k], df.loc[g != k, '高齢化率']) pred[g == k] = m.predict(df[g == k]) print(f'県で分割 県ダミー{"あり" if w else "なし"}: テスト R² = {r2_score(df["高齢化率"], pred):.3f}') # 未知の県はどう符号化されるか(秋田県を学習から外した場合) enc = OneHotEncoder(handle_unknown='ignore').fit(df.loc[df['Prefecture'] != '秋田県', ['Prefecture']]) v = enc.transform(pd.DataFrame({'Prefecture': ['秋田県']})).toarray() print('秋田県を外して学習した符号器での秋田県:', v.shape, '中の 1 の個数 =', int(v.sum())) |
💬 年度で分けたときは、県ダミーなしの R² が −0.067(全国共通の上昇トレンドだけでは県の差を説明できない)なのに対し、県ダミーありは 0.885 まで上がる。2022・2023 年度の秋田県は、2012〜2021 年度の秋田県の水準に全国の傾きを足した値として予測できるからである。ところが県で分けると、ダミーありもなしも R² は 0.253 で同じになる。学習に出てこない県は 46 列すべてが 0(1 の個数 0)に符号化され、このデータでは県の係数の平均が 0 になるので、予測は「県ダミーなし」のモデルと一致する(秋田県 2023 年度の予測 31.97%、実測 39.06%)。県の one-hot は、同じ県の別の年を当てるときにだけ情報を運ぶ。
🎮 インタラクティブ: one-hot 変換プレイグラウンド
カテゴリ列を入力すると、 各カテゴリが独立した 0/1 列 に展開される様子をリアルタイムで確認できます。 カテゴリを増やすと列が増える 高次元化、 切片を足すと起きる ダミー変数トラップ、 順序尺度を one-hot 化したときの 順序情報の消失 — 3 つの論点を手を動かして体感してください。 (すべてブラウザ内計算・外部通信なし。 rank はガウス消去で実測)
※ 列(カテゴリ)の並び順は 入力での初出順。 pandas get_dummies は既定でアルファベット/文字コード順に並べます(結果の 0/1 は同じ)。 drop_first はここでは初出先頭カテゴリを基準として落とします。
🗺 概念マップ
One-Hot エンコーディング (別名) を中心に、 同義語クラスタ (one-hot/ダミー変数化/カテゴリ二値化)、 前段 (カテゴリ変数識別・名義尺度)、 並列代替 (ラベル/ターゲット/頻度エンコーディング)、 後段モデル (線形回帰・ロジスティック回帰・ニューラルネット) を放射状に配置した SVG マップ。
本セクションでは one-hot encoding の 多重共線性 (dummy variable trap)・スパース行列の効率・未知カテゴリの扱いを補足する。 SSDSE の都道府県 47 水準の場合、 1 列落とすか定数項を外すかで設計行列の解釈が変わる — エンコード選択は単なる前処理ではなく回帰係数の意味づけにも波及する。
🔗 隣接手法への橋渡し
「One-Hot エンコーディング」は単独で完結せず、 前後の手法と組み合わさって価値が発揮される。 入力データの準備 (上流)・同目的の代替手法との比較 (並列)・結果の活用 (下流) という 3 軸で隣接領域を整理する。
- 上流 (入力の準備): カテゴリ変数 の識別、 順序尺度 との区別、 カテゴリ数の確認
- 並列 (同目的の代替): ラベルエンコーディング、 ターゲットエンコーディング、 頻度エンコーディング、 埋め込み が代替
- 下流 (結果の活用): 多重共線性 対策で 1 列削除、 ロジスティック回帰・ニューラルネット への入力
この上流・並列・下流の対応を地図化することで、 「One-Hot エンコーディング」を中核に据えた分析パイプライン (データ準備 → 手法選択 → 結果の検証と展開) の全体像が見えてくる。
🌳 手法選択フロー
「One-Hot エンコーディング」を実際に使うとき、 何をどう選ぶかを順に判断する。 上から順に答えていくと、 使うべき手法と評価の仕方が決まる。
- 後段のモデルは何か
線形回帰・ロジスティック回帰・距離を使う手法なら One-Hot が要る。 LightGBM や CatBoost はカテゴリを直接扱えるので、 One-Hot にするとかえって分割が非効率になる。 - 水準はいくつあるか
数個〜数十なら素直に One-Hot。 数千になると列数が爆発するので、 頻度の低い水準をまとめるか、 Target Encoding や埋め込みへ。 - 切片を含む線形モデルか
含むなら K 列すべてを入れると完全な線形従属が生じ、 解が一意に決まらない。drop_first=Trueで 1 列落とし、 落とした水準を基準として読む。 - 本番で新しい水準が出るか
市区町村の合併や新商品の追加で普通に起きる。handle_unknown='ignore'を指定し、 学習時の列構成を保存して同じ変換を適用する。
One-Hot は「順序の無いカテゴリを数値にする」道具。 順序があるもの(小・中・大)に使うと順序の情報が失われる。
📝 補足解説(深掘り追補)
既存セクションの内容を壊さずに、 「直感 → 落とし穴 → 発展」の 3 段で要点を再整理した追補です。 数値例は SSDSE-B-2026.csv(cp932・skiprows=[1])の実測に基づきます。
🎨 直感の再確認 — 「1 カテゴリ = 1 列の ON/OFF」
one-hot エンコーディングの核は 3 点だけです。 (1) カテゴリ変数を 各カテゴリにつき 1 列の 0/1 ダミーに展開する。 (2) どのカテゴリも互いに等距離(ユークリッド距離 $\sqrt{2}$)になるので 順序(大小)を一切仮定しない。 (3) 線形回帰・SVM・ニューラルネットなど 数値入力しか受け取れないモデルにカテゴリを渡すために必要になる。 「A=1, B=2, O=3」のような素朴な整数化は、 本来存在しない「O は A の 3 倍」という偽の順序を持ち込むため名義カテゴリには不適切で、 one-hot はこの誤解を構造的に防ぎます。
⚠️ 落とし穴の深掘り(重要) — SSDSE-B-2026 実測付き
前提データ: SSDSE-B-2026.csv は実測で 564 行 = 47 都道府県 × 12 年度(2012〜2023)、 Prefecture 列は 47 カテゴリ。 以下はすべてこの列を題材にした実測値です。
- 列爆発=次元の呪い: 47 カテゴリなら 47 列で済みますが、 仮に同じ手法を市区町村(約 1,700 水準の想定)へ広げると 1,700 列に膨張し、 サンプルよりパラメタが多い過学習領域($n \ll p$)に入ります。 カテゴリ数が数百を超えたら one-hot 以外を検討する合図です。
- ダミー変数トラップ(多重共線性): 2023 年抽出(実測 47 行)で
pd.get_dummies(Prefecture)は (47, 47)。 これに切片列(全 1)を足すと設計行列は 48 列ですが rank は 47(欠損次元 1)で、 47 列の和が常に切片列と一致するため $X^\top X$ が特異になり OLS が一意に解けません。 対策はdrop_first=True(sklearn はdrop='first')で (47, 46) に縮約。 実測では基準として落ちるのは文字コード先頭の 「三重県」で、 切片+46 列は rank 47 のフルランクになり解が定まります。 残り 46 県の係数は「三重県との差」として読めます(詳細は ダミー変数・多重共線性)。 - 疎行列(sparse): 全 564 行を one-hot 化すると (564, 47) で、 非零はちょうど 564 個(各行 1 つだけ 1)。 スパース率は $1 - 1/47 \approx 97.87\%$。 高次元では dense 配列よりも CSR などの疎表現でメモリ・計算を節約するのが定石で、 sklearn の線形モデルの多くは疎行列を直接受け取れます。
- 木モデルでは不要な場合がある: 決定木・Random Forest・GBDT は分割閾値を探すだけで設計行列の逆行列を必要とせず、 多重共線性に頑健なので
drop_firstは不要。 LightGBM/CatBoost は native categorical 機能を持ち、 one-hot 化せずに直接カテゴリを扱う方が高速・省メモリになることが多いです。 - 未知カテゴリの扱い: 学習時に無かったカテゴリが推論時に来ると、 既定では sklearn が例外を投げます。
handle_unknown='ignore'(未知は全 0 ベクトル)か、 前処理で "Other" 列に寄せる設計が実用的です。 - train/test でカテゴリ集合がずれる:
pd.get_dummiesを train と test に別々に掛けると列数・列順がずれ、 推論時に破綻します。 必ずOneHotEncoder.fit(train)→transform(test)と train の語彙を固定して使い回すのが正解です。
🌐 発展 — 代替エンコーディングとの使い分け
- ラベルエンコーディング / 順序エンコーディング: どちらも 1 列の整数化。 ラベルは順序を持たせない前提で主に木系モデル向け、 順序エンコーディングは「S<M<L」「学年・等級」のように 本当に順序があるときだけ使います。 名義カテゴリを線形モデルに整数のまま入れると偽の順序を持ち込むため不可。
- ターゲット / 頻度エンコーディング: ターゲットエンコーディングはカテゴリを目的変数の平均で 1 列に圧縮し、 高カーディナリティに強い一方でリーク対策(K-Fold・leave-one-out・ベイズ平滑化)が必須。 頻度エンコーディングは出現頻度で置換し、 頻度自体が情報を持つ場面で有効です。
- 埋め込み(entity embedding): カテゴリを低次元の密ベクトルに学習し、 カテゴリ間の意味的近さを捉えます(Guo & Berkhahn 2016)。 大規模・高カーディナリティ・ニューラルネット向け。 詳細は 埋め込み。
- 疎表現・ハッシュトリック: one-hot をそのまま使いつつ CSR 等の疎表現でコストを抑える、 あるいはハッシュ関数で列数を固定(衝突許容)して超高カーディナリティ・オンライン学習に対応します。
🔗 関連ページ(このサイト内)
- one-hot エンコーディング(本家解説)
- カテゴリ変数 / 名義尺度 / 順序尺度
- ダミー変数 / 多重共線性 / 正則化
- 特徴量エンジニアリング / 埋め込み(embedding)
- ラベルエンコーディング(専用ページ未整備。 上記「順序尺度」「特徴量エンジニアリング」を参照)