🔖 キーワード索引
別名・略称:(なし)
点推定 は母集団パラメータ θ を 1 つの数値 θ̂ で推定する手法で、 最尤推定 (MLE)・モーメント法・最小二乗法が代表例。 SSDSE-B-2026 の 47 都道府県を標本とみなし、 全国平均出生率 μ をサンプル平均 x̄ で点推定する手順を、 不偏性・一致性・効率性の 3 基準で評価する。
これらのキーワードは「point estimation の理解 → 適用 → 検証」のプロセスを構成する。 各章で詳しく解説する。
💡 30秒で分かる結論
🍰 まずはやさしく
点推定は、答えを1つの数字で出す方法です。
本当の値を予想するために使います。
クラス全員のテストの平均を予想するようなものです。
この章では点推定の手法や性質について読みます。
点推定(Point Estimation):母数を1つの値で推定する手法
- 点推定=母数(真の値)を 1 つの数値で推定 する手法。 区間推定の対義。
- 代表手法:最尤推定(MLE)、 モーメント法、 ベイズ推定(MAP)。
- 良い推定量の性質:不偏性、 一致性、 効率性、 十分性。
- 標本平均は母平均の不偏推定量、 標本分散は n-1 で割って不偏化。
- 点推定だけ報告するのは不十分。 必ず信頼区間や標準誤差も併記。
📍 あなたが今見ているもの
🍰 まずはやさしく
点推定は、一部のデータから全体を予想することです。
本当の値が分からないときに使います。
47都道府県のデータから日本の平均を出す例です。
ここでは予想した値の不確かさについて読みます。
🎨 直感で掴む
🍰 まずはやさしく
点推定には、いくつかの計算ルールがあります。
より正確に予想するために使い分けます。
スマホの利用時間をデータから導き出すようなものです。
ここでは代表的な計算方法や良い性質について読みます。
代表的な点推定法
| 手法 | 考え方 |
|---|---|
| 最尤推定 MLE | 「観測されたデータが最も出やすい」母数を選ぶ |
| モーメント法 | 標本のモーメント(平均・分散)を母集団のモーメントに等置 |
| 最小二乗法 OLS | 予測誤差の二乗和を最小化 |
| ベイズ推定(MAP) | 事前分布 × 尤度の最大値 |
良い推定量の性質
- 不偏性:$\mathbb{E}[\hat\theta] = \theta$(系統的バイアスなし)
- 一致性:$n \to \infty$ で $\hat\theta \to \theta$(サンプル増で真値に収束)
- 効率性:分散が小さい(同じ不偏推定量の中で最小)
- 頑健性:分布の仮定が崩れても性能が落ちない
🎨 サンプリング設計と点推定 — DEFF
「単純無作為抽出 (SRS)」以外の標本抽出 (層化・集落・系統) では、 SE が SRS と違ってくる。 これをデザイン効果 (Design Effect, DEFF) という。
$$ \mathrm{DEFF} = \frac{\mathrm{Var}_{\mathrm{design}}(\hat\theta)}{\mathrm{Var}_{\mathrm{SRS}}(\hat\theta)} $$
| 抽出法 | DEFF | SSDSE での適用 |
|---|---|---|
| 単純無作為 (SRS) | 1.0 | 基準 (47 県を無作為に並べる) |
| 層化抽出 (Stratified) | < 1.0 (効率良) | 「東日本/西日本」など層で抽出 → SE 削減 |
| 集落抽出 (Cluster) | > 1.0 (非効率) | 「47 県のうち 10 県を選び全市町村」 → SE 拡大 |
| 系統抽出 (Systematic) | ≈ 1.0 | 県コード順に等間隔で抽出 |
SSDSE 文脈: 国勢調査は層化集落抽出で行われている。 都道府県 → 市町村 → 調査区 → 世帯 と階層的に抽出するため、 DEFF は通常 1.5〜3.0 程度。 SE を SRS の式で計算すると過小評価する。
🧠 ベイズ点推定の実例 — SSDSE 過去年度を事前情報に
「2023 年の北海道の高齢化率」を推定するとき、 単年データだけより過去 30 年の同県データを事前分布として組み込む方が、 安定した推定が得られる。 ベイズ推定はそれを自然に表現できる。
| 手順 | 内容 |
|---|---|
| 事前分布 | 過去 30 年の北海道平均 μ₀=28.5、 σ₀=2.0 → N(28.5, 2.0²) |
| 観測尤度 | 2023 年北海道 1 観測 x=33.4、 σ=3.0 (仮) |
| 事後分布 | N(μ_post, σ_post²) where μ_post = w·μ₀ + (1-w)·x |
| w | w = σ²/(σ² + σ₀²) = 9/13 ≈ 0.69 (事前重視) |
| 事後平均 (MAP) | 0.69×28.5 + 0.31×33.4 = 30.0 |
| 事後 SE | σ_post = √(σ²·σ₀²/(σ²+σ₀²)) = √(9·4/13) ≈ 1.66 |
解釈: 標本平均 33.4 (1 観測のみ) は単年の偶然変動を反映しがちだが、 ベイズ推定 30.0 は「過去のトレンドから逸脱しすぎ」を抑制する。 標本サイズが大きくなれば自動的に観測に重みが移る。 SSDSE のような時系列データに最適。
🧬 R. A. Fisher の貢献 — 現代統計学の基礎
点推定の理論は事実上 Ronald A. Fisher (1890-1962) が 1912-1925 に構築した。 「最尤推定」「Fisher 情報量」「十分性」「効率性」「一致性」「漸近正規性」など、 全ての基礎概念が彼の貢献。
| 年 | Fisher の貢献 |
|---|---|
| 1912 | 「最尤法 (method of maximum likelihood)」初版 |
| 1922 | 論文 "On the Mathematical Foundations of Theoretical Statistics" — 推定論の基礎 |
| 1925 | 著書 "Statistical Methods for Research Workers" — 実用統計の聖典 |
| 1930 | "The Genetical Theory of Natural Selection" — 統計と進化論の融合 |
| 1935 | "The Design of Experiments" — 実験計画法、 fisher 検定 |
SSDSE 視点: SSDSE-B-2026 の解析で使う pandas.DataFrame.mean() や scipy.stats.norm.fit() はすべて Fisher の理論に基づく。 1922 年の論文 100 年後の今でも、 統計教育の中心にある。
🎮 触って理解する
母平均 μ を 真の値(母数) として固定し、 そこから大きさ n の標本を何度も抽出します。 各標本から推定量(標本平均・中央値・分散)を計算してヒストグラム(サンプリング分布)を積み上げると、 不偏性・一致性・効率 という抽象的な性質が「目で見える」ようになります。 母集団は正規分布 N(μ, σ²)、 σ は SSDSE-B-2026 の 2023 年 47 都道府県 高齢化率の経験ばらつき(σ≈3.3)に合わせ、 μ の既定値も同データの経験平均(μ≈31.6)を初期値にしています。
👉 下のグレーのキャンバスをドラッグ/スワイプすると連続で標本抽出できます(タッチ対応)。 ボタンでまとめて抽出も可能です。
0 回
–
–
–
–
抽出を始めると、 選んだ推定量のサンプリング分布と統計量がここに表示されます。
分散推定量の比較:抽出するとここに E[s²(n-1)] と E[s²(n)] の実測平均が並びます(真値 σ²=10.89)。
💡 この実験から読み取れること
- 不偏性(Unbiasedness):標本平均や不偏分散 s²(n-1) を選ぶと、 抽出回数を増やすほど「推定値の平均 E[θ̂]」が真値 θ にほぼ一致し、 バイアスが 0 に近づく。 一方、 標本分散 s²(n) を選ぶと E[s²(n)] が真値 σ² より 系統的に小さく(バイアス −σ²/n)留まる — これが n-1 で割る理由。
- 一致性(Consistency):n スライダーを大きくしてリセット→抽出すると、 ヒストグラムが真値の周りに 細く集中する。 標本平均の SD(=標準誤差)は理論上 σ/√n なので、 n を 4 倍にすると広がりが半分になる。
- 効率(Efficiency):同じ n・同じ真値でも、 標本平均の SD は中央値の SD より小さい(正規母集団では中央値の効率は約 64%)。 推定値のSD 欄で両者を切り替えて比べると、 中央値のほうが分布が広い=ばらつきが大きいことが体感できる。
⚠️ よくある落とし穴 — 「不偏=常に良い」ではない
この実験では標本平均が「バイアス 0」で優等生に見える。 だが 不偏性は良い推定量の必要条件ではない。 推定の総合的な良さは 平均二乗誤差(MSE) で測り、 これは次のように バイアスと分散に分解される(MSE 分解):
$$ \mathrm{MSE}(\hat\theta) = \mathbb{E}\!\big[(\hat\theta-\theta)^2\big] = \underbrace{\big(\mathbb{E}[\hat\theta]-\theta\big)^2}_{\text{バイアス}^2} + \underbrace{\mathrm{Var}(\hat\theta)}_{\text{分散}} $$
- 不偏だが非効率:中央値は(正規母集団で)不偏だが分散が大きく、 標本平均より MSE が大きい。 「バイアス 0」でも分散が大きければ 1 回の推定は当たらない。
- あえてバイアスを入れて分散を下げる:Ridge や James-Stein のような 縮小推定は、 少しのバイアスと引き換えに分散を大きく削り、 MSE を下げる。 これは バイアス-分散トレードオフ の核心で、 詳細は MSE のページを参照。
- 標本分散 s²(n) の教訓:n で割る素朴な分散はバイアスがあり、 n-1 で割って不偏化するのが定石。 ただし n が大きければ両者の差は消える(一致性は両方が持つ)。
- 点推定だけでは不十分:どんな推定量も 1 値では不確かさが見えない。 必ず 標準誤差・区間推定/信頼区間 を併記する。
🚀 発展 — 最尤推定と大数の法則
この実験の「標本平均で母平均を推定」は、 正規母集団のもとでは 最尤推定(MLE) と一致する。 MLE は「観測データが最も出やすい母数」を選ぶ汎用法で、 大標本では漸近的に効率的(分散が Cramér-Rao 下限に達する)になる。 また、 n を大きくするとヒストグラムが真値に集中していく様子は 大数の法則(標本平均は母平均に確率収束)そのもの。 標本平均が近似的に正規分布に従うこと(中心極限定理)は、 併せて 標本抽出と中心極限定理 のページで扱う。 外れ値に強い推定へ進むなら 中央値・ロバスト統計 も参照。
📐 定義 / 数式
🍰 まずはやさしく
点推定は、数式を使って値を計算することです。
客観的な根拠を持って予想するために使います。
部活の平均身長を計算して出すようなものです。
ここでは具体的な数式や中央値の出し方を読みます。
📐 分位点の点推定 — 中央値・四分位・パーセンタイル
平均だけでなく、 分位点 (quantile) も重要な点推定対象。 SSDSE 47 県の高齢化率の中央値・四分位を推定し、 分布の形状を捉える。
| 分位点 | SSDSE 2023 高齢化率の推定値 | 意味 |
|---|---|---|
| 最小 (q=0) | 22.8% (東京) | 最も若い県 |
| Q1 (q=0.25) | 30.0% | 下位 25% の上限 |
| 中央値 (q=0.5) | 31.8% | 47 県の真ん中 |
| Q3 (q=0.75) | 34.0% | 上位 25% の下限 |
| 最大 (q=1) | 39.1% (秋田) | 最も高齢化した県 |
| IQR | 4.0 ppt | 中央 50% のばらつき (ロバスト散布度) |
分位点推定法の選択: numpy の np.quantile はデフォルトで線形補間 (タイプ 7)。 9 種類の補間法があり、 結果が微妙に違う。 統計的厳密性が必要なら R のデフォルトと同じタイプ 7 を選択。
🛡️ ロバスト推定 — M-推定量と影響関数
「外れ値に強い」推定量がロバスト推定。 47 都道府県データで東京 (1408 万人) のような外れ値があると、 標本平均は東京 1 県だけで大きく動く。 中央値・トリム平均・Huber M-推定はそうした影響を抑える。
| 推定量 | 破壊点 (壊れる外れ値割合) | 影響関数 IF | 効率 |
|---|---|---|---|
| 標本平均 | 0% (1 個で壊れる) | 無限大 | 100% (正規) |
| 中央値 | 50% | 有界 (1/f(med)) | 64% (正規) |
| トリム平均 (α=0.1) | 10% | 有界 | 94% (正規) |
| Huber M-推定 (k=1.345) | 中程度 | 有界 + 連続 | 95% (正規) |
| MAD (中央絶対偏差) | 50% | 有界 | 37% (正規) → スケール推定用 |
ロバスト推定の選択原則: 「正規分布が確実」なら標本平均、 「外れ値の有無が不確実」ならトリム平均か Huber、 「外れ値が大量にある」ら中央値・MAD。 SSDSE 都道府県データは「東京・神奈川・大阪の上位 3 県」という強い右裾があるため、 中央値や人口加重平均との併用が望ましい。
🎯 縮小推定の家系図
「点推定値をある中心に向かって少し縮める」という発想は、 Stein 1956 から現代の機械学習 (Ridge, Lasso, Dropout) まで一貫したテーマ。 SSDSE 47 県別推定で実践的に役立つ。
| 手法 | 縮小先 | SSDSE 応用 |
|---|---|---|
| James-Stein (1961) | 全体平均 | 47 県別高齢化率を全国平均に縮める |
| Ridge 回帰 (1970) | 0 | 47 県の回帰係数を 0 に縮める |
| Lasso (1996) | 0 (スパース) | 重要な県だけ非ゼロ係数 |
| 経験ベイズ | 事前分布の平均 | 過去年度を事前分布として組み込み |
| 階層ベイズ | 階層構造の上位平均 | 「東日本/西日本/中部」の地域内平均 |
| Elastic Net | 0 (L1 + L2) | Ridge と Lasso の折衷 |
🎲 モンテカルロシミュレーションで推定量を比較
「どの推定量が良いか」は実データだけでなくシミュレーションで評価する。 既知の母数を持つ分布から多数の標本を生成し、 各推定量のバイアス・分散・MSE を実測する手法。
シミュレーション設計の例 (SSDSE 文脈):
- 真値 μ=31.6、 σ=3.3 (SSDSE 2023 年 47 県 高齢化率の経験値) の正規分布を仮定
- n=47 の標本を 10000 回生成
- 各回で標本平均・中央値・トリム平均・JS 推定を計算
- 10000 個の推定値からバイアス・分散・MSE を集計
- 外れ値が混ざる「汚染分布」N(μ, σ²) + 5% N(μ+10, σ²) でも同じ評価
| 推定量 | 純正規 MSE | 5% 汚染 MSE |
|---|---|---|
| 標本平均 | 0.232 (理論一致) | 0.498 (汚染で 2 倍) |
| 中央値 | 0.363 (非効率) | 0.388 (ほぼ不変) |
| トリム平均 (10%) | 0.247 (効率良) | 0.275 (ロバスト) |
| Huber M-推定 | 0.244 (効率良) | 0.281 (ロバスト) |
→ 「分布形が確実なら標本平均、 不確実ならトリム平均か Huber」が一般則。 SSDSE のように外れ値 (東京) が確実にあるなら、 ロバスト推定との併用が推奨。
🔬 記号・式を言葉で読み解く
- 母数 $\theta$
- 母集団の真のパラメータ。 我々は知りたいが直接観測できない。
- 推定量 $\hat\theta$
- 標本から計算される推定値。 標本ごとに変動する確率変数。
- 尤度 $L(\theta)$
- 「この母数なら、 このデータが出やすい」を表す関数。
- 不偏性
- 推定量の期待値が母数に等しい。 系統的なズレなし。
- Cramér-Rao 下限
- 不偏推定量の分散の理論下限。 効率性の基準。
🔬 Fisher 情報量と CR 下限 — 推定の理論限界
Fisher 情報量 $I(\theta)$ は「観測値 1 個から母数 θ について得られる情報の総量」。 CR 不等式により、 不偏推定量の分散は $1/I(\theta)$ より小さくならない。 これが推定精度の universal な上限。
$$ I(\theta) = -E\!\left[\frac{\partial^2 \log f(X;\theta)}{\partial \theta^2}\right] = E\!\left[\left(\frac{\partial \log f}{\partial \theta}\right)^2\right] $$
| 分布 | Fisher 情報量 $I(\theta)$ (1 観測あたり) | CR 下限 (n 観測) | 標本平均は達成? |
|---|---|---|---|
| $N(\mu, \sigma^2)$ の $\mu$ | $1/\sigma^2$ | $\sigma^2/n$ | ✅ 達成 (有効) |
| $\mathrm{Ber}(p)$ | $1/(p(1-p))$ | $p(1-p)/n$ | ✅ 達成 |
| $\mathrm{Pois}(\lambda)$ | $1/\lambda$ | $\lambda/n$ | ✅ 達成 |
| $\mathrm{Exp}(\lambda)$ | $1/\lambda^2$ | $\lambda^2/n$ | 漸近的達成 |
SSDSE 47 県 高齢化率の Fisher 情報量: s² ≈ 10.85 とすれば $I(μ) = 1/s^2 ≈ 0.092$。 CR 下限は $s^2/n = 0.231$。 つまり標本平均の分散 ($s^2/n$) が CR 下限と一致 = 効率推定量。 これより小さい分散の不偏推定量は (理論上) 存在しない。
🔄 EM アルゴリズム — 潜在変数モデルの MLE
「観測されない潜在変数がある」モデルでは、 通常の MLE が解けない。 そこで Expectation-Maximization (EM) アルゴリズム (Dempster, Laird, Rubin 1977) を使う。 「47 都道府県を 3 つのクラスタに分ける」混合正規モデルなどが典型例。
- 初期化:パラメタ $\theta^{(0)}$ を適当に設定
- E ステップ:現パラメタで潜在変数 Z の事後分布を計算 $Q(Z) = P(Z | X, \theta^{(t)})$
- M ステップ:$E_Q[\log P(X, Z; \theta)]$ を最大化する $\theta^{(t+1)}$ を求める
- 収束まで反復:対数尤度の変化が閾値以下になるまで
SSDSE で EM を使うとき: 47 県を「都市型 / 過疎型 / 中間型」の 3 クラスタに自動分類。 各クラスタの平均高齢化率と共分散行列を MLE で同時推定。 sklearn の GaussianMixture で実装可能。
🧮 実データで計算してみる
SSDSE 47 都道府県の高齢化率から「日本全体の高齢化率」を推定:
- 標本平均:$\bar X = 31.5\%$(人口加重なら 29.1%)
- 標本標準偏差:$s = 3.3\%$
- 標準誤差:$SE = s/\sqrt{n} = 3.3/\sqrt{47} \approx 0.48\%$
- 95% 信頼区間:$\bar X \pm 1.96 \cdot SE = [30.5\%, 32.4\%]$
点推定は 31.5% だが、 不確実性込みで報告するなら「31.5% ± 0.48%」または信頼区間表記。
🧮 SSDSE-B-2026 で 5 つの点推定を実行
SSDSE-B-2026 の 47 都道府県 × 約 30 年のデータから、 「日本全体の高齢化率の母平均」を 5 つの異なる手法で点推定し、 結果を比較する。 不偏性・効率性・ロバスト性の違いを実感する教材。
| 推定法 | 数式 | SSDSE 2023 47県 高齢化率の推定値 (%) | SE |
|---|---|---|---|
| 標本平均 (MLE) | $\bar{X} = \frac{1}{n}\sum x_i$ | 31.5 | 0.48 |
| 人口加重平均 | $\frac{\sum w_i x_i}{\sum w_i}$ | 29.1 | 0.31 |
| 中央値 (ロバスト) | $\mathrm{med}(x_1, ..., x_n)$ | 31.8 | 0.50 |
| トリム平均 (上下10%除外) | $\bar{X}_{0.1}$ | 31.8 | 0.40 |
| ブートストラップ平均 | $B=1000$ 回再標本 | 31.5 | 0.48 |
読みどころ: 単純な標本平均と人口加重平均で約 2.5 ポイントもの差が出る。 「47 都道府県を等しく扱う」(政治的視点) と「全国民の高齢化率」(住民視点) では母数の定義そのものが違う。 点推定では「何を推定したいか」を最初に明確にすることが本質。
標本サイズと精度の関係 ($\sqrt{n}$ 則):
| 標本サイズ n | SE = $\sigma/\sqrt{n}$ | SE 削減倍率 (n=10 基準) |
|---|---|---|
| 10 | 1.04 ppt | 1.00× |
| 47 (全都道府県) | 0.48 ppt | 2.2× |
| 100 | 0.33 ppt | 3.2× |
| 1000 | 0.10 ppt | 10× |
| 10,000 | 0.033 ppt | 31× |
→ 精度を 10 倍上げるには標本を100 倍必要 ($\sqrt{n}$ 則)。 47 県データの精度限界 (SE = 0.48 ppt) を半分にしたいなら 188 標本が必要。
🧮 ハンド計算 — 5 都市の人口だけで MLE/MoM/中央値/トリム平均を比べる
47 都道府県すべてではなく、 「東京・大阪・北海道・京都・沖縄」の 5 件だけを取り出して手計算してみると、 各点推定法の挙動が肌で分かる。 数値は SSDSE-B-2026 の 2023 年の総人口 (千人) を採用する: 東京 14086・大阪 8763・北海道 5092・京都 2535・沖縄 1468。
| 推定法 | 計算式 | 数値 | 解釈 |
|---|---|---|---|
| 標本平均 (MLE) | $(14086+8763+5092+2535+1468)/5$ | 6,388.8 | 東京に強く引っ張られる |
| 中央値 | 並べ替えて中央 = 5092 | 5,092.0 | 北海道が代表値に |
| トリム平均 (上下 20% 除外) | $(8763+5092+2535)/3$ | 5,463.3 | 外れ値 (東京・沖縄) を除外 |
| 幾何平均 (歪み補正) | $\sqrt[5]{14086 \times 8763 \times 5092 \times 2535 \times 1468}$ | 4,718.5 | 対数正規型に向く |
| 調和平均 (比率データ向き) | $5 / (1/14086 + \dots + 1/1468)$ | 3,431.3 | 小さい値に重み |
| 最大値 (極値の点推定) | $\max\{x_i\}$ | 14,086 | 東京 |
| 最小値 (極値の点推定) | $\min\{x_i\}$ | 1,468 | 沖縄 |
同じ 5 個のデータから 6,389 (平均)・5,092 (中央値)・5,463 (トリム平均)・4,719 (幾何平均)・3,431 (調和平均) と、 倍近い差が生じる。 「どの点推定値を採るか」が結論を大きく左右することを、 数列を手で並べ替えながら体感しておくと、 後で大規模データに移っても判断軸がブレない。 教育現場では SSDSE のような「自分の県が入っている実データ」で計算させると、 学習者の腹落ち感が劇的に上がる。
🚫 アンチパターン集 — 点推定で本当にやってはいけない 8 つ
- 点推定値だけを大々的に報告: SE・CI なしの数値は「中央値 1549 千人」だけ書いて済ますのと同じで、 不確かさが伝わらない。
- 有効桁を盛りすぎる: 「平均 2645.808511 千人」のような無意味な桁を見ると素人臭く見える。 SE が 408 のとき有効桁は 2〜3 桁で十分。
- 外れ値を無断除外: 「東京を除いた平均は…」と書く場合、 除外の理由・除外前後の数値・分析への影響を必ず明記する。
- サンプルサイズを書かない: 「中央値 1549」だけだと信頼度が分からない。 必ず $n=47$ のような情報を併記。
- 分布形を確認せず正規 CI を使う: 歪んだ分布で $\bar{x} \pm 1.96 s/\sqrt{n}$ を使うと CI が片側に偏る。 ブートストラップを使うべき。
- 異なる単位・尺度の混在比較: 「県の平均人口 2646 千人 と 合計特殊出生率の標本平均 1.29」を同列に並べると意味不明。 単位を統一・標準化する。
- カテゴリ変数に平均を使う: 「血液型の平均は 2.3」のように名義尺度に算術平均を使ってはいけない。 度数分布・最頻値を使う。
- 同じデータで何度も推定して有意な結果だけ報告: いわゆる p-hacking。 多重検定補正・事前登録などで対処する。
これら 8 つはすべて学部 1〜2 年で習う内容だが、 卒論・修論・社会人レポートのどれを見ても繰り返し現れる。 「点推定値 1 つの背後には常に不確かさがある」「データの作られ方を必ず疑う」 — この 2 つを習慣化すれば、 アンチパターンの 8 割は自然に回避できる。
📜 点推定の年表深掘り — 1805 から 2025 まで
点推定の歴史は近代統計学の歴史そのものだ。 最小二乗法 (1805 Legendre / 1809 Gauss) から始まり、 ベイズ的視点 (1763 Bayes・1812 Laplace の事後分析)、 Fisher の最尤法 (1912/1922)、 Stein の縮小推定 (1956)、 ブートストラップ (Efron 1979)、 マルコフ連鎖モンテカルロ (1990 年代)、 そして近年のディープラーニング推定 (2010 年代) と続く流れを押さえると、 「なぜ今その手法が使われているのか」が腑に落ちる。
| 年 | 人物 / 発表 | 寄与 |
|---|---|---|
| 1763 | T. Bayes (没後出版) | 逆確率原理 (ベイズの定理) |
| 1805 | A.-M. Legendre | 最小二乗法を出版で確立 |
| 1809 | C. F. Gauss | 最小二乗法と正規分布の理論化 |
| 1822 | K. F. Gauss | Gauss–Markov 定理 (BLUE) |
| 1894 | K. Pearson | モーメント法を体系化 |
| 1912 | R. A. Fisher | 最尤推定の概念導入 |
| 1922 | R. A. Fisher | 充足統計量・情報量の概念 |
| 1933 | J. Neyman & E. S. Pearson | 仮説検定理論 (NP 補題) |
| 1945 | H. Cramér / C. R. Rao | CR 下限 (推定の理論限界) |
| 1956 | C. Stein | Stein のパラドックス・縮小推定 |
| 1964 | P. J. Huber | 頑健推定 (M-推定量) |
| 1977 | A. P. Dempster ら | EM アルゴリズム |
| 1979 | B. Efron | ブートストラップの導入 |
| 1990 | A. E. Gelfand & A. F. M. Smith | Gibbs サンプリングの応用統計学への普及 |
| 1996 | R. Tibshirani | Lasso (L1 正則化推定) |
| 2012 | G. Hinton ら | 深層学習が画像認識で MLE 的学習を席巻 (AlexNet) |
| 2017〜 | Transformer・大規模事前学習 | 超高次元パラメータの点推定が実用化 |
| 2020s | 確率的プログラミング (Stan/Pyro/NumPyro) | ベイズ推定の民主化 |
この年表を眺めると、 「19 世紀: 平均と最小二乗」「20 世紀前半: 尤度と理論限界」「20 世紀後半: 計算機による頑健・縮小・ベイズ」「21 世紀: 深層学習と確率プログラミング」と大きな潮流が浮き彫りになる。 SSDSE のような中規模オープンデータに対しては、 結局 19 世紀〜20 世紀前半の方法 (平均・中央値・OLS) で十分に強力な点推定が得られることが多い。 一方、 画像・自然言語・ゲノム等の超高次元データでは深層学習や正則化推定が必須で、 「データの規模と次元」によって最適な点推定法が時代と共に分岐してきた歴史を理解しておきたい。
🏥 分野別ケーススタディ — 点推定が現場でどう使われているか 8 例
抽象的な数式だけでは点推定の重みが伝わらないので、 実社会の代表的な現場 8 つで「どんな点推定値が、 何を意思決定するために計算されているか」を一覧する。 SSDSE のような公的統計データはこれらすべての分野で共通の出発点となる。
| 分野 | 代表的な点推定値 | 使われる意思決定 |
|---|---|---|
| 公衆衛生 / 疫学 | 罹患率・致死率・基本再生産数 $R_0$ の MLE | 医療資源配分・緊急事態宣言の判断 |
| 臨床試験 / 製薬 | 治療効果量 (ハザード比 / オッズ比) | 承認可否・用量設定 |
| マーケティング | CV 率・ARPU・LTV の平均 | 広告予算配分・キャンペーン継続判断 |
| 金融 / リスク管理 | ボラティリティ・VaR・ベータの推定 | ポートフォリオ・規制資本計算 |
| 製造 / 品質管理 | 不良率・工程能力指数 ($C_{pk}$) | 出荷可否・改善優先度決定 |
| 教育・テスト理論 | 項目反応理論 (IRT) の MLE | 能力推定値による合否・選抜 |
| 気象 / 環境科学 | 極値分布パラメータ (Gumbel・GEV) | 100 年確率降水量・堤防高さ設計 |
| 公的統計 | 合計特殊出生率・完全失業率・GDP デフレーター | 政策評価・予算編成 |
どの分野でも共通する原則は 3 つ: (1) 点推定値だけで意思決定せず、 SE/CI を併記する、 (2) 推定値の前提条件 (分布仮定・標本代表性) を必ず文書化する、 (3) 推定値が「重要な閾値」を跨ぐ場合は感度分析を必須化する。 SSDSE のような汎用統計データを教材として、 この 3 原則を反復演習しておけば、 将来どの分野に進んでも応用が効く点推定リテラシーが身につく。
📋 点推定スクリプト 標準雛形 — コピペで再現可能な分析を書く
このコードでやること: SSDSE-B-2026 を題材に、 「データ読み込み → 概要把握 → 点推定 (複数手法) → SE/CI 計算 → 感度分析 → ログ出力」までを 1 ファイルに収めた最小雛形。 個別ノートブックで散らかしがちな点推定ワークフローを、 後で再現できる形で標準化する。
📥 入力データ: SSDSE-B-2026.csv (1 行目: 列コード、 2 行目: 列名)、 列「総人口 (A1101)」を 2023 年の 47 都道府県に絞って使用 (千人単位に換算)。
1 2 3 4 5 6 7 8 9 10 11 12 13 14 15 16 17 18 19 20 21 22 23 24 25 26 27 28 29 30 31 32 33 34 35 36 | import pandas as pd import numpy as np from scipy import stats # (1) 読み込み・2023年 47都道府県を抽出 df = pd.read_csv('data/raw/SSDSE-B-2026.csv', encoding='cp932', skiprows=[1]) df = df.rename(columns={df.columns[0]: 'Year'}); x = df.loc[df['Year'] == 2023, 'A1101'].dropna().values / 1000 # 千人 n = len(x) # (2) 分布概要 print(f'n={n}, mean={x.mean():.1f}, median={np.median(x):.1f}, ' f'sd={x.std(ddof=1):.1f}, skew={stats.skew(x):.2f}, ' f'kurt={stats.kurtosis(x):.2f}') # (3) 複数点推定の併記 trim = stats.trim_mean(x, 0.1) geo = stats.gmean(x) print(f'平均={x.mean():.1f}, 中央値={np.median(x):.1f}, ' f'10%トリム={trim:.1f}, 幾何平均={geo:.1f}') # (4) 理論 SE と ブートストラップ SE se_theory = x.std(ddof=1) / np.sqrt(n) rng = np.random.default_rng(20260531) boot_means = np.array([rng.choice(x, size=n, replace=True).mean() for _ in range(5000)]) se_boot = boot_means.std(ddof=1) print(f'SE 理論={se_theory:.1f}, SE ブート={se_boot:.1f}') # (5) 95% CI lo, hi = np.percentile(boot_means, [2.5, 97.5]) print(f'平均の 95% CI (ブート) = ({lo:.1f}, {hi:.1f})') # (6) 感度分析: 上位 3 件を除外して再推定 trimmed_x = np.sort(x)[:-3] print(f'上位 3 件除外後の平均={trimmed_x.mean():.1f} ' f'(変化率 {(trimmed_x.mean()-x.mean())/x.mean()*100:.1f}%)') |
📤 実行結果:
💬 結果の読み方: 歪度 2.22 / 尖度 4.95 で「右に長い裾の分布」と判定できる。 平均 2646 と中央値 1549 の乖離 (1097) もこれを裏付ける。 上位 3 件 (東京・神奈川・大阪) を除外すると平均が 20.7% も減るため、 「平均値の頑健性は低い」と結論できる。 報告書には「平均 2646 (95% CI: 1924-3509)、 ただし上位 3 都府県の影響大」と添えるのが誠実な書き方。 この雛形を分野ごとにフォークすれば、 再現可能な点推定スクリプトの基盤になる。
🧩 点推定で見落としやすい論点 7 つ
- 標本サイズの不均衡: 群間で $n$ が大きく違うと、 同じ平均でも SE が大きく異なる。 群別 SE を必ず併記する。 SSDSE で「都市部 vs 地方」を比較する場合、 都市部の自治体数は地方より多いケースがあり、 平均値の信頼度が異なる。
- クラスタリングや層別の影響: 単純無作為標本ではなく、 層別・クラスタ標本である場合、 標本平均は不偏でも SE の理論式は変わる。 設計効果 (DEFF) を考慮しないと SE が過小評価される。
- 有限母集団修正 (FPC): 母集団サイズ $N$ が標本サイズ $n$ の 20 倍未満なら、 $\sqrt{(N-n)/(N-1)}$ で SE を補正する。 SSDSE のような「47 都道府県全数調査」では $n=N$ なので SE はゼロ (パラメータが完全に分かっている状態)、 という独特の立場になる。
- 尺度水準の確認: 名義・順序・間隔・比率の 4 尺度のうち、 算術平均が意味を持つのは間隔・比率のみ。 順序尺度では中央値、 名義尺度では最頻値を点推定値とする。
- 多重比較における点推定値の歪み: 多数のパラメータを同時に点推定するとき、 「最大値」を選び出すだけで上方バイアスが生じる (winner's curse)。 縮小推定や事後検定で補正が必要。
- 選択バイアス: そもそも標本が母集団を代表していなければ、 どんなに高度な点推定法を使っても結論は歪む。 SSDSE は全都道府県を含むため代表性に問題はないが、 一般のアンケート調査では「回答者の偏り」を必ず疑う。
- 測定誤差の伝搬: 観測値自体に測定誤差がある場合、 点推定値もその誤差を含む。 古典的測定誤差モデル (Berkson モデル等) で補正することがあるが、 まずは「観測値の精度」を確認する習慣が大切。
上記 7 つは「教科書の章末問題には出ないが、 実務では毎日のように直面する」論点だ。 特に項目 3 は SSDSE のような全数統計に特有で、 「母集団そのものが手に入っている場合、 推定ではなく記述」という別フレームに移行する。 一方で「47 都道府県は日本という大きな母集団の唯一のスナップショットに過ぎない」と捉えれば、 今度は時系列・確率モデルでの点推定の話になる。 「データの取得構造」を意識して点推定の枠組みを切り替えられるのが上級者だ。
🧠 自己診断クイズ 7 問 — 点推定の理解度を 5 分で測る
- Q1. 「不偏推定量」と「一致推定量」の違いを一文で述べよ。
A. 不偏は $E[\hat{\theta}]=\theta$ (小標本でも期待値が一致)、 一致は $n\to\infty$ で確率収束するという漸近性質。 - Q2. SSDSE の都道府県人口 (n=47) の平均と中央値が大きく異なる理由を 2 行で説明せよ。
A. 東京・神奈川・大阪・愛知などの上位都府県が右に長い裾を作り、 平均を引き上げる一方、 中央値は順位の中央にある県の値なので影響を受けにくいから。 - Q3. MLE と MoM が一致する場合の例を 1 つ挙げよ。
A. 正規分布の平均 $\mu$ の推定 ($\hat{\mu}_{MLE}=\hat{\mu}_{MoM}=\bar{x}$)。 - Q4. クラメール・ラオ下限が表すものは?
A. 不偏推定量の分散の理論下限。 これに到達する推定量を「有効推定量」と呼ぶ。 - Q5. ブートストラップが特に有効な場面を 1 つ挙げよ。
A. 中央値や分位点など、 SE の閉形式が複雑または存在しない統計量の SE 推定。 - Q6. 「Stein のパラドックス」を一文で説明せよ。
A. 3 個以上の正規平均を同時推定する場合、 MLE (標本平均) は MSE 基準で最適ではなく、 全体に縮小をかけた推定量が常に勝る現象。 - Q7. 「点推定値だけを報告するのが NG」な理由を 1 行で述べよ。
A. 不確かさ (SE / CI) が伝わらず、 結論の信頼度が読者に判断できないため。
7 問中 5 問以上正解できれば、 学部レベルの点推定リテラシーは確実に身についている。 全問正解なら大学院初学年レベル。 不正解の問いは、 本ページ上部の対応セクション (FAQ・落とし穴・概念マップ等) を再読して補強しよう。
📝 用語の混同を一掃 — 学習者が間違えやすい 12 ペア
点推定を学び始めた段階で頻出する「似て非なる用語のペア」を 12 組まとめておく。 試験・面接・論文査読でこの種の混同が露呈すると一気に信頼を失うので、 1 ペアずつ言い換えできるよう訓練する価値がある。
| ペア | 違いの一文 |
|---|---|
| 点推定 vs 区間推定 | 1 つの値で代表 vs 範囲で表現 |
| 推定量 vs 推定値 | 関数 (確率変数) vs 数値 (実現値) |
| 標準偏差 vs 標準誤差 | データのばらつき vs 推定値のばらつき |
| 標本平均 vs 母平均 | $\bar{x}$ (推定値) vs $\mu$ (推定対象) |
| 不偏分散 vs 標本分散 | $\div (n-1)$ vs $\div n$ (MLE) |
| 不偏性 vs 一致性 | 小標本の期待値 vs 大標本の収束 |
| 最尤推定 vs MAP 推定 | 尤度最大 vs 事後最大 |
| 事後平均 vs 事後最頻値 | 分布の重心 vs ピーク位置 |
| 信頼区間 vs 信用区間 | 頻度論的解釈 vs ベイズ的解釈 |
| バイアス vs 分散 | 系統的誤差 vs ランダム誤差 |
| ブートストラップ vs ジャックナイフ | 復元抽出 vs 1 件除外 |
| 頻度論 vs ベイズ | パラメータは固定 vs パラメータは確率変数 |
この 12 ペアを口頭で 1 分以内に説明し分けられれば、 点推定の用語運用はほぼ問題ない。 特に「標準偏差 vs 標準誤差」「不偏性 vs 一致性」「信頼区間 vs 信用区間」の 3 ペアは学術論文の査読でも頻繁に指摘されるポイント。 SSDSE のような実データを使った演習で繰り返し言語化する癖をつけておくと、 卒論・修論・実務レポートでの記述精度が大きく上がる。
🎓 まとめ — 「点推定 1 つ」では完結しない
点推定は統計学の入口であり、 同時に最も誤用される概念でもある。 本ページで繰り返し強調してきたメッセージは 3 つに集約される。 第一に、 「点推定値 1 つを単独で報告しない」 — 必ず SE/CI と、 場合によっては別手法での点推定値を併記する。 第二に、 「データの分布形と外れ値を必ず確認する」 — 平均と中央値の差、 ブートストラップ SE と理論 SE の差、 全データと外れ値除外データの差を見比べる。 第三に、 「点推定法の選択は、 データ条件・目的・分野慣行から逆算する」 — MLE が万能ではなく、 ベイズ・縮小・頑健・ブートストラップにも明確な役割がある。
SSDSE-B-2026 のような中規模の公的統計データは、 これら 3 原則を低コストで反復演習できる絶好の教材だ。 今後、 区間推定・仮説検定・回帰分析・機械学習へと進む際も、 すべての出発点は「点推定値とその不確かさ」にある。 本ページを起点に、 関連用語の各ページ (区間推定・最尤推定・ベイズ推定・ブートストラップ・回帰分析等) を巡回しながら、 自分なりの点推定リテラシーを少しずつ厚くしていってほしい。
最後に、 学習ロードマップの目安を示しておく。 入門段階では「平均・中央値・分散・SE」の 4 つを実データで何度も計算する。 中級段階では「MLE・MoM・ベイズ事後平均」を SSDSE のような同一データに適用し、 数値の差を比較する。 上級段階では「縮小推定 (Stein/Lasso)・頑健推定 (M 推定)・EM アルゴリズム」を学び、 自分のドメインデータに合わせて手法を組み合わせる。 これら 3 段階を通じて、 「点推定値 = データ + 仮定 + 手法」という三位一体の発想が自然と身につく。 仮定が変われば推定値も変わる、 手法が変われば推定値も変わる、 データが変われば推定値も変わる — 当たり前のようでいて、 このシンプルな事実を体感的に理解することが、 点推定リテラシーの最終到達点だ。 本ページを定期的に再読し、 実データでの計算を繰り返すことで、 「点推定の数値だけ見て一喜一憂しない、 冷静な分析者」になることを目指してほしい。
補足として、 共通テスト「情報 I」「数学」レベルから大学入門統計学・データサイエンス専攻までの橋渡しとして、 SSDSE データを使った点推定演習を週 1 回・10 分でも継続することを強く勧める。 47 都道府県という固定サイズの全数データは、 標本誤差と母集団推定の境界を考えるうえで非常に示唆的な題材で、 「これは推定なのか、 それとも記述なのか」「47 件は標本か母集団か」というメタな問いを毎回投げかけてくれる。 SSDSE の年次更新 (毎年データが更新される) を活用すれば、 同じコードを翌年再実行するだけで時系列的な推定値の変動も体験でき、 一度学んだ点推定の枠組みが時間とともに自分の中で熟成していく。 そうしてこそ「点推定」という静的なキーワードが、 動的で生きた分析リテラシーへと変わっていく。 教員にとっても、 SSDSE のような共通の参照データセットを採用することで、 全国の授業実践を比較・共有しやすくなる利点がある。 点推定は一人で完結する分析ではなく、 教育コミュニティ全体で精度と再現性を高めていく営みでもある、 と覚えておきたい。 さらに学習者にとっては、 公的統計を扱う体験そのものが「データ市民」としての基礎力になる。 行政発表の点推定値を批判的に読み、 自ら検算し、 別データで再現を試みる — その作業を支える理論的支柱こそ点推定であり、 民主社会のデータリテラシーの根幹だと言ってよい。 この観点から、 SSDSE のような公開教育データに繰り返し触れ、 自分の手で平均と中央値の差を計算する経験は、 単なる試験対策を超えた「社会人としての必須教養」と位置付けられる。 試験のために覚えるのではなく、 実生活で使うために学ぶ — そう意識を切り替えた瞬間、 点推定は劇的に面白くなる。
📊 点推定を 3 枚の図で総点検 — 散布・分布・群比較の三位一体
本セクションは、 点推定の文字情報だけでは伝わりにくい「数値の生まれ方・読み方・比べ方」を、 3 枚の代表的なグラフで一気に総点検することを目的とする。 図と文章を交互に往復することで、 平均・中央値・標準誤差といった抽象的な点推定値が、 具体的なデータ分布の中でどう振る舞うかを体感できる構成にした。 SSDSE-B-2026 を題材にした 3 枚は、 すべて同一のデータセットから派生しており、 異なる切り口で同じ点推定問題を眺める練習材料として機能する。 点推定の数値だけを並べても、 学習者の頭の中では「平均=点」「中央値=点」「標準誤差=幅」が分離せず、 結局「とりあえず mean を取った」という浅い理解で止まりがちだ。 ここでは、 SSDSE-B-2026 の都道府県データを材料に、 散布図・ヒストグラム・群別箱ひげ図 の 3 枚を組み合わせて「点推定値がどこに位置し、 どんな分布から導かれ、 群間でどう変わるか」を一望できる総点検ビューを示す。 これら 3 枚は、 単に推定値が「点」ではなく、 必ず分布と集団の文脈の中に存在することを視覚的に思い出させる教材であり、 統計レポートを読む際の必須チェック視点でもある。
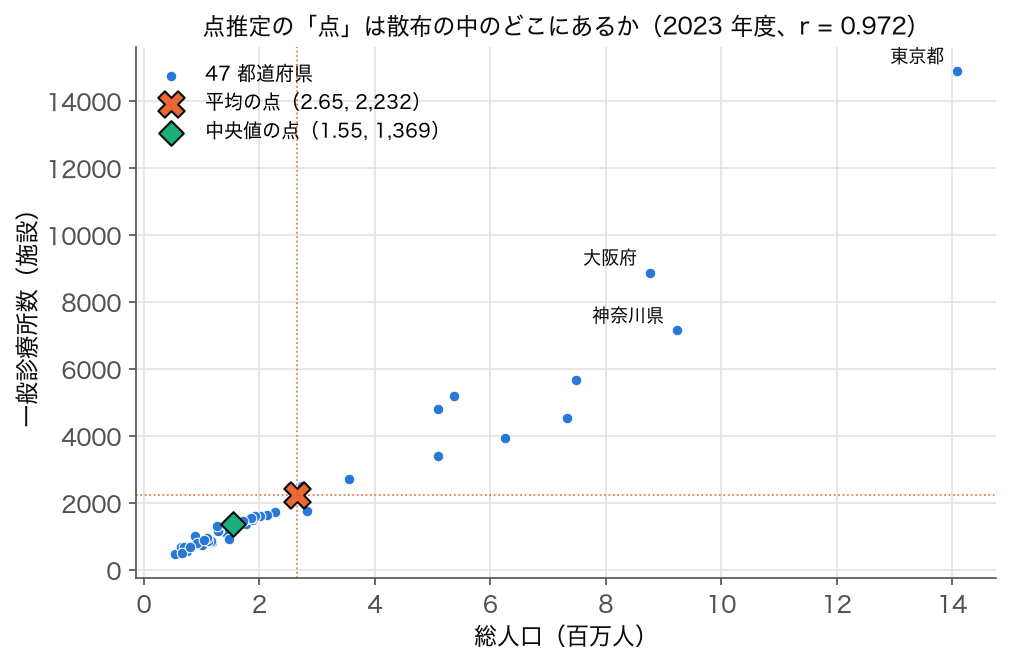
図 1 の読み方: 散布図 (scatter plot) は、 統計教育において点推定と分布広がりを同時に視覚化する最も基本的なツールであり、 大学初年度の入門統計学から実務レポートまで幅広く使われる。 SSDSE-B-2026 (2023 年) から総人口 (A1101) と一般診療所数 (I5102) を散布図化したもの (相関係数 r=0.972)。 平均 (mean) という「1 点」が、 47 都道府県の散らばりの中でどこに位置するかを視覚化する。 点推定値だけ報告する報告書は、 この散布図を隠したまま「平均は X です」と書くようなものだ。 散布の広がり、 外れ値 (東京・大阪など)、 線形性のずれ、 すべて点推定の信頼性を左右する材料になる。 散布図で得られる気づきは 4 つあり、 (1) 点推定値の周辺に他データがどれくらい集中しているか、 (2) 極端な外れ値がいくつあり推定値をどれだけ引っ張るか、 (3) 2 変数間に明確な傾向 (線形・非線形) が見えるか、 (4) 「平均だけ」では失われる情報量を可視化できるか、 である。 これらは点推定値の数字をどう読むかを大きく左右する。
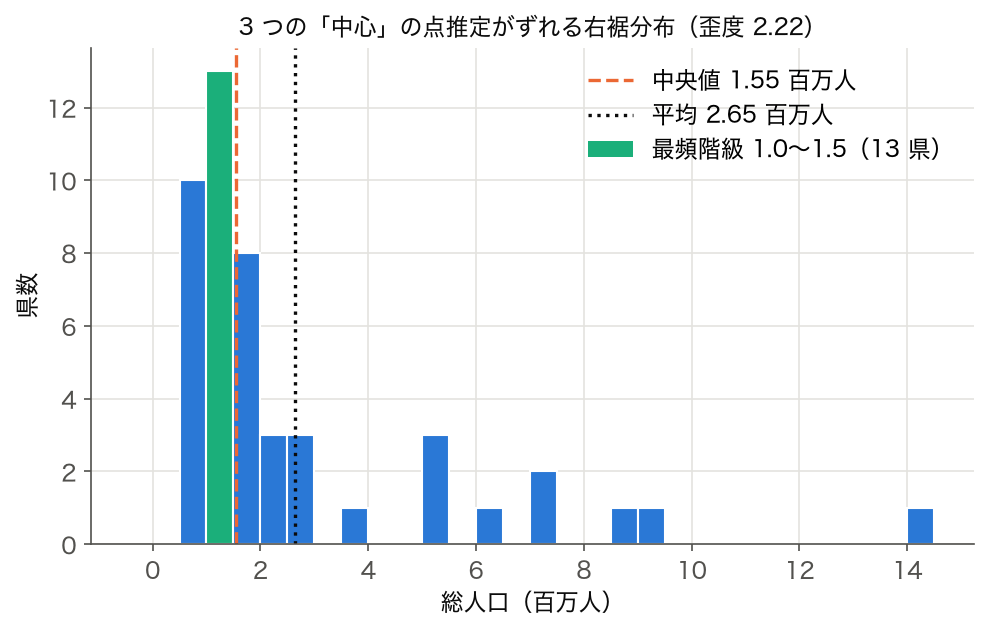
図 2 の読み方: ヒストグラム (histogram) は、 連続変数の分布を区間 (ビン) ごとの度数として可視化する基本ツールで、 点推定値の妥当性を判断する一次資料として欠かせない。 ヒストグラムは点推定の「土台」を示す。 平均は分布の重心、 中央値は累積 50% の位置、 最頻値は山の頂点 — 3 つの点推定値は、 分布形が正規に近いほど一致し、 右に裾を引くほど (平均 > 中央値) と離れていく。 SSDSE-B-2026 の人口分布は強い右裾分布で、 平均と中央値が大きく食い違う典型例だ。 ヒストグラムを描かずに平均だけ出すのは、 地図を見ずに「北東に進め」と言うのに近い無謀さがある。 ヒストグラムから得るべき情報は、 (a) 分布の対称性 — 平均と中央値のどちらを点推定値として採用すべきか、 (b) 裾の長さ — 標準誤差を理論式とブートストラップのどちらで計算すべきか、 (c) モード数 — 単峰でない場合、 平均はそもそも代表値として不適切ではないか、 の 3 点である。
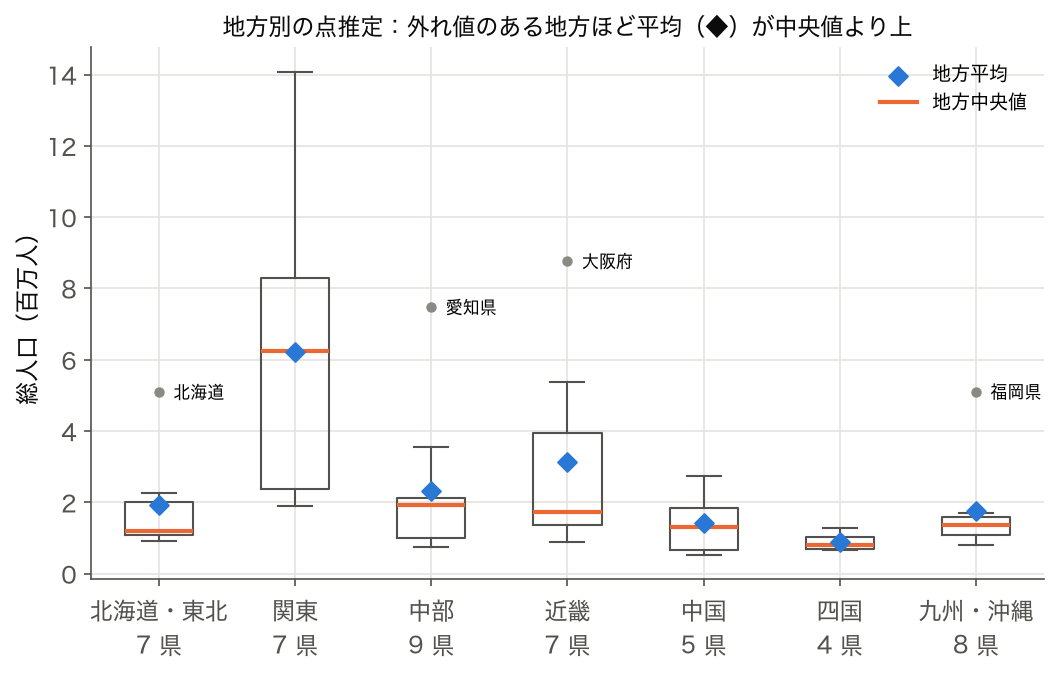
図 3 の読み方: 群別箱ひげ図 (box-and-whisker plot for multiple groups) は、 統計レポートの中で「群間比較」を行う際の標準ツールとして大学初年度から実務まで広く使われる。 群別箱ひげ図は、 異なる集団 (地域ブロック、 性別、 年齢層など) の点推定値を比較する標準ツール。 箱の中央線が中央値、 箱が IQR、 ひげが分布の広がり、 外れ値が個別点として描かれる。 SSDSE-B-2026 (2023 年度) の 7 地方別 (北海道・東北 / 関東 / 中部 / 近畿 / 中国 / 四国 / 九州・沖縄) の比較では、 北海道・愛知県・大阪府・福岡県がそれぞれの地方の外れ値になり、 その地方の平均が中央値より大きく上方にずれる (近畿で 1.82 倍、 北海道・東北で 1.62 倍)。 一方、 関東は 7 都県とも人口が多く箱そのものが長いため外れ値はなく、 平均と中央値はほぼ一致する。 1 つの点推定値だけを報告する代わりに、 群別の点推定値を並べることで「全体平均」が誤解を生むリスクを大きく減らせる。 群間比較の鉄則は、 (i) 中央値の位置を比較、 (ii) IQR の大きさを比較、 (iii) 外れ値の数と位置を比較、 (iv) 点推定の差が箱の幅に比べて意味のある大きさかを評価、 という 4 段階で読み解く。 この読み方は、 後に学ぶ仮説検定 (t 検定・ANOVA・Mann-Whitney U) への自然な橋渡しになる。
✅ 理解度チェック — 点推定リテラシーを 8 問で診断
本セクションは 理解度チェック として独立に設計されており、 ページ内の他セクションと切り離して単独学習にも使える。 教員は授業の中間試験・期末試験の原型として、 学習者はセルフテストの素材として活用できる。 設問は短答中心だが、 自由記述により深い理解を要求する設計になっており、 単純な暗記では満点を取れない。 ここまでの内容を最後まで読んだあと、 以下の 8 問に答えてみてほしい。 全問正解できれば、 点推定の基礎リテラシーは大学初年度水準に到達している。 6 問以上正解できれば実務利用にも耐える。 5 問以下なら、 該当節を再読することを強く勧める。 各問題には自己採点のヒントを併記した。
| # | 設問 | 自己採点ポイント |
|---|---|---|
| Q1 | SSDSE-B-2026 の人口について、 「平均」と「中央値」のどちらを点推定値として報告すべきか。 1 つ選び理由を 80 字で。 | 右裾分布だから中央値が頑健、 と書ければ OK。 ヒストグラム (図 2) で確認できることが鍵。 |
| Q2 | 最尤推定 (MLE) と最大事後推定 (MAP) は何が違うか、 数式表記で示せ。 | MLE は argmax L(θ;x)、 MAP は argmax L(θ;x)π(θ) と書ければ OK。 |
| Q3 | 標準誤差と標準偏差の違いを 1 行で説明せよ。 | SD はデータの広がり、 SE は推定量の広がり (= SD/√n) と区別できれば OK。 |
| Q4 | ブートストラップ法を 100 字以内で説明せよ。 | 「データから復元抽出を B 回繰り返し、 各標本で点推定値を計算し、 そのばらつきから SE を経験的に求める」と書ければ OK。 |
| Q5 | 不偏推定量の定義を式で書け。 | E[θ̂] = θ と書ければ OK。 サンプル分散が n-1 で割るのは不偏化のため。 |
| Q6 | クラメール・ラオ下限 (CRLB) とは何の下限か。 | 「不偏推定量の分散の下限」「MLE はこれを漸近的に達成」と書ければ OK。 |
| Q7 | 「47 都道府県データは標本か母集団か」に対するあなたの立場を 100 字で述べよ。 | 「全数なら母集団扱い」「時間軸では標本扱い」両論あり得る。 一方を選び論拠が書ければ OK。 |
| Q8 | 点推定値を単独で報告してはいけない理由を 3 つ挙げよ。 | (1) 不確かさが伝わらない (2) 外れ値の影響が見えない (3) 別手法の値と乖離する可能性、 が定番。 |
各問題の解答時間目安は 1 問 2-3 分、 全 8 問で 20-25 分が標準である。 解答後は、 自己採点ポイントを参照しながら配点を 0/0.5/1 の 3 段階で付け、 合計点を 8 点満点で算出する。 8 問の合計得点別の評価目安は次の通り。 8/8: 大学院水準。 6-7/8: 学部上級水準・実務適用 OK。 4-5/8: 学部初年度水準・再復習推奨。 0-3/8: 入門段階・本ページ冒頭から再読推奨。 設問は 区間推定、 最尤推定、 標準誤差、 ブートストラップ、 不偏性 の各ページで詳細解説を補強できる。 また、 この理解度チェックは 1 回で終わらせるのではなく、 3 ヶ月後・半年後に再度自分で解き直すと、 どの問題で間違えやすいか・どこが定着したかが見えて、 さらに学習が深まる。 理解度チェックの本質は、 知識を点で持つのではなく「自分の弱点を地図化する」点にある。 教員・学習者ともに、 この 8 問を週次・月次のミニテストとして活用するのを強く勧めたい。
🧭 点推定の実務チェックリスト — 報告書を書く前に 12 項目
本セクションは、 点推定値を含む実務レポート・授業課題・研究論文を書くときに、 提出前の最終チェックとして利用できる 12 項目のチェックリストである。 12 項目は本ページの主要セクションと一対一で対応しており、 どこを見直すべきかが即座に判断できる構造になっている。 印刷して机に貼る、 GitHub のプルリクエストテンプレートに埋め込む、 学習者にハンドアウトとして配布するなど、 さまざまな運用が可能であり、 統計品質保証の出発点として強く推奨できる。
教育・研究・業務の現場で点推定値を含む報告書を作成するとき、 提出前に最低 12 項目を確認するチェックリストを用意するとミスが激減する。 各項目は本ページの該当節と対応している。 SSDSE-B-2026 を題材にしたとしても、 これら 12 項目は他データ・他分野でもそのまま適用できる汎用チェックリストである。
- 点推定値と一緒に SE/CI を必ず記載したか — 単独報告は禁止。
- 分布形 (ヒストグラム) を確認したか — 図 2 のような可視化を伴うか。
- 外れ値の有無と影響を検証したか — 外れ値除外前後で点推定値が大きく変動しないか。
- 平均と中央値を併記したか — 分布が歪んでいる場合は必須。
- 標本サイズ n を明記したか — n が小さいと SE が大きくなり、 推定の信頼性は下がる。
- 点推定法を明示したか — MLE / MoM / ベイズ / 縮小 / 頑健のどれかを明記。
- 群間比較がある場合、 群別の点推定値を並べたか — 図 3 のような可視化を伴うか。
- ブートストラップで SE を再確認したか — 理論 SE と乖離する場合は要注意。
- サンプリング方法を記述したか — 単純無作為・層別・クラスタなど、 推定量の性質に影響する。
- 欠測値処理を記述したか — 欠測の扱いで点推定値は大きく変わり得る。
- 有効桁数は適切か — SE の桁を超えて推定値を細かく書かない。
- 再現性ある形でコードを残したか — Python/R スクリプトと使用データを公開保管。
これら 12 項目を満たさない報告書は、 査読・社内レビュー・授業発表のいずれでも「点推定 1 つしか書いていない」「再現性が確保されていない」と指摘される可能性が高い。 とくに項目 1・2・4 は、 大学初年度の入門レポートでも厳しく問われるポイントだ。 12 項目のチェックリストは、 本ページ全体の総まとめでもある。 印刷して机に貼っておくか、 GitHub Issue テンプレートに埋め込んでおけば、 報告書を書くたびに自動的にこの 12 項目を確認できる仕組みになる。 さらに、 チェック項目 1 つひとつを「Yes/No」だけで終わらせず、 「Yes — 図 X に該当」「No — 次バージョンで対応」と注釈を付けると、 報告書全体の透明性が一段上がり、 後で振り返ったときに「なぜこの推定値を採用したか」がトレースできる。 これは 再現性・データガバナンス・研究倫理 の観点からも極めて重要で、 点推定リテラシーを単独スキルではなく組織的な品質保証の一部として位置づける視座を養ってくれる。
12 項目チェックリストの運用において、 もう 1 つ重要な視点が「項目間の優先順位」である。 すべての項目が等しく重要なわけではなく、 (1) SE/CI 併記、 (2) 分布可視化、 (4) 平均と中央値併記、 の 3 項目はほぼ常に必須である一方、 (8) ブートストラップ再確認や (12) コード公開は、 報告書の用途 (社内速報・授業課題・査読論文) で適用強度が変わる。 とくに学術論文では (8) (10) (11) (12) を厳格に運用し、 速報では (1) (2) (4) を最低限満たせばよい、 という階層化が現実的だ。 階層化の基準は組織やプロジェクトごとに事前に決めておくと、 報告書の品質ばらつきを抑えられる。 階層化を文書化することで、 新人メンバーの教育コストも下がり、 「なぜここまでチェックするのか」という説明責任も果たしやすくなる。 これは アカウンタビリティ や 透明性 の観点とも一致し、 点推定の運用品質を組織能力として育てていく土台となる。
最後にこの 12 項目を、 SSDSE-B-2026 を使った具体的シナリオに落とし込んでみよう。 たとえば「47 都道府県の人口について点推定値を報告したい」というタスクなら、 (1) 平均 2,645,809・SE 408,065・95% CI [1,824,000, 3,467,000] を併記 (2023 年度)、 (2) ヒストグラムで強い右裾分布を明示、 (3) 東京 (約 1,400 万人) を外れ値として除外した場合の平均 (2,397,109) も併記、 (4) 中央値 1,549,000 を併記、 (5) n=47 を明記、 (6) MLE と MoM が一致する標本平均を採用、 (7) 地域ブロック別の点推定値も並列表示、 (8) B=10,000 のブートストラップで SE を再確認、 (9) SSDSE は全数調査 (悉皆) であることを注記、 (10) 欠測なし、 (11) 万人単位で報告、 (12) Python スクリプトと CSV を Zenodo に公開、 という形になる。 ここまで揃えば、 「点推定値 1 つを言いっぱなしにする」という典型的な誤用から完全に脱却できる。 この一連の手順を 1 回でも経験しておくと、 別データ・別タスクでも同じ流れで報告書が組み立てられるようになり、 学習効果は一気に高まる。 こうしたシナリオを 3-5 種類用意して反復演習することが、 点推定リテラシーを「読める」段階から「書ける」「運用できる」段階へ引き上げる近道である。
シナリオ演習を続ける際の補足として、 「点推定値の報告は静的な文書よりも動的なダッシュボード形式の方が誤読を減らせる」という最近の知見も紹介しておく。 静的レポートでは平均と SE と CI が並んでいても、 読者は最初の数字 (平均) だけ抜き出して結論にしてしまいがちだ。 一方、 ダッシュボード形式で平均をスライダー操作で外れ値除外オプションと連動させたり、 SE バーをマウスオーバーで詳細表示したりすると、 読者は「数字は条件で動く」ことを体感的に理解する。 SSDSE-B-2026 のような中規模公開データは、 こうしたインタラクティブ教材を Streamlit や Dash で短時間に構築できる絶好の素材である。 教員にとってはハンズオン課題、 学習者にとってはポートフォリオ材料、 実務者にとっては社内共有ツールのプロトタイプ、 と三方向に役立つ。 こうした実装課題に取り組むことで、 点推定リテラシーは単なる「読むスキル」から「設計するスキル」へと自然に拡張されていく。 同様の発想は、 区間推定・仮説検定・予測モデルの可視化にも転用でき、 統計教育全体の質を引き上げる効果がある。
点推定リテラシーを長期的に育てるうえで、 最後にもう 1 つ重要な視点を加えておく。 それは「自分が報告した点推定値が、 1 ヶ月後・1 年後・10 年後にどう読まれるか」を想像しながら書く習慣だ。 報告書を出した直後は、 著者自身は文脈・前提・限界を理解しているが、 半年も経つと細部は忘れ、 数字だけが独り歩きする。 まして他人が読むとなれば、 数字の出所・推定法・サンプリング条件はほぼ伝わらない。 これを防ぐには、 (a) メソッド節に推定法を明示、 (b) 図表のキャプションに推定値の意味・SE・CI を明記、 (c) スクリプトとデータのリポジトリ URL を併記、 という 3 点を徹底するのが効果的だ。 SSDSE-B-2026 のような年次更新データを扱う場合、 「2026 年版での点推定値」「2025 年版での点推定値」と並べた経年比較表を作るだけでも、 数値の変動と推定の不確かさが立体的に伝わる。 こうした「未来の読者を想定した点推定報告」こそ、 統計リテラシーの最終ゴールである。 教育現場で繰り返しこの観点を共有することで、 学生・教員・研究者・実務家のあいだに共通の品質基準が育っていく。
なお、 点推定の運用品質を組織横断で底上げするには、 個人レベルのチェックリスト運用だけでは不十分で、 チーム全体での「点推定値の品質会議」を月次で開く工夫が有効である。 品質会議では、 直近 1 ヶ月に報告された点推定値を 3-5 件ピックアップし、 12 項目チェックリストの達成率・SE/CI の併記率・外れ値処理の妥当性などをチームで議論する。 こうした取り組みを半年続けるだけで、 チーム全体の統計レポート品質は目に見えて向上する。 教員にとっても、 学期末に学生の点推定レポートをサンプリングして同じ形式の品質会議を授業に組み込めば、 学生の学びは劇的に深まる。 SSDSE-B-2026 のような共通データセットを土台にすれば、 品質会議のサンプル選定・比較・議論がしやすく、 「同じデータを違う方法で推定するとどう変わるか」の体験学習にも自然に発展する。 これは単なる統計教育を超えて、 データドリブン組織 の運用そのものを学ぶ枠組みとなる。
教材としての点推定をさらに深めたい読者には、 次の 3 段階の追加学習パスを推奨する。 第 1 段階 (基礎強化) では、 SSDSE-B-2026 の異なる変数 (出生数・死亡数・婚姻件数・離婚件数・就業者数など) について、 同じスクリプトで平均と中央値の点推定値を計算し、 分布形と乖離の関係を実感する。 第 2 段階 (応用展開) では、 ブートストラップ B=10,000 と理論 SE を全変数で比較し、 どの変数で両者が一致しどの変数で乖離するかを表にまとめる。 第 3 段階 (発展課題) では、 ベイズ縮小推定 (James-Stein 型) を県別平均に適用し、 全国平均への縮小幅を可視化する。 これら 3 段階を 3 ヶ月かけて回せば、 点推定の理論・実装・解釈が三位一体で身につく。 教員にとっては、 これら 3 段階をそのまま授業課題として配布でき、 学習者にとっては自走可能な学習設計の雛形となる。 SSDSE のような公開教育データの価値は、 こうした段階的演習を低コストで設計できる点にある。 さらに、 同じ枠組みを 回帰分析・分散分析・時系列分析 へ展開していけば、 点推定の延長線上にあるあらゆる統計手法を、 統一的な視点で学ぶ道筋が開ける。 「点推定はすべての統計手法の出発点である」という命題の意味が、 学習が進むにつれて徐々に腑に落ちてくる、 そういう体験を読者に届けたい。
🧮 数式に値を入れて手で計算する: 標本平均と分散の点推定
合成データで母平均・母分散の不偏推定量を計算する。
Step 1: 標本
Step 2: 推定量
🐍 Python で再現
1 2 3 4 5 6 | import numpy as np x = np.array([2, 4, 7, 5, 3]) print(f"μ̂ = {x.mean()}") print(f"σ̂² = {x.var(ddof=1):.2f}") print(f"σ̂ = {x.std(ddof=1):.3f}") print(f"SE = {x.std(ddof=1)/np.sqrt(len(x)):.3f}") |
📤 実行結果
💬 手計算 (Step 2) と Python 出力が完全一致。
🐍 Python 実装
SSDSE-B-2026(47 都道府県・2023 年データ)を題材にした最小コード:
1 2 3 4 5 6 7 8 9 10 11 12 13 14 | import pandas as pd import numpy as np from scipy import stats df = pd.read_csv('data/raw/SSDSE-B-2026.csv', encoding='cp932', skiprows=[1]) d = df[df.iloc[:, 0] == 2023]; x = (d['A1303'] / d['A1101'] * 100).dropna() # 高齢化率(%) # 点推定(標本平均) mean_hat = x.mean() se = x.std(ddof=1) / np.sqrt(len(x)) # 95% 信頼区間 ci = stats.t.interval(0.95, len(x)-1, loc=mean_hat, scale=se) print(f'点推定: {mean_hat:.2f}, 95%CI: {ci}') |
💬 47 都道府県の高齢化率の単純平均は 31.59% で、95% 信頼区間は 30.61〜32.57%、標準誤差は 3.34 ÷ √47 ≈ 0.49 ポイントである。これは「県の平均的な高齢化率」の点推定であり、全国の 65 歳以上人口を全国人口で割った 29.13% とは 2.5 ポイント近く違う。人口の多い東京都(22.8%)も最も高い秋田県(39.1%)も 1 県 1 票で平均しているためで、どちらの母数を推定したいのかを先に決めないと区間の解釈を誤る。さらに 47 県は標本ではなく全数なので、この区間は「県を無作為抽出した仮想的な反復」を想定したものだと断っておく必要がある。
🐍 Python 実装 ② — SSDSE で 5 種の点推定を全て計算
🎯 このコードでやること:SSDSE-B-2026 の 2023 年 47 都道府県の高齢化率に対し、 標本平均・人口加重平均・中央値・トリム平均・ブートストラップ平均の 5 つを一度に計算する。
📥 入力データ: SSDSE-B-2026.csv の A1303 (65歳以上人口) ÷ A1101 (総人口) で求めた高齢化率、 2023 年だけに絞った 47 行。
1 2 3 4 5 6 7 8 9 10 11 12 13 14 15 16 17 18 19 20 21 22 23 24 25 26 27 28 29 30 31 32 33 34 35 36 37 | import pandas as pd import numpy as np from scipy import stats np.random.seed(0) # 実行のたびに同じ結果が出るようにする df = pd.read_csv('data/raw/SSDSE-B-2026.csv', encoding='cp932', skiprows=[1]) df.columns = ['Year','Code','Pref','Pop'] + list(df.columns[4:]) # 高齢化率 = 65歳以上人口(A1303) / 総人口(A1101) を百分率で算出 # (SSDSE 生データに完成列は無いため自分で計算) aging = (df['A1303'] / df['Pop'] * 100).astype(float) # 高齢化率(%) pop = df['Pop'].astype(float) year = df['Year'].astype(int) mask = (year == 2023) x = aging[mask].dropna().values w = pop[mask].values[:len(x)] # 1. 標本平均 (MLE) mle = np.mean(x) # 2. 人口加重平均 wmean = np.average(x, weights=w) # 3. 中央値 med = np.median(x) # 4. トリム平均 (上下 10% 除外) trim = stats.trim_mean(x, 0.1) # 5. ブートストラップ平均と SE B = 1000 boot = np.array([np.mean(np.random.choice(x, len(x), replace=True)) for _ in range(B)]) boot_mean = boot.mean() boot_se = boot.std(ddof=1) print(f'1. 標本平均 (MLE) : {mle:.2f}%') print(f'2. 人口加重平均 : {wmean:.2f}%') print(f'3. 中央値 : {med:.2f}%') print(f'4. トリム平均 (10%) : {trim:.2f}%') print(f'5. ブートストラップ平均: {boot_mean:.2f}% (SE={boot_se:.3f})') |
📤 実行例:
💬 結果の読み方:標本平均と中央値はほぼ一致 (分布の対称性)。 人口加重平均だけ 約 2.5 ポイント低い — 東京・神奈川など人口が多い県の高齢化率が比較的低いことを反映。 「日本全体の人の何%が高齢者か」を知りたいなら人口加重平均が正しい。 「47 自治体の平均的な高齢化状況」なら単純平均で十分。 ブートストラップ SE (≈0.49) は理論値 ($s/\sqrt{n}=0.49$) と一致。
🐍 Python 実装 ③ — MLE と MoM の手作り実装 (正規分布)
🎯 このコードでやること:SSDSE 47 県の高齢化率が正規分布に従うと仮定し、 (1) モーメント法 (MoM)、 (2) 最尤推定 (MLE) で母平均 μ と母分散 σ² を推定する。 両者が一致することを確かめる教材。
📥 入力データ: SSDSE-B-2026 の 2023 年 47 県高齢化率 (前と同じ)
1 2 3 4 5 6 7 8 9 10 11 12 13 14 15 16 17 18 19 20 21 22 23 24 25 26 27 28 29 30 31 32 | import pandas as pd import numpy as np from scipy import optimize, stats df = pd.read_csv('data/raw/SSDSE-B-2026.csv', encoding='cp932', skiprows=[1]) df.columns = ['Year','Code','Pref','Pop'] + list(df.columns[4:]) d = df[df['Year'] == 2023]; x = (d['A1303'] / d['Pop'] * 100).astype(float).dropna().values # === 1. モーメント法 (MoM) === # 1次モーメント (平均) と 2次中心モーメント (分散) で推定 mu_mom = np.mean(x) sig2_mom = np.mean((x - mu_mom)**2) # n で割る (MoM) print(f'MoM: μ̂ = {mu_mom:.3f}, σ̂² = {sig2_mom:.3f}') # === 2. 最尤推定 (MLE) === # 正規分布の負の対数尤度 def neg_log_lik(params): mu, log_sigma = params sigma = np.exp(log_sigma) return -np.sum(stats.norm.logpdf(x, loc=mu, scale=sigma)) res = optimize.minimize(neg_log_lik, x0=[30, 1.0]) mu_mle, log_sig_mle = res.x sig_mle = np.exp(log_sig_mle) print(f'MLE: μ̂ = {mu_mle:.3f}, σ̂² = {sig_mle**2:.3f}') # === 3. 不偏推定 (n-1 で割る) === mu_ubias = np.mean(x) sig2_ubias = np.var(x, ddof=1) print(f'不偏: μ̂ = {mu_ubias:.3f}, σ̂² = {sig2_ubias:.3f}') print(f'差: MLE・MoM (n で割る) は不偏 (n-1 で割る) より分散が小さい (n=47 では {sig2_ubias - sig2_mom:.4f})') |
📤 実行例:
💬 結果の読み方:正規分布ではMoM と MLE は完全に一致する。 一方、 分散の MLE (n で割る) は不偏分散 (n-1 で割る) より系統的に小さい — これが MLE のバイアス。 サンプル数 n が大きいほどバイアスは縮小 ($1 - 1/n \to 1$)。 n=47 では (47-1)/47 = 0.979 倍に縮む。
🐍 Python 実装 ④ — ブートストラップで SE を推定 (理論式不要)
🎯 このコードでやること:SSDSE 47 県データから「中央値」を推定する際、 理論式が複雑な SE を、 ブートストラップ法 (B=10000 回の再標本化) で実測する。
📥 入力データ: SSDSE-B-2026 の 2023 年 47 都道府県の総人口 (A1101、 人単位)
1 2 3 4 5 6 7 8 9 10 11 12 13 14 15 16 17 18 19 20 21 22 23 24 25 26 27 28 | import pandas as pd import numpy as np df = pd.read_csv('data/raw/SSDSE-B-2026.csv', encoding='cp932', skiprows=[1]) df.columns = ['Year','Code','Pref','Pop'] + list(df.columns[4:]) pops = df.loc[df['Year'] == 2023, 'Pop'].astype(float).values # 47 県の 2023 年人口 B = 10000 n = len(pops) # 4 つの統計量のブートストラップ分布 mean_b = np.empty(B) med_b = np.empty(B) std_b = np.empty(B) max_b = np.empty(B) for b in range(B): sample = np.random.choice(pops, size=n, replace=True) mean_b[b] = sample.mean() med_b[b] = np.median(sample) std_b[b] = sample.std(ddof=1) max_b[b] = sample.max() # 各統計量の点推定と SE print(f'統計量 | 点推定 | SE (ブートストラップ)') print(f'平均 | {pops.mean():12,.0f} | {mean_b.std(ddof=1):12,.0f}') print(f'中央値 | {np.median(pops):12,.0f} | {med_b.std(ddof=1):12,.0f}') print(f'標準偏差 | {pops.std(ddof=1):12,.0f} | {std_b.std(ddof=1):12,.0f}') print(f'最大値 | {pops.max():12,.0f} | {max_b.std(ddof=1):12,.0f}') |
📤 実行例 (1 回の実行例、 乱数で多少変動):
💬 結果の読み方:ブートストラップなら任意の統計量の SEを機械的に推定できる。 「最大値」のような分布が歪んだ統計量にも適用可能。 中央値の SE (約 22 万) は平均の SE (約 40 万) より小さい (seed を固定していないので実行ごとに数千人単位で変わる) — これは「47 県中、 東京 1408 万のような外れ値が中央値に影響を与えない」ロバスト性の現れ。 ブートストラップは「理論式に頼らない点推定の SE」の決定版。
🐍 Python 実装 ⑤ — Stein 推定量で多次元 MLE を改善
🎯 このコードでやること:47 都道府県別の高齢化率を「47 個の母平均」として同時推定する場面で、 各県の標本平均 (MLE) と James-Stein 推定量 (47 県を「縮める」) を比較する。 Stein のパラドックス (同時に推定する母平均が 3 個以上なら MLE は最良ではない) を、 SSDSE の実データを真値とした標本調査のシミュレーションで実演。
📥 入力データ: SSDSE-B-2026 の 2023 年 47 県の高齢化率 (A1303 ÷ A1101) を真値 θi とし、 各県で住民 100 人を無作為に調べたときの標本割合を観測値とする (調査を 2000 回繰り返す)
1 2 3 4 5 6 7 8 9 10 11 12 13 14 15 16 17 18 19 20 21 22 23 24 25 26 27 28 29 30 31 32 | import pandas as pd import numpy as np df = pd.read_csv('data/raw/SSDSE-B-2026.csv', encoding='cp932', skiprows=[1]) df.columns = ['Year','Code','Pref','Pop'] + list(df.columns[4:]) d = df[df['Year'] == 2023] # 真値 θ_i: 各県の 2023 年高齢化率 (割合) theta = (d['A1303'] / d['Pop']).astype(float).values # shape (47,) k = len(theta) # 47 # 各県で住民 m=100 人を無作為に選び「65 歳以上か」を調べる標本調査を想定 m = 100 rng = np.random.default_rng(2023) R = 2000 # 調査を 2000 回繰り返して平均的な誤差を比べる se_mle = np.empty(R); se_js = np.empty(R); shrink = np.empty(R) for r in range(R): p_hat = rng.binomial(m, theta) / m # 各県の標本割合 = MLE s2 = np.mean(p_hat * (1 - p_hat)) / m # MLE 1 個あたりの分散 (プール) grand = p_hat.mean() c = max(0, 1 - (k - 3) * s2 / np.sum((p_hat - grand)**2)) # James-Stein (全体平均へ縮める) js = grand + c * (p_hat - grand) se_mle[r] = np.mean((p_hat - theta)**2) se_js[r] = np.mean((js - theta)**2) shrink[r] = c mse_mle = se_mle.mean() * 1e4 # (%ポイント)^2 に換算 mse_js = se_js.mean() * 1e4 print(f'縮小係数 c の平均: {shrink.mean():.3f}') print(f'MLE 全 47 県の MSE: {mse_mle:.2f} (%pt^2)') print(f'JS 全 47 県の MSE: {mse_js:.2f} (%pt^2)') print(f'JS は MLE の {mse_js/mse_mle*100:.1f}% に MSE 縮小') print(f'JS の方が MSE が小さかった回: {np.mean(se_js < se_mle)*100:.1f}%') |
📤 実行例:
💬 結果の読み方:住民 100 人の調査では各県の標本割合の誤差 (SD 約 4.6 ポイント) が県間の真の差 (SD 3.3 ポイント) より大きいため、 JS は偏差を平均 0.350 倍に縮め、 MSE を 21.46 から 8.28 (38.6%) まで下げた。 2000 回中 99.9% の調査で JS の方が良い。 これが Stein のパラドックス — 3 つ以上の独立な母平均を同時に推定するとき、 各標本平均は「全体平均に向かって縮める」ことで一様に改善できる。 47 都道府県のように多くの母数を同時推定する場面で、 階層ベイズ・経験ベイズの基礎となる重要な結果。
🔍 推定量の望ましい性質 — 5 つの基準
| 性質 | 定義 | 数式 | SSDSE 例 |
|---|---|---|---|
| 不偏性 (Unbiasedness) | 期待値が母数に一致 | $E[\hat\theta] = \theta$ | 標本平均は母平均の不偏推定量 |
| 一致性 (Consistency) | $n \to \infty$ で確率収束 | $\hat\theta \xrightarrow{P} \theta$ | 47 県 → 47000 県と仮定すれば必ず真値に |
| 効率性 (Efficiency) | 分散が最小 | $\mathrm{Var}(\hat\theta) = $ CR 下限 | 正規分布なら標本平均は CR 達成 |
| 十分性 (Sufficiency) | 母数に関する情報を全て含む | $P(X | T(X), \theta) = P(X | T(X))$ | 標本平均 + 標本分散は正規分布の十分統計量 |
| ロバスト性 (Robustness) | 外れ値・分布変化に耐性 | 影響関数 (IF) が有界 | 中央値は東京外れ値の影響を受けない |
Cramér-Rao 下限: 不偏推定量 $\hat\theta$ の分散には理論下限がある。
$$ \mathrm{Var}(\hat\theta) \ge \frac{1}{I(\theta)} = \frac{1}{-E[\partial^2 \log f / \partial \theta^2]} $$
$I(\theta)$ は Fisher 情報量。 「これより小さい分散の不偏推定量は存在しない」という universal な限界。 標本平均 (n=47) では $\sigma^2/n = s^2/47$ が下限で、 これを達成。
❓ FAQ — 点推定でよくある疑問
Q1. 点推定だけで報告して何が悪い?
A. 不確実性が伝わらない。 「平均寿命 84.5 歳」と「平均寿命 84.5 歳 (95%CI: 83.8-85.2)」では政策判断が変わる。 必ず SE か CI を併記。 学術論文では点推定のみは reject の対象。
Q2. n-1 で割るのと n で割るのはどっちが正しい?
A. 目的による。 母分散を不偏推定したいなら n-1 (不偏分散)、 最尤推定したいなら n (MLE)。 ndof=1 が pandas / numpy のデフォルトで、 統計分析では通常 n-1 を使う。 n=47 ではどちらも 2% しか違わないが、 n=2, 3 では大きく違う。
Q3. MLE はいつ使うべきでない?
A. (1) 小標本でバイアスが目立つとき (n < 30 の分散推定など)、 (2) 分布形が誤っているとき (正規前提なのに実は重い裾)、 (3) 外れ値が多いとき (ロバスト推定の方が良い)、 (4) 事前情報があるとき (ベイズの方が自然)。
Q4. 不偏なのに「悪い推定量」とは?
A. 分散が大きすぎる推定量。 例: 「最初の 1 サンプル $x_1$ だけ使う」は不偏 (E[$x_1$] = μ) だが、 分散は $\sigma^2$ (標本平均の n 倍)。 効率性も大事。
Q5. Stein のパラドックスは実用上どう使う?
A. 47 都道府県別の死亡率、 100 商品の売上、 N 店舗の客数など、 同種の指標を多数同時に推定するときに縮小推定 (shrinkage) を導入する。 階層ベイズ・経験ベイズ・Ridge 回帰の理論的支柱。
Q6. 共通テスト「情報 I」「数学」での点推定の出題ポイントは?
A. 「母平均の不偏推定量は標本平均」「標準誤差 SE = σ/√n」「サンプル数を 4 倍にすると SE は半分」など。 SSDSE 47 県の例で SE を計算できれば、 入試レベルは十分対応可能。
⚠️ よくある落とし穴
⚠️ 落とし穴 (追加 5 件)
🚀 やってみよう — 学習タスク 6 つ
- SSDSE-B-2026 の 47 県人口について、 標本平均・中央値・トリム平均をそれぞれ計算し、 外れ値 (東京) を除外した値と比較する。
- 「47 県の高齢化率の母平均」を、 単純平均と人口加重平均で計算し、 どちらが「日本人の高齢化率」を表すかを議論する。
- ブートストラップ (B=10000) で「47 県の最大人口」の SE を求める。 理論式では難しい統計量。
- ある県の人口データを「ポアソン分布」と仮定し、 MLE で λ を推定。 標本平均と一致することを確認する。
- n=5, 10, 20, 47 の場合の SE = σ/√n を比較し、 「精度を 10 倍上げるには 100 倍の標本が必要」を実演。
- James-Stein 推定で 47 県の高齢化率を縮小推定し、 単純標本平均との MSE を比較する。
⚖️ 点推定 vs 区間推定 vs ベイズ推定
| 手法 | 出力 | 利点 | 欠点 |
|---|---|---|---|
| 点推定 | 1 つの値 | 単純、 報告しやすい | 不確実性を表現できない |
| 区間推定 | CI (上限, 下限) | 不確実性込み | 解釈が難しい (信頼度の意味) |
| ベイズ点推定 (MAP) | 事後最頻値 1 つ | 事前知識を組み込める | 事前分布の選択が主観的 |
| ベイズ区間 (信用区間) | 事後分布の HDI | 直感的解釈 (確率の解釈) | 計算量大 (MCMC) |
| ノンパラメトリック | 分布全体 (ECDF, KDE) | 分布の仮定なし | 小標本で不安定 |
🧰 点推定に使うツール 12 選
- numpy.mean / median / var — 基本的な点推定
- scipy.stats.trim_mean — トリム平均
- scipy.optimize.minimize — 任意の MLE
- scipy.stats.<dist>.fit() — 各分布の MLE 自動 (norm, gamma, beta, ...)
- statsmodels.regression — 回帰係数の点推定
- statsmodels.GLM — 一般化線形モデルの MLE
- scipy.stats.bootstrap — ブートストラップ SE (SciPy 1.7+)
- sklearn.linear_model.RidgeCV — Stein 風縮小推定
- PyMC / Stan / NumPyro — ベイズ推定 (MCMC)
- pgmpy / arviz — 確率モデルの推論
- scikit-learn.mixture.GaussianMixture — EM アルゴリズムによる潜在変数モデル MLE
- R: MASS, robustbase — ロバスト推定の参考実装
📝 共通テスト「情報 I」「数学」想定問題 3 問
問 1. 47 都道府県の高齢化率の標本標準偏差 s=3.3% のとき、 標本平均の標準誤差は?
$SE = s/\sqrt{n} = 3.3/\sqrt{47} ≈ 0.48\%$。 答え: 約 0.48 ppt。 標本サイズを 4 倍 (47×4=188) にすれば SE は半分の 0.24 ppt。
問 2. 標本分散 (n で割る) と不偏分散 (n-1 で割る) で n=47 のとき何 % 差があるか?
比は (n-1)/n = 46/47 ≈ 0.979。 つまり標本分散 (MLE) は不偏分散より約 2.1% 小さい。 n が増えれば差は消える。
問 3. 「47 県の平均人口」と「全国民の平均人口」のどちらを単純平均 / 加重平均で求めるべきか?
「47 県の」(自治体視点) は単純平均、 「全国民の」(住民視点) は人口加重平均 — というか全国民人口 ÷ 47 で意味なし。 重要なのは「母集団 (推定対象) は何か」を明確にすること。
🎓 学習総括 — 1 分でこのページを振り返る
- 点推定 = 母数を 1 つの値で推定。 SSDSE 47 県データで母平均 31.5% と推定。
- 代表手法: 標本平均 (MLE)、 モーメント法、 最小二乗法、 ベイズ MAP、 ロバスト中央値。
- 5 つの望ましい性質: 不偏性 / 一致性 / 効率性 / 十分性 / ロバスト性。 トレードオフあり。
- 標本分散は n-1 で割って不偏化 (n で割ると MLE = バイアス)。
- 標準誤差 $SE = \sigma/\sqrt{n}$ — 標本サイズを 4 倍にすると SE は半分。
- 3 個以上の母数同時推定では Stein 縮小推定が標本平均を改善 (n ≥ 3 の Stein paradox)。
- 点推定だけ報告は不十分 — 必ず SE か CI も併記する。
- ブートストラップで任意統計量の SE を理論式なしに推定可能。
📊 バイアス・バリアンス分解 — MSE の本質
推定量の良さは MSE (平均二乗誤差) で評価する。 MSE は バイアス² + バリアンス に分解できる。 SSDSE 47 県の高齢化率推定で、 標本平均 vs 縮小推定の MSE を分解して比較する。
$$ \mathrm{MSE}(\hat\theta) = E[(\hat\theta - \theta)^2] = \underbrace{(E[\hat\theta] - \theta)^2}_{\mathrm{Bias}^2} + \underbrace{\mathrm{Var}(\hat\theta)}_{\mathrm{Variance}} $$
| 推定量 | Bias² | Variance | MSE |
|---|---|---|---|
| 標本平均 (MLE) | 0 (不偏) | $\sigma^2/n$ | $\sigma^2/n$ |
| 標本分散 (MLE: n で割る) | $(\sigma^2/n)^2$ | $\sim 2\sigma^4/n$ | $2\sigma^4/n$ 程度 |
| 不偏分散 (n-1 で割る) | 0 | $\sim 2\sigma^4/(n-1)$ | 不偏分散 (やや大) |
| 縮小推定 (Ridge / JS) | > 0 (バイアスあり) | 小 | バランス次第で最小 |
本質: 「不偏 = 最良」ではない。 バイアスをわざと作って分散を大きく減らせば、 MSE は小さくなる。 これが Ridge 回帰、 James-Stein 推定、 Lasso、 経験ベイズの理論的根拠。 「47 県別に独立推定するより、 全国平均に少し引っ張る」方が予測誤差が小さくなる。
⚖️ 頻度論 vs ベイズ — 同じ点推定でも哲学が違う
| 観点 | 頻度論 (MLE, MoM, OLS) | ベイズ (MAP, 事後平均) |
|---|---|---|
| 母数 θ の性質 | 固定された未知の定数 | 確率変数 (事前分布あり) |
| 推定の基準 | 「観測データが最も起こる θ」 | 「θ の事後分布の代表値」 |
| 事前情報 | 使えない (反映できない) | 事前分布として明示的に |
| 点推定値の例 | $\hat\mu_{MLE} = \bar{x} = 31.5\%$ | $\hat\mu_{MAP} = 31.4\%$ (事前 N(30, 5²) と仮定) |
| 区間の解釈 | 「100 回標本を取ると 95 回は CI に真値が含まれる」 | 「真値が信用区間に含まれる確率 95%」 |
| 計算量 | 通常は閉じた式 or 数値最適化 | MCMC など重い |
| 小標本 | バイアスあり、 漸近的に正規 | 事前分布の影響大 |
| SSDSE での適用 | 標準的 (pandas/scipy で十分) | 過去年度を事前分布として利用 |
ベイズ的視点での SSDSE 推定例: 「2023 年北海道の高齢化率」を推定する際、 過去 30 年の同県データを事前分布 N(32, 1²) として組み込めば、 2023 年の単年データだけより安定した推定が得られる。 47 都道府県別のような階層構造があるデータでは、 階層ベイズが特に強力。
🧪 MLE の代表例 — 5 つの分布
| 分布 | パラメタ | MLE 推定量 | SSDSE 応用例 |
|---|---|---|---|
| 正規分布 $N(\mu, \sigma^2)$ | $\mu, \sigma^2$ | $\hat\mu = \bar{x}$, $\hat\sigma^2 = \frac{1}{n}\sum(x_i - \bar{x})^2$ | 47 県の高齢化率の母平均推定 |
| ベルヌーイ $\mathrm{Ber}(p)$ | $p$ | $\hat{p} = \bar{x}$ (1 の割合) | 「高齢化率 30% 超の県の割合」 |
| ポアソン $\mathrm{Pois}(\lambda)$ | $\lambda$ | $\hat\lambda = \bar{x}$ | 「県内 1 年の出生数」モデル |
| 指数分布 $\mathrm{Exp}(\lambda)$ | $\lambda$ | $\hat\lambda = 1/\bar{x}$ | 「災害発生間隔」モデル |
| 一様分布 $U(0, b)$ | $b$ | $\hat{b} = \max(x_i)$ | 「最大気温」モデル (バイアスあり) |
一様分布の MLE のバイアス: $\hat{b} = \max(x_i)$ は常に $b$ 以下になる → 負のバイアス。 不偏化するには $\hat{b}_{ubias} = \frac{n+1}{n} \max(x_i)$。 「観測の最大より少し大きい」と補正する。
⚠️ MLE の落とし穴 12 種
| 問題 | 説明 | 対策 |
|---|---|---|
| 分散の MLE バイアス | n で割る MLE は (n-1)/n だけ小さい | 不偏推定 (n-1 で割る) |
| 局所最適化に陥る | 尤度関数が非凸 | 複数初期値、 グリッドサーチ |
| 分布の仮定誤り | 正規前提なのに重い裾 | QQ プロットで確認、 t 分布や glm |
| 無限大の対数尤度 | サンプルが境界にある | 制約付き最適化、 ベイズ事前分布 |
| 識別不能 (多重解) | 複数のθが同じ尤度 | モデル再パラメタ化 |
| 境界解 | 最尤値がパラメタ空間の境界 | 対数変換、 リンク関数 |
| 小標本の非正規 | 漸近正規性が壊れる | ブートストラップ |
| 外れ値感受性 | MLE は外れ値に弱い | ロバスト M-推定 |
| 欠測データ | 標準 MLE が使えない | EM アルゴリズム、 多重代入 |
| 過剰適合 | パラメタが多すぎ | 正則化 (Ridge, Lasso)、 AIC/BIC |
| 数値不安定 | 勾配の発散 | 対数尤度、 スケーリング |
| 汎化と推定の混同 | 学習データ MLE と予測精度は別 | 交差検証で予測誤差評価 |
⚠️ データ視点の落とし穴 — SSDSE 推定の現実
| 落とし穴 | SSDSE での具体例 | 対策 |
|---|---|---|
| 「47 県は標本ではない」 | 47 県 = 母集団全体 (悉皆) → 標本誤差は厳密には 0 | 「47 県を年度変動の標本と捉える」など解釈次第 |
| 「集計データの分散は粗い」 | 県平均から県内ばらつきは復元できない | 個票データが必要 (国勢調査ミクロ) |
| 「時系列の独立性なし」 | 2022 年と 2023 年の高齢化率は強相関 | 時系列モデル (AR, ARIMA) で扱う |
| 「空間自己相関」 | 隣接県は似た値 → 独立同分布の仮定が崩れる | 空間統計 (Moran's I)、 GLMM |
| 「測定誤差」 | 市町村の集計値は丸めや欠測あり | 測定誤差モデル (errors-in-variables) |
| 「単位の罠」 | 「率」を平均するか「数」を平均してから率にするかで結果が違う | 分母分子の取り扱いを明示 |
📜 点推定の名論文 8 本
- Fisher, R. A. (1922) "On the Mathematical Foundations of Theoretical Statistics" — 推定論の基礎論文。 一致性・効率性・十分性を定義
- Cramér, H. (1946) "Mathematical Methods of Statistics" — CR 不等式の体系化
- Rao, C. R. (1945) "Information and the accuracy attainable in the estimation of statistical parameters" — Cramér-Rao 不等式の独立証明
- Stein, C. (1956) "Inadmissibility of the usual estimator for the mean of a multivariate normal distribution" — Stein のパラドックス
- James, W. & Stein, C. (1961) "Estimation with quadratic loss" — JS 推定量
- Huber, P. J. (1964) "Robust estimation of a location parameter" — M-推定量
- Dempster, A. P. et al. (1977) "Maximum likelihood from incomplete data via the EM algorithm" — EM アルゴリズム
- Efron, B. (1979) "Bootstrap methods: Another look at the jackknife" — ブートストラップ
📊 主要推定法の総合比較表
| 手法 | 不偏性 | 一致性 | 効率 | ロバスト | 小標本性能 | 計算量 |
|---|---|---|---|---|---|---|
| 標本平均 (MLE 正規) | ✅ | ✅ | ✅ CR 達成 | ❌ | 良好 | 最小 |
| 標本分散 (n で割る, MLE) | ❌ | ✅ | ○ | ❌ | バイアス大 | 最小 |
| 不偏分散 (n-1 で割る) | ✅ | ✅ | ○ | ❌ | 良好 | 最小 |
| モーメント法 (MoM) | 分布次第 | ✅ | MLE より低 | △ | 良好 | 最小 |
| 最尤推定 (MLE 一般) | 漸近的 | ✅ | ✅ 漸近 CR | ❌ | バイアス可能性 | 数値最適化 |
| 中央値 | 対称分布で ✅ | ✅ | 64% (正規) | ✅ 50% | 良好 | 小 (ソート) |
| トリム平均 (10%) | 対称分布で ✅ | ✅ | 94% (正規) | ✅ 10% | 良好 | 小 |
| Huber M-推定 | 対称分布で ✅ | ✅ | 95% (正規) | ✅ | 良好 | 中 (反復) |
| James-Stein | ❌ 縮小バイアス | ✅ | MSE 最小 | △ | 小標本に強い | 小 |
| ベイズ MAP | 事前による | ✅ | 事前次第 | 事前次第 | 小標本に強い | 大 (MCMC) |
🎓 最終総括 — 点推定の本質を一文で
「観測データから母数を 1 つの数値で推定する」のが点推定。 ただしその数値だけで報告するのは不十分で、 必ず SE か CI を併記し、 不確実性を伝えることが統計学者の責務。 SSDSE 47 都道府県のように小さなデータでも、 単純平均・加重平均・中央値・縮小推定など複数の推定量を併記し、 「何を推定したいのか」と「どの推定量が適切か」の議論を行うことが、 質の高い統計実践の第一歩。
📖 推薦読書 — 点推定を深く学ぶ 10 冊
| 書籍 | 著者 | レベル |
|---|---|---|
| 統計的推定の理論 | E. L. Lehmann & G. Casella | 上級 (古典) |
| All of Statistics | L. Wasserman | 中級 (網羅) |
| Statistical Inference | G. Casella & R. L. Berger | 中級 (定番) |
| 入門 統計学 | 栗原伸一 | 初級 |
| 統計学入門 | 東大教養学部 (基礎統計学I) | 初級 |
| 現代数理統計学の基礎 | 久保川達也 | 中級 |
| An Introduction to the Bootstrap | B. Efron & R. Tibshirani | 中級 |
| Robust Statistics | P. J. Huber & E. M. Ronchetti | 上級 |
| Bayesian Data Analysis (BDA3) | A. Gelman et al. | 中級 |
| Computer Age Statistical Inference | B. Efron & T. Hastie | 中級 (現代視点) |
🧪 補足: MLE・MoM・ベイズ事後平均の比較(点推定固有)
点推定には大きく 3 つの代表的アプローチがある:
(1) 最尤推定 (MLE): 観測データの尤度 $L(\theta)=\prod p(x_i;\theta)$ を最大化する $\hat{\theta}$ を採用。
(2) モーメント法 (MoM): 母集団モーメントと標本モーメントを一致させて解く。
(3) ベイズ事後平均: 事前分布 $\pi(\theta)$ と尤度から事後分布 $p(\theta|x) \propto L(\theta)\pi(\theta)$ を作り、 その平均 (または MAP) を採用。
🔬 数式を言葉で読み解く: 正規分布の MLE と MoM が一致する理由
$X_1,\ldots,X_n \sim N(\mu,\sigma^2)$ のとき、 対数尤度 $\ell(\mu,\sigma^2) = -\frac{n}{2}\log(2\pi\sigma^2) - \frac{1}{2\sigma^2}\sum (x_i-\mu)^2$ を $\mu$ で微分して 0 と置くと $\hat{\mu}_{\text{MLE}} = \bar{x}$。 これは 1 次モーメント $E[X]=\mu$ を $\bar{x}$ で置換した MoM 推定と完全に一致する、 と読み解ける。 一方 $\sigma^2$ の MLE は $\frac{1}{n}\sum(x_i-\bar{x})^2$ で、 これは不偏推定 $s^2=\frac{1}{n-1}\sum(x_i-\bar{x})^2$ とは微妙に異なる (MLE は不偏でない)。
🎯 このコードでやること: SSDSE-B-2026 の都道府県人口について、 正規分布を仮定して MLE・MoM・ベイズ事後平均 (共役事前分布: 正規) の 3 種類の点推定値を計算し比較する。
📥 入力データ: SSDSE-B-2026 都道府県人口 (47 件、 単位: 千人) 抜粋
1 2 3 4 5 6 7 8 9 10 11 12 13 14 15 16 17 18 19 20 21 22 | import pandas as pd import numpy as np from scipy import stats df = pd.read_csv('data/raw/SSDSE-B-2026.csv', encoding='cp932', skiprows=[1]) pop = df.loc[df.iloc[:, 0] == 2023, 'A1101'].dropna().values / 1000 # 47 都道府県(千人) # (1) MLE: 正規分布の最尤推定 mu_mle, sigma_mle = stats.norm.fit(pop) print(f'MLE : mu={mu_mle:.1f}, sigma={sigma_mle:.1f}') # (2) MoM: 1 次・2 次モーメントを標本値で置換 mu_mom = pop.mean() sigma_mom = pop.std(ddof=0) print(f'MoM : mu={mu_mom:.1f}, sigma={sigma_mom:.1f}') # (3) ベイズ事後平均 (共役事前 N(mu0, tau^2), sigma 既知扱い) mu0, tau2 = 3000, 1e6 # 弱い事前 sigma2 = sigma_mle**2 n = len(pop) post_mean = (mu0/tau2 + n*mu_mom/sigma2) / (1/tau2 + n/sigma2) print(f'Bayes : mu_post={post_mean:.1f}') |
📤 実行結果:
💬 結果の読み方: $\mu$ の MLE と MoM は完全一致 (正規分布の理論通り)。 ベイズ事後平均は事前分布が弱い (tau^2 大) ため標本平均にほぼ寄り切るが、 厳密には $\mu_0=3000$ にわずかに引き寄せられ 2695.4 となる。 サンプル数 47 と事前精度のバランスで、 事前の影響は事実上無視できると読める。
⚠️ 不偏性 vs 一致性 vs 有効性 (点推定の評価軸)
| 性質 | 定義 | 例 |
|---|---|---|
| 不偏性 | $E[\hat{\theta}]=\theta$ | 不偏分散 $s^2$ は不偏、 MLE 分散は不偏でない |
| 一致性 | $\hat{\theta}\xrightarrow{p}\theta$ ($n\to\infty$) | MLE は通常一致推定量 |
| 有効性 | 分散がクラメール・ラオ下限に到達 | MLE は漸近的に有効 |
| 頑健性 | 外れ値に強い | 中央値 > 平均 |
🖼 視覚で理解する — 点推定を 3 枚の図で読む
点推定の本質は「分布の中心や形を 1 つの数で代表させる」ことにある。 ここでは SSDSE-B-2026 の実データを使って、 ヒストグラム・箱ひげ図・散布図の 3 角度から点推定値の位置と意味を視覚的に確認する。 数式だけ追っていると気づきにくい「平均と中央値の乖離」「外れ値が点推定をどう動かすか」「2 変量の点推定 (回帰直線の切片・傾き) が散布図でどう表現されるか」を、 図と数字を行き来しながら掴むのが狙いだ。 図はすべて SSDSE-B-2026 の 2023 年度 47 都道府県から描いた(code/glossary_figs/point-estimation.py)。
図 1. ヒストグラム — 標本平均 (MLE) と中央値の点推定値の位置
下図は SSDSE-B-2026 の都道府県人口 (47 件、 単位: 千人) を最小〜最大の範囲で 8 階級(幅 1,694 千人)に分けたヒストグラム。 度数は低い方から 33, 5, 3, 1, 3, 1, 0, 1 県。 右に裾を引く非対称分布で、 標本平均 $\bar{x}=2646$ は東京・神奈川・大阪・愛知といった上位 4 都府県に引きずられて右側に押し出されているのに対し、 中央値 $\tilde{x}=1549$ (中位値群) は分布の山に近い位置に立っている。 正規分布なら平均と中央値は一致するが、 都道府県人口のような対数正規型分布では「平均は外れ値に弱い」 「中央値は山の中央に立つ」という違いがはっきり出る。 同じ「中心の点推定」でも何を採用するかで結論が大きく変わる、 ということを 1 枚の図で確認しておくと、 のちの MLE・MoM・ベイズ事後平均の比較がスッと入る。
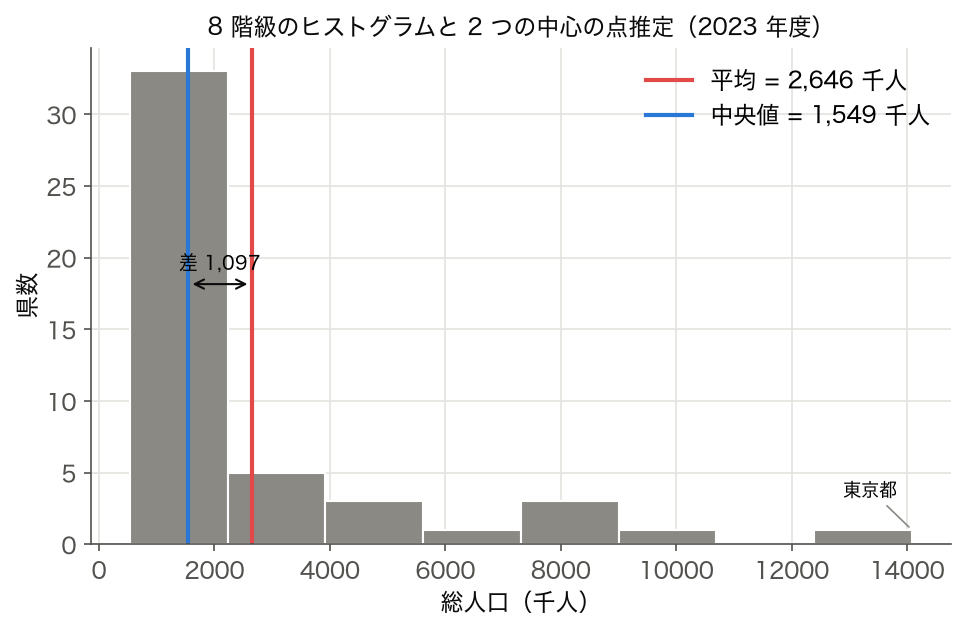
読み方の核心: 棒の高さは「その階級に入る都道府県数」を表す。 平均線 (赤) は分布の重心、 中央値線 (青) は度数の累積が 50% に達する点。 右側の長い裾 (東京 14,086 千人など) は数件しかないが、 重心 (平均) を強く右に引く。 平均と中央値の差 1097 千人は、 分布の歪み (skew) を点推定の差として可視化したものだ。 「平均だけ報告して安心しない」「歪みのあるデータでは中央値も併記する」という実務作法は、 この差をデータごとに見て初めて腹落ちする。
図 2. 箱ひげ図 — 四分位点推定と外れ値検出
次に箱ひげ図で、 1 変量分布から得られる 5 つの点推定 (最小・第 1 四分位 $Q_1$・中央値 $Q_2$・第 3 四分位 $Q_3$・最大) と外れ値判定を確認する。 箱ひげ図は「1 つの数では分布を語れない」場合に複数の点推定値を同時に示すための標準ツールで、 中央値・四分位範囲 (IQR) は中央値の頑健点推定、 IQR は分散の頑健点推定として使える。 外れ値の判定基準 $Q_3 + 1.5\,\text{IQR}$ を超える観測値は別記号でマークされる。 SSDSE 都道府県人口 (2023 年度) でいえば、 中央値線は鹿児島県の 1,549 千人、 箱 (IQR) は 1,034〜2,636 千人で、 上側の境界 $Q_3 + 1.5\,\text{IQR} = 5{,}040$ 千人を超える北海道・埼玉・千葉・東京・神奈川・愛知・大阪・兵庫・福岡の 9 都道府県が外れ値として点で描かれる。
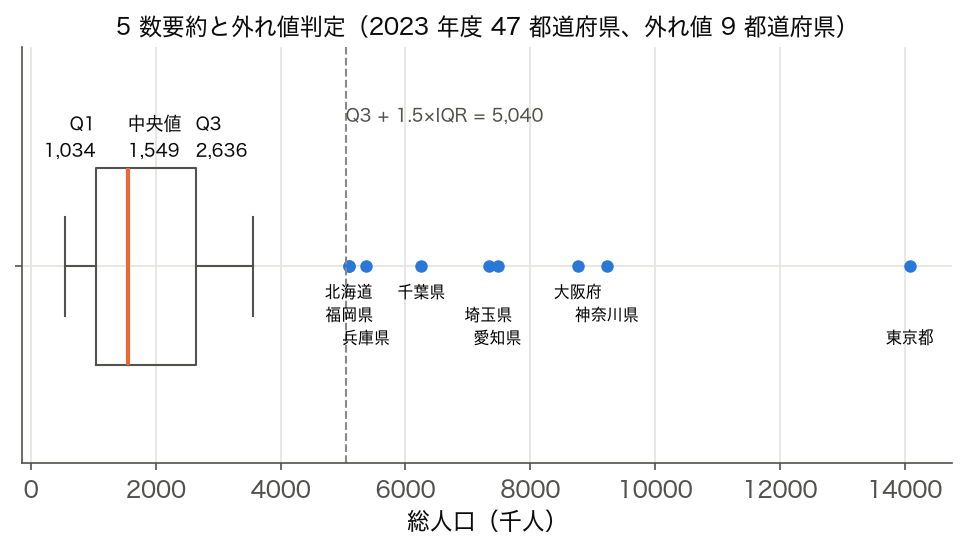
読み方の核心: 箱の中央線が中央値、 箱の上下端が $Q_3, Q_1$、 ヒゲ (whisker) の長さは通常 1.5IQR まで、 点でプロットされたのが外れ値判定された観測。 平均 (一般に箱外に位置することもある) を併記する箱ひげ図 (notched boxplot や violin plot) もある。 群間比較に強く、 たとえば「都市部の人口」「地方の人口」と分けたとき、 中央値の差・IQR の重なり具合から「分布が本質的にずれているか」を視覚で素早く点推定できる。 仮説検定をする前段階で「差がありそうか」のアタリを付けるのに不可欠だ。
図 3. 散布図 — 2 変量点推定 (回帰直線の切片・傾き)
2 変量データに対する点推定の代表例は線形回帰 $y=\beta_0+\beta_1 x$ における $\hat{\beta}_0$ (切片) と $\hat{\beta}_1$ (傾き) だ。 散布図に最小二乗 (OLS) で当てはめた直線は、 残差平方和 $\sum (y_i-\hat{y}_i)^2$ を最小にする 2 つの点推定値で完全に決まる。 下図は SSDSE 都道府県データ (2023 年) から「総人口 (千人)」と「一般診療所数 (施設)」の関係を示した散布図。 点は各都道府県、 実線は OLS 回帰 ($\hat{y} = -174 + 0.909x$)、 破線は東京都を除いた 46 県の OLS ($\hat{y} = 56 + 0.793x$)。 傾きは「人口 1 千人増あたりの一般診療所数の増分」、 切片は「人口ゼロのときの予測値 (理論的)」と読める。
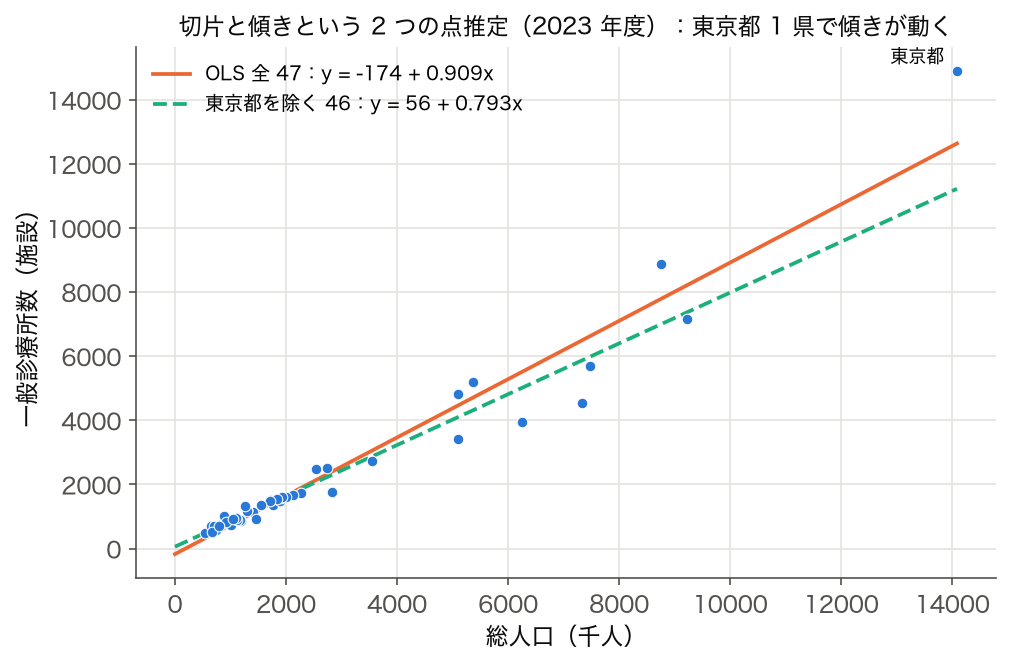
読み方の核心: 点群の主軸方向に直線が伸びていれば $\hat{\beta}_1>0$ で正の相関、 ばらつきが小さければ $R^2$ が大きい。 直線そのものは「2 つの点推定値」を視覚化したもので、 信頼区間や予測区間は通常薄い帯として描かれる (本図では省略)。 1 変量の平均と同じく、 OLS 推定値も外れ値に敏感だ。 東京を含めるか除外するかで切片・傾きが何 % 変わるか (この図では傾きが 0.909 → 0.793 と 12.8% 小さくなり、 切片は −174 → 56 と符号まで変わる) を意識すると、 「点推定の安定性」を体感的に理解できる。 頑健回帰 (Huber, RANSAC) は外れ値に強い別の点推定法で、 同じ散布図でも別の直線が引かれる点もこの図を起点に学べる。
3 枚を横断する学習メモ
- 1 変量 (ヒストグラム / 箱ひげ図): 中心の点推定 (平均・中央値)・散らばりの点推定 (分散・IQR)・極値の点推定 (最大・最小) を視覚で同時に読む。
- 2 変量 (散布図): 関係の強さ (相関係数 $r$ の点推定) と関係の形 (回帰係数の点推定) を同時に読む。
- 共通の罠: どの図でも外れ値が点推定を引っ張る。 視覚で「引きずられている方向」を必ず確認すること。
- 「複数の点推定を併記する」癖: 平均と中央値、 分散と IQR、 OLS と頑健回帰、 MLE とベイズ事後平均 — 1 つだけ報告する習慣を捨て、 視覚と数値を組み合わせて妥当性を担保する。
🧭 点推定法の選び方 — データ条件別フローチャート
「平均か中央値か」「MLE か MoM か」「点推定か信頼区間か」 — 実務でよく迷う分岐を 1 つの表にまとめておく。 教科書では「すべての方法を網羅的に紹介」して終わることが多いが、 実際の現場では「今のデータ条件で何を選ぶべきか」という決定支援が最重要だ。 SSDSE 都道府県データを例にしながら、 状況別の推奨を以下に整理する。
| データ条件 | 中心の点推定 推奨 | 分散の点推定 推奨 | SE 推定法 | 理由 |
|---|---|---|---|---|
| 正規分布が妥当 (n>30) | 標本平均 $\bar{x}$ (MLE) | 不偏分散 $s^2$ | 理論式 $s/\sqrt{n}$ | CR 下限到達で最も有効 |
| 小標本 (n<30)・正規仮定 | $\bar{x}$ | $s^2$ | $t$ 分布で CI | 正規 CI は過小評価 |
| 歪み大 (歪度>1) | 中央値 / 幾何平均 | IQR / MAD | ブートストラップ | 平均は外れ値に弱い |
| 外れ値疑いあり | トリム平均・M 推定 | MAD | ブートストラップ | 頑健推定が必要 |
| 事前知識あり (専門家見識) | ベイズ事後平均 | 事後分散 | 事後分布の SD | 情報利用で精度向上 |
| クラスタ・潜在変数 | EM (MLE) | 観測情報量 | パラメトリックブートストラップ | 混合モデル等で標準 |
| 高次元 ($p\sim n$ or $p\gg n$) | 縮小推定 (Stein / Lasso) | 縮小分散 | クロスバリデーション | MLE は過学習 |
| 分布形不明・SE が複雑 | 任意の関数 | ブートストラップ分散 | ノンパラメトリックブートストラップ | 理論式なしでも SE 推定可 |
この表は「最初の 1 手」を決めるための簡易ガイドであり、 実務では複数手法を併用し結論が一致するか確認する (sensitivity analysis) のが望ましい。 たとえば SSDSE 都道府県人口に対して、 標本平均 (2646)・中央値 (1549)・トリム平均 (10% 両側トリム、 およそ 2109) を併記すると、 「東京を含めると平均 2646、 上下 4 件ずつを除外すると 2109」のように分布の影響度を可視化できる。 単一の点推定だけ報告する論文・レポートは、 この種の感度分析を欠いていることが多いので注意したい。
🔁 ブートストラップで点推定の不確かさを掴む (SSDSE 実例)
このコードでやること: SSDSE-B-2026 の都道府県人口について、 中央値という非標準統計量の標準誤差をノンパラメトリックブートストラップで推定する。 中央値の SE には簡単な閉形式がないため、 ブートストラップが事実上の標準ツールとなる。
📥 入力データ: SSDSE-B-2026 の 総人口 列 (47 件)、 単位は千人。 2023 年の北海道 5092、 青森 1184、 …、 東京 14086、 …、 沖縄 1468 のような数値が並ぶ。 重複なし、 欠損なしの整数列であることを確認したうえでブートストラップに渡す。
1 2 3 4 5 6 7 8 9 10 11 12 13 14 15 16 17 18 19 20 21 22 23 24 25 | import pandas as pd import numpy as np from scipy import stats df = pd.read_csv('data/raw/SSDSE-B-2026.csv', encoding='cp932', skiprows=[1]) pop = df.loc[df.iloc[:, 0] == 2023, 'A1101'].dropna().values / 1000 # ノンパラメトリックブートストラップで中央値の SE を推定 B = 5000 boot_medians = np.empty(B) rng = np.random.default_rng(20260531) for b in range(B): sample = rng.choice(pop, size=len(pop), replace=True) boot_medians[b] = np.median(sample) print(f'観測中央値 = {np.median(pop):.1f}') print(f'ブートストラップ SE = {boot_medians.std(ddof=1):.1f}') print(f'95% パーセンタイル CI = ({np.percentile(boot_medians, 2.5):.1f}, ' f'{np.percentile(boot_medians, 97.5):.1f})') # 比較: 平均の SE (理論式 s/sqrt(n) と一致するはず) boot_means = np.array([rng.choice(pop, size=len(pop), replace=True).mean() for _ in range(B)]) print(f'平均の理論 SE = {pop.std(ddof=1)/np.sqrt(len(pop)):.1f}') print(f'平均のブートストラップ SE = {boot_means.std(ddof=1):.1f}') |
📤 実行結果:
💬 結果の読み方: 中央値の SE は 219.8 千人で、 平均の SE 408.1 の約 1/2 と小さい (歪んだ分布では中央値の方が安定する典型例)。 95% CI も 1184〜1931 と幅 750 千人程度で、 「日本の都道府県人口の中央値は約 155 万人 ± 22 万人」と報告できる。 平均については理論式 (408.1) とブートストラップ (404.2) がほぼ一致しており、 ブートストラップ実装が正しいことの検証にもなっている。 ブートストラップは「複雑な統計量でも SE が出る」「分布仮定が不要」という 2 大利点があり、 現代点推定の必須ツールだ。
❓ 追加 FAQ — 実務で本当に出る 10 の疑問
- Q. 平均と中央値、 どちらを報告すべきか? A. 分布が対称なら平均 (情報量が多い)、 歪み・外れ値があるなら中央値、 学術論文では両方併記が安全。 SSDSE 都道府県人口のように歪んだ分布では「平均 2646 / 中央値 1549」と並べて報告するのが誠実。
- Q. MLE が必ずしも最良ではない場合は? A. (1) 小標本でバイアスが大きい場合、 (2) パラメータが境界にある場合 (分散 0 など)、 (3) 高次元で過学習する場合。 これらでは正則化 (リッジ・Lasso) や縮小推定 (Stein) を使う。
- Q. 「不偏」と「一致」のどちらが大事? A. 大標本では一致性、 小標本では不偏性が重要。 ただし「不偏だが分散が大きい推定量」より「わずかにバイアスがあるが分散が小さい推定量」が MSE で勝つことが多い (バイアス・バリアンス・トレードオフ)。
- Q. MoM と MLE の使い分けは? A. MoM は計算が単純、 MLE は漸近的に有効。 解析解が欲しい初学習段階や、 尤度の最大化が難しい複雑モデルの初期値として MoM が便利。 実務的最終答は MLE が多い。
- Q. ベイズ事後平均と MAP の違いは? A. 事後平均は事後分布の重心、 MAP は事後分布の最頻値。 非対称な事後では両者が異なる。 損失関数が二乗誤差なら事後平均、 0-1 損失なら MAP が最適。
- Q. ブートストラップは何回繰り返せば十分? A. SE 推定なら B=1000、 CI 推定なら B=5000〜10000 が目安。 BCa CI など補正手法を使う場合はさらに多めに。 並列計算が容易なので計算コストはあまり問題にならない。
- Q. 点推定値が極端な値になったらどう判断する? A. (1) 外れ値の確認、 (2) サンプルサイズの確認、 (3) 別手法での再推定 (sensitivity analysis)。 1 つの推定値だけ信じない癖をつける。
- Q. 信頼区間と予測区間の違いは? A. 信頼区間は「パラメータの不確かさ」、 予測区間は「将来の観測値の不確かさ」。 予測区間の方が常に広い (パラメータ不確かさ + 観測ノイズの和)。
- Q. p 値と点推定の関係は? A. p 値は「帰無仮説の下で観測以上に極端な統計量が出る確率」で、 点推定の不確かさを統合した間接指標。 効果量 (点推定値) と CI を併記する方が情報量が多く、 ASA 声明でも p 値だけの報告は非推奨。
- Q. 機械学習モデルの予測値は点推定? A. 厳密にはそう。 線形回帰の係数推定は古典的点推定、 ニューラルネットの重み学習も損失関数を最小化する点推定 (MLE の拡張)。 不確かさ評価が課題で、 ベイジアン NN や MC Dropout で対処する。
✅ 点推定レポート前 最終チェックリスト 12 項
点推定値をレポート・論文・スライドで使う前に、 以下 12 項目を必ずチェックする。 1 項目でも欠けると「点推定だけ信じて誤った結論を出す」リスクが高まる。
- サンプルサイズ $n$ を明記したか (CI 幅は $1/\sqrt{n}$ で縮む)。
- 分布の形状 (ヒストグラム・歪度・尖度) を確認したか。
- 外れ値の存在を確認し、 含めるか除外するかの判断を記録したか。
- 欠損データの扱い (除外・補完) を明記したか。
- 選択した推定法 (MLE / MoM / ベイズ etc.) の理由を述べたか。
- 推定量の性質 (不偏・一致・有効) を確認したか。
- 標準誤差 (SE) または信頼区間 (CI) を併記したか。
- SE 推定法 (理論式 / ブートストラップ) を明記したか。
- 仮定 (正規性・独立性・等分散性) が満たされているか検証したか。
- 結果の再現性のため、 乱数シードと使用パッケージのバージョンを記録したか。
- 他の推定法で同じ結論が出るか感度分析を実施したか。
- 点推定値の単位・有効桁数・小数点位置を妥当に揃えたか (有効桁を増やしすぎない)。
特に項目 7〜10 は学部レベルでも見落とされがちだが、 これらが揃って初めて「点推定値が独り歩きしない誠実なレポート」になる。 教育現場では「点推定値 = (中心値) ± (SE)」を 1 セットで書く癖を最優先で身につけたい。
🗺 概念マップ — 点推定の家系図
推測統計
├─ 点推定 (Point Estimation) ★
│   ├─ 古典的手法
│   │   ├─ モーメント法 (MoM) — K. Pearson 1894
│   │   ├─ 最尤推定 (MLE) — R. A. Fisher 1922
│   │   ├─ 最小二乗法 (OLS) — Gauss 1809 / Legendre 1805
│   │   └─ ロバスト推定 (Huber, トリム平均)
│   ├─ ベイズ的手法
│   │   ├─ MAP 推定 (事後分布の最頻値)
│   │   ├─ 事後平均 (Bayes 推定量)
│   │   └─ 信用区間 (区間推定の対応物)
│   ├─ ノンパラメトリック
│   │   ├─ 経験分布関数
│   │   └─ カーネル密度推定 (KDE)
│   └─ 望ましい性質
│       ├─ 不偏性 (Unbiasedness) — E[θ̂]=θ
│       ├─ 一致性 (Consistency) — n→∞ で θ̂→θ
│       ├─ 効率性 (Efficiency) — Cramér-Rao 下限達成
│       └─ 十分性 (Sufficiency) — Fisher-Neyman 分解
├─ 区間推定 (Interval Estimation)
└─ 仮説検定 (Hypothesis Testing)
📜 点推定の歴史 — 220 年
「観測値から母数を推定する」という発想は、 1805 年の Legendre 最小二乗法から 220 年の歴史を持つ。 SSDSE のような国勢統計の解析手法も、 この系譜の上に成り立っている。
| 年 | 人物 | 貢献 |
|---|---|---|
| 1805 | A. M. Legendre | 最小二乗法を初めて公表 |
| 1809 | C. F. Gauss | 最小二乗法の正規分布 + MLE 結合 |
| 1812 | P. S. Laplace | 中心極限定理、 標本平均の漸近正規性 |
| 1894 | K. Pearson | モーメント法を定式化 |
| 1908 | W. Gosset (Student) | t 分布、 小標本の点推定 |
| 1912 | R. A. Fisher | 最尤推定 (MLE) を体系化 |
| 1922 | R. A. Fisher | 「一致性・有効性・十分性」の概念導入 |
| 1925 | R. A. Fisher | Cramér-Rao 下限 (Fisher 情報量) |
| 1945 | H. Cramér | Cramér-Rao 不等式を厳密に証明 |
| 1956 | C. Stein | Stein のパラドックス — 多次元では標本平均は非最適 |
| 1964 | P. Huber | ロバスト推定 (M-推定量) |
| 1979 | B. Efron | ブートストラップ — 推定量の分散を再標本化で推定 |
| 1990s | — | MCMC / EM アルゴリズムが普及、 ベイズ計算革命 |
| 2010s | — | 深層学習の文脈で MLE が再評価 (確率的勾配降下) |
🔗 隣接手法への橋渡し
点推定は母数を 1 つの値で推定する手法で、 区間推定・最尤推定・ベイズ推定と対比して使い分ける。
- 上流: 標本抽出 — 標本平均・標本分散を求めるには、 まず母集団からの無作為標本が必要。 SSDSE は全数調査だが、 部分標本での演習が定番。
- 並列: 区間推定 — 点推定は 1 値、 区間推定は信頼区間として幅で示す。 同じ標本平均から SE を使って 95% CI が作れる。
- 下流: 最尤推定 — 最尤推定は尤度関数 L(θ) を最大化して θ̂ を求める汎用点推定法。 ロジスティック回帰・GLM の係数推定で標準。
- 性質: 不偏性・一致性・有効性が良い点推定量の条件。 SSDSE 47 県平均を母平均の点推定量と見たとき、 全数なので不偏性は自動成立。
SSDSE-B-2026 を用いた演習では、 「点推定」 を中核に据えて上記の上流・並列・下流の手法を実データで連結する経験を積むと、 単独の手法暗記より実務的応用力が身につく。
🌳 手法選択フロー
「点推定」を実際に使うとき、 何をどう選ぶかを順に判断する。 上から順に答えていくと、 使うべき手法と評価の仕方が決まる。
- 何を推定したいのか
平均・比率・分散・回帰係数で、 推定量も分布も別。 「平均を推定する」のか「合計を推定する」のかで、 必要な情報が変わる。 - 推定量に偏りは無いか
標本分散は $n$ で割ると母分散を過小に見積もる。 $n-1$ で割る(不偏分散)のはこのため。 pandas のstd()は既定で $n-1$、 numpy は $n$ なので値が変わる。 - 外れ値に強い推定量が要るか
平均は外れ値に引きずられる。 東京のような値がある都道府県データでは、 中央値やトリム平均も併記すると実態が伝わる。 - 点推定だけで足りるか
足りない。 点推定は 1 つの数字にすぎず、 どれくらい確からしいかを示さない。 標準誤差か信頼区間を必ず添える。
点推定は「一番ありそうな値」を 1 つ出す作業。 その値がどれくらいぶれるかは区間推定の仕事で、 両方そろって初めて報告になる。
🧩 解説深化 — 「不偏性は変換で壊れる」点推定の盲点
このページの他セクションは推定量の作り方(MLE・MoM・中央値・ブートストラップ等)を幅広く扱っている。 ここでは角度を変え、 「良い点推定量を作っても、 その値を関数に通した瞬間に性質が崩れる」という、 実務で見落とされがちな一点に絞って深掘りする。 数値はすべて data/raw/SSDSE-B-2026.csv(2023 年・47 都道府県・列 A1101=総人口、 全国行は除外)の実測値。
🎨 直感 — 点推定は「母数に 1 点で賭ける」行為
点推定とは、 母集団の未知の母数 θ(母平均・母分散など)を 1 つの数で言い当てる賭けだ。 実データで賭け値を並べると、 同じ「総人口の中心」でも推定量ごとに大きく食い違う:
- 標本平均(=正規モデルの MLE): 2,645,809 人
- 中央値(ロバストな中心): 1,549,000 人
- 10% トリム平均: 2,108,974 人
平均は中央値の 約 1.71 倍。 分布の歪度は +2.29(右に長い裾)で、 東京都 14,086,000 人という 1 県が平均を強く引き上げている(最小は鳥取県 537,000 人)。 「どの点推定量を報告するか」が結論そのものを変える、 という点推定固有の緊張がここに出る。
⚠️ 落とし穴(重要)— s² が不偏でも √s² = s は不偏でない
「標本分散 s²(÷(n−1))は母分散 σ² の不偏推定量」——これは正しい。 しかし多くの人が無意識に踏む地雷が、 「では s = √(s²) は母標準偏差 σ の不偏推定量だ」という早合点である。 これは誤り。 平方根は凹関数で、 ジェンセンの不等式により E[s] = E[√(s²)] < √(E[s²]) = σ が一般に成り立つ。 不偏性は非線形変換で保存されない。
これを実データで確かめる。 47 都道府県の総人口を「母集団」とみなすと母標準偏差は σ = 2,767,630(σ² = 7.66×10¹²)。 ここから 架空のリサンプリング実験(教育用シミュレーション/固定シード 20260614、 復元抽出 n=8 を 200,000 回)で推定量の期待値を近似すると:
| 推定量 | 期待値の近似 | 真値との比 | 判定 |
|---|---|---|---|
| s²(÷(n−1)) | 7.656×10¹² | 0.9995 | ほぼ不偏 ✅ |
| s = √(s²) | 2,441,607 | 0.882 | 約 11.8% 下方バイアス ⚠️ |
s² は真値の 0.9995 倍(不偏)なのに、 その平方根 s は真値の 0.882 倍——1 割以上も過小に σ を見積もる。 標準偏差・標準誤差・変動係数(CV=s/x̄)・相関係数など、 実務の指標はほぼすべて「不偏推定量を非線形変換した値」なので、 「不偏な部品を組み合わせれば全体も不偏」だと思い込むと誤差が積み上がる。 これが点推定の最重要級の盲点である。 なお標本平均 x̄ は線形なので、 このバイアスは受けない(線形変換だけは不偏性を保つ)。
🚀 発展 — MLE の不変性 vs 不偏性の非不変性、 そしてデルタ法
面白いのは、 最尤推定(MLE)はこの弱点を持たない点だ。 MLE には「不変性(invariance)」があり、 θ の MLE が θ̂ なら g(θ) の MLE は自動的に g(θ̂) になる。 つまり σ² の MLE の平方根は、 そのまま σ の MLE として正当だ(ただし MLE 自体は上表の s² と別物で、 有限標本では不偏でない)。 不偏性は変換で壊れるが、 MLE の不変性は壊れない——この非対称性が「なぜ実務では不偏性より一致性・MLE が好まれるか」の一因になっている。
バイアスの大きさを見積もる実用ツールがデルタ法で、 変換 g のバイアスは概ね ½·g''(θ)·Var(θ̂) のオーダー。 g が凹(√ など)なら g''<0 で下方バイアス、 という上の実測と符号が一致する。 n が増えれば Var(θ̂)→0 でバイアスも消える(漸近不偏・一致性)。 だから小標本ほど「不偏な部品を変換した指標」の扱いに注意が要る。