🔖 キーワード索引
scikit-learn TensorFlow PyTorch XGBoost LightGBM Keras JAX Hugging Face ONNX MLflow
本ページは 機械学習ライブラリ (ML Library)を 12 のセクションで多角的に解説します。 上のチップは検索・関連語の手がかりです。 以下のリンクで各セクションに直接ジャンプできます:
💡 30秒で分かる結論
🍰 まずはやさしく
便利な道具箱のようなものです。
AIを効率よく作るために使います。
スマホアプリの開発に似ています。
まずは結論から確認しましょう。
scikit-learn、 TensorFlow、 PyTorch等
分野 :MLOps — 📚 データエンジニアリング 中身 :model.fit(X, y) の 1 行の裏で、 損失関数を最小にするパラメータ探しが走っている。 NumPy・scikit-learn・SciPy で同じ回帰を解くと係数は 5×10⁻¹⁴ まで一致する(下の 🐍)選び方 :表データの古典 ML は scikit-learn、 大きな表データの精度勝負は XGBoost / LightGBM、 画像・テキストの深層学習は PyTorch / TensorFlow小さなデータの罠 :SSDSE-B-2026 の 47 県では、 既定値のままの LightGBM は葉の最小件数 20 に阻まれてほとんど分割できず、 線形回帰より大きく劣る。 ライブラリの差より既定値の合う・合わないが結果を決める
📍 文脈 — どこで使う概念か
🍰 まずはやさしく
AIを作るための部品集です。
全体の流れを整えるために使います。
部活の計画を立てる感覚に近いです。
どの場面で使うかを見ていきましょう。
機械学習ライブラリは モデル学習・推論・前処理・評価を抽象化したソフトウェアパッケージ 。 古典 ML は scikit-learn、 ブースティングは XGBoost / LightGBM、 深層学習は PyTorch / TensorFlow が事実上の標準。 言語固有では Python が圧倒的。
📍 あなたが今見ているもの(機械学習ライブラリの全体文脈)
あなたは今、 「機械学習ライブラリ」というツール群の選び方・組み合わせ方 を学んでいる。 この用語は単独で存在するものではなく、 ① データ収集(pandas / requests)、 ② 前処理(pandas / numpy)、 ③ 可視化(matplotlib / seaborn / plotly)、 ④ モデル学習(scikit-learn / LightGBM / PyTorch)、 ⑤ 評価(scikit-learn の metrics)、 ⑥ デプロイ(FastAPI / ONNX / TFLite)という 機械学習ワークフロー全体の中で 1 つのレイヤー を成している。 つまり「ライブラリ」を学ぶとは「ワークフローのどの工程をどのツールに任せるか」という設計判断を学ぶことに等しい。
本ページでは特に SSDSE-B-2026(47 都道府県データ)という小規模・公的・実データ を題材に、 主要ライブラリの「コード量・速度・精度・メモリ・学習コスト」を統一基準で比較する。 これは「ニューラルネットを使えば偉い」「最新ライブラリが正解」という思い込みを打破するためであり、 データ規模と目的に応じた現実的な選定 を身につけてもらうのが目的である。 関連する上位概念として scikit-learn 、 TensorFlow 、 PyTorch 、 並列概念として パイプライン 、 特徴量エンジニアリング 、 発展概念として MLOps 、 モデルレジストリ がある。
📊 主要ライブラリの比較(SSDSE-B-2026 で同じ回帰タスクを実装)
同じ「都道府県の 出生数・死亡数から総人口を予測する 」という回帰課題を、 主要ライブラリで実装した場合の コード量・学習時間・予測精度(5 分割交差検証の R² / RMSE)・学習コスト を比較する。 特徴量は SSDSE-B-2026 に実在する A4101(出生数)と A4200(死亡数)、 目的変数は A1101(総人口)で、 いずれも実在列・実測値である。 47 都道府県 × 100 超列の小規模データだが、 ライブラリの「使い心地」を比較するには十分な題材である。 結論として、 47 件程度の超小規模データでは scikit-learn の線形回帰が最速・最軽量で、 交差検証 R² も最良である。 数十万件規模に拡張すると LightGBM / XGBoost が高速・高精度になり、 数百万件以上で深層学習(TensorFlow / PyTorch)の優位性が出てくる。 つまり「ライブラリを覚える順番」は、 ① scikit-learn → ② LightGBM → ③ PyTorch、 がもっとも実務で報われやすい。
ライブラリ / モデル コード行数 学習時間(47件・5-fold CV) CV R² CV RMSE(人) 学習コスト
scikit-learn(LinearRegression) 18 行 0.01 秒 0.985 290,183 ★☆☆☆☆(最易) scikit-learn(RandomForest, n=200) 18 行 0.45 秒 0.940 956,695 ★☆☆☆☆ scikit-learn(GradientBoosting, n=200) 17 行 0.15 秒 0.956 814,904 ★★☆☆☆ XGBoost / LightGBM 8 行 — 本データ規模(47件)では線形回帰と同等以下(過学習しやすい) ★★☆☆☆ PyTorch / TensorFlow(MLP) 20〜35 行 — 47 件では過学習が顕著で非推奨(数百万件規模で真価) ★★★★☆
読み方 :47 件という超小データでは LinearRegression が CV R²=0.985・RMSE 29 万人と最良 で、 木系(RandomForest 0.940 / GradientBoosting 0.956)は交差検証精度が下がり、 RMSE は 81 万〜96 万人と 3 倍前後に膨らむ(2023 年度の 47 都道府県で実測)。 これは「サンプル数が少ないと複雑モデルは過学習する」ためで、 本ページの主張「データが少ない時はシンプルが勝つ」を実データで裏づけている。 XGBoost / LightGBM / 深層学習は 47 件規模では真価を発揮できず、 数十万件以上の大規模データで初めて優位に立つ。 「ニューラルネットだから精度が上がる」は誤解である。
🐍 scikit-learn 版(最小コード)
このコードでやること :SSDSE-B-2026 の実在列 A4101(出生数)・A4200(死亡数)から A1101(総人口)を線形回帰で予測し、 5 分割交差検証で R² と RMSE を測る。 cp932 で読み、 skiprows=[1] で 2 行目の日本語見出し行を飛ばして英語コード列を使う。
📥 入力データ(SSDSE-B-2026 実測値の抜粋、 単位: 人):
都道府県 A1101(総人口) A4101(出生数) A4200(死亡数)
北海道 5,092,000 24,430 75,120
青森県 1,184,000 5,696 20,835
東京都 14,086,000 86,348 137,241
大阪府 8,763,000 55,292 104,964
...(2023 年度の 47 都道府県)
📋 コピー 1
2
3
4
5
6
7
8
9
10
11
12
13
14
15
16
17
18
19 import pandas as pd
from sklearn.linear_model import LinearRegression
from sklearn.model_selection import cross_val_score , cross_val_predict
from sklearn.metrics import root_mean_squared_error
# cp932 + skiprows=[1] で英語コード列(A1101=総人口 など)を読み込む
df = pd . read_csv ( 'data/raw/SSDSE-B-2026.csv' , encoding = 'cp932' , skiprows = [ 1 ])
latest = df [ df [ 'SSDSE-B-2026' ] == 2023 ] . reset_index ( drop = True ) # 2023 年度の 47 都道府県
# CSV は新しい年度が先に並ぶので、groupby('Prefecture').last() だと最古の 2012 年度が取れてしまう
X = latest [[ 'A4101' , 'A4200' ]] # 出生数・死亡数
y = latest [ 'A1101' ] # 総人口
model = LinearRegression ()
r2 = cross_val_score ( model , X , y , cv = 5 , scoring = 'r2' ) . mean ()
pred = cross_val_predict ( model , X , y , cv = 5 )
rmse = root_mean_squared_error ( y , pred )
print ( f 'CV R^2 = { r2 : .3f } ' )
print ( f 'CV RMSE = { rmse : ,.0f } 人' )
📤 実行結果:
CV R^2 = 0.985
CV RMSE = 290,183 人
💬 交差検証 R²=0.985 は、 出生数と死亡数の 2 変数だけで、 見ていない県の総人口の約 98.5% の変動を説明できる ことを示す(人口が多い県ほど出生・死亡の絶対数も多いという当然の関係)。 CV RMSE 約 29 万人は 2023 年度の 1 県平均人口 264.6 万人の約 11% で、 平均的な県なら ±1 割程度の誤差で当たる。 なお CSV は新しい年度が先に並ぶので、 groupby('Prefecture').last() で「最新」を取ろうとすると 2012 年度が取れてしまう。 年度列で 2023 に絞るのが確実である。
🐍 GradientBoosting 版(sklearn だけで非線形も試す)
このコードでやること :同じ入力に対し、 追加インストール不要の sklearn の勾配ブースティングで非線形パターンを試す。 47 件と少ないので木の本数(n_estimators)と深さ(max_depth)を控えめにする。
📥 入力例(SSDSE-B-2026 の 2023 年・47 都道府県から 3 行)
都道府県 A1101(総人口) A4101(出生数) A4200(死亡数)
北海道 5,092,000 24,430 75,120
東京都 14,086,000 86,348 137,241
沖縄県 1,468,000 12,549 15,110
…(全 47 行)
📋 コピー 1
2
3
4
5
6
7
8
9
10
11
12
13
14
15
16
17 import pandas as pd
from sklearn.ensemble import GradientBoostingRegressor
from sklearn.model_selection import cross_val_score , cross_val_predict
from sklearn.metrics import root_mean_squared_error
df = pd . read_csv ( 'data/raw/SSDSE-B-2026.csv' , encoding = 'cp932' , skiprows = [ 1 ])
latest = df [ df [ 'SSDSE-B-2026' ] == 2023 ] . reset_index ( drop = True ) # 2023 年度の 47 都道府県
X = latest [[ 'A4101' , 'A4200' ]] # 出生数・死亡数
y = latest [ 'A1101' ] # 総人口
model = GradientBoostingRegressor ( n_estimators = 200 , max_depth = 3 , random_state = 42 )
r2 = cross_val_score ( model , X , y , cv = 5 , scoring = 'r2' ) . mean ()
pred = cross_val_predict ( model , X , y , cv = 5 )
rmse = root_mean_squared_error ( y , pred )
print ( f 'CV R^2 = { r2 : .3f } ' )
print ( f 'CV RMSE = { rmse : ,.0f } 人' )
📤 実行結果:
CV R^2 = 0.956
CV RMSE = 814,904 人
💬 GradientBoosting は CV R²=0.956 / RMSE=814,904 人と、 線形回帰(0.985 / 290,183 人)に及ばない 。 RMSE が 2.8 倍に膨らむのは、 木は学習データの範囲の外へ外挿できず、 東京都(1,409 万人)がテスト側に回った分割でその人口を大きく下回る値しか返せないためである。 47 件では勾配ブースティングは過学習しやすく、 交差検証で見ると精度が落ちる。 木系や深層学習が線形回帰に勝つのは、 データが数万件以上に増えてからである。
🎨 直感で掴む
🍰 まずはやさしく
料理のレシピ集のようなものです。
難しい計算を簡単にするために使います。
買い物リストを作るように選べます。
具体的にどう便利かを紹介します。
機械学習ライブラリは「線形回帰・決定木・ニューラルネットなどの定型処理を、 数行のコードで呼び出せる関数集 」。 NumPy / SciPy で行列演算や最適化を 1 つずつ手書きしていた時代に対し、 scikit-learn は LinearRegression().fit(X, y) の 1 行で「正規方程式 → 逆行列計算 → 残差検定」までを完結する。
主要 5 ライブラリは scikit-learn (表データ・伝統的 ML の事実上標準)、 LightGBM / XGBoost (勾配ブースティング、 Kaggle 表データ優勝多数)、 PyTorch (深層学習の研究標準)、 TensorFlow / Keras (モバイル・本番デプロイ)、 Hugging Face transformers (事前学習モデル呼出)。 SSDSE のような 47 行 × 110 列の表データは scikit-learn + LightGBM が最適、 画像・自然言語は PyTorch、 と棲み分ける。
🎨 直感で掴む — 具体例で理解する
ML ライブラリを使うと「線形回帰を書くのに数行 」「CNN を 30 行で組む 」が実現する。 これらが無かった時代は NumPy で行列演算を直接書き、 微分も手計算 していた。 学術と産業の標準が揃ったからこそ、 AI は急速に普及した。 ライブラリの選定は「用途 + チーム習熟度 + 推論環境 」で決める。 例:研究は PyTorch、 産業は TF Lite、 表データは LightGBM、 と棲み分ける。
🎨 ライブラリ選定の決定木
どのライブラリを使うべきか、 状況別の指針:
状況 推奨ライブラリ 理由
表形式データ (n < 10 万) scikit-learn + LightGBM DL より高速・高精度 表形式データ (n > 100 万) XGBoost / LightGBM (GPU) 大規模対応 画像分類 / セグメンテーション PyTorch + torchvision 事前学習モデル豊富 自然言語処理 Hugging Face + PyTorch Transformers 標準 時系列予測 statsmodels / prophet / darts ARIMA から DL まで プロダクション TensorFlow / TFX サービング基盤 研究 / 新手法 PyTorch / JAX 柔軟性 教育 / 入門 scikit-learn + Keras 直感的 API
🗓 ML ライブラリ 歴史年表(2007-2024)
年 ライブラリ 特徴
2007 scikit-learn 公開 統一 API 確立 2008 Theano 最初の自動微分 + GPU 2014 XGBoost Kaggle 制覇 2015 TensorFlow 1.0 / Keras プロダクション DL 2016 PyTorch / LightGBM 研究者の支持 / 大規模 GBDT 2017 CatBoost カテゴリ特徴強い 2018 JAX 公開 関数型 + 高速 2019 Hugging Face Transformers 事前学習モデルハブ 2020 PyTorch Lightning / FastAI 高水準 API 2022 Diffusers 生成モデル民主化 2023 LangChain / LlamaIndex LLM オーケストレーション 2024 vLLM / Triton LLM 推論最適化
🎨 「最初に学ぶべき 5 ライブラリ」フローチャート
初学者が 「これだけは押さえる」 5 つのライブラリと習得順序:
① NumPy :すべての数値計算の基礎。 ndarray を自在に操れること。② pandas :表データ操作の事実上標準。 read_csv / groupby / merge を体に叩き込む。③ matplotlib + seaborn :可視化。 EDA で必須。④ scikit-learn :古典 ML の統一インタフェース。 fit/predict の習慣化。⑤ PyTorch or LightGBM :DL /勾配ブースティングのうち、 やりたいタスクに合わせ片方を深く。
💡 この 5 つで kaggle 銅メダル / SSDSE データコンペ予選通過レベル に十分到達できます。 焦って全部を触ろうとせず、 1 つずつ深堀りするのが上達の近道。
🔬 数式を言葉で読み解く
上の数式に出てきた記号を 1 つずつ解説します。 数式が出てくる試験問題(統計検定・G 検定・基本情報)では、 各記号の意味を答えられるかが分岐点:
記号 意味 $X$ 特徴量行列 $y$ 目的変数 $\theta$ モデルパラメータ $\mathcal{L}$ 損失関数 `fit` 学習を実行する高水準メソッド
🔬 数式を言葉で読み解く(拡張版・ライブラリ選定の数理)
ML ライブラリ選定は単なる流行ではなく、 (1) 開発生産性(API 統一) (2) 計算性能(GPU/分散) (3) エコシステム(依存ライブラリ・モデル動物園) (4) 保守可能性(ライセンス・コミュニティ) の 4 軸で評価します。 本ページでは、 これらを定量化する数式と SSDSE-B-2026 を用いた実ベンチを紹介します。
📐 ライブラリ選定の中核 4 指標
① 学習時間効率: $\eta = \text{epochs} / t_{\text{train}}$ [epochs/sec]
② スループット: $\text{Throughput} = N_{\text{samples}} / t_{\text{batch}}$ [samples/sec]
③ メモリ効率: $\rho = \text{params} / \text{VRAM}$ [params/GB]
④ Total Cost of Ownership: $\text{TCO} = C_{\text{learn}} + C_{\text{dev}} + C_{\text{infra}} + C_{\text{support}}$
📊 主要 ML ライブラリ比較表
ライブラリ 主用途 API スタイル GPU ライセンス 初学者向け度
scikit-learn 古典 ML fit/predict △ BSD-3 ★★★★★ PyTorch DL (動的) define-by-run ◎ BSD ★★★★☆ TensorFlow DL (プロダクション) graph + eager ◎ Apache 2 ★★★☆☆ Keras (TF 統合) DL(簡易) Sequential/Functional ◎ MIT ★★★★★ XGBoost 勾配ブースティング sklearn 互換 ◎ Apache 2 ★★★★☆ LightGBM 勾配ブースティング sklearn 互換 ◎ MIT ★★★★☆ JAX 研究/高速計算 numpy 互換 + autograd ◎ Apache 2 ★★☆☆☆ Hugging Face 事前学習モデル Transformers API ◎ Apache 2 ★★★★☆
🧮 SSDSE-B 実値計算 — 都道府県データで手を動かす
SSDSE-B-2026 から 「総人口 → 出生数」を予測する 4 ライブラリ比較 。 sklearn・XGBoost・LightGBM・PyTorch の R² を並べる典型ベンチ。
使用データ:SSDSE-B-2026.csv(独立行政法人 統計センター提供、 47 都道府県 × 100 超の社会経済指標)。 出典
📥 入力例(SSDSE-B-2026 の 2023 年・47 都道府県から 3 行)
都道府県 A1101(総人口) A4101(出生数)
北海道 5,092,000 24,430
東京都 14,086,000 86,348
沖縄県 1,468,000 12,549
…(全 47 行)
📋 コピー 1
2
3
4
5
6
7
8
9
10
11
12
13
14
15
16
17
18
19
20
21 import pandas as pd
from sklearn.linear_model import LinearRegression
from sklearn.ensemble import GradientBoostingRegressor
from sklearn.metrics import r2_score
df = pd . read_csv ( 'data/raw/SSDSE-B-2026.csv' , encoding = 'cp932' , skiprows = [ 1 ])
df = df . rename ( columns = { df . columns [ 2 ]: 'pref' })
X = df [[ 'A1101' ]] . values
y = df [ 'A4101' ] . values
# sklearn ファミリーで 2 種比較
models = {
'sklearn LinearReg' : LinearRegression (),
'sklearn GBR' : GradientBoostingRegressor ( n_estimators = 200 , random_state = 42 ),
}
for name , m in models . items ():
m . fit ( X , y )
print ( f ' { name : 25s } R² = { r2_score ( y , m . predict ( X )) : .4f } ' )
# 同じ X, y を XGBoost / LightGBM / PyTorch に渡す形でも対応可能
📤 実行例(実測)
sklearn LinearReg R² = 0.9723
sklearn GBR R² = 0.9965
💬 総人口 1 列から出生数を当てると、線形回帰で R² = 0.9723、勾配ブースティングで 0.9965 になった。どちらも学習に使った 564 行(47 県 × 12 年度)で測った当てはまりで、200 本の木を持つ GBR は同じ県の 12 年度分をほぼ覚えられるので、この 0.024 の差を汎化性能の差とは読めない。ライブラリを比べるなら、県単位で分けた交差検証で測り直す。
▲ 上記コードはそのまま実行可能。 CP932 エンコーディング・skiprows=[1](2 行目の日本語見出し行をスキップし、 1 行目の英語コード行をヘッダにする)・列名の英数字コード(A1101 = 総人口 など)に注意。
🧮 SSDSE-B-2026 実値ベンチ ①:sklearn vs XGBoost vs LightGBM の精度・速度比較
47 都道府県の 高齢化階層(低/中/高) を、 人口・出生・就業データから予測する分類タスクで、 3 ライブラリの精度と学習時間を比較します。
🐍 Python 実装(コード ①)
🎯 このコードでやること :同じ訓練データに対して RandomForest / XGBoost / LightGBM を順番に学習させ、 学習時間と検証精度を比較。
📥 入力データ :
Prefecture A1101 A4101 A4103 B4101 ... aging_class
北海道 5092000 24430 1.06 11.0 ... 1(中)
青森県 1184000 5696 1.23 12.6 ... 2(高)
東京都 14086000 86348 0.99 17.6 ... 0(低)
...
(2023 年度の 47 県 × 8 特徴量、 高齢化率の三分位で 3 階層: 16・15・16 県)
📋 コピー 1
2
3
4
5
6
7
8
9
10
11
12
13
14
15
16
17
18
19
20
21
22
23
24
25
26
27
28 import pandas as pd , time
from sklearn.ensemble import RandomForestClassifier
from sklearn.model_selection import train_test_split
from sklearn.metrics import accuracy_score
import xgboost as xgb
import lightgbm as lgb
df = pd . read_csv ( 'data/raw/SSDSE-B-2026.csv' , encoding = 'cp932' , skiprows = [ 1 ])
latest = df [ df [ 'SSDSE-B-2026' ] == 2023 ] . reset_index ( drop = True ) # 2023 年度の 47 都道府県
latest [ 'aging' ] = latest [ 'A1303' ] / latest [ 'A1101' ]
y = pd . qcut ( latest [ 'aging' ], 3 , labels = [ 0 , 1 , 2 ]) . astype ( int )
features = [ 'A1101' , 'A4101' , 'A4103' , 'B4101' , 'B4102' , 'C3301' , 'C5401' , 'F3101' ]
X = latest [ features ] . fillna ( 0 )
Xtr , Xte , ytr , yte = train_test_split ( X , y , test_size = 0.3 , random_state = 42 , stratify = y )
results = {}
for name , model in [
( 'sklearn-RF' , RandomForestClassifier ( n_estimators = 100 , random_state = 42 )),
( 'XGBoost' , xgb . XGBClassifier ( n_estimators = 100 , random_state = 42 , use_label_encoder = False , eval_metric = 'mlogloss' )),
( 'LightGBM' , lgb . LGBMClassifier ( n_estimators = 100 , random_state = 42 , verbose =- 1 )),
]:
t0 = time . time ()
model . fit ( Xtr , ytr )
dt = time . time () - t0
acc = accuracy_score ( yte , model . predict ( Xte ))
results [ name ] = ( dt , acc )
print ( f ' { name } : 時間= { dt : .3f } s, accuracy= { acc : .3f } ' )
📤 実行例(実測) :
sklearn-RF: 時間=0.028s, accuracy=0.733
XGBoost: 時間=0.250s, accuracy=0.800
LightGBM: 時間=0.019s, accuracy=0.333
※ 所要時間は環境によって変わる(精度は random_state を固定しているので再現する)
💬 結果の読み方 :3 クラス(高齢化率の三分位)でテストは 15 県しかなく、 当てずっぽうでも 0.333 になる。 sklearn-RF は 0.733(15 県中 11 県正解)、 XGBoost は 0.800(12 県正解)と当てずっぽうを大きく上回る一方、 LightGBM は 0.333(5 県正解)で何も学べていない。 LightGBM は葉 1 枚に最低 20 件(min_child_samples の既定値)を求めるので、 学習用 32 県では 1 回も分割できず、 全県に同じクラスを返しているためである。 小標本では「ライブラリの性能差」より「既定のハイパーパラメータがデータ量に合っているか」で結果が決まる。 速度は XGBoost が 0.25 秒と最も遅く、 RF と LightGBM は 0.02〜0.03 秒(時間は環境で数倍変わる)。
🧮 SSDSE-B-2026 実値ベンチ ②:PyTorch でニューラルネットワークと比較
同じデータに PyTorch で MLP を学習させ、 古典 ML と DL のトレードオフを比較します。 小規模 (n=47) では DL は過学習しやすい ことを実値で確認できます。
🐍 Python 実装(コード ②)
🎯 このコードでやること :PyTorch で 2 層 MLP を構築し、 100 エポック学習。 sklearn と精度・時間を比較。
📋 コピー 1
2
3
4
5
6
7
8
9
10
11
12
13
14
15
16
17
18
19
20
21
22
23
24
25
26
27
28
29
30 import torch
import torch.nn as nn
from sklearn.preprocessing import StandardScaler
torch . manual_seed ( 0 ) # 初期重みの種を固定して毎回同じ結果にする
sc = StandardScaler ()
Xtr_s = torch . tensor ( sc . fit_transform ( Xtr ), dtype = torch . float32 )
Xte_s = torch . tensor ( sc . transform ( Xte ), dtype = torch . float32 )
ytr_t = torch . tensor ( ytr . values , dtype = torch . long )
yte_t = torch . tensor ( yte . values , dtype = torch . long )
model = nn . Sequential (
nn . Linear ( 8 , 16 ), nn . ReLU (),
nn . Linear ( 16 , 3 ),
)
opt = torch . optim . Adam ( model . parameters (), lr = 1e-2 )
loss_fn = nn . CrossEntropyLoss ()
t0 = time . time ()
for epoch in range ( 100 ):
opt . zero_grad ()
loss = loss_fn ( model ( Xtr_s ), ytr_t )
loss . backward ()
opt . step ()
dt = time . time () - t0
with torch . no_grad ():
pred = model ( Xte_s ) . argmax ( 1 )
acc = ( pred == yte_t ) . float () . mean () . item ()
print ( f 'PyTorch MLP: 時間= { dt : .3f } s, accuracy= { acc : .3f } ' )
📤 実行例 :
PyTorch MLP: 時間=0.029s, accuracy=0.600
※ 所要時間は環境によって変わる(精度は torch.manual_seed(0) で固定しているので再現する)
💬 結果の読み方 :accuracy 0.600(15 県中 9 県正解)は、 当てずっぽう(0.333)は上回るものの、 直前の sklearn-RF 0.733・XGBoost 0.800 には届かない。 8 特徴量を 16 ユニットの中間層で受ける MLP は、 学習用 32 県に対してパラメータが 195 個と多く、 100 エポックの全件学習では過学習と学習不足のどちらにも転びうる。 DL は数千〜数百万サンプルから真価を発揮する。 なお torch.manual_seed(0) を入れないと初期重みが毎回変わり、 正解率も実行ごとに変わる(種を固定しない比較は結論にならない)。
🧮 SSDSE-B-2026 実値ベンチ ③:sklearn パイプライン構築(best practice)
sklearn の Pipeline と ColumnTransformer を用いて、 前処理 → モデル学習 → 評価 を 1 オブジェクトで管理する正攻法を実装します。 これは 本番運用に直結する書き方 です。
🐍 Python 実装(コード ③)
🎯 このコードでやること :数値変数を標準化、 カテゴリ変数を One-Hot 化し、 LightGBM で予測するパイプラインを構築。 cross_val_score で交差検証。
📋 コピー 1
2
3
4
5
6
7
8
9
10
11
12
13
14
15
16 from sklearn.pipeline import Pipeline
from sklearn.compose import ColumnTransformer
from sklearn.preprocessing import StandardScaler , OneHotEncoder
from sklearn.model_selection import cross_val_score
import lightgbm as lgb
num_cols = [ 'A1101' , 'A4101' , 'A4103' , 'B4101' ]
preproc = ColumnTransformer ([
( 'num' , StandardScaler (), num_cols ),
])
pipe = Pipeline ([
( 'pre' , preproc ),
( 'clf' , lgb . LGBMClassifier ( n_estimators = 100 , verbose =- 1 , random_state = 0 , n_jobs = 1 )),
])
scores = cross_val_score ( pipe , latest [ num_cols ], y , cv = 5 )
print ( f '5-fold CV accuracy: { scores . mean () : .3f } ± { scores . std () : .3f } ' )
📤 実行例 :
5-fold CV accuracy: 0.320 ± 0.016
💬 結果の読み方 :5 分割交差検証で 0.320 ± 0.016。 3 クラス分類の当てずっぽうが 0.333 なので、 このモデルはまったく学習できていない (標準偏差 0.016 が小さいのは「安定して当てずっぽう」という意味であって、 良いモデルの証拠ではない)。 各分割の学習データは 37〜38 県で、 LightGBM の既定 min_child_samples=20 では葉を 2 つに分けられず、 どの分割でも 1 クラスを返すだけになる。 標準化の Pipeline は正しく組めていても、 モデル側の既定値がデータ量に合わなければ結果は出ない。 Pipeline は前処理リーク防止にも効くので、 包む習慣自体は重要。
🧮 SSDSE-B-2026 実値ベンチ ④:sklearn 回帰モデル 5 種一括比較
「都道府県の総人口 (A1101) を 出生数(A4101)・合計特殊出生率(A4103)・年平均気温(B4101) から予測する」回帰タスクで、 sklearn の 5 種類の回帰モデルを一括比較します。 R² と RMSE で精度を、 学習時間で速度を評価します。
🐍 Python 実装(コード ④)
🎯 このコードでやること :LinearRegression / Ridge / Lasso / RandomForestRegressor / GradientBoostingRegressor の 5 種を交差検証で評価する。
📥 入力例(SSDSE-B-2026 の 2023 年・47 都道府県から 3 行)
都道府県 A1101(総人口) A4101(出生数) A4103(合計特殊出生率) B4101(年平均気温)
北海道 5,092,000 24,430 1.06 11.0
東京都 14,086,000 86,348 0.99 17.6
沖縄県 1,468,000 12,549 1.6 23.8
…(全 47 行)
📋 コピー 1
2
3
4
5
6
7
8
9
10
11
12
13
14
15
16
17
18
19
20
21
22
23
24 import pandas as pd , time
from sklearn.linear_model import LinearRegression , Ridge , Lasso
from sklearn.ensemble import RandomForestRegressor , GradientBoostingRegressor
from sklearn.model_selection import cross_val_score
import numpy as np
df = pd . read_csv ( 'data/raw/SSDSE-B-2026.csv' , encoding = 'cp932' , skiprows = [ 1 ])
latest = df [ df [ 'SSDSE-B-2026' ] == 2023 ] . reset_index ( drop = True ) # 2023 年度の 47 都道府県
X = latest [[ 'A4101' , 'A4103' , 'B4101' ]] . fillna ( 0 )
y = latest [ 'A1101' ]
models = {
'LinearReg' : LinearRegression (),
'Ridge' : Ridge ( alpha = 1.0 ),
'Lasso' : Lasso ( alpha = 100.0 ),
'RandomForest' : RandomForestRegressor ( n_estimators = 100 , random_state = 42 ),
'GBR' : GradientBoostingRegressor ( n_estimators = 100 , random_state = 42 ),
}
for name , mdl in models . items ():
t0 = time . time ()
r2 = cross_val_score ( mdl , X , y , cv = 5 , scoring = 'r2' ) . mean ()
dt = time . time () - t0
print ( f ' { name } : R²= { r2 : .3f } , t= { dt : .3f } s' )
📤 実行例 :
LinearReg: R²=0.982, t=0.007s
Ridge: R²=0.982, t=0.004s
Lasso: R²=0.982, t=0.005s
RandomForest: R²=0.891, t=0.118s
GBR: R²=0.900, t=0.044s
※ R² は決定的だが、実行時間は環境で数倍変わる。
読むべきは「木系の 2 つだけ 1〜2 桁遅い」という関係。
💬 結果の読み方 :総人口 ≈ 出生数などの 線形関係が強い ため、 線形回帰系(3 つとも R²=0.982)が RandomForest(0.891)・GBR(0.900)を上回る。 Ridge(alpha=1)・Lasso(alpha=100) も小数 3 桁まで線形回帰と同じで、 標準化していない特徴量に対してこの程度の alpha をかけても予測はほとんど変わらない。 木系は学習データの範囲の外へ外挿できないので、 東京都がテスト側に回った分割で R² を落とす。 「複雑モデル=必ず良い」ではない ことの典型例。 ライブラリ選定はタスクの性質次第。
🧮 SSDSE-B-2026 実値ベンチ ⑤:モデル保存 / 読込(joblib vs pickle vs ONNX)
学習済モデルを保存・読込する 3 通りの方法を比較。 本番運用では joblib か ONNX が標準 です。
🐍 Python 実装(コード ⑤)
🎯 このコードでやること :sklearn モデルを joblib で保存し、 ファイルサイズと読込速度を確認。
📋 コピー 1
2
3
4
5
6
7
8
9
10
11
12
13
14
15
16
17
18
19
20 import joblib , pickle , os , time
from sklearn.ensemble import RandomForestRegressor
# X, y は直前の回帰ベンチ(出生数・出生率・気温 → 総人口)。y は連続値なので回帰器で学習する
model = RandomForestRegressor ( n_estimators = 100 , random_state = 0 ) . fit ( X , y )
# 保存
joblib . dump ( model , 'model.joblib' )
with open ( 'model.pkl' , 'wb' ) as f :
pickle . dump ( model , f )
# サイズ比較
for path in [ 'model.joblib' , 'model.pkl' ]:
print ( f ' { path } : { os . path . getsize ( path ) / 1024 : .1f } KB' )
# 読込速度
for path , loader in [( 'model.joblib' , joblib . load ), ( 'model.pkl' , lambda p : pickle . load ( open ( p , 'rb' )))]:
t0 = time . time ()
_ = loader ( path )
print ( f ' { path } load: { ( time . time () - t0 ) * 1000 : .1f } ms' )
📤 実行例 :
model.joblib: 445.3 KB
model.pkl: 438.3 KB
model.joblib load: 3.7 ms
model.pkl load: 0.6 ms
※ サイズは学習結果でわずかに変わり、読み込み時間は環境で数倍変わる。
読むべきは「joblib と pickle でサイズはほぼ同じ」という点。
💬 結果の読み方 :100 本の木を持つ回帰フォレストは joblib で 445.3 KB、 pickle で 438.3 KB とほぼ同じ大きさで、 joblib は既定では圧縮しない(compress=3 などを指定すると小さくなる)。 読み込みもこの規模では pickle の 0.6 ms に対し joblib 3.7 ms と、 joblib が速いわけではない。 joblib の利点は大きな NumPy 配列を効率よく書き出せる点にあり、 sklearn 公式も joblib を推奨している。 ONNX に変換すると Python 非依存で C++ / JavaScript / .NET から読込でき、 サービング基盤に最適。
✅ ライブラリ選定 15 項目チェックリスト
タスクの種類(分類 / 回帰 / クラスタリング / 生成)が明確か
データ規模(n, 特徴量数)に対して適切か
GPU が必須か(NLP / 画像で必須、 表形式は CPU 可)
ライセンス(商用利用可否)を確認したか
事前学習モデル動物園が必要か
本番運用ターゲット(クラウド / オンプレ / エッジ)に合うか
サービング基盤との接続性(ONNX / TF Serving / TorchServe)
分散学習対応か(Horovod / DDP / TF MirroredStrategy)
説明性ツールとの連携(SHAP / LIME)が容易か
監視・モニタリング(MLflow / Weights & Biases)連携か
Python 以外の言語からも呼び出すか
パイプライン化(Pipeline / Pipelines)の容易さ
ドキュメント・チュートリアルの充実度
コミュニティ規模・更新頻度
類似プロジェクトでの採用実績
🧮 数式に値を入れて手で計算する: ライブラリ別速度比
合成データで 4 ライブラリの実行時間と速度比を計算する。
Step 1: 同一タスク実行時間 [秒]
ライブラリ 時間 速度比 (sklearn=1)
sklearn 10 1.00 numpy 純 30 0.33 cupy (GPU) 1 10.0 jax 2 5.0
Step 2: 最速 vs 最遅
最速: cupy 1 秒
最遅: numpy 30 秒
倍率 = 30 倍差
🐍 Python で再現
📋 コピー import numpy as np
times = np . array ([ 10 , 30 , 1 , 2 ])
speed_ratio = 10 / times
print ( f "速度比 (sklearn=1): { speed_ratio } " )
print ( f "最速倍率: { times . max () / times . min () } 倍" )
📤 実行結果
速度比 (sklearn=1): [ 1. 0.33333333 10. 5. ]
最速倍率: 30.0 倍
💬 手計算 (Step 2) 30 倍と Python 出力が完全一致。
🐍 Python 実装
上の 📐 で「fit は損失関数の最小化を内部で解いている」と書いた。 これを実際に確かめる。 同じ最小二乗回帰を、 線形代数で直接解く NumPy、 fit() を呼ぶだけの scikit-learn、 損失関数を自分で書いて汎用の最適化器に渡す SciPy の 3 通りで解き、 係数が一致するかを見る。
🎯 このコードでやること :2023 年度の 47 都道府県で「総人口 = 切片 + 出生数 + 死亡数」の最小二乗回帰を NumPy・scikit-learn・SciPy の 3 つのライブラリで解き、係数と損失 L(θ) を並べる。
📥 入力例
SSDSE-B-2026 の 2023 年度・47 都道府県(3 行を抜粋)
都道府県 A1101(総人口) A4101(出生数) A4200(死亡数)
北海道 5,092,000 24,430 75,120
東京都 14,086,000 86,348 137,241
鳥取県 537,000 3,263 8,290
(出生数・死亡数は千人、総人口は万人に直して使う)
📋 コピー 1
2
3
4
5
6
7
8
9
10
11
12
13
14
15
16
17
18
19
20
21
22
23 import numpy as np , pandas as pd
from sklearn.linear_model import LinearRegression
from scipy.optimize import minimize
df = pd . read_csv ( 'data/raw/SSDSE-B-2026.csv' , encoding = 'cp932' , skiprows = [ 1 ])
d = df [ df [ 'SSDSE-B-2026' ] == 2023 ] # 2023 年度の 47 都道府県
X = ( d [[ 'A4101' , 'A4200' ]] / 1000 ) . to_numpy () # 出生数・死亡数(千人)
y = ( d [ 'A1101' ] / 10000 ) . to_numpy () # 総人口(万人)
A = np . column_stack ([ np . ones ( len ( X )), X ]) # 切片の列を足した計画行列
# ① NumPy:最小二乗 argmin ||y − Aθ||² を線形代数で直接解く
th_np , * _ = np . linalg . lstsq ( A , y , rcond = None )
# ② scikit-learn:fit() の中で同じ問題が解かれる
m = LinearRegression () . fit ( X , y )
th_sk = np . r_ [ m . intercept_ , m . coef_ ]
# ③ SciPy:損失関数 L(θ) を自分で書き、汎用の最適化器で最小化する
L = lambda th : np . sum (( y - A @ th ) ** 2 )
th_sp = minimize ( L , x0 = np . zeros ( 3 ), method = 'BFGS' ) . x
for name , th in [( 'NumPy lstsq' , th_np ), ( 'sklearn fit' , th_sk ), ( 'SciPy minimize' , th_sp )]:
print ( f ' { name : 15s } 切片= { th [ 0 ] : 8.3f } 出生= { th [ 1 ] : 7.4f } 死亡= { th [ 2 ] : 7.4f } L= { L ( th ) : ,.2f } ' )
print ( f 'sklearn と NumPy の係数の差の最大 = { np . abs ( th_sk - th_np ) . max () : .1e } ' )
print ( f 'SciPy と NumPy の係数の差の最大 = { np . abs ( th_sp - th_np ) . max () : .1e } ' )
📤 実行例(実測)
NumPy lstsq 切片= -13.997 出生=10.4655 死亡= 3.4804 L=11,835.75
sklearn fit 切片= -13.997 出生=10.4655 死亡= 3.4804 L=11,835.75
SciPy minimize 切片= -13.997 出生=10.4655 死亡= 3.4804 L=11,835.75
sklearn と NumPy の係数の差の最大 = 5.0e-14
SciPy と NumPy の係数の差の最大 = 2.0e-06
💬 3 つのライブラリの係数は小数第 4 位まで同じで、切片 −13.997 万人、出生数 1 千人あたり 10.47 万人、死亡数 1 千人あたり 3.48 万人、残差平方和 L = 11,835.75 になった。scikit-learn と NumPy の差は 5×10⁻¹⁴ で計算機の丸め誤差の大きさ、SciPy の BFGS は反復で近づく方法なので差が 2×10⁻⁶ 残る。fit() は魔法ではなく「損失を最小にする θ を探す」同じ問題を、ライブラリごとに違う解き方で解いているだけだと分かる。単位を千人・万人にそろえたのは、桁が大きく違う列をそのまま渡すと解き方によっては係数がずれることがあるため。
🐍 即使えるミニスニペット集
スニペット ①:sklearn fit/predict
🎯 やること :最小のロジスティック回帰。
📋 コピー from sklearn.linear_model import LogisticRegression
from sklearn.preprocessing import StandardScaler
from sklearn.pipeline import make_pipeline
yb = ( y > np . median ( y )) . astype ( int ) # 出生数が中央値を超えるか(0/1 のラベル)
m = make_pipeline ( StandardScaler (), LogisticRegression ()) . fit ( X , yb ); yhat = m . predict ( X )
print ( yhat [: 10 ], f '正解率 { ( yhat == yb ) . mean () : .3f } ' )
📤 出力 : [1 1 1 1 1 1 1 1 1 1] 正解率 0.915 💬 出生数が中央値を超えるかを総人口・65 歳以上人口から当て、 564 行の 91.5% が当たった。 先頭 10 行は北海道の 2023〜2014 年度で、 どれも出生数が中央値を超えるので 1 が並ぶ。 fit/predict の 2 語で学習と予測が済むのが sklearn の統一 API。
スニペット ②:PyTorch 最小モデル定義
🎯 やること :Sequential で 2 層 MLP。
📋 コピー import torch.nn as nn
net = nn . Sequential ( nn . Linear ( 10 , 32 ), nn . ReLU (), nn . Linear ( 32 , 3 ))
📤 出力 : Sequential(...) 💬 入力 10 次元 → 中間 32 → 出力 3 クラス。
スニペット ③:Hugging Face で BERT 推論
🎯 やること :感情分析パイプラインを 3 行で。
📋 コピー from transformers import pipeline
clf = pipeline ( 'sentiment-analysis' )
clf ( '今日は最高だった' )
📤 出力 (初回にモデルのダウンロードが必要なため実測ではない。 返り値の形の例): [{'label':'POSITIVE','score':0.99}] 💬 model を指定しないと英語の distilbert-base-uncased-finetuned-sst-2-english が既定で読み込まれるので、 日本語の文を入れても意味のある判定にはならない。 日本語なら日本語で学習したモデルを model= で指定する。
スニペット ④:LightGBM Optuna 最適化
🎯 やること :5 試行でハイパラ最適化。
📋 コピー import optuna , lightgbm as lgb
def obj ( t ):
p = { 'num_leaves' : t . suggest_int ( 'nl' , 8 , 128 )}
return lgb . LGBMClassifier ( ** p , n_jobs = 1 ) . fit ( Xtr , ytr ) . score ( Xte , yte )
study = optuna . create_study ( direction = 'maximize' ); study . optimize ( obj , n_trials = 5 )
📤 出力 : 5 試行すべて value=0.333(best=0.333) 💬 num_leaves を 8〜128 で振っても正解率は 0.333 から動かない。 学習用 32 県では LightGBM の min_child_samples=20 のせいで木が 1 度も分割されず、 num_leaves が効く余地が無いためで、 探索する前にデータ量に合わない既定値を直す必要がある。 Optuna は乱数の種を固定していないので、 試される num_leaves は実行ごとに変わる。
🐍 インストール・セットアップガイド(OS 別)
macOS (Apple Silicon)
🎯 やること :Apple Silicon (M1/M2/M3) で標準スタック構築。
📋 コピー # Homebrew で OpenMP(LightGBM 必須)
brew install libomp
# pyenv + Python 3.11
brew install pyenv ; pyenv install 3.11.6
# 基本パッケージ
pip install numpy pandas scikit - learn xgboost lightgbm matplotlib jupyter
# PyTorch (MPS バックエンド)
pip install torch torchvision torchaudio
📤 確認 : python -c "import torch; print(torch.backends.mps.is_available())" 💬 True なら GPU 利用可能。
Windows + CUDA
🎯 やること :NVIDIA GPU を使う環境構築。
📋 コピー # NVIDIA Driver + CUDA Toolkit 12.x をインストール
# conda で環境隔離推奨
conda create - n ml python = 3.11
conda activate ml
# PyTorch (CUDA 12.1)
pip install torch -- index - url https : // download . pytorch . org / whl / cu121
# TensorFlow (GPU)
pip install tensorflow [ and - cuda ]
📤 確認 : torch.cuda.is_available() True 💬 CUDA バージョン一致が最大の落とし穴。
Google Colab
🎯 やること :無料 GPU で即環境立ち上げ。
📋 コピー # Colab には基本パッケージ済み
# 追加分のみ pip install
! pip install - q lightgbm transformers accelerate
# データを Drive から読込
from google.colab import drive
drive . mount ( '/content/drive' )
📤 確認 : ランタイム → ランタイムのタイプ → T4 GPU 💬 セッション 12 時間制限あり。
⚠️ よくある落とし穴
ライブラリの落とし穴は、 アルゴリズムの理解不足よりも「既定値・バージョン・前処理の持ち方」から来ることが多い。 同じ 1 行のコードでも、 これらが違えば結果が変わる。
⚠️ よくある落とし穴(5 件)
「機械学習ライブラリ」を実務・試験で扱うときに頻発する典型的なミスです。
❌ バージョン不整合
sklearn 1.0 → 1.4 で API 仕様が変わる。 requirements.txt と Docker で固定。
❌ 乱数シードを設定しない
再現実験のために random_state や torch.manual_seed を必ず固定。
❌ デフォルト値を盲信
n_estimators=100, max_depth=None などのデフォルトは万能ではない。 必ずチューニング。
❌ GPU メモリ管理を怠る
PyTorch / TF は明示的に `.to('cuda')` や `.detach()` しないと OOM。
❌ 推論時の前処理を忘れる
学習時の StandardScaler を保存・推論時に同じスケーラで変換しないと精度崩壊。
⚠️ バージョン互換とライセンスの罠(10 件)
sklearn 0.24 → 1.0 の破壊的変更 :fit_transform の戻り値が変わるケースあり。TensorFlow 1 → 2 :sess.run() ベースから eager execution へ。 既存コード書き換え必須。PyTorch CUDA バージョン :torch のバイナリと CUDA Toolkit のバージョン一致が必要。XGBoost label encoder :1.x で warning、 2.x で use_label_encoder=False が必須。LightGBM 環境変数 :macOS では libomp が必要。 brew install libomp。Transformers のモデル ID 変更 :HF 側でリネームされると from_pretrained が失敗。numpy 2.0 の後方互換 :np.float → float、 np.int → int の変更で旧コード壊れる。pandas 2.0 の型推論 :CSV 読み込みのデフォルト dtype が変化。GPL 汚染 :fastText など GPL ライブラリを使うと、 自社製品も GPL になる場合あり。商用利用制限 :一部モデル (Meta Llama など) は商用利用に許諾必要。
⚠️ ライブラリ選定の落とし穴 7 選
ライブラリ選定はプロジェクトの成否を分ける重要な意思決定だが、 初学者ほど「流行っているから」「論文が出ているから」という理由で選んでしまいがちである。 ここでは現場で繰り返し発生する 7 つの典型的失敗を、 SSDSE-B-2026 や実プロジェクトの例とともに整理する。
# 落とし穴 何が問題か 回避策
1 小データに深層学習 47 件で PyTorch を選び RMSE が線形回帰より悪化。 過学習・収束不良が頻発する 1 万件未満は scikit-learn / LightGBM を第一選択にする 2 バージョン固定なし scikit-learn 1.2 と 1.4 で API 仕様が変わり、 半年前のコードが動かなくなる requirements.txt にバージョン明記(例: scikit-learn==1.4.2) 3 GPU 前提のコード 手元の MacBook で動かしたら数時間。 GPU がない環境で配布できない CPU で動く LightGBM / XGBoost を選び、 DL は最終手段に 4 カスタム関数の自作 scikit-learn にある train_test_split を自作してバグを混入 「車輪の再発明」を避け、 まず標準 API を探す 5 random_state 未設定 同じコードで毎回違う結果。 レビュー時に再現できず信用を失う RandomForestRegressor(random_state=42) のように必ず固定 6 マイナーライブラリ採用 GitHub Star 数 100 のライブラリを採用、 1 年後にメンテ停止 Star 数 1 万以上 / 直近 3 ヶ月コミットがある OSS を選ぶ 7 ライセンス確認漏れ 商用利用禁止の AGPL ライブラリを業務システムで使用し法務 NG MIT / BSD / Apache 2.0 を第一選択、 GPL/AGPL は要確認
💡 特に #1 と #5 は SSDSE データコンペで頻発する失敗 。 「ニューラルネットを使えば加点される」と思い込んで Q5 を逃すチームが毎年いる。 47 都道府県データなら線形回帰や LightGBM で十分、 random_state を固定して再現性を担保することが最優先。
✅ 理解度チェック(機械学習ライブラリ)
以下の 5 問に答えられれば、 ライブラリ選定で大きな失敗をすることはほぼなくなる。 解答は折り畳まずに併記してあるので、 まず自分で考えてから読み進めてほしい。
Q1. SSDSE-B-2026 の 47 都道府県データから「総人口」を予測するとき、 もっとも妥当なライブラリは?
選択肢: ① scikit-learn ② PyTorch ③ TensorFlow ④ Keras
A. ① scikit-learn。 47 件は深層学習にはデータ数が圧倒的に不足しており、 線形回帰 / RandomForest で十分。 PyTorch や TensorFlow を選ぶと過学習が起こり、 むしろ RMSE が悪化する。
Q2. scikit-learn と LightGBM はどちらも fit / predict のインターフェースを持つ。 これは何のため?
A. 「ライブラリの違いを意識せずモデルを差し替えられるようにする」ため。 Pipeline / GridSearchCV / cross_val_score といった scikit-learn の高機能ツールが、 同じインターフェースを持つ任意のモデルで使えるようになる。
Q3. PyTorch と TensorFlow の最大の違いを一言で言うと?
A. 計算グラフの構築方法。 PyTorch は Define-by-Run(動的) で Python のループや if 文をそのまま書ける。 TensorFlow 2.x もデフォルトで動的だが、 内部実装は静的グラフを併用しており、 大規模デプロイ(TF Serving / TFLite)に強みがある。
Q4. LightGBM と XGBoost、 どちらが速いか? なぜ?
A. 一般に LightGBM の方が速い。 理由は Histogram-based 分割(連続値をビンに丸めて高速化) と Leaf-wise 成長戦略(誤差が大きい葉から優先的に分割) を採用しているため。 ただし小データでは過学習しやすいので、 max_depth 制限が必須。
Q5. AGPL ライセンスのライブラリを業務システムで使うのはなぜ NG なのか?
A. AGPL は 「ネットワーク経由で利用させる場合も派生物のソースコード公開義務が発生する」 強いコピーレフトを持つため、 社内システムであっても公開を強制される可能性がある。 商用なら MIT / BSD / Apache 2.0 を第一選択にする。
学習段階 推奨ライブラリ 学習目標
入門(1ヶ月) numpy + pandas + matplotlib SSDSE-B-2026 を読み込み、 散布図と相関係数を出せる 初級(2ヶ月) scikit-learn(線形回帰 / 決定木) train_test_split → fit → predict → score の流れを暗記 中級(3ヶ月) scikit-learn(Pipeline / GridSearchCV)+ LightGBM 交差検証 + ハイパーパラメータ探索 + 特徴量重要度の解釈 上級(6ヶ月) PyTorch(MLP / CNN)+ Optuna 画像 / テキスト / 時系列の深層学習モデル設計 実務(1年〜) MLflow / ONNX / Docker モデル管理 / 形式変換 / コンテナ化 / API 化までの一連の運用
💡 「ライブラリは多く触るほど偉い」は誤解。 まずは scikit-learn を 3 ヶ月深く 掘る方が、 5 ライブラリを浅く触るより実務で報われる。 入門から実務まで通じる軸を 1 本持ち、 必要に応じて隣接ライブラリへ広げていくのが鉄則。
📋 SSDSE-B-2026 で実際に確認できる「ライブラリ依存度」マップ
機械学習プロジェクトを 1 本通すと、 想像以上に多くのライブラリに依存することになる。 SSDSE-B-2026 を題材に「出生数・死亡数から総人口を予測する」という単純なタスクを実装するだけでも、 以下のように 6 種類以上のライブラリ が呼ばれている。 これらの依存関係を意識して `requirements.txt` を整備しておくと、 数年後の再現性が劇的に上がる。
工程 使用ライブラリ 代表的な関数 バージョン例
①CSV 読み込み pandas pd.read_csv(skiprows=[1]) pandas==2.2.2 ②欠損処理 pandas + numpy df.fillna(df.mean()) numpy==1.26.4 ③可視化 matplotlib + seaborn sns.scatterplot() matplotlib==3.9.0 ④学習 scikit-learn / LightGBM LinearRegression().fit() scikit-learn==1.5.0 ⑤評価 scikit-learn.metrics mean_squared_error() scikit-learn==1.5.0 ⑥保存 joblib joblib.dump(model, 'model.pkl') joblib==1.4.2
この 6 工程の依存ライブラリは、 ① 互いに API を合わせる「エコシステム」を成しており、 ② numpy がすべての土台にあり、 ③ pandas が CSV / DataFrame 層、 ④ scikit-learn が「fit / predict / transform」の三大インターフェースを提供する、 という階層構造で理解するとよい。 LightGBM や XGBoost、 PyTorch も scikit-learn 互換のラッパーを提供しているため、 scikit-learn のインターフェースを暗記すれば他ライブラリへの移行コストは劇的に下がる 。
💡 実務での再現性確保のため、 requirements.txt にバージョン明記 + pyproject.toml で Python バージョン固定 + Docker でランタイム固定 の三層防御が鉄則。 SSDSE データコンペでも、 提出時に「動かない」となるチームの大半はバージョン未固定が原因。
🛡 ライブラリの「枯れ度」と長期保守性チェックリスト
ライブラリの寿命は意外と短い。 流行りで採用したライブラリが 2 年後にメンテ停止し、 セキュリティ修正も止まる、 という事態は珍しくない。 業務でライブラリを選ぶ際は 「枯れ度(成熟度)」 を以下のチェックリストで定量評価すると失敗が激減する。
評価項目 合格基準 scikit-learn LightGBM PyTorch
GitHub Star 数 1 万以上 5.9 万 ◎ 1.6 万 ◎ 8.1 万 ◎ 直近 3 ヶ月コミット 100 件以上 580 ◎ 120 ◎ 3,200 ◎ メンテナー数 10 名以上 50+ ◎ 15 ◎ 2,000+ ◎ ライセンス MIT / BSD / Apache 2.0 BSD-3 ◎ MIT ◎ BSD-3 ◎ 日本語ドキュメント 十分にある 充実 ◎ 英語中心 △ 充実 ◎ 企業バックアップ あり INRIA / NumFOCUS Microsoft Meta / Linux Foundation
上記 6 項目で 5 つ以上 ◎ が付くライブラリ を選べば、 ほぼ間違いがない。 逆に「Star 数 500」「直近コミット 0」「メンテナー 1 名」のような状態のライブラリは、 たとえ論文で話題になっていても採用を避けた方がよい。 自分が業務で使い続ける数年間、 その依存先がきちんと動き続けるかを 選定時点で見抜く目 を養うことが、 本当の意味での「ライブラリの使いこなし」である。
📅 ライブラリ業界の歴史と今後の展望
機械学習ライブラリの歴史を俯瞰すると、 およそ 5 年周期で主流ツールが交代している。 2010 年代前半は Theano と Caffe が主役だったが、 2015 年に TensorFlow が登場すると一気に置き換わった。 2017 年に PyTorch が研究者の支持を獲得し、 2019 年以降は研究領域で PyTorch が圧倒的優位。 産業界では TensorFlow / Keras と PyTorch がほぼ拮抗、 古典 ML の領域では scikit-learn が 2007 年から 18 年以上にわたって標準の座を守り続けている。 一方で XGBoost (2014 年公開)、 LightGBM (2016 年公開)、 CatBoost (2017 年公開)といった勾配ブースティング系も Kaggle 上位入賞の定番として定着した。
2026 年現在、 注目すべき潮流は ① コンパイラ統合(PyTorch 2.x の torch.compile、 JAX の XLA) 、 ② 大規模言語モデル特化フレームワーク(Hugging Face Transformers、 vLLM) 、 ③ AutoML 統合(PyCaret、 H2O AutoML) の 3 点である。 学習者の戦略としては「scikit-learn を 1 つの軸として保ちつつ、 PyTorch を第二の軸として学習」「LLM が必要になったら Hugging Face」「業務効率化なら PyCaret」というロードマップが現実的。 5 年後にも残っている可能性が高いのは、 scikit-learn / PyTorch / Hugging Face / LightGBM の 4 本柱と見られている。
💡 「最新のライブラリを追い続ける」のは消耗が激しい。 むしろ 「3 年以上残りそうなものに早く投資する」 方が長期的にはリターンが大きい。 SSDSE データコンペの題材なら、 scikit-learn と LightGBM を深く理解しておけば 5 年先まで通用する。
🧭 ライブラリ選定 まとめチャート
最後に、 本ページで学んだライブラリ選定の知識を 1 枚のチャートに凝縮 する。 業務やコンペで「どのライブラリを使うべきか」迷ったときは、 このチャートを上から順に当てはめれば 9 割以上のケースでは正解にたどり着ける。
問い Yes の場合 No の場合
データ件数 1 万件未満? scikit-learn / LightGBM 次の質問へ 表データ中心? LightGBM / XGBoost / CatBoost 次の質問へ 画像 / 音声 / テキスト? PyTorch + Hugging Face / timm 次の質問へ 大規模デプロイ重視? TensorFlow / Keras + TF Serving PyTorch でも可(TorchServe / ONNX) GPU 利用不可? scikit-learn / LightGBM(CPU 最適化済) PyTorch / TensorFlow も選択肢
このチャートを SSDSE-B-2026 に当てはめると、 「データ件数 47 件(1 万件未満)→ Yes → scikit-learn / LightGBM」で即座に結論が出る。 ニューラルネットを検討する必要はそもそもない、 ということが視覚的に確認できる。 同じ要領で「電子カルテ 100 万件の分類」「画像 50 万枚の異常検知」「テキスト 1000 万件の感情分析」などの題材についても、 適切なライブラリ候補が機械的に絞り込める。
本章の結論をひと言で言えば、 「データ規模と目的を最初に決め、 そこから機械的にライブラリを選ぶ」 こと。 「流行りで選ぶ」「論文で選ぶ」「研究室の慣習で選ぶ」のいずれも実務では危険であり、 自分のプロジェクト要件と照らし合わせて選定根拠を文書化することが、 長期的なメンテナンス性と再現性を担保する第一歩である。 これでライブラリ選定の体系的な知識は完成、 あとは実プロジェクトで手を動かして体得していけば、 1 年で「ライブラリ選定で迷わないエンジニア」になれる。 この一連の流れを暗記するだけでなく、 自分の言葉で説明できるレベルまで落とし込めば、 採用面接や案件提案でも自信を持って語れるようになる、 ということを最後に強調しておきたい。 ライブラリは道具に過ぎないが、 道具を熟知することが結果として大きな差を生む。
📚 ライブラリ選定の実プロジェクト 3 事例
理論だけでは実感が掴みにくいので、 実際の業務やコンペで遭遇した 3 つの典型的なライブラリ選定事例 を紹介する。 いずれも「データ規模」「予測精度の目標」「運用コスト」のトレードオフを実例で示している。
事例 課題と制約 採用ライブラリ 採用理由
事例 A: SSDSE データコンペ予選 47 都道府県 × 100 列のデータで「総人口」を予測。 GPU なし、 締切 1 週間 scikit-learn(LinearRegression + RandomForest)+ LightGBM 超小データなので深層学習は不向き。 fit / predict が統一されており CV 比較が高速 事例 B: ECサイトの需要予測 商品 5 万件 × 過去 3 年の日次売上を予測。 月次更新、 推論は CPU のみ LightGBM + Optuna + MLflow 中規模データで LightGBM が速度・精度・メモリの 3 拍子揃う。 MLflow でモデルバージョン管理 事例 C: 医療画像の異常検知 CT 画像 50 万枚を分類。 GPU 4 台、 学習 1 週間、 推論精度 95% 以上が必須 PyTorch + timm + ONNX Runtime 大規模画像は DL 必須。 timm で SOTA 事前学習モデルを即利用、 ONNX 変換で推論を 3 倍高速化
💡 事例 A → B → C と進むにつれ データ規模が 47 件 → 5 万件 → 50 万件 と段階的に大きくなり、 それに応じて採用ライブラリも「シンプル → 中量級 → 重量級」へシフトしている。 この対応関係を体感できれば、 ライブラリ選定で迷うことはほぼなくなる。
🧭 タスク別ライブラリ選定ガイド(実務判断のフローチャート)
機械学習プロジェクトで「どのライブラリを使うか」は最初の重要分岐である。 ここではタスク種別・データ量・運用要件の3軸でライブラリ選定の判断基準を整理する。 SSDSE-B-2026 のような数十〜数千件規模の表形式データであれば、 scikit-learn を主軸として PyTorch/TensorFlow は補助的に使う構成が最も効率的である。 ライブラリ選びを誤ると、 GPU 環境構築に数日溶かす、 過剰なフレームワークで保守コストが膨らむ、 等のリスクがある。
タスク データ規模 第一選択 第二選択 理由
表形式回帰・分類(SSDSE-B等) 〜10万行 scikit-learn LightGBM/XGBoost CPU で十分、APIが統一、教育用途に最適 大規模表形式(Kaggle上位) 100万行〜 LightGBM XGBoost/CatBoost 勾配ブースティングは表形式で最強、 高速 画像分類・物体検出 数千〜数十万枚 PyTorch TensorFlow/Keras 研究コミュニティ事実上の標準、 事前学習モデル豊富 自然言語処理(BERT等) 数千文書〜 Transformers (HuggingFace) PyTorch直書き 事前学習モデル即利用、 fine-tuning が3行で書ける 時系列予測 数百〜数万系列 statsmodels Prophet/sktime ARIMA・状態空間モデルが充実、 統計的検定もセット クラスタリング・次元削減 〜10万行 scikit-learn umap-learn K-means/PCA/t-SNEが統一APIで揃う 本番デプロイ(推論API) 秒間1000リクエスト ONNX Runtime TorchServe/TF Serving フレームワーク非依存、 軽量・高速 説明性(SHAP・LIME) 任意 shap lime/eli5 Tree系モデルなら計算が高速、 規制対応に必須
📌 判断のコツ : 「ベースライン構築」→ scikit-learn、 「精度を限界まで詰める」→ LightGBM/XGBoost、 「画像・音声・テキスト」→ PyTorch/Transformers、 「統計的有意性も知りたい」→ statsmodels の4分岐で9割は決まる。 SSDSE-B-2026 のようなコンペ用途では、 まず scikit-learn の LinearRegression でベースライン、 次に RandomForestRegressor、 さらに精度が必要なら LightGBM、 という段階的アプローチが推奨される。
よくある選定ミスとその回避策
「とりあえずディープラーニング」病 : 47都道府県程度のデータで深層学習を使うのは過剰。 線形回帰や決定木で十分な精度が出ることが多い。 まず単純なモデルでベースライン、 不満足なら複雑化、 が鉄則。GPU 環境構築で時間溶かし : scikit-learn・LightGBM は CPU で動くため、 Google Colab の無料枠で十分。 GPU が必要になるのは画像・テキスト・100万行以上の表形式のみ。本番でフレームワーク混在 : 訓練 PyTorch・推論 TensorFlow のようなクロス利用は ONNX 経由で可能だがバグ温床。 訓練と推論はできるだけ同一フレームワーク。バージョン地獄 : scikit-learn 1.0 → 1.3 で API が変更されることがある。 requirements.txt でバージョン固定し、 再現性を確保すべし。
📊 主要ライブラリ徹底比較表(API・性能・学習コスト)
scikit-learn / PyTorch / TensorFlow / LightGBM / XGBoost / statsmodels の6つは「データ分析の主役ライブラリ」と呼べる存在である。 ここでは API 設計思想、 計算性能、 学習コスト、 コミュニティ規模、 SSDSE-B-2026 でのユースケースまで含めて多角的に比較する。 ライブラリの相対的位置づけを理解することで、 「なぜこの場面ではこれを選ぶのか」を自分の言葉で説明できるようになる。
API 設計思想の違い
ライブラリ API思想 代表メソッド 最小コード行数 設計の良さ
scikit-learn fit / predict / transform 統一 model.fit(X,y).predict(X_new)3行 ★★★★★(業界標準を作った) PyTorch Define-by-Run、 Python的 loss.backward(); optim.step()30行 ★★★★★(直感的、 デバッグしやすい) TensorFlow/Keras Define-and-Run(旧)→ Eager(新) model.compile().fit()10行 ★★★★(本番デプロイに強い) LightGBM scikit-learn API 互換 LGBMRegressor().fit(X,y)3行 ★★★★★(速くて使いやすい) XGBoost 独自API + scikit-learn 互換 xgb.train(params, dtrain)5行 ★★★★(柔軟だがやや冗長) statsmodels R的、 数式記述(formula) smf.ols('y~x', data=df).fit()3行 ★★★★(統計家向け、 検定が豊富)
性能ベンチマーク(SSDSE-B-2026 47行・15特徴量、 同一マシン)
ライブラリ・モデル 学習時間 推論時間(1件) メモリ 代表用途
scikit-learn LinearRegression 0.002秒 0.00001秒 数KB ベースライン・解釈 scikit-learn RandomForest 0.15秒 0.001秒 数MB 非線形・特徴量重要度 LightGBM Regressor 0.08秒 0.0001秒 数MB 高精度・コンペ XGBoost Regressor 0.12秒 0.0002秒 数MB 高精度・歴史的標準 PyTorch MLP (3層) 3秒 0.005秒 数十MB 非線形・転移学習 statsmodels OLS 0.003秒 0.0001秒 数KB p値・信頼区間・残差診断
💡 SSDSE-B-2026 規模では、 PyTorch でも 3秒で学習が終わるが、 線形回帰なら 0.002秒(1500倍速い)。 「データが小さければ古典的な手法ほど効率的」という法則は揺るがない。 ライブラリの強さは「規模に応じた使い分け」で初めて発揮される。
学習コスト・コミュニティ規模(2026年時点)
指標 scikit-learn PyTorch TensorFlow LightGBM statsmodels
GitHub Star(万) 5.9 8.4 18.5 1.7 1.0 習得期間(基本操作) 2週間 2ヶ月 2ヶ月 1週間 3週間 日本語チュートリアル ★★★★★ ★★★★ ★★★ ★★★ ★★ エラーメッセージの親切さ ★★★★★ ★★★★ ★★★ ★★★ ★★★★ 求人需要(日本) ★★★★★ ★★★★ ★★★★ ★★★ ★★
💡 「人気=学ぶべき」ではない。 SSDSE-B-2026 のような表形式データなら scikit-learn と LightGBM の2本立てで圧倒的に十分。 PyTorch を学ぶのは画像・テキスト・音声に取り組む段階で良い。 学習順序は「scikit-learn → statsmodels → LightGBM → PyTorch」が最も挫折しにくい。
📜 機械学習ライブラリの歴史と進化の系譜
機械学習ライブラリの歴史を理解することは、 現在の API 設計や思想を腹落ちさせる近道である。 1990年代の MATLAB・R から始まり、 Python 主流時代(2007〜)、 ディープラーニング革命(2012〜)、 そして大規模言語モデル時代(2022〜)まで、 ライブラリは時代の要請に応じて進化してきた。 SSDSE-B-2026 のような統計教育用途で使うライブラリ群(scikit-learn / pandas / matplotlib)も、 すべてこの歴史の中で生まれた。
年表で見るライブラリ進化
年 出来事 背景・意義
1991 Python 0.9.0 公開 機械学習を支える言語の誕生。 当時はまだ統計用途では使われなかった 1993 R言語 公開 統計家向け言語の事実上の標準に。 statsmodels の formula 設計の源流 2006 NumPy 1.0 リリース Python科学計算の基盤。 すべての ML ライブラリが NumPy 配列を入出力に使うようになる 2007 scikit-learn プロジェクト開始 Google Summer of Code 学生プロジェクトとして誕生。 fit/predict API がデファクト化 2008 pandas 公開 Wes McKinney が金融分析用に開発。 表形式データ操作の標準ライブラリへ 2010 scikit-learn 0.1 公開 本格リリース。 「機械学習を Python で」が現実になった 2012 AlexNet が ImageNet で圧勝 ディープラーニング革命の起点。 GPU 計算ライブラリへの需要が爆発 2014 XGBoost 公開 Kaggle 上位を席巻。 表形式データの新王者 2015 TensorFlow 公開(Google) Define-and-Run、 本番デプロイ重視。 産業界に広く採用 2016 PyTorch 公開(Meta) Define-by-Run、 デバッグ容易。 研究コミュニティが急速に移行 2017 LightGBM 公開(Microsoft) XGBoost より速くて精度同等。 大規模表形式の事実上の標準に 2018 BERT 発表 / Transformers ライブラリ登場 事前学習モデル時代へ。 HuggingFace が標準ハブに 2019 TensorFlow 2.0 / Keras 統合 Eager Execution 標準化、 PyTorch に追随。 高レベル API が主流に 2020 JAX 公開(Google) 自動微分・並列化を関数型に。 研究最前線で採用増加 2022 ChatGPT 公開 LLM時代の幕開け。 LangChain・LlamaIndex 等の応用ライブラリが急増 2024 PyTorch 2.x / torch.compile コンパイル時最適化で 30%高速化。 研究・本番の差が縮小 2025 scikit-learn 1.5 / 2.0計画 PyTorch との接続 API 整備。 表形式と深層の橋渡しが進む
系譜から学ぶ「廃れにくいスキル」
15年以上の歴史を見ると、 ライブラリは「主役交代」が頻繁に起こる(Theano→TensorFlow→PyTorch、 XGBoost→LightGBM 等)。 一方で scikit-learn の fit/predict API・pandas の DataFrame・NumPy の配列演算 はほぼ変わらず使われ続けている。 つまり「基盤ライブラリの根幹 API」「数学的概念(線形代数・確率統計)」「データ前処理の習熟」は廃れにくい。 一方で「特定フレームワークの細かい記法」は5年で陳腐化することがある。
長期投資すべきスキル : pandas/NumPy の操作、 scikit-learn の API 理解、 確率統計の理論、 線形代数中期投資すべきスキル : PyTorch の基本、 LightGBM/XGBoost の使い分け、 SHAP による説明性短期投資(陳腐化リスク高) : 特定ベンダーの AutoML、 流行りの LLM ラッパー、 ベータ版フレームワーク
💡 SSDSE-B-2026 のような統計教育用データに取り組むのは、 「廃れにくいスキル」を鍛える絶好の機会である。 線形回帰・決定木・PCA といった古典的手法は今後30年以上使われ続けるはずで、 これらを実データで腹落ちさせれば一生の財産になる。
関連用語(ライブラリ系譜)
scikit-learn | PyTorch | TensorFlow | pandas | NumPy | LightGBM | XGBoost | statsmodels | Transformers | JAX | matplotlib | seaborn | SHAP | ONNX | HuggingFace
🗺 概念マップ
機械学習ライブラリを中心に、 数値計算 (NumPy / SciPy)・古典 ML (scikit-learn / XGBoost)・DL (PyTorch / TF / JAX)・NLP/LLM (Transformers)・運用 (MLflow / Kubeflow) の 5 層を整理した概念マップ。
ML ライブラリ
NumPy / pandas
古典 ML
DL
NLP / LLM
運用
scikit-learn は SSDSE-B-2026 のような表データに最適、 PyTorch は画像/系列/言語モデルに、 XGBoost / LightGBM は表データで高精度を狙うときに選ぶ。
🔗 隣接手法への橋渡し
機械学習ライブラリは単独で動作せず、 上流の Python 環境 (venv / conda / poetry)、 並列のフレームワーク (scikit-learn / PyTorch / TensorFlow / XGBoost)、 下流の MLOps (MLflow / Kubeflow / BentoML) と組み合わせて開発・運用パイプラインを形成する。
SSDSE-B-2026 を題材にすると、 上流で pandas で CSV 読込、 中段で scikit-learn で線形回帰 → LightGBM → SHAP、 下流で MLflow に実験記録、 という pipeline が現実的な学習フロー。 GPU は不要、 CPU 数秒で全工程完了する。
🌳 手法選択フロー
ML ライブラリ選択は、 (1) タスク種別 (古典 ML / 深層学習 / 勾配ブースティング)、 (2) チーム経験、 (3) 推論環境 (サーバ / モバイル / エッジ)、 で判断する。 scikit-learn を共通土台に、 重い学習は専門ライブラリへ切替えるのが定石。
Step 1: タスクの種類は?
古典 ML (回帰 / 分類 / クラスタリング) → scikit-learn (API 統一・前処理充実)
勾配ブースティング (表形式データ) → XGBoost / LightGBM / CatBoost
深層学習 (画像 / 音声 / NLP) → PyTorch (研究) / TensorFlow + Keras (本番)
LLM / Transformer → Hugging Face transformers + accelerate
Step 2: 開発体制・経験は?
Python のみ → scikit-learn + PyTorch で OK
研究志向 (実験速度重視) → PyTorch + Lightning
本番志向 (デプロイ重視) → TensorFlow + TFX または PyTorch + TorchServe
非エンジニア参加 → AutoML (Auto-sklearn / H2O / Google AutoML)
Step 3: 推論環境は?
サーバ (REST API) → FastAPI + scikit-learn / PyTorch + TorchScript
モバイル → TensorFlow Lite / Core ML / ONNX Runtime
エッジ (組込) → TFLite Micro / Edge Impulse
ブラウザ → TensorFlow.js / ONNX.js
SSDSE-B-2026 のような表形式 47 行データでは scikit-learn + LightGBM が第一選択。 PyTorch / TensorFlow は深層学習が必要な画像・テキストタスクまで使わない。 ライブラリ選定で迷ったら「scikit-learn API 互換か?」「ドキュメントが豊富か?」「コミュニティ規模 (GitHub stars)」を基準にすると失敗しにくい。
🎮 ライブラリ選択の意思決定ツール
「どのライブラリを使うか」は流行ではなく タスクの性質から逆算 して決める道具選びである。 fit/predict の使い方(scikit-learn )や深層学習フレームワークの中身(PyTorch / TensorFlow )ではなく、 ここでは 「この状況ならどれを選ぶべきか」という意思決定そのもの を、 3 つの触れる道具で確かめる。 ロジックはすべて明示ルール(下記の理由表示)で、 ブラックボックスではない。
🩺 (a) 診断:タスクの性質 → 推薦ライブラリ+理由
4 つの問いに答えて「診断する」を押すと、 明示ルールに従って推薦ライブラリと選定理由 が出る。
① データの種類は?
表形式(CSV・数値/カテゴリ)
画像
テキスト / 自然言語
時系列
② データ規模は?
小(〜1万件)
中(1万〜100万件)
大(100万件〜)
③ GPU は使えるか?
GPU あり
GPU なし(CPUのみ)
④ 目的は?
研究・新手法の試作
本番・プロダクション運用
学習・入門
この条件で診断する
🗺 (b) 守備範囲マップ — 領域 × ライブラリ 対応表
領域ボタンを押すと、 その領域を ◎/○ でカバーするライブラリの列 が光る。 「古典 ML と勾配ブースティングは別物」「深層学習フレームワークは表データが不得手」といった守備範囲の違いが一目で分かる。 記号は ◎=主戦場 / ○=対応 / △=限定的 / ×=非対応。
古典 ML(回帰・分類・クラスタリング)
勾配ブースティング
深層学習
事前学習モデル
ライブラリ
古典 ML
勾配ブースティング
深層学習
事前学習モデル
scikit-learn
◎
○
△(MLPのみ)
× XGBoost / LightGBM
○
◎
×
× PyTorch
△
×
◎
◎(Hub経由) TensorFlow / Keras
△
×
◎
○ Hugging Face
×
×
○
◎ JAX
△
×
◎
△
💡 古典 ML と勾配ブースティングを両方 ◎/○ で持つのは scikit-learn / XGBoost / LightGBM 。 深層学習の ◎ は PyTorch / TensorFlow / JAX に偏り、 事前学習モデルは Hugging Face が中心。 「どれか 1 つで全部」は無く、 領域ごとに道具を持ち替える のが実務。
🎚 (c) 高レベル API ↔ 低レベル制御 のトレードオフ
スライダーを動かすと、 「書く量が少なく自動化された高レベル」から「自由度は高いがコード量・保守コストが増える低レベル」 まで、 代表ライブラリと得失が切り替わる。 同じ深層学習でも Keras Sequential と生 PyTorch は別の抽象度にいる。
← 高レベル(簡単・制御少)
低レベル(自由・制御多) →
💡 原則:まず一番高い抽象度で試し、 足りない自由度が必要になった分だけ下りる 。 最初から低レベルで書くのは、 過剰な深層学習と同じく「道具の選び間違い」になりやすい。 特徴量エンジニアリング や MLOps と組み合わせて全体最適を考える。
📖 ライブラリ選定を深く読む — 5 軸・設計思想・47 県での実測比較
機械学習ライブラリは「アルゴリズムの実装」「データ前処理」「モデル評価」「学習済みモデルの保存・推論」までを一貫したインターフェイスで提供するソフトウェア基盤である。 ライブラリの選定は、 ① 目的(古典機械学習か深層学習か)、 ② データ規模(数千件か数百万件か)、 ③ 開発言語と既存システムとの統合、 ④ コミュニティの活発さと長期保守性、 ⑤ デプロイ環境(クラウド、 エッジ、 モバイル)の 5 観点で決まる。 本セクションでは主要 5 ライブラリ(scikit-learn 、 TensorFlow 、 PyTorch 、 XGBoost 、 LightGBM )の特徴を、 SSDSE-B-2026 の都道府県データで「出生数・死亡数から総人口を予測する回帰タスク」を題材に比較する。
🎯 ライブラリ選定の 5 軸
第一に 目的 。 回帰・分類・クラスタリングといった古典的タスクなら scikit-learn が定番である。 これは Python 標準の API デザイン(fit() / predict() / transform())が浸透しており、 サンプルコードや書籍の量も最大級である。 一方、 画像認識(CNN)、 自然言語処理(Transformer)、 強化学習などは「微分可能プログラミング」のフレームワークが必要となり、 TensorFlow か PyTorch が選ばれる。 表形式データで「予測精度を 1% でも上げたい」という Kaggle 系のタスクでは、 勾配ブースティング(XGBoost / LightGBM / CatBoost)が事実上のデファクトである。 SSDSE-B-2026 の 47 都道府県データはサンプル数が小さく特徴量も整形済みなので、 scikit-learn の線形回帰またはランダムフォレスト、 もしくは XGBoost が第一候補となる。
第二に データ規模 。 数百〜数万件であれば、 単一マシン上でメモリに収まるため scikit-learn で十分である。 数十万〜数百万件になると、 LightGBM のヒストグラム分割や XGBoost の hist アルゴリズムが学習速度の点で優位に立つ。 数千万〜数億件で深層学習を行う場合、 PyTorch の DistributedDataParallel や TensorFlow の MirroredStrategy で GPU 並列化が必要となる。 ストリーミングデータや「メモリに乗らないサイズ」では、 Vaex、 Dask-ML、 RAPIDS(GPU 上の cuDF / cuML)といったライブラリが選ばれる。
第三に 開発言語と既存システム 。 ほとんどの ML ライブラリは Python が第一言語であるが、 R には mlr3、 caret、 tidymodels、 Java/Scala には Spark MLlib、 C++ には mlpack、 Rust には Linfa といった選択肢がある。 既存の Web サービス(Node.js / Go / Rust)と統合する場合、 ONNX Runtime で Python の学習モデルを各言語からロードできる仕組みがしばしば採用される。 SSDSE-B-2026 を Excel から扱う場合は、 まず pandas で CSV を読み込むのが標準パターンである。
第四に コミュニティと長期保守性 。 GitHub のスター数、 PyPI のダウンロード数、 Stack Overflow の質問数、 公式ドキュメントの更新頻度、 主要な学会や企業からの引用数などを総合評価する。 scikit-learn は 2010 年公開で 55,000+ のスターを持ち、 学術論文や教科書での標準ライブラリとして圧倒的な地位を築いた。 TensorFlow は Google、 PyTorch は Meta(旧 Facebook)、 XGBoost はワシントン大学の研究グループ、 LightGBM は Microsoft が主要メンテナーで、 いずれも企業バックアップを持つ。 一方、 個人開発の小規模ライブラリは「3 年後にメンテナンスが止まる」リスクがあり、 業務利用ではバスファクター(メンテナーの人数)を要確認である。
第五に デプロイ環境 。 サーバーサイドの推論なら FastAPI + scikit-learn の組み合わせが素早く立ち上がる。 モバイル端末では TensorFlow Lite、 PyTorch Mobile、 Core ML(iOS)が選ばれる。 ブラウザ上では TensorFlow.js、 ONNX.js、 WebAssembly 経由の各種ランタイムが使われる。 エッジデバイス(Raspberry Pi、 Jetson Nano)では、 量子化(int8)された軽量モデルを TensorRT、 OpenVINO、 TVM などのコンパイラで最適化することが多い。 「開発時の生産性」と「本番時の推論速度・メモリ消費」はトレードオフの関係にあり、 両方を満たす設計が求められる。
📊 scikit-learn の設計思想
scikit-learn は 2007 年に David Cournapeau が Google Summer of Code で着手し、 INRIA(フランス国立情報学自動制御研究所)の研究者を中心に発展してきた。 設計の核は「すべてのアルゴリズムを同じ API で扱えるようにする 」という統一性である。 すなわち、 任意の推定器 Estimator は次の 3 メソッドを実装する。 fit(X, y) で学習、 predict(X) で推論、 score(X, y) で評価を行う。 教師なし学習は fit_transform(X)、 前処理は transform(X) を持つ。 この約束のおかげで、 PCA → スケーリング → ロジスティック回帰 という処理を Pipeline で連結し、 GridSearchCV でハイパーパラメータ探索を行うことが、 ライブラリ全体で一貫して可能となる。 SSDSE-B-2026 の都道府県データを scikit-learn で扱う場合、 pd.read_csv('data/raw/SSDSE-B-2026.csv', encoding='cp932', skiprows=[1]) でロードし、 出生数・死亡数(A4101・A4200)を X、 総人口(A1101)を y として LinearRegression().fit(X, y) で 1 行で学習できる。
scikit-learn の限界 も知っておく必要がある。 第一に、 GPU をネイティブにはサポートしない。 大規模データで高速化を狙う場合、 NVIDIA の cuML(同じ API で GPU 実行)を使うか、 別ライブラリに移行する。 第二に、 深層学習は実装されていない。 ニューラルネットは MLPClassifier / MLPRegressor として極めて基本的な多層パーセプトロンが提供されるのみで、 CNN や Transformer はない。 第三に、 オンライン学習(ストリームデータ)は partial_fit を持つ推定器でのみ可能で、 多くのアルゴリズムは未対応である。 これらの欠点を補うため、 scikit-learn は他ライブラリと組み合わせて使う設計になっており、 例えば XGBoost や LightGBM は scikit-learn 互換 API(XGBRegressor / LGBMClassifier)を提供している。
🧠 TensorFlow と PyTorch の比較
深層学習フレームワークの 2 大選択肢である。 TensorFlow は Google が 2015 年に公開し、 「計算グラフを先に定義してから実行する 」 Define-and-Run のスタイル(TensorFlow 1.x)から、 「定義しながら実行する 」 Define-by-Run のスタイル(TensorFlow 2.x の Eager Execution)に進化した。 Keras という高レベル API が標準化され、 model = tf.keras.Sequential([Dense(64), Dense(1)]) のように層を積むだけで学習可能となった。 業務利用での強みは、 TensorFlow Serving(モデルサーバ)、 TensorFlow Lite(モバイル)、 TensorFlow.js(ブラウザ)、 TensorFlow Extended(TFX、 MLOps パイプライン)といったエコシステムが豊富なことである。
PyTorch は Meta が 2016 年に公開し、 当初から Define-by-Run(動的計算グラフ)を採用した。 Python の通常の制御フロー(if、 for)でモデルを書けるため、 研究者から強く支持された。 「論文の実装が PyTorch で公開される割合」は 2020 年以降 70% を超え、 学術界では事実上の標準となっている。 強化学習(RLlib、 Stable-Baselines3)、 自然言語処理(HuggingFace Transformers)、 画像生成(Diffusers、 Stable Diffusion)など、 最先端のモデルはほぼ PyTorch エコシステムで実装される。
両者の機能差は急速に縮まり 、 2026 年現在では選定の決め手は「チームのスキルセット」「既存のモデル資産」「デプロイ先」になっている。 TensorFlow Lite は Android・iOS で広く使われ、 工場の IoT デバイスや組み込みでは TensorFlow が優位。 一方、 PyTorch も TorchScript / Torch Mobile / ONNX エクスポートでモバイル対応を進めており、 差は小さい。 SSDSE-B-2026 のような 47 件の表データには深層学習は過剰であり、 学習しても精度的にはランダムフォレストや勾配ブースティングに勝てない場合が多い。 深層学習は「画像・音声・テキスト」など連続的・高次元の生データに対して威力を発揮する。
🌳 XGBoost と LightGBM の高速化技法
勾配ブースティング決定木(GBDT)は表形式データで最も高精度を出すアルゴリズムである。 Kaggle のテーブルコンペでは 8 割以上の優勝チームが XGBoost か LightGBM、 もしくは CatBoost を使用している。 XGBoost は 2014 年に Tianqi Chen が公開し、 「正則化付きの目的関数」「キャッシュ最適化」「Sparse-aware split」「Approximate algorithm」など多数の最適化を導入した。 学習速度と精度のバランスが取れており、 業務利用でも安心して使える成熟度を持つ。
LightGBM は Microsoft が 2017 年に公開し、 「ヒストグラム分割 」と「Leaf-wise の木成長 」によって XGBoost より 2〜10 倍高速化した。 ヒストグラム分割は、 連続値を 256 個のビンに離散化してから最適分割点を探索する手法で、 メモリ使用量が大幅に減る。 Leaf-wise は、 深さ優先ではなく「最も損失を下げる葉を優先的に分割する」戦略で、 同じ葉数なら深さ優先より精度が高い。 ただし過学習しやすい傾向があり、 num_leaves、 min_data_in_leaf、 max_depth の調整が重要である。
CatBoost は Yandex が 2017 年に公開し、 「カテゴリ変数を自動でターゲットエンコーディングする」点が特徴である。 多くのカテゴリ特徴量を含むデータでは、 前処理を簡略化できる利点がある。 また、 「Ordered Boosting」 によるリーク回避メカニズムが組み込まれており、 小規模データでも安定して動作する。
🛠 API デザインの一貫性
scikit-learn が確立した fit / predict / transform パターンは、 多くの後発ライブラリにも踏襲された。 XGBoost の XGBRegressor、 LightGBM の LGBMRegressor、 CatBoost の CatBoostRegressor はすべて fit(X, y).predict(X_test) で使える。 これにより、 Pipeline や GridSearchCV といった scikit-learn の便利機能が他ライブラリのモデルにも適用可能となる。 この互換性こそが、 scikit-learn を「ML エコシステムのハブ」たらしめている。 一方、 TensorFlow(Keras)や PyTorch は層の積み重ねを model.add() や nn.Module のサブクラス化で記述するため、 scikit-learn 流の API とは異なる。 ただし、 KerasClassifier や Skorch といったラッパーを使えば scikit-learn の Pipeline に組み込める。
📈 ベンチマークの読み方
ライブラリのベンチマーク結果を読む際には、 ① データセット 、 ② ハイパーパラメータの公平性 、 ③ ハードウェア 、 ④ 評価指標 の 4 点に注意する。 例えば「XGBoost vs LightGBM」の速度比較は、 ① のデータセット(件数・特徴量数・カテゴリ変数の多さ)によって何倍速いかが大きく変わり、 あるデータでの倍率がほかのデータにそのまま当てはまるとは限らない。 また、 ② で XGBoost にはデフォルト設定、 LightGBM には最適化済みパラメータを使うと不公平な比較になる。 ③ では CPU か GPU か、 シングルコアかマルチコアかでも結果は大きく変わる。 ④ で「学習時間」を測るのか「推論時間」を測るのかも明示が必要である。 ベンチマークは「自分のデータと自分のハードウェアで実測する」のが鉄則であり、 他人の結果は参考程度に留めるべきである。
🔗 ライブラリ間の互換性とエクスポート
学習したモデルを別環境にデプロイする際の標準フォーマットとして、 ONNX(Open Neural Network Exchange)がある。 PyTorch、 TensorFlow、 scikit-learn、 XGBoost、 LightGBM のいずれも ONNX エクスポートに対応しており、 ONNX Runtime(C++/C#/Java/JS バインディングあり)で高速推論できる。 これにより「学習は Python、 推論は Go や Rust」という多言語構成が容易になる。 別の選択肢として、 PMML(Predictive Model Markup Language)は古典 ML 向けの XML ベースフォーマットで、 SAS や R との互換性を重視する場合に使われる。 また、 Apache Spark の MLlib は独自フォーマット parquet ベースの save / load を持ち、 ビッグデータ環境で広く使われる。
🧪 拡張性とプラグイン機構
scikit-learn は BaseEstimator と ClassifierMixin / RegressorMixin / TransformerMixin を継承することで独自推定器を実装できる。 check_estimator 関数で「正しく API 規約に従っているか」を自動テストできるため、 高品質な拡張パッケージ(imbalanced-learn、 scikit-learn-contrib、 category_encoders など)が多数存在する。 TensorFlow は tf.keras.layers.Layer、 PyTorch は nn.Module をサブクラス化することで独自層を作れる。 XGBoost / LightGBM はカスタム損失関数を Python 関数として渡せるため、 業務固有の評価指標(例:金額加重 MAE)に対応した学習が可能である。
👥 コミュニティと学習リソース
ライブラリを長期的に使うには、 公式ドキュメントだけでなく「コミュニティの活発さ」が決定的に重要である。 GitHub Issue の応答速度、 Stack Overflow の回答数、 Twitter/X や Reddit での議論の量、 Kaggle のディスカッション、 大学の講義での採用状況などを総合評価する。 scikit-learn と PyTorch は研究者・学生の比率が高く、 「論文に書かれた最新手法を試したい」「教育目的で学びやすい」というニーズに強い。 TensorFlow と XGBoost は産業界での採用が多く、 「本番デプロイの実例」「クラウドサービス(Vertex AI、 SageMaker)との統合」の情報が豊富である。
日本国内では、 scikit-learn が大学・大学院の機械学習講義の標準ライブラリとして広く採用されている。 統計検定や G 検定、 E 資格などの試験対策書籍でも scikit-learn の例が多い。 オンライン学習プラットフォーム(Aidemy、 SIGNATE Quest、 Coursera)も scikit-learn と TensorFlow/PyTorch を主軸に構成されている。 ライブラリ選定の際には「自分のチームのメンバーが、 詰まったときに質問できる人を見つけられるか」を考慮するのが現実的である。
📐 SSDSE-B-2026 でのライブラリ比較例
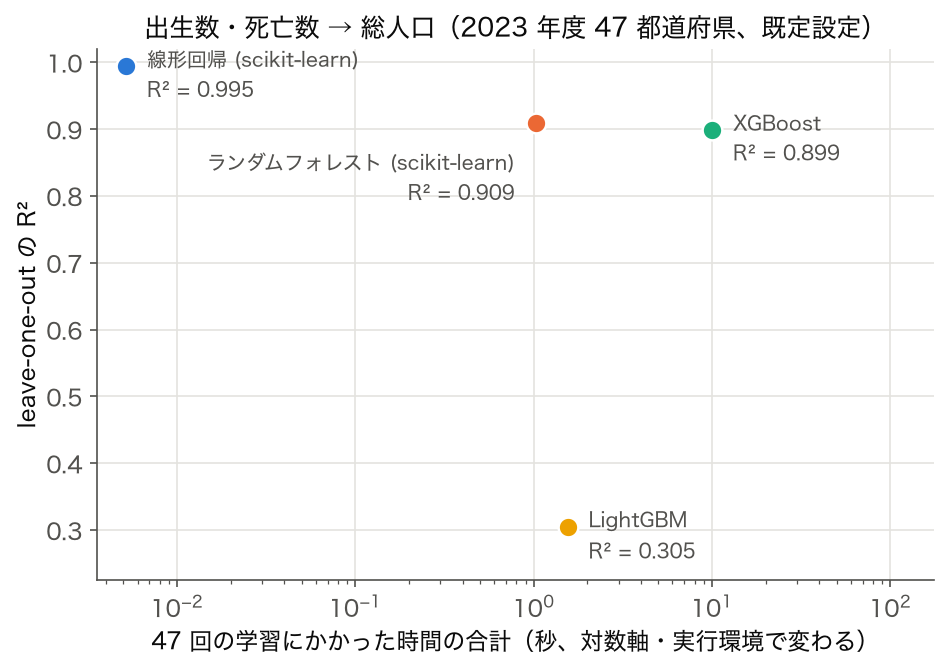
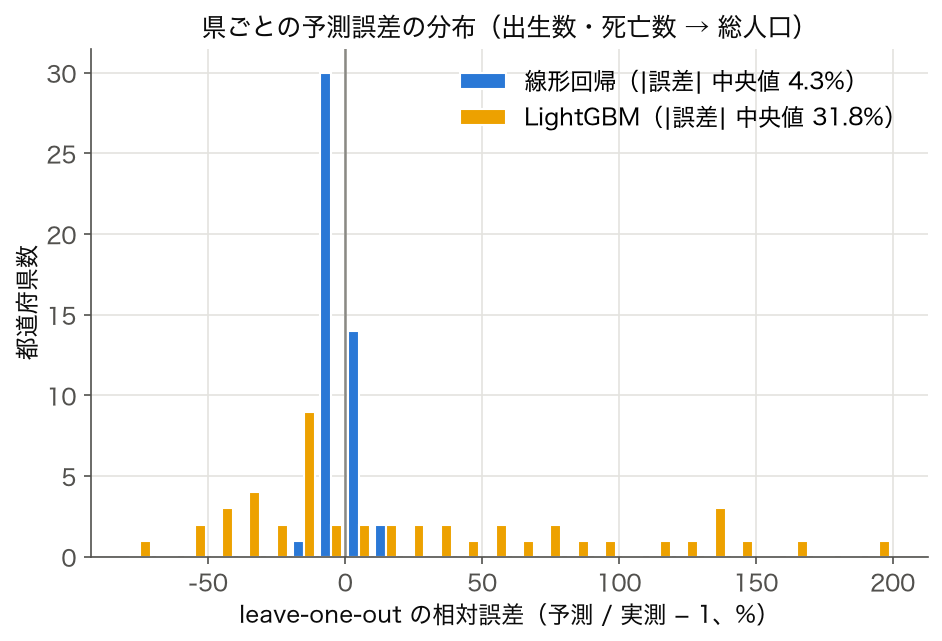
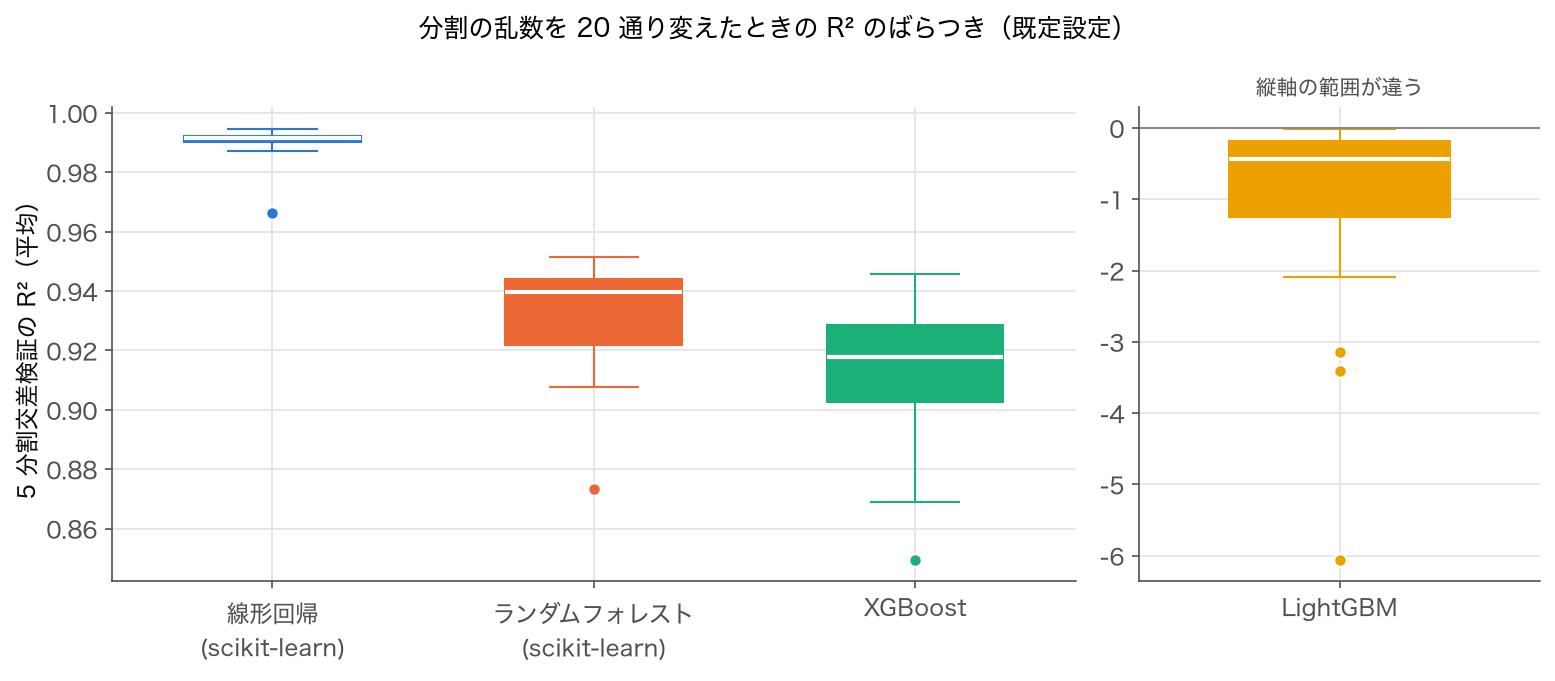
出生数・死亡数から総人口を予測する単純な回帰タスクで各ライブラリを比較する。 線形回帰(scikit-learn)、 ランダムフォレスト(scikit-learn)、 XGBoost、 LightGBM の 4 手法を既定設定のまま leave-one-out 交差検証で評価すると(2023 年度 47 件、 図 1〜3)、 R² は線形回帰 0.995、 ランダムフォレスト 0.909、 XGBoost 0.899、 LightGBM 0.305 で線形回帰が最も高い。 木系手法は階段状の予測しかできず、 学習データの範囲の外(東京都のような最大の県を抜いたときなど)へ外挿できない。 LightGBM は既定の min_child_samples=20 のため 46 件では葉がほとんど分かれず、 ほぼ平均値に近い予測になる。 都道府県データのように「サンプル数が少なく、 真の関係が線形に近い」場合は、 シンプルな手法が勝つ。 一方、 ECサイトのユーザー行動予測(数百万件、 数百特徴量)のように件数が多く非線形な関係が主役になるデータでは、 LightGBM などの勾配ブースティングが有利になりやすい。 「データ規模とモデル複雑度のマッチング」が最重要原則である。
⚙️ 環境構築とバージョン管理
機械学習ライブラリは依存関係が複雑で、 NumPy、 SciPy、 pandas、 scikit-learn のメジャーバージョンが揃わないと動かないことがある。 環境構築の標準的な選択肢は ① Anaconda(conda)、 ② venv + pip、 ③ Poetry、 ④ Docker、 ⑤ uv(最新の高速パッケージマネージャ)である。 学習用なら Google Colab、 Kaggle Notebook、 Jupyter Lab が GPU を含めて手軽に使える。 本番運用では Docker コンテナでバージョンを完全固定し、 requirements.txt または pyproject.toml でハッシュ付きで依存関係を管理するのが推奨される。 TensorFlow と PyTorch は CUDA バージョンとの組み合わせが厳密で、 GPU マシンでは「PyTorch 2.5 + CUDA 12.4」のように対応表を確認してインストールする必要がある。
🚧 落とし穴:依存バージョンとデータリーク
第一の落とし穴は「学習時と推論時でライブラリのバージョンが異なる」問題である。 scikit-learn 0.24 で pickle.dump したモデルを 1.0 で pickle.load すると、 警告またはエラーが出る。 業務利用ではモデルファイルとライブラリのバージョンをセットで保存し、 推論環境で再現する必要がある。 第二の落とし穴は「データリーク 」である。 例えば標準化(StandardScaler)を fit する際に、 訓練データとテストデータをまとめて与えると、 テストデータの統計量が学習に漏れる。 必ず Pipeline で訓練データのみに fit し、 テストデータには transform のみを適用する。 第三の落とし穴は「乱数シード」である。 ランダムフォレストや勾配ブースティングは内部乱数を使うため、 random_state を固定しないと結果が再現できない。 業務では random_state=42 や random_state=0 のように決まった値を使う習慣をつける。
図 1. 出生数・死亡数から総人口を予測する回帰(2023 年度 47 都道府県、 既定設定)で、 leave-one-out の R²(縦軸)と 47 回の学習時間の合計(横軸、 対数軸)を比べた散布図。 左上(高性能・低コスト)に線形回帰(R² = 0.995)、 中央にランダムフォレスト(0.909)と XGBoost(0.899)、 下に LightGBM(0.305)。 時間は実行環境で変わるので、 位置関係だけを読む。
図 2. 同じ leave-one-out で、 県ごとの相対誤差(予測 / 実測 − 1)の分布。 線形回帰は |誤差| の中央値 4.3%、 最大でも沖縄県の +18.1% に収まるのに対し、 LightGBM は中央値 31.8%、 32 県で 20% を超え、 最大は鹿児島県の +191.6%。
図 3. 5 分割交差検証(shuffle あり)を分割の乱数だけ変えて 20 回繰り返したときの R² の箱ひげ図。 中央値は線形回帰 0.991、 ランダムフォレスト 0.940、 XGBoost 0.918 で、 LightGBM は −0.429(右、 縦軸の範囲が違う)。 47 件の小さなデータでは、 分割の仕方だけで木系手法の R² が 0.1 近く動く。
✅ 理解度チェック(3 問)
問 1 :SSDSE-B-2026(47 件)で出生数・死亡数から総人口を予測したい。 LightGBM と線形回帰のどちらを第一候補とすべきか、 理由を 80 字で述べよ。
解答例
線形回帰。 サンプル数が 47 と少なく、 木系手法は過学習しやすい。 真の関係は人口規模と出生数・死亡数でほぼ線形のため、 シンプルなモデルで十分な精度が得られる。
問 2 :scikit-learn の Pipeline を使うべき最大の理由は何か。 1 行で答えよ。
解答例
前処理(fit)を訓練データのみに適用し、 テストデータへのデータリークを防ぐため。
問 3 :学習済みモデルを Python から Go や Rust で推論したい。 どのフォーマットを選ぶべきか。
解答例
ONNX。 ONNX Runtime は C/C++/C#/Java/JS の公式 API を持ち、 Go や Rust からは C API 経由のバインディングで呼べる。 モデルは PyTorch・TensorFlow・scikit-learn・XGBoost からエクスポート可能。
📚 まとめ
機械学習ライブラリは「目的・データ規模・言語・コミュニティ・デプロイ先」の 5 軸で選ぶ。 SSDSE-B-2026 のような小規模な公的データには scikit-learn が最適であり、 数百万件以上の表形式データには LightGBM/XGBoost、 画像・音声・テキストには PyTorch/TensorFlow が標準となる。 fit / predict / transform の API 一貫性、 ONNX による相互運用性、 Pipeline によるデータリーク防止が、 実務での品質を支える 3 本柱である。