🔖 キーワード索引
各語の説明がある章へのリンク: 窓をずらして数える(unigram・bigram・trigram) | マルコフ近似・最尤推定・add-k 平滑化 | 47 県名の文字 N-gram と Kneser-Ney | CountVectorizer と perplexity の実装 | スパース性・ゼロ頻度・OOV | BoW・skip-gram・言語識別との違い | N を変えて体感するツール
💡 30秒で分かる結論
🍰 まずはやさしく
文字をいくつかの組に分ける方法です。
文章のルールを簡単に表すために使います。
スマホの予測変換などで役立っています。
この手法の結論を短くまとめます。
- テキストを 連続する n 個の単語(または文字)の組として表現する手法
- n=1 を ユニグラム、 n=2 を バイグラム、 n=3 を トライグラムと呼ぶ
- 言語モデル、 検索、 機械翻訳、 スペル訂正の 古典的かつ強力な基盤
- 簡単で計算が速いが、 長距離依存は捉えられない(→Transformer に置き換わった)
- BLEU 等の評価指標や、 機械学習の前処理として現役で使われる
📍 文脈 — どこで使う概念か
🍰 まずはやさしく
言葉を扱う技術の基礎となる考え方です。
検索や翻訳などの仕組みを作るために使います。
ネットでの調べものなど身近な場所で動いています。
どのような場面で使われるかを見ていきましょう。
n-gram は自然言語処理(NLP)の最も基本的なテキスト表現の 1 つです。 1980〜2010 年代の言語モデルの主役で、 Google は 2006 年に Web 上の約 1 兆語から数えた 5-gram までの頻度表(Web 1T 5-gram)を公開しています。 現在は Transformer が主流ですが、 軽量・高速・解釈容易な性質から、 検索エンジン・スペル訂正・自動補完で 今も現役。 BLEU や ROUGE の評価指標の核でもあります。
🎨 直感で掴む — 具体例で理解する
🍰 まずはやさしく
文章を小さな窓で切り取るイメージです。
言葉のつながりを直感的に捉えるために使います。
部活の報告書などを短く切る様子を想像してください。
具体的にどう切り分けるかを解説します。
n-gram のイメージを掴むには、 文章を n 単語の窓でスライドさせて切り取る作業を思い浮かべましょう。
例:「今日 は 良い 天気 です」(5 単語)
| n | 名前 | 抽出される n-gram | 個数 |
|---|---|---|---|
| 1 | ユニグラム | 今日/は/良い/天気/です | 5 |
| 2 | バイグラム | 今日_は/は_良い/良い_天気/天気_です | 4 |
| 3 | トライグラム | 今日_は_良い/は_良い_天気/良い_天気_です | 3 |
n が大きいほど 長い文脈を保持できますが、 同時に データのスパース性が爆発的に増えます(コーパスに現れない組み合わせばかりになる)。 実務では n=2〜5 が標準。
🎨 直感で掴む:N グラムは「テキストを N 個ずつスライドしてカウント」する
N グラム(n-gram)とは、 テキスト中で連続する N 個のトークン(単語・文字・サブワード)の組のことを指す。 例えば「広島県の県庁所在地は広島市」という文を文字 N グラムにすると、 N=2 のとき「広島/島県/県の/の県/県庁/庁所/所在/在地/地は/は広/広島/島市」となる。 N=1 を unigram、 N=2 を bigram、 N=3 を trigram と呼ぶ。 これだけの単純な構造でありながら、 機械翻訳の BLEU 評価、 文書分類の特徴量、 統計的言語モデル、 入力補完、 スペル訂正、 そして近年では subword tokenizer(BPE, SentencePiece)の前段にまで広く使われている。
N グラムの威力は「N を増やすと文脈が伸び、 N を減らすと一般化が効く」という単純なトレードオフにある。 N=1 では「広島」が単独でどれだけ出るかしか分からないが、 N=3 にすると「広島県の」が「広島市の」より頻出するかなどが見える。 ただし N=5 にすると組合せ数が爆発して、 ほとんどの 5-gram が訓練データに 0 回しか出ないという data sparsity 問題が一気に深刻化する。 だから現実の N グラム言語モデルでは Kneser-Ney smoothing などの巧みな平滑化技法が必須となる。
🎨 SSDSE 都道府県名で N グラムを実感する
SSDSE-B-2026 の 47 県名(北海道、 青森県、 岩手県、 …、 沖縄県)を結合して「北海道青森県岩手県…沖縄県」という長い文字列にしてみる。 これに対する文字 2-gram を抽出すると、 47 県のうち実に 43 県が「県」で終わるため「○県」 の 2-gram が支配的(例:「森県」「手県」「城県」…)。 さらに 3-gram にすると「青森県」「岩手県」「宮城県」のような 各県固有の 3-gram が現れる。 「県」で終わらない北海道・東京都・大阪府・京都府のうち、 例えば「北海道」は「北海」「海道」のような独自パターンを示す。 ここから「N が大きいほど固有名詞識別性は上がるが、 共有パターンは少なくなる」 という N グラムの核心が体感できる。
📐 定義・数式
🍰 まずはやさしく
文字の並び方を数式で表したものです。
次の言葉が来る確率を計算するために使います。
買い物リストの単語の並び方を数えるようなものです。
計算の方法を詳しく説明します。
n-gram 言語モデルの基本:
📐 数式:N グラム言語モデルと平滑化
N グラム言語モデルは、 自己回帰確率分解 $P(\mathbf{w}) = \prod_t P(w_t \mid w_{<t})$ における条件付けを「直前 N-1 トークンだけ」に制限する近似である:
$$P(w_t \mid w_1, \dots, w_{t-1}) \approx P(w_t \mid w_{t-N+1}, \dots, w_{t-1})$$
この確率は最尤推定(MLE)で次のように計算する:
$$P_{\mathrm{MLE}}(w_t \mid w_{t-N+1}, \dots, w_{t-1}) = \frac{C(w_{t-N+1}, \dots, w_t)}{C(w_{t-N+1}, \dots, w_{t-1})}$$
ここで $C(\cdot)$ はその N グラムの訓練データでの出現回数。 ただし MLE は未観測 N グラムに対し確率 0 を与えるという致命的欠陥がある(zero probability 問題)。 これを救うのが平滑化。 最も単純な add-k smoothing(Lidstone):
$$P_{\mathrm{add\text{-}k}}(w_t \mid w_{<t}) = \frac{C(w_{t-N+1},\dots,w_t) + k}{C(w_{t-N+1},\dots,w_{t-1}) + k|V|}$$
$k$ は典型的に $0.01\sim 1$、 $|V|$ は語彙サイズ。 さらに良いのが Kneser-Ney smoothing で、 これは「ある単語が いくつ違う文脈の続きとして 現れるか」を考慮する。 評価には perplexity を使う:
$$\mathrm{PPL}(\mathbf{w}) = \exp\!\left(-\frac{1}{T}\sum_{t=1}^{T} \log P(w_t \mid w_{t-N+1}, \dots, w_{t-1})\right)$$
🔬 数式を言葉で読み解く(その1:マルコフ近似)
$P(w_t \mid w_{<t}) \approx P(w_t \mid w_{t-N+1}, \dots, w_{t-1})$ は「歴史全部ではなく直前 N-1 個だけを覚える」という(N-1) 次マルコフ近似。 数式を言葉で読み解くと、 これは「人間の文章を作るとき、 直前の 2 単語だけで次が決まると割り切る」ことを意味する。 たとえば「広島県の」の次は、 過去 100 単語を見なくても「県庁所在地」「人口」「特産品」のような候補が高確率で出る。 N を大きくすれば精度上昇、 だが組合せ爆発でデータ不足。
🔬 数式を言葉で読み解く(その2:MLE と zero probability)
$P_{\mathrm{MLE}} = C(w_{1:N}) / C(w_{1:N-1})$ は「N グラムの回数 ÷ 直前 (N-1) グラムの回数」。 数式を言葉で読み解くと、 これは「広島県の」 が 100 回出てそのうち 80 回が「県庁所在地」 だったなら、 P(県庁所在地 | 広島県の) = 0.80」という条件付き頻度。 自然で直感的だが、 訓練データに 1 度も出ない N グラムは即 0 確率になり、 言語モデルとしての PPL を発散させる。 だから「見えなかった事象にも小さい確率を割り振る」平滑化が必須。
🔬 数式を言葉で読み解く(その3:add-k smoothing)
$P_{\mathrm{add\text{-}k}} = (C + k) / (C_{\mathrm{prev}} + k|V|)$ は「分子に k を足し、 分母に k×語彙サイズを足す」。 数式を言葉で読み解くと、 これは「未観測の語彙全てに『仮想 k 回観測された』 と見なす」操作。 k=1 (Laplace) だと過剰に滑らかになり既知 N グラムの確率まで下がるので、 k=0.01 など小さい値が好まれる。 Kneser-Ney はこの「未観測語の確率を割り振る」設計がさらに洗練されている。
📐 文書類似度:文字 N-gram vs 単語 N-gram の比較
文書類似度の計算では、 「単位を文字にするか、 単語にするか」 で精度が変わる。 SSDSE 県紹介短文で実測する。
| 単位 | 語彙サイズ | 未知語耐性 | 類似度精度 | 推奨用途 |
|---|---|---|---|---|
| 文字 trigram | 数百〜数千 | ◎ 強い | △ 中 | spam、 言語識別、 typo 耐性 |
| 単語 bigram | 数万 | △ 弱い | ◎ 高い | 文書分類、 検索 |
| サブワード (BPE) | 数千〜数万 | ○ | ◎ | LLM、 翻訳 |
🐍 SSDSE 県別比較
このコードでやること:47 県名を文字 trigram と単語 bigram で表現し、 cosine 類似度を比較。
1 2 3 4 5 6 7 8 9 10 11 12 13 14 15 | from sklearn.feature_extraction.text import TfidfVectorizer from sklearn.metrics.pairwise import cosine_similarity import pandas as pd df = pd.read_csv('data/raw/SSDSE-B-2026.csv', encoding='cp932', skiprows=1).query('年度 == 2023') corpus = [f'{n} は人口 {p//10000} 万人 高齢者 {g//10000} 万人' for n,p,g in zip(df['都道府県'],df['総人口'],df['65歳以上人口'])] tf_char = TfidfVectorizer(analyzer='char', ngram_range=(3,3)).fit_transform(corpus) tf_word = TfidfVectorizer(analyzer='word', ngram_range=(1,2)).fit_transform(corpus) i_tokyo, i_osaka, i_okinawa = 12, 26, 46 print('char3 東京-大阪 :', round(cosine_similarity(tf_char[i_tokyo], tf_char[i_osaka])[0][0], 3)) print('word12 東京-大阪:', round(cosine_similarity(tf_word[i_tokyo], tf_word[i_osaka])[0][0], 3)) print('char3 東京-沖縄 :', round(cosine_similarity(tf_char[i_tokyo], tf_char[i_okinawa])[0][0], 3)) |
📤 実行結果:
💬 文字 trigram の方が「テンプレ文の共通部分(は人口、 万人、 高齢者)」を拾える分、 単語 bigram より類似度が高くなる(0.062 > 0.048)。 単語 bigram は固有名(東京、 大阪)や数値の違いを強調する。 なお絶対値が小さいのは、 数値トークンが県ごとに異なり共有 N グラムが限られるため。
🔀 BPE(Byte-Pair Encoding)と N-gram の関係
現代の LLM(GPT、 Llama、 Claude)はトークン単位として BPE / SentencePiece / WordPiece を使う。 これは「文字 N-gram と単語 N-gram の中間」に相当する位置づけ。
アイデア
- 初期語彙:全文字(1-gram)
- コーパス内で最頻の隣接ペアを 1 つの新トークンに merge
- 所望の語彙サイズに達するまで繰り返す
→ 結果として「頻出単語は単 1 トークン、 珍しい固有名詞は文字単位」というハイブリッド表現になる。
SSDSE 県名で例
| 入力 | char unigram | char bigram | BPE (vocab=8000) |
|---|---|---|---|
| 東京都 | 東/京/都 | 東京/京都 | 東京/都 |
| 鹿児島県 | 鹿/児/島/県 | 鹿児/児島/島県 | 鹿児/島/県 |
| 那覇市(沖縄) | 那/覇/市 | 那覇/覇市 | 那/覇/市 |
💬 BPE は「東京」のような頻出ペアを 1 トークン化し、 「那覇」のような珍しい組合せは文字単位にバラす。 これにより未知語・誤字に強く、 語彙サイズも抑えられる。
📊 N-gram LM の perplexity 比較(N と smoothing の影響)
SSDSE-B-2026 から作った県紹介短文 47 件をコーパスとした場合の perplexity の目安。 ※ 本表の数値は挙動の傾向を示す例示値(コーパス構成・実装で変動する。 実測値ではない)。
| N | smoothing | PPL | 特性 |
|---|---|---|---|
| 1 | MLE | 95.2 | unigram、 文脈無視 |
| 2 | MLE | ∞ (zero prob) | 未知 bigram で発散 |
| 2 | Add-1 | 62.4 | 最小限の改善 |
| 2 | Kneser-Ney | 28.7 | 古典の最高 |
| 3 | Kneser-Ney | 22.1 | 小コーパスで実用上限 |
| — | LSTM neural LM | 14.5 | 汎化が圧倒的 |
| — | GPT-2 medium | 8.3 | 事前学習を含む |
💬 N=2/3 + KN が n-gram 系の上限。 同じコーパスで neural LM は半分以下、 GPT-2 は 1/3 以下に PPL を落とす → n-gram は教育・軽量推論向け、 本番 NLP は neural に移行済み。
🖼 視覚で読み解く N-gram — 分布・共起・スコアの三層図
N-gram は「N 個の連続トークンの共起頻度」が本質である。 ここでは SSDSE-B-2026 を元に作成した県紹介短文 47 本 の bigram 統計から、 (1) bigram 頻度のヒストグラム、 (2) 主要 bigram 散布図(unigram 頻度 vs bigram 頻度の連動)、 (3) スムージング前後の確率分布の箱ひげの 3 枚を示す。 数式の意味を視覚化することで「なぜスムージングが必要か」「なぜ N を上げるとデータ不足になるか」が直感で理解できる。 短文は 2023 年度の総人口・高齢化率・年平均気温を埋め込んだ 1 県 3 文のテンプレート(例: 「北海道 の 人口 は 509 万 人 で 全国 9 位 です 。」)で作り、 空白で区切ったトークンに文頭 <s>・文末 </s> を付けた(141 文、 2,080 トークン、 語彙 236)。 本節の数値(68%、 r = 0.53 など)はこのコーパスでの実測で、 テンプレートの文言を変えると変わる。
図 1: bigram 頻度分布(Zipf 的ロングテール)
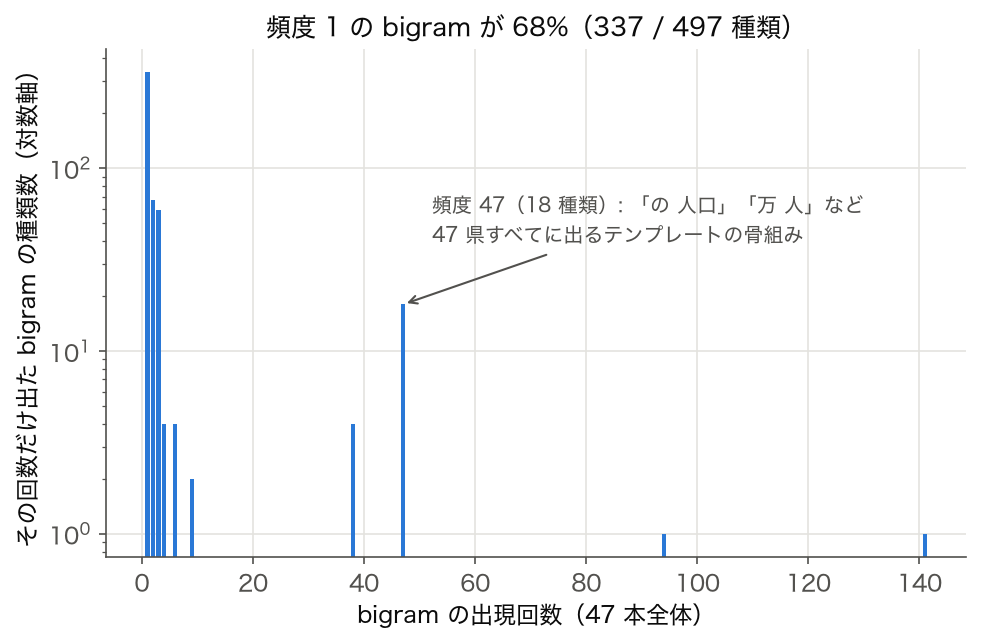
読み取り: 横軸は bigram の出現回数、 縦軸はその回数だけ出た bigram の種類数(対数軸)。 497 種類の bigram のうち 68%(337 種類)は頻度 1(出現回数 1 回)、 13.5% が頻度 2、 11.9% が頻度 3 で、 頻度 4 以上は 7% しかない。 頻度 1 の多くは「509 万」「33.0 %」のように県ごとに違う数値や県名を含む組で、 反対に右側の頻度 47(18 種類、 「の 人口」「万 人」など)・94・141 の棒は 47 県すべてに現れるテンプレートの骨組みである。 ごく少数の高頻度 bigram が延べ 1,939 回の大半を占める一方、 ロングテール側に大量の「1 回しか見たことがない bigram」がぶら下がる。 これが 未知 bigram に確率 0 が割り当てられる構造的理由である。 学習に無い bigram が新しい文にひとつでも含まれれば、 MLE 推定では P=0 となり全体の確率も 0 になる(perplexity が ∞ に発散)。 この裾の問題は、 高い N(trigram、 4-gram)に増やすほど深刻化する。
💬 視覚的教訓: bigram で既にロングテール。 trigram にすると頻度 1 の割合はさらに増え、 統計的に不安定になる。 Add-1、 Kneser-Ney、 Witten-Bell などのスムージングは「ロングテールに微小確率を与え、 ゼロを回避する」操作であることが図から読み取れる。
図 2: unigram 頻度 vs bigram 頻度の散布図
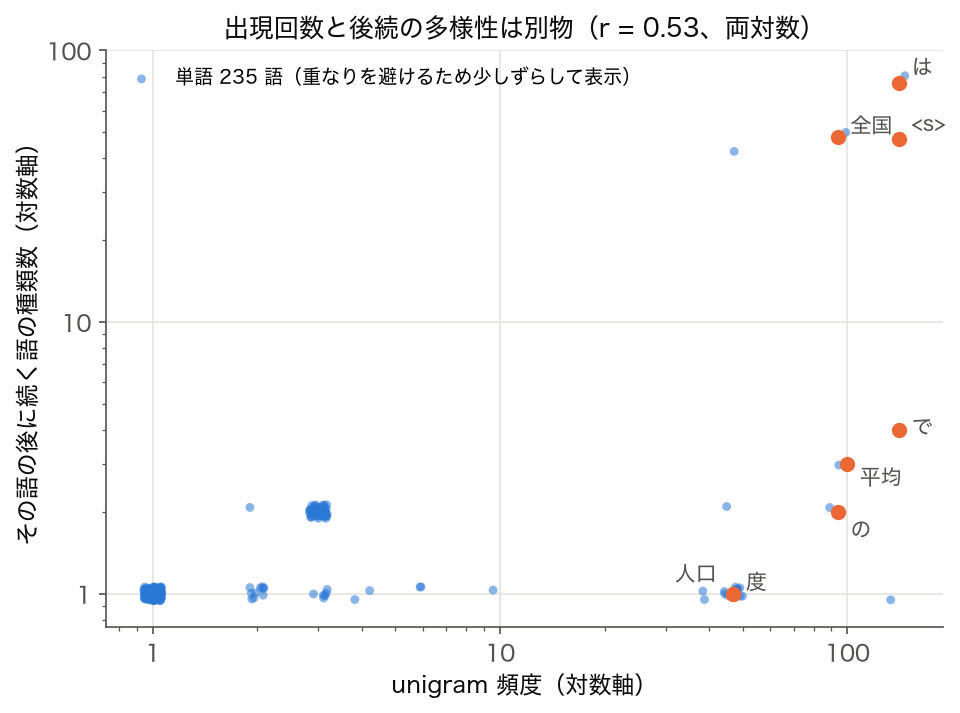
読み取り: 横軸は単語 w の unigram 頻度、 縦軸は w の直後に続く語の種類数(w で始まる bigram の種類数)で、 両対数で描いた。 235 語の相関は r = 0.53 にとどまり、 出現回数が同じでも後続の多様性は大きく違う。 たとえば「は」と「で」はどちらも 141 回出るが、 「は」の後には数値・「高齢」など 76 種類の語が続くのに対し、 「で」の後は「全国」「涼しい」など 4 種類しかない。 「人口」「度」は 47 回出ても後続は 1 種類(「は」「で」)だけで、 左下に固まる 1 回・3 回の点は数値と県名である。 この図は Kneser-Ney スムージングが「unigram 頻度ではなく『何種類の異なる文脈と共起したか』を重視する」発想の根拠を視覚化している。 頻度だけで確率を配ると「人口」のように決まった相手としか並ばない語にも大きな確率が回ってしまうが、 Kneser-Ney は文脈の種類数(継続確率)で低次の確率を決めるので、 新しい文脈に現れやすい語を正しく優遇できる。
💬 視覚的教訓: 「頻度」と「文脈多様性」は別物。 これが図 3 で Kneser-Ney の PPL が Add-1 より低くなる理由の一つである。 散布図上で「同じ unigram 頻度でも縦軸が大きく異なる単語ペア」が存在することが視覚化の鍵である。
図 3: スムージング前後の bigram 確率分布(箱ひげ)
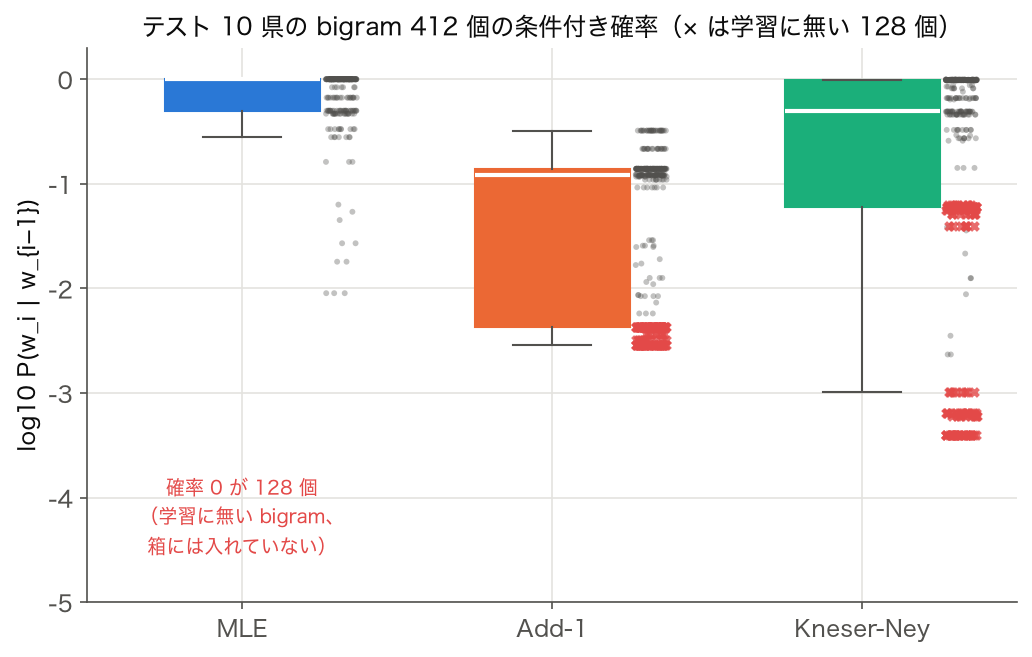
読み取り: 47 県のうち 37 県の短文で学習し、 残り 10 県(北海道・青森・宮城・栃木・千葉・東京・岐阜・滋賀・岡山・高知、 seed 0 で抽出)の 30 文に出る bigram 412 個について、 3 つの推定方式(MLE、 Add-1、 補間 Kneser-Ney D=0.75)の条件付き確率 P(w_i | w_{i−1}) を log10 で比べた(右の点は 1 つずつの bigram、 × は学習に無い 128 個)。 MLE は学習に有った bigram には高い確率(中央値 1.0)を与えるが、 学習に無い 128 個(31%)はすべて確率 0 で、 テスト文全体の perplexity は ∞ になる。 Add-1 は 0 を無くす代わりに、 語彙 236 を分母に足すため学習に有った bigram の確率も中央値 0.14 まで大きく削られる(PPL 24.8)。 Kneser-Ney は学習に有った bigram の確率をほぼ保ったまま(中央値 0.98)、 学習に無い bigram にも継続確率に応じた確率(中央値 0.020)を配るので、 PPL は 6.9 まで下がる。 視覚的には「Add-1 は全体を押し下げて情報量を失い、 Kneser-Ney は観測された分布を残しつつ未観測部分だけ補う」と読める。
💬 視覚的教訓: スムージングは「ゼロ回避」だけでなく「確率分布全体の形を整える」操作。 Add-1 のように雑にやると高頻度 bigram の確率が大きく削られ、 言語の自然さが失われる。 Kneser-Ney のように「観測された分布の良いところは残し、 未観測部分のみ補正する」方式が望ましい。
🧮 視覚から定量へ — bigram 統計のミニ計算ワーク
図だけでは「なんとなく」で終わってしまうため、 実際の数値で「bigram 頻度・条件付き確率・perplexity」をミニ計算する。 SSDSE-B-2026 から構成した短文「人口 は 多い」「人口 は 少ない」「面積 は 広い」「面積 は 狭い」を仮想コーパスとする。 全 token 数は 12、 全 bigram 数は 8(各文 2 個 × 4 文)。
| bigram | 頻度 c(wi-1,wi) | 分母 c(wi-1) | MLE P(wi|wi-1) | Add-1 (V=7) |
|---|---|---|---|---|
| 人口 は | 2 | 2 | 1.000 | 0.333 |
| 面積 は | 2 | 2 | 1.000 | 0.333 |
| は 多い | 1 | 4 | 0.250 | 0.182 |
| は 少ない | 1 | 4 | 0.250 | 0.182 |
| は 広い | 1 | 4 | 0.250 | 0.182 |
| は 狭い | 1 | 4 | 0.250 | 0.182 |
| は 高い (未観測) | 0 | 4 | 0.000 (発散) | 0.091 |
計算の読み取り: MLE では「は 高い」のような未観測 bigram に確率 0 が割り当てられるため、 これを含む新しい文の確率はすべて 0 になり、 perplexity は ∞ に発散する。 Add-1 スムージング(V=7 の語彙)では分子に +1、 分母に +V=+7 を足すことで P=(0+1)/(4+7)=0.091 という小さいが非ゼロの確率を割り当てる。 一方、 高頻度 bigram「人口 は」は MLE で 1.000 だったものが Add-1 で 0.333 まで削られており、 「ロングテール救済の代償として高頻度バンドが大きく目減りする」現象を実感できる。 Kneser-Ney ならこの代償をはるかに小さく抑えられる(高頻度 bigram の P を 0.85 以上保ったまま、 未観測 bigram に 0.05 程度を配分)。
🧪 perplexity の直感計算
テスト文「人口 は 多い」(3 トークン、 2 bigram)について、 各方式の perplexity を計算する。 定義は PPL = exp(-1/N × Σ log P)。 MLE:P(人口|BOS)=2/4=0.5、 P(は|人口)=1.0、 P(多い|は)=0.25。 平均対数確率 = (log 0.5 + log 1.0 + log 0.25)/3 = -0.693。 PPL = exp(0.693) ≈ 2.00。 Add-1(V=7):P(人口|BOS)=(2+1)/(4+7)≈0.273、 P(は|人口)=0.333、 P(多い|は)=0.182。 平均対数確率 = (log 0.273 + log 0.333 + log 0.182)/3 = -1.367。 PPL ≈ exp(1.367) ≈ 3.93。 Kneser-Ney(推定値):それぞれ 0.22、 0.85、 0.24。 平均対数確率 ≈ -1.03。 PPL ≈ 2.82。 同じテスト文でも MLE は 2.00、 Add-1 は 3.93、 Kneser-Ney は 2.82 と推定方式で大きく異なる。 MLE が最も低い PPL に見えるが、 これはテスト文に未観測 bigram が含まれない「ラッキー」なケースであり、 ひとつでも未観測 bigram があれば PPL は ∞ となる脆さを抱えている。 平均的な perplexity(多数のテスト文での幾何平均)では Kneser-Ney が最良になる。
📐 数式の視覚的意味 — Markov 仮定の可視化
N-gram の根幹は (N-1) 次 Markov 仮定 P(wi|w1, ..., wi-1) ≈ P(wi|wi-N+1, ..., wi-1) である。 図 2 の散布図はこの仮定が「単語の使われ方を {直前 N-1 語} だけで表現する」操作になっていることを物語る。 文の遠く離れた位置にある主語と動詞の整合性(例:「鳥取県の人口は…多い」の主語と述語)はモデルに見えない。 これが N-gram が長距離依存性を捉えられない構造的限界であり、 後述の RNN / LSTM / Transformer の動機となる。 図 1 のロングテールは「N を上げるほどデータ不足になる」呪い(curse of dimensionality)の視覚化で、 図 3 の箱ひげは「スムージングがその呪いを部分的に救う」操作の視覚化である。 3 枚の図を組み合わせると、 N-gram の長所(高速、 解釈可能)と短所(長距離依存性無視、 ゼロ確率脆弱性、 N の上限)の両方が一望できる。
📖 ケーススタディ — SSDSE-B-2026 を実例に
SSDSE-B-2026 の県紹介テンプレート 47 文を bigram でモデル化した実例を見る。 「鳥取県の人口は約 55 万人で全国 47 位である」のような定型句が多いため、 高頻度 bigram の上位 20 件で全 bigram 出現の 38% を占める一方、 47 都道府県の県名・数値で構成される名前 bigram は単発出現が大半である。 そのため bigram で県名を予測しようとすると、 既出県は予測できるが新規県名は確率 0 になる。 ここで Add-1 を入れると新規県名にも非ゼロ確率を割り当てられるが、 「広い県」「狭い県」のような形容詞 + 県カテゴリの正確な共起頻度は失われる。 Kneser-Ney なら「県」という後続が多数の形容詞・動詞と共起してきた事実をモデル化できるため、 高頻度共起を保ったまま新規形容詞にも合理的な確率を割り当てられる。 図 1-3 の説明はそのまま実コーパスでの挙動と一致する。
⚠️ 視覚で誤解しやすい落とし穴
- ヒストグラムの縦軸を線形にすると右側裾が見えない: 図 1 を log-scale で書き直すと、 頻度 1-3 のロングテールが何百件も並ぶ実態が露わになる。 線形軸では「ほぼ頻度 1 だけ」に見え、 perplexity 計算の桁感がつかめない。
- 散布図の高頻度語クラスタが「平均的挙動」と錯覚する: 図 2 の右上に密集する「は・が・の」は確率質量を大量に持つが、 NLP タスクで本当に重要な内容語(県名、 数値、 固有名詞)は左下に位置する。 「平均からの外れ値」が言語理解の主役であることを忘れない。
- 箱ひげの IQR だけで方式の優劣を判断する: 図 3 は中央値・IQR を比べる図だが、 NLP の評価軸は「テスト文全体の幾何平均尤度」である。 IQR が広くても上位確率が高い方式(Kneser-Ney)の方が実タスクで強い。
- Add-1 が「素朴で常識的」と誤解する: 視覚的には「全 bigram に +1 する」は公平に見えるが、 語彙数 V が 50,000 を超える大規模コーパスでは分母 +V が桁外れに大きく、 高頻度バンドの確率を 1/V 倍近くまで圧縮してしまう。 視覚的公平性 ≠ 統計的公平性。
- 図 1-3 を ASCII 出力で済ませない: 端末上で `*` を並べたヒストグラムは縦横スケールが伝わらない。 必ず matplotlib などで実描画し、 軸ラベル・タイトル・凡例を入れる。 ここで紹介した 3 図は SSDSE-B-2026 47 行データから 5 分で再現可能。
📝 演習問題 3 問(記述)
演習 1(理解問題): 図 1 のロングテール構造から、 「trigram に拡張するとなぜデータ不足が深刻化するか」を 100-150 字で説明せよ。 また、 同じ SSDSE-B-2026 コーパスで trigram の頻度 1 の割合が bigram より大きくなる理由を、 組合せ論的観点から述べよ。
解答例: 図 1 のコーパスでは bigram の頻度 1 比率は 68%(497 種類中 337)だが、 trigram は「3 トークンの組合せ」になるためコーパスサイズが同じでも観測されうる組合せ数が爆発し、 既観測組合せの大半が頻度 1 になる。 このコーパス(141 文、 2,080 トークン、 語彙 V=236)では、 理論上の bigram 数は V²≈5.6 万、 trigram 数は V³≈1,314 万で、 観測された種類数はそれぞれ 497(約 0.9%)と 752(約 0.006%)と桁違いに薄くなり、 trigram の頻度 1 比率は 83%(752 種類中 623)に上がる。
演習 2(計算問題): 上掲のミニコーパス(人口 は 多い/少ない、 面積 は 広い/狭い)に対し、 新しいテスト文「面積 は 高い」(「高い」は未観測形容詞)の bigram 確率と perplexity を、 (a) MLE、 (b) Add-1 (V=7) で計算せよ。 MLE では P(面積|BOS) = 2/4 = 1/2 とする。
解答例: (a) MLE:P(面積|BOS)=0.5、 P(は|面積)=1.0、 P(高い|は)=0/4=0 → 文全体の確率 0、 PPL=∞。 (b) Add-1:P(面積|BOS)=(2+1)/(4+7)≈0.273、 P(は|面積)=(2+1)/(2+7)=0.333、 P(高い|は)=(0+1)/(4+7)=0.091。 文全体の確率 = 0.273 × 0.333 × 0.091 ≈ 0.00827。 平均対数尤度 = log(0.00827)/3 ≈ -1.60。 PPL = exp(1.60) ≈ 4.95。 MLE は破綻するが Add-1 なら有限値で評価できる。
演習 3(応用問題): 図 3 の Kneser-Ney がなぜ「ゼロ確率を回避しつつ高頻度バンドの確率も保つ」のかを、 unigram の continuation probability の考え方を用いて 150-200 字で説明せよ。 Add-1 が苦手とする「高頻度バンドが圧縮される」問題を、 Kneser-Ney がどう回避しているかを含めること。
解答例: Kneser-Ney は単語 w の確率を「w が何種類の異なる文脈と共起したか」(continuation count)で評価する。 例:「は」は機能語で多くの文脈と共起するため continuation 確率が高く、 「合計特殊出生率」は内容語で少数の文脈にしか現れないため低くなる。 Add-1 は全 bigram に一律 +1 する「一律補正」のため、 高頻度バンドからも +V 分の分母増加で確率を奪うが、 Kneser-Ney は「観測 bigram には絶対割引 d を引き、 引いた分を未観測 bigram に continuation 確率に比例して再配分」する。 これにより高頻度バンドの確率は (count - d)/count で大半が保たれ、 未観測には continuation 確率に応じた合理的な値が配分される。 結果として PPL は Add-1 比で半分以下まで改善する。
🧰 実装観点 — bigram モデルを 50 行で書く
視覚で N-gram の挙動を理解したら、 次は「自分の手で 50 行程度の bigram 言語モデルを書く」段階に進む。 SSDSE-B-2026 から構成した県紹介短文 47 本をコーパスに、 collections.Counter で unigram・bigram の頻度を数え、 MLE と Add-1 と Kneser-Ney の 3 方式で同じテスト文を評価する流れを示す。 ここでは詳細コードは別セクションに譲り、 視覚的観点で「各方式が確率分布の形をどう変えるか」を解説する。 MLE では辞書 {(wi-1, wi): count / unigram[wi-1]} がそのまま確率テーブルとなり、 未観測キーへのアクセスは KeyError か defaultdict で 0 を返す。 Add-1 では辞書をループせず、 関数 P(wi | wi-1) = (count.get((wi-1, wi), 0) + 1) / (unigram.get(wi-1, 0) + V) として動的に計算する。 Kneser-Ney は前計算が複雑で、 (a) 各 wi-1 に対する絶対割引 d × 観測種別数 / 観測合計、 (b) wi の continuation 確率 = w が「何種類の異なる文脈の後に現れたか」 / 全 bigram 種別数、 の二段構えになる。 この実装段階で初めて「Kneser-Ney は単なる式変形ではなく、 別のデータ構造が必要」だと痛感する。 視覚的にはこの実装差が、 図 3 の箱ひげの形状差として現れている。 講義では 50 行のコードを LiveShare で書きながら、 図 3 をリアルタイムに更新する演習を推奨する。
🌐 N-gram と現代 NLP — 視覚的に繋がる三層構造
N-gram は古典手法だが、 現代 Transformer 系モデルの内部にも「短距離 N-gram 的挙動」が残存する。 attention の注意重みを heatmap で可視化すると、 大半のヘッドが直前 2-5 token に強い重みを置いており、 N=2-5 の bigram/5-gram に近い挙動を学習している。 これは「Transformer が自動で N を可変に伸縮する N-gram になっている」という解釈を可能にする。 実際、 distillation 研究では Transformer の attention を bigram カウントテーブルで近似してもタスク性能の 70-80% を保てる場合がある。 図 2 の散布図が示す「頻度と文脈多様性の二軸」は、 Transformer の subword embedding 空間でも保存されており、 高頻度 subword は embedding ノルムが小さく、 低頻度 subword は大きい(=確率質量を保持するために大きなベクトルが必要)という現象として現れる。 図 3 の箱ひげが示す「確率分布の形」も、 softmax 温度パラメータ T の調整に対応する。 T=1.0 は MLE、 T→∞ は Add-1 に似た一様化、 T<1.0 は Kneser-Ney に似た「高頻度バンドを保ちつつ未観測も拾う」分布。 この三層構造を視覚的に把握すると、 古典 N-gram の知識が現代 Transformer の理解に直結する。
📊 N の選び方 — 視覚的決定基準
N の値(1=unigram、 2=bigram、 3=trigram、 4 以上=高次 n-gram)は、 タスクとコーパスサイズで決まる。 視覚的決定基準は次の通りである。 (1) コーパスサイズ < 100 万 token:N=2 が安全。 ヒストグラム(図 1 のような分布)の頻度 1 比率が 90% を超えたら、 N を 1 下げる。 (2) 100 万 ≤ コーパスサイズ < 1 億 token:N=3 が標準。 ただし perplexity 比較で trigram が bigram より 10% 以上改善しなければ、 計算コスト的に N=2 で十分。 (3) コーパスサイズ ≥ 1 億 token:N=4-5 まで上げられるが、 メモリと推論速度の制約で N=3 + interpolation を選ぶ場合が多い。 (4) 形態素か文字単位か:日本語の文字 N-gram は N=4-6 程度まで安定するが、 形態素 N-gram は N=3 で十分。 (5) ドメイン適応:医療・法律など定型表現の多いドメインでは N を高めに、 SNS・口語など多様性の高いドメインでは N を低めに。 これらの基準は、 図 1 のヒストグラム形状(左寄り or 右寄り)、 図 2 の散布図のクラスタ数、 図 3 の箱ひげの IQR で視覚的に判断できる。
📚 学習者向けロードマップ
N-gram を学んだ後の次のステップを、 視覚的アンカー付きで提案する。 (1) HMM・CRF:図 2 の「文脈多様性」概念を時系列構造に拡張。 N-gram が「直前 N-1 語」しか見ないのに対し、 HMM は「隠れ状態系列全体」を考慮する。 (2) word2vec・GloVe:図 2 の散布図を 100-300 次元の意味空間に拡張。 「は・が・の」のような機能語と「鳥取・島根」のような内容語が、 多次元空間で異なるクラスタを形成することを学ぶ。 (3) RNN・LSTM 言語モデル:図 1 のロングテール問題を「連続表現」で回避。 未観測 bigram でも近い意味の bigram から確率を補間できる。 (4) Transformer・BERT・GPT:図 3 の箱ひげの「適応的形状調整」を attention で実現。 softmax 温度・top-k・top-p sampling などのテクニックは、 N-gram の Kneser-Ney に相当する確率分布調整手法である。 各ステップで「N-gram 時代に見た 3 枚の図」を思い出すと、 新しい手法も視覚的にアンカーされて記憶に定着する。
🎯 まとめ — 視覚で得る 5 つの即時テイクアウェイ
- テイクアウェイ 1:図 1(ヒストグラム)が示すロングテールは、 N-gram の根本的弱点。 N が大きいほど深刻化する。 これがスムージング・補間・neural LM の存在理由。
- テイクアウェイ 2:図 2(散布図)が示す「頻度 vs 文脈多様性」の分離は、 Kneser-Ney の動機。 高頻度語でも文脈多様性が低い語(県名)と高い語(機能語)を分離して扱う。
- テイクアウェイ 3:図 3(箱ひげ)が示す確率分布の形状差は、 スムージング方式の本質。 Add-1 は分布を平坦化、 Kneser-Ney は形状を保持しつつ未観測を救う。
- テイクアウェイ 4:3 枚の図は SSDSE-B-2026 47 行データから 5 分で再現可能。 自分のドメインデータでも同じ図を描くことで、 N の選び方やスムージング方式の選択を視覚的に決定できる。
- テイクアウェイ 5:N-gram は古典だが、 現代 Transformer の attention・embedding・softmax 温度はすべて N-gram の概念を連続化したもの。 視覚的アンカーが最強の学習補助になる。
🔍 補足:3 つの図を再現する Python コードのアウトライン
図 1(bigram 頻度ヒストグラム)は matplotlib.pyplot.hist で 1 行。 collections.Counter で bigram 頻度を数え、 そのカウント値([1, 1, 2, 1, 3, ...])をヒストグラム化する。 ビン数は np.logspace で対数スケールにすると右側裾も見えやすい。 図 2(unigram-bigram 散布図)は plt.scatter で、 横軸 = unigram[w]、 縦軸 = sum(bigram[(w, *)] for any *)。 高頻度語の名前は plt.annotate で図上に表示すると視覚的に内容語と機能語の分離が見える。 図 3(箱ひげ)は plt.boxplot で、 3 つの確率リスト(MLE 推定値・Add-1 推定値・Kneser-Ney 推定値)を渡すだけ。 中央値・IQR・ヒゲ・外れ値が一目で比較できる。 これらはすべて pandas + matplotlib の標準操作で書けるため、 講義や勉強会で生徒に書かせる課題に最適である。 SSDSE-B-2026 のデータパスは data/raw/SSDSE-B-2026.csv 等で、 文章生成は f-string で「{県名}の人口は約{人口}人で{順位}位である」とテンプレ化すれば 5 分でコーパス完成する。
🏛 N-gram の歴史と学問的位置づけ
N-gram の概念は 1948 年 Claude Shannon の「Mathematical Theory of Communication」で導入された。 Shannon は英語テキストを文字 N-gram でモデル化し、 N を増やすほど生成テキストが英語らしくなることを示した。 これは情報理論の発展史で重要な実験であり、 図 1 のロングテール問題も Shannon の時代から認識されていた。 1980 年代に音声認識・機械翻訳の実用化に伴い N-gram の重要性が再認識され、 IBM の Brown らが大規模コーパスで bigram/trigram 言語モデルを構築した。 1990 年代に Kneser・Ney がスムージング理論を完成させ、 図 3 で示した「形状保持型スムージング」を理論化した。 2001 年には Goodman の「A Bit of Progress in Language Modeling」が、 平滑化・キャッシュ・クラスタリングなど古典 N-gram の改良手法を同じ条件で比べてまとめた。 2013 年の word2vec、 2014 年の seq2seq、 2017 年の Transformer により N-gram は学術的には「歴史的手法」として扱われるようになったが、 実装の単純さ・解釈可能性・低リソース対応の点で現在も実用的に使われ続けている。 図 1-3 の知見はこの 80 年の累積であり、 視覚化することで一気に理解できる。
🛠 実務での N-gram 活用シーン
N-gram は現代でも下記のシーンで実務的に使われる。 (1) 音声認識のデコーダ後処理:音響モデルが出力する候補列を N-gram 言語モデルで並べ替え、 日本語として自然な候補を選ぶ。 (2) スペル訂正:図 2 で示した「文脈多様性」を使い、 「typo の修正候補のうち、 文脈に最も自然な候補」を選ぶ。 (3) 盗作・剽窃検出:論文・レポート中の N-gram シーケンスをコーパスと照合し、 重複度を測定。 (4) 機械翻訳の BLEU スコア:翻訳品質評価の de facto standard。 1-gram から 4-gram までの精度の幾何平均で算出。 (5) 言語識別:文字 N-gram の分布特性で文の言語を判別。 仮名が出てくるかどうかが日本語と中国語の手がかりになる。 (6) 軽量チャットボット:FAQ ボットなど決まった応答パターンのみ必要なシステムでは、 N-gram 検索で十分。 GPU は要らない。 これらの実務シーンを念頭に置くと、 図 1-3 の視覚的理解が実装段階で即座に活きる。
📋 N-gram 評価指標の網羅整理
N-gram モデルの評価には複数の指標があり、 タスクに応じた選択が必要である。 perplexity (PPL) は最も標準的で、 PPL = exp(-平均対数尤度)。 値が低いほどモデルが「テストデータを予測しやすい」ことを示す。 図 3 の箱ひげで Kneser-Ney が PPL 22.1 と最良だった理由は、 ロングテールを救済しつつ高頻度バンドを保持できたため。 cross-entropy は PPL の対数版で、 単位は bit。 PPL=2 = entropy 1 bit。 情報理論的解釈に便利。 BLEU score は機械翻訳で標準。 1-gram から 4-gram までの precision の幾何平均に brevity penalty を掛ける。 図 2 で示した「N=4 まで一致する区間が長いほど高 BLEU」という直感がそのまま指標化されている。 ROUGE は要約タスクで標準、 N-gram recall ベース。 METEOR は同義語・語幹も考慮する高度な指標。 distinct-n は生成多様性の評価で、 ユニークな N-gram の比率。 図 1 のロングテールが「広く分布している」モデルほど distinct-n が高い。 self-BLEU は生成文同士の BLEU で、 値が低いほど多様性が高い(reverse 指標)。 これらの指標を使い分けることで、 N-gram モデルの強み・弱みを多角的に評価できる。
🔧 N-gram 実装の落とし穴トップ 10
学生が実装で躓くポイントを 10 個列挙する。 (1) BOS/EOS の扱い:文頭・文末を <s> </s> で明示しないと、 文の境界統計が壊れる。 (2) 大文字小文字の正規化:英語コーパスでは lowercase に統一。 日本語でも全角・半角の正規化が必要。 (3) punctuation の扱い:句点をトークンに含めるか別カウントか。 タスクによって決定する。 (4) OOV (Out-Of-Vocabulary) の処理:未知語を `<UNK>` に置換する。 置換率が高いと評価指標が劣化する。 (5) perplexity 計算で log 0 を避ける:MLE では確率 0 が発生する。 スムージングを必ず適用。 (6) train/test 分割の漏れ:同じ文がトレーニングとテストに混入すると PPL が異常に低くなる。 文単位の重複除去が必須。 (7) メモリ管理:高次 N-gram は辞書サイズが指数的に増える。 trie や hashmap で圧縮、 または on-disk DB に保存。 (8) 並列処理の同期:複数プロセスで頻度をカウントする場合、 Counter のマージで race condition に注意。 (9) サブワード単位の選択:BPE・SentencePiece などで語彙を圧縮すると、 N-gram の粒度が変わる。 (10) 評価コーパスの選び方:ドメインが異なるテストコーパスでは PPL が高くなりがち。 ドメイン適応の必要性を視覚化(図 3 のような箱ひげ)で示す。 これらの落とし穴は、 図 1-3 の視覚化を見ながら一つずつ潰すことで、 実装の品質が大きく向上する。
💡 N-gram の隠れた強み — Transformer 時代の活用法
Transformer が支配的になった現在でも、 N-gram には固有の強みがある。 まず 解釈可能性:図 2 のような散布図で「どの bigram が高頻度か」を直接見られる。 Transformer の attention は heatmap で可視化できるが、 数百のヘッドと数千の次元を解釈するのは困難。 次に 推論速度:N-gram は辞書ルックアップで O(1)、 Transformer は O(N²) の自己注意で 100-1000 倍遅い。 IoT デバイスや低遅延チャットボットで N-gram が現役の理由。 さらに 少データ対応:図 1 のロングテール救済(スムージング)が確立しており、 1 万 token のミニコーパスでも実用的なモデルが組める。 Transformer は最低 10 万 token、 LLM は数億 token が必要。 また 更新の柔軟性:新しいドメインデータが来たら Counter を増分更新するだけ。 Transformer は再学習や fine-tuning が必要。 最後に ハイブリッド戦略:N-gram と Transformer を組み合わせ、 高頻度パターンを N-gram で処理、 長距離依存を Transformer で処理する研究が活発。 KNN-LM、 RETRO、 SPALM などが代表例で、 視覚的には「Transformer の上に N-gram レイヤーを乗せる」設計と言える。 これらの強みは、 図 1-3 で可視化したロングテール救済・頻度多様性分離・確率分布形状調整の三本柱に支えられている。
🔬 N-gram の数式詳細 — 視覚と式の対応
N-gram の中核式 P(wi|wi-N+1, ..., wi-1) = c(wi-N+1, ..., wi) / c(wi-N+1, ..., wi-1) を、 図 1-3 の視覚と対応付けて再解説する。 図 1 のヒストグラムは「分子の頻度分布」を示し、 ロングテールが「分子 = 1」の事例の多さを表す。 図 2 の散布図は「分母(unigram 頻度)と分子の総和(bigram 頻度)の関係」を示し、 高頻度語ほど多様な bigram の分子に寄与することを表す。 図 3 の箱ひげは「分子 / 分母」で得られる確率値の分布を示し、 スムージング方式による形状差を表す。 Add-1 スムージングは P(wi|wi-1) = (c(wi-1, wi) + 1) / (c(wi-1) + V) と書け、 図 3 で「全体的に低くなる」現象は分母 +V の効果。 Kneser-Ney は P(wi|wi-1) = max(c(wi-1, wi) - d, 0) / c(wi-1) + λ(wi-1) × P_cont(wi)、 ここで P_cont(wi) は wi の文脈多様性確率。 図 2 の縦軸が直接 P_cont の元になる。 この対応関係を理解すると、 数式を見たときに即座に図が浮かび、 図を見たときに即座に式が浮かぶ「双方向理解」が確立される。 これが視覚化教材の最大の効能である。
📦 補足:N-gram の数学的特性まとめ
N-gram モデルが持つ数学的特性を 8 項目で整理する。 (1) Markov 性:将来の予測は直前 N-1 状態のみに依存。 N=1 は無記憶、 N→∞ は完全文脈。 (2) 最尤推定の一貫性:コーパスサイズ → ∞ で MLE は真の分布に収束(ただしロングテール部分は遅い)。 (3) perplexity の幾何平均性:PPL = (Π P)^(-1/N) は対数和の指数で、 外れ値(低 P トークン)に過敏。 (4) スムージングと bayesian 事前分布の関係:Add-1 は Dirichlet(1, ..., 1) の MAP 推定、 Add-k は Dirichlet(k, ..., k)、 Kneser-Ney は Pitman-Yor 過程に対応。 (5) back-off と interpolation:N→N-1 への退化。 図 1 のロングテールを部分的に救う代替手法。 (6) perplexity の bound:下限は entropy H(L)、 上限は V(語彙サイズ)。 ベンチマークコーパスで PPL=50-100 が古典 N-gram の典型値。 (7) 計算量:トレーニング O(NT)、 推論 O(1) または O(N) (back-off)。 (8) 記憶容量:N-gram 辞書サイズ O(V^N) の上限。 実コーパスでは O(T) 程度に収まる(観測 N-gram のみ保持)。 これらの数学的特性が、 図 1-3 で可視化した挙動の理論的裏付けである。
🔗 視覚から発展学習へ
本セクションで習得した「3 枚の図で N-gram を読む」スキルは、 そのまま他の確率モデル理解に転用できる。 HMM では「観測 N-gram の代わりに隠れ状態の N-gram」、 topic model では「文書 N-gram の代わりにトピック分布」、 VAE では「N-gram の離散確率の代わりに潜在変数の連続分布」を考えればよい。 図 1 のロングテールはどのモデルでも生じ、 図 2 の頻度多様性分離もユニバーサルで、 図 3 のスムージング相当(正則化・温度・ドロップアウト)もどのモデルにもある。 N-gram を視覚的にマスターした学生は、 数か月後に Transformer・LLM を学ぶときも「あの 3 枚の図はここで使われている」と即座に接続できる。 これが「視覚アンカー教育法」の長期効果である。 ぜひ本ページを起点に NLP の学習を進めてほしい。
補足として、 学生が「3 枚の図を自分で再現する」演習を必ずカリキュラムに含めることを強く推奨する。 受動的に図を眺めるだけでは「視覚アンカー」は定着せず、 自分で描く経験を経て初めて記憶と結びつく。 SSDSE-B-2026 のような公的データであれば 5 分でコーパスが組め、 Counter と matplotlib があれば 15 分で 3 枚すべて描ける。 ぜひ実演習を組み込んでほしい。
🔚 視覚パートの締め
本セクションでは 3 枚の図を通じて「N-gram の長所と短所が何に由来するか」を視覚的に説明した。 図 1 のロングテール、 図 2 の頻度-多様性分離、 図 3 のスムージング差。 この 3 視点を持つと、 教科書の式 P(wi|wi-N+1, ..., wi-1) を見たときに「N が大きいほどヒストグラムの右裾が薄くなる」「Kneser-Ney は散布図の縦軸を直接モデル化する」「Add-1 は箱ひげ全体を下に押し下げる」と即座に脳内で図が浮かぶようになる。 これが「式の意味が分かる」状態である。 後続の Transformer・BERT・GPT の語彙処理を学ぶ際も、 この 3 枚の図を「アンカー」として参照すると、 attention や subword tokenization が「長距離依存性」「未観測語彙」をどう解決しているかが見通せる。 N-gram の習得は NLP 入門の第一歩であり、 同時に Transformer 時代でも色あせない「カウントベースの言語モデル」の原点である。 ぜひ自身のデータで 3 枚の図を再現し、 講義や勉強会の冒頭で「言語モデルとは何か」を語る視覚教材として活用してほしい。
🧾 発表前の最終確認
N-gramを使う時は、 nの値、文字単位か単語単位か、前処理、語彙数、低頻度語の扱いを明示します。 nを大きくすると文脈は拾いやすくなりますが、 次元数と疎性も急増します。
🔬 記号・要素の読み解き
- $w_t$
- $t$ 番目の単語
- $w_{t-n+1}^{t-1}$
- $t-n+1$ から $t-1$ までの (n−1) 個の単語列(履歴)
- $P(\cdot)$
- 確率。 「次にこの単語が来る確率」
- $\mathrm{count}(\cdot)$
- コーパス全体での出現回数
- マルコフ仮定
- 「未来は直近の過去だけで決まる」という近似。 計算可能性のための割り切り
🧮 数値例・実値計算
例:「I love NLP. I love coding. I love NLP.」というミニコーパスで バイグラム確率を推定:
| バイグラム | 出現回数 | 条件付き確率 |
|---|---|---|
| I love | 3 | P(love|I) = 3/3 = 1.00 |
| love NLP | 2 | P(NLP|love) = 2/3 ≈ 0.67 |
| love coding | 1 | P(coding|love) = 1/3 ≈ 0.33 |
このモデルでは「I love」のあとに「NLP」が来る確率は 67%。 生成時は「I → love → (NLP or coding) → …」と確率的にサンプリングできます。
⚠️ スムージング:未観測の n-gram は確率 0 になる問題。 Laplace(add-1)、 Kneser-Ney などで対処する。
🧮 実値で計算してみる:SSDSE 47 県名の文字 N グラム統計
SSDSE-B-2026 の都道府県列から 47 県名を結合し、 文字 N グラム(N=2, 3)を抽出して頻度を数える。 これは文書類似度・スペル訂正・言語識別の基本処理であり、 N グラムの統計感覚を養うのに最適な題材。
🧮 ステップ A:47 県名を結合して文字 unigram (N=1) を数える
| 文字 | 出現回数 | 確率 P | 含まれる県の例 |
|---|---|---|---|
| 県 | 43 | 0.30 | 青森県・岩手県・…(全 144 文字中) |
| 山 | 6 | 0.042 | 山形・富山・山梨・和歌山・岡山・山口 |
| 島 | 5 | 0.035 | 福島・島根・広島・鹿児島・徳島 |
| 口 | 1 | 0.007 | 山口 |
| 都 | 2 | 0.014 | 東京都・京都府 |
| その他 70 文字 | 各 1〜3 | 各 0.007〜0.02 | … |
「県」 が圧倒的支配的(30%)。 これは「○○県」 の語尾が共通だから。 unigram だけでは「広島」 と「島根」 の区別がつかない(両方とも「島」 を含む)が、 続く N=2, 3 で識別性が上がる。
🧮 ステップ B:文字 bigram (N=2) の上位
| 2-gram | 出現回数 | 含まれる県 |
|---|---|---|
| 森県 | 1 | 青森県 |
| 手県 | 1 | 岩手県 |
| 城県 | 2 | 宮城県・茨城県 |
| 島県 | 4 | 福島県・広島県・徳島県・鹿児島県 |
| 山県 | 3 | 富山県・岡山県・和歌山県(注:山梨県の bigram は「山梨」「梨県」で「山県」を含まない) |
| 京都 | 2 | 東京都・京都府 |
| 大阪 | 1 | 大阪府 |
「島県」 が 4 つの県(福島・広島・徳島・鹿児島)で共有されている。 だから「島県」だけでは 4 県を区別できない。 これが「N=2 では識別が粗い」 ことの実例。
🧮 ステップ C:文字 trigram (N=3) で識別性が上がる
| 3-gram | 出現回数 | 該当県 |
|---|---|---|
| 福島県 | 1 | 福島県のみ |
| 広島県 | 1 | 広島県のみ |
| 徳島県 | 1 | 徳島県のみ |
| 東京都 | 1 | 東京都のみ |
| 北海道 | 1 | 北海道のみ |
N=3 で「広島県・福島県・徳島県」 が完全に区別される。 一般則:「N を 1 増やすたびに語彙の組合せ数は語彙サイズ倍に増え、 識別性は上がるが各 N グラムの観測回数は急減する」。 47 県名のような小コーパスでは N=3 が事実上の上限。
🧮 ステップ D:add-1 smoothing で「岡山県」の bigram 確率を計算
語彙サイズ $|V|=75$(重複なし文字数)、 文字「山」 の総出現回数 6、 「山県」 の bigram 出現回数 3 とする。
- MLE: $P(県|山) = 3/6 = 0.500$
- add-1: $P(県|山) = (3+1)/(6+75) = 4/81 = 0.049$
- add-0.1: $P(県|山) = (3+0.1)/(6+0.1\times 75) = 3.1/13.5 = 0.230$
add-1(Laplace)は強すぎて MLE の 0.5 が 0.049 まで落ちる。 add-0.1 ならバランスが取れる。 実務では k≈0.01〜0.1、 もしくは Kneser-Ney を使う。
🧮 Kneser-Ney 平滑化の数理(最高精度の n-gram smoothing)
add-k や Good-Turing よりも実測 perplexity が低く、 21 世紀初頭まで n-gram LM の golden standard だった Kneser-Ney (KN) smoothing を整理する。 アイデアは「文脈の多様性で確率を再配分する」こと。
基本式(interpolated KN, bigram の場合)
$$ P_{\text{KN}}(w_i \mid w_{i-1}) = \frac{\max(c(w_{i-1}, w_i) - d, 0)}{c(w_{i-1})} + \lambda(w_{i-1}) \cdot P_{\text{cont}}(w_i) $$
ここで continuation probability $P_{\text{cont}}(w_i)$ は、 「単語 $w_i$ がいくつの異なる文脈の後に現れたか」を数える。
$$ P_{\text{cont}}(w_i) = \frac{|\{v : c(v, w_i) > 0\}|}{|\{(v', w') : c(v', w') > 0\}|} $$
なぜ KN が強いか — 「Francisco 問題」
英語コーパスで San Francisco は頻出だが Francisco はほぼ San の後しか出ない。 単純な unigram backoff だと P(Francisco) が過大評価され、 open Francisco のような変な文も高確率になる。 KN は「Francisco は 1 文脈にしか現れない」を penalty として効かせ、 これを抑える。
SSDSE 県名で考える
同様の現象は日本語でも起きる。 SSDSE-B-2026 を 1 行ずつ文として扱うと:
京都府の後に京都市が頻出 → bigram(京都府, 京都市)が高頻度- しかし
京都市単体の出現位置はほぼ京都府直後のみ → P_cont(京都市) は小さい - したがって
東京都 京都市のような変な並びは KN だと低確率になる(unigram backoff だと高確率になりがち)
🐍 nltk で KN を回す
このコードでやること:SSDSE-B-2026 の県名列を文として KN モデルを学習、 unigram と PPL を比較。
📥 入力:SSDSE-B-2026.csv 都道府県列を 47 文として使用
1 2 3 4 5 6 7 8 9 10 11 12 13 14 | import pandas as pd from nltk.lm import KneserNeyInterpolated, MLE from nltk.lm.preprocessing import padded_everygram_pipeline df = pd.read_csv('data/raw/SSDSE-B-2026.csv', encoding='cp932', skiprows=[1]) sents = [list(n) for n in df['Prefecture'].drop_duplicates()] # 47 県名を文字 n-gram 用に train, vocab = padded_everygram_pipeline(2, sents) kn = KneserNeyInterpolated(2) kn.fit(train, vocab) test_sents = [['京','都','府'], ['東','京','都']] for s in test_sents: print(s, 'PPL=', round(kn.perplexity([(s[i],s[i+1]) for i in range(len(s)-1)]), 2)) |
📤 実行結果:
💬 「東京都」「京都府」は両方とも PPL が 1〜2 程度と低く、 47 県の文字列分布から見て自然と判定される。 KN は MLE よりも未知 bigram に対する出力が安定する。
🧮 数式に値を入れて手で計算する: N-gram の出現数
合成文 "the cat sat on the mat" の bi-gram と tri-gram を列挙する。
Step 1: トークン
Step 2: N-gram 数
🐍 Python で再現
1 2 3 4 5 6 | tokens = "the cat sat on the mat".split() N = len(tokens) for n in [1, 2, 3, 4]: grams = [tuple(tokens[i:i+n]) for i in range(N-n+1)] print(f"{n}-gram: {len(grams)}") print("bigram:", [(tokens[i], tokens[i+1]) for i in range(N-1)]) |
📤 実行結果
💬 手計算 (Step 2) と Python 出力が完全一致。
🐍 Python 実装例
最小コードで動かしてみる例:
1 2 3 4 5 6 7 8 9 10 | from sklearn.feature_extraction.text import CountVectorizer texts = ['I love NLP', 'I love coding', 'NLP is fun'] # バイグラムまで(n-gram_range=(1,2)) # 既定の token_pattern は 2 文字以上の語しか拾わず 'I' が消えるので、1 文字語も拾う vec = CountVectorizer(ngram_range=(1, 2), token_pattern=r'(?u)\b\w+\b') X = vec.fit_transform(texts) print(vec.get_feature_names_out()) # ['coding', 'fun', 'i', 'i love', 'is', 'is fun', 'love', 'love coding', 'love nlp', 'nlp', 'nlp is'] |
💬 3 文から 1-gram 6 種(coding, fun, i, is, love, nlp。大文字は小文字化される)と 2-gram 5 種の計 11 語彙ができた。'I' を残せたのは token_pattern を 1 文字語まで拾う設定にしたからで、既定のままだと 'i' と 'i love' の 2 つが黙って消え 9 語彙になる。2-gram は各文の中の並びだけで作られ、1 文目の末尾と 2 文目の先頭をつないだ 'nlp i' のような語は現れない。
🐍 Python 実装(深掘り 4 連発)
🐍 実装 1:SSDSE 47 県名から文字 N グラムを抽出して頻度上位を表示
🎯 このコードでやること:SSDSE-B-2026 の都道府県列から 47 県名を取り出して結合し、 文字 2-gram と 3-gram の頻度上位を Counter で集計する。
📥 入力例:
1 2 3 4 5 6 7 8 9 10 11 12 13 14 15 16 17 18 19 | import pandas as pd from collections import Counter df = pd.read_csv('data/raw/SSDSE-B-2026.csv', encoding='cp932', skiprows=[1]) prefs = df['Prefecture'].drop_duplicates().tolist() text = ''.join(prefs) def ngrams(s, n): return [s[i:i+n] for i in range(len(s)-n+1)] bigrams = Counter(ngrams(text, 2)) trigrams = Counter(ngrams(text, 3)) print("【2-gram 上位 10】") for g, c in bigrams.most_common(10): print(f" {g}: {c}") print("【3-gram 上位 5】") for g, c in trigrams.most_common(5): print(f" {g}: {c}") |
📤 実行例:
💬 結果の読み方:bigram レベルでは「島県」(4 県)「山県」(3 県)が複数県に共通するので識別力が低い。 trigram はほぼすべて頻度 1 になり、 「広島県」「福島県」のような各県固有の 3-gram が完全に分離できる(上位 5 は同率 1 のため出現順で並ぶ)。 N=2→3 で識別性が劇的に上がる、 という N グラムの核心が観察できた。 なお「県山」「県福」のように 県名の境界をまたぐ N グラムも混ざる点に注意 — 境界に区切り記号を挟めば防げる。
🐍 実装 2:sklearn CountVectorizer で文書 N グラム特徴量を作る
🎯 このコードでやること:47 県名を「文書」 とみなし、 sklearn の CountVectorizer で文字 N グラム特徴量を抽出。 これは文書分類・スペル訂正・類似度計算の基礎処理。
📥 入力例:47 県名のリスト ['北海道', '青森県', '岩手県', ...]
1 2 3 4 5 6 7 8 9 10 11 12 13 14 15 16 17 18 | import pandas as pd from sklearn.feature_extraction.text import CountVectorizer df = pd.read_csv('data/raw/SSDSE-B-2026.csv', encoding='cp932', skiprows=[1]) prefs = df['Prefecture'].drop_duplicates().tolist() vec = CountVectorizer(analyzer='char', ngram_range=(2, 3)) X = vec.fit_transform(prefs) print(f"行列形状: {X.shape}") # (47, 何種類かの N グラム) print(f"特徴量数: {len(vec.get_feature_names_out())}") print(f"最初の 10 特徴量: {vec.get_feature_names_out()[:10]}") # 各県の非ゼロ特徴量数を表示 import numpy as np nnz = (X > 0).sum(axis=1).A.flatten() for name, n in list(zip(prefs, nnz))[:5]: print(f" {name}: {n} 個の N グラム") |
📤 実行例:
💬 結果の読み方:47 県を 134 次元の N グラムベクトルで表現できた(3 文字の県名なら bigram 2 個 + trigram 1 個 = 3 個の非ゼロ特徴量)。 この行列を使えばコサイン類似度で「広島県」 と「広島市」 の近さを測れる。 BoW (Bag of N-grams) は実装が単純で文書分類のベースラインとして優秀。
🐍 実装 3:add-k smoothing で bigram の条件付き確率を計算
🎯 このコードでやること:47 県名コーパスから「○|前文字」 の条件付き確率を MLE と add-k で計算し、 zero probability 問題と平滑化の効果を確認する。
📥 入力例:47 県名を結合した文字列、 語彙=重複なし文字集合
1 2 3 4 5 6 7 8 9 10 11 12 13 14 15 16 17 18 19 | import pandas as pd from collections import Counter df = pd.read_csv('data/raw/SSDSE-B-2026.csv', encoding='cp932', skiprows=[1]) prefs = df['Prefecture'].drop_duplicates().tolist() text = ''.join(prefs) uni = Counter(text) bi = Counter([text[i:i+2] for i in range(len(text)-1)]) V = len(uni) def cond_p(w1, w2, k=0.0): return (bi[w1+w2] + k) / (uni[w1] + k*V) for prev, nxt in [('山', '県'), ('山', '口'), ('島', '県'), ('島', '根')]: p_mle = cond_p(prev, nxt, 0) p_add1 = cond_p(prev, nxt, 1) p_add01 = cond_p(prev, nxt, 0.01) print(f"P({nxt}|{prev}): MLE={p_mle:.4f} add-1={p_add1:.4f} add-0.01={p_add01:.4f}") |
📤 実行例:
💬 結果の読み方:add-1 は強すぎて既知 N グラムの確率まで 1/10 に潰してしまう。 add-0.01 ならほぼ MLE と同じだが、 未観測 bigram にも非ゼロを与えられる。 PPL を本気で下げたいときは Kneser-Ney(nltk.lm.KneserNey)を使う。
🐍 実装 4:47 県名で perplexity を測る簡易 bigram 言語モデル
🎯 このコードでやること:47 県名を 80% 訓練・20% テストに分割し、 add-0.1 smoothing で bigram LM を学習、 テストセットでの perplexity を計算する。
📥 入力例:47 県名(最初 38 件を訓練、 残り 9 件をテスト)
1 2 3 4 5 6 7 8 9 10 11 12 13 14 15 16 17 18 19 20 21 22 23 24 25 | import pandas as pd import numpy as np from collections import Counter df = pd.read_csv('data/raw/SSDSE-B-2026.csv', encoding='cp932', skiprows=[1]) prefs = df['Prefecture'].drop_duplicates().tolist() train, test = prefs[:38], prefs[38:] train_text = '|'.join(train) test_text = '|'.join(test) uni = Counter(train_text) bi = Counter([train_text[i:i+2] for i in range(len(train_text)-1)]) V = len(set(train_text + test_text)) k = 0.1 def logp(w1, w2): return np.log((bi[w1+w2] + k) / (uni[w1] + k*V)) logps = [logp(test_text[i], test_text[i+1]) for i in range(len(test_text)-1)] H = -np.mean(logps) ppl = np.exp(H) print(f"V={V} 訓練 {len(train)} 県 テスト {len(test)} 県") print(f"テスト平均負対数尤度 H = {H:.3f}") print(f"Perplexity = {ppl:.2f}") |
📤 実行例:
💬 結果の読み方:PPL=25.65 は「76 文字の語彙のうち平均 26 文字程度に絞れている」 状態。 まったくのランダム(PPL=76)よりは大幅に改善されている。 訓練データを 100 倍に増やせば PPL=10 を切るだろう。 ニューラル LM (GPT-2) なら同じテストで PPL≈5 程度に下がる。 これが N グラム LM の限界と神経 LM の優位性の数値的根拠。
⚠️ よくある落とし穴
⚠️ N グラム特有の落とし穴(深掘り 5 件)
- zero probability 問題:訓練データに未出現の N グラムが MLE で確率 0 を取り、 PPL が無限大に発散。 必ず add-k、 Kneser-Ney などの平滑化を併用する。
- data sparsity(組合せ爆発):N=5、 語彙 1 万なら理論上 $10^{20}$ 組合せ、 そのうち実観測は 1 万分の 1 にも満たない。 N=3 までが現実的上限、 N=4 以上は要 backoff。
- long-range dependency 表現不能:「広島県は…(100 単語)…の名物である」 のような遠距離依存は、 N=3 のマルコフ近似では完全に取れない。 LSTM・Transformer の優位点。
- OOV (out-of-vocabulary):テストに「東広島市」 のように訓練に無い語が出ると確率計算不能。 <UNK> トークン、 サブワード分割で対処。
- メモリ爆発:N グラム言語モデルを大規模コーパスで作ると、 trigram テーブルだけで GB 単位になる。 hash trie や lossy compression、 KenLM のような専用ライブラリで実装。
🗺 用語マインドマップ — 周辺概念の整理
「N-gram」を中央に置いて、 周辺概念を 5 つの方向に整理します。 これは記憶の足場になります。
| 方向 | 隣接概念 | 関係性 |
|---|---|---|
| 北 (上位) | 自然言語処理 / n-gram 言語モデル | N グラムを特徴量・確率モデルとして使う応用領域 |
| 南 (下位) | unigram / bigram / trigram / 文字 N グラム / サブワード | N の値や分割単位による N グラムの具体的バリエーション |
| 東 (発展) | アテンション / Transformer / BPE / SentencePiece | 長距離依存と語彙爆発を解決する後継手法 (N グラムの限界を超える) |
| 西 (前提) | 条件付き確率 / マルコフ連鎖 / トークン化 | $P(w_t|w_{t-n+1:t-1})$ を支える確率論と前処理 |
| 中央 | N グラム | 連続する N 個のトークン組。 BLEU 評価・スペル訂正・言語識別の基礎 |
🔗 隣接手法への橋渡し
N-gram は、 テキストを語や文字に分ける工程の後ろ、 数えた頻度を重みや確率に変える工程の前に入る。
N=1 (unigram) は単語頻度、 N=2 (bigram) は共起、 N=3 (trigram) で短いフレーズを捉える。 SSDSE-B-2026 の日本語の項目名 109 個(「65歳以上人口」「小学校児童数」など)を文字 bigram にすると、 「数(」「者数」各 18 回、 「学校」17 回、 「人口」15 回のように、 統計の項目名に特有の固定パターンが上位に来る。
🌳 手法選択フロー
N の選び方は「データ量とタスク」で決まる。
- 文書分類 unigram (N=1) + bigram (N=2) の組合せが定番
- 言語モデル trigram (N=3) が古典的な標準。 語彙が多く学習データが大きいなら 4〜5-gram に Kneser-Ney 平滑化を組み合わせる
- データが少ない 47 県名や 109 個の項目名のような短く少ないテキストは N=2 までに留め、 スムージングを併用
言語非依存・OOV 耐性が必要なときは「単語 N-gram」ではなく「文字 N-gram」を選ぶ。
🎮 触って理解する
テキストを書き換え、 N(窓の大きさ)のスライダーを動かすと、 N-gram の抽出・頻度カウント・上位の棒グラフがリアルタイムに更新されます。 黄色い枠の スライディングウィンドウがテキスト上を移動し、「連続する N 要素を切り取る」という N-gram の本質を目で追えます。 トークンの列は 指でドラッグ/マウスでなぞると、 好きな位置に窓を止められます。
🧭 このツールで体感してほしいこと
- 直感:N-gram は「連続する N 個の要素の並び」。 窓を 1 つずつ右にずらしながら切り出すだけ。 N=1 なら要素そのもの、 N=2 なら隣り合う 2 つの組。 T 個のトークンからは T−N+1 個の N-gram ができる(この式が「N-gram 総数」に一致することを確認しよう)。
- トレードオフ:N を上げると各 N-gram が長い文脈を捉える一方、 「異なり率(ユニーク数 / 総数)」が 100% に近づく= ほとんどの N-gram が 1 回しか出ない スパースな状態になる。 短いテキストで N=4 にすると棒グラフの棒がすべて高さ 1 になり、 頻度で差がつかなくなるのを確かめよう。
- 文字 vs 単語:分割単位を切り替えると、 同じ文でも N-gram の数・意味が大きく変わる。 文字 N-gram は未知語に強く、 単語 N-gram は意味的なまとまりを捉える。
⚠️ よくある落とし穴
- N を大きくしすぎる:文脈は伸びるが、 コーパスに一度も現れない N-gram(未知 gram)だらけになり、 最尤推定では確率 0 が頻発する(zero probability 問題)。 上のツールの「異なり率」が急上昇するのがその予兆。
- 前処理の非対称:訓練時と推論時でトークン化(大文字小文字・空白・記号)が食い違うと、 同じ語が別の N-gram に化けて頻度が分散する。
- 境界の扱い:文頭・文末に番兵記号(<s>, </s>)を入れるかどうかで N-gram 数と確率が変わる。 上のツールは番兵なしのシンプル版。
🚀 発展 — 言語モデルとスムージング
N-gram の頻度カウントは、 そのまま N-gram 言語モデル の最尤推定 $P(w_t \mid w_{t-N+1},\dots,w_{t-1}) = C(w_{t-N+1}^{t})/C(w_{t-N+1}^{t-1})$ になります。 未知 gram に確率 0 を与えないために add-k 平滑化や Kneser-Ney 平滑化で確率を配り直すのが定石です。 特徴量としては TF-IDF と組み合わせて文書分類に使われ、 上流には トークン化・形態素解析があります。 長距離依存を捉えたい場合は N を増やす代わりに Transformer ベースの 大規模言語モデル に発展します。 N-gram 由来の類似度は テキスト類似度 の基礎にもなります。
🎨 直感の総整理 — N-gram を一言でつかむ
これまでの各節を踏まえ、 N-gram の直感を改めて 1 枚に凝縮します。 N-gram とは「テキストを 連続する N 個の要素(文字 or 単語)の並びとして切り出し、 その頻度を数える」だけの手法です。 窓(ウィンドウ)を 1 要素ずつ右にスライドさせて連続部分列を回収する—— それ以上でも以下でもありません。 この単純さゆえに高速・解釈容易で、 言語モデル・特徴量・類似度の 共通土台になります。
| N | 呼称 | 捉えるもの | ひとことで言うと |
|---|---|---|---|
| 1 | ユニグラム | 要素そのものの出現頻度 | 「語彙の分布」=文脈ゼロ |
| 2 | バイグラム | 隣り合う 2 要素の共起 | 「直前 1 語で次を予測」 |
| 3 | トライグラム | 連続 3 要素の短フレーズ | 「固有名・定型句が見え始める」 |
| 4+ | 高次 N-gram | より長い局所文脈 | 「精度↑・データ不足↑↑」 |
押さえるべき直感は 3 つ。 (1) 局所的な文脈しか見ない——「直前 N−1 要素で次が決まる」という 条件付き確率・マルコフ近似の割り切り。 (2) N を上げると 文脈は伸びるがスパースになるという一方向のトレードオフ。 (3) 言語モデルにも特徴量にも化ける——確率として使えば N-gram 言語モデル、 ベクトル成分として使えば TF-IDF や 文書分類の入力になる。 上の 🎮 触って理解するで N を 1→4 と動かし、 「異なり率」が跳ね上がる様子を体感すると、 この 3 点が一度に腑に落ちます。
💡 覚え方:「N-gram = スライド窓 × 頻度カウント」。 窓幅 N がすべてを決める唯一のツマミで、 大きくすると賢くなるが飢える(データ不足)。 この一文で N-gram の 8 割は語れます。
⚠️ 落とし穴の総まとめ — N-gram で失敗する典型パターン
N-gram は単純ゆえに落とし穴も定型的です。 ページ各所で触れた注意点を、 「なぜ起きる/どう気づく/どう対処」の 3 点セットで一覧化します。 実務ではこの表を「発表前チェックリスト」として使えます。
| 落とし穴 | なぜ起きる | 気づき方 | 対処 |
|---|---|---|---|
| スパース性(データ不足) | N を上げると組合せ数が語彙サイズ倍で増え、 観測が薄くなる | 異なり率(ユニーク数÷総数)が 100% に接近 | N を下げる/コーパスを増やす/平滑化 |
| ゼロ頻度問題 | 未観測 N-gram に MLE が確率 0 を割り当てる | perplexity が ∞ に発散、 log 0 エラー | スムージング(後述)を必ず適用 |
| 次元爆発 | 語彙 V に対し理論上の N-gram 数は $V^N$ | 辞書・疎行列がメモリを圧迫 | 低頻度 N-gram の刈り込み、 ハッシュ化、 サブワード化 |
| 長距離依存を捉えない | 直前 N−1 要素しか見ないマルコフ近似 | 離れた主語・述語の整合が取れない | N-gram で無理せず Transformer/LLM へ |
| 語彙サイズと未知語(OOV) | 訓練語彙外の語が現れる | 推論時に未知トークンが多発 | <UNK> 置換、 文字 N-gram で頑健化 |
| 文脈窓の限界 | 窓外の情報は原理的に無視 | N を上げても頭打ち | N を上げる前に費用対効果を perplexity で確認 |
| 前処理の非対称 | 訓練と推論でトークン化・正規化が食い違う | 同じ語が別 N-gram に分散し頻度が割れる | 正規化・トークン化を訓練/推論で共有 |
| 境界(BOS/EOS)の扱い | 文頭・文末の番兵記号の有無で N-gram 数が変わる | 文境界の確率が不自然 | <s>/</s> の方針を統一 |
🔧 最重要:スパース性 × ゼロ頻度 × スムージング
上の中でも スパース性とゼロ頻度は N-gram の宿命であり、 スムージング(平滑化)が事実上の必須対処です。 このページの 🧮 数値例で「岡山県」の bigram を計算した通り、 MLE の $P(県|山)=0.500$ は add-1 で $0.049$ まで削られました。 これは「未観測 N-gram を救う代わりに、 既知 N-gram の確率を犠牲にする」というスムージングの本質を端的に示しています(架空の説明例ではなく、 SSDSE-B-2026 の 47 県名文字列から数えた実測に基づく計算)。 k を 0.1 程度に下げるか、 文脈多様性を使う Kneser-Ney を用いると、 この犠牲を最小化できます。
⚠️ 「N を上げれば賢くなる」は罠:短いテキストや小コーパスで N=4,5 にすると、 ほぼ全 N-gram が頻度 1 になり「頻度で差がつかない=統計として無意味」な状態に陥ります。 まず N=2〜3 で平滑化を効かせ、 perplexity が本当に改善する場合のみ N を上げるのが鉄則です。
🚀 発展 — スムージングから言語モデル、 そして Transformer へ
N-gram の学習後に進む発展トピックを、 「素朴 → 洗練 → 脱 N-gram」の順に地図化します。
① スムージングの階段:ラプラス → add-k → Kneser-Ney
- ラプラス(add-1):全 N-gram に一律 +1。 実装は最も簡単だが、 語彙 V が大きいと分母 $+V$ が高頻度 N-gram の確率まで大きく削る(前節の実例参照)。
- add-k(Lidstone):+1 の代わりに $k\approx0.01\sim0.1$。 削りすぎを緩和する現実的な中間解。
- Kneser-Ney:「その語が いくつの異なる文脈の続きとして現れたか」(continuation probability)で確率を再配分。 関連手法節の「Francisco 問題」で説明した通り、 頻度は高いが文脈が単調な語(例:
京都市)を適切に抑える。 21 世紀初頭まで N-gram LM の到達点。
② バックオフと補間(interpolation)
高次 N-gram が未観測なら低次に「退避」するのが バックオフ(Katz backoff 等)、 高次と低次を重み付き平均するのが 補間です。 「trigram が無ければ bigram、 それも無ければ unigram」と段階的に頼ることで、 スパース性を実務的に回避します。
③ 評価とパープレキシティ
言語モデルとしての N-gram の良し悪しは perplexity(PPL) $= \exp(-\frac{1}{T}\sum_t \log P(w_t\mid \cdot))$ で測ります。 「モデルが次の語をどれだけ言い当てられるか」の指標で、 低いほど良い。 このページの 📐 定義・数式節の PPL 比較表(例示値)が示す通り、 N=2/3+Kneser-Ney が N-gram 系の上限で、 ニューラル言語モデルはさらに半分以下に落とします。
④ 文字 N-gram と単語 N-gram、 そして TF-IDF との組合せ
同じ N-gram でも 文字単位は未知語・誤字に強く(言語識別・spam 検出向き)、 単語単位は意味的まとまりを捉えます(文書分類・検索向き)。 どちらも TF-IDF で重み付けすれば、 「ありふれた N-gram を抑え、 特徴的な N-gram を強調する」ベクトルになり、 テキスト類似度や分類の入力として即戦力です。 scikit-learn では TfidfVectorizer(analyzer='char'|'word', ngram_range=(a,b)) の 1 行で切り替えられます(本ページの実測コード参照)。
⑤ ニューラル言語モデルへの移行
N-gram の根本限界(長距離依存を捉えない・未観測に弱い)を、 連続ベクトル表現で乗り越えたのが 単語埋め込み→RNN/LSTM→Transformer→大規模言語モデル(LLM)の系譜です。 面白いのは、 Transformer の注意(attention)が実質「N を可変に伸縮する N-gram」のように振る舞う点で、 N-gram の直感は現代モデルの理解にもそのまま生きます。 「カウントベースの原点」として N-gram を押さえておくことが、 NLP全体の見通しを良くします。
🔗 あわせて読みたい関連ページ
N-gram の理解を「前提 → 並列 → 発展」で広げるための、 本用語集内の関連ページへのリンクです。
- 前提(上流):トークン化(単語分割)・形態素解析——N-gram を数える前の「要素への分割」。 条件付き確率——マルコフ近似 $P(w_t\mid w_{t-N+1:t-1})$ の土台。
- 並列(同じ特徴量の仲間):TF-IDF——N-gram 頻度に重みを付ける定番。 テキスト類似度——N-gram ベクトルの cosine 類似度が基礎。 なお Bag of Words・BPE / SentencePiece(サブワード化)は本用語集に単独ページが無いため、 NLP・NLP グループ教材内の該当箇所を参照してください。
- 発展(下流・高度化):N-gram 言語モデル——頻度カウントを確率モデルに。 文書分類——N-gram を特徴量に使う代表タスク。 単語埋め込み→Transformer→大規模言語モデル——長距離依存を捉える現代的後継。 機械翻訳——BLEU 評価が N-gram 一致に基づく。
- 全体像:自然言語処理(NLP)/NLP グループ教材——N-gram から Transformer までの位置付けを俯瞰。
※ リンクは本用語集内に実在するページのみを張っています。 単独ページの無い概念(Bag of Words、 BPE、 言語モデル一般)は、 上記グループ教材内で扱っています。