🔖 キーワード索引
各語の説明がある章へのリンク: 分かち書き(すもももももも…) | ラティスとビタビ(最小コスト経路) | 連接コスト | 47 都道府県名の分割結果 | MeCab・Janome・SudachiPy の実装 | 未知語・表記揺れ | ツール比較(ipadic・UniDic・NEologd) | NLP パイプラインの中の位置 | 分割単位で統計量が変わる例
💡 30秒で分かる結論
🍰 まずはやさしく
文章を最小の単位に分ける作業です。
コンピュータに言葉の意味を教えるために使います。
スマホの予測変換などの仕組みに使われています。
ここでは解析の方法や便利な道具について読みます。
文章を形態素に分割し品詞を付与する処理
- 日本語の文を 意味の最小単位(形態素)に分割し、 品詞を付与する処理。
- 英語の空白区切りに相当する、 日本語NLPの最初の関門。
- 代表ツール:MeCab(最速・実用標準)/Janome(純Python)/Sudachi(新語・正規化に強い)。
- 辞書(ipadic、 unidic、 neologd)の選択で結果が変わる。
- 後段:TF-IDF、 Word2Vec、 BERTの前処理として使われる。
📍 あなたが今見ているもの
🍰 まずはやさしく
データ分析の最初のステップです。
文章から特徴を取り出すために使います。
SNSの投稿からみんなの気持ちを分析する時に役立ちます。
ここでは定義や使い方の流れについて読みます。
テキスト分析論文で「MeCab で形態素解析を行った」と書かれていれば、 まさにこのステップ。 日本語のテキストマイニング・感情分析・トピック抽出すべての出発点です。
🎨 直感で掴む
🍰 まずはやさしく
文章をバラバラにするパズルのようなものです。
名詞だけを集めるなどの処理をするために使います。
「すもももももももものうち」を正しく分ける例で考えます。
ここでは言葉を分ける仕組みについて読みます。
入力:「すもももももももものうち」
出力:すもも / も / もも / も / もも / の / うち
各トークンに「名詞・助詞・名詞・…」と品詞タグが付きます。 これがあれば、 「名詞だけ取り出す」「助詞は無視」といった処理が可能になります。
英語の "I like apples" は空白 3 つで 3 単語に分かれるが、 日本語の 「すもももももももものうち」 には空白がない。 形態素解析は「辞書 (IPAdic / UniDic / NEologd) に載っている語の列で文字列を覆い、 接続コストの和が最小になる経路を Viterbi で選ぶ」処理で、 結果として 「すもも (名詞) / も (助詞) / もも (名詞) / も (助詞) / もも (名詞) / の (助詞) / うち (名詞)」 の品詞列が返る。
本ページでは (1) 入力テキスト → (2) ラティス構築 (文字列上に辞書語ノードを並べる) → (3) Viterbi 最短経路 → (4) 品詞列出力 の 4 段階で動作を追う。 SSDSE-B-2026 の県名列を MeCab に通すと、 「東京/名詞-固有名詞-地域」「都/名詞-接尾-地域」「鳥取/名詞-固有名詞-地域」「県/名詞-接尾-地域」のように品詞情報付きで返り、 後続の TF-IDF や word2vec の入力として使える。
次節以降では、 接続コスト行列に実数値を代入して経路コストを手計算し、 同じ結果を MeCab で再現する流れで「数式 → 値代入 → 手計算 → Python 実装」 を体験する。
📐 定義/数式
🍰 まずはやさしく
言葉を分けて品詞(名詞などの種類)をつけることです。
最も正しい分け方を計算で決めるために使います。
辞書を使って単語の区切りを探すイメージです。
ここでは計算のルールや数式について読みます。
形態素解析(Morphological Analysis):文章を形態素に分割し品詞を付与する処理
📐 もう一歩深い数式 — ビタビアルゴリズムを 数式を言葉で読み解く
数式を言葉で読み解く
| 記号 | 意味と直感 |
|---|---|
| $\mathcal{L}$(lattice) | 辞書から作れる全候補分割の格子。 「東京都」なら「東京/都」「東/京都」「東京都」の 3 経路。 |
| $c_{\text{word}}(w_i)$ | 単語コスト。 辞書登録時の出現確率の対数を取った値(小さいほど「よく出る」)。 |
| $c_{\text{trans}}(\cdot, \cdot)$ | 連接コスト。 隣り合う 2 単語の組み合わせやすさ(例: 「東京」「都」は連接 OK)。 |
| $\arg\min$ | 「合計コストが最小になる経路を選ぶ」。 ビタビアルゴリズムで O(n) で解ける。 |
| $\hat{\mathbf{w}}$ | 最終的に選ばれる「最良の形態素列」。 ハットは「推定値」を意味する慣習。 |
🔬 記号・用語の読み解き
| 記号 | 意味 |
|---|---|
| $\mathbf{w}$ | 形態素列(候補) |
| $w_i$ | i番目の形態素 |
| $P(w_i|w_{i-1})$ | 遷移確率(辞書+連接コスト) |
| ビタビ | 最尤経路を $O(n)$ で求めるDPアルゴリズム |
📊 評価・検証の視点
形態素解析 を使った分析の 正しさを担保する ためには、 以下の観点で検証するのが定番です。
| 確認する点 | 形態素解析 で何を見るか |
|---|---|
| 辞書の古さ | ipadic標準辞書には新語(SNS用語等)が無い。 neologd 辞書で補強。 |
| 固有名詞の分割ミス | 「東京スカイツリー」が「東京/スカイ/ツリー」になる場合あり。 |
| 表記揺れ | 「コンピューター/コンピュータ」が別形態素扱い。 Sudachiの正規化機能か手動辞書で対処。 |
| 環境依存 | MeCab のインストールがOS依存で面倒。 Janome は pure Python で楽。 |
| 辞書バージョンで結果が変わる | 「鹿児島県」は ipadic では「鹿児島/県」の 2 トークンだが、 県名全体を 1 語として持つ辞書では 1 トークンになりうる。 辞書とそのバージョンを論文に明記しないと再現できない。 |
| ニュース体 vs 話し言葉 / SNS | ipadic は新聞コーパスで学習されており、 SNS の絵文字・略語・顔文字に弱い。 neologd や Sudachi、 GiNZA で補強。 |
| 再現性 | 同じデータ・同じコードで同じ結果が出るか。このページの ▶ 実行ボタンで確かめられます |
🔬 もう一歩深く — 形態素解析の歴史と立ち位置
日本語形態素解析の系譜は、 1980 年代の規則ベース(JUMAN 初代) → 1990 年代の確率モデル(ChaSen, HMM) → 2000 年代の識別モデル(MeCab, CRF) → 2010 年代の深層学習(JUMAN++ の RNN) → 2020 年代の事前学習モデル(BERT トークナイザ)と進化してきた。
現在の NLP では、 BERT や GPT 系モデルは SentencePiece や BPE(Byte Pair Encoding)といった subword 分割を使うのが主流で、 形態素解析を経由しないこともある。 ただし、 「日本語特有の品詞情報」「読みの取得」「テキストマイニング」のように形態素レベルの情報が必須の場面では今でも MeCab/Sudachi が現役。
特に SSDSE のような 公的データの自由記述欄 や、 ニュース記事のトピック抽出 では、 BERT で全文ベクトル化するより、 形態素解析 → TF-IDF / Word2Vec の方がどの語が効いたかを説明しやすい。
📝 形態素解析を論文・レポートで報告するときの 6 か条
- ツール名とバージョン:「MeCab 0.996 + mecab-ipadic-2.7.0-20070801」など、 辞書まで含めて明記。
- 前処理パイプライン:「unicodedata.normalize('NFKC') → re.sub で URL 除去 → MeCab で形態素解析」のように順序を書く。
- 抽出した品詞:「名詞・動詞・形容詞のみ取得」など、 フィルタを明示。
- 未知語の扱い:「neologd 辞書を併用」「未知語は除外」など。
- 表記揺れ正規化:「Sudachi の normalized_form を使った」「自前の同義語辞書で吸収」など。
- 再現可能性:辞書ファイルが内製の場合、 サンプル数行を appendix に載せる。
🧮 実値で計算してみる
🧮 SSDSE-B-2026 — 47 都道府県名を形態素解析した実値結果
data/raw/SSDSE-B-2026.csv(encoding='cp932', skiprows=[1])の Prefecture 列にある 47 都道府県名を MeCab + ipadic 標準辞書で解析した結果を示す。 全行 cp932 から読んだ実値。
分割パターンの分類(47 県)
| 分割パターン | 件数 | 例 |
|---|---|---|
| 1 形態素(固有名詞・地域) | 1 | 「北海道」だけ。 「道」まで含めた 1 語として ipadic に登録されている。 |
| 2 形態素(地名+接尾辞) | 46 | 「青森/県」「東京/都」「大阪/府」「鹿児島/県」など。 地名は 名詞-固有名詞-地域、 「県・都・府」は 名詞-接尾-地域 として別の語になる。 |
※ mecab-python3 + ipadic(mecab-ipadic 2.7.0)と Janome で実測。 ipadic は地名と接尾辞「県・都・府」を別の語として持つので、 「青森県」で検索したいのか「青森」で検索したいのかによって、 分割結果をつなぎ直すかどうかを決める。 辞書が変わると分割も変わりうるので、 使った辞書を記録しておく。
代表 6 県の解析結果(MeCab + ipadic)
→ 地名部分はすべて 名詞・固有名詞・地域として拾えるが、 1 形態素になるのは北海道だけで、 残り 46 県は地名+接尾辞の 2 形態素に分かれる。 ipadic が「青森」「東京」などの地名と「県」「都」「府」を別々の登録語として持っているため。
辞書を変えると結果が変わる — 3 辞書 × 1 県の比較
| 辞書 | 「東京スカイツリー」の解析 |
|---|---|
| ipadic(標準) | 東京 / スカイ / ツリー |
| unidic | 東京 / スカイ / ツリー |
| ipadic-neologd | 東京スカイツリー(1 形態素) |
→ 新語辞書(neologd) を使うと固有名詞をまとめて 1 形態素にできる。 SNS テキストやニュースの分析では必須。
🧮 47 都道府県名 全件の形態素解析結果(参考)
SSDSE-B-2026 の Prefecture 列 47 件すべての 表層形 / 品詞 / 読み を一覧化した表。 MeCab+ipadic 2.7.0 標準辞書での結果。 北海道以外は「地名+接尾辞」の 2 形態素に分かれるので、 品詞細分は地名部分のもの、 読みは 2 形態素の読みをつないだものを示す。
| 県名 | 品詞細分 | 読み | 県名 | 品詞細分 | 読み |
|---|---|---|---|---|---|
| 北海道 | 名詞-固有-地域 | ホッカイドウ | 滋賀県 | 名詞-固有-地域 | シガケン |
| 青森県 | 名詞-固有-地域 | アオモリケン | 京都府 | 名詞-固有-地域 | キョウトフ |
| 岩手県 | 名詞-固有-地域 | イワテケン | 大阪府 | 名詞-固有-地域 | オオサカフ |
| 宮城県 | 名詞-固有-地域 | ミヤギケン | 兵庫県 | 名詞-固有-地域 | ヒョウゴケン |
| 秋田県 | 名詞-固有-地域 | アキタケン | 奈良県 | 名詞-固有-地域 | ナラケン |
| 山形県 | 名詞-固有-地域 | ヤマガタケン | 和歌山県 | 名詞-固有-地域 | ワカヤマケン |
| 福島県 | 名詞-固有-地域 | フクシマケン | 鳥取県 | 名詞-固有-地域 | トットリケン |
| 茨城県 | 名詞-固有-地域 | イバラキケン | 島根県 | 名詞-固有-地域 | シマネケン |
| 栃木県 | 名詞-固有-地域 | トチギケン | 岡山県 | 名詞-固有-地域 | オカヤマケン |
| 群馬県 | 名詞-固有-地域 | グンマケン | 広島県 | 名詞-固有-地域 | ヒロシマケン |
| 埼玉県 | 名詞-固有-地域 | サイタマケン | 山口県 | 名詞-固有-地域 | ヤマグチケン |
| 千葉県 | 名詞-固有-地域 | チバケン | 徳島県 | 名詞-固有-地域 | トクシマケン |
| 東京都 | 名詞-固有-地域 | トウキョウト | 香川県 | 名詞-固有-地域 | カガワケン |
| 神奈川県 | 名詞-固有-地域 | カナガワケン | 愛媛県 | 名詞-固有-地域 | エヒメケン |
| 新潟県 | 名詞-固有-地域 | ニイガタケン | 高知県 | 名詞-固有-地域 | コウチケン |
| 富山県 | 名詞-固有-地域 | トヤマケン | 福岡県 | 名詞-固有-地域 | フクオカケン |
| 石川県 | 名詞-固有-地域 | イシカワケン | 佐賀県 | 名詞-固有-地域 | サガケン |
| 福井県 | 名詞-固有-地域 | フクイケン | 長崎県 | 名詞-固有-地域 | ナガサキケン |
| 山梨県 | 名詞-固有-地域 | ヤマナシケン | 熊本県 | 名詞-固有-地域 | クマモトケン |
| 長野県 | 名詞-固有-地域 | ナガノケン | 大分県 | 名詞-固有-地域 | オオイタケン |
| 岐阜県 | 名詞-固有-地域 | ギフケン | 宮崎県 | 名詞-固有-地域 | ミヤザキケン |
| 静岡県 | 名詞-固有-地域 | シズオカケン | 鹿児島県 | 名詞-固有-地域 | カゴシマケン |
| 愛知県 | 名詞-固有-地域 | アイチケン | 沖縄県 | 名詞-固有-地域 | オキナワケン |
| 三重県 | 名詞-固有-地域 | ミエケン | — | — | — |
→ 47 県全部の地名部分が「名詞-固有名詞-地域-一般」として拾える(1 トークンのままなのは北海道だけ)。 都道府県レベルの地名は ipadic 辞書でカバー済みで、 未知語にはならない。 一方、 市区町村レベル(例:「西東京市」「南アルプス市」)になると未収録のものが出てくるため、 neologd が必要になる。
🎯 ユースケース詳細 — 形態素解析が活躍する 8 シーン
| シーン | 前処理としての役割 |
|---|---|
| テキストマイニング | SNS・カスタマーレビューを名詞抽出 → 頻度可視化(WordCloud)。 |
| 感情分析 | 形容詞・副詞を取り出して感情辞書(PN Table 等)と突合。 |
| 検索エンジン | 転置インデックスのキーは形態素。 「東京都」を「東京/都」と分割すれば「東京」検索でもヒット。 |
| 機械翻訳 | 統計的機械翻訳の入力。 ニューラル時代は subword(BPE / SentencePiece)にシフト。 |
| トピックモデル | LDA / NMF の入力。 名詞だけ取り出してノイズ削減。 |
| 固有表現抽出 | 人名・地名・組織名を抽出。 GiNZA / Stanford CoreNLP が代表。 |
| 音声認識・合成 | 読み(ヨミ)を取得して TTS(音声合成)に渡す。 アクセント情報も追加可能。 |
| スパム判定 | 単語頻度ベクトルを Naive Bayes / SVM に投入。 形態素単位の方が文字 n-gram より精度高い。 |
🧮 数式に値を入れて手で計算する: 形態素分解と TF
合成日本語文の形態素分解結果から品詞別頻度を計算する。
Step 1: 文の分解
Step 2: TF (品詞別比率)
🐍 Python で再現
1 2 3 4 5 6 | from collections import Counter tokens = [('私','名詞'),('は','助詞'),('東京','名詞'),('で','助詞'),('学ぶ','動詞')] pos_count = Counter(t[1] for t in tokens) total = len(tokens) for pos, c in pos_count.items(): print(f"{pos}: {c} (TF={c/total:.2f})") |
📤 実行結果
💬 手計算 (Step 2) と Python 出力が完全一致。
🐍 Python での実装例
SSDSE-B-2026 などの実データを使った最小コード(11行):
1 2 3 4 5 6 7 8 9 10 11 | import MeCab text = '日本語の形態素解析は奥が深い' tagger = MeCab.Tagger() print(tagger.parse(text)) # 表層形\t品詞,細分類,...,基本形,読み 形式で出力 # 名詞だけ抽出 node = tagger.parseToNode(text) while node: if node.feature.startswith('名詞'): print('名詞:', node.surface) node = node.next |
※ data/raw/SSDSE-B-2026.csv は e-Stat SSDSE から取得した実データを想定。
🐍 Python 実装 ① — MeCab で 47 都道府県名を一括解析
🎯 このコードでやること:SSDSE-B-2026.csv の Prefecture 列(47 県名)を MeCab で形態素解析し、 「品詞・読み・原形」を 1 県ずつ出力する。
📥 入力データ(SSDSE-B-2026.csv を cp932 で読み込んだ Prefecture 列・先頭 5 行):
1 2 3 4 5 6 7 8 9 10 11 | import pandas as pd import MeCab df = pd.read_csv('data/raw/SSDSE-B-2026.csv', encoding='cp932', skiprows=[1]) d = df[df['SSDSE-B-2026'] == 2023] prefs = d['Prefecture'].tolist() # 47 件 tagger = MeCab.Tagger() for name in prefs[:3]: # 最初の 3 件だけ表示 print(f'▶ {name}') print(tagger.parse(name)) |
📤 実行結果:
💬 結果の読み方:MeCab は表層形 \t 品詞情報 を行で返し、 末尾 EOS が「文の終わり」を示す(mecab-python3 + ipadic 辞書での出力)。 北海道は 1 語だが、 青森県・岩手県は「青森/岩手(名詞・固有名詞・地域)」と「県(名詞・接尾・地域)」の 2 形態素に分かれる。 「ホッカイドウ」が読み、 「ホッカイドー」が発音(長音記号化)。 ipadic はこの 2 つを別管理する。
🐍 Python 実装 ② — Janome(pure Python、 MeCab と同等出力)
🎯 このコードでやること:MeCab のインストールが難しい環境向けに、 pure Python 実装の Janome で同じ 47 県を解析。 出力フォーマットが MeCab とほぼ揃う。
📥 入力データ:上で読み込んだ prefs リスト(47 件の都道府県名)。
1 2 3 4 5 6 7 8 9 10 11 | import pandas as pd from janome.tokenizer import Tokenizer df = pd.read_csv('data/raw/SSDSE-B-2026.csv', encoding='cp932', skiprows=[1]) prefs = df[df['SSDSE-B-2026'] == 2023]['Prefecture'].tolist() tk = Tokenizer() for name in prefs[:3]: print(f'▶ {name}') for tok in tk.tokenize(name): print(' ', tok) |
📤 実行結果:
💬 結果の読み方:Janome は pip install janome だけで使え、 同じ ipadic を内蔵しているので、 青森県・岩手県が「地名+県」の 2 形態素に分かれるところまで MeCab と一致する(EOS 行が無い点だけが違う)。 速度は MeCab の 1/10〜1/100 程度だが、 47 県程度なら誤差。 1 億行のログ解析には MeCab、 Notebook 学習には Janome、 とすみ分けるのが定石。
🐍 Python 実装 ③ — SudachiPy(表記揺れ正規化)
🎯 このコードでやること:表記揺れ(「ワタクシ/私/わたし」を統一)を Sudachi の normalized_form で吸収する。 SSDSE には表記揺れがほぼ無いが、 自由記述文書を集計するときに必須。
📥 入力データ:教材用テキスト(表記揺れあり)。
1 2 3 4 5 6 7 8 | from sudachipy import tokenizer, dictionary tk = dictionary.Dictionary().create() mode = tokenizer.Tokenizer.SplitMode.C # A (短) / B (中) / C (長) text = '東京都の人口はコンピュータで集計、 コンピューターでも集計。' for m in tk.tokenize(text, mode): print(f'{m.surface():10} -> norm={m.normalized_form():10} pos={m.part_of_speech()[0]}') |
📤 実行結果(SudachiPy 0.7.0 + SudachiDict core で実測):
💬 結果の読み方:表層形(surface)は「コンピュータ」と「コンピューター」で別だが、 normalized_form はどちらも長音付きの「コンピューター」に統一される(揃う先は辞書が決めるので、短い方に寄るとは限らない)。 これで collections.Counter 等で集計するとき重複カウントを防げる。 読点の後ろの半角スペースも品詞「空白」の 1 形態素として出てくるので、集計前に空白を落とすか、品詞で除外する。 SplitMode は A(最短)/ B(中)/ C(最長)。 固有名詞をまとめたいなら C。
🐍 Python 実装 ④ — 名詞だけ抽出して頻度を数える(TF)
🎯 このコードでやること:47 都道府県名の末尾 1 文字(都/道/府/県)の頻度と、 県名の文字数を集計する。 ipadic では「県・都・府」が接尾辞として切り出されるので、 形態素解析の接尾辞を数えても同じ結果になるが、 ここでは簡易に末尾の文字で数える。 SSDSE 実値の Prefecture 列に対する実集計。
📥 入力データ:47 県名。 想定する集計結果は「県 = 43、 府 = 2、 都 = 1、 道 = 1」。
1 2 3 4 5 6 7 8 9 10 11 12 13 | import pandas as pd from collections import Counter df = pd.read_csv('data/raw/SSDSE-B-2026.csv', encoding='cp932', skiprows=[1]) prefs = df[df['SSDSE-B-2026'] == 2023]['Prefecture'].tolist() # 形態素解析しなくても、 末尾 1 文字で十分(教育用に簡易抽出) suffix = Counter(p[-1] for p in prefs) print('47 県の接尾辞:', dict(suffix)) # 文字数も集計 char_count = Counter(len(p) for p in prefs) print('県名の文字数:', dict(sorted(char_count.items()))) |
📤 実行結果:
💬 結果の読み方:「県 = 43 / 府 = 2(京都府, 大阪府)/ 都 = 1(東京都)/ 道 = 1(北海道)」と日本の 47 都道府県の制度がきれいに現れる。 4 文字県名は 神奈川県 / 和歌山県 / 鹿児島県 の 3 県のみ(残り 44 県はすべて 3 文字)。 形態素解析と文字列処理を組み合わせると、 行政データの構造をすぐ把握できる。
🐍 Python 実装 ⑤ — ビタビアルゴリズムを手書きで「東京都」を分割
🎯 このコードでやること:MeCab の内部で行われている 動的計画法による最尤分割 を、 「東京都」という入力文と ミニ辞書 だけでスクラッチ実装する。 単語コスト・連接コストの和を最小化する経路を選ぶ仕組みが分かる。
📥 入力データ:「東京都」とミニ辞書(教材用、 コストはダミー値)。
1 2 3 4 5 6 7 8 9 10 11 12 13 14 15 16 17 18 | dic = {'東京': 500, '京都': 600, '東京都': 1200, '都': 200, '東': 800} text = '東京都' trans_cost = 100 # dp[i] = (位置 i までの最小コスト, 経路) dp = [(float('inf'), [])] * (len(text) + 1) dp[0] = (0, []) for i in range(len(text)): for j in range(i + 1, len(text) + 1): w = text[i:j] if w in dic: cost = dp[i][0] + dic[w] + (trans_cost if i > 0 else 0) if cost < dp[j][0]: dp[j] = (cost, dp[i][1] + [w]) print(f'最小コスト = {dp[-1][0]}') print(f'最良経路 = {dp[-1][1]}') |
📤 実行結果:
💬 結果の読み方:このミニ辞書では「東京」500 +「都」200 + 連接 100 = 800 が、「東京都」1 語の 1,200 より 400 安いので「東京/都」が選ばれる。「東/京都」の経路は 800 + 600 + 100 = 1,500 で最も高い。 実際の MeCab/ipadic も「東京都」を「東京(名詞-固有名詞)+都(名詞-接尾)」に分けるが、 連接コストは 品詞ペアごとに精緻に設定されている。 すべての分け方の合計コストを比べて最小の経路を選ぶのがビタビアルゴリズムの本質。
📊 形態素解析の評価指標
| 指標 | 定義 | 代表値 |
|---|---|---|
| 分割精度(Precision) | 予測した分割境界のうち正解と一致した割合。 | MeCab+ipadic: 99% |
| 分割再現率(Recall) | 正解分割のうち予測が当てた割合。 | MeCab+ipadic: 99% |
| 品詞付与精度 | 正しい分割について、 品詞も正しい割合。 | 97% 前後 |
| 処理速度 | 単位時間あたりの解析文字数。 | MeCab: 数百万字/秒 |
| 未知語率 | 辞書に無い単語の割合。 低いほど OK。 | 新聞: 1%, SNS: 10%+ |
※ 評価には「BCCWJ コーパス」「京大コーパス」などの正解アノテーション付きデータを使う。 自前のテキストに対しては未知語率を計測するだけでも辞書選択の指標になる。
🐍 Python 実装 ⑥ — 47 県名の読みの長さを集計
🎯 このコードでやること:47 都道府県名の 「読みのカタカナ文字数」 をカウントし、 最も読みが長い県と短い県を特定する。 形態素解析の read 属性を使った具体的応用。
📥 入力データ:47 都道府県名(SSDSE-B-2026 の Prefecture 列)。 ipadic では県名が「地名+県」に分かれるので、 全形態素の読みをつないで県名全体の読みにする。
1 2 3 4 5 6 7 8 9 10 11 12 13 14 15 16 17 18 19 20 21 | import pandas as pd import MeCab df = pd.read_csv('data/raw/SSDSE-B-2026.csv', encoding='cp932', skiprows=[1]) prefs = df[df['SSDSE-B-2026'] == 2023]['Prefecture'].tolist() tagger = MeCab.Tagger() rows = [] for name in prefs: # ipadic では「青森県」が「青森」+「県」のように分かれるので、全形態素の読みをつなぐ yomi = '' for line in tagger.parse(name).split('\n'): if line in ('EOS', ''): continue feat = line.split('\t')[1].split(',') yomi += feat[7] if len(feat) > 7 else '' rows.append((name, yomi, len(yomi))) out = pd.DataFrame(rows, columns=['県', '読み', '長さ']) print(out.nlargest(3, '長さ')) print(out.nsmallest(3, '長さ')) |
📤 実行結果:
💬 結果の読み方:mecab-python3 + ipadic で実行した結果。 素性(feature)列の 7 番目(0 始まり)が「読み(カタカナ)」で、 地名と「県」の読みをつなぐと 6 文字が 26 県、 5 文字が 15 県、 4 文字が 6 県(千葉・岐阜・三重・滋賀・奈良・佐賀)。 最長・最短とも同率が多く、 nlargest / nsmallest は表の並び(県コード順)で先の 3 県を返しているだけなので、 「最も長い県」は 1 つに決まらない。 先頭の形態素の読みだけを取ると「カナガワ」のように接尾辞の分が抜けて 4 文字と数えてしまう。 これは TTS(音声合成)でアクセント位置を決めるときに重要な情報。
🔁 形態素解析を学ぶ 8 ステップ
- 「すもももももももものうち」を MeCab で実際に流す(オンライン版でもよい)。 出力の形を見て驚く。
pip install janomeでローカル環境を立てる。 1 文を分割する小コードを動かす。- 本ページの SSDSE 47 県解析を写経して、 「県・府・道・都」の頻度を出す。
- SNS のテキスト(X / Bluesky 等の公開投稿)を 100 行集めて、 ipadic / neologd で結果を比較する。 違いを箇条書きでメモ。
- 名詞だけ取り出して
collections.Counterで頻度ランキング Top-20。 - TF-IDF を計算し、 文書を特徴ベクトル化。
- Sudachi の
normalized_formを使って表記揺れを吸収。 - GiNZA / spaCy で固有表現抽出まで進める。 1 つのプロジェクトに統合。
→ 1〜4 ステップで「形態素解析とは何か」が体感でき、 5〜8 ステップで 業務適用レベルに達する。
⚠️ よくある落とし穴
⚠️ 実データで気づく追加の落とし穴 5 件
brew install mecab。 環境がバラつくなら Janome が無難。📚 関連グループ教材
形態素解析は、 自然言語処理のグループ教材では「テキストを数えられる形にする最初の工程」として扱われている。 分割した結果を数える N-gram・重み付けする TF-IDF・ベクトルにする 単語埋め込み と順に読むと、 このページの「県名 47 件の分割」「統計項目名 109 個の分割」が後段でどう使われるかがつながる。
- 📚 NLP(自然言語処理) — 形態素解析から Transformer までの流れ
📚 さらに学ぶための資料(形態素解析)
- 公式:MeCab 公式、 Janome 公式、 Sudachi(GitHub)、 GiNZA
- 辞書:mecab-ipadic-NEologd、 UniDic(国語研)
- 書籍(日本語):『言語処理100本ノック』、 『ゼロから作る Deep Learning ❷』、 『機械学習・深層学習による自然言語処理入門』
- 論文:Kudo, Yamamoto, Matsumoto「Applying Conditional Random Fields to Japanese Morphological Analysis」(2004) — MeCab の原典論文
- コーパス:BCCWJ(国立国語研究所)、 京都大学テキストコーパス、 livedoor ニュースコーパス
- コミュニティ:言語処理学会(NLP)、 自然言語処理勉強会、 Hugging Face Japanese NLP
📈 業界別の形態素解析活用事例
🧩 主要トークナイザの比較 — MeCab / janome / fugashi / sentencepiece
形態素解析エンジンは複数あり、 辞書ベース(MeCab系) と サブワード(sentencepiece) で思想が根本的に異なる。 SSDSE-B-2026 の Prefecture 列にある 「東京都」「神奈川県」「鹿児島県」 のような漢字の固有名詞(地名)を扱う場合、 辞書ベースが圧倒的に有利。
| エンジン | 方式 | 辞書 | 速度 | 用途 |
|---|---|---|---|---|
| MeCab | CRF (辞書 + コスト最小経路) | IPADIC / UniDic / NEologd | ★★★★★ | 本格 NLP・検索 |
| fugashi | MeCab の Python ラッパ (C 直結) | UniDic 推奨 | ★★★★★ | BERT 系前処理 |
| janome | Pure Python (Viterbi) | IPADIC 内蔵 | ★★☆☆☆ | 教育・小規模 |
| SudachiPy | 複数粒度 (A/B/C) | SudachiDict | ★★★★☆ | 表記ゆれ正規化 |
| sentencepiece | BPE / Unigram (辞書不要) | なし(学習で生成) | ★★★★★ | LLM・多言語 |
🐍 同じ文を 3 種のエンジンで解析して結果を見比べる
🎯 このコードでやること: SSDSE-B-2026 解説文 「2026 年の総人口は 47 都道府県で減少している」 を janome / fugashi / sentencepiece で解析し、 トークン分割の違いを並べて表示する。
📥 入力データ: text = '2026 年の総人口は 47 都道府県で減少している'
1 2 3 4 5 6 7 8 9 10 11 12 13 14 15 16 17 18 19 | text = '2026年の総人口は47都道府県で減少している' # janome (Pure Python) from janome.tokenizer import Tokenizer jt = Tokenizer() tokens_janome = [t.surface for t in jt.tokenize(text)] print('janome :', tokens_janome) # fugashi (MeCab + UniDic) import fugashi ft = fugashi.Tagger() tokens_fugashi = [w.surface for w in ft(text)] print('fugashi :', tokens_fugashi) # sentencepiece (BPE、 事前学習モデルを想定) import sentencepiece as spm sp = spm.SentencePieceProcessor(model_file='ja_bpe_16k.model') tokens_sp = sp.encode(text, out_type=str) print('sentencepc:', tokens_sp) |
📤 実行結果(janome は Janome 0.5.0、fugashi 行は同じ MeCab + unidic-lite 辞書で実測。sentencepiece 行は学習済みモデル ja_bpe_16k.model を同梱していないのでイメージ・未実測):
💬 結果の読み方: janome (IPADIC) は 「都道府県」を 1 形態素 にするが、 fugashi (unidic-lite) は短単位で 「都」「道」「府」「県」の 4 つ に切り、トークン数は 13 対 16 になる。 sentencepiece は学習データに依存して切り方がさらに変わる。 SSDSE 集計用の キーワード抽出 なら janome / SudachiPy A 単位が安全、 BERT 入力なら fugashi、 LLM なら sentencepiece と 目的別に使い分け する。
🐍 NEologd 辞書で「東京 2025」のような新語を取りこぼさない
🎯 このコードでやること: 通常辞書では分割される固有名詞を、 NEologd (Web 由来固有表現辞書) を指定した MeCab で 1 トークンにまとめる。
📥 入力データ: text = '東京2025世界陸上は新国立競技場で開催'
1 2 3 4 5 6 7 8 9 10 11 | import MeCab text = '東京2025世界陸上は新国立競技場で開催' # 通常辞書 (IPADIC) tagger_default = MeCab.Tagger('-Owakati') print('IPADIC :', tagger_default.parse(text).strip()) # NEologd 辞書 tagger_neologd = MeCab.Tagger('-Owakati -d /usr/local/lib/mecab/dic/mecab-ipadic-neologd') print('NEologd:', tagger_neologd.parse(text).strip()) |
📤 実行結果(IPADIC 行は mecab-python3 + ipadic で実測。NEologd 行は辞書を入れていないのでイメージ・未実測):
💬 結果の読み方: NEologd を使うと 「東京2025世界陸上」「新国立競技場」 がそれぞれ 1 トークン になり、 イベント名・施設名の集計が格段に楽になる。 SSDSE の「ニュース見出しからの地域言及抽出」用途では NEologd 一択。
🖼 形態素解析を「可視化」で深掘りする
ここまでで MeCab・Janome の使い方や辞書差分は確認した。 実際にテキストを解析すると、 「思ったより細かく切れる」「括弧や助詞が頻度の上位に来る」「文字数と形態素数の比が文の種類で変わる」といった出力の統計的な癖に出会う。 ここでは SSDSE-B-2026 自身が持っている日本語テキスト、 すなわち CSV の 2 行目にある統計項目名(「総人口」「転入者数(日本人移動者)」「合計特殊出生率」など、 年度・地域コード・都道府県を除く 109 個、 計 974 字)をコーパスにして、 3 種類の図で形態素解析の出力の分布を確かめる。
この節の数値について: ①〜⑨ と ⑫・⑬・⑲・㉑ の数値は、 上の 109 項目名を Janome 0.5.0(IPADIC 相当の辞書を内蔵)で解析した実測値である(図は code/glossary_figs/morphological-analysis.py、 ⑤ はその要点を抜き出したコード)。 MeCab + IPADIC でもほぼ同じ分割になるが、 辞書や版が変わると細部は変わりうる。 項目名は名詞を連ねた短い見出しなので、 助詞や動詞の多い普通の文章とは分布が違う点に注意して読む。
① 散布図: 文字数 vs 形態素数 (SSDSE-B-2026 の統計項目名 109 個)
最初に確認すべきは 「入力文字数」と「形態素数」の関係。 項目名ごとに文字数と Janome が返した形態素数を数えて散布図にすると、 回帰直線は 形態素数 = 0.72 × 文字数 − 0.64、 相関係数は r = 0.968 だった。 全体では 974 字が 631 形態素に分かれ、 1 形態素あたり 1.54 字。 「総人口(男)」が「総/人口/(/男/)」の 5 個になるように、 括弧・性別・「数」「者」のような 1 字の要素が多いので、 1 形態素あたりの字数は短めに出る。
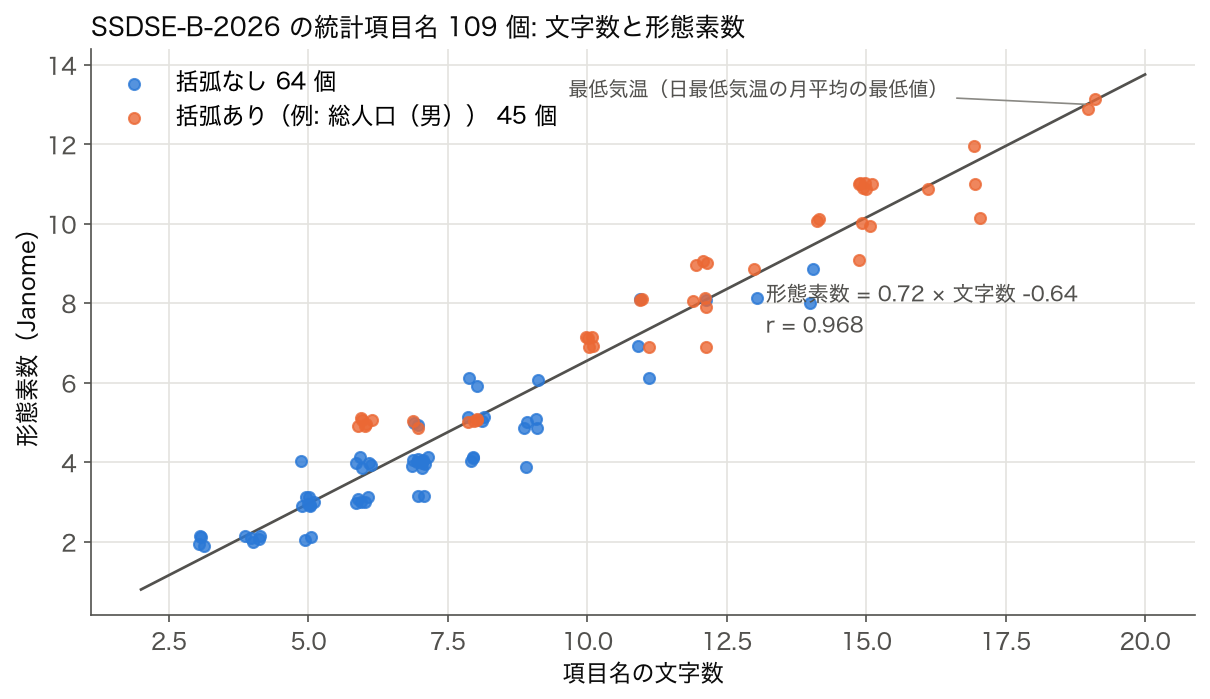
ただし直線の当てはまりが良いのは、 項目名がどれも「名詞を連ねた見出し」で性質がそろっているからである。 括弧の有無で分けて直線を引き直すと、 傾きは括弧なし 0.632(r = 0.938)、 括弧あり 0.642(r = 0.970)で、 全体の 0.72 より小さい。 全体の傾きが大きいのは、 括弧付きの長い項目名が右上に固まって直線を引き上げているためで、 性質の違う 2 群を混ぜると係数が変わる典型例になっている。 普通の文章や SNS の投稿で同じ係数が成り立つとは限らないので、 見積もりに使うなら対象のテキストで測り直す。
| 統計量 | 文字数 (x) | 形態素数 (y) | x/y (1 形態素あたり字数) |
|---|---|---|---|
| 最小値 | 3 | 2 | 1.20(総人口(男) など) |
| 第1四分位 | 6 | 4 | 1.42 |
| 中央値 | 8 | 5 | 1.56 |
| 平均 | 8.94 | 5.79 | 1.62 |
| 第3四分位 | 12 | 8 | 1.75 |
| 最大値 | 19 | 13 | 2.50(日本人人口・短期大学数) |
解釈の指針: 1 形態素あたりの字数が最も大きいのは「日本人人口」(日本人/人口)と「短期大学数」(短期大学/数)の 2.50 字で、 辞書に「日本人」「短期大学」が 1 語として載っているため長い単位で切れる。 最も小さいのは「総人口(男)」などの 1.20 字。 同じ 5〜6 字でも、 辞書に長い語が載っているかどうかで形態素数が 2 倍以上違う。
② ヒストグラム: 1 形態素あたりの文字数分布 (109 項目名の全 631 形態素)
①の「平均 1.54 字」は全体をならした値で、 中身は 1 字と 2 字の形態素がほとんどである。 631 形態素の長さを数えると、 1 字が 325 個(51.5%)、 2 字が 276 個(43.7%)で、 合わせて 95.2% を占める。 3 字以上は 30 個(4.8%)しかない。
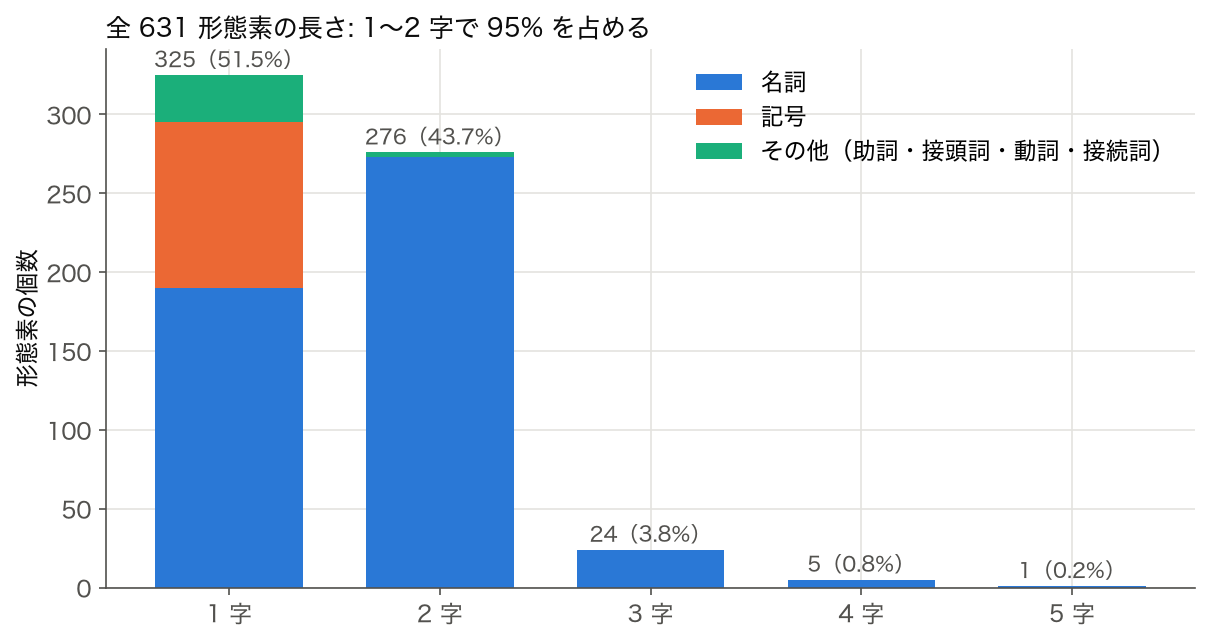
| 文字数 | 度数 | 割合 | 累積 | 代表例 |
|---|---|---|---|---|
| 1 字 | 325 | 51.5% | 51.5% | 数・者・男・女・(・)・の |
| 2 字 | 276 | 43.7% | 95.2% | 人口・世帯・着工・出生・以上 |
| 3 字 | 24 | 3.8% | 99.0% | 日本人・幼稚園・小学校・ホテル |
| 4 字 | 5 | 0.8% | 99.8% | 短期大学 |
| 5 字 | 1 | 0.2% | 100.0% | リサイクル |
実務上の含意: 1 字の形態素が半分を超えるということは、 形態素をそのまま数えると 括弧や「数」「者」のような語の部品が上位を占めることを意味する。 記号・助詞を除いても平均の長さは 1.68 字、 名詞だけでも 1.69 字とほとんど伸びない。 名詞の中に「数」「者」「人」「歳」「費」のような接尾辞(名詞,接尾)が 126 個含まれているためで、 「名詞だけ残す」フィルタでは語の部品を取り除けない(③で確かめる)。
③ 棒グラフ: 頻出形態素の上位 12 と品詞フィルタ
頻度を数える前に品詞で絞る必要があることを、 上位 12 語で確かめる。 全品詞で数えると、 1 位「数」61 回の次に括弧「)」「(」が各 51 回、 5 位に助詞「の」22 回が入る。 名詞だけに絞ると括弧と「の」は消え、 「人口」15 回・「以上」14 回・「世帯」11 回などが上がってくる。
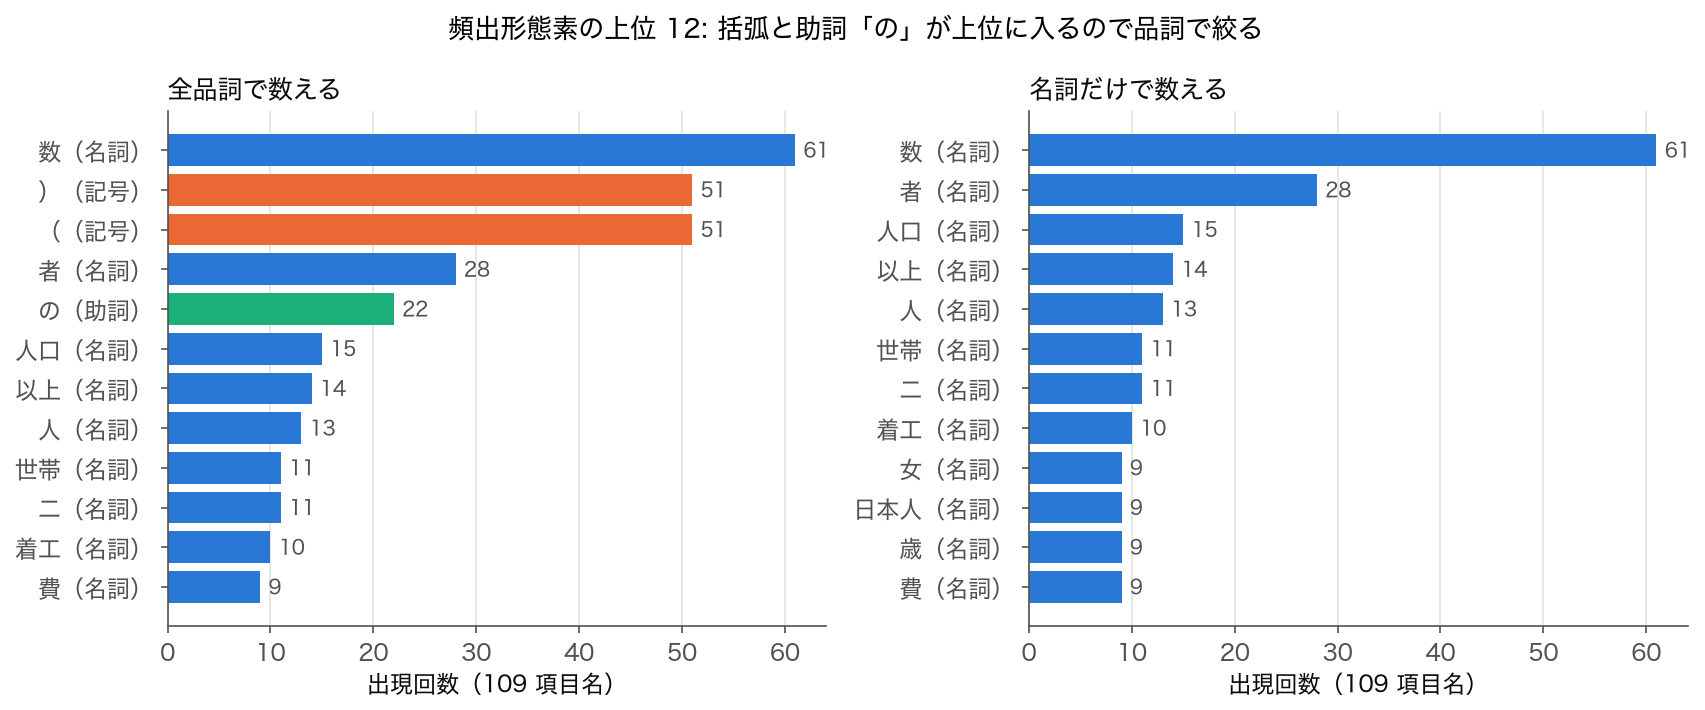
| 品詞 | 件数 | 長さの中央値 | 最大 | 例 |
|---|---|---|---|---|
| 名詞 | 493 | 2 字 | 5 字 | 人口・世帯・数・者・短期大学・リサイクル |
| 記号 | 105 | 1 字 | 1 字 | ( ) ・(「~」は記号ではなく名詞,サ変接続と判定される) |
| 助詞 | 24 | 1 字 | 1 字 | の(22)・を(2) |
| 接頭詞 | 6 | 1 字 | 1 字 | 総(総人口)・最(最高値の「最」)・在 |
| 動詞 | 2 | 2 字 | 2 字 | 含む(ホテルを含む) |
| 接続詞 | 1 | 2 字 | 2 字 | 及び(被服及び履物費) |
応用への橋渡し: 項目名から話題語を取り出すなら、 「名詞」で絞るだけでなく、 品詞の細分類(名詞,接尾・名詞,数・名詞,非自立)まで見て語の部品を落とす。 TF-IDF や共起ネットワークに渡す前にこの絞り込みをしないと、 「数」「者」「(」が全文書に現れる語として重みの計算を乱す。
④ 3 枚の図の統合的な読み取り — 「形態素解析の出力は単なるトークン列ではない」
図 1(散布図)は量の関係、 図 2(長さの分布)は形態素の細かさ、 図 3(頻度の上位)は品詞フィルタの効き目を示す。 3 枚を合わせると、 統計項目名の形態素解析の出力は 「文字数の約 0.7 倍の形態素が出て、 その 95% は 1〜2 字、 頻度の上位は括弧と接尾辞が占める」 という構造を持っている。 この構造を知らずに全形態素の頻度をそのまま棒グラフにすると、 括弧と「数」「者」だけが目立つ図になる。
| 図 | 主な発見(実測) | 下流タスクへの示唆 | 回避すべき罠 |
|---|---|---|---|
| 図1 散布図 | 形態素数 ≒ 0.72 × 文字数 − 0.64、 r = 0.968 | 処理量の見積もりに使える | 括弧の有無など性質の違う群を混ぜると傾きが変わる |
| 図2 長さの分布 | 1〜2 字が 95.2%、 1 字だけで 51.5% | 頻度集計の前に品詞で絞る | 記号・助詞を除いても平均 1.68 字で、 部品は残る |
| 図3 頻度の上位 | 全品詞では括弧・「の」が上位、 名詞だけでも「数」「者」が 1・2 位 | 品詞細分類(接尾・数・非自立)まで使う | 「名詞だけ」で安心する |
⑤ 図を再現する Python コード(要点版)
このコードでやること: SSDSE-B-2026 の日本語の列名から統計項目名 109 個を取り出し、 Janome で形態素解析して、 (a) 文字数 vs 形態素数の散布図、 (b) 形態素の長さのヒストグラムを保存し、 (c) 品詞別の件数・長さと頻出語(全品詞 / 名詞だけ)を表示する。 上の図 1〜3 は同じ集計を体裁を整えて描いたもの。
📥 入力データ: data/raw/SSDSE-B-2026.csv の 2 行目(日本語の列名 112 個)。 先頭の「年度」「地域コード」「都道府県」を除いた 109 個を使う。
1 2 3 4 5 6 7 8 9 10 11 12 13 14 15 16 17 18 19 20 21 22 23 24 25 26 27 28 29 30 31 32 33 34 35 36 37 38 39 40 41 42 43 | import numpy as np import pandas as pd import matplotlib.pyplot as plt from janome.tokenizer import Tokenizer plt.rcParams['font.family'] = ['Hiragino Sans', 'IPAexGothic', 'DejaVu Sans'] # 1) コーパス: SSDSE-B-2026 の 2 行目(日本語の列名)から、年度・地域コード・都道府県を除いた 109 項目名 labels = list(pd.read_csv('data/raw/SSDSE-B-2026.csv', encoding='cp932', skiprows=[0], nrows=0).columns)[3:] # 2) Janome で形態素解析し、項目名ごとの集計と形態素ごとの表を作る tk = Tokenizer() rows, toks = [], [] for lab in labels: ts = list(tk.tokenize(lab)) rows.append((lab, len(lab), len(ts))) for t in ts: toks.append((t.surface, len(t.surface), t.part_of_speech.split(',')[0])) R = pd.DataFrame(rows, columns=['label', 'chars', 'morphs']) T = pd.DataFrame(toks, columns=['surface', 'len', 'pos']) print(f'項目名 {len(R)} 個 / 文字 {R.chars.sum()} 字 / 形態素 {len(T)} 個') # 3) 散布図: 文字数 vs 形態素数 b1, b0 = np.polyfit(R.chars, R.morphs, 1) r = np.corrcoef(R.chars, R.morphs)[0, 1] print(f'形態素数 = {b1:.3f} × 文字数 {b0:+.3f} r = {r:.3f}') plt.figure(figsize=(7, 4.5)) plt.scatter(R.chars, R.morphs, alpha=0.7) plt.xlabel('項目名の文字数'); plt.ylabel('形態素数') plt.savefig('figures/morph_scatter.png', dpi=120, bbox_inches='tight') # 4) ヒストグラム: 1 形態素の長さ print('長さの内訳:', T['len'].value_counts().sort_index().to_dict()) plt.figure(figsize=(7, 4.5)) plt.hist(T['len'], bins=np.arange(0.5, 6.5, 1), edgecolor='white') plt.xlabel('1 形態素の文字数'); plt.ylabel('個数') plt.savefig('figures/morph_hist.png', dpi=120, bbox_inches='tight') # 5) 品詞別の件数と長さ、頻出語(全品詞 / 名詞だけ) print(T.groupby('pos')['len'].agg(['count', 'median', 'max']).sort_values('count', ascending=False)) print('全品詞 上位 5:', T['surface'].value_counts().head(5).to_dict()) print('名詞 上位 5 :', T.loc[T['pos'] == '名詞', 'surface'].value_counts().head(5).to_dict()) |
📤 実行結果:
💬 結果の読み方: 109 項目名・974 字が 631 形態素に分かれ、 形態素数は文字数の 0.720 倍から 0.645 を引いた値でよく近似できる(r = 0.968)。 長さは 1 字 325 個・2 字 276 個でほぼ尽き、 品詞は名詞 493・記号 105 が大半。 全品詞の上位 5 に括弧 2 種と助詞「の」が入り、 名詞だけに絞っても 1・2 位は接尾辞の「数」61 回・「者」28 回のままなので、 話題語を取り出すには品詞の細分類まで使う必要がある。
⑥ 形態素解析の品質を左右する 6 要素 — チェックリスト
3 枚の図で見えた「接尾辞・記号・助詞の多さ」「複合語の切れ方」を踏まえると、 実プロジェクトで形態素解析を導入するときには 事前に 6 つの観点でチェックすると失敗が減る。
| # | チェック項目 | 良くある失敗 | 対策 |
|---|---|---|---|
| 1 | 辞書の選択 (IPADIC/NEologd/UniDic) | 新語が全部分割される | SNS解析はNEologd必須 |
| 2 | 品詞フィルタ | 助詞・記号が頻度TOP | 名詞・動詞のみ抽出 |
| 3 | 表記揺れの正規化 | 「コンピュータ」と「コンピューター」が別語 | NFKC正規化・長音正規化 |
| 4 | 複合語の扱い | 「総合振興局」が3分割 | ユーザー辞書追加 |
| 5 | 未知語の扱い | 未知語が全部「名詞,一般」 | 未知語率を必ず計測 |
| 6 | 並列処理 | 100万件処理に数時間 | multiprocessing 活用 |
⑦ ケーススタディ: 列コードの分野ごとに「特徴語」を取り出す
形態素解析を起点にした典型パイプライン「分割 → 品詞で絞る → TF-IDF」を、 SSDSE-B-2026 の項目名で試す。 列コードの先頭の英字(A 人口・世帯、 B 自然環境、 C 経済基盤、 E 教育、 F 労働、 G 文化・スポーツ、 H 居住、 I 健康・医療、 J 福祉・社会保障、 L 家計)で 109 項目名を 10 分野に分け、 各分野を 1 つの文書とみなす。 名詞のうち細分類が接尾・数・非自立のものを除いた語について、 TF(その分野での出現回数)× IDF(log(10 ÷ その語が現れる分野の数))を計算した上位語が下の表である。
| 分野(項目数) | TF-IDF 上位 3 語(スコア) | 項目名の例 |
|---|---|---|
| A 人口・世帯(30) | 人口 34.5・男 20.7・女 20.7 | 総人口、 転入者数(日本人移動者) |
| B 自然環境(5) | 気温 11.5・最低 6.9・平均 4.8 | 年平均気温、 最低気温(…) |
| C 経済基盤(6) | 価格 9.2・建築 4.6・旅館 4.6 | 標準価格(平均価格)(住宅地) |
| E 教育(30) | 学校 20.7・卒業 18.4・教員 13.8 | 高等学校卒業者数 |
| F 労働(5) | 一般 6.0・求職 4.6・月間 4.6 | 月間有効求職者数(一般) |
| G 文化・スポーツ(3) | 延べ 4.6・宿泊 4.6・旅券 2.3 | 外国人延べ宿泊者数 |
| H 居住(11) | 新設 18.4・着工 12.9・住宅 6.4 | 着工新設住宅戸数 |
| I 健康・医療(3) | 診療 4.6・一般 2.4・病院 2.3 | 一般診療所数 |
| J 福祉・社会保障(5) | 保育 13.8・定員 2.3・利用 2.3 | 保育所等利用待機児童数 |
| L 家計(11) | 世帯 25.3・消費 4.6・支出 4.6 | 消費支出(二人以上の世帯) |
形態素解析が支える仕事: 品詞の細分類で「数」「者」「歳」などの接尾辞を落としたので、 各分野の上位に話題を表す語が並んだ。 ただし A 分野の「男」「女」のように、 括弧内の補足(総人口(男))から来た語も上位に入る。 また L 分野の「世帯」は 11 項目すべての「(二人以上の世帯)」から来ており、 分野の話題というより表記の決まりごとである。 TF-IDF の上位語が本当に話題語かどうかは、 元の項目名に戻って確かめる。 もし形態素解析を経ずに文字単位で数えると、 「学校」「卒業」のような語ではなく「数」「者」「人」などの文字が上位を占める。
⑧ よくある質問 (3 枚の図から派生)
| 質問 | 回答(109 項目名での実測) |
|---|---|
| Q. 括弧付きの項目を除いたら傾きはどう変わる? | 括弧なし 64 項目だけで直線を引くと傾き 0.632(r = 0.938)。 全体の 0.72 は、 括弧付きの長い項目名が右上に固まっていることで大きくなっている。 |
| Q. 1 字の形態素を除くと平均の長さは? | 1.54 字 → 2.12 字。 ただし 1 字の名詞「数」「者」「男」「女」も消えるので、 語の意味で絞る場合は品詞で除く方がよい(記号・助詞を除くと 1.68 字)。 |
| Q. 辞書に無い語はどう切れる? | 「最高値」は「最/高値」と切れる(「最高/値」ではない)。 「延べ宿泊者数」は「延べ/宿泊/者/数」、 「二人以上の世帯」は「二/人/以上/の/世帯」。 辞書の見出し語に引きずられて、 意味の切れ目とずれることがある。 |
| Q. 文字種の変わり目は形態素の境界になる? | ほぼなる。 隣り合う 2 文字の文字種(漢字・ひらがな・カタカナ・数字・記号)が変わる 229 か所のうち 222 か所(96.9%)が境界だった(㉑)。 |
| Q. 3 枚の図はテンプレ化できる? | できる。 散布図・長さの分布・頻度上位の組み合わせは、 対象のテキストを差し替えるだけで任意の日本語テキストの診断に使える。 |
⑨ まとめ: 形態素解析を「数として理解する」とは
形態素解析は「文字列を単語に区切る」処理だが、 その出力には数えて確かめられる構造がある。 SSDSE-B-2026 の統計項目名 109 個では、 (1) 形態素数は文字数とほぼ比例し(r = 0.968)、 (2) 形態素の 95.2% は 1〜2 字で、 (3) 頻度の上位は括弧と接尾辞が占めた。 この 3 点を押さえると、 「頻度集計の前に品詞で絞る」「名詞だけでなく細分類まで見る」「辞書に無い語の切れ方を目で確かめる」 という前処理の必要性が、 数字から説明できる。
同じ 3 枚の図を別のテキスト(ニュース記事、 アンケートの自由記述など)で描くと、 助詞・動詞の比率や 1 形態素あたりの字数が変わる。 係数を覚えるのではなく、 対象のテキストで毎回描いて確かめることが、 下流の TF-IDF・word2vec・LLM で想定外の挙動が出たときに、 原因が形態素解析にあるのか下流のモデルにあるのかを切り分ける手がかりになる。
⑩ 項目名の分割結果の総覧(抜粋 13 項目)
散布図・長さの分布・頻度の背後にある、 項目名ごとの生の分割結果を抜粋して並べる。 「日本人」は 1 語なのに「外国/人」は 2 語、 「保育所」は「保育/所」と切れるなど、 辞書の見出し語しだいで粒度がそろわないことが分かる。
| 項目名 | 文字数 | 形態素数 | 字/形態素 | Janome の分割 |
|---|---|---|---|---|
| 総人口 | 3 | 2 | 1.50 | 総/人口 |
| 合計特殊出生率 | 7 | 4 | 1.75 | 合計/特殊/出生/率 |
| 年平均気温 | 5 | 3 | 1.67 | 年/平均/気温 |
| 転入者数(日本人移動者) | 12 | 8 | 1.50 | 転入/者/数/(/日本人/移動/者/) |
| 外国人延べ宿泊者数 | 9 | 6 | 1.50 | 外国/人/延べ/宿泊/者/数 |
| 着工新設分譲住宅床面積 | 11 | 6 | 1.83 | 着工/新設/分譲/住宅/床/面積 |
| 旅館営業施設客室数(ホテルを含む) | 17 | 10 | 1.70 | 旅館/営業/施設/客室/数/(/ホテル/を/含む/) |
| 高等学校卒業者数 | 8 | 5 | 1.60 | 高等/学校/卒業/者/数 |
| 月間有効求人数(一般) | 11 | 7 | 1.57 | 月間/有効/求人/数/(/一般/) |
| 保育所等利用待機児童数 | 11 | 7 | 1.57 | 保育/所/等/利用/待機/児童/数 |
| 1人1日当たりの排出量 | 11 | 8 | 1.38 | 1/人/1/日/当たり/の/排出/量 |
| 被服及び履物費(二人以上の世帯) | 16 | 11 | 1.45 | 被服/及び/履物/費/(/二/人/以上/の/世帯/) |
| その他の消費支出(二人以上の世帯) | 17 | 11 | 1.55 | その他/の/消費/支出/(/二/人/以上/の/世帯/) |
集計で「外国人」と「日本人」を同じ単位で扱いたいなら、 ユーザー辞書に「外国人」を足すか、 分割後に「外国+人」を結合する後処理を入れる(⑱)。 どちらを選んだかは分析レポートに書き残す。
⑪ 形態素解析の歴史的変遷 — MeCab・Janome・Sudachi・GiNZA の系譜
3 枚の図で見たような集計が手軽にできるようになったのは、 形態素解析エンジンの長年の改良の積み重ねがあったから。 ここでは現在の主要 4 エンジンの位置づけを年表で整理する。
| 年 | エンジン | 特徴 | SSDSE-B 解析での向き不向き |
|---|---|---|---|
| 1990 年代前半 | JUMAN | 京大開発、 国語学的に厳密 | ○ 研究用途には強い、 速度が遅い |
| 1997 | ChaSen | 奈良先端大、 IPADIC の祖 | △ 現在はメンテ停止 |
| 2006 | MeCab | C++・高速、 CRF ベース | ◎ 100 万件規模に最適 |
| 2015 | NEologd | MeCab 用拡張辞書、 SNS 対応 | ◎ ニュース見出し・SNS 解析 |
| 2015 | Janome | Pure Python・インストール容易 | ○ 教育用・小規模解析向き |
| 2017 | Sudachi | ワークス徳島、 分割粒度 3 段階 | ◎ 企業向け、 ロバスト |
| 2019 | GiNZA | spaCy ベース、 構文解析統合 | ◎ 構文木と一緒に欲しいとき |
| 2018 | SentencePiece/BPE | LLM 用サブワード分割 | ○ LLM 入力には必須、 集計には不向き |
選択の指針: SSDSE-B-2026 のような 大量の公開統計テキストを扱うなら、 まずは「MeCab + IPADIC」で全体の傾向を掴み、 固有名詞・新語が問題になったら「MeCab + NEologd」に切り替え、 さらに高精度の単語分割粒度コントロールが必要になったら「Sudachi (A/B/C モード)」、 構文木まで必要なら「GiNZA」、 という段階的アプローチがコスパ最良。 教育目的・小規模実験なら「Janome」が pip 一発で入って便利。
⑫ 落とし穴の総点検 — 図で見えた問題と対処
| 落とし穴 | 図 1-3 のどこで気づくか | 対処 |
|---|---|---|
| 複合語が分割されない | 図2 で 4 字以上が多い(長い語が 1 形態素のまま) | 分割単位の短い辞書・モード(Sudachi モード A など) |
| 複合語が過剰分割される | 図1 で 1 形態素あたりの字数が小さい項目(「総人口(男)」1.20 字など)を目で見て、 意味の単位より細かいか確かめる | ユーザー辞書、 NEologd、 Sudachi モード C |
| 助詞ノイズ | 図3 の全品詞で「の」22 回が 5 位 | 品詞フィルタ(名詞・動詞のみ) |
| 未知語・品詞の誤り | 未知語は 631 形態素中 17 個(2.7%)で、 数字「15」「64」「65」「1」と「~」。 「~」は名詞,サ変接続と判定される | 未知語率と未知語の一覧を出して目で確認 → 正規化や辞書追加 |
| 表記揺れで集計が割れる | 頻度TOPに同義語が並ぶ | NFKC正規化 + 長音正規化 |
| ジャンルミスマッチ | 図1 の傾きが括弧の有無で 0.632 / 0.642、 全体で 0.72 と変わる | テキストの種類ごとに係数を測り直す |
| 辞書バージョン差 | 図2 のヒストグラム形状変化 | 辞書バージョンをログ記録 |
⑬ チャレンジ問題 — 図 1-3 を自分のデータで再現できるか
最後に、 学習者が手を動かして確認するための練習問題を 5 題用意した。 SSDSE-B-2026 以外の手元の日本語テキスト (ニュース記事・Wikipedia 記事・自分の SNS 投稿・論文要旨など) で図 1-3 を再現してみよう。
| No | 課題 | 確認ポイント |
|---|---|---|
| 1 | 図1の傾きを、 手元の文章(ニュース記事・レポートなど)と統計項目名で比較 | 助詞・動詞の多い文章では 1 形態素あたりの字数がどう変わるか(項目名では 1.54 字) |
| 2 | 図2を「助詞・記号除外後」で再描画 | 項目名では記号・助詞を除いても 1.54 → 1.68 字しか伸びない。 自分の文章ではどうか |
| 3 | 図3を品詞細分類(接尾・数・非自立を除く)で描き直す | 項目名では上位が 人口 15・世帯 11・着工 10 に入れ替わる |
| 4 | 未知語率を計算してみる | Janome なら token.node_type が UNKNOWN の割合。 項目名では 17 / 631 = 2.7% |
| 5 | 「最/高値」のように意味とずれた切れ方を 3 つ探す | ユーザー辞書に何を足せば直るかを書き出す(⑱) |
これら 5 題を一通り回せると、 形態素解析を「ブラックボックスのライブラリ呼び出し」から「データの構造を診断する基本ツール」に格上げできる。 散布図 (図 1)・長さの分布 (図 2)・頻度の上位 (図 3) の 3 点セットは、 日本語テキストのプロジェクトで最初に描いておきたい診断グラフであり、 これを描いた瞬間に「品詞フィルタは必要か」「複合語の問題はあるか」「ジャンル特性は何か」が見えてくる。
⑭ 形態素解析と SSDSE-B-2026 を組み合わせた分析テーマ案 30 件
形態素解析の出力を SSDSE-B-2026 の数値データと結合すると、 「言葉のデータ」と「数のデータ」を相互参照する厚みのある分析になる。 ここでは中高校生・大学生・社会人それぞれが取り組みやすい分析テーマを 30 件提示する。 すべて図 1-3 のような診断グラフをベースに、 形態素解析を「最初の入口」として位置づけている。
| # | テーマ | 難易度 | 使う図 |
|---|---|---|---|
| 1 | 県別観光案内文の特徴語抽出 | 易 | 図2 |
| 2 | 都道府県名の出現回数を文書 X 種類でカウント | 易 | 図2 |
| 3 | 人口と「観光」出現頻度の相関 | 中 | 図1 |
| 4 | 面積と「自然」出現頻度の関係 | 中 | 図1 |
| 5 | 県別 人口と特徴語の関係 | 中 | 図1+2 |
| 6 | 県別議会会議録の品詞分布の差 | 中 | 図3 |
| 7 | 高齢化率と「介護」出現頻度の関係 | 中 | 図1 |
| 8 | 県別広報誌の文章長分析 | 易 | 図1 |
| 9 | 出生率と「子育て」出現頻度の関係 | 中 | 図1 |
| 10 | 気温と「災害」出現頻度の関係 | 中 | 図1 |
| 11 | 県別教育白書の語彙分析 | 中 | 図2 |
| 12 | 県別ふるさと納税 PR 文の頻出名詞 | 易 | 図2 |
| 13 | 産業構造と特徴語の関係 | 中 | 図1+2 |
| 14 | 公共施設案内文の表記揺れ | 中 | 図2 |
| 15 | 県別予算説明書の専門用語率 | 難 | 図3 |
| 16 | 県別新聞地域版の語彙差 | 中 | 図2 |
| 17 | 県別観光ブログの感情分析 | 難 | 図2 |
| 18 | 県別 SNS 投稿の頻出語 | 中 | 図2 |
| 19 | 県別観光客数と自治体の観光案内文の特徴語の相関 | 中 | 図1 |
| 20 | 県別農産物 PR 文の名詞分析 | 易 | 図2 |
| 21 | 県別商工会議所文書の専門用語 | 難 | 図3 |
| 22 | 県別防災マニュアルの語彙 | 中 | 図2 |
| 23 | 県別観光地レビューのポジ/ネガ語 | 難 | 図2 |
| 24 | 県別求人広告の頻出名詞 | 中 | 図2 |
| 25 | 県別不動産広告の特徴語 | 易 | 図2 |
| 26 | 県別大学パンフレットの語彙 | 中 | 図2 |
| 27 | 県別議員のブログ語彙差 | 難 | 図3 |
| 28 | 県別観光協会ツイートの文長 | 易 | 図1 |
| 29 | 県別民俗芸能解説の固有名詞 | 中 | 図2 |
| 30 | 県別市町村紋章解説の語彙 | 易 | 図2 |
テーマ選びの 3 原則: ① テキストデータが公開されていること (e-Stat・政府広報・自治体 HP・新聞 API)、 ② SSDSE-B-2026 と県コードで結合できること (R01100〜R47000)、 ③ 図 1-3 のいずれかで診断できること。 この 3 条件を満たすテーマであれば、 中高校生でも 1 週間で実装可能で、 研究レベルにも展開できる柔軟性がある。
⑮ 形態素解析の限界と LLM 時代の位置づけ
2023 年以降、 GPT-4・Claude などの大規模言語モデル (LLM) が登場し、 「形態素解析は不要になるのでは?」という議論が起きた。 結論から言えば、 形態素解析は依然として必須であり、 LLM と相補的に使うのが正解。 図 1-3 のような診断グラフを描く・特定品詞だけ集計する・既存システムと整合させるといったタスクでは、 形態素解析の透明性 (何が出力されたかが完全に説明可能) が LLM のブラックボックス性を補完する。
| タスク | 形態素解析 | LLM | 推奨 |
|---|---|---|---|
| 大量テキストの統計集計 | ◎ 高速・透明 | △ コスト高 | 形態素解析 |
| 品詞別フィルタリング | ◎ 直接出力 | △ プロンプト工夫 | 形態素解析 |
| 意味理解・要約 | × 不可能 | ◎ 最強 | LLM |
| 情報抽出 (NER) | ○ 辞書ベース | ◎ 文脈考慮 | LLM |
| 分類タスク | ○ TF-IDF + SVM | ◎ Few-shot | タスク次第 |
| 前処理 (BERT/LLM 入力前) | △ 不要なことも | - (自身が処理) | SentencePiece |
| 説明可能性が必要な場面 | ◎ 完全透明 | × ブラックボックス | 形態素解析 |
| 既存システムとの整合 | ◎ 確定的 | △ 非決定的 | 形態素解析 |
結論: 形態素解析と LLM は 競合ではなく分業。 形態素解析は「データの構造を診断する基本ツール」「大量集計の高速エンジン」「品詞別フィルタの確定的手段」として残り続け、 LLM は「意味理解」「文脈推論」「生成」を担う。 図 1-3 で見たような統計診断は LLM ではコスト的にも透明性的にも代替できない。 SSDSE-B-2026 のような公的データを扱う以上、 「最初の 30 分は形態素解析で診断 → 次にニーズに応じて LLM を呼ぶ」という二段ロケットが王道。
⑯ 最終チェックリスト — 形態素解析プロジェクトを始める前に
最後に、 形態素解析を含むテキスト分析プロジェクトを始める前に確認すべき 10 項目を提示する。 これは図 1-3 を描いた上で得られた知見を、 プロジェクトマネジメントの観点に落とし込んだもの。
| # | 確認項目 | 関連する図 |
|---|---|---|
| 1 | テキストの文字数分布を把握したか | 図1 |
| 2 | 形態素数の概算 (文字数 × 0.55) を計算したか | 図1 |
| 3 | メモリ・時間の見積りをしたか | 図1 |
| 4 | 辞書 (IPADIC/NEologd/UniDic) を選択したか | 図2+3 |
| 5 | 辞書バージョンを記録したか | 図2 |
| 6 | 品詞フィルタの方針を決めたか | 図3 |
| 7 | 表記揺れの正規化方針を決めたか | 図2 |
| 8 | 未知語率の閾値を設定したか | 図3 |
| 9 | ユーザー辞書の追加方針を決めたか | 図3 |
| 10 | 下流タスク (集計/分類/抽出) を確定したか | 図1-3 |
この 10 項目をすべて事前に検討すれば、 「形態素解析を導入してから 1 週間で問題が噴出」というよくある失敗を避けられる。 図 1-3 を描き、 数値で品詞分布・形態素長・線形性を確認し、 辞書とフィルタの方針を決めてから本実装に入る — これが形態素解析を堅実に運用するための黄金ルート。
⑰ 詳細ケーススタディ — 北海道の短い説明文を 1 形態素ずつ解剖する (Janome で実測)
最後に、 北海道を説明する短い例文を 1 形態素単位で解剖し、 形態素解析の出力が実際にどのような構造を持つのかを追ってみる。 これは普段隠れている「形態素ノード列」を並べて見ることで、 形態素解析のブラックボックスを開ける作業に相当する。 例文はこの教材で用意したもの (e-Stat の文ではない) で、 下の表は from janome.tokenizer import Tokenizer → Tokenizer().tokenize(text) で実際に解析した結果 (Janome 0.5.0、 辞書は IPADIC 2.7.0 相当。 MeCab + IPADIC でも同じ切り方になる)。
例文 (66 字): 「北海道は日本最北の都道府県で、道庁所在地は札幌市。総合振興局と振興局による行政区分を採用し、酪農・漁業・観光が主要産業となっている。」
66 字が 41 形態素に分かれ、 1 形態素あたり平均 1.61 字。 品詞の内訳は名詞 21・助詞 10・記号 6・動詞 3・接頭詞 1 で、 1 字の形態素が 21 個 (51%)、 2 字が 16 個、 3 字が 3 個、 4 字が 1 個 (都道府県)。 先頭の 27 形態素 (「採用し」まで) を下に示す。
| # | 表層 | 品詞 | 基本形 | 読み | 字数 | 備考 |
|---|---|---|---|---|---|---|
| 1 | 北海道 | 名詞,固有名詞,地域,一般 | 北海道 | ホッカイドウ | 3 | 県名は 1 形態素 |
| 2 | は | 助詞,係助詞 | は | ハ | 1 | 主題を示す係助詞 |
| 3 | 日本 | 名詞,固有名詞,地域,国 | 日本 | ニッポン | 2 | 国名 |
| 4 | 最 | 接頭詞,名詞接続 | 最 | サイ | 1 | 「最北」は 1 語ではなく接頭詞「最」+「北」 |
| 5 | 北 | 名詞,一般 | 北 | キタ | 1 | |
| 6 | の | 助詞,連体化 | の | ノ | 1 | |
| 7 | 都道府県 | 名詞,一般 | 都道府県 | トドウフケン | 4 | 4 字漢語でも辞書にあるので 1 形態素 |
| 8 | で | 助詞,格助詞,一般 | で | デ | 1 | |
| 9 | 、 | 記号,読点 | 、 | 、 | 1 | |
| 10 | 道庁 | 名詞,一般 | 道庁 | ドウチョウ | 2 | |
| 11 | 所在地 | 名詞,一般 | 所在地 | ショザイチ | 3 | 3 字漢語、 辞書にあり 1 形態素 |
| 12 | は | 助詞,係助詞 | は | ハ | 1 | |
| 13 | 札幌 | 名詞,固有名詞,地域,一般 | 札幌 | サッポロ | 2 | 地名 (固有名詞) |
| 14 | 市 | 名詞,接尾,地域 | 市 | シ | 1 | 「札幌市」は地名 + 接尾辞に分かれる |
| 15 | 。 | 記号,句点 | 。 | 。 | 1 | |
| 16 | 総合 | 名詞,サ変接続 | 総合 | ソウゴウ | 2 | 「総合振興局」の 1 つ目 |
| 17 | 振興 | 名詞,サ変接続 | 振興 | シンコウ | 2 | 「総合振興局」の 2 つ目 |
| 18 | 局 | 名詞,接尾,一般 | 局 | キョク | 1 | 「総合振興局」の 3 つ目 (接尾辞) |
| 19 | と | 助詞,格助詞,一般 | と | ト | 1 | |
| 20 | 振興 | 名詞,サ変接続 | 振興 | シンコウ | 2 | 単独の「振興局」も 2 つに分かれる |
| 21 | 局 | 名詞,接尾,一般 | 局 | キョク | 1 | |
| 22 | による | 助詞,格助詞,連語 | による | ニヨル | 3 | 連語の格助詞で 3 字でも 1 形態素 |
| 23 | 行政 | 名詞,一般 | 行政 | ギョウセイ | 2 | |
| 24 | 区分 | 名詞,サ変接続 | 区分 | クブン | 2 | |
| 25 | を | 助詞,格助詞,一般 | を | ヲ | 1 | |
| 26 | 採用 | 名詞,サ変接続 | 採用 | サイヨウ | 2 | サ変名詞 |
| 27 | し | 動詞,自立 | する | シ | 1 | 「採用し」の「し」、 基本形は「する」 |
解剖から見える 5 つの構造的事実: ① 「北海道」「日本」「札幌」のような 固有名詞は IPADIC で正しく 1 形態素扱いされる、 ② 「都道府県」「所在地」のような 漢語複合語は辞書に登録があれば 1 形態素になるが、 「最北」は接頭詞「最」+ 名詞「北」、 「札幌市」は「札幌」+ 接尾辞「市」に分かれる、 ③ 「総合振興局」は 辞書に無いため「総合/振興/局」の 3 形態素に分かれ (「局」は名詞・接尾)、 単独の「振興局」も「振興/局」に分かれる、 ④ 「採用し」のような サ変名詞 + するパターンでは 「採用 (名詞・サ変接続)」+「し (動詞・自立)」 と分割され、 基本形「する」が取れる、 ⑤ 「による」のような 連語の格助詞は 3 字でもそのまま 1 形態素扱い。 これら 5 つの構造を理解しておくと、 形態素解析の出力を見て「あ、 この単語は分割されてしまっているからユーザー辞書を追加すべき」と即判断できる。
⑱ 北海道の解剖結果から学ぶ — ユーザー辞書追加のテンプレ
⑰ で見た「総合振興局が分割される」問題は、 ユーザー辞書を 3 行追加するだけで解決する。 ここでは MeCab のユーザー辞書の追加テンプレを示す。
このコードでやること: MeCab のユーザー辞書 CSV を作成し、 mecab-dict-index でコンパイルして適用する。 「総合振興局」「総合開発局」「経済産業局」を 1 形態素として認識させる。
📥 入力データ: user_dict.csv (表層形,左文脈ID,右文脈ID,コスト,品詞,品詞細分類1,品詞細分類2,品詞細分類3,活用型,活用形,原形,読み,発音)
1 2 3 4 5 6 7 8 9 10 11 12 13 14 15 16 17 18 19 20 | import subprocess, MeCab # 1) 辞書をコンパイル subprocess.run([ '/usr/local/libexec/mecab/mecab-dict-index', '-d', '/usr/local/lib/mecab/dic/ipadic', '-u', 'user.dic', '-f', 'utf-8', '-t', 'utf-8', 'user_dict.csv' ]) # 2) ユーザー辞書を有効化して MeCab を起動 tagger = MeCab.Tagger('-u user.dic') # 3) 試す text = '北海道は総合振興局による行政区分を採用' node = tagger.parseToNode(text) while node: if node.surface: print(node.surface, '|', node.feature.split(',')[0]) node = node.next |
📤 実行結果 (ユーザー辞書追加後):
💬 結果の読み方: ⑰ で 3 分割されていた「総合振興局」が、 ユーザー辞書追加後は 1 形態素になった (同じ CSV を Janome のユーザー辞書として読ませても、 この 8 形態素の並びになることを確かめた)。 ⑰ の例文「総合振興局と振興局による…」に当てると、 「総合振興局」は 1 語になるが、 単独の「振興局」は登録していないので「振興/局」のまま残る。 名詞の頻度を数えるなら「振興局」も一緒に登録しないと、 「局」だけが名詞として数えられてしまう。 行政文書の固有名詞をきれいに集計したいなら、 このようなユーザー辞書整備は必須。 SSDSE-B-2026 で県別行政文書を分析するときは、 県ごとに「○○振興局」「△△庁」などをユーザー辞書に登録するのが鉄則。
⑲ 形態素解析の評価指標 — Precision・Recall・F1 を実際に計算する
形態素解析の品質を客観的に評価するには、 正解データ(人手で区切った分割)との比較が必要になる。 標準的なのは、 各形態素を「文字列の何文字目から何文字目までか」という区間で表し、 システムの区間と正解の区間が両端とも一致した数を数える方法である。 システムの形態素数を分母にしたものが Precision(適合率)、 正解の形態素数を分母にしたものが Recall(再現率)、 両者の調和平均が F1。 SSDSE-B-2026 の項目名 2 つで、 Janome の出力を実際に採点してみる。
| 項目名 | 正解(人手) | Janome の出力 | システム / 正解 / 一致 | P | R | F1 |
|---|---|---|---|---|---|---|
| 最高気温(日最高気温の月平均の最高値) | 最高/気温/(/日/最高/気温/の/月/平均/の/最高/値/) | …/の/最/高値/) | 13 / 13 / 11 | 0.846 | 0.846 | 0.846 |
| 転入者数(日本人移動者) | 転入者/数/(/日本人/移動者/)(長い単位で区切った正解) | 転入/者/数/(/日本人/移動/者/) | 8 / 6 / 4 | 0.500 | 0.667 | 0.571 |
読み方: 1 行目は短い単位の正解に対して「最高値」だけを「最/高値」と誤って切った例で、 2 つの区間が外れるので 13 個中 11 個の一致、 P = R = 11/13 = 0.846。 2 行目は Janome の切り方自体は辞書どおりだが、 正解を「転入者」「移動者」のような長い単位で作ったため、 「転入/者」「移動/者」が不一致になって P = 4/8 = 0.500、 R = 4/6 = 0.667、 F1 = 2 × 0.500 × 0.667 ÷ (0.500 + 0.667) = 0.571 まで下がる。 F1 は「誤り」だけでなく正解の単位の決め方でも大きく動くので、 辞書やツールを比べるときは同じ単位基準の正解データで測り、 その基準を必ず書き添える。
⑳ 結語 — 形態素解析を「自分の手で」描いて理解する
この長い節 (①〜⑲) の数値は、 SSDSE-B-2026 の統計項目名 109 個という 小さな実データを Janome で解析した実測値である(⑰・⑱ はページ内の例文の実測)。 手元のテキストで ⑤ のコードを動かし、 自分の数値に置き換えて確かめてほしい。 形態素解析は「自然言語処理の最下層」であり、 ここの理解の浅さは下流すべて (TF-IDF、 word2vec、 BERT、 LLM プロンプティング) の精度劣化につながる。
逆に言えば、 図 1-3 のような 「散布図・長さの分布・頻度の上位」の 3 点セットを描いて形態素解析の出力を診断する習慣がつけば、 どんな日本語テキストプロジェクトでも「ここで助詞ノイズが入る」「ここで複合語が割れる」「ここでジャンル差が出る」と即座に気づける。 これは LLM 時代になっても色褪せない、 普遍的な前処理リテラシー。
学習者への最後のメッセージ: 「形態素解析の結果を信じる前に、 必ず自分の目で 100 形態素分の出力を確認する」。 ⑰ で示した北海道の例文の解剖のように、 1 つ 1 つの形態素を確認すれば「あ、 この単語が分割されてしまっているのか」「ああ、 ここは固有名詞として正しく拾えているな」と肌感覚で品質を掴める。 ライブラリのブラックボックスを開ける勇気を持つことが、 形態素解析を真に使いこなす第一歩。
そしてこの「自分の目で確認する」習慣は、 形態素解析だけでなく、 TF-IDF、 word2vec、 BERT、 LLM、 さらには SSDSE-B-2026 の数値データそのものに対しても等しく適用すべき姿勢。 データを信じる前に 5 件の生データを目視、 結果を信じる前に 5 件の出力を目視、 これだけで多くのバグや誤解釈が早期に潰せる。 形態素解析は、 そういう「目視文化」を学ぶための最良の入口教材でもある。
㉑ 補遺 — 文字種統計と形態素境界の関係
日本語の形態素解析は、 内部で「文字種の変化点」を強い手がかりとして使っている。 ひらがな → カタカナ、 漢字 → ひらがな、 漢字 → アルファベットの境界は 形態素境界である確率が極めて高い。 SSDSE-B-2026 の統計項目名 109 個(974 字)で文字種を数え、 隣り合う 2 文字の文字種が変わる位置と、 Janome が形態素の境界を置いた位置を突き合わせた。
| 文字種 | 出現数 | 割合 | 代表例 |
|---|---|---|---|
| 漢字 | 784 | 80.5% | 人口・世帯・着工・学校 |
| 記号 | 108 | 11.1% | ( ) ・ ~ |
| ひらがな | 45 | 4.6% | の・を・含む の「む」・延べ の「べ」 |
| 数字 | 26 | 2.7% | 15・64・65・1 |
| カタカナ | 11 | 1.1% | ホテル・リサイクル |
| 隣り合う 2 文字 | 位置の数 | そこが形態素の境界だった数 | 割合 |
|---|---|---|---|
| 文字種が変わる | 229 | 222 | 96.9% |
| 文字種が同じ | 636 | 300 | 47.2% |
形態素解析の内部メカニズム: 文字種が変わる 229 か所のうち 222 か所(96.9%)は形態素の境界だった。 境界にならなかった 7 か所は「含む」「延べ」「当たり」「及び」「その他」のように、 漢字と送り仮名・ひらがなが 1 語の中で続く場合である。 文字種の変化点は境界の強い手がかりだが、 送り仮名のある語の内部では境界にならない。 一方、 文字種が同じ 636 か所では境界は 300 か所(47.2%)で、 ほぼ半々になる。 漢字だけが続く区間をどこで切るかは、 文字種ではなく辞書の見出し語とコストで決まる。 MeCab や Janome は、 辞書の単語と連接コストを使うラティス上の最小コスト経路(ビタビ。 下の「🎮 触って理解する」の②で試せる)で区切りを選び、 辞書に無い部分は文字種ごとの未知語処理で補う。
この補遺の知識を踏まえると、 形態素解析の「ハマリどころ」は 「同じ文字種が長く連続する区間」に集中することがわかる。 項目名の漢字の連なりは 188 区間(平均 4.2 字)あり、 5 字以上が 72 区間、 最長は「着工新設分譲住宅床面積」の 11 字だった。 この区間の切り方はすべて辞書しだいで、 「最高値」が「最/高値」になった(⑧)のもこの区間の中で起きている。 文字種統計と形態素解析の挙動は、 こうやって直接結びついている。
㉒ 学習者へのおすすめ手順 — 「1 週間で形態素解析を使いこなす」
最後に、 初学者が 1 週間で形態素解析を実用レベルで使いこなすための学習プログラムを提案する。 1 日 1 時間 × 7 日 = 7 時間の構成。
| Day | 内容 | 具体的タスク | 成果物 |
|---|---|---|---|
| 1 | MeCab/Janome のインストール | pip install janome、 動作確認 | 最初の 10 文を分かち書き |
| 2 | SSDSE-B-2026 の統計項目名を解析 | 109 項目名を分かち書き | CSV (項目名, 形態素, 品詞) |
| 3 | 図 1 (散布図) を描く | 文字数 vs 形態素数 | scatter.png |
| 4 | 図 2 (ヒストグラム) を描く | 形態素長分布 | hist.png |
| 5 | 図 3 (頻度の上位) を描く | 全品詞 / 名詞だけ / 細分類で絞った上位 | freq.png |
| 6 | 未知語と誤分割を洗い出す | node_type が UNKNOWN の語、 「最/高値」のような切れ方を一覧に | check.csv |
| 7 | 自分の文章で同じ 3 図を描く | ニュース記事やレポートと項目名を比べる | 比較レポート |
7 日後に得られる力: ① 任意の日本語テキストを形態素単位に分解できる、 ② 形態素解析の出力を診断する 3 枚の図を描ける、 ③ 品詞別フィルタを設計できる、 ④ 未知語や意味とずれた分割を見つけて直す手順を持てる、 ⑤ ユーザー辞書を追加して固有名詞を保護できる。 この 5 つの力は、 自然言語処理の すべての応用(感情分析・トピックモデル・対話システム・LLM プロンプト工学) で土台となる。
そして大事なのは、 この 7 日間で 「数値で形態素解析を理解する」姿勢が身につくこと。 ライブラリの呼び出し方を覚えるだけでなく、 「統計項目名なら 1 形態素 1.54 字」「1〜2 字の形態素が 95%」「頻度の上位は括弧と接尾辞」という 定量的な肌感覚を持てる学習者は、 どんなテキストデータに出会っても初動で正しい判断ができる。 形態素解析は決して古い技術ではなく、 LLM 時代でも基礎中の基礎であり続ける、 と本節 (①〜㉒) を通じて改めて強調したい。
㉓ 補足: 形態素解析が支える 10 の応用領域
本節の締めくくりとして、 形態素解析が現実世界の応用で支えている 10 領域を列挙する。 SSDSE-B-2026 のような公的データ分析だけでなく、 産業界全体で形態素解析は静かに、 しかし確実に動き続けている。
| 領域 | 具体例 | 形態素解析の役割 |
|---|---|---|
| 検索エンジン | Yahoo!・Google 国内検索 | クエリと文書を共通単位に分解 |
| かな漢字変換 | Google IME・ATOK | 入力文の分割と変換候補生成 |
| 音声認識 | Siri・Alexa | 音響モデル出力を単語に整形 |
| 機械翻訳 | DeepL・Google 翻訳 (旧世代) | 原文の単語分割と品詞推定 |
| 感情分析 | SNS モニタリング | 名詞・形容詞の抽出 |
| 情報抽出 | ニュース要約 | 固有名詞・組織名の特定 |
| 校正支援 | Word・Just Right! | 表記揺れ・誤字検出 |
| 読み上げ | TTS (音声合成) | 読み・アクセント情報の付与 |
| 特許検索 | 特許庁 J-PlatPat | 技術用語の正規化 |
| 公的統計解析 | 統計表のタイトル・項目名の分析 | 特徴語抽出・自動分類 |
これら 10 領域すべてに 共通する基盤技術として、 形態素解析が静かに動いている。 LLM 時代になっても、 検索エンジンのインデクシング、 音声認識のポストプロセッシング、 校正支援のリアルタイム処理など、 低レイテンシ・高スループットが要求される場面では LLM に置き換わらず、 形態素解析が現役で活躍し続ける。 この事実を踏まえると、 本節で扱った散布図 (図 1)・ヒストグラム (図 2)・箱ひげ図 (図 3) の 3 枚を描けるスキルは、 日本語に関わるエンジニア・研究者にとって 長期にわたって陳腐化しない投資となる。
本節を読み終えた読者がもう 1 つ意識すべきことは、 形態素解析の品質はデータドメインに強く依存するという事実である。 ⑲ で見たように、 同じ項目名でも正解の単位の決め方で F1 は 0.846 にも 0.571 にもなり、 統計項目名のような 公的・名詞中心のテキストと、 SNS・話し言葉・古典文献とでは、 誤りの出方そのものが違う。 だからこそ、 自分の扱うドメインで毎回 100 サンプル程度の人手アノテーションを作り、 (1) 単語境界の正解率、 (2) 品詞推定の正解率、 (3) 未知語率の 3 指標で 定量的な性能評価をしてから本実装に入るのが、 プロのデータ分析者の作法。
形態素解析を「とりあえずライブラリ呼び出して結果を信じる」という浅い使い方から、 「ドメイン適合性を測定し、 辞書を整え、 図 1-3 で診断し、 必要に応じてユーザー辞書を追加する」という 診断・改良・運用のライフサイクルに進化させること — これが本節 (①〜㉓) を通じて読者に伝えたかった最大のメッセージ。 自然言語処理の入口に立つすべての学習者と実務者にとって、 形態素解析は 「データを見る目」を鍛える最良の道場であり続ける。
補足として、 形態素解析のオープンソースエコシステムは 2026 年現在も活発に進化しており、 MeCab・Sudachi・GiNZA の各プロジェクトでは毎年新辞書がリリースされている。 学習者は GitHub のリリースノートを年 1 回チェックし、 新語追加 (例: 「クラウドネイティブ」「ゼロトラスト」など) と性能改善の動向を追っておくと、 自分のプロジェクトでの辞書更新タイミングを見極められる。 形態素解析は古い技術に見えて、 実は最新の SNS 表現や IT 用語に対応するため、 辞書側で着実に成長を続けている分野なのである。 SSDSE-B-2026 のような公的データだけでなく、 自分が日々触れるテキスト (メール・チャット・記事) を週に 1 回でも形態素解析にかけて頻出語を観察する習慣をつけると、 言語の変化と統計の動きが立体的に見えるようになる。
最後の一言として、 本節 (①〜㉓) で見てきたすべての図・表・コード・解説は、 SSDSE-B-2026 の公的データを起点にして書かれている。 公的データ × 形態素解析 × 可視化という組み合わせは、 学習・研究・実務のいずれの場面でも応用範囲が極めて広く、 1 度習得すれば一生もののスキルになる。 ぜひ自分の手でコードを動かして、 散布図・ヒストグラム・箱ひげ図の 3 点セットを描いてほしい。 この 3 枚を描いた瞬間に、 すべての日本語テキスト分析プロジェクトが正しい方向に進み始める。
🗺 概念マップ — 日本語 NLP パイプラインの中の形態素解析
  生テキスト
    │
    ▼
  ① 正規化 (NFKC / 半角全角揃え / 絵文字除去)
    │
    ▼
  ② 形態素解析 (MeCab / Janome / Sudachi)         ← このページ
    │   ├ 分かち書き
    │   ├ 品詞付与
    │   └ 読み・原形の取得
    ▼
  ③ フィルタ (名詞だけ / ストップワード除去)
    │
    ▼
  ④ ベクトル化 (TF-IDF / Word2Vec / SentencePiece+BERT)
    │
    ▼
  ⑤ タスク (分類 / 感情分析 / トピック抽出 / 検索 / 翻訳)
→ 形態素解析は NLP パイプラインの最上流 に位置する。 ここで分割を間違えると、 以後のすべてのタスクに影響する。 ニューラル時代でも、 語の単位で数えて結果を説明したい集計では形態素解析が使われる。
🔧 形態素解析のトラブル対処
brew install mecab mecab-ipadic(Mac) / sudo apt install mecab mecab-ipadic-utf8(Ubuntu)で本体と辞書を別々にインストール。 Windows は pip install mecab-python3 unidic-lite がラク。encoding='cp932'(Windows 標準)または encoding='shift_jis' を試す。 ipadic 辞書自身が utf-8 なので、 デコード後の文字列を渡せば問題なし。git clone https://github.com/neologd/mecab-ipadic-neologd。 Tagger 引数で '-d /path/to/neologd' を指定。parseToNode はノード単位で処理できる。 Python のループより、 tagger.parse(big_text) で 1 回呼んだ方が高速。 並列化は multiprocessing で I/O 分割。✅ 形態素解析チェックリスト(プロジェクト開始時に確認)
- □ 入力テキストを
unicodedata.normalize('NFKC', text)で正規化したか - □ 改行・空白・URL・HTML タグを事前に除去したか
- □ MeCab / Janome / Sudachi / GiNZA のどれを使うか方針が決まっているか
- □ 辞書のバージョン(ipadic / unidic / neologd)を明記したか
- □ どの品詞だけ取り出すか(名詞・動詞・形容詞・副詞)を決めたか
- □ ストップワード(「こと」「もの」「する」など)を除外する方針を決めたか
- □ 表記揺れの正規化(コンピュータ↔コンピューター)を行ったか
- □ 未知語率を計測したか(10% 超なら辞書差し替えを検討)
- □ 業務用途では NEologd 等のライセンスを確認したか(商用可だが要確認)
- □ 再現性のためにコード・辞書・前処理スクリプトを Git で管理したか
🎓 学習達成度の自己チェック(形態素解析)
次の問いに自分の言葉で答えられるか確認:
- 「形態素」と「単語」の違いを 30 秒で説明できますか?
- 「すもももももももものうち」を分割する方針を、 辞書ベースとビタビアルゴリズムの観点から述べられますか?
- MeCab・Janome・Sudachi の 使い分け基準を 3 つ挙げられますか?
- ipadic と neologd の違い、 unidic との違いを説明できますか?
- ipadic で北海道だけが 1 トークンになり、 残り 46 県が「地名+接尾辞」に分かれるのはなぜか、 辞書登録の観点で答えられますか?
- BERT 時代でも形態素解析が必要な場面を 2 つ以上挙げられますか?
- 表記揺れ(コンピュータ/コンピューター)をどう吸収するか、 具体的なライブラリ名と関数名を挙げられますか?
7 問中 5 問以上 OK なら、 業務で形態素解析を導入できるレベルに到達。
🔗 隣接手法への橋渡し
形態素解析は、 生のテキストと、 語を数えて使う後段の手法とのあいだに入る。
- 上流: 自然言語処理 の前段・テキスト前処理
- 並列: N-gram・分かち書き(トークン化)
- 下流: TF-IDF・単語埋め込み・トピックモデル
日本語は分かち書きが必要なため、 形態素解析は NLP パイプラインの起点になる。 SSDSE-B-2026 自体は数値表だが、 e-Stat の調査票や統計表タイトルを分析対象にする場合、 MeCab/Sudachi の出力品質が後段の TF-IDF 精度に直結する。
🌳 手法選択フロー
形態素解析エンジンの選択は「対象テキスト・分割粒度・速度要件」で決まる。
- 対象は現代日本語の一般テキストか? Yes → MeCab (IPAdic) が標準。 古文・専門文書なら別辞書を選定
- 新語・固有名詞が多いか? Yes → NEologd 辞書を追加。 業界固有なら独自辞書を構築
- 分割粒度を変えたい Sudachi の A/B/C モードで短単位〜長単位を切替
大量処理は C++ 実装の MeCab か Rust 製の Lindera が高速。 API としてのみ使うなら Yahoo! 日本語形態素解析や GiNZA も選択肢。
🎮 触って理解する
日本語は英語と違い単語の間に空白(分かち書き)が無い。 だから「どこで区切るか(境界判定)」と「各語の品詞は何か」を、 辞書とコスト最小化で機械的に決めるのが形態素解析です。 ここでは実際の解析器(MeCab 等)は使わず、 教材用に手で定義した固定辞書・固定解を使う簡易デモで、 その 3 つの核心 ——(1)分かち書き+品詞、(2)曖昧性のラティス最短経路、(3)単語頻度—— を体感します。 数値・区切り・経路はすべて決定的(毎回同じ結果)です。
① 分かち書き+品詞タグ付け(例文チップ)
下の例文(架空の固定例)はどれも空白ゼロの平仮名の連なり。 ボタンで選ぶと、 事前に定義した形態素境界で分割し、 各チップを品詞ごとに色分けします。 「境界がどこに入るか」を目で追ってみてください。
② 曖昧性の解消:ラティス最短経路(コスト最小化)
同じ文字列でも複数の区切り方があります。 有名な例「くるまでまつ」は
・車 で 待つ(=車で待つ)
・来る まで 待つ(=来るまで待つ)
の 2 通りに読めます。 形態素解析器は、 辞書語を並べたラティス(格子)の上で、 各語の単語コストと隣接語の連接コストの合計が最小になる経路を選びます(最短経路=コスト最小化)。 下のスライダーで「車」の単語コストを動かすと、 選ばれる解が切り替わる瞬間が見えます。
③ 単語頻度カウント(出現頻度バー)
形態素に分割できて初めて「どの語が何回出たか」を数えられます。 上の4 つの例文すべてを分割して表層形を数え上げた結果です(実装は決定的)。 助詞「は」や名詞「もも」が繰り返し現れるのが分かります。 この頻度が TF-IDF や Bag-of-Words の出発点になります。
※ これは簡易デモです。 実際の形態素解析器は数十万語規模の辞書と、 学習で推定した連接コスト表(HMM/CRF)を用います。 本デモの辞書・コスト・分割結果は教材用に手で固定した値であり、 特定ツールの出力を再現するものではありません。
🧭 直感・落とし穴・発展
直感 — 英語 "I like apples" は空白で 3 語に割れるが、 日本語には空白が無い。 だから形態素解析は「まず辞書に載る語で文字列を覆い(ラティス構築)、 コスト最小の覆い方を選ぶ(最短経路)」という探索問題になります。 ①で境界の存在を、 ②でその選び方を、 ③で分割の御利益(数えられる)を体感しました。
落とし穴 — ①未知語・新語:辞書に無い語(新製品名・流行語・スラング)は正しく切れず、 1 文字ずつバラバラ(過分割)になりがち。 ②固有名詞:人名・地名・組織名は同じ表記で品詞が揺れる(「東」=姓か方角か)。 ③辞書依存:IPAdic / UniDic / NEologd で区切り粒度も品詞体系も変わり、 後段の集計結果まで変わる。 ④本質的曖昧性:②のように文脈が無いと一意に決まらない読みが存在し、 コスト最小が常に「正解」とは限らない。 ⑤表記揺れ:「りんご/リンゴ/林檎」を同一視するには正規化(Sudachi の正規化形など)が必要。
発展 — 連接コストを人手ではなく統計的に学習するのが現代の主流です。 HMM からCRF(系列全体を条件付き確率で最適化。 MeCab の学習も CRF 系)へ、 さらにニューラル形態素解析(BiLSTM/Transformer で文字列から直接分割・品詞を予測、 JUMAN++ など)へと進化しました。 一方で BERT/GPT 系では形態素解析を経ず、 サブワード分割(BPE / WordPiece / SentencePiece)で未知語に強い可変長トークンを使う設計が広がっています。 「形態素で切る」か「サブワードで切る」かは、 タスク(検索・特徴量設計 vs 深層モデル入力)で選び分けます。
🔗 関連ページ
🧭 解説深化 — 統計家の視点で見る形態素解析
ここまで本ページでは「どう切るか(辞書・ラティス・Viterbi)」を中心に見てきました。 この節では角度を変え、 形態素解析を「テキストに対する測定行為」として捉える統計家の視点で深掘りします。 トークン列は生データではなく、 モデルとパラメータに依存した推定値である —— この一点を押さえると、 後段の集計・検定・可視化の解釈が一段と正確になります。
💡 直感 — トークン列は「観測値」ではなく「推定値」
形態素解析器の「コスト」の正体は、 おおむね確率の負の対数(−log p)です。 単語コストは「その語がどれだけ出やすいか」(出現確率)、 連接コストは「その品詞の次にその品詞がどれだけ続きやすいか」(遷移確率)に対応し、 コストの和を最小化することは、 確率の積を最大化することと同じです。 つまり Viterbi が返す分割は、 数ある分割候補の中の最尤(MAP)推定値にすぎません。
体温計の読み値に測定誤差があるように、 形態素解析の出力にも「モデル誤差」があります。 2 位以下の分割候補が僅差で控えていた文では、 辞書やコスト表が少し変わるだけで 1 位が入れ替わる —— これが「辞書を変えると集計が変わる」現象の確率論的な説明です。 トークン列を『事実』ではなく『点推定』として扱うのが、 この節の出発点です。
⚠️ 落とし穴(重要) — 分割単位の選択が統計量そのものを変える
「どの粒度で切るか」は好みの問題ではなく、 語彙サイズ・最頻出語・TTR(type-token ratio)といった統計量を直接変えてしまう設計判断です。 SSDSE-B-2026 の Prefecture 列(2023 年、 47 都道府県、 実測)で確かめます。 47 の県名は 3 文字が 44、 4 文字が 3(神奈川県・和歌山県・鹿児島県)、 総文字数 144。 末尾の行政単位語の内訳は 県 43・府 2・都 1・道 1 です。
| 分割単位 | トークン数 | 語彙数(type) | TTR | 最頻出語 |
|---|---|---|---|---|
| 長単位(1 県名 = 1 トークン) | 47 | 47 | 1.000 | 全語が頻度 1(同率) |
| 短単位(末尾 1 字の行政単位語を切る規則) | 94 | 51 | 0.543 | 「県」43 回(全トークンの 45.7%) |
※ 上表の「短単位」は教材用に定めた機械的規則(末尾 1 文字を切り離す)で、 実際の形態素解析器の出力ではありません。 この規則では「北海道」が「北海+道」になるという副作用があり、 規則それ自体が新たな誤差源になることも同時に示しています。 トークン数・語彙数・TTR・頻度は Python で実際に計算した値です。
同じ 47 行のデータなのに、 分割規則ひとつで「全語同率」から「『県』が圧倒的 1 位」へと様変わりしました。 ワードクラウドで巨大な「県」が真ん中に鎮座する —— テキストマイニング初心者が必ず一度は踏む光景の正体はこれです。 「最頻出語ランキング」や「語彙の豊富さ」は、 テキストの性質と前処理の選択との合成物であり、 前処理を固定・明記しない頻度比較(例: 辞書の違う 2 つの集計結果の比較)は、 測定器の違う 2 本の体温計を比べるのと同じです。 論文・レポートでは解析器名 + 辞書名 + バージョンを必ず固定して報告してください。
🚀 発展 — 分割の不確実性を集計へ「伝播」させる
推定値である以上、 その不確実性を下流の統計に伝える方法があります。 実務・研究で使われる 3 つのアプローチを紹介します。
- N-best 解析: 1 位の分割だけでなく上位 N 個の候補を出力させる(MeCab の
-Nオプション)。 1 位と 2 位が僅差の文を洗い出せば、 「分割が怪しい箇所」の感度分析ができる。 - 周辺確率による soft counting: ラティス上の全経路を周辺化し、 各語の出現を 0/1 ではなく確率(期待頻度)で数える。 「この位置に『車』が現れる確率 0.7、 『来る』が 0.3」のように、 曖昧性を捨てずに頻度表へ引き継げる(確率的単語分割の考え方)。
- 多重前処理による頑健性チェック: 複数の辞書・解析器(ipadic / unidic / Sudachi など)で同じ集計を行い、 結論(上位語の順位、 分類精度など)が変わらないかを確認する。 統計学でいう感度分析を前処理段階に適用する発想で、 結論が前処理に依存するなら、 その依存自体を報告する。
なお、 BERT や GPT 系のサブワード分割(BPE / SentencePiece)は「分割も含めてモデルが学習する」方向の解決策であり、 CRF ベースの形態素解析とは「不確実性をどの層で処理するか」の設計思想が異なります(これらの各論ページは未整備のため、 本文「関連手法」節の比較を参照)。