🔖 キーワード索引
非構造化データに関連する 12 個のキーワード。 各チップから関連ページへジャンプできる。
💡 30秒で分かる結論
🍰 まずはやさしく
自由な形のデータのことです。
大量の情報を活用するために使います。
スマホの写真や動画が例です。
データの種類と扱い方を学びます。
テキスト・画像など決まった構造を持たないデータ
- 表形式に収まらないデータ。 テキスト、 画像、 音声、 動画、 ログなど。
- そのままでは分析不可 → 埋め込み(embedding)で数値ベクトル化するのが近年の標準。
- 格納:オブジェクトストレージ(S3, GCS, Azure Blob)/検索:Elasticsearch/処理:Spark, ML。
- 深層学習・LLM の登場で 非構造化データの価値が急上昇。
📍 あなたが今見ているもの
🍰 まずはやさしく
表にまとめられないデータのことです。
世の中の多様な情報を分析するために使います。
SNSの投稿などが例です。
数値になっていない情報の扱い方を学びます。
「SNS投稿を分析」「監視カメラ映像から異常検知」「PDF報告書から数値抽出」— すべて非構造化データ処理。 Excel に収まらない世界です。
📍 文脈ボックス: あなたが今見ているもの
あなたは今、 「非構造化データ」のページにいる。 これは 「データの形式」 系列の概念の 1 つで、 行・列に整わない自由形式のデータ(テキスト、 画像、 音声、 動画、 PDF、 SNS 投稿)を指す。 公式統計の SSDSE-B-2026 は CSV で配布される構造化データだが、 公開資料の本文や報道記事は非構造化データであり、 両者は補完関係にある。 本ページで扱うのは「数値化されていない情報の取り扱い手順」である。
🎨 直感で掴む
🍰 まずはやさしく
本の本文のような自由な形式のデータです。
中身を自動で要約したり分類したりするために使います。
LINEのチャット履歴などが例です。
データを数値に変換する方法を学びます。
図書館に例えると:
- 構造化=蔵書カード(行・列が決まった整然データ)
- 非構造化=本の本文そのもの(自由形式)
カードだけ見ても本の内容は分からない。 でも本文を全部読むのは大変 → そこで自動的に「要約」「分類」する技術(NLP・CV)が必要になります。
身近な「非構造化データ」の例: スマホで撮った写真、 LINE のチャット履歴、 YouTube の動画、 PDF の研究論文、 録音した会議音声。 どれも CSV のように「行=サンプル、 列=変数」と整理されておらず、 そのままでは pd.read_csv() も df.mean() も使えない。 SSDSE-B-2026 は CSV (構造化) だが、 各県の公式サイトの「観光案内文」は非構造化で、 両方を組み合わせて分析するのが現代の典型タスク。
処理の基本は「非構造化 → 埋め込みベクトル → 構造化テーブル」の変換。 例えば「47 県の観光紹介文」を BERT で 768 次元ベクトル化すれば、 47 行 × 768 列の行列ができ、 ここから先は通常の構造化データ解析 (クラスタリング・回帰) と同じ。 形式上は構造化に「翻訳」される点が重要。
次節以降では、 テキスト・画像・音声という非構造化データを sentence-transformers / OpenCV / librosa で数値ベクトル化する Python 実装を示す。 「生データ → 埋め込みベクトル → 類似度・クラスタリング」の流れで実感する。 対になる構造化データ側は 構造化データ のページを参照。
📐 定義/数式
🍰 まずはやさしく
決まった構造を持たないデータのことです。
計算ができる形式に変えるために使います。
画像やテキストなどが例です。
データをベクトル(数値の列)にする定義を学びます。
非構造化データ(Unstructured Data):テキスト・画像など決まった構造を持たないデータ
🔬 記号・用語の読み解き
| 記号 | 意味 |
|---|---|
| $x$ | 生の非構造化データ(文字列・画素配列等) |
| $\mathbf{v}$ | 埋め込みベクトル |
| $d$ | 埋め込み次元(768がBERT基準) |
| Embed | BERT・CLIP・Sentence-Transformers 等の符号化モデル |
🔬 数式を言葉で読み解く
非構造化データを定量化する代表手段が TF-IDF と 埋め込みベクトルである。 TF-IDF 式 $\mathrm{tfidf}(t,d) = \mathrm{tf}(t,d) \cdot \log \frac{N}{\mathrm{df}(t)}$ を言葉で読むと:
- $t$(term): 単語。 例「人口」「総生産」「北海道」
- $d$(document): 文書。 例「都道府県名と説明文の 1 行」
- $\mathrm{tf}(t,d)$: 文書 $d$ に単語 $t$ が出る回数。 多く出るほど重要
- $N$: 全文書数。 SSDSE-B-2026 なら 47(都道府県)
- $\mathrm{df}(t)$: 単語 $t$ が出る文書数。 すべての文書に出る単語は重要度が下がる(IDF=log(N/N)=0)
- 積: 「ある文書に頻出するが、 他の文書にはあまり出ない単語」が高得点
cosine 類似度 $\cos\theta = \frac{\vec{a}\cdot\vec{b}}{\|\vec{a}\|\|\vec{b}\|}$ は、 2 つのベクトル(文書)が同じ方向を向いていれば 1、 直交(無関係)なら 0、 反対方向なら −1 という直感的な意味を持つ。
🔬 深掘り Q&A: 設計・実装の最前線
DQ1. 非構造化と半構造化の境界線は?
明確な定義はないが、 実務では「自動的に行・列に展開できるかどうか」で判定する。 JSON はキーがあるので半構造化、 PDF 本文は半構造化要素(見出し)と非構造化要素(自由文)の混在。 SSDSE-B-2026 のような CSV は厳密には構造化だが、 セル内に長文コメントが混じれば半構造化扱いとなる。
DQ2. 「非構造化を構造化に変換すれば全部解決」は本当か?
部分的には正しいが、 全部ではない。 自由文の感情・意図・暗喩は、 表形式に落とすと必ず情報が失われる。 「数値化できる側面」だけ構造化し、 原本は raw のまま残す二段構えが現実解。 SSDSE-B-2026 で「人口」を扱うのと、 自治体広報誌で「市民の声」を扱うのは、 必要な深さが異なる。
DQ3. 埋め込みの次元数はどう選ぶ?
小さい(128〜384)= 軽くて速いが表現力低い。 大きい(1024〜3072)= 精度高いがストレージと計算コスト増。 OpenAI text-embedding-3-large(3072 次元)は MTEB 上位だが、 SSDSE 規模(47 行)なら text-embedding-3-small(1536 次元)で十分。 「次元数を半分にしても精度低下が許容範囲か」を必ず検証する。
DQ4. ベクトル DB と通常 DB は併用すべきか?
pgvector のように既存 RDB に拡張する形か、 専用ベクトル DB(Pinecone / Qdrant / Weaviate)を別建てするかは規模次第。 100 万ベクトル未満は pgvector で十分、 1000 万以上で専用 DB を検討。 SSDSE-B-2026 規模なら数百ベクトルしか作らないので、 pgvector でも oversized。
DQ5. 非構造化データのバージョン管理は?
Git は大容量バイナリに不向き。 代替として DVC(Data Version Control)、 LakeFS、 S3 Versioning を使う。 「同じ raw に対して、 異なる埋め込みモデルでベクトル化したバージョン」も管理対象。 SSDSE-B-2026 のように年度版が明示されているデータは命名規則だけで十分だが、 SNS スクレイピング等は時刻スナップ+ハッシュ管理が必須。
DQ6. テストはどう書く?
構造化なら「行数・型・主キー」の単体テストで済むが、 非構造化は「サンプル文書を埋め込んで、 想定上位 3 件に含まれるか」のような結合テストが中心。 LLM 出力は確率的なので、 完全一致ではなく類似度しきい値(cosine > 0.85 等)で判定する。
DQ7. SSDSE-B-2026 と LLM をどう組合せると面白いか?
「都道府県統計を LLM に説明させ、 そこに別途集めた口コミ・SNS テキストを RAG で補強」が王道。 例えば「沖縄の出生率はなぜ高いか」を質問すると、 LLM が SSDSE-B-2026 の数値を踏まえつつ、 沖縄県の文化・経済に関する非構造化文書から関連箇所を引いて回答する。 これは構造化と非構造化の理想的な融合形。
🧮 実値で計算してみる
🧮 数式に値を入れて手で計算する: 非構造データのサイズ
合成 100 枚画像 + 200 件テキスト + 50 件音声のバイト数を集計する。
Step 1: データ別
| 種 | 件数 | 平均サイズ | 合計 |
|---|---|---|---|
| 画像 (PNG) | 100 | 500 KB | 50,000 KB |
| テキスト | 200 | 2 KB | 400 KB |
| 音声 (WAV) | 50 | 3000 KB | 150,000 KB |
Step 2: 合計
🐍 Python で再現
1 2 3 | files = [(100, 500), (200, 2), (50, 3000)] total_kb = sum(n*s for n, s in files) print(f"合計: {total_kb:,} KB ≈ {total_kb/1024:.1f} MB") |
📤 実行結果
💬 合計 200,400 KB は手計算 (Step 2) と完全に一致する。 MB に直すと Python は 1 MB = 1,024 KB で割るので 195.7 MB、 手計算の「≈ 200 MB」は 1,000 で割った概算で、 差の約 4.3 MB は単位の定義の違い。 内訳では音声 50 件(150,000 KB)が全体の 75% を占め、 件数が最も多いテキスト 200 件は 0.2% にすぎない。
🧮 実データで比べる:同じ 47 個の値を表・文章・画像で持つと
上の手計算は「平均サイズ」を仮定した見積もりでした。ここでは同じ情報を形式だけ変えて実際に保存し、大きさを測ります。材料は SSDSE-B-2026 の 2023 年度 47 都道府県の総人口 A1101 です。表(CSV)・JSON・「北海道の総人口は5,092,000人です。」という文章・棒グラフの画像(PNG)の 4 通りにして、UTF-8 のバイト数を比べます。
🎯 このコードでやること:2023 年度 47 都道府県の総人口を、CSV・JSON・文章・PNG 画像の 4 形式に変換してバイト数を測り、CSV の何倍かを表示する。
📥 入力データ:SSDSE-B-2026 の 2023 年度 47 行の Prefecture(都道府県名)と A1101(総人口)の 2 列。文章はこの値から機械的に作ったもの。
1 2 3 4 5 6 7 8 9 10 11 12 13 14 15 16 17 18 19 20 21 22 23 24 25 26 | import io import json import pandas as pd import matplotlib matplotlib.use('Agg') import matplotlib.pyplot as plt df = pd.read_csv('data/raw/SSDSE-B-2026.csv', encoding='cp932', skiprows=[1]) d = df[df['SSDSE-B-2026'] == 2023][['Prefecture', 'A1101']] # 2023 年度 47 都道府県の総人口 forms = {} forms['CSV(表)'] = d.to_csv(index=False).encode('utf-8') forms['JSON'] = json.dumps(dict(zip(d['Prefecture'], d['A1101'].astype(int).tolist())), ensure_ascii=False).encode('utf-8') text = ''.join(f'{p}の総人口は{v:,}人です。' for p, v in zip(d['Prefecture'], d['A1101'])) forms['文章(テキスト)'] = text.encode('utf-8') fig, ax = plt.subplots(figsize=(6.4, 4.0), dpi=100) # 同じ 47 個の値を棒グラフ画像に ax.bar(range(47), d['A1101']) buf = io.BytesIO() fig.savefig(buf, format='png') forms['画像(PNG 640×400)'] = buf.getvalue() base = len(forms['CSV(表)']) for k, b in forms.items(): print(f'{k:<16} {len(b):>7,} バイト(CSV の {len(b) / base:5.1f} 倍)') print(f'文章の先頭: {text[:40]}…') |
📤 実行結果:
💬 結果の読み方:中身の情報は 4 つとも同じ 47 組の「県名と人数」なのに、CSV 863 バイトに対して、キー名の引用符や括弧が付く JSON が 1.2 倍、「の総人口は」「人です。」が毎回付く文章が 2.4 倍、画像が 10.8 倍(9,305 バイト)になりました(画像の大きさは描画ライブラリの版で数百バイト変わります)。しかも CSV と JSON はそのまま数値として読み戻せますが、文章は読み取りの処理が要り(下の ⚠️)、画像から数値に戻すには目盛りの読み取りや OCR が必要で、戻した値は元の値と一致しません。
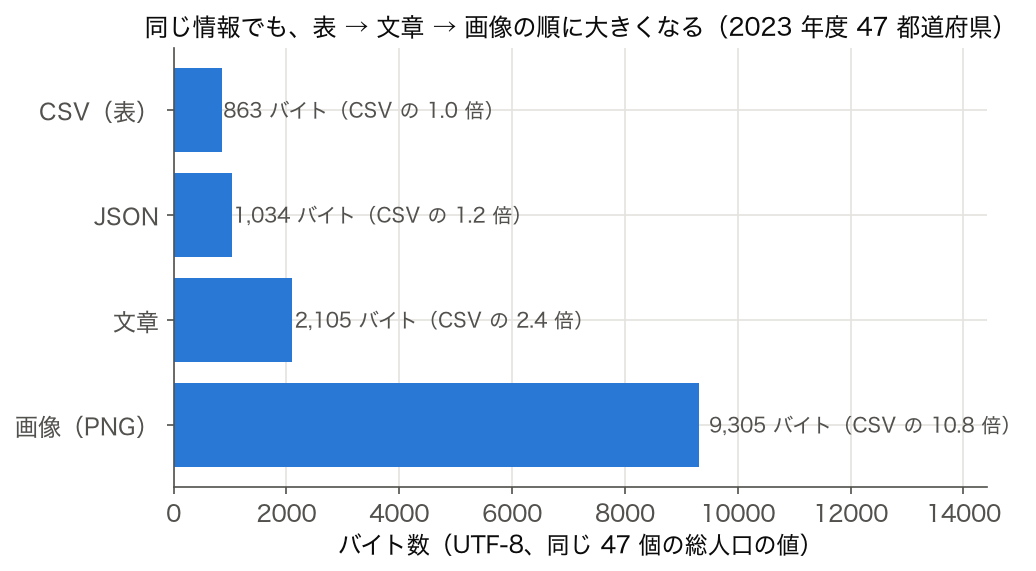
→ 非構造化データが大きくなるのは、1 件あたりに「情報でない部分」(文章の定型の言い回し、画像の背景の画素)が多く含まれるからです。上の手計算の「画像 1 枚 500 KB」のような見積もりは、写真のように情報が画面全体に詰まったデータの目安で、グラフや文書のスキャン画像では中身の割に大きさが増えることを覚えておくと、保存先の容量見積もりで外しにくくなります。
圧縮すると差はどこまで縮むか
🎯 このコードでやること:図 1 の CSV・JSON・文章の 3 形式を gzip で圧縮し、圧縮前後のバイト数と圧縮率を比べる(画像の PNG はすでに圧縮された形式なので除く)。
📥 入力データ:図 1 と同じ、2023 年度 47 都道府県の Prefecture と A1101 の 2 列から作った 3 つの文字列。
1 2 3 4 5 6 7 8 9 10 11 12 13 14 15 | import gzip import json import pandas as pd df = pd.read_csv('data/raw/SSDSE-B-2026.csv', encoding='cp932', skiprows=[1]) d = df[df['SSDSE-B-2026'] == 2023][['Prefecture', 'A1101']] forms = { 'CSV(表)': d.to_csv(index=False), 'JSON': json.dumps(dict(zip(d['Prefecture'], d['A1101'].astype(int).tolist())), ensure_ascii=False), '文章': ''.join(f'{p}の総人口は{v:,}人です。' for p, v in zip(d['Prefecture'], d['A1101'])), } for k, s in forms.items(): raw = s.encode('utf-8') z = gzip.compress(raw, mtime=0) print(f'{k:<8} そのまま {len(raw):>5,} B → gzip {len(z):>4,} B({len(z) / len(raw):.0%})') |
📤 実行結果:
💬 結果の読み方:圧縮前は 2.4 倍あった CSV と文章の差が、gzip 後は 495 バイトと 529 バイトで 1.07 倍まで縮みました。文章は 25% まで縮み、CSV(57%)よりずっとよく縮みます。「の総人口は」「人です。」のように毎回同じ言い回しは、圧縮で「前と同じ」と書くだけで済むからです。つまり文章の余分な大きさは情報ではなく繰り返しで、保存は圧縮すれば安く済みます。ただし分析に使うには毎回展開して読み取る手間が残り、下の ⚠️ のような取り出しの誤りは圧縮では解決しません。
🐍 Python での実装例
テキスト(非構造化データ)を埋め込みベクトルに変換し、 類似度を測る最小コード(7行):
1 2 3 4 5 6 7 | from sentence_transformers import SentenceTransformer import numpy as np texts = ['機械学習は強力なツール', '今日は良い天気', 'AIは社会を変える'] model = SentenceTransformer('paraphrase-multilingual-MiniLM-L12-v2') vec = model.encode(texts, normalize_embeddings=True) # 長さ 1 に揃える print('形状:', vec.shape) # (3, 384) print('コサイン類似度行列:'); print((vec @ vec.T).round(2)) |
💬 長さ 1 に正規化してから内積を取っているので、対角が 1.00 になり、非対角がそのままコサイン類似度になる。「機械学習は強力なツール」と「AIは社会を変える」は 0.34 で、共通の単語は無いのに AI 関連という意味の近さを拾っている。一方「今日は良い天気」は両者と 0.05、-0.00 でほぼ無関係と判定された。正規化を忘れると内積はベクトルの長さに引きずられ(自分自身との内積が 10〜24 と文ごとにばらつく)、長い文ほど何にでも似ている結果になるので、比較の前に正規化を確かめる。
※ 出力の (3, 384) は「3 文 × 384 次元」の埋め込み行列。 対の構造化データ側の読み込みは 構造化データ(pd.read_csv('data/raw/SSDSE-B-2026.csv', encoding='cp932', skiprows=[1]))を参照。
💾 ストレージ選定の指針(構造化 vs 非構造化)
「どこに保存すべきか」は非構造化データ案件で最初に詰まる論点。 用途別に推奨先を整理する。
| 用途 | 推奨ストレージ | 構造化データなら | 非構造化データなら |
|---|---|---|---|
| 日次バッチ集計 | DWH | BigQuery / Snowflake / Redshift | 前処理して特徴量化 → DWH 投入 |
| 原本長期保管 | オブジェクトストレージ | CSV/Parquet を S3 へ | 画像 / 動画 / PDF をそのまま S3 |
| 類似検索 | ベクトル DB | あまり使わない | pgvector / Pinecone / Qdrant |
| 全文検索 | 検索エンジン | あまり使わない | Elasticsearch / OpenSearch |
| 配信 | CDN | あまり使わない | CloudFront / Cloudflare |
原本(raw)はオブジェクトストレージに置き、 そこから派生する特徴量や検索インデックスを各専用ストアに展開する「メダリオン構成」が現代の定石。
✅ 非構造化データ採用チェックリスト(10 項目)
- 原本のオーナーは誰か(取得元・更新責任者)が明文化されているか
- ファイル命名規則・フォルダ階層が決まっているか
- PII(個人情報)・機密情報の混入リスクを把握しているか
- ファイル形式と文字コードを標準化しているか
- 取り込み時のサイズ・件数監視を行っているか
- 特徴抽出モデルのバージョンを記録しているか
- 類似検索のインデックスを再構築する手順があるか
- ストレージのライフサイクル(保存期間・削除)が決まっているか
- 監査ログ(誰が何にアクセスしたか)を保管しているか
- ダウンストリーム(BI / API / RAG)の影響範囲を把握しているか
10 項目中 7 以上に「Yes」と答えられれば、 非構造化データ運用の基本ラインに乗れている。
🐍 CSV の見出し(日本語の文字列)から分野を当てる — 非構造化テキストを数値に変える
SSDSE-B-2026 の CSV の 2 行目には、 「15~64歳人口(男)」「着工新設持家床面積」のような日本語の見出しが 109 列ぶん並んでいる。 見出しは決まった形の無い短い文章で、 そのままでは計算に使えない非構造化データである。 一方、 1 行目の項目コード(A1101、 H2601 など)の先頭 1 文字は分野(A 人口・世帯、 B 自然環境、 C 経済基盤、 E 教育、 F 労働、 G 文化・スポーツ、 H 居住、 I 健康・医療、 J 福祉・社会保障、 L 家計)を表す構造化された情報になっている。 見出しの文字だけを数値ベクトルに変えて、 この分野をどこまで当てられるかを確かめる。
🎯 このコードでやること:CSV の 1〜2 行目を読み、 109 列の日本語見出しを文字 1〜2 グラムの TF-IDF ベクトルに変え、 ロジスティック回帰で項目コードの先頭 1 文字(分野)を当てる。 3 分割交差検証の正解率と、 外した見出しを出す。
1 2 3 4 5 6 7 8 9 10 11 12 13 14 15 16 17 18 19 | import pandas as pd from sklearn.feature_extraction.text import TfidfVectorizer from sklearn.linear_model import LogisticRegression from sklearn.model_selection import cross_val_predict, StratifiedKFold head = pd.read_csv('data/raw/SSDSE-B-2026.csv', encoding='cp932', header=None, nrows=2) cols = pd.DataFrame({'code': head.iloc[0, 3:].to_numpy(), 'label': head.iloc[1, 3:].to_numpy()}) cols['cat'] = cols['code'].str[0] # 項目コードの先頭 1 文字 = 分野(A 人口 … L 家計) print('列の数:', len(cols), ' 分野ごとの列数:', cols['cat'].value_counts().sort_index().to_dict()) print(cols.sample(4, random_state=0).to_string(index=False)) vec = TfidfVectorizer(analyzer='char', ngram_range=(1, 2)) # 日本語の見出しを文字 1〜2 グラムに分けて数える X = vec.fit_transform(cols['label']) print('文字 1〜2 グラムの種類(列数):', X.shape[1]) cv = StratifiedKFold(n_splits=3, shuffle=True, random_state=0) pred = cross_val_predict(LogisticRegression(max_iter=2000, C=10), X, cols['cat'], cv=cv) print(f'見出しの文字だけから分野を当てた正解率(3 分割): {(pred == cols["cat"]).mean():.3f} (多数派 A を答え続けると {(cols["cat"] == "A").mean():.3f})') miss = cols[pred != cols['cat']].assign(予測=pred[pred != cols['cat']]) print(miss[['code', 'label', '予測']].to_string(index=False)) |
💬 見出しの文字だけで 109 列中 102 列(正解率 0.936)の分野を当て、 多数派の A を答え続ける 0.275 を大きく上回る。 文字の組み合わせ(「人口」「学校」「支出」など)が分野ごとに偏っているので、 文章のままでは使えなかった見出しが、 数えられる特徴に変わったとたん分類できる。 外した 7 列には理由がある。 「着工建築物数」「着工建築物床面積」(C 経済基盤)は「着工」の字を共有する H 居住の「着工新設住宅戸数」などに引っ張られ、 「一般旅券発行件数」(G)は「件数」「一般」が F 労働の「就職件数(一般)」と共通で F と答えている。 ごみの 3 列(H)と「一般病院数」(I)は、 同じ分野に似た見出しがほとんど無く、 列数の多い A と答えている。 文字の並びが似ていても分野が違う(逆もある)のは、 分野を決めたのが人の判断だからで、 見出しの文字だけから取り出せる構造には限りがある。
🎯 このコードでやること:同じ分類を、 見出しの切り方を変えて比べる。 文字 1 グラム・1〜2 グラム・1〜3 グラムと、 英語のように空白で区切った「単語」の 4 通りで特徴の数と正解率を出す。 あわせて、 (男)(女)(一般)などの括弧を除くと見出しが何種類になるかを数える。
1 2 3 4 5 6 7 8 9 10 11 12 | # ud1.py の続き(cols, cv を使う) import re for name, kw in [('文字 1 グラム', dict(analyzer='char', ngram_range=(1, 1))), ('文字 1〜2 グラム', dict(analyzer='char', ngram_range=(1, 2))), ('文字 1〜3 グラム', dict(analyzer='char', ngram_range=(1, 3))), ('空白区切りの「単語」', dict(analyzer='word', token_pattern=r'\S+'))]: Xk = TfidfVectorizer(**kw).fit_transform(cols['label']) p = cross_val_predict(LogisticRegression(max_iter=2000, C=10), Xk, cols['cat'], cv=cv) print(f'{name:12s} 特徴の数 {Xk.shape[1]:4d} 正解率 {(p == cols["cat"]).mean():.3f}') # 括弧の中(男・女・一般 など)を取り除いた見出しで同じことをすると base = cols['label'].str.replace(r'(.*?)', '', regex=True) print('括弧を除いた見出しの種類:', base.nunique(), '/', len(base)) |
💬 文字で切ると 1 グラム(192 種類)でも 1〜3 グラム(838 種類)でも正解率は 0.936 で変わらない。 空白で「単語」に切ると、 日本語の見出しには空白が無いので見出し全体が 1 語になり、 109 種類の語がどれも 1 回しか出てこない。 学習に使っていない見出しの語はどれも未知になり、 正解率は多数派と同じ 0.275 まで落ちる。 日本語のテキストを数えるときは、 文字 n-gram か 形態素解析 で語に分けてから数える。 また括弧を除くと 109 列の見出しは 90 種類に減る(19 列は、 括弧の中の「男」「女」「一般」などだけが違う見出しを持つ)。 性別の内訳の列を別の分野と間違えないのは、 括弧の外の「総人口」「出生数」が同じだからである。
🎯 このコードでやること:ud1.py で作った 109 列の TF-IDF ベクトルどうしのコサイン類似度を計算し、 「出生数」「一般病院数」「消費支出(二人以上の世帯)」の 3 つの見出しに最も似た見出しを 3 つずつ探す(ベクトル検索の最小形)。
1 2 3 4 5 6 7 | # ud1.py の続き(cols, vec, X を使う) from sklearn.metrics.pairwise import cosine_similarity S = cosine_similarity(X) for q in ['出生数', '一般病院数', '消費支出(二人以上の世帯)']: i = cols.index[cols['label'] == q][0] top = [j for j in S[i].argsort()[::-1] if j != i][:3] print(q, '→', ' / '.join(f"{cols['label'][j]}({cols['code'][j]}, {S[i, j]:.2f})" for j in top)) |
💬 「出生数」には「出生数(男)」「出生数(女)」が類似度 0.73 で並び、 「消費支出」には同じ「(二人以上の世帯)」の家計の列が 0.57〜0.80 で並ぶ。 文字が多く重なる見出しはうまく見つかる。 一方「一般病院数」に最も近いのは「一般診療所数」(0.23)で、 2 位・3 位は「一般」の字を共有するだけの労働の列「充足数(一般)」「就職件数(一般)」になる。 文字の重なりで測る類似度は意味の近さとは限らないので、 検索結果は人が確かめる。 意味の近さまで測るには、 文を学習済みのモデルでベクトルにする埋め込み(下の B 節)を使う。
⚠️ よくある落とし穴
⚠️ 落とし穴(追加 5 件)
- ストレージ容量: 動画 1 時間 ≒ 1〜10GB。 構造化データなら 1MB に収まる行数でも、 非構造化なら 1000 倍以上の容量を食う。 S3 等のオブジェクトストレージとライフサイクル管理が必須。
- スキーマレス管理の罠: 「とりあえず保存」を続けると、 後から「どこに何があるか」が誰にも分からなくなる(データスワンプ化)。 メタデータカタログを必ず併用する。
- トークン化の言語依存: 英語は空白区切りで済むが、 日本語は形態素解析器(MeCab / Sudachi)が必要。 解析器の辞書バージョン差で同じ文章でも結果が変わる点に注意。
- 埋め込みモデルの陳腐化: 2 年前の embedding モデルで作ったベクトル DB は、 新モデルと意味空間が異なるため再計算が必要。 「ベクトルだけ保存」では将来の再現性が失われる。
- PII(個人情報)混入リスク: テキスト・画像には氏名・顔・住所が紛れやすい。 構造化データのように「カラム単位でマスク」できないため、 取り込み前の検出・マスキングが必須。
⚠️ 実データで見る落とし穴:文章から数値を取り出すと「黙って」間違える
非構造化データを分析に使う最初の一手は、文章から数値や項目を取り出して表にすることです。ここでは SSDSE-B-2026 の 2023 年度の総人口(正解が分かっている値)を、5 通りの書き方で文章にしてから、正規表現で取り出して正解と照合します。文章は説明用に作ったものですが、書き方の揺れ(全角数字、「万」の単位、概数)は行政文書や報道で実際によく見かけるものです。
🎯 このコードでやること:47 都道府県の総人口を A〜E の 5 通りの書き方で文章にし、素朴な正規表現と、NFKC 正規化+小数・「万」に対応した正規表現の 2 通りで値を取り出して、正解・取り出せず・誤った値の件数と最大の相対誤差を数える。
📥 入力データ:SSDSE-B-2026 の 2023 年度 47 行の Prefecture と A1101(総人口)を正解とし、そこから「東京都の総人口は14,086,000人です。」のような文章を 5 通り × 47 件作る。
1 2 3 4 5 6 7 8 9 10 11 12 13 14 15 16 17 18 19 20 21 22 23 24 25 26 27 28 29 30 31 32 33 34 35 36 37 38 39 40 41 42 43 44 | import re import unicodedata import pandas as pd df = pd.read_csv('data/raw/SSDSE-B-2026.csv', encoding='cp932', skiprows=[1]) d = df[df['SSDSE-B-2026'] == 2023] truth = dict(zip(d['Prefecture'], d['A1101'].astype(int))) # 正解(2023 年度の総人口) def to_zen(s): # 半角の数字とカンマを全角に return s.translate(str.maketrans('0123456789,', '0123456789,')) # 同じ値を 5 通りの書き方で文章にする(書き方は説明用に作ったもの) styles = { 'A 14086000人': lambda v: f'{v}人', 'B 14,086,000人': lambda v: f'{v:,}人', 'C 全角': lambda v: to_zen(f'{v:,}') + '人', 'D 1408.6万人': lambda v: f'{v / 1e4:.1f}万人', 'E 約1409万人': lambda v: f'約{round(v / 1e4)}万人', } def naive(s): # 素朴な正規表現: 数字とカンマの並び+「人」 m = re.search(r'(\d[\d,]*)人', s) return int(m.group(1).replace(',', '')) if m else None def careful(s): # NFKC で全角→半角、小数と「万」も読む s = unicodedata.normalize('NFKC', s) m = re.search(r'(\d[\d,]*(?:\.\d+)?)(万)?人', s) if not m: return None v = float(m.group(1).replace(',', '')) return round(v * (1e4 if m.group(2) else 1)) for name, f in styles.items(): row = [] for fn in (naive, careful): got = {p: fn(f'{p}の総人口は{f(v)}です。') for p, v in truth.items()} ok = sum(got[p] == v for p, v in truth.items()) miss = sum(got[p] is None for p in truth) wrong = 47 - ok - miss errs = [abs(got[p] - v) / v for p, v in truth.items() if got[p] is not None] e = f'{max(errs):.1%}' if errs else '—' row.append(f'正解 {ok:2d} 取れず {miss:2d} 誤値 {wrong:2d}(最大誤差 {e})') print(f'{name:<14} 素朴: {row[0]} / 丁寧: {row[1]}') print('全角の東京都を素朴に読むと:', naive('東京都の総人口は' + styles['C 全角'](14086000) + 'です。')) |
📤 実行結果:
💬 結果の読み方:半角の A・B はどちらの方法でも 47 件すべて正解です。全角数字の C では、素朴な正規表現は 47 件すべてで誤った値を返しました。\d は全角の数字にも一致する一方、全角のカンマ「,」は [\d,] に含まれないので、末尾の「000」だけを拾って 0 人と読むからです。エラーも警告も出ないので、取り出した表だけを見ていると気づけません。「万」を使う D・E は素朴な方法では 1 件も取り出せませんでした。NFKC 正規化(全角→半角)と「万」への対応を入れると A〜D は全件正解になりますが、概数の E は元の値に戻らず、正解は 1 万人ちょうどの 2 県だけで、最大 0.7% ずれます。
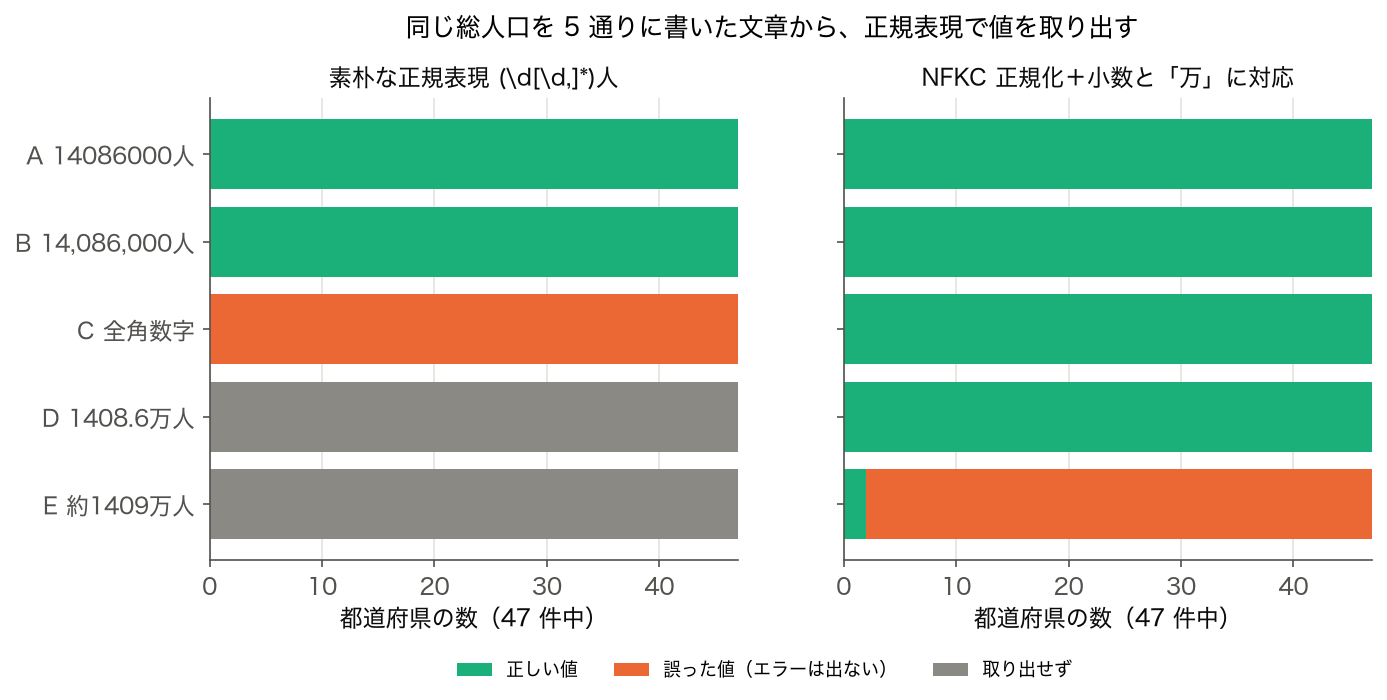
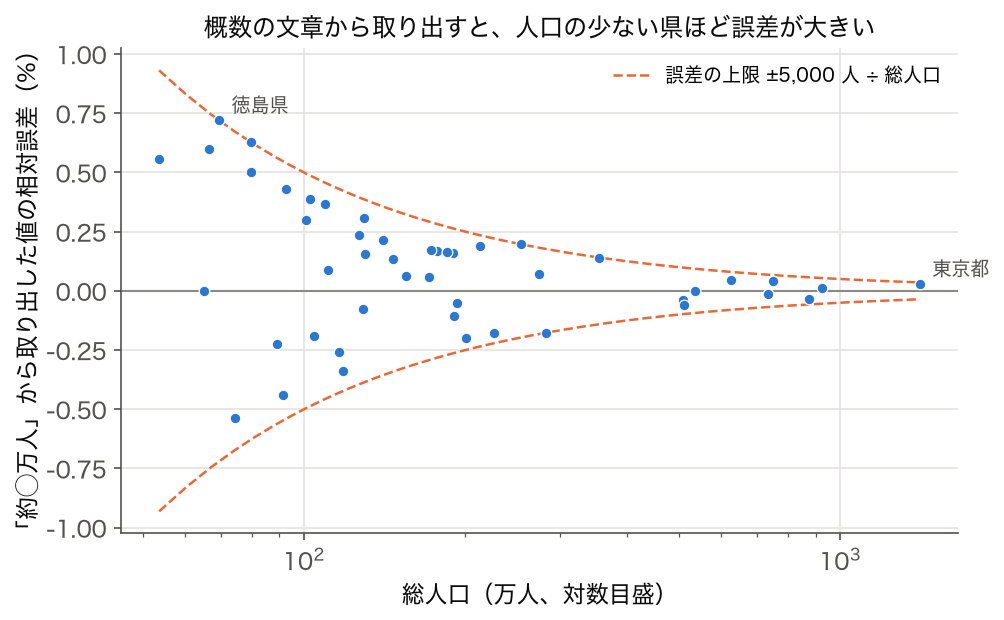
→ 取り出しの失敗には 3 種類あり、危険度が違います。「取り出せず」は件数を数えれば気づけます。「誤った値」は表に数値が入ってしまうので最も危険で、図 2 の全角数字のように 1 件残らず間違っていても見た目は普通の表です。「概数」は間違いではありませんが、図 3 のように人口の少ない県ほど相対誤差が大きく、県どうしの比較にかたよりを持ち込みます。対策は、①取り出す前に NFKC などで表記を正規化する、②取り出した値を件数・範囲・合計(ここなら 47 県の合計が全国の人口に近いか)で検算する、③原文の書き方(概数か、単位は何か)を別の列に残す、の 3 つです。
🎮 触って理解する — 非構造化テキストを「構造化」する
非構造化データの本質は「そのままでは集計できない」こと。 このデモでは、 架空の宿泊レビュー 5 件(自由記述テキスト)に、 ルールベースの抽出パターン(正規表現風のパターンマッチ)を 1 ステップずつ適用し、 非構造化テキストが構造化テーブルに組み上がっていく過程を体感する。 わざと「表記揺れで取れない例(抽出漏れ)」と「文脈を読めず間違える例(誤抽出)」を仕込んであるので、 探してみてほしい。
📄 非構造化データ(架空レビュー 5 件)
適用中のパターン: (未適用 — ただの文字列の海)
📊 組み上がる構造化テーブル
| ID | 金額 | 日付 | 評価 |
|---|
🧭 抽出メーター
📈 単語頻度カウント(簡易テキストマイニング)
もう 1 つの構造化手段が「単語頻度」への変換(TF-IDF の TF 部分)。 ここでは 漢字 2 文字以上 または カタカナ 2 文字以上の連続を「単語」とみなす超簡易トークン化で、 5 件のレビュー全文を集計する。
🎨 直感: 「形の決まっていないデータの海」から情報をすくい上げる
上のデモで体感した通り、 非構造化テキストは「金額」「日付」という列(スキーマ)が最初から存在しない。 人間が読めば一瞬で分かる情報も、 機械にとっては単なる文字の並びであり、 「どこが金額か」を教えるパターン(網)を投げ込んで初めてすくい上げられる。 網の目に合わない魚(一万二千円、 先週末)は取り逃がし、 形が似た別の魚(悪くない の「悪く」)を誤って捕まえる。 構造化データのページが「最初から整った表」を扱うのに対し、 このページの主題は「海から表を作る変換プロセス」そのものである。
⚠️ このデモに仕込んだ「よくある落とし穴」
- 抽出漏れ(表記揺れ): R2 の「一万二千円」は漢数字なので
[0-9][0-9,]*円に掛からない。 「先週末」は相対表現なので日付パターンでは取れない(基準日が別途必要)。 実務では表記揺れの網羅がルールベース抽出の最大コスト。 - 誤抽出(文脈依存): R4 の「悪くない」は肯定表現なのに、 単語辞書は「悪く」に反応してネガ判定する。 否定・反語・皮肉は単語マッチでは扱えず、 文脈を読む自然言語処理(NLP)が必要になる。
- 変換コスト: たった 5 件・3 フィールドでもパターン設計と検証が必要だった。 実データは数万件 × 表記揺れ無限で、 ルール保守が破綻しやすい。 正解データを作って精度測定するアノテーションのコストも見積もりに入れること。
- 精度は 100% にならない前提で設計する: 上のメーターが示すように、 充足率と正抽出率は別物。 「セルが埋まった=正しい」ではない(R4 の評価欄参照)。 抽出結果を統計値として使う前に、 サンプリング検品で精度を確認するのが作法。
🚀 発展: ルールベースの先へ
このデモのルールベース抽出(正規表現 + 辞書)は今も現役だが、 限界も体感した通り。 現代の主流は次の段階に進む: (1) NLP の固有表現抽出(NER)モデルは「一万二千円」も金額と認識できる。 (2) 埋め込み(embedding)はテキスト全体を数百次元ベクトルに変換し、 「悪くない」と「良い」が近い位置に来る意味空間を作る。 (3) マルチモーダルモデルはテキスト・画像・音声を同じベクトル空間で扱い、 レビュー本文と投稿写真をまとめて分析できる。 いずれも本質は同じで、 「非構造化 → 数値(構造化)への変換器」が賢くなっただけ。 変換に漏れ・誤りが必ず混じるという本デモの教訓は、 LLM 時代でもそのまま通用する。
🗺 概念マップ
非構造化データ (テキスト・画像・音声・動画) を中心に、 構造化変換 (OCR・ASR・特徴量抽出)、 ベクトル化 (TF-IDF・Embedding)、 ML 適用 (分類・検索) への流れを 6 方向に整理。
非構造化データは 構造化データ (CSV / SQL) と対をなし、 公的統計 (SSDSE-B-2026) と SNS / 報道記事のような自由テキストを組み合わせる時の中核概念。 周辺に 埋め込み・自然言語処理・CV・音声認識・データレイク が並ぶ。
🔗 隣接手法への橋渡し
非構造化データの処理は「収集 → ベクトル化 → 構造化テーブル化 → 分析」の流れで、 各段階で異なる技術が連接する。
- 上流: スクレイピング / API 取得 でテキスト・画像を収集 → データレイク に格納 → クリーニング (HTML タグ除去・文字コード統一)
- 並列: 構造化データ (CSV、 RDB)、 半構造化データ (JSON、 XML)、 ストリーミングデータ (Kafka)
- 下流: 埋め込み (BERT / CLIP) で d 次元ベクトル化 → ベクトル DB (Faiss / Pinecone) で検索 → クラスタリング や 分類 で分析
SSDSE-B-2026 (構造化) と各県観光協会の紹介文 (非構造化) を組み合わせ、 観光客数 (構造化) を目的変数として「紹介文の特徴 → 観光客数」の回帰モデルを作るのが、 ハイブリッド分析の典型例。
🌳 手法選択フロー
非構造化データに何を適用するかは、 データ種別とタスクで 4 通りに分岐する。
- テキスト + 分類タスク? Yes → BERT + 分類ヘッド、 軽量なら TF-IDF + SVM
- 画像 + 分類 / 物体検出? Yes → ResNet / ViT、 物体検出は YOLO / Faster R-CNN
- マルチモーダル (テキスト + 画像)? Yes → CLIP で共通ベクトル空間に埋め込み
- 音声? Yes → Whisper で文字起こし → テキスト処理へ
SSDSE-B-2026 と組み合わせる場合、 「県の紹介文 (テキスト)」を BERT で 768 次元ベクトル化 → 県別 SSDSE 指標とマージ → 重回帰、 という pipeline が一般的。 各段階で構造化 / 非構造化を意識して使い分ける。
📝 補足: 直感・落とし穴・発展をもう一段深く
本ページは既にレビュー済みで内容が充実しているが、 学習者がつまずきやすい「なぜ扱いにくいのか」を、 構造化データ(SSDSE-B-2026)との数値での対比を交えて追記する。 以下は既存の解説を置き換えるものではなく、 視点を足す補足である。
🎨 直感(追記)— 「表に収まるか」で世界を二分する
データを見分ける最短の問いは「行と列の表(マトリクス)にそのまま収まるか?」である。 収まるものが構造化データ、 収まらないものが非構造化データ、 その中間が半構造化データ(JSON / XML — キーはあるが入れ子や任意属性で表に落としにくい)。
- 構造化: SSDSE-B-2026 は 564 行 × 112 列 = 63,168 セルがすべて「行=市区町村、 列=指標」という決まった枠に収まる。 CSV ファイルはわずか約 351 KB。
df.mean()がそのまま効く。 - 半構造化: 同じ数値を Web API の JSON で受け取ると、 キー名は付くが入れ子の深さが可変。 必要な属性を列に「降ろして」初めて表になる。
- 非構造化: その市区町村の観光案内文・広報写真・議会音声には「列」に相当する枠が最初から存在しない。 スマホ写真 1 枚(約 3〜5 MB)は、 SSDSE-B-2026 全体(約 351 KB)のおよそ 10 倍の容量を食う。
世界に存在するデータの大半(一般に 8 割以上と言われる)は、 この「枠のない」非構造化側にある。 構造化データは人間が事前に枠を設計して整えた完成品で、 実は例外的な少数派だ、 という感覚を持つと全体像がつかめる。 → 構造化データ のページと対で読むと対比が鮮明になる。
⚠️ 落とし穴(追記・重要)— 「入り口」で必ず一手間かかる
非構造化データ最大の落とし穴は、 そのままでは統計・機械学習の入力にできない点である。 構造化データなら df.corr() や回帰にそのまま流せるが、 非構造化は必ず前段に「数値化(特徴抽出/ベクトル化)」が挟まる。 この一手間が、 以下の連鎖的な難しさを生む。
- ① そのまま入らない(特徴抽出が必須): 文字列・画素・波形は数値ベクトルに変換しないと距離も平均も定義できない。 テキスト→TF-IDF/埋め込み、 画像→CNN 特徴、 音声→MFCC。 「変換器」の選択自体が分析結果を左右する。
- ② ストレージと検索が難しい: 容量が桁違い(写真 1 枚 > SSDSE 全体)で、 SQL の
WHEREで「似た画像」は引けない。 原本はオブジェクトストレージ、 類似検索はベクトルDB、 全文検索は検索エンジン、 と保管先が分裂する。 - ③ ラベル付け(アノテーション)コストが高い: 教師あり学習用の正解付けは、 構造化データの集計に比べて多くの人手を要しやすい(1 件ごとに人が読んで判断する必要があるため)。 「正解」の定義自体が主観的になりやすい(感情のポジ/ネガ等)。
- ④ 前処理が多様でパイプラインが枝分かれ: テキストは形態素解析、 画像はリサイズ/正規化、 音声はサンプリングレート統一…と、 データ種別ごとに別工程。 構造化のような共通の「型変換」で済まない。
- ⑤ メタデータが欠けやすい: 「いつ・誰が・どこから・何のために」が付いていない生ファイルは、 後から意味を復元できずデータスワンプ(沼)化する。 カラム名で自己記述される構造化データと対照的。
- ⑥ 品質評価が難しい: 構造化なら「欠損率・型整合・主キー一意性」で機械的に測れるが、 非構造化の「良し悪し」(OCR の読み取り精度、 音声のノイズ、 抽出の正しさ)は正解データを別途用意しないと測れない。 上の🎮ウィジェットが示すとおり、 「セルが埋まった率(充足率)」と「正しく抽出できた率」は別物である。
要点: 非構造化データは「分析が難しい」のではなく、 分析の土俵(=数値の表)に乗せるまでが難しい。 一度ベクトル化して構造化に「翻訳」できれば、 その先はクラスタリング・回帰など通常の手法(→ k-means / クラスタリング)がそのまま使える。
🚀 発展(追記)— 特徴抽出から基盤モデルまで
「非構造化 → 数値化」の変換器は、 ルールベース → 専用モデル → 汎用基盤モデルへと進化してきた。 到達点は「非構造化 → 構造化パイプライン」を 1 つの基盤モデルで賄う形である。
- 特徴抽出(feature extraction): テキストは TF-IDF や 埋め込み(embedding)、 画像は CNN の中間層特徴、 音声は MFCC。 詳しくは 特徴量 / 特徴量エンジニアリング を参照。
- ベクトルDB: 抽出した密ベクトルを類似検索に特化して格納(pgvector / FAISS / Pinecone)。 数式的な扱いは ベクトル演算、 「似ている」の測り方は テキスト類似度 を参照。
- マルチモーダル: テキスト・画像・音声を同じベクトル空間に写す(CLIP 等)。 レビュー本文と投稿写真をまとめて 1 つの空間で比較できる。 → マルチモーダル。
- 基盤モデルによる汎用埋め込み: 大規模事前学習された基盤モデル(詳細は 基盤モデル(詳細))は、 タスク固有の学習なしに高品質なベクトルを出す。 テキストなら NLP、 画像なら 画像認識 / 画像分類 の前段を汎用モデル 1 つで置き換えられる。
- 非構造化→構造化パイプライン: 固有表現抽出(NER)や LLM の構造化出力で、 自由文から「金額・日付・評価」を自動で表に落とす。 本ページの 構造化データ生成 的な工程で、 SSDSE-B-2026 のような公的統計と結合可能な形に整える。
現代の主流は、 これらを組み合わせた RAG(本ページ上部で詳述)やデータレイク基盤である。 いずれも本質は「賢くなった変換器で非構造化を数値化し、 構造化統計と同じ土俵に乗せる」こと。 変換に漏れ・誤りが必ず混じる(🎮ウィジェットの教訓)点は、 基盤モデル時代でも変わらない。
🔗 関連ページ(この補足からの導線)
- 対概念: 構造化データ — 表に収まる完成品との対比。 半構造化(JSON / XML)は両者の中間(専用ページは未整備のためテキストで補足)。
- 数値化の道具: TF-IDF / 埋め込み / 特徴量 / 特徴量エンジニアリング / ベクトル演算
- 類似・検索: テキスト類似度 / クラスタリング / k-means
- 種別ごとの解析: 自然言語処理(NLP) / 画像認識 / 画像分類 / マルチモーダル
- 汎用化・基盤: 基盤モデル / 基盤モデル(詳細) / データレイク / 構造化データ生成
注: 構造化データの数値(564 行 × 112 列 = 63,168 セル、 CSV 約 351 KB)は SSDSE-B-2026(encoding='cp932', skiprows=[1])の実測。 レビュー文・写真・音声などの非構造化の例はすべて説明用の架空データであり、 実在の値ではない。