🔖 拡張キーワード索引
本ページは 行動ログ (Behavior Log) を、 定義・収集・前処理・分析・可視化まで一気通貫で詳述します。 関連概念: ログデータ、 イベントデータ、 クリックストリーム。
行動ログ (Behavior Log) は『人・モノ・システムの動作を時刻・主体・対象とともに記録した時系列イベントデータ』を指す。 Web の click stream、 IoT の sensor log、 POS の購買履歴、 公共統計の人流データなどが該当。 解析には event-based モデル (Markov chain, RNN, Transformer) や cohort 分析が頻繁に使われる。
💡 30秒で分かる結論
🍰 まずはやさしく
行動ログは、日々の足跡のようなデータです。
分析や予測に役立てるために使います。
スマホアプリの操作履歴などが例です。
まずは重要ポイントを短く確認しましょう。
ユーザーの行動を時系列記録
- 分野:データエンジニアリング — 📚 データエンジニアリング
- 用途:分析・前処理・モデル構築・解釈支援などの場面で使われます
- 注意:適用条件と限界を理解してから使うのが鉄則
behavior log を 30 秒で把握する重要ポイント:
- 何ができるか: behavior log は統計・データ分析で特定の目的のために使う概念・手法。 詳細は後続の各章を参照。
- いつ使うか: 適切な前提条件下で、 他の手法より優位な場面で使う。 適用範囲と限界を理解することが重要。
- 注意点: 前提確認 / 過大解釈の回避 / 他手法との比較検証 が不可欠。
- 関連: 上位概念・並列手法・派生形をネットワークで理解すると応用の幅が広がる。
📍 あなたが今見ているものと行動ログ
🍰 まずはやさしく
行動ログは、出来事の記録です。
状態がどう変わったかを知るために使います。
Webサイトでリンクを押したときも記録されます。
ログをどう読み解くかについて解説します。
あなたが今見ているものを行動ログとして考えると、 「ページを開いた」「用語を読んだ」「関連リンクを押した」「コード例をコピーした」という一つ一つの出来事が、 時刻・主体・対象・文脈を持つイベントになります。 行動ログデータは、 このようなイベントを時系列に並べ、 ユーザーや地域や設備がどのように状態を変えたかを読むためのデータです。
統計データ解析コンペでは、 Web のクリック履歴そのものが無くても、 SSDSE-B-2026 の都道府県別・年次別指標を「地域の行動が残したログ」とみなせます。 例えば人口移動、 消費支出、 医療資源、 教育環境、 産業構成の変化は、 県単位の長い行動履歴として扱えます。 重要なのは、 行動ログを単なる時刻付き表ではなく、 誰が、 何に対して、 いつ、 どの状態からどの状態へ移ったかを記録した分析素材として読むことです。
📍 文脈 — 行動ログをどこで使うか
行動ログ (Behavior Log) は Web アクセス、 IoT センサ、 POS 購買、 公共統計の人流データなど、 主体・対象・時刻が記録されたイベント時系列の総称。 リアルタイムなレコメンド、 異常検知、 シーケンス予測、 セグメント分析、 ジャーニー設計など、 データ駆動意思決定の出発点。 統計・データ解析コンペでは、 47 都道府県 × 複数年の SSDSE-B 公的統計を行動ログ的時系列とみなして時間構造を抽出するアプローチが定番。
🎨 直感で掴む
🍰 まずはやさしく
お店の監視カメラのようなデータです。
ありのままの動きを正しく知るために使います。
レジの買い物履歴などが身近な例です。
データの形や集め方の流れを学びましょう。
データを「分析・モデリングに使える形に整える」工程。 分析の質はここで 8 割決まります。
本ページでは 行動ログデータ を、 定義・前提条件・使い方・落とし穴の順に整理して解説します。 厳密な定義より、 まず何を、 いつ、 どう使うかを理解することを優先してください。
もう一つの直感は「ストアの監視カメラ録画 + POS レジ伝票 + 会員カード履歴」の三点セット。 行動ログは「いつ・誰が・どこで・何をした」を時刻付きで全件記録する点で、 アンケート (主観・回答時の記憶バイアスあり) や統計集計 (個人を捨てて代表値のみ) と本質的に異なる。 SSDSE-B-2026 のような集計済み公的統計は「行動ログを都道府県集計に丸めた最終アウトプット」と位置付けられる。
本ページでは行動ログを、 (1) イベントスキーマ (user_id, timestamp, event_type, properties)、 (2) 収集方法 (Web のクリックストリーム / アプリの SDK / IoT センサ)、 (3) 保管形式 (Parquet/JSON Lines)、 (4) 集計→分析→可視化までの ETL の 4 段階で具体化する。 セッション化・ファネル分析・コホート分析という固有のテクニックがここから派生する。
公的統計の都道府県別集計に至る前段には「住民一人ひとりの購買・移動・公共サービス利用の行動ログ」が想定される。 このイベント列を user_id でセッション化して集約すれば集計指標になり、 逆に集計指標から個々の行動傾向を推測することもできる。 以降では、 行動ログを実務で読むための設計ノートと、 滞在時間の手計算例で理解を固める。
📐 定義
🍰 まずはやさしく
行動ログは、行動を時間順に並べた記録です。
データエンジニアリング(データの整備)で使います。
誰がいつ何をしたかをまとめたものです。
詳しい定義と使い方のルールを説明します。
ユーザーの行動を時系列記録
英語名 Behavior Log Data。
🎯 いつ・どこで使うか
- 「データエンジニアリング」分野の標準的な道具として、 多くの分析で登場します。
- 📚 データエンジニアリング を学ぶときに必ず通過する基本概念です。
- 論文・実務レポートで頻出する用語なので、 1 度はちゃんと理解しておくと後が楽です。
📋 前提条件・適用範囲
この用語を理解・使用するときは、 次のような前提を意識してください:
- データの性質:尺度(名義/順序/間隔/比例)と分布を確認
- サンプル数:手法によって最低限のサンプル数が異なります
- 独立性:観測が独立であるかを確認(時系列・パネル等では別の手法が必要)
- 欠損・外れ値:前処理の方針を明確に
📐 定義を式で読み解く
行動ログは、 主体・対象・時刻・文脈を持つイベントの集合として、 次のように書けます。
各記号の意味は次の通りです。
u_i= 主体 (ユーザー・端末・世帯・店舗・都道府県 など)a_i= 対象/行為 (閲覧・クリック・購買・移動・受診 など)t_i= タイムスタンプ (秒・日・年など任意の粒度)c_i= 文脈・属性 (デバイス・地域・キャンペーン など)N= 記録されたイベント総数 (1 行 = 1 イベント)
同一主体のイベントを時刻順に並べた列がセッションや行動系列になり、 遷移確率 P(a_(t+1) | a_t) やコホート継続率といった特徴量がここから導かれます。
🔬 記号・要素の読み解き
行動ログを数式で表すと L = {(u_i, e_i, t_i, c_i)} となる。 ここで:
u_i= ユーザー / 主体識別子 (SSDSE-B では Prefecture)e_i= イベント種別 (購買・閲覧・移動・出生・転入 など)t_i= タイムスタンプ (SSDSE-B では年次)c_i= 文脈情報 / 属性 (年齢・性別・地域・産業 など)L= ログ全体集合 (行が個別イベント、 列がフィールド)
行動ログ分析では、 (1) frequency (頻度集計)、 (2) recency (直近性)、 (3) monetary (金銭的価値)、 (4) sequence (順序パターン) の 4 観点で特徴量を抽出する RFMS 設計が定番。
🧮 行動ログの実装と手計算
🧭 行動ログを実務で読むための補強ノート
行動ログ分析で最初に決めるべきことは、 ログの粒度です。 クリック単位で見るのか、 セッション単位で見るのか、 ユーザー単位で集約するのか、 地域や店舗単位で集約するのかによって、 同じデータから得られる結論は大きく変わります。 例えば EC サイトでは「商品詳細を見た」「カートに入れた」「購入した」を別々のイベントとして扱う一方、 経営会議では週次の閲覧数、 CVR、 離脱率へ集約します。 統計データ解析コンペでも同じで、 都道府県を主体、 年を時刻、 人口や消費や医療資源をイベント状態とみなすか、 県をセッションのようにまとめるかで、 ストーリーの組み立て方が変わります。
行動ログは「事実を細かく記録しているから客観的」と思われがちですが、 実際には欠測、 観測窓、 計測仕様、 ボット、 同一人物の重複、 デバイスまたぎ、 同意取得、 追跡拒否、 サンプリングなどの影響を強く受けます。 そのため、 分析前にはイベント定義書を作り、 イベント名、 主体ID、 対象ID、 タイムスタンプ、 発火条件、 重複排除ルール、 個人情報の扱いを表にして確認します。 この定義書がない行動ログは、 後から再現できない「現場の記憶」に近く、 モデル精度が高くても説明責任を果たせません。
設計チェック: イベントを分析単位へ落とす
| 観点 | 確認すること | 失敗例 | 対策 |
|---|---|---|---|
| 主体 | ユーザー、 端末、 世帯、 店舗、 県のどれを単位にするか | 端末変更で同一人物が二重計上される | 匿名化IDと集計単位を明記する |
| 時刻 | 秒、 日、 週、 年のどの粒度で読むか | 休日効果と施策効果を混同する | 曜日、 季節、 祝日を特徴量に含める |
| 対象 | ページ、 商品、 施設、 指標、 地域のどれが対象か | 名称変更で同じ対象が別物になる | マスターデータを固定し履歴管理する |
| 状態 | 遷移前後の状態をどう定義するか | しきい値変更で前年比較が壊れる | 分析期間内で分類規則を固定する |
SSDSE-B-2026 のような公的統計を行動ログ的に読む場合、 個人のクリック履歴とは異なり、 県単位に集約された「遅いログ」を扱います。 このときの強みは、 47 都道府県という比較可能な単位が揃っていることです。 弱みは、 個人の意思決定が既に集計されていて、 クリックから購入までのような細かな順序が見えないことです。 したがって、 地域の状態遷移、 年次の変化、 高低区分の持続性、 外れ値県の説明、 政策前後の差分を中心に据えると、 行動ログという概念を無理なく応用できます。
レポートでは、 「ログ件数が多いから重要」とは書かず、 何を母数にした率なのかを必ず示します。 ページ閲覧数ならユーザー数、 購買数なら訪問数、 県別イベントなら人口や世帯数で割る必要があります。 母数を示さない行動ログ分析は、 大都市やヘビーユーザーを過大評価しやすく、 コンペの講評でも「規模の差を効果と読み違えている」と指摘されます。 率、 構成比、 一人当たり、 前年比、 標準化スコアを使い分けることが、 行動ログを統計分析として成立させる条件です。
分析ストーリーへの落とし込み
行動ログを発表で使うときは、 「何が多いか」よりも「どの順序で行動が変わったか」を中心に話すと伝わりやすくなります。 例えば、 観光統計なら来訪、 滞在、 消費、 再訪の順序を置き、 医療統計なら受診、 診断、 治療、 継続支援の順序を置きます。 SSDSE-B-2026 では個人イベントが直接見えないため、 県ごとの年次状態をイベント列に置き換え、 「人口減少が先に起き、 消費支出が遅れて変化した」「医療資源の増加後に高齢者比率との関係が変わった」といった状態遷移の物語を組み立てます。 こうすると、 行動ログという用語が Web サイト分析だけでなく、 公的統計の時系列解釈にも使えることが明確になります。
さらに、 行動ログは予測にも説明にも使えます。 予測で使う場合は、 過去30日の閲覧回数、 直近購入からの日数、 前回状態、 連続滞在日数のように、 次の行動を当てる特徴量へ変換します。 説明で使う場合は、 代表的な遷移パターン、 離脱前に起きるイベント、 異常値の直前行動、 施策前後の行動変化を示します。 どちらの場合も、 時系列の前後関係を崩してランダムに分割すると情報漏洩が起きやすいため、 学習データと評価データは時刻で分けるのが基本です。 コンペでモデルを出すなら、 ランダム分割の点数だけでなく、 過去年で学習して翌年を予測する検証も併記すると、 行動ログの時間構造を理解していることが伝わります。
最後に、 倫理とプライバシーも分析設計に含めます。 行動ログは個人の関心、 移動、 生活リズム、 購買力、 健康状態を推測できるため、 直接識別子を外しただけでは十分でないことがあります。 集計単位を粗くする、 希少な行動を丸める、 目的外利用を避ける、 保持期間を決める、 可視化で少数者が特定されないようにする、 という手当てが必要です。 県別の公的統計でも、 小地域や少数カテゴリに分けすぎると同じ問題が起きます。 行動ログ分析の品質は、 精度、 再現性、 説明可能性、 プライバシー配慮の4点を同時に満たして初めて評価できます。
発表スライドに落とす時は、 まずログの1行を見せ、 次に集計表、 その次に遷移や分布の図を示します。 いきなりモデル係数を出すと、 聴き手は「その数値がどの行動から作られたのか」を追えません。 具体的には、 1枚目でイベント定義、 2枚目で欠測・重複処理、 3枚目で主要な頻度分布、 4枚目で状態遷移、 5枚目で施策や地域差の解釈、 という順に並べると、 行動ログがデータ生成過程から結論までつながります。 この順序は、 Webログ、 POSログ、 IoTログ、 SSDSEの年次指標のどれにも使える汎用的な説明型テンプレートです。
また、 行動ログは「観測された行動」しか残しません。 見なかった、 買わなかった、 来なかった、 回答しなかったという非行動は、 そのままではログに現れません。 そのため、 離脱率や未利用率を扱う時は、 行動した人だけでなく、 行動する機会があった母集団を定義する必要があります。 コンペでは、 県別統計の全47県を母集団として明示し、 そこから特定条件に該当する県を取り出す形にすると、 非行動や未発生イベントの扱いが曖昧になりません。 行動ログを正しく読むとは、 記録されたイベントだけでなく、 記録されなかった可能性まで設計に含めることです。
品質管理では、 生ログ、 加工ログ、 分析用特徴量の3層を分けて保存します。 生ログは後から仕様を検証するために残し、 加工ログでは重複排除や時刻丸めを明示し、 分析用特徴量ではモデルに入れた列だけを固定します。 この3層が混ざると、 同じ集計値を再計算できず、 発表後の質問に答えられません。 特に時刻の丸め、 セッション切断時間、 同一イベントの再送、 タイムゾーン、 欠測補完は、 行動ログの結論を左右する重要な前処理です。 ノートブック内の一時処理ではなく、 仕様表として残しておくことが再現性の最低条件です。
読み手に刺さる結論にするには、 行動ログから「頻度」「順序」「継続」「離脱」「復帰」のどれを主役にするかを一つに絞ります。 頻度ならヒストグラム、 順序なら遷移行列、 継続ならコホート表、 離脱ならファネル、 復帰なら再訪率が向いています。 図の種類と問いを一致させることで、 行動ログは単なる膨大な履歴ではなく、 意思決定に使える証拠になります。
まとめると、 行動ログデータは「細かく記録された出来事」ではなく、 目的に合わせて再構成する時系列の証拠です。 どのイベントを採用し、 どの母数で割り、 どの順序を意味のある遷移とみなすかを決めて初めて、 分析対象になります。 この設計を明示できれば、 行動ログは予測、 異常検知、 施策評価、 利用者理解のどれにも展開できます。
実務で迷ったら、 まず「このログは何の意思決定を変えるのか」と問い直します。 意思決定が明確なら、 必要な粒度、 集計単位、 可視化、 評価指標も自然に決まり、 余計なログ収集を避けられます。 判断単位を先に固定することが重要です。
理解度チェック
- 行動ログの4要素である主体、 イベント、 時刻、 文脈を、 自分の分析テーマに合わせて一つずつ書けますか。
- イベント数、 ユーザー数、 セッション数、 一人当たり回数の違いを説明できますか。
- 欠測、 重複、 ボット、 デバイスまたぎのうち、 自分のデータで最も危険なものを一つ選べますか。
- SSDSE-B-2026 を行動ログ的に扱う場合、 県、 年、 指標、 状態をそれぞれ何に対応させるか説明できますか。
- 「ログが増えた」だけで施策成功と言えない理由を、 母数と交絡の観点から説明できますか。
- 遷移行列、 コホート分析、 RFM/RFMS、 異常検知のうち、 目的に合う手法を選べますか。
- (実データ)2023 年度の出生数は東京都が 86,348 件で 1 位だが、人口千人あたりでは 12 位、合計特殊出生率では 47 位だった。「東京都は出生が最も活発な県」と言えない理由を、分母の言葉で説明できますか。
→ 答え:件数は主体の大きさ(人口 1,409 万人)を掛けた量で、起こりやすさを比べるには「その出来事が起こり得た人数」で割る必要がある。出産年齢の人口構成まで調整した合計特殊出生率 0.99 は全国最低。 - (実データ)転入超過/転出超過の遷移 517 回のうち、状態が入れ替わったのは 21 回で、沖縄県が 5 回を占めた。全体の遷移確率(転入超過が翌年も続く 0.857)だけを報告すると何を見落としますか。
→ 答え:入れ替わりが一部の主体(転入と転出が拮抗した県)に集中していること。全体の確率は、ほとんど状態が動かない多数の主体と、頻繁に動く少数の主体を平均した値になる。 - (実データ)ログの行を 5% 落としただけで、2021 年度の全国の出生数が 17.2% 減って見えた。なぜ 5% の欠落が 17% の誤差になるのか、どうすれば集計の前に気づけるかを説明できますか。
→ 答え:落ちた行に東京都・北海道・京都府という件数の大きい主体が含まれたから。欠落の影響は落ちた行数ではなく落ちた件数で決まる。年度・イベントごとに主体数(47 県そろっているか)を数える完全性チェックで検出できる。
🧮 数式に値を入れて手で計算する: 行動ログの滞在時間統計
合成セッションログ 5 件から平均滞在時間と中央値を計算する。
Step 1: セッション別滞在時間 [秒]
| セッション | 滞在時間 |
|---|---|
| s1 | 30 |
| s2 | 120 |
| s3 | 60 |
| s4 | 180 |
| s5 | 90 |
Step 2: 平均と中央値
🐍 Python で再現
1 2 3 4 5 | import numpy as np dur = np.array([30, 120, 60, 180, 90]) print(f"平均: {dur.mean()} 秒") print(f"中央値: {np.median(dur)} 秒") print(f"最大-最小: {dur.max() - dur.min()} 秒") |
📤 実行結果
💬 手計算 (Step 2) 平均 96 秒, 中央値 90 秒と Python 出力が完全一致。
ファネルを実際に数えてみる ── 「直前比」を見ないと打ち手を間違える
行動ログの最初の使い道はファネル分析です。ここでは再現可能な合成ログ (2,000 ユーザ・3,615 行、乱数の種を 20260804 に固定した架空データ。SSDSE には行動ログが無いため)で、 実際に数え上げた結果を示します。
| 段階 | 到達人数 | 先頭比 | 直前比 | 読み方 |
|---|---|---|---|---|
| 閲覧 view | 2,000 | 100.0% | — | 母数 |
| カート cart | 814 | 40.7% | 40.7% | ここが最大の脱落。59.3% が消える |
| レジ checkout | 458 | 22.9% | 56.3% | カート放棄が 43.7% |
| 購入 purchase | 343 | 17.2% | 74.9% | 最後まで来れば 4 人に 3 人は買う |
💬 ここが要点:先頭比だけを見ると「購入は 17.2% しかない」で終わってしまい、 どこを直せばいいのかが分かりません。直前比を並べると話が変わります。 脱落率は 閲覧→カートで 59.3%、カート→レジで 43.7%、レジ→購入で 25.1%。 いちばん漏れているのは入口で、レジ画面をいくら改善しても効果は限定的だと分かります。 「最終指標が低い」ことと「どの工程が悪い」ことは別問題です。必ず段階ごとの直前比を出してください。
もう一つ注意があります。この表は「人数」で数えており「回数」ではありません。 同じ人が 3 回カートに入れても 1 人と数えています。回数で数えると、 熱心な少数ユーザが何度も往復した分だけ数字が膨らみ、 「カート投入は閲覧より多い」という奇妙な表ができあがることさえあります。 ファネルは原則としてユニークユーザ数で数え、回数で見たいときは別の表にしてください。
セッションの区切り方で「訪問回数」は 1.5 倍変わる
行動ログは連続した点の列でしかないので、「何回訪問したか」を数えるには どこで切るかを人間が決めなければなりません。 広く使われるのは「無操作が 30 分続いたら別の訪問とみなす」という規則です。 この 30 分という数字に理論的な根拠はなく、慣習です。実際に閾値を変えて数え直すとこうなります。
| 区切る閾値 | 5 分 | 15 分 | 30 分 | 60 分 | 120 分 |
|---|---|---|---|---|---|
| セッション数 | 3,158 | 2,493 | 2,062 | 2,000 | 2,000 |
| 1 ユーザ平均 | 1.58 | 1.25 | 1.03 | 1.00 | 1.00 |
💬 ここが要点:まったく同じログなのに、閾値を 5 分にするか 30 分にするかで セッション数は 3,158 と 2,062、およそ 1.5 倍違います。 「訪問あたりの購入率」を KPI に置いている組織で、誰かが黙って閾値を変えれば、 施策を何もしていないのに KPI が 5 割動きます。 行動ログの数字を比べるときは、集計期間だけでなくセッション定義もそろっているかを必ず確認してください。 社内で数字が 食い違うとき、原因の多くはモデルではなくこの種の定義のズレです。
RFM ── 3 つの軸で客を分けると「離脱しかけている優良客」が見える
行動ログのうち購買履歴に対してよく使われるのが RFM です。 R(最終購買からの日数・小さいほど良い)、F(購買回数・多いほど良い)、 M(累計金額・多いほど良い)の 3 つをそれぞれ 5 段階に区切り、5 が最良になるようスコアを振ります。 再現可能な合成購買ログ(1,200 人・乱数の種 20260804 の架空データ)で実際に集計すると次のようになります。
| 層 | 人数 | 平均累計金額 | 平均最終購買 | 打ち手 |
|---|---|---|---|---|
| 全体 | 1,200 人 | 7,743 円 | — | — |
| 優良客(R・F・M すべて 4 以上) | 82 人(6.8%) | 14,918 円 | 69 日前 | 維持。値引きは不要で、むしろ特別扱いが効く |
| 離脱危険(F・M は高いが R が低い) | 86 人(7.2%) | 13,992 円 | 294 日前 | 最優先で呼び戻す。放置すると失う |
💬 ここが要点:この 2 つの層は平均累計金額がほぼ同じ(14,918 円 と 13,992 円)です。 金額だけで客を並べたら、まったく区別がつきません。 違うのは 最終購買が 69 日前か 294 日前かという一点だけ。 R を軸に加えて初めて「たくさん買ってくれていたのに、ここ 10 か月来ていない人が 86 人いる」 という行動可能な事実が浮かび上がります。これが「3 軸で見る」ことの価値です。
ついでに確認しておくと、この合成データでは金額上位 20% の客が売上の 47.5% を占めていました。 よく言われる「上位 2 割が売上の 8 割」(パレートの法則)ほど極端ではありません。 経験則をデータで確かめずに前提として使わないことも、行動ログを扱ううえで大切な姿勢です。 自社のデータで数えれば、5 割かもしれないし 9 割かもしれない。数えてから語ってください。
なお RFM のスコア化には落とし穴があります。上の計算では順位を 5 等分(qcut)しました。
この方法だと必ず各層が全体の 20% ずつになります。
「優良客が 20% もいる」のではなく「上位 20% を優良客と呼んだ」だけです。
絶対的な基準(例: 累計 10 万円以上)で切るのか、相対的な順位で切るのかで、
出てくる人数も解釈もまったく変わります。報告するときは、どちらで切ったかを必ず書いてください。
コホート分析 ── 「全体の継続率」は、いつも嘘をつく
行動ログを時間で切るとき、全ユーザをひとまとめにした継続率は必ず誤解を生みます。 新規が増えている時期は「入りたての人」が母数に多く入るので継続率が高く見え、 新規が止まると古株ばかりになって継続率が跳ね上がる——サービスの実力とは無関係に動くのです。 そこで「いつ入ってきたか」でグループ(コホート)に分け、加入からの経過月で並べます。 再現可能な合成ログ(乱数の種 20260804 の架空データ)での例が次です。
| 加入月 | 人数 | 1 か月後 | 2 か月後 | 3 か月後 | 4 か月後 | 5 か月後 |
|---|---|---|---|---|---|---|
| 2026-01 | 487 人 | 56.6% | 49.5% | 41.0% | 37.4% | 34.4% |
| 2026-02 | 426 人 | 68.5% | 55.1% | 46.3% | 37.6% | 33.8% |
| 2026-03 | 463 人 | 55.6% | 44.7% | 40.9% | 37.1% | 29.9% |
💬 ここが要点:縦に読むと施策の効果が、横に読むとそのコホートの寿命が見えます。 2 月加入だけ 1 か月後の継続率が 68.5% と突出しており(他は 55〜57%)、 2 月に何かが起きたと分かります。オンボーディングの改善か、 たまたま質の良い流入があったか。ここが調査の出発点になります。 一方、横に見ると 3 コホートとも 5 か月後には 30〜34% に収束しており、 初月の差は時間とともに消えていくことも読み取れます。 「初月の継続率だけを KPI にすると、長続きしない改善を高く評価してしまう」という教訓です。
実務でコホート表を作るときの注意点が 2 つあります。第一に、 直近のコホートは経過月が短く、右側が空欄になります。 ここを 0% と読んで平均に混ぜると、継続率が実際より低く出ます。空欄は「まだ分からない」であって 0 ではありません。 第二に、「継続」の定義を決める必要があります。 1 回でもログインしたら継続なのか、購入したら継続なのか。 定義次第で数字は倍近く変わるので、セッション定義と同じく文書に残して固定してください。
🎮 触って理解する
下のミニデモでは、 このページでのあなたの操作そのものが行動ログとして記録されます。 ボタン A (商品閲覧)・B (カート追加)・C (購入) を押したり、 スクロール枠を動かしたりすると、 タイムスタンプ付きのイベント行が「生ログ」に溜まり、 その場で 集計 → 時系列プロット → ファネル分析 に変換されます。 「新しいセッション」を押すと現在のセッションを区切って次のセッションを開始でき、 セッションをまたいだファネル到達率 (A→B→C) が計算されます。
🔒 プライバシー注記: このデモで生成されるログはすべてブラウザ内 (このページの JavaScript 変数) だけに存在し、 サーバー等どこにも送信・保存されません。 ページを再読み込みすると消えます。
| 総イベント数 | 0 |
| A: 商品閲覧 | 0 |
| B: カート追加 | 0 |
| C: 購入 | 0 |
| scroll | 0 |
| セッション数 (イベントあり) | 0 |
「A を含むセッション」を母数 100% とし、 A の後に B、 さらにその後に C が起きたセッションの割合。 順序が逆 (B→A) のものは到達と数えません。
💡 示唆: まだデータがありません。 A→B→C の順に押してから「新しいセッション」で区切り、 次のセッションでは A だけ押して離脱してみると、 ファネルの落ち込みが見えます。
🎨 直感 — 行動の足跡がそのままデータになる
上のデモで体感できるように、 行動ログは「わざわざ回答してもらうデータ」ではなく、 操作の副産物として自動的に溜まるデータです。 1 行 1 イベント (時刻・セッション・種別) という生ログは、 それ単体ではただの膨大な履歴ですが、 (1) 種類別に数える、 (2) 時間軸に並べる、 (3) 順序をファネルとして読む、 という 3 つの変換を通すと「どこで人が離脱するか」という意思決定に使える示唆へ変わります。 このデモの「生ログ→集計→示唆」の流れは、 実務の Web ログ分析でも ログデータ基盤上で同じ形で行われます。
⚠️ よくある落とし穴 — デモで確かめられる 3 点
- 欠測イベント: デモで B を押さずに C を押すと、 ファネル上は「C 到達」と数えられません。 実務でも計測タグの実装漏れや通信失敗でイベントが欠けると、 「行動しなかった」のか「記録されなかった」のか区別できません (欠損値の問題)。 イベント定義書と欠測率の監視が必須です。
- セッション定義: このデモは「新しいセッション」ボタンで明示的に区切りますが、 実務では「30 分無操作で分割」などの規則で機械的に切ります。 切断時間を変えるとセッション数もファネル到達率も変わるため、 分析期間内で定義を固定しないと数値が比較できません。
- プライバシー: このデモはブラウザ内で完結しますが、 実サービスでは行動ログから個人の関心・生活パターンが推測できるため、 同意取得・匿名化・保持期間の設計が法的にも倫理的にも必要です (プライバシー)。
🚀 発展 — ここから先の分析
- ファネル分析の本格運用: デモの A→B→C を実サービスの導線 (LP→商品→カート→決済) に置き換え、 段ごとの離脱率をセグメント別 (デバイス・流入元・地域) に比較すると、 改善すべきボトルネックが特定できます。
- A/B テスト: ボタンの文言やレイアウトを 2 群にランダム割付し、 行動ログから群別のファネル到達率を比較すると、 施策の因果効果を推定できます — A/Bテスト。
- イベント設計: 「取れるログを全部取る」のではなく、 検証したい仮説から逆算してイベント名・プロパティ・発火条件を設計します。 収集の考え方は データ収集、 蓄積後の時間構造の分析は 時系列データ が隣接領域です。
🐍 Python での扱い
SSDSE-B-2026 の横持ちの表を、 行動ログと同じ「主体・時刻・イベント・値」の縦持ちに組み替えて集計する基本パターン:
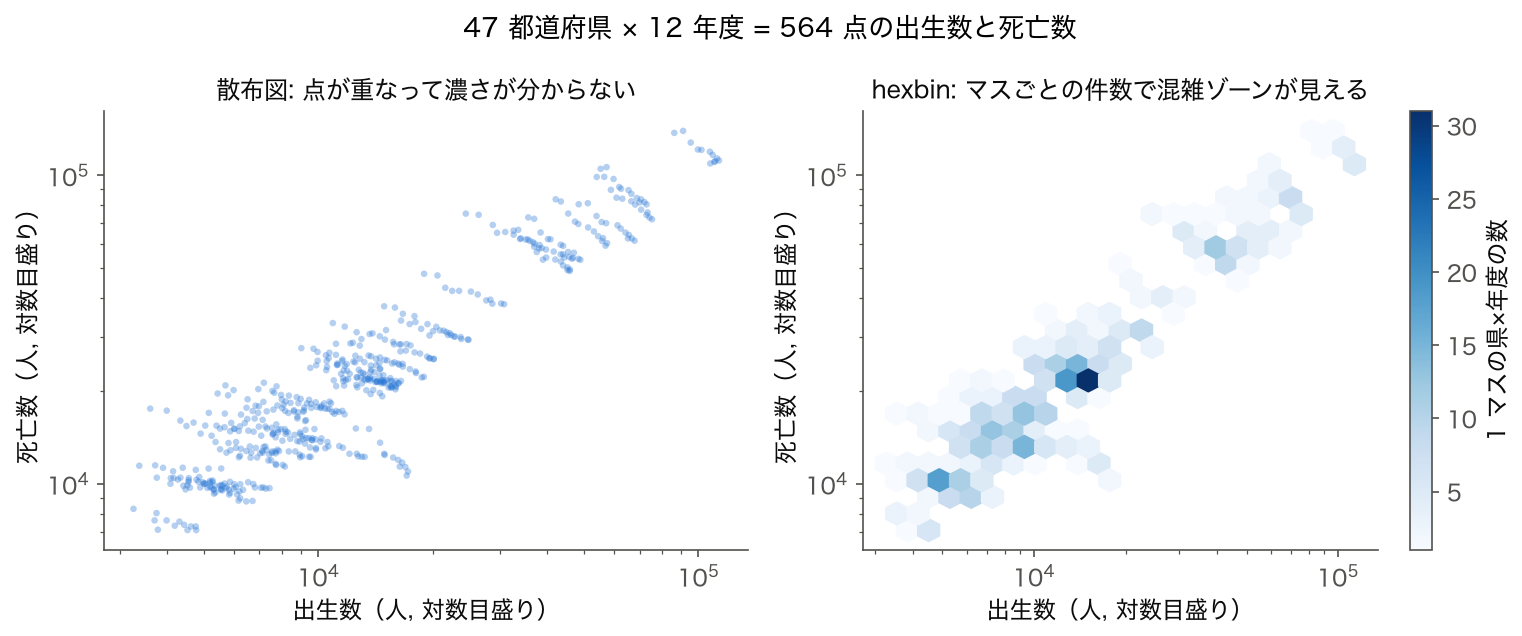
1 2 3 4 5 6 7 8 9 10 11 12 13 14 15 16 17 18 | import pandas as pd # データ読み込み(skiprows=1 で日本語の列名をヘッダにする) df = pd.read_csv('data/raw/SSDSE-B-2026.csv', encoding='cp932', skiprows=1) print(df.shape) # (564, 112) = 47 都道府県 × 12 年度 # 行動ログの形(主体・時刻・イベント・値 の縦持ち)に組み替える log = df.melt(id_vars=['都道府県', '年度'], value_vars=['出生数', '死亡数'], var_name='イベント', value_name='件数') order = pd.CategoricalDtype(df['都道府県'].unique(), ordered=True) # CSV の県順(北海道→沖縄) log['都道府県'] = log['都道府県'].astype(order) log = log.sort_values(['都道府県', '年度', 'イベント']).reset_index(drop=True) print(log.shape) print(log.head(4).to_string(index=False)) # ログ的な集計: 主体(県)× イベントごとに、前年からの増減を求める log['前年差'] = log.groupby(['都道府県', 'イベント'], observed=True)['件数'].diff() print(log.groupby('イベント')['前年差'].agg(['count', 'mean']).round(1)) |
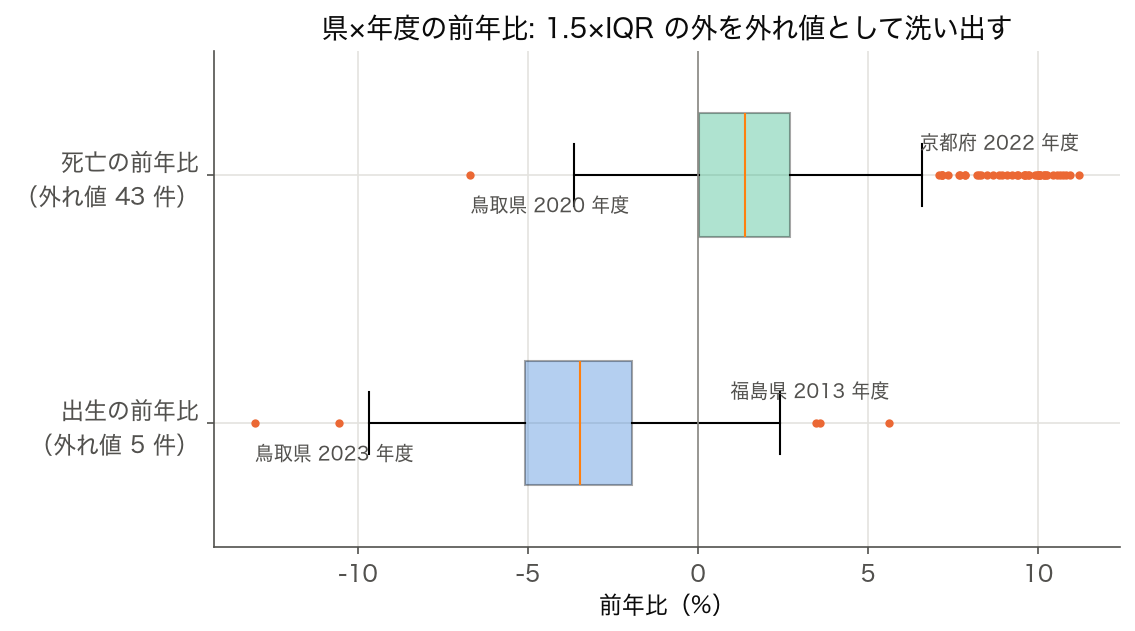
💬 564 行 × 112 列の横持ちの表は、1 行が「ある県のある年度」の集計値で、1 回の操作を 1 行に記録する行動ログとは粒度が違う。出生数と死亡数の 2 列を縦持ちにすると、主体(県)・時刻(年度)・イベント(出生/死亡)・件数の 4 列、1,128 行(564 × 2)のログ風の表になる。県 × イベントごとの前年差は 47 県 × 11 年 = 517 件ずつ計算でき、平均すると出生数は 1 年に 599.4 件減り、死亡数は 619.4 件増えている。ただしこれは県・年度に集計済みの件数で、誰がいつ何をしたかは復元できないので、ログと突き合わせるときはログ側を県 × 年度に集計してから結合する。
具体的なコードは データエンジニアリング を参照してください。
📝 レポートでの報告
分析結果を報告するときに含めるべき情報:
- 使ったデータ:出典・期間・サンプル数
- 適用条件の確認:前提が満たされているか
- 計算結果:数値だけでなく不確実性(CI・SE)も
- 解釈:何を意味するか、 何を意味しないか
- 限界:適用範囲外への拡張は避ける
✅ チェックリスト
- □ 「行動ログデータ」を使う場面か再確認したか
- □ データの尺度・分布・サンプル数を確認したか
- □ 前提条件を満たしているか
- □ 計算した値だけでなく不確実性も把握したか
- □ 解釈と限界を区別したか
- □ 関連グループ教材で全体像を確認したか
🐍 実データで確かめる ① 件数のログは「母数」で割らないと主体を比べられない
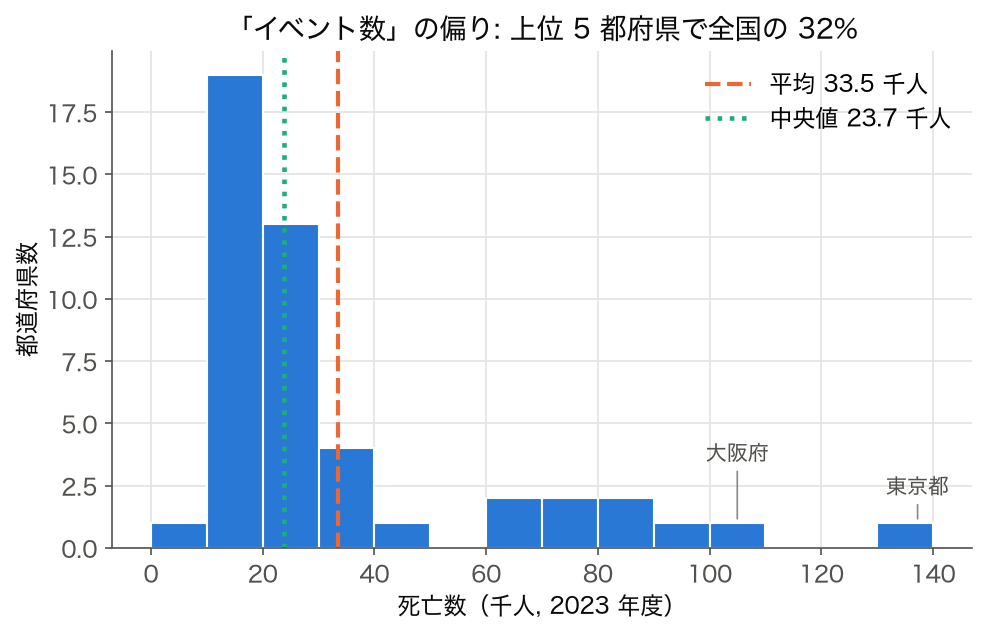
行動ログの集計で最初に出てくるのは「どのユーザ(主体)が何回その行動をしたか」という件数です。ところが件数は、行動の起こりやすさと主体の大きさ(会員数・在籍日数・表示回数)の掛け算なので、そのまま並べると「大きい主体ほど活発」に見えます。上の Python 例と同じく、SSDSE-B-2026 の県×年度を「主体 × 期間」、出生をイベントとみなして、件数と率(人口千人あたり)で順位がどれだけ変わるかを確かめます。Web サービスなら「クリック数」と「表示 1,000 回あたりのクリック数(CTR)」の違いにあたります。
🎯 このコードでやること:2023 年度の 47 都道府県について、出生数(件数)の上位 5 県と、人口千人あたり出生数(率)の上位 5 県を並べ、2 つの順位の相関(スピアマン)を出す。
1 2 3 4 5 6 7 8 9 10 11 12 13 14 | import pandas as pd df = pd.read_csv('data/raw/SSDSE-B-2026.csv', encoding='cp932', skiprows=[1]) d = df[df['SSDSE-B-2026'] == 2023].copy() d['千人あたり'] = d['A4101'] / d['A1101'] * 1000 cols = ['Prefecture', 'A4101', '千人あたり'] print('件数の上位 5') print(d.nlargest(5, 'A4101')[cols].round(2).to_string(index=False)) print('率の上位 5') print(d.nlargest(5, '千人あたり')[cols].round(2).to_string(index=False)) rho = d['A4101'].rank().corr(d['千人あたり'].rank()) print(f'件数の順位と率の順位のスピアマン相関 = {rho:.3f}') print(f'東京都: 件数 {int(d.loc[d.Prefecture=="東京都","A4101"].iloc[0]):,} 件で 1 位、' f'率は 47 県中 {int(d["千人あたり"].rank(ascending=False)[d.Prefecture=="東京都"].iloc[0])} 位') |
💬 件数の上位 5 県(東京・大阪・神奈川・愛知・埼玉)は人口の上位とほぼ同じ顔ぶれですが、率の上位 5 県は沖縄 8.55・福岡 6.65・滋賀 6.57・熊本 6.55・愛知 6.47 で、両方に入るのは愛知県だけです。件数 1 位の東京都(86,348 件)は率では 6.13 で 12 位、件数の順位と率の順位のスピアマン相関は 0.262 しかありません。行動ログで「アクティブなユーザ」「よく使われる機能」を件数で並べると、ほとんど「大きいユーザ」「よく表示される機能」の順位になってしまいます。比べたいのが起こりやすさなら、何で割るか(人口・会員数・表示回数・在籍日数)を先に決めます。
🐍 実データで確かめる ② 主体の「状態」を年ごとに追うと、遷移行列ができる
ページ後半の「遷移行列 ── 次にどこへ行くかを数えると導線が見える」は、1 ユーザの画面遷移を数える例でした。同じ数え方は、主体の状態が期間ごとにどう移るか(無料会員 → 有料会員 → 解約、のような状態遷移)にも使えます。ここでは各県の各年度を、転入者数 A5101 が転出者数 A5102 を上回る「転入超過」か、下回る「転出超過」かの 2 状態に分け、前年度の状態から今年度の状態への移り変わりを数えます。
🎯 このコードでやること:2012〜2023 年度の 47 都道府県それぞれで「転入超過/転出超過」の状態を作り、前年度→今年度の遷移を 47 県 × 11 回 = 517 件数えて遷移行列(件数と行ごとの割合)にする。状態が入れ替わった回数の多い県も数える。
1 2 3 4 5 6 7 8 9 10 11 12 13 | df = df.sort_values(['Code', 'SSDSE-B-2026']).copy() # 年度を古い順に(CSV は新しい年度が先) df['状態'] = (df['A5101'] > df['A5102']).map({True: '転入超過', False: '転出超過'}) df['前年の状態'] = df.groupby('Code')['状態'].shift() t = df.dropna(subset=['前年の状態']) cnt = pd.crosstab(t['前年の状態'], t['状態']) print(cnt) print((cnt.div(cnt.sum(axis=1), axis=0)).round(3)) sw = t[t['前年の状態'] != t['状態']] print(f'状態が入れ替わった回数 {len(sw)} / {len(t)}') print(sw['Prefecture'].value_counts().head(4).to_dict()) for y in [2012, 2023]: s = df[df['SSDSE-B-2026'] == y] print(y, '転入超過:', s.loc[s['状態'] == '転入超過', 'Prefecture'].str.rstrip('都府県').tolist()) |
💬 517 回の遷移のうち、前年度に転出超過だった県は 98.1%(426 回中 418 回)が翌年度も転出超過で、転入超過だった県も 85.7%(91 回中 78 回)がそのままでした。状態が入れ替わったのは 21 回(4.1%)だけで、そのうち沖縄県が 5 回、宮城県・滋賀県が 3 回ずつと、転入と転出が拮抗している一部の県に集中しています。転入超過の県は 2012 年度の 11 県から 2023 年度の 6 県(埼玉・千葉・東京・神奈川・大阪・福岡)に減りました。会員ステータスの遷移でも同じで、全体の遷移確率を 1 つの行列で見るだけでなく、「入れ替わりを起こしているのは誰か」を主体ごとに数えると、遷移が一部の境界にいる主体に偏っていることが分かります。
🐍 実データで確かめる ③ 「全体の変化」と「主体ごとの変化」は別物
行動ログのダッシュボードでは、全体の合計(全ユーザの総購入数など)の推移がまず表示されます。しかし全体の変化は、1 人ひとりの行動の変化と、主体の構成(どの主体がどれだけの比重を持つか)の変化が混ざったものです。2012 年度から 2023 年度の出生数で、全国合計の減り方と、県ごとの減り方の分布、そして全国に占める各県の比重の変化を比べます。
🎯 このコードでやること:出生数 A4101 について、2012 年度→2023 年度の全国合計の変化率と、47 県それぞれの変化率の中央値・最小・最大を出す。全国に占める東京都と上位 4 都府県の比重が 2012→2023 でどう変わったかも出す。
1 2 3 4 5 6 7 8 9 10 11 | b = df.pivot(index='Prefecture', columns='SSDSE-B-2026', values='A4101')[[2012, 2023]] nat = b.sum() print(f'全国: {nat[2012]:,} → {nat[2023]:,} ({nat[2023] / nat[2012] - 1:+.1%})') chg = b[2023] / b[2012] - 1 print(f'県ごとの変化率: 中央値 {chg.median():+.1%} 最小 {chg.min():+.1%} ({chg.idxmin()})' f' 最大 {chg.max():+.1%} ({chg.idxmax()})') print(f'全国より減り方が大きい県 {int((chg < nat[2023] / nat[2012] - 1).sum())} / 47') share = b / b.sum() top4 = ['東京都', '神奈川県', '大阪府', '愛知県'] print('東京都の比重', share.loc['東京都'].round(4).to_dict()) print('4 都府県の比重', share.loc[top4].sum().round(4).to_dict()) |
💬 全国の出生数は 1,037,165 → 727,269 と 29.9% 減りましたが、47 県の変化率の中央値は −33.3% で、全国より大きく減った県が 36 県あります。最も減ったのは秋田県の −44.8%、最も減り方が小さいのは東京都の −19.6% でした。全国の減り方が「典型的な県」より小さく見えるのは、減り方の小さい東京都の比重が 10.36% から 11.87% に、東京・神奈川・大阪・愛知の 4 都府県で 31.22% から 33.55% に上がったためです。行動ログでも、全体の購入数の減り方が穏やかに見えるとき、ヘビーユーザの比重が増えて多数のユーザの落ち込みを隠していることがあります。全体の推移を報告するときは、主体ごとの変化の分布(中央値や、全体より悪化した主体の数)を並べて示します。
🐍 実データで確かめる ④ 「何で割るか」で主体の順位は入れ替わる
① で件数を率に直すと順位が大きく変わりました。では率にすれば 1 つに決まるかというと、そうではありません。Web サービスのクリック率でも、分母を「表示回数」にするか「訪問ユーザ数」にするか「対象になり得たユーザ数」にするかで、施策の評価が変わります。出生について、分母を総人口・15〜64 歳人口にした率と、年齢構成の違いを調整した合計特殊出生率 A4103 の 3 つで、各県の順位を比べます。
🎯 このコードでやること:2023 年度の 47 都道府県で、出生数を総人口で割った率・15〜64 歳人口で割った率・合計特殊出生率の 3 つの指標について順位を付け、東京都・北海道・宮城県・秋田県・沖縄県の順位と、3 指標の順位相関を出す。
1 2 3 4 5 6 7 8 9 10 11 | import pandas as pd df = pd.read_csv('data/raw/SSDSE-B-2026.csv', encoding='cp932', skiprows=[1]) d = df[df['SSDSE-B-2026'] == 2023].copy() d['総人口あたり'] = d['A4101'] / d['A1101'] * 1000 d['15-64歳あたり'] = d['A4101'] / d['A1302'] * 1000 d['合計特殊出生率'] = d['A4103'] cols = ['総人口あたり', '15-64歳あたり', '合計特殊出生率'] rank = d.set_index('Prefecture')[cols].rank(ascending=False).astype(int) print(rank.loc[['東京都', '北海道', '宮城県', '秋田県', '沖縄県']]) print(d[cols].corr(method='spearman').round(3)) |
💬 東京都は総人口あたりでは 12 位ですが、15〜64 歳人口あたりでは 37 位、合計特殊出生率では 47 位(0.99)と最下位まで落ちます。東京都は若い働き手が多く流入しているので、総人口で割ると「子どもが生まれやすい県」に見えますが、出産年齢の人数や年齢構成を考えると最も出生率の低い県です。一方、沖縄県は 3 指標とも 1 位、秋田県は 47・47・44 位と、どの分母でも順位がほとんど変わらない県もあります。総人口あたりの率と合計特殊出生率の順位相関は 0.549 しかなく、「率にしたから公平に比べられる」とは言えません。行動ログでも、分母を「全ユーザ」にするか「その機能を使える状態にあったユーザ」にするかで同じことが起き、若いユーザが多いサービスほど前者の率が高く出ます。分母は「その行動をし得た主体の数」に近いものを選び、どの分母かを必ず明記します。
🐍 実データで確かめる ⑤ 入ってきた時期でまとめる ── 転入超過の「継続率」をコホートで見る
② の遷移行列は「前年に転入超過なら 85.7% が翌年も転入超過」という全体の数字でした。ページ前半の「コホート分析 ── 全体の継続率は、いつも嘘をつく」と同じ考え方で、状態に入った時期ごとに主体をまとめ(コホート)、その後も状態を保った割合を追うと、全体の数字では見えない違いが出ます。2012 年度にすでに転入超過だった県と、途中の年度で新たに転入超過になった県を分けて、何年続いたかを数えます。連続年数はその年度自身を 1 年目と数え、データが 2023 年度で終わるところで打ち切っています。そのため 2021 年度に入った県は最長でも 3 年にしかならず、「短い」ことの一部はデータの終わりによる打ち切り(右側打ち切り)である点に注意して読みます。
🎯 このコードでやること:② と同じ手順で、年度を古い順に並べた 564 行に「転入超過/転出超過」の状態と前年の状態を付け直す(途中の ④ で df を読み直しているため)。2012 年度に転入超過だった県を「2012 年コホート」、2013 年度以降に転出超過から転入超過に変わった県・年度を「新規コホート」とし、その年度から何年連続で転入超過を保ったかを数える。
1 2 3 4 5 6 7 8 9 10 11 12 13 14 15 16 17 18 19 20 21 22 23 24 25 26 | import pandas as pd df = pd.read_csv('data/raw/SSDSE-B-2026.csv', encoding='cp932', skiprows=[1]) df = df.sort_values(['Code', 'SSDSE-B-2026']).copy() df['状態'] = (df['A5101'] > df['A5102']).map({True: '転入超過', False: '転出超過'}) df['前年の状態'] = df.groupby('Code')['状態'].shift() def streak(code, start): s = df[(df['Code'] == code) & (df['SSDSE-B-2026'] >= start)]['状態'].tolist() n = 0 for v in s: if v != '転入超過': break n += 1 return n # start から何年連続したか(1 = その年だけ) base = df[(df['SSDSE-B-2026'] == 2012) & (df['状態'] == '転入超過')] c2012 = [(p, streak(c, 2012)) for p, c in zip(base['Prefecture'], base['Code'])] print('2012 年コホート(11 県)の連続年数:', dict(c2012)) print(f' 2023 年度まで 12 年続いた県: {sum(n == 12 for _, n in c2012)} / {len(c2012)}') new = df[(df['前年の状態'] == '転出超過') & (df['状態'] == '転入超過')] cnew = [(f'{p}{y}', streak(c, y)) for p, c, y in zip(new['Prefecture'], new['Code'], new['SSDSE-B-2026'])] print('新規コホート(転出→転入に変わった県・年度)の連続年数:', dict(cnew)) print(f' 1 年で転出超過に戻った割合: {sum(n == 1 for _, n in cnew)} / {len(cnew)}') |
💬 2012 年コホート 11 県のうち 12 年間ずっと転入超過だったのは埼玉・東京・神奈川・福岡の 4 県で、滋賀・岡山・香川の 3 県は 2012 年度だけ、愛知県は 8 年(2019 年度まで)で終わりました。新しく転入超過になった 8 件では、2013 年度の千葉県(11 年)と 2015 年度の大阪府(9 年)が 2023 年度まで続いているのに対し、2021 年度に入った宮城・茨城・滋賀・山梨の 4 県はどれも 1〜2 年で転出超過に戻っています。2021 年度は東京都の転入超過が 10,815 人と 12 年間で最も小さかった年で、この年に入ったコホートは「一時的な流れの変化で入ってきた主体」だったと読めます。全体の継続率 0.857 は、ずっと続く大都市圏と、すぐ抜ける境界の県を平均した数字です。サービスの継続率でも、キャンペーン月に入ったユーザのように入り方が違うコホートは、同じ継続率になると仮定せずに分けて追います。
⚠️ よくある落とし穴
behavior log を実務で使う際に頻発する誤用・落とし穴を列挙する。 多くは「前提の確認不足」「結果の過信」「他手法との比較不足」が原因で、 事前にチェックリスト化することで回避できる。
- データ前提の見落とし: behavior log の理論的前提が成立していないのに適用してしまう。 対策: 適用前に前提検定や図示で確認。
- 結果の過大解釈: 統計的有意性と実用的重要性を混同。 サンプルが大きければ p 値は容易に小さくなる。 効果量も併記。
- 外れ値の影響: 平均ベースの手法は外れ値で結果が大きく揺れる。 中央値や頑健統計量で頑健性を確認。
- 多重比較の問題: 複数の検定を繰り返すと偽陽性が累積。 Bonferroni 補正や FDR 制御を導入。
- 他手法との比較不足: 「behavior log を使った結果」が正しく見えても、 別手法で違う結論が出る場合がある。 必ず 2 種類以上の手法で検証。
記録されなかった行動は「無かった」ではない
行動ログのいちばん怖い性質は、ログに無い=起きなかった、とは限らないことです。 実際には次の 4 つが混ざっており、集計上はすべて同じ「記録なし」として現れます。
| 記録が無い理由 | 実際に起きたこと | 見誤ると何が起きるか |
|---|---|---|
| 本当にしていない | ユーザは商品を見ていない | これだけが「正しい 0」 |
| 計測漏れ | 見たがタグが発火しなかった、通信が切れた | 興味の過小評価。改善余地を見落とす |
| 計測拒否 | Cookie 同意を断った、追跡防止機能が働いた | プライバシー意識の高い層が丸ごと消え、母集団が偏る |
| 画面外 | スクロールせず、そもそも表示されなかった | 「不人気」と判定して撤去 → 実は置き場所が悪かっただけ |
💬 ここが要点:推薦システムで「クリックされなかった商品」を機械的に負例として学習させると、 上の 4 つを区別せずにすべて「嫌い」と教えることになります。 その結果、表示されなかった商品はいつまでも表示されず、 ログが自分の予測を裏付ける形に育っていく——これが フィードバックループや 選択バイアスと呼ばれる問題です。
対処は「ログを見る前」に仕込みます。表示されたかどうか(インプレッション)を、 クリックとは別に記録しておくのが基本です。そうすれば 「表示されたのにクリックされなかった」=本物の負例と、 「そもそも表示されていない」=情報なし、を分けられます。 さらに一部のユーザにわざとランダムな内容を見せておく(探索枠を確保する)と、 偏りのない比較用データが手に入ります。 行動ログの品質は、集計時の工夫ではなく設計時の仕込みで決まります。
行動ログを扱うときの実務チェックリスト
| 確認すること | なぜ必要か |
|---|---|
| セッションの定義は文書化されているか | 30 分か 15 分かで訪問回数が 1.5 倍動きます。定義を変えるときは、過去分も同じ定義で数え直さないと時系列比較が壊れます。 |
| ボット・社内アクセスを除いているか | クローラは人間よりはるかに速く大量に回遊します。除外しないと「滞在時間が短く回遊数が多い優良ユーザ」という幻の層ができます。 |
| タイムゾーンは統一されているか | UTC と JST が混ざると 9 時間ずれ、「深夜のアクセスが多い」という誤った日内変動が出ます。保存は UTC、表示で変換が原則です。 |
| 重複イベントを排除しているか | 再送・リトライで同じイベントが 2 回届くことがあります。イベント ID を持たせて一意化しないと、コンバージョンが水増しされます。 |
| 個人情報が紛れていないか | URL のクエリにメールアドレスや氏名が入ることがあります。個人情報を保存すると、目的外利用や漏えいの責任が生じます。取得時点でマスキングしてください。 |
| インプレッションを別途記録しているか | 「表示されたのに押されなかった」と「そもそも表示されていない」を分けられません。推薦の学習データとしては致命的な違いです。 |
| 保持期間を決めているか | 行動ログは放っておくと際限なく増えます。「何日で消すか」を先に決めないと、費用も法的リスクも膨らみ続けます。 |
この 7 項目のうち上から 4 つは集計の正しさ、下 3 つは設計と責任の問題です。 前者は後から直せますが、後者は取り始めてからでは取り返しがつきません。 行動ログのプロジェクトが失敗するときの原因は、分析手法の選択より 「最初に何を、どの粒度で、どこまで残すか」を決めなかったことにあります。
よくある質問
Q1. 平均滞在時間が伸びました。良い変化ですか?
一概には言えません。滞在時間は「熱心に読んでいる」でも「目的のものが見つからず迷っている」でも伸びます。
しかも最後のページの滞在時間は原理的に測れません(次の操作が無いので終了時刻が分からない)。
多くのツールは最終ページを平均から除外しており、
そのため直帰したユーザの滞在時間は 0 秒として扱われがちです。
滞在時間が伸びたときは、必ず「離脱率」「目的達成率」と一緒に見てください。
Q2. ユニークユーザ数は足し算できますか?
できません。1 月の UU が 100、2 月の UU が 100 でも、
2 か月間の UU は 200 とは限らず、両方来た人がいれば 100〜200 のどこかになります。
UU は期間を変えるたびに数え直しが必要な指標です。
日次 UU を 30 日ぶん足して月次 UU としている集計を見かけたら、それは誤りです。
同じ理由で、UU は部門ごとに足し合わせることもできません。
Q3. ログが大きすぎて集計が終わりません。
まず生ログを直接集計しない設計にします。
日次で「ユーザ×日×イベント種別」の集計テーブルを作っておき、
分析はそちらに対して行うのが定石です。生ログは 90 日で消し、
集計済みテーブルは長期保存する、といった二段構えにすると費用も抑えられます。
列指向形式(Parquet)で日付パーティションを切っておけば、
「特定の 1 日だけ読む」ときにファイル全体を走査せずに済みます。
ビッグデータのページで扱う分散処理は、この工夫をしてもなお足りないときの手段です。
Q4. 個人を特定しなければ自由に使えますか?
いいえ。行動ログは単体では個人名を含まなくても、他の情報と組み合わせると個人を特定できることがあります。
「特定の時刻に特定の店舗で買い物をした人」は、レシートや防犯カメラと突き合わせれば絞り込めます。
匿名 ID であっても、長期間の行動パターンはそれ自体が指紋のように働きます。
個人情報や
匿名加工情報の考え方を踏まえ、
「取得時に何の目的で使うと説明したか」の範囲内で使うのが原則です。
⚠️ 実データで確かめる ── 記録漏れ 5% と二重送信 3% が集計をどう歪めるか
上の表の「計測漏れ」と、チェックリストの「重複イベント」が、集計値にどのくらい効くのかを数字で見ておきます。完全なログとして SSDSE-B-2026 の出生数・死亡数(47 県 × 12 年度 × 2 イベント = 1,128 行)を使い、そこから行をわざと 5% 落としたログと、3% の行を 2 回送ったログを作って、年度ごとの全国合計を比べます。本物の行動ログでは「完全なログ」が手元に無いので、ここでは正解が分かっている公的統計を使って、壊れ方の大きさを先に体験しておきます。
🎯 このコードでやること:1,128 行の縦持ちログから、乱数(seed 0)で各行を 5% の確率で落とす。年度・イベントごとの全国合計を完全なログと比べてずれ(%)を出し、主体数(県数)の数え上げで欠落を検出する。
1 2 3 4 5 6 7 8 9 10 11 12 13 14 15 16 17 18 19 20 21 | import numpy as np import pandas as pd df = pd.read_csv('data/raw/SSDSE-B-2026.csv', encoding='cp932', skiprows=[1]) log = df.melt(id_vars=['Prefecture', 'SSDSE-B-2026'], value_vars=['A4101', 'A4200'], var_name='イベント', value_name='件数') rng = np.random.default_rng(0) lost = log[rng.random(len(log)) >= 0.05] print(f'完全なログ {len(log)} 行 → 記録漏れ後 {len(lost)} 行') true = log.groupby(['SSDSE-B-2026', 'イベント'])['件数'].sum().unstack() seen = lost.groupby(['SSDSE-B-2026', 'イベント'])['件数'].sum().unstack() gap = (seen / true - 1) * 100 print('全国合計のずれ(%): 出生', gap['A4101'].round(1).tolist()) b = true['A4101']; bl = seen['A4101'] print(f'2020→2021 の出生数の前年比: 本当は {b[2021] / b[2020] - 1:+.1%}、' f'記録漏れのログでは {bl[2021] / bl[2020] - 1:+.1%}') n = lost.groupby(['SSDSE-B-2026', 'イベント'])['Prefecture'].nunique().unstack() print('県数が 47 に満たない (年度, イベント) の数:', int((n < 47).sum().sum()), '/ 24') miss = log.merge(lost, how='left', indicator=True).query('_merge == "left_only"') print('2021 年度に落ちた出生の行:', miss.query('`SSDSE-B-2026` == 2021 and イベント == "A4101"')['Prefecture'].tolist()) |
💬 1,128 行のうち 51 行(4.5%)が落ちただけですが、年度ごとの全国の出生数は 0.0%〜−17.2% ずれ、ずれ方は年度によってばらばらです。とくに 2021 年度は北海道・東京都・京都府の出生の行が落ち、東京都だけで全国の 1 割強を占めるため −17.2% になりました。その結果、2020→2021 年度の出生数の前年比は本当は −3.5% なのに、記録漏れのログでは −16.0% と「急減」に見えます。行が落ちる確率は一様な 5% でも、落ちた行が大きな主体かどうかで集計の誤差が大きく変わるのが要点です。検出は難しくなく、年度・イベントごとに主体(県)の数を数えれば 24 組中 22 組で 47 に届いていないことがすぐ分かります。行動ログでも「日ごとのアクティブ端末数」「計測タグごとのイベント数」のように、本来ほぼ一定のはずの数を毎日数えておくと、計測漏れを集計の前に見つけられます。
🎯 このコードでやること:同じ 1,128 行から、3% の確率で選んだ行をもう 1 回送る(再送で重複した)ログを作る。重複を含むまま集計した全国合計のずれを出し、「県・年度・イベント」の組が一意かを確かめて drop_duplicates で直す。
1 2 3 4 5 6 7 8 9 | dup = pd.concat([log, log[rng.random(len(log)) < 0.03]], ignore_index=True) key = ['Prefecture', 'SSDSE-B-2026', 'イベント'] print(f'重複送信後 {len(dup)} 行(キーが重複する組 {dup.duplicated(key).sum()} 件)') tot_dup = dup.groupby('イベント')['件数'].sum() tot = log.groupby('イベント')['件数'].sum() print('12 年分の合計のずれ(%):', ((tot_dup / tot - 1) * 100).round(2).to_dict()) fixed = dup.drop_duplicates(key) print('drop_duplicates 後:', len(fixed), '行 合計が一致:', bool((fixed.groupby('イベント')['件数'].sum() == tot).all())) |
💬 3% の確率で再送した結果、42 行が重複して 1,170 行になり、12 年分の合計は出生で +6.43%、死亡で +3.90% 水増しされました。重複した行の割合(3.7%)より出生の水増しが大きいのは、重複した行にたまたま大きい県が多く含まれたためで、ここでも「何行壊れたか」と「集計がどれだけ歪むか」は一致しません。「県・年度・イベント」の組が一意であるべき、というキーを決めておけば duplicated で 42 件を見つけられ、drop_duplicates で元の 1,128 行・元の合計に戻ります。本物の行動ログでは同じユーザが同じ秒に同じ操作を 2 回することもあり得るので、キーには送信側で振ったイベント ID を使うのが基本です。
🗺 概念マップ
行動ログ (Behavior Log)
├── 上位概念
│   ├── ログデータ (Log Data)
│   ├── イベントデータ (Event Data)
│   └── 時系列データ (Time Series)
├── 収集源
│   ├── クリックストリーム (Web)
│   ├── イベントログ (アプリ SDK)
│   ├── センサログ (IoT)
│   └── POS 購買履歴 (実店舗)
├── 前処理
│   ├── セッション化 (30 分無操作で分割)
│   ├── 重複排除・ボット除去
│   └── PII マスキング
└── 分析手法
    ├── ファネル分析
    ├── コホート分析
    ├── RFM / RFMS
    ├── 遷移行列 (Markov)
    └── 異常検知
上の木構造を図にすると、行動ログが「どこから来て、何を経て、何に化けるか」の流れとして見えます。 中心が行動ログ、左が入り口(どこで生まれるか)、上が正体(どの種類のデータか)、 右が出口(何に使うか)、下が通らねばならない関門(前処理)です。
図で強調したいのは下の「関門」です。行動ログは収集源から出た瞬間は 「いつ・誰が・何をした」が延々と並んだだけの列で、そのまま集計すると ボットのアクセスが人間の 3 倍といった結果を平気で出します。 セッション化・重複排除・ボット除去・個人情報のマスキングを通して初めて、 右側の分析手法が意味のある数字を返します。矢印が中心を経由しているのは、 「どの収集源から来ても、同じ関門を通る」ことを表しています。
🔗 隣接手法への橋渡し
行動ログは「いつ・誰が・何をしたか」のイベント時系列で、 収集→保管→セッション化→集計→分析のパイプラインで動く。
- 上流: SDK/Tag による収集と ログ基盤 (Fluentd/Fluent Bit)、 スキーマ定義 (user_id, timestamp, event_type, properties)、 PII マスキング。
- 並列: アクセスログ (Web サーバ生成)・イベントログ (アプリ内行動)・センサログ (IoT) — 同じ「時刻付き観察記録」だが収集源と粒度が異なる。
- 下流: セッション化 (30 分無操作で分割)・ファネル分析 (購入導線の離脱率)・コホート分析 (登録週ごとの継続率)・レコメンデーションの学習データ。
SSDSE-B-2026 は都道府県集計の最終成果物だが、 その背後には住民の購買・移動・公共サービス利用の膨大な行動ログが存在し、 集計値の妥当性は元ログの品質に依存する。
遷移行列 ── 「次にどこへ行くか」を数えると導線が見える
ファネルは「決められた順路をどれだけ通ったか」しか見ませんが、実際のユーザは行ったり来たりします。 そこで「いまどの画面にいると、次はどこへ行くか」を全部数え上げた表=遷移行列を作ります。 再現可能な合成回遊ログ(4,000 セッション・乱数の種 20260804 の架空データ)での実測が次です。
| いまいる画面 | 件数 | 次にどこへ行ったか(行内の割合) |
|---|---|---|
| トップ | 4,000 | 検索 44.0%/商品 31.1%/離脱 24.9% |
| 検索 | 3,069 | 商品 60.7%/検索 19.2%(絞り込み直し)/離脱 20.2% |
| 商品 | 3,679 | カート 33.9%/検索 22.0%/商品 14.1%/離脱 30.0% |
| カート | 1,178 | 購入 59.8%/商品 14.9%/離脱 25.3% |
💬 ここが要点:ファネルでは見えなかった「戻る」動きがはっきり出ます。 検索から検索へ 19.2%、商品から検索へ 22.0%——つまり 5 人に 1 人は「探し直している」。これは検索結果の質に問題があるサインです。 ファネルの直線的な図だけを見ていると、この往復はまったく見えません。
ただし、ここで因果を読み取ってはいけません。同じログで 「検索を通った人の購入率 19.3%」「検索を通らなかった人の購入率 15.8%」でした。 差は 3.5 ポイント。ここで「検索機能を使わせれば購入率が上がる」と結論するのは誤りです。 そもそも買う気のある人ほど熱心に検索する、という逆向きの流れがあり得るからです。 行動ログは観察データであって実験データではありません。 因果を主張したいなら A/B テスト のように こちらで割り付けを決める必要があります。 遷移行列が教えてくれるのは「どこで詰まっているか」という仮説までで、 「何をすれば直るか」は別途確かめる話です。
行動ログと公的統計は、まったく性質が違う
このサイトで多く扱う SSDSE のような公的統計と、行動ログはデータとしての性質が正反対です。 どちらが優れているという話ではなく、答えられる問いが違います。
| 観点 | 公的統計(SSDSE など) | 行動ログ |
|---|---|---|
| 母集団 | 明確。47 都道府県すべてなど、定義が公開されている | 曖昧。「自社サービスを使った人」であり、使わなかった人は写らない |
| 粒度 | 粗い。年次・都道府県単位 | 極めて細かい。ミリ秒・個人単位 |
| 定義の安定性 | 高い。同じ定義で何十年も継続 | 低い。画面改修のたびにイベント名も意味も変わる |
| 得意な問い | 「日本全体でどうなっているか」 | 「この画面のこのボタンは押されているか」 |
| 苦手な問い | 「昨日の夜、何が起きたか」 | 「世の中一般ではどうか」 |
💬 ここが要点:行動ログは件数が多いので統計的に強そうに見えますが、 件数が多いことと母集団を代表していることは別です。 100 万件のログがあっても、それが「自社アプリを入れた人」だけなら、 日本全体について何かを言う根拠にはなりません。標本誤差は小さくても、 選択バイアスは件数を増やしても消えないからです。 行動ログで「傾向」を掴み、公的統計で「位置づけ」を確認する—— この往復ができると、どちらか一方だけでは出せない結論にたどり着けます。
イベント設計 ── 後から直せないのは「名前」と「粒度」
行動ログの分析でつまずく原因の大半は、分析手法ではなくイベントの設計にあります。 集計はやり直せますが、そもそも記録していない情報は後から復元できません。 最低限そろえておきたい 5 つの要素が次です。
| 要素 | 例 | 無いと何ができなくなるか |
|---|---|---|
| いつ | タイムスタンプ(UTC・ミリ秒) | セッション化も時系列分析もできない。端末側とサーバ側の両方を持つと時刻ずれを検出できる |
| 誰が | 匿名 ID(ログイン前)+ ユーザ ID(ログイン後) | ログイン前後がつながらず、「初訪問から購入まで」の経路が切れる |
| 何を | イベント名(item_view など) | 名前が揺れると集計で拾えない。命名規則を最初に決めることが決定的に重要 |
| どこで | 画面 ID・要素の位置・流入元 | 「同じボタンでも置き場所で効果が違う」が分からない |
| 文脈 | 検索語・並び順・表示された候補一覧 | 推薦の評価ができない。「何を見せた上での行動か」が復元できない |
💬 ここが要点:とくにイベント名の揺れは深刻です。
item_view / view_item / ProductView が混在すると、
集計する人はどれが正しいか判断できません。しかも過去分は書き換えられないので、
「2026 年 4 月以前は別名でした」という注釈が永久に付いて回ります。
命名規則(動詞+名詞か、名詞+動詞か。スネークケースか)を最初に 1 枚の紙に決めて、
レビューで守らせるだけで、後年の分析コストが大きく変わります。
粒度についても同じことが言えます。「ページを見た」だけを記録していると、 ページ内のどこまでスクロールしたか、どの候補が画面に入ったかが分かりません。 細かく取れば取るほど後の分析は自由になりますが、 その分だけ保存費用とプライバシー上の責任が増えます。 「将来この問いに答えたいか」を先に列挙し、それに必要な最小限を決めるのが現実的な落とし所です。 迷ったときは、メタデータとして 「いつ・誰が・どういう定義でこのイベントを追加したか」を残しておくと、 数年後に見返したときに救われます。
最後に、行動ログを扱う人へ。 行動ログは「ユーザが何をしたか」の記録であって、「ユーザが何を望んだか」の記録ではありません。 押されたボタンは記録されますが、押したかったのに見つけられなかったボタンは記録されません。 この非対称性が、行動ログだけで意思決定したときに起きる失敗のほとんどを説明します。 数字が示すのは「いま提供している選択肢の中での振る舞い」であり、 提供していない選択肢への需要は、原理的にログの外にあります。 だからこそ、ログの分析と、実際に人に聞く調査(調査データ)や A/B テストのような介入を組み合わせる必要があります。 ログは「何が起きたか」に強く、「なぜ起きたか」「他に何がありえたか」には弱い—— この線引きを忘れなければ、行動ログはきわめて強力な道具になります。
用語の整理:日本語では「行動ログ」「アクセスログ」「イベントログ」「操作ログ」が ほぼ同じ意味で使われますが、厳密には範囲が違います。 アクセスログは Web サーバが自動的に残す通信の記録(IP・URL・ステータスコード)で、 サーバに届いたリクエストしか写りません。 イベントログはアプリ側で明示的に仕込んだ計測点の記録で、 「画面のどこを見たか」まで取れる代わりに、仕込み忘れた行動は一切残りません。 行動ログはこれらを含む広い呼び方です。 社内で数字が合わないとき、そもそも見ているログの種類が違うことが原因の場合があるので、 最初に「どのログの話か」をそろえてから議論してください。
🎨 直感をさらに深める — 行動の「足跡」と暗黙的フィードバック
行動ログのいちばん素朴なイメージは雪の上の足跡です。 歩いた本人は「どこへ向かうか」を意識していなくても、 足跡は「いつ・どこを・どの向きで通ったか」を勝手に残します。 行動ログも同じで、 ユーザーがクリック・閲覧・購入するたびに、 意図の有無に関わらず時刻付きの痕跡が積み上がります。 アンケートが「答えてください」と明示的に意見を聞くのに対し、 行動ログは操作の副産物として暗黙的フィードバック (implicit feedback) を集める点が本質的な違いです。
この「暗黙的」という性質が、 行動ログの強みと弱みを同時に生みます。 強みは、 回答者の記憶違いや見栄 (社会的望ましさバイアス) が入りにくく、 大量・連続に自動収集できること。 弱みは、 行動の意味が一意に決まらないことです。 ある商品ページを長く見たのは「好きだから」かもしれないし、 「価格に納得できず迷った」からかもしれず、 単に「別の作業をしていて放置した」だけかもしれません。 明示的フィードバック (★5 評価) と違い、 閲覧≠好み・クリック≠満足 であることを、 解釈の出発点に置く必要があります。
| 観点 | 明示的フィードバック | 暗黙的フィードバック (行動ログ) |
|---|---|---|
| 例 | ★評価・アンケート回答 | クリック・閲覧秒数・購入・スクロール |
| 取得コスト | 高い (回答してもらう必要) | 低い (自動で溜まる) |
| 量・粒度 | 少・粗い | 大量・細かい・スパース |
| 意味の明確さ | 高い (好意を直接表明) | 低い (行動の理由は多義的) |
| 「関心なし」の記録 | 低評価として残る | 基本残らない (足跡が付かない) |
もう一つ重要な直感がスパース性 (疎)です。 商品が10万点あるEC で、 一人のユーザーが触れるのはせいぜい数十点。 「ユーザー×商品」の巨大な表を作ると、 ほとんどのセルが空欄になります。 空欄は「嫌い」ではなく「まだ出会っていないだけ」のことが多く、 これを0点 (低評価) と誤読すると分析全体が歪みます。 行動ログは大量・スパース・非構造という三拍子で、 「たくさんある」のに「ほしい所は空いている」データだと掴んでおくと、 後述の落とし穴が腑に落ちます。
⚠️ 落とし穴をさらに深める — 記録されなかった行動をどう扱うか
行動ログの最大の危険は「記録されたイベントだけを見て全体を語ってしまう」ことです。 ログは観測された行動しか残さないため、 見えているデータの背後にある選択の網を意識しないと、 因果を取り違えます。 以下は、 実務とコンペの講評で繰り返し指摘される代表的な罠です。
| 落とし穴 | 何が起きるか | 対策 |
|---|---|---|
| 生存者バイアス | 離脱・退会したユーザーはログが途切れ「残った人」だけで分析される。 継続率を過大評価しやすい | 観測期間の開始時点で母集団を固定し、 離脱者も分母に含めた 選択バイアス の検討をする |
| 暗黙フィードバックの誤読 | 閲覧・滞在=好意と解釈。 実は迷い・誤クリック・放置かもしれない | 複数シグナル (再訪・購入・完読) を組み合わせ、 単一イベントで意図を断定しない |
| ボット・外れ値 | クローラや自動化が人間の何百倍もイベントを発火し、 平均・合計を汚染する | UA・発火間隔・異常頻度でボット除去。 中央値など頑健統計で確認 |
| 欠損 (未ログイン) | ログインしていない行動は主体IDが欠け、 別人扱い・欠測になる | 欠測メカニズムを明示 (欠損値)。 ログイン層と全体の偏りを点検 |
| プライバシー | 関心・移動・生活リズムが推測でき、 直接識別子を外しても再識別され得る | 集計粒度を粗く・希少行動を丸め・保持期間を設定 (プライバシー) |
| 相関≠因果 | 「レコメンドを見た人はよく買う」は、 元々買う気の人がよく見ているだけかもしれない | 交絡を疑い、 介入は A/Bテスト で因果効果を推定 (相関) |
| セッション区切りの恣意性 | 「30分無操作で分割」の閾値を変えるとセッション数もCVRも動く | 分析期間内で定義を固定し、 閾値感度を併記する |
生存者バイアスは特に見落とされがちです。 第二次大戦で「帰還した爆撃機の被弾箇所」を集めて装甲を厚くしようとした逸話が有名で、 本当に補強すべきは帰還できなかった機体が撃たれた場所 (=データに現れない箇所) でした。 行動ログでも「今アクティブなユーザーの行動パターン」だけを見て施策を決めると、 すでに離脱した人がなぜ離脱したかという最重要情報を丸ごと捨ててしまいます。 上の 🎮 触って理解する デモで、 A だけ押して「新しいセッション」で区切ると、 そのセッションはファネル上「A で離脱」と残りますが、 実サービスでは離脱者はそもそもタグが発火せずログ自体が存在しないことが多い、 という非対称を意識してください。
SSDSE-B-2026 を行動ログ的に読む場合も同型の注意が要ります。 都道府県別・年次の集計は「残った記録」であり、 統計に載る前に廃止・統合された制度や、 転出して県から消えた住民の行動は数字に現れません。 全47県を母集団として明示し、 欠測や定義変更のある指標を除外・注記することが、 生存者バイアスと選択バイアスへの最小限の防御になります。
🚀 発展をさらに深める — 生ログから意思決定へつなぐ5技法
生ログは1行1イベントの膨大な履歴にすぎません。 それを意思決定に使える証拠へ変換する代表的な流れが、 セッション化 → ファネル → コホート → レコメンド → A/Bテストです。 それぞれ「どの問いに答えるための変換か」をセットで押さえます。
- セッション化 (sessionization): バラバラのイベントを、 同一主体の「ひとまとまりの訪問」に束ねる前処理。 一般に「30分以上の無操作で区切る」ルールを使いますが、 この閾値が全下流指標を左右するため固定が鉄則です。 束ねて初めて「1訪問あたり何ページ」「滞在時間」が計算できます。
- ファネル分析 (funnel): 「閲覧→カート→購入」のような順序のある導線で、 各段の到達率と離脱率を見ます。 問いは「どこで人が落ちるか」。 上のデモの A→B→C 到達率がそのミニ版です。 段ごとにデバイスや流入元で分解すると、 改善すべきボトルネックが特定できます。
- コホート分析 (cohort): 「同じ週に登録した人」などの集団 (コホート) を追い、 時間経過に伴う継続率を比較します。 問いは「新しく来た人は定着しているか」。 全体の平均だけでは、 新規流入で薄まった離脱を見逃すため、 登録時期でそろえて追跡します。
- レコメンド (協調フィルタリング): 「あなたと似た行動をした人が好んだ物」を推薦する手法。 前述の「ユーザー×アイテム」のスパースな行動ログ行列を埋める問題として定式化されます。 暗黙的フィードバックでは空欄=低評価ではない点の扱いが肝で、 「観測された行動は弱い正例」と置く手法が使われます — レコメンデーション。
- A/Bテストとの連携: ファネルやレコメンドで見つけた仮説を、 ランダム割付で検証します。 行動ログは観察データなので相関しか語れませんが、 A/B は介入の因果効果を推定できます。 行動ログでボトルネックを見つけ→改善案をA/Bで検証、 が王道の往復です — A/Bテスト。
これら全ての土台がイベントスキーマ設計です。 「取れるログを全部取る」のではなく、 検証したい仮説から逆算して event_name・user_id・timestamp・properties と発火条件を定義書に固定します。 スキーマが場当たりだと、 後からセッションもファネルも再計算できず、 コホートの起点もずれます。 蓄積後の時間構造の扱いは 時系列データ、 収集の設計は データ収集、 基盤としての蓄積は ログデータ が隣接領域です。
🔗 深掘りに使う関連ページ
本ページの各テーマを掘り下げるための、 用語集内の実在ページへのリンクです。
- ログデータ — 行動ログを蓄積・処理する基盤としての上位概念。
- 選択バイアス — 生存者バイアス・離脱者欠落を体系的に扱う。
- A/Bテスト — 行動ログの相関を因果へつなぐ介入実験。
- レコメンデーション — 協調フィルタリングと暗黙的フィードバックの活用。
- 相関 — 「相関≠因果」を判断するための基礎。
- 欠損値 — 未ログイン・計測漏れによる欠測の扱い。
- プライバシー — 匿名化・保持期間・再識別リスクの設計。
- データ収集 — イベントスキーマ設計とタグ実装。
- 時系列データ — セッション・コホートの時間構造分析。
補足: 本文で触れた「コホート分析」「ファネル分析」「セッション化」「協調フィルタリング」「ユーザー行動」は、 現時点で用語集に独立ページがないため本ページ内で解説しています (専用ページができ次第リンク化予定)。
🌳 手法選択フロー
行動ログ設計の判断は「保管形式」「集計頻度」「プライバシー」の 3 軸で決まる。
- 保管形式: JSON Lines (柔軟だが容量大)・Parquet (カラム指向で集計高速、 圧縮率高)・Avro (スキーマ進化対応) — 大規模なら Parquet 一択、 日付別パーティション必須。
- 集計頻度: 日次バッチ (BI ダッシュボード用) で十分か、 リアルタイム必要 (異常検知、 RTB) か。 SSDSE-B-2026 のような年次集計レポートなら日次バッチで OK。 不正検知なら 5 分窓ストリーミング。
- プライバシー: GDPR/CCPA/個人情報保護法対応で、 PII の Hash 化、 IP の /24 マスク、 user_id の pseudonymization、 一定期間 (例 2 年) 後の自動削除 (Retention Policy) を実装。 オプトアウト機構必須。
「ログを取れるだけ取って後で考える」が初期の典型エラー。 (a) 仮説とそれを検証するイベント設計、 (b) 容量予測 (1 日 N MB → 年 N×365 MB)、 (c) PII リスクレビュー、 を運用開始前に固める。