🔖 キーワード索引
このページ内のセクションへ素早く飛べます(クリックで該当箇所へジャンプ):
💡 30秒で分かる結論 — 調査データ
🍰 まずはやさしく
アンケートなどで集めたデータのことです。
人々の考えや行動を分析するために使います。
クラスで好きな食べ物を調べる時に似ています。
まずは結論と注意点を短く確認しましょう。
- 一言で:アンケート・面接などで取得した主観・行動データ。 国勢調査、 世論調査、 顧客満足度調査など。
- 分野:データ種 — 全体像は data-types ページで
- SSDSE-B-2026 は調査データを都道府県ごとに集計した表。 総人口は国勢調査年(2015・2020 年度)だけ 1 人単位の実数で、 他の年度は千人単位の推計値
- 家計の列(L3221 消費支出など)は家計調査の二人以上の世帯の、 県庁所在市の値で、 標本調査なので標本誤差を含む
- 47 都道府県は全数なので、 県の値そのものに標本誤差は無い。 ただし元の調査の非標本誤差(無回答・誤回答)は残る
- 比率 50% を n = 1,000 で推定すると 95% 信頼区間は ±3.1 ポイント。 精度を 2 倍にするには n を 4 倍にする
📍 あなたが今見ているもの
🍰 まずはやさしく
データの集め方についてのガイドです。
正しい結果を出すための方法を学びます。
部活のアンケートで誰に聞くかを決める例です。
このページにある12の解説を順番に見ていきます。
標本抽出法(無作為・層化・割当)、 回答バイアス、 無回答処理 — 調査データ特有の落とし穴は多い。 サンプリングの理論が結果の信頼性を決める。
🎨 直感で掴む — 調査データとは何者か
🍰 まずはやさしく
一部の人から得た回答のようなものです。
全体がどうなっているかを予想するために使います。
スマホの利用時間を数人に聞いて調べる例です。
計算方法や注意点を具体的に体験しましょう。
調査データ(Survey Data)は、 SSDSE-B-2026 のような公的統計の背後にある「47 都道府県を 1 件ずつ調べた」プロセスそのもの。 国勢調査 (悉皆) と消費動向調査 (層化二段抽出) では、 同じ「平均」でも誤差構造がまったく違います。 ここでは標本誤差・カバレッジ誤差・非回答誤差の 3 種を SSDSE-B-2026 で具体的に体感しましょう。
🎨 直感で掴む
調査データは「母集団全体ではなく、 抽出された一部から得た回答」のデータ。 国勢調査(全数)、 家計調査(約 9000 世帯)、 国民生活基礎調査(約 30 万人)など方式は多様で、 SSDSE-B-2026 の 47 都道府県データはこれら原調査の集計結果である。 「一部から推測する」性質上、 標本誤差・回答バイアス・無回答調整が必然的に絡む。
例: 「世帯の食料費」を SSDSE-B-2026 で見ると 47 県平均 80.60 千円 / 月だが、 これは家計調査(二人以上の世帯は全国で約 8,000 世帯)の県庁所在市の値で、 1 市あたりの調査世帯はその一部にとどまるため、 全国平均より標本誤差がずっと大きい。 県全体の値ではない点と、 年ごとの上下に標本誤差が混ざる点に注意して読む。
🎨 直感で掴む(深掘り版):調査データは「質問して答えてもらう」データ
調査データ (survey data) とは、 アンケート・面接・国勢調査など、 調査主体が対象者に質問を投げ、 回答を集約することで生じるデータ。 SSDSE-B-2026 は元をたどれば国勢調査・人口動態統計・家計調査といった政府の調査・統計の集約物で、 まさに調査データの代表例だ。 行動ログのように「センサが自動で拾う」のではなく、 「人間が質問に答える」プロセスを介する点が特徴。
調査データの強みは 「観察できない内面(意識・態度・記憶)を測れる」こと。 「あなたは現在の暮らしに満足していますか?」「政治に関心はありますか?」「将来の不安は何ですか?」など、 行動からは推定困難な変数が直接取れる。 一方、 弱みは 「回答が真実とは限らない」こと。 社会的望ましさバイアス・記憶バイアス・質問順序効果など、 多種多様な歪みが入り込む。
SSDSE-B-2026 を例にとると、 「総人口 (A1101)」は人数を数えれば客観的だが、 「主観的健康度」や「政治意識」を測ろうとすれば、 国民生活基礎調査や社会意識調査の自己申告に頼る。 同じ「健康」でも、 客観指標(受診回数、 BMI)と主観指標(健康だと感じるか)は乖離する。 だからこそ調査設計時には 「何を測りたいのか」「どう聞けば本心が出るか」「比較可能性をどう担保するか」を厳しく詰める必要がある。
調査データの 4 つのタイプ
- 悉皆調査 (census):対象集団全員を調査。 国勢調査が典型(5 年に一度、 全人口を対象)。 SSDSE-B-2026 の人口・世帯統計の多くはこれが源泉。
- 標本調査 (sample survey):母集団から一部を抽出して調査。 家計調査・労働力調査・国民生活基礎調査など。 効率的だが標本誤差を伴う。
- パネル調査 (panel survey):同じ対象者を時系列で繰り返し調査。 個体内変化を追える。 例:JGSS(日本版総合的社会調査)、 慶應 KHPS。
- 横断調査 (cross-sectional):1 時点で異なる対象者を調査。 集団間比較に強い。 SSDSE-B-2026 の 47 都道府県データは典型的な横断データ。
🎨 SSDSE-B-2026 の列は、 どんな集め方のデータか
SSDSE-B-2026 の 109 の指標列は、 列コードの頭文字ごとに元の統計が違い、 集め方も「全数を数える調査」「届出や業務の記録を集計したもの」「一部を選んで調べる標本調査」に分かれる。 標本誤差を気にする必要があるのは主に最後の種類である。
| 頭文字 | 内容(列の例) | 主な集め方 | 読むときの注意 |
|---|---|---|---|
| A | 人口・出生・死亡・転出入・婚姻(A1101・A4101) | 国勢調査(全数)と、 それを基準にした推計・人口動態の届出 | 総人口は 2015・2020 年度だけ 1 人単位、 他の年度は千人単位の推計 |
| B | 気温・降水量(B4101) | 気象の観測値 | 質問して集める調査データではない |
| C・H | 建築着工・住宅着工(C3301・H1800)、 ごみ(H5609) | 届出や自治体の報告の集計 | 届出の基準が変わると時系列が不連続になる |
| E | 学校数・児童生徒数・進学者数(E2501) | 学校への全数調査 | 標本誤差は無いが、 回答の誤りなど非標本誤差は残る |
| F | 求職・求人・就職件数(F3101) | ハローワークの業務記録 | ハローワークを通さない求人・就職は含まない |
| L | 消費支出と費目(L3221・L322101) | 家計調査(標本調査、 二人以上の世帯) | 県全体ではなく県庁所在市の値で、 年ごとの上下に標本誤差が混ざる |
📐 数式・定義
🍰 まずはやさしく
調査データのきまりや定義のことです。
分析の根拠をはっきりさせるために使います。
買い物での満足度を数値にする例です。
計算式や使う時のルールについて詳しく読みます。
📐 数式:標本誤差・重み付き集計・有限母集団修正
標本平均 $\bar{x}$ の 標本誤差 (sampling error) は、 母集団からのランダム抽出に伴う偶然のバラツキで、 標本標準偏差を用いて
$$\text{SE}(\bar{x}) = \frac{s}{\sqrt{n}}$$
で表される。 母集団が有限で標本割合 $f = n/N$ が無視できない場合、 有限母集団修正 (finite population correction, FPC)
$$\text{SE}_{\text{FPC}}(\bar{x}) = \frac{s}{\sqrt{n}} \sqrt{\frac{N - n}{N - 1}}$$
を適用する。 95% 信頼区間は
$$\bar{x} \pm 1.96 \cdot \text{SE}(\bar{x})$$
層化抽出 (stratified sampling) では、 各層 $h$ の標本平均 $\bar{x}_h$ と層サイズ $N_h$ を用いて
$$\bar{x}_{\text{strat}} = \sum_{h=1}^{H} \frac{N_h}{N} \bar{x}_h$$
で重み付き集計する。 層内のバラツキが小さいほど、 単純無作為抽出より精度が上がる(分散減少効果)。 不均等抽出後の 事後層別重み (post-stratification weight) は
$$w_i = \frac{N_h / N}{n_h / n}$$
で、 「母集団に占める層比率」を「標本に占める層比率」で割った値。 これで小集団のオーバーサンプル分を打ち消す。
🔬 数式・定義を「言葉」で読み解く
📐 章の 4 つの式に出てくる記号を、 調査の場面に当てはめて読む。
| 記号 | 調査の場面での意味 | 2023 年度の高齢化率(47 県)で読むと |
|---|---|---|
| $N$ | 母集団の大きさ(調べたい対象の全数) | 47(都道府県) |
| $n$ | 実際に調べた数(標本サイズ) | たとえば 10 県だけ選んで調べる |
| $s$($\sigma$) | 母集団の中での値のばらつき | 47 県の高齢化率の標準偏差 3.302 ポイント |
| $s/\sqrt{n}$ | 選び直すたびに標本平均がどれだけ揺れるか(無限母集団の場合) | n = 10 で 3.302/√10 = 1.044 |
| $\sqrt{(N-n)/(N-1)}$ | 有限母集団修正。 母集団の多くを調べるほど揺れが小さくなる分 | n = 10 で √(37/46) = 0.897、 n = 47 で 0 |
| $N_h/N$ | 層 $h$ が母集団に占める割合(層化抽出の重み) | 3 大都市圏 10 県なら 10/47 |
| $w_i$ | 事後層別ウェイト。 標本で多すぎる層を小さく、 少なすぎる層を大きく数え直す | 高齢者が答えすぎた調査では高齢層の重みが 1 より小さくなる |
🔬 数式を言葉で読み解く
数式を言葉で読み解くと、 まず 標本誤差 $s/\sqrt{n}$ は「同じ母集団から $n$ 人を選び直すたびに、 標本平均がどれくらい揺らぐか」の標準偏差。 $n$ を 4 倍にすれば標本誤差は半分になる($\sqrt{4} = 2$)が、 4 倍未満では効果が小さい。 「精度を 10 倍にしたい」なら 100 倍のサンプルが必要、 という非対称な関係がここから来る。
有限母集団修正は「全人口を調べた極端なケース ($n=N$) では誤差ゼロ」を保証する。 SSDSE-B-2026 のような 悉皆データ(全 47 都道府県すべて)の場合、 $f = n/N = 1$ で FPC = 0 となり、 標本誤差は理論上ゼロ。 つまり「平均値そのものが母集団値」になる。 ただしこれは「集計後の値」の話で、 元データ収集時の 非標本誤差(質問の誤解、 入力ミス)は別途残る。
層化抽出の数式は「層ごとに代表値を計算し、 層の重さで加重平均」を取ることを意味する。 例えば男女比 1:1 の母集団から「女性 200 人・男性 100 人」をサンプリングした場合、 単純平均は男性過小評価/女性過大評価となる。 事後層別重みで「女性 1.0 倍・男性 2.0 倍」と補正すれば、 母集団推定が正しくなる。 政府統計の多くはこの層化+重み付け方式で公表されている。
🔬 有限母集団修正の式を、 47 県からの抽出で確かめる
🎯 このコードでやること:2023 年度の 47 県の高齢化率を母集団とみなし、 そこから n 県を非復元で選んで平均する作業を 20,000 回繰り返して、 標本平均の実際のばらつきを、 σ/√n と有限母集団修正(FPC)付きの式の値と比べる
1 2 3 4 5 6 7 8 9 10 11 12 13 14 15 16 17 | import numpy as np import pandas as pd df = pd.read_csv('data/raw/SSDSE-B-2026.csv', encoding='cp932', skiprows=[1]) d = df[df['SSDSE-B-2026'] == 2023] aging = (d['A1303'] / d['A1101'] * 100).to_numpy() # 高齢化率(%), N = 47 の母集団 N = len(aging) sigma = aging.std(ddof=0) # 47 県全体(母集団)の標準偏差 print(f'47 県の高齢化率: 平均 {aging.mean():.3f}%, σ {sigma:.3f}') rng = np.random.default_rng(0) for n in [5, 10, 20, 40]: # 47 県から n 県を非復元で選んで平均する、 を 20,000 回 means = [rng.choice(aging, n, replace=False).mean() for _ in range(20000)] se = sigma / np.sqrt(n) fpc = np.sqrt((N - n) / (N - 1)) print(f'n={n:2d}: 実際のばらつき {np.std(means):.3f} / σ/√n {se:.3f} / FPC 付き {se * fpc:.3f}') |
💬 47 県から 10 県を選ぶと、 標本平均の実際のばらつき(標準偏差)は 0.932 で、 σ/√n の 1.044 より小さく、 FPC を掛けた 0.937 とほぼ一致する。 n = 40 では σ/√n が 0.522 なのに実際は 0.205 と半分以下で、 FPC 付きの 0.204 がちょうど合う。 母集団の大部分を調べると、 選び直しても同じ県がほとんど入るので平均が揺れにくい。 FPC を付けないと、 全数に近い調査ほど誤差を大きく見積もりすぎる。 n = 47(全数)なら FPC は 0 で、 47 県の値そのものに標本誤差は無い。
🔬 事後層別ウェイト $w_i$ を実際の人口で 1 つ計算する
2023 年度の 47 県合計で、 15〜64 歳人口(A1302)は 73,954,000 人、 65 歳以上人口(A1303)は 36,229,000 人なので、 15 歳以上に占める 65 歳以上の割合は $N_h/N = 36{,}229{,}000 / 110{,}183{,}000 = 0.329$ である。 ある調査で 15 歳以上の回答者 1,000 人のうち 500 人($n_h/n = 0.5$)が 65 歳以上だったとすると、 高齢の回答者のウェイトは $w = 0.329 / 0.5 = 0.658$、 15〜64 歳の回答者は $w = 0.671 / 0.5 = 1.342$ になる。 高齢者の回答 1 件を 0.66 件分、 現役世代の回答 1 件を 1.34 件分として数え直すことで、 回答者の年齢構成を人口の構成(33% と 67%)に合わせる。 ウェイトの合計は 500 × 0.658 + 500 × 1.342 = 1,000 で、 回答者数は変わらない。
仮に、 ある質問に「はい」と答えた割合が 65 歳以上の回答者で 60%、 15〜64 歳の回答者で 40% だったとする(数値は説明のための仮定)。 ウェイトを付けずに 1,000 人をそのまま集計すると (500 × 0.60 + 500 × 0.40) / 1,000 = 50.0% だが、 ウェイトを付けると 0.329 × 60 + 0.671 × 40 = 46.6% になる。 高齢者が答えすぎた分だけ、 単純集計は 3.4 ポイント高く出ていたことになる。 ただしこの補正が正しいのは、 同じ年齢層の中では「答えた人」と「答えなかった人」の意見が同じ場合に限られる。
🧮 SSDSE-B 実値で計算してみる
SSDSE-B-2026 の 2023 年度から 4 県を並べる。 総人口と高齢化率は人口推計(千人単位の推計値)、 TFR は人口動態統計、 消費支出は家計調査(二人以上の世帯・県庁所在市)と、 列ごとに元の調査が違う。
| 都道府県 | 総人口(千人) | 高齢化率(%) | TFR | 消費支出(円/月) |
|---|---|---|---|---|
| 東京 | 14,086 | 22.8 | 0.99 | 341,320 |
| 大阪 | 8,763 | 27.7 | 1.19 | 271,246 |
| 沖縄 | 1,468 | 23.8 | 1.60 | 251,222 |
| 秋田 | 914 | 39.1 | 1.10 | 272,086 |
| 全国 ※ | 124,353 | 29.1 | 1.29 | 295,856 |
※ 全国行は、 総人口 = 47 都道府県合計、 高齢化率 = 65 歳以上人口合計 ÷ 総人口合計、 TFR・消費支出 = 47 都道府県の単純平均(SSDSE-B-2026・2023 年実測値から算出)。
🧮 実値で計算してみる:SSDSE-B-2026 は調査データの集約結果
SSDSE-B-2026 は政府の各種調査・統計(国勢調査、 学校基本調査、 人口動態統計、 家計調査など)を都道府県単位で集約したものだ。 ここから「調査データを集約した値」の性質を確認しよう。
例 1:人口データ(国勢調査と、 それを基準にした推計)に標本誤差は無い
国勢調査は 悉皆調査のため、 標本誤差は理論上ゼロ。 SSDSE-B-2026 の「総人口 A1101」は、 国勢調査の年(2015・2020 年度)はその調査の実数(例: 2020 年度の北海道 5,224,614 人)で、 それ以外の年度は国勢調査を基準に出生・死亡・転出入を足し引きした推計値を千人単位に丸めたもの(2023 年度の 47 都道府県合計 124,353,000 人)。 どちらにも「±X 万人」のような標本誤差は付かない(が、 回答漏れなどによる カバレッジ誤差や、 推計値の誤差はある)。
例 2:標本調査ベースの「世帯あたり消費支出」
SSDSE-B-2026 の家計関連項目(L3221 「消費支出」、 L322107 「交通・通信費」など)は、 家計調査の二人以上の世帯の値。 家計調査は 標本調査(二人以上の世帯は全国で約 8,000 世帯)で、 SSDSE-B-2026 に入っているのは県全体ではなく県庁所在市の値なので、 1 市あたりの調査世帯は少なく、 標本誤差が大きい。 下の ⚠️ 章で実測するとおり、 前年比の絶対値の中央値は 4.12% で、 総人口(0.59%)の約 7 倍揺れる。
例 3:標本サイズと信頼区間の関係
| 標本サイズ n | 標本誤差 (比率 50% 時) | 95% 信頼区間幅 | 用途例 |
|---|---|---|---|
| 100 | ±5.0% | ±9.8% | パイロット調査 |
| 400 | ±2.5% | ±4.9% | 市町村調査 |
| 1,000 | ±1.6% | ±3.1% | 世論調査の標準 |
| 10,000 | ±0.5% | ±1.0% | 全国規模の標本調査 |
| 100,000 | ±0.2% | ±0.3% | 大規模な標本調査 |
「n=1,000 で 95% CI ±3.1%」は世論調査でよく見る数字。 新聞報道で「支持率 50%、 ±3 ポイント」と書いてあれば n≈1,000 と推測できる。
🧮 表の値をコードで検算する
🎯 このコードでやること:比率 50% を推定するときの標準誤差と 95% 信頼区間の幅を、 標本サイズごとに式 √(p(1−p)/n) から計算し、 「±3 ポイント以内」に必要な n を逆算する(上の表の検算)
1 2 3 4 5 6 7 8 9 10 11 12 | import numpy as np from scipy import stats p = 0.5 z = stats.norm.ppf(0.975) for n in [100, 400, 1000, 1600, 10000]: se = np.sqrt(p * (1 - p) / n) print(f'n={n:6,d}: 標準誤差 ±{se*100:.2f} ポイント / 95% 信頼区間 ±{z*se*100:.2f} ポイント') # 逆算: 95% 信頼区間を ±3 ポイント以内にしたいときの n m = 0.03 print('±3 ポイントに必要な n:', int(np.ceil((z / m) ** 2 * p * (1 - p)))) |
💬 上の表の値(n = 100 で ±9.8、 400 で ±4.9、 1,000 で ±3.1)がそのまま再現される。 n を 400 から 1,600 へ 4 倍にすると幅は ±4.90 から ±2.45 へちょうど半分になり、 「精度を 2 倍にするには標本を 4 倍」という関係が数字で確かめられる。 ±3 ポイント以内に収めるには n = 1,068 が必要で、 世論調査がおおむね 1,000 人前後を目標にする理由がここにある。 ただしこれは無作為に選んだ場合の標本誤差だけで、 非回答や質問文による偏りは含まない。
🧮 国勢調査の年と推計の年で、 同じ列の性質が変わる
🎯 このコードでやること:SSDSE-B-2026 の総人口(A1101)を年度ごとに 47 県で合計し、 千人単位に丸められた県の数と前年差を並べて、 国勢調査の年と推計の年の違いを確かめる
1 2 3 4 5 6 7 8 9 10 | import pandas as pd df = pd.read_csv('data/raw/SSDSE-B-2026.csv', encoding='cp932', skiprows=[1]) g = df.groupby('SSDSE-B-2026') tab = pd.DataFrame({ '47県合計(人)': g['A1101'].sum(), '千人単位の県': g['A1101'].apply(lambda s: int((s % 1000 == 0).sum())), }) tab['前年差(人)'] = tab['47県合計(人)'].diff() print(tab.loc[2014:2022].to_string()) |
💬 2015 年度と 2020 年度だけは千人単位に丸められた県が 0 で、 47 県すべてが国勢調査の 1 人単位の実数になっている。 それ以外の年度は 47 県すべてが千人単位の推計値である。 47 県合計の前年差は 2016〜2019 年度に −5 万〜−19 万人だったのが、 2020 年度は −40.9 万人と急に大きくなる。 この前年差には実際の増減だけでなく、 推計の基準が 2015 年国勢調査から 2020 年国勢調査へ切り替わったずれも混ざりうる。 国勢調査の年をまたいで前年差や伸び率を読むときは、 「調査の方式が変わった年」であることを先に確かめる。
🐍 Python 実装
以下は 調査データ を SSDSE-B-2026 で扱うときの典型コード。 encoding='cp932' は政府統計の Shift-JIS 対応。 skiprows=1(header=1 と同じ)は 1 行目の英字コード行を飛ばし、2 行目の日本語項目名を列名にする定石。
🐍 12 年度を混ぜた 564 行と 2023 年度の 47 行で検定結果を比べる
1 2 3 4 5 6 7 8 9 10 11 12 13 14 15 16 17 18 19 20 21 22 23 24 25 | import pandas as pd from scipy import stats # 調査データ 文脈での基本的な仮説検定 df = pd.read_csv('data/raw/SSDSE-B-2026.csv', encoding='cp932', header=1) # 見出しの下に地域コード以外の行が混ざるので、47 都道府県だけ残して数値に直す df = df[df['地域コード'].astype(str).str.match(r'^R\d{5}$', na=False)].copy() for _c in df.columns[3:]: df[_c] = pd.to_numeric(df[_c], errors='coerce') # 同じ県が 12 年度ぶん入っているので、2023 年度の 47 行だけを使う # (12 年度を混ぜると同じ県を 12 回数え、n が水増しされて p 値が小さく出すぎる) df = df[df['年度'] == 2023].copy() df['aging'] = df['65歳以上人口'] / df['総人口'] * 100 df['region'] = df['都道府県'].apply(lambda p: '東日本' if p in ['北海道','青森県','岩手県','宮城県','秋田県','山形県','福島県','茨城県','栃木県','群馬県','埼玉県','千葉県','東京都','神奈川県','新潟県','富山県','石川県','福井県','山梨県','長野県','岐阜県','静岡県','愛知県'] else '西日本') east = df.loc[df['region']=='東日本', 'aging'] west = df.loc[df['region']=='西日本', 'aging'] t, p = stats.ttest_ind(east, west, equal_var=False) print(f'東日本 平均高齢化率: {east.mean():.2f}%') print(f'西日本 平均高齢化率: {west.mean():.2f}%') print(f't = {t:.3f}, p = {p:.4f}') print('判定:', '有意差あり' if p < 0.05 else '有意差なし') |
💬 2023 年度の 47 行で、東日本 31.18%・西日本 31.97%、t = −0.804、p = 0.43 で有意差なし。12 年度を混ぜた 564 行のまま検定すると t = −2.81、p = 0.005 と有意に見えたが、それは同じ県を 12 回数えて標本数を水増ししたため。調査データの検定では「1 行が独立な 1 回答(1 単位)か」を最初に確かめ、繰り返し観測なら年度を絞るかクラスタを考慮する。
🐍 Python 実装 1:SSDSE-B-2026 の都道府県データに標本誤差を付与してみる
🎯 このコードでやること:SSDSE-B-2026 を「悉皆データ」として扱いつつ、 仮に標本調査だったら標本誤差がどれくらい付くかを計算する。 pandas と scipy.stats を併用。
📥 入力例:
1 2 3 4 5 6 7 8 9 10 11 12 13 14 15 16 17 18 19 20 21 22 23 24 25 26 27 | import pandas as pd from scipy import stats df = pd.read_csv('data/raw/SSDSE-B-2026.csv', encoding='cp932', skiprows=[1]) latest = df[df['SSDSE-B-2026'] == df['SSDSE-B-2026'].max()] # 都道府県別人口の記述統計(悉皆データ) pop = latest['A1101'] print(f'47 都道府県の人口(悉皆)') print(f' 平均: {pop.mean():,.0f} 人') print(f' 標準偏差: {pop.std():,.0f}') print(f' 合計: {pop.sum():,.0f} 人(2023 年度の推計人口)') # もし「47 都道府県のうち 10 県だけサンプリングしたら?」 sample = pop.sample(10, random_state=42) se = sample.std(ddof=1) / (len(sample) ** 0.5) # 有限母集団修正 (FPC) N, n = 47, 10 fpc = ((N - n) / (N - 1)) ** 0.5 se_fpc = se * fpc print(f'10 県サンプル平均: {sample.mean():,.0f} 人') print(f'標本誤差 SE: {se:,.0f}') print(f'FPC = {fpc:.4f}') print(f'FPC 補正後 SE: {se_fpc:,.0f}') print(f'95% CI: [{sample.mean()-1.96*se_fpc:,.0f}, {sample.mean()+1.96*se_fpc:,.0f}]') |
📤 実行例:
💬 結果の読み方:悉皆データの真の平均は 2,645,809 人。 10 県サンプルでは 4,220,400 人(過大推定)、 95% CI [1,823,883, 6,616,917] と非常に広い。 サンプリングしないと精度は出ない。 政府がわざわざ全 47 都道府県を悉皆で集める理由がここにある。
🐍 Python 実装 2:層化抽出と重み付き集計
🎯 このコードでやること:47 都道府県を「3 大都市圏/地方」に層化し、 層別重みで集計する。 単純平均との差を可視化。
📥 入力例:
1 2 3 4 5 6 7 8 9 10 11 12 13 14 15 16 17 18 19 20 21 22 23 24 25 | import pandas as pd df = pd.read_csv('data/raw/SSDSE-B-2026.csv', encoding='cp932', skiprows=[1]) latest = df[df['SSDSE-B-2026'] == df['SSDSE-B-2026'].max()] # 層化:3 大都市圏 vs 地方 metro = ['東京都', '神奈川県', '千葉県', '埼玉県', '大阪府', '京都府', '兵庫県', '愛知県', '三重県', '岐阜県'] latest.loc[:, 'stratum'] = latest['Prefecture'].apply( lambda p: '都市圏' if p in metro else '地方') # 層別の人口・件数 summary = latest.groupby('stratum').agg(prefs=('Prefecture', 'count'), pop_sum=('A1101', 'sum'), pop_mean=('A1101', 'mean')) print(summary) # 単純平均(県を 1 票として平等) simple_mean = latest['A1101'].mean() # 人口加重平均(人を 1 票として) weighted = (latest['A1101'] * latest['A1101']).sum() / latest['A1101'].sum() print(f'単純平均(県単位): {simple_mean:,.0f} 人/県') print(f'人口加重平均: {weighted:,.0f} 人') |
📤 実行例:
💬 結果の読み方:3 大都市圏 10 県だけで全国人口の 52% を占める(64,706,000/124,353,000)。 単純平均だと「県の平均人口は 264 万人」だが、 人口加重平均では「平均的な日本人が住む県の人口は 554 万人」と倍以上の差。 同じデータでも 「県を 1 単位とするか/人を 1 単位とするか」で結論が変わる典型例。 調査データの読み方では集計単位の明示が必須。
🐍 Python 実装 3:比率の信頼区間(世論調査の典型計算)
🎯 このコードでやること:世論調査で「内閣支持率 45%、 サンプル数 1,200」のとき、 95% 信頼区間を Wilson 法で計算する。
📥 入力例:
1 2 3 4 5 6 7 8 9 10 11 12 13 14 15 16 17 18 | from statsmodels.stats.proportion import proportion_confint n = 1200 success = 540 p_hat = success / n # Wilson 法(小標本・極端比率に強い) low, up = proportion_confint(success, n, alpha=0.05, method='wilson') print(f'支持率: {p_hat*100:.1f}%') print(f'95% CI (Wilson): [{low*100:.1f}%, {up*100:.1f}%]') # 正規近似版(広く使われるが、 比率が極端だと不正確) low2, up2 = proportion_confint(success, n, alpha=0.05, method='normal') print(f'95% CI (正規近似): [{low2*100:.1f}%, {up2*100:.1f}%]') # 「支持率 50% 前後では n=1200 で ±2.8%」が世論調査の経験則 margin = 1.96 * ((p_hat * (1 - p_hat)) / n) ** 0.5 print(f'マージン: ±{margin*100:.2f}%') |
📤 実行例:
💬 結果の読み方:n=1,200 での 95% CI は [42.2%, 47.8%]。 「先月 47%、 今月 45%」のような変化は CI が重なるので「有意な変化ではない」と判断するのが統計的に正しい。 メディアが「支持率急落!」と報じても、 標本誤差を考慮すると有意でないことが多い。 世論調査結果は 必ず標本誤差と一緒に読むこと。
🐍 Python 実装 4:非回答バイアスのシミュレーション
🎯 このコードでやること:SSDSE-B-2026 を母集団とし、 「高齢者ほど回答する」という仮想の回答パターンを想定して、 単純集計と重み付け補正の差を見る。
📥 入力例:
1 2 3 4 5 6 7 8 9 10 11 12 13 14 15 16 17 18 19 20 21 22 23 24 25 26 27 28 29 30 31 32 33 34 35 36 37 38 | import pandas as pd df = pd.read_csv('data/raw/SSDSE-B-2026.csv', encoding='cp932', skiprows=[1]) latest = df[df['SSDSE-B-2026'] == df['SSDSE-B-2026'].max()] # 母集団:全国の生産年齢人口と高齢人口 N_work = latest['A1302'].sum() # 15-64 歳 N_old = latest['A1303'].sum() # 65+ # 仮想:内閣支持率は生産年齢 40%, 高齢者 60% true_support_work = 0.40 true_support_old = 0.60 true_overall = (N_work * true_support_work + N_old * true_support_old) / (N_work + N_old) # 回答率:生産年齢 20%, 高齢者 60%(高齢者が答えやすい) resp_work = 0.20 resp_old = 0.60 # 回答者数(n=2000 配布したと仮定) n_target = 2000 share_work = N_work / (N_work + N_old) sent_work = n_target * share_work sent_old = n_target * (1 - share_work) resp_w = sent_work * resp_work resp_o = sent_old * resp_old # 単純集計(バイアスあり) naive_support = (resp_w*true_support_work + resp_o*true_support_old) / (resp_w + resp_o) # 重み付け補正(事後層別) w_work = (N_work / (N_work+N_old)) / (resp_w / (resp_w+resp_o)) w_old = (N_old / (N_work+N_old)) / (resp_o / (resp_w+resp_o)) adj_support = (w_work*resp_w*true_support_work + w_old*resp_o*true_support_old) \ / (w_work*resp_w + w_old*resp_o) print(f'真の支持率: {true_overall*100:.1f}%') print(f'単純集計(バイアスあり): {naive_support*100:.1f}%') print(f'重み付け補正後: {adj_support*100:.1f}%') |
📤 実行例:
💬 結果の読み方:高齢者が答えやすい状況で単純集計すると真値より +5.3 ポイントも過大評価される。 事後層別重み付けで補正すれば真値に一致する。 これが 非回答バイアス (non-response bias)。 ただし「回答した高齢者と回答しなかった高齢者でも意見が違う」場合は重み補正でも消せないので、 回答率そのものを上げる工夫が要る。
⚠️ よくある落とし穴
⚠️ 追加の落とし穴 — 「調査データだからこそ」起こる 5 つの罠
本ページ上部の「よくある落とし穴」を補完する、 調査データ特有の罠をさらに 5 件挙げます。 これらは ML 系の教材ではあまり強調されませんが、 公的統計を扱うときには必ず意識すべきポイントです。
罠 1: 時系列の定義変更を見落とす
調査票や集計区分は数年ごとに見直されることがあり、 同じ列名でも年度によって意味が違うことがあります。 「2010 年と 2020 年の数値を単純比較したら、 実は 2015 年に分類が変わっていた」というのは公的統計分析でよくある失敗です。 出典 PDF の「調査の概要」や「変更点」セクションは必ず確認しましょう。
罠 2: 季節調整済値と原数値の取り違え
完全失業率や鉱工業生産指数などは「原数値」と「季節調整値」の 2 種類が公開されています。 月次の動きを論じるなら季節調整値、 年計や前年同月比なら原数値、 と使い分けが必要です。 取り違えると「失業が増えた/減った」の結論が逆になることもあります。
罠 3: 単位の桁を見落とす
「100 万円」「億円」「千円」が列によってバラバラだったり、 同じ調査内でも年度によって変わったりします。 数値が大き過ぎる/小さ過ぎると感じたら、 まず単位を疑うのが鉄則。 SSDSE のような集約データでも列ごとに単位が違うので、 必ずメタデータを確認してください。
罠 4: 標本ウェイトを無視した記述統計
標本調査の個票には抽出ウェイトがついていることが多く、 これを無視して単純平均を取ると母集団の特性を歪んで推定してしまいます。 個票を扱う際は weights 引数を取れる関数(numpy.average, statsmodels の WLS 等)を使うか、 ウェイトの意味を理解した上で集計しましょう。
罠 5: 「都道府県」を独立サンプル扱いする
SSDSE のような都道府県データでは n=47 ですが、 これは厳密には「ランダムサンプル」ではなく「日本という母集団そのもの」です。 ですから p 値を計算しても、 通常の標本論的解釈は当てはまりません。 「47 都道府県の全数を観察した上での記述」と捉えるのが本来正しい立場です。
🎯 調査設計の品質管理 — TSE フレームワークで誤差を分解する
公的統計や社会調査の世界では、 調査の品質を体系的に評価する枠組みとして TSE (Total Survey Error) モデルが広く使われています。 これは「最終的に分析者が手にする数値」に至るまでに、 どこでどんな誤差が混入するかを系統的に整理する考え方です。
TSE は誤差を大きく 表現誤差 (representation error) と 測定誤差 (measurement error) の 2 系統に分けます。 前者は「誰を観察するか」に関わる誤差、 後者は「観察した内容が正しいか」に関わる誤差です。 SSDSE-B-2026 のような集約データを使う場合、 すでに統計部局によってこれらの誤差が一定程度コントロールされていますが、 「ゼロではない」ことを忘れてはいけません。
表現誤差の典型
「カバレッジ誤差」は対象母集団と抽出枠の不一致から生じます。 たとえば 20 年前の住民票ベースで電話調査をすれば、 すでに転居した人や固定電話を持たない人が抜け落ちます。 「無回答誤差」は回答拒否や不在が原因で、 回答する人と回答しない人の特性が違うと、 集計値が偏ります。 「標本抽出誤差」は前述したように、 標本サイズに依存する確率的なズレです。
測定誤差の典型
「質問文の曖昧さ」「回答選択肢の不適切さ」「面接員効果」「社会的望ましさバイアス」など、 回答プロセスそのものに起因する誤差です。 たとえば「あなたは差別をしますか?」と直接聞けば、 多くの人が「しない」と答えるでしょうが、 これは真実とは限りません。 質問文のワーディング 1 つで、 集計結果が大きく変わる例は調査研究の歴史に数多くあります。
分析者がチェックすべきこと
公開データを使う側は、 これらの誤差源を「すでに統計部局が処理してくれている」と思いがちですが、 実際には残存誤差が必ずあります。 調査の「結果概要」「利用上の注意」セクションには、 回答率・標本誤差・系統誤差の評価結果が記載されているので、 分析前に必ず一読することが推奨されます。 ここを飛ばすと、 「数値だけ見て解釈を間違える」という典型的な失敗に陥ります。
🤔 よくある誤解 Q&A — 「調査データ」をめぐる素朴な疑問
Q. 「公的統計だから信用できる」と考えてよい?
A. 信頼性の高さは概ね事実ですが、 「無条件に信用」は危険です。 統計法の下で厳密な手順を踏んでいる一方、 過去には毎月勤労統計問題のように、 調査手順の逸脱が大きく報道された事例もあります。 また、 調査設計そのものに時代遅れの部分があれば、 結果は現実を捉えきれません。 「数値の背景にあるプロセス」を理解した上で使うのが正しい姿勢です。
Q. ビッグデータがあれば調査データは不要?
A. むしろ補完関係です。 SNS ログや POS データは大量・即時性が魅力ですが、 「誰のデータか」が不明な自己選抜サンプルです。 一方、 調査データは標本設計に基づき母集団を代表できるという強みがあります。 たとえば「全国民の労働状態」を捉えるには、 やはり労働力調査のような正式な調査が必要で、 SNS データだけでは代替できません。
Q. n=47 (都道府県) は標本として小さすぎない?
A. 「標本」ではなく「日本という母集団そのもの」と捉えれば、 n=47 で十分です。 ただし、 通常の標準誤差や p 値を計算する場合は「47 という数」を意識した解釈が必要です。 また、 検定よりも記述統計(散布図や順位)の方が情報量が大きいこともあります。 統計検定にこだわらず、 視覚的に「県ごとの違い」を表現する方が、 むしろ生産的なケースが多いです。
Q. 調査データから機械学習モデルを作ってもよい?
A. 技術的には可能で、 実際多くの研究で行われています。 ただし、 調査データは観察データなので、 「予測精度の高いモデル」と「因果関係を捉えたモデル」は別物だと意識する必要があります。 たとえば「消費支出を予測するモデル」が高精度でも、 「どの政策を打てば消費支出が増えるか」には直接答えてくれません。 因果推論の枠組みと併用するか、 「予測課題か因果課題か」を最初に明確化することが重要です。
Q. 古い調査データはもう使えない?
A. 「最新性」が重要な分析(現状の把握、 政策判断)には適しませんが、 「時系列での変化」「歴史的検証」には不可欠です。 たとえば人口の長期トレンドを論じるには、 1920 年の国勢調査から始まる 100 年分のデータが必要です。 むしろ「古いから使えない」と切り捨てるのではなく、 「いつのデータを、 何の目的で使うのか」を意識して使い分けるのが正しい姿勢です。
⚠️ 落とし穴(調査データに固有の罠)
- ① 非回答バイアス (non-response bias):回答する人と回答しない人で意見が体系的に異なる場合、 回答者だけの集計は母集団を代表しない。 高齢者は固定電話に出やすい、 若年層はオンライン回答が多い、 など回答チャンネルでも偏りが生じる。 回答率 50% 以下では大きな影響。
- ② 社会的望ましさバイアス (social desirability bias):「環境にやさしい行動をしていますか?」と聞かれると、 実際以上に「している」と答える傾向。 投票行動・節電・食習慣・性行動など、 社会的評価が絡むテーマで顕著。 匿名性確保や間接質問法(リスト実験)で軽減。
- ③ 質問順序効果 (order effect):先に「日本の経済」を聞いてから「あなたの暮らし」を聞くと、 後者の評価が経済評価に引きずられる。 質問順をランダム化するか、 影響を分析する split-ballot 設計を取る。
- ④ 質問文ワーディングの影響:「死刑制度に賛成ですか」と「死刑制度を残すべきですか」では回答が変わる。 単語の感情価・文の長さ・尺度の数(4 段階 vs 5 段階)でも結果が動く。 過去調査との比較は同一ワーディングが必須。
- ⑤ 自己申告 (self-report) の限界:「1 週間の歩数」を自己申告で聞くと、 加速度計の実測値より多めの回答が出やすい。 体重・食事量・運動・睡眠時間など、 自己申告は系統的に歪む。 客観指標と併用するのが望ましい。
- ⑥ サテライス (satisficing):長い質問票では「真剣に考えず最初の選択肢を選ぶ」「全部 3 にする」など手抜き回答が増える。 質問数を絞る、 注意確認質問 (attention check) を入れるなどの対策が要る。
- ⑦ カバレッジ誤差 (coverage error):「家庭の固定電話」だけで世論調査をすると、 携帯のみの世帯(特に若年単身)が除外される。 住民台帳ベースか、 RDD(ランダム数字ダイヤリング)か、 サンプリングフレームの選択で結果が変わる。
⚠️ 調査データ特有の回答バイアス 5 類型
調査データ (survey data) は「人が回答する」という性質上、 観測データとは別種のバイアスが入り込む。 SSDSE-B-2026 が依拠する政府統計 (国勢調査、 家計調査、 労働力調査) でも、 以下の 5 類型に対する補正が掛けられている。
| 類型 | 発生機序 | SSDSE での該当例 | 補正法 |
|---|---|---|---|
| 社会的望ましさバイアス | 「正しい」と思われる回答に寄る | 家計調査の喫煙・飲酒支出が過少報告 | 税収統計との突合補正 |
| 非回答バイアス | 回答拒否者と回答者で属性が異なる | 単身高齢世帯の回答率低下 | 層別ウエイト調整 (post-stratification) |
| 想起バイアス | 過去の出来事を正確に思い出せない | 家計調査の月次支出回答 | 家計簿実測法に切替 |
| 質問順効果 | 前問が次問の回答を誘導 | 満足度→具体的問題点の順で満足度低下 | ランダム化提示 |
| 標本抽出バイアス | サンプリングフレームの偏り | 固定電話のみの世論調査が高齢層偏重 | RDD + 携帯併用、 web 補完 |
💡 観測データ (POS / センサーログ) ではこれらは原理的に発生しないが、 代わりに「測定機器の経年劣化」「ログ取得条件のサンプリング」など別系統のバイアスを抱える。 調査データと観測データのバイアス対比を理解しておくことが、 公式統計の正しい解釈の第一歩。
⚠️ 標本調査の列は、 1 年ごとの上下を実際の変化と読まない
🎯 このコードでやること:総人口(A1101)と、 家計調査由来の消費支出(L3221、 二人以上の世帯・県庁所在市)の前年比を 47 県 × 11 年度ぶん計算し、 どれだけ年ごとに揺れるかを比べる
1 2 3 4 5 6 7 8 9 10 11 12 13 14 15 16 17 | import pandas as pd df = pd.read_csv('data/raw/SSDSE-B-2026.csv', encoding='cp932', skiprows=[1]) df = df.sort_values(['Code', 'SSDSE-B-2026']) # 新しい年度が先なので並べ替える yoy = df.groupby('Code')[['A1101', 'L3221']].pct_change() * 100 yoy['Prefecture'] = df['Prefecture'] yoy = yoy.dropna() print('前年比の絶対値(%)の中央値 総人口:', round(yoy['A1101'].abs().median(), 2), ' 消費支出:', round(yoy['L3221'].abs().median(), 2)) print('前年比が ±10% を超えた県・年の数 総人口:', int((yoy['A1101'].abs() > 10).sum()), ' 消費支出:', int((yoy['L3221'].abs() > 10).sum()), '/', len(yoy)) big = yoy.loc[yoy['L3221'].abs().idxmax()] print('消費支出の前年比が最も大きく動いた例:', big['Prefecture'], df.loc[yoy['L3221'].abs().idxmax(), 'SSDSE-B-2026'], '年度', f"{big['L3221']:+.1f}%") s = df[df['Prefecture'] == '秋田県'].set_index('SSDSE-B-2026')['L3221'] print('秋田県の消費支出(円/月):', s.loc[2016:2023].to_dict()) |
💬 前年比の絶対値の中央値は、 総人口が 0.59% なのに対し消費支出は 4.12% と約 7 倍で、 ±10% を超える動きは総人口では 0 件、 消費支出では 517 件中 34 件ある。 最大は愛知県の 2022 年度で +21.0%。 秋田県も 2018 年度に 280,058 円へ上がり翌年 261,579 円に戻るなど、 1 年ごとに上下する。 消費支出は県庁所在市の限られた世帯を調べた標本調査の値なので、 この上下の多くは標本誤差と考えられる。 標本調査の列で「1 年で 2 割増えた」を実際の変化と読む前に、 数年の平均や全国の動きと見比べる。
⚠️ 単年の順位は動く — 複数年の平均と並べて読む
🎯 このコードでやること:消費支出(L3221)について、 2023 年度単年の県の順位と 2021〜2023 年度の 3 年平均の順位を比べ、 3 年移動平均にしたときに前年比の揺れがどれだけ小さくなるかを測る
1 2 3 4 5 6 7 8 9 10 11 12 13 14 15 16 17 18 | import pandas as pd df = pd.read_csv('data/raw/SSDSE-B-2026.csv', encoding='cp932', skiprows=[1]) w = df.pivot(index='Prefecture', columns='SSDSE-B-2026', values='L3221') # 県 × 年度 single = w[2023] avg3 = w[[2021, 2022, 2023]].mean(axis=1) print('2023 年度単年の上位 5:', single.nlargest(5).index.tolist()) print('2021-23 年度平均の上位 5:', avg3.nlargest(5).index.tolist()) print('順位の相関(スピアマン):', round(single.rank().corr(avg3.rank()), 3)) moved = (single.rank(ascending=False) - avg3.rank(ascending=False)).abs() print('順位が 10 位以上ずれた県:', int((moved >= 10).sum()), '県 /', moved.idxmax(), f'{int(moved.max())} 位') # 3 年移動平均にすると、 前年比の揺れはどれだけ小さくなるか ma = w.T.sort_index().rolling(3).mean() raw_yoy = w.T.sort_index().pct_change().abs().stack().median() * 100 ma_yoy = ma.pct_change().abs().stack().median() * 100 print(f'前年比の絶対値の中央値: 単年 {raw_yoy:.2f}% → 3 年移動平均 {ma_yoy:.2f}%') |
💬 単年と 3 年平均の順位の相関は 0.906 と高いが、 上位 5 県は 3 県しか重ならず(単年の三重県・栃木県が 3 年平均では岐阜県・千葉県に入れ替わる)、 10 位以上順位がずれた県が 4 県あり、 最大は山口県の 14 位。 前年比の絶対値の中央値は、 単年の 4.12% から 3 年移動平均では 1.52% まで下がる。 標本調査の列で県の順位を報告するときは、 単年の順位だけで「何位に上がった」と書かず、 複数年の平均も並べる。
⚠️ 標本調査の列どうしの相関は、 年度によって符号まで変わる
🎯 このコードでやること:高齢化率と消費支出(L3221)の相関係数を、 12 年度それぞれの 47 県で計算し、 年度によってどれだけ変わるかを見る
1 2 3 4 5 6 7 8 9 | import pandas as pd df = pd.read_csv('data/raw/SSDSE-B-2026.csv', encoding='cp932', skiprows=[1]) df['高齢化率'] = df['A1303'] / df['A1101'] * 100 r = df.groupby('SSDSE-B-2026')[['高齢化率', 'L3221']].apply( lambda g: g['高齢化率'].corr(g['L3221'])) print('年度ごとの r(高齢化率 × 消費支出, 47 県)') print(r.round(3).to_string()) print(f'最小 {r.min():.3f}({r.idxmin()} 年度) 〜 最大 {r.max():.3f}({r.idxmax()} 年度)') |
💬 同じ 2 つの列の相関が、 2012 年度は +0.117、 2022 年度は −0.361 と、 年度によって符号まで変わる。 2016 年度以降は負の値が続くので「高齢化率の高い県ほど県庁所在市の消費支出が少ない」傾向はありそうだが、 単年だけを見ると −0.03 の年も −0.36 の年もある。 片方の列が標本調査の値だと、 その標本誤差が相関にもそのまま乗る。 1 年分の 47 県だけで「関係がある/ない」と結論せず、 複数年で同じ向きの関係が続くかを確かめる。
🧠 数値で確かめる理解度チェック
- Q1. 47 県の高齢化率(σ = 3.302)から 10 県を非復元で選んで平均するとき、 FPC 付きの標準誤差はいくつか。
- Q2. SSDSE-B-2026 の総人口が 1 人単位の値になっているのは何年度か。 それ以外の年度の値はどう作られているか。
- Q3. 消費支出(L3221)の前年比の絶対値の中央値は 4.12% で、 総人口の 0.59% の約 7 倍だった。 この差は主に何から来ると考えられるか。
- Q4. 比率 50% を n = 400 で推定したときの 95% 信頼区間の幅(±)はいくつか。 幅を半分にするには n をいくつにすればよいか。
- Q5. 12 年度を混ぜた 564 行で東西の高齢化率を t 検定すると p = 0.005、 2023 年度の 47 行では p = 0.43 だった。 どちらを採るべきで、 なぜか。
- Q6. 消費支出の 2023 年度単年の上位 5 県と、 2021〜2023 年度平均の上位 5 県は何県重なったか。 県の順位を報告するときの注意は何か。
- Q7. 高齢化率と消費支出の 47 県の相関係数は、 2012 年度と 2022 年度でそれぞれいくつだったか。 ここから何が言えるか。
解答
- 3.302/√10 × √(37/46) = 1.044 × 0.897 = 0.937。 20,000 回のシミュレーションの実際のばらつき 0.932 とほぼ一致する。
- 国勢調査の年である 2015・2020 年度。 それ以外の年度は国勢調査を基準に出生・死亡・転出入を足し引きした推計値で、 千人単位に丸められている。
- 消費支出は家計調査の県庁所在市の値で、 限られた世帯を調べる標本調査なので、 年ごとの上下の多くは標本誤差。 総人口は全数調査とそれに基づく推計なので揺れが小さい。
- 1.96 × √(0.25/400) = ±4.9 ポイント。 幅を半分にするには n を 4 倍の 1,600 にする。
- 2023 年度の 47 行。 564 行は同じ県を 12 回数えており、 独立な観測が 564 個あるとみなすと標本数を水増しして p 値が小さく出すぎる。
- 3 県(埼玉県・東京都・富山県)。 単年の順位は標本誤差で動く(10 位以上ずれた県が 4 県)ので、 複数年の平均の順位も並べる。
- 2012 年度 +0.117、 2022 年度 −0.361。 同じ 2 列の相関が年度で符号まで変わるので、 1 年分の 47 県だけで関係の有無を結論しない。
🎮 触って理解する — 標本誤差とバイアスを体感する
世論調査でおなじみの「支持率 ○○%、 誤差 ±△ ポイント」。 この 誤差の幅がどこから来るのかを、 実際にスライダーを動かして体感します。 母集団の 真の割合 $p$(例: 本当の支持率)に対して、 サンプルサイズ $n$ を変えると 95% 信頼区間の幅が変わります。 さらに 非標本誤差(無回答・質問文バイアス)を加えると、 $n$ をいくら増やしても真値からズレが消えないことも確かめられます。
数直線をタップ/ドラッグしても真の割合を変えられます。 計算式は 95%CI $= \hat{p} \pm 1.96\sqrt{\hat{p}(1-\hat{p})/n}$($\hat{p}$ は観測された割合=真値+バイアス)です。
バイアス 0 のとき、 n を増やすと誤差幅(オレンジ)がぐんぐん縮みます。 バイアスを付けると、 推定(青)が真値(緑)からズレ、 n を最大にしても信頼区間が真値を外し続けることを確認してください。
🧭 直感:質問して集めたデータには「2種類の誤差」がある
調査データの誤差は大きく 標本誤差と 非標本誤差に分かれます。 標本誤差は「母集団の一部だけを見た」ことによる偶然のブレで、 上のオレンジの幅がそれ。 サンプルを増やせば $1/\sqrt{n}$ の速さで縮み、 悉皆調査(全員調査)では理論上ゼロになります。 一方 非標本誤差は「そもそも測り方が偏っている」ことによる系統的なズレで、 上の青いマーカーの移動がそれ。 n をいくら増やしても消えません。 精度(誤差幅の狭さ)と正確性(真値への近さ)は別物、 というのが調査データを読む最重要ポイントです。
⚠️ よくある落とし穴:標本誤差 vs 非標本誤差
- 「サンプルが大きいから信頼できる」の誤解:n=10万でも、 無回答が偏っていれば真値から大きく外れる。 大標本は誤差幅を狭くするだけで、 バイアスは補正しない。 むしろ「狭い区間が堂々と間違った値を指す」危険がある。
- 無回答バイアス (non-response bias):忙しい人・関心の低い人ほど回答しない。 回答者だけで平均を取ると、 母集団と体系的にズレる。 回収率が低いほど深刻。
- 質問文・質問順序バイアス:誘導的な語(「無駄な支出を減らすべきだと思うか」)や、 前の質問が次の回答を引っ張る順序効果。 これらは上の③スライダーが表す系統ズレの正体。
- 社会的望ましさバイアス:投票率・寄付・健康行動などは「良く見せたい」方向に過大申告されがち。
🚀 発展:バイアスを減らす「重み付け・層化・調整」
非標本誤差は設計と後処理で軽減します。 層化抽出で年齢・地域ごとに一定数を確保し、 集計時に 事後層別重み $w_i = (N_h/N)/(n_h/n)$ で母集団構成に合わせます。 複数の周辺分布(年齢×性別×地域)に同時整合させる レーキング、 補助変数と整合させる キャリブレーション、 無回答項目を埋める 多重代入法などが実務の標準です。 ただし重み付けは「観測できた偏り」しか直せない点に注意——回答者に一切現れない層のズレ(=カバレッジ誤差)は重みでも救えません。 詳しくは 標本抽出・標準誤差・信頼区間・母集団・標本 の各ページも参照。
🔎 さらに深掘り — 調査データを読み解く追加ノート
本ページはすでに直感・落とし穴・発展を厚く扱っていますが、 補足として「見落とされやすい 3 つの角度」——非確率標本、 リッカート尺度の扱い、 混合モード——を追記します。 いずれも SSDSE-B-2026 が依拠する公的調査(家計調査・国勢調査など)の理解に直結する論点です。
🎨 直感(追記):調査データは「スープの味見」
調査データの発想は スープの味見に似ています。 鍋全部を飲まなくても、 スプーン一杯で全体の味が分かる——これが「標本から母集団を推測する」ということ。 ただし成立条件が 1 つあり、 飲む前によくかき混ぜること。 かき混ぜが 無作為抽出に対応し、 具が下に沈んだまま上澄みだけすくえば(=偏った抽出)、 一口の味は全体を代表しません。 調査は大きく ①質問設計(何をどう聞くか)→ ②標本抽出(誰に聞くか)→ ③回収(実際に何件戻ったか)の 3 工程で、 どの工程が崩れても「一口の味」が全体からズレます。 SSDSE-B-2026 の数値も、 元をたどればこの 3 工程を経た国勢調査・家計調査などの 公的調査由来であり、 集約後の綺麗な表の裏側にこのプロセスが隠れています。
⚠️ 落とし穴(追記・重要):ここは特に踏みやすい
上部の落とし穴群を補完する、 とりわけ実務で頻発する 4 点です。
- 非確率標本を確率標本のように扱う:Web の公募モニタ・SNS 拡散アンケート・街頭調査は 自己選抜(self-selection)で集まった 非確率標本です。 各人の抽出確率が定義できないため、 本来「±○ポイント」の標本誤差や信頼区間を計算する前提が成り立ちません。 数字は出せても意味が伴わない、 という危険。 母集団を代表させたいなら 確率抽出が原則で、 非確率標本を使うなら「代表性は保証されない」と明記します。 選択バイアスの典型例です。
- リッカート尺度を「等間隔の数量」として平均する:「1=全く不満 … 5=非常に満足」の 5 件法は 順序尺度であって、 「4 と 5 の差」が「1 と 2 の差」と等しい保証はありません。 それを 3.7 のように単純平均するのは、 厳密には 間隔尺度を仮定した操作です。 実務では平均も使いますが、 中央値・度数分布・Top-2 Box(上位 2 選択肢の割合)を併記するのが安全。 尺度の性質は 順序尺度・尺度水準を参照。 なお中立(真ん中)の選択肢を置くか、 4 件法にするかでも回答分布は動きます。
- 「標本を増やせば増やすほど精度が上がる」の勘違い:標本誤差は $1/\sqrt{n}$ でしか縮まないため、 精度を 2 倍にするには標本を 4 倍、 10 倍にするには 100 倍必要という非線形の関係です。 しかも縮むのは 標本誤差だけで、 無回答バイアスや質問文の誘導といった 非標本誤差は n をいくら増やしても消えません(上の🎮ウィジェットで体感できます)。 「大標本=正確」ではなく「大標本=区間が狭い」に過ぎない点に注意。
- 重み付けを万能薬だと思う:事後層別・レーキングは「観測できた偏り」しか補正できません。 抽出枠に最初から載っていない層(例:住民票ベースの枠から漏れる外国人・ホームレス・施設入居者)は、 どんな重みでも救えない カバレッジ誤差として残ります。 重みは魔法ではなく「観測済みの歪みの引き直し」です。
📊 公的調査データの実測例(SSDSE-B-2026・2023 年・47 都道府県)
家計調査(=標本調査)由来の「二人以上世帯・月平均支出」を県単位で見ると、 消費支出 L3221 は 47 県平均 295,856 円、 標準偏差 24,144 円、 変動係数 8.2%(最小=愛媛 223,423 円/最大=埼玉 344,092 円)。 一方、 内訳の小項目である 教育費 L322108 は 47 県平均 9,577 円、 標準偏差 4,212 円、 変動係数 44.0%(最小=秋田 4,316 円/最大=東京 24,160 円)と、 相対的なバラツキが桁違いに大きくなります。 教育費の県差は「実際の地域差」に加え、 支出額が小さい項目ほど家計調査のサブサンプルで標本誤差が相対的に効きやすいことも一因です。 集約後の表を鵜呑みにせず「元は標本調査」という出自を思い出す好例です。
🚀 発展(追記):混合モード・質問設計の原則・誤差の全体設計
混合モード調査(mixed-mode survey)とは、 郵送・訪問・電話・Web など複数の回収方法を組み合わせる設計です。 回収率とカバレッジを底上げできる反面、 同じ質問でもモードによって回答が変わる モード効果(例:面接だと社会的望ましさバイアスが強まる、 Web だと中間選択肢が選ばれやすい)が混入します。 近年の公的統計・世論調査は Web 併用へ移行が進んでおり、 時系列比較のときに「モードが変わった年」を確認することが必須になっています。
質問設計の原則も発展的に押さえておきましょう。 ①ダブルバーレル質問を避ける(「価格とデザインに満足ですか」は 2 つの問いを 1 問に混ぜており回答不能)、 ②誘導語・感情語を避け中立に(「無駄な支出を減らすべきか」ではなく「支出をどう評価するか」)、 ③選択肢を網羅的かつ排他的に、 ④尺度の点数(4 件法 vs 5 件法、 中立選択肢の有無)を目的に応じて決める、 ⑤本調査前にパイロット調査で誤解を洗い出す。 これらは前ページで触れた順序効果・ワーディング効果を「設計段階で潰す」ための実務原則です。
最後に、 これらすべてを俯瞰する枠組みが本ページ上部でも触れた Total Survey Error(TSE)です。 標本誤差・カバレッジ誤差・非回答誤差・測定誤差・処理誤差という 5 系統を、 「どこにコストをかければ全体の誤差が最小になるか」という 予算配分の問題として捉え直すのが TSE の実践的な使い方。 例えば「n を倍増して標本誤差を縮める」より「無回答フォローアップに投資して非回答バイアスを減らす」方が、 全体誤差の削減に効くことは珍しくありません。 精度(狭さ)と正確性(真値への近さ)を分けて考える——調査データを読む姿勢の総まとめです。
🔗 関連ページ(追記)
本節で触れた論点を掘り下げるための、 用語集内の実在ページです:
※ 質問票設計(questionnaire)の専用ページは用語集内に未整備のため、 本節の「質問設計の原則」を暫定的な参照先とします。
🔗 関連用語(前提・並列・発展)
このページの例に当てはめると、 前提の「1次データ」は調査主体が自分で集めた回答そのもの、 並列の「2次データ」はそれを他人が集計した SSDSE-B-2026 のような表、 「横断データ」は 2023 年度の 47 県のような 1 時点の断面にあたる。 発展の「仮説検定」は、 東西の高齢化率の比較で見たように、 1 行が独立な 1 単位かを確かめてから使う。 「EDA」では、 消費支出のような標本調査の列は年ごとの上下が大きいので、 1 年分の図だけでなく複数年を重ねて描いてから傾向を読む。 「データ利活用」の段では、 どの列がどの調査から来たのか(🎨 章の表)を報告書に書き添える。
📘 前提(先に理解しておきたい)
調査データ を学ぶうえで、 これらを先に押さえると吸収が早い:
📗 並列(同じ階層の関連用語)
対比・補完して理解すべき同階層の用語:
📕 発展(一歩進んだ応用・拡張)
調査データ を理解した後の自然な発展先:
🧪 理解度チェック — 調査データを「自分の言葉」で説明できるか
以下の問いに「自分の言葉」で答えられれば、 調査データの本質を掴めています。 まずは紙とペンを用意して、 1 問あたり 30 秒以内で回答してみましょう。 回答後に下の「想定解」を開き、 自分の答えがどこまで噛み合っていたかを照らし合わせてください。
Q1. 「調査データ」と「実験データ」の最大の違いを 1 文で説明せよ
想定解を見る
調査データは「介入を加えず観測のみ」によって得られるのに対し、 実験データは「研究者が条件を操作(割付)」して得られる。 ゆえに調査データは因果推論に追加の工夫(傾向スコア・操作変数・差の差分法など)が必要だが、 実験データは無作為割付の力で原則として因果が直接読める。
Q2. SSDSE-B-2026 は調査データか? その根拠は?
想定解を見る
SSDSE-B-2026 は都道府県別の社会経済統計を集約した 2 次データであり、 元データは国勢調査・人口動態統計・学校基本調査・家計調査などの公的調査データから構成される。 各列は「自治体・国が住民・事業所を観測・申告させて集計」したものであり、 介入操作はないため、 構造としては調査データに該当する。
Q3. 調査データから「相関」は読めても「因果」が直接読めないのはなぜか?
想定解を見る
第三の変数(交絡因子)と逆因果の可能性を実験的に排除できないため。 例:「平均寿命が長い都道府県ほど病院数が多い」を観測しても、 「病院が寿命を延ばした」のか「人口が多いから病院が増えた」のか「高齢者が多いから両方とも見かけ上増えた」のかを、 観察データだけでは区別できない。
Q4. 調査データの「標本誤差」と「非標本誤差」の違いは?
想定解を見る
標本誤差は「母集団から一部を抜き出すこと自体」に起因する確率的なズレで、 標本サイズを増やすほど小さくなる(おおむね 1/√n で減少)。 一方非標本誤差は無回答・誤回答・調査票設計ミス・入力ミス・カバレッジ不足など、 サイズを増やしても消えない系統的な誤差。 後者の方が結果を歪める影響が大きいことも多い。
Q5. 調査データを Python で扱うとき、 最初に必ず確認すべき 3 点は?
想定解を見る
(1) 欠損 (df.isna().sum())、 (2) 型 (df.dtypes)、 (3) 分布の形 (df.describe() と df.hist())。 この 3 点を最初に押さえておくと、 後段のモデリングや可視化で発生する不可解なエラーの大半を未然に防げる。
🖼 図で見る — 調査データを「分布」「群間差」「相関」で読む
調査データの解析は、 まず分布の形を眺めるところから始まります。 ここでは SSDSE-B-2026 を題材に、 「ヒストグラム」「箱ひげ図」「散布図」の 3 つの基本ビューを示します。 これらは EDA(探索的データ分析)の出発点であり、 どんな高度なモデルでも最初の数分はこの 3 枚で「データの素性」を掴むのが定石です。
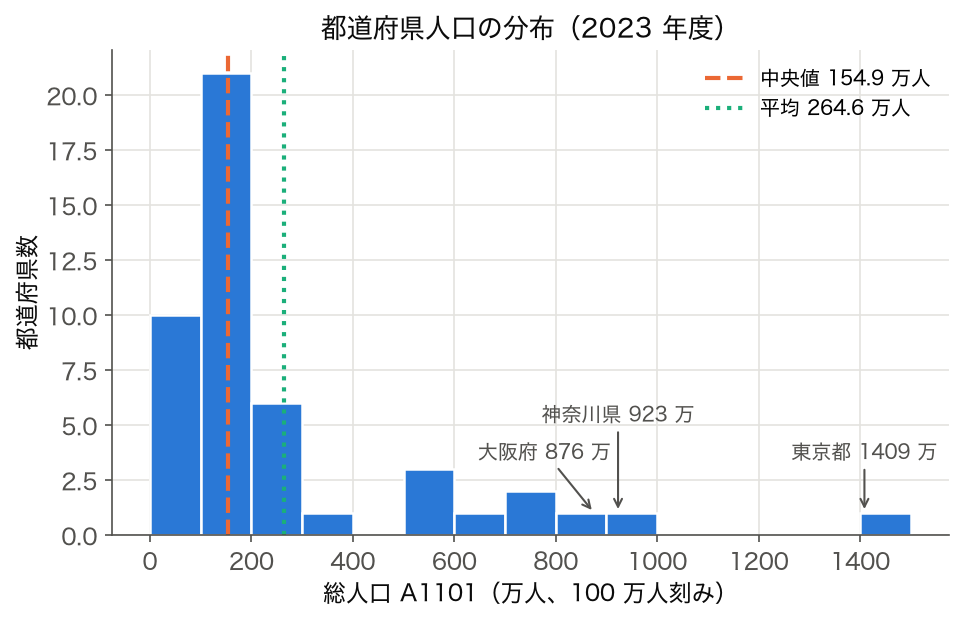
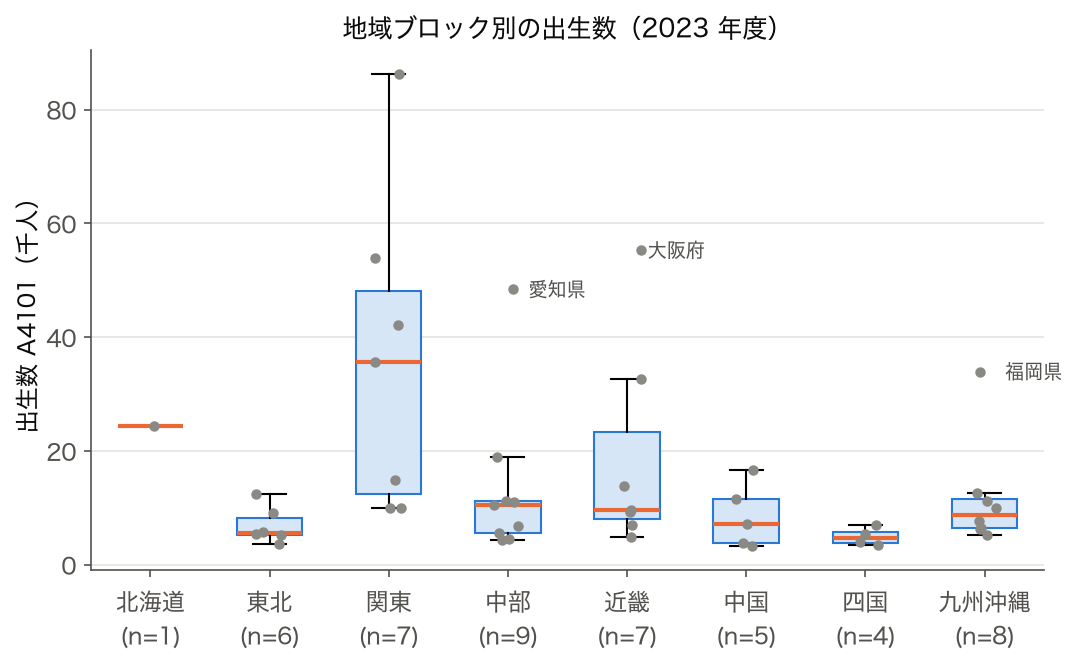
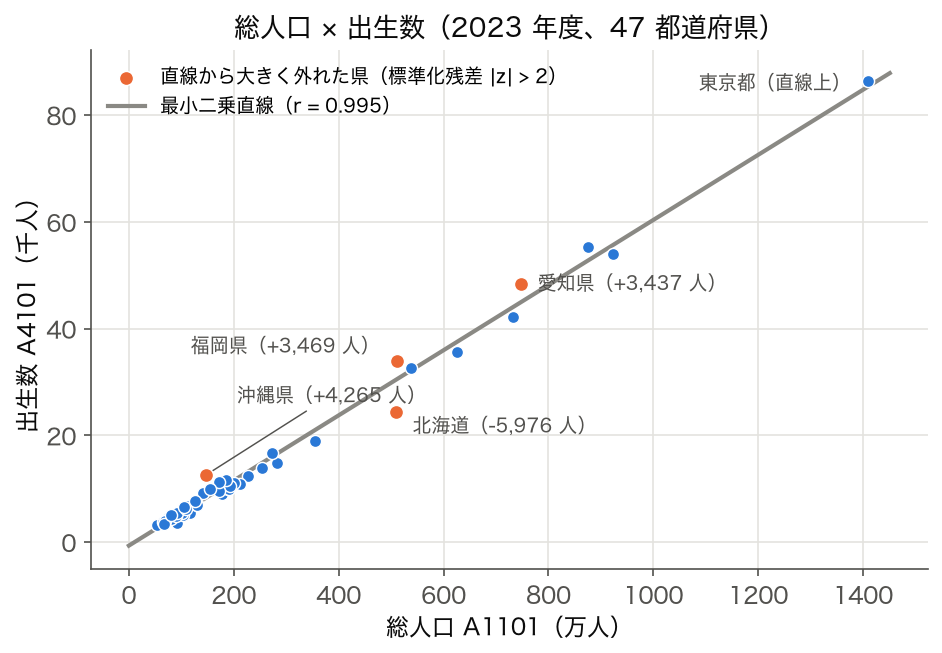
上記 3 枚のうち、 ヒストグラムは 1 変量の分布、 箱ひげ図は 群間比較、 散布図は 2 変量の関係を担います。 調査データの初期 EDA では、 まずこの 3 枚を全主要変数で一度ずつ描き、 「何を分析する価値があるか」の感覚を養うことが推奨されます。
🔄 調査データのライフサイクル — 「企画」から「公開」までの 8 段階
調査データは「ある日突然 CSV として降ってくる」ものではなく、 企画・設計・収集・処理・公開という長いライフサイクルを経て世に出ます。 分析者が「データの背後にどんなプロセスがあるか」を知っておくことは、 結果の解釈・限界の把握・他データとの比較すべてに直結します。
| 段階 | 主担当 | 主な作業 | 分析者が知っておくべきこと |
|---|---|---|---|
| ① 企画 | 統計部局・研究者 | 調査目的・対象母集団の定義、 法的根拠の確認 | 「何のために集めたか」が後の解釈を決める |
| ② 設計 | 調査設計者 | 標本抽出法・調査票設計・プレテスト | 標本誤差・カバレッジエラーの源泉 |
| ③ 収集 | 調査員・Web フォーム | 訪問・郵送・電話・オンライン回答 | 回答モード効果が結果に影響することがある |
| ④ 入力 | 事務局 | 紙票のデジタル化・OCR・コード化 | 入力ミスは非標本誤差の典型 |
| ⑤ 検証 | 統計部局 | エディット・矛盾チェック・補定 | 公開データには既にこの工程が反映済 |
| ⑥ 集計 | 統計部局 | 集計表・標準誤差の計算・秘匿処理 | 秘匿セルは「***」「-」等で表現される |
| ⑦ 公開 | e-Stat・各省庁 | CSV/Excel/API 配信・利用条件提示 | 利用条件(商用可否・改変可否)を確認 |
| ⑧ 再利用 | 研究者・教育者 | EDA・モデリング・教材化(本サイトもここ) | 出典の明示は必須 |
この 8 段階のどこかでエラーや判断ミスが入ると、 最終的な分析結果が歪みます。 とりわけ ② 設計と ③ 収集は分析者がコントロールできない部分なので、 公開資料(調査の概要 PDF など)で前提条件を必ず確認しましょう。
🧭 調査手法の比較 — 全数調査・標本調査・パネル調査・モニター調査
「調査データ」と一口に言っても、 母集団全部を見るのか、 一部だけを抜き出すのか、 同じ対象を追跡するのかで性格が大きく違います。 主要な 4 タイプを比較しておきます。
| 手法 | 対象 | 代表例 | 強み | 弱み |
|---|---|---|---|---|
| 全数調査 | 母集団全員 | 国勢調査・経済センサス | 標本誤差ゼロ、 細かい地域別集計が可能 | コストと時間が膨大、 頻繁にできない |
| 標本調査 | 無作為に抽出した一部 | 労働力調査・家計調査 | コスト効率が高い、 頻繁な実施が可能 | 標本誤差あり、 抽出枠の質が結果に直結 |
| パネル調査 | 同じ対象を追跡 | JHPS/KHPS(家計パネル) | 個人内変化が捉えられる、 固定効果が使える | 脱落(パネル摩耗)、 学習効果 |
| モニター調査 | 登録モニターから | Web リサーチ各社 | 即時性・低コスト | 代表性が弱い、 自己選抜バイアス |
SSDSE-B-2026 はこの分類で言えば「全数調査(国勢調査)」と「標本調査(労働力調査等)」の集計値を組み合わせた2 次データです。 個票(マイクロデータ)ではなく集計値なので、 都道府県単位での比較は容易ですが、 個人レベルの分析はできません。
📜 歴史的視点 — 調査統計はどう発展してきたか
調査統計の歴史は、 「国家が国民を数える」という古代の徴税・徴兵の必要から始まりました。 現代の調査データを理解するには、 こうした歴史的経緯を知っておくと、 「なぜ今この形になっているのか」が見えてきます。
古代~中世:徴税・徴兵のための人口調査
古代ローマや古代中国では、 すでに人口調査(センサス)が行われていました。 目的はもっぱら税収や兵役の動員力を把握すること。 日本でも律令制下の「戸籍」「計帳」、 江戸時代の「宗門人別改帳」などが該当します。 ただしこれらは「分析のためのデータ」というよりは「行政管理のための台帳」でした。
19 世紀:近代統計の確立
19 世紀のヨーロッパで「統計」という学問が確立されました。 ベルギーのケトレーが「平均人」概念を提唱し、 ナイチンゲールが看護記録から戦死者死亡原因を可視化(バラ図)。 各国で統計局が設立され、 国勢調査も近代的な手法で実施されるようになります。 日本では明治政府がこの流れに倣い、 1872 年に統計寮を設置、 1920 年に第一回国勢調査を実施しました。
20 世紀:標本調査と推測統計
20 世紀前半、 ネイマンらが厳密な標本理論を確立し、 「全数を見なくても一部から母集団を推定できる」というアイデアが普及しました。 これにより、 毎月や四半期ごとの調査が現実的になり、 経済・社会の動向を頻繁にモニターできるようになりました。 第二次世界大戦後、 各国の統計組織は急速に充実し、 公的統計は政策判断の基盤となります。
21 世紀:行政記録・ビッグデータとの融合
現在、 各国の統計機関は「伝統的な調査」と「行政記録(税・社会保険)」「民間ビッグデータ(POS・センサー)」を組み合わせる方向に動いています。 北欧諸国(特にデンマーク)は早くから行政記録ベースの統計に移行しており、 オンライン調査・スマートフォンアプリ調査も進化中です。 日本でも e-Stat の API 公開、 SSDSE のような教育用データセットの整備など、 「使いやすさ」への投資が進んでいます。
これから:オープンデータと AI
今後の調査データは、 「オープンデータ化(誰でも使える)」「機械可読化(API・JSON 形式)」「リアルタイム化」が大きなトレンドです。 同時に、 AI による異常検知や自動補定、 差分プライバシーによる秘匿処理など、 技術的にも進化しています。 「調査データを読む力」は、 これからのデータサイエンス人材にとって、 ますます重要なリテラシーになっていくでしょう。
❓ 補足 Q&A — 学習者からの追加の質問
Q. 調査データは「真実」を映しているか?
A. 「真実」というよりは「最良の近似」と捉えるのが正確です。 どんなに丁寧な調査でも標本誤差・非標本誤差は残りますし、 質問文や回答方法によって結果は変わります。 「ある時点で、 ある方法で測ったらこういう数値になった」という記述として扱うのが正しい姿勢で、 絶対的真理ではありません。 とはいえ、 公的統計は世界的に見ても極めて精密に作られているので、 「信頼できる近似」として日常的に使えます。
Q. 数値が「変だな」と思ったらどうする?
A. まず自分の理解を疑い、 次にデータの解釈を疑い、 最後にデータそのものを疑うのが順番です。 「単位を間違えていないか」「列の意味を取り違えていないか」「年度を取り違えていないか」を順にチェックします。 それでも納得できないなら、 出典資料の「利用上の注意」を熟読、 あるいは統計部局に問い合わせる手もあります。 公的統計の問い合わせ窓口は意外と丁寧に対応してくれます。
Q. 異なる調査を結合してもよい?
A. 「キー(都道府県コード・年・性別など)」が揃っていれば、 集約データ同士は pd.merge で結合できます。 SSDSE-B-2026 自体が、 複数の調査を都道府県単位で結合した産物です。 ただし、 「調査時点が違う」「定義が違う」「カバレッジが違う」場合は注意。 結合した結果が「意味的に整合するか」を必ず吟味しましょう。 個票同士の結合は法的に厳しく制限されているので、 通常は研究者向けの匿名化マイクロデータ申請が必要です。
Q. なぜ「平均」より「中央値」「四分位範囲」が推奨されるのか?
A. 調査データは右に長い裾を持つ分布が多く(収入・人口・面積など)、 平均値は少数の極端値に引っ張られて典型的な値からズレがちです。 「日本人の平均年収」よりも「中央値」「最頻層」の方が実感に近い数値になります。 中央値と四分位範囲は外れ値に強い(ロバストな)統計量なので、 調査データの初期 EDA では平均より優先して使うのが定石です。 もちろん「総額」を論じるなら平均×人数=総量という形で平均値も役立ちます。
Q. 学習中に最も詰まりやすいポイントは?
A. 多くの学習者が詰まるのは「文字コード(CP932 vs UTF-8)」「列名の半角・全角・スペース混在」「欠損値の特殊コード(-1, 9999 など)」の 3 つです。 これらは技術的な落とし穴で、 統計的な本質とは関係ありませんが、 つまずくと先に進めません。 「データを開けない」「列を選択できない」と感じたら、 まずこの 3 つを疑ってみてください。 解決すれば、 統計の本質的な学習に集中できるようになります。
🗺 概念マップ:調査データを中心とした関連概念のツリー
ツリーの 4 つの枝のうち、 このページで SSDSE-B-2026 を使って数値を確かめたのは「サンプリング」と「誤差源」の 2 つである。 悉皆(国勢調査)の枝は総人口が 1 人単位になる 2015・2020 年度、 層化抽出の枝は 3 大都市圏と地方の重み付き集計、 標本誤差の枝は有限母集団修正のシミュレーションと消費支出の年ごとの揺れに対応する。 図の周辺の 6 ノード(標本設計・事後層別・レーキング・キャリブレーション・欠測値補完・小地域推定)は、 誤差を小さくしたり、 偏りを重みで直したりするための手法で、 家計調査の県庁所在市の値のように 1 地域あたりの標本が少ないときに使われるのが小地域推定である。
🔗 隣接手法への橋渡し
調査データ (survey data) は「サンプリングを通じて母集団の特性を推定するために収集されたデータ」。 SSDSE-A (家計調査) は無作為抽出された世帯の調査データで、 SSDSE-B-2026 (都道府県別基本指標) は調査ではなく既存統計の集約。 調査データには無回答 / 標本誤差 / 回答バイアスの 3 つの不確実性が常につきまとう。
- 上流: サンプリング (単純無作為抽出 / 層化抽出 / 多段抽出)、 質問票設計、 パイロット調査。
- 並列: 行政データ (国勢調査 / 住民票)、 行動ログ (アプリ・購買履歴)、 実験データ (RCT)。 SSDSE-B は集約された行政データに近い。
- 下流: 重み付け (人口統計に合わせた事後重み)、 欠損メカニズム 分析 (MCAR/MAR/MNAR)、 信頼区間 推定。
調査データは「真の値 + 標本誤差 + 非標本誤差 (回答バイアス・カバレッジ誤差)」の合成。 SSDSE-B-2026 のような集約済みデータは元の調査誤差が見えなくなるので、 出典統計の調査設計を確認する習慣をつける。
🌳 手法選択フロー
調査データを分析する際のサンプリング設計と分析手法の選択フロー。
- ① サンプリング方式は? 単純無作為 → そのまま推定。 層化抽出 (都道府県別配分) → 層別重み付け。 多段抽出 (市区町村→世帯) → 集計クラスタ SE 補正。 SSDSE-A は層化多段抽出。
- ② 無回答率は? < 10% → 完全データ補完 (平均/回帰補完)、 10〜30% → 多重補完 (MICE)、 > 30% → 結果の頑健性をセンシティビティ分析で確認。
- ③ 推定 vs 検定? 母平均・割合 → 重み付き平均 + 信頼区間 (Taylor 線形化 SE)。 群間比較 → 重み付き t 検定 (survey パッケージ)。 因果効果 → 傾向スコア + IPW。
SSDSE-B-2026 を「調査データ」として扱う場合、 元の調査 (国勢調査・家計調査等) のサンプリング設計を参照し、 47 都道府県の値が母集団推定値か全数値かを区別する。