🔖 キーワード索引
このページ内のセクションへ素早く飛べます(クリックで該当箇所へジャンプ):
「横断面データ (cross-sectional data)」は同一時点で複数主体を観測したデータ形式。 47 都道府県 × 1 時点、 1000 世帯 × 1 調査回など。 時系列データ・パネルデータと対比される。 本ページでは横断面データの定義・標本抽出設計・回帰分析の前提・時系列との違い・パネルへの拡張を整理する。
これらのキーワードは「同一時点の複数主体観測 → i.i.d. 仮定 → OLS / GLM の適用 → パネル化で因果推論へ」という横断面データの典型的学習動線を構成する。
💡 30秒で分かる結論 — 横断データ
🍰 まずはやさしく
ある瞬間の様子を切り取った写真のようなデータです。
グループの中での違いを比べるために使います。
クラス全員の今の身長を測るような例です。
この章では横断データの基本と注意点を読みます。
- 一言で:ある一時点で複数の主体(個体)を観測したデータ。 47 都道府県の 2023 年データなどが典型。
- 時系列データ(同一個体を時間で追う)と対比される概念。 個体間の 横の比較・要因分析 に向くが、 時間変化は分からない。
- 縦(時間)×横(個体)の両方を持つ パネルデータ が情報量は最大。
- SSDSE-B も基本は横断(年次更新だが各年は独立した断面)。
- 絶対に外せない落とし穴:横断データからは因果を主張できないのが最大の注意点。 ⚠️ セクションの各項目に目を通すこと。
- レポートでは:『出典・期間・サンプル数・前提・限界』の 5 点を明示。
📍 あなたが今見ているもの
🍰 まずはやさしく
今の状態をまとめた一覧表のようなデータです。
データの種類を正しく見分けるために使います。
47都道府県の最新データを比べるような例です。
1 年度に絞るとなぜ横断データになるのかも読みます。
SSDSE-B-2026 は 47 都道府県 × 12 年度 (2012〜2023) のパネルで、 1 つの年度 (例: 2023 年度) に絞った 47 行が典型的な横断データ。 時系列データ・パネルデータと対比される。 OLS 重回帰の基本想定。
「47都道府県の高齢化率」「全国の事業所の従業員数」 — こうした「同時点・複数主体」のデータは典型的な横断データです。
🎨 直感で掴む — 横断データとは何者か
🍰 まずはやさしく
みんなが同時に写っている集合写真のようなものです。
個体ごとの特徴を比べるために使います。
スマホの利用時間をクラス全員分集めるような例です。
このあと計算方法や使い方の落とし穴を読みます。
横断データとは「同じ時点での複数主体 (47 都道府県・1000 人の回答者・100 社の財務指標) を 1 枚の表に並べたデータ」。 縦軸は時間ではなく 主体。 SSDSE-B-2026 の 2023 年スライス (47 行 × 多変量) はまさに横断データで、 OLS 回帰や PCA の入力として直接使える。 「2010 年から 2023 年までの推移」のように時間方向に伸ばすと時系列、 両方を持つとパネルデータと呼び方が変わる。
写真に例えると:
- 横断データ=集合写真1枚(全員が同時に写っている)
- 時系列データ=1人の連続写真(同じ人を時間で追う)
- パネル=全員の連続写真(横と縦を両方持つ)
「太郎は3年で身長10cm伸びた」は時系列の話、 「クラスの平均身長は男子の方が高い」は横断の話。 質問の種類で必要なデータが変わります。
🎮 触って理解する — 同じデータを3通りに切る
SSDSE-B-2026 は実は 47都道府県 × 12年(2012〜2023年)= 564観測 の大きな箱です。 この同じ箱からどの断面を切り出すかで、 分析単位も「言えること」も変わります。 下のボタンで 横断 / 時系列 / パネル を切り替え、 グリッド上でどこがハイライトされるかを体感してください(セルをタップすると切り出す年・県を変えられます)。 数値は A1101(総人口・万人)の実測値です。
※表示は6県の抜粋。実際のSSDSE-B-2026は全47県×12年=564行。数値は総人口(万人・実測)。
時間軸=なし(1時点に固定)
📋 3構造 → 何が分析できるか(対応表)
| 構造 | 分析単位 | 主にできる分析 | できないこと |
|---|---|---|---|
| 横断 | 47県 × 1時点 (n=47) | 地域間比較・格差の記述・相関/回帰・クラスタリング | 時間変化・因果の時間順序 |
| 時系列 | 1県 × 12年 (T=12) | 推移・トレンド・変化率・将来予測 | 県間の差の説明 |
| パネル | 47県 × 12年 (N×T=564) | 両方+固定効果で時不変の個体差を除去→交絡を軽減 | 時不変×時変の完全分離は要工夫 |
- 因果の時間順序が不明:横断では「Xが先か Yが先か」を観察できない。 例:高齢化率と財政力の相関を見ても、どちらが原因かは1時点では決められない。
- エコロジカル相関(生態学的誤謬):県平均どうしの相関が、個人レベルの関係と一致する保証はない(Robinson, 1950)。
- 一時点の特殊性:その年だけの景気・災害・制度変更の影響を「普遍的な構造」と誤読しやすい。 結論には必ず時点を併記する。
図で見る — 同じ高齢化率を 3 通りに切る
上の表の切り方を、高齢化率(65 歳以上人口 ÷ 総人口)の実データで図にしました。同じ 564 個の数値でも、どこを切り出すかで見えるものがまったく違います。
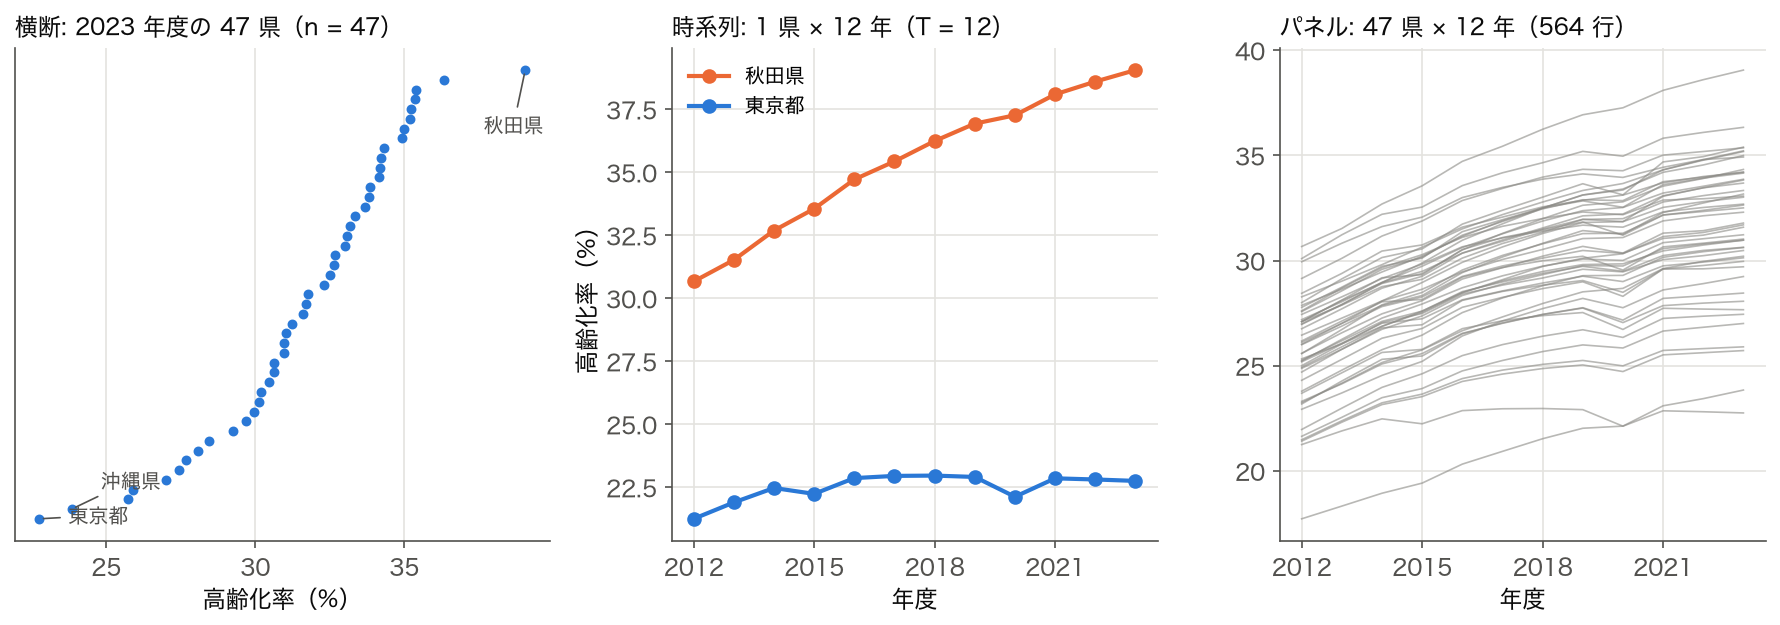
左の横断図が答えられるのは「2023 年度にどの県の高齢化率が高いか」だけで、秋田県が 12 年で 8.4 ポイント上がったこと(中の図)は左の図のどこにも写っていません。右のパネル図を見ると、県の順位はほとんど入れ替わらずに全体が右上がりに動いていることが分かります。横断面で見つけた県の間の差と、時間とともに起きる変化は、別々の量として扱う必要があります。
📐 数式・定義
🍰 まずはやさしく
時間を固定して集めたデータの集まりのことです。
平均や相関(関係性)を計算するために使います。
部活のメンバー全員の体重を一度に測るような例です。
ここでは数式を使った正確な定義について読みます。
横断データは「ある時点 $t_0$ における複数個体 $i$ の観測集合」として形式化される。 時間添字 $t$ が固定 (実質ない) 点が、 時系列・パネルとの本質的な違い。
① 形式: $$ D_{\text{cross}} = \{(y_i, \mathbf{x}_i) \mid i=1,2,\dots,n\}, \quad t = t_0 \text{ (固定)} $$
② 平均・分散・相関といった個体間集計量を計算する: $$ \bar{y} = \frac{1}{n}\sum_{i=1}^{n} y_i, \quad s_{xy} = \frac{1}{n-1}\sum_{i=1}^{n}(x_i - \bar{x})(y_i - \bar{y}) $$
③ パネルとの対比: $D_{\text{panel}} = \{(y_{it}, \mathbf{x}_{it}) \mid i=1\dots n, t=1\dots T\}$。 添字が 1 本減ることで「同一個体の時間内変化」を追えない代わり、 同一時点での多個体比較に専念できる。
📐 横断面データの厳密定義と典型例
横断面データ(Cross-sectional Data)とは、 「ある特定時点(または短期間)に、 複数の主体(個人・企業・地域など)について同時に観測された」データです。 主体添字 $i$ のみを持ち、 時間添字 $t$ を持たない(または固定)点が特徴です。
$$\text{横断面}: \{(y_i, x_i) : i = 1, 2, \dots, n\}$$ $$\text{時系列}: \{(y_t, x_t) : t = 1, 2, \dots, T\}$$ $$\text{パネル}: \{(y_{it}, x_{it}) : i = 1, \dots, n,\ t = 1, \dots, T\}$$🔬 数式を言葉で読み解く(その 1:3 つのデータ構造比較)
| 構造 | 添字 | 典型的サイズ | SSDSE-B-2026 での該当 |
|---|---|---|---|
| 横断面 | $i$ のみ | $n=47$(都道府県) | 2026 年版そのもの |
| 時系列 | $t$ のみ | $T=10\sim100$(年) | 全国合計の年次推移 |
| パネル | $i, t$ 両方 | $n \times T$ | SSDSE-B 過去年版を連結 |
| 反復横断面 | $i_t, t$(i は各 t で別人) | $n_t \times T$ | 国民生活基礎調査 |
SSDSE-B-2026 は典型的な横断面データで、 「2026 年公表時点での 47 都道府県」を切り取った断面です。 時間的変動は捕えられないので、 推論できるのは「時点間の差異」ではなく「主体間の差異」になります。
🔬 数式・定義を「言葉」で読み解く
先ほどの数式・定義に出てきた記号や概念を、 一つずつ確認します。 とくに 横断データ の文脈で意味を取り違えやすい部分を強調します。
| 記号 | 意味と注意点 |
|---|---|
| $i$ | 個体添字。 SSDSE-B-2026 なら $i=1,\dots,47$(都道府県)。 横断データはこの添字「のみ」で構造化される |
| $t, t_0$ | 時間添字と固定時点。 横断データでは $t$ は実質存在せず $t = t_0$ に固定(時間変動を捕えない) |
| $n, T$ | $n$ は個体数(横断データの行数)、 $T$ は観測期間長(時系列・パネルで登場) |
| $y_i, \mathbf{x}_i$ | 個体 $i$ の被説明変数と説明変数ベクトル。 添字 1 本のみ → 横断データの典型表記 |
| $y_{it}, \mathbf{x}_{it}$ | パネルデータの表記。 添字が 2 本 → 同一個体の時間内変化を追える |
| $s_{xy}$ | 標本共分散 $s_{xy} = \frac{1}{n-1}\sum (x_i - \bar{x})(y_i - \bar{y})$。 横断データの個体間関係を要約する |
横断データの記号は「個体添字 $i$ が存在し時間添字 $t$ が存在しない(または固定)」が判別の鍵です。 $y_{it}$ のように添字が 2 本ある式はパネル、 $y_t$ のように $t$ のみは時系列で、 横断データを混同すると「同じ個体が時点間でどう変化したか」を推定しようとして失敗します。 $n$(個体数)と $N$(母集団サイズ)の区別、 $s^2$(標本分散)と $\sigma^2$(母分散)の区別も論文ごとに確認してください。
🔬 数式を言葉で読み解く(その 2:横断面 OLS の前提)
横断面データに OLS(最小二乗法)を適用する典型モデルは:
$$y_i = \beta_0 + \beta_1 x_{i1} + \beta_2 x_{i2} + \dots + \beta_p x_{ip} + \varepsilon_i$$OLS が一致推定量となるためには、 以下のガウス・マルコフ前提を満たす必要があります:
- 線形性:$y_i$ は $\beta_j$ について線形
- 無作為標本:$(y_i, x_i)$ は i.i.d.
- 外生性:$E[\varepsilon_i | x_i] = 0$(誤差項と説明変数が無相関)
- 不偏分散:$\mathrm{Var}(\varepsilon_i | x_i) = \sigma^2$(均一分散)
- 共線性なし:$X$ の階数がフル
SSDSE のような都道府県横断面では、 とくに「無作為標本」が成立しません。 47 都道府県は「全数」であり、 母集団からのランダムサンプルではないのです。 推論の解釈は「その年度 (例: 2023 年度) の県間構造」に限定する必要があります。
また、 均一分散の仮定は「大都市は分散大、 地方は分散小」のような場面で破れがちで、 横断面では White の不均一分散頑健標準誤差を使うのが定番です:
$$\widehat{\mathrm{Var}}(\hat\beta) = (X^\top X)^{-1}\left(\sum_i \hat\varepsilon_i^2 x_i x_i^\top\right)(X^\top X)^{-1}$$🔬 数式を言葉で読み解く(その 3:横断面で因果が言えない理由)
横断面 OLS の係数 $\hat\beta_j$ は「他の変数を一定としたときの $x_j$ と $y$ の相関」ですが、 これを因果と読むには「条件付き独立性」が必要です:
$$\varepsilon_i \perp x_{ij} | x_{i,-j} \quad \text{(条件付き外生性)}$$この前提が破れる典型ケース:
- 省略変数バイアス:未観測の交絡因子 $u$ が $y$ と $x$ 両方に影響。 例:「県の子育て支援策・産業構造」は SSDSE-B に指標として無いが、 出生率 A4103 と住宅着工 C3301 の両方に影響しうる
- 逆因果:$y$ が $x$ を引き起こす方向もある。 例:出生率 A4103 が高い県ほど後に年少人口 A1301 が増える($y \to x$ の逆向き経路)
- 測定誤差:$x$ が誤差付きで観測される(attenuation bias)
- セレクション:観測される主体が母集団からの無作為抽出でない
横断面データのみで因果を主張するには、 道具変数(IV)、 回帰不連続デザイン(RDD)、 傾向スコアマッチング(PSM)、 差分の差分(DID、 ただしパネルが必要)などの工夫が必要です。
SSDSE のように 1 時点 47 県の限定状況では、 因果より「関連の構造記述」「仮説生成」「予測モデル構築」に留めるのが誠実な姿勢です。
🧮 SSDSE-B 実値で計算してみる
横断データの最初の一歩は、 同じ年度の複数の県を並べて代表値と散らばりを求めること。 この章では 2023 年度の 5 道府県の合計特殊出生率で平均と標本標準偏差を手で計算し、 同じ計算を Python で再現して一致を確かめる。
🧮 数式に値を入れて手で計算する: クロスセクション平均と分散
クロスセクションデータの典型例として、 SSDSE-B-2026 の同一年度 (2023 年度) における 5 道府県の合計特殊出生率 (A4103) を並べ、 同時点スナップショットの代表値 (平均・標本標準偏差) を求める (時間方向の集約は行わない)。
Step 1: 5 県データ
| 都道府県 | 合計特殊出生率 (2023 年度) |
|---|---|
| 北海道 | 1.06 |
| 秋田県 | 1.10 |
| 東京都 | 0.99 |
| 大阪府 | 1.19 |
| 沖縄県 | 1.60 |
Step 2: 平均と標本標準偏差
🐍 Python で再現
1 2 3 4 5 6 7 | import numpy as np # SSDSE-B-2026 の 2023 年度・合計特殊出生率(A4103): 北海道, 秋田県, 東京都, 大阪府, 沖縄県 x = np.array([1.06, 1.10, 0.99, 1.19, 1.60]) print(f"合計: {x.sum():.2f}") print(f"平均: {x.mean():.3f}") print(f"偏差平方和: {((x - x.mean())**2).sum():.5f}") print(f"標準偏差 (標本): {x.std(ddof=1):.4f}") |
📤 実行結果
💬 手計算 (Step 2) の平均 1.188・偏差平方和 0.23308・s = 0.2414 と Python 出力が一致。 偏差平方和 0.233 のうち 0.170 (73%) は沖縄県 1 県から来ており、 5 県の横断データでは 1 県の値が散らばりの大半を決めてしまうことが分かる。
🐍 Python 実装
以下は 横断データ を SSDSE-B-2026 で扱うときの典型コード。 encoding='cp932' は政府統計の Shift-JIS 対応。 skiprows=1(header=1 と同じ)は 1 行目の英字コード行を飛ばし、2 行目の日本語項目名を列名にする定石。
① 基本パターン(読み込み・確認・主要列抽出)
1 2 3 4 5 6 7 8 9 10 11 12 13 14 15 16 17 18 19 20 21 | import pandas as pd # 横断データ に関連する SSDSE-B-2026 分析の基本パターン df = pd.read_csv('data/raw/SSDSE-B-2026.csv', encoding='cp932', header=1) # 見出しの下に地域コード以外の行が混ざるので、47 都道府県だけ残して数値に直す df = df[df['地域コード'].astype(str).str.match(r'^R\d{5}$', na=False)].copy() for _c in df.columns[3:]: df[_c] = pd.to_numeric(df[_c], errors='coerce') # 横断データ = ある 1 時点の断面。12 年度が縦に積まれているので 2023 年度だけ切り出す df = df[df['年度'] == 2023].copy() print(df.shape) # (47, 112) = 2023 年度の 47 都道府県 print(df.dtypes.head(10)) print(df.describe().T.head(10)) # 主要列にエイリアス df['総人口'] = df['総人口'] df['65歳以上'] = df['65歳以上人口'] df['高齢化率'] = df['65歳以上'] / df['総人口'] * 100 print(df[['都道府県','総人口','高齢化率']].head()) |
💬 2023 年度だけを切り出すと (47, 112) になり、年度列の標準偏差が 0(全行 2023)であることが「1 時点の断面」になった証拠。総人口は平均 264.6 万人に対し中央値 154.9 万人で、少数の大都市県が平均を押し上げる横断データ特有の右裾の形が出ている。head の北海道 33.0%・秋田県 39.1%・宮城県 29.2% のように、横断データでは県同士の差を比べるのが基本の見方になる。
③ 前処理:欠損・外れ値・型変換
1 2 3 4 5 6 7 8 9 10 11 12 13 14 15 16 17 18 19 20 21 22 23 24 25 26 27 28 29 30 31 32 33 34 35 36 | import pandas as pd import numpy as np # 横断データ に関わる前処理の典型パターン df = pd.read_csv('data/raw/SSDSE-B-2026.csv', encoding='cp932', header=1) # 見出しの下に地域コード以外の行が混ざるので、47 都道府県だけ残して数値に直す df = df[df['地域コード'].astype(str).str.match(r'^R\d{5}$', na=False)].copy() for _c in df.columns[3:]: df[_c] = pd.to_numeric(df[_c], errors='coerce') # 横断データ = ある 1 時点の断面。12 年度が縦に積まれているので 2023 年度だけ切り出す df = df[df['年度'] == 2023].copy() # ① 欠損値の確認 print('欠損数:') print(df.isna().sum().sort_values(ascending=False).head(10)) # ② 数値変換(カンマ・%除去 など) def to_num(s): if isinstance(s, str): return float(s.replace(',', '').replace('%', '')) return s _num_cols = [c for c in df.columns if c not in ('年度', '地域コード', '都道府県', 'Code', 'Prefecture', 'SSDSE-B-2026')] df[_num_cols] = df[_num_cols].apply(lambda col: col.map(to_num)) # ③ 外れ値検出(IQR) # 地域コードや都道府県名は大小比較できないので、数値の列だけで判定する _num = df.select_dtypes(include='number') q1 = _num.quantile(0.25) q3 = _num.quantile(0.75) iqr = q3 - q1 outlier_mask = ((_num < q1 - 1.5*iqr) | (_num > q3 + 1.5*iqr)).any(axis=1) print('外れ値を含む行数:', outlier_mask.sum()) |
💬 2023 年度の 47 行で欠損は 0、外れ値を含む県は 22 県。東京都は 92 列、大阪府は 86 列で外れているのに対し、青森県は年平均気温、岐阜県は交通・通信費の 1 列だけで引っかかっており、同じ「外れ値あり」でも中身がまったく違う。横断データでは県の規模差がそのまま外れ値になるので、人口当たりに直してから判定し直すと本当に特殊な県が見えてくる。
④ 検定・推定の最小例(scipy.stats)
1 2 3 4 5 6 7 8 9 10 11 12 13 14 15 16 17 18 19 20 21 22 23 24 | import pandas as pd from scipy import stats # 横断データ 文脈での基本的な仮説検定 df = pd.read_csv('data/raw/SSDSE-B-2026.csv', encoding='cp932', header=1) # 見出しの下に地域コード以外の行が混ざるので、47 都道府県だけ残して数値に直す df = df[df['地域コード'].astype(str).str.match(r'^R\d{5}$', na=False)].copy() for _c in df.columns[3:]: df[_c] = pd.to_numeric(df[_c], errors='coerce') # 横断データ = ある 1 時点の断面。12 年度が縦に積まれているので 2023 年度だけ切り出す df = df[df['年度'] == 2023].copy() df['aging'] = df['65歳以上人口'] / df['総人口'] * 100 df['region'] = df['都道府県'].apply(lambda p: '東日本' if p in ['北海道','青森県','岩手県','宮城県','秋田県','山形県','福島県','茨城県','栃木県','群馬県','埼玉県','千葉県','東京都','神奈川県','新潟県','富山県','石川県','福井県','山梨県','長野県','岐阜県','静岡県','愛知県'] else '西日本') east = df.loc[df['region']=='東日本', 'aging'] west = df.loc[df['region']=='西日本', 'aging'] t, p = stats.ttest_ind(east, west, equal_var=False) print(f'東日本 平均高齢化率: {east.mean():.2f}%') print(f'西日本 平均高齢化率: {west.mean():.2f}%') print(f't = {t:.3f}, p = {p:.4f}') print('判定:', '有意差あり' if p < 0.05 else '有意差なし') |
💬 2023 年度という 1 時点の断面で比べると、東日本 31.18%・西日本 31.97%、t = −0.804、p = 0.43 で有意差なし。12 年度を積んだ 564 行で検定すると t = −2.81、p = 0.005 と「有意」になっていたが、それは同じ県を 12 回数えただけで、横断データとパネルデータを取り違えた典型例。年度の違いまで使いたいなら、県を単位にした固定効果などパネルの手法に切り替える。
※ より高度な例(クロス集計、 機械学習、 ベイズ推定)は data-types のグループ教材を参照。
🐍 SSDSE-B-2026 で典型的な横断面回帰
このコードでやること:SSDSE-B-2026(47 都道府県の典型的横断面データ)で「合計特殊出生率」を被説明変数として OLS を実行し、 通常標準誤差と White の頑健標準誤差を比較します。
📥 入力データ:47 都道府県、 6 指標(A1101 総人口・A1301 年少人口〈15歳未満人口〉・B4101 年平均気温・C3301 着工建築物数・E3501 中学校生徒数・E3701 中学校卒業者数)。 被説明変数は A4103 合計特殊出生率。
1 2 3 4 5 6 7 8 9 10 11 12 13 14 15 16 17 | import numpy as np import pandas as pd import statsmodels.api as sm df = pd.read_csv('data/raw/SSDSE-B-2026.csv', encoding='cp932', skiprows=[1]).query('`SSDSE-B-2026` == 2023') features = ['A1101','A1301','B4101','C3301','E3501','E3701'] X = df[features].astype(float) y = df['A4103'].astype(float) # 合計特殊出生率 X = sm.add_constant(X) res_ols = sm.OLS(y, X).fit() print(res_ols.summary().tables[1]) # White の不均一分散頑健標準誤差 (HC1) res_hc1 = sm.OLS(y, X).fit(cov_type='HC1') print('--- HC1 (Robust SE) ---') print(res_hc1.summary().tables[1]) |
📤 実行例:
💬 通常 SE でも頑健 SE (HC1) でも、 総人口 A1101(負・規模が大きい県ほど出生率が低い)と 年平均気温 B4101(正・温暖な県ほど出生率が高い=沖縄の TFR が高いことと整合)は有意なまま。 HC1 で標準誤差はやや広がるが主要な結論は頑健です。 横断面では県の規模が大きく異なるため、 頑健 SE を併記して「結論の頑健性」を確認するのが定石です。
skiprows=[1]・年度 2023 で抽出して再計算した実測値。 被説明変数は A4103 合計特殊出生率。 SSDSE-B-2026 のコード対応は A1301=年少人口(15 歳未満人口, ≠ 出生数)、 B4101=年平均気温(≠ 財政力指数) である点に注意(旧版の変数名ラベルを訂正)。📊 横断面 vs 時系列:何ができて何ができないか
| 観点 | 横断面データ | 時系列データ |
|---|---|---|
| 単位 | 主体(個人・地域・企業) | 時間(日・月・年) |
| 問える問い | 「県間でなぜ違うか」 | 「いつ変化したか」 |
| 独立性仮定 | 主体間が独立 | 時点間に強い系列相関 |
| 代表的手法 | OLS, GLM, クラスタリング | ARIMA, 状態空間, GARCH |
| 外生性脅威 | 省略変数バイアス、 セレクション | 単位根・共和分・系列相関 |
| 因果推論 | IV・RDD・PSM が標準 | VAR・グレンジャー因果 |
| サンプルサイズ概念 | $n$(主体数) | $T$(時点数) |
| 頑健 SE | White / HC0-HC3 | Newey-West / HAC |
🐍 横断面の相関と、県の中の時間変化の相関は別物 — 気温と出生率
上の表の「問える問い」の違いを、実データで確かめます。年平均気温と出生率(人口千人あたり出生数)の関係を、(1) 年度ごとの横断面、(2) 県ごとの 12 年平均を引いた「県の中の時間変化」、(3) 564 行をそのまま混ぜたもの、の 3 通りで計算します。
🎯 このコードでやること:年平均気温(B4101)と出生率(A4101 ÷ A1101 × 1000)の相関を、年度ごとの横断面(各 47 県)、県内の時間変化(県ごとに 12 年平均を引いた 564 行)、564 行をそのまま混ぜたもの、の 3 通りで計算する。
1 2 3 4 5 6 7 8 9 10 11 12 13 14 15 16 17 18 19 20 21 22 | import pandas as pd from scipy import stats df = pd.read_csv('data/raw/SSDSE-B-2026.csv', encoding='cp932', skiprows=[1]) df['出生率'] = df['A4101'] / df['A1101'] * 1000 # 人口千人あたり出生数 df['気温'] = df['B4101'] # 年平均気温(℃) # (1) 横断: 年度ごとに 47 県で相関をとる rows = [] for y, g in df.groupby('SSDSE-B-2026'): r, p = stats.pearsonr(g['気温'], g['出生率']) rows.append((y, len(g), round(r, 3), f'{p:.1e}')) print(pd.DataFrame(rows, columns=['年度', 'n', '横断の r', 'p']).to_string(index=False)) # (2) 県の中の時間変化: 県ごとに 12 年の平均を引いてから相関をとる dev = df[['気温', '出生率']] - df.groupby('Code')[['気温', '出生率']].transform('mean') print(f'県内の時間変化どうしの r = {dev.corr().iloc[0, 1]:.3f}(564 行)') # (3) 564 行をそのまま混ぜた r print(f'564 行をそのまま混ぜた r = {df[["気温", "出生率"]].corr().iloc[0, 1]:.3f}') nat = df.groupby('SSDSE-B-2026').agg(気温=('気温', 'mean'), 出生=('A4101', 'sum'), 人口=('A1101', 'sum')) print(f'47 県平均の気温 2012 {nat["気温"].iloc[0]:.2f}℃ → 2023 {nat["気温"].iloc[-1]:.2f}℃、' f'全国の出生率 {nat["出生"].iloc[0] / nat["人口"].iloc[0] * 1000:.2f} → {nat["出生"].iloc[-1] / nat["人口"].iloc[-1] * 1000:.2f}') |
💬 年度ごとの横断面では、12 年すべてで r = 0.723〜0.774(p はすべて 10⁻⁸ 以下)と、「暖かい県ほど出生率が高い」関係が毎年はっきり出ます。ところが県の中の時間変化で見ると r = −0.726 と、符号が逆になります。この 12 年で 47 県平均の気温は 15.20℃ → 16.80℃ と上がり、全国の出生率は 8.13 → 5.85 と下がったため、どの県でも「気温が上がった年ほど出生率が低い」形になるからです。564 行をそのまま混ぜると r = 0.439 で、2 つの逆向きの関係が打ち消し合った、どちらの問いにも答えていない数字になります。
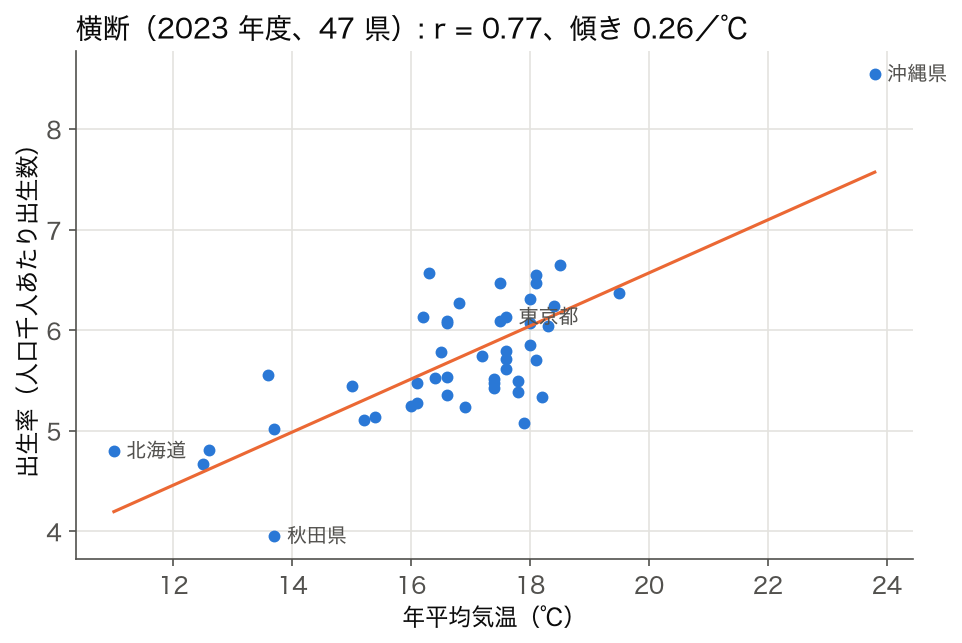
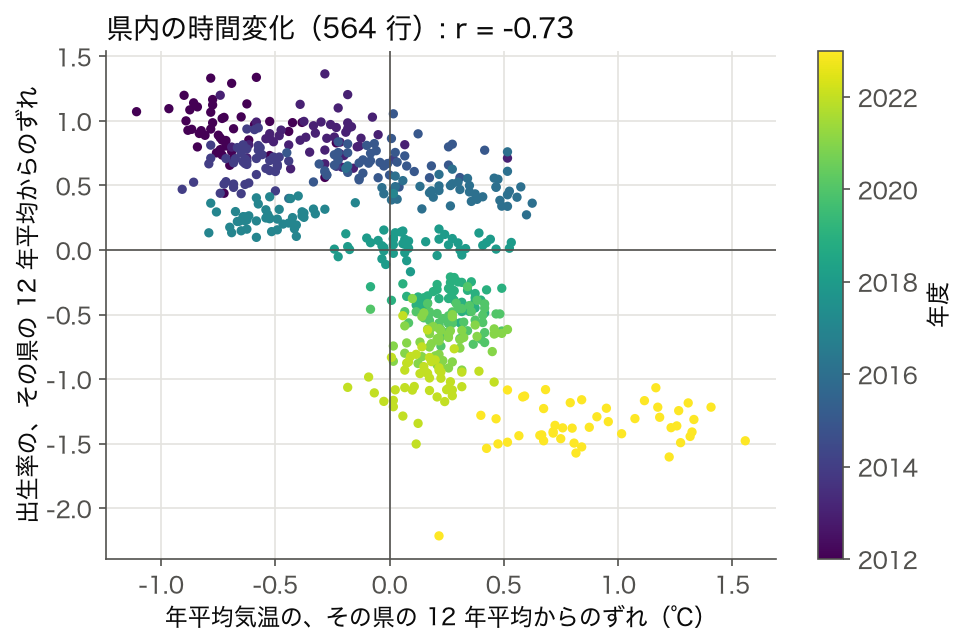
図 2 と図 3 を並べると、「気温と出生率は正の関係か負の関係か」という問い自体が、どの切り方で問うかを決めないと意味を持たないことが分かります。横断面の r = 0.77 は「暖かい地域の県は出生率が高い」という地域差の記述で、図 3 の r = −0.73 は「全国共通の時間の流れの中で、気温は上がり出生は減った」という時間方向の記述です。どちらも「気温が出生を左右する」という因果の証拠ではありません。図 3 で点が年度ごとに固まっていることから分かるとおり、時間方向の相関は、年ごとに全国で共通して動く要因(年の効果)がほぼすべてを作っています。
🐍 不均一分散の Breusch-Pagan 検定
このコードでやること:横断面 OLS で頻発する不均一分散を Breusch-Pagan 検定で確認します。 残差の二乗を説明変数で回帰し、 説明力があれば「分散が説明変数に依存している」と判定します。
📥 入力:上記 OLS の結果(残差 $\hat\varepsilon_i$)。
1 2 3 4 5 6 7 8 9 10 11 12 13 14 15 16 17 18 19 20 21 22 23 24 25 26 | import numpy as np import pandas as pd import statsmodels.api as sm from statsmodels.stats.diagnostic import het_breuschpagan, het_goldfeldquandt df = pd.read_csv('data/raw/SSDSE-B-2026.csv', encoding='cp932', skiprows=[1]).query('`SSDSE-B-2026` == 2023') features = ['A1101','A1301','B4101','C3301','E3501','E3701'] X = sm.add_constant(df[features].astype(float)) y = df['A4103'].astype(float) res = sm.OLS(y, X).fit() # Breusch-Pagan 検定 bp_stat, bp_pval, _, _ = het_breuschpagan(res.resid, X) print(f'Breusch-Pagan LM 統計量: {bp_stat:.3f}') print(f'Breusch-Pagan p 値: {bp_pval:.4f}') # Goldfeld-Quandt 検定(A1101 で分割) gq_stat, gq_pval, _ = het_goldfeldquandt(y, X, idx=1) print(f'Goldfeld-Quandt F 統計量: {gq_stat:.3f}') print(f'Goldfeld-Quandt p 値: {gq_pval:.4f}') # 残差の絶対値と説明変数の相関 print('--- 残差絶対値 vs 説明変数 相関 ---') for f in features: r = np.corrcoef(np.abs(res.resid), df[f].astype(float))[0,1] print(f' |resid| vs {f}: r = {r:+.3f}') |
📤 実行例:
💬 BP 検定 p=0.378、 Goldfeld-Quandt 検定 p=0.307 で いずれも 5% 有意でない → この 6 変数モデルでは不均一分散の強い証拠は見られない(残差絶対値と各説明変数の相関も |r|≲0.23 と小さい)。 ただし横断面では県規模の差から不均一分散が生じやすいため、 頑健 SE (HC1/HC3) を併記して確認するのは依然として良い習慣です。 「検定してから頑健 SE の要否を判断する」 という手順自体が横断面分析の型です。
🐍 47 県の K-means クラスタリング
このコードでやること:典型的な横断面分析として、 SSDSE-B-2026 の 47 県を 5 つのクラスタに分けます。 横断面データは「主体間の類似性」を扱える代表的データ形式で、 クラスタリングが定番手法です。
📥 入力:47 県 × 6 指標(標準化済)
1 2 3 4 5 6 7 8 9 10 11 12 13 14 15 16 17 18 19 20 | import numpy as np import pandas as pd from sklearn.cluster import KMeans from sklearn.preprocessing import StandardScaler df = pd.read_csv('data/raw/SSDSE-B-2026.csv', encoding='cp932', skiprows=[1]).query('`SSDSE-B-2026` == 2023') features = ['A1101','A1301','B4101','C3301','E3501','E3701'] X = StandardScaler().fit_transform(df[features].astype(float)) km = KMeans(n_clusters=5, n_init=20, random_state=0).fit(X) df['cluster'] = km.labels_ # クラスタ別の県と平均 for c in range(5): members = df[df['cluster']==c]['Prefecture'].tolist() avg = df[df['cluster']==c][features].mean() print(f'\n--- Cluster {c} ({len(members)} 県) ---') print('代表県:', members[:6]) print(f'平均: 人口={avg["A1101"]:.0f}, 出生率={df[df["cluster"]==c]["A4103"].mean():.3f}') print(f'\n慣性 (inertia): {km.inertia_:.1f}') |
📤 実行例:
💬 6 指標のうち 5 つが人口・生徒数・着工数といった「規模」の変数なので、クラスタはまず規模で分かれる。人口 1,408.6 万人の東京都が単独(出生率 0.990)、平均 820 万人の埼玉・神奈川・愛知・大阪(1.188)、平均 507 万人の千葉・静岡・兵庫・福岡(1.235)と、規模が大きいほど出生率が低い並びになる。残る 38 県は年平均気温で割れ、北海道・東北・北関東・新潟・長野の 11 県(平均 14.1℃、出生率 1.185)と、西日本中心の 27 県(17.5℃、1.372)に分かれた。「社会経済構造の類型」と呼ぶ前に、規模の変数を人口当たりに直してから分け直すと、規模以外の違いが見えるかを確かめられる。
✅ 横断面データ分析チェックリスト
- □ データの「時点」を明示したか(2023 年度時点、 など)
- □ 主体(県・個人・企業)の母集団・抽出方法を確認したか
- □ サンプルサイズ $n$ と説明変数 $p$ の比は十分か($n > 10p$ が目安)
- □ 不均一分散検定(BP, White)を実施したか
- □ 不均一分散があれば頑健 SE(HC1-HC3)を採用したか
- □ 外れ値(東京など)の影響を Cook 距離で確認したか
- □ 空間相関(Moran's I)をチェックしたか(地域データの場合)
- □ 「県間関係」を「時間因果」と取り違えていないか
- □ 省略変数バイアスの可能性を議論したか
- □ パネル化・時系列化で頑健性を確認できないか検討したか
- □ 結論を「該当時点・該当主体集合」に限定したか
⚠️ よくある落とし穴(7 件)
横断データ に取り組むときに、 学生・実務者・研究者がよく踏むワナをまとめました。 該当しそうな項目があれば、 自分の分析を見直してみてください。
⚠️ 横断面分析の落とし穴(深掘り)
- サンプル数 $n=47$ の罠:都道府県横断面はサンプル数が小さいので、 自由度を消費しすぎると過剰適合します。 説明変数は最大でも 6-8 個程度に抑え、 ステップワイズや Lasso で慎重に絞ること。
- 時間変動の見落とし:「2023 年度だけの構造」を「普遍的関係」と誤解するのは典型ミス。 結論は必ず「2023 年度時点」と但し書きを付け、 同じ SSDSE-B-2026 に入っている 2012〜2022 年度でも同じ構造かを確認しましょう。
- 空間相関の無視:隣接県は経済構造や人口動態が似ています。 「主体間独立」の前提が崩れ、 標準誤差が過小評価されます。 空間計量モデル(SAR, SEM)や地理加重回帰(GWR)の検討が必要。
- 異質性:「平均効果」だけで議論すると、 「東京と沖縄では係数の符号さえ違う」可能性を見落とします。 ローカル回帰、 量子点回帰、 群別 OLS で異質性をチェック。
- 外れ値県の影響:東京は人口・経済規模で他県と桁違い。 外れ値が回帰係数を支配するので、 Cook 距離・てこ比で確認し、 ロバスト回帰(Huber, RANSAC)の併用が安全。
- 標準化と単位:人口(百万単位)、 進学率(%単位)、 財政力指数(無次元)の混在する横断面では係数の解釈に混乱が起きます。 比較目的なら標準化済係数(βスタンダード化)も併記。
- 横断面 → 時系列の越権:「県間で X が高い県は Y も高い」から「X を上げれば Y も上がる」と推論するのは典型誤り。 時間方向の因果は時系列・パネル分析で別途検証が要ります。
- クロスセクション・ディペンデンス:マクロショック(全国共通の景気変動)があると、 県間の誤差が共通要因で相関します。 マクロダミーやクラスタ標準誤差で対処。
⚠️ 実データで確かめる — 横断面の相関は 1 県で動き、別の変数で説明できてしまう
上の「外れ値県の影響」と「横断面 → 時系列の越権」を、気温と出生率の例で数字にします。横断面の r = 0.77 がどれくらい頑健か、また別の説明が立たないかを調べます。
🎯 このコードでやること:2023 年度の横断面で、年平均気温と出生率の相関・順位相関・回帰の傾きを、47 県と沖縄県を除く 46 県で比べる。出生率の高い県・低い県と、気温と高齢化率の相関も出す。
1 2 3 4 5 6 7 8 9 10 11 12 13 14 15 16 17 18 19 20 21 22 23 | import numpy as np import pandas as pd from scipy import stats df = pd.read_csv('data/raw/SSDSE-B-2026.csv', encoding='cp932', skiprows=[1]) d = df[df['SSDSE-B-2026'] == 2023].copy() # 2023 年度の横断面(47 行) d['出生率'] = d['A4101'] / d['A1101'] * 1000 x, y = d['B4101'], d['出生率'] def show(label, x, y): fit = stats.linregress(x, y) rho = stats.spearmanr(x, y)[0] print(f'{label:12s} n={len(x):2d} r={fit.rvalue:.3f} ρ={rho:.3f} 傾き={fit.slope:.3f}(気温 1℃あたりの出生率の差)') show('47 県', x, y) ok = d['Prefecture'] != '沖縄県' show('沖縄県を除く', x[ok], y[ok]) top = d.nlargest(3, '出生率')[['Prefecture', 'B4101', '出生率']].round(2) low = d.nsmallest(3, '出生率')[['Prefecture', 'B4101', '出生率']].round(2) print('出生率の高い 3 県:'); print(top.to_string(index=False)) print('出生率の低い 3 県:'); print(low.to_string(index=False)) aging = d['A1303'] / d['A1101'] * 100 print(f'気温と高齢化率の r = {stats.pearsonr(x, aging)[0]:.3f}、高齢化率と出生率の r = {stats.pearsonr(aging, y)[0]:.3f}') |
💬 沖縄県 1 県を除くだけで、r は 0.767 → 0.671、傾きは気温 1℃あたり 0.264 → 0.215 と 2 割近く小さくなります。順位相関 ρ は 0.614 → 0.588 とあまり動かないので、r の大きさの一部は沖縄県の極端な位置(23.8℃、8.55)が作っていると分かります。さらに、気温と高齢化率の r は −0.445、高齢化率と出生率の r は −0.615 です。出生率が最も低い秋田県(3.95)は高齢化率も最高の県で、「暖かい県ほど出生率が高い」の一部は「暖かい県ほど若い人の割合が高い」で説明できます。出生数を総人口で割った粗い出生率は、年齢構成の影響をそのまま受けるからです。
横断面の分析で強い相関を見つけたら、(1) 1 県ずつ除いて結果がどれだけ動くか、(2) 年齢構成・人口規模など、両方の変数に効く第 3 の変数がないか、(3) 別の年度の横断面でも同じか(上の 12 年分の r)、の 3 点を確かめてから文章にします。(3) で毎年同じ結果が出ても、それは「毎年同じ地域差がある」ことの確認であって、時間方向の因果の確認にはなりません。
⚠️ 実データで確かめる — どの年度を切り出すかで相関の符号まで変わる
横断データはある 1 時点の集合写真なので、 撮る年度を変えると写るものも変わる。 SSDSE-B-2026 の 12 年度それぞれから 47 行の横断データを作り、 同じ 2 変数の相関がどれだけ動くかを確かめる。
🎯 このコードでやること:年度ごとに 47 都道府県の横断データを切り出し、 (a) 有効求人倍率(月間有効求人数 ÷ 月間有効求職者数、 一般)と転入超過率(人口 1000 人あたり)、 (b) 年平均気温と合計特殊出生率、 の 2 組についてピアソン相関を 12 年度分並べる。
1 2 3 4 5 6 7 8 9 10 11 12 13 14 15 16 17 | import pandas as pd import numpy as np df = pd.read_csv('data/raw/SSDSE-B-2026.csv', encoding='cp932', skiprows=[1]) df['求人倍率'] = df['F3103'] / df['F3102'] # 月間有効求人数 ÷ 月間有効求職者数(一般) df['転入超過率'] = (df['A5101'] - df['A5102']) / df['A1101'] * 1000 # 人口 1000 人あたり rows = [] for year, g in df.groupby('SSDSE-B-2026'): # 年度ごとに 47 行の横断データを作る rows.append({'年度': year, 'r(求人倍率, 転入超過率)': np.corrcoef(g['求人倍率'], g['転入超過率'])[0, 1], 'r(年平均気温, 合計特殊出生率)': np.corrcoef(g['B4101'], g['A4103'])[0, 1]}) r = pd.DataFrame(rows).set_index('年度').round(2) print(r.T.to_string()) print('\n符号が + の年度:', r.index[r['r(求人倍率, 転入超過率)'] > 0].tolist()) print('幅: 求人倍率×転入超過率', r.iloc[:, 0].min(), '〜', r.iloc[:, 0].max(), ' / 気温×出生率', r.iloc[:, 1].min(), '〜', r.iloc[:, 1].max()) |
💬 求人倍率と転入超過率の相関は、 2012〜2019 年度の 8 年度では +0.02〜+0.33 と「求人倍率が高い県ほど人が転入している」向きなのに、 2020 年度から −0.42、 −0.57、 −0.46、 −0.37 と符号が逆になる。 2015 年度の横断データだけを見た人は「仕事の多い県に人が集まる(r = +0.33)」と書き、 2021 年度だけを見た人は逆の関係(r = −0.57)を書くことになる。 一方、 年平均気温と合計特殊出生率は 12 年度とも +0.42〜+0.57 に収まり、 年度を変えても結論は変わらない。 1 時点の相関を報告するときは年度を明記し、 ほかの年度でも同じ向きかを確かめてから一般化する。 なお、 符号が変わった理由(求人の減り方や人の動きの変化)は、 この横断データの相関だけからは特定できない。
🔭 さらに深掘り — 直感・落とし穴・発展(追記)
ここまでの各セクションを踏まえ、 横断面データの「掴み方」「踏みやすい罠」「次の一手」を、 SSDSE-B-2026 の実測値とともに一枚にまとめ直します。 既に上で触れた論点も、 直感 → 落とし穴 → 発展 の順に並べ替えると腹落ちしやすくなります。
🎨 直感:横断面は「ある一瞬の集合写真」
横断面データとは、 ある一時点で多数の個体を横一列に切り取ったスナップショットです。 SSDSE-B-2026 の「2023 年・47 都道府県」はまさにこれ。 この 1 枚の中では、 総人口 A1101 は 鳥取 53.7 万人 〜 東京 1408.6 万人(47 県平均 264.6 万人)と県間で大きくばらつきます(いずれも 2023 年の実測値・万人換算)。 「どの県が多い/少ないか」という横の比較はこの 1 枚で十分できます。
一方、 同じ大きな箱(47 県 × 2012〜2023 年)を県で固定して時間方向に切ると時系列になり、 東京は 2012→2023 で +85.2 万人、 秋田は −14.9 万人という時間変化が初めて見えます(実測値)。 縦(時間・1 個体)=時系列、 横(個体・1 時点)=横断面、 両方=パネル、 という三つの切り口の違いを、 同一データで体感できるのが SSDSE-B の強みです。
SSDSE-B のパネル(47 県 × 12 年)で総人口の分散を分解すると、 県間のばらつき(between)が全分散の約 99.95%を占め、 県内の年変動(within)はごくわずかでした(実測)。 つまり「1 時点の横断面でも県間構造はほぼ丸ごと捉えられる」半面、 「1 県を固定すると時間変化は小さい」。 これが、 横断面が地域間比較に強く時間変化に弱い理由を数値で裏づけます。 そして次に述べる固定効果は、 この巨大な between をまるごと差し引く操作にほかなりません。
⚠️ 落とし穴(重要)— 早見表
横断面データで最も多い誤りは、 1 時点しかないのに「因果」や「時間変化」を語ってしまうことです。 代表的な罠と対処・関連ページを一覧にします。
| 落とし穴 | 何が起きるか | 対処・関連ページ |
|---|---|---|
| 因果・時間順序が不明 | 1 時点では「X が先か Y が先か」を観察できない。 相関を因果と読むと逆因果を見落とす。 | 因果と相関/逆因果 |
| 横断相関を経時変化と誤読 | 「県間で X が高い県は Y も高い」を「X を増やせば Y が増える」と読み替える越権。 断面の傾きは時間方向の変化率ではない。 | 時系列/パネル |
| 生態学的誤謬 | 県平均どうしの相関が個人レベルの関係と一致する保証はない(Robinson, 1950)。 集計単位を変えると相関の符号すら変わりうる。 | 専用ページは未整備のため本文で解説/見かけの相関 |
| 選択バイアス | 「回答できた人/存在する主体」だけが標本になると母集団からずれる(生存者バイアス等)。 | 選択バイアス |
| 観測されない個体異質性 | 県固有の時不変要因(風土・産業構造)をモデルに入れ忘れると交絡が残る。 横断面では固定効果で除けない。 | 交絡/固定効果 |
| 一時点の外れ値 | 東京(1408.6 万人)は他県と桁違いで、 回帰係数やてこ比を支配しがち。 その年だけの災害・制度変更も「普遍構造」と誤読しやすい。 | 外れ値/ロバスト統計 |
🚀 発展:時間軸を足すと解ける問題
- パネルデータ+固定効果:同一個体を複数時点で追い、 within 変換(各県の期間平均を引く)で時不変の個体異質性を丸ごと除去できます。 前述のとおり総人口の分散の約 99.95% は県間差(between)ですが、 固定効果はこの between を吸収し、 残る within(年変動)だけで係数を識別します。 → パネルデータ/固定効果/パネル因果推論/変量効果(固定 vs 変量の選択は Hausman 検定)
- 反復横断面(repeated cross-section):各時点で別々の標本を横断的に取り直す設計(国民生活基礎調査など)。 個体は追えませんが、 集計量の時間変化や擬似パネル(pseudo-panel)による分析は可能です。 本サイトでは縦断データもパネルデータのページで扱っています。
- 横断面回帰の限界と因果の道具:1 時点・n=47 では原則として因果は語れません。 時間差を使う 差分の差分(DID)(パネルが必要・前提は 平行トレンド)、 外生変動を使う 操作変数(IV)、 閾値を使う 回帰不連続(RDD) などを併用して初めて因果に近づけます。 横断面単独では「関連の構造記述・仮説生成・予測」に留めるのが誠実です。
🔗 このテーマの深掘り先(相対リンク)
上の各論点に対応する用語ページ(いずれも本用語集内に存在):
※「生態学的誤謬」「個体異質性」の独立ページは未整備のため本文で解説。 「縦断データ」は パネルデータ のページで扱っています。
🗺 概念マップ
クロスセクションデータを中心に、 時系列データ・パネルデータ・反復横断データとの比較関係、 サンプリング (層化・クラスター)、 分析手法 (回帰・主成分・クラスタリング) への接続を整理した。 SSDSE-B-2026 が典型的な 47 都道府県 × 単一時点のクロスセクションデータであることを念頭に、 どの手法が直接適用でき、 どの手法が時系列構造を要求するかを判断する地図として使える。
概念マップ中央のクロスセクションデータから 3 方向に枝が伸びる: 上方の「公的統計の活用」は SSDSE や国勢調査のような 同一時点で全 47 都道府県を一気に観察する 典型例。 右方の「学術研究」は社会学・経済学で家計・企業を横並びにする横断調査。 左下の「実務応用」は商品別売上比較や店舗別 KPI ベンチマークなど、 日々の意思決定で最も頻出する形態。
クロスセクションの強みは 時間軸を固定して個体差だけに集中できる 点だが、 同時に「因果方向が不明」「コーホート効果が紛れ込む」という弱みも持つ。 図右下の「時系列データ」「パネルデータ」は、 これらの弱みを時間情報を加えて補完する隣接概念で、 SSDSE-B-2026 のように年度別ファイルを縦結合すればパネルデータに昇格できる。
🔗 隣接手法への橋渡し
「クロスセクションデータ」は単独で完結する手法ではなく、 隣接領域と連携することで真価を発揮する。
- 上流: 入力データの前処理・整備 (データ収集、 データクレンジング)
- 並列: データ構造の兄弟 — 時系列データ (時間方向、 同一個体の経時変化)、 パネルデータ (時間×個体、 両方向の変動を分離可能) と比較・併用 (時系列データ、 パネルデータ)
- 下流: 出力結果の評価・解釈 (重回帰分析、 代表値 (記述統計))
クリーニング → 記述統計 → 群間検定/回帰 → 政策示唆の流れで、 因果は推論できないため「相関の段で結論を急がない」設計が要点。
🌳 手法選択フロー
横断データ(同一時点で個体を横並びに観測)は、 時間軸の扱い・個体追跡の有無・因果推論の意図で、 どのデータ構造へ展開するかを多段で決める。
- ① 時間軸の情報は必要か?
- No(1 時点での比較のみ)→ 横断データ 確定 → ② へ
- Yes → 時間情報の扱い方を ③ で決める
- ② 横断データ内での分析目的は?
- ③ 時間軸を加えるなら、 個体は追跡するか?
- ④ 因果推論をしたいか?
- ⑤ サンプリングは適切か?
- 無作為抽出 → 単純無作為 でそのまま分析
- 層別構造あり → 層別抽出 + 重み付き集計
- 選択バイアス疑い → 選択バイアス 補正 / Heckman 2 段階
💡 ポイント: 「時点の扱い → 個体追跡の有無 → 因果意図 → サンプリング」 の順で多段判定すると、 横断 → 反復横断 → パネル → 時系列の使い分けが整理できる。