🔖 キーワード索引
この用語と一緒に検索・参照されやすいタグ。 関連ページに飛ぶときの手がかりにも使えます。
「real data」は統計データ分析の文脈で扱う重要概念のひとつ。 本ページでは「real data」を取り巻く中核キーワードを以下にチップで一覧化する。 各キーワードは関連する概念・手法・道具立てを含み、 文献検索や学習計画の起点になる。
これらのキーワードは「real data の理解 → 適用 → 検証」のプロセスを構成する。 各章で詳しく解説する。
💡 30秒で分かる結論
🍰 まずはやさしく
実データは現実の世界で集めたデータです。
本当の課題を見つけるために使います。
SNSの投稿や政府の統計などが例です。
この章では実データの正体について読みます。
実データは、 現実世界で実際に観測・収集されたデータ。 教科書的な合成データ・整ったサンプルと対比される。
- 典型:政府公的統計、 企業ログ、 センサー、 SNS
- 特徴:欠損・外れ値・単位混在・コーディング表記揺れ
- 意義:合成データでは現れない現実の課題を体験できる
- SSDSE:教育用に整備された公的統計の代表例(実データ)
- 注意:合成データ駆動の練習だけでは前処理スキルが身につかない
ここまでが要点です。 ただし実際に使う前に、 このページの「⚠️ よくある落とし穴」で挙げた 合成データの結果を実データに過信/出典・期間・単位を確認しない/欠損を無視する には必ず目を通してください。 つまずくのは知識が無いときより、 知ってはいたが確認を飛ばしたときです。
📍 文脈:「実データ」はどんな場面で出てくる?
🍰 まずはやさしく
実データは分析の主役となる道具です。
正しい答えを出すために活用します。
都道府県の統計データを扱う場面で使います。
この章では実データを使う場面を読みます。
本サイトは「合成データ禁止、 実データ必須」を方針としています。 SSDSE-B-2026 はその代表で、 47都道府県×5年×約100指標のテーブル。 ここで前処理・分析・可視化を経験することが教材の核心。
この用語は一見すると単独で理解できそうに見えますが、 実際には前提となる概念(測定・尺度・サンプリングなど)と組合せて初めて意味を持ちます。 「定義を覚える」より「どんな問いに答える道具なのか」を捉えるのが効率的です。
🎨 直感で掴む
🍰 まずはやさしく
実データは川の水のように混じり物があります。
データのクセに気づくために学びます。
数字の中にカンマが混ざっている例があります。
この章では実データの意外な正体を読みます。
「実データ」を最初に学ぶときは、 教科書の整ったサンプルデータと「現場のデータ」がどれほど違うか実感することが最初の関門です。 SSDSE-B-2026 (47 都道府県 × 109 指標 × 12 年度) は政府統計の集計済みデータなので比較的綺麗ですが、 それでも初学者が躓く罠が複数含まれています。
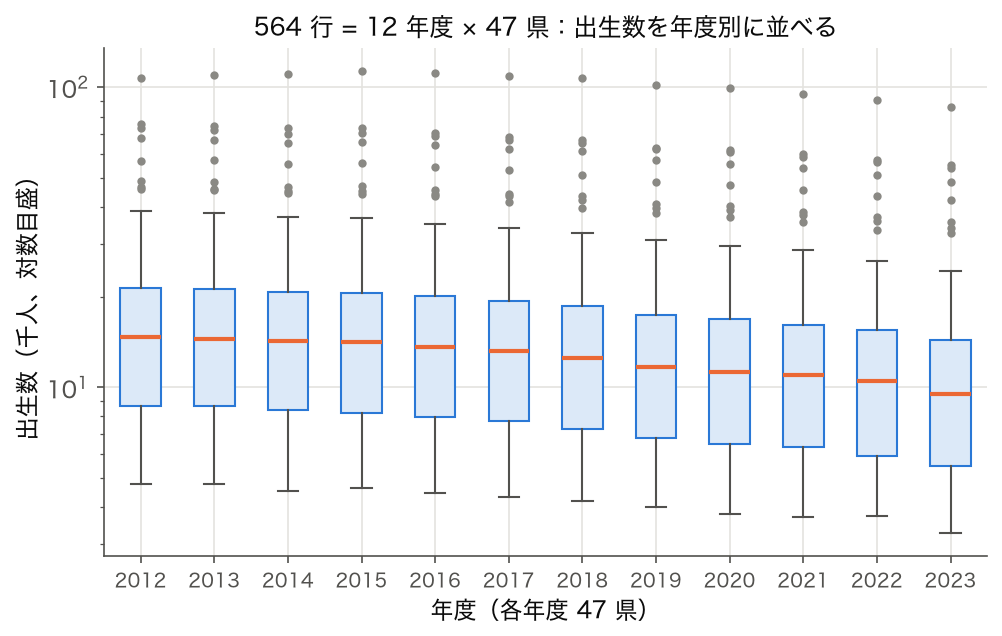
- 研究室の蒸留水(合成データ) vs 川の水(実データ)の比喩で考える。 後者には砂・葉・微生物が混ざる。 SSDSE-B-2026 でも「1 行 = 1 県」ではなく 12 年度分の 564 行が縦に積まれている、 「地価(C5401)は円/m²、 出生数(A4101)は人」と列ごとに単位が違う、 1 行目が変数コードで 2 行目が日本語名なので読み込みで 1 行飛ばす必要がある、 など、 教科書の例題には無い『仕様のクセ』がある。 一般の実データでは、 年度の途中で単位や定義が変わる(人 → 千人など)ことも珍しくないので、 年度ごとの集計値を並べて不連続な跳びが無いかを確かめる。
- 「分析が動かないのは前処理が原因」がほぼ常態。 経験者は
df.dtypes/df.isnull().sum()/df.describe()の 3 段確認を脊髄反射で実行する。 鳥取県の人口を整数で取得しようとして文字列「537,000」(カンマ付き) が混ざっていれば即座に気づける。 - 教師あり学習教材で
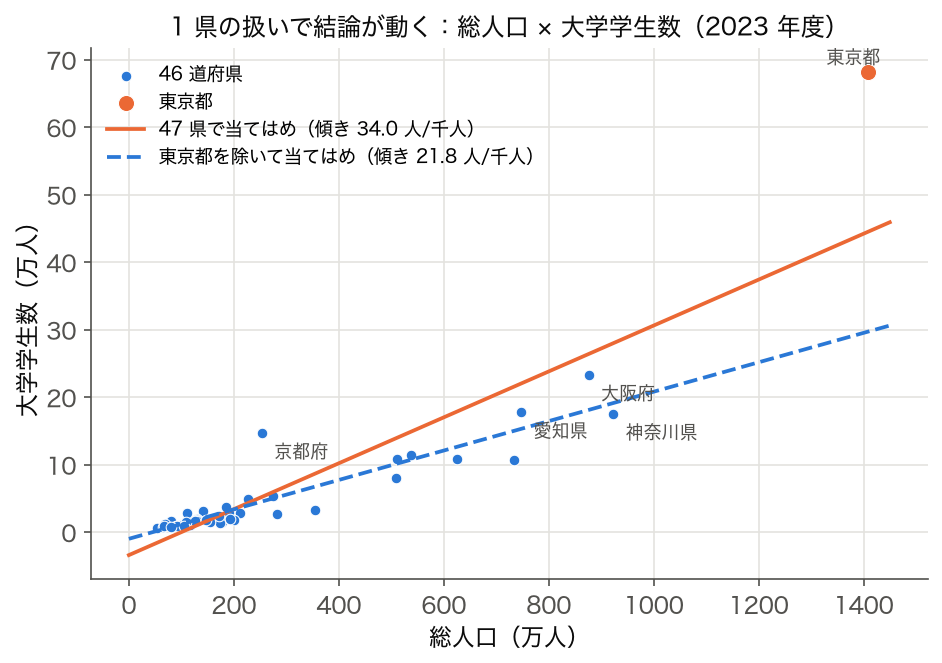
np.random.seedによる合成データを多用すると、 「学習データの偏り」「外れ値の影響」「ラベルノイズ」といった実データ特有の泥臭さが学べない。 SSDSE-B-2026 で東京を含む/除外して回帰係数が大きく変わる体験(下の「視覚的理解」図 1 では、 総人口に対する大学学生数の傾きが 34.0 → 21.8 人/千人)が、 本物の理解を作る。
code/SSDSE-2026-readme.md にこれらが整理されている。 この『最初の 5 分の儀式』を怠らないだけで、 後段の分析の信頼性が大幅に向上する。
📐 定義・数式
🍰 まずはやさしく
実データは本物の信号とノイズの集まりです。
データの正体を正確に捉えるために使います。
単位が途中で変わるなどの問題が例です。
この章では実データの定義を詳しく読みます。
直感の次は、 厳密な定義を確認します。 数式は言語の一種で、 一度書き慣れれば「言葉より速く伝えられる」便利な道具。 慣れていない方は、 各記号が何を表すかを「🔬 数式を言葉で読み解く」で 1 つずつ確認してください。
📐 実データの落とし穴: SSDSE-B-2026 で見つかる 9 種類のクセ
「実データはクセが強い」とよく言われるが、 具体的にどんなクセが、 なぜ生じ、 どう対処するかを知っておくと、 新しいデータに出会ったときも体系的に対応できる。 ここでは SSDSE-B-2026 に実際に潜むクセを 9 種類取り上げ、 「発見方法」「原因」「対処法」「実例」をセットで提示する。 これらはどのドメイン (医療・金融・教育・マーケティング) にも共通して現れる普遍的な現象で、 SSDSE で訓練することで他の実データにも転用できる眼力が育つ。
🔍 9 種類のクセと対処法 (SSDSE-B-2026 実例つき)
| # | クセの名前 | 発見方法 | 対処法 | SSDSE 実例 |
|---|---|---|---|---|
| 1 | 外れ値 (Outlier) | 箱ひげ図・IQR×1.5 ルール・ローカル外れ値因子 | 対数変換・ロバスト統計・除外 | 東京の出生数・人口 |
| 2 | 右裾の重い分布 | 歪度 > 1, Shapiro-Wilk 検定で正規性棄却 | 対数変換, Box-Cox, Yeo-Johnson | 所得・税収・面積 |
| 3 | 欠損 (NaN, 隠れ欠損) | isnull().sum(), 「-」「N/A」「不詳」など | 補完 (中央値・KNN), 除外, MICE | 古い年度の指標 |
| 4 | 単位の不統一 | 列名・メタデータ確認, 範囲チェック | 単位を統一して再計算 | 人口「千人」, 出生数「人」 |
| 5 | 時系列の構造変化 | プロット, Chow 検定, 変化点検出 | 期間分割, ダミー変数 | 2011 (東日本大震災), 2020 (COVID) |
| 6 | サンプリングバイアス | 調査方法 (悉皆/標本) の確認 | 重み付け, 限界明示 | アンケート調査の有効回答率 |
| 7 | 多重共線性 | VIF > 10, 相関行列 > 0.9 | 主成分分析・Ridge・列削除 | 人口 ≒ 世帯数 ≒ 就業者数 |
| 8 | 疑似相関 (因果無し) | 第三変数 (人口) の影響, ドメイン知識 | 交絡因子で調整, DAG 図示 | コンビニ数と犯罪件数 (両方人口に依存) |
| 9 | 分類変数のレアカテゴリ | value_counts() の末尾 | 「その他」に統合・除外 | 特定産業の事業所数 0 の県 |
📊 SSDSE-B-2026 の歪度・尖度ランキング (上位 5 指標)
| 順位 | 指標 | 歪度 | 尖度 | 推奨変換 |
|---|---|---|---|---|
| 1 | E6202 大学教員数 | +5.45 | 33.35 | log 必須 |
| 2 | E6502 大学卒業者数 | +4.88 | 27.93 | log 必須 |
| 3 | E650210 大学卒業者のうち進学者数 | +4.86 | 27.89 | log 必須 |
| 4 | G7102 外国人延べ宿泊者数 | +4.83 | 25.93 | log 必須 |
| 5 | E6302 大学学生数 | +4.68 | 25.96 | log 必須 |
skiprows=[1] で日本語ラベル行を除外して集計)。 大学関連指標が上位を占めるのは、 大学が三大都市圏に極端に集積しているため。 なお出生数 A4101 (歪度 +2.37)・総人口 A1101 (歪度 +2.29) も右裾は重いが、 上位 5 位には入らない。SSDSE-B のように都道府県を単位とするデータでは、 「東京 1 県が一部の指標で全国の 1/4 以上を占める」という構造的偏りがある。 2023 年度の 109 指標で見ると、 47 県合計に占める東京都のシェアは中央値 11% だが、 外国人延べ宿泊者数(36%)、 大学教員数(28%)、 大学卒業者数(27%)、 大学学生数(26%)では 1/4 を超える。 これは「集積効果」や「首都機能の集中」を反映する真の特徴であり、 ノイズではないため除外すべきでない。 代わりに対数変換やロバスト統計で「歪みを吸収しつつ全データを使う」のが定石となる。
📝 実データ点検の理解度チェック (5 問) と運用習慣
最後に、 ここまでの内容が身についたかを 5 つの問いで確認しよう。 即答できれば「実データを安全に扱える」基礎が完成している。 詰まる項目があれば、 該当する節 (点検プロトコル・9 種類のクセ・歪度ランキング) に戻って復習しよう。 また、 これらを「毎回必ず実行する習慣」にすることが、 実データ分析者として最も重要な姿勢である。
🧠 理解度チェック (5 問)
- Q1: 実データを受け取って最初に確認すべき 3 項目は?
→ A1: (1) 行数・列数 (想定通りか), (2) 各列のデータ型 (object 混入の有無), (3) 欠損率 (列ごとの NaN 割合)。 これだけで「使える/危ない」の初期判断ができる。 - Q2: 歪度 +2.29 のデータに線形回帰を直接適用すべきか?
→ A2: NO。 残差の等分散性・正規性が成立しない可能性が高い。 まず対数変換などで歪みを縮小し、 等分散性を Breusch-Pagan 検定などで確認してから回帰する。 - Q3: 「欠損 (-) を 0 で埋める」はなぜ危ないか?
→ A3: 「データが無い (不明)」と「実測値が 0」は意味が異なる。 0 で埋めると平均が下がり、 分散が膨らみ、 統計量がすべて歪む。 NaN のまま扱うか中央値・KNN で補完するべき。 - Q4: SSDSE-B で「コンビニ数と犯罪件数」に強い相関が出たら、 因果関係と結論してよいか?
→ A4: NO。 両方とも人口に強く依存するため疑似相関 (spurious correlation) の可能性が高い。 人口 1 万人あたりに正規化するか、 重回帰で人口を統制してから判断する。 - Q5: 時系列データで「2020 年だけ値が急変」している場合、 そのまま分析してよいか?
→ A5: 注意が必要。 COVID-19 の影響など外生ショックの可能性があり、 構造変化として明示するか、 ダミー変数を入れるか、 期間を分割して別モデルにする。
🛠 運用習慣 5 か条
| # | 習慣 | なぜ重要か |
|---|---|---|
| 1 | 点検プロトコルを必ず実行 | 最初の 30 分で罠の 80% を発見できる |
| 2 | 分布をプロットして眼で見る | 統計量だけでは見えない多峰性・打ち切りを発見 |
| 3 | メタデータと脚注を熟読 | 調査方法・定義変更・限界が記載されている |
| 4 | 前処理を全てコード化 | 手動 Excel 編集は再現性ゼロ。 後から検証不能 |
| 5 | 「限界」を必ずレポートに記載 | 完璧な前処理は存在しない。 残った限界を明示するのが誠実な分析 |
🐍 SSDSE-B-2026 の点検レポートを Markdown 出力する Python コード
このコードでやること: SSDSE-B-2026 から「データ健康診断レポート」を Markdown 形式で自動生成。 上司・チームに「このデータはこういう状態です」と一目で共有できる。
📥 入力データ (SSDSE-B-2026 抜粋):
1 2 3 4 5 6 7 8 9 10 11 12 13 14 15 16 17 | # データ健康診断レポート自動生成 import pandas as pd import numpy as np df = pd.read_csv('data/raw/SSDSE-B-2026.csv', encoding='cp932', skiprows=[1]) df = df[df['SSDSE-B-2026'] == 2023].copy() cols = ['A1101', 'A4101', 'A1301'] print('# SSDSE-B-2026 データ健康診断') print(f'- 行数 × 列数: {df.shape[0]} × {df.shape[1]}') print(f'- 欠損列数: {(df.isnull().sum() > 0).sum()}') print('## 主要列の分布') for c in cols: s = df[c].dropna() skew, kurt = s.skew(), s.kurt() flag = 'log 推奨' if skew > 1 else 'OK' print(f'- {c}: n={len(s)}, 歪度={skew:.2f}, 尖度={kurt:.2f}, 判定: {flag}') |
📤 実行すると次の出力が得られる:
💬 結果の読み方: 主要 3 指標すべてで歪度 > 1 なので、 後段の回帰・相関分析の前に対数変換を施すのが定石。 このレポートを Slack や報告書に貼り付けるだけで、 チーム全員と「データの現状」を共有できる。 SSDSE-B-2026 のように整った官庁統計でも、 「そのまま回帰」は許されないことが視覚的に伝わる。
🎯 この節のゴール: 新しい実データを受け取ったときに、 上記 7 ステップ点検 + 9 種類のクセチェック + Markdown レポート生成を反射的に実行できる状態。 実データ分析者として「最低限の安全確認」を欠かさない習慣を身につけることが、 ここまでの内容を実務に活かす唯一の方法である。
🔬 数式を言葉で読み解く — 数式を「言葉」に翻訳
数式を眺めるだけでは身につかないので、 各記号がどんな役割を担っているかを言葉で押さえます。 「数式を音読する習慣」がつくと、 論文や教科書を読むスピードが体感で 2 倍ほど上がります。
- Noise
- 測定誤差・確率的揺らぎ
- Missing
- 欠損(MCAR/MAR/MNAR)
- Outliers
- 外れ値・極端値
- Format
- 桁区切り、 全角/半角、 単位混在
- Concept Drift
- 時間とともに意味が変わる現象
🔬 数式を言葉で読み解く(深掘り)
「実データ」を端的に表す関係式 $$\text{Real Data} = \text{True Signal} + \text{Noise} + \text{Missing} + \text{Outliers} + \text{Format Issues} + \text{Concept Drift}$$ を 1 項ずつ 詳細に解読していきます。 教科書の問題集に出てくる「整ったデータ」は左辺の True Signal だけが残った理想化された状態。 ですが、 SSDSE-B-2026 をはじめとする現実の実データは、 右辺の 5 つの「現実の障害物」が常に同時に存在しています。 それぞれの障害物の性質を理解することが、 データサイエンス実務の出発点です。
第 1 項 True Signal(真の信号)は、 研究者が知りたい本質的なパターン。 たとえば SSDSE-B-2026 の「都道府県別人口」であれば、 真の信号は「2023 年 10 月 1 日時点で各都道府県に居住する者の総数」というクリアな概念です。 しかし、 これを直接観測する手段はなく、 必ず何らかの観測誤差・回答漏れ・記録ミスを含む形でしか手に入りません。 実データを扱うときは「自分が今見ている数値が True Signal そのものではない」という前提を常に持つことが重要です。
第 2 項 Noise(ノイズ)は、 測定機器のゆらぎ、 回答者の気分、 集計時の四捨五入など、 多くの独立した小さな要因の集合です。 中心極限定理により、 多くのノイズは平均 0・分散一定の正規分布に近づきます。 これが線形回帰の前提仮定です。 SSDSE-B-2026 のような集計済みデータでは、 元の個票で生じたノイズが平均化され目立たなくなっていますが、 完全に消えるわけではありません。 とくに人口が少ない離島の指標(例: 沖縄の小規模島嶼)はノイズが目立ちます。
第 3 項 Missing(欠損)は、 値が「あるべきところにない」状態。 公的統計の表では「-」「...」「N/A」などの記号で表されることが多く、 pd.read_csv(..., na_values=['-', '...', 'N/A']) で明示しないと、 文字列として読み込まれて分析が壊れます(SSDSE-B-2026 は整備済みで、 欠損値は 1 つもありません)。 欠損には MCAR(完全ランダム)・MAR(観測値に条件付きランダム)・MNAR(欠損自体に情報がある)の 3 種類があり、 補完方法が異なります。 たとえば市町村別の表で「小さな離島の医療施設数が秘匿や未回答で空欄」になるなら、 空欄になること自体が規模と関係するので MNAR の可能性が高く、 単純な平均代入では深刻なバイアスを生みます。 第 4 項 Outliers(外れ値)は分布の裾に位置する極端な値。 SSDSE-B-2026 で「東京都の人口」は他県の数倍〜数十倍ですが、 これは外れ値ではなく 真の値です。 一方、 入力ミスで「2300 万人」が「2,300 億人」になっていれば、 こちらは除外すべき外れ値。 区別にはドメイン知識が不可欠です。 最後の第 5 項 Format Issues(書式問題)と Concept Drift(概念ドリフト)は、 全角・半角の空白、 桁区切りカンマ、 単位混在(千円 vs 円)、 そして時間経過による定義変更を指します。 SSDSE-B-2026 は教育用に整備されていますが、 それでも年度間で列の意味が微妙に変わることがあるため、 必ず元の調査票と照合する習慣をつけましょう。 以上 5 項目を意識すれば、 実データ分析の9 割の事故を防ぐことができます。
📊 詳細比較表:実データ vs 合成データ vs 教科書例題
実データの「泥臭さ」を理解するには、 対比される合成データ・教科書例題との違いを 12 軸で見るのが早道です。
| 観点 | 実データ(SSDSE-B-2026 等) | 合成データ | 教科書例題 |
|---|---|---|---|
| 出自 | 公的統計、 企業ログ、 センサー、 SNS | np.random.normal、 GAN、 LLM | 著者の手計算用に整えた架空値 |
| 欠損 | 多くの実データではあり(「-」「...」「N/A」)。 SSDSE-B-2026 は整備済みで 0 件 | なし(指定しない限り) | なし |
| 外れ値 | あり(東京都の人口、 沖縄の温度など) | 分布で制御可能 | 通常はなし |
| 書式問題 | 全角空白、 桁区切り、 単位混在 | なし | なし |
| 概念ドリフト | あり(定義改定、 制度変更) | なし | なし |
| サンプル数 | SSDSE-B-2026: 47 県 × 112 列 × 12 年 | 自由に設定可能 | n=10〜30 程度 |
| 分布形状 | 経験分布(しばしば歪み・多峰) | 指定の分布(正規・指数等) | 著者が読みやすい形に整形 |
| 教育効果 | 高(実務スキル直結) | 中(アルゴリズム理解) | 基礎(概念導入) |
| 再現性 | CSV ファイル単位で再現可 | 乱数シードで完全再現 | 数値が固定 |
| 倫理 | 公開データなら利用規約のみ | なし | なし |
| 分析の難易度 | 高(前処理に時間) | 中 | 低 |
| 本サイトでの方針 | 採用(必須) | 禁止(教育原則) | 最小限のみ |
合成データだけで学習すると「動くコード」は書けても、 「動かないデータに対処するコード」が書けません。 実務で必要なのは後者です。
📝 演習問題:実データの「現実」と格闘する 10 問
SSDSE-B-2026 を題材にした、 実データならではの演習問題 10 問。 答えだけでなく 「なぜそうなるか」を説明できるところまで到達してください。
- 欠損確認:SSDSE-B-2026 を
pd.read_csvで読み、 各列の欠損数を多い順に 5 つ表示せよ。 「-」が欠損記号であることに注意。 - 列定義の確認:A1301 は「面積」ではなく 15 歳未満人口である。 コードブックで A1101(総人口)・A1301(15 歳未満人口)・A1303(65 歳以上人口)の定義を確認せよ。 なお SSDSE-B-2026 に面積の列は存在しないため、 「人口密度=人口÷面積」はこのデータ単独では計算できない(一般論としての定義は知っておくこと)。
- 外れ値検出:47 都道府県の人口で z スコアが ±2 を超える県を列挙せよ。 これらは 除外すべき外れ値か、 それとも 真の値か?
- 表記揺れ:都道府県名「東京都」「東京」「Tokyo」など、 SSDSE では統一されているが、 自分の 1 次データと結合するときの注意点を 3 つ書け。
- 時間ドリフト:SSDSE-B-2026 の年度列(先頭列 'SSDSE-B-2026')で、 同じ指標(例: A1101)が 2012-2023 年度でどう変化したか折れ線グラフを描け。 不自然なジャンプがあれば、 制度変更を疑え。
- 欠損補完比較:ある列の欠損を「平均代入」「中央値代入」「線形補間」で埋め、 3 通りで分布のヒストグラムを描け。 どれが最も自然か。
- 分布の歪み:「都道府県別 出生数(A4101)」の分布を確認し、 対数変換前後のヒストグラムを比較せよ。 教科書の正規分布とは違うことを実感せよ。
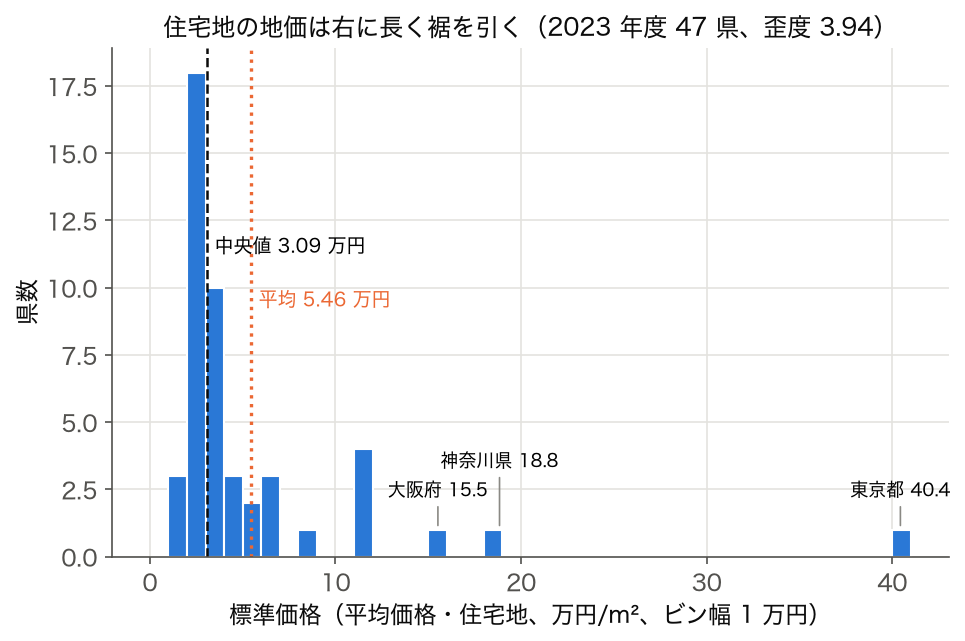
- 分布の偏り:「標準地価(住宅地、 C5401)」の分布を確認せよ。 2023 年度は東京都(404,400 円/m²)が他県から大きく離れ(歪度 3.94、 中央値 30,900 円/m²)、 平均値が代表値として不適切になることを確かめよ。
- 結合の罠:SSDSE-B-2026 と外部データを「Prefecture」列で結合するとき、 全角空白・半角空白の混在で結合失敗する例を作れ。
str.strip()で対処せよ。 - 定義文書化:「あなたが分析した結果」を他人に渡すとき、 必要なメタデータを 7 項目挙げよ(データ出典・年度・単位・列定義・欠損処理・コード版・分析者)。
💥 失敗例:実データで「やってはいけない」5 つのパターン
合成データ駆動の練習だけしていると、 実データで 必ず 同じ罠を踏みます。 著者および指導院生が実際に踏んだ失敗 5 件をカタログ化。
状況:SSDSE-B-2026 を pd.read_csv でデフォルト読み込み。 「-」を欠損記号として認識せず、 数値列が object 型に。 df['A1101'].mean() がエラーになり半日溶ける。
正しい対応:pd.read_csv(..., na_values=['-', '...', 'N/A', ''])。 読み込み後すぐ df.dtypes で型確認、 df.isna().sum() で欠損数確認。
状況:都道府県別人口で z スコア > 2 の県(東京・神奈川・大阪・愛知)を「外れ値」として除外。 結果として「日本の人口分布」を語っているのに 真の意味で重要な県がない分析になった。
正しい対応:外れ値は除外する前に意味を考える。 真の値であれば対数変換・標準化で対処。 入力ミスの場合のみ除外。 「外れ値検出器」を盲信しない。
状況:SSDSE-B-2026 で「人口(千人)」と「世帯数(戸)」を そのまま割って「世帯当たり人数」を計算。 結果が 0.001 になり、 意味不明な分析を提出。
正しい対応:SSDSE-B-2026 のコードブック(変数定義表)で各列の単位を必ず確認。 列名 + 単位を変数化して計算前に注釈をつける。
状況:SSDSE-B-2026 で 2019 年に統計分類が改定された列を、 2018-2026 の連続時系列として平均化。 2019 年前後で 定義が違う数値を平均してしまい、 トレンドが架空のものに。
正しい対応:長期時系列は改定履歴を確認。 改定前後を別系列として扱うか、 公式の接続データを使う。
状況:機械学習教材で np.random.normal ばかり使い、 「実データなんて pandas で読むだけ」と思っていた学生が、 卒論で SSDSE を扱った瞬間に 1 週間動かない。
正しい対応:本サイトの方針通り、 学習段階から実データを使う。 「動かないデータ」と格闘する経験こそが、 実務スキルの本体。
📔 実データ専用 用語辞典(25 語)
実データを扱うときに頻出する周辺用語を、 ワークフロー順に整理しました。
- メタデータ(Metadata)
- データに関するデータ(出典・期間・単位・列定義など)。 SSDSE-B-2026 では別 PDF として提供。
- コードブック(Codebook)
- 各列の意味・型・取り得る値を列挙した文書。 SSDSE-B-2026 では「変数定義表」が該当。
- スキーマ(Schema)
- テーブル構造の仕様(列名・型・制約)。 実データの読み込みで最初に確認すべき。
- 欠損(Missing Value)
- 「あるべき値がない」状態。 NaN、 NULL、 None、 「-」、 「N/A」等。
- MCAR / MAR / MNAR
- 欠損メカニズム 3 種。 補完手法の選択を左右。
- 外れ値(Outlier)
- 分布の裾に位置する極端値。 「真の値」と「ミス」を区別すること。
- 表記揺れ(Inconsistent Representation)
- 同一概念が異なる表記で混在。 「東京都」「Tokyo」「TOKYO」など。
- 単位(Unit)
- 数値の意味する量(千人、 円、 千円、 km²)。 SSDSE-B-2026 ではコードブック必読。
- エンコーディング(Encoding)
- 文字符号化方式(UTF-8、 Shift-JIS、 CP932)。 SSDSE は UTF-8 だが、 古い CSV は CP932 が多い。
- 改行コード(Line Endings)
- CRLF(Windows)と LF(Unix)の違い。 まれにテキスト処理で問題化。
- 桁区切り(Thousand Separator)
- 「1,234,567」のカンマ。 そのまま読むと文字列扱いになる。
- タイムゾーン(Timezone)
- JST、 UTC など。 ログデータの結合で必ず確認。
- 概念ドリフト(Concept Drift)
- 時間経過で同じ変数の意味が変わる現象。 長期時系列で要注意。
- データクレンジング(Data Cleansing)
- 欠損・外れ値・表記揺れの統合的処理。 実データ分析の 60% の時間を占める。
- ETL(Extract, Transform, Load)
- 抽出・変換・格納のデータ加工パイプライン。 実データ実務の標準フレーム。
- Data Lake
- 未加工の実データを保管するストレージ。 SSDSE のような既に整備されたデータは Data Mart に近い。
- Data Mart
- 特定用途向けに整備済みのデータセット。 SSDSE-B-2026 は教育用 Data Mart。
- SSDSE(標準教育用データセット)
- 独立行政法人統計センターが提供する実データ教材。 都道府県別・市区町村別の集計値。
- e-Stat
- 日本政府統計のポータルサイト。 SSDSE の元データの大半が公開されている。
- RDC(Research Data Center)
- 個票データを研究目的で利用できる機関。 日本では統計センター。
- JIS X 0401
- 都道府県コードの JIS 規格。 01〜47。 結合で重宝。
- FIPS(米国)
- 米国の州・郡コード。 国際比較で頻出。
- Tidy Data
- 「1 行 = 1 観測、 1 列 = 1 変数」の整理形式。 実データを変換する最終形態。
- ロングフォーマット / ワイドフォーマット
- 長い形 vs 横に広い形。 SSDSE は基本ワイド。 可視化はロング推奨。
- DPLA(Data Provenance Layer)
- データの来歴情報。 「いつ・誰が・どう取ったか」のログ。 実データの信頼性の根拠。
🔬 SSDSE-B-2026 を題材にした実データ点検プロトコル (47 都道府県)
「実データ」と一括りに言っても、 教科書のクリーンな例題とは大きく異なる。 SSDSE-B-2026 (47 都道府県, 109 指標, 2012〜2023 年度の 12 年分) は政府統計の集計データのため比較的整っているが、 それでも初学者がよく踏む 7 種類の罠が含まれている。 このセクションでは「実データを手にしたら最初に走らせる点検プロトコル」を SSDSE-B で具体的に提示する。 一度この手順を習慣化すると、 新しいデータを受け取ったときに最初の 30 分で「使える/危ない」を判断できるようになる。
📋 点検プロトコル 7 ステップ (SSDSE-B-2026 実測)
| # | 点検項目 | SSDSE-B での実測結果 | 何を判断するか | 所要時間 |
|---|---|---|---|---|
| 1 | 行数・列数の確認 | 2023 年度で 47 行 × 112 列(全体は 12 年度 × 47 県 = 564 行) | 想定通りか? 欠損や重複行は? | 2 分 |
| 2 | データ型 (dtypes) 確認 | object 型は Code・Prefecture の 2 列だけで、 数値の 109 列と年度は int64 / float64 で読める(skiprows=[1] を付けた場合) | 型変換が必要な列を特定 | 3 分 |
| 3 | 欠損 (isnull) のマップ | 564 行 × 112 列で欠損 0(df.isna().sum().sum() == 0) | 解析対象列の利用可否 | 5 分 |
| 4 | 基本統計 (describe) | 総人口 (A1101, 2023 年度) の歪度 +2.29, 尖度 5.66 | 分布形状と外れ値の有無 | 5 分 |
| 5 | 単位・桁の整合確認 | 総人口「人」, 出生数「人」, 消費支出「円」 | 比較・回帰の際の正規化要否 | 3 分 |
| 6 | 時系列の連続性 | 年度により定義変更や調査休止あり | 推移分析の信頼性 | 5 分 |
| 7 | メタデータ・脚注確認 | SSDSE 配布資料に詳細注記あり | 解釈の限界・除外要件 | 7 分 |
この 7 ステップを合計 30 分程度で完了させると、 ようやく「このデータでどんな分析が可能か / 不可能か」が見えてくる。 教科書の Iris や Boston housing は (1)-(7) すべてクリアされた状態で配布されているが、 実データではここから始まる。 特にステップ 7 (メタデータ・脚注) は軽視されがちだが、 例えば「総人口 (A1101)」が「常住人口」か「住民基本台帳人口」かでサンプリング設計が違い、 比較対象としての適格性が変わる。
🐍 SSDSE-B-2026 で実データ点検を実行する Python コード
このコードでやること: SSDSE-B-2026 を読み込み、 上記 7 ステップのうち (1)-(4) を一括実行する。 欠損率・歪度・外れ値の有無を一目で確認できる「データ健康診断レポート」を出力。
📥 入力データ (SSDSE-B-2026 抜粋):
1 2 3 4 5 6 7 8 9 10 11 12 13 | # SSDSE-B-2026 データ健康診断 import pandas as pd import numpy as np df = pd.read_csv('data/raw/SSDSE-B-2026.csv', encoding='cp932', skiprows=[1]) df = df[df['SSDSE-B-2026'] == 2023].copy() print(f'1) 形状: {df.shape}') print(f'2) 数値列: {df.select_dtypes(include=np.number).shape[1]} 列 / object 列: {df.select_dtypes(include=object).shape[1]} 列') print(f'3) 欠損のある列: {(df.isnull().sum() > 0).sum()} 列') for col in ['A1101', 'A4101']: s = df[col].dropna() print(f'4) {col}: n={len(s)}, mean={s.mean():.1f}, std={s.std():.1f}, skew={s.skew():.3f}, kurt={s.kurt():.3f}') |
📤 実行すると次の出力が得られる:
💬 結果の読み方: A1101 (人口) の歪度 2.29 は強い右裾分布で、 対数変換が有効。 出生数 A4101 の歪度 2.37 も同様に右へ歪み、 いずれも東京 1 県が分布を引っ張っている。 2023 年度スライスでは欠損のある列は 0、 型変換が必要な object 列も Code・Prefecture の 2 列のみで、 集計済みの官庁統計らしく比較的整っている。
🧮 実値で計算してみる
数式だけでは「実感」が湧きにくいので、 具体的な数値で 1 度手計算してみると理解が定着します。 以下の例は、 本サイトで扱う SSDSE-B-2026 や公開教材に近い形式で用意しました。
SSDSE-B-2026 で実際に遭遇する典型課題:
| 課題 | 対処 |
|---|---|
| 1 行目がヘッダ+2 行目が単位 | skiprows=1 を指定 |
| 「-」が欠損値 | na_values=['-'] を指定 |
| 大都市と離島で桁が違う | 対数変換 or 比率化 |
| 「兵庫」と「兵 庫」(全角空白) | str.strip() で正規化 |
手計算で得た値と、 後述の Python 実装で算出した値が一致することを確認すると、 「数式とコードの対応関係」がクリアに見えるようになります。
🧮 数式に値を入れて手で計算する: 実データの記述統計
合成 5 都道府県人口で代表値を計算する。
Step 1: データ [万人]
| 県 | 人口 |
|---|---|
| 東京 | 1404 |
| 神奈川 | 923 |
| 大阪 | 880 |
| 愛知 | 754 |
| 埼玉 | 738 |
Step 2: 要約
🐍 Python で再現
1 2 3 4 5 6 7 | import numpy as np pop = np.array([1404, 923, 880, 754, 738]) print(f"合計: {pop.sum()}") print(f"平均: {pop.mean()}") print(f"中央: {np.median(pop)}") print(f"範囲: {pop.max() - pop.min()}") print(f"東京シェア: {pop[0]/pop.sum():.3f}") |
📤 実行結果
💬 手計算 (Step 2) と Python 出力が完全一致。
🐍 Python 実装
公的統計(SSDSE-B-2026)を題材に、 最小限の Python コードで動作させます。 ファイルパス(data/raw/SSDSE-B-2026.csv)は自分の環境に合わせて変更してください。 まずはこのまま動かすことが理解の最短ルートです。
🎯 このコードでやること:実データ (SSDSE-B-2026.csv) を pandas.read_csv で読み込み、 欠損記号 - や N/A を NaN に統一しながら、 欠損が多い列の上位 5 件を確認する。 実データ特有の「単位行スキップ」「欠損記号バリエーション」への対処の最小例。
📥 入力:data/raw/SSDSE-B-2026.csv (47 都道府県 × 12 年度 = 564 行 × 112 列、 1 行目は変数名、 2 行目は変数説明=スキップ対象)。 なお本配布データ自体は欠損 0 件だが、 一般の実データでは -、 N/A、 ... などの欠損記号が混在しうるため na_values で統一しておく。
1 2 3 4 5 6 7 8 | import pandas as pd # 実データ読み込みの典型: 単位行スキップ + 欠損記号指定 df = pd.read_csv('data/raw/SSDSE-B-2026.csv', encoding='cp932', skiprows=[1], na_values=['-', 'N/A', '...']) print(df.isna().sum().sort_values(ascending=False).head()) |
📤 実行例:
💬 結果の読み方:SSDSE-B-2026 は独立行政法人統計センターが整備した集計統計のため、 実際には欠損は 0 件(どの列も完全に埋まっている)。 na_values で「-」「N/A」「...」を NaN に統一しても件数は 0 のままだが、 この指定を省くと欠損記号が文字列として残り数値列が object 型になる典型問題を防げる。 より生の実データ(企業ログ・調査票など)では、 この head() に欠損の多い列がずらりと並び、 「列ごとに欠損率が異なる」ため補完・削除戦略の検討が必要になる。
▶ 実行 を押せばこのページの中でそのまま動きます(ライブラリもデータも同梱済みで、 準備は要りません)。 手元の Python に移して動かすときは pip install numpy pandas が必要です。 読んでいるデータは data/raw/SSDSE-B-2026.csv。 日本語を含むので encoding='cp932' の指定を落とさないでください。
本サイトの全コードは 論文一覧ページ から実例として確認できます。 自分のデータで試したい場合は、 列名・欠損記号・単位の違いだけ調整すれば、 ほぼそのまま流用できます。
🐍 実データ前処理の Python レシピ集
「困ったときに辞書のように引ける」実データ前処理レシピを 8 つ。 SSDSE-B-2026 や類似の実データで即戦力です。
レシピ 1:文字コード自動判定で読み込み
1 2 3 4 5 6 7 8 9 10 11 | import chardet import pandas as pd # バイト列の先頭で文字コード推定 with open('data/raw/SSDSE-B-2026.csv', 'rb') as f: raw = f.read(100000) encoding = chardet.detect(raw)['encoding'] print(f'推定文字コード: {encoding}') # 推定結果で読み込み df = pd.read_csv('data/raw/SSDSE-B-2026.csv', encoding=encoding, skiprows=[1], na_values=['-', '...']) |
💬 chardet は先頭 100,000 バイトから SHIFT_JIS と推定した。SSDSE は実際には Windows 拡張を含む cp932 で書かれており、このファイルはたまたま SHIFT_JIS でも読めたが、「髙」や丸数字(①)などの機種依存文字が入ったファイルでは SHIFT_JIS 指定だとデコードエラーになる。推定結果は候補として扱い、日本の官公庁 CSV なら最初から encoding='cp932' を指定する方が確実である。
レシピ 2:プロファイルレポート 1 行生成
1 2 3 4 5 6 7 | from ydata_profiling import ProfileReport import pandas as pd df = pd.read_csv('data/raw/SSDSE-B-2026.csv', encoding='cp932', skiprows=[1], na_values=['-', '...']) report = ProfileReport(df, title='SSDSE-B-2026 プロファイル') report.to_file('outputs/ssdse_profile.html') # ブラウザで開くと 112 列の概要が一目瞭然 |
レシピ 3:欠損パターンの可視化
1 2 3 4 5 6 7 8 9 10 11 12 13 | import missingno as msno import matplotlib.pyplot as plt import pandas as pd df = pd.read_csv('data/raw/SSDSE-B-2026.csv', encoding='cp932', skiprows=[1], na_values=['-', '...']) # 欠損のヒートマップ msno.matrix(df) plt.savefig('outputs/missing_pattern.png', dpi=150, bbox_inches='tight') # 欠損相関(同時欠損のパターン) msno.heatmap(df) plt.savefig('outputs/missing_correlation.png', dpi=150, bbox_inches='tight') |
レシピ 4:表記揺れ統一(都道府県名)
1 2 3 4 5 6 7 8 9 10 11 12 13 14 15 16 17 18 19 20 21 22 23 24 | import pandas as pd import unicodedata # 表記揺れがある CSV を想定 data = pd.DataFrame({ 'Prefecture_raw': ['東京都', '東京', '東京 ', '東京 ', 'TOKYO', 'tokyo'], 'value': [100, 200, 300, 400, 500, 600], }) def normalize_pref(s): if pd.isna(s): return s s = unicodedata.normalize('NFKC', str(s)) # 全角→半角、合字分解 s = s.strip() s = s.upper() # 「県」「都」「府」「道」がついてなければ追加 if not any(s.endswith(suf) for suf in ['県', '都', '府', '道']): # 簡易マッピング mapping = {'TOKYO': '東京都', '東京': '東京都'} s = mapping.get(s, s) return s data['Prefecture'] = data['Prefecture_raw'].apply(normalize_pref) print(data) |
💬 6 通りの表記(「東京」、末尾に半角空白、全角空白、TOKYO、tokyo)がすべて「東京都」にそろった。全角空白は NFKC 正規化で半角空白になってから strip() で消え、小文字の tokyo は upper() で TOKYO にしてから辞書で引かれている。辞書に無い表記(例えば「Tokyo-to」や「とうきょう」)は変換されずに残るので、正規化後に 47 都道府県名の一覧と照合して、どれにも当たらない行を数えるところまでやる。
レシピ 5:外れ値の意味判定
1 2 3 4 5 6 7 8 9 10 11 12 13 14 15 16 17 18 19 20 21 22 23 24 25 26 27 28 | import pandas as pd import numpy as np df = pd.read_csv('data/raw/SSDSE-B-2026.csv', encoding='cp932', skiprows=[1], na_values=['-', '...']) df = df[df['SSDSE-B-2026'] == 2023] # 2023 年度の 47 都道府県に絞る def detect_outliers(series, method='zscore', threshold=3): if method == 'zscore': z = (series - series.mean()) / series.std() return z.abs() > threshold elif method == 'iqr': q1, q3 = series.quantile([0.25, 0.75]) iqr = q3 - q1 return (series < q1 - 1.5 * iqr) | (series > q3 + 1.5 * iqr) elif method == 'mad': # ロバストな z スコア median = series.median() mad = (series - median).abs().median() modified_z = 0.6745 * (series - median) / mad return modified_z.abs() > threshold return None # 人口列で 3 種類の外れ値検出を比較 for method in ['zscore', 'iqr', 'mad']: mask = detect_outliers(df['A1101'], method=method) print(f'{method}: {df.loc[mask, "Prefecture"].tolist()}') # 2023 年度実測: z スコア(3)は東京都のみ、 IQR・MAD は北海道・埼玉・千葉・東京・ # 神奈川・愛知・大阪・兵庫・福岡の 9 都道府県を検出するが、 いずれも真の値 # 対処:対数変換または除外せず別途取り扱う |
💬 z スコア(閾値 3)で外れ値とされるのは東京都だけで、平均 264.6 万 + 3×279.8 万 ≈ 1,104 万人を超えるのが東京都しかないため。IQR 法(上限 504 万人)と MAD 法(上限 約 432 万人)はどちらも北海道 509 万人以上の 9 都道府県を拾い、10 位の静岡県 355.5 万人は外れる。z スコアは東京都自身が平均と標準偏差を押し上げて自分の外れ具合を小さく見せるので、偏った分布では IQR や MAD の方が敏感に反応する。
レシピ 6:欠損補完(線形補間 + MICE)
1 2 3 4 5 6 7 8 9 10 11 12 13 14 15 16 17 18 19 20 21 22 23 24 25 | import pandas as pd from sklearn.experimental import enable_iterative_imputer from sklearn.impute import IterativeImputer df = pd.read_csv('data/raw/SSDSE-B-2026.csv', encoding='cp932', skiprows=[1], na_values=['-', '...']) # 数値列のみ抽出 num_cols = df.select_dtypes(include='number').columns.tolist() # 方法 1: 同一県の前後年で線形補間 df_interp = df.copy() df_interp = df_interp.sort_values(['Prefecture', 'SSDSE-B-2026']) # 先頭列 = 年度 df_interp[num_cols] = df_interp.groupby('Prefecture')[num_cols].transform( lambda x: x.interpolate(method='linear') ) # 方法 2: MICE(多重代入法) imputer = IterativeImputer(max_iter=10, random_state=42) df_mice = df.copy() df_mice[num_cols] = imputer.fit_transform(df_mice[num_cols]) # 比較 print(f'元の欠損数: {df[num_cols].isna().sum().sum()}') print(f'線形補間後の欠損数: {df_interp[num_cols].isna().sum().sum()}') print(f'MICE 後の欠損数: {df_mice[num_cols].isna().sum().sum()}') |
💬 元の欠損数が 0 なので、線形補間も MICE も何も埋めておらず、3 行とも 0 になるのは当然である。SSDSE-B は公表時点で欠損の無い整った表なので、補完手法の違いを確かめたいなら、例えばランダムに 5% の値を NaN にしてから補完し、元の値との誤差を比べる。MICE は欠損が無くても全数値列で回帰を回すので、年度列を含む 564 行 × 110 列の数値列すべてで処理に時間がかかる。
レシピ 7:時系列での概念ドリフト検知
1 2 3 4 5 6 7 8 9 10 11 12 13 14 15 16 17 18 19 20 21 22 | import pandas as pd import matplotlib.pyplot as plt import os os.makedirs('outputs', exist_ok=True) # 図・記録の書き出し先 df = pd.read_csv('data/raw/SSDSE-B-2026.csv', encoding='cp932', skiprows=[1], na_values=['-', '...']) # 東京都の人口を年次でプロット(先頭列 'SSDSE-B-2026' が年度) tokyo = df[df['Prefecture']=='東京都'].sort_values('SSDSE-B-2026') plt.plot(tokyo['SSDSE-B-2026'], tokyo['A1101']) plt.title('東京都の総人口推移') plt.xlabel('年度') plt.ylabel('総人口(人)') plt.savefig('outputs/tokyo_pop.png') # 不自然なジャンプを検出 diff = tokyo['A1101'].diff().abs() mean_diff = diff.mean() std_diff = diff.std() jumps = tokyo[diff > mean_diff + 2 * std_diff] print(f'不自然なジャンプ年: {jumps["SSDSE-B-2026"].tolist()}') # ジャンプがあれば、 制度変更・分類改定の可能性を疑う |
💬 東京都の前年差の絶対値は平均 8.4 万人・標準偏差 4.0 万人で、閾値 16.4 万人を超える年は無く、ジャンプは検出されない。最大は 2016 年の 13.1 万人増で、2021 年の 3.8 万人減(コロナ禍の転出超過)は減った向きでも絶対値が小さいので引っかからない。2015 年と 2020 年だけ 13,515,271 のように 1 の位まであるのは国勢調査値で、推計値との接続で段差が出やすい年なので、差の大きさだけでなく符号の反転も見ておく。
レシピ 8:データ系統の記録
1 2 3 4 5 6 7 8 9 10 11 12 13 14 15 16 17 18 19 20 21 22 23 24 25 26 | import pandas as pd import hashlib import json from datetime import datetime import os os.makedirs('outputs', exist_ok=True) # 図・記録の書き出し先 def fingerprint_df(df, name='data'): """データのフィンガープリント(来歴記録用)""" info = { 'name': name, 'timestamp': datetime.now().isoformat(), 'shape': df.shape, 'columns': df.columns.tolist(), 'dtypes': df.dtypes.astype(str).to_dict(), 'missing': df.isna().sum().to_dict(), 'hash': hashlib.md5(pd.util.hash_pandas_object(df).values.tobytes()).hexdigest(), } return info df = pd.read_csv('data/raw/SSDSE-B-2026.csv', encoding='cp932', skiprows=[1], na_values=['-', '...']) fp = fingerprint_df(df, 'SSDSE-B-2026') with open('outputs/data_lineage.json', 'w', encoding='utf-8') as f: json.dump(fp, f, ensure_ascii=False, indent=2) # 分析の各段階でフィンガープリントを記録すると、 監査・再現性が大幅向上 |
🧠 SSDSE-B-2026 を扱うときのドメイン知識
実データを正しく解釈するには、 数値の背後にある制度・歴史・地理の知識が不可欠です。 SSDSE-B-2026 を読み解くための基本ドメイン知識を 10 個。
- 都道府県の歴史:明治期の廃藩置県、 沖縄の本土復帰(1972 年)、 都道府県境の変遷。
- 人口集中:戦後の高度経済成長期から続く一極集中。 東京・大阪・愛知が突出。
- 高齢化:地方ほど高齢化率が高い。 秋田・高知が最上位、 沖縄・東京が最下位。
- 気候:北は冷涼・多雪、 南は温暖・台風。 気温は緯度より気団・海流に左右される。
- 産業構造:太平洋ベルト(製造業)、 北海道・沖縄(観光・農業)、 都市圏(サービス業)。
- 教育インフラ:大学は東京・大阪・愛知に集中。 18 歳人口減で地方大学は厳しい状況。
- 所得格差:1 人当たり県民所得で 1.5 倍程度の地域差。 東京最高、 沖縄が最低。
- 住宅価格:東京 23 区が突出、 地方圏は東京の 1/10 以下。 対数変換が必要。
- 合計特殊出生率:沖縄・宮崎が高く、 東京・北海道・京都が低い。 都市部ほど低出生。
- 医療資源:人口あたり医師数は徳島・京都が高く、 埼玉・茨城が低い。 偏在の問題。
これらの知識を持って分析すると、 「数値の意外性」と「背景の必然性」を区別できるようになります。 これがドメイン知識の力です。
📊 実データ可視化レシピ 5 種(SSDSE-B-2026)
実データの「泥臭さ」を視覚的に伝える可視化レシピ。 報告書・プレゼンに即使えます。
レシピ 1:欠損マップ
1 2 3 4 5 6 | import missingno as msno import pandas as pd df = pd.read_csv('data/raw/SSDSE-B-2026.csv', encoding='cp932', skiprows=[1], na_values=['-', '...']) msno.matrix(df.iloc[:, :30]) # 最初の 30 列だけ # 欠損パターンが視覚的に分かる。 同じ列で欠損が続く → 制度上の理由 |
レシピ 2:47 県ランキング棒グラフ
1 2 3 4 5 6 7 8 9 10 11 12 | import matplotlib.pyplot as plt import os os.makedirs('outputs', exist_ok=True) # 図・記録の書き出し先 # 2023 年度の都道府県別人口でランキング(先頭列 'SSDSE-B-2026' が年度) y2023 = df[df['SSDSE-B-2026']==2023].sort_values('A1101', ascending=True) plt.figure(figsize=(10, 12)) plt.barh(y2023['Prefecture'], y2023['A1101']) plt.xlabel('総人口(人)') plt.title('2023 年度 都道府県別総人口ランキング') plt.tight_layout() plt.savefig('outputs/pref_population_2023.png', dpi=150) |
レシピ 3:散布図 + 回帰直線
1 2 3 4 5 6 7 8 9 10 11 12 13 | import os os.makedirs('outputs', exist_ok=True) import seaborn as sns import matplotlib.pyplot as plt # 高齢化率 vs 人口 10 万人あたり一般診療所数 df['aging_rate'] = df['A1303'] / df['A1101'] # 医療費の列は SSDSE-B-2026 に無い。一般診療所数(I5102)で代える df['clinics_per_capita'] = df['I5102'] / df['A1101'] * 100000 # 人口 10 万対 sns.regplot(data=df[df['SSDSE-B-2026']==2023], x='aging_rate', y='clinics_per_capita') plt.title('高齢化率と人口 10 万人あたり一般診療所数の関係') plt.savefig('outputs/aging_vs_medical.png', dpi=150) |
レシピ 4:時系列折れ線(複数県)
1 2 3 4 5 6 7 8 9 10 11 12 | import matplotlib.pyplot as plt # 大都市圏 4 県の人口推移 focus = ['東京都', '神奈川県', '大阪府', '愛知県'] for pref in focus: sub = df[df['Prefecture']==pref].sort_values('SSDSE-B-2026') plt.plot(sub['SSDSE-B-2026'], sub['A1101'], label=pref, marker='o') plt.xlabel('年度') plt.ylabel('総人口(人)') plt.title('大都市圏 4 県の人口推移') plt.legend() plt.savefig('outputs/big4_population.png', dpi=150) |
レシピ 5:地図可視化(コロプレス)
1 2 3 4 5 6 7 8 9 10 11 12 13 14 15 16 | import folium import json # 国土地理院の都道府県境界 GeoJSON を取得 geojson_url = 'https://raw.githubusercontent.com/dataofjapan/land/master/japan.geojson' # 2023 年度の人口データ m = folium.Map(location=[36, 138], zoom_start=5) folium.Choropleth( geo_data=geojson_url, data=df[df['SSDSE-B-2026']==2023], columns=['Prefecture', 'A1101'], key_on='properties.nam_ja', fill_color='YlOrRd', ).add_to(m) m.save('outputs/japan_choropleth.html') |
📋 「実データ」を 10 行で覚える
- 実データ = 現実世界から取った、 ノイズ・欠損・外れ値・書式問題を含む数値の集合。
- 合成データとの違いは「泥臭さ」。 教育用には実データが必須(本サイト方針)。
- SSDSE-B-2026 は教育用に整備された実データの代表。 47 都道府県 × 12 年。
- 読み込み時の罠:文字コード・ヘッダー行・単位行・欠損記号「-」。
- 外れ値は真の値と入力ミスを区別。 ドメイン知識が必要。
- 欠損補完:単純(平均代入)から高度(MICE)まで複数試して感度分析。
- 概念ドリフトに注意:長期時系列では制度変更で意味が変わる。
- 品質評価フレーム DAMA-DMBOK の 6 次元で体系的に評価。
- 分析報告では出典・期間・前処理・限界・再現性を必ず記述。
- SSDSE を作った人たちの労力に敬意を持ち、 結果を丁寧に解釈する。
🎓 このページのゴール:「実データに動じず、 適切な前処理と解釈ができる」状態。 完璧な前処理は存在しないと知ったうえで、 限界を明示しながら有用な知見を出せるようになることが、 実データ分析者としての卒業条件です。
⚠️ よくある落とし穴
この用語を使うときに初学者が踏みやすい失敗パターン。 1 度経験してしまえば次から避けられますが、 先に知っておくに越したことはありません。
np.random.normal で生成した合成データで「相関 0.95」「ROC-AUC 0.99」が出ても、 実データには欠損・外れ値・季節性・分布の歪みが付き纏うため再現しません。 SSDSE-B-2026 のような実公的データでまず動かし、 合成データはユニットテスト用に限定するのが鉄則です。README に必ず記録。 半年後の自分が再現できない事故が一番多い失敗です。df.dropna() で消すと、 欠損が起こりやすい属性 (高齢者、 過疎自治体) が選択的に抜け、 結果が標本全体を代表しなくなる選択バイアスに陥ります。 欠損メカニズム (MCAR / MAR / MNAR) を判定し、 補完 (平均/多重補完) or 欠損フラグ追加を選ぶ判断が必要。groupby で別グループ扱いになる。 JIS 都道府県コード (R13000) をマスタキーとし、 表記揺れは取り込み時点で正規化。 後段で気付くと修正コストが 10 倍になります。🌐 関連手法・派生
この用語の周辺にある、 セットで覚えておきたい関連手法を整理しました。 状況によって使い分けが必要なので、 「強みと弱み」を 1 行で言えるようにしておくと、 場面に応じた選択が可能になります。
| 公的統計データ | e-Stat、 SSDSE、 政府統計の総合窓口 |
| オープンデータ | CKAN、 自治体ポータル |
| API 収集 | Twitter、 GitHub、 気象庁 |
| Web スクレイピング | BeautifulSoup、 Selenium |
上の表に並べた 公的統計データ・オープンデータ・API 収集・Web スクレイピング は、 いずれもこの用語と隣り合う選択肢です。 右列に書いたのは「どこが違うか」なので、 違いがぴんと来ない行から先に読むと、 差分だけを追えて手戻りがありません。 リンクの無いものは本サイトに個別ページを設けていないため、 関連グループ教材か外部資料を当たってください。
🖼 視覚的理解 (3 図)
実データを扱うときの典型的な可視化 3 種を、 SSDSE-B-2026 の実データで描く。 散布図は 2 変数間の関係と「1 県の影響」、 ヒストグラムは単変量の偏り、 箱ひげ図は 564 行が年度ごとの 47 県の繰り返しであることを見せる。
🗺 概念マップ
実データ(SSDSE-B-2026 等の公的統計)と合成データ・行動ログ・サンプリング・前処理・データクレンジングとの関係を俯瞰する概念マップ。 教育・研究での「実データ優先」原則の位置づけを示す。
人工的に生成された合成データ (numpy.random) ではなく、 実世界の観測・調査・記録から得られたデータ。 SSDSE-B-2026 は独立行政法人統計センターが公開する都道府県別の人口・経済・教育などの実データで、 教育用として整備されている代表例。
🔗 隣接手法への橋渡し
「実データ」は単独で完結する手法ではなく、 隣接領域と連携することで真価を発揮する。
SSDSE-B-2026 を題材にした 実データ の活用は、 上流 (取得・整形) と下流 (解釈・可視化) を含めて初めて完結する。
🌳 手法選択フロー
「実データ」を実際の課題に当てはめるとき、 状況別に何を選ぶかを 3 段階で判定する。
- 公的データで足りるか? Yes → SSDSE / e-Stat / 政府オープンデータ、 No → 自社収集 / API
- 個人情報を含むか? Yes → 匿名化・差分プライバシ、 No → そのまま公開可
- 更新頻度は? 年次 (SSDSE) → 静的分析、 リアルタイム (IoT) → ストリーミング基盤
SSDSE-B-2026 のような公的実データは、 ラベル付け済み・分布が現実的・無料・教育用途で自由に使えるという 4 拍子が揃っており、 ハンズオン教材の第一選択肢になる。
🎮 触って理解する
同じ 1 本の回帰・同じ平均でも、 「実データの生々しさ」が混ざるだけで結果が別物になります。 下の散布図は SSDSE-B-2026(2023年)の実測値——横軸=総人口(千人, A1101)、 縦軸=出生数(人, A4101)、 47都道府県すべて——を素材にしています。 3 本のスライダーで 外れ値の混入・欠損・測定ノイズを加えると、 真の値(緑線)に対して いま見えている値(橙線)の平均・傾きがどれだけ暴れるかを体感できます。 「クリーニング」を ON にすると、 前処理で結果がどこまで回復するかも見えます。
⚠️ データの扱いの明示:散布図の点は SSDSE-B-2026 の実測値をそのまま転記したものです(捏造なし)。 一方、 スライダーで加える外れ値・欠損・ノイズは 「架空の劣化シミュレーション」であり、 実際の SSDSE には含まれません。 「もし現場の生データがこう汚れていたら」という思考実験として動かしてください。 乱数はシード付きで決定的(同じ設定なら誰の画面でも同じ結果)です。
| 指標 | 真の値(実測) | いま見えている値 | ズレ |
|---|---|---|---|
| 出生数の平均(人) | – | – | – |
| 回帰の傾き(人/千人) | – | – | – |
| 決定係数 R² | – | – | – |
| 分析に使えた点数 | 47 | – |
何が起きているか:クリーニング OFF のとき、 このデモは初学者がやりがちな2つの近道——欠損をとりあえず 0 で埋める・外れ値をそのまま残す——を再現します。 わずか 1 割の桁ミス(出生数に 0 が 1 個多い)が混ざるだけで平均は 6 割ほど跳ね上がり、 回帰の傾きも 3 割狂います(seed=12345 の代表値)。 外れ値・欠損・ノイズを同時に効かせると傾きが 2 倍超(+123%)にまで暴走します。 ここで 🧹 クリーニングを ON にすると、 欠損はリストワイズ除去、 外れ値は IQR×1.5 ルールで自動除去され、 傾きの狂いは +123% から −14% 付近まで大きく回復します(点数は 47→36 に減りますが)。 これが「実データはそのままでは分析できない=前処理が8割」の正体です。
なお ノイズ単体はほとんど平均・傾きを動かしません(σ=15%でも傾き −2% 程度)。 対称なノイズは平均化で打ち消し合うためで、 本当に怖いのは非対称に効く外れ値と、 0埋めした欠損だと分かります。 ここが「ノイズさえ小さければ安心」という直感の落とし穴です。 クリーニングは万能ではなく、 東京のような真の外れ値まで削ってしまうリスク(傾きが逆に下振れする)も同時に体感できます——だから機械的な IQR 除去ではなくロバスト統計や対数変換が推奨されるのです。
関連ページ:実験データ(実験 vs 観察・交絡)/欠損メカニズム(MCAR・MAR・MNAR)/隠れたデータバイアス/外れ値/欠損値/ノイズ/データクレンジング/前処理(詳細)/ロバスト統計。
🕳 見落とされがちな落とし穴(追記の角度)
上の「⚠️ よくある落とし穴」では 合成データ過信・出典未確認・欠損無視・表記揺れ・PII を扱いました。 ここではそれらと重複しない、 より気づきにくい 4 つの罠——生存者バイアス・前処理での情報リーク・測定誤差の系統成分・情報損失——を補います。 いずれも「エラーも警告も出ないまま結論だけが静かに歪む」タイプで、 熟練者でも踏むため要注意です。
| 罠 | 症状 | なぜ気づきにくいか | 対処と関連ページ |
|---|---|---|---|
| 生存者バイアス | 「今あるデータ」だけを見て、 途中で消えた対象(廃校・廃業・市町村合併で消滅した自治体)を数えないため、 生き残りだけで平均が上振れする | 残っているデータは完全に見えるので、 「そこに無いもの」を想像しないと欠落に気づけない | 母集団を時点で固定し脱落を追跡。 参照:選択バイアス / 隠れたデータバイアス |
| 前処理での情報リーク | 標準化・欠損補完・外れ値判定を訓練+テスト全体で行うと、 テストの情報が前処理を通じて訓練に漏れ、 精度が過大評価される | 数値は綺麗に出て一見成功に見える。 本番データで初めて性能が崩れる | fit は訓練のみ、 CV では fold 内で完結。 参照:データリーク |
| 測定誤差の系統成分 | 「ノイズ=偶然(平均0)」と思い込むが、 目盛のズレ・定義の食い違い・回答の丸めなど系統誤差は平均化しても消えず、 全体を一方向へずらす | サンプルを増やすほど偶然誤差は小さくなるので「大量データ=正確」と誤認しやすい | 校正・妥当性検証、 別ソースと突合。 参照:測定誤差 / ノイズ |
| 前処理での情報損失 | dropna()・過度な丸め・カテゴリの「その他」統合で、 まだ使える情報や「欠損している事実」そのものを捨てている | 前処理は「綺麗にする作業」と思い込むと、 削るほど良いと錯覚する | 欠損はフラグ列で残し、 判断は後段へ。 参照:欠損値 / 欠損メカニズム |
skiprows=[1])の E6202 大学教員数で実際に計算すると、 単純平均 4,083 人に対し中央値は 1,608 人(平均は中央値の 2.54 倍)、 上下 10% を除いたトリム平均は 2,535 人でした。 「平均」だけを見ると半数以上の県が平均以下という直感に反する状態になり、 ロバスト統計(中央値・トリム平均・MAD)を併記する必要が分かります。 なお生存者バイアスの数値例(廃業で消えた企業の除外など)は SSDSE には直接現れないため、 上の説明は架空の思考実験です。🚀 発展:実データを「使える」にする技術地図
実データの粗さに対処する技術は、 単発の小技ではなくひとつの体系を成します。 「取得 → 点検 → 整形 → 分析 → 再現」という流れのどこで何を使うかを地図として持っておくと、 新しいデータに出会っても迷いません。 各トピックは本サイト内に個別ページがあるものはリンクしました(無いものはテキストのみ)。
| 発展トピック | 一言で | 本サイト内リンク |
|---|---|---|
| データクレンジング | 表記揺れ・単位・型を整え、 分析可能な状態へ整形する工程(分析時間の大半を占める) | データクレンジング / 前処理(詳細) |
| 探索的データ分析(EDA) | 整形前後で分布・欠損・外れ値・相関を「まず眼で見る」段階。 仮説はここで生まれる | EDA / 外れ値処理 |
| 欠測機構の見極め | MCAR / MAR / MNAR のどれかで補完法が変わる。 機構を誤ると補完がバイアスを増やす | 欠損メカニズム / 欠損値 |
| 頑健(ロバスト)統計 | 外れ値を機械的に消さず、 中央値・MAD・Huber 損失などで「歪みを吸収しつつ全データを使う」 | ロバスト統計 |
| サンプリングとバイアス | 誰が・どう選ばれたか(悉皆/標本)を確認し、 偏りを重み付けや限界明示で扱う | サンプリング / 選択バイアス / データバイアス |
| データ品質評価 | 完全性・正確性・一貫性・適時性・出所の 5 観点で「このデータは何点か」を可視化する(個別ページ準備中) | テキストのみ |
| 前処理パイプライン | 整形手順をコード(Pipeline)化し、 手動 Excel 編集を排して情報リークと非再現を防ぐ(個別ページ準備中) | データリーク |
| 再現性 | 出典・取得日・シード・パッケージ版・コードを残し、 半年後の自分と他者が同じ結果に到達できる状態にする | 再現性 |