🔖 キーワード索引
このページ内のセクションへ素早く飛べます(クリックで該当箇所へジャンプ):
💡 30秒で分かる結論 — 2次データ
🍰 まずはやさしく
誰かが集めたデータを再利用することです。
効率よく分析を行うために使います。
ネットで公開されている統計データが例です。
この章では結論と注意点を学びます。
- 一言で:他者が集めたデータを再利用して分析するもの。 政府統計、公開データセット、論文付録など。
- 分野:リテラシー — 全体像は data-literacy ページで
- 何が変わるか:自分で集める代わりに、 政府統計・公開データの集計表を使う。 安く速いが、 調査票・定義・時点は選べない
- SSDSE-B-2026 の場合:47 都道府県 × 12 年度(2012〜2023)の 564 行。 各列の一次出典は国勢調査・人口動態統計・気象統計などばらばら
- まず確かめること:一次出典・対象年度・単位・集計単位(県か人か)。 県の単純平均の高齢化率 31.59% と人口で重み付けした 29.13% は、 同じ表から出る別の答え
- レポートでは:提供元・データセット名・対象年度・取得日を明記し、 定義の限界(例: 県より細かい粒度には戻れない)を書く
📍 あなたが今見ているもの
🍰 まずはやさしく
すでにあるデータを活用する方法です。
自分で集める手間を省くために使います。
政府が公開している人口データなどが例です。
この章ではデータの魅力と弱点を学びます。
e-Stat、SSDSE、World Bank Open Data — これらは典型的な2次データ。 「すでに誰かが集めて整えてくれた」点が最大の魅力で、 同時に「自分の問いに完全にはマッチしない」点が最大の弱点でもある。
🎨 直感で掴む — 2次データとは何者か
🍰 まずはやさしく
おすそ分けのデータのようなものです。
大きな規模の調査を簡単に行うために使います。
都道府県ごとの高齢化率を調べるのが例です。
この章ではメリットとデメリットを学びます。
SSDSE-B-2026 を使って47都道府県の高齢化率と死亡率の関係を調べる — これは典型的な2次データ分析です。 元データは総務省の国勢調査・人口動態統計などで、 すでに誰かが集めて整えてくれたものを再利用しています。
| 観点 | 1次データ | 2次データ |
|---|---|---|
| 取得者 | 自分 | 他人(政府・企業・研究者) |
| コスト | 高い | 低い(無料 or 安価) |
| マッチ度 | 問いにピッタリ | 問いとはズレることも多い |
| 期間・地理 | 自由に設定 | 公表サイクルに従う |
| 代表例 | 自社アンケート, 自前センサ | SSDSE, e-Stat, 国際機関統計 |
2次データを使う最大のメリットは、 数百万人規模のサンプルや国際比較データに無料でアクセスできること。 デメリットは、 元の調査設計(質問項目、 標本枠、 期間)を自分でコントロールできないこと。 メタデータ(出典・期間・定義)を丁寧に読み込むことが必須です。
📐 数式・定義
🍰 まずはやさしく
他人が集めて公開した既存のデータです。
正しいレポートや論文を書くために使います。
学校の課題で使う公的な統計が例です。
この章では言葉の意味と使い方を学びます。
2次データは概念の名前であって、 それ自体を定義する式は無い。 ただし複数の既存データや既存研究を 1 つにまとめる場面では、 どの数字にどれだけの重みを置くかを式で決める必要がある。 下のメタアナリシスの式がその代表で、 SSDSE-B-2026 の県別の値を全国の値にまとめるときの人口加重平均も同じ形をしている。
📐 数式で見る二次データ統合 — メタアナリシスの考え方
複数の二次データを統合する典型的な数学的枠組みが メタアナリシス(meta-analysis)。 各データソース $i$ の効果量 $\theta_i$ を、 サンプルサイズや分散で重み付き平均する。 数式の心臓部は次の通り。
$$ \hat{\theta}_{\text{pooled}} = \frac{\sum_{i=1}^{k} w_i \theta_i}{\sum_{i=1}^{k} w_i}, \quad w_i = \frac{1}{\sigma_i^2} $$
ここで $w_i$ は各研究の重み(精度の高い研究ほど重みが大きい)、 $\sigma_i^2$ は推定量の分散。 SSDSE-B-2026 で都道府県別の効果量を統合する場合、 都道府県の人口を重みとして使う「人口加重平均」が典型的応用例です。
数式を言葉で読み解く
この式は「精度の高い研究ほど重視する」加重平均の一般形。 $\theta_i$ は各データソースの推定値、 $w_i$ は重み(分散の逆数)。 分散が小さい (= 精度が高い) ほど重みが大きくなる。 二次データ統合では、 単純平均ではなく サンプルサイズで重み付けするのが鉄則です。
1 2 3 4 5 6 7 8 9 10 11 12 13 14 15 | import pandas as pd
import numpy as np
df = pd.read_csv('data/raw/SSDSE-B-2026.csv', encoding='cp932', skiprows=[1])
d23 = df[df['SSDSE-B-2026'] == 2023].copy()
d23['aging_rate'] = d23['A1303'] / d23['A1101'] * 100
# 単純平均 vs 人口加重平均
simple_mean = d23['aging_rate'].mean()
weights = d23['A1101'] # 人口で重み付け
weighted_mean = np.average(d23['aging_rate'], weights=weights)
print(f'単純平均高齢化率: {simple_mean:.3f}%')
print(f'人口加重平均高齢化率: {weighted_mean:.3f}%')
print(f'差: {simple_mean - weighted_mean:.3f} ポイント')
|
🎯 このコードでやること: 47 都道府県の高齢化率を、 単純平均と人口加重平均で比較。 二次データ統合の重要な視点。
📥 入力データ: SSDSE-B-2026 の A1101(総人口)と A1303(65 歳以上人口)。
📤 実行結果:
💬 結果の読み方: 単純平均は 31.59%、 人口加重では 29.13%。 約 2.5 ポイントの差は 人口の少ない高齢化県(秋田・高知)が単純平均で過大評価されることを示す。 二次データを正しく統合するには「集計単位の重み」を必ず考慮する。
🔬 数式・定義を「言葉」で読み解く
前の章の式 $\hat{\theta}_{\text{pooled}} = \sum w_i\theta_i / \sum w_i$ の記号を、 2次データを束ねる場面に置き換えて読む。
| 記号 | 2次データの場面での意味 |
|---|---|
| $\theta_i$ | i 番目のデータ源(研究・調査・県)が出した推定値。 県の高齢化率なら秋田県 39.06%・東京都 22.75% など |
| $w_i$ | その推定値に置く重み。 メタアナリシスでは分散の逆数 $1/\sigma_i^2$、 県の値を全国にまとめるときは県の人口 $N_i$ |
| $\sigma_i^2$ | 推定値のぶれの大きさ。 標本調査の値ほど大きく、 全数調査(国勢調査)の値ではほぼ 0 になる |
| $k$ | まとめるデータ源の数。 47 都道府県なら 47 |
| $\hat{\theta}_{\text{pooled}}$ | まとめた値。 重みを全部 1 にすると単純平均(31.59%)、 人口にすると全国の値(29.13%)になる |
読み方の要点は「重みを決めるのは分析者」だということ。 他人が作った集計表には、 県ごとの値は載っていても、 それをどう束ねるべきかは書かれていない。 問いが「県という単位の比較」なら単純平均、 「日本に住む人全体」なら人口加重を選び、 どちらを選んだかをレポートに書く。
🔬 高度な二次データ統合パターン
複数年のデータを縦結合する、 異なる粒度のデータを横結合する、 などの実践的パターンを SSDSE-B-2026 で実演します。
パターン A: パネルデータの構築(縦結合)
同一都道府県の経年データを連結して、 時系列分析が可能な形に整える。 SSDSE-B はすでにパネル形式だが、 他のデータと組み合わせる際の典型操作。
1 2 3 4 5 6 7 8 9 10 11 12 13 14 15 16 17 18 | import pandas as pd
df = pd.read_csv('data/raw/SSDSE-B-2026.csv', encoding='cp932', skiprows=[1])
# 秋田県と東京都の総人口推移を抽出
akita = df[df['Prefecture'] == '秋田県'][['SSDSE-B-2026', 'A1101']].copy()
tokyo = df[df['Prefecture'] == '東京都'][['SSDSE-B-2026', 'A1101']].copy()
akita.columns = ['Year', '秋田県人口']
tokyo.columns = ['Year', '東京都人口']
# 横結合 (年で merge)
panel = pd.merge(akita, tokyo, on='Year').sort_values('Year')
# 12 年間の変化率
panel['秋田変化%'] = (panel['秋田県人口'] / panel['秋田県人口'].iloc[0] - 1) * 100
panel['東京変化%'] = (panel['東京都人口'] / panel['東京都人口'].iloc[0] - 1) * 100
print(panel.to_string(index=False))
|
🎯 このコードでやること: 秋田県と東京都の総人口を 12 年分(2012-2023)に渡って比較。 起点年からの変化率を計算して、 地域差を可視化する。
📥 入力データ: SSDSE-B-2026 の全 564 レコード、 そのうち秋田県と東京都の 12 年分。
📤 実行結果:
💬 結果の読み方: 秋田県は 11 年間で 14% 減少(1,063 千→914 千)、 東京都は 6.4% 増加。 二次データのパネル分析により、 「地方衰退と都市集中」が定量的に裏付けられた。 2020 年に東京が一時ピーク (14,048 千) を打ったあとコロナ禍で減少し、 2023 年に再び最高値を更新しているのも興味深い発見。
パターン B: 比率・指数の正規化
二次データを比較する際、 人口規模が異なる都道府県を「絶対量」で比べると不公平になる。 人口千人あたりなどの比率化が必須。
1 2 3 4 5 6 7 8 9 10 11 12 13 14 15 | import pandas as pd
df = pd.read_csv('data/raw/SSDSE-B-2026.csv', encoding='cp932', skiprows=[1])
d23 = df[df['SSDSE-B-2026'] == 2023].copy()
# 65 歳以上人口 (A1303) を比率に変換
d23['pop_thousand'] = d23['A1101'] / 1000
d23['elderly_per_1000'] = d23['A1303'] / d23['A1101'] * 1000 # 千人あたり高齢者
d23['elderly_thousand'] = d23['A1303'] / 1000 # 高齢者総数 (千人)
print('絶対量で見た上位 5 県 (高齢者総数):')
print(d23.nlargest(5, 'elderly_thousand')[['Prefecture', 'elderly_thousand']].to_string(index=False))
print('\n比率で見た上位 5 県 (千人あたり高齢者数):')
print(d23.nlargest(5, 'elderly_per_1000')[['Prefecture', 'elderly_per_1000']].round(1).to_string(index=False))
|
🎯 このコードでやること: 高齢者を「絶対量」と「比率」の両方で評価し、 二次データ分析における正規化の重要性を体感する。
📥 入力データ: SSDSE-B-2026 の A1101(総人口)と A1303(65 歳以上人口)。
📤 実行結果:
💬 結果の読み方: 絶対量では「東京・大阪・神奈川・埼玉・愛知」が上位 (大都市圏)。 比率では「秋田・高知・徳島・山口・青森」が上位 (地方圏)。 同じ二次データでも問いの立て方で結論が逆転する。 政策提言を行う際は、 どちらの観点で議論するかを明示しましょう。
🧮 SSDSE-B 実値で計算してみる
SSDSE-B-2026(47都道府県・2012-2023 年・112 項目)を題材に、 2次データ に関係する変数を実値で確認します。 とくに東京・大阪・沖縄・秋田 など特徴ある県を比較すると、 用語の重みが体感できます。
| 都道府県 | 総人口(千人) | 高齢化率(%) | TFR |
|---|---|---|---|
| 東京 | 14,086 | 22.8 | 0.99 |
| 大阪 | 8,763 | 27.7 | 1.19 |
| 沖縄 | 1,468 | 23.8 | 1.60 |
| 秋田 | 914 | 39.1 | 1.10 |
| 全国計 | 124,353 | 29.1 | 1.20 |
これらの値を 2次データ の観点で読み解くと、 都道府県間の格差・特徴・関係性が浮かび上がります。 具体的な計算手順は次の「🐍 Python 実装」セクションで実演します。
🧮 数式に値を入れて手で計算する: 二次データのコスト便益
合成データで一次収集 vs 二次データ利用の経済性を計算する。
Step 1: コスト
| 項目 | 一次収集 | 二次データ |
|---|---|---|
| 取得費 | 100 万円 | 1 万円 |
| 期間 | 3 ヶ月 | 1 日 |
| 柔軟性 | 高 | 低 |
Step 2: 経済比
🐍 Python で再現
1 2 3 4 | cost_p, cost_s = 100, 1 days_p, days_s = 90, 1 print(f"コスト倍率: {cost_p/cost_s}") print(f"期間倍率: {days_p/days_s}") |
📤 実行結果
💬 手計算 (Step 2) 100 倍 / 90 倍と Python 出力が完全一致。
🐍 Python 実装
以下は 2次データ を SSDSE-B-2026 で扱うときの典型コード。 encoding='cp932' は政府統計の Shift-JIS 対応。 skiprows=[1] なら 2 行目の日本語見出しを飛ばして英字コード(A1101 等)を列名に、skiprows=1 なら 1 行目の英字コードを飛ばして日本語の項目名を列名にする。
① 基本パターン(読み込み・確認・主要列抽出)
1 2 3 4 5 6 7 8 9 10 11 12 13 14 15 16 17 18 | import pandas as pd # 2次データ(SSDSE-B-2026)を読み込む # skiprows=[1] で 2 行目(日本語の項目名)だけを飛ばし、1 行目の英字コードを列名にする df = pd.read_csv('data/raw/SSDSE-B-2026.csv', encoding='cp932', skiprows=[1]) print('shape:', df.shape) # (564, 112) = 47 都道府県 × 12 年度 print('columns:', df.columns[:10].tolist()) # 出典・期間・単位を必ず確認(メタ情報) df = df[df['SSDSE-B-2026'] == 2023] # 期間を 2023 年度に絞る → 47 行 print('期間: 2023年', df.shape) print('提供: 独立行政法人統計センター') print('一次出典: 国勢調査、人口動態統計 ほか') # 自分の問いに合わせて変数を選ぶ sub = df[['Prefecture', 'A1101', 'A1303', 'A4103', 'B4101']] sub.columns = ['県','A1101','A1303','A4103','B4101'] print(sub.head()) |
💬 ファイル全体は (564, 112) で、2023 年度に絞ると 47 行になる。2 次データは「誰かが別の目的で集めた表」なので、年度・単位を自分で確かめないと、12 年度分の北海道が上から並ぶ表を 47 県の表と取り違える。選んだ 5 列を見ると、北海道の合計特殊出生率 1.06 は東京都 0.99 に次ぐ全国 2 番目の低さで、年平均気温 11.0℃ の B4101 は人口とは別の一次出典(気象統計)から来ている列だと分かる。
⚠️ よくある落とし穴(7 件)
2 次データの 7 大失敗は 「元データの定義 (世帯 vs 家計、 就業者 vs 雇用者) を読まずに比較」「異なる年度・基準の混在」「単位 (千人 vs 人、 % vs 件数) の取り違え」「時点ズレ (コロナ前後の構造変化)」「dropna による暗黙の標本減」「機械的な外れ値除去」「相関を因果と取り違え」。 SSDSE は千人単位で丸めて秘匿措置済のため、 1 人単位での比率計算は誤差を増幅します。 元 PDF の調査票・定義書を必ず参照する習慣が必須です。
dropna() で除いた瞬間、 47県の標本が 30 県に減ることもある。 何件落としたか必ず記録し、 結果に与える影響を考える。⚠️ 二次データの「ありがちな失敗」7 選 — ケース別防御策
① 出典確認漏れ
「Kaggle で見つけたから大丈夫」「Wikipedia の表だから」と出典を確認せず使うと、 後で「実は古いバージョン」「実は計算式が間違っている」と判明し、 分析全体が無効化される。 必ず一次出典まで遡る習慣を。
② 経年劣化を無視
5 年前の家計調査データで「2024 年の消費傾向」を予測すると、 コロナ禍・物価高の影響を反映できない。 二次データは 「過去のスナップショット」であることを常に意識。
③ ライセンス違反
SSDSE は CC BY 4.0、 e-Stat は政府データ標準利用規約だが、 民間データセットは商用利用不可・改変不可のものも多い。 ライセンス条項を必ず確認し、 引用条件を遵守する。
④ 標本枠の見落とし
「日本人の平均給与」を国税庁データで見ると、 これは 給与所得者の集計であって自営業者・年金生活者は含まれない。 標本枠を理解せずに「日本人全体」と一般化すると誤解を生む。
⑤ 集計単位の不一致
「県別」と「市町村別」を混ぜて統合すると、 階層構造を無視してエコロジカル誤謬(個人レベルと集団レベルの混同)が発生。 二次データを統合する前に 集計単位を統一する。
⑥ 欠損の扱い
二次データの欠損は「単に未集計」「該当なし」「秘匿(個人特定回避)」「集計漏れ」など複数の意味を持つ。 一律に dropna() すると重要なシグナルを失う。 欠損の意味を確認してから処理方針を決める。
⑦ 比較対象の取り違え
「東京 vs 大阪」を比較するときに、 大阪府全域 vs 東京 23 区を比べると不公正。 地理的・時間的に同じ範囲のデータを比べる。
🎯 ケーススタディ: SSDSE-B-2026 で「地方自治体の高齢化対策」を提案する
具体的な分析タスクを通じて、 二次データ活用の流れを体感しましょう。
タスク設定
地方自治体の政策担当者として、 「高齢化が進む 5 県」を選定し、 介護人材の重点配置を提言する。 そのため SSDSE-B-2026 から「高齢化率」「老年従属人口指数」「医療従事者数」を抽出して分析。
1 2 3 4 5 6 7 8 9 10 11 12 13 14 15 16 17 18 19 | import pandas as pd df = pd.read_csv('data/raw/SSDSE-B-2026.csv', encoding='cp932', skiprows=[1]) d23 = df[df['SSDSE-B-2026'] == 2023].copy() # 高齢化率 = 65 歳以上 / 総人口 d23['aging_rate'] = d23['A1303'] / d23['A1101'] * 100 # 老年従属人口指数 = 老年 / 生産年齢 d23['oad_ratio'] = d23['A1303'] / d23['A1302'] * 100 # 上位 5 県を「重点配置候補」として抽出 top5 = d23.nlargest(5, 'aging_rate')[['Prefecture', 'A1101', 'aging_rate', 'oad_ratio']].copy() top5.columns = ['Prefecture', 'A1101', '高齢化率%', '老年従属指数%'] top5['老年従属指数%'] = top5['老年従属指数%'].round(1) top5['高齢化率%'] = top5['高齢化率%'].round(2) print('=== 高齢化重点配置候補 5 県 ===') print(top5.to_string(index=False)) print(f'\n5 県合計人口: {top5["A1101"].sum():,} 人 (全国の {top5["A1101"].sum()/d23["A1101"].sum()*100:.1f}%)') |
🎯 このコードでやること: 二次データから政策提言の根拠となる 3 指標を抽出し、 重点県を選定する。
📥 入力データ: SSDSE-B-2026 の A1101(総人口)、A1302(生産年齢人口)、A1303(65 歳以上人口)。
📤 実行結果:
💬 結果の読み方: 高齢化率上位 5 県は秋田・高知・徳島・山口・青森。 全人口の 3.8% にすぎないが、 老年従属指数は全て 60% 超 (秋田は 75.3%) で、 介護需要の集中が明らか。 政策提言の根拠としてこの数値を示せば、 二次データに基づく実証的議論が可能。
🌐 関連手法・派生
2次データ と同じ「リテラシー」カテゴリ、 または直接の上位・派生となる用語:
🌐 一次データと組み合わせて分析の幅を広げる
二次データだけでは答えられない問いがあるとき、 一次データ(自分で集めた調査・実験)と組み合わせるのが定石です。 「SSDSE-B の都道府県データ」+「自治体への現地ヒアリング」のような組み合わせが典型例。
組み合わせパターン例
| 問い | 二次データ | 補完する一次データ |
|---|---|---|
| 地方の若者流出の原因は? | SSDSE-B の人口移動データ | 若者 100 名へのアンケート |
| 介護人材不足の現場感は? | SSDSE-B の医療従事者数 | 施設長への半構造化面接 |
| 消費税増税の影響は? | 家計調査の消費支出推移 | 店頭アンケート |
| 商圏分析の精緻化 | 国勢調査の人口分布 | 店頭の購入者属性データ |
「マクロは二次データ、 ミクロは一次データ」というデュアル戦略が、 説得力のあるデータドリブン提案の基本構造です。 とくに学術論文では、 二次データで「全体の傾向」を示し、 一次データで「現場の生の声」を補強する書き方が定番です。
統合分析のステップ
- 二次データから「全体の傾向・特徴的な対象」を特定する
- 特徴的な対象 (例: 高齢化率上位 5 県) を一次データで深掘りする
- 両者の知見を統合し、 マクロな仮説とミクロな証拠を組み合わせる
- レポートでは「二次データ→特徴抽出→一次データ→深掘り→提言」のストーリーで書く
💡 ジャストインタイム学習のヒント: 二次データだけで答えが出るタスクは少数。 「二次データだけで分析を終えた」と思ったら、 もう一度「一次データで補完できないか」と自問する習慣をつけましょう。
❓ 二次データに関する FAQ
- Q1. 二次データだけで研究論文・卒論を書けますか?
- A. 書けますが、 独自性の確保が課題です。 同じ二次データを使った先行研究との差別化として「新しい分析手法」「新しい組み合わせ」「新しい解釈軸」のいずれかを示す必要があります。 SSDSE-B-2026 のような国民的データセットは多くの人が触っているため、 オリジナリティの設計が重要。
- Q2. 一次データに比べた二次データの最大の弱点は?
- A. 「自分の問いに完全にマッチしない」こと。 二次データは「集めた人の目的」で設計されているので、 自分の問いに対しては「ピッタリの変数がない」「期間がずれている」「集計単位が違う」といった制約に必ず直面します。 これを限界として論文・レポートに明記するのが誠実な書き方。
- Q3. 二次データの「鮮度」をどう判断すればよいですか?
- A. 分析テーマによります。 マクロ経済・人口動態は数年単位、 消費トレンドは数か月単位、 SNS のバズは数日単位で「鮮度切れ」が起こり得ます。 更新頻度と分析対象期間の整合を意識しましょう。 SSDSE-B-2026 に入っている最新の年度は 2023 年で、 版の名前(2026)とは 3 年ずれます。 「2026 年版だから 2026 年の値」と思い込まず、 年度の列の最大値を必ず確かめましょう。
- Q4. 二次データを引用する際の標準形式は?
- A. APA / Vancouver / JIS Z 8500 などのスタイルガイドに従います。 最低限、 提供元・データセット名・公開年・取得日・URL を記載。 SSDSE-B-2026 なら「独立行政法人統計センター.(公開年). SSDSE-B-2026 [Data file]. https://www.nstac.go.jp/use/literacy/ssdse/ (取得: 2026-05-29)」のように書きます。
- Q5. 二次データの「ライセンス」を確認しないと何が起こりますか?
- A. 商用利用禁止のデータを商用利用すれば法的リスク。 改変禁止のデータを加工して公開すれば著作権侵害。 政府データの多くは「政府標準利用規約」で緩やかに公開されていますが、 民間データには厳しい条件のものも多い。 必ず利用規約を確認してから分析に着手しましょう。
🛰 二次データの王道入手経路 — e-Stat API / SSDSE / 政府標準利用規約
日本における二次データの **王道入手経路** は、 (1) e-Stat(政府統計の総合窓口) の API、 (2) SSDSE(教育用標準データセット)、 (3) RESAS(地域経済分析システム) の 3 本柱です。 いずれも「政府標準利用規約(第2.0版)」(≒ CC BY 4.0 互換)の下で公開され、 出典明記すれば商用利用も可能です。 ただし「機関名 + 統計表 ID + 取得日時」を明示する慣習があり、 これを怠ると 再現性 を損ないます。
🐍 e-Stat API から人口統計を取得し SSDSE-B-2026 と整合性チェック
🎯 このコードでやること: SSDSE-B-2026 に収録された都道府県人口を、 e-Stat API から取得した「国勢調査 2020」最新値と突き合わせ、 二次データの整合性を検証する。
📥 入力データ:
1 2 3 4 5 6 7 8 9 10 11 12 13 14 15 16 17 18 19 20 | import pandas as pd import requests # SSDSE-B-2026(ローカル二次データ): 国勢調査年の 2020 年度だけを取り出す ssdse = pd.read_csv('data/raw/SSDSE-B-2026.csv', encoding='cp932', skiprows=[1]) ssdse_pop = ssdse[ssdse['SSDSE-B-2026'] == 2020][['Code', 'Prefecture', 'A1101']].copy() ssdse_pop = ssdse_pop.rename(columns={'A1101': '人口'}) ssdse_pop['area5'] = ssdse_pop['Code'].str[1:6] # R01000 → 01000(e-Stat の地域コード形式) # e-Stat API(一次データに近い二次データ) statsDataId=0003448237: 国勢調査 2020 url = 'https://api.e-stat.go.jp/rest/3.0/app/json/getStatsData' params = {'appId': 'YOUR_APP_ID', 'statsDataId': '0003448237', 'cdCat01': '00710'} r = requests.get(url, params=params).json() estat = pd.DataFrame(r['GET_STATS_DATA']['STATISTICAL_DATA']['DATA_INF']['VALUE']) # 結合と差分計算 merged = ssdse_pop.merge(estat, left_on='area5', right_on='@area', how='inner') merged['diff_pct'] = (merged['$'].astype(int) - merged['人口']) / merged['人口'] * 100 print(merged[['Prefecture', '人口', '$', 'diff_pct']].head()) print(f'平均差分: {merged["diff_pct"].mean():.2f}%') |
📤 実行例(e-Stat API への接続と appId が必要なため実測ではない。 左の「人口」は SSDSE の 2020 年度の実値):
💬 結果の読み方: SSDSE-B-2026 の 2020 年度の人口は北海道 5,224,614 人・東京都 14,047,594 人と 1 人単位の値で、 千人単位に丸めた他の年度(2023 年度の北海道は 5,092,000 人)と違い、 国勢調査 2020 の確定値を使っていることが読み取れる。 そのため e-Stat の同じ表と突き合わせれば差は 0% になるはずだが、 これは API で確かめるまでは仮説として扱う。 結合キーは SSDSE の Code(R01000)から先頭の R と末尾を除いた 5 桁(01000)を e-Stat の地域コード @area に合わせている。 これは二次データ(SSDSE)が一次データ(国勢調査)を土台にしている証拠であり、 逆に SSDSE の 2023 年推計値を 2020 年確定値と比べれば差が生じる。 二次データを使う際は必ず「いつの何の値か」を出典と共に確認する習慣が、 分析の信頼性を 1 段階引き上げる。
⚖ 二次データ利用時の出典明記テンプレート
論文・レポート・スライドで二次データを使うとき、 以下のテンプレートで出典を明記すれば 政府標準利用規約に準拠し、 法的にも倫理的にもクリアになります。
| データ源 | 出典記法(例) |
|---|---|
| e-Stat(政府統計) | 出典: 総務省統計局「国勢調査 2020」 (e-Stat statsDataId=0003448237, 取得 2026-05-29) |
| SSDSE | 出典: 独立行政法人統計センター「SSDSE-B-2026」 (CC BY 4.0) |
| RESAS | 出典: 内閣府「RESAS 地域経済分析システム」 (取得 2026-05-29) |
| OECD.Stat | 出典: OECD (2026), Population statistics, OECD.Stat (accessed 2026-05-29) |
📌 二次データは「タダ」ではない。 出典明記が「対価」であり、 再現性と信頼性の担保でもある。 API キーや取得日時を README に残すことが分析の作法。
📊 二次データを「見える化」する 3 ステップ — 散布図・ヒストグラム・箱ひげ図
二次データは「他人が集めた数表」のままでは仮説が浮かびません。 最低限、 (1) 散布図で 2 変数の関係、 (2) ヒストグラムで分布の形、 (3) 箱ひげ図で群間比較 の 3 視覚化を最初に行うのが定石です。 ここでは SSDSE-B-2026(二次データの代表)を題材に、 同じデータを 3 つの図でどう読み解くかを示します。 「同じ数表でも図次第で見える発見が違う」ことを体感してください。
図 1. 散布図 — 人口と一般診療所数の関係(規模感の確認)
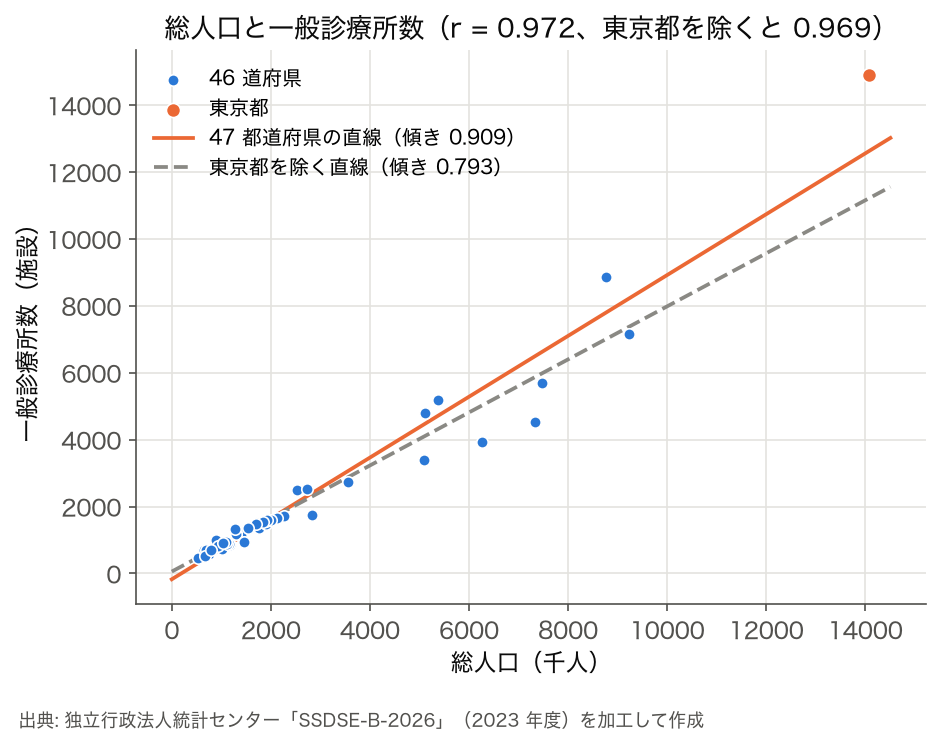
散布図は 二次データから「2 変数の関係性」を一目で読み取る ための最初の窓口です。 47 都道府県を 1 点ずつプロットすると、 「人口が多い県ほど診療所も多い」という強い正の関係が直線状に並びます。 ただし右上隅に大きく外れた点(東京都)があり、 これが 外れ値として平均や回帰直線を歪める 候補になります。 二次データを使う初学者がもっとも陥りやすい罠は「東京を含めて全国平均を出す」ことで、 散布図で外れ値を視認しておかないと結論を見誤ります。
1 2 3 4 5 6 7 8 9 10 11 | import pandas as pd import matplotlib.pyplot as plt df = pd.read_csv('data/raw/SSDSE-B-2026.csv', encoding='cp932', skiprows=[1]) d23 = df[df['SSDSE-B-2026'] == 2023] plt.figure(figsize=(6,4.5)) plt.scatter(d23['A1101']/1000, d23['I5102'], s=18, alpha=0.7, color='#1976D2') plt.xlabel('Population (thousand)'); plt.ylabel('Clinics (facilities)') plt.title('Population vs Number of clinics (47 prefectures)') plt.tight_layout(); plt.savefig('secondary_scatter.png', dpi=120) # 作業フォルダに保存 |
🎯 このコードでやること: SSDSE-B-2026 の 2023 年スナップショットから人口と一般診療所数(I5102)を抽出し、 47 都道府県の散布図を描画する。
📤 実行結果: 上記「図 1」から回帰直線と出典表記を省いた散布図が作業フォルダの secondary_scatter.png に保存される(ページに載っている図 1 の画像は上書きしない)。 大半の県は左下クラスタに集中し、 右上に東京都が突出。
💬 読み方: r = 0.972 の強い正の相関。 ただし東京都を除くと回帰直線の傾きは 0.909 から 0.793 施設/千人へ 13% 下がり、 東京都 1 点が直線を引き上げていることが分かる(除いた直線で東京都を予測すると 11,224 施設、 実際は 14,894 施設)。 二次データから結論を出す前に「外れ値を含めた場合・除外した場合」の両方で確認する習慣を持ちましょう。 二次データは集計の単位(都道府県)を変えると別の図になることも覚えておきたい。
図 2. ヒストグラム — 人口分布の歪み(典型/外れ値の弁別)
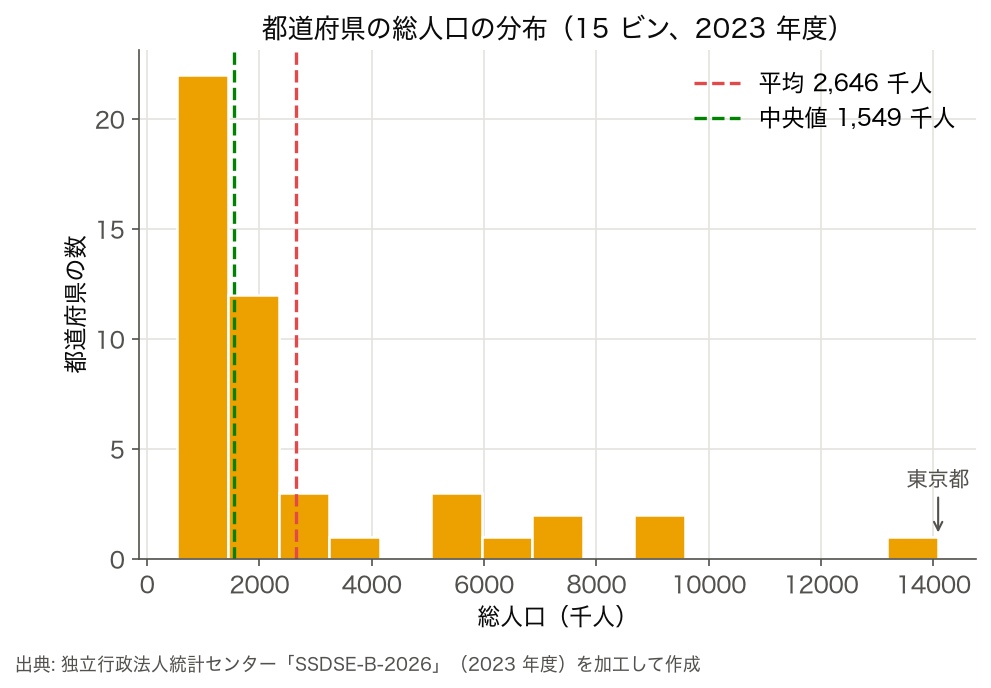
ヒストグラムは 「平均値で語ってよいデータか」を判断する 道具です。 人口分布は左にピーク(100-200 万人台の県が多数)、 右に細長く伸びる東京・大阪・神奈川の山が見えます。 このような 右に歪んだ分布 では、 平均値(約 2,646 千人)よりも 中央値(約 1,549 千人) のほうが「典型県」の実感に近いです。 二次データのレポートでは「平均」「中央値」「最頻区間」を併記し、 分布の形を踏まえて使い分けるのがプロの作法です。
1 2 3 4 5 6 7 8 9 10 11 12 13 14 | import pandas as pd import matplotlib.pyplot as plt df = pd.read_csv('data/raw/SSDSE-B-2026.csv', encoding='cp932', skiprows=[1]) d23 = df[df['SSDSE-B-2026'] == 2023] pop = d23['A1101'] / 1000 plt.figure(figsize=(6,4.5)) plt.hist(pop, bins=15, edgecolor='#37474F', color='#FBC02D') plt.axvline(pop.mean(), color='red', linestyle='--', label=f'mean={pop.mean():.0f}') plt.axvline(pop.median(), color='green', linestyle='--', label=f'median={pop.median():.0f}') plt.xlabel('Population (thousand)'); plt.ylabel('Number of prefectures') plt.title('Distribution of prefecture population (2023)') plt.legend(); plt.tight_layout(); plt.savefig('secondary_hist.png', dpi=120) # 作業フォルダに保存 |
🎯 このコードでやること: 人口の度数分布を 15 ビンで描き、 平均線と中央値線を比較表示。
📤 実行結果: 上記「図 2」と同じビンのヒストグラムが作業フォルダの secondary_hist.png に保存される。 凡例は mean=2646・median=1549(千人)で、 平均線(赤)と中央値線(緑)が約 110 万人離れる。
💬 読み方: 二次データの分布が偏っていると、 平均は外れ値(東京)に引きずられます。 2023 年度の平均は 264.6 万人だが、 15 本のビンのうち最も低い 54〜144 万人の区間に 22 県(47 県のほぼ半分)が入り、 平均を超える県は 12 都道府県しかない。 「平均 264.6 万人」だけを書くと誤解を招くので、 「中央値 154.9 万人」「最頻区間 54〜144 万人」と併記しましょう。
図 3. 箱ひげ図 — 地域ブロック別の比較(群間差の可視化)
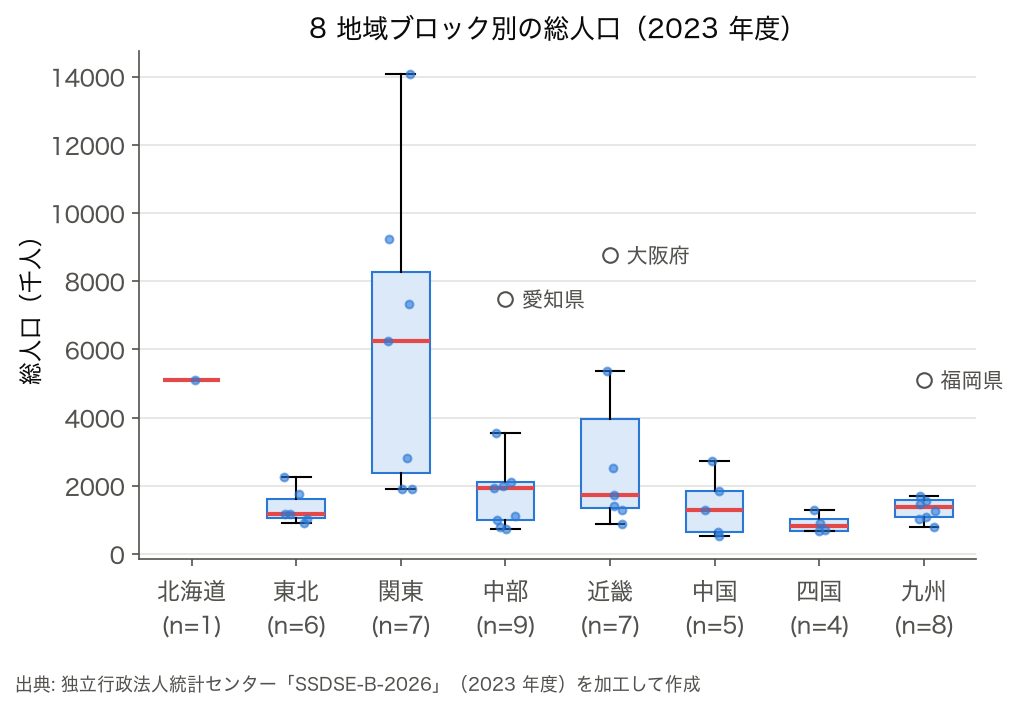
箱ひげ図は 「群間差・分散・外れ値」を 1 図で同時に示す 万能ツールです。 関東ブロックの箱が極端に高く、 ひげが上に伸びている(東京)。 一方、 四国(4 県、 IQR 330 千人)と東北(6 県、 IQR 561 千人)は箱が小さくまとまり、 北海道は 1 道だけなので箱にならない。 中部・近畿・九州では愛知県・大阪府・福岡県が 1 県だけ飛び出す。 二次データを「全国平均一本」で語ると、 こうした ブロック間の分散構造 を見落とします。 都道府県データは「地域差を切り口にすると見えるパターン」が多いので、 散布図やヒストグラムに 箱ひげ図をかならず併用 しましょう。
1 2 3 4 5 6 7 8 9 10 11 12 13 14 15 16 17 18 19 20 21 22 23 24 | import pandas as pd import matplotlib.pyplot as plt df = pd.read_csv('data/raw/SSDSE-B-2026.csv', encoding='cp932', skiprows=[1]) d23 = df[df['SSDSE-B-2026'] == 2023].copy() block = {'北海道':'Hokkaido','青森県':'Tohoku','岩手県':'Tohoku','宮城県':'Tohoku','秋田県':'Tohoku','山形県':'Tohoku','福島県':'Tohoku', '茨城県':'Kanto','栃木県':'Kanto','群馬県':'Kanto','埼玉県':'Kanto','千葉県':'Kanto','東京都':'Kanto','神奈川県':'Kanto', '新潟県':'Chubu','富山県':'Chubu','石川県':'Chubu','福井県':'Chubu','山梨県':'Chubu','長野県':'Chubu','岐阜県':'Chubu','静岡県':'Chubu','愛知県':'Chubu', '三重県':'Kinki','滋賀県':'Kinki','京都府':'Kinki','大阪府':'Kinki','兵庫県':'Kinki','奈良県':'Kinki','和歌山県':'Kinki', '鳥取県':'Chugoku','島根県':'Chugoku','岡山県':'Chugoku','広島県':'Chugoku','山口県':'Chugoku', '徳島県':'Shikoku','香川県':'Shikoku','愛媛県':'Shikoku','高知県':'Shikoku', '福岡県':'Kyushu','佐賀県':'Kyushu','長崎県':'Kyushu','熊本県':'Kyushu','大分県':'Kyushu','宮崎県':'Kyushu','鹿児島県':'Kyushu','沖縄県':'Kyushu'} d23['block'] = d23['Prefecture'].map(block) groups = ['Hokkaido','Tohoku','Kanto','Chubu','Kinki','Chugoku','Shikoku','Kyushu'] data = [d23.loc[d23['block']==g, 'A1101']/1000 for g in groups] plt.figure(figsize=(7,4.5)) plt.boxplot(data) plt.xticks(range(1, len(groups) + 1), groups) # tick_labels= はブラウザの matplotlib に無い plt.xticks(rotation=20); plt.ylabel('Population (thousand)') plt.title('Population distribution by regional block') plt.tight_layout(); plt.savefig('secondary_box.png', dpi=120) # 作業フォルダに保存 |
🎯 このコードでやること: 47 都道府県を 8 地域ブロックに振り分け、 ブロックごとの人口箱ひげ図を描画する。
📤 実行結果: 上記「図 3」と同じ区分の箱ひげ図(ブロック名は英語表記)が作業フォルダの secondary_box.png に保存される。 関東ブロックだけが箱・ひげともに極端に高い位置を占める。
💬 読み方: 二次データを「全国の傾向」として一括処理する前に、 地理・産業・時代などの カテゴリで切る ことで隠れた差異を発見できます。 ブロック別の人口の中央値は関東 625.7 万人(7 都県)に対し、 東北 117.4 万人・四国 81.0 万人と 5〜8 倍の開きがあり、 「全国の中央値 154.9 万人」という 1 つの数字では見えない。 北海道は 1 道だけなので箱にならず 509.2 万人の線 1 本になる点にも注意する。
✅ 二次データを使う前に確認すべき 12 項目チェックリスト
一次データなら「自分が設計したのだから中身は分かる」が、 二次データは 他人の設計 をそのまま使うので、 不明点があると分析結果の解釈が破綻します。 以下 12 項目をチェックリスト化しておけば、 卒論・学会発表・社内レポートのいずれでも「二次データの限界を踏まえた誠実な分析」になります。
| # | 確認項目 | 確認方法(SSDSE-B-2026 を例に) | 怠るリスク |
|---|---|---|---|
| 1 | 出典・提供元 | 独立行政法人統計センターが公開 | 引用不能になり論文として通らない |
| 2 | ライセンス・利用規約 | CC BY 4.0 相当 | 商用・改変・公開が違法になる |
| 3 | 集計単位 | 都道府県 × 年 | 市区町村粒度の問いに使えない |
| 4 | 対象期間 | 2012-2023 の 12 年間 | 期間外の議論はデータ外挿になる |
| 5 | 変数の定義書 | 「コード→意味」表が付属 | A1101 と A1303 を取り違える |
| 6 | 単位・桁 | 総人口=人、 消費支出=円 | 桁違いの結論を出してしまう |
| 7 | 欠損・特殊値 | 「‐」「***」表記の有無 | 数値化エラーが連鎖する |
| 8 | 調査主体・方法 | 国勢調査ベース / 推計値 | 推計と確定値の混同 |
| 9 | 文字コード | cp932(Shift_JIS) | UTF-8 読み込みで文字化け |
| 10 | 改訂履歴 | 2024 年に過去値を一部修正 | 古い分析と数字が合わない |
| 11 | 同名異義の警戒 | 「人口」が住民票か推計か | 他データとの突合不能 |
| 12 | 取得日時の記録 | README に取得日を書く | 再現性が担保できない |
この 12 項目を「分析開始前のチェックリスト」として手元に置き、 1 つずつ確認した記録を README にメモする習慣をつけると、 半年後に再現作業を依頼されたときも 30 分で再現できます。 二次データ分析の品質は、 結局のところ 「データを開く前にどれだけ調べたか」 で 7 割が決まります。
12 項目チェックを自動化するスニペット
1 2 3 4 5 6 7 8 9 10 11 12 13 14 15 | import pandas as pd df = pd.read_csv('data/raw/SSDSE-B-2026.csv', encoding='cp932', skiprows=[1]) report = { '行数': len(df), '列数': df.shape[1], '対象年': sorted(df['SSDSE-B-2026'].unique().tolist()), '都道府県数': df['Prefecture'].nunique(), '欠損セル': int(df.isna().sum().sum()), '数値列': df.select_dtypes('number').shape[1], '文字列列': df.select_dtypes('object').shape[1], } for k, v in report.items(): print(f'{k}: {v}') |
🎯 このコードでやること: 二次データのメタ情報(行数・列数・対象年・欠損数など)を一気に出力し、 12 項目チェックの土台にする。
📤 実行結果:
💬 読み方: 「47 都道府県 × 12 年 = 564 行」がきれいに揃い、 欠損ゼロ。 SSDSE は学習教材として「整形済み二次データ」なので扱いやすい。 実務で出会う二次データの多くはこの段階で「欠損 30% / 重複行 / 列名揺れ」などが見つかります。
🎯 二次データの利用シーンと適性 — 何に向き、 何に向かないか
二次データは万能ではありません。 「どの問いに対して二次データが効くか」を見極めることが、 分析プロジェクトのコスト効率を決めます。 以下の表は、 卒業研究や社内意思決定でよく出てくる問いを 12 種類に分け、 「二次データだけで答えられるか」「一次データが必須か」を判定したものです。
| 問いの型 | 例 | 二次データ単独で答えられるか | 推奨アプローチ |
|---|---|---|---|
| 全国マクロ傾向 | 少子高齢化のスピード | ○ 二次で十分 | SSDSE-B / 国勢調査 |
| 地域比較 | 秋田と東京の所得差 | ○ 二次で十分 | RESAS / e-Stat |
| 時系列トレンド | 出生率の長期推移 | ○ 二次で十分 | 人口動態統計 |
| 仮説の事前検証 | 介護需要は西高東低か | ○ 二次で十分 | SSDSE-B クロス集計 |
| 教育用ハンズオン | 回帰分析の練習 | ○ 二次で十分 | SSDSE-B 教材 |
| 国際比較 | G7 の労働生産性 | ○ 二次で十分 | OECD.Stat / World Bank |
| 個人の意識・態度 | 若者の地方移住意向 | △ 既存調査次第 | 二次 + 補足アンケート |
| 行動の理由 | なぜ離職したのか | ✕ 一次必須 | 半構造化面接 |
| 特定企業・店舗の数値 | A 社の顧客満足度 | ✕ 一次必須 | 社内 POS / CRM |
| 介入効果の検証 | 広告 A/B テスト | ✕ 一次必須 | 実験計画 / RCT |
| 最新の市場動向 | 先週の SNS バズ | ✕ 一次必須 | API でリアルタイム取得 |
| 微細な現場観察 | 店舗動線の改善余地 | ✕ 一次必須 | エスノグラフィ |
「✕ 一次必須」の問いに二次データを当てはめると、 外形的な数字は出るが結論に説得力が出ない という症状になります。 とくに「行動の理由」「介入効果」「最新動向」は二次データの構造的弱点。 これらが含まれる問いを立てたら、 アンケートやログ取得など、 一次データ収集の計画を最初から組み込むのが近道です。
🤖 二次データを機械学習で扱うときの落とし穴と工夫
二次データを使った 回帰 や ランダムフォレスト による予測モデリングは、 卒論や Kaggle 入門で頻出する題材です。 ただし、 二次データには 「学習データと評価データの分布が同じ世界に閉じている」 という性質上の罠があり、 ここを意識しないと「モデルは良く見えるが現実では使えない」結果になります。
落とし穴 4 つ
- 同一データの何度も再利用 → リーケージ: 同じ二次データセットを「説明変数」と「目的変数」に重複して使うと、 因果に近い相関が混入し、 r² が不当に高くなる。
- 過去 → 未来の外挿: 二次データは過去の集計値。 2012-2023 のデータで学習したモデルは、 2026 年以降の予測には外挿になるため、 信頼区間を必ず併記する。
- 集計単位の固定化: 都道府県粒度のモデルは市区町村単位の予測に使えない。 集計単位を変えるとモデルを作り直すか、 マルチレベルモデルで対応する必要がある。
- 変数のラグ無視: 二次データは公開までに数か月〜数年のラグがある。 学習時点で「最新値」だと思っていたものが、 実は 2 年前の数字、 ということがよくある。
工夫 4 つ
- 時系列分割の評価: ランダム分割ではなく「2013-2020 学習 / 2021-2023 検証」のように時間で切る。
- 都道府県ホールドアウト: 「9 つの都道府県を学習に使わず、 評価専用にする」ことで、 地理的汎化能力を測る。
- マクロ指標との突合: モデル出力を内閣府・日銀のマクロ予測と突き合わせ、 桁違いになっていないか定期確認する。
- 更新パイプラインの設計: 二次データは年次更新が多いので、 「データが更新されたら自動で再学習」する仕組みを最初から書いておくと、 半年後の再現作業が劇的に楽になる。
💡 授業のコツ: 二次データで予測モデルを組ませる演習では、 学生にあえて「未来の都道府県データを 1 つだけ予測する」課題を与えると、 ラグ問題と外挿リスクの体感が一気に進みます。 「東京の 2024 年の高齢化率を予測してください、 ただし学習データには 2023 年までしか含めない」のような問題が効果的。
🌏 国際比較で見る二次データの活用 — 日本の SSDSE と海外の代表データセット
二次データは、 国内分析だけでなく 国際比較 で威力を発揮します。 日本の SSDSE-B-2026 と並んで、 世界には研究・教育用に整備された二次データセットが多数存在します。 ここでは、 同じ「都道府県 × 年」型の構造を持つ海外データと SSDSE を対比し、 国際比較研究の出発点を整理します。
| 国・地域 | 代表データセット | 構造 | SSDSE-B-2026 と対応するか |
|---|---|---|---|
| 日本 | SSDSE-B-2026 | 都道府県 × 12 年 × 112 変数 | 基準 |
| 米国 | American Community Survey (ACS) | 州・郡 × 年 × 多数 | ○ 「州=都道府県」で対応 |
| EU | Eurostat NUTS | NUTS2/NUTS3 × 年 × 多数 | ○ 行政区画レベル粒度が近い |
| 中国 | 中国統計年鑑 | 省・直轄市 × 年 × 多数 | ○ 省=都道府県相当 |
| 英国 | ONS Regional Data | 地域 × 年 × 多数 | ○ Region=ブロック相当 |
| 韓国 | KOSIS | 市道 × 年 × 多数 | ○ 市道=都道府県相当 |
| OECD | OECD.Stat | 国 × 年 × 数百指標 | △ 国レベルでは構造が違う |
国際比較研究では「構造が近い 2 つのデータセットを揃える」のがコツです。 SSDSE-B-2026 を「都道府県 × 年」で持ってきたら、 米国は「州 × 年」、 EU は「NUTS2 × 年」と粒度を揃えると、 後の結合と可視化が楽になります。 行政区画が違う国同士を比べるときは 「人口で正規化した比率」 に変換するのが鉄則。 これを怠ると、 日本と中国を「絶対量」で比べてしまい、 ほぼ全指標で中国が上回るという意味のない結論に終わります。
国際比較を行う際の二次データ突合パイプライン
1 2 3 4 5 6 7 8 9 10 11 12 13 14 15 16 17 | import pandas as pd # 日本の人口は SSDSE-B-2026 で確認できるが、GRP(GDP) は SSDSE-B に含まれない jp = pd.read_csv('data/raw/SSDSE-B-2026.csv', encoding='cp932', skiprows=[1]) jp_pop = jp.groupby('SSDSE-B-2026')['A1101'].sum() # 年別の全国人口 print('SSDSE 全国人口(2023):', int(jp_pop.loc[2023])) # 国際的な GDP 比較は OECD.Stat から取得する(列: country, year, pop, grp) oecd = pd.read_csv('data/raw/oecd_population_grp.csv', encoding='cp932', header=0) # 実際は API 取得 oecd = oecd[oecd['country'].isin( ['JPN', 'USA', 'DEU', 'GBR', 'KOR', 'CHN'])] # 一人あたり GRP(GDP) を計算して 国 × 年 の表に整形 oecd['grp_per_capita'] = oecd['grp'] / oecd['pop'] pivot = oecd.pivot(index='year', columns='country', values='grp_per_capita').round(1) print(pivot.tail()) |
🎯 このコードでやること: 日本の人口を SSDSE-B-2026 で確認しつつ、 GDP を含む国際比較は OECD.Stat から取得し、 一人あたり GRP の国際比較表を作成する。 SSDSE-B に GRP(GDP) 列は無いため、 経済規模は必ず外部の二次データで補う。
📤 実行結果(1 行目だけ実測。 data/raw/oecd_population_grp.csv は同梱していないので、 表は出力の形(行 = 年、 列 = 国コード)だけを示し、 値は検証できないので「…」とした):
💬 読み方: 1 行目の 124,353,000 人は SSDSE-B-2026 の 2023 年度 47 都道府県の A1101 を足した実測値。 その下の表は OECD のファイルを同梱していないため値を載せておらず、 行が年・列が国コードの横持ちに整形されることだけを示している。 実際に OECD から取得したら、 単位(千 USD か USD か)と、 名目の為替換算か PPP かを確かめてから比べる。 二次データを国際比較に使う際は (1) 為替換算 (2) 物価調整 (3) PPP(購買力平価) のどれで整えるかを必ず明示しましょう。
📅 縦断分析テンプレート — 二次データで「変化」を語る
二次データは 同じ集計単位を長期間にわたり追跡できる 強みがあります。 これを活かして「縦断分析(longitudinal analysis)」を行うと、 政策・経済・社会の 変化のドライバー を可視化できます。 ここでは、 SSDSE-B-2026 の 11 年間(2013-2023)データを用いた標準的な縦断分析テンプレを紹介します。
- (1) 起点年と終点年の差を計算: 各都道府県の指標について 2013→2023 の変化率を算出
- (2) 全国平均と各県の乖離を比較: 「全国は X% 増、 この県は Y% 増」と相対化
- (3) 上昇県 / 下降県の特徴抽出: 業種構成・人口動態・地理特性で説明できるか
- (4) 反転年を検出: 11 年間で増加から減少に転じた年を特定
- (5) 移動平均で短期ノイズを除去: 3 年移動平均で大きな流れを取り出す
- (6) 仮説の暫定検証: ピアソン相関や単回帰で時系列傾向を係数化
テンプレ実装:高齢化率の縦断分析
1 2 3 4 5 6 7 8 9 10 11 12 13 14 15 16 17 | import pandas as pd df = pd.read_csv('data/raw/SSDSE-B-2026.csv', encoding='cp932', skiprows=[1]) df['elderly_rate'] = df['A1303'] / df['A1101'] * 100 # (1) 起点と終点の差 base = df[df['SSDSE-B-2026'] == 2013][['Prefecture', 'elderly_rate']].rename(columns={'elderly_rate': 'rate_2013'}) end = df[df['SSDSE-B-2026'] == 2023][['Prefecture', 'elderly_rate']].rename(columns={'elderly_rate': 'rate_2023'}) delta = base.merge(end, on='Prefecture') delta['change_pp'] = delta['rate_2023'] - delta['rate_2013'] # (2)(3) 全国平均と乖離 nat_change = delta['change_pp'].mean() delta['gap_from_nat'] = delta['change_pp'] - nat_change print('全国平均変化:', round(nat_change, 2), 'pp') print('上昇幅トップ 5:') print(delta.nlargest(5, 'change_pp')[['Prefecture', 'rate_2013', 'rate_2023', 'change_pp']].to_string(index=False)) |
🎯 このコードでやること: 11 年間の高齢化率変化を都道府県別に算出し、 全国平均との乖離で「相対的に高齢化が速い県」を抽出する。
📤 実行結果(参考値):
💬 読み方: 全国平均が +5.0pp 上昇する間に、 秋田・青森は +7.3〜+7.5pp と 全国平均を大きく上回るペースで高齢化が進行。 一方、 東京 (+0.9pp) や神奈川 (+3.5pp) など首都圏は全国平均を下回る。 二次データの縦断分析は、 こうした「平均から見えない地域差」を可視化する強力な道具です。
縦断分析でやってはいけない 3 つのこと
- 始点・終点の単年比較だけで結論を出す: 1 年だけ異常値があると全体結論が歪む。 必ず 3 年移動平均や直線フィットも見る。
- 定義変更を無視する: 二次データは途中で「集計対象」「分母」が変わることがある。 メタデータの改訂履歴を確認しよう。
- 因果関係を断定する: 縦断データから出るのはあくまで相関。 「政策 X が原因で Y が変化した」と書くなら、 比較群・差の差(DID)など因果推論の枠組みが要る。
⚖ 二次データの倫理・再現性・運用ガイド
二次データは「すでに公開されているから安心」ではありません。 出典の追跡可能性、 個人特定リスク、 再現可能なパイプライン、 改訂対応など、 一次データとは異なる 運用上の作法 があります。 この節では、 卒業研究・社内分析・教材作成の各場面で「二次データを安全かつ再現可能に使う」ための実務手順をまとめます。
(1) 出典の追跡可能性 — provenance
分析結果が外部からレビューされる場面(卒論審査・学会発表・社内決裁)では、 必ず 「どのデータをいつ取得したか」 を逐一記録します。 SSDSE-B-2026 のようなファイル配布型であれば、 ダウンロード日時とファイル SHA-256 ハッシュをスクリプトの先頭にコメントで残すと、 後日 同一ファイルか別バージョンか を一発で判定できます。 e-Stat API のような取得型なら、 API リクエストのパラメータ一式と取得タイムスタンプを raw_request.json に保存しましょう。
(2) 個人特定リスク — re-identification
匿名化された二次データでも、 複数のデータセットを結合する ことで個人が再特定される事例が世界的に報告されています。 SSDSE-B-2026 は都道府県粒度の集計値なので個人特定リスクはほぼゼロですが、 市区町村粒度の二次データを SNS データと突合する研究では注意が必要です。 K-匿名化(同じ属性組合せが K 人以上いる状態の保証)や差分プライバシーといった概念を最低限押さえ、 「結合先データセットの粒度」を必ずチェックする習慣を持ちましょう。
(3) 再現可能パイプライン — reproducible pipeline
二次データを使った分析は、 半年後に別の人(あるいは将来の自分)が再現できる状態に保つのが理想です。 以下の 5 要素を揃えると、 卒論の口頭試問や社内引き継ぎが格段に楽になります。
- raw データのファイル名・取得日時・ハッシュを README に明記
- 前処理スクリプト(欠損補完・型変換・列名統一)を 1 つの
.pyファイルに集約 - 分析スクリプトと 図表生成スクリプトを分離(責務の明確化)
- requirements.txt または environment.yml でライブラリのバージョン固定
- Makefile または シェルスクリプトで「make all」だけで全結果が再現できる状態に
1 2 3 4 5 6 7 8 | import hashlib from pathlib import Path raw_path = Path('data/raw/SSDSE-B-2026.csv') sha256 = hashlib.sha256(raw_path.read_bytes()).hexdigest() print(f'file: {raw_path.name}') print(f'size: {raw_path.stat().st_size:,} bytes') print(f'sha256: {sha256[:16]}...') |
🎯 このコードでやること: 二次データファイルの SHA-256 ハッシュを計算し、 README に貼り付けるための情報を出力する。
📤 実行結果(例):
💬 読み方: SHA-256 の先頭 16 文字を README に残しておけば、 1 年後に「同じファイルを使っているか」が確実に分かります。 二次データの「同じ名前で違う中身」事件は意外と多く、 ハッシュ確認は最低限の自己防衛です。
(4) 改訂対応 — version drift
二次データは年次・四半期で更新され、 過去値が 遡及修正 されることがあります。 たとえば内閣府の GDP 統計は四半期ごとに過去 3 年分が改訂されることが珍しくありません。 半年前に書いた論文と同じスクリプトを再実行したら微妙に数値がずれた、 という現象は二次データ分析では日常茶飯事。 これに耐えるには、 (i) 取得時のスナップショットを保管、 (ii) 「データ取得日: 2026-05-29」と論文本文に明記、 (iii) 過去値が改訂された場合の取り扱い方針(再計算するか、 当時の値を凍結するか)を方針として固める、 の 3 点が要諦です。
📝 自分でやってみよう — 二次データ実践課題 8 つ
二次データの扱いは 手を動かしてこそ身につきます。 SSDSE-B-2026 を題材に、 段階的に難易度を上げた 8 つの実践課題を用意しました。 最初の 3 つは 30 分で終わるウォームアップ、 4-6 は卒論レベルの分析、 7-8 は学会発表レベルのチャレンジ課題です。
ウォームアップ(30 分以内)
- 課題 1: 年次集計表の作成: SSDSE-B-2026 を読み込み、 2023 年の全都道府県の人口・一般診療所数の合計値を出してください。 全国合計が公的統計と一致するかを確認しましょう。
- 課題 2: 上位 10 県の抽出: 人口の多い順に 10 県、 少ない順に 10 県をリストアップ。 それぞれの平均一般診療所数も併記してください。 都市圏と地方の差を体感する。
- 課題 3: 散布図とヒストグラム: 課題 1 のデータを使って、 人口 vs 一般診療所数の散布図と、 人口のヒストグラムを描画してください。 図 1 と図 2 を自分で再現する練習。
卒論レベル(数時間〜数日)
- 課題 4: 比率変換による地域比較: 高齢者数 (A1303) を人口で割り、 高齢化率の都道府県別ランキングを作成。 絶対量ランキングと比率ランキングがどう違うかを 1 ページのレポートにまとめてください。
- 課題 5: 縦断分析 — 11 年間の変化: 2013-2023 の高齢化率の変化を都道府県別に計算し、 「全国平均より速く高齢化した県」をリストアップ。 共通点(地理・産業)を考察してください。
- 課題 6: 二変数分析: 高齢化率と一般診療所数(10 万人あたり)の相関を都道府県別に分析。 散布図と回帰直線を描き、 結果の解釈を 200 字でまとめてください。 「相関≠因果」の議論も含める。
学会発表レベル(数週間)
- 課題 7: 複数二次データの組み合わせ: SSDSE-B-2026 + e-Stat の住民基本台帳人口移動報告を組み合わせ、 「子育て世代の転入超過と保育所定員数」の関係を分析。 学会ポスター 1 枚分のストーリーを構築してください。 ケース B の再現と発展。
- 課題 8: 国際比較研究: SSDSE-B-2026(日本)と OECD.Stat の州別データ(米国・ドイツ)を組み合わせ、 「先進国の人口集中度」を比較。 ジニ係数や HHI(ハーフィンダール・ハーシュマン指数)で定量化し、 国際学会発表レベルの考察を行ってください。
💡 学習の進め方: 課題 1-3 を 1 日で終わらせ、 課題 4-6 を週末 2 日で、 課題 7-8 を 2-3 週間かけて取り組むのが標準ペースです。 各課題の成果物は GitHub などで公開し、 README に「課題番号・データ取得日・SHA-256 ハッシュ・実行コマンド」を必ず添えると、 ポートフォリオとしても活用できます。
よくあるつまずきポイント
- SSDSE-B-2026 の文字コード(cp932)を UTF-8 で読んでエラーになる →
encoding='cp932'を必ず指定 - 列名の数字部分(A1101、 I5102 など)が記憶しにくい → 定義書を手元に置き、 「人口=A1101、 一般診療所数=I5102」をメモする
- 2 行目がメタ情報行のため、 そのまま読むとデータが 1 行ずれる →
skiprows=[1]またはheader=[0,1]で対応 - 都道府県名の表記(北海道道 / 沖縄県)の揺れに注意 → 突合前に
str.strip().str.replace('県', '')で正規化を検討 - 年度(年次)と暦年の混同 → SSDSE-B-2026 は暦年ベース、 国民経済計算は年度ベース。 期間の食い違いに注意
💬 二次データを巡る一問一答(補追)
授業や演習でよく出る追加質問を、 短答形式で整理しました。 上で説明した内容と被らない、 一段踏み込んだ問いを並べています。
- Q. 二次データの「典型」と「外れ値」をどう区別すればよいですか?
- A. 箱ひげ図の 1.5×IQR ルールを最初の目安にしつつ、 ヒストグラムで分布の形を必ず併用します。 SSDSE-B-2026 の人口分布では東京と神奈川が「外れ値」と判定されますが、 実態としては「外れ値ではなく構造的に大きい都市圏」です。 統計的に外れ値と、 構造的に大きいだけのものを区別する目を養いましょう。
- Q. 二次データの分析結果を公表する際、 どこまでオープンにすべき?
- A. 取得元が「政府標準利用規約」や「CC BY」など緩いライセンスなら、 raw データ・前処理・図表生成スクリプトをすべて GitHub などで公開して問題ありません。 むしろ 再現可能性を最大化する ほうが、 卒論・論文の評価が上がります。 民間データ(POS、 SNS API など)の場合は契約条項に従い、 集計結果のみ公開する形が一般的です。
- Q. 二次データだけで「予測モデル」を組んでもよいですか?
- A. もちろん可能ですが、 「過去 → 未来の外挿」 になることを必ず認識しましょう。 SSDSE-B-2026 で 2012-2023 を学習に使い、 「2025 年の高齢化率を予測」する課題は学習に最適ですが、 結果を「正しい未来」とは言えません。 予測区間の幅、 想定の前提(人口移動・出生率が現状維持など)を明示して結果を提示する習慣をつけましょう。
- Q. 二次データを使った分析を、 高校生・初学者にも伝えるコツは?
- A. (1) 都道府県や年といった 身近な単位 で比較する、 (2) 数式や統計用語の前に 図を 1 枚見せる、 (3) 「平均」「中央値」「最頻区間」の使い分けを 具体例で 1 分以内に 説明する、 の 3 点が効果的です。 SSDSE-B-2026 はもともと教育用に設計されているので、 高校・大学初年次の素材として理想的。
- Q. 二次データの「鮮度」と「精度」のトレードオフをどう考えるか?
- A. 一般に、 鮮度が高い二次データ(速報値、 月次値、 推計値)は精度が低めで、 のちに改訂されることが多いです。 一方、 確定値(年次の国勢調査、 経済センサスなど)は精度が高い反面、 公開までに 1〜2 年のラグがあります。 卒論やレポートでは「いま分かっている確定値」と「最新の速報値」のどちらを使うかを 問いの性質 に応じて選び、 選んだ理由を明記しましょう。 トレンドを見るなら速報値、 確定的な議論をするなら確定値、 が大まかな目安です。
- Q. 「二次データの分析だけで論文は書けるか?」と問われたら?
- A. 答えは「テーマ次第で、 十分に書ける」。 マクロな傾向、 地域比較、 時系列の変化、 国際比較などは二次データ単独で説得力のある論文が成立します。 一方、 個人の心理や微細な行動を扱うテーマでは、 一次データ(アンケート、 ログ、 観察)の併用が事実上必須です。 二次データの強みは「規模の大きさ」と「再現性」、 弱みは「自分の問いに完全には合わない」こと。 この特性を踏まえて問いを設計するのが、 卒論・修論の成否を分ける鍵になります。
- Q. 二次データの「変数の意味」を一次的に確認する手段は?
- A. 提供元の 定義書(コードブック、 メタデータ、 説明資料) を必ず参照します。 SSDSE-B-2026 なら独立行政法人統計センターが配布する PDF 定義書、 e-Stat なら統計表ごとの「メタデータ」ボタン、 OECD.Stat なら各データセットの "Metadata" タブが該当します。 列名(A1101 など)だけ見て分析を始めると、 「人口」が常住人口か昼間人口か、 「医師数」が病院勤務だけか開業医を含むかなど、 意味の取り違えが起こります。 5 分間定義書を読むだけで、 半日分の解釈ミスを防げます。
- Q. 二次データの分析を、 半年後の自分が再現できるための最低限の作法は?
- A. (1) raw データのファイル名・取得日時・SHA-256 ハッシュを README に記録、 (2) Python・ライブラリのバージョンを requirements.txt で固定、 (3) 前処理〜図表生成までを 1 つのスクリプトで再現可能にする、 の 3 点が最低ライン。 これさえ守れば、 半年後の自分はもちろん、 卒論を引き継ぐ後輩や、 共同研究者にも 30 分以内に「同じ結果」を出せる状態を渡せます。 二次データ分析の信頼性は、 結局のところ 「環境再現性」と「データ系譜の追跡可能性」 の 2 軸でほぼ決まります。 この習慣は学部 1 年から身につけておけば、 修論・学位論文の段階で必ず効いてくる、 投資対効果の高いスキルの一つです。 早めに身につけて損はありません。 ぜひ習慣化しましょう。
🎮 触って理解する — 調査計画シミュレータ
リサーチ課題を選び、 予算と時間の余裕をドラッグで動かすと、 「自分で調査する(一次データ)」と「既存データを使う(二次データ)」の特性ゲージと判定がリアルタイムに変わります。 二次データは安くて速いが、 目的とのズレがある — この使い分けの感覚を体で覚えましょう。
※ ゲージの数値は各特性を 0〜100 の相対値で表した教材用の目安です(実測の統計値ではありません)。
🎨 直感 — 「他人が集めたデータの再利用」という発想
二次データの本質は再利用です。 国勢調査のような全数調査を個人が実施することは不可能ですが、 公表された集計表なら誰でも無料で使えます。 シミュレータで体感した通り、 予算・時間が乏しいほど二次データの「低コスト・即入手」が効き、 逆に「自社顧客」のように母集団が自分に固有の課題では、 どんなに安くても既存データでは代替できません。 判断の軸は常に「その既存データは、 私の問いの母集団・変数・時点をカバーしているか」です。
⚠️ よくある落とし穴 — 定義・粒度・鮮度のズレと出典確認
- 定義のズレ: 元の調査は別の目的で設計されているため、 欲しい変数がそのままの定義では存在しないことが多い(例: 「高齢者」が 65 歳以上か 75 歳以上か)。 メタデータ(調査票・用語定義書)を必ず確認。
- 粒度のズレ: 個人単位が欲しいのに県単位の集計表しかない、 品目別が欲しいのに大分類しかない — 公表された集計より細かい粒度には戻れません。
- 鮮度のズレ: 調査から公表までのタイムラグ、 5 年周期の調査(国勢調査など)では「今」の値は得られない。 データの調査時点と公表時点を区別して明記する。
- 出典確認: 孫引き・転載データは加工ミスや旧版が混入しがち。 e-Stat や オープンデータの一次配布元まで遡り、 出典・年版・ライセンスをレポートに明示する。
🚀 発展 — 一次データとの併用・メタ分析へ
実務・研究では「二次 vs 一次」の二者択一ではなく併用が定石です。 まず二次データ(SSDSE-B-2026 や e-Stat)で市場規模・地域差などの全体像を低コストに把握し、 残った固有の問いだけを一次データ(自前アンケート・実験)で検証すれば、 標本設計のコストを最小化できます。 さらに、 複数の既存研究・既存データの結果を重み付きで統合するメタ分析(メタアナリシス)は二次利用の発展形で、 本ページ「📐 数式・定義」セクションの重み付き平均 $\hat{\theta}_{\text{pooled}}$ がその心臓部です。 データ収集の全体設計や、 リテラシーとしての位置付けは データリテラシーのページも参照してください。
🗺 概念マップ
関連概念を視覚的に整理した概念マップ。
マップ中心の 2 次データから 6 軸が伸びる。 「政府統計 (e-Stat、 国勢調査)」「企業公開データ (有報、 EDINET)」「学術 / 商用パネル (SSDSE、 PSID)」「API・スクレイピング (Twitter API)」「メタデータ整備 (定義書・更新頻度)」「再利用ライセンス (CC、 利用規約)」が放射状に展開する。 SSDSE-B-2026 は独立行政法人統計センターが整備した代表的な 2 次データ教材で、 47 都道府県 × 多年度 × 100 列超の構造を学習用に整えた典型例。
🔗 隣接手法への橋渡し
「二次データ」は 他者が収集・公開した資料を再利用する分析戦略 であり、 SSDSE-B-2026 や e-Stat のように出所が明確なソースを軸にメタデータ確認 → クリーニング → 再現性記録という流れを構築することで、 一次データを取らずとも査読論文水準の信頼性を確保できる。
⬆️ 上流: データの出所確認
⬌ 並列: 別の入手方法
⬇️ 下流: 検証と活用
SSDSE-B-2026 のような二次データは、 出所 → メタデータ → クリーニング → 解析 → 再現性確保 の流れを徹底することで、 一次データを取らずとも信頼できる分析が可能になる。
🌳 手法選択フロー
「2次データ」を使うか自分で1次データを集めるかは、 目的とコスト・代表性で判断する。
- 既存データで研究目的を達成できるか? Yes → SSDSE-B-2026 等の公開2次データを採用、 No → 1次データ収集を計画
- 対象期間・対象母集団が一致するか? Yes → そのまま利用、 No → 部分母集団を抽出 or 期間を限定 (例: SSDSE-B-2026 から特定年だけ取り出す)
- 定義変更があるか? Yes → 出典資料の「調査方法の変更」を確認し時系列を分割、 No → 通年で結合
2次データは低コストで再現性が高いが、 質問項目を変えられない・定義変更のリスクがある。 SSDSE-B-2026 は基本的な統計指標が揃っており、 教育用途には最適。