🔖 キーワード索引
「データのメタ化」を取り巻く中核キーワード群です。 検索やインデックス作成で参照する際の手がかりにしてください。 各キーワードは関連する概念・手法・道具立てを含み、 文献検索や学習計画の起点になります。
このページの節への目次です。
💡 30秒で分かる結論 — データのメタ化
🍰 まずはやさしく
データについての説明書を作ることです。
必要なデータをすぐに見つけるために使います。
スマホの写真に日付や場所を付けるようなものです。
この章ではメタ化の結論について読みます。
最も忙しい読者のために、 まず結論だけまとめます。 詳細は以下のセクションへ:
- データのメタ化=データそのものだけでなく、 「データに関するデータ」(メタデータ)を整備する考え方。
- メタデータ例:作成日時、 出所、 カラム定義、 単位、 更新頻度、 アクセス権、 リネージ(系譜)。
- 目的:探索性(必要なデータが見つかる)・信頼性(出所が分かる)・再現性(誰が見ても同じ理解)。
- ツール:DataHub, Amundsen, Apache Atlas, dbt docs などのデータカタログ。
- FAIR 原則:Findable, Accessible, Interoperable, Reusable。
- SSDSE で確かめると:CSV に単位の行は無く、列ごとの調査年・「年齢不詳を含む」「県庁所在市の値」といった注記も CSV の外にある。これを知らずに計算すると、2020 年度に 30 県で高齢化率が下がって見えるなどの誤読が起きる(⚠️ 章)。
📍 文脈 — どこで出会うか
🍰 まずはやさしく
データの迷子を防ぐための仕組みです。
分析の時間を短くして効率を上げるために使います。
部活の集計表で単位が分からず困る時に役立ちます。
この章ではメタ化が必要な場面について読みます。
「このカラム何を意味してるんだろう?」 「この CSV いつ作ったやつ?」 「単位は円?千円?」 — メタデータが整っていないと、 こんな疑問が毎回発生し、 分析の効率が落ちます。
🎨 直感で掴む
🍰 まずはやさしく
図書館の本にある目録のようなものです。
大量のデータから目的のものを探すために使います。
買い物で商品のラベルを見て中身を判断する感覚です。
この章ではメタ化のイメージについて読みます。
図書館の本に喩えると:
- データ=本の中身
- メタデータ=著者・出版年・分類記号・所蔵場所・あらすじ
本が 1 万冊あっても、 メタデータ(目録)がなければ目的の本は見つかりません。 同様に、 データレイクに 10 万ファイルあっても、 メタデータがなければ 事実上「無い」 のと同じ。
🎨 概念図で押さえる
データのメタ化の核心を 3 つの図で押さえる。 ① メタデータの 3 層構造、 ② メタ化前後のデータ可用性比較、 ③ メタ化された資産の流通サイクル。


図のまとめ: メタデータは 3 層 (記述・管理・構造) で構成され、 メタ化されたデータは検索性と再利用性が桁違いに高まり、 収集 → メタ化 → 公開 → 再利用のサイクルで継続的に価値を生み続ける。
📐 定義 — メタ化の形式化
🍰 まずはやさしく
データに意味や出所を紐付けることです。
誰が見ても同じ理解ができるようにするために使います。
テストの点数表に、何の科目か名前を付けることです。
この章ではメタ化の詳しい定義について読みます。
「データ $D$ をメタ化する」とは、 値の集合 $D = \{x_1, x_2, \ldots, x_n\}$ に対して、 各要素・データセット全体・出自を記述する メタデータ写像 $\mu: D \to M$ を構築することを指す。 ここで $M$ はメタデータ空間(スキーマ・型・出自・意味タグの集合)。
SSDSE-B-2026(47 都道府県 × 112 列)の場合、 $\mu$ は「列名 → 単位・出典・更新日」「行ラベル → 都道府県コード」「ファイル全体 → 出典 URL・取得日時」を返す関数として実装される。 メタ化が無いとデータは「不明な数字の羅列」のままで、 監査も再利用もできない。
μ の 4 つの成分を、SSDSE-B-2026 で具体的に埋めると次のようになります(数値はこのページの 🐍・⚠️ のコードで実データから確かめたもの)。
| 成分 | SSDSE-B-2026 での中身 | CSV の中にあるか |
|---|---|---|
| technical(技術) | 564 行 × 112 列、cp932、見出し 2 行、整数 104 列・小数 6 列・文字列 2 列、主キー(年度, 地域コード) | 値と見出しから自動で取れる |
| business(意味) | A1101 = 総人口、L3221 = 県庁所在市の二人以上の世帯の 1 か月の消費支出、単位 | 項目名はあるが、単位と範囲は無い |
| operational(運用) | 2026 年版、収録は 2012〜2023 年度、国勢調査の年と推計の年が混在 | 年度の列はあるが、推計か実数かは無い |
| lineage(来歴) | 元の統計(国勢調査・人口推計・人口動態統計・家計調査など)と、派生列の作り方 | 無い(配布元の説明と、利用者の記録で補う) |
🔬 記号・要素の読み解き
- 技術メタデータ
- スキーマ、 データ型、 行数、 ファイルサイズ、 更新日時。
- ビジネスメタデータ
- カラムの意味、 集計の定義、 部門名、 所有者、 用語集との対応。
- 運用メタデータ
- パイプライン実行履歴、 SLA、 障害履歴、 アクセスログ。
- 系譜 (lineage)
- 「このテーブルはどのソースから作られた?」 「変更すると何が影響を受ける?」
- データカタログ
- メタデータを横串検索できるシステム。 組織内 Google 検索。
🔬 数式を言葉で読み解く
メタデータの完備性は、 必要メタフィールド数 $K$ のうち実際に記入されている数 $k$ の比率 $C = k / K$ で測れる。 また再発見性 $R = 1/T$(検索から発見までの平均時間 $T$ 秒の逆数)も使われる。 両者の積 $CR$ をデータカタログ評価指標とする。
ただし $C$ は「項目が埋まっているか」を数えるだけで、「中身が正しく十分か」は測りません。SSDSE-B-2026 の CSV では、L3221(消費支出)は項目名に「(二人以上の世帯)」の注記があって $C = 0.75$ と高めに出ますが、「県庁所在市の値」という最も誤解を生む範囲の情報は入っていません。A1101(総人口)は $C = 0.50$ ですが、足りないのは単位だけでなく「国勢調査の年は年齢不詳を含む」「推計の年は千人単位」という注記です。$C$ を上げることを目標にすると、誤読を防がない注記で項目を埋める方向に進みがちなので、「その列でどんな誤読が起きうるか」から必要な項目 $K$ を決めるのが先です。
🏭 産業界活用事例 6 件
データのメタ化 は研究室の中だけでなく、 現場で大きな価値を生み出している。 業界別に 6 例を紹介する。
| 業界 | 具体事例 |
|---|---|
| 金融 | ISIN(国際証券識別番号)など、同じ銘柄を指す識別子を複数の体系で対応づけて管理 |
| 医療 | DICOM 画像にメタタグ(患者 ID、 撮影機器、 ピクセル間隔)を埋め込み。 PACS で検索 |
| 製造 | IoT センサーログにメタ(センサー ID、 ロット、 校正日)。 Industry 4.0 の前提 |
| 行政・統計 | SSDSE-B-2026 の列コード(A1101 = 総人口)。 e-Stat の統計表 ID 体系 |
| 放送・映像 | EBUCore メタデータで「タイトル / 出演者 / 著作権者 / 放送日」を XML 記述 |
| 学術 | DataCite DOI で論文付属データに永続識別子。 引用情報が機械可読 |
📊 関連手法 比較表
データのメタ化 と近接する手法群の位置づけを並べる。 隣接領域を押さえると、 自分のタスクで何を使うべきかが立体的に見えてくる。
| 手法 | 位置づけ | 代表ツール |
|---|---|---|
| Dublin Core | 汎用 15 要素 | 図書館・博物館 |
| Schema.org | Web 検索エンジン向け | Google 検索結果リッチスニペット |
| DCAT | データカタログ標準 | EU/US 政府オープンデータ |
| ISO 19115 | 地理空間データ | GIS, 衛星画像 |
| PROV-O | 来歴メタデータ | 再現性確保 |
| DataCite | 学術データ DOI | 研究データ引用 |
💥 現場の失敗例 5 件
「うまくいくケース」より「失敗ケース」のほうが学びが多い。 実プロジェクトで頻発する 5 つを示す。
🧮 実値で計算してみる
SSDSE-B-2026 の CSV を受け取った人が、ファイルの横に書き添えておくべきデータセット全体のメタデータの例です(ファイルそのものには、この表の情報は入っていません)。
| 項目 | 値 |
|---|---|
| 名称 | SSDSE-B 都道府県年次データ |
| 出所 | 独立行政法人統計センター(元データは総務省統計局などの公的統計) |
| 更新頻度 | 年次 |
| 行数 | 564(47 都道府県 × 2012〜2023 年度の 12 年度) |
| 主キー | (年度, 都道府県コード) |
| A4103 合計特殊出生率の単位 | 単位なし(1 人の女性が一生に産む子どもの数に相当する値) |
| 利用条件 | 配布元(統計センター)の利用規約を確認して、その名称と URL を書く |
🧮 数式に値を入れて手で計算する: SSDSE-B-2026 の CSV のメタデータ完備性
🔬 の完備性 $C = k / K$ を、SSDSE-B-2026 の CSV そのものに当てはめます。CSV は 1 行目が項目コード(A1101 など)、2 行目が日本語の項目名で、3 行目からデータです。指標列 109 本それぞれについて、必要なメタ項目を $K = 4$ 個(① 項目コード、② 項目名、③ 単位、④ 集計対象の注記)とし、CSV の中に書かれているものを $k$ と数えます。④ は「総人口(男)」「消費支出(二人以上の世帯)」のように、項目名に括弧で対象の限定が書かれていれば 1 とします。
$$\bar{C} = \frac{1}{109}\sum_{j=1}^{109} \frac{k_j}{4} = \frac{\sum_j k_j}{109 \times 4}$$
| Step | 計算 | 結果 |
|---|---|---|
| 1. 項目ごとに、書かれている列を数える | ① コード 109 本、② 項目名 109 本、③ 単位 0 本(単位の行が無い)、④ 注記 45 本 | 109 / 109 / 0 / 45 |
| 2. 合計 $\sum_j k_j$ | 109 + 109 + 0 + 45 | 263 |
| 3. 分母 $109 \times 4$ | 109 × 4 | 436 |
| 4. 平均完備性 $\bar{C}$ | 263 ÷ 436 | 0.6032 |
| 5. 列ごとの例 | A1101 総人口 = (1+1+0+0)/4、A110101 総人口(男)= (1+1+0+1)/4 | 0.50 / 0.75 |
平均は 0.60 ですが、足りない 4 割の中身が問題です。単位は 109 本すべてで欠けているので、H5610「1人1日当たりの排出量」が g なのか kg なのか、L3221「消費支出」が 1 か月か 1 年かは、CSV だけでは分かりません。
🎯 このコードでやること:Step 1〜5 を pandas で再現する。CSV の先頭 2 行(項目コードと項目名)だけを読み、指標列ごとに 4 つのメタ項目の有無を 0/1 で表にして、完備性 C を計算する。
1 2 3 4 5 6 7 8 9 10 11 12 13 14 15 16 17 18 19 | import pandas as pd # 1 行目 = 項目コード、2 行目 = 日本語の項目名。データ行は読まない head = pd.read_csv('data/raw/SSDSE-B-2026.csv', encoding='cp932', header=None, nrows=2) codes, names = head.iloc[0, 3:], head.iloc[1, 3:] # 先頭 3 列(年度・地域コード・都道府県)は識別子 K = 4 # コード・項目名・単位・集計対象の注記 meta = pd.DataFrame({ 'コード': codes.notna().astype(int).values, '項目名': names.notna().astype(int).values, '単位': 0, # CSV には単位の行が無い '注記': names.str.contains('(').astype(int).values, # 例: 総人口(男), 消費支出(二人以上の世帯) }, index=codes.values) meta['C'] = meta.sum(axis=1) / K print('指標列の数', len(meta)) print(meta.drop(columns='C').sum().to_string()) print(f"C の平均 = {meta['C'].mean():.4f}") print(meta.loc[['A1101', 'A110101', 'L3221', 'H5610']].to_string()) |
💬 指標列 109 本、コード 109・項目名 109・単位 0・注記 45 と Step 1 の数え上げに一致し、C の平均 0.6032 は Step 4 の 263 ÷ 436 と一致します。A1101 の 0.50 と A110101 の 0.75 も Step 5 のとおりです。L3221 は「(二人以上の世帯)」の注記があるので 0.75 ですが、この値が県全体ではなく県庁所在市の家計調査の値であることは項目名に書かれていません。注記があるから十分とは限らないことも、この表から読み取るべき点です。
🐍 Python での扱い
最小再現コード。 SSDSE-B のような実データを前提に、 4〜8 行で動く例です:
1 2 3 4 5 6 7 8 9 10 11 12 13 14 | import pandas as pd, json df = pd.read_csv('data/raw/SSDSE-B-2026.csv', skiprows=[1], encoding='cp932') year = df['SSDSE-B-2026'] metadata = { 'source': '独立行政法人統計センター SSDSE-B-2026', 'years': [int(year.min()), int(year.max())], # 収録年度(版の名前の 2026 ではない) 'n_rows': len(df), 'columns': list(df.columns), 'dtypes': {c: str(df[c].dtype) for c in df.columns}, } with open('SSDSE-B-2026.meta.json', 'w', encoding='utf-8') as f: # データの横に置くサイドカー json.dump(metadata, f, ensure_ascii=False, indent=2) print(metadata['source'], metadata['years'], metadata['n_rows'], '行', len(metadata['columns']), '列') print(pd.Series(metadata['dtypes']).value_counts().to_dict()) |
💬 収録年度は 2012〜2023 年度で、版の名前の「2026」とは違うので、年を 1 つだけ書く項目にせず、収録の最初と最後を years として値から取り出しています。型は整数 104 列・小数 6 列・文字列 2 列(地域コード・都道府県名)で、このメタデータを JSON のサイドカー(データの横に置く別ファイル)として保存しました。サイドカーはデータと一緒に移動し忘れやすいので(💥 失敗例 2)、フォルダごと受け渡すか、下の df.attrs や CSVW のように形式の中に持たせます。
🐍 Python 実装 — 4 段構え narration 付き
各コードブロックは 🎯 目的 / 📥 入力 / 🐍 コード / 📤 出力 / 💬 解説 の 5 要素セット。 SSDSE-B-2026 の 47 都道府県データ(2023 年)に実値計算して結論まで導く。
🎯 このコードでやること:SSDSE-B-2026.csv の各列に Dublin Core 風メタを Python の dict で付与し、 47 都道府県分の人口データに「説明」を貼り付ける
1 2 3 4 5 6 7 | import pandas as pd, json meta = { 'A1101': {'title': '総人口', 'unit': '人', 'source': '人口推計', 'year': 2023, 'creator': '総務省統計局'}, 'A4101': {'title': '出生数', 'unit': '人', 'source': '人口動態統計', 'year': 2023, 'creator': '厚生労働省'}, 'A5101': {'title': '転入者数', 'unit': '人', 'source': '住民基本台帳人口移動報告', 'year': 2023, 'creator': '総務省統計局'}, } print(json.dumps(meta['A1101'], ensure_ascii=False, indent=2)) |
💬 結果の読み方:列 A1101 を見て「総人口(人)」「2023 年・人口推計・総務省統計局」と即座に解釈できる。2023 年は国勢調査の年ではないので、総人口は国勢調査を基準に毎年推計した「人口推計」の値で、source を国勢調査と書くと来歴を誤る。A5101 も和名を「死亡数」と取り違えやすいが、正しくは転入者数(北海道 2023 年で 47,388 人)で、列コードだけの 5092000 や 47388 は、メタが無ければ何の数かを取り違える。
🎯 このコードでやること:pandas DataFrame の `df.attrs` 機能を使って、 SSDSE-B-2026 の 47 都道府県データ全体にデータセットレベルのメタを埋め込む
1 2 3 4 5 6 7 8 9 10 11 12 | import pandas as pd df = pd.read_csv('data/raw/SSDSE-B-2026.csv', encoding='cp932', skiprows=[1]) d2023 = df[df['SSDSE-B-2026'] == 2023].reset_index(drop=True) d2023.attrs = { 'identifier': 'SSDSE-B-2026', 'title': 'SSDSE-B-2026(都道府県別データ)の 2023 年度分', 'creator': '独立行政法人統計センター', 'year_covered': 2023, 'license': '(配布元の利用規約を確認して記入)', } print(d2023.attrs) print('行数:', len(d2023)) |
💬 結果の読み方:df.attrs に 5 項目のメタが入り、2023 年度の 47 行と一緒に持ち運べます。pandas 2.1 以降は pyarrow で Parquet に保存すると attrs も残るので、1 年後にファイルを開いて出所を確かめる手がかりになります。ただし CSV に書き出すと attrs は消えます。license は、配布元の利用規約を確かめずに CC BY などと書くと誤った来歴になるので、確かめるまでは「要記入」のままにしておきます。
🎯 このコードでやること:JSON-LD(DataCite 互換)で「総人口 A1101 の 2023 年データ」に DOI 風の機械可読メタを付け、 W3C 推奨形式で出力する
1 2 3 4 5 6 7 8 9 10 11 12 13 14 15 | import json rec = { '@context': 'https://schema.org/', '@type': 'Dataset', 'identifier': 'doi:10.0000/ssdse-b-2026-A1101', 'name': '都道府県別総人口 2023', 'creator': {'@type':'Organization','name':'総務省統計局'}, 'publisher': '独立行政法人統計センター', 'datePublished': '(配布元の公開日を記入)', 'license': '(配布元の利用規約の URL を記入)', 'variableMeasured': {'@type':'PropertyValue','name':'総人口','unitText':'人'}, 'spatialCoverage': '日本', 'temporalCoverage': '2023', } print(json.dumps(rec, ensure_ascii=False, indent=2)) |
💬 結果の読み方:出力は 11 項目の JSON-LD で、creator(総務省統計局)と publisher(統計センター)を分け、variableMeasured に単位「人」を持たせている。公開日とライセンスは配布元で確かめて書く項目なので、「記入」と明示した仮の値にしてある。Schema.org/Dataset 形式は Google データセット検索にもインデックスされる。identifier の doi:10.0000/… は説明用の架空の DOI なので、実際に公開するときは登録機関から発行された DOI に置き換える。
🎯 このコードでやること:メタ完備性指標 C = k/K を関数化し、 SSDSE-B-2026 のメタ辞書を 10 項目で採点する
1 2 3 4 5 6 7 8 | REQUIRED = ['identifier', 'name', 'creator', 'publisher', 'datePublished', 'license', 'variableMeasured', 'spatialCoverage', 'temporalCoverage', '@type'] def metadata_completeness(meta, required): k = sum(1 for f in required if f in meta and meta[f]) return k / len(required) rec = {'@context':'https://schema.org/','@type':'Dataset','identifier':'doi:...','name':'都道府県別総人口','creator':'X','publisher':'Y','datePublished':'2026-04-01','license':'CC-BY-4.0','variableMeasured':'人口','spatialCoverage':'日本','temporalCoverage':'2023'} C = metadata_completeness(rec, REQUIRED) print(f'メタ完備性 C = {C:.2f}({int(C*len(REQUIRED))}/{len(REQUIRED)})') |
💬 結果の読み方:REQUIRED の 10 項目がすべて rec に入っていて空でもないので、C = 10/10 = 1.00 になる。この関数は値が空でないかしか見ないため、creator が 'X' のような仮の値でも 1 点に数えられてしまう。C が 1.00 でも中身の正しさまでは保証しないので、値の形式(DOI の書式、日付、ライセンス URL)を別のチェックで確かめる。
🐍 コード体系そのものがメタデータ — 項目コードを読む
SSDSE-B-2026 の項目コード(A1101・E2501・L3221 …)は、でたらめな番号ではありません。1 文字目は総務省統計局の「社会・人口統計体系」の分野を表し、桁が増えると内訳になります(A1101 総人口 → A110101 男・A110102 女)。コードの規則を知っていれば、単位や定義が書かれていない CSV からでも、列どうしの関係の一部を機械的に取り出せます。
🎯 このコードでやること:CSV の先頭 2 行から項目コードと項目名を取り出し、1 文字目で分野ごとの列数を数える。コードが 5 文字より長い「内訳」の列について、親の列(先頭 5 文字)が同じファイルにあるかを確かめる。
1 2 3 4 5 6 7 8 9 10 11 12 13 14 15 16 | import pandas as pd head = pd.read_csv('data/raw/SSDSE-B-2026.csv', encoding='cp932', header=None, nrows=2) cols = pd.DataFrame({'コード': head.iloc[0, 3:].values, '項目名': head.iloc[1, 3:].values}) # 項目コードの 1 文字目は「社会・人口統計体系」の分野を表す field = {'A': '人口・世帯', 'B': '自然環境', 'C': '経済基盤', 'E': '教育', 'F': '労働', 'G': '文化・スポーツ', 'H': '居住', 'I': '健康・医療', 'J': '福祉・社会保障', 'L': '家計'} cols['分野'] = cols['コード'].str[0].map(field) print(cols.groupby('分野', sort=False).size().to_string()) # コードの桁が増えると内訳になる: A1101 総人口 → A110101(男)・A110102(女) kids = cols[cols['コード'].str.len() > 5] parent = kids['コード'].str[:5] print('内訳の列', len(kids), '個 / 親の列が同じファイルにある:', int(parent.isin(cols['コード']).sum()), '個') print(kids.head(4).to_string(index=False)) |
💬 109 列のうち人口・世帯と教育が 30 列ずつで最も多く、健康・医療と文化・スポーツは 3 列だけです。D(行政基盤)・K(安全)の分野の列は SSDSE-B-2026 には入っていません。内訳の列 32 個のうち 31 個は親の列が同じファイルにあり、残る 1 個は I510120(一般病院数)で、先頭 5 文字 I5101 の列はありません。コードの規則は便利ですが、「親が必ずある」とは限らないので、規則に頼るときも例外を数えておく必要があります。
🐍 メタデータ辞書で計算の前に止める — 範囲と単位の確認
メタデータは読むためだけのものではありません。列ごとの単位と「値がどの範囲を表すか」を辞書で持っておけば、意味のない計算をコードの側で止められます。SSDSE-B-2026 では、消費支出などの家計の列(L3xxx)は県全体ではなく県庁所在市の二人以上の世帯の値で、年平均気温(B4101)は県庁所在地の観測点の値です。
🎯 このコードでやること:5 つの列に単位と範囲のメタデータを付けた辞書を作り、割り算の前に範囲と単位を確かめる関数を通して、高齢化率(65 歳以上人口 ÷ 総人口)と「消費支出 ÷ 総人口」を計算する。
1 2 3 4 5 6 7 8 9 10 11 12 13 14 15 16 17 18 19 20 21 22 23 24 25 26 27 28 | import pandas as pd df = pd.read_csv('data/raw/SSDSE-B-2026.csv', encoding='cp932', skiprows=[1]) d = df[df['SSDSE-B-2026'] == 2023].set_index('Prefecture') # 列ごとのメタデータ(単位と、値がどの範囲を表すか)を辞書で持つ META = { 'A1101': {'名称': '総人口', '単位': '人', '範囲': '県全体'}, 'A1303': {'名称': '65歳以上人口', '単位': '人', '範囲': '県全体'}, 'L3221': {'名称': '消費支出(二人以上の世帯)', '単位': '円/世帯・月', '範囲': '県庁所在市'}, 'H5610': {'名称': '1人1日当たりの排出量', '単位': 'g/人・日', '範囲': '県全体'}, 'B4101': {'名称': '年平均気温', '単位': '℃', '範囲': '県庁所在地の観測点'}, } print(pd.DataFrame(META).T.to_string()) def ratio(num, den): """num / den を計算する前に、メタデータで範囲と単位を確かめる""" a, b = META[num], META[den] if a['範囲'] != b['範囲']: print(f"警告: {a['名称']}({a['範囲']})÷ {b['名称']}({b['範囲']})は範囲が違う") if '/' in a['単位'] or '/' in b['単位']: print(f"警告: {a['名称']} の単位は {a['単位']}(すでに率)。人数で割ると意味を失う") return d[num] / d[den] r1 = ratio('A1303', 'A1101') print(f"高齢化率 東京都 {r1['東京都'] * 100:.2f}%") r2 = ratio('L3221', 'A1101') print(f"消費支出 ÷ 総人口 東京都 {r2['東京都']:.4f} 鳥取県 {r2['鳥取県']:.4f}") |
💬 高齢化率(東京都 22.75%)は範囲も単位もそろっているので警告なしで計算されます。「消費支出 ÷ 総人口」は、県庁所在市の 1 世帯・1 か月の金額を県全体の人数で割ることになるので 2 つの警告が出ます。それでも計算自体は止まらず、東京都 0.0242、鳥取県 0.5076 と、人口の少ない県ほど大きくなるだけの数が出てしまいます。メタデータが無ければこの数を「1 人あたり消費」として 47 県で順位づけしかねません。実務では警告でなく例外(raise)にして、計算を止めるのが安全です。
🐍 リネージを残す — 派生列が「どこから・どう」作られたか
分析では、元の列から率や指数などの派生列を作ります。その派生列だけが別のファイルや図に渡ると、分母が何だったかが分からなくなります。派生列 1 本ごとに、入力の列・式・行の絞り込み・元ファイルの指紋(ハッシュ値)を記録しておくのがリネージ(系譜)の最小形です。
🎯 このコードでやること:2023 年度の 47 行から高齢化率を作り、入力列・式・絞り込み条件・行数・元ファイルの SHA-256 の先頭 16 桁を JSON で出力する。
1 2 3 4 5 6 7 8 9 10 11 12 13 14 15 16 17 18 19 20 21 22 23 | import hashlib import json import pandas as pd path = 'data/raw/SSDSE-B-2026.csv' digest = hashlib.sha256(open(path, 'rb').read()).hexdigest() # 入力ファイルの指紋 df = pd.read_csv(path, encoding='cp932', skiprows=[1]) d = df[df['SSDSE-B-2026'] == 2023].copy() d['高齢化率'] = d['A1303'] / d[['A1301', 'A1302', 'A1303']].sum(axis=1) * 100 # 派生列 1 本ごとに「どこから・どう作ったか」を残す(リネージ) lineage = { 'output': '高齢化率', 'unit': '%', 'inputs': ['A1303', 'A1301', 'A1302'], 'formula': 'A1303 / (A1301 + A1302 + A1303) * 100', 'filter': 'SSDSE-B-2026 == 2023', 'rows': int(len(d)), 'source_sha256': digest[:16], } print(json.dumps(lineage, ensure_ascii=False, indent=1)) print(d.nlargest(3, '高齢化率')[['Prefecture', '高齢化率']].round(2).to_string(index=False)) |
💬 JSON を見れば、高齢化率の分母が総人口 A1101 ではなく年齢 3 区分の合計であること、2023 年度の 47 行だけから作ったこと、元ファイルの指紋が 0fdbe5f603bb8e1e で始まることが分かります(ファイルが 1 バイトでも違えば指紋は変わる)。上位 3 県は秋田県 39.06%・高知県 36.28%・山口県 35.36% です。分母を年齢 3 区分の合計にした理由は、⚠️ 章の「年齢不詳」の節で実データを使って説明します。このような記録が図や表に付いていれば、別の人が同じ値を再現でき、分母の違う別の資料の値と比べてしまう事故も防げます。
🐍 列ごとに調査年が違う — SSDSE-A-2026 の「年度」の行
市区町村のデータ SSDSE-A-2026 は、SSDSE-B と違って先頭が 3 行あり、2 行目に列ごとの年度が書かれています。1 つの行(1 市区町村)に、国勢調査の年の値と最近の年の値が並んでいるからです。この行は、ファイルの中に埋め込まれた数少ないメタデータの 1 つです。
🎯 このコードでやること:SSDSE-A-2026.csv の先頭 3 行(項目コード・年度・項目名)を読み、指標列ごとの年度の分布と、総人口・出生数・転入者数の年度を並べる。
1 2 3 4 5 6 7 8 9 10 | import pandas as pd # SSDSE-A(市区町村)は 1 行目 = 項目コード、2 行目 = 列ごとの年度、3 行目 = 項目名 h = pd.read_csv('data/raw/SSDSE-A-2026.csv', encoding='cp932', header=None, nrows=3, dtype=str) meta = pd.DataFrame({'コード': h.iloc[0, 3:].values, '年度': h.iloc[1, 3:].values, '項目名': h.iloc[2, 3:].values}) print('指標列', len(meta), '本 / 年度の種類', meta['年度'].nunique()) print(meta['年度'].value_counts().sort_index().to_string()) # 同じ 1 行(1 市区町村)に、違う年の値が並んでいる例 print(meta[meta['コード'].isin(['A1101', 'A4101', 'A5101'])].to_string(index=False)) |
💬 指標列 125 本の年度は 2019〜2024 年の 6 種類に分かれ、2020 年が 39 本、2021 年が 43 本、2024 年が 19 本です。同じ行でも総人口は 2020 年(国勢調査)、出生数は 2023 年、転入者数は 2024 年の値です。「出生数 ÷ 総人口」で出生率を作ると、分子と分母で 3 年ずれた値を割ることになります。年度の行を読み飛ばす(skiprows=[1, 2])と、この情報は DataFrame から消えるので、読み込む前に列ごとの年度を別の表に取っておくのが安全です。
🐍 版が変わるとスキーマも変わる — SSDSE-A の 2022 版と 2026 版を比べる
同じ名前のデータでも、版が変わると列の名前や中身が変わります。手元の SSDSE-A の 2022 版と 2026 版の先頭 3 行だけを比べて、何が変わったかを数えます。スキーマの変更履歴(いつ・どの列が・どう変わったか)は、データそのものには書かれないメタデータの代表です。
🎯 このコードでやること:SSDSE-A-2022.csv と SSDSE-A-2026.csv の先頭 3 行から、識別子の列名、追加・削除された項目コード、項目名が変わった列、年度が変わった列を数え、項目名で 2 つの版を突き合わせたときに見つからない列の数を出す。
1 2 3 4 5 6 7 8 9 10 11 12 13 14 15 16 17 18 19 | import pandas as pd def header(year): """SSDSE-A の先頭 3 行(項目コード・年度・項目名)を列ごとの表にする""" h = pd.read_csv(f'data/raw/SSDSE-A-{year}.csv', encoding='cp932', header=None, nrows=3, dtype=str) return pd.DataFrame({'年度': h.iloc[1, 3:].values, '項目名': h.iloc[2, 3:].values}, index=h.iloc[0, 3:].values), list(h.iloc[0, :3]) old, id_old = header(2022) new, id_new = header(2026) print('識別子の列名', id_old, '→', id_new) print('追加された列', sorted(set(new.index) - set(old.index)), ' 消えた列', sorted(set(old.index) - set(new.index))) both = old.index.intersection(new.index) renamed = both[old.loc[both, '項目名'] != new.loc[both, '項目名']] moved = both[old.loc[both, '年度'] != new.loc[both, '年度']] print('共通の列', len(both), ' 項目名が変わった列', len(renamed), ' 年度が変わった列', len(moved)) print(pd.DataFrame({'2022 版': old.loc[renamed[:3], '項目名'], '2026 版': new.loc[renamed[:3], '項目名']}).to_string()) # 項目名で 2 つの版をつなぐと、つながらない列が出る print('項目名で突き合わせて見つからない列', int((~new.loc[both, '項目名'].isin(old['項目名'])).sum())) |
💬 識別子の列名が prefecture → Prefecture と大文字に変わったので、2022 版を前提に df["prefecture"] と書いたコードは 2026 版で KeyError になります。項目コードは D1202 が 1 本増えただけで、共通の 124 本はコードのまま対応がつきますが、そのうち 27 本は項目名が変わっています。多くは「農業,林業」→「農業、林業」のような読点や全角数字の表記の変更ですが、A8201 は「高齢夫婦のみの世帯数」から「夫65歳以上、妻60歳以上の夫婦のみの世帯数」へ、定義がはっきり書かれた名前に変わりました。項目名で突き合わせると 27 本がつながらないので、版をまたぐ比較は項目コードをキーにし、名前の変更と年度の変更(85 本)を変更履歴として残しておきます。
🐍 値から技術メタデータを起こす — 型・小数・丸めの単位
単位や精度が書かれていなくても、値そのものから読み取れるメタデータ(技術メタデータ)があります。列ごとに型、小数を含むか、値が 1,000 の倍数になっている割合、最小・最大を並べると、「率の列」「千人単位で丸めた列」の見当がつきます。
🎯 このコードでやること:SSDSE-B-2026 の指標列 109 本について、型・小数の有無・1,000 の倍数の割合・最小・最大を列ごとの表にし、小数を含む列と、8 割以上が 1,000 の倍数の列を取り出す。
1 2 3 4 5 6 7 8 9 10 11 12 13 14 15 16 17 18 19 20 | import pandas as pd df = pd.read_csv('data/raw/SSDSE-B-2026.csv', encoding='cp932', skiprows=[1]) names = pd.read_csv('data/raw/SSDSE-B-2026.csv', encoding='cp932', header=None, nrows=2).iloc[1] names.index = df.columns x = df.iloc[:, 3:] # 指標列 109 本 # 値そのものから読み取れる「技術メタデータ」を列ごとに作る prof = pd.DataFrame({ '型': x.dtypes.astype(str), '小数あり': x.apply(lambda s: bool((s % 1 != 0).any())), '千の倍数の割合': x.apply(lambda s: round(float((s % 1000 == 0).mean()), 2)), '最小': x.min(), '最大': x.max(), }) print(prof['型'].value_counts().to_string()) print('小数を含む列:', ', '.join(f'{c} {names[c]}' for c in prof.index[prof['小数あり']])) thousand = prof.index[prof['千の倍数の割合'] >= 0.8] print('8 割以上の値が 1,000 の倍数の列:', len(thousand), '本 →', ', '.join(thousand[:8]), '…') print(prof.loc[['A1101', 'A4101', 'H5614', 'C5401']].to_string()) |
💬 109 列のうち 103 列が整数、6 列が小数を含む列で、それは合計特殊出生率・気温 3 列・降水量・ごみのリサイクル率と、いずれも率や測定値の列です。8 割以上(12 年度中 10 年度)の値が 1,000 の倍数の列は 15 本で、すべて人口の列(総人口・日本人人口・年齢 3 区分とその男女)でした。国勢調査の 2 年度だけが 1 人単位なので 0.83 = 10/12 になります。出生数 A4101 は 0.00 で、1 人単位で数えた列です。こうして起こした表を列の説明に添えておけば、「この列は千人単位の推計を含む」ことを次の人が値を調べ直さずに知ることができます。ただし C5401(住宅地の標準価格)が 1,000 の倍数でないのは単位が円/m² だからで、値から分かるのは丸めの有無までで、単位そのものは人が書くしかありません。
🐍 DCAT の形でデータセットを記述する — 自動で埋まる項目と、人が書く項目
🌳 の Step 3(社会公開)では、データセット全体を DCAT などの共通の語彙で機械可読に記述します。項目の一部はファイルから自動で埋められますが、発行者やライセンスはファイルを見ても分かりません。どこまでが自動で、どこからが人の仕事かを、SSDSE-B-2026 で分けてみます。
🎯 このコードでやること:SSDSE-B-2026.csv から、期間(年度の最小・最大)・地域の数・形式・文字コード・ファイルサイズ・チェックサム・行数・列数を取り出して DCAT 風の JSON-LD を作り、人が調べて書くしかない項目を並べる。
1 2 3 4 5 6 7 8 9 10 11 12 13 14 15 16 17 18 19 20 21 22 23 24 25 26 27 28 29 | import hashlib import json import os import pandas as pd path = 'data/raw/SSDSE-B-2026.csv' df = pd.read_csv(path, encoding='cp932', skiprows=[1]) year = df['SSDSE-B-2026'] # ファイルと中身から自動で埋められる項目 auto = { 'dct:temporal': {'dcat:startDate': str(year.min()), 'dcat:endDate': str(year.max())}, 'dct:spatial': f"日本の {df['Code'].nunique()} 都道府県", 'dcat:distribution': { 'dcat:mediaType': 'text/csv', 'ex:encoding': 'cp932', 'dcat:byteSize': os.path.getsize(path), 'spdx:checksum': 'sha256:' + hashlib.sha256(open(path, 'rb').read()).hexdigest()[:16], }, 'ex:rows': len(df), 'ex:columns': df.shape[1], # ex: は DCAT に無い独自の項目 } # 人が調べて書くしかない項目(ファイルからは分からない) manual = ['dct:title', 'dct:publisher', 'dct:license', 'dct:issued', 'dcat:landingPage', '列ごとの単位'] context = {'dcat': 'http://www.w3.org/ns/dcat#', 'dct': 'http://purl.org/dc/terms/', 'spdx': 'http://spdx.org/rdf/terms#', 'ex': 'https://example.org/ssdse#'} record = {'@context': context, '@type': 'dcat:Dataset', **auto} print(json.dumps(record, ensure_ascii=False, indent=1)) print('自動で埋めた項目', len(auto), ' 人が書く項目', len(manual), '→', ', '.join(manual)) |
💬 期間 2012〜2023、47 都道府県、359,821 バイト、564 行 × 112 列、SHA-256 の先頭 0fdbe5f603bb8e1e は、どれもファイルから機械的に取れた値です(リネージの節の指紋と同じ値になっている)。一方、タイトル・発行者・ライセンス・公開日・配布ページ・列ごとの単位の 6 項目は、ファイルをいくら調べても出てきません。メタ化の手間の大部分はこの「人が書く項目」で、ここを空欄のまま公開すると FAIR の Reusable(再利用の条件が分かる)を満たせません。DCAT に無い行数・列数は ex: という独自の名前空間に入れて、標準の語彙と混ぜないようにしています。
🐍 「見出しは何行か」もメタデータ — 読み込みの 1 行目で壊れる
SSDSE-B は見出しが 2 行(項目コード・項目名)、SSDSE-A は 3 行(項目コード・年度・項目名)です。この「見出しの行数」は小さなメタデータですが、知らずに読むと、数値の列がすべて文字列として読み込まれます。
🎯 このコードでやること:SSDSE-B-2026 と SSDSE-A-2026 を、見出しの行数を正しく指定した場合と間違えた場合で読み、形・数値型の列の数・データの 1 行目を比べる。文字列のまま総人口を足すとどうなるかも見る。
1 2 3 4 5 6 7 8 9 10 11 12 13 14 15 16 17 18 19 | import pandas as pd path_b = 'data/raw/SSDSE-B-2026.csv' path_a = 'data/raw/SSDSE-A-2026.csv' # 見出しの行数(メタデータ)を知らずに 1 行目だけを見出しにして読むと wrong = pd.read_csv(path_b, encoding='cp932') print('B 見出し 1 行で読む:', wrong.shape, ' 数値型の列', int(wrong.select_dtypes('number').shape[1]), ' 1 行目のデータ:', list(wrong.iloc[0, :4])) right = pd.read_csv(path_b, encoding='cp932', skiprows=[1]) print('B 2 行目を飛ばす :', right.shape, ' 数値型の列', int(right.select_dtypes('number').shape[1])) # SSDSE-A は見出しが 3 行(コード・年度・項目名) wrong_a = pd.read_csv(path_a, encoding='cp932', skiprows=[1]) print('A 2 行目だけ飛ばす:', wrong_a.shape, ' 数値型の列', int(wrong_a.select_dtypes('number').shape[1]), ' 1 行目のデータ:', list(wrong_a.iloc[0, :4])) right_a = pd.read_csv(path_a, encoding='cp932', skiprows=[1, 2]) print('A 2・3 行目を飛ばす:', right_a.shape, ' 数値型の列', int(right_a.select_dtypes('number').shape[1])) print('文字列のまま足すと', str(wrong['A1101'].iloc[1:3].sum())[:20], '… 正しく読むと', int(right['A1101'].iloc[:2].sum())) |
💬 SSDSE-B を見出し 1 行で読むと 565 行になり、項目名の行(年度・地域コード・都道府県・総人口…)が 1 行目のデータとして入るため、数値型の列が 0 本になります。2 行目を飛ばせば 564 行・数値型 110 列(年度を含む)です。SSDSE-A で 2 行目だけ飛ばすと 1,742 行・数値型 0 列、2・3 行目を飛ばして 1,741 行・125 列になります。文字列のまま北海道の 2023・2022 年度の総人口を足すと「50920005140000」と文字がつながるだけで、エラーにならないのが厄介です。CSVW の headerRowCount のように見出しの行数をメタデータとして書いておけば、読み込む側の道具がこれを自動で扱えます。
🐍 CSV に列の説明を付ける標準 — CSVW(CSV on the Web)
CSV のような表のファイルに、列の名前・見出し・型・説明・主キーを JSON で添える W3C の標準が CSVW(CSV on the Web、2015 年勧告)です。SSDSE-B-2026 の 2 行の見出しは、そのまま CSVW の name(項目コード)と titles(項目名)に写せます。型は値から自動で決め、説明は人が書き足します。
🎯 このコードでやること:SSDSE-B-2026 の先頭 2 行と値の型から、112 列ぶんの CSVW の列の記述を自動で作り、総人口と消費支出の 2 列にだけ人が書いた説明を足す。主キー(年度・地域コード)に重複が無いかも確かめる。
1 2 3 4 5 6 7 8 9 10 11 12 13 14 15 16 17 18 19 20 21 22 23 24 25 | import json import pandas as pd path = 'data/raw/SSDSE-B-2026.csv' head = pd.read_csv(path, encoding='cp932', header=None, nrows=2) df = pd.read_csv(path, encoding='cp932', skiprows=[1]) def dtype(s): return 'integer' if pd.api.types.is_integer_dtype(s) else ('decimal' if pd.api.types.is_float_dtype(s) else 'string') columns = [{'name': str(c), 'titles': str(t), 'datatype': dtype(df[c])} for c, t in zip(head.iloc[0], head.iloc[1])] # 人が書き足す項目(ここでは 2 列だけ例として埋める) extra = {'A1101': {'dc:description': '総人口(国勢調査の年は調査結果で年齢不詳を含む。それ以外の年は千人単位の推計)'}, 'L3221': {'dc:description': '県庁所在市の二人以上の世帯の 1 か月の消費支出(円)'}} for col in columns: col.update(extra.get(col['name'], {})) meta = {'@context': 'http://www.w3.org/ns/csvw', 'url': 'SSDSE-B-2026.csv', 'dialect': {'encoding': 'cp932', 'headerRowCount': 2}, 'tableSchema': {'columns': columns, 'primaryKey': ['SSDSE-B-2026', 'Code']}} print('列の記述', len(columns), '本 datatype の内訳', pd.Series([c['datatype'] for c in columns]).value_counts().to_dict()) print(json.dumps([c for c in columns if c['name'] in ('Code', 'A1101', 'A4103', 'L3221')], ensure_ascii=False, indent=1)) print('主キーの重複', int(df.duplicated(['SSDSE-B-2026', 'Code']).sum()), '件') |
💬 112 列のうち整数 104・小数 6・文字列 2(地域コードと都道府県名)の型が自動で付き、年度と地域コードの組は 564 行で重複 0 件なので、主キーとして宣言できます。A1101 と L3221 には、⚠️ 章と 🐍 のメタデータ辞書の節で実データから確かめた注記(年齢不詳を含む年があること、県庁所在市の世帯の値であること)を説明として入れました。A4103 のように説明の無い列は、型が decimal であることしか伝わりません。headerRowCount: 2 と書いておけば、CSVW に対応した道具は 2 行目の項目名をデータとして読まずに済みます。
📝 演習問題 5 問
手を動かさないと身につかない。 5 問とも SSDSE-B-2026 を必ず触る前提で設計。
- SSDSE-B-2026.csv の列辞書を Dublin Core 15 要素で記述し、 YAML として書け
- 47 都道府県データの DataCite 風 DOI メタ(identifier, creator, title, publisher, publicationYear, resourceType)を JSON-LD で書け
- pandas DataFrame の各列に `df.attrs` でメタを付与し、 Parquet 保存時にメタが残ることを確認せよ
- 「人口」「出生数」「死亡数」を Schema.org の `StatisticalPopulation` に対応付け、 RDF Turtle で記述せよ
- メタ完備性 C と再発見性 R(仮想時間で良い)を計算する関数 `eval_metadata(meta:dict, found_in_sec:float) -> float` を実装せよ
📝 理解度チェック — SSDSE の実データで確かめる(Q1〜Q8)
Q1. SSDSE-B-2026 の CSV に書かれているメタ項目(項目コード・項目名・単位・集計対象の注記)から、指標列 109 本の平均完備性 $\bar{C}$ を計算すると何になりますか。最も欠けている項目は何ですか。
答え. (109 + 109 + 0 + 45) ÷ (109 × 4) = 263 ÷ 436 = 0.6032。単位は 109 本すべてで欠けています(🧮)。
Q2. 2020 年度の高齢化率を A1303 ÷ A1101 で計算すると、47 県中 30 県で前年より下がります。この「低下」は本当の変化ですか。
答え. ほとんどは違います。2020 年度は国勢調査の年で、総人口 A1101 に年齢不詳(47 県計 2,931,838 人)が含まれるため、分母だけが大きくなっています。分母を年齢 3 区分の合計にすると、下がった県は 3 県です(⚠️)。
Q3. 2023 年度の総人口で「男 + 女 ≠ 総数」となる県が 16 県あります。データの誤りとして除くべきですか。
答え. 除くべきではありません。国勢調査の年以外は千人単位の推計で、男・女・総数を別々に丸めているため、最大 1,000 人ずれるだけです。国勢調査の 2015・2020 年度や、出生数・死亡数ではずれは 0 です。
Q4. SSDSE-A の 2022 版と 2026 版を項目名で突き合わせると、共通の 124 列のうち何列がつながりませんか。どうすれば防げますか。
答え. 27 列です(読点や全角数字の表記の変更と、A8201・A8301 の名前の変更)。版をまたぐ結合は項目コードをキーにし、名前の変更を変更履歴として残します。識別子の列名も prefecture → Prefecture と変わっているので、コードを版ごとに確かめる必要があります。
Q5. SSDSE-A-2026 のある市区町村について「出生数 ÷ 総人口」で出生率を計算しました。列ごとの年度の行を見ると、何が問題ですか。
答え. 出生数(A4101)は 2023 年、総人口(A1101)は 2020 年の値で、3 年ずれた値を割っています。年度の行を読み飛ばすとこのずれに気づけないので、列ごとの年度を別の表に取っておき、割り算の前に年度がそろっているかを確かめます。
Q6. SSDSE-B-2026 の消費支出(L3221)を使って「茨城県の家計」を論じるレポートがあります。メタデータの観点から、何を書き添えるべきですか。
答え. L3221 は県庁所在市(水戸市)の二人以上の世帯の値で、水戸市の人口は茨城県の 9.4%(2020 年、SSDSE-A-2026 から計算)しかありません。「茨城県の家計」ではなく「水戸市の二人以上の世帯の家計」と範囲を明記し、県全体の議論に使うなら、その限界を書きます(⚠️ 章)。
Q7. SSDSE-A-2026 の市区町村データで、出生数 ÷ 総人口 の出生率を都道府県ごとに計算すると、秋田県は正しい値より何 % 低く出ますか。それはなぜですか。
答え. 4.74% 低く出ます(3.76 と 3.95)。分子の出生数は 2023 年、分母の総人口は 2020 年の値で、秋田県の人口はこの 3 年で 4.74% 減ったので、その分だけ分母が大きすぎるからです。
Q8. SSDSE-B-2026 を pd.read_csv(path, encoding='cp932') だけで読むと、数値型の列はいくつになりますか。
答え. 0 本です。2 行目の項目名が 1 行目のデータとして入り、すべての列が文字列になります。skiprows=[1] で 2 行目を飛ばすと 564 行・数値型 110 列(年度を含む)になります。
📜 歴史と系譜
データのメタ化 の歴史 — メタデータ標準の主な出来事
| 年 | 出来事 | このページとのつながり |
|---|---|---|
| 1995 | 米国オハイオ州ダブリンでの会合から Dublin Core(15 要素)が生まれる | 🐍 の 4 段構えの 1 例目で使う記述の型 |
| 2003 | Dublin Core が ISO 15836 として国際規格になる | 図書館以外の分野でも共通の型として使われる根拠 |
| 2008 | 日本の政府統計の総合窓口 e-Stat の運用が始まる | 統計表に表 ID・調査名・調査年などのメタデータを付けて横断検索 |
| 2009 | DataCite 設立(研究データに DOI を付ける) | JSON-LD の例で使った identifier・creator・publicationYear |
| 2011 | schema.org 公開(検索エンジン各社が共同で語彙を定義) | Web 上のデータセットを検索エンジンに見つけてもらう記述 |
| 2013 | W3C が来歴の語彙 PROV-O を勧告 | 🐍 のリネージの記録(入力・式・指紋)の標準形 |
| 2014 | W3C が DCAT(データカタログの語彙)を勧告。改訂版 DCAT 2 は 2020 年 | 🌳 Step 3 の「機械可読のカタログ記述」 |
| 2016 | Wilkinson らが FAIR 原則を Scientific Data 誌に発表 | 💡 の Findable・Accessible・Interoperable・Reusable |
⚠️ よくある落とし穴
データのメタ化で典型的に失敗するのは、 (1) 「あとで書く」と先送りしてメタデータが永久に未整備、 (2) 単位 (円/千円/百万円) の取り違え、 (3) スキーマ変更にメタが追従せず古い情報が残る、 の 3 パターンです。 FAIR 原則 (Findable, Accessible, Interoperable, Reusable) を出発点にして、 データ生成と同時にメタを自動生成する仕組みに乗せれば、 ほぼすべて回避できます。
⚠️ 実データで確かめる — 「総人口には年齢不詳を含む」という注記が落ちると
SSDSE-B-2026 の総人口 A1101 と、年齢 3 区分(A1301 15 歳未満・A1302 15〜64 歳・A1303 65 歳以上)の合計は、一致するとは限りません。国勢調査では年齢を回答しなかった人(年齢不詳)が総人口にだけ含まれるからです。この注記は CSV のどこにも書かれていないので、知らずに高齢化率を A1303 ÷ A1101 で計算すると、国勢調査の年だけ値が下がって見えます。
🎯 このコードでやること:総人口と年齢 3 区分の合計の差(内訳外)を年度ごとに合計する。高齢化率を「分母 = 総人口」と「分母 = 年齢 3 区分の合計」の 2 通りで作り、2020 年度に前年より下がった県の数と、東京都の 2020 年度の値を比べる。
1 2 3 4 5 6 7 8 9 10 11 12 13 14 15 16 17 18 | import pandas as pd df = pd.read_csv('data/raw/SSDSE-B-2026.csv', encoding='cp932', skiprows=[1]) df = df.rename(columns={'SSDSE-B-2026': '年度'}) # 総人口 − (15歳未満 + 15〜64歳 + 65歳以上) = 年齢の内訳に入らない人数 df['内訳外'] = df['A1101'] - df[['A1301', 'A1302', 'A1303']].sum(axis=1) print(df.groupby('年度')['内訳外'].sum().to_string()) # 高齢化率を 2 通りに定義する df['率_総人口'] = df['A1303'] / df['A1101'] * 100 df['率_内訳計'] = df['A1303'] / df[['A1301', 'A1302', 'A1303']].sum(axis=1) * 100 w1 = df.pivot(index='Prefecture', columns='年度', values='率_総人口') w2 = df.pivot(index='Prefecture', columns='年度', values='率_内訳計') print('2020 年度に前年より下がった県 分母=総人口:', int((w1[2020] < w1[2019]).sum()), ' 分母=年齢 3 区分の合計:', int((w2[2020] < w2[2019]).sum())) t = df[(df['年度'] == 2020) & (df['Prefecture'] == '東京都')].iloc[0] print(f"東京都 2020 内訳外 {t['内訳外']:,.0f} 人 高齢化率 {t['率_総人口']:.2f}% / {t['率_内訳計']:.2f}%") |
💬 47 県の内訳外の合計は、国勢調査の 2015 年度に 1,453,758 人、2020 年度に 2,931,838 人と大きく、2021 年度以降は −7,000〜−1,000 人(千人単位の丸めの範囲)です。2016〜2019 年度も 11.2 万〜38.2 万人の差が残っています。分母を総人口にすると 2020 年度に高齢化率が前年より下がった県は 30 県ありますが、分母を年齢 3 区分の合計にすると 3 県だけです。東京都の 2020 年度は内訳外が 428,739 人あり、高齢化率は 22.12% と 22.82% で 0.70 ポイント違います。「2020 年に 30 県で高齢化が一時的に止まった」という読みは、メタデータの注記 1 行で防げる誤りです。
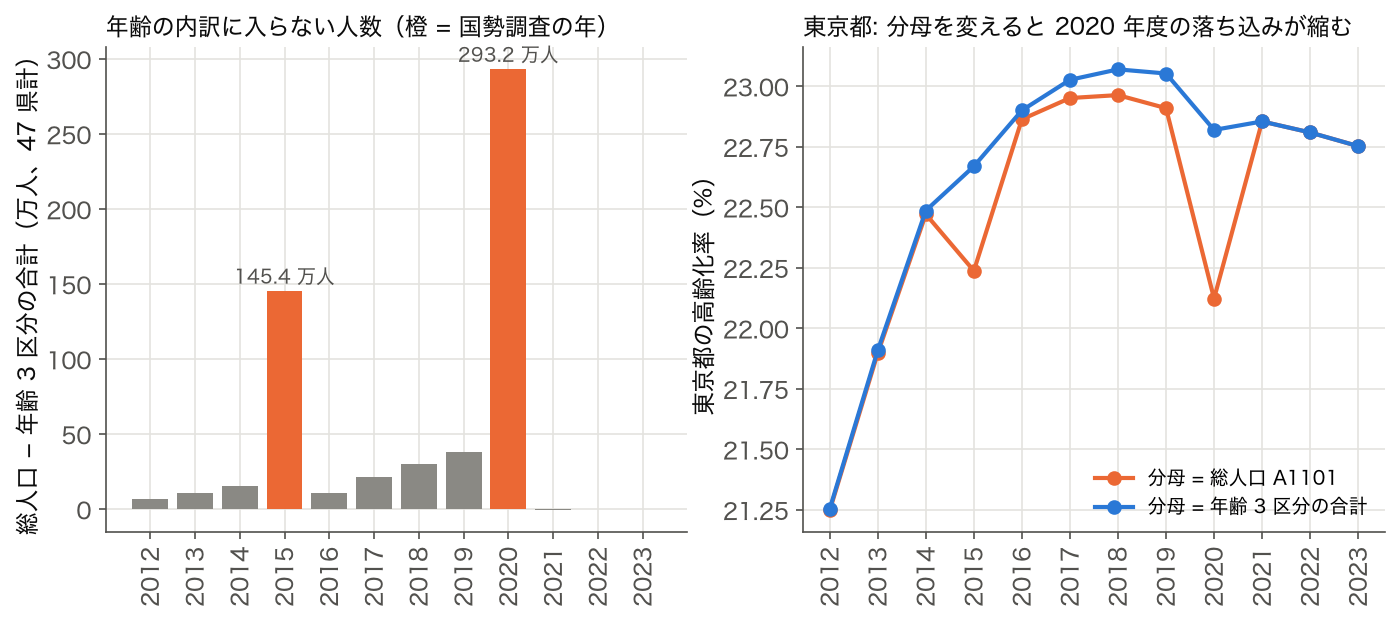
東京都は、分母を変えても 2020 年度にわずかに下がる 3 県の 1 つです。つまり「年齢不詳」の注記で説明できるのは落ち込みの大部分(0.79 ポイントのうち 0.56 ポイント)で、残りは別の理由(年齢が分かっている人の中での実際の変化や、推計と調査の違い)を考える必要があります。メタデータは誤読を防ぐ道具であって、すべての変化を説明するものではありません。
⚠️ 実データで確かめる — 同じ「総人口」の列に、千人単位の推計と 1 人単位の実数が混ざる
SSDSE-B-2026 の総人口は、年度によって作り方が違います。国勢調査の年は調査の結果(1 人単位)、それ以外の年は推計人口(千人単位で丸めた値)です。値の精度という来歴のメタデータは CSV に書かれていませんが、値そのものから確かめられます。
🎯 このコードでやること:年度ごとに、総人口が 1,000 の倍数になっている県の数と、「男 + 女 ≠ 総数」となる県の数とずれの最大値を数える。出生数・死亡数でも同じ確認をする。
1 2 3 4 5 6 7 8 9 10 11 12 13 14 15 16 17 | import pandas as pd df = pd.read_csv('data/raw/SSDSE-B-2026.csv', encoding='cp932', skiprows=[1]) df = df.rename(columns={'SSDSE-B-2026': '年度'}) g = df.groupby('年度') out = pd.DataFrame({ # 総人口が 1,000 の倍数(千人単位で丸めた値)になっている県の数 '千人単位の県': g['A1101'].apply(lambda s: int((s % 1000 == 0).sum())), # 男 + 女 が総数と一致しない県の数と、ずれの最大 '男+女≠総数': g.apply(lambda t: int((t['A110101'] + t['A110102'] != t['A1101']).sum()), include_groups=False), 'ずれの最大': g.apply(lambda t: int((t['A1101'] - t['A110101'] - t['A110102']).abs().max()), include_groups=False), }) print(out.to_string()) # 出生数・死亡数でも同じ確認をする for tot, m, f in [('A4101', 'A410101', 'A410102'), ('A4200', 'A420001', 'A420002')]: print(tot, '男+女≠総数 の行数:', int((df[m] + df[f] != df[tot]).sum())) |
💬 2015・2020 年度は 47 県とも 1,000 の倍数でない実数(国勢調査の結果)、それ以外の 10 年度は 47 県すべてが千人単位の値です。千人単位の年は、男と女を別々に丸めているので、男 + 女が総数と 1,000 人ずれる県が年に 4〜16 県あります。国勢調査の年と、1 人単位で数える出生数・死亡数には、このずれはありません。1,000 人のずれは総人口に比べれば小さいものの、「男女の合計が総数と合わないのでデータが壊れている」と判断して行を捨てたり、2019→2020 年度の差を 1 人単位の実際の増減と読んだりすると誤ります。列ごとに「どの年が推計で、何の単位で丸めているか」を書き添えるのが、ここでのメタ化です。
⚠️ 実データで確かめる — 「2026 年版」は 2026 年のデータではない
SSDSE の版の名前(SSDSE-A-2026 など)は公開の年で、中身の年ではありません。しかも 🐍 で見たとおり、列ごとに中身の年が違います。手元にある SSDSE-A の 2022〜2026 年版の 5 つで、総人口と出生数の中身の年と全国計を並べます。
🎯 このコードでやること:SSDSE-A の 2022〜2026 年版それぞれで、総人口(A1101)と出生数(A4101)の列の年度(2 行目のメタデータ)と、1,741 市区町村の合計を並べる。出生数の変化を「版の名前」で並べた場合と「中身の年」で並べた場合で比べる。
1 2 3 4 5 6 7 8 9 10 11 12 13 14 15 16 17 18 19 20 | import pandas as pd rows = [] for ver in [2022, 2023, 2024, 2025, 2026]: path = f'data/raw/SSDSE-A-{ver}.csv' h = pd.read_csv(path, encoding='cp932', header=None, nrows=2, dtype=str) year = dict(zip(h.iloc[0, 3:], h.iloc[1, 3:])) # 列ごとの年度(メタデータの行) d = pd.read_csv(path, encoding='cp932', skiprows=[1, 2]) for code in ['A1101', 'A4101']: rows.append({'版': f'SSDSE-A-{ver}', '列': code, '中身の年': int(year[code]), '全国計': int(d[code].sum())}) t = pd.DataFrame(rows) print(t.pivot(index='版', columns='列', values=['中身の年', '全国計']).to_string()) # 出生数の変化を「版の名前」で並べた場合と「中身の年」で並べた場合 b = t[t['列'] == 'A4101'] by_ver = b.set_index('版')['全国計'] print('版の名前で並べた前年比(%):', (by_ver.pct_change() * 100).round(1).dropna().to_dict()) by_year = b.drop_duplicates('中身の年').set_index('中身の年')['全国計'] print('中身の年で並べた前年比(%):', (by_year.pct_change() * 100).round(1).dropna().to_dict()) |
💬 総人口は 5 つの版すべてで 2020 年(国勢調査)の値 126,146,099 人のままです。「SSDSE-A-2026 の総人口」を 2026 年の人口として使うと 6 年前の値を使うことになります。出生数は 2022 年版と 2023 年版がどちらも 2020 年の 840,808 人なので、版の名前で並べると「2023 年は前年比 0.0%」と横ばいに見えますが、実際には同じ年の値が 2 回入っているだけです。中身の年で並べ直すと 2021 年 −3.5%、2022 年 −5.0%、2023 年 −5.6% と、毎年減少幅が大きくなっています。版をまたいで時系列を作るときは、ファイル名ではなく列ごとの年度のメタデータを時間の軸にします。
⚠️ 実データで確かめる — 「県の家計」の値が代表しているのは県の何割か
SSDSE-B-2026 の消費支出などの家計の列(L3xxx)は、家計調査の県庁所在市(東京都は区部)の値です。項目名にはこの範囲が書かれていないので、県全体の値と思って使われがちです。市区町村のデータ SSDSE-A-2026 を使えば、その県庁所在市に県の人口の何割が住んでいるか、つまり L3xxx の値が県のどれだけを代表しているかを計算できます。
🎯 このコードでやること:SSDSE-A-2026 の市区町村の総人口(2020 年)から、47 都道府県それぞれで県庁所在市(東京都は 23 区の合計)の人口が県の人口に占める割合を計算し、小さい県・大きい県・中央値を出す。
1 2 3 4 5 6 7 8 9 10 11 12 13 14 15 16 17 18 19 20 | import pandas as pd # 家計の列(L3xxx)が代表する「県庁所在市」の人口は、県の人口の何割か a = pd.read_csv('data/raw/SSDSE-A-2026.csv', encoding='cp932', skiprows=[1, 2]) # 1,741 市区町村(A1101 は 2020 年) capital = ['札幌市', '青森市', '盛岡市', '仙台市', '秋田市', '山形市', '福島市', '水戸市', '宇都宮市', '前橋市', 'さいたま市', '千葉市', '区部', '横浜市', '新潟市', '富山市', '金沢市', '福井市', '甲府市', '長野市', '岐阜市', '静岡市', '名古屋市', '津市', '大津市', '京都市', '大阪市', '神戸市', '奈良市', '和歌山市', '鳥取市', '松江市', '岡山市', '広島市', '山口市', '徳島市', '高松市', '松山市', '高知市', '福岡市', '佐賀市', '長崎市', '熊本市', '大分市', '宮崎市', '鹿児島市', '那覇市'] pref = a['Prefecture'].unique() # 北海道 → 沖縄県 の順 a['区部'] = (a['Prefecture'] == '東京都') & a['Municipality'].str.endswith('区') # 東京都は 23 区の合計 rows = [] for p, c in zip(pref, capital): t = a[a['Prefecture'] == p] cap = t.loc[t['区部'], 'A1101'].sum() if c == '区部' else t.loc[t['Municipality'] == c, 'A1101'].sum() rows.append({'都道府県': p, '県庁所在市': '東京都区部' if c == '区部' else c, '割合': cap / t['A1101'].sum()}) s = pd.DataFrame(rows).sort_values('割合') print('割合の最小 3', s.head(3).round(3).to_string(index=False, header=False), sep='\n') print('割合の最大 3', s.tail(3).round(3).to_string(index=False, header=False), sep='\n') print(f"中央値 {s['割合'].median():.3f} 5 割を超える県 {int((s['割合'] > 0.5).sum())} 2 割未満の県 {int((s['割合'] < 0.2).sum())}") |
💬 県庁所在市の人口の割合は、茨城県(水戸市)の 9.4% から東京都(区部)の 69.3% まで 7 倍以上違い、中央値は 31.2% です。2 割未満の県が 9 県あり、そうした県の L3xxx の値は県の人口の 8 割以上が住む県庁所在市以外の暮らしを反映していません。L3xxx を「県の消費」として県の人口あたり指標と並べて回帰すると、県によって代表する範囲が違う値を同じ扱いにすることになります。範囲のメタデータ(「県庁所在市、二人以上の世帯」)を列に付けておくこと、分析の報告にその範囲を明記することが、ここでの対策です。
⚠️ 実データで確かめる — 年のずれた分子と分母で率を作ると、人口の減った県ほど低く出る
🐍 の「列ごとに調査年が違う」節で見たとおり、SSDSE-A-2026 の出生数は 2023 年、総人口は 2020 年の値です。これをそのまま割って出生率を作ると、どれだけずれるのでしょうか。SSDSE-B-2026 には同じ 2023 年度の出生数と総人口があるので、都道府県単位で「年ずれ」と「年そろえ」の出生率を比べられます。
🎯 このコードでやること:SSDSE-A-2026 の市区町村の出生数(2023 年)と総人口(2020 年)を都道府県ごとに合計して人口千人あたりの出生率を作り、SSDSE-B-2026 の 2023 年度の出生数 ÷ 2023 年度の総人口と比べる。差が大きい県と小さい県を並べる。
1 2 3 4 5 6 7 8 9 10 11 12 13 14 15 16 17 18 | import pandas as pd # SSDSE-A-2026: 出生数 A4101 は 2023 年、総人口 A1101 は 2020 年(列ごとの年度の行で確認済み) a = pd.read_csv('data/raw/SSDSE-A-2026.csv', encoding='cp932', skiprows=[1, 2]) pa = a.groupby('Prefecture', sort=False)[['A4101', 'A1101']].sum() mixed = pa['A4101'] / pa['A1101'] * 1000 # 分子 2023 年 ÷ 分母 2020 年 # SSDSE-B-2026: 同じ 2023 年度の出生数と総人口 b = pd.read_csv('data/raw/SSDSE-B-2026.csv', encoding='cp932', skiprows=[1]) b = b[b['SSDSE-B-2026'] == 2023].set_index('Prefecture') same = b['A4101'] / b['A1101'] * 1000 # 分子 2023 年 ÷ 分母 2023 年 t = pd.DataFrame({'年ずれ': mixed, '年そろえ': same.reindex(mixed.index)}) t['差(%)'] = (t['年ずれ'] / t['年そろえ'] - 1) * 100 t['人口の変化(%)'] = (b['A1101'].reindex(t.index) / pa['A1101'] - 1) * 100 print('出生数の合計の一致:', int(pa['A4101'].sum()), int(b['A4101'].sum())) print(t.sort_values('差(%)').round(2).iloc[[0, 1, 2, -3, -2, -1]].to_string()) print('年ずれで低く出る県', int((t['差(%)'] < 0).sum()), ' 高く出る県', int((t['差(%)'] > 0).sum())) |
💬 出生数の合計は 2 つのファイルで 727,269 人と一致するので、違いは分母の年だけです。年のずれた出生率は、秋田県で 3.76 と正しい 3.95 より 4.74% 低く、青森県・山形県も約 4% 低く出ます。東京都は逆に 0.27% 高く出ます。差の大きさは 2020→2023 年の人口の変化とぴったり同じ値で、これは「年ずれの率 ÷ 正しい率 = 2023 年の人口 ÷ 2020 年の人口」になるからです。人口が減っている県ほど出生率が低く出るので、「人口減少の県は出生率も低い」という関係を、分母の年のずれだけで作り出してしまいます。列ごとの年度というメタデータを読み飛ばさなければ防げる誤りです。
🗺 概念マップ
関連概念を視覚的に整理した概念マップ。
データのメタ化は「データそのもの」と「データを説明するデータ (メタデータ)」を切り分ける営みである。 SSDSE-B-2026 で言えば、 個別の数値 (例: 北海道の人口 5,140,354) が「データ」、 列名「総人口」「単位: 人」「集計年: 2020」「出典: 国勢調査」が「メタデータ」に相当する。 メタデータが整備されていると、 Schema Registry やデータ契約 (Data Contract) を通じて再利用・自動結合・改廃管理が可能になる。
🔗 隣接手法への橋渡し
メタ化はデータの素性を可視化し、 下流の検証可能性と上流のデータ品質保証の両方を支える:
- 上流: 変数の型・尺度と 前処理 — 元データの定義を確認
- 並列: アノテーションと データセット整備 — メタ情報を付与する同階層の作業
- 下流: 機械学習データセットのバイアス検証と AI の信頼性 — メタ化が品質保証の前提
データのメタ化はデータセットの素性を可視化し、 下流の検証可能性を高める。
🌳 手法選択フロー
メタ化のレベルは「内部用 → 組織共有 → 社会公開」の 3 段階で深まる。 どこを目指すかで実装が変わる。
- Step 1: 個人 / 小規模チーム (1 ファイル単位)
- CSV の 1 行目に項目定義、 README に出典・取得日・単位 — まずは Markdown で十分
- pandas で
df.attrsや YAML サイドカーで列定義を保持
- Step 2: 組織内 (複数チーム共有)
- Data Catalog 導入 (Amundsen / DataHub / OpenMetadata) でテーブル横断検索
- Schema Registry (Confluent / Apicurio) で Avro/Protobuf を中央管理 — 上流の breaking change を CI でブロック
- Data Contract で SLA・所有者・更新頻度を明文化、 違反は監視で即検知
- Step 3: 社会公開 (オープンデータ・研究)
- FAIR 原則 (Findable / Accessible / Interoperable / Reusable) を満たす
- DCAT / Dublin Core / schema.org Dataset で機械可読メタデータを付与
- DOI で永続識別、 ライセンス (CC BY 等) と引用情報を明示
SSDSE-B-2026 の CSV は Step 1 と Step 3 のあいだにあります。1 行目に項目コード(A1101 など)、2 行目に日本語の項目名が入っていて、ファイルだけで「何の列か」は分かりますが、単位・元の統計名・調査時点の行はありません(🧮 で数えます)。これらは配布元の説明資料で補う必要があり、ファイルを受け取った人が単位を書き足しておかないと、Step 2 以降でメタデータが途切れます。