🔖 キーワード索引
この用語と一緒に検索・参照されやすいタグ。 関連ページに飛ぶときの手がかりにも使えます。
このページの節への目次です。
💡 30秒で分かる結論
🍰 まずはやさしく
データの物語を伝える技法です。
相手に納得して動いてもらうために使います。
部活の改善案をグラフで伝えるときなどに役立ちます。
この章では結論と注意点を学びます。
データストーリーテリングは、 数値・グラフ・物語を組み合わせて聞き手の意思決定を促す表現技法。
- 3 要素:データ/ナラティブ/ビジュアル
- 目的:「事実の羅列」ではなく「行動を引き起こす」
- 典型構成:状況 → 課題 → 解決策(または発見)→ 行動
- 道具:ダッシュボード、 スライド、 インフォグラフィック
- 注意:物語が強くなりすぎると事実を曲げるリスク
ここまでが要点です。 ただし実際に使う前に、 このページの「⚠️ よくある落とし穴」で挙げた ストーリーが事実を曲げる/ジャンクチャート/数字の羅列 には必ず目を通してください。 つまずくのは知識が無いときより、 知ってはいたが確認を飛ばしたときです。
📍 文脈:「データストーリーテリング」はどんな場面で出てくる?
🍰 まずはやさしく
分析結果を伝えるための道具です。
正しい分析を相手に届けるために使います。
スマホの利用時間をまとめて発表する場面で使えます。
この章では使う場面や考え方を学びます。
「分析結果が良い」と「伝わる」は別物。 本サイトの再現論文も、 分析(コード)の後段で解釈とレポートを必ず作ります。 そこで活きるのがストーリーテリング。
🎨 直感で掴む
🍰 まずはやさしく
映画のような構成で伝える方法です。
相手に直感的に理解してもらうために使います。
買い物の傾向をグラフで見出し付きで伝える例です。
この章ではイメージの掴み方を学びます。
- 映画のように主人公・葛藤・解決を組む。 「都道府県データから見えた格差」「政策の壁」「打開策」のように。
- 1 グラフ 1 メッセージ。 「このグラフから何を読み取ってほしいか」を見出しで明示。
- 「聞き手の関心」から逆算。 経営層には ROI、 現場には運用負荷、 アカデミーには方法論の新規性。
📐 定義・数式
🍰 まずはやさしく
伝えるための決まった型のことです。
誰にでも伝わる構成を作るために使います。
文化祭の計画を状況と課題に分けて話す例です。
この章では具体的な構成のルールを学びます。
🔬 数式を言葉で読み解く — 数式を「言葉」に翻訳
- Situation
- 現状の事実共有
- Complication
- 問題・葛藤・発見
- Resolution
- 解決策・推奨アクション
- KPI
- 聞き手にとっての関心指標
- Call to Action
- 「次に何をすべきか」
📐 の $\text{Situation} \to \text{Complication} \to \text{Resolution}$ の矢印は、「聞き手がすでに知っている事実から始め、予想とのずれを示し、次の行動で閉じる」という順序を表しています。数式というより、文の並べ方の規則です。3 つの項を言葉に直すと、S は「誰も反論しない事実」(出生数は 11 年で 29.9% 減った)、C は「S のままでは済まない理由」(2019 年度以降は減り方が年率 −2.6% から −4.3% に速まった)、R は「だから何をするか」(速まった原因が産む人の数か産み方かを確かめる)です。C が無いと S は単なる報告で終わり、R が無いと聞き手は行動できません。逆に S を飛ばして C から始めると、聞き手は前提を共有していないので、ずれの大きさを評価できません。この章の 🐍 の「見出しの数字を選ぶ」節で、SSDSE-B-2026 の数字を使って 3 つの項を実際に埋めています。
🧮 実値で計算してみる — 数式に値を入れて手で計算する
データストーリーテリングに数式はないが、 「ストーリーの骨格となる集計指標」を手計算で確認することが理解の核心。 ここでは SCR フォーマット(Situation→Complication→Resolution)に対応する 3 つの指標を SSDSE-B-2026 の 5 県データで手計算する。
使用する数式(ストーリーの強さを定量化する「効果量 Cohen's d」):
📥 使用データ(SSDSE-B-2026 2023年、5県抜粋)
| 都道府県 | グループ | 高齢化率 (%) |
|---|---|---|
| 東京都 | 大都市圏 | 22.8 |
| 神奈川県 | 大都市圏 | 25.9 |
| 鳥取県 | 過疎県 | 33.3 |
| 島根県 | 過疎県 | 34.9 |
| 秋田県 | 過疎県 | 39.1 |
Step 1: 各グループの平均を計算
大都市圏グループ(n=2): $\bar{x}_A = \frac{22.8 + 25.9}{2} = \frac{48.7}{2} = 24.35$
過疎県グループ(n=3): $\bar{x}_B = \frac{33.3 + 34.9 + 39.1}{3} = \frac{107.3}{3} = 35.77$
Step 2: 各グループの分散・標準偏差
大都市圏 $s_A$: 偏差 = $(22.8-24.35)^2 + (25.9-24.35)^2 = 2.4025 + 2.4025 = 4.805$。 $s_A = \sqrt{4.805/1} = 2.192$
過疎県 $s_B$: 偏差 = $(33.3-35.77)^2 + (34.9-35.77)^2 + (39.1-35.77)^2 = 6.084 + 0.751 + 11.111 = 17.947$。 $s_B = \sqrt{17.947/2} = 2.996$
Step 3: プール標準偏差と効果量 d
$$s_{\text{pooled}} = \sqrt{\frac{(n_A-1)s_A^2 + (n_B-1)s_B^2}{n_A+n_B-2}} = \sqrt{\frac{1 \times 4.805 + 2 \times 8.973}{3}} = \sqrt{\frac{22.752}{3}} = \sqrt{7.584} \approx 2.754$$
$$d = \frac{24.35 - 35.77}{2.754} = \frac{-11.42}{2.754} \approx -4.15$$
手計算結果: $d \approx -4.15$(大都市圏の高齢化率が低い方向に 4 標準偏差以上の差)。 $|d| > 0.8$ の閾値を大幅に超え、 「東京 vs 秋田」のストーリーに 統計的根拠 を付与できる。
手計算で得た値と、 下記の Python 実装で算出した値が一致することを確認する。
🎯 このコードでやること:上記 Step 1〜3 の手計算(Cohen's d = −4.15)を numpy で再現し、 一致を確認する。
📥 入力: 大都市圏 [22.8, 25.9]、 過疎県 [33.3, 34.9, 39.1](SSDSE-B-2026 2023年 高齢化率、 65 歳以上人口 ÷ 総人口 × 100 を小数 1 桁に丸めた値)
1 2 3 4 5 6 7 8 9 10 11 12 13 14 15 | import numpy as np # SSDSE-B-2026 2023年 高齢化率 (5 県、65 歳以上人口 ÷ 総人口 × 100 を小数 1 桁に丸めた値) metro = np.array([22.8, 25.9]) # 東京都, 神奈川県 rural = np.array([33.3, 34.9, 39.1]) # 鳥取県, 島根県, 秋田県 mean_a, mean_b = metro.mean(), rural.mean() var_a, var_b = metro.var(ddof=1), rural.var(ddof=1) na, nb = len(metro), len(rural) pooled_std = np.sqrt(((na-1)*var_a + (nb-1)*var_b) / (na+nb-2)) d = (mean_a - mean_b) / pooled_std print(f'大都市圏平均: {mean_a:.2f} %') print(f'過疎県平均 : {mean_b:.2f} %') print(f'プール SD : {pooled_std:.3f}') print(f"Cohen's d : {d:.2f}") |
💬 Python 出力の平均 24.35 % と 35.77 %、プール SD 2.754、d = −4.15 が手計算の Step 1〜3 と一致。 差 11.42 ポイントがグループ内のばらつき約 2.75 ポイントの 4 倍以上あり、 「大都市圏と過疎県の高齢化率は標準偏差 4 個分以上離れている」というストーリーの数値根拠になる。 ただし 2 県対 3 県を選んで比べた値なので、 両端の県を選べば d はいくらでも大きくなることも添えておく。
実際に、47 都道府県をすべて使い、2023 年度の総人口の上位 10 県と残り 37 県に分けて同じ式で計算すると、平均は 27.99% と 32.56%、プール標準偏差は 2.78 で、d = −1.64 になります。−4.15 の 4 割ほどの大きさです。5 県を選んだ d も 47 県で分けた d も計算としては正しいので、物語に効果量を添えるときは「どの県をどう分けたか」を必ず書き、選び方で値が変わることを聞き手に隠さないようにします。
同じ事実から 3 つの物語 — 出生数の 12 年
データストーリーテリングの核心は「どの切り口を選ぶか」です。 SSDSE-B-2026 の出生数(2012 → 2023)を例に、 すべて正しいのに印象がまったく違う 3 つの語り方を作ってみます。
| 語り口 | 見せる数字 | 読み手が受け取る印象 |
|---|---|---|
| A. 全国で語る | 1,037,165 → 727,269 件、−29.9% | 「日本全体が一様に 3 割減った」 |
| B. 最も減った県で語る | 秋田県 −44.8%、岩手県 −41.4% | 「地方は半減寸前、危機的だ」 |
| C. 最も減らなかった県で語る | 東京都 −19.6%、大阪府 −24.3% | 「都市部は持ちこたえている」 |
3 つとも数字は正確で、SSDSE-B-2026 から直接計算できます。 にもかかわらず、A だけを見せられた読み手は地域差の存在に気づけません。 実際には 47 都道府県の変化率は −44.8%(秋田)から −19.6%(東京)まで 25 ポイントの幅があり、 中央値は −33.3% で、全国値 −29.9% より悪いのです。 全国値が中央値より高く出るのは、東京・大阪など出生数の多い都市部の減り方が小さいからで、 人口の重みが平均を押し上げています。
💬 誠実な語り方は、A・B・C のどれか 1 つを選ぶことではなく、 「全国で −29.9%。ただし県別には −44.8% 〜 −19.6% と 25 ポイントの幅があり、中央値は −33.3%」 と代表値と散らばりを同時に出すことです。 ストーリーを作る技術は「印象的な 1 つの数字を選ぶ技術」だと誤解されがちですが、 実際には「1 つの数字が隠しているものを、もう 1 行で補う技術」だと考えてください。
もう一点。B と C はどちらも極端値を代表として語る形になっています。 47 個のうち最大・最小を選ぶ行為は、それだけで 選択バイアスそのものです。 「秋田県では」と書くときは、必ず「47 県中最も減少幅が大きい県」と添えてください。 それを書くだけで、読み手は自分で割り引いて受け取れるようになります。
図で見る — 1 つの数字が隠している 47 個の値
上の表の A・B・C を 1 枚にまとめると、全国値・中央値・両端の県の位置関係が一目で分かります。
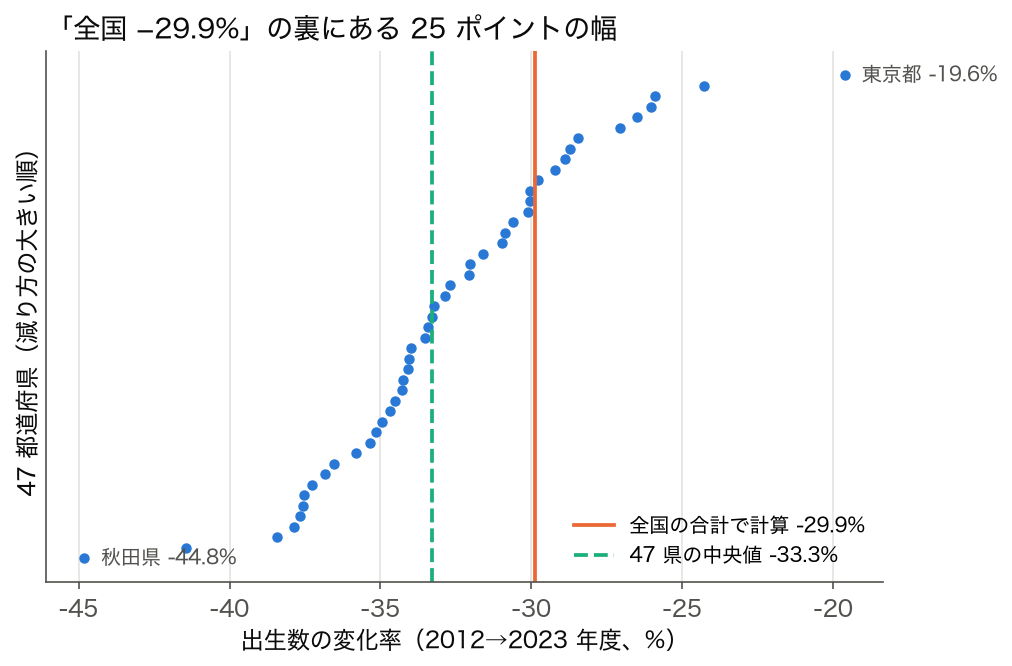
全国値の実線より左(減り方が大きい側)に 47 のうち 36 の県があります。「全国で −29.9%」という見出しは、多くの県にとっては実態より楽観的な数字です。誠実なストーリーは、この図のように代表値と散らばりを同時に見せるところから始まります。図を載せられないスライドや見出しでは、「全国 −29.9%(県別の中央値 −33.3%、範囲 −44.8〜−19.6%)」のように括弧で 1 行を補うだけでも、散らばりの存在は伝わります。
期間を変えると物語の主役が変わる
語り口 C は「東京都が最も減らなかった」でした。これは 2012 年度を起点に選んだ場合の話です。起点を 2019 年度に変えると、同じ SSDSE-B-2026 から別の主役が現れます。本文に書く数字を手で写すと起点を変えたときに書き直し漏れが起きるので、文章そのものをコードで作ります。
🎯 このコードでやること:出生数の変化率を「起点の年度・終点の年度」を引数にして計算し、全国値・中央値・東京都の順位・最も減らなかった県と最も減った県を 1 つの文章にして出力する。起点を 2012 年度と 2019 年度にした 2 通りを並べる。
1 2 3 4 5 6 7 8 9 10 11 12 13 14 15 | import pandas as pd df = pd.read_csv('data/raw/SSDSE-B-2026.csv', encoding='cp932', skiprows=[1]) b = df.pivot(index='Prefecture', columns='SSDSE-B-2026', values='A4101') # 行 = 県、列 = 年度の出生数 def story(start, end, pref='東京都'): chg = (b[end] / b[start] - 1) * 100 rank = int(chg.rank(ascending=False)[pref]) # 減り方が小さい順の順位 nat = (b[end].sum() / b[start].sum() - 1) * 100 return (f'{start}→{end} 年度: 全国 {nat:+.1f}%、47 県の中央値 {chg.median():+.1f}%。' f'{pref}は {chg[pref]:+.1f}% で、減り方の小さい順に 47 県中 {rank} 位。' f'最も小さいのは{chg.idxmax()}({chg.max():+.1f}%)、最も大きいのは{chg.idxmin()}({chg.min():+.1f}%)。') print(story(2012, 2023)) print(story(2019, 2023)) |
💬 2012→2023 年度では東京都(−19.6%)が 47 県中 1 位で「都市部は持ちこたえている」物語の主役ですが、2019→2023 年度では東京都は −15.2% で 11 位に下がり、最も減らなかったのは大阪府(−11.6%)になります。一方、最も減ったのはどちらの期間でも秋田県(−44.8%、−23.1%)で、こちらは期間を選んでも変わらない、頑健な事実です。「どの期間でも成り立つこと」と「特定の起点でだけ成り立つこと」を区別し、後者を語るときは起点を必ず書きます。
このように文章をコードで生成しておけば、データが更新されたときも起点を変えたときも、本文の数字が自動で正しい値に置き換わります。図と本文で数字が食い違う事故は、ストーリーテリングで最も信頼を失うミスの 1 つです。
人数で語るか、率で語るか — 同じ東京都が「最も減らなかった県」にも「2 番目に多く減った県」にもなる
起点の年度と並んで物語を左右するのが、増減を人数で見るか率で見るかの選択です。出生数の 2012→2023 年度の変化を、両方の物差しで並べます。
🎯 このコードでやること:47 県の出生数の 2012→2023 年度の増減を、人数(増減数)と率(増減率)の 2 通りで計算し、それぞれの順位をつける。人数・率で最も減った 3 県と、2 つの順位の順位相関を出す。
1 2 3 4 5 6 7 8 9 10 11 12 13 | import pandas as pd df = pd.read_csv('data/raw/SSDSE-B-2026.csv', encoding='cp932', skiprows=[1]) b = df.pivot(index='Prefecture', columns='SSDSE-B-2026', values='A4101') t = pd.DataFrame({'2012': b[2012], '2023': b[2023]}) t['増減数'] = t['2023'] - t['2012'] t['増減率(%)'] = (t['増減数'] / t['2012'] * 100).round(1) t['人数で多く減った順'] = t['増減数'].rank().astype(int) # 1 = 最も多くの人数が減った t['率で大きく減った順'] = t['増減率(%)'].rank().astype(int) # 1 = 最も大きな率で減った print(t.loc[['東京都', '大阪府', '神奈川県', '秋田県', '鳥取県']].to_string()) print('人数で最も減った 3 県:', '、'.join(f'{p}({v:,})' for p, v in t['増減数'].nsmallest(3).items())) print('率で最も減った 3 県:', '、'.join(f'{p}({v}%)' for p, v in t['増減率(%)'].nsmallest(3).items())) print('2 つの順位の順位相関 ρ =', round(t['人数で多く減った順'].corr(t['率で大きく減った順'], method='spearman'), 3)) |
💬 東京都は率では −19.6% で「最も減らなかった県」(率で大きく減った順に 47 位)ですが、人数では −21,053 人で「2 番目に多く減った県」です。人数で最も減ったのは神奈川県(−21,486 人)、率で最も減ったのは秋田県(−44.8%)で、2 つの順位の順位相関は ρ = −0.231 とむしろ逆向きです。秋田県の −2,932 人は人数では 47 県中 36 番目の減り方にすぎず、鳥取県(−1,508 人、−31.6%)は人数では最も少ない減少です。
人数は「全国の出生数の減少にどの県がどれだけ寄与したか」、率は「その県の中でどれだけ深刻か」に答える物差しです。「東京都でも出生数は大きく減っている」も「東京都は相対的に持ちこたえている」も、物差しを書けばどちらも正しい文になります。物差しを書かずに片方だけを見出しにするのが、ストーリーテリングでの典型的な印象操作です。
「秋田県 −44.8%」を分解する — 物語に「なぜ」を足す
語り口 B(最も減った県)を使うなら、読み手が次に知りたいのは「なぜそんなに減ったのか」です。出生数は「15〜64 歳人口 × 15〜64 歳人口千人あたりの出生数」に分けられるので、減少のどれだけが人口の縮小から来ているかを計算できます(15〜64 歳人口は出産年代の人口そのものではなく、その目安です)。
🎯 このコードでやること:出生数の 2012→2023 年度の変化を、15〜64 歳人口の変化と、15〜64 歳人口千人あたり出生数の変化に分解する(対数で足し算になる)。秋田県・東京都・沖縄県と全国について、減少のうち人口要因が占める割合を出す。
1 2 3 4 5 6 7 8 9 10 11 12 13 14 15 16 17 18 19 20 21 | import numpy as np import pandas as pd df = pd.read_csv('data/raw/SSDSE-B-2026.csv', encoding='cp932', skiprows=[1]) p = lambda c: df.pivot(index='Prefecture', columns='SSDSE-B-2026', values=c) births, work = p('A4101'), p('A1302') # 出生数、15〜64 歳人口 rate = births / work * 1000 # 15〜64 歳人口千人あたりの出生数 # 出生数の変化(対数)= 15〜64 歳人口の変化(対数)+ 千人あたり出生数の変化(対数) t = pd.DataFrame({ '出生数(%)': (births[2023] / births[2012] - 1) * 100, '15〜64歳人口(%)': (work[2023] / work[2012] - 1) * 100, '千人あたり出生数(%)': (rate[2023] / rate[2012] - 1) * 100, }) t['人口要因の割合'] = np.log(work[2023] / work[2012]) / np.log(births[2023] / births[2012]) print(t.loc[['秋田県', '東京都', '沖縄県']].round(2).to_string()) tot = births.sum(), work.sum() nat_b = tot[0][2023] / tot[0][2012] - 1 nat_w = tot[1][2023] / tot[1][2012] - 1 print(f'全国: 出生数 {nat_b:+.1%} 15〜64 歳人口 {nat_w:+.1%} 人口要因の割合 {np.log(1 + nat_w) / np.log(1 + nat_b):.2f}') print('47 県で 千人あたり出生数 が減った県:', int((t['千人あたり出生数(%)'] < 0).sum())) |
💬 秋田県の出生数 −44.81% は、15〜64 歳人口の減少(−23.42%)と、千人あたり出生数の減少(−27.93%)の両方から来ており、対数で見た減少の 45% が人口要因です。一方、千人あたり出生数の減り方だけを比べると、秋田県 −27.93%、東京都 −23.41%、沖縄県 −24.09% と大きな差はなく、47 県すべてで減っています。東京都は 15〜64 歳人口が +4.98% 増えたので、人口要因はむしろ出生数を支えました(割合 −0.22)。全国では減少の 23% が人口要因です。
ここから組み立てられる物語は「秋田県は特別に子どもを産まなくなった県」ではなく、「どの県でも人口あたりの出生は 2〜3 割減っており、秋田県ではそれに働き手世代の人口の 23% 減が重なった」です。極端な値を語るときは、それを部品に分けて、どの部品が極端なのかまで示すと、読み手は数字を正しい大きさで受け取れます。
🐍 Python 実装
公的統計(SSDSE-B-2026)を題材に、 最小限の Python コードで動作させます。 ファイルパス(data/raw/SSDSE-B-2026.csv)は自分の環境に合わせて変更してください。 まずはこのまま動かすことが理解の最短ルートです。
data/raw/SSDSE-B-2026.csv (ヘッダ 2 行・47 都道府県、 2023 年度)。 X 軸=高齢化率(65 歳以上人口割合)、 Y 軸=死亡率(人口千人あたり死亡数)を散布図に。1 2 3 4 5 6 7 8 9 10 11 12 13 14 15 16 17 18 19 20 21 22 | # 「結論を見出しに」型グラフ:タイトルに結論を書く import os import pandas as pd import matplotlib.pyplot as plt df = pd.read_csv('data/raw/SSDSE-B-2026.csv', encoding='cp932', skiprows=1) df = df[df['地域コード'].astype(str).str.match(r'^R\d{5}$', na=False)].copy() df['年度'] = pd.to_numeric(df['年度'], errors='coerce') df = df[df['年度'] == df['年度'].max()].copy() for _c in ['総人口', '65歳以上人口', '死亡数']: df[_c] = pd.to_numeric(df[_c], errors='coerce') # 高齢化率・死亡率は SSDSE にそのままの列が無いので、実在する列から計算する df['高齢化率'] = df['65歳以上人口'] / df['総人口'] * 100 df['死亡率'] = df['死亡数'] / df['総人口'] * 1000 r = df['高齢化率'].corr(df['死亡率']) df.plot.scatter(x='高齢化率', y='死亡率', figsize=(7, 4)) plt.title(f'高齢化が進む県ほど死亡率も高い(r={r:+.2f})', fontsize=14) os.makedirs('figures', exist_ok=True) plt.savefig('figures/story.png', dpi=120) print(f'高齢化率と死亡率の相関係数 r = {r:.3f}') |
▶ 実行 を押せばこのページの中でそのまま動きます(ライブラリもデータも同梱済みで、 準備は要りません)。 手元の Python に移して動かすときは pip install matplotlib numpy pandas が必要です。 読んでいるデータは data/raw/SSDSE-B-2026.csv。 日本語を含むので encoding='cp932' の指定を落とさないでください。
上のコードが描く図 — そして「当たり前」を取り除いた後の物語
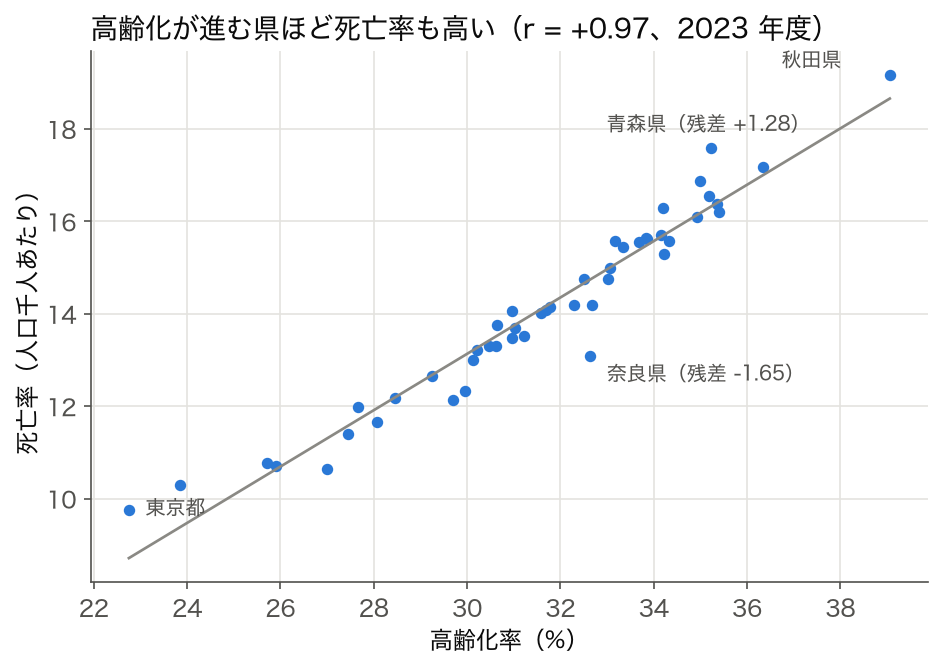
図 2 のタイトルは一目で伝わりますが、上の 💬 にあるとおり、この関係は「高齢者の多い県では亡くなる人も多い」という年齢構成の当たり前を言っているにすぎません。聞き手にとって新しい情報は、むしろその当たり前から外れている県にあります。回帰直線からのずれ(残差)を計算して、物語の焦点を移します。
🎯 このコードでやること:2023 年度の 47 県で、死亡率(人口千人あたり死亡数)を高齢化率で直線回帰し、高齢化率では説明できない部分(残差)が大きい県と小さい県を 3 つずつ挙げる。
1 2 3 4 5 6 7 8 9 10 11 12 13 14 15 16 17 18 19 | import numpy as np import pandas as pd df = pd.read_csv('data/raw/SSDSE-B-2026.csv', encoding='cp932', skiprows=[1]) d = df[df['SSDSE-B-2026'] == 2023].copy() d['高齢化率'] = d['A1303'] / d['A1101'] * 100 d['死亡率'] = d['A4200'] / d['A1101'] * 1000 # 人口千人あたり死亡数 b, a = np.polyfit(d['高齢化率'], d['死亡率'], 1) # 死亡率 ≈ a + b × 高齢化率 d['予測'] = a + b * d['高齢化率'] d['残差'] = d['死亡率'] - d['予測'] # 高齢化率では説明できない部分 r = d['高齢化率'].corr(d['死亡率']) print(f'r = {r:.3f} 決定係数 R² = {r ** 2:.3f} 傾き = {b:.3f}(高齢化率 1 ポイントあたり千人あたり死亡数)') cols = ['Prefecture', '高齢化率', '死亡率', '予測', '残差'] print('高齢化率から予測されるより死亡率が高い 3 県:') print(d.nlargest(3, '残差')[cols].round(2).to_string(index=False)) print('予測より低い 3 県:') print(d.nsmallest(3, '残差')[cols].round(2).to_string(index=False)) print(f'残差の標準偏差 = {d["残差"].std():.2f}、死亡率の標準偏差 = {d["死亡率"].std():.2f}') |
💬 高齢化率だけで死亡率のばらつきの 94.5%(R² = 0.945)が説明でき、死亡率の標準偏差 2.09 に対して残差の標準偏差は 0.49 まで小さくなります。残ったずれで見ると、青森県は高齢化率 35.22% から予測される 16.32 より 1.28 高い 17.60、東京都も予測 8.71 に対して 9.74 と 1.03 高くなっています。逆に奈良県は予測 14.74 に対して 13.10 と 1.65 低い県です。「秋田県の死亡率が最も高い」(19.17)は高齢化率でほぼ説明がつく一方、「青森県は同じくらい高齢化した県より死亡率が高い」は、図 2 の見出しからは出てこない、次の分析に値する物語です。
ただし、この残差も年齢構成の影響を完全には取り除けていません(65 歳以上をひとまとめにしているため、75 歳以上の割合の違いが残差に混ざります)。「青森県は健康状態が悪い」と見出しにするには年齢調整死亡率での確認が必要で、ここで言えるのは「調べる価値のある県が見つかった」までです。ストーリーの見出しは、データが支える範囲より一歩手前で止めるのが誠実な書き方です。
「代表値だけの物語」を自分で壊してみる
このコードでやること:全国 1 つの数字で語りたくなったときに、 その裏にある散らばりを 5 行で出すためのコードです。 ストーリーを書く前に必ず実行して、自分の主張が中央値・四分位と矛盾しないか確かめます。
📥 入力データ(SSDSE-B-2026 の出生数、2012 年と 2023 年):
1 2 3 4 5 6 7 8 9 10 11 12 13 14 15 16 17 18 19 | # 「全国 -29.9%」が隠しているもの — 県別の散らばりを出す import pandas as pd df = pd.read_csv("data/raw/SSDSE-B-2026.csv", encoding="cp932", header=1) df = df[df["地域コード"].astype(str).str.match(r"^R\d{5}$", na=False)].copy() df["出生数"] = pd.to_numeric(df["出生数"], errors="coerce") df["年度"] = pd.to_numeric(df["年度"], errors="coerce") a = df[df["年度"] == 2012].set_index("都道府県")["出生数"] b = df[df["年度"] == 2023].set_index("都道府県")["出生数"] chg = ((b - a) / a * 100).sort_values() print(f"全国合計 : {(b.sum() - a.sum()) / a.sum() * 100:+.1f}%") print(f"県別の中央値 : {chg.median():+.1f}%") print(f"県別の範囲 : {chg.min():+.1f}% 〜 {chg.max():+.1f}%") print(f"25%点 / 75%点 : {chg.quantile(.25):+.1f}% / {chg.quantile(.75):+.1f}%") print() print("最も減った 3 県:", ", ".join(f"{k} {v:+.1f}%" for k, v in chg.head(3).items())) print("最も減らない 3 県:", ", ".join(f"{k} {v:+.1f}%" for k, v in chg.tail(3).items())) |
📤 実行結果:
💬 読み方:全国合計 −29.9% と県別中央値 −33.3% の 3.4 ポイントのずれが、 「全国で語ると実態より穏やかに見える」ことを数値で示しています。 さらに 25%点 −35.2%、75%点 −30.1% を見れば、真ん中の半数の県は −35.2% 〜 −30.1% という狭い帯に収まっており、全国値 −29.9% はその帯の外(より穏やかな側)にあることが分かります。 ストーリーに書くべきは「−29.9%」ではなく、 「全国では約 3 割減。ただし県別には 2 割減から 4 割半減まで開きがある」という 1 文です。
このコードは出生数以外でもそのまま使えます。
"出生数" を "婚姻件数" や "着工新設住宅戸数" に差し替えるだけで、
別の指標について同じ確認ができます。
「全国 1 つの数字を出す前に、必ず散らばりを見る」——
これを習慣にするだけで、誤解を招くストーリーの大半は防げます。
見出しの数字を選ぶ — 同じ「少子化」が 3 割減にも 1 割減にも見える
ストーリーの冒頭(Situation)に置く数字は 1 つに絞るのが定石ですが、どの数字を選ぶかで聞き手の受け取る深刻さが変わります。SSDSE-B-2026 の 2012→2023 年度について、「子どもが減っている」ことを表す候補の数字を並べます。
🎯 このコードでやること:47 都道府県の合計で、出生数の減少数と変化率、人口千人あたりの出生数、合計特殊出生率(47 県の単純平均)、15 歳未満人口の変化率を 2012 年度と 2023 年度で比べる。出生数の前年比を並べ、2019 年度の前後で減り方の速さ(年率)を比べる。
1 2 3 4 5 6 7 8 9 10 11 12 13 14 15 16 17 18 19 20 21 22 23 | import pandas as pd df = pd.read_csv('data/raw/SSDSE-B-2026.csv', encoding='cp932', skiprows=[1]) df = df.rename(columns={'SSDSE-B-2026': '年度'}) g = df.groupby('年度')[['A4101', 'A1101', 'A1301']].sum() tfr = df.groupby('年度')['A4103'].mean() # 47 県の単純平均(全国値ではない) a, b = 2012, 2023 cands = { '出生数の減少数(人)': g.loc[a, 'A4101'] - g.loc[b, 'A4101'], '出生数の変化率(%)': (g.loc[b, 'A4101'] / g.loc[a, 'A4101'] - 1) * 100, '人口千人あたり出生数 2012→2023': f"{g.loc[a, 'A4101'] / g.loc[a, 'A1101'] * 1000:.2f} → {g.loc[b, 'A4101'] / g.loc[b, 'A1101'] * 1000:.2f}", '合計特殊出生率(47県平均)2012→2023': f'{tfr[a]:.3f} → {tfr[b]:.3f}', '15歳未満人口の変化率(%)': (g.loc[b, 'A1301'] / g.loc[a, 'A1301'] - 1) * 100, } for k, v in cands.items(): print(f'{k:<28} {v:,.1f}' if not isinstance(v, str) else f'{k:<28} {v}') # 物語の「転」を探す: 出生数の前年比 yoy = (g['A4101'].pct_change() * 100).round(1) print('出生数の前年比(%)', yoy.dropna().to_dict()) print(f'2012→2019 年率 {((g.loc[2019, "A4101"] / g.loc[2012, "A4101"]) ** (1 / 7) - 1) * 100:.2f}% ' f'2019→2023 年率 {((g.loc[2023, "A4101"] / g.loc[2019, "A4101"]) ** (1 / 4) - 1) * 100:.2f}%') |
💬 同じ 11 年間の少子化が、出生数なら「31 万人減・−29.9%」、合計特殊出生率なら「1.460 → 1.293(−11.4%)」、15 歳未満人口なら「−14.3%」と表せます。出生数が合計特殊出生率より大きく減っているのは、合計特殊出生率が女性 1 人あたりの値で、子どもを産む年齢の女性の人数の減少を含まないからです。「女性 1 人が産む子どもの数は 1 割しか減っていないのに、生まれる子どもは 3 割減った」という対比そのものが物語の核になります。どれか 1 つを見出しにするなら、聞き手の問い(出生の「件数」が知りたいのか、「産み方」の変化が知りたいのか)に合わせて選び、他の数字との違いを脚注に書きます。合計特殊出生率はここでは 47 県の単純平均で、国全体の値とは一致しない点も明記が必要です。
前年比の並びは、SCR の Complication(転)を探す材料になります。出生数は 2012→2019 年度には年率 −2.56% で減っていたのが、2019→2023 年度は年率 −4.25% と減り方が速まっています。この数字を使うと、SCR は次のように書けます。
| SCR | SSDSE-B-2026 の数字を使った文 |
|---|---|
| Situation(状況) | 47 都道府県の出生数の合計は、2012 年度から 2023 年度までに 29.9%(31 万人)減った。 |
| Complication(課題) | 減り方は一定ではなく、2019 年度までの年率 −2.6% から、2019 年度以降は年率 −4.3% に速まった(前年比は 2019 年度 −5.8%、2022 年度 −5.0%、2023 年度 −5.6%)。 |
| Resolution(次の一手) | 速まった原因が「産む人の数」か「産み方」かを分けるため、合計特殊出生率(47 県平均 1.460 → 1.293)と、出産年齢の女性人口の推移を別の統計で確かめる。 |
Resolution を「対策」ではなく「次に確かめること」にしているのは、SSDSE-B-2026 だけでは速まった原因を特定できないからです。データが言えることの範囲で物語を閉じることも、ストーリーテリングの技術の一部です。
🎮 体験:注釈・強調・順序で「伝わるメッセージ」は変わる
同じ実データ(SSDSE-B-2026 の 2023 年・高齢化率=65歳以上人口÷総人口×100、 10 県抜粋)を使っても、 注釈(基準線・ハイライト・矢印)と結論見出しを足すだけで「ただのグラフ」が「主張が伝わる図」に変わります。 下のトグルを切り替えて体感してください。 さらに「全体→注目→示唆」のステップ送りで語りの順序を、 最後の「y軸切詰め」で強調とごまかしの境界を確認できます。
🧭 直感:データに「文脈」と「焦点」を与える
上の実験でオフ状態のグラフは、 数値としては完全に正しいのに「だから何?」に答えられません。 基準線は「多い/少ないの物差し」という文脈を、 ハイライトと矢印は「どこを見るべきか」という焦点を、 見出しは「何が言いたいか」という結論を与えます。 データストーリーテリングの本質は新しい数値を足すことではなく、 既にある数値に文脈と焦点を重ねる注釈レイヤにあります。
📊 実データで確かめる — 強調する 2 本を決めると図が語り出す
上のウィジェットの「強調」を、SSDSE-B-2026 の実データで試します。47 県の出生数を 2012 年度 = 100 の指数にして、同じ 47 本の線を 2 通りに描きました。
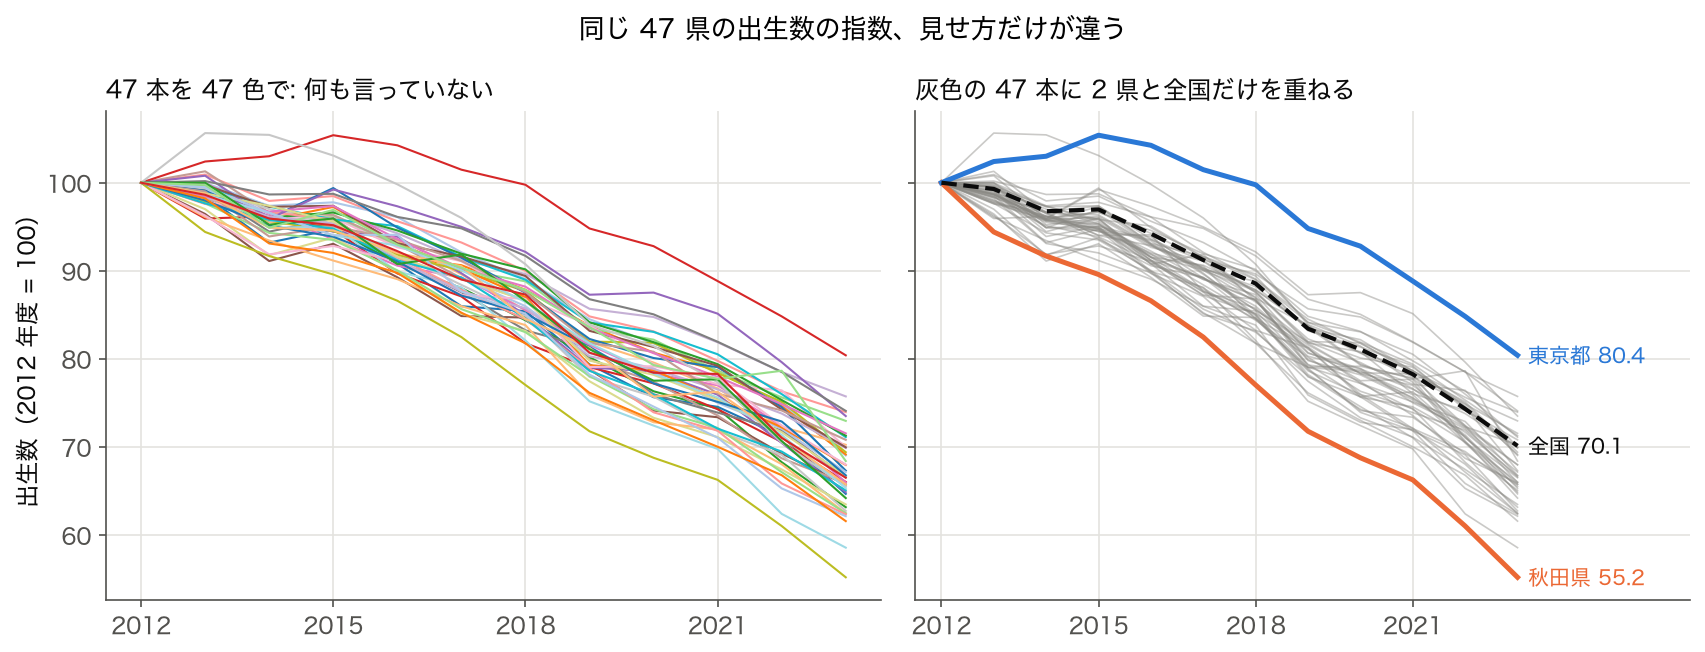
🎯 このコードでやること:47 県の出生数を 2012 年度 = 100 の指数にし、図 3 の右で強調する秋田県・東京都・全国の 2023 年度の値と、47 県の最小・中央値・最大、全国の指数を下回る県の数を出す。
1 2 3 4 5 6 7 8 9 10 11 12 13 | import pandas as pd df = pd.read_csv('data/raw/SSDSE-B-2026.csv', encoding='cp932', skiprows=[1]) b = df.pivot(index='Prefecture', columns='SSDSE-B-2026', values='A4101') idx = b.div(b[2012], axis=0) * 100 # 各県の 2012 年度 = 100 nat = b.sum() / b[2012].sum() * 100 # 全国の指数 focus = ['秋田県', '東京都'] for p in focus: print(f'{p}: 2023 年度の指数 {idx.loc[p, 2023]:.1f}') print(f'全国: 2023 年度の指数 {nat[2023]:.1f}') print(f'47 県の 2023 年度の指数: 最小 {idx[2023].min():.1f} 中央値 {idx[2023].median():.1f} 最大 {idx[2023].max():.1f}') below = (idx[2023] < nat[2023]).sum() print(f'全国の指数 {nat[2023]:.1f} を下回る県: {below} / 47') |
💬 強調した 2 県は、2023 年度の指数で最小(秋田県 55.2)と最大(東京都 80.4)の両端です。47 県の中央値は 66.7 で、全国の 70.1 を下回る県が 47 のうち 36 あります。右の図の灰色の束の大半が全国の破線より下にあるのは、この 36 県のためです。左の図では 47 色のどれが何県かを凡例で探すことすらできず、この情報は何も伝わりません。
強調する線を選ぶことは、同時に「何を語らないか」を選ぶことでもあります。右の図で両端の 2 県だけを強調すると、中央付近の県は背景に退きます。両端を選んだことを図の注記に書き(「2023 年度の指数が最小と最大の県」)、全国の線を基準として一緒に描くことで、読み手が自分の県を灰色の束の中に位置づけられるようにします。これが、上の「⚠️ 落とし穴」にある誤解を招く強調と、正当な焦点の違いです。
⚠️ 落とし穴:チェリーピッキング・過剰演出・誤解を招く強調
- チェリーピッキング:主張に都合の良い県だけ残す。 上の 10 県は最小(東京)・最大(秋田)・全国平均を含む代表抜粋で、 全 47 県の分布を歪めていないことが前提です。
- 過剰演出:矢印・色・見出しを盛りすぎると、 読み手は「誘導されている」と感じて信頼を失います。 1 図 1 メッセージが鉄則。
- 誤解を招く強調:「✂ y軸を切り詰める」を押すと差が約 2 倍に膨らみます。 見た目の演出がデータの構造そのものを歪めると、 強調は「ごまかし」に転落します。 誤解を招くグラフ を参照。
🚀 発展:ナラティブ可視化・注釈レイヤ・オーサリング
このウィジェットは Segel & Heer のナラティブ可視化(martini-glass 構造=著者が順序を導いた後に読み手の自由探索へ渡す)を最小実装したものです。 「注釈トグル」は注釈レイヤ(データ層と分離した強調要素)を、 「ステップ送り」は著者が意図を設計するオーサリングの工程を体験させます。 実務では 注釈・インタラクティブ可視化・視覚属性・複合的なグラフ と組み合わせ、 データ可視化 の素材に物語の骨格を与えます。
⚠️ よくある落とし穴
データストーリーテリングで頻出する失敗は、 (1) ストーリーに合わせて事実を曲げる (チェリーピッキング)、 (2) ビジュアルに凝りすぎて根拠数値が薄い、 (3) 主役のメッセージが拡散して結論が伝わらない、 の 3 つです。 Cole Nussbaumer Knaflic が勧める「誰に向けて」「何を知って・してほしいか」「データでどう示すか」の 3 つを毎回先に書き出せば、 大半は事前に回避できます。
⚠️ 実データで確かめる — 見出しの言葉と指標がずれていないか
「高齢化が進んだ県ほど子どもが生まれにくい」という見出しは、多くの人が直感的に正しいと感じます。これを SSDSE-B-2026 で裏づけようとすると、どの指標を使うかで結論が逆になります。
🎯 このコードでやること:12 年度それぞれの 47 県の横断面で、高齢化率と「粗出生率(人口千人あたり出生数)」の相関、高齢化率と「合計特殊出生率(女性 1 人あたりの子どもの数)」の相関を計算する。代表的な 4 県の値も並べる。
1 2 3 4 5 6 7 8 9 10 11 12 13 14 15 | import pandas as pd df = pd.read_csv('data/raw/SSDSE-B-2026.csv', encoding='cp932', skiprows=[1]) df['高齢化率'] = df['A1303'] / df['A1101'] * 100 df['出生率'] = df['A4101'] / df['A1101'] * 1000 # 人口千人あたり出生数(粗出生率) df['TFR'] = df['A4103'] # 合計特殊出生率(女性 1 人あたり) rows = [] for y, g in df.groupby('SSDSE-B-2026'): rows.append((y, g['高齢化率'].corr(g['出生率']), g['高齢化率'].corr(g['TFR']))) t = pd.DataFrame(rows, columns=['年度', 'r(高齢化率, 粗出生率)', 'r(高齢化率, 合計特殊出生率)']).round(3) print(t.iloc[[0, 3, 6, 9, 11]].to_string(index=False)) print('12 年の範囲:', t.iloc[:, 1].min(), '〜', t.iloc[:, 1].max(), '/', t.iloc[:, 2].min(), '〜', t.iloc[:, 2].max()) d = df[df['SSDSE-B-2026'] == 2023].set_index('Prefecture') print(d.loc[['秋田県', '沖縄県', '東京都', '島根県'], ['高齢化率', '出生率', 'TFR']].round(2).to_string()) |
💬 粗出生率との相関は 12 年すべてで −0.692〜−0.554 と、見出しどおり「高齢化した県ほど出生が少ない」になります。ところが合計特殊出生率との相関は 0.04〜0.227 と弱い正で、「高齢化した県ほど女性 1 人あたりの子どもが少ない」とは言えません。島根県は高齢化率 34.92% と高いのに合計特殊出生率は 1.46 と上位で、東京都は高齢化率 22.75% と最も低いのに 0.99 で最下位です。粗出生率の負の相関は、高齢化した県では出産する年代の人口の割合が小さいという年齢構成の効果です。
見出しの「子どもが生まれにくい」が「出生数が少ない」の意味なら粗出生率、「1 人の女性が産む子どもが少ない」の意味なら合計特殊出生率が対応する指標で、後者の意味ではこの見出しはデータに支えられません。ストーリーを書いたら、見出しの言葉を 1 語ずつ指標の定義に置き換え、その指標で確かめたかを点検します。都合のよい指標だけを示すことは、数値が正確でもチェリーピッキングの一種です。
⚠️ 実データで確かめる — 「何と比べて」を書かない物語は、差を大きくも小さくも見せられる
「秋田県の出生数の減り方は深刻だ」という物語の強さは、比べる相手(ベンチマーク)で変わります。全国と比べるか、同じ地方の他県と比べるか、47 県の中央値と比べるかを、実データで並べます。
🎯 このコードでやること:出生数の 2012→2023 年度の変化率を、秋田県と東京都について、全国の合計・同じ地方の他県の合計(東北 6 県・関東 7 都県から自県を除く)・47 県の中央値と並べ、47 県の中での順位を出す。
1 2 3 4 5 6 7 8 9 10 11 12 13 14 | import pandas as pd df = pd.read_csv('data/raw/SSDSE-B-2026.csv', encoding='cp932', skiprows=[1]) w = df.pivot(index='Prefecture', columns='SSDSE-B-2026', values='A4101') # 出生数 47 × 12 ch = (w[2023] / w[2012] - 1) * 100 # 2012→2023 の変化率 tohoku = ['青森県', '岩手県', '宮城県', '秋田県', '山形県', '福島県'] kanto = ['茨城県', '栃木県', '群馬県', '埼玉県', '千葉県', '東京都', '神奈川県'] for pref, region, name in [('秋田県', tohoku, '東北 6 県'), ('東京都', kanto, '関東 7 都県')]: others = [p for p in region if p != pref] reg = (w.loc[others, 2023].sum() / w.loc[others, 2012].sum() - 1) * 100 nat = (w[2023].sum() / w[2012].sum() - 1) * 100 rank = int(ch.rank(ascending=True)[pref]) # 1 = 最も減った print(f'{pref}: {ch[pref]:+.1f}% 全国 {nat:+.1f}% {name}の他県 {reg:+.1f}% 中央値 {ch.median():+.1f}% 減少の大きさ {rank} 位/47') |
💬 秋田県の −44.8% は全国(−29.9%)より 14.9 ポイント大きく減っていますが、同じ東北の他の 5 県(−36.4%)と比べると差は 8.4 ポイントに縮みます。東京都の −19.6% は全国より 10.3 ポイント小さい減少ですが、関東の他の 6 県(−29.1%)とは 9.5 ポイント差です。どの比較も事実ですが、「全国より 15 ポイントも多く減った」と「東北の中では 8 ポイント多い」では、聞き手の受け取る深刻さが違います。秋田県が 47 県で最も減った県であること(1 位)は比較の相手によらず変わらないので、順位と、比べた相手の名前をセットで書くのが誠実な書き方です。東北全体も中央値(−33.3%)より大きく減っているという事実は、「秋田県だけの問題」という物語を弱める反例として、Complication に入れておく価値があります。
図にするときは、比べる相手を図の中に描き込みます。秋田県の折れ線だけを描いて「45% 減」と見出しを付けるのではなく、全国(−29.9%)と東北の他の 5 県(−36.4%)の線を細い灰色で重ね、見出しを「秋田県の出生数は 11 年で 44.8% 減、東北の他県(36.4% 減)よりさらに大きく減った」とすれば、比較の相手が見出しと図の両方に現れ、聞き手は自分で差の大きさを確かめられます。
🗺 概念マップ
「データストーリーテリング」は、 データ可視化・ナラティブ・聴衆設計の三位一体。 以下の概念マップで中核概念と隣接領域の包含・対比関係を整理する。
公的統計
前処理・集計
三幕構成
Pyramid Principle
散布図・棒・箱ひげ
Plotly / matplotlib
研究者・市民
Call to Action
SVG 関係図: データストーリーテリングを中心とした概念の包含・上下関係
| 概念 | データSTとの関係 | 違い・注意 |
|---|---|---|
| データ可視化 | 手段・部品 | 可視化単独ではストーリーにならない |
| インフォグラフィック | 並列 (静的情報伝達) | 物語構造より情報圧縮に重点 |
| プレゼンテーション | 媒体・チャネル | データ ST が中身、プレゼンは形式 |
| EDA (探索的分析) | 上流フェーズ | EDA で発見 → ST で伝達 |
| データジャーナリズム | 応用分野 | 報道目的に特化した ST |
🔗 隣接手法への橋渡し
「データストーリーテリング」は単独で完結する手法ではなく、 上流・並列・下流の隣接手法と連携することで真価を発揮する。
| 位置 | 隣接手法 | 接続ポイント | 実務での順序 |
|---|---|---|---|
| 上流 | データリテラシー / EDA | 「何が面白いか」を発見 | EDA → DS |
| 並列 | データ可視化 / BI ツール | 図表生成・ダッシュボード | DS と同時並行 |
| 統計的根拠 | 相関分析 / ANOVA | 「差は偶然か?」の検証 | DS の「Conflict」補強 |
| 下流 | 政策提言 / レポート執筆 | 「Resolution」の実装 | DS → 報告書 |
SSDSE コンペでは「EDA (散布図) → DS (三幕) → 統計検定 (ANOVA p=0.0003) → 報告書(Result セクション)」の順が高評価を得やすい。 DS は「つなぎ役」として機能し、 データと聴衆の橋渡しをする。
🌳 手法選択フロー
「データストーリーテリング」は適切な場面で使って初めて効果を発揮する。 以下のフローで「この場面に DS が適切か」を 4 分岐で判断する。
| 判断基準 | Yes の場合 | No の場合 |
|---|---|---|
| ① 伝達相手が人間か? | 次へ | 自動処理なら DS 不要 |
| ② 行動変容を求めるか? | DS が最適。 3 幕構成を採用 | 記録・参照用なら BI ダッシュボード |
| ③ データに驚きの落差はあるか? | Discovery Arc or Problem-Solution Arc | 落差を探す EDA を先行 |
| ④ 聴衆の専門知識は? | 専門家 → 統計指標主体の DS | 一般 → 比喩・具体例主体の DS |
SSDSE-B-2026 コンペでの典型ケース: ① 審査員(人間)→ ② 政策示唆あり(行動変容あり)→ ③ 東京と秋田の高齢化率 16 ポイント差(22.8% 対 39.1%)が落差 → ④ 専門家向けに p 値・効果量を添えた DS を選択。
🧠 直感を深める:3 要素の「かけ算」で洞察を運ぶ
冒頭の「🎨 直感で掴む」を一歩進めます。 データストーリーテリングの正体は、 データ(data)・ビジュアル(visual)・ナラティブ(narrative)の 3 要素を足し算ではなくかけ算で重ねる営みです。 かけ算なので、 どれか一つが 0 に近いと全体が伝わらなくなります。
| 要素 | 担う役割 | これが欠けると起きること |
|---|---|---|
| データ | 主張の根拠・信頼性の源泉 | 「印象論」になり、 反論で崩れる |
| ビジュアル | 一瞬で構造を掴ませる知覚の近道 | 数字の羅列になり、 記憶に残らない |
| ナラティブ | 「だから何?」に答え、 行動へ導く | 図の墓場になり、 意思決定が動かない |
鍵は文脈化(contextualization)です。 単独の数値「東京都の高齢化率 22.8%(SSDSE-B-2026・2023年・実測)」は、 それだけでは高いか低いか判断できません。 基準(全国の人口加重平均 29.1%)と対比(秋田県 39.1%)を隣に置いて初めて「東京は全国平均より 6 ポイント以上低く、 最高の秋田とは 16.3 ポイントの開きがある」という意味が立ち上がります。 このページ上部の「🎮 体験」ウィジェットで、 同じ実データが注釈レイヤの追加だけで「ただのグラフ」から「主張が伝わる図」へ変わるのを確認できます。
そして 3 要素の先には必ず聴衆に合わせた翻訳と行動喚起(call to action)を置きます。 「格差 16.3 ポイント」という事実を、 知事には「地方拠点への介入シナリオ」、 現場には「市区町村別の年齢層変動」へと翻訳して初めて、 グラフの羅列ではない物語になります。
⚠️ 落とし穴を深掘り(重要)
「物語を強くしたい」という動機は、 容易に事実を曲げる圧力に転化します。 上部の「⚠️ よくある落とし穴」を、 可視化の欺き・認知バイアス・文脈の欠落の 3 系統に整理して深掘りします。 いずれも「悪意」ではなく「善意の熱意」から起きるのが厄介な点です。
| 落とし穴 | 何が起きるか | 対処 |
|---|---|---|
| 軸操作(y 軸切り詰め・対数の乱用) | 見た目の差を数倍に誇張。 量の比較で 0 起点を捨てると印象がねじれる | 量の比較は 0 起点が原則。 変化率を語るなら軸の非 0 を明示 |
| チェリーピッキング | 主張に都合の良い県・期間だけ抽出し、 全体分布を歪める | 代表抜粋(最小・最大・平均を含む)か全数。 逆の結論を支持する数値も並べる |
| data-ink 比の無視・過剰装飾 | 3D・影・無意味な色でメッセージが薄まる(チャートジャンク) | Tufte の data-ink 比を意識し、 意味のないインクを削る |
| 聴衆を無視した専門用語 | 「効果量 d」「p 値」を説明なしに出し、 相手が置き去りになる | 相手のリテラシーに合わせ翻訳。 専門家には指標、 一般には比喩 |
| 相関を因果と語る | 「高齢化が進む県ほど死亡率も高い」を因果と断言してしまう | 交絡(年齢構成など)を疑い、 「観察された関連」と明記 |
| 確証バイアス・結論先行 | 先に結論を決め、 それを支持するデータだけ集める | 反証データを能動的に探す。 「間違っていたら何が見えるはず?」を自問 |
| 文脈欠如の数値 | 基準・単位・母数のない「裸の数字」で誤解を招く | 基準線・n・期間・単位を必ず添える |
とりわけ軸操作は「強調」と「ごまかし」の境界に立ちます。 上部ウィジェットの「✂ y軸を切り詰める」を押すと、 東京と秋田の実際の差(16.3 ポイント)が見た目で約 2 倍に膨らむ様子を体感できます。 詳細は 誤解を招くグラフ を参照。 過剰装飾と知覚の話は 視覚属性 と ゲシュタルト原則、 色の乱用は 配色 に整理があります。
相関と因果の混同は、 ストーリーが最も「気持ちよく嘘になる」瞬間です。 相関分析 で得た関連を、 因果 と 交絡 の観点で吟味し、 断定を避けます。 聴衆の専門用語問題は、 読み手のリテラシーを測る データリテラシー とセットで考えると事故が減ります。
🚀 発展:ナラティブ構造・注釈設計・倫理的可視化
最後に、 実装レベルで効く 6 つの発展トピックを整理します。 上部の「🎮 体験」ウィジェットは、 このうちナラティブ構造・注釈レイヤ・プログレッシブディスクロージャーを最小実装したものです。
- ナラティブ構造(状況→複雑化→解決):SCR / SCQA / 三幕構成のいずれも骨格は同じ。 「状況(現状の共有)→ 複雑化(想定との落差・葛藤)→ 解決(推奨アクション)」で 1 図 1 メッセージを積む。 落差(driving question)が弱いと物語は動かない。
- アノテーション・強調:基準線・ハイライト・矢印・結論見出しは、 データ層と分離した注釈レイヤ。 「どこを・なぜ見るか」を明示する。 詳しくは 注釈・視覚属性。
- プログレッシブディスクロージャー:一度に全部見せず「全体 → 注目 → 示唆」と段階開示する。 Segel & Heer の martini-glass 構造(著者が順序を導いた後、 読み手の自由探索へ渡す)が代表例。
- 聴衆分析:意思決定者・専門家・一般市民で、 求める粒度(結論ファースト/方法論/比喩)が変わる。 「誰の、 どの意思決定を動かすか」を先に一文で書く。
- 行動喚起(call to action):物語の出口は必ず「次に何をすべきか」。 事実の提示で終えず、 選択肢を 2〜3 個に絞って提示する。
- 倫理的可視化:軸・抽出・色・見出しで印象を操作しない。 不確実性(信頼区間・n・期間)を隠さず併記する。 「強調」と「ごまかし」の一線は 誤解を招くグラフ にまとめた原則で判断する。
なお、 これら注釈は 棒グラフ や散布図といった素材(=データ可視化)の上に重ねて初めて機能します。 「効果量で驚きを裏づける」手法は 効果量 を、 全体の素材づくりは データ可視化 を参照してください。(本サイトに独立ページのない「データビジュアライゼーション基礎」等は、 これらの実在ページで代替できます。)