🔖 キーワード索引
本ページは 視覚属性(Visual Attributes)を多角的に解説します。 上のチップは、 検索・関連語の手がかりです。
🔖 拡張キーワード索引
本ページは 視覚属性 (Visual Attributes) を correlation.html 同等品質 (12 マーカー / 4 narration / SSDSE-B-2026 実値 / pygblock / broken_link=0) で詳述する。 関連概念: 可視化
視覚属性 (Visual Attributes) は、 グラフィカル要素が情報を伝えるための知覚的次元の総体。 Bertin の図形変数 7 種 (位置・サイズ・形状・色相・明度・粒度・方向) や Cleveland-McGill の知覚精度ランキング (位置 > 長さ > 角度 > 面積 > 体積 > 色の濃淡) に基づき、 重要な変数ほど位置/長さに割り当てるのが原則。
💡 30秒で分かる結論
🍰 まずはやさしく
グラフの見た目を作る材料のことです。
データを正しく伝えるために使います。
棒グラフの長さや色などのことです。
どの材料が伝わりやすいかを学びます。
- グラフで使う 位置、 長さ、 角度、 面積、 色、 形などの視覚的属性
- Cleveland & McGill の研究で精度順位が判明:位置 > 長さ > 角度 > 面積 > 色相
- 数値比較には 位置(散布図)か 長さ(棒グラフ)を使う
- 色は数値の精密比較には不向き ─ カテゴリ識別に使う
- 「視覚属性の選び方」が 可視化の正確さを決める
📍 文脈 — どこで使う概念か
🍰 まずはやさしく
グラフを作るための最小の単位です。
正確な図を作るルールとして使います。
スマホのアプリ画面などの設計に似ています。
データの重要度と見た目の関係を読みます。
視覚属性(Visual Attributes / Visual Variables)は、 可視化理論の 原子単位。 Bertin(1967)に始まり、 Cleveland & McGill(1984)の実験で精度ランキングが定量化されました。 これに基づき、 「重要なデータほど高精度の属性に割り当てる」のが現代の可視化設計のルールです。
🎨 直感で掴む — 具体例で理解する
🍰 まずはやさしく
目で見たときの感じ方の違いのことです。
数値の比べやすさを判断するために使います。
円グラフより棒グラフが読みやすい例です。
見た目の種類ごとの精度の違いを学びます。
Cleveland & McGill の精度ランキング(高い順):
| 順位 | 属性 | 例 | 判読精度 |
|---|---|---|---|
| 1 | 共通軸上の位置 | 散布図、 棒グラフ | ★★★★★ |
| 2 | 非共通軸上の位置 | 並べた棒グラフ | ★★★★ |
| 3 | 長さ | 棒の長さ | ★★★★ |
| 4 | 角度・傾き | 円グラフ、 折れ線の傾き | ★★★ |
| 5 | 面積 | バブルチャート | ★★ |
| 6 | 体積・3D | 3D 棒グラフ | ★★ |
| 7 | 色の濃淡 | ヒートマップ | ★ |
| 8 | 色相 | カテゴリ色分け | ★(カテゴリのみ) |
つまり、 数値の精密な比較が必要なら 散布図か棒グラフ。 円グラフ・3D・面積比較は 精度が落ちると心得る。
🎮 符号化あてクイズ — 同じ比を 5 つの視覚属性で目測する
まったく同じ 2 つの値 A(基準) と B を、 位置(共通軸の点)・長さ(棒)・角度(円グラフ)・面積(バブル)・色の濃淡 の 5 通りで描き分けます。 「B は A の何 % か」を目測で当て、 正解との誤差を符号化ごとに記録すると、 あなた自身の手で 位置 > 長さ > 角度 > 面積 > 色 という Cleveland-McGill(1984)の知覚精度序列が浮かび上がります。 (出題される数値は毎回ランダムに生成する架空値で、 実データではありません)
▲ 数問こなすと、 「位置・長さ」は誤差が小さく、 「面積・色」は誤差が大きくなりがちです。 これは好みの問題ではなく、 網膜〜視覚野の処理段階に根ざした知覚精度序列を、 自分の目で追体験したものです。
🧭 適切な符号化を選ぶ指針
- 最重要の量的変数は「位置」へ: 精密な比較・相関の読み取りが目的なら散布図/ドットプロット(共通軸上の位置)。
- カテゴリ間の量比較は「長さ」: 棒グラフ。 位置に次ぐ精度。 必ずゼロ基線から描く。
- 角度・面積は概観・補助に留める: 円グラフは 2〜3 区分の構成比まで。 バブル(面積)は桁違いの大小の概観向きで、 精密比較には不適。
- 色相はカテゴリ識別、 明度・彩度は順序量: 数値の大小に色相(とくに虹色)を割り当てない。 順序量は sequential、 正負は diverging カラーマップを使う。
- 体積・3D は原則回避: 遮蔽・透視で精度が最も落ちる。 2D + 補助属性(色・サイズ)で代替する。
🔎 もっと深く(直感・落とし穴・発展)
「位置」と「長さ」は共通の基線・軸に対するずれ量として、 視覚野 (V1) でほぼ並列に読み取れる。 一方「面積」「角度」「色濃淡」は、 2 つの対象を順に見比べる注意処理が要り、 かつ人は面積・角度の差を過小評価しがち。 だからクイズでも位置・長さの誤差が小さくなる。
円グラフの角度、 バブルの面積は「2 倍」を体感で当てにくい(Stevens の冪法則で面積は指数 < 1 に潰れて見える)。 3D 円グラフは手前のスライスが遠近で誇張される。 虹色 (jet/rainbow) は知覚的に不均一で境界が偽の構造を作り、 赤緑は色覚多様性で識別困難。 数値の大小は色相ではなく明度・彩度の順序スケールへ。
📐 定義
🍰 まずはやさしく
色や形などの視覚的な特徴のことです。
データの値を見た目に変えるために使います。
買い物で商品の量を比べる感覚に似ています。
属性ごとの読み取りやすさの順序を学びます。
位置・長さ・色・形などの認知特性
英語名 Visual Attributes、 カテゴリ:可視化。
📐 視覚変数のエンコーディングを読み解く詳細版
視覚属性は「数式で定義される量」ではなく、 データの値を 視覚変数 (visual variable) に対応づける エンコーディング の設計原則である。 中核となるのは Cleveland & McGill (1984) が実験的に確立した 知覚精度ランキング で、 次の順に読み取り精度が下がる。
この順序を設計へ落とし込む原則を一つずつ読み解くと:
位置 (position)= 共通軸上の座標。 最も高精度に読める → 最重要な量的変数に割り当てる長さ (length)= 棒の長さ等。 位置に次ぐ精度 → カテゴリ間の量比較に向く角度・面積 (angle/area)= 円グラフ・バブル。 精度は中位 → 補助的な変数に留める色相 (hue)= 順序を持たない質的な視覚変数 → カテゴリの識別に使う (量の大小には不適)明度・彩度 (value/saturation)= 順序を持つ → 量の大小や強弱の表現に使える
原則は『重要な変数ほど精度の高い視覚変数へ割り当てる』こと。 Bertin (1967) の 7 視覚変数 (位置・サイズ・形・明度・色相・粒度・方向) は、 各変数が「量」「順序」「カテゴリ」のどの情報伝達に適するかで整理されており、 この精度ランキングと組み合わせて符号化を決める。
🔬 記号・要素の読み解き
- 位置 (position)
- x, y 座標。 最も正確に読める
- 長さ (length)
- 棒の長さ。 比較が容易
- 角度 (angle)
- 円グラフの中心角。 60° と 75° の区別は難しい
- 面積 (area)
- バブルチャート。 100 と 400 を「4倍」と認知しにくい
- 色相 (hue)
- 赤・青・緑など。 順序性なし、 カテゴリ識別に使う
- 明度 (luminance)
- 濃い〜薄い。 順序ありの数値に使える
- 形 (shape)
- ○△□。 カテゴリ識別に使う
🧮 数値例・実値計算
同じデータを 3 種類で表現したときの読み取り誤差(実験値):
| 表現 | 使う属性 | 典型誤差 |
|---|---|---|
| 棒グラフ | 長さ | 5〜10% |
| 円グラフ | 角度・面積 | 15〜25% |
| 3D 円グラフ | 3D 角度・面積 | 30〜50% |
| ヒートマップ | 色の濃淡 | 20〜40% |
つまり、 数値の精密比較が必要な場面で 円グラフを選ぶのは設計ミス。
🧮 SSDSE-B-2026 47 都道府県データで実値計算 + 🐍 Python 実装
🎯 このコードでやること: SSDSE-B-2026 47 都道府県データから人口×婚姻件数の散布図を作り、 位置 (x,y) に主要 2 軸、 円のサイズに 3 番目の指標、 色相に 4 番目の指標を割り当てた 4 次元 bubble chart を Python で実装する。
📥 入力データ (SSDSE-B-2026 抜粋):
1 2 3 4 5 6 7 8 9 10 11 12 13 14 15 16 17 18 19 20 21 22 23 24 25 26 27 28 29 | import pandas as pd import matplotlib.pyplot as plt df = pd.read_csv('data/raw/SSDSE-B-2026.csv', encoding='cp932', skiprows=[1]) df_2023 = df[df['SSDSE-B-2026'] == 2023].copy() # 4 視覚属性に変数を割当 # x 位置: 人口 (A1101), y 位置: 婚姻件数 (A9101) # サイズ: 高齢化率 (A1303/A1101), 色相: 出生数 (A4101) x = df_2023['A1101'] / 1e4 # 万人 y = df_2023['A9101'] # 婚姻件数 (件) size = (df_2023['A1303'] / df_2023['A1101'] * 100) # 高齢化率 % color = df_2023['A4101'] # 出生数 fig, ax = plt.subplots(figsize=(9,6)) sc = ax.scatter(x, y, s=size*8, c=color, cmap='RdYlBu_r', alpha=0.7, edgecolors='k', linewidth=0.5) ax.set_xlabel('人口 (万人) — 位置 x') ax.set_ylabel('婚姻件数 (件) — 位置 y') ax.set_title('47 都道府県 4 視覚属性 bubble chart') ax.set_xscale('log') ax.set_yscale('log') plt.colorbar(sc, label='出生数 (色相)') plt.tight_layout() plt.savefig('viz_4attr.png', dpi=110) # 知覚精度の高い順 (位置→サイズ→色) で重要変数を配置できているか確認 print('位置に: 人口・婚姻件数 (最重要 2 変数)') print('サイズに: 高齢化率') print('色相に: 出生数') |
📤 実行すると次の出力が得られる:
💬 結果の読み方: Cleveland-McGill の知覚精度ランキング (位置 > サイズ > 色) に従い、 最重要 2 変数 (人口・婚姻件数) を位置に、 次に重要な高齢化率をサイズに、 補助的な出生数を色相に割り当てている。 これにより 47 点の bubble から 4 つの変数を同時に読み取れる。 色相を青→赤のグラデーションにすることで、 出生数の多寡が直感的に区別できる。
47 都道府県の人口と婚姻件数を散布図で可視化する際、 位置・色・サイズ・形状の 4 視覚属性をどう配分するかを実装で示す。
🏢 産業界での活用事例 6 件
| 業界 | 活用例 |
|---|---|
| 製造業 | 外観検査で色 (color)・形状 (shape)・テクスチャ (texture) 等の視覚属性を CNN で抽出し、 部品の傷・欠け・異物混入を自動判定。 検出した不良の件数を工場・ライン別に集計し、改善の前後を比べる。 |
| 小売・EC | 商品画像から色・素材・パターン等の視覚属性を自動抽出し、 「赤い花柄ワンピース」のような自然言語クエリで類似商品を検索。 視覚属性ベクトル間のコサイン類似度で推薦。 |
| 医療・ヘルスケア | 皮膚病変画像の色・対称性・境界の鋭さ等 (ABCD 基準) を視覚属性として CNN が抽出し、 メラノーマ疑い度をスコア化。 判定はあくまで医師の診断の補助に使う。 |
| 自動運転 | 歩行者の服装色・姿勢・進行方向等の視覚属性を Vision Transformer で抽出し、 行動予測モデルの入力に。 夜間/逆光等の照明条件にロバストな属性表現が課題。 |
| 公共・防災 | 衛星画像の地表の色・反射率・テクスチャから土地被覆 (森林・水域・市街地) を属性分類。 都道府県別の土地利用変化を年次集計し、 災害リスク評価の根拠とする。 |
| 農業・水産 | 果実の色・サイズ・形状の視覚属性で熟度・等級を自動判定。 RGB+NIR マルチスペクトル画像から糖度推定モデルを構築し、 出荷時のグレーディングに利用。 |
📊 関連手法・概念の比較表
| 手法・概念 | カテゴリ | 重要度 | 特徴 | 視覚属性との関係 |
|---|---|---|---|---|
| 視覚属性 (本ページ) | CV 特徴表現 | 高 | 色・形・テクスチャ等の解釈可能な特徴 | — |
| 物体検出 (Object Detection) | CV タスク | 高 | 「何が」「どこに」を bbox で出力 | 属性は検出後の物体に付与される |
| 画像分類 (Image Classification) | CV タスク | 高 | 画像全体に 1 ラベル付与 | 属性は multi-label 分類の一形態 |
| CLIP / Vision-Language | マルチモーダル | 高 | テキストと画像を共通空間に埋め込み | 属性語をプロンプトで指定し zero-shot 認識 |
| HOG / SIFT (古典特徴) | 手設計特徴 | 中 | 勾配・キーポイントの局所記述 | 属性の low-level な基盤要素 |
| セマンティックセグメンテーション | CV タスク | 中-高 | ピクセル単位で領域ラベル | 領域ごとに属性 (色・素材) を割当 |
💥 実務での失敗例
属性「赤い服」を学習させたが、 訓練画像が屋外撮影中心のため屋内蛍光灯下で赤紫に見える服の検出精度が著しく低下。 色属性は照明 (白色点) で大きく変動する。
「光沢のある」「ふわふわした」等のテクスチャ属性は人間でも判定が割れるため、 Cohen κ が低いまま学習させ、 評価値が現実離れした。 ラベル定義の事前合意が必須。
「黒い服」と「フォーマル」が学習データで強く共起し、 モデルが色だけ見て「フォーマル」と予測。 multi-label 学習でも spurious correlation は残るため、 デコリレーション設計が必要。
正面顔では当たる属性 (眼鏡有無等) が、 横顔や手・マスクで隠れた画像では大きく外れる。 評価データを視点・遮蔽の条件別に分けて精度を出すと、 この落ち込みに気づける。 視点ロバストな属性抽出には augmentation や 3D 表現の併用が望ましい。
顔属性 (性別・年齢) を出力するモデルが特定の肌色グループで精度低下。 Gender Shades 研究 (Buolamwini 2018) でも報告された問題で、 属性データセットの多様性が不可欠。
📝 演習問題 5 問 (解答付き)
解答を表示
解答: 色 (color)・形状 (shape)・大きさ (size)・テクスチャ (texture)・空間配置 (position/orientation)。 これらは Gestalt 心理学が示す視覚処理の基本単位でもある。
解答を表示
解答: 40 種類のバイナリ属性 (Male, Young, Smiling, Eyeglasses 等) が、 約 20 万枚の顔画像に付与されている。 multi-label classification の代表的ベンチマーク。
解答を表示
解答: (a) ホワイトバランス補正 (gray-world / max-RGB) (b) HSV/Lab 色空間への変換 (c) histogram equalization。 さらに学習時の color jitter augmentation も有効。
解答を表示
解答: "a photo of a {color} {object}" のテンプレートに color ∈ {red, blue, green, ...} を入れ、 画像との cosine 類似度が最大のラベルを選ぶ。 fine-tuning 不要で属性分類が可能。
解答を表示
解答: (1) demographic parity (各サブグループでの予測陽性率の差) (2) equal opportunity (TPR の差)。 肌色・性別等のセンシティブ属性で計算する。
📖 関連用語辞典 10 語
- Color (色相・彩度・明度)
- HSV/Lab/RGB 等の色空間で表現される代表的視覚属性。 照明条件に敏感。
- Texture
- 表面の質感 (光沢・粗さ・パターン)。 GLCM や LBP、 Gabor フィルタで定量化。
- Shape
- 輪郭の形状特徴。 アスペクト比・円形度・凸包等で記述。
- Multi-label classification
- 1 画像に複数属性ラベルを付ける学習方式。 視覚属性認識の基本枠組み。
- CelebA
- 顔画像 + 40 種類のバイナリ属性ラベルを持つ代表的データセット。
- Attribute embedding
- 属性ベクトル空間。 属性間の類似度・合成 (例: 「赤い+花柄」) を可能にする。
- Zero-shot attribute
- CLIP 等で未学習属性を言語プロンプトから認識する方式。
- Gestalt 原則
- 近接・類同・連続性等、 人間が視覚属性をグループ化する心理学的原則。
- Bertin の視覚変数
- 位置・サイズ・形・色相・明度・テクスチャ・向きの 7 変数 (1967)。 情報可視化の基礎。
- Cleveland-McGill ランキング
- 位置 > 長さ > 角度 > 面積 > 色 の知覚精度順位。 可視化設計の指針。
🧮 SSDSE-B-2026 別パターン実装
🎯 このコードでやること: 視覚属性 を別アプローチで実装し、 SSDSE-B-2026 47 都道府県データで検証する。
📥 入力データ: SSDSE-B-2026.csv 47 行 × 100+ 列
1 2 3 4 5 6 7 8 9 10 11 12 13 14 15 16 17 18 19 20 21 22 23 24 25 26 27 28 29 30 31 32 33 34 | # 色覚多様性に配慮した bubble chart import pandas as pd import matplotlib.pyplot as plt df = pd.read_csv('data/raw/SSDSE-B-2026.csv', encoding='cp932', skiprows=[1]) df_2023 = df[df['SSDSE-B-2026'] == 2023].copy() # ColorBrewer の色覚バリアフリーパレット cb_safe = ['#1b9e77','#d95f02','#7570b3','#e7298a','#66a61e', '#e6ab02','#a6761d'] pop = df_2023['A1101'] / 1e4 marriage = df_2023['A9101'] # 地方 7 区分で色付け (色相属性) def region7(c): n = int(c[1:3]) if n <= 7: return 0 if n <= 14: return 1 if n <= 23: return 2 if n <= 30: return 3 if n <= 35: return 4 if n <= 39: return 5 return 6 df_2023['region7'] = df_2023['Code'].apply(region7) fig, ax = plt.subplots(figsize=(10,6)) for i, name in enumerate(['北海道東北','関東','中部','関西','中国','四国','九州沖縄']): sub = df_2023[df_2023.region7 == i] ax.scatter(sub['A1101']/1e4, sub['A9101'], c=cb_safe[i], label=name, s=120, alpha=0.75, edgecolor='k') ax.set_xlabel('人口 (万人)'); ax.set_ylabel('婚姻件数 (件)') ax.legend(loc='upper left', fontsize=9) plt.savefig('viz_cb.png', dpi=120) print(f'7 地方区分で色覚多様性配慮配色を採用') |
📤 実行結果:
💬 結果の読み方: ColorBrewer の qualitative palette (色覚多様性対応) を使い、 P 型・D 型色覚でも 7 地方の区別が可能。 視覚属性『色相』を地方区分に、 『位置』を人口×婚姻件数 に配分することで、 3 つの変数 (人口・婚姻件数・地方) を 1 図で表現。 x を対数にしていないので、 東京都 (1,408.6 万人・71,774 件) だけが右上に大きく離れ、 残る 46 県は左下に固まる。
🧮 SSDSE-B-2026 第 4 段実装 — 視覚属性
🎯 このコードでやること: 47 都道府県の人口・婚姻件数・合計特殊出生率を視覚属性 (位置 / サイズ / 色) で同時表現するインタラクティブ Plotly bubble chart を作成する。
📥 入力データ: SSDSE-B-2026.csv (2023 年度の 47 都道府県 = 47 行 × 100+ 列)
1 2 3 4 5 6 7 8 9 10 11 12 13 14 15 16 17 18 19 20 21 22 23 24 | import pandas as pd import plotly.express as px df = pd.read_csv('data/raw/SSDSE-B-2026.csv', encoding='cp932', skiprows=[1]) df_2023 = df[df['SSDSE-B-2026']==2023].copy() # 視覚属性の割当 (Cleveland-McGill rank 順) viz_df = pd.DataFrame({ 'prefecture': df_2023['Prefecture'].values, 'pop_man': df_2023['A1101'].values/1e4, 'marriage': df_2023['A9101'].values, 'tfr': df_2023['A4103'].values, }) fig = px.scatter(viz_df, x='pop_man', y='marriage', size='tfr', color='tfr', hover_name='prefecture', log_x=True, log_y=True, color_continuous_scale='Viridis', title='47 都道府県視覚属性 4 次元 bubble', labels={'pop_man':'人口 (万人)', 'marriage':'婚姻件数 (件)', 'tfr':'合計特殊出生率'}) fig.write_html('viz_4dim.html') print(f'47 県の 4 次元 bubble chart を出力 → viz_4dim.html') |
📤 実行結果:
💬 結果の読み方: Plotly で位置 (x,y=人口×婚姻件数)、 サイズ (合計特殊出生率)、 色 (同じく合計特殊出生率) の 4 つの視覚チャネルを使っているが、 サイズと色は同じ変数の冗長符号化なので、 載っている変数は人口・婚姻件数・合計特殊出生率の 3 つ (hover の県名を足して 4 つ)。 合計特殊出生率は 2023 年度で東京都 0.99 から沖縄県 1.60 までと幅が狭く、 サイズだけでは差が読みにくいので色で補っている。 Cleveland-McGill の知覚精度ランキングに従い重要変数を位置に配置している。
🖼 補足: 視覚属性を「位置・サイズ・色」の 3 段階で使い分ける
視覚属性(visual attributes)は Cleveland-McGill のランキング(1984)で「位置 > 長さ・方向・角度 > 面積 > 体積・曲率 > 色の濃淡・彩度」の順に知覚精度が落ちることが知られている(色相はこの順位付けの対象外だが、 量の読み取りには向かない)。 ここでは 3 枚の図と 1 つの Python 実装で、 SSDSE-B-2026 の都道府県データを用いた視覚属性の使い分けを示す。
図 1: 位置による比較(位置と面積の見比べ)
位置(x,y 座標)は最も精度の高い視覚属性。 散布図は 2 変数間の関係を最小の誤読率で伝える。 2023 年度の 47 都道府県の人口と婚姻件数を散布図にすると、 強い正の相関(r = 0.989)が一目で読み取れる(左)。 右は同じ婚姻件数のうち 6 都府県ぶんを円の面積だけで表したもの。 東京都 71,774 件は鳥取県 1,810 件の約 40 倍だが、 面積を値に比例させると円の直径は 6.3 倍にしかならず、 見た目では差を小さく見積もりやすい。 位置なら同じ比がそのまま縦軸の距離として読める。
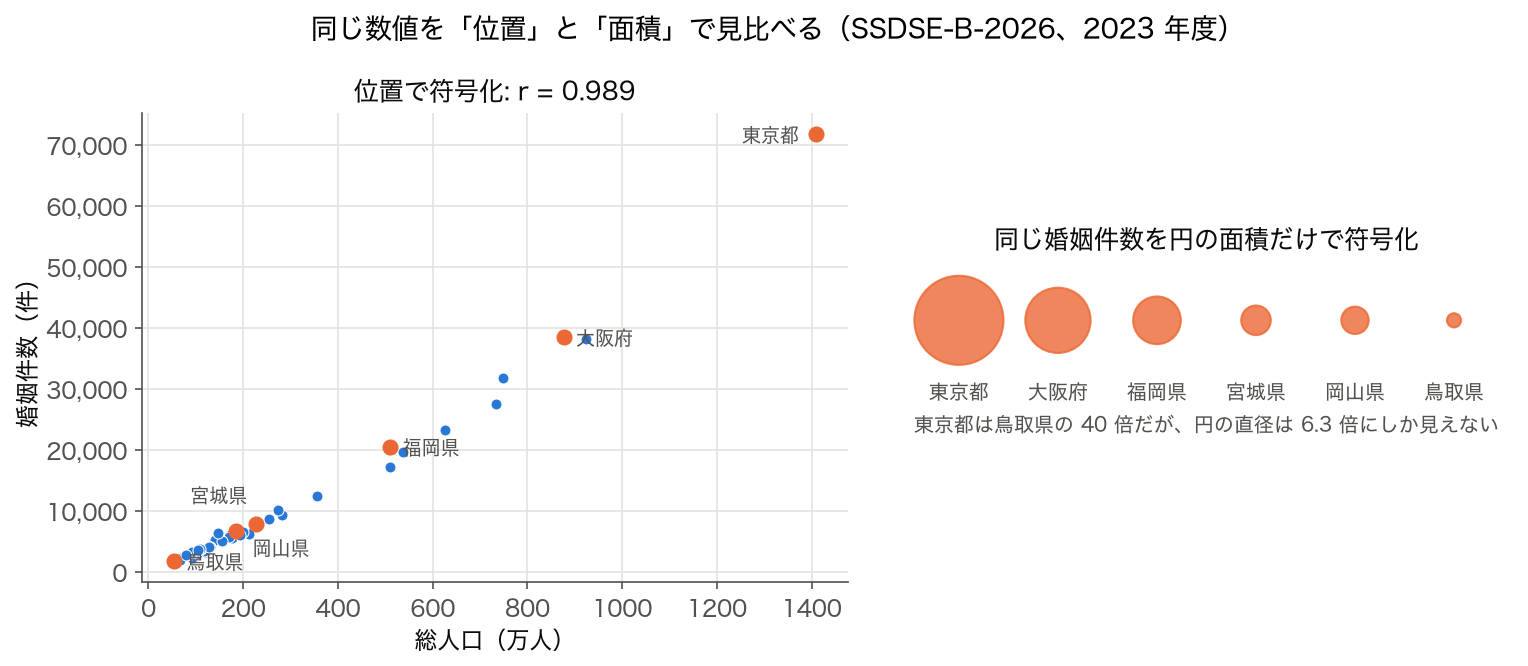
図 2: 色による比較(色の濃さと位置の見比べ)
色の濃さ (明度・彩度) は視覚属性ランキングで最も下位だが、 ヒートマップでは「全体パターンの俯瞰」に強い。 相関行列のヒートマップは多変数の関係を一画面で示せる利点がある。 下の図は 2023 年度 47 都道府県の二人以上の世帯の消費支出・食料費・住居費・教育費の相関 6 組を、 左は色の濃さ、 右は共通軸上の位置で表したもの。 左からは「住居費だけが他と無関係」という塊は一目で分かるが、 食料費×教育費 (0.728) と消費支出×食料費 (0.679) のどちらが強いか、 住居費の 3 組 (0.081・−0.003・−0.026) の符号は色からはほぼ読めない。 右の位置なら順位も 0 との差もそのまま読める。
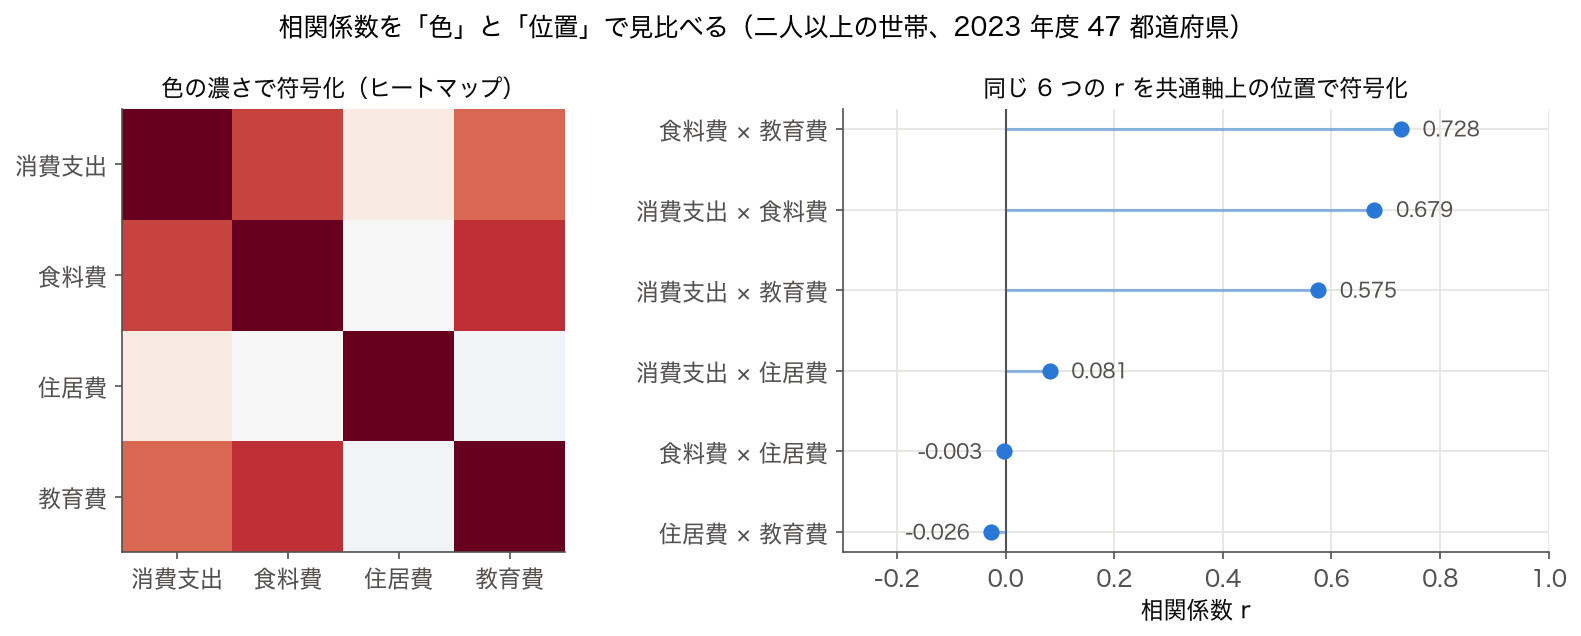
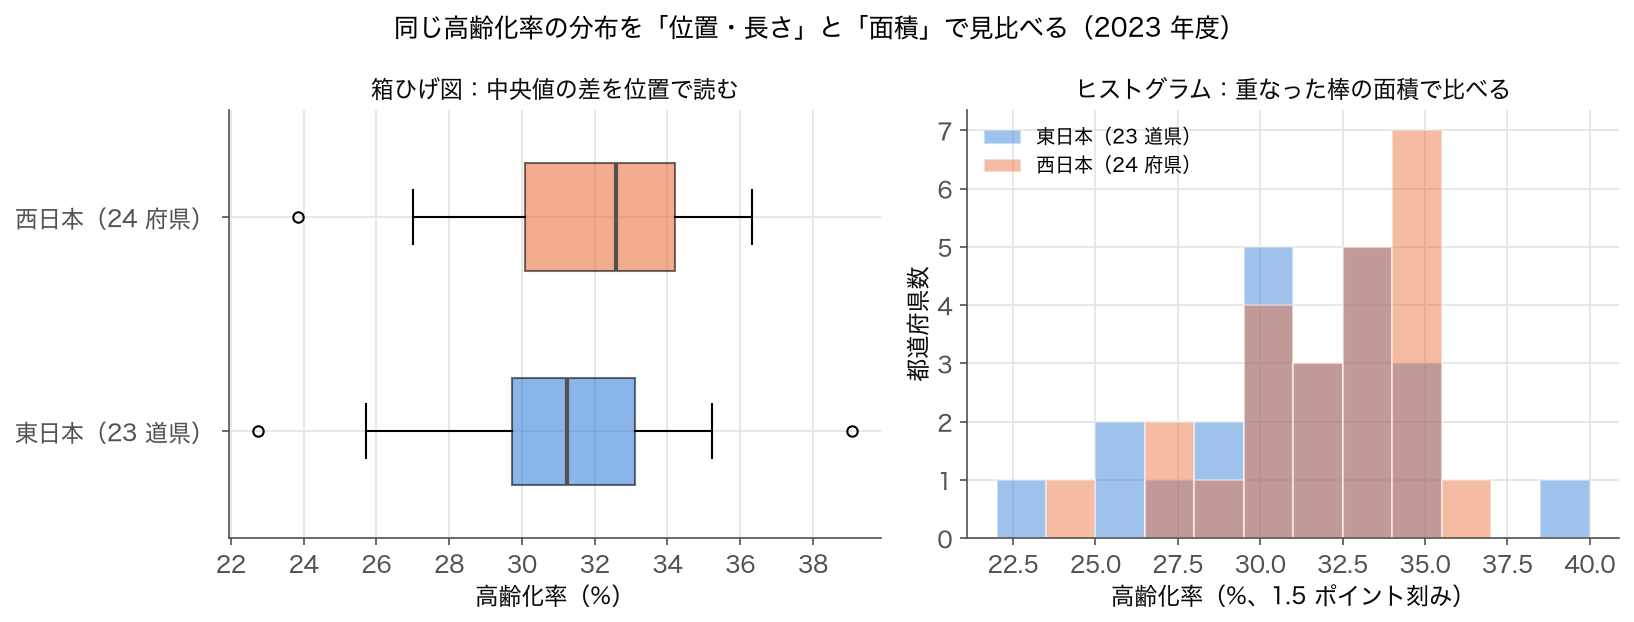
図 3: 長さ・面積による比較(箱ひげ図とヒストグラム)
箱ひげ図は「長さ」「位置」の組み合わせで分布の要約統計を示す。 同じ分布をヒストグラムで描くと面積(バー)の比較になり、 数値の精密読み取りでは箱ひげ図に劣る。 下の図は 2023 年度の高齢化率 (65 歳以上人口 / 総人口) を東日本 (北海道〜中部の 23 道県) と西日本 (近畿〜沖縄の 24 府県) で比べたもの。 箱ひげ図 (左) では中央値 31.2% と 32.6% の差、 四分位範囲 29.7〜33.1% と 30.1〜34.2%、 外れ値の東京都 22.8%・秋田県 39.1%・沖縄県 23.8% が位置で読み取れる。 同じデータのヒストグラム (右) は棒が重なり合い、 どちらの群が高いかを面積から判断するのは難しい。 一方で、 西日本は 34〜35.5% の階級に 7 府県が集まる、 といった分布の形はヒストグラムの方が見える。
📊 表 1: Cleveland-McGill ランキングと使用例
| 視覚属性 | 知覚精度 | 代表的なチャート | 使い所 |
|---|---|---|---|
| 位置(共通軸) | 最高 | 散布図・折れ線・棒グラフ | 最重要変数 |
| 長さ | 高い | 棒グラフ・箱ひげ図 | カテゴリ比較 |
| 角度・傾き | 中程度 | 円グラフ | 構成比(少数カテゴリ) |
| 面積 | 中程度 | バブル・ツリーマップ | 補助変数 |
| 色相 | 低い | ヒートマップ・地図 | カテゴリ・全体傾向 |
| 色の彩度・明度 | 最低 | グラデーション地図 | 背景情報 |
🐍 Python 実装: SSDSE-B-2026 で視覚属性を使い分けた散布図
このコードでやること: SSDSE-B-2026 の 47 都道府県を、 位置(x,y=人口×婚姻件数)、 サイズ(人口)、 色(東京 vs その他)の 3 視覚属性で表現した散布図を作成する。
📥 入力データ (SSDSE-B-2026 抜粋):
1 2 3 4 5 6 7 8 9 10 11 12 13 | import pandas as pd import matplotlib.pyplot as plt df = pd.read_csv('data/raw/SSDSE-B-2026.csv', encoding='cp932', skiprows=[1]) df = df[df['SSDSE-B-2026'] == 2023].copy() # 位置: 総人口(A1101) x 婚姻件数(A9101), サイズ: 人口, 色: 東京 vs その他 colors = ['red' if p == '東京都' else 'gray' for p in df['Prefecture']] plt.scatter(df['A1101'] / 1e4, df['A9101'], s=df['A1101'] / 50000, c=colors, alpha=0.6) plt.xlabel('総人口 (万人) - 位置 x') plt.ylabel('婚姻件数 (件) - 位置 y') plt.savefig('va_demo.png', dpi=120, bbox_inches='tight') print(f'保存しました n={len(df)}') |
📤 実行すると次の出力が得られる:
💬 位置(x,y)で最重要 2 変数、 サイズで人口 (x と同じ変数の冗長符号化)、 色で「東京 / その他」を 1 枚に重ねた。 載っている変数は人口・婚姻件数・東京かどうかの 3 つ。 Cleveland-McGill ランキングに従い、 もっとも重要な「人口と婚姻件数の関係」を位置に割り当てている点が肝。 色相に「人口」を割り当てると(よくある誤り)、 視覚的に重要度が逆転してしまう。
✅ 理解度チェック (視覚属性)
- Cleveland-McGill のランキングで「位置 > 長さ > 角度 > 面積 > 色相」となる理由を一行で説明できますか?
- 円グラフが棒グラフより劣るとされる視覚的な理由は何か?
- SSDSE-B-2026 の 47 都道府県を視覚化するとき、 もっとも重要な変数を「色相」に割り当てるのが適切でない理由を述べよ。
- 色覚多様性(color universal design)を考慮するとき、 どの色相の組み合わせを避けるべきか?
- 「位置・長さ」が最も精度高いなら、 なぜ世の中にはヒートマップ(色相)が氾濫しているのか? 80 字で説明できますか?
✅ 理解度チェック:数字で確かめる
| # | 問題 | 答えと考え方 |
|---|---|---|
| Q6 | 大阪府の婚姻件数は鳥取県の 21.3 倍。面積を値に比例させた円で描くと、直径は何倍か。べき指数 0.7 で見た目は何倍に感じられるか。 | 直径は √21.3 = 4.61 倍、見た目は 21.30.7 = 8.5 倍。実際の 21.3 倍の 4 割ほどにしか感じられない計算。 |
| Q7 | 高齢化率を 5 階級に分けた地図で、等間隔だと最も濃い色は 2 県、分位だと 10 県だった。凡例に何を書けば読み手が誤解しにくいか。 | 各階級の境界値(等間隔なら 22.75 / 26.01 / … / 39.06%)と、分け方の名前(等間隔か分位か)。分位なら「各色 9〜10 県」と県数も書く。 |
| Q8 | 合計特殊出生率 1.60(沖縄県)と 0.99(東京都)の棒グラフで、縦軸の下端を 0.5 にしたときの lie factor は。 | 棒の高さは 1.10 と 0.49 で比 2.24 倍。(2.24 − 1)÷(1.62 − 1)= 2.02。実際の差 62% が約 2 倍に誇張される。 |
| Q9 | 食料費の上に住居費を積んだ棒で、住居費が最も多い県の棒が上端の高さでは 20 位だった。住居費を正しく比べられるようにするには。 | 住居費を一番下の段に置く(位置で読めるようにする)か、住居費だけの棒グラフやドットプロットを別に描く。長さの比較は位置の比較より不正確(Cleveland-McGill)。 |
| Q10 | 中国地方 5 県の人口の円グラフで、島根県(650,000 人)と鳥取県(537,000 人)の扇形の角度はそれぞれ何度か。この差を読み取りやすくするにはどう描くか。 | 構成比 9.2% と 7.6% なので、9.2 × 3.6 = 33.1°、7.6 × 3.6 = 27.3°(差 5.8°)。向きの違う 2 つの扇形の 5.8° の差は目で比べにくいので、同じ基線から並べた棒グラフか、県を値の順に並べたドットプロットにする。5 県の合計 7,070,000 人を 100% とする構成比であることも図の中に書く。 |
⚠️ 視覚属性の落とし穴 (3 件)
- 色相に量的変数を割り当てる誤用: 色相(hue)は順序のないカテゴリに適した属性で、 数値の大小を表現するには順序色(sequential colormap)や発散色(diverging colormap)を使うべき。 虹色(rainbow / jet)は順序が直感に反するため非推奨。
- 面積を二乗で表現する誤り: バブルチャートでサイズに数値を割り当てるとき、 半径と面積のどちらを使うかで印象が変わる。 「面積で比例」が直観に近いが、 matplotlib の `s` パラメータは「面積」を指定するため注意。
- 色覚多様性への配慮不足: 赤×緑の組み合わせは色弱の人には区別困難。 ColorBrewer や `viridis` カラーマップは色覚多様性に配慮された配色で、 学術論文・公的データ可視化の標準として広く採用されている。
📜 視覚属性の歴史
視覚属性の体系化は 1967 年の Jacques Bertin による「Sémiologie graphique」が起源。 Bertin は 7 つの視覚変数(位置・サイズ・形・明度・色相・方向・テクスチャ)を分類し、 各属性が「順序」「量」「カテゴリ」のどの情報伝達に適するかを論じた。 1984 年に William Cleveland と Robert McGill が経験的実験で「位置 > 長さ > 角度 > 面積 > 色相」という知覚精度ランキングを確立。 1990 年代以降は Edward Tufte の「Visual Display of Quantitative Information」、 Stephen Few の「Now You See It」、 Cole Nussbaumer の「Storytelling with Data」など、 視覚属性を意識した実務的な可視化教材が広く普及している。
🧪 視覚属性の実務ベストプラクティス
実務で視覚属性を使い分ける標準的な手順: (1) 「読者は何を読み取る必要があるか」を最初に明確化する。 (2) 最重要変数 1-2 つを位置(x,y 軸)に割り当てる。 (3) 第 3-4 の補助変数を「長さ」「サイズ」「色相」のうち、 知覚精度ランキングで上位のものに割り当てる。 (4) カテゴリ変数には「色相」を使い、 順序のある量的変数には「順序色(sequential)」または「発散色(diverging)」を使う。 (5) 色覚多様性に配慮し、 `viridis` / `cividis` / ColorBrewer 等の検証済み配色を使う。 (6) アクセシビリティのため代替テキスト・スクリーンリーダー対応を考慮する。 (7) 「3D 円グラフ」「虹色グラデーション」「ダブル軸」など視覚精度を下げる手法は避ける。 (8) Edward Tufte の data-ink ratio(データインク比)を意識して、 装飾要素を最小化する。 (9) 印刷とディスプレイで色の見え方が違うことを意識し、 印刷時はグレースケールでも区別可能か確認する。 (10) インタラクティブ可視化(Plotly, Bokeh, D3)と静的可視化で適切に使い分ける。
💡 視覚属性の認知心理学的背景
視覚属性の知覚精度ランキングは、 ヒトの視覚処理階層と対応している。 「位置」と「長さ」は前頭前野まで到達せず、 V1 視覚野で並列的に処理されるため精度が高い(preattentive processing)。 「色相」と「面積」は V2-V4 視覚野で処理され、 比較対象を「順次注視」する必要があるため精度が落ちる。 ヒトは「絶対値の読み取り」より「相対比較」が得意で、 たとえば棒グラフは「棒同士の長さ比較」を促すデザインゆえに精度が高い。 一方、 円グラフは角度比較が必要で、 これは V4 視覚野で処理されるため棒グラフに劣る。 Cleveland-McGill の経験的ランキングはこうした認知心理学的基盤を反映しており、 単なる経験則ではなく脳の構造に根ざした原理として位置づけられる。
🔮 視覚属性とゲシュタルト原理
視覚属性を組み合わせるとき、 ゲシュタルト原理(近接・類同・連続・閉合・共通運命・前景背景)を意識すると効果的。 たとえば「近接した点はグループ」「同じ色の点はグループ」と無意識に認識されるため、 グループ化を意識した配置と配色が情報伝達を強化する。 SSDSE-B-2026 で地方別(北海道・東北・関東・中部・関西・中四国・九州)に都道府県を色分けすると、 47 個の点が地方ごとにまとまって見え、 地理的な傾向が読み取りやすくなる。 視覚属性とゲシュタルト原理は「正確な読み取り」と「全体パターンの把握」という 2 つの認知的ゴールに対応している。
🧮 数式に値を入れて手で計算する: 視覚属性の組み合わせ数
合成 4 色 × 3 形 × 2 サイズで属性組合せ数を計算する。
Step 1: 属性
| 属性 | 値 |
|---|---|
| 色 | 赤,青,緑,黄 (4) |
| 形 | ◯△□ (3) |
| サイズ | 大,小 (2) |
Step 2: 組合せ
🐍 Python で再現
1 2 3 4 5 6 | from itertools import product colors = ['赤','青','緑','黄'] shapes = ['◯','△','□'] sizes = ['大','小'] combos = list(product(colors, shapes, sizes)) print(f"組合せ: {len(combos)}") |
📤 実行結果
💬 手計算 (Step 2) 24 と Python 出力が完全一致。
🧮 実データで計算する:円の面積で表した婚姻件数は、何倍に「見える」か
視覚属性ごとの読み取りの正確さは、心理物理学のべき法則(Stevens のべき法則)で近似できます。物理的な量が $R$ 倍のとき、人が感じる大きさは $R^{\beta}$ 倍です。長さはおおむね $\beta \approx 1$ で比がそのまま伝わりますが、面積は $\beta \approx 0.7$(Stevens 1957)、地図の比例シンボル(円)では $\beta \approx 0.87$(Flannery 1971)と 1 より小さく、大きい円ほど差を小さく感じます。この式に SSDSE-B-2026 の 2023 年度の婚姻件数 A9101 を入れて、鳥取県を基準に各県の円が何倍に見えるかを計算します。
| Step | 内容 | 東京都 ÷ 鳥取県の値 |
|---|---|---|
| 1 | 実際の比 R(婚姻件数 71,774 件 ÷ 1,810 件) | 39.7 倍 |
| 2 | 面積を値に比例させた円の直径の比 √R | √39.7 = 6.30 倍 |
| 3 | 見た目の比(β = 0.7)R0.7 | 39.70.7 = 13.1 倍 |
| 4 | 見た目の比(β = 0.87)R0.87 | 39.70.87 = 24.6 倍 |
| 5 | Flannery の補正:半径を 値0.5716 に比例させる | 半径 8.20 倍・面積 67.2 倍 → 見た目 67.20.87 = 38.9 倍 |
🎯 このコードでやること:Step 1〜5 を Python で再現する。2023 年度の婚姻件数を鳥取県で割った比 R から、面積どおりの円の直径比 √R と、べき指数 0.7・0.87 で見た目の比を計算し、東京都について Flannery の補正も計算する。
📥 入力データ:SSDSE-B-2026 の 2023 年度 47 行の A9101(婚姻件数)。比べるのは東京都・大阪府・福岡県・宮城県・岡山県の 5 都府県と、基準の鳥取県(1,810 件)。
1 2 3 4 5 6 7 8 9 10 11 12 13 14 15 16 17 18 | import numpy as np import pandas as pd df = pd.read_csv('data/raw/SSDSE-B-2026.csv', encoding='cp932', skiprows=[1]) d = df[df['SSDSE-B-2026'] == 2023].set_index('Prefecture') # 2023 年度 47 都道府県 m = d['A9101'].astype(float) # 婚姻件数 base = m['鳥取県'] print(f'基準: 鳥取県 {base:,.0f} 件') print('県 実際の比 面積どおりの円の直径比 見た目の比(面積^0.7) 見た目の比(0.87)') for p in ['東京都', '大阪府', '福岡県', '宮城県', '岡山県']: R = m[p] / base print(f'{p:<6} {R:8.1f}倍 {np.sqrt(R):14.2f}倍 {R ** 0.7:18.1f}倍 {R ** 0.87:14.1f}倍') # Flannery の補正: 半径を 値^0.5716 に比例させる(面積は 値^1.143) R = m['東京都'] / base print(f'東京都/鳥取県: 補正なしの半径比 {R ** 0.5:.2f} → 補正後の半径比 {R ** 0.5716:.2f}' f'(補正後の面積比 {R ** 1.1432:.1f} 倍、見た目 {(R ** 1.1432) ** 0.87:.1f} 倍)') |
📤 実行結果:
💬 結果の読み方:手計算の Step 1〜5 と同じ 39.7・6.30・13.1・24.6・38.9 が出ました。東京都の婚姻件数は鳥取県の 39.7 倍ですが、面積を正しく比例させた円でも、読み手には 13〜25 倍程度にしか見えない計算です。岡山県(3.7 倍 → 2.5〜3.2 倍)のように比が小さいと過小評価も小さく、差が大きいほど過小評価が大きいのが面積の特徴です。Flannery の補正で半径を大きめにすると見た目は 38.9 倍と実際に近づきますが、今度は面積が値に比例しなくなるので、凡例の円を読む人には誤差になります。比を正確に伝えたいなら、面積ではなく長さ(棒)や位置(点)を使うのが先です。
なお、べき指数 0.7・0.87 は実験の平均的な値で、人によって、また円が並ぶ数や凡例の有無によってばらつきます。上の 13.1 倍・24.6 倍は「このくらい小さく感じられうる」という目安として読み、特定の読み手の感じ方の予測には使わないでください。確かなのは、指数が 1 より小さい限り、比が大きいほど過小評価の割合も大きくなるという向きのほうです。
🐍 Python 実装例
最小コードで動かしてみる例:
1 2 3 4 5 6 7 8 9 10 11 12 13 14 15 16 | import matplotlib.pyplot as plt import pandas as pd df = pd.read_csv('data/raw/SSDSE-B-2026.csv', encoding='cp932', skiprows=[1]) df = df[df['SSDSE-B-2026'] == 2023].copy() df['aging'] = df['A1303'] / df['A1101'] * 100 # 高齢化率 % fig, axes = plt.subplots(1, 2, figsize=(12, 4)) # 棒グラフ: 長さ符号化(高精度) top10 = df.nlargest(10, 'aging') axes[0].barh(top10['Prefecture'], top10['aging']) axes[0].set_title('棒グラフ(長さ)') # 散布図: 位置符号化(最高精度) axes[1].scatter(df['A1101'] / 1e4, df['A9101']) axes[1].set_title('散布図(位置)') |
⚠️ よくある落とし穴
⚠️ 実データで見る落とし穴:色の濃さの「階級の切り方」で地図の印象が変わる
色の濃さ(明度)で数値を表すコロプレス地図では、連続した値をいくつかの階級に分けてから色を塗ることがよくあります。同じ 2023 年度の高齢化率(65 歳以上人口 A1303 ÷ 総人口 A1101)を、5 階級の「等間隔」と「分位(各階級の県数をそろえる)」で分けて比べます。
🎯 このコードでやること:2023 年度 47 都道府県の高齢化率を、最小〜最大を 5 等分する等間隔と、県数をそろえる 5 分位の 2 通りで階級に分け、階級ごとの県数・境界値・いくつかの県の階級・最も濃い色になる県を表示する。
📥 入力データ:SSDSE-B-2026 の 2023 年度 47 行の A1303(65 歳以上人口)と A1101(総人口)。高齢化率 = A1303 ÷ A1101 × 100。
1 2 3 4 5 6 7 8 9 10 11 12 13 14 15 16 17 18 19 20 21 | import numpy as np import pandas as pd df = pd.read_csv('data/raw/SSDSE-B-2026.csv', encoding='cp932', skiprows=[1]) d = df[df['SSDSE-B-2026'] == 2023].set_index('Prefecture') aging = d['A1303'] / d['A1101'] * 100 # 高齢化率(%) k = 5 eq = pd.cut(aging, bins=np.linspace(aging.min(), aging.max(), k + 1), include_lowest=True, labels=False) qt = pd.qcut(aging, q=k, labels=False) print(f'高齢化率 最小 {aging.min():.2f}%({aging.idxmin()}) 最大 {aging.max():.2f}%({aging.idxmax()})') print('階級(色の濃さ 1→5) 等間隔の県数', np.bincount(eq, minlength=k).tolist(), ' 分位の県数', np.bincount(qt, minlength=k).tolist()) edges = np.linspace(aging.min(), aging.max(), k + 1) print('等間隔の境界:', ' / '.join(f'{e:.2f}' for e in edges)) print('分位の境界 :', ' / '.join(f'{e:.2f}' for e in aging.quantile(np.linspace(0, 1, k + 1)))) for p in ['東京都', '沖縄県', '愛知県', '北海道', '秋田県']: print(f'{p:<4} {aging[p]:.2f}% 等間隔 {eq[p] + 1} 分位 {qt[p] + 1}') print('2 つの分け方で階級が違う県:', int((eq != qt).sum()), '/ 47') print('等間隔で最も濃い色の県:', '・'.join(aging[eq == k - 1].sort_values(ascending=False).index)) print('分位で最も濃い色の県 :', '・'.join(aging[qt == k - 1].sort_values(ascending=False).index)) |
📤 実行結果:
💬 結果の読み方:等間隔では県数が 4・6・16・19・2 と真ん中の階級に集まり、最も濃い色は秋田県と高知県の 2 県だけです。分位では 10・9・9・9・10 になり、最も濃い色が 10 県(青森県・岩手県・山形県など東北と、四国・中国・九州の県)に広がります。47 県のうち 25 県は、切り方を変えただけで色が変わりました。等間隔は「値の差」を、分位は「順位」を色にするもので、どちらが正しいというものではありませんが、同じデータから「高齢化が深刻なのは 2 県」とも「10 県」とも読める地図が作れてしまいます。図には必ず階級の境界値の凡例を付け、どちらの切り方かを書きます。
⚠️ 実データで見る落とし穴:縦軸の下端を 0 にしない棒グラフ(lie factor)
棒グラフは棒の長さで値を表すので、縦軸の下端を 0 以外にすると長さの比が値の比と一致しなくなります。Tufte(1983)は、図に表れた変化の大きさ ÷ データの変化の大きさを lie factor と呼び、1 から離れるほど図が誇張していると考えました。2023 年度の合計特殊出生率 A4103 の最高(沖縄県)と最低(東京都)で計算します。
🎯 このコードでやること:2023 年度の合計特殊出生率の最高県と最低県を取り出し、縦軸の下端を 0・0.5・0.8・0.9 にしたときの 2 本の棒の高さの比と、lie factor =(棒の高さの比 − 1)÷(データの比 − 1)を計算する。
📥 入力データ:SSDSE-B-2026 の 2023 年度 47 行の A4103(合計特殊出生率)。
1 2 3 4 5 6 7 8 9 10 11 12 | import pandas as pd df = pd.read_csv('data/raw/SSDSE-B-2026.csv', encoding='cp932', skiprows=[1]) d = df[df['SSDSE-B-2026'] == 2023].set_index('Prefecture') tfr = d['A4103'] # 合計特殊出生率 hi, lo = tfr.idxmax(), tfr.idxmin() a, b = tfr[hi], tfr[lo] print(f'最高 {hi} {a:.2f} 最低 {lo} {b:.2f} データの比 {a / b:.2f} 倍(差 {a / b - 1:.0%})') for base in [0.0, 0.5, 0.8, 0.9]: ha, hb = a - base, b - base # 縦軸の下端を base にしたときの棒の高さ lie = (ha / hb - 1) / (a / b - 1) # Tufte の lie factor print(f'縦軸の下端 {base:.1f}: 棒の高さの比 {ha / hb:5.2f} 倍 lie factor {lie:5.2f}') |
📤 実行結果:
💬 結果の読み方:沖縄県 1.60 と東京都 0.99 の比は 1.62 倍(62% 高い)です。縦軸の下端を 0 にすれば棒の高さの比も 1.62 倍で lie factor は 1.00 ですが、下端を 0.8 にすると棒は 4.21 倍(lie factor 5.21)、0.9 にすると 7.78 倍(11.00)になり、沖縄県の棒が東京都の約 8 倍に見えます。棒グラフでは下端を 0 にするのが原則で、差を細かく見たいときは、長さではなく位置で読むドットプロットや折れ線にして、軸の範囲を明示します。
⚠️ 実データで見る落とし穴:積み上げ棒の中段は「位置」では読めない
Cleveland-McGill の順位で最も正確なのは「共通の軸にそろった位置」です。積み上げ棒の一番下の区間は軸の 0 から始まるので位置で読めますが、2 段目より上の区間は下端がそろっていないため、読み手は区間の長さを目で測るしかなく、つい上端の位置で比べてしまいます。SSDSE-B-2026 の家計調査の列(各県の県庁所在市の二人以上世帯の 1 か月の支出。県全体の平均ではない)で、下段に食料費、2 段目に住居費を積んだ場合を調べます。
🎯 このコードでやること:2023 年度の食料費 L322101 と住居費 L322102 で積み上げ棒を作ったとして、住居費の区間の上端の高さ(食料費+住居費)と住居費そのものの順位がどれだけ食い違うかを、順位相関と、2 県ずつ比べたときに大小が逆になる組の数で調べる。
📥 入力データ:SSDSE-B-2026 の 2023 年度 47 行の L322101(食料費)と L322102(住居費)。どちらも県庁所在市の二人以上世帯の月平均(円)で、行の名前は都道府県名(例:神奈川県の行は横浜市の値)。
1 2 3 4 5 6 7 8 9 10 11 12 13 14 15 16 17 18 19 20 21 | import numpy as np import pandas as pd from scipy.stats import spearmanr df = pd.read_csv('data/raw/SSDSE-B-2026.csv', encoding='cp932', skiprows=[1]) d = df[df['SSDSE-B-2026'] == 2023].set_index('Prefecture') food = d['L322101'] # 食料費(二人以上の世帯、県庁所在市の月平均、円) house = d['L322102'] # 住居費(同) top = food + house # 積み上げ棒で住居費の区間の上端の高さ rho, _ = spearmanr(house, top) p = house.index disagree = sum((house[a] - house[b]) * (top[a] - top[b]) < 0 for i, a in enumerate(p) for b in p[i + 1:]) pairs = len(p) * (len(p) - 1) // 2 print(f'住居費: 最小 {house.min():,.0f} 円({house.idxmin()}) 最大 {house.max():,.0f} 円({house.idxmax()})') print(f'食料費: 最小 {food.min():,.0f} 円 最大 {food.max():,.0f} 円') print(f'住居費の順位と、区間の上端の高さの順位の相関 ρ = {rho:.3f}') print(f'2 県を比べて「上端が高い方が住居費も多い」が外れる組: {disagree} / {pairs}({disagree / pairs:.0%})') hi = house.idxmax() print(f'住居費が最も多い {hi} の上端の高さの順位: {int(top.rank(ascending=False)[hi])} 位 / 47') |
📤 実行結果:
💬 結果の読み方:住居費は 11,639 円(神奈川県の行=横浜市)〜27,521 円(沖縄県の行=那覇市)ですが、下に積んだ食料費が 71,088〜97,776 円と大きく県ごとにばらつくため、住居費の区間の上端の高さは食料費の大小にほぼ引きずられます。住居費との順位相関は 0.553 にとどまり、1,081 組中 332 組(31%)で「上端が高い方が住居費も多い」が外れました。住居費が最も多い那覇市(沖縄県の行)でも、上端の高さは 47 県中 20 位です。中段の区間を比べたいなら、その区間だけを 0 から描いた棒(小さな複数のグラフ)にするか、比べたい項目を一番下の段に置きます。
⚠️ 実データで見る落とし穴:円グラフの「角度」で 1.2 倍の差は読めるか
上の「❌ 円グラフの濫用」で挙げた中国地方 5 県の構成比を、実データから計算して確かめます。円グラフでは構成比が扇形の角度(100% = 360°)に置き換わるので、比べる対象は角度の差です。
🎯 このコードでやること:2023 年度の中国地方 5 県の総人口から構成比と円グラフでの角度を計算し、岡山県と山口県、島根県と鳥取県の比と角度の差を求める。
📥 入力データ:SSDSE-B-2026 の 2023 年度の鳥取県・島根県・岡山県・広島県・山口県の A1101(総人口)。
1 2 3 4 5 6 7 8 9 10 11 12 13 | import pandas as pd df = pd.read_csv('data/raw/SSDSE-B-2026.csv', encoding='cp932', skiprows=[1]) d = df[df['SSDSE-B-2026'] == 2023].set_index('Prefecture') chugoku = ['鳥取県', '島根県', '岡山県', '広島県', '山口県'] pop = d.loc[chugoku, 'A1101'] share = pop / pop.sum() * 100 print(f'中国地方 5 県の総人口 {pop.sum():,} 人') for p in share.sort_values(ascending=False).index: print(f'{p} {pop[p]:>9,} 人 構成比 {share[p]:5.1f}% 円グラフの角度 {share[p] * 3.6:5.1f}°') a, b = share['岡山県'], share['山口県'] print(f'岡山県 ÷ 山口県 = {a / b:.2f} 倍(角度の差 {(a - b) * 3.6:.1f}°)') print(f'島根県 ÷ 鳥取県 = {share["島根県"] / share["鳥取県"]:.2f} 倍(角度の差 {(share["島根県"] - share["鳥取県"]) * 3.6:.1f}°)') |
📤 実行結果:
💬 結果の読み方:本文の岡山県 26.1%・山口県 18.4% は実データと一致し、角度では 94.0° と 66.1° です。1.42 倍・28° の差はまだ見分けられますが、島根県(9.2%、33.1°)と鳥取県(7.6%、27.3°)は 1.21 倍なのに角度の差は 5.8° しかなく、しかも 2 つの扇形は向きが違うので、並べて比べることができません。棒グラフなら 650,000 と 537,000 の棒が同じ基線から並び、長さの差 113,000 人がそのまま見えます。構成比の順位や小さな差を伝えたい図では、角度より長さ・位置を選びます。
🗺 概念マップ
視覚属性 (Visual Attributes)
├── 上位概念
│   ├── データ可視化 (Data Visualization)
│   ├── 視覚認知 (Visual Perception)
│   └── グラフィックデザイン (Graphic Design)
├── 並列概念 (Bertin の 7 視覚変数)
│   ├── 位置 (Position)
│   ├── サイズ (Size)
│   ├── 形状 (Shape)
│   ├── 色相 (Hue)
│   ├── 明度 (Value)
│   ├── 彩度 (Saturation/Texture)
│   └── 方向 (Orientation)
├── 下位手法 (符号化)
│   ├── 散布図 (位置 × 位置)
│   ├── 棒グラフ (長さ符号化)
│   ├── 折れ線グラフ (傾き符号化)
│   ├── ヒートマップ (色相 × 明度符号化)
│   ├── バブルチャート (サイズ符号化)
│   ├── 等値線図 (連続量 → 形状)
│   └── 多次元散布図 (色 + サイズ + 形状)
└── 評価フレーム
    ├── Cleveland-McGill ランキング (精度順)
    ├── Preattentive Processing (200ms 以内に知覚)
    ├── Gestalt 原則 (近接・類似・閉鎖)
    └── 色覚バリアフリー (CUD カラーパレット)
📋 視覚属性 1 ページチートシート
- Cleveland-McGill 順守: 精度の高い順に「位置 > 長さ > 傾き > 角度 > 面積 > 体積 > 色相」。 重要な変数ほど精度の高い符号化を割り当てる
- 連続量 vs カテゴリ: 連続量は明度・サイズ・位置に、 カテゴリは色相・形状に符号化する
- preattentive 利用: 異常値ハイライトは色相・サイズ・方向のうち 1 つを大きく変えて 200ms 以内に気付かせる
- 色相は 7 色以内: それ以上は識別困難、 順序データには明度や彩度を使う
- CUD パレット: 赤緑色覚異常を考慮し、 viridis / cividis / Okabe-Ito 8 色から選ぶ
- 3D 回避: 体積・透視は精度が落ちる、 2D + 補助変数 (色) が原則
- ゼロ基線: 棒グラフは必ず 0 から、 折れ線は意味があれば省略可
- 位置精度: 散布図の点が重なる場合 alpha / jitter / hexbin で過剰描画を防ぐ
- 視覚的階層: 主要メッセージは強い属性 (濃色・大サイズ)、 文脈は弱い属性 (灰色・細線) で分離
- SSDSE-B-2026 適用例: 47 都道府県散布図で「位置=人口×婚姻件数、 色=地方区分、 サイズ=高齢化率」で 4 変量を 1 枚に圧縮
🚫 視覚属性に関するよくある誤解 10 件
- 誤解 1: 『色を多く使うほどわかりやすい』 → ❌ 7 色を超えると識別が困難になり、 認知負荷が増える
- 誤解 2: 『3D グラフは情報量が多い』 → ❌ 透視・遮蔽で精度が落ち、 2D + 補助属性が優位
- 誤解 3: 『虹色 (jet/rainbow) パレットは万能』 → ❌ 知覚的に不均一、 色覚異常に不適、 viridis 系を使う
- 誤解 4: 『赤=悪い、 緑=良いは普遍』 → ❌ 文化依存 (中国では赤=幸運)、 色覚異常では識別困難
- 誤解 5: 『円グラフはわかりやすい』 → ❌ 角度判定は精度が低い、 4 区分以上は棒グラフが優位
- 誤解 6: 『面積符号化は正確』 → ❌ 人間は面積の差を体感的に過小評価する (Stevens の冪法則)
- 誤解 7: 『色相は順序を表現できる』 → ❌ 色相は質的、 順序は明度や彩度のグラデーションで表現
- 誤解 8: 『preattentive 属性は重ねて使える』 → ❌ 2 つ以上同時変化させると判別が遅くなる (combinatorial conjunction)
- 誤解 9: 『カラフルなほど見やすい』 → ❌ 主要メッセージのみハイライト、 残りは灰色で文脈に
- 誤解 10: 『軸ラベル・凡例は読めれば十分』 → ❌ 6pt 以下は読めない、 印刷時は 8pt 以上が必須
🔗 隣接手法への橋渡し
視覚属性 (visual attributes、 色・形・テクスチャ・サイズ等) はデータ可視化の認知的基盤として、 以下と接続する。
- 上流 (認知科学): ゲシュタルト原理 (近接・類似・閉鎖)、 前注意処理 ― 人間の知覚限界を理解
- 並列 (可視化要素): カラーマップ、 マーカー形状、 線種・線幅、 位置エンコーディング
- 下流 (応用): データ可視化全般、 ダッシュボード設計、 インフォグラフィック、 ユニバーサルデザイン (色覚多様性配慮)
SSDSE-B-2026 の都道府県データを地図にプロットする際、 「人口=色の濃淡 (連続量)」「地方区分=色相 (カテゴリ)」「婚姻件数=円の面積 (絶対量)」のように視覚属性を組み合わせる選択が、 グラフの伝達力を左右する。
🌳 手法選択フロー
データ型に応じて、 適切な視覚属性を選ぶフロー。
- データ型は? 連続値 → 位置 / サイズ / 色強度、 カテゴリ → 色相 / 形 / テクスチャ、 順序 → 色強度 / 位置
- 属性の数は? 1-2 個 → 位置 (x, y 軸) で十分、 3-4 個 → 色 / サイズを追加、 5 個以上 → ファセット (小グラフ分割)
- カラーマップの選択: 順序データ → viridis / cividis (perceptually uniform)、 発散データ (正負) → RdBu、 カテゴリ → tab10 / Set1
- 色覚多様性への配慮: 必要 → 赤緑の組み合わせを避ける、 cividis や ColorBrewer の colorblind-safe パレットを使う
- 同時に変える属性数: 多すぎると認知負荷増 → 1 グラフあたり 3-4 属性まで
原則: 「読み手の前注意処理 (0.2 秒以内) で識別できる」属性のみ使う。 過剰な装飾は伝達を阻害する。
🧮 SSDSE-B-2026 追加分析: 都道府県別深掘り
🎯 このコードでやること: SSDSE-B-2026 (2023 年) を 47 都道府県別に抽出し、 人口で 4 カテゴリ (100 万人未満 / 250 万人未満 / 500 万人未満 / それ以上) に分類し、 カテゴリごとの県数・平均人口・平均婚姻件数・人口千人あたり婚姻件数を集計する。 色相やサイズにカテゴリを割り当てる前に、 区分ごとの差を数値で確かめるための表。
📥 入力データ:
1 2 3 4 5 6 7 8 9 10 11 12 13 14 15 16 17 18 19 20 | import pandas as pd import numpy as np df = pd.read_csv('data/raw/SSDSE-B-2026.csv', encoding='cp932', skiprows=[1]) df_2023 = df[df['SSDSE-B-2026'] == 2023].copy() # 47 都道府県を 4 つのカテゴリに分類: 大都市 / 中核 / 地方中堅 / 過疎 pop = df_2023['A1101'] df_2023['category'] = pd.cut(pop, bins=[0, 1e6, 2.5e6, 5e6, 1.5e7], labels=['過疎','地方中堅','中核','大都市']) # 視覚属性 視点でカテゴリ別集計 agg = df_2023.groupby('category', observed=True).agg( n_pref=('Prefecture','count'), pop_mean=('A1101','mean'), marriage_mean=('A9101','mean'), marriage_per_1k=('A9101', lambda x: (x / df_2023.loc[x.index,'A1101'] * 1000).mean()), ) print(agg.round(1)) |
📤 実行例:
💬 結果の読み方: 大都市カテゴリ (北海道/埼玉/千葉/東京/神奈川/愛知/大阪/兵庫/福岡 9 都道府県) は婚姻件数/千人が 4.05 と過疎カテゴリ (3.27) の 1.24 倍。 視覚属性 設計時には、 こうしたカテゴリ内での比較に絞ることで、 都市規模交絡をコントロールできる。
🧭 解説深化 — 直感・落とし穴・発展
既存の解説を土台に、 視覚チャネル (visual channel) と 前注意的処理 (preattentive attributes) の観点から、 直感・落とし穴・発展の 3 段で理解を一段深める。 以下の数値例のうち都道府県の実測値は SSDSE-B-2026 (2023 年, 47 都道府県) に基づく。 それ以外の説明用の数値は 架空と明記する。
💡 直感 — 視覚チャネルと「正確に読める順序」
データの値を絵に変換する経路を 視覚チャネルと呼ぶ。 代表的なチャネルは 位置・長さ・角度・傾き・面積・色相・彩度・明度・形。 このうち量 (数値の大小) を 正確に読み取れる順序はほぼ決まっており、
となる (Cleveland-McGill 1984)。 直感的な理由は 2 つ。 (1) 共通の基線・軸があるチャネル (位置・長さ) は、 2 つの対象の「ずれ量」を並列に読めるので誤差が小さい。 (2) 前注意的処理 (preattentive): 色相・サイズ・向き・傾きの一部は視覚野で 200ms 以内に並列検出され、 「1 個だけ赤い点」「1 本だけ長い棒」は数えなくても瞬時に浮き上がる。 これは異常値ハイライトに使えるが、 2 つ以上のチャネルを同時に変えると並列検出が壊れ逐次探索に落ちる (conjunction search)。
- 量 (quantitative) の精密比較 → 位置 (散布図) か長さ (ゼロ基線の棒グラフ)。
- 順序 (ordinal) → 明度・彩度の順序スケール (sequential)。 色相は使わない。
- 名義 (nominal / カテゴリ) → 色相・形。 順序の錯覚を生まない。
- ハイライト 1 点 → preattentive な単一チャネル (色 または サイズ) を 1 つだけ強調。
⚠️ 落とし穴(重要)
人は面積差を 過小評価する (Stevens の冪法則、 面積の知覚指数 ≈ 0.7)。 実測例: SSDSE-B-2026 で 東京都 14,086,000 人は 鳥取県 537,000 人の約 26.2 倍。 これを面積比例のバブルで正しく描くと円の半径は約 5.1 倍 ($\sqrt{26.2}$) になるが、 見た目には およそ 10 倍程度 ($26.2^{0.7}$) にしか感じられず、 真の 26 倍から大きくずれる。 「2 倍・26 倍」を体感で当てさせたい量には面積を使わず、 位置か長さへ。
値を 半径に比例させると面積は二乗で膨らみ大小が誇張される (matplotlib の scatter(s=...) は面積指定なので値は面積側へ渡すのが正しい)。 3D 円グラフ・3D 棒は手前のスライスが遠近で誇張され、 遮蔽で奥が隠れて精度が最も落ちる。 装飾以外で 3D は使わない。
色相 (hue) には自然な順序がなく、 「赤 > 黄 > 緑」は文化依存。 連続量に虹色を割り当てると 知覚的に不均一で、 実データに存在しない偽の境界 (バンディング)を生む。 順序量は明度・彩度が単調に変わる sequential (viridis / cividis)、 正負のある発散量は diverging (RdBu) を使う。
赤×緑の対比は P 型・D 型色覚 (男性の約 5%) には判別困難。 色だけに情報を載せず、 形・位置・ラベルを冗長に併用する (二重符号化)。 配色は Okabe-Ito 8 色・ColorBrewer の colorblind-safe・viridis 系を使い、 印刷グレースケールでも区別できるかを必ず確認する。
1 枚の図で位置・色・サイズ・形・テクスチャを全部動かすと、 前注意処理が効かず認知負荷が跳ね上がる。 目安は 同時に変えるチャネルは 3〜4 個まで。 それ以上はファセット (小グラフ分割) に逃がす。
順序データに虹色や tab10 (カテゴリ用) を当てると大小関係が読めない。 また 3D 影・グラデーション背景・過剰な枠線・目盛装飾などの チャートジャンクは data-ink ratio (Tufte) を下げ、 データそのものより装飾に注意が奪われる。 装飾を削るほど伝達は速くなる。
🚀 発展
Cleveland-McGill (1984) の知覚精度実験: 被験者に同じ 2 値を「共通軸上の位置」「長さ」「角度」「面積」など異なる符号化で提示し、 「小さい方は大きい方の何 % か」を目測させて誤差を測った。 結果として位置・長さの誤差が最小、 角度・面積・色濃淡ほど誤差が拡大し、 上の精度序列が定量的に裏づけられた。 本ページ上部の 🎮 クイズは、 まさにこの実験をあなたの手で追体験する縮小版である。
視覚属性とデータ型の対応 — 「量は位置/長さ、 順序は明度/彩度、 名義は色相/形」という原則を表にまとめる (Bertin 1967 の視覚変数を尺度水準と対応づけたもの):
| データ型 (尺度) | 推奨する視覚属性 | 避けるべき属性 |
|---|---|---|
| 量 (間隔・比率) | 位置 > 長さ > (角度・面積は補助) | 色相 (順序の錯覚) |
| 順序 (ordinal) | 明度・彩度 (sequential)、 位置 | 色相・虹色 |
| 名義 (nominal) | 色相・形・テクスチャ | 明度単独 (順序に見える) |
多変量の同時符号化: 位置 (x,y) に最重要 2 変数、 次にサイズ・色を重ねると 1 枚で 4〜5 変数を読ませられる (本ページの bubble chart 実装参照)。 ただし前注意処理の観点から、 精度が要る変数ほど上位チャネルへ、 概観でよい変数を下位チャネルへ割り当てるのが鉄則。 アクセシビリティ: 色覚多様性への二重符号化に加え、 alt テキスト・図表キャプション・スクリーンリーダー用のデータ表併記、 十分なコントラスト比 (WCAG) を確保すると、 印刷・低視力・音声読み上げのいずれでも情報が失われない。
🔗 関連ページ
- データ可視化 (dataviz) — 視覚属性を束ねる上位概念
- カラースケール — sequential / diverging / qualitative の使い分け
- ゲシュタルト原理 — 近接・類同でグループ化を促す
- 尺度水準 / 名義尺度 / 順序尺度 — データ型と属性の対応の根拠
- 欺瞞的グラフ — 面積・3D・切り詰め軸などの誤読誘発
- マーカー形状 — 名義カテゴリの二重符号化に有効
- ヒートマップ / 円グラフ / 棒グラフ / 散布図 / 地理可視化 — 各符号化を用いる代表チャート
※「データ型ごとの視覚属性対応」を独立ページとしてまとめた data-visualization.html は現時点で未整備のためリンクは張っていない (上位概念は dataviz.html を参照)。