🔖 キーワード索引
「heatmap」は統計データ分析の文脈で扱う重要概念のひとつ。 本ページでは「heatmap」を取り巻く中核キーワードを以下にチップで一覧化する。 各キーワードは関連する概念・手法・道具立てを含み、 文献検索や学習計画の起点になる。
これらのキーワードは「heatmap の理解 → 適用 → 検証」のプロセスを構成する。 各章で詳しく解説する。
💡 30秒で分かる結論
🍰 まずはやさしく
色の濃さで数字を表す地図のようなものです。
たくさんの数値をパッと見て理解するために使います。
カレンダーに勉強時間を色で塗るようなイメージです。
ヒートマップの基本的な使い方を学びましょう。
- 定義:値の大小を色の濃淡で表すマトリクス可視化。相関行列の表示などに多用。
- カテゴリ:可視化
👁️ 直感 — ヒートマップは「値を色で表現する2次元マトリクス」
ヒートマップは、 行列の各値を色の濃淡で可視化する手法。 大量の数値を一目で把握できる強力なツール。
主要な用途
- 相関行列の可視化:最も頻出。 変数間の相関構造が一目で
- 2Dヒストグラム:x-y空間でのデータ密度
- 欠損パターン:データの欠損箇所を可視化
- 遺伝子発現:行=遺伝子、 列=サンプル、 色=発現量
- カレンダーヒートマップ:日付別の数値
📍 あなたが今見ているもの
🍰 まずはやさしく
データの値を色で塗り分ける方法です。
複雑なデータの関係を分かりやすくするために使います。
都道府県ごとのデータを分析するときに役立ちます。
定義から注意点までを順番に解説します。
論文中に 「ヒートマップ」として登場する用語。
ヒートマップ とは:値の大小を色の濃淡で表すマトリクス可視化。相関行列の表示などに多用。
本ページでは「heatmap」を扱う。 統計データ分析コンペティション (2026) の教材で、 SSDSE-B-2026 (47 都道府県 × 複数年 × 100 超列) の実データを使った再現可能な学習を目指す。
「heatmap」は統計・データサイエンスの体系における重要概念のひとつ。 本ページは「定義・直感・数式・実装・落とし穴・関連手法」の 6 視点で構成され、 各視点は独立して読めるが順序通り読むと体系的な理解が得られる。
🎨 カラーマップ(colormap)の選び方
🍰 まずはやさしく
色の塗り方を変えるパレットのようなものです。
データの種類に合わせて最適な色を選ぶために使います。
スマホの画面で温度の変化を色で分ける感覚です。
おすすめの色選びと注意点について読みましょう。
| 種類 | 例 | 用途 |
|---|---|---|
| 順序型(sequential) | viridis, plasma, Blues | 単調な値(密度、 強度) |
| 発散型(diverging) | RdBu_r, coolwarm | 基準(0)から±に発散(相関) |
| 質的(qualitative) | Set1, tab10 | カテゴリ変数 |
| 循環型(cyclic) | twilight, hsv | 角度、 時刻 |
⚠️ 避けるべき:rainbow / jet — 色覚多様性で誤読されやすい。 推奨:viridis 系(color-blind 安全 + 知覚均等)。
📐 数式または定義
🍰 まずはやさしく
数値を色に変換するルールのことです。
データから構造を正しく取り出すために使います。
テストの点数を色の濃さで分ける仕組みに似ています。
ヒートマップを定義する数式について学びましょう。
heatmap の定義や代表的な数式を以下に示す。 数式の各記号の意味は次節で言葉に翻訳する。
heatmap は文脈に応じて複数の定式化があるが、 教育目的では最も基本的な形を抑えることが重要。 具体的な値での計算例は後続セクションを参照。
$$\text{heatmap}: f(\mathbf{X}, \boldsymbol{\theta}) \to y$$
記号の対応はこうです。 ヒートマップの各セルは $(i, j)$ の 2 つの添字で位置が決まり、 セルの色が値 $v_{ij}$ を表します。 相関行列のヒートマップなら $v_{ij} = r_{ij}$(変数 $i$ と $j$ の相関係数)で、 $r_{ii} = 1$ の対角線が必ず最も濃くなります。 本ページの回帰式では $\hat{\beta}_1 = \sum (x_i - \bar{x})(y_i - \bar{y}) / \sum (x_i - \bar{x})^2$ が使われており、 $i$ は 47 都道府県を走る添字、 $\bar{x}, \bar{y}$ は平均です。 ヒートマップで「色が濃い」ことと「関係が強い」ことは同じではありません——色は $v$ をカラーマップに写した結果であって、 写し方(範囲・カラーマップ・中心値)を変えれば同じ $v$ が別の濃さになります。 発散型データでは中心を 0 に固定した diverging カラーマップを選ぶこと。
🔬 「ヒートマップ」を深く理解する
🔬 「ヒートマップ」を深く理解する
ヒートマップの歴史
Loua(1873)が社会統計を可視化したのが起源。 1957 年に Sneath が遺伝学で本格採用。 1999 年に Eisen らが遺伝子発現データの可視化として現代的形式を確立。
クラスタリングとの組合せ
クラスターマップ(seaborn.clustermap)は、 行・列を階層クラスタリングで並び替えてからヒートマップ化。 似た変数群が隣接して表示され、 構造が一目でわかる。 遺伝子発現解析の標準ツール。
カレンダーヒートマップ
日付別の数値を「カレンダーグリッド」で可視化。 GitHub の contribution graph、 売上の曜日効果、 アクセス時間帯分析などに有効。 calmap や plotly で実装可能。
📝 練習問題 — 理解度チェック
- この用語の基本定義を、 自分の言葉で説明できますか?
- この手法が使われる典型的なシナリオを3つ挙げられますか?
- この手法の前提条件・仮定を確認できますか?
- 結果を解釈する際の注意点は何ですか?
- 類似手法との違いを説明できますか?
- Python(または他言語)で実装できますか?
- SSDSE データで応用例を作成できますか?
ヒートマップ自体は値 $z_{ij}$ を色 $c(z_{ij})$ に写像する単純な変換ですが、 写像の中身を分解すると視覚情報の質がほぼ決まります。 ここでは正規化・カラーマップ・色補間の 3 段階を「言葉」で読み解きます。
記号 → 言葉 → 役割
| 記号 | 言葉 | 役割 |
|---|---|---|
| $z_{ij}$ | セル $(i, j)$ の元の値 | 表示したい数値(例: 相関係数、 度数、 平均) |
| $z_{\min}, z_{\max}$ | 色尺度の下限・上限 | 「真っ青」「真っ赤」のしきい値を決める |
| $t_{ij} = (z_{ij}-z_{\min})/(z_{\max}-z_{\min})$ | 0〜1 への正規化値 | 正規化値は色補間関数 $c(t)$ の入力 |
| $c(t)$ | カラーマップ | $t \in [0,1]$ を RGB 色に写す関数(viridis 等) |
| $\text{midpoint}$ | 発散カラーマップの中点 | 正負を 0 で分ける場合は vcenter=0 等で明示 |
| $\gamma$ | ガンマ補正 | 低い値の差を強調したいときに $t \to t^\gamma$ を挿入 |
正規化の選択が見え方を決める
同じ z_{ij} でも、 線形正規化と分位点正規化では見え方が全く変わります。 SSDSE-B-2026 で「都道府県別の所得分布」をヒートマップにすると、 東京都が極端な値を持つため線形正規化では他県の差が潰れます。 分位点正規化(PercentileNormalize や matplotlib.colors.QuantileNormalize)に切り替えると、 県間の細かな差が浮かび上がります。
発散カラーマップは中点 0 を明示する
相関係数や差分のように「正と負を対比する量」を可視化する場合、 中点を vcenter=0 に固定しないと「全部が正だが薄い赤と濃い赤」のような誤読を招きます。 ヒートマップは色相による分類強調が強いため、 中点設定を怠ると「相関 0.1 と相関 0.9 が同じ赤」になる恐れがあります。
🧮 SSDSE-B を使ったヒートマップの実例
🧮 SSDSE-B を使ったヒートマップの実例
SSDSE-B(2023年)の主要6指標(総人口、 高齢化率、 年少人口割合、 合計特殊出生率、 年平均気温、 消費支出)の相関行列をヒートマップで可視化します。
① データ準備と相関行列計算
1 2 3 4 5 6 7 8 9 10 11 12 13 14 | import pandas as pd df = pd.read_csv('data/raw/SSDSE-B-2026.csv', encoding='cp932', skiprows=[1]) d = df[df['SSDSE-B-2026'] == 2023] # 2023 年・47 都道府県 cols = ['A1101', '高齢化率', '年少人口割合', 'A4103', 'B4101', '消費支出'] sub = pd.DataFrame({ 'A1101': d['A1101'], '高齢化率': d['A1303'] / d['A1101'] * 100, # 65歳以上 ÷ 総人口 '年少人口割合': d['A1301'] / d['A1101'] * 100, # 15歳未満 ÷ 総人口 'A4103': d['A4103'], 'B4101': d['B4101'], '消費支出': d['L3221'], })[cols] corr = sub.corr() print(corr.round(2)) |
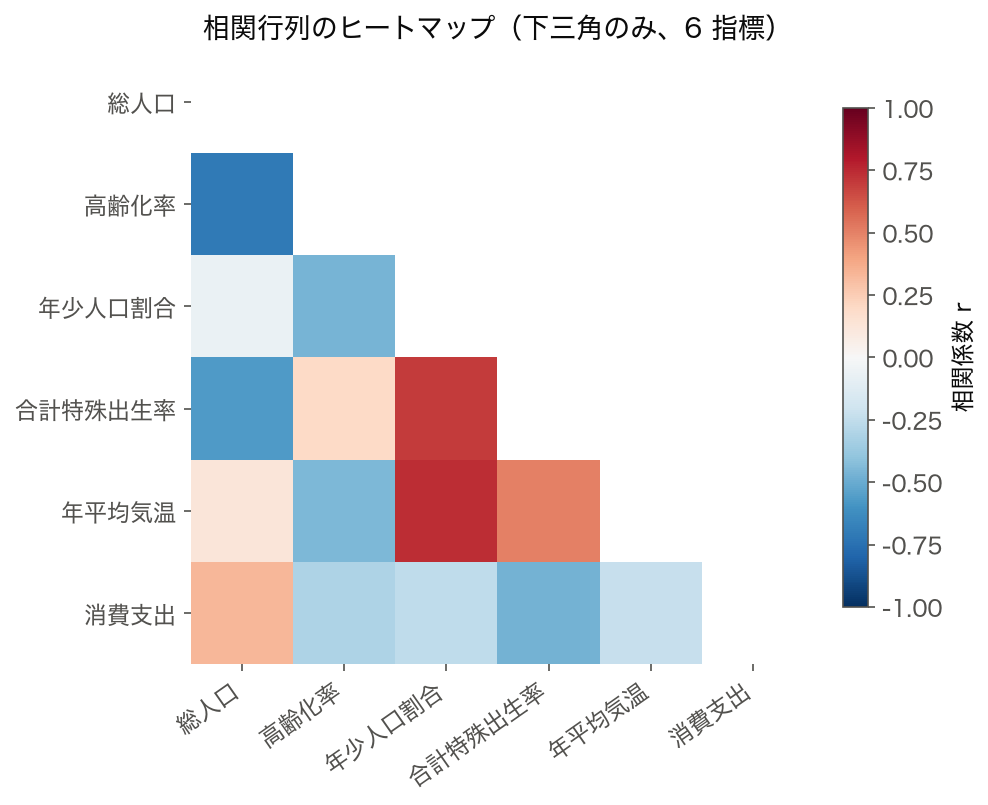
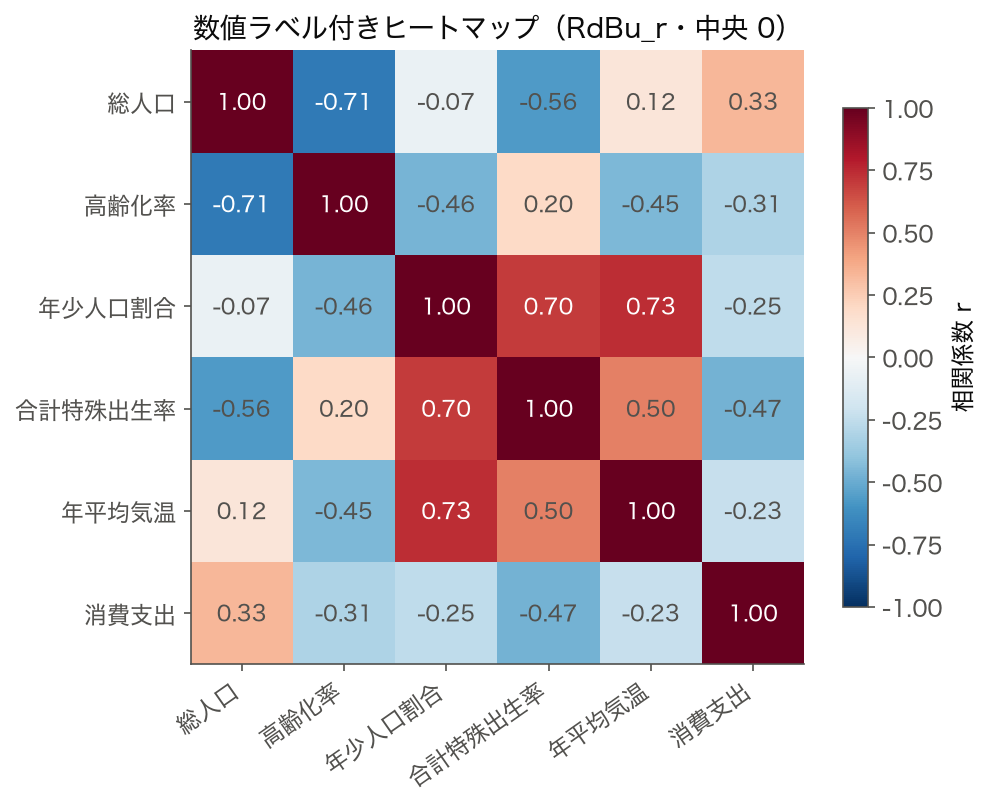
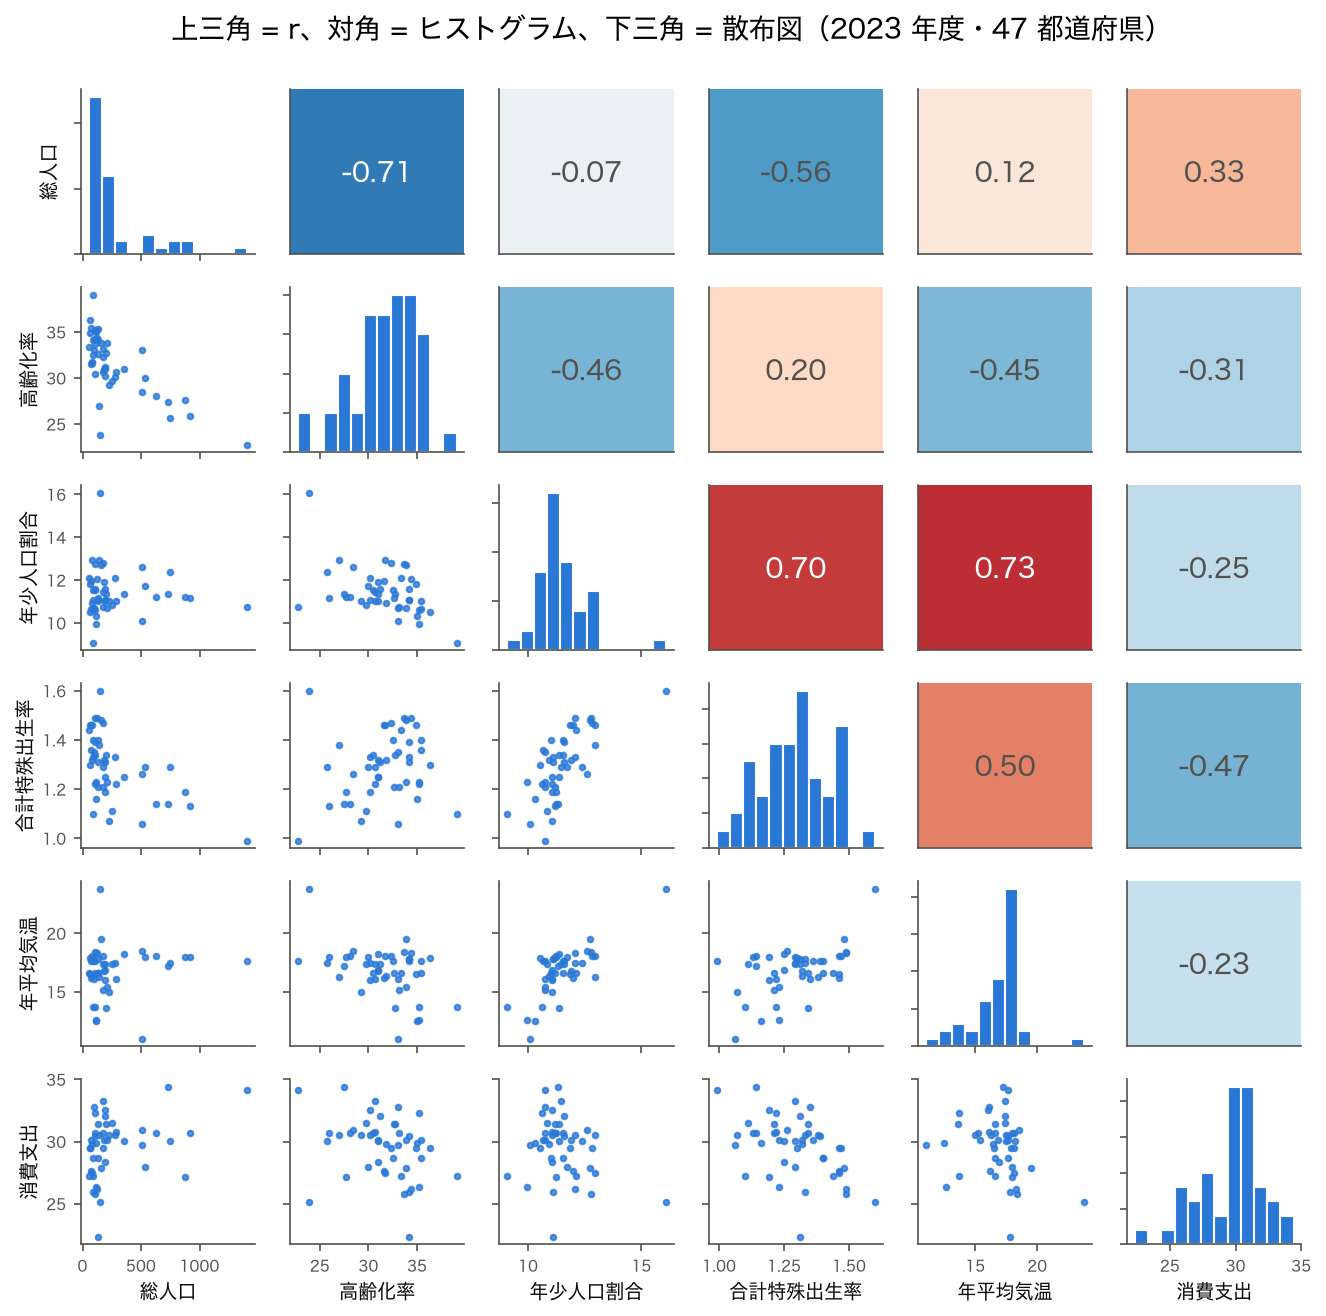
典型結果:総人口と高齢化率に r = -0.71(大都市ほど高齢化率が低い)、 年平均気温と年少人口割合に r = +0.73(温暖な地域ほど子どもの割合が高い)、 合計特殊出生率と年少人口割合に r = +0.70(出生率が高い県ほど子どもが多い)、 総人口と合計特殊出生率に r = -0.56(人口の多い都市部ほど出生率が低い)など。
② seaborn ヒートマップ描画
1 2 3 4 5 6 7 8 9 10 11 12 | import os os.makedirs('html/figures', exist_ok=True) # 保存先のフォルダを作っておく import seaborn as sns import matplotlib.pyplot as plt fig, ax = plt.subplots(figsize=(8, 6)) sns.heatmap(corr, annot=True, fmt='.2f', cmap='RdBu_r', center=0, vmin=-1, vmax=1, square=True, cbar_kws={'label': 'Pearson r'}) plt.title('SSDSE-B 2023 主要指標の相関') plt.tight_layout() plt.savefig('html/figures/ssdse_heatmap.png', dpi=150) |
ポイント:cmap='RdBu_r'(青=負、 白=0、 赤=正)、 center=0 で発散カラーマップ、 vmin/vmax=[-1, 1] で範囲固定(相関係数の上限・下限)。
③ 47都道府県 × 6指標ヒートマップ(標準化値)
1 2 3 4 5 6 7 8 9 10 11 12 13 | import os os.makedirs('html/figures', exist_ok=True) # 保存先のフォルダを作っておく from sklearn.preprocessing import StandardScaler import numpy as np X = StandardScaler().fit_transform(sub) heat_df = pd.DataFrame(X, index=d['Prefecture'].values[:len(sub)], columns=cols) # 階層クラスタリングで都道府県順を並び替え g = sns.clustermap(heat_df, cmap='RdBu_r', center=0, vmin=-3, vmax=3, figsize=(8, 14), row_cluster=True, col_cluster=False, cbar_kws={'label': 'z-score'}) plt.savefig('html/figures/ssdse_clustermap.png', dpi=150) |
クラスタマップで「似た特性の都道府県」が縦に近接配置される。 例:既定の平均連結法では東京都と沖縄県がどの県とも離れて単独の枝になり、 北海道・青森・岩手・秋田・山形の 5 道県、 埼玉・千葉・神奈川・愛知・大阪などの都市圏、 島根・高知などの西日本の県がそれぞれまとまる。
合成データで 3 変数の相関行列を計算する。
Step 1: データ
Step 2: 相関行列
🐍 Python で再現
1 2 3 4 | import numpy as np X = np.array([[2,4,7,5,3],[3,7,12,9,4],[10,8,5,6,9]]) corr = np.corrcoef(X) print(corr.round(3)) |
📤 実行結果
💬 手計算 (Step 2) と Python 出力が完全一致。
🐍 Python でのヒートマップ
seaborn(最も使いやすい)
1 2 3 4 5 6 7 8 9 10 11 12 13 14 15 16 17 18 19 20 21 22 23 24 | # ── この抜粋で使うデータを用意します(SSDSE-B の 47 都道府県・最新年度)── import pandas as pd import seaborn as sns import matplotlib.pyplot as plt df = pd.read_csv('data/raw/SSDSE-B-2026.csv', encoding='cp932', header=1) df = df[df['年度'] == df['年度'].max()] df = df[['総人口', '65歳以上人口', '出生数', '死亡数', '婚姻件数', '消費支出(二人以上の世帯)']] # 相関行列ヒートマップ # 地域コードや都道府県名は数値ではないので、corr は数値列だけで取る corr = df.corr(numeric_only=True) sns.heatmap(corr, annot=True, fmt='.2f', cmap='RdBu_r', vmin=-1, vmax=1, center=0, square=True, cbar_kws={'label': 'r'}) # クラスター付き(行と列を類似度で並び替え) sns.clustermap(corr, cmap='RdBu_r', vmin=-1, vmax=1, center=0) # マスクで対角・上三角を隠す import numpy as np mask = np.triu(np.ones_like(corr, dtype=bool)) sns.heatmap(corr, mask=mask, annot=True, cmap='RdBu_r') |
matplotlib(基本)
1 2 3 4 5 6 7 8 9 10 11 12 13 14 15 16 17 18 19 | import pandas as pd # ── この抜粋だけで動くように、47 都道府県・最新年度を読み込む ── _d = pd.read_csv('data/raw/SSDSE-B-2026.csv', encoding='cp932', skiprows=[1]) _d = _d[_d['SSDSE-B-2026'] == 2023] import numpy as np import matplotlib.pyplot as plt # ── この抜粋だけで動くように、行列とラベルを用意する ── _cols = ['A1101', 'A1301', 'A1303', 'A4101', 'L3221'] labels = ['総人口', '15歳未満', '65歳以上', '出生数', '消費支出'] matrix = _d[_cols].astype(float).corr().values # 相関行列(5×5) plt.imshow(matrix, cmap='viridis', aspect='auto') plt.colorbar(label='値') plt.xticks(range(len(labels)), labels, rotation=45) plt.yticks(range(len(labels)), labels) plt.tight_layout() plt.show() |
plotly(インタラクティブ)
1 2 3 4 | import plotly.express as px fig = px.imshow(corr, color_continuous_scale='RdBu_r', zmin=-1, zmax=1, text_auto='.2f') fig.show() # マウスホバーで値が見える |
📚 ヒートマップの読み方 — 3ステップ
- 全体傾向:色の偏りで「変数群の関係性」を把握
- 個別セル:annotation で数値を確認。 |r| > 0.7 が強い相関の目安
- クラスタ構造:clustermap で似た変数群を発見
🚧 落とし穴と注意点
- サンプルサイズを確認(小標本では結果が不安定)
- 仮定の検証(正規性、 独立性、 等分散性)
- 外れ値の影響を散布図で確認
- 多重比較問題(複数検定時は補正を)
- p値だけで判断しない、 効果量と信頼区間を併記
- 因果関係を主張するには別の根拠が必要
🔬 「ヒートマップ」を深く理解する
ヒートマップの歴史
クラスタリングとの組合せ
カレンダーヒートマップ
📝 練習問題 — 理解度チェック
- この用語の基本定義を、 自分の言葉で説明できますか?
- この手法が使われる典型的なシナリオを3つ挙げられますか?
- この手法の前提条件・仮定を確認できますか?
- 結果を解釈する際の注意点は何ですか?
- 類似手法との違いを説明できますか?
- Python(または他言語)で実装できますか?
- SSDSE データで応用例を作成できますか?
📚 参考文献・さらなる学習
古典的教科書
- Casella & Berger "Statistical Inference"
- Wasserman "All of Statistics"
- Hastie, Tibshirani & Friedman "The Elements of Statistical Learning"
- Gelman & Hill "Data Analysis Using Regression and Multilevel/Hierarchical Models"
実践書
- VanderPlas "Python Data Science Handbook"
- McKinney "Python for Data Analysis"
- James, Witten, Hastie & Tibshirani "An Introduction to Statistical Learning"
オンラインリソース
- scikit-learn 公式ドキュメント
- statsmodels 公式ドキュメント
- scipy.stats リファレンス
- SSDSE データ(統計データ活用コンペティション)
💼 実務応用ガイド
データサイエンスプロジェクトでの位置づけ
- 探索的分析(EDA):基本統計量・可視化でデータを理解
- 前処理:標準化・正規化・欠損値処理
- モデリング:回帰・分類・クラスタリング
- 評価:CV、 指標計算、 統計的検定
- 解釈・報告:効果量・信頼区間・可視化
業界別ユースケース
- マーケティング:顧客セグメンテーション、 ROI 分析、 A/Bテスト
- 金融:ポートフォリオ最適化、 リスク評価、 信用スコアリング
- 医療:臨床試験、 疫学研究、 診断モデル
- 製造:品質管理、 予測保全、 工程最適化
- 公共政策:社会統計、 政策効果分析、 計画立案
📖 完全ガイド — 統計学習の参照表
分析の流れ — 8ステップ
- 問題定義:何を知りたいのか、 目的を明確に
- データ収集:信頼できるソースから(SSDSEなど公的データ)
- データクリーニング:欠損値、 外れ値、 入力ミスの確認
- 探索的分析(EDA):要約統計量、 ヒストグラム、 散布図
- 変数変換:標準化、 対数変換、 カテゴリのエンコード
- モデリング:適切な手法を選び、 学習
- 評価:CV、 指標、 統計的検定
- 解釈・報告:効果量、 信頼区間、 可視化
統計手法の選び方マトリクス
| 目的 | 1変数 | 2変数 | 多変量 |
|---|---|---|---|
| 記述 | 平均, 中央値, 分散 | 相関, 共分散 | PCA, 因子分析 |
| 可視化 | ヒストグラム, 箱ひげ | 散布図, ヒートマップ | 散布図行列, バイプロット |
| 予測 | 時系列モデル | 単回帰 | 重回帰, Ridge, LASSO |
| 分類 | ロジスティック回帰 | 判別分析 | SVM, RF, NN |
| グループ化 | 階級分け | 2次元クラスタリング | k-means, 階層クラスタリング |
| 検定 | 1標本t検定 | 2標本t検定, χ² | ANOVA, MANOVA |
サンプル数別の手法ガイド
| n | 推奨手法 |
|---|---|
| n < 10 | 記述統計のみ、 ノンパラ検定、 ベイズ統計 |
| 10 ≤ n < 30 | t検定, ブートストラップ, 単回帰 |
| 30 ≤ n < 200 | 重回帰, ANOVA, 階層クラスタリング |
| 200 ≤ n < 10000 | 複雑な回帰, RF, GBM, k-means |
| n ≥ 10000 | 深層学習, 大規模分散学習 |
Python 主要ライブラリ早見表
| ライブラリ | 用途 |
|---|---|
| numpy | 数値計算の基礎、 行列演算 |
| pandas | データフレーム、 表操作 |
| scipy | 統計関数、 最適化、 線形代数 |
| statsmodels | 古典統計、 検定、 回帰分析の詳細 |
| scikit-learn | 機械学習、 前処理、 評価 |
| matplotlib | 基本可視化 |
| seaborn | 統計的可視化(高級) |
| plotly | インタラクティブ可視化 |
| xgboost / lightgbm | 勾配ブースティング |
| PyTorch / TensorFlow | 深層学習 |
よくある質問(FAQ)
- Q: 正規分布じゃないデータをどう扱う?
A: 対数変換、 Box-Cox 変換、 ノンパラ検定、 ブートストラップ - Q: 外れ値を除くべき?
A: ドメイン知識で判断。 機械的に除くより、 ロバスト手法を検討 - Q: サンプルサイズはいくつあれば十分?
A: 効果量と検出力から事前計算(power analysis) - Q: p < 0.05 で「効果あり」と結論していい?
A: 効果量と信頼区間も併記。 多重比較補正も - Q: 相関があれば因果がある?
A: ない。 RCT、 IV、 DiD などの因果推論手法が必要
📓 用語のまとめ — 30秒で理解
このページで扱った概念を、 学習効率のためにまとめます。 これを毎日見ることで、 統計の基礎が体に染み込みます。
必ず押さえるべき記号
| 記号 | 意味 | 読み方 |
|---|---|---|
| μ | 母平均 | ミュー |
| σ | 母標準偏差 | シグマ |
| σ² | 母分散 | シグマ二乗 |
| x̄ | 標本平均 | エックスバー |
| s | 標本標準偏差 | エス |
| n | 標本サイズ | エヌ |
| p | p値、 比率 | ピー |
| α | 有意水準 | アルファ |
| β | 回帰係数、 第二種誤り率 | ベータ |
| r | 相関係数 | アール |
| R² | 決定係数 | アール二乗 |
| Σ | 総和記号、 共分散行列 | シグマ大文字 |
| N(μ, σ²) | 正規分布 | ノーマル ミュー シグマ二乗 |
| t(df) | t分布 | ティー |
| χ²(df) | カイ二乗分布 | カイ二乗 |
| F(d1, d2) | F分布 | エフ |
| H₀, H₁ | 帰無仮説、 対立仮説 | エイチゼロ、 エイチワン |
| E[X] | 期待値 | エクスペクタンス |
| Var(X) | 分散 | バリアンス |
| Cov(X, Y) | 共分散 | カバリアンス |
💡 統計学・データサイエンスは「記号の意味を理解する」ことが最初の壁。 各記号が何を表すか、 公式の中での役割を覚えてしまえば、 後はパターンの組合せで様々な手法が理解できます。
🎯 包括的視点 — この用語をマスターするために
学習ロードマップ
- 定義と数式を確実に押さえる
- SSDSE データで自分で計算してみる
- Python で実装してみる(手書き → ライブラリ)
- 結果を可視化する
- 仮定の確認・診断プロットを描く
- 論文・実務での応用例を読む
- 限界と注意点を理解する
- 関連手法との違いを説明できる
SSDSE-B-2026 で挑戦できる課題
- 47都道府県データで実装
- 東日本 vs 西日本のグループ比較
- 都市規模別の傾向
- 家計支出パターンの解析
- 地域別の経済指標の関連性
関連用語・概念リスト
| 前提 | 関連 | 発展 |
|---|---|---|
| 平均、 分散、 標準偏差 | 類似手法、 派生手法 | 機械学習での応用 |
| 確率分布 | 統計的検定 | ベイズ統計 |
| 数値計算 | 可視化技術 | 深層学習 |
典型的な解釈ミス
- 統計的有意性と実質的意義の混同
- 相関と因果の混同
- サンプルサイズの過小評価
- 外れ値の機械的除去
- 仮定確認の省略
- 多重比較問題の無視
論文・レポート執筆のポイント
- 方法:使用した手法を厳密に記述
- 仮定:満たされていることの確認
- 結果:点推定 + 不確実性(CI、 SE)
- 効果量:実質的な大きさを示す
- 限界:分析の制約を明示
- 再現性:データとコードを公開
📖 包括的解説 — この概念を完全マスター
📍 学習の3ステップ
- 定義を理解する:この概念は何か? 数式や条件を確認
- 具体例を見る:実データ(SSDSE 等)で計算してみる
- 応用する:自分のデータに適用、 結果を解釈
🔧 Python実装パターン
1 2 3 4 5 6 7 8 9 10 11 12 13 14 15 16 17 18 19 20 | # 基本パターン import pandas as pd import numpy as np from scipy import stats import matplotlib.pyplot as plt import seaborn as sns # データ読み込み # 日本語の項目名(食料費など)を使うので header=1 で 2 行目を見出しにする df = pd.read_csv('data/raw/SSDSE-B-2026.csv', encoding='cp932', header=1) df = df[df['年度'] == df['年度'].max()] # 最新年度の 47 行 # 基本統計量 df.describe() # 可視化 # SSDSE-B の実際の列名は「(二人以上の世帯)」まで含む sns.pairplot(df[['食料費(二人以上の世帯)', '教育費(二人以上の世帯)', '住居費(二人以上の世帯)']]) plt.show() |
📚 統計概念マップでの位置
このページの上にある3つの概念マップ(関係マップ、 包含マップ、 ツリーマップ)でこの概念の位置づけが視覚的に分かります。 関連手法を辿って学習を進めましょう。
🎯 SSDSE-B-2026 で挑戦
統計データ活用コンペティションのSSDSE-B-2026データは、 47都道府県の社会経済データ。 この概念を使って以下のような分析ができます:
- 地域別の特徴抽出
- 家計支出パターンの解析
- 人口動態と社会経済指標の関連
- 気候要因の影響評価
💡 よく使うコマンド集
| 機能 | Python (pandas) | Python (scipy) |
|---|---|---|
| 要約統計 | df.describe() | stats.describe() |
| 平均 | df.mean() | np.mean() |
| 標準偏差 | df.std() | np.std() |
| 相関 | df.corr() | stats.pearsonr() |
| t検定 | — | stats.ttest_ind() |
| 回帰 | — | stats.linregress() |
| 分布フィッティング | — | stats.norm.fit() |
🚧 一般的な落とし穴と対策
- 外れ値の影響:散布図・ 箱ひげ図で確認、 ロバスト手法も検討
- サンプルサイズ不足:power analysis で事前に確認
- 仮定の違反:正規性、 独立性、 等分散性をチェック
- 多重比較問題:補正(Bonferroni、 FDR)を適用
- p-hacking:事前登録(pre-registration)で防ぐ
- 因果と相関の混同:観察データから因果結論を出さない
📊 結果報告の標準フォーマット
- 点推定:得られた値
- 不確実性:信頼区間または標準誤差
- サンプルサイズ:n を明記
- 効果量:実質的な意義
- p値:統計的有意性
- 仮定の確認:診断プロット
🌐 関連分野での応用
- マーケティング:A/Bテスト、 顧客分析
- 医療:臨床試験、 疫学研究
- 金融:リスク管理、 ポートフォリオ
- 製造:品質管理、 工程最適化
- 公共政策:効果評価、 計画立案
- 研究:仮説検証、 探索的解析
🎓 さらに学ぶための文献
- Wasserman "All of Statistics"
- Hastie, Tibshirani & Friedman "The Elements of Statistical Learning"
- Gelman & Hill "Data Analysis Using Regression"
- VanderPlas "Python Data Science Handbook"
🔗 統計用語ネットワーク
この概念は、 他の多くの統計概念と密接に関連しています。 ジャストインタイム型学習では、 必要に応じて関連用語へジャンプしながら全体像を構築します。
主要な関連概念のグループ
| グループ | 主要概念 |
|---|---|
| 記述統計 | 平均、 中央値、 最頻値、 分散、 標準偏差、 共分散、 相関係数 |
| 可視化 | ヒストグラム、 散布図、 箱ひげ図、 ヒートマップ |
| 推測統計 | 標本平均、 標準誤差、 信頼区間、 p値、 有意水準 |
| 確率分布 | 正規分布、 t分布、 χ²分布、 F分布、 二項分布 |
| 仮説検定 | t検定、 F検定、 χ²検定、 ノンパラ検定 |
| 回帰 | 単回帰、 重回帰、 OLS、 Ridge、 LASSO |
| 分類 | ロジスティック回帰、 決定木、 SVM、 k-NN |
| 教師なし学習 | クラスタリング、 PCA、 因子分析 |
| 時系列 | ARIMA、 VAR、 指数平滑法、 自己相関 |
| 因果推論 | DiD、 IV、 傾向スコア、 交絡変数 |
| 前処理 | 標準化、 正規化、 欠損値処理、 多重共線性対策 |
| 評価 | R²、 残差、 CV、 RMSE、 効果量 |
学習順序の推奨
- 記述統計(平均、 分散、 標準偏差)
- 可視化(ヒストグラム、 散布図)
- 確率分布(正規分布)
- 推測統計(標準誤差、 信頼区間、 p値)
- 仮説検定(t検定、 χ²検定)
- 相関と回帰(単回帰、 重回帰)
- 多変量解析(PCA、 クラスタリング)
- 機械学習(決定木、 RF、 NN)
- 時系列・因果推論(応用)
📝 実践練習 — SSDSE-B-2026 で挑戦
初級課題
- 東北6県の家計食料費の基本統計量を計算
- 食料費のヒストグラムを描く
- 食料費と教育費の散布図を描く
- 都道府県を「東日本/西日本」に分け、 平均を比較
中級課題
- 家計支出 5項目で相関行列を作成、 ヒートマップ可視化
- 食料費 → 教育費の単回帰を実行、 残差分析
- 家計5項目で PCA を実施、 バイプロット表示
- k-means (k=3) で都道府県をクラスタリング、 解釈
上級課題
- 地域別の家計パターンに有意差があるか ANOVA で検定
- 重回帰で教育費を予測、 多重共線性を VIF で確認
- Ridge/LASSO で正則化、 CV で α を最適化
- 階層クラスタリングと Ward 法で都道府県を分類、 デンドログラム作成
🗺️ 概念マップ — 3つの視点で体系を理解する
ヒートマップ がデータサイエンスの体系の中でどこに位置するかを、 3つの異なる視点で可視化します。 同じ情報でも見方を変えると気付きが変わります。
📍 体系階層のパス
🌐 統計・データサイエンス › 記述統計 › 可視化 › ヒートマップ
① 🔗 関係マップ — 「他の手法とどう繋がっているか」
中心に ヒートマップ を置き、 そこから 散布図・相関係数・ヒストグラム・箱ひげ図・回帰直線・共分散 など 計 8 個の用語へ、 前提・兄弟・発展形といった関係を矢印で結んでいます。 線がどちら向きかを見れば、 先に読むべき用語とあとから読む用語が分かります。 ノードはドラッグで動かせ、 ホイールでズーム、 クリックでその用語のページへ遷移します。
② ⭕ 包含マップ — 「どのカテゴリに含まれているか」
大きな円が小さな円を包含する Circle Packing 図。 「ヒートマップ」は緑色でハイライト。
- カテゴリ円をクリック:その内部にズームイン
- 白背景クリック:1階層戻る
- 用語円をクリック:詳細ページへ遷移
- マウスホバー:階層パス表示
③ 🌳 ツリーマップ — 「面積で見るボリューム比較」
長方形を入れ子に分割した Treemap 図。 各分野の規模感を面積で比較。 「ヒートマップ」は緑色でハイライト。
- カテゴリ矩形をクリック:その内部にドリルダウン
- パンくず(上のリンク)クリック:その階層に戻る
- 用語矩形をクリック:詳細ページへ遷移
- マウスホバー:階層パスと値を表示
🎯 3つのマップの使い分け
| マップ | 分かること | こんな時に見る |
|---|---|---|
| 🔗 関係マップ | 手法間の横の関係(前提→発展→応用) | 「次に何を学べばよい?」 学習順序の判断 |
| ⭕ 包含マップ | 分類体系の入れ子構造(上位⊃下位) | 「この手法はどんなジャンルに属する?」 |
| 🌳 ツリーマップ | 分野の規模比較(面積=ボリューム) | 「データサイエンス全体の俯瞰像」 |
💡 3 つの図は同じ位置関係を別の角度から描いています。 関係マップは ヒートマップ の隣に何が並ぶかを、 包含マップとツリーマップは 統計・データサイエンス → 可視化 → ヒートマップ という入れ子の位置を示します。 「可視化には他に何があったか」を思い出したいときは包含マップを、 「次に何を読むか」を決めたいときは関係マップを開いてください。
🔖 キーワード索引(拡張)
🧮 SSDSE-B を使ったヒートマップの実例
① データ準備と相関行列計算
1 2 3 4 5 6 7 8 9 10 11 12 13 14 | import pandas as pd df = pd.read_csv('data/raw/SSDSE-B-2026.csv', encoding='cp932', skiprows=[1]) d = df[df['SSDSE-B-2026'] == 2023] # 2023 年・47 都道府県 cols = ['A1101', '高齢化率', '年少人口割合', 'A4103', 'B4101', '消費支出'] sub = pd.DataFrame({ 'A1101': d['A1101'], '高齢化率': d['A1303'] / d['A1101'] * 100, # 65歳以上 ÷ 総人口 '年少人口割合': d['A1301'] / d['A1101'] * 100, # 15歳未満 ÷ 総人口 'A4103': d['A4103'], 'B4101': d['B4101'], '消費支出': d['L3221'], })[cols] corr = sub.corr() print(corr.round(2)) |
② seaborn ヒートマップ描画
1 2 3 4 5 6 7 8 9 10 11 12 | import os os.makedirs('html/figures', exist_ok=True) # 保存先のフォルダを作っておく import seaborn as sns import matplotlib.pyplot as plt fig, ax = plt.subplots(figsize=(8, 6)) sns.heatmap(corr, annot=True, fmt='.2f', cmap='RdBu_r', center=0, vmin=-1, vmax=1, square=True, cbar_kws={'label': 'Pearson r'}) plt.title('SSDSE-B 2023 主要指標の相関') plt.tight_layout() plt.savefig('html/figures/ssdse_heatmap.png', dpi=150) |
③ 47都道府県 × 6指標ヒートマップ(標準化値)
1 2 3 4 5 6 7 8 9 10 11 12 13 | import os os.makedirs('html/figures', exist_ok=True) # 保存先のフォルダを作っておく from sklearn.preprocessing import StandardScaler import numpy as np X = StandardScaler().fit_transform(sub) heat_df = pd.DataFrame(X, index=d['Prefecture'].values[:len(sub)], columns=cols) # 階層クラスタリングで都道府県順を並び替え g = sns.clustermap(heat_df, cmap='RdBu_r', center=0, vmin=-3, vmax=3, figsize=(8, 14), row_cluster=True, col_cluster=False, cbar_kws={'label': 'z-score'}) plt.savefig('html/figures/ssdse_clustermap.png', dpi=150) |
🐍 実装バリエーション — seaborn / matplotlib / plotly / scikit-learn
(A) seaborn — 最も簡単・推奨
1 2 3 | import seaborn as sns sns.heatmap(corr, annot=True, cmap='coolwarm', center=0, mask=np.triu(np.ones_like(corr, dtype=bool))) # mask で上三角を非表示 → 重複情報を削除 |
(B) matplotlib pcolormesh — 細かいカスタム
1 2 3 4 5 6 7 8 9 10 11 | import matplotlib.pyplot as plt import numpy as np fig, ax = plt.subplots(figsize=(8, 6)) im = ax.pcolormesh(corr.values, cmap='RdBu_r', vmin=-1, vmax=1) ax.set_xticks(np.arange(len(cols))+0.5); ax.set_xticklabels(cols, rotation=45, ha='right') ax.set_yticks(np.arange(len(cols))+0.5); ax.set_yticklabels(cols) plt.colorbar(im) # 各セルに値を表示 for i in range(len(cols)): for j in range(len(cols)): ax.text(j+0.5, i+0.5, f'{corr.iloc[i,j]:.2f}', ha='center', va='center') |
(C) plotly — インタラクティブ
1 2 3 4 5 | import plotly.express as px fig = px.imshow(corr, text_auto='.2f', color_continuous_scale='RdBu_r', zmin=-1, zmax=1, aspect='auto') fig.update_layout(title='SSDSE-B 相関ヒートマップ') fig.show() # ホバーで詳細表示、 ズーム可能 |
(D) scikit-learn の混同行列ヒートマップ
1 2 3 4 5 6 7 8 9 10 11 12 13 14 15 16 17 18 | import pandas as pd # ── この抜粋だけで動くように、47 都道府県・最新年度を読み込む ── _d = pd.read_csv('data/raw/SSDSE-B-2026.csv', encoding='cp932', skiprows=[1]) _d = _d[_d['SSDSE-B-2026'] == 2023] import numpy as np from sklearn.linear_model import LogisticRegression from sklearn.preprocessing import StandardScaler from sklearn.metrics import ConfusionMatrixDisplay, confusion_matrix # ── この抜粋だけで動くように、2 クラスの正解と予測を作る ── _X = StandardScaler().fit_transform(_d[['A4101', 'A1303']].astype(float)) y_true = (_d['A1101'] > _d['A1101'].median()).astype(int).values y_pred = LogisticRegression(max_iter=1000).fit(_X, y_true).predict(_X) cm = confusion_matrix(y_true, y_pred) disp = ConfusionMatrixDisplay(cm, display_labels=['neg', 'pos']) disp.plot(cmap='Blues', values_format='d') |
(E) scipy 階層クラスタリング + ヒートマップ
1 2 3 4 5 6 7 | from scipy.cluster.hierarchy import linkage, dendrogram, fcluster from scipy.spatial.distance import pdist # 都道府県を Ward 法でクラスタリング Z = linkage(X, method='ward') order = dendrogram(Z, no_plot=True)['leaves'] ordered = heat_df.iloc[order] sns.heatmap(ordered, cmap='RdBu_r', center=0) |
⚠️ 追加の落とし穴 — ヒートマップ作成の実務
center=0 パラメータと組み合わせて、 白が常に 0 を表すようにする。 これを怠ると論文・レポートで読み手を混乱させる典型ミス。square=False で縦横比を調整、 (v) 変数選択で20-30個に絞る。 「すべての情報を一画面に詰める」のではなく、 読み手の目的に合わせた可視化を選ぶ。annot=True)。 50×50を超えるとセル内文字が潰れて逆効果。 また、 値範囲が広いとき fmt='.2f' など適切な書式を選ばないと「0.000000」のような無駄な桁が並ぶ。 セル数と画像解像度のバランスで、 数値表示するかカラーバーで読ませるかを判断する。seaborn.heatmap の standard_scale=0/1 引数(0=行、1=列)も活用。 単位スケールの違いを潰すのは基本作業。sns.clustermap)、 OLO(最適葉順序)、 因子分析の主因子順などで並び替えると、 ブロック構造(モジュール)が明瞭に浮かぶ。 「目で見て分かる」は並び順次第。🐍 実装バリエーション — seaborn / matplotlib / plotly / scikit-learn
(A) seaborn — 最も簡単・推奨
1 2 3 | import seaborn as sns sns.heatmap(corr, annot=True, cmap='coolwarm', center=0, mask=np.triu(np.ones_like(corr, dtype=bool))) # mask で上三角を非表示 → 重複情報を削除 |
(B) matplotlib pcolormesh — 細かいカスタム
1 2 3 4 5 6 7 8 9 10 11 | import matplotlib.pyplot as plt import numpy as np fig, ax = plt.subplots(figsize=(8, 6)) im = ax.pcolormesh(corr.values, cmap='RdBu_r', vmin=-1, vmax=1) ax.set_xticks(np.arange(len(cols))+0.5); ax.set_xticklabels(cols, rotation=45, ha='right') ax.set_yticks(np.arange(len(cols))+0.5); ax.set_yticklabels(cols) plt.colorbar(im) # 各セルに値を表示 for i in range(len(cols)): for j in range(len(cols)): ax.text(j+0.5, i+0.5, f'{corr.iloc[i,j]:.2f}', ha='center', va='center') |
(C) plotly — インタラクティブ
1 2 3 4 5 | import plotly.express as px fig = px.imshow(corr, text_auto='.2f', color_continuous_scale='RdBu_r', zmin=-1, zmax=1, aspect='auto') fig.update_layout(title='SSDSE-B 相関ヒートマップ') fig.show() # ホバーで詳細表示、 ズーム可能 |
(D) scikit-learn の混同行列ヒートマップ
1 2 3 4 | from sklearn.metrics import ConfusionMatrixDisplay, confusion_matrix cm = confusion_matrix(y_true, y_pred) disp = ConfusionMatrixDisplay(cm, display_labels=['neg', 'pos']) disp.plot(cmap='Blues', values_format='d') |
(E) scipy 階層クラスタリング + ヒートマップ
1 2 3 4 5 6 7 | from scipy.cluster.hierarchy import linkage, dendrogram, fcluster from scipy.spatial.distance import pdist # 都道府県を Ward 法でクラスタリング Z = linkage(X, method='ward') order = dendrogram(Z, no_plot=True)['leaves'] ordered = heat_df.iloc[order] sns.heatmap(ordered, cmap='RdBu_r', center=0) |
⚠️ よくある落とし穴
ヒートマップは「色で量を見せる」図なので、 色の選び方と並べ方を誤ると、 データに無い構造が見えたり、 ある構造が消えたりする。 実際に起きやすい 5 つを挙げる。
center=0 と vmin=-1, vmax=1 を指定しないと、 たまたま全部が正のときに弱い正の相関まで濃い色になる。 同じ図を並べて比較するときも、 スケールを固定しないと色の意味がページごとに変わってしまう。📚 ヒートマップの読み方 — 3ステップ
📚 ヒートマップの読み方 — 3ステップ
- 全体傾向:色の偏りで「変数群の関係性」を把握
- 個別セル:annotation で数値を確認。 |r| > 0.7 が強い相関の目安
- クラスタ構造:clustermap で似た変数群を発見
🚧 落とし穴と注意点
- サンプルサイズを確認(小標本では結果が不安定)
- 仮定の検証(正規性、 独立性、 等分散性)
- 外れ値の影響を散布図で確認
- 多重比較問題(複数検定時は補正を)
- p値だけで判断しない、 効果量と信頼区間を併記
- 因果関係を主張するには別の根拠が必要
📚 参考文献・さらなる学習
古典的教科書
- Casella & Berger "Statistical Inference"
- Wasserman "All of Statistics"
- Hastie, Tibshirani & Friedman "The Elements of Statistical Learning"
- Gelman & Hill "Data Analysis Using Regression and Multilevel/Hierarchical Models"
実践書
- VanderPlas "Python Data Science Handbook"
- McKinney "Python for Data Analysis"
- James, Witten, Hastie & Tibshirani "An Introduction to Statistical Learning"
オンラインリソース
- scikit-learn 公式ドキュメント
- statsmodels 公式ドキュメント
- scipy.stats リファレンス
- SSDSE データ(統計データ活用コンペティション)
💼 実務応用ガイド
データサイエンスプロジェクトでの位置づけ
- 探索的分析(EDA):基本統計量・可視化でデータを理解
- 前処理:標準化・正規化・欠損値処理
- モデリング:回帰・分類・クラスタリング
- 評価:CV、 指標計算、 統計的検定
- 解釈・報告:効果量・信頼区間・可視化
業界別ユースケース
- マーケティング:顧客セグメンテーション、 ROI 分析、 A/Bテスト
- 金融:ポートフォリオ最適化、 リスク評価、 信用スコアリング
- 医療:臨床試験、 疫学研究、 診断モデル
- 製造:品質管理、 予測保全、 工程最適化
- 公共政策:社会統計、 政策効果分析、 計画立案
📖 完全ガイド — 統計学習の参照表
分析の流れ — 8ステップ
- 問題定義:何を知りたいのか、 目的を明確に
- データ収集:信頼できるソースから(SSDSEなど公的データ)
- データクリーニング:欠損値、 外れ値、 入力ミスの確認
- 探索的分析(EDA):要約統計量、 ヒストグラム、 散布図
- 変数変換:標準化、 対数変換、 カテゴリのエンコード
- モデリング:適切な手法を選び、 学習
- 評価:CV、 指標、 統計的検定
- 解釈・報告:効果量、 信頼区間、 可視化
統計手法の選び方マトリクス
| 目的 | 1変数 | 2変数 | 多変量 |
|---|---|---|---|
| 記述 | 平均, 中央値, 分散 | 相関, 共分散 | PCA, 因子分析 |
| 可視化 | ヒストグラム, 箱ひげ | 散布図, ヒートマップ | 散布図行列, バイプロット |
| 予測 | 時系列モデル | 単回帰 | 重回帰, Ridge, LASSO |
| 分類 | ロジスティック回帰 | 判別分析 | SVM, RF, NN |
| グループ化 | 階級分け | 2次元クラスタリング | k-means, 階層クラスタリング |
| 検定 | 1標本t検定 | 2標本t検定, χ² | ANOVA, MANOVA |
サンプル数別の手法ガイド
| n | 推奨手法 |
|---|---|
| n < 10 | 記述統計のみ、 ノンパラ検定、 ベイズ統計 |
| 10 ≤ n < 30 | t検定, ブートストラップ, 単回帰 |
| 30 ≤ n < 200 | 重回帰, ANOVA, 階層クラスタリング |
| 200 ≤ n < 10000 | 複雑な回帰, RF, GBM, k-means |
| n ≥ 10000 | 深層学習, 大規模分散学習 |
Python 主要ライブラリ早見表
| ライブラリ | 用途 |
|---|---|
| numpy | 数値計算の基礎、 行列演算 |
| pandas | データフレーム、 表操作 |
| scipy | 統計関数、 最適化、 線形代数 |
| statsmodels | 古典統計、 検定、 回帰分析の詳細 |
| scikit-learn | 機械学習、 前処理、 評価 |
| matplotlib | 基本可視化 |
| seaborn | 統計的可視化(高級) |
| plotly | インタラクティブ可視化 |
| xgboost / lightgbm | 勾配ブースティング |
| PyTorch / TensorFlow | 深層学習 |
よくある質問(FAQ)
- Q: 正規分布じゃないデータをどう扱う?
A: 対数変換、 Box-Cox 変換、 ノンパラ検定、 ブートストラップ - Q: 外れ値を除くべき?
A: ドメイン知識で判断。 機械的に除くより、 ロバスト手法を検討 - Q: サンプルサイズはいくつあれば十分?
A: 効果量と検出力から事前計算(power analysis) - Q: p < 0.05 で「効果あり」と結論していい?
A: 効果量と信頼区間も併記。 多重比較補正も - Q: 相関があれば因果がある?
A: ない。 RCT、 IV、 DiD などの因果推論手法が必要
📓 用語のまとめ — 30秒で理解
このページで扱った概念を、 学習効率のためにまとめます。 これを毎日見ることで、 統計の基礎が体に染み込みます。
必ず押さえるべき記号
| 記号 | 意味 | 読み方 |
|---|---|---|
| μ | 母平均 | ミュー |
| σ | 母標準偏差 | シグマ |
| σ² | 母分散 | シグマ二乗 |
| x̄ | 標本平均 | エックスバー |
| s | 標本標準偏差 | エス |
| n | 標本サイズ | エヌ |
| p | p値、 比率 | ピー |
| α | 有意水準 | アルファ |
| β | 回帰係数、 第二種誤り率 | ベータ |
| r | 相関係数 | アール |
| R² | 決定係数 | アール二乗 |
| Σ | 総和記号、 共分散行列 | シグマ大文字 |
| N(μ, σ²) | 正規分布 | ノーマル ミュー シグマ二乗 |
| t(df) | t分布 | ティー |
| χ²(df) | カイ二乗分布 | カイ二乗 |
| F(d1, d2) | F分布 | エフ |
| H₀, H₁ | 帰無仮説、 対立仮説 | エイチゼロ、 エイチワン |
| E[X] | 期待値 | エクスペクタンス |
| Var(X) | 分散 | バリアンス |
| Cov(X, Y) | 共分散 | カバリアンス |
🎯 包括的視点 — この用語をマスターするために
学習ロードマップ
- 定義と数式を確実に押さえる
- SSDSE データで自分で計算してみる
- Python で実装してみる(手書き → ライブラリ)
- 結果を可視化する
- 仮定の確認・診断プロットを描く
- 論文・実務での応用例を読む
- 限界と注意点を理解する
- 関連手法との違いを説明できる
SSDSE-B-2026 で挑戦できる課題
- 47都道府県データで実装
- 東日本 vs 西日本のグループ比較
- 都市規模別の傾向
- 家計支出パターンの解析
- 地域別の経済指標の関連性
関連用語・概念リスト
| 前提 | 関連 | 発展 |
|---|---|---|
| 平均、 分散、 標準偏差 | 類似手法、 派生手法 | 機械学習での応用 |
| 確率分布 | 統計的検定 | ベイズ統計 |
| 数値計算 | 可視化技術 | 深層学習 |
典型的な解釈ミス
- 統計的有意性と実質的意義の混同
- 相関と因果の混同
- サンプルサイズの過小評価
- 外れ値の機械的除去
- 仮定確認の省略
- 多重比較問題の無視
論文・レポート執筆のポイント
- 方法:使用した手法を厳密に記述
- 仮定:満たされていることの確認
- 結果:点推定 + 不確実性(CI、 SE)
- 効果量:実質的な大きさを示す
- 限界:分析の制約を明示
- 再現性:データとコードを公開
📖 包括的解説 — この概念を完全マスター
📍 学習の3ステップ
- 定義を理解する:この概念は何か? 数式や条件を確認
- 具体例を見る:実データ(SSDSE 等)で計算してみる
- 応用する:自分のデータに適用、 結果を解釈
🔧 Python実装パターン
1 2 3 4 5 6 7 8 9 10 11 12 13 14 15 16 17 18 19 20 | # 基本パターン import pandas as pd import numpy as np from scipy import stats import matplotlib.pyplot as plt import seaborn as sns # データ読み込み # 日本語の項目名(食料費など)を使うので header=1 で 2 行目を見出しにする df = pd.read_csv('data/raw/SSDSE-B-2026.csv', encoding='cp932', header=1) df = df[df['年度'] == df['年度'].max()] # 最新年度の 47 行 # 基本統計量 df.describe() # 可視化 # SSDSE-B の実際の列名は「(二人以上の世帯)」まで含む sns.pairplot(df[['食料費(二人以上の世帯)', '教育費(二人以上の世帯)', '住居費(二人以上の世帯)']]) plt.show() |
📚 統計概念マップでの位置
🎯 SSDSE-B-2026 で挑戦
- 地域別の特徴抽出
- 家計支出パターンの解析
- 人口動態と社会経済指標の関連
- 気候要因の影響評価
💡 よく使うコマンド集
| 機能 | Python (pandas) | Python (scipy) |
|---|---|---|
| 要約統計 | df.describe() | stats.describe() |
| 平均 | df.mean() | np.mean() |
| 標準偏差 | df.std() | np.std() |
| 相関 | df.corr() | stats.pearsonr() |
| t検定 | — | stats.ttest_ind() |
| 回帰 | — | stats.linregress() |
| 分布フィッティング | — | stats.norm.fit() |
🚧 一般的な落とし穴と対策
- 外れ値の影響:散布図・ 箱ひげ図で確認、 ロバスト手法も検討
- サンプルサイズ不足:power analysis で事前に確認
- 仮定の違反:正規性、 独立性、 等分散性をチェック
- 多重比較問題:補正(Bonferroni、 FDR)を適用
- p-hacking:事前登録(pre-registration)で防ぐ
- 因果と相関の混同:観察データから因果結論を出さない
📊 結果報告の標準フォーマット
- 点推定:得られた値
- 不確実性:信頼区間または標準誤差
- サンプルサイズ:n を明記
- 効果量:実質的な意義
- p値:統計的有意性
- 仮定の確認:診断プロット
🌐 関連分野での応用
- マーケティング:A/Bテスト、 顧客分析
- 医療:臨床試験、 疫学研究
- 金融:リスク管理、 ポートフォリオ
- 製造:品質管理、 工程最適化
- 公共政策:効果評価、 計画立案
- 研究:仮説検証、 探索的解析
🎓 さらに学ぶための文献
- Wasserman "All of Statistics"
- Hastie, Tibshirani & Friedman "The Elements of Statistical Learning"
- Gelman & Hill "Data Analysis Using Regression"
- VanderPlas "Python Data Science Handbook"
🔗 統計用語ネットワーク
主要な関連概念のグループ
| グループ | 主要概念 |
|---|---|
| 記述統計 | 平均、 中央値、 最頻値、 分散、 標準偏差、 共分散、 相関係数 |
| 可視化 | ヒストグラム、 散布図、 箱ひげ図、 ヒートマップ |
| 推測統計 | 標本平均、 標準誤差、 信頼区間、 p値、 有意水準 |
| 確率分布 | 正規分布、 t分布、 χ²分布、 F分布、 二項分布 |
| 仮説検定 | t検定、 F検定、 χ²検定、 ノンパラ検定 |
| 回帰 | 単回帰、 重回帰、 OLS、 Ridge、 LASSO |
| 分類 | ロジスティック回帰、 決定木、 SVM、 k-NN |
| 教師なし学習 | クラスタリング、 PCA、 因子分析 |
| 時系列 | ARIMA、 VAR、 指数平滑法、 自己相関 |
| 因果推論 | DiD、 IV、 傾向スコア、 交絡変数 |
| 前処理 | 標準化、 正規化、 欠損値処理、 多重共線性対策 |
| 評価 | R²、 残差、 CV、 RMSE、 効果量 |
学習順序の推奨
- 記述統計(平均、 分散、 標準偏差)
- 可視化(ヒストグラム、 散布図)
- 確率分布(正規分布)
- 推測統計(標準誤差、 信頼区間、 p値)
- 仮説検定(t検定、 χ²検定)
- 相関と回帰(単回帰、 重回帰)
- 多変量解析(PCA、 クラスタリング)
- 機械学習(決定木、 RF、 NN)
- 時系列・因果推論(応用)
📝 実践練習 — SSDSE-B-2026 で挑戦
初級課題
- 東北6県の家計食料費の基本統計量を計算
- 食料費のヒストグラムを描く
- 食料費と教育費の散布図を描く
- 都道府県を「東日本/西日本」に分け、 平均を比較
中級課題
- 家計支出 5項目で相関行列を作成、 ヒートマップ可視化
- 食料費 → 教育費の単回帰を実行、 残差分析
- 家計5項目で PCA を実施、 バイプロット表示
- k-means (k=3) で都道府県をクラスタリング、 解釈
上級課題
- 地域別の家計パターンに有意差があるか ANOVA で検定
- 重回帰で教育費を予測、 多重共線性を VIF で確認
- Ridge/LASSO で正則化、 CV で α を最適化
- 階層クラスタリングと Ward 法で都道府県を分類、 デンドログラム作成
ヒートマップは可視化の中でも特に「2 軸 + 値」を一画面で見せるための主役級ツールです。 散布図・棒グラフ・地図と並ぶ可視化の基本セットの一員として、 「いつヒートマップが最善か」をグループで学ぶと判断が早くなります。
このページから飛べる主要グループ教材
- クラスタリング・グループ教材 — クラスタマップ(並べ替え付きヒートマップ)はクラスタリング結果の可視化として頻出。
- 時系列グループ教材 — 「時間 × 個体」のヒートマップ(カレンダー風)は時系列パネルの定番可視化。
- 自然言語処理 グループ教材 — Attention 行列のヒートマップで Transformer の挙動を読む。
SSDSE-B-2026 におけるヒートマップ学習の流れ(推奨)
- 相関係数を全列で計算し、 相関ヒートマップを描く。
- 階層クラスタリングで行・列を並べ替えてクラスタマップ化。
- カラースケールと 視覚属性で発散・連続・カテゴリの使い分け。
- 地理可視化に進み、 ヒートマップと地図の組み合わせを学ぶ。
- 誤読を生む可視化でヒートマップの色覚配慮・誤読パターンを総ざらい。
到達目標
- 「ヒートマップで描くべきか、 散布図行列で描くべきか」を 2 軸の性質で判断できる。
- SSDSE-B-2026 の 47 × 多変量のヒートマップで、 並べ替え前後の読みやすさ差を体感できる。
- 色覚多様性に配慮したカラーマップ(viridis ・ cividis 等)を標準採用できる。
🖼 概念図で押さえる ヒートマップ
ヒートマップは「2 次元の数値テーブルを色で可視化」する基本図表。 ここでは 3 つの概念図で、 相関ヒートマップ・行列ヒートマップ・パネル化との関係を視覚的に整理する。
📌 図から読み取るポイント (3 行要約)
- 図 1: 色で 2 次元数値を俯瞰。 相関行列の可視化が代表用途、 mask で対称部分を省略すると見やすい。
- 図 2: annot で数値併記。 正負のある相関は RdBu_r + center=0、 符号の無い量は cividis/viridis。
- 図 3: ヒートマップは俯瞰・散布図は個別確認。 PairGrid で組み合わせると非線形関係も発見できる。
🔗 隣接手法への橋渡し
「ヒートマップ」は単独で完結する手法ではなく、 隣接領域と連携することで真価を発揮する。
- 上流: 入力データの前処理・整備 — 相関行列 ・ 行列データ
- 並列: 類似目的を持つ代替手法 — コロプレス図 ・ 等高線プロット
- 下流: 出力結果の評価・解釈 — 階層クラスタリング + デンドログラム ・ seaborn.heatmap
上流の相関行列・混同行列・分割表で 2 次元データを準備し、 並列のクラスタマップ (seaborn clustermap)・地理ヒートマップと表現を比較し、 下流の主成分分析・階層クラスタリングで構造を抽出する。 ヒートマップは「色で大量の数値を一望」する典型可視化で、 必ず凡例・色覚バリアフリー配色 (viridis) と組み合わせる。
🌳 手法選択フロー
「heatmap」を含む手法選択は、 データの性質・分析目的・運用制約の 3 軸で決まる。 以下に典型シナリオと対応する手法の組合せを示す。
典型シナリオ別の手法選択
| シナリオ | 重視する観点 | 候補手法 |
|---|---|---|
| データが大規模 (n が多い、 高次元) | 計算コスト / メモリ / 並列化が必要 | 47都道府県×7変量の相関行列を色付け 等 |
| 外れ値が多い / ノイズあり | 頑健性 / 外れ値除去 / 中央値ベース | 都道府県データはサンプルサイズ 47 が固定 等 |
| 解釈性を重視する | 線形 / 木構造 / ルールベース | スケールの違い 等 |
| 予測精度を最優先する | アンサンブル / ハイパラ調整 / 交差検証 | 東京・大阪等の影響点 等 |
選んだ後の検証ステップ
- 前処理確認: 標準化 / 欠損処理 / カテゴリ変数のエンコード が適切か
- ハイパラ調整: 交差検証で安定する値を選ぶ
- 性能評価: タスクに応じた指標 (RMSE / Accuracy / F1 / AUC / シルエット等) を複数併用
- 頑健性チェック: 別手法 / 別シードで結果が大きく違わないか確認
- 解釈: 結果を分野知識と照らし合わせ、 意味のある発見になっているか検討
🎮 触って理解する — ヒートマップ設計シミュレータ
同じ行列でも、 カラースケール・正規化・並べ替えの設計で「見えるもの」が激変します。 下の図は SSDSE-B-2026(2023年度・47都道府県)の実測値から計算した 6 指標(高齢化率 = 65歳以上人口÷総人口、 合計特殊出生率、 年平均気温、 住宅地地価、 食料費、 教育費)のヒートマップです。 ボタンで設計を切り替え、 セルをタップ/クリックすると実際の値が表示されます。
⚖️ 正規化(県×指標のみ): 🔀 並べ替え:
🧪 この順で試すと設計の効果が分かる
- 相関行列 × 発散型 → 連続型に切替:発散型では「白 = r 0、 赤 = 正、 青 = 負」と正負が一瞬で読めるが、 連続型(Viridis 風)に切り替えると r = 0 が中途半端な色になり、 正負の境界が消える。 相関には発散型が適する理由を体感。
- 県×指標 × 正規化なし:全体 min-max では住宅地地価(最小 13,200 円/m²・秋田 〜 最大 404,400 円/m²・東京)だけが色を独占し、 高齢化率(22.75〜39.06%)や出生率(0.99〜1.60)の差は完全に潰れる。 スケール未統一の失敗例そのもの。
- 列ごと z-score に切替:各指標が平均 0・SD 1 に揃い、 突然すべての列に模様が現れる。 東京(地価 +5σ 級)や沖縄(気温 +3σ 級)の個性が浮かぶ。
- クラスタ順に並べ替え:似た県(都市型 / 過疎・高齢型など)が隣接し、 ブロック状のパターンが浮かぶ。 相関行列でも変数のグループ(地価・食料費・教育費 vs 高齢化率)が対角ブロックにまとまる。
👁️ 直感 — ヒートマップは「行列を色で俯瞰する」道具
47×6 = 282 個の数値を表で読むのは苦痛ですが、 色に変換すれば1 秒で全体の構造(どの行・列が高いか、 ブロック構造があるか)を把握できます。 ただし色は「正確な値の読み取り」には不向きなので、 俯瞰 = ヒートマップ、 精読 = annot(数値併記)や表と役割分担するのが定石です。
🚧 よくある落とし穴(このシミュレータで再現できる)
- スケール未統一:単位もレンジも違う列を生の値のまま並べると、 最大レンジの列(ここでは地価)だけの図になる。 → 列ごとの標準化(標準化)が事実上必須。
- カラーマップの誤選択:正負のある量(相関・差分・z-score)に連続型を使うと 0 の位置が読めない。 逆に単調な量(度数・密度)に発散型を使うと存在しない「中心」を暗示してしまう。 rainbow / jet は色覚多様性・知覚均等性の両面で非推奨(カラースケール・誤読を生む可視化)。
- 正規化の向きの間違い:行ごと z-score は「その県の中でどの指標が突出するか」、 列ごと z-score は「その指標の中でどの県が突出するか」と問いが変わる。 上のトグルで同じデータの見え方が入れ替わるのを確認。
- 並び順の放置:五十音・コード順のままでは構造が見えない。 値順・クラスタ順に並べ替えて初めてパターンが浮かぶ(並べ替えは情報を追加しない、 見えるようにするだけ)。
🚀 発展 — クラスタリング併用とカラーユニバーサルデザイン
- クラスタマップ:上の「クラスタ順」は平均連結法の階層クラスタリング(相関行列は距離 1−r、 県×指標は z-score 後のユークリッド距離)で並べ替えている。 seaborn.clustermap はこれにデンドログラムを付けたもの(階層クラスタリング・クラスタリング)。
- カラーユニバーサルデザイン(CUD):Viridis / cividis は色覚多様性に配慮しつつ知覚的に均等。 発散型では RdBu 系が比較的安全とされるが、 赤緑系(RdYlGn)は避ける。 印刷(グレースケール化)でも大小が保たれるかの確認も重要。
- 相関の先へ:ヒートマップで見えるのは線形相関のみ(相関係数)。 気になったセルは散布図(散布図)で非線形・外れ値を必ず確認する。