🔖 キーワード索引
「複合グラフ・2軸グラフ」を取り巻く中核キーワード群です。 検索やインデックス作成で参照する際の手がかりにしてください。 各キーワードは関連する概念・手法・道具立てを含み、 文献検索や学習計画の起点になります。
💡 30秒で分かる結論 — 複合グラフ・2軸グラフ
🍰 まずはやさしく
2種類のグラフを重ねた図です。
単位が違うデータを比べるために使います。
売上と成長率を一緒に見たい時に便利です。
このグラフの特徴と注意点を学びます。
最も忙しい読者のために、 まず結論だけまとめます。 詳細は以下のセクションへ:
- 複合グラフ・2軸グラフ=異なる種類のグラフ(棒+折れ線など)を 1 枚に重ねた図。
- 用途:単位の違う 2 系列を比較(売上額+成長率、 人口+出生率)。
- 強み:1 枚で多次元情報。 弱み:誤読されやすい、 副軸の目盛り次第で印象操作可能。
- 代替案:小さな多重チャート(small multiples)、 散布図、 比率系列に変換。
- 実装:Matplotlib の
twinx()、 Excel の「2 軸グラフ」、 plotly のsecondary_y。
📍 文脈 — どこで出会うか
🍰 まずはやさしく
お店の分析などでよく使われる図です。
2つのデータの関係をひと目で伝えるためです。
客数と客単価を同時にグラフにします。
この図がどこで使われ、何に注意するか読みます。
「店舗別 売上(棒)と 客単価(折れ線)を同じグラフで」 — マーケ資料で頻出。 ただし副軸のスケールを変えると「客単価が伸びている!」と 意図的に印象操作 もできるので、 読み手も作り手も注意が必要。
このページの読み方:まず 30秒結論 と 直感 を読み、 必要に応じて 数式 や 計算例、 落とし穴 に進んでください。
🎨 直感で掴む
🍰 まずはやさしく
左右に2つの目盛りがあるグラフです。
量と比率のような違う情報を並べるためです。
人口の数と出生率を重ねて考えます。
正しい作り方と、やってはいけない書き方を学びます。
1 つのグラフに 2 つの目盛り(左右)を入れることで、 絶対値と比率 のような異質な情報を並べられます。
- 左軸:売上(円) — 棒
- 右軸:成長率(%) — 折れ線
「売上は伸びている」「でも成長率は鈍化」のような 2 つのストーリーを 1 枚で 語れる。 反面、 左右の軸の取り方で印象が大きく変わるため、 倫理的配慮が必要。
🎨 概念図で押さえる
複合グラフ・2軸グラフ は「異なる単位の指標」を 1 枚に重ねる可視化。 ここでは「2軸グラフの正しい構造」「棒+折れ線の重ね方」「やってはいけない 2 軸スケール詐術」を視覚化する。
</text><line x1="80" y1="60" x2="80" y2="220" stroke="%231976D2" stroke-width="2"/><line x1="80" y1="220" x2="540" y2="220" stroke="%23333" stroke-width="2"/><line x1="540" y1="60" x2="540" y2="220" stroke="%23E65100" stroke-width="2"/><text x="40" y="65" font-size="11" fill="%231976D2" font-family="Hiragino Sans, Yu Gothic, Noto Sans CJK JP, Meiryo, sans-serif">人口 (万人)</text><text x="40" y="145" font-size="11" fill="%231976D2" font-family="Hiragino Sans, Yu Gothic, Noto Sans CJK JP, Meiryo, sans-serif">500</text><text x="40" y="225" font-size="11" fill="%231976D2" font-family="Hiragino Sans, Yu Gothic, Noto Sans CJK JP, Meiryo, sans-serif">0</text><text x="555" y="65" font-size="11" fill="%23E65100" font-family="Hiragino Sans, Yu Gothic, Noto Sans CJK JP, Meiryo, sans-serif">出生率</text><text x="555" y="145" font-size="11" fill="%23E65100" font-family="Hiragino Sans, Yu Gothic, Noto Sans CJK JP, Meiryo, sans-serif">7</text><text x="555" y="225" font-size="11" fill="%23E65100" font-family="Hiragino Sans, Yu Gothic, Noto Sans CJK JP, Meiryo, sans-serif">5</text><rect x="110" y="120" width="40" height="100" fill="%23BBDEFB" stroke="%231976D2"/><rect x="180" y="80" width="40" height="140" fill="%23BBDEFB" stroke="%231976D2"/><rect x="250" y="150" width="40" height="70" fill="%23BBDEFB" stroke="%231976D2"/><rect x="320" y="130" width="40" height="90" fill="%23BBDEFB" stroke="%231976D2"/><rect x="390" y="100" width="40" height="120" fill="%23BBDEFB" stroke="%231976D2"/><rect x="460" y="170" width="40" height="50" fill="%23BBDEFB" stroke="%231976D2"/><polyline points="130,150 200,170 270,110 340,90 410,130 480,100" stroke="%23E65100" stroke-width="3" fill="none"/><circle cx="130" cy="150" r="5" fill="%23E65100"/><circle cx="200" cy="170" r="5" fill="%23E65100"/><circle cx="270" cy="110" r="5" fill="%23E65100"/><circle cx="340" cy="90" r="5" fill="%23E65100"/><circle cx="410" cy="130" r="5" fill="%23E65100"/><circle cx="480" cy="100" r="5" fill="%23E65100"/><text x="125" y="240" font-size="11" fill="%23333" font-family="Hiragino Sans, Yu Gothic, Noto Sans CJK JP, Meiryo, sans-serif">北海道</text><text x="195" y="240" font-size="11" fill="%23333" font-family="Hiragino Sans, Yu Gothic, Noto Sans CJK JP, Meiryo, sans-serif">東京</text><text x="265" y="240" font-size="11" fill="%23333" font-family="Hiragino Sans, Yu Gothic, Noto Sans CJK JP, Meiryo, sans-serif">沖縄</text><text x="335" y="240" font-size="11" fill="%23333" font-family="Hiragino Sans, Yu Gothic, Noto Sans CJK JP, Meiryo, sans-serif">大阪</text><text x="405" y="240" font-size="11" fill="%23333" font-family="Hiragino Sans, Yu Gothic, Noto Sans CJK JP, Meiryo, sans-serif">愛知</text><text x="475" y="240" font-size="11" fill="%23333" font-family="Hiragino Sans, Yu Gothic, Noto Sans CJK JP, Meiryo, sans-serif">島根</text><rect x="120" y="255" width="14" height="10" fill="%23BBDEFB" stroke="%231976D2"/><text x="140" y="265" font-size="11" fill="%23333" font-family="Hiragino Sans, Yu Gothic, Noto Sans CJK JP, Meiryo, sans-serif">人口 (棒・左軸)</text><line x1="270" y1="261" x2="290" y2="261" stroke="%23E65100" stroke-width="3"/><circle cx="280" cy="261" r="4" fill="%23E65100"/><text x="295" y="265" font-size="11" fill="%23333" font-family="Hiragino Sans, Yu Gothic, Noto Sans CJK JP, Meiryo, sans-serif">出生率 (折れ線・右軸)</text></svg>)


📝 理解度チェック(練習問題)
複合グラフの核を本当に掴めたかを 6 問で確認する。 すべて 1 分以内で答えられる粒度。 「自分で」答えを口に出して言える状態を目指したい。
Q1. 複合グラフが必要になる典型シーン 3 つ
Q2. 2 軸グラフ最大の詐術とは
Q3. 棒グラフと折れ線グラフを重ねるときの色選び
Q4. 積み上げ棒と並列棒、 どう使い分けるか
Q5. SSDSE-B-2026 で「人口(棒)+ 高齢化率(折れ線)」を 47 県で描くときの注意
Q6. ヒートマップ + 帯グラフ複合の典型用途
これらの問題に詰まった項目があれば、 「複合グラフの 3 パターン」「2 軸の詐術」セクションへ戻ろう。 複合グラフは強力だが、 軸操作で印象を捏造できる「諸刃の剣」でもある。 必ず「正直なスケール」を心がけたい。
📐 数式または定義
🍰 まずはやさしく
2つのデータを同じ場所に描く仕組みです。
それぞれの目盛りを調整して高さを決めるためです。
スマホの画面に合うよう数値を変換します。
目盛りの範囲を変えると見え方が変わる理由を読みます。
複合グラフ・2軸グラフに固有の「数式」は、 2 つの系列を同じ描画領域に写像するためのスケール変換である。 左軸の系列と右軸の系列は、 それぞれ独立な線形変換で描画位置 (高さ) に変換される。
$$h(v) = \frac{v - v_{\min}}{v_{\max} - v_{\min}} \times H$$
ここで $v$ は系列の値、 $[v_{\min},\ v_{\max}]$ はその軸の表示範囲、 $H$ は描画領域の高さ。 左軸と右軸で $[v_{\min},\ v_{\max}]$ を別々に選べる — これが 2 軸グラフの表現力の源泉であり、 同時に「範囲の恣意的な選択で 2 系列の見かけの関係を操作できる」という最大の弱点でもある。 具体的な値での計算例は実値で計算してみるを参照。
🔬 記号・要素の読み解き
- 主軸 (Primary axis)
- 通常左側。 主たる注目情報を配置。
- 副軸 (Secondary axis)
- 右側。 異なる単位・スケールの情報。
- 棒+折れ線
- 定番。 棒で量、 折れ線で変化率や比率。
- Small Multiples
- 複合の代替案。 同じ図を並べて比較。 Tufte 推奨。
- 視覚的バランス
- 軸スケール、 色の濃淡、 凡例配置で誤読を防ぐ。
🔬 2 軸グラフの構成を言葉で読み解く
2 軸グラフは「左軸 = 量 (絶対値)」「右軸 = 率 (比率・割合)」の役割分担が定石。 SSDSE-B-2026 なら、 左軸に A1101 (総人口) の棒、 右軸に A4103 (合計特殊出生率) の折れ線を対応させる。 読むときは次の 3 点を必ず確認する:
- どの系列がどちらの軸か — 凡例と軸ラベル・色の対応を見る
- 各軸の表示範囲は 0 起点か — 特に右軸が狭い範囲に切られていないか
- 右軸の範囲に根拠があるか — caption や注記で説明されているか
⚖️ 複合グラフの組合せパターン比較
| パターン | 構成 | 向いている用途 | SSDSE-B-2026 での例 |
|---|---|---|---|
| 棒 + 折れ線 (2 軸) | 左軸に量、 右軸に率 | 単位の異なる 2 系列の同時表示 | 総人口 (A1101) × 合計特殊出生率 (A4103) |
| 積み上げ棒 | 1 本の棒を内訳で分割 | 合計と内訳の同時表示 | 年齢 3 区分人口の構成 |
| 折れ線 + 面 | 累積を面、 推移を線 | 時系列の累積比較 | 年度別人口の推移と累積差 |
| Small Multiples | 同型の小グラフを並置 | 2 軸の代替。 誤読リスクが低い | 人口と出生率を上下 2 パネルに分割 |
※ 積み上げ棒の詳細は積み上げ棒グラフ、 誤読リスクの体系は誤解を招くグラフを参照。
この章の要点
2 軸グラフを見たら、必ず次の 3 手順を踏んでください。 本章の家計データの例では、この手順で「見た目は無関係、実は −0.668」という発見にたどり着きました。
| 手順 | やること | 家計データでの結果 |
|---|---|---|
| 1 | 水準の相関を計算する | −0.121。ここで止めると「関係なし」と誤判断する |
| 2 | 前年差の相関を計算する | −0.668。エンゲルの法則が現れる |
| 3 | 別の切り口(断面)でも確かめる | 2023 年 47 県で −0.562。時間・地域の両方で成立 |
3 手順すべてで符号が一致したときだけ、「関係がある」と書いてよい—— これくらい慎重でちょうどよいと考えてください。 2 軸グラフはこの 3 手順の入口にすぎず、それ自体は何も証明しません。
🧮 実値で計算してみる
都道府県の人口(棒・左軸)と TFR(折れ線・右軸)を 2 軸グラフで表示する設計:
- 人口の単位:万人。 左軸 0〜1500
- TFR の単位:人。 右軸 0.8〜2.0
- 棒色:薄いグレー、 折れ線色:濃い赤(注目させたいほうを目立たせる)
- 軸ラベルに 単位を明示し、 凡例で色対応を示す
- 副軸のスケールを 恣意的に設定しない(誤読防止)
🧮 数式に値を入れて手で計算する: 右軸レンジと「見かけの高さ」
右軸 (合計特殊出生率 A4103) に値 1.21 (SSDSE-B-2026 の 2023 年度における福島県・奈良県の実測値) を描くとき、 表示範囲の取り方で描画位置がどれだけ変わるかを、 スケール変換 $h(v) = (v - v_{\min}) / (v_{\max} - v_{\min})$ で計算する。 なお 0.99 は 2023 年度の全国最小値 (東京都)、 最大値は 1.60 (沖縄県)。
Step 1: 自然な範囲 0.8〜2.0 の場合
Step 2: 恣意的に狭めた範囲 0.99〜1.21 の場合
🐍 Python で再現
1 2 3 4 5 6 7 | def h(v, vmin, vmax): """軸範囲 [vmin, vmax] に対する値 v の相対的な描画位置 (0〜1)""" return (v - vmin) / (vmax - vmin) v = 1.21 # 例: 合計特殊出生率 (A4103)。2023 年度の福島県・奈良県の実測値 print(f"自然な範囲 0.8〜2.0 : {h(v, 0.8, 2.0):.2f}") print(f"狭めた範囲 0.99〜1.21: {h(v, 0.99, 1.21):.2f}") |
📤 実行結果
💬 手計算 (Step 1・Step 2) と Python 出力が一致。 同じ 1.21 という値が、 右軸の範囲次第で「下から 1/3」にも「最上端」にもなる — これが 2 軸グラフ最大の落とし穴 (スケール操作) の正体である。
実データ演習 — 消費支出(棒)とエンゲル係数(線)
2 軸グラフの典型例をもう 1 つ、SSDSE-B-2026 の家計データで作ります。 棒に消費支出(二人以上の世帯、月額・円)、線にエンゲル係数(食料費 ÷ 消費支出 × 100、%)。 円と % なので単位が違い、桁も 29 万 vs 27 と 4 桁違うので、まさに 2 軸の出番に見えます。 値はいずれも 47 都道府県の平均です。
| 年度 | 消費支出(円/月) | 食料費(円/月) | エンゲル係数(%) |
|---|---|---|---|
| 2012 | 286,665 | 66,705 | 23.3 |
| 2014 | 290,114 | 69,073 | 23.8 |
| 2016 | 287,056 | 72,227 | 25.2 |
| 2018 | 288,163 | 73,443 | 25.5 |
| 2020 | 279,688 | 75,585 | 27.0 |
| 2022 | 289,630 | 76,598 | 26.4 |
| 2023 | 295,856 | 80,598 | 27.2 |
2 軸グラフにすると、棒はほぼ横ばい(28.7 万〜29.6 万)なのに、線だけが 23.3 → 27.2 と右上がりになります。 ここから読み手が受け取る物語は「支出は変わらないのに食費の比率が上がった=生活が苦しくなった」でしょう。 実際、食料費は 66,705 → 80,598 円と +20.8% 増えており、 同じ期間に消費支出全体は +3.2% しか増えていません。 この読み取り自体は正しいのですが、それは 2 軸グラフのおかげではなく、 食料費という 3 本目の系列を別途確認したからです。
水準の相関が弱く、差分の相関が強い例
消費支出とエンゲル係数の相関を 2 通りで計算すると、興味深い結果になります。
| 計算のしかた | 相関係数 | 意味 |
|---|---|---|
| 水準(12 年の値そのもの) | −0.121 | ほとんど無相関。図では線が右上がり、棒が横ばいなので当然 |
| 前年差(変化量どうし) | −0.668 | 支出が増えた年はエンゲル係数が下がる、という明確な関係 |
| 2023 年・47 都道府県の断面 | −0.562 | 支出の多い県ほどエンゲル係数が低い(地域差としても成立) |
💬 ここが重要です。 水準では見えなかった関係が、差分では −0.668 とはっきり現れました。 エンゲルの法則(所得が増えると食費の比率は下がる)が、年ごとの変動として実際に確認できたわけです。 2 軸グラフを眺めているだけでは、この関係には絶対にたどり着けません。 棒が横ばいで線が右上がりなら、多くの人は「関係なし」か「逆相関」と判断してしまうからです。
しかも 2023 年の 47 都道府県断面でも −0.562。 エンゲル係数は愛媛県 31.82% が最高、岐阜県 23.89% が最低で、 8 ポイント近い地域差があります。 時間方向でも地域方向でも同じ符号の関係が確認できる—— これで初めて「支出とエンゲル係数には実質的な関係がある」と言えます。 2 軸グラフはこの結論を示す図ではなく、結論を探すきっかけにすぎません。
なお前ページの複合グラフの例(出生数と婚姻件数)では逆に、 水準で +0.972 と強かった相関が差分で −0.169 に消えました。 水準と差分のどちらが強いかは、データによって逆転します。 「差分をとれば真実が出る」わけでもなく、 両方を計算して食い違いを検討するプロセスそのものが必要だ、というのが教訓です。
🎮 触って理解する
2 軸グラフの怖さは「同じデータでも右軸の目盛りの取り方だけで、 2 系列が連動して見えたり無関係に見えたりする」こと。 下のグラフは SSDSE-B-2026 の 2023 年度・実測値で、 左軸に総人口 (A1101) の棒、 右軸に合計特殊出生率 (A4103) の折れ線を重ねた複合グラフ。 右軸の最小値・最大値スライダーを動かして、 折れ線の「見かけの激しさ」がどう変わるか体感しよう。 データは一切変わっていないのに、 印象だけが激変する。
💡 グラフ上を上下にドラッグ(スマホはスワイプ)しても右軸の最大値を絞れます。 「同一スケールに揃える」で両系列を 0〜1 に正規化し、 本当の関係を確認。
この体感からの学び
- 広い右軸 (0〜2.0):出生率 0.99〜1.29 が広い範囲の中に埋もれ、 折れ線はほぼ横ばい → 「人口と出生率は無関係に見える」。
- 狭い右軸 (0.95〜1.30):わずか 0.3 の差が画面いっぱいに拡大され、 折れ線が激しく上下 → 「人口が減ると出生率が跳ね上がる、 強い逆相関に見える」。
- 同一スケールに揃えると、 両系列を 0〜1 に正規化した本当の姿が見える。 この 8 都市では相関係数 r ≒ −0.82 (人口が多い都市ほど出生率が低い、 47 都道府県全体でも r ≒ −0.56)。 これが「真の関係」で、 右軸を絞って作った「激しさ」は演出にすぎない。
2 軸グラフの正当な使いどころ vs 誤用
| 正当な使いどころ | 誤用 (相関の演出) | |
|---|---|---|
| 目的 | 単位が根本的に異なる 2 系列を 1 枚で見せる (人口[人] と 出生率[無次元]) | 2 系列が連動していると印象づける |
| 軸範囲 | 各軸を 0 起点または自然な範囲にし、 根拠を caption に明記 | 右軸を恣意的に狭めて折れ線の変動を誇張 |
| 主張 | 「2 つの指標の推移をそれぞれ示す」にとどめる | 「両者は連動 → 因果がある」と飛躍する |
| 代替 | 比率化・指数化して同一軸へ、 スモールマルチプルで並置 | — |
単位が同じ (どちらも「率」など) なら、 わざわざ 2 軸にせず同一軸で並べるのが誠実。 2 軸が本当に必要なのは「万人」と「無次元の率」のように単位が違って同じ軸に載せられないときだけ。 迷ったら基準化 (最初の年=100 の指数など) して 1 軸にまとめるか、 折れ線グラフを上下 2 段に分けるスモールマルチプルを検討しよう。 相関を主張したいなら 2 軸グラフではなく誤解を招くグラフで扱う散布図・回帰が本筋。
🐍 Python での扱い
最小再現コード。 SSDSE-B のような実データを前提に、 4〜8 行で動く例です:
1 2 3 4 5 6 7 8 9 | import pandas as pd, matplotlib.pyplot as plt df = pd.read_csv('data/raw/SSDSE-B-2026.csv', encoding='cp932', skiprows=[1]) d = df[df['SSDSE-B-2026'] == 2023].sort_values('A1101', ascending=False).head(10) fig, ax1 = plt.subplots(figsize=(10,5)) ax1.bar(d['Prefecture'], d['A1101'] / 1e4, color='lightgray', label='総人口') ax2 = ax1.twinx() ax2.plot(d['Prefecture'], d['A4103'], 'r-o', label='合計特殊出生率') ax1.set_ylabel('総人口 (万人)'); ax2.set_ylabel('合計特殊出生率') plt.savefig('complex_graph.png') |
補足:ライブラリのバージョンや前処理状態によって出力は変わります。 自分の環境で動かすときは pip list でバージョンを確認し、 入力 CSV のパス・列名を実態に合わせてください。
🐍 Python 完全コード(4 要素ナレーション付き)
コード:SSDSE-B-2026 で「総人口 (棒・左軸) × 合計特殊出生率 (折れ線・右軸)」
🎯 このコードでやること:2023 年度の人口上位 10 都道府県について、 左軸に総人口の棒、 右軸に合計特殊出生率の折れ線を重ねた 2 軸グラフを描く。 両軸とも 0 起点にして錯覚を防ぐ。
📥 入力データ:SSDSE-B-2026 (2012〜2023 年度 × 47 都道府県 = 564 行)。 使用列は SSDSE-B-2026 (先頭列 = 年度)・Prefecture・A1101 (総人口)・A4103 (合計特殊出生率)。
1 2 3 4 5 6 7 8 9 10 11 12 13 14 15 16 17 18 19 20 21 22 23 | import pandas as pd import matplotlib.pyplot as plt df = pd.read_csv('data/raw/SSDSE-B-2026.csv', encoding='cp932', skiprows=[1]) d = df[df['SSDSE-B-2026'] == 2023].sort_values('A1101', ascending=False).head(10) fig, ax1 = plt.subplots(figsize=(10, 5)) ax1.bar(d['Prefecture'], d['A1101'] / 1e4, color='#B0BEC5', label='総人口 (万人)') ax1.set_ylabel('総人口 (万人)') ax1.set_ylim(0, None) # 棒はゼロ起点が原則 ax2 = ax1.twinx() ax2.plot(d['Prefecture'], d['A4103'], color='#D32F2F', marker='o', label='合計特殊出生率') ax2.set_ylabel('合計特殊出生率') ax2.set_ylim(0, 2.0) # 右軸も 0 起点で誇張を防ぐ h1, l1 = ax1.get_legend_handles_labels() h2, l2 = ax2.get_legend_handles_labels() ax1.legend(h1 + h2, l1 + l2, loc='upper right') plt.title('人口上位 10 都道府県: 総人口と合計特殊出生率 (2023 年度)') plt.tight_layout() plt.savefig('complex_graph.png', dpi=100) |
📤 実行結果:
💬 結果の読み方:人口の多い大都市圏ほど出生率が低めに見える傾向が読み取れる (2023 年度・47 都道府県全体で総人口と合計特殊出生率の相関係数は r ≒ −0.56、 最小は東京都 0.99・最大は沖縄県 1.60)。 ただしこれは「相関」であって「因果」ではない点に注意 (よくある落とし穴参照)。 右軸を 0〜2.0 に固定したので折れ線の変動は控えめに見える — これが「正直なスケール」。 右軸を狭い範囲に切ると、 同じデータでも劇的な変動に見えてしまう。
実装メモ — 主要ライブラリでの 2 軸グラフ
| 環境 | 書き方 | 注意点 |
|---|---|---|
| Matplotlib | ax2 = ax1.twinx() | 凡例は両軸分を手動で結合する |
| Plotly | make_subplots(specs=[[{"secondary_y": True}]]) | secondary_y=True でトレースを右軸へ |
| Excel | 系列を右クリック →「第 2 軸」 | 既定の軸範囲が恣意的になりがち。 必ず手動確認 |
| pandas | df.plot(secondary_y='列名') | 簡便だが軸ラベル・凡例の調整は別途必要 |
2 軸グラフの「見た目」を数値で裏取りする
このコードでやること:消費支出とエンゲル係数について、 年ごとの変化量(前年差)を並べ、水準の相関と差分の相関を比べます。 2 軸グラフを見て「関係がなさそう」と判断する前に必ずやるべき確認です。
📥 入力データ(SSDSE-B-2026、47 都道府県 × 12 年の家計項目):
1 2 3 4 5 6 7 8 9 10 11 12 13 14 15 16 17 18 19 20 21 | # 2 軸グラフでは見えない関係を、差分で確かめる import pandas as pd df = pd.read_csv("data/raw/SSDSE-B-2026.csv", encoding="cp932", header=1) df = df[df["地域コード"].astype(str).str.match(r"^R\d{5}$", na=False)].copy() C, F = "消費支出(二人以上の世帯)", "食料費(二人以上の世帯)" for c in [C, F]: df[c] = pd.to_numeric(df[c], errors="coerce") df["年度"] = pd.to_numeric(df["年度"], errors="coerce") nat = df.groupby("年度")[[C, F]].mean() # 47 都道府県の平均 nat["エンゲル係数"] = nat[F] / nat[C] * 100 diff = nat.diff().dropna() # 前年差をとる print("年ごとの変化(2 軸グラフでは読み取れない部分)") for y, r in diff.iterrows(): print(f" {int(y)}: Δ消費支出 {r[C]:+8.0f} 円 Δエンゲル係数 {r['エンゲル係数']:+6.2f} pt") print() print(f"水準の相関 : {nat[C].corr(nat['エンゲル係数']):+.3f}") print(f"差分の相関 : {diff[C].corr(diff['エンゲル係数']):+.3f} ← こちらが本当の関係") |
📤 実行結果:
💬 読み方:表を上から追うと、符号の対応がはっきり見えます。 消費支出が大きく減った 2015 年(−3,961 円)と 2020 年(−8,837 円)は、 エンゲル係数が大きく上がっています(+1.05 pt、+1.48 pt)。 逆に支出が大きく増えた 2021・2022 年は、エンゲル係数が下がりました(−0.35、−0.22 pt)。 これがエンゲルの法則そのものです。
2 軸グラフでは、棒(消費支出)の 8,837 円の凹みは 29 万円のスケールでは 3% 程度の変化にすぎず、 ほとんど目に見えません。線のほうも右上がりのトレンドに埋もれます。 図では見えない関係が、差分をとった瞬間に −0.668 として現れる—— これが「2 軸グラフは仮説を立てる道具であって、検証する道具ではない」ということの実例です。
ちなみに 2023 年だけは、支出が +6,226 円と増えたのにエンゲル係数も +0.80 pt 上がっており、 法則から外れています。食料費が 76,598 → 80,598 円と 5.2% 上がった影響で、 支出の増加分以上に食費が伸びたためです。 相関 −0.668 は「全体の傾向」であって、すべての年に当てはまるわけではありません。 外れた年を見つけて理由を考えるところに、本当の分析があります。
🐍 実データ検証 ① 軸の範囲だけで「線が交わる回数」は 0 回にも 3 回にもなる
上の実データ演習の消費支出とエンゲル係数を、今度は両方とも折れ線にして 2 軸グラフに描きます。2 本の線が交わる点は、2 軸グラフでいちばん「意味ありげ」に見える場所です(「2015 年にエンゲル係数が消費支出を追い抜いた」のように読まれがちです)。しかし左右の軸は単位も目盛りも別々に決められるので、交点の位置と数は、データではなく軸の範囲で決まります。4 通りの軸の範囲で、描かれた 2 本の線が何回交わるかを数えます。
🎯 このコードでやること:47 都道府県平均の消費支出(L3221、万円/月)とエンゲル係数(食料費 L322101 ÷ 消費支出 × 100)を 2012〜2023 年度で作り、4 通りの軸の範囲について、各年の点が軸の下端から何割の高さに描かれるかを計算し、2 本の線の上下が入れ替わる(交わる)年を数える。
1 2 3 4 5 6 7 8 9 10 11 12 13 14 15 16 17 18 19 20 21 22 23 24 | import numpy as np import pandas as pd df = pd.read_csv('data/raw/SSDSE-B-2026.csv', encoding='cp932', skiprows=[1]) nat = df.groupby('SSDSE-B-2026')[['L3221', 'L322101']].mean() # 47 都道府県の平均 spend = nat['L3221'].values / 1e4 # 万円/月 eng = (nat['L322101'] / nat['L3221'] * 100).values # % yrs = nat.index.values def pad(v): # matplotlib の自動範囲(最小〜最大に 5% の余白) r = v.max() - v.min() return (v.min() - 0.05 * r, v.max() + 0.05 * r) settings = {'(a) 両軸 0 起点': ((0, 32), (0, 40)), '(b) 自動': (pad(spend), pad(eng)), '(c) 左 27〜30・右 20〜30': ((27, 30), (20, 30)), '(d) 左 27.5〜30・右 23〜28': ((27.5, 30), (23, 28))} for name, (al, bl) in settings.items(): ha = (spend - al[0]) / (al[1] - al[0]) # 左軸の線の描画上の高さ(0〜1) hb = (eng - bl[0]) / (bl[1] - bl[0]) # 右軸の線の描画上の高さ(0〜1) s = np.sign(ha - hb) cross = [f'{yrs[i]}→{yrs[i + 1]}' for i in np.where(np.diff(s) != 0)[0]] print(f'{name:22s} 交差 {len(cross)} 回 {cross}') print(f'データの相関(軸の範囲に依存しない): {np.corrcoef(spend, eng)[0, 1]:+.3f}') |
💬 描かれた 2 本の線の交差は、(a) 両軸 0 起点で 0 回、(b) 自動範囲で 1 回(2015→2016 年度)、(c) で 2 回、(d) で 3 回と、軸の範囲を変えるだけで 0〜3 回まで変わりました。交わる年も 2015→2016・2019→2020・2021→2022 などばらばらです。一方、2 系列の相関は軸の設定と無関係に −0.121 で一定です。2 軸グラフの交点や「追い抜き」は、単位の違う 2 つの量を同じ高さに並べたことで生まれる図の上だけの現象で、データの性質ではありません。交点について何かを言いたくなったら、まず軸の範囲を変えても同じ交点が残るかを確かめます。
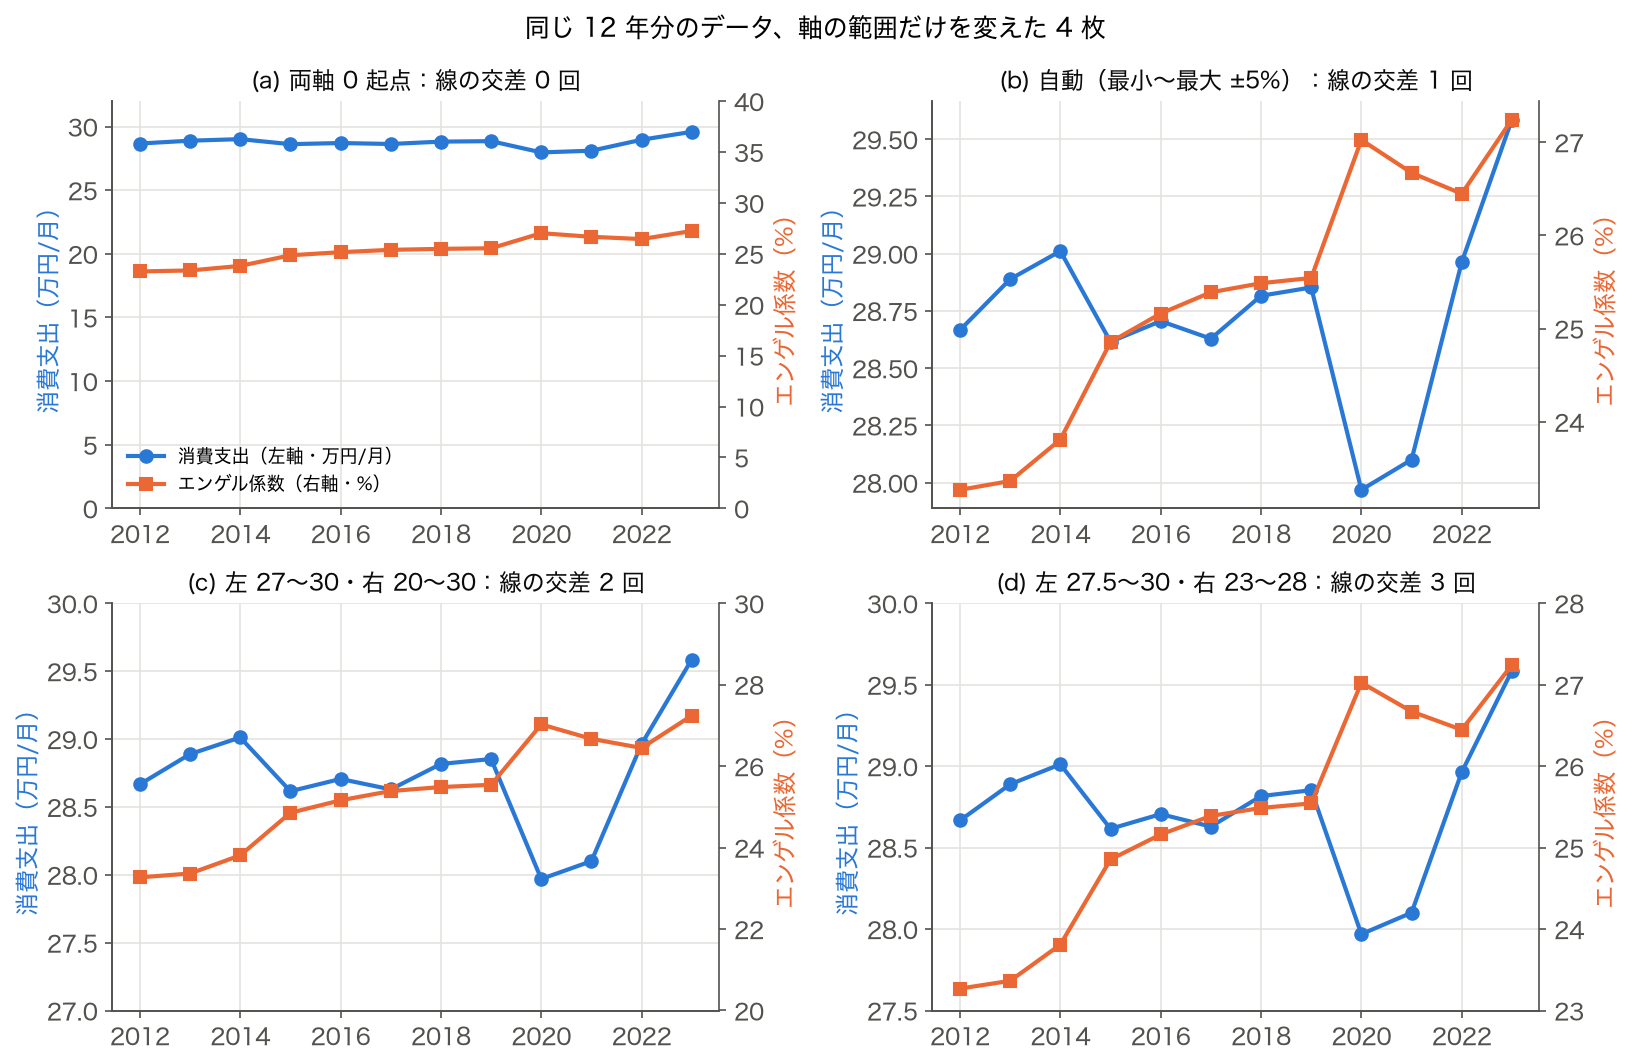
図の読み方: (a) は両軸とも 0 から描いたもので、消費支出(青)はほぼ水平、エンゲル係数(橙)は 23% から 27% へゆっくり上がる 2 本の線が離れたまま並びます。(b) は何も指定しないときの matplotlib の自動範囲で、同じデータなのに 2020 年度の消費支出の落ち込みが画面の底まで届き、2 本の線が 2015→2016 年度で交わって「ここで入れ替わった」ように見えます。(c) と (d) は範囲を少し変えただけで、交わる回数が 2 回・3 回と増え、交わる年もずれます。どの図も数値は 1 つも変えていません。図の作成スクリプトは code/glossary_figs/complex-graph.py。
🐍 実データ検証 ② 棒を 0 から始めないと、変化は何倍に見えるか(Lie factor)
複合グラフの棒の側は、線の側と違って「高さ=量」として読まれます。そのため棒の軸を 0 以外から始めると、変化の大きさそのものが誇張されます。Tufte は「図の上での変化の大きさ ÷ データの変化の大きさ」を Lie factor(嘘の倍率)と呼び、1 から離れるほど誤解を招く図だとしました。2020 年度から 2023 年度への消費支出(47 都道府県平均)の増加を例に、棒の下端をどこに置くかで Lie factor がいくらになるかを計算します。
🎯 このコードでやること:消費支出(47 都道府県平均)の 2020 年度と 2023 年度について、棒の下端を 0・25 万円・27.5 万円・27.9 万円にしたときの見かけの伸び(棒の高さの比 − 1)と、データの伸び、その比(Lie factor)を計算する。
1 2 3 4 5 | a, b = nat.loc[2020, 'L3221'], nat.loc[2023, 'L3221'] print(f'2020 年度 {a:,.0f} 円 → 2023 年度 {b:,.0f} 円(データの伸び {b / a - 1:+.2%})') for base in [0, 250000, 275000, 279000]: visual = (b - base) / (a - base) - 1 # 棒の高さの伸び print(f'棒の下端 {base:>7,} 円: 見かけの伸び {visual:+8.1%} Lie factor = {visual / (b / a - 1):5.1f}') |
💬 2020→2023 年度の消費支出の伸びは +5.78% です。棒を 0 から描けば見かけの伸びも +5.8% で Lie factor は 1.0 ですが、下端を 25 万円にすると見かけは +54.5%(9.4 倍の誇張)、27.5 万円なら +344.9%(59.7 倍)、2020 年度の値のすぐ下の 27.9 万円なら +2,351%(406.7 倍)になります。棒の下端をデータの最小値に近づけるほど、誇張は際限なく大きくなります。折れ線は「形(上下の動き)」を読む図なので 0 を含まない範囲も許されますが、棒は「長さ」を読む図なので、複合グラフでも棒の軸は 0 から始めます。0 から始めると変化が見えないときは、その変化は棒で見せる量ではないので、前年差の棒や指数の折れ線に切り替えます。
🐍 実データ検証 ③ 2 軸をやめて指数にする ── 「何 % 動いたか」を 1 本の軸で比べる
このページ後半の「🌱 発展」で東京都の総人口と出生率を指数化しました。同じ方法を消費支出とエンゲル係数にも使うと、軸の範囲を恣意的に選ぶ余地がなくなります。さらにエンゲル係数の分子である食料費も同じ軸に載せ、エンゲル係数の上昇が「食費が増えたから」なのか「支出全体が減ったから」なのかを分けて読みます。
🎯 このコードでやること:消費支出・食料費・エンゲル係数(47 都道府県平均)を 2012 年度 = 100 の指数にし、2015・2020・2023 年度の値を出す。エンゲル係数の指数が「食料費の指数 ÷ 消費支出の指数 × 100」に一致することも確かめる。
1 2 3 4 5 6 7 8 | t = nat.copy() t['エンゲル係数'] = t['L322101'] / t['L3221'] * 100 idx = t / t.loc[2012] * 100 idx.columns = ['消費支出', '食料費', 'エンゲル係数'] print(idx.loc[[2012, 2015, 2020, 2023]].round(1).to_string()) chk = idx['食料費'] / idx['消費支出'] * 100 print(f'2023 年度: 食料費 {idx.loc[2023, "食料費"]:.1f} ÷ 消費支出 {idx.loc[2023, "消費支出"]:.1f} × 100 = {chk[2023]:.1f}' f'(エンゲル係数の指数 {idx.loc[2023, "エンゲル係数"]:.1f})') |
💬 2012 年度を 100 とすると、2023 年度は消費支出 103.2・食料費 120.8・エンゲル係数 117.1 です。エンゲル係数の指数は「食料費の指数 ÷ 消費支出の指数 × 100」= 120.8 ÷ 103.2 × 100 = 117.1 とぴったり一致し、エンゲル係数の上昇を食料費と消費支出の 2 つの動きに分けて読めます。2015 年度は消費支出 99.8・食料費 106.6、2020 年度は消費支出 97.6・食料費 113.3 で、2020 年度のエンゲル係数 116.1 の跳ね上がりには、食費の増加に加えて支出全体の落ち込みが効いています。単位の違う量を比べたいときは、軸を 2 本にする前に「同じ基準年で割って単位をそろえられないか」を考えます。
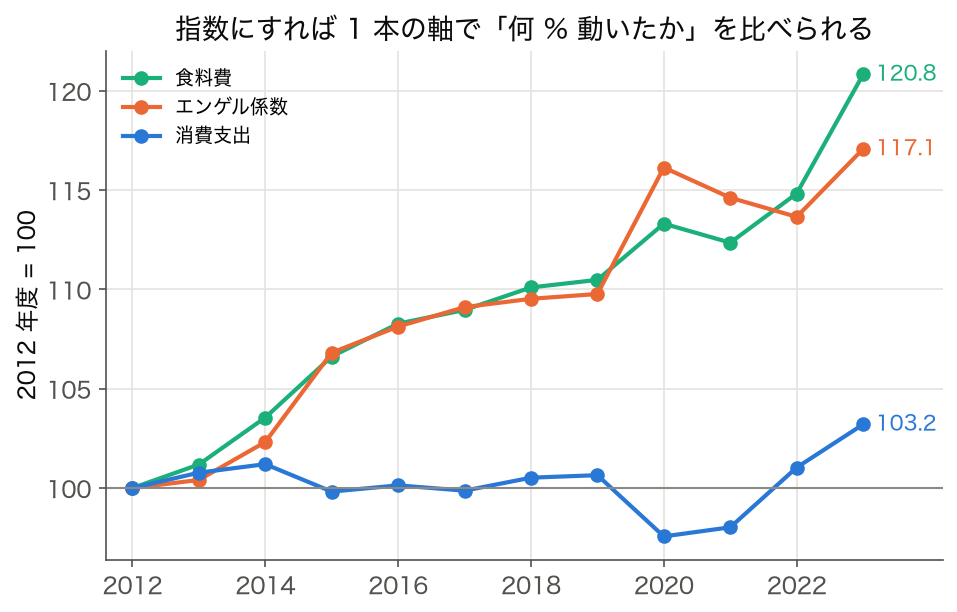
図の読み方: 1 本の軸に載せると、12 年で食料費が 20.8% 増えたのに対し消費支出は 3.2% しか増えておらず、エンゲル係数の 17.1% の上昇はほとんど食料費の伸びで説明できることが分かります。2020 年度だけは消費支出が 97.6 に下がり、食料費の伸び(113.3)以上にエンゲル係数が 116.1 まで跳ねています。「支出全体が減った年」と「食費が増えた年」が同じ上昇に見える 2 軸グラフ(①の図)と違い、指数の図では 2 つの原因を線の組み合わせで見分けられます。指数化の弱点は水準(29 万円・27% という大きさ)が消えることで、水準は表か注記で添えます。
🐍 実データ検証 ④ 「2 つの量の関係」を言いたいなら散布図にする
上の完全コードは、人口上位 10 都道府県の総人口(棒)と合計特殊出生率(折れ線)を 2 軸で描きました。「人口の多い県ほど出生率が低い」という関係を主張したいなら、10 県を人口順に並べた 2 軸グラフより、47 県すべてを使った散布図のほうが正確に伝わります。2 軸グラフでは、横軸の並べ方(人口順か、県コード順か)で折れ線の形が変わってしまうからです。
🎯 このコードでやること:2023 年度の 47 都道府県で、総人口と合計特殊出生率の相関(そのまま・人口の対数・東京都を除く)を計算する。あわせて、2 軸グラフの横軸を「人口順」「県コード順」にしたとき、折れ線が上下に向きを変える回数と、横位置と出生率の順位相関を数える。
1 2 3 4 5 6 7 8 9 10 11 | d = df[df['SSDSE-B-2026'] == 2023] print(f'r(総人口, 出生率) = {d["A1101"].corr(d["A4103"]):+.3f}') print(f'r(log10 総人口, 出生率) = {np.log10(d["A1101"]).corr(d["A4103"]):+.3f}') nt = d[d['Prefecture'] != '東京都'] print(f'東京都を除く 46 県の r = {nt["A1101"].corr(nt["A4103"]):+.3f}') for key, asc in [('A1101', False), ('Code', True)]: s = d.sort_values(key, ascending=asc)['A4103'].values turn = np.sign(np.diff(s)); turn = turn[turn != 0] rho = pd.Series(s).corr(pd.Series(np.arange(47)), method='spearman') print(f'横軸を {key:5s} 順: 折れ線の向きが変わる回数 {int((np.diff(turn) != 0).sum())}' f' 横位置と出生率の順位相関 {rho:+.3f}') |
💬 総人口と合計特殊出生率の相関は 47 県で −0.564、人口を対数にすると −0.588 で、東京都を除いても −0.480 と負の関係が残ります。一方、2 軸グラフの形は横軸の並べ方しだいです。人口の多い順に並べると折れ線は 27 回向きを変え(上がる・下がるが頻繁に入れ替わり)、横位置と出生率の順位相関は +0.574 で右上がりに見えます。ところが県コード順(北から南)に並べても順位相関は +0.759 で、むしろ強い右上がりになります。出生率は西南の県ほど高いので、並べ方しだいで「人口の少ない県ほど」とも「南の県ほど」とも読めてしまうわけです。カテゴリを横に並べた 2 軸グラフの折れ線は、並べ方という分析者の選択を映しているにすぎず、2 つの量の関係を主張する図には向きません。
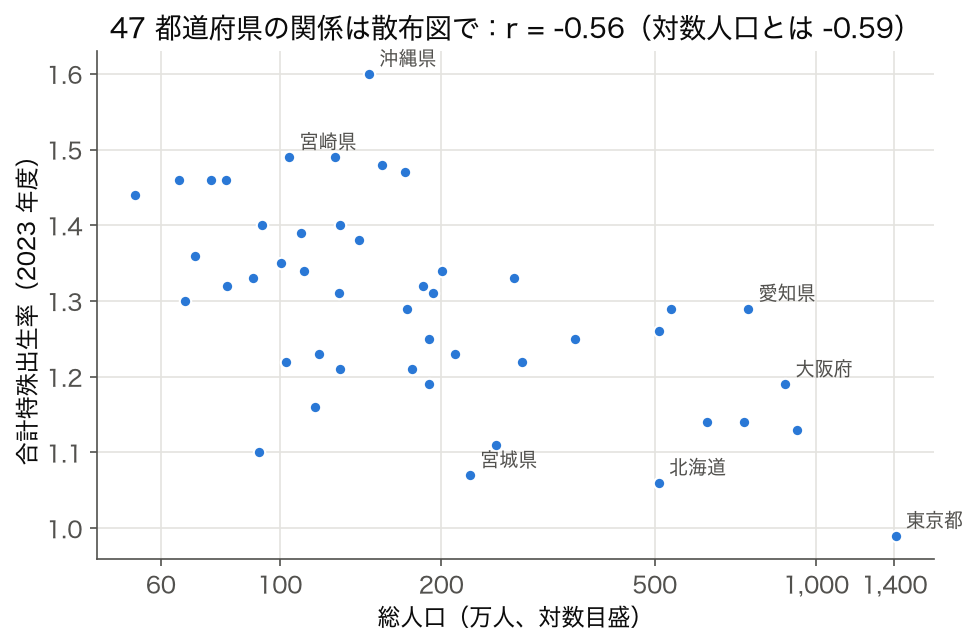
図の読み方: 横軸を対数にすると、人口 50 万〜1,400 万人の 47 県が横に均等に広がり、右に行くほど出生率が下がる傾向(r = −0.56)が 1 枚で見えます。同時に、人口 150 万人前後の沖縄県(1.60)と、人口 100 万人未満でも 1.10 の県が並んでいるように、人口だけでは説明できないばらつきが大きいことも分かります。人口順に並べた 10 県の 2 軸グラフでは、このばらつきも、人口の小さい 37 県の情報も見えません。
🐍 実データ検証 ⑤ それでも 2 軸を使うなら ── 左右の軸の「比率」をそろえる規則
① で見たように、左右の軸の範囲を自由に選べることが 2 軸グラフの弱点でした。どうしても 2 軸で描く場合(水準の数字を両方とも目盛りで読ませたい場合など)に使える規則が、「基準年の値を同じ高さに置き、左右とも基準年の値の ±k % を範囲にする」ことです。こうすると、どちらの線も「高さ 1 目盛り = 基準年から同じ % の変化」になり、交点や傾きの比較に意味が生まれます。実質的には ③ の指数のグラフに、元の単位の目盛りを付け直したものです。
🎯 このコードでやること:消費支出とエンゲル係数それぞれについて、2012 年度の値を中心に ±25% を軸の範囲にしたときの各年の描画上の高さを計算し、③ の指数(2012 = 100)から計算した高さと一致すること、交差の回数を確かめる。
1 2 3 4 5 6 7 8 9 10 11 12 13 14 15 | spend = nat['L3221'].values / 1e4 eng = (nat['L322101'] / nat['L3221'] * 100).values yrs = nat.index.values k = 0.25 al = (spend[0] * (1 - k), spend[0] * (1 + k)) # 左軸: 2012 年度の ±25% bl = (eng[0] * (1 - k), eng[0] * (1 + k)) # 右軸: 2012 年度の ±25% ha = (spend - al[0]) / (al[1] - al[0]) hb = (eng - bl[0]) / (bl[1] - bl[0]) print(f'左軸 {al[0]:.2f}〜{al[1]:.2f} 万円 右軸 {bl[0]:.2f}〜{bl[1]:.2f} %') h_idx = (spend / spend[0] * 100 - 75) / 50 # 指数 75〜125 を 0〜1 に print('左の線の高さと指数から求めた高さの最大差:', float(np.abs(ha - h_idx).max()).__round__(12)) s = np.sign(ha - hb)[1:] # 2012 年度は両方とも中央(同じ高さ)なので除く y1 = yrs[1:] print('2013 年度以降の交差:', [f'{y1[i]}→{y1[i + 1]}' for i in np.where(np.diff(s) != 0)[0]] or 'なし') print('2023 年度の高さ: 消費支出', round(ha[-1], 3), ' エンゲル係数', round(hb[-1], 3)) |
💬 左軸を 21.50〜35.83 万円、右軸を 17.45〜29.09% にすると、どちらも 2012 年度の値がちょうど真ん中に来て、1 目盛りが「2012 年度から同じ % の変化」を表します。左の線の高さは指数から求めた高さと差 0.0 で完全に一致し、この 2 軸グラフは ③ の指数のグラフに元の単位の目盛りを付けたものだと確かめられます。この規則の下では交差は 2013→2014 年度の 1 回だけで、それ以降はエンゲル係数の線が上にあり続けます。これは「2014 年度以降、エンゲル係数の伸び率が消費支出の伸び率を上回り続けた」という、データに裏付けられた読み方ができる交点です。2023 年度の高さは消費支出 0.564・エンゲル係数 0.841 で、差の 0.277 は 2 つの伸び率の差(103.2 と 117.1 → 13.9 ポイント ÷ 目盛り幅 50)に対応します。規則を使ったときは、図の注記に「左右とも 2012 年度 ±25%」と書き添えます。
🐍 実データ検証 ⑥ 内訳の変化を見せたいなら 100% 積み上げ棒 ── エンゲル係数の裏側
エンゲル係数は「消費支出のうち食料費が占める割合」なので、本当は 10 項目の内訳(食料・住居・光熱水道・家具家事用品・被服履物・保健医療・交通通信・教育・教養娯楽・その他)の 1 つにすぎません。消費支出の棒にエンゲル係数の線を重ねる 2 軸グラフでは、食料費の割合が増えたとき「どの項目が割合を減らしたのか」が見えません。内訳の変化を伝えるなら、各年度の 10 項目の構成比を 100% 積み上げ棒にするのが自然な複合表現です。その元になる構成比を計算します。
🎯 このコードでやること:10 項目(L322101〜L322110)の 47 都道府県平均を消費支出 L3221 で割って構成比(%)にし、2012 年度と 2023 年度を並べて差(ポイント)を出す。10 項目の合計が消費支出と一致するかも確かめる。
1 2 3 4 5 6 7 8 9 | names = {'L322101': '食料', 'L322102': '住居', 'L322103': '光熱・水道', 'L322104': '家具・家事用品', 'L322105': '被服及び履物', 'L322106': '保健医療', 'L322107': '交通・通信', 'L322108': '教育', 'L322109': '教養娯楽', 'L322110': 'その他'} m = df.groupby('SSDSE-B-2026')[['L3221'] + list(names)].mean() print('10 項目の合計と消費支出の差の最大:', round(float((m[list(names)].sum(axis=1) - m['L3221']).abs().max()), 2), '円') share = m[list(names)].div(m['L3221'], axis=0) * 100 tab = share.loc[[2012, 2023]].T.rename(index=names).round(2) tab['差'] = (tab[2023] - tab[2012]).round(2) print(tab.sort_values('差').to_string()) |
💬 10 項目の合計と消費支出の差は最大 0.28 円で、内訳の合計が消費支出に一致する(47 県平均の丸めの誤差だけ)ことが確かめられます。2012→2023 年度で構成比を最も増やしたのは食料(+3.97 ポイント)、次いで交通・通信(+1.08)で、最も減らしたのは「その他の消費支出」(−3.98)、被服及び履物(−0.87)、教育(−0.71)でした。エンゲル係数の +3.97 ポイントは、ほぼそのまま「その他」の −3.98 ポイントと入れ替わっています。消費支出の棒とエンゲル係数の線の 2 軸グラフでは、このような「何が何と入れ替わったか」は読み取れません。構成の変化が主題なら 100% 積み上げ棒(または差の棒グラフ)、合計と 1 つの比率の同時表示が主題なら 2 軸、と目的で表現を選びます。
🐍 実データ検証 ⑦ 桁の違う 2 系列 ── 2 軸ではなく対数の 1 軸にする
2 軸グラフが使われるもう 1 つの典型は、単位は同じでも桁が違う 2 系列(全体と、その一部)を並べたいときです。全国の延べ宿泊者数と、そのうちの外国人延べ宿泊者数は、同じ「万人泊」ですが 5 倍から 70 倍以上の開きがあります。普通の 1 軸では小さいほうが底に張り付き、2 軸にすると今度は「どちらも同じくらい動いた」ように見えます。対数の 1 軸なら、縦の同じ距離が同じ倍率を表すので、単位を保ったまま変化の大きさを正しく比べられます。
🎯 このコードでやること:延べ宿泊者数 G7101 と外国人延べ宿泊者数 G7102 の全国合計(47 都道府県の合計、万人泊)を年度ごとに作り、外国人の割合と、2019→2021 年度・2019→2023 年度の変化率、対数(log10)での差を出す。
1 2 3 4 5 6 7 8 | t = df.groupby('SSDSE-B-2026')[['G7101', 'G7102']].sum() / 1e4 # 万人泊 t['外国人の割合%'] = t['G7102'] / t['G7101'] * 100 print(t.loc[[2012, 2019, 2020, 2021, 2023]].round(1).to_string()) for a, b in [(2019, 2021), (2019, 2023)]: r = t.loc[b, ['G7101', 'G7102']] / t.loc[a, ['G7101', 'G7102']] print(f'{a}→{b}: 延べ {r["G7101"] - 1:+.1%}(log10 差 {np.log10(r["G7101"]):+.2f})' f' 外国人 {r["G7102"] - 1:+.1%}(log10 差 {np.log10(r["G7102"]):+.2f})') print(f'延べ ÷ 外国人 の倍率: 最小 {(t["G7101"] / t["G7102"]).min():.1f} 倍 最大 {(t["G7101"] / t["G7102"]).max():.1f} 倍') |
💬 延べ宿泊者数は 2019 年度 50,098 万人泊から 2021 年度 25,888 万人泊へ −48.3%、外国人延べ宿泊者数は 10,131 万人泊から 344 万人泊へ −96.6% で、外国人の割合は 20.2% から 1.3% まで下がりました。対数(log10)の差は延べ −0.29、外国人 −1.47 で、対数の軸では外国人の落ち込みが約 5 倍の深さに描かれます。2023 年度には延べ −0.2%・外国人 −6.2%(2019 年度比)とほぼ元の水準に戻っています。2 つの系列の開きは 4.9 倍から 75.3 倍まで年度で大きく変わるので、どこかの年に合わせて 2 軸の範囲を決めると、別の年の見え方が歪みます。倍率で比べたい系列は、2 軸にせず対数の 1 軸に載せます。
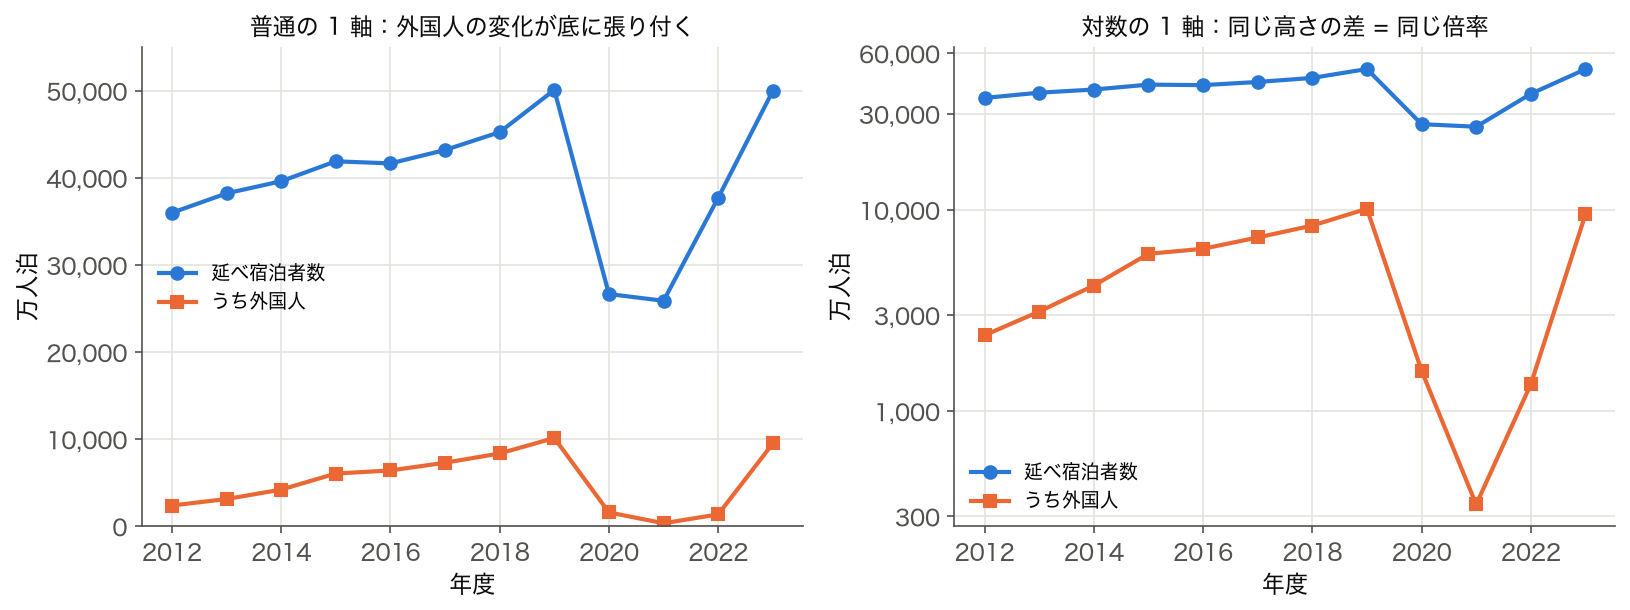
図の読み方: 左の普通の 1 軸では、延べ宿泊者数(青)の 2020〜2021 年度の落ち込みは大きく見えますが、外国人(橙)は 0〜1 万の底を這っていて、どれだけ落ちたかが読めません。右の対数の 1 軸では、外国人の線が 10,131 万人泊(2019 年度)から 344 万人泊(2021 年度)まで約 30 分の 1 に落ちた深い谷が、延べ宿泊者数の約半減(青の浅い谷)と比べられる形で現れます。2 軸にして左右を別々に伸縮すれば、2 つの谷を同じ深さにも描けてしまいますが、対数の 1 軸なら「縦の距離 = 倍率」という 1 つの規則で両方が描かれます。対数軸の弱点は、0 や負の値を描けないこと、差(何万人泊減ったか)が読みにくいことで、増減の絶対量を伝えたいときは普通の軸に戻します。
🐍 実データ検証 ⑧ 無関係な 2 系列でも、2 軸にすると「連動」して見える
上の実データ演習は「水準の相関が弱く、差分の相関が強い」例でした。逆向きの落とし穴もあります。どちらも年々増えている(または減っている)2 系列を 2 軸に描くと、自動の軸範囲は両方の最小〜最大を画面いっぱいに広げるので、2 本の線は画面の下から上へ並んで伸び、連動しているように見えます。全国の死亡数と大学学生数は、どちらも 2012 年度から 2023 年度にかけて増えていますが、互いに原因と結果の関係はありません。2 軸に描いたときの線の近さと、水準・差分の相関を計算します。
🎯 このコードでやること:全国の死亡数 A4200 と大学学生数 E6302(47 都道府県の合計)を 2012〜2023 年度で作り、matplotlib の自動範囲(最小〜最大 ±5%)の 2 軸に描いたときの 2 本の線の高さの差(平均)を計算する。あわせて、水準の相関と前年差の相関を出す。
1 2 3 4 5 6 7 8 9 10 11 12 13 | t = df.groupby('SSDSE-B-2026')[['A4200', 'E6302']].sum() print(t.loc[[2012, 2015, 2019, 2023]].to_string()) def h(v): # 自動範囲での描画上の高さ(0〜1) lo, hi = v.min() - 0.05 * (v.max() - v.min()), v.max() + 0.05 * (v.max() - v.min()) return (v - lo) / (hi - lo) gap = np.abs(h(t['A4200']) - h(t['E6302'])) print(f'2 軸(自動範囲)での線の高さの差: 平均 {gap.mean():.3f} 最大 {gap.max():.3f}(図の高さ = 1)') print(f'水準の相関 r = {t["A4200"].corr(t["E6302"]):+.3f}') d = t.diff().dropna() print(f'前年差の相関 r = {d["A4200"].corr(d["E6302"]):+.3f}') print('前年差(死亡数, 大学学生数):', list(zip(d['A4200'].astype(int), d['E6302'].astype(int)))[:6], '...') |
💬 全国の死亡数は 125.5 万人から 157.5 万人へ、大学学生数は 256.1 万人から 263.3 万人へと、どちらも 2012→2023 年度で増えています。自動範囲の 2 軸に描くと、2 本の線の高さの差は平均 0.143(図の高さの 14%)で、どちらも左下から右上へ伸びるため、「大学生が増えると死亡数も増える」ような連動に見えます。水準の相関も +0.890 と高く出ます。ところが前年差どうしの相関は +0.022 で、ある年に死亡数が大きく増えたからといって大学学生数も大きく増えるわけではありません(2014 年度は死亡数 +4,717 人に対し大学学生数 −10,046 人)。水準の相関の高さは「どちらも長期的に増えた」という共通の傾向から来ていて、2 系列のあいだの関係ではありません。2 軸グラフで 2 本の線が連動して見えたら、上の実データ演習と同じく差分の相関で確かめます。
🐍 実データ検証 ⑨ 47 本の棒に折れ線を重ねると何が読めなくなるか(練習問題 Q5 の数値版)
練習問題 Q5 は「人口(棒)+ 高齢化率(折れ線)を 47 県で描くときの注意」でした。その注意がどれくらい効くのかを数字で確かめます。棒の軸を 0 から東京都までにとると、人口の小さい県の棒はどのくらいの高さになるか。人口順に並べた折れ線の形は、人口と高齢化率の関係をどこまで表しているか。
🎯 このコードでやること:2023 年度の 47 都道府県で、総人口の棒を 0〜東京都の人口の軸に描いたときの各県の棒の高さ(図の高さ = 1)を計算し、高さ 0.1 未満の県の数と最も低い県を出す。高齢化率(A1303 ÷ A1101)と総人口の相関(そのまま・対数)、人口順に並べた折れ線が向きを変える回数も数える。
1 2 3 4 5 6 7 8 9 10 11 | d = df[df['SSDSE-B-2026'] == 2023].sort_values('A1101', ascending=False).copy() d['棒の高さ'] = d['A1101'] / d['A1101'].max() d['高齢化率'] = d['A1303'] / d['A1101'] * 100 low = d[d['棒の高さ'] < 0.1] print(f'棒の高さが 0.1 未満の県: {len(low)} / 47(最も低い {d.iloc[-1]["Prefecture"]} {d.iloc[-1]["棒の高さ"]:.3f})') print(f'東京都 ÷ {d.iloc[-1]["Prefecture"]} = {d["A1101"].max() / d["A1101"].min():.1f} 倍') print(f'r(総人口, 高齢化率) = {d["A1101"].corr(d["高齢化率"]):+.3f}') print(f'r(log10 総人口, 高齢化率) = {np.log10(d["A1101"]).corr(d["高齢化率"]):+.3f}') s = np.sign(np.diff(d['高齢化率'].values)); s = s[s != 0] print(f'人口順の折れ線が向きを変える回数: {int((np.diff(s) != 0).sum())}') print(d[['Prefecture', '棒の高さ', '高齢化率']].iloc[[0, 1, 2, -3, -2, -1]].round(3).to_string(index=False)) |
💬 棒の軸を 0〜東京都(1,409 万人)にとると、47 県のうち 22 県の棒は図の高さの 1 割に届かず、最も低い鳥取県は 0.038 です。図の高さが 300 ピクセルなら鳥取県の棒は約 11 ピクセルで、隣の島根県(0.046)・高知県(0.047)との差は 1〜3 ピクセルしかなく、棒で人口を比べられるのは上位の 20 県ほどに限られます。一方、高齢化率と総人口の相関は −0.710(対数で −0.718)と、人口と出生率(−0.564)よりはっきりした負の関係がありますが、人口順に並べた折れ線は 23 回も上下に向きを変えるため、2 軸グラフからこの傾向を読み取るのは難しくなります。東京都 22.8%・神奈川県 25.9% から高知県 36.3%・鳥取県 33.3% へという傾向を伝えるなら、④ と同じく対数の人口を横軸にした散布図が向いています。47 県の棒を見せたいときは、人口と高齢化率を別のパネルに分けて縦に並べる(小倍数図)か、地方ごとに分けます。
🐍 実データ検証 ⑩ 右軸を上下反転すると、負の関係が「ともに増える」に化ける
2 軸グラフには、右軸の目盛りを上下逆さま(上ほど小さい値)にできるという、もう 1 つの自由があります。減っている系列の軸を反転すると、その線は右上がりに描かれ、増えている系列と並んで「同じ方向に動いている」ように見えます。全国の 65 歳以上人口(増加)と小学校児童数(減少)で、反転しない場合とした場合の描画上の高さを比べます。
🎯 このコードでやること:全国の 65 歳以上人口 A1303 と小学校児童数 E2501(47 都道府県の合計)を 2012〜2023 年度で作り、自動範囲の 2 軸で、右軸をそのまま描いた場合と上下反転した場合の、2 本の線の高さの相関と、2012→2023 年度に線が上がったか下がったかを出す。
1 2 3 4 5 6 7 8 9 10 11 12 13 14 15 16 | t = df.groupby('SSDSE-B-2026')[['A1303', 'E2501']].sum() print(f'65 歳以上人口 {t["A1303"].iloc[0]:,} → {t["A1303"].iloc[-1]:,}') print(f'小学校児童数 {t["E2501"].iloc[0]:,} → {t["E2501"].iloc[-1]:,}') def h(v, invert=False): lo, hi = v.min() - 0.05 * (v.max() - v.min()), v.max() + 0.05 * (v.max() - v.min()) x = (v - lo) / (hi - lo) return 1 - x if invert else x ha = h(t['A1303']) for inv in [False, True]: hb = h(t['E2501'], invert=inv) move = '上がる' if hb.iloc[-1] > hb.iloc[0] else '下がる' print(f'右軸の反転 {str(inv):5s}: 高さの相関 {np.corrcoef(ha, hb)[0, 1]:+.3f} ' f'右の線は 2012→2023 で{move} 線の高さの差の平均 {np.abs(ha - hb).mean():.3f}') print(f'データの相関(反転と無関係): {t["A1303"].corr(t["E2501"]):+.3f}') |
💬 65 歳以上人口は 3,079 万人から 3,623 万人へ増え、小学校児童数は 676 万人から 605 万人へ減っていて、データの相関は −0.911 です。右軸をそのまま描けば、2 本の線は交差するように逆向きに動き(高さの相関 −0.911、線の差の平均 0.493)、「高齢者が増え、子どもが減っている」という実態どおりに見えます。右軸を上下反転すると、同じデータなのに右の線は右上がりになり、高さの相関は +0.911、線の差の平均も 0.186 まで縮んで、2 本がそろって上がっていくように見えます。反転した軸は目盛りを読まない限り気づけず、グラフの第一印象で「増加」と読まれます。2 軸グラフを読むときは左右両方の目盛りの向きを確かめ、描くときは反転を使わないのが原則です。どうしても逆向きの量を重ねたいなら、「小学校児童数の減少数」のように量の定義そのものを変え、軸の名前にそう書きます。
✅ 理解度チェック(実データ検証 ①〜⑩ の数字で)
①〜⑩ で計算した実測値だけで答えられる問題です。答えを読む前に、どの検証の出力のどの数字を使えばよいかを自分で探し、電卓で確かめてみてください。「図の印象」ではなく「数字」で答えられるかどうかが、複合グラフを正しく読めるかどうかの分かれ目です。
- Q7:① で、消費支出とエンゲル係数の 2 軸グラフの交差は、軸の範囲しだいで 0〜3 回になった。2 系列の相関 −0.121 は軸の範囲で変わったか。交差について何か言いたいとき、最初に何を確かめるか。
→ 答え:変わらない(相関はデータだけで決まる)。交差は左右の軸の対応のさせ方で生まれる図の上の現象なので、軸の範囲を変えても同じ交差が残るか、⑤ の比率をそろえた軸や ③ の指数で確かめる。 - Q8:② で、2020→2023 年度の消費支出の伸びは +5.78% だった。棒の下端を 27.5 万円にしたときの見かけの伸び +344.9% から、Lie factor を計算せよ。
→ 答え:344.9 ÷ 5.78 ≈ 59.7。棒の長さで読む図では、下端を 0 から動かすと変化が数十倍に誇張される。 - Q9:③ で 2023 年度の食料費の指数は 120.8、消費支出の指数は 103.2 だった。エンゲル係数の指数を、エンゲル係数そのものを使わずに求めよ。
→ 答え:120.8 ÷ 103.2 × 100 ≈ 117.1。比率の指数は、分子の指数 ÷ 分母の指数 × 100 で求まる。 - Q10:④ で、47 県を人口順に並べた折れ線も、県コード順に並べた折れ線も、合計特殊出生率が右上がりに見えた(順位相関 +0.574 と +0.759)。「人口が少ない県ほど出生率が高い」と言いたいとき、どの図を使い、どの数字を添えるか。
→ 答え:47 県の散布図(人口は対数目盛)に、相関 r = −0.564(対数では −0.588)と、東京都を除いた r = −0.480 を添える。並べ方で形が変わる折れ線は、関係の主張には使わない。 - Q11:⑦ で 2019→2021 年度に延べ宿泊者数は −48.3%、外国人延べ宿泊者数は −96.6% だった。対数の 1 軸で、2 つの落ち込みの縦の長さの比はおよそいくつになるか。
→ 答え:log10 の差は延べ −0.29、外国人 −1.47 なので、縦の長さの比は約 5 倍。普通の軸では外国人のほうが小さく見える落ち込みが、倍率で比べると 5 倍深い。 - Q12:⑧ で、全国の死亡数と大学学生数は水準の相関が +0.890、前年差の相関が +0.022 だった。この 2 系列を 2 軸グラフに描いて「連動している」と説明してよいか。
→ 答え:よくない。水準の相関の高さは、どちらも 12 年で増えたという共通の傾向から来ている。年ごとの変化どうしには関係が無い(前年差の相関 +0.022)ので、連動とは言えない。 - Q13:⑨ で、東京都の人口は鳥取県の 26.2 倍あり、0 起点の棒では 22 県の棒が図の高さの 1 割未満になった。高齢化率との関係(r = −0.710)を伝えるには、どの図に描き替えるのがよいか。
→ 答え:横軸に総人口(対数目盛)、縦軸に高齢化率をとった 47 県の散布図。棒の一覧を見せたいなら、人口と高齢化率を別のパネルに分けて縦に並べる。 - Q14:⑩ で、65 歳以上人口と小学校児童数(データの相関 −0.911)の 2 軸グラフの右軸を上下反転すると、描かれた線の高さの相関は +0.911 になった。反転に気づくには、グラフのどこを見ればよいか。反転しないで 2 つの量を重ねたいときはどうするか。
→ 答え:右軸の目盛りの数字が上に行くほど小さくなっていないかを見る。重ねたいときは反転せず、逆向きの動きのまま描くか、「児童数の減少数」のように量の定義を変えて軸名に明記する。
⚠️ よくある落とし穴
複合グラフ・2軸グラフ を実務で扱うとき、 多くの分析者が同じところでつまずきます。 代表的な失敗パターンを先回りで押さえておくと、 後工程のトラブルを大幅に減らせます。
※ 上記 5 件は SSDSE-B-2026 (12 年度 × 47 都道府県 = 564 行、 112 列) で 2 軸グラフを描く際に実際に起こる事故パターン。 「総人口 (A1101) × 合計特殊出生率 (A4103)」「延べ宿泊者数 (G7101) × 消費支出 (L3221)」など単位の異なる 2 量を重ねるたびに、 この 5 点をチェックする。
🧠 よくある誤解 — 2 軸グラフの「読み方」で騙されないために
作り手だけでなく読み手も知っておくべき誤解パターン。 本編の 5 件と合わせてチェックリストとして活用してください。
🗺 概念マップ
「複合グラフ・2軸グラフ」を中心に、 Small Multiple・Sparklines・Bubble Chart・Parallel Coordinates・Radar Chart・落とし穴 (二重 Y 軸の誤解) を 6 方向で配置した俯瞰図。 単一グラフでは表せない多変量関係を複合 vs 代替案で比較する地図。
上の概念マップは「複合グラフ・2 軸グラフ」を中心に、 Small Multiple (小分割反復)・Sparklines (極小グラフ)・Bubble Chart (大きさで第 3 変数)・Parallel Coordinates (多変量平行軸)・Radar Chart (極座標多軸)・落とし穴 (2 軸の縦軸スケール乱用) を 6 方向に展開した俯瞰図である。 単一グラフでは表現しきれない多変量関係を表す代替案として、 「複合グラフ以外の選択肢」を常に思い出すための地図でもある。
🔗 隣接手法への橋渡し
「複合グラフ」は異なる尺度の系列を 1 枚に重ねる図で、 上流の単位・スケール整理と下流の二重 Y 軸の誤解リスク評価を組まないと「相関があるように見える」錯覚を生む。
- 上流: 複合グラフ の入力となるA1101 総人口と A4103 合計特殊出生率を二軸グラフで描画 を整える前処理 (データクレンジング、 欠損値処理)
- 並列: 類似目的を持つ代替手法 (棒グラフ、 折れ線グラフ) と比較・併用
- 下流: 出力結果の評価・解釈 (誤解を招くグラフ、 ゲシュタルトの法則)
上流で系列の単位・尺度を確認し、 並列の小倍数 (Small Multiples) を代替案として検討し、 下流で読者の誤解 (相関を演出してしまう) を回避する設計を入れれば、 SSDSE 経時データの複数指標比較を歪みなく伝えられる。
🌳 手法選択フロー
「複合グラフ・2軸グラフ」を実際の課題に当てはめるとき、 状況別に何を選ぶかを 3 段階で判定する。
- 目的が明確か? Yes → 次へ、 No → まず 文脈 — どこで出会うか を確認
- 単位の異なる 2 系列を重ねる必要があるか? Yes → 複合グラフ・2軸グラフ を適用、 No → 棒グラフや折れ線グラフ単体、 前処理はデータクレンジングを先行
- 結果の解釈は? 単独で判断せず、 関連用語 (small multiples 等の代替案) と組み合わせる
上記は 複合グラフ を 「A1101 (総人口) と A4103 (合計特殊出生率) を 2 軸グラフで描画」する課題に適用するときの典型フロー。 都道府県データ特有の小標本(n=47)・地域固有のサンプリング誤差を考慮し、 必要に応じて分析設計を調整する。
🎨 直感を深める — なぜ「第2軸」という発明が要るのか
第2軸は「1枚の紙に、住所の違う2つの世界を貼り合わせる」発明だと考えると腑に落ちます。 左軸の住所は「万人」、 右軸の住所は「無次元の率」。 両者はそもそも別の物差しなので、 同じ高さに並んでいても「高さの比較」には意味がありません。 「棒より折れ線が上にある=出生率が人口より大きい」といった読み方は無意味です。
では第2軸は何を与えるのか。 それは「横軸(都道府県や年)を共有させ、 2系列の動き方だけを見比べる」機会です。 SSDSE-B-2026 なら、 都道府県という同じ横軸の上で「総人口 (A1101・万人)」と「合計特殊出生率 (A4103・無次元)」の増減パターンを並べて眺める — これが正当な使い方です。 見るのは「高さ」ではなく「向きと変化」だけ、 と割り切るのが第2軸を正しく読むコツです。
だから第2軸を使う条件はただ1つ、 「横軸(観測対象)は共有できるが、 縦軸の単位が根本的に違う」ときだけです。 逆に、 2系列がどちらも「率」や「円」など同じ単位なら第2軸は不要で、 同一軸に並べるほうが誠実です(高さを直接比較できるため)。 「2つのストーリーを1枚で」という利点の裏返しとして、 第2軸は「2つの物差しを分けて描く」という契約でもあります。 読者にその契約(左はこれ、 右はこれ)を明示する義務が作り手に生じる — 図Aのように軸の色を系列の色に一致させるのは、 その契約書に判子を押す行為なのです。
⚠️ 落とし穴を深める — 2軸グラフはこうして嘘をつく
本編の落とし穴を、 「どの操作が」「どんな錯覚を」生むかで分解します。 いずれもデータを1文字も変えずに、 印象だけを操作する手口です。 このページ上部の 🎮 触って理解する と 実値で計算してみる で、 1番目の手口は実際に体感できます。
| 手口 | 具体的な操作 | 生まれる錯覚 | 見破り方 |
|---|---|---|---|
| 右軸レンジ圧縮 | 右軸を実変動幅ぎりぎり (例 0.99〜1.29) まで狭める | 微差が画面全体に拡大 → 「激しい連動」に見える | 右軸範囲と実変動幅の比を確認 (ウィジェットの詐術プリセット) |
| 軸起点操作 (ゼロ切り) | 棒・折れ線の下端を0でなく途中から始める | 小さな差が「倍以上」に誇張される | 軸が0から始まっているか目視 |
| 左右ゼロ位置ずらし | 左軸の0と右軸の0を別の高さに置く | 棒と折れ線の「交差点」に意味があるように誤読 | 交差の位置に意味を読み取らない |
| 軸反転 | 片方の軸だけ上下を反転させる | 無相関を「逆相関」に、 正の関係を「負」に偽装 | 両軸の向き (上が大か小か) を確認 |
| 折れ線化詐術 | 47都道府県のような離散カテゴリを線でつなぐ | 存在しない「中間値」や「トレンド」を暗示 | カテゴリは点のみ・線で結ばない |
🚦 いつ2軸グラフを「避ける」べきか
2軸は強力ですが、 次のいずれかに当てはまるなら使わないほうが誠実です。
- 単位が同じとき (両方「率」、 両方「円」など) → 素直に同一軸に並べる。 高さを直接比較できる。
- 2系列の関係・相関・因果を主張したいとき → 2軸ではなく散布図+回帰/相関で示す。 2軸の見かけのシンクロは関係の証拠にならない。
- 横軸が離散カテゴリで系列が3つ以上のとき → 小倍数図 (small multiples) に分割する。 3軸以上は実質読めない。
- 読者が非専門家、 または一瞬しか見ないとき → 誤読リスクが情報密度の利得を上回る。 1軸を2枚 (上下パネル) に分けるほうが安全。
※ 相関の演出という「軸そのものによる欺瞞」の体系は誤解を招くグラフ、 読者の知覚を利用した誤読 (近接・共通運命) はゲシュタルトの法則を参照。
🌱 発展 — 2軸を使わずに、 同じことをより正直に
2軸グラフの目的(「単位の違う2系列の動きを見比べる」)は、 多くの場合もっと誤読の少ない方法で達成できます。 代表的な3つの代替表現を押さえておきましょう。
- 基準化 (標準化):各系列を平均0・標準偏差1のzスコアに変換すれば、 単位が消えて同一軸に載る。 「平均から何σ離れているか」で動きを直接比較できる。 詳細は標準化。
- 指数化 (基準年=100):時系列でとくに強力。 基準年の値を100として各年を相対値に直せば、 単位の違う系列を1本の軸に統一できる。
- 小倍数図 (small multiples):同型の小パネルを上下・左右に並べる。 軸スケールを揃えられ、 3系列以上でも破綻しない。 Tufte が2軸の代替として推奨する定番。 折れ線グラフを上下2段に分ければ実現できる。
🧮 指数化の実例(SSDSE-B-2026 実測・東京都 2012→2023)
「万人」と「無次元の率」という別単位の2系列も、 2012年=100の指数に直せば同じ軸に正直に並べられます。 東京都の実測値で確かめます。
2軸グラフなら「人口の棒」と「出生率の折れ線」を別々の物差しで眺めるしかありませんでしたが、 指数化すれば同一軸で「人口は微増・出生率は明確に減少」を高さごと直接比較できます。 これが「単位が違うから2軸」ではなく「単位を揃えてから1軸」という発想の転換です。
1 2 3 4 5 6 7 8 9 10 11 12 | import pandas as pd df = pd.read_csv('data/raw/SSDSE-B-2026.csv', encoding='cp932', skiprows=[1]) tk = df[df['Prefecture'] == '東京都'].sort_values('SSDSE-B-2026') base = tk[tk['SSDSE-B-2026'] == 2012].iloc[0] # 基準年 2012 tk = tk.assign( pop_idx=tk['A1101'] / base['A1101'] * 100, # 総人口の指数 tfr_idx=tk['A4103'] / base['A4103'] * 100, # 合計特殊出生率の指数 ) print(tk[['SSDSE-B-2026', 'pop_idx', 'tfr_idx']].tail(1).round(1)) # → 2023: pop_idx 106.4 / tfr_idx 90.8 (同じ「2012=100」軸に載る) |
💬 2012 年度を 100 とすると、東京都の総人口は 1,323.4 万人 → 1,408.6 万人で 106.4、合計特殊出生率は 1.09 → 0.99 で 90.8 になった。万人と無次元の率という別単位の 2 系列が同じ「2012=100」の軸に載り、人口が 6.4% 増える間に出生率は 9.2% 下がったことを高さで直接比べられる。tail(1) が 2023 年度の行を返すのは年度で昇順に並べ直してあるからで、CSV の並び(新しい年度が先)のまま tail を取ると 2012 年度の 100.0 / 100.0 が出てしまう。
🧭 適切な複合表現の選び方
| やりたいこと | 第一候補 | 参照ページ |
|---|---|---|
| 単位の違う2量の推移を1枚で | 2軸 (範囲根拠を明記) or 指数化して1軸 | — |
| 内訳と合計を同時に | 積み上げ棒 | 積み上げ棒グラフ |
| 2量の関係・相関を主張 | 散布図+回帰 | 散布図・相関 |
| 3系列以上・カテゴリ多数 | 小倍数図 (small multiples) | 折れ線グラフを分割 |
| 単一種類で十分 | 棒 or 折れ線 単体 | 棒グラフ・折れ線グラフ |
| 色・凡例の設計 | 淡色背景+濃色前景、 色覚配慮 | カラースケール・ゲシュタルトの法則 |
🔗 さらに深めるための関連ページ
本ページと合わせて読むと理解が立体的になる、 用語集内の実在ページです:積み上げ棒グラフ/棒グラフ/折れ線グラフ/散布図/相関/誤解を招くグラフ/ゲシュタルトの法則/カラースケール/標準化/尺度水準/合計特殊出生率/高齢化率/時系列/グループ教材:データ可視化。
※ 「小倍数図 (small multiples)」「指数 (index number)」の独立ページは用語集に未収録のため、 本ページ内の解説を参照してください(リンクなし)。
※ 上記 5 件は 2 軸グラフを matplotlib (twinx) や Plotly (secondary_y) で実装するときに発生する典型事例。 SSDSE-B-2026 で「左軸=総人口 (A1101)、 右軸=合計特殊出生率 (A4103)」「左軸=消費支出 (L3221)、 右軸=高齢化率 (A1303/A1101)」のように単位の異なる 2 量を重ねるたびにチェックしてほしい。
📜 ひとことヒストリー
複合グラフ・2軸グラフ は「可視化」分野の中で発展してきた概念・手法です。 学術的には継続的な研究で精緻化され、 実務的にはツール・ライブラリの普及で誰でも使えるようになってきました。 用語の使い方・意味は時代と分野で少しずつ変わるため、 文脈に応じた解釈が大切です。 入門書だけでなく、 標準的な教科書(例:データサイエンス・統計学の定本)や信頼できるオンライン教材も併用すると、 ぶれない理解に近づけます。
✅ 実務チェックリスト — 複合グラフ・2軸グラフ
- □ 用語の定義を自分の言葉で説明できるか
- □ 使うべき場面と使ってはいけない場面を区別できているか
- □ 数式や指標の前提条件を確認したか
- □ 入力データの尺度・分布・サンプル数を確認したか
- □ 結果の不確実性(信頼区間・標準誤差)を把握しているか
- □ 解釈と限界を区別できているか
- □ 関連用語・落とし穴を一通り点検したか
- □ レポートに必要な情報(出典・前提・限界)を含められるか