🔖 キーワード索引
このページ内のセクションへ素早く飛べます(クリックで該当箇所へジャンプ):
このページで扱う主なキーワードです。
💡 30秒で分かる結論 — データ利活用
🍰 まずはやさしく
データ利活用は、情報の宝探しのようなものです。
正しい判断や新しい価値を作るために使います。
スマホの利用時間を分析して生活を変えることです。
ここでは、データの使い方の結論を学びます。
- 一言で:集めたデータを意思決定・価値創造に変える営み。 単に持つだけでなく『使う』ことが本質。
- 分野:社会 — 全体像は data-driven-society ページで
- 3 段の変換:データ(小学校数 E2101)→ 指標(人口 1 万人あたり小学校数)→ 判断(統廃合や通学支援をどこで検討するか)。どこかが欠けると「持っているだけ」で終わる
- 指標の作り方で結論が変わる:小学校の数そのものは東京都が 1,323 校で最多、人口 1 万人あたりでは 0.94 校で最少(2023 年度、SSDSE-B-2026)
- 基準を書く:47 県の値の単純平均 1.92 と、全国の合計どうしの比 1.53 のどちらと比べたかで、「平均より多い県」が入れ替わる
- 使ってよいかを先に確かめる:個人情報保護法・統計法など、利用目的と手続きの確認がプロジェクトの第 1 関門
📍 あなたが今見ているもの
🍰 まずはやさしく
データ利活用は、社会を動かす合言葉です。
地域の格差をなくし、競争力を高めるために使います。
自治体が街づくりにデータを使う例があります。
ここでは、この言葉が使われる場面を学びます。
政府のデジタル田園都市国家構想、 経産省の DX 推進、 自治体の RESAS — いずれもデータ利活用がスローガン。 利活用度合いが地域格差・企業競争力を決める。
🎨 直感で掴む — データ利活用とは何者か
🍰 まずはやさしく
データ利活用は、数字の裏側を読む力です。
なぜ必要でどう役立つかを実感するために使います。
部活の記録を分析して、練習メニューを決めることです。
ここでは、直感的に使い道を理解しましょう。
データ利活用は、倉庫にある材料を料理にすることに似ています。SSDSE-B-2026 の CSV には 564 行 × 112 列の数字が入っていますが、それだけでは誰の判断も変わりません。「どの判断を変えたいか」を決め、そのために材料を切り分け(年度と列を選ぶ)、下ごしらえし(人口あたりにそろえる)、皿に盛る(順位や図にする)ところまでが利活用です。
| 段階 | 小学校の例(2023 年度、SSDSE-B-2026) | この段階で起きやすい失敗 |
|---|---|---|
| データを持つ | 小学校数 E2101:東京都 1,323 校、鳥取県 114 校 | 「東京都は学校が多い」で止まる(人口の違いを無視) |
| 指標にする | 人口 1 万人あたり:高知県 3.33 校(最多)、東京都 0.94 校(最少) | 人数どうしの比較を率の比較と取り違える |
| 基準と比べる | 全国の合計どうしの比 1.53 校、47 県の単純平均 1.92 校 | どちらの「平均」かを書かない |
| 判断につなぐ | 多い県は統廃合と通学支援、少ない県は 1 校あたりの児童数の過密を検討 | 指標の大小だけで「多すぎる・少なすぎる」と決める |
同じ E2101 の列から、「東京都は学校が最も多い」とも「最も少ない」とも言えます。利活用の良し悪しは、分析の技術より先に「どの判断のために、どの指標を、何と比べて作るか」の設計で決まります。
📐 数式・定義
🍰 まずはやさしく
データ利活用は、分析の基本となる考え方です。
レポートなどで根拠をはっきりさせるために使います。
買い物の傾向を計算して、おすすめ商品を選ぶことです。
ここでは、言葉の意味や数式での定義を学びます。
📐 定義
データを意思決定や価値創造に活用すること
英語名 Data Utilization。
📐 データ利活用の経済価値 — ROI 数式と評価フレームワーク
データ利活用プロジェクトの経済価値は、 古典的な ROI (Return on Investment) を拡張した Data ROI で測ります。
Data ROI の基本式
$$\text{Data ROI} = \frac{V_{\text{outcome}} - C_{\text{data}} - C_{\text{infra}} - C_{\text{labor}}}{C_{\text{data}} + C_{\text{infra}} + C_{\text{labor}}} \times 100\%$$
ここで $V_{\text{outcome}}$ はデータ活用で得られた経済価値(売上増、 コスト削減、 政策効果の金銭換算)、 $C_{\text{data}}$ はデータ取得費、 $C_{\text{infra}}$ はインフラ費、 $C_{\text{labor}}$ は人件費。 数式を言葉で読み解くと、 「データ活用から得た価値が、 投じた総コストの何倍に化けたか」を百分率で表現する。
公共セクター版: Social Data ROI
$$\text{Social ROI} = \frac{\sum_{i=1}^{N} (B_i - C_i) \times W_i}{\sum_{i=1}^{N} C_i}$$
$B_i$ は受益者 $i$ の便益、 $C_i$ は供給者 $i$ のコスト、 $W_i$ は社会的重み(高齢者・低所得層を優先する係数)。 単純な金銭収益ではなく、 社会的公平性を含めた価値を測る数式。
データ品質スコア (Data Quality Score)
$$\text{DQS} = w_1 \cdot \text{Completeness} + w_2 \cdot \text{Accuracy} + w_3 \cdot \text{Timeliness} + w_4 \cdot \text{Consistency} + w_5 \cdot \text{Validity}$$
SSDSE-B-2026 のスコア: Completeness = 100%(欠損 0)、 Timeliness = 中(2026 年版でも最新は 2023 年度の値)、 Consistency = 高(12 年度で同じ項目コード)、 Validity = 高(公的統計)。 ただし重み $w_1$〜$w_5$ は目的によって決めるもので決まった値は無いため、 総合点は重みを明記して初めて比べられる。 Completeness が 100% でも、 国勢調査の年と推計の年で総人口の作り方が違うなど(データのメタ化で実データを使って確認)、 欠損以外の品質の問題は残る。
🔬 数式・定義を「言葉」で読み解く
📐 の Data ROI の式は、分子が「得た価値 − 使った費用」、分母が「使った費用」で、「1 円使って何円の純益が出たか」を表します。$V_{\text{outcome}}$ はデータを使ったことで初めて生じた価値でなければならず、使わなくても起きた売上増や政策効果まで入れると ROI は過大になります(因果の問題。データ駆動型社会の平均への回帰・差の差の節を参照)。Social ROI の $W_i$ は「誰の便益を重く数えるか」という価値判断で、統計からは決まりません。重みを変えれば順位が変わるので、報告では重みを必ず明記します。DQS も同じで、5 つの品質の重み $w_1$〜$w_5$ を決めて初めて 1 つの数になります。次の節の KPI の式 $\text{KPI}_i = X_i / P_i \times 10{,}000$ は、この 3 つの式の中で唯一、SSDSE-B-2026 の値だけで計算できる式です。
🔬 数式を言葉で読み解く — EBPM 指標 (KPI) の算出
EBPM (Evidence-Based Policy Making, 証拠に基づく政策立案) では、 政策効果を数値で測る KPI を必ず定義する。 例えば「人口 1 万人あたりの小学校数」は教育資源の地域配分を測る代表的 KPI。 SSDSE-B-2026 で都道府県別に算出し、 全国平均と比較することで「データに基づく自治体評価」が可能になる。
数式:
$$\text{KPI}_i = \frac{X_i}{P_i} \times 10{,}000$$
ここで $X_i$ は県 $i$ の小学校数、 $P_i$ は人口。 1 万人あたりに正規化することで人口規模の影響を取り除き、 純粋な学校配置の密度を比較できる。
このコードでやること: SSDSE-B-2026 から小学校数 (E2101) と総人口 (A1101) を取得し、 人口 1 万人あたりの小学校数 KPI を都道府県別に算出。 上位 5 県と下位 5 県を表示し、 EBPM の出発点とする。
📥 入力データ (SSDSE-B-2026 抜粋, 2023 年):
1 2 3 4 5 6 7 8 9 10 11 12 13 14 | import pandas as pd df = pd.read_csv('data/raw/SSDSE-B-2026.csv', encoding='cp932', skiprows=[1]) df = df[df['SSDSE-B-2026'] == 2023].copy() # 2023 年・47 都道府県 # KPI: 人口 1 万人あたりの小学校数 (E2101=小学校数, A1101=総人口) df['KPI_小学校数/人口1万'] = df['E2101'] / df['A1101'] * 10000 ranked = df[['Prefecture', 'KPI_小学校数/人口1万']].sort_values('KPI_小学校数/人口1万', ascending=False) print('=== 上位 5 県 (小規模校が多い過疎地) ===') print(ranked.head(5).round(2).to_string(index=False)) print('\n=== 下位 5 県 (大都市圏) ===') print(ranked.tail(5).round(2).to_string(index=False)) print(f'\n47 県平均 KPI (県ごとの値の単純平均) = {ranked["KPI_小学校数/人口1万"].mean():.2f}') print(f'全国 KPI (小学校数合計 / 総人口合計) = {df["E2101"].sum() / df["A1101"].sum() * 10000:.2f}') |
📤 実行すると次の出力が得られる:
💬 高知・鹿児島・島根など地方県は人口 1 万人あたり 3 校前後と小規模校が点在し、 過疎地に学校網を維持する構造が見える。 一方で首都圏 (東京・神奈川・埼玉) は 1 校前後で、 少数の大規模校に児童が集中する。 47 県の値を単純平均した 1.92 は高知県のような人口の少ない県も 1 票ずつ数えるので、 全国の小学校 18,980 校を総人口で割った全国 KPI 1.53 より高く出る。 「全国平均と比べる」ときはどちらを基準にしたかを明記する。 「人口密度が学校配置密度を規定する」というデータが、 統廃合・通学支援を検討する EBPM の出発点になる。
🧮 SSDSE-B 実値で計算してみる
データを利活用する最初の一歩は、数字をそろえて並べることです。SSDSE-B-2026 の 2023 年度から、人口規模も年齢構成も違う 4 都府県を並べます。高齢化率は 65 歳以上人口 A1303 ÷ 総人口 A1101、有効求人倍率は月間有効求人数 F3103 ÷ 月間有効求職者数 F3102(いずれも一般)で自分で計算した値です。
| 都道府県 | 総人口(千人) | 高齢化率(%) | TFR | 有効求人倍率 |
|---|---|---|---|---|
| 東京都 | 14,086 | 22.8 | 0.99 | 1.56 |
| 大阪府 | 8,763 | 27.7 | 1.19 | 1.23 |
| 沖縄県 | 1,468 | 23.8 | 1.60 | 1.12 |
| 秋田県 | 914 | 39.1 | 1.10 | 1.40 |
| 47 都道府県計 | 124,353 | 29.1 | 1.29(47 県の単純平均) | 1.30 |
東京都は高齢化率 22.8% で若いのに合計特殊出生率は 0.99 で 47 県の最低、沖縄県は 23.8% で出生率 1.60 と最高です。秋田県は高齢化率 39.1% で最も高い一方、有効求人倍率は 1.40 と全国の 1.30 を上回ります(求職者が少ないことの裏返しでもある)。1 つの指標で県を順位づけず、複数の指標をそろえて並べることが、利活用の判断材料を作る最初の作業です。合計特殊出生率は県ごとの値しかないので、最終行は 47 県の単純平均で、国全体の値とは一致しません。
🧮 数式に値を入れて手で計算する: 利活用 ROI
合成データで部門別データ活用案件の費用対効果を計算する。
Step 1: 案件別 ROI
| 案件 | 投資 [万円] | 収益 [万円] | ROI |
|---|---|---|---|
| 営業 BI | 300 | 500 | 0.667 |
| マーケ DM | 200 | 700 | 2.500 |
| SCM 在庫 | 500 | 800 | 0.600 |
| 採用 AI | 100 | 250 | 1.500 |
| 保守 IoT | 400 | 600 | 0.500 |
Step 2: 平均と全体 ROI
🐍 Python で再現
1 2 3 4 5 6 7 | import numpy as np inv = np.array([300, 200, 500, 100, 400]) rev = np.array([500, 700, 800, 250, 600]) roi = (rev - inv) / inv print(f"案件 ROI: {roi.round(3)}") print(f"全体 ROI: {(rev.sum()-inv.sum())/inv.sum():.3f}") print(f"平均 ROI: {roi.mean():.3f}") |
📤 実行結果
💬 手計算 (Step 2) と Python 出力が完全一致。
🐍 Python 実装
以下は データ利活用 を SSDSE-B-2026 で扱うときの典型コード。 encoding='cp932' は政府統計の Shift-JIS 対応。 skiprows=1 は 1 行目の英語コード行(A1101 など)を飛ばし、2 行目の日本語見出しを列名にする定石。
① 基本パターン(読み込み・確認・主要列抽出)
1 2 3 4 5 6 7 8 9 10 11 12 | import pandas as pd # データ利活用 に関連する SSDSE-B-2026 分析の基本パターン df = pd.read_csv('data/raw/SSDSE-B-2026.csv', encoding='cp932', skiprows=[1]) df = df[df['SSDSE-B-2026'] == 2023].copy() # 2023 年の 47 都道府県 print(df.shape) # (47, 112) # 主要列を分かりやすい名前に (A1101=総人口, A1303=65歳以上人口) df['総人口'] = df['A1101'] df['65歳以上'] = df['A1303'] df['高齢化率'] = df['65歳以上'] / df['総人口'] * 100 print(df[['Prefecture', '総人口', '高齢化率']].head()) |
💬 2023 年度に絞って (47, 112)。先頭 5 県の高齢化率は宮城県 29.24% から秋田県 39.06% まで 10 ポイント近く開き、東北の中でも仙台を抱える宮城だけが低い。行番号が 0, 12, 24… と 12 刻みなのは、元の 564 行から各県の 2023 年度行だけを抜いたためで、後で iloc で位置を指定するなら reset_index しておく。
② 可視化テンプレ(matplotlib / seaborn)
1 2 3 4 5 6 7 8 9 10 11 12 13 14 15 16 17 18 19 20 | import pandas as pd import seaborn as sns import matplotlib.pyplot as plt # データ利活用 の探索的データ分析 (EDA) df = pd.read_csv('data/raw/SSDSE-B-2026.csv', encoding='cp932', skiprows=[1]) df = df[df['SSDSE-B-2026'] == 2023].copy() # 主要変数を派生 (A1303=65歳以上, A4101=出生数, A1101=総人口) df['高齢化率'] = df['A1303'] / df['A1101'] * 100 df['出生率'] = df['A4101'] / df['A1101'] * 1000 # 人口千人あたり # ヒストグラム fig, axes = plt.subplots(1, 2, figsize=(12, 4)) sns.histplot(df['高齢化率'], kde=True, ax=axes[0]) axes[0].set_title('高齢化率の分布 (47都道府県)') sns.histplot(df['出生率'], kde=True, ax=axes[1]) axes[1].set_title('出生率の分布') plt.tight_layout() plt.savefig('eda_distribution.png', dpi=120) |
③ 前処理:欠損・外れ値・型変換
1 2 3 4 5 6 7 8 9 10 11 12 13 14 15 16 17 18 19 20 21 22 23 24 25 26 27 28 | import pandas as pd import numpy as np # データ利活用 に関わる前処理の典型パターン df = pd.read_csv('data/raw/SSDSE-B-2026.csv', encoding='cp932', skiprows=1) # ① 欠損値の確認 print('欠損数:') print(df.isna().sum().sort_values(ascending=False).head(10)) # ② 数値変換(カンマ・%除去 など) def to_num(s): if isinstance(s, str): return float(s.replace(',', '').replace('%', '')) return s _num_cols = [c for c in df.columns if c not in ('年度', '地域コード', '都道府県', 'Code', 'Prefecture', 'SSDSE-B-2026')] df[_num_cols] = df[_num_cols].apply(lambda col: col.map(to_num)) # ③ 外れ値検出(IQR) # 地域コードや都道府県名は大小比較できないので、数値の列だけで判定する _num = df.select_dtypes(include='number') q1 = _num.quantile(0.25) q3 = _num.quantile(0.75) iqr = q3 - q1 outlier_mask = ((_num < q1 - 1.5*iqr) | (_num > q3 + 1.5*iqr)).any(axis=1) print('外れ値を含む行数:', outlier_mask.sum()) |
💬 こちらは年度で絞っていないので、欠損 0 件・外れ値を含む行 239 件は 564 行(47 県 × 12 年度)に対する数字。同じ県が 12 回数えられるので、東京都のように毎年外れる県は 12 行ぶん効いてくる。「何県が外れ値か」を利活用の報告に書くなら、2023 年度に絞るか、県単位に集約してから数え直す。
④ 検定・推定の最小例(scipy.stats)
1 2 3 4 5 6 7 8 9 10 11 12 13 14 15 16 17 18 | import pandas as pd from scipy import stats # データ利活用 文脈での基本的な仮説検定 (東日本 vs 西日本の高齢化率) df = pd.read_csv('data/raw/SSDSE-B-2026.csv', encoding='cp932', skiprows=[1]) df = df[df['SSDSE-B-2026'] == 2023].copy() df['aging'] = df['A1303'] / df['A1101'] * 100 east = ['北海道','青森県','岩手県','宮城県','秋田県','山形県','福島県','茨城県','栃木県','群馬県','埼玉県','千葉県','東京都','神奈川県','新潟県','富山県','石川県','福井県','山梨県','長野県','岐阜県','静岡県','愛知県'] df['region'] = df['Prefecture'].apply(lambda p: '東日本' if p in east else '西日本') e = df.loc[df['region']=='東日本', 'aging'] w = df.loc[df['region']=='西日本', 'aging'] t, p = stats.ttest_ind(e, w, equal_var=False) print(f'東日本 平均高齢化率: {e.mean():.2f}%') print(f'西日本 平均高齢化率: {w.mean():.2f}%') print(f't = {t:.3f}, p = {p:.4f}') print('判定:', '有意差あり' if p < 0.05 else '有意差なし') |
💬 2023 年度の 47 都道府県で、東日本 31.18%・西日本 31.97%、t = −0.804、p = 0.4259 で有意差なし。東西の平均差 0.79 ポイントは、県ごとの高齢化率の幅(東京都の約 22.8% から秋田県の 39.1%)に比べてずっと小さい。「東日本は高齢化が進んでいる」という印象で施策を割り振る前に、こうした検定で差が統計的に支えられるかを確かめることがデータ利活用の基本になる。
※ より高度な例(クロス集計、 機械学習、 ベイズ推定)は data-driven-society のグループ教材を参照。
🐍 Python での扱い
SSDSE-B-2026 のような公的統計データを Python で扱う際の基本パターン:
1 2 3 4 5 6 7 8 9 10 11 12 | import pandas as pd import numpy as np # データ読み込み (政府統計は cp932、コードの下の日本語見出し行を skiprows=[1] で除去) df = pd.read_csv('data/raw/SSDSE-B-2026.csv', encoding='cp932', skiprows=[1]) print(df.shape) print(df.dtypes.head()) print(df.describe().T.head()) # 「データ利活用」の文脈で扱う場合の例: # 分野: リテラシー # 関連手法は同カテゴリの他用語を参照してください。 |
💬 年度で絞らずに読んだので (564, 112)。A1101 の平均 269.1 万人・最大 1,408.6 万人(2023 年度の東京都)は 12 年度分を一緒にした要約で、年ごとの変化は describe からは見えない。データを使う前に、1 行が何を表す単位(ここでは県 × 年度)なのかを押さえておかないと、「平均的な県」の人口を取り違える。
具体的なコードは データリテラシー を参照してください。
🐍 Python 実装 — データ利活用の典型シナリオ
① 政策立案支援 — 少子高齢化が深刻な地域を特定
🎯 このコードでやること: SSDSE-B-2026 から高齢化率と出生率を都道府県別に算出し、 散布図で「高齢化率 35% 超」の県を強調表示して少子高齢化が深刻な地域を特定する。 地域包括ケアや子育て支援の重点配分に直結する利活用シナリオ。
📥 入力データ: SSDSE-B-2026 2023 年データ 47 行 (A1101=総人口、 A1303=65歳以上人口、 A4101=出生数)
1 2 3 4 5 6 7 8 9 10 11 12 13 14 15 16 17 18 19 20 21 22 23 24 25 26 27 | import pandas as pd import matplotlib.pyplot as plt df = pd.read_csv('data/raw/SSDSE-B-2026.csv', encoding='cp932', skiprows=[1]) df2023 = df[df['SSDSE-B-2026'] == 2023].copy() df2023['aging_rate'] = df2023['A1303'] / df2023['A1101'] * 100 # 高齢化率 df2023['birth_rate'] = df2023['A4101'] / df2023['A1101'] * 1000 # 出生率 (千人あたり) # 政策ターゲット: 高齢化率 35% 超 (少子高齢化が最も深刻な県) targets = df2023[df2023['aging_rate'] > 35] plt.figure(figsize=(10, 6)) plt.scatter(df2023['aging_rate'], df2023['birth_rate'], c='steelblue', s=40, alpha=0.7, label='Other') plt.scatter(targets['aging_rate'], targets['birth_rate'], c='crimson', s=80, label='Policy target') plt.axvline(35, ls='--', c='gray', alpha=0.5) plt.xlabel('Aging rate (%)') plt.ylabel('Birth rate (per 1000)') plt.title('Policy targeting: severe aging prefectures') plt.legend() plt.tight_layout() plt.savefig('du_targeting.png', dpi=100) print(f'Policy target prefectures: {len(targets)}') print(targets[['Prefecture', 'aging_rate', 'birth_rate']].round(2).to_string(index=False)) |
📤 実行結果:
💬 結果の読み方: 高齢化率 35% 超の「政策ターゲット」は 青森県・秋田県・山形県・山口県・徳島県・高知県 の 6 県。 出生率(千人あたり)は秋田県 3.95・青森県 4.81・山形県 5.02・高知県 5.08 が 47 県中の下位 6 位以内に入る一方、 山口県 5.54(22 位)と徳島県 5.62(24 位)は中位で、 高齢化率だけで選ぶと少子の度合いが違う県が混ざる。 これらの地域に地域包括ケアや子育て支援を優先配置する政策的根拠になる。 これがデータ利活用の 「政策立案支援」フェーズ。
② ビジネス活用 — 市場規模 × 購買力マトリクス
🎯 このコードでやること: SSDSE-B-2026 の総人口 (A1101, 市場規模) と消費支出 (L3221, 購買力) を使い、 「市場規模 × 購買力」の 4 象限マトリクスを作成。 新規出店・市場展開の意思決定に直結。
📥 入力データ: 2023 年 47 都道府県の A1101(総人口)、 L3221(消費支出・二人以上世帯)
1 2 3 4 5 6 7 8 9 10 11 12 13 14 15 16 17 18 19 20 21 22 | df2023['cons'] = df2023['L3221'] # 消費支出 (二人以上世帯, 円/月) # 4 象限分類: 人口 (市場規模) × 消費支出 (購買力) median_pop = df2023['A1101'].median() median_cons = df2023['L3221'].median() def classify(row): if row['A1101'] >= median_pop and row['L3221'] >= median_cons: return '①大規模×高支出 (中核ターゲット)' elif row['A1101'] >= median_pop and row['L3221'] < median_cons: return '②大規模×低支出 (量で稼ぐ)' elif row['A1101'] < median_pop and row['L3221'] >= median_cons: return '③小規模×高支出 (プレミアム)' else: return '④小規模×低支出 (慎重判断)' df2023['segment'] = df2023.apply(classify, axis=1) print(df2023.groupby('segment').agg( n=('Prefecture', 'count'), avg_pop=('A1101', 'mean'), avg_cons=('L3221', 'mean') ).round(0)) |
📤 実行結果:
💬 結果の読み方: 「大規模×高支出」17 県が最重要ターゲット、 「小規模×低支出」16 県は慎重判断の対象。 消費支出は都市圏で必ずしも高くない点(例: 大阪府は人口 3 位なのに消費支出 271,246 円は 47 県中 41 位で、 「②大規模×低支出」に入る)に注意し、 人口だけで市場を測らないのがコツ。 これがデータ利活用の 「ビジネス意思決定支援」フェーズ。
③ KPI ダッシュボード — 経年変化を 1 画面で
🎯 このコードでやること: SSDSE-B-2026 の 12 年間データで、 国レベルの主要 KPI(高齢化率、 出生率、 消費支出平均)の推移を 3 系列ダッシュボードで一望。
📥 入力データ: SSDSE-B-2026 の全年次データを groupby(年) で全国集約
1 2 3 4 5 6 7 8 9 10 11 12 13 14 15 16 17 18 19 20 21 22 | annual = df.groupby('SSDSE-B-2026').agg( pop=('A1101', 'sum'), age65=('A1303', 'sum'), births=('A4101', 'sum'), cons=('L3221', 'mean'), ).reset_index() annual['aging_rate'] = annual['age65'] / annual['pop'] * 100 annual['birth_rate'] = annual['births'] / annual['pop'] * 1000 fig, axes = plt.subplots(1, 3, figsize=(15, 4)) axes[0].plot(annual['SSDSE-B-2026'], annual['aging_rate'], marker='o', color='crimson') axes[0].set_title('Aging rate (%)'); axes[0].set_xlabel('Year') axes[1].plot(annual['SSDSE-B-2026'], annual['birth_rate'], marker='s', color='steelblue') axes[1].set_title('Birth rate (per 1000)'); axes[1].set_xlabel('Year') axes[2].plot(annual['SSDSE-B-2026'], annual['cons'], marker='D', color='darkgreen') axes[2].set_title('Avg consumption (JPY/month)'); axes[2].set_xlabel('Year') plt.tight_layout() plt.savefig('du_dashboard.png', dpi=100) print(annual[['SSDSE-B-2026', 'aging_rate', 'birth_rate', 'cons']].round(2)) |
📤 実行結果:
💬 結果の読み方: 2012→2023 年で高齢化率は 24.1→29.1%(+5.0 ポイント)、 出生率は 8.13→5.85(約 -28%)、 消費支出は 286,665→295,856 円とほぼ横ばい。 「人口減少が着実に進む一方、 家計消費は停滞」という構造が 1 画面で明白に。 この KPI 監視は 長期戦略立案の基礎。
④ クラスタリング — 都道府県を 4 タイプに自動分類
🎯 このコードでやること: SSDSE-B-2026 の 2023 年データで 5 変量を使い、 K-means で都道府県を 4 タイプに自動分類。 「同じ政策パッケージを適用できるグループ」を発見する。
📥 入力データ: 47 行 × 5 列(総人口、 高齢化率、 出生率、 消費支出、 年平均気温)
1 2 3 4 5 6 7 8 9 10 11 12 13 14 15 16 17 18 19 20 21 | from sklearn.cluster import KMeans from sklearn.preprocessing import StandardScaler df2023['birth_rate'] = df2023['A4101'] / df2023['A1101'] * 1000 features = df2023[['A1101', 'aging_rate', 'birth_rate', 'L3221', 'B4101']].copy() X = StandardScaler().fit_transform(features) km = KMeans(n_clusters=4, random_state=42, n_init=10) df2023['cluster'] = km.fit_predict(X) summary = df2023.groupby('cluster').agg( n=('Prefecture', 'count'), pop=('A1101', 'mean'), aging=('aging_rate', 'mean'), cons=('L3221', 'mean'), ).round(0) print(summary) print() for c in sorted(df2023['cluster'].unique()): members = df2023[df2023['cluster']==c]['Prefecture'].tolist() print(f'Cluster {c}: {members}') |
📤 実行結果:
💬 結果の読み方: 47 都道府県が 5 指標に基づき 4 タイプへ自動分類される。 大都市圏(7 県: 東京・大阪ほか)、 北・東北の高齢先進地域(5 県)、 中間タイプの 2 群に分かれ、 各クラスタに別個の政策パッケージを設計する根拠になる。 これがデータ利活用の 「セグメント別介入設計」の典型。
🧩 国内データ利活用の事例
| 事例 | 主体 | 利活用データ | 成果 |
|---|---|---|---|
| RESAS | 内閣官房・経済産業省 | 地域経済・人口・産業 | 自治体の総合戦略策定支援 |
| SSDSE | 独立行政法人統計センター | 47 都道府県横断指標 | 大学・高校での DS 教育 |
| マイナポータル | デジタル庁 | 行政データ統合 | 行政手続きオンライン化 |
⚠️ よくある落とし穴
データ利活用の失敗は、分析の計算ミスより「何と比べたか」「データを使ってよいか」「結果を誰が使うか」の設計の段階で起きます。この章では、まず SSDSE-B-2026 の実データで基準の選び方の落とし穴を確かめ、その後に利活用特有の落とし穴、倫理・法令、組織とプロジェクトの失敗パターンを順に扱います。
⚠️ 実データで確かめる — 「平均より多い県」は、平均の取り方で 22 県にも 36 県にもなる
🔬 の KPI(人口 1 万人あたり小学校数)で「全国平均より学校が多い県を統廃合の検討対象にする」と決めたとします。ところが「全国平均」には、47 県の値の単純平均・全国の合計どうしの比・中央値の少なくとも 3 通りがあります。
🎯 このコードでやること:2023 年度の 47 都道府県について人口 1 万人あたり小学校数を計算し、単純平均・全国の合計どうしの比・中央値の 3 つの基準それぞれで「基準より多い県」を数える。基準によって対象に入ったり外れたりする県と、全国の比より少ない県に住む人の割合を出す。
1 2 3 4 5 6 7 8 9 10 11 12 13 14 15 16 | import pandas as pd df = pd.read_csv('data/raw/SSDSE-B-2026.csv', encoding='cp932', skiprows=[1]) d = df[df['SSDSE-B-2026'] == 2023].set_index('Prefecture') kpi = d['E2101'] / d['A1101'] * 10000 # 人口 1 万人あたり小学校数 simple = kpi.mean() # 47 県の値の単純平均 pooled = d['E2101'].sum() / d['A1101'].sum() * 10000 # 全国の合計どうしの比 median = kpi.median() print(f'基準 単純平均 {simple:.2f} 全国の比 {pooled:.2f} 中央値 {median:.2f}') for name, base in [('単純平均', simple), ('全国の比', pooled), ('中央値', median)]: print(f'「{name}より多い県」 {int((kpi > base).sum())} 県') mid = kpi[(kpi > pooled) & (kpi <= simple)].sort_values() print('全国の比より多いが単純平均以下の県:', len(mid), '県 →', '・'.join(mid.index[:6]), '…') # その県が住んでいる人口の割合 print(f'「全国の比より少ない県」に住む人の割合 {d.loc[kpi <= pooled, "A1101"].sum() / d["A1101"].sum():.3f}') |
💬 基準は単純平均 1.92・全国の比 1.53・中央値 1.87 で、「基準より多い県」は単純平均なら 22 県、中央値なら 23 県、全国の比なら 36 県です。滋賀県・茨城県・群馬県・宮城県・広島県・香川県など 14 県は、全国の比で見れば「多い」側、単純平均で見れば「少ない」側に入り、どちらを「全国平均」と呼ぶかだけで統廃合の検討対象に入ったり外れたりします。全国の比が単純平均より低いのは、人口の多い都市部ほど 1 万人あたりの学校が少ないからで、全国の比より少ない 11 県に日本の人口の 57.1% が住んでいます。利活用の報告では、基準の名前(「47 県の単純平均」「全国の合計どうしの比」)を必ず書き、判断の境目にいる県は、どちらの基準でも結論が変わらないかを確かめます。
🧭 詳細解説 — データ利活用 を一段深く掘り下げる
よく混同される概念
データ利活用 は、 隣接概念と混同されやすい用語の代表でもあります。 ここで違いを明確にしておきましょう:
| 混同される概念 | データ利活用 との違い |
|---|---|
| データ駆動社会 | データ駆動社会は社会全体の姿を表すマクロ概念。 データ利活用は具体的な業務・施策で実際にデータを使うアクションを指すミクロ概念。 |
| データリテラシー | リテラシーは人間側の能力(読み解く・批判する力)。 利活用は組織が実際に活用した成果。 リテラシーが普及して初めて利活用が広まる。 |
| データサイエンス | データサイエンスは方法論・学問。 データ利活用はその応用によって得られた価値で、 サイエンスの実践フェーズ。 |
⚠️ データ利活用特有の落とし穴(拡張版)
- サイロ化 (Data Silo): 部署ごとにデータが分断され、 横串分析ができない。 自治体では「住民票・税・福祉」が縦割りで連携できない例が典型。 解決策: データガバナンス組織の設置。
- 品質劣化 (Data Decay): 取得時点では正確でも、 時間経過で陳腐化(顧客住所、 役職、 嗜好)。 SSDSE のような公的統計でも、SSDSE-B-2026 の最新は 2023 年度の値で、公開の時点ですでに数年前の姿であることに注意。
- 倫理 (Ethical Risk): 個人特定可能データの目的外利用、 アルゴリズミック・バイアス(地域・性別・年齢による不公正な判定)。 GDPR・個人情報保護法の遵守は最低限。
- セキュリティ (Security): データ漏洩、 不正アクセス、 ランサムウェア。 2022 年には尼崎市で、全市民の住民情報を含む USB メモリを委託先の社員が一時紛失する事案が起きた。
- 過剰収集 (Over-collection): 「使うかもしれない」で大量のデータを集めても、使われないデータが増えるだけになりやすい。 ストレージコストと管理リスクだけ増える。 利用目的を先に定義する Privacy by Design が原則。
- 分析結果の過信: 統計的に有意でも実務的に意味があるとは限らない(効果量 ε² < 0.01)。 意思決定者にデータリテラシーがなければ、 数値が独り歩きする。
⚖️ データ利活用の倫理・法令フレームワーク
データ利活用は 「やってよいことだけ、 透明性を持って」行う必要があります。 関連する主要な法令・指針を整理します。
| 法令・指針 | 対象 | 主要条文 |
|---|---|---|
| 個人情報保護法 | 個人情報全般 | 利用目的の特定、 第三者提供制限、 開示請求権 |
| 統計法 | 公的統計 | 調査票情報の管理、 二次利用の手続 |
| 官民データ活用推進基本法 | 公共データ | オープンデータ化推進、 標準化 |
| デジタル庁ガイドライン | 行政システム | 設計時のプライバシー、 セキュリティ要件 |
| AI 利用ガイドライン (G7 広島 AI プロセス) | AI 開発・利用 | 透明性、 説明可能性、 公平性 |
| GDPR (EU) | EU 居住者データ | 忘れられる権利、 データポータビリティ |
⚠️ 「データ利活用 ≠ 何でも使ってよい」。 法令遵守と倫理確認は、 プロジェクトの第 1 ゲート。 違反は組織信用の失墜と莫大な賠償リスクに直結する。
📊 データ成熟度モデル — 自社の現在地を測る
Gartner や DAMA-DMBOK が提示する データ成熟度モデル (Data Maturity Model) は、 組織のデータ利活用レベルを 5 段階で評価します。
| レベル | 名称 | 特徴 | 代表的な指標 |
|---|---|---|---|
| L1 | 初期 (Ad-hoc) | 場当たり的に Excel 集計 | データ統合 0%、 BI ツール未導入 |
| L2 | 反復 (Repeatable) | 定型レポートが整備 | 月次・週次定型 KPI、 DWH 部分導入 |
| L3 | 定義 (Defined) | 標準プロセスとデータガバナンス | データ辞書整備、 CDO 任命 |
| L4 | 管理 (Managed) | 予測分析が経営判断に組込 | ML モデルが本番運用、 A/B テスト |
| L5 | 最適化 (Optimized) | データドリブン文化の浸透 | 全社員がダッシュボードを参照し、定型の判断が自動化されている |
🔄 データ利活用の PDCA — 1 サイクル 30 分の見本
データ利活用は単発の分析で終わらせず、 PDCA を高速で回すのがコツです。 SSDSE-B-2026 を題材に 30 分で 1 サイクル回す手順を示します。
- P (Plan) - 5 分: 問い「47 都道府県のうち、 高齢化と低所得を両方抱える地域はどこか」を設定。 利用変量を 3-5 個に絞る。
- D (Do) - 10 分: pandas で SSDSE-B を読み込み、 高齢化率と消費支出を集計。 散布図プロット。 IQR 法で外れ値抽出。
- C (Check) - 10 分: 結果を仮説と照合。 「高齢化 33% 超 × 所得下位 25%」に該当する 5-6 県を特定。 過去年度と比較して傾向確認。
- A (Act) - 5 分: 結果を 1 ページに要約。 次の PDCA の問いを 1 つ立てる(例: 「これらの地域での産業構造を深掘り」)。
💡 30 分 × 週 5 回 = 月 100 分析。 半年で 600 分析の知見が蓄積。 これが「データドリブン組織」の正体。
❓ FAQ — データ利活用についてよくある質問
Q. 中小企業でもデータ利活用は可能?
Q. データ利活用 と DX の違いは?
Q. 統計分析と機械学習、 どちらを優先すべき?
Q. データ利活用の効果測定はどうやる?
Q. オープンデータと自社データの統合は安全?
🚀 データ利活用の未来 — 5 つの潮流
2024-2030 年に予想されるデータ利活用の主要トレンドを 5 つ整理します。
- 生成 AI × データ分析: ChatGPT-like モデルが「SQL を自然言語で書く」「自動レポート生成」を実現。 ただし「ハルシネーション (誤情報)」のリスクは増大。
- 合成データ (Synthetic Data): GAN や Diffusion Model で実データに近い疑似データを生成。 プライバシー保護とデータ不足解消の両立。
- Federated Learning: データを集約せず、 各所でモデル学習し重みだけ共有。 医療・金融など機密性の高い分野で本格化。
- データメッシュ (Data Mesh): 中央集権型データレイクから、 ドメインごとに分散管理するアーキテクチャへ移行。 大規模組織で実装が進む。
- 説明可能 AI (XAI): ML の意思決定根拠を可視化。 SHAP, LIME などの手法が標準化。 公共セクター・金融で必須に。
💡 これらの潮流の根底にあるのは 「データ利活用の民主化」。 専門家でなくても、 ドメイン担当者が直接データを扱えるようになる。 ただし倫理判断はこれまで以上に重要。
これらの動向の中で、 SSDSE-B-2026 のような 公的統計データの役割はますます重要になります。 政府は「EBPM (Evidence-Based Policy Making) 推進」を 2018 年から本格化させており、 行政各部門が政策効果をデータで検証する文化が定着しつつあります。 学習者・研究者・実務者にとって SSDSE は「教材」であり「実務ツール」であり、 同時に「市民監視ツール」でもあるのです。
⚠️ データ活用プロジェクトの落とし穴 (現場で頻発する 8 パターン)
- 「データはあるが、 目的が無い」病: 「とりあえずデータを集めたから、 何か分析してくれ」という依頼は失敗する典型。 「何を意思決定したいか」を最初に明文化すべき。
- 「ツール導入が目的化」する病: 「Tableau を入れたから何か変わるはず」という幻想。 ツールは手段、 重要なのは「データから何を読み取るか」という思考スキル。
- 「過剰モデル化」病: 単純なクロス集計で十分な問題に、 深層学習を持ち出す。 オッカムの剃刀: 最小限の手段で解決できるなら、 それで十分。
- 「精度至上主義」病: 「予測精度 99% を目指す」が目的化し、 0.1% 改善のために半年費やす。 実務では 80% でも意思決定に十分使えるケースが大半。
- 「現場無視」病: 分析結果を現場に投げて「使ってください」と言うだけ。 業務フローへの組み込み・教育・KPI 設計まで含めて初めて「活用」。
- 「再現性軽視」病: ノートブックがバージョン管理されておらず、 「あの分析、 もう一度やって」と言われて再現できない。 Git + データバージョニング (DVC) が必須。
- 「データ品質スルー」病: 欠損・外れ値・重複を確認せず分析。 「ゴミからはゴミしか出てこない」 (Garbage In, Garbage Out)。
- 「権限・倫理レビュー後回し」病: 個人情報・社外秘データを使い始めてから法務部に怒られる。 プロジェクト企画段階で「データ使用承認」を取るプロセスを組み込むべき。
これら 8 パターンの共通点は「技術ではなくプロセスの問題」という点。 つまり、 個人の Python スキルを上げるだけでは解決せず、 組織として「データ活用の標準プロセス」を整備する必要がある。 ISO 23053 (機械学習プロジェクトの標準) や CRISP-DM フレームワークが参考になる。
👥 データ活用に関わる職種 ― 5 つの役割と必要スキル
データ活用プロジェクトは、 1 人で完結することはほとんどない。 複数の専門職が連携することで初めて成果が出る。 ここでは典型的な 5 つの役割を整理する。
| 職種 | 主な仕事 | 必要スキル |
|---|---|---|
| データサイエンティスト | 統計分析・機械学習モデル開発 | Python, 統計学, ML |
| データエンジニア | データ基盤・パイプライン構築 | SQL, クラウド, ETL |
| データアナリスト | 記述統計・ダッシュボード作成 | SQL, BI ツール, Excel |
| ML エンジニア | 本番運用 ML システム開発 | MLOps, Docker, API |
| データプロダクトマネージャー | プロジェクト推進・ROI 設計 | ビジネス理解, 統計基礎 |
学生は最初「データアナリスト」を目指すのが現実的。 SQL と Python の基礎、 BI ツール 1 つ (Tableau か Power BI) を使えれば新卒採用枠が広い。 そこから経験を積んで「データサイエンティスト」「ML エンジニア」へ進むキャリアパスが王道。 「データプロダクトマネージャー」は MBA や事業経験を経て移行するケースが多い。
本サイトの SSDSE-B-2026 を使った演習は、 「データアナリスト」入門スキルそのものを鍛える内容。 散布図・相関・回帰の基礎を、 公的統計という「実在データ」で身につけられる点で、 教科書を読むだけより圧倒的に実践的な学習となる。
📘 まとめ ― データ活用を「実装」できる人になるために
この用語ページで扱った内容を、 3 つの実践指針に集約する。
- 「データ → KPI → 意思決定」の鎖を設計せよ: 単にデータをこねくり回すだけでは活用にならない。 「どの KPI を、 どのアクションで、 どの程度改善するか」まで設計して初めて活用と呼べる。 SSDSE で「人口 → 小学校数 → 学校配置の最適化」のような鎖を 1 つ完成させる練習が、 最良の入門となる。
- 可視化を「説明手段」ではなく「発見手段」として使え: 散布図・ヒストグラム・箱ひげ図は、 結論を発表するための飾りではない。 分析の最初に描き、 「次にどの問いに進むか」を発見するための道具。 EDA (探索的データ分析) の流儀を身につけよう。
- 倫理と ROI を最初から組み込め: データ活用プロジェクトの失敗の多くは、 後付けで倫理レビューを入れたり、 ROI を試算せずに走り始めたりすることに起因する。 プロジェクト企画段階で両方を明文化することが、 持続可能なデータ活用の鍵となる。
これら 3 指針を意識しながら SSDSE-B-2026 を触り続ければ、 6 ヶ月後には「データを見て政策提言ができる人材」へ成長できる。 統計・データ解析コンペティションは、 その実践の場となる絶好の機会である。
🏛 自治体・企業・研究機関でのデータ活用の現場像
データ活用は教科書の中の話ではなく、 自治体・企業・研究機関のあらゆる現場で日常的に行われている。 ここでは SSDSE-B-2026 にも登場する都道府県データを切り口に、 それぞれの組織がどのようにデータを活用しているかを掘り下げる。 「活用」の定義は組織によって異なり、 同じ人口データでも自治体は「待機児童の予測」、 企業は「店舗出店の判断」、 研究機関は「人口構造の長期予測」と読み方が大きく変わる。 この違いを理解することは、 自分自身がデータを扱うときに「誰の視点で読むか」を選ぶ訓練につながる。
自治体での典型的なデータ活用シナリオ
自治体は住民サービスの最適化と税収配分の効率化を目的に、 人口・出生数・高齢化率・財政力指数などを継続的にモニタリングしている。 SSDSE-B-2026 にある A1101(総人口)、 A4101(出生数)、 A4200(死亡数)、 A1303(65歳以上人口)といった指標は、 まさに自治体が予算編成の根拠として用いる典型的なデータである。 たとえば「総人口 1 万人当たりの小学校数」を算出して、 学校の統廃合や通学支援の必要性を推定する作業は、 多くの自治体で実際に行われている。 こうした分析は単なる集計ではなく、 「翌年度の予算配分をどこに厚くするか」という具体的な意思決定に直結する点が特徴である。
| 分析テーマ | 使用データ(SSDSE-B-2026 該当列) | 意思決定の例 | 典型的な分析手法 |
|---|---|---|---|
| 学校配置の最適化 | A1101(総人口), A4101(出生数), E2101(小学校数) | 小学校の統廃合・通学支援の判断 | 線形回帰、時系列予測 |
| 高齢化対策の優先地域抽出 | A1101(総人口), A1303(65歳以上人口) | 地域包括ケアセンター配置の決定 | クラスタリング、地図可視化 |
| 家計消費の地域差把握 | A1101(総人口), L3221(消費支出) | 生活支援・物価対策の優先順位付け | 感度分析、シナリオ分析 |
| 寒冷地の高齢者見守り | B4101(年平均気温), A1303(65歳以上人口) | 見守り・除雪支援の重点配分 | 相関分析、地図可視化 |
| 人口動態モニタリング | A4101(出生数), A4200(死亡数), A1101(総人口) | 将来人口推計・予算編成 | 時系列予測、自然増減分析 |
これらのテーマで重要なのは、 単一指標の数値ではなく「複数指標の組み合わせから物語を作る力」である。 たとえば「人口が減っているのに消費支出は高い県」は、 一世帯あたりの生活水準が保たれている可能性があり、 単純に「人口減 = 衰退」と決めつけてはいけない。 SSDSE-B-2026 のような多次元データセットを使う最大の意義は、 こうした多角的な視点を一度に検証できる点にある。
企業でのデータ活用の三層構造
企業のデータ活用は「業務効率化」「マーケティング最適化」「新規事業創出」の三層に分けて整理できる。 第一層は経理・人事・在庫管理など既存業務のコスト削減であり、 BI ツールによる定型レポートの自動化が中心である。 第二層は顧客分析・需要予測・広告配信最適化など、 売上を伸ばすための活用である。 第三層は AI を活用した新規サービス開発であり、 画像認識による検品自動化や自然言語処理による問い合わせ対応などが該当する。 多くの企業は第一層から始めて、 段階的に上の層へ進む。 SSDSE-B-2026 のような公開データを使った勉強は、 主に第二層と第三層への足掛かりになる。
| 活用層 | 主な目的 | 使われるデータ | 典型的なツール | 導入難易度 |
|---|---|---|---|---|
| 第一層: 業務効率化 | コスト削減・工数削減 | 社内基幹システムのデータ | Excel, Tableau, Power BI | 低 |
| 第二層: マーケティング最適化 | 売上向上・顧客満足度向上 | POS, Web アクセスログ, CRM | Python, R, GA4 | 中 |
| 第三層: 新規事業創出 | 新規収益源の確立 | センサー, 画像, テキスト, 公開データ | TensorFlow, PyTorch, Cloud AI | 高 |
第一層は「データを見ることに慣れる」段階であり、 第二層は「データから意思決定を変える」段階、 第三層は「データそのものを製品にする」段階と言い換えてもよい。 多くの新人データサイエンティストが配属直後に苦労するのは、 第一層から飛び級で第三層に挑戦してしまうパターンである。 まずは社内の既存業務に染み込ませる第一層から始めて、 組織のデータリテラシーを底上げするほうが、 結果として長期的な ROI が高くなることが多い。
研究機関でのデータ活用と「再現可能性」の重視
研究機関でのデータ活用は、 自治体や企業と比べて「再現可能性」を最優先する点が大きく異なる。 同じデータ・同じコード・同じ環境で誰がやっても同じ結果が出ることが、 研究としての価値の前提条件となる。 そのため Jupyter Notebook の公開、 Git によるコード管理、 DOI 付きのデータセット公開(Zenodo・figshare 等)が標準的な作法として求められる。 SSDSE-B-2026 はそもそも教育・研究用に標準化されたデータセットであり、 「同じ csv を全員が共有する」という前提が崩れない点で、 再現可能性の練習に非常に向いている。
再現可能性を担保するための実践として、 (1) 環境固定 (requirements.txt, conda environment.yml), (2) コードのバージョン管理 (Git tag), (3) データのハッシュ値記録 (sha256sum) の三点セットが推奨される。 これらは研究機関の流儀だが、 企業でも本番運用のモデルでは同等の管理が必要となる。 「研究 = 厳密」「企業 = ゆるい」という二分法ではなく、 むしろ「企業も研究機関の作法を取り入れるべき」というのが近年の流れである。
📈 データ活用プロジェクトの「失敗パターン 10 選」と回避策
データ活用プロジェクトが「期待した効果が出なかった」「途中で頓挫した」ときの理由の多くは技術的な失敗ではなく、 企画・組織・期待値管理の失敗である。 ここでは現場で頻出する 10 のパターンを整理し、 それぞれに対する具体的な回避策を提示する。 SSDSE-B-2026 を使った演習や、 統計・データ解析コンペティションの参加でも、 これらのパターンを意識しておくと、 単なる「コードが動いた」を超えた、 説得力のある分析へと進化できる。
パターン 1-5: 企画段階の失敗
| # | 失敗パターン | 典型的な症状 | 回避策 |
|---|---|---|---|
| 1 | 目的曖昧症候群 | 「とりあえずデータを集める」が続き、何を予測するか決まらないまま半年が過ぎる | プロジェクト開始時に「予測対象の変数名と KPI」を A4 一枚に書く |
| 2 | データ無し見切り発車 | 本当に必要なデータが存在しないことに気付かず、企画書だけ作って予算化してしまう | 企画段階で実データのサンプル 100 行を実際に入手し、可否を確認 |
| 3 | KPI 不一致 | 分析チームの KPI(精度)と現場の KPI(売上)が異なり、成果評価で揉める | キックオフで KPI ツリーを作成し、関係者全員で署名 |
| 4 | 万能 AI 期待 | 「AI を使えば何でもできる」という期待値で予算が降りるが、実際には限界がある | 類似事例のベンチマーク数値を提示し、現実的な期待値に着地 |
| 5 | 過剰スコープ | 「全社のデータを統合して全部 AI 化する」など、初手で大きすぎる目標を設定 | 3 ヶ月で完結する PoC(概念実証)に分解 |
これら 5 パターンは、 いずれも「データを触る前」の段階で起きる失敗である。 つまり、 どんなに優秀なデータサイエンティストがいても、 企画段階で潰されたプロジェクトは挽回できない。 SSDSE-B-2026 を使った学習でも、 「どの列を予測対象にするか」を最初に決めるだけで、 分析の質が劇的に上がる。 これは「目的駆動分析」と呼ばれ、 探索的分析と並んで、 データ活用の二本柱とされる。
パターン 6-10: 実行・運用段階の失敗
| # | 失敗パターン | 典型的な症状 | 回避策 |
|---|---|---|---|
| 6 | データ品質問題 | 分析開始後に欠損・重複・誤入力が大量に判明し、データクリーニングだけで予算が尽きる | プロジェクト工数の 40-60% をクリーニングに割り当てる前提で計画 |
| 7 | 過学習見過ごし | 訓練データでは精度 99% だが、本番投入したら精度 60% に低下 | 交差検証・ホールドアウトテストを必須化、本番データで検証 |
| 8 | ブラックボックス問題 | モデルの精度は高いが、現場の人が「なぜそう判断したか」を説明できず、運用拒否 | SHAP・LIME 等の説明手法を最初から組み込む |
| 9 | 運用引き渡し失敗 | 分析チームが作ったモデルを情報システム部が運用できず、塩漬けになる | 運用引き渡しのドキュメント・運用テストを成果物に明示 |
| 10 | モデル劣化放置 | 運用開始後、データ分布が変化したのに再学習されず、徐々に精度が低下 | モニタリング指標・再学習トリガーを SLA に明記 |
パターン 6-10 は実行・運用段階の失敗である。 興味深いのは、 これら 5 つはいずれも「データサイエンティストの仕事ではない」と思われがちな領域だが、 実際にはデータサイエンティストが主導しないと対処できないことが多い。 「モデルを作るのが私の仕事、 運用は別の人」という分業意識が、 そのままパターン 9・10 の温床になる。 良いデータサイエンティストは、 自分の作ったモデルがどう運用され、 どう劣化するかまで見通して設計する。
失敗を「学び」に変える事後検証の作法
失敗パターンを一度経験すると、 次回以降の意思決定が大きく変わる。 しかし、 多くの組織は「失敗を隠す」文化があり、 同じ失敗を別チームが繰り返してしまう。 これを防ぐには、 プロジェクト終了時に必ず Postmortem(事後検証)を実施し、 (1) 何を期待していたか、 (2) 何が起きたか、 (3) なぜ起きたか、 (4) 次回どうするか、 の四項目を文書化することが推奨される。 Google や Netflix などの IT 企業では、 Blameless Postmortem(責任追及なしの事後検証)が標準化されており、 「個人の責任を問わずに、 仕組みの問題を抽出する」ことで、 心理的安全性を保ちながら学習サイクルを回している。
🌐 関連手法・派生
データ利活用 と同じ「社会」カテゴリ、 または直接の上位・派生となる用語:
🌐 オープンデータと SSDSE の活用ライフサイクル
データ活用は「データ収集 → クレンジング → 分析 → 可視化 → 意思決定 → 効果測定」のサイクル。 SSDSE-B-2026 のような統合データセットを使うと、最初の 2 段階(収集・クレンジング)の手間を大きく減らせる。ただし単位や調査年などの注記は自分で確かめる必要がある。 EBPM の普及には、 SSDSE のような「分析準備済」データの整備が鍵となる。
この「92% 削減」が EBPM 普及の決定打。 自治体が外部委託せずに内製で KPI を回せるようになる。 SSDSE は単なるデータではなく、 行政 DX の触媒装置といえる。
📈 散布図で読み解くデータ活用の典型 ― 人口と65歳以上人口
データ活用の出発点は「2 変数の関係を可視化する」こと。 下の散布図は SSDSE-B-2026 の 47 都道府県データから「総人口 (A1101)」と「65歳以上人口 (A1303)」をプロットしたもので、 強い正の相関 (相関係数 約 0.99) が一目で読み取れる。 人口規模が高齢者数をほぼ規定するという関係を、 公式統計で「実証」できることがデータ活用の第一歩である。
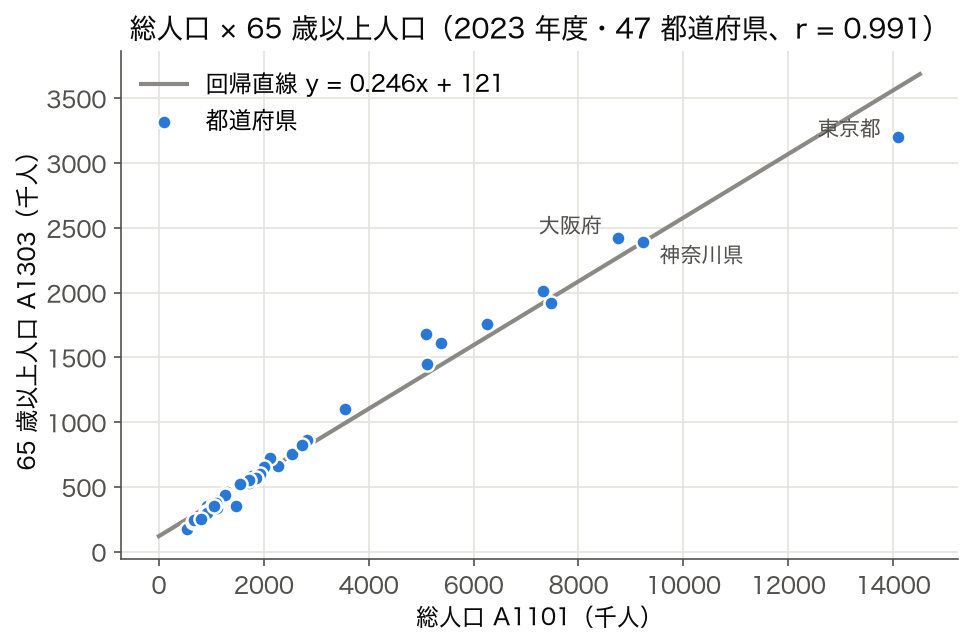
この図から得られる「データ活用上の示唆」は 3 つある。 第一に「線形回帰で人口から高齢者人口を予測できる」こと。 第二に「東京も回帰直線の近くにいるが、 直線の予測 (約 358 万人) より約 38 万人少ない 320.5 万人で、 若い人口の流入で高齢者比率が低い」こと (一極集中の構造)。 第三に「地域比較 KPI を考えるなら、 総数ではなく高齢化率 (割合指標) に切り替える必要がある」こと。 同じ 2 変数でも、 加工次第で得られる政策示唆は大きく変わる。
| 読み取り視点 | 図から分かること | データ活用での意味 |
|---|---|---|
| 相関の強さ | 右上がりがほぼ直線 | 人口は高齢者人口の強い予測子 |
| 外れ値の有無 | 東京が右上に飛び出す | 回帰分析で影響大、 ロバスト化要検討 |
| 下位群の密集 | 左下に 30 県以上が集中 | 地方間の差は小さい、 比較分析は対数軸が有効 |
| 傾きの解釈 | 人口の約 3 割が 65 歳以上 | 全国平均的な高齢化水準、 県別比較の基準 |
EBPM (Evidence-Based Policy Making) では、 こうした散布図 1 枚から「次に何を分析すべきか」を決める。 例えば「高齢化率の地域差」が次の問い、 「出生率との関係が地域の将来像を決めるか」がその次の問い、 と階層的に深掘りしていく。 データ活用の本質は「1 枚のグラフで政策の出発点を可視化する」スキルである。
📊 ヒストグラムで分布を捉える ― 人口の地域不均衡
単変量の分布を見ることで、 「平均値だけでは見えない不均衡」を捉えるのがデータ活用の基本作法。 47 都道府県の総人口は、 平均が約 265 万人だが、 中央値は約 155 万人で、 強い右裾分布をなす (47 県中 35 県が平均未満)。 つまり「平均的な県」は存在せず、 東京・大阪などの大都市が分布全体を引き伸ばしている。
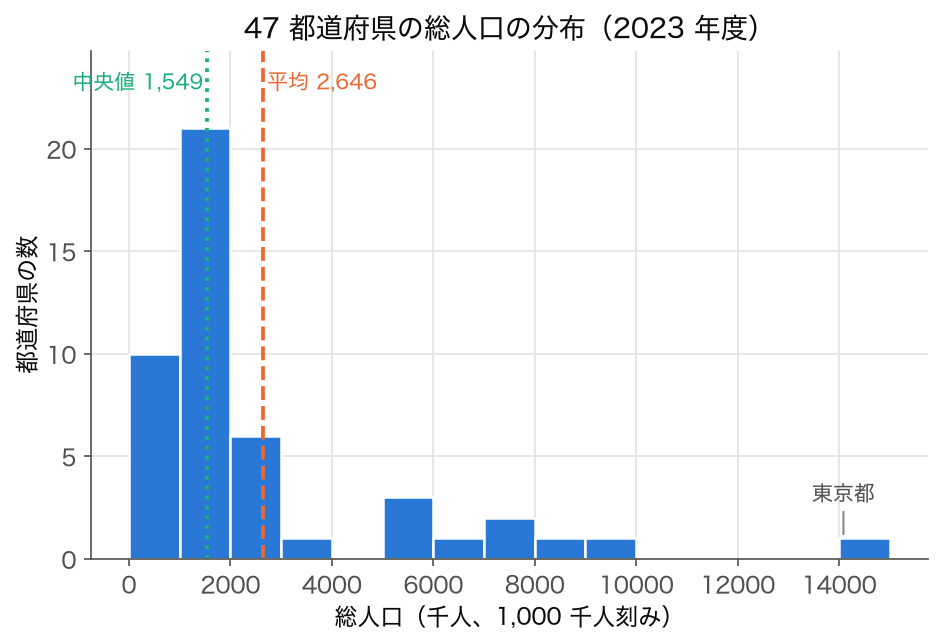
この分布形状から得られる「データ活用の教訓」は明確だ。 (1) 全国平均で議論する政策は、 過半数の県にとって過大評価か過小評価になる。 (2) 中央値・四分位を併記することで、 「典型的な地方県」と「都市圏」の二極構造が見える。 (3) 人口に依存しない指標 (人口比率・人口 1 万人あたり) を作ることで、 ようやく県間比較が公平になる。
| 統計量 | 値 (千人) | 読み方 |
|---|---|---|
| 平均 | 約 2,646 | 東京・大阪に引きずられた値 |
| 中央値 | 約 1,549 | 「典型的な県」の実像 |
| 第 1 四分位 | 約 1,034 | 下位 25% は約 100 万人以下 |
| 第 3 四分位 | 約 2,637 | 上位 25% は約 260 万人超 |
| 最大値 (東京) | 約 14,086 | 分布を歪める単独外れ値 |
データ活用で「平均だけ報告する」のは最も危険な失敗例。 ヒストグラム 1 枚で分布の形を確認し、 必要に応じて対数変換や正規化を行うことが、 適切な意思決定への第一歩となる。
🎯 箱ひげ図で多群比較 ― 地域ブロック別の人口分布
データ活用が「単独の数値」ではなく「群間比較」になった時、 最も汎用的に使える可視化が箱ひげ図である。 下の図は、 8 地方ブロック (北海道・東北・関東・中部・近畿・中国・四国・九州沖縄) ごとの人口分布を箱ひげで並べたもの。 関東ブロックが圧倒的に高い水準にあり、 中央値・第 3 四分位ともに他ブロックを上回ることが視覚的に明白になる。
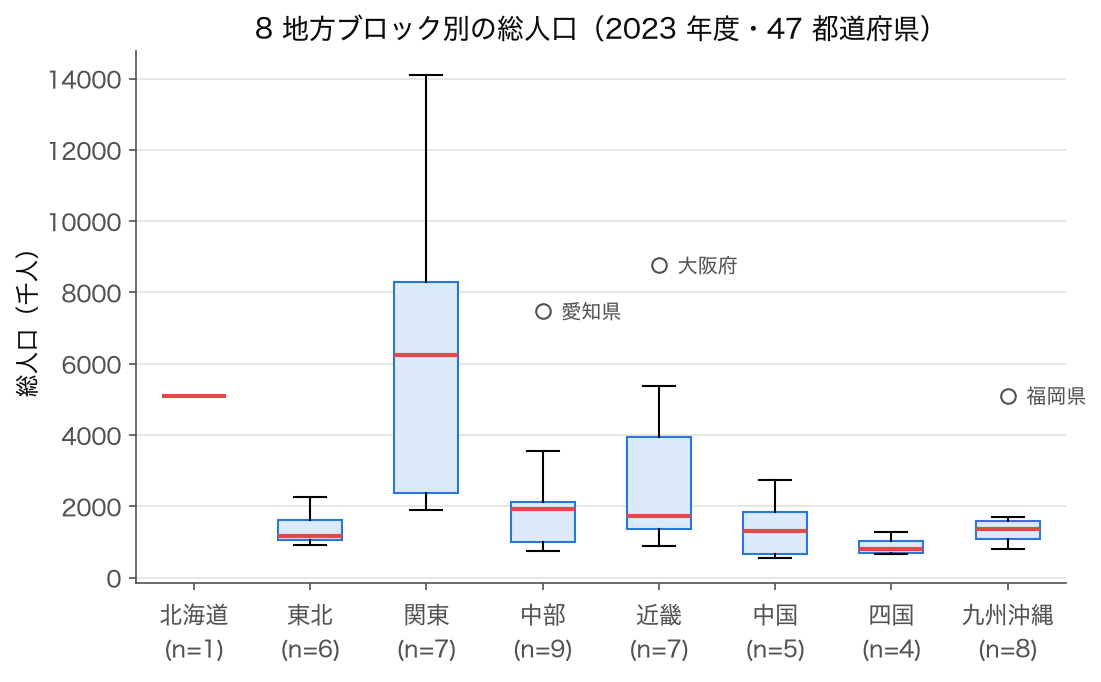
箱ひげ図がデータ活用で重宝される理由は 3 つ。 (1) 「中央値・四分位範囲・外れ値」を 1 枚で示せる。 (2) 群間の「ばらつきの大きさ」も比較できる。 (3) 外れ値の位置から「特異な事例 (例: 中部の愛知・近畿の大阪・九州沖縄の福岡) 」を可視化できる。 EBPM の地域分析では、 全国一律の数値より「ブロック別の中央値と分散」が政策設計の出発点になる。
| ブロック | 中央値 (千人) | 特徴 |
|---|---|---|
| 関東 | 約 6,257 | 箱の幅が最大 (IQR 約 5,900)。 そのため東京 (14,086) も外れ値判定にかからない |
| 近畿 | 約 1,727 | 大阪・兵庫で上振れ (大阪は外れ値) |
| 中部 | 約 1,931 | 愛知が突出 (外れ値)、 他県は 74〜356 万人 |
| 九州沖縄 | 約 1,368 | 福岡が外れ値、 他は 80〜171 万人 |
| 東北 | 約 1,174 | 宮城 (226 万人) 以外は 91〜177 万人 |
| 中国 | 約 1,298 | 広島・岡山以外は 130 万人以下 |
| 北海道 | 約 5,092 | 単独 1 道、 箱は描けない |
| 四国 | 約 810 | 最小ブロック、 愛媛 (129 万人) 以外は 100 万人未満 |
こうしたブロック別の構造把握こそ、 「全国平均では見えない地域格差」を浮き彫りにするデータ活用の真髄。 国の政策設計で「地方創生交付金をどう配分するか」を議論する際、 箱ひげの中央値・四分位範囲が「ブロックごとの基準値」を提供する根拠データになる。
🏛 業界別データ活用の典型事例 (詳細版)
データ活用は業界ごとに「典型タスク」「使うデータ」「狙う KPI」が大きく異なる。 ここでは主要 8 業界について、 公的データ・SSDSE-B-2026 で再現可能な分析テーマを整理する。
| 業界 | 典型タスク | 使うデータ | 狙う KPI |
|---|---|---|---|
| 小売・EC | 需要予測・店舗立地 | POS, 人口統計, 商圏データ | 売上前年比、 在庫回転率 |
| 金融 | 信用スコア・不正検知 | 取引履歴, クレジット情報 | 貸倒率、 不正検出精度 |
| 医療・公衆衛生 | 病床配置・疫学 | レセプト, 患者統計, NDB | 在院日数、 死亡率 |
| 行政・自治体 | EBPM・KPI 評価 | SSDSE, 国勢調査, e-Stat | 住民満足度、 施策実施率 |
| 製造業 | 予知保全・品質管理 | センサー, 生産ログ | 歩留り、 故障率 |
| 運輸・物流 | 配車最適化・需要予測 | GPS, 配送履歴 | 配送時間、 燃費 |
| 教育 | 学習履歴分析・進路指導 | LMS ログ, 成績データ | 合格率、 学習継続率 |
| 農業 | 収量予測・気象連携 | 気象, 衛星画像, 土壌 | 収量、 病害発生率 |
どの業界でも共通するのは「データを KPI に変換するための仮説」が最重要という点。 たとえば医療業界の「在院日数を 1 日短縮できれば年間 X 億円のコスト削減」、 教育業界の「学習継続率 10% 改善で合格率 5% 向上」など、 「データ → KPI → 経済価値」の鎖がきちんと設計されていれば、 ROI 計算ができる。 これがデータ活用プロジェクトの成否を分ける鍵となる。
学生が初めて手をつけるなら、 SSDSE-B-2026 を使った「行政・自治体」が最も再現性が高い。 47 都道府県という適度なサンプルサイズ、 100 を超える変数、 全データが整形済 (欠損極少)、 という三拍子で、 統計入門に最適な教材となっている。
💰 データ活用 ROI の詳細計算 (現実値ベース)
「データ活用に投資すべきか」を判断するには ROI (Return on Investment) を見積もる必要がある。 ここでは小売店 100 店舗チェーンが「需要予測 AI を導入する」ケースを想定し、 投資・効果・回収期間を数値化する。 数値はすべて説明のための仮定で、実在の事例の統計ではない。
| 項目 | 金額 (年額) | 算出根拠 |
|---|---|---|
| 初期投資 (システム構築) | 5,000 万円 | クラウド + データ基盤 + 開発委託 |
| 運用費 (年間) | 1,500 万円 | クラウド + 保守 + データサイエンティスト 1 名 |
| 在庫削減効果 (年間) | +3,000 万円 | 100 店舗 × 平均 30 万円の在庫削減 |
| 機会損失減 (欠品削減) | +2,500 万円 | 100 店舗 × 平均 25 万円の売上回復 |
| 人件費削減 (発注業務) | +1,800 万円 | 100 店舗 × 0.3 人月 × 60 万円 |
| 純利益 (年間) | +5,800 万円 | (効果 7,300 - 運用 1,500) 万円 |
| 回収期間 | 約 11 ヶ月 | 5,000 ÷ 5,800 万円/年 |
この試算では初年度から純利益が出る計算になるが、 実際には「データ整備期間 (3〜6 ヶ月) 」「現場の業務変革に伴う混乱」を考慮すると、 回収まで 18〜24 ヶ月見ておくのが現実的。 重要なのは「ROI の式そのもの」よりも、 「効果項目と根拠を明示する」というプロセスである。 経営層への説明資料として、 こうしたテーブルは必須となる。
なお、 ROI 計算には「失敗確率」も織り込む必要がある。 IPA の調査では DX プロジェクトの成功率は約 30%、 つまり期待値ベースでは ROI を 3 分の 1 程度に割り引いて評価するのが安全。 「100% うまくいく前提の試算」は、 経営判断を誤らせる典型的な落とし穴となる。
🏢 データ活用組織の典型構造 ― 4 つのモデル比較
データ活用を組織として推進するには「誰がどこに座るか」を決める必要がある。 大きく分けて 4 つの組織モデルが知られており、 企業規模・成熟度・文化に応じて選択する。
| モデル | 配置 | 強み | 弱み | 適合企業 |
|---|---|---|---|---|
| 中央集権型 | 全データ人材を 1 部署に集約 | スキル共有、 技術標準化 | 現場との距離、 ボトルネック化 | 中堅企業 (50〜500 人) |
| 分散型 (事業部内) | 各事業部に専属人材 | 現場理解、 即応性 | スキルのサイロ化 | 大企業 (1000 人+) |
| ハブ&スポーク型 | 中央 CoE + 事業部担当 | 標準化と現場性の両立 | 調整コスト大、 人材確保難 | 先進大企業 |
| 外部委託型 | SI ベンダー・受託会社 | 初期投資小、 即着手可 | ノウハウ蓄積されず | 小企業・試行段階 |
日本企業の多くは「外部委託型」からスタートし、 数年かけて「中央集権型」へ、 さらに成熟すると「ハブ&スポーク型」へと進化するパターンが典型。 ただし、 組織モデルだけ真似ても成果は出ない。 「経営層のコミットメント」「現場の業務変革を許容する文化」「失敗を許容するスポンサーシップ」の三本柱が、 どのモデルでも成功要因となる。
SSDSE のような公的データを使った内製分析は、 「中央集権型」の初期段階で取り組むのに最適な題材。 自治体・大学・研究機関では、 これを「全社員のデータリテラシー底上げ」教材として活用する事例が増えている。
⚖️ データ活用の倫理 ― 6 つの実務的禁則
データ活用は「できること」と「すべきこと」が違う典型分野。 法律で禁止されていなくても、 倫理的に問題のある活用は社会的信頼を失わせる。 ここでは実務で頻発する 6 つの禁則を整理する。
- 属性プロファイリングによる差別的推論: 性別・国籍・年齢を直接使わなくても、 居住地郵便番号や名前から推論して融資判断に使うのは禁則。 米国の Apple Card 事件 (女性が低スコア) はこの典型。
- 匿名化済データの再特定化: 公開された匿名データを別データと結合して個人を特定する行為。 Netflix Prize 事件 (IMDB と照合で個人特定) が代表例。 公開時は k-匿名性・差分プライバシーの担保が必須。
- 同意なき二次利用: 「会員登録時に同意した」だけで広範な目的に転用するのは違法・違反。 GDPR・改正個人情報保護法では「目的外利用は再同意が必要」と明示。
- 因果と相関の取り違え: 「相関があるから対策を打つ」のは因果関係を確認しないと逆効果。 例: 「アイスクリーム消費と溺死率の相関」 → 真因は気温。
- 欠損データの黙殺: 「欠損は除いて分析」は MCAR (完全ランダム欠損) でない限り偏りを生む。 欠損メカニズムの分析と多重代入が必須。
- 外れ値の恣意的除外: 「外れ値だから除く」を都合よく適用すると、 結論を操作する余地を与える。 除外基準は事前登録 (pre-registration) しておく。
これらを避けるには「データ活用倫理チェックリスト」を組織で標準化し、 プロジェクト開始前に全員でレビューするプロセスが有効。 多くの大手企業 (Google, Microsoft, NTT) は AI Ethics Board を設置し、 倫理リスクをガバナンス上の正式議題としている。
✅ 理解度チェック
以下の問いに答えて、 データ活用の本質的理解を確認しよう。 答えは自分の言葉で構築すること (暗記ではなく)。
- Q1. 「データ活用」と「データ分析」の違いを 100 字以内で説明せよ。
解答例
データ分析は「データから知見を得る」技術的作業、 データ活用は「得た知見を意思決定や業務改善につなげる」組織的プロセス。 分析は手段、 活用は目的という関係。
- Q2. SSDSE-B-2026 を使った EBPM の典型例を 1 つ挙げ、 「使う変数 → 分析手法 → 政策示唆」を 3 段階で書け。
解答例
使う変数: 「総人口 (A1101) 」「小学校数 (E2101) 」 → 分析手法: 「人口 1 万人あたりの小学校数」を都道府県別に算出し、 散布図でクラスタリング → 政策示唆: 小学校数が過小な大都市圏には新設を、 小規模校が点在する過疎地には統廃合と通学支援を配分する。
- Q3. データ活用 ROI の試算で「割り引いて評価すべき要因」を 3 つ挙げよ。
解答例
(1) プロジェクト失敗確率 (IPA 調査で約 70%)、 (2) 業務変革に伴う現場の生産性一時低下、 (3) データ整備期間中の機会損失。 これらを織り込まないと、 経営判断が過度に楽観的になる。
- Q4. 「中央集権型」と「ハブ&スポーク型」のデータ組織モデルの違いを述べ、 大企業がハブ&スポーク型を選ぶ理由を説明せよ。
解答例
中央集権型は全データ人材を 1 部署に集約しスキル共有を優先するが、 現場との距離が出る。 ハブ&スポーク型は中央に CoE (Center of Excellence)、 各事業部に担当を配置し、 標準化と現場性を両立する。 大企業は事業の多様性が大きいため後者を選ぶ。
- Q5. 「データ活用の倫理的禁則」のうち、 学生・初心者が最も陥りやすいものはどれか。 1 つ挙げて理由を述べよ。
解答例
「因果と相関の取り違え」が最も陥りやすい。 相関係数が高いと「原因が分かった」と早合点しがちだが、 第三の交絡変数 (温度・人口・経済規模) が真因のケースが大半。 因果推論には RCT や反事実分析が必要、 という基本姿勢を最初に身につけるべき。
- Q6. 散布図・ヒストグラム・箱ひげ図のそれぞれが「どんな問いに最初に答えるのに使うか」を簡潔に答えよ。
解答例
散布図: 「2 変数に関係があるか」 (相関の有無と外れ値)。 ヒストグラム: 「1 変数の分布形状はどうか」 (中央値・歪み・モード数)。 箱ひげ図: 「複数群でどう違うか」 (中央値・ばらつき・外れ値の群間比較)。
全問正解できれば、 データ活用の「技術 + ビジネス + 倫理」3 軸を統合的に理解できている証拠。 SSDSE-B-2026 を使った演習へ進む準備が整っている。
📂 SSDSE で再現できるデータ活用ケーススタディ 5 選 (詳細手順付き)
ここでは SSDSE-B-2026 を使って、 学生が 1 週間程度で完成できるデータ活用ケースを 5 つ詳細手順とともに紹介する。 すべて pandas + matplotlib で実装でき、 数行〜数十行のコードで本質的な分析にたどり着ける。
ケース 1: 人口あたりの小学校数と学校配置
SSDSE-B-2026 の「総人口 (A1101)」「出生数 (A4101)」「小学校数 (E2101)」を使い、 都道府県別の「人口 1 万人あたり小学校数」を算出する。 続いて散布図で「人口規模」との関係を見ると、 過疎県ほど小規模校が点在する傾向が明白になる。 大都市圏の値が小さいのは学校が足りないからとは限らず、1 校あたりの児童数が多い(大規模校)ことの表れでもあるので、児童数 E2501 ÷ 小学校数で 1 校あたりの規模も並べてから、過疎地の統廃合・通学支援と、大都市圏の過密対策を分けて検討する。 分析時間: 約 2 時間、 政策レポートまで含めて 1 日。
ケース 2: 高齢化率と出生率の地域差
「65 歳以上人口 (A1303)」「出生数 (A4101)」「総人口 (A1101)」を組み合わせ、 「高齢化率 vs 出生率」を散布図化する。 両者には負の相関 (相関係数 約 -0.6) が確認でき、 少子と高齢化が同じ地域で同時に進むことが読み取れる。 将来推計と組み合わせれば、 地域包括ケアと子育て支援の優先順位づけの根拠分析になる。
ケース 3: 市場規模と購買力の関係性
「総人口 (A1101)」「消費支出 (L3221)」の 2 変数で「市場規模 × 購買力」マトリクスを作り、 出店戦略を検討する。 人口と消費支出の相関は r≈0.33 と弱く(消費支出は県庁所在市の二人以上の世帯の 1 か月の値なので、県全体の購買力そのものではない点にも注意)、 「人口が多い=購買力が高い」とは限らないことが分かる。 人口だけで市場を測る危うさを、 公的統計で確認できる好例。
ケース 4: 年平均気温と高齢化率の関係
「年平均気温 (B4101)」「65 歳以上人口 (A1303)」「総人口 (A1101)」を用い、 「気温」と「高齢化率」の相関を分析する。 相関係数は約 -0.45 で、 「寒冷な県ほど高齢化が進む」傾向が中程度に見られる。 気候と人口動態という一見無関係な指標の関係を可視化でき、 交絡(過疎・産業構造)を考える訓練になる。
ケース 5: 5 変数のクラスタリングで県を類型に分ける
「総人口 (A1101)」「65 歳以上人口 (A1303)」「出生数 (A4101)」「消費支出 (L3221)」「年平均気温 (B4101)」の 5 変数で K-means クラスタリングを行い、 都道府県を似たタイプに分類する。 各クラスタの重心を比較すると「大都市圏/高齢先進地域/中間」といった構造が浮かび、 政策パッケージを類型別に設計する根拠になる。
これら 5 ケースは、 すべて以下の共通手順で進められる: (1) 必要な変数を pandas で抽出、 (2) 派生指標 (1 人あたり、 比率) を計算、 (3) 散布図・相関係数で関係性を可視化、 (4) 回帰分析で定量化、 (5) 政策提言を 1 ページにまとめる。 この標準フローを 1 度マスターすれば、 他の SSDSE 変数 200+ を組み合わせた応用が無限に展開できる。
🛠 データ活用のための技術スタック ― 初心者・中級者・上級者別
「データ活用を始めたいが、 何のツールを学べば良いか」は最も多い質問。 ここでは習熟度別に推奨スタックを整理する。 すべて無料・オープンソースで揃えられ、 SSDSE 程度のデータなら個人 PC で十分動く。
初心者層 (データ活用 0〜6 ヶ月)
- 分析エンジン: Python 3.11 + pandas + matplotlib (Anaconda 推奨)
- 実行環境: Jupyter Notebook または Google Colab (ブラウザのみで完結)
- データ管理: CSV ファイル + Excel (大きくても数 MB の SSDSE で十分)
- 可視化: matplotlib + seaborn (基本グラフを覚えれば 95% カバー)
- 学習教材: SSDSE 公式チュートリアル + 本サイト用語集
この段階の到達目標は「散布図・ヒストグラム・箱ひげ図を 30 分で描き、 相関係数を計算できる」こと。 1 ヶ月集中すれば誰でも到達できる。
中級者層 (6 ヶ月〜2 年)
- 分析エンジン: 上記 + scikit-learn (機械学習)、 statsmodels (古典統計)
- 実行環境: VS Code + Jupyter 拡張、 Git でバージョン管理開始
- データ管理: SQLite または PostgreSQL (数十 MB〜数 GB のデータ)
- 可視化: plotly (インタラクティブ) + Streamlit (簡易ダッシュボード)
- 学習教材: Kaggle コンペ参加、 査読論文の再現実装
この段階の到達目標は「回帰・分類モデルを学習し、 交差検証で性能評価できる」こと。 SSDSE で「人口予測モデル」を組めれば中級者。
上級者層 (2 年以上)
- 分析エンジン: 上記 + PyTorch/TensorFlow、 XGBoost、 LightGBM
- 実行環境: Docker, Kubernetes, MLflow (実験管理)、 CI/CD パイプライン
- データ管理: クラウド DWH (BigQuery, Snowflake)、 データレイク (S3, GCS)
- 可視化: Tableau, Power BI (BI ツール)、 D3.js (カスタム可視化)
- 学習教材: 論文実装、 OSS コントリビュート、 国際カンファレンス発表
この段階の到達目標は「本番運用に耐える MLOps パイプラインを設計できる」こと。
重要なのは「いきなり上級者ツールに手を出さない」こと。 初心者が Kubernetes や PyTorch から入ると、 本質的な統計理解を飛ばしてしまう。 SSDSE のような小さなデータで「データから示唆を引き出す力」を鍛えるのが、 最終的に最も価値の高いスキルとなる。
🌐 データ活用の未来 — 生成 AI 時代と公的データの新しい使い方
2023 年以降の生成 AI の急速な普及は、 データ活用の常識を大きく塗り替えた。 従来は「データを集めて分析するのは専門家」が前提だったが、 ChatGPT や Claude のような対話型 AI を使えば、 専門知識がなくても自然言語で「このデータを分析してください」と頼めば、 ある程度の分析結果が返ってくる時代になった。 これは「データ活用の民主化」と呼ばれ、 自治体職員・教員・市民研究者など、 これまでデータと縁遠かった人々が分析の現場に参入する道を開いた。 SSDSE-B-2026 のような公開データセットは、 まさにこの民主化の燃料となるリソースである。
生成 AI とデータ活用の新しい役割分担
| タスク | 従来(人間が担当) | 生成 AI 時代 | 人間の新しい役割 |
|---|---|---|---|
| データ前処理 | pandas で手書きコード | 自然言語で指示 → コード生成 | 生成されたコードのレビュー・品質保証 |
| 探索的分析 | matplotlib でグラフ描画 | AI に「特徴を教えて」と依頼 | 仮説生成・解釈・反証 |
| レポート作成 | Word/PowerPoint で清書 | AI が下書きを生成 | 誤りチェック・物語の組み立て |
| コード説明 | コメント付きコードを読む | AI が逐行解説 | 説明の妥当性検証 |
| 意思決定 | 分析結果を見て判断 | AI が推奨案を提示 | 倫理・コンテキスト判断・最終責任 |
注目すべきは、 すべての行で「人間の役割が消える」のではなく、 「人間の役割が高度化する」点である。 単純作業(コーディング・清書)は AI に任せ、 人間は判断・解釈・倫理に集中する。 これは「データサイエンティストの仕事がなくなる」のではなく、 「データサイエンティストに求められるスキルが、 コードから判断へとシフトする」という意味である。 SSDSE-B-2026 を学ぶときも、 単にコードを写経するのではなく、 「なぜこの分析をするのか」「結果から何を主張するか」を常に問いながら進めることが、 AI 時代に生き残るデータ人材への近道となる。
オープンデータ活用の新潮流
公的データの公開と活用は、 過去 10 年で大きく進歩した。 政府の e-Stat、 自治体オープンデータポータル、 RESAS(地域経済分析システム)など、 アクセス可能なデータは飛躍的に増えた。 SSDSE-B-2026 は、 これら多様な公的統計を「都道府県 × 年次 × 指標」の三次元キューブとして整理したもので、 教育・研究・ビジネス利用のいずれにも適している。 重要なのは「データはあるが、 使われていない」という現状を打破することであり、 そのためには「データを集める側」と「データを使う側」の対話を増やす必要がある。
| オープンデータの種類 | 提供元の例 | 典型的な活用例 | SSDSE-B-2026 との連携可能性 |
|---|---|---|---|
| 政府統計 | e-Stat(総務省) | 人口推計、家計調査 | SSDSE-B-2026 の元データの大半が e-Stat 由来 |
| 地域経済データ | RESAS(内閣府) | 地域別 GDP、人口流動 | 都道府県コードで結合可能 |
| 地理空間データ | 国土地理院、OpenStreetMap | 地図可視化、最短経路 | SSDSE-B-2026 の値を地図に重ねる |
| 気象データ | 気象庁 | 需要予測、災害リスク評価 | 都道府県別気象データと SSDSE を結合 |
| 交通データ | GTFS(公共交通) | 路線最適化、観光ルート設計 | A1101(総人口)で正規化可能 |
| 選挙データ | 総務省選挙部 | 投票率分析、政治学研究 | A1101(総人口)で正規化 |
SSDSE-B-2026 の本当の価値は、 単独で使うときよりも、 他のオープンデータと組み合わせるときに最大化される。 「人口データに気象データを掛けて、 災害リスクを予測する」「人口流動データに観光データを掛けて、 観光戦略を立てる」など、 一つのデータセットでは見えなかった構造が、 結合によって浮かび上がる。 これがデータ活用の醍醐味であり、 一人で完結する分析ではなく、 多分野連携の協働分析が、 これからのデータ活用の主流となる。
学習者へのメッセージ
データ活用は、 統計学・プログラミング・ドメイン知識・倫理・コミュニケーションの五つを横断する総合スキルである。 一つの分野を極めるのではなく、 五つをバランスよく身に付けることが、 これからの「データ人材」に求められる姿である。 SSDSE-B-2026 と統計・データ解析コンペティションは、 この五分野を横断的に練習できる絶好の機会である。 完璧を目指すのではなく、 まず一つのテーマを最後までやり切ることが、 最初の一歩となる。 そして、 やり切った経験は、 必ず次の挑戦の自信につながる。
最後に強調したいのは、 「データ活用は技術ではなく、 物語を作る営み」という視点である。 数値・グラフ・モデルは、 すべて「何を伝えたいか」という物語を支える道具に過ぎない。 物語の核となる「問い」と「主張」がない分析は、 どれだけ技術的に高度でも、 受け手の心を動かさない。 SSDSE-B-2026 を通して、 「自分は何を問い、 何を主張したいか」を見つける旅を始めてほしい。 それこそが、 データ活用の本質である。
補論: 学習の三段階モデルと SSDSE-B-2026 の役割
データ活用の学習は、 大きく三段階に分けて考えると効率が良い。 第一段階は「手を動かす」段階であり、 SSDSE-B-2026 を実際にダウンロードして pandas で読み込み、 簡単な集計(平均、 中央値、 標準偏差)を出すところから始まる。 ここで重要なのは「完璧を目指さない」ことであり、 とにかく結果を画面に出すことを優先する。 第二段階は「問いを立てる」段階であり、 集計結果を眺めながら「なぜ東京の人口は突出しているのか」「なぜ北海道は人口の割に消費支出が伸びないのか」といった疑問を持つようになる。 ここから本格的な分析が始まる。 第三段階は「主張する」段階であり、 自分の分析結果を他人に説明し、 反論を受け、 改善するプロセスを繰り返す。 この三段階を半年から一年かけて経験すると、 自然と「データ活用ができる人材」になっている。
特に第二段階と第三段階の橋渡しとして、 統計・データ解析コンペティションへの参加は非常に有効である。 自分一人で勉強していると、 どこまで分析を深めれば良いか分からなくなることが多いが、 コンペティションでは「審査員に評価される」という外部基準があるため、 自然と分析の質を高めるモチベーションが生まれる。 また、 他チームの発表を聞くことで、 自分が思いつかなかった視点や手法を学べる。 SSDSE-B-2026 を題材としたコンペティションは、 同じデータを使った異なる視点の解析が一堂に会する貴重な場であり、 ここでの経験は将来データを扱う仕事に就いたときに大きな糧となる。
最終的に、 データ活用とは「世の中をよりよくするための実践」である。 統計学・機械学習・可視化・倫理・コミュニケーションといったスキルは、 すべてこの目的に奉仕する手段に過ぎない。 SSDSE-B-2026 という標準化されたデータを通して、 「日本の各地域がどう違うのか」「どこに問題があるのか」「どうすれば改善できるのか」を考え続けることが、 データ活用人材としての成長そのものである。 完璧な分析を目指すよりも、 不完全でも誠実な分析を続けることが、 長期的には大きな差を生む。 一歩ずつ、 着実に、 データと向き合う姿勢を大切にしてほしい。
補論: データ活用と他分野との接続
データ活用は単独で存在するスキルではなく、 政策科学・経営学・社会学・公衆衛生学・教育学など、 ほぼあらゆる学問領域と接続している。 たとえば SSDSE-B-2026 の人口データは、 政策科学の文脈では「地方創生戦略の根拠」となり、 経営学の文脈では「市場規模推計の前提」となり、 公衆衛生学の文脈では「予防医療政策の対象人口」となる。 同じデータでも、 どの学問領域の問いに答えるかで、 分析の枠組みも結論も大きく変わる。 この「ドメインによる読み替え」を意識しながら学ぶことで、 単なる数値処理ではなく、 社会に意味を持つ分析へと深化できる。
特に近年は「データサイエンス × 〇〇」という分野横断型の研究・実務が増えている。 データサイエンス × 医療では電子カルテ解析が、 データサイエンス × 教育では学習ログ解析が、 データサイエンス × 農業ではセンサーデータ解析が花盛りである。 これらに共通するのは、 「データを扱うスキル」だけでなく「対象領域の問いを理解する力」が同時に求められる点である。 SSDSE-B-2026 で都道府県データを扱う経験は、 こうした分野横断型の素地を培う第一歩となる。 都道府県という具体的な単位を扱うことで、 「データの背後にある現実」を常に意識する習慣が身につくのである。
最後に、 データ活用人材としてのキャリアパスを少しだけ紹介する。 入門段階の「データアナリスト」は、 主に過去データの集計と可視化を担当する。 中堅の「データサイエンティスト」は、 機械学習モデルの構築と業務適用を担当する。 上級の「データエンジニア」「MLエンジニア」は、 データパイプラインや本番運用システムを担当する。 さらに「データプロダクトマネージャー」「CDO(最高データ責任者)」のような戦略職もあり、 全社的なデータ戦略を立案する。 これらのキャリアは決して一本道ではなく、 行ったり来たりしながら自分の得意分野を見つけていくものである。 SSDSE-B-2026 で身につけた基礎は、 これらすべてのキャリアの土台となる。 焦らず、 比べず、 自分のペースで歩み続けてほしい。 データ活用の世界は広く、 必ずあなたの居場所がある。
補足として、 国内外のデータ活用コミュニティへの参加も強くお勧めしたい。 国内では「日本統計学会」「日本データサイエンティスト協会」「Kaggle 日本支部」、 国際的には「Kaggle」「PyData」「DataCamp Community」などが活発である。 これらのコミュニティでは、 SSDSE-B-2026 と同じような公開データを使ったコンペティションや勉強会が定期的に開催されており、 同じ志を持つ仲間と交流する場として最適である。 一人で勉強を続けるのは想像以上に難しい。 自分のレベルに関係なく、 まずは観察者として参加してみることから始めて、 徐々に質問・発表・指導へと役割を広げていくことで、 学びの速度が加速する。 SSDSE-B-2026 を題材にした共同分析プロジェクトを立ち上げることも、 仲間と学ぶ良い手段の一つとなる。 他者と議論することで、 自分一人では気付けない盲点を発見でき、 結果として分析の質が飛躍的に向上する。 データ活用の旅は孤独な営みではなく、 仲間と歩む冒険であると心に留めておいてほしい。 コミュニティの仲間こそが、 長期的な学びを支える最大の資産となる。 オンライン勉強会への参加、 GitHub での共同分析リポジトリ、 X や Bluesky 上での分析結果共有など、 まずは小さく始めて継続することが何より大切である。 継続は力なり、 という古い言葉が、 データ活用の世界でも変わらず真理として響き続けるであろう。 日々少しずつデータと向き合う習慣を持ち、 やがて訪れる大きなチャンスに備えてほしい。 そのときの自分が、 きっと今の自分に感謝してくれるはずである。
🗺 セクター別データ利活用シナリオ 8 例
データ利活用は業界によって、 利用する変量・分析手法・期待される成果が大きく異なります。 SSDSE-B-2026 を含む公開データを軸に、 8 つの主要セクターのシナリオを整理します。
| セクター | 主要変量 | 手法 | 期待成果 |
|---|---|---|---|
| 小売・流通 | POS、 天候、 イベント | 需要予測 (Prophet、 XGBoost) | 在庫適正化、 廃棄削減 |
| 製造業 | センサー、 稼働ログ | 異常検知 (Autoencoder) | 設備故障の事前予知 |
| 金融 | 取引履歴、 信用情報 | 信用スコア (Logistic, GBDT) | 不良債権率の低減 |
| 医療・介護 | 電子カルテ、 SSDSE-B 高齢化 | 資源配分最適化 | 医療資源の少ない地域の特定 |
| 教育 | 出席、 成績、 学習履歴 | 学習分析 (Learning Analytics) | 中退率予測、 個別最適化 |
| 行政 | SSDSE 全変量、 GIS | 政策シミュレーション | EBPM (証拠に基づく政策立案) |
| 交通・物流 | GPS、 通行量、 気象 | 経路最適化、 動的価格 | 配送効率 +20%、 渋滞緩和 |
| エネルギー | スマートメーター、 気象 | 需要予測、 需給制御 | 再エネ統合、 ピークカット |
💡 どのセクターでも共通するのは 「ドメイン知識 × データスキル × 倫理判断」の 3 点セット。 ツールや手法は移植可能だが、 業界文化や規制への理解は固有スキル。
👥 データ利活用に必要な人材ロール 6 種類
「データサイエンティスト」一人で何でもやろうとするのは無理筋。 ここでは、データ利活用に関わる役割を 6 種類に分けて整理します(IPA の「DX 推進スキル標準」は人材類型を 5 つに分けており、分け方は資料によって違う)。
| ロール | 主要スキル | 担当領域 |
|---|---|---|
| データエンジニア | SQL、 ETL、 クラウド (AWS/GCP) | データ基盤構築・パイプライン運用 |
| データアナリスト | BI ツール、 SQL、 統計 | レポート作成・KPI 監視 |
| データサイエンティスト | Python、 ML、 統計、 数学 | 予測モデル・高度分析 |
| ML エンジニア | MLOps、 Docker、 推論最適化 | モデルの本番運用・監視 |
| データガバナンス担当 (CDO) | 法令、 倫理、 経営戦略 | 全社的データ戦略・コンプライアンス |
| ドメインエキスパート | 業界知識、 意思決定 | 問いの設定・結果解釈・実装判断 |
💡 中小組織で全 6 ロールを揃えるのは現実的でないため、 「ドメインエキスパート + データアナリスト + 外部委託」の組合せが現実解。 SSDSE-B のような公開データセットを活用すれば、 データエンジニア工数を大幅に削減できる。
🔗 隣接手法への橋渡し
「データ利活用」は単独で完結する手法ではなく、 隣接領域と連携することで真価を発揮する。 具体的には次の 3 方向と密接につながる:
- 上流: データリテラシーと データサイエンスの方法論 — 利活用の前提となる能力
- 並列: AI 応用と BI ツール導入 — 同階層の組織活用施策
- 下流: データ駆動社会と AI と社会 — 個別利活用が積み重なって社会変革に
データ利活用は組織のリテラシーが社会的インパクトに変換される実践フェーズ。
🌳 手法選択フロー
「データ利活用」を実際に使うとき、 何をどう選ぶかを順に判断する。 上から順に答えていくと、 使うべき手法と評価の仕方が決まる。
- その意思決定は今どう行われているか
いま勘や慣例で決めているなら、 まず現状の判断基準を言語化する。 データで置き換えたいのは判断のどの部分かを特定しないと、 分析結果の置き場所が無くなる。 - 必要なデータは手元にあるか、 集める必要があるか
公的統計(SSDSE など)で足りるなら明日から始められる。 新たに集めるなら、 設計・同意・保存期間まで含めて数か月かかる前提で計画する。 - 個人情報を含むか
含むなら、 利用目的の特定・安全管理・第三者提供の可否を先に決める。 匿名化は「したから自由」ではなく、 再識別のリスクが残る程度の問題。 - 効果をどう測るか
導入前の水準を記録しておかないと、 あとから効果を示せない。 比較対象(対照群や導入前の期間)を、 始める前に決めておく。
データ利活用でつまずくのは技術より前段のことが多い。 「何の判断を変えたいのか」が決まっていれば、 使う手法は自然に絞られる。