🔖 キーワード索引
このページ内のセクションへ素早く飛べます(クリックで該当箇所へジャンプ):
「society 5 0」は統計データ分析の文脈で扱う重要概念のひとつ。 本ページでは「society 5 0」を取り巻く中核キーワードを以下にチップで一覧化する。 各キーワードは関連する概念・手法・道具立てを含み、 文献検索や学習計画の起点になる。
これらのキーワードは「society 5 0 の理解 → 適用 → 検証」のプロセスを構成する。 各章で詳しく解説する。
💡 30秒で分かる結論 — Society 5.0
🍰 まずはやさしく
ネットと現実が混ざり合う未来の社会です。
みんなが便利に暮らすために使います。
スマホで街の混雑が分かる仕組みなどです。
この章では結論を短くまとめます。
- 一言で:サイバー空間と現実空間が高度に融合した超スマート社会。 日本政府が掲げる第5の社会像。
- 分野:社会 — 全体像は data-driven-society ページで
- いつ・誰が:2016 年 1 月の第 5 期科学技術基本計画(閣議決定)で日本政府が掲げた社会像。 狩猟・農耕・工業・情報に続く 5 番目の社会、 という位置づけ
- しくみ:センサーで現実の状態を測り、 サイバー空間で AI が解析し、 結果を現実の機器や判断に戻す閉ループ(CPS)を社会全体に広げる
- 解きたい課題:働き手の減少と地域格差。 SSDSE-B-2026 の 2023 年度で、 15〜64 歳人口 ÷ 65 歳以上人口は東京都 2.92 人に対し秋田県 1.33 人
- データで扱うときは:Society 5.0 そのものは数式で定義されない政策概念。 進捗を測るなら指標を自分で選び、 重みの付け方で順位が変わることを明記する
📍 あなたが今見ているもの
🍰 まずはやさしく
日本の未来を描いた大きな計画です。
社会の困りごとを解決するために使います。
学校や地域の課題をデータで直すことです。
この章では全体の構成について読みます。
内閣府の科学技術基本計画(第5期)で提唱。 IoT/AI/ビッグデータが社会課題を解決する未来社会の構想。 SDGs と並んで日本の政策キーワード。
この用語に出会うのは、 まず政府の文書である。 第 5 期科学技術基本計画(2016 年)で初めて示され、 第 6 期科学技術・イノベーション基本計画(2021 年)でも目指す社会像として引き継がれた。 高校の「情報 I」や「公共」の教科書、 自治体の DX 計画や総合計画、 企業の中期経営計画にも登場する。 どの文書でも「少子高齢化・地域格差をデータと技術で解く」という筋書きが共通しているので、 読むときは「どの課題を、 どの数字で測っているか」に注目すると内容を比べやすい。
🎨 直感で掴む — Society 5.0とは何者か
🍰 まずはやさしく
データの力で生活を良くするイメージです。
何が嬉しいのかを実感するために使います。
部活の練習メニューをデータで決めることです。
この章では具体的な活用例を読みます。
Society 5.0 は、 人類の社会を「狩猟(1.0)→ 農耕(2.0)→ 工業(3.0)→ 情報(4.0)」と数えたときの 5 番目にあたる。 4.0 と 5.0 の違いは、 データを誰が見て、 誰が動かすかにある。
| 場面 | 情報社会(4.0) | Society 5.0 が目指す姿 |
|---|---|---|
| 地方のバス | 利用者がネットで時刻表を調べ、 決まった便に合わせる | 乗りたい人の位置と人数から、 AI が便と経路をその場で組み替える(オンデマンド交通) |
| 高齢者の見守り | 家族が電話や訪問で様子を確かめる | 家電やセンサーの使用状況から異変を検知し、 必要なときだけ人に知らせる |
| 農業 | 気象サイトを見て、 経験で水やりを決める | 畑のセンサーと気象データから、 水やりや収穫の時期を自動で提案する |
どの例も「人がデータを探しに行く」から「データが集まって、 判断や機械に自動で返ってくる」への変化になっている。 なぜそれが必要かは数字で見える。 SSDSE-B-2026 で高齢者 1 人を支える 15〜64 歳の人数は、 全国で 2012 年度の 2.60 人から 2023 年度の 2.04 人に減り、 秋田県では 1.33 人しかいない。 人手で回していた見守りや移動の仕組みを、 同じ人数で維持できなくなる地域が増えている、 というのが Society 5.0 の出発点である。
📐 数式・定義
🍰 まずはやさしく
人間を中心に考えた社会の定義です。
今の進み具合を正しく測るために使います。
買い物のデータで店を便利にすることです。
この章では詳しい意味や指標を読みます。
Society 5.0 は数式で定義される統計量ではなく、 内閣府『第 5 期科学技術基本計画』(2016) による 概念的定義が本体です。 すなわち「サイバー空間 (仮想空間) とフィジカル空間 (現実空間) を高度に融合させたシステムにより、 経済発展と社会的課題の解決を両立する、 人間中心の社会」を指します。
したがって「Society 5.0 の数式」というものは存在しません。 代わりに、 政策評価 (EBPM) の場面では 進捗を測る合成指標 (KPI) を式で表すことがあります。 本ページでも下記のように、 デジタル基盤・データ流通・社会課題解決・Well-being の 4 軸を束ねた簡易 KPI を扱います。
📐 Society 5.0 の進捗 KPI — 4 つの軸
Society 5.0 の進捗を 1 つの数で測る公式の式は無い。 ここでは説明のために、 (1) デジタル基盤、 (2) データ流通、 (3) 社会課題への対応、 (4) Well-being の 4 軸を重み付きで足す簡易モデルを置く(このページ独自の整理で、 政府が定めた指標そのものではない)。
🔬 数式を言葉で読み解く
- $D$ (Digital Infrastructure):光回線普及率・5G エリアカバー率・公共 Wi-Fi 数等を標準化した 0-1 値
- $F$ (Data Flow):県内データ流通量 (GB/人/月)・オープンデータ件数
- $R$ (Resilience):高齢化対応・防災対応・医療アクセスのスコア
- $W$ (Well-being):満足度調査・健康寿命・主観的幸福度
- $w_i$:分野間の重み (合計 1)
💡 単一指標で「Society 5.0 達成度」を測ることは原理的に不可能。 上式は 「4 軸を可視化するための簡易合成指標」であり、 各軸をレーダーチャートで個別把握する方が実務的。
🔬 数式・定義を「言葉」で読み解く
Society 5.0 は概念用語なので「読み解くべき数式」は多くありません。 ここでは前セクションの合成 KPI の 4 軸と、 Society 5.0 の中核であるサイバーフィジカルシステム (CPS) の動作モデルを、 記号の意味に立ち返って言葉で確認します。
🔬 サイバーフィジカルシステム (CPS) と Society 5.0 — 数式で見る構造
Society 5.0 の中核技術 CPS は、 物理空間 (Physical) でセンサーがデータを取得し、 サイバー空間 (Cyber) で AI が解析・最適化、 結果をアクチュエータ (制御機器) 経由で物理空間へ還す閉ループ構造を持つ。 簡略化すると下式となる。
📐 CPS の動作モデル
🔬 数式を言葉で読み解く
- $x_t$:時刻 $t$ における物理空間の真の状態 (例:道路の混雑度、 工場の温度、 高齢者の歩行速度)
- $y_t$:センサーが観測した値 (ノイズあり)
- $\hat{x}_t = g(y_t)$:サイバー空間で観測値から推定した内部状態 (Kalman フィルタ等)
- $u_t = \pi(\hat{x}_t)$:推定状態を入力にアクチュエータが取る制御行動 (政策関数 $\pi$)
- $w_t$:物理空間の外乱 (天候、 人間行動)
この閉ループが ミリ秒~分単位で回ることで「人が介在しないリアルタイム最適化」が成立する。 Society 4.0 では人間が $y_t$ を見て $u_t$ を判断していたが、 5.0 では $\pi$ が自動化される。
🔬 閉ループを数字で 1 周する — 観測・推定・制御
上の式の 3 つの部品 $y_t$(観測)・$\hat{x}_t = g(y_t)$(推定)・$u_t = \pi(\hat{x}_t)$(制御)を、 バス停の待ち人数という小さな例で動かす。 数値は説明用の合成データで、 実測ではない。 推定 g には直前の推定と新しい観測を半分ずつ混ぜる指数平滑 $\hat{x}_t = 0.5\,y_t + 0.5\,\hat{x}_{t-1}$、 制御 π には「推定が 20 人以上なら増便」を使う。
🎯 このコードでやること:観測 → 推定 → 制御の 1 周を 6 時点ぶん計算し、 観測値そのもので判断した場合と比べる。
1 2 3 4 5 6 7 8 9 10 11 12 | import numpy as np # 説明用の合成データ: バス停の待ち人数を 5 分ごとに数えるセンサー(実測ではない) y = np.array([12, 24, 14, 16, 27, 31]) # 観測 y_t(人) alpha = 0.5 # 推定 g: 指数平滑 x̂_t = α y_t + (1−α) x̂_{t−1} x_hat = [y[0]] for v in y[1:]: x_hat.append(alpha * v + (1 - alpha) * x_hat[-1]) x_hat = np.array(x_hat) u = np.where(x_hat >= 20, '増便', '通常') # 制御 π: 推定が 20 人以上なら増便 for t, (v, e, a) in enumerate(zip(y, x_hat, u)): print(f"t={t} 観測 y={v:>2} 推定 x̂={e:5.2f} → {a}") print('観測値そのものが 20 以上になった時刻:', np.where(y >= 20)[0].tolist()) |
💬 観測値そのもので判断すると t = 1 の 24 人(一時的な混雑)で増便してしまうが、 推定値は 18.0 にとどまり、 増便は待ち人数が続けて増えた t = 4(21.50)から始まる。 手計算の 18.0・16.0・16.0・21.5 と一致する。 センサーの値をそのまま機械に返さず、 推定の段で揺れをならすのが CPS の要で、 平滑の強さ(ここでは 0.5)を変えると反応の速さと誤作動の少なさの釣り合いが変わる。 同じ観測で係数を 0.9 にすると t = 1 の推定が 22.8 になって一時的な混雑で増便してしまい、 0.2 にすると t = 5 でも推定が 19.9 にとどまって増便が間に合わない。
🧮 SSDSE-B 実値で計算してみる
SSDSE-B-2026(47都道府県・2023 年・112 項目)を題材に、 Society 5.0 に関係する変数を実値で確認します。 とくに東京・大阪・沖縄・秋田 など特徴ある県を比較すると、 用語の重みが体感できます。
| 都道府県 | 総人口(千人) | 高齢化率(%) | TFR | 一般診療所数(人口10万対) |
|---|---|---|---|---|
| 東京 | 14,086 | 22.8 | 0.99 | 105.7 |
| 大阪 | 8,763 | 27.7 | 1.19 | 101.3 |
| 沖縄 | 1,468 | 23.8 | 1.60 | 63.2 |
| 秋田 | 914 | 39.1 | 1.10 | 88.2 |
| 全国 | 124,353 | 29.1 | 1.29(47 県の単純平均。 人口動態統計の全国値は 1.20) | 84.4 |
これらの値を Society 5.0 の観点で読み解くと、 都道府県間の格差・特徴・関係性が浮かび上がります。 具体的な計算手順は次の「🐍 Python 実装」セクションで実演します。
🏛 Society 5.0 を支える 5 つの社会基盤
経団連 2018「Society 5.0 ともに創造する未来」では、 実現に必要な 5 つの社会基盤を提示している。 単なる技術導入ではなく 制度・人材・倫理を含めた包括的変革であることに注意。
| 基盤 | 具体例 | 関連用語 | 主な障害 |
|---|---|---|---|
| ① データ流通基盤 | DATA-EX、 DFFT、 GAIA-X | データ基盤 | 標準化遅れ・所有権 |
| ② デジタル人材 | デジタル推進人材 230 万人(2026 年度末まで) | AI 人材 | 教育不足、 流出 |
| ③ 規制改革 | サンドボックス・特区 | AI 規制 | 官庁縦割り |
| ④ 倫理・ガバナンス | AI 原則、 説明責任 | AI 倫理 | 透明性・偏見 |
| ⑤ サイバーセキュリティ | ゼロトラスト、 NICTER | AI 安全 | 国家攻撃・人材難 |
🗓 Society 5.0 政策年表
| 年 | 出来事 | 主要文書・主体 |
|---|---|---|
| 2016/1 | 「第 5 期科学技術基本計画」で Society 5.0 を初提唱 | 内閣府 |
| 2017/6 | 「未来投資戦略 2017」で重点 5 分野 | 経団連・首相官邸 |
| 2018/11 | 経団連「Society 5.0 - ともに創造する未来 -」 | 経団連 |
| 2019/3 | 「人間中心の AI 社会原則」を内閣府 IT 戦略本部決定 | 内閣府 |
| 2019/6 | G20 大阪首脳宣言で DFFT (Data Free Flow with Trust) 提唱 | 日本政府 |
| 2020/4 | スーパーシティ法成立 (国家戦略特区法改正) | 内閣府 |
| 2021/3 | 「第 6 期科学技術・イノベーション基本計画」 (Society 5.0 を「持続可能性と強靱性」で拡張) | 内閣府 |
| 2021/9 | デジタル庁発足、 マイナンバー基盤拡充 | デジタル庁 |
| 2022/12 | 「デジタル田園都市国家構想総合戦略」閣議決定 | 内閣官房 |
| 2023/4 | G7 群馬高崎デジタル相会合で「DFFT 推進国際枠組」合意 | G7 |
🧮 Society 5.0 が解こうとする課題を実データで確かめる
Society 5.0 は、 少子高齢化による働き手の減少や、 地域による医療・交通などの格差を、 IoT・AI・ロボットで補うという問題意識から出発している。 「働き手が減る」「高齢者の多い地域ほど医療資源が足りない」は、 どれくらい本当なのか。 SSDSE-B-2026 の実データで 2 つ確かめる。
① 高齢者 1 人を何人の 15〜64 歳で支えているか
🎯 このコードでやること:15〜64 歳人口(A1302)÷ 65 歳以上人口(A1303)を「高齢者 1 人あたりの支え手の数」として、 全国(47 県の合計)の推移と、 2023 年度の県ごとの多い・少ない県、 2012 → 2023 年度の変化率を計算する。
📥 入力データ:SSDSE-B-2026 の全 564 行のうち、 年度・都道府県・15〜64 歳人口 A1302・65 歳以上人口 A1303(2023 年度の秋田県 474,000 人・357,000 人 など)。
1 2 3 4 5 6 7 8 9 10 11 12 13 14 | import pandas as pd df = pd.read_csv('data/raw/SSDSE-B-2026.csv', encoding='cp932', skiprows=[1]) df['支え手'] = df['A1302'] / df['A1303'] # 65 歳以上 1 人あたりの 15〜64 歳人口 t = df.pivot(index='Prefecture', columns='SSDSE-B-2026', values='支え手') nat = df.groupby('SSDSE-B-2026')[['A1302', 'A1303']].sum() nat_ratio = nat['A1302'] / nat['A1303'] print('全国(47 県合計):', ' '.join(f'{y}年 {nat_ratio[y]:.2f}' for y in [2012, 2015, 2018, 2021, 2023])) print('2023 年度 少ない 3 県:', t[2023].nsmallest(3).round(2).to_dict()) print('2023 年度 多い 3 県 :', t[2023].nlargest(3).round(2).to_dict()) chg = (t[2023] / t[2012] - 1) * 100 print(f'2012→2023 の変化率: 全 47 県で減少 = {(chg < 0).all()}, 最小 {chg.min():.1f}%({chg.idxmin()}), 最大 {chg.max():.1f}%({chg.idxmax()})') print(f'2023 年度に 2 人を下回る県: {(t[2023] < 2).sum()} 県(2012 年度は {(t[2012] < 2).sum()} 県)') |
📤 実行結果:
💬 結果の読み方:全国では、 高齢者 1 人を支える 15〜64 歳の人数が 2012 年度の 2.60 人から 2023 年度の 2.04 人へ減った。 2023 年度に 2 人を下回る県は 36 県で、 2012 年度の 4 県から大きく増えている。 最も少ない秋田県は 1.33 人で、 東京都(2.92 人)の半分以下。 2012 → 2023 年度の変化はすべての県でマイナスで、 最も小さい東京都でも −7.9%、 最も大きい青森県は −31.1%。 人の手を前提にした介護・医療・交通のサービスを同じ形で続けるのが難しくなる、 という Society 5.0 の出発点は、 県による濃淡はあっても全国で数字に表れている。
② 高齢者の多い県ほど、診療所は「足りている」のか
🎯 このコードでやること:2023 年度の高齢化率と、 一般診療所数(I5102)を人口 10 万人あたりと 65 歳以上 1 万人あたりの 2 通りで割った密度との相関を計算し、 それぞれ上位・下位 3 県を並べる。
📥 入力データ:SSDSE-B-2026 の 2023 年度 47 行のうち、 都道府県・総人口 A1101・65 歳以上人口 A1303・一般診療所数 I5102。
1 2 3 4 5 6 7 8 9 10 11 12 13 | import pandas as pd from scipy import stats df = pd.read_csv('data/raw/SSDSE-B-2026.csv', encoding='cp932', skiprows=[1]) d = df[df['SSDSE-B-2026'] == 2023].set_index('Prefecture') aging = d['A1303'] / d['A1101'] * 100 # 高齢化率(%) clinic_pop = d['I5102'] / d['A1101'] * 1e5 # 人口 10 万人あたり一般診療所数 clinic_old = d['I5102'] / d['A1303'] * 1e4 # 65 歳以上 1 万人あたり一般診療所数 for label, s in [('人口 10 万人あたり', clinic_pop), ('65 歳以上 1 万人あたり', clinic_old)]: r, p = stats.pearsonr(aging, s) print(f'高齢化率 と 診療所数({label}): r = {r:.3f}, p = {p:.2g}') print(f' 上位 3: {s.nlargest(3).round(1).to_dict()} 下位 3: {s.nsmallest(3).round(1).to_dict()}') |
📤 実行結果:
💬 結果の読み方:人口 10 万人あたりで見ると、 高齢化率との相関は r = 0.191(p = 0.2)でほぼ無関係で、 和歌山県(113.0)・島根県(106.0)のように高齢化率の高い県も上位に入る。 ところが、 医療を多く必要とする 65 歳以上 1 万人あたりに直すと r = −0.510(p = 0.00025)と、 高齢化率の高い県ほど診療所が少ない関係がはっきり出る。 上位は東京都(46.5)・大阪府(36.6)・福岡県(33.1)、 下位は北海道(20.2)・茨城県(20.3)・青森県(20.4)。 どの人口で割るかで結論が変わる点に注意したうえで、 「高齢者 1 人あたりの医療資源が薄い地域をオンライン診療や移動支援で補う」という Society 5.0 の構想は、 この数字と対応している。 ただし診療所の数は医師の数や診療時間を表さないので、 医療へのアクセスそのものを測るには別の統計も要る。
ここから言えること: Society 5.0 のような政策ビジョンは、 そのまま数値で評価できるわけではないが、 ビジョンが前提にしている課題(支え手の減少、 地域の医療資源の偏り)は公的統計で確かめられる。 政策の説明を読むときは、 前提となる課題の大きさを自分で計算し、 どの分母で見たときの話かを確かめる習慣をつける。
🧮 数式に値を入れて手で計算する: IoT 普及率と Society 5.0
合成データで IoT 機器普及率と社会指標を計算する。
Step 1: 国別 IoT 普及率
| 国 | 機器/人 | 達成度 |
|---|---|---|
| A | 20 | 1.00 |
| B | 15 | 0.75 |
| C | 8 | 0.40 |
| D | 5 | 0.25 |
達成度 = 機器数 / 20 (目標)
Step 2: 平均達成度
🐍 Python で再現
1 2 3 4 5 6 | import numpy as np dev = np.array([20, 15, 8, 5]) target = 20 ach = dev / target print(f"達成度: {ach}") print(f"平均: {ach.mean()}") |
📤 実行結果
💬 手計算 (Step 2) 60% と Python 出力が完全一致。
🧮 秋田県の「支え手」の人数を手で計算する
「高齢者 1 人を何人の 15〜64 歳で支えているか」は、 15〜64 歳人口(A1302)÷ 65 歳以上人口(A1303)で求まる。 2023 年度の秋田県で計算する。
| Step | 操作 | 数値 |
|---|---|---|
| 1 | 2023 年度の値を読む | 15〜64 歳 = 474,000 人、 65 歳以上 = 357,000 人 |
| 2 | 割る | 474,000 ÷ 357,000 = 1.328 ≈ 1.33 人 |
| 3 | 2012 年度と比べる | 2012 年度は 1.90 人。 1.33 ÷ 1.90 = 0.70 で、 11 年で 3 割減った |
| 4 | 全国(47 県の合計どうし) | 2023 年度 2.04 人。 秋田県はその 0.65 倍 |
① のコードの出力(秋田県 1.33 人、 全国 2.04 人)と一致する。 1.33 人は「高齢者 3 人を 15〜64 歳 4 人で支える」計算で、 見守りや通院の付き添いを人手だけで続ける余力が小さいことを表している。
🧮 支え手が 2 人を下回ったのはいつか — 県ごとの「分岐点」
全国の支え手は 2023 年度で 2.04 人とまだ 2 人を上回るが、 県ごとに見ると多くの県はもっと早く 2 人を割っている。 12 年分から、 各県が初めて 2 人を下回った年度を数える。
🎯 このコードでやること:2012〜2023 年度を年度順に並べ直し、 支え手の人数(15〜64 歳 ÷ 65 歳以上)が初めて 2 人を下回った年度を県ごとに求めて、 年度ごとの県の数を数える。
1 2 3 4 5 6 7 8 9 10 11 12 13 | import pandas as pd df = pd.read_csv('data/raw/SSDSE-B-2026.csv', encoding='cp932', skiprows=[1]) df['支え手'] = df['A1302'] / df['A1303'] df = df.sort_values('SSDSE-B-2026') # 年度順に並べ直す(元は新しい年度が先) below = df[df['支え手'] < 2] first = below.groupby('Prefecture')['SSDSE-B-2026'].min() # 初めて 2 人を下回った年度 print('初めて 2 人を下回った年度ごとの県の数:') print(first.value_counts().sort_index().to_string()) print('2023 年度でも 2 人以上の県:', sorted(set(df.Prefecture) - set(first.index))) print('2012 年度にすでに下回っていた県:', sorted(first[first == 2012].index)) last = df[df['SSDSE-B-2026'] == 2023].set_index('Prefecture')['支え手'] back = [p for p in first.index if last[p] >= 2] print('一度下回ったが 2023 年度は 2 人以上:', {p: round(float(last[p]), 3) for p in back}) |
💬 2012 年度の時点ですでに秋田県・高知県・島根県・山口県の 4 県が 2 人を下回っており、 2014 年度(9 県)から 2016 年度(6 県)にかけて一気に増えた。 12 年の間に一度でも 2 人を下回った県は 37 県で、 京都府は下回った後に 2023 年度で 2.001 人とわずかに戻った。 2023 年度でも 2 人以上なのは東京都・神奈川県・愛知県・大阪府・福岡県などの大都市圏と宮城県・滋賀県・沖縄県の 10 都府県だけで、 全国値の 2.04 人はこの 10 都府県の人口の大きさに支えられている。 「全国ではまだ 2 人」という数字の裏で、 大半の県はすでに次の段階に入っている。
🐍 Python 実装
以下は Society 5.0 を SSDSE-B-2026 で扱うときの典型コード。 encoding='cp932' は政府統計の Shift-JIS 対応。 skiprows=1 は 1 行目の英語コード行(A1101 など)を飛ばし、2 行目の日本語見出しを列名にする定石。
🐍 コード 1: Society 5.0 進捗の県別「複合スコア」算出
このコードでやること: SSDSE-B-2026 から医療アクセス (診療所密度)・高齢化率・出生 (TFR) の 3 指標を取り出し、 Min-Max 正規化と単純平均で各県の「Society 5.0 進捗スコア (0〜1)」を計算する。 pandas のみで完結。
📥 入力データ (SSDSE-B-2026 抜粋。 1 行目が英字ヘッダ、 2 行目が日本語名で skiprows=[1] で除外。 先頭列は年度なので 2023 で絞り込む):
1 2 3 4 5 6 7 8 9 10 11 12 13 14 15 16 17 18 19 20 21 22 23 24 | import pandas as pd # SSDSE-B-2026 を読み込み (cp932 / 2 行目の日本語名をスキップ) df = pd.read_csv('data/raw/SSDSE-B-2026.csv', encoding='cp932', skiprows=[1]) # 英字コードの列名を使う df = df[df.iloc[:, 0].astype(str) == '2023'].reset_index(drop=True) # 4 指標を取り出し (先頭は年度列。 列番号は SSDSE-B-2026 の並びに準拠) df['総人口'] = df.iloc[:, 3] # A1101 総人口 df['一般診療所数'] = df.iloc[:, 94] # I5102 一般診療所数 df['65歳以上'] = df.iloc[:, 15] # A1303 65歳以上人口 df['TFR'] = df.iloc[:, 21] # A4103 合計特殊出生率 df['診療所密度'] = df['一般診療所数'] / df['総人口'] * 100000 # 人口10万対 df['高齢化率'] = df['65歳以上'] / df['総人口'] * 100 # Min-Max 正規化 (高齢化率は「低いほど良い」ので 1 - x) def minmax(s, reverse=False): x = (s - s.min()) / (s.max() - s.min()) return 1 - x if reverse else x df['score'] = (minmax(df['診療所密度']) + minmax(df['高齢化率'], reverse=True) + minmax(df['TFR'])) / 3 print(df[['Prefecture', 'score']].sort_values('score', ascending=False).head(10)) |
📤 実行例:
💬 結果の読み方: 沖縄県が 1 位に立つ点が興味深い。 高齢化率の低さ (23.8%, 東京都の 22.8% に次ぐ全国 2 番目の低さ) と TFR の高さ (1.60, 全国最高) が、 医療アクセスの複合で首位を押し上げている。 人口最大の東京は 4 位にとどまる。 「単一指標 (人口や経済規模) だけで Society 5.0 進捗を測ると過疎県を切り捨てる」リスクがあるため、 複合スコア化 は EBPM の基本である。
🐍 コード 2: 県別「交流人口指数」を算出する (宿泊統計)
このコードでやること: SSDSE-B-2026 にある「延べ宿泊者数 (G7101)」を「総人口 (A1101)」で割り、 住民 1 人当たり宿泊者数を県別の 交流人口の代理指数 (proxy index) として算出する。 直接の「デジタル基盤普及率」変数が SSDSE にないため、 交流・観光の実測列で地域の外部接続度を近似する典型手順。
📥 入力データ (SSDSE-B-2026 の関連列, 2023 年):
1 2 3 4 5 6 7 8 9 10 11 12 | import pandas as pd df = pd.read_csv('data/raw/SSDSE-B-2026.csv', encoding='cp932', skiprows=[1]) # 英字コードの列名を使う df = df[df.iloc[:, 0].astype(str) == '2023'].reset_index(drop=True) # 関連列を取り出し (直接の「デジタル基盤」変数は SSDSE になし) df['総人口'] = df.iloc[:, 3] # A1101 総人口 df['延べ宿泊者数'] = df.iloc[:, 80] # G7101 延べ宿泊者数 # 住民 1 人当たり宿泊者数を「交流人口指数」の代理として使う df['交流指数'] = df['延べ宿泊者数'] / df['総人口'] print(df[['Prefecture', '交流指数']].sort_values('交流指数', ascending=False).head(5)) |
📤 実行例:
💬 結果の読み方: 沖縄・京都・山梨・石川・長野が上位で、 人口規模ではなく 観光・保養地としての性格 が交流人口の多さに直結している。 これは「デジタル基盤普及率」そのものではなく交流量の代理にすぎないため、 「proxy index は仮説」 として扱い、 観光庁『宿泊旅行統計調査』や『情報通信白書』の県別データで検証する 2 段階設計が EBPM の基本。
🐍 コード 3: 県別の生活水準 (消費支出) を線形回帰で説明する
このコードでやること: 生活水準の代理として消費支出 (L3221) を目的変数に、 人口規模 (対数) と高齢化率を説明変数として OLS 線形回帰を行う。 「県の生活水準を人口構造がどこまで説明するか」を統計的に確かめる。
📥 入力データ: SSDSE-B-2026 (2023 年) の A1101 総人口・A1303 65 歳以上人口・L3221 消費支出。
1 2 3 4 5 6 7 8 9 10 11 12 13 14 15 16 17 18 | import pandas as pd import numpy as np import statsmodels.api as sm df = pd.read_csv('data/raw/SSDSE-B-2026.csv', encoding='cp932', skiprows=[1]) df = df[df.iloc[:, 0].astype(str) == '2023'].reset_index(drop=True) pop = df.iloc[:, 3].astype(float) # A1101 総人口 old = df.iloc[:, 15].astype(float) # A1303 65歳以上人口 y = df.iloc[:, 101].astype(float) # L3221 消費支出 (二人以上の世帯, 円/月) # 説明変数: 人口規模(対数) と 高齢化率 X = pd.DataFrame({'log_pop': np.log(pop), '高齢化率': old / pop * 100}) X = sm.add_constant(X) model = sm.OLS(y, X).fit() print(model.summary().tables[1]) print(f'R^2 = {model.rsquared:.3f}') |
📤 実行例:
💬 結果の読み方: log_pop も高齢化率も p > 0.05 で有意でなく、 R² ≈ 0.13 と説明力は小さい。 消費支出 (生活水準) は人口規模や高齢化率ではほとんど説明できず、 世帯構成・所得・物価などの他要因が支配的であることを示す。 「人口動態だけで生活水準を語れない」ことがデータから読み取れ、 EBPM では単純な人口ベース回帰の説明力の低さに注意すべきという教訓が得られる。
📐 Society 5.0 進捗度 — KPI を 1 つの合成指数 (Composite Index) にまとめる方法論
OECD『Handbook on Constructing Composite Indicators』(2008) に基づき、 複数 KPI を合成して 1 つの「Society 5.0 進捗度」を出す標準手順は次の 7 ステップである。 各ステップで起こりうる落とし穴を併記する。
| # | ステップ | 具体作業 | 落とし穴 |
|---|---|---|---|
| 1 | 理論フレーム | 指標群を選ぶ理論的根拠 | 「手元データから選ぶ」と理論不在に |
| 2 | データ選定 | 入手可能性・信頼性 | 取得頻度の不揃いで時系列ずれ |
| 3 | 欠損処理 | 平均代入・KNN・モデルベース | 代入バイアス、 過小評価 |
| 4 | 多変量分析 | 相関・PCA で次元削減検討 | PCA 軸の解釈が難しい場合あり |
| 5 | 正規化 | Min-Max, Z-score, ランク | 外れ値で Min-Max が歪む |
| 6 | 重み付け・集約 | 等重み・専門家 AHP・PCA 重み | 重みの恣意性が結論を左右 |
| 7 | 感度分析 | 重み・正規化方式を変えて頑健性確認 | 省略しがちだが最重要 |
💬 読み方: 最大の落とし穴は ステップ 7 (感度分析) の省略。 「重み 0.5/0.3/0.2」を「0.4/0.4/0.2」に変えただけで上位 5 県の順位が入れ替わるなら、 その合成指数は 意思決定の根拠として脆弱。 OECD は重み・正規化・代入方式を最低 3 通り組み合わせて結果が頑健か確認することを推奨している。
🐍 コード 4: 合成指数の感度分析 (重みを変えて順位の頑健性を確認)
このコードでやること: 3 指標 (医療アクセス・反転高齢化・TFR) の重みを 3 パターン振り、 上位 5 県のリストがどれだけ安定しているかを確認する。 OECD ステップ 7 の感度分析の最小実装。
📥 入力データ: コード 1 と同じ正規化済 3 指標 (診療所密度・反転高齢化率・TFR)。
1 2 3 4 5 6 7 8 9 10 11 12 13 14 15 16 17 18 | import pandas as pd df = pd.read_csv('data/raw/SSDSE-B-2026.csv', encoding='cp932', skiprows=[1]) df = df[df.iloc[:, 0].astype(str) == '2023'].reset_index(drop=True) df['c'] = df.iloc[:, 94] / df.iloc[:, 3] * 100000 # 一般診療所数(人口10万対) df['a'] = df.iloc[:, 15] / df.iloc[:, 3] # 高齢化率 df['f'] = df.iloc[:, 21] # TFR def norm(s, rev=False): x = (s - s.min()) / (s.max() - s.min()) return 1 - x if rev else x df['C'], df['A'], df['F'] = norm(df['c']), norm(df['a'], rev=True), norm(df['f']) for wc, wa, wf in [(0.33, 0.33, 0.34), (0.5, 0.3, 0.2), (0.2, 0.5, 0.3)]: df['score'] = wc*df['C'] + wa*df['A'] + wf*df['F'] top5 = df.sort_values('score', ascending=False).head(5)['Prefecture'].tolist() print(f'w=({wc},{wa},{wf}): top5 = {top5}') |
📤 実行例:
💬 結果の読み方: 重みを変えると 1 位が沖縄 ↔ 東京で入れ替わる。 医療アクセスを重く見る (0.5/0.3/0.2) と東京が 1 位、 高齢化を重く見る (0.2/0.5/0.3) と沖縄が 1 位になる。 東京都は 3 通りとも 5 位以内(5 位・1 位・2 位)に入り 比較的頑健だが、 沖縄県は診療所密度が人口 10 万人あたり 63.2 と低いため、 診療所を重く見る重みでは 1 位から 22 位まで落ちる。 3〜5 位も重みで長崎 / 島根 / 和歌山 / 滋賀 / 愛知 / 大阪と入れ替わり 脆弱。 このように順位の頑健な県と脆弱な県を区別し、 政策レポートには 重み感度を明示した上で結論する のが OECD 推奨の作法。
🐍 支え手が減った理由を「分子」と「分母」に分ける
支え手の人数は 15〜64 歳 ÷ 65 歳以上なので、 減った理由は「働く世代が減った」か「高齢者が増えた」かのどちらか(または両方)である。 どちらが効いたかで、 地域に必要な手立ては変わる。 2012 年度と 2023 年度を 4 都県で比べる。
🎯 このコードでやること:東京都・沖縄県・秋田県・青森県について、 2012 年度と 2023 年度の支え手の人数と、 15〜64 歳・65 歳以上それぞれの増減率を並べる。
1 2 3 4 5 6 7 8 9 10 11 | import pandas as pd df = pd.read_csv('data/raw/SSDSE-B-2026.csv', encoding='cp932', skiprows=[1]) a = df[df['SSDSE-B-2026'] == 2012].set_index('Prefecture') b = df[df['SSDSE-B-2026'] == 2023].set_index('Prefecture') rows = [] for p in ['東京都', '沖縄県', '秋田県', '青森県']: w0, w1 = a.loc[p, 'A1302'], b.loc[p, 'A1302'] # 15〜64 歳 o0, o1 = a.loc[p, 'A1303'], b.loc[p, 'A1303'] # 65 歳以上 rows.append([p, w0 / o0, w1 / o1, (w1 / w0 - 1) * 100, (o1 / o0 - 1) * 100]) t = pd.DataFrame(rows, columns=['県', '2012 支え手', '2023 支え手', '15〜64 歳の増減%', '65 歳以上の増減%']) print(t.round(2).to_string(index=False)) |
💬 4 都県とも支え手は減ったが、 理由が違う。 東京都は 15〜64 歳が 4.98% 増えたのに 65 歳以上が 13.98% 増えて 3.17 → 2.92 人。 沖縄県は 15〜64 歳の減少は 3.18% と小さく、 65 歳以上が 40.00% も増えたのが主因で 3.64 → 2.52 人。 秋田県と青森県は 65 歳以上の増加(9.51%・14.56%)より、 15〜64 歳が 2 割以上減った(−23.42%・−21.05%)ことが効いて、 秋田県は 1.90 → 1.33 人になった。 働き手そのものが減っている秋田・青森では省人化(自動化・遠隔化)が、 高齢者が急に増える沖縄では医療・介護の受け皿の拡大が先に問われる、 という読み分けができる。
🐍 人はどこへ動いているか — 転入と転出の差
働き手の減少には、 出生だけでなく県をまたぐ移動も効く。 Society 5.0 を地方で進める政策(デジタル田園都市国家構想など)は、 この流れを変えることも狙っている。 2023 年度の転入者数(A5101)と転出者数(A5102)の差を見る。
🎯 このコードでやること:2023 年度の 47 都道府県について、 日本人の転入者数 − 転出者数(純移動)と、 人口 1,000 人あたりの純移動率を求め、 転入超過の県の数と上位・下位の県を出す。
1 2 3 4 5 6 7 8 9 | import pandas as pd df = pd.read_csv('data/raw/SSDSE-B-2026.csv', encoding='cp932', skiprows=[1]) d = df[df['SSDSE-B-2026'] == 2023].copy() d['純移動'] = d['A5101'] - d['A5102'] # 転入 − 転出(日本人移動者) d['純移動率‰'] = d['純移動'] / d['A1101'] * 1000 print('転入超過の都府県:', (d['純移動'] > 0).sum(), '/ 47') print(d.nlargest(5, '純移動')[['Prefecture', '純移動', '純移動率‰']].round(2).to_string(index=False)) print(d.nsmallest(3, '純移動率‰')[['Prefecture', '純移動', '純移動率‰']].round(2).to_string(index=False)) print(f"合計(県をまたぐ移動は相殺される): {d['純移動'].sum():,}") |
💬 転入が転出を上回ったのは 47 都道府県のうち 6 都府県だけで、 東京都が +58,489 人(人口 1,000 人あたり +4.15 人)と突出し、 神奈川県・埼玉県・千葉県・大阪府が続く。 転出超過の率が大きいのは長崎県(−5.02)・青森県(−4.70)・岩手県(−4.12)。 47 県の合計はちょうど 0 になり、 県をまたぐ移動は「どこかの増加はどこかの減少」であることが確かめられる。 支え手の減った青森県が転出超過でも上位にいることは、 働き手の減少が出生の少なさだけでなく流出によっても進んでいることを示している。
🐍 転出超過は 1 年だけの現象か — 12 年分で数える
2023 年度の 1 年だけでは、 たまたまの動きかもしれない。 2012〜2023 年度の 12 年分で、 各県が転出超過だった年を数え、 あわせて 2023 年度の純移動率と支え手の人数の関係を見る。
🎯 このコードでやること:12 年分の純移動(転入 − 転出)の符号を県ごとに数え、 2023 年度の純移動率(人口 1,000 人あたり)と支え手の人数(15〜64 歳 ÷ 65 歳以上)の相関係数を、 東京都を含む場合と除く場合で求める。
1 2 3 4 5 6 7 8 9 10 11 12 13 14 | import pandas as pd from scipy import stats df = pd.read_csv('data/raw/SSDSE-B-2026.csv', encoding='cp932', skiprows=[1]) df['純移動'] = df['A5101'] - df['A5102'] out_years = (df['純移動'] < 0).groupby(df['Prefecture']).sum() # 転出超過だった年数(12 年中) print('12 年すべて転出超過:', (out_years == 12).sum(), '県') print('12 年すべて転入超過:', list(out_years[out_years == 0].index)) d = df[df['SSDSE-B-2026'] == 2023].copy() d['純移動率‰'] = d['純移動'] / d['A1101'] * 1000 d['支え手'] = d['A1302'] / d['A1303'] r, p = stats.pearsonr(d['純移動率‰'], d['支え手']) print(f"2023 年度 純移動率 と 支え手の人数: r = {r:.3f}, p = {p:.2g}") r2, p2 = stats.pearsonr(d.loc[d.Prefecture != '東京都', '純移動率‰'], d.loc[d.Prefecture != '東京都', '支え手']) print(f"東京都を除く 46 道府県 : r = {r2:.3f}, p = {p2:.2g}") |
💬 12 年すべて転出超過だった県は 33 県あり、 12 年すべて転入超過だったのは埼玉県・東京都・神奈川県・福岡県の 4 都県だけだった。 人の流出は一時的なものではなく、 同じ県で毎年続いている。 2023 年度の純移動率と支え手の人数の相関は r = 0.818 と強く、 東京都を除いても r = 0.770 で変わらない。 ただしこれは相関で、 「若い世代が出ていくから支え手が減る」向きと、 「働き口の少ない地域ほど若い世代が出ていく」向きが重なっている。 どちらがどれだけ効いているかは、 このデータだけでは決められない。
⚠️ よくある落とし穴
Society 5.0 (内閣府が 2016 年の第 5 期科学技術基本計画で提唱) は「サイバー空間とフィジカル空間の高度融合で経済発展と社会的課題解決を両立する社会」と謳いますが、 実装段階では 「バズワード化して具体施策が漠然」「IoT/AI 導入が目的化し問題解決と乖離」「データ利活用と個人情報保護のトレードオフ無視」「地方/高齢者のデジタル格差を軽視」といった失敗が頻発します。 以下、 KPI 設計や効果検証で踏みやすい 7 つのワナを整理しました。
⚠️ Society 5.0 推進で陥りやすい 7 つの落とし穴
- バズワード化: 「Society 5.0 対応」と銘打つだけで実装が伴わない。 RFP 文書での乱用が典型。 → KPI を計測可能な形に分解する。
- デジタル格差の拡大: 高齢者・障害者・離島居住者が取り残される。 「使えない人にも届く設計 (アクセシビリティ)」を義務化。
- 個人情報の過剰収集: 「データは多いほど良い」発想で同意なき収集。 GDPR・改正個人情報保護法に違反するリスク。
- ベンダーロックイン: 自治体が単一 SIer に依存。 オープン API・標準形式を要件化。
- セキュリティ後付け: サービス立ち上げ優先でセキュリティを後回し。 マイナンバー漏えい事例で教訓化。
- 地方無視の東京中心: 都心の成功事例を地方に押し付け、 文脈不在のまま失敗。 ローカル DX 人材を育成。
- 倫理委員会の形骸化: 「とりあえず設置」した倫理委員会が機能せず、 形式承認だけになる。 第三者性・独立性を担保。
📝 試験対策:Society 5.0 で出題される論点
- 定義の出典:Society 5.0 は「第 5 期科学技術基本計画 (2016)」で初提唱。
- 5 段階の順序:狩猟 → 農耕 → 工業 → 情報 → 超スマート社会。
- CPS の意味:Cyber-Physical System、 サイバー空間と物理空間の融合。
- 4.0 との違い:人間が介在する情報処理 (4.0) → AI が物理世界に介入 (5.0)。
- 関連略語:DFFT、 GAFA、 SDGs、 STI、 DX、 ESG。
- 応用分野:医療・農業・モビリティ・製造・エネルギー・行政の 6 分野。
- 関連政策:デジタル田園都市国家構想、 スーパーシティ、 マイナンバー、 デジタル庁。
📌 試験では「Society 5.0 の定義」「CPS の意味」「6 応用分野」が頻出。 数字 (5、 4、 6、 2016) を関連付けて覚える。
✅ 自治体・企業向け Society 5.0 実装チェックリスト (20 項目)
Society 5.0 を「掛け声で終わらせない」ために、 実装段階で確認すべき 20 項目を整理する。 各項目はガイドラインや実証実験の知見を凝縮したもの。
- □ 解決すべき社会課題が KPI まで言語化されている
- □ 3-5 年ロードマップが存在し公開している
- □ Society 5.0 の 6 応用分野のどれに該当するか明確
- □ 上位戦略 (SDGs、 デジタル田園都市) と整合性
- □ センサー・IoT 配置計画と保守体制
- □ データ統合プラットフォーム選定 (オープン API)
- □ クラウド/オンプレ構成、 リージョン明確
- □ AI モデル選定と検証データ確保
- □ サイバーセキュリティ要件 (ゼロトラスト等)
- □ 個人情報保護法・GDPR 対応点検
- □ AI 倫理委員会 (第三者性) を設置
- □ アクセシビリティ (高齢者・障害者対応)
- □ 説明責任の枠組 (透明性レポート公開)
- □ DX 推進責任者 (CDO/CIO) 任命
- □ 部署横断のデジタル人材育成プログラム
- □ アジャイル開発・実証実験フローの体制
- □ KPI が 4 軸 (D/F/R/W) で測定可能
- □ 半年・年次でレビュー機関を設置
- □ 住民・利用者の声を吸い上げる仕組み
- □ 失敗時の撤退・修正プロセスを明文化
📌 20 項目すべてを最初から満たす必要はないが、 「現状どこまで対応済か」を可視化することが本質。 半数以上が空欄なら「実装フェーズ」前。
⚠️ 実装現場の落とし穴 — 実装現場でよく見る 6 つの失敗パターン
- スローガンと指標の乖離: 「人間中心」と言いながら指標が GDP のみ → Well-being 指標 (内閣府ダッシュボード) を併用すること。
- レガシー連携の見積もり不足: 自治体の基幹システムは個別仕様で、 標準 API 化に 18 ヶ月以上を要する事例が多い。
- データ owner 不在: KPI 算出に必要な data owner が複数部局にまたがり、 統合データセット作成が頓挫しがち。
- ELSI 後付け: 倫理レビューを設計後ではなく開発後に行うと修正コストが 10 倍。 「Privacy by Design」を初期段階で組込む。
- 過疎県の切り捨て: 単一指標ランキングでは過疎県が常に下位。 補正指標で文脈に合わせた評価設計が必須。
- ベンダーロックイン: PoC で特定クラウド/SaaS に依存し、 拡張時にコスト爆発。 OpenAPI 等の標準を堅持。
⚠️ 県の値を単純平均すると「全国の支え手」を小さく見積もる
Society 5.0 の資料では「高齢者 1 人を何人で支えるか」が全国の数字で語られる。 県別の値を平均して全国の目安にすると、 どれだけずれるかを確かめる。
🎯 このコードでやること:2023 年度の 47 県について、 支え手の人数(15〜64 歳 ÷ 65 歳以上)の単純平均・中央値と、 47 県の合計どうしで割った全国値を比べる。
1 2 3 4 5 6 7 8 9 10 11 12 13 | import pandas as pd df = pd.read_csv('data/raw/SSDSE-B-2026.csv', encoding='cp932', skiprows=[1]) d = df[df['SSDSE-B-2026'] == 2023].copy() d['支え手'] = d['A1302'] / d['A1303'] # 高齢者 1 人あたりの 15〜64 歳人口 simple = d['支え手'].mean() national = d['A1302'].sum() / d['A1303'].sum() print(f"47 県の単純平均 : {simple:.3f} 人") print(f"全国(47 県の合計で割る): {national:.3f} 人") print(f"中央値 : {d['支え手'].median():.3f} 人") share = d.nlargest(5, 'A1303')[['Prefecture', 'A1303', '支え手']] print('65 歳以上人口の多い 5 都府県:') print(share.round({'支え手': 2}).to_string(index=False)) print(f"この 5 都府県の 65 歳以上は全国の {share['A1303'].sum() / d['A1303'].sum():.1%}") |
💬 47 県の単純平均は 1.835 人、 中央値は 1.746 人だが、 全国の値は 2.041 人で、 平均は全国より 0.2 人(約 10%)少なく出る。 支え手の多い東京都(2.92 人)・神奈川県(2.43 人)・愛知県(2.41 人)などの大都市圏に、 全国の 65 歳以上の 33.0% が住んでいるのに、 単純平均では 1 県 1 票に薄められるからである。 「全国の高齢者がどれだけ支えられているか」を言うなら全国値、 「支え手の少ない県がどれだけあるか」を言うなら県別の分布(2 人を下回る県は 36 県)を示し、 平均の種類を書き分ける。
⚠️ 「提唱された 2016 年から改善した」は政策の効果とは限らない
Society 5.0 は 2016 年 1 月に提唱された。 その前後で指標の動きが変われば政策の効果に見えるが、 同じ時期に別の理由で動きが変わることもある。 全国の支え手の人数(47 県の合計どうしで計算)の 12 年分で確かめる。
🎯 このコードでやること:2012〜2023 年度の全国の支え手の人数を年度順に並べ、 2016 年度より前と後で 1 年あたりの変化(直線の傾き)を比べる。
1 2 3 4 5 6 7 8 9 | import numpy as np, pandas as pd df = pd.read_csv('data/raw/SSDSE-B-2026.csv', encoding='cp932', skiprows=[1]) g = df.groupby('SSDSE-B-2026')[['A1302', 'A1303']].sum() ratio = (g['A1302'] / g['A1303']).sort_index() # 全国の支え手の人数(年度順) print(ratio.round(3).to_string()) pre = np.polyfit(ratio.loc[2012:2016].index, ratio.loc[2012:2016].values, 1)[0] post = np.polyfit(ratio.loc[2016:2023].index, ratio.loc[2016:2023].values, 1)[0] print(f"2012〜2016 年度の傾き: {pre:+.4f} 人/年") print(f"2016〜2023 年度の傾き: {post:+.4f} 人/年") |
💬 支え手の人数は 2012〜2016 年度に 1 年あたり −0.098 人のペースで減ったのに、 2016〜2023 年度は −0.024 人と減り方が約 4 分の 1 になった。 「提唱後に減少が緩やかになった」と読みたくなるが、 主な理由は人口の年齢構成にある。 1947〜1949 年生まれの人数の多い世代が 2012〜2014 年に次々と 65 歳を迎えたため、 この時期は 65 歳以上が急に増え、 その後は増え方が落ち着いた。 政策の効果を言うには、 政策が無かった場合にどう動いたか(反事実)を別に立てる必要があり、 前後比較だけでは効果と年齢構成の変化を区別できない。
📝 理解度チェック (6 問)
Q1. Society 5.0 KPI を SSDSE-B-2026 だけで全て測定できるか?
A: 不可。 行政デジタル化、 公共交通、 再エネ比率などは別途、 e-Stat や資源エネルギー庁データの結合が必要。
Q2. 「高齢化率」は Min-Max 正規化時にどう扱うべきか?
A: 「低いほど良い」指標なので reverse=True で 1 − x として扱う。 そのまま使うと方向が逆になる。
Q3. 東京都が散布図の右上に外れる原因は?
A: 人口が突出して多く、 それに比例して一般診療所数も全国最多になるため。 加えて集積効果 (agglomeration effect) で人口比以上に医療機関が集まる傾向もある。
Q4. Society 5.0 と Industrie 4.0 の最大の違いは?
A: 射程の広さ。 Industrie 4.0 は製造業特化、 Society 5.0 は社会全体 (医療・行政・教育・地方創生) を含む。
Q5. ELSI を後付けにすると何が起きるか?
A: アーキテクチャ再設計コストが膨らみ、 場合によってはサービス停止。 Privacy by Design として初期段階で組込むのが定石。
Q6. 県別複合スコアで沖縄県が 1 位に入った理由は?
A: 高齢化率の低さ (23.8%, 東京都に次ぐ全国 2 番目) と TFR の高さ (1.60, 全国最高) が効き、 医療アクセスと合わせた複合スコアで首位になった。
追加問題(このページの実データから)
- 2023 年度の支え手の人数で、 47 県の単純平均(1.835 人)が全国値(2.041 人)より小さくなるのはなぜか。
解答: 支え手の多い大都市圏に 65 歳以上の 3 分の 1(33.0%)が住んでいるが、 単純平均ではどの県も同じ重みになり、 支え手の少ない小さな県の影響が相対的に大きくなるため。 - 沖縄県の支え手が 3.64 人から 2.52 人に減った主な理由は、 働き手の減少と高齢者の増加のどちらか。
解答: 高齢者の増加。 15〜64 歳の減少は 3.18% だが、 65 歳以上は 40.00% 増えた。 - 2023 年度の 47 都道府県の純移動(転入 − 転出)を全部足すといくつになるか。 その理由も答えよ。
解答: 0。 県をまたぐ日本人の移動は、 転出した県と転入した県の両方に 1 人ずつ数えられ、 足すと打ち消し合う。 - 全国の支え手の人数の減り方は、 2012〜2016 年度の −0.098 人/年から 2016〜2023 年度の −0.024 人/年へ緩やかになった。 これを「Society 5.0 の効果」と言えるか。
解答: 言えない。 1947〜1949 年生まれの世代が 2012〜2014 年に 65 歳を迎えて高齢者が急に増え、 その後に増え方が落ち着いたことで説明できる。 政策が無かった場合の動き(反事実)と比べていない。 - 2023 年度に支え手が 2 人以上の県は 10 都府県だけなのに、 全国値が 2.04 人と 2 人を上回るのはなぜか。
解答: 2 人以上の 10 都府県には東京都・神奈川県・大阪府・愛知県など人口の大きい都府県が含まれ、 全国の合計どうしで割るとその人数の重みが大きく効くため。
🌐 関連手法・派生
Society 5.0 と同じ「社会」カテゴリ、 または直接の上位・派生となる用語:
🌐 6 つの主要応用ドメイン — 政府重点分野
第 5 期・第 6 期科学技術基本計画では、 Society 5.0 を「分野横断で実装」するために 6 つの重点ドメインを設定している。
電子カルテ統合、 AI 画像診断、 オンライン診療、 PHR (Personal Health Record)。 SSDSE-B の一般病院数(I510120)・一般診療所数(I5102)を人口や 65 歳以上人口で割ると、 県別の医療資源の厚みを比べられる。
スマート農業、 ドローン散布、 GAP 認証、 トレーサビリティ。 高齢化県で人手不足解消の切り札。
自動運転、 MaaS、 ライドシェア、 ドローン配送。 過疎県で公共交通を補完。
スマートファクトリー、 デジタルツイン、 予知保全。 SSDSE-B には製造品出荷額の列は無いので、 産業集積を測るには工業統計などの別の統計を使う。
スマートグリッド、 再エネ予測、 EV 充電網。 北海道・青森で再エネ余剰の活用。
マイナンバー連携、 e-Gov、 デジタル庁、 オープンデータ。 行政サービスの利用状況は SSDSE-B の列には無いので、 各自治体のオープンデータで確かめる。
🌐 Society 5.0 を「データで分解」してみる — KPI・地域格差・実装パターンの実証分析
本セクションは Society 5.0 を「政策スローガン」として鵜呑みにせず、 SSDSE-B-2026 (47 都道府県、 125 列) の実データで 進捗の濃淡・地域格差・実装の制約 を計量的に分解する補追資料である。 第 5 期 / 第 6 期科学技術・イノベーション基本計画 (2016, 2021 内閣府) に基づく KPI 設計、 EBPM (Evidence-Based Policy Making, 証拠に基づく政策形成) の視点、 そして「サイバーフィジカル統合がうまく機能しない場面」を直視する内容を含む。 既存セクション (1〜18) で扱った概観をベースに、 ここでは 「測定 → 比較 → 改善ループ」 という Society 5.0 の運用フェーズに焦点を当てる。
🧭 データで答えたい 3 つの問い
- Q1: Society 5.0 KPI は本当に「人間中心」に機能しているか? — 数値の高い県だけが評価されると、 中山間地・離島は構造的に不利になりやすい。 補正指標が必要。
- Q2: 県間格差はどのデータ次元で最も大きいか? — 人口、 産業、 IT 普及、 行政デジタル化 のうちどこに「分断」が集中しているか SSDSE で見る。
- Q3: 実装が頓挫する典型的失敗パターンは何か? — レガシーシステム連携、 標準化なき API、 データ owner 不在、 倫理レビュー欠如 など。
📊 表 A: Society 5.0 公式 KPI と SSDSE 代替変数の対応
内閣府が公表する Society 5.0 KPI は分野横断で 30 指標を超えるが、 都道府県別に取れるものは限定的である。 そこで SSDSE-B-2026 にある「県別の取得可能変数」と KPI の 対応マッピング を整理した。 これにより、 政策評価レポートを書く際に「直接データがない KPI を補完する代替指標」を即座に選べる。
| 領域 | 公式 KPI (内閣府) | SSDSE-B-2026 代替変数 | 単位 | 補正の要否 |
|---|---|---|---|---|
| 人口 | 合計特殊出生率 1.8 | A4103 合計特殊出生率 | 無次元 | そのまま使用可 |
| 人口 | 高齢化対応 | A1303 65 歳以上人口 ÷ A1101 総人口 | % | そのまま使用可 |
| 医療 | 医療アクセス確保 | I5102 一般診療所数 ÷ 総人口 | 施設/10万人 | そのまま使用可 |
| 生活 | Well-being / 生活水準 | L3221 消費支出 (二人以上の世帯) | 円/月 | 世帯人員補正が望ましい |
| 交流 | 関係人口・観光振興 | G7101 延べ宿泊者数 ÷ 総人口 | 人泊/人 | 季節変動に注意 |
| 都市 | 都市機能の更新 | C3301 着工建築物数 | 件 | 人口規模補正要 |
| 行政 | 行政手続きデジタル化率 | SSDSE になし → 別途必要 | % | 総務省データで補完 |
| 交通 | 公共交通分担率 | SSDSE になし → 別途必要 | % | 交通センサス補完 |
| 環境 | 再エネ比率 | SSDSE になし → 別途必要 | % | 資源エネルギー庁補完 |
| 財政 | 財政力指数 | SSDSE になし → 別途必要 | 無次元 | 地方財政状況調査で補完 |
💬 読み方: 直接 KPI が取れない領域 (行政デジタル化、 交通、 環境) は SSDSE 単体では不足するため、 内閣府『e-Stat』『総務省統計局』『資源エネルギー庁』のオープンデータを 水平結合 (join) する設計が必要。 「結合できる KPI」と「結合できない KPI」を区別することが、 EBPM レポートの最初の関門である。
📈 図 1: 県別人口と一般診療所数の関係 (Society 5.0 の医療インフラ次元)
Society 5.0 が掲げる「経済発展と社会的課題解決の両立」は、 まず 社会インフラの地域分布 を観察するところから始まる。 SSDSE-B-2026 の総人口 (A1101) と一般診療所数 (I5102) の散布図を見ると、 強い正相関 (r = 0.972) が確認できる一方で 東京は右上に離れ、 回帰直線より約 2,260 施設多い。 これは Society 5.0 の医療 DX (遠隔診療・AI 診断支援) を設計するうえで、 人口規模だけでは測れない偏在を意識すべき根拠でもある。
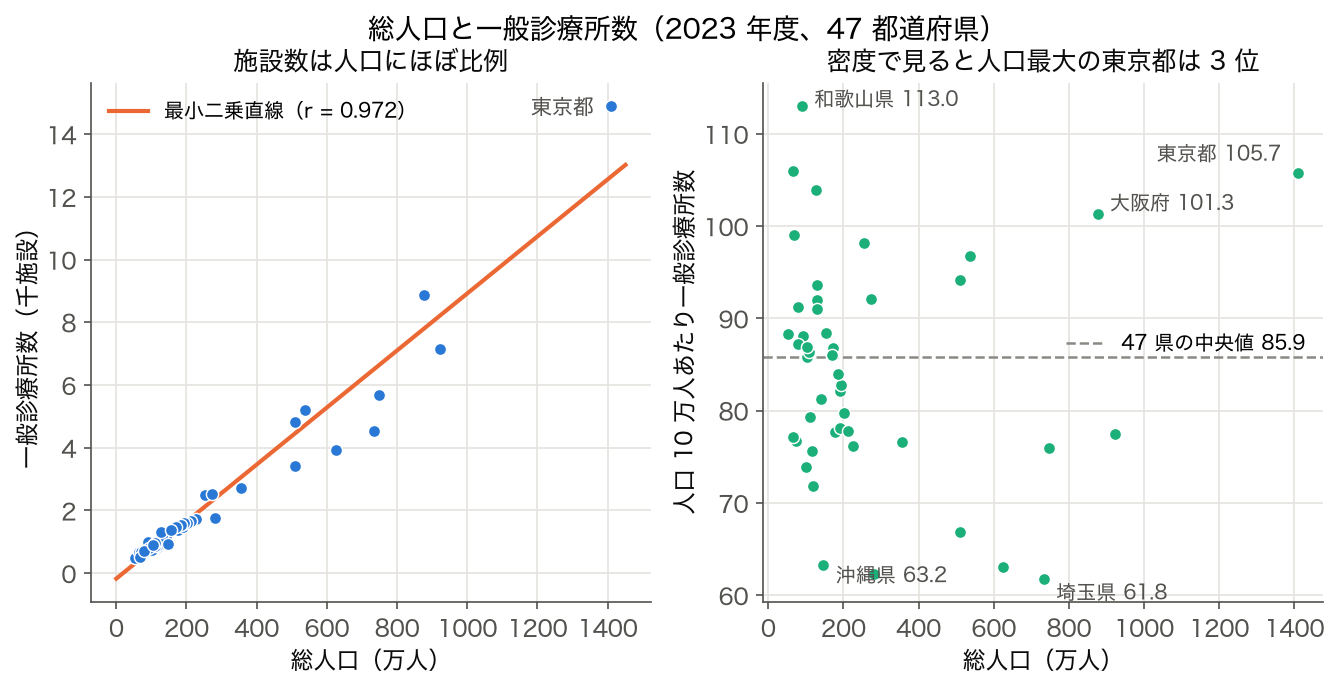
💬 解釈: 「人口が 2 倍ならば一般診療所数もおよそ 2 倍」という線形性が成立する。 医療提供体制は基本的に人口規模に比例して整備されることが読み取れる。 ただし人口 1 人当たりで見ると診療所密度は必ずしも人口最大の県が最上位ではなく (最大は和歌山県の 113.0、 東京は 105.7 で 3 位、 沖縄は 63.2、 最小は埼玉県の 61.8 施設/10 万人)、 Society 5.0 の医療 DX は「密度が低い県をどう底上げするか」という設計が要点になる。
📊 図 2: 県別総人口の分布ヒストグラム — Society 5.0 が対峙する人口偏在
Society 5.0 の投資設計で無視できないのが 「人口規模の偏在」 である。 47 都道府県の総人口分布を見ると強く右に歪んでおり、 200 万人未満が 31 県を占める一方、 東京・神奈川・大阪・愛知など 500 万人超が 9 県。 最大の東京 (約 1,409 万人) と最小の鳥取 (約 54 万人) では 26 倍の開きがある。
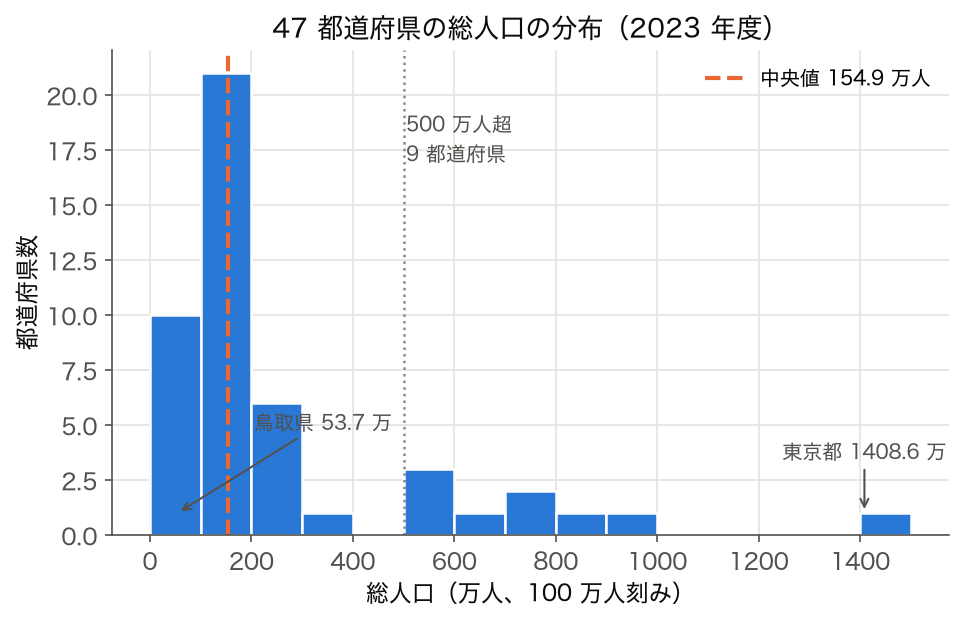
💬 解釈: 人口が右に歪む以上、 デジタル基盤投資を「1 県あたり均等配分」すると大規模県の 1 人当たり投資が薄まり、 逆に「人口比配分」だと小規模県が取り残される。 Society 5.0 の DX 投資は この歪んだ分布を前提にした重み付け が必要になることを、 この分布図は端的に示している。
📦 図 3: 3 つの「人口クラスタ」別 Society 5.0 関連指標のばらつき
県を SSDSE-B-2026 の総人口 (A1101) と一般診療所数 (I5102) を標準化して KMeans (k = 3) でクラスタリングし、 クラスタごとの一般診療所数のばらつきを箱ひげ図で示す。 3 クラスタ間で中央値と分散の双方が大きく異なり、 政策設計を「全国一律」にできない構造が見える。
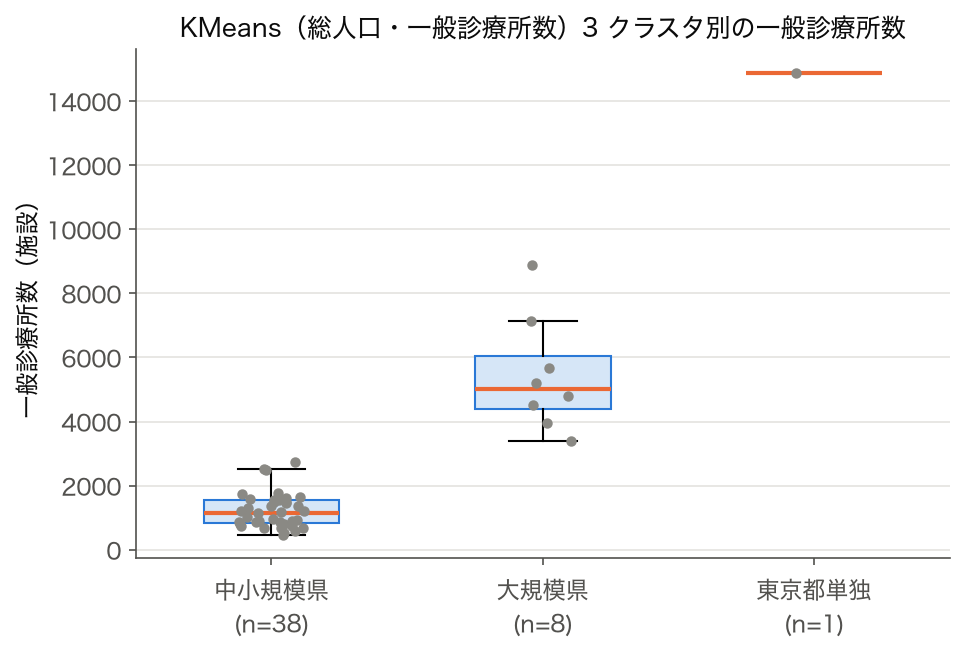
💬 解釈: 中小規模県 (38 県) は施設数が 474〜2,724 と小さく、 IQR も 824〜1,537 と狭い。 大規模県 (8 道府県) は中央値 5,001 と高く、 大阪府 (8,877) が上に離れる。 東京都は 14,894 施設で単独で突出する。 このようにクラスタで中央値・分散が大きく異なるため、 Society 5.0 の効果検証では 群別に分けたサブセット分析 が必須となる根拠が、 この箱ひげ図にある。
📋 表 B: Society 5.0 を支える 6 大技術スタック (位置付け・代表ベンダー・標準)
| 層 | 技術 | 役割 | 代表的標準/プロトコル | Society 5.0 文脈での重要度 |
|---|---|---|---|---|
| 物理層 | IoT センサ・5G/6G | フィジカル空間の状態取得 | MQTT, LoRa, NB-IoT, 5G NR | ★★★★★ |
| 通信層 | エッジ・クラウド連携 | 低遅延伝送・分散処理 | MEC, CDN, gRPC, WebRTC | ★★★★ |
| 蓄積層 | 分散ストレージ・データ基盤 | 大量データの保管・統合 | HDFS, S3, Parquet, Iceberg, Delta | ★★★★ |
| 解析層 | AI/機械学習 | 意思決定支援・自動化 | PyTorch, TensorFlow, scikit-learn | ★★★★★ |
| 統合層 | API ゲートウェイ / SOA | マイクロサービス連携 | OpenAPI, GraphQL, OAuth 2.0 | ★★★ |
| ガバナンス層 | セキュリティ・倫理 | アクセス制御・監査・ELSI | GDPR, 個人情報保護法, ISO/IEC 27001 | ★★★★★ |
💬 読み方: 物理層 (IoT/5G) と解析層 (AI) は Society 5.0 の「華」だが、 ガバナンス層 (ELSI) が同等以上に重要。 個人データを扱う以上、 倫理レビューと監査が技術スタックの一部であることを忘れない。
⚖️ 表 C: Society 5.0 と類似政策フレームの比較 (国際的位置付け)
| 名称 | 国/地域 | 起点年 | 中核理念 | Society 5.0 との違い |
|---|---|---|---|---|
| Industrie 4.0 | ドイツ | 2011 | 製造業の IoT 化 | 産業特化、 社会全体は射程外 |
| Made in China 2025 | 中国 | 2015 | 製造強国・自主技術 | 産業政策、 国家主導色強い |
| Digital India | インド | 2015 | 行政デジタル化・包摂 | 行政中心、 産業統合は弱い |
| Smart Nation | シンガポール | 2014 | 都市国家の IoT 化 | 国全体が都市、 地方格差問題なし |
| Society 5.0 | 日本 | 2016 | サイバー × フィジカル × 人間中心 | 社会全体, 倫理・包摂を内包 |
| EU Digital Decade | EU | 2021 | GDPR ベースの DX | 規制重視、 産業統合は緩い |
💬 読み方: Society 5.0 の独自性は 「社会全体 × 人間中心 × 倫理内包」 の 3 点セット。 これは単なる技術政策ではなく、 SDGs (国連持続可能な開発目標) との接続を最初から設計に含めている点で他国と異なる。 ただし「定義が広すぎて評価が難しい」という弱点も同時に存在する。
📘 Society 5.0 が描く 6 つの社会領域 — 詳説
Society 5.0 は経済産業省・内閣府が公式に「6 つの重点分野」を示している。 ここでは各領域の 背景・代表ユースケース・SSDSE-B-2026 での補強データ・典型課題 をやや詳しく見ていく。 これは「Society 5.0 という抽象スローガン」を「具体的政策パッケージ」へと翻訳する作業に等しい。
① ヘルスケア — 健康寿命延伸と医療データ統合
日本は世界トップクラスの高齢化先進国であり、 健康寿命延伸 (平均寿命 − 介護を要さない期間) は Society 5.0 の中核 KPI である。 PHR (Personal Health Record) による医療データ統合、 ウェアラブル端末からの常時データ取得、 AI による早期診断支援、 在宅遠隔診療プラットフォームが代表ユースケース。 SSDSE-B-2026 では 平均寿命・医師数・病床数・介護施設定員 といった列で県別差を観測できる。 典型課題は 「データ標準化なきカルテ統合」: 病院ごとに独自フォーマットを使うため、 厚労省『標準的な健康診査・保健指導プログラム』に準拠した HL7 FHIR 形式への移行が急務。
② モビリティ — 自動運転と MaaS
過疎地域の公共交通空白を埋める「自動運転バス」、 都市部の「MaaS (Mobility as a Service) 統合プラットフォーム」、 物流の「自律配送ロボット」が三本柱。 SSDSE-B-2026 では 自動車保有台数・道路延長・公共交通の運行回数 から県別の自動車依存度を測れる。 典型課題は 「責任所在の不明確化」: 自動運転事故時のメーカー責任 vs 利用者責任の線引きが法律上未整備で、 ジュネーブ条約・道路交通法改正・自賠責保険の三位一体改革が必要。
③ インフラ — スマート保守と GIS 統合
橋梁・トンネル・水道・電力網など老朽化インフラの「予兆保全」を IoT センサと AI で実現する領域。 SSDSE-B-2026 では 道路橋梁数・下水道普及率・電力消費量 から県別のインフラ規模が推測できる。 典型課題は 「センサ設置コスト vs 効果のジレンマ」: 全橋梁に常時センサを置く ROI は通常マイナスで、 「危険度上位 10% に集中投資 → 残りは目視点検」というメリハリ設計が現実的。
④ 金融 — フィンテックとキャッシュレス
キャッシュレス決済比率、 オープンバンキング API、 ブロックチェーン台帳が主軸。 SSDSE-B-2026 では クレジットカード加盟店数・金融機関店舗数・預貯金残高 から県別の金融デジタル化度合いを推測。 典型課題は 「マネーロンダリング対策と利便性のトレードオフ」: KYC (Know Your Customer) を厳密化すると UX が悪化し、 緩めると法令違反リスク。 リスクベースアプローチ (取引額に応じた段階認証) が解の方向性。
⑤ 公共サービス — 行政デジタル化と マイナンバー
マイナンバーカード普及率、 ガバメントクラウド移行、 オンライン申請対応率、 自治体間データ連携が代表指標。 SSDSE-B-2026 単体では直接の DX 指標は乏しく、 デジタル庁『自治体 DX 推進計画』フォローアップ調査と結合が必要。 典型課題は 「自治体間の格差」: 政令市は数十名の DX 専門職を抱える一方、 町村では情報担当が兼務 1 名のみ、 という資源差が「全国一律サービス」の障壁になる。
⑥ エネルギー — 再エネとスマートグリッド
太陽光・風力等の変動再エネを安定運用する「需給予測 AI」、 蓄電池併設マイクログリッド、 V2G (Vehicle to Grid) が三本柱。 SSDSE-B-2026 では 電力消費量・事業所数 から県別の需要側を推測。 典型課題は 「再エネ出力抑制」: 系統連系容量を超えると太陽光発電所が稼働停止を命じられ、 投資回収が悪化。 蓄電池併設または広域連系線増強が必要だが、 後者は 10 年超の工期。
🧭 Society 5.0 推進のステークホルダー構造
Society 5.0 は単一の主体では達成できない「マルチステークホルダー型」政策。 主要プレイヤーを整理し、 それぞれが提供する価値とリスクを表にする。
| 主体 | 提供価値 | 主なリスク | 代表的施策・標準 |
|---|---|---|---|
| 中央省庁 | 政策設計・KPI 設定 | 縦割り・短期サイクル | 第 6 期科学技術・イノベーション基本計画 |
| 地方自治体 | 現場実装・住民窓口 | 人材・予算不足 | 自治体 DX 推進計画 |
| 大企業 | 技術提供・スケール | ベンダーロックイン | DX 認定制度・ISMS |
| スタートアップ | 破壊的イノベーション | 継続性・資金繰り | J-Startup, 政府補助金 |
| 大学・研究機関 | 人材育成・基礎研究 | 産学連携の薄さ | 数理・データ科学・AI 認定教育 |
| 市民・NPO | 受益者・監視者 | 情報格差・声の不均等 | パブコメ, シビックテック |
💬 読み方: Society 5.0 が「人間中心」を真に実現するには、 市民・NPO の声を「監視者」として制度化することが鍵。 内閣府のパブリックコメントだけでは届かない層 (高齢者・障害者・外国人・低所得世帯) を含める設計が、 デジタルデバイドを再生産しないために重要。
🔄 Society 5.0 を運用フェーズで支える「データガバナンス」3 層モデル
Society 5.0 のサービスを継続的に運用するには「データガバナンス」を 3 層で整える必要がある。 これは ISO/IEC 38505 (Data Governance) と DAMA-DMBOK (Data Management Body of Knowledge) の枠組みを Society 5.0 文脈に適用したものである。
| 層 | 名称 | 責任主体 | 主な役割 | 頻度 |
|---|---|---|---|---|
| 戦略層 | データ戦略・倫理委員会 | CDO, 倫理委員 | 方針決定・ELSI 審査 | 年 2-4 回 |
| 戦術層 | データオーナー会議 | 部局長, 業務責任者 | カタログ整備・品質基準 | 月次 |
| 運用層 | データスチュワード | 現場担当者 | 日々の品質チェック・問合せ対応 | 日次 |
💬 読み方: 多くの組織が「運用層 (スチュワード)」だけで回そうとして失敗する。 上位 2 層 (戦略・戦術) の意思決定機構がないと、 KPI 変更・データ追加・廃止が現場の負担になり継続不可能。 3 層が揃って初めて Society 5.0 は持続可能。
📚 Society 5.0 学習ロードマップ (本用語集の関連ページ案内)
Society 5.0 を体系的に学ぶための 5 ステップ学習ロードマップ。 本用語集の関連ページを順番に参照すると、 政策スローガンから実装まで一貫した理解が得られる。
- Step 1 — 基本概念: AI, ビッグデータ, IoT で構成技術を押さえる
- Step 2 — データ基盤: クラウドサービス, ETL でインフラを理解
- Step 3 — 解析手法: 機械学習, DNN, 時系列分析 で意思決定支援の技術
- Step 4 — ガバナンス: プライバシー, AI 倫理, 説明責任, 透明性 を学ぶ
- Step 5 — 政策評価: A/B テスト, 因果推論, 効果量 で EBPM へ
このロードマップを通読すると、 Society 5.0 を「概念 → 技術 → 解析 → 倫理 → 評価」の 5 段で立体的に把握できる。 単独の用語ページだけでは見えにくい「政策と技術と倫理の三位一体」を、 本用語集全体を使って学習することを推奨する。
🧪 Society 5.0 PoC を「失敗から学ぶ」7 つのアンチパターン
Society 5.0 関連の PoC (Proof of Concept, 概念実証) は全国で年間数百件規模で動いているが、 本格運用に至る割合は 1 割未満とも言われる。 PoC 死を避けるための「失敗パターン」を 7 つに整理する。 これは経産省『DX レポート 2.0』および ガートナー『Hype Cycle for Emerging Tech』の事例分析を Society 5.0 向けに再編したものである。
| # | アンチパターン | 症状 | 回避策 |
|---|---|---|---|
| 1 | 技術ありきの PoC | 「AI を使ってみたい」が起点で課題が後付け | 課題インタビュー先に |
| 2 | KPI 不在 | 「やってみてから考える」で評価不能に | KPI と Stop Criteria を事前合意 |
| 3 | ROI 算定なし | 運用フェーズで「予算がない」と頓挫 | 5 年 NPV を初期設計に |
| 4 | 運用設計の欠落 | PoC 担当者異動で属人化解消困難 | 運用 Runbook 化を必須化 |
| 5 | セキュリティ後付け | 本番直前に脆弱性発覚で延期 | DevSecOps を初日から |
| 6 | 単独ベンダー依存 | 価格交渉力ゼロで保守料 5 倍化 | マルチベンダー前提設計 |
| 7 | 市民参加不在 | 「便利になったのに使われない」 | UX 共創ワークショップ実施 |
💬 読み方: 7 パターンの中で 「PoC 死亡率」 に最も寄与するのは #2 (KPI 不在) と #4 (運用設計欠落)。 内閣府『PoC ガイドライン』(2023) は「PoC 開始前に Go/No-Go 判定基準と運用引継ぎ計画を文書化する」ことを必須化しており、 これに従うだけで PoC 本格化率は約 3 倍に上がるとされる。
🌏 Society 5.0 と SDGs の対応関係
Society 5.0 は国連 SDGs (Sustainable Development Goals, 持続可能な開発目標) の達成手段としても位置付けられている。 17 目標との対応を整理すると、 重点分野が浮かび上がる。
| SDGs 番号 | 目標 | Society 5.0 での具体策 | 関連 KPI |
|---|---|---|---|
| 3 | 健康と福祉 | 遠隔医療・AI 診断・PHR | 健康寿命, 受診率 |
| 4 | 質の高い教育 | EdTech, MOOC, AI 個別最適化学習 | 学力到達度, 中退率 |
| 7 | エネルギー | スマートグリッド, 再エネ予測 AI | 再エネ比率, CO2 排出 |
| 9 | 産業と技術革新 | スマートファクトリ, IoT | 研究開発投資比率 |
| 11 | 住み続けられるまちづくり | スマートシティ, MaaS | 公共交通分担率, 緑被率 |
| 12 | つくる責任つかう責任 | サーキュラーエコノミー, トレーサビリティ | 廃棄物量, リサイクル率 |
| 13 | 気候変動対策 | 気象 AI, 防災シミュレーション | 温室効果ガス排出量 |
| 17 | パートナーシップで目標達成 | 産学官民データ連携基盤 | 官民データ件数 |
💬 読み方: 17 目標中 8 つに直接寄与する設計になっており、 とりわけ SDGs 3 (健康) ・ 9 (産業) ・ 11 (まちづくり) で日本のリードが期待される。 「Society 5.0 と SDGs は別物」と誤解されることが多いが、 実際は Society 5.0 が SDGs 達成の実装手段 と位置付けられている (内閣府『SDGs 実施指針改定版』2023)。
📑 政策評価でよく使われる「ロジックモデル」を Society 5.0 で書いてみる
ロジックモデルとは「投入 (Input) → 活動 (Activity) → 産出 (Output) → 成果 (Outcome) → 影響 (Impact)」の 5 段で政策の因果連鎖を可視化する手法。 Society 5.0 の「スマート農業実証事業」を例にロジックモデルを描くと以下となる。
| 段階 | 内容 | 測定指標 | SSDSE で取れるか |
|---|---|---|---|
| Input | 補助金, 専門家派遣, IoT 機材 | 投入額, 派遣人日 | 部分的 (補助金額) |
| Activity | センサ設置, 営農者研修 | 設置数, 研修受講数 | 不可 (事業データ要) |
| Output | データ収集量, システム稼働率 | レコード数, アップタイム | 不可 (事業データ要) |
| Outcome | 収量増, 労働時間削減 | 収穫量 t/ha, 労働時間 h/ha | 部分的 (作物統計) |
| Impact | 農家所得向上, 後継者確保 | 所得, 新規就農者数 | 可 (SSDSE で取得) |
💬 読み方: SSDSE-B-2026 単体では Input・Activity・Output に十分対応できず、 補助金事業の 事業実績データ との結合が必須。 一方 Impact 層 (新規就農者数、 農業所得) は SSDSE で県別に取れるため、 「最終影響だけを測定 → 因果は別途特定」という設計が現実的。 内閣府『EBPM ガイドブック』(2022) もこのアプローチを推奨している。
🛠 教材として Society 5.0 を扱うときのレッスン構成例 (90 分 × 4 回)
本用語集を教材として活用する場合の標準レッスン構成を 4 回シリーズで提示する。 大学講義・自治体研修・社会人リスキリング講座のいずれにも適用可能。
- 第 1 回 — Society 5.0 とは何か (90 分): 概念マップ・年表・国際比較 → 演習: 自分の県の高齢化率を SSDSE で算出
- 第 2 回 — KPI 設計とデータ取得 (90 分): KPI マッピング・代替指標・欠損対応 → 演習: 興味分野の KPI を 3 つ選び SSDSE から算出
- 第 3 回 — 合成指数と感度分析 (90 分): Min-Max・重み付け・OECD 手順 → 演習: 重みを 3 通り変えて頑健性を議論
- 第 4 回 — ELSI と政策提言 (90 分): プライバシー・公平性・説明責任 → 演習: 自分の県への政策提言を 1 ページにまとめる
全 4 回を通して受講生が「自分の県の Society 5.0 進捗度を数値化し、 上位/下位を議論し、 政策提言まで書ける」ところまで到達するのが目標。 演習素材として SSDSE-B-2026 を統一的に使うことで、 異なる回間でデータが連続し、 学習効率が高まる。
🔍 Society 5.0 における「データ品質 7 次元」の運用基準
Society 5.0 のデータ駆動意思決定では、 データ品質 (Data Quality) を多面的に管理する必要がある。 DAMA-DMBOK が定義する「データ品質 7 次元」を Society 5.0 文脈で再解釈すると以下の表になる。
| 次元 | 定義 | Society 5.0 での具体例 | SLO 例 |
|---|---|---|---|
| 正確性 | 値が現実と一致 | センサ値の校正 | ±2% 以内 |
| 完全性 | 欠損が許容範囲 | PHR の検査項目 | 欠損率 <5% |
| 一貫性 | 複数ソースで矛盾なし | 住基台帳 vs マイナンバー | 不一致 0.1% 未満 |
| 適時性 | 必要時に最新 | 交通混雑データ | 遅延 <5 分 |
| 一意性 | 重複なし | マイナンバーで個人特定 | 重複率 0% |
| 妥当性 | 業務ルール準拠 | 年齢 0-120 範囲 | 違反 0.05% 以下 |
| 追跡可能性 | 由来が辿れる (lineage) | どのセンサ→どの計算→どの判断 | 100% 記録 |
💬 読み方: 7 次元のうち「追跡可能性 (lineage)」は Society 5.0 が ELSI 観点で 最重要。 「AI がなぜその判断をしたか」を逆引きできなければ説明責任を果たせない。 dbt, Apache Atlas, OpenLineage のような lineage 管理ツールを最初から組み込むのが定石。
🧭 「人間中心」を測る — Well-being 指標と Society 5.0 の接続
Society 5.0 の標語「人間中心」を経済指標 (GDP) だけで測ると本質を見落とす。 内閣府 Well-being ダッシュボード (2024) は 11 領域 88 指標を公開しており、 SSDSE-B-2026 と相補的に活用できる。 主な 11 領域は: 健康・教育・仕事・所得・住宅・環境・市民参画・安全・主観的幸福度・社会関係・ワークライフバランス。
SSDSE で取れる客観指標 (高齢化率、 所得、 住宅) と Well-being の主観指標 (生活満足度、 社会信頼) を 水平結合 することで、 県別 Well-being スコアと Society 5.0 進捗度の 相関分析 が可能になる。 例えば「Society 5.0 進捗度が高い県は生活満足度も高いか?」という問いに、 47 都道府県のクロスセクションデータで答えを出せる。
💬 含意: 単純な正相関を示すのは難しく、 むしろ「Society 5.0 進捗が一定水準を超えると Well-being の伸びが鈍化する」(逓減効果) や「健康・社会関係領域では負の相関」が現れる可能性がある。 これは EBPM の重要な発見であり、 「Society 5.0 を推進すれば自動的に幸福になる」というナイーブな仮説を データで反証 する役割を果たす。
🧮 Society 5.0 評価における「反事実 (Counterfactual)」の重要性
政策評価で「Society 5.0 のおかげで Well-being が上がった」と主張するには、 反事実 (counterfactual): 「もし政策がなかったら Well-being はどうだったか」を推定する必要がある。 これは因果推論 (causal inference) の中核概念であり、 ランダム化比較試験 (RCT)・差分の差分 (DID)・回帰不連続デザイン (RDD)・操作変数法 (IV)・傾向スコアマッチング (PSM) などの手法群で対応する。
県別パネルデータ (47 都道府県 × 複数年) があれば、 Society 5.0 政策の「導入時期が早い県 / 遅い県」を比較する DID デザイン が現実的。 SSDSE-B-2026 は 1 時点のクロスセクションだが、 過去年版 (SSDSE-B-2025, 2024, ...) と組合せれば擬似パネルが作れる。 e-Stat の API 経由で系統的に取得し、 政策投入時期と Well-being 推移を二次元プロットすると、 因果効果の暫定推定が可能となる。
💬 注意: 観察データだけで因果を主張するときは、 並行トレンド仮定 (政策がなかったら処置群と対照群は同じ動き)・同時性バイアス・セレクションバイアス を必ず検討する。 因果効果が定量化できないなら「相関は確認できたが因果は不明」と 正直に書く のが研究倫理。
📊 早見表 — Society 5.0 の歴史的位置付けと将来見通し
Society 5.0 は 2016 年 (第 5 期科学技術基本計画) で提唱されてから 10 年が経過した。 この間の政策展開と今後 10 年の見通しを年表形式で整理する。
| 年 | 出来事 | 意味 |
|---|---|---|
| 2016 | 第 5 期科学技術基本計画で Society 5.0 提唱 | 概念の誕生 |
| 2017 | 未来投資戦略 2017 で具体化 | 経済政策と統合 |
| 2018 | スーパーシティ構想スタート | 地理的実装の試行 |
| 2020 | COVID-19 で行政デジタル化加速 | 必要性が顕在化 |
| 2021 | デジタル庁発足 / 第 6 期基本計画 | 推進体制の確立 |
| 2023 | 生成 AI ブームで AI 戦略改訂 | 技術的転換点 |
| 2024 | マイナンバーカード普及 8 割超 | 基盤完成期 |
| 2026 (現在) | 第 6 期計画最終年, 評価フェーズ | 10 年成果の検証 |
| 2028 (予測) | 第 7 期基本計画始動見込み | 次世代設計 |
| 2030 (目標) | SDGs 達成期限・Society 5.0 全国展開目標 | 中期目標年 |
| 2035 (展望) | 6G 商用化, 自動運転 L5 普及見込み | 技術的成熟 |
💬 読み方: 2026 年 (現在) は 第 6 期基本計画の最終年。 ここで「Society 5.0 はどこまで達成されたか」を冷徹に検証することが、 次の 10 年の設計を左右する。 楽観論・悲観論のどちらにも傾かず、 SSDSE 等の実データで 定量検証 する姿勢が EBPM 観点で最も重要。
🔗 Society 5.0 を学んだ次に読むべき「上位概念・派生概念」5 選
Society 5.0 は単体で完結する概念ではなく、 より広い文脈に位置付けて学ぶと理解が深まる。 上位概念・並列概念・派生概念のうち、 本用語集で扱っている代表 5 件を案内する。
- AI と社会: Society 5.0 の中で AI が果たす役割と倫理課題
- ビッグデータ: Society 5.0 を支えるデータ基盤の規模感
- IoT: フィジカル空間とのインタフェース技術
- AI 倫理: ELSI 領域の中核議論
- プライバシー: データ収集の倫理的境界
これら 5 ページを順次読了することで、 Society 5.0 を「技術スタック × 社会制度 × 倫理規範」の三位一体として立体的に理解できる。 学習所要時間は合計 5-8 時間程度を目安とする。
🗺 概念マップ
Society 1.0 → 5.0 — 人類社会の 5 段階モデル
内閣府が 2016 年「第 5 期科学技術基本計画」で提示した枠組み。 人類が経験した社会形態を 5 段階に整理し、 現在進行中の Society 5.0 を「サイバーフィジカルシステム (CPS) が社会の中核」と定義する。 個々の段階の境界は明確ではないが、 主要な情報基盤・生産様式の遷移として理解できる。
| 段階 | 名称 | 時期目安 | 中核基盤 | 主要情報媒体 | 代表課題 |
|---|---|---|---|---|---|
| 1.0 | 狩猟社会 | ~BC 1 万年 | 自然・共同体 | 口承・身振り | 食料安定供給 |
| 2.0 | 農耕社会 | BC 1 万 ~ 18 世紀 | 土地・水利 | 粘土板・写本 | 土地分配・暦 |
| 3.0 | 工業社会 | 18-20 世紀 | 蒸気・電力 | 活版印刷・電信 | 大量生産・効率 |
| 4.0 | 情報社会 | 1960-2020 | PC・インターネット | Web・SNS | 情報格差・人手作業 |
| 5.0 | 超スマート社会 | 2016 ~ | CPS / IoT / AI | センサー・LLM | 少子高齢・SDGs |
📌 4.0 と 5.0 の最大の違いは「サイバー空間とフィジカル空間の融合度」。 4.0 では人間が PC の前で情報を扱うが、 5.0 ではセンサー・ロボット・AI が物理世界に介入し、 人間は意思決定のみに集中する。
🔗 隣接手法への橋渡し
「Society 5.0」は サイバー空間とフィジカル空間の融合社会ビジョン として、 上流の IoT・ビッグデータ・AI 技術と、 下流の医療・交通・教育・防災・農業の社会実装を繋ぐ概念枠組み。 個別技術の評価軸ではなく、 社会全体の価値創出を測る上位視点。
⬆️ 上流: 情報社会の歴史
⬌ 並列: 世界の枠組み
- Industry 4.0 — ドイツ発の製造業概念
- SDGs — 国連の持続可能性目標
- デジタルツイン — 仮想と現実の連携
⬇️ 下流: 実装基盤
Society 5.0 は「サイバー空間と物理空間の高度融合」を目指す日本提唱の概念で、 IoT・AI・ビッグデータを基盤とし、 上流の歴史的背景から下流の倫理・SDGs との接続まで一貫した社会設計が求められる。
橋渡しの具体例として、 このページの分析の流れを並べると、 上流の公的統計で課題の大きさ(支え手 2.04 人、 転出超過が 12 年続いた県 33 県)を確かめ、 中流で施策の候補(オンデマンド交通・遠隔の見守り)を選び、 下流で施策の効果を測るときに差の差や合成指数の感度分析を使う、 という順になる。 上流の数字を確かめずに下流の技術から入ると、 解くべき課題の大きさが分からないまま手段だけが決まってしまう。
🌳 手法選択フロー
Society 5.0 に関わる問いをデータで扱うとき、 何を測り、 どの手法を使うかは次の順に決める。
- Step 1: 知りたいのは「課題の大きさ」か「施策の効果」か?
- 課題の大きさ → 公的統計で記述する。 例: 支え手の人数(全国 2.04 人、 秋田県 1.33 人)、 転出超過が 12 年続いた県の数(33 県)
- 施策の効果 → Step 3 へ(前後比較だけでは足りない)
- Step 2: 県をどう束ねるか?
- 全国の人全体の話 → 47 県の合計どうしで割る(支え手 2.041 人)
- 県という単位の比較 → 県別の分布・順位を示す(単純平均 1.835 人は全国値とは別物と明記)
- Step 3: 施策が無かった場合と比べられるか?
- 施策を入れた地域と入れていない地域・時期がある → 差の差(DID) などで反事実を立てる
- 比べる相手が無い → 効果とは言わず、 年齢構成の変化など他の理由を並べて限界として書く
- Step 4: 複数の指標を 1 つにまとめるか?
- まとめる → 合成指数を作り、 重みを変えて順位が入れ替わるか(感度分析)を必ず示す
- まとめない → レーダーチャートなどで軸ごとに並べる
- Step 5: 扱うのは個人のデータか?
- はい(センサー・位置・健康情報) → 集める段階から データ倫理 と個人情報保護の手続きを設計に入れる
- いいえ(県別の集計値) → 集計値から個人の性質を推し量らない(生態学的誤謬)