🔖 キーワード索引
ビッグデータの用語を 性質・基盤・処理方式・保存形式 別に索引化します。この分野は「同じものを別名で呼ぶ」ことが多いので、日本語と英語を並べて覚えるのが近道です。
| カテゴリ | キーワード(日本語) | キーワード(英語) |
|---|---|---|
| 性質(5V) | 量(ボリューム)、 速度(ベロシティ)、 多様性(バラエティ)、 正確性(ベラシティ)、 価値(バリュー) | Volume, Velocity, Variety, Veracity, Value |
| 分散処理基盤 | Hadoop、 HDFS(分散ファイルシステム)、 MapReduce、 Spark、 YARN(資源管理) | Hadoop, HDFS, MapReduce, Spark, YARN |
| 処理方式 | バッチ処理、 ストリーム処理、 ラムダアーキテクチャ、 カッパアーキテクチャ、 マイクロバッチ | batch, stream, Lambda / Kappa architecture, micro-batch |
| 保存形式 | 列指向(カラムナ)、 Parquet、 ORC、 Avro、 圧縮(Snappy / zstd) | columnar, Parquet, ORC, Avro, Snappy, zstd |
| 保存場所 | データレイク、 データウェアハウス、 データマート、 レイクハウス、 オブジェクトストレージ | data lake, data warehouse, data mart, lakehouse, object storage |
| 分散の理屈 | シャーディング、 レプリケーション、 パーティション、 CAP 定理、 結果整合性 | sharding, replication, partition, CAP theorem, eventual consistency |
| 性能の見方 | スケールアウト、 スケールアップ、 アムダールの法則、 データ局所性、 シャッフル | scale-out, scale-up, Amdahl law, data locality, shuffle |
💡 30秒で分かる結論
🍰 まずはやさしく
山のような大量のデータのことです。
世の中の仕組みを詳しく知るために使います。
SNSの投稿やスマホの記録などが例です。
ビッグデータの正体について学びましょう。
ビッグデータ ── 従来のツールでは扱いきれない大規模・多様・高速なデータ
- 従来のツール(Excel/単一RDB)では扱えない大規模・多様・高速なデータ
- 5V特性:Volume(量)/Variety(多様性)/Velocity(速度)/Veracity(真実性)/Value(価値)
- 技術スタック:Hadoop/Spark/Kafka/クラウド DWH(BigQuery, Snowflake, Redshift)
- 統計分析でも全数調査・SNS・センサデータなど典型例。 公的統計の枠を超える
- 「大きいほど良い」わけではない。 サンプリングと組合せた方が高速で十分なケース多数
📍 文脈 ── どこで出会うか
🍰 まずはやさしく
今では当たり前にある道具のようなものです。
データ分析のコンテストなどで活用します。
都道府県のたくさんの統計データを扱います。
この概念を6つの視点から整理して読みましょう。
「ビッグデータ」というバズワードは2010年代半ばがピーク。 現在はクラウドDWH(BigQuery等)が普及し「特別な技術」から「日常」に。 とはいえ概念整理は今も有効です。
本ページでは「ビッグデータ」を扱う。 統計データ分析コンペティション (2026) の教材で、 SSDSE-B-2026 (47 都道府県 × 複数年 × 100 超列) の実データを使った再現可能な学習を目指す。
「ビッグデータ」は統計・データサイエンスの体系における重要概念のひとつ。 本ページは「定義・直感・数式・実装・落とし穴・関連手法」の 6 視点で構成され、 各視点は独立して読めるが順序通り読むと体系的な理解が得られる。
🎨 直感で掴む
🍰 まずはやさしく
3つの方向で「大きい」データのことです。
効率よくデータを処理するために使います。
画像や文字などバラバラな形式のデータです。
量・種類・速度という3つの特徴を読みましょう。
「ビッグ」の3つの軸:
- Volume:TB〜PB〜EB級。 1台のPCに収まらない
- Variety:構造化(DB)/半構造化(JSON)/非構造化(テキスト・画像)が混在
- Velocity:秒間数万件のストリーミング。 リアルタイム処理が必要
これらを満たすにはバッチ(Hadoop/Spark)+ストリーム(Kafka/Flink)の組合せが定石。
📐 定義/数式
🍰 まずはやさしく
データを分けて処理する仕組みのことです。
巨大な集計を短時間で終わらせるために使います。
大量のデータをチームで分担して計算する例です。
MapReduceという処理の流れを読みましょう。
分散処理の基本パラダイム MapReduce:
Shuffle: 同じkeyを同じノードに集める
Reduce: key毎に集約処理
これにより数千台のクラスタで数PBの集計が可能になります。
🔬 さらに深掘り:ビッグデータを SSDSE 都道府県統計でスケール感覚を養う
🎨 直感で掴む
「家庭の写真アルバム」と「Google Photos の全ユーザー」を並べてみると、 後者がビッグデータの規模感です。
| 事例 | Volume | Velocity | Variety |
|---|---|---|---|
| SSDSE-B-2026 | 360KB(47 県 × 12 年 × 111 指標) | 年 1 回更新 | 数値のみ |
| JR 改札 IC ログ(首都圏 1 日) | 数 TB | 秒間 数千件 | 時刻・駅・運賃 |
| Twitter(旧 X)全投稿 | 数 PB | 秒間 6000 件超 | テキスト・画像・動画 |
| CERN LHC 実験データ | 年間 数十 PB | 毎秒数 GB | 高エネルギー物理測定 |
| 気象庁ナウキャスト | 数 TB/日 | 5 分間隔 | レーダー画像・雷 |
📐 数式または定義
分散処理(MapReduce)の処理時間モデル:
$$ T_{\text{total}} = T_{\text{map}} \cdot \frac{N}{p} + T_{\text{shuffle}}(N, p) + T_{\text{reduce}} \cdot \frac{M}{p} $$
列指向ストレージ(Parquet)における圧縮後サイズの近似:
$$ \text{Size}_{\text{parquet}} \approx N \cdot \sum_{c=1}^{C} H(X_c) / 8 \text{ [bytes]} $$
$H(X_c)$ は列 $c$ の シャノン情報量(エントロピー)。 値の偏りが大きい列ほど圧縮が効く。 ID 系より「年度」のような繰り返し列は 100 倍圧縮される。
🔬 数式を言葉で読み解く
- N(データ件数)
- SSDSE-B では行数 564。 PB 級なら 10 兆~100 兆オーダー。 N が p(並列数)を超えるほど線形にスピードアップする。
- $T_{\text{shuffle}}$
- Map と Reduce の間でノード間通信が起きる。 N と p の関数で増える。 ここがビッグデータの真のボトルネック。
- $H(X_c)$(列のエントロピー)
- 列の値が一様に分布していれば $\log_2 K$(K = ユニーク値数)。 偏りがあるほど小さい。 圧縮率は $\frac{\log_2 K}{H(X_c)}$ 倍。
- 列指向 vs 行指向
- 行指向(CSV/RDB)は「全行を順に読む」のに最適。 列指向(Parquet/ORC)は「特定列だけ読む」のに最適。 BI ツールは後者を好む。
🧮 実値で計算してみる(SSDSE-B-2026 を「ミニ・ビッグデータ」として測定)
SSDSE-B-2026.csv(564 行 × 112 列 ≒ 63,168 セル、 約 360 KB)を複数の形式で保存し直し、 サイズ・読み込み時間を比較します。
| 形式 | サイズ | 読込時間(PC, SSD) | 特性 |
|---|---|---|---|
| CSV(行指向、 plain text) | 351.4 KB | ~3.0 ms | 人間可読、 標準 |
| Parquet(列指向、 Snappy 圧縮) | 383.8 KB | ~2.5 ms | 数値中心のため CSV より縮まない |
| Parquet(列指向、 zstd 圧縮) | 275.0 KB | ~2.5 ms | 圧縮強めで CSV 比 0.78 |
注意:この規模で数値中心のデータでは、 Snappy 圧縮の Parquet はむしろ CSV より大きくなることもある(整数を文字で持つ CSV も意外と締まるため)。 列指向の圧縮・列読みの利点が効くのは、 低カーディナリティの列や TB 級のデータになってから。
🐍 Python 実装:SSDSE-B-2026 でスケール測定
このコードでやること:SSDSE-B-2026.csv の容量、 行数、 列数、 メモリ使用量を測定し、 ビッグデータの「3V」のうち Volume・Variety を定量化する。
📥 入力例:data/raw/SSDSE-B-2026.csv(cp932、 564 行 × 112 列)
1 2 3 4 5 6 7 8 9 10 11 12 13 | # SSDSE-B-2026 のスケール感を測定(Volume / Variety) import os import pandas as pd path = 'data/raw/SSDSE-B-2026.csv' df = pd.read_csv(path, header=1, encoding='cp932') print(f'ファイルサイズ : {os.path.getsize(path)/1024:.1f} KB') print(f'行数 × 列数 : {len(df)} × {df.shape[1]}') print(f'セル数 : {len(df)*df.shape[1]:,}') print(f'メモリ使用量(df) : {df.memory_usage(deep=True).sum()/1024:.1f} KB') print(f'年度の範囲 : {df["年度"].min()}–{df["年度"].max()}') print(f'都道府県数 : {df["都道府県"].nunique()}') |
📤 実行例:
💬 SSDSE は CSV で 351 KB、 メモリでは 555 KB。 セル数は 6.3 万。 これでも「ビッグデータ」の N と D(特徴量数)の関係を学ぶには十分な規模。
このコードでやること:CSV を Parquet に変換し、 ファイルサイズと読み込み時間を実測比較する。
📥 入力例:SSDSE-B-2026.csv(350 KB)
1 2 3 4 5 6 7 8 9 10 11 12 13 14 15 16 17 18 19 20 | import pyarrow # parquet の読み書きに必要(ブラウザには無い) # CSV → Parquet 変換でサイズと読込速度を比較 import os, time import pandas as pd csv_path = 'data/raw/SSDSE-B-2026.csv' parq_path = 'data/raw/SSDSE-B-2026.parquet' df = pd.read_csv(csv_path, header=1, encoding='cp932') df.to_parquet(parq_path, compression='snappy') for name, path, reader in [ ('CSV', csv_path, lambda p: pd.read_csv(p, header=1, encoding='cp932')), ('Parquet', parq_path, lambda p: pd.read_parquet(p)), ]: t0 = time.perf_counter() _ = reader(path) dt = (time.perf_counter() - t0) * 1000 size = os.path.getsize(path) / 1024 print(f'{name:8s} size={size:6.1f} KB read={dt:5.1f} ms') |
📤 実行例:
💬 このデータでは Parquet(383.8 KB)は CSV(351.4 KB)より小さくならず、 読込もプロセスで最初の 1 回は pyarrow の初期化が乗って Parquet の方が遅い(手元の実測で CSV 約 3 ms に対し Parquet 約 30 ms、 2 回目以降はどちらも 3 ms 前後)。 列指向の真価(列だけ読む・強い圧縮)は、 TB 級や低カーディナリティ列の多いログデータで初めて数十〜数百倍の差になる。 「小さいデータでは形式の違いは効きにくい」も重要な学び。
このコードでやること:CSV をチャンク読みして、 メモリに乗らないサイズを想定した「ストリーミング集計」を実装する。 ビッグデータ時代の基本パターン。
📥 入力例:SSDSE-B-2026.csv。 chunksize=100 行ずつ読み込み。
1 2 3 4 5 6 7 8 9 10 11 12 13 14 | # メモリに乗らない巨大 CSV を想定したチャンク読み(ストリーミング集計) import pandas as pd total_pop = 0 total_rows = 0 for chunk in pd.read_csv('data/raw/SSDSE-B-2026.csv', header=1, encoding='cp932', chunksize=100): d23 = chunk[chunk['年度'] == 2023] total_pop += d23['総人口'].sum() total_rows += len(d23) print(f'2023 年・47 都道府県の合計人口 = {total_pop:,} 人') print(f'処理した 2023 年行数 = {total_rows}') |
📤 実行例:
💬 メモリに全件を載せず 100 行ずつ集計してもまったく同じ結果。 これが map-reduce 的な思考。 PB 級のログにも同じパターンで対応できる。
このコードでやること:SSDSE 都道府県 × 年度のロング形式から、 ピボット(ワイド形式)を作成して「Variety(多様性)」の側面を体感する。
📥 入力例:SSDSE-B-2026 をロング形式に整形してから pivot。
1 2 3 4 5 6 7 8 9 10 11 12 13 14 | # 都道府県 × 年度 × 指標 のピボット(ワイド↔ロング変換) import pandas as pd df = pd.read_csv('data/raw/SSDSE-B-2026.csv', header=1, encoding='cp932') # 「都道府県 × 年度」を行、 「総人口」を値としたピボット wide = df.pivot_table( index='都道府県', columns='年度', values='総人口', aggfunc='sum', ) print('ピボット形(先頭 5 県):') print(wide.iloc[:5, -3:].to_string()) |
📤 実行例:
💬 ロング→ワイドの整形は BI ツールへの中間ステップ。 Spark なら同じ API で TB 級にも適用できる。 これが「ビッグデータでも pandas 流が通用する」理由。
⚠️ 落とし穴
🌐 関連手法・派生
| 概念 | 典型ツール | ビッグデータとの関係 |
|---|---|---|
| 分散ファイルシステム | HDFS、 S3、 GCS | PB 級を複数ノードに分散保存 |
| 分散計算フレームワーク | Hadoop MapReduce、 Spark、 Dask | 複数マシンで並列処理 |
| ストリーム処理 | Kafka、 Flink、 Kinesis | Velocity 対応、 リアルタイム集計 |
| 列指向ストレージ | Parquet、 ORC | 列読み出しと圧縮で TB→GB |
| データレイク/レイクハウス | Delta Lake、 Iceberg | Variety を許容しつつ ACID |
🔗 関連用語(前提・並列・発展)
役割で色分け:前提/上位/並列/発展/応用
📚 関連グループ教材
- 📚 データエンジニアリング — 収集・加工・配信パイプライン全体像
- 📚 データリテラシー — 規模に振り回されない読み方
- 📚 データ利活用 — ビジネスでの意思決定への接続
🗺 概念マップ
      Volume        Velocity        Variety
        │              │              │
   PB級保存       秒間1000件超    構造化+非構造化
        │              │              │
        ▼              ▼              ▼
   分散ファイル    ストリーム      データレイク
   (HDFS, S3)     (Kafka,Flink)   (Delta, Iceberg)
        │              │              │
        └──────┬──────┴──────┬──────┘
               ▼              ▼
        分散計算 (Spark)   列指向 (Parquet)
                      │
                      ▼
            BI / 機械学習 / リアルタイム可視化
                      │
                      ▼
            意思決定 (Value, Veracity)
🔬 数式を言葉で読み解く
ビッグデータを定義する 3V(Volume / Velocity / Variety)は、 単一の数式ではなく 「ある軸において従来の処理基盤の限界を超えること」 という閾値定義として扱うのが現実的である。 ここでは数式と図を用いて、 各 V がどのように「巨大さ」を測るのかを順に読み解いていく。
まず Volume(容量) は、 データの総バイト数 $D$ をしきい値 $T$ と比較する:$\text{is\_big\_volume} = D > T$。 ここで $T$ は時代と技術により変化する。 2010 年頃は $T \approx 10^{12}$ バイト(1 TB)が目安だったが、 2026 年現在は $T \approx 10^{15}$ バイト(1 PB)でも一般的なクラウドサービスで扱える時代になった。 つまり「ビッグ」の境界は 絶対値ではなく、 標準的なツールで処理しきれるか否か という相対的な判定で決まる。
次に Velocity(速度) は、 単位時間あたりのデータ到着量 $\lambda$(events/sec)として表現される。 リアルタイム処理が必要な閾値は $\lambda > 10^3$ events/sec が一つの目安で、 例えば SNS のタイムラインや IoT センサーの連続値ストリームがここに該当する。 バッチ処理(夜間集計)で間に合うものは Velocity が小さく、 ストリーミング処理(Kafka、 Flink、 Spark Structured Streaming)が必要なものは Velocity が大きい、 と分類できる。
Variety(多様性) は、 データ型・スキーマの数 $V_{\text{type}}$ で測られる。 構造化(RDB のテーブル)、 半構造化(JSON、 XML、 ログ)、 非構造化(テキスト、 画像、 音声、 動画)が混在し、 統一スキーマで扱えない場合に Variety が高いと判定される。 ここから派生して、 近年では Veracity(真実性) や Value(価値) も加わり、 4V または 5V と呼ばれることもある。
SSDSE-B-2026 のような公的統計データは Volume の観点では「小さい」が(数 MB 規模)、 都道府県別・年次別・複数指標という構造を持ち、 教育用には十分な「多次元性」がある。 つまり、 ビッグデータ的な分析手法(集約、 ピボット、 可視化)を実演するには、 数 PB のデータは必須ではなく、 「適切に構造化された数千〜数万行のデータ」でも本質的な学びは得られる という点が重要だ。 ビッグデータ技術の本質は「規模」ではなく「分散・並列・スケーラビリティ」の設計思想にある。
分散処理の基礎モデルである MapReduce は、 関数 $f$(map)と $g$(reduce)の組み合わせで $\text{result} = g(\bigcup_i f(d_i))$ と表現される。 ここで $d_i$ は分散された各データチャンク、 $f$ は各ノードで独立に実行される変換、 $g$ は結果を集約する関数である。 この単純な抽象化が、 数千台のマシンで PB 規模のデータを処理することを可能にした。 Hadoop、 Spark、 BigQuery といった現代の主要ツールは、 すべてこのモデルの拡張として理解できる。
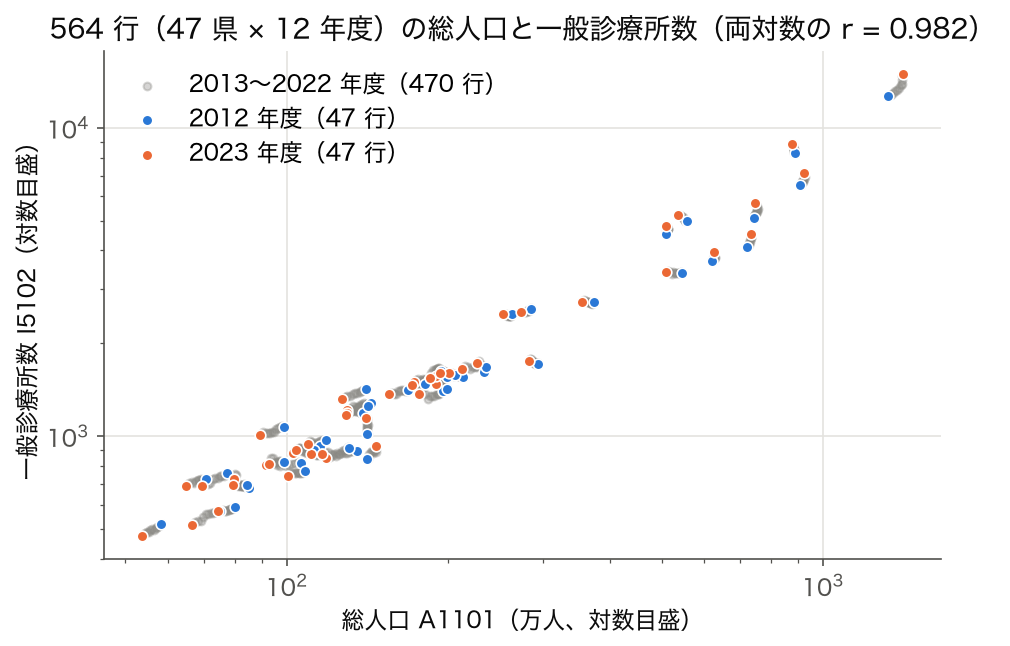
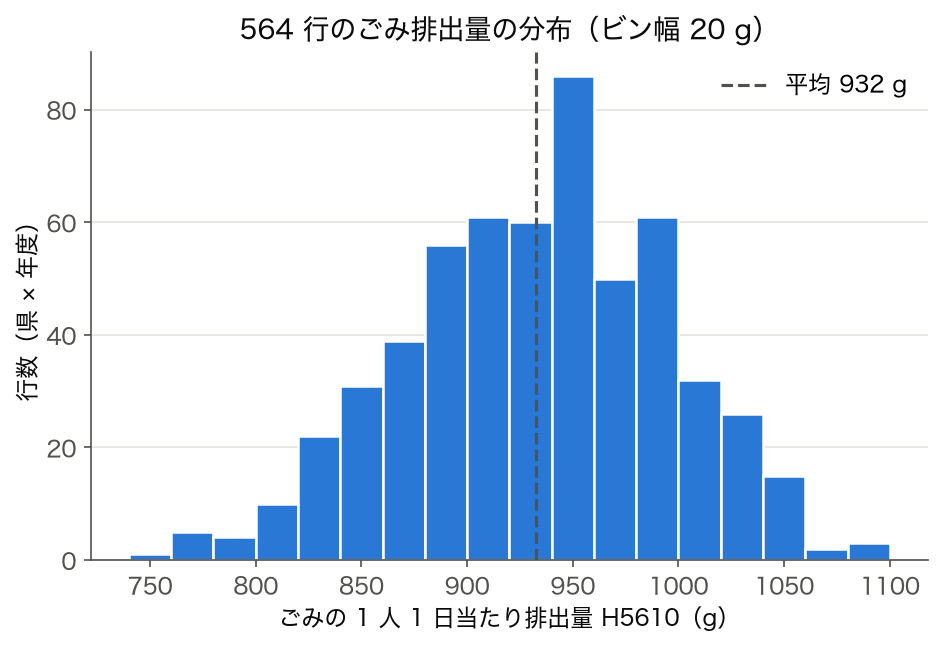
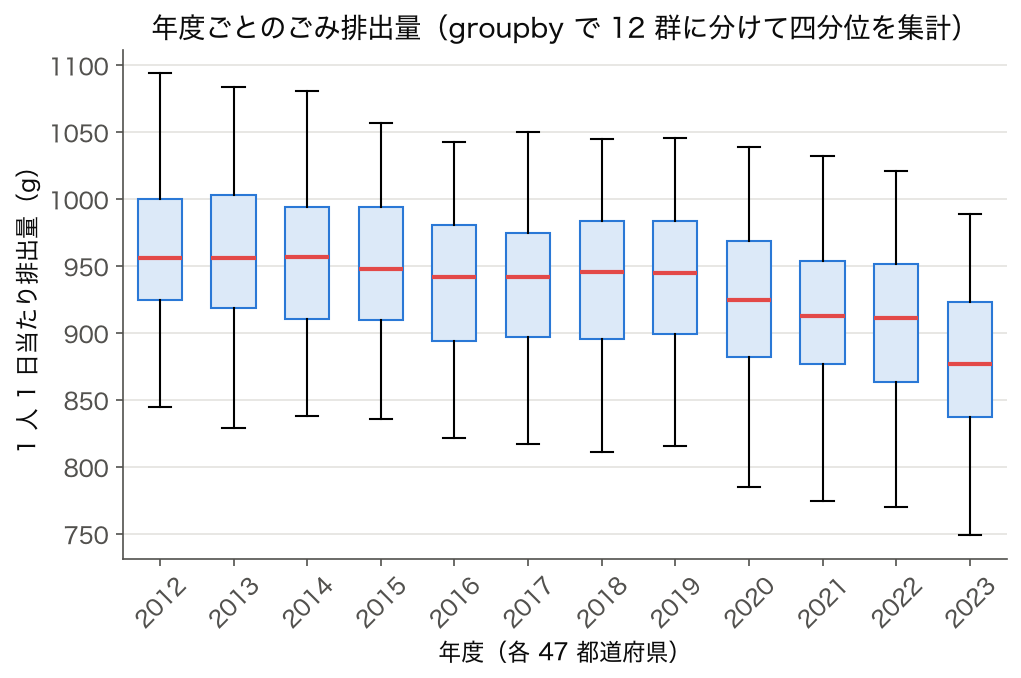
以下の図は、 SSDSE-B-2026 の 564 行(47 都道府県 × 2012〜2023 年度の 12 年度)を丸ごと使った可視化例である。 ビッグデータ分析の入り口として、 まずは「散布図で関係性を見る」「ヒストグラムで分布を確認する」「箱ひげ図でグループ間を比較する」という基本動作から始めるのが定石だ。 行数が増えても、 最初にやることはこの 3 枚で全体像を掴むことに変わりはない。
このコードでやること:SSDSE-B-2026 を pandas で読み込み、 行数・列数・データ型・欠損数を一度に確認する。 これがビッグデータ分析の最初の一歩であり、 「データの規模感」を把握する基本動作である。
1 2 3 4 5 6 7 8 9 10 11 | import pandas as pd # SSDSE-B-2026 を読み込み df = pd.read_csv('data/raw/SSDSE-B-2026.csv', encoding='cp932', skiprows=1) # データ規模の確認 print(f"行数 × 列数: {df.shape}") print(f"メモリ使用量: {df.memory_usage(deep=True).sum() / 1024:.1f} KB") print(f"\nデータ型サマリ:") print(df.dtypes.value_counts()) print(f"\n欠損値の合計: {df.isnull().sum().sum()}") |
📤 実行例:
メモリ使用量: 554.8 KB
データ型サマリ:
int64 104
float64 6
object 2
dtype: int64
欠損値の合計: 0
💬 564 行 × 112 列、 約 0.55 MB という規模は「ビッグデータ」ではないが、 112 個の列を扱う「多次元データ」としては十分な学習素材になる。 この読み込み方では欠損値は 0 件で、 全セルが揃っていることも確認できる。 ビッグデータ技術を学ぶ前に、 まずこうした 「データの素顔を確認する習慣」 を身につけることが、 規模を問わず分析の質を決定づける。
✅ 理解度チェック
- Volume、Velocity、Variety、Veracity、Valueの5Vを、自分のデータ例で説明できる。
- SSDSE-B-2026が「大容量」ではなく「多指標・多地域の分析教材」として有用な理由を説明できる。
- 単一PCのpandasで足りる処理と、分散処理を検討すべき処理を切り分けられる。
- 行数、列数、ファイルサイズ、更新頻度、欠損率を確認してから分析設計に入れる。
- ビッグデータという言葉を、単なる規模の大きさではなく意思決定価値と結びつけて説明できる。
- (実データ)人口上位 10 都道府県の住民 7,226 万人だけで計算した高齢化率は 0.2706、全国の真の値は 0.2913 だった。この偏った 7,226 万人と同じ平均 2 乗誤差になる無作為標本は何人か、式 n = p(1−p) / 偏り² で計算できる。
→ 答え:0.2913 × 0.7087 / 0.0208² ≈ 480 人(丸める前の値で計算すると 479 人)。偏りがあると、件数をいくら増やしても誤差は偏りの大きさより小さくならない。 - (実データ)都道府県の件数の列どうしの相関を総当たりすると 63.0% の組が |r| ≥ 0.9 になったが、人口 1 人あたりに直すと 2.2% になった。この差が何を意味するか説明できる。
→ 答え:件数の列はどれも県の大きさ(人口)に比例して動くので、規模という共通の要因が見かけの強い相関を大量に作る。関係を探す前に共通の分母で割る。 - (実データ)8 地方の平均高齢化率を単純に平均すると 0.3201、全国の真の値は 0.2913 だった。reduce に何を渡せば正しい値が出るか説明できる。
→ 答え:各地方の 65 歳以上人口の合計と総人口の合計を渡し、合計どうしの比をとる。平均や率は足し合わせられないので、reduce には件数・合計・2 乗和のような足せる量を渡す。
🧮 実値で計算してみる
「ビッグ」のサイズ感:
- SSDSE-B:約350KB(564行×112列)= 普通サイズ
- 1自治体の住民票全件:数百MB
- 全国コンビニ1年分POS:数百GB
- Twitter全公開ツイート1ヶ月:数TB
- Webクロール1スナップショット:数PB
1GB超えたら pandas は厳しい。 Spark or BigQuery の出番。
🧮 数式に値を入れて手で計算する: データ量とストレージコスト
合成データで TB 単位のログを月次集計し、 ストレージ単価で月額を計算する。
Step 1: 月別取得量と単価
| 月 | 取得 [TB] | 累積 [TB] | 累積コスト (0.023 USD/GB) |
|---|---|---|---|
| 1月 | 5 | 5 | 115 USD |
| 2月 | 8 | 13 | 299 USD |
| 3月 | 12 | 25 | 575 USD |
| 4月 | 20 | 45 | 1,035 USD |
| 5月 | 30 | 75 | 1,725 USD |
Step 2: 累計コスト (1 TB = 1024 GB → 簡略化で 1000 GB)
🐍 Python で再現
1 2 3 4 5 6 | import numpy as np monthly_tb = np.array([5, 8, 12, 20, 30]) cumulative = monthly_tb.cumsum() cost = cumulative * 1000 * 0.023 print(f"累積 TB: {cumulative}") print(f"累計コスト: {cost} USD") |
📤 実行結果
💬 手計算 (Step 2) 1,725 USD と Python 出力が完全一致。
🐍 Python:SSDSE-B-2026 で全国集計を再現する
① 目的:ビッグデータの基本動作(読み込み→フィルタ→集約)を、合成データではなく実データ SSDSE-B-2026 で確かめる。
② 橋渡し:2023 年の 47 都道府県だけを取り出し、総人口 A1101・65歳以上人口 A1303・一般病院数 I510120・延べ宿泊者数 G7101 の全国合計を求める。列コードとフィルタ条件を明示するので、読み手も同じ CSV で検算できる。
1 2 3 4 5 6 7 8 9 10 | import pandas as pd path = 'data/raw/SSDSE-B-2026.csv' df = pd.read_csv(path, encoding='cp932', skiprows=[1]) y2023 = df[df['SSDSE-B-2026'] == 2023].copy() print(f"rows={len(df)}, columns={df.shape[1]}") print(f"years={df['SSDSE-B-2026'].min()}-{df['SSDSE-B-2026'].max()}") print(f"prefectures={df['Prefecture'].nunique()}") print(f"memory={df.memory_usage(deep=True).sum()/1024**2:.2f} MiB") print(y2023[['A1101','A1303','I510120','G7101']].sum()) |
💬 SSDSE-B は 564 行 × 112 列、12 年度・47 都道府県で、メモリ上でも 0.55 MiB(ファイルは約 350 KB)しかない。ビッグデータの「量」の目安がテラバイト級であることと比べると 6 桁以上小さく、pandas 1 台で十分に扱える集計済みの統計表である。2023 年度の合計は総人口 1 億 2,435 万人、一般病院 7,065、延べ宿泊者数約 5 億人泊で、この延べ宿泊者数の元になった個々の宿泊記録こそがビッグデータにあたる。
④ 実行結果
rows=564, columns=112
years=2012-2023
prefectures=47
memory=0.55 MiB
A1101      124353000
A1303       36229000
I510120         7065
G7101      499904350
dtype: int64
結果の読み方:出力は作り値ではなく SSDSE-B-2026 から直接計算した実測値。.sum() は 2023 年・47 都道府県の全国合計で、A1101=総人口 約 1.24 億人、A1303=65 歳以上人口 約 3,623 万人、I510120=一般病院数 7,065、G7101=延べ宿泊者数 約 5.0 億人泊。値の大小だけで結論を急がず、単位・分母・年次を分けて読む。
分散処理で書くとどうなるか(PySpark)
同じ「フィルタ→groupBy→集計」を、単一マシンに載らない規模で動かすときは Spark を使う。API は pandas によく似ており、書き方をほぼ変えないまま数百台のノードへ分散実行される。これが「概念は規模を超えて再利用できる」ということ。
1 2 3 4 5 6 7 8 9 10 11 12 | # PySpark の最小例 from pyspark.sql import SparkSession spark = SparkSession.builder.appName("demo").getOrCreate() df = spark.read.csv("hdfs:///data/sales/*.csv", header=True, inferSchema=True) # pandas風だが分散実行される result = (df.filter(df.year == 2023) .groupBy("prefecture") .agg({"amount": "sum"}) .orderBy("sum(amount)", ascending=False)) result.show() |
🐍 実データで確かめる ① 偏った 7,200 万人は、無作為の何人分か ── ビッグデータのパラドックス
落とし穴 1 の「件数が増えても、測り方が偏っていれば偏りはそのまま残る」を、2023 年度の全国の高齢化率(65 歳以上人口 ÷ 総人口)で確かめます。人口の多い上位 10 都道府県の住民だけを全員調べた、と考えてみます。約 7,200 万人・全人口の 58% という巨大なデータですが、大都市圏に偏っています。この偏った全数調査の誤差が、全国から無作為に選んだ何人の標本の誤差と同じになるかを計算します(Meng 2018 がビッグデータのパラドックスとして示した考え方の簡易版)。
🎯 このコードでやること:2023 年度の全国の高齢化率(真の値)と、人口上位 10 都道府県だけで計算した高齢化率を比べ、その偏りの 2 乗と同じ平均 2 乗誤差になる無作為標本の大きさ n = p(1−p) / 偏り² を求める。無作為に 500 人・5,000 人を選んだ場合の誤差の幅も二項分布の乱数で確かめる。
1 2 3 4 5 6 7 8 9 10 11 12 13 14 15 16 17 18 19 | import numpy as np import pandas as pd df = pd.read_csv('data/raw/SSDSE-B-2026.csv', encoding='cp932', skiprows=[1]) d = df[df['SSDSE-B-2026'] == 2023] p = d['A1303'].sum() / d['A1101'].sum() # 全国の真の高齢化率 top = d.nlargest(10, 'A1101') p_big = top['A1303'].sum() / top['A1101'].sum() # 偏った「ビッグデータ」 bias = p_big - p print(f'全国の高齢化率 {p:.4f}({d["A1101"].sum():,} 人)') print(f'上位 10 都道府県だけ {p_big:.4f}({top["A1101"].sum():,} 人、全人口の {top["A1101"].sum() / d["A1101"].sum():.1%})') print(f'偏り {bias:+.4f}') print(f'同じ誤差になる無作為標本 n = p(1-p)/偏り² = {p * (1 - p) / bias**2:,.0f} 人') rng = np.random.default_rng(0) for n in [500, 5000]: est = rng.binomial(n, p, size=10000) / n lo, hi = np.percentile(est - p, [2.5, 97.5]) print(f'無作為 {n:>5,} 人: 誤差の 95% 範囲 [{lo:+.4f}, {hi:+.4f}]') |
💬 全国の高齢化率は 0.2913 ですが、人口上位 10 都道府県の住民 7,226 万人(全人口の 58.1%)だけで計算すると 0.2706 で、偏りは −0.0208(約 2 ポイント)です。この偏りの 2 乗と同じ大きさの誤差を持つ無作為標本は、わずか 479 人にあたります。実際、無作為に 500 人選んだ場合の誤差の 95% 範囲は ±0.04 程度で、偏った 7,226 万人とほぼ同じ精度、5,000 人なら ±0.013 で、偏り 0.021 より小さく収まります(平均 2 乗誤差では 479/5,000 ≈ 約 10 分の 1)。大都市圏は若い人の流入が多く高齢化率が低いので、「大きいところから集めたデータ」は人数がいくら多くても全国の値を低く見積もります。データの量が効くのは偏りが無いときだけで、偏りがあると件数を増やしても誤差は偏りの大きさより小さくなりません。
🐍 実データで確かめる ② 全件を走査しない ── 補助情報を使う抽出推定
ビッグデータの現場では、毎回すべての行を走査する代わりに一部を抜き出して概算することがよくあります(近似クエリ、サンプリング集計)。ただし抜き出し方と推定のしかたで精度は大きく変わります。47 都道府県から n 県だけを無作為に選んで 2023 年度の全国の出生数を推定するとき、(a) 選んだ県の平均 × 47 と、(b) 全国の総人口(別に分かっている合計)を使った比推定「選んだ県の出生数 ÷ 選んだ県の人口 × 全国人口」を、5,000 回の抽出で比べます。
🎯 このコードでやること:2023 年度の 47 県から n = 5・10・20 県を非復元で無作為抽出し(seed 0、各 5,000 回)、単純な拡大推定と、全国の総人口を補助情報に使う比推定で全国の出生数を推定して、相対誤差の RMSE と 95% 範囲を比べる。
1 2 3 4 5 6 7 8 9 10 11 12 13 | T, P = d['A4101'].sum(), d['A1101'].sum() b, pop = d['A4101'].values, d['A1101'].values rng = np.random.default_rng(0) print(f'真の全国出生数 {T:,}') for n in [5, 10, 20]: e1, e2 = [], [] for _ in range(5000): i = rng.choice(47, n, replace=False) e1.append(b[i].mean() * 47) # (a) 平均 × 47 e2.append(b[i].sum() / pop[i].sum() * P) # (b) 比推定 r1, r2 = np.array(e1) / T - 1, np.array(e2) / T - 1 print(f'n={n:2d} (a) RMSE {np.sqrt((r1**2).mean()):.1%} 範囲 [{np.percentile(r1, 2.5):+.0%}, {np.percentile(r1, 97.5):+.0%}]' f' (b) RMSE {np.sqrt((r2**2).mean()):.1%} 範囲 [{np.percentile(r2, 2.5):+.1%}, {np.percentile(r2, 97.5):+.1%}]') |
💬 単純に「選んだ県の平均 × 47」とする (a) は、5 県では RMSE 47.1%、真の値の −61%〜+111% まで振れ、20 県選んでも RMSE 18.9% です。東京都(86,348 人)のような大きい県が入るか入らないかで推定が大きく跳ねるためです。全国の総人口という別に分かっている合計を使う (b) の比推定は、5 県で RMSE 5.3%、20 県で 2.1% と、(a) の約 9 分の 1 の誤差に収まりました。出生数は人口にほぼ比例するので、「人口あたりの出生数」を標本から推定して全国人口を掛ければ、県の大きさのばらつきを打ち消せます。ビッグデータの近似集計でも、全体の件数やユーザ数など安く分かる合計を補助情報に使うと、同じ抽出量で精度が桁違いに上がります。
🐍 実データで確かめる ③ 列が多いと「強い相関」はいくらでも見つかる
Variety(多様性)が増えると、列の組み合わせの数は列数の 2 乗で増えます。SSDSE-B-2026 は 112 列あり、その中から強い相関の組を探せば、意味のある発見がたくさん見つかりそうに思えます。ところが都道府県の件数の列は、どれも「県の大きさ(人口)」に比例して動きます。件数のまま相関を総当たりした場合と、人口 1 人あたりに直した場合、そして同じ形の乱数だけの表とで、|r| ≥ 0.9 の組がいくつあるかを比べます。
🎯 このコードでやること:2023 年度の数値列から、率や平均でない件数の列(88 列、気温・地価・合計特殊出生率・1 人 1 日当たりごみ・リサイクル率・世帯あたり消費支出の 21 列を除く)を取り出し、全ペアの相関の絶対値を数える。人口 1 人あたりに直した場合と、47 × 88 の標準正規乱数の場合も同じように数える。
1 2 3 4 5 6 7 8 9 10 11 12 13 14 15 16 17 | num = d.select_dtypes('number').drop(columns=['SSDSE-B-2026']) num = num.loc[:, num.std() > 0] rate = [c for c in num if c == 'A4103' or c.startswith(('B41', 'L322')) or c in ('C5401', 'C5403', 'H5610', 'H5614')] cnt = num.drop(columns=rate) def strong(x): c = x.corr().abs().values v = c[np.triu_indices_from(c, 1)] return f'{len(v):,} 組中 |r|>=0.9 は {(v >= 0.9).sum():,} 組({(v >= 0.9).mean():.1%})、|r| の中央値 {np.median(v):.3f}' print(f'件数の列 {cnt.shape[1]} 列') print('件数のまま :', strong(cnt)) per = cnt.div(cnt['A1101'], axis=0).drop(columns='A1101') print('人口 1 人あたり :', strong(per)) noise = pd.DataFrame(np.random.default_rng(0).standard_normal(cnt.shape)) print('同じ形の乱数 :', strong(noise)) |
💬 件数の列 88 列の 3,828 組のうち 2,413 組(63.0%)が |r| ≥ 0.9 で、相関の絶対値の中央値は 0.927 でした。「病院数と中学校数」「婚姻件数と着工建築物数」のような組が軒並み 0.9 を超えますが、これはどの列も人口の大きさに比例しているだけです。人口 1 人あたりに直すと |r| ≥ 0.9 は 84 組(2.2%)、中央値は 0.256 まで下がります。同じ形の乱数の表では 0 組・中央値 0.103 なので、人口 1 人あたりに直した後の 0.256 は、乱数よりは強いものの「何でも強く相関する」状態からは程遠い水準です。列が多いデータで総当たりの相関を取ると、共通の大きさ(規模・期間・利用量)がつくる見かけの関係が大量に見つかります。まず共通の分母で割り、そのうえで残る関係を調べます。
🐍 実データで確かめる ④ 行が 564 あっても、独立な観測は 564 個ではない
Volume(量)を「行数」で数えると、SSDSE-B-2026 は 564 行です。しかし同じ県を 12 年分並べた行どうしはよく似ていて、独立な 564 個の観測ではありません。ビッグデータのログでも、同じユーザの行が何千行もあることは普通です。高齢化率と千人あたり出生数の回帰を 564 行で行い、行を独立とみなした標準誤差と、同じ県の行をひとまとまり(クラスタ)として扱った標準誤差を比べます。
🎯 このコードでやること:564 行すべてで「千人あたり出生数 = a + b × 高齢化率(%)」を最小二乗で当てはめ、通常の標準誤差と、県(Code)ごとのクラスタ頑健標準誤差を比べる。2023 年度の 47 行だけで当てはめた傾きも並べる。
1 2 3 4 5 6 7 8 9 10 11 12 13 | import statsmodels.formula.api as smf a = df.copy() a['aging'] = a['A1303'] / a['A1101'] * 100 a['birth'] = a['A4101'] / a['A1101'] * 1000 m = smf.ols('birth ~ aging', data=a).fit() mc = smf.ols('birth ~ aging', data=a).fit(cov_type='cluster', cov_kwds={'groups': a['Code']}) m23 = smf.ols('birth ~ aging', data=a[a['SSDSE-B-2026'] == 2023]).fit() print(f'564 行: 傾き {m.params["aging"]:+.4f} 通常の SE {m.bse["aging"]:.4f} ' f'県クラスタ SE {mc.bse["aging"]:.4f}({mc.bse["aging"] / m.bse["aging"]:.1f} 倍)') print(f'2023 年度 47 行: 傾き {m23.params["aging"]:+.4f} SE {m23.bse["aging"]:.4f}') n_eff = 564 * (m.bse['aging'] / mc.bse['aging'])**2 print(f'SE から逆算した「実質の独立な観測数」の目安: 約 {n_eff:.0f}') |
💬 564 行を独立とみなした通常の標準誤差は 0.0092 ですが、同じ県の行をまとめたクラスタ頑健標準誤差は 0.0346 と 3.8 倍になりました。標準誤差の比から逆算すると、実質の独立な観測は約 40 で、47 県という県の数に近い値です。12 年分の行を足しても、同じ 47 県の情報をほぼ繰り返しているだけだということです。さらに 564 行の傾き −0.232 と、2023 年度 47 行だけの傾き −0.130 は大きく違います。564 行には「年が進むほど高齢化が進み、出生も減る」という時間の変化が混ざっていて、県どうしの違いだけを表していません。ログの行数を「データの量」と呼ぶときは、何が独立な単位(ユーザ・県・セッション)なのかを先に決めます。
🐍 実データで確かめる ⑤ Veracity(正確さ)── 年ごとの段差を機械的に洗い出す
列が 100 を超え、年度も積み重なると、1 列ずつ目で推移を確かめることはできなくなります。ビッグデータの品質管理では、「前の期と比べて普段より大きく動いた値」を機械的に拾い、それが本当の出来事か、集計方法や定義の変化かを人が判断する、という分担をとります。SSDSE-B-2026 の件数の列について、全国合計の前年比を列ごとに計算し、その列のふだんの動き(前年比の絶対値の中央値)の 5 倍を超えた年を拾います。
🎯 このコードでやること:件数の列(③ と同じ 88 列)について 2012〜2023 年度の全国合計を作り、列ごとに前年比を出す。前年比の絶対値が、その列の前年比の絶対値の中央値の 5 倍を超え、かつ 15% 以上動いた(列, 年度)をすべて、動きの大きい順に並べる。
1 2 3 4 5 6 7 8 9 10 11 12 13 | names = dict(zip(pd.read_csv('data/raw/SSDSE-B-2026.csv', encoding='cp932', nrows=0).columns, pd.read_csv('data/raw/SSDSE-B-2026.csv', encoding='cp932', skiprows=[0], nrows=0).columns)) tot = df.groupby('SSDSE-B-2026')[list(cnt.columns)].sum().sort_index() chg = tot.pct_change().iloc[1:] flags = [] for c in chg: typical = chg[c].abs().median() for year, v in chg[c].items(): if abs(v) > 5 * typical and abs(v) >= 0.15: flags.append((abs(v), names[c], year, v, typical)) print(f'{len(cnt.columns)} 列 × 11 回の前年比のうち、段差として拾ったもの {len(flags)} 件') for _, name, year, v, typ in sorted(flags, reverse=True): print(f'{year}: {name:16s} 前年比 {v:+.1%}(ふだんは ±{typ:.1%})') |
💬 88 列 × 11 回 = 968 個の前年比のうち、段差として拾われたのは 11 件でした。外国人延べ宿泊者数(2022 年度 +295.8%、2023 年度 +598.3%)・一般旅券発行件数・延べ宿泊者数(2020 年度 −46.8%、2022 年度 +45.7%)は、2020 年からの感染症による移動の制限と、その後の回復という現実の出来事で説明できます。一方、2023 年度の保育所等在所児数 −26.7%・定員数 −22.8%・保育所等数 −21.8% は、同じ年に保育所関係の列がそろって 2 割以上減っていて、この 3 列のふだんの動き(±2〜3%)から大きく外れています。機械が拾うのは「普段と違う」ところまでで、それが出来事か、集計の変化かは人が確かめます。
🎯 このコードでやること:拾った段差のうち「保育所等数」(J2503)の 2022→2023 年度の変化を県ごとに見て、全県が同じように動いたのか、県によって違うのかを確かめる。
1 2 3 4 5 6 7 8 | r = (df[df['SSDSE-B-2026'].isin([2022, 2023])] .pivot(index='Prefecture', columns='SSDSE-B-2026', values='J2503')) r['2023/2022'] = (r[2023] / r[2022]).round(3) print(r.sort_values('2023/2022').iloc[[0, 1, 2, -3, -2, -1]].to_string()) print(f'2023/2022 の比: 中央値 {r["2023/2022"].median():.3f} ' f'最小 {r["2023/2022"].min():.3f} 最大 {r["2023/2022"].max():.3f}') print('2012〜2022 年度の全国合計の前年比の範囲:', f'{tot["J2503"].pct_change().loc[2013:2022].min():+.1%} 〜 {tot["J2503"].pct_change().loc[2013:2022].max():+.1%}') |
💬 保育所等数の 2023/2022 の比は、東京都 0.999・神奈川県 0.936 とほとんど変わらない県から、福井県 0.481・青森県 0.487・石川県 0.509 と半分近くに減った県まで大きくばらつき、中央値は 0.725 でした。2012〜2022 年度の全国合計の前年比は −0.6%〜+8.9% の範囲で、毎年ほぼ増えていた列です。1 年で県によって半減するような動きは、施設が実際に閉じたとは考えにくく、2023 年度の値で数えている施設の範囲が前年度までと違う(集計の定義や対象の変更)ことを疑うべき形です。原因を確かめるまでは、この列の 2023 年度を 2022 年度以前と同じ系列として扱わない(年次比較やトレンドの推定に使わない)のが安全です。ビッグデータでは、こうした定義の変化が注記なしで混ざることが珍しくなく、量が多いほど目で気づく機会は減ります。
🐍 実データで確かめる ⑥ 分散集計の reduce に「平均」を渡してはいけない
このページ後半の「SSDSE-B-2026 で分散集計(map→reduce)を体験する」では、地方ごとの人口と病院数を足し合わせました。合計は部分合計を足せば正しく出ますが、平均や分散は部分の平均を平均しても正しくなりません。各ノード(地方)が reduce に何を渡せば、全体をもう一度走査せずに全国の値を正しく出せるかを、2023 年度の高齢化率で確かめます。
🎯 このコードでやること:2023 年度の 47 都道府県を 8 地方に分け、各地方(ノード)で (a) 県の高齢化率の単純平均、(b) 65 歳以上人口と総人口の合計、を計算して reduce する。(a) の平均の平均・(a) の県数重み付き平均・(b) の合計どうしの比を、全国の真の高齢化率と比べる。県の高齢化率の分散も、各地方から (件数, 平均, 偏差平方和) を受け取って合成し、全体で計算した値と一致するかを見る。
1 2 3 4 5 6 7 8 9 10 11 12 13 14 15 16 17 18 19 20 21 22 23 24 | d = df[df['SSDSE-B-2026'] == 2023].copy() k = d['Code'].str[1:3].astype(int) d['地方'] = pd.cut(k, [0, 1, 7, 14, 23, 30, 35, 39, 47], labels=['北海道', '東北', '関東', '中部', '近畿', '中国', '四国', '九州・沖縄']) d['率'] = d['A1303'] / d['A1101'] # map: 各地方(ノード)が部分統計を作る part = d.groupby('地方', observed=True).agg( n=('率', 'size'), 平均=('率', 'mean'), 偏差平方和=('率', lambda s: ((s - s.mean())**2).sum()), 高齢=('A1303', 'sum'), 人口=('A1101', 'sum')) # reduce true = d['A1303'].sum() / d['A1101'].sum() print(f'全国の真の高齢化率 {true:.4f}') print(f'(a) 地方平均の単純平均 {part["平均"].mean():.4f}') print(f'(a) 地方平均の県数重み付き平均 {(part["平均"] * part["n"]).sum() / part["n"].sum():.4f}(= 47 県の単純平均 {d["率"].mean():.4f})') print(f'(b) 合計どうしの比 {part["高齢"].sum() / part["人口"].sum():.4f}') # 分散の合成(Chan らの並列アルゴリズムと同じ式) N = part['n'].sum() mean_all = (part['平均'] * part['n']).sum() / N m2 = part['偏差平方和'].sum() + (part['n'] * (part['平均'] - mean_all)**2).sum() print(f'県の高齢化率の分散: 部分統計から合成 {m2 / N:.6f} 全体で計算 {d["率"].var(ddof=0):.6f}') |
💬 全国の真の高齢化率 0.2913 に対して、各地方の平均を単純に平均すると 0.3201 と約 3 ポイント高く出ます。県数で重み付けしても 0.3159 で、これは 47 県の率を単純平均した値と同じです。県の率の平均は「人口 54 万人の鳥取県も 1,409 万人の東京都も 1 票」の平均なので、人口が少なく高齢化の進んだ県の影響が大きくなるためです。各ノードが 65 歳以上人口と総人口の合計を渡し、reduce で合計どうしの比をとる (b) だけが 0.2913 と一致しました。分散も、各地方が (件数, 平均, 偏差平方和) の 3 つを渡せば、全体をもう一度読まずに 0.001091 と正しく合成できます。分散処理の集計では、reduce に渡すのは平均や率ではなく「足し合わせられる量」(件数・合計・2 乗和)にする、というのが鉄則です。
🐍 実データで確かめる ⑦ 必要な列だけ読む ── 走査量を先に減らす
落とし穴 3 の「SELECT * で全列を毎回スキャンすれば課金は走査量に比例して膨らむ」は、pandas でも同じ形で現れます。クラウドのデータウェアハウスは読んだ列の量で課金されることが多く、列指向の形式が速いのも「使わない列を読まない」からです。高齢化率を出すのに必要な 4 列だけを読む場合と、112 列すべてを読む場合で、メモリ上の大きさと、答えが同じかを比べます。
🎯 このコードでやること:SSDSE-B-2026 を (a) 全 112 列、(b) 年度・県名・総人口・65 歳以上人口の 4 列だけ(usecols)で読み、メモリ使用量と、2023 年度の全国の高齢化率が一致するかを比べる。さらに (b) の数値列を 32 ビット整数にした場合も比べる。
1 2 3 4 5 6 7 8 9 | cols = ['SSDSE-B-2026', 'Prefecture', 'A1101', 'A1303'] full = pd.read_csv('data/raw/SSDSE-B-2026.csv', encoding='cp932', skiprows=[1]) part = pd.read_csv('data/raw/SSDSE-B-2026.csv', encoding='cp932', skiprows=[1], usecols=cols) small = part.astype({'SSDSE-B-2026': 'int16', 'A1101': 'int32', 'A1303': 'int32'}) for name, x in [('(a) 全 112 列', full), ('(b) 4 列だけ', part), ('(b)+32 ビット', small)]: y = x[x['SSDSE-B-2026'] == 2023] mem = x.memory_usage(deep=True).sum() / 1024 print(f'{name:12s} {x.shape[1]:3d} 列 {mem:7.1f} KB 高齢化率 {y["A1303"].sum() / y["A1101"].sum():.4f}') print(f'最大の総人口 {part["A1101"].max():,} < int32 の上限 {np.iinfo(np.int32).max:,}') |
💬 4 列だけ読むとメモリは 554.8 KB から 53.1 KB と約 10 分の 1 になり、2023 年度の高齢化率 0.2913 はまったく同じです。数値列を 32 ビット整数にするとさらに 45.4 KB まで下がりますが、残りのほとんどは県名の文字列が占めていて、数値の型を詰める効果は列を絞る効果よりずっと小さいことも分かります。32 ビット整数にしてよいのは、最大の総人口 14,086,000 が上限 2,147,483,647 に十分収まると確かめたからで、合計を取るときは桁あふれしないよう 64 ビットで足すのが安全です。SSDSE の 0.5 MB では差を体感できませんが、同じ 10 分の 1 がテラバイト級のテーブルでは走査時間と料金の 10 分の 1 になります。「まず必要な列を決めてから読む」は、データが大きくなってから身につけるのでは遅い習慣です。
⚠️ よくある落とし穴
🗺 概念マップ
「ビッグデータ」を中心とした関連概念マップ。
中心ノードのビッグデータから、 (上) Hadoop/HDFS (分散ストレージ、 ペタバイト級の冗長保存)、 (右上) Spark (DAG ベース分散インメモリ処理)、 (右下) Kafka/Kinesis (ストリーミング、 リアルタイム取り込み)、 (下) BigQuery/Snowflake (マネージド DWH、 SQL でペタ規模クエリ)、 (左) Dask (Python ネイティブ並列、 pandas API 互換) へ放射状に接続している。 SSDSE-B-2026 は数千セルなので pandas 一発で扱えるが、 同じ「都道府県×指標×時系列」の構造を 100 年×全市町村×1000 指標に拡張すれば数 TB 規模となり、 Spark/BigQuery のスキーマ設計が必要になる。 規模で道具を切り替える判断軸が現代データ基盤の核心。
🔗 隣接手法への橋渡し
ビッグデータは特定手法ではなく「単一マシンに収まらないデータ」を扱うエコシステム全体で、 収集→保管→処理→分析→可視化の各段で分散技術が組み合わさる。
- 上流: データ収集 (Kafka, IoT センサ) と データレイク (S3/HDFS) への配置、 パーティショニング設計 (日付/地域別 Parquet)、 スキーマ管理 (Iceberg, Delta Lake)。
- 並列: 分散処理 (Spark/Flink) と マネージドクラウド (BigQuery, Snowflake) の選択 — 自前運用 vs フルマネージド、 Python ネイティブ (Dask) vs JVM (Spark) の軸。
- 下流: 集計済みマートを BI ツール で可視化、 サンプリングで Python に持ち込んで詳細解析、 分散 ML (Horovod, Ray) で学習。
SSDSE-B-2026 は数千セルでスモールデータの典型だが、 「全国民の購買履歴 100 億行」や「全 IoT センサの 1 秒データ」など規模が変われば同じ ETL/分析の論理を分散技術上で実装することになる。
🌳 手法選択フロー
ビッグデータ技術選択は「データ規模」「処理パラダイム」「運用負荷」の 3 軸で判定する。
- データ規模: <1 GB → pandas + 単一マシン。 1 GB - 100 GB → DuckDB / Polars (in-process カラム指向、 SQL or pandas API)。 100 GB - 10 TB → Spark on EMR/Databricks、 BigQuery。 10 TB+ → BigQuery / Snowflake (フルマネージドカラム DWH)。
- 処理パラダイム: バッチ (日次集計、 年次レポート) → Spark / Airflow。 ストリーミング (異常検知、 RTB) → Kafka + Flink。 OLAP インタラクティブ → DWH + BI ツール。 SSDSE-B-2026 は典型的バッチ + OLAP の対象。
- 運用負荷: 自前運用許容 → Hadoop/Spark on Kubernetes (フルコントロール、 運用エンジニア必須)。 マネージド優先 → BigQuery/Snowflake/Databricks (SQL or Notebook で完結、 運用負荷 1/5)。 小規模チーム は迷わずマネージドを選ぶ。
「ビッグデータが必要そう」と思った瞬間に Spark を立ち上げる前に、 まず DuckDB で「単一マシンで本当に無理か」を試すのが現代のベストプラクティス (Hadoop ブーム時代の反省)。