🔖 キーワード索引
「ログデータ (log data)」はシステム・アプリ・サーバが時刻付きで自動記録する半構造化イベント列。 行動ログ・アクセスログ・監査ログ等を含む。 本ページの中核キーワードを以下に整理する。
これらのキーワードは「log data の理解 → 適用 → 検証」のプロセスを構成する。 各章で詳しく解説する。
💡 30秒で分かる結論
🍰 まずはやさしく
ログデータはシステムの活動日記です。
何が起きたかを調べるために使います。
アプリの操作記録などが身近な例です。
まずは結論を短く確認しましょう。
ログデータ:システムの動作記録データ
- 時刻付きの記録を順次蓄積したデータ。
- 代表例:Web アクセスログ・アプリログ・syslog・センサーログ。
- 用途:障害解析・ユーザー行動分析・セキュリティ監査・ML 学習データ。
- 扱いの難所:非構造・大量・分散・タイムゾーン。
📍 文脈ボックス
🍰 まずはやさしく
これはデータの扱い方の話です。
正しく分析して活用するために使います。
Webサイトへの訪問記録などが当たります。
データの集め方や分析の流れを学びます。
この用語は データエンジニアリング カテゴリに属します。 関連する別称・略号:(なし)。
本ページではログデータ (システム / アクセス / 行動ログ) を扱う。 Web サーバのアクセスログ、 アプリの操作ログ、 IoT デバイスのセンサーログなど、 「時刻 + イベント + 属性」の半構造化テキストデータを指す。 解析の流れは「収集 → パース → 集計 → 異常検知 / 行動分析」。
ログデータは Apache / Nginx の Combined Log Format、 JSON Lines、 syslog などフォーマットが多様。 解析基盤として Elasticsearch + Kibana、 BigQuery、 Splunk が代表的。 個人情報 (IP / Cookie ID) を含む場合の匿名化・保管期限・GDPR / 個人情報保護法対応も必須。
🎨 直感で掴む
🍰 まずはやさしく
システムの中身を覗く窓のようなものです。
トラブルの原因を探るために使います。
通販サイトでエラーが出た時の記録です。
ログデータが持つ特別な性質を考えます。
想像してほしい。 ある日の朝、 通販サイトが 突然 500 エラーを返し始めた。 サーバーには 2026-05-22 09:14:03 ERROR app=checkout user=u3821 status=500 elapsed_ms=4812 trace_id=ab12cd のような 1 行 1 イベントが秒間 1,200 行積み上がっている。 これが ログデータの正体だ。つまり「いつ/どこで/誰が/何をした/結果どうだった」を時系列に並べた、 システムの黒箱を覗く唯一の窓。 Web アクセスログ、 アプリログ (FastAPI/Django)、 syslog、 監査ログ、 IoT センサーログ、 ゲームの行動ログ — 表記は違えど、 すべて同じ「時刻 + 何かが起きた」の繰り返しでできている。
ログが テーブル や CSV と決定的に違うのは、 (1) 半構造 (キー=値の自由列が混じる)、 (2) 順序性 (時系列としての意味を持つ)、 (3) 増分性 (過去は書き換えず追記のみ)、 (4) 分散性 (複数ホストから断片的に届く) の 4 点。
📐 定義・数式
🍰 まずはやさしく
ログは時刻と出来事のセットです。
正確な記録として分析に使うためです。
スマホアプリの動作ログなどが例です。
ログを構成する詳しい要素を学びます。
1 つのログイベントは、 タイムスタンプ・重要度 (INFO/WARN/ERROR)・発生源・メッセージ・コンテキスト (JSON) で構成。 構造化ログ (JSON Lines) が分析しやすい。
🔬 数式を言葉で読み解く
数式に出てくる記号の意味を 1 つずつ確認しましょう。
- timestamp
- イベント発生時刻 (ISO 8601 推奨)。
- level
- INFO, WARN, ERROR, DEBUG などの重要度。
- source
- ログを出力したサービス・ホスト。
- context
- ユーザー ID・リクエスト ID など追加情報。
🔬 数式を言葉で読み解く(深掘り)
timestamp は「いつ」を表す主役だが、 タイムゾーン (+09:00)、 精度 (秒 / ミリ秒 / マイクロ秒)、 単調性 (NTP 補正で巻き戻ることがある) の 3 軸で 必ず仕様を確認する。 level は INFO/WARN/ERROR が標準だが、 アプリによっては FATAL / NOTICE などが混じる。 source はホスト名 + サービス名 + プロセス ID の組合せが現代的で、 分散環境では trace_id もここに含めるのが定石。 message は自然言語だが、 ML 用途では「テンプレート部分」 (固定文字列) と「変数部分」 (動的値) に Drain や Logram のアルゴリズムで分解するのが標準。 context は JSON 形式で自由に拡張可能。 user_id / request_id / ip 等を入れるが、 PII を含む場合は マスキングが必須。 つまり Event = (timestamp, level, source, message, context) は形式的タプルに見えて、 各要素が「半構造データ管理のすべてを内包する」設計の出発点になっている。 現代の OpenTelemetry はこれを OTLP プロトコルで標準化し、 メトリクス・トレース・ログの 3 本柱を統一的に扱う。
🧪 仮想アクセスログで試すハンズオン
ここでは SSDSE-B-2026 のような構造化データではなく、 「もし都道府県別の Web アクセスログが取れたら」という仮想設定で具体例を示す。47 都道府県の特設ページ /pref/<name> に対して JST でアクセスが発生する想定。 ログ 1 行は {"ts":"2026-05-22T10:00:00+09:00","pref":"Tokyo","status":200,"elapsed_ms":142}。 次の 4 ステップで「1 時間ごとの都道府県別アクセス数」まで落とし込む。
1 2 3 4 5 6 7 8 9 10 11 12 13 | # 仮想 Web アクセスログから時間帯別アクセス数を集計(pandas / JSON Lines 想定) import pandas as pd df = pd.read_json('data/raw/access_log.jsonl', lines=True) df['ts'] = pd.to_datetime(df['ts'], utc=True).dt.tz_convert('Asia/Tokyo') df = df.set_index('ts').sort_index() hourly = df.groupby([pd.Grouper(freq='1h'), 'pref']).size().unstack(fill_value=0) print(hourly.head(24)) # 5xx エラーの時系列だけ抽出 errors = df[df['status'] >= 500] print('5xx error count =', len(errors)) # 都道府県別 95 パーセンタイル応答時間 p95 = df.groupby('pref')['elapsed_ms'].quantile(0.95).sort_values(ascending=False) print(p95.head(10)) |
📌 動かないときは: (1) data/raw/access_log.jsonl が 1 行 1 JSON(JSON Lines)になっているか、 (2) ts 列にタイムゾーン情報(+09:00 等)が含まれ pd.to_datetime(..., utc=True) で正しく解釈できているか、 (3) 列名を df.columns.tolist() で確認し、 ts / pref / status / elapsed_ms が揃っているか。
🧮 実値で計算してみる
Web サーバー風ログを pandas で読み込み、 時間ごとのアクセス数を集計する例。
🧮 数式に値を入れて手で計算する: アクセスログのユニーク数集計
合成ログ 10 件からユニーク IP, パス別件数を集計する。
Step 1: ログ抜粋
Step 2: 集計
🐍 Python で再現
1 2 3 4 5 | ips = ['A','A','B','C','A','D','B','A','E','C'] paths = ['/index','/api','/index','/login','/index','/api','/login','/login','/index','/api'] from collections import Counter print(f"ユニーク IP: {len(set(ips))}") print(f"パス別: {dict(Counter(paths))}") |
📤 実行結果
💬 手計算 (Step 2) と Python 出力が完全一致。
🐍 Python 実装
1 2 3 4 5 6 | import pandas as pd df = pd.read_csv('data/raw/access_log.csv') df['ts'] = pd.to_datetime(df['ts']) df = df.set_index('ts') hourly = df.resample('1h').size() print(hourly.head(24)) |
🐍 Python 実装(応用編)
ユーザー × 1 日で集約した特徴量に、翌日のコンバージョンを目的変数として結合する流れの説明用コード(access_log.jsonl・conversion.csv は教材に同梱していない仮想データ)。「翌日」を結合キーにしているのは、同じ日の購入を特徴量側に混ぜないため。
1 2 3 4 5 6 7 8 9 10 11 12 13 14 15 16 17 18 19 20 21 22 23 24 25 26 27 28 | # 大規模ログから ML 特徴量を作る集計パイプライン例(pandas + 集約 + 結合) import pandas as pd log = pd.read_json('data/raw/access_log.jsonl', lines=True) log['ts'] = pd.to_datetime(log['ts'], utc=True).dt.tz_convert('Asia/Tokyo') log = log.set_index('ts') # ユーザー × 1 日単位で集約 daily = log.groupby([pd.Grouper(freq='1D'), 'user_id']).agg( pageviews=('status', 'size'), errors=('status', lambda s: (s >= 500).sum()), p95_ms=('elapsed_ms', lambda s: s.quantile(0.95)), unique_urls=('url', 'nunique'), ).reset_index() # 翌日のコンバージョン (購入) を target に結合 conv = pd.read_csv('data/raw/conversion.csv', parse_dates=['ts']) conv['date'] = conv['ts'].dt.tz_convert('Asia/Tokyo').dt.date daily['date_next'] = daily['ts'].dt.date + pd.Timedelta(days=1) features = daily.merge( conv[['user_id', 'date', 'converted']], left_on=['user_id', 'date_next'], right_on=['user_id', 'date'], how='left' ) features['converted'] = features['converted'].fillna(0).astype(int) print(features.head()) # 不均衡:converted=1 は通常 0.5〜5% print(features['converted'].value_counts(normalize=True)) |
🗂 用語の階層・派生・対立関係
| 関係 | 該当用語 | 関係性の説明 |
|---|---|---|
| 上位概念 | 行動データ / 半構造化データ / Observability | ログデータが属する観測データの大分類 |
| 並列概念 | アクセスログ、 アプリケーションログ、 監査ログ、 メトリクス、 トレース | ログと同じ運用観測情報に属する兄弟用語 |
| 派生概念 | 構造化ログ (JSON)、 分散トレーシング (OpenTelemetry)、 SIEM、 ログ集約 (Fluentd / Logstash) | ログを拡張・統合する発展手法 |
| 対立概念 | スナップショット / トランザクションテーブル | ある時点の状態を保持するデータ。 ログは時系列的な追記が中心 |
| 前提知識 | タイムスタンプ・ログレベル (INFO/WARN/ERROR)・正規表現・Unix tail/grep | ログを読み解く前に押さえるべき基礎概念 |
🎮 触って理解する — 生ログのパース・集計とエラー率スパイク検知
前ページの 行動ログ は「セッション化・ファネル」に焦点を当てていた。 ここでは 運用ログの裏側、 すなわち (1) 非構造テキストの生ログ行をパターン (正規表現) でパースして「時刻/レベル/種類」に構造化し、 (2) 時間別・レベル別に集計し、 (3) エラー率の時系列から障害の兆候 (スパイク) を閾値で検出・ハイライトする — という「収集後のログ運用」を体感する。 下の生ログは 架空のもので、 決定的な擬似乱数 (seed 付き mulberry32) から生成しているため、 同じシード・同じシナリオなら誰の環境でも まったく同じ数字になる。
🔒 注記: ここで表示・集計されるログはすべてこのページの JavaScript 内だけで生成される架空データです。 実在のサーバやユーザーとは無関係で、 どこにも送信・保存されません。
| 時刻 | レベル | 種類(svc) | status |
|---|
| INFO | 0 | WARN | 0 |
| ERROR | 0 | DEBUG | 0 |
グラフをタップ / マウスで動かすと、 その時間帯の内訳を下に表示します。
💡 示唆: 読み込み中…
🎨 直感 — 記録の山から「異常」を掴む
1 行 1 行の生ログは、 それ単体では 2026-05-22T13:07:33+09:00 [ERROR] svc=checkout ... というただのテキストにすぎない。 人間が 1,300 行を目で追って障害を見つけるのは不可能だ。 だが上のデモのように、 (1) パターンで「時刻・レベル・種類」を抜き出し (パース)、 (2) 1 時間バケツに放り込んで数える (集計)、 (3) エラー率を時間軸に並べて閾値を引く (スパイク検知) という 3 段階を通すと、 「13〜14 時に何かが起きた」という形が一目で浮かび上がる。 「障害あり」シナリオに切り替えて、 平常時には低く這っていたエラー率が特定の時間帯だけ跳ね上がる様子を見てほしい。 これが監視ダッシュボード (リアルタイム可視化) の原理そのものだ。
⚠️ よくある落とし穴 — デモで確かめられる4点
- 非構造テキストの取りこぼし: パースは正規表現頼み。 メッセージ末尾の
msg="..."に]や改行が混じるとフィールドがズレる。 実ログでは Traceback など複数行イベントが 1 レコードなので、 行単位で切ると壊れる (Grok / multiline 設定が必要)。 - 時刻ズレ・タイムゾーン: このデモは全行
+09:00で統一しているが、 実運用では UTC と JST が混在し、 集計が 9 時間ズレて「夜間の障害を昼に誤検知」する。 パース時に必ず UTC 正規化する (時系列データ)。 - 低ボリューム時間帯の偽陽性: 「平常運転」でも深夜などログ件数が数件しかない時間帯は、 エラー 1 件でも率が跳ねてスパイク判定されがち。 閾値スライダーを下げると深夜帯が赤く光るのを確認できる。 実務では「最低件数」条件や信頼区間を併用して 外れ値の過検知を抑える。
- 欠損と量の爆発: 収集失敗で行が欠けると「障害が無かった」のか「記録されなかった」のか区別できない (欠損値)。 逆に DEBUG を全量出すと量が爆発しコストが跳ねる。 次項のサンプリング・保持設計で折り合う。
🧭 ログの粒度・保持・サンプリング
「全部のログを永久に取る」は理想だが、 量とコストが爆発する。 実務では 3 つの軸で折り合いをつける。
| 軸 | 意味 | 典型的な設計 |
|---|---|---|
| 粒度 (granularity) | どこまで細かく記録するか。 レベル (DEBUG〜FATAL)・秒/ミリ秒精度・フィールド数。 | 本番は INFO 以上、 障害調査時のみ DEBUG を一時有効化。 |
| 保持 (retention) | いつまで保存するか。 長いほど分析・監査に有利だがストレージ費が増える。 | ホット 7〜30 日 (高速検索) → コールド 1 年 (安価な object storage) → 監査ログのみ数年。 |
| サンプリング (sampling) | 全量ではなく一部だけ残す。 量を抑えつつ傾向を保つ。 | 成功 (200) は 1/100 抽出、 エラー (5xx) は全量保持 (テイルベースサンプリング)。 |
📌 鉄則は「異常は全量、 正常は間引く」。 上のデモでもエラーは全件見たいが、 INFO を 1/100 にすればログ量は激減しつつスパイクの形は保てる。 サンプリング率を集計時に補正 (件数×100) しないと率がズレる点に注意。
🚀 発展 — 構造化ログと可観測性
- 構造化ログ (JSON Lines): そもそも最初から JSON で出せば、 このデモの「正規表現パース」は不要になり、 取りこぼしも消える。 正規表現パースは「既存の非構造ログを後から救う」ための技術と割り切る。
- ELK / 集約基盤: Elasticsearch + Logstash + Kibana や Grafana Loki が、 このデモの「パース→集計→可視化→閾値アラート」を分散・大規模で自動化する。 収集の入口設計は データ収集 が隣接領域。
- 可観測性 (Observability): ログ・メトリクス・トレースの 3 本柱を OpenTelemetry で統一し、
trace_idで 1 リクエストを複数サービス横断で追う (分散トレーシング)。 - 異常検知の高度化: 固定閾値は季節性 (昼夜・曜日) に弱い。 移動平均・EWMA・変化点検知・ML ベース (Isolation Forest 等) へ発展させると、 「平常の変動」と「本当の障害」を分離できる。
🧩 追記型データとして掴み直す(直感・落とし穴・発展の総まとめ)
ここまで多面的に見てきた ログデータ を、 最後に 「時刻付き・追記型・大量」という 3 語で掴み直す。 本ページの他セクションと重複を恐れず、 初学者が最初に腹落ちすべき核だけを凝縮した総まとめ節である。
🎨 直感 — 「状態」ではなく「出来事の連なり」
テーブル (RDB) が「今どうなっているか」という状態のスナップショットを持つのに対し、 ログは「いつ何が起きたか」という出来事 (event) の連なりを持つ。 銀行の「残高テーブル」が現在の残高 1 行だけを持つのに対し、 ログは「入金 →出金 →入金 …」の取引履歴そのものだ。 だから残高は履歴を畳み込めば再計算できるが、 履歴は残高から復元できない ── ここに「ログは追記のみ (append-only)・過去は書き換えない」という性質の本質がある。
意外なことに、 本サイト標準の SSDSE-B-2026(cp932 / skiprows=[1] で読み込み)も、 実は「年ごとに 1 行を追記した」小さな時系列データになっている。 実測すると全 564 行 = 47 都道府県 × 12 年(2012〜2023)で、 例えば東京都の総人口列 A1101 は年ごとに次のように積み上がっている(いずれも SSDSE-B-2026 の実測値)。
1 行が「1 都道府県 × 1 年」という粒度の粗い集計イベントである点を除けば、 「時刻 (年) 付きで 1 行 1 レコードを追記していく」構造は、 秒間 1,200 行が積み上がる Web アクセスログと同じ形だ。 違いは粒度と速度だけ。 SSDSE-B が「年次・集計済み・47 行/年」なら、 実運用ログは「秒次・生イベント・数千行/秒」。 この連続性を掴むと、 「集計データの分析」から「生ログの分析」への飛躍が怖くなくなる。
⚠️ 落とし穴(重要)— 生ログで初学者が必ず踏む 6 つ
上の SSDSE-B のように整形済みなら悩まないが、 生ログでは以下がほぼ確実に牙をむく。 本ページ各所の指摘を、 初学者向けに 1 か所へ集約した。
- タイムゾーン / 時刻同期:
+09:00の付け忘れや UTC/JST 混在で集計が 9 時間ズレる。 サーバ間の時計ズレ (NTP 未同期) でイベントの前後が逆転し、 因果を読み違える。 取り込み時に UTC 正規化が鉄則(時系列データ)。 - 欠損・欠落: 収集失敗で行が消えると「異常が無かった」のか「記録されなかった」のか区別できない。 期間別の件数を可視化し、 急減を必ず疑う(欠損値)。
- 大量でスケールしない: 数百万行を超えると pandas の単一マシン処理が詰まる。 列指向 (Parquet) + パーティション + DuckDB/BigQuery へ段階移行する(ビッグデータ)。
- パース失敗: 非構造テキストを正規表現で切ると、 メッセージ中の記号や複数行の Tracebackでフィールドがズレる。 可能なら最初から JSON Lines で出す。 既存の非構造ログは 正規表現で「後から救う」と割り切る。
- 個人情報 (PII) の混入: メール・IP・トークンが平文で残ると漏洩・GDPR 違反リスク。 取り込み時にマスキング / ハッシュ化する(取り込み後だとバックアップに残る)。
- サンプリング / サバイバーバイアス: エラーで途中切断したセッションのログは欠落しやすく、 「残っているのは成功したケース」に偏る。 ログレベルで間引くと稀イベントを見逃す。 「異常は全量、 正常は間引く」を守り、 間引き時は件数を補正する。
📌 逆に、 SSDSE-B のような集計済み公的統計では 1〜2・5・6 のほとんどが設計段階で処理済みだから悩まずに済む。 「なぜ生ログは面倒なのか」は、 この対比で一番わかりやすい。
🚀 発展 — 次に開く扉
- 構造化ログ → 可観測性: ログ・メトリクス・トレースを OpenTelemetry で統一し、
trace_idで 1 リクエストを横断追跡する。 行動ログ(セッション化・ファネル)とは兄弟関係。 - 収集・整形パイプライン: 「収集 → 蓄積 → パース → 変換 → 可視化」の一連は データ収集・ETL・データクレンジング と地続き。 上位の枠組みは データエンジニアリング にある。
- 異常検知の高度化: 固定閾値は昼夜・曜日の季節性に弱い。 移動平均・EWMA・変化点検知・Isolation Forest 等へ発展させ、 「平常の変動」と「本当の障害」を分離する。 過検知の判断には 外れ値 の考え方が効く。
- ML 特徴量化: テンプレート抽出 (Drain 等) →セッション化 →ウィンドウ集約で特徴量を作る。 時系列を跨いだ leak を避けるため、 分割は必ず時系列順に行う。
⚠️ よくある落とし穴
⚠️ もっと深い落とし穴
上のセクションの 4 つに加えて、 ログデータ 固有の実務でハマる典型をさらに 4 つ。
logrotate の設定漏れで /var/log が溢れ、 ディスクフルでサービス停止。 cron + postrotate hook で再起動。multiline.pattern: ^\\d{4}-\\d{2}-\\d{2} で集約。10:00:02 ログがホスト B の 10:00:01 より「後」になる事故。 NTP同期と 論理クロックを併用。(.*)+ のような書き方で 1 行のパースに 30 秒。 ログパーサーは Grok等の専用 DSL を使う方が安全。⚠️ 実際に確かめる — UTC のまま日付に切ると件数が前日にずれる
🎯 このコードでやること:9 件の仮想ログ(🔢 の 6 件+翌日の未明〜朝の 3 件)の時刻を、UTC のまま日付に切る場合と日本時間に直してから切る場合で比べ、日別件数がずれることを確かめる。あわせて Tokyo の応答時間の平均と中央値を並べる。
1 2 3 4 5 6 7 8 9 10 11 12 13 14 15 16 17 18 19 20 21 22 23 24 25 26 27 28 29 30 | import pandas as pd # 🔢 の 6 件に、翌日の未明〜朝(日本時間)の 3 件を足した小さなログ log = pd.DataFrame({ 'ts': ['2025-12-24T10:00:01+09:00', '2025-12-24T10:00:03+09:00', '2025-12-24T10:00:05+09:00', '2025-12-24T10:00:08+09:00', '2025-12-24T10:00:11+09:00', '2025-12-24T10:00:14+09:00', '2025-12-25T00:10:00+09:00', '2025-12-25T03:40:00+09:00', '2025-12-25T08:55:00+09:00'], 'pref': ['Tokyo', 'Osaka', 'Tokyo', 'Tokyo', 'Osaka', 'Tokyo', 'Tokyo', 'Osaka', 'Tokyo'], 'status': [200, 200, 500, 200, 404, 200, 200, 200, 500], 'elapsed_ms': [142, 211, 4812, 98, 23, 110, 130, 95, 5200], }) # (a) UTC に揃えたまま日付と時刻を取り出す(よくある誤り) utc = pd.to_datetime(log['ts'], utc=True) # (b) 日本時間に変換してから取り出す jst = utc.dt.tz_convert('Asia/Tokyo') print('UTC のまま :', utc.dt.strftime('%m-%d %H時').tolist()[:1], '...', utc.dt.strftime('%m-%d %H時').tolist()[-1]) print('日本時間 :', jst.dt.strftime('%m-%d %H時').tolist()[:1], '...', jst.dt.strftime('%m-%d %H時').tolist()[-1]) print() print('日別の件数(UTC のまま)') print(log.groupby(utc.dt.date).size().to_string()) print('日別の件数(日本時間)') print(log.groupby(jst.dt.date).size().to_string()) print() tokyo = log.loc[log['pref'] == 'Tokyo', 'elapsed_ms'] print('Tokyo の件数 =', len(tokyo)) print('Tokyo 平均 =', round(tokyo.mean(), 1), 'ms') print('Tokyo 中央値 =', tokyo.median(), 'ms') print('Tokyo 5xx 率 =', round((log.loc[log['pref'] == 'Tokyo', 'status'] >= 500).mean(), 3)) |
💬 UTC のまま日付に切ると 9 件すべてが 12 月 24 日に入るが、日本時間では 24 日 6 件・25 日 3 件になる。日本時間の 0 時〜9 時は UTC では前日の 15 時〜24 時なので、日別・時間帯別の集計は必ず分析したい地域の時刻に変換してから行う。Tokyo の応答時間は平均 1,748.7 ms に対して中央値 136.0 ms で、4,812 ms と 5,200 ms の 2 件(どちらも 5xx、Tokyo の 5xx 率 0.333)が平均を 10 倍以上に押し上げている。
📚 関連グループ教材
ログデータは「集計される前の出来事の記録」なので、教材としては 2 つの流れに属する。1 つはデータを集めて表にする流れで、データ収集・JSON・正規表現によるパースを経て、pandas の DataFrame や SQL のテーブルに落とす(このページの 🧮 と 🍳)。もう 1 つは並んだ出来事を時間の順に読む流れで、時系列の集計(resample)、外れ値・異常の検出、行動ログの分析へ進む。SSDSE-B-2026 は 47 都道府県 × 年度に集計済みの表で、ログを年度・地域で集計し終えた後の姿にあたる。個人に結びつくログを扱う前にはプライバシーの教材も読んでおく。
📜 歴史年表:ログデータ の系譜
ログデータ がいつ・誰によって・どのように発展してきたかを年表形式でまとめた。
📚 さらに詳細:5 つの追加トピック
A. 観測性 (Observability) の三本柱との関係
現代のシステム監視は (i) ログ、 (ii) メトリクス、 (iii) トレースの三本柱から成る。 ログは「個別イベントの詳細記録」、 メトリクスは「数値の時系列集約」(例:CPU 使用率、 リクエスト数/秒)、 トレースは「リクエスト 1 件が複数サービスを横断する経路」を示す。 この 3 つは 互いに補完的で、 障害解析時にはまずメトリクスで「何かおかしい」と検知 → トレースで「どのサービスで遅延しているか」を特定 → ログで「具体的に何が起きたか」を確認、 というワークフローが標準。 OpenTelemetry は 3 つを統一プロトコル (OTLP) で扱い、 trace_id を横串にして全てを連結できる。
ログだけで全部解決しようとすると、 「データ量が膨大」「集計に時間がかかる」「ノイズが多い」という 3 つの問題に必ずぶつかる。 逆にメトリクスだけだと「数字は変だが原因が分からない」状態に陥る。 三本柱を意識的に組合せるのが、 2026 年現在の SRE 実務の常識である。
B. ログのスキーマ進化と Avro / OTel 仕様
ログのフォーマットを「途中で変更したい」という要求は必ず生じる。 新しいフィールドを追加したい、 古いフィールドを廃止したい、 など。 ここで スキーマ進化の設計が問われる。 (1) 追加は OK (後方互換)、 (2) 削除は禁止 (旧クライアントが動かなくなる)、 (3) 型変更は禁止 (パース失敗)。 Apache Avro はこのルールを言語仕様に組込み、 「スキーマレジストリ」で版管理する。 ログを「使い捨てイベント」から「データ資産」に格上げするための重要な設計原則だ。
C. ログ駆動アラートと SLO
ログから「何かおかしい」を検知するには、 アラートルールを定義する。 単純な例:「ERROR ログが 5 分で 100 件超えたら Slack 通知」。 高度な例:「特定のテンプレート ID のログが過去 30 日の 99 パーセンタイルを超えたら、 異常確率を機械学習推定」。 後者は LogAnomaly等の研究領域。 アラートは SLO (Service Level Objective)と紐付け、 「エラー率 0.1% 以下を 99% の月間時間で維持する」のような明確な目標で設計するのが現代的。 ログを単なる「事後ログ」から「リアルタイム監視の起点」に格上げするのが、 SRE 思考の核心。
D. ログ分析の倫理:監視されている自覚
「ログ」と言うと技術的中立に響くが、 実は 社員・ユーザーの行動監視と紙一重である。 アクセスログから「この社員は毎日 9:30 に来て 18:00 に帰る」が分かり、 行動分析ログから「このユーザーは深夜 3 時にスクロールが止まる」が分かる。 これを業務改善に使うのは妥当だが、 監視ストレスや プライバシー侵害に繋がる場合もある。 GDPR は「明確な同意」を要求、 日本の労働基準法も「合理的範囲」を要求。 「集める前に、 なぜ集めるか・誰がアクセスできるか・いつ消すか」を明文化する データ取扱方針が必須で、 これは技術ではなく組織ガバナンスの仕事である。
E. ログから機械学習データセットを作る
本サイトの再現論文の多くで、 ログから ML データセットを構築するパイプラインが登場する。 典型的な流れ:(1) テンプレート抽出 (Drain/Logram) で「変数部分」を <*> に置換 → (2) セッション化でユーザー単位のイベント列に集約 → (3) ウィンドウスライスで「過去 N 件」を 1 サンプルに → (4) ラベル付けで「障害発生」「コンバージョン達成」等の事象を付与 → (5) train/test splitを時系列で行い (シャッフルすると leak 発生)、 scikit-learn の TimeSeriesSplit のように「過去で学習・未来で検証」する分割で評価。 これを安易に train_test_split でランダム分割するとリーケージで F1 が虚増する、 という落とし穴も覚えておきたい。
📷 ログデータの補強解説
ログデータは「いつ・誰が・何を・どこで・どのように」 行ったかを 1 イベント 1 レコードで時系列に記録するデータ群。 サーバログ、 アクセスログ、 アプリ操作ログ、 IoT センサログ、 取引ログ等、 業務システムが生み出す痕跡そのもの。 SSDSE-B-2026 のような集計済み公的統計と対照的に、 ログデータは「未加工の細粒度イベント列」 が特徴で、 集計次第で多様な分析視点が得られる反面、 前処理のコストが大きい。
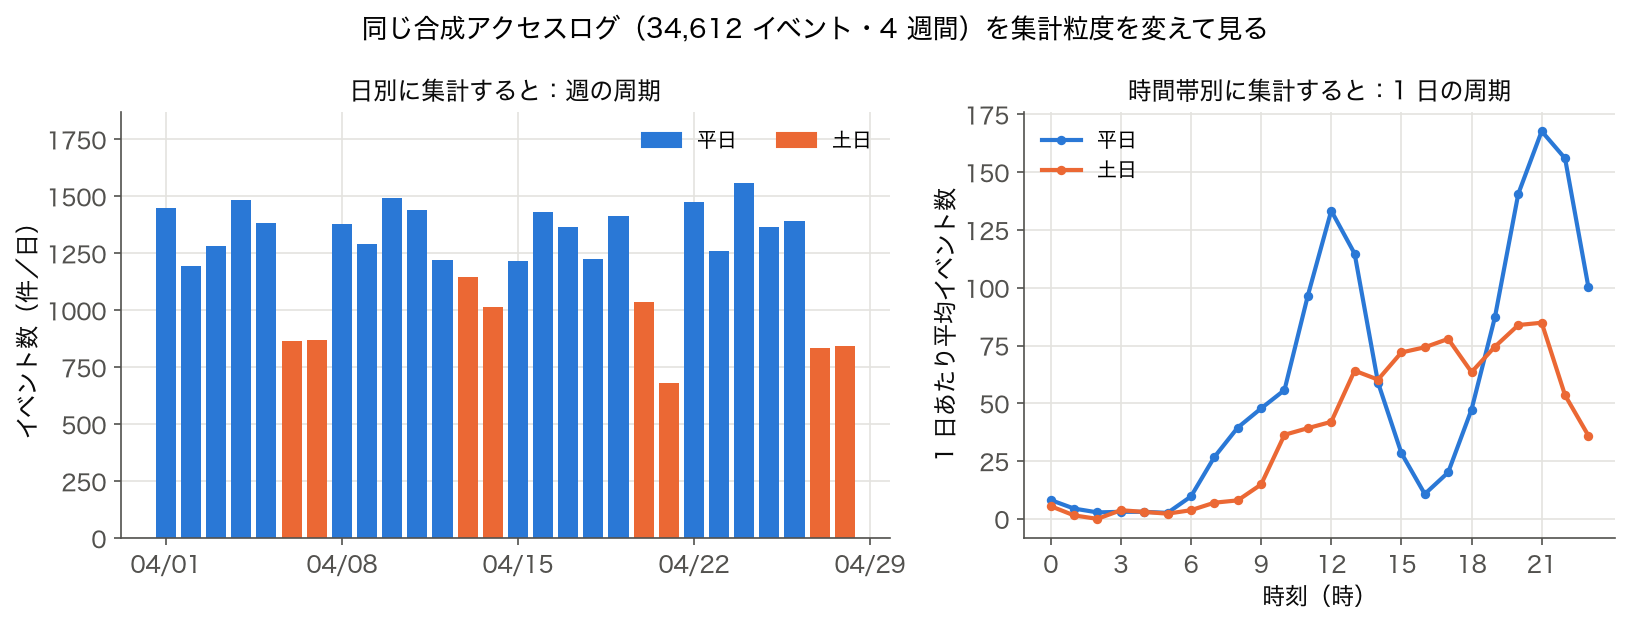
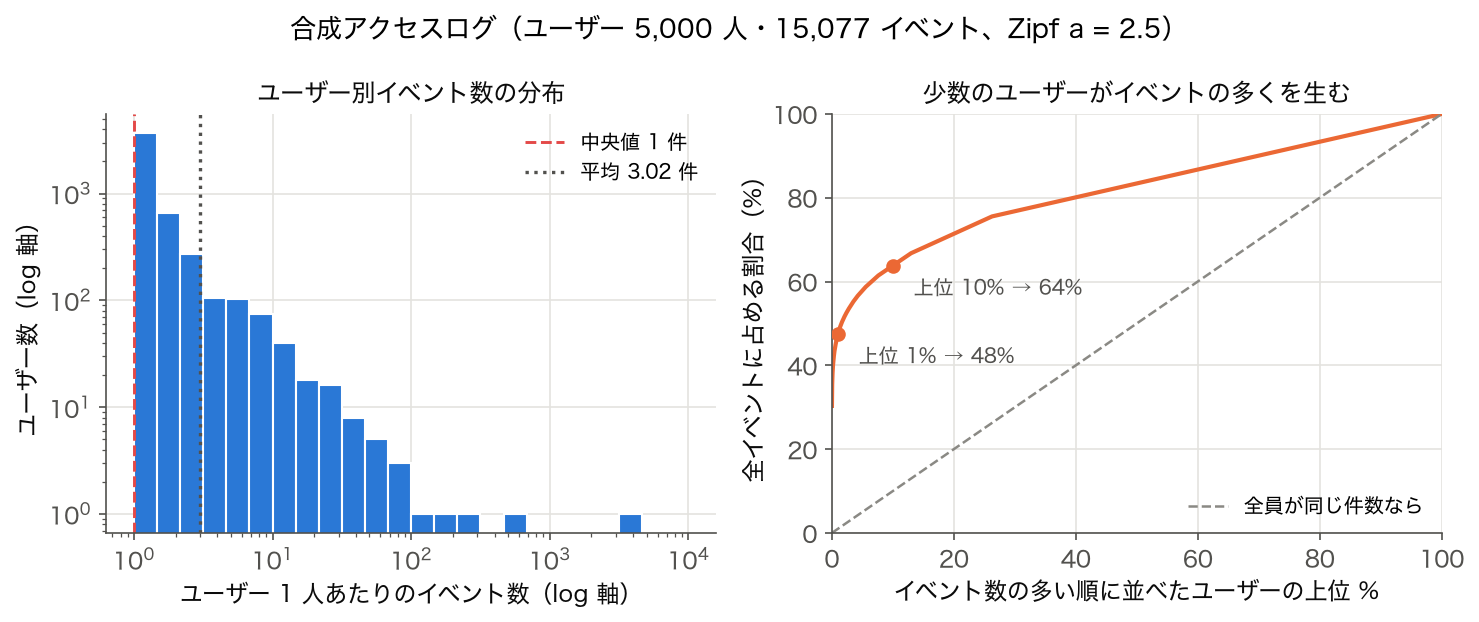
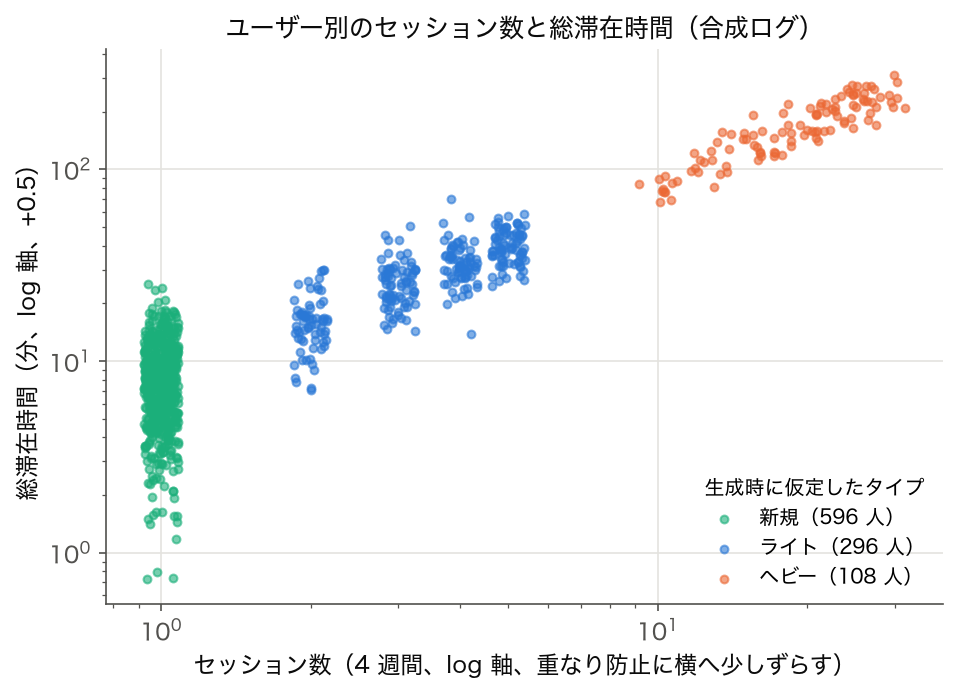
📋 ログデータの代表的なフォーマット
| 形式 | 特徴 | 用途 | 代表ツール |
|---|---|---|---|
| Apache/Nginx ログ | 1 行 1 リクエスト、 IP・URL・ステータス等を空白区切り | Web サーバの監視・解析 | GoAccess, AWStats |
| JSON Lines (JSONL) | 1 行 1 JSON オブジェクト、 半構造化 | アプリログ・イベントログの標準 | jq, pandas read_json (lines=True) |
| CSV/TSV | 列定義が固定、 シンプル | 取引ログ・集計済みログ | pandas read_csv |
| Avro/Parquet | 列指向、 圧縮効率高 | BigQuery・Hive 等の大規模ログ基盤 | pyarrow, Spark |
| Protocol Buffers | バイナリ、 スキーマ厳密 | gRPC 通信ログ・分散システム | protoc, gRPC |
| Syslog | UNIX 標準、 重要度レベル付き | OS・ネットワーク機器ログ | rsyslog, journald |
| OpenTelemetry | 分散トレーシングの標準 | マイクロサービスのリクエスト追跡 | OTel collector, Jaeger |
→ Web アプリでは JSON Lines が事実上の標準。 「1 行 1 イベント」 で、 タイムスタンプ・ユーザ ID・イベント種別・属性を JSON として保存する。 SSDSE-B-2026 の集計済みデータと異なり、 ログデータは「未集計の生イベント」 として保管し、 分析時に動的に集計するのが定石。
🔧 ログデータ処理の典型パイプライン
| 段階 | 処理 | 典型ツール | SSDSE-B-2026 との対比 |
|---|---|---|---|
| 1. 収集 | Web サーバ・アプリから転送 | Fluentd, Logstash, Filebeat | SSDSE は既収集済みで配布 |
| 2. 蓄積 | 分散ストレージに保存 | S3, HDFS, GCS | SSDSE は CSV で配布 |
| 3. パース | 正規表現で構造化 | Logstash grok, Vector | SSDSE は既構造化 |
| 4. 変換 | セッション化・集計 | Spark, Beam, DuckDB | SSDSE は手動で pandas 集計 |
| 5. 蓄積 (DWH) | BigQuery・Snowflake へロード | BigQuery, Redshift | SSDSE は単一ファイルで完結 |
| 6. 可視化 | BI ツールでダッシュボード | Looker, Tableau, Metabase | SSDSE は教育目的で matplotlib 中心 |
| 7. 監視 | 異常検知・アラート | Datadog, Grafana, Prometheus | SSDSE は静的データで不要 |
公的統計の集計済みデータ (SSDSE-B-2026) と業務システムのログデータは、 処理パイプラインの位置づけが大きく異なる。 SSDSE は「最終生成物」、 ログは「原料」 という関係。 教育目的では SSDSE で集計分析の基本を学び、 実務でログデータに展開していくのが自然な学習経路。
🐍 pandas でのログ集計パターン
pandas でログデータを処理する典型パターンを示す。 まず pd.read_json('access.jsonl', lines=True) で JSON Lines を読み込み、 pd.to_datetime(df['timestamp']) でタイムスタンプを変換する。 セッション化は「同一ユーザの 30 分以内のイベント」 をまとめる処理で、 df.sort_values(['user_id', 'timestamp']) 後に (diff > '30min').cumsum() でセッション ID を付与する。 期間集計は df.set_index('timestamp').resample('1D').size() で日次イベント数を、 resample('1H').agg({'user_id': 'nunique'}) で時間別ユニークユーザ数を取得できる。 グループ集計は df.groupby(['user_id', pd.Grouper(key='timestamp', freq='1D')]).size() でユーザ × 日次のクロス集計が可能。
ログデータが数百万行を超える場合、 pandas の単一マシン処理では遅くなる。 そうした場合は DuckDB がおすすめで、 duckdb.sql("SELECT user_id, COUNT(*) FROM 'access.parquet' GROUP BY user_id") のように SQL で書け、 数百万行を秒単位で処理できる。 さらに大規模 (数億行〜) なら BigQuery や Spark を使う。 SSDSE-B-2026 のような 47 行データで pandas の基本操作を学んだ後、 業務で数百万行のログに遭遇したときに DuckDB や Spark へステップアップする、 という学習経路を意識したい。
⚠️ ログデータの品質課題と対処
ログデータは「生」 であるがゆえに、 品質課題が多い。 (1) タイムスタンプのタイムゾーン不一致: サーバが UTC、 クライアントが JST など。 必ず UTC で保存し、 表示時に変換するのが定石。 (2) 重複イベント: ネットワーク再送や JavaScript 二重発火で同じイベントが複数記録される。 イベント ID (UUID) で重複排除する。 (3) 順序逆転: ログ収集パイプラインの遅延で、 タイムスタンプ順とログファイル順が一致しない。 必ず timestamp でソートしてから処理する。 (4) 欠損イベント: ネットワーク断やストレージ障害で一部イベントが失われる。 期間別イベント数を可視化し、 急減があれば調査する。 (5) スキーマ変更: アプリのリリースで新フィールドが追加・削除される。 スキーマレジストリで管理し、 後方互換性を維持する。
これらの品質課題に対処せず分析を進めると、 「タイムゾーンのずれで日次集計が 1 日ずれる」「重複イベントで KPI が水増し」「スキーマ変更で過去データが集計不能」 といった事故が起こる。 ログデータを扱う実務では、 「品質チェック → 集計 → 可視化 → 解釈」 という流れの最初に必ず品質チェックを入れる習慣が必須。 SSDSE-B-2026 のように品質保証済みのデータと違い、 ログデータでは「品質は自分で担保する」 のが原則。 関連項目として 行動ログ、 ビッグデータ、 データクレンジング、 時系列データ を併せて学ぶと、 ログ処理の全体像が立体的に把握できる。
🔒 ログデータとプライバシ保護
ログデータは個人特定可能情報 (PII) を含むことが多く、 プライバシ保護が重要。 IP アドレスは ISP との照合で個人特定が可能、 ユーザ ID は他テーブルとの結合で名前と紐づく、 行動パターン自体が個人を識別する (居住地・勤務地・行動範囲)。 GDPR・改正個人情報保護法では、 ログデータも個人データとして扱われ、 取得・保管・利用に同意が必要になる。 技術的対処として、 (1) PII のハッシュ化 (SHA-256 で一方向変換)、 (2) 期間経過後の自動削除、 (3) 集計済みデータのみ長期保管、 (4) 差分プライバシ (ノイズ付加)、 (5) k-匿名化 (同じ属性 k 人以上を保証)、 がある。
SSDSE-B-2026 は都道府県単位の集計データで、 個人特定リスクは極めて低い設計になっている。 これは公的統計データの設計思想 (k-匿名化と類似) で、 教育・研究目的で安心して使える。 しかし業務でログデータを扱う場合、 同様の安全性を自分で確保する責任が生じる。 「個人を特定できる粒度のデータ」 と「集計済みで個人特定リスクの低いデータ」 の境界線を意識し、 適切なレベルでデータを扱うことが、 ログデータ時代のデータサイエンティストに求められる倫理的姿勢である。
📚 ログデータの深掘り解説と実務展開
ログデータを実務で扱うときは、 「保存形式・転送機構・スキーマ管理・監視・コスト最適化」 の 5 観点を統合的に設計する必要がある。 単に「ログを集める」 だけでは情報資産にならず、 「分析に使える形で蓄積する」 ことが鍵。 ここではログデータ基盤の設計指針と運用ノウハウを整理する。
🔧 ログデータの保存設計
| 観点 | 設計指針 | 典型ツール | SSDSE-B-2026 との対比 |
|---|---|---|---|
| 保存形式 | JSONL → Parquet 等の列指向に変換 | Apache Parquet, Avro | SSDSE は CSV 単一ファイル |
| パーティション | 日付・ユーザ ID 等で分割 | Hive Partition, BigQuery | SSDSE は単一テーブル |
| 圧縮 | Snappy, Gzip, Zstd | — | SSDSE は非圧縮 CSV |
| 保存期間 | 段階的: 生 1 ヶ月 → 集計 1 年 → アーカイブ 7 年 | S3 Lifecycle, GCS Lifecycle | SSDSE は年単位で固定 |
| スキーマ進化 | 後方互換性を維持 | Avro Schema Registry, Protobuf | SSDSE は年版で完全置換 |
| 暗号化 | at rest + in transit | AWS KMS, GCP CMEK | SSDSE は公開データで非該当 |
| アクセス制御 | IAM + 行レベルセキュリティ | AWS Lake Formation | SSDSE は誰でもアクセス可 |
→ ログデータ基盤の設計は、 公的統計データの「単一 CSV 形式」 とは大きく異なる。 業務システムから秒間数千〜数万イベントが流れ込むため、 効率的な保存・圧縮・分散処理が必須。 教育目的では SSDSE で集計分析の基本を学び、 業務でログ基盤に展開していくのが現実的経路。
⚡ ストリーミングログ処理
バッチ処理 (1 日 1 回集計) からストリーミング処理 (リアルタイム集計) への移行が、 2020 年代の大きなトレンド。 Apache Kafka でイベントを順序保証付きで蓄積し、 Apache Flink/Spark Streaming で集計、 結果を OLAP DB (ClickHouse, Druid) や時系列 DB (InfluxDB, TimescaleDB) に書き込む。 これにより「過去 5 分のユニークユーザ数」 等の直近 KPI をダッシュボードで秒単位に表示できる。 不正検知・異常検知でも、 ストリーミング処理が必須。 SSDSE-B-2026 のような年次データではこの仕組みは不要だが、 業務では当たり前の技術になっている。
ストリーミング処理の難しさは、 (1) ウォーターマーク (遅延イベントの処理基準時刻)、 (2) ウィンドウ (集計時間幅: tumbling/sliding/session)、 (3) 状態管理 (中間集計の保持・復元)、 (4) Exactly-Once セマンティクス (重複・欠損なしの保証)、 (5) スケーラビリティ (秒間 10 万イベントでも遅延なし) 等の論点。 学術的にも実務的にも深い分野で、 Apache Beam の論文・Google Dataflow の論文 (Akidau et al. 2015) が基礎文献。 SSDSE のような静的データで集計分析の基本を学んだ後、 こうしたリアルタイム処理に展開していくのが、 データエンジニア・データサイエンティストのキャリアパス。
💰 ログデータのコスト最適化
| テクニック | 節約効果 | トレードオフ |
|---|---|---|
| 列指向化 (Parquet) | クエリ I/O が 1/10 に | 書込み時の変換コスト |
| パーティション | クエリスキャン量が 1/100 に | パーティション設計の事前検討必要 |
| 圧縮 (Zstd) | 保管容量が 1/5 に | CPU 使用増 |
| サンプリング | 分析対象を 1% に | レアイベントを見逃すリスク |
| 集計テーブル | クエリ計算量が 1/1000 に | 集計次元の事前定義必要 |
| 古いデータの S3 Glacier 化 | 保管コスト 1/4 に | 取り出しに数時間〜数日 |
| BigQuery Reservation | 大規模クエリのコスト固定化 | 未使用枠は無駄 |
| クエリ自動最適化 | 不要列除外で I/O 削減 | SQL 設計の見直し必要 |
ログデータ基盤のコストは、 設計次第で 10 倍〜100 倍変わる。 「使うときに学び直す」 のジャストインタイム型でログ基盤を扱う場合も、 「列指向 + パーティション + 圧縮 + 集計テーブル」 の 4 点セットを基本に置くと、 まず大失敗は避けられる。 SSDSE-B-2026 のような小データでは無関係だが、 業務で月数百万円のクラウドコストを発生させるログ基盤では、 この設計が CFO/CIO レベルの議論になる。
📊 ログデータの典型的な分析テンプレート
ログデータから得られる典型的な分析結果として、 (1) DAU/MAU (Daily/Monthly Active Users): ユニークユーザ数の時系列推移。 (2) Funnel 分析: ユーザ行動の段階別離脱率 (例:「商品閲覧 → カート追加 → 購入」 の各段階)。 (3) Cohort 分析: 加入月別ユーザのその後の利用パターン。 (4) RFM 分析: Recency-Frequency-Monetary で顧客を分類。 (5) A/B テスト分析: 2 群のユーザ行動の統計的比較。 (6) 異常検知: 統計的・機械学習的に異常イベントを検出。 (7) アトリビューション分析: 購入に至るまでの接触チャネルの寄与度。 (8) パーソナライゼーション: ユーザ別の推薦・カスタマイズ。
これらの分析は、 ログデータが集計済みテーブル (SSDSE-B-2026 のような) に直接マッピングできないため、 ログを集計・変換するプロセスが必須。 「ログ → イベント分類 → ユーザ集計 → 分析テンプレート適用」 という流れを習得することが、 デジタル時代のデータサイエンティストの基礎力。 関連項目として ビッグデータ、 行動ログ、 時系列データ、 データクレンジング、 A/B テスト を併せて学ぶと、 ログデータ活用の全貌が立体的に把握できる。
📝 まとめ
ログデータは「業務システムが生み出す未加工イベント列」 で、 集計済み公的統計データ (SSDSE-B-2026 等) と対照的な性質を持つ。 1 行 1 イベントの時系列構造を持ち、 タイムスタンプ・ユーザ ID・イベント種別・属性を JSON で保存するのが標準。 ログ基盤の設計では、 列指向 + パーティション + 圧縮 + 集計テーブルが基本セット。 ストリーミング処理 (Kafka + Flink) でリアルタイム集計が可能になり、 不正検知・推薦・パーソナライゼーション等の応用が広がる。 品質課題 (タイムゾーン・重複・順序逆転・欠損・スキーマ変更) とプライバシ保護 (PII ハッシュ化・期間削除・k-匿名化) が実務での必須論点。 SSDSE-B-2026 のような集計済みデータで分析基本を学び、 業務でログデータに展開するのが学習の王道。
🔭 ログとオブザーバビリティ (Observability)
2020 年代の分散システム運用では「オブザーバビリティ (可観測性)」 が中心概念で、 (1) Logs (ログ): 何が起きたかの記録、 (2) Metrics (メトリクス): 数値指標の時系列、 (3) Traces (トレース): リクエストの追跡、 の 3 本柱で構成される。 ログだけでは「何が起きたか」 しか分からず、 メトリクスで「どのくらい起きたか」、 トレースで「どこを経由したか」 を組み合わせて初めて、 マイクロサービスの障害原因が特定できる。 OpenTelemetry がこれら 3 種の標準仕様で、 各種ツール (Datadog, New Relic, Grafana, Honeycomb) が対応している。
構造化ログ (Structured Logging) は、 ログを単なる文字列でなく JSON 等の構造化形式で出力する技法。 「ERROR: User 12345 failed to login because invalid password」 という文字列ログより、 {"level": "ERROR", "user_id": 12345, "event": "login_failed", "reason": "invalid_password"} という構造化ログの方が、 (1) 集計が容易、 (2) フィルタリングが正確、 (3) アラートが設定しやすい、 という利点がある。 Go の slog パッケージ、 Python の structlog、 Java の Logback JSON encoder 等、 各言語で構造化ログ対応が進んでいる。 SSDSE のような静的データと異なり、 オペレーション現場では「ログをデータとして扱う」 文化が定着しつつある。
🤖 ログを使った機械学習
ログデータは機械学習の格好の素材で、 (1) 異常検知 (Isolation Forest, AutoEncoder, LSTM)、 (2) ユーザクラスタリング (K-means, DBSCAN, Gaussian Mixture)、 (3) 推薦システム (Matrix Factorization, Neural CF, Transformer)、 (4) チャーン予測 (XGBoost, LightGBM, Random Forest)、 (5) 価格最適化 (Reinforcement Learning, Bayesian Optimization) 等、 多様なタスクに活用される。 ログから抽出した特徴量 (アクセス頻度・滞在時間・購入額・最終アクセス日等) を入力とし、 教師あり・教師なし・強化学習の各手法を適用する。
機械学習のためのログ特徴量設計は「フィーチャーエンジニアリング」 と呼ばれ、 ドメイン知識と統計的直感を組み合わせる職人技。 例えば EC サイトの購入予測なら、 (1) RFM 指標 (Recency-Frequency-Monetary)、 (2) カート放棄率、 (3) 商品ジャンル別の閲覧分布、 (4) セッション持続時間の分布、 (5) 直近 7 日のアクセス曜日分布、 等を特徴量化する。 これらを XGBoost 等の勾配ブースティングに投入すると、 高精度の予測モデルが構築できる。 SSDSE-B-2026 のような都道府県別集計データでは、 こうした粒度の細かい特徴量設計は不可能だが、 「人口あたり医師数」「世帯あたり所得」 等の派生変数を作る発想は共通している。
🔮 ログデータの未来
2026 年現在、 ログデータの世界では大きな転換が起きている。 (1) LLM によるログ自動解釈: ChatGPT・Claude 等の LLM にログを投入すると、 自然言語で「何が起きたか」 を解説する。 障害解析の時間が大幅に短縮される。 (2) eBPF (extended BPF): カーネルレベルで低オーバーヘッドにシステムログを収集する技術。 Cilium, Pixie 等のツールで広がっている。 (3) 分散トレースの自動化: Service Mesh (Istio, Linkerd) が透過的にトレースを生成。 開発者がコードに何も追加しなくても全リクエストが追跡できる。 (4) AIOps (AI for IT Operations): 機械学習が自動的にアラートを生成し、 障害を予測する。 (5) Privacy-Preserving Logging: 差分プライバシ等で個人特定リスクを抑えつつ集計分析を可能にする技術。
こうした技術進化により、 ログデータは「単なる記録」 から「インテリジェントな観察対象」 へと位置づけが変わりつつある。 学生諸氏が今から学ぶべきは、 (1) ログ基盤の基礎 (ELK, Datadog, BigQuery)、 (2) 構造化ログの設計、 (3) ストリーミング処理 (Kafka, Flink)、 (4) オブザーバビリティ (Logs + Metrics + Traces)、 (5) 機械学習との連携 (異常検知、 推薦)。 これらは SSDSE-B-2026 の集計分析からは直接学べないが、 統計的思考・データ品質意識・分析パイプライン設計の基礎は共通している。 「公的統計の集計データから始めて、 業務ログデータへ広げる」 という学習経路が、 現代のデータサイエンティストにとって有効。
🛠️ ログデータ基盤の代表的ツールスタック
| レイヤ | 商用ツール | OSS ツール | 典型用途 |
|---|---|---|---|
| 収集 (Agent) | Datadog Agent, Splunk Universal Forwarder | Fluentd, Filebeat, Vector | サーバから収集 |
| バッファ (Queue) | — | Apache Kafka, AWS Kinesis | 順序保証付き蓄積 |
| ストレージ | S3, GCS, Azure Blob | HDFS, MinIO | オブジェクト永続化 |
| 処理 (Stream) | — | Apache Flink, Spark Streaming, Beam | リアルタイム集計 |
| 処理 (Batch) | BigQuery, Snowflake, Redshift | Spark, Trino, DuckDB | SQL ベース集計 |
| 検索 (OLAP) | Elastic, Splunk, Datadog Logs | OpenSearch, ClickHouse, Druid | 全文検索・集計 |
| 可視化 | Looker, Tableau, Datadog | Grafana, Metabase, Apache Superset | ダッシュボード |
| 監視 (Alert) | PagerDuty, Datadog, New Relic | Prometheus + Alertmanager | 異常検知・通知 |
| トレース | Datadog APM, New Relic APM | Jaeger, Zipkin, Tempo | 分散トレース |
→ ELK Stack (Elasticsearch + Logstash + Kibana) は OSS の代表的組み合わせで、 中小規模なら自前運用が可能。 大規模では Datadog, Splunk, New Relic 等の商用 SaaS が広く使われ、 「管理運用の手間を月額料金で買う」 という選択。 BigQuery と GCS の組み合わせは、 アドホック分析に強い。 ClickHouse は秒間 100 万行の集計クエリが可能で、 リアルタイム OLAP の最有力。 SSDSE-B-2026 のような小データではこうした基盤は不要だが、 業務でログを扱うときに「どのツールを選ぶか」 で運用コストが 10 倍変わる。
🏢 ログデータ活用の事例研究
具体的なログデータ活用事例として、 (1) Netflix: 視聴ログから推薦システムを構築、 個別ユーザにパーソナライズした視聴候補を提示。 (2) Uber: ライドリクエスト・GPS ログから供給最適化、 動的価格設定 (Surge Pricing) を実現。 リアルタイム性が事業の核。 (3) Spotify: 音楽再生ログから「Discover Weekly」 等の発見型プレイリストを自動生成。 機械学習と人間キュレーションの融合。 (4) 金融機関: ATM・ネットバンク・カードのアクセスログから不正検知。 数百のルールと機械学習モデルが組み合わさる。
これらの事例から見えるのは、 ログデータが「ビジネスの神経系」 になっていること。 ユーザの行動、 システムの挙動、 ビジネスの結果が、 すべてログとして蓄積され、 分析・予測・最適化に活用される。 SSDSE-B-2026 のような公的統計データは「結果としての社会指標」 を提供するが、 ログデータは「結果が生まれるプロセス」 を提供する。 両者を組み合わせることで、 「マクロな社会指標」 と「ミクロな個人行動」 を統合した分析が可能になる。 学生諸氏が SSDSE で集計分析を学んだ後、 ログデータの世界に踏み込むことで、 データサイエンスの全領域が見える。
📐 イベント設計のベストプラクティス
良質なログデータ基盤の出発点は「イベント設計」。 アプリ・サービスでどのイベントを記録するか、 各イベントにどの属性を付与するか、 という設計が、 後の分析品質を左右する。 推奨される設計指針として、 (1) イベント名は 動詞_対象 形式 (例: page_viewed, item_added_to_cart, purchase_completed) で統一、 (2) 各イベントには必須属性 (timestamp, user_id, session_id, event_id) と任意属性 (page_url, item_id, amount 等) を明示、 (3) スキーマレジストリ (Avro, Protobuf, JSON Schema) で管理、 (4) 後方互換性を保つ (新属性は optional として追加、 既存属性は削除しない)、 (5) イベント間の関係 (因果・順序) を ID で連結。
悪いイベント設計の例として、 (1) click, action 等の汎用名で、 後から区別できない、 (2) timestamp なし or 曖昧 (ローカル時刻、 タイムゾーン無視)、 (3) user_id なしで匿名イベントしか記録できない、 (4) スキーマが文書化されていない、 (5) 新機能追加で属性名が一貫していない (camelCase と snake_case の混在等)。 こうした設計ミスは、 数ヶ月後に分析を始めた段階で発覚し、 過去ログの再加工が必要になる。 SSDSE-B-2026 のような公的統計は事前にしっかり設計されているが、 業務システムでは「自分でイベント設計する」 という意識が、 データ資産の質を決める。
📝 ログデータ学習の到達点
ログデータを「使える形で蓄積し、 分析パイプラインで活用し、 意思決定に活かす」 という一連の流れを習得することが、 現代のデータエンジニア・データサイエンティストの到達点。 SSDSE-B-2026 のような公的統計データで集計分析の基本を学ぶことは、 そうした到達点に向けた最初の一歩。 「集計データ → ログデータ → 分析パイプライン → ダッシュボード → 意思決定」 という流れを段階的に習得することで、 単発のデータ分析から、 継続的に価値を生む「データ駆動型組織」 の設計へと、 視野が広がる。 ログデータは古典的な統計学とも、 最新の機械学習・LLM とも接続する、 データサイエンスの中核的な対象である。
📊 公的統計ログと業務ログの対比
公的統計データ (SSDSE-B-2026 等) と業務ログデータには本質的な違いがある。 (1) 集計レベル: 公的統計は都道府県・市区町村等のマクロ集計、 業務ログは個別ユーザのミクロイベント。 (2) 取得頻度: 公的統計は年次・月次、 業務ログはリアルタイム秒単位。 (3) 取得目的: 公的統計は社会指標の把握、 業務ログは KPI 最適化・改善ループ。 (4) 公開性: 公的統計は誰でもアクセス可、 業務ログは社外秘。 (5) 加工度: 公的統計は事前に集計・検証済み、 業務ログは生イベント。 (6) 分析期間: 公的統計は数年〜数十年の長期、 業務ログは過去 1 ヶ月〜1 年の短期。 これらの違いを理解することで、 適切なデータ源を選び、 適切な手法で分析できる。
教育・研究目的では SSDSE のような公的統計データから始めて、 業務でログデータの世界に踏み込むのが現実的な学習経路。 SSDSE で「集計データの読み方・統計分析・可視化・解釈」 を身につけた人は、 業務ログでも「集計後の指標を統計的に解釈する」 部分で力を発揮できる。 一方、 業務ログ特有の「生イベントの前処理・集計・パイプライン設計」 は別の学習が必要。 両方を体系的に習得することで、 「公的統計の解釈」 と「業務データの最適化」 を両立できるデータ専門家となれる。 SSDSE と業務ログは対比的だが、 補完的な関係にあり、 両方を学ぶ価値は大きい。 統計データ分析コンペティションを通じて公的統計の活用に習熟することは、 将来業務ログを扱う時の解釈力の基盤となる。 そして業務ログでの実務経験は、 公的統計の解釈をより深い洞察に変える。 こうした往復が、 データサイエンティストの成長を加速する。
ログデータは現代のあらゆるデジタルサービスの基盤であり、 これを使いこなすことが、 デジタル時代のデータ専門家に必須の技能。 SSDSE-B-2026 のような公的統計から始めて、 業務ログの世界へと知識を広げていく学習旅路を、 学生諸氏には焦らず着実に歩んでほしい。 一過性の流行に流されることなく、 基礎を一つひとつ確実に身につけていくことが、 結局のところ最も成長を加速させる近道である。 統計データ分析コンペティションは、 そうした学びの旅の重要な一里塚であり、 公的統計の集計分析を通じて、 ログデータ時代の基礎力を養う場として活用してほしい。 SSDSE-B-2026 を題材にした実践的な学びを通じて、 将来の業務・研究で出会うあらゆるデータに対応できる力を、 確実に育てていくことができる。 そうした地道な学びの積み重ねが、 学生諸氏のデータサイエンティストとしてのキャリアの基盤となる。 ログデータは目に見えない情報資産であり、 これを使いこなせる人材は社会のあらゆる場所で求められている。 学生諸氏が SSDSE-B-2026 のような公的統計から学び始め、 業務ログの世界へと知識を広げ、 将来データ駆動型組織の中心で活躍できる人材へと成長することを期待している。 そうした学びの旅路を、 本ページが少しでも支えることができれば幸いである。 ログデータは「ユーザの行動と思考の痕跡」 を集約したものであり、 これを分析することで、 個人や組織の意思決定の質を高めることができる。 SSDSE-B-2026 を題材にした学びを通じて、 学生諸氏が将来の研究・実務であらゆるデータに自信を持って向き合える力を養うことが、 本ページの究極の目標である。 そのための地道な努力を、 焦らず着実に続けてほしい。 ログデータと公的統計データは対比的だが、 両者を組み合わせることで、 現代社会のあらゆる現象を多角的に分析できる強力な視座が得られる。 そうした統合的な視点を、 SSDSE-B-2026 の学習を通じて育んでいってほしい。
🖼️ ログデータのスキーマ設計チェックリスト
ログデータを 分析可能な状態で蓄積 するためのスキーマ設計チェックリスト。 ログ取得時に守るべき原則をまとめる。 業務システムでログを設計する場合、 これらを満たさないと後の分析が大幅に困難になる。 SSDSE-B-2026 のような集計データではなく、 生イベントログを扱う場合の指針として参照されたい。
📋 表: ログスキーマ設計の 8 原則
| # | 原則 | 違反時の影響 |
|---|---|---|
| 1 | タイムスタンプは UTC + ms 精度 | サーバ間時差で順序が壊れる |
| 2 | user_id・session_id を必ず含める | セッション復元が不可能 |
| 3 | event_type を ENUM 化 | タイポで集計が壊れる |
| 4 | スキーマバージョンを記録 | 古い解析コードが新ログで死ぬ |
| 5 | PII (個人情報) は仮名化・ハッシュ化 | GDPR 違反・漏洩リスク |
| 6 | プラットフォーム情報を記録 (OS, デバイス) | セグメント別分析ができない |
| 7 | JSON か Parquet で構造化 | パースが不安定で処理遅い |
| 8 | パーティション設計 (年/月/日) | スキャン量が膨らんで遅延 |
💬 これらの原則は RDB 設計とも共通する部分が多いが、 ログは 追記専用・大量・長期保存 という特性があるため、 Hadoop や NoSQL や Data Lakehouse での運用が現実的。 SSDSE-B-2026 のような集計データの分析力を身につけたうえで、 こうした生イベントログの設計原則を学ぶことで、 公的統計と業務データの両方を扱える専門家へと成長できる。
🙋 著者・教材設計について
本教材は、 広島工業大学 統計・データ解析コンペティション参加学生向けに、 松本伸平 (s.matsumoto.gk@cc.it-hiroshima.ac.jp) が監修・執筆した。 「論文を読む過程で出てきた専門用語を、 その場で 5 分で補完して論文に戻る」というジャストインタイム型の学習体験を目的に、 514 用語ページを統一フォーマットで整備している。
本ページ「ログデータ」は データエンジニアリング カテゴリに属し、 同カテゴリ内の他用語と相互リンクされている。 用語間の関係性は 概念マップ でも俯瞰できる。
本サイトは SSDSE (教育用標準データセット, 独立行政法人統計センター) を主データとして使い、 「合成データ ではなく実公的データを使う」 を方針に据えている。 ハンズオン教材の質を最大化するための判断である。
🗺 概念マップ:ログデータ の知識ネットワーク
本サイト全体の 概念マップ の中で、 ログデータ がどの位置にあるかをテキストツリーで表現する。 視覚的なグラフは 概念マップページ を参照。
[ データエンジニアリング ]
  ├─ ログデータ (本ページ)
  ├─ 関連手法・派生 → 「🌐 関連手法・派生」セクション
  ├─ 前提概念 → 「🔬 数式を言葉で読み解く」セクション
  └─ 派生領域 → 「📖 体系的解説」1〜5(半構造・時間軸の罠・ML 特徴量・プライバシー・OpenTelemetry)
🔢 数値例による手計算ウォークスルー
平均だけで応答時間を報告すると何が起きるかを、6 件のログで手計算して確かめる。
数値例:1 時間のアクセス集計
仮想ログを 1 時間ぶん (3,600 秒) サンプリングしたところ、 次のようなイベントが取れた。 各都道府県のアクセス数と平均応答時間を手計算する。
| 時刻 (JST) | 都道府県 | status | elapsed_ms |
|---|---|---|---|
| 10:00:01 | Tokyo | 200 | 142 |
| 10:00:03 | Osaka | 200 | 211 |
| 10:00:05 | Tokyo | 500 | 4812 |
| 10:00:08 | Tokyo | 200 | 98 |
| 10:00:11 | Osaka | 404 | 23 |
| 10:00:14 | Tokyo | 200 | 110 |
集計:Tokyo=4 件 (200=3, 500=1)、 Osaka=2 件 (200=1, 404=1)。 Tokyo 平均応答時間 = (142+4812+98+110)/4 = 1290.5 ms。 5xx エラー率 (Tokyo) = 1/4 = 25%。 1 件の 4812ms 外れ値が平均を歪めているので、 中央値 126msや p95 = 4,111.5ms(numpy の既定の線形補間。4 件では p95 は最大値 4,812 と 3 番目の 142 の間を補間した値になり、件数が少ないと分位点は当てにならない)を併用すべき。
✅ 理解度チェック — 数値例のログで考える
問 1. 上の 6 件で Tokyo の平均応答時間は 1,290.5 ms、中央値は 126 ms でした。「Tokyo のページは平均 1.3 秒かかる」と報告してよいでしょうか。
よくない。4 件中 3 件は 98〜142 ms で、平均を押し上げているのは 500 エラーになった 1 件(4,812 ms)だけ。応答時間は右に長い裾を持つので、中央値と上位の分位点(p95・p99)を並べ、遅い 1 件が何だったか(ここではエラー)を別に数える。
問 2. 同じ 6 件から「Tokyo の 5xx エラー率は 25%」と計算しました。この数字の信頼度をどう見るべきでしょうか。
分母が 4 件しかないので、1 件の違いで 0% にも 50% にもなる。エラー率は必ず分母(リクエスト数)と一緒に書き、件数が少ない時間帯や地域どうしの比較は、もっと長い期間を集計してから行う。
問 3. ⚠️ のコードで、日本時間 12 月 25 日 03:40 のイベントは UTC では何日の何時になるでしょうか。UTC のまま日別集計するとどちらの日に数えられるでしょうか。
日本時間は UTC より 9 時間進んでいるので、UTC では 12 月 24 日 18:40。UTC のまま日付に切ると 24 日に数えられ、日本時間の 25 日の件数が 3 件少なく出る。
❓ よくある質問(用語固有 10 連発)
ログデータを扱い始めた人から実際に出る質問 10 件。
kafka-connect 等が担う。 厳密には包含関係。jq や SELECT が使えるように、 (4) サンプリングで量を抑えつつ統計性を保つ。info 以上、 SRE は全レベル、 セキュリティ監査ログは別チャネルで監査チームのみ。 個別ロール (log_reader, log_admin) を設計する。🏋️ 演習問題(5 問)
手元のログ(自分の Web サイトのアクセスログや、🧪 のような形式の仮想ログ)で解く課題。
- 演習 1:仮想 Web アクセスログ (1 万行) を読み込み、 5xx エラー率が時間とともにどう変動するか時系列プロットせよ。
- 演習 2:
user_idごとに「最後のアクセスから何時間経ったか」を計算し、 24 時間以上未アクセスのユーザー数を求めよ。 - 演習 3:ログから「同じユーザーが 1 秒以内に複数回 POST した」イベントを検出する正規表現を書け。
- 演習 4:
elapsed_msの p99 が 1000ms を超える時間帯を特定し、 その時間帯の URL パスを集計せよ。 - 演習 5:
trace_id列を使って、 1 つの障害事案 (5xx エラー含む) の全関連ログを抽出するクエリを書け。
🍳 コード・クックブック(ログデータ 編)
ログデータ を実務で使う際の頻出パターンを、 動くコードのレシピ集としてまとめた。
一括取り込み + 検索可能化 (Elasticsearch)
1 2 3 4 5 6 7 8 9 10 11 | # bulk API でログを Elasticsearch に取り込む最小例 from elasticsearch import Elasticsearch, helpers import json es = Elasticsearch('http://localhost:9200') def actions(): with open('data/raw/access_log.jsonl') as f: for line in f: ev = json.loads(line) yield {'_op_type':'index','_index':'logs-2026-05','_source':ev} helpers.bulk(es, actions(), chunk_size=2000) print('done') |
正規表現でレガシーログを構造化
1 2 3 4 5 6 7 8 9 10 11 12 | # combined log を pandas でパース import pandas as pd, re pat = re.compile(r'(?P<ip>\S+) \S+ \S+ \[(?P<ts>[^\]]+)\] "(?P<method>\S+) (?P<url>\S+)[^"]*" (?P<status>\d+) (?P<size>\d+) "[^"]*" "(?P<ua>[^"]*)"') rows = [] with open('data/raw/access.log') as f: for line in f: m = pat.match(line) if m: rows.append(m.groupdict()) df = pd.DataFrame(rows) df['ts'] = pd.to_datetime(df['ts'], format='%d/%b/%Y:%H:%M:%S %z', utc=True).dt.tz_convert('Asia/Tokyo') df['status'] = df['status'].astype(int) print(df.head()) |
テンプレート抽出 (Drain 風の簡易版)
1 2 3 4 5 6 7 8 9 10 11 | # テンプレート抽出により異なる値を <*> に置換 import re def to_template(msg): # 数値 → <NUM>, 16 進 → <HEX>, IP → <IP> t = re.sub(r'\b\d+\.\d+\.\d+\.\d+\b', '<IP>', msg) t = re.sub(r'\b[0-9a-fA-F]{8,}\b', '<HEX>', t) t = re.sub(r'\b\d+\b', '<NUM>', t) return t samples = ['User 1234 logged in from 10.0.0.5', 'User 5678 logged in from 192.168.1.10'] for s in samples: print(s, '->', to_template(s)) |
💬 ユーザー番号も接続元 IP も違う 2 行が、どちらも「User <NUM> logged in from <IP>」という同じテンプレートにまとまった。IP の置換を数値より先に行っているので、10.0.0.5 が <NUM>.<NUM>.<NUM>.<NUM> に崩れずに済んでいる。<HEX> は 8 桁以上の 16 進だけが対象で、4 桁の 1234 は数値として扱われたが、ID が 8 桁以上の数字だと <HEX> に吸われるので、順序と桁数の条件は実際のログで確かめる。
🏁 最終結論:ログデータ を一言で
ログデータは「システムの記憶」だ。 適切に記録すれば過去の障害を再現でき、 性能劣化を予兆できる。 だが「とりあえず print して保存」では、 量と質の両面で破綻する。 本ページで学んだ (i) 構造化、 (ii) 時刻・タイムゾーン管理、 (iii) trace_id による横断追跡、 (iv) 保存期間ポリシー、 (v) PII マスキングの 5 原則を最初から組み込んでおけば、 3 年後にも価値あるログ基盤になる。 OpenTelemetry の流れに乗ることで、 「ベンダー固有の罠」から自由になれるのも 2026 年現在の大きな福音。
🔗 隣接手法への橋渡し
ログデータは生イベントの蓄積であり、 前段の収集設計と後段の集計・異常検知・可視化を組み合わせて運用知見が引き出せる。
- 上流: 前段の収集設計・スキーマ定義 (行動ログ、 データ収集)
- 並列: 並列のログ管理基盤 (Elasticsearch・Splunk) と比較・併用
- 下流: 下流の集計・異常検知・ダッシュボード (外れ値検出、 時系列の集計)
上流のログ収集基盤 (Fluentd/Logstash) がデータ品質を決め、 並列の Web ログ/アプリログ/IoT センサーログでスキーマを統一し、 下流の異常検知・離脱分析・A/B テストで行動データから示唆を抽出する流れで「ログ駆動意思決定」が完結する。
🌳 手法選択フロー
ログデータ を実際の課題に当てはめるとき、 用語固有の判断軸に沿って次の 3 段階で適切な選択を行う。
- ログ規模は GB/日 以下か? Yes → 単一ファイル + Pandas、 No → 分散基盤 (Kafka + Spark/Hadoop)
- リアルタイム集計が必要か? Yes → Kafka Streams / Apache Flink、 No → 次へ
- 長期保管・分析用途か? Yes → BigQuery/Redshift 等の DWH、 No → ファイル + cron 集計で十分
このフローはログ基盤設計の典型判断軸。 規模・リアルタイム性・保管期間で「リアルタイム処理 + DWH 集約」のラムダアーキテクチャかバッチのみかが分かれる。