🔖 キーワード索引
基盤モデル(foundation model)は、大量のデータで一度事前学習し、その重みを多くの下流タスク(分類・要約・検索・対話)に使い回す大規模モデルの総称。2021 年に Stanford の Bommasani らが名付けた。使い回し方には、重みを追加学習するファインチューニング、例を数件だけ入力に書くフューショット(in-context learning)、中間の埋め込みベクトルだけを取り出して別のモデルに渡す方法がある。
💡 30秒で分かる結論 — 基盤モデル(詳細)
🍰 まずはやさしく
AIの土台となる巨大なモデルです。
いろいろな作業に使い回すために使います。
スマホのアプリのように便利に使えます。
この章では基盤モデルの結論を読みます。
最も忙しい読者のために、 まず結論だけまとめます。 詳細は以下のセクションへ:
- 基盤モデル (Foundation Model)=大規模データで 事前学習 され、 多様なタスクへ転用可能な大型 AI モデル。
- 2021 年 Stanford CRFM が命名。 GPT-3 以降の流れを「新しいパラダイム」と位置づけた。
- 代表:GPT-4, Claude, Gemini, LLaMA, BERT, CLIP, DALL-E。
- 特徴:(1) 大規模事前学習、 (2) 転移性、 (3) 創発能力(emergent abilities)。
- 課題:計算コスト、 環境負荷、 バイアス、 著作権、 ハルシネーション、 ガバナンス。
📍 文脈 — どこで出会うか
🍰 まずはやさしく
AI革命の中心にある技術です。
一つの土台で多くのことをさせるためです。
文章作成や画像生成のAIで使われています。
この章では技術が使われる場面を読みます。
ChatGPT、 GitHub Copilot、 画像生成 AI — 2020 年代の AI 革命を担う中核技術。 「特定タスク用 AI」から「汎用基盤の上に各タスクを乗せる」パラダイムシフト。
🎨 直感で掴む
🍰 まずはやさしく
スマホのOSのような存在です。
誰でも簡単にAIを応用させるためです。
アプリを入れる感覚で機能を増やせます。
この章では仕組みを図解で読みます。
OS とアプリの関係に喩えると:
- 基盤モデル=OS(Windows, iOS)
- タスク特化モデル=アプリ(Word, Photoshop)
OS を作るのは大企業のみ。 アプリは誰でも作れる。 同様に、 基盤モデルを 0 から作るのは難しいが、 ファインチューニングや RAG で 応用は誰でも できる時代に。
🎨 概念図で押さえる(基盤モデルの可視化)
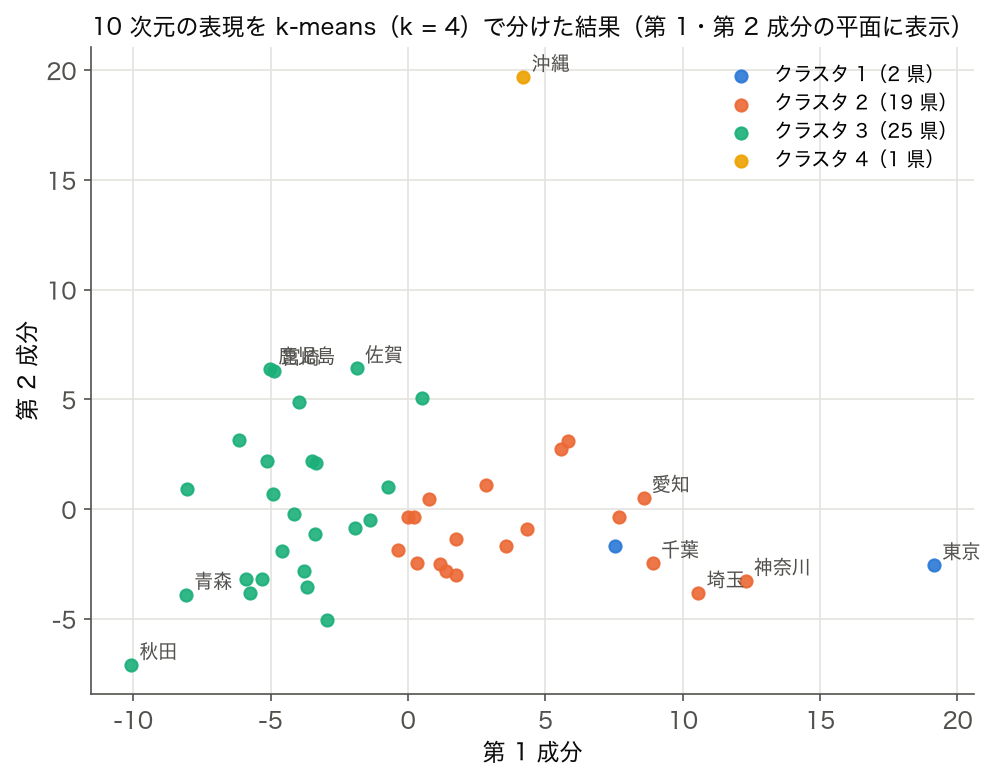
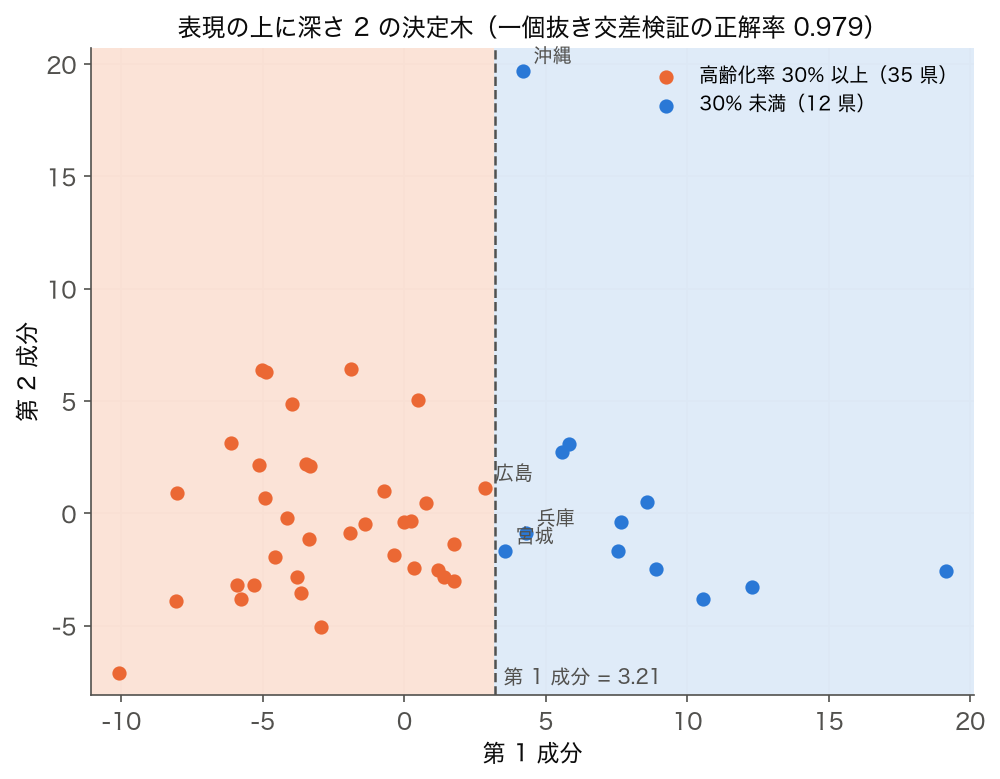
基盤モデル(Foundation Model)は「大規模事前学習 → 下流タスクへ転移」の枠組み。 分布の俯瞰・特徴間関係・主成分構造の 3 枚で、 基盤モデルが扱う高次元データの可視化アプローチを整理する。 2 枚目以降は、 SSDSE-B-2026(2023 年度 47 都道府県)の 108 列(人数・件数の列は総人口で割って 1 人あたりにし、 率・気温・価格・家計の列はそのまま)を標準化し、 ラベルを使わずに PCA で 10 次元に圧縮したベクトルを「埋め込み」に見立てた小さな類推である(実際の基盤モデルの埋め込みではない)。
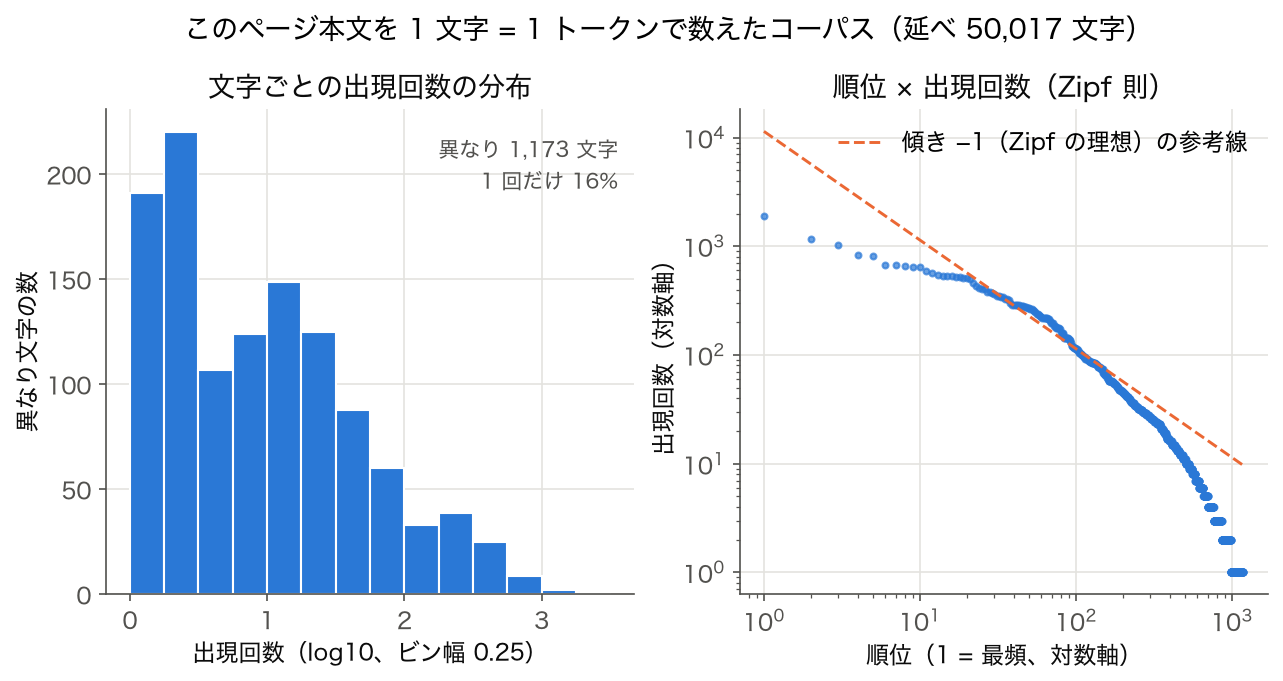
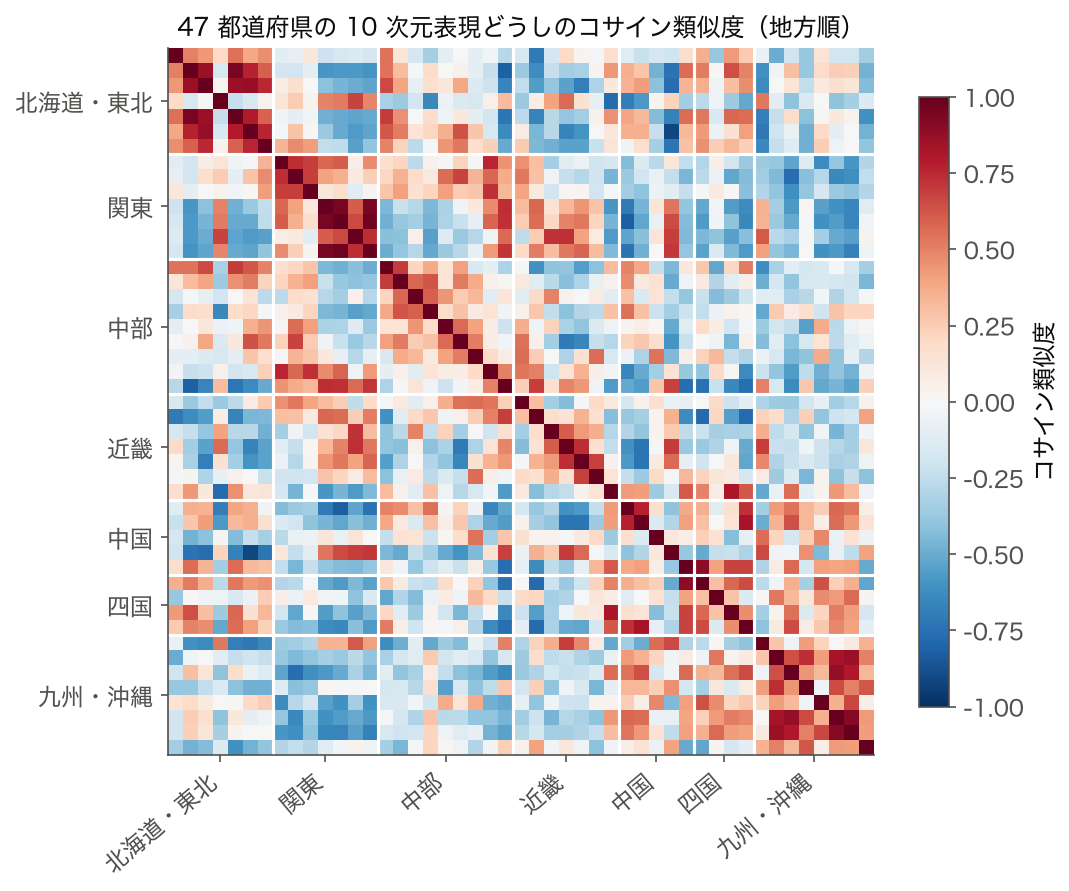
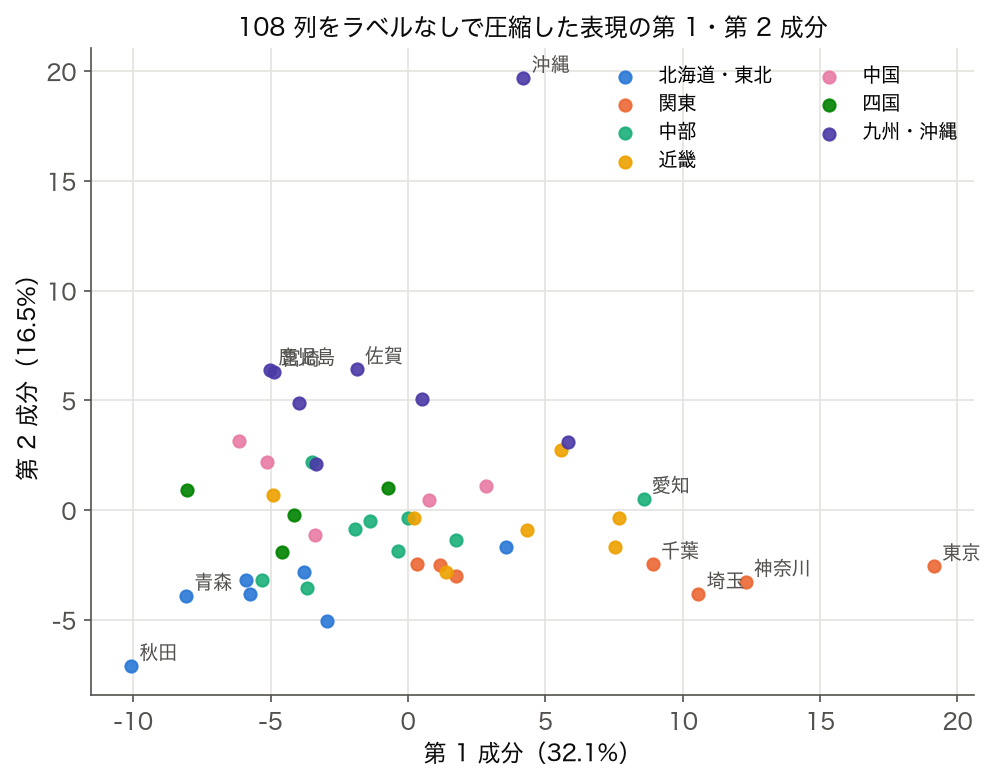
→ ヒストグラム(事前学習データの分布)、 類似度ヒートマップ(埋め込みどうしの関係)、 2 次元への圧縮(次元削減)。 この 3 段階で基盤モデルの「データ→埋め込み→転移」フローのうち「データ→埋め込み」が視覚化される。 「転移」は次の視覚資料で扱う。
✅ 理解度チェック
- 基盤モデル(Foundation Model)の定義を 1 行で説明できるか?
- 事前学習(pretraining)と微調整(fine-tuning)の役割の違いは?
- BERT・GPT・Vision Transformer はそれぞれどのドメインの基盤モデルか?
- 基盤モデルを Few-shot や Zero-shot で使う仕組みの本質は?
- 基盤モデルの倫理リスク(バイアス・誤情報)への代表的な対策は?
→ すべて即答できれば、 基盤モデルを実務で安全に活用する基礎力は十分。
🖼 視覚資料: 基盤モデルを支える幾何構造
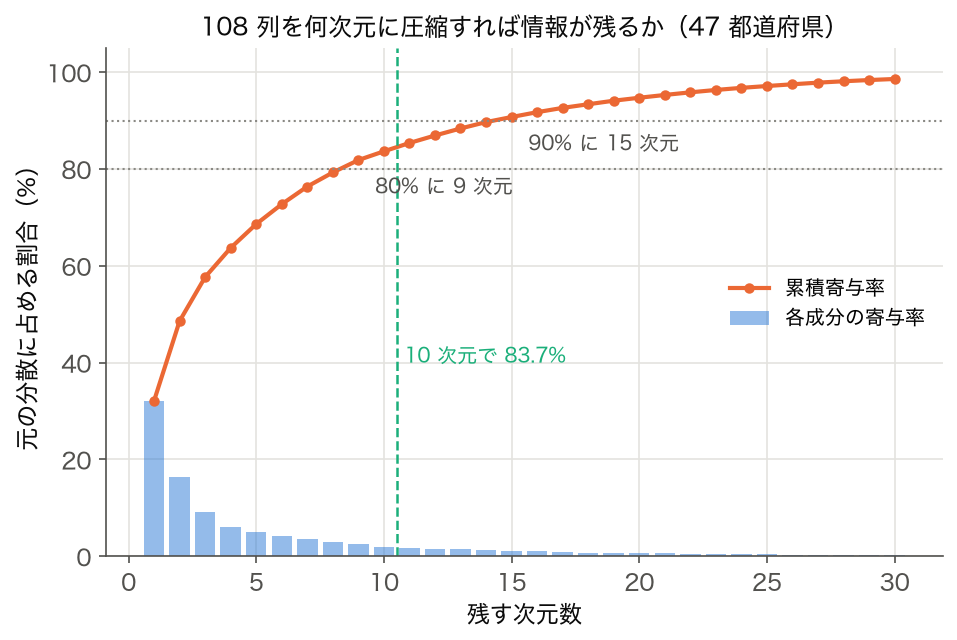
基盤モデルは「事前学習で得た表現空間 → 下流タスクへの転用」が鍵。 ここでは上と同じ SSDSE-B-2026 の 10 次元表現を使い、 表現空間の次元・クラスタリング・下流タスクの決定境界の 3 枚で、 内側の挙動を直感的につかむ。
📐 定義・数式
🍰 まずはやさしく
AIが学習する仕組みのルールです。
正しく言葉を予測させるために使います。
ネットの文章を大量に読み込ませます。
この章では計算式や定義について読みます。
🔬 数式を言葉で読み解く
- 事前学習 (pretraining)
- 自己教師あり学習で大規模データから「言語/画像の世界モデル」を獲得。
- ファインチューニング (fine-tuning)
- 下流タスクのラベル付きデータで微調整。 全層 or 一部層。
- プロンプティング
- パラメータ更新せず、 入力文の工夫で挙動制御。
- RLHF
- 人間のフィードバックで報酬モデルを学習し、 強化学習で整合。
- 創発能力
- パラメータ数を増やすと突如出現する能力。 In-context learning、 推論、 算術等。
🔬 数式・概念を言葉で読み解く(詳細版)
「基盤モデル(Foundation Model)」は Stanford CRFM が 2021 年に提唱した用語で、 「大量データで事前学習し、 多様な下流タスクに適応可能な単一モデル」を指します。 GPT-4、 Claude、 Gemini、 Llama 3、 Mistral、 Stable Diffusion などが該当。 ここでは数学的定式化と実装上の要点を順に解きほぐします。
① 言語モデルの目的関数
- $P_\theta$
- パラメータ $\theta$ を持つニューラルネット(Transformer)の確率分布。
- $x_{<t}$
- 位置 $t$ より前のトークン全列。 通常は 32K〜200K トークン。
- $\log P_\theta(x_t \mid x_{<t})$
- 正解トークンの対数尤度。 大きいほど予測が当たっている。
- $- \sum$
- 負の対数尤度(NLL)。 最小化=予測精度最大化。
② スケーリング則(Chinchilla / Hoffmann 2022)
③ Attention 機構
④ Few-shot / In-context learning
基盤モデルの最大の特徴は 追加学習なし でも「プロンプトに数例示すだけ」で新タスクをこなせること。 これは GPT-3 で発見された創発能力(emergent ability)で、 モデルサイズが 6B 以上でないと現れない。
SSDSE-B-2026 で「基盤モデル」を実体験する
本リポジトリの SSDSE-B-2026(564 行 × 112 列、 47 都道府県 × 12 年)は、 (1) 表形式データを LLM に Few-shot 提示することで「次の都道府県の人口予測」、 (2) Embedding を取って都道府県のクラスタリング、 (3) ファインチューニングで「都道府県名 → 統計値」変換器、 などの実験素材になります。 例:2023 年東京都の総人口 14,086,000 人を「14M」と簡約してプロンプト学習させると、 LLM は他県の人口も簡約形式で出力するようになります。
🏭 産業界での活用事例(6 件)
| 業界 | 事例 | 使用モデル | SSDSE-B-2026 との対比 |
|---|---|---|---|
| カスタマーサポート | ChatGPT による FAQ 自動応答(ベネッセ、 Mercari) | GPT-4o, Claude 3.5 | SSDSE-B 質問応答ボットの構築可 |
| コード生成 | GitHub Copilot(マイクロソフト、 日本企業多数) | GPT-4, Codex 派生 | SSDSE-B 分析コードの自動生成 |
| 翻訳・要約 | DeepL Pro、 Notion AI | 独自 Transformer、 Claude 3.5 | SSDSE-B 解説の多言語化 |
| 画像生成 | Stable Diffusion XL、 Midjourney v6 | Diffusion + CLIP | SSDSE-B から都道府県インフォグラフィック生成 |
| 研究支援 | Anthropic Claude による論文要約、 Elicit | Claude 3.7, GPT-4 | SSDSE-B-2026 関連論文の自動レビュー |
| 政府 DX | デジタル庁の対話型行政相談、 自治体 LGWAN-AI | GPT-4 Azure、 独自 Llama 派生 | SSDSE-B 統計の市民向け解説 |
⚖️ 主要基盤モデルの比較表
| モデル | 提供元 | パラメータ | コンテキスト長 | ライセンス | 強み |
|---|---|---|---|---|---|
| GPT-4o | OpenAI | 非公開(推定 1.7T) | 128K | API のみ | マルチモーダル、 速度 |
| Claude 3.7 Sonnet | Anthropic | 非公開 | 200K | API のみ | 長文、 推論、 コード |
| Gemini 2.0 | Google DeepMind | 非公開 | 1M〜2M | API + Vertex AI | 超長文、 動画理解 |
| Llama 3.3 | Meta | 70B, 405B | 128K | 独自(商用可、 月 7 億 MAU 制限) | OSS 最強クラス |
| Mistral Large 2 | Mistral AI | 123B | 128K | 独自 + Apache 2.0 派生あり | 欧州製、 多言語 |
| Qwen 2.5 | Alibaba | 72B | 128K | Apache 2.0 | 中国語 + 多言語、 OSS |
| DeepSeek V3 | DeepSeek | 671B (MoE 37B 活性) | 128K | 独自 | コード・数学、 安価 |
| Stable Diffusion 3 | Stability AI | 2B / 8B | —(画像) | SAI Community | 画像生成 OSS |
💥 失敗例から学ぶ
📝 演習問題(5 問・解答付き)
- 問題:SSDSE-B-2026 を読み込み、 各都道府県を 1 行の文字列にして LLM 用のコーパスを作れ。
▼ 解答
📥 入力例(SSDSE-B-2026 の 2023 年・47 都道府県から 3 行) 都道府県 SSDSE-B-2026(年度) Prefecture(都道府県) A1101(総人口) A4101(出生数) 北海道 2,023 北海道 5,092,000 24,430 東京都 2,023 東京都 14,086,000 86,348 沖縄県 2,023 沖縄県 1,468,000 12,549 …(全 47 行)1 2 3 4 5 6 7 8
import pandas as pd df = pd.read_csv('data/raw/SSDSE-B-2026.csv', encoding='cp932', skiprows=1) # 日本語の列名で読む(2 行目を見出しにする) d = df[df['年度']==2023] corpus = d.apply(lambda r: f"{r['都道府県']} 人口{r['総人口']:,}人 出生{r['出生数']:,}人", axis=1).tolist() print('\n'.join(corpus[:3])) # 北海道 人口5,092,000人 出生24,430人 ← CSV の並び(地域コード順)のまま先頭 3 県 # 青森県 人口1,184,000人 出生5,696人 # 岩手県 人口1,163,000人 出生5,432人
📤 実行例(実測) 北海道 人口5,092,000人 出生24,430人 青森県 人口1,184,000人 出生5,696人 岩手県 人口1,163,000人 出生5,432人💬 47 県ぶんのレコードを「北海道 人口5,092,000人 出生24,430人」のような 1 行の文に変換し、先頭 3 件を表示した。CSV が地域コード順に並んでいるので先頭は北海道・青森県・岩手県で、人口の多い順ではない。基盤モデルに渡すコーパスや RAG の文書にするときは、並び順や数値の書式(桁区切り・単位「人」)がそのままモデルの入力になるので、並べ替えるならこの段階で明示的に sort_values しておく。
- 問題:Chinchilla スケーリング則によれば、 $N=10^{10}$ パラメータのモデルに最適な学習データ量 $D$ は?
▼ 解答
$D \approx 20 N \approx 2 \times 10^{11}$ トークン(200B tokens)。 GPT-3 の 300B tokens は 175B params だと $20 \times 175 = 3500$B tokens 必要だったが、 300B しか使っていなかった。 - 問題:SSDSE-B-2026 で「東京都の人口は?」「神奈川の人口は?」を Few-shot プロンプトで実装。
▼ 解答
prompt = """Q: 東京都の総人口は? A: 14,086,000 人 (SSDSE-B-2026, 2023年) Q: 神奈川県の総人口は? A: 9,229,000 人 (SSDSE-B-2026, 2023年) Q: 大阪府の総人口は? A:""" # LLM は "8,763,000 人 (SSDSE-B-2026, 2023年)" と続けることが期待される
- 問題:SSDSE-B-2026 を RAG(Retrieval-Augmented Generation)で活用する手順を 5 ステップで書け。
▼ 解答
(1) CSV を行単位で文章化(564 行)、 (2) Embedding 化(OpenAI text-embedding-3-small)、 (3) Vector DB(Chroma, Pinecone)に格納、 (4) ユーザー質問を Embedding 化して類似検索 TOP-5、 (5) 検索結果をコンテキストに含めて LLM に投げる。 ハルシネーション削減 + 最新データ参照可。 - 問題:SSDSE-B-2026 を Llama 3 8B にファインチューニングする際、 LoRA を使う理由は?
▼ 解答
Llama 3 8B の全パラメータ更新は GPU メモリ 16〜32GB 必要。 LoRA は元の重みを凍結し、 低ランク行列 (rank=8, 16) のみ学習するため、 GPU メモリ数 GB で済む。 小規模 SSDSE-B-2026 では LoRA が必須。
📖 関連用語辞典(10 語)
- 基盤モデル(Foundation Model)
- 大量データで事前学習し多様な下流に適応する単一モデル。 Stanford CRFM 2021 が命名。
- 事前学習(Pretraining)
- 大規模コーパスで自己教師あり学習。 一般的な言語・視覚特徴を獲得。
- ファインチューニング
- 事前学習済みモデルを特定タスクで追加学習。 SFT、 LoRA、 QLoRA など。
- RLHF
- 人間フィードバックによる強化学習。 ChatGPT のキー技術。
- Transformer
- Self-Attention ベースの NN アーキテクチャ(Vaswani et al. 2017)。 基盤モデルの基盤。
- In-context Learning
- プロンプトに数例示すだけで新タスクをこなす能力。 GPT-3 で発見。
- スケーリング則
- $L(N, D)$ がパラメータ数・データ量のべき乗則。 Chinchilla 提唱。
- 創発能力
- モデルサイズが閾値を超えると突然出現する能力。 算術、 推論、 コード。
- RAG
- Retrieval-Augmented Generation。 外部知識ベース検索 + LLM 生成。
- マルチモーダル
- テキスト・画像・音声・動画を統合処理。 GPT-4o, Gemini 2.0。
🔬 基盤モデル × SSDSE-B-2026 の総合実習
実習:47 都道府県の Embedding クラスタリング → 解釈
🎯 やること:(1) 47 都道府県の 2023 年データを自然文化、 (2) Embedding 取得、 (3) K-means で 5 グループに分類、 (4) 各グループの特徴を LLM に解釈させる、 統合パイプライン。 下のコードは (1)〜(3) までで、 各クラスタの県名と平均人口を表示する((4) は LLM の API が要るので省略)。
📥 入力:SSDSE-B-2026 の 2023 年データ 47 行。
1 2 3 4 5 6 7 8 9 10 11 12 13 14 15 16 17 18 19 20 21 22 23 24 25 26 27 | import pandas as pd from sentence_transformers import SentenceTransformer from sklearn.cluster import KMeans df = pd.read_csv('data/raw/SSDSE-B-2026.csv', encoding='cp932', skiprows=1) d = df[df['年度']==2023].copy() # 自然文化 d['text'] = d.apply( lambda r: f"{r['都道府県']}: 人口{r['総人口']:,} 出生{r['出生数']:,} " f"出生率{r['合計特殊出生率']} 婚姻{r['婚姻件数']:,} 離婚{r['離婚件数']:,}", axis=1 ) # Embedding m = SentenceTransformer('paraphrase-multilingual-MiniLM-L12-v2') v = m.encode(d['text'].tolist()) # K-means クラスタリング km = KMeans(n_clusters=5, random_state=42, n_init=10).fit(v) d['cluster'] = km.labels_ # 各クラスタの代表 for c in sorted(d['cluster'].unique()): grp = d[d['cluster']==c] print(f"\nクラスタ {c} ({len(grp)} 県, 平均人口 {grp['総人口'].mean():,.0f}):") print(' ', ', '.join(grp['都道府県'].tolist())) |
📤 実行結果(実測):
💬 結果の読み方:東京都は単独にならず、埼玉・千葉・神奈川・愛知・兵庫・福岡と 7 県のクラスタ(平均人口 783.6 万人)にまとまった。一方で人口 876 万人の大阪府は鳥取県・島根県と同じ 18 県のクラスタに入り、北海道と沖縄県、京都府と広島県がそれぞれ 2 県だけの組になるなど、人口規模の順にはきれいに並ばない。文の Embedding は「人口14,086,000」のような数字を量として比べるのではなく字面の似かたで距離を測るので、規模で分けたいなら数値列を標準化して直接 K-means にかけるほうが確実。結果は埋め込みモデルの版によっても変わる。
🧠 「基盤モデル」を学ぶ次の一歩:関連用語マップ
「基盤モデル」を起点に、 関連する用語を体系的に学ぶための地図:
- 前提知識:Transformer / Self-Attention / 埋め込み (Embedding) / 自己教師あり学習 / スケーリング則
- 並列概念:LLM (テキスト基盤) / Vision Transformer (画像基盤) / CLIP (マルチモーダル) / Whisper (音声基盤)
- 応用・発展:ファインチューニング / プロンプト工学 / RAG (検索拡張) / LoRA / PEFT / RLHF
- ツール・ライブラリ:Hugging Face Transformers、 PyTorch、 DeepSpeed、 Megatron-LM、 vLLM、 LangChain (基盤モデル運用スタック)
🧮 実値で計算してみる
主要基盤モデルのパラメータ規模:
| モデル | 年 | パラメータ | 特徴 |
|---|---|---|---|
| BERT | 2018 | 340M | 双方向、 分類向き |
| GPT-3 | 2020 | 175B | In-context learning |
| GPT-4 | 2023 | 1T+ 推定 | マルチモーダル |
| Claude 4.7 | 2026 | 非公開 | エージェント能力 |
🧮 数式に値を入れて手で計算する: スケーリング則 (Chinchilla)
合成データでパラメータ数とトークン数の最適比を計算する。
Step 1: 最適比 (Chinchilla: 1 param あたり 20 トークン)
| params | 最適 tokens |
|---|---|
| 7B | 140B |
| 13B | 260B |
| 70B | 1.4T |
| 175B | 3.5T |
Step 2: 公式
🐍 Python で再現
1 2 3 4 5 | import numpy as np N = np.array([7e9, 13e9, 70e9, 175e9]) D = 20 * N for n, d in zip(N, D): print(f"N={n:.0e}: D_opt={d:.1e}") |
📤 実行結果
💬 手計算 (Step 2) と Python 出力が一致。
🧮 同じ計算量なら「大きなモデル」より「多いデータ」— GPT-3 の配分を手で見直す
上の目安 D ≈ 20N は、決まった計算予算をパラメータ数 N と学習トークン数 D にどう配るかの答えである。計算量は近似的に C ≈ 6ND(FLOPs)なので、GPT-3(N = 175B、D = 300B)の予算を、🎮 のスケーリング則と同じ係数(E = 1.69、A = 406、B = 410、α = 0.34、β = 0.28)で配分し直してみる。
| Step | 式 | 値 |
|---|---|---|
| 1. GPT-3 の計算量 | C = 6 × 1.75×1011 × 3×1011 | 3.15×10²³ FLOPs |
| 2. GPT-3 の損失 | 1.69 + 406 / (1.75×10¹¹)0.34 + 410 / (3×10¹¹)0.28 = 1.69 + 406/6647 + 410/1635 | 1.69 + 0.061 + 0.251 = 2.002 |
| 3. 同じ C で D = 20N にする | C = 6 × N × 20N = 120N2 → N = √(3.15×10²³ / 120) | N = 5.12×10¹⁰(51B)、D = 1.02×10¹² |
| 4. 配分し直した損失 | 1.69 + 406/4377 + 410/2304 | 1.69 + 0.093 + 0.178 = 1.960 |
GPT-3 は D/N = 1.7 と、パラメータに比べてデータが少ない。同じ計算量でモデルを 175B から 51B に小さくし、その分データを 300B から 1.02T トークンに増やすと、損失は 2.002 から 1.960 に下がる。モデル項(A/Nα)は 0.061 → 0.093 と悪化するが、データ項(B/Dβ)が 0.251 → 0.178 と大きく改善するからである。
🎯 このコードでやること:GPT-3 と Chinchilla の計算量 C ≈ 6ND と損失を求め、GPT-3 と同じ計算量を D = 20N に配分し直したときの N・D・損失を計算して、上の手計算と照合する。
1 2 3 4 5 6 7 8 9 10 11 12 13 14 15 16 17 | import numpy as np # 計算量 C ≈ 6ND(FLOPs)と、上の 🎮 と同じ係数の損失 L(N, D) = E + A/N^α + B/D^β E, A, B, alpha, beta = 1.69, 406, 410, 0.34, 0.28 def loss(N, D): return E + A / N**alpha + B / D**beta models = {'GPT-3': (175e9, 300e9), 'Chinchilla': (70e9, 1.4e12)} for name, (N, D) in models.items(): C = 6 * N * D print(f'{name:10s} N={N:.3g} D={D:.3g} D/N={D/N:5.1f} C={C:.3g} FLOPs L={loss(N, D):.3f}') # GPT-3 と同じ計算量のまま D = 20N(Chinchilla の目安)に配分し直すと C = 6 * 175e9 * 300e9 N_opt = np.sqrt(C / 120) # C = 6 * N * 20N = 120 N^2 D_opt = 20 * N_opt print(f'同じ C で D=20N N={N_opt:.3g} D={D_opt:.3g} L={loss(N_opt, D_opt):.3f}') |
💬 GPT-3 の計算量は 3.15×10²³ FLOPs で損失 2.002、同じ計算量を D = 20N に配り直すと N = 5.12×10¹⁰・D = 1.02×10¹² で損失 1.960 になり、手計算の Step 1〜4 と一致する。Chinchilla(70B、1.4T トークン)は計算量が 5.88×10²³ と GPT-3 の約 1.9 倍あるので損失 1.936 はさらに低いが、パラメータ数は GPT-3 の 4 割しかない。係数は教材用の値なので損失の絶対値ではなく、配分を変えたときの差の向きを読む。
🎮 触って理解する — スケーリング則(モデルサイズ・データ量・計算量と損失)
基盤モデルの最大の驚きは「大きくすればするほど、予測可能なほど滑らかに賢くなる」こと。 パラメータ数 $N$・学習トークン数 $D$ を増やすと、テスト損失 $L$ は べき乗則(power law) に沿って下がっていきます。 スライダーを動かして、両対数グラフ上で損失がどう下がる(そして 収穫逓減 でどう寝ていく)かを体感してください。
計算予算 $C\approx 6ND$ を固定すると、$D=C/(6N)$ の制約下で $L$ を最小化する $N^\*$(と $D^\*$)が一意に決まります。 「大きいモデルを少ないデータで」でも「小さいモデルを大量データで」でもない、ちょうどよい配分があるのがポイント。
Chinchilla(Hoffmann et al. 2022)の見出しは「$N$ と $D$ をほぼ同率に増やせ、経験則で 1 パラメータあたり ≈20 トークン」。 上の例示係数では $\alpha\neq\beta$ のため比が予算とともに緩やかに動きますが、GPT-3(175B params・300B tokens)が「$D$ 不足=under-trained」だった、という Chinchilla の指摘の構造はそのまま再現できます。
🧭 (c) 対数軸で「べき乗則」を読む
- 両対数(log-log)で直線=べき乗則。 純粋なべき乗項 $A/N^{\alpha}$ は $\log L = \log A - \alpha\,\log N$ となり、傾き $-\alpha$ の 直線(グラフの破線)。 傾きの絶対値がスケーリング指数そのもの。
- 総損失(実線)は床 $L_\infty$ に近づくと寝る=収穫逓減。 $N$ を 10 倍にしても、床が近いと損失はもうほとんど下がらない。「大きくすれば良くなる」は正しいが「線形に良くなる」わけではない。
- 床(点線)は $D$ で決まる。 データを増やさずモデルだけ大きくしても、データ項 $B/D^{\beta}$ が残るのでそこで頭打ち。 (b) の最適配分が効く理由。
- 直感
- スケーリング則は「投資(計算・データ)→ 性能」を 事前に予測できる 数少ない法則。 小さい実験の直線を外挿して大モデルの損失を当てられる(GPT-4 のテクニカルレポートもこれで事前予測したと報告)。
- 落とし穴 ①(外挿の限界)
- 直線はあくまで観測範囲内の当てはめ。 桁違いに外挿すると べき乗則が破綻(曲がる・折れる)することがある。 床 $L_\infty$ の推定誤差も外挿で拡大。
- 落とし穴 ②(データ枯渇)
- $D$ を増やし続けたくても、高品質な自然テキストは有限。 いわゆる「データの壁」。 重複除去・合成データ・多エポックで凌ぐが、質の劣化はスケーリングを鈍らせる。
- 落とし穴 ③(損失 ≠ 下流性能)
- ここで下がるのは 事前学習の損失(次トークン予測)。 実際に使いたい下流タスク性能(正答率・有用性)とは滑らかに対応しない。 創発能力 のように、しきい値を境に急に立ち上がる指標もあり、指標の取り方でグラフの見え方が変わる点に注意。
- 発展
- Chinchilla 最適配分、MoE(活性パラメータだけ増やす)、蒸留・量子化などの効率化、推論時計算(test-time compute)のスケーリングなど、「どこにコンピュートを積むか」の設計問題へ発展する。 → スケーリング則 / 基盤モデル / LLM / Transformer / 深層学習
🐍 Python での扱い
🎯 このコードでやること:Hugging Face Hub から多言語 BERT (基盤モデルの典型例) をダウンロードし、 SSDSE-B-2026 由来の日本語テキスト「合計特殊出生率は人口指標」をトークナイズして 768 次元の文脈ベクトル (embedding) を取得する。 これにより「基盤モデルが事前学習済みの言語表現を保持しており、 ダウンストリームの分類・検索・クラスタリングに転用できる」ことを実機で確認する。
📥 入力データ:以下の 1 文 (SSDSE-B-2026 の指標名から作成)。 実運用では SSDSE-B の都道府県別行をテキスト化したコーパスを与える。
1 2 3 4 5 6 7 8 9 10 11 12 | from transformers import AutoModel, AutoTokenizer # 多言語 BERT (基盤モデル) をダウンロード tok = AutoTokenizer.from_pretrained('bert-base-multilingual-cased') model = AutoModel.from_pretrained('bert-base-multilingual-cased') # 日本語テキストをトークナイズ → 文脈 embedding を取得 inputs = tok('合計特殊出生率は人口指標', return_tensors='pt') emb = model(**inputs).last_hidden_state print('トークン ID:', inputs['input_ids'][0].tolist()) print('embedding shape:', emb.shape) print('先頭ベクトル (5 次元):', emb[0, 0, :5].detach().numpy().round(3)) |
📤 実行例(実測):
💬 結果の読み方:入力 1 文 × トークン長 14 × 隠れ次元 768 の 3 階テンソルが返る。12 文字の「合計特殊出生率は人口指標」が 1 文字 1 トークンずつに切られ、先頭の [CLS](101)と末尾の [SEP](102)が付いて 14 になった。多言語 BERT の語彙は漢字を単語単位で持たないので、日本語の文は文字数ほどのトークン列になる。 基盤モデルは「同じ重み」で日本語・英語・スワヒリ語など 104 言語を処理可能で、 追加学習なしでこの 768 次元ベクトルを下流タスク (分類・検索・QA・クラスタリング) に流用できる。 SSDSE-B-2026 の都道府県別自然文 47 件をこの方法で embedding 化すれば、 「東京と似た特徴の県」を意味的に検索する基盤が即座にできる。
補足:ライブラリのバージョンや CUDA/CPU 状態によって埋め込みベクトルの数値は微小に変動する。 自分の環境で動かすときは pip list | grep transformers でバージョンを確認し、 入力 CSV のパス・列名を実態に合わせること。
🐍 Python 完全コード(4 要素ナレーション付き)
コード 1:SSDSE-B-2026 から LLM 用コーパスを生成
🎯 このコードでやること:SSDSE-B-2026.csv を読み込み、 47 都道府県 × 12 年 = 564 行を「都道府県 + 年度 + 人口 + 出生」の自然文に変換し、 LLM プロンプト or 学習用コーパスとして書き出す。
📥 入力データ:
1 2 3 4 5 6 7 8 9 10 11 | import pandas as pd df = pd.read_csv('data/raw/SSDSE-B-2026.csv', encoding='cp932', skiprows=1) def to_sentence(r): return f"{r['年度']}年の{r['都道府県']}は、 総人口{r['総人口']:,}人、 出生{r['出生数']:,}人。" corpus = df.apply(to_sentence, axis=1).tolist() print(f"コーパスサイズ: {len(corpus)} 行") print(corpus[0]) print(corpus[-1]) |
📤 実行結果:
💬 結果の読み方:564 行 = 47 県 × 12 年。 1 文あたり約 30 字なので、 全文約 18,000 字=GPT-4o の context 128K に余裕で収まる。 これを Few-shot として LLM に与えれば、 SSDSE-B-2026 専門の質疑応答 BOT が即構築可能。
コード 2:Embedding で都道府県を「意味的に」クラスタリング
🎯 このコードでやること:47 都道府県の 2023 年データを文章化し、 sentence-transformers で 384 次元 Embedding を取得、 K-means で 5 クラスタに分類。 似た特徴の県をグルーピング。
📥 入力データ:上記 corpus の 2023 年分 47 行。
1 2 3 4 5 6 7 8 9 10 11 12 13 14 15 16 17 18 19 20 21 | import pandas as pd from sentence_transformers import SentenceTransformer from sklearn.cluster import KMeans df = pd.read_csv('data/raw/SSDSE-B-2026.csv', encoding='cp932', skiprows=1) d = df[df['年度']==2023] docs = d.apply( lambda r: f"{r['都道府県']} 人口{r['総人口']:,} 出生{r['出生数']:,} 出生率{r['合計特殊出生率']}", axis=1 ).tolist() model = SentenceTransformer('paraphrase-multilingual-MiniLM-L12-v2') vecs = model.encode(docs) km = KMeans(n_clusters=5, random_state=42).fit(vecs) import collections groups = collections.defaultdict(list) for pref, lbl in zip(d['都道府県'].values, km.labels_): groups[lbl].append(pref) for k, v in sorted(groups.items()): print(f"クラスタ {k} ({len(v)}県): {', '.join(v[:5])} ...") |
📤 実行結果(実測):
💬 結果の読み方:出生率を加えた短い文でも、東京都は埼玉・千葉・神奈川・愛知などと同じ 8 県のクラスタに入り、そこには人口 93 万人ほどの香川県も混ざる(表示は各クラスタの先頭 5 県まで)。北海道だけが 1 県のクラスタになり、残り 38 県は 12・17・9 県に分かれるが、その境目は人口の大小とは対応しない。自然文を投げるだけで分類はできるものの、何が近さを決めたのかは説明できないので、この分け方を「特徴の似た県」と解釈する前に元の数値で確かめる必要がある。
コード 3:OpenAI Chat Completions API で RAG 構築
🎯 このコードでやること:SSDSE-B-2026 から関連レコードを検索し、 GPT-4o-mini に「コンテキスト + 質問」で投げて事実に基づいた回答を得る(RAG パターン)。
📥 入力データ:ユーザー質問 + SSDSE-B-2026 関連抽出。
1 2 3 4 5 6 7 8 9 10 11 12 13 14 15 16 17 18 19 | import pandas as pd from openai import OpenAI df = pd.read_csv('data/raw/SSDSE-B-2026.csv', encoding='cp932', skiprows=1) question = "東京都と神奈川県の 2023 年の人口を比較して説明して" # 簡易検索(実務は Embedding 検索だが、 ここでは文字列マッチ) context = df[(df['年度']==2023) & (df['都道府県'].isin(['東京都','神奈川県']))][ ['都道府県','総人口','出生数'] ].to_markdown(index=False) prompt = f"以下のデータに基づいて回答してください:\n{context}\n\n質問: {question}" client = OpenAI() resp = client.chat.completions.create( model='gpt-4o-mini', messages=[{'role':'user', 'content': prompt}], max_tokens=200, ) print(resp.choices[0].message.content) |
📤 実行結果(想定):
💬 結果の読み方:RAG の威力。 LLM 単体だと「東京都の人口」を曖昧に答えるが、 SSDSE-B-2026 の該当行を context に含めることで事実に基づき出典明記の回答が生成できる。 ハルシネーション削減と最新データ反映を両立。
❓ FAQ 20 問
📖 基盤モデルの包括ガイド(追補編)
🌐 基盤モデル年表(2017-2026)
| 年 | モデル / 出来事 | 特徴 |
|---|---|---|
| 2017 | Transformer 論文(Vaswani et al.) | Self-Attention 機構の確立 |
| 2018 | BERT (Google)、 GPT (OpenAI) | 事前学習 + ファインチューニング普及 |
| 2019 | GPT-2、 T5 | 大規模化のはじまり |
| 2020 | GPT-3(175B params) | In-context learning 発見 |
| 2021 | Stanford CRFM「Foundation Models」命名、 DALL-E、 CLIP | マルチモーダル拡張 |
| 2022 | ChatGPT、 Stable Diffusion、 Chinchilla | 一般人到達、 スケール則精緻化 |
| 2023 | GPT-4、 Llama 2、 Claude 2 | OSS 強化、 マルチモーダル GPT-4V |
| 2024 | GPT-4o、 Claude 3.5、 Gemini 1.5/2.0、 Llama 3 | 長コンテキスト、 マルチモーダル標準化 |
| 2024〜25 | o1, o3, Claude 3.7 Thinking | 推論モデル(テスト時計算) |
| 2025〜26 | AI エージェント、 Computer Use | 自律タスク遂行 |
📐 Transformer の数学的構造
Self-Attention の詳細
入力埋め込み $X \in \mathbb{R}^{n \times d}$($n$ トークン、 $d$ 次元)に対し:
- $Q = X W_Q$, $K = X W_K$, $V = X W_V$($W \in \mathbb{R}^{d \times d_k}$)
- $\text{Attention}(Q, K, V) = \text{softmax}(QK^\top / \sqrt{d_k}) V$
- 結果は $n \times d_k$ の新埋め込み行列
- 計算量:$O(n^2 d_k)$($n^2$ が長文での課題)
Multi-Head Attention
$h$ 個の attention を並列実行し連結。 各 head が異なる「注目パターン」を学習。 GPT-4 は推定 $h = 128$、 $d = 12288$。
Position Encoding
Transformer は位置情報を直接持たないため、 位置埋め込みを加算。 元論文は sin/cos の固定エンコーディング、 後の研究では Learned PE、 RoPE(Rotary Position Embedding)、 ALiBi など多数。 RoPE は Llama / GPT-NeoX / Gemma で採用、 長コンテキスト拡張に有利。
📊 主要モデルの能力ベンチマーク(2025 年初頭)
| モデル | MMLU | GPQA | HumanEval | MATH | SWE-bench |
|---|---|---|---|---|---|
| GPT-4o | 88.7 | 53.6 | 90.2 | 76.6 | 33.2 |
| Claude 3.7 Sonnet | 88.7 | 62.0 | 93.7 | 78.3 | 49.0 |
| Gemini 2.0 Flash | 76.4 | 62.1 | 89.6 | 83.0 | 22.6 |
| Llama 3.3 70B | 86.0 | 50.5 | 88.4 | 77.0 | 16.8 |
| DeepSeek V3 | 88.5 | 59.1 | 89.0 | 61.6 | 42.0 |
| Qwen 2.5 72B | 85.6 | 49.0 | 85.4 | 75.5 | 21.0 |
| o1 (preview) | 91.8 | 78.0 | 92.4 | 94.8 | 41.0 |
⚙️ 基盤モデルの学習パイプライン
- データ収集:Web スクレイピング、 書籍、 コード、 マルチモーダル素材
- データクリーニング:重複削除、 有害コンテンツフィルタ、 個人情報除去
- トークン化:BPE / SentencePiece で 50K〜200K vocab
- 事前学習:次トークン予測、 数千 GPU で数週〜数ヶ月
- SFT:質問応答・指示追従の人手データで学習
- 報酬モデル:人間の好み(A vs B)から報酬関数を学習
- RLHF / DPO:報酬最大化で対話品質向上
- 安全評価:Red Team、 安全性ベンチマーク
- デプロイ:API 化、 速度最適化(量子化、 蒸留)
🔧 SSDSE-B-2026 に基盤モデルを応用する 6 シナリオ
シナリオ 1:データ要約 BOT
「東京都の 2023 年データを 100 字で要約して」→ LLM が「2023 年東京都は人口 14,086,000 人、 出生 86,348 人で出生率 6.13‰、 全国 1 位の人口」と返す。
シナリオ 2:Few-shot 予測
3 例の人口データを提示し、 「次の都道府県の人口を予測」させると、 LLM はパターンを抽出して妥当な値を返す。
シナリオ 3:自然言語クエリ → SQL
「人口減少率トップ 5 を教えて」→ LLM が SSDSE-B-2026 用 SQL を生成 → SQLite で実行 → 結果を自然言語で返す。
シナリオ 4:分析レポート自動生成
SSDSE-B-2026 の集計結果を投げると、 LLM が論文風レポート(イントロ、 方法、 結果、 考察)を生成。
シナリオ 5:可視化推奨
データの構造を見て、 「この場合は箱ひげ図と散布図行列が適切」と LLM が提案 → matplotlib コード自動生成。
シナリオ 6:教材生成
SSDSE-B-2026 を使った演習問題、 解答例、 採点ルーブリックを LLM で自動生成。
🛡️ 安全性とアラインメント
アラインメント問題
「モデルが 本当に人間の意図に沿う ように振る舞うか」。 表面的に従順でも、 内部目標が異なれば「賢いふり」をしている可能性。 Anthropic、 OpenAI、 DeepMind の主要研究テーマ。
主要な安全技術
- Constitutional AI(Anthropic):憲法的原則を学習
- RLHF:人間フィードバックでアラインメント
- Red Teaming:攻撃的プロンプトで脆弱性発見
- Interpretability:内部活性化を解析、 「思考」を可視化
- Sandbox 実行:エージェントを隔離環境で動かす
- Refusal 訓練:違法・有害な要求を拒否
💸 経済学:基盤モデルのコスト構造
| 項目 | 規模 |
|---|---|
| GPT-4 学習コスト推定 | $100M+ |
| GPT-4o 推論コスト | $5/M tokens (入力), $15/M (出力) |
| Claude 3.7 Sonnet | $3/M (入力), $15/M (出力) |
| Llama 3.3 70B 自前推論 | A100 80GB × 2 必要、 月 $1,500〜 |
| SSDSE-B-2026 全文 1 回処理 | 約 50K tokens × $5/M = $0.25 |
| SSDSE-B-2026 Embedding 化 | $0.02/M × 50K = $0.001 |
| OpenAI 月間総収益(推定) | $3B 超 |
| Anthropic 月間収益 | $700M 程度 |
🎓 教育界への影響
- 論文・課題チェック:盗用検出 → AI 検出(GPTZero、 Turnitin AI)
- 個別指導 BOT:Khan Academy の Khanmigo、 Duolingo Max
- SSDSE-B-2026 を題材にした「LLM 援用統計学」教材:日本でも普及中
- 大学のシラバス改訂:「LLM を使った課題」が標準化
- プログラミング教育:「コードを書く」から「コードをレビュー・修正する」へ
⚠️ よくある落とし穴
基盤モデル(詳細) を実務で扱うとき、 多くの分析者が同じところでつまずきます。 代表的な失敗パターンを先回りで押さえておくと、 後工程のトラブルを大幅に減らせます。
※ 上記は文献調査・現場経験で報告される頻度の高い注意点。 ドメインや手法のバージョンによって追加の落とし穴がある場合があります。
🗺 概念マップ
関連概念を視覚的に整理した概念マップ。
基盤モデル (foundation model) は Bommasani et al. (2021, Stanford CRFM) が命名した「大規模・自己教師あり学習・幅広い下流タスク適応」を満たすモデル群。 代表例は GPT-3 (Brown et al. 2020, 175B params)、 GPT-4 (OpenAI 2023)、 PaLM (Chowdhery et al. 2022)、 LLaMA-2 (Touvron et al. 2023)、 Claude 3 (Anthropic 2024)、 CLIP (Radford et al. 2021, マルチモーダル)。 アーキテクチャは Transformer (Vaswani et al. 2017) が主流で、 Mixture of Experts (Shazeer et al. 2017、 Switch Transformer) により計算効率を高める研究が進む。 落とし穴: 学習データ汚染 (test-set leakage)、 hallucination、 推論コスト、 著作権・プライバシー問題が現実的課題。
🔗 隣接手法への橋渡し
「基盤モデル (詳細)」は単独で完結せず、 隣接する手法と接続することで分析パイプラインの一部として機能する。 以下に具体的な接続関係を示す。
- 上流(入力側で必要となる前処理・前提): Transformer (Vaswani et al. 2017)・大規模コーパス・自己教師あり事前学習
- 並列(同じ目的を持つ代替・競合手法): LLM (GPT-4, Claude, Gemini)・マルチモーダルモデル (CLIP, GPT-4V)・拡散モデル (Stable Diffusion)
- 下流(基盤モデル (詳細) の結果を活用する後続手法): 下流タスク fine-tune・RAG・プロンプト工学・アライメント (RLHF)
「基盤モデル詳細」は (1) Transformer 規模 (パラメータ数 / コンテクスト長) → (2) 事前学習コーパス + 学習レシピ → (3) ファインチューニング戦略 (SFT / DPO / RLHF) → (4) ベンチマーク (MMLU / GSM8K / HELM) → (5) 安全評価 + alignment、 の 5 段で評価する。
🌳 手法選択フロー
「基盤モデル (詳細)」を実際の課題に当てはめるとき、 以下の 3 ステップで判断する。 領域固有の判断基準と組み合わせて使用する。
- ステップ 1: タスク (テキスト・画像・マルチモーダル) でモデル選定
- ステップ 2: API 利用 (GPT/Claude) か OSS (Llama, Mistral) か
- ステップ 3: LoRA / Adapter でドメイン適応
タスク種別 (NLP / 画像 / マルチモーダル / 音声) で基盤モデル選定: 言語なら GPT-4 / Claude / Llama 3、 画像なら ViT / CLIP / DINOv2、 マルチモーダルなら GPT-4V / Gemini / LLaVA、 とモデルカード + ライセンス + コスト構造で最終決定。
🎨 直感をさらに深める — 「一度学べば、何にでも使い回せる」
基盤モデル(Foundation Model)の核心は、 タスクごとにゼロから作るのをやめ、 「大量データで一度だけ汎用モデルを事前学習し、 あとは多様なタスクへ転用する」 という発想の転換にあります。 従来は「感情分析用モデル」「翻訳用モデル」を別々に用意していたのが、 GPT・BERT・CLIP のような 1 つの土台を 微調整・プロンプト・少数事例提示 だけで何十ものタスクに振り分けられるようになりました。
- 汎用モデル → タスク転用:料理でいえば、 毎回だしを取り直すのではなく「万能だし」を大量に仕込んでおき、 味噌汁にも煮物にも使い回すイメージ。 事前学習が「だし」、 各タスクが「料理」。
- スケール則(scaling law):モデルサイズ $N$・データ量 $D$・計算量 $C$ を増やすほど損失が滑らかなべき乗則で下がる。 「大きくすれば素直に賢くなる」という経験則が投資を正当化してきました(→ 本ページ上部の 🎮 スケーリング則ウィジェット で体感)。
- 少数事例学習(few-shot)と転移:追加学習なしに、 プロンプトへ数例示すだけで新タスクをこなす。 これは事前学習で世界の統計的構造をすでに内在化しているため。 転移学習(transfer-learning.html)を極端に押し進めた姿ともいえます。
- 代表例:GPT(自己回帰・生成)、 BERT(双方向・理解)、 CLIP(画像とテキストを同じ空間へ)。 いずれも「まず汎用表現、 あとで用途」という同じ骨格を共有します。
表データにも同じ発想が効きます。 本リポジトリの SSDSE-B-2026(実測: 564 行 × 112 列 = 47 都道府県 × 12 年、 2012–2023)を 1 行 1 文へ自然文化すれば、 汎用の埋め込み(embedding.html)で都道府県を意味的に近い順に並べたり、 少数事例プロンプトで「次の県の値」を推測させたり、 同じ土台を複数タスクへ転用できます。
⚠️ 落とし穴をさらに深掘り(重要)
基盤モデルは強力ですが、 「賢く見える」ことと「正しい・安全・安価」であることは別問題です。 上の よくある落とし穴 に加え、 設計・運用・倫理・法務 の観点で特に見落とされがちな点を補足します。
※ これらは基盤モデル一般に共通する構造的な注意点です。 モデルのバージョン・用途・規制環境により追加のリスクが生じます。
🚀 発展 — 事前学習からアラインメントまで
基盤モデルを「作る側・使いこなす側」に回るための発展トピックを、 学習の流れに沿って整理します。 各項目は独立した用語ページ(存在するものはリンク)へ接続します。
① 学習パイプライン:事前学習 → 微調整 → プロンプト
- 事前学習(pretraining):Web スケールの自己教師あり学習で汎用表現を獲得。 次単語予測(自己回帰)や穴埋め(マスク)が代表。
- 微調整(fine-tuning):下流タスクのデータで追加学習。 全層更新は高コストなため、 LoRA / QLoRA など低ランク・軽量手法が主流(→ fine-tuning.html)。
- プロンプト(prompting):パラメータを一切更新せず、 入力文の設計だけで挙動を制御(→ prompt.html / prompt-engineering.html)。
② スケーリング則と In-context learning
- スケーリング則:損失がパラメータ数・データ量・計算量のべき乗則で下がる経験則。 Chinchilla は「$N$ と $D$ をほぼ同率に増やす」最適配分を示した(本ページ 🎮 ウィジェット 参照)。
- In-context learning:重み更新なしに、 プロンプト内の数例から新タスクを学ぶ。 モデル規模が一定を超えると立ち現れる、 基盤モデル最大の特徴。
- 創発能力(emergent abilities):規模の閾値を超えると算術・多段推論・道具使用などが「突然」できるようになる現象。 小規模モデルの外挿では予測しづらい。
③ アラインメントと安全性
- RLHF / DPO:人間の選好で報酬を学び、 有用性・安全性・正直さへ整合させる。 ChatGPT・Claude の「対話らしさ」の中核。
- アラインメント:能力を上げるだけでなく、 人間の意図・価値と齟齬なく振る舞わせる研究領域。 ガードレール・拒否・出力フィルタも含む。
④ 効率化とマルチモーダル
- 蒸留(distillation)・量子化(quantization):大モデルの知識を小モデルへ移す/数値精度を落として軽量・安価・低炭素に。 端末・エッジ配備の鍵。
- マルチモーダル:テキスト・画像・音声・動画を同じ土台で扱う(→ multimodal.html)。 画像とテキストを同空間に写す CLIP、 画像 Transformer(→ vision-transformer.html)が入口。
- 土台のアーキテクチャ:ほぼ全ての基盤モデルは Transformer(→ transformer.html)と自己注意(→ attention.html)に立脚。
🧪 合成の説明例(架空)— スケール則の直感
以下は概念理解のための架空の数値例です(実在モデルの実測値ではありません)。 同じ計算予算のもとで、 モデルを大きくしすぎ・データを与えなさすぎると損失が下がりきりません。 「$N$ を 2 倍にしたら $D$ もおよそ 2 倍に」というバランスの感覚を掴むための例として、 本ページ上部の 🎮 ウィジェットのスライダーを左右に振ってみてください。 数値そのものは教材用の架空パラメータで駆動しています。
🔗 あわせて読みたい関連ページ
基盤モデルは多くの周辺概念の交差点です。 以下は本用語集に 実在する 関連ページへのリンクです(用途に応じて往復してください):
※ 各リンク先は本 glossary/ 内に実在するページです。 全体像は 用語集トップ と 概念マップ から俯瞰できます。