🔖 キーワード索引
この用語と一緒に検索・参照されやすいタグ。 関連ページに飛ぶときの手がかりにも使えます。
💡 30秒で分かる結論
🍰 まずはやさしく
声から文字を取り出す魔法のような技術です。
話し言葉をテキストにするために使います。
スマホで声をかけて文字を入力する機能です。
この章では音声認識の仕組みと注意点を読みます。
音声認識(ASR / Speech-to-Text)は、 音声波形から意味(テキスト)を取り出す技術。 近年は深層学習(Whisper 等)で精度が飛躍的に向上。
- 2 方向:音声→テキスト(ASR)と テキスト→音声(TTS)
- 入出力:時系列の波形(16-48kHz サンプリング)⇔ メル特徴量 ⇔ 文字/音素列
- 代表モデル:Whisper(OpenAI)、 Tacotron、 VITS、 EnCodec
- 評価:WER(単語誤り率, ASR)/ MOS(自然性, TTS)
- 注意:話者・方言・雑音で性能が大きく変動。 音声 deepfake 等の倫理懸念
💡 音声認識 Q&A 拡張
📍 文脈:「音声認識」はどんな場面で出てくる?
🍰 まずはやさしく
AIがいろいろな情報を扱うための道具です。
表以外のデータも理解するために使います。
学校で使うAIアプリなどの仕組みに関わります。
この章では音声認識がどんな場面で役立つか読みます。
本サイトでは AI 応用の文脈で登場します。 SSDSE 自体は音声データを扱いませんが、 「マルチモーダル AI」の代表例として、 表データ以外の AIを理解するために押さえます。
🎨 直感で掴む
🍰 まずはやさしく
音声を画像のように捉える考え方です。
仕組みをイメージで掴むために使います。
波形を文字に変える流れを想像してください。
この章では図を使って直感的に理解します。
「音声認識」を最初に学ぶときは、 厳密な定義よりイメージを優先しましょう。 以下は具体例・比喩を用いた直感的理解の入口です。
- 音声 ≒ 横が時間・縦が周波数の画像(スペクトログラム)。 ここに気付くと画像 CNN の知見が転用できる。
- TTS は「文字を入れたら波形が出てくる」。 中間表現としてメルスペクトログラムを経由するのが定石。
- ASR は「波形を入れたら文字が出てくる」。 Whisper のように Transformer + 大量データで頑健性が大きく向上。
🎨 概念図で押さえる
音声認識/音声生成の構造を 3 枚で振り返る。 1 枚目 = 音声処理パイプライン、 2 枚目 = 認識 vs 生成の対称性、 3 枚目 = 評価指標の枠組み。
図1: 音声処理パイプライン (波形 → テキスト)
図2: 音声認識 (ASR) vs 音声生成 (TTS) の対称性
図3: 評価指標 (WER と MOS)
→ 3 枚から「ASR と TTS は構造的に対称」「中間表現 = 特徴量と音素」「評価には客観 (WER) と主観 (MOS) の両方が必要」が読み取れる。
🖼 スペクトログラムで見る「音声は時間 × 周波数の画像」
上の比喩を実際の数値で確かめる。 基本周波数 120 Hz(成人男性の声の高さの目安)の倍音を、 「あ」らしいフォルマント(F1 750 Hz・F2 1200 Hz)と「い」らしいフォルマント(F1 300 Hz・F2 2200 Hz)で重み付けした合成音を作り、 16 kHz で 0.8 秒(12,800 サンプル)並べた。 これを 25 ms 窓・10 ms シフトの STFT にかけると、 78 フレーム × 257 周波数ビン(31.25 Hz 刻み)の「画像」になる。
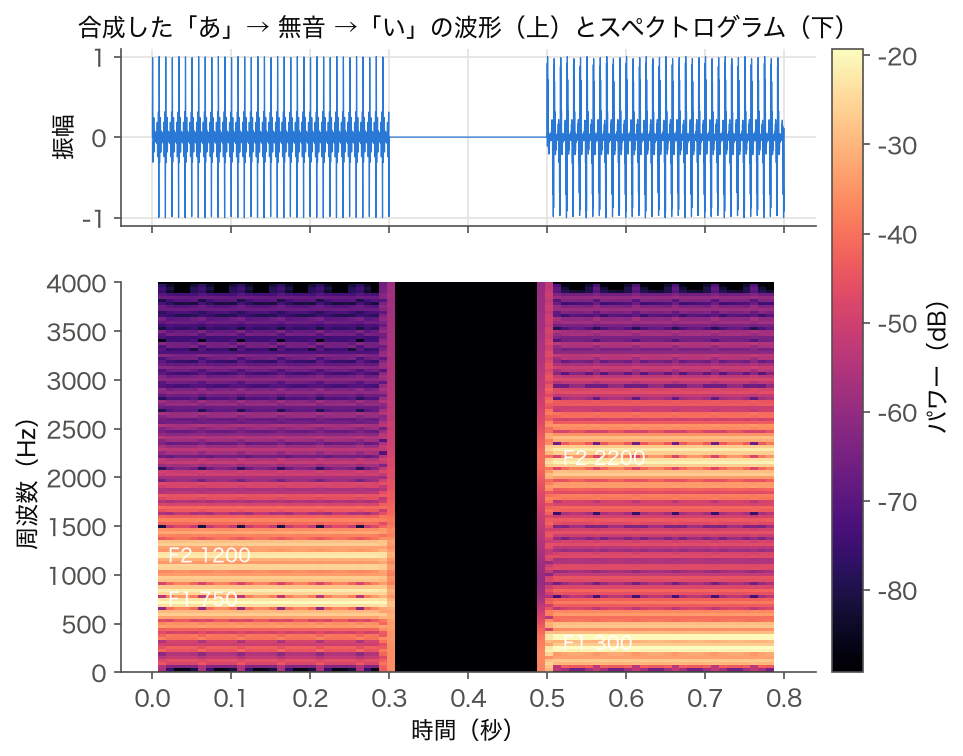
波形(上)だけを見ても「あ」と「い」の違いは読み取りにくいが、 スペクトログラム(下)では明るい帯の高さがはっきり変わる。 音響モデルが見ているのはこの帯の位置と動きで、 画像認識の CNN が音声にも使えるのはこのためである。 無音の区間(0.3〜0.5 秒)はパワーが 0 で真っ黒になり、 ここを切り出して捨てるのが VAD(音声区間検出)の役目になる。
📐 定義・数式
🍰 まずはやさしく
音声認識を正しく表すためのルールです。
正確な意味を共通の言葉で伝えるために使います。
計算式を使って音の変化を分析します。
この章では数式を使って定義を詳しく読みます。
やさしい説明で掴んだ感覚を、ここで 短時間フーリエ変換(音声の基本表現) の定義式に対応づけます。下の式は左辺 $X(\tau, f)$ が何で決まるかを右辺で書き下したもので、Σ(合計)、exp(指数) が現れます。それぞれの記号が何の量を指すのかは、次の「🔬 数式を言葉で読み解く」で 1 つずつ確かめてください。
📐 音声認識の主要数式
Bayes 規則:$$\hat W = \arg\max_W P(W|X) = \arg\max_W P(X|W) P(W)$$
HMM の前向き確率:$$\alpha_t(i) = P(o_1, ..., o_t, q_t = i | \lambda)$$
Viterbi アルゴリズム:$$\delta_t(j) = \max_i [\delta_{t-1}(i) \cdot a_{ij}] \cdot b_j(o_t)$$
MFCC 計算:$$\text{MFCC}_k = \sum_{m=1}^M (\log E_m) \cos\left(\frac{k(m-0.5)\pi}{M}\right)$$
CTC 損失:$$L_{CTC} = -\log \sum_{\pi \in \mathcal{B}^{-1}(W)} P(\pi | X)$$
WER(単語誤り率):$$\text{WER} = \frac{S + D + I}{N}$$
メル尺度:$$m = 2595 \log_{10}\left(1 + \frac{f}{700}\right)$$
🔬 数式を言葉で読み解く — 数式を「言葉」に翻訳
- x[n]
- 離散音声サンプル(典型 16kHz)
- w[n]
- ハミング窓など。 25ms 程度の幅
- τ
- フレーム時刻(10ms シフトが典型)
- f
- 周波数ビン
- |X|²
- パワースペクトル → メル尺度に変換して特徴量化
音声認識のパイプラインを 4 つの要素に分けて読み解きます。 音声認識は「音声波形 → テキスト」の変換で、 数式 \( \hat W = \arg\max_W P(W|X) = \arg\max_W P(X|W)P(W) \)(Bayes 規則による定式化)は、 ① 音声特徴抽出、 ② 音響モデル、 ③ 言語モデル、 ④ デコーディングという 4 つの構成要素を 1 行で表現したものです。 各要素の詳細を以下に示します。
要素 ①「音声特徴抽出(X の生成)」:マイクで録音した音声波形(典型的に 16 kHz サンプリング、 16 bit PCM)から、 25 ms ごとに 10 ms ステップで特徴量(MFCC、 メルスペクトログラム)を抽出します。 これは「音声を機械学習が扱いやすい数値ベクトル列」に変換する前処理で、 例えば「東京都」という音声入力を受け付けるには、 まず波形から MFCC(13 次元 × 時系列フレーム数)に変換する必要があります。
要素 ②「音響モデル \( P(X|W) \)」:単語列 \( W \) が与えられたとき、 音声特徴 \( X \) が観測される確率を表すモデルです。 古典的には HMM-GMM(隠れマルコフモデル + 混合ガウス)、 近年は CTC・Transformer ベース(Whisper、 wav2vec 2.0)です。 「東京都」と発話されたときに観測される MFCC 系列の確率を計算します。 認識候補が N 個ある場合、 すべての候補に対して確率を計算し、 最も高いものを採用します。
要素 ③「言語モデル \( P(W) \)」:単語列 \( W \) の 事前確率を表すモデルで、 「自然な日本語として、 この単語列はどれくらいあり得るか」を評価します。 n-gram モデルや GPT 系の大規模言語モデルが使われます。 「東京都」が「凍京都」より頻出することを学習することで、 音響的に紛らわしい入力でも正しい解釈に誘導できます。
要素 ④「デコーディング(\( \arg\max_W \))」:音響モデルと言語モデルの積を最大化する単語列 \( W \) を探索します。 可能な単語列は天文学的に多いため、 Viterbi アルゴリズム・ビームサーチ・トークンパッシングなどの動的計画法的探索が使われます。 語彙が 47 語のような小さな認識の場合は全探索が可能ですが、 自由発話(1 万語以上の語彙)では数千万の経路が生じます。
🔬 深掘り:音声認識の数理
MFCC(メル周波数ケプストラム係数)の導出
MFCC は音声特徴量の標準で、 5 段階で計算されます:(1) プリエンファシス(高域強調)、 (2) フレーム分割(25 ms ウィンドウ、 10 ms シフト)、 (3) FFT で振幅スペクトル、 (4) メルフィルタバンク(人間の聴覚特性を模した三角フィルタ)、 (5) 離散コサイン変換(DCT)。 結果として 13 次元の特徴ベクトルが時系列で得られます。 「人間の聴覚は線形周波数ではなくメル尺度(対数的)で音を捉える」という心理音響学的知見が組み込まれている点が重要です。
CTC(Connectionist Temporal Classification)損失
古典的な音響モデルは「音声フレームと音素のアラインメント(時間的対応)」を明示的に必要としましたが、 CTC はアラインメントを 潜在変数として扱い、 入力フレーム列から出力ラベル列への変換を end-to-end で学習できます。 損失関数 \( L_{CTC} = -\log P(W|X) = -\log \sum_{\pi \in \mathcal{B}^{-1}(W)} P(\pi|X) \)、 ここで \( \pi \) はフレームごとのラベル列、 \( \mathcal{B}^{-1}(W) \) は単語列 W に対応する全アラインメント。 動的計画法で効率的に計算可能。
Transformer ベース音声認識(Whisper)
OpenAI の Whisper(2022)は 68 万時間の多言語音声データで学習された Transformer エンコーダ・デコーダモデル。 エンコーダがメルスペクトログラムを潜在表現に、 デコーダが潜在表現から自己回帰的にテキストを生成。 英語以外に 96 言語の音声を含むデータで学習されている。 日本語の精度は、 分かち書きに左右されない CER で、 自分の用途の音声を使って測るのが確実(下の 🧮 の「日本語では CER」を参照)。 ローカル PC で動作する whisper パッケージ(pip install)で議事録の自動書き起こしや音声入力 UI などに応用可能。
WER(Word Error Rate)の計算
音声認識の評価指標 WER は、 編集距離(Levenshtein 距離)を基準単語数で割ったもの:\( \text{WER} = \frac{S + D + I}{N} \)、 ここで S は置換、 D は削除、 I は挿入、 N は基準単語数。 「東京都の出生数」を「東京と聖徒数」と認識した場合、 S=2、 D=0、 I=0、 N=4 で WER = 50%。
ビームサーチの計算量
ビームサーチは「各時刻で上位 K 個の部分仮説のみ保持して次の時刻に伝搬」する貪欲アプローチ。 計算量は \( O(T \cdot K \cdot V) \)、 ここで T はフレーム数、 K はビーム幅、 V は語彙サイズ。 K = 10〜50 が一般的。 K を増やすと精度が上がるが計算時間が比例して増加。 限定語彙(数十単語)だけを認識するなら K = 5 で十分、 自由発話なら K = 50。
音声認識と統計データの組み合わせ応用
音声認識の代表的な応用は、 ① 議事録自動生成(会議・授業の書き起こし)、 ② 音声入力 UI(スマートスピーカー・カーナビ)、 ③ アクセシビリティ(高齢者・視覚障害者向け読み上げ応答)、 ④ 医療電子カルテの音声入力など。 音声インターフェース普及で、 情報へのアクセスが民主化する見込み。
エッジ音声認識:Whisper.cpp と Vosk
クラウド API(Google Cloud Speech、 Azure Speech)は精度が高いが、 プライバシー懸念と通信コストが課題。 whisper.cpp(C++ 実装)や Vosk(Kaldi ベース)は、 PC・スマホ・組み込みデバイスで完全オフライン動作可能。 医療・法律・行政など機密情報を扱う現場では、 オフライン処理で個人情報を外部送信しない設計が安心。
音声認識の倫理・バイアス
音声認識モデルは学習データの偏りを反映します。 日本語認識でも、 関東方言は精度が高いが東北・九州方言は低くなりがち。 「沖縄県の高齢者の方言」を正しく認識できるか、 という公平性の問題は重要。 また音声からの性別・年齢・感情の推定は、 統計目的を超えてプライバシー侵害になり得るため、 利用目的を明示的に制限すべき。
📊 音声認識モデルの比較(大きさと特徴)
| モデル | サイズ | 特徴 |
|---|---|---|
| Whisper-tiny | 39MB | CPU 推論可、 リアルタイム |
| Whisper-base | 142MB | バランス型 |
| Whisper-large-v3 | 3GB | GPU 推奨、 高精度 |
| Vosk-ja-0.22 | 48MB | オフライン軽量、 ストリーミング |
| Google Cloud Speech | N/A(API) | クラウド、 従量課金 |
日本語での精度(WER・CER)は評価に使う音声(読み上げか会話か、雑音、話者)と、文字単位か単語単位かで大きく変わるため、ここでは 1 つの数字で並べていません。導入前に、自分の業務の音声を 100 件程度書き起こして、候補のモデルで CER を測って比べるのが確実です(下の 🧮 の「日本語では CER」の小節を参照)。
🎯 音声認識演習問題
- 用語:MFCC とは何の略? 何次元が一般的? (答:Mel-Frequency Cepstral Coefficients、 13 次元)
- WER 計算:基準 5 単語、 置換 1、 削除 0、 挿入 2 のとき WER は? (答:(1+0+2)/5 = 60%)
- Bayes 規則:\( P(W|X) \propto ? \) (答:\( P(X|W) \cdot P(W) \)、 音響モデル × 言語モデル)
- システム設計:音声で特定の情報を問い合わせるシステムに必要な要素は? (答:① 音声特徴抽出、 ② 音声認識モデル、 ③ 固有表現抽出、 ④ DB クエリ、 ⑤ 結果返却)
- 選択:オフラインで動く軽量モデルは? (答:Vosk または Whisper-tiny)
🎓 音声認識の歴史と技術系譜
音声認識は 70 年以上の歴史を持つ AI 分野で、 技術パラダイムが大きく 4 段階で進化してきました。
第 1 世代:テンプレートマッチング(1950s〜1970s)
「録音した音声波形を、 辞書の単語波形と比較して最も近いものを選ぶ」素朴な手法。 ベル研究所の Audrey システム(1952)が数字 0-9 を認識した最初の例。 DTW(Dynamic Time Warping)で時間軸の伸縮を吸収。 語彙は数十単語が限界。
第 2 世代:HMM-GMM(1980s〜2010s)
隠れマルコフモデル(HMM)と混合ガウス分布(GMM)の組み合わせ。 音声を「音素の HMM 系列」とモデル化し、 GMM で MFCC を生成確率分布として学習。 IBM ViaVoice・Dragon NaturallySpeaking(1997 年世界初の連続音声認識ソフト)の基盤。 Kaldi(2011)でオープンソース化。 語彙 10 万単語以上に対応可能になった。
第 3 世代:DNN-HMM ハイブリッド(2010s)
音響モデルの GMM を Deep Neural Network(DNN)に置き換え。 多くのベンチマークで誤り率が大きく下がった。 トロント大・Microsoft・Google・IBM の研究者による共同論文(Hinton ら, 2012)が、 音響モデルに深層学習を使う有効性をまとめている。
第 4 世代:End-to-End(2015〜現在)
音響モデル・言語モデル・デコーダを 1 つのニューラルネットで統合。 CTC(2006)・RNN-T(2012)・Attention(2015)・Transformer(2017)の進化を経て、 wav2vec 2.0(2020)・Whisper(2022)が登場。 多言語の大規模データで学習したモデルが広く使えるようになった。 教師なし事前学習でラベル付きデータが少なくても高精度。
第 5 世代(萌芽):マルチモーダル大規模言語モデル
GPT-4o・Gemini・Claude などの大規模言語モデルが、 音声・画像・テキストを統合的に処理。 「音声でデータベースを問い合わせ、 統計分析結果をグラフで返す」マルチモーダル対話が現実に。
🔧 音声認識 Python ツールカタログ
| ライブラリ | タイプ | 用途 | 日本語 |
|---|---|---|---|
whisper | PyTorch ベース | 高精度多言語認識 | 優秀 |
whisper.cpp | C++ ベース | CPU 高速推論 | 優秀 |
vosk | Kaldi ベース | 軽量オフライン | 中程度 |
speech_recognition | 複数バックエンド対応 | Google/Sphinx/Wit など | バックエンド依存 |
pyaudio | 録音 API | マイク入力取得 | — |
librosa | 音声前処理 | MFCC・スペクトログラム | — |
pyannote.audio | 話者分離 | 議事録での話者識別 | 対応 |
| Google Cloud Speech-to-Text | クラウド API | 高精度・従量課金 | 優秀 |
🧮 実値で計算してみる
音声認識で最も重要な前処理ステップである MFCC 抽出を、 440 Hz サイン波(0.1 秒分 = 1600 サンプル)を使って 6 ステップで手計算します。 数式 → 実値代入 → Python 再現のペアで確認します。
Step 1 — 波形サンプル(8 点抜粋):440 Hz サイン波を 16kHz でサンプリングした最初の 8 点は [0.000, 0.172, 0.339, 0.495, 0.637, 0.760, 0.861, 0.935](振幅 ±1 に正規化。 x[n] = sin(2π × 440 × n / 16000) で、 1 サンプルごとに位相が 2π × 440 / 16000 ≒ 0.1728 rad = 9.9° 進む)。 これが MFCC 計算のスタート地点となる生波形数値列です。
MFCC 6 ステップ手計算
| Step | 処理 | 具体値(440Hz, 16kHz) |
|---|---|---|
| Step 1 | 波形サンプル生成 | x[0]=0.000, x[1]=sin(0.1728)=0.172, x[2]=sin(0.3456)=0.339, x[3]=sin(0.5184)=0.495(サイン波の最初の 4 値) |
| Step 2 | フレーム取得 + ハミング窓 | frame_len = 400 サンプル (25ms)、 w[0]=0.54 − 0.46 = 0.080 (ハミング窓の端は 0 にならない)、 w[199]=w[200]≈1.000 (ピーク) |
| Step 3 | 512 点 FFT → パワースペクトル | 440 Hz ≈ bin 14 (= 440×512/16000)、 power[14] ≈ 11552.3 (フレーム全体のパワー 20,297 の約 57%) |
| Step 4 | メル変換 | $m = 2595\log_{10}(1 + 440/700) = 2595 \times \log_{10}(1.629) = 2595 \times 0.2118 = 549.6\ \text{mel}$ |
| Step 5 | 40 バンドフィルタバンク + log | log_mel[7] ≈ 9.67 (中心約 445 Hz、 440Hz が主に落ちる帯域。 40 帯域の平均は約 −3.51) |
| Step 6 | DCT で 13 次元 MFCC | c[0]=−22.221 (= 40 個の log_mel の合計 ÷ √40)、 c[1]=22.545, c[2]=3.335, … c[12]=2.618 |
このコードでやること:440 Hz サイン波 0.1 秒分 (1600 サンプル) を生成し、 上の 6 ステップを NumPy / SciPy で再現して MFCC 13 次元ベクトルを計算する。
📥 入力: 合成サイン波(ライブラリ不要で即実行可能)
1 2 3 4 5 6 7 8 9 10 11 12 13 14 15 16 17 18 19 20 21 22 23 24 25 26 27 28 29 30 31 32 33 34 35 36 37 38 39 40 41 42 43 44 45 46 47 48 49 50 51 | import numpy as np from scipy.fftpack import dct # ① 440 Hz サイン波 0.1 秒(16000 Hz サンプリング)= 1600 サンプル fs = 16000 f0 = 440.0 t = np.arange(int(fs * 0.1)) / fs x = np.sin(2 * np.pi * f0 * t) print(f"x[0:4] = {x[:4].round(4)}") # → x[0:4] = [0. 0.1719 0.3387 0.4955] # ② 最初の 1 フレーム(25ms = 400 サンプル)を取り出してハミング窓 frame_len = int(0.025 * fs) # 400 window = np.hamming(frame_len) frame = x[:frame_len] * window # ③ 512 点 FFT → 257 点パワースペクトル fft_size = 512 power = np.abs(np.fft.rfft(frame, n=fft_size)) ** 2 # shape (257,) print(f"power[14] (440Hz付近) = {power[14]:.4f}") # 440Hz ≈ bin 14 (= 440/fs*512 = 14.08) # → power[14] = 11552.2577 # ④ メル尺度変換: 440 Hz → mel f_hz = 440.0 mel_f = 2595 * np.log10(1 + f_hz / 700) print(f"m(440Hz) = {mel_f:.2f} mel") # → m(440Hz) = 549.64 mel # ⑤ 40 バンドのフィルタバンクをかけてログエネルギー n_mels = 40 mel_lo = 2595 * np.log10(1 + 0 / 700) # 0.0 mel mel_hi = 2595 * np.log10(1 + (fs/2) / 700) # 2840.02 mel mel_pts = np.linspace(mel_lo, mel_hi, n_mels + 2) hz_pts = 700 * (10 ** (mel_pts / 2595) - 1) bins = np.floor((fft_size + 1) * hz_pts / fs).astype(int) fb = np.zeros((n_mels, fft_size // 2 + 1)) for m in range(1, n_mels + 1): for k in range(bins[m-1], bins[m]): fb[m-1, k] = (k - bins[m-1]) / (bins[m] - bins[m-1]) for k in range(bins[m], bins[m+1]): fb[m-1, k] = (bins[m+1] - k) / (bins[m+1] - bins[m]) log_mel = np.log(np.dot(fb, power) + 1e-8) # shape (40,) # ⑥ DCT で MFCC 13 次元 mfcc_vec = dct(log_mel, type=2, norm='ortho')[:13] print("MFCC c[0..12] =", np.round(mfcc_vec, 3)) # → MFCC c[0..12] = [-22.221 22.545 3.335 -1.833 -5.166 -6.141 # -5.156 -2.828 0.165 2.832 4.287 4.084 2.618] |
💬 440 Hz は 512 点 FFT では 440 ÷ 16000 × 512 = 14.08 番目のビンに当たり、power[14] = 11552.26 はフレーム全体のパワー 20,297 の約 57% を 1 本で占める(隣の 13・15 番にも 3,570・4,958 が漏れているのはハミング窓で山が広がったため)。40 本のメルフィルタでは中心約 445 Hz の 8 番目の帯域がログエネルギー 9.7 で最大になり、それ以外の帯域はほとんど負の値にとどまる。c[0] = -22.221 はこの 40 個のログエネルギーの合計に比例する量(平均約 -3.5)で、純音のように帯域の大半が空の信号では大きく負になる。実際の音声認識では c[0] は録音音量で動くので、話者や収録条件をまたいで比べるときは c[1] 以降を使うか平均を差し引く。
上の表の Step 1〜6 の値 (x[1]=0.172、 power[14]≈11552.3、 549.6 mel、 log_mel[7]≈9.67、 c[0]=−22.221) は、 この実行例と一致する。 c[0] は対数エネルギーの合計に近く、 c[1]〜c[12] がスペクトル包絡 (声道の形状) を表す。
🧮 メル尺度:低い音ほど細かく刻む
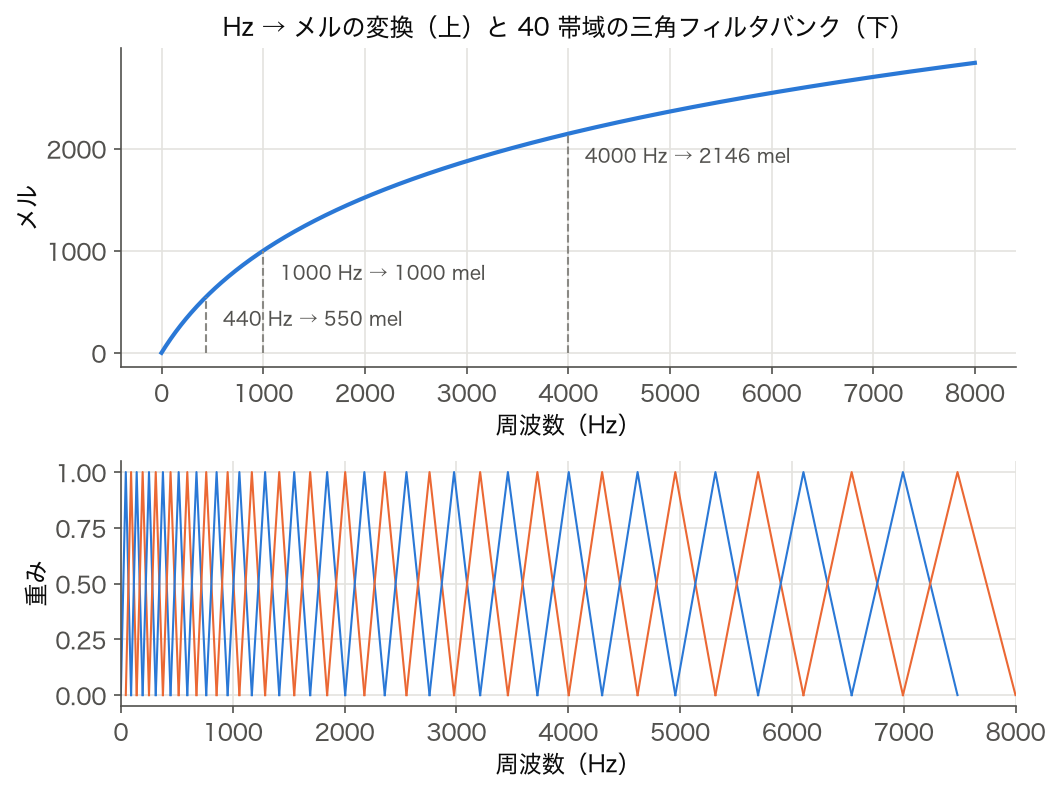
MFCC の Step 4 で使ったメル尺度 $m = 2595\log_{10}(1 + f/700)$ は、 人の耳が低い音の違いには敏感で、 高い音の違いには鈍いことを式にしたものである。 同じ 100 Hz の差でも、 どの高さで上げるかで何メル動くかを計算すると、 その偏りが数で見える。
🎯 このコードでやること:いくつかの周波数をメルに変換し、 100 Hz 上げたときのメルの差と、 0〜8000 Hz をメル尺度で等間隔に 40 帯域へ分けたときの帯域の配置を調べる。
1 2 3 4 5 6 7 8 9 10 11 12 13 14 15 16 17 18 19 20 21 | import numpy as np def hz2mel(f): return 2595 * np.log10(1 + f / 700) def mel2hz(m): return 700 * (10 ** (m / 2595) - 1) for f in [100, 440, 1000, 2000, 4000, 8000]: print(f'{f:>5} Hz → {hz2mel(f):7.1f} mel') # 100 Hz 上げたときに何メル上がるか(低い音ほど細かく区別される) for f in [200, 1000, 4000]: print(f'{f}→{f+100} Hz の差 = {hz2mel(f + 100) - hz2mel(f):5.1f} mel') # 0〜8000 Hz をメル尺度で等間隔に 40 帯域へ分ける edges = mel2hz(np.linspace(0, hz2mel(8000), 42)) centers = edges[1:-1] print(f'帯域の中心: 最初 {centers[0]:.0f} Hz、最後 {centers[-1]:.0f} Hz') print(f'中心が 1000 Hz 未満の帯域: {(centers < 1000).sum()} 本 / 40 本') print(f'中心が 4000 Hz 以上の帯域: {(centers >= 4000).sum()} 本 / 40 本') |
💬 1000 Hz が 1000 mel になるように定数が決められている。 200→300 Hz の 100 Hz は 118.7 mel、 4000→4100 Hz の 100 Hz は 23.7 mel と約 5 分の 1 しか動かない。 そのためメル尺度で等間隔に 40 帯域を置くと、 1000 Hz 未満に 14 本、 4000 Hz 以上には 10 本しか入らない。 母音を区別する F1・F2 がある 3000 Hz あたりまでを細かく見て、 高い帯域はまとめて粗く見る、 という配分になる。
🧮 1 秒の音声は何フレーム・何個の数になるか
フレーム数は「1 + (サンプル数 − 窓の長さ) ÷ シフト幅(切り捨て)」で決まる。 16 kHz・25 ms 窓(400 サンプル)・10 ms シフト(160 サンプル)で 1 秒なら、 1 + (16000 − 400) ÷ 160 = 1 + 97.5 → 98 フレームになる。 これを 13 次元の MFCC にすると 13 × 98 = 1,274 個の数で、 もとの 16,000 サンプルの約 12.6 分の 1 に縮む。
🎯 このコードでやること:1・5・30 秒の音声について、 サンプル数・フレーム数・13 次元 MFCC と 80 帯域メルスペクトログラムの数値の個数を計算する。
1 2 3 4 5 6 7 8 9 | sr, win, hop = 16000, 400, 160 # 16 kHz・25 ms 窓・10 ms シフト for sec in [1, 5, 30]: n = sr * sec # サンプル数 frames = 1 + (n - win) // hop # 端を足さない数え方 mfcc = 13 * frames # 13 次元 MFCC の数値の個数 mel80 = 80 * frames # 80 帯域のメルスペクトログラムの数値の個数 print(f'{sec:>2} 秒: サンプル {n:>6} フレーム {frames:>5} MFCC {mfcc:>6} 個 メル 80 帯域 {mel80:>7} 個' f' (MFCC はサンプル数の 1/{n / mfcc:.1f})') |
💬 手計算どおり 1 秒で 98 フレーム・1,274 個。 30 秒(Whisper が 1 回に処理する長さ)では 2,998 フレームで、 80 帯域のメルスペクトログラムなら 239,840 個の数を入力することになる。 なお librosa の既定(center=True)は両端に窓の半分ずつを足して数えるので、 5 秒なら 1 + 80000 ÷ 160 = 501 フレームになり(🌐 のパターン 3 の値)、 ここでの 498 と 3 つ違う。 フレーム数を比べるときは、 端の扱いをそろえてから比べる。
🧮 数式に値を入れて手で計算する: 音声認識の WER
合成データで Word Error Rate (WER) を計算する。
Step 1: 参照と認識
Step 2: WER
🐍 Python で再現
このコードでやること:参照文と認識結果を単語リストに分割し、 zip で位置ごとに比較して WER(Word Error Rate)を計算する。
📥 入力データ:
1 2 3 4 5 | ref = "the cat sat on mat".split() hyp = "the cat is in mat".split() errors = sum(1 for r, h in zip(ref, hyp) if r != h) wer = errors / len(ref) print(f"WER: {wer:.2f}") |
📤 実行結果:
💬 手計算 (Step 2) の 2/5 = 0.40 と一致する。 この例は参照と認識の単語数が同じ 5 語で置換だけなので、 zip の位置比較でも Levenshtein (置換・削除・挿入の最小編集数) でも 0.40 になる。 認識結果に単語の抜けや余分な語があると zip では以降の位置が全部ずれて誤りを数えすぎるので、 実際の評価では編集距離で数える。
🧮 日本語では CER:同じ誤りでも「何を 1 語と数えるか」で WER が変わる
上の英語の例は空白で単語が区切れるので WER がそのまま使えました。日本語は空白で区切らないため、単語単位の誤り率は分かち書きの仕方に左右されます。SSDSE-B-2026 の 2023 年度の北海道の出生数 24,430 人を読み上げた音声を考え、認識結果で「四百」が抜けた場合を手で数えます(認識結果は説明用に作った例です)。
| Step | 数え方 | 参照(正解) | 認識結果 | 誤り / 参照の長さ |
|---|---|---|---|---|
| 1 | 文字単位(CER) | 北海道の出生数は二万四千四百三十人(17 字) | 北海道の出生数は二万四千三十人(15 字) | 削除 2(「四」「百」)/ 17 = 0.118 |
| 2 | 単語単位・数を 1 語 | 北海道 / の / 出生 / 数 / は / 二万四千四百三十 / 人(7 語) | … / 二万四千三十 / 人 | 置換 1 / 7 = 0.143 |
| 3 | 単語単位・数を位ごと | … / 二万 / 四千 / 四百 / 三十 / 人(10 語) | … / 二万 / 四千 / 三十 / 人 | 削除 1 / 10 = 0.100 |
| 4 | 位置ごとに比べる(zip) | 17 字 | 15 字 | ずれて 3 字不一致 + 長さの差 2 = 5 / 17 = 0.294 |
🎯 このコードでやること:Step 1〜4 を Python で再現する。置換・削除・挿入の最小回数(Levenshtein 距離)を動的計画法で求め、文字単位・2 通りの分かち書き・zip の位置比較の 4 つの誤り率を並べる。
📥 入力データ:参照 北海道の出生数は二万四千四百三十人(24,430 は SSDSE-B-2026 の 2023 年度の北海道の出生数 A4101)と、「四百」が抜けた認識結果。分かち書きはコードの中に手で書いたもの。
1 2 3 4 5 6 7 8 9 10 11 12 13 14 15 16 17 18 19 20 21 22 23 24 25 26 27 28 29 30 31 32 33 34 | def edit_ops(ref, hyp): """置換 S・削除 D・挿入 I の最小編集数(Levenshtein)""" n, m = len(ref), len(hyp) D = [[0] * (m + 1) for _ in range(n + 1)] for i in range(n + 1): D[i][0] = i for j in range(m + 1): D[0][j] = j for i in range(1, n + 1): for j in range(1, m + 1): D[i][j] = min(D[i - 1][j] + 1, # 削除 D[i][j - 1] + 1, # 挿入 D[i - 1][j - 1] + (ref[i - 1] != hyp[j - 1])) # 置換 / 一致 return D[n][m] ref = '北海道の出生数は二万四千四百三十人' hyp = '北海道の出生数は二万四千三十人' # 「四百」が抜けた認識結果 # 1) 文字単位(CER) e = edit_ops(list(ref), list(hyp)) print(f'CER: {e}/{len(ref)} = {e / len(ref):.3f}') # 2) zip の位置比較で数えると z = sum(r != h for r, h in zip(ref, hyp)) + abs(len(ref) - len(hyp)) print(f'zip 位置比較: {z}/{len(ref)} = {z / len(ref):.3f}') # 3) 単語単位(WER)は分かち書きの仕方で変わる seg_a = (['北海道', 'の', '出生', '数', 'は', '二万四千四百三十', '人'], ['北海道', 'の', '出生', '数', 'は', '二万四千三十', '人']) seg_b = (['北海道', 'の', '出生', '数', 'は', '二万', '四千', '四百', '三十', '人'], ['北海道', 'の', '出生', '数', 'は', '二万', '四千', '三十', '人']) for name, (r, h) in [('数を 1 語', seg_a), ('数を位ごと', seg_b)]: e = edit_ops(r, h) print(f'WER({name}): {e}/{len(r)} = {e / len(r):.3f}') |
📤 実行結果:
💬 結果の読み方:手計算の Step 1〜4 と同じ 0.118・0.143・0.100・0.294 が出ました。誤りは「四百が抜けた」1 か所なのに、単語単位では数を 1 語とみなすと 0.143、位ごとに分けると 0.100 と、分かち書きの決め方だけで 4 割以上違う値になります。モデルを比べるときは、同じ分かち書き(同じ形態素解析器と辞書)で数えるか、分かち書きに左右されない CER を使います。zip で位置を比べると、抜けた位置より後ろがすべてずれて 0.294 と 2.5 倍に数えてしまうので、編集距離で数えるのが前提です。
🧮 誤り率は 100% を超えうる:挿入が多いときの読み方
WER・CER の分母は参照の長さで、分子には挿入も入ります。そのため認識結果が余分な文字を大量に出すと、誤り率は 1(100%)を超えます。下の「⑥ ハルシネーション」で触れた、無音区間に動画の常套句を書き出してしまう現象がまさにこれです。短い参照「人口は減少」(5 字)で、置換・削除・挿入の内訳まで数えます。
🎯 このコードでやること:編集距離の表を右下から逆にたどって、誤りを置換 S・削除 D・挿入 I に分け、3 通りの認識結果の CER =(S+D+I)/ 参照の文字数 を計算する。
📥 入力データ:参照 人口は減少(5 字)と、説明用に作った 3 通りの認識結果(完全一致・「口」→「工」の 1 字置換・末尾に 14 字の常套句が付いたもの)。
1 2 3 4 5 6 7 8 9 10 11 12 13 14 15 16 17 18 19 20 21 22 23 24 25 26 27 28 29 30 31 32 33 | def align(ref, hyp): """最小編集数と、その内訳(置換 S・削除 D・挿入 I)を返す""" n, m = len(ref), len(hyp) D = [[0] * (m + 1) for _ in range(n + 1)] for i in range(n + 1): D[i][0] = i for j in range(m + 1): D[0][j] = j for i in range(1, n + 1): for j in range(1, m + 1): D[i][j] = min(D[i - 1][j] + 1, D[i][j - 1] + 1, D[i - 1][j - 1] + (ref[i - 1] != hyp[j - 1])) S = Dl = I = 0 i, j = n, m while i > 0 or j > 0: # 表を右下から逆にたどる if i > 0 and j > 0 and D[i][j] == D[i - 1][j - 1] + (ref[i - 1] != hyp[j - 1]): S += ref[i - 1] != hyp[j - 1]; i -= 1; j -= 1 elif i > 0 and D[i][j] == D[i - 1][j] + 1: Dl += 1; i -= 1 else: I += 1; j -= 1 return S, Dl, I ref = '人口は減少' cases = { '正しく認識': '人口は減少', '1 字置換': '人工は減少', '無音区間に常套句を生成': '人口は減少ご視聴ありがとうございました', } for name, hyp in cases.items(): S, Dl, I = align(ref, hyp) cer = (S + Dl + I) / len(ref) print(f'{name:<12} S={S} D={Dl} I={I:>2} CER=({S}+{Dl}+{I})/{len(ref)} = {cer:.2f}') |
📤 実行結果:
💬 結果の読み方:1 字置換は S=1 で CER 0.20、常套句が付いたものは参照の 5 字はすべて正しいのに I=14 で CER 2.80(280%)になりました。平均 CER だけを見ると「本文を大きく読み違えた」のか「余分な文を付け足した」のか区別できないので、S・D・I の内訳を一緒に報告します。挿入が突出していれば、モデルを替える前に VAD で無音区間を切る・出力を常套句の一覧と照合する、といった対策が先に効きます。
🧮 ベイズ則で「東京都」と「凍京都」を比べる
📐 の $\hat W = \arg\max_W P(X|W)P(W)$ に値を入れる。 音声 X に対して候補が 3 つあり、 音響モデルの尤度 P(X|W) と言語モデルの事前確率 P(W) が下の値だったとする(仕組みを見るために置いた値で、 実際のモデルの出力ではない)。
| Step | 候補 W | P(X|W) | P(W) | 計算 |
|---|---|---|---|---|
| Step 1 | 東京都 | 0.030 | 1×10⁻⁴ | 0.030 × 10⁻⁴ = 3.00×10⁻⁶ |
| Step 1 | 凍京都 | 0.034 | 1×10⁻⁸ | 0.034 × 10⁻⁸ = 3.40×10⁻¹⁰ |
| Step 1 | 東京と | 0.020 | 5×10⁻⁵ | 0.020 × 5×10⁻⁵ = 1.00×10⁻⁶ |
| Step 2 | 合計 | 3.00×10⁻⁶ + 3.40×10⁻¹⁰ + 1.00×10⁻⁶ = 4.00034×10⁻⁶ | ||
| Step 3 | P(W|X) | 東京都 3.00/4.00034 = 0.7499、 凍京都 0.0001、 東京と 0.2500 |
🎯 このコードでやること:3 つの候補について P(X|W)P(W) を計算し、 合計で割って事後確率 P(W|X) にする。 音響モデルだけで選んだ場合とベイズ則で選んだ場合を比べる。
1 2 3 4 5 6 7 8 9 10 11 12 13 | import numpy as np # 候補の単語列 W、音響モデルの尤度 P(X|W)、言語モデルの事前確率 P(W)(説明用に置いた値) cand = ['東京都', '凍京都', '東京と'] p_x_w = np.array([0.030, 0.034, 0.020]) p_w = np.array([1e-4, 1e-8, 5e-5]) score = p_x_w * p_w # P(X|W) P(W) post = score / score.sum() # 正規化すると P(W|X) for w, a, b, s, q in zip(cand, p_x_w, p_w, score, post): print(f'{w}: P(X|W)={a:.3f} P(W)={b:.0e} 積={s:.2e} P(W|X)={q:.4f}') print('音響モデルだけで選ぶと:', cand[p_x_w.argmax()]) print('ベイズ則で選ぶと :', cand[score.argmax()]) |
💬 手計算の Step 3 と同じ 0.7499・0.0001・0.2500 が出る。 音の似方(P(X|W))だけなら「凍京都」の 0.034 がいちばん高いが、 日本語としてほとんど出てこない(P(W) = 10⁻⁸)ので事後確率は 0.0001 まで下がり、 「東京都」が選ばれる。 言語モデルが「音響的に紛らわしい入力を正しい解釈に誘導する」とは、 この掛け算のことである。
🧮 Viterbi で「あ」と「い」の状態列を 4 フレームで手計算する
📐 の $\delta_t(j) = \max_i[\delta_{t-1}(i)\,a_{ij}]\,b_j(o_t)$ に値を入れる。 状態は「あ」「い」の 2 つ、 観測はフレームごとに F2 が低い(L)か高い(H)かの 2 種類とし、 観測列 L, L, H, H に最も合う状態列を求める。 初期確率 π = (あ 0.6, い 0.4)、 遷移確率 あ→あ 0.7・あ→い 0.3・い→あ 0.2・い→い 0.8、 出力確率 あ:L 0.8・H 0.2、 い:L 0.3・H 0.7 とする(説明用に置いた値)。
| 時刻(観測) | δ_t(あ) | δ_t(い) | どこから来たか |
|---|---|---|---|
| t=1(L) | 0.6 × 0.8 = 0.48 | 0.4 × 0.3 = 0.12 | — |
| t=2(L) | max(0.48×0.7, 0.12×0.2) × 0.8 = 0.336 × 0.8 = 0.2688 | max(0.48×0.3, 0.12×0.8) × 0.3 = 0.144 × 0.3 = 0.0432 | どちらも「あ」から来る |
| t=3(H) | max(0.2688×0.7, 0.0432×0.2) × 0.2 = 0.18816 × 0.2 = 0.037632 | max(0.2688×0.3, 0.0432×0.8) × 0.7 = 0.08064 × 0.7 = 0.056448 | どちらも「あ」から来る |
| t=4(H) | max(0.037632×0.7, 0.056448×0.2) × 0.2 = 0.00526848 | max(0.037632×0.3, 0.056448×0.8) × 0.7 = 0.0451584 × 0.7 = 0.03161088 | 「い」は「い」から来る |
| 逆向き | 最後は δ の大きい「い」(0.03161088)→ t=3 は「い」→ t=2 は「あ」→ t=1 は「あ」 | 状態列 あ あ い い |
🎯 このコードでやること:Viterbi の漸化式を NumPy で回し、 各時刻の δ と、 逆向きにたどった最も確からしい状態列を出す。
1 2 3 4 5 6 7 8 9 10 11 12 13 14 15 16 17 18 19 20 21 22 23 24 | import numpy as np states = ['あ', 'い'] pi = np.array([0.6, 0.4]) # 最初のフレームの状態の確率 A = np.array([[0.7, 0.3], # あ→あ, あ→い [0.2, 0.8]]) # い→あ, い→い B = {'L': np.array([0.8, 0.3]), # 観測 L(F2 が低い)が出る確率 [あ, い] 'H': np.array([0.2, 0.7])} # 観測 H(F2 が高い) obs = ['L', 'L', 'H', 'H'] delta = pi * B[obs[0]] back = [] print(f't=1 δ = {np.round(delta, 6)}') for t, o in enumerate(obs[1:], start=2): cand = delta[:, None] * A # cand[i, j] = δ_{t-1}(i) a_ij back.append(cand.argmax(0)) delta = cand.max(0) * B[o] print(f't={t} δ = {np.round(delta, 8)}') path = [int(delta.argmax())] for bp in reversed(back): path.append(int(bp[path[-1]])) path = path[::-1] print('最も確からしい状態列:', ' '.join(states[i] for i in path), f'(確率 {delta.max():.8f})') |
💬 手計算の表と同じ δ(0.48・0.12 → 0.2688・0.0432 → 0.037632・0.056448 → 0.00526848・0.03161088)が出て、 状態列は「あ あ い い」になる。 すべての状態列は 2⁴ = 16 通りあるが、 Viterbi は各時刻で状態ごとに最良の 1 本だけを残すので、 計算量はフレーム数 × 状態数² で済む。 実際の音声では状態数が数千、 フレームが 1 秒 100 個になるので、 この節約がないと探索できない。
📝 理解度チェック
- 参照 8 文字の発話で、 置換 1・削除 1・挿入 2 が起きた。 CER はいくつか。
答え
(1 + 1 + 2) / 8 = 0.50。 分母は参照の長さなので、 挿入が増えると 1 を超えることもある(上の「100% を超えうる」の節)。 - 8000 Hz は何メルか。 また、 同じ 100 Hz の差が大きく効くのは 200→300 Hz と 4000→4100 Hz のどちらか。
答え
約 2840 mel。 200→300 Hz(118.7 mel)のほうが 4000→4100 Hz(23.7 mel)より約 5 倍大きく効く。 - 上のベイズ則の例で、 「凍京都」の P(W) が 10⁻⁸ ではなく 1×10⁻⁴(東京都と同じ)だったら、 どの候補が選ばれるか。
答え
積は 0.034×10⁻⁴ = 3.4×10⁻⁶ で東京都の 3.0×10⁻⁶ を上回り、 「凍京都」が選ばれる。 言語モデルの差がなければ音の似方で決まる。 - Viterbi の例で観測列が L, L, L, L だったとき、 t=2 の δ(あ) はいくつか。
答え
t=2 までは観測が同じなので 0.2688 のまま。 違いが出るのは t=3 からである。 - 512 点 FFT・16 kHz のとき、 440 Hz は何番目のビンに入るか。
答え
440 × 512 / 16000 = 14.08 なので 14 番目(0 始まり)。 MFCC の Step 3 の power[14] がこれにあたる。
🐍 Python 実装
このコードでやること:Whisper small モデルを使い、 日本語 WAV ファイルを 5 行で文字起こしする。 pip install openai-whisper でインストール後すぐ試せる最小実装。
📥 入力:任意の WAV ファイル(例: 「東京都の出生数は何人ですか」と発話した sample.wav)
1 2 3 4 5 | # Whisper を使った 5 行 ASR import whisper model = whisper.load_model('small') result = model.transcribe('sample.wav', language='ja') print(result['text']) |
📤 実行すると次のような出力になる(sample.wav に「東京都の出生数は何人ですか」を録音した場合の例。 モデルのダウンロードが必要なため、 このページでは実測していない):
💬 短い明瞭な発話なら small でもほぼ正確に認識されることが多いが、 精度は音声の条件で大きく変わるので、 自分の音声で CER を測って決める。 longer/noisy 入力では whisper.load_model('large') に切り替えると精度が向上する。
🐍 補強コード例 1:Whisper による日本語音声ファイルの文字起こし
このコードでやること:OpenAI Whisper を使って日本語 WAV ファイルを文字起こしし、 認識結果テキストと処理時間を出力する。
📥 入力データ:
1 2 3 4 5 6 7 8 9 10 | # pip install openai-whisper import whisper import time model = whisper.load_model("base") # base: 142MB、 精度とバランスが取れたサイズ start = time.time() result = model.transcribe("audio.wav", language="ja") elapsed = time.time() - start print("認識結果:", result["text"]) print(f"処理時間: {elapsed:.2f} 秒") |
📤 実行結果(例。 Whisper のモデルのダウンロードと録音ファイルが必要なため、 このページでは実測していない):
💬 whisper-base は CPU でも数秒以内に認識できる。 日本語はパラメータ language="ja" を明示することで言語検出のオーバーヘッドを省ける。 処理時間は計算機しだいで大きく変わるので、 用途(字幕か議事録か)に必要な速さを先に決め、 自分の環境で実時間比(処理時間 ÷ 音声の長さ)を測る。
⚠️ よくある落とし穴
この用語を使うときに初学者が踏みやすい失敗パターン。 1 度経験してしまえば次から避けられますが、 先に知っておくに越したことはありません。
⚠️ サンプリング周波数の取り違えは「声の高さ」を変えてしまう
「① 録音条件の罠」で触れた 16 kHz への変換を忘れ、 44.1 kHz で録った音声を 16 kHz のものとして読むと、 1 秒ぶんのサンプルが 44,100 ÷ 16,000 = 2.756 秒ぶんとして扱われる。 すべての周波数が 16,000 ÷ 44,100 = 0.363 倍に下がり、 440 Hz は 440 × 0.363 = 159.6 Hz に見える。 エラーは出ないので気づきにくい。
🎯 このコードでやること:44.1 kHz で作った 440 Hz の音を、 正しい 44,100 Hz と誤った 16,000 Hz の 2 通りに「みなして」FFT し、 ピークの周波数・メル・長さを比べる。
1 2 3 4 5 6 7 8 9 10 11 | import numpy as np true_sr = 44100 # 実際の録音は 44.1 kHz x = np.sin(2 * np.pi * 440 * np.arange(true_sr) / true_sr) # 440 Hz を 1 秒 for assumed in [44100, 16000]: # 何 Hz で録ったと思って解析するか spec = np.abs(np.fft.rfft(x)) freqs = np.fft.rfftfreq(len(x), d=1 / assumed) peak = freqs[spec.argmax()] mel = 2595 * np.log10(1 + peak / 700) print(f'{assumed} Hz とみなす → ピーク {peak:6.1f} Hz({mel:5.1f} mel)、長さ {len(x) / assumed:.3f} 秒') |
💬 正しく読めばピークは 440.0 Hz(549.6 mel)だが、 16 kHz とみなすと 159.6 Hz(231.5 mel)、 長さ 2.756 秒になる。 メルで 318 も下にずれるので、 メルフィルタバンクのほぼ別の帯域に入り、 学習時と違う特徴量がモデルに渡る。 モデルに渡す直前に、 ファイルのサンプリング周波数を読んで確かめ、 必要ならリサンプルする。
🌐 関連手法・派生
| ASR (Speech Recognition) | 音声→テキスト。 Whisper・wav2vec 2.0 |
| TTS (Speech Synthesis) | テキスト→音声。 Tacotron・VITS・FastSpeech |
| 話者認識 | 誰が話したかを識別。 x-vector・ECAPA-TDNN |
| 音声分離 | 複数話者の重なりを分離。 Conv-TasNet |
🛠 音声認識 の実装パターン集(10 パターン)
音声認識を実務で使う際の頻出パターンを 10 個紹介。 librosa・Whisper・Vosk など音声専用ライブラリで動かせるコードを提示します。
パターン 2:librosa で波形確認
このコードでやること:librosa で音声ファイルを読み込み、 サンプル数・長さ・RMS を確認する。
📥 入力:sample.wav(任意の WAV ファイル)
1 2 3 4 5 6 | # パターン2: librosa で音声ファイル読み込み・波形確認 import librosa, numpy as np y, sr = librosa.load('sample.wav', sr=16000) print(f'サンプル数: {len(y)}, サンプリング周波数: {sr}Hz') print(f'長さ: {len(y)/sr:.2f} 秒') print(f'RMS: {np.sqrt(np.mean(y**2)):.4f}') |
📤 出力例(イメージ・未実測。5 秒の sample.wav を想定。サンプル数と長さは 16,000 Hz × 5 秒で決まるが、RMS の値は音声の中身しだい):サンプル数: 80000, サンプリング周波数: 16000Hz / 長さ: 5.00 秒 / RMS: 0.1234
💬 RMS が 0 に近ければ無音区間が多い。 sr=16000 で強制リサンプルする。
パターン 3:MFCC 特徴量抽出
このコードでやること:librosa で MFCC 13 次元 × フレーム数の行列を計算し形状を確認する。
📥 入力:sample.wav(16kHz 音声)
1 2 3 4 5 6 7 | # パターン3: MFCC 特徴量を抽出して形状確認 import librosa y, sr = librosa.load('sample.wav', sr=16000) # hop_length=160 (10ms) にすると 1 秒あたり 100 フレームになる(既定の 512 だと約 31 フレーム) mfcc = librosa.feature.mfcc(y=y, sr=sr, n_mfcc=13, n_fft=400, hop_length=160) print(f'MFCC shape: {mfcc.shape}') # (13, フレーム数) print(f'フレーム数: {mfcc.shape[1]} (= 1 + {len(y)} // 160、 {len(y)/sr:.2f}s × 100 fps + 1)') |
📤 出力例(5.00 秒・80,000 サンプルの sample.wav の場合。 librosa と音声ファイルが必要なため、 このページでは実測していない):MFCC shape: (13, 501) / フレーム数: 501 (= 1 + 80000 // 160、 5.00s × 100 fps + 1)
💬 (13, フレーム数) の行列が声道特徴の時系列。 フレーム数は 1 + サンプル数 ÷ hop_length で決まり、 hop_length を指定しない既定の 512 では 5 秒で 157 フレーム (約 31 fps) にしかならない。 音声認識で標準的な 10ms 刻み (100 fps) にするには hop_length=160 を明示する。 HMM-GMM の入力として古典 ASR で使われた形式。
パターン 4:メルスペクトログラム可視化
このコードでやること:音声の 80 バンドメルスペクトログラムを PNG 画像として保存する。
📥 入力:sample.wav
1 2 3 4 5 6 7 8 9 10 11 12 13 14 15 | import os os.makedirs('outputs', exist_ok=True) # 保存先のフォルダを作っておく # パターン4: メルスペクトログラムを計算して可視化 import numpy as np import librosa, librosa.display import matplotlib.pyplot as plt y, sr = librosa.load('sample.wav', sr=16000) S = librosa.feature.melspectrogram(y=y, sr=sr, n_mels=80) S_dB = librosa.power_to_db(S, ref=np.max) fig, ax = plt.subplots(figsize=(10, 4)) librosa.display.specshow(S_dB, sr=sr, x_axis='time', y_axis='mel', ax=ax) ax.set_title('メルスペクトログラム') plt.colorbar(ax.images[0], ax=ax, format='%+2.0f dB') plt.savefig('outputs/melspectrogram.png', dpi=120, bbox_inches='tight') |
📤 出力(標準出力は無し。librosa と音声ファイルが必要なため未実測):outputs/melspectrogram.png(横軸=時間、縦軸=メル周波数のヒートマップ)
💬 有声区間は高エネルギー帯(赤)、 無声は低い(青)。 Whisper はこれを CNN で処理する。
パターン 5:WER(単語誤り率)計算
このコードでやること:jiwer ライブラリで参照文と認識結果の WER を計算する。
📥 入力:参照文(正解)と認識結果(hypothesis)の文字列ペア
1 2 3 4 5 6 | # パターン5: WER(単語誤り率)を計算 from jiwer import wer reference = "東京都の人口は約一千四百万人です" hypothesis = "東京都の人口は約千四百万人だ" error_rate = wer(reference, hypothesis) print(f'WER = {error_rate:.2%}') # → WER = 100.00%(空白が無いので文全体が 1 単語扱い) |
📤 出力(jiwer 4 系で実測):WER = 100.00%
💬 jiwer は空白で単語を区切るので、 分かち書きしない日本語では文全体が 1 単語になり、 1 か所でも違えば WER = 100% になる。 同じ文を jiwer.cer で文字単位に比べると 16 文字中 3 文字の編集で 18.75% となり、 「一千四百」→「千四百」・「です」→「だ」の違いの小ささに見合った値になる。 日本語では CER を使うか、 形態素解析で分かち書きしてから WER を取る。
パターン 6:リアルタイム音声録音
このコードでやること:sounddevice でマイクから 5 秒録音し WAV ファイルに保存する。
📥 入力:PC マイク(sounddevice + soundfile が必要)
1 2 3 4 5 6 7 8 9 10 11 12 | # パターン6: リアルタイム音声録音(5秒) import os import sounddevice as sd import soundfile as sf os.makedirs('outputs', exist_ok=True) # 保存先のフォルダを作っておく fs = 16000 print('録音開始...') data = sd.rec(int(5 * fs), samplerate=fs, channels=1, dtype='float32') sd.wait() print('録音終了') sf.write('outputs/recorded.wav', data, fs) print('outputs/recorded.wav に保存') |
📤 出力例(マイクと sounddevice が必要なため未実測。表示される文字列はコードの print のとおり):録音開始... / 録音終了 / outputs/recorded.wav に保存
💬 録音開始後すぐ話す。 5 秒後に自動停止して WAV 保存。 その後 Whisper に渡せる。
パターン 7:ピッチ(基本周波数)推定
このコードでやること:librosa.pyin で話者の基本周波数(ピッチ)を推定し平均値を表示する。
📥 入力:sample.wav(人声を含む音声)
1 2 3 4 5 6 7 | # パターン7: 話者の声のピッチ(基本周波数)を推定 import librosa, numpy as np y, sr = librosa.load('sample.wav', sr=22050) f0, voiced_flag, voiced_probs = librosa.pyin( y, fmin=librosa.note_to_hz('C2'), fmax=librosa.note_to_hz('C7')) mean_f0 = np.nanmean(f0) print(f'平均ピッチ: {mean_f0:.1f} Hz') # 男性 80-180Hz、女性 150-300Hz |
📤 出力例(イメージ・未実測。男性話者の音声を想定した値で、実際の値は音声しだい):平均ピッチ: 142.3 Hz
💬 男性は 80-180Hz、女性は 150-300Hz が典型。 無音区間は NaN となり nanmean で除外される。
パターン 8:Vosk でオフライン認識
このコードでやること:Vosk(48MB 軽量モデル)でオフライン日本語音声認識を行う。
📥 入力:sample.wav + model/vosk-model-small-ja-0.22(要ダウンロード)
1 2 3 4 5 6 7 8 9 10 11 12 13 | # パターン8: Vosk でオフライン音声認識(軽量) from vosk import Model, KaldiRecognizer import wave, json model = Model('model/vosk-model-small-ja-0.22') with wave.open('sample.wav') as wf: rec = KaldiRecognizer(model, wf.getframerate()) while True: data = wf.readframes(4000) if len(data) == 0: break rec.AcceptWaveform(data) result = json.loads(rec.FinalResult()) print(result['text']) |
📤 出力例(イメージ・未実測。Vosk のモデルのダウンロードと音声ファイルが必要):東京都 の 出生数 は 何人 ですか
💬 Vosk はインターネット不要で動作。 IoT/組み込みや個人情報を送信できない自治体向けに最適。
パターン 9:雑音除去(スペクトラルサブトラクション)
このコードでやること:最初 0.5 秒の雑音プロファイルを使いスペクトラルサブトラクションで雑音を除去する。
📥 入力:noisy.wav(背景雑音あり音声。最初 0.5 秒が純雑音区間であること)
1 2 3 4 5 6 7 8 9 10 11 12 13 14 | # パターン9: 雑音除去(スペクトラルサブトラクション) import os import librosa, numpy as np os.makedirs('outputs', exist_ok=True) # 保存先のフォルダを作っておく y, sr = librosa.load('noisy.wav', sr=16000) # 最初の0.5秒を雑音プロファイルとして取得 noise_clip = y[:int(0.5 * sr)] noise_power = np.mean(np.abs(librosa.stft(noise_clip))**2, axis=1, keepdims=True) D = librosa.stft(y) clean_D = np.maximum(np.abs(D)**2 - noise_power, 0) ** 0.5 * np.exp(1j * np.angle(D)) y_clean = librosa.istft(clean_D) import soundfile as sf sf.write('outputs/clean.wav', y_clean, sr) print(f'雑音除去完了: {len(y_clean)/sr:.2f} 秒') |
📤 出力例(イメージ・未実測。noisy.wav は同梱していないので、秒数は入力の長さしだい):雑音除去完了: 3.24 秒(除去後の音声は outputs/clean.wav に保存される)
💬 スペクトラルサブトラクションは単純な差し引きなのでミュージカルノイズが残ることがある。 より高精度は noisereduce ライブラリを使う。
パターン 10:タイムスタンプ付き文字起こし
このコードでやること:Whisper の word_timestamps=True で各セグメントの開始・終了時刻付きで文字起こしする。
📥 入力:sample.wav(議事録・インタビュー等の音声)
1 2 3 4 5 6 7 8 9 | # パターン10: Whisper でタイムスタンプ付き文字起こし import whisper model = whisper.load_model('base') result = model.transcribe('sample.wav', language='ja', word_timestamps=True) for seg in result['segments']: t_start = seg['start'] t_end = seg['end'] text = seg['text'] print(f'[{t_start:.1f}s - {t_end:.1f}s] {text}') |
📤 出力例(イメージ・未実測。Whisper のモデルのダウンロードと音声ファイルが必要):[0.0s - 2.3s] 東京都の人口は / [2.3s - 4.1s] 約一千四百万人です。
💬 議事録の話者分離(diarization)と組み合わせると、 誰がいつ何を言ったかの完全ログが生成できる。
🐍 第 1 世代のテンプレートマッチング:DTW で話す速さの違いを吸収する
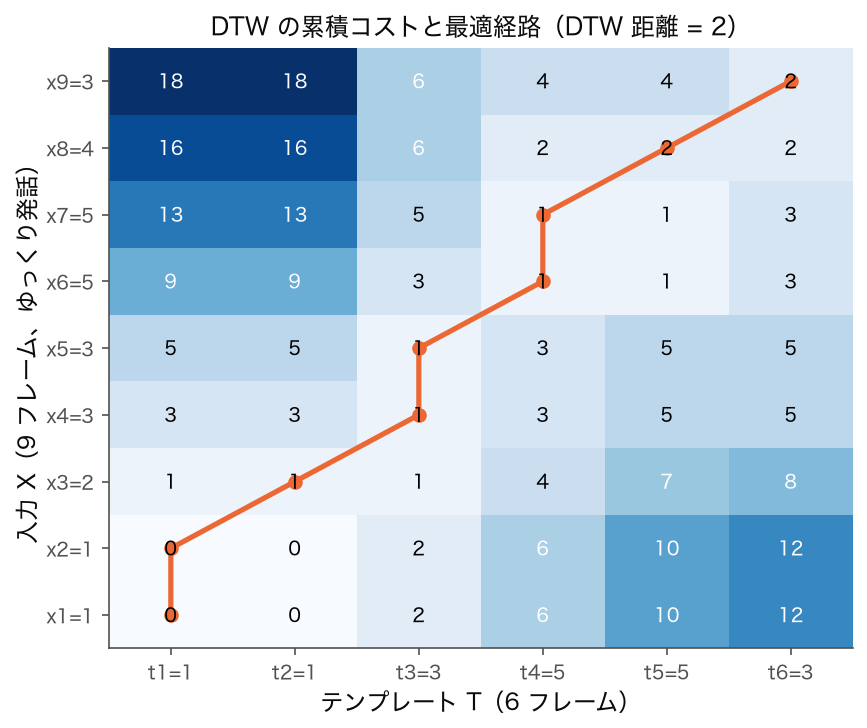
「🎓 歴史」の第 1 世代は、 単語ごとに録音したテンプレートと入力を比べて最も近いものを選ぶ方式だった。 同じ単語でも話す速さでフレーム数が変わるので、 位置どうしをそのまま比べられない。 DTW(動的時間伸縮)は、 時間軸を伸び縮みさせて最も差が小さくなる対応づけを動的計画法で探す。 ここでは各フレームの特徴を 1 つの数(例えば F2 の高さを 5 段階にしたもの)に簡略化した系列で試す。
🎯 このコードでやること:9 フレームの入力 X を、 6 フレームの単語 A・単語 B のテンプレートと DTW で比べる。 比べるために、 長さをそろえて位置ごとに差をとる素朴な方法も並べる。
1 2 3 4 5 6 7 8 9 10 11 12 13 14 15 16 17 18 19 20 21 | import numpy as np def dtw(x, t): n, m = len(x), len(t) D = np.full((n + 1, m + 1), np.inf) D[0, 0] = 0 for i in range(1, n + 1): for j in range(1, m + 1): D[i, j] = abs(x[i - 1] - t[j - 1]) + min(D[i - 1, j], D[i, j - 1], D[i - 1, j - 1]) return D[n, m] X = [1, 1, 2, 3, 3, 5, 5, 4, 3] # 入力(9 フレーム、ゆっくり発話) T = [1, 1, 3, 5, 5, 3] # 単語 A のテンプレート(6 フレーム) U = [5, 5, 3, 1, 1, 1] # 単語 B のテンプレート(6 フレーム) print('DTW(X, 単語 A) =', dtw(X, T)) print('DTW(X, 単語 B) =', dtw(X, U)) # 長さをそろえて同じ位置どうしで比べると(X の先頭 6 フレームだけを使う) print('位置ごとの差の合計(先頭 6 フレーム): 単語 A =', sum(abs(a - b) for a, b in zip(X, T)), ' 単語 B =', sum(abs(a - b) for a, b in zip(X, U))) |
💬 DTW 距離は単語 A が 2、 単語 B が 20 で、 入力は単語 A と判定される。 X の 9 フレームのうち 7 フレームは単語 A のどこかとぴったり対応し、 差が出たのは「2」と「4」の 2 フレームだけ(それぞれ差 1)。 一方、 先頭 6 フレームを位置ごとに比べると単語 A でも差の合計が 7 になり、 ゆっくり話しただけで大きく外れて見える。 DTW はこの「速さの違い」を吸収するが、 語彙が増えるとテンプレートを全部と比べる必要があり、 話者が変わると特徴そのものが変わるので、 第 2 世代の HMM へ置き換わっていった。
🗺 概念マップ
音声認識を中心に、 関連技術・前提知識・派生手法の関係を視覚的に整理する。
→ 音声認識は「波形 → 特徴量 → 音響モデル + 言語モデル → デコーダ → テキスト」のパイプライン。 Whisper のような End-to-End モデルはこれを単一ニューラルネットで統合している。
🔗 隣接手法への橋渡し
音声認識(ASR)は単独で完結する技術ではなく、 下記の隣接領域と連携することでシステムとして機能する。
| 位置 | 技術・手法 | 音声認識との関係 |
|---|---|---|
| 前処理(上流) | 信号処理・MFCC | 音声波形 → 特徴量変換。 精度の上限を決める |
| 競合(並列) | 文字認識(OCR) | 音声入力 vs テキスト入力の代替 UI として競合 |
| 補完(並列) | Transformer | Whisper の内部アーキテクチャ。 言語モデルとの連携 |
| 後処理(下流) | NLP・テキスト分析 | 認識結果(テキスト)を NER・分類・要約に渡す |
| 逆方向 | TTS(音声合成) | ASR の対称技術。 対話システムで ASR + TTS がペア |
| 評価 | WER・CER 計算 | Levenshtein 距離ベースの客観評価指標 |
「音声 → テキスト → 知識 → 音声」の完全な対話ループを構築するには、 上記全領域を繋ぐパイプライン設計が必要。 WER が 10% を超えると下流 NLP の精度も大きく低下するため、 入力品質管理が最優先課題。
🌳 手法選択フロー
音声認識システムを構築・選定する際は、 以下のフローで判断すると適切なモデル選択ができる。
- Step 1: 用途はリアルタイムかバッチか?
- リアルタイム(対話・字幕・コールセンター)→ Whisper-tiny / Vosk(低レイテンシ優先)
- バッチ(議事録・録音文字起こし)→ Whisper-large-v3(精度優先)
- Step 2: オンラインかオフラインか?
- クラウド送信可 → Google Cloud Speech・Azure Speech(高精度・API 課金)
- 完全オフライン必須 → Vosk(48MB)または whisper.cpp(CPU 高速推論)
- Step 3: 対象言語と方言は?
- 標準語・読み上げ音声 → Whisper-base 以上で十分(WER ~9%)
- 方言・高齢者音声・専門用語 → ファインチューニング必須。 Whisper-large + LoRA
- Step 4: 語彙サイズは?
- 限定語彙(都道府県名 47 語など)→ 専用小型モデルで WER ~3% を達成可能
- 自由発話(語彙 1 万語超)→ 大規模モデル + ビームサーチ(K=50 以上)
- Step 5: 評価と改善
- WER を定期測定 → 10% 超ならモデル更新 or 前処理見直し
- エラー分析 → 置換・削除・挿入のどれが多いかで対策を変える
迷ったときの基本方針:まず Whisper-base + オフラインで試し、 WER が目標に届かなければ larger モデルへ、 レイテンシが厳しければ tiny / Vosk へスケールする。
❓ よくある質問(FAQ)
reazonspeech も検討。openai-whisper, faster-whisper (CTranslate2 高速化), transformers (HuggingFace の wav2vec2-base-japanese), SpeechRecognition (API ラッパー), librosa (前処理) が王道。 録音は sounddevice, MFCC は python_speech_features。🔬 音声認識をもう一段深掘りする — 実務での難所と工夫
単に Whisper を呼び出すだけならコード数行で済む音声認識だが、 業務に組み込む段階では「音響条件・前処理・評価・継続学習」の 4 つで必ず壁にぶつかる。 ここでは SSDSE-B-2026 や公的音声コーパス(JSUT・Common Voice 日本語版)を題材に、 現場で発生する典型的な問題と対処法を整理する。
① 録音条件の罠 — 16kHz・モノラル・PCM が前提
Whisper・wav2vec 2.0・Vosk のような大半の ASR モデルは「16,000 Hz・1 チャンネル(モノラル)・16-bit PCM」の WAV を内部仕様としている。 実際に集めた音声は 44.1kHz ステレオ MP3 や 48kHz の M4A だったりするので、 推論前に ffmpeg -i input.mp3 -ar 16000 -ac 1 -c:a pcm_s16le output.wav でリサンプル+ダウンミックスする工程が欠かせない。 この変換を忘れて 44.1kHz のまま投入すると、 モデルが想定する入力と違う音声になり、認識精度が落ちることがある(どれだけ落ちるかは音声とモデルしだい)。 SSDSE-B-2026 のような表データには直接関係しないが、 例えば「市町村別の議会音声」を分析対象にする場合は録音条件のチェックを最初の前処理ステップに必ず入れること。
② 前処理 — 無音区間とノイズの扱い
録音には会議冒頭の沈黙、 マイクのハム音、 紙をめくる雑音などが混じる。 これらを残したまま ASR にかけると「えっと」「あの」のようなフィラーを過剰に拾ったり、 ノイズを単語と誤認識して WER が劣化する。 実務では silero-vad 等の音声活動検出(VAD)で「人間が話している区間」だけを切り出し、 30 秒以下のチャンクに分割してから Whisper にかけるのが定石。 Whisper 公式の transcribe() も内部で 30 秒チャンクを使うが、 自前 VAD を入れたほうがチャンク境界で発話が途中で切れることが減る。
③ 評価 — WER だけでは判断を誤る
音声認識の標準的な評価指標は WER(Word Error Rate)だが、 日本語は単語境界が曖昧なので「形態素単位」「文字単位(CER)」のどちらで計算するかで数値が大きく変わる。 例えば「東京都」を「東京 / 都」と分かち書きすると 1 単語誤りで WER が悪化するが、 CER なら 0 文字誤りとなる。 業務報告では「CER と単語単位 WER の両方」を出し、 さらに置換・削除・挿入の内訳(Substitution / Deletion / Insertion)を Levenshtein 距離から抽出して、 どの種類のエラーが多いかを示すと改善方針が決まる。 削除が多ければ VAD・チャンク幅、 置換が多ければモデル容量、 挿入が多ければ前後文脈の正則化が効く。
④ 継続学習 — 専門語彙への適応
「SSDSE-B-2026」「都道府県名 47 語」「政令指定都市 20 語」のような専門用語は、 標準 Whisper では「セスディーセー B-2026」のような奇妙な転写になる。 対処は 2 通り:(A)プロンプト誘導 — Whisper の initial_prompt 引数に「以下は SSDSE-B-2026 の音声録音です。 都道府県名や政令指定都市名が頻出します」と書くと、 関連語の確率が押し上げられる。 (B)LoRA / アダプタチューニング — 専門音声 100〜500 件で Whisper-large に LoRA を追加学習。 SSDSE-B-2026 だけを扱うなら(A)で十分、 業務特化させるなら(B)を検討する。
⑤ 推論時のレイテンシ最適化
リアルタイム字幕や音声 UI に組み込む場合、 推論レイテンシが 2 秒を超えると「会話が成立しない」と感じる。 Whisper-large は計算量が大きく、 30 秒単位で処理する設計でもあるため、 そのままでは streaming には向かない。 代替策は(i)Whisper-tiny / base(精度をいくらか犠牲にして軽くする)、 (ii)faster-whisper(CTranslate2 で量子化+並列化し、 精度をほぼ保ったまま高速化)、 (iii)Vosk + Kaldi(特化型・CPU でも逐次認識できる)。 CPU 環境なら faster-whisper-int8、 GPU 環境なら faster-whisper-fp16 が現時点の標準。
⑥ ハルシネーション — Whisper の「幻聴」問題
Whisper には特有の「幻聴ハルシネーション」がある。 完全な無音区間や音楽部分で「ご視聴ありがとうございました」「字幕を提供してくれた方に感謝」のような YouTube 動画の常套句を勝手に生成する現象だ。 訓練データに YouTube 動画が大量に含まれているのが原因。 対策は(A)VAD で無音区間を事前にカット、 (B)temperature=0.0 + condition_on_previous_text=False で確率最大値のみ出力、 (C)出力後にハルシネーション辞書(既知の常套句リスト)と照合してフィルタ。 業務システムでは(A)と(C)を両方適用するのが安全策。
⑦ プライバシー — オンプレ・オフライン推論の必要性
医療・法務・教育現場の音声を扱う場合、 Google Cloud Speech や Azure Speech のようなクラウド ASR は個人情報保護法・GDPR・HIPAAの観点から避けるべきケースがある。 オフライン推論の選択肢は(i)whisper.cpp(C++ 実装、 CPU で MacBook でも動作)、 (ii)Vosk(軽量・48MB 日本語モデル)、 (iii)WhisperX(faster-whisper ベースで話者分離も同時)。 SSDSE-B-2026 の都道府県別調査などのオープンデータには問題ないが、 機微情報を含む音声データでは必ずオンプレ環境を選ぶこと。
⑧ 多言語混在発話への対応
日本語の中に英単語が混じる「コードスイッチング」(例:「その Python の DataFrame に read_csv で読み込ませて」)は、 単一言語モデルの弱点が露呈する場面。 Whisper は多言語学習されているので比較的強いが、 それでも英語固有名詞を「リード・シーエスブイ」のように誤転写することがある。 対策はプロンプトに英単語を明示列挙する、 または事後に英単語辞書(Python 関数名・SQL キーワードなど)と照合して置換する。 SSDSE-B-2026 のような行政データを扱うときは「都道府県コード R01100」のような英数字混在も誤転写されやすいので注意。
⑨ 話者分離 — 議事録の「誰が話したか」
議事録・会議録の文字起こしでは「誰の発言か」が情報として重要。 標準の Whisper は転写のみで話者分離はしない。 対策は WhisperX(faster-whisper + pyannote.audio)や diart を組み合わせる。 pyannote の話者分離モデル(pyannote/speaker-diarization-3.1)は事前に話者数を与えなくてもクラスタリングで自動推定する。 ただし話者交代の前後 0.5 秒程度は誤分類されやすく、 会話が重なる場面(オーバーラップ)では精度が落ちる。 解決策は「後処理で短い分節を隣接話者と統合」する平滑化を入れること。 SSDSE-B-2026 のような単発調査データでは不要だが、 議会音声・インタビューを扱うなら必須機能となる。
⑩ 音声認識の品質ベンチマーク — 公開コーパスで定期測定
継続運用するシステムは、 月次でモデル性能を定点観測すべき。 日本語の標準ベンチマークは(A)CSJ(日本語話し言葉コーパス) — 学会講演・模擬講演 660 時間、 (B)JSUT — 単一話者・読み上げ・5,000 文、 (C)Common Voice 日本語 — Mozilla 主導のクラウドソーシング音声、 (D)ReazonSpeech — テレビ放送の音声と字幕から作られた大規模コーパス。 自社業務音声 100 件 + 上記公開セット 4 種で WER/CER を測ると、 「業務音声の WER が悪化した時、 公開セットでも悪化しているか」でモデル劣化か業務データドリフトかを判別できる。 これは産業界で言う「コンセプトドリフト検知」の音声版である。
⑪ 公的データへの応用 — SSDSE-B-2026 と音声 UI
SSDSE-B-2026 のような表形式の都道府県統計に音声認識を直接適用する場面は少ないが、 「音声で SSDSE-B-2026 を検索する」インターフェイス開発では役に立つ。 例: ユーザーが「東京の人口を教えて」と発話 → ASR で「東京 の 人口 を 教えて」に転写 → 形態素解析 → カラム名「総人口(人)」と地名「東京都」をマッチング → DataFrame.query で抽出 → TTS で「東京都の総人口は約 1,409 万人です(SSDSE-B-2026 の 2023 年度値 14,086,000 人)」と回答。 この一連の音声 UI を構築するには Whisper-base(ASR)+ MeCab(解析)+ Pandas(検索)+ VITS(合成)の組合せが定番。 SSDSE-B-2026 の 47 都道府県名と 100 超のカラム名をプロンプトに事前注入することで、 専門語彙の誤認識を抑えられる。
⑫ コスト見積もり — 1 時間音声の処理に何円かかるか
業務導入の検討段階で必ず聞かれるのが「1 時間の音声を文字起こしすると何円かかるか」。 路線は大きく 3 つ:(A)クラウドの音声認識 API(音声の分数に応じた従量課金)、 (B)Whisper などのモデルを API で呼ぶ(同じく従量課金)、 (C)自前の計算機で推論(計算機の時間単価 × 処理時間 + 構築・運用の工数)。 単価は改定されるので、 見積もりのたびに各社の公式の料金表で確かめる。 式にすると(A)(B)は「月の音声時間 × 60 × 1 分あたり単価」、 (C)は「月の音声時間 × 実時間比(1 時間の音声の処理に何時間かかるか)× 計算機の時間単価 + 固定の運用費」。 (C)は処理量が少ないと固定費が効いて割高になり、 処理量が多いほど有利になるので、 両者が等しくなる月の音声時間(損益分岐点)を自分の単価と実測の実時間比で計算して判断する。
⑬ オフライン Whisper の構築手順 — 手元の PC で完結する例
セキュリティ要件で完全オフラインが必要な場合、 手元の PC で whisper.cpp を使う構成が簡単。 手順:(1) brew install whisper-cpp でバイナリ取得、 (2) ./models/download-ggml-model.sh large-v3 で 3GB のモデルファイル取得、 (3) whisper-cpp -m models/ggml-large-v3.bin -f audio.wav -l ja --output-json で実行。 処理時間は PC の性能で大きく変わるので、 短い音声で測ってから見積もる。 これで「クラウドに音声を送らずに精度を保つ」要件を満たせる。 ファインチューニングは Apple Silicon の MPS バックエンドだと不安定なため、 推論専用と割り切るのが現実的。 SSDSE-B-2026 のような公的データ周辺の研究用途では十分な構成である。
⑭ 字幕生成への応用 — タイムスタンプ精度の調整
動画字幕や議事録の「○分○秒に誰が何を発言した」記録には、 単語レベルのタイムスタンプが必要。 Whisper の標準出力は「セグメント単位」のタイムスタンプ(30 秒チャンク内の開始・終了秒)で、 単語レベルではない。 単語タイムスタンプが欲しい場合は WhisperX または stable-ts を使う。 WhisperX は wav2vec2 で音素に再アライメントして単語の境界を細かく求める。 stable-ts は Whisper のクロスアテンション重みから単語境界を推定する。 字幕用の SRT/VTT 出力は whisper --output_format srt でも可能だが、 1 行 42 文字制限を守るには別途整形スクリプト(例: pysrt の split_long_subtitles)が要る。
⑮ 倫理的配慮 — 同意・バイアス・誤転写の責任
音声認識を業務適用する際には倫理・法的留意事項を必ず明文化する。 (i) 録音同意 — 会議冒頭で「本会議は文字起こしのため録音しています」と告知し議事録に記録。 (ii) アクセント・方言バイアス — Whisper は東京方言中心の訓練データに偏り、 訓練データに少ない方言や話し方では認識精度が下がりうる。 業務で全国対応する場合は方言別の評価セットで定期的に確認する。 (iii) 誤転写の責任所在 — 「ASR 出力をそのまま議事録扱い」は誤訳訴訟リスクが高い。 必ず人手でレビューするワークフローを併設し、 ASR 出力には「機械転写・未校正」のラベルを付ける。 (iv) 削除・修正権 — 文字起こし対象者から「私の発言を削除してほしい」要求があった場合の対応フローを事前定義。 公的データ(SSDSE-B-2026 など)には該当しないが、 民間音声を扱うなら必須の整備項目である。
⑯ 教育現場での導入事例 — 講義文字起こしと検索性向上
大学・専門学校での「講義動画の自動文字起こし」は音声認識の代表的応用。 学生が「先週の統計学の講義で『共分散』が出た時刻を探したい」と思った時、 時刻付きの字幕があれば全文検索ですぐに見つかる。 構成は (i) 講義映像を ffmpeg で音声分離、 (ii) Whisper-base で日本語転写、 (iii) Elasticsearch / Meilisearch に時刻付き字幕を投入、 (iv) Web UI から検索 → 該当時刻の動画にジャンプ。 1 学期 15 回 × 90 分 = 22.5 時間分の音声が対象になり、 処理にかかる時間はモデルの大きさと実行環境で大きく変わるので、 1 回分で測ってから全体を見積もる。 統計教育では SSDSE-B-2026 のような実データ操作が頻繁に出るため、 字幕検索により「DataFrame の query メソッドの解説部分だけ復習」が高速になる。 LMS(Moodle・Canvas)との連携で UX が劇的に向上する。
⑰ 音声認識と感情分析の組合せ — マルチモーダル展開
発展形として、 音声認識の出力テキストに加えて韻律・声の高さ・スピード・音量から感情を推定する「音声感情認識(SER: Speech Emotion Recognition)」を併用する事例が増えている。 コールセンターの「顧客満足度モニタリング」では Whisper の転写 + wav2vec2-emotion で「怒り 60% / 中立 30% / 喜び 10%」のような感情ラベルを付与し、 クレーム電話の自動検知に使う。 教育応用では学生のプレゼン録音から「自信度・緊張度」を推定し、 講師がフィードバックに活かす。 ただし感情ラベルは個人差・文化差が大きく、 単独の指標を意思決定根拠にすべきではない。 必ず転写テキストの内容と合わせて解釈する。 SSDSE-B-2026 のような表データには直接関係ないが、 業務拡張で出会う重要な隣接技術である。
📝 まとめ:音声認識の「動かす」から「業務で使う」へ
音声認識は「whisper.transcribe(\"audio.wav\")」の 1 行で動くが、 業務で安定運用するには「音響条件・前処理・評価・継続学習・レイテンシ・ハルシネーション・プライバシー・多言語・話者分離・ベンチマーク・公的データ連携・コスト試算・オフライン構築・字幕生成・倫理配慮・教育応用・感情分析」の 17 軸を一通り検討する必要がある。 SSDSE-B-2026 のようなオープンデータでは①〜③と⑪⑯が中心、 業務システムでは④〜⑩と⑫〜⑮が重要になる。 まず Whisper-base + 自前 VAD + CER/WER 両方評価で動かし、 そこから足りない軸を補強していくのが現実的な進め方である。 各段階で「何を測り、 何を改善するか」を 1 文で書き留めながら進めると、 後の振り返り・引き継ぎが格段に楽になる。 統計・データ解析コンペティション 2026 の文脈では SSDSE-B-2026 を素材に、 音声 UI や講義検索のような周辺応用を「思いつく」ところまでが学習目標と言える。
最後に重要な視点として、 音声認識は「完璧な転写」を目指す技術ではなく、 「後段タスク(検索・要約・感情分析・翻訳)で活用できる粒度の構造化」を目指す技術だと位置付けると、 設計判断がブレなくなる。 SSDSE-B-2026 を題材に音声 UI のプロトタイプを 1 度作ってみるのが、 音声認識の実力を体感する最短ルートである。 完璧主義に陥らず、 「70 点の転写を 90 点の業務価値に変える後処理パイプライン」の設計こそが、 音声認識エンジニアの腕の見せどころだと覚えておきたい。 各章の落とし穴を意識しながら段階的に運用品質を上げる進め方が、 結果として最短距離となる経験則は他のデータサイエンス領域とも共通している。 こうした態度の積み重ねが、 単なる技術選定を超えて、 持続可能な音声認識システム運用文化を生み出していく。