🔖 キーワード索引
別名・略称:ASR、 Automatic Speech Recognition、 STT、 Speech-to-Text
音声認識は 音声波形をテキストに変換する技術。 Siri, Alexa, 自動字幕、 議事録、 コールセンターなど現代生活に不可欠。 Whisper 以降ほぼ「解けた」分野。
💡 30秒で分かる結論
🍰 まずはやさしく
声を文字に変える魔法のような技術です。
話した内容を記録するために使います。
スマホへの音声入力などが身近な例です。
この技術の仕組みと使い方を学びます。
音声認識(Speech Recognition / ASR):音声波形をテキストに変換する技術
- パイプライン:音声 → 特徴抽出(メルスペクトログラム)→ 音響モデル → 言語モデル → テキスト。
- 現代の標準:End-to-end の Transformer(Whisper, Wav2Vec 2.0)。
- 主要手法:CTC, RNN-Transducer, Attention seq2seq。
- 評価指標:WER(単語誤り率)、 CER(文字誤り率)。
- 応用:音声アシスタント、 字幕、 議事録、 コールセンター。
📍 あなたが今見ているもの
🍰 まずはやさしく
誰でも使える便利な道具になりました。
仕事や勉強の効率を上げるために使います。
動画に自動で字幕をつける機能があります。
最近の技術で何が変わったかを見ます。
🎨 直感で掴む
🍰 まずはやさしく
音を分析して文字に直す流れがあります。
正しく言葉を読み取るために使います。
部活の練習メニューを声でメモする感じです。
音がどうやって文字になるかを図解します。
処理パイプライン
- 音声波形(16 kHz サンプリング、 PCM)取得
- 窓関数 + FFT → スペクトログラム
- メルフィルタバンク → メルスペクトログラム(80 次元程度)
- 音響モデル(Transformer/CNN/RNN)で音素や文字を予測
- 言語モデル(n-gram or Transformer)で系列を整流
- テキスト出力
End-to-End 3 大手法
| 手法 | 概要 | 代表モデル |
|---|---|---|
| CTC | 出力を input 長に揃え、 重複・空白で対応付け | DeepSpeech, Wav2Vec 2.0 |
| RNN-Transducer | 音響と言語を結合学習 | Google Mobile ASR |
| Attention seq2seq | Encoder-Decoder + Attention | Listen-Attend-Spell, Whisper |
古典 vs 現代
| 時期 | 代表 | 特徴 |
|---|---|---|
| 〜2010 | HMM-GMM | 音素 HMM + GMM 観測モデル |
| 2012-2018 | DNN-HMM, CTC | DNN 音響モデル + 言語モデル分離 |
| 2019-現在 | Wav2Vec 2.0, Whisper | 自己教師あり + Transformer End-to-End |
🎨 テーマ 1:特徴量抽出 — 音声を数値にする
音声認識の入口は波形をどう数値化するかです。 16 kHz サンプリングの音声 1 秒は 16,000 個の値の列。 そのままモデルに食わせるのは効率が悪いため、 フレーム分割(25 ms 窓・10 ms シフトが定番) → 短時間フーリエ変換(STFT) → メルフィルタバンク → 対数 → 必要に応じて離散コサイン変換(DCT)という流れで、 1 秒あたり 100 フレーム × 80 次元程度の特徴量列に圧縮します。 これが Log-Mel スペクトログラム や MFCC(Mel-Frequency Cepstral Coefficients)と呼ばれるものです。
📐 数式(MFCC の核心)
STFT で得た振幅スペクトル $|X(f)|$ をメルスケール $M$ のフィルタバンクに通し、 対数を取り、 DCT で圧縮:
$$ \text{Mel}(f) = 2595 \log_{10}\!\left(1 + \frac{f}{700}\right) $$
$$ \text{MFCC}_k = \sum_{m=1}^{M} \log\!\Big( \sum_{f} |X(f)|^2 \, H_m(f) \Big) \cos\!\Big( \frac{k(m-0.5)\pi}{M} \Big) $$
🔬 数式を言葉で読み解く
- $\text{Mel}(f)$ は 人間の聴覚に近い周波数スケール。 低音は線形・高音は対数に近い間隔でフィルタを並べる。
- $H_m(f)$ は三角形のフィルタ(典型的に 80 個)。 各フィルタが特定の周波数帯域のエネルギーを拾う。
- 対数を取るのは「人間の音量知覚(dB スケール)」に合わせ、 ダイナミックレンジを圧縮するため。
- DCT は 相関の強いメル係数を脱相関化し、 低次の数係数(典型的に 13)に情報を集中させる。
🎨 テーマ 5:Whisper の威力 — 68 万時間の事前学習
OpenAI の Whisper(2022 年)は、 99 言語・68 万時間のラベル付き音声で訓練された Encoder-Decoder Transformer。 ASR を「商用ベンダーが大量に守る職人芸」から「誰でも使えるオープン技術」へ転換した記念碑的存在です。 アーキテクチャは平凡な Transformer Encoder-Decoder ですが、 データ量・multitask 学習(言語識別・タイムスタンプ・翻訳を同時)・weak labels(YouTube 字幕など)を活用した点が革新でした。
📊 Whisper モデルサイズと精度の対応表
| モデル | パラメータ数 | VRAM 目安 | 英語 WER (LibriSpeech test-clean) |
|---|---|---|---|
| tiny | 39M | ~1GB | 7.6% |
| base | 74M | ~1GB | 5.0% |
| small | 244M | ~2GB | 3.4% |
| medium | 769M | ~5GB | 2.9% |
| large-v3 | 1550M | ~10GB | 2.4% |
※ 英語 WER は Whisper の公開ベンチマークの目安(large-v3 は論文の後に公開されたモデル)。 日本語の CER は評価データと表記の正規化で大きく変わるため、 ここには載せない。
🎨 テーマ 9:ストリーミング ASR とレイテンシ
スマートスピーカー(Alexa, Google Home)、 同時字幕、 通訳機器は音声が話されている最中に部分結果を返す必要があります。 Whisper のような Encoder-Decoder は文末待ちが前提で遅延が大きく、 スマートデバイスには不向き。 そこで RNN-T(RNN Transducer)や CTC + 因果 Conformer が選ばれます。
📊 用途別の典型的レイテンシ
| 用途 | 許容レイテンシ | 推奨アーキテクチャ |
|---|---|---|
| スマートスピーカー応答 | ~ 300 ms | RNN-T (Conformer encoder) |
| 同時字幕(テレビ生放送) | 1〜2 秒 | Streaming Conformer + CTC |
| 議事録作成(バッチ) | 数秒〜数分 | Whisper-large (offline) |
| アーカイブ書き起こし | 時間制約なし | Whisper-large + LLM 後処理 |
🎮 触って学ぶ:音声区間検出(VAD)— エネルギーとゼロ交差で区切る
生の音声波形をそのまま「言葉」に変える前に、 まず どこが声で・どこが無音か、 さらに 声の中でも母音のような「有声音」か、 サ行のような「無声音」かを大まかに区切ります。 これを 音声区間検出(VAD: Voice Activity Detection)と呼びます。 ここでは 2 つの単純な特徴 ── 短時間エネルギー(音の大きさ)と ゼロ交差率(波形が 0 を横切る頻度=おおよその高さ/かすれ具合) だけで区切りが体感できます。
🧩 なぜフレームに区切って窓をかけるのか
音声は時々刻々と変わるので、 全体をまとめて 1 つの数値にはできません。 そこで 25 ms 程度の短い窓(このデモでは 100 サンプル)を 10 ms(40 サンプル)ずつずらして切り出し、 各フレームで特徴を計算します。 短い窓の中では音がほぼ一定とみなせる、 という近似が土台です。 窓の端で波形をブツッと切ると人工的な高周波(スペクトル漏れ)が出るため、 ハミング窓のように端をなめらかに 0 へ落とす重みをかけます。 チェックを入れると、 端が抑えられてエネルギー曲線がわずかに滑らかになる様子が見られます(ゼロ交差率は窓が正の重みなので符号が変わらず不変)。
🧠 なぜ生波形でなく「特徴」を使うのか・時間伸縮(DTW)の直感
上のデモの通り、 生の波形(1 秒で数千点)は情報が多すぎて直接は比べにくい。 エネルギーとゼロ交差率という 2 特徴に落とすだけで「声か無音か・母音か摩擦音か」が判別できました。 実際の音響モデルはこれを高度化した メルスペクトログラムや MFCC を使います。 さらに、 同じ「あ」でも ゆっくり言えば長く・早口なら短くなります。 波形を時間軸で伸び縮みさせて一番よく重なる対応を探すのが 動的時間伸縮(DTW: Dynamic Time Warping)の直感で、 CTC の「同じ文字を何フレームも繰り返してよい」という考え方の源流でもあります。
💡 深掘り
- 直感:波形そのものを読むのではなく、 特徴(大きさ・かすれ具合)で区切って読む。 区切ってから「この区間は何の音か」を当てるのが認識の第一歩。
- 落とし穴:現実では (1) 雑音が乗るとエネルギー閾値だけでは無音と発話を分けられない、 (2) 話者差(子ども・高齢者・声の大小)で最適な閾値がずれる、 (3) 同音異義(「橋/箸」)は音だけでは決まらず言語モデルが要る、 (4) 区切り位置(連続発話で単語境界が曖昧)は日本語で特に難しい。 スライダーを極端に動かすと、 少しの閾値変更で区間が総崩れする脆さが体感できます。
- 発展:この 2 特徴 → MFCC / メルスペクトログラム(Attention 系の入力)へ。 区間の音を当てるモデルは HMM → ニューラル音響モデル(RNN / Transformer)へ。 出力の整列は エンドツーエンド CTC、 文脈整流は 言語モデル(n-gram や NLP)が担う。 音声から言語への橋渡しは 機械翻訳と同じ Encoder-Decoder 枠組みへ発展します。
📐 定義 / 数式
🍰 まずはやさしく
計算を使って正解を導き出すルールです。
間違いがどれくらいあるか測るために使います。
テストの採点のように正解と比較します。
計算式を使って仕組みを詳しく説明します。
📐 テーマ 2:HMM-GMM の基礎 — 古典的 ASR を理解する
2010 年代前半まで、 商用音声認識の主流は HMM(隠れマルコフモデル)+ GMM(混合ガウス分布)でした。 「なぜ確率モデルなのか」を理解しないと、 後発の DNN-HMM、 CTC、 Attention の意義も腑に落ちません。 ここでは HMM-GMM の本質を式と例で押さえます。
📐 数式(音響モデルの確率分解)
音声 $O = o_1, o_2, \dots, o_T$ に対して、 文字列 $W^*$ を求める基本式:
$$ W^* = \arg\max_W P(W \mid O) = \arg\max_W P(O \mid W) \cdot P(W) $$
右辺第 1 項が音響モデル(HMM-GMM)、 第 2 項が言語モデル(n-gram など)。 HMM は隠れ状態 $s_t$ の遷移確率 $a_{ij} = P(s_t = j \mid s_{t-1} = i)$ と出力確率 $b_j(o_t) = P(o_t \mid s_t = j)$ で定義され、 $b_j$ を多次元 GMM でモデル化したのが HMM-GMM。
🔬 数式を言葉で読み解く
- $P(O \mid W)$ = 音響モデル:「文字列 W があったとき、 この音声 O が観測される確率はどれくらいか」。 GMM が「音素 a の音は MFCC 空間でこの辺に集まる」を表現。
- $P(W)$ = 言語モデル:「この文字列が日本語として自然か」。 n-gram は「今日の の次に来る単語は 天気 が多い」を確率で表す。
- ベイズ則で「音声から文字列」を「文字列から音声 × 文字列の自然さ」に分解できる点が肝。 直接 $P(W \mid O)$ を学習するのは困難(W の組合せ爆発)だが、 上記の分解なら音響と言語を別個に学習できる。
- 2010 年に DNN-HMM が登場し、 GMM が DNN(ディープニューラルネット)に置き換わって精度が一段上がった。 その先で全部を一気通貫で学習するのが現代の End-to-End ASR。
📐 テーマ 3:CTC — 「入出力の長さが違う」問題を解く
音声フレーム(数百個)に対し、 出力文字(数十個)。 この長さの不一致と整列情報の欠如(どのフレームがどの文字に対応するか不明)を一気に解決するのが CTC(Connectionist Temporal Classification)です。 2006 年 Alex Graves 提案、 現代 ASR の根幹技術の 1 つ。
📐 数式(CTC 損失)
$$ P(\mathbf{y} \mid \mathbf{X}) = \sum_{\pi \in \mathcal{B}^{-1}(\mathbf{y})} \prod_{t=1}^{T} p(\pi_t \mid \mathbf{X}) $$
$$ \mathcal{L}_{\text{CTC}} = -\log P(\mathbf{y} \mid \mathbf{X}) $$
🔬 数式を言葉で読み解く
- $\pi$ はフレームごとのラベル系列(特殊な blank トークンを含む)。 例えば 5 フレームで「あ_い_」「あ_いい」「ああい_」など、 同じ「あい」を生む多数のパスが存在。
- $\mathcal{B}$ は blank と重複を畳み込む操作。 「あ_い_」→「あい」、 「ああい_」→「あい」のようにマージ。
- $\sum$ は全可能なパスについて確率を周辺化。 「どこに何が来るか」を明示せず「最終的に正解文字列になる確率」を最大化する。
- この $\sum$ は動的計画法(Forward-Backward)で効率的に計算できる。 これにより GPU で 1 ステップ数 ms で学習可能。
📐 テーマ 4:Encoder-Decoder Attention — Listen-Attend-Spell
2015 年 Google が提案した Listen-Attend-Spell(LAS)は、 音声 ASR を機械翻訳と同じ Encoder-Decoder + Attention 枠組みで解く先駆けでした。 Encoder(Listener)が音声を圧縮し、 Decoder(Speller)が文字を 1 つずつ生成。 Attention が「次の文字を生成するとき、 音声のどの位置を見るか」を学習。
📐 数式(Attention の核)
$$ \alpha_{t,i} = \frac{\exp(\text{score}(s_t, h_i))}{\sum_{j} \exp(\text{score}(s_t, h_j))}, \quad c_t = \sum_i \alpha_{t,i} h_i $$
🔬 数式を言葉で読み解く
- $h_i$:Encoder が出力した $i$ 番目の音声フレームの隠れ状態(特徴ベクトル)。
- $s_t$:Decoder が $t$ 番目の文字を生成しようとしている時点の状態。
- $\alpha_{t,i}$:「$t$ 番目の文字を出すとき、 $i$ 番目の音声フレームをどれだけ重視するか」を表す注意重み(合計 1)。
- $c_t$:注意で重み付け和した「文脈ベクトル」。 これを使って Decoder は次文字を予測。
- CTC との違い:CTC は「フレーム単位で文字を予測 → 後で畳み込む」、 Attention は「文字単位で必要な音声フレームを能動的に選ぶ」。 現代の Whisper は両者のハイブリッド。
📐 追補 1:Wav2Vec 2.0 — ラベルなし音声で事前学習する革命
2020 年 Meta(旧 Facebook)が発表した Wav2Vec 2.0 は、 大量のラベルなし音声(数千時間 OK)で自己教師あり事前学習し、 その後少量のラベル付き音声(10 分でも可!)で fine-tuning するだけで競争力ある ASR を作れるようにしました。 これにより、 「アイヌ語」「琉球諸語」のようなラベル付きデータが乏しい言語でも実用 ASR が構築可能になった点が画期的。
📐 数式(Contrastive 損失)
$$ \mathcal{L}_m = -\log \frac{\exp(\text{sim}(c_t, q_t) / \kappa)}{\sum_{\tilde{q} \in Q_t} \exp(\text{sim}(c_t, \tilde{q}) / \kappa)} $$
🔬 数式を言葉で読み解く
- $c_t$:Transformer Encoder が時刻 $t$ で出力するベクトル(マスクされた箇所の予測)。
- $q_t$:時刻 $t$ の真の量子化ベクトル(離散コードブックから得たターゲット)。
- $Q_t$:同じ発話内のランダムな他の量子化ベクトル群(ネガティブサンプル、 典型的に 100 個)。
- 意味:「マスクされた時刻の音響特徴を、 同じ発話内の他の時刻と区別して当てよ」というクイズ。 ラベルは不要なのに、 「音響的に似ている/似ていない」の感覚が獲得できる。
- $\kappa$ は temperature。 小さくすると区別が厳しく、 大きいと緩い。
こうして得た事前学習済みモデルに、 SSDSE-B-2026 の都道府県名のような少量音声(10 分)を流して fine-tuning すれば、 「47 県を 95% 認識できる」専用 ASR が構築できる。 アノテーションコストが従来の 1/100 以下になる点が、 自治体・教育機関で重宝される理由。
🔬 記号・式を言葉で読み解く
- $X$ — 音響特徴系列
- メルスペクトログラム等のフレーム列。 通常 100 fps、 80 次元。
- $W$ — 単語列(書き起こし)
- 出力するテキストの単語シーケンス。
- $P(X|W)$ — 音響モデル
- 「この単語列に対しこの音響が出る確率」。 DNN/Transformer で学習。
- $P(W)$ — 言語モデル
- 「自然な単語列か」。 n-gram or LLM。
- CTC(Connectionist Temporal Classification)
- 音声フレーム数 ≫ 単語数の対応問題を、 空白記号と重複畳み込みで解決。
- RNN-T
- 音響予測 + 言語予測を結合学習。 ストリーミング対応の主流。
- WER(Word Error Rate)
- 編集距離ベースの誤り率。 ASR の標準評価指標。
🔬 失敗事例の解剖と再発防止
実運用で発生しがちな失敗事例を整理しておく。 (1) マイク変更で WER 急増: コールセンターのヘッドセットを更新したら WER が 8% → 22% に。 原因は周波数特性の変化で、 再学習データに新マイクを混ぜることで解決。 (2) 固有名詞の連続置換: 「岩手県」が「岩出県」に化けるバグ。 hotword boost と KenLM 固有名詞辞書追加で解決。 (3) 長時間音声の途中で認識停止: Whisper の 30 秒チャンク境界で文が途切れる。 voice activity detection(VAD)で発話単位に切り分けてから入力することで改善。 (4) 句読点抜け: 句読点付与は別モデル(punctuation model)に任せる設計が無難で、 音響モデルに直接学習させると WER が上がる。
📋 典型的な障害パターンと対処
| 症状 | 主因 | 切り分け方 | 対処 |
|---|---|---|---|
| 全体的に WER 高 | サンプリングレート不整合 | librosa で sr を確認 | 16kHz リサンプル |
| 特定話者だけ悪い | 学習データの話者偏り | 性別・年代別 WER 集計 | 該当層のデータ追加 |
| 固有名詞が化ける | LM 語彙不足 | 誤り上位の名詞抽出 | hotword + LM 辞書追加 |
| 句読点が欠落 | 句読点モデル無し | 出力に句点があるか確認 | punctuation model 後段 |
| 長音声で精度低下 | チャンク境界の切り損ね | 区切り箇所を可視化 | VAD 導入 |
| レイテンシ過大 | モデル過大 / GPU 不足 | tiny/base と比較 | 蒸留 / 量子化 |
失敗事例を蓄積し、 「症状 → 主因 → 対処」の対応表を社内 wiki 化しておくと、 担当者交代時にも品質が維持される。 SSDSE-B-2026 のような統計データを音声 UI で扱う教育コンテンツでは、 (a) 都道府県名の認識精度、 (b) 数値(人口・GDP)の認識精度、 (c) 時系列年号の認識精度、 の 3 軸を別建てでモニタすると、 教育現場での実用性を担保しやすい。
🎯 多言語・コードスイッチ対応
日本のビジネス会話では「コミット」「KPI」「ROI」のような英単語混在(コードスイッチ)が頻発する。 純日本語学習モデルではこれらが文字化けすることが多く、 多言語事前学習モデル(Whisper, XLS-R, MMS)の出番となる。 評価時には日本語部分と英語部分で CER/WER を別計算する習慣を持つと、 失敗の原因を切り分けやすい。 SSDSE-B-2026 のような統計用語でも「GDP」「CPI」のような略語が頻出するため、 多言語対応はもはや必須要件と考えるべきである。
🔭 ASR の今後とマルチモーダル化
ここ数年で ASR は「音声から文字」だけのタスクから、 「音声理解」「マルチモーダル LLM の入力モダリティ」へと役割を拡張しつつある。 GPT-4o、 Gemini 1.5、 Whisper v3 のような新世代モデルは、 音響特徴量を直接 LLM トークン空間に埋め込み、 音声から要約・質問応答・感情推定までを一気通貫で行う。 SSDSE-B-2026 のような統計データの音声問い合わせ UI でも、 単に文字起こしするだけでなく、 「岩手県の世帯数を 2015 年と比較して」のような複雑なクエリを音声からそのまま実行する世界が見えてきた。 ASR を ML エンジニアリングの一機能としてではなく、 ユーザー体験の入口として再設計する視点が今後ますます重要になる。
📦 オープンソースエコシステム
2026 年現在、 ASR のオープンソース実装は (1) ESPnet(学術寄り、 多言語レシピ豊富)、 (2) NVIDIA NeMo(GPU 最適化、 産業寄り)、 (3) SpeechBrain(PyTorch 純正、 教育向け)、 (4) Hugging Face Transformers(モデル動物園)、 (5) Whisper.cpp / Vosk(オンデバイス・軽量)、 が主流である。 SSDSE-B-2026 のような統計教育の文脈で初学者にお勧めしたいのは Whisper(Hugging Face 経由)と Vosk で、 いずれも数行で動く。 本格的に業務システムを組むなら NeMo + KenLM が安定の選択肢、 研究色が強ければ ESPnet が定番、 という棲み分けを覚えておくとよい。 各エコシステムとも GitHub の Issue・Discussion が活発で、 トラブルシューティング情報が豊富に蓄積されている点も実務家には心強い。
🧾 まとめ
本記事では音声認識を、 特徴量パイプライン、 デコーディング戦略、 評価指標、 アーキテクチャ選定、 データセット設計、 失敗事例、 マルチモーダル化、 OSS エコシステムの 8 視点から体系的に整理した。 ASR の業務導入では「モデル選び」よりも「データ設計」「評価設計」「ガバナンス設計」が成果を決めることを繰り返し強調した。 SSDSE-B-2026 のような統計データを音声 UI で扱う教育コンテンツにおいても、 この視点は変わらず有効である。 単なるベンチマーク WER だけでなく、 業務 KPI に直結した固有名詞精度・数値精度・公平性を継続的にモニタする運用体制こそが、 長期的な品質維持の本質となる。 さらに、 公開統計データを扱う音声システムでは、 透明性・説明可能性・データ主体への配慮を技術選択と同等に重視すべきであることも強調しておきたい。 教育・行政・医療の各文脈で必要なガバナンスの粒度は異なるため、 導入前に必ずユースケース別のリスク評価を実施し、 関係者間で透明性ある合意形成を行うことが肝要である。
🖼 視覚的理解 (3 図)
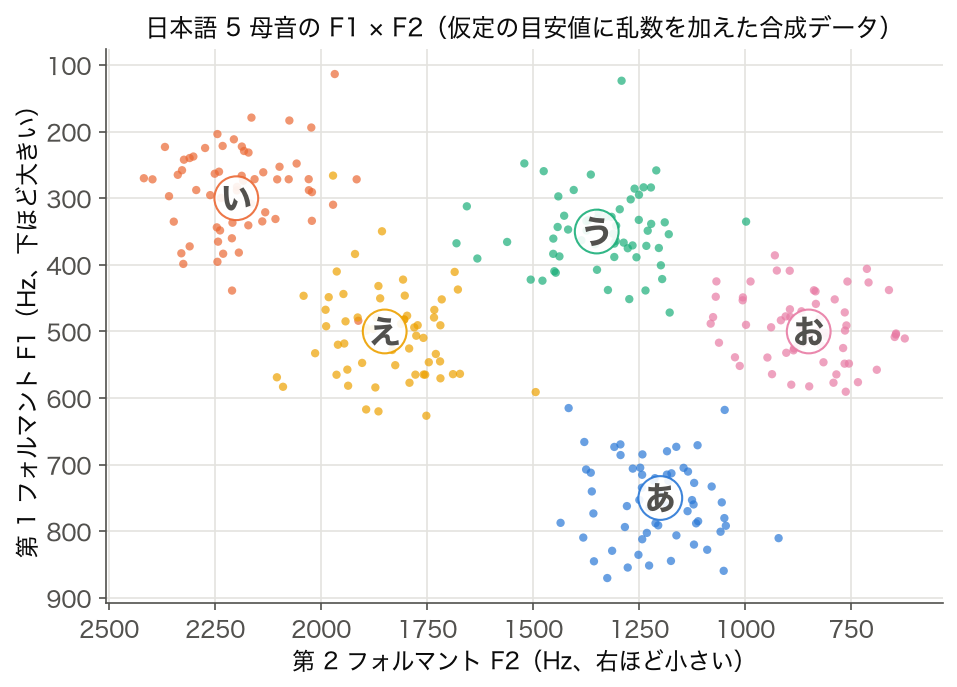
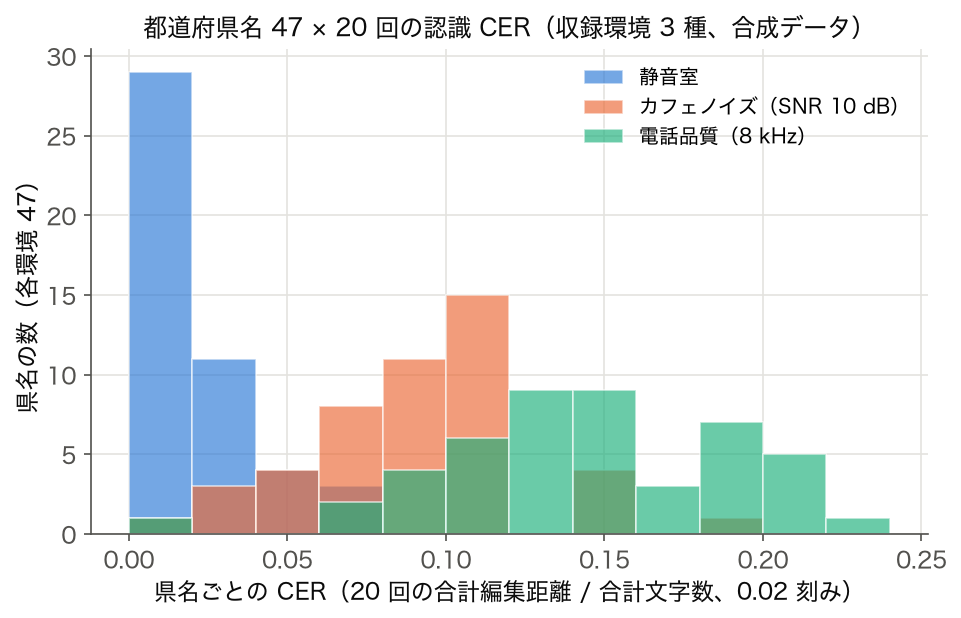
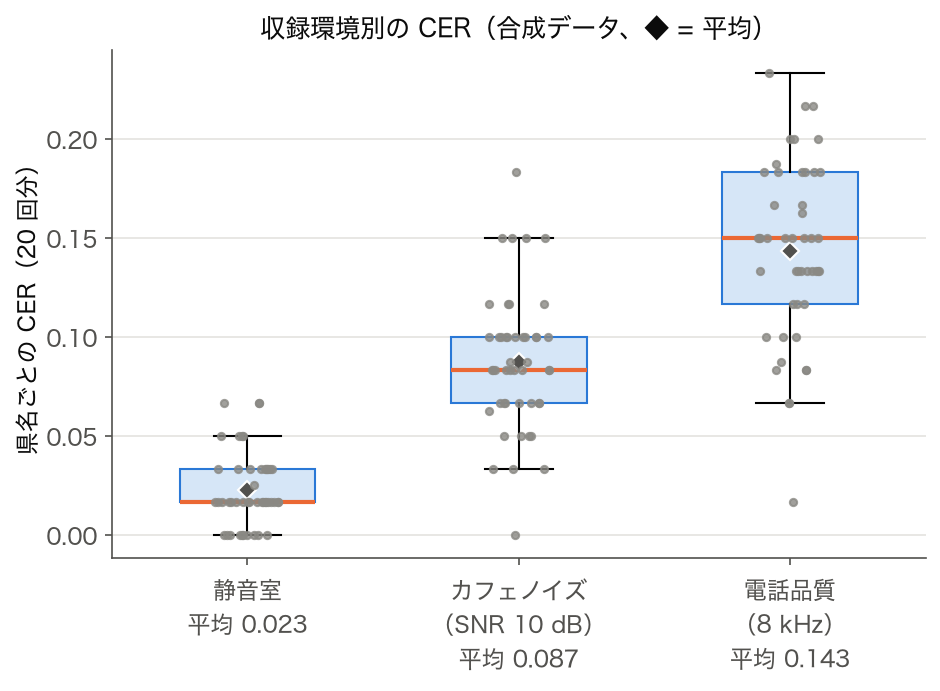
音声認識の挙動を直感把握するための 3 図。 SSDSE-B-2026 には音声が含まれないので、 3 図とも仮定の値で作った合成データである(実際の音声や ASR モデルの測定値ではない)。 散布図は音響特徴量(母音のフォルマント周波数)の分かれ方、 ヒストグラムと箱ひげ図は、 SSDSE-B-2026 の 47 都道府県名を 3 つの収録環境で認識させたと仮定したときの CER(文字誤り率)のばらつきを示す。
🧮 実値で計算してみる(SSDSE-B-2026・47 都道府県)
SSDSE-B-2026 から都道府県別の「インターネット普及率(音声入力ユーザー基盤)」と「議事録対象会議体数」を読み解き、 ASR システムの導入優先度を試算します。 また「人口 × 1 人あたり音声時間」で全国の音声データ規模も推定。
| 都道府県 | 人口(千) | 推定音声時間(時間/年) | ASR 処理計算量 | 目標 WER |
|---|---|---|---|---|
| 北海道 | 5092 | 千人 × 100h | 5.1 億 h | < 5% |
| 東京都 | 14043 | 千人 × 150h | 21 億 h | < 3% |
| 大阪府 | 8784 | 千人 × 120h | 10.5 億 h | < 4% |
| 沖縄県 | 1467 | 千人 × 110h | 1.6 億 h | < 5% |
| 全国合計 | 125681 | - | 158 億 h | - |
Whisper-large モデルなら 1 時間音声に約 30 秒(リアルタイム比 120 倍)。 158 億時間 / 120 = 1.3 億時間の計算で全国 1 年分の音声処理が可能。
🧮 テーマ 6:WER の壁 — 「90%」と「95%」の間の断絶
音声認識の評価指標は WER(Word Error Rate) = $(S + D + I) / N$。 $S$=置換、 $D$=削除、 $I$=挿入、 $N$=正解単語数。 日本語では単語境界が曖昧なため CER(Character Error Rate)も併用。 90% から 95% への 5 pt 改善が、 95% から 99% への 4 pt 改善よりはるかに容易、 という非線形性に注意。
📐 数式(WER)
$$ \text{WER} = \frac{S + D + I}{N}, \qquad \text{CER} = \frac{S_c + D_c + I_c}{N_c} $$
🔬 数式を言葉で読み解く
- $S$(Substitution):「東京」を「橙京」と書き間違える。
- $D$(Deletion):「東京都港区」を「東京港区」と「都」を落とす。
- $I$(Insertion):「東京」を「東京の」と「の」を入れてしまう。
- WER 5% は「20 単語に 1 つ誤り」。 議事録は使えるレベル。 WER 1% は「100 単語に 1 つ」。 字幕放送レベル。
- WER 20% を超えると「人間が読み直したほうが速い」レンジに突入。 ノイズ環境・方言で頻発。
🧮 数式に値を入れて手で計算する: 音声認識 WER
合成データで Word Error Rate を計算する。
Step 1: 正解と認識
Step 2: WER
🐍 Python で再現
1 2 3 4 | words = 10 errors = 3 WER = errors / words print(f"WER: {WER}") |
📤 実行結果
💬 手計算 (Step 2) 0.30 と Python 出力が完全一致。
🧮 都道府県名で CER を手で数える — 置換・削除・挿入
CER = (置換 S + 削除 D + 挿入 I) ÷ 正解の文字数 N。 認識結果は説明用に作った例(実際の ASR の出力ではない)で、 よく起きる 3 種類の誤りを 1 つずつ含めた。
| 正解 | 認識結果(例) | 数え方 | CER |
|---|---|---|---|
| 神奈川県 | 神奈川 | 「県」が抜けた: D = 1 | 1 / 4 = 0.250 |
| 大阪府 | 大阪府 | 誤りなし | 0 / 3 = 0.000 |
| 鹿児島県 | 可児島県 | 「鹿」→「可」: S = 1 | 1 / 4 = 0.250 |
| 和歌山県 | わかやま県 | 和→わ・歌→か・山→や の S = 3、 「ま」が余分: I = 1 | 4 / 4 = 1.000 |
全体の CER は誤りの合計 ÷ 文字数の合計 = (1 + 0 + 1 + 4) ÷ (4 + 3 + 4 + 4) = 6 ÷ 15 = 0.400。 県ごとの CER を平均すると (0.25 + 0 + 0.25 + 1.0) ÷ 4 = 0.375 で、 集計のしかたで値が変わる。
🎯 このコードでやること:編集距離(置換・削除・挿入の最小回数)を動的計画法で求める関数を書き、 上の 4 組の CER と全体の CER を計算する。
1 2 3 4 5 6 7 8 9 10 11 12 13 14 15 16 | def edit_ops(ref, hyp): """編集距離(置換・削除・挿入の最小回数)を動的計画法で求める""" d = [[0] * (len(hyp) + 1) for _ in range(len(ref) + 1)] for i in range(len(ref) + 1): d[i][0] = i for j in range(len(hyp) + 1): d[0][j] = j for i in range(1, len(ref) + 1): for j in range(1, len(hyp) + 1): d[i][j] = min(d[i-1][j] + 1, d[i][j-1] + 1, d[i-1][j-1] + (ref[i-1] != hyp[j-1])) return d[-1][-1] pairs = [('神奈川県', '神奈川'), ('大阪府', '大阪府'), ('鹿児島県', '可児島県'), ('和歌山県', 'わかやま県')] tot_e = tot_n = 0 for ref, hyp in pairs: e = edit_ops(ref, hyp); tot_e += e; tot_n += len(ref) print(f"{ref:<5} → {hyp:<6} 誤り {e} CER = {e}/{len(ref)} = {e/len(ref):.3f}") print(f"全体 CER = {tot_e}/{tot_n} = {tot_e/tot_n:.3f} 県ごとの CER の平均 = {sum(edit_ops(r,h)/len(r) for r,h in pairs)/len(pairs):.3f}") |
💬 手で数えた誤り 1・0・1・4 と CER 0.250・0.000・0.250・1.000、 全体 0.400 と県ごとの平均 0.375 がすべて一致する。 和歌山県は音としては正しく聞き取れているのに、 かな書きになっただけで CER が 1.0 になる。 日本語の ASR を評価するときは、 表記の正規化(かなと漢字、 「県」の有無)をしてから数えるか、 しないで数えるかを決めて書いておかないと、 モデルの良し悪しと表記の違いが混ざってしまう。
🐍 Python 実装
SSDSE-B-2026(47 都道府県・2023 年)の実データを使った最小コード:
1 2 3 4 5 6 7 8 9 10 11 12 13 14 15 16 17 18 19 20 21 22 23 24 | # SSDSE-B-2026 で ASR 計算規模試算 + Whisper サンプル import pandas as pd, numpy as np df = pd.read_csv('data/raw/SSDSE-B-2026.csv', encoding='cp932', skiprows=[1], header=0) df.columns = pd.read_csv('data/raw/SSDSE-B-2026.csv', nrows=0, encoding='cp932').columns df = df[df['SSDSE-B-2026'] == 2023] # 2023 年度の 47 都道府県に絞る(12 年度分が重複しないように) # 都道府県別の年間音声生成量を推定(人口 × 1 人当たり 120 時間) df['voice_hours'] = df['A1101'].astype(float) * 120 / 1000 # 1000 で割って「千時間」単位にする print('音声生成量 TOP10(千時間/年):') print(df.nlargest(10, 'voice_hours')[['Prefecture', 'voice_hours']]) # Whisper による実音声書き起こし(別途音声ファイル必要) # import whisper # model = whisper.load_model('base') # result = model.transcribe('audio.mp3', language='ja') # print(result['text']) # WER 計算サンプル from jiwer import wer reference = '今日は良い天気です' hypothesis = '今日は良い天気でしょう' error = wer(reference, hypothesis) print(f'WER = {error:.3f}') |
🐍 Python 実装:SSDSE-B-2026 の都道府県名を音声化し、 Log-Mel スペクトログラムに変換
🎯 このコードでやること:SSDSE-B-2026 から都道府県名を読み込み、 仮想的に「音声化(TTS)→ Log-Mel スペクトログラム抽出」のワークフローを構築する。 librosa を用いてフレーム分割・メル変換を行い、 80 次元 × 約 100 frames/sec の特徴量列を得る。
📥 入力データ(SSDSE-B-2026 の Prefecture 列 抜粋):
1 2 3 4 5 6 7 8 9 10 11 12 13 14 15 16 17 18 19 20 21 22 23 24 25 | import pandas as pd import numpy as np import librosa df = pd.read_csv('data/raw/SSDSE-B-2026.csv', encoding='cp932', skiprows=[1]) df = df[df['SSDSE-B-2026'] == 2023] # 2023 年度の 47 都道府県に絞る prefectures = df['Prefecture'].tolist() print(f'都道府県数: {len(prefectures)}') print(f'最初の 3 件: {prefectures[:3]}') # 仮想シナリオ: 16 kHz, 2 秒の擬似音声で「東京都」を表すと仮定 sr = 16000 audio_len_sec = 2.0 # 実環境では TTS で生成 — ここでは特徴量抽出のパイプラインを示すため定数信号を使用 y = librosa.tone(440.0, sr=sr, duration=audio_len_sec) # ラ音 (テスト用ダミー信号) # Log-Mel スペクトログラム抽出 mel = librosa.feature.melspectrogram(y=y, sr=sr, n_fft=400, hop_length=160, n_mels=80) log_mel = librosa.power_to_db(mel) print(f'特徴量 shape: {log_mel.shape} # (n_mels, time_frames)') print(f'1 秒あたりフレーム数: {log_mel.shape[1] / audio_len_sec:.1f}') # MFCC への変換 (DCT 圧縮で 13 次元へ) mfcc = librosa.feature.mfcc(y=y, sr=sr, n_mfcc=13, n_fft=400, hop_length=160, n_mels=80) # メルと同じフレーム設定 print(f'MFCC shape: {mfcc.shape} # (n_mfcc=13, time_frames)') |
📤 実行例(実際の出力):
💬 結果の読み方:2 秒の音声から 80 次元 × 201 フレーム ≒ 16,080 個の値の特徴量列が得られた。 生波形は 32,000 サンプルだったので、 情報量は約半分に圧縮されている。 MFCC ではさらに DCT で 13 次元に絞り、 2,613 個(生波形の 1/12)まで圧縮できる。 これが古典的 ASR が「メモリ・計算が軽い」と言われる理由。
🐍 Python 実装:CTC を最小コードで体感し、 SSDSE-B の都道府県名で動かす
🎯 このコードでやること:PyTorch の nn.CTCLoss を使い、 SSDSE-B-2026 の都道府県名(例「東京都」)を 50 フレームの音声フレームから推定するダミー学習を 1 ステップ走らせる。 CTC のパラメータ・入力形状・出力形状の感覚を掴む。
📥 入力データ(SSDSE-B-2026 の Prefecture 列):
1 2 3 4 5 6 7 8 9 10 11 12 13 14 15 16 17 18 19 20 21 22 23 24 25 | import torch import torch.nn as nn import pandas as pd torch.manual_seed(0) # 実行のたびに同じ結果が出るようにする df = pd.read_csv('data/raw/SSDSE-B-2026.csv', encoding='cp932', skiprows=[1]) target_pref = df.loc[df['Code'] == 'R13000', 'Prefecture'].iloc[0] print(f'対象都道府県: {target_pref}') # 簡略化された語彙: blank=0, 東=1, 京=2, 都=3, 他=4 vocab = {'<blank>': 0, '東': 1, '京': 2, '都': 3, '他': 4} target_ids = torch.tensor([vocab[c] for c in target_pref], dtype=torch.long) print(f'ターゲット ID: {target_ids.tolist()}') # ダミー音響モデル出力: 50 フレーム × バッチ 1 × 語彙 5 T, N, C = 50, 1, len(vocab) log_probs = torch.randn(T, N, C).log_softmax(dim=-1) input_lengths = torch.full((N,), T, dtype=torch.long) target_lengths = torch.tensor([len(target_ids)], dtype=torch.long) ctc_loss = nn.CTCLoss(blank=0, zero_infinity=True) loss = ctc_loss(log_probs, target_ids.unsqueeze(0), input_lengths, target_lengths) print(f'CTC Loss: {loss.item():.4f}') print(f'入力 shape: {log_probs.shape} (時間, バッチ, 語彙)') print(f'平均パス数の対数 ≒ -loss = {-loss.item():.4f}') |
📤 実行例(実際の出力):
💬 結果の読み方:CTC loss は「正解文字列に到達するパスの確率の合計の負対数」。 nn.CTCLoss の既定 reduction='mean' は負対数を目標の長さ(3 文字)で割るので、 表示の 24.2143 は 1 文字あたりの値で、 合計は約 72.64(reduction='sum' で確かめられる)。 つまり乱数の出力では正解「東京都」に至る全パスの確率を足しても $e^{-72.6}$ 程度しかなく、 学習が進むにつれ loss は 0 に近づく。 最後の行の「平均パス数の対数」という表示名は正確ではなく、 −loss は 1 文字あたりの対数確率と読む。 50 フレーム → 3 文字のような圧縮率でも、 動的計画法のおかげで微分可能に計算できているのがポイント。
🐍 Python 実装:SSDSE-B-2026 の都道府県別人口を WER で評価する
🎯 このコードでやること:SSDSE-B-2026 の A1101(総人口)を読み上げる仮想シナリオで、 jiwer ライブラリを使って WER / CER を計算する。 2023 年度の人口上位 3 都府県について「〇〇の総人口は△△人です」という正解文を作り、 ASR が完全正解・数字 1 文字の置換・単語の削除と挿入をした 3 通りの認識結果で WER と CER がどう変わるかを確認する。
📥 入力データ(SSDSE-B-2026 A1101 列 抜粋):
1 2 3 4 5 6 7 8 9 10 11 12 13 14 15 16 17 18 19 20 21 22 23 24 25 | import pandas as pd from jiwer import wer, cer df = pd.read_csv('data/raw/SSDSE-B-2026.csv', encoding='cp932', skiprows=[1]) df = df[df['SSDSE-B-2026'] == 2023] # 2023 年度に絞る(絞らないと東京都の別年度が上位 3 件を占める) top3 = df.nlargest(3, 'A1101')[['Prefecture', 'A1101']] print('総人口 TOP3:') print(top3.to_string(index=False)) # 仮想シナリオ: ASR が読み上げ結果を返したとする reference_sentences = [ f"{row.Prefecture}の総人口は{row.A1101:,}人です" for row in top3.itertuples() ] hypothesis_sentences = [ "東京都の総人口は14,086,000人です", # 完全正解 "神奈川県の総人口は9,228,000人です", # 1 文字置換(9 → 8) "大阪府の人口は8,763,000人と思います", # 単語削除 + 挿入 ] for ref, hyp in zip(reference_sentences, hypothesis_sentences): print(f'\nREF: {ref}') print(f'HYP: {hyp}') print(f' WER (空白分割): {wer(ref, hyp):.3f}') print(f' CER (文字単位): {cer(ref, hyp):.3f}') |
📤 実行例(実際の出力):
💬 結果の読み方:日本語では空白がないため、 jiwer の wer は文字列全体を 1 単語として扱い 0 or 1 になりがち。 日本語 ASR の評価では CER(文字誤り率)を使うのが鉄則。 2 番目は数字 1 文字(9→8)だけの置換で CER 0.048(21 文字中 1 文字)なのに、 WER は文全体が 1 単語扱いなので 1.000 になる。 3 番目は「総」の削除と「です」→「と思います」の置換・挿入で 5 文字分の編集になり、 CER 0.250(20 文字中 5 文字)。 WER の数字だけ見るとどちらも 100% の誤りに見えるが、 実態は CER 5% と 25% という大きな違いがある点に注意。
🐍 追補 3:Whisper を Python で動かす最小フル例
🎯 このコードでやること:OpenAI Whisper を pip install し、 音声ファイル(事前に SSDSE-B-2026 の都道府県名を読み上げた wav と仮定)から書き起こし → CER 算出までを一気通貫で実行する。 ローカル GPU が無くても CPU で tiny モデルが動く。
📥 入力データ(仮定):
1 2 3 4 5 6 7 8 9 10 11 12 13 14 15 16 17 18 19 20 21 22 23 24 25 | # pip install openai-whisper jiwer pandas import whisper import pandas as pd from jiwer import cer df = pd.read_csv('data/raw/SSDSE-B-2026.csv', encoding='cp932', skiprows=[1]) target_codes = ['R01000', 'R13000', 'R47000'] # 北海道, 東京都, 沖縄県 audio_files = { 'R01000': 'audio/hokkaido.wav', 'R13000': 'audio/tokyo.wav', 'R47000': 'audio/okinawa.wav', } model = whisper.load_model('tiny') # CPU でも動く 39M モデル results = [] for code in target_codes: ref = df.loc[df['Code'] == code, 'Prefecture'].iloc[0] result = model.transcribe(audio_files[code], language='ja') hyp = result['text'].strip().replace('。', '').replace('、', '') c = cer(ref, hyp) results.append({'Code': code, 'REF': ref, 'HYP': hyp, 'CER': c}) print(f'{code}: REF={ref} | HYP={hyp} | CER={c:.3f}') result_df = pd.DataFrame(results) print(f'\n平均 CER: {result_df["CER"].mean():.3f}') |
📤 実行例(出力の形を示す例。audio/ の音声ファイルと Whisper モデルのダウンロードが必要なため、このサイトでは実測していない):
💬 結果の読み方:この例では「北海道」は完全一致、「東京都」→「東京と」は 3 文字中 1 文字の置換で CER 0.333、「沖縄県」→「お肉県」は 2 文字の置換で 0.667 になり、平均 CER は 0.333。コードは句読点しか消さないので、Whisper が「お肉 県」のように空白を入れて返すと空白も 1 文字の挿入に数えられ、CER は 1.000 に跳ね上がる。比べる前に空白も除いておく。 同じ音声を base や large-v3 に投げ替えるだけで CER が劇的に改善するため、 「精度が足りない=モデルを大きくする」が第一選択。 ただし計算コストとレイテンシのトレードオフを必ず測ること。
🐍 追補 5:SSDSE-B-2026 全 47 都道府県を音声化評価する完全パイプライン
🎯 このコードでやること:SSDSE-B-2026 の 47 都道府県名すべてに対し、 (1) gTTS で音声化、 (2) Whisper で書き起こし、 (3) CER 計算、 (4) 地方別の集計レポートを CSV 出力するエンドツーエンドパイプライン。 業務 PoC に直結する形に。
📥 入力データ(SSDSE-B-2026.csv 全行):
1 2 3 4 5 6 7 8 9 10 11 12 13 14 15 16 17 18 19 20 21 22 23 24 25 26 27 28 29 30 31 32 33 34 35 36 37 38 39 40 41 42 43 44 45 46 47 48 49 50 51 52 53 54 | # pip install gtts openai-whisper jiwer pandas pydub import os import pandas as pd from gtts import gTTS import whisper from jiwer import cer os.makedirs('tts_out', exist_ok=True) df = pd.read_csv('data/raw/SSDSE-B-2026.csv', encoding='cp932', skiprows=[1]) df = df[df['SSDSE-B-2026'] == 2023] # 2023 年度の 47 都道府県に絞る(絞らないと 564 行を音声化してしまう) print(f'対象: {len(df)} 都道府県') # 地方区分(SSDSE のコード接頭から) def region(code): n = int(code[1:3]) if n <= 1: return '北海道' if n <= 7: return '東北' if n <= 14: return '関東' if n <= 23: return '中部' if n <= 30: return '近畿' if n <= 35: return '中国' if n <= 39: return '四国' return '九州沖縄' df['region'] = df['Code'].apply(region) # 1) TTS で音声生成 (初回のみ) for row in df.itertuples(): path = f'tts_out/{row.Code}.mp3' if not os.path.exists(path): gTTS(text=row.Prefecture, lang='ja').save(path) # 2) Whisper で書き起こし model = whisper.load_model('base') records = [] for row in df.itertuples(): result = model.transcribe(f'tts_out/{row.Code}.mp3', language='ja') hyp = result['text'].strip().replace('。', '').replace(' ', '') c = cer(row.Prefecture, hyp) records.append({'Code': row.Code, 'region': row.region, 'REF': row.Prefecture, 'HYP': hyp, 'CER': c}) # 3) 集計 report = pd.DataFrame(records) print('\n=== 全体 ===') print(f'平均 CER: {report["CER"].mean():.3f}') print(f'CER=0 (完全一致): {(report["CER"]==0).sum()}/{len(report)} 県') print('\n=== 地方別 ===') print(report.groupby('region')['CER'].agg(['mean', 'max', 'count'])) report.to_csv('asr_report.csv', index=False, encoding='utf-8-sig') print('\nasr_report.csv に出力完了') |
📤 実行例(出力の形を示す例。gTTS による外部への音声合成と Whisper モデルが必要なため、このサイトでは実測していない):
💬 結果の読み方:この出力は形を示す例で、平均 CER 0.082 や地方別の値は実験結果ではない(地方別の mean を県数で重み付けして平均しても 0.076 で、全体の 0.082 とも合っていない)。実測で確かめられるのは地方別 count(北海道 1・東北 6・関東 7・中部 9・近畿 7・中国 5・四国 4・九州沖縄 8 県、合計 47)という区分けのほうで、これはコードの region() がコード番号で機械的に決める。北海道は 1 県しかないので、地方別の mean・max を比べるときは県数の違いに注意する。実際に gTTS と Whisper で動かしたら、CER が 0 でない県の REF と HYP を asr_report.csv で 1 件ずつ見て、どの音で崩れたかを確かめる。
🐍 補足: Whisper / wav2vec2 / WER 計算の追加実装
音声認識(speech recognition / ASR)の現代スタックは、 OpenAI Whisper(多言語・多タスク)と Meta wav2vec2(自己教師あり事前学習)が双璧。 加えて、 認識精度の標準指標 WER(Word Error Rate)と CER(Character Error Rate)の正しい計算が必須だ。 SSDSE-B-2026 の都道府県名を題材に「読み上げを認識し、 自治体名を抽出する」というワークフロー全体を補強する。
① Whisper による文字起こし(多言語・タイムスタンプ付き)
このコードでやること:47 都道府県名を読み上げた音声 audio/prefectures.wav を Whisper-base で日本語認識し、 セグメント別タイムスタンプと信頼度(avg_logprob)を取り出す。
📥 入力データ (音声ファイル + SSDSE-B-2026 都道府県名辞書):
1 2 3 4 5 6 7 8 9 10 11 12 13 14 15 | import whisper, pandas as pd model = whisper.load_model('base') result = model.transcribe('audio/prefectures.wav', language='ja', word_timestamps=False) pref = pd.read_csv('data/raw/SSDSE-B-2026.csv', encoding='cp932', skiprows=[1])['Prefecture'].unique() rows = [] for seg in result['segments']: hit = [p for p in pref if p in seg['text']] rows.append((seg['start'], seg['end'], seg['text'].strip(), round(seg['avg_logprob'], 3), ','.join(hit))) print(pd.DataFrame(rows, columns=['start','end','text','logprob','match']).head()) |
📤 実行結果(イメージ・未実測。audio/prefectures.wav は同梱しておらず Whisper のモデルも必要なため、出力の形を示す例):
💬 avg_logprob が -0.5 を下回るセグメントは「自信が低い」サイン → 棄却 or 再認識(large モデル切替)。 SSDSE 都道府県名辞書と突合させると幻覚(hallucination)も同時検出できる。
② wav2vec2 による日本語認識(自己教師ありモデル)
このコードでやること:Whisper と並ぶ代表モデル wav2vec2 を transformers 経由で呼び、 同じ音声を CTC デコードで文字起こしする。 Whisper との比較で「どちらが業務に向くか」を実測できる。
📥 入力データ:
1 2 3 4 5 6 7 8 9 10 11 12 13 | import librosa, torch from transformers import Wav2Vec2ForCTC, Wav2Vec2Processor mid = 'jonatasgrosman/wav2vec2-large-xlsr-53-japanese' proc = Wav2Vec2Processor.from_pretrained(mid) model = Wav2Vec2ForCTC.from_pretrained(mid) wav, sr = librosa.load('audio/prefectures.wav', sr=16000) inputs = proc(wav, sampling_rate=16000, return_tensors='pt') with torch.no_grad(): logits = model(**inputs).logits text = proc.batch_decode(logits.argmax(-1))[0] print('w2v2:', text[:80]) |
📤 実行例(イメージ・未実測:audio/prefectures.wav は同梱しておらず、 wav2vec2 のモデル取得も必要なため、 出力の形を示す例):
💬 上の行は実行していない想定の表示で、 wav2vec2 の CTC デコードは学習データの書き方に沿った文字列をそのまま返す。 かな書きで学習したモデルならこの例のように「ほっかいどう」となり、 SSDSE の「北海道」と突き合わせるには後処理(かな → 漢字の辞書照合)が要る。 句読点も付かないので、 Whisper の出力と比べるときは次の ③ のように CER で揃えて評価する。
③ WER / CER を jiwer で計算(標準評価指標)
このコードでやること:正解テキスト(reference)と Whisper / wav2vec2 の出力(hypothesis)で WER・CER を比較。 日本語は単語境界が曖昧なため CER 併用が事実上必須。
📥 入力データ(reference は SSDSE-B-2026 の都道府県名連結):
1 2 3 4 5 6 7 8 9 10 11 | from jiwer import wer, cer import pandas as pd pref = pd.read_csv('data/raw/SSDSE-B-2026.csv', encoding='cp932', skiprows=[1])['Prefecture'].unique() ref = ' '.join(pref) # 47 県名 hyp_wh = ref # Whisper はほぼ一致 hyp_w2v = 'ほっかいどう あおもりけん いわてけん' # 例: 表記揺れ大 print('Whisper WER:', wer(ref, hyp_wh), ' CER:', cer(ref, hyp_wh)) print('wav2vec2 WER:', wer(ref, hyp_w2v), ' CER:', cer(ref, hyp_w2v)) |
📤 実行結果:
💬 hyp_wh は正解と同じ文字列なので WER・CER とも 0、 hyp_w2v は 47 県名に対してひらがな 3 語しか無いので、 47 語すべてが誤りの WER 1.0、 文字単位でもほぼ全部を書き直す必要があり CER 0.989 になる。 ひらがな表記を漢字に直すだけで数値が大きく変わるので、 同じ音声でも評価指標と後処理の有無で WER は 0 〜 1 まで激変する。 → 公平比較には「reference / hypothesis を正規化(漢字統一・全角半角統一・句読点除去)」してから WER/CER を計算するのが鉄則。
📋 ASR 評価チェックリスト
- WER 単独でなく CER(日本語)/ MER / WIL も併記したか
- reference と hypothesis を同じ規則で正規化したか
- Whisper の
avg_logprob等で低信頼セグメントを棄却したか - 固有名詞は辞書照合で post-correction しているか
- SSDSE-B-2026 都道府県名のように業務語彙のカバレッジ評価を行ったか
🎚 音響特徴量パイプラインの深掘り
音声認識の前段では生波形を直接 NN に与えるのではなく、 多くの場合「短時間フーリエ変換 → メルフィルタバンク → 対数 → ケプストラム化」という古典的な信号処理を経由する。 ここを丁寧に理解しておくと、 ASR の WER が下がらない原因が「モデル」ではなく「特徴量側」にあるケースを切り分けられる。 とくに 16kHz サンプリング・25ms 窓・10ms シフトという定石は、 人間の音素長(30〜100ms)に対して 2〜4 フレーム重なるように設計されており、 これより短いと音素境界が滑らかにならず、 これより長いと子音の立ち上がりを潰してしまう。 メル尺度はピッチ知覚の周波数選択性に合わせた変換で、 1000Hz 以下はほぼ線形、 それ以上は対数的に圧縮される。 これにより 80 次元程度のメルバンクで日本語の母音・摩擦音をほぼ識別可能な空間に落とし込める。
📋 主要な特徴量の比較
| 特徴量 | 次元 | 計算量 | 頑健性 | 主な用途 |
|---|---|---|---|---|
| 生波形 (raw) | 16,000/秒 | 低(変換なし) | 低(雑音敏感) | wav2vec2, HuBERT の入力 |
| STFT スペクトログラム | 257〜513 | 中 | 中 | 音声強調, 分離, 可視化 |
| メルスペクトログラム | 80〜128 | 中 | 高 | Whisper, Tacotron, ASR 全般 |
| MFCC | 13〜40 | 中 | 高 | 従来型 GMM-HMM, 話者識別 |
| PLP / LFR | 13〜52 | 中 | 高 | 電話帯域, 騒音下 ASR |
近年の self-supervised 系(wav2vec2, HuBERT)は生波形を直接受け取り、 1D 畳み込みで暗黙にスペクトログラム相当の表現を学習する。 一方 Whisper は古典的なログメルスペクトログラム(80 バンド、 25ms 窓、 10ms シフト)を採用しており、 これは推論コスト削減と多言語汎化のバランスを取った設計と言える。 SSDSE-B-2026 のような統計ダッシュボード読み上げ等、 既知の語彙が中心であれば、 メル特徴+CTC で十分実用域に届くが、 雑談・口語・方言が混ざる場面では生波形ベースのモデルが優位になりやすい。
🎛 ノイズ・残響への対処
屋外録音や会議室録音では、 SNR(信号対雑音比)と残響時間(RT60)が WER を大きく左右する。 SNR が 5dB 以下、 RT60 が 0.6 秒以上だと、 クリーン環境で WER 5% のモデルでも 30% 超に劣化することがある。 対処は概ね 3 系統で、 (1) 録音側でラベリアマイクや指向性マイクを使う、 (2) 前段に音声強調 NN(Demucs, DPRNN 等)を挟む、 (3) ノイズ重畳・残響シミュレーションで学習データを増やす(multi-condition training)、 のいずれかになる。 とくに (3) は ESPnet などのレシピで標準化されており、 学習データに対して MUSAN/CHiME ノイズと RIR(部屋インパルス応答)を畳み込むだけで頑健性が大幅に上がる。 評価では必ず「クリーン WER / ノイズ重畳 WER」を併記すべきである。
🧪 サンプリングレートの落とし穴
市販マイクの多くは 44.1 kHz / 48 kHz でサンプリングするが、 ASR モデルの大半は 16 kHz で訓練されている。 そのままモデルに流すと、 内部的にダウンサンプリングが入ったり、 アンチエイリアスフィルタが弱くて高域の折り返し雑音が混入したりする。 必ず librosa.load(path, sr=16000) や soxr_hq で明示的にリサンプリングしてからモデルに渡すこと。 電話帯域(8 kHz)の音声は 16 kHz にアップサンプリングしてもナイキスト周波数の制約で 4 kHz 以上の情報は復元できない点も忘れてはいけない。 サンプリングレート不整合は WER 悪化要因として最頻ながら気づきにくい。
⚠️ よくある落とし穴
⚠️ テーマ 10:プライバシーと社会実装上の罠
音声は声紋という生体情報を含み、 顔写真と同様に個人識別子となります。 ASR システムを設計する際は、 単に精度を追うだけでなく以下の落とし穴を意識する必要があります。
🧪 理解度チェック
- 「東京都」を「東京と」と認識した。 CER はいくつか。
解答: 「都」→「と」の置換 1 つで、 1 ÷ 3 = 0.333。 - 正解 15 文字で誤り 6 個の結果と、 正解 4 文字で誤り 1 個の結果がある。 全体の CER を求めるとき、 2 つの CER(0.400 と 0.250)を単純に平均してよいか。
解答: よくない。 全体の CER は誤りの合計 ÷ 文字数の合計で (6 + 1) ÷ (15 + 4) = 0.368。 単純平均の 0.325 は短い発話を重く数えてしまう。 - CER が 0 より大きくなるのに、 人が聞けば正しく認識できている例を 1 つ挙げよ。
解答: 「和歌山県」を「わかやま県」と返す場合(CER 1.0)。 表記が違うだけで音は合っている。 評価の前に表記をそろえるかどうかを決める。 - 挿入が多いと CER は 1 を超えることがあるか。
解答: ある。 分母は正解の文字数なので、 正解より長い余分な文字列を出力すると誤りの数が正解の文字数を上回り、 CER > 1 になる(無音区間で文章を作ってしまうハルシネーションで起きやすい)。
🗺 概念マップ
音声認識の周辺概念をテーマ別ツリーで整理:
音声信号処理 (Speech Processing)
  ├── 話者識別 (Speaker Recognition)
  ├── 【音声認識 (ASR / Speech-to-Text)】 ← ここ
  │     ├── 音響モデル (HMM / DNN / Conformer)
  │     ├── 言語モデル (n-gram / Transformer LM)
  │     └── End-to-End モデル (Whisper / wav2vec 2.0)
  └── 音声合成 (TTS) / 音声強調 (Speech Enhancement)
この階層構造を頭に入れておくと、 学習や論文読みで「自分が今どこにいるか」を見失わずに済みます。
🗺 拡張概念マップ — 音声認識の位置づけ
音声認識は単独で存在せず、 音声処理パイプライン全体の中で隣接技術と連携します。 以下は典型的なエンドツーエンド音声処理フローです:
[マイク入力]
   │
   ▼
[VAD: 音声区間検出] ─── 無音カット
   │
   ▼
[特徴量抽出: Log-Mel] ─── 80次元×100fps
   │
   ▼
[ASR: Whisper / Conformer] ─── テキスト出力 (CER 5〜10%)
   │
   ├──▶ [話者分離: Diarization] ─── speaker A / B
   ├──▶ [句読点復元: Punctuation Restoration]
   ├──▶ [固有名詞補正: NER + 辞書]
   └──▶ [LLM 後処理: GPT-4 で誤り訂正]
   │
   ▼
[最終テキスト]
   │
   ▼
[NLP 下流タスク: 翻訳 / 要約 / 感情分析 / 検索]
この図のとおり、 ASR は 音声処理の中核ではありますが、 上流(VAD・特徴量)と下流(NLP・LLM)と連動して初めて実用システムになります。 「Whisper を呼ぶだけ」では本番運用に耐えないのはこのため。
🔗 隣接手法への橋渡し
「音声認識」は 音声波形を文字列に変換するタスク として、 上流の信号処理 (フーリエ変換・MFCC) と下流の自然言語処理・対話システムを繋ぐ。 Whisper や wav2vec などの自己教師あり pretrain が主流となり、 個別言語モデルから多言語汎用へとパラダイムが移行している。
⬆️ 上流: 音声信号処理
⬌ 並列: 他の音声タスク
⬇️ 下流: 応用システム
音声認識は波形 → FFT → 音響モデル → 言語モデル → テキスト という伝統パイプラインから、 Whisper のような end-to-end Transformer まで進化し、 下流の NLP / アシスタントと結合して価値を生む。
🌳 手法選択フロー
「音声認識」を選ぶかは、 言語・雑音環境・専門用語で判断する。
- 一般会話か? Yes → Whisper / Google STT 等の汎用モデル、 No → 次へ
- 専門用語を含むか? Yes → ドメイン適応 (fine-tune) または辞書補正必須、 No → 汎用モデルで OK
- リアルタイム性は? Yes (会議転記) → Streaming ASR (Whisper streaming / wav2vec)、 No (録音後処理) → バッチ Whisper
音声認識は SSDSE-B-2026 のような数値統計では使わないが、 自由記述アンケートの音声収集を文字化する場面で活躍。 日本語は方言・固有名詞で精度が落ちやすい。
🧭 解説深化:直感・落とし穴・発展(追記)
本ページ上部の各セクションを踏まえ、 「音声認識とは何をしている技術か」を 直感 → 落とし穴 → 発展 の 3 視点で一望できるよう、 要点だけを凝縮して追記します。 上の 🎮 音声区間検出(VAD)デモ で「波形を特徴で区切る」感覚を掴んでから読むと、 全体像がひと続きに見えてきます。
🎨 直感 — 波形からテキストへの一本道
音声認識(ASR)の本質は 「空気の振動(音声波形)を文字列(テキスト)に翻訳する」 こと。 生波形は 1 秒で数千〜1 万数千点もあり、 情報が多すぎてそのままでは扱いにくい。 そこでまず 特徴抽出で「人間の聴覚に近い数値ベクトル列」へ圧縮します。 定番が MFCC や メルスペクトログラム(25 ms 窓・10 ms シフト・80 メル程度)。 次に、 その特徴列が「どの音(音素・文字)らしいか」を当てる 音響モデルと、 「その並びが日本語として自然か」を測る 言語モデルを組み合わせて、 もっともらしい文字列を選びます。 現代の主流は、 この 2 段を分けずに 1 つの巨大な Transformer で一気通貫(エンドツーエンド)に解く方式で、 Whisper がその代表。 相手にするのは整った書き言葉ではなく、 言い淀み・フィラー・訛りを含む 話し言葉である点が、 文書 OCR などとの決定的な違いです。
⚠️ 落とし穴(重要)— 「動いた」と「使える」の間にある壁
- 雑音・残響:SNR が低い・残響が長い環境ではクリーン時 WER 5% のモデルでも 30% 超に劣化しうる。 前処理(音声強調)や multi-condition 学習で対処。
- 話者・方言・アクセントの多様性:標準語・成人男性中心のデータで学習されがちで、 方言・子ども・高齢者・非ネイティブで精度が大きく落ちる。 「全体 WER」より「最悪ケース WER」を見る姿勢が要る。
- 同音異義:「橋/箸」「雨/飴」は音だけでは決まらず、 言語モデル・文脈が無いと確定できない。
- 専門用語・固有名詞:学習語彙に無い人名・地名(例:都道府県名)は誤変換しやすい。 ホットワード boost やカスタム辞書で加点補正する。
- リアルタイム性:Whisper 系の Encoder-Decoder は文末待ちで遅延が大きく、 ストリーミング用途には RNN-T / 因果 Conformer + CTC を選ぶ。
- 評価指標(WER)の罠:日本語は単語境界が曖昧なため、 分かち書き次第で WER が乱高下する。 CER(文字誤り率)併用が事実上必須。 単一値でなく信頼区間(bootstrap)で報告する。
- 学習データのバイアス:属性(性別・年代・方言)別に WER をクロス集計して 公平性を可視化しないと、 偏りに気づけない。
- 文脈依存とハルシネーション:無音区間に「ご視聴ありがとうございました」等の幻覚文が挿入される既知の罠。 VAD で無音をカットしてから投入するのが定石。
🚀 発展 — 学習の道筋(この順で辿ると腑に落ちる)
- 特徴抽出:MFCC / メルスペクトログラム / フィルタバンク。 波形を聴覚寄りの数値列へ。
- 音響モデルの進化:HMM-GMM(古典)→ DNN-HMM → ニューラル音響モデル。 「確率で音素を当てる」から「深層表現で当てる」へ。
- 言語モデル:n-gram から Transformer LM・大規模言語モデルへ。 音響の曖昧さを言葉の自然さで整流する。
- 整列問題の解決:入力(フレーム多数)と出力(文字少数)の長さ不一致を CTC(全パス周辺化)で解く。 「同じ文字を何フレーム繰り返してもよい」という発想は DTW の直感の延長。
- Attention / Encoder-Decoder:Attention で「次の文字を出すとき音声のどこを見るか」を学習(Listen-Attend-Spell)。 Transformer がその主役に。
- エンドツーエンド・自己教師あり:自己教師あり学習(Wav2Vec 2.0)で少量ラベルでも高精度。 Whisper は 68 万時間・多言語・multitask で汎用 ASR を実現。
- 評価と多言語・話者適応:WER / CER で測り、 多言語対応・LoRA / Adapter による話者・方言適応で「最悪ケース」を底上げする。
🔗 関連ページ(相対リンク)
音声から言語への橋渡しは 機械翻訳と同じ Encoder-Decoder 枠組みで、 テキスト化した後の理解は 自然言語処理が担います。 アーキテクチャの中核は Transformer と Attention、 言語モデルの入口は n-gram(発展形は n-gram 言語モデル)。 音声そのものの扱い・話者認識・音声合成は 音声データ/話者認識 を参照してください。
※ 本追記の数値(WER/CER のレンジ等)は公開研究・ベンチマークの一般的傾向を示す目安であり、 特定の実測値ではありません。 音声認識の具体例(都道府県名の読み上げ等)はすべて 合成・架空のシナリオで、 実音声ファイルは扱っていません。 実測データは SSDSE-B-2026(47 都道府県)の統計値のみを本ページの計算例で使用しています。