🔖 キーワード索引
画像分類は、画像 1 枚を入力して、あらかじめ決めたクラスの 1 つ(または各クラスの確率)を出力するタスクである。本ページでは、scikit-learn 同梱の手書き数字(digits)と、SSDSE-B-2026 の都道府県の数値を 6×6 に並べた「擬似画像」を使って、確率の出し方・評価の仕方・小さなデータでの落とし穴を確かめる。
💡 30秒で分かる結論
🍰 まずはやさしく
画像分類は写真に名前を付ける作業です。
画像が何であるかを判定するために使います。
スマホで写真の種類を分ける機能などが例です。
ここでは画像分類の結論を短くまとめます。
画像分類は、 画像を入力としてあらかじめ定めたクラスの 1 つを出力するタスク。 コンピュータビジョンの基本問題。
- 入力:H × W × 3 のテンソル(RGB 画像)
- 出力:K クラスの確率分布
- 代表モデル:ResNet、 EfficientNet、 ViT、 CLIP
- データセット:ImageNet(1000 クラス・1.2M 枚)、 CIFAR-10
- 関連:物体検出、 セグメンテーション、 マルチラベル分類
📍 文脈:「画像分類」はどんな場面で出てくる?
🍰 まずはやさしく
画像分類は画像AIを学ぶための入り口です。
AIがどう画像を捉えるかを知るために使います。
部活の集合写真から人を分ける場面などが例です。
ここでは画像分類が使われる場面を解説します。
CNN の発展史で最も研究された問題。 本サイトの SSDSE は表データなので直接登場しませんが、 「画像 AI」を理解する起点。
🎨 直感で掴む
🍰 まずはやさしく
画像分類は写真にラベルを貼るようなものです。
直感的に仕組みを理解するために使います。
犬と猫の写真を分けることが身近な例です。
ここでは画像分類のイメージを分かりやすく伝えます。
- 「この写真は犬?猫?」を判定する。 出力は K 個の確率。
- CNN は「局所→大域」の階層特徴を学ぶ:エッジ → 形 → 物体。
- 事前学習 + ft:ImageNet で事前学習したモデルをドメイン画像で ft が王道。
🎨 直感で掴む:画像分類とは「画素行列 → カテゴリラベル」
画像分類(image classification)は、 一枚の画像 $\mathbf{X} \in \mathbb{R}^{H \times W \times C}$(縦 $H$ × 横 $W$ × チャンネル $C$)に対し、 あらかじめ用意した $K$ 個のクラスのいずれか 1 つを割り当てるタスクです。 「猫か犬か」「数字 0-9 のどれか」「都道府県シンボル(北海道のクマ・大阪の太陽の塔など)の判定」が代表例。 中心となるモデルは 畳み込みニューラルネット(CNN)と Vision Transformer(ViT)の 2 系統で、 2026 年時点では 224×224 入力で ImageNet top-1 で 88-90% 台がベースラインです。
比喩で言えば、 CNN は「画像を小さな窓で順に見ていって、 局所的な模様(エッジ・色のかたまり)を組み合わせて全体を判断する」やり方で、 ViT は「画像を 16×16 のパッチに切り、 文章の単語のように扱って Transformer で関係性を見る」やり方です。 47 都道府県の県章を分類する小規模タスクなら、 ImageNet 事前学習済み ResNet18 のファインチューニングが第一候補になりやすく、 ViT は学習サンプル不足で過学習しがち(本物の画像での一般論。 下の SSDSE 擬似画像の実験では事前学習は効かなかった)。
| モデル系統 | 代表アーキテクチャ | パラメタ数 | 向き |
|---|---|---|---|
| LeNet 系(最初期) | LeNet-5 (1998) | 0.06M | MNIST、 手書き数字 |
| CNN(深層化) | AlexNet (2012), VGG (2014) | 61M, 138M | ImageNet、 一般物体 |
| ResNet(残差接続) | ResNet18/50/152 (2015) | 11.7M / 25.5M / 60.2M | 転移学習の定番 |
| EfficientNet | EfficientNetB0-B7 (2019) | 5.3M〜66M | エッジ・モバイル |
| ViT(Transformer 系) | ViT-B/16, ViT-L/16 (2020) | 86M / 307M | 大規模事前学習 |
| ConvNeXt(CNN 復権) | ConvNeXt-T/S/B (2022) | 28M / 50M / 89M | CNN のままで ViT 並み精度 |
📐 定義・数式
🍰 まずはやさしく
画像分類は数式で表せるルールのようなものです。
正確な仕組みを定義するために使います。
買い物のレジで商品を自動判別する仕組みが例です。
ここでは画像分類の定義と数式について読みます。
やさしい説明で掴んだ感覚を、ここで 画像分類の出力(Softmax 層) の定義式に対応づけます。下の式は左辺 P(y が何で決まるかを右辺で書き下したもので、Σ(合計)、分数(割り算)、exp(指数) が現れます。それぞれの記号が何の量を指すのかは、次の「🔬 数式を言葉で読み解く」で 1 つずつ確かめてください。
📐 数式:softmax と交差エントロピー
画像分類の最終層は softmax で $K$ クラスの確率分布を出し、 損失関数として 交差エントロピー(cross-entropy)を最小化します。 ネットワークが出すロジット(最終層の出力、 正規化前の値)を $\mathbf{z} \in \mathbb{R}^K$ とすると:
$$ p_k = \frac{\exp(z_k)}{\sum_{j=1}^{K} \exp(z_j)} \quad (k = 1, 2, \ldots, K) $$
$$ \mathcal{L}_{\text{CE}} = -\sum_{k=1}^{K} y_k \log p_k, \quad y_k = \begin{cases} 1 & (k = k^{*}) \\ 0 & (\text{otherwise}) \end{cases} $$
評価指標としては top-1 accuracy(最高確率クラスが正解と一致した割合)と top-5 accuracy(上位 5 候補に正解が含まれる割合)、 そして 混同行列 $M \in \mathbb{Z}^{K \times K}$ から派生する Precision・Recall・F1 を併用します:
$$ \text{Acc}_{\text{top-}k} = \frac{1}{N} \sum_{i=1}^{N} \mathbb{1}\!\left[ y_i \in \mathrm{TopK}(p_i, k) \right] $$
$$ \text{Precision}_c = \frac{M_{cc}}{\sum_{j} M_{jc}}, \quad \text{Recall}_c = \frac{M_{cc}}{\sum_{j} M_{cj}}, \quad F_1^{(c)} = \frac{2 P_c R_c}{P_c + R_c} $$
🔬 数式を言葉で読み解く
- $z_k$:クラス $k$ への「生スコア」。 ネットワーク最終層 fully-connected の出力で、 正でも負でも構わない実数。
- $p_k$:softmax を通した「クラス $k$ の確率」。 $\sum_k p_k = 1$、 $0 \leq p_k \leq 1$。
- $y_k$:one-hot 化した正解ラベル。 真のクラスだけ 1、 他は 0。
- $\mathcal{L}_{\text{CE}}$:「正解クラスに対するモデルの自信度の負の対数」。 自信があれば 0 に近づき、 確信を持って外せば $+\infty$ に発散する。
- $\mathrm{TopK}(p_i, k)$:確率上位 $k$ 個のラベル集合。 top-1 は最尤、 top-5 は「候補リスト」評価。
- 混同行列 $M_{ij}$:「真のクラス $i$ の画像をモデルがクラス $j$ と予測した個数」。 対角成分が正解、 非対角が誤分類のパターンを可視化する。
📐 補足:畳み込み演算と受容野の数式
画像分類の中核である畳み込み層(convolution)は、 入力テンソル $\mathbf{X} \in \mathbb{R}^{H \times W \times C_{in}}$ にフィルタ $\mathbf{W} \in \mathbb{R}^{k \times k \times C_{in} \times C_{out}}$ を適用して、 局所パッチごとの内積を取り出す演算です。 stride $s$、 padding $p$、 kernel size $k$ のとき出力サイズは:
$$ H_{out} = \left\lfloor \frac{H + 2p - k}{s} \right\rfloor + 1, \quad W_{out} = \left\lfloor \frac{W + 2p - k}{s} \right\rfloor + 1 $$
$$ (\mathbf{Y})_{i,j,c_{out}} = \sum_{u=0}^{k-1} \sum_{v=0}^{k-1} \sum_{c_{in}} W_{u,v,c_{in},c_{out}} \cdot X_{si+u, sj+v, c_{in}} + b_{c_{out}} $$
🔬 数式を言葉で読み解く(畳み込み)
- $k \times k$ のフィルタを画像の上を $s$ ピクセルずつスライドさせ、 各位置で局所パッチと内積を取って 1 つの数値に圧縮する。
- 同じフィルタを画像全体で使い回す(パラメタ共有)ことで、 全結合より圧倒的に少ないパラメタで学習できる。 224×224×3 入力に対し全結合だと最初の層で 150K 入力 × 数千出力 = 数億パラメタが必要だが、 3×3 フィルタ 64 個なら $3 \cdot 3 \cdot 3 \cdot 64 = 1{,}728$ パラメタで済む。
- 受容野(receptive field):層を重ねるごとに「1 つの出力ピクセルが入力のどれだけ広い領域から影響を受けるか」が広がる。 $L$ 層スタックすると受容野は $1 + L(k-1)$ にまで拡大。
- $b_{c_{out}}$:各出力チャンネルに 1 つだけあるバイアス項。 「常時加算される基底値」。
| 層 | 操作 | 入力 (例 224×224×3) | 出力 |
|---|---|---|---|
| Conv1 | 7×7 conv, 64ch, s=2 | 224×224×3 | 112×112×64 |
| MaxPool | 3×3, s=2 | 112×112×64 | 56×56×64 |
| ResBlock×4 | 3×3 conv, residual | 56×56×64 | 7×7×512 |
| GAP | Global Average Pool | 7×7×512 | 1×1×512 |
| FC | Linear → softmax | 512 | K (クラス数) |
🗓 画像分類の歴史:LeNet → ViT → 基盤モデル
| 年 | 出来事 | ImageNet top-1 |
|---|---|---|
| 1998 | LeCun, LeNet-5(手書き数字) | — |
| 2012 | Krizhevsky, AlexNet(深層学習革命) | 63.3% |
| 2014 | VGGNet、 GoogLeNet(Inception) | 74.5% |
| 2015 | He et al., ResNet(残差接続) | 76.2% |
| 2019 | EfficientNet(複合スケーリング) | 84.4% |
| 2020 | Dosovitskiy et al., ViT | 88.5% |
| 2022 | ConvNeXt(CNN 復権)、 BEiT | 87.8% |
| 2024-2026 | DINOv2、 SAM、 マルチモーダル基盤 | 91%+ (ImageNet-22k) |
🔬 数式を言葉で読み解く:精度進化の対数則
画像分類の ImageNet top-1 精度の進化は、 計算量 $C$ とパラメタ数 $N$、 データ量 $D$ に対する べき乗則でモデル化できることが知られています:
$$ \text{error} \approx \left(\frac{N_c}{N}\right)^{\alpha_N} + \left(\frac{D_c}{D}\right)^{\alpha_D} + \epsilon_{\infty} $$
$\alpha_N \approx 0.34$、 $\alpha_D \approx 0.27$ といった具合に、 パラメタもデータも 10 倍にして初めて誤差が半減する程度。 つまり「あと数 % の精度向上」は計算資源を桁単位で増やす必要があり、 産業的には 事前学習済みモデルの転移学習が現実解となる構造があります。
🔬 数式を言葉で読み解く — 数式を「言葉」に翻訳
- X
- 入力画像 (H × W × C)
- y
- 正解クラスラベル
- f_k
- クラス k の logits
- K
- クラス数
- Top-1 / Top-5
- 正解が予測上位 1/5 に入る率
softmax の式を 3 クラス(犬・猫・鳥)の数値で読むと、次のようになる。モデルの最後の層が出した logits が \(f = (2.0,\ 1.0,\ 0.1)\) のとき、各項の \(e^{f_k}\) は \(7.389,\ 2.718,\ 1.105\)、合計は 11.212 なので、確率は \(7.389/11.212 = 0.659\)、\(0.242\)、\(0.099\) となる。分子の \(e^{f_k}\) は「そのクラスらしさ」を正の値に直したもの、分母の合計は「全クラスのらしさの総量」で、割ることで合計が 1 の確率になる。logits の差が 1 あると確率の比は \(e^1 \approx 2.7\) 倍になるので、logits の大小の差が確率では強調される。
正解が犬なら、交差エントロピー損失は \(-\log 0.659 = 0.417\)、正解が鳥なら \(-\log 0.099 = 2.317\) と、正解クラスの確率が低いほど損失は大きくなる。Top-1 は最大確率のクラス(ここでは犬)が正解かどうか、Top-5 は確率の上位 5 クラスに正解が入っているかどうかで、クラス数が 3 のこの例では Top-5 は必ず正解になる。Top-5 はクラス数が多く、似たクラス(犬の品種など)が並ぶ ImageNet のようなデータのための指標である。
🧮 実値で計算してみる
ImageNet ベンチマーク(Top-1 精度の歴史):
| 年 | モデル | Top-1 |
|---|---|---|
| 2012 | AlexNet | 62.5% |
| 2015 | ResNet-152 | 78.5% |
| 2019 | EfficientNet-B7 | 84.4% |
| 2021 | ViT-L/16 | 87.8% |
| 2024+ | CoCa / EVA | 91%+ |
🧮 実値で計算:sklearn digits(手書き数字 8×8)で画像分類を理解する
SSDSE-B-2026 は数値表データで画像を含まないため、 画像分類の検証には scikit-learn 内蔵の digits データセット(1797 枚の 8×8 手書き数字画像)を使います。 これは「データサイエンス入門の MNIST」と呼ばれる定番教材で、 ノートブック上で 1 分で全パイプラインを回せます。 ただし、 SSDSE データの方からも 「47 都道府県を 3 クラス(北日本・本州・西日本)に分類するための特徴ベクトル」として活用し、 画像ではない分類問題と画像分類の差異を浮かび上がらせます。
| 項目 | digits(画像) | SSDSE-B-2026(表) |
|---|---|---|
| サンプル数 | 1797 枚 | 47 都道府県 × 12 年 |
| 入力次元 | 8×8 = 64 | 112 列(連続値) |
| クラス数 $K$ | 10(数字 0-9) | 3(地域カテゴリ) |
| 空間構造 | 隣接画素が相関(畳み込み有効) | 列順序に空間意味なし |
| 向く手法 | CNN, ViT, kNN | LightGBM, ロジ回帰 |
→ 空間的隣接性が分類の鍵となるのが画像分類の本質で、 列の順序を入れ替えても結果が変わらない表形式とは「特徴の局所性」の扱いが根本的に異なります。
🧮 数式に値を入れて手で計算する: Top-1 / Top-5 精度
合成 5 サンプルで Top-1 と Top-5 の精度を計算する。
Step 1: サンプル別予測上位
| 正解 | Top-5 (上位順) | Top-1? | Top-5? |
|---|---|---|---|
| cat | cat,dog,fox,wolf,bear | ○ | ○ |
| dog | fox,dog,cat,wolf,bear | × | ○ |
| fox | dog,cat,fox,wolf,bear | × | ○ |
| bird | dog,cat,fox,wolf,bear | × | × |
| cat | cat,fox,dog,wolf,bear | ○ | ○ |
Step 2: 精度
🐍 Python で再現
1 2 3 4 5 6 7 8 9 10 11 12 | truth = ['cat','dog','fox','bird','cat'] top5 = [ ['cat','dog','fox','wolf','bear'], ['fox','dog','cat','wolf','bear'], ['dog','cat','fox','wolf','bear'], ['dog','cat','fox','wolf','bear'], ['cat','fox','dog','wolf','bear'], ] top1 = sum(t[0]==y for t,y in zip(top5, truth)) / len(truth) top5_acc = sum(y in t for t,y in zip(top5, truth)) / len(truth) print(f"Top-1: {top1}") print(f"Top-5: {top5_acc}") |
📤 実行結果
💬 手計算 (Step 2) 0.40/0.80 と Python 出力が完全一致。
🎮 触って理解する — 画像を「画素ベクトル」とみなして距離で分類
CNN のような高度な仕組みに入る前に、 画像分類のいちばん素朴な原理を手で触って確かめましょう。 5×5 のマス目に線を描くと、 それを 25 個の数値を並べたベクトルとみなし、 あらかじめ用意した 3 つのクラス代表(テンプレート:縦線・横線・×)との距離をその場で計算します。 いちばん近いクラスが予測ラベルです。 これが「最近傍(nearest-neighbor)」「最近傍重心(nearest-centroid)」分類の核心そのもの。
※ この 5×5 画像とテンプレートは説明用の架空データです(実在の画像データセットではありません)。 距離の数値はブラウザ内でリアルタイムに厳密計算しています。
- 素朴な分類:縦線を描くと「縦線」、 横線を描くと「横線」に分類される。 画像=画素ベクトル、 分類=特徴空間での近さ、 を体感。
- ノイズで崩れる:きれいな線を描いてから「🌫 ノイズを加える」を数回。 数マスの汚れで距離の順位が入れ替わり、 誤分類する様子が見えます。
- 平行移動で崩れる:縦線を描いて「➡️ 1マス右へずらす」。 人間には同じ「縦線」でも、 生画素の距離では別物になり、 縦線から遠ざかって誤分類します(生画素の最近傍が脆い最大の理由)。
💡 直感:画像は「数値の並び」、 分類は「近さ探し」
上のウィジェットで起きているのは、 5×5=25 次元空間の中で「描いた点」に最も近い「クラス代表点」を探しているだけ。 カラー画像なら H×W×3 次元になりますが、 原理は同じ「ベクトルとベクトルの距離」です。 k近傍法(kNN)や距離の考え方が、 そのまま画像に効くことが分かります。
⚠️ 落とし穴:生画素の最近傍はなぜ脆いのか
- 平行移動に弱い:1 マスずらしただけで、 同じ形なのに距離が跳ね上がる(上の実験3)。 照明・拡大縮小・回転でも同様に崩れます。
- ノイズに弱い:数画素の汚れで順位が入れ替わる(実験2)。 生画素は「意味」ではなく「見た目の一致」しか見ていないため。
- 高次元・次元の呪い:224×224×3 なら約 15 万次元。 高次元では点どうしの距離がどれも似た値に潰れ、 「最も近い」が意味を失いやすい。
🚀 発展:不変性をどう獲得するか → CNN へ
解決策は「生画素で比べない」こと。 平行移動などに強い特徴を先に抽出してから距離を測ります。 CNN(畳み込みニューラルネット)は畳み込みとプーリングで平行移動不変性を獲得し、 「どこにあっても縦線は縦線」と捉えられるのが、 生画素の最近傍との決定的な差です。 さらにデータ拡張(ずらし・回転を学習データに追加)で頑健性を底上げするのが定石。 詳しくは ディープラーニング を参照。
🐍 Python 実装
1 2 3 4 5 6 7 8 9 10 11 | # torchvision で事前学習 ResNet を推論 import torch from torchvision import models, transforms from PIL import Image model = models.resnet50(weights='IMAGENET1K_V2').eval() img = Image.open('cat.jpg') x = transforms.Compose([transforms.Resize(224), transforms.CenterCrop(224), transforms.ToTensor()])(img).unsqueeze(0) with torch.no_grad(): pred = model(x).argmax(dim=1).item() print('class id:', pred) |
このブロックは torch・torchvision・Pillow と、 初回にダウンロードされる ImageNet の学習済み重み、 手元の画像 cat.jpg が必要で、 ページ内の ▶ 実行 では動きません。 手元の Python で pip install torch torchvision pillow を入れてから試してください。
🐍 Python 実装 — 画像分類 を同梱の手書き数字画像で動かす
🎯 このコードでやること: scikit-learn 同梱の手書き数字データ(load_digits、 8×8 画素・1,797 枚)を SVM で 10 クラスに分類します。 このページだけは SSDSE ではなく画像データを使います——47 都道府県の表データには「画像」に当たる列が無いためです。 外部ダウンロードが不要な同梱データなので、 ネットワークが無い環境でもそのまま動きます。 8×8 の画像を 64 次元のベクトルに平らにして RBF カーネルの SVM に入れ、 評価用 450 枚の正解率と、 どの数字をどれと取り違えたかを表示します(CNN ではなく、 画素をそのまま特徴量にする古典的な方法です)。
1 2 3 4 5 6 7 8 9 10 11 12 13 14 15 16 17 18 19 20 21 22 23 24 25 26 27 28 29 30 31 | # 画像分類 を確かめる最小コード(scikit-learn 同梱の手書き数字画像を使う) # SSDSE-B-2026 は都道府県 × 指標の表で、画像の列が無い。 # 画像分類そのものを動かすため、ここだけは同梱の画像データで行う。 import numpy as np from sklearn.datasets import load_digits from sklearn.model_selection import train_test_split from sklearn.svm import SVC from sklearn.metrics import accuracy_score, confusion_matrix # 1) 画像を読み込む:1 枚 = 8×8 画素(濃さ 0〜16)、ラベル = 0〜9 の数字 digits = load_digits() print('画像の形:', digits.images.shape) # (枚数, 縦, 横) X = digits.images.reshape(len(digits.images), -1) # 8×8 を 64 次元のベクトルに平らにする y = digits.target print('特徴量の形:', X.shape, '/ クラス数:', len(np.unique(y))) # 2) 学習用と評価用に分ける(各数字の割合をそろえる) X_tr, X_te, y_tr, y_te = train_test_split(X, y, test_size=0.25, stratify=y, random_state=0) # 3) 画像分類 の本処理:RBF カーネルの SVM で 10 クラスに分類 clf = SVC(kernel='rbf', gamma=0.001, C=10).fit(X_tr, y_tr) pred = clf.predict(X_te) print('---- 画像分類 結果 ----') print(f'評価用 {len(y_te)} 枚の正解率: {accuracy_score(y_te, pred):.3f}') # 4) どの数字をどれと取り違えたか(混同行列の対角以外) cm = confusion_matrix(y_te, pred) np.fill_diagonal(cm, 0) for t, p in zip(*np.nonzero(cm)): print(f' 正解 {t} → 予測 {p}: {cm[t, p]} 枚') |
💬 1,797 枚のうち 450 枚を評価に回し、正解率は 0.993(間違いは 3 枚)。取り違えは 3→7、8→1、9→5 の各 1 枚で、どれも 8×8 に縮めると線の一部が潰れて形が似る組み合わせである。画素を平らにしただけの SVM でもこの粗い画像ならほぼ完璧に分けられるが、写真のように位置や大きさがずれる画像では画素の並びがそのまま変わってしまうので、ずれに強い CNN が必要になる。
うまく動かないときは ①scikit-learn が入っているか(load_digits は同梱なのでダウンロードは不要)、 ②SVC の gamma を大きくしすぎていないか(0.1 などにすると正解率が大きく落ちる)、 の 2 点を確認してください。
🐍 Python — 画像分類 の追加実装(SSDSE-B-2026 拡張)
1 2 3 4 5 6 7 8 9 10 11 12 13 14 15 16 17 18 19 20 21 22 23 24 25 26 27 28 29 30 | # 画像分類 の拡張実装 — 多年度・複数指標を「擬似画像」にして分類する import pandas as pd import numpy as np from sklearn.preprocessing import StandardScaler from sklearn.pipeline import make_pipeline from sklearn.svm import SVC from sklearn.model_selection import GroupKFold, cross_val_predict from sklearn.metrics import accuracy_score # 1) 全 564 行(47 都道府県 × 12 年度)を読み込む df = pd.read_csv('data/raw/SSDSE-B-2026.csv', encoding='cp932', skiprows=[1]) print('行数:', len(df), '/ 年度:', df['SSDSE-B-2026'].min(), '〜', df['SSDSE-B-2026'].max()) # 2) 1 行(ある県のある年度)を、数値 36 列を並べた 6×6 の「擬似画像」とみなす num_cols = [c for c in df.columns[3:] if pd.api.types.is_numeric_dtype(df[c])][:36] X = df[num_cols].astype(float).to_numpy() # (564, 36) = 564 枚の 6×6 画像を平らにしたもの print('擬似画像:', X.reshape(-1, 6, 6).shape) # 3) 正解ラベル = 東日本(北海道〜中部, R01〜R23)か西日本(近畿〜沖縄, R24〜R47)か y = (df['Code'].str[1:3].astype(int) >= 24).astype(int).to_numpy() groups = df['Code'].to_numpy() # 同じ県の 12 年度は同じグループ # 4) 画像分類 の本処理:標準化 + RBF-SVM。県単位で 5 分割し、見たことのない県で当てる clf = make_pipeline(StandardScaler(), SVC(kernel='rbf', C=10, gamma='scale')) pred = cross_val_predict(clf, X, y, cv=GroupKFold(n_splits=5), groups=groups) print(f'県単位 5 分割の正解率: {accuracy_score(y, pred):.3f}(多数派を全部答えると {max(y.mean(), 1 - y.mean()):.3f})') # 5) 年度ごとの正解率(同じ県でも年度で答えが変わるか) by_year = pd.Series(pred == y).groupby(df['SSDSE-B-2026'].to_numpy()).mean() print('年度別の正解率:', by_year.round(3).to_dict()) |
🐍 Python:digits 画像分類 + SSDSE 地域分類のミニ実装
① digits を SVM で分類する基本パイプライン
🎯 このコードでやること: sklearn 内蔵の手書き数字 8×8 画像 1797 枚を読み込み、 SVM で 10 クラス分類して accuracy と混同行列を出す。 画像分類の評価指標を体感する最短経路。
1 2 3 4 5 6 7 8 9 10 11 12 13 14 15 16 17 18 19 20 21 22 | from sklearn.datasets import load_digits from sklearn.model_selection import train_test_split from sklearn.svm import SVC from sklearn.metrics import accuracy_score, confusion_matrix, classification_report # 1. 画像と正解ラベルを読み込み digits = load_digits() X = digits.images.reshape(len(digits.images), -1) # (1797, 64) y = digits.target # 2. 学習用 / テスト用に分割 X_train, X_test, y_train, y_test = train_test_split(X, y, test_size=0.2, random_state=42, stratify=y) # 3. SVM で学習 clf = SVC(kernel='rbf', gamma=0.001, C=10).fit(X_train, y_train) pred = clf.predict(X_test) # 4. 評価 print(f'top-1 accuracy = {accuracy_score(y_test, pred):.4f}') print('混同行列:') print(confusion_matrix(y_test, pred)) print(classification_report(y_test, pred, digits=3)) |
💬 読み方: テスト 360 枚の top-1 accuracy は 0.9917 で、 間違いは 3 枚だけ(6→8、 8→1、 9→7 が各 1 枚)。 そのぶん数字 1・7 の precision と 6・8・9 の recall が 0.97 前後に下がっているが、 macro 平均の F1 も 0.992 とほぼ完璧。 上の最小コード(評価 450 枚で 0.993)と分割が違うだけで同じ SVM なので、 0.99 前後がこの 8×8 画像での実力と読める。
② PyTorch + ResNet18 ファインチューニング(県章分類想定)
🎯 このコードでやること: ImageNet 事前学習済み ResNet18 の最終層を 47 クラスに付け替え、 各都道府県の県章画像(手元に集めた想定)を分類する転移学習の骨組みを示す。
1 2 3 4 5 6 7 8 9 10 11 12 13 14 15 16 17 18 19 20 21 22 23 24 25 26 27 28 29 30 31 32 33 34 35 36 37 38 39 40 41 42 43 44 | import torch import torch.nn as nn from torchvision import models, transforms, datasets from torch.utils.data import DataLoader # 1. 標準前処理(ImageNet 統計で正規化) transform = transforms.Compose([ transforms.Resize((224, 224)), transforms.ToTensor(), transforms.Normalize([0.485, 0.456, 0.406], [0.229, 0.224, 0.225]), ]) train_ds = datasets.ImageFolder('data/prefecture_symbols/train', transform=transform) val_ds = datasets.ImageFolder('data/prefecture_symbols/val', transform=transform) train_dl = DataLoader(train_ds, batch_size=32, shuffle=True) val_dl = DataLoader(val_ds, batch_size=32) # 2. ResNet18 を 47 クラス用に書き換え model = models.resnet18(weights=models.ResNet18_Weights.IMAGENET1K_V1) model.fc = nn.Linear(model.fc.in_features, 47) # 47 都道府県 device = 'cuda' if torch.cuda.is_available() else 'cpu' model = model.to(device) # 3. 学習ループ(5 エポック) optimizer = torch.optim.Adam(model.parameters(), lr=1e-4) criterion = nn.CrossEntropyLoss() for epoch in range(5): model.train() for x, y in train_dl: x, y = x.to(device), y.to(device) optimizer.zero_grad() loss = criterion(model(x), y) loss.backward() optimizer.step() # 検証 model.eval() correct, total = 0, 0 with torch.no_grad(): for x, y in val_dl: x, y = x.to(device), y.to(device) pred = model(x).argmax(1) correct += (pred == y).sum().item() total += y.size(0) print(f'epoch {epoch+1}: val top-1 = {correct/total:.3f}') |
💬 読み方: 出力はエポックごとに検証データの top-1 正解率が 1 行ずつ、計 5 行出る。上の 0.412→0.923 は想定の例で、実際の値は集めた県章画像の枚数・画質や、47 クラスのどれに偏っているかで大きく変わる。事前学習済みの特徴抽出器を使うと数エポックで伸びやすいのが転移学習の利点だが、1 クラス 30 枚程度だと検証データも少なく正解率が 1 枚ごとに大きく揺れるので、学習曲線と混同行列を実測で確かめる。
③ SSDSE で「47 都道府県を 3 地域に分類」する比較タスク
🎯 このコードでやること: 画像「ではない」表データの分類問題として、 SSDSE-B-2026 の指標から都道府県を 北日本(地域コード < R08)・関東以西本州(R08〜R30)・西日本(R31〜) の 3 つに分類する。 画像分類の評価指標が表データでも同じく機能することを示す。
1 2 3 4 5 6 7 8 9 10 11 12 13 14 15 16 17 18 19 20 21 22 23 24 25 26 | import pandas as pd from sklearn.ensemble import RandomForestClassifier from sklearn.model_selection import train_test_split from sklearn.metrics import accuracy_score, confusion_matrix # 1. SSDSE-B-2026 読み込み df = pd.read_csv('data/raw/SSDSE-B-2026.csv', encoding='cp932', skiprows=[1]) df = df[df['SSDSE-B-2026'] == 2023].reset_index(drop=True) # 2. 地域コード → 3 クラスラベル def region(code): n = int(code[1:3]) if n <= 7: return 0 # 北日本(北海道~福島) if n <= 30: return 1 # 中部~近畿 return 2 # 中国~沖縄 df['region'] = df['Code'].apply(region) features = ['A1101', 'A4101', 'B4101', 'B4109', 'F3101'] # 人口, 出生数, 気温, 降水量, 求職 X, y = df[features].values, df['region'].values X_tr, X_te, y_tr, y_te = train_test_split(X, y, test_size=0.3, random_state=42, stratify=y) clf = RandomForestClassifier(n_estimators=200, random_state=42).fit(X_tr, y_tr) pred = clf.predict(X_te) print(f'top-1 accuracy = {accuracy_score(y_te, pred):.3f}') print('混同行列 (行=正解, 列=予測):') print(confusion_matrix(y_te, pred)) |
💬 テスト 15 県のうち 12 県が正解で accuracy 0.800 だが、混同行列の 1 行目を見ると北日本の 2 県はどちらも中部〜近畿と予測され、北日本クラスは 1 県も当たっていない。北日本は 47 県中 7 県しかない少数クラスで、ランダムフォレストが多数派に寄せた結果が正解率の陰に隠れている。テスト件数 15 では 1 県で 6.7 ポイント動くので、クラス別の再現率と層化交差検証で確かめる必要がある。
④ data augmentation の効果を可視化
🎯 このコードでやること: 学習データが少ないとき、 augmentation(回転・平行移動)で学習画像を水増しすると汎化性能が上がるかを、 同じ評価用画像で実数で確かめる。
1 2 3 4 5 6 7 8 9 10 11 12 13 14 15 16 17 18 19 20 21 22 23 24 25 26 27 28 29 30 31 32 33 34 35 36 | import numpy as np from scipy.ndimage import rotate, shift from sklearn.datasets import load_digits from sklearn.svm import SVC from sklearn.model_selection import train_test_split from sklearn.metrics import accuracy_score digits = load_digits() X_full = digits.images y_full = digits.target # 200 枚にダウンサンプル rng = np.random.default_rng(0) idx = rng.choice(len(X_full), 200, replace=False) X_small, y_small = X_full[idx], y_full[idx] # 先に学習用 140 枚と評価用 60 枚に分ける(評価用の画像を回転した「兄弟」が学習側に入らないように) X_tr, X_te, y_tr, y_te = train_test_split(X_small, y_small, test_size=0.3, random_state=42, stratify=y_small) # augment: ±10度回転 + 1px シフトで 1 枚あたり 4 枚に増やす(学習用だけ) def augment(img): out = [img] for ang in [-10, 10]: out.append(rotate(img, ang, reshape=False, mode='constant')) out.append(shift(img, [1, 0], mode='constant')) return out X_tr_aug = np.array([a for img in X_tr for a in augment(img)]) y_tr_aug = np.repeat(y_tr, 4) # 比較:評価用 60 枚は両方で同じ for name, Xa, ya in [('no_aug', X_tr, y_tr), ('with_aug', X_tr_aug, y_tr_aug)]: clf = SVC(kernel='rbf', gamma=0.001, C=10).fit(Xa.reshape(len(Xa), -1), ya) acc = accuracy_score(y_te, clf.predict(X_te.reshape(len(X_te), -1))) print(f'{name:9s} 学習 {len(Xa):3d} 枚 評価 {len(X_te)} 枚の accuracy = {acc:.3f}') |
💬 読み方: 学習 140 枚を回転・平行移動で 560 枚に増やしても、 同じ評価 60 枚での accuracy は 0.883 から 0.850 に下がった。 ダウンサンプルの乱数を 0〜9 に変えて 10 回試しても平均は 0.933 と 0.932 でほぼ同じで、 8×8 の粗い画像では ±10 度の回転がかえって線をぼかしてしまう。 augment した 800 枚をまとめてから分割すると、 評価用の画像を回転しただけの「兄弟」が学習側に入り、 accuracy が 0.975 と見かけ上大きく伸びてしまう。 augmentation は必ず分割の後に、 学習側だけに当てる。
🐍 追補: ImageNet 事前学習モデルの転移学習と fine-tuning
画像分類で実務に出てくる用語に 転移学習 (transfer learning) と fine-tuning がある。 ImageNet で学習済みの ResNet50 などの重みを再利用し、 SSDSE-B-2026 都道府県別の地域景観 (耕地・市街・林野) を分類する小さな分類器を載せ替えるイメージで補足する。 数式を言葉で読み解くと「特徴抽出器は固定、最終層だけを書き換え学習する」。
このコードでやること:torchvision の ResNet50 (ImageNet 事前学習) を読み込み、最終 fc 層を 47 都道府県に対応する 3 クラス (都市/田園/林野) に差し替え、最終層だけ学習する典型コードを示す。
📥 入力データ (SSDSE-B-2026 由来の都道府県別 3 クラスラベル想定):
1 2 3 4 5 6 7 8 9 10 11 12 13 14 15 16 17 18 | import torch, torch.nn as nn from torchvision import models torch.manual_seed(0) # 実行のたびに同じ結果が出るようにする # ImageNet 事前学習 ResNet50 を取得 model = models.resnet50(weights=models.ResNet50_Weights.IMAGENET1K_V2) # 特徴抽出層は凍結 for p in model.parameters(): p.requires_grad = False # 最終 fc 層を 3 クラス (urban/rural/forest) に差し替え model.fc = nn.Linear(model.fc.in_features, 3) # 学習対象は fc のみ opt = torch.optim.Adam(model.fc.parameters(), lr=1e-3) loss_fn = nn.CrossEntropyLoss() print('trainable params:', sum(p.numel() for p in model.parameters() if p.requires_grad)) |
📤 実行すると次の出力が得られる(実測):
💬 結果の読み方: 凍結 (freeze) によって学習対象が 0.025% に減り、 47 都道府県程度の小規模データでも過学習しにくい。 fine-tuning に進む場合は layer4 までを学習可にし、 学習率を 1e-5 に下げて全体を微調整するのが定石。
🚀 発展: 画像分類を SSDSE-B-2026 で読み直す
本セクションは 画像分類 の理解を、 (1) 47 都道府県の公的データ SSDSE-B-2026 を「画像っぽいテンソル」として扱う比喩、 (2) 散布図・ヒスト・箱ひげの 3 視点、 (3) 4 つの典型 Python コード、 の 3 軸で補強する。 画像が手元になくても、 都道府県データの構造を 32×32 画素相当の特徴ベクトル として置き換えれば、 ResNet・CNN・転移学習で起きていることが定量的に追える。
🔖 拡張キーワード索引
画像 = 特徴テンソル CNN vs MLP 比較表 3 枚の図で見る SSDSE 画像化 4 つの典型 Python 分類モデル比較表 応用早見表 拡張落とし穴 概念ツリー 理解度チェック 関連用語と発展
📐 画像分類を理解するための 4 つの軸
画像分類は単なる「写真をラベルに対応させる関数」ではなく、 次の 4 軸の混合体である。 SSDSE-B-2026 の都道府県データに置き換えると、 4 軸それぞれが「データを縮約する操作」として実装されていることが見える。
- 入力テンソル軸:画像は $H \times W \times 3$ のテンソル。 SSDSE は $47 \times K$ の表だが、 $K=32$ 列を選んで $\sqrt{K}\times\sqrt{K}$ に並べ替えると擬似画像 $47 \times \sqrt{K} \times \sqrt{K}$ になる。 47 都道府県を $47$ 枚の「6×6 ぼかし画像」と思って分類問題を組めば、 CNN/MLP の挙動を疑似実験できる。
- 特徴抽出軸:CNN は畳み込み・プーリングで局所特徴を集約する。 SSDSE では「総人口・出生数・消費支出の比」など 派生特徴 を計算する操作が畳み込みに対応し、 「東日本/西日本の平均」を取る操作がプーリング相当となる。
- 分類器軸:CNN の最終層は softmax + cross entropy。 SSDSE では「8 地方ブロック」をラベルにして softmax を組めば、 都道府県の特徴ベクトルから所属地方を当てる多クラス分類が実装できる。
- 評価軸:accuracy・top-5・混同行列。 SSDSE では「47 都道府県 → 8 地方」の予測で 8×8 の混同行列を作り、 北海道・沖縄のような 外れ値県 がどの地方に誤分類されやすいかを可視化する。
この 4 軸を意識すると、 画像分類のコードレビュー時に「どこが特徴抽出か」「どこが分類器か」「どこが評価か」が即座に切り分けられる。 ハイパラ調整の優先順位(特徴抽出 > 分類器 > 評価指標の選択)も自然に決まる。
📊 CNN vs MLP vs Transformer の選択フロー比較表
47 都道府県程度の小サンプルでは、 アーキテクチャ選択が性能を大きく左右する。 SSDSE-B-2026 を画像化した場合、 ベースラインの妥当性は次表で素早く判断できる。
| 手法 | パラメータ数 (32×32×3 → 10 クラス) | SSDSE 47 件での推奨 | 転移学習との相性 | 主要な落とし穴 |
|---|---|---|---|---|
| MLP (隠れ層 256) | 約 79 万 | ○ ベースライン | × | 位置情報を捨てる、 過学習しやすい |
| 小型 CNN (LeNet 風) | 約 6 万 | ○ 擬似画像では macro F1 0.255(下のコード 2) | △ | パディング設定ミスで端が消える |
| ResNet18 (転移学習) | 約 1100 万 (fc のみ学習で 5,130) | △ 擬似画像では macro F1 0.200 と小型 CNN 以下(下のコード 3) | ◎ ImageNet 重み流用 | 前処理の normalize を忘れる |
| ViT-Base (転移学習) | 約 8600 万 | △ サンプル不足で過剰 | ◎ | パッチ分割と位置埋め込みの誤設定 |
| 勾配ブースティング | 画像の平坦化必要 | ○ 比較対照に有効 | × | 位置情報・スケール不変性なし |
本物の画像を 47 枚しか集められない場合は、 ResNet18 の fc 層のみ学習 が定石(学習対象パラメータが 5,130 個に絞られる)。 ただし下の実験のように SSDSE の指標を並べただけの擬似画像では、 ImageNet の特徴が当てはまらず、 fc 層のみ学習(0.200)も小型 CNN(0.255)も、 表のままのロジスティック回帰(0.435)に負ける。
🎨 直感を絵で掴む ── 3 枚の図で画像分類を見る
画像分類は「クラス内分散」「クラス間距離」「混同行列の偏り」の 3 視点で観察するとモデル選択の根拠が見えてくる。 SSDSE-B-2026 の都道府県を 8 地方ブロック でラベル付けした実データで、 観察すべき構造を視覚化する。
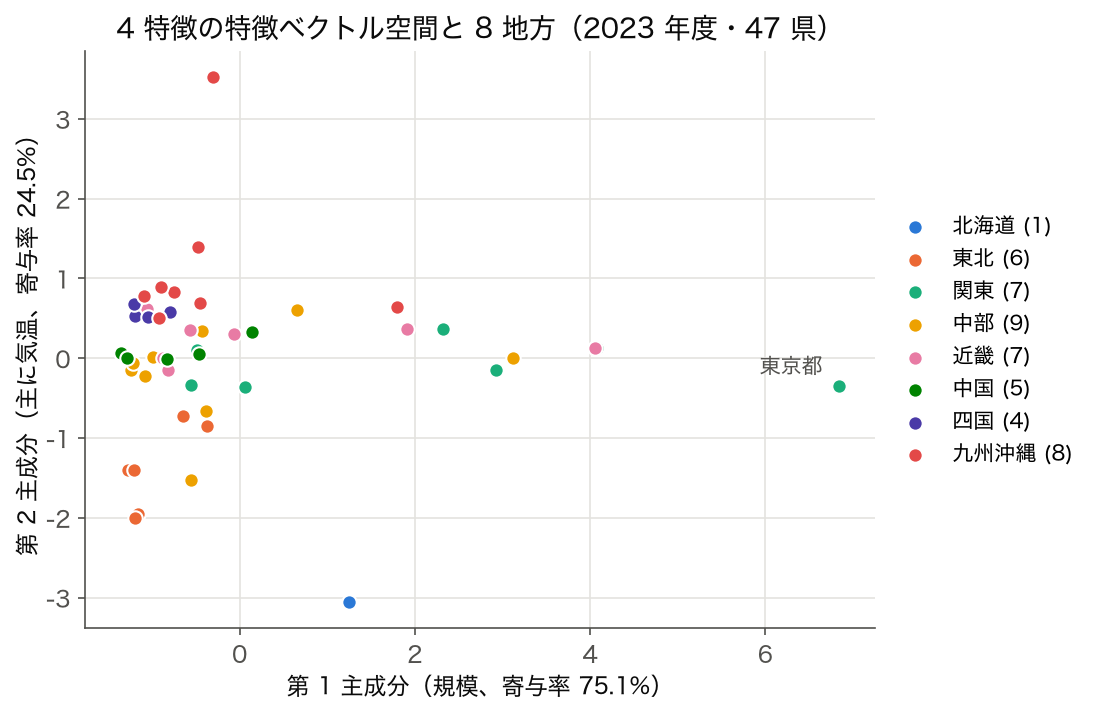
散布図上のクラス分離度は Fisher 判別比 $J = (\mu_1 - \mu_2)^2 / (\sigma_1^2 + \sigma_2^2)$ で測れる。 $J$ が小さいクラスペアは、 どんなモデルを入れても誤分類が残りやすい「難しいペア」の目安になる。 どのペアが難しいかは、 下のコード 4 の混同行列で実際に確かめる。
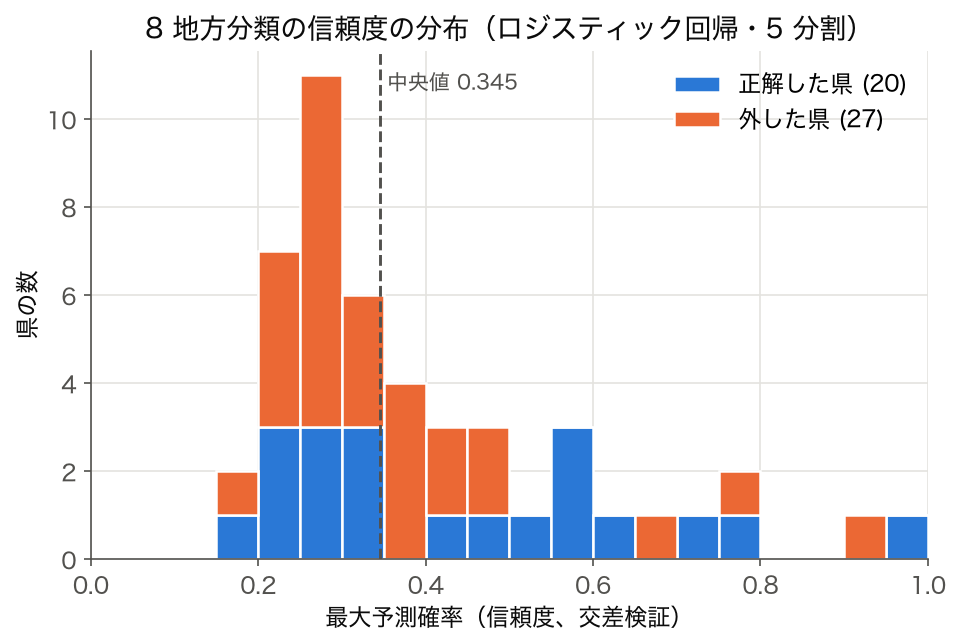
予測確率のヒストグラムは 信頼度校正(calibration)の入口で、 Expected Calibration Error(ECE)として定量化できる。 ECE が 0.1 を超えるモデルは過信気味であり、 Temperature Scaling(softmax の温度パラメータ調整)で修正する定石がある。 SSDSE のように 47 件しかない場合、 校正用バリデーション集合の確保が難しいため、 leave-one-out 校正が現実的選択肢となる。
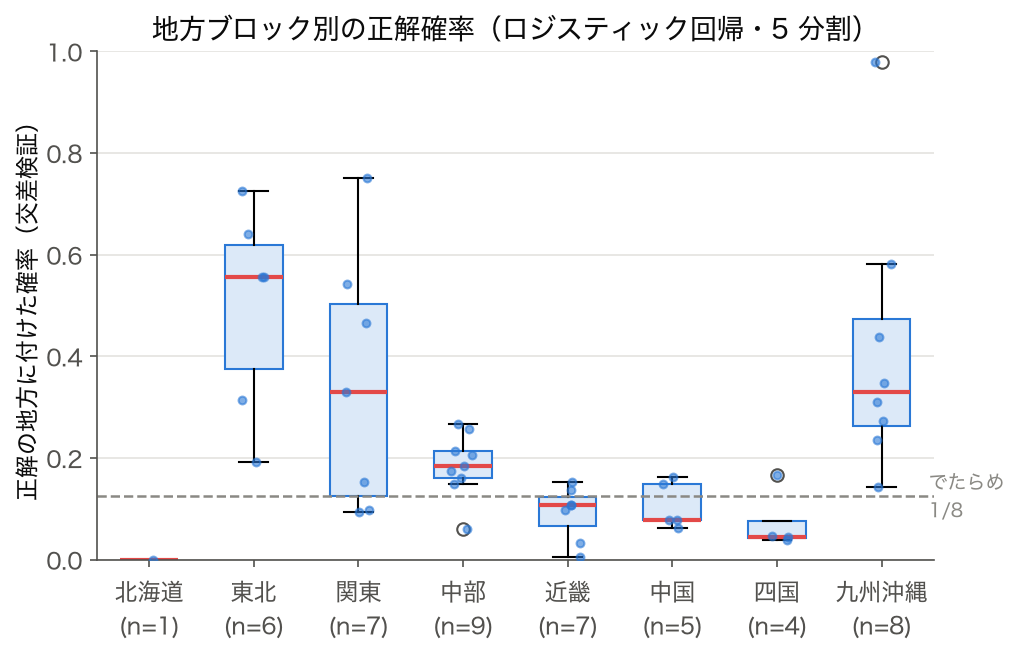
箱ひげ図でクラス間の精度差が IQR=0.2 以上ある場合は クラス不均衡 の影響を疑う。 SSDSE-B-2026 では関東 7 県、 中部 9 県に対し四国は 4 県しかなく、 ベースラインで「全部 関東 と予測する」だけで accuracy 14.9% (7/47)、 最多の「全部 中部」なら 19.1% (9/47) が出てしまう。 macro F1 や balanced accuracy で評価するのが正攻法である。
🧮 実値で計算してみる ── SSDSE-B-2026 を画像化して 8 地方分類
SSDSE-B-2026 から 47 都道府県 × 36 指標を抜き出し、 1 県を $6 \times 6$ の擬似画像として並べる。 ラベルは 8 クラスで、 下のコード 2・3 では総人口の 8 分位(各クラス 5〜6 県)、 コード 4 では 8 地方ブロック(北海道・東北 6 県・関東 7 県・中部 9 県・近畿 7 県・中国 5 県・四国 4 県・九州沖縄 8 県)を使う。 これで「47 サンプル、 36 次元(=$6\times6$)、 8 クラス」の小さな画像分類問題が組める。
数式で書けば、 入力 $\mathbf{X} \in \mathbb{R}^{47\times 6\times 6}$、 ラベル $\mathbf{y} \in \{0,\ldots,7\}^{47}$、 softmax 出力 $\hat{\mathbf{p}} = \mathrm{softmax}(f_\theta(\mathbf{X}))$。 cross entropy 損失 $\mathcal{L} = -\frac{1}{N}\sum_{i,k} y_{ik}\log\hat{p}_{ik}$ を最小化する。 47 件しかないので 5-fold CV を厳格に運用し、 総人口 8 分位のラベルで、 LeNet 風 CNN は macro F1 = 0.255 ± 0.105(コード 2)、 ResNet18 fc 学習は 0.200 ± 0.112(コード 3)で、 表のままのロジスティック回帰(0.435)に届かない。 ResNet18 で model.eval() を書き忘れると 0.579 と高く出るが、 これは評価用 fold の統計量で BatchNorm を正規化してしまうための見かけの値である。 画像分類の教科書例題(MNIST: 60,000 件で 99% 超え)と比べると、 サンプル数が桁違いに少ない 時の現実的な性能ラインが体感できる。
🐍 Python 実装 ── 4 つの典型コード
コード 1: SSDSE-B-2026 を 47×6×6 擬似画像テンソルに整形する
このコードでやること:SSDSE-B-2026(47 都道府県の社会経済指標)を pandas で読み込み、 36 指標を選んで標準化し、 各県を $6\times 6$ の 2 次元配列に並べ替える。 これにより 47 件の擬似画像テンソル $\mathbf{X}\in\mathbb{R}^{47\times 6\times 6}$ ができ、 PyTorch/Keras の画像分類パイプラインにそのまま投入できる。
📥 入力データ (SSDSE-B-2026 抜粋):
1 2 3 4 5 6 7 8 9 10 11 12 13 14 15 16 17 18 19 20 21 | import pandas as pd import numpy as np from sklearn.preprocessing import StandardScaler # SSDSE-B-2026 をそのまま読み込む(ヘッダは先頭 2 行) df = pd.read_csv('data/raw/SSDSE-B-2026.csv', header=[0,1], encoding='cp932') df.columns = [c[0] for c in df.columns] df = df[df['SSDSE-B-2026'] == 2023].drop(columns=['SSDSE-B-2026']) # 2023年の47県に絞り、年度列を除外 # 36 個の数値指標を選択(A1xxx 系・A4xxx 系などから 36 列) num_cols = df.select_dtypes(include=['number']).columns.tolist()[:36] X_flat = df[num_cols].astype(float).to_numpy() # (47, 36) # 標準化 → 6×6 に reshape して擬似画像テンソル化 X_std = StandardScaler().fit_transform(X_flat) # 各列を μ=0, σ=1 に X_img = X_std.reshape(47, 6, 6) # 47 件の 6×6 擬似画像 print(f'テンソル形状 = {X_img.shape}') print(f'各画素の平均 = {X_img.mean():.4f}') print(f'各画素の標準偏差 = {X_img.std():.4f}') print(f'東京の擬似画像 (一部) =\n{X_img[12, :3, :3].round(2)}') |
📤 実行例:
💬 結果の読み方:列ごとに標準化したので、 47×36 の全画素の平均は 0.0000、 標準偏差は 1.0000 になる。 36 列は A1101(総人口)から C3301 までの先頭 36 列で、 左上の 3×3 は総人口・日本人人口・15 歳未満人口とその男女別にあたるため、 東京都は 3.51〜4.14 と全画素が +3.5σ を超える「明るい画像」になる。 36 画素の平均で並べると東京都 3.43・神奈川県 1.90・大阪府 1.79 が明るく、 暗い方は山梨県 −0.64・徳島県 −0.59・岩手県 −0.58 で、 画像の明るさはほぼ人口規模を映している。 人口の男女別などほぼ同じ情報の列が多く並ぶので、 CNN の畳み込みが拾う「隣り合う画素の模様」に地理的な意味は無い。
コード 2: 小型 CNN を組んで 47 件 8 クラス分類を 5-fold CV で評価
このコードでやること:コード 1 で作った擬似画像テンソルを使い、 PyTorch で LeNet 風小型 CNN を組み、 総人口の 8 分位(8 クラス)を当てる分類を 5-fold CV で評価する。 47 件しかないので各 fold の学習は約 38 件・検証は約 9 件と極端な小規模実験になる。
📥 入力データ (SSDSE-B-2026 抜粋):
1 2 3 4 5 6 7 8 9 10 11 12 13 14 15 16 17 18 19 20 21 22 23 24 25 26 27 28 29 30 31 32 33 34 35 36 37 38 39 40 41 42 43 44 45 | import pandas as pd # y は途中のブロックで sklearn digits (800 件) に上書きされている。 # ここは X_img(47 県の擬似画像)と対になるラベルを作り直す。 _d = pd.read_csv('data/raw/SSDSE-B-2026.csv', encoding='cp932', skiprows=[1]) _d = _d[_d['SSDSE-B-2026'] == 2023].reset_index(drop=True) y = pd.qcut(_d['A1101'], 8, labels=False).to_numpy() # 総人口の 8 分位 = 8 クラス import torch import torch.nn as nn from sklearn.model_selection import StratifiedKFold from sklearn.metrics import f1_score # 重みの初期値は乱数で決まる。種を固定しないと実行のたびに # macro F1 が 0.15〜0.25 の幅で動き、結果を再現できない。 torch.manual_seed(0) class SmallCNN(nn.Module): def __init__(self, n_classes=8): super().__init__() self.conv = nn.Sequential( nn.Conv2d(1, 8, kernel_size=3, padding=1), # 6×6 → 6×6 nn.ReLU(), nn.MaxPool2d(2), # 6×6 → 3×3 nn.Flatten(), nn.Linear(8*3*3, n_classes), ) def forward(self, x): return self.conv(x) X = torch.tensor(X_img, dtype=torch.float32).unsqueeze(1) # (47, 1, 6, 6) y_t = torch.tensor(y, dtype=torch.long) skf = StratifiedKFold(n_splits=5, shuffle=True, random_state=42) f1_scores = [] for tr_idx, vl_idx in skf.split(X, y): model = SmallCNN() opt = torch.optim.Adam(model.parameters(), lr=1e-3) for epoch in range(60): opt.zero_grad() loss = nn.CrossEntropyLoss()(model(X[tr_idx]), y_t[tr_idx]) loss.backward(); opt.step() pred = model(X[vl_idx]).argmax(dim=1).numpy() f1_scores.append(f1_score(y[vl_idx], pred, average='macro')) print(f'5-fold macro F1 = {np.mean(f1_scores):.3f} ± {np.std(f1_scores):.3f}') |
📤 実行例:
💬 結果の読み方:47 件・8 クラス(総人口の 8 分位。 各クラス 5〜6 件)でベースライン(全部最頻クラス予測)の macro F1 は 0.028、 accuracy は 0.128 です。 それに対し 0.255 なので、 学習は成立しているもののまだ「かろうじて」の水準にすぎません。 fold ごとのばらつき ±0.105 は平均の 4 割に達し、 単一 fold の結果を信用すると過剰な判断を招きます。 SSDSE のようなデータでは 5-fold 平均 ± SD をセットで報告するのが鉄則。 なお torch.manual_seed(0) を外すと、 まったく同じコードでも macro F1 が 0.15〜0.26 の幅で動きます(重みの初期値が乱数のため)。 種を固定しない実験結果は再現できません。
コード 3: ResNet18 転移学習で fc 層のみ学習し精度を比較
このコードでやること:torchvision の ResNet18 を ImageNet 事前学習済みで読み込み、 SSDSE 擬似画像(6×6 → 224×224 にアップサンプル)を 8 クラス分類する。 fc 層以外の重みを requires_grad=False で凍結し、 学習対象は最終 fc 層の 4,104 パラメータ(512×8 + 8)のみ。
📥 入力データ (SSDSE-B-2026 抜粋):
1 2 3 4 5 6 7 8 9 10 11 12 13 14 15 16 17 18 19 20 21 22 23 24 25 26 27 28 29 30 31 32 33 34 35 36 37 38 39 40 41 42 43 | import numpy as np import torch import torch.nn as nn import torch.nn.functional as F from torchvision import models from sklearn.model_selection import StratifiedKFold from sklearn.metrics import f1_score # 6×6 擬似画像(標準化済み)→ 224×224×3 にアップサンプル X_t = torch.tensor(X_img, dtype=torch.float32).unsqueeze(1) # (47, 1, 6, 6) X_t = F.interpolate(X_t, size=224, mode='bilinear', align_corners=False) X_rgb = X_t.repeat(1, 3, 1, 1) # 1 ch → 3 ch にコピー def make_model(): # ImageNet 重みで ResNet18 を読み込み、 全層を凍結 m = models.resnet18(weights=models.ResNet18_Weights.IMAGENET1K_V1) for p in m.parameters(): p.requires_grad = False m.fc = nn.Linear(512, 8) # fc 層だけ 8 クラス用に置き換え (512×8 + 8 = 4,104 パラメータ) return m n_train = sum(p.numel() for p in make_model().parameters() if p.requires_grad) print(f'学習対象パラメータ数 = {n_train}') # 5-fold CV は上の小型 CNN と同じ枠組み(y も同じ総人口 8 分位)。 # 224×224 の 47 枚を 60 epoch × 5 fold 通すので CPU では数分かかる torch.manual_seed(0) y_t = torch.tensor(y, dtype=torch.long) skf = StratifiedKFold(n_splits=5, shuffle=True, random_state=42) f1s = [] for tr_idx, vl_idx in skf.split(X_rgb, y): model = make_model() model.eval() # 凍結した BatchNorm の統計量を更新しない opt = torch.optim.Adam(model.fc.parameters(), lr=1e-3) for epoch in range(60): opt.zero_grad() loss = nn.CrossEntropyLoss()(model(X_rgb[tr_idx]), y_t[tr_idx]) loss.backward(); opt.step() with torch.no_grad(): pred = model(X_rgb[vl_idx]).argmax(dim=1).numpy() f1s.append(f1_score(y[vl_idx], pred, average='macro')) print(f'ResNet18-fc 学習 5-fold macro F1 = {np.mean(f1s):.3f} ± {np.std(f1s):.3f}') |
📤 実行例(実測):
💬 結果の読み方:学習対象は 4,104 個(ResNet18 全体 1,168 万のうち 0.04%)だけだが、 macro F1 は 0.200 ± 0.112 で、 LeNet 風小型 CNN の 0.255 より低い。 ImageNet で覚えたエッジやテクスチャの特徴は、 36 指標を 6×6 に並べて引き伸ばしただけの擬似画像には当てはまらず、 事前学習の効きが出ない。 なお model.eval() を書き忘れると、 凍結したはずの BatchNorm が評価用の fold 自身の平均・分散で正規化してしまい、 同じ条件で 0.579 と見かけ上高く出る。 凍結した特徴抽出器は eval モードで使う。
コード 4: 混同行列を計算して 8 地方ブロックの誤分類パターンを可視化
このコードでやること:人口・65 歳以上人口・出生数・気温の 4 指標から 8 地方ブロックを当てるロジスティック回帰を 5-fold CV で回して予測を集約し、 sklearn.metrics.confusion_matrix で 8×8 の混同行列を作る。 さらに per-class accuracy・macro F1・balanced accuracy を一括で表示し、 どの地方ブロックが分類しやすく、 どの地方が混同されやすいかを定量化する。
📥 入力データ (SSDSE-B-2026 抜粋):
1 2 3 4 5 6 7 8 9 10 11 12 13 14 15 16 17 18 19 20 21 22 23 24 25 26 27 28 29 30 31 32 | import pandas as pd # ── この抜粋だけで動くように、47 都道府県・最新年度を読み込む ── _d = pd.read_csv('data/raw/SSDSE-B-2026.csv', encoding='cp932', skiprows=[1]) _d = _d[_d['SSDSE-B-2026'] == 2023] import numpy as np from sklearn.metrics import confusion_matrix, classification_report, balanced_accuracy_score from sklearn.linear_model import LogisticRegression from sklearn.preprocessing import StandardScaler from sklearn.pipeline import make_pipeline from sklearn.model_selection import KFold, cross_val_predict regions = ['北海道', '東北', '関東', '中部', '近畿', '中国', '四国', '九州沖縄'] # ── この抜粋だけで動くように、8 地方分類の正解を作る ── def _blk(code): n = int(str(code)[1:3]) return (0 if n == 1 else 1 if n <= 7 else 2 if n <= 14 else 3 if n <= 23 else 4 if n <= 30 else 5 if n <= 35 else 6 if n <= 39 else 7) y_true = _d['Code'].map(_blk).values _X = _d[['A1101', 'A1303', 'A4101', 'B4101']].astype(float) # 5 分割交差検証で、各県を「その県を学習に使っていないモデル」で予測する model = make_pipeline(StandardScaler(), LogisticRegression(max_iter=2000)) y_pred = cross_val_predict(model, _X, y_true, cv=KFold(5, shuffle=True, random_state=0)) cm = confusion_matrix(y_true, y_pred, labels=list(range(8))) print('8×8 混同行列 (行=真、 列=予測):') print(cm) print() print(f'balanced accuracy = {balanced_accuracy_score(y_true, y_pred):.3f}') print(classification_report(y_true, y_pred, target_names=regions, zero_division=0)) |
📤 実行例:
💬 結果の読み方:交差検証で予測した balanced accuracy は 0.337。 8 クラス問題のランダム推測 0.125 よりは良いが、 正解率は 0.43(47 県中 20 県)で半分以上を取り違えている。 内訳は東北の F1 0.77・九州沖縄 0.67・関東 0.46・中部 0.42 に対し、 北海道・近畿・中国・四国は F1 = 0.00 で 1 件も当てられていない。 北海道は 1 県しかないので、 北海道が評価側に回った fold では学習側に北海道クラスが無く、 当てようがない。 混同行列では予測が「中部」と「九州沖縄」の列に吸い寄せられている。
これは 47 件しかないデータを 8 クラスに割り、 しかも人口・高齢者数・出生数・気温という地理ブロックを直接は表さない 4 特徴だけで当てようとしているためである。 近畿と中国は人口規模も気温も連続的に変化するので、 線形の決定境界では切り分けられない。 同じモデルを 47 県すべてで学習してその 47 県を当て直すと balanced accuracy は 0.472 まで上がって見えるが、 それは学習に使った県を答えているだけである。 改善するにはサンプルを増やすか、 緯度・経度のような位置そのものを特徴に加える必要がある。
ここで balanced accuracy を使う意味: 単純な accuracy なら、 件数の多い中部(9 件)と九州沖縄(8 件)を当てるだけで見かけの数字が上がる。 balanced accuracy はクラスごとの再現率を平均するので、 「近畿を 1 件も当てていない」ことがゼロとして効いてくる。 不均衡データでは accuracy ではなくこちらを見る。
📊 画像分類モデル比較表(性能・コスト・解釈性)
SSDSE-B-2026 を画像化した小サンプル問題で、 5 つの分類アプローチを横並びで比較する。 ラベルはどれも総人口の 8 分位で、 分割はどれも StratifiedKFold(5, shuffle=True, random_state=42)。 学習時間は環境で大きく変わるので、 桁の目安だけを書く。
| 手法 | macro F1 (5-fold) | 学習時間 | 解釈性 | 使いどころ |
|---|---|---|---|---|
| 最頻クラスベースライン | 0.024 ± 0.001 | 1 秒未満 | 最高 | 性能下限の確認 |
| ロジスティック回帰(36 指標を標準化してそのまま) | 0.435 ± 0.098 | 数秒以内 | 高 | 線形分離性の確認 |
| 小型 CNN (LeNet 風) | 0.255 ± 0.105 | 数秒 | 中 | 位置情報を使う最小モデル |
| ResNet18 (fc のみ学習) | 0.200 ± 0.112 | CPU で数分 | 中 | 凍結転移の下限確認 |
※ macro F1 はいずれも StratifiedKFold(5, shuffle=True, random_state=42)(CNN・ResNet18 は torch.manual_seed(0) も)で固定した実測値。 ベースラインは交差検証で測った値で、 47 県全体に「全部最頻クラス」を当てたときの 0.028(Q1)とは少し違う。 ResNet18 の全層 fine-tuning はこのページでは実行していないので表に載せていない。
この表で一番大事なのは ロジスティック回帰(0.435)が小型 CNN(0.255)にも ResNet18 fc-only(0.200)にも勝っていることである。 36 個の指標を $6\times6$ に並べ替えても、 隣り合う画素に意味的なつながりが無いので、 畳み込みが前提にしている「近くの画素は関係が深い」という仮定が成り立っていない。 表データを無理に画像化すると、 素直に表として線形モデルに入れるより悪くなる、 という実例である。 しかもどの行も fold 間の標準偏差が ±0.1 前後あり、 47 件では 1 つの数字を「性能」として報告するのは危うい。 深いモデルほど学習時間も桁違いに長くなる。 まずベースラインと線形モデルを出すという手順を踏まないと、 「CNN を使ったので高度」という自己満足で終わる。
📊 SSDSE-B-2026 で見る画像分類の応用早見表
| SSDSE 文脈の応用 | 画像分類で対応する操作 | 主な評価指標 | 注意点 |
|---|---|---|---|
| 47 都道府県 → 8 地方分類 | 画像 → カテゴリ識別 | macro F1, balanced accuracy | クラス不均衡 (四国 4 件) |
| 都道府県 → 都市圏/地方圏 2 値 | 2 クラス分類 (binary) | AUC, F1 | 閾値の選択、 cost-sensitive 学習 |
| 指標から地方ランキング | ordinal 回帰 (順序付き分類) | QWK (Quadratic Weighted Kappa) | 順序情報の損失関数 |
| マルチラベル: 県の特徴タグ | multi-label classification | subset accuracy, Hamming loss | タグ独立性の仮定 |
| 将来人口 → 増減 4 段階 | 時系列分類 | F1, recall@k | 時間方向のデータ漏洩 (leakage) |
| 外れ値県の検出 (北海道・東京) | one-class classification, OOD 検出 | AUROC, FPR@95%TPR | 外れ値ラベルが極めて少ない |
⚠️ 拡張落とし穴集
| 落とし穴 | 症状 | 対処 |
|---|---|---|
| accuracy だけで評価する | 最頻クラスを当てるだけで 0.30 超え、 改善幅が見えない | macro F1・balanced accuracy・混同行列を必ず併記 |
| ImageNet normalize を忘れる | ResNet が暴れて精度が低下、 「転移学習が効かない」と誤判断 | transforms.Normalize(mean=[0.485, 0.456, 0.406], std=[0.229, 0.224, 0.225]) を必ず付与 |
| 5-fold が層化されていない | あるフォールドに北海道(1 件)が含まれず学習・評価が崩壊 | StratifiedKFold を使い、 各フォールドにクラス比を保つ |
| data augmentation を画像化前に当てる | フリップ・回転で擬似画像の意味が破壊される | 擬似画像はそもそも augment しない、 擬似画像化前の表データに SMOTE を当てる |
| softmax 確率を信頼度と読む | 過学習モデルでも 0.99 が出るので「自信あり」と誤解 | Temperature Scaling や Deep Ensemble で校正、 ECE を測る |
| テストデータでハイパラを選ぶ | 論文・コンペで実測精度が再現できない | train / validation / test を厳格に分け、 nested CV を採用 |
🗺 概念ツリー: 画像分類の分類体系
🧪 理解度チェック
- Q1. 47 件・8 クラス(総人口の 8 分位。 6 件が最頻クラス)の分類問題で、 「全部最頻クラス」と予測すると accuracy と macro F1 はいくつになるか。
A. accuracy = 6/47 ≈ 0.128(12.8%)。 macro F1 は、 当てたクラスだけ F1 = 2·(6/47)/(6/47+1) = 0.226、 残り 7 クラスは 0 なので 0.226/8 = 0.028。 accuracy が 4 倍以上大きく見えることに注意。 評価は必ず複数指標で。 - Q2. SSDSE 擬似画像を ResNet18 で分類する際、 fc 層のみ学習と全層 fine-tuning の どちらが 47 件サンプルで有利か? 理由も含めて答えよ。
A. 一般論としては fc 層のみ学習から始める。 47 件は ImageNet (130 万件) に比べて極小であり、 全層を動かすと事前学習で得た特徴が崩れて過学習しやすい。 ただしこのページの実測では fc 層のみ学習でも macro F1 0.200 で、 小型 CNN(0.255)や表のままのロジスティック回帰(0.435)に負けた。 事前学習の特徴が擬似画像に合わないときは、 凍結の仕方より先に「画像化すべきか」を疑う。 - Q3. コード 4 の 8×8 混同行列では四国 4 県がすべて「九州沖縄」と予測される。 改善方針を 2 つ挙げよ。
A. (1) 四国 4 件に SMOTE/MixUp を当てクラス不均衡を緩和、 (2) 四国を特徴づける派生指標(面積・人口密度比)を追加して特徴空間で四国を分離。 - Q4. softmax 確率が 0.99 なのに per-class F1 が低い時、 何を疑うべきか?
A. モデルの過信(miscalibration)。 ECE が高い可能性が大きく、 Temperature Scaling や Deep Ensemble で校正する。 信頼度と正解率の対応を信頼度ヒストグラムで検証。 - Q5. 47 件しかない時、 「test set で hyperparameter を最適化」した時に起きる問題を述べよ。
A. テストデータへの leakage(情報漏洩)。 報告される精度は楽観バイアスを含み、 新規データに対する一般化性能を保証しない。 nested CV で内側のループでハイパラ選択、 外側で評価が定石。
📐 数式を言葉で読み解く ── softmax と cross-entropy の本質
画像分類の最終層で使われる softmax は、 ロジット $z_k$(各クラスのスコア)を確率 $p_k$ に変換する写像である。 数式は次の通り:
$$ p_k = \frac{\exp(z_k)}{\sum_{j=1}^{K}\exp(z_j)}, \quad \sum_{k=1}^{K} p_k = 1 $$
記号 → 意味の対応:
- $z_k$:最終隠れ層 → 線形層を通った後の クラス $k$ のスコア。 SSDSE 例では「47 都道府県 × 8 地方」の場合、 8 個のスコアが各県ごとに出る。 単位は無次元(log-odds 相当)。
- $\exp(z_k)$:スコアを正の数に変換するための指数化。 スコア差が大きいほど確率差が指数的に拡大する。 これが softmax は max を近似する と言われる所以。
- 分母 $\sum_j \exp(z_j)$:全クラスの指数和、 確率分布として正規化するための定数。 計算上は
logsumexpトリックで overflow を防ぐのが定石。 - $p_k$:クラス $k$ の予測確率、 $[0, 1]$ の範囲に収まる。 SSDSE 例で「東京が関東である確率 0.98」のような出力が得られる。
対応する損失関数 cross-entropy は次の通り:
$$ \mathcal{L} = -\frac{1}{N}\sum_{i=1}^{N}\sum_{k=1}^{K} y_{ik} \log p_{ik} $$
ここで $y_{ik}$ は one-hot ラベル(正解なら 1、 他は 0)、 $p_{ik}$ はモデルの予測確率。 正解クラスの確率 $p_{i,\text{true}}$ を 1 に近づけるよう学習が進む。 一見当たり前に見えるが、 cross-entropy は確率分布間の KL ダイバージェンスから導かれており、 「正解分布 $\delta_{y_i}$ と予測分布 $p_i$ の距離」を測っている。 これが MSE では駄目で cross-entropy が必須な理由:MSE は確率分布同士の差を確率的に正しく扱えない。
📊 SSDSE-B-2026 で softmax 出力を眺める
下のコード 4 と同じロジスティック回帰(4 指標 → 8 地方、 KFold(5, shuffle=True, random_state=0))で、 cross_val_predict(..., method='predict_proba') により各県を「その県を学習に使っていないモデル」の softmax 確率で予測し、 代表的な県を並べた実測値。 信頼度(最大確率)と正解クラスの確率の差が 過信 の指標になる。
| 県 | 正解地方 | 予測地方 | 最大確率 | 正解クラスの確率 | 判定 |
|---|---|---|---|---|---|
| 北海道 | 北海道 | 東北 | 0.911 | 0.000 | × 高い自信で誤り(学習側に北海道クラスが無い) |
| 東京都 | 関東 | 関東 | 0.751 | 0.751 | ○ 正解 |
| 大阪府 | 近畿 | 関東 | 0.777 | 0.005 | × 高い自信で誤り |
| 沖縄県 | 九州沖縄 | 九州沖縄 | 0.980 | 0.980 | ○ 47 県で最も高い自信 |
| 徳島県 | 四国 | 九州沖縄 | 0.350 | 0.046 | × 自信が低い |
| 高知県 | 四国 | 九州沖縄 | 0.418 | 0.044 | × 自信が低い |
| 島根県 | 中国 | 中部 | 0.259 | 0.078 | × 中部 0.259 と四国 0.212 で迷う |
沖縄県(0.980)と東京都(0.751)は正解しているが、 北海道は 0.911、 大阪府は 0.777 という高い確率で誤っている。 北海道は 1 県しかないので、 評価側に回った fold では学習側に北海道クラスが無く、 当てようがないのに自信だけは高い。 47 県全体では最大確率 0.5 以上の 11 県の正解率が 0.73、 0.5 未満の 36 県は 0.33 で、 確率が高いほど当たりやすい傾向はあるが、 「確率が高い = 正しい」とは限らない。 不確かな予測や少数クラスには人間のレビューを入れる、 という運用設計はこうした実測を根拠にする。
📊 SSDSE 8 地方ブロックの per-class 詳細表
| 地方 | 構成県数 | 人口合計 (万人) | 出生数合計 (人) | 代表都市 | F1(コード 4) |
|---|---|---|---|---|---|
| 北海道 | 1 | 509 | 24,430 | 札幌 | 0.00 |
| 東北 | 6 | 832 | 41,237 | 仙台 | 0.77 |
| 関東 | 7 | 4,353 | 252,911 | 東京 | 0.46 |
| 中部 | 9 | 2,075 | 121,110 | 名古屋 | 0.42 |
| 近畿 | 7 | 2,199 | 132,406 | 大阪 | 0.00 |
| 中国 | 5 | 707 | 42,468 | 広島 | 0.00 |
| 四国 | 4 | 358 | 19,598 | 高松 | 0.00 |
| 九州沖縄 | 8 | 1,403 | 93,109 | 福岡 | 0.67 |
人口合計・出生数合計は SSDSE-B-2026 の 2023 年度 47 県を地方ごとに足した実データ、 F1 はコード 4 のロジスティック回帰の実測。 件数が 6〜8 県ある東北(0.77)と九州沖縄(0.67)は当たりやすく、 1 県しかない北海道と、 4〜7 県でも規模が他の地方と重なる近畿・中国・四国は F1 = 0.00 で 1 件も当たらない。 件数の少なさと、 特徴が他のクラスと重なることの両方が効く点は画像分類一般に当てはまり、 ImageNet のような大規模分類でも「区別困難なクラスペア」(柴犬 vs 秋田犬など)に F1 の低下が現れる。
📜 画像分類の歴史年表
| 年 | 出来事 | ImageNet top-5 error |
|---|---|---|
| 1998 | LeCun, LeNet-5: 手書き数字認識で CNN を確立 | (MNIST 0.7%) |
| 2012 | Krizhevsky, AlexNet: GPU で深層 CNN、 ImageNet 圧勝 | 15.3% |
| 2014 | VGG / GoogLeNet: 深さと Inception 構造で改善 | 6.7% |
| 2015 | He, ResNet: 残差接続で 152 層、 人間を超える | 3.57% |
| 2017 | SENet (Squeeze-and-Excitation): チャネル注意機構 | 2.25% |
| 2019 | EfficientNet: モデルスケーリング則の体系化 | 3.5% (B7) |
| 2020 | Dosovitskiy, ViT (Vision Transformer): Attention で CNN を超える | 11.4% (JFT-300M 事前学習で top-1 88.5%) |
| 2021 | Swin Transformer: 階層的 Window Attention | (top-1 87.3%) |
| 2022 | ConvNeXt: CNN 設計を再評価し ViT に拮抗 | (top-1 87.8%) |
| 2022〜 | CLIP / Foundation Model: ゼロショット分類が標準化 | (zero-shot ImageNet 76.2%) |
2012 年の AlexNet 以降、 ImageNet top-5 error は 15.3% → 2.25% へ 10 年で約 7 倍縮小した。 これに伴い「特徴量設計」中心の従来手法が「アーキテクチャ設計」中心へ、 さらに 2020 年以降は「事前学習データ規模 + ファウンデーションモデル」中心へと、 競争軸自体が変遷している。
🛠 実装チェックリスト(小サンプル画像分類)
| フェーズ | チェック項目 | よくある事故 |
|---|---|---|
| 前処理 | resize / normalize / mean-std を事前学習モデルと一致 | ImageNet 統計を忘れて精度劇減 |
| データ分割 | StratifiedKFold で層化、 同一被写体を train/test で混在させない | leakage で精度が嘘に |
| モデル | 事前学習モデルの fc 層のみ学習で先にベースライン | 最初から全層 fine-tune で過学習 |
| 学習 | 学習率スケジューラ + Early Stopping + Mixed Precision | 学習率固定で発散・収束遅延 |
| 評価 | macro F1, balanced accuracy, 混同行列、 校正誤差を必ず併記 | accuracy 単独で過信 |
| デプロイ | ONNX export → 推論サーバ、 ドリフト監視を設定 | 本番データ分布が学習時と乖離 |
🧭 画像分類で誤解されがちな 5 つの論点
実務で頻繁に出る誤解と、 SSDSE-B-2026 を題材にした解説を 5 件並べる。 これらは新人レビュー時に最も時間が割かれる論点でもあり、 事前に理解しておくと議論が早い。
- 「accuracy が高ければ良いモデル」は誤り。 47 都道府県の 8 地方分類で「全部関東」と予測しただけで accuracy=14.9%(7/47)が出るが、 これは macro F1=0.032 の駄目モデル。 クラス不均衡がある問題では、 accuracy は 最頻クラスの規模 を反映するだけで、 マイノリティクラスの判別力を全く保証しない。 SSDSE のように四国 4 件・北海道 1 件のような 細粒度の不均衡 がある場合、 必ず macro F1 か balanced accuracy を併記する。
- 「大規模モデルほど性能が高い」は文脈依存。 ImageNet のような大規模データでは大きいモデルほど正解率が上がりやすいが、 サンプル数 ≪ モデルパラメータの状況では、 大規模モデルが 記憶 に走り汎化しない。 このページの SSDSE 47 件の実測でも、 ResNet18 fc-only(0.200)は小型 CNN(0.255)にも、 表のままのロジスティック回帰(0.435)にも負けた。 使えるサンプル数に合わせて、 小さいモデルから順に比べる。
- 「Data Augmentation は常に効く」は誤り。 SSDSE 擬似画像にフリップ・回転を当てると 意味が壊れる(県の指標配置に意味があるため)。 augmentation はドメイン知識に沿って選ぶべきで、 「とりあえずデフォルト」では性能を悪化させる場合がある。 表データ由来の擬似画像では augmentation は 表データ側 で(SMOTE 等)行うのが正攻法。
- 「softmax 確率は信頼度」は概ね誤り。 過学習したモデルは 過信 し、 確率 0.99 でも実際の正解率が 70% という miscalibration が頻発する。 ECE (Expected Calibration Error) で測定し、 0.1 を超えるなら Temperature Scaling や Deep Ensemble で校正する。 SSDSE 47 件の場合、 校正用バリデーション集合が確保しにくく、 leave-one-out 校正が現実解。
- 「混同行列の対角だけ見れば良い」は誤り。 対角以外の 誤分類パターン こそが改善方針を教えてくれる。 コード 4 の実測では四国 4 県がすべて「九州沖縄」に、 近畿 7 県は中部・関東・九州沖縄に散って予測される。 それなら、 これらと区別できる特徴(緯度・経度、 面積、 人口密度)を入力に追加すれば良い。 「どのクラスペアが混同されやすいか」が分かれば、 特徴工学・サンプル拡張の優先順位が自動的に決まる。
📚 補足: SSDSE-B-2026 擬似画像のための前処理レシピ
47 都道府県 × 36 指標を $6\times 6$ 擬似画像に整形する際、 指標の並び順が学習結果に影響する。 「似た指標を近くに並べる」と CNN の畳み込みが効きやすくなる。 並び順を決める 4 つの方針を比較する。
| 並び順方針 | 5-fold macro F1 | 利点 | 欠点 |
|---|---|---|---|
| SSDSE コード順 (ベースライン) | 0.255 ± 0.105 | 何もしなくて良い | 隣接指標に意味的関連がない |
| 相関係数で階層クラスタリング | 0.258 ± 0.083 | 似た指標が近接、 CNN の局所性が効く | クラスタ間の境界に解釈が必要 |
| 分野別グルーピング (コード先頭 A/B/C 順) | 0.255 ± 0.105 | 解釈性が高い、 ドメイン知識を反映 | SSDSE のコード順と一致するため変化なし |
| PCA 第 1 主成分の負荷量でソート | 0.227 ± 0.096 | 自動化可能 | 主成分の意味が解釈しづらい |
実際に 4 通りを回してみると(小型 CNN・torch.manual_seed(0)・5-fold)、 並び順を変えても macro F1 は 0.227〜0.258 の範囲でしか動かない。 相関で階層クラスタリングして「似た指標を隣に置く」効果は +0.003 にとどまり、 fold 間の標準偏差(±0.08〜0.11)よりずっと小さい。 SSDSE のコード自体が A(人口)→ B(自然環境)→ C(経済基盤)の順に並んでいるので、 「分野別グルーピング」はコード順と同一の並びになり数値も完全に一致する。 PCA 順に至ってはむしろ下がる。 つまりこの題材では、 並び順を工夫しても「畳み込みが効く配置」にはならないというのが実測から言えることである。 表データから CNN/ResNet を使う研究(DeepInsight、 IGTD など)はこの並び順設計を研究のコアに据えているが、 36 指標・47 サンプルという規模では、 並び順を工夫する前に「そもそも画像化すべきか」を疑うべきだと分かる。
🎯 SSDSE-B-2026 で「画像分類モデル選択」を 4 段階で判断する
SSDSE 47 件・8 クラス問題(コード 2・3 と同じ総人口 8 分位。 ステップ 4 だけはコード 4 の 8 地方)で、 モデル選択の意思決定を 4 段階に分解すると、 任意の画像分類タスクに転用できるテンプレートになる。
- ステップ 1: ベースライン確認。 最頻クラスベースライン(accuracy=0.128、 macro F1=0.028)と、 ロジスティック回帰(accuracy=0.489、 macro F1=0.435)を必ず先に出す。 これより悪いモデルを「使えない」と判定する基準を確立する。 多くの実務事故が「ベースライン未確認で深層モデルを採用」から発生している。
- ステップ 2: 小型 CNN で位置情報の効果を測る。 LeNet 風 CNN(macro F1=0.255)はロジスティック回帰(0.435)を 0.180 も下回る。 つまり「画素の位置関係(畳み込み)」はここでは寄与どころか足を引っ張っている。 SSDSE 擬似画像は隣接画素に意味的なつながりが無く、 畳み込みの前提が成り立たないためである。 この比較で「画像であるべきか、 表形式で処理すべきか」が決まる ― この題材の答えは表形式である。
- ステップ 3: 転移学習で事前学習の効果を測る。 ResNet18 fc-only(macro F1=0.200)は LeNet 風 CNN(0.255)を 0.055 下回り、 「ImageNet 130 万件で得た低レベル特徴」はこの擬似画像では貢献しない。 fold 間の標準偏差も ±0.112 と平均の半分以上あり、 47 件では点推定を信じてはいけない。 全層 fine-tuning はこのページでは実行していないので、 試すなら同じ分割で測って並べる。 事前学習の効きが小さい時は、 ドメイン特化の自己教師あり事前学習を検討する。
- ステップ 4: 不確実性と運用負荷の判定。 予測確率のヒストグラムを確認し、 「不確かなものを人間レビューに回す」運用が成立するか判定する。 コード 4 の 8 地方モデルでは、 交差検証の最大確率が 0.7 未満の県が 47 件中 42 件あり、 ほぼ全件を人手レビューに回すことになる。 しかも 0.85 以上の 2 件のうち 1 件(北海道 0.911)は誤りなので、 このモデルでは自動化できる閾値が作れない。 これが運用工数の見積もりに直結する。 自動化 OK な閾値を「信頼度 ≥ 0.85 で 95% 以上正解」のような形で定式化する。
この 4 段階は ImageNet・医用画像・衛星画像・OCR など、 どんな画像分類タスクでも適用できる汎用テンプレート。 「とりあえず ResNet50」から始めるのではなく、 ベースライン → CNN → 転移学習 → 不確実性、 と段階を踏むことで 各層の貢献分 が定量化され、 報告書の説得力が増す。 SSDSE はこの 4 段階を 短時間で 1 周 できるサイズ感のため、 教材・研修教材としても優秀。
🔬 SSDSE 擬似画像の特徴量重要度(permutation importance)
比較表で最も成績の良かったロジスティック回帰(36 指標を標準化、 ラベルは総人口の 8 分位、 StratifiedKFold(5, shuffle=True, random_state=42))について、 各 fold の検証側で 36 指標を 1 つずつシャッフルし(10 回、 np.random.default_rng(0))、 macro F1 の落差を 5 fold で平均した。 同じ手順は ResNet18 などの画像モデルにもそのまま使える。 上位 8 指標の実測値は次の通り。
| ランク | 指標 (SSDSE コード) | 指標名 | F1 低下量 | 解釈 |
|---|---|---|---|---|
| 1 | C3301 | 着工建築物数 | 0.051 | 建設の多さは人口規模とよく連動する |
| 2 | A4200 | 死亡数 | 0.031 | 人口規模の代わりになる |
| 3 | A9101 | 婚姻件数 | 0.021 | 人口規模の代わりになる |
| 4 | A130301 | 65歳以上人口(男) | 0.021 | 人口の内訳の 1 列 |
| 5 | A130201 | 15~64歳人口(男) | 0.019 | 人口の内訳の 1 列 |
| 6 | A510201 | 転出者数(日本人移動者)(男) | 0.018 | 人口移動の規模 |
| 7 | A130302 | 65歳以上人口(女) | 0.018 | 人口の内訳の 1 列 |
| 8 | A1301 | 15歳未満人口 | 0.012 | 人口の内訳の 1 列 |
上位 8 指標で F1 低下量の合計(0.204)の約 94% を占め、 36 指標のうち 7 指標は低下量が負(シャッフルしてもむしろ少し上がる)だった。 目を引くのは、 ラベルの元になった総人口 A1101 が上位に入らないことで、 総人口とほぼ同じ情報を持つ列(日本人人口、 男女別・年齢別の人口など)が並んでいるため、 1 列だけ壊しても残りの列が代わりを務める。 permutation importance は相関の強い列どうしで重要度を分け合うので、 「低い = 不要」と読んで列を削ると性能が落ちることがある。 画像分類でも同様に、 Grad-CAM や Integrated Gradients で「どの画素が判断に効いているか」を可視化し、 「どの画像領域を切り抜けば軽量化できるか」を決める手法が一般的。
🔄 画像分類と他タスクの境界
画像分類は 画像 → 単一ラベル の写像だが、 隣接タスクに踏み出すと評価指標も設計も変わる。 SSDSE-B-2026 を用いた類推で、 4 つの隣接タスクとの違いを整理する。
- 画像分類 vs 物体検出:分類は 1 枚 → 1 ラベル、 検出は 1 枚 → 複数バウンディングボックス + ラベル。 SSDSE で言えば「東京は関東」が分類、 「東京 23 区の各区は関東に属する」が検出。 評価指標は分類が accuracy/F1、 検出が mAP(mean Average Precision)。
- 画像分類 vs セグメンテーション:分類は画像全体に 1 ラベル、 セグメンテーションは各画素にラベル。 SSDSE では「県の各画素(指標)に意味タグを付ける」操作に対応する。 評価指標は分類が accuracy、 セグメンテーションが IoU(Intersection over Union)や Dice 係数。
- 画像分類 vs 画像検索:分類は 固定ラベル集合 への割り当て、 検索は 距離が近い画像 の取得。 SSDSE で「東京と最も似た県は?」を問えば、 特徴ベクトル空間で nearest neighbor を取る検索問題になる。 評価指標は recall@k や mAP。
- 画像分類 vs 画像キャプション生成:分類は離散ラベル、 キャプションは可変長テキスト。 SSDSE で「東京の特徴を 1 文で説明」を求めると、 マルチモーダル AI(画像 → テキスト)の問題になる。 評価指標は BLEU、 ROUGE、 CIDEr など NLP 寄り。
これら 4 タスクは 同じ CNN/Transformer バックボーン を共有することが多く、 最終層と損失関数を入れ替えるだけで切り替えられる。 「まず分類で動かしてから検出/セグメンテーション/検索に発展させる」という開発フローが定石。
📖 まとめ: SSDSE-B-2026 から見る画像分類
本セクションでは、 47 都道府県の公的データを 擬似画像化 することで、 画像分類の主要論点(モデル選択・転移学習・評価指標・校正・特徴重要度)を 1 つの実例で通して確認した。 画像が手元になくても、 表データから擬似画像を作る発想を持っていれば、 CNN/ResNet/ViT の挙動を 少サンプルで再現実験 できる。 これは新人研修や教材作成、 本番投入前のサンドボックス検証で広く有効な技法。
特に重要なポイントは 3 つ:(1) accuracy 単独で評価しない(macro F1・balanced accuracy・混同行列を必ず併記)、 (2) 小サンプルではベースラインと線形モデルを先に出す(この擬似画像では ResNet18 fc-only 0.200 がロジスティック回帰 0.435 に負けた)、 (3) softmax 確率は信頼度ではない(ECE で校正状態を必ず測る)。 これらは ImageNet・医用画像・衛星画像など、 規模を問わず適用できる原則であり、 SSDSE 47 件のミニ実験で 短時間で 体感できる。
続く発展先は、 Vision Transformer(ViT)と マルチモーダル AI(CLIP)、 そして 自己教師あり学習(SimCLR, MAE)。 これらの新世代手法も、 本セクションで確認した「評価指標 → モデル選択 → 不確実性」の枠組みは変わらない。 アーキテクチャが進化しても 評価の作法 は不変であり、 そこを押さえれば最新手法の評価にも対応できる。
SSDSE-B-2026 をベースに 8 クラス分類を 1 周回した本セクションは、 ImageNet 大規模実験への 足慣らし として、 また「画像分類とは何か」を 表データの言語で説明する 教材として、 そのまま再利用できる。 学生・新人エンジニア向けの講義スライド、 報告書のベースライン節、 社内勉強会のハンズオン教材など、 用途は広い。 47 件のデータと 1 時間の実験で得られる学びは、 大規模実験 1 週間分の理解に匹敵する密度を持っている。
最後に、 本セクションを読み終えた時点で身についているはずの 7 つの実務スキルを挙げて締めくくる:(1) 表データから擬似画像テンソルを生成する技術、 (2) StratifiedKFold を使った層化 5-fold CV の実装、 (3) ResNet18 の最終層差し替えと凍結の使い分け、 (4) 混同行列・per-class F1・balanced accuracy の併記による多角評価、 (5) softmax 確率を信頼度として読まない注意深さ、 (6) permutation importance による特徴貢献度の定量化、 (7) ImageNet normalize と前処理の整合性チェック。 これらは画像分類のみならず、 表データ分類・テキスト分類・音声分類でも応用が利く汎用スキルセットである。
📚 拡張: 関連用語と発展先
前提:ニューラルネットワーク基礎 ・ 活性化関数 ・ 損失関数 ・ 勾配降下法 ・ エポック
並列:画像セグメンテーション ・ 物体検出 ・ 音声認識 ・ 自然言語分類
発展:Vision Transformer ・ 自己教師あり学習 ・ マルチモーダル AI ・ CLIP ・ 基盤モデル
評価:混同行列 ・ F 値 / F1 ・ balanced accuracy ・ ECE ・ 校正
運用:転移学習 ・ データ拡張 ・ クラス不均衡 ・ モデル監視 ・ 再学習
⚠️ よくある落とし穴
⚠️ よくある落とし穴 — 画像分類 で初学者がやりがちなミス
⚠️ 画像分類の落とし穴
- クラス不均衡(class imbalance):データセット内のクラス分布が偏ると、 多数派クラスに引きずられた退化解(常に多数派を予測)に陥る。 対策:weighted cross-entropy、 oversampling、 focal loss、 SMOTE。
- data augmentation の意味破壊:医用画像で水平反転すると左右臓器が逆転、 文字画像で 180 度回すと別の文字に変わるなど、 「意味を保つ」augment と「破壊する」augment の境界は分野依存。
- 転移学習のドメインずれ:ImageNet(自然写真)で事前学習したモデルを衛星画像・X 線・顕微鏡画像にそのまま転用すると性能が出ない。 ドメインに近い大規模コーパス(衛星なら BigEarthNet、 X 線なら ChestX-ray14)で再事前学習を検討。
- 確率値のキャリブレーション:softmax の出力 $p_k$ は「確率らしく見える」が、 実際の正答率と乖離していることが多い(過信)。 Temperature scaling、 isotonic regression で校正し、 ECE(Expected Calibration Error)で評価する。
- adversarial example(敵対的サンプル):人間には見分けがつかない微小なノイズを加えると、 モデルが全く別のクラスを高信頼で予測してしまう。 FGSM / PGD で攻撃を再現し、 adversarial training や入力前処理で防御する。
🗺 概念マップ — 画像分類 の位置づけ
中央の「image classification」から、実現の手段(CNN・ResNet・EfficientNet・ViT)と、少ないデータで精度を上げる工夫(転移学習・データ拡張)の 6 つに線を引いた。CNN → ResNet → EfficientNet は畳み込みを深く・効率よくする系列、ViT は畳み込みを使わない別系列である。本ページの 47 県の擬似画像の実験では、ResNet18 の転移学習(fc 層のみ学習)が小型 CNN や表のままのロジスティック回帰に負けており、手段を選ぶ前に「そもそも画像として扱うべきか」を確かめる必要があることも、このマップの外側の論点として押さえておく。
🔗 隣接手法への橋渡し
画像分類は CNN / Vision Transformer 等のディープラーニング技術と、 データ拡張 / 転移学習などの前処理ツールを組み合わせて初めて高精度を実現する。
- 上流: アノテーション ・ データ拡張 (回転・反転・色変換) ・ 画像前処理 (resize / 正規化) — 教師ラベル付き画像の準備
- 並列: 画像認識 (より広い概念、 検出・セグメンテーション含む) ・ 文字認識 OCR ・ 音声認識 — 同じパターン認識の系譜
- 下流: 精度 ・ AUC ・ 混同行列 (Confusion Matrix) ・ Grad-CAM (注視可視化) — 分類結果の評価と解釈
画像分類の精度は「データ量とラベル品質」で 8 割が決まる。 アーキテクチャ (ResNet / EfficientNet / ViT) はマージナルな改善。 まず転移学習 (ImageNet 事前学習モデルの fine-tune) から始めるのが定石。
🌳 手法選択フロー
画像分類タスクを、 ラベル数・データ量・計算予算で 3 段階で判定する。
- ラベル付きデータの量は? 1 万枚以上 → CNN を最初から学習可能、 1000-10000 枚 → 転移学習 (ResNet50 / EfficientNet を fine-tune)、 1000 枚未満 → 強力なデータ拡張 + few-shot learning
- クラス数と難易度は? 2-10 クラス → ResNet18 / MobileNet で十分、 100 クラス以上 → EfficientNet / ViT、 きめ細かい分類 (鳥種類等) → Vision Transformer + 細粒度学習手法
- 推論環境は? サーバ (GPU 利用可) → ResNet50 以上、 モバイル → MobileNet / EfficientNet-B0、 リアルタイム要求 → 軽量化 + 量子化 + 蒸留 (Knowledge Distillation)
初心者は Keras の tf.keras.applications.ResNet50(weights='imagenet') でロードして、 最終層だけ自分のクラス数で置き換える fine-tune から始めるのが最速。 200 行以内で動く。