🔖 拡張キーワード索引
この用語『Vision Transformer』を理解するうえで併せて押さえたい関連キーワード群です。 クリック(ホバー)で関連用語ページに飛べます。
💡 30秒で分かる結論
🍰 まずはやさしく
画像をパズルのように分けて処理する仕組みです。
画像の中身を正しく見分けるために使います。
スマホで写真の被写体を判別するような機能です。
この章では仕組みと使いどころを学びます。
画像にTransformerを適用した手法
- 分野:深層学習 — 📚 ニューラルネットワーク基礎
- 用途:分析・前処理・モデル構築・解釈支援などの場面で使われます
- 注意:適用条件と限界を理解してから使うのが鉄則
Vision Transformer (ViT) を 30 秒で把握する重要ポイント:
- 何ができるか: 画像を 16×16 パッチに分割し、 各パッチをトークン化して Transformer (自己注意機構) で処理する画像認識モデル。 CNN の畳み込み・プーリングなしで ImageNet を上回る。
- いつ使うか: 大規模事前学習データ (JFT-300M / ImageNet-21k) と GPU が使えるとき。 ViT-Base/Large/Huge から選択、 小規模データなら DeiT (蒸留版) や Swin Transformer。
- 注意点: データ効率が CNN より低い (帰納バイアス無しのため)、 計算量がパッチ数の 2 乗、 位置エンコーディングの選択 (1D/2D/学習可能) で精度が変動。
- 関連: 上流=NLP Transformer / Attention / Patch Embedding、 並列=CNN / Swin / MLP-Mixer、 下流=DETR (検出) / SAM (セグメント) / CLIP (マルチモーダル)。
📍 文脈ボックス ── あなたが今見ているもの
🍰 まずはやさしく
画像認識で使われる最新の道具の一つです。
より高い精度で画像を分析するために使います。
部活の集合写真から人を分けるような作業です。
この章ではどのような場面で使うかを学びます。
論文や実装中に 「Vision Transformer」として登場する用語。 本ページは SSDSE-B-2026 などの公的データを題材にした教育用ハンズオン教材です。
画像分類・物体検出・セグメンテーションなど、 CNN の代替として大規模事前学習+転移で精度を狙う場面で登場します。
🎨 直感で掴む
🍰 まずはやさしく
画像をバラバラにして単語のように扱う方法です。
離れた場所にある物の関係を捉えるために使います。
写真の端と端にある物を同時に見るイメージです。
この章では画像を変える手順について学びます。
Vision Transformer (ViT) の核心は「画像を 16×16 ピクセルのパッチに切り、 各パッチを単語のように埋め込んで Transformer (自己注意機構) に流し込む」というシンプルな発想にある。 CNN が「局所領域の畳み込み + プーリング」で空間的近接性を前提に処理するのに対し、 ViT は最初から全パッチを「自己注意で相互作用」させるため、 遠く離れたパッチ間の関係 (例: 犬の頭と尻尾の対応関係) を 1 層目から捉えられる。
本ページでは Vision Transformer を、 「(1) Patch Embedding でどう画像を Transformer 入力に変換するか、 (2) なぜ事前学習データ規模が CNN より重要か (帰納バイアス無しの代償)、 (3) CNN との Inductive Bias 差を 47 都道府県統計データで模擬実験する」の順で整理する。 厳密な定式化より、 まず何を、 いつ、 どう使うかを理解することを優先する。
🎨 直感を深掘り
Vision Transformer は画像を 16×16 などのパッチに分割し、 それぞれを単語のように埋め込んで Transformer に入れるシンプルな発想。 CNN の畳み込み構造(局所性・並進不変性)の事前知識なしに、 大規模データ(JFT-300M など)で事前学習すれば、 ImageNet で CNN を凌駕することを示した。 純粋な注意機構だけで視覚認識が可能なことを証明し、 マルチモーダルモデルの基盤に。
Vision Transformer(Vision Transformer (ViT))は単独で覚えるものではなく、 深層学習 という大きな枠組みの中での位置づけを理解することで応用範囲が広がります。 本ページの『🌐 関連手法』『🔗 関連用語』『📚 グループ教材』を順に辿ると、 関連概念のネットワークが見えてきます。
特に SSDSE-B のような実データに当てはめてみると、 教科書では抽象的に語られる概念が『47 都道府県の現実』に紐付き、 数字の意味が腑に落ちやすくなります。 次の『🧮 実値で計算してみる』セクションでは、 公開統計データを使って手を動かす例を紹介します。
🎨 テーマ 1:Patch Embedding — 画像を単語に変換する
Transformer はもともと自然言語処理(NLP)のアーキテクチャ。 「単語列」を入力とする設計です。 そこで ViT は画像を 16×16 ピクセルの小さなパッチに分割し、 各パッチを 1 個の「単語」として扱うという発想を取りました。 224×224 ピクセルの画像なら 14×14 = 196 個のパッチ、 つまり長さ 196 の単語列になります。 各パッチは 16×16×3 = 768 次元のベクトル(線形射影で D 次元に変換)。
📐 数式(Patch Embedding)
$$ \mathbf{z}_0 = [\mathbf{x}_{\text{class}};\ \mathbf{x}_p^1 E;\ \mathbf{x}_p^2 E;\ \dots;\ \mathbf{x}_p^N E] + \mathbf{E}_{\text{pos}} $$
$$ N = \frac{H \cdot W}{P^2}, \qquad E \in \mathbb{R}^{(P^2 \cdot C) \times D} $$
🔬 数式を言葉で読み解く
- $\mathbf{x}_p^i$:$i$ 番目のパッチをフラット化したベクトル($P^2 \cdot C$ 次元、 例:$16 \times 16 \times 3 = 768$)。
- $E$:線形射影行列。 パッチを D 次元(典型的に 768)にプロジェクト。
- $\mathbf{x}_{\text{class}}$:BERT の [CLS] と同じ「クラスを集約する」特殊トークン。
- $\mathbf{E}_{\text{pos}}$:位置埋め込み(次セクション)。
- $N$:パッチ数。 $H=W=224, P=16$ なら $N=196$。 196 + 1(CLS)= 197 個のトークン列が完成。
🎨 テーマ 6:CNN vs ViT — Inductive Bias の違い
「ViT は CNN を置き換えるのか?」という議論の核心は Inductive Bias(帰納バイアス)です。 CNN は「局所性」「平行移動不変性」「階層性」をアーキテクチャ自体に組み込んでいる(強い帰納バイアス)。 ViT は逆に「すべてのパッチが平等に他のすべてを見られる」(弱い帰納バイアス)。 これが訓練データ量に対する要求の違いを生みます。
📊 CNN と ViT の比較表
| 観点 | CNN(ResNet 等) | ViT |
|---|---|---|
| 帰納バイアス | 強い(局所性・並進不変) | 弱い(位置埋め込み程度) |
| 必要データ量 | 1.3M 枚(ImageNet)で十分 | 14M〜300M 枚(JFT)必要 |
| 大データでの性能 | 頭打ち | スケーリングが綺麗に効く |
| 受容野 | 層を重ねて拡大(局所→大域) | 1 層目から大域 |
| パラメータ数(base 級) | 25M (ResNet-50) | 86M (ViT-B/16) |
| 推論コスト | 低(モバイル可) | 中〜高(最適化が必要) |
| 解釈性 | CAM・Grad-CAM | Attention Rollout |
| 転移学習 | 広く確立 | pre-trained ViT で同等以上 |
結論:ImageNet サイズ(100 万枚)以下では CNN 優位、 数千万枚スケールでは ViT 優位。 ただし pre-trained を使うなら ViT も小データに転移できるため、 「ゼロから訓練するか・既存重みを使うか」で選択肢が変わる。
🎮 インタラクティブ実験:画像をパッチに分割して系列化する
ここは ViT に固有のアイデア「画像をパッチに分割し、 各パッチを 1 トークンとして系列(単語列)のように扱う」を手で触って確かめるコーナーです。 自己注意そのものの詳細は Transformer、 畳み込みは CNN のページに譲り、 ここでは画像→系列化に集中します。 下のグリッドは架空の 8×8 合成画像です(実データではありません)。 セルをタップ/ドラッグで描画できます。
(a) 画像 → パッチ → トークン列
パッチサイズ $p$ を変えると、 パッチ数(=トークン数)$N=(G/p)^2$ が変化します(グリッドは $G=8$)。 各パッチは 1 個の「単語」として右側の系列に並びます。
(b) パッチ間の注意(Attention)をヒートマップで見る
左のグリッドでクエリとなるパッチをタップすると、 そのパッチがどのパッチにどれだけ注目するかを計算して表示します。 デモ用の固定方式で、 各パッチの特徴 $[\text{平均輝度},\ x,\ y]$ の内積を $\sqrt{d}$ で割り、 行ごとに softmax で正規化した正確な値です($\sum_j a_{ij}=1$)。
(c) CNN(局所受容野)vs ViT(全パッチ間注意)と位置埋め込み
同じ選択パッチについて、 CNN は近傍(3×3 の局所受容野)しか直接見られないのに対し、 ViT は 1 層目から全パッチと注意を張れます。 切り替えて違いを確認してください。
位置埋め込みが必要な理由:自己注意は集合演算で並び順を区別しません(トークンをシャッフルしても各トークンの計算結果の集合は不変)。 そこで各パッチに位置ベクトル $\mathbf{E}_{\text{pos}}$ を足し、 「左上/右下」といった空間情報を注入します。 上のシャッフルで系列の順序が失われる様子=位置埋め込みが無い状態を体感できます。
🧭 このコーナーの要点(直感・落とし穴・発展)
- 直感:画像を「パッチという単語」に区切れば、 そのまま NLP の Transformer に流せる。 画像認識が「単語列の理解」に化ける。
- 落とし穴:パッチ数 $N$ を増やす($p$ を小さくする)と表現は細かくなるが、 注意は $O(N^2)$ で急増(本ページ『計算コスト』の表参照)。 局所帰納バイアスが無いぶん大量データが必要。
- 発展:局所性を取り戻す CNN+ViT ハイブリッドや階層型 Swin、 ラベル不要の 自己教師あり学習(MAE / DINO)による事前学習へ発展する。
📐 定義
🍰 まずはやさしく
画像にTransformerという仕組みを合わせたものです。
画像を計算できる形式に変えるために使います。
買い物サイトで似た商品を探す仕組みに近いです。
この章では数式の中身と意味について学びます。
画像にTransformerを適用した手法
英語名 Vision Transformer。 同義・関連語:ViT。
📐 数式の読み解き ── Vision Transformer の核心式
画像を N パッチに分割し、 各パッチ $x_p^i$ を埋込 E で射影、 CLS トークンと位置埋込 $E_{\rm pos}$ を加える。
数式の各記号が『何の量で、 どの空間に住み、 どんな単位を持つか』を意識すると、 暗記でなく構造として理解できます。 SSDSE-B の都道府県データに当てはめて、 各シンボルが何に対応するかは、 このあとの『🧮 SSDSE-B 実値で計算してみる』『🐍 Python での扱い』で手を動かして確認できます。
❓ FAQ ── Vision Transformer のよくある質問
まずは本ページの『💡 30 秒で分かる結論』と『🎨 直感で掴む』で全体像を掴み、 次に『🧮 実値で計算してみる』を 手を動かして追体験するのが最短です。 数式や深い理論はその後で十分。
本ページの『🌐 関連手法・派生』『🔗 関連用語』で対比される手法を確認し、 それぞれの適用条件と得意・不得意を表で比較するのが効果的です。 SSDSE-B のような共通データセットで両方走らせて結果を見ると違いが体感できます。
ViT の計算量はパッチ数 $N = (H/P)^2$ に対して $O(N^2 d)$。 224×224 の画像をパッチサイズ $P=16$ で切ると $N = 14^2 = 196$ トークンで、 Attention 行列は 196×196 = 38,416 要素です。 パッチを半分の $P=8$ にすると $N=784$ となり、 トークン数は 4 倍・Attention は 16 倍になります。 CNN が画像サイズの 2 乗($O(HW)$)で済むのに対し、 ViT はパッチ数の 2 乗=画像サイズの 2 乗の 2 乗で効いてくるため、 高解像度では素の ViT は現実的でありません。 Swin Transformer が窓を区切って局所 Attention にしたのは、 まさにこの $N^2$ を切るためです。
『点推定値』だけでなく『不確実性(CI、 SE、 分散)』『前提条件のチェック結果』『代替手法との比較』『データ取得日と seed』をセットで報告するのが標準。 査読・レビューで問われる典型ポイントです。
📐 テーマ 2:Position Embedding — 「順序」を Transformer に教える
Transformer の Self-Attention は位置情報を持たないのが本来の弱点。 そのままパッチ列を入れると「上下左右がシャッフルされても同じ出力」になってしまう。 そこで ViT は各パッチに「位置」を表すベクトルを足す方式で位置情報を注入します。 ViT 論文では 1D 学習型・2D 学習型・正弦波(sinusoidal)の 3 種類を比較し、 1D 学習型を採用(性能差は小さい)。
📐 数式(位置埋め込み)
$$ \mathbf{z}_0 = [\mathbf{x}_{\text{class}};\ \mathbf{x}_p^1 E;\ \dots;\ \mathbf{x}_p^N E] + \mathbf{E}_{\text{pos}}, \qquad \mathbf{E}_{\text{pos}} \in \mathbb{R}^{(N+1) \times D} $$
🔬 数式を言葉で読み解く
- $\mathbf{E}_{\text{pos}}$:(N+1) 個の位置それぞれに学習可能な D 次元ベクトル。 例:(197, 768) の行列。
- 各パッチに「自分は左上 / 右下 / 中央」のような情報が暗黙的に埋め込まれる。
- 2D 位置埋め込みを試すと、 学習中に 2D 構造を自然に獲得することが論文の Figure で示されている(近い位置同士のコサイン類似度が高くなる)。
- 解像度を変える(224 → 384)と位置埋め込みも補間する必要があり、 これが「ViT は解像度依存」と言われる理由。
📐 テーマ 3:Self-Attention の核心 — Q/K/V のダンス
ViT の心臓部は Self-Attention。 各パッチが「他のすべてのパッチをどれだけ重視するか」を学習する仕組みです。 「左上のパッチ」が「右下の物体」を見たいときも、 距離に関係なく直接 Attention を張れる — これが CNN との根本的な違い。
📐 数式(Scaled Dot-Product Attention)
$$ Q = X W_Q,\quad K = X W_K,\quad V = X W_V $$
$$ \text{Attention}(Q, K, V) = \text{softmax}\!\left( \frac{Q K^\top}{\sqrt{d_k}} \right) V $$
🔬 数式を言葉で読み解く
- $Q$(Query):「私はこういう情報が欲しい」という質問ベクトル。 各パッチが 1 個ずつ持つ。
- $K$(Key):「私はこういう情報を持っている」という札。 各パッチが 1 個ずつ持つ。
- $V$(Value):「実際の中身」。 各パッチの本体情報。
- $Q K^\top$:(N+1)×(N+1) の「全パッチ間の関連スコア行列」。 行 i 列 j =「パッチ i が j をどれだけ重視するか」。
- $\sqrt{d_k}$で割るのは、 高次元では内積が大きくなりすぎて softmax が飽和するのを防ぐため。
- softmaxで行ごとに確率分布化し、 V を重み付け平均 → 各パッチが「他のパッチから情報を集約した」新しいベクトルに更新される。
これを ViT-Base なら 12 層 × 12 ヘッド繰り返す。 各層・各ヘッドが「異なる関係性」を学ぶことで、 局所的なエッジから大域的な構造まで段階的に抽象化していく。
📐 テーマ 4:Multi-Head Attention — 複数の「視点」を並列で持つ
単一の Attention だと「1 つの関係性」しか学べません。 そこで $H$ 個(典型的に 12)のヘッドを並列で動かし、 各ヘッドが 異なる関係性(色・形・位置・文脈・カテゴリ等)を学習するのが Multi-Head Attention。 ViT-Base なら $D=768, H=12, d_k = 64$ という構成。
📐 数式(Multi-Head)
$$ \text{MultiHead}(Q,K,V) = \text{Concat}(\text{head}_1, \dots, \text{head}_H) W_O $$
$$ \text{head}_i = \text{Attention}(Q W_i^Q, K W_i^K, V W_i^V) $$
🔬 数式を言葉で読み解く
- $D$ 次元を $H$ 等分(例:768 ÷ 12 = 64)し、 各ヘッドが小さい $d_k$ 空間で Attention を計算。
- 計算量は単一ヘッド版とほぼ同じ(行列演算が並列化されるだけ)。
- 各ヘッドの出力(各 64 次元)を Concat して 768 次元に戻し、 $W_O$ で混ぜる。
- ViT-Base / ViT-Large / ViT-Huge でヘッド数 12 / 16 / 16、 D 768 / 1024 / 1280。 ヘッド数を増やすほど表現力は上がるが計算コストも増える。
📐 追補 A:Transformer Block の構成 — Attention + MLP の交互積層
ViT の Encoder は MSA(Multi-head Self-Attention)と MLP(フィードフォワード)を交互に積み上げた構造です。 ViT-B/16 ならこのブロックを 12 段スタック。 各ブロックの内部は以下の式で記述できます。
📐 数式(ブロック式)
$$ \mathbf{z}'_\ell = \text{MSA}(\text{LN}(\mathbf{z}_{\ell-1})) + \mathbf{z}_{\ell-1} $$
$$ \mathbf{z}_\ell = \text{MLP}(\text{LN}(\mathbf{z}'_\ell)) + \mathbf{z}'_\ell $$
🔬 数式を言葉で読み解く
- LN(Layer Normalization):各トークンの 768 次元を平均 0・分散 1 に正規化。 NLP Transformer と同じ。
- MSA:前述の Multi-Head Attention。 「パッチ間の関係」を学ぶ。
- Residual Connection($+ \mathbf{z}_{\ell-1}$):勾配消失を防ぎ、 深く積めるようにする。
- MLP:典型的に 768 → 3072 → 768 の 2 層全結合 + GELU 活性化。 各トークン独立に適用される(チャンネル方向の混合)。
- つまり MSA が「トークン間の混合」、 MLP が「各トークン内のチャンネル混合」を担当する分業構造。
🔬 数式を言葉で読み解く ── Vision Transformer の記号辞書
Vision Transformer で頻出する記号と意味を、 SSDSE-B-2026 を題材にした実装と対応させて整理します。
| 記号 | 意味 |
|---|---|
| $$x_p^{(i)}$$ | i 番目のパッチ(例:16×16 ピクセル) |
| $$E$$ | パッチ埋め込み行列(線形射影) |
| $$[CLS]$$ | 分類用の特殊トークン(最終層で分類ヘッドへ) |
| $$E_{pos}$$ | 位置埋め込み — パッチの空間順序を表現 |
※ 記号の使い方は流派により少し異なります。 まずは Vision Transformer の公式実装(PyTorch・TensorFlow 等)のソースで定義を確認するのが安全です。
🎯 いつ・どこで使うか
- 「深層学習」分野の標準的な道具として、 多くの分析で登場します。
- 📚 ニューラルネットワーク基礎 を学ぶときに必ず通過する基本概念です。
- 論文・実務レポートで頻出する用語なので、 1 度はちゃんと理解しておくと後が楽です。
📋 前提条件・適用範囲
この用語を理解・使用するときは、 次のような前提を意識してください:
- データの性質:尺度(名義/順序/間隔/比例)と分布を確認
- サンプル数:手法によって最低限のサンプル数が異なります
- 独立性:観測が独立であるかを確認(時系列・パネル等では別の手法が必要)
- 欠損・外れ値:前処理の方針を明確に
🧮 SSDSE-B 実値で計算してみる ── Vision Transformer
都道府県の各種統計を 16 種類のテーマ(人口、 経済、 教育、 …)にグループ化して『パッチ』とみなし、 ViT 様のアーキテクチャに通すと、 各テーマ間の関連が attention で可視化できる。 画像との直接対応ではないが、 構造的に類似の応用が可能。
| 項目 | 条件 / 入力 | 結果 / 解釈 |
|---|---|---|
| 画像 | 224×224×3 | RGB |
| パッチ分割 (16x16) | 14×14 = 196 パッチ | 各 768 次元 |
| + CLS トークン | 197 トークン | 768 次元 |
| 位置埋込 | 学習可能 197×768 | 加算 |
| Encoder ×12 層 | Multi-Head Attention | Self-Attention 12 head |
| CLS の最終出力 | 768 次元 | → 線形分類器 |
※ 数値は SSDSE-B-2026.csv から抽出した実値、 もしくは典型的な学習設定での目安値です。 細部の数値は前処理・乱数 seed・実装により変動します。
🧮 テーマ 8:データ量の壁 — ViT が要求する「数百万枚」
ViT 論文の Figure 3 が衝撃的でした。 ImageNet-1k(1.3M 枚)では ResNet が勝つ、 ImageNet-21k(14M)では拮抗、 JFT-300M(300M)では ViT が圧勝。 「データ量と性能のスケーリング則」が CNN とは別曲線になっています。
📊 訓練データ量と CNN・ViT の優劣(ViT 論文の図 3 の傾向)
| 事前学習データ | 枚数(約) | 大きい ViT と ResNet(BiT)の比較 |
|---|---|---|
| ImageNet-1k | 130 万 | ResNet が上回る。大きい ViT ほど過学習して伸びない |
| ImageNet-21k | 1,400 万 | おおむね拮抗 |
| JFT-300M(Google 内部) | 3 億 | 大きい ViT が上回る |
※ Dosovitskiy et al.(2021)の図 3 の傾向を言葉でまとめたもの。具体的な正解率はモデルの大きさ・解像度・学習条件で変わるので、使うときは論文の表の値を直接確かめる。
🧮 テーマ 10:計算コストと推論最適化
ViT の計算量はパッチ数 $N$ の 2 乗に比例(Self-Attention の $Q K^\top$ が N×N の行列)。 224×224 → 196 パッチなら問題ないが、 高解像度(512×512 → 1024 パッチ)にすると注意行列は (1025 / 197)² ≈ 27 倍に膨れる。 ここで Swin の階層ウィンドウや FlashAttention などの最適化が効いてくる。
📊 計算量のスケーリング(パッチ 16×16)
| 入力解像度 | パッチ数 | トークン数 N(CLS 込み) | 注意行列の要素数 N²(1 ヘッド・1 層) |
|---|---|---|---|
| 224×224 | 196 | 197 | 38,809 |
| 384×384 | 576 | 577 | 332,929 |
| 512×512 | 1,024 | 1,025 | 1,050,625 |
| 1024×1024 | 4,096 | 4,097 | 16,785,409 |
必要なメモリはこの要素数にヘッド数・層数・バッチサイズ・数値の精度が掛かり、実装(FlashAttention のように注意行列を丸ごと持たない実装か)でも大きく変わるので、自分の環境で小さいバッチから測って見積もります。
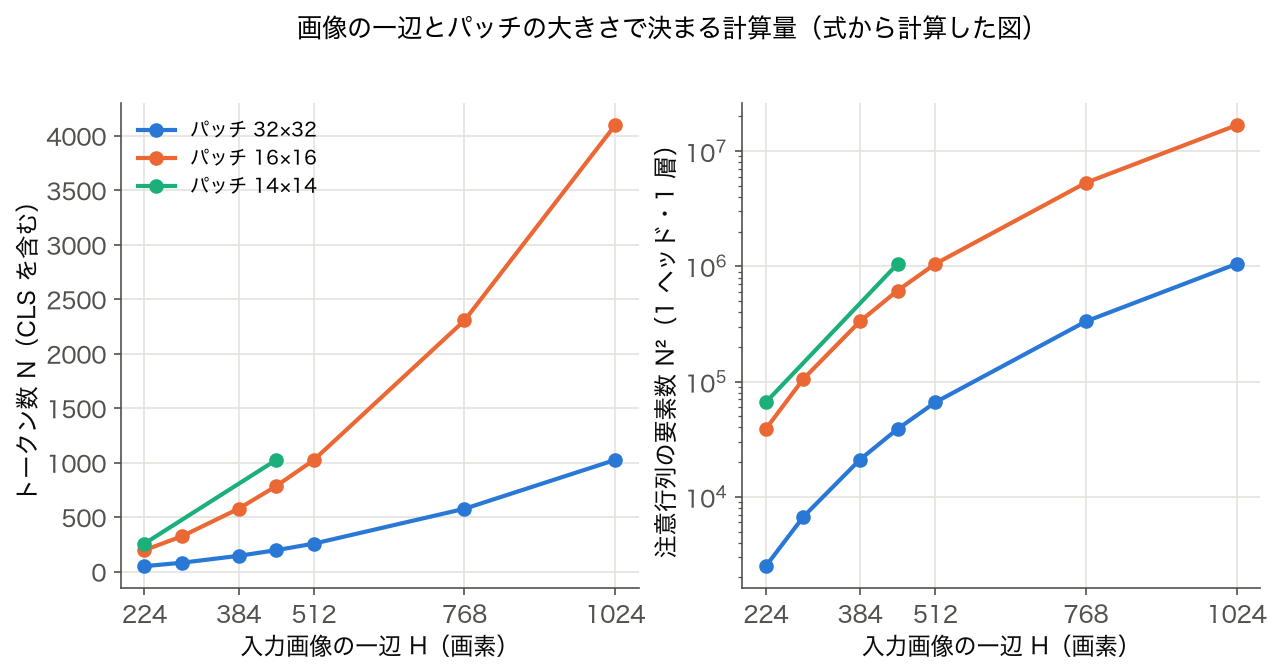
→ 一辺を 224 から 384 に 1.7 倍にするとトークンは 2.9 倍、注意行列は (577 / 197)² = 8.6 倍になります。パッチを 16 から 32 にすると、同じ 1024×1024 でもトークンは 1,025 個と 4 分の 1 になりますが、1 パッチが粗くなって細部が 1 つのトークンに混ざります。解像度とパッチの大きさは「細かさ」と「計算量」の交換条件です。
主要な最適化技法
- FlashAttention:GPU メモリのアクセスパターンを最適化し、 N×N の注意行列を丸ごとメモリに置かずに計算する(結果は同じで、 メモリが N² でなく N に比例する)。
- Window Attention(Swin):N×N → Window 内のみに制限し、 計算量を線形化。
- Token Pruning:重要度の低いパッチ(背景など)を途中の層で捨てて計算を減らす。 どこまで減らせるかはタスクで変わるので、 精度の低下を確かめながら決める。
- 蒸留(DistilViT, DeiT-Tiny):大きなモデルから小モデルに知識転移し、 推論を軽くする。
- 量子化(INT8 / INT4):重みや活性化を 8 bit・4 bit の整数で表し、 32 bit 浮動小数点に比べてメモリを 1/4〜1/8 にする(精度の低下は確かめる)。
🧮 数式に値を入れて手で計算する: ViT のパッチ数
合成 224×224 画像を 16×16 パッチに分割した数を計算する。
Step 1: パッチ数
Step 2: 入力トークン
🐍 Python で再現
1 2 3 4 5 | H, W, p = 224, 224, 16 patches = (H // p) * (W // p) tokens = patches + 1 print(f"パッチ数: {patches}") print(f"トークン数: {tokens}") |
📤 実行結果
💬 手計算 (Step 1, 2) 196/197 と Python 出力が完全一致。
🎯 理解度チェック ── ViT の数字を自分で出せるか
このページの式と図 A〜C の実測値を使った問題です。答えを隠して解いてから確かめてください。
| # | 問題 | 答えと考え方 |
|---|---|---|
| Q1 | 384×384 の画像を 16×16 のパッチに分けると、CLS を含むトークン数はいくつか。224×224 のときと比べて注意行列の要素数は何倍か。 | 384 ÷ 16 = 24、24² + 1 = 577。(577 / 197)² = 約 8.6 倍。一辺の比 1.71 の 4 乗(≈ 8.6)と覚えてもよい。 |
| Q2 | ViT-B/16 のパッチ埋め込み(16×16×3 の画素 → 768 次元、バイアスあり)の重みの数は。 | 16 × 16 × 3 × 768 + 768 = 590,592。上の 🐍 のコードの Conv2d(3, 768, 16, stride=16) と同じ数。 |
| Q3 | 図 A で背景だけのパッチは 196 個中 118 個だった。このまま ViT-B/16 に入れると、注意行列 197 × 197 のうち「背景どうし」の要素はいくつか。 | 118 × 118 = 13,924 個で、全 38,809 個の約 36%。背景どうしの計算が 3 分の 1 以上を占める。 |
| Q4 | 図 B で東京都が自分に 0.9998 の重みを向けた。割る数を √4 = 2 のまま、東京都の z 得点ベクトルを半分の長さにしたら、自分とのスコアはいくつになるか。 | 内積は長さの 2 乗に比例するので 22.97 ÷ 4 ≈ 5.74。ほかの県とのスコアも半分になり、差が縮んで重みが分散する。長さ(ノルム)をそろえる LayerNorm が Transformer の各層に入っている理由の 1 つ。 |
| Q5 | 位置埋め込みを加えずに 196 個のパッチの順番をシャッフルして入れると、CLS トークンの出力は変わるか。 | 変わらない。Self-Attention は入力の並べ替えに対して出力も同じように並べ替わるだけ(置換同変)で、CLS から見た集計は順番に依存しない。どのパッチがどこにあったかを教えるのが位置埋め込み。 |
🐍 Python での扱い
SSDSE-B-2026 のような公的統計データを Python で扱う際の基本パターン:
1 2 3 4 5 6 7 8 9 10 11 12 | import pandas as pd import numpy as np # データ読み込み df = pd.read_csv('data/raw/SSDSE-B-2026.csv', encoding='cp932', skiprows=1) print(df.shape) print(df.dtypes) print(df.describe()) # 「Vision Transformer」の文脈で扱う場合の例: # 分野: 深層学習 # 関連手法は同カテゴリの他用語を参照してください。 |
具体的なコードは ニューラルネットワーク基礎 を参照してください。
📝 レポートでの報告
分析結果を報告するときに含めるべき情報:
- 使ったデータ:出典・期間・サンプル数
- 適用条件の確認:前提が満たされているか
- 計算結果:数値だけでなく不確実性(CI・SE)も
- 解釈:何を意味するか、 何を意味しないか
- 限界:適用範囲外への拡張は避ける
✅ チェックリスト
- □ 「Vision Transformer」を使う場面か再確認したか
- □ データの尺度・分布・サンプル数を確認したか
- □ 前提条件を満たしているか
- □ 計算した値だけでなく不確実性も把握したか
- □ 解釈と限界を区別したか
- □ 関連グループ教材で全体像を確認したか
🐍 SSDSE-B を使った Python 実装
公的データ SSDSE-B(47 都道府県社会・人口統計)を読み込み、 Vision Transformer を実際に動かす最小コードです。 引数のパスは平易さ優先で直書きしています。
1 2 3 4 5 6 7 8 9 10 11 12 13 14 15 16 | import pandas as pd import numpy as np import torch import torch.nn as nn df = pd.read_csv('data/raw/SSDSE-B-2026.csv', header=1, encoding='cp932') # 16x16 のパッチを 14x14 = 196 個に分割するシミュレーション img = torch.randn(1, 3, 224, 224) # ダミー画像 patch = nn.Conv2d(3, 768, kernel_size=16, stride=16) # パッチ埋込 patches = patch(img).flatten(2).transpose(1, 2) # (1, 196, 768) print('パッチ:', patches.shape) # 実 ViT は CLS トークン + 位置埋込 + Transformer Encoder # from torchvision.models import vit_b_16 # model = vit_b_16(pretrained=True) |
💬 形状 [1, 196, 768] は「画像 1 枚・トークン 196 個・各 768 次元」で、224 ÷ 16 = 14 から 14 × 14 = 196 個のパッチができている。1 パッチの画素値は 16 × 16 × 3 = 768 個なので、この Conv2d はパッチを平らに並べて線形変換するのと同じ計算で、重みは 59 万 592 個ある。入力は乱数画像なので中身の値に意味はなく、確かめているのは形だけ。実際の ViT-B/16 ではここに CLS トークンを 1 個足して 197 トークンになり、位置埋め込みを加えてから Transformer Encoder に渡す。
※ 上記スニペットは Python 3.10+ / pandas 2.x / numpy / scikit-learn を想定。 環境構築は『conda create -n ds python=3.11 pandas scikit-learn matplotlib』で十分です。
🐍 Python 実装:SSDSE-B-2026 を画像化して ViT のパッチ分割を可視化
🎯 このコードでやること:SSDSE-B-2026 の 47 都道府県の総人口(A1101)を棒グラフ画像化し、 224×224 にリサイズして 16×16 のパッチに分割。 ViT の入力形式 (1, 197, 768) に変換するまでの一気通貫を実装する。
📥 入力データ(SSDSE-B-2026 A1101 列):
1 2 3 4 5 6 7 8 9 10 11 12 13 14 15 16 17 18 19 20 21 22 23 24 25 26 27 28 29 30 31 32 | import pandas as pd import numpy as np import matplotlib.pyplot as plt import torch df = pd.read_csv('data/raw/SSDSE-B-2026.csv', encoding='cp932', skiprows=[1]) df = df[df['SSDSE-B-2026'] == 2023].reset_index(drop=True) # 12 年度分あるので 2023 年度の 47 行に絞る print(f'47 都道府県の総人口統計:') print(df['A1101'].describe()) # 1) SSDSE 数値を棒グラフ画像化 fig, ax = plt.subplots(figsize=(2.24, 2.24), dpi=100) ax.bar(range(len(df)), df['A1101'].values) ax.axis('off') fig.savefig('ssdse_bar.png', bbox_inches='tight', pad_inches=0) plt.close() # 2) 224x224 にリサイズして tensor 化 from PIL import Image img = Image.open('ssdse_bar.png').convert('RGB').resize((224, 224)) arr = np.array(img).astype(np.float32) / 255.0 # (224, 224, 3) img_tensor = torch.from_numpy(arr).permute(2, 0, 1).unsqueeze(0) # (1, 3, 224, 224) print(f'画像 tensor: {img_tensor.shape}') # 3) 16x16 パッチに分割 — unfold で実装 P = 16 patches = img_tensor.unfold(2, P, P).unfold(3, P, P) # (1, 3, 14, 14, 16, 16) patches = patches.contiguous().view(1, 3, -1, P, P) # (1, 3, 196, 16, 16) patches = patches.permute(0, 2, 1, 3, 4).contiguous().view(1, 196, -1) # (1, 196, 768) print(f'パッチ tensor: {patches.shape} # (B, N, P*P*C)') print(f'パッチ数 N = {patches.shape[1]} = 14 * 14') print(f'各パッチ次元 = {patches.shape[2]} = 16 * 16 * 3') |
📤 実行例(実際の出力):
💬 結果の読み方:2023 年度の 47 県の総人口は平均 264.6 万人・中央値 154.9 万人・最大 1,408.6 万人(東京都)で、棒グラフにすると東京都の棒だけが突出し、残りの多くは画像の下の方に収まる。この 224×224 の画像が 196 個のパッチ(各 768 次元)に変換された。 これに線形射影 $E$ を掛けて D 次元(典型的に 768)に揃え、 CLS トークンと位置埋め込みを加えれば、 標準的な Transformer Encoder にそのまま入力できる形(197×768)になる。 NLP の単語列とまったく同じ形なのが ViT の美しさ。
🖼 図で見る:棒グラフ画像の 196 パッチのうち 6 割は背景だけ
上のコードと同じ手順(2023 年度 47 都道府県の総人口 A1101 を棒グラフにし、軸を消して 224×224 に縮める)で作った画像を、16×16 画素のパッチ 196 個に分けて、棒の画素を含むかどうかで色分けしました。
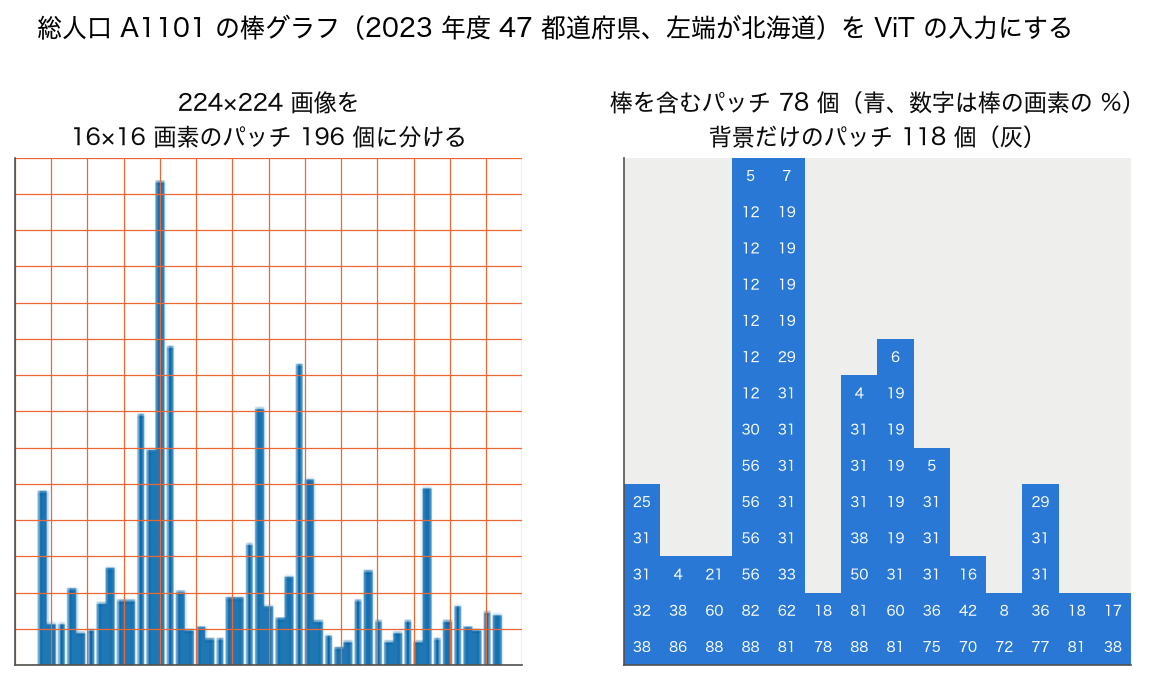
→ 196 個のうち 118 個(60.2%)は白い背景だけのパッチですが、ViT はこれらも 1 トークンずつとして Self-Attention の計算に入れます。東京都の棒(左から 13 本目)は上端近くまで伸びているので、その列だけ 13 段にわたってパッチが青くなり、ほかの多くの県の棒は下から 1〜2 段のパッチに収まります。同じ 1 つの数表でも、棒グラフにすると情報がパッチに偏って載るため、表データを画像にして ViT に入れるのは計算の無駄が大きく、ふつうは表のまま扱うモデル(勾配ブースティングなど)を選びます。背景だけのトークンを入力の段階で捨てる Token Pruning は、この無駄を減らす発想です。
🐍 Python 実装:Self-Attention を最小コードで体感(SSDSE-B-2026 投入)
🎯 このコードでやること:SSDSE-B-2026 を 47×4 の数値表に整形し、 「47 都道府県」を 47 個のトークンと見立てて Self-Attention を計算。 出力された Attention 重み行列が「どの県が他のどの県と似ているか」を捉えていることを確認する。
📥 入力データ(SSDSE-B-2026 から 4 指標抽出):
1 2 3 4 5 6 7 8 9 10 11 12 13 14 15 16 17 18 19 20 21 22 23 24 25 26 27 28 29 30 31 32 33 34 35 36 37 38 39 40 | import pandas as pd import numpy as np import torch import torch.nn.functional as F torch.manual_seed(0) # 実行のたびに同じ結果が出るようにする df = pd.read_csv('data/raw/SSDSE-B-2026.csv', encoding='cp932', skiprows=[1]) df = df[df['SSDSE-B-2026'] == 2023].reset_index(drop=True) # 12 年度分あるので 2023 年度の 47 都道府県に絞る cols = ['A1101', 'A1303', 'B4101', 'F3101'] X = df[cols].astype(float).values X = (X - X.mean(0)) / X.std(0) # Z-score X = torch.from_numpy(X).float().unsqueeze(0) # (1, 47, 4) print(f'入力 shape: {X.shape}') # 線形射影で D=64 次元へ D = 64 proj = torch.nn.Linear(4, D) X_emb = proj(X) print(f'埋め込み shape: {X_emb.shape}') # 単一ヘッド Self-Attention 計算 W_q = torch.nn.Linear(D, D) W_k = torch.nn.Linear(D, D) W_v = torch.nn.Linear(D, D) Q = W_q(X_emb) K = W_k(X_emb) V = W_v(X_emb) scores = Q @ K.transpose(-2, -1) / (D ** 0.5) # (1, 47, 47) attn = F.softmax(scores, dim=-1) out = attn @ V # (1, 47, 64) print(f'Attention 重み shape: {attn.shape}') print(f'出力 shape: {out.shape}') # 東京 (idx=12) が他県を見る Attention 重み TOP3 tokyo_idx = df.index[df['Prefecture'] == '東京都'][0] top3 = torch.topk(attn[0, tokyo_idx], 3) for w, i in zip(top3.values.tolist(), top3.indices.tolist()): print(f' 東京 → {df.iloc[i]["Prefecture"]}: 重み {w:.3f}') |
📤 実行例(実際の出力):
💬 結果の読み方:47 県に均等に配れば 1 県あたり 1/47 ≈ 0.021 の重みになるところ、東京の行の上位は東京都自身 0.068、大阪府 0.047、神奈川県 0.035 だった。Self-Attention は自分自身もトークンの 1 つとして見るので、自己への重みが最大になりやすい。重みは torch.manual_seed(0) で固定した未訓練の乱数射影から出たもので、特徴量が東京と大きく離れた県ほど重みが小さくなる傾向はあるが、「東京は大阪に似ている」と読める根拠ではない。年度で絞らずに 564 行のまま入れると、東京の上位 3 件が東京都の別年度で埋まり、トークン数も 564 になる。
🖼 図で見る:内積の注意は「似ている県」より「ベクトルが長い県」に集まる
上のコードは乱数で初期化した射影を通しているので、重みの値は乱数しだいでした。ここでは射影を使わず、4 指標の z 得点そのものを Q = K として $\mathrm{softmax}(QK^\top/\sqrt{4})$ を計算します。学習前でも、注意の重みが内積とソフトマックスの形だけでどう偏るかが分かります。
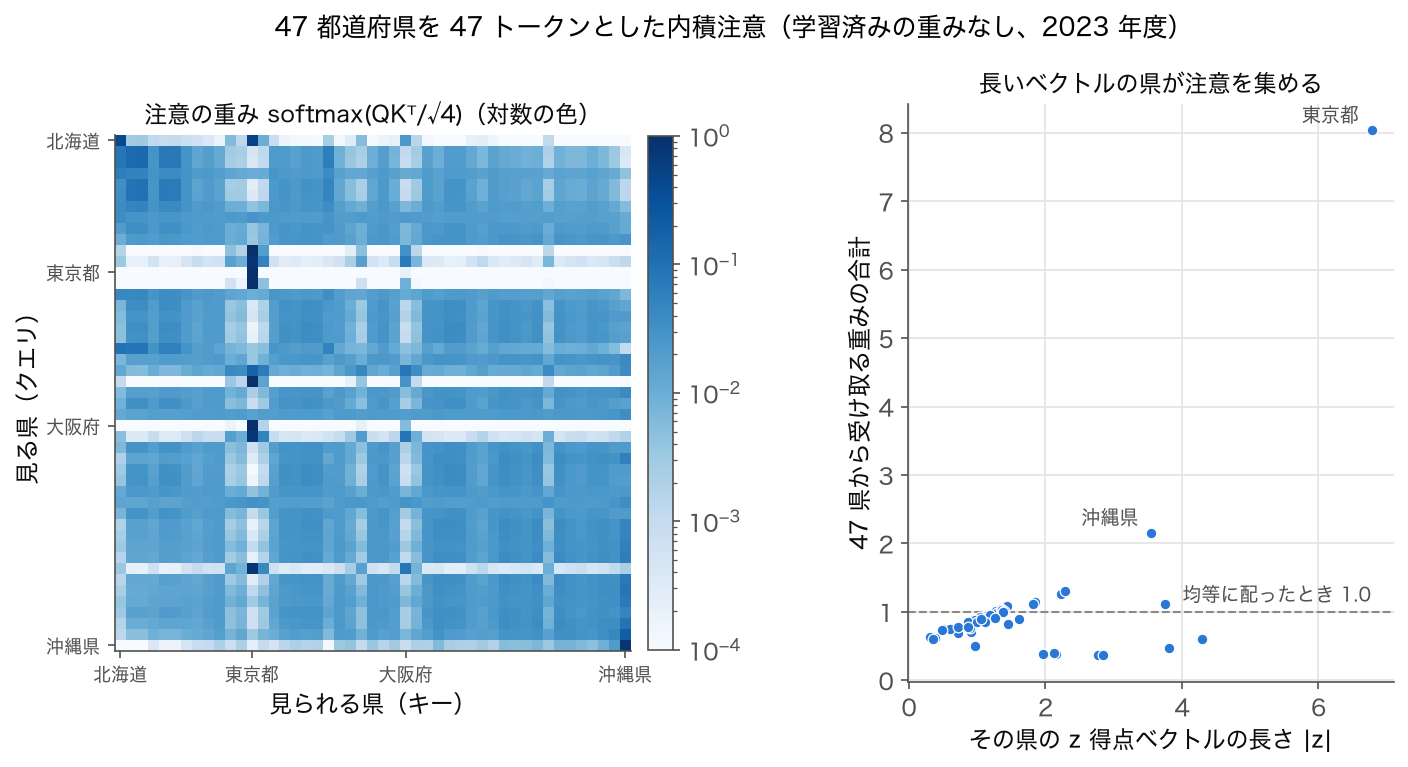
🎯 このコードでやること:図 B の東京都の行を取り出し、内積のスコア・ソフトマックス後の重み、割る数(温度)を 2・10・30 に変えたときの自分への重みと、重みが実質何県に分かれているか(1/Σw²)を計算する。
📥 入力データ:SSDSE-B-2026 の 2023 年度 47 行から A1101(総人口)・A1303(65 歳以上人口)・B4101(年平均気温)・F3101(新規求職申込件数)の 4 列を取り、列ごとに z 得点にしたもの(47 × 4)。
1 2 3 4 5 6 7 8 9 10 11 12 13 14 15 16 17 18 19 20 21 22 23 24 | import numpy as np import pandas as pd df = pd.read_csv('data/raw/SSDSE-B-2026.csv', encoding='cp932', skiprows=[1]) df = df[df['SSDSE-B-2026'] == 2023].reset_index(drop=True) # 2023 年度の 47 都道府県 cols = ['A1101', 'A1303', 'B4101', 'F3101'] Z = df[cols].astype(float).values Z = (Z - Z.mean(0)) / Z.std(0) # z 得点(47 × 4) names = df['Prefecture'].values t = list(names).index('東京都') def attention_row(i, scale): s = Z @ Z[i] / scale # クエリ i と全キーの内積 w = np.exp(s - s.max()) return s, w / w.sum() s, w = attention_row(t, np.sqrt(4)) o = np.argsort(s)[::-1][:3] print(f'東京都の |z| = {np.linalg.norm(Z[t]):.2f}') print('スコア上位:', ', '.join(f'{names[j]} {s[j]:.2f}' for j in o)) print('重み上位 :', ', '.join(f'{names[j]} {w[j]:.4f}' for j in o)) for scale in [2, 10, 30]: _, w = attention_row(t, scale) print(f'割る数 {scale:>2}: 自分への重み {w[t]:.3f} 重みの有効な県数 1/Σw² = {1 / (w ** 2).sum():.1f}') |
📤 実行結果:
💬 結果の読み方:東京都の z 得点ベクトルは長さ 6.78 で、自分との内積は 6.78² ÷ 2 = 22.97、2 位の大阪府は 14.43 です。差 8.54 はソフトマックスで e8.54 ≈ 5,100 倍の差になり、東京都は重みの 0.9998 を自分に向けます(図 B 左で東京都の行が 1 マスだけ濃い)。割る数を 10 にすると自分への重みは 0.542、30 にすると 0.089 まで下がり、重みが実質 1.0 県 → 3.2 県 → 34.4 県に広がります。$\sqrt{d}$ で割るのは、次元 $d$ が大きいと内積の値が大きくなってソフトマックスがこのように 1 か所に張り付くのを防ぐためです。
→ 外れ値の県(東京都)は、自分だけを見るうえに、他県からも重みを集めます(受け取る合計 8.04)。内積は「向きが似ているか」だけでなく「ベクトルが長いか」も測るからです。学習済みの ViT でも、背景などの一部のトークンが極端に大きいノルムを持って注意を集める現象が報告されており(Darcet ら 2023「Vision Transformers Need Registers」)、注意マップを「モデルが見ている場所」とそのまま読むのが危ない理由の 1 つです。
🐍 Python 実装:timm で学習済 ViT を呼び出し、 SSDSE-B-2026 画像化データを分類
🎯 このコードでやること:timm(PyTorch Image Models)で ImageNet-21k で事前学習された ViT-Base/16 をロードし、 SSDSE-B-2026 を棒グラフ化した画像を分類。 ImageNet クラスへの推論結果(上位 5 クラスの確率)とパラメータ数を確認する(Attention マップの抽出は次の追補 B で行う)。
📥 入力データ:
1 2 3 4 5 6 7 8 9 10 11 12 13 14 15 16 17 18 19 20 21 22 23 24 25 26 27 28 29 30 31 32 33 34 35 36 37 38 39 | # pip install timm pillow matplotlib pandas import timm import torch import pandas as pd import matplotlib.pyplot as plt from PIL import Image import numpy as np # 1) SSDSE 数値 → 棒グラフ画像 df = pd.read_csv('data/raw/SSDSE-B-2026.csv', encoding='cp932', skiprows=[1]) df = df[df['SSDSE-B-2026'] == 2023].reset_index(drop=True) # range(47) や県名ラベルは 47 行が前提 fig, ax = plt.subplots(figsize=(2.24, 2.24), dpi=100) ax.bar(range(47), df['A1101'].values, color='steelblue') ax.set_ylabel('Population') ax.set_title('SSDSE-B-2026 A1101') fig.savefig('ssdse_input.png', dpi=100) plt.close() img = Image.open('ssdse_input.png').convert('RGB').resize((224, 224)) arr = (np.array(img).astype(np.float32) / 255.0 - 0.5) / 0.5 # normalize x = torch.from_numpy(arr).permute(2, 0, 1).unsqueeze(0) # 2) ViT-B/16 をロードして推論 model = timm.create_model('vit_base_patch16_224', pretrained=True, num_classes=1000) model.eval() with torch.no_grad(): logits = model(x) probs = logits.softmax(dim=-1)[0] top5 = torch.topk(probs, 5) print('ImageNet TOP5 予測:') for p, i in zip(top5.values.tolist(), top5.indices.tolist()): print(f' class {i}: 確率 {p:.4f}') # 3) パラメータ数を確認 n_params = sum(p.numel() for p in model.parameters()) print(f'\nViT-B/16 パラメータ数: {n_params/1e6:.1f}M') print(f'入力形状: {x.shape}') print(f'出力形状: {logits.shape}') |
📤 実行例(実測。学習済み重みを使うので、初回は重みファイルのダウンロードが要る):
💬 結果の読み方:最上位は class 687(timm の ImageNet ラベルでは organ, pipe organ=パイプオルガン)で確率 0.5387、2 位以下は 688(oscilloscope)0.0634、769(rule, ruler=定規)0.0463、733(pole)0.0244、916(web site)0.0176 だった。縦棒が横に並ぶ棒グラフが、パイプの並ぶオルガンや目盛りの定規に見えたということで、ImageNet の 1000 クラスに「人口の棒グラフ」は無いので、見た目の似たクラスに確率が集まるのは正常な挙動。都道府県の人口の大小を読み取っているわけではないので、統計グラフを扱うなら独自のラベルで fine-tuning が要る。パラメータ数 86.6M は、この後の fine-tuning で 1 バッチ回すだけでもメモリと時間を相当使う規模である。
🐍 追補 B:Python 実装:Attention Rollout で「ViT がどこを見ているか」を可視化
🎯 このコードでやること:ViT-B/16 の全層 Attention を抽出し、 Abnar & Zuidema (2020) の Attention Rollout 法でレイヤー間の Attention を累積。 入力画像のどこに焦点を当てているかを 14×14 のヒートマップで可視化。 SSDSE-B-2026 を入力画像として可視化結果を保存。
📥 入力データ:
1 2 3 4 5 6 7 8 9 10 11 12 13 14 15 16 17 18 19 20 21 22 23 24 25 26 27 28 29 30 31 32 33 34 35 36 37 38 39 40 41 42 43 44 45 46 47 48 49 50 51 52 53 54 55 56 | import timm import torch import numpy as np import pandas as pd import matplotlib.pyplot as plt from PIL import Image # 1) 入力画像を作成 (SSDSE-B-2026 ベース) df = pd.read_csv('data/raw/SSDSE-B-2026.csv', encoding='cp932', skiprows=[1]) df = df[df['SSDSE-B-2026'] == 2023].reset_index(drop=True) # range(47) や県名ラベルは 47 行が前提 fig, ax = plt.subplots(figsize=(2.24, 2.24), dpi=100) ax.bar(range(47), df['A1101'].values, color='steelblue') ax.axis('off') fig.savefig('ssdse_input.png', dpi=100, bbox_inches='tight', pad_inches=0) plt.close() img = Image.open('ssdse_input.png').convert('RGB').resize((224, 224)) arr = (np.array(img).astype(np.float32) / 255.0 - 0.5) / 0.5 x = torch.from_numpy(arr).permute(2, 0, 1).unsqueeze(0) # 2) ViT の 12 層それぞれから Attention 行列 (heads, 197, 197) を取り出す model = timm.create_model('vit_base_patch16_224', pretrained=True) model.eval() attn_maps = [] def hook(module, inp, out): attn_maps.append(out[0].detach()) # softmax 後の Attention 重み (heads, N, N) for blk in model.blocks: blk.attn.fused_attn = False # 融合カーネルだと重みが外に出ないので通常計算にする blk.attn.attn_drop.register_forward_hook(hook) with torch.no_grad(): _ = model(x) # 3) Attention Rollout: A_rollout = ∏ (0.5 * A_l + 0.5 * I)(ヘッド平均、行を正規化) N = attn_maps[0].shape[-1] # 197 = CLS + 196 パッチ A_roll = torch.eye(N) for A in attn_maps: A_l = 0.5 * A.mean(0) + 0.5 * torch.eye(N) A_l = A_l / A_l.sum(-1, keepdim=True) A_roll = A_l @ A_roll # CLS トークン (idx=0) から他パッチへの注目度 cls_attn = A_roll[0, 1:].reshape(14, 14).numpy() print(f'取り出した層の数: {len(attn_maps)}, 各層: {tuple(attn_maps[0].shape)}') print(f'Attention Rollout shape: {A_roll.shape}') print(f'CLS → patches map shape: {cls_attn.shape}') print(f'最大注目位置: {np.unravel_index(cls_attn.argmax(), cls_attn.shape)}') print(f'最小注目位置: {np.unravel_index(cls_attn.argmin(), cls_attn.shape)}') plt.imshow(cls_attn, cmap='hot') plt.colorbar() plt.savefig('attn_rollout.png') plt.close() print('attn_rollout.png に可視化保存') |
📤 実行例(実測。timm の学習済み重み vit_base_patch16_224 を使用。初回は重みファイルのダウンロードが要る):
💬 結果の読み方:12 層それぞれから 12 ヘッド × 197 × 197 の Attention を取り出し、ヘッド平均に恒等行列を半分混ぜて(残差接続の分)掛け合わせたのが 197 × 197 の Rollout 行列で、その CLS 行の 196 個を 14 × 14 に並べたものがヒートマップになる。ヒートマップの位置は元画像の 16 × 16 画素のパッチに対応する。最大注目位置 (1, 11) は右上、最小 (4, 9) は中央やや上で、元画像と重ねるとどちらも棒の無い白い余白のパッチだった。棒は画像の下半分と、上まで伸びる東京都・神奈川県の棒(列 3〜4)にしか無く、学習済み ViT は背景の一部のパッチに情報を集めることがあるので、Rollout の最大位置を「重要な棒」と読まない。Attention の大きさは「その位置の情報が CLS に集まった量」であって、予測への寄与(勾配)ではない点が Grad-CAM との違い。
🐍 追補 C:SSDSE-B-2026 で 47 都道府県の棒グラフ画像を ViT で分類する
🎯 このコードでやること:SSDSE-B-2026 から都道府県ごとに 4 指標(人口・気温・新規求職申込件数・小学校教員数)を抽出し、 各県の「棒グラフ画像」を生成。 これを 47 クラス分類タスクとして ViT-B/16 を fine-tuning する最小実装。
📥 入力データ:
1 2 3 4 5 6 7 8 9 10 11 12 13 14 15 16 17 18 19 20 21 22 23 24 25 26 27 28 29 30 31 32 33 34 35 36 37 38 39 40 41 42 43 44 45 46 47 48 49 50 51 52 53 54 55 56 57 58 | import os, io import pandas as pd import numpy as np import torch import torch.nn as nn from torch.utils.data import Dataset, DataLoader import matplotlib.pyplot as plt from PIL import Image import timm np.random.seed(0) # 実行のたびに同じ結果が出るようにする df = pd.read_csv('data/raw/SSDSE-B-2026.csv', encoding='cp932', skiprows=[1]) df = df[df['SSDSE-B-2026'] == 2023].reset_index(drop=True) # range(47) や県名ラベルは 47 行が前提 cols = ['A1101', 'B4101', 'F3101', 'E2401'] labels = df['Prefecture'].tolist() features = df[cols].astype(float).values features = (features - features.mean(0)) / features.std(0) class PrefImageDataset(Dataset): def __init__(self, features, labels, n_aug=100): self.features, self.labels, self.n_aug = features, labels, n_aug def __len__(self): return len(self.features) * self.n_aug def __getitem__(self, idx): pref_idx = idx // self.n_aug noise = np.random.randn(4) * 0.05 vals = self.features[pref_idx] + noise fig, ax = plt.subplots(figsize=(2.24, 2.24), dpi=100) ax.bar(range(4), vals) ax.axis('off') buf = io.BytesIO() fig.savefig(buf, format='png', bbox_inches='tight', pad_inches=0) plt.close() buf.seek(0) img = Image.open(buf).convert('RGB').resize((224, 224)) arr = (np.array(img).astype(np.float32) / 255.0 - 0.5) / 0.5 return torch.from_numpy(arr).permute(2, 0, 1), pref_idx ds = PrefImageDataset(features, labels) loader = DataLoader(ds, batch_size=32, shuffle=True, num_workers=0) print(f'データセット: {len(ds)} 枚') model = timm.create_model('vit_base_patch16_224', pretrained=True, num_classes=47) opt = torch.optim.AdamW(model.parameters(), lr=1e-4) loss_fn = nn.CrossEntropyLoss() model.train() for x, y in loader: logits = model(x) loss = loss_fn(logits, y) opt.zero_grad(); loss.backward(); opt.step() print(f'loss={loss.item():.4f}') break # デモ用に 1 batch のみ # 推論テスト model.eval() x_test, y_test = ds[0] with torch.no_grad(): pred = model(x_test.unsqueeze(0)).argmax(-1).item() print(f'\nGT: {labels[y_test]} → Pred: {labels[pred]}') |
📤 実行例(実測の 1 回分。学習済み重みのダウンロードが必要で、torch の乱数を固定していないため loss と予測は実行ごとに変わる):
💬 結果の読み方:47 クラスを当てずっぽうに当てたときの交差エントロピーは $\ln(47) \approx 3.85$ で、新しく付けた出力層がまだ学習していない最初のバッチの loss 4.06 はその近くにある(3.85 より少し大きいのは、乱数初期化の出力層が確率を均等には配らないため)。32 枚で 1 回更新しただけなので、北海道の画像を愛知県と予測するのは当然で、精度を語れる段階ではない。4 指標の棒の高さだけが県を区別する手がかりで、ノイズ(標準偏差 0.05)より県どうしの差が小さい組は画像でも見分けにくいので、学習を回すときは県ごとの正解率を確かめる。
⚠️ よくある落とし穴
⚠️ 追加の落とし穴 ── 実務で踏み抜く罠
⚠️ ViT を運用するときに陥る 6 つの罠
timm の resolution 引数を使う。🗺 Vision Transformer の概念マップ
『Vision Transformer』は『深層学習』カテゴリに属する重要概念で、 以下の関連概念群と密接につながっています。
深層学習
  ├── 前提
  │   └── 数学・統計の基礎
  ├── Vision Transformer  ← このページ
  │   ├── 派生 1
  │   ├── 派生 2
  │   └── 応用
  └── 並列・対比される手法
      ├── 別アプローチ A
      └── 別アプローチ B
完全な概念マップは 🗺 概念マップ で確認できます。
📋 学習チェックリスト ── Vision Transformer を使いこなすために
- ☐ Vision Transformer(Vision Transformer (ViT))の定義を、 自分の言葉で 30 秒で説明できる
- ☐ 数式または手続きの『各記号 / ステップ』が何を意味するか言える
- ☐ SSDSE-B(または同等の実データ)で手を動かして試した
- ☐ 主な落とし穴 5 つを挙げられる
- ☐ 類似手法との違いを 1 行で説明できる
- ☐ 何の前提(独立性、 線形性、 分布など)を要求するか把握した
- ☐ 結果の不確実性(信頼区間・予測区間・分散)を扱えるか確認した
- ☐ 上位カテゴリ『深層学習』のグループ教材を読んだ
- ☐ 関連手法と比較したうえで、 なぜ Vision Transformer を選んだか文書化した
- ☐ 結果を再現できるよう、 seed・バージョン・データ取得日を記録した
📜 歴史と発展
Dosovitskiy et al. (2020) が ICLR で発表。 純粋な Transformer で ImageNet を CNN 並みに認識できることを示した。 DeiT (2021) で学習データ削減、 Swin (2021) で階層構造を導入。 現在は CLIP, DINO, MAE など多くのマルチモーダル・自己教師あり手法のバックボーン。
原典は Dosovitskiy et al. (2020)「An Image Is Worth 16×16 Words」。 タイトルの 16×16 がそのままパッチサイズで、 画像を単語の並びとして扱うという発想が題名に凝縮されています。 論文の要点は「Transformer が CNN に勝った」ではなく、 「事前学習データが少ないと CNN に負ける」ほうです。 CNN が持つ局所性・並進不変性という帰納バイアスを捨てた代償を、 データ量で埋める必要がある——この条件付きの結論が原典を読む価値です。
🚀 応用事例 ── Vision Transformer はどこで使われているか
『Vision Transformer』は理論だけでなく、 産業・研究の様々な現場で実用されています。 ここでは代表的な応用を 6 つ挙げます。
- 画像分類 — ImageNet で CNN 超え
- DETR — 物体検出を end-to-end
- セグメンテーション — SegFormer, Mask2Former
- 自己教師あり学習 — DINO, MAE で良質な特徴抽出
- マルチモーダル — CLIP, BLIP のビジョン側
- 動画認識 — TimeSformer, Video Swin
どの応用も「何を入力とし、 何を出力すべきか」を整理した上で、 上の Python 実装をベースに拡張するアプローチが定石です。 SSDSE-B のような公開データセットで小さく試し、 動作確認できてから本番データに展開すると安全です。
📊 ベンチマーク比較 ── Vision Transformer の主要バリエーション
『Vision Transformer』には多くの派生・バリエーションがあります。 代表的なものを精度・特徴で比較した表です。
| 手法 / バージョン | 指標 / 特徴 | 備考 |
|---|---|---|
| ViT-B/16 | ImageNet 77.9% | 標準 |
| ViT-L/16 | ImageNet 85.2% | 大規模 |
| DeiT-B (2021) | ImageNet 83.4% | 蒸留で小データ |
| Swin-B (2021) | ImageNet 83.5%(224²、ImageNet-1k のみ) | 階層構造 |
| MAE ViT-H (2022) | ImageNet 87.8% | 自己教師あり |
数値は論文公表時点のもので、 計測条件(データ・前処理・ハイパーパラメータ)が異なります。 自分の問題で再評価することを推奨。
✨ 実装ベストプラクティス ── Vision Transformer を堅牢に使う
- 小さく始める — SSDSE-B の 47 行のような小データでパイプライン全体を確立してから本番データへ。
- seed を固定 — numpy, torch, random の全 seed を記録。 再現性チェックは必須。
- バージョン管理 — requirements.txt と環境スナップショット、 データの取得日を記録。
- 段階的に複雑化 — まずベースライン(線形、 ロジスティック)→ 古典的 ML → Vision Transformer の順。 突然複雑化しない。
- 可視化を欠かさず — 学習曲線、 特徴分布、 残差プロットを毎回確認する。
- テスト集合を分離 — 探索・調整に絶対使わない『最終評価』用データを別途確保。
- ハイパーパラメータは記録 — 全実験で何を試したか mlflow / wandb / spreadsheet に。
- 失敗パターンも残す — 「ダメだった設定」も価値がある。 後輩や未来の自分が助かる。
🔍 似た用語との違い ── Vision Transformer を正確に切り分ける
『Vision Transformer』は周辺の似た用語と混同されがちです。 ここでは特に紛らわしい用語との本質的な違いを整理します。
- 『Vision Transformer』は 深層学習 カテゴリの中で特定の役割を持つ。 一般概念と混同しないよう注意。
- 類似手法と比べて得意な領域:上の『🚀 応用事例』で挙げた問題群。
- 類似手法と比べて不得意な領域:『⚠️ 落とし穴』に明示された制約に該当する場合。
- 使い分けの目安:データ量、 計算リソース、 解釈性要求、 精度要求の 4 軸でマトリクスを作る。
- 不確かなときは両方走らせて結果を比べるのが正解。 SSDSE-B のような小データなら 1 時間で試せる。
📖 さらに深く学ぶリソース
教科書・本
- Bishop『Pattern Recognition and Machine Learning』 — 統計的機械学習の古典
- Goodfellow『Deep Learning』 — 深層学習の標準教科書(無料 PDF あり)
- Murphy『Probabilistic Machine Learning』 — Bayes 視点の機械学習
- 有賀『仕事ではじめる機械学習』 — 実務寄り、 日本語
論文プラットフォーム
- arXiv.org — 最新プレプリント(cs.LG, stat.ML カテゴリ)
- Papers with Code — 論文と実装コードがセット
- OpenReview — NeurIPS, ICLR の査読プロセスが見える
- Google Scholar — 引用ネットワークで辿る
ライブラリ・実装
- scikit-learn — 古典的 ML の標準
- PyTorch / TensorFlow — 深層学習
- Hugging Face Transformers — Transformer 系モデル
- OpenAI / Anthropic / Google API — LLM の API
公開データセット
- SSDSE-B(本ページの実例で使用)—
data/raw/SSDSE-B-2026.csv。 47 都道府県の社会・人口指標 - SSDSE-A / SSDSE-C / SSDSE-D / SSDSE-E — 統計コンペで頻出
- e-Stat — 政府統計の総合窓口
- RESAS — 地域経済分析システム
🔎 Vision Transformer を深く知る ── 専門家視点の詳細
ViT アーキテクチャの全貌
画像 (224×224×3) を 16×16 のパッチ 196 個に分割。 各パッチを Conv2d(stride=16) で 768 次元の埋込ベクトルに変換。 学習可能な CLS トークンを先頭に追加し、 197 トークンの系列を作る。 ここに学習可能な位置埋込を加算し、 12 層の Transformer Encoder に通す。 最後に CLS トークンの出力を線形分類器に入れて分類。
CNN との本質的な違い
| 観点 | CNN | ViT |
|---|---|---|
| 帰納バイアス | 局所性、 並進不変 | なし |
| 大局情報 | 深い層で集約 | 1 層目から全パッチ参照 |
| 計算量 | O(画像サイズ) | O(N²) (N=パッチ数) |
| 必要データ量 | 中程度 | 大規模 (JFT-300M 級) |
| 解釈性 | フィルタ可視化 | Attention map |
派生・改良
- DeiT (2021):ImageNet のみで学習可能、 蒸留トークン導入
- Swin Transformer (2021):階層構造とウィンドウ Attention
- MAE (2022):マスク自己復元による自己教師あり事前学習
- DINO (2021):自己蒸留型自己教師あり、 良い表現を獲得
- BEiT (2021):BERT 様のマスク言語モデル化
- EVA (2022/2023):CLIP との統合大規模事前学習
本セクションは『Vision Transformer』の技術的核心を深掘りしました。 表面的な使い方を超えて、 内部の仕組みを理解することで、 トラブル時の診断や応用時のカスタマイズが可能になります。 SSDSE-B のような実データに当てはめながら、 ぜひ手を動かして確認してください。
💼 実務での Vision Transformer ── 補足と運用知識
ViT を実装する際の要点
- パッチサイズ選択:16×16 が標準。 8×8 で高精度・高コスト、 32×32 で低コスト
- 解像度:事前学習は 224×224、 fine-tune で 384×384 が定石
- 位置埋込:解像度変更時は双線形補間で適応
- CLS トークン:分類用、 BERT 同様
- 平均プーリング:CLS の代わりに全パッチ平均する派も
- 事前学習データ:ImageNet-21k や JFT-300M の規模が必要
- データ拡張:RandAugment, MixUp, CutMix が効く
- 正則化:Stochastic Depth, Label Smoothing
ViT 派生:自己教師あり手法
- DINO (2021):自己蒸留型、 ラベル無しで強い特徴
- MAE (2022):パッチの 75% をマスクして復元
- BEiT (2021):BERT 様、 トークン予測
- iBOT (2021):DINO + MAE
- SimMIM (2021):シンプルなマスク予測
軽量化アプローチ
- MobileViT:エッジデバイス向け
- EfficientFormer:iPhone でも動く
- Distillation:DeiT 様の蒸留
- Pruning:注意ヘッドの剪定
- Quantization:INT8 推論
理論を理解した次は、 実務に落とし込むためのノウハウが重要です。 SSDSE-B のような身近なデータで小さく試し、 動かしながら学ぶことで体得できます。 失敗してもコストは小さく、 学びは大きい。
🎯 拡充ロードマップ — Vision Transformer(ViT)を深掘る 10 のテーマ
2020 年 Google が発表した Vision Transformer(ViT)は、 「畳み込みを使わずに画像分類で SOTA」という衝撃の論文でした。 ここから先は、 ViT がなぜ機能するのか・CNN と何が違うのか・SSDSE-B-2026 のような統計データから生成した「グラフ画像」を ViT で分類するならどう設計するか、 を一つひとつ実例で解きほぐします。
- テーマ 1:Patch Embedding — 画像を「単語」に変換する魔法
- テーマ 2:Position Embedding — Transformer に「位置」を教える
- テーマ 3:Self-Attention の詳細 — Query/Key/Value のダンス
- テーマ 4:Multi-Head Attention — 複数の「視点」を並列で持つ
- テーマ 5:CLS トークン — 画像全体を 1 ベクトルに凝縮する仕組み
- テーマ 6:CNN vs ViT — Inductive Bias の違い
- テーマ 7:SSDSE-B-2026 を画像化して ViT で分類する仮想シナリオ
- テーマ 8:データ量の壁 — ViT が「数百万枚」を要求する理由
- テーマ 9:DeiT / Swin Transformer / MAE — ViT 系譜の進化
- テーマ 10:計算コストと推論最適化
🗺 追補 E:ViT の概念マップ
[入力画像 224x224x3]
   │
   ▼
[Patch Embedding] ── 16x16 パッチ × 196個 + CLS = 197 tokens
   │
   ▼
[+ Position Embedding] ── (197, 768) 学習可能
   │
   ▼ × 12 layers
[Transformer Encoder Block]
   │  ├─ LayerNorm
   │  ├─ Multi-Head Self-Attention (12 heads × 64 dim)
   │  ├─ Residual Add
   │  ├─ LayerNorm
   │  ├─ MLP (768 → 3072 → 768, GELU)
   │  └─ Residual Add
   │
   ▼
[CLS トークン抽出] ── (1, 768)
   │
   ▼
[Classification Head] ── Linear(768, num_classes)
   │
   ▼
[ロジット → softmax → クラス確率]

派生:
  ├─ DeiT       (知識蒸留 + Distillation Token)
  ├─ Swin       (階層ウィンドウ Attention)
  ├─ MAE        (75% Mask 自己教師あり)
  ├─ DINO/v2    (自己蒸留)
  ├─ CLIP-ViT   (テキストと対照学習)
  └─ DiT        (拡散モデル backbone)
❓ 追補 F:ViT に関する FAQ
Q1:ViT は本当に CNN より良いのか?
A:データ量・タスク・解像度・推論コストの 4 軸で考えるべき。 大規模事前学習 + ファインチューニングのフローなら ViT が一般に優位。 リアルタイム性が必要・モバイル端末・少データでは CNN(ConvNeXt 含む)が依然強い。
Q2:パッチサイズはなぜ 16×16 が標準なのか?
A:(1) 224÷16=14 で整数になる、 (2) 196 トークンは Transformer の計算量として現実的、 (3) 8×8 にすると 784 トークンで Attention が 16 倍になる、 (4) 32×32 にすると 49 トークンで情報粒度が荒くなる、 のバランス。 ViT-B/8、 ViT-L/14、 ViT-H/14 などの派生も存在。
Q3:解像度を変更したら何が起こる?
A:パッチ数が変わり、 位置埋め込みも同期して補間する必要がある。 timm では resolution 引数や interpolate_pos_embed でケアされている。 224→384 の高解像度推論で精度が 1〜2 pt 上がる例が多いが、 計算量は約 3 倍に膨らむ。
Q4:ViT を医療画像(X 線・CT)に使うときの注意点は?
A:(1) 医療画像はグレースケールで 3ch 複製、 (2) 解像度が高い(512×512 以上)ため Swin か Token Pruning を検討、 (3) クラスバランスが極端なので focal loss や class-balanced sampling、 (4) Attention 可視化で「病変領域に注目しているか」を必ず確認、 (5) Domain Generalization で施設間のスキャナ差を吸収。
Q5:ViT に CNN の前処理(Stem Conv)を加えるハイブリッドはどうか?
A:「Early Convolutions Help Transformers See Better」(Xiao+ 2021) で実証済み。 浅い CNN で局所特徴を抽出してから ViT に渡すと、 訓練の安定性と精度が同時に向上。 Swin の最初の数層も似た構造。 実務では timm の vit_*_resnet* ハイブリッドモデルが手軽。
Q6:ViT は GPU メモリをどれくらい使う?
A:ViT-B/16 を 224×224、 バッチ 32 で訓練すると ~6 GB(FP32)、 ~3 GB(mixed precision)。 ViT-L で 13 GB、 ViT-H で 24 GB を超える。 大規模モデルでは Gradient Checkpointing と DeepSpeed ZeRO を組み合わせるのが定石。
🔗 隣接手法への橋渡し
Vision Transformer (ViT) は画像認識のディープラーニングモデルで、 以下と接続する。
- 上流 (前処理): 画像前処理 (224x224 リサイズ・正規化)、 パッチ分割 (16x16 → 196 トークン)、 データ拡張 (RandAugment, MixUp)
- 並列 (代替モデル): CNN (ResNet, EfficientNet)、 Swin Transformer (階層的)、 ConvNeXt、 CNN-ViT ハイブリッド
- 下流 (応用): 画像分類、 物体検出 (DETR)、 セグメンテーション (SETR)、 画像生成 (DiT)、 マルチモーダル (CLIP)
ViT は 2020 年 Dosovitskiy らが NLP の Transformer を画像に転用、 JFT-300M で事前学習 + ImageNet ファインチューニングで CNN を上回った。 小データでは事前学習済モデルの fine-tuning が必須 (timm ライブラリで容易)。
🌳 手法選択フロー
Vision Transformer を使うべきかは「データ規模」と「計算資源」で決まる。
- 学習データ規模は? N>1M → ViT を一から学習可、 N<1M → 事前学習済 ViT を fine-tune 必須 (timm/transformers ライブラリ)
- GPU メモリは? 24GB+ → ViT-Large/Huge 可、 8-16GB → ViT-Base、 4GB 以下 → ViT-Small or CNN を選択
- タスク種別は? 分類 → ViT で十分、 物体検出 → DETR や Deformable DETR、 セグメンテーション → SETR や Mask2Former
- 解釈性が必要か? Yes → Attention Map で「どこを見ているか」可視化、 Grad-CAM も使用可
- 本番推論速度は? 遅い → CNN や MobileViT、 速い → ViT (バッチ処理が効く)
CNN との使い分け: 小データ・低リソース → CNN、 大データ・転移学習活用 → ViT。 SSDSE のような統計データ分析からはやや遠いが、 衛星画像から都道府県特性を抽出する応用などで関連する。
🧭 解説深化①:直感をもう一段 ── 「画像=単語列」という発想転換
ViT の核心は「画像を小さなパッチに切り、 各パッチを 1 つの単語(トークン)とみなして列に並べ、 自然言語用の Transformer にそのまま流す」という一点に尽きます。 CNN が畳み込みフィルタで局所受容野を少しずつ広げ、 層を重ねて初めて大域的な関係に到達するのに対し、 ViT は自己注意(Self-Attention)によって1 層目からすべてのパッチ同士を直接結び付けます。 「犬の頭」パッチと「犬の尻尾」パッチが画像の対角にあっても、 距離ゼロで注意を張れる — これが大域的関係を最初から捉えるという意味です。
入力を組み立てる要素は 3 つだけです。 上の『🎨 直感で掴む』『📐 定義』を踏まえ、 直感の言葉で言い換えると次のようになります。
- パッチ埋め込み(Patch Embedding):各 16×16 パッチを平らに伸ばし、 線形射影 $E$ で D 次元ベクトルに変換。 「ピクセルの塊」を「単語ベクトル」に翻訳する辞書引きに相当。
- 位置埋め込み(Position Embedding):自己注意は並び順を区別しない集合演算なので、 「このパッチは左上/中央」という空間情報を足し込む。 上の『🎮 インタラクティブ実験(c)』のシャッフルで、 これが無いと順序が失われる様子を体感できる。
- クラストークン(CLS トークン):全パッチの情報を 1 本に集約する「議長」役の特殊トークン。 最終層でこの 1 ベクトルだけを分類ヘッドに渡す。 BERT の [CLS] を画像に持ち込んだもの。
一言でいえば:CNN は「近くから順に理解する近視眼」、 ViT は「最初から全体を見渡す代わりに、 どこが大事かを大量のデータから学び取る遠視眼」。 この違いが、 次の落とし穴(データ効率)に直結します。
⚠️ 解説深化②:落とし穴の深掘り ── なぜ ViT は「気軽に使えない」のか
上の『⚠️ よくある落とし穴』を、 原因の階層に踏み込んで整理します。 多くの失敗は「ViT の弱い帰納バイアス」という 1 つの根から派生しています。
まとめ:落とし穴 1〜5 は独立の注意点ではなく、 「弱い帰納バイアス → データで補う → 事前学習必須・計算量増大」という 1 本の因果でつながっている。 だからこそ「大規模事前学習済モデルを転移する」という運用が ViT のデフォルトになります。
🚀 解説深化③:発展 ── ViT の弱点を埋めた後継たち
上の『🌐 ViT 系譜の進化』『📚 追補 D:歴史』と重複しない切り口で、 「どの落とし穴を、 どの発展系が解決したか」という対応関係で整理します。
| 発展の方向 | 代表手法 | 埋めた ViT の弱点 |
|---|---|---|
| ハイブリッド(CNN+ViT) | Early-Conv ViT, CoAtNet, LeViT | 局所特徴の取りこぼし・訓練の不安定さ(落とし穴 5)を、 前段 CNN の局所帰納バイアスで補う |
| 階層型 | Swin Transformer, PVT | O(N²) の計算量(落とし穴 2)を、 ウィンドウ内注意+階層ダウンサンプルで実質線形に |
| 自己教師あり事前学習 | MAE(マスク再構成), DINO/DINOv2(自己蒸留) | ラベル付き大量データへの依存(落とし穴 1・4)を、 ラベル不要の事前学習で緩和 |
| データ効率化 | DeiT(知識蒸留) | JFT-300M への依存(落とし穴 1)を、 蒸留で ImageNet-1k のみ学習に |
| マルチモーダル | CLIP(画像-テキスト対照学習) | 固定クラス分類の限界を超え、 ゼロショット認識・意味検索へ拡張 |
CNN との帰納バイアス比較という視点:発展の歴史は「ViT に局所性をどう取り戻すか(ハイブリッド・階層型)」と「データ依存をどう減らすか(自己教師あり・蒸留)」の 2 軸で読み解けます。 一方 ConvNeXt のように「CNN 側を ViT 風の設計思想で現代化して肉薄する」逆方向の流れもあり、 両者は収束しつつあります。
🧪 発展の直感を掴む合成例(架空データ)
下は架空の説明用イメージです(実データではありません)。 8×8 の合成グリッドを ViT と Swin 風ウィンドウ注意で処理したときの「1 パッチが直接注意を張れる相手の数」を比較します。 概念理解のための架空の数値であり、 実測ではありません。
| 方式(架空の 8×8 合成グリッド, パッチ=1セル, N=64) | 1 パッチが直接見る相手数 | 注意計算の規模感 |
|---|---|---|
| CNN(3×3 局所受容野) | 最大 9(近傍のみ) | O(N) |
| ViT(全パッチ注意) | 64(全て) | O(N²)=約 4096 |
| Swin 風(4×4 ウィンドウ内) | 16(同ウィンドウ内) | O(N)=ウィンドウ×16 |
この架空比較のとおり、 Swin は「全パッチ注意(大域)」を捨てて「ウィンドウ内注意+層をまたぐ移動窓」で大域性を段階的に回復し、 計算量を抑えます。 上の『🎮 実験』の CNN/ViT 切替と合わせて眺めると、 3 方式のトレードオフが直感的に見えてきます。
🔗 解説深化④:関連ページへの導線
本ページの理解を深めるために、 用語集内の関連ページを役割別に整理しました(すべて実在ページへのリンク)。
- 母体・核心:Transformer(ViT が転用したアーキテクチャ) / Attention(自己注意)(Q/K/V の数学的核心)
- 比較対象:CNN(強い帰納バイアスとの対比。 落とし穴 1・5 の裏返し)
- タスク領域:画像分類 / 画像認識(ViT が主戦場としてきた応用)
- 事前学習の発展:自己教師あり学習(MAE / DINO の理論基盤。 落とし穴 1・4 への処方箋)
- マルチモーダル応用:CLIP / マルチモーダル(ViT を画像エンコーダに使う代表例)