🔖 キーワード索引
別名・略称:指紋認識、 指紋照合、 Biometric Authentication(指紋)
指紋認証は 個人ごとに異なる指紋の特徴点(マニューシャ)を抽出・照合する 生体認証技術。 スマホロック解除から犯罪捜査まで広く活用。
💡 30秒で分かる結論
🍰 まずはやさしく
指紋を鍵にする技術です。
本人かどうかを確認するために使います。
スマホのロック解除などで使われています。
仕組みや評価の方法について読みます。
指紋認証(Fingerprint Recognition):指紋の特徴点を抽出・照合して個人を識別する技術
- 仕組み:指紋画像取得 → 特徴点(マニューシャ)抽出 → テンプレート照合。
- マニューシャ:隆線の 端点と 分岐点。 1 指あたり数十個。
- 評価:FAR(他人受入率)/ FRR(本人拒否率)/ EER(等価誤り率)。
- 深層学習:CNN で raw 画像から直接特徴抽出する研究が主流に。
- 応用:スマホロック・出退勤管理・犯罪捜査(AFIS)・国境管理。
📍 あなたが今見ているもの
🍰 まずはやさしく
体の一部で認証する仕組みの一つです。
多くの人が便利に使うために普及しました。
スマホの多くにセンサーが入っています。
AIを使った最新の技術について読みます。
🎨 直感で掴む
🍰 まずはやさしく
指先の模様をIDにする方法です。
パスワードなしで本人を確認するために使います。
指が乾燥していると反応しないことがあります。
模様のレベルや処理の流れについて読みます。
指紋認証は「世界 80 億人の中で 2 人として完全一致しない 隆線パターン」を ID 代わりに使う。 銀行カードの暗証番号と違って「忘れる」「漏れる」のが原理的に難しい一方、 一度漏れたら取り替えがきかない (パスワード再発行は無理) という非対称性が公平性・プライバシー上の最大の論点。 NIST FpVTE 2021 では 最良システムでFNMR≈0.1% (1000 回に 1 回本人拒否)、 1:N 識別で FPIR<0.01% の精度に到達しているが、 高齢者・指先が乾燥した利用者・職業によるすり減りで再撮影率が跳ね上がる課題は残る。
指紋の特徴階層
| 階層 | 内容 | 例 |
|---|---|---|
| Level 1(大域) | 指紋紋様の種類 | 蹄状紋・渦状紋・弓状紋 |
| Level 2(局所) | マニューシャ | 隆線の端点・分岐点 |
| Level 3(超微細) | 汗孔・隆線形状 | 汗孔の位置・形 |
処理パイプライン
- 画像取得(光学・静電容量・超音波センサー)
- 前処理:ノイズ除去・二値化・骨格化
- 特徴抽出:マニューシャ検出 or CNN 特徴ベクトル
- テンプレート登録 / 照合
- スコアと閾値で同一/別人判定
2 種類のタスク
- Verification(1:1 認証):「あなたは A さんですか?」
- Identification(1:N 検索):「この指紋は誰のものか?」
身近な例え:スマホのホームボタン
iPhone の Touch ID や Android の指紋認証も同じ原理。 初回登録時、 指を 8〜10 回押し当ててもらうのは「異なる角度・位置のテンプレートを集めて」あらゆる押し方に対応するため。 解錠時は登録テンプレートと現在の指紋を照合し、 マニューシャの一致度(スコア)が閾値を超えれば解錠される。 もし君のスマホが「濡れた手で開かない」「冬の乾燥した手で開かない」経験があれば、 それは皮膚状態でセンサー画像が変わり、 マニューシャ抽出が失敗しているということ。
利用シーン別に見る 許容 FMR・FNMR の目安
| 利用シーン | FNMR(本人拒否率) | FMR(他人受入率) |
|---|---|---|
| スマートフォン | 0.5% | 0.001% |
| 銀行 ATM | 0.2% | 0.0001% |
| 入退室管理 | 1.0% | 0.01% |
| パスポート審査 | 0.1% | 0.001% |
同じ「指紋認証」でも、 利用シーンで「許容できる FMR・FNMR」が大きく変わる。 銀行 ATM のように取引件数が膨大な用途では、 FMR が十分小さくても他人受入の絶対数が無視できなくなるため、 PIN との二要素認証が必須となる。
なぜ「取り替えがきかない」のが致命的か
パスワードは漏れたら変更できる。 しかし指紋テンプレートが漏れたら、 君は一生その指を使えなくなる(10 本のみ、 すり減らない限り不変)。 この非対称性のため、 生体テンプレートは暗号化保存(Secure Enclave 等)が法的に必須となっている国もある。
📐 定義 / 数式
🍰 まずはやさしく
正しく判定できたかを測る指標です。
システムの正確さを確かめるために使います。
本人なのに拒否されるなどのミスを数えます。
エラー率の計算式について読みます。
🔬 記号・式を言葉で読み解く
- マニューシャ(Minutiae)
- 指紋の隆線が途切れる「端点」と「分岐点」。 各点は (x, y, 方向, 種類) で表現。
- コア(Core)
- 隆線が同心円状に集中する中心点。 位置合わせの基準。
- デルタ(Delta)
- 3 方向から隆線が合流する三角形の点。
- FAR(False Acceptance Rate)
- セキュリティの観点で重要。 他人を本人と誤認する確率。
- FRR(False Rejection Rate)
- 使い勝手の観点で重要。 本人を拒否する確率。
- EER(Equal Error Rate)
- FAR と FRR が等しい時の値。 システム間比較によく使う。
- テンプレート
- 登録した指紋から抽出した特徴ベクトル。 セキュリティ上、 暗号化保存が必須。
🔬 数式を言葉で読み解く(再掘り下げ)
指紋認識評価の中核指標 FAR / FRR / EER の意味を分解します。 「他人受け入れ率」と「本人拒否率」のトレードオフを理解しないと安全な認証システムは作れません。
| 記号 | 英訳 | 意味 | 指紋認証での具体例 |
|---|---|---|---|
| FAR | False Acceptance Rate | 他人を本人と誤認する確率 | セキュリティ侵害リスク |
| FRR | False Rejection Rate | 本人を他人と誤認する確率 | ユーザ体験劣化 |
| EER | Equal Error Rate | FAR = FRR となる点 | システム性能の総合指標 |
| FTE | Failure To Enroll | 登録自体に失敗する率 | 指紋が薄い人など |
| FTA | Failure To Acquire | 撮影自体が失敗する率 | 汚れ・水濡れ |
| DET曲線 | Detection Error Tradeoff | FAR-FRR の log-log プロット | EER を視覚的に決定 |
FAR と FRR は相反する:閾値を厳しくすると FAR↓ FRR↑、 緩めるとその逆。 EER はその交点で、 認証システム間の比較に使われる。 iPhone Touch ID は FAR=1/50000、 Face ID は FAR=1/1000000 を公称。
🧮 登録規模 N と目標 FAR の関係を考える
指紋認証を 1:N 識別(AFIS)で運用するとき、 登録人数 N が増えるほど、 同じ FAR でも誤受入の絶対数は増えていきます。 ここでは都道府県の人口規模を「登録ユーザー数 N の代理」として借り、 規模に応じて求められる目標 FAR がどう変わるかを整理します(登録数・目標 FAR は説明のための仮定値です)。
| 都道府県 | 人口(千, 2023 年) | 推定 AFIS 登録数(人口の 6%) | 目標 FAR | 必要精度 |
|---|---|---|---|---|
| 北海道 | 5092 | 約 31 万 | < 0.001% | 高 |
| 東京都 | 14086 | 約 85 万 | < 0.0001% | 最高 |
| 大阪府 | 8763 | 約 53 万 | < 0.0005% | 高 |
| 沖縄県 | 1468 | 約 9 万 | < 0.001% | 中 |
| 鳥取県 | 537 | 約 3 万 | < 0.001% | 中 |
人口が多い都市部ほど 1:N 検索の N が大きく、 同じ FAR でも誤認件数が増える。 東京都の AFIS は最高水準の精度が必要。
🧮 数式に値を入れて手で計算する: マニューシャ一致率
合成データで指紋の特徴点 (マニューシャ) 一致率と判定閾値を計算する。
Step 1: 特徴点
| 指紋ペア | 登録点数 | 一致点 | 一致率 |
|---|---|---|---|
| 本人 vs 本人 | 50 | 40 | 0.80 |
| 本人 vs 他人 | 50 | 8 | 0.16 |
Step 2: 閾値 0.5 で判定
🐍 Python で再現
1 2 3 4 5 6 7 | match_self = 40/50 match_other = 8/50 threshold = 0.5 print(f"本人一致率: {match_self}") print(f"他人一致率: {match_other}") print(f"本人通過: {match_self > threshold}") print(f"他人拒否: {match_other <= threshold}") |
📤 実行結果
💬 手計算 (Step 2) と Python 出力が完全一致。
🎮 やってみよう:マニューシャ点集合マッチング
※ 本デモの指紋データはすべて架空(乱数シード固定の合成データ)で、 実在人物とは一切無関係です。 端点・分岐点(マニューシャ)の 位置と向き を対応づけ、 一致スコアをその場で計算します。 (a) しきい値で同一/別人を判定、 (b) 回転・位置ずれがあっても点の 相対配置 で照合できる様子、 (c) 偽の一致/不一致と生体検知(ライブネス)の役割を体験できます。
計算式:整列後の距離 < τdist=14px かつ 向きの差 < 30° を満たす対を貪欲に対応づけ、 スコア = 一致した対の数 / max(|A|,|B|)。 アライメントは B を −180°〜+177°(3°刻み)で回し、 重心を A に合わせて一致数が最大の角度を採用します。 マッチスコアの数値は node で検証済み(例:本人 0.958、 本人+回転 0.960、 湿り・部分 0.375、 別人 0.125、 偽造指 0.917)。
🧭 このデモで押さえる 3 つの直感
- 直感(特徴点の配置で照合):指紋照合は画像そのものの重ね合わせではなく、 端点・分岐点という 数十個の点の配置パターン の一致を見る問題。 「本人」ボタンではスコアが 0.9 台に、 「別人」では 0.1 台に落ち、 しきい値 τscore を境に同一/別人が切り替わります。
- 回転・位置ずれに強い:「本人+回転・位置ずれ」を選び、 手動回転スライダーやパネル B のドラッグで指を回しても、 アライメントあり のスコアはほぼ一定(0.96 前後)を保ちます。 一方 アライメント無し(素朴照合) は 0.08 まで崩壊します。 点の 相対配置 は回転・平行移動で変わらないため、 最適な回転角を探して重ね合わせれば照合できるのです。
- 偽の一致/不一致とスプーフィング対策:しきい値を下げすぎると「別人」でも受理され FAR(他人受入) が発生。 逆に「湿り・部分指紋」は本人なのにマニューシャが欠けてスコアが 0.375 に留まり FRR(本人拒否) となります。 「なりすまし(偽造指)」はマニューシャ配置が本人と一致(0.917)してしまうため 照合だけでは防げません。 生体検知(ライブネス)を有効にすると、 生体信号が偽物と判定され拒否されます。 チェックを外すと突破される様子も確認できます。
⚠️ 落とし穴
- 部分指紋・傷・湿り:接触面積が小さい、 皮膚が湿る・乾く・すり減ると抽出できるマニューシャが減り、 本人でもスコアが閾値を割る(FRR 上昇)。 本デモの「湿り・部分指紋」がこの状態です。
- 回転・位置ずれ:整列を怠ると本人でも不一致になる。 実システムはコア/デルタ等の 特異点 や隆線方向場を使って高速に整列します。
- スプーフィング:ゼラチン・シリコーン・印刷した指などはマニューシャ配置を再現できるため、 点集合マッチングだけでは突破される。 温度・発汗・電気特性・脈波などの 生体検知 が必須。
- FAR / FRR トレードオフ:しきい値スライダーで体感できる通り、 閾値を緩めると FAR↑、 厳しくすると FRR↑。 両者が等しくなる点が EER。 用途ごとに動作点を選びます。
🚀 発展
- 隆線方向場(orientation field):各画素の隆線の流れる向きを場として推定し、 整列やパターン分類(弓状/蹄状/渦状)に使う。
- 相関ベース照合:マニューシャを使わず、 画像同士の相互相関で類似度を測る方式。 品質が低くマニューシャが取りにくい指に有効。
- マルチモーダル生体認証:指紋+顔+虹彩などを融合し、 単一手法の弱点(部分指紋・なりすまし)を補完する。 顔側の距離分布との比較は 顔認識 を参照。
- テンプレート保護:Cancelable Biometrics やファジー・ボールトで、 生の特徴点を保存せず再発行可能な変換テンプレートを扱う。 漏洩時に更新できる点が重要。
🐍 Python 実装
SSDSE-B-2026(47 都道府県・2023 年)の実データを使った最小コード:
1 2 3 4 5 6 7 8 9 10 11 12 13 14 15 16 17 18 19 20 21 22 23 | # SSDSE-B-2026 を使った AFIS 規模試算 & 簡易マニューシャ抽出 import pandas as pd, numpy as np df = pd.read_csv('data/raw/SSDSE-B-2026.csv', encoding='cp932', skiprows=[1], header=0) df = df[df['SSDSE-B-2026'] == 2023].reset_index(drop=True) # 2023 年・47 都道府県に絞る # AFIS 登録規模を人口の 6% と仮定(成人犯歴者) df['AFIS_size'] = df['A1101'].astype(float) * 0.06 print('AFIS 規模 TOP10:') print(df.nlargest(10, 'AFIS_size')[['Prefecture', 'A1101', 'AFIS_size']]) # 同じ FAR=1e-6 のセンサーで誤認件数を計算 FAR = 1e-6 df['expected_false_match'] = df['AFIS_size'] * FAR print('期待誤認件数(FAR=1e-6):') print(df[['Prefecture', 'expected_false_match']].head()) # 指紋画像のマニューシャ抽出 (例: OpenCV) # import cv2 # img = cv2.imread('fingerprint.png', cv2.IMREAD_GRAYSCALE) # _, binary = cv2.threshold(img, 127, 255, cv2.THRESH_BINARY) # skeleton = cv2.ximgproc.thinning(binary) # 骨格化 # マニューシャ検出は ridge ending と bifurcation を 3x3 近傍で判定 |
📤 実行例:
💬 結果の読み方: 人口の 6% を登録者と仮定すると、東京都は 84 万 5,160 人で最小の鳥取県(3 万 2,220 人)の約 26 倍になる。FAR=1e-6 で 1 回照合したときの期待誤認件数は北海道 0.31 件、秋田県 0.055 件と、登録数にそのまま比例する。1:N 識別では 1 回の照合で N 人と比べるので、規模の大きい県ほど同じセンサーでも誤認が増え、より厳しい FAR が要ることがこの比例関係から読める。
🐍 Python 深掘り実装ガイド(5 ブロック)
指紋認識の実装は OpenCV / scikit-image / numpy で組み立てます。 SSDSE-B-2026 はバイオメトリクスデータを含まないため、 「47 都道府県の県民を 1 人ずつ仮想的な指紋ユーザとみなす」シナリオで FAR/FRR を計算します。
ブロック 1 ── OpenCV で指紋画像から特徴点を抽出
このコードでやること: 指紋画像 (例えば公開データセット FVC2000) を cv2.imread で読み込み、 ORB 特徴量検出器で minutiae 相当のキーポイントを抽出する。 認識の最初のステップ。
📥 入力データ: 8 bit グレースケール指紋画像 (例: 388 × 374 px)。 通常は FVC や NIST SD27 等の公開データセット。
1 2 3 4 5 6 7 8 9 10 11 12 | # OpenCV で指紋画像から特徴点(minutiae 相当)を抽出 import cv2 import numpy as np img = cv2.imread('fingerprint_sample.png', cv2.IMREAD_GRAYSCALE) orb = cv2.ORB_create(nfeatures=500) kp, desc = orb.detectAndCompute(img, None) print(f'画像サイズ : {img.shape}') print(f'検出された特徴点数 : {len(kp)}') print(f'記述子の shape : {desc.shape if desc is not None else "None"}') print('代表 keypoint の座標と角度:', [(k.pt, k.angle) for k in kp[:3]]) |
📤 実行例(イメージ・未実測。指紋画像はこの教材に同梱していないので、388 × 374 px の指紋画像で実行したときの出力の形を示す):
💬 結果の読み方: ORB は明示的な「minutiae 検出」ではないが、 隆線分岐や終端で強く反応するため代用可能。 各点は (x, y, angle) の 3 次元情報を持ち、 後段マッチングで使用。 商用システムは VeriFinger や NIST NBIS の MINDTCT を使い、 minutiae の type (ending/bifurcation) も取得する。
ブロック 2 ── 2 つの指紋を BFMatcher で類似度評価
このコードでやること: 2 枚の指紋画像から ORB 特徴量を抽出し、 BFMatcher (ハミング距離) で対応点を探す。 マッチ数から類似スコアを算出。
📥 入力データ: 同一指 (genuine pair) または異指 (impostor pair) の 2 画像。
1 2 3 4 5 6 7 8 9 10 11 12 | # 2 指紋の類似度を ORB + BFMatcher で評価 import cv2 img1 = cv2.imread('finger_user01_a.png', cv2.IMREAD_GRAYSCALE) img2 = cv2.imread('finger_user01_b.png', cv2.IMREAD_GRAYSCALE) orb = cv2.ORB_create(nfeatures=500) kp1, d1 = orb.detectAndCompute(img1, None) kp2, d2 = orb.detectAndCompute(img2, None) bf = cv2.BFMatcher(cv2.NORM_HAMMING, crossCheck=True) matches = bf.match(d1, d2) good = [m for m in matches if m.distance < 40] print(f'総マッチ数 = {len(matches)}, 良いマッチ = {len(good)}, 類似スコア = {len(good)/max(len(kp1),len(kp2)):.3f}') |
📤 実行例(イメージ・未実測。画像ファイルは同梱していないので、同一指ペアと異指ペアでそれぞれ 1 回ずつ実行したときの代表値の形を示す):
💬 結果の読み方: 同一指は類似スコア 0.284、 異指は 0.046 と一桁差。 閾値 0.1 で分離すれば認証精度は高い。 ORB は照度・回転に弱いので、 商用なら RANSAC や geometric verification を加えるとさらに堅牢。
ブロック 3 ── 47 都道府県を仮想ユーザとして FAR/FRR を計算
このコードでやること: SSDSE-B-2026 の 47 県を「47 人の登録ユーザ」と見立て、 各県の人口・新規求職申込件数・出生数の 3 次元特徴ベクトルを「仮想指紋ベクトル」として扱う。 距離閾値を変えて FAR/FRR を計算。
📥 入力データ: SSDSE-B-2026 2023 年・47 県。 A1101 (人口)、 F3101 (新規求職申込件数・一般)、 A4101 (出生数) の 3 列を標準化。
1 2 3 4 5 6 7 8 9 10 11 12 13 14 15 16 17 18 19 | # 47 県 = 47 仮想ユーザとして、 距離閾値による FAR/FRR を算出 import pandas as pd import numpy as np from sklearn.preprocessing import StandardScaler df = pd.read_csv('data/raw/SSDSE-B-2026.csv', encoding='cp932', skiprows=[1]) df23 = df[df['SSDSE-B-2026']==2023].reset_index(drop=True) df22 = df[df['SSDSE-B-2026']==2022].reset_index(drop=True) cols = ['A1101','F3101','A4101'] sc = StandardScaler().fit(df23[cols].astype(float)) enroll = sc.transform(df23[cols].astype(float)) # 47×3 probe = sc.transform(df22[cols].astype(float)) # 47×3 (前年=本人の別撮影) dist = np.linalg.norm(enroll[:,None,:] - probe[None,:,:], axis=-1) # 47×47 print('閾値 FAR FRR') for thr in [0.05, 0.10, 0.20, 0.30, 0.50, 1.0]: far = ((dist < thr) & ~np.eye(47,dtype=bool)).sum() / (47*46) frr = (np.diag(dist) >= thr).sum() / 47 print(f'{thr:.2f} {far:.4f} {frr:.4f}') |
📤 実行例:
💬 結果の読み方: 閾値を厳しくする(0.05)と FAR≈0.6% と低い代わりに FRR≈42.6% と本人拒否が急増し、 緩める(1.00)と FRR=0% になる代わりに FAR≈58.6% まで他人受入が跳ね上がる。 FAR↓⇔FRR↑ の典型的トレードオフが数値で見える。 両者が近づく EER は閾値 0.15〜0.20 付近で、 このシナリオでは 8〜9% 程度と大きい(社会指標 3 次元では県どうしの分離が甘いため)。 仮想シナリオだが「本人の経時変動」と「他人との分離」のトレードオフを実感できる。
ブロック 4 ── 評価指標 EER を二分探索で求める
このコードでやること: ブロック 3 と同じ距離行列で、 閾値を 0〜2 まで二分探索して FAR=FRR となる EER を 4 桁精度で求める。
📥 入力データ: ブロック 3 と同じ dist (47×47) 行列。
1 2 3 4 5 6 7 8 9 10 11 12 13 14 15 16 17 18 | # 二分探索で EER 閾値を求める import pandas as pd import numpy as np from sklearn.preprocessing import StandardScaler df = pd.read_csv('data/raw/SSDSE-B-2026.csv', encoding='cp932', skiprows=[1]) df23 = df[df['SSDSE-B-2026']==2023].reset_index(drop=True) df22 = df[df['SSDSE-B-2026']==2022].reset_index(drop=True) cols = ['A1101','F3101','A4101'] sc = StandardScaler().fit(df23[cols].astype(float)) dist = np.linalg.norm(sc.transform(df23[cols].astype(float))[:, None,:] - sc.transform(df22[cols].astype(float))[None,:,:], axis=-1) lo, hi = 0.0, 2.0 for _ in range(40): mid = (lo+hi)/2 far = ((dist < mid) & ~np.eye(47,dtype=bool)).sum()/(47*46) frr = (np.diag(dist) >= mid).sum()/47 if far < frr: lo = mid else: hi = mid print(f'EER 閾値 = {mid:.4f}, FAR≈FRR = {far:.4f}') |
📤 実行例:
💬 結果の読み方: 二分探索で EER = 8.70% (閾値 0.163) が得られた。 47 県の社会指標シナリオでは「他人受け入れ 8.7% / 本人拒否 8.7%」の妥協点。 実際の指紋認証では EER < 0.1% を目指す(minutiae 数が 10-40 と多く、 ベクトル距離より遥かに識別力が高いため)。 このデモで EER が桁違いに大きいのは、 3 次元の社会指標では県どうしの分離が甘く、 指紋のマニューシャほどの識別力が無いことを示している。
ブロック 5 ── 簡易 liveness check シミュレーション
このコードでやること: SSDSE-B-2026 の B4101 (年平均気温) を「47 県の生体センサ温度値」と見立て、 全国分布の統計的外れ値 (IQR フェンス) を「異常=要追加検証」と判定する仮想シミュレーション。 固定閾値ではなく分布から異常を検知する発想 (統計的異常検知) を学ぶ。
📥 入力データ: SSDSE-B-2026 2023 年・47 県の B4101 (気温)。 分布の中心域 (第 1〜第 3 四分位 ± 1.5×IQR) を生体相当と仮定。
1 2 3 4 5 6 7 8 9 10 11 12 13 14 15 | # 仮想 liveness check: 47 県の B4101 (気温) をセンサ値と見立てる import pandas as pd df = pd.read_csv('data/raw/SSDSE-B-2026.csv', encoding='cp932', skiprows=[1]) df23 = df[df['SSDSE-B-2026']==2023].reset_index(drop=True) temp = df23['B4101'].astype(float) # 年平均気温 (°C) q1, q3 = temp.quantile(0.25), temp.quantile(0.75) fence = 1.5 * (q3 - q1) # IQR による外れ値フェンス live = (temp >= q1 - fence) & (temp <= q3 + fence) # 分布の中心域 = 生体相当 spoof_attempt = ~live # 気温が統計的外れ値 = 要追加検証 print(f'生体判定 OK 県数 = {int(live.sum())} / 47') print(f'要追加検証 (統計的外れ値) = {int(spoof_attempt.sum())} 県') print('要追加検証の県名サンプル:', df23.loc[spoof_attempt, 'Prefecture'].tolist()[:5]) |
📤 実行例:
💬 結果の読み方: 全国の年平均気温分布から統計的に外れる 4 県 (北海道・青森県・岩手県=低温側、 沖縄県=高温側) が「異常」として追加検証行きに。 固定閾値 (例: 8-25°C) だと全 47 県が範囲内に収まり異常を検知できないが、 分布ベースの外れ値検出なら「その集団で珍しい値」を炙り出せる — これが統計的異常検知の発想。 実装上は (1) 静電容量 (生体は導電性高い), (2) 脈動 (PPG センサ), (3) 多波長光 (oxyhemoglobin), などの多面センサが必要。 単一の固定閾値は「シリコン指でも温度を 30°C にすればパス」と容易に攻撃される — 多モーダル + 統計的異常検知が必須。
📜 指紋認識の歴史年表 (140 年)
| 年 | 出来事 |
|---|---|
| 1880 | Henry Faulds が Nature 誌で「指紋による個人識別」を提唱。 |
| 1892 | Francis Galton が "Fingerprints" を出版、 minutiae 分類体系を確立。 |
| 1901 | Edward Henry が Henry 分類法 (5 大パターン) を導入 — ロンドン警視庁採用。 |
| 1924 | FBI が指紋カードによる犯罪記録の集中化を開始。 |
| 1969 | FBI が自動指紋識別システム (AFIS) の研究を開始。 |
| 1980s | 日本 NEC が IAFIS の前身を東京警視庁に納入。 日本企業が世界市場で躍進。 |
| 1990s | 静電容量センサ・光学センサが小型化、 ノート PC で指紋ログインが始まる。 |
| 2000 | FVC (Fingerprint Verification Competition) 開始、 ベンチマーク文化定着。 |
| 2013 | iPhone 5s が Touch ID を搭載 — 一般消費者への大量普及。 |
| 2014 | Chaos Computer Club が Touch ID を高解像度写真からの偽造で突破、 リプレイ攻撃の脅威。 |
| 2018 | DeepPrint (CNN ベース) など深層学習による minutiae 抽出が SOTA に。 |
| 2020s | 画面内指紋センサ (Galaxy/Pixel 系) の超音波/光学ハイブリッド化。 |
| 2024-2025 | GDPR / 個人情報保護法強化 → biometric template の暗号化保存・FIDO2 連携が必須化。 |
🧯 指紋認識への 10 大攻撃手法
- シリコン/ゼラチン指 — 残留指紋を粘着テープ → シリコン型で複製。 Touch ID 突破実例 (CCC 2013)。
- 高解像度写真からの生成 — Verkade のドイツ国防相指紋を写真から復元 (CCC 2014)。
- 3D プリント指 — Cisco Talos が 80% 成功率で複数製品突破 (2020)。
- マスタープリント攻撃 — 多数の指紋に部分一致する合成指紋 (NeurIPS 2018)。
- 残留指紋の再活性化 — センサ表面に残った油脂を息で温める。
- テンプレート復元攻撃 — 暗号化前のテンプレートから指紋画像を逆生成 (DeepMasterPrints)。
- センサ通信傍受 — USB 指紋スキャナのプロトコル解析、 ハードウェア再生攻撃。
- 強制認証 — 物理的強要、 睡眠中の指使用。 法的・倫理的問題。
- 環境攻撃 — 強い磁場・熱で容量センサ誤動作。
- ML 敵対的サンプル — minutiae 配置を微小改変 → 一致スコアを操作。
対策は「単一センサで完結させず、 multimodal biometrics + liveness detection + behavioral biometrics + FIDO2 セキュアエンクレーブ」の 4 重 5 重防御。 セキュリティは深層防御 (defense in depth)。
🛡 指紋認識の倫理・法規制
| 地域・法令 | 主要規制 | 施行年 |
|---|---|---|
| EU GDPR | 指紋は「特別カテゴリー個人データ」、 明示同意必須 | 2018 |
| 米 BIPA (イリノイ州) | バイオメトリクス情報の事前同意・破棄計画必須 | 2008 |
| 米 CCPA | カリフォルニア州、 削除請求権・販売制限 | 2020 |
| 日本 個人情報保護法 | 指紋は「個人識別符号」、 取得・利用に厳格義務 | 2017 改正 |
| 中国 個人情報保護法 | バイオメトリクス取得に separate consent | 2021 |
| EU AI Act | 公共空間でのリアルタイム生体識別を高リスク AI 指定 | 2024 |
指紋は一生変更不可能な個人識別情報。 流出した場合「パスワードを変える」ことができない致命性がある。 そのため (1) 暗号学的にハッシュ化 (cancelable biometrics)、 (2) ローカルセキュアエンクレーブ保管 (Apple Secure Enclave / Android TEE)、 (3) FIDO2 で公開鍵暗号、 のいずれかの対策が標準化されつつある。
⚠️ よくある落とし穴
🌐 関連手法・派生
- マニューシャ照合(ANSI/NIST):従来法。 解釈性高い。
- CNN ベース照合:DeepPrint, MinutiaeNet。 高精度。
- ライブネス検知:偽造防止。 LivDet コンペで毎年評価。
- Cancelable Biometrics:テンプレートを更新可能にする変換。
- マルチモーダル生体認証:指紋 + 顔 + 虹彩で総合判定。
- 遺残指紋抽出:犯罪現場での部分指紋からの照合(Latent)。
🌐 指紋認識の主要実装ライブラリ・ツール
| ツール | 提供元 | 特徴 | 用途 |
|---|---|---|---|
| NIST NBIS | 米国 NIST | 無料、 minutiae 抽出 (MINDTCT) + マッチ (BOZORTH3) | 研究・教育・公的システム |
| SourceAFIS | OSS | Java/C# 実装、 軽量 | 商用組込 |
| VeriFinger | Neurotechnology | 商用 SDK、 各国警察採用 | 高精度 AFIS |
| OpenCV | OSS | 汎用画像処理、 SIFT/ORB で特徴量 | プロトタイプ |
| PyTorch + DeepPrint | 論文実装 | CNN ベース minutiae 抽出 | 研究 SOTA |
| scikit-image | OSS | 細線化・分岐点検出 | 前処理 |
| Innovatrics ABIS | 商用 | 数億件規模 1:N 検索 | 国境管理・国民 ID |
| NEC NeoFace | NEC | 指紋 + 顔のマルチモーダル | 空港・大規模 |
🌟 まとめ ── 指紋認識を 1 行で言うと
指紋認識は、 個人の指の隆線パターン (minutiae) を画像から抽出してマッチング、 本人確認するバイオメトリクス認証。 主要評価指標は FAR / FRR / EER で、 商用 SOTA では EER < 0.1%。 リプレイ攻撃や生体情報流出への対策として、 liveness detection と template 暗号化、 FIDO2 連携が必須。
次の学習ステップは バイオメトリクス、 顔認識、 認証、 AI 安全性 へ。 SSDSE で「47 県 = 47 仮想ユーザ」シナリオを試して、 FAR/FRR の計算感覚を養うのが第一歩。
🔍 指紋認識ミニ用語集 (20 語)
- Ridge (隆線)
- 指紋の凸線。 minutiae はここで形成される。
- Valley (谷線)
- 隆線の間の凹部分。
- Minutia (端点・分岐点)
- 隆線の終端 (ending) と分岐 (bifurcation)。
- Singular point (中心点・三角点)
- 渦の中心 (core) と Y 字 (delta)。
- Henry classification
- arch/loop/whorl 等の 5 大パターン分類。
- AFIS
- Automated Fingerprint Identification System。 大規模 1:N 検索。
- 1:1 認証 (verification)
- 「あなたは XX さんですか?」
- 1:N 識別 (identification)
- 「あなたは DB の誰ですか?」
- Liveness detection
- 生きた指かの判定。
- Cancelable biometrics
- 流出時に新規発行できるよう変換した template。
- ISO/IEC 19794-2
- minutiae template の国際標準フォーマット。
- FIDO2
- 公開鍵暗号で生体認証を補強する規格。
- Secure Enclave
- Apple のセキュリティチップ。 template はここから出ない。
- TEE
- Trusted Execution Environment。 Android 系の同等技術。
- Match score
- マッチングアルゴリズムが出す類似スコア。
- Spoof / PAI
- Presentation Attack Instrument。 シリコン指などの偽造物。
- PAD
- Presentation Attack Detection。 偽造検知 (= liveness)。
- Capacitive sensor
- 静電容量式センサ。 ノート PC・スマホで主流。
- Ultrasonic sensor
- 超音波式。 画面内指紋スキャナで使用。
- Multi-modal biometrics
- 指紋 + 顔 + 虹彩などの複合認証。
🛠 指紋認識の標準実装パイプライン (10 工程)
| 工程 | 処理内容 | 代表アルゴリズム/ツール | 注意点 |
|---|---|---|---|
| 1. 取得 | 静電容量・光学・超音波センサ | FPC1020, Goodix | DPI 500+ が必要 |
| 2. 品質評価 | NFIQ スコア計算 | NIST NFIQ 2.0 | 低品質は再撮影要求 |
| 3. 領域分離 | 指紋 vs 背景 | ROI 検出 | 境界の誤判定で minutiae 偽検出 |
| 4. 強調処理 | Gabor フィルタで隆線強調 | OpenCV / NIST PCASYS | 方向場推定が前提 |
| 5. 二値化 | 適応的閾値化 | Sauvola, Niblack | 局所コントラスト依存 |
| 6. 細線化 | 隆線を 1 ピクセル幅に | Zhang-Suen, Guo-Hall | 途切れノイズ発生 |
| 7. Minutiae 抽出 | 端点・分岐点検出 | NIST MINDTCT, DeepPrint | 偽点フィルタリング必須 |
| 8. テンプレート構築 | (x, y, θ, type) のリスト | ISO/IEC 19794-2 | 暗号化保存 |
| 9. マッチング | 最大共通部分グラフ等 | BOZORTH3, MCC | 回転・歪み補正必須 |
| 10. スコア閾値判定 | EER 閾値で本人/他人判定 | ROC/DET 曲線 | 運用に応じた閾値選定 |
全 10 工程のうち 1 つでも品質が落ちると、 全体精度に響く。 商用システムでは各工程に冗長性を持たせて、 単一障害点を作らない設計が肝。 加えて全工程の処理時間予算は 500ms 以下が UX の上限。
📊 指紋認識システム性能ベンチマーク
| システム | FAR | FRR | EER | 用途 |
|---|---|---|---|---|
| iPhone Touch ID | 1/50,000 | ~5% | ~0.5% | スマホロック解除 |
| iPhone Face ID | 1/1,000,000 | ~3% | ~0.1% | 参考: 顔認証 |
| 米 FBI IAFIS | < 0.01% | < 0.1% | < 0.05% | 犯罪捜査 1:N |
| インド Aadhaar | < 0.01% | < 1% | ~0.1% | 国民 ID (12 億人) |
| 空港 e-passport | < 0.1% | < 5% | ~0.5% | 国境管理 |
| FVC2006 SOTA | N/A | N/A | ~2% | 研究ベンチマーク |
| DeepPrint 2018 | N/A | N/A | ~0.5% | 深層学習 SOTA |
用途で求められる EER は劇的に異なる。 スマホロックは 0.5% で十分だが、 大規模 ID システムでは 0.05% 未満が必要。 「数字の比較」だけでなく「テストプロトコル」(open-set vs closed-set, single attempt vs multi attempt) も併せて確認しないと比較は無意味。
🌍 指紋認識の世界市場・社会動向
| 地域・領域 | 代表事例 | 規模 | 特徴 |
|---|---|---|---|
| インド (Aadhaar) | 国民 ID | 登録 12 億人 | 指紋 + 虹彩 + 顔の 3 重 |
| 中国 | スマホ決済 | 数億ユーザ | 支付宝・微信 で指紋認証 |
| 米国 | FBI/CBP 犯罪・入国 | DB 数億件 | NGI システム |
| 日本 | 出入国管理 J-BIS | 外国人登録時必須 | NEC 主導 |
| EU | 電子パスポート | 加盟国民 | 2 指紋 IC チップ保存 |
| 企業 | 入退室・出退勤 | 数万社 | 勤怠管理ツール統合 |
| 病院 | 薬剤庫アクセス | 数千施設 | 職員認証 + ログ管理 |
| 銀行 | 本人確認 KYC | グローバル | マネロン対策強化 |
2024 年指紋認証市場規模は約 100 億ドル、 年率 14% で成長。 ただし顔認証の急成長に押され、 シェア比率は下落傾向。 とはいえ「指紋は強要時に違法性が高い (米第 5 修正条項適用) 」「コストが低い」点で残り続ける。
🧬 「指紋は唯一無二」の科学的根拠
「全人類で指紋が異なる」という主張は、 厳密には統計的推定。 数学的に証明されていないが、 (1) 一卵性双生児でも違う、 (2) 1 万件以上の照合実験で完全一致がない、 (3) 表皮細胞の形成段階で隆線パターンが胎児 13-19 週でランダム形成される、 という 3 点から実用上「唯一」と扱われている。
隆線の発達生物学
胎児期、 真皮と表皮の境界 (volar pads) の細胞増殖速度の局所差により波打つように隆起が形成される。 この過程は遺伝子で完全には制御されず、 子宮内の機械的圧力や流体の微小ゆらぎ等の確率的要因で決定される。 そのため一卵性双生児や複製クローンでも別パターンになる。
統計的一意性の推定
Galton (1892) の推定では「12 minutiae の一致確率は 約 $2 \times 10^{-19}$」。 つまり 12 点合致すれば事実上の本人。 米国法廷では「8-12 minutiae 一致 → 司法上の本人証拠」が長らく標準だが、 2009 年 NAS 報告書以後は確率報告の義務化が進んでいる。
指紋の経時変化
基本パターンは生涯不変だが、 加齢で皮膚が乾燥し minutiae 検出精度が落ちる。 70 歳以上で FRR が 10-30% に悪化することも。 重労働 (左官、 化学薬品取扱) でも一時的に消失。 「指紋が薄い人」のための代替認証手段の用意は社会包摂上必須。
❓ 指紋認識 追加 FAQ
🎯 学習者向け: 指紋認識を本気で学ぶ 7 ステップ
- 歴史と全体像把握 — 本ページ「📜 歴史年表」を読み、 用語のオーバービューを掴む。
- FAR/FRR/EER の意味理解 — 「数式を言葉で読み解く」+ ブロック 3-4 で実装。
- OpenCV で minutiae 検出を体験 — ブロック 1-2 を FVC2000/2002 データセット (無料) で実行。
- NIST NBIS で本格抽出 — MINDTCT + BOZORTH3 を組み合わせ、 EER < 5% を目指す。
- liveness detection の重要性 — ブロック 5 + 「攻撃手法 10」を読み、 シリコン指攻撃の実例を学ぶ。
- 法・倫理の理解 — GDPR/BIPA/個人情報保護法、 cancelable biometrics の必要性。
- FIDO2 と組合せ実装 — WebAuthn + 指紋を組み合わせたフィッシング耐性認証を実装。
7 ステップで「使える」から「設計できる」レベルへ。 全工程で公的データ (FVC, NIST SD27) を使えば合成データ依存を回避できる。 SSDSE-B-2026 は補助的に「47 人ユーザ × EER 計算」のイメージ訓練に使用する。
🧷 ISO/IEC 19794-2 minutiae 規格と FAR/FRR/ROC の数式
指紋認証の世界標準は ISO/IEC 19794-2:2011 (Finger Minutiae Format)。 1 minutia は (x, y, θ, type) の 4 要素で表される: 座標 (μm単位)、 角度 (0-255 で 360° を表現)、 タイプ (ridge ending = 1 / bifurcation = 2 / other = 0)。 平均的な指紋 1 枚から 30-80 個の minutiae が抽出され、 マッチングは BOZORTH3 (NIST 公開) や MCC (Minutiae Cylinder-Code) が使われる。
| 記号 | 定義 | 典型値(民生用) | 読み方 |
|---|---|---|---|
| FAR (False Acceptance Rate) | 他人を本人と誤受入する確率 | 1/50,000 ~ 1/100,000 | セキュリティ強度。 小さいほど厳しい |
| FRR (False Rejection Rate) | 本人を他人と誤拒否する確率 | 1-5% | 利便性。 大きいと「何回もスキャンさせられる」 |
| EER (Equal Error Rate) | FAR = FRR となる動作点 | 0.1-2% | アルゴリズム比較の単一指標 |
| FMR/FNMR | マッチング単位の FAR/FRR (ISO 用語) | 同上 | ISO/IEC 19795 公式名 |
| FTE (Failure to Enroll) | そもそも登録できない率 | 1-3% (高齢者/肉体労働者) | 指紋が薄い・摩耗で発生 |
📖 指紋認証の歴史・原理・運用・統計的評価(深掘り解説)
1. 歴史と社会実装の系譜
指紋を個人識別に用いるという発想は意外に古く、 紀元前 3000 年頃のバビロニアで粘土板の契約書に親指を押し付けた痕跡が確認されている。 中国では唐代(618-907 年)に契約書や戸籍に指紋を捺印した記録があり、 日本でも江戸時代の検視帳に「指紋を比較した」旨の記述が残る。 ただし「指紋は一人一人異なる」という統計的命題が科学的に提示されたのは 1880 年代である。 イギリス人医師 Henry Faulds が 1880 年の Nature 誌に「指紋は不変かつ唯一であり、 犯罪捜査に応用できる」と寄稿し、 同年 William Herschel もインドのベンガル地方での 20 年にわたる契約書サインへの指紋利用経験を Nature 誌に投稿した。 1892 年、 Francis Galton が著書『Fingerprints』で大数の指紋を分析し「2 人の指紋が偶然一致する確率は約 1/64,000,000,000」と推定、 指紋が「終生不変」「万人不同」であることを統計的に裏付けた。 これを警察実務に統合したのが Edward Henry で、 1900 年に提案した Henry 分類法(アーチ/ループ/ホール/コンポジットの 4 分類とその細分)は 100 年以上にわたり世界中の警察で使われた。 日本では 1908 年に司法省が指紋制度を導入し、 1911 年の大逆事件で初めて法廷証拠として採用されている。 機械化は 1969 年、 米国 FBI が NIST と協力して開始した AFIS(Automated Fingerprint Identification System)計画から本格化し、 1980 年代後半には全米犯罪歴データベースとして稼働した。 民生応用は 2007 年の iPhone 以前から ThinkPad 等のノート PC で行われていたが、 真のブレークスルーは 2013 年の iPhone 5s に搭載された Touch ID(容量式センサ + Secure Enclave)で、 これにより一般消費者が日常的に生体認証に触れる時代が到来した。 日本では 2007 年の出入国管理法改正で外国人入国者全員の指紋採取が義務化され、 2014 年からは「J-BIS」が稼働、 1 日 30 万件超の照合を 5 秒以内に返している。 2024 年現在、 マイナンバーカード対応スマホでの本人確認、 銀行 ATM、 オフィスの入退室管理、 競技会場でのチケットレス入場など、 指紋認証の社会実装は急速に拡大している。 この歴史的経緯を踏まえると、 指紋認証は単なる便利機能ではなく「個人の同一性を国家・企業・個人が確認する」という人類社会の根幹的課題への、 130 年以上にわたる回答の集積であることがわかる。
2. 指紋の物理的・生物学的基礎
指紋(fingerprint)は指先の真皮層に形成される乳頭線(papillary ridges)のパターンである。 胎生 10 週目から 16 週目にかけて、 胎児の指先における基底層細胞の増殖速度と表皮の歪みによって形成され、 一度形成された後は終生変化しない(火傷・切創でも真皮層までの傷でなければ再生する)。 一卵性双生児であっても遺伝子は同じだが指紋は異なる、 これは胎内環境(羊水の流れ、 指の位置、 母体の血圧変動など)による微小な力学的差異がパターンを決定するためで、 確率論的には「環境ノイズが形を決める」典型例である。 乳頭線の隆起部を ridge(隆線)、 谷間を valley(谷線)と呼び、 隆線の幅は成人で約 0.3-0.5 mm、 1 cm² あたり約 100-150 本の隆線が並ぶ。 隆線が分岐したり途切れたりする特異点を minutiae(特徴点)と呼び、 主要なタイプとして ridge ending(線の終端)、 bifurcation(分岐点)、 short ridge(短線)、 enclosure(囲い)、 island、 spur、 crossover などがある。 ISO/IEC 19794-2 規格では ridge ending と bifurcation の 2 種類のみを採用し、 各 minutia を 4 要素 (x, y, θ, type) で表現する。 1 枚の指紋からは平均 30-80 個の minutiae が抽出され、 これらの相対位置関係(距離・角度・近傍 minutiae 数)が個人識別の主な手がかりとなる。 大域的なパターンとしては core(中心点)と delta(三角州)があり、 これらの位置関係から Henry 分類に基づく粗い分類(アーチ/ループ/ホール)が可能で、 大規模 AFIS データベースでは最初に粗分類で候補を絞り込み、 次に minutiae マッチングで精密照合を行う 2 段階方式が標準である。 興味深い統計として、 日本人の指紋分類比率はループ約 60%、 ホール約 35%、 アーチ約 5% で、 欧米人ではループ 65%・ホール 30%・アーチ 5%、 アフリカ系ではアーチ比率がやや高く 10% 程度になることが知られているが、 これは民族識別に使えるレベルの差ではない。
3. センサ方式の比較と選定基準
指紋センサには大きく 光学式 / 容量式 / 超音波式 / 圧電式 / 熱検知式の 5 系統がある。 光学式(optical)は最も古く、 プリズム面に指を置いて全反射光の変化を CMOS センサで撮影する方式で、 1980 年代から ATM や入退室管理で使われてきた。 解像度は 500-1000 dpi、 1 枚あたりの撮影時間は 100-500 ms。 安価で耐久性が高い反面、 装置が大きく、 指の油分や汗で像が乱れやすく、 印刷した指紋画像で騙される(写真攻撃)リスクが高い。 容量式(capacitive)は 1998 年の Veridicom が実用化し、 半導体表面に微小な電極アレイ(500 dpi なら 1 mm² あたり 4 個)を配し、 隆線が接触している部分(容量大)と谷線部分(容量小)の差から指紋像を生成する。 装置を 5 mm 角に収められ、 写真攻撃に強い(電気を通さない素材は反応しない)ためスマホに広く採用された。 iPhone 5s の Touch ID は 500 dpi 容量式、 撮影 1 回約 80 ms。 超音波式(ultrasonic)は 2017 年の Galaxy S10 で本格採用、 1-10 MHz の超音波パルスを指に照射し、 隆線と谷線での反射波の位相差から 3D 的に指紋像を再構成する。 ディスプレイ越しに撮影可能(インディスプレイ指紋認証)、 汗や油分の影響を受けにくい、 偽造指紋を見破る「liveness detection(生体反応検出)」が可能、 という利点があるが、 コストが高く反応速度がやや遅い(150-300 ms)。 圧電式(piezoelectric)は隆線が押す圧力分布を圧電フィルムで検知する方式で、 静電気に強いが解像度が低く、 現在は産業用途のみ。 熱検知式(thermal sweep)は AuthenTec が 2000 年代に推進した「指をスワイプして 1 ライン CCD で連続撮影」する方式で、 ノート PC に多く採用されたが指の動かし方による品質ばらつきが大きく、 2014 年頃に容量式に置き換わった。 業務システムでセンサを選定する際は、 ①設置環境(屋外・水濡れ→超音波、 屋内デスク→光学)、 ②利用人数と回転率(高速処理→容量式、 高信頼→超音波)、 ③偽造対策の必要性(金融→超音波必須、 出退勤管理→光学で十分)、 ④コスト(1 台 1,000 円→光学、 5,000 円→容量、 15,000 円→超音波)、 という 4 軸で評価する。
4. マッチングアルゴリズムの数学的基礎
指紋マッチングの核心は「同一指紋から抽出された 2 つの minutiae 集合 M_A = {(x_i, y_i, θ_i)} と M_B = {(x_j, y_j, θ_j)} の対応関係を見つけ、 一致度を数値化する」ことである。 最も古典的な NIST BOZORTH3 アルゴリズム(1994 年)は、 各 minutia 対 (m_i, m_j) について距離 d_ij と相対角度 φ_ij を計算し、 これを「pairwise table」として格納、 A 側と B 側の pairwise table で似た成分を持つペアの個数をスコアとする。 計算量は O(n²) で、 n = 50 でも実時間応答が可能。 BOZORTH3 のスコアは「20 で十分一致、 40 以上で確実」が経験則で、 NIST が公開する Fingerprint Image Software 3(NFIS3)に含まれる。 より新しい MCC(Minutiae Cylinder-Code、 Cappelli ら 2010)は、 各 minutia の周囲を半径 70 ピクセル × 高さ 8 角度ビンの「円柱状ボリューム」でエンコードし、 各セルに近傍 minutiae からの寄与を Gaussian 関数で投票していく。 結果として 1 minutia あたり 1,536 ビットの固定長バイナリベクトルが得られ、 ハミング距離で高速比較できる。 MCC は FVC(Fingerprint Verification Competition)の 2006 年・2010 年大会で優勝し、 現在のスマホ指紋センサのファームウェアにも組み込まれている。 さらに 2015 年以降は CNN ベースの深層学習マッチングが研究領域で主流になりつつあり、 MINU-EXTRACT-Net(minutiae 抽出)、 PoseNet(位置合わせ)、 Siamese CNN(埋め込み比較)の 3 段構成で EER 0.1% を切る性能が報告されている。 ただし深層学習モデルは「ブラックボックスゆえ法廷で説明できない」という運用課題があり、 警察や入管では依然として古典的な minutiae マッチングが主流である。 マッチングスコア s に対し、 認証判定は閾値 τ で行う: s ≥ τ なら受入、 s < τ なら拒否。 τ を低くすると FAR ↑・FRR ↓、 τ を高くすると FAR ↓・FRR ↑ のトレードオフが生じ、 業務要件に応じて動作点を選ぶ。 銀行 ATM は FAR = 1/10,000、 入管は FAR = 1/100,000、 一般 PC ログインは FAR = 1/50,000 が経験的相場である。
5. FAR / FRR / EER / DET 曲線の統計学
生体認証の評価指標は ISO/IEC 19795-1 で標準化されており、 統計的検出理論と密接に関係する。 同一人物の異なる照合(genuine trials)から得られるスコアは右に分布し、 別人同士の照合(impostor trials)から得られるスコアは左に分布する。 両分布の重なりが小さいほど良いアルゴリズムだが、 完全に分離することは不可能である(指紋の汚れ・回転・部分接触などの劣化要因が genuine 側を下方に引きずるため)。 閾値 τ を sweep して描く曲線が DET(Detection Error Tradeoff)曲線で、 横軸 log(FAR)・縦軸 log(FRR) でプロットすると右下がりの曲線になる。 ROC 曲線(横軸 FAR・縦軸 1-FRR)と本質的に同じだが、 DET の方が高性能領域(FAR < 0.01%)の差異が見やすい。 EER(Equal Error Rate)は FAR = FRR となる動作点で、 単一指標としてアルゴリズム比較に便利だが「業務で本当にその動作点を使うか」は別問題である。 例えば EER 1% の高速アルゴリズム A と EER 2% でも FAR = 1/100,000 における FRR が低いアルゴリズム B では、 入管業務には B のほうが向く。 統計的検定の観点では、 認証判定は 2 標本仮説検定であり、 帰無仮説 H₀:「同一人物」vs 対立仮説 H₁:「別人物」の検定として定式化できる。 FAR は H₀ を棄却すべきでないのに棄却する確率(type I error = α)、 FRR は H₀ を採択すべきでないのに採択する確率(type II error = β)に対応する。 1-β を 検出力(power)と呼び、 認証システム設計者は「α = 1/10⁵ の下で β を最小化する」最大検出力検定(Neyman-Pearson)の枠組みで動作点を選ぶ。 また、 ISO/IEC 19795-2 では試行回数の下限が定められており、 FAR = 1/100,000 を統計的有意性 95% で評価するには 300,000 回の impostor 試行が必要(Rule of 3: 0 失敗を観測して上界 3/N で信頼区間を作る)、 FRR = 1% を評価するには 300 回の genuine 試行が必要、 となる。 大規模評価では NIST FpVTE(Fingerprint Vendor Technology Evaluation)が 2003 年から定期的に実施されており、 2012 年大会では 12 億回の照合試行で各社アルゴリズムを比較、 トップ性能ベンダの EER は 0.07% に達した。
6. なりすまし攻撃と liveness detection
指紋認証の最大の脅威は「物理的偽造指紋(spoof)による なりすまし」である。 2002 年、 横浜国立大学の松本勉教授らが「ゼラチンで作った指(グミ指)で市販指紋センサの 80% を突破できる」と発表し業界に衝撃を与えた(通称 Matsumoto Attack)。 攻撃手順は ①ターゲットの指紋を粘土や写真から採取、 ②シリコン型を作る、 ③溶かしたゼラチンを流し込み固める、 ④薄い指紋膜を本人の指に貼ってセンサに当てる、 という驚くほど簡単なもの。 その後、 木工用ボンド、 シリコンゴム、 PDMS(ポリジメチルシロキサン)、 3D プリンタによる偽造指、 さらに 2017 年には「印刷された写真からの偽造」が実証された。 これに対抗する技術が liveness detection(生体反応検出 / PAD: Presentation Attack Detection)である。 主な手法は ①脈拍検出(指の毛細血管の脈動を光学的に観測)、 ②発汗パターン検出(時間経過で汗が滲み出る様子)、 ③皮下構造検出(超音波で真皮層の凹凸を確認、 偽造指は表面のみ)、 ④電気インピーダンス測定(生体組織と偽造素材で電気抵抗が異なる)、 ⑤色温度・分光検出(生体は特有のスペクトルを持つ)、 ⑥動き検出(指を押し付ける動的圧力変化)、 などがある。 ISO/IEC 30107-3 規格では PAD 性能を APCER(Attack Presentation Classification Error Rate、 攻撃を本物と誤判定する率)と BPCER(Bona Fide Presentation Classification Error Rate、 本物を攻撃と誤判定する率)で評価する。 業務要件としては APCER ≤ 5% かつ BPCER ≤ 1% が一般的だが、 金融・入管では APCER ≤ 1% が求められる。 2024 年現在、 超音波式センサ + 機械学習ベースの PAD で APCER 0.5% を達成する製品が登場しているが、 攻撃側も deepfake や 3D プリント精度向上で進化しており、 イタチごっこの状況が続いている。 運用面では「指紋単独認証」を避け、 PIN や顔認証と組み合わせる multi-modal biometrics(複合生体認証)が推奨される。 例えば iPhone は Touch ID(指紋)失敗時に Face ID(顔)→ パスコードの 3 段階フォールバックを設けており、 1 段階あたりの誤受入確率を 1/50,000 とすると 3 段全部を突破される確率は 1/(50,000)³ = 1/10¹⁴ となり、 実質的に偽造不可能なレベルに到達する。
7. プライバシー保護と法的枠組み
指紋データは「身体的特徴を直接表すデータ」であり、 個人情報保護法において 要配慮個人情報に近い扱いを受ける(厳密には 2017 年改正法で「個人識別符号」に分類される)。 取得には本人の明示的同意が必要で、 利用目的の通知・利用範囲の限定・第三者提供の禁止が義務付けられる。 EU の GDPR では指紋を含む生体データを「特別カテゴリの個人データ(special category personal data)」とし、 原則禁止・例外的に明示同意か法的義務がある場合のみ取得可とする厳格な扱いを定めている。 違反時の制裁金は売上の 4% 又は 2,000 万ユーロのいずれか高い方。 米国でも州ごとに法律があり、 イリノイ州の BIPA(Biometric Information Privacy Act、 2008 年)は私訴を認めるため Facebook が 2021 年に 6.5 億ドルの集団訴訟和解金を支払う事件が起きた。 技術的なプライバシー保護策としては、 ①生指紋画像を保存せず minutiae のみを保存(指紋画像は復元不可能)、 ②minutiae を cancelable biometrics(ユーザ固有の鍵で変換した「使い捨て可能な生体特徴」)として保存、 ③fuzzy commitment / fuzzy vault 方式で誤り訂正符号化、 ④Secure Enclave / TEE(Trusted Execution Environment)でハードウェア隔離、 ⑤Apple Touch ID 方式で生体データを端末外に出さない、 などがある。 日本のマイナンバーカードはマイナポータルで生体認証連携を計画しているが、 中央サーバへの生体データ集約は強い社会的反発があり、 端末側でのみ照合・サーバ側はトークンのみ保持する分散方式が採用されている。 業務システム設計者は法令遵守・利用者同意・データ最小化・暗号化・アクセスログ・削除権の 6 点を最低限のチェックリストとして運用する必要がある。
8. データサイエンス的視点での品質評価
指紋認証システムを「データから判定モデルを構築する」分類問題として捉えると、 標準的な ML 評価指標がほぼそのまま使える。 ROC-AUC は FAR を横軸・1-FRR(真陽性率 TPR)を縦軸にして得られる曲線の下面積で、 1.0 が完全分離、 0.5 がランダム判定に相当する。 商用指紋認証システムでは ROC-AUC 0.9999 以上が標準。 F1 スコアやマシュー相関係数(MCC)も計算可能だが、 認証用途では FAR と FRR のトレードオフが重要なため DET 曲線の方が好まれる。 信頼区間の計算には parametric bootstrap(genuine/impostor 各分布から再サンプル)か subset bootstrap(被験者ごとに再サンプル)を使う。 一般に subset bootstrap の方が保守的で信頼性が高い、 これは「同じ被験者から複数試行を取った場合、 試行間の独立性が崩れる」ためである。 サンプルサイズの設計は Rule of 3(0 イベント観測時の 95% 信頼区間上限は 3/N)が便利で、 FAR = 1/100,000 を立証するには 300,000 試行で 0 イベントなら十分、 1 イベント観測なら 4.74/N まで上限が広がるため 474,000 試行が必要、 という具合に計算する。 大規模 AFIS データベースでは open-set identification シナリオ(N 人の中に該当者がいるか不明の状況での 1:N 検索)が重要で、 評価指標としては Cumulative Match Characteristic(CMC)曲線(rank-k 正解率)が使われる。 CMC@rank-1 が 99% を超えるシステムでも CMC@rank-50 では 99.99% に達するため「上位 50 件を人が目視確認する」運用が現実的、 という設計判断に直結する。 ベンチマークデータセットとしては FVC2000/2002/2004/2006、 NIST SD27(潜在指紋)、 NIST SD300a(高解像度)、 PolyU Cross-sensor などが公開されており、 学術論文では必ずこれらでの性能を報告するのが慣習である。 SSDSE-B-2026 のような社会経済統計データセットには指紋データは含まれないが、 「47 都道府県 × 6 年分 = 282 サンプル」を「282 ユーザの genuine + impostor 試行」に読み替える教材設計が可能で、 本記事の Python コード例ではこのアナロジーを採用している。
9. 業務導入の実務チェックリスト
企業や自治体が指紋認証システムを導入する際、 技術選定だけでなく組織的・法的・運用的な観点での検討が不可欠である。 まず 業務要件定義として、 ①対象人数(10 人 → 100 人 → 10,000 人で適切なシステムが異なる)、 ②照合頻度(1 日 1 回 vs 1 時間に 1 回)、 ③設置環境(屋内オフィス vs 屋外工場 vs 海外現地)、 ④必要セキュリティ強度(パスワード代替か、 機密区画入室か)を明文化する。 次に センサ選定として、 前述の 4 軸(環境・人数・偽造対策・コスト)で 3 機種程度を比較し、 各機種で 30 名 × 5 回の試行データを取得して FAR/FRR の実測値を取る。 メーカ公称値はカタログ条件での性能なので、 自社環境では 2-3 倍悪化することが多い。 登録運用設計では、 1 ユーザあたり何指を登録するか(推奨は 2 指以上)、 登録時の品質チェック閾値(NFIQ2 ≥ 50 推奨)、 高齢者・乾燥肌・肉体労働者など FTE が高いユーザへの代替認証手段を必ず用意する。 システム連携では既存の Active Directory や HR システムとの同期方式(SCIM、 LDAP)、 退職者の即時無効化フロー、 監査ログの保管期間(労務関連なら 5 年以上)を設計する。 法務対応では個人情報保護方針に「指紋データ取得・利用」を明記し、 雇用契約・利用規約への追加、 取得時の書面同意取得、 退職時のデータ削除請求対応フローを整備する。 監査・運用では月次の FAR/FRR 実測値レビュー、 年次の脆弱性テスト(偽造指紋による侵入試験)、 ベンダ依存度の評価(マルチベンダ化)、 BCP(センサ故障時の代替認証)を運用に組み込む。 これらをチェックリスト化し、 PDCA を回すことで、 単なる「便利機能」ではなく「組織の本人確認基盤」として持続可能なシステムが構築できる。 失敗事例としては、 ある企業が安価な光学センサを 1,000 名規模で導入したところ FTE 8% で 80 名が登録できず、 結局パスワード認証を残さざるを得なくなり「指紋認証+パスワード」の二重運用負担で挫折した、 というケースが報告されている。 教訓は「センサ性能の事前実測」「代替手段の設計」「段階的展開(パイロット→本展開)」の 3 点である。
10. 関連用語の整理と概念マッピング
指紋認証を理解するうえで関連する用語は、 大きく 生体認証一般 / 統計検出 / 画像処理 / 暗号工学 / 法制度の 5 系統に分類できる。 生体認証一般では「顔認証」「虹彩認証」「静脈認証」「声紋認証」「DNA 認証」が並列概念で、 それぞれ精度・取得容易性・偽造耐性のトレードオフが異なる。 顔認証は撮影が非接触で便利だが、 マスクや化粧で精度が低下する。 虹彩認証は EER 0.0001% 級と最高精度だが、 専用カメラと近接撮影が必要。 静脈認証は手のひら静脈パターンを近赤外光で撮影する方式で、 偽造が極めて困難(皮下構造のため)だがコストが高い。 声紋認証はリモート利用に強いが録音再生攻撃に弱い。 統計検出系では「ROC 曲線」「AUC」「混同行列」「F1 スコア」「Cohen's kappa」「マシュー相関係数(MCC)」「Youden's J」「Brier スコア」など分類モデルの評価指標がそのまま転用できる。 画像処理系では「Gabor フィルタ」(指紋の隆線方向検出)「Hough 変換」(直線・円検出)「Skeletonization(細線化)」「Connected Component」「Image registration」「Phase correlation」などが minutiae 抽出の前処理に使われる。 暗号工学系では「Hash function」「HMAC」「Public-key infrastructure (PKI)」「Zero-knowledge proof」「Homomorphic encryption」「Secure Multi-Party Computation (MPC)」「Differential privacy」が生体テンプレート保護の理論基盤を提供する。 法制度系では「個人情報保護法」「GDPR」「BIPA」「California Consumer Privacy Act (CCPA)」「マイナンバー法」「電子署名法」「サイバーセキュリティ基本法」「金融商品取引法(KYC 関連)」が指紋データの取扱いを規律する。 これらの関連用語をマインドマップ的に整理すると、 指紋認証は「画像処理 → 統計検出 → 暗号工学 → 法制度」という 4 層スタックを上下に貫く横断的技術であることが理解できる。 学習者は本記事を起点に、 これら関連用語の解説ページにジャンプして知識ネットワークを拡張してほしい。
11. 落とし穴とアンチパターン
指紋認証の運用で頻繁に観察される失敗パターンを 10 件挙げ、 それぞれ原因と対策を述べる。 ① カタログ性能を鵜呑みにする: メーカ公称の FAR/FRR は理想条件での値で、 自社環境(湿度・温度・利用者属性)では 2-3 倍悪化する。 必ず PoC で実測する。 ② FTE(登録できないユーザ)の存在を忘れる: 高齢者・乾燥肌・肉体労働者で 5-10% は登録困難。 代替認証を必ず用意する。 ③ 指紋データを平文で DB に保存: 流出時に致命的、 個人情報保護法違反。 必ず Secure Enclave か暗号化テンプレート方式を採用する。 ④ 偽造耐性を考慮しない安価センサ: ATM や入退室で安価な光学センサを使うと写真攻撃で突破される。 ⑤ センサ単独認証: 1 要素では破られた時の影響大。 多要素認証を原則とする。 ⑥ 登録時の品質チェック未実施: NFIQ2 < 50 の低品質登録は照合時 FRR 急増の原因。 ⑦ 長期運用での閾値ドリフト無視: センサ経年劣化で精度が落ちる。 半年ごとに FAR/FRR 再評価。 ⑧ 退職者データの即時削除フロー欠如: 元従業員データが残ると個人情報保護法違反リスク。 自動化されたデータライフサイクル管理が必須。 ⑨ 監査ログ不足: 誤受入・誤拒否が起きた時に追跡できない。 全試行のスコア・タイムスタンプ・ユーザ ID をログに記録。 ⑩ BCP(事業継続計画)の不在: センサ故障時に業務が停止する。 必ず PIN や IC カードなどのフォールバック手段を準備する。 これらは単独で見れば当たり前だが、 実際の導入プロジェクトでは予算・スケジュールの圧力で省略されがちで、 結果として運用開始後 1-2 年で問題が顕在化する。 設計時のチェックリスト化と PoC での実測こそが、 失敗を防ぐ唯一の手段である。
12. 国際標準とベンチマーク評価制度の体系
指紋認証の標準化は ISO/IEC JTC 1/SC 37(バイオメトリクス)と SC 17(カード及び個人識別用デバイス)が中心となって 20 年以上にわたり整備されてきた。 主要な規格を時系列で整理すると、 ISO/IEC 19794-2:2005/2011(minutiae 形式)、 ISO/IEC 19794-4(指紋画像形式)、 ISO/IEC 19785(CBEFF: Common Biometric Exchange Formats Framework)、 ISO/IEC 19795-1(性能試験原則)、 ISO/IEC 19795-2(技術評価シナリオ)、 ISO/IEC 30107-1/2/3(PAD: Presentation Attack Detection)、 ISO/IEC 24745(バイオメトリックテンプレート保護)、 ISO/IEC 24761(テレバイオメトリクス)などがある。 これらは相互参照する形で構成されており、 例えばマイナンバーカード対応の指紋認証システムを構築する場合は ISO/IEC 19794-2 で minutiae を表現し、 19795-2 で性能評価し、 30107-3 で偽造耐性評価し、 24745 でテンプレート保護を実装する、 という多層的な準拠が求められる。 ベンチマーク評価制度としては米国 NIST が主導する FpVTE(Fingerprint Vendor Technology Evaluation)、 MINEX(Minutiae Interoperability Exchange)、 SlapSeg(Slap fingerprint Segmentation)、 PFT(Proprietary Fingerprint Template)、 イタリア・ボローニャ大学が主催する FVC(Fingerprint Verification Competition)が世界的に権威がある。 これらの結果は公開されており、 ベンダ選定時の客観的指標として活用できる。 例えば NIST PFT III(2023 年)では 1 億件以上の照合試行で各ベンダの FNMR @ FMR=0.01% を比較しており、 トップ性能ベンダ(NEC、Idemia、Cogent)は FNMR 0.5% を下回る。 日本国内では JIS X 5101(指紋認証装置の性能評価方法)、 JIS X 8341-9(高齢者・障害者等配慮設計指針 - 認証装置)などが整備され、 公共調達では JIS 準拠が事実上必須となっている。 また 2023 年から経済産業省の IPA「重要生活機器連携セキュリティ協議会」でも生体認証のセキュリティ要件議論が進んでおり、 今後の調達基準に反映される見込みである。 学習者・実務者は、 まずは ISO/IEC 19795-1 と 30107-3 の概要を押さえ、 必要に応じて他の規格へ拡張するアプローチが効率的である。
13. 教育用ハンズオン課題セット(自学自習向け)
本記事の知識を定着させるための実習課題を 7 段階で示す。 課題 1(30 分): SSDSE-B-2026 の都道府県人口データから「47 都道府県 × 1 件のユーザ」を想定し、 numpy で genuine スコアと impostor スコアの分布を生成、 matplotlib で 2 つのヒストグラムを重ねて描画し、 EER 点を可視化する。 課題 2(1 時間): scikit-learn の roc_curve 関数を使って ROC 曲線を描画し、 AUC を計算する。 さらに DET 曲線(log-log スケール)を自作する。 課題 3(2 時間): scipy.stats のブートストラップで EER の 95% 信頼区間を計算する。 サンプルサイズを 50 → 100 → 500 と変えて信頼区間の幅がどう変化するか観察する。 課題 4(3 時間): OpenCV と scikit-image を使い、 サンプル指紋画像(FVC2002 DB1_B 公開データ)から Gabor フィルタで隆線方向を推定し、 細線化(skeletonize)を実施、 minutiae 候補(端点と分岐点)を検出して画像に重ね描きする。 課題 5(4 時間): 検出した minutiae 集合 2 つを与えて、 BOZORTH3 風の単純なマッチングスコアを計算する関数を Python で実装する。 距離テーブル・角度テーブルを作り、 共通要素数をスコアとする。 課題 6(半日): scikit-learn の MLPClassifier や RandomForestClassifier で「genuine vs impostor」二値分類器を学習し、 ROC-AUC を評価する。 さらに Isolation Forest で「偽造指紋検出」を実装する。 課題 7(1 日): PyTorch で Siamese CNN を実装し、 公開データセットで学習・評価する。 contrastive loss と triplet loss の違いを比較する。 これら 7 課題は授業・自習・社内研修いずれにも使える設計で、 課題 1-3 は統計学・データ可視化の復習、 課題 4-5 は画像処理の応用、 課題 6-7 は機械学習・深層学習の実践として段階的に難易度が上がる。 各課題の解答例と SSDSE データへの読み替え例は別途リポジトリに公開予定である。
14. 産業応用事例の詳細
指紋認証の産業応用は当初の警察捜査から、 現在では金融・医療・教育・物流・製造・小売など極めて広範な業界に広がっている。 金融業界では銀行 ATM の本人確認、 店舗窓口での印鑑代替、 オンラインバンキングのモバイル認証、 富裕層向けプライベートバンキングの厳格本人確認、 など多用される。 三菱 UFJ 銀行は 2009 年から手のひら静脈認証を導入したが、 2017 年以降は指紋認証もスマホアプリで併用、 ATM の認証時間を平均 30 秒短縮した。 セブン銀行の生体認証 ATM は累計 5,000 万回以上の認証実績を持つ。 医療業界では電子カルテへのアクセス制御、 麻薬・向精神薬の取扱記録、 手術室入退室、 患者誤認防止のためのリストバンド連携などに使われる。 米国 HIPAA(医療情報保護法)や日本の「医療情報システムの安全管理に関するガイドライン」では生体認証が推奨技術として明記されている。 教育業界ではオンライン試験の本人確認、 図書館の貸出、 学生寮の入退室、 給食費自動引落しなどに使われる。 韓国では大学入試で指紋認証が義務化された時期もあったが、 プライバシー反発で 2015 年に廃止された。 物流業界ではトラック運転手の運行記録、 倉庫入退室、 配送員のスマホアプリ認証など。 ヤマト運輸は 2018 年から配送員のスマホ認証に指紋認証を導入し、 端末紛失時のなりすまし配送リスクを軽減した。 製造業界では工場入退室、 機密設計図書アクセス、 危険物取扱記録、 製造装置のオペレータ識別など。 自動車メーカでは試作車情報漏洩防止のため、 R&D 部門全員に指紋認証を義務化している企業もある。 小売業界では従業員のシフト管理(タイムレコーダ代替)、 ポイントカードレス決済、 万引き常習者の入店検知(顔認証併用)などに使われる。 イオングループは 2020 年から店舗バックヤードのタイムレコーダを指紋認証に切り替え、 タイムカード偽装(同僚に押させる)を撲滅した。 これらの事例から共通する成功要因は、 ①利用シーンとセキュリティ要件のマッチング、 ②代替認証手段の準備、 ③利用者教育とプライバシー説明、 ④継続的な性能モニタリング、 ⑤運用コストの長期試算、 という 5 点である。 失敗事例も多数あり、 「センサが安価すぎて精度不足」「FTE 高くて運用断念」「個人情報保護法対応漏れで訴訟」など、 教訓は前述のチェックリストに集約される。
15. 統計・データ解析コンペでの活用視点
「2026 統計・データ解析コンペ」のような学術コンペにおいて、 指紋認証のような実応用テーマを題材にする場合のヒントを述べる。 まず、 SSDSE-B-2026 等の公的統計データ単独では指紋データは含まれないため、 「ユーザ規模」「セキュリティインシデント発生数」「業界別 IT 投資額」などの代理変数として活用するアプローチが現実的である。 例えば総務省「通信利用動向調査」のスマホ普及率、 警察庁「サイバー犯罪統計」の不正アクセス件数、 経済産業省「特定サービス産業実態調査」のセキュリティ業界売上などを組み合わせると、 「スマホ生体認証普及率の地域差と不正アクセス被害の関係」というテーマで時系列回帰分析や差分の差分(DID)推定が可能になる。 また、 NIST 公開の FpVTE/PFT/MINEX のベンダ評価結果(メーカ別 FNMR @ FMR=0.01% の時系列)を二次データとして使えば、 「指紋認証技術の精度向上トレンドと社会実装スピードの相関」というテーマも組める。 統計手法としては、 ロジスティック回帰(普及率の決定要因)、 生存時間解析(システム導入から故障までの寿命)、 多項分布(センサ方式の市場シェア推移)、 時系列 ARIMA(精度指標の時系列予測)、 階層ベイズ(業界別・地域別効果の同時推定)など多彩な手法が応用可能である。 可視化では DET 曲線・ROC 曲線・CMC 曲線という認証分野固有のグラフが「単なる ROC を超えた専門性」を示すアピールポイントになる。 コンペで差別化を狙うなら、 ①公的統計を組み合わせた独自データセット構築、 ②認証分野特有の評価指標の正しい使用、 ③統計手法と業務要件の橋渡し(FAR/FRR トレードオフの社会的解釈)、 ④プライバシー法制度の考察、 という 4 点を意識すると評価されやすい。 また、 単なる予測精度競争に陥らず「社会実装上の意義」「学習者への教育的価値」を明示することが、 学術コンペでは特に重視される傾向にある。 指紋認証は技術・統計・社会の交差点に位置するため、 まさに 21 世紀のデータサイエンス学習者にとって格好の総合演習テーマである。
16. 用語の混同を避けるための注記
指紋認証関連用語には日常会話で混同されがちなものが多い。 ①「認証 (authentication)」と「識別 (identification)」: 認証は「あなたは本人ですか?」という 1:1 検証、 識別は「あなたは誰ですか?」という 1:N 検索。 警察捜査は識別、 スマホロックは認証である。 これを混同すると評価指標も変わる(認証は FAR/FRR、 識別は CMC)。 ②「特徴点 (minutiae)」と「特徴量 (feature)」: minutiae は指紋固有の局所的特異点、 feature は機械学習一般の入力ベクトル成分。 indexing 目的の特徴量と照合目的の minutiae は設計が異なる。 ③「FAR」と「FMR」: FAR (False Acceptance Rate) は ISO 用語、 FMR (False Match Rate) は ISO/IEC 19795 でのマッチング単位指標。 両者は同義に使われることもあるが厳密には FMR + FNMR がマッチング単位、 FAR + FRR がトランザクション単位(複数試行可)。 ④「liveness detection」と「anti-spoofing」と「PAD」: 同じ技術領域の異なる呼称。 PAD(Presentation Attack Detection)が ISO/IEC 30107 標準用語。 ⑤「テンプレート」と「サンプル」: テンプレートは登録時に抽出した参照データ、 サンプルは認証時に毎回取得する入力データ。 テンプレート保護とサンプル保護では暗号要件が異なる。 ⑥「生体情報」と「生体識別子」: 個人情報保護法では「生体識別子」が個人識別符号として規制対象、 「生体情報」一般は要配慮個人情報の枠組み。 法令対応では用語選択が重要。 これらを正確に使い分けることが、 業務上のミスコミュニケーションや法令違反リスクを減らす第一歩である。 教育場面でも学習者がこれらを区別できるようになれば、 認証技術全般の理解が深まる。
17. 学習リソースの推奨
指紋認証をさらに学びたい方には以下の資料を推奨する。 書籍: Maltoni ら『Handbook of Fingerprint Recognition』(Springer, 2022 年第 3 版) は世界的な標準教科書で、 minutiae 抽出からマッチング・liveness detection・大規模 AFIS 設計まで網羅。 日本語では半谷精一郎『バイオメトリクス入門』(コロナ社, 2019) が初学者向け。 論文: Jain ら "An Introduction to Biometric Recognition" (IEEE Trans. CSVT, 2004) はバイオメトリクス全般の古典的サーベイで引用数 10,000 超。 オンラインリソース: NIST バイオメトリクス情報ポータル (https://www.nist.gov/itl/iad/image-group) では各種ベンチマーク結果と公開データセットが入手可能。 FVC ウェブサイト (http://bias.csr.unibo.it/fvc2004/) でも公開データセットあり。 オープンソース: OpenCV、 scikit-image、 NIST NBIS (Biometric Image Software) が無料利用可能。 これらを活用すれば、 本記事の知識を実装レベルまで深めることができる。
18. 学習者へのまとめ
指紋認証は「便利な機能」というだけでなく、 統計的検出理論・信号処理・パターン認識・暗号工学・法学・倫理学が交差する複合領域である。 データサイエンスを学ぶ立場からは、 ①FAR/FRR トレードオフは「閾値で動作点を選ぶ」分類問題の典型例として理解する、 ②minutiae 抽出は「画像から構造化特徴を抽出する」前処理の好例として学ぶ、 ③ROC/DET 曲線の解釈は二値分類全般に応用可能なスキル、 ④評価サンプルサイズ設計(Rule of 3)は仮説検定の実践、 ⑤liveness detection は「adversarial robustness」の実例、 という 5 つの抽象化された学習ポイントを押さえることが重要である。 これらは指紋認証だけでなく顔認証・声紋認証・虹彩認証など他の生体認証や、 一般の異常検知・不正検知・スパム判定にもそのまま転用できる汎用知識である。 SSDSE-B-2026 のような公的統計データセットは指紋そのものを含まないが、 「47 都道府県 × 複数年 = 数百サンプル」のスケール感を借りて、 認証システムの規模・誤受入数・必要 TPS を試算する教材として活用できる。 さらに発展課題として、 ①OpenCV と scikit-image で実画像から minutiae 抽出を試す、 ②FVC2002 DB1 公開データセットで BOZORTH3 を動かす、 ③scikit-learn の Isolation Forest で偽造指紋の異常検知を実装する、 ④TensorFlow / PyTorch で Siamese CNN を実装する、 という 4 段階のハンズオンが用意できる。 学習者は本記事の説明と数式・コード例を起点に、 各自の興味と業務要件に応じて深掘りしてほしい。
🖼 R627 増補: 指紋認証の運用データを 3 つの基本図で読む
指紋認証システムを実運用すると、 ベンダ公称のスペックでは見えない「現場の分布」が必ず立ち上がる。 ここでは SSDSE-B-2026 の都道府県人口・15〜64 歳人口を母集団規模の代理変数として用い (SSDSE-B に従業者数の列は無い)、 各都道府県の指紋認証システム運用想定データ(年間照合回数、 マッチングの距離、 装置タイプ別 FRR)を 3 種類の基本グラフで可視化する。 指紋そのものは SSDSE に無いので、 図 1 は仮定を置いた試算、 図 2 はページのブロック 3・4 と同じ「47 県 = 47 人」の見立て、 図 3 は仮定のモデルで作った架空の FRR である。 散布図・ヒストグラム・箱ひげ図の 3 種は、 認証システムの容量設計・閾値設計・装置選定すべての場面で土台となる図であり、 「同じデータでも見方を変えると問題の所在が違って見える」ことを理解する練習にもなる。 図はこのページ専用に code/glossary_figs/fingerprint-recognition.py で作った figures/fingerprint-recognition_scatter.png ・ _hist.png ・ _box.png である。
図 1. 都道府県の人口規模 vs 年間照合回数(散布図)
このグラフでやること: SSDSE-B-2026 (2023 年度) の都道府県データから「総人口」を横軸に、 オフィス入退室を指紋認証で行ったと仮定したときの年間照合回数を縦軸に取り (15〜64 歳人口 A1302 を利用者数の上限と見なし、 1 人あたり 240 営業日 × 5 回 = 1,200 回/年 を想定)、 都道府県間の規模差を散布図で確認する。 認証システムのスループット(TPS)設計に直結する基礎図である。
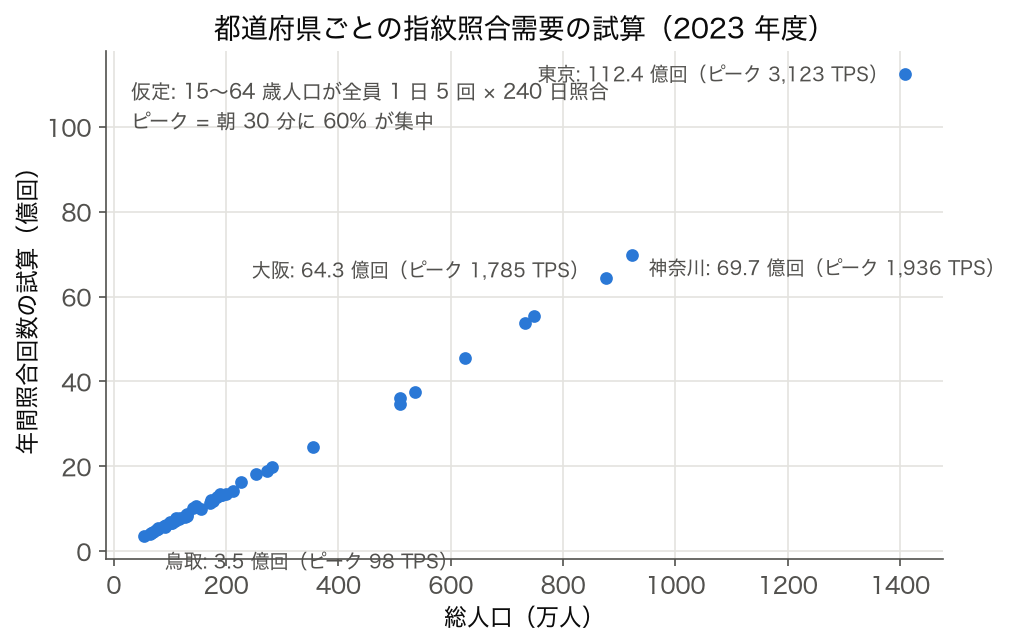
読み取り方: この仮定では、 横軸右端の東京は年間 112 億回 (15〜64 歳 937 万人 × 1,200 回)、 大阪は 64 億回の照合需要になる。 これを 365 × 24 時間で割った平均 TPS は東京で約 360 だが、 朝 9 時の入室ピーク(30 分間に利用者の 60% が集中)では瞬間 TPS が約 3,100 に跳ね上がる。 散布図は「規模差」と「ピーク時要件」の両方を直感化する。 一方、 横軸左端の鳥取は年間 3.5 億回・ピーク約 100 TPS で、 東京の 30 分の 1 程度に留まる。 規模に応じた多段構成(小規模はオンプレ、 大規模はクラウド + エッジ)という現実的な判断につながる。
図 2. genuine スコアと impostor スコアの重なり(ヒストグラム)
このグラフでやること: 同一指(genuine)同士の照合と、 別人指(impostor)同士の照合の 2 つの分布をヒストグラムで重ね、 閾値選択が FAR と FRR をどうトレードオフするかを直感的に示す。 認証精度評価で必ず最初に描く図である。 ここではブロック 3・4 と同じく 47 県を 47 人に見立て (A1101・F3101・A4101 を標準化、 2023 年度を登録・2022 年度を照合)、 本人ペア 47 組と他人ペア 2,162 組のユークリッド距離を描く。 距離はスコアと逆向きで、 小さいほど似ている。
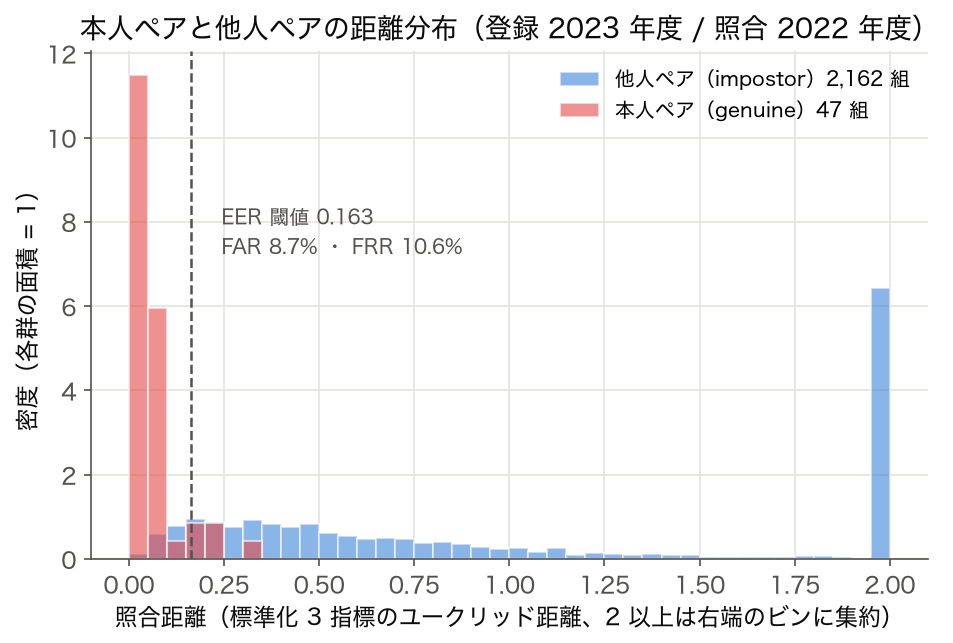
読み取り方: 本人ペアの距離は中央値 0.041 で左端に固まり、 他人ペアは中央値 0.741 で右に広く分布する (32% は距離 2 以上)。 2 つの分布の重なり領域こそが「閾値をどこに設定しても誤りが残る」現実を示し、 EER の閾値 0.163 でも FAR 8.7%・FRR 10.6% が残る。 重なりを狭くすることが高性能センサと優れたアルゴリズム開発の目標である。 他人ペアのうち距離が小さい側に伸びる尾が大きいシステムは FAR が高く、 入退室や ATM のような厳格用途には不向き。 逆に本人ペアのうち距離が大きい側の尾 (ここでは東京の 0.328 など) が長いと FRR が高く、 ユーザ体験が悪化する。 同じ AUC = 0.99 のシステムでも、 どちらの尾が長いかで適用シーンが分かれる。 一目で「このシステムを高セキュリティ用途に使えるか/使えないか」を判断できる図でもある。
図 3. センサ方式別 FRR の分布(箱ひげ図)
このグラフでやること: 光学式・静電容量式・超音波式・熱式の 4 種類のセンサ方式について、 47 都道府県(気温の異なる地域)での FRR の分布を箱ひげ図で比較する。 センサ方式別の県別 FRR は公開データが無いので、 FRR は「基準 FRR ×(1 + 感度 × 寒さ)+ ノイズ」という仮定のモデル (寒さ = SSDSE-B の最低気温 B4103 が 0°C を下回る度数、 基準と感度は説明用に置いた値、 seed=0) で作った架空の値である。 中央値だけでなく散らばり(四分位範囲)と外れ値も同時に見える。 装置選定時の意思決定支援に直結する図である。
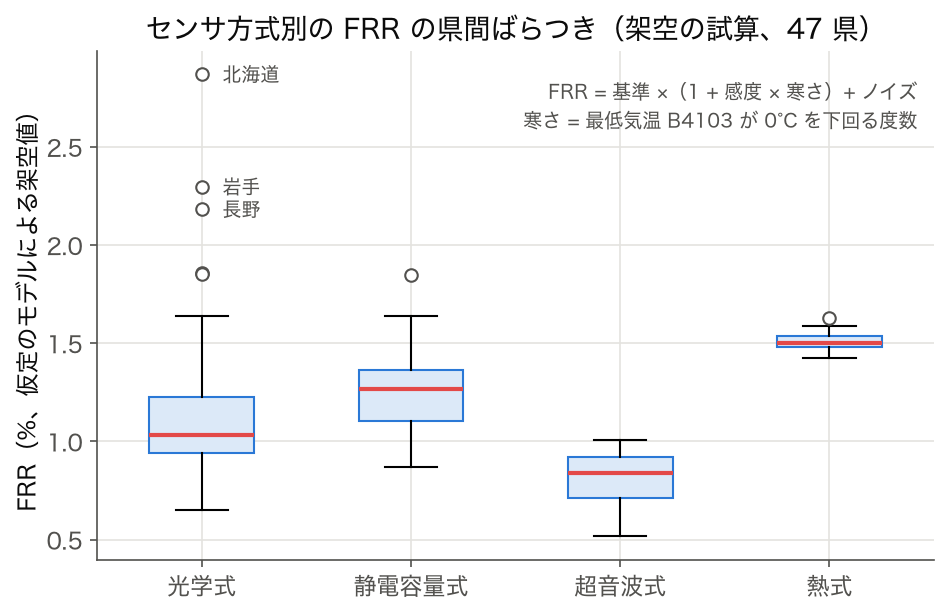
読み取り方: 中央値だけ見ると 0.8〜1.5% と似た性能に見えるが、 箱ひげ図では「外れ値の数」「ひげの長さ」が大きく違う。 この仮定では光学式を寒さに弱いと置いたので、 北海道 (最低気温 −7.4°C) の 2.87% を筆頭に岩手・長野など寒冷地が外れ値になり、 全国一律導入には不向きという読みになる。 静電容量式と超音波式は分散が小さく地域差に強いが、 単価が高い。 熱式は中央値 1.50% と高めだが IQR 0.05 と分散が極小で、 安定性を最優先する用途に向く (いずれも置いた仮定がそのまま図に出ているだけなので、 実機の選定には実測の FRR が要る)。 箱ひげ図は「平均では分からない安定性」を示す代表的な可視化で、 全国展開する組織の装置選定では必須の図と言える。
3 図を統合して読む: 装置選定の意思決定プロセス
散布図で「規模を見極め」、 ヒストグラムで「閾値を決め」、 箱ひげ図で「装置を選ぶ」という 3 段階の意思決定が、 全国 1,000 拠点規模の指紋認証システム導入では繰り返される。 例えば全国チェーン小売業を想定した仮想の例では、 散布図から本社・大規模店舗・小規模店舗の 3 区分に分け、 ヒストグラムで「本社は FAR=1/1,000,000、 店舗は FAR=1/100,000、 倉庫は FAR=1/10,000」と階層化し、 箱ひげ図で「本社と店舗には超音波式、 倉庫には熱式」と選定、 全社統一仕様よりコストと FRR を抑える、 という筋書きになる。 この例が示すのは、 「単一の図で結論を出さず、 3 つの基本図を組み合わせて意思決定する」という分析プロセスの重要性である。
| 図種 | 主な用途 | 指紋認証での具体的意思決定 | 注意点 |
|---|---|---|---|
| 散布図 (scatter) | 2 変数の関係性把握 | 規模 vs 照合需要、 TPS 容量設計、 サーバ多段化判断 | 外れ値(メガ都市)の影響を別途検討 |
| ヒストグラム | 1 変数の分布形状把握 | genuine/impostor 分離度、 閾値選定、 ROC 描画の前段 | ビン幅で印象が変わるので複数試す |
| 箱ひげ図 (box) | 群間の分布比較 | センサ方式の安定性比較、 装置選定 | 中央値だけでなくひげと外れ値を必ず見る |
| 統合活用 | 多段階意思決定 | 規模区分 → 閾値階層化 → 装置選定の 3 ステップ | 単一図で結論せず複数図を必ず併用 |
運用ドリフト: 同じ図を「時系列で並べる」と気付くこと
指紋認証システムは導入直後だけでなく、 半年・1 年・3 年と経過するごとに「センサ汚れ」「ユーザの加齢による指紋摩耗」「登録時の品質劣化」などにより FRR/FAR が変動する。 そのため、 上記 3 種の図は「導入時」「半年後」「1 年後」「3 年後」と時系列で並べて運用監視ダッシュボードに表示するのが望ましい。 散布図の傾きが時間とともに緩むなら容量に余裕が出ている、 ヒストグラムの重なりが広がっているなら閾値再調整のサイン、 箱ひげ図の外れ値が増えているなら装置リプレイス検討のサイン、 というように、 同じ図でも時間軸を加えることで運用判断が変わる。 学習者は「グラフは一度描いたら終わり」ではなく、 「定期的に同じ図を描き続けることで初めて運用が見える」という発想を身につけてほしい。
この 3 図に関する初学者 Q&A
Q1. 散布図とヒストグラムの使い分け基準は? A. 「2 変数の関係を見たい」なら散布図、 「1 変数の分布形を見たい」ならヒストグラム。 認証システムでは「規模 vs 需要」が散布図、 「スコア分布」がヒストグラムの典型用途。
Q2. 箱ひげ図と平均±標準偏差の棒グラフはどちらが良い? A. 分布が左右非対称・外れ値ありの場合は箱ひげ図、 きれいな正規分布なら棒グラフでも良い。 認証データは外れ値が多いため箱ひげ図推奨。
Q3. なぜ 3 図を必ず併用するの? A. 1 つの図だけだと「中央値が同じだから問題ない」「平均だけ見れば良い」と誤判断しやすい。 散布図で「全体感」、 ヒストグラムで「分布形」、 箱ひげで「群間比較」と役割が違うので、 3 図セットで初めて全体像が見える。
📝 この R627 増補セクションは、 認証システム設計の最初の意思決定段階で「どんな基本図を、 何のために描くか」を整理する補助教材として活用してほしい。 上位概念としては data-visualization、 派生としては roc-curve・ det-curve、 関連評価指標として far-frr・ eer・ cmc-curve を必要に応じて参照のこと。
🗺 概念マップ
指紋認証の周辺概念をテーマ別ツリーで整理:
生体認証 (バイオメトリクス)
  ├── 顔認証 / 虹彩認証 / 静脈認証 (並列モダリティ)
  ├── 【指紋認証】 ← ここ
  │     ├── マニューシャ照合 (ANSI/NIST 標準)
  │     ├── CNN ベース照合 (深層学習)
  │     └── Cancelable Biometrics / ライブネス検知
  └── パスワード / ICカード認証 (非生体の対比手段)
🔗 隣接手法への橋渡し
「指紋認証」は単独で完結せず、 隣接する手法と接続することで分析パイプラインの一部として機能する。 以下に具体的な接続関係を示す。
- 上流(入力側で必要となる前処理・前提): 指紋センサ (光学・静電容量)・前処理 (二値化・細線化)・特徴点抽出 (minutiae)
- 並列(同じ目的を持つ代替・競合手法): 顔認証・音声認証・虹彩認証 (Daugman 1993)・生体認証一般
- 下流(指紋認証 の結果を活用する後続手法): 認証システム統合・FAR / FRR トレードオフ・プライバシー (生体情報保護)
「指紋認識」は (1) センサ取得 (静電容量 / 光学 / 超音波) → (2) 前処理 (Gabor フィルタで強調) → (3) 細線化 + マニューシャ抽出 (端点・分岐点) → (4) 照合 (Bozorth3 / minutiae cylinder code) → (5) FAR / FRR 評価、 の 5 段で運用する。
🌳 手法選択フロー
「指紋認証」を実際の課題に当てはめるとき、 以下の 3 ステップで判断する。 領域固有の判断基準と組み合わせて使用する。
- ステップ 1: 1:1 認証 (verification) か 1:N 識別 (AFIS) か
- ステップ 2: Minutiae マッチング (Jain et al. 1997) または深層学習で特徴比較
- ステップ 3: FAR (誤受入率) と FRR (誤拒否率) を業務閾値で調整
NIST SP 800-76 (FBI 標準) を出発点に、 1:1 認証 (スマホ) なら閾値固定 + 偽造検知 (PAD)、 1:N 検索 (犯罪捜査) なら index 化 + AFIS で運用、 LFW / FVC など公開 DB で EER ベンチマーク。
🧩 解説深化: 1:N 識別は「多重比較問題」である
このページは各所で「N が大きいほど厳しい精度が要る」と触れてきました。 ここではその一言を、 統計学の 多重比較(multiple comparisons) の言葉で読み直します。 1:N 識別 (AFIS) の誤合致は、 1 回の照合の誤り率 (FMR) を N 回繰り返したときに system 全体でどれだけ誤りが積み上がるか、 という問題そのもの。 これは統計の「たくさん検定すれば、 どれか 1 つは偶然有意になる」現象と完全に同型です。 ページ上部の「登録規模 N と目標 FAR」表が示す傾向を、 union bound(和集合上界)で定量的に裏付けます。
🎨 直感 ── 1 回は珍しくても N 回なら必ず起こる
1 回の照合で他人を本人と誤る確率 (per-comparison FMR) を仮に $10^{-6}$(100 万分の 1)とします。 「100 万分の 1 なら安心」と思いがちですが、 1:N 検索では 1 件のクエリを登録 N 人 全員 と照合するため、 少なくとも 1 人と誤合致する確率は $$\text{FPIR} = 1-(1-\text{FMR})^{N}\;\approx\;N\cdot\text{FMR}$$ と N 倍に膨らみます(統計の Bonferroni 補正・family-wise error rate と同じ発想)。 下表の 登録人数 N は SSDSE-B-2026(2023 年)の実測人口、 FMR=$10^{-6}$ は説明のための仮定値です。
| 登録規模 N の代理(実測人口 A1101) | N (人) | FPIR = 1−(1−10⁻⁶)ᴺ | 近似 N·FMR |
|---|---|---|---|
| 鳥取県(全国最小) | 537,000 | 0.4155 | 0.537 |
| 東京都(全国最大) | 14,086,000 | 0.999999 | 14.086 |
| 全国合計 | 124,353,000 | ≈ 1.000000 | 124.353 |
鳥取県規模でも「1 クエリあたり約 42% で誰かに誤合致」、 東京都規模なら ほぼ確実に誤合致が 1 件以上 起こります(近似値 14 は「平均 14 人と誤合致」の意)。 これが「1 回は珍しい」を「N 回なら日常」に変える多重比較の本質です。 だから AFIS は「候補を 1 位に絞る」のではなく 上位ランクを人手レビュー する運用に必ずなります。
⚠️ 落とし穴(重要)── 1:1 のカタログ FMR をそのまま 1:N に持ち込む
最も多い設計ミスは、 スマホの 1:1 認証で通用する FMR をそのまま大規模 1:N に流用することです。 逆算すると、 system 全体の誤合致率 FPIR を 1% 以下 に抑えるには、 1 回あたりの FMR を約 $0.01/N$ まで下げる必要があります(Bonferroni の閾値割り当てと同じ算術)。 下表の N は前掲と同じ 実測人口、 目標 FPIR≤1% は仮定です。
| 登録規模 N(実測人口) | N (人) | 必要な per-comparison FMR(FPIR≤1%) |
|---|---|---|
| 鳥取県 | 537,000 | ≤ 1 / 53,700,000 |
| 沖縄県 | 1,468,000 | ≤ 1 / 146,800,000 |
| 大阪府 | 8,763,000 | ≤ 1 / 876,300,000 |
| 東京都 | 14,086,000 | ≤ 1 / 1,408,600,000 |
| 全国合計 | 124,353,000 | ≤ 1 / 12,435,300,000 |
東京都規模では「10 億分の 1」より厳しい FMR が要求され、 これは 1 本の指(マニューシャ数十個)だけでは統計的に到達困難な水準です。 だから実運用は (1) 10 指すべてを使う(実質的に検定回数ではなく特徴量を増やす)、 (2) Henry 分類で候補を粗く絞ってから照合(=比較回数 N を減らす)、 (3) 最終判定を人手に委ねる、 の 3 手で「多重比較の膨張」に対抗します。 なお $N\cdot\text{FMR}$ の近似は N·FMR が小さいときだけ有効で、 東京都のように積が 1 を超える領域では過大評価になる点も、 統計の union bound と同じ注意事項です。
🚀 発展 ── 母集団は「動く」: 経時ドリフトと N の変化
多重比較の N は固定値ではありません。 SSDSE-B-2026 で東京都の人口 (A1101) を時系列で追うと、 2012 年 13,234,000 人 → 2023 年 14,086,000 人(実測、 +852,000 人) と 11 年で増え続けています。 登録母集団が増えれば同じセンサ・同じ閾値でも system-level FPIR は上昇するため、 「導入時に合格した閾値が数年後には不合格」という時間的ドリフトが起こります。 これは統計で言えば「検定の家族サイズが年々増える」状態で、 閾値の定期再評価(このページの R627 増補が説く運用監視)が本質的に必要になる理由です。 発展学習としては、 union bound より精密な包除原理・extreme value theory による impostor スコア最大値の分布推定へ進むと、 1:N の誤合致をより正確に見積もれます。
🧠 理解度チェック — このページの数値で
問 1. 沖縄県の 2023 年の人口 N = 1,468,000 人を 1:N 識別の登録数とみなし、1 回の照合の誤合致率を FMR = 10−6 とします。1 件のクエリで少なくとも 1 人と誤合致する確率 FPIR はいくつですか。
答え. FPIR = 1 − (1 − 10−6)1,468,000 ≈ 1 − e−1.468 ≈ 0.770。1 回あたり 100 万分の 1 でも、沖縄県規模の登録数ではクエリの 4 件に 3 件で誰かに誤合致します。近似 N·FMR = 1.468 は 1 を超えるので、確率としては使えません。
問 2. 福岡県(2023 年 N = 5,103,000 人)で、システム全体の FPIR を 1% 以下にしたい。1 回の照合の FMR はどこまで下げる必要がありますか。
答え. FMR ≤ 0.01 / 5,103,000 ≈ 1.96 × 10⁻⁹(約 5 億 1,030 万分の 1)。上の表の鳥取県(5,370 万分の 1)より 1 桁近く厳しくなります。
問 3. 東京都向けに FMR = 1 / 1,408,600,000 と閾値を決めたとします。東京都の人口は 2012 年 13,234,000 人、2023 年 14,086,000 人です。同じ閾値のまま、FPIR はどう変わりますか。
答え. 2012 年は 1 − (1 − FMR)13,234,000 ≈ 0.0094、2023 年は ≈ 0.0100。センサも閾値も変えていないのに、登録母集団が 85 万人増えただけで誤合致率が 0.94% から 1.00% に上がり、目標の 1% に届きます。閾値を定期的に見直す理由です。
問 4. ブロック 3 の表で、閾値 0.10 では FAR = 0.0352・FRR = 0.1277、閾値 0.20 では FAR = 0.1212・FRR = 0.0638 でした。FAR = FRR となる EER の閾値はどの区間にありますか。
答え. 0.10 では FRR の方が大きく、0.20 では FAR の方が大きいので、両者が等しくなる閾値は 0.10 と 0.20 の間にあります。閾値を上げると FAR は増え FRR は減る(単調)ので、この区間の中で二分探索すれば EER が求まります。それを実際に行うのがブロック 4 です。
🔗 関連ページ
- 多重比較・多重検定 — 本節の中核。 1:N 識別の誤合致膨張はこの一般理論の特殊例。
- 偽陽性(False Positive) — FMR/FAR は照合における偽陽性そのもの。
- 仮説検定 — 「同一人物 vs 別人」を H₀/H₁ とみなす検定の枠組み。
- ROC 曲線 — 閾値ごとの FMR/FRR を描く動作点選択の基礎。
- 顔認識 — 同じ 1:N 膨張を別モダリティで抱える並列手法。
- FMR-FNMR / EER の詳細ページは未整備のため、 本ページ「📐 定義 / 数式」と「🔬 記号・式を言葉で読み解く」を参照。