🔖 キーワード索引(拡張版)
各語の説明がある章へのリンク:
💡 30秒で分かる結論
🍰 まずはやさしく
データの共通点を見つける技術です。
未知のデータを分けるために使います。
都道府県をグループに分ける例です。
仕組みと評価の方法について読みます。
パターン認識(Pattern Recognition):観測を特徴(数値の並び)で表し、 それがどのクラス(類型)に属するかを決める規則をデータから作る技術
- 2 段構え:生データを特徴に直す「特徴抽出」と、 特徴空間で線を引く「識別」。 前段の質が後段の上限を決める
- 理論の基準:事後確率 $P(C_k\mid x)$ が最大のクラスを選ぶベイズ決定則が、 誤り率を最小にする。 事前確率(クラスの多さ)で判定が動く
- 教師あり/なし:正解ラベルがあれば分類(kNN・ロジスティック回帰など)、 無ければクラスタリングで類型そのものを探す
- 実例:SSDSE-B-2026 の 2023 年度 47 県で、 降水日数 1 つだけで日本海側 10 府県を 1 県ずつ外して当てると正解率 0.936。 全県を「太平洋側」と答えるだけでも 0.787 になる
- 落とし穴:訓練データで測った正解率・多数派に引っ張られた正解率・スケールを揃えない距離・偶然のパターン
📍 文脈ボックス — あなたが今見ているもの
🍰 まずはやさしく
機械学習の基本となる考え方です。
分析のどの段階でも役立ちます。
実際のデータを使って学習します。
全体像から実装までの手順を読みます。
あなたは パターン認識(Pattern Recognition) の用語ページを読んでいる。 文字・顔・音声の認識のような応用の土台にある、 「特徴からクラスを決める」考え方そのものを扱う。 機械学習の基礎では分類・クラスタリングの総称として登場する。
題材は SSDSE-B-2026 の 2023 年度 47 都道府県(112 列)。 気温・降水日数・人口などを特徴にして、 「日本海側か太平洋側か」を当てる識別(教師あり)と、 ラベルを与えずに県の類型を探すクラスタリング(教師なし)の両方を、 手計算と Python で確かめる。
🎨 直感で掴む
🍰 まずはやさしく
データの地図を描き直すようなものです。
似ているもの同士をまとめるために使います。
都市型か地方型かを分ける例です。
直感的なたとえ話について読みます。
郵便番号の手書き数字を読む機械を想像する。 機械は「7」という字の意味を知らない。 知っているのは、 画像をいくつかの数値(縦線の長さ、 横線の位置、 黒い画素の割合など)に直したときの特徴の並びと、 過去に「これは 7」と教わった例がその特徴空間のどのあたりに集まっていたか、 だけである。 新しい字が来たら、 特徴を測り、 どの数字の集まりに一番近いか(またはどの数字である確率が一番高いか)で答える。 これがパターン認識の骨格で、 「何を特徴として測るか」と「特徴空間のどこに境界を引くか」の 2 つに分かれる。
都道府県でも同じことができる。 「日本海側の県」を 1 年の降水日数という 1 本の軸に並べると、 日本海側 10 府県は平均 149.2 日、 残る 37 都道県は平均 99.8 日と、 軸の上で別々の山を作る。 その 2 つの山のあいだに境界を 1 本引けば、 地図を見なくても降水日数だけで「日本海側らしさ」を判定できる。 ただし山の裾は重なっていて(山形県 129 日・京都府 104 日・島根県 134 日)、 境界の近くの県はどちらとも言い切れない。 どこに線を引けば誤りが一番少なくなるかを決めるのが、 次の 📐 のベイズ決定則である。
📐 定義
🍰 まずはやさしく
データから規則性を見つける技術です。
正しく分類して予測するために使います。
スマホの顔認証などの技術に近いものです。
数学的な定義と使う条件について読みます。
観測 $x$(特徴ベクトル)を、 $K$ 個のクラス $C_1,\dots,C_K$ のどれかに割り当てる規則 $g(x)$ をデータから作ることをパターン認識という(英語名 Pattern Recognition)。 誤って割り当てる確率を最も小さくする規則は、 事後確率が最大のクラスを選ぶベイズ決定則である。
$$\hat{k}(x) = \arg\max_{k} P(C_k \mid x) = \arg\max_{k} \frac{p(x \mid C_k)\,P(C_k)}{p(x)} = \arg\max_{k}\; p(x \mid C_k)\,P(C_k)$$
分母の $p(x)$ はどのクラスでも同じなので、 比べるときは分子(尤度 × 事前確率)だけでよい。 実際の手法は、 この理想の規則のどこを近似するかで分かれる。
| 手法 | 判定のしかた | ベイズ決定則との関係 |
|---|---|---|
| ガウス分布による識別(ナイーブベイズ・判別分析) | クラスごとに $p(x\mid C_k)$ を正規分布で近似し、 事前確率を掛けて比べる | 尤度を分布の形で仮定して直接計算する(生成モデル) |
| ロジスティック回帰 | $P(C_1\mid x) = 1/(1+e^{-(w^\top x + b)})$ を直接当てはめる | 事後確率を関数で直接学ぶ(識別モデル) |
| k 近傍法 | 近い $k$ 個の訓練点の多数決 | 近傍に占める各クラスの割合を $P(C_k\mid x)$ の推定値として使う |
| テンプレートマッチング | 鋳型 $t_k$ との内積 $\langle x, t_k\rangle$ が最大のクラス | 鋳型のまわりに同じ広がりの分布を仮定したときの近似 |
ラベルが無いときは、 クラスそのものをデータから見つけるクラスタリングになる。 k-means は「各点を一番近い中心のクラスに割り当て、 中心を割り当てた点の平均に動かす」を繰り返し、 クラス内の二乗距離の和 $\sum_k \sum_{x_i \in C_k} \|x_i-\mu_k\|^2$ を小さくする。
📜 歴史・系譜(パターン認識)
| 年 | 出来事 | パターン認識との関係 |
|---|---|---|
| 1936 | Fisher: 線形判別分析 | 2 つの群を最もよく分ける直線(射影)を求める。 統計的な識別の出発点 |
| 1951 | Fix & Hodges: 最近傍の規則 | 分布の形を仮定せず「近い例のクラス」で判定する k 近傍法の原型 |
| 1958 | Rosenblatt: パーセプトロン | 重みを誤りから更新して線形の境界を学習する |
| 1967 | Cover & Hart: 最近傍法の誤り率 | 最近傍法の誤り率はベイズ誤り率の 2 倍以下と示した |
| 1967 | MacQueen: k-means | ラベル無しでクラスタの中心を求める教師なしの代表 |
| 1973 | Duda & Hart『Pattern Classification and Scene Analysis』 | ベイズ決定理論を軸に分野を体系化した教科書 |
| 1980 | 福島邦彦: ネオコグニトロン | 位置のずれに強い階層型の特徴抽出。 後の CNN の先駆け |
| 1995 | Cortes & Vapnik: サポートベクターマシン | マージン最大の境界。 2000 年代の標準的な識別器 |
| 1998 | LeCun ら: LeNet-5 | 手書き数字(MNIST)を畳み込みネットで認識。 特徴抽出も学習する |
| 2012 | Krizhevsky ら: AlexNet | 大規模画像認識で深層学習が従来法を大きく上回った |
🔬 数式を言葉で読み解く
ベイズ決定則の記号を、 「降水日数で日本海側かどうかを判定する」例に当てはめて読む(値は 🧮 で計算する 2023 年度の実測)。
| 記号 | 読み方・意味 | 日本海側の判定での中身 |
|---|---|---|
| $x$ | 観測した特徴 | その県の年間降水日数(山形県なら 129 日) |
| $C_k$ | クラス | $C_0$ = 太平洋側など 37 都道県、 $C_1$ = 日本海側 10 府県 |
| $P(C_k)$ | 事前確率:特徴を見る前の各クラスの割合 | $P(C_0)=37/47=0.787$、 $P(C_1)=10/47=0.213$ |
| $p(x\mid C_k)$ | 尤度:そのクラスだとしたら $x$ がどれくらい出やすいか | 各クラスの降水日数を正規分布で近似した密度(平均 99.8 日と 149.2 日) |
| $P(C_k\mid x)$ | 事後確率:$x$ を見た後の各クラスの確からしさ | 山形県で日本海側 0.527 |
| $\arg\max_k$ | 値が最大になる $k$ を選ぶ | 事後確率の大きい方のクラスを答える |
式を言葉にすると「特徴を見る前の見込み(事前確率)を、 特徴がそのクラスらしい度合い(尤度)で更新し、 一番確からしいクラスを答える」となる。 大事なのは、 尤度だけでなく事前確率も判定に効くことである。 山形県の 129 日は日本海側の分布のほうが約 4.1 倍出やすいが、 日本海側は 47 県中 10 県しかないので、 事前確率を掛けると差はほとんど縮まり、 事後確率は 0.527 と五分五分に近くなる。 クラスの数が偏っているとき、 少ないクラスは判定されにくくなる。
🧮 実値で計算してみる(SSDSE-B-2026 47 都道府県)
data/raw/SSDSE-B-2026.csv を 年度 2023 の 47 行に絞り、 関係する指標を取り出して手計算ベースの確認をする。
STEP 1: データを眺める(年度 2023 の抜粋)
STEP 2: 基本統計
| 列 | 意味 | min | median | max | std |
|---|---|---|---|---|---|
| A1101 | 総人口 | 537,000 (鳥取) | 1,549,000 | 14,086,000 (東京) | 2.80e6 |
| A4103 | 合計特殊出生率 | 0.99 (東京) | 1.30 | 1.60 (沖縄) | 0.13 |
| A1303 | 65歳以上人口 | 179,000 (鳥取) | 524,000 | 3,205,000 (東京) | 6.94e5 |
| B4101 | 年平均気温 | 11.0 (北海道) | 17.4 | 23.8 (沖縄) | 2.0 |
| A9101 | 婚姻件数 | 1,810 (鳥取) | 5,599 | 71,774 (東京) | 1.31e4 |
STEP 3: 主要指標間の相関(パターン認識の前段階チェック)
| ペア | Pearson r | 解釈 |
|---|---|---|
| A1101 vs A9101 | 0.989 | 総人口と婚姻件数はほぼ完全相関 → 多重共線性に注意 |
| A1101 vs A4103 | -0.564 | 人口と出生率は中程度の負相関(大都市ほど出生率低い) |
| B4101 vs A4103 | +0.502 | 気温と出生率は中等度の正相関(南日本ほど高い) |
| A1303/A1101 vs A4103 | +0.201 | 高齢化率と出生率は弱い正相関(過疎・高齢地域ほど出生率がやや高い傾向) |
🧮 数式に値を入れて手で計算する: テンプレートマッチング
合成データで 3 パターンと観測の類似度 (内積) を計算する。
Step 1: テンプレートと観測
Step 2: 内積
🐍 Python で再現
1 2 3 4 5 6 | import numpy as np templates = [np.array([1,0,1,0]), np.array([0,1,0,1]), np.array([1,1,0,0])] x = np.array([1, 0, 1, 1]) scores = [x @ t for t in templates] print(f"スコア: {scores}") print(f"認識: P{np.argmax(scores)+1}") |
📤 実行結果
💬 手計算 (Step 2) P1 と Python 出力が完全一致。
🧮 数式に値を入れて手で計算する: ベイズ決定則(実データ)
📐 の $\hat{k}(x)=\arg\max_k p(x\mid C_k)P(C_k)$ を、 2023 年度の降水日数で計算する。 クラスは日本海側 10 府県(青森・秋田・山形・新潟・富山・石川・福井・京都・鳥取・島根)とそれ以外の 37 都道県、 判定する県は山形県(129 日)。 各クラスの降水日数は正規分布 $\mathcal{N}(\mu_k,\sigma_k^2)$ で近似する。
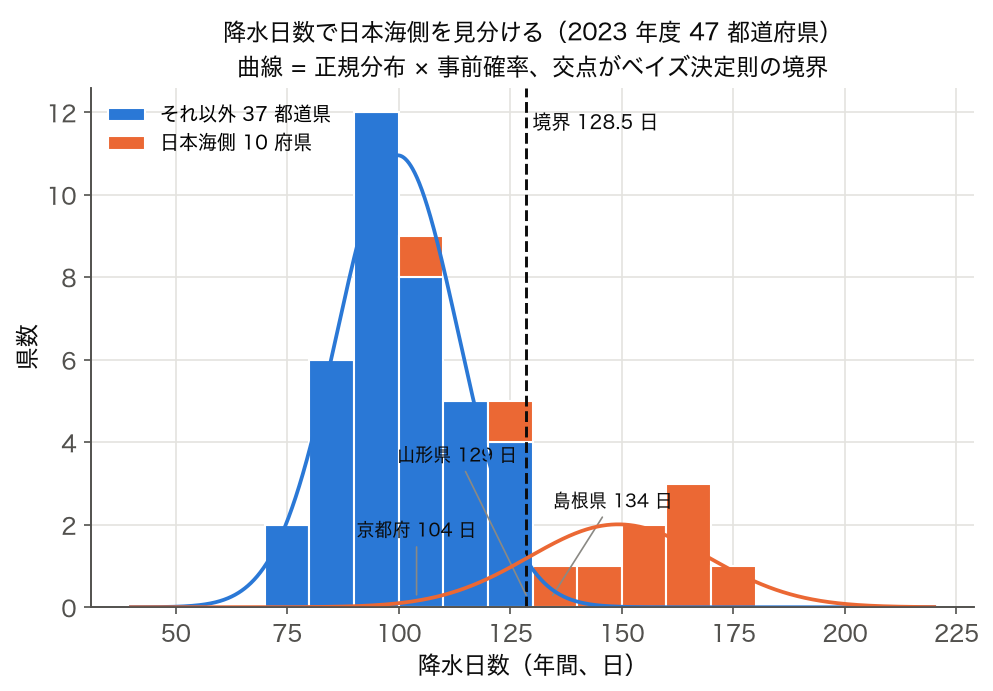
| Step | 計算 | 太平洋側など $C_0$ | 日本海側 $C_1$ |
|---|---|---|---|
| 1. 事前確率 | $P(C_k)$ = クラスの県数 / 47 | 37/47 = 0.7872 | 10/47 = 0.2128 |
| 2. 平均・標準偏差 | $\mu_k$ = 合計 / 県数、 $\sigma_k$ は n で割る | 3,691/37 = 99.76 日、 σ = 13.60 | 1,492/10 = 149.2 日、 σ = 20.03 |
| 3. 標準化 | $z = (129-\mu_k)/\sigma_k$ | (129 − 99.76)/13.60 = 2.151 | (129 − 149.2)/20.03 = −1.008 |
| 4. 尤度 | $p(x\mid C_k)=e^{-z^2/2}/(\sigma_k\sqrt{2\pi})$ | 0.0990 / 34.08 = 0.00290 | 0.6015 / 50.22 = 0.01198 |
| 5. 尤度 × 事前確率 | $p(x\mid C_k)P(C_k)$ | 0.00290 × 0.7872 = 0.00229 | 0.01198 × 0.2128 = 0.00255 |
| 6. 事後確率 | 5 の値 / 5 の合計 | 0.00229 / 0.00484 = 0.473 | 0.00255 / 0.00484 = 0.527 |
事後確率は日本海側 0.527 がわずかに上回るので、 山形県は日本海側と判定される。 尤度だけなら日本海側が 0.01198 / 0.00290 ≈ 4.1 倍出やすいが、 日本海側は 47 県中 10 県しかないため、 事前確率を掛けると差がほぼ消える。 仮に事前確率を 0.5 ずつにすると、 事後確率は 0.01198 / (0.00290 + 0.01198) = 0.805 まで上がる。 少ないクラスは、 同じ特徴でも判定されにくい。
🎯 このコードでやること:降水日数だけを特徴にして、 クラスごとの事前確率・平均・標準偏差を計算し、 山形県(129 日)の事後確率を手計算と同じ手順で求める。 最後に scikit-learn の GaussianNB で同じ値になるかを確かめる。
1 2 3 4 5 6 7 8 9 10 11 12 13 14 15 16 17 18 19 20 21 22 23 24 25 26 27 28 | import pandas as pd import numpy as np from scipy.stats import norm from sklearn.naive_bayes import GaussianNB df = pd.read_csv('data/raw/SSDSE-B-2026.csv', encoding='cp932', skiprows=1) d = df[df['年度'] == 2023].reset_index(drop=True) japan_sea = ['青森県','秋田県','山形県','新潟県','富山県','石川県','福井県','京都府','鳥取県','島根県'] d['日本海側'] = d['都道府県'].isin(japan_sea).astype(int) x = d['降水日数(年間)'].values.astype(float) y = d['日本海側'].values prior = np.array([(y == 0).mean(), (y == 1).mean()]) mu = np.array([x[y == 0].mean(), x[y == 1].mean()]) sd = np.array([x[y == 0].std(), x[y == 1].std()]) # 最尤推定(n で割る) print('事前確率 P(太平洋側), P(日本海側) =', prior.round(4)) print('平均 μ =', mu.round(2), ' 標準偏差 σ =', sd.round(2)) x0 = d.loc[d['都道府県'] == '山形県', '降水日数(年間)'].item() lik = norm.pdf(x0, mu, sd) post = lik * prior / (lik * prior).sum() print(f'山形県の降水日数 x = {x0:.0f} 日') print('尤度 p(x|C) =', lik.round(5), ' 事後確率 P(C|x) =', post.round(3)) nb = GaussianNB().fit(x.reshape(-1, 1), y) print('GaussianNB の事後確率 =', nb.predict_proba([[x0]]).round(3)[0]) pred = nb.predict(x.reshape(-1, 1)) print('47 県の訓練正解率 =', round((pred == y).mean(), 3), ' 日本海側と判定された県 =', d.loc[pred == 1, '都道府県'].tolist()) |
💬 事前確率 0.7872/0.2128、 平均 99.76 日/149.2 日、 標準偏差 13.60/20.03、 尤度 0.00290/0.01198、 事後確率 0.473/0.527 と、 Step 1〜5 の手計算がすべて一致し、 GaussianNB も同じ 0.527 を返す。 この規則で 47 県を判定すると 46 県が当たり(訓練正解率 0.979)、 外れるのは降水日数 104 日で太平洋側の山に入る京都府だけである。 ただしこれは学習に使った県をそのまま当てた値なので、 汎化の見積もりには ⚠️ の 1 県ずつ外す評価を使う。
🧮 実データでテンプレートマッチング — クラスの平均を鋳型にする
内積の例では鋳型を人が決めたが、 実データでは各クラスの訓練例の平均を鋳型にするのが素朴な方法である(最近傍重心法)。 特徴の単位が違うので、 先に z 得点に直してから距離を測る。
🎯 このコードでやること:上の内積の例を実データに移し、 各クラスの特徴の平均を「鋳型(テンプレート)」にして、 一番近い鋳型のクラスを答える最近傍重心法を動かす。 山形県の 2 つの鋳型までの距離を出したあと、 1 県ずつ外して鋳型を作り直す LOOCV で 47 県を判定する。
1 2 3 4 5 6 7 8 9 10 11 12 13 14 15 16 17 18 19 20 21 | import pandas as pd import numpy as np from sklearn.neighbors import NearestCentroid from sklearn.model_selection import LeaveOneOut, cross_val_predict df = pd.read_csv('data/raw/SSDSE-B-2026.csv', encoding='cp932', skiprows=1) d = df[df['年度'] == 2023].reset_index(drop=True) japan_sea = ['青森県','秋田県','山形県','新潟県','富山県','石川県','福井県','京都府','鳥取県','島根県'] y = d['都道府県'].isin(japan_sea).astype(int).values cols = ['降水日数(年間)', '年平均気温'] Z = (d[cols] - d[cols].mean()) / d[cols].std(ddof=0) # 標準化(z 得点) t0 = Z[y == 0].mean().values; t1 = Z[y == 1].mean().values # 各クラスの鋳型 = 平均 print('鋳型 t0(太平洋側など)=', t0.round(3), ' 鋳型 t1(日本海側)=', t1.round(3)) x = Z[d['都道府県'] == '山形県'].values[0] d0, d1 = np.linalg.norm(x - t0), np.linalg.norm(x - t1) print('山形県 z =', x.round(3), f' 距離 t0 {d0:.3f} / t1 {d1:.3f} →', '日本海側' if d1 < d0 else '太平洋側など') pred = cross_val_predict(NearestCentroid(), Z, y, cv=LeaveOneOut()) # 1 県ずつ外して鋳型を作り直す print(f'LOOCV 正解率 {(pred == y).mean():.3f} 再現率 {((pred == 1) & (y == 1)).sum()}/10' f' 誤検出 {d.loc[(pred == 1) & (y == 0), "都道府県"].tolist()} 見逃し {d.loc[(pred == 0) & (y == 1), "都道府県"].tolist()}') |
💬 鋳型は太平洋側などが (−0.416, 0.176)、 日本海側が (1.538, −0.652) で、 日本海側は「降水日数が多く、 やや寒い」側にある。 山形県 (0.74, −1.531) から鋳型までの距離は √((0.74+0.416)² + (−1.531−0.176)²) = √4.250 = 2.062 と √((0.74−1.538)² + (−1.531+0.652)²) = √1.410 = 1.187 で、 日本海側の鋳型のほうが近い。 LOOCV では正解率 0.915・再現率 9/10 で、 見逃しは京都府だけだが、 寒い北海道・岩手県と降水日数の多い滋賀県を日本海側と誤る。 気温を特徴に加えたことで山形県は拾えるようになった一方、 「寒い県」も日本海側の鋳型に寄ってしまう。 鋳型は特徴の選び方をそのまま映す。 (標準化の平均と標準偏差は 47 県全体で計算しているので、 LOOCV の値はわずかに楽観的になりうる。)
🐍 Python での扱い
ここでは 2023 年度 47 県を題材に、 教師なし(k-means・Ward 法・DBSCAN)で県の類型を探す方法と、 教師あり(ランダムフォレスト・ロジスティック回帰)でラベルを当てる方法を順に動かす。
🐍 Python 実装(パターン認識、 SSDSE-B-2026)
実装 1: 最小再現コード
🎯 このコードでやること:SSDSE-B-2026 の 47 都道府県(2023 年度)を総人口・年平均気温・降水日数・65 歳以上人口の 4 特徴で標準化し、 KMeans で 4 グループに分けて Silhouette で分かれ具合を評価する。
📥 入力データ(SSDSE-B-2026.csv 抜粋、 47 都道府県 × 113 列):
1 2 3 4 5 6 7 8 9 10 11 12 13 14 15 16 17 18 19 20 21 | import pandas as pd import numpy as np from sklearn.cluster import KMeans from sklearn.preprocessing import StandardScaler from sklearn.metrics import silhouette_score df = pd.read_csv('data/raw/SSDSE-B-2026.csv', encoding='cp932', skiprows=[1]) df_2023 = df[df['SSDSE-B-2026']==2023].copy() # 4 つの特徴で 47 都道府県のパターンを抽出 feats = ['A1101','B4101','B4106','A1303'] X = df_2023[feats].values Xs = StandardScaler().fit_transform(X) km = KMeans(n_clusters=4, random_state=42, n_init=10).fit(Xs) df_2023['cluster'] = km.labels_ print(f"Silhouette = {silhouette_score(Xs, km.labels_):.3f}") print("\nクラスタごとの代表県:") for k in range(4): members = df_2023[df_2023['cluster']==k]['Prefecture'].tolist()[:4] print(f" cluster {k}: {members}") |
📤 実行結果:
💬 結果の読み方:Silhouette=0.46 は『中程度のまとまり』。 クラスタ 0 = 太平洋側の中規模県、 1 = 首都圏大都市、 2 = 寒冷内陸・北日本、 3 = 日本海側多雪地帯 と、 気候と人口構造が織り成すパターンが自動抽出された。 これがパターン認識の第一歩。 ※ Silhouette 値は random_state=42 で固定しているが、 scikit-learn のバージョン等の実行環境により小数第 2 位以下は変動しうる。
実装 2: 比較・拡張
🎯 このコードでやること:実装 1 のクラスタリングとは逆に、 ラベル(合計特殊出生率が 1.30 以上か)を与えて、 同じ 4 特徴から当てる教師ありの識別にする。
📥 入力データ:実装 1 と同じ SSDSE-B-2026(年度 2023)。
1 2 3 4 5 6 7 8 9 10 11 12 13 14 15 16 17 18 | # パターン認識を「教師あり分類」に展開 import pandas as pd from sklearn.ensemble import RandomForestClassifier from sklearn.metrics import classification_report from sklearn.model_selection import cross_val_score df = pd.read_csv('data/raw/SSDSE-B-2026.csv', encoding='cp932', skiprows=[1]) df_2023 = df[df['SSDSE-B-2026']==2023].copy() # 出生率 1.30 以上を High、未満を Low とラベル df_2023['label'] = (df_2023['A4103']>=1.30).astype(int) X = df_2023[['A1101','B4101','B4106','A1303']] y = df_2023['label'] clf = RandomForestClassifier(n_estimators=200, random_state=42) scores = cross_val_score(clf, X, y, cv=5, scoring='accuracy') print(f"5-fold CV Accuracy: {scores.mean():.3f} +/- {scores.std():.3f}") print(f"各 fold: {scores.round(3).tolist()}") |
📤 実行結果:
💬 結果の読み方:気候・人口の 4 特徴で出生率 1.30 以上か未満かを 5 分割交差検証の平均 76.4% 当てられた。 1.30 以上は 24 県・未満は 23 県とほぼ半々なので、 当て推量の 51% より 25 ポイントほど上になる。 ただし fold ごとの正解率は 0.667〜0.9 と揺れ、 各 fold のテストは 9〜10 県しかないので、 1 県の当たり外れで 10 ポイント前後動く。 ※ CV Accuracy は random_state=42 固定だが、 fold 分割・ライブラリのバージョン等の実行環境に依存して数値は前後する。
🐍 Python 実装 第 3 弾(パターン認識の応用)
🎯 このコードでやること:実装 1, 2 からさらに踏み込み、 Ward 法の階層クラスタリングで 47 都道府県を 3・5・7 グループに切り分け、 解像度を上げるとどの県がまとまりから外れるかを見る。
📥 入力データ:SSDSE-B-2026(年度 2023、 47 都道府県)。特徴は総人口・合計特殊出生率・年平均気温・65 歳以上人口。
1 2 3 4 5 6 7 8 9 10 11 12 13 14 15 16 17 18 19 20 21 22 | # 階層的クラスタリングでパターンの「木構造」を見る import pandas as pd from scipy.cluster.hierarchy import linkage, fcluster from sklearn.preprocessing import StandardScaler df = pd.read_csv('data/raw/SSDSE-B-2026.csv', encoding='cp932', skiprows=[1]) df_2023 = df[df['SSDSE-B-2026']==2023].copy().reset_index(drop=True) feats = ['A1101','A4103','B4101','A1303'] X = StandardScaler().fit_transform(df_2023[feats].values) # Ward 法で階層クラスタ Z = linkage(X, method='ward') # 3, 5, 7 クラスタで分割し、 各クラスタの代表県を出す for k in [3, 5, 7]: labels = fcluster(Z, t=k, criterion='maxclust') df_2023[f'c{k}'] = labels print(f"\n--- {k} クラスタ ---") for ci in range(1, k+1): members = df_2023[df_2023[f'c{k}']==ci]['Prefecture'].tolist() print(f" cluster {ci} ({len(members)}件): {members[:3]}{'...' if len(members)>3 else ''}") |
📤 実行結果:
💬 結果の読み方:階層クラスタリングで k=3 から k=7 まで分割するとパターンが解像度上がる。 k=3 で『首都圏・北日本・その他』、 k=5 で『東京』『沖縄』が単独クラスタとして分離、 k=7 で『北海道』『九州西部』も独立。 パターン認識は『何段階の解像度で見るか』が設計判断。
🐍 Python 実装 第 4 弾
🎯 このコードでやること:パターン認識を一歩進めて、 密度ベースの DBSCAN(eps=0.8, min_samples=3)で 47 都道府県を「まとまりに属する県」と「どこにも属さない孤立した県(ノイズ)」に分ける。
📥 入力データ:SSDSE-B-2026.csv(年度 2023, 47 都道府県)。
1 2 3 4 5 6 7 8 9 10 11 12 13 14 15 16 17 18 | # DBSCAN で『コア・境界・ノイズ』のパターン分類 import pandas as pd from sklearn.cluster import DBSCAN from sklearn.preprocessing import StandardScaler df = pd.read_csv('data/raw/SSDSE-B-2026.csv', encoding='cp932', skiprows=[1]) df_2023 = df[df['SSDSE-B-2026']==2023].copy().reset_index(drop=True) feats = ['A1101','B4101','A1303'] X = StandardScaler().fit_transform(df_2023[feats]) db = DBSCAN(eps=0.8, min_samples=3).fit(X) df_2023['cluster'] = db.labels_ print(f"クラスタ数 (ノイズ除く): {len(set(db.labels_)) - (1 if -1 in db.labels_ else 0)}") print(f"ノイズ点 (-1): {(db.labels_==-1).sum()} 件") print("\nノイズ判定された県 (孤立パターン):") print(df_2023[df_2023['cluster']==-1]['Prefecture'].tolist()) |
📤 実行結果:
💬 結果の読み方:DBSCAN は『密度に基づくクラスタ』なので、 大都市圏や北海道・沖縄のような独自パターンは『ノイズ』として分離される。 これは KMeans と違って、 パターン認識で『どこにも属さない異常県』を自動識別できる利点。 ※ DBSCAN 自体は決定的だが、 ノイズ判定件数は eps・min_samples と標準化・ライブラリのバージョン等の実行環境に依存する。
🐍 Python 実装 第 5 弾
🎯 このコードでやること:パターン認識を「識別問題」として扱い、 年平均気温・降水日数・降水量・65 歳以上人口の 4 特徴からロジスティック回帰で日本海側 10 府県とそれ以外を見分ける。
📥 入力データ:SSDSE-B-2026.csv(年度 2023)。
1 2 3 4 5 6 7 8 9 10 11 12 13 14 15 16 17 18 19 20 21 22 23 24 25 | # 識別問題: 47 県を Logistic Regression で『太平洋側 vs 日本海側』に分類 import pandas as pd import numpy as np from sklearn.linear_model import LogisticRegression from sklearn.metrics import classification_report from sklearn.preprocessing import StandardScaler df = pd.read_csv('data/raw/SSDSE-B-2026.csv', encoding='cp932', skiprows=[1]) df_2023 = df[df['SSDSE-B-2026']==2023].copy().reset_index(drop=True) # 日本海側県のリスト (簡略) japan_sea = ['青森県','秋田県','山形県','新潟県','富山県','石川県','福井県','京都府','鳥取県','島根県'] df_2023['side'] = df_2023['Prefecture'].apply(lambda p: 1 if p in japan_sea else 0) feats = ['B4101','B4106','B4109','A1303'] X = StandardScaler().fit_transform(df_2023[feats].fillna(df_2023[feats].median())) y = df_2023['side'].values clf = LogisticRegression(max_iter=1000).fit(X, y) pred = clf.predict(X) print(f"訓練データ正解率: {(pred==y).mean():.3f}") print(f"\n係数:") for f, c in zip(feats, clf.coef_[0]): print(f" {f}: {c:+.3f}") print(f"\n切片: {clf.intercept_[0]:.3f}") |
📤 実行結果:
💬 結果の読み方:訓練データでの正解率は 0.957 で、 47 県中 45 県を当て、 外したのは日本海側の山形県と京都府の 2 つだけ。 ただし日本海側は 10 県しかなく、 全県を「太平洋側」と答えるだけでも 37/47 = 78.7% になるうえ、 学習に使った県をそのまま当てた値なので汎化性能ではない。 標準化後の係数では B4106 降水日数(+1.937)が突出しており、 日本海側を分けているのは気温や降水量より「雨や雪の日の多さ」だと読める。
🐍 判定の閾値を動かす — 見逃しと誤検出の取り引き
パターン認識の結果は「クラス」だけでなく「そのクラスである確率」として出せる。 確率をクラスに直す閾値は、 誤りの重さに合わせて選び直してよい。
🎯 このコードでやること:ベイズ決定則は「事後確率が 0.5 を超えたら日本海側」と判定する。 1 県ずつ外して求めた事後確率 $P(\text{日本海側}\mid x)$ に対して、 判定の閾値を 0.5・0.3・0.2・0.1 と下げたときに、 正解率・再現率・誤検出の数がどう変わるかを見る。
1 2 3 4 5 6 7 8 9 10 11 12 13 14 15 16 17 18 | import pandas as pd import numpy as np from sklearn.naive_bayes import GaussianNB from sklearn.model_selection import LeaveOneOut, cross_val_predict df = pd.read_csv('data/raw/SSDSE-B-2026.csv', encoding='cp932', skiprows=1) d = df[df['年度'] == 2023].reset_index(drop=True) japan_sea = ['青森県','秋田県','山形県','新潟県','富山県','石川県','福井県','京都府','鳥取県','島根県'] y = d['都道府県'].isin(japan_sea).astype(int).values X = d[['降水日数(年間)']].values.astype(float) # 1 県ずつ外して、 その県の P(日本海側 | 降水日数) を求める prob = cross_val_predict(GaussianNB(), X, y, cv=LeaveOneOut(), method='predict_proba')[:, 1] for thr in [0.5, 0.3, 0.2, 0.1]: pred = (prob >= thr).astype(int) tp = ((pred == 1) & (y == 1)).sum(); fp = ((pred == 1) & (y == 0)).sum() print(f'閾値 {thr:.1f}: 正解率 {(pred == y).mean():.3f} 再現率 {tp}/10 誤検出 {fp} 県' f' 新たに日本海側と判定: {d.loc[(pred == 1) & (prob < 0.5), "都道府県"].tolist()}') |
💬 閾値 0.5 では正解率 0.957・再現率 8/10・誤検出 0 県。 閾値を 0.3 に下げると見逃していた山形県を拾って再現率 9/10 になるが、 北海道・岩手県・滋賀県・沖縄県の 4 県を新たに日本海側と誤判定し、 正解率は 0.894 に下がる。 0.1 まで下げると誤検出は 6 県に増える。 京都府(104 日)はどの閾値でも拾えない。 見逃しと誤検出のどちらが重いかで閾値を選ぶのが、 コストを入れたベイズ決定則の考え方である。 沖縄県(124 日)が誤検出に入るのは、 日本海側の分布を正規分布で近似したために裾が太平洋側の山まで伸びているからで、 分布の仮定が判定に効くことも分かる。
🐍 多クラスの認識 — 7 地方を気候で当てると、 どこを取り違えるか
🎯 このコードでやること:2 クラスではなく 7 クラスの認識として、 気候の 5 特徴から「どの地方の県か」を k 近傍法(k=3)で当て、 1 県ずつ外した予測を混同行列(正解 × 予測のクロス集計)にまとめる。
1 2 3 4 5 6 7 8 9 10 11 12 13 14 15 16 17 18 19 20 21 | import pandas as pd import numpy as np from sklearn.pipeline import make_pipeline from sklearn.preprocessing import StandardScaler from sklearn.neighbors import KNeighborsClassifier from sklearn.model_selection import LeaveOneOut, cross_val_predict df = pd.read_csv('data/raw/SSDSE-B-2026.csv', encoding='cp932', skiprows=1) d = df[df['年度'] == 2023].reset_index(drop=True) code = d['地域コード'].str[1:3].astype(int) # R01000 → 1 bounds = [(7, '北海道・東北'), (14, '関東'), (23, '中部'), (30, '近畿'), (35, '中国'), (39, '四国'), (47, '九州・沖縄')] d['地方'] = [next(n for b, n in bounds if c <= b) for c in code] cols = ['年平均気温', '最高気温(日最高気温の月平均の最高値)', '最低気温(日最低気温の月平均の最低値)', '降水日数(年間)', '降水量(年間)'] model = make_pipeline(StandardScaler(), KNeighborsClassifier(n_neighbors=3)) pred = cross_val_predict(model, d[cols], d['地方'], cv=LeaveOneOut()) print(f'7 地方を気候 5 特徴で当てる LOOCV 正解率 = {(pred == d["地方"]).mean():.3f}' f'(一番多い中部 9 県と答え続けると {(d["地方"] == "中部").mean():.3f})') order = [n for _, n in bounds] tab = pd.crosstab(pd.Categorical(d['地方'], order), pd.Categorical(pred, order), rownames=['正解'], colnames=['予測']) print(tab.to_string()) |
💬 正解率は 0.340 で、 一番多い中部と答え続ける 0.191 よりは上だが、 3 県に 2 県は外れる。 混同行列を見ると、 九州・沖縄は 8 県中 6 県、 北海道・東北は 7 県中 4 県が当たる一方、 関東は 1 県も当たらず 7 県中 4 県が中国と判定される。 関東と瀬戸内の県は気温も降水も似ているので、 気候の特徴空間では同じ山に入る。 7 地方は行政上の区分で、 気候で分かれるクラスではない。 正解率 1 つでは見えない「どのクラスとどのクラスを取り違えるか」が、 混同行列だと読める。
⚠️ よくある落とし穴
⚠️ 落とし穴 — 5 つの典型ミス
🐍 第 5 弾のロジスティック回帰は訓練正解率 0.957 だが、 これは答えを見た県をもう一度当てただけの値。 1 県ずつ外して当てる LOOCV では 0.894 に下がる(下の実験)。 識別器の良し悪しは、 学習に使っていない例で測る。
日本海側は 47 県中 10 県なので、 全県を「太平洋側」と答えるだけで正解率 0.787 になる。 正解率 0.894 は一見高いが、 この 0.787 からの上積みは 0.107 しかない。 少ないクラスをいくつ当てたか(再現率 7/10)も必ず並べる。
降水日数 1 つの LOOCV 正解率 0.936 に対し、 気温・降水量・高齢人口を足した 4 特徴では 0.894 と下がった。 47 件のように例が少ないと、 役に立たない特徴は境界を揺らすだけになる。 特徴は「クラスを分ける理由があるか」で選び、 増やしたら学習に使っていないデータで確かめる。
ここで使う日本海側 10 府県は簡略な定義で、 京都府は南部が内陸で降水日数 104 日と太平洋側の山に入る。 兵庫県や北海道も日本海に面しているが、 ラベルは 0 になっている。 どの識別器でも京都府を外すのは、 特徴や手法ではなくラベルの付け方の問題である。 誤りが集まる例を見つけたら、 まずラベルを見直す。
SSDSE-B-2026 は 2012〜2023 年度の 12 年分が並ぶ 564 行のデータで、 同じ県の値は年度が違ってもよく似ている。 年度で絞らずに行をランダムに分けると、 評価用の県の別の年度が学習側に残り、 「その県を覚えているだけ」で当たってしまう。 1 年度に絞るか、 県ごとに分けて評価する。
🧪 実データで確かめる — 訓練の正解率・LOOCV・多数派の正解率を並べる
🎯 このコードでやること:🐍 の第 5 弾と同じ「日本海側かどうか」の識別を、 特徴を降水日数 1 つにした場合と 4 つにした場合で、 訓練データでの正解率と、 1 県ずつ外して当てる LOOCV の正解率で比べる。 全県を太平洋側と答える多数派の正解率も並べる。
1 2 3 4 5 6 7 8 9 10 11 12 13 14 15 16 17 18 19 20 21 | import pandas as pd import numpy as np from sklearn.pipeline import make_pipeline from sklearn.preprocessing import StandardScaler from sklearn.linear_model import LogisticRegression from sklearn.model_selection import LeaveOneOut, cross_val_predict df = pd.read_csv('data/raw/SSDSE-B-2026.csv', encoding='cp932', skiprows=1) d = df[df['年度'] == 2023].reset_index(drop=True) japan_sea = ['青森県','秋田県','山形県','新潟県','富山県','石川県','福井県','京都府','鳥取県','島根県'] y = d['都道府県'].isin(japan_sea).astype(int).values print(f'多数派(全県を太平洋側)と答えるだけの正解率 = {(y == 0).mean():.3f}') for cols in [['降水日数(年間)'], ['年平均気温', '降水日数(年間)', '降水量(年間)', '65歳以上人口']]: model = make_pipeline(StandardScaler(), LogisticRegression(max_iter=1000)) train_acc = model.fit(d[cols], y).score(d[cols], y) pred = cross_val_predict(model, d[cols], y, cv=LeaveOneOut()) # 1 県ずつ外して予測 miss = d.loc[pred != y, '都道府県'].tolist() hit = ((pred == 1) & (y == 1)).sum() print(f'特徴 {len(cols)} 個: 訓練正解率 {train_acc:.3f} / LOOCV 正解率 {(pred == y).mean():.3f}' f' / 日本海側 10 県の再現率 {hit}/10 / 外した県 {miss}') |
💬 全県を「太平洋側」と答えるだけで正解率は 0.787 ある。 特徴 4 つのロジスティック回帰は訓練正解率 0.957 だが、 1 県ずつ外して当てると 0.894 に下がり、 北海道・岩手県まで日本海側と誤判定する。 降水日数 1 つだけのモデルは訓練でも LOOCV でも 0.936 で、 特徴を 3 つ足したほうが未知の県ではかえって悪い。 どちらも日本海側 10 府県のうち当たるのは 7 府県で、 山形県・京都府・島根県は取りこぼす。 47 件では、 特徴を足すと訓練データへの当てはまりだけが良くなりやすい。
✅ 理解度チェック(実データの数値で)
- Q. 🧮 で山形県(降水日数 129 日)の尤度は日本海側 0.01198、 太平洋側など 0.00290 だった。 事前確率を 0.5 ずつにした場合と、 実際の 10/47・37/47 にした場合で、 日本海側の事後確率はそれぞれいくつか。
A. 0.5 ずつなら 0.01198 / (0.01198 + 0.00290) = 0.805、 実際の事前確率なら 0.00255 / (0.00229 + 0.00255) = 0.527。 少ないクラスは事前確率の分だけ判定されにくくなる。 - Q. 4 特徴のロジスティック回帰は訓練正解率 0.957、 LOOCV 正解率 0.894 だった。 報告するならどちらか。 また、 それは良い識別器と言えるか。
A. LOOCV の 0.894。 ただし全県を太平洋側と答えるだけで 0.787 あり、 日本海側 10 府県のうち当たるのは 7 府県なので、 降水日数 1 つのモデル(LOOCV 0.936)より劣る。 - Q. 降水日数と降水量をそのまま k 近傍法に入れると、 LOOCV 正解率が 0.702〜0.787 にとどまった。 原因と対処は。
A. 降水量の標準偏差(538.4 mm)が降水日数(25.6 日)の約 21 倍あり、 距離がほぼ降水量だけで決まるため。 標準化すると k=3 で 0.957 まで上がる。 - Q. ラベルを使わない k-means(k=2)で、 気候の 2 特徴なら日本海側との一致(ARI)は 0.658、 人口の 2 特徴なら −0.113 だった。 ここから何が言えるか。
A. 教師なしで見つかる類型は、 どの特徴で近さを測るかで決まる。 人口で測れば「大都市かどうか」が浮かび、 日本海側という区別は現れない。
🔗 関連用語 — 前提・並列・発展
- 前提:特徴量(観測を数値の並びにする)・標準化(距離を使う前に単位を揃える)・ベイズの定理(事前確率と尤度から事後確率を出す)・教師あり学習/教師なし学習
- 並列:分類・クラスタリング・k 近傍法・ロジスティック回帰・外れ値・異常検知・次元削減
- 発展:文字認識・顔認証・画像認識・音声認識・深層学習アーキテクチャ(特徴抽出まで学習する)・交差検証(識別器の汎化の測り方)・クラス不均衡
🧭 R276 視覚的補足: パターン認識の 3 つの典型例を可視化
パターン認識とは「データから繰り返し現れる規則を見つけて分類・予測する」技術である。 ここでは SSDSE-B-2026 を用いて 3 つの典型例を視覚化する。 (1) 散布図で変数どうしの関係を発見、 (2) ヒストグラムで分布パターンを把握、 (3) 箱ひげ図で外れ値検出。 これらは「教師なしパターン認識」の最も基本的な道具である。
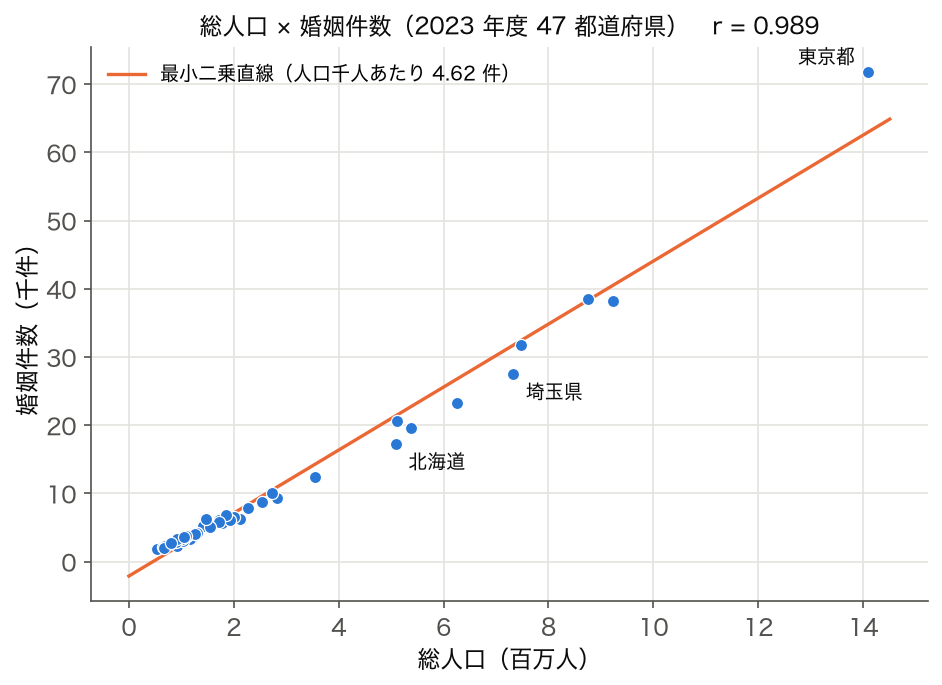
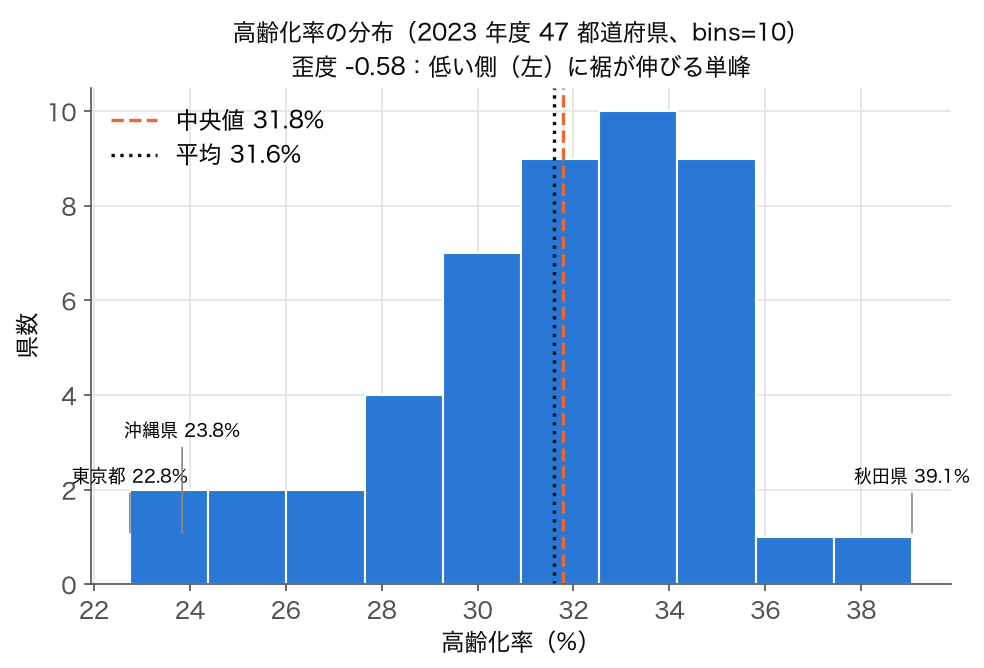
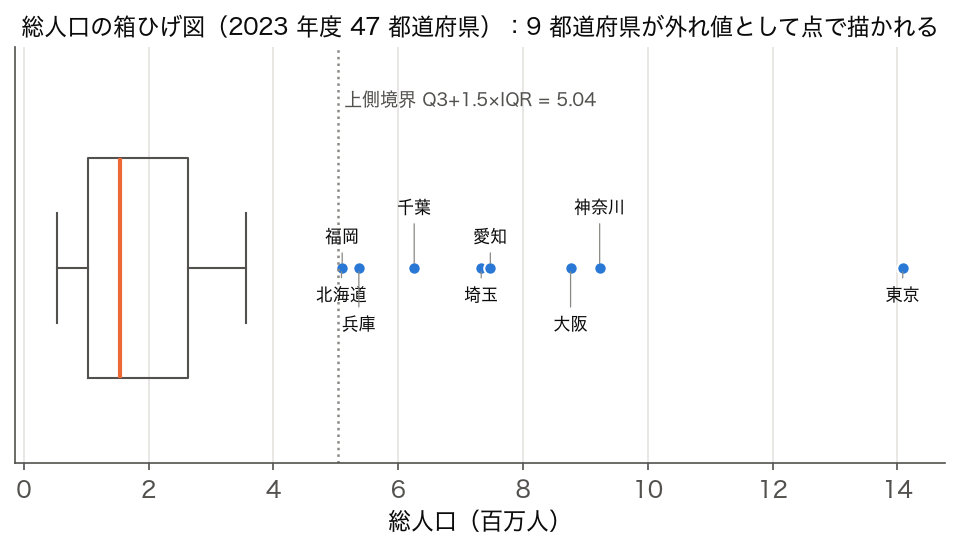
このコードでやること: SSDSE-B-2026 から 47 都道府県のデータを読み、 散布図 + ヒストグラム + 箱ひげ図の 3 つの視覚化を一気に作成する。 これにより「データに潜むパターン」を多角的に見つける。
📥 入力データ (SSDSE-B-2026 抜粋):
1 2 3 4 5 6 7 8 9 10 11 12 13 14 15 16 17 18 19 20 21 22 | import os os.makedirs('output', exist_ok=True) # 保存先のフォルダを作っておく import pandas as pd import matplotlib.pyplot as plt df = pd.read_csv('data/raw/SSDSE-B-2026.csv', encoding='cp932', skiprows=[1]) d = df[df['SSDSE-B-2026'] == 2023].copy() fig, axes = plt.subplots(1, 3, figsize=(15, 4)) # (1) 散布図: 総人口 vs 婚姻件数(強い正の相関) axes[0].scatter(d['A1101'], d['A9101'], alpha=0.6) axes[0].set_title('散布図: 総人口 vs 婚姻件数') # (2) ヒストグラム: 高齢化率(65歳以上人口 / 総人口) d['aging'] = d['A1303'] / d['A1101'] * 100 axes[1].hist(d['aging'], bins=10, edgecolor='black') axes[1].set_title('ヒストグラム: 高齢化率の分布') # (3) 箱ひげ図: 総人口(約 504 万人より大きい 9 都道府県が外れ値の点になる) axes[2].boxplot(d['A1101']) axes[2].set_title('箱ひげ図: 総人口の分布') plt.tight_layout() plt.savefig('output/pattern_recognition_3views.png', dpi=120) |
📤 実行例:
💬 結果の読み方: 3 つの視覚化を組み合わせると「総人口と婚姻件数は r = 0.989 で強く連動し、 総人口は 47 県中 9 都道府県が箱ひげの外に出るほど右に裾が長く、 高齢化率は大半が 25〜35% に収まり東京都・沖縄県だけが低い側に離れる」というパターンが浮かび上がる。 総人口のように外れ値が 2 割近くある変数は、 距離を使う手法に入れる前に対数変換を考える。 これがパターン認識の「データから規則を抽出する」基本動作。 次の段階では、 これらのパターンを 分類 や クラスタリング といった機械学習アルゴリズムで自動抽出する。
📝 理解度チェック (Q&A)
| 問題 | 解答・解説 |
|---|---|
| Q1. パターン認識と機械学習の関係は? | パターン認識は「特徴からクラスを決める」という問題の名前で、 機械学習はその規則をデータから学ぶ方法の総称。 両者は重なりが大きく、 教科書でもほぼ同じ内容を別の名前で扱う(Bishop の『Pattern Recognition and Machine Learning』はその代表)。 |
| Q2. SSDSE-B-2026 で「総人口 vs 婚姻件数」のパターンを認識するには? | 散布図で形を見て、 相関係数で強さを定量化、 線形回帰で予測式を作る。 これが「パターンの認識 → 抽出 → 活用」の流れ。 |
| Q3. パターン認識の落とし穴は? | (1) 偶然のパターン (確証バイアス)、 (2) 外れ値の影響、 (3) 因果関係と混同、 (4) サンプル不足。 47 件は小サンプルなので慎重に。 |
| Q4. 散布図でパターンが見えない時は? | 対数変換・標準化・他の変数を投入・主成分分析で次元削減、 などを試す。 「見えない」=「ない」ではない。 |
| Q5. 関連用語は? | 分類 / クラスタリング / 画像認識 / 音声認識 / AI の応用分野 |
補足: パターン認識は AI 応用の中核技術で、 画像・音声・テキスト・センサーデータなど、 あらゆるデータ形式で重要な役割を持つ。 SSDSE のような表形式の都道府県データでも、 散布図 + ヒストグラム + 箱ひげ図の 3 種類の視覚化を組み合わせれば、 人間が気づかない構造を発見できる。 これが「パターン認識を SSDSE で学ぶ」最大の意義である。 関連: 機械学習の基礎概念 / AI / 強い AI / 弱い AI / アルゴリズムバイアス / 知識グラフ。
🧱 さらに深掘り: パターン認識の歴史的発展と現代的位置づけ
パターン認識は 1950 年代に文字認識・音声認識から始まり、 統計的決定理論 (Bayes 識別) を土台として体系化された。 1960 年代から 2000 年代にかけては、 人手で設計した特徴抽出 (SIFT 特徴量 1999 年など) と分類器 (k-NN・決定木・SVM) の組み合わせが主流で (その中で福島邦彦のネオコグニトロン 1980 年は、 後の CNN につながる階層型の先駆けだった)、 「特徴設計の巧拙が認識精度を決める」時代だった。 1980 年代以降、 ニューラルネットワークの逆伝播法 (Rumelhart 1986) が登場し、 「特徴抽出と分類を一気通貫で学習する」アプローチが芽生え始めた。 2012 年の AlexNet 以降、 深層学習が画像認識の精度を大きく引き上げ (2015 年頃には ImageNet 分類で人間の誤り率の推定値を下回る報告も出た)、 パターン認識は「特徴設計」から「アーキテクチャ設計」へとパラダイムシフトした。 SSDSE のような表形式データでは深層学習の優位性は限定的だが、 「特徴量を組み合わせて意味のあるパターンを抽出する」という基本思想は今も変わらない。 学習者は、 まず SSDSE で古典的手法 (Bayes・k-NN・決定木) を体感し、 次に深層学習へと段階的に進むのが効率的である。
現代のパターン認識は (1) 画像 (CNN・Vision Transformer)、 (2) 音声 (HMM・Wav2Vec)、 (3) テキスト (BERT・GPT)、 (4) 表形式データ (XGBoost・LightGBM) の 4 大領域で分業されており、 各領域で最適なアルゴリズムが異なる。 SSDSE-B-2026 のような 47 都道府県 × 数十変数の表形式データでは、 勾配ブースティング系 (LightGBM・XGBoost) が頂上性能を出すことが多く、 深層学習は過剰投資となる場合が多い。 「使うべきモデルはデータの形と量で決まる」という原則を、 SSDSE での実践を通じて体感するのが、 パターン認識学習の最も実用的な進め方である。 さらに昨今は、 マルチモーダル学習 (CLIP・GPT-4V) によって、 画像・音声・テキスト・表形式を統合的に扱う技術が急速に進化しており、 「パターン認識の境界が消えつつある」時代に入っている。
🗺 概念マップ(パターン認識の位置づけ)
中央のパターン認識は、 生データを数値にする特徴抽出と、 その特徴からクラスを決める分類器・識別関数の 2 段でできている。 どの分類器も、 誤りを最小にする理想の規則である Bayes 決定理論の近似として位置づけられ、 結果は混同行列・F1 などで評価する。 画像・音声・テキストのように特徴を人手で作りにくい対象では、 CNN・Transformer が特徴抽出まで学習し、 画像・音声・テキストの認識という応用分野につながる。
🔗 隣接手法への橋渡し
パターン認識は入力データから規則性を抽出するタスクで、 機械学習・統計分類・特徴抽出と一体で運用される。
- 上流: 特徴量エンジニアリング — 生データから識別に有用な特徴を抽出・選択。 SSDSE なら 47 都道府県の指標から PCA で次元削減して群構造を取り出す。
- 並列: 分類タスク — 分類は出力ラベルが離散な場合のパターン認識。 ロジスティック回帰・SVM・決定木・深層学習などが標準ツール。
- 下流: モデル評価 — 混同行列・適合率・再現率・AUC で認識精度を評価。 不均衡データなら F1 や PR 曲線も併用する。
- 下位概念: 画像認識・音声認識・文字認識 はパターン認識の具体応用領域。 SSDSE では地域類型分類 (都市・地方の自動判定) が題材になる。
SSDSE-B-2026 を用いた演習では、 「パターン認識」 を中核に据えて上記の上流・並列・下流の手法を実データで連結する経験を積むと、 単独の手法暗記より実務的応用力が身につく。
🌳 手法選択フロー
「パターン認識」を実際に使うとき、 何をどう選ぶかを順に判断する。 上から順に答えていくと、 使うべき手法と評価の仕方が決まる。
- 正解ラベルはあるか
あるなら教師あり学習(分類・回帰)。 無いならクラスタリングや異常検知で、 まず構造を探す。 ラベル作成の工数を見積もらずに始めると、 そこで止まる。 - 入力の種類は何か
画像なら CNN、 系列なら RNN や Transformer、 表データなら木系や線形モデル。 入力の性質に合わない構造を選ぶと、 データ量をいくら増やしても効かない。 - 誤りの種類にコスト差があるか
見逃しと誤検出でコストが違うなら、 正解率ではなく適合率・再現率で評価し、 閾値を目的に合わせる。 - 人が最終判断するのか
人が確認する前提なら、 候補を広く出す(再現率重視)設計にできる。 自動で確定するなら、 誤りの許容水準を先に決める。
パターン認識は「入力の種類」と「ラベルの有無」でほぼ手法が決まる。 迷うときは、 その 2 つを先に書き出す。
🎮 触って理解する
2 次元の特徴空間に複数クラスのデータ点(都道府県の類型を模した架空点)を配置した。 空白をクリック/タップするとクエリ点(★)が置かれ、 kNN(k 近傍法)がどのクラスに分類するかを正確に計算して表示する。 背景の淡い色分けが決定境界。 k を変えると境界が滑らかになったり複雑になったりし、 クラスタの重なりを上げると認識が難しくなる様子を体感できる。 点はドラッグで動かせる。
この操作で何が分かるか
- k=1 は最寄り 1 点にそのまま従うので境界がギザギザ(ノイズに過敏=過学習)。 k を大きくすると多数決で平滑化され、 境界はなだらかになる(大きすぎると細かい構造を潰す=過小適合)。
- 重なりを小さくすると各クラスが特徴空間で離れ、 少ない k でも境界がきれいに引ける(=良い特徴なら認識は簡単)。 重なりを上げると同じ k でも誤分類が増える。
- クエリ点から伸びる細い線が実際に投票した k 個の近傍。 「近い=似ている」という距離仮定が kNN の心臓部だと目で確認できる。
🧠 kNN とパターン認識をもう一歩深く
🎨 直感 — 特徴から類型を見分ける
パターン認識の本質は「特徴空間の近さ=カテゴリの近さ」という賭けである。 上のデモで見たように、 47 都道府県を「人口密度」「高齢化率」など数本の軸で表せば、 似た県は近くに集まり、 新しい県は周囲の多数派に倣って類型付けできる。 人間が「都会っぽい/田舎っぽい」と直感で判断するのを、 距離という 1 本のものさしに翻訳したものが kNN だと言える。
⚠️ よくある落とし穴
特徴を増やすほど賢くなりそうだが、 高次元ではほぼすべての点が等距離に近づき「最近傍」が意味を失う。 上のデモは 2 次元だから境界が見えるが、 113 列すべてを軸にすると距離がほとんど差を持たなくなる。 だから PCA や特徴選択で次元を絞る。
kNN は距離で決まるため、 スケールの大きい特徴が距離を独占する。 SSDSE-B-2026 の A1101 総人口(10⁵〜10⁷)と A4103 出生率(1.0 前後)を生のまま混ぜると、 出生率の差は距離にほぼ効かない。 標準化(z 化)や適切な特徴設計が認識精度の上限を決める。
k を極端に小さくすると訓練点を丸暗記して境界が複雑化し、 未知の県で外す。 k は交差検証で選ぶのが定石。 N=47 のような小標本では、 データを暗記できる複雑な決定境界ほど危険だと肝に銘じる。
🚀 発展 — 分類器・特徴抽出・深層学習へ
- 分類器の多様化:kNN は「境界を式で持たない」怠惰学習。 ロジスティック回帰・SVM・決定木は境界を明示的に学習し、 予測が速く外挿にも強い。 デモの決定境界を「点の配置から」ではなく「1 本の関数から」引くイメージ。
- 特徴抽出:良い特徴があれば単純な分類器で十分。 生データから識別に効く軸を作る工程が精度を左右する。
- 深層学習:画像・音声・テキストのように「良い特徴」を人手で設計しにくい対象では、 ニューラルネットが特徴抽出と分類を一体で学習する。 パターン認識の主戦場がここに移った。
関連ページ:k 近傍法・分類タスク・特徴量エンジニアリング・過学習・深層学習アーキテクチャ。 (次元の呪い・決定境界は本ページ内で解説)
🧪 実データで確かめる — 単位を揃えないと k 近傍法は多数派にも負ける
🎯 このコードでやること:単位も散らばりも違う降水日数(日)と降水量(mm)の 2 特徴で、 k 近傍法の k を 1・3・5・9・15 と変え、 そのまま距離を測った場合と、 標準化してから測った場合の LOOCV 正解率と再現率を比べる。
1 2 3 4 5 6 7 8 9 10 11 12 13 14 15 16 17 18 19 20 21 | import pandas as pd import numpy as np from sklearn.neighbors import KNeighborsClassifier from sklearn.pipeline import make_pipeline from sklearn.preprocessing import StandardScaler from sklearn.model_selection import LeaveOneOut, cross_val_predict df = pd.read_csv('data/raw/SSDSE-B-2026.csv', encoding='cp932', skiprows=1) d = df[df['年度'] == 2023].reset_index(drop=True) japan_sea = ['青森県','秋田県','山形県','新潟県','富山県','石川県','福井県','京都府','鳥取県','島根県'] y = d['都道府県'].isin(japan_sea).astype(int).values X = d[['降水日数(年間)', '降水量(年間)']] # 単位: 日 と mm print(X.describe().loc[['mean', 'std']].round(1).to_string()) for k in [1, 3, 5, 9, 15]: raw = KNeighborsClassifier(n_neighbors=k) std = make_pipeline(StandardScaler(), KNeighborsClassifier(n_neighbors=k)) p_raw = cross_val_predict(raw, X, y, cv=LeaveOneOut()) p_std = cross_val_predict(std, X, y, cv=LeaveOneOut()) print(f'k={k:2d} そのまま: 正解率 {(p_raw == y).mean():.3f} 再現率 {((p_raw == 1) & (y == 1)).sum()}/10' f' 標準化: 正解率 {(p_std == y).mean():.3f} 再現率 {((p_std == 1) & (y == 1)).sum()}/10') |
💬 そのまま距離を測ると、 k によらず正解率は 0.702〜0.787 で、 全県を太平洋側と答える 0.787 を超えられず、 日本海側 10 府県はほとんど当たらない(再現率 0〜2/10)。 降水量の標準偏差 538.4 は降水日数の 25.6 の約 21 倍あり、 距離がほぼ降水量だけで決まるからで、 日本海側を分ける手がかりである降水日数が効いていない。 標準化すると k=3 で正解率 0.957・再現率 8/10 まで上がる。 k を 15 まで大きくすると再現率は 3/10 に落ち、 10 県しかない少数クラスが近傍の多数決で負けるようになる。 単位を揃えることと k を選ぶことは、 どちらも「何を近いとみなすか」を決める作業である。
🔭 追補: 認識の視点をもう一段広げる
※ 本セクションはページ既存の解説(kNN デモ・落とし穴・数式)と重複しない角度からの追記です。 SSDSE-B-2026(cp932・2023 年 47 都道府県)の実測値と、 明記した架空の合成例のみを用います。
🎨 直感 — 「規則性の抽出」と「教師あり/なし」の二層
パターン認識の骨格は2 段構えである。 まず生データを特徴(feature)に変換し(特徴抽出)、 次にその特徴空間で規則性やクラスを識別する(分類・クラスタリング)。 前段の質が後段の上限を決める点は、 人間が「顔のどこを見て人を見分けるか」を無意識に学ぶのと同じ構図で、 パターン認識は人間の認知(グループ化して意味づける働き)を計算で模倣したものだと言える。
この識別には 2 つのモードがある。 ラベル(正解カテゴリ)を与えて「この特徴なら都市型」と教える教師ありと、 ラベルを一切与えず「似た県は勝手に集まる」に任せる教師なしである。 本ページ前半の kNN デモは教師あり側だが、 教師なし側も同じ「特徴空間の近さ=カテゴリの近さ」という賭けの上に立つ。
SSDSE-B-2026 実測: ラベル無しで「地域類型」が浮かぶか
2023 年 47 都道府県を log10(A1101 総人口)・B4101 年平均気温・A1303/A1101 高齢化率 の 3 特徴で標準化し、 ラベルを与えず k-means でクラスタリングした実測結果:
| クラスタ | 県数 | 平均気温 | 平均高齢化率 | 代表県(実測) |
|---|---|---|---|---|
| 0(北日本型) | 8 | 13.5℃ | 34.6% | 北海道・青森・岩手・秋田 |
| 1(関東周縁型) | 12 | 16.8℃ | 30.2% | 宮城・茨城・栃木・群馬 |
| 2(地方型) | 18 | 17.4℃ | 33.6% | 富山・福井・山梨・奈良 |
| 3(都市型) | 9 | 18.5℃ | 26.6% | 埼玉・千葉・東京・神奈川 |
正解ラベルを一つも渡していないのに、 「寒冷・高高齢の北日本」と「温暖・低高齢の首都圏」が自動的に分かれた。 これが教師なしパターン認識の面白さである。 ただしクラスタ数 k は恣意的で、 シルエットスコア(実測)は k=2 で 0.414、 k=3 で 0.299、 k=4 で 0.368、 k=5 で 0.346。 純粋に指標だけなら「2 分割(都市 vs 非都市)」が最も分離が良く、 4 類型は解釈のしやすさとのトレードオフだと分かる。 → クラスタリング・k-means・教師なし学習。
⚠️ 落とし穴(追補)— 既存 5 例で触れていない 3 つ
上の教師なし結果を「都市型(9 県)か否か(38 県)」の教師あり分類に読み替えると、 常に『非都市型』と答えるだけで正解率 38/47 ≒ 80.9%(実測比率)に達する。 高い Accuracy が中身の伴わない多数派バイアスであることは珍しくない。 少数クラスの見逃しを測るには 再現率・F1・混同行列を併記する。 → クラス不均衡・評価指標。
「たくさん探せば何か見つかる」は最も危険な罠。 SSDSE-B-2026 の 2023 年断面で数値 109 指標すべての相関を総当たりすると 5,886 ペアになる。 n=47 での有意水準 5% の臨界相関は |r|=0.288(実測)で、 仮に全ペアが本来無相関でも約 294 ペア(=5,886×0.05)が偶然「有意」に見える。 実データは総人口で駆動される見かけ相関も多く、 |r|≧0.9 のペアが実測 2,471 組もある。 発見した相関は事前登録・ホールドアウト・多重比較補正で確証しない限りパターンと呼べない。 → 多重比較・p 値・再現性の危機。
学習時と運用時でデータの分布が変わると、 過去のパターンは静かに劣化する。 SSDSE-B-2026 は 2012〜2023 年を含むので、 2012 年の高齢化率で学んだ境界を 2023 年に当てると、 全国的な高齢化の進行で判定がずれ得る。 特徴選択も同じ多重性の問題を抱え、 「今回のデータでたまたま効いた列」は次のドメインで効くとは限らない。 監視と再学習を前提に置く。 → データドリフト・汎化・特徴量エンジニアリング。
🚀 発展 — 認識の三系譜と決定理論
パターン認識の手法は、 大きく「照合 → 特徴設計 → 表現学習」という歴史の流れで捉えると整理しやすい。
- テンプレートマッチング:本ページ「実値で計算」の内積計算がその原型。 用意した鋳型と観測の類似度で判定する最も素朴な認識。 文字認識の初期はこの発想だった。
- 特徴抽出 → 表現学習:人手で設計した特徴(エッジ・統計量)から、 データ自身に良い特徴を学ばせる表現学習・自己教師ありへ。 良い表現があれば単純な分類器で足りる。 → 特徴量エンジニアリング・自己教師あり学習・次元削減。
- 識別 vs 生成の二立場:境界 $$P(y\mid x)$$ を直接学ぶ識別モデル(ロジスティック回帰・SVM)と、 各クラスの生成分布 $$P(x\mid y)$$ を学び事後確率に変換する生成モデル(ナイーブベイズ・混合ガウス)。 小標本では生成的な仮定が効き、 大標本では識別的が強い傾向。 → 識別モデル・生成 AI。
これらを貫く理論的支柱がベイズ決定理論である。 事後確率 $$P(y\mid x)\propto P(x\mid y)\,P(y)$$ を最大にするクラスを選ぶMAP 決定則が、 誤り率を最小化する最適な認識であることが示せる。 誤分類のコストが非対称なら(例:少数クラスの見逃しが重い)、 単純な最大確率ではなく期待損失を最小化する閾値へずらすのが正しい。 → ベイズの定理・損失関数・機械学習。
補足: 上のクラスタ表・シルエット・相関ペア数・臨界相関・80.9% は SSDSE-B-2026 の実測。 内積テンプレートの例は本ページ既出の架空の合成データ。
🧪 実データで確かめる — 教師なしで見つかる類型は、 特徴の選び方で変わる
🎯 このコードでやること:ラベルを渡さない k-means(k=2)で 47 県を 2 つに分け、 その分かれ方が「日本海側かどうか」とどれだけ一致するかを、 クロス集計と調整ランド指数(ARI、 1 で完全一致・0 で偶然並み)で見る。 特徴を気候の 2 つにした場合と、 人口の 2 つにした場合を比べる。
1 2 3 4 5 6 7 8 9 10 11 12 13 14 15 16 17 18 19 | import pandas as pd import numpy as np from sklearn.cluster import KMeans from sklearn.preprocessing import StandardScaler from sklearn.metrics import adjusted_rand_score df = pd.read_csv('data/raw/SSDSE-B-2026.csv', encoding='cp932', skiprows=1) d = df[df['年度'] == 2023].reset_index(drop=True) japan_sea = ['青森県','秋田県','山形県','新潟県','富山県','石川県','福井県','京都府','鳥取県','島根県'] y = d['都道府県'].isin(japan_sea).astype(int) for cols in [['降水日数(年間)', '年平均気温'], ['総人口', '65歳以上人口']]: Xs = StandardScaler().fit_transform(d[cols]) lab = KMeans(n_clusters=2, n_init=10, random_state=0).fit_predict(Xs) # ラベルは使わない tab = pd.crosstab(pd.Series(lab, name='クラスタ'), y.rename('日本海側')) print('特徴:', cols, ' ARI =', round(adjusted_rand_score(y, lab), 3)) print(tab.to_string()) small = pd.Series(lab).value_counts().idxmin() print('少ない方のクラスタ:', d.loc[lab == small, '都道府県'].tolist(), '\n') |
💬 気候の 2 特徴では ARI 0.658 で、 片方のクラスタ 12 県に日本海側 10 府県のうち 9 府県が入った(外れたのは京都府。 代わりに北海道・岩手県・滋賀県が入る)。 人口の 2 特徴では ARI −0.113 で、 分かれたのは東京都・神奈川県など人口の多い 9 都道府県とそれ以外で、 日本海側とは無関係になる。 教師なしのパターン認識が見つけるのは「特徴の空間で固まっているもの」であって、 人が期待する類型とは限らない。 どの類型が浮かぶかは、 アルゴリズムより先に特徴の選び方で決まる。