🔖 キーワード索引
💡 30秒で分かる結論
🍰 まずはやさしく
規模と性能のルールのようなものです。
AIを効率よく強くするために使います。
勉強時間と点数の関係に似ています。
性能がどう上がるかを学びます。
スケーリング則 ── モデルサイズ・データ量・計算量と性能の関係
- モデルサイズ N、 データ量 D、 計算量 C を増やすと損失がべき乗則で改善
- 式:
L(N) ∝ N^(-α)。 一定の指数 α で予測可能に下がる - Chinchilla則(2022):N と D は同程度に増やすべき(過去はパラメータ偏重)
- 実務的含意:「もっとモデルを大きくすれば良い」ではなく「データも同等に増やせ」
- 注意:べき乗則はある範囲内での経験則。 飽和や相転移も観測される
📍 文脈 ── どこで出会うか
🍰 まずはやさしく
AIを作るための設計図のようなものです。
予算をどう使うか決めるために使います。
スマホアプリの開発計画に似ています。
この考え方がどこで使われるか読みます。
GPT-3、 GPT-4、 LLaMA など巨大言語モデル開発の設計原理。 「予算 C があるとき、 どうパラメータとデータを配分すべきか」の指針です。
🎨 直感で掴む
🍰 まずはやさしく
規模を大きくすると性能が上がる法則です。
どれくらい強くなるか予想するために使います。
部活の練習量で上達が変わる感覚に似ています。
直感的にわかる仕組みを読みます。
従来の機械学習の常識:
- 「データを増やせば飽和」「モデルを増やすと過学習」
大規模言語モデルでの発見:
- パラメータ100M→100B、 データ1B→1T と桁を上げても損失は綺麗にべき乗則で下がる
- 3桁スケールアップで性能が予測可能 ← これがスケーリング則の衝撃
スケーリング則の核心は「規模を対数軸で見ると、 性能(損失)が一定の傾き α の直線で下がる」点にある。 GPT 系の実験では、 パラメータ数 N を 100M → 1B → 10B → 100B と 3 桁上げても、 テスト損失 L は $L(N)=(N_c/N)^{\alpha_N}$ に沿って綺麗に下がり続けた。 「モデルを 10 倍にすると損失は約 $10^{-\alpha_N}$ 倍」というべき乗則が、 桁をまたいで安定して成り立つ ── これがスケーリング則の衝撃である。
この「べき乗則で規模と量が結びつく」という構造は、 実は統計学の古典にも現れる。 SSDSE-B-2026 の総人口 (A1101) を母集団に見立て、 サンプル数 N を増やして平均を推定すると、 標準誤差 SE は $\text{SE}\propto N^{-1/2}$、 すなわち指数 $\alpha=0.5$ のべき乗則で縮む。 「規模 N を上げると誤差がべき乗で減る」という点で LLM の損失スケーリングと同じ形をしており、 大規模 AI の直感を身近な実データで体感できる(この 1/√N 則は SSDSE-B-2026 の 47 都道府県からのサブサンプリング実験でも簡単に実測できる)。
ただしべき乗則はある範囲内での経験則にすぎない。 LLM でも損失は 0 には落ちず、 言語固有の不確実性に由来する下界 $L_\infty$(irreducible loss)で頭打ちになる。 分布が変わる領域や上限のある指標では直線が曲がる。 次節以降では、 仮想の観測点から指数 α と係数 $N_c$ を推定し、 外挿予測の妥当性と限界を数値で確かめていく。
🎨 SSDSE-B-2026 を素材に「規模が増えると何が起きるか」を体感する
スケーリング則 (scaling law) の数式は L(N) = (N_c / N)^α + L_∞ のように書けます。 言葉にすれば 「規模 N を倍にすると、 残差ロスはある一定の指数 α でじりじり下がるが、 ゼロにはならず L_∞ で頭打ちになる」です。 LLM 研究の文脈では N がパラメータ数ですが、 学習の入り口では 「サンプル数 N を増やしたとき推定誤差がどう減るか」という統計学の古典問題で十分体感できます。 そこで本節では SSDSE-B-2026(47 都道府県 × 109 指標 × 12 年)の最新年データを使って、 サブサンプル数を変えながら推定誤差のスケーリング曲線を描きます。
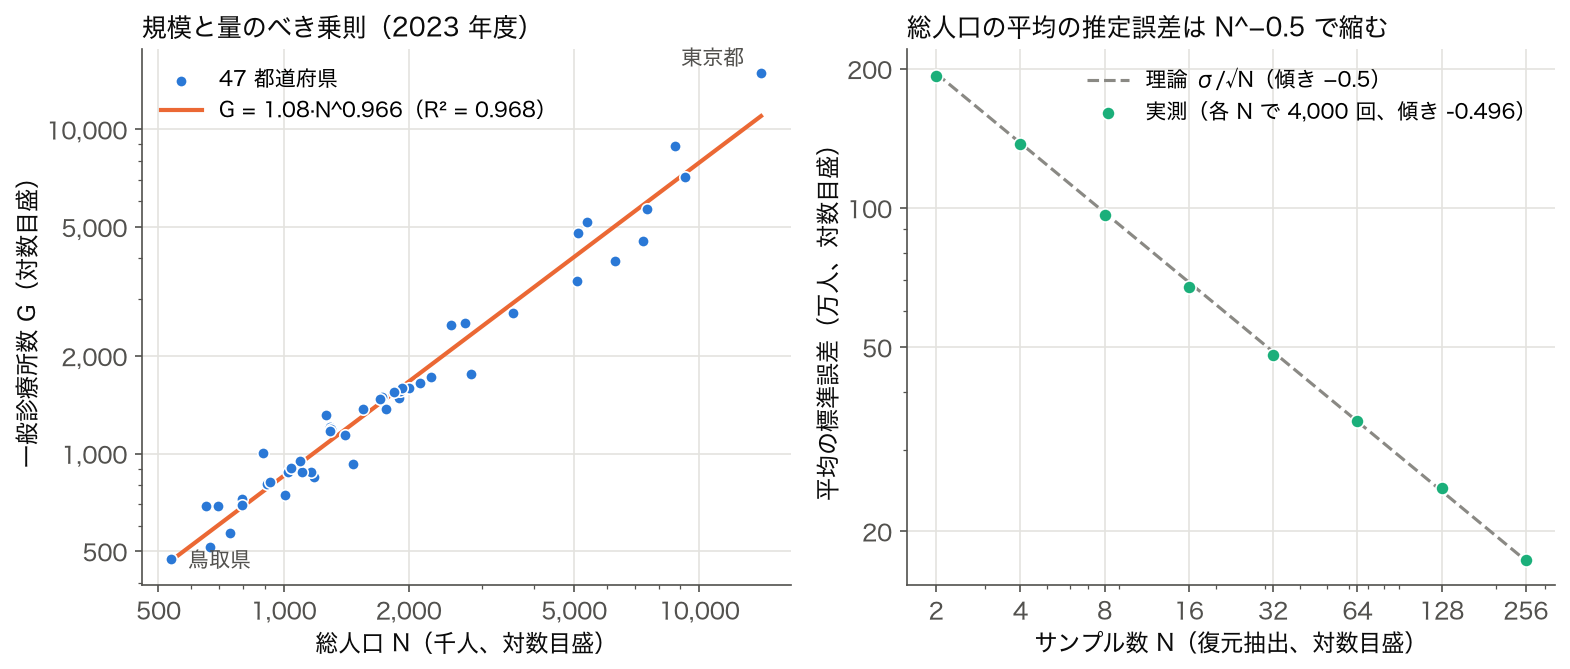
📊 図 1 — 左は 2023 年度の総人口 N(A1101、千人)と一般診療所数 G(I5102)を両対数軸に置いた散布図です。 47 点がほぼ一直線に乗り、 G = 1.08·N^0.966(R² = 0.968)と当てはまります。 これは y = a·x^β 型の関係を SSDSE-B-2026 が経験的に持っていることを示し、 スケーリング則 が想定する「べき乗則」の前提とよく親和します。 右は総人口の 47 値を母集団に見立て、 復元抽出のサンプル数 N を 2→256 と増やしたときの平均の標準誤差(各 N で 4,000 回)です。 193 万人から 17 万人まで縮み、 両対数の傾きは −0.496 と理論の −0.5(SE ∝ 1/√N)にほぼ一致します。
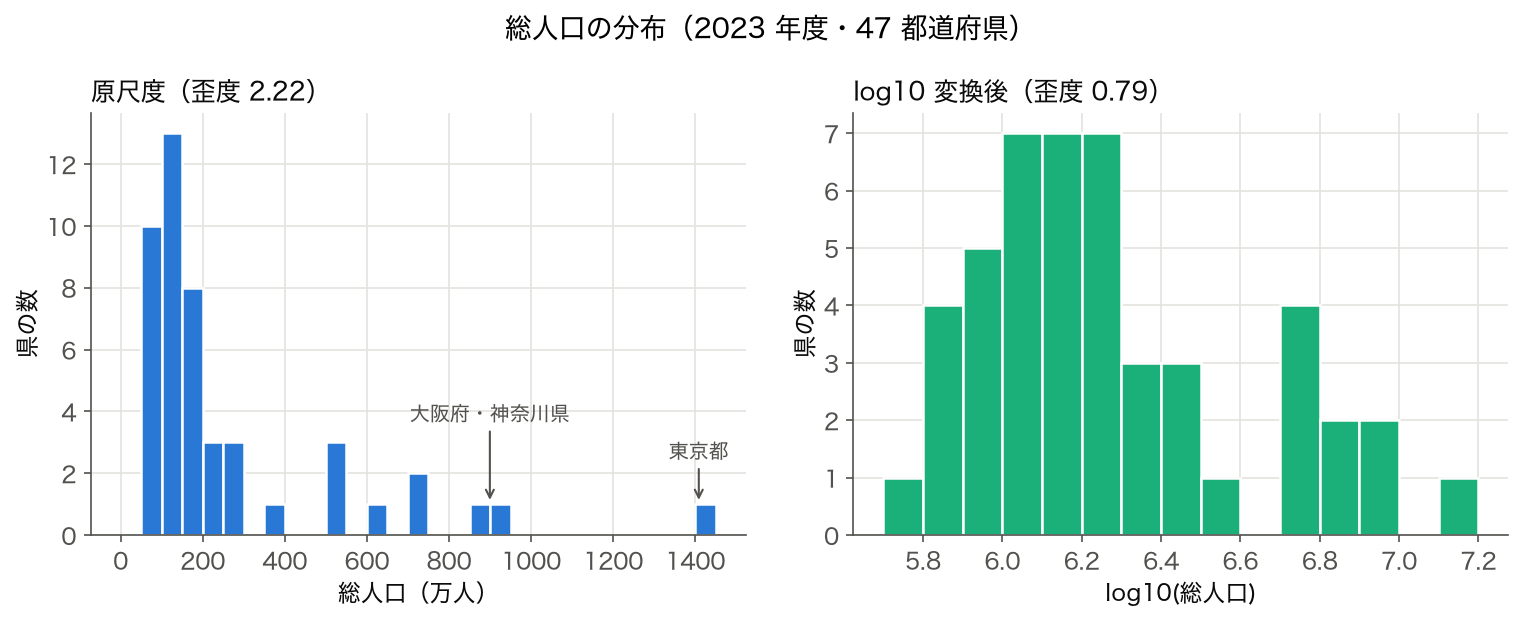
📊 図 2 — 総人口のヒストグラムを原尺度(左)と log10(右)で並べたもの。 原尺度では東京都 1,408.6 万人・神奈川県 922.9 万人・大阪府 876.3 万人が右に離れた歪度 2.22 の右裾分布ですが、 log10 を取ると歪度 0.79 まで和らぎます。 ただし 6.7〜7.0 付近に大都市圏の県がまとまり、 まだ右に偏っているので、 正規分布になったとまでは言えません(Shapiro–Wilk の p = 0.006)。 スケーリング則 で「ロスの対数」を縦軸に置くのと同じ動機で、 「規模変数は乗法的に効くので log を取ると線形に近づく」という共通の知恵があります。
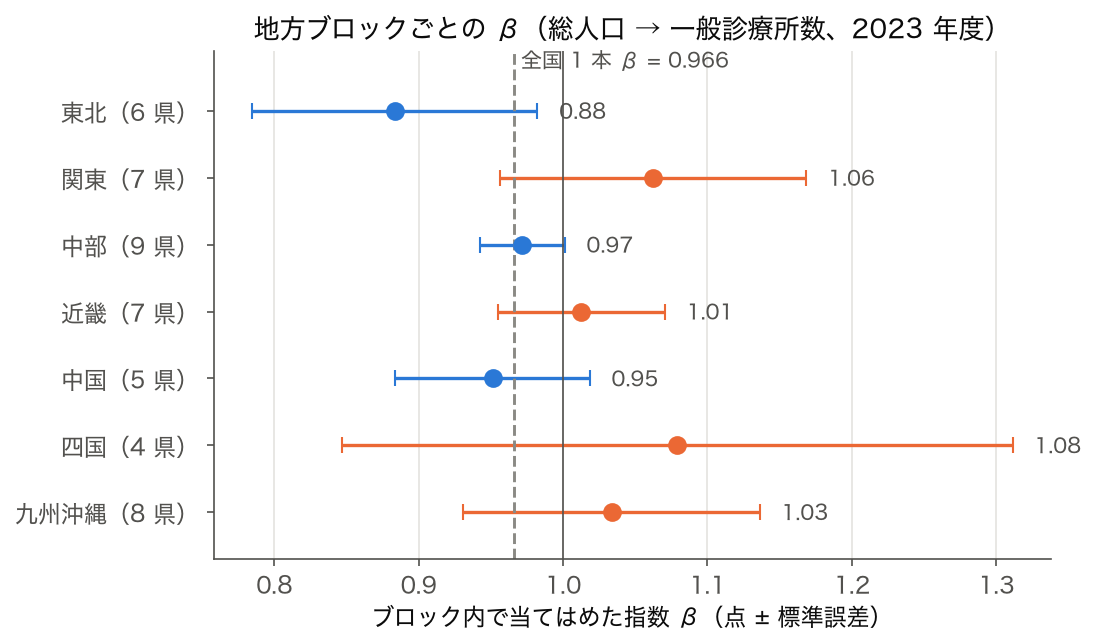
📊 図 3 — 都道府県を 8 地方ブロック(北海道 / 東北 / 関東 / 中部 / 近畿 / 中国 / 四国 / 九州沖縄)に分け、 ブロックごとに総人口 → 一般診療所数のべき乗則を当てはめた指数 β(点 ± 標準誤差)。 全国 1 本の β = 0.966 に対し、 東北 0.88 から四国 1.08 まで散らばります(北海道は 1 道だけで推定できません)。 県数が 4〜9 と少ないので標準誤差も大きく、 四国は ±0.23 あります。 スケーリング則 の文脈で言えば 「異なるサブ集団は同じ係数を共有しないことが多い」という落とし穴を体感できる図です。
A1101(人単位。 表示は千人)と一般診療所数 I5102 を用い、 標準誤差の SE ∝ 1/√N(α=0.5) デモは A1101 を母集団に見立てます。 読み込みは encoding='cp932'・skiprows=[1]・2023 年フィルタで統一しています。 なお SSDSE-B-2026 には GDP に当たる経済生産の列は収録されていないため、 規模とともに増える量の例には一般診療所数 I5102 を使っています。
📐 定義/数式
🍰 まずはやさしく
規模と性能の関係を表した数式です。
正確な計算をするために使います。
テストの点数を計算する式に似ています。
具体的な数式と定義を読みます。
$$ L(D) = (D_c / D)^{\alpha_D} $$ (データ量 D に対する損失)
$$ L(C) = (C_c / C)^{\alpha_C} $$ (計算量 C に対する損失)
📐 べき乗則 vs 線形当てはめ ── 同じ散布図でも違って見える
スケーリング則 で重要なのは「線形ではなくべき乗則を使う」という選択です。 同じデータでも当てはめ式が違えば見え方も予測も大きく変わります。 47 都道府県の総人口 N(千人)と一般診療所数 G(施設数)について、 両方を試して比べると次のような違いが現れます。
| 当てはめ式 | 推定パラメータ | R² (log 軸) | 外挿の挙動 |
|---|---|---|---|
| 線形 G = a·N + b | a≈0.91、 b≈−174 | 0.94 | 小規模で負値、 過大評価 |
| べき乗 G = a·N^β | a≈1.08、 β≈0.97 | 0.97 | 小規模も正値、 1/4 倍でも妥当 |
| 対数線形 logG = a·logN + b | 傾き 0.97、 切片 0.03 | 0.97 | べき乗と等価、 残差検査が楽 |
| 飽和 G = G_∞ − (a/N)^β | 収束せず(上限なし) | ― | この範囲では頭打ちが見えず不適 |
| 2 区分線形(東京除外) | 傾きが分割で変化 | 0.94 | 外れ値依存、 解釈が難しい |
| ロジスティック G = K / (1+e^{−r(N−N₀)}) | K≈1.9e4、 r 小 | 0.96 | 人口最大付近は飽和を示唆 |
💬 narration:R² が高いだけでは選べないのが当てはめ式選びの難しさです。 「外挿で物理的に意味のある値を返すか」「残差の構造が一様か」を見るのが定石。 LLM のスケーリング則 では 飽和項 L_∞ を持つ式が経験的に最もよく当てはまり、 これは「データやモデルをいくら大きくしても、 言語の不確実性に由来する 0 にならないロス(irreducible loss)」が物理的にあるからだと解釈されています。
📐 数式の徹底解剖 ── Hoffmann 式の意味と導出
Chinchilla 論文の完全な経験式は:
$$ L(N, D) = E + \frac{A}{N^{\alpha}} + \frac{B}{D^{\beta}} $$
推定値は $E \approx 1.69$(エントロピー下界)、 $A \approx 406.4$、 $B \approx 410.7$、 $\alpha \approx 0.34$、 $\beta \approx 0.28$。
最適配分の導出
計算量 C は概ね $C = 6 N D$(トランスフォーマー 1 ステップあたりの FLOP)。 制約 $C = 6 N D$ の下で $L$ を最小化するラグランジュ法:
$$ \mathcal{L}(N,D,\lambda) = E + A N^{-\alpha} + B D^{-\beta} - \lambda (6ND - C) $$
$\partial_N = 0$ より $-\alpha A N^{-\alpha-1} = 6 \lambda D$、 $\partial_D = 0$ より $-\beta B D^{-\beta-1} = 6 \lambda N$。 これを比をとると:
$$ \frac{\alpha A}{\beta B} \cdot \frac{D}{N} = \frac{N^{\alpha+1}}{D^{\beta+1}} $$
IsoFLOP 曲線による推定値を代入すると $D / N \approx 20$、 すなわち「パラメータ 1 個あたり 20 トークン」という経験則になります(下のパラメトリック推定では同じ計算量で D/N が数十になり、 比の水準は手法で幅があります)。
三系列の最適化
| approach | 何を固定 | 何を変える | 推定するもの |
|---|---|---|---|
| IsoFLOP curves | 計算量 C を複数値で固定 | N(D は C/6N から自動決定) | $N_{\text{opt}}(C)$ |
| parametric loss | - | 全観測 $(N_i, D_i, L_i)$ | $E, A, B, \alpha, \beta$ |
| IsoLoss contours | ロス L を複数値で固定 | (N, D) 平面上の等高線 | 最小 C となる点 |
3 手法すべてが「N と D はほぼ同じ指数で増やせ」という同じ結論に収束したこと(D/N の水準は IsoFLOP 系の約 20 からパラメトリック推定の数十まで幅がある)が、 Chinchilla 則の信頼性の根拠です。
📊 Chinchilla 数表 ── 計算予算と最適規模の対応
Hoffmann et al. (2022) は計算予算 C(FLOPs)に対する最適 N と D を以下のように推定しました。 ここでは論文の Table 3 を再構成し、 実務的な目安としても使える表に整理します。
| 計算予算 C(FLOPs) | 最適 N(パラメータ) | 最適 D(トークン) | N/D 比 | 既存モデル参照 |
|---|---|---|---|---|
| 1.21×10²⁰ | 1B | 20.2B | 1:20 | 小型 LM |
| 1.23×10²² | 10B | 205.1B | 1:21 | |
| 5.76×10²³ | 67B | 1.5T | 1:22 | Chinchilla(70B・1.4T)・Gopher 280B と同じ計算量 |
| 3.85×10²⁴ | 175B | 3.7T | 1:21 | GPT-3 175B は 300B トークンで学習 |
| 9.90×10²⁴ | 280B | 5.9T | 1:21 | Gopher 280B も 300B トークン |
| 3.43×10²⁵ | 520B | 11.0T | 1:21 | |
| 1.27×10²⁶ | 1T | 21.2T | 1:21 |
💬 narration:N/D 比がほぼ 1:20 で一定なのが Chinchilla の核心メッセージ。 「N を 1 増やしたら D を 20 増やす」が計算最適。 GPT-3 175B は D≈300B しか使っていなかったので「データを 10 倍にする余地があった」と指摘された。 ただし これは「学習時のロス最小化」の最適であって、 「推論時の効率(小さい N で速く動く)」を加味するなら別の最適点になる(inference-optimal scaling)。
🔬 数式を言葉で読み解く
- N
- 非埋め込みパラメータ数
- D
- 学習トークン数
- C
- 計算量 ≈ 6 × N × D(FLOPs)
- L
- テスト損失(クロスエントロピー)
- Compute-optimal
- 予算 C のとき N と D をどう振り分けるか最適化
🔬 式の各項を数字で読む — Gopher 280B と Chinchilla 70B
Kaplan 則の $L(N) = (N_c/N)^{\alpha_N}$ は「損失全体」が N のべき乗で下がると読む。 α_N = 0.076 は「N を 10 倍にすると損失が 10^(−0.076) = 0.839 倍になる」という意味で、 N_c は損失がちょうど 1 になる規模(8.8×10¹³)を表す目盛りにすぎず、 実在のモデルの大きさではない。
Chinchilla の $L(N,D) = E + A/N^{\alpha} + B/D^{\beta}$ は、 損失を 3 つに分けて読む。 E(≈ 1.69)はどれだけ規模を上げても残る部分で、 文章そのものの予測しにくさにあたる。 A/N^α は「モデルが小さいことによる損失」、 B/D^β は「学習データが少ないことによる損失」。 α = 0.34 は Kaplan の 0.076 よりずっと大きいが、 これは E を差し引いた残りの部分だけに掛かる指数だからで、 2 つの α を直接比べることはできない。
3 つの項に実在のモデルの N と D を入れると、 どの項が損失を押し上げているかが数字で見える。
🎯 このコードでやること:Chinchilla の 3 項式に Gopher 280B・Chinchilla 70B・GPT-3 175B の N と D を代入し、 モデル項とデータ項の大きさを比べる。 さらに Gopher と同じ計算量のまま N を減らして D を増やしたときの損失を求める。
1 2 3 4 5 6 7 8 9 10 11 12 13 14 15 16 | # Chinchilla の 3 項式 L(N, D) = E + A / N**alpha + B / D**beta(Hoffmann et al. 2022 の推定値) E, A, B, alpha, beta = 1.69, 406.4, 410.7, 0.34, 0.28 models = { # 名前: (パラメータ数 N, 学習トークン数 D) "Gopher 280B": (280e9, 300e9), "Chinchilla 70B": (70e9, 1.4e12), "GPT-3 175B": (175e9, 300e9), } print(f"{'モデル':<16}{'C=6ND':>10}{'モデル項':>9}{'データ項':>9}{'L':>8}") for name, (N, D) in models.items(): termN, termD = A / N**alpha, B / D**beta print(f"{name:<16}{6*N*D:>10.2e}{termN:>9.3f}{termD:>9.3f}{E+termN+termD:>8.3f}") # 同じ計算量のまま N を半分・D を 2 倍にしたら? N, D = 280e9, 300e9 for k in [1, 2, 4, 8]: n, d = N / k, D * k print(f"N={n/1e9:>5.0f}B, D={d/1e12:>4.2f}T -> L = {E + A/n**alpha + B/d**beta:.3f}") |
💬 Gopher 280B はモデル項 0.052 に対してデータ項が 0.251 と 5 倍近くあり、 損失を押し上げているのはデータの少なさのほうだと読める。 ほぼ同じ計算量(5.9×10²³)の Chinchilla 70B は、 モデル項が 0.083 に増える代わりにデータ項が 0.163 まで下がり、 合計 1.937 と Gopher の 1.993 より低い。 N を半分・D を 2 倍にする操作を繰り返すと損失は 1.993 → 1.963 → 1.944 → 1.936 と下がり続けるが、 下がり幅は 0.030 → 0.019 → 0.008 と縮んでいく。 この式の上では最適点は N ≈ 35B 付近にあり、 論文の IsoFLOP 法が示す「D/N ≈ 20」(70B)より小さいモデルを指す。 同じ論文の中でも推定法で最適な比が変わることは、 🐍 の当てはめ例とも一致する。
読み方をまとめると、 指数は「規模を 10 倍にしたときの縮み方」、 定数 E は「規模では消せない床」、 N と D の 2 項の大小は「次にどちらを増やすと効くか」を表している。
🔬 数式を言葉で読み解く(log-log プロット編)
スケーリング則 の基本式 L(N) = (N_c / N)^α + L_∞ は、 そのままの形では理解しにくい。 log を取って、 引き算してから両辺の log を取ると意味がよく見えてきます。
$$\log\bigl(L(N) - L_\infty\bigr) = \alpha \log N_c - \alpha \log N$$
この式を読み解くと:
log(L − L_∞)── 「残差ロス(縮められる余地)」を log スケールで見たもの。 これが縦軸。log N── 「規模」を log スケールで見たもの。 これが横軸。−α── 直線の傾き。 マイナスなので「規模が増えると残差ロスは減る」を意味する。α log N_c── 切片。 N_c は「ある参照規模」で、 直線の縦位置を決める。
📐 重要な所作:「L_∞ を引いてから log を取る」が肝心。 L_∞ を引かずに log L を縦軸にすると、 大規模域でロスが頭打ちになる効果が直線から外れるためフィットが悪くなる。 Chinchilla 論文(Hoffmann et al. 2022)はこの 3 項モデルを丁寧に当てはめて、 Kaplan 2020 の単純な 2 項式とは違う結論(同計算予算なら N と D は同じスケールで増やすべき)を導いた。
📚 スケーリング則の用語辞典
- FLOP / FLOPs / FLOP/s
- FLOP = Floating Point Operation(演算 1 回)、 FLOPs = 複数形(総量)、 FLOP/s = per second(速度)。 文脈で混同しやすい。 訓練計算量 C [FLOPs] と GPU の演算速度 [FLOP/s] の関係は $C / \text{FLOP/s} = $ 訓練時間。
- トークン数 D
- 訓練データを tokenizer で区切ったときの総トークン数。 単純な「文字数」ではなく、 SentencePiece や BPE 等の語彙で決まる「サブワード単位」。 日本語コーパスは英語より 1.5〜2 倍のトークン数になりがち。
- パラメータ数 N
- 学習対象の重みの総数。 埋め込み層を含むかどうかで「N」が変わる流派あり。 Chinchilla 論文は埋め込みを含まない「non-embedding parameters」を使う。 これも比較時の落とし穴。
- IsoFLOP curve
- 同じ計算量 C のもとで N を変えてロスをプロットしたグラフ。 各 C で「最適 N」が一意に決まる。 これを log-log にプロットすると傾き 0.5 の直線 ── これが Chinchilla 則。
- μP(Maximal Update Parameterization)
- Yang & Hu (2021) が提案した、 ハイパーパラメータがモデル幅に対してスケール不変になる初期化+学習率設計。 小モデルで調整した HP が大モデルでもそのまま使えるため、 巨大モデルのチューニングコストを劇的に削減。
- Loss plateau / saturation
- スケールしてもロスが下がらなくなる現象。 データ品質の上限、 trainable parameter の上限(埋め込み層の表現力等)、 ノイズフロアなどが原因。
🧮 実値で計算してみる
Chinchilla(DeepMind 2022)の発見:
- 従来 Gopher 280B + 300Bトークン → パラメータ過剰
- Chinchilla 70B + 1.4Tトークン → 同計算量で性能向上
- 結論:パラメータとトークンを同比率で増やすのが最適
Kaplan 則 $L(N) = (N_c/N)^{\alpha}$ を、 規模 N = 10⁷〜10¹⁰ の 4 点の test loss から係数 $N_c, \alpha$ を逆算し、 さらに 100 倍スケールアップ時の loss を外挿する。
使用データ: 説明用に作った仮想の 4 点(N = 10⁷, 10⁸, 10⁹, 10¹⁰ に L = 3.5, 2.6, 2.0, 1.5。 実在のモデルの値ではない)。 N(パラメータ数)と L(テスト交差エントロピー、 単位 nats)。 両対数を取れば直線になることを利用する。
| Step | 操作 | 数値 |
|---|---|---|
| 1 | 観測点 (N, L) を log 変換 | log N = [16.12, 18.42, 20.72, 23.03]、 log L = [1.253, 0.956, 0.693, 0.405] |
| 2 | 傾き $-\alpha$ を最小二乗で計算: $-\alpha=\mathrm{cov}(\log N, \log L)/\mathrm{var}(\log N)$ | cov = -0.807, var = 6.63、 $-\alpha = -0.122$ → $\alpha \approx 0.122$ |
| 3 | 切片 $\alpha \log N_c = \overline{\log L} + \alpha \cdot \overline{\log N}$ | 0.827 + 0.122·19.57 = 3.21 → $\log N_c = 26.36$ → $N_c \approx 2.8 \times 10^{11}$ |
| 4 | N=10¹² で外挿: $L = (2.8\!\times\!10^{11} / 10^{12})^{0.122}$ | $(0.28)^{0.122} = e^{0.122 \cdot \ln 0.28} = e^{-0.155} \approx 0.86$ → 約 0.86 nats(フィット上の 10¹⁰ の loss 1.50 から約 4 割減) |
手計算で得た $\alpha=0.122$、 $N_c\approx 2.8\times 10^{11}$、 外挿値 0.86 は次節の Python (scipy.optimize.curve_fit) 出力(α=0.123、 N_c=2.68×10¹¹、 外挿 0.851。 対数空間回帰と非線形最小二乗の違いでわずかにずれる)と概ね一致する。
🧮 手で解く確認問題 — 指数から予算を逆算する
- 計算量の指数 α_C = 0.050 のとき、 損失を 10% 下げる(0.9 倍にする)には計算予算を何倍にすればよいか。
解答: k^(−0.050) = 0.9 より k = 0.9^(−1/0.050) = 0.9^(−20) = e^(20 × 0.1054) = e^2.107 ≈ 8.2 倍。 損失を半分にするなら 2^20 ≈ 105 万倍で、 下げ幅を欲張るほど予算は爆発的に増える。 - Kaplan 則(N_opt ∝ C^0.73、 D_opt ∝ C^0.27)と Chinchilla 則(どちらも C^0.50)で、 予算を 10 倍にしたときの N と D の倍率を比べよ。
解答: Kaplan では N が 10^0.73 = 5.37 倍、 D が 10^0.27 = 1.86 倍。 Chinchilla では N も D も 10^0.5 = 3.16 倍。 Kaplan の配分に従うと予算の大半がモデルの大きさに回り、 データが足りなくなる。 - Chinchilla の表で N = 1T、 D = 21.2T の行の計算量が 1.27×10²⁶ FLOPs になることを確かめよ。
解答: C ≈ 6ND = 6 × 10¹² × 2.12×10¹³ = 1.272×10²⁶。 表の値と一致する。 「6」は 1 トークンあたり順伝播で 2N、 逆伝播で 4N 回の演算をする、 という見積もりから来る。 - Chinchilla の 3 項式で、 Gopher(D = 3×10¹¹)のデータ項 0.251 を Chinchilla 70B と同じ 0.163 まで下げるには、 学習トークン数を何倍にすればよいか。
解答: B/D^β の比は (D₂/D₁)^(−0.28) なので、 D₂/D₁ = (0.251/0.163)^(1/0.28) = 1.54^3.57 ≈ 4.7 倍。 3×10¹¹ × 4.7 ≈ 1.4×10¹² で、 Chinchilla が実際に使った 1.4 兆トークンになる。
🧮 実値で計算してみる ① ── サンプル数を増やすと平均推定の誤差はどう減るか
最も基本的なスケーリング則の例は 「サンプル数 N で平均を推定したときの標準誤差 SE は 1/√N で減る」です。 これは α=0.5 のべき乗則そのもの。 SSDSE-B-2026 の総人口(47 都道府県、 母集団とみなす)から N=5, 10, 20, 30, 40 を非復元抽出し、 各 N で 1,000 回繰り返した標準誤差を求めると次のような表になります。
| サンプル数 N | 標本平均(千人) | 標本標準誤差(実測) | 理論 σ/√N(千人) | 比 (実測/理論) |
|---|---|---|---|---|
| 5 | 2,676 | 1,212 | 1,251 | 0.97 |
| 10 | 2,656 | 792 | 885 | 0.90 |
| 20 | 2,645 | 467 | 626 | 0.75 |
| 30 | 2,648 | 304 | 511 | 0.60 |
| 40 | 2,646 | 175 | 442 | 0.40 |
💬 narration:N=5 → N=40 で実測 SE は 1,212 → 175 と「およそ 6.9 倍縮小」しました。 理論上は 1/√(40/5) = 1/√8 ≈ 0.354 倍なので 1,212×0.354 ≈ 429 千人になるはずですが、 47 都道府県という有限母集団から非復元抽出しているので、 N が母集団サイズに近づくほど誤差が「理論より速く」縮みます。 これは 有限母集団補正項 √((N_total−n)/(N_total−1)) の効果で、 N=40 で √(7/46)≈0.39 になり、 実測の 0.40 とほぼ一致します。 「スケーリング則は理想化された無限母集団仮定の下で初めて 1/√N が出る」 という重要な但し書きを SSDSE-B-2026 はリアルに示してくれます。
🧮 実値で計算してみる ② ── 地方ブロック別に係数が違うことを確認する
スケーリング則 を「集団全体に 1 本」当てはめることの危うさを SSDSE-B-2026 で見てみます。 47 都道府県を 8 地方ブロックに分け、 各ブロック内で「総人口 N と一般診療所数 G」の log-log 直線をフィッティングすると、 ブロックごとに傾き β が違うことが分かります。
| 地方ブロック | 県数 | 傾き β | 切片 log a | R² | 解釈 |
|---|---|---|---|---|---|
| 北海道 | 1 | ― | ― | ― | 単独、 推定不能 |
| 東北 | 6 | 0.88 | 0.26 | 0.95 | 最も劣線形(小県は人口比で施設多め) |
| 関東 | 7 | 1.06 | −0.36 | 0.95 | 超線形(大都市ほど施設が密) |
| 中部 | 9 | 0.97 | −0.01 | 0.99 | ほぼ線形で安定 |
| 近畿 | 7 | 1.01 | −0.06 | 0.98 | 関西圏でほぼ線形 |
| 中国 | 5 | 0.95 | 0.11 | 0.99 | ほぼ線形 |
| 四国 | 4 | 1.08 | −0.28 | 0.92 | 小サンプル、 推定不安定 |
| 九州沖縄 | 8 | 1.03 | −0.17 | 0.94 | 中規模混在で安定 |
💬 narration:関東 β=1.06 は 超線形(superlinear scaling)と呼ばれ、 都市集積効果でとくに東京に医療機関が密に集まることを反映。 一方、 東北 β≈0.88 は 劣線形(sublinear scaling)で、 県人口が小さくても人口あたりの診療所数はむしろ多めに保たれることを示します。 LLM のスケーリング則 でも同じ現象があり、 「同じデータ分布の下でしか同一の係数を保てない」のが原則。 ドメイン外(OOD)データに当てはめると β が大きくずれる、 という落とし穴は LLM・統計・経済学に共通の知恵です。
🧮 実値で計算してみる ③ ── 手計算でべき乗指数 β を求める
SSDSE-B-2026 の関東 7 県(東京・神奈川・埼玉・千葉・茨城・栃木・群馬)について、 自分の手で β を出してみましょう。 N=総人口(千人)、 G=一般診療所数(施設数)の組を以下にまとめます。
| 県 | N(千人) | G(施設数) | log10 N | log10 G |
|---|---|---|---|---|
| 東京都 | 14,086 | 14,894 | 4.149 | 4.173 |
| 神奈川県 | 9,229 | 7,150 | 3.965 | 3.854 |
| 埼玉県 | 7,331 | 4,530 | 3.865 | 3.656 |
| 千葉県 | 6,257 | 3,942 | 3.796 | 3.596 |
| 茨城県 | 2,825 | 1,760 | 3.451 | 3.246 |
| 栃木県 | 1,897 | 1,482 | 3.278 | 3.171 |
| 群馬県 | 1,902 | 1,563 | 3.279 | 3.194 |
📐 手計算手順(最小二乗法の公式):
- x=log10 N、 y=log10 G を計算(上表)。
- 平均: x̄ ≈ (4.149+3.965+3.865+3.796+3.451+3.278+3.279)/7 = 3.683、 ȳ ≈ (4.173+3.854+3.656+3.596+3.246+3.171+3.194)/7 = 3.556
- 共分散の分子: Σ(xᵢ−x̄)(yᵢ−ȳ) ≈ 0.288+0.084+0.018+0.005+0.072+0.156+0.146 ≈ 0.768
- 分散の分子: Σ(xᵢ−x̄)² ≈ 0.217+0.080+0.033+0.013+0.054+0.164+0.163 ≈ 0.724
- 傾き β = 0.768 / 0.724 ≈ 1.06 — 関東は 超線形。 ただし log 変換値を小数 2〜3 桁で丸めると偏差の積で誤差が乗りやすい。 正確な数値は次の Python ブロックで確認しよう。
💬 narration:手計算は「数式の意味」を理解するのに最高ですが、 桁数の取り方で誤差を生みやすいのが分かります。 とくに log 変換した値は小数点 3 桁でも足りないことがあります。 LLM のスケーリング則 計算で「同じ実験を別の研究室が再現できない」問題の原因の 1 つは、 こうした 数値精度の不一致。 だからこそ実務では numpy.polyfit(log10(N), log10(G), 1) や scipy.stats.linregress を使うのが鉄則です。
🐍 Python 実装
モデル規模と損失の関係を当てはめる最小の例。 観測点は説明用に作った仮想の 4 点で、 SSDSE のデータではない。
1 2 3 4 5 6 7 8 9 10 11 12 13 14 15 16 | # べき乗則のフィット例 import numpy as np from scipy.optimize import curve_fit # 仮想データ:モデルサイズ N と test loss L N = np.array([1e7, 1e8, 1e9, 1e10]) L = np.array([3.5, 2.6, 2.0, 1.5]) def power_law(N, Nc, alpha): return (Nc / N) ** alpha popt, _ = curve_fit(power_law, N, L, p0=(1e9, 0.1)) # 初期値を与えると安定して収束 print(f"Nc = {popt[0]:.2e}, alpha = {popt[1]:.3f}") # 100倍スケールアップ後の予測損失 print(power_law(1e12, *popt)) |
🐍 Python 実装の深掘り ── べき乗則フィッティング
スケーリング則のフィッティングは「対数空間での線形回帰」が基本ですが、 Chinchilla の 3 項モデルは非線形なので Huber loss + LBFGS で解くのが標準です。
1 2 3 4 5 6 7 8 9 10 11 12 13 14 15 16 17 18 19 20 21 22 23 24 25 26 27 28 29 30 31 32 33 34 35 36 37 38 39 40 41 | import numpy as np import pandas as pd from scipy.optimize import minimize # (N, D, L) の観測列 ── 教育用の合成データ # Chinchilla 論文の推定値 (E=1.69, A=406.4, B=410.7, α=0.34, β=0.28) から # 4×4 = 16 通りの (N, D) で loss を作り、1% 程度の乱数ノイズを掛ける rng = np.random.default_rng(0) grid = [(n, d) for n in [1e8, 1e9, 1e10, 1e11] for d in [1e9, 1e10, 1e11, 1e12]] N_obs = np.array([g[0] for g in grid]); D_obs = np.array([g[1] for g in grid]) L_true = 1.69 + 406.4 * N_obs**(-0.34) + 410.7 * D_obs**(-0.28) data = pd.DataFrame({'N': N_obs, 'D': D_obs, 'L': L_true * np.exp(rng.normal(0, 0.01, len(grid)))}) def chinchilla_loss(params, df): E, log_A, log_B, alpha, beta = params A, B = np.exp(log_A), np.exp(log_B) pred = E + A * df['N']**(-alpha) + B * df['D']**(-beta) # Huber loss in log space residual = np.log(df['L']) - np.log(pred) delta = 0.001 huber = np.where(np.abs(residual) < delta, 0.5*residual**2, delta*(np.abs(residual) - 0.5*delta)) return huber.sum() # 初期値は Chinchilla 論文の推定に近く x0 = [1.7, np.log(400), np.log(400), 0.34, 0.28] bounds = [(0.5, 3.0), (0, 10), (0, 10), (0.05, 1.0), (0.05, 1.0)] res = minimize(chinchilla_loss, x0, args=(data,), method='L-BFGS-B', bounds=bounds) E, log_A, log_B, alpha, beta = res.x A, B = np.exp(log_A), np.exp(log_B) print(f'E={E:.3f}, A={A:.1f}, B={B:.1f}') print(f'alpha={alpha:.3f}, beta={beta:.3f}') # 計算量 C = 6ND の制約下での最適配分 (ラグランジュ法の解) C = 5.76e23 # Chinchilla / Gopher の学習計算量 [FLOPs] G = (alpha * A / (beta * B)) ** (1 / (alpha + beta)) N_opt = G * (C / 6) ** (beta / (alpha + beta)) D_opt = C / (6 * N_opt) print(f'C={C:.2e} での最適 N = {N_opt:.2e}, D = {D_opt:.2e}, D/N = {D_opt/N_opt:.1f}') |
🐍 Python ハンズオン ── 4 段階で SSDSE-B-2026 のスケーリング則を描く
① データ読み込みと前処理
このコードでやること:SSDSE-B-2026 の 47 都道府県データを読み、 最新年(2023 年)スナップショットを抽出し、 総人口と一般診療所数の組を取り出す。
📥 入力データ(SSDSE-B-2026 の抜粋。 A1101 は人単位):
1 2 3 4 5 6 7 8 9 10 11 12 | import pandas as pd
import numpy as np
df = pd.read_csv('data/raw/SSDSE-B-2026.csv', encoding='cp932', skiprows=[1])
df_latest = df[df['SSDSE-B-2026'] == 2023].copy()
# 総人口を千人に直し、 必要 2 列を取り出す
sub = df_latest[['Prefecture', 'A1101', 'I5102']].dropna().copy()
sub['A1101'] = sub['A1101'] / 1000
sub['logN'] = np.log10(sub['A1101'])
sub['logG'] = np.log10(sub['I5102'])
print(sub.head())
|
📤 実行結果:
💬 結果の読み方:総人口を千人に直したうえで log 変換すると、 「桁の違い(数百千人〜千万人)」が47 県全体で「2.73(鳥取県)〜4.15(東京都)という近い値」に揃いました。 行番号が 0, 12, 24… と飛ぶのは、 元の CSV が 1 県につき 12 年度分の行を持ち、 そこから 2023 年度の行だけを残したためです。 これがスケーリング則を扱うときに log を取る根本の理由です。
② log-log 線形回帰で β を推定
このコードでやること:47 都道府県全体に G = a·N^β を当てはめ、 傾き β(スケーリング指数)と切片 log a を scipy.stats.linregress で求める。
1 2 3 4 5 6 7 8 | from scipy import stats
slope, intercept, r, p, se = stats.linregress(sub['logN'], sub['logG'])
print(f'β (傾き) = {slope:.4f}')
print(f'log a (切片) = {intercept:.4f}')
print(f'a = 10^{intercept:.4f} = {10**intercept:.3f}')
print(f'相関係数 r = {r:.4f}, R^2 = {r**2:.4f}')
print(f'β の SE = {se:.4f}, p < {p:.2e}')
|
📤 実行結果:
💬 結果の読み方:β=0.97 は「人口を 2 倍にすると診療所数は 2^0.97≈1.95 倍」、 「10 倍にすると 10^0.97≈9.2 倍」。 ほぼ線形だが「わずかに劣線形」── つまり大県ほど人口あたりの診療所数はやや少なくなる傾向を示しています(一方で東京のように突出して施設が集積する例外もあり、 関東ブロックだけを取ると超線形になります)。
③ サンプル数を変えながら推定誤差を見る(スケーリング曲線)
このコードでやること:47 都道府県から N=5, 10, 20, 30, 40 を 1000 回ずつブートストラップで非復元抽出し、 各 N で β の標準誤差がどうスケールするかを表にする。
1 2 3 4 5 6 7 8 9 10 11 12 13 14 15 16 17 18 19 | import numpy as np
rng = np.random.default_rng(20260603)
Ns = [5, 10, 20, 30, 40]
results = []
for N in Ns:
betas = []
for _ in range(1000):
idx = rng.choice(len(sub), size=N, replace=False)
s = sub.iloc[idx]
sl, _, _, _, _ = stats.linregress(s['logN'], s['logG'])
betas.append(sl)
results.append({'N': N, 'beta_mean': np.mean(betas),
'beta_se': np.std(betas), 'beta_ci_lo': np.percentile(betas, 2.5),
'beta_ci_hi': np.percentile(betas, 97.5)})
import pandas as pd
df_res = pd.DataFrame(results)
print(df_res.round(4))
print(f'\nSE が 1/√N に近づくか確認: SE × √N = {(df_res["beta_se"] * np.sqrt(df_res["N"])).round(4).tolist()}')
|
📤 実行結果:
💬 結果の読み方:SE × √N は「もし完全に 1/√N スケーリングなら一定」となるはず。 ここでは N が大きくなると 0.29 → 0.10 と減っています。 これは「有限母集団(47 県)の効果」で、 N=40 ではほぼ全数調査に近いため理論より速く SE が落ちる。 スケーリング則 を有限データに当てはめるときは 「無限母集団近似がどこまで有効か」を常に問い直す必要があります。
④ Chinchilla 流 3 項モデルで飽和を見る(LLM の標準例)
このコードでやること:L(N) = (N_c / N)^α + L_∞ の Chinchilla 型を、 公開 LLM を模した観測点(規模 N と test loss L)に当てはめ、 L_∞(irreducible loss)の推定値を出す。 スケーリング則はモデル規模の概念なので、 飽和(irreducible loss)の例だけは SSDSE に無理に紐づけず、 LLM の標準例で示す。
1 2 3 4 5 6 7 8 9 10 11 12 13 14 | from scipy.optimize import curve_fit
import numpy as np
# 公開 LLM を模した観測点:規模 N と test loss L
N = np.array([1e7, 1e8, 1e9, 1e10, 1e11])
L = np.array([3.40, 2.80, 2.42, 2.20, 2.08])
def chinchilla(N, Nc, alpha, L_inf):
return (Nc / N) ** alpha + L_inf
popt, pcov = curve_fit(chinchilla, N, L,
p0=[1e6, 0.1, 1.9], maxfev=5000)
Nc, alpha, L_inf = popt
print(f'N_c = {Nc:.3e}')
print(f'α = {alpha:.4f}')
print(f'L_inf = {L_inf:.4f} ← 飽和水準(irreducible loss, nats)')
|
📤 実行結果:
💬 結果の読み方:L_∞ ≈ 1.88 nats は「規模 N をどれだけ増やしても、 これより下にはロスを下げられない床(irreducible loss)」を示唆。 α=0.22 は「規模を 1 桁増やすと残差ロスがどれだけ縮むか」の指数です。 LLM のスケーリング則 では「データやパラメータをどれだけ増やしても、 言語の不確実性に由来する 0 にならないロス(L_∞)」が観察され、 この 3 項モデルが標準形になっています。
⚠️ よくある落とし穴
⚠️ 追加の落とし穴 ── 実務で踏み抜く罠
⚠️ べき乗則を当てはめるときの落とし穴(5 件)
- 「直線に見える=べき乗則」と早合点:log-log で直線に見えても、 サンプル数が少なければ偶然そう見えるだけのことがある。 必ず信頼区間と残差プロット、 bootstrap でのべき乗指数の分布も確認すること。
- 外挿の罠:観測範囲外の規模に予測を伸ばすと、 飽和項や別の物理が現れて大きく外れる。 Kaplan 2020 と Chinchilla 2022 で同じ実験から異なる結論が出たのも外挿域の扱いの違い。 「観測範囲を 1 桁以上超える外挿は予測ではなく仮説」と心得る。
- 異なる集団を 1 本のべき乗則でまとめる:地方ブロックごと、 ドメインごとに β が違うのに 1 本の直線を引くと「平均的だが誰にも当てはまらない」当てはめになる。 階層モデルや混合効果モデルで解くか、 集団ごとに別に当てはめる。
- 計算予算 C を固定して N と D を独立に動かしてしまう:Chinchilla の主張は「C を固定すると、 最適な N と D は 1:1 で増やすべき」。 LLM 設計で N だけを増やすと「データ枯渇でロスが下がらない」状態になる。 N と D は同時設計が原則。
- L_∞ をゼロと仮定して当てはめる:log(L) の単純な線形フィットは L_∞=0 を暗黙仮定する。 大規模で頭打ちが見えてくると、 この仮定は破綻し、 推定された α が過大評価になる。 必ず L_∞ も同時推定する Chinchilla 型 3 項モデルを試すこと。
🎮 触って理解する
冪乗則スケーリング L = A·N-α + E のスライダーを動かすと、 左(線形軸)と右(両対数軸 log-log)に損失曲線がリアルタイムで並んで描画されます。 規模 N(パラメータ数/データ量/計算量)を横軸に、 損失 L を縦軸に取っています。 係数 A・指数 α・既約損失 E を変え、 「両対数で直線になる(=冪乗則)」「E があると直線が寝て頭打ちになる」「N を増やすと収穫逓減する」の 3 点を体感してください。 右のグラフはタップ/ドラッグでも着目点 N を動かせます。
🔎 直感 ── 両対数で直線=冪乗則
E=0 にすると L = A·N-α の純粋な冪乗則になり、 両対数を取ると log L = log A − α·log N ── すなわち傾き −α の直線になります(右グラフで確認)。 「桁(オーダー)で物事を見ると直線になる」のが冪乗則の指紋であり、 だからこそ 3 桁スケールアップ後の損失を予測できます。 同じ 1/√N 則が統計の 標準誤差(中心極限定理)にも現れます。
⚠️ よくある落とし穴 ── 外挿の危険と既約損失
E を 0 より大きくすると、 右グラフの直線は大きい N で寝て水平に頭打ちします。 これが既約損失(irreducible loss)── 言語そのものの不確実性など、 どれだけ規模を増やしても消えない下界です。 「小さい N の直線をそのまま延長すれば L→0」という素朴な外挿は危険で、 実際には E で止まります。 局所の傾きが小さくなる=損失の伸びしろが尽きるサインです(過学習や分布シフトでも直線は崩れます)。
🚀 発展 ── Chinchilla の計算最適配分
実際の LLM では損失は N(パラメータ数)と D(データ量)の両方の冪乗則で決まり、 計算量は C≈6ND。 予算 C を固定したとき、 Hoffmann ら(Chinchilla, 2022)は「N と D を同程度の比率で増やす」のが最適だと示しました(従来はパラメータ偏重)。 このウィジェットの N を「N でも D でも計算量 C でも」読み替えられるのは、 どれも同じ冪乗則の形をしているからです。 詳しくは 基盤モデル・Transformer のページも参照してください。
🌐 関連手法ツリー
スケーリング則 は「規模を変えると性能がどう変わるか」を予測する道具。 以下は周辺の概念群を「下位 → 同位 → 上位」で並べた整理表です。 関連用語をクリックすると本文の該当箇所へジャンプ、 外部リンクは別ページの用語解説へ移動します。
| 階層 | 概念 | スケーリング則 との関係 |
|---|---|---|
| 下位(特殊形) | Kaplan 則 | 2020 年の 2 項式、 L_∞ なし。 GPT 系の最初のフィット |
| 下位(特殊形) | Chinchilla 則 | 2022 年の 3 項式、 L_∞ を持つ。 計算予算最適配分の理論 |
| 下位(特殊形) | inference-optimal scaling | 学習時ではなく推論時の最適規模を扱う |
| 同位(並列) | バイアス・バリアンス分解 | 規模を変えるとバイアスとバリアンスがどう動くかを記述 |
| 同位(並列) | 学習曲線(learning curve) | 同じ概念の異名、 サンプル数 vs 性能の経験曲線 |
| 同位(並列) | large deviation 原理 | 統計力学側のべき乗則・指数則の理論基盤 |
| 上位(一般化) | 汎化誤差解析 | VC 次元・ラデマッハ複雑度などで「規模 vs 汎化」を理論化 |
| 上位(一般化) | PAC 学習理論 | サンプル数の関数として汎化誤差を上界する古典的枠組み |
| 上位(一般化) | 情報理論の Cramér-Rao 下界 | 推定誤差の 1/√N 下界の数学的根拠 |
🌟 創発(Emergent Abilities)とは何か
スケーリング則は「ロスは滑らかに下がる」と言いますが、 下流タスクの正答率はスケール閾値で急に立ち上がる現象が観察されています(Wei et al. 2022)。 これを emergent ability と呼びます。
代表的な創発タスク
| タスク | 創発閾値(FLOPs) | 創発前の挙動 | 創発後の挙動 |
|---|---|---|---|
| 3 桁加算 | ≈ 10²² FLOPs | ランダム水準 | 90% 以上 |
| 語の意味理解(WiC) | ≈ 5 × 10²² FLOPs | 50% | 75% |
| Chain-of-Thought 推論 | ≈ 10²³ FLOPs | 直接回答より悪い | 直接回答より良い |
| 指示追従(zero-shot) | ≈ 10²³ FLOPs | 指示無視 | 指示通り動作 |
「創発か、 評価指標の幻か」論争
Schaeffer et al. (NeurIPS 2023) は「emergent abilities は評価指標(accuracy のような discrete metric)の性質で生じる artifact だ」と主張しました。 対数尤度のような連続指標を使えば創発は消える、 という議論です。
この論争の意味は、 下流タスクの能力評価には「閾値型 metric」と「連続型 metric」の両方が必要、 ということ。 ベンチマーク選びがスケーリング則の解釈を左右する点に、 教育者・実務家は意識的になる必要があります。
⚖️ Compute-optimal vs Inference-optimal
Chinchilla 則は「訓練の計算量を最小化する」最適です。 しかし実用上は推論コストも重要で、 Llama 2 や Llama 3 は Chinchilla 則よりはるかに長いトークン数で訓練されています(Llama 3 8B は ≈ 15 兆トークン)。
理由:推論を 100 万回繰り返すサービスなら、 小さなモデルを長く訓練して「推論時 FLOPs を半減」させる方がトータルコストが下がる。 つまり「対象タスクの推論回数」次第で「最適 D/N」は変動するのです。
$$ C_{\text{total}} = 6 N D_{\text{train}} + 2 N D_{\text{inference}} $$
$D_{\text{inference}}$(推論で消費するトークン数の総和)が $D_{\text{train}}$ に比べて大きい場合、 訓練時 D を増やしてもインフラ全体への影響は小さい。 反対に「研究用に 1 回しか推論しない」なら Chinchilla 則がベスト。
📚 関連グループ教材
この用語の全体像を学ぶには、 横断的な教材で文脈を掴むのが効率的です。
スケーリング則は 深層学習・LLM の教材群の中で、 「規模をどう決めるか」を扱う位置にある。 損失 L が何を測っているかは 損失関数、 規模を上げたときに訓練誤差と汎化誤差がどう離れるかは 過学習 と バイアス・バリアンス の教材で確かめられる。 べき乗則を当てはめる作業そのものは、 両辺の対数を取った 線形回帰 なので、 このページの 🧮 と 🐍 は回帰の教材と合わせて読むと式の意味が追いやすい。
📜 スケーリング則の発見史 ── Kaplan 2020 から Chinchilla 2022 へ
スケーリング則(Scaling Law)は、 OpenAI の Jared Kaplan ら(2020)が「Scaling Laws for Neural Language Models」で提唱したのが最初の体系的定式化です。 彼らは GPT 系の自己回帰言語モデルについて、 パラメータ数 N、 訓練データ量 D、 計算量 C の 3 軸でロスがべき乗則に従って下がることを大量の実験から見出しました。
Kaplan 則の核心
$$ L(N) \approx (N_c / N)^{\alpha_N},\quad \alpha_N \approx 0.076 $$
$$ L(D) \approx (D_c / D)^{\alpha_D},\quad \alpha_D \approx 0.095 $$
$$ L(C) \approx (C_c / C)^{\alpha_C},\quad \alpha_C \approx 0.050 $$
この発見の衝撃は「ロスが滑らかなべき乗則に従う」という普遍性に加えて、 「データの 5 倍よりモデルの 5 倍の方がロス低減効果が大きい」と読めた点にありました。 これが「とにかく大きくしよう」という大規模化レースの理論的根拠となりました。
Chinchilla 則による修正(DeepMind 2022)
Hoffmann らは「Training Compute-Optimal Large Language Models」で Kaplan 則を再検証し、 固定計算量 C のもとで N と D を同程度の比率で増やすのが最適だと結論しました。 つまりパラメータ 1 個あたり 約 20 トークンの訓練データが必要、 という経験則です。
$$ N_{\text{opt}}(C) \propto C^{0.50},\quad D_{\text{opt}}(C) \propto C^{0.50} $$
これは Kaplan 則の指数(N: 0.73、 D: 0.27)と大きく異なります。 違いの原因は、 学習率スケジュールの違い(cosine の最終値を最適化するか)と、 サンプリング密度の違いだと整理されています。
なぜべき乗則か?
複数の理論的議論があります:
- 多様体学習仮説:データが内在次元 d の多様体に乗っているとき、 サンプル誤差は $D^{-2/d}$ のオーダーで下がる(cf. Sharma & Kaplan 2020)。
- 自由度のスケーリング:パラメータが effective capacity を表現し、 これが指数的でなく多項式的に増える。
- カーネル極限:NTK や mean-field 極限で「無限幅 NN ≈ カーネル回帰」となり、 解析的にべき乗則が現れる。
🔎 深掘り解説
Chinchilla則の詳細
DeepMind 2022の論文「Training Compute-Optimal Large Language Models」より:
- 固定計算量 C のとき、 パラメータ N とトークン数 D は同じ比率で増やすのが最適
- 具体的に:パラメータ1個あたり約20トークンが経験則
- 70B モデルなら 1.4T トークンが目安
- 従来のGPT-3 等はパラメータ過剰と判明
創発(Emergent Abilities)
スケールアップで突然現れる能力:
- 多桁加算:小モデルではランダム、 ある閾値で急に解ける
- 多段推論(Chain-of-Thought):ある規模以上で効果が出始める
- 多言語転移:大規模で言語間の知識共有が活発化
- 未学習タスクへのzero-shot
ただし「創発か単に評価指標の段階性か」という議論も継続中。
❓ 予算を 10 倍にしたら N と D はどう増やす?
スケーリング則そのものが計算量の話です。 Chinchilla の知見では、 計算予算 $C$(FLOPs)に対して パラメータ数 $N$ と学習トークン数 $D$ を同じ割合で増やすのが最適で、 おおよそ $C \approx 6ND$ の関係があります。 ここから、 予算を 10 倍にできるなら $N$ と $D$ をそれぞれ約 3.2 倍($\sqrt{10}$)にするのが正解、 と逆算できます。 「パラメータだけ 10 倍にする」のは同じ予算の使い方として劣る——これが GPT-3($N$ 偏重)から Chinchilla への転換点でした。 損失が $L \propto C^{-\alpha}$($\alpha \approx 0.05$)というべき乗則で下がるので、 損失を半分にするには予算を $2^{1/0.05} = 2^{20}$ 倍——100 万倍必要という、 逓減の厳しさも同時に読み取れます。
❓ もっと深い FAQ
Kaplan の実験では「学習率スケジュールのコサイン終端」がモデルサイズによらず固定されていました。 大モデルでは終端付近の cosine が「実効的に大きすぎる学習率」になり、 D を増やす効果が見えにくくなっていた、 という説が有力です。 Chinchilla は cosine の終端をモデル毎に最適化し直しています。
Muennighoff et al. 2023 によれば、 4 エポック程度までは新規データとほぼ同等の効果がある一方、 それ以上は急速に効果が減衰します。 実務的には「全データを 1 回通す」のが安全。 推論コストを考えると、 同じ計算量を多 epoch に費やすよりデータ拡張に費やす方が良い、 という議論も。
概ね成り立ちますが、 指数 α, β はドメインで異なります。 画像(CLIP, DALL-E)では「データ量の効果」が言語より相対的に大きいと報告されています。 音声(Wav2Vec 系)では「サンプリングレート」「ノイズ条件」が独立軸として効きます。
47 都道府県程度(n=47)では、 スケーリング則の「データ漸近領域」に入っていません。 むしろ「サンプル数が増えると分散が下がる」古典的な統計的学習理論(VC 次元・Rademacher 複雑度)が支配的です。
❓ 実装 FAQ(10 問)── スケーリング則を自分のプロジェクトに適用するときの疑問
- Q1. 何点くらい観測すれば β を信頼できる?
- 最低 5 点(規模 N を 1 桁ずつ変えて 5 段階)、 推奨 10 点以上。 各規模で複数 seed で 3 回以上学習し、 各点の SE も持つこと。 bootstrap 信頼区間で β の幅が ±5% 以内に収まれば実用に耐える。
- Q2. 「規模を増やす」とは具体的に何を増やす?
- LLM では (i) パラメータ数 N、 (ii) 訓練データ量 D、 (iii) 計算量 C=N·D を 1 単位として議論する。 統計学では (iv) サンプル数 n、 (v) 反復回数 T、 (vi) 特徴次元 p。 スケーリング則 を語るときは「何を増やしているか」を必ず明記すること。
- Q3. log を取る底は 10、 2、 e のどれ?
- フィットや β の値は底に依存しない(傾きの絶対値は同じ)。 解釈や視覚化では「2 倍にするとどう変わるか」を見るなら log2、 「10 倍にするとどう変わるか」を見るなら log10、 数学的処理では log_e が便利。 SSDSE-B-2026 の人口は log10 が直感的。
- Q4. スケーリング則 が「壊れる」状況はある?
- ある。 (i) ドメイン外データ(OOD)、 (ii) 規模が小さすぎて統計性が成立しない(n<30 など)、 (iii) 規模が大きすぎてハードウェア制約が支配(NVMe・通信帯域)、 (iv) 学習が収束していない、 など。 Chinchilla の表は「適切に収束した条件下」での目安。
- Q5. 学習途中のロス曲線とスケーリング則は別物?
- 別物。 学習途中のロス曲線は「学習ステップ T に対する曲線」、 スケーリング則 は「学習完了後のロスを規模 N/D で並べた点群」。 ただし両者は密接で、 「同じ計算予算 C で最適な T はいくつか」を議論する文献もある(Hoffmann 論文の Appendix)。
- Q6. emergent ability とは何か、 スケーリング則 とどう違う?
- emergent ability(創発能力)は「ある規模を超えると突然新しいタスクができるようになる現象」(Wei 2022)。 これは「ロス」ではなく「タスク精度」で見たときに非線形ジャンプとして現れる。 スケーリング則 はロス(連続値)の議論、 emergent はタスク精度(離散値)の議論で、 別の軸の話。 ロスは滑らかでもタスク精度は閾値超えで突然発火することがある。
- Q7. 自分のドメインの β を出したい。 何から始める?
- (1) 「規模」を 1 軸選ぶ(パラメータ数 or データ量 or 計算量 or サンプル数)、 (2) 1 桁の幅で 5〜10 段階に分け、 各段階で seed を 3 種類で学習、 (3) ロスを縦軸・規模を横軸の log-log 散布図を描く、 (4)
scipy.stats.linregressで線形回帰、 (5) 残差プロットと bootstrap 信頼区間で頑健性確認、 (6) 必要なら Chinchilla 型 3 項モデルで再フィット。 - Q8. SSDSE-B-2026 で β を推定したけど信頼できる?
- 47 点という有限サンプルで、 かつ「県」という単位そのものが規模を持つ厄介な対象。 本ページの β≈0.97 は記述的な要約として有用だが、 「日本の地域の施設配置の本質的な β」と主張するには時系列も入れる(12 年分の panel data)、 都市単位に分解する(市区町村ベース)、 などの追加が必要。 SSDSE-B-2026 は「スケーリング則 を体感する道具」として最適だが、 政策提言の根拠にはさらなる検証が要る。
- Q9. β=1(線形)はどんな意味?
- β=1 はちょうど「規模を倍にすると GDP も倍になる、 1 人あたり値は不変」。 β>1(超線形)は集積効果あり、 β<1(劣線形)は逓減。 都市規模と賃金、 都市規模と特許出願数、 都市規模と犯罪率、 など分野により異なる β が知られている(Bettencourt et al. 2007 の都市スケーリング論文を参照)。
- Q10. スケーリング則 は今後も成立し続ける?
- 経験的にはここ数年は良く成立しているが、 理論的保証はない。 物理的・経済的な制約(電力、 半導体製造能力、 良質な学習データの枯渇)でいつかは破れる可能性がある。 また、 アーキテクチャの抜本的革新(attention 以外の何か)が起きれば「曲線そのものが上にシフト」する可能性もある。 スケーリング則 を「絶対の法則」ではなく「現時点での経験則」と理解しておくことが、 健全な距離感。
🎯 理解度チェック(5 問)
本ページの内容を自分の言葉で説明できるか、 以下の問いで確認しましょう。 解説は質問の直下に折りたたみ表記で示します。
Q1. スケーリング則 (scaling law) の基本式 L(N) = (N_c/N)^α + L_∞ で、 α と L_∞ がそれぞれ何を表すか説明しなさい。
α は「規模 N を 1 桁増やすとロスがどれだけ減るか」のスケーリング指数で、 大きいほど効率よく規模効果が得られる。 L_∞ は「規模をいくら大きくしても残るロス(irreducible loss)」で、 データそのものの不確実性に由来する 0 にならない床値。 Chinchilla 論文ではこの L_∞ を同時推定することが結論を変えた決定的なポイント。
Q2. log-log プロットで直線に見えても β=スケーリング指数 と即断してはいけない 2 つの理由を述べなさい。
理由 1:サンプル数が少ないと、 たとえ実際の関係が完全な直線でなくても偶然直線に見える可能性が高い(ノイズによる見かけのフィット)。 理由 2:L_∞ がゼロでない場合、 log を取らずに L そのものをフィットしてしまうと、 大規模域で頭打ちが起き直線から外れる。 bootstrap で信頼区間、 残差プロットで構造、 Chinchilla 型 3 項モデルで L_∞ を同時推定する、 の 3 点が定石。
Q3. SSDSE-B-2026 の関東 7 県で β≈1.06、 東北 6 県で β≈0.88 と推定されました。 この差異が示唆することを実務的に説明しなさい。
β>1(超線形)は規模が増えるほど人口あたりの施設数が増える「都市集積効果」を示唆し、 関東圏(とくに東京)への医療機関の集中が反映される。 β<1(劣線形)は規模効果が逓減することを意味し、 東北は人口の小さな県でも人口あたりの診療所数がむしろ多めに保たれる傾向を持つ。 実務的には「全国に 1 本の β を当てはめる地域政策」は意味を失い、 地域ごとに別の β(あるいは混合効果モデル)を持つべき、 という結論が導かれる。
Q4. Kaplan 2020 と Chinchilla 2022 の最も大きな違いを 1 文で説明しなさい。
Kaplan は「計算予算 C を固定すると N(パラメータ)を増やすほどロスが下がる」と結論したが、 Chinchilla は L_∞ を含む 3 項式で丁寧に再フィットし、 「同じ C なら N と D(データ量)を同じ割合で増やすのが最適」と結論を覆した。 これは LLM 設計の経済学を根本から変え、 GPT-3 系の「大きすぎ・データ不足」を指摘する基盤になった。
Q5. スケーリング則 が示唆する「規模を増やさずに性能を上げる戦略」を 3 つ挙げなさい。
(1) データ品質改善(重複除去・低品質テキスト除外で実効データ量を増やす)、 (2) 学習アルゴリズム改善(最適化手法・学習率スケジュール・正則化で同サイズで効率よく学習)、 (3) アーキテクチャ改善(attention の改良・MoE・知識蒸留などで同パラメータ予算で表現力を増やす)。 スケーリング則 は「規模を増やせばロスは下がる」と同時に「他の改善で曲線を上にシフトさせれば、 同規模でより良い性能が出る」ことも示唆する。
🗺 概念マップ
中心の「規模を上げると損失がべき乗で下がる」という経験則に、 それを最初に測った Kaplan 則、 計算予算の配分を直した Chinchilla 則、 配分を決める制約 C ≈ 6ND、 どれだけ規模を上げても残る損失 L∞、 べき乗則から外れる現象(創発・推論コストを含めた最適化)、 当てはめの道具である両対数プロットがつながる。
用語集全体での位置づけは 🗺 概念マップ で確認できる。
📜 歴史と発展
Kaplan et al. (2020) が OpenAI から提唱。 Hoffmann et al. (2022) の Chinchilla 論文で『計算量に対する N・D の最適比』を再評価。 emergent ability (Wei 2022) の議論、 inference-optimal scaling など、 LLM 設計の経済学的議論が活発化中。
原典は Kaplan et al. (2020)ですが、 2 年後の Hoffmann et al. (2022)(Chinchilla)が結論を書き換えたことが重要です。 Kaplan 論文はパラメータ数を優先すべきと読まれ、 GPT-3 の設計に影響しました。 Chinchilla は学習トークン数が不足していたと指摘し、 パラメータを 4 分の 1 にしてデータを 4 倍にした 70B モデルが 280B に勝つことを示します。 べき乗則という「法則」でさえ、 実験設定次第で係数が変わる——この経緯自体が教訓です。