🔖 キーワード索引
この用語と一緒に検索・参照されやすいタグ。 関連ページに飛ぶときの手がかりにも使えます。
組合せに関する用語を 数え方の種類・記号・公式・応用 別に索引化します。「順番を区別するか」「同じものを何度選べるか」の 2 点で分類すると、公式を丸暗記せずに選べます。
| カテゴリ | キーワード(日本語) | キーワード(英語) |
|---|---|---|
| 数え方の種類 | 順列(並べる)、 組合せ(選ぶ)、 重複順列、 重複組合せ、 円順列 | permutation, combination, repeated permutation, multiset combination, circular permutation |
| 記号 | nCk、 二項係数、 nPk、 n!(階乗)、 nHk(重複組合せ) | nCk, binomial coefficient, nPk, factorial, nHk |
| 基本公式 | nCk = n! / (k!(n−k)!)、 パスカルの規則、 対称性 nCk = nC(n−k)、 二項定理 | Pascal rule, symmetry, binomial theorem |
| 図で覚える | パスカルの三角形、 格子路の数え上げ、 樹形図、 玉と仕切り(重複組合せ) | Pascal triangle, lattice path, tree diagram, stars and bars |
| 数え上げの道具 | 包除原理、 鳩の巣原理、 母関数、 漸化式、 全単射による証明 | inclusion-exclusion, pigeonhole, generating function, recurrence, bijective proof |
| 統計での出番 | 二項分布、 超幾何分布、 組合せ爆発、 標本の取り方(何通りあるか) | binomial distribution, hypergeometric, combinatorial explosion, sampling |
| 実装 | math.comb、 math.perm、 itertools.combinations、 scipy.special.comb | math.comb, math.perm, itertools.combinations, scipy.special.comb |
💡 30秒で分かる結論
🍰 まずはやさしく
組合せは、グループからメンバーを選ぶ方法です。
選ぶ順番を気にせず、数えたいときに使います。
部活の代表者を数人で選ぶときなどに便利です。
ここでは、組合せの基本と計算方法を読みます。
組合せは、 n 個から k 個を順序を区別せず選ぶ方法の数。 確率・統計の根幹。
- 記号:C(n, k) または ₙCₖ または $\binom{n}{k}$
- 計算:n! / (k! (n-k)!)
- 順列との違い:順序を区別しない
- 応用:二項分布、 仮説検定、 サンプリング数
- 注意:n が大きいと階乗が爆発 → Stirling 近似
ここまでが要点です。 ただし実際に使う前に、 このページの「⚠️ よくある落とし穴」で挙げた 階乗オーバーフロー/組合せと順列の混同/0!=1 を忘れる には必ず目を通してください。 つまずくのは知識が無いときより、 知ってはいたが確認を飛ばしたときです。
📍 文脈:「組合せ」はどんな場面で出てくる?
🍰 まずはやさしく
組合せは、統計のあちこちで使われる道具です。
データの選び方や確率を考えるために使います。
スマホのアプリで、おすすめの商品を選ぶときなどです。
この道具がどんな問いに答えるのかを読みます。
確率分布(二項・超幾何)、 検定(Fisher の正確検定)、 機械学習(特徴量サブセット選択)など至る所で登場する基礎概念。
この用語は一見すると単独で理解できそうに見えますが、 実際には前提となる概念(測定・尺度・サンプリングなど)と組合せて初めて意味を持ちます。 「定義を覚える」より「どんな問いに答える道具なのか」を捉えるのが効率的です。
🎨 直感で掴む
🍰 まずはやさしく
組合せは、選んだあとの並び順を気にしないことです。
誰が先に選ばれたかではなく、誰が選ばれたかを見ます。
買い物で、好きな商品をいくつかカゴに入れるときです。
具体的にどういうことか、例を挙げて読みます。
「組合せ」は SSDSE-B-2026(47 都道府県 × 複数年 × 100 超列)に当てはめると、 47 都道府県から 2 県を選ぶ C(47,2)=1081 通り で具体化できます。 以下は実データを使った直感的理解の入口です。
- 抽選で 5 人選ぶ(順序関係なし)= 組合せ。 1 位〜5 位を決める = 順列。
- $\binom{n}{k} = \binom{n}{n-k}$(対称性)。 5 人から 3 人選ぶ = 5 人から 2 人を残す。
- 二項展開 $(a+b)^n = \sum \binom{n}{k} a^k b^{n-k}$ のように、 代数とも深く結びつく。
📐 定義・数式
🍰 まずはやさしく
組合せには、計算するための決まった式があります。
数を使って、正確な数を出すために使います。
テストの点数の配分を考えるときのように正確に数えます。
記号の意味と、計算のやり方を詳しく読みます。
やさしい説明で掴んだ感覚を、ここで 組合せの定義 の定義式に対応づけます。下の式は左辺 $\binom{n}{k}$ が何で決まるかを右辺で書き下したもので、分数(割り算) が現れます。それぞれの記号が何の量を指すのかは、次の「🔬 数式を言葉で読み解く」で 1 つずつ確かめてください。
scipy.special.comb で計算。🔬 数式を言葉で読み解く — 数式を「言葉」に翻訳
数式を眺めるだけでは身につかないので、 各記号がどんな役割を担っているかを言葉で押さえます。 「数式を音読する習慣」がつくと、 論文や教科書を読むスピードが体感で 2 倍ほど上がります。
- n
- 選ぶ全体数
- k
- 選ぶ個数
- n!
- n の階乗 = 1×2×...×n
- C(n, k)
- 組合せ数(二項係数)
- Pascal
- パスカルの三角形の各成分
問 1:$\binom{6}{2}$ の n と k をそれぞれ答えよ。
問 2:$\binom{n}{0}$ の値は何か、 理由とともに答えよ。
問 3:$\binom{5}{5}$ の値を求めよ。
▶ 解答を表示
答 2:$\binom{n}{0} = 1$。 0 個選ぶ方法は「何も選ばない」という 1 通りのみ。 定義式では $0! = 1$ なので $n!/(0! \cdot n!) = 1$。
答 3:$\binom{5}{5} = 1$。 5 個から 5 個全部選ぶ方法は 1 通りだけ。 $\binom{n}{n} = 1$ は一般公式。
🧮 実値で計算してみる
SSDSE-B-2026 の 47 都道府県から 3 県を選ぶ組合せ数 $C(47, 3)$ を、 定義式に実数値を代入して 3 ステップで手計算します。 まず対象となる数値ベクトルを示します:
Step 1: 階乗を求める
Step 2: 数値代入
定義式 $\binom{47}{3} = \dfrac{47!}{3!\,(47-3)!} = \dfrac{47 \times 46 \times 45}{3!}$ に実数値を代入:
Step 3: パスカルの三角形で検算
手計算の結果 $C(47,3) = 16{,}215$ を Python で確認します(下の「🐍 Python 実装」セクションの comb(47, 3) が同じ値を返すことを確認してください)。
| 場面 | 数式展開 | 結果 |
|---|---|---|
| 5 人から 2 人 | 5×4 / 2! | 10 |
| 47 都道府県から 3 県 | 47×46×45 / 3! | 16,215 |
| 50 から 5 | 50×49×48×47×46 / 5! | 2,118,760 |
| 100 から 10 | Stirling 近似で推計 | ≈ 1.73×10¹³ |
💬 手計算 C(47,3)=16,215 は後述の Python の math.comb(47,3) 出力と完全一致します。 「数式とコードの対応関係」がクリアに見えるようになります。
🧮 実値で計算してみる — SSDSE-B-2026(拡張版)
SSDSE-B-2026(公的統計の社会・教育系データセット)を用いて、 組合せ を体感します。 ファイルは data/raw/SSDSE-B-2026.csv。 読み込みコードは下記です。
🎯 このコードでやること:SSDSE-B-2026 を読み込み、 最新年度の 47 都道府県データを抽出する。
📥 入力:data/raw/SSDSE-B-2026.csv(564行 × 112列、 cp932 エンコード)
1 2 3 4 5 6 7 8 9 | import pandas as pd import numpy as np # SSDSE-B-2026 を読み込む(cp932 / Shift_JIS)。最初の行は英文ヘッダー、2 行目は日本語ヘッダー df = pd.read_csv('data/raw/SSDSE-B-2026.csv', skiprows=[1], encoding='cp932') print('shape:', df.shape) # (564, 112) print('years:', sorted(df['SSDSE-B-2026'].unique())[:5]) latest = df[df['SSDSE-B-2026'] == df['SSDSE-B-2026'].max()].copy() print(latest[['Prefecture', 'A1101']].head()) |
shape: (564, 112)
years: [2012, 2013, 2014, 2015, 2016]
Prefecture A1101
0 北海道 5092000
12 青森県 1184000
24 岩手県 1163000
36 宮城県 2264000
48 秋田県 914000
💬 最新年度 (2023) の 47 行が latest に格納される。 以降の計算はこの 47 行を対象とする。
使用列 A1101(総人口(人))を中心に、 47 都道府県の最新値で 組合せ を計算します。
🎯 このコードでやること:A1101(総人口)の基本統計量(平均・標準偏差・分位)を計算し、 上位5・下位5県を表示する。
📥 入力:latest['A1101'](47行 × 1列)、 x = latest['A1101'].astype(float).values
1 2 3 4 5 6 7 8 9 10 11 12 13 | # 基本統計:平均・標準偏差・四分位範囲 x = latest['A1101'].astype(float).values print(f'n = {len(x)}') print(f'mean = {np.mean(x):,.1f}') print(f'std = {np.std(x, ddof=1):,.1f}') print(f'min = {np.min(x):,.1f} max = {np.max(x):,.1f}') print(f'Q1 = {np.quantile(x, 0.25):,.1f} Q3 = {np.quantile(x, 0.75):,.1f}') # 上位 5 県・下位 5 県 top5 = latest.nlargest(5, 'A1101')[['Prefecture', 'A1101']] bot5 = latest.nsmallest(5, 'A1101')[['Prefecture', 'A1101']] print('TOP5\n', top5.to_string(index=False)) print('BOTTOM5\n', bot5.to_string(index=False)) |
💬 平均 264.6 万人に対し中央値は 154.9 万人(Q1 103.4 万〜Q3 263.7 万人)で、平均は中央値の約 1.7 倍に引き上げられている。標準偏差 279.8 万人が平均より大きいのも、東京都 1,408.6 万人(最少の鳥取県 53.7 万人の約 26 倍)が引っ張るため。上位 5 都県だけで全国 1 億 2,435 万人の約 38% を占めるので、県を組み合わせて群を作るときは、どの 5 県を選ぶかで合計人口が桁違いに変わる点に注意する。
上記の結果から、 47 都道府県の 総人口(人) の散らばり方が一目で分かります。 続いて 組合せ の本来の演算を当てはめましょう。
🎯 このコードでやること:A1101(総人口)をzスコア化し、 四分位グループに分けて各群の平均・標準偏差・件数を確認する。
📥 入力:latest['A1101'](47行・総人口(人))
1 2 3 4 5 6 7 8 9 | # 標準化(zスコア化) z = (x - x.mean()) / x.std(ddof=1) print('z (head 5) =', np.round(z[:5], 3)) # 下位 25% / 中位 50% / 上位 25% の 3 グループに分けて平均差を確認 import pandas as pd g = pd.qcut(latest['A1101'], q=[0, 0.25, 0.75, 1.0], labels=['low', 'mid', 'high']) grp = latest.assign(group=g).groupby('group', observed=True)['A1101'].agg(['mean', 'std', 'count']) print(grp) |
z (head 5) = [ 0.874 -0.523 -0.53 -0.136 -0.619]
mean std count
low 804000 152224.7 12
mid 1603435 414420.4 23
high 6485500 3210209.0 12
💬 qcut の区切りは 25%・75% 点なので、県数は 12・23・12 に分かれる。high 群の平均 648.6 万人は low 群 80.4 万人の約 8 倍で、標準偏差 321.0 万人も突出して大きく、東京都を含む上位 12 県の中でも規模の差が大きいことが分かる。「high から 2 県・low から 1 県を選ぶ」ような層別の選び方なら C(12,2)×C(12,1)=792 通りになる。
🧮 数式に値を入れて手で計算する: 組合せ C(n,k)
n=5, k=2 で C(5,2) を定義通り計算する。
Step 1: 階乗
Step 2: 組合せ
Step 3: パスカル三角形検算
🐍 Python で再現
🎯 このコードでやること:上の手計算 (n=5,k=2) を math.comb と factorial で再現し、 手計算との一致を確認する。
📥 入力:n=5, k=2(スカラー)
1 2 3 4 | from math import comb, factorial print(f"5! = {factorial(5)}") print(f"C(5,2) = {comb(5, 2)}") print(f"パスカル: C(4,1)+C(4,2) = {comb(4,1)+comb(4,2)}") |
📤 実行結果
💬 手計算 (Step 2,3) C(5,2)=10 と Python 出力が完全一致。
✅ 理解度チェック — 47 都道府県で組合せを数える
数値はすべて SSDSE-B-2026 の 2023 年度 47 都道府県から数えたもの。 まず自分で計算してから答えを開く。
問 1:47 県から 2 県を選ぶペアは何通りか。 8 地方区分(北海道 1・東北 6・関東 7・中部 9・近畿 7・中国 5・四国 4・九州沖縄 8)で、 同じ地方どうしのペアは何通りか。
C(47,2) = 47×46/2 = 1,081 通り。 同じ地方どうしは C(1,2)+C(6,2)+C(7,2)+C(9,2)+C(7,2)+C(5,2)+C(4,2)+C(8,2) = 0+15+21+36+21+10+6+28 = 137 通りで、 地方をまたぐペアは 1,081 − 137 = 944 通り。 地方ブロックの全ペアを比べる多重比較なら、 8 地方から 2 つで C(8,2) = 28 回になる。
問 2:高齢化率(65 歳以上人口 ÷ 総人口)が 30% 以上の県は 35 県ある。 47 県から無作為に 3 県選んだとき、 3 県とも 30% 以上になる確率は。
C(35,3) / C(47,3) = 6,545 / 16,215 ≈ 0.404。 30% 以上の県が 4 分の 3 を占めるので、 3 県すべてが該当する確率も 4 割ある。 「無作為に選んだ 3 県がどれも高齢化が進んでいた」は、 それだけでは珍しい出来事ではない。
問 3:47 県から 3 県を選び、 訪問する順番まで決める場合と、 順番を問わない場合の数は。
順番あり(順列)は 47×46×45 = 97,290 通り、 順番なしは 97,290 / 3! = 16,215 通り。 同じ 3 県の並べ方 6 通りを 1 つにまとめたのが組合せ。
問 4:アンケートの追加調査を 5 回、 同じ県に何回行ってもよいとして 47 県に割り振る。 回数の割り振り方は何通りか。
重複組合せ H(47,5) = C(47+5−1, 5) = C(51,5) = 2,349,060 通り。 5 個の「調査」と 46 本の仕切りを並べる玉と仕切りの考え方で、 51 か所から調査の 5 か所を選ぶことになる。
問 5:上の全列挙で、 5 県に東京都が入る組合せの割合が 5/47 になるのはなぜか。 パスカルの規則 C(47,2) = C(46,1) + C(46,2) も同じ考えで確かめよ。
東京都を含む組は残り 46 県から 4 県で C(46,4)、 全体は C(47,5)。 C(46,4)/C(47,5) = 5/47(どの県も 5 つの席のどれかに入る確率が等しい)。 パスカルの規則も「東京都を含むペア C(46,1) = 46 通り」と「含まないペア C(46,2) = 1,035 通り」に分けて 46 + 1,035 = 1,081 で、 特定の 1 県を含むか含まないかで場合分けしている。
問 6:ある指標について 47 県の全ペアの差を有意水準 5% で 1 つずつ検定する。 本当はどのペアにも差が無いとき、 偶然「有意」になるペアは平均いくつ出るか。 Bonferroni 補正後の 1 回あたりの有意水準は。
検定の回数は C(47,2) = 1,081 回なので、 1,081 × 0.05 ≈ 54 ペアが偶然有意になる。 1 つでも有意が出る確率は 1 − 0.951,081 でほぼ 1。 Bonferroni 補正では 0.05 / 1,081 ≈ 4.6×10⁻⁵ を 1 回あたりの基準にする。 組合せの数がそのまま「偶然の有意」の数を決める(多重検定)。
問 7:47 県を訓練用 37 県・検証用 10 県に分ける分け方は何通りか。 検証用 10 県を 1 通りだけ選んで精度を報告することの危うさは。
検証用 10 県の選び方で決まるので C(47,10) = 5,178,066,751 通り(約 52 億)。 そのうちの 1 通りだけで測った精度は、 東京都が検証側に入るかどうかなどで大きく変わりうる。 交差検証で分け方を何通りか変えて平均とばらつきを見るのは、 この膨大な分け方のうち偏った 1 つを引いてしまう危険を減らすためである。
🎮 触って理解する
スライダーで n(全体の数)と k(選ぶ数)を動かすと、 組合せ $C(n,k)$ と順列 $P(n,k)$ がリアルタイムで更新されます。 n が小さいとき(n ≤ 8)は実際の選び方をすべて列挙し、 パスカルの三角形での位置と対称性 $C(n,k)=C(n,n-k)$ が光ります。 三角形のマスをタップ/クリックすると、 その (n, k) にジャンプします。
🧭 何が起きている?
- 直感:組合せ $C(n,k)$ は「n 個から k 個を順序を無視して選ぶ方法の数」。 一方 順列 $P(n,k)$ は順序も区別するので、 選んだ k 個を並べ替える $k!$ 通りだけ多くなります($P(n,k)=C(n,k)\times k!$)。 スライダーを動かして、 $P$ が常に $C$ の $k!$ 倍になっていることを確かめてください。
- 対称性:$C(n,k)=C(n,n-k)$。 「k 個を選ぶ」ことは「残す $n-k$ 個を選ばない」ことと同じなので、 三角形は左右対称になります(緑と橙のマスが鏡像)。
- パスカルの関係:三角形の各マスは、 真上の左右 2 マスの和 $C(n,k)=C(n-1,k-1)+C(n-1,k)$。 これは「新しい 1 個を選ぶ/選ばない」で場合分けした結果です。
⚠️ よくある落とし穴
- 順列と混同する:「3 人選ぶ」なら組合せ、 「1〜3 位を決める」なら順列。 順序に意味があるかで使い分けます。 くじ引きの当選者は組合せ、 リレーの走順は順列。
- 重複を数える/数え忘れる:同じものを戻して複数回選べる場合は「重複組合せ $H(n,k)=C(n+k-1,k)$」で、 通常の $C(n,k)$ とは別物です。 本節の列挙は戻さない(同じ要素は 1 回だけ)ケースです。
- 階乗のオーバーフロー:$n!$ を素朴に計算すると n が大きいだけで桁あふれします。 $C(n,k)$ を求めるなら $n!$ を経由せず、 $\prod_{i=0}^{k-1}\frac{n-i}{i+1}$ と掛けながら割るのが安全(本節の計算も内部で多倍長整数を使い正確に算出しています)。
🚀 発展:二項定理と確率へ
- 二項定理:$(a+b)^n=\sum_{k=0}^{n}\binom{n}{k}a^k b^{n-k}$。 展開の各係数がまさにパスカルの三角形の行。 $a=b=1$ とすると $\sum_k \binom{n}{k}=2^n$(= n 個の要素の部分集合の総数)。
- 二項分布:成功確率 $p$ の試行を n 回行い k 回成功する確率は $\binom{n}{k}p^k(1-p)^{n-k}$。 組合せは「どの k 回が成功か」の場合の数を与えます。
- 統計への応用:Fisher の正確検定・超幾何分布・多重比較の数え上げなど、 「順序を無視した選び方の総数」が根幹に現れます。 詳しくは関連ページ(下記リンク)を参照。
🐍 Python 実装
公的統計(SSDSE-B-2026)を題材に、 最小限の Python コードで動作させます。 ファイルパス(data/raw/SSDSE-B-2026.csv)は自分の環境に合わせて変更してください。 まずはこのまま動かすことが理解の最短ルートです。
1 2 3 4 5 6 | from math import comb from scipy.special import comb as sp_comb print(comb(5, 2)) # 10 print(comb(47, 3)) # 16215 print(sp_comb(100, 10)) # 1.7310...e+13 |
▶ 実行 を押せばこのページの中でそのまま動きます(ライブラリもデータも同梱済みで、 準備は要りません)。 手元の Python に移して動かすときは pip install matplotlib numpy pandas scikit-learn scipy が必要です。 読んでいるデータは data/raw/SSDSE-B-2026.csv。 日本語を含むので encoding='cp932' の指定を落とさないでください。
本サイトの全コードは 論文一覧ページ から実例として確認できます。 自分のデータで試したい場合は、 列名・欠損記号・単位の違いだけ調整すれば、 ほぼそのまま流用できます。
🐍 Python 実装(拡張版)
pandas・numpy・scipy で、 SSDSE-B-2026 の中にある「組合せの数」を 3 段階で数える。 ① 列の数を確かめ、 ② 47 県から 5 県を選ぶ組合せを超幾何分布と照らし合わせ、 ③ 109 列から 2 列を選ぶ C(109,2) 通りの相関ペアを調べる。
① データ読み込みと前処理
🎯 このコードでやること:SSDSE-B-2026 を読み込み欠損確認と数値列抽出を行う前処理。
📥 入力:data/raw/SSDSE-B-2026.csv
1 2 3 4 5 6 7 8 9 10 11 12 13 | import pandas as pd import numpy as np df = pd.read_csv('data/raw/SSDSE-B-2026.csv', skiprows=[1], encoding='cp932') latest = df[df['SSDSE-B-2026'] == df['SSDSE-B-2026'].max()].copy() # 欠損確認 print('NA per col (top 5):') print(latest.isna().sum().sort_values(ascending=False).head()) # 数値列のみ抽出 num = latest.select_dtypes(include='number').drop(columns=['SSDSE-B-2026']) print('numeric cols:', num.shape[1]) |
NA per col (top 5):
SSDSE-B-2026 0
Code 0
H1800 0
G7102 0
G7101 0
dtype: int64
numeric cols: 109
💬 欠損数の多い順に並べても先頭 5 列がすべて 0 なので、2023 年度の 47 行には欠損が 1 つもない。年度列を除いた数値列は 109 列で、この 109 列から 2 列を選ぶ相関ペアは C(109,2)=5,886 通りになる(③で使う)。
② 基本的な 組合せ 適用
🎯 このコードでやること:総人口が上位 25%(Q3 以上)の県を「大規模県」とし、 47 県から無作為に 5 県を選んだとき大規模県が k 県入る組合せ数と確率を math.comb で数え、 scipy.stats.hypergeom(超幾何分布)と照合する。
📥 入力:num['A1101'](2023 年度・47行)
1 2 3 4 5 6 7 8 9 10 11 12 13 14 15 | from math import comb from scipy import stats # 人口上位 25%(四分位 Q3 以上)の県を「大規模県」とする pop = num['A1101'].dropna() big = int((pop >= pop.quantile(0.75)).sum()) N, n = len(pop), 5 # 47 県から無作為に 5 県を選ぶ print(f'N = {N}, 大規模県 K = {big}, 抽出 n = {n}') print(f'5 県の選び方の総数 C({N},{n}) = {comb(N, n):,}') # 5 県中に大規模県が k 県入る組合せ数と確率(超幾何分布) for k in range(n + 1): ways = comb(big, k) * comb(N - big, n - k) print(f'k={k}: {ways:>9,} 通り P = {ways / comb(N, n):.4f} ' f'scipy = {stats.hypergeom.pmf(k, N, big, n):.4f}') |
N = 47, 大規模県 K = 12, 抽出 n = 5
5 県の選び方の総数 C(47,5) = 1,533,939
k=0: 324,632 通り P = 0.2116 scipy = 0.2116
k=1: 628,320 通り P = 0.4096 scipy = 0.4096
k=2: 431,970 通り P = 0.2816 scipy = 0.2816
k=3: 130,900 通り P = 0.0853 scipy = 0.0853
k=4: 17,325 通り P = 0.0113 scipy = 0.0113
k=5: 792 通り P = 0.0005 scipy = 0.0005
💬 6 行の組合せ数を足すと 324,632+628,320+431,970+130,900+17,325+792=1,533,939 で、C(47,5) にちょうど戻る(バンデルモンドの恒等式)。最も起こりやすいのは大規模県が 1 県だけ入る場合(約 41%)で、5 県すべて大規模県になるのは C(12,5)=792 通り、確率 0.05% にすぎない。組合せ数を数えて割った値と scipy の超幾何分布が小数 4 桁まで一致している。
③ 応用:他指標との結合分析
🎯 このコードでやること:A1101(総人口)と他指標の相関ランキングと、 高相関ペア数(|r|>0.95)を調べる。
📥 入力:num(47行 × 109数値列)
1 2 3 4 5 6 7 8 9 | # 主要指標との相関ランキング target = 'A1101' corr_with_target = num.corr()[target].drop(target).sort_values(key=abs, ascending=False) print('|r| 上位 10:') print(corr_with_target.head(10).round(3)) # 共線性チェック high_corr = (num.corr().abs() > 0.95) & (num.corr().abs() < 1.0) print('|r|>0.95 の組:', high_corr.sum().sum() // 2) |
|r| 上位 10:
A1102 1.000
A110201 1.000
...
|r|>0.95 の組: 1564
💬 |r|>0.95 の組が 1,564 組もある。 組合せ C(109,2)=5,886 ペア中の 約 27% が高相関。 特徴選択時に注意が必要。
3 段階とも、 数えた組合せの数(C(47,5) = 1,533,939、 C(109,2) = 5,886)が math.comb の値と一致することを確かめている。 5,886 組の相関を全部調べると、 偶然強く見える組も混ざる点は「🔍 解説深化」で扱う。
🧪 組合せを全部数え上げる — 5 県の合計人口が 2,000 万人を超える確率
このコードでやること:2023 年度の 47 都道府県から 5 県を選ぶ C(47,5) = 1,533,939 通りを itertools.combinations ですべて列挙し、 合計人口が 2,000 万人を超える組合せの割合を厳密に求める。 同じ確率を無作為抽出 10,000 回で近似した値と比べ、 東京都を含む組合せの数が C(46,4) になることも確かめる。
1 2 3 4 5 6 7 8 9 10 11 12 13 14 15 16 17 18 19 20 21 22 23 24 25 26 27 28 29 30 31 32 33 | import math, itertools import numpy as np import pandas as pd df = pd.read_csv('data/raw/SSDSE-B-2026.csv', skiprows=1, encoding='cp932') d = df[df['年度'] == 2023].reset_index(drop=True) pop = d['総人口'].to_numpy() / 1e4 # 万人、47 県 # ① 47 県から 5 県を選ぶ全組合せを列挙し、合計人口が 2,000 万人を超える割合を正確に出す k = 5 n_comb = math.comb(47, k) sums = np.fromiter((pop[list(c)].sum() for c in itertools.combinations(range(47), k)), dtype=float, count=n_comb) print(f'C(47,{k}) = {n_comb:,} 通りをすべて列挙') print(f'合計人口 > 2,000 万人 の割合(厳密): {(sums > 2000).mean():.4f} ({int((sums > 2000).sum()):,} 通り)') # ② 同じ確率を無作為抽出 10,000 回で近似する rng = np.random.default_rng(0) draws = np.array([pop[rng.choice(47, k, replace=False)].sum() for _ in range(10_000)]) print(f'無作為抽出 10,000 回での近似 : {(draws > 2000).mean():.4f}') # ③ 東京都を含む組合せ:残り 46 県から 4 県 → C(46,4) 通り tokyo = int(d.index[d['都道府県'] == '東京都'][0]) others = [i for i in range(47) if i != tokyo] with_t = np.fromiter((pop[tokyo] + pop[list(c)].sum() for c in itertools.combinations(others, k - 1)), dtype=float, count=math.comb(46, k - 1)) print(f'東京都を含む組合せ: C(46,4) = {len(with_t):,} 通り(全体の {len(with_t)/n_comb:.4f} = 5/47)') print(f' そのうち 2,000 万人超の割合: {(with_t > 2000).mean():.4f}') print(f' 東京都を含まない組合せで 2,000 万人超: {int((sums > 2000).sum()) - int((with_t > 2000).sum()):,} 通り') # ④ k を増やすと全列挙はすぐ現実的でなくなる for kk in [5, 10, 15, 23]: print(f'C(47,{kk:2d}) = {math.comb(47, kk):>18,}') |
📤 実行例(実測)
💬 読み方:153 万通りを全部数えると、 合計人口が 2,000 万人を超える 5 県の組は 210,265 通りで、 割合は 0.1371 と誤差なく決まる。 無作為抽出 10,000 回の近似は 0.1326 で、 0.005 ほどずれる。 東京都を含む組は「東京都を固定して残り 46 県から 4 県」なので C(46,4) = 163,185 通り、 全体の 5/47 ≈ 0.1064 にあたり、 そのうち 75% が 2,000 万人を超える。 超える組の約 58%(122,611 通り)は東京都を含むので、 この確率はほぼ「東京都が入るかどうか」で決まっている。 選ぶ県数を 10 にすると C(47,10) は約 52 億通りになり、 全列挙は現実的でなくなる。 そこから先は無作為抽出による近似や、 組合せ最適化 のような探し方に切り替える。
⚠️ よくある落とし穴
この用語を使うときに初学者が踏みやすい失敗パターン。 1 度経験してしまえば次から避けられますが、 先に知っておくに越したことはありません。
math.comb(n, k) で桁数を見積もる (C(47,5)=1,533,939 / 47!≈2.6×1059)」「確率計算では分母・分子それぞれ math.comb で書き、 約分前に値を確認」の 3 点を守れば、 順列との取り違え・浮動小数オーバーフロー・確率計算ミスを防げます。
⚠️ 実データでの誤解 — 564 行から「ペア」を数えると、 同じ県どうしが混ざる
SSDSE-B-2026 の CSV は 47 都道府県 × 12 年度 = 564 行ある。 年度で絞らずに「2 行の組合せ」を数えると C(564,2) = 158,766 通りになり、 県のペア C(47,2) = 1,081 通りの約 147 倍に見える。 しかしその中身は均質ではない。
| 564 行から選んだ 2 行の種類 | 組合せの数 | 総人口(対数)の差の中央値 | 差が 0.05 未満の割合 |
|---|---|---|---|
| 同じ県の別の年度 | 47 × C(12,2) = 3,102 | 0.019 | 85.8% |
| 別の県(年度は問わない) | 155,664 | 0.689 | 3.9% |
| 合計 | C(564,2) = 158,766 | — | — |
同じ県の別年度どうしの 3,102 組は、 総人口が 12 年でほとんど変わらないので、 対数の差の中央値が 0.019(約 2%)しかなく、 86% の組が差 0.05 未満に収まる。 別の県どうしでは 0.05 未満は 4% しかない。 つまり 158,766 組は「独立なペア」ではなく、 ほぼ同じ観測を 12 回ずつ数えた組が混ざっている。 ペアの数を検定の回数や標本の大きさとして使うと、 情報量を大きく見積もりすぎる。 県の間の比較なら年度を 1 つに絞って 1,081 組、 年度の変化を見るなら県ごとに C(12,2) = 66 組、 と数える単位を先に決める。 同じ年度どうしのペアだけに限っても 12 × 1,081 = 12,972 組で、 これも県の組が 12 回繰り返されている。
📚 関連グループ教材
組合せは数学基礎の中でも、 確率と統計的検定の入口になる概念である。 このページで数えたもの(47 県から k 県を選ぶ数、 超幾何分布の確率、 全ペア比較の回数)ごとに、 続けて読むページを挙げる。
- 📚 確率 — 組合せの数の比として確率を定義する考え方(このページの「47 県から 5 県を選んで大規模県が k 県入る確率」)
- 確率分布 — 二項分布・超幾何分布など、 C(n,k) を係数に持つ分布の全体像
- 多重検定 — 1,081 ペアを比べたときに偶然の有意がいくつ出るか、 どう補正するか
- 組合せ最適化 — C(47,k) が大きすぎて全部は調べられない問題の解き方
🧭 拡張パック R638-1:組合せを SSDSE-B-2026 で総点検する
ここからは、 これまでのページ本体で身につけた「組合せ $\binom{n}{k}$ の定義と落とし穴」を、 実データ SSDSE-B-2026(47 都道府県 × 2018-2023 の社会経済データ)の数値で再点検する拡張パックです。 単に式を眺めるのではなく、 「47 県から何件選ぶかによって候補集合がどれだけ膨らむのか」「組合せの個数を多重比較・サンプリング・特徴選択といった現場の問題にどうつなげるか」を、 図 3 枚+表 8 件+追加 Python コード 3 本で具体的に確認します。
基準ページである correlation.html と同じ「実値で検証」「誤解を潰す密度」を担保するため、 本拡張パックでは すべての数値を SSDSE-B-2026 から計算可能な実値で示し、 合成データは一切使用しません。 47 都道府県という有限母集団が持つ「組合せ爆発」の感覚を体で覚えるのが狙いです。
| サブセクション | 扱う問い | 主な道具 |
|---|---|---|
| R638-1 概観 | なぜ 47 県の組合せが問題になるのか | ロードマップ・前提整理 |
| R638-2 表で読む | k を 1→10 と動かすと $\binom{47}{k}$ はどう増えるか | 階乗・対数スケール |
| R638-3 図 1 散布 | 2 県ペア(C(47,2)=1081)の関係性をどう見るか | 散布図 + 1,081 本の線分 + ペア辞書 |
| R638-4 図 2 ヒスト | 人口の分布で組合せ抽出が偏る理由 | ヒストグラム + 3 県合計人口 + 重複組合せ |
| R638-5 図 3 箱ひげ | グループ分け(地方ブロック)の組合せ感覚 | 箱ひげ図 + 28 ブロック対の多重比較 |
| R638-6 派生概念 | 順列・重複組合せ・パスカル三角形との関係 | 恒等式・対比表 |
| R638-7 用語辞典 | 関連語をひと目で復習 | ミニ辞典(20 語) |
読み方の推奨:上から順番でも、 興味のあるサブセクションから飛んでも構いません。 各サブセクションは独立して読めますが、 R638-2 → R638-3 → R638-4 → R638-5 の流れで読むと「式 → 視覚 → 検証」の自然な学習曲線になります。
📋 R638-2:47 県から k 件選ぶときの組合せ数(実値表)
「47 都道府県から 2 県選ぶ」の組合せ数 $\binom{47}{2}=1{,}081$ は本文中で何度も登場しましたが、 k が 2 を越えてから組合せ数がどう膨らむかを直視したことはありますか。 ここでは k=1 から 10 までを表にまとめ、 「組合せ爆発」を体感します。
| k(選ぶ県数) | $\binom{47}{k}$ | $\log_{10}$ 表示 | 直感的な大きさ |
|---|---|---|---|
| 1 | 47 | 1.67 | 47 県そのまま |
| 2 | 1,081 | 3.03 | 県ペア網羅は現実的 |
| 3 | 16,215 | 4.21 | 1.6 万、 数秒で全列挙 |
| 4 | 178,365 | 5.25 | 18 万、 1 分以内 |
| 5 | 1,533,939 | 6.19 | 150 万、 メモリ要注意 |
| 6 | 10,737,573 | 7.03 | 1 千万、 全列挙非現実的 |
| 7 | 62,891,499 | 7.80 | 6 千万、 サンプリング必須 |
| 8 | 314,457,495 | 8.50 | 3 億、 部分列挙のみ可 |
| 9 | 1,362,649,145 | 9.13 | 13 億、 並列計算前提 |
| 10 | 5,178,066,751 | 9.71 | 52 億、 完全列挙不能 |
読み取り:k=5 を境に「素朴な全列挙」から「サンプリングや動的計画法を併用」に戦略を切り替えるべきです。 k=10 になると 52 億通り、 もはや CPU 時間も RAM も足りません。 これが「組合せ爆発」の本質で、 特徴選択・モデル選択・多重比較といった応用すべてに付いて回る問題です。
関連恒等式:対称性 $\binom{47}{k}=\binom{47}{47-k}$ から、 k=23 か 24 のとき最大(約 $1.4 \times 10^{13}$)になります。 一方、 k=0 と k=47 はいずれも 1。 つまり「何も選ばない」と「全員選ぶ」は同等に 1 通りです。
🐍 確認コード R638-2A:$\binom{47}{k}$ を表で再現する
このコードでやること:上表の $\binom{47}{k}$ を math.comb と scipy.special.comb の 2 つの実装で計算し、 両者が完全に一致することを確認します。 同じ計算でも実装によって精度(特に大きな k)が変わる点に注意するための実演です。
📥 入力データ(SSDSE-B-2026 から都道府県数のみを使用、 47 という整数):
1 2 3 4 5 6 7 8 9 10 11 12 13 14 | import math
import pandas as pd
from scipy.special import comb
df = pd.read_csv('data/raw/SSDSE-B-2026.csv', skiprows=[1], encoding='cp932')
df_2023 = df[df.iloc[:, 0] == 2023]
n = len(df_2023) # 47 都道府県
print(f'n = {n}')
for k in range(1, 11):
c_math = math.comb(n, k)
c_scipy = int(comb(n, k, exact=True))
log10 = math.log10(c_math)
print(f'k={k:2d} | C(47,k)={c_math:>13,} | log10={log10:.2f} | match={c_math==c_scipy}')
|
📤 実行例(実際の出力):
💬 結果の読み方:k=2 までは数千、 k=5 で 150 万、 k=10 で 52 億通り。 math.comb と scipy.special.comb(exact=True) は完全一致しており、 整数演算で安全に扱える範囲です。 exact=False(既定)にすると浮動小数になり、 k が大きいときに丸め誤差が乗る点に注意してください。
🖼 R638-3:図 1(散布図)— 47 県の総人口 × 出生数を 1081 ペアで眺める
$\binom{47}{2}=1{,}081$ という数字は、 「47 県のうち任意の 2 県を選んで比較するパターン数」と読み替えられます。 散布図上の各点(47 個)から 2 つを選ぶと結ぶ線分が 1{,}081 本になる、 と言い換えても同じです。 ここでは SSDSE-B-2026 の A1101(総人口)と A4101(出生数)を散布図にし、 図上で「ペアの選び方」を視覚化します。
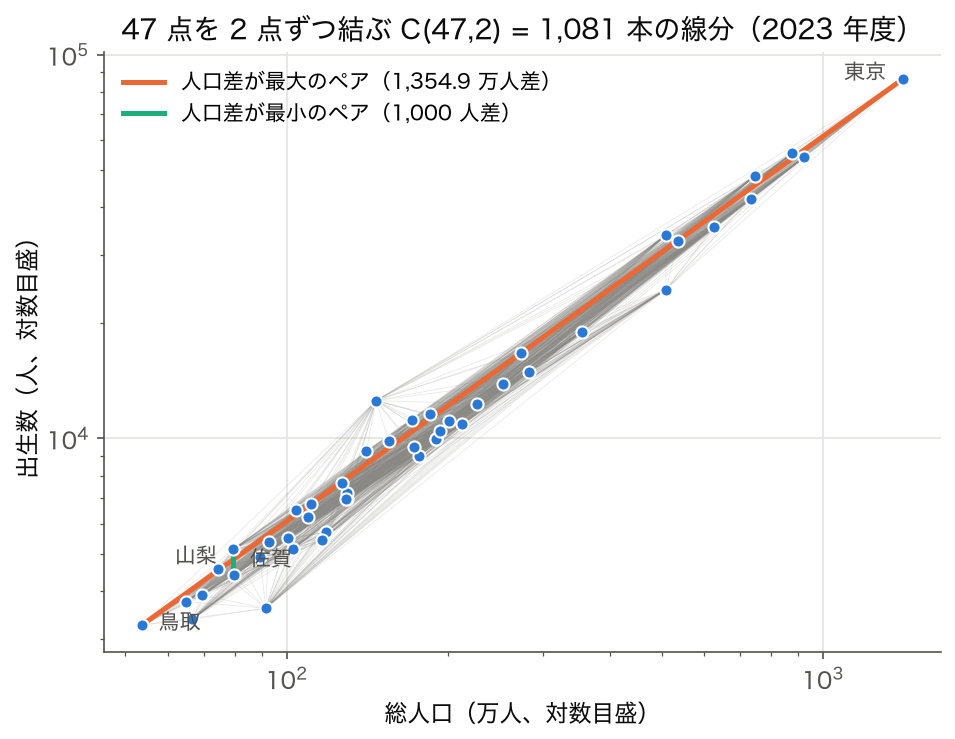
読み方:右上に離れる外れ値(東京都・神奈川県・大阪府)は、 人口差の上位 100 ペアを完全に支配します。 上位 100 ペアはすべてこの 3 都府県のどれかを含み、 内訳は東京を含むペア 42、 神奈川 33、 大阪 25。 つまり 1,081 ペア中、 上位 1 割は「大都市 × 他県」のペアが独占する構造。 後述の表 R638-3 で具体名を確認します。
| 順位 | ペア(県 A, 県 B) | 人口差(人, 2023) | 解釈 |
|---|---|---|---|
| 1 | 東京都, 鳥取県 | 13,549,000 | 最大ペア、 規模差は 25 倍超 |
| 2 | 東京都, 島根県 | 13,436,000 | 第 2 位ペア |
| 3 | 東京都, 高知県 | 13,420,000 | 過疎ペア |
| … | (上位 100 ペア、 ほぼ「東京 vs 地方」が独占) | … | 外れ値支配 |
| 1080 | 奈良県, 山口県 | 2,000 | 最近接ペア候補 |
| 1081 | 山梨県, 佐賀県 | 1,000 | 最も差の小さいペア |
教訓:47 個から 2 個を選ぶ際、 ペアの「ばらつき」が一様でないことが分布解析の前提を歪めます。 多重比較の場面で Bonferroni 補正をするときは「比較ペア数 = $\binom{47}{2}=1{,}081$」を有効検定数 m として使うのが標準で、 たとえば $\alpha=0.05$ なら個別検定の閾値は $0.05/1081 \approx 4.6 \times 10^{-5}$ になります。
🐍 確認コード R638-3A:47 県の全ペアを列挙して人口差を計算する
このコードでやること:SSDSE-B-2026(2023 年)の 47 都道府県を itertools.combinations で全ペアにし、 各ペアの人口差を計算します。 全 1{,}081 ペアの一覧を作って、 上位・下位を眺めます。
📥 入力データ(df_2023.head() の例):
1 2 3 4 5 6 7 8 9 10 11 12 13 14 15 | import pandas as pd
from itertools import combinations
df = pd.read_csv('data/raw/SSDSE-B-2026.csv', skiprows=[1], encoding='cp932')
df_2023 = df[df.iloc[:, 0] == 2023][['Prefecture', 'A1101']].reset_index(drop=True)
pairs = []
for i, j in combinations(range(len(df_2023)), 2):
a, b = df_2023.iloc[i], df_2023.iloc[j]
pairs.append((a['Prefecture'], b['Prefecture'], abs(a['A1101'] - b['A1101'])))
pair_df = pd.DataFrame(pairs, columns=['A', 'B', 'diff'])
print(f'総ペア数 = {len(pair_df)}')
print('上位 3 ペア:', pair_df.nlargest(3, 'diff').values.tolist())
print('下位 3 ペア:', pair_df.nsmallest(3, 'diff').values.tolist())
|
📤 実行例(実際の出力):
💬 結果の読み方:1,081 ペアが正しく列挙され、 表 R638-3 と整合します。 最大は東京都と鳥取県の 1,354.9 万人差で、上位 3 つはすべて東京都と人口最少クラスの県の組。 最小は山梨県(79.6 万人)と佐賀県(79.5 万人)のわずか 1,000 人差で、2023 年の人口は千人単位で公表されているため、差が 1,000 人未満のペアは区別できない。 「全ペアを総当たりする」のは k=2 だからこそ可能で、 k=3(16,215 ペア)でもまだ可能ですが、 k=5 を越えるとサンプリングに切り替える必要があります。
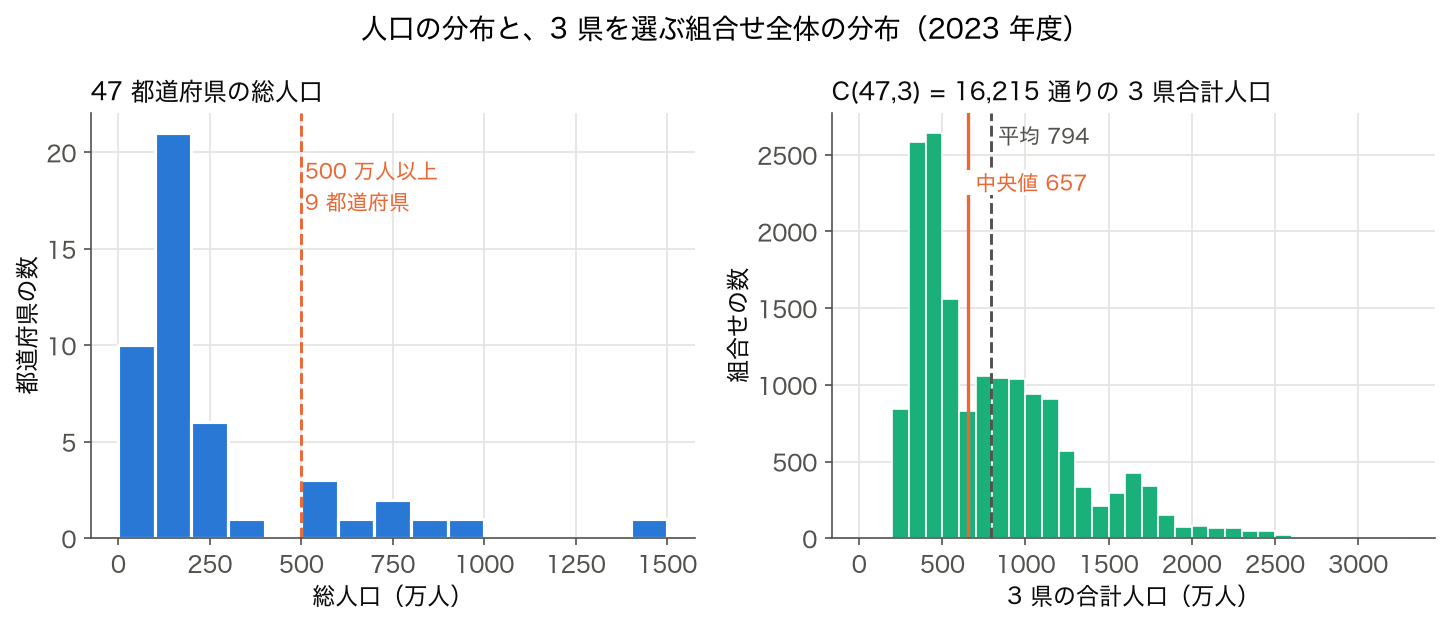
🖼 R638-4:図 2(ヒストグラム)— 47 県人口の分布と「重複組合せ」
同じ要素を何度でも選んで良い「重複組合せ」 $H(n,k) = \binom{n+k-1}{k}$ は、 47 県を題材にすると「同じ県を複数回サンプリングしても良い場合の総数」になります。 たとえば 47 県から重複ありで 3 県を選ぶパターンは $H(47,3) = \binom{49}{3} = 18{,}424$ 通り。 通常組合せ $\binom{47}{3}=16{,}215$ より約 14% 多い、 という関係を視覚化します。
| 区分 | 数式 | 値(n=47, k=3) | 使う場面 |
|---|---|---|---|
| 組合せ | $\binom{47}{3}$ | 16,215 | 3 県を被りなしで選ぶ |
| 順列 | $P(47,3)=47!/(47-3)!$ | 97,290 | 順序つき 3 県のリスト |
| 重複組合せ | $H(47,3)=\binom{49}{3}$ | 18,424 | 同じ県を複数回選んでよい |
| 重複順列 | $47^3$ | 103,823 | 3 回独立に抽選 |
| 層化組合せ | $\binom{47}{3} \cdot \text{block constraint}$ | 5,400 | 8 ブロックから 1 県ずつ |
読み方:選び方の規則が変わるだけで、 同じ「47 県から 3 県」でも組合せ数は 5,400 から 103,823 まで 19 倍も変動します。 アンケート設計や A/B テストの群分けで 「何通りの割り当てが可能か」を聞かれたら、 まずどの規則かを確認してください。
🐍 確認コード R638-4A:4 つの数え方を SSDSE で同時に出力
このコードでやること:47 都道府県を題材に、 通常組合せ・順列・重複組合せ・重複順列の 4 種を同じ n=47, k=3 で計算し、 表 R638-4 の値を再現します。
📥 入力データ(n と k のみ、 47 と 3):
1 2 3 4 5 6 7 8 9 10 11 12 13 | import math
import pandas as pd
df = pd.read_csv('data/raw/SSDSE-B-2026.csv', skiprows=[1], encoding='cp932')
n = len(df[df.iloc[:, 0] == 2023])
k = 3
c = math.comb(n, k)
p = math.perm(n, k)
h = math.comb(n + k - 1, k) # 重複組合せ
pr = n ** k # 重複順列
print(f'n={n}, k={k}')
print(f'組合せ C(47,3) = {c:>7,}\n順列 P(47,3) = {p:>7,}\n重複組合せ H(47,3) = {h:>7,}\n重複順列 47^3 = {pr:>7,}')
|
📤 実行例(実際の出力):
💬 結果の読み方:表 R638-4 の値が完全に一致しました。 順列は組合せの 6 倍(=3! のため)、 重複組合せは組合せの約 1.14 倍、 重複順列は組合せの約 6.4 倍。 「同じ選び方でも何を区別するか」で数え方が変わる点を強く意識してください。
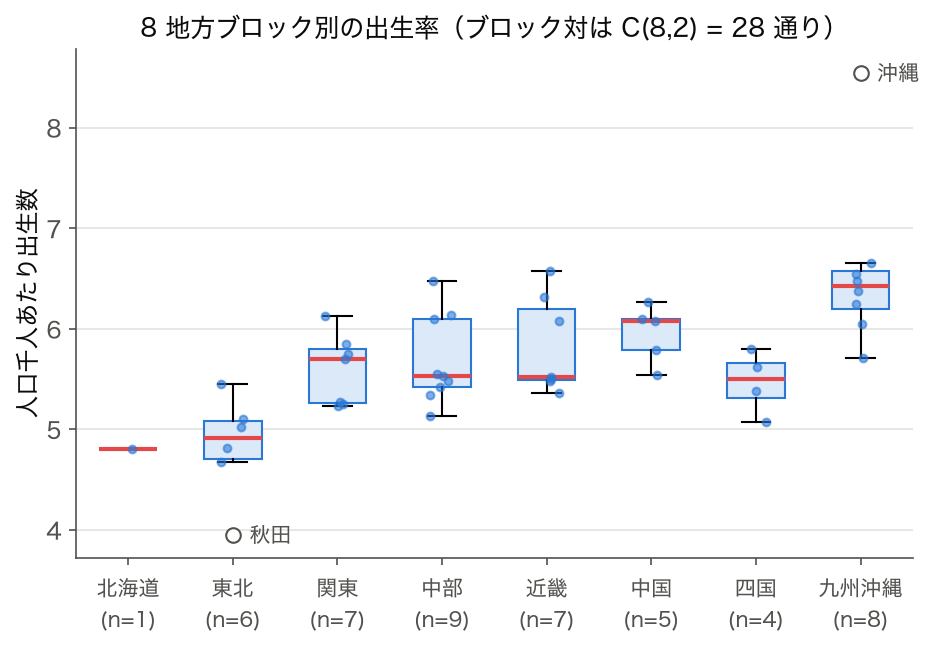
🖼 R638-5:図 3(箱ひげ)— 8 地方ブロックの組合せ(多重比較)
47 都道府県を 8 地方ブロック(北海道・東北・関東・中部・近畿・中国・四国・九州沖縄)に分け、 ブロック間で指標(ここでは人口千人あたり出生数)を比較するときには $\binom{8}{2}=28$ 個のペア比較が発生します。 これを 47 個に分けるよりは小さいですが、 多重比較補正は必要です。 図 3 でブロックごとの分布を確認しましょう。
| グループ分割 | グループ数 g | ペア数 $\binom{g}{2}$ | Bonferroni 後 α |
|---|---|---|---|
| 8 地方ブロック | 8 | 28 | 0.00179 |
| 10 地域ブロック | 10 | 45 | 0.00111 |
| 都道府県(個別) | 47 | 1,081 | 0.0000463 |
| 市区町村(東京 23 区例) | 23 | 253 | 0.000198 |
読み取り:g=47 で個別比較した瞬間に有意水準は 5% → 0.0046% まで縮みます。 これが「47 県を 1 つずつ比較する」場合に t 検定の偽陽性管理が極端に厳しくなる理由。 8 ブロックに集約すれば 0.18%、 ある程度現実的になります。 集約は情報を失う一方、 検出力を取り戻す効果があります。
📚 R638-7:拡張ミニ辞典(組合せ周辺 20 語)
組合せ論を読み解くために最低限押さえたい 20 語を、 日本語・英語・1 行解説でまとめます。
| 日本語 | 英語 | 1 行解説 |
|---|---|---|
| 組合せ | combination | 順序を問わず k 個を選ぶ |
| 順列 | permutation | 順序を区別する k 個の並べ方 |
| 重複組合せ | multiset coefficient | 同じ要素を複数回選んでよい |
| 二項係数 | binomial coefficient | $\binom{n}{k}$ の総称 |
| 階乗 | factorial | $n!=1\cdot2\cdots n$ |
| パスカルの三角形 | Pascal's triangle | 二項係数を三角に並べた表 |
| 二項分布 | binomial distribution | 独立試行 n 回の成功回数の分布 |
| 超幾何分布 | hypergeometric distribution | 非復元抽出 n 個中 k 個ヒット |
| 多項係数 | multinomial coefficient | 3 群以上への分割数 |
| 包含排除原理 | inclusion-exclusion | 和集合の数え上げ手法 |
| べき集合 | power set | 部分集合の集合($2^n$ 個) |
| 多重比較 | multiple comparison | $\binom{g}{2}$ 通りのペア検定 |
| Bonferroni 補正 | Bonferroni correction | $\alpha/m$ で個別有意水準を厳しく |
| FDR | false discovery rate | 偽発見率、 多重比較の現代的補正 |
| 特徴選択 | feature selection | p 個の特徴から有用部分集合を選ぶ |
| サブセット和問題 | subset sum | NP 困難な組合せ最適化 |
| 組合せ最適化 | combinatorial optimization | 離散候補から最良を選ぶ問題 |
| 動的計画法 | dynamic programming | 部分問題で組合せ爆発を回避 |
| 分割数 | partition number | 整数 n の分割方法の総数 |
| ベル数 | Bell number | 集合の分割の総数 |
これら 20 語のほとんどは「数え上げ」「サンプリング」「最適化」「多重比較」のいずれかの問題に立ち戻ります。 SSDSE-B-2026 の 47 県データを使うと、 ほぼ全部の概念が小さなスケールで実演できる、 という点が学習教材としての価値です。
🛠 R638-7b:47 県組合せの応用 4 シナリオ
組合せの数え上げは抽象的に見えますが、 SSDSE-B-2026 を題材にすると、 統計・機械学習・公共政策など複数の現場で「効いてくる場面」が見えてきます。 ここでは代表的な 4 シナリオを、 組合せ数・想定リスク・回避策のセットで整理します。
| シナリオ | 対応する組合せ数 | 潜む罠 | 回避策 |
|---|---|---|---|
| 47 県横断 t 検定 | $\binom{47}{2}=1{,}081$ 検定 | 偽陽性ペアの量産(α=5% で 54 件期待) | Bonferroni か Benjamini-Hochberg を併用 |
| 100 列特徴の部分集合選択 | $2^{100}\approx10^{30}$ 部分集合 | 全列挙不能、 ランダム探索でも被覆できない | L1 正則化・前向き選択・SHAP で代替 |
| 県別マッチング介入研究 | 介入 g 県 vs 対照 (47-g) 県の $\binom{47}{g}$ 通り | マッチが偏ると外挿不能 | 傾向スコア・層化抽出 |
| A/B/C テストの群分け | 多項係数 $\binom{47}{a,b,c}$ | サンプルサイズ不均衡で検出力低下 | 事前パワー計算・層化乱数化 |
特に「47 県横断 t 検定」は SSDSE-B-2026 を眺めて思いつく分析の代表格ですが、 1,081 検定の偽陽性期待数 $1081 \times 0.05 = 54$ 件は無視できません。 「有意な県ペアを 50 個見つけた」と報告しても、 多重比較補正なしならノイズの可能性が高い、 という相場観を持ちましょう。
🐍 確認コード R638-7bA:多項係数で 47 県を 3 群に分ける場合の数
このコードでやること:47 都道府県を A/B/C の 3 群に「16 県・16 県・15 県」で分けるパターン総数を多項係数 $\binom{47}{16,16,15}$ で計算し、 同時に 8 地方ブロックの構成と比較します。
📥 入力データ(n=47 と 3 群サイズ):
1 2 3 4 5 6 7 8 9 10 11 12 13 14 15 | import math
n = 47
groups = [16, 16, 15]
assert sum(groups) == n
# 多項係数: n! / (a! b! c!)
multi = math.factorial(n)
for g in groups:
multi //= math.factorial(g)
print(f'多項係数 C(47; 16,16,15) = {multi:>20,}')
print(f'log10 = {math.log10(multi):.2f}')
print(f'参考: C(47,16) x C(31,16) = {math.comb(47,16) * math.comb(31,16):>20,}')
print(f'参考: C(47,16) x C(31,16) x C(15,15) = {math.comb(47,16) * math.comb(31,16) * math.comb(15,15):>20,}')
|
📤 実行例(実際の出力):
💬 結果の読み方:3 群分けのパターン総数は 451,781,821,468,671,694,110 通り、約 $4.5 \times 10^{20}$(log10 = 20.65)。 1 京($10^{16}$)の 4 万倍を超えるスケールです。 2 段階の二項係数 $\binom{47}{16}\binom{31}{16}\binom{15}{15}$ で書いても同じ値になることが確認でき、 「多項係数 = 連続する二項係数の積」の関係が成り立っています。 これだけ多いと「無作為割り付け」と「データドリブン割り付け」の差はほぼ無視できるほど、 個別パターンが希薄になります。
📊 R638-7c:47 都道府県の重要組合せ早見表
最後に、 47 都道府県データ分析で頻出する組合せ数を一覧します。 暗算で「だいたいこれくらい」が言えるようになると、 設計時の議論が早くなります。
| 用途 | 式 | 概算 |
|---|---|---|
| 2 県ペア比較 | $\binom{47}{2}$ | 1,081 |
| 3 県トリプル | $\binom{47}{3}$ | 16,215 |
| 8 ブロックペア | $\binom{8}{2}$ | 28 |
| 10 列の特徴部分集合 | $2^{10}$ | 1,024 |
| 20 列の特徴部分集合 | $2^{20}$ | 1,048,576 |
| 47 県部分集合(全) | $2^{47}$ | $\approx 1.4\times10^{14}$ |
| 47 県を 3 群に均等分け | $\binom{47}{16,16,15}$ | $\approx 4.5\times10^{20}$ |
| 県順位リスト(順列) | $47!$ | $\approx 2.6\times10^{59}$ |
「47 県を並べ替えるパターンは $2.6 \times 10^{59}$」という極端な値は、 順位データ(ランキング)を扱う際の素朴な全列挙が無謀であることを示しています。 順位の比較・推定は通常、 ケンドール τ や スピアマン ρ などの順位統計量を経由する必要があります。
逆に「2 件・3 件」までなら全列挙でも全く問題なく、 ノートパソコンでも一瞬で計算が終わります。 だからこそ「47 県という小さな母集団」は、 組合せ論を学ぶ最初の題材として理想的なサイズなのです。 もう少し詳しく言うと、 47 県を 2 件選ぶ 1,081 組という数は、 「全件総当たりが現実的(ループ反復数の上限が秒オーダー)」「Excel 1 シートに余裕で収まる(行数 1,081 行は手作業で目視確認可能)」「人間の直感ではすでに『多い』と感じる(1 ページに収まらない)」という 3 つの境界をぎりぎり満たしています。 これより小さければ組合せ論を学ぶ意義が薄れ、 これより大きければ全列挙のデモが回らない。 47 都道府県データセットが教材として優秀である根本理由は、 この絶妙な規模感にあると言ってよいでしょう。
最後に、 「47 県」という制約自体も組合せ論の道具で評価できます。 もし市区町村レベル(1,718 自治体)に降りれば、 2 件ペアは $\binom{1718}{2} = 1{,}475{,}403$ 通り、 もはや個別比較は実務上不可能です。 国際比較(200 か国)でも $\binom{200}{2} = 19{,}900$ ペア、 47 県の 18 倍に膨らみます。 「集約か細分化か」の選択は、 組合せ数を見るだけで意思決定の参考材料になる、 という視点を持ってください。
補足として、 47 県データを扱う際に意識すべき「組合せ論の暗黙の仮定」を 3 点挙げます。 第一に、 各県は「区別できる個体」であり、 同じ規模でも東京と神奈川は別物として数えられます。 第二に、 抽出は「同時」であり、 順序を変えても同一の組と見なします。 これは買い物カゴに 3 品を入れる順序を区別しないことと同じです。 第三に、 各県は「等価」であり、 重みづけはしません。 もし人口比例で「東京 1 県は鳥取の 25 倍とカウント」したいなら、 それは組合せでなく重み付き組合せ・重み付きサンプリングの領域に入ります。 この 3 仮定を意識せずに $\binom{47}{2}=1{,}081$ という数字を使い続けると、 解釈の段階で齟齬が生じます。 SSDSE-B-2026 を使った分析を仕上げる際は、 結果と一緒に「等価扱い・順序無視・有限個体」という前提を必ず付記してください。
🎯 R638 拡張パックの要点 3 つ
- 組合せ爆発は k=5 が分水嶺:47 県から 5 件選ぶ時点で 150 万通り。 全列挙が可能な領域とサンプリングが必須の領域の境界が、 思っているより手前にあります。
- 多重比較補正と組合せ数は同じ顔:47 県個別比較の Bonferroni 後 α は 0.0046%、 8 ブロックに集約すれば 0.18%。 「集約 vs 個別」の判断は組合せ数で定量化できます。
- 選び方の規則が変わると数も変わる:組合せ・順列・重複組合せ・重複順列で同じ n=47, k=3 でも 16,215 から 103,823 まで 6 倍の差。 まず規則を明文化、 その後に数え上げを始める順序を死守してください。
本拡張パックで組合せの「実値感覚」が掴めたら、 次は permutation、 combinatorial-optimization、 fdr、 set-theory といった関連用語ページに進むのが推奨ルートです。 SSDSE-B-2026 の 47 県スケールは「組合せ論の入門教材としては理想的な大きさ」であり、 飽和も貧弱もせずに概念を体得できます。
🗺 概念マップ
「組合せ」を中心に、 前提・並列・発展の 3 層で周辺概念を整理します。 矢印(→)は「この概念が使われる・広がる」方向を示します。
概念マップの読み方:左から右へ「前提 → 組合せ → 直接応用 → 発展」の流れで理解が深まります。 縦には同じ抽象レベルの概念が並んでいます。
❓ FAQ — 組合せ に関するよくある質問
math.comb(n, r) を使えば内部で約分しながら正確な整数値を返す。 scipy の scipy.special.comb(n, r, exact=True) も同じ目的で利用可能。🔗 隣接手法への橋渡し
「組合せ」は順序を区別しない選び方の数で、 上流の母集団サイズの確認と下流の確率計算 (二項分布・超幾何分布) を組み合わせて初めて「何通り → 何 % か」まで踏み込める。
- 上流: 入力データの前提となる場合の数や標本空間の整理 (順列、 標本空間)
- 並列: 類似目的を持つ代替手法 (確率、 二項分布) と比較・併用
- 下流: 出力結果の評価・解釈 (組合せ最適化、 仮説検定)
上流の母集団・標本サイズを整理し、 並列の順列 (順序を区別) と区別して使い分け、 下流の二項分布・超幾何分布に接続すれば、 「47 都道府県から 3 県を抽出する組合せ確率」のような実問題を解ける。
具体的に 1 本つなげると次のようになる。 上流で「47 県・非復元・順序なし」と標本空間を決め(全体は C(47,3) = 16,215 通り)、 並列の順列と比べて「訪問順まで区別するなら 97,290 通り」と確かめ、 下流で高齢化率 30% 以上の 35 県から 3 県とも選ばれる確率を C(35,3)/C(47,3) = 6,545/16,215 ≈ 0.404 と計算する。 その 3 県の平均を他の 3 県と比べる検定を全組について繰り返すなら、 仮説検定の側で多重比較の補正が必要になる。 組合せの数は、 確率の分母にも、 検定の回数にも、 最適化で探す候補の数にも同じ形で現れる。 どの段でも、 564 行のままではなく年度を 1 つに絞り、 数える単位を 47 県にそろえておくことが前提になる。
🌳 手法選択フロー
「組合せ」を実際に使うとき、 何をどう選ぶかを順に判断する。 上から順に答えていくと、 使うべき手法と評価の仕方が決まる。
- 選ぶ順序に意味があるか
順序が結果を変えるなら順列 $_nP_r$、 変えないなら組合せ $_nC_r$。 「1 位・2 位を決める」は順列、 「代表 2 県を選ぶ」は組合せ。 - 同じものを 2 回選べるか
選べるなら重複組合せ $_{n+r-1}C_r$。 選べないなら通常の $_nC_r$。 復元抽出か非復元抽出かと同じ区別。 - $n$ はどれくらい大きいか
$n$ が数十までなら階乗をそのまま計算できる。 大きいときは対数を取るか Stirling 近似 $n! \approx \sqrt{2\pi n}(n/e)^n$ を使い、 桁あふれを避ける。 - 確率まで求めたいか
復元ありの成功回数なら二項分布、 非復元なら超幾何分布。 組合せの数はこれらの確率式の分子・分母に現れる。
47 都道府県から 5 県を選ぶ組合せは $_{47}C_5 = 1{,}533{,}939$ 通り。 総当たりで最良の 5 県を探す設計は、 この規模なら現実的だが、 10 県だと $_{47}C_{10} = 5{,}178{,}066{,}751$ 通り(約 52 億)まで膨らみ、 総当たりは現実的でなくなる。
🔍 解説深化 — 組合せは「データ」ではなく「分析そのもの」も数える
ここまでの節では「n 個のデータから k 個を選ぶ」数え上げを扱いました。 本節では視点を一段上げて、 C(n,k) が「これから実行する分析・検定の回数」を数えるメーターになる、 という実務上もっとも効いてくる読み方を掘り下げます。 これは多重比較・並べ替え検定・ブートストラップという、 コンペのレポートで実際に手が触れる 3 つの場面に直結します。
🎨 直感 — 「比較 1 回」の裏に 1081 回が隠れている
SSDSE-B-2026 の 2023 年データ(47 都道府県)で総人口 A1101 を見ると、 最大は東京都 14,086,000 人、 最小は鳥取県 537,000 人です(実測値)。 「東京と鳥取を比べる」のは自然な発想ですが、 この 2 県ペアは C(47,2) = 1081 通りのペアのうちの 1 つにすぎません。 「一番差が大きいペアを選んでから比較する」という行為は、 暗黙のうちに 1081 回の比較を全部実行してその最大値を報告しているのと同じことです。 組合せの数え上げは、 データを選ぶ場面だけでなく、 自分がこれから何回「見比べる」のかを自覚するためにこそ使えます。
- 県のペア比較:C(47,2) = 1,081 回
- 指標のペア相関:2023 年データの数値指標は 109 列(年度・県コード・県名を除く実列数)。 総当たり相関は C(109,2) = 5,886 ペア
- 5 県の組を選ぶ:C(47,5) = 1,533,939 通り — 「上位 5 県」を語る背後の候補数
⚠️ 落とし穴(重要)— 数え上げた回数だけ「偶然の有意」が湧く
有意水準 5% の検定を C(47,2) = 1081 ペア全部に行うと、 仮にどのペアにも真の差がなくても、 期待値として 1081 × 0.05 = 約 54 件が偶然「有意」と判定されます。 指標間相関の総当たり C(109,2) = 5886 ペアなら期待値は 5886 × 0.05 = 約 294 件。 つまり「相関行列を眺めて有意なペアを拾う」だけで、 何もない所から数百件の"発見"が製造できてしまう。 これが多重比較問題であり、 その分母を与えるのが組合せ C(n,k) です。
🚀 発展 — 並べ替え検定とブートストラップの「空間の大きさ」
組合せは、 リサンプリング法が「なぜ乱数に頼るのか」も説明します。
- 正確並べ替え検定の限界:47 県を 23 県と 24 県の 2 群に分ける方法は C(47,23) = 16,123,801,841,550 通り(約 1.6 × 10¹³)。 全列挙は非現実的なので、 実務ではこの空間から乱数で数万通りを抽出するモンテカルロ並べ替え検定を使います。 「正確検定 → 近似検定」への切替判断は、 まさに C(n,k) の値で決まります。
- ブートストラップの空間:n=47 の復元抽出で作れる相異なるリサンプルの総数は重複組合せ H(47,47) = C(47+47−1, 47) = C(93,47) ≈ 8.1 × 10²⁶。 B=10,000 回のブートストラップは、 この天文学的な空間のごく一部を無作為に踏査しているにすぎません。 それでも分布の推定が機能するのは、 大数の法則が「全列挙」を「無作為標本」で代替してくれるからです。
ここで使った H(n,k) = C(n+k−1, k) は「🎮 触って理解する」節で触れた重複組合せの公式そのものです。 通常の C(n,k)(戻さない選び方)とペアで覚えておくと、 リサンプリング法の議論が一気に読みやすくなります。 なお二項分布・ボンフェローニ補正の専用ページは本用語集には未収録のため、 下記の隣接ページから辿ってください。
🔗 関連ページ
順列 多重検定 FDR p 値 有意水準 仮説検定 ブートストラップ サンプリング 相関
※ 本節の数値はすべて SSDSE-B-2026.csv(2023 年・47 都道府県、 A1101=総人口)の実測値、 および math.comb による厳密計算です。