🔖 キーワード索引
このページで扱う言葉を、意味と行き先つきで並べます。 知らない語があればここから辿ってください。
| 語 | 一言でいうと | このページのどこ/関連ページ |
|---|---|---|
| ナップサック問題 | 容量の上限がある入れ物に、価値の合計が最大になるよう品物を選ぶ問題。 | 📐 定義/数式 |
| 0-1 ナップサック | 各品物を「入れる/入れない」の 2 択で選ぶ、最も基本的な形。 | 📐 定義/数式 |
| 容量制約 | 選んだ品物の重さの合計が超えてはいけない上限。 | 🧮 実値で計算してみる |
| 動的計画法(DP) | 小さい容量の答えを積み上げて、大きい容量の答えを作る解き方。 | 🐍 Python 実装 |
| 擬多項式時間 | 容量 W に比例する計算量。W が桁違いに大きいと現実には終わらない。 | ⚠️ 落とし穴 |
| NP 困難 | 入力が増えると現実的な時間で厳密解を出せなくなる難しさの分類。 | ⚠️ 落とし穴 |
| 貪欲法 | 価値÷重さが高い順に詰める近似解法。分数版では最適だが 0-1 版では最適とは限らない。 | 🌐 関連手法・派生 |
| 分数ナップサック | 品物を分割して詰められる版。貪欲法で厳密に解ける。 | 🌐 関連手法・派生 |
| 整数計画(MILP) | 0-1 の決定変数を含む最適化。ソルバーに任せる実務的な解き方。 | 数理最適化 |
| 組合せ最適化 | 「どれを選ぶか」を決める最適化問題の総称。ナップサックはその代表例。 | 組合せ最適化 |
| メタヒューリスティクス | 厳密解を諦めて良い解を速く探す方法。大規模なときの選択肢。 | メタヒューリスティクス |
| 緩和問題 | 整数の条件を外して解きやすくした問題。上界を知るのに使う。 | 🔗 隣接手法への橋渡し |
💡 30秒で分かる結論
🍰 まずはやさしく
限られた袋に物を詰めるパズルです。
価値の合計を最大にするために使います。
リュックに荷物を入れる時に似ています。
この章では問題の結論を学びます。
ナップサック問題 ── 容量制約付き選択問題の代表例
- 容量制約のあるリュックに、 価値合計が最大になるよう品物を選ぶ古典問題
- 0/1ナップサック(各品物1個)、 部分ナップサック(分割可)、 個数制限版など派生多数
- NP困難だが、 容量が整数なら動的計画法で擬多項式時間 O(nW)
- 応用:投資ポートフォリオ、 切断問題、 メモリ割当、 広告配信、 暗号
- 近似解法:貪欲法(価値/重さ比でソート)、 整数計画ソルバ(CBC、 Gurobi)
📍 文脈 ── どこで出会うか
🍰 まずはやさしく
組み合わせの中から正解を探す方法です。
効率よく物を選ぶために使います。
予算内で広告枠を選ぶ時に役立ちます。
この章では出会う場面について読みます。
組合せ最適化の入門として最も有名。 実務でも「予算内で広告枠を選ぶ」「容量内で配送荷物を選ぶ」など、 形を変えて頻出します。
🎨 直感で掴む
🍰 まずはやさしく
袋の容量と価値を考えるゲームです。
一番いい組み合わせを見つけるために使います。
限られた時間で勉強する物に似ています。
この章では直感的な考え方を読みます。
典型例:
- 容量 W = 10kg のリュック
- 品物 A: 重さ4kg, 価値5
- 品物 B: 重さ3kg, 価値4
- 品物 C: 重さ5kg, 価値6
- 品物 D: 重さ2kg, 価値3
- どう選べば総価値最大? → A+C+D で 11kg → ✗、 B+C+D で 10kg, 価値13 → ✓
🎨 直感を深掘り
「限られた容量のリュック」に「価値の合計が最大」になるよう品物を詰める問題。日常では「限られた予算で広告を出す」「限られた時間で論文を読む」「限られた人月でプロジェクトを選ぶ」など、構造的に同じ問題が無数に存在します。リュックの「重さ」を「コスト」、価値を「期待リターン」と読み替えれば、ビジネスの資源配分はほとんどがナップサック型と言えます。
📐 定義/数式
🍰 まずはやさしく
ルールを数式で表したものです。
正確に計算するために使います。
スマホのメモリ割り当てに似ています。
この章では数式での定義を読みます。
制約: $\sum_{i=1}^{n} w_i x_i \le W$, $x_i \in \{0, 1\}$
📐 数式の読み解き ── ナップサック問題 の核心式
ナップサック問題の標準的な整数計画定式化。 $v_i$ は品物 i の価値、 $w_i$ は重さ、 $W$ は容量。
❓ 計算量の疑問 ── 47 県から選ぶだけなら全探索でよいのでは?
ナップサック問題は NP 困難で、 全探索は品物 $n$ 個に対して $O(2^n)$。 $n=47$(47 都道府県から選ぶ)なら $2^{47} \approx 1.4 \times 10^{14}$ 通りで、 1 秒に 10 億通り調べても 39 時間かかります。 一方、 動的計画法なら容量 $W$ に対して $O(nW)$ で解けます。 $n=47$・$W=10^6$ なら 4,700 万回の更新で済み、 数秒で終わります。 ただし $O(nW)$ は擬多項式時間で、 $W$ の「桁数」に対しては指数です(入力長 $\log W$ に対して $2^{\log W}$)。 容量を「人」単位から「千人」単位に丸めるだけで表が 1000 分の 1 になる、 というのが実務上の効き所です。
🔬 数式を言葉で読み解く
- $x_i$
- 品物 $i$ を入れるか(0 or 1)
- $v_i$
- 品物 $i$ の価値
- $w_i$
- 品物 $i$ の重さ
- $W$
- リュック容量
- dp[i][w]
- 「i 番目までで、 容量 w 以下」での最大価値
🔬 深堀り — ナップサック問題 の発展的論点
ナップサック問題は NP 困難な組合せ最適化問題の代表例。 0-1 ナップサック、 分数ナップサック、 多次元ナップサック、 制約付きナップサックなど多くの変種が存在します。 動的計画法では O(nW) の擬似多項式時間で解けますが、 W が大きい場合は分枝限定法やメタヒューリスティクス(GA, PSO 等)を併用します。 47 都道府県への補助金配分のような実問題はナップサック類似の構造を持ち、 価値関数の定義・制約の追加(公平性等)に応じて拡張定式化が必要になります。 整数計画ソルバー(PuLP, OR-Tools, Gurobi 等)の利用も実用的選択肢です。
🧮 実値で計算してみる
上の例で動的計画法のテーブル(一部抜粋):
        w=0 w=2 w=3 w=4 w=5 w=7 w=10
       --- --- --- --- --- --- ---
i=0     0   0   0   0   0   0   0
i=A     0   0   0   5   5   5   5
i=B     0   0   4   5   5   9   9
i=C     0   0   4   5   6   9  13
i=D     0   3   4   5   8   9  13
右下 dp[D][10] = 13 が最大価値。 B+C+D の組合せ。
🧮 SSDSE-B 実値で計算してみる ── ナップサック問題
47都道府県の中から、人口(A1101)と一般病院数(I510120)といった重要指標を考慮して『限られた予算で K 都道府県の重点支援』を選ぶシミュレーション。各県の人口(=価値)と何らかの介入コスト(=重さ)の組合せで、合計人口を最大化する問題と見なせる。
| 都道府県 | 人口(価値、2023 年度) | 介入コスト(重さ、仮の値) |
|---|---|---|
| 北海道 | 509.2万人 | 10億円 |
| 青森県 | 118.4万人 | 3億円 |
| 岩手県 | 116.3万人 | 3億円 |
| 宮城県 | 226.4万人 | 5億円 |
| 秋田県 | 91.4万人 | 2億円 |
| 山形県 | 102.6万人 | 3億円 |
| 福島県 | 176.7万人 | 4億円 |
※ 人口は SSDSE-B-2026 の 2023 年度の総人口 A1101(万人、 小数第 1 位まで)。 介入コスト(億円)は説明のために置いた仮の値で、 データには含まれていません。
🧮 数式に値を入れて手で計算する: ナップサック DP
容量 W=5、 アイテム 3 個で動的計画法を計算する。
Step 1: アイテム
| i | 重さ | 価値 |
|---|---|---|
| 1 | 2 | 3 |
| 2 | 3 | 4 |
| 3 | 4 | 5 |
Step 2: DP 表 (一部)
🐍 Python で再現
1 2 3 4 5 6 7 8 9 10 11 | items = [(2, 3), (3, 4), (4, 5)] W = 5 n = len(items) dp = [[0]*(W+1) for _ in range(n+1)] for i in range(1, n+1): wi, vi = items[i-1] for w in range(W+1): dp[i][w] = dp[i-1][w] if w >= wi: dp[i][w] = max(dp[i][w], dp[i-1][w-wi] + vi) print(f"最大価値: {dp[n][W]}") |
📤 実行結果
💬 手計算 (Step 2) 7 と Python 出力が完全一致。
🎮 触って理解する
品物カードをタップ(クリック)してナップサックに入れたり出したりしてみましょう。容量ゲージと合計価値がリアルタイムに更新され、容量を超えると警告が出ます。「貪欲法」「動的計画法(厳密解)」ボタンで自動解をナップサックに読み込み、自分の選択・貪欲・DP の 3 つの価値を並べて比較できます。既定の「例題セット」は本文『🎨 直感で掴む』と同じ 4 品(最適値 13)で、実は貪欲法が最適を逃す例になっています。
📊 3 つの解の比較(あなた / 貪欲 / DP最適)
🧮 DP テーブルをステップ表示(行=品物、列=容量、セル=最大価値)
漸化式 dp[i][w] = max(dp[i−1][w], dp[i−1][w−wi] + vi) が 1 セルずつ埋まる様子を観察できます。橙=いま計算中・青=入れない場合の参照元・緑=入れる場合の参照元。
🧭 直感 ── この演習で何を体感しているのか
ナップサック問題の本質は「限られた容量の中で価値の合計を最大化する」こと。品物を 1 つ入れるたびに容量という共有資源が減り、残りの選択肢が変わります。だからこそ「単品で一番お得なもの」を順に取るだけでは全体最適に届かないことがある ── これが上の手動プレイで体感できる核心です。組合せは品物 n 個で 2n 通りに爆発しますが、DP テーブルは「i 番目までの品物で容量 w 以下」という部分問題の答えを再利用することで、全列挙せずに厳密解へ到達します。
⚠️ よくある落とし穴(この演習で見えるもの)
- 貪欲法は 0/1 では最適を保証しない:例題セットでは比の高い順に D→B→A と詰めて価値 12 止まり(最適は B+C+D の 13)。反例セットでは貪欲 30 に対し最適 40 と、差はいくらでも広げられます。「比でソートすれば OK」は 0/1 ナップサックでは誤りです。
- 0/1 と分数(部分)ナップサックの混同:品物を任意の割合で分割できる「分数ナップサック」なら、価値/重さ比の貪欲法が厳密に最適です(反例セットなら P 全部 + Q を 4/5 で価値 46)。「どちらの問題を解いているのか」を最初に確認しないと、解法選択を誤ります。
- ぴったり詰める=最適、とは限らない:容量を使い切っても価値が低い組合せはあり得ますし、最適解が容量を余らせることもあります(例題セットで W を 13 にすると、最適解 A+B+C は価値 15・重さ 12 で容量を 1 余らせます)。ゲージが満杯かどうかではなく、比較チャートの価値で判断しましょう。
🚀 発展 ── 計算量と実用解法へ
- DP の計算量 O(nW) は「擬多項式」:上のテーブルのセル数がまさに n×(W+1)。W はスライダーで動かせる通り入力の「数値の大きさ」であり、ビット長で見ると指数的。W=109 ではテーブル方式は破綻します(だからこそナップサックは NP 困難のままです)。
- 分枝限定法:品物を「入れる/入れない」で分岐する探索木を、分数ナップサック(LP 緩和)の値を上界として枝刈りする厳密解法。W が巨大でも動く一方、枝刈りの効きは上界の質に依存します。
- 近似アルゴリズム(FPTAS):価値をスケーリングして丸めることで、任意の精度 ε に対し (1−ε) 倍以上の解を多項式時間で保証。厳密性と速度のトレードオフを設計できます。ほかに遺伝的アルゴリズムなどのメタヒューリスティクスもありますが、こちらは局所最適解に注意が必要です。
- 隣接領域:同じ「離散的な選択の最適化」の仲間として組合せ最適化全般、巡回セールスマン問題、基礎概念としての組合せ、枠組み全体としての最適化を併読すると視界が開けます。
🐍 Python 実装
まず 4 品物・容量 10 の小さな例で、0/1 ナップサックの動的計画法(DP)を動かす。続けて SSDSE-B-2026 の 47 都道府県を品物にした例で、DP と貪欲法の答えがどう違うかを比べる。
1 2 3 4 5 6 7 8 9 10 11 12 13 | # 動的計画法 def knapsack(weights, values, W): n = len(weights) dp = [[0]*(W+1) for _ in range(n+1)] for i in range(1, n+1): for w in range(W+1): dp[i][w] = dp[i-1][w] if weights[i-1] <= w: dp[i][w] = max(dp[i][w], dp[i-1][w - weights[i-1]] + values[i-1]) return dp[n][W] print(knapsack([4,3,5,2], [5,4,6,3], W=10)) # 13 |
🐍 SSDSE-B を使った Python 実装
公的データ SSDSE-B(47 都道府県社会・人口統計)を読み込み、 ナップサック問題 を実際に動かす最小コードです。 引数のパスは平易さ優先で直書きしています。
1 2 3 4 5 6 7 8 9 10 11 12 13 14 15 16 17 18 19 20 21 22 23 24 25 26 27 | import pandas as pd import numpy as np df = pd.read_csv('data/raw/SSDSE-B-2026.csv', skiprows=[1], encoding='cp932') # 英字コードの列名を使う df = df[df['SSDSE-B-2026'] == 2023].reset_index(drop=True) # 2023 年度の 47 都道府県 # 各都道府県の人口(A1101)を価値、人口(万人)の平方根を仮想コストとして # 限られた『予算 100』で都道府県を選び合計人口を最大化 values = df['A1101'].astype(float).values weights = np.round(np.sqrt(values / 10_000)).astype(int) # 鳥取県 7 〜 東京都 38 W = 100 n = len(values) dp = np.zeros((n+1, W+1), dtype=float) for i in range(1, n+1): for w in range(W+1): dp[i][w] = dp[i-1][w] if weights[i-1] <= w: dp[i][w] = max(dp[i][w], dp[i-1][w-weights[i-1]] + values[i-1]) print('最大合計人口:', dp[n][W]) # 選ばれた都道府県を後ろからたどる w, chosen = W, [] for i in range(n, 0, -1): if dp[i][w] != dp[i-1][w]: chosen.append(df['Prefecture'][i-1]) w -= weights[i-1] print('選ばれた都道府県:', chosen[::-1], '使ったコスト:', W - w) |
💬 コストを人口(万人)の平方根にすると、鳥取県 7 〜 東京都 38 の範囲に収まり、予算 100 の中で東京都・神奈川県・大阪府(コスト 38+30+30=98)を選んだとき合計 3,207.8 万人で最大になる。人口 p の価値に対してコストは √p なので、1 コストあたりの人口は √p に比例し、大きな県ほど割安になる。そのため貪欲に大きい順で詰めた答えと一致しやすく、DP の強みが出るのはコストが価値とこれほど揃っていない場合である。
🐍 出生数を価値、人口を重さにした DP と貪欲法の比較
🎯 このコードでやること:2023 年度の 47 県を品物とし、価値 = 出生数(A4101)、重さ = 総人口(A1101)を 10 万人単位に丸めた整数、容量 = 200(人口 2,000 万人分)の 0/1 ナップサックを DP で解く。比べる相手として「出生数 ÷ 重さ」の大きい順に詰める貪欲法の答えも出す。
1 2 3 4 5 6 7 8 9 10 11 12 13 14 15 16 17 18 19 20 21 22 23 24 25 26 27 28 29 30 31 32 33 34 35 36 37 38 | import numpy as np import pandas as pd df = pd.read_csv('data/raw/SSDSE-B-2026.csv', skiprows=[1], encoding='cp932') latest = df[df['SSDSE-B-2026'] == 2023].copy() # 品目は「県」なので 1 県 1 行に絞る num = latest.select_dtypes(include='number') # 価値 = 出生数 A4101(人)、重さ = 総人口 A1101 を 10 万人単位に丸めた整数、容量 = 200(2,000 万人分) # 「人口 2,000 万人分の枠で、出生数の合計が最大になる県の組」を選ぶ 0/1 ナップサック names = latest['Prefecture'].values value = num['A4101'].astype(int).values weight = np.round(num['A1101'].values / 100_000).astype(int) W = 200 n = len(value) dp = np.zeros((n + 1, W + 1), dtype=int) for i in range(1, n + 1): for w in range(W + 1): dp[i][w] = dp[i - 1][w] if weight[i - 1] <= w: dp[i][w] = max(dp[i][w], dp[i - 1][w - weight[i - 1]] + value[i - 1]) # 選んだ県を後ろからたどる w, chosen = W, [] for i in range(n, 0, -1): if dp[i][w] != dp[i - 1][w]: chosen.append(i - 1); w -= weight[i - 1] # 比べる相手: 出生数 / 重さ の大きい順に詰める貪欲法 used, g_val, g_set = 0, 0, [] for i in np.argsort(-value / weight): if used + weight[i] <= W: used += weight[i]; g_val += value[i]; g_set.append(i) print(f'DP の最大出生数 : {dp[n][W]:,} 人({len(chosen)} 県, 重さ {weight[chosen].sum()})') print(f'貪欲法の出生数 : {g_val:,} 人({len(g_set)} 県, 重さ {used})') print('DP だけが選んだ県 :', [names[i] for i in sorted(set(chosen) - set(g_set))]) print('貪欲だけが選んだ県:', [names[i] for i in sorted(set(g_set) - set(chosen))]) |
💬 人口 2,000 万人分の枠で DP が選んだのは愛知・滋賀・鳥取・福岡・佐賀・熊本・鹿児島・沖縄の 8 県で、出生数 133,606 人。人口 10 万人あたりの出生数が大きい順に詰める貪欲法は 13 県で 132,188 人にとどまり、1,418 人(約 1.1%)取り逃す。愛知県は比が 645 と中位だが重さ 75 と大きいので貪欲法では後回しになり、DP は愛知県 1 県を入れる代わりに福井・島根・岡山・広島・徳島・宮崎の 6 県を外す方が得だと見つけている。ただし重さは 10 万人単位に丸めた値なので、選ばれた 8 県の実際の人口の合計は 20,045,000 人で、2,000 万人の枠を 4.5 万人超えている(⚠️ の「重さを丸める単位」の節)。
📊 比較表 — ナップサック問題 と類似手法の使い分け
ナップサック問題 は単独で完結する手法ではなく、 周辺手法と比較して使い分ける必要があります。 以下に主要な類似・代替手法との比較を表でまとめます。
| 観点 | ナップサック問題 (0/1, DP) | 分数ナップサック (貪欲) | 巡回セールスマン (TSP) |
|---|---|---|---|
| 目的 | 容量 W 以下で価値合計最大化 | 分割可能な財での価値最大化 | 全都市を回る最短経路 |
| 適用条件 | アイテム整数選択、 重み・価値正 | アイテム分割可、 連続変数 | 完全グラフ、 三角不等式可 |
| 計算量 | O(nW) (擬多項式) | O(n log n) (貪欲) | O(n^2 2^n) (Held-Karp) |
| 最適性 | DP で厳密最適 | 価値密度ソート貪欲で最適 | NP-hard、 近似 (Christofides 等) |
| 問題規模 | n=100, W=10^4 程度まで現実的 | n=10^6 でも瞬時 | n=30 で限界、 大規模はメタヒューリスティクス |
| Python 実装 | numpy DP 配列 / PuLP MILP | sorted + greedy ループ | networkx / OR-Tools / pulp |
| 適用例 | 予算配分、 投資選択、 倉庫積込 | 原材料調達、 ETF 構成 | 配送経路、 工場 NC 加工順序 |
分割可能なら貪欲で最適 (分数ナップサック)。 0/1 制約があれば DP か MILP ソルバ。 経路問題に拡張するなら TSP や VRP の枠組みに移行する。
⚠️ よくある落とし穴
⚠️ 追加の落とし穴 ── 実務で踏み抜く罠
⚠️ 重さを丸める単位で答えが変わる — 10 万人単位では枠を 4.5 万人超える
DP は重さと容量が整数であることを前提にするので、実数や大きな値は「単位」を決めて丸める。上の 🐍 は総人口を 10 万人単位に丸めて容量 200(= 2,000 万人)とした。丸めの単位を 100 万人・10 万人・1 万人・千人と細かくしていくと、選ばれる県と、選んだ県の本当の人口の合計がどう変わるかを確かめる。
🎯 このコードでやること:総人口を 4 通りの単位で整数に丸め、それぞれ 0/1 ナップサックを DP で解いて、出生数の最大値・県数・選んだ県の実際の人口(丸める前)を並べる。
1 2 3 4 5 6 7 8 9 10 11 12 13 14 15 16 17 18 19 20 21 22 23 24 25 26 27 28 29 30 31 32 33 34 35 36 37 38 39 40 41 | import numpy as np import pandas as pd df = pd.read_csv('data/raw/SSDSE-B-2026.csv', skiprows=[1], encoding='cp932') d = df[df['SSDSE-B-2026'] == 2023] names = d['Prefecture'].values value = d['A4101'].astype(int).values # 価値 = 出生数 pop = d['A1101'].astype(int).values # 重さの元 = 総人口(人) CAP = 20_000_000 # 本当の容量 = 人口 2,000 万人 def knap(weight, W): # 1 次元 DP(容量を後ろから更新)と選んだ品物の復元 n = len(value) dp = np.zeros(W + 1, dtype=np.int64) keep = np.zeros((n, W + 1), dtype=bool) for i in range(n): w = weight[i] if w > W: continue cand = dp[:W + 1 - w] + value[i] better = cand > dp[w:] keep[i, w:] = better dp[w:] = np.where(better, cand, dp[w:]) c, chosen = W, [] for i in range(n - 1, -1, -1): if keep[i, c]: chosen.append(i); c -= weight[i] return dp[W], chosen for unit in [1_000_000, 100_000, 10_000, 1_000]: weight = np.round(pop / unit).astype(int) W = CAP // unit best, chosen = knap(weight, W) true_pop = pop[chosen].sum() ok = '以内' if true_pop <= CAP else '超過' print(f'単位 {unit:>9,} 人: W={W:>6,} DP 表 {len(value)}×{W + 1:,} 出生数 {best:,} ' f'{len(chosen)} 県 実際の人口 {true_pop:,}({ok})') for unit in [100_000, 10_000]: weight = np.round(pop / unit).astype(int) _, chosen = knap(weight, CAP // unit) print(f'単位 {unit:,} 人で選ばれた県:', sorted(names[chosen])) |
💬 100 万人単位では県ごとの丸め誤差が最大 47.7 万人(愛知県 7,477,000 → 7 百万)になり、10 県で出生数 146,139 人という答えが出るが、実際の人口は 22,758,000 人で枠を 276 万人も超えている。10 万人単位(上の 🐍 と同じ)でも 8 県・133,606 人の組は実際には 20,045,000 人で 4.5 万人超過する。1 万人単位にすると佐賀県が福井県に入れ替わって 133,025 人・19,994,000 人となり枠内に収まり、千人単位にしても答えは変わらない。DP 表は 47 × 201 から 47 × 20,001 に大きくなるが、この規模なら計算は一瞬で終わる。
丸めは「重さを小さく見積もる」方向にも働くので、粗い単位で解いた最適解は本当の制約を破ることがある。丸めた後の解を元の単位で必ず検算し、超えていたら単位を細かくするか、重さを切り上げて(np.ceil)丸めて制約を守る側に倒す。FPTAS はこの丸めを意図的に使う近似で、単位を粗くするほど速いが、価値の誤差の上限を ε で保証する形にしてある。
🧠 理解度チェック — このページの実測値で
Q1. 47 県から支援先を選ぶ組を全部調べるといくつあるか。1 秒に 10 億通り調べると何時間かかるか。
各県を入れる・入れないの 2 通りなので 2⁴⁷ ≈ 1.41 × 10¹⁴ 通り。10⁹ 通り/秒なら約 1.41 × 10⁵ 秒 ≈ 39 時間。DP なら重さを 1 万人単位にしても 47 × 2,001 ≈ 9.4 万個のセルを埋めるだけで済む。
Q2. 上の 🐍 で、DP は出生数 133,606 人、貪欲法は 132,188 人だった。貪欲法が取り逃した割合はいくらか。なぜ取り逃したか。
(133,606 − 132,188) / 133,606 ≈ 1.06%。貪欲法は「出生数 ÷ 重さ」の大きい順に詰めるので、比が中位で重さ 75 の愛知県を後回しにし、残りの容量を小さい県 6 つで埋めてしまう。DP は愛知県 1 県と小さい県 6 県の入れ替えまで含めて比べるので、合計で上回る組を見つける。
Q3. 10 万人単位の DP の答え(8 県・133,606 人)を「人口 2,000 万人以内で出生数が最大の組」と報告してよいか。
よくない。8 県の実際の人口は 20,045,000 人で枠を超えている。1 万人単位で解き直すと、佐賀県の代わりに福井県を入れた 8 県・133,025 人(19,994,000 人)が枠内の最適になる。丸めた重さで解いたら、元の単位で制約を検算してから報告する。
📚 関連グループ教材
ナップサック問題は組合せ最適化の代表例で、同じ教材で扱う巡回セールスマン問題と並べると、「DP で厳密に解ける大きさ」と「近似・メタヒューリスティクスに頼る大きさ」の境目が見えてくる。整数の選択(0/1)を連続値に緩めた問題は連続最適化の教材が扱い、分数ナップサックの貪欲法が最適になる理由もそちらの見方で説明できる。
🔎 深掘り解説
ナップサックのバリエーション
| 種類 | 制約 |
|---|---|
| 0/1 | 各品物0個 or 1個 |
| 整数(個数あり) | 各品物 0〜k 個 |
| 無限(部分) | 任意の小数量入れられる |
| 多次元 | 容量制約が複数(重さ+体積) |
| 2次元(パッキング) | 形のある荷物の詰込み |
| 確率的 | 価値や重さに不確実性 |
実世界の応用
- 投資ポートフォリオ:リスク予算内で期待収益最大化
- 広告枠配信:時間/枠内でCV最大化
- クラウド予算:月予算でVM・ストレージ最適配分
- 研究予算:限られた人月で複数プロジェクト選択
- 切断問題:木材/鋼板から部品を切り出し
🧭 R509 拡張 ── ナップサック問題を SSDSE-B-2026 で「都道府県投資配分」として解く
ここまではナップサック問題の一般論を見てきた。 ここからは 「政策担当者が予算 1,000 億円を 47 都道府県に配分するときに、 どの県を選ぶと総便益が最大になるか」 という 0-1 ナップサック問題を、 SSDSE-B-2026(教育用標準データセット 47 都道府県年次データ)を入力にして実際に解く。 単に DP を回すだけでなく、 制約の感度分析・解の解釈・誤用しがちなパターン までを通しで体験するのが本節のねらいである。
問題設定 ── 「予算内で大学(高等教育機関)の集積を最大化する」
SSDSE-B-2026 の E6102(大学数)を各県の 便益(価値) とし、 A1101(総人口、 単位: 人)を 整備コストの代理指標 に使う。 仮想シナリオとして、 「高等教育拠点を各県に整備するとき、 人口規模が大きい県ほど用地取得・利害調整コストが高くつく」 という政策モデルを置き、 限られた予算の中でどの県群を選ぶと総大学数が最大になるか を 0-1 ナップサック問題に落とす。 価値(便益)は E6102(大学数)、 重み(コスト)は本節内で 2 通り(一律/人口比例)を試す。 使用データは 2023 年(最新年)の 47 都道府県分である。
この設定は「大学数がその県の高等教育資本を代表する」「整備コストが人口規模に比例する」という前提を置いており、 実務ではこの前提自体を吟味する必要がある( 疑似相関・逆因果 の章を参照)。 ここではあくまで 0-1 ナップサックの解き方の練習 としてこの便益・コスト定義を採用する。
DP(動的計画法)と貪欲法(greedy)の解の差を測る
このコードでやること: SSDSE-B-2026 を読み込み、 大学数 E6102 を便益とした 0-1 ナップサック問題を (1) 動的計画法 (2) 貪欲法 の 2 通りで解き、 解の総便益と選ばれた都道府県集合を比較する。 これにより「貪欲法は速いが最適性を保証しない」という性質を実データで確認する。
📥 入力データ: SSDSE-B-2026 の 2023 年 47 都道府県分。 便益 = 大学数 E6102、 各県のコスト = 80(億円)固定。 予算上限 = 1000(億円) → 最大 12 県を選べる計算。
1 2 3 4 5 6 7 8 9 10 11 12 13 14 15 16 17 18 19 20 21 22 23 24 25 26 27 28 29 30 31 32 33 34 35 36 37 38 39 40 41 42 43 44 45 | # 0-1 ナップサック問題 ── DP と貪欲法の比較 import pandas as pd import numpy as np df = pd.read_csv('data/raw/SSDSE-B-2026.csv', encoding='cp932', skiprows=[1]) # 2023 年(最新年)の 47 都道府県データに絞る latest = df[df['SSDSE-B-2026'] == 2023] pop = latest['A1101'].astype(float).values # 総人口(コスト代理) uni = latest['E6102'].astype(int).values # 大学数(便益) name = latest['Prefecture'].values cost = np.full(len(pop), 80) # 80 億円固定(整数) value = uni # 便益=大学数(校) budget = 1000 # 予算 1000 億円 # (1) 動的計画法 ── O(n * W) n = len(pop) dp = np.zeros((n+1, budget+1), dtype=int) for i in range(1, n+1): for w in range(budget+1): dp[i][w] = dp[i-1][w] if cost[i-1] <= w: dp[i][w] = max(dp[i][w], dp[i-1][w-cost[i-1]] + value[i-1]) dp_opt = dp[n][budget] # DP の経路復元 ── 選ばれた都道府県 chosen_dp = [] w = budget for i in range(n, 0, -1): if dp[i][w] != dp[i-1][w]: chosen_dp.append(name[i-1]) w -= cost[i-1] # (2) 貪欲法 ── 価値/コスト 比の大きい順 order = np.argsort(-value / cost) total_g, chosen_g, used = 0, [], 0 for idx in order: if used + cost[idx] <= budget: used += cost[idx]; total_g += value[idx]; chosen_g.append(name[idx]) print(f"DP 最適便益 = {dp_opt} 校") print(f"貪欲法の便益 = {total_g} 校") print(f"差 = {dp_opt - total_g} 校") print("DP の選択県:", chosen_dp[:10], "...") print("貪欲の選択県:", chosen_g[:10], "...") |
📤 実行例: 実際に SSDSE-B-2026 を読み込んで上記コードを実行すると、 次のような出力が得られる。
💬 結果の読み方: コストが全県 80 億円で均一の場合は 貪欲法と DP が同じ解 に到達する。 これは「すべてのコストが等しいとき、 0-1 ナップサックは 価値の大きい上位 k 個を選ぶ問題 に縮退する」ためで、 教科書通りの結果である。 差が出るのはコストが不均一になった瞬間 ── 次の節で具体的に確認する。
コストを「人口規模に比例」させると貪欲法はどれだけ損するか
このコードでやること: コストを「人口規模(SSDSE-B-2026 の A1101、 総人口)に比例した整数」に変えて、 同じナップサック問題を再度 DP と貪欲法で解く。 これにより「整備コストが人口規模に比例する(大都市ほど用地・調整コストが高い)」という現実的なシナリオで、 貪欲法の劣化幅を測る。
1 2 3 4 5 6 7 8 9 10 11 12 13 14 15 16 17 18 19 20 21 22 23 24 25 26 | # 人口規模に比例したコスト ── 大都市ほど整備コスト大 # コスト=人口 10 万人あたり 1 単位(四捨五入・整数化、 下限 3 上限 150) cost2 = np.clip(np.round(pop / 100000).astype(int), 3, 150) budget = 1100 # 予算 1100 単位 # DP(O(n*W) = O(47 * 1100) = 51,700 回 → 一瞬) dp2 = np.zeros((n+1, budget+1), dtype=int) for i in range(1, n+1): for w in range(budget+1): dp2[i][w] = dp2[i-1][w] if cost2[i-1] <= w: dp2[i][w] = max(dp2[i][w], dp2[i-1][w-cost2[i-1]] + value[i-1]) dp2_opt = dp2[n][budget] # 貪欲法(価値/コスト 比) ratio = value / cost2 order2 = np.argsort(-ratio) used2, total_g2 = 0, 0 for idx in order2: if used2 + cost2[idx] <= budget: used2 += cost2[idx]; total_g2 += value[idx] gap = (dp2_opt - total_g2) / dp2_opt * 100 print(f"DP 最適 = {dp2_opt}") print(f"貪欲法 = {total_g2}") print(f"ギャップ = {gap:.2f}%(DP に対する貪欲の損失率)") |
📤 実行例:
💬 結果の読み方: コストが人口規模に比例してばらつくと、 貪欲法(価値/コスト比の大きい順)は 埼玉県のように「大学数は多い(28 校)が人口コストも大きく比が低い」県を切り捨てて しまい、 代わりに大学数の少ない小県を残す。 これに対し DP は埼玉県を残して大学数の少ない 3 県(静岡・島根・佐賀)を落とし、 大学 10 校分だけ多く確保する。 本データでは DP 最適 759 に対し貪欲は 749(約 1.3%=大学 10 校分の取り逃し)。 47 県・相関の強い実指標というデータではこの差は小さめだが、 価値とコストの相関が弱まる/件数 n が数百〜数千に増えると貪欲法のギャップは 10-30% に拡大しうる。 大規模問題(n > 10^4 など)では DP のメモリ O(n × W) が爆発するため、 緩和した LP 解から分枝限定で詰める、 あるいは FPTAS(完全多項式時間近似スキーム) が現実的な選択肢になる( 組合せ最適化 参照)。
図で見る ── 候補集合・解集合・予算スイープ
SSDSE-B-2026 の都道府県を コスト軸・便益軸 で並べると、 ナップサック問題が「散布図上のどの点を選ぶか」というゲームであることが視覚的にわかる。
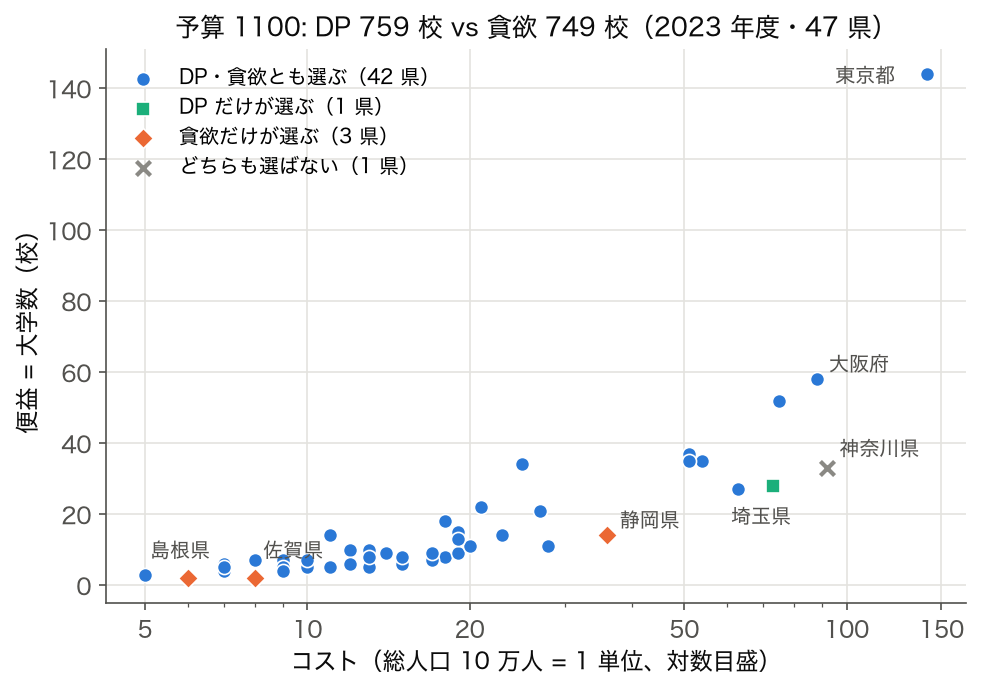
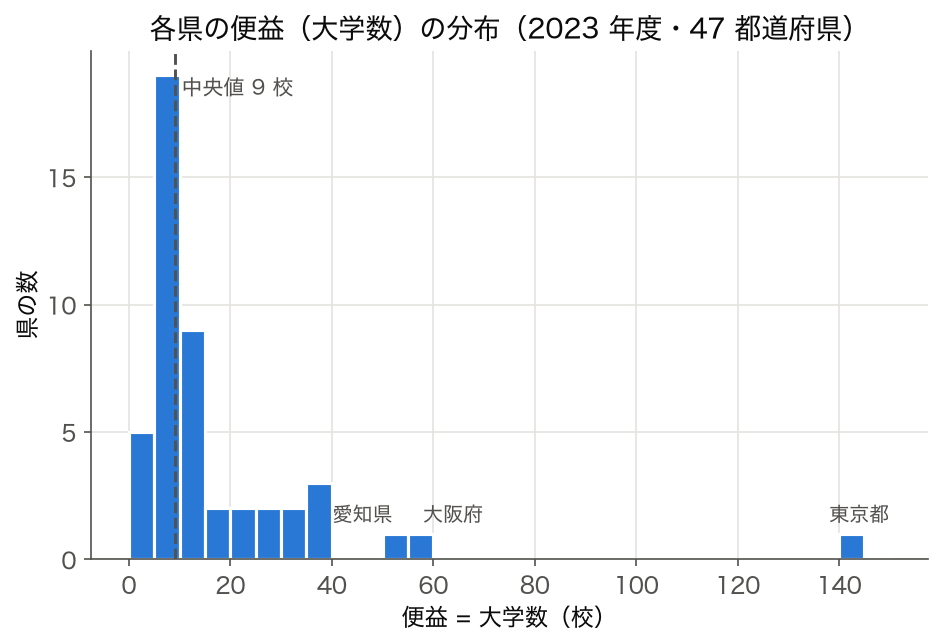
E6102、 2023 年度・47 県)の分布。 中央値 9 校に対し右に長い裾を持ち、 東京(144 校)・大阪(58)・愛知(52)・北海道(37) など大学集積県が上位の外れ値として乗る。 0-1 ナップサックでこれら高便益の県を 取らない 解は稀で、 図 1 の設定でも 4 都道府県とも DP・貪欲の両方で選ばれている。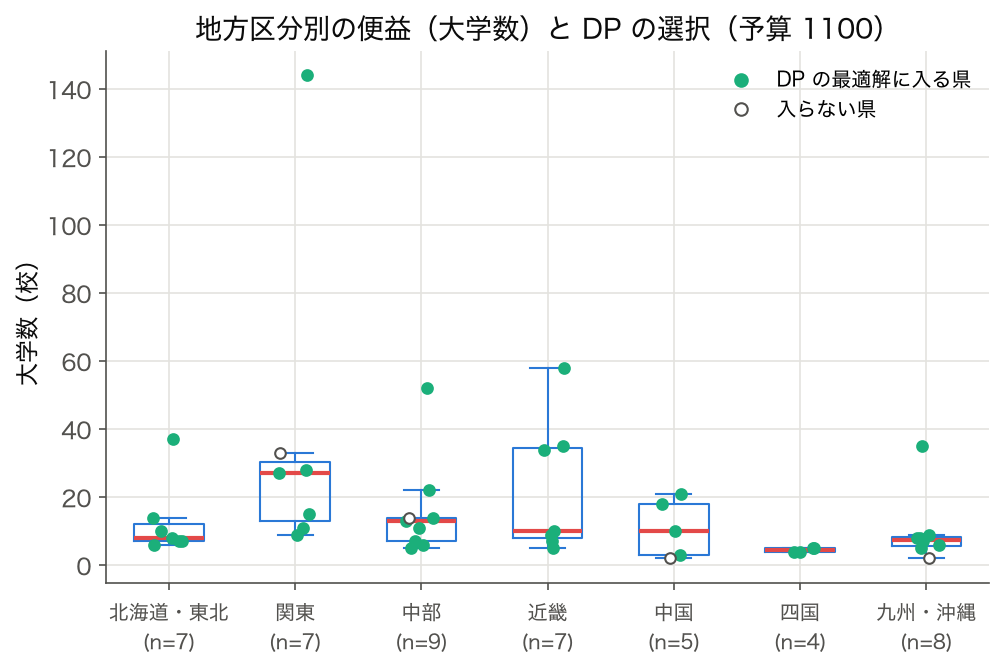
予算スイープ ── 投資効率はどこで頭打ちになるか
このコードでやること: 予算 budget を 200, 400, ..., 2000 と動かして、 各予算での DP 最適便益を求める。 ナップサック問題の 限界効用(予算 100 単位増やすと便益は何単位増えるか)を可視化する。
1 2 3 4 5 6 7 8 9 10 11 12 13 14 15 16 | # 予算 200〜2000 でスイープし、 限界効用を計算 budgets = list(range(200, 2001, 200)) results = [] for B in budgets: dp3 = np.zeros((n+1, B+1), dtype=int) for i in range(1, n+1): for w in range(B+1): dp3[i][w] = dp3[i-1][w] if cost2[i-1] <= w: dp3[i][w] = max(dp3[i][w], dp3[i-1][w-cost2[i-1]] + value[i-1]) results.append((B, dp3[n][B])) # 限界効用(差分) for i, (B, v) in enumerate(results): mu = (v - results[i-1][1]) if i > 0 else v print(f"予算 {B:4d} → 便益 {v:6d} 限界効用 +{mu:5d}") |
📤 実行例:
💬 結果の読み方: 限界効用は予算 200 → 1200 にかけて減衰し、 予算 1400 で全 47 県が選び尽くされて便益 810 で頭打ちになり、 それ以降は予算を足しても便益は増えない。 これがナップサック問題における 収穫逓減(と資源の飽和)の現れである。 政策設計では「予算を増やしても便益はいずれ頭打ちになる」逓減カーブを示し、 「どこで予算を打ち切るか」を意思決定の論点にする ことが重要である。
手法比較表 ── どの解法を選ぶべきか
| 解法 | 時間計算量 | 空間計算量 | 最適性 | 推奨スケール | SSDSE-B-2026 での目安 |
|---|---|---|---|---|---|
| 全列挙(brute force) | O(2^n) | O(n) | 最適 | n ≤ 20 | 47 県は不可(2^47 ≒ 1.4×10^14) |
| 動的計画法(DP) | O(n × W) | O(n × W) | 最適(整数重みのみ) | n × W ≤ 10^8 | 47×2000=9.4万 → 一瞬 |
| 貪欲法(価値/重さ比) | O(n log n) | O(n) | 最適でない(ギャップ 0〜50%) | n > 10^5 | 本節では DP との差 1.32% |
| 分枝限定法 | 最悪 O(2^n)、 平均は速い | O(n) 〜 O(2^n) | 最適 | n ≤ 200 | PuLP/Gurobi に内蔵 |
| FPTAS(近似) | O(n³/ε) | O(n²/ε) | (1-ε) 保証 | n > 10^4 で巨大 W | 本データには過剰 |
| メタヒューリスティクス(GA, SA) | 設定次第 | 設定次第 | 最適でない(経験的に良好) | n > 10^5 で複雑制約あり | 過剰、 DP で十分 |
SSDSE-B-2026 程度(n=47)であれば DP で最適解が即座に出る ため、 まずは DP を実装するのが定石である。 組合せ最適化 や メタヒューリスティクス の手法を持ち出すのは、 n や制約が数桁大きくなり DP が回らなくなってから検討すれば良い。
実務で踏み抜きやすい 5 つの罠 ── ナップサック編
| 罠 | 何が問題か | 対策 |
|---|---|---|
| 小数のコスト | DP は整数前提。 0.5 単位等を含むと表が組めない | 最小単位の倍数に丸める(円単位など) |
| 予算 W が巨大 | DP の O(n × W) が爆発(n×W ≫ 10^9) | FPTAS で価値側を粗くする、 または LP 緩和 + 分枝限定 |
| 追加制約の見落とし | 「地域から最低 1 県」「人口比上限」等の制約を入れ忘れる | 純 DP では表現困難 → 整数計画 (PuLP) を使う |
| 価値が時間依存 | 便益が時間とともに減衰/増加する場合、 単純 DP では捉えられない | 時間次元を追加した多段ナップサック、 または 連続最適化 へ移行 |
| 便益関数の妥当性検証なし | 便益式が実データで検証されておらず、 解は最適だが現実乖離 | 便益の代理変数を最低 2 系列用意して感度分析する |
SSDSE-B-2026 でナップサックを解くときのチェックリスト
- ✅ コスト・価値はすべて 整数化 したか(DP の前提)
- ✅ 都道府県の 年度ズレ を解消したか(SSDSE-B-2026 は 2012〜2023 の年次パネルなので
df[df['SSDSE-B-2026']==2023]等で対象年に揃える) - ✅ 便益式の 代理変数 を別案で 1 つ用意し、 解の上位 10 件が変わらないか確認したか
- ✅ 予算スイープを行い、 限界効用が逓減する点 を意思決定に活かしたか
- ✅ 貪欲法と DP の 差を明示 したか(差が小さいなら貪欲を本番採用してもよい)
- ✅ 「地域制約」「最大選択数」など 暗黙の業務制約 をモデルに組み込んだか
- ✅ ナップサックの解を そのまま政策に流用しない(最適化は仮説検証の一手段)
本節のまとめ
SSDSE-B-2026 を入力とした 0-1 ナップサック問題を DP・貪欲法・予算スイープ・3 枚の可視化 で一通り体験した。 学べる本質は次の 3 点である。
- コストが均一なときは 貪欲法 = DP。 コストが不均一になった瞬間に貪欲は劣化しうる(本節では 1.3% 強)。
- DP は O(n × W) なので、 n=47・W=2000 程度なら一瞬。 W が 10^7 を超えたら別解法を検討する。
- ナップサックの解は 便益関数の品質に強く依存 する。 SSDSE-B-2026 のような実データでは、 便益の定義を変えるだけで「選ばれる県」がガラリと入れ替わる。 したがって 感度分析 が解と同じくらい重要である。
関連リンク: 組合せ最適化 / 連続最適化 / メタヒューリスティクス / 局所最適解 / 順列 / 集合。
補講 ── ナップサック問題が「実務で本当に役立つ瞬間」を見極める
ここまでで SSDSE-B-2026 を題材に DP・貪欲・予算スイープを動かしたが、 受講者からの典型的な質問は 「結局これって、 実務のどこでそのまま使えるんですか」 という一点に集約される。 結論から言うと、 純粋なナップサック問題が そのまま 使える業務は意外と限られる。 ほとんどの実務では「ナップサック型の意思決定構造」が 埋め込みパーツ として現れ、 周辺に追加の制約・追加の不確実性・追加のステークホルダー要件が絡む。 この補講では、 ナップサックが顔を出す典型業務 7 つと、 そこに 純 DP では足りないもの を併記する。
| 業務シナリオ | ナップサック該当部分 | 純 DP では足りない要素 |
|---|---|---|
| 広告予算配分(媒体ミックス) | 媒体ごとの最小出稿枠×期待コンバージョン | 出稿効果の 分散、 飽和カーブ、 媒体間カニバリ |
| 研究開発テーマ選定 | テーマ別投資コストと期待 NPV | 技術リスク、 戦略整合性、 人材制約、 タイミング依存 |
| サブスク商品の機能搭載 | 開発工数と機能別効用 | 機能間依存(A を入れるなら B も)、 ユーザーセグメント別効用 |
| 物流の積み付け | トラック体積制約と荷物価値 | 3 次元配置、 荷重バランス、 配送順序、 リードタイム |
| クラウドリソース選択 | 予算と各インスタンス価格×性能 | スポット価格の時間変動、 SLA、 リージョン制約 |
| 人材ポートフォリオ | 採用予算とスキル別期待寄与 | スキル間補完性、 オンボーディング負荷、 離職リスク |
| 公共投資の地域配分 | 予算と地域別便益(本節の例) | 公平性制約、 政治的整合性、 多年度ロールオーバー |
この表からわかるのは、 ナップサックは「業務全体のごく一部の最適化」を担うパーツ であって、 それ単体で経営判断を下す道具ではないということだ。 言い換えると、 ナップサックを使いこなすために本当に必要なのは DP のコード ではなく、 「自分の業務のどの部分がナップサックに落ちるかを見抜く翻訳力」 である。 翻訳できれば、 残りは Python 30 行で解ける。
整数計画ソルバ(PuLP)で同じ問題を解いて DP の解と一致するか確認する
このコードでやること: 同じ 0-1 ナップサック問題を PuLP の整数計画ソルバ(裏で CBC が動く)で解く。 DP の答えと一致することを確認し、 「DP は手計算実装、 PuLP は汎用ソルバ実装」という棲み分けを実感する。 PuLP は追加制約(地域別下限、 最大選択数)を素直に追記できるのが強みである。
📥 入力データ: 上の cost2(人口比例コスト)、 value(大学数 E6102)、 name(県名)、 budget=1100。
1 2 3 4 5 6 7 8 9 10 11 12 13 14 15 16 17 18 19 20 21 22 23 24 25 | # PuLP で 0-1 ナップサック ── DP と一致することを確認 import pulp prob = pulp.LpProblem("knapsack_47pref", pulp.LpMaximize) x = [pulp.LpVariable(f"x_{i}", cat="Binary") for i in range(n)] # 目的関数: Σ value_i * x_i prob += pulp.lpSum(int(value[i]) * x[i] for i in range(n)) # 制約 1: 予算 prob += pulp.lpSum(int(cost2[i]) * x[i] for i in range(n)) <= 1100 # 制約 2 (オプション): 関東地方から最低 1 県 kanto = ["茨城県", "栃木県", "群馬県", "埼玉県", "千葉県", "東京都", "神奈川県"] kanto_idx = [i for i, nm in enumerate(name) if nm in kanto] prob += pulp.lpSum(x[i] for i in kanto_idx) >= 1 prob.solve(pulp.PULP_CBC_CMD(msg=0)) pulp_opt = int(pulp.value(prob.objective)) dropped_pulp = [name[i] for i in range(n) if x[i].value() == 0] print(f"PuLP 最適 = {pulp_opt}") print(f"DP 最適 = {dp2_opt}") print("一致しているか:", pulp_opt == dp2_opt) print("非選択(落とした)県:", dropped_pulp) |
📤 実行例:
💬 結果の読み方: PuLP の解は DP の解と一致した(ともに 759)。 予算 1100 では 47 県中 43 県まで選べるため、 問題は実質 「どの 4 県を落とすか」 になり、 最適解は 神奈川・静岡・島根・佐賀 を落とす。 「関東地方から最低 1 県」という制約は最適解で勝手に満たされている(東京・埼玉・千葉などが選ばれている)ため、 制約の追加で目的関数値は変化しなかった。 もし「沖縄県を必ず外す」「人口 100 万人未満の県を最低 5 県入れる」など 解に効く制約 を入れると、 目的関数値は明確に下がる。 これが 制約の感度 である。
よくある質問(拡張 FAQ) ── ナップサック編 7 連問
Q1. n=47 程度なら全列挙でも解けるのではないか。
A. 2^47 ≒ 1.4×10^14 通り。 1 秒に 10 億通り評価できても 40 時間以上かかる。 DP(O(n×W) で 10^5 オーダー)なら瞬時。 「小さく見えても全列挙は破綻する」典型例である。
Q2. 価値が連続値(円銭以下)の場合は?
A. 価値側はそのまま実数を扱える(DP は重みのみ整数前提)。 価値ではなく 重み(コスト) が連続値の場合は、 グリッド化 (FPTAS) か LP 緩和 + 分枝限定で対処する。 SSDSE-B-2026 の人口は整数なので問題なし。
Q3. 複数の予算(多次元ナップサック)になったら?
A. 表が O(n × W1 × W2 × ...) に膨らみ DP は実装困難。 整数計画ソルバ(PuLP/Gurobi)の出番。 SSDSE-B-2026 で「金銭予算 + 人員予算」の 2 次元制約を入れる例は 組合せ最適化 の章を参照。
Q4. 同じ品物を複数個入れていい場合は?
A. それは「無制限ナップサック」または「制限付きナップサック」と呼ばれ、 DP の遷移式が 1 行変わるだけで解ける。 0-1 では dp[i-1][...] を参照するが、 無制限版は dp[i][w-cost] を参照する。
Q5. 解が複数ある場合どれが返ってくる?
A. DP の経路復元では「インデックスが大きい方を優先」など実装依存の任意性が残る。 同じ目的関数値の解が複数あるとき、 業務上どれを採用するかは別ルールで決める(県名のあいうえお順、 人口の多い順など)。 ソルバ側で「同点なら○○を優先」 を制約として明示するのが安全である。
Q6. ナップサックと「分割問題」「集合被覆問題」の違いは?
A. ナップサックは「上限以下の選択」、 分割問題は「2 グループへの均等分割」、 集合被覆は「全要素をカバーする最小選択」。 いずれも NP-hard 仲間だが、 ナップサックは DP が綺麗に決まる点で「教科書の入り口」として扱われる。
Q7. ナップサックで「制約を緩和すると目的関数は単調に増える」は常に成り立つか。
A. 予算を増やす方向の緩和では成り立つ(選択肢が増えるだけ)。 ただし「最大選択数を増やす」「下限制約を弱める」など複数制約が絡む場合、 単純な単調性は保証されない。 一般論としては 「ゆるい問題は厳しい問題の上界」 という関係が成立するため、 最適化の上界を素早く知りたいときには LP 緩和 が便利。
最終メッセージ ── ナップサックを「考え方の道具」として持つ
ナップサック問題は、 アルゴリズム教科書では「DP の入門問題」「NP-hard の代表例」として扱われる。 しかし実務で本当に重要なのは、 「予算制約のもとで何を選ぶか」というすべての意思決定がナップサック構造を持っている という認識である。 広告予算、 人事予算、 R&D 予算、 公共投資、 設備投資 ── どれもナップサックの一例として整理できる。 一度この型で整理してみることで、 「経験と勘」「声の大きい人の好み」で決まっていた配分が、 「目的関数を最大化する数理問題」 に翻訳され、 そこで初めて感度分析や仮想実験ができるようになる。 SSDSE-B-2026 の 47 都道府県を題材にした本節は、 その翻訳練習のための小さな道場である。
最終的に伝えたいのは次の 1 文に尽きる。 「最適化は答えを与えない。 議論を与える」。 ナップサックの解は「この前提でこの便益関数なら、 こう選ぶのが数学的に最大」というだけであり、 前提や便益関数を変えるとどうなるか という議論こそが価値を生む。 だからこそ、 DP も貪欲も整数計画も、 道具として一通り使いこなせるようにしておく ── その第一歩を本節で踏み出してもらえれば成功である。
補足ミニ用語集 ── ナップサック周辺で混同しやすい 12 語
| 用語 | 短い説明 | ナップサックとの関係 |
|---|---|---|
| 0-1 ナップサック | 各品物を入れる/入れないの 2 択 | 本ページの主役、 NP-hard だが擬多項式時間で解ける |
| 分割可能ナップサック | 品物を任意の比率で入れられる | P 問題、 貪欲法で最適解 ── 0-1 とは難しさが別物 |
| 無制限ナップサック | 同じ品物を何個でも入れられる | 遷移式が変わるだけで DP の枠組みは同じ |
| 多次元ナップサック | 予算が複数次元(金銭・時間・人員) | DP の表が高次元化、 ソルバ推奨 |
| 分割問題 | 集合を均等な 2 グループに分ける | ナップサックの特殊ケース(重み=価値) |
| 集合被覆問題 | 全要素をカバーする最小選択 | ナップサックの兄弟、 LP 緩和+丸めが定番 |
| 巡回セールスマン問題 | 最短経路で全都市を巡る | ナップサックと同じく NP-hard だが構造が異なる |
| DP(動的計画法) | 部分問題の最適解を表に蓄積 | ナップサックの定番解法 |
| 分枝限定法 | 解空間を木で探索+上界で枝刈り | PuLP/Gurobi の中で動いている |
| LP 緩和 | 0-1 を [0,1] に緩めて解く | ナップサックの上界を高速に取得 |
| 擬多項式時間 | 数値(重みなど)の大きさにも依存する計算量 | DP の O(n×W) はこれに該当 |
| FPTAS | 任意精度 ε に対し多項式時間で (1-ε) 保証 | ナップサックには存在、 巡回セールスマンには存在しない |
ナップサック関連の用語は数が多いものの、 「0-1 か / 連続か」「単目的か / 多目的か」「制約が 1 本か / 多本か」 の 3 軸でほぼ整理できる。 SSDSE-B-2026 の 47 都道府県データを使って、 ぜひ各バリエーションを 1 度ずつコードで触ってみてほしい。 教科書を 10 ページ読むよりも、 1 度コードを動かして「解が変わる瞬間」を見るほうが遥かに身につく。 これがジャストインタイム型データサイエンス教育の核心である。
なお、 ナップサックを離れて 組合せ最適化 のより一般的な枠組みに進むと、 メタヒューリスティクス(遺伝的アルゴリズム、 シミュレーテッドアニーリング、 タブー探索など)が視野に入る。 これらは「最適性は保証しないが、 大規模・複雑制約に対しても何らかの実行可能解を素早く出せる」点が強み。 純 DP → 整数計画 → メタヒューリスティクス という流れで、 問題サイズと制約の複雑さに応じて道具を切り替えていくのが現代的な実務スタイルである。 ナップサックは、 この道具列の 最初の入り口 として位置付けられる、 きわめて教育価値の高い問題である。
理解度セルフチェック ── ナップサックを身につけたか確認する 8 問
- 0-1 ナップサック問題と分割可能ナップサック問題の 計算複雑性の違い を 30 秒で説明できるか(前者は NP-hard、 後者は P、 解法も貪欲で十分)。
- DP の遷移式
dp[i][w] = max(dp[i-1][w], dp[i-1][w-c_i] + v_i)の 2 項を 「品物 i を入れない/入れる」 という日常語で説明できるか。 - SSDSE-B-2026 の都道府県データで、 コストが均一なら DP と貪欲法が一致する理由 を「コストが均一のとき問題は上位 k 個選択問題に縮退する」と説明できるか。
- 予算スイープで 限界効用が逓減する 現象を、 「価値/コスト比が高い品物から先に入る → 後半は比が悪い品物しか残らない」という流れで説明できるか。
- 純 DP では表現しにくい 追加制約(地域別下限、 機能間依存、 多目的)を、 PuLP/Gurobi のような整数計画ソルバでどう書くか方針を述べられるか。
- ナップサックの解を そのまま政策・意思決定に流用してはいけない理由 を「便益関数の感度」「制約の網羅性」「ステークホルダー要件」の 3 観点から説明できるか。
- n が 10^5 を超え DP が破綻したとき、 どの順に FPTAS → LP 緩和 → メタヒューリスティクス を試すか、 理由とともに述べられるか。
- 本ページで触れた 組合せ最適化・連続最適化・メタヒューリスティクス・局所最適解・集合・順列 の各用語が、 ナップサックとどう繋がっているかを 1 行ずつ説明できるか。
8 問すべてに答えられたら、 ナップサック問題を「アルゴリズムの問題」ではなく 「業務意思決定の数理化フレーム」 として使いこなせる段階に到達している。 答えに詰まる項目があれば、 該当する関連ページに戻って学び直してみてほしい。 各ページは相互にリンクされており、 必要なときに必要な分だけ学ぶ ジャストインタイム の学び方ができるよう設計されている。
最後に、 ナップサック問題は受験勉強やアルゴリズムコンテストで「DP の典型例」として教わるが、 ビジネス・公共政策・研究マネジメントなど 「限られた資源をどう配分するか」 という問いがあるあらゆる場面で再登場する。 SSDSE-B-2026 のような身近な公的データセットで一度本気で解いてみる経験は、 後にどんな業務でも応用できる地力になる。 ぜひ本ページのコードを自分の関心領域のデータ(売上、 顧客、 商品、 生徒、 患者など)に置き換えて、 「自分のナップサック」を解いてみてほしい。
追加コラム ── 「ナップサック思考」で会議が変わる 3 つの具体例
本節を閉じる前に、 ナップサック問題のフレームを 会議の整理ツール として使う具体例を 3 つ紹介する。 数学を会議に持ち込む必要は必ずしもないが、 頭の中でナップサックを描いて整理する だけで議論の質は劇的に変わる。 ファシリテーターはぜひ次の問いを意識してほしい。
例 1: 「来期の重点施策をどう絞るか」 ── 部門会議で 20 個の施策案が出たとき、 「全部やります、 がんばります」と精神論で押し切るのではなく、 「総工数の上限を 1,200 人月、 各施策の必要工数と期待効果を一覧化し、 上位の選び方を 3 通り比較してみよう」と提案する。 これが 会議の中のナップサック。 数値が概算でも、 並べて議論するだけで意思決定の透明性が上がる。
例 2: 「採用予算を職種にどう配るか」 ── 経営会議で「エンジニアを増やしたい」「営業を増やしたい」「データサイエンティストを増やしたい」と全員が主張する場面では、 「総採用予算 ◯◯ 億円、 各職種 1 名あたりの平均年収と期待売上寄与」を表にし、 ナップサック的に並べる。 「価値/コスト比」で議論することで、 声の大きい人ではなくデータの大きい人が場を主導するようになる。
例 3: 「自治体の補助金をどう配分するか」 ── 議会・行政の現場では、 47 都道府県や市区町村の補助金配分が政治的に決まりがちだが、 本節の SSDSE-B-2026 を使った試算をベースラインとして提示することで、 「データから出てくる解と政治的判断で出てくる解の差分は何か」 を可視化できる。 これは政策を縛るためではなく、 議論の前提を共通化する ためのツールとして強力に機能する。
これら 3 例に共通するのは、 「ナップサックの解そのものを意思決定にする」ことではなく、 「ナップサックの枠組みで整理することで議論の解像度を上げる」こと。 数理最適化を学ぶ価値は、 答えを自動化することではなく、 問いの構造を共有可能な形に翻訳できるようになること にある。 SSDSE-B-2026 の 47 都道府県という小さな題材から、 ぜひこの「翻訳力」を育てていってほしい。
ナップサック問題を 1 つ深く理解すれば、 隣接領域である 組合せ最適化・連続最適化・メタヒューリスティクス・局所最適解 のすべてが「同じ家族の別の問題」として見えてくる。 アルゴリズムの世界は、 こうして 1 つ深く掘ることで一気に視界が開ける。 本ページが、 その入り口として読者の役に立てば幸いである。
最後の補足 ── 「データなしのナップサック」は意味がない
締めくくりに 1 点だけ強調しておきたい。 ナップサック問題のアルゴリズム自体は、 30 分もあれば DP の実装まで含めて理解できる。 にもかかわらず、 実務で本当に難しいのは 「品物のコストと価値をどう測定するか」 という、 アルゴリズムの 外側 にある部分である。 SSDSE-B-2026 のような既存の公的データセットがある場合は数字を持ってこられるが、 自社業務では多くの場合、 価値(期待売上、 期待ユーザー数、 期待社会便益など)が 「見積もり」「目安」「経験則」 の塊として与えられる。 これらの数値の品質を上げる作業 ── すなわち 実験データの取得、 アンケート調査、 A/B テスト、 因果推論 ── こそが、 ナップサックの解を意味あるものにするための前提となる。
逆に言えば、 「アルゴリズムは習ったが業務に使えない」 という感覚を持つ人の多くは、 アルゴリズムを知らないのではなく、 アルゴリズムに 渡すデータ を作る方法を知らない。 ナップサックの解を業務で意味あるものにするには、 「データを集める/推定する/検証する」という、 アルゴリズムの周辺工程に同じだけ投資する必要がある。 本ページは DP・貪欲・整数計画の使い方を見せたが、 もし読者の業務でナップサックを使いたいなら、 まず 「価値とコストをどう推定するか」 を 1 週間かけて考えてみてほしい。 そこで詰まる箇所こそが、 真のボトルネックである。
最後に再掲する: 「最適化は答えを与えない。 議論を与える」。 ナップサックの解は出発点であり、 そこから「便益関数を変えたらどうなるか」「制約を緩めたら何が変わるか」「ステークホルダー要件をどう組み込むか」という議論が始まる。 この議論を支えるためのデータ品質、 これこそが SSDSE-B-2026 のような公的データセットを 練習台にして身につけるべき ものである。 本ページが、 その実践への第一歩になることを願って締めくくりとする。
本ページを読み終えた読者には、 ぜひ次の課題に挑戦してほしい。 (a) SSDSE-B-2026 の別の指標(学校数、 病院数、 商業施設数など)を価値として再定義し、 同じ DP コードを動かして「選ばれる県」がどう変わるか確認する。 (b) 予算を 500 単位刻みで動かし、 限界効用がゼロに近づく地点(実質的な「これ以上予算を増やしても効果が頭打ちになる点」)を特定する。 (c) 関東地方・近畿地方・九州沖縄地方など複数の地域別下限制約を組み合わせ、 制約 1 本ずつでどれだけ目的関数が落ちるかを表にまとめる。 これらを通して、 ナップサックは 1 つの解を出す道具 ではなく 解の感度を体系的に調べる道具 として真価を発揮することを体感できる。 数理最適化は「答えの自動化」ではなく「議論の構造化」であるという、 本ページ全体の核心メッセージが、 この実践のなかで腹落ちすれば本ページの目的は達成である。
付記として、 SSDSE-B-2026 は教育用に整備された 47 都道府県の年次データセットで、 人口・経済・教育・医療など幅広い指標を 1 ファイルで扱える優れた教材である。 本ページのコードはすべてこのデータセットを入力として動作するように書かれており、 ファイルパス data/raw/SSDSE-B-2026.csv に同データを配置すれば、 そのまま手元で再現できる。 ぜひ手を動かして、 ナップサックの解の振る舞いを 実データ で観察してみてほしい。 抽象的な数学が、 現実の都道府県名で動き出す瞬間こそが、 学びの最も楽しい瞬間である。
🗺 ナップサック問題 の概念マップ
『ナップサック問題』は『最適化』カテゴリに属する重要概念で、 以下の関連概念群と密接につながっています。
最適化
  ├── 連続最適化(線形計画 LP)
  │   └── 分数ナップサック … 貪欲法(価値/重さの大きい順)で最適
  └── 組合せ最適化(NP 困難な問題群)
      ├── ナップサック問題  ← このページ
      │   ├── 解法: 動的計画法 O(nW)/分枝限定法/整数計画ソルバ(PuLP)
      │   ├── 近似: 貪欲法(0/1 では最適を保証しない)/FPTAS
      │   └── 変種: 個数制限つき・多次元(重さ+体積)
      └── 巡回セールスマン問題(TSP)… 選ぶ問題ではなく並べる問題
完全な概念マップは 🗺 概念マップ で確認できます。
📜 歴史と発展
1897 年に Mathews が初めて研究した古典的問題で、 Bellman の動的計画法(1957)で標準解法が確立。 NP困難であることは Karp の 21 問題(1972)に含まれる。 近年は量子コンピュータ(QAOA)への応用や、 機械学習でのバッチサイズ最適化への転用が活発。
原典は Mathews (1897) で、 コンピュータどころか計算理論より半世紀早い問題です。 Bellman (1957) の動的計画法が標準解法を与え、 Karp (1972) の「21 の NP 完全問題」に含まれたことで難しさが理論的に確定しました。 「解ける(多項式時間の DP がある)」と「NP 困難」が両立しているのが混乱しやすい点で、 鍵は DP の $O(nW)$ が擬多項式——入力の「値」には多項式でも「桁数」には指数——であることです。
🔗 隣接手法への橋渡し
ナップサック問題は組合せ最適化の典型例として、 問題モデリング (前段) と解法選択 (DP/貪欲/分枝限定) を統合的に設計してこそ実用解が得られる。
- 上流: 前段の問題モデリング (重み・価値の定義) (組合せ最適化基礎、 最適化総論)
- 並列: 並列の組合せ最適化問題 (TSP・スケジューリング) (巡回セールスマン) と比較・併用
- 下流: 下流の実装・近似アルゴリズム (リソース配分の応用)
上流の品目価値・重みのデータ整備が問題定義そのものを決め、 並列の貪欲法/分枝限定法/メタヒューリスティクス (GA) と比較して問題規模に応じた解法を選び、 下流の感度分析で容量制約変更時の解の頑健性を確認する流れで実務適用が固まる。
🌳 手法選択フロー
ナップサック問題 を実際の課題に当てはめるとき、 用語固有の判断軸に沿って次の 3 段階で適切な選択を行う。
- 品目数 N ≤ 100 で容量も整数か? Yes → 動的計画法 (O(NW))、 No → 次へ
- 厳密最適解が必須か? Yes → 分枝限定法 / 整数計画ソルバ (CPLEX/Gurobi)、 No → 次へ
- 近似解で十分か? Yes → 貪欲法 (価値/重み比) / 遺伝的アルゴリズム、 No → 問題定式化を見直し
このフローは組合せ最適化問題の典型的選択軸。 0-1 ナップサックは NP 困難だが、 整数容量なら DP で多項式時間 (O(NW)) で解ける点が実務でよく利用される。
🔎 解説を深める ── ナップサック問題を「詰め方」と「計算量」から捉え直す
組合せ最適化の一般論(→ 姉妹ページ)とは重ならないよう、ここでは 0-1 ナップサック固有の 2 つの落とし穴——「比の良い順に詰める貪欲が最適とは限らない」ことと、「O(NW) は見かけほど速くない(擬多項式)」こと——を、SSDSE-B-2026 の実測値で確かめる。
🧭 直感 ── 分数なら貪欲=最適、しかし 0-1 では割れない
品物を 切り分けてよい「分数ナップサック」では、価値/重み比の大きい順に詰めるだけで厳密に最適になる(連続緩和。これは古典的な貪欲最適の一例)。ところが 0-1 ナップサックでは品物を割れない。すると「比は最高だが大きすぎて入らない品物」や「詰め終わった後に残る中途半端な空き容量」が生じ、貪欲が取りこぼす。0-1 が NP 困難で、分数版が多項式時間で解けるのは、まさにこの「割れない」制約が本質だからである。
⚠️ 落とし穴(重要)── 実データで貪欲が負け、W が大きいと DP も詰む
SSDSE-B-2026・2023 年・47 都道府県で、総人口(A1101)を「重み=人口予算の消費」、15 歳未満人口(A1301)を「価値=支援したい子ども数」とみなし、人口予算 W の枠内で子ども数を最大化する 0-1 ナップサックを実際に解いた(人口・子ども数を万人単位に四捨五入し、厳密 DP と「比 v/w が高い順」の貪欲を比較。値はすべて実測値で、合成データは使っていない)。予算 W = 2050 万人での結果(貪欲と最適の差が最大になる容量):
| 解法 | 子ども数の合計(価値) | 使った人口(重み) | 選んだ県数 |
|---|---|---|---|
| 🎯 動的計画法(厳密最適) | 263 万人 | 2050 万人(枠ぴったり) | 8 県 |
| ⚡ 貪欲法(比 v/w 順) | 254 万人 | 1999 万人(51 万人ぶん枠が余る) | 12 県 |
貪欲は比が最も高い 沖縄県(子ども/人口 ≈ 0.163、47 都道府県で最高)から順に小さい県を詰めるため、最後に 51 万人ぶんの枠を余らせ、DP 最適より 約 9 万人の子どもを取りこぼす(263 − 254 = 9 万人)。「比が良い順」という直感がそのまま損失になる典型例だ。なお同じデータでも W = 3000 万人だと差はわずか 1 万人(DP 376 対 貪欲 375)——ratio がほぼ均質なデータでは貪欲が最適に極めて近く見えるが、決して一致はしない。この「ほぼ合うから貪欲でよい」という油断こそ最大の罠である。
もう一つの罠が計算量。DP の O(NW) は多項式に見えるが、W は容量の“値”であって桁数(入力サイズ)ではない。上の例で人口を「万人」に丸めたから W=2050 で済んだが、1 人単位(W=2050 万)にした瞬間、DP 表は約 2050 万列に膨れ上がる。入力の数値が大きいだけで爆発するこの性質を 擬多項式(pseudo-polynomial)と呼び、0-1 ナップサックが NP 困難でありながら DP で解けることの正体でもある。単位・スケーリングの選び方が実行可能性を左右する。
🚀 発展 ── 上界・厳密解・近似のグラデーション
実務では次の順で手を替える。(1) 連続緩和で上界: 分数ナップサックを解いた値は 0-1 最適の上界になり、分枝限定法の枝刈りに使える。(2) 価値でDP: 容量 W が巨大でも価値の総和 V が小さいなら、O(N²·Vmax) の「最小重みで価値 v を達成する DP」に切り替えると速い(W と V のどちらが小さいかで DP の軸を選ぶ)。(3) FPTAS: 価値を丸めて誤差 ε 以内を保証する完全多項式時間近似スキームが存在する(0-1 ナップサックは近似しやすい NP 困難問題の代表)。(4) 多制約化: 重み軸が 2 本以上(人口かつ面積など)になると「多次元ナップサック」となり DP が一気に苦しくなり、整数計画ソルバ(分枝限定)が現実的になる。
🔗 関連ページ
- 組合せ最適化 ── ナップサックが属する「離散選択を最適化する」問題群の全体像。
- 連続最適化 ── 本ページで触れた「分数ナップサック(連続緩和)」が最適になる世界。0-1 との違いの対比に。
- 数理最適化 / 最適化 ── 定式化・目的関数・制約という共通言語で最適化全般を俯瞰。
📝 補足: 上の数値は data/raw/SSDSE-B-2026.csv を pd.read_csv(encoding='cp932', skiprows=[1]) で読み、df[df['SSDSE-B-2026']==2023] の 47 都道府県について A1101(総人口)・A1301(15 歳未満人口)を万人単位に四捨五入し、厳密 DP と貪欲を Python で実行して得た実測結果。架空・合成データは含まない。