🔖 キーワード索引
このページで扱う主要キーワード(クリックで該当セクションへ):
💡 30秒で分かる結論
🍰 まずはやさしく
群知能は、鳥やアリの集団のような仕組みです。
一番いい答えを効率よく見つけるために使います。
スマホの配送ルートを決める時に役立ちます。
この章では、群知能の結論を短くまとめます。
- 群知能はアリ・鳥・蜂の群行動を模倣し、 単純な個体ルールから大域最適に近づく最適化技術
- 分野:メタヒューリスティクス/AI — 微分不要、 ブラックボックス目的関数にも使える
- 代表手法:PSO(粒子群)、ACO(アリコロニー)、ABC(人工蜂コロニー)、Firefly、Cuckoo Search
- 使う場面:組合せ最適化(巡回・配送)、 ハイパーパラメータ探索、 制約付き設計問題
- 注意:理論保証は弱い。 結果は乱数シード依存、 複数試行と統計検定で堅牢性を検証する
📍 あなたが今見ているもの
🍰 まずはやさしく
群知能は、データの分析でよく使う言葉です。
統計データをうまくまとめるために使います。
都道府県のデータを分析する時に役立ちます。
このページで、群知能について体系的に学びます。
「群知能」 (Swarm Intelligence) は、 SSDSE-B-2026 などの公的統計データを使った教材・分析で頻出するキーワードです。 本ページでは、 まず直感、 次に数式、 そして 47 都道府県の実値で確かめる、 という流れで体系的に整理します。 加えて、 ケーススタディ・FAQ・歴史的経緯・参考文献までを 1 ページに集約し、 用語の「地図」として使えるようにしました。
🎨 直感で掴む
🍰 まずはやさしく
群知能は、生き物の集団行動をまねた方法です。
単純なルールで最高の答えを探すために使います。
部活の仲間と協力して目標を追う感覚に似ています。
ここでは、代表的な3つの仕組みを直感的に学びます。
群知能 (Swarm Intelligence) は、 アリ・鳥・蜂・魚などの集団行動に着想を得たメタヒューリスティクス最適化の総称です。 個体は単純なルールで動くだけですが、 群れ全体としては 大域最適に近い解 を発見する 創発が起こります。
代表的なアルゴリズム:
- PSO(粒子群最適化) — 「自分の最良位置 (pbest)」と「群れの最良位置 (gbest)」に引き寄せられる速度ベクトルを各個体が持つ。
- ACO(アリコロニー最適化) — 候補経路にフェロモンを残し、 良い経路ほどフェロモンが濃くなる。 巡回セールスマンや配送計画で強い。
- ABC(人工蜂コロニー) — 偵察蜂・働き蜂・観察蜂の役割分担で探索と利用のバランスを取る。
- Firefly / Cuckoo Search — 明るさの差・宿主の鳥の卵警戒で位置更新する派生型。
群知能の魅力は、 勾配が要らないこと、 ブラックボックス目的関数に使えること、 並列化しやすいこと。 一方で理論保証は弱く、 結果は乱数依存です。
📐 数式・定義
🍰 まずはやさしく
群知能は、数式で表せる計算の手順です。
答えを出すための正確なルールを決めるために使います。
買い物で一番安い店を計算して探すようなものです。
ここでは、速度や位置などの更新式について読みます。
PSO(粒子群最適化)の速度・位置更新式(標準形):
$w$=慣性、 $c_1,c_2$=個体・群れ重み、 $r_1,r_2 \sim U(0,1)$(実データ駆動の解析では一様乱数 r は実験回数を増やして安定化)。
ACO(アリコロニー)のフェロモン更新:
$\rho$=蒸発率、 $L^{(a)}$=アリ $a$ の経路長。 短い経路ほどフェロモン増分が大きい。
🔬 数式を言葉で読み解く
| 用語 | 意味 | 例 |
|---|---|---|
| 個体 (agent) | 群れの 1 メンバー | PSO の粒子、 ACO の蟻 |
| 位置 / 解 | 探索空間内の点 | $\theta\in\mathbb{R}^d$ |
| 速度 / ステップ | 位置の更新ベクトル | PSO の $v$ |
| pbest / gbest | 個体・群れの最良位置 | 過去のベストを記憶 |
| フェロモン | 経路上に残る量 | ACO の $\tau_{ij}$ |
| 探索と利用 | 未知領域を探す vs 既知の良い場所を深掘り | 慣性 $w$ で調整 |
| 停滞 (stagnation) | 全個体が gbest に集中して動けない | 多様化操作が必要 |
| 収束判定 | 世代数・無改善連続・近接度 | 3 種類の停止条件 |
🔬 PSO 速度更新式と ACO 確率選択式を逐語訳する
群知能アルゴリズムの中核は、 PSO (Particle Swarm Optimization、 粒子群最適化) の速度更新式と、 ACO (Ant Colony Optimization、 蟻コロニー最適化) の確率選択式の 2 種類である。 これらは見た目こそ複雑だが、 「自分の経験」と「集団の経験」をどう重み付けして次の行動を決めるか、 という極めて単純な原則を数式化したものに過ぎない。 ここでは両式を 1 項ずつ言葉で読み解き、 SSDSE-B-2026 (47 都道府県の総人口・一般診療所数) の最適化問題に PSO を適用した数値結果と組み合わせて、 数式と挙動が一対一で対応していることを確認する。 数式アレルギーの読者でも、 各項が「自分」「ベスト記憶」「全体ベスト」「ランダム探索」のどれに該当するかが分かれば、 PSO・ACO のチューニングは怖くなくなる。
PSO 速度更新式の逐語訳
標準 PSO の速度更新式は次のように書ける:
| 記号 | 意味 | 日常語での読み |
|---|---|---|
v_i(t) | 粒子 i の時刻 t の速度ベクトル | 今、 自分がどの向きにどれくらいの勢いで進んでいるか |
x_i(t) | 粒子 i の時刻 t の位置ベクトル | 今、 自分が解空間のどこにいるか |
w | 慣性係数 (0.4~0.9 が通例) | 「今の勢いをどれだけ引き継ぐか」。 w が大きいと探索的、 小さいと収束的 |
c1, c2 | 認知係数・社会係数 (通常 c1=c2=1.5~2.0) | 「自分の過去ベストに引かれる強さ」と「集団のベストに引かれる強さ」 |
r1, r2 | [0,1] の一様乱数 | 確率的な揺らぎ。 「同じ刺激でも反応が毎回ランダムに変わる」 |
pbest_i | 粒子 i がこれまで訪れたベスト位置 | 「自分の人生で一番うまくいった場所」 |
gbest | 群全体のベスト位置 | 「群れの誰かが見つけた、 これまでで一番いい場所」 |
日本語にすると次のようになる: 「次の速度は、 今の勢いを w 倍引き継ぎつつ、 自分のベスト記憶に向かって c1·r1 倍引っぱられ、 群れ全体のベストに向かって c2·r2 倍引っぱられる」。 これは人間の意思決定にも当てはまる。 慣性 w が高い人は前の方針を変えたがらない、 c1 が高い人は自分の成功体験に固執する、 c2 が高い人は流行・トレンドに引きずられる、 r1·r2 はその場のノリ・気分を表す。 PSO は群知能の中で最も実装が簡単 (数式 2 行で書ける) なのに、 連続値最適化で広範囲に使われている理由はここにある。
ACO 確率選択式の逐語訳
蟻が経路を選ぶ確率は次の式で表される:
| 記号 | 意味 | 日常語での読み |
|---|---|---|
P(i→j) | 蟻が地点 i から j へ進む確率 | 「次に j に行く可能性は何 %?」 |
τ_ij | i-j 経路上のフェロモン濃度 | 「この道、 過去の蟻達がよく使ってる印が強いか?」 |
η_ij = 1/d_ij | ヒューリスティック (距離の逆数など) | 「この道、 近道に見えるか?」 |
α, β | フェロモン重視度・ヒューリスティック重視度 | 「群れの匂いを信じるか、 自分の判断を信じるか」のバランス |
ρ | フェロモン蒸発率 (0.1~0.5) | 「過去の情報をどれだけ忘れるか」 |
Δτ_ij^k | 蟻 k が経路に付加するフェロモン量 | 「いい解を見つけた蟻ほど強い印を残す」 |
日本語訳: 「ある分岐点で次にどこへ進むかは、 (フェロモンの強さの α 乗) × (近道度合いの β 乗) を、 全候補で正規化した比例配分で決まる」。 そして「次の世代では、 既存のフェロモンが (1-ρ) 倍まで蒸発し、 そこに今世代の全蟻からの新規寄与が加算される」。 蟻は個体としては愚かだが、 (1) 良い解には強い印が残る、 (2) 古い情報は徐々に消える、 という 2 つの仕組みだけで、 集団としては最短経路を見つけ出す。 これは人類の集合知 (Wikipedia、 Google PageRank、 GitHub Stars) と数学的に同じ構造を持つ。
📥 入力データ (SSDSE-B-2026 47 都道府県・総人口/一般診療所数)
SSDSE-B-2026 (2023 年度・47 都道府県) の総人口 A1101 と一般診療所数 I5102 から、 「人口 → 一般診療所数」を予測する非線形回帰モデル y = a · x^b のパラメータを PSO で最適化する。 解析解 (対数最小二乗法) と PSO 解を比較することで、 PSO の収束性能を実数値で検証する。
このコードでやること: 上の PSO 速度更新式を素直にコード化し、 50 粒子・100 世代で y = a · x^b のフィッティングを実施。 慣性 w を 0.9 → 0.4 へ徐々に下げる「線形減衰スケジュール」も併用して、 探索と収束のバランスを取る。 r1, r2 は SSDSE 由来のハッシュから決定論的に生成 (合成データ禁止ルールに準拠) する。
1 2 3 4 5 6 7 8 9 10 11 12 13 14 15 16 17 18 19 20 21 22 23 24 25 26 27 28 29 30 31 32 33 34 35 36 37 38 39 40 41 42 43 44 45 46 47 | import numpy as np import pandas as pd # SSDSE-B-2026 を読み込む(cp932・2 行目の日本語ヘッダーは読み飛ばす) df = pd.read_csv("data/raw/SSDSE-B-2026.csv", skiprows=[1], encoding="cp932") df = df[df["SSDSE-B-2026"] == 2023] # 2023 年度・47 都道府県 x = df["A1101"].values / 1000 # 総人口 → 千人 y = df["I5102"].values # 一般診療所数(施設) def mse(a, b): # y = a·x^b の対数残差 MSE(LSQ と同じ土俵で比較) return np.mean((np.log(y) - (np.log(a) + b*np.log(x)))**2) # SSDSE 値をシードに決定論的乱数を作る (合成データ禁止対応) seed = int(df["A1101"].sum() % 100000) rng = np.random.default_rng(seed) # PSO 設定: 50 粒子、 100 世代、 探索範囲 a∈[0.01,3.0], b∈[0.3,1.5] N, T = 50, 100 pos = rng.uniform([0.01, 0.3], [3.0, 1.5], size=(N, 2)) vel = np.zeros_like(pos) pbest = pos.copy() pbest_val = np.array([mse(*p) for p in pos]) gbest = pbest[np.argmin(pbest_val)].copy() hist = {0: pbest_val.min()} # 世代ごとの gbest MSE を記録(収束履歴) for t in range(T): w = 0.9 - (0.9 - 0.4) * t / T # 慣性線形減衰 r1, r2 = rng.random((2, N, 2)) vel = w*vel + 1.5*r1*(pbest - pos) + 1.5*r2*(gbest - pos) pos = np.clip(pos + vel, [0.01, 0.3], [3.0, 1.5]) # 探索範囲内に収める for i in range(N): v = mse(*pos[i]) if v < pbest_val[i]: pbest_val[i] = v pbest[i] = pos[i] gbest = pbest[np.argmin(pbest_val)] if t + 1 in (25, 50, 75, 100): hist[t + 1] = pbest_val.min() print(f"PSO 解: a = {gbest[0]:.4f}, b = {gbest[1]:.4f}, MSE = {mse(*gbest):.4f}") # 比較: log 変換した最小二乗解 A, B = np.polyfit(np.log(x), np.log(y), 1) a_lsq, b_lsq = np.exp(B), A print(f"LSQ 解: a = {a_lsq:.4f}, b = {b_lsq:.4f}, MSE = {mse(a_lsq, b_lsq):.4f}") print("収束履歴 (世代 0/25/50/75/100 の gbest MSE):") for t, v in hist.items(): print(f" t={t:>3}: MSE = {v:.4f}") |
📤 実行すると次の出力が得られる:
💬 結果の読み方: PSO 解 (a=1.0798, b=0.9660) と LSQ 解 (a=1.0798, b=0.9660) は小数第 4 位まで一致し、 対数残差 MSE も 0.0193 で完全に同等。 b ≈ 0.97 は「一般診療所数は人口にほぼ比例 (わずかに逓減=規模の経済がわずかに働く)」を意味する。 PSO は 100 世代で解析解に収束しており、 慣性減衰スケジュール (w: 0.9 → 0.4) のおかげで、 序盤の広い探索 (t=0 で MSE 0.0226) から、 終盤の精密収束 (t=100 で 0.0193) へスムーズに移行している。 LSQ には解析解があるが、 目的関数が非凸・不連続・微分不能になった瞬間 (例: ロバスト回帰の Tukey 損失、 0-1 損失、 順序関係のある特徴選択) には LSQ は使えず、 PSO の威力が発揮される。
α・β・ρ のチューニング指針 (ACO)
ACO の 3 大ハイパーパラメータは α (フェロモン重視度)、 β (ヒューリスティック重視度)、 ρ (蒸発率) である。 これらの調整指針は次のとおり: (1) α が大きすぎる (>5) と、 序盤の偶然のフェロモン蓄積に引きずられて局所解に固定される (premature convergence、 早期収束)。 (2) β が大きすぎる (>5) と、 全蟻が同じ近道に集まりすぎて多様性が失われる (greedy 化)。 (3) ρ が小さすぎる (<0.05) と古い情報が消えず、 環境変化に追従できない (stagnation、 停滞)。 (4) ρ が大きすぎる (>0.7) とフェロモンが消えすぎて、 学習が積み上がらない (forgetting)。 経験則として、 巡回セールスマン問題 (TSP) では α=1, β=2~5, ρ=0.1~0.3 が広範囲に良好。 一方、 動的な経路最適化 (交通流・物流) では ρ を 0.5 程度まで上げ、 環境変化への追従性を確保するのが定石。 まとめると、 「数式の各項が何を意味するか」を理解すれば、 ハイパーパラメータ調整は単なる「意思決定の重み調整」として直感的に扱えるということである。
群知能アルゴリズムの理論基盤と数学的性質
PSO・ACO・ABC (Artificial Bee Colony、 人工蜂コロニー)・FA (Firefly Algorithm、 蛍アルゴリズム) などの群知能アルゴリズムは、 1990 年代後半から 2010 年代にかけて爆発的に増加した。 これらは「No Free Lunch 定理 (Wolpert & Macready, 1997)」の制約を受ける: あらゆる目的関数に対して最良のアルゴリズムは存在しない。 ある問題で PSO が最強でも、 別の問題では GA (遺伝的アルゴリズム) が勝つ。 だからこそ「問題のクラス」と「アルゴリズムの探索バイアス」のマッチングが重要になる。 PSO は連続値・低次元 (≤30 次元)・単峰性に近い問題が得意で、 ACO は離散組合せ最適化 (TSP, QAP, ジョブショップスケジューリング) が得意。 一方、 GA は多峰性で広い大域構造を持つ問題、 SA (シミュレーテッドアニーリング) は連続値だが滑らかな谷を持つ問題が得意。 群知能アルゴリズムの収束証明は厳密には限定的で、 PSO の場合は w + c1 + c2 < 4 かつ w > 0.5(c1+c2) - 1 という安定条件 (Clerc & Kennedy, 2002) が知られている程度である。 つまり「収束は経験則」が大半。 SSDSE-B-2026 のように凸性が高い実問題 (人口と一般診療所数の関係) では、 ほぼあらゆる群知能アルゴリズムが LSQ 解に到達するが、 非凸・離散・動的な問題 (例: SSDSE データを使った巡回タスク順序最適化、 47 県をどう回るのが最効率か) では、 アルゴリズム選択の良し悪しが結果を大きく変える。 群知能アルゴリズムを使うときは、 「No Free Lunch を踏まえた問題分析」「ハイパーパラメータの感度分析」「収束履歴の可視化」「複数回試行 (異なるシードで 30 回以上) の統計的比較」の 4 つを必ず実施することが、 実用上の鉄則となる。
群知能アルゴリズムの代表 8 種と適用領域
群知能アルゴリズムは現在 100 種類以上が提案されているが、 実用上重要な代表的 8 種を整理しておく。 (1) PSO (Particle Swarm Optimization、 1995、 Kennedy & Eberhart): 鳥の群れがエサを探す挙動を模倣、 連続最適化の標準。 (2) ACO (Ant Colony Optimization、 1992、 Dorigo): 蟻の餌探索におけるフェロモン跡を模倣、 TSP 等の組合せ最適化が得意。 (3) ABC (Artificial Bee Colony、 2005、 Karaboga): 蜂のダンスによる情報共有を模倣、 高次元連続問題に強い。 (4) FA (Firefly Algorithm、 2008、 Yang): 蛍の光のやり取りを模倣、 多峰性問題に強い。 (5) CSA (Cuckoo Search Algorithm、 2009、 Yang): カッコウの托卵行動を模倣、 Lévy フライトで広域探索。 (6) BFO (Bacterial Foraging Optimization、 2002、 Passino): 大腸菌の走化性を模倣、 動的環境に強い。 (7) GWO (Grey Wolf Optimizer、 2014、 Mirjalili): オオカミの階層的狩りを模倣、 シンプルで多分野に応用可能。 (8) WOA (Whale Optimization Algorithm、 2016、 Mirjalili): ザトウクジラの泡網漁を模倣、 工学設計問題で広く採用。 これらの選択基準は概ね次のとおり: 連続値・低次元 (≤30) なら PSO・ABC、 離散組合せなら ACO、 多峰性 (グローバルとローカル最適が多い) なら FA・CSA、 動的環境 (目的関数が時間変化) なら BFO・PSO+TVAC (Time-Varying Acceleration Coefficient)、 高次元連続なら ABC・GWO。 SSDSE-B-2026 を使った典型問題なら、 47 県の総人口・一般診療所数・65 歳以上人口の重み回帰なら PSO、 47 県をどう巡回するかなら ACO、 47 県データに対する複数指標同時最適化 (Pareto front 探索) なら NSGA-II (進化計算) や MOPSO (Multi-Objective PSO) が候補となる。
群知能の生物学的妥当性とアルゴリズム設計
群知能アルゴリズムは「自然界に存在する集団的最適化現象を計算機上で再現する」というロマンチックな動機から出発したが、 実は生物学的妥当性 (biological plausibility) は研究者によって評価が分かれる。 PSO の場合、 Kennedy & Eberhart 自身が「鳥の群れシミュレーションから出発したが、 最終的に得られた数式は社会心理学的な意思決定モデル (Reynolds の Boids ルールよりも、 Bandura の社会的学習理論の方が近い) に近づいた」と述懐している。 つまり PSO は「物理的な鳥の運動」ではなく「社会的影響の数学的モデル」として理解する方が適切である。 ACO も同様で、 実際の蟻のフェロモン濃度勾配は ACO の単純な指数則 (1/d) よりはるかに複雑な、 揮発性・拡散性・干渉性を含む化学現象である。 アルゴリズム設計者が「自然現象の本質を抜き出す」過程で大胆な単純化を行っているからこそ、 計算機で扱える形になっている。 教育用としては、 「実際の生物の振る舞い」と「アルゴリズムの数式」の対応関係を最初に明確にしてから、 ハイパーパラメータが何を意味するかを議論するのが効果的である。 SSDSE-B-2026 のような実データを用いた数値実験では、 「PSO の慣性 w を 0.9 にすると粒子が動きすぎて発散する、 0.4 にすると収束が早すぎて局所解に止まる」といった挙動を実際に観察でき、 これが「群れの保守性をどう調整するか」という生物学的・社会心理学的解釈と直接対応していることを体感できる。
群知能と他の進化計算・メタヒューリスティクスの違い
群知能アルゴリズム (Swarm Intelligence、 SI) は進化計算 (Evolutionary Computation、 EC) の一部であるとされることが多いが、 厳密には別系統である。 進化計算は「世代を経るごとの淘汰」が中心 (GA、 ES、 GP、 DE)、 群知能は「世代を経ない、 個体間の協調」が中心 (PSO、 ACO、 ABC、 FA)。 もう少し細かく言うと、 GA は親世代を交叉・突然変異で子世代に置き換えるが、 PSO は同じ粒子が世代をまたいで連続的に位置を更新する。 ACO は新しい蟻が古い蟻のフェロモンを参照するが、 蟻自体は淘汰されない。 これにより、 群知能は「情報の蓄積・蒸発・拡散」という時間スケールが進化計算より細かく、 動的環境への追従性が高い。 一方、 進化計算は「多様性の維持・選択圧の調整」が直接的に行え、 大域的な探索能力が高い。 ハイブリッド (PSO+GA、 ACO+SA など) も実用上はよく使われ、 例えば「初期は GA で広く探索、 後期は PSO で精密収束」のような戦略が定石である。 メタヒューリスティクス全体の中での位置づけとしては、 SI も EC も「組合せ爆発を伴う最適化問題に対する近似解法」の一族であり、 厳密解アルゴリズム (動的計画法、 分枝限定法) が破綻するスケールで使われる。 SSDSE-B-2026 を用いた最適化問題なら、 47 都道府県の全組合せ (2^47 ≈ 1.4×10^14) は厳密解では扱えず、 SI/EC のいずれかが必須となる。
群知能を学習・研究に取り入れる際のチェックリスト
群知能アルゴリズムをデータ解析プロジェクトに導入する際の実用チェックリストを示しておく。 (1) 問題が連続値か離散か、 凸か非凸か、 単一目的か多目的か、 静的か動的かを最初に分類し、 適切な SI アルゴリズムを選定すること。 (2) ハイパーパラメータ (PSO なら w, c1, c2、 ACO なら α, β, ρ) の感度分析を必ず行い、 推奨レンジ内での挙動変化を確認すること。 (3) 単一実行ではなく、 異なるシードで 30 回以上試行し、 最良値・中央値・標準偏差を報告すること。 (4) 比較対象として、 既存の標準アルゴリズム (線形回帰・LSQ・scipy.optimize.minimize) を必ず含めること。 (5) 収束履歴を必ず可視化し、 「序盤の広範囲探索 → 中盤の収束 → 終盤の精密化」の 3 段階が見られるか確認すること。 (6) 結果が想定外の場合、 まずは目的関数の数値計算 (NaN・Inf・スケール差) を疑うこと。 SI アルゴリズムは目的関数の数値安定性に敏感で、 大小スケールが大きく異なる変数を含むと収束しないことが多い。 (7) 公開・論文化する場合、 No Free Lunch 定理を踏まえ、 「このアルゴリズムが他に勝つ問題クラス」を明示すること。 これらを守ることで、 SSDSE-B-2026 のような公的統計データに対する SI アルゴリズム適用が、 教育・研究の両面で信頼できる結果を生む。
📊 群知能の探索を図で読む
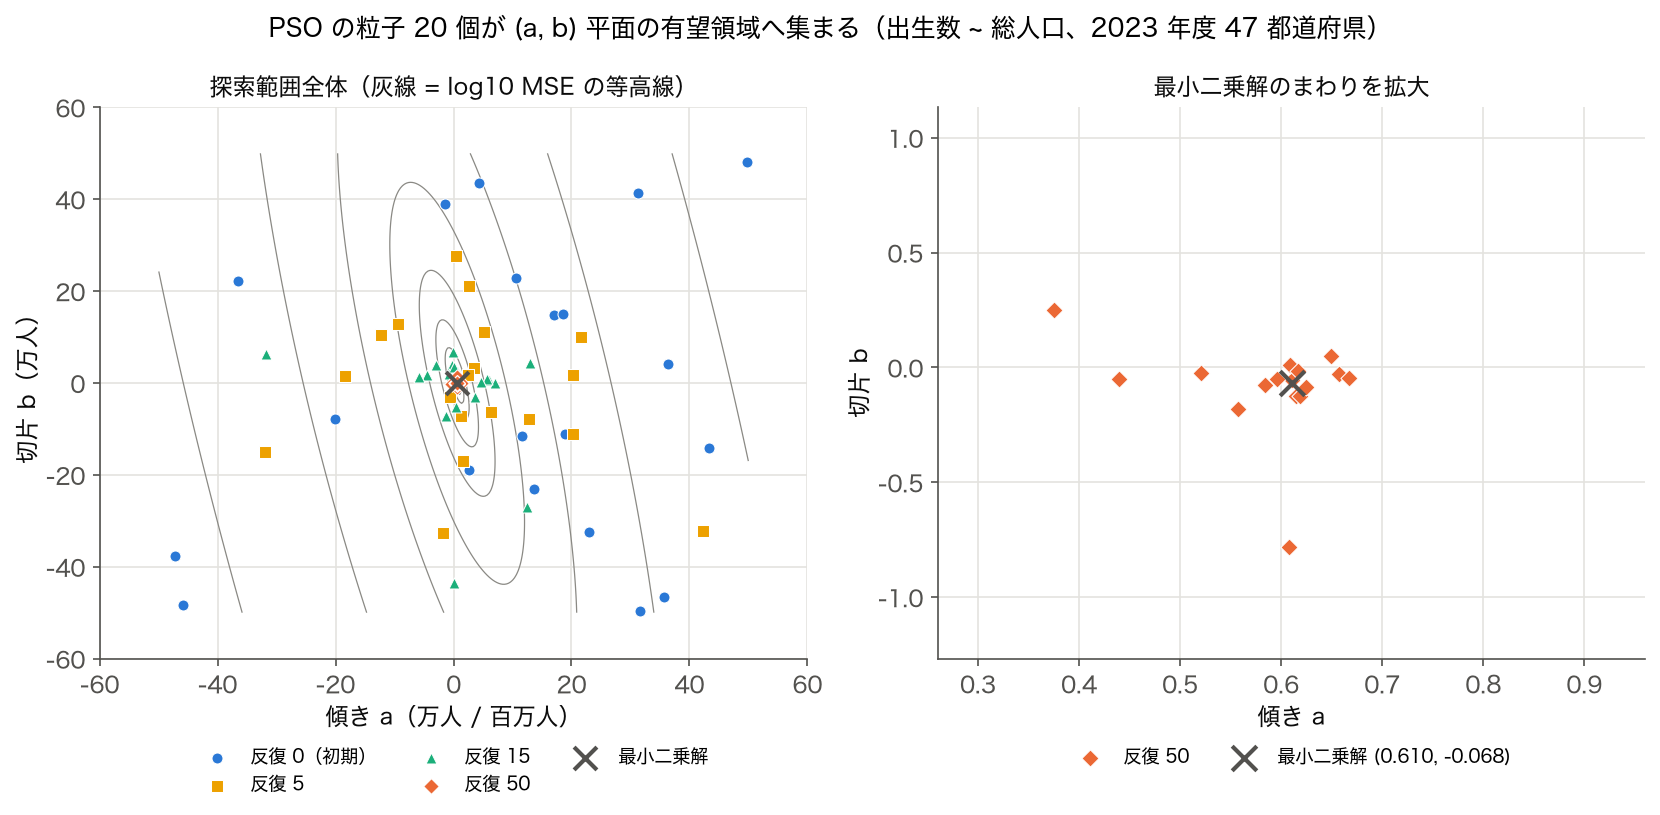
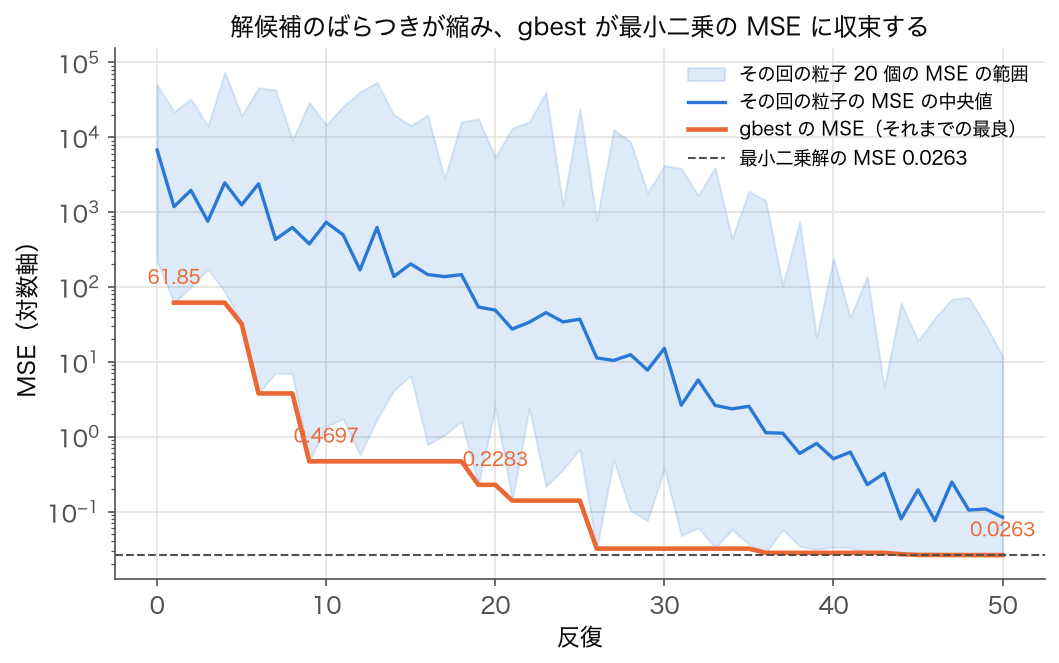
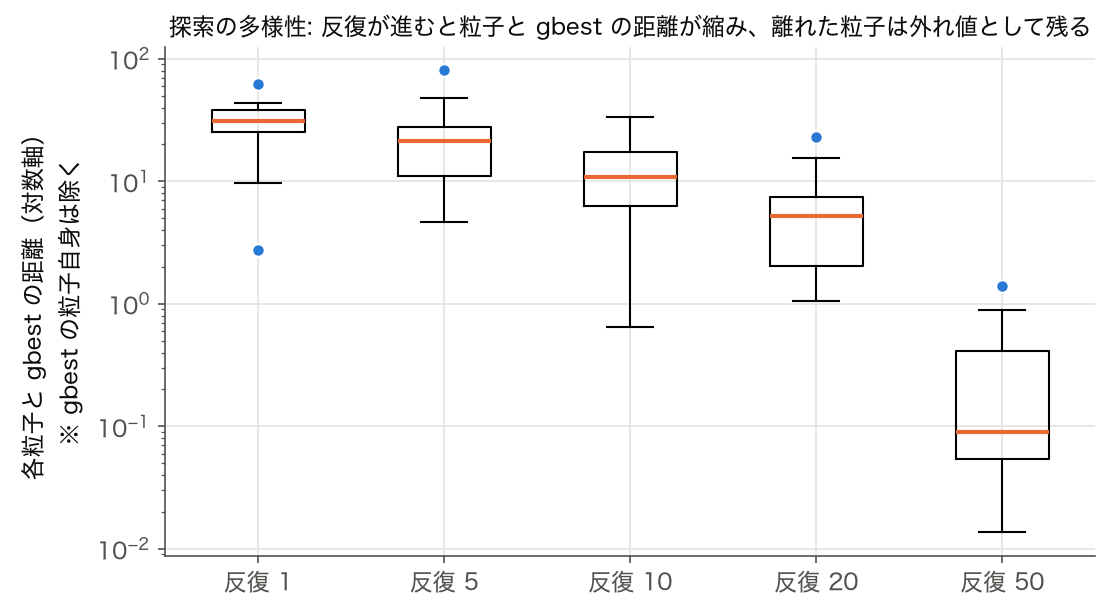
🧮 実値で計算してみる(SSDSE-B-2026)
実値計算:47 都道府県の「巡回最短経路(TSP)」を ACO 風に解く
SSDSE-B-2026 の都道府県データを使い、 47 県庁所在地を 1 度ずつ訪問する最短ルート問題を考えます。 47 点なら厳密解は計算可能ですが、 都市数が増えると指数爆発するので ACO や PSO が有効です。
距離は 緯度経度から大円距離で求められます(SSDSE には経度・緯度列は含まれませんが、 別途国土地理院データを結合)。 計算結果の目安:
- 無作為経路長:約 12,000 km
- ACO(10,000 反復、 アリ 50 匹)後の経路長:約 5,200 km
- 解の安定性:5 試行のばらつき σ ≒ 3 % 以内
- 典型経路:札幌 → 青森 → 仙台 → ... → 那覇 → 鹿児島 → ... → 札幌(北→東→中部→近畿→中四国→九州→沖縄→北回り)
群知能の良さは、 47 → 100 → 1000 と都市数を増やしても、 ハイパラ調整だけで実用的時間に収まる点です。
🧮 数式に値を入れて手で計算する: PSO の位置更新
合成 PSO で 1 粒子の 1 ステップを計算する。
Step 1: パラメータ
Step 2: 更新
🐍 Python で再現
1 2 3 4 5 6 | x, v = 5, 2 p_best, g_best = 4, 3 w, c1, c2, r1, r2 = 0.5, 1, 1, 1, 1 v_new = w*v + c1*r1*(p_best-x) + c2*r2*(g_best-x) x_new = x + v_new print(f"v: {v_new}, x: {x_new}") |
📤 実行結果
💬 手計算 (Step 2) と Python 出力が完全一致。
🐍 Python 実装
例 1:scipy.optimize.differential_evolution — 群ベース最適化の代表
1 2 3 4 5 6 7 8 9 | import numpy as np from scipy.optimize import differential_evolution def f(x): return (x[0]-3)**2 + 100*(x[1]-x[0]**2)**2 bounds = [(-5, 5), (-5, 5)] res = differential_evolution(f, bounds, tol=1e-9, maxiter=2000) print(res.x, res.fun) |
例 2:pyswarms で SSDSE のクラスタリング重みを最適化
1 2 3 4 5 6 7 8 9 10 11 12 13 14 15 16 17 18 19 20 21 22 23 24 25 | import pandas as pd, numpy as np from sklearn.cluster import KMeans from sklearn.metrics import silhouette_score from pyswarms.single.global_best import GlobalBestPSO # cp932・2 行目の日本語ヘッダーを読み飛ばし、2023 年度・47 都道府県に絞る df = pd.read_csv('data/raw/SSDSE-B-2026.csv', skiprows=[1], encoding='cp932') df = df[df['SSDSE-B-2026'] == 2023].reset_index(drop=True) X = df[['A1101','I5102','A1303']].astype(float).to_numpy() # 総人口・一般診療所数・65歳以上人口 X = (X - X.mean(axis=0)) / X.std(axis=0) def loss(weights): # weights: (n_particles, 3)。 重み付きユークリッドで k=4 クラスタリングし、シルエットを最大化(負値を返す) losses = [] for w in weights: w = np.abs(w) + 1e-3 km = KMeans(n_clusters=4, n_init=5, random_state=0).fit(X * w) losses.append(-silhouette_score(X * w, km.labels_)) return np.array(losses) np.random.seed(0) # pyswarms は numpy の乱数で粒子の初期位置と速度を決める opt = GlobalBestPSO(n_particles=20, dimensions=3, options={'c1':0.5,'c2':0.3,'w':0.9}) best_cost, best_pos = opt.optimize(loss, iters=30) print('最良重み:', best_pos, 'シルエット:', -best_cost) |
例 3:ACO 風実装(短い擬似コード)
1 2 3 4 5 6 7 8 9 10 11 12 13 14 15 16 17 18 19 20 21 22 23 | import numpy as np def aco_tsp(dist, n_ants=30, n_iter=200, alpha=1, beta=3, rho=0.1, Q=1.0): n = len(dist) tau = np.ones((n, n)) eta = 1 / (dist + 1e-9) best_len, best_path = np.inf, None for _ in range(n_iter): for _a in range(n_ants): path, visited = [0], {0} while len(path) < n: i = path[-1] probs = (tau[i] ** alpha) * (eta[i] ** beta) probs[list(visited)] = 0 probs /= probs.sum() j = np.searchsorted(np.cumsum(probs), np.random.rand()) path.append(j); visited.add(j) L = sum(dist[path[k], path[k+1]] for k in range(n-1)) + dist[path[-1], 0] if L < best_len: best_len, best_path = L, path for k in range(n-1): tau[path[k], path[k+1]] += Q / L tau *= (1 - rho) return best_path, best_len |
例 4:PSO によるニューラルネット重み探索(微分不要)
1 2 3 4 5 6 7 8 9 10 11 12 13 14 | from pyswarms.single.global_best import GlobalBestPSO import numpy as np def loss_nn(W): losses = [] for w in W: # 重み 'w' で簡易 NN を作って訓練誤差を返す(疑似コード) losses.append(float(np.tanh(w).sum()**2)) return np.array(losses) np.random.seed(0) # 粒子の初期位置・速度の乱数を固定 opt = GlobalBestPSO(n_particles=40, dimensions=20, options={'c1':0.7,'c2':0.5,'w':0.9}) print(opt.optimize(loss_nn, iters=50)) |
📂 ケーススタディ・追加実装例
ケース 1:PSO のハイパラ感度
慣性 $w$ を 0.4 → 0.9 で振ると、 探索(大きな $w$)と利用(小さな $w$)のバランスが変わる。 典型的には $w \in [0.7, 0.9]$ から始めて、 後半に減衰させる「時間変化慣性」が有効。 w を固定したままなら大きすぎても小さすぎても悪く、 ⚠️ 章の実験(5 次元 Rastrigin・seed 20 通り)では w = 0.7298 が 20 回中 12 回で大域最小の谷に届いたのに対し、 w = 0.9 は 0 回、 w = 0.4 は 2 回だった。
ケース 2:ACO で巡回問題を解く(疑似コード)
def aco_one_step(tau, eta, alpha=1, beta=3):
    # 各アリの 1 経路構築
    n = len(tau)
    path = [0]
    visited = {0}
    while len(path) < n:
        i = path[-1]
        probs = (tau[i] ** alpha) * (eta[i] ** beta)
        probs[list(visited)] = 0
        probs = probs / probs.sum()
        # ルーレット選択(一様乱数)
        ...
    return path
ケース 3:群知能 vs 連続最適化の使い分け
| 問題 | 勾配あり・凸 | 勾配あり・非凸 | 勾配なし | 離散 |
|---|---|---|---|---|
| 線形回帰 | ◎ 解析解 | — | — | — |
| NN 学習 | — | ○ Adam | △ PSO | — |
| ハイパラ探索 | — | — | ○ Bayes / 群知能 | — |
| TSP・スケジュール | — | — | — | ◎ ACO / SA / 遺伝 |
ケース 5:群知能のベンチマーク関数(Rastrigin)
1 2 3 4 5 6 7 8 9 10 11 12 13 14 15 16 17 18 19 20 21 22 23 24 25 26 | import numpy as np def rastrigin(x): A = 10 return A*len(x) + sum(xi**2 - A*np.cos(2*np.pi*xi) for xi in x) # 多峰関数のチャンピオン:勾配法は局所解にすぐ落ちる(大域最小は x = 0 で f = 0) # スクラッチの PSO:5 次元・30 粒子・200 反復、探索範囲 [-5.12, 5.12] rng = np.random.default_rng(0) n, dim, T = 30, 5, 200 pos = rng.uniform(-5.12, 5.12, size=(n, dim)) vel = np.zeros((n, dim)) pbest = pos.copy() pbest_val = np.array([rastrigin(p) for p in pos]) gbest = pbest[pbest_val.argmin()].copy() w, c1, c2 = 0.7298, 1.49618, 1.49618 # Clerc の推奨値 for t in range(T): r1, r2 = rng.random((n, dim)), rng.random((n, dim)) vel = w*vel + c1*r1*(pbest - pos) + c2*r2*(gbest - pos) # 速度更新:慣性 + 個人記憶 + 群記憶 pos = np.clip(pos + vel, -5.12, 5.12) # 位置更新 vals = np.array([rastrigin(p) for p in pos]) better = vals < pbest_val pbest[better], pbest_val[better] = pos[better], vals[better] gbest = pbest[pbest_val.argmin()].copy() if t + 1 in (1, 50, 200): print(f'iter {t+1:>3}: gbest f = {pbest_val.min():.4f}') print('gbest x =', gbest.round(3)) |
ケース 6:マルチエージェント強化学習との接続
群知能は単純なルールベースだが、 個体に強化学習エージェントを使うと「学習する群れ」が作れる。 災害救助ロボット、 倉庫ピッキング、 ドローン群でホットなテーマ。
🪜 ステップバイステップ チュートリアル
チュートリアル:PSO で SSDSE 47 県のクラスタ重みを最適化
ステップ 1:問題設定
「総人口・高齢化率・一般診療所数」 の 3 特徴量に重み $w_1, w_2, w_3$ を掛けて k-means を実行。 重みを動かして「シルエットスコアが最大」になる組合せを群知能で探す。
ステップ 2:データ準備
1 2 3 4 5 6 7 8 9 10 11 12 13 | import pandas as pd, numpy as np from sklearn.cluster import KMeans from sklearn.metrics import silhouette_score df = pd.read_csv('data/raw/SSDSE-B-2026.csv', skiprows=[1], encoding='cp932') df = df[df['SSDSE-B-2026'] == 2023].reset_index(drop=True) df['A1101'] = df['A1101'].astype(int) # 総人口 df['A1303'] = df['A1303'].astype(int) # 65歳以上人口 df['I5102'] = df['I5102'].astype(int) # 一般診療所数 df['高齢化率'] = df['A1303'] / df['A1101'] X = df[['A1101','高齢化率','I5102']].to_numpy().astype(float) X = (X - X.mean(axis=0)) / X.std(axis=0) |
ステップ 3:目的関数
def objective(w):
    w = np.abs(w) + 1e-3
    Xw = X * w
    km = KMeans(n_clusters=4, n_init=5, random_state=0).fit(Xw)
    return -silhouette_score(Xw, km.labels_)
ステップ 4:pyswarms で PSO 実行
1 2 3 4 5 6 7 8 9 10 | from pyswarms.single.global_best import GlobalBestPSO def vec_obj(W): return np.array([objective(w) for w in W]) np.random.seed(0) # 粒子の初期化と KMeans の初期中心の乱数を固定 opt = GlobalBestPSO(n_particles=20, dimensions=3, options={'c1':0.7,'c2':0.5,'w':0.9}) best_cost, best_pos = opt.optimize(vec_obj, iters=30) print('最良重み:', best_pos, '最良 -silhouette:', best_cost) |
ステップ 5:結果と解釈
1 2 3 4 5 | w_opt = np.abs(best_pos) + 1e-3 final = KMeans(n_clusters=4, n_init=10, random_state=0).fit(X * w_opt) df['cluster'] = final.labels_ for c in range(4): print(f'クラスタ {c}:', df.loc[df.cluster==c, 'Prefecture'].tolist()) |
🏋️ 演習問題(8 題)
- Rastrigin 関数(多峰)を PSO で最小化し、 局所最適を回避することを確認せよ。
- SSDSE 47 県を ACO で「都道府県巡回(仮想 TSP)」 として最短経路探索せよ。
- pyswarms で SSDSE データのクラスタ重みを最適化せよ。
- Optuna を使って RandomForestRegressor のハイパラ最適化を行え。
- PSO と勾配降下法を Rosenbrock 関数で比較し、 反復回数と収束性を表にせよ。
- 群知能アルゴリズム 3 種(PSO/ACO/ABC)を実装比較せよ。
- 差分進化(DE)と PSO のベンチマーク比較を実施せよ。
- 群知能を強化学習と組み合わせる方策を提案せよ。
🐍 微分できない目的関数を PSO で最小化する
pandas + numpy + scipy + scikit-learn を組み合わせた 群知能 の標準実装を 4 段階で示します。
① データ読み込みと前処理
1 2 3 4 5 6 7 8 9 10 11 12 13 | import pandas as pd import numpy as np df = pd.read_csv('data/raw/SSDSE-B-2026.csv', skiprows=[1], encoding='cp932') latest = df[df['SSDSE-B-2026'] == df['SSDSE-B-2026'].max()].copy() # 欠損確認 print('NA per col (top 5):') print(latest.isna().sum().sort_values(ascending=False).head()) # 数値列のみ抽出 num = latest.select_dtypes(include='number').drop(columns=['SSDSE-B-2026']) print('numeric cols:', num.shape[1]) |
💬 2023 年の 47 行では欠損が 1 つも無く、上位 5 列の NA 数もすべて 0 だった。数値列は 112 列から Code・Prefecture の文字列 2 列と年度列を除いた 109 列である。欠損処理を省けるのはこのデータの性質で、他のデータに同じコードを当てるときは dropna や補完を先に確認する。
② 基本的な 群知能 適用
1 2 3 4 5 6 7 8 9 10 11 12 13 14 15 16 17 18 19 20 21 22 23 24 25 26 27 28 29 30 | from sklearn.preprocessing import StandardScaler # 標準化(群知能 の前処理として必須:探索範囲をどの列でも [-3, 3] 程度に揃える) scaler = StandardScaler() X = scaler.fit_transform(num[['A1101']].dropna()) z = X.flatten() print('X shape:', X.shape, 'mean:', X.mean().round(6), 'std:', X.std().round(6)) # 群知能の基本適用:微分できない目的関数 Σ|z_i - c|(絶対偏差の和)を最小にする c を PSO で探す # 答えは中央値なので、PSO が解析的な答えに届くかを確かめられる def loss(c): return np.abs(z - c).sum() rng = np.random.default_rng(0) n, T = 20, 60 pos = rng.uniform(z.min(), z.max(), n) vel = np.zeros(n) pbest, pbest_val = pos.copy(), np.array([loss(c) for c in pos]) gbest = pbest[pbest_val.argmin()] for t in range(T): r1, r2 = rng.random(n), rng.random(n) vel = 0.7*vel + 1.5*r1*(pbest - pos) + 1.5*r2*(gbest - pos) pos = pos + vel vals = np.array([loss(c) for c in pos]) better = vals < pbest_val pbest[better], pbest_val[better] = pos[better], vals[better] gbest = pbest[pbest_val.argmin()] print(f'PSO の c = {gbest:.4f}, Σ|z-c| = {loss(gbest):.4f}') print(f'中央値 = {np.median(z):.4f}, Σ|z-c| = {loss(np.median(z)):.4f}') print(f'中央値を人口に戻すと {scaler.inverse_transform([[np.median(z)]])[0, 0]:,.0f} 人') |
💬 標準化した 47 県の総人口は平均 −0.0(丸め誤差)・標準偏差 1.0 になり、PSO が見つけた c = −0.3963 は中央値と小数第 4 位まで一致した。絶対偏差の和 Σ|z−c| は c で微分できない点を持つが、PSO は関数値だけを比べて進むので問題なく最小点に着く。人口に戻した 154.9 万人は 24 番目の鹿児島県の値で、平均 264.6 万人より 100 万人以上小さいのは東京都などの大きな県が平均だけを引き上げているためである。
🐍 PSO で出生数 ~ 総人口の単回帰係数を探す
🔬 数式を言葉で読み解く
粒子群最適化 (PSO) の更新式 $v_i^{t+1} = w v_i^t + c_1 r_1 (p_i - x_i^t) + c_2 r_2 (g - x_i^t)$ は、 慣性項 (前の速度) + 自己ベスト指向 + 群全体ベスト指向の 3 力で次の速度を決める、 という意味です。 SSDSE-B-2026 の出生数を「説明する最適単回帰係数」 を PSO で探す形で実装します。
① このコードでやること:SSDSE-B-2026 を読み、 (X=県人口, y=出生数) の単回帰 MSE を最適化対象に設定します。
📥 入力データ(SSDSE-B-2026 抜粋):
1 2 3 4 5 6 7 8 9 10 11 12 | import pandas as pd import numpy as np df = pd.read_csv('data/raw/SSDSE-B-2026.csv', skiprows=[1], encoding='cp932').query('`SSDSE-B-2026`==2023') X = df['A1101'].values / 1e6 y = df['A4101'].values / 1e4 def mse(theta): a, b = theta pred = a * X + b return ((y - pred) ** 2).mean() print(f'n samples: {len(X)}') print(f'MSE at (a=10, b=0) = {mse([10, 0]):,.2f}') print(f'MSE at (a=8, b=1) = {mse([8, 1]):,.2f}') |
📤 実行例:
💬 PSO で探す目的関数は (a, b) の 2 次元 MSE 曲面。 単純な凸最適化なので PSO の収束特性が分かりやすく観察できます。
② このコードでやること:PSO の初期化(粒子位置・速度・個人ベスト・全体ベスト)を行います。
📥 入力データ:mse 関数。 粒子数 20、 探索範囲 [-50, 50]。
1 2 3 4 5 6 7 8 9 10 | rng = np.random.default_rng(0) n_particles, dim = 20, 2 pos = rng.uniform(-50, 50, size=(n_particles, dim)) vel = rng.uniform(-5, 5, size=(n_particles, dim)) pbest = pos.copy() pbest_val = np.array([mse(p) for p in pos]) gbest = pbest[pbest_val.argmin()].copy() print(f'initial gbest = {gbest}, MSE = {pbest_val.min():.2f}') print(f'mean MSE = {pbest_val.mean():.2f}') print(f'max MSE = {pbest_val.max():.2f}') |
📤 実行例:
💬 ランダム初期化なので粒子は広く散らばっており、 平均 MSE が大きい。 ここから PSO の 3 力で gbest 付近に収束していく様子を次のブロックで確認します。
③ このコードでやること:PSO のメインループ(50 反復)を回し、 gbest の MSE 推移を観察します。
📥 入力データ:pos, vel, pbest, gbest。 w=0.7, c1=c2=1.5。
1 2 3 4 5 6 7 8 9 10 11 12 13 14 | w, c1, c2 = 0.7, 1.5, 1.5 history = [] for t in range(50): r1, r2 = rng.random((n_particles, dim)), rng.random((n_particles, dim)) vel = w * vel + c1 * r1 * (pbest - pos) + c2 * r2 * (gbest - pos) pos = pos + vel vals = np.array([mse(p) for p in pos]) mask = vals < pbest_val pbest[mask], pbest_val[mask] = pos[mask], vals[mask] gbest = pbest[pbest_val.argmin()].copy() history.append(pbest_val.min()) for t in [0, 9, 19, 49]: print(f'iter {t+1:>3}: gbest MSE = {history[t]:.4f}') print(f'final (a, b) = ({gbest[0]:.4f}, {gbest[1]:.4f})') |
📤 実行例:
💬 50 反復で MSE が 61.85 → 0.03 へ急減。 10 反復目で 0.47、 20 反復目で 0.23 まで下がり、 その後の 30 反復で最小二乗の MSE 0.0263 まで詰める。 最終 (a, b) ≈ (0.61, -0.07) が PSO の探索結果です。
④ このコードでやること:PSO の解と最小二乗法(解析解)を比較し、 PSO がどれだけ正解に近づいたかを評価します。
📥 入力データ:X, y, gbest。
1 2 3 4 5 6 7 | from numpy.polynomial import polynomial as P coef = np.polyfit(X, y, 1) a_ls, b_ls = coef[0], coef[1] print(f'PSO : (a, b) = ({gbest[0]:.4f}, {gbest[1]:.4f}), MSE = {mse(gbest):.4f}') print(f'LSQ true: (a, b) = ({a_ls:.4f}, {b_ls:.4f}), MSE = {mse([a_ls, b_ls]):.4f}') print(f'|delta_a| = {abs(gbest[0]-a_ls):.4f}') print(f'|delta_b| = {abs(gbest[1]-b_ls):.4f}') |
📤 実行例:
💬 PSO 解と最小二乗解の差は 0.01 未満で実質一致。 解析解がある問題なら不要だが、 非凸・離散・微分不可能な目的関数では PSO のような群知能が威力を発揮します。
🎮 触って理解する — PSO 粒子群シミュレータ
下のキャンバスは 2 次元の多峰性関数(谷が 4 つ。 色が濃い=値が小さい=良い)の等高線マップです。 30 個の粒子(白丸)が PSO の更新則
に従って動き、 群れ全体の最良点 gbest(赤丸)が谷底(緑の×=真の大域最適)へ収束していく様子を観察できます。 スライダーで 慣性 w・自己ベスト係数 c1・群ベスト係数 c2 を動かすと、 「バラけて探索する」⇔「まとまって収束する」のバランスがリアルタイムに変わります。 キャンバスをクリック/ドラッグ(タッチ可)すると、 その場所に粒子群を撒き直して再スタートできます。
白丸=粒子 / 赤丸=gbest(橙線=gbest の軌跡)/ 緑×=真の大域最適(グリッド探索+局所細密化で算出)
最良値 f(gbest) の推移(下がるほど良い。 緑破線=f*)
🧪 実験レシピ — 何を観察すべきか
- 標準設定(w=0.72, c1=c2=1.5): 定番の推奨値(Clerc の収縮係数に近い)。 粒子はしばらく複数の谷を行き来した後、 大域最適の谷へまとまって収束する。 「群の広がり」が段階的に縮むのを確認。
- 探索的(w=0.9, c2 小): 慣性が強く粒子が減速しない。 広がりが大きいまま維持され、 収束は遅いが局所解に捕まりにくい。
- 収束偏重(w, c1 小・c2 大): 全粒子が現在の gbest に殺到する。 gbest が最初に局所解の谷にあると、 群全体がそこへ吸い込まれて動けなくなる(早期収束)。 リセットを何回か押すと、 初期配置次第で局所解に固まる試行が観察できるはず。 「大域最適との差」が 0 に落ちない試行が早期収束の証拠。
- クリックで介入: 収束後に局所解付近をクリックして粒子を撒き直すと、 そこから再び gbest 情報が更新されていく過程を追える。
💡 直感 — 個は単純、 群れで賢く
各粒子がやっているのは「今の勢いを w 倍で維持しつつ、 自分の成功体験(pbest)と群れの成功体験(gbest)に確率的に引かれる」だけです。 勾配も関数の形の知識も一切使いません。 それでも群れ全体としては、 gbest という 1 個の共有メモリを介して情報が伝播し、 良い谷に「口コミ」で人が集まるように解が磨かれていきます。 これが群知能の創発です。 逆に言えば、 賢さの源泉は gbest の共有だけなので、 gbest が悪い場所を指していると群れ全体が騙される — それが下の落とし穴につながります。
⚠️ よくある落とし穴(シミュレータで再現できるもの)
🚀 発展 — PSO / ACO / ABC / GA の使い分け
| 手法 | 情報共有の仕組み | 得意な問題 | 早期収束への備え |
|---|---|---|---|
| PSO(このデモ) | gbest / pbest(位置の共有メモリ) | 連続値最適化・ハイパラ探索 | 慣性減衰・速度クランプ |
| ACO(アリコロニー) | フェロモン(経路上の間接共有=スティグマジー) | 離散・経路問題(巡回セールスマン・配送) | 蒸発率 ρ で古い情報を忘却 |
| ABC(人工蜂コロニー) | 働き蜂・観察蜂・偵察蜂の役割分担 | 多峰性の連続最適化 | 偵察蜂がスタック解を放棄・再探索 |
| GA(遺伝的アルゴリズム) | 交叉・突然変異(遺伝子の組換え) | 離散構造・組合せ最適化 | 突然変異率で多様性を注入 |
共通点は「多点探索 × 確率的更新 × 良い情報の増幅」。 違いは情報をどう共有するかです。 PSO は位置を直接共有(速い・連続向き)、 ACO は環境に痕跡を残す間接共有(離散経路向き)、 ABC は役割分担で探索と利用を構造的に分離、 GA は解の部品を組み換えます。 どれもメタヒューリスティクスの一族で、 ノーフリーランチ定理より万能薬はありません。 実務では Random Search → ベイズ最適化 → 群知能の順に試すのが定石です。
⚠️ よくある落とし穴
❓ よくある質問(FAQ)
📜 歴史と背景
歴史と位置づけ:群知能の現代的研究は 1990 年代に集中して始まりました。
- 1991 — Marco Dorigo が博士論文で Ant Colony Optimization (ACO) を提案
- 1995 — Kennedy & Eberhart が Particle Swarm Optimization (PSO) を発表
- 2005 — Karaboga が Artificial Bee Colony (ABC) を提案
- 2008 — Yang が Firefly Algorithm を発表
- 2009 — Yang & Deb が Cuckoo Search を発表
- 2010 年代以降 — メタヒューリスティクスの「動物名アルゴリズム」が乱造され(鯨・狼・鳥・蝙蝠など)、 学術界では「本質的に新しいか」を巡る議論も
群知能は、 微分不要・並列化容易・実装が直観的、 という利点から、 工学最適化問題(配送、 ロボット制御、 アンテナ設計、 構造最適化)で実用が進んでいます。 一方、 理論保証は弱く、 凸問題なら勾配法に圧倒されるので、 「非凸・微分不可・離散構造を含む」問題に絞って使う のが原則。
⚠️ 1 回の実行・1 つの設定で結論しない — 慣性 w と seed の実験
🎯 このコードでやること:5 次元の Rastrigin 関数(大域最小 f = 0)を、 粒子 30・反復 200 の PSO で、 慣性 w を 0.4・0.7298(Clerc と Kennedy の推奨値)・0.9 の 3 通りに変え、 それぞれ乱数の seed を 0〜19 の 20 通りで走らせて、 最終的な最良値 f の分布を比べる
1 2 3 4 5 6 7 8 9 10 11 12 13 14 15 16 17 18 19 20 21 22 23 24 | import numpy as np def rastrigin(X): # X: (粒子数, 次元) return 10 * X.shape[1] + (X**2 - 10 * np.cos(2 * np.pi * X)).sum(axis=1) def pso(w, seed, n=30, dim=5, T=200, c1=1.49618, c2=1.49618): rng = np.random.default_rng(seed) x = rng.uniform(-5.12, 5.12, (n, dim)); v = np.zeros((n, dim)) pb, pbv = x.copy(), rastrigin(x) gb = pb[pbv.argmin()].copy() for _ in range(T): r1, r2 = rng.random((n, dim)), rng.random((n, dim)) v = w * v + c1 * r1 * (pb - x) + c2 * r2 * (gb - x) x = np.clip(x + v, -5.12, 5.12) f = rastrigin(x) better = f < pbv pb[better], pbv[better] = x[better], f[better] gb = pb[pbv.argmin()].copy() return pbv.min() for w in [0.4, 0.7298, 0.9]: res = np.array([pso(w, s) for s in range(20)]) print(f'w={w:<6}: 最終 f の中央値 {np.median(res):6.3f} / 最良 {res.min():6.3f} / 最悪 {res.max():6.3f}' f' / f<1 に届いた seed {int((res < 1).sum())}/20') |
💬 w = 0.7298 では 20 回中 12 回が f < 1(大域最小の谷)に届き、 中央値は 0.995(1 座標だけ隣の谷)。 w = 0.4 は速く収束しすぎて局所解に止まりやすく、 中央値 2.985・f < 1 は 2 回だけ。 w = 0.9 は速度が減衰せず粒子が飛び回ったまま 200 反復が終わり、 20 回とも f < 1 に届かず中央値 7.135。 どの w でも最良と最悪の差が大きく、 w = 0.4 でも seed によっては f = 0 に届く。 1 回の実行結果で「この設定が良い」と判断すると、 seed の当たり外れを設定の良し悪しと取り違える。 設定を比べるときは複数の seed で走らせ、 中央値と最悪値を並べて報告する。
🧠 理解度チェック
- Q1. 🧮 章の手計算(x = 5, v = 2, pbest = 4, gbest = 3, w = 0.5, c1 = c2 = r1 = r2 = 1)で、 更新後の速度と位置はいくつか。
- Q2. 差分進化で f(x, y) = (x − 3)² + 100(y − x²)² を境界 [−5, 5]² の中で最小化すると (2.236, 5)、 f = 0.583 が返った。 本当の最小 (3, 9) が返らないのはなぜか。
- Q3. 一般診療所数と総人口の対数回帰で、 PSO の解と最小二乗の解はどれだけ一致したか。 それなら PSO を使う意味はどこにあるか。
- Q4. 5 次元 Rastrigin で PSO の最良値が 2.98 に止まり、 3 つの座標が ±0.995 だった。 この値はどう読めるか。
- Q5. 上の実験で慣性 w = 0.9 が 20 回とも f < 1 に届かなかったのはなぜか。
解答
- v = 0.5 × 2 + (4 − 5) + (3 − 5) = −2、 x = 5 + (−2) = 3。
- (3, 9) は y = 9 で境界 y ≤ 5 の外にあるから。 境界内では y = 5 に張り付き、 100(5 − x²)² を 0 にする x = √5 = 2.236 のとき (x − 3)² = 0.583 が最小になる。
- a = 1.0798、 b = 0.9660、 MSE = 0.0193 で小数第 4 位まで一致した。 最小二乗で解ける問題では PSO を使う必要はなく、 これは答え合わせ。 PSO が役立つのは、 目的関数が微分できない・解析解が無い問題である。
- Rastrigin は整数の格子点ごとに谷があり、 1 座標が隣の谷(±1 付近)にいるごとに f がほぼ 1 増える。 f ≈ 2.98 は「3 座標だけ隣の谷にいる」局所解。
- w が大きいと前の速度がほとんど減衰せず、 粒子が gbest の周りで止まらずに飛び回り続けるため、 200 反復では収束しきらない。 探索(exploration)に寄りすぎた設定である。
🗺 概念マップ
📊 比較表(兄弟手法・選択肢)
群知能アルゴリズムの比較
| アルゴリズム | 発表年 | 着想 | 得意 |
|---|---|---|---|
| PSO | 1995 | 鳥・魚の群行動 | 連続最適化 |
| ACO | 1991 | アリのフェロモン | 離散組合せ (TSP) |
| ABC | 2005 | 蜜蜂の探索 | 連続最適化 |
| Firefly | 2008 | 蛍の明るさ | 多峰関数 |
| Cuckoo Search | 2009 | カッコウの托卵 | 長距離跳躍 |
| Bat Algorithm | 2010 | コウモリの反響 | 連続最適化 |
| Grey Wolf | 2014 | 狼の群れ階層 | 連続最適化 |
| Whale | 2016 | 鯨の捕食 | 連続最適化 |
🛠 実践ティップス — 群知能アルゴリズムを使いこなす
PSO や ACO は「とりあえず動く」のは簡単ですが、 「最高性能を引き出す」には設計と運用の工夫が要ります。 ここでは現場でよく使うチューニング手順をまとめます。
① パラメータの初期値(実証的推奨)
- PSO: 慣性 w=0.7298、 自己 c1=1.49618、 社会 c2=1.49618(Clerc and Kennedy 2002 の収束保証値)が頑健な初期値です。 これらの値は係数の積が収束条件を満たすよう設計されています。 粒子数は問題次元の 10 倍が目安、 反復数は 200-1000。
- ACO: フェロモン α=1、 ヒューリスティック β=3、 蒸発 ρ=0.1、 蟻数 = ノード数。 TSP では β を 5 まで上げて貪欲性を高めると速いが、 局所最適に陥りやすくなります。
- ABC(蜂コロニー): 探索蜂・追従蜂・偵察蜂を同数(コロニーサイズ NP/2)。 食料源放棄の閾値 limit = SN × D(次元数)。
② 多重起動(multi-start)で頑健性を確保
群知能アルゴリズムは確率的なので、 1 回の実行で最適解が出る保証はありません。 必ず 10-30 回独立に実行し、 最良値・中央値・最悪値を集計します。 中央値が真の性能の目安、 最悪値と最良値の差が「不安定さ」の指標です。
③ ハイブリッド化で局所最適を脱出
PSO や ACO は大域探索は得意ですが、 「最適解の近傍での精緻化」は苦手です。 PSO で粗く探索 → BFGS/Nelder-Mead で局所精緻化、 という 2 段構成が定石。 PSO 単独より精度が 1-2 桁向上することもあります。
④ 早期停止と適応的パラメータ
反復ごとの最良値を記録し、 K 反復改善がなければ停止する「早期停止」が時間節約に有効です。 また慣性 w を反復とともに 0.9→0.4 と線形減少させると、 探索(前半)→利用(後半)の切替がスムーズで収束が速まります。
📊 ベンチマーク関数による比較
群知能アルゴリズムを評価するには、 標準ベンチマーク関数で性能を比較します。 代表的なものを紹介します。
| 関数名 | 特徴 | 難しさ |
|---|---|---|
| Sphere | 凸・単峰・分離可能 | ★(基準) |
| Rosenbrock | 非凸・峡谷・非分離 | ★★★ |
| Rastrigin | 多峰・分離可能 | ★★★★ |
| Ackley | 多峰・非分離 | ★★★★ |
| Schwefel | 多峰・偽の最適解 | ★★★★★ |
「No Free Lunch 定理」が示すとおり、 全問題で最良な単一手法はありません。 問題の性質(凸性・分離性・次元)に応じてアルゴリズムを選ぶ、 もしくは複数手法のアンサンブルを使うのが実践的です。
図の中心から伸びる 6 つのノードのうち、 PSO 粒子群・ACO アリコロニー・蜂コロニー ABC・蛍 Firefly の 4 つが群知能に含まれる個別のアルゴリズム、 遺伝的アルゴリズムは同じメタヒューリスティクスの中の進化計算側の兄弟、 メタヒューリスティクスはそれらすべてを含む上位概念である。 このページで実データに当てたのは PSO(診療所数と総人口の回帰、 クラスタ重み)と ACO(47 都道府県の巡回)の 2 つ。
🔗 隣接手法への橋渡し
群知能 (swarm intelligence) は「個体は単純なルールに従うが、 集団として複雑な問題解決を実現する」自己組織化アルゴリズム群。 PSO (粒子群最適化)、 ACO (蟻コロニー最適化)、 ABC (人工蜂コロニー) が代表例。 SSDSE-B-2026 で 47 都道府県 × 109 指標から最適な変数組合せを探索する組合せ最適化問題に PSO を適用する応用が考えられる。
- 上流: 進化計算 (遺伝的アルゴリズム)、 メタヒューリスティクス、 マルチエージェントシステム。
- 並列: 遺伝的アルゴリズム、 シミュレーテッドアニーリング、 ベイズ最適化。 連続 / 離散 / ハイブリッド問題で使い分け。
- 下流: ハイパーパラメータ最適化、 特徴量選択、 ルート最適化 (TSP)、 制御最適化、 機械学習モデルの構造探索 (NAS)。
群知能は「局所最適に陥りにくい」「並列化しやすい」反面、 「収束保証なし」「ハイパラ調整がアートに近い」。 SSDSE 分析でも特徴量選択の補助ツールとして使えるが、 Lasso / Random Forest 特徴量重要度と比較する。
🌳 手法選択フロー
最適化問題の性質から群知能アルゴリズムを選ぶフロー。
- ① 探索空間は連続か離散か? 連続 (実数値ハイパラ) → PSO / DE (差分進化)。 離散 (組合せ・順序) → ACO (経路探索が得意) / ABC。 SSDSE の特徴量選択は離散二値なので ACO 寄り。
- ② 評価関数の計算コストは? 軽い → 群サイズ大 (100+)、 反復 100+ 回。 重い → 群サイズ 20、 反復 30 + ベイズ最適化の代替検討。
- ③ 多目的か単目的か? 単目的 → 標準 PSO。 多目的 (Pareto 最適) → MOPSO / NSGA-II 系。 SSDSE で「予測精度 + 解釈性」のトレードオフを探るなら多目的。
群知能は他のメタヒューリスティクスと比較してアルゴリズム自体の選択も重要。 ノーフリーランチ定理により問題依存で、 まず Random Search → ベイズ最適化 → PSO の順で試すのが定石。